العربية
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 हिन्दी

الحجة تسير هكذا. اشتراك الذكاء الاصطناعي من الفئة الأعلى يكلّف 200 دولار شهريًا، أي 2,400 دولار سنويًا. ويمكن لجهاز MacBook Pro بذاكرة موحّدة سعة 128 GB تشغيل النماذج اللغوية الكبيرة محليًا، بخصوصية ودون حدود للاستخدام. إذن ألغِ الاشتراك، واشترِ MacBook لتشغيل LLMs محليًا بدلًا منه، وبعد سنة أو سنتين يكون قد سدّد ثمنه.
ستجد نسخًا منها في كل مكان خلال 2026: في فيديوهات YouTube التي تسأل إن كان عليك إلغاء خطة الذكاء الاصطناعي بـ 200 دولار وشراء جهاز Mac بـ 9,499 دولار، وفي منشورات Medium التي تقسم سعر Mac على 200، وفي عمود في Forbes أجرى الحسابات حين أطلقت Apple جهاز Mac Studio الجديد في أغسطس. وفي إطلاق MacBook Pro بـ M5 Max، قال مسؤول العتاد في Apple، John Ternus، إن الأجهزة الجديدة تتيح للمحترفين “تشغيل نماذج LLM متقدمة على الجهاز”.
شراء MacBook لتشغيل LLMs محليًا فكرة جيدة تمامًا لبعض الناس. أما كبديل عن خطة Claude أو ChatGPT بـ 200 دولار، فهو يفشل، ويفشل في الشيء الوحيد الذي لا تحسب الحجة سعره أبدًا: الجودة. الاشتراك يمنحك استئجار أفضل النماذج في العالم. أما Mac فيشغّل أفضل النماذج التي تتسع في 128 GB. ومنذ يوم أمس، يمكننا قياس المسافة بين هذين الأمرين بدقة أكبر من أي وقت مضى، وهي أوسع مما توحي به الضجة.
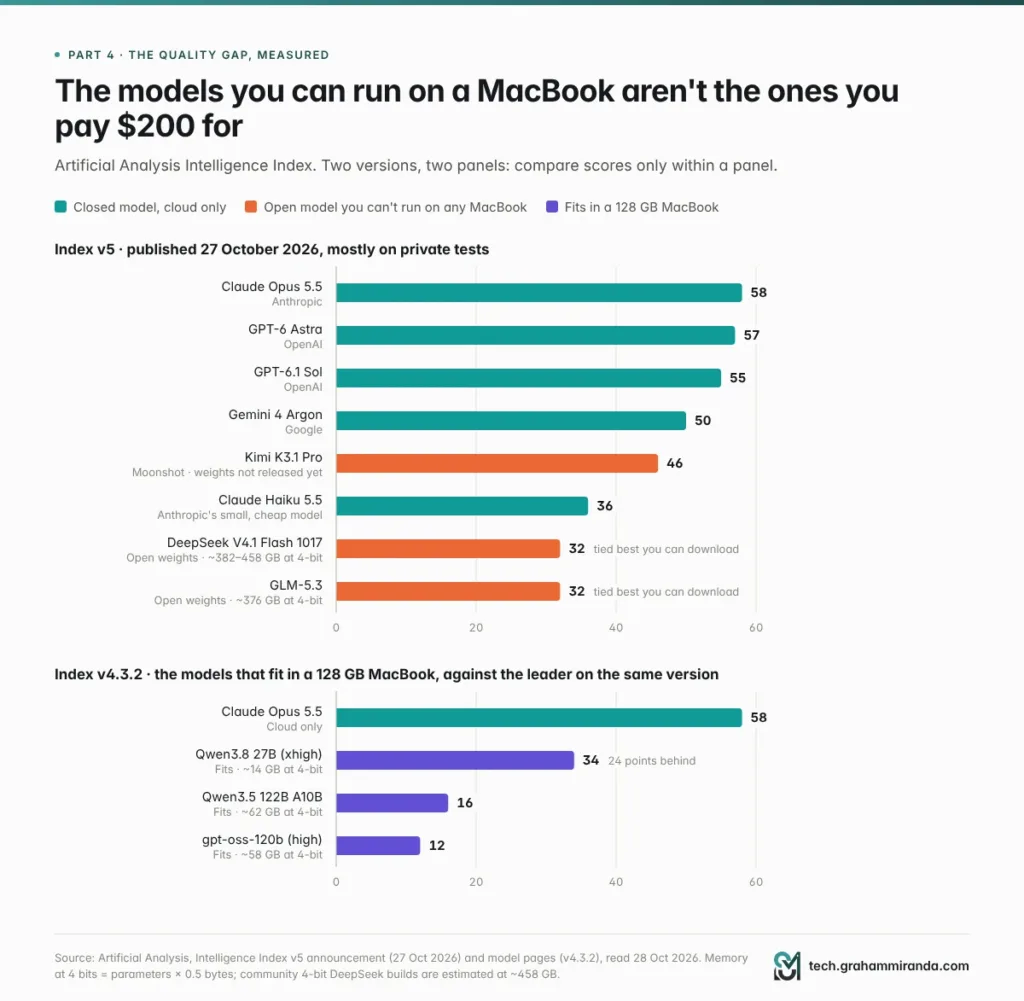
في 27 أكتوبر، أعادت Artificial Analysis بناء مؤشر الذكاء لديها على أساس اختبارات خاصة في معظمها. ويتصدر Claude Opus 5.5 بـ 58. أفضل النماذج مفتوحة الأوزان التي يمكنك تنزيلها فعلًا، DeepSeek V4.1 Flash 1017 وGLM-5.3، تحصل على 32، أي أقل من Claude Haiku 5.5، نموذج Anthropic الصغير والرخيص، عند 36. ولا يتسع أي من هذين النموذجين المفتوحين في أي MacBook: فعند 4 بتات يحتاجان إلى ما بين 375 و460 GB. وأقوى نموذج وجدته يتسع فعلًا في MacBook بذاكرة 128 GB، وهو Qwen3.8 27B، يحصل على 34 في النسخة السابقة من المؤشر، وهي النسخة التي يحصل فيها Opus 5.5 أيضًا على 58.
في هذه الأثناء، أصبح العتاد أغلى. في يونيو، ضاعفت Apple سعر ترقية الذاكرة إلى 128 GB في M5 Max. ويبلغ سعر MacBook Pro مقاس 16 بوصة بذاكرة 128 GB الآن $6,999 في الولايات المتحدة، وبحسب تقديري، نحو €8,199 في ألمانيا.
إذن هذه هي النسخة الصادقة من الحسابات: ماذا يشتري 200 دولار شهريًا فعلًا، وماذا يشتري 7,000 دولار فعلًا، وما حجم فجوة الجودة ولماذا توجد، وما مدى سرعة M5 Max حقًا، وما الذي يكلّفك إياه التكميم، ومتى يكون شراء Mac للذكاء الاصطناعي المحلي منطقيًا، وطرقًا أرخص لخفض فاتورة 200 دولار إذا كان ذلك هو ما تسعى إليه حقًا. وقد جرى التحقق من كل رقم مقابل مصدره في 28 أكتوبر 2026.
باختصار — النسخة في 60 ثانية
- النماذج التي تدفع 200 دولار مقابلها لا يمكن تنزيلها، وأفضلها بين ما يمكنك تنزيله لا يتسع في MacBook. في مؤشر الذكاء الجديد v5 من Artificial Analysis، يحصل Claude Opus 5.5 على 58. وأفضل النماذج المفتوحة القابلة للتنزيل، DeepSeek V4.1 Flash 1017 وGLM-5.3، تحصل على 32 وتحتاج إلى نحو 375–460 GB من الذاكرة عند 4 بتات.
- أما ما يتسع فيحصل على درجات أدنى بكثير. أقوى نموذج وجدته لجهاز MacBook بذاكرة 128 GB، وهو Qwen3.8 27B، يحصل على 34 مقابل 58 لـ Opus 5.5 في الإصدار نفسه من المؤشر (v4.3.2). أما نماذج فئة 120B التي تحتاج فعلًا إلى الذاكرة الإضافية فتحصل على درجات أدنى: 16 لـ Qwen3.5 122B و12 لـ gpt-oss-120b.
- أصبح MacBook بذاكرة 128 GB أغلى. ضاعفت Apple سعر ترقية 128 GB إلى 2,000 دولار في يونيو، لذا يبلغ سعر MacBook Pro مقاس 16 بوصة بـ M5 Max وذاكرة 128 GB الآن 6,999 دولار (نحو €8,199 في ألمانيا، بحسب تقديري). أما الشريحة والذاكرة نفساهما في Mac Studio فتكلفان 4,799 دولار.
- نقطة التعادل بعد ثلاث إلى أربع سنوات، لا بعد سنة. وحتى لو حلّ Mac محل الاشتراك بالكامل، فسيستغرق نحو 37 شهرًا ليتفوق على خطة بـ 200 دولار، و41 شهرًا إذا أبقيت خطة بـ 20 دولارًا للأعمال الصعبة، وأكثر من ست سنوات مقابل خطة بـ 100 دولار.
- الكتابة سريعة، والقراءة بطيئة. يولّد M5 Max ما بين 55 و88 رمزًا في الثانية على نماذج خليط الخبراء، وهو ليس بعيدًا عن 98 لـ Opus 5.5 على API من Anthropic. لكنه يحتاج من 13 إلى 55 ثانية لمجرد قراءة موجّه من 32,000 رمز، ووكلاء الذكاء الاصطناعي يعيدون قراءة الموجّهات الطويلة طوال اليوم.
- حشر النماذج الكبيرة يكلّفك الجودة. التكميم عند 4 بتات يكاد يكون بلا فقدان في المهام القصيرة، لكنه كلّف ما يصل إلى 59% في المدخلات الطويلة بحسب دراسة في EMNLP 2025، وأكثر من ذلك في لغات غير الإنجليزية. وعند 3 بتات، هبطت درجة الحساب لنموذج استدلال صغير من 85.6% إلى 47.0%.
- يبدو أن معايير القياس العامة تجامل النماذج المفتوحة. حين انتقلت Artificial Analysis إلى اختبارات خاصة في معظمها، فقدت أربعة من النماذج الرائدة مفتوحة الأوزان 13 نقطة في المتوسط. أما أربعة من النماذج الرائدة المغلقة فلم تكد تتحرك.
- لا يزال المحلي متفوقًا في الخصوصية والاستخدام دون اتصال وغياب حدود المعدل والمهام الكبيرة، وعندما كنت ستشتري Mac على أي حال. اشترِ واحدًا لهذه الأسباب، لا لإلغاء اشتراك.
- هناك طرق أرخص للتوفير. انزل إلى فئة 100 دولار ووفّر 1,200 دولار سنويًا، أو ادفع حسب الرمز للنماذج المفتوحة (يكلّف DeepSeek V4.1 Flash نحو 0.60 دولار لكل مليون رمز إخراج خارج أوقات الذروة)، أو استخدم خطة برمجة تبدأ من 18 دولارًا شهريًا.
الحجة مقابل الواقع
| الحجة | الواقع، أكتوبر 2026 |
|---|---|
| “يسدّد ثمنه في سنة” | يكلّف MacBook Pro مقاس 16 بوصة بذاكرة 128 GB مبلغ 6,999 دولار. وبمعدل 200 دولار شهريًا، يعني ذلك 35 شهرًا قبل احتساب الكهرباء، و41 شهرًا بعد إضافة خطة الـ 20 دولارًا التي ستبقيها للمهام الصعبة |
| “النماذج المحلية أصبحت جيدة بالقدر نفسه تقريبًا الآن” | يحصل Opus 5.5 على 58. وأفضل نموذج يتسع في 128 GB يحصل على 34 (Qwen3.8 27B، المؤشر v4.3.2). وأفضل النماذج المفتوحة القابلة للتنزيل تحصل على 32 في الإصدار الجديد v5 |
| “ذاكرة 128 GB تشغّل النماذج المفتوحة الكبيرة” | يحتاج GLM-5.3 إلى نحو 376 GB عند 4 بتات، وDeepSeek V4.1 Flash إلى نحو 380–460 GB، وKimi K3 إلى نحو 1.5 TB. ولا يتسع أي منها في أي MacBook |
| “الـ M5 Max سريع” | في الكتابة، نعم: 55–88 رمزًا في الثانية على نماذج خليط الخبراء. أما في قراءة موجّه من 32K رمز: فمن 13 إلى 55 ثانية |
| “4 بتات بلا فقدان” | في معايير القياس القصيرة، يكاد يكون كذلك. أما في المدخلات التي تتجاوز 64K رمز، فأسوأ بما يصل إلى 59% في إحدى الدراسات، وأسوأ مرة أخرى خارج الإنجليزية |
| “بلا حدود، وخصوصية تامة” | صحيح. وهذا هو السبب الحقيقي لشراء واحد |
جدول المحتويات
- باختصار — النسخة في 60 ثانية
- الحجة مقابل الواقع
- الجزء 1 — حجة “ألغِ خطتك بـ 200 دولار”، ولماذا تبدو مقنعة إلى هذا الحد
- الجزء 2 — ماذا يشتري 200 دولار شهريًا فعلًا في أكتوبر 2026
- الجزء 3 — كم يكلّف MacBook بذاكرة 128 GB فعلًا الآن
- الجزء 4 — فجوة الجودة، مقيسة
- الجزء 5 — لماذا لا تتسع النماذج التي تريدها فعلًا
- الجزء 6 — التكميم: ضريبة الجودة التي تدفعها لتتسع
- الجزء 7 — السرعة: سريع في الكتابة، بطيء في القراءة
- الجزء 8 — مشكلة الحاسوب المحمول
- الجزء 9 — فجوة البرمجيات: ما سيتعين عليك بناؤه من جديد
- الجزء 10 — حسابات التعادل، بصدق
- الجزء 11 — الحجة المنصفة: متى يكون شراء Mac للذكاء الاصطناعي المحلي منطقيًا
- الجزء 12 — طرق أرخص لخفض فاتورة ذكاء اصطناعي بـ 200 دولار
- الجزء 13 — هل يجب أن تشتري MacBook لتشغيل LLMs محليًا؟ دليل القرار
- الجزء 14 — إذا اشتريت واحدًا على أي حال: كيف تستفيد منه إلى أقصى حد
- الأسئلة الشائعة
- هل يمكن لـ MacBook أن يحل محل اشتراك ChatGPT Pro أو Claude Max؟
- ما أفضل LLM محلي لجهاز MacBook Pro بذاكرة 128 GB في 2026؟
- كم يكلّف MacBook Pro بذاكرة 128 GB الآن؟
- كم يستغرق MacBook ليسدّد ثمنه مقارنةً باشتراك ذكاء اصطناعي بـ 200 دولار؟
- هل M5 Max سريع بما يكفي لـ LLMs المحلية؟
- هل أصبحت LLMs المحلية جيدة بقدر ChatGPT أو Claude الآن؟
- هل يجعل التكميم النماذج المحلية أسوأ؟
- هل يمكنني تشغيل DeepSeek V4.1 Flash أو GLM-5.3 على MacBook؟
- هل تكفي 64 GB للذكاء الاصطناعي المحلي، أم أحتاج إلى 128 GB؟
- هل أشتري Mac Studio بدلًا من MacBook Pro لتشغيل LLMs محليًا؟
- هل تشغيل الذكاء الاصطناعي محليًا أفضل من حيث الخصوصية وGDPR؟
- هل يمكنني استخدام Claude Code مع نموذج محلي؟
- هل سيغيّر MacBook Pro الجديد بـ OLED أي شيء من هذا؟
- الخلاصة
الجزء 1 — حجة “ألغِ خطتك بـ 200 دولار”، ولماذا تبدو مقنعة إلى هذا الحد
لنبدأ بسبب انتشار هذه الحجة الواسع، لأن معظمها معقول.
ثلاثة مختبرات اتفقت على 200 دولار. يكلّف Claude Max 20× من Anthropic مبلغ 200 دولار شهريًا. ويأتي ChatGPT Pro من OpenAI بثلاث نسخ بـ 100 و200 و500 دولار. ولدى AI Ultra من Google فئة بـ 100 دولار وأخرى بـ 200. ادفع ذلك كل شهر وسيعلق الرقم: 2,400 دولار سنويًا، و7,200 دولار على مدى ثلاث سنوات.
أصبح العتاد جادًا. جهاز MacBook Pro بـ M5 Max، المعروض للبيع منذ مارس، يستوعب حتى 128 GB من الذاكرة الموحدة بعرض نطاق 614 GB/s، وقد وضعت Apple مُسرّعًا عصبيًا، وهو عتاد مخصص لحسابات المصفوفات، في كل نواة GPU. وفي أغسطس، وصل Mac Studio بخيار M5 Ultra مصمم حتى 512 GB. وتسوّق Apple للذكاء الاصطناعي المحلي بقوة أكبر من أي وقت مضى.
أصبحت الاشتراكات أكثر شحًا. الحدود الأسبوعية لـ Claude Max، التي أُضيفت بعد أشهر من إطلاق الخطة، هي موضوع دعوى جماعية رُفعت في 8 سبتمبر، وتقول إن تسميتي “5×” و“20×” لا توضحان الحدود الأسبوعية بما يكفي. ويُقال إن OpenAI خفّضت الحصة في خطة Pro بـ 200 دولار للمشتركين الجدد من 20 ضعف ChatGPT Plus إلى 10 أضعاف. وحين يستمر الشيء الذي تستأجره في التقلص، يبدأ التملّك في الظهور جاذبًا.
الخصوصية مصدر قلق حقيقي. أي شيء تلصقه في نموذج سحابي يغادر جهازك. وبالنسبة لشركة ألمانية تحتفظ ببيانات عملاء، فهذا ليس هوسًا؛ إنه GDPR.
والحساب سهل. النسخة الأكثر مشاركة: جهاز Mac Studio بـ 2,499 دولار مقسومًا على 200 دولار شهريًا يساوي نحو 12.5 شهرًا. وقد نشر Forbes نسخة أكثر عناية بكثير في أغسطس، بتكوينات حقيقية وثلاث سنوات من الكهرباء، وخلص إلى أن Mac على الأرجح لن يتيح لك إلغاء خطة Claude أو ChatGPT إذا كنت تبرمج باستخدام الوكلاء. لكن النسخة القصيرة هي التي يتذكرها الناس.
وهنا العيب. الحجة تقارن سعرًا بسعر. وكان ينبغي أن تقارن منتجًا بمنتج. وهذا ما تفعله بقية هذه المقالة، بدءًا بما يدفع 200 دولار مقابله فعلًا.
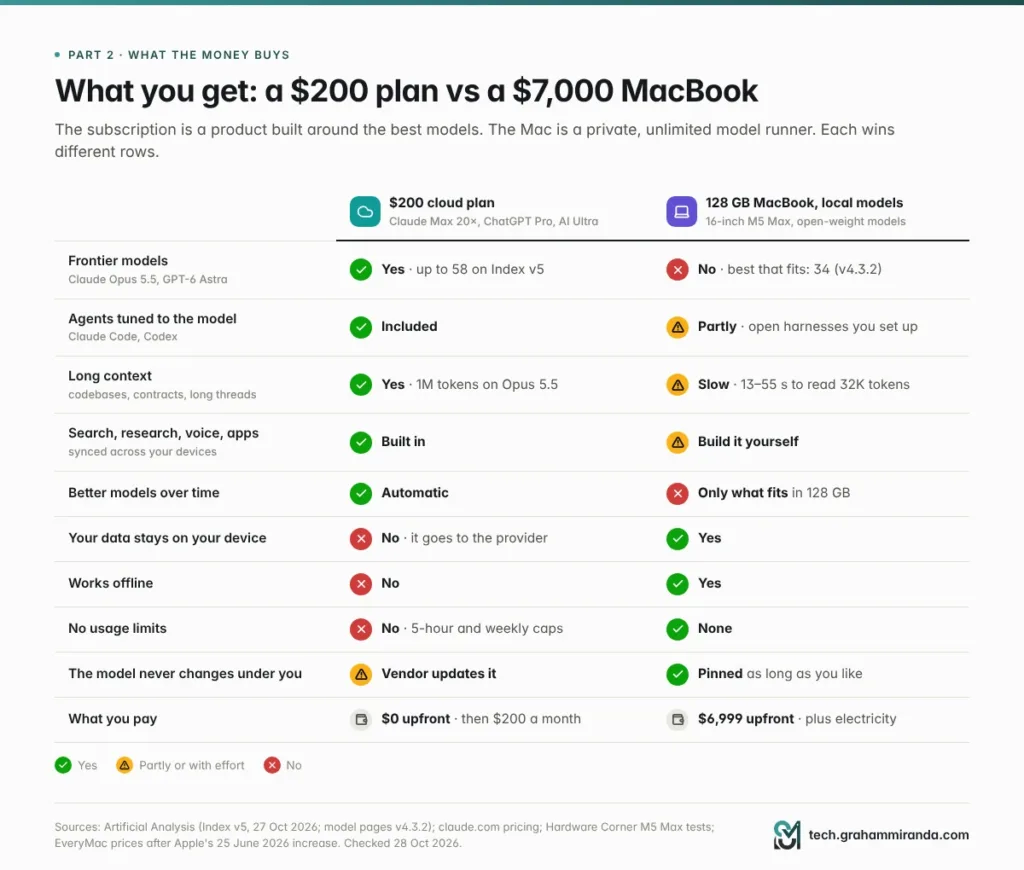
الجزء 2 — ماذا يشتري 200 دولار شهريًا فعلًا في أكتوبر 2026
| المزوّد | فئة 20 دولارًا | فئة 100 دولار | فئة 200 دولار | أكثر من 200 دولار |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: 20 دولارًا (17 دولارًا شهريًا عند الفوترة السنوية) | Max 5×: 100 دولار | Max 20×: 200 دولار | الفريق والمؤسسات |
| OpenAI (ChatGPT) | Plus: 20 دولارًا (Go: 8 دولارات) | Pro 100: 100 دولار | Pro 200: 200 دولار | Pro 500: 500 دولار |
| Google (Gemini) | AI Pro: 20 دولارًا | AI Ultra: 100 دولار | AI Ultra: 200 دولار | — |
الأسعار بالدولار الأمريكي شهريًا، دون ضريبة القيمة المضافة. Claude من claude.com؛ وChatGPT من متتبّع AI Business Weekly، المحدّث في 4 أكتوبر؛ وGoogle من تقرير Engadget عن إعادة الإطلاق في مايو. تتغير الأسعار والحصص كثيرًا، لذا تحقق قبل أن تشترك.
ما الذي يدفع المال مقابله فعلًا
1. نماذج الحدود القصوى، التي لا يمكنك الحصول عليها في أي مكان آخر. في مؤشر Artificial Analysis الجديد، تحتل Anthropic وOpenAI المراكز الخمسة الأولى كلها. ولا يمكن تنزيل أي من تلك النماذج بأي سعر. والاشتراك هو أرخص طريقة سيحصل بها معظم الناس على فرصة استخدامها.
2. وكلاء مبنيون حول تلك النماذج. تتضمن خطط Claude المدفوعة Claude Code؛ وتتضمن خطط ChatGPT برنامج Codex. ويُضبط الهارنس والنموذج معًا، وهو ما يساعد في تفسير تربعهما على قمة لوحات صدارة البرمجة بالوكلاء. (قارنت 28 من هذه الأدوات في مقارنة بين جميع هارنسات البرمجة بالذكاء الاصطناعي.)
3. سياق هائل. يمتلك Claude Opus 5.5 نافذة سياق تبلغ مليون رمز، بحسب Artificial Analysis: قواعد برمجيات كاملة، وعقود كاملة، وربع سنة كامل من البريد الإلكتروني.
4. المنتج المحيط بالنموذج. البحث على الويب والبحث العميق، وتحليل الملفات، والصوت، والذاكرة، وتوليد الصور، وموصّلات إلى بريدك ومستنداتك، وتطبيقات تتزامن عبر هاتفك وحاسوبك المحمول ومتصفحك. ولا شيء من ذلك يأتي مع ملف نموذج.
5. ترقيات لا تحتاج إلى تثبيتها. النموذج الذي يقف خلف اشتراكك في الربع القادم سيكون أفضل من نموذج اليوم. أما النموذج على جهاز Mac فلا يتغير إلا عندما تنزّل نموذجًا آخر، وفقط إذا كان الجديد يتسع.
6. بعض المال يعود إليك. تسرد صفحة الأسعار لدى Anthropic الآن أرصدة API شهرية مع Max: 100 دولار في خطة 5× و200 دولار في خطة 20×.
ما لا يشتريه
استخدام بلا حدود. تعمل خطط Claude بنوافذ متجددة مدتها خمس ساعات إضافة إلى حدود أسبوعية، وتصف OpenAI وGoogle في الغالب فئاتهما العليا كمضاعفات للفئات الأرخص، إن وصفَتها أصلًا. تحكّم في مكان ذهاب بياناتك، وهو أمر بالغ الأهمية للبيانات الشخصية وبيانات العملاء. و القابلية للتوقع: لقد تغيرت الحصص أكثر من مرة هذا العام.
أبقِ هذه الثلاثة في ذهنك. فهي الحجة الصادقة للذكاء الاصطناعي المحلي، والجزء 11 يمنحها سماعًا كاملًا.
عرض الصورة الاشتراك منتج؛ وMac مشغّل نماذج. وكل منهما يتفوق في صفوف مختلفة، ولهذا فالإجابة الصحيحة لمعظم الناس هي الاثنان معًا.
الجزء 3 — كم يكلّف MacBook بذاكرة 128 GB فعلًا الآن
شريحة واحدة فقط توصلك إلى 128 GB. في جيل M5، لا تأتي هذه السعة من الذاكرة الموحدة إلا مع M5 Max ببطاقة GPU من 40 نواة، التي تملك عرض نطاق ذاكرة يبلغ 614 GB/s. أما M5 Max بـ GPU من 32 نواة فثابت عند 36 GB و460 GB/s، ويبلغ M5 Pro حده الأقصى 64 GB و307 GB/s.
| التكوين | السعر في الولايات المتحدة | ألمانيا |
|---|---|---|
| 16″ M5 Max (CPU بـ18 نواة، GPU بـ40 نواة)، 48 GB، 2 TB | $4,999 | €5,699 |
| الترقية إلى 128 GB | +$2,000 (كان +$1,000 حتى 25 يونيو) | نحو +€2,500 (كان +€1,250 عند الإطلاق)، تقديري |
| 16″ M5 Max، 128 GB، 2 TB | $6,999 | نحو €8,199 (تقديري؛ €6,249 عند الإطلاق) |
| بأقصى تكوين: 128 GB، 8 TB، شاشة nano-texture | $10,149 | — |
| للمقارنة: Mac Studio، M5 Max، 128 GB | $4,799 | — |
الأسعار الأمريكية لا تشمل ضريبة المبيعات؛ أما الأسعار الألمانية فتشمل ضريبة القيمة المضافة 19%. ترقية 128 GB الألمانية تقدير مني: فقد طلبت Apple €1,250 مقابلها عند الإطلاق، وتضاعفت ترقية الدولار في يونيو. تحقّق من أداة التكوين لدى Apple قبل الشراء.
ثلاثة أمور تبرز.
الذاكرة هي الجزء المكلف الآن. رفعت Apple الأسعار عبر خط Mac في 25 يونيو وأرجعت ذلك إلى تكاليف الذاكرة والتخزين. وقالت لرويترز إنها “لم ترَ قط زيادة في سعر مكوّن بهذا الحجم وبهذه السرعة”. تضاعفت ترقيتا 64 GB و128 GB في M5 Max. والمكوّن الذي يحتاجه الذكاء الاصطناعي المحلي أكثر من غيره هو نفسه الذي صار أغلى مرتين.
علاوة الحاسوب المحمول هي $2,200. كلّف نفس M5 Max بنفس 128 GB داخل Mac Studio $4,799 عندما سعّره Forbes في أغسطس. إذا أردت الذاكرة لأجل الذكاء الاصطناعي، فإن شكل الحاسوب المحمول يكلّف 46% أكثر.
نسخة 14 بوصة حلّ وسط. يمكنك طلب نسخة 14 بوصة بـ128 GB أيضًا، لكن في مراجعة Notebookcheck واجه هيكلها صعوبة في تبريد M5 Max تحت الحمل المستمر. المزيد عن ذلك في الجزء 8.
أجهزة Mac جديدة هذا الأسبوع. في 27 أكتوبر أعلنت Apple عن MacBook Pro مقاس 14 بوصة بمعالج M6 الأساسي: حتى 32 GB و170 GB/s، ابتداءً من $1,999. إنه حاسوب محمول جيد، وليس آلة LLM. والليلة (28 أكتوبر، 10:00 بتوقيت المحيط الهادئ، 18:00 في ألمانيا) تعقد Apple فعالية “Pro and Tell”، حيث يُتوقع على نطاق واسع إطلاق MacBook Pro بشاشة OLED تعمل باللمس . وتقول التقارير إنه يستخدم نفس شرائح M5 Pro وM5 Max، ما سيُبقي سقف 128 GB و614 GB/s دون تغيير.
الجزء 4 — فجوة الجودة، مقيسة
كيف تقارن نموذجًا على مكتبك بآخر في مركز بيانات؟ ليس بالانطباعات، وليس بجدول معايير قياس يقدّمه البائع نفسه. Artificial Analysis (AA) تُجري المجموعة نفسها من الاختبارات على مئات النماذج، عبر الهارنس نفسه، وتكثّف النتائج في مؤشر ذكاء واحد Intelligence Index. لا يوجد مؤشر مثالي، لكن مؤشر AA مستقل، وهو أقرب ما لدى الصناعة إلى مقياس مشترك.
في 27 أكتوبر، نشرت AA الإصدار 5. التغيير الأبرز: نحو 60% من المؤشر يعمل الآن على مجموعات اختبار خاصة أو إجابات محجوزة، بحيث لا يكون النموذج قد رأى الأسئلة أثناء التدريب. ويُحتسب العمل المعرفي والبرمجة والعلوم والمعرفة العامة بربع لكل منها.
لوحة الصدارة الجديدة
| الطراز | هل يمكنك تنزيله؟ | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | لا | 58 |
| GPT-6 Astra (max) | لا | 57 |
| GPT-6.1 Sol (max) | لا | 55 |
| Gemini 4 Argon (high) | لا | 50 |
| Kimi K3.1 Pro | ليس بعد؛ الأوزان غير منشورة | 46 |
| Claude Haiku 5.5 (max) | لا | 36 |
| DeepSeek V4.1 Flash 1017 (max) | نعم، رخصة MIT | 32 |
| GLM-5.3 (max) | نعم | 32 |
المصدر: Artificial Analysis، إعلان Intelligence Index v5، 27 أكتوبر 2026.
ثلاثة أمور في ذلك الجدول تهمّك إذا كنت تحسب تكلفة MacBook.
- المراكز الخمسة الأولى كلها لـAnthropic وOpenAI، ولا يمكن تنزيل أي من تلك النماذج بأي سعر.
- أفضل نموذج مفتوح، Kimi K3.1 Pro، لم ينشر أوزانه. بين النماذج التي يمكنك تنزيلها فعليًا، أفضل نتيجة هي 32، ما يتركها متأخرة 26 نقطة عن المتصدر. في الإصدار السابق كان الفارق بين أفضل نموذج مفتوح وأفضل نموذج مغلق 3 نقاط. الآن صار 12، أو 26 إذا احتسبت فقط الأوزان التي يمكنك تنزيلها.
- Claude Haiku 5.5 يتفوق على كل نموذج مفتوح قابل للتنزيل. هذه فئة Anthropic الصغيرة السريعة الرخيصة، لا طرازها الرائد.
البرمجة تحديدًا
يتضمن المؤشر الجديد FrontierCode 2.0، 132 مهمة برمجة خاصة من Cognition. حلّ Claude Opus 5.5 نسبة 46%؛ وحلّ DeepSeek V4.1 Flash 1017، الأقوى مناصفة بين النماذج القابلة للتنزيل، نسبة 28%. وفي Terminal-Bench-Science، 70 مهمة علمية وكيلية، النسبة 59% مقابل 13%.
إنصافًا للنماذج المفتوحة: Kimi K3.1 Pro يتصدر Terminal-Bench 4.0 بنسبة 67%، متقدمًا على كل نموذج مغلق. النماذج المفتوحة تستطيع الفوز بمعايير قياس فردية، وهي تفعل ذلك. لكن ذلك النموذج غير قابل للتنزيل بعد، وسلفه Kimi K3 لديه 2.8 تريليون معامل. لن تشغّله على حاسوب محمول.
لماذا اتسعت الفجوة للتو
الانتقال من v4.3 إلى v5 لم يعامل الجميع بالتساوي.
| الطراز | النوع | v4.3 | v5 | التغيير |
|---|---|---|---|---|
| Claude Opus 5.5 | مغلق | 58 | 58 | 0 |
| GPT-6 Astra | مغلق | 53 | 57 | +4 |
| Claude Sonnet 5.5 | مغلق | 56 | 54 | −2 |
| Gemini 4 Argon | مغلق | 53 | 50 | −3 |
| Kimi K3.1 Pro | مفتوح (غير منشور) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | فتح | 45 | 32 | −13 |
| Muse Spark Open (Meta) | فتح | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | فتح | 46 | 30 | −16 |
أرقام v4.3 وv5 كما نقلها Trending Topics في 28 أكتوبر، مع تطابق نتائج v5 مع إعلان AA.
في المتوسط، خسرت تلك النماذج الأربعة المفتوحة 13 نقطة. أما النماذج المغلقة الأربعة فتحركت بربع نقطة.
لم تقل AA لماذا. القراءة الواضحة هي أن الأسئلة عندما تكون سرية لا يكون النموذج قد رآها، وأن معايير القياس العلنية تجامل النماذج المدرّبة بكثافة على بيانات علنية. والاعتراض المقابل منصف أيضًا: لا يمكن التحقق من الاختبارات الخاصة من الخارج، وطريقة ترجيح الفئات تحرّك الترتيب. لا تعتبر أي مؤشر منفرد إنجيلًا. لكن عندما تنخفض أربعة نماذج مفتوحة بأكثر من تسع نقاط ولا يحدث ذلك مع أربعة نماذج مغلقة، فهذه إشارة تستحق الأخذ بجدية: جداول معايير القياس المنشورة، وخاصة جداول البائعين أنفسهم، تبالغ في تقدير مدى قرب النماذج المفتوحة.
والنماذج التي تتسع فعلًا في MacBook
النماذج التي أعادت AA تقييمها لإعلانها أكبر بكثير من أن تعمل على حاسوب محمول في الغالب. أما النماذج التي تتسع له، فصفحات النماذج لدى AA لا تزال تعرض v4.3.2 نتائج v4.3.2، وفي ذلك الإصدار يسجل Opus 5.5 أيضًا 58. إذن هذه هي المقارنة على مقياس واحد متسق:
| الطراز | هل يتسع في MacBook بـ128 GB؟ | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | لا، سحابي فقط | 58 |
| Qwen3.8 27B (xhigh) | نعم، بدقة 4 بت وحتى على Mac بـ32 GB | 34 |
| Qwen3.5 122B A10B (استدلال) | نعم، نحو 70 GB بدقة 4 بت | 16 |
| gpt-oss-120b (high) | نعم، نحو 64 GB | 12 |
المصدر: صفحات النماذج في Artificial Analysis، بالاطلاع في 28 أكتوبر 2026.
تصنّف AA نموذج Qwen3.8 27B أولًا بين 141 نموذجًا قابلًا للمقارنة. إنه ممتاز حقًا بالنسبة لحجمه، ونموذج مفتوح صدر برخصة Apache 2.0. ورغم ذلك لا يزال متأخرًا 24 نقطة.
عرض الصورة نسختان من المؤشر، ولوحتان منفصلتان، ولا محور واحد أبدًا. الأعلى: مؤشر الذكاء من Artificial Analysis الإصدار v5 (27 أكتوبر 2026). الأسفل: النماذج التي تتسع في MacBook بذاكرة 128 GB، على الإصدار v4.3.2، وهو الإصدار الذي تُنشر عليه درجاتها.
مفارقة 128 GB
انظر إلى الجدول الأخير مرة أخرى. أفضل نموذج لـMacBook بـ128 GB يتسع في 32 GB. النماذج التي تحتاج فعليًا الذاكرة الإضافية، أي نماذج خليط الخبراء بـ120 مليار معامل، تسجل نتائج أقل، أساسًا لأنها أقدم: صدر gpt-oss-120b في أغسطس 2025، وكان Qwen3.5 122B يُقاس بالفعل على M5 Max في مارس، قبل أشهر من وصول Qwen3.8 27B.
إذن ماذا تشتري لك ترقية $2,000 من 48 GB إلى 128 GB اليوم؟ مساحة: سياقات أطول، ودقة 8 بت بدل 4 بت، وتحميل عدة نماذج في آن واحد، وخيار تشغيل نموذج قوي من فئة 100 مليار إذا صدر. هذه فوائد حقيقية. لكن نموذجًا أذكى ليس منها، على الأقل ليس في لوحة الصدارة الحالية. تحقّق من AA قبل الشراء؛ فهذا نوع من الحقائق يتغير بإصدار واحد.
كيف تبدو 34 مقابل 58 في الممارسة
نقاط المؤشر ليست “نسبة ذكاء”، ولا تتوزع بالتساوي على المهام.
في المهام القصيرة المحددة جيدًا، مثل إعادة صياغة بريد إلكتروني أو تلخيص مستند تلصقه أو استخراج حقول من فاتورة، غالبًا لا يمكن تمييز نموذج 27B جيد عن نموذج متقدم. الفجوة تظهر في العمل الطويل متعدد الخطوات: وكيل عليه قراءة قاعدة شيفرة، والتخطيط، وتعديل خمسة ملفات، وتشغيل الاختبارات، والتعافي من أخطائه؛ وبحث عليه التوفيق بين مصادر؛ واستدلال تُفسد فيه خطوة خاطئة واحدة الباقي. وهذا بالضبط العمل الذي يشتري الناس له خطط $200.
قدّم مقال Forbes في أغسطس مثالًا ملموسًا من ورقة بحث Qwen نفسها: Qwen3-Coder-Next أثناء عمله في Claude Code سجل 30.9% في Terminal-Bench 2.0، مقابل 53.9% لـClaude Opus 4.5 في الورقة نفسها. تلك نماذج العام الماضي، لكن الشكل لم يتغير: في المهام الوكيلية، فشل الإعداد المحلي أكثر بكثير.
الجزء 5 — لماذا لا تتسع النماذج التي تريدها فعلًا
حجم النموذج في الذاكرة سهل التقدير:
نص
الأوزان (GB) ≈ المعاملات (بالمليارات) × البايتات لكل معامل
               8 بت → × 1.0     4 بت → × 0.5     2 بت → × 0.25
ثم أضف ذاكرة KV المؤقتة، وهي ذاكرة عمل النموذج لمحادثتك، وتنمو مع طول السياق. وتذكّر أن macOS لا يمنح كل ذاكرتك الموحدة لـGPU: افتراضيًا يسمح لـGPU بحجز نحو 75% على أجهزة Mac ذات الذاكرة الكبيرة، نحو 96 GB من جهاز بـ128 GB. يمكنك رفع الحد باستخدام sudo sysctl iogpu.wired_limit_mb=…، على مسؤوليتك؛ فأي قدر تمنحه للنموذج لن يحصل عليه متصفحك ومحررك ونظام التشغيل.
وهذا ما يعنيه ذلك للنماذج التي يتحدث عنها الناس فعليًا:
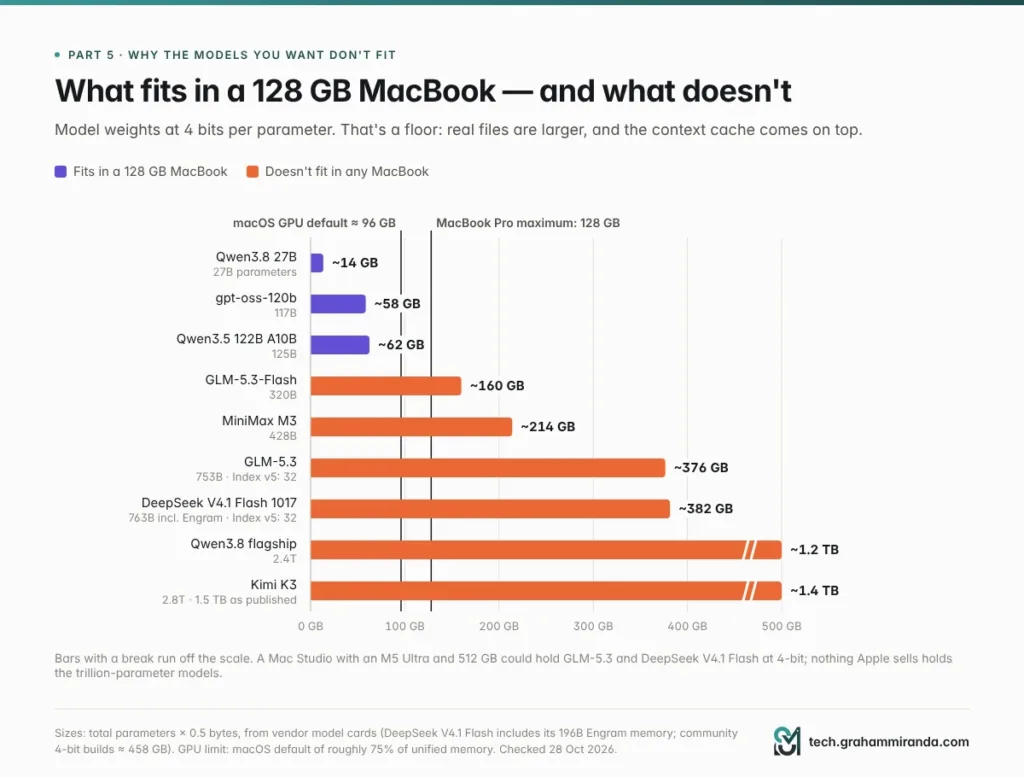
| الطراز | إجمالي المعاملات | أوزان 4 بت (الحد الأدنى) | هل يتسع في MacBook بـ128 GB؟ |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ بسهولة |
| gpt-oss-120b | 117B | ~58 GB (ملف 64 GB) | ✅ نعم |
| Qwen3.5 122B A10B | 125B | ~62 GB (ملف 69.6 GB) | ✅ نعم |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ لا |
| MiniMax M3 | 428B | ~214 GB | ❌ لا |
| GLM-5.3 | 753B | ~376 GB | ❌ لا |
| DeepSeek V4.1 Flash 1017 | 763B بما يشمل ذاكرة Engram | ~382 GB (تقديرات نسخ 4 بت المجتمعية عند ~458 GB) | ❌ لا |
| Qwen3.8 الرائد | 2.4T | ~1.2 TB | ❌ لا |
| Kimi K3 | 2.8T | ~1.5 TB كما هو منشور (MXFP4 أصلي) | ❌ لا |
عمود 4 بت هو المعاملات × 0.5 بايت: الأوزان فقط، قبل ذاكرة KV المؤقتة وحِمل الملف، لذا الملفات الحقيقية أكبر. أحجام الملفات من اختبارات Hardware Corner على M5 Max.
النماذج التي تسجل 32 على المؤشر الجديد، وهي أفضل ما يمكنك تنزيله، تحتاج ثلاث إلى أربع مرات أكثر مما يملكه MacBook. والنماذج الوسيطة لا تتسع هي الأخرى. إذا منحت أوزان النموذج 100 GB من أصل 128 GB، فهذه هي البتات لكل وزن التي يمكنك تحمّل تكلفتها:
| الطراز | البتات لكل وزن ضمن ميزانية 100 GB |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
عند نحو ثلاث بتات أو أقل، تنهار الجودة (الجزء 6 يتضمن البحث). بت واحد لكل وزن ليس تكميمًا، بل بتر.
السياق يستهلك ذاكرة أيضًا. في اختبارات Hardware Corner، استخدم Qwen3-Coder-Next بدقة 8 بت مقدار 87.1 GB عند سياق 4K و92.6 GB عند 64K: خمسة جيجابايت ونصف إضافية لمجرد استيعاب محادثة أطول. الوكلاء الذين يقرؤون مستودعات كاملة يحتاجون سياقات طويلة، لذا تختفي تلك المساحة الاحتياطية بسرعة.
وماذا عن Mac Studio بـ512 GB؟ يمكن لـMac Studio من طراز M5 Ultra بـ512 GB استيعاب GLM-5.3 أو DeepSeek V4.1 Flash بدقة 4 بت. قالت Apple إن ذلك التكوين سيصل في أواخر أكتوبر؛ ويتوقع MacRumors أن يكلف أكثر من $10,000 بكثير، ولم تكن Apple قد نشرت سعرًا حين تحققت. ستكون دافعًا مبلغًا من خمسة أرقام لتشغيل نماذج تسجل 32 على المؤشر الجديد، وعلى الأرجح بسرعة أقل مما يقدمه صانعوها. مقارنتي Kimi K3 مقابل Fable 5.1 مقابل GLM-5.3 تتعمق أكثر في ما يتطلبه الاستضافة الذاتية للنماذج المفتوحة الكبيرة فعليًا.
عرض الصورة الأوزان فقط، عند 4 بتات لكل معامل؛ وتأتي ذاكرة السياق المؤقتة فوق ذلك. وكل ما يقع يمين خط 128 GB يحتاج إلى Mac Studio أو خادم.
الجزء 6 — التكميم: ضريبة الجودة التي تدفعها لتتسع
التكميم يخزّن أوزان النموذج في بتات أقل، 8 أو 4 بدل 16 التي دُرّب بها، فيستهلك ذاكرة أقل ويعمل أسرع. كل نموذج محلي ستشغّله على Mac مكمّم. السؤال هو ماذا يكلف ذلك، والبحث يعطي إجابة واضحة وغير مريحة قليلًا.
الخبر الجيد: 8 بتات شبه مجانية، و4 بتات مقبولة في الغالب
- إحدى أكبر الدراسات حتى الآن، أجراها Eldar Kurtic وزملاؤه، شملت أكثر من 500,000 تقييم على نماذج Llama 3.1 المكمّمة. كان FP8 بلا خسارة فعليًا في كل الأحجام؛ وكلف INT8 نحو 1–3% مع ضبط دقيق؛ وكان تكميم الأوزان إلى 4 بت فقط “أكثر تنافسية مما كان متوقعًا”، قريبًا من 8 بت.
- أما نماذج الاستدلال، فقد وجدت دراسة عام 2025 أجراها Ruikang Liu وزملاؤه أن أوزانًا وتنشيطات بـ8 بت، أو أوزان 4 بت مع تنشيطات 16 بت، يمكن أن تكون بلا خسارة في معايير قياس الرياضيات والعلوم والبرمجة. وقد جاءت عروض البتات الأقل بما يسميه المؤلفون مخاطر دقة كبيرة، وأثرت صعوبة المهمة بشدة في مقدار ما فُقد.
إذا كنت لا تطرح إلا أسئلة قصيرة بالإنجليزية، فسيبدو نموذج 4 بت قريبًا من الأصل.
الخبر السيئ: المدخلات الطويلة واللغات الأخرى وأي شيء دون 4 بتات
- السياق الطويل. اختبر Anmol Mekala وزملاؤه خمس طرق تكميم على 9,700 مثال بمدخلات من 64,000 رمز أو أكثر (EMNLP 2025). كلف 8 بت نحو 0.8% في المتوسط. وكلف 4 بت حتى 59%، واعتمد الضرر بشدة على النموذج: تحت إحدى طرق 4 بت، انخفض Llama 3.1 70B بنسبة 32% في مهمة صمد فيها Qwen 2.5 72B.
- لغات غير الإنجليزية. وجدت الدراسة نفسها أن التدهور كان يميل إلى أن يكون أسوأ عندما لا تكون المدخلات بالإنجليزية. إذا كنت تعمل بالألمانية، فاختبر بالألمانية.
- تحت 4 بت، ينهار الاستدلال. نشر باحثون في Meta FAIR دراسة في يونيو 2026 تُظهر أن نماذج الاستدلال المكمّمة تفرط في التفكير. تحت AWQ بـ3 بت، انخفضت نتيجة نموذج استدلال بـ1.5B على معيار MATH-500 من 85.6% إلى 47.0%، ونما سلسلة تفكيره من 5,200 إلى 23,400 رمز، أطول بـ4.5 مرة. على حاسوب محمول يكتب بسرعة 20 إلى 80 رمزًا في الثانية، يكون النموذج الذي يفكر أطول بأربع مرات أبطأ بنحو أربع مرات أيضًا.
عرض الصورة ما يقوله البحث عن تكلفة كل خطوة نزولًا في الدقة. الضغط الذي قد يُدخل نموذجًا أكبر في 128 GB هو بالضبط ما يضر أكثر من غيره.
ماذا يعني ذلك لجهاز MacBook بذاكرة 128 GB
التكميم الذي يمكنك تحمّل تكلفته لنموذج تريده هو التكميم الذي يضر أكثر من غيره. نموذج 27B يمكن تشغيله بدقة 8 بت على Mac بمساحة فائضة، وينبغي ذلك. نماذج فئة 120B تعمل بدقة 4 بت، وهو مقبول للمحادثة ومحفوف بالمخاطر في المستندات الطويلة. والسبيل الوحيد لإدخال أي شيء من فئة 300B+ إلى حاسوب محمول هو بتان أو ثلاث بتات لكل وزن، وهناك تقول الدراسات أعلاه إن الاستدلال ينهار.
قواعدي العملية:
- استخدم 8 بت في كل ما ستعتمد عليه، خصوصًا المستندات الطويلة وعمل الوكلاء.
- 4 بت كافٍ للمحادثة والصياغة والمهام القصيرة. اختبر سلوكه مع السياق الطويل على مستنداتك.
- لا تشغّل نماذج الاستدلال أو البرمجة بأقل من 4 بت إلا إذا كنت تجري تجارب.
- اختبر باللغة التي تعمل بها.
الجزء 7 — السرعة: سريع في الكتابة، بطيء في القراءة
يؤدي LLM مهمتين مختلفتين بسرعتين مختلفتين. التعبئة المسبقة يقرأ موجّهك، كل ما لصقته إضافة إلى المحادثة حتى الآن، ويحدّه الحساب الخام. التوليد يكتب الإجابة رمزًا برمز، ويحدّه عرض النطاق الترددي للذاكرة. قاس باحثو تعلّم الآلة لدى Apple كليهما على M5: فمسرّعات GPU العصبية الجديدة جعلت زمن أول رمز أسرع بـ3.3 إلى 4.1 مرة مما كان عليه على M4، بينما تحسّن التوليد بنحو 1.19 إلى 1.27 مرة فقط، بما يتوافق تقريبًا مع النطاق الترددي الإضافي.
إذن ماذا يفعل M5 Max بـ128 GB فعليًا؟ نشر Hardware Corner اختبارات أُجريت بإطار MLX من Apple على MacBook Pro مقاس 14 بوصة بطراز M5 Max وذاكرة 128 GB:
| الطراز | السياق | القراءة (التعبئة المسبقة)، رمز/ثانية | الوقت اللازم لقراءة الموجّه كاملًا | الكتابة، رمز/ثانية |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3.1 ثانية | 87.9 |
| 32K | 2,537 | 12.9 ثانية | 64.5 | |
| Qwen3.5 122B A10B (4 بت) | 4K | 881 | 4.6 ثانية | 65.9 |
| 32K | 1,068 | 30.7 ثانية | 54.9 | |
| Qwen3.5 27B (كثيف، 6 بت) | 4K | 811 | 5.1 ثانية | 23.6 |
| 32K | 591 | 55.4 ثانية | 14.9 | |
| Qwen3-Coder-Next (8 بت) | 64K | 1,432 | 45.8 ثانية | 48.2 |
قاسها مستخدم Reddit المسمى cryingneko ونشرها Hardware Corner. “الوقت اللازم لقراءة الموجّه كاملًا” هو طول السياق مقسومًا على سرعة التعبئة المسبقة المقاسة.
سرعة الكتابة جيدة الآن، على الأقل مع نماذج MoE
نماذج خليط الخبراء لا تستخدم إلا جزءًا من أوزانها لكل رمز، لذا تكتب بسرعة: 55 إلى 88 رمزًا في الثانية على M5 Max. للمقارنة، تقيس Artificial Analysis نموذج Claude Opus 5.5 عند 98 رمزًا في الثانية على API الخاص بـ Anthropic. عند الدردشة مع نموذج من فئة 120B، يكون M5 Max مريحًا فعلًا. أما النماذج الكثيفة فحكاية أخرى: نموذج بحجم 27B يستخدم كل وزن في كل رمز يكتب بسرعة 15 إلى 24 رمزًا في الثانية.
وهناك تأثيران أصغر يتراكمان أيضًا. تتباطأ الكتابة مع نمو المحادثة: من 17% إلى 37% أبطأ عند 32K مما هي عند 4K في تلك النماذج الثلاثة. كما تنفق نماذج الاستدلال مئات أو آلاف الرموز في التفكير قبل أن تجيب.
القراءة هي موضع الانتظار
انظر إلى عمود زمن القراءة مرة أخرى. موجّه بطول 32,000 رمز (بضعة ملفات مصدرية، عقد طويل، سلسلة بريد كبيرة) يستغرق من 13 إلى 55 ثانية للقراءة قبل أن تظهر أول كلمة في الإجابة.
وهذا يهم أكثر في العمل الذي تُشترى خطة بـ 200 دولار من أجله تحديدًا. وكلاء البرمجة بالذكاء الاصطناعي يرسلون إلى النموذج موجّه نظام كبير، وتعريفات كل أداة، والملفات التي فتحوها، والمحادثة حتى الآن، ويفعلون ذلك في كل خطوة. يمكن للخوادم المحلية إعادة استخدام الجزء الذي لم يتغير من الموجّه، وهذا يساعد كثيرًا. لكن كلما تغيّر شيء في بداية السياق، مثلًا عندما يضغط الوكيل سجلّه أو تنتقل إلى مهمة جديدة، يجب قراءة كل ما يأتي بعد تلك النقطة من جديد. نقلت Forbes عن مطوّر انتظر نحو 90 ثانية للحصول على أول رمز على جهاز M3 Ultra بسعة 512 GB مع موجّه نظام بطول 16,000 رمز، وآخر رأى نحو 20 ثانية من البداية الباردة على حاسوب M4 Pro بسعة 48 GB. شرائح جيل M5 أسرع بكثير في هذا من أجهزة Mac الأقدم، وفق قياسات Apple نفسها، لكن شكل المشكلة هو نفسه.
للمقارنة، أُجريت اختبارات Hardware Corner نفسها على بطاقة عمل Nvidia RTX Pro 6000، التي تكلف وحدها نحو 8,800 دولار: قرأت الموجّهات أسرع بمقدار 2 إلى 2.4 مرة وكتبت أسرع بمقدار 1.7 إلى 2.8 مرة من M5 Max.
عرض الصورة قياسات بـ MLX على M5 Max بسعة 128 GB. الكتابة سريعة بما يكفي؛ أما قراءة الموجّهات الطويلة، التي يفعلها الوكلاء باستمرار، فهي مكان الانتظار.
الجزء 8 — مشكلة الحاسوب المحمول
حتى لو كانت النماذج جيدة بما يكفي، فالحاسوب المحمول مكان غير مناسب لتشغيلها.
الحرارة. تشغيل نموذج كبير حمل مستمر: دقائق أو ساعات من عمل GPU والذاكرة بكامل طاقتهما، لا انفجار لعشر ثوانٍ. خلصت مراجعة Notebookcheck لجهاز M5 Max مقاس 14 بوصة إلى أن هيكله ونظام تبريده “ببساطة لا يستطيعان التعامل مع M5 Max بالشكل الكافي”: انخفض الأداء في اختبار ضغط CPU لمدة 30 دقيقة بنسبة 24%، ووصلت المراوح إلى 53.2 dB(A) في وضع High Power. قاست تلك المراجعة أحمال CPU والرسوميات لا النماذج اللغوية، وتقترح Notebookcheck نفسها أن مكان M5 Max هو مقاس 16 بوصة. إن اشتريت فعلًا MacBook للذكاء الاصطناعي المحلي، فاشترِ مقاس 16 بوصة. دليلي إلى دليل MacBook Pro M5 Pro بسعة 64 GB وصل إلى الخلاصة نفسها بشأن العمل المستمر على الهيكل الأصغر.
وهو أيضًا حاسوبك اليومي. حمّل نموذجًا بحجم 70 GB مع سياقه، وسيبقى لديك متسع لمتصفح ومحرر. ادفع نحو الـ 96 GB التي يحصل عليها GPU افتراضيًا، أو ارفع الحد لتحشر شيئًا أكبر، وستبدأ بقية عملك في التنافس مع النموذج على الذاكرة. كل نموذج تبقيه محمّلًا هو ذاكرة لا تحصل عليها تطبيقاتك الأخرى.
والبطاريات لا تحب ذلك. الحمل المستمر على GPU يستنزف بطارية الحاسوب المحمول بسرعة، لذا تنتهي جلسات الاستدلال المحلي الطويلة بالعمل موصولًا بالكهرباء، وهذا يقوّض إلى حد ما فكرة “الذكاء الاصطناعي في أي مكان، دون اتصال”.
أنت تشتري سقفك في اليوم الأول. لا يمكن ترقية الذاكرة الموحّدة بعد الشراء. إذا احتاج أفضل نموذج مفتوح العام القادم إلى 160 GB، فحاسوب MacBook بسعة 128 GB ببساطة لن يشغّله.
كما أنه يفقد قيمته بسرعة. حلّلت MacFinder، المتخصصة البريطانية في تجديد الأجهزة، ست سنوات من بيانات مشترياتها ووجدت أن معظم أجهزة MacBook تفقد نحو نصف قيمتها في السنة الأولى، وأن الطرازات الراقية غالبًا تهبط أكثر: MacBook Pro M4 مقاس 16 بوصة فقد حتى 60% في سنة. جهاز بـ 6,999 دولار هو رهان بـ 6,999 دولار على أن سقف ذاكرة اليوم سيظل مفيدًا بعد ثلاث سنوات.
الحاسوب المكتبي صندوق أفضل للنماذج اللغوية. إذا كان الذكاء الاصطناعي المحلي هو الهدف، فإن Mac Studio بالشريحة نفسها M5 Max وذاكرة 128 GB يكلف أقل بـ 2,200 دولار، وليس فيه بطارية تُطبخ ولا غطاء يُغلق، ويمكنه العمل على مدار الساعة كخادم خاص لحاسوبك وهاتفك. واقرنه بأي حاسوب محمول تحبه أصلًا.
الجزء 9 — فجوة البرمجيات: ما سيتعين عليك بناؤه من جديد
الاشتراك هو نموذج زائد منتج. الإعداد المحلي يمنحك النموذج ويترك المنتج عليك.
| ما يفعله الاشتراك من أجلك | ما ستفعله محليًا |
|---|---|
| يستضيف النموذج ويحدّثه | تنزيل النماذج وتحويلها وتحديثها بنفسك (LM Studio أو Ollama أو MLX) |
| البحث على الويب والبحث المعمّق | ربط API بحث أو محرك بحث مستضاف ذاتيًا، مع وكيل يديره |
| يقرأ ملفات PDF والجداول والصور | اختيار نماذج بصرية وإضافة تحليل المستندات |
| الصوت والذاكرة وتوليد الصور | نماذج وتطبيقات منفصلة لكل منها (Whisper للكلام، وDraw Things أو ComfyUI للصور) |
| تطبيقات على كل جهاز، متزامنة | تشغيل خادم وواجهة أمامية، وإتاحتهما لهاتفك بأمان |
| Claude Code أو Codex، مضبوطان على نموذجيهما | توجيه هارنس مفتوح، أو Claude Code نفسه، إلى خادم محلي |
| يتولى قوالب الدردشة وصيغ استدعاء الأدوات والسلامة | تصحيحها عندما يصدر نموذج جديد بقالب لا تفهمه أدواتك |
الأدوات جيدة فعلًا الآن. LM Studio هي أسهل بداية على Mac، وOllama يمنحك API واحدًا للنماذج المحلية والسحابية، وMLX من Apple عادةً الأسرع. بل إن Ollama يوفّر API متوافقًا مع Anthropic، فيمكنك توجيه Claude Code إلى نموذج محلي بضبط ANTHROPIC_BASE_URL=http://localhost:11434. لكن توثيقه صريح بشأن الفجوات: عناصر التحكم في تخزين الموجّهات المؤقت لدى Anthropic، وعدّ الرموز، والدفعات، وإدخال PDF غير مدعومة. كما أن Claude Code مضبوط على نماذج Claude؛ وعلى النموذج المحلي أن يتعامل مع موجّه النظام الطويل وتعريفات الأدوات في Claude Code، وهنا تظهر أزمنة التمهيد المذكورة في الجزء 7.
لا شيء من هذا مستحيل. مقالي OpenCode v2 مقابل Hermes Agent مقابل OpenClaw الذي يتناول الوكلاء المفتوحين الذين يعملون مع النماذج المحلية يغطي ذلك. لكنه عمل حقيقي، وساعاتك ليست مجانية. خصّص عطلة نهاية أسبوع لإعداده وبضع ساعات شهريًا لإبقائه محدّثًا.
الجزء 10 — حسابات التعادل، بصدق
إليك الحساب الذي تتخطاه الفكرة عادةً.
الخطوة 1: النسخة الساذجة
6,999 دولار ÷ 200 دولار شهريًا = 35 شهرًا. ليس اثني عشر. قرابة ثلاث سنوات، وهذه أفضل نسخة ممكنة.
الخطوة 2: أضف الكهرباء
قدّرت Forbes نحو 10 دولارات شهريًا لجهاز Mac يشغّل الذكاء الاصطناعي ثماني ساعات يوميًا بمتوسط الأسعار الأمريكية. أما في ألمانيا، بمتوسط أكتوبر البالغ 29.68 سنتًا لكل kWh، فحاسوب محمول يستهلك في المتوسط 60–150 W لثماني ساعات يوميًا يكلف نحو 4–11 يورو شهريًا. مبلغ صغير، لكنه يدفع نقطة التعادل إلى نحو 37 شهرًا.
الخطوة 3: أبقِ خطة رخيصة للأمور الصعبة
ستحتاجه. قليلون هم من استخدموا نموذجًا متقدمًا للبرمجة الوكيلية أو لبحث جاد ثم عادوا إلى نموذج بـ 34 نقطة لكل شيء. أبقِ خطة بـ 20 دولارًا للنسبة الصعبة 10%، وسيوفّر عليك Mac 170 دولارًا شهريًا، لا 200: نحو 41 شهرًا.
الخطوة 4: قارن بما ستنزل إليه فعلًا
إذا كنت حريصًا على التكلفة بما يكفي للتفكير في حاسوب بـ 7,000 دولار، فأنت حريص بما يكفي للانتقال إلى فئة 100 دولار. مقابل 100 دولار شهريًا تصبح نقطة التعادل نحو 78 شهرًا، أي أكثر من ست سنوات ونصف، أطول مما يحتفظ كثيرون بحاسوب محمول.
| السيناريو | المبلغ المقدم | ما تزال تدفعه | التوفير الشهري | نقطة التعادل |
|---|---|---|---|---|
| MacBook مقابل خطة 200 دولار، دون الكهرباء | $6,999 | — | $200 | 35 شهرًا |
| MacBook مقابل خطة 200 دولار، مع الكهرباء | $6,999 | $10 | $190 | 37 شهرًا |
| … مع الاحتفاظ بخطة 20 دولارًا | $6,999 | $30 | $170 | 41 شهرًا |
| MacBook مقابل خطة 100 دولار | $6,999 | $10 | $90 | 78 شهرًا |
| Mac Studio (128 GB) مقابل خطة 200 دولار | $4,799 | $10 | $190 | 25 شهرًا |
| Mac Studio مقابل خطة 200 دولار، مع الاحتفاظ بخطة 20 دولارًا | $4,799 | $30 | $170 | 28 شهرًا |
كل هذه الأرقام تفترض أن Mac يقوم بعمل الاشتراك بالكامل. الأجزاء من 4 إلى 9 تشرح لماذا لا يفعل.
عرض الصورة التكلفة التراكمية على أربع سنوات، بافتراض أن Mac يحل محل الاشتراك بالكامل، وهو ما لا يحدث. الكهرباء بنحو 10 دولارات شهريًا.
الخطوة 5: ثلاث سنوات، مع إعادة البيع
للعتاد قيمة إعادة بيع، وهذا أقوى حجة للشراء. افترض أنك تبيعه بعد ثلاث سنوات مقابل 35% من سعر الشراء. هذا افتراضي، وليس عرض سعر، مستندًا إلى بيانات MacFinder التي تُظهر أن نحو نصف القيمة يضيع في السنة الأولى ثم تتباطأ الخسائر بعدها.
| الخيار | تكلفة 36 شهرًا |
|---|---|
| خطة 200 دولار | $7,200 |
| MacBook (128 GB) + الكهرباء، يُباع بـ 35% | $4,909 |
| … إضافة إلى خطة 20 دولارًا للعمل المتقدم | $5,629 |
| Mac Studio (128 GB) + الكهرباء + خطة 20 دولارًا، يُباع بـ 35% | $4,199 |
| خطة 100 دولار | $3,600 |
| خطة 20 دولارًا | $720 |
إذن نعم: على مدى ثلاث سنوات، يمكن أن يأتي MacBook مع خطة 20 دولارًا أرخص بنحو 1,600 دولار من خطة 200 دولار، إن بعته بسعر معقول. لكن انظر إلى ما يشتريه هذا المال. على جانب، أفضل النماذج في العالم مع كل أداة حولها. وعلى الجانب الآخر، نموذج بـ 34 نقطة، وبضعة آلاف من الدولارات من الإهلاك، وخطة رخيصة للحالات التي تحتاج فيها الشيء الحقيقي. خطة 100 دولار تتفوق على كل خيار عتاد من حيث التكلفة، وخطة 20 دولارًا تتفوق على كل شيء.
أنت لا توفّر مالًا كثيرًا بشراء MacBook للنماذج المحلية. أنت تنفق مبلغًا مشابهًا على منتج مختلف: الخصوصية والتحكم والتحرر من الحدود، مع ذكاء أقل.
منظور التكلفة الحدية
هناك صياغة واحدة يكون فيها الشراء أكثر منطقية: أنك تحتاج إلى MacBook جديد على أي حال. حينها تكون التكلفة الخاصة بالذكاء الاصطناعي مجرد ترقية الذاكرة من 48 GB إلى 128 GB، أي 2,000 دولار، أو عشرة أشهر من خطة 200 دولار. هذا ليس جنونًا. لكن تذكّر مفارقة 128 GB من الجزء 4: على لوحة الصدارة اليوم، تشتري تلك الترقية نماذج أكبر، لا أذكى. إن كنت ستشتري MacBook على أي حال، فسعة 48–64 GB تشغّل أفضل نموذج بحجم Mac بدقة 8-bit مع سياق وافر.
ما الذي يشتريه 6,999 دولار بدلًا من ذلك
- 35 شهرًا من خطة 200 دولار، 70 شهرًا من خطة 100 دولار، أو 29 سنة من خطة 20 دولارًا
- نحو 11.7 مليار رمز إخراج من DeepSeek V4.1 Flash بسعر API خارج أوقات الذروة، وهو نموذج يتفوق على كل ما يمكن تشغيله على MacBook
- نحو 350 مليون رمز إخراج من Claude Opus 5.5 عبر API الخاص بـ Anthropic، بسعر 20 دولارًا لكل مليون رمز كما تذكره Artificial Analysis
الجزء 11 — الحجة المنصفة: متى يكون شراء Mac للذكاء الاصطناعي المحلي منطقيًا
لا شيء من هذا يعني أن الذكاء الاصطناعي المحلي حيلة. أكتب عنه باستمرار في هذه المدونة لأنه مفيد. لكنه مفيد لأسباب مختلفة عن التي تدّعيها الفكرة الترويجية. هذه هي الأسباب الجيدة.
1. بيانات يجب ألا تخرج عن سيطرتك
إذا كنت تتعامل مع ملفات عملاء أو معلومات صحية أو بيانات مالية غير منشورة أو أي شيء يخضع لواجب سرية، فالنموذج المحلي يعني أن لا شيء يذهب إلى طرف ثالث. لا اتفاقية معالج، ولا نقل دولي، ولا تساؤل عن إعدادات التدريب. في ألمانيا، المهنيون الملتزمون بـ § 203 StGB، مثل المحامين والأطباء ومستشاري الضرائب، يحتاجون إلى ضمانات تعاقدية قبل أن تذهب بيانات العملاء إلى أي مزوّد خدمة خارجي، بمن فيهم مزوّدو الذكاء الاصطناعي. النموذج المحلي يتجاوز هذه المسألة تمامًا. هذا أقوى سبب لامتلاك العتاد، وهو لا يعتمد على ما إذا كان النموذج المحلي ذكيًا مثل Opus. تقريري حالة الذكاء الاصطناعي 2026 يتناول جانب التكلفة والامتثال في تشغيل الذكاء الاصطناعي دون اتصال بمزيد من التفصيل.
2. العمل دون اتصال
على متن طائرة، أو في موقع عميل بلا شبكة، أو في منشأة تكون فيها الشبكة هي الشيء المحظور.
3. لا حدود، ولا انحراف في السياسات، ونموذج لا يتغير أبدًا
لا نوافذ خمس ساعات، ولا سقوف أسبوعية، ولا دعاوى جماعية بشأن طريقة الإفصاح عنها. والنموذج المحلي يتصرف بعد سنة كما يتصرف اليوم، وهذا مهم إن كنت قد بنيت سير عمل حول طريقة تصرف النموذج.
4. عمل كمّي وممل ومحدد جيدًا
تصنيف آلاف تذاكر الدعم، واستخراج الحقول من الفواتير، وتلخيص ملاحظاتك، وترجمة المسودات، ووسم الصور، وتوليد التضمينات للبحث في مستنداتك، وتفريغ الاجتماعات بـ Whisper. النماذج المحلية متوسطة الحجم ممتازة في هذه المهام، وتشغيل مليون منها لا يكلف شيئًا سوى الكهرباء.
5. التعلّم والبناء
إذا كنت تبني تطبيقات local-first، أو تضبط نماذج صغيرة ضبطًا دقيقًا، أو تريد فقط فهم كيف تعمل هذه الأشياء، فامتلاك العتاد هو أفضل معلم. (وإن كان بناء التطبيقات بالذكاء الاصطناعي هو شغفك، فقد كتبت العملية كاملة في كيف تبني تطبيقًا من الصفر بالذكاء الاصطناعي في 2026.)
6. كنت ستشتري Mac على أي حال
حينها اشترِ ذاكرة تكفي النماذج التي ستشغّلها فعلًا (انظر الجزء 14)، وتعامل مع الذكاء الاصطناعي المحلي كميزة إضافية، لا كحجة اقتصادية.
ما يعمل جيدًا محليًا
| المهمة | ما تشغّله | ذاكرة مريحة |
|---|---|---|
| دردشة خاصة وصياغة وإعادة كتابة | Qwen3.8 27B بدقة 8-bit | 48–64 GB |
| التلخيص والأسئلة والأجوبة على مستنداتك | Qwen3.8 27B مع نموذج تضمين | 48–64 GB |
| الاستخراج والتصنيف بالجملة | نماذج أصغر (Gemma 4، gpt-oss-20b) | 16–32 GB |
| تحويل الكلام إلى نص | Whisper | 8–16 GB |
| توليد الصور | Draw Things أو ComfyUI مع نماذج من فئة FLUX | 32 GB+ |
| نموذج دردشة كبير وسريع | gpt-oss-120b أو Qwen3.5 122B | 128 GB |
لتوليد الفيديو محليًا، تبقى أجهزة Mac بطيئة مقارنة بعتاد Nvidia أو وحدات GPU السحابية؛ دليلي إلى M5 Pro بسعة 64 GB فيه الأرقام.
الجزء 12 — طرق أرخص لخفض فاتورة ذكاء اصطناعي بـ 200 دولار
إذا كان ما تريده فعلًا هو فاتورة ذكاء اصطناعي أصغر، فهناك طرق أرخص من حاسوب بـ 7,000 دولار.
1. انزل فئة. Claude Max 5× وChatGPT Pro 100 يكلفان 100 دولار، وAI Ultra من Google يبدأ الآن من 100 دولار. إن كنت نادرًا ما تصل إلى حدودك في خطة 200 دولار، فهذا يوفّر 1,200 دولار سنويًا دون أي خسارة في الجودة.
2. اجمع خطتين بـ 20 دولارًا. Claude Pro مع ChatGPT Plus يكلف 40 دولارًا شهريًا ويمنحك مجموعتين منفصلتين من الحدود وعائلتي نماذج متقدمة للتنقل بينهما.
3. ادفع حسب الرمز للنماذج المفتوحة. النماذج ذات الأوزان المفتوحة نفسها التي كنت ستشغّلها على Mac، ونماذج أكبر لن تتسع أبدًا، متاحة بالرمز من مزوّدين كثيرين، بسرعة مركز بيانات. DeepSeek V4.1 Flash، الذي يتفوق على كل نموذج يتسع في MacBook، يكلف 0.15 دولار لكل مليون رمز إدخال و0.60 دولار لكل مليون رمز إخراج خارج أوقات الذروة على API الخاص بـ DeepSeek (ضعف ذلك في أوقات الذروة). Qwen3.8 27B مذكور على OpenRouter من نحو 0.035 دولار لكل مليون رمز إدخال. للبيانات الشخصية أو بيانات العملاء، استخدم مزوّدًا يستضيف في الاتحاد الأوروبي ولديه اتفاقية معالجة بيانات بدلًا من API الخاص بـ DeepSeek، الذي يعالج البيانات في الصين.
4. استخدم خطة برمجة بسعر ثابت للنماذج المفتوحة. خطة Z.ai GLM Coding Plan تبدأ من 18 دولارًا شهريًا وتشمل GLM-5.3، الأفضل مناصفة بين النماذج القابلة للتنزيل على المؤشر الجديد، إضافة إلى GLM-5.3-Flash، وهي تعمل في Claude Code وCodex وOpenCode وأدوات أخرى. احصل على خصم 10% على GLM Coding Plan عبر رابط الأفلييت الخاص بي. (رابط تابع — راجع الإفصاح في أعلى الصفحة.) إنه ليس Opus 5.5، والمؤشر يقول ذلك بصراحة، لكنه يكلف أقل من عُشر خطة 200 دولار. قارنته بعرض MiniMax في GLM-5.3-Flash مقابل MiniMax M3.
5. استخدم الـ Mac الذي لديك بالفعل. إذا كان جهاز Mac الحالي لديك بسعة 16 إلى 32 GB، فالنماذج المحلية الصغيرة تتولى قدرًا مفاجئًا من العمل الكثيف المذكور في الجزء 11 مجانًا.
6. وجّه حسب المهمة. الإعداد الذي يناسب معظم الناس: نموذج محلي للمهام الخاصة والكثيفة، وخطة رخيصة أو نموذج مفتوح بالرمز للعمل اليومي، ووصول إلى نموذج متقدم للنسبة الصعبة 10%. مقالي مقارنة هارنسات البرمجة بالذكاء الاصطناعي فيه خمسة إعدادات مفصّلة بميزانيات مختلفة.
عرض الصورة التكلفة الشهرية لكل خيار بالدولار الأمريكي، قبل ضريبة القيمة المضافة. تكاليف الدفع حسب الرمز تعتمد على مقدار استخدامك؛ تم التحقق من الأسعار في 28 أكتوبر 2026.
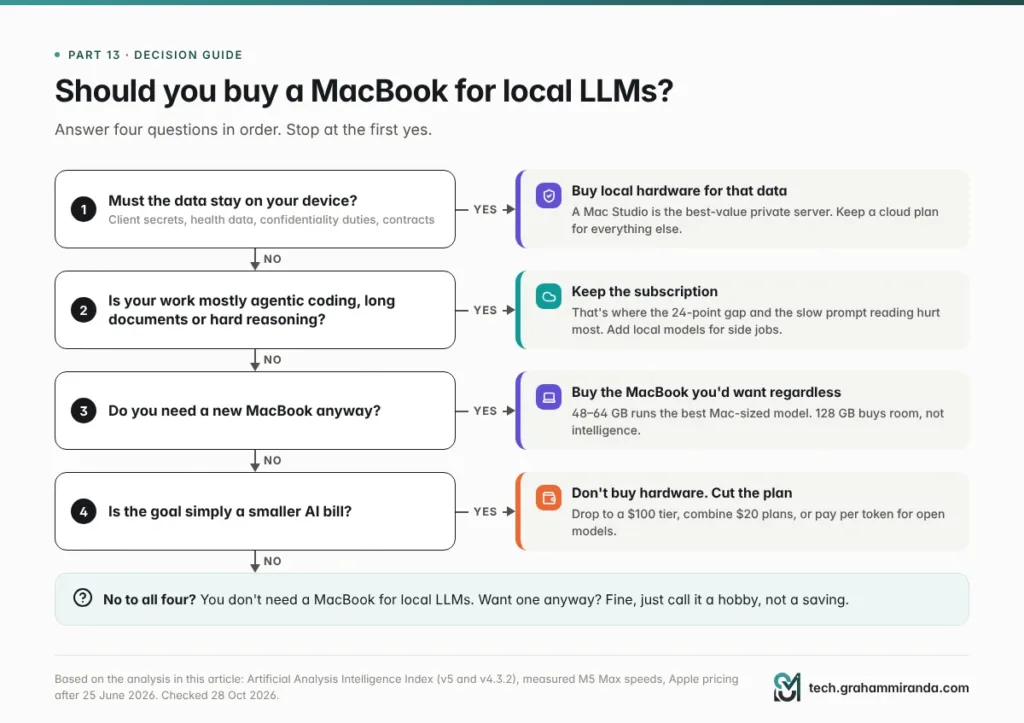
الجزء 13 — هل يجب أن تشتري MacBook لتشغيل LLMs محليًا؟ دليل القرار
عرض الصورة ابدأ من الأعلى. معظم المسارات تنتهي بـ“الاحتفاظ بخطة سحابية”، وهذا هو المقصود.
أجب عن أربعة أسئلة بالترتيب.
1. هل يجب أن تبقى البيانات على جهازك؟ إن كانت الإجابة نعم، بسبب سرية العملاء أو البيانات الصحية أو عقد، فاشترِ عتادًا محليًا: هذا الشرط لا يهتم بمعايير القياس. فكّر في Mac Studio كخادم خاص، واحتفظ بخطة سحابية للأعمال التي لا تشمل تلك البيانات.
2. هل عملك في أغلبه برمجة وكيلية أو مستندات طويلة أو استدلال صعب؟ إن كانت الإجابة نعم، فأبقِ على الاشتراك. فهنا تحديدًا تؤذي فجوة الـ 24 نقطة وأزمنة التمهيد أكثر ما تؤذي. ويمكن للنموذج المحلي أن يساعد في المهام الجانبية.
3. هل تحتاج إلى MacBook جديد على أي حال؟ إن كانت الإجابة نعم، فاشترِ الذي تريده بغض النظر عن ذلك. سعة 48–64 GB تشغّل أفضل نموذج بحجم Mac تشغيلًا جيدًا. اذهب إلى 128 GB فقط إذا كنت تريد تحديدًا نماذج من فئة 120B أو عدة نماذج محمّلة في وقت واحد، وأنت تعرف أنك تدفع 2,000 دولار مقابل مساحة، لا مقابل ذكاء.
4. هل الهدف مجرد فاتورة أصغر؟ حينها لا تشترِ عتادًا. انزل فئة، أو اجمع خطتين بـ 20 دولارًا، أو ادفع حسب الرمز للنماذج المفتوحة (الجزء 12).
إذا أجبت بـ لا على الأسئلة الأربعة كلها، فأنت لا تحتاج إلى MacBook للنماذج المحلية. قد تريده مع ذلك، ولا بأس. فقط سمّه هواية، لا توفيرًا.
الجزء 14 — إذا اشتريت واحدًا على أي حال: كيف تستفيد منه إلى أقصى حد
اختر الجهاز المناسب.
- اشترِ مقاس 16 بوصة، لا 14 بوصة، إن كان M5 Max لعمل ذكاء اصطناعي مستمر.
- فكّر في Mac Studio بدلًا منه. الشريحة والذاكرة نفسها بأقل بـ 2,200 دولار، وتبريد أفضل، ويمكنه خدمة حاسوبك وهاتفك على مدار الساعة.
- لا تشترِ ذاكرة أكثر من اللازم من أجل نماذج اليوم. سعة 48–64 GB تشغّل Qwen3.8 27B بدقة 8-bit مع سياقات طويلة. اشترِ 128 GB لنماذج من فئة 120B، أو لعدة نماذج في وقت واحد، أو لهامش للإصدارات القادمة، وأنت تعرف تكلفة ذلك.
- إن كنت ستشتري هذا الأسبوع، فانتظر حتى بعد فعالية الليلة. ستعرف ما يقدمه MacBook Pro OLED وما يكلف قبل أن تلتزم.
أعدّه إعدادًا صحيحًا.
- ابدأ بـ LM Studio (MLX على Apple Silicon) لأسهل طريق، أو Ollama إن أردت API واحدًا للنماذج المحلية والسحابية.
- فضّل 8-bit لأي شيء ستعتمد عليه؛ واستخدم 4-bit للسرعة في الدردشة.
- اضبط طول السياق بوعي. كثير من بيئات التشغيل تفترض سياقات صغيرة افتراضيًا؛ والوكلاء يحتاجون أكثر بكثير.
- لا ترفع حد ذاكرة GPU إلا إذا كنت تفهم المقايضة، واترك مساحة لـ macOS.
- احتفظ بخطة سحابية بـ 20 دولارًا للنسبة الصعبة 10%. فهي أرخص من وقتك.
اختبره على عملك أنت. خذ 20 موجّهًا حقيقيًا من الشهر الماضي: رسائل بريد، ومستندات، ومهام برمجة، وأي شيء تفعله فعلًا. مرّر كل واحد على نموذجك المحلي ونموذجك السحابي، وأخفِ أيّهما أيّ، وقيّمها. افعل ذلك باللغة التي تعمل بها. ستخبرك تلك الساعة أكثر من أي لوحة صدارة، بما فيها تلك الموجودة في هذا المقال.
الأسئلة الشائعة
هل يمكن لـ MacBook أن يحل محل اشتراك ChatGPT Pro أو Claude Max؟
ليس في الجودة. النماذج التي يقف خلفها اشتراك بـ 200 دولار، مثل Claude Opus 5.5 وGPT-6 Astra، لا يمكن تنزيلها، وأفضل النماذج المفتوحة القابلة للتنزيل تحتاج إلى 375–460 غيغابايت من الذاكرة عند 4 بت، أي أكثر بكثير من أي MacBook. وعلى مؤشر Artificial Analysis يسجّل Opus 5.5 النتيجة 58؛ وأقوى نموذج وجدته يتّسع في MacBook بذاكرة 128 غيغابايت، وهو Qwen3.8 27B، يسجّل 34 على الإصدار نفسه. يمكن لـ MacBook أن يحل محل الاشتراك في الأعمال الخاصة أو دون اتصال أو الكميات الكبيرة من العمل، لا في المهام المتقدمة.
ما أفضل LLM محلي لجهاز MacBook Pro بذاكرة 128 GB في 2026؟
من ناحية الجودة، Qwen3.8 27B: يصنّفه Artificial Analysis الأول بين 141 نموذجًا قابلًا للمقارنة، بـ 34 على مؤشر Intelligence Index v4.3.2، ويتّسع بسهولة عند 8 بت. ومن ناحية السرعة، gpt-oss-120b وQwen3.5 122B نموذجان قائمان على مزيج الخبراء يكتبان 55–88 رمزًا في الثانية على M5 Max، لكن نتيجتهما أدنى (12 و16). تحقّق من Artificial Analysis قبل أن تختار، لأن النماذج المفتوحة الجديدة تغيّر هذا الترتيب كل بضعة أسابيع.
كم يكلّف MacBook Pro بذاكرة 128 GB الآن؟
يبلغ سعر MacBook Pro مقاس 16 بوصة مع M5 Max (معالج CPU بـ 18 نواة، وGPU بـ 40 نواة) وذاكرة 128 غيغابايت وسعة 2 تيرابايت، 6,999 دولار في الولايات المتحدة، قبل ضريبة المبيعات. رفعت Apple أسعار Mac في 25 يونيو 2026، وضاعفت سعر ترقية الذاكرة إلى 128 غيغابايت من 1,000 إلى 2,000 دولار. وفي ألمانيا كان سعر التكوين نفسه €6,249 عند الإطلاق، ويبلغ الآن نحو €8,199 بحسب تقديري. أما Mac Studio بالشريحة والذاكرة نفسيهما فكان بـ $4,799.
كم يستغرق MacBook ليسدّد ثمنه مقارنةً باشتراك ذكاء اصطناعي بـ 200 دولار؟
نحو 35 شهرًا عند $6,999، إن حلّ محل الاشتراك بالكامل ولم يكلّف شيئًا في التشغيل. ومع نحو $10 شهريًا للكهرباء يصبح نحو 37 شهرًا، وإذا أبقيت اشتراكًا بـ $20 للمهام المتقدمة فيصبح نحو 41 شهرًا. ومقابل اشتراك بـ $100 يستغرق أكثر من ست سنوات. أما Mac Studio بالشريحة نفسها فيستعيد تكلفته أسرع، بعد نحو 25 إلى 28 شهرًا.
هل M5 Max سريع بما يكفي لـ LLMs المحلية؟
في كتابة الإجابات بنماذج مزيج الخبراء، نعم: بقياس MLX أنتج M5 Max بذاكرة 128 غيغابايت من 55 إلى 88 رمزًا في الثانية، وهو قريب من 98 التي يسجّلها Claude Opus 5.5 على واجهة Anthropic البرمجية. أما قراءة الموجّهات الطويلة فهي نقطة الضعف. موجّه من 32,000 رمز استغرق 13 ثانية مع gpt-oss-120b، و31 ثانية مع Qwen3.5 122B، و55 ثانية مع نموذج كثيف بـ 27B، ووكلاء البرمجة بالذكاء الاصطناعي يعيدون قراءة الموجّهات الطويلة باستمرار.
هل أصبحت LLMs المحلية جيدة بقدر ChatGPT أو Claude الآن؟
ليست النماذج التي تتّسع في حاسوب محمول. على مؤشر Artificial Analysis الجديد Intelligence Index v5، المنشور في 27 أكتوبر 2026، سجّلت أفضل النماذج المفتوحة القابلة للتنزيل 32 مقابل 58 لـ Claude Opus 5.5، وأدنى من Claude Haiku 5.5 الذي سجّل 36. والنماذج الصغيرة بما يكفي لـ MacBook سجّلت 34 كحد أقصى على الإصدار السابق من المؤشر، حيث سجّل Opus 5.5 أيضًا 58. في المهام القصيرة والبسيطة يكون الفرق صغيرًا غالبًا، أما في البرمجة بالوكلاء والمستندات الطويلة والاستدلال الصعب فالفرق كبير.
هل يجعل التكميم النماذج المحلية أسوأ؟
قليلًا عند 8 بت، وأكثر عند 4 بت، وكثيرًا دون ذلك. وجدت دراسة شملت أكثر من 500,000 عملية تقييم أن FP8 بلا خسارة تُذكر تقريبًا، وأن التكميم بأوزان 4 بت يقترب من 8 بت على المعايير القياسية. لكن في المدخلات التي تبلغ 64,000 رمز أو أكثر، قاست دراسة من EMNLP 2025 انخفاضات تصل إلى 59% عند 4 بت، تكون أسوأ في النص غير الإنجليزي، وعند 3 بت هبطت نتيجة الرياضيات لنموذج استدلال من 85.6% إلى 47.0%.
هل يمكنني تشغيل DeepSeek V4.1 Flash أو GLM-5.3 على MacBook؟
لا. يبلغ عدد معاملات GLM-5.3 نحو 753 مليارًا، ويبلغ DeepSeek V4.1 Flash 763 مليارًا بما في ذلك ذاكرة Engram، لذا فهما يحتاجان حتى عند 4 بت إلى نحو 375–460 غيغابايت، أي أكثر بكثير من الحد الأقصى البالغ 128 غيغابايت في أي MacBook. أما Mac Studio مع M5 Ultra وذاكرة 512 غيغابايت فيستطيع استيعابهما. والطريقة العملية لاستخدامهما هي عبر API، والأفضل مزوّد يستضيف في الاتحاد الأوروبي ولديه اتفاقية معالجة بيانات.
هل تكفي 64 GB للذكاء الاصطناعي المحلي، أم أحتاج إلى 128 GB؟
لمعظم الناس تكفي 48–64 غيغابايت. أفضل نموذج بحجم يناسب Mac على مؤشر Artificial Analysis، وهو Qwen3.8 27B، يتّسع عند 8 بت مع متسع للسياقات الطويلة. أما 128 غيغابايت فتتيح تشغيل نماذج من فئة 120B مثل gpt-oss-120b، والاحتفاظ بعدة نماذج محمّلة، واستخدام سياقات أطول، لكن هذه النماذج الأكبر تسجّل نتائج أدنى على لوحة الترتيب الحالية، لذا تشتري ترقية الـ $2,000 مساحة لا ذكاءً.
هل أشتري Mac Studio بدلًا من MacBook Pro لتشغيل LLMs محليًا؟
إن كان الذكاء الاصطناعي المحلي هو السبب الأساسي، فالجواب عادة نعم. كان Mac Studio بالشريحة M5 Max نفسها وذاكرة 128 غيغابايت بـ $4,799، أي $2,200 أقل من MacBook Pro مقاس 16 بوصة، مع تبريد مستمر أفضل ولا بطارية تقلق بشأنها. ويستطيع العمل على مدار الساعة كخادم نماذج خاص لحاسوبك المحمول وهاتفك. اشترِ MacBook Pro إذا كنت تحتاج إلى التنقل لأسباب أخرى.
هل تشغيل الذكاء الاصطناعي محليًا أفضل من حيث الخصوصية وGDPR؟
نعم، هذه أقوى ميزة فيه. مع نموذج محلي، لا تخرج الموجّهات والمستندات من جهازك أبدًا، فلا وجود لاتفاقية معالجة بيانات لتوقّعها ولا لنقل بيانات دولي. وهذا مهم لبيانات العملاء والمعلومات الصحية والمهن الملتزمة بالسرية، مثل المهن المشمولة بالفقرة § 203 StGB في ألمانيا. وتبقى ميزة الخصوصية قائمة سواء كان النموذج المحلي بنفس قدرة النموذج السحابي أو أقل. هذا ليس استشارة قانونية.
هل يمكنني استخدام Claude Code مع نموذج محلي؟
نعم. يوفّر Ollama واجهة API متوافقة مع Anthropic، فيمكنك توجيه Claude Code إلى نموذج محلي بضبط ANTHROPIC_BASE_URL على http://localhost:11434. توقّع مقايضات: لا يدعم Ollama أدوات التحكم في التخزين المؤقت للموجّهات لدى Anthropic، كما أن موجّه النظام الطويل وتعريفات الأدوات في Claude Code تجعل النموذج المحلي يقرأ كثيرًا في كل خطوة، وClaude Code مضبوط لنماذج Claude. أما الهارنسات المفتوحة مثل OpenCode فغالبًا أنسب للنماذج المحلية.
هل سيغيّر MacBook Pro الجديد بـ OLED أي شيء من هذا؟
على الأرجح ليس كثيرًا بالنسبة للذكاء الاصطناعي المحلي. تُقام فعالية Apple بعنوان “Pro and Tell” في 28 أكتوبر 2026 الساعة 10:00 بتوقيت المحيط الهادئ، ويُذكر أن MacBook Pro بشاشة OLED تعمل باللمس والمتوقع ظهوره فيها يستخدم الشرائح نفسها M5 Pro وM5 Max، ما يعني بقاء سقف 128 غيغابايت وعرض نطاق 614 غيغابايت/ثانية. أما MacBook Pro مقاس 14 بوصة مع M6 المعلن في 27 أكتوبر فيتوقف عند 32 غيغابايت.
الخلاصة
“ألغِ اشتراكك بـ $200 واشترِ Mac” — تصيب هذه الفكرة في أمرين: الاشتراكات مكلفة، والذكاء الاصطناعي المحلي مفيد فعلًا. لكنها تخطئ في الأمر المهم. اشتراك بـ $200 يؤجّر لك أفضل النماذج في العالم، والوكلاء المبنيين حولها، ومنتجًا يتحسّن كل شهر. أما MacBook بـ $7,000 فيشغّل أفضل النماذج التي تتّسع في 128 غيغابايت، وهذه تسجّل اليوم 34 مقابل 58 للنماذج المتقدمة، وتقرأ الموجّهات الطويلة ببطء، وتفقد الجودة في المواضع نفسها التي ستضغط عليها فيها بأقصى ما يمكن.
والحسابات لا تنقذ الفكرة أيضًا. حتى في أكثر الحالات سخاءً، يحتاج MacBook من ثلاث إلى أربع سنوات ليستعيد تكلفته، وعلى مدى ثلاث سنوات تبلغ تكلفته ضمن نطاق ألفي دولار من الاشتراك، بحسب ما يمكنك بيعه به. أي فاتورة مشابهة لمنتج أقل قدرة.
لذا اشترِ MacBook للنماذج اللغوية المحلية إن كانت بياناتك لا تستطيع مغادرة المكان، أو إن كنت تعمل دون اتصال، أو إن أردت عملًا بلا حدود ونموذجًا لا يتغيّر، أو إن كنت ستشتري Mac على أي حال. هذه أسباب وجيهة، وكثير من الناس لديهم هذه الأسباب. لكن لا تشتره لتلغي اشتراكك. أبقِ اشتراكًا سحابيًا للنسبة الصعبة البالغة 10%، وضع النسبة الخاصة والمملة البالغة 90% على عتادك، ودع لوحات الترتيب تخبرك متى يتغيّر هذا التوازن.
هل تشغّل نماذج محلية في العمل، أو وجدت عكس ما يقوله هذا المقال؟ يهمّني أن أعرف أي نموذج وأي جهاز وأي مهام، مع الأرقام إن كانت لديك. التصحيحات والأدلة المخالفة مرحّب بها؛ يُحدَّث هذا المقال عندما تتحرك لوحات الترتيب والأسعار، وهذا في 2026 يعني كثيرًا.
تم التحقق من الحقائق: 28 أكتوبر 2026.