
 العربية
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 हिन्दी

هناك نوع محدّد جدًا من إجهاد القرار يصيبك في نحو الحادية عشرة مساءً، بعد ثلاثة أكواب قهوة، وأنت تحدّق في منتقي النماذج في OpenCode’s.
لديك مفتاح Z.ai. ولديك مفتاح MiniMax. كلا النموذجين يدّعي نافذة سياق بمليون رمز. وكلاهما مفتوح الأوزان. وكلاهما لا يكلّف تقريبًا شيئًا مقارنة بالنماذج المغلقة المتقدمة. ولكل منهما مخطط معيار قياس يظهر فيه متقدّمًا. وكل ما تريده هو أن تعرف أيّهما تضبط كنموذجك الافتراضي لتعود إلى عملك.
هذا المقال هو الجواب عن ذلك السؤال — النسخة الطويلة، لأن النسخة القصيرة (“GLM-5.3-Flash، على الأرجح”) تخفي نحو ستة تحفّظات ستنالك إن تجاهلتها.
لقد جمعت تفاصيل البنية، ومعايير قياس الشركات المصنّعة، والتقييمات المحايدة، والأسعار الحقيقية لكل رمز بما في ذلك فخّ السياق الطويل متعدد الشرائح، وبيانات الاستخدام التي نشرتها OpenCode نفسها، وملفات التهيئة الفعلية لكليهما. ثم حسبت تكلفة شهر عمل عادي بدلًا من سيناريو بيانات صحفية.
وهذا ما خرجت به النتيجة.
باختصار — الحكم في 30 ثانية
شغّل GLM-5.3-Flash كنموذجك الافتراضي في OpenCode. إنه أذكى في كل معيار قياس تقريبًا يهمّ في العمل الوكيلي والبرمجة، ويكلّف نحو نصف التكلفة لكل رمز، ورخصته MIT حقيقية، وهو الوجهة التي ذهب إليها مجتمع OpenCode فعليًا.
وأبقِ MiniMax M3 في مسار السرعة. إنه يولّد أسرع بنحو ثلاث مرات ويردّ أسرع بنحو مرتين عند أول رمز. وفي الحلقات كثيرة الأدوار قليلة الصعوبة — إعادة تسمية الملفات، وبناء هياكل الاختبارات، وتوليد الوثائق، وجولات الفحص والإصلاح، وإعادة الهيكلة الميكانيكية الكبيرة — يُحسّ فرق السرعة هذا أكثر من فجوة الذكاء.
الخلاصة الصادقة في سطر واحد: GLM-5.3-Flash يفكّر أفضل، وMiniMax M3 يكتب أسرع. البرمجة الوكيلية مشكلة تفكير في معظمها، لذا يفوز GLM بالمقعد الافتراضي. لكن إن كنت لا تشغّل الاثنين معًا، فأنت تترك إنتاجية على الطاولة، وOpenCode يجعل تشغيل الاثنين سهلًا للغاية.
جدول مقارنة سريع
| GLM-5.3-Flash | MiniMax M3 | |
|---|---|---|
| المطوّر | Z.ai (Zhipu AI) | MiniMax |
| تاريخ الإصدار | 26 أغسطس 2026 | 1 June 2026 |
| إجمالي المعاملات | 320B | ~428B |
| النشطة لكل رمز | 18B | ~23B |
| البنية | انتباه خطي هجين بـKDA + MLA متفرّق بدون NoPE، وMoE (8 من 288 خبيرًا + 1 مشترك) | عمود فقري GQA + MiniMax Sparse Attention (MSA)، وMoE متفرّق |
| نافذة السياق | 1M (1,048,576) | 1M (حد أدنى مضمون 512K) |
| أقصى إخراج | 131,072 رمزًا | حتى 262,144 رمزًا |
| إدخال متعدد الوسائط | نص، صورة، فيديو، ملف | نص وصورة وفيديو |
| الترخيص | MIT | MiniMax Community License |
| سعر إدخال API | $0.15 / 1M ($0.03 مخزّن مؤقتًا) | $0.30 / 1M ($0.06 مخزّن مؤقتًا) |
| سعر إخراج API | $0.50 / 1M | $1.20 / 1M |
| رسم إضافي للسياق الطويل | لا يوجد معلن | 2× فوق إدخال 512K |
| سرعة الإخراج | ~48.6 tok/sec | ~147.9 tok/sec |
| زمن أول رمز | ~1.51s | ~0.99s |
| Terminal-Bench 2.1 | 84.3 | 66.0 |
| Artificial Analysis Intelligence | 57 | 45 |
| حصة OpenCode من الرموز | 10.3% | 1.12% |
| وضع التفكير | مفعّل دائمًا (لا يمكن تعطيله) | قابل للتهيئة |
| سعر الاشتراك المبدئي | $18/شهر (GLM Coding Plan Lite) | $20/شهر (MiniMax Plus) |
الأسعار هي أسعار القائمة الرسمية من كل بائع. بوابات التوجيه مثل OpenRouter تظهر غالبًا بأسعار فعلية أقل لأنها توازن الأحمال بين مضيفين خارجيين — المزيد عن ذلك أدناه، لأنه مهم.
لماذا هذه المقارنة هي المهمة الآن
قبل اثني عشر شهرًا، كان الحديث عن البرمجة بأوزان مفتوحة يدور حول ما إذا كانت هذه النماذج صالحة للاستخدام أصلًا. تلك المسألة حُسمت. والحديث في النصف الثاني من 2026 أضيق وأكثر تشويقًا: أي نموذج مفتوح الأوزان توجّه إليه هارنس الوكلاء لديك، وما الذي يكلّفك إياه أن تخطئ؟
OpenCode شحذ ذلك السؤال. فهو ليس نافذة محادثة — بل وكيلًا أصيلًا في الطرفية يخطّط، ويقرأ الملفات، ويعدّلها، ويشغّل الأوامر، ويقرأ المخرجات، ويكرّر. هذا العبء يعاقب النماذج بطرق لا يكشفها معيار قياس المحادثة. النموذج الذي يكتب دوالّ معزولة جميلة قد يبقى عديم الفائدة في OpenCode إن فقد الخيط بعد عشرين استدعاء أداة، أو هلوس مسار ملف، أو أحرق 90,000 رمز في تقرير ما يجب فعله.
GLM-5.3-Flash وMiniMax M3 هما النموذجان المفتوحا الأوزان الأكثر جدارة بالثقة في ذلك الحديث الآن. ظهرا خلال ثلاثة أشهر من بعضهما، ويستهدفان المهمة نفسها، وسعرهما في نطاق متقارب، وقد قاما برهانات هندسية شبه متعاكسة.
هذا الجزء الأخير هو المثير للاهتمام.
ما هو GLM-5.3-Flash فعلًا
كان لـGLM-5.3-Flash أحد أفضل الإطلاقات هذا العام، ولم يكن ذلك مصادفة.
قبل أن تضع Z.ai اسمها على أي شيء، ظهر النموذج على OpenRouter بالاسم الرمزي “Ox Alpha.” بلا نسبة إلى مختبر، ووصول شبه مجاني، وبلا تسويق. تسلّق بهدوء إلى قمة مخططات الاستخدام على OpenRouter وOpenCode وبقي هناك نحو أسبوع بينما كان المجتمع يتجادل حول من بناه. وفي 26 أغسطس 2026، أكّدت Z.ai أنه لها وأصدرت الأوزان مفتوحة بترخيص MIT.
إطلاق نموذج في البرّية وتركه يكسب المصداقية قبل أن تنسبه إليك خطوة جيدة حقًا، وقد نجحت — كان للنموذج بيانات استخدام حقيقية وراءه قبل أن يرى أحد مخطط معيار قياس.
البنية بلغة مبسطة
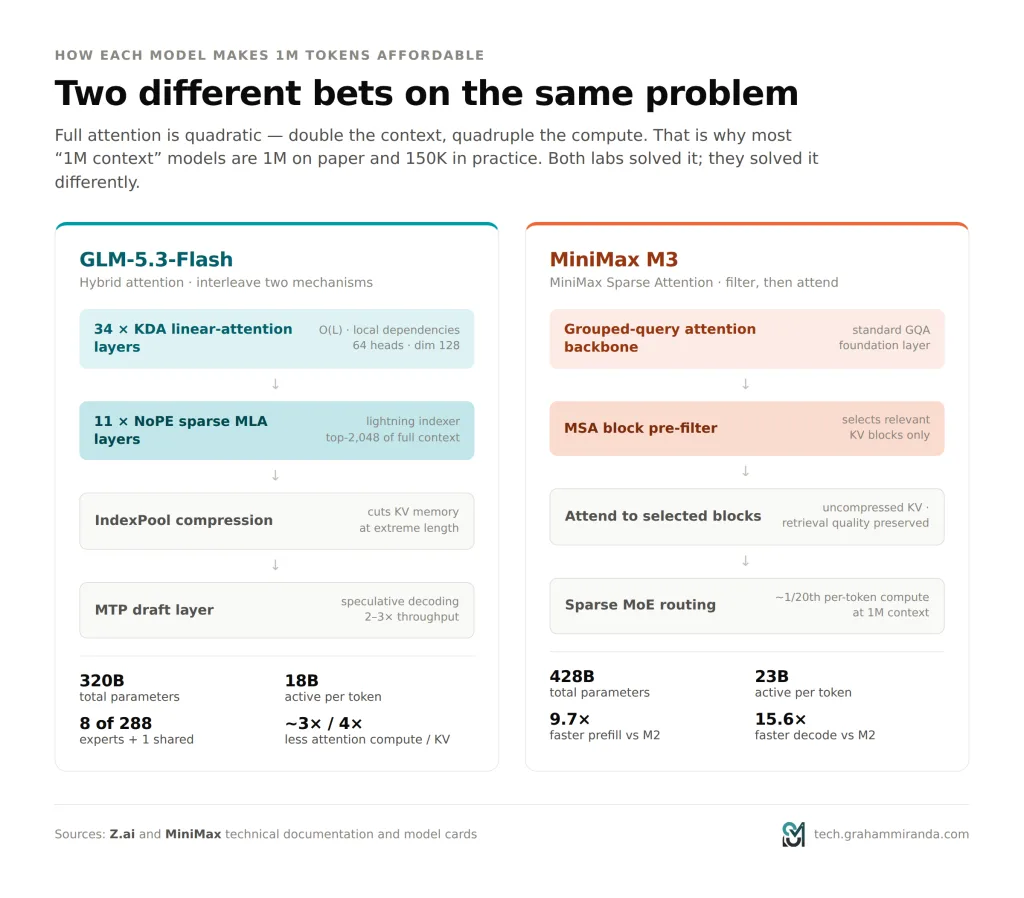
GLM-5.3-Flash نموذج خليط خبراء بـ320 مليار معامل لا ينشّط سوى نحو 18 مليار معامل لكل رمز. يوجّه كل رمز عبر 8 من 288 خبيرًا موجّهًا زائد خبير مشترك واحد — أي أن نحو 2.8% من أوزان الخبراء تعمل في أي تمريرة أمامية. من هنا تأتي اقتصاديات “Flash”: معرفة بمقياس النماذج المتقدمة، بتكلفة استدلال نموذج صغير.
تصميم الانتباه هو الجزء الجديد حقًا. فبدل آلية انتباه واحدة موحّدة، يمزج بين اثنتين:
- 34 طبقة انتباه خطي KDA. تعمل هذه في زمن خطي نسبةً إلى طول التسلسل بدل الزمن التربيعي. تتعامل مع التبعيات المحلية بتكلفة زهيدة وتمنع الإنتاجية من الانهيار مع نمو سياقك.
- 11 طبقة MLA متفرّقة بدون NoPE. انتباه كامن متعدد الرؤوس على نمط DeepSeek بلا تضمينات موضعية، تسبقه “مفهرسة صاعقة” تختار أفضل 2,048 رمزًا الأكثر صلة من السياق الكامل. هذا ما يحافظ على جودة الاسترجاع بعيد المدى.
وهناك أيضًا IndexPool خطوة ضغط تجمع متجهات مفاتيح المفهرسة لتقليل كلفة الذاكرة عند أطوال السياق القصوى، و رأس تنبؤ متعدد الرموز للفك التخميني — تنفيذ vLLM يعتمد افتراضيًا 5 رموز تخمينية لكل خطوة فك، بما يعادل إنتاجية 2–3× عند أحجام الدفعات الصغيرة.
الأثر الصافي مقابل GLM-5.3 الكامل: حساب انتباه أقل بنحو 3× وذاكرة KV أصغر بأكثر من 4×. لهذا السبب يصبح سياق المليون رمز قابلًا للاستخدام فعليًا بدل أن يكون متاحًا نظريًا.
لماذا يهم ذلك لوكلاء البرمجة
ثلاثة أشياء تحديدًا.
إنه متعدد الوسائط أصيلًا، وهذا ليس حيلة هنا. كانت نماذج GLM البرمجية الأقدم ذات نقطة عمياء تجاه أي شيء لا تستطيع قراءته كنص. إن كسر وكيلك تخطيطًا، فلا سبيل لنموذج نصي أن يعرف. GLM-5.3-Flash يقبل الصور والفيديو والملفات أصيلًا، ما يعني أن تصحيح الأخطاء عبر لقطات الشاشة، والتحويل من تصميم إلى كود، وحلقات التحقق من “هل يبدو هذا صحيحًا فعلًا” كلها مطروحة.
التفكير إلزامي. لا يمكنك تعطيله. يمكنك ضبط reasoning_effort إلى منخفض, مرتفع، أو أقصى (القيمة الافتراضية الموثّقة هي أقصى)، لكن النموذج يفكّر دائمًا قبل أن يتصرف. في العمل الوكيلي هذا هو الافتراضي الصحيح — نمط فشل نماذج البرمجة الرخيصة هو تصرّف واثق بلا تخطيط، وقد أزالت Z.ai ذلك الخيار.
القفزة الجيلية حقيقية، وقد جاءت من التدريب اللاحق. يعيد GLM-5.3 استخدام النموذج الأساسي نفسه الذي في GLM-5.2. كل المكاسب جاءت من توسيع التدريب اللاحق — يُقال إن بيئات المهام طويلة الأفق صارت عشرة أضعاف، مع مهام تدريب تحاكي دورات حياة برمجية كاملة من تحديد الخطأ حتى الاختبار والنشر، بعضها بحجم “عبء عمل مهندس أول على مدى عدة أيام”. ارتفعت نتيجة DeepSWE v1.1 من 46.2 إلى 63.4. وارتفع Terminal-Bench 3.0 من 4.6 إلى 28.3. هذه ليست فروق ضجيج ضبط.
ما هو MiniMax M3 فعلًا
ظهر MiniMax M3 في 1 يونيو 2026 وقام برهان مختلف: بدلًا من التحسين لأقصى قدرة استدلال، حسّن من أجل اقتصاديات حلقات الوكلاء الممتدة.
إنه MoE متفرّق بنحو 428 مليار معامل، مع نحو 23 مليار معامل نشط لكل رمز، مبني على عمود فقري لانتباه الاستعلامات المجمّعة، مع MSA من MiniMax’s MSA (MiniMax Sparse Attention) فوقه.
رهان MSA
الانتباه التقليدي تربيعي: ضاعف السياق، يتضاعف الحساب أربع مرات. لهذا السبب معظم نماذج “سياق 1M” هي سياق 1M على الورق و150K في الممارسة — يمكنك تقنيًا ملء النافذة، لكنك لن ترغب في دفع ثمنها.
يستبدل MSA الانتباه الكامل بـ اختيار كتل KV. فهو يفلتر السياق مسبقًا وصولًا إلى الكتل ذات الصلة ولا ينتبه إلا إليها، مستخدمًا قيم مفاتيح غير مضغوطة كي تنجو جودة الاسترجاع من الفلترة. وتُبلِغ MiniMax عن النتيجة بنحو 1/20 من الحساب لكل رمز مقارنة بالجيل السابق عند سياق 1M، مع تعبئة أولية أسرع 9.7× وفك أسرع 15.6× مقارنة بـM2.
هذه قطعة هندسية ذكية بحق، وتظهر في الأرقام التي تشعر بها: نحو 148 رمزًا/ثانية إخراجًا وزمن أقل من ثانية لأول رمز. وبجانب سرعة GLM-5.3-Flash’s البالغة ~49 رمزًا/ثانية وزمن ~1.5 ثانية لأول رمز، يبدو M3 فئة مختلفة من الأدوات. وفي حلقة وكيل طويلة بعشرات الأدوار، يتراكم ذلك إلى دقائق من فرق الزمن الفعلي لكل مهمة.
تسوّق MiniMax أيضًا M3 بقدرته على “جلسات برمجة ذاتية تتجاوز 8 ساعات”. اعتبر ذلك ادعاءً لا مواصفة — لم يُتحقّق منه باستقلالية.
أين يكون M3 قويًا فعلًا
الجانب متعدد الوسائط وجانب وكيل سطح المكتب في M3 مُقلَّل التقدير. OSWorld-Verified عند 70.06% نتيجة جدية لمهام وكلاء سطح المكتب وواجهة المستخدم الرسومية. MCP Atlas عند 74.2% يقول إن سلوك استدعاء الأدوات لديه متين. GPQA Diamond عند 92.9% قريب من حدود النماذج المتقدمة في الاستدلال الصعب. و SWE-bench Verified عند 80.5% رقم رئيسي قوي.
إن كان عبء عملك هو “تشغيل متصفح، وقراءة فيديو، وتشغيل واجهة مستخدم، واستدعاء اثنتي عشرة أداة MCP بالتتابع”، فـM3 ليس تنازلًا. بل هو الأداة الأفضل على الأرجح.
معايير القياس — وما تخفيه
هنا أحتاج إلى الحذر، لأن كلا البائعين ينشر أرقامه، والنموذجان يُقيَّمان في الغالب على مجموعات معايير قياس مختلفة. وهذا ليس مصادفة. المختبرات تختار التقييمات التي تفوز فيها.
حيث يتقاطعان مباشرة
| معيار القياس | GLM-5.3-Flash | MiniMax M3 | ما يقيسه |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 66.0 | مهام وكيل الصدفة والطرفية |
| Artificial Analysis Intelligence Index | 57 | 45 | الذكاء المجمّع |
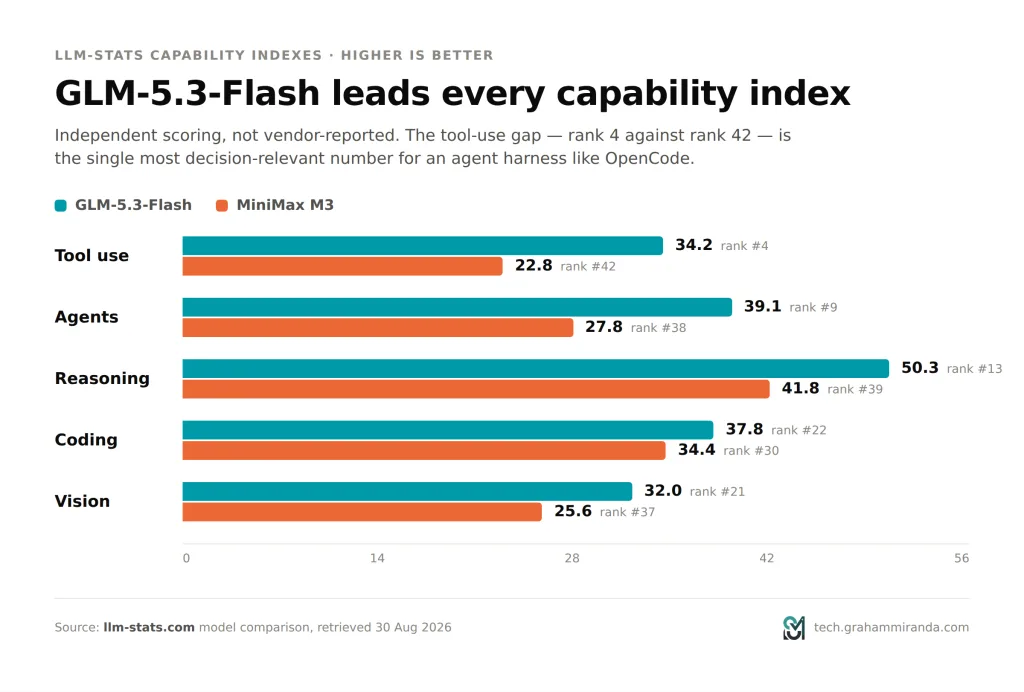
| مؤشر الاستدلال (llm-stats) | 50.3 (#13) | 41.8 (#39) | استدلال متعدد الخطوات |
| مؤشر البرمجة (llm-stats) | 37.8 (#22) | 34.4 (#30) | توليد الكود |
| مؤشر الوكلاء (llm-stats) | 39.1 (#9) | 27.8 (#38) | إنجاز المهام الوكيلية |
| مؤشر استخدام الأدوات (llm-stats) | 34.2 (#4) | 22.8 (#42) | استدعاء الدوال والأدوات |
| مؤشر الرؤية (llm-stats) | 32.0 (#21) | 25.6 (#37) | الفهم متعدد الوسائط |
Terminal-Bench 2.1 هو المعيار الذي يستحق أكبر وزن في OpenCode، لأنه أقرب بديل عام لما يفعله OpenCode فعليًا: وكيل في طرفية، يشغّل الأوامر، ويقرأ المخرجات، ويكرّر. فجوة 18 نقطة هناك ليست خطأ تقريب.
ترتيب استخدام الأدوات هو الآخر الذي لن أتجاوزه. GLM-5.3-Flash في المركز الرابع إجمالًا مقابل M3 في #42 هو السطر الأكثر صلة بالقرار في هذا المقال كله. هارنس الوكلاء آلة استدعاء أدوات. والنموذج الذي يحتل المركز 42 في استخدام الأدوات سينتج استدعاءات مشوّهة أكثر، وإعادات محاولة أكثر، وأدوارًا مهدورة أكثر — وكل دور مهدور يكلّفك رموزًا و و زمنًا فعليًا، وهذا يمحو بهدوء ميزة M3’s في السرعة.
أين يقف GLM-5.3-Flash بمفرده
- Terminal-Bench 2.1: 84.3 — مقابل Claude Opus 4.8 عند 85.0. على بعد نقطة من نموذج مغلق متقدم، بنحو 1/30 من السعر.
- DeepSWE v1.1: 63.4 — ارتفاعًا من نتيجة GLM-5.2’s البالغة 46.2.
- AutomationBench v1.0.6: 48.8 — مقابل Opus 4.8 عند 41.0. هذا أكبر تقدّم له على نموذج متقدم.
- Z.ai Code Bench v1.0: 29.0 — يسجّل Opus 4.8 نتيجة 29.5.
- GDPval-AA v2: 1773 — أعلى نتيجة بين النماذج المقارنة في قدرة العمل المعرفي.
- Toolathlon: 78.4 · OfficeQA Pro: 62.4 · CharXiv-R: 89.4% · MMVU: 80.5 · Chartography: 78.0
أين يقف MiniMax M3 بمفرده
- SWE-bench Verified: 80.5%
- SWE-bench Pro: 59.0% — مستودعات أصعب، شُغّلت بهيكل Claude Code
- MCP Atlas: 74.2% · OSWorld-Verified: 70.06% · GPQA Diamond: 92.9%
- KernelBench Hard: 28.8% · SWE-fficiency: 34.8%
التحفّظ الذي ينبغي أن تطبّقه فعلًا
أرقام الإطلاق عند كلا المختبرين’ مُبلَّغ عنها ذاتيًا. ومجموعة معايير MiniMax’s تحديدًا لم تكن قد ظهرت على لوحات التقييم المحايدة وقت إصدارها، ولاحظ محللو Z.ai’s أنفسهم أن إعادة التوجيه التلقائي من إصدارات النماذج الأقدم على منصة Z.ai’s تجعل مقارنات A/B النظيفة صعبة حقًا.
وحيث أجرى المجمّعون المحايدون — Artificial Analysis وllm-stats — تقييماتهم الخاصة، يفوز GLM-5.3-Flash في كل فئة. وهذا هو الدليل الذي أعطيه أكبر وزن، لأن أيًا من البائعين لم يختر تلك المعايير. هذا هو الدليل الذي أعطيه أكبر وزن، لأن أيًّا من المورّدين لم يختر تلك المعايير.
الإشارة التي لا يتحدث عنها أحد: بيانات استخدام OpenCode نفسه
هذا هو الجزء الذي وجدته الأكثر إقناعًا، وهو الجزء الذي تتخطاه معظم مقالات المقارنة تمامًا.
ينشر OpenCode بيانات قياس الاستخدام للنماذج التي تعمل داخله. ليست ادعاءات مورّدين. وليست مجموعات معايير. بل مطورون فعليون، يقومون بعمل فعلي، ويختارون ما يستمرون في استخدامه.
| المقياس | GLM-5.3-Flash | MiniMax M3 |
|---|---|---|
| المستخدمون الفريدون | 566K | 436K |
| حصة الرموز المعالَجة | 10.3% | 1.12% |
| الرموز خلال شهرين | 46T (+100%) | 5T (−51%) |
| المستخدمون العائدون في الأسبوع الأول | قيد الانتظار | 66% (32K أسبوع مستخدم) |
اقرأ رقمي حصة الرموز مرة أخرى. أعداد المستخدمين متقاربة تقريبًا — لدى GLM-5.3-Flash نحو 30% ممن جرّبوه أكثر — لكن إنتاجية رموز تزيد على تسعة أضعاف.
هذه الفجوة ليست عن مَن جرّب ماذا. إنها عن مَن بقي مع ماذا في العمل الحقيقي. الناس يفتحون جلسة مع M3، والناس يعيشون داخل جلسات مع GLM-5.3-Flash.
ويقول خط الاتجاه الشيء نفسه بصوت أعلى: ضاعف GLM-5.3-Flash حجم رموزه خلال شهرين بينما فقد M3 نصف حجمه.
تحفّظان منصفان. أولًا، GLM-5.3-Flash أحدث بثلاثة أشهر، والنماذج الجديدة تحصل على دفعة جِدّة؛ وسوف يستوي منحناها. ثانيًا، احتفاظ M3 بنسبة 66% في الأسبوع الأول رقم صحي — فمن اختاروه لا يتخلون عنه، لكن عددهم أقل ويستخدمونه بشكل أخف. وانخفاض M3 جزء منه استحواذ من خلفائه ومن وتيرة الإصدارات الصينية المفتوحة الأوزان الأوسع، وليس رفضًا خالصًا.
لكن إذا كنت تسأل “ما الذي يشغّله مستخدمو OpenCode ذوو الخبرة طوال اليوم فعلًا،” فتجيب البيانات عن ذلك دون لبس.
إعداد MiniMax M3 في OpenCode
الفضل لمن يستحقه: إعداد MiniMax أسهل، لأن OpenCode يأتي بمزوّد MiniMax مدمج. لا ملف إعدادات، لا JSON، لا عنوان أساسي.
bash
# 1. Install OpenCode (skip if you already have it)
curl -fsSL https://opencode.ai/install | bash
# or: npm i -g opencode-ai

# 2. Authenticate
opencode auth login
# Select: "MiniMax Token Plan (minimax.io)"
# Paste your Subscription Key (starts sk-cp-...)

# 3. Go
opencode
ثم /models داخل الجلسة واختر MiniMax-M3.
فخ نوع المفتاح
هذا الفخ يوقع الجميع تقريبًا. مفاتيح MiniMax Token Plan (الاشتراك) ومفاتيح API للدفع حسب الاستخدام غير قابلة للتبادل. فهي تُوجَّه بشكل مختلف وتُحاسَب بشكل مختلف. إذا صادقت بمفتاح PAYG على مزوّد Token Plan فستحصل على أخطاء مصادقة أو رصيد تبدو كأنها انقطاع خدمة، لكنها في الحقيقة عدم تطابق.
تبدأ مفاتيح الاشتراك بـ sk-cp- وتحتاج إلى مقعد مخصص أو أرصدة. احصل على مفتاحك من صفحة Token Plan في مركز مستخدم MiniMax، لا من صفحة مفاتيح API العامة.
إذا كنت تحتاج كتلة مزوّد يدوية
إذا كانت نسخة OpenCode لديك أقدم من المزوّد المدمج، أو أردت التوجيه صراحة إلى مفتاح PAYG:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "minimax": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "MiniMax",
      "options": {
        "baseURL": "https://api.minimax.io/v1",
        "apiKey": "{env:MINIMAX_API_KEY}"
      },
      "models": {
        "MiniMax-M3": {
          "name": "MiniMax M3",
          "limit": {
            "context": 1000000,
            "output": 262144
          }
        }
      }
    }
  }
}
لاحظ limit.context. هذا ليس زخرفة — انظر القسم التالي.
فخ نافذة السياق في MiniMax (اقرأ هذا قبل أن تلتزم)
إذا وجّهت MiniMax M3 عبر هارنس متوافق مع Anthropic — Claude Code، أو إعداد OpenCode يستخدم @ai-sdk/anthropic على https://api.minimax.io/anthropic — فهناك خلل موثّق وما زال مفتوحًا تحتاج إلى معرفته.
الـ /anthropic فإن نقطة النهاية تعلن نافذة سياق 200K بدلًا من 1M الفعلية لدى M3.
يبدو أن طبقة التوافق ترث بيانات Claude Sonnet الوصفية بدلًا من الإبلاغ عن مواصفات M3 الحقيقية. ووكلاء البرمجة يثقون بتلك البيانات ويحددون ميزانية سياقهم وفقها — ما يعني أن الضغط التلقائي يبدأ عند نحو 167K رمز رغم أن النموذج يستوعب بسهولة خمسة أضعاف ذلك.
هذا نمط فشل مزعج بحق، لأنه غير مرئي. لا يُخطئ وكيلك. بل يبدأ بهدوء في نسيان الأشياء قبل وقت أبكر بكثير مما ينبغي، وتقضي أنت عصرًا تتساءل لماذا يفقد نموذج بنافذة مليون رمز خيط العمل عند الملف الثاني في إعادة هيكلة. وقد سُجّلت المشكلة يوم إصدار M3 وما زالت مفتوحة.
الالتفاف حوله
في OpenCode: استخدم مزوّد MiniMax المدمج (مسار متوافق مع OpenAI) بدلًا من مسار Anthropic، واضبط limit.context صراحةً إذا عرّفت كتلة مزوّد يدوية.
في Claude Code، تجاوز نافذة الضغط مباشرة:
json
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.minimax.io/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "<YOUR_MINIMAX_SUBSCRIPTION_KEY>",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "MiniMax-M3[1m]"
  }
}
تفصيلان مهمان: لاحقة [1m] على معرّف النموذج تطلب النسخة كاملة السياق، و متغيرات بيئة الصدفة تتجاوز settings.json في سلوك MiniMax الموثّق. وإذا كان لديك ANTHROPIC_BASE_URL قديم مُصدَّر في ملف .zshrc، فهو يفوز بصمت وستدور في حلقة مفرغة.
أيضًا — لا تضبط بيانات اعتماد المزوّد كمتغيرات مُصدَّرة عامة. ANTHROPIC_BASE_URL متغير عام؛ وتصديره بشكل دائم سيحوّل بصمت كل أداة تتحدث Anthropic على جهازك إلى MiniMax. احصره لكل مشروع أو لكل استدعاء.
إعداد GLM-5.3-Flash في OpenCode
يأتي OpenCode أيضًا بمزوّد Z.AI مدمج، لذا الأمر سهل بالقدر نفسه تقريبًا — مع مفترق طريق واحد.
bash
# 1. Get a key from Z.ai — either a standard API key or a GLM Coding Plan key
# 2. Authenticate
opencode auth login
# Select "Z.AI" for a standard API key
# Select "Z.AI Coding Plan" for a Coding Plan subscription key

# 3. Start OpenCode, then pick your model
opencode
/models   # select GLM-5.3-Flash
طابِق المزوّد مع نوع المفتاح. مفاتيح API القياسية ومفاتيح Coding Plan تستخدم مسارات مختلفة وفوترة مختلفة. واختيار الخطأ ينتج أخطاء مصادقة أو رصيد تبدو كأن الحساب معطّل.
نقاط نهاية Coding Plan
إذا كنت تربط الأمور يدويًا أو تُعدّ أداة أخرى، فإن حزمة مطوّري Z.ai تكشف ثلاثة:
| البروتوكول | عنوان URL الأساسي |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
هناك قيد واحد يستحق التنبيه: خطة GLM Coding محدودة تعاقديًا بالأدوات المدعومة رسميًا — Claude Code وOpenCode وCline وRoo Code وKilo Code وCursor وGoose وCrush وOpenClaw وحفنة أخرى. وإذا كنت تخطط لتوجيه مفتاح Coding Plan إلى هارنس من صنعك، فاقرأ الشروط أولًا. استخدم API القياسي لذلك.
كتلة مزوّد يدوية
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3-flash": {
          "name": "GLM-5.3-Flash",
          "limit": {
            "context": 1048576,
            "output": 131072
          },
          "options": {
            "reasoning_effort": "high",
            "temperature": 1,
            "top_p": 0.95
          }
        }
      }
    }
  },
  "model": "zai/glm-5.3-flash"
}
إعدادات أخذ العينات الموصى بها
توصيات Z.ai الموثّقة لـ GLM-5.3-Flash، ولن أحيد عنها دون سبب:
temperature: 1top_p: 0.95reasoning_effort: max(الافتراضي الموثّق)thinking.clear_thinking: falsestream: trueوtool_stream: trueلطلبات البث
reasoning_effort هو مقبضك الرئيسي بين الجودة وزمن الاستجابة. منخفض للعمل الحساس لزمن الاستجابة، مرتفع للبرمجة الجوهرية، أقصى لأصعب المشكلات. وبما أن GLM-5.3-Flash هو الأبطأ أصلًا بين النموذجين بنحو 49 رمزًا/ثانية، فإن مرتفع إعداد يومي معقول و أقصى هو ما تلجأ إليه عندما تكون مهمة قد هزمت فعلًا مرتفع.
الإعداد الذي أوصي به فعلًا: شغّل الاثنين
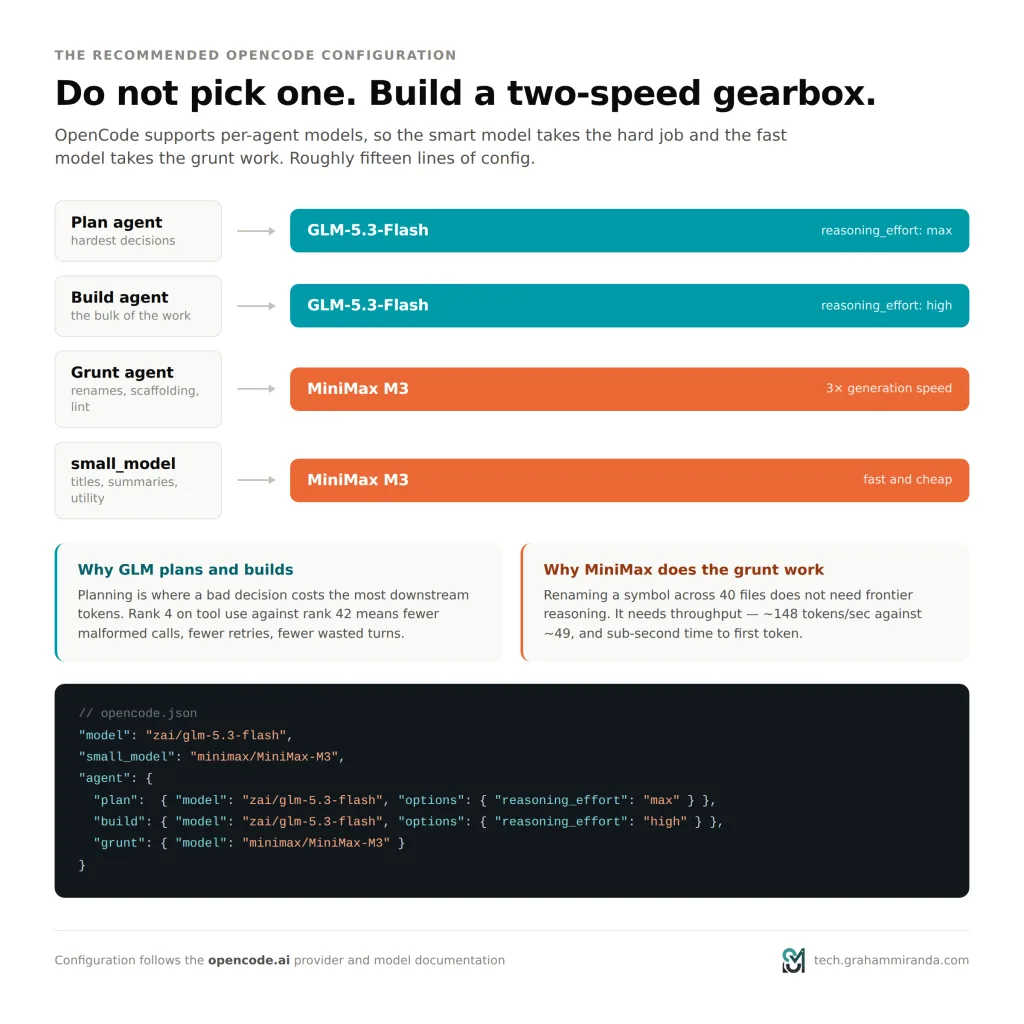
هنا ينهار إطار “المواجهة”، لأن OpenCode لا يفرض عليك اختيار واحد. فإعداداته تدعم نماذج لكل وكيل، ما يعني أنك تستطيع وضع النموذج الذكي على المهمة الصعبة والسريع على العمل الشاق.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3-flash",
  "small_model": "minimax/MiniMax-M3",
  "agent": {
    "build": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "high" }
    },
    "plan": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "max" }
    },
    "grunt": {
      "description": "Mechanical, high-volume edits: renames, test scaffolding, docstrings, lint fixes",
      "model": "minimax/MiniMax-M3"
    }
  }
}
المنطق:
- التخطيط يحصل
reasoning_effort: maxعلى GLM-5.3-Flash. التخطيط هو حيث يكلفك القرار السيئ أكبر قدر من الرموز اللاحقة. اشترِ أفضل تفكير تستطيع تحمّله في هذه الخطوة. - البناء يحصل
مرتفع. على توازن جيد بين الجودة وزمن الاستجابة لمعظم العمل. - العمل الميكانيكي يذهب إلى M3. إعادة تسمية رمز في 40 ملفًا لا تحتاج نموذجًا مصنّفًا في المرتبة الرابعة في استخدام الأدوات. تحتاج إنتاجية، وM3 أسرع ثلاث مرات.
small_modelيتولى الأعمال الداخلية لـ OpenCode — توليد العناوين، والتلخيص، والاستدعاءات المساعدة الصغيرة. وجّهه إلى السريع الرخيص.
أنت لا تختار فائزًا. أنت تبني صندوق تروس بسرعتين.
حساب التكلفة بأرقام حقيقية
المعايير مجردة. أما الفواتير فليست كذلك. دعني أنمذج مهمة وكيلية واقعية وأمرّرها عبر قائمتي الأسعار.
السيناريو
ميزة واحدة متوسطة الحجم، منفّذة بوكيل في OpenCode: نحو 60 دورة استدعاء أدوات، بمتوسط 45K رمز إدخال لكل دورة مع تراكم السياق، و 2K رمز إخراج لكل دورة.
- إجمالي الإدخال: 2.7 مليون رمز
- إجمالي الإخراج: 120 ألف رمز
- معدل إصابة ذاكرة التخزين المؤقت للموجّهات المفترض: 80% (2.16 مليون مخزّن مؤقتًا، 540 ألف جديد)
GLM-5.3-Flash
| المكوّن | الرموز | السعر | التكلفة |
|---|---|---|---|
| إدخال جديد | 540K | $0.15/M | $0.081 |
| إدخال مخزّن مؤقتًا | 2.16M | $0.03/M | $0.065 |
| الإخراج | 120K | $0.50/M | $0.060 |
| الإجمالي | ≈ $0.21 |
MiniMax M3 (الفئة القياسية، إدخال ≤512K)
| المكوّن | الرموز | السعر | التكلفة |
|---|---|---|---|
| إدخال جديد | 540K | $0.30/M | $0.162 |
| إدخال مخزّن مؤقتًا | 2.16M | $0.06/M | $0.130 |
| الإخراج | 120K | $1.20/M | $0.144 |
| الإجمالي | ≈ $0.44 |
GLM-5.3-Flash أرخص بنحو 2.1× للعمل نفسه. وهذا يتوافق مع التقدير المستقل بأنه أرخص بنحو 2.2× على أساس مزيج 3:1 من الإدخال إلى الإخراج.
القياس على شهر
أربع مهام كهذه يوميًا، عشرون يوم عمل — 80 تشغيلًا بالوكيل:
- GLM-5.3-Flash: ≈ $16.50 شهريًا
- MiniMax M3: ≈ $35 شهريًا
رسوم السياق الطويل التي لا يذكرها أحد
هنا الفخ. أسعار MiniMax M3 مقسّمة بحسب طول الإدخال، وبمجرد أن يتجاوز أي طلب واحد 512K رمز إدخال، يتضاعف السعر:
| الفئة | المدخل | الإخراج | قراءة من الذاكرة المؤقتة |
|---|---|---|---|
| إدخال ≤512K | $0.30/M | $1.20/M | $0.06/M |
| إدخال >512K | $0.60/M | $2.40/M | $0.12/M |
| فئة الأولوية | 1.5× القياسي | 1.5× القياسي | 1.5× القياسي |
إذن عنوان “سياق 1M” يأتي مع حاشية: النصف الثاني من تلك النافذة يكلف الضعف. وإذا كان سير عملك يتضمن فعلًا تحميل مستودعات ضخمة في السياق، فإن M3 ينتقل من أغلى بمرتين من GLM-5.3-Flash إلى نحو أغلى بـ 4× بالضبط عندما تكون في أشد الحاجة إلى السياق.
لا تنشر Z.ai أي رسوم إضافية مماثلة لـ GLM-5.3-Flash. فمليون رمز لديها بسعر ثابت.
الاشتراكات مقابل الدفع حسب الاستخدام
| GLM Coding Plan | MiniMax Token Plan | |
|---|---|---|
| المبتدئة | Lite $18 شهريًا (~80 موجّهًا/5 ساعات، ~400/أسبوع، 100 استدعاء MCP شهريًا) | Plus $20 شهريًا (~3–4 وكلاء) |
| المتوسطة | Pro $72 شهريًا (~400 موجّه/5 ساعات، ~2,000/أسبوع، 1,000 استدعاء MCP) | Max $50 شهريًا (~4–5 وكلاء، 3 عمليات توليد فيديو يوميًا) |
| العليا | Max $160 شهريًا (~1,600 موجّه/5 ساعات، ~8,000/أسبوع، 4,000 استدعاء MCP) | Ultra $120 شهريًا (~6–7 وكلاء، 5 عمليات توليد فيديو يوميًا) |
| خصم سنوي | خصم ~30% | غير منشور |
| النماذج المشمولة | GLM-5.3، GLM-5.3-Flash، GLM-5.2، GLM-5-Turbo | عائلة نماذج MiniMax |
تفصيلان يغيّران الحساب.
GLM-5.3-Flash يحصل على حصة 3× داخل Coding Plan مقارنة بـ GLM-5.3، والاستخدام خارج الذروة يستهلك 50% من النقاط القياسية. واختيار Flash بدل GLM-5.3 الكامل يضاعف قيمة اشتراكك ثلاث مرات فعليًا، ونقل التشغيلات الثقيلة خارج نافذة الذروة 14:00–18:00 UTC+8 يمدّها أكثر.
حصة MiniMax لا تُرحَّل. تنتهي الحصة غير المستخدمة في نهاية كل دورة فوترة، وMiniMax نفسها توصي بالدفع حسب الاستخدام لعمليات النشر الإنتاجية بدلًا من Token Plan.
باستخدامي المقدَّر (~$16–35 شهريًا من الرموز)، يتعادل الدفع حسب الاستخدام والاشتراكات المبتدئة تقريبًا. وبعد نحو 6–8 ساعات من العمل الوكيلي اليومي، تفوز الاشتراكات بفارق حاسم — فخطة GLM Coding Plan Lite بـ $18 التي تغطي ~400 موجّه أسبوعيًا يصعب التغلب عليها فعلًا.
ملاحظة عن أسعار البوابات
سترى أرقامًا مختلفة جدًا بحسب المكان الذي تنظر إليه. يعرض OpenRouter سعر GLM-5.3-Flash بنحو $0.05/M للإدخال و$0.17/M للإخراج؛ بينما تُظهر بيانات نماذج OpenCode نفسها $0.07/M و$0.25/M. وكلاهما أقل من سعر Z.ai الرسمي $0.15/$0.50.
هذا ليس تناقضًا. البوابات الموجّهة توزّع الحمل على أكثر من 20 مضيفًا خارجيًا — Baseten وDeepInfra وNovita وCloudflare وغيرها — وهؤلاء المضيفون يتنافسون على السعر. يمكنك بالتأكيد الحصول على GLM-5.3-Flash أرخص من السعر المعلن عبر بوابة. لكنك تقايض الثبات: تتراوح الإنتاجية على OpenRouter بين 8 و111 رمزًا/ثانية بحسب المزوّد الذي تصله، وهذا في حلقة وكيل طويلة يعني الفرق بين مهمة من دقيقتين ومهمة من خمس عشرة دقيقة.
بالنسبة لعمل الوكلاء، أفضّل دفع السعر المعلن إلى الجهة الأولى والحصول على زمن استجابة متوقّع. استخدم البوابات للدفعات والتجارب.
الترخيص والاستضافة الذاتية: الجزء الذي يجب أن تقرأه الشركات الأوروبية مرتين
إذا كنت تدير شركة داخل الاتحاد الأوروبي، فالترخيص ليس حاشية. إنه مسألة مشتريات.
GLM-5.3-Flash: MIT
الأوزان متاحة على Hugging Face في zai-org/GLM-5.3-Flash بموجب رخصة MIT. وهذا تقريبًا أقصى ما تبلغه المرونة في ترخيص البرمجيات: استخدمه تجاريًا، وعدّله، وأعد توزيعه، وأدمجه في منتج، بلا حدود للإيرادات، وبلا ملحق للاستخدام المقبول، وبلا قيود على مجال الاستخدام. احتفظ بإشعار حقوق النشر وانتهيت.
بالنسبة لشركة ألمانية أو أوروبية، يعني MIT مع أوزان قابلة للاستضافة الذاتية أنك تستطيع وضع كل شيء داخل بنيتك التحتية وجعل إقامة البيانات أمرًا غير ذي بال — لا تقييم لنقل البيانات عبر الحدود، ولا اتفاقية معالج مع مورّد صيني، ولا اعتماد على جهوزية شخص آخر.
MiniMax M3: MiniMax Community License
أوزان M3 مفتوحة أيضًا على Hugging Face، لكن بموجب MiniMax Community License — رخصة مخصّصة، لا رخصة متساهلة قياسية. كان استقبال المجتمع إيجابيًا على نطاق واسع (فهي أكثر تساهلًا من الرخصة التي صدرت بها M2.7)، وتصف مصادر متعددة الاستخدام التجاري بأنه غير مقيّد عمليًا.
لكن “موصوف بأنه غير مقيّد” و“مدقّق من مستشارك القانوني” أمران مختلفان. إذا كان MiniMax M3 سيدخل في منتج تجاري، فاقرأ نص الرخصة بنفسك قبل الإطلاق. الرخصة المخصّصة تضيف عبئًا في المراجعة لا يفرضه MIT إطلاقًا.
فحص واقع الاستضافة الذاتية
كلا النموذجين بأوزان مفتوحة. ولا أي منهما يعمل على حاسوبك المحمول.
GLM-5.3-Flash:
- نقطة حفظ FP8: 331 GB موزّعة على 62 شريحة (~306 GiB من الأوزان قبل ذاكرة KV المؤقتة)
- نسخة BF16: 640 GB موزّعة على 120 شريحة
- FP8 عند TP=4 على GB200 واحد: ~386 GB من VRAM
- BF16 عند TP=8: ~772 GB من VRAM
- يتطلب جيل Hopper أو أحدث — H100/H200/B200/B300/GB200/GB300، أو AMD MI300X/MI325X/MI355X
- الحزمة البرمجية: vLLM 0.29.0+ وFlashInfer 0.6.17+؛ وأيضًا SGLang وTokenSpeed وKTransformers وTransformers وUnsloth
MiniMax M3:
- نحو 214 GB بتكميم 4 بت — أصغر، لكنه يبقى ضمن فئة الخوادم بلا منازع
تُبلغ بنية Z.ai المستضافة عن نحو 48.7 رمز إخراج/ثانية مع زمن 1.52 ثانية حتى أول رمز، وعند TP=4 على GB200 تجمع KV بسعة 14.92 مليون رمز يدعم تزامنًا أقصى ×113.81 عند سياق 128K. هذا هو حجم العتاد اللازم لتقديم الخدمة بشكل صحيح.
الترجمة العملية: استضافة أي من النموذجين ذاتيًا تعني استئجار أو شراء عدة وحدات GPU لمراكز بيانات. بالنسبة لمعظم الفرق — بمن فيها معظم عملائي — الجواب الصحيح هو API، مع قيام الأوزان المفتوحة بدور التأمين. إذا رفع المورّد الأسعار أو أضعف النموذج أو اختفى، فلديك مخرج. ولهذا الخيار قيمة حقيقية حتى لو لم تستخدمه أبدًا.
أين ينكسر كل طراز فعليًا
لا قسم للترويج. هذه نقاط الضعف بصدق.
نقاط ضعف GLM-5.3-Flash
إنه بطيء. نحو 48.6 رمز/ثانية إخراجًا ونحو 1.51 ثانية حتى أول رمز. مقابل نحو 148 رمز/ثانية و0.99 ثانية لدى M3، تشعر بكل توليد طويل. وفي حلقة وكيل من 40 دورًا يتراكم ذلك إلى دقائق حقيقية من التلاهي بانتظار النتيجة.
لا يمكنك إيقاف التفكير. الاستدلال الإلزامي صحيح في عمل الوكلاء الصعب ومضيعة في الطلبات التافهة. وكل طلب من نوع “أضف docstring إلى هذه الدالة” يدفع ضريبة استدلال. ولهذا بالضبط تريد ربط M3 أو نموذج أصغر بالأعمال الروتينية.
رموز الاستدلال تُحسب ضمن الرموز المفوترة. مع reasoning_effort: max كإعداد افتراضي موثّق، تتجاوز التكلفة الفعلية لكل مهمة التقديرات الساذجة المبنية على أعداد الإدخال والإخراج وحدها. اضبطه على مرتفع إلا إذا استحقّت المهمة أقصى.
إنه جديد. صدر في 26 أغسطس 2026. ولم تظهر بعد كل أخطاء التكامل طويلة الذيل في منظومة الهارنس، والمعرفة المجتمعية ما زالت ضئيلة. إذا صادفت نمط فشل غامضًا، فقد تكون أول من يبلّغ عنه.
لا تخلطه مع GLM-5.3. إنهما نموذجان مختلفان بقدرات مختلفة — والجدير بالذكر أن GLM-5.3 غير Flash نصّي فقط. وإرسال الصور إلى معرّف النموذج الخطأ خطأ شائع في البداية.
نقاط ضعف MiniMax M3
ترتيب استخدام الأدوات هو المشكلة الحقيقية. المرتبة 42 في مؤشر استخدام الأدوات لدى llm-stats، مقابل المرتبة 4 لـ GLM-5.3-Flash. وبالنسبة لهارنس الوكلاء هذه هي القدرة الحاملة. توقّع استدعاءات أدوات مشوّهة أكثر، وإعادات محاولة أكثر، وأدوارًا أكثر تُهدر في التعافي — وهذا يلتهم ميزة السرعة التي دفعت مقابلها.
خطأ الإبلاغ عن السياق لم يُحلّ. مفتوح منذ الإصدار. ويمكن الالتفاف حوله، لكنه جرح ورقي تحمله معك.
التحقق المستقل ضئيل. لم تكن معايير قياس الإطلاق من MiniMax قد ظهرت على لوحات محايدة، وحيث قاست مجمعات محايدة تأتي M3 في منتصف الجدول لا قرب القمة. والفجوة بين طرح المورّد وقياس الطرف الثالث أوسع هنا مما هي لدى Z.ai.
الأسعار في السياق الطويل تتضاعف فوق 512K. الميزة الرئيسية المعلنة تأتي مع رسم إضافي.
رخصة مخصّصة. مراجعة قانونية إضافية قبل النشر التجاري.
استخدام متراجع. انخفاض حجم الرموز في OpenCode بنسبة 51% خلال شهرين إشارة إلى زخم المنظومة، أيًا كان السبب. ومستخدمون أقل يعني أشخاصًا أقل يواجهون ويصلحون الأخطاء نفسها التي ستصادفها.
إطار القرار: خمسة سيناريوهات
1. “أريد نموذجًا واحدًا، أضبطه وأنساه.”
GLM-5.3-Flash. أفضل في كل معيار قياس محايد، وبنصف السعر، وبرخصة MIT، وإليه استقرّ المجتمع. اضبط reasoning_effort: high، وأضف GLM Coding Plan Lite بـ $18 شهريًا إذا كنت تبرمج يوميًا، ثم امضِ في حياتك.
2. “أجري عمليات إعادة هيكلة ضخمة وميكانيكية عبر قواعد شيفرة هائلة.”
MiniMax M3 للتمريرات الميكانيكية، وGLM-5.3-Flash للتخطيط. تجعل MSA من M3 خيارًا اقتصاديًا فعلًا في السياق الطويل، وسرعة التوليد ×3 تُحسّ أكثر ما تُحسّ في التعديلات الكثيفة منخفضة الصعوبة. راقب فقط حدّ الأسعار عند 512K، ودع GLM يخطط لإعادة الهيكلة قبل أن تنفّذها M3.
3. “عملي بصري — واجهات المستخدم، والتحويل من التصميم إلى الشيفرة، وتصحيح الأخطاء عبر لقطات الشاشة.”
GLM-5.3-Flash أولًا، وM3 خيارًا ثانيًا قويًا. تعدد الوسائط الأصلي في GLM مصمّم لهذا بالضبط، وهو يتقدم على M3 في مؤشر الرؤية (32.0 مقابل 25.6). لكن نتيجة M3 في OSWorld-Verified البالغة 70.06% تجعله الخيار الأفضل تحديدًا في وكيل سطح المكتب وواجهات GUI — تشغيل التطبيقات الفعلية بدل قراءة لقطات الشاشة.
4. “أحتاج إلى الاستضافة الذاتية لأسباب إقامة البيانات أو الامتثال.”
GLM-5.3-Flash، بلا تردّد. مقارنة MIT برخصة مجتمعية مخصّصة ليست متقاربة عندما يكون فريقك القانوني طرفًا، والاستضافة الذاتية بموجب MIT تُخرج مسألة نقل البيانات عبر الحدود من الحساب كليًا. ورصد ميزانية لعتاد من فئة Hopper أو مضيف GPU أوروبي.
5. “أدير فريقًا صغيرًا بميزانية محدودة.”
GLM Coding Plan Lite بـ $18 شهريًا، مع GLM-5.3-Flash كخيار افتراضي. مضاعف الحصة ×3 لـ Flash داخل الخطة يجعله أعلى خيار قيمة مقابل اليورو متاح الآن. وجدول تشغيلات الدفعات الثقيلة خارج نافذة الذروة 14:00–18:00 UTC+8 لتحصل على خصم 50% من النقاط. وأضف MiniMax لاحقًا إذا أصبحت الإنتاجية عنق الزجاجة.
ما سأراقبه خلال الربع القادم
تشغيلات مستقلة لـ Terminal-Bench وSWE-bench Pro على GLM-5.3-Flash. أرقام المورّد ممتازة. والمجمعات المحايدة تؤكدها على نطاق واسع. لكن الادعاء المحدد بأنه “على بُعد نقطة واحدة من Claude Opus 4.8 في Terminal-Bench 2.1” يستحق تكرارًا من طرف ثالث قبل أن يبني أحد عليه حالة عمل.
ما إذا كان خطأ MiniMax /anthropic المتعلق بالسياق قد أُصلح. إنه صغير، وموثّق، ومفتوح منذ يونيو. وسرعة إغلاقه تخبرك بشيء عن وتيرة الصيانة.
منحنى بقاء GLM-5.3-Flash في OpenCode. رقم حصة الرموز مذهل لكنه حديث. ونقطة البيانات المثيرة هي ما إذا كان سيصمد فوق 10% حين تخبو الجِدّة. فإن صمد، فليست هذه لحظة عابرة — بل افتراضي جديد.
وتيرة الإصدارات من مختبرات الأوزان المفتوحة الصينية. صدر Qwen3.8-Flash-Next في الوقت نفسه تقريبًا مع GLM-5.3-Flash. وKimi K3 يتفوق أصلًا على GLM-5.3 في DeepSWE (67.5 مقابل 66.9) وفي Toolathlon (76.5 مقابل 73.0). والفجوة بين “أفضل نموذج برمجة مفتوح الأوزان حاليًا” و“الثاني” تُقاس الآن بالأسابيع. ابنِ إعدادك بحيث يكون تبديل سلسلة اسم النموذج تغييرًا في سطر واحد، لأنك ستجري هذا التغيير مرة أخرى.
ما إذا كانت Z.ai ستنشر سعرًا موحّدًا ومستقلًا لواجهة API للنموذج الكامل GLM-5.3. حتى وقت الكتابة، كان صف السعر لكل رمز لـ GLM-5.3 ما زال غائبًا عن صفحة الأسعار الرسمية بينما كان GLM-5.3-Flash مسعّرًا بالكامل. وهذا تفاوت غريب يستحق المراقبة.
الأسئلة الشائعة
هل GLM-5.3-Flash أفضل من MiniMax M3 في البرمجة؟ بحسب الأدلة المتاحة، نعم. يتقدم GLM-5.3-Flash في Terminal-Bench 2.1 (84.3 مقابل 66.0)، وفي مؤشر الذكاء لدى Artificial Analysis (57 مقابل 45)، وفي كل مؤشر قدرات لدى llm-stats بما فيها البرمجة والوكلاء واستخدام الأدوات. وهو أيضًا بنصف السعر لكل رمز تقريبًا. وMiniMax M3 أسرع — نحو ×3 في سرعة الإخراج — لكن البرمجة بالوكلاء تكافئ جودة الاستدلال أكثر من سرعة التوليد الخام.
أيهما أرخص، GLM-5.3-Flash أم MiniMax M3؟ GLM-5.3-Flash، بنحو النصف. فالسعر الرسمي $0.15 لكل مليون رمز إدخال و$0.50 لكل مليون رمز إخراج لـ GLM-5.3-Flash، مقابل $0.30 و$1.20 لـ MiniMax M3. وتتسع الفجوة إلى نحو ×4 في الطلبات التي تتجاوز 512K رمز إدخال، حيث تضاعف MiniMax أسعارها بينما لا تنشر Z.ai أي رسم إضافي.
هل يمكنني تشغيل GLM-5.3-Flash محليًا؟ فقط على عتاد من فئة الخوادم. فنقطة حفظ FP8 بحجم 331 GB وتحتاج نحو 386 GB من VRAM عند TP=4، على وحدات GPU من جيل Hopper أو أحدث. وليس نموذجًا لعتاد المستهلكين. رخصة MIT تجعل الاستضافة الذاتية مباشرة قانونيًا؛ والعتاد يجعلها مكلفة.
هل يدعم OpenCode كلا النموذجين أصليًا؟ نعم. يشحن OpenCode مزوّدين مدمجين لكل من Z.AI وMiniMax. نفّذ opencode auth login، واختر المزوّد المطابق لنوع مفتاحك، ثم /models لاختيار نموذجك. لا حاجة إلى تعديل opencode.json في إعداد قياسي.
لماذا يُظهر MiniMax M3 سياقًا بحجم 200K فقط في Claude Code؟ خطأ معروف وما زال مفتوحًا في نقطة النهاية المتوافقة مع Anthropic لدى MiniMax: فهي تُبلّغ ببيانات Claude Sonnet الوصفية بدل مواصفات M3 الحقيقية، ما يفعّل الضغط التلقائي عند نحو 167K رمز. اضبط CLAUDE_CODE_AUTO_COMPACT_WINDOW إلى 1000000 في إعداداتك، أو استخدم المسار المتوافق مع OpenAI بدلًا منه.
ما الفرق بين GLM-5.3 وGLM-5.3-Flash؟ نموذجان مختلفان. صدر GLM-5.3 في 14 أغسطس 2026 وهو نصّي فقط ويشارك GLM-5.2 نموذجه الأساسي. وصدر GLM-5.3-Flash في 26 أغسطس، وهو متعدد الوسائط أصليًا، ويستخدم معمارية MoE بتركيز هجين 320B/18B، وبرخصة MIT مع أوزان مفتوحة، ويكلّف نحو عُشر التكلفة. وداخل GLM Coding Plan يحصل Flash أيضًا على حصة ×3.
هل MiniMax M3 مفتوح المصدر حقًا؟ الأوزان قابلة للتنزيل علنًا من Hugging Face، لكن بموجب رخصة MiniMax Community License المخصّصة لا رخصة متساهلة قياسية مثل MIT أو Apache 2.0. ويوصف الاستخدام التجاري على نطاق واسع بأنه غير مقيّد، لكن اقرأ نص الرخصة قبل إطلاق منتج تجاري عليها.
هل أستخدم خطط الاشتراك أم الدفع حسب الاستخدام؟ تحت إنفاق يقارب $20–30 شهريًا على الرموز، يكون الفارق قريبًا من نقطة التعادل. وفوق 6–8 ساعات يوميًا من البرمجة بالوكلاء، تفوز الاشتراكات بوضوح — فخطة GLM Coding Plan Lite بـ $18 شهريًا التي تغطي نحو 400 موجّه أسبوعيًا هي أقوى قيمة للمبتدئين متاحة. ولاحظ أن حصة MiniMax لا تُرحّل، وأن MiniMax نفسها توصي بالدفع حسب الاستخدام لأحمال الإنتاج.
الخلاصة
إن أخذت شيئًا واحدًا من هذا: GLM-5.3-Flash هو الافتراضي الأفضل لـ OpenCode في أواخر 2026، والحسم ليس متقاربًا في الأبعاد التي تحدد نتائج البرمجة بالوكلاء — جودة الاستدلال، وموثوقية استخدام الأدوات، والتكلفة لكل مهمة مكتملة.
MiniMax M3 ليس نموذجًا سيئًا. إنه نموذج محسّن بشكل مختلف، ومعماريته MSA إجابة أنيقة فعلًا لمشكلة اقتصاديات السياق الطويل. وهناك أحمال عمل حقيقية — التعديلات الميكانيكية الكثيفة، ومهام وكلاء سطح المكتب وواجهات GUI، وأي شيء تهيمن فيه سرعة التوليد ×3 — يكون فيها الأداة الصحيحة.
لكن البرمجة بالوكلاء مشكلة اتخاذ قرار في جوهرها، لا مشكلة سرعة كتابة. فالنموذج الذي يخطط أفضل، ويستدعي الأدوات بموثوقية أكبر، ويتعافى من الفشل بأناقة أكبر، سينجز مهامًا أكثر لكل يورو، حتى وهو يولّد الرموز أبطأ بثلاث مرات.
النهج العملي هو علبة تروس بسرعتين: GLM-5.3-Flash في التخطيط والبناء، وMiniMax M3 في الأعمال الشاقة، small_model موجّهًا إلى الأسرع. ويجعل OpenCode ذلك تعديلًا في خمسة عشر سطرًا من الإعداد، ويمنحك الذكاء حيث يهم والإنتاجية حيث لا يهم.
واكتب ذلك الإعداد بحيث يسهل تبديل معرّفات النماذج. ففي هذا السوق، عمر الجواب البديهي اليوم يُقاس بالأسابيع.
هل شغّلت أيًا من هذين كنموذجك اليومي في OpenCode؟ يهمني خصوصًا ما إذا كانت أرقام GLM-5.3-Flash في Terminal-Bench تصمد في مستودعات حقيقية، وما إذا كان أحد قد وجد حلًا أنظف لخطأ الإبلاغ عن السياق في MiniMax. تواصل معي — فالتصحيحات والأدلة المضادة مرحّب بها، ويُحدّث هذا المقال حين تتغير الصورة.
آخر تحديث: 30 أغسطس 2026.


