Русский
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 العربية
 हिन्दी

Аргумент звучит так. Подписка на ИИ топового уровня стоит $200 в месяц, то есть $2 400 в год. MacBook Pro с 128 ГБ объединённой памяти может запускать большие языковые модели локально, приватно и без ограничений на использование. Так что отмените подписку, купите вместо неё MacBook для локальных LLM — и через год-два он окупится.
Вы найдёте вариации этого довода повсюду в 2026 году: в видео на YouTube, где спрашивают, стоит ли отменять план за $200 и покупать Mac за $9 499, в постах на Medium, которые делят цену Mac на $200, и в колонке Forbes, где подсчитали цифры после того, как Apple в августе выпустила новый Mac Studio. На презентации MacBook Pro с M5 Max глава аппаратного направления Apple Джон Тернус сказал, что новые машины позволяют профессионалам “запускать продвинутые LLM на устройстве”.
Покупка MacBook для локальных LLM — вполне разумная идея для некоторых людей. Но как замена плану Claude или ChatGPT за $200 она не работает, и не работает именно в том, что этот аргумент никогда не учитывает: качество. Подписка даёт вам в аренду лучшие модели в мире. Mac запускает лучшие модели, которые помещаются в 128 ГБ. С вчерашнего дня мы можем измерить расстояние между этими двумя вещами точнее, чем когда-либо, и оно больше, чем предполагает хайп.
27 октября Artificial Analysis перестроил свой Intelligence Index вокруг преимущественно закрытых тестов. Лидирует Claude Opus 5.5 с 58. Лучшие модели с открытыми весами, которые вы действительно можете скачать, DeepSeek V4.1 Flash 1017 и GLM-5.3, набирают 32, ниже Claude Haiku 5.5 — небольшой и дешёвой модели Anthropic — с 36. Ни одна из этих открытых моделей не помещается ни в один MacBook: в 4-битном варианте им нужно от 375 до 460 ГБ. Самая сильная модель, которую мне удалось найти и которая действительно помещается в MacBook с 128 ГБ, Qwen3.8 27B, набирает 34 в предыдущей версии индекса — той, где Opus 5.5 тоже набирает 58.
Тем временем железо подорожало. В июне Apple удвоила цену апгрейда памяти до 128 ГБ на M5 Max. 16-дюймовый MacBook Pro с 128 ГБ теперь стоит $6,999 в США и, по моей оценке, около €8,199 в Германии.
Так что вот честная версия расчётов: что на самом деле дают $200 в месяц, что на самом деле дают $7 000, насколько велик разрыв в качестве и почему он существует, насколько быстр M5 Max на самом деле, чего вам стоит квантование, когда покупка Mac для локального ИИ действительно имеет смысл и какие есть более дешёвые способы сократить счёт в $200, если это то, к чему вы на самом деле стремитесь. Каждая цифра была сверена с источником 28 октября 2026.
Кратко — версия за 60 секунд
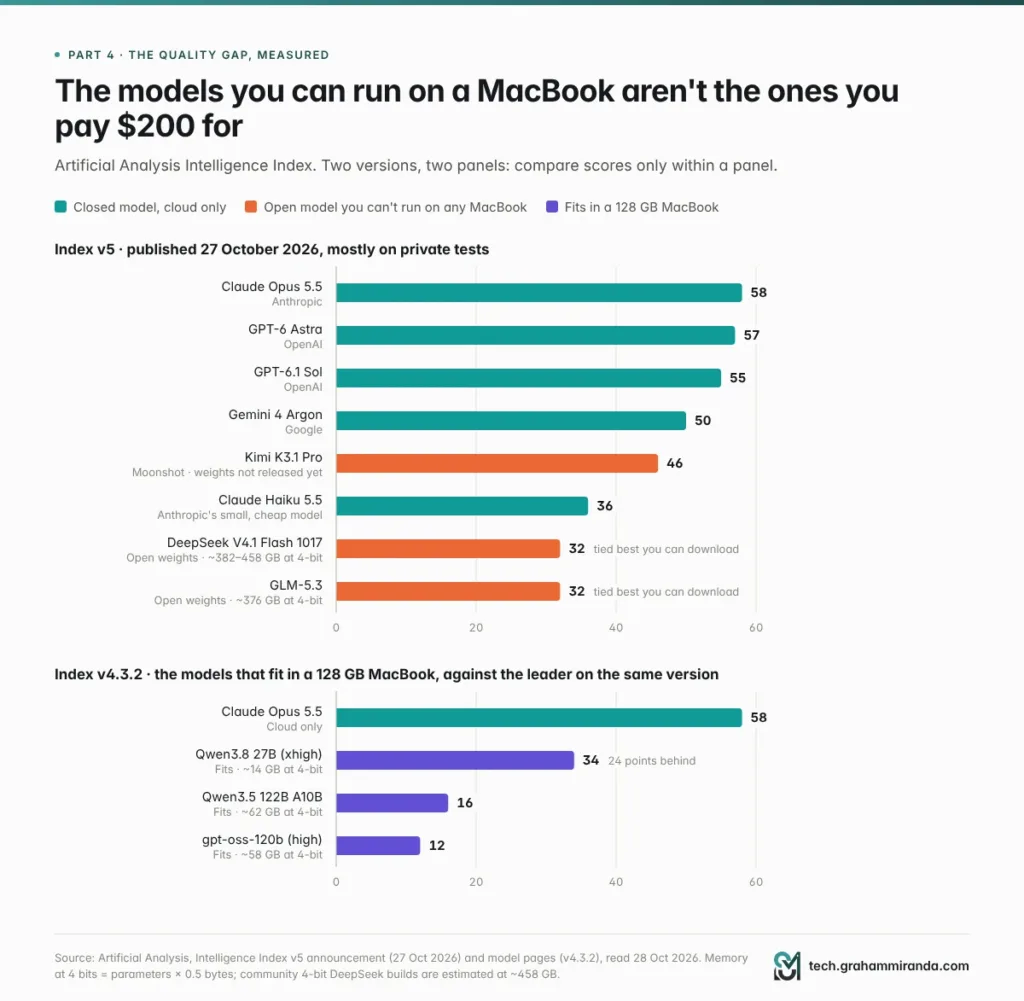
- Модели, за которые вы платите $200, нельзя скачать, а лучшие из тех, что можно скачать, не помещаются в MacBook. В новом Intelligence Index v5 от Artificial Analysis Claude Opus 5.5 набирает 58. Лучшие скачиваемые открытые модели, DeepSeek V4.1 Flash 1017 и GLM-5.3, набирают 32 и требуют примерно 375–460 ГБ памяти в 4-битном варианте.
- То, что помещается, набирает гораздо меньше. Самая сильная модель, которую я нашёл для MacBook с 128 ГБ, Qwen3.8 27B, набирает 34 против 58 у Opus 5.5 в той же версии индекса (v4.3.2). Модели класса 120B, которым действительно нужна дополнительная память, набирают ещё меньше: 16 у Qwen3.5 122B и 12 у gpt-oss-120b.
- MacBook с 128 ГБ подорожал. В июне Apple удвоила цену апгрейда до 128 ГБ — до $2 000, поэтому 16-дюймовый M5 Max с 128 ГБ теперь стоит $6 999 (около €8 199 в Германии по моей оценке). Тот же чип и та же память в Mac Studio стоят $4 799.
- Окупаемость наступает через три-четыре года, а не через год. Даже если бы Mac полностью заменил подписку, чтобы обойти план за $200, потребовалось бы около 37 месяцев, 41 — если вы оставите план за $20 для сложных задач, и больше шести лет — против плана за $100.
- Пишет быстро, читает медленно. M5 Max генерирует 55–88 токенов в секунду на моделях со смесью экспертов, что ненамного отличается от 98 у Opus 5.5 в API Anthropic. Но ему нужно 13–55 секунд только на чтение промпта в 32 000 токенов, а ИИ-агенты перечитывают длинные промпты целыми днями.
- Втиснуть большие модели стоит качества. 4-битное квантование почти не теряет качества на коротких задачах, но в исследовании EMNLP 2025 оно стоило до 59% на длинных входных данных и ещё больше — в языках, отличных от английского. При 3 битах оценка небольшой reasoning-модели по математике упала с 85,6% до 47,0%.
- Публичные бенчмарки, похоже, льстят открытым моделям. Когда Artificial Analysis перешёл в основном на закрытые тесты, четыре ведущие модели с открытыми весами потеряли в среднем 13 баллов. Четыре ведущие закрытые модели почти не изменились.
- Локальный вариант по-прежнему выигрывает в конфиденциальности, работе офлайн, отсутствии лимитов и массовых задачах, а также когда вы и так собирались купить Mac. Покупайте его по этим причинам, а не ради отмены подписки.
- Есть более дешёвые способы сэкономить. Перейдите на тариф за $100 и экономьте $1 200 в год, платите за токены для открытых моделей (DeepSeek V4.1 Flash стоит $0,60 за миллион выходных токенов в непиковые часы) или используйте план для кодинга от $18 в месяц.
Аргумент против реальности
| Аргумент | Реальность, октябрь 2026 |
|---|---|
| “Он окупится за год” | 16-дюймовый MacBook Pro с 128 ГБ стоит $6 999. При $200 в месяц это 35 месяцев без учёта электричества и 41 месяц, если добавить план за $20, который вы оставите для сложных задач |
| “Локальные модели теперь в целом так же хороши” | Opus 5.5 набирает 58. Лучшая модель, которая помещается в 128 ГБ, набирает 34 (Qwen3.8 27B, индекс v4.3.2). Лучшие скачиваемые открытые модели набирают 32 в новом v5 |
| “128 ГБ запускают большие открытые модели” | GLM-5.3 нужно около 376 ГБ в 4-битном варианте, DeepSeek V4.1 Flash — около 380–460 ГБ, Kimi K3 — около 1,5 ТБ. Ни одна не помещается ни в один MacBook |
| “M5 Max быстрый” | В генерации — да: 55–88 токенов в секунду на моделях со смесью экспертов. В чтении промпта на 32K токенов: от 13 до 55 секунд |
| “4 бита — без потерь” | На коротких бенчмарках — почти. На входных данных свыше 64K токенов — до 59% хуже в одном исследовании и ещё хуже вне английского |
| “Никаких лимитов, полная конфиденциальность” | Верно. Это и есть настоящая причина купить его |
Содержание
- Кратко — версия за 60 секунд
- Аргумент против реальности
- Часть 1 — Аргумент “отмените свой план за $200” и почему он звучит так убедительно
- Часть 2 — Что на самом деле дают $200 в месяц в октябре 2026 года
- Часть 3 — Сколько на самом деле стоит MacBook с 128 ГБ сейчас
- Часть 4 — Разрыв в качестве, измеренный
- Часть 5 — Почему модели, которые вам действительно нужны, не помещаются
- Часть 6 — Квантование: налог на качество, который вы платите за то, чтобы всё поместилось
- Часть 7 — Скорость: быстро пишет, медленно читает
- Часть 8 — Проблема ноутбука
- Часть 9 — Разрыв в ПО: что вам пришлось бы воссоздавать
- Часть 10 — Расчёт окупаемости, сделанный честно
- Часть 11 — Справедливый случай: когда покупка Mac для локального ИИ имеет смысл
- Часть 12 — Более дешёвые способы сократить счёт за ИИ на $200
- Часть 13 — Стоит ли покупать MacBook для локальных LLM? Руководство по решению
- Часть 14 — Если вы всё-таки его купили: как получить от него максимум
- Часто задаваемые вопросы
- Может ли MacBook заменить подписку ChatGPT Pro или Claude Max?
- Какая лучшая локальная LLM для MacBook Pro с 128 ГБ в 2026 году?
- Сколько сейчас стоит MacBook Pro с 128 ГБ?
- За сколько окупится MacBook по сравнению с подпиской на ИИ за $200?
- Достаточно ли быстр M5 Max для локальных LLM?
- Так же ли хороши локальные LLM, как ChatGPT или Claude, сегодня?
- Ухудшает ли квантование локальные модели?
- Могу ли я запустить DeepSeek V4.1 Flash или GLM-5.3 на MacBook?
- Хватит ли 64 ГБ для локального ИИ или нужно 128 ГБ?
- Стоит ли купить Mac Studio вместо MacBook Pro для локальных LLM?
- Лучше ли запуск ИИ локально для конфиденциальности и GDPR?
- Могу ли я использовать Claude Code с локальной моделью?
- Изменит ли что-то из этого новый OLED MacBook Pro?
- Итог
Часть 1 — Аргумент “отмените свой план за $200” и почему он звучит так убедительно
Начнём с того, почему этот аргумент так хорошо расходится: большая его часть разумна.
Три лаборатории сошлись на $200. Claude Max 20× от Anthropic стоит $200 в месяц. ChatGPT Pro от OpenAI выпускается в версиях за $100, $200 и $500. У AI Ultra от Google есть тариф за $100 и за $200. Платите так каждый месяц — и цифра накапливается: $2 400 в год, $7 200 за три года.
Железо стало серьёзным. MacBook Pro с M5 Max, продающийся с марта, вмещает до 128 ГБ объединённой памяти с пропускной способностью 614 ГБ/с, а Apple встроила Neural Accelerator — специализированное железо для матричной математики — в каждое ядро GPU. В августе появился Mac Studio с вариантом M5 Ultra, рассчитанным на 512 ГБ. Маркетинг Apple делает упор на локальный ИИ сильнее, чем когда-либо.
Подписки стали скупее. Недельные лимиты Claude Max, добавленные через несколько месяцев после запуска плана, стали предметом коллективного иска, поданного 8 сентября: в нём утверждается, что обозначения “5×” и “20×” недостаточно ясно отражают недельные ограничения. По сообщениям, OpenAI сократила лимит на своём плане Pro за $200 для новых подписчиков с 20 раз по сравнению с ChatGPT Plus до 10. Когда то, что вы арендуете, постоянно урезают, владение начинает выглядеть привлекательно.
Конфиденциальность — реальная проблема. Всё, что вы вставляете в облачную модель, покидает вашу машину. Для немецкой компании, хранящей данные клиентов, это не паранойя, а GDPR.
А арифметика простая. Чаще всего цитируют такую версию: $2 499 за Mac Studio, делённые на $200 в месяц, дают около 12,5 месяцев. Forbes в августе провёл гораздо более аккуратный расчёт — с реальными конфигурациями и тремя годами электричества — и пришёл к выводу, что Mac, вероятно, не позволит вам отменить план Claude или ChatGPT, если вы пишете код с агентами. Но запоминается именно короткая версия.
Вот в чём изъян. Аргумент сравнивает цену с ценой. А нужно сравнивать продукт с продуктом. Именно это и делает остальная часть статьи, начиная с того, за что на самом деле платят $200.
Часть 2 — Что на самом деле дают $200 в месяц в октябре 2026 года
| Провайдер | Тариф $20 | Тариф $100 | Тариф $200 | Дороже $200 |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: $20 ($17 в месяц при годовой оплате) | Max 5×: $100 | Max 20×: $200 | Team и Enterprise |
| OpenAI (ChatGPT) | Plus: $20 (Go: $8) | Pro 100: $100 | Pro 200: $200 | Pro 500: $500 |
| Google (Gemini) | AI Pro: $20 | AI Ultra: $100 | AI Ultra: $200 | — |
Цены в США за месяц, без НДС. Claude — с claude.com; ChatGPT — из трекера AI Business Weekly, обновлённого 4 октября; Google — из отчёта Engadget о майском перезапуске. Цены и лимиты меняются часто, поэтому проверяйте перед подпиской.
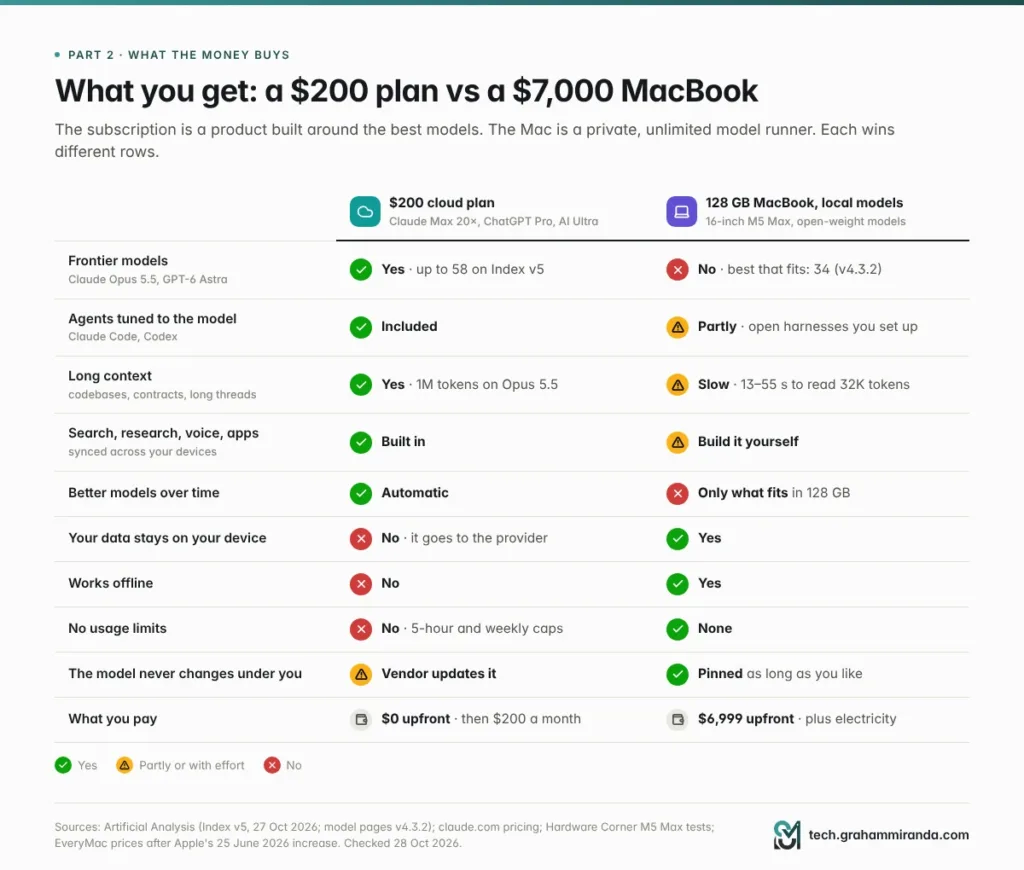
За что на самом деле платят деньги
1. Фронтирные модели, которых больше нигде не достать. В новом индексе Artificial Analysis все пять верхних мест занимают Anthropic и OpenAI. Ни одну из этих моделей нельзя скачать ни за какие деньги. Подписка — самый дешёвый способ, которым большинство людей когда-либо сможет ими воспользоваться.
2. Агенты, построенные вокруг этих моделей. Платные планы Claude включают Claude Code; планы ChatGPT — Codex. Harness и модель настроены друг под друга, что помогает объяснить, почему они занимают верхние строчки в таблицах лидеров агентного кодинга. (Я сравнил 28 таких инструментов в Сравнение всех harness для ИИ-кодинга.)
3. Огромное контекстное окно. По данным Artificial Analysis, Claude Opus 5.5 принимает контекстное окно в миллион токенов: целые кодовые базы, целые договоры, целые кварталы переписки.
4. Продукт вокруг модели. Веб-поиск и глубокое исследование, анализ файлов, голос, память, генерация изображений, коннекторы к вашей почте и документам и приложения, которые синхронизируются между телефоном, ноутбуком и браузером. Ничего из этого не поставляется с файлом модели.
5. Обновления, которые не нужно устанавливать. Модель, стоящая за вашей подпиской в следующем квартале, будет лучше сегодняшней. Модель на вашем Mac меняется только тогда, когда вы скачиваете другую, и только если новая помещается.
6. Часть денег обратно. На странице цен Anthropic теперь указаны ежемесячные кредиты API в составе Max: $100 на плане 5× и $200 на 20×.
Чего они не покупают
Неограниченное использование. Планы Claude работают на скользящих пятичасовых окнах плюс недельные ограничения, а OpenAI и Google в основном описывают свои топовые тарифы как кратные более дешёвым — если вообще их описывают. Контроль над тем, куда уходят ваши данные, что очень важно для личных данных и данных клиентов. А предсказуемость: лимиты в этом году менялись не раз.
Держите эти три пункта в голове. Это честное обоснование локального ИИ, и часть 11 разбирает их в полном объёме.
Показать изображение Подписка — это продукт; Mac — это запуск моделей. Каждый выигрывает в своих строках, поэтому для большинства людей правильный ответ — и то, и другое.
Часть 3 — Сколько на самом деле стоит MacBook с 128 ГБ сейчас
До 128 ГБ вас доведёт только один чип. В поколении M5 такая объединённая память доступна только с M5 Max с 40-ядерным GPU, у которого пропускная способность памяти 614 ГБ/с. M5 Max с 32-ядерным GPU фиксирован на 36 ГБ и 460 ГБ/с, а M5 Pro максимум на 64 ГБ и 307 ГБ/с.
| Конфигурация | Цена в США | Германия |
|---|---|---|
| 16″ M5 Max (18-ядерный CPU, 40-ядерный GPU), 48 ГБ, 2 ТБ | $4,999 | €5,699 |
| Обновление до 128 ГБ | +$2 000 (было +$1 000 до 25 июня) | около +€2 500 (было +€1 250 на старте), оценка |
| 16″ M5 Max, 128 ГБ, 2 ТБ | $6,999 | около €8 199 (оценка; €6 249 на старте) |
| Максимальная конфигурация: 128 ГБ, 8 ТБ, дисплей nano-texture | $10,149 | — |
| Для сравнения: Mac Studio, M5 Max, 128 ГБ | $4,799 | — |
Цены в США без налога с продаж; немецкие цены включают 19% НДС. Немецкая доплата за 128 ГБ — моя оценка: на старте Apple брала за неё €1 250, а долларовая доплата удвоилась в июне. Перед покупкой проверьте конфигуратор Apple.
Бросаются в глаза три вещи.
Память теперь — дорогая часть. Apple подняла цены на всю линейку Mac 25 июня и объяснила это стоимостью памяти и накопителей. В разговоре с Reuters она заявила, что “никогда не видела, чтобы компонент дорожал настолько и так быстро”. Обновления до 64 ГБ и до 128 ГБ на M5 Max подорожали вдвое. Именно тот компонент, который нужнее всего для локального ИИ, подорожал вдвое.
Надбавка за ноутбук — $2 200. Тот же M5 Max с теми же 128 ГБ в Mac Studio стоил $4 799, когда Forbes считал цены в августе. Если память нужна для ИИ, форм-фактор ноутбука обходится на 46% дороже.
14-дюймовая модель — компромисс. 14-дюймовую модель тоже можно заказать со 128 ГБ, но в обзоре Notebookcheck её корпус плохо справлялся с охлаждением M5 Max под длительной нагрузкой. Подробнее — в части 8.
Новые Mac на этой неделе. 27 октября Apple представила 14-дюймовый MacBook Pro с базовым M6 чипом: до 32 ГБ и 170 ГБ/с, от $1 999. Это хороший ноутбук, но не машина для LLM. А сегодня вечером (28 октября, 10:00 по тихоокеанскому времени, 18:00 в Германии) Apple проводит мероприятие “Pro and Tell”, где MacBook Pro с OLED-сенсорным экраном ожидается с нетерпением. По сообщениям, в нём те же чипы M5 Pro и M5 Max, так что потолок 128 ГБ и 614 ГБ/с останутся прежними.
Часть 4 — Разрыв в качестве, измеренный
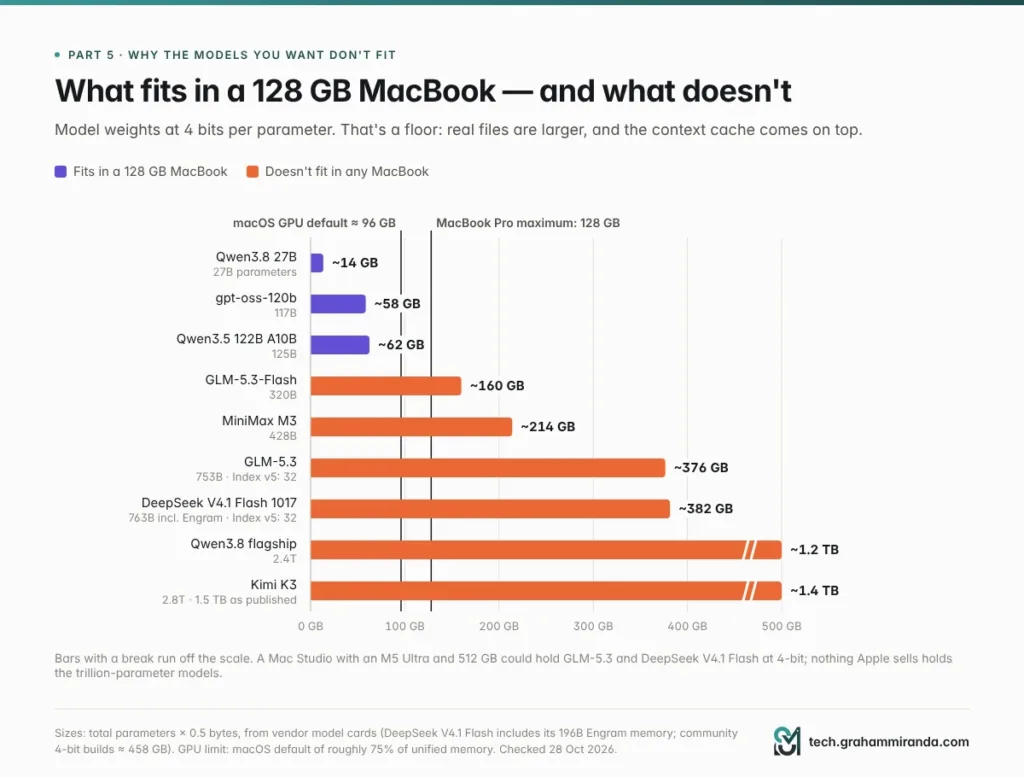
Как сравнить модель на вашем столе с моделью в дата-центре? Не по ощущениям и не по таблице бенчмарков самого производителя. Artificial Analysis (AA) прогоняет один и тот же набор тестов по сотням моделей через один и тот же harness и сводит результаты в единый Intelligence Index. Ни один индекс не идеален, но индекс AA независим, и это самое близкое к общей мерке, что есть у индустрии.
27 октября AA опубликовала версию 5. Главное изменение: около 60% индекса теперь приходится на закрытые тестовые наборы и отложенные ответы, так что модель не могла видеть эти вопросы во время обучения. Работа со знаниями, программирование, наука и общие знания дают по четверти каждая.
Новая таблица лидеров
| Модель | Можно ли её скачать? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | Нет | 58 |
| GPT-6 Astra (max) | Нет | 57 |
| GPT-6.1 Sol (max) | Нет | 55 |
| Gemini 4 Argon (high) | Нет | 50 |
| Kimi K3.1 Pro | Пока нет; веса не опубликованы | 46 |
| Claude Haiku 5.5 (max) | Нет | 36 |
| DeepSeek V4.1 Flash 1017 (max) | Да, лицензия MIT | 32 |
| GLM-5.3 (max) | Да | 32 |
Источник: Artificial Analysis, анонс Intelligence Index v5, 27 октября 2026 г.
Три вещи в этой таблице важны, если вы считаете стоимость MacBook.
- Все пять первых мест принадлежат Anthropic и OpenAI, и ни одну из этих моделей нельзя скачать ни за какие деньги.
- Лучшая открытая модель, Kimi K3.1 Pro, не опубликовала свои веса. Среди моделей, которые действительно можно скачать, лучший результат — 32, и это оставляет их на 26 баллов позади лидера. В предыдущей версии разрыв между лучшей открытой и лучшей закрытой моделью составлял 3 балла. Теперь он 12, или 26, если считать только веса, которые можно скачать.
- Claude Haiku 5.5 обходит каждую открытую модель, которую можно скачать. Это младший, быстрый и дешёвый уровень Anthropic, а не её флагман.
Конкретно кодинг
Новый индекс включает FrontierCode 2.0, 132 закрытые задачи по программированию от Cognition. Claude Opus 5.5 решила 46%; DeepSeek V4.1 Flash 1017, сильнейшая вместе с другими среди скачиваемых моделей, — 28%. На Terminal-Bench-Science, 70 агентных научных задач, результат 59% против 13%.
Чтобы быть справедливым к открытым моделям: Kimi K3.1 Pro лидирует Terminal-Bench 4.0 с 67%, обгоняя любую закрытую модель. Открытые модели могут и действительно выигрывают отдельные бенчмарки. Но эту пока нельзя скачать, а у её предшественницы, Kimi K3, 2,8 трлн параметров. На ноутбуке вы её не запустите.
Почему разрыв только что стал шире
Переход с v4.3 на v5 оказался неодинаковым для всех.
| Модель | Тип | v4.3 | v5 | Изменение |
|---|---|---|---|---|
| Claude Opus 5.5 | Закрытые | 58 | 58 | 0 |
| GPT-6 Astra | Закрытые | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Закрытые | 56 | 54 | −2 |
| Gemini 4 Argon | Закрытые | 53 | 50 | −3 |
| Kimi K3.1 Pro | Открытая (не опубликована) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Открыть | 45 | 32 | −13 |
| Muse Spark Open (Meta) | Открыть | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | Открыть | 46 | 30 | −16 |
Цифры v4.3 и v5 по данным Trending Topics от 28 октября; оценки v5 совпадают с анонсом AA.
В среднем эти четыре открытые модели потеряли 13 баллов. Четыре закрытые сдвинулись на четверть балла.
AA не объяснила почему. Очевидное прочтение: когда тестовые вопросы держатся в секрете, модель не могла их видеть, а публичные бенчмарки льстят моделям, которые много тренировались на публичных данных. Контраргумент тоже справедлив: закрытые тесты нельзя проверить извне, а от весов категорий зависит рейтинг. Не принимайте какой-либо один индекс за истину. Но когда четыре открытые модели падают на двузначные числа, а четыре закрытые — нет, это сигнал, который стоит воспринять серьёзно: опубликованные таблицы бенчмарков, и особенно собственные таблицы производителей, преувеличивают, насколько открытые модели близки к лидерам.
И модели, которые действительно помещаются в MacBook
Модели, которые AA пересчитала к своему анонсу, в основном слишком велики для ноутбука. Для тех, что помещаются, страницы моделей AA по-прежнему показывают v4.3.2 оценки, и в этой версии Opus 5.5 тоже набирает 58. Итак, сравнение в одной согласованной шкале:
| Модель | Помещается в MacBook со 128 ГБ? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | Нет, только облако | 58 |
| Qwen3.8 27B (xhigh) | Да, в 4 битах даже на Mac с 32 ГБ | 34 |
| Qwen3.5 122B A10B (reasoning) | Да, около 70 ГБ в 4 битах | 16 |
| gpt-oss-120b (high) | Да, около 64 ГБ | 12 |
Источник: страницы моделей Artificial Analysis, данные на 28 октября 2026 г.
AA ставит Qwen3.8 27B на первое место среди 141 сопоставимой модели. Для своего размера она действительно отличная, и это открытая модель под Apache 2.0. И всё же она на 24 балла позади.
Показать изображение Две версии индекса, две отдельные панели, ни в коем случае не одна ось. Сверху: Artificial Analysis Intelligence Index v5 (27 октября 2026). Снизу: модели, которые помещаются в MacBook с 128 ГБ, по версии v4.3.2 — той, на которой публикуются их оценки.
Парадокс 128 ГБ
Взгляните ещё раз на последнюю таблицу. Лучшая модель для MacBook со 128 ГБ помещается в 32 ГБ. Модели, которым действительно нужна дополнительная память, смеси экспертов на 120 млрд параметров, набирают меньше — в основном потому, что они старше: gpt-oss-120b вышла в августе 2025 года, а Qwen3.5 122B уже тестировали на M5 Max в марте, за несколько месяцев до появления Qwen3.8 27B.
Так что же даёт сегодня обновление с 48 до 128 ГБ за $2 000? Запас: более длинные контексты, 8-битная точность вместо 4-битной, несколько моделей одновременно и возможность запустить сильную модель класса 100 млрд, если такая выйдет. Всё это реальные плюсы. Более умная модель в их число не входит — по крайней мере, в сегодняшнем рейтинге. Перед покупкой проверьте AA: такие факты меняются с одним релизом.
Как 34 против 58 ощущаются на практике
Баллы индекса — не “процент ума”, и они распределяются по задачам неравномерно.
На коротких, чётко очерченных задачах — переписать письмо, пересказать вставленный документ, вытащить поля из счёта — хорошая модель на 27B часто неотличима от передовой. Разрыв открывается на длинной многошаговой работе: агент, которому нужно прочитать кодовую базу, спланировать, отредактировать пять файлов, прогнать тесты и исправить собственные ошибки; исследование, где надо согласовать источники; рассуждение, где один неверный шаг портит всё остальное. Именно за такую работу люди и покупают тарифы за $200.
Колонка Forbes за август привела конкретный пример из собственной статьи Qwen: Qwen3-Coder-Next в Claude Code набрала 30.9% на Terminal-Bench 2.0 против 53.9% у Claude Opus 4.5 в той же статье. Это модели прошлого года, но картина не изменилась: на агентных задачах локальная связка ошибалась гораздо чаще.
Часть 5 — Почему модели, которые вам действительно нужны, не помещаются
Размер модели в памяти оценить просто:
текст
веса (ГБ) ≈ параметры (млрд) × байт на параметр
               8 бит → × 1,0     4 бита → × 0,5     2 бита → × 0,25
Затем прибавьте KV-кэш, рабочую память модели для вашего диалога, которая растёт вместе с длиной контекста. И помните, что macOS отдаёт GPU не всю объединённую память: по умолчанию она позволяет GPU закрепить примерно 75% на Mac с большой памятью, около 96 ГБ из 128 ГБ. Поднять лимит можно командой sudo sysctl iogpu.wired_limit_mb=…, на свой риск; сколько бы вы ни отдали модели, браузеру, редактору и операционной системе этого не достанется.
Вот что это значит для моделей, о которых действительно говорят:
| Модель | Всего параметров | Веса в 4 битах (минимум) | Помещается в MacBook со 128 ГБ? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 ГБ | ✅ Легко |
| gpt-oss-120b | 117B | ~58 ГБ (файл 64 ГБ) | ✅ Да |
| Qwen3.5 122B A10B | 125B | ~62 ГБ (файл 69,6 ГБ) | ✅ Да |
| GLM-5.3-Flash | 320 млрд | ~160 ГБ | ❌ Нет |
| MiniMax M3 | 428B | ~214 ГБ | ❌ Нет |
| GLM-5.3 | 753 млрд | ~376 ГБ | ❌ Нет |
| DeepSeek V4.1 Flash 1017 | 763B, включая память Engram | ~382 ГБ (4-битные сборки от сообщества оценивают в ~458 ГБ) | ❌ Нет |
| Флагман Qwen3.8 | 2,4 трлн | ~1,2 ТБ | ❌ Нет |
| Kimi K3 | 2,8 трлн | ~1,5 ТБ в опубликованном виде (нативный MXFP4) | ❌ Нет |
Столбец 4 бита — это параметры × 0,5 байта: только веса, без KV-кэша и накладных расходов файла, поэтому реальные файлы больше. Размеры файлов взяты из тестов Hardware Corner на M5 Max.
Модели, которые набирают 32 в новом индексе, лучшие из доступных для скачивания, требуют в три-четыре раза больше, чем есть в MacBook. И промежуточные тоже не втискиваются. Если отдать под веса модели 100 ГБ из 128, вот сколько бит на вес вы сможете себе позволить:
| Модель | Бит на вес при бюджете в 100 ГБ |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Примерно на трёх битах и ниже качество обваливается (исследования — в части 6). Один бит на вес — это не квантизация. Это ампутация.
Контекст тоже стоит памяти. В тестах Hardware Corner Qwen3-Coder-Next в 8 битах занимала 87,1 ГБ при контексте 4K и 92,6 ГБ при 64K: лишние пять с половиной гигабайт только за более длинный диалог. Агентам, которые читают целые репозитории, нужны длинные контексты, так что этот запас быстро исчезает.
А что насчёт Mac Studio на 512 ГБ? Mac Studio с M5 Ultra на 512 ГБ мог бы вместить GLM-5.3 или DeepSeek V4.1 Flash в 4 битах. Apple говорила, что такая конфигурация появится в конце октября; MacRumors ожидает цену существенно выше $10 000, а на момент проверки Apple цену не публиковала. Вы платили бы пятизначную сумму за модели с 32 баллами в новом индексе, вероятно, работающие медленнее, чем их предлагают сами создатели. Мой Kimi K3 vs Fable 5.1 vs GLM-5.3 сравнение подробнее разбирает, что на самом деле нужно для self-hosted (самостоятельного хостинга) больших открытых моделей.
Показать изображение Только веса, по 4 бита на параметр; кэш контекста идёт сверху. Всё, что правее линии 128 ГБ, требует Mac Studio или сервера.
Часть 6 — Квантование: налог на качество, который вы платите за то, чтобы всё поместилось
Квантизация хранит веса модели в меньшем числе бит — 8 или 4 вместо 16, в которых её обучали, — поэтому модель занимает меньше памяти и работает быстрее. Любая локальная модель, которую вы запустите на Mac, квантована. Вопрос в том, чего это стоит, и исследования дают ясный и слегка неудобный ответ.
Хорошая новость: 8 бит почти ничего не стоят, 4 бита в основном приемлемы
- Одно из крупнейших исследований на сегодня, проведённое Эльдаром Куртичем и коллегами, включало более 500 000 оценок квантованных моделей Llama 3.1. FP8 практически не теряла качества при любом размере; INT8 стоила около 1–3% при аккуратной настройке; а 4-битная квантизация только весов оказалась “конкурентнее, чем ожидалось”, почти как 8-битная.
- Для рассуждающих моделей исследование 2025 года Руйкана Лю и коллег показало, что 8-битные веса и активации или 4-битные веса с 16-битными активациями могут быть без потерь на бенчмарках по математике, науке и программированию. Меньшая разрядность несла, по словам авторов, значительные риски точности, и сложность задачи сильно влияла на величину потерь.
Если вы задаёте только короткие вопросы на английском, 4-битная модель будет ощущаться почти как оригинал.
Плохая новость: длинные входные данные, другие языки и всё, что ниже 4 бит
- Длинный контекст. Анмол Мекала и коллеги проверили пять методов квантизации на 9 700 примерах со входными данными от 64 000 токенов и больше (EMNLP 2025). 8 бит стоили около 0.8% в среднем. 4 бита стоили до 59%, и ущерб сильно зависел от модели: при одном из 4-битных методов Llama 3.1 70B просела на 32% в задаче, где Qwen 2.5 72B удержалась.
- Языки, кроме английского. То же исследование показало, что деградация обычно хуже, когда входные данные не на английском. Если вы работаете на немецком, тестируйте на немецком.
- Ниже 4 бит рассуждения рушатся. Исследователи из Meta FAIR опубликовали в июне 2026 года работу о том, что квантованные рассуждающие модели передумывают. При 3-битной AWQ результат рассуждающей модели на 1,5B в бенчмарке MATH-500 упал с 85,6% до 47,0%, а цепочка рассуждений выросла с 5 200 до 23 400 токенов, в 4,5 раза длиннее. На ноутбуке, который пишет 20–80 токенов в секунду, модель, думающая в четыре раза дольше, ещё и примерно в четыре раза медленнее.
Показать изображение Что, по данным исследований, стоит каждая ступень снижения точности. Сжатие, которое позволило бы втиснуть модель побольше в 128 ГБ, — ровно то, что бьёт сильнее всего.
Что это значит для MacBook с 128 ГБ
Квантизация, которую вы можете себе позволить для нужной модели, — это и есть квантизация, которая бьёт сильнее всего. Модель на 27B может работать в 8 битах на Mac с большим запасом — так и стоит делать. Модели класса 120B работают в 4 битах: это нормально для чата и рискованно на длинных документах. А единственный способ затащить что-то из класса 300B+ на ноутбук — два-три бита на вес, где, по исследованиям выше, рассуждения разваливаются.
Мои проверенные правила:
- Используйте 8 бит для всего, на что будете полагаться, особенно для длинных документов и работы агентов.
- 4 бита подходят для чата, черновиков и коротких задач. Проверьте её поведение на длинном контексте на своих документах.
- Не запускайте рассуждающие и кодовые модели ниже 4 бит , если только вы не экспериментируете.
- Тестируйте на том языке, на котором работаете.
Часть 7 — Скорость: быстро пишет, медленно читает
LLM выполняет две разные работы с разной скоростью. Prefill читает ваш промпт — всё, что вы вставили, плюс диалог на данный момент, — и ограничен чистой вычислительной мощностью. Генерация пишет ответ по одному токену и ограничена пропускной способностью памяти. Собственные исследователи Apple по машинному обучению измерили обе величины на M5: новые Neural Accelerators в GPU сделали время до первого токена в 3,3–4,1 раза быстрее , чем на M4, тогда как генерация улучшилась лишь в 1,19–1,27 раза, что примерно соответствует приросту пропускной способности.
Так что же на деле выдаёт M5 Max со 128 ГБ? Hardware Corner опубликовал тесты, выполненные во фреймворке Apple MLX на 14-дюймовом M5 Max со 128 ГБ:
| Модель | Контекст | Чтение (prefill), ток/с | Время на чтение всего промпта | Запись, ток/с |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 ГБ) | 4K | 1,325 | 3,1 с | 87.9 |
| 32K | 2,537 | 12,9 с | 64.5 | |
| Qwen3.5 122B A10B (4 бита) | 4K | 881 | 4,6 с | 65.9 |
| 32K | 1,068 | 30,7 с | 54.9 | |
| Qwen3.5 27B (плотная, 6 бит) | 4K | 811 | 5,1 с | 23.6 |
| 32K | 591 | 55,4 с | 14.9 | |
| Qwen3-Coder-Next (8 бит) | 64K | 1,432 | 45,8 с | 48.2 |
Измерено пользователем Reddit cryingneko и опубликовано Hardware Corner. “Время на чтение всего промпта” — это длина контекста, делённая на измеренную скорость prefill.
Скорость генерации теперь в порядке, по крайней мере на моделях MoE
Модели-смеси экспертов используют на каждый токен лишь часть своих весов, поэтому пишут быстро: 55–88 токенов в секунду на M5 Max. Для сравнения: Artificial Analysis измеряет Claude Opus 5.5 на уровне 98 токенов в секунду в API Anthropic. Для чата с моделью класса 120B M5 Max действительно приятен. Плотные модели — совсем другое дело: модель на 27B, которая использует каждый вес для каждого токена, пишет со скоростью 15–24 токена в секунду.
Складываются и два эффекта поменьше. Запись замедляется по мере роста разговора: на 32K она на 17–37% медленнее, чем на 4K, у всех трёх моделей. А рассуждающие модели тратят сотни или тысячи токенов на размышления, прежде чем ответить.
Ожидание — в чтении
Взгляните ещё раз на столбец времени чтения. Промпт на 32 000 токенов (несколько исходных файлов, длинный договор, большая ветка писем) требует от 13 до 55 секунд на чтение, прежде чем появится первое слово ответа.
Это важнее всего именно для той работы, ради которой покупают план за $200. ИИ-агенты для кодинга отправляют модели большой системный промпт, определения всех инструментов, открытые файлы и всю переписку на текущий момент — и делают это на каждом шаге. Локальные серверы умеют переиспользовать ту часть промпта, которая не изменилась, и это сильно помогает. Но как только что-то в начале контекста меняется — например, агент сжимает историю или вы переключаетесь на новую задачу — всё после этой точки приходится читать заново. Forbes приводит слова одного разработчика, который ждал около 90 секунд первого токена на M3 Ultra с 512 ГБ и системным промптом на 16 000 токенов, и другого, у которого на ноутбуке M4 Pro с 48 ГБ холодный старт занял около 20 секунд. Чипы поколения M5, по собственным замерам Apple, работают с этим намного быстрее старых Mac, но форма проблемы та же.
Для сравнения: те же тесты Hardware Corner запускали на рабочей видеокарте Nvidia RTX Pro 6000, которая сама по себе стоит около $8 800: она читала промпты в 2–2,4 раза быстрее и писала в 1,7–2,8 раза быстрее чем M5 Max.
Показать изображение Измерено с MLX на M5 Max с 128 ГБ. Запись достаточно быстрая; ожидание возникает при чтении длинных промптов, а агенты делают это постоянно.
Часть 8 — Проблема ноутбука
Даже если бы модели были достаточно хороши, ноутбук — неудобное место для их запуска.
Нагрев. Запуск большой модели — это длительная нагрузка: минуты или часы работы GPU и памяти на пределе, а не десятисекундный всплеск. В обзоре 14-дюймового M5 Max издание Notebookcheck пришло к выводу, что его корпус и охлаждение “просто не справляются с M5 Max должным образом”: производительность в 30-минутном стресс-тесте CPU упала на 24%, а вентиляторы в режиме High Power достигали 53,2 dB(A). В том обзоре измерялись нагрузки на CPU и графику, а не LLM, и сам Notebookcheck считает, что M5 Max место в 16-дюймовом корпусе. Если вы всё же покупаете MacBook для локального ИИ, берите 16-дюймовый. Моё Руководство по MacBook Pro M5 Pro 64 GB пришло к тому же выводу о длительной работе на меньшем корпусе.
Это ещё и ваш повседневный компьютер. Загрузите модель на 70 ГБ вместе с её контекстом — и у вас ещё останется место для браузера и редактора. Приблизьтесь к примерно 96 ГБ, которые GPU получает по умолчанию, или поднимите лимит, чтобы втиснуть что-то побольше, — и остальная работа начнёт конкурировать с моделью за память. Каждая загруженная модель — это память, которой не достаётся другим приложениям.
Батареи этого не любят. Длительная нагрузка на GPU быстро сажает батарею ноутбука, так что долгие сессии локального инференса в итоге проходят с подключённым питанием — что изрядно подрывает тезис “ИИ везде, офлайн”.
Потолок вы покупаете в первый же день. Единую память нельзя увеличить после покупки. Если лучшей открытой модели следующего года понадобится 160 ГБ, MacBook с 128 ГБ её просто не запустит.
И она быстро дешевеет. Британская компания MacFinder, торгующая восстановленной техникой, проанализировала шесть лет собственных данных о закупках и выяснила, что большинство MacBook теряют около половины стоимости в первый год, а топовые модели часто падают сильнее: 16-дюймовый MacBook Pro M4 за год подешевел до 60%. Машина за $6 999 — это ставка $6 999 на то, что сегодняшний потолок памяти останется полезным через три года.
Настольный компьютер лучше подходит для LLM. Если цель — локальный ИИ, Mac Studio с тем же M5 Max и 128 ГБ стоит на $2 200 меньше, у него нет батареи, которую можно угробить, и крышки, которую нужно закрывать, и он может круглосуточно работать частным сервером для вашего ноутбука и телефона. Берите к нему любой ноутбук, который вам уже нравится.
Часть 9 — Разрыв в ПО: что вам пришлось бы воссоздавать
Подписка — это модель плюс продукт. Локальная установка даёт вам модель, а продукт оставляет на вас.
| Что подписка делает за вас | Что пришлось бы делать локально |
|---|---|
| Размещает и обновляет модель | Скачивать, конвертировать и обновлять модели самостоятельно (LM Studio, Ollama или MLX) |
| Веб-поиск и глубокое исследование | Подключить поисковый API или self-hosted (самостоятельный хостинг) поиск плюс агента для управления им |
| Читает PDF, таблицы и изображения | Выбрать модели со зрением, добавить разбор документов |
| Голос, память, генерация изображений | Отдельные модели и приложения для каждого (Whisper для речи, Draw Things или ComfyUI для изображений) |
| Приложения на всех устройствах, с синхронизацией | Запустить сервер и фронтенд и безопасно открыть доступ с телефона |
| Claude Code или Codex, настроенные под свои модели | Направить открытый harness или сам Claude Code на локальный сервер |
| Шаблоны чата, форматы вызова инструментов и безопасность уже настроены | Отлаживать их, когда новая модель выходит с шаблоном, которого ваши инструменты не понимают |
Инструменты сейчас действительно хороши. LM Studio — самый простой старт на Mac, Ollama даёт один API для локальных и облачных моделей, а MLX от Apple обычно самый быстрый. Ollama даже предоставляет совместимый с Anthropic API, так что вы можете направить Claude Code на локальную модель, задав ANTHROPIC_BASE_URL=http://localhost:11434. Правда, документация честно говорит о пробелах: управление кешированием промптов Anthropic, подсчёт токенов, пакеты и ввод PDF не поддерживаются. И Claude Code настроен под модели Claude; локальной модели приходится справляться с длинным системным промптом и определениями инструментов Claude Code — именно здесь больнее всего бьёт время префилла из части 7.
Ничего из этого не невозможно. Мой OpenCode v2 vs Hermes Agent vs OpenClaw материал рассказывает об открытых агентах, которые работают с локальными моделями. Но это настоящая работа, и ваши часы не бесплатны. Заложите выходные на настройку и несколько часов в месяц на поддержку актуальности.
Часть 10 — Расчёт окупаемости, сделанный честно
Вот расчёт, который в таких презентациях обычно пропускают.
Шаг 1: наивная версия
$6 999 ÷ $200 в месяц = 35 месяцев. Не двенадцать. Почти три года, и это самый лестный вариант.
Шаг 2: добавьте электричество
Forbes оценил примерно в $10 в месяц для Mac, работающего с ИИ восемь часов в день, по средним тарифам США. В Германии при среднем октябрьском тарифе 29,68 цента за кВт·ч ноутбук, потребляющий в среднем 60–150 Вт восемь часов в день, обходится примерно в €4–11 в месяц. Мелочь, но она отодвигает точку окупаемости до примерно 37 месяцев.
Шаг 3: оставьте дешёвый план для сложных задач
Останетесь. Немногие, кто пробовал фронтирную модель для агентского кодинга или серьёзных исследований, возвращаются к модели с 34 баллами для всего подряд. Оставьте план за $20 для сложных 10% — и Mac сэкономит вам $170 в месяц, а не $200: примерно 41 месяц.
Шаг 4: сравните с тем, до чего вы действительно готовы понизиться
Если вы настолько считаете деньги, что рассматриваете ноутбук за $7 000, то вы достаточно считаете деньги, чтобы перейти на тариф за $100. Против $100 в месяц окупаемость наступает через примерно 78 месяцев, больше шести с половиной лет, дольше, чем многие держат ноутбук.
| Сценарий | Первоначально | Продолжаете платить | Экономия в месяц | Окупаемость |
|---|---|---|---|---|
| MacBook против плана за $200, без электричества | $6,999 | — | $200 | 35 месяцев |
| MacBook против плана за $200, с электричеством | $6,999 | $10 | $190 | 37 месяцев |
| … и вы оставляете план за $20 | $6,999 | $30 | $170 | 41 месяц |
| MacBook против плана за $100 | $6,999 | $10 | $90 | 78 месяцев |
| Mac Studio (128 ГБ) против плана за $200 | $4,799 | $10 | $190 | 25 месяцев |
| Mac Studio против плана за $200, с сохранением плана за $20 | $4,799 | $30 | $170 | 28 месяцев |
Все они исходят из того, что Mac полностью заменяет подписку. Части 4–9 объясняют, почему это не так.
Показать изображение Совокупные затраты за четыре года в предположении, что Mac полностью заменяет подписку, а это не так. Электричество — около $10 в месяц.
Шаг 5: три года, с учётом перепродажи
У техники есть остаточная стоимость, и это самый сильный аргумент за покупку. Предположим, вы продаёте её через три года за 35% от цены покупки. Это моё допущение, а не котировка, основанное на данных MacFinder: около половины стоимости уходит в первый год, дальше потери медленнее.
| Вариант | Затраты за 36 месяцев |
|---|---|
| План за $200 | $7,200 |
| MacBook (128 ГБ) + электричество, продан за 35% | $4,909 |
| … плюс план за $20 для фронтирных задач | $5,629 |
| Mac Studio (128 ГБ) + электричество + план за $20, продан за 35% | $4,199 |
| План за $100 | $3,600 |
| План за $20 | $720 |
Так что да: за три года MacBook плюс план за $20 может выйти примерно на $1 600 дешевле плана за $200, если продать его по приличной цене. Но посмотрите, что покупают эти деньги. С одной стороны — лучшие модели мира со всеми инструментами вокруг них. С другой — модель с 34 баллами, несколько тысяч долларов амортизации и дешёвый план на случаи, когда нужна настоящая вещь. План за $100 обходит по стоимости любой вариант с техникой, а план за $20 обходит всё.
На MacBook для локальных LLM вы экономите немного. Вы тратите примерно те же деньги на другой продукт: конфиденциальность, контроль и свободу от лимитов — с меньшим интеллектом в комплекте.
Взгляд через предельные издержки
Есть одна постановка вопроса, при которой покупка имеет больше смысла: вам в любом случае нужен новый MacBook. Тогда затраты именно на ИИ — это только апгрейд памяти с 48 ГБ до 128 ГБ, $2 000, или десять месяцев плана за $200. Это не безумие. Но вспомните парадокс 128 ГБ из части 4: на сегодняшней таблице лидеров этот апгрейд покупает модели побольше, а не поумнее. Если вы всё равно берёте MacBook, 48–64 ГБ позволяют запускать лучшую модель размера Mac в 8-битном квантовании с приличным контекстом.
Что можно купить вместо этого за $6 999
- 35 месяцев плана за $200, 70 месяцев плана за $100, или 29 лет плана за $20
- Около 11,7 млрд выходных токенов на DeepSeek V4.1 Flash по его цене API вне пиковых часов — модели, которая обходит всё, что помещается в MacBook
- Около 350 млн выходных токенов Claude Opus 5.5 через API Anthropic по указанной Artificial Analysis цене $20 за миллион
Часть 11 — Справедливый случай: когда покупка Mac для локального ИИ имеет смысл
Всё это не значит, что локальный ИИ — пустая игрушка. Я постоянно пишу о нём в этом блоге, потому что он полезен. Просто полезен по другим причинам, чем утверждает реклама. Вот хорошие.
1. Данные, которые не должны выходить из-под вашего контроля
Если вы работаете с файлами клиентов, медицинскими данными, непубличной финансовой отчётностью или чем-либо, что покрыто обязанностью конфиденциальности, локальная модель означает, что ничего не уходит третьей стороне. Никакого соглашения об обработке, никакой международной передачи, никаких сомнений насчёт настроек обучения. В Германии специалисты, связанные § 203 StGB, — юристы, врачи и налоговые консультанты — нуждаются в договорных гарантиях, прежде чем данные клиентов попадут к любому внешнему поставщику услуг, включая поставщиков ИИ. Локальная модель полностью обходит этот вопрос. Это самая сильная причина владеть техникой, и она не зависит от того, насколько локальная модель умна по сравнению с Opus. Мой Состояние ИИ 2026 отчёт подробнее разбирает затраты и комплаенс при работе с ИИ офлайн.
2. Работа офлайн
В самолёте, у клиента без сети, на объекте, где сеть — это то, что запрещено.
3. Никаких лимитов, никаких сдвигов политики, модель, которая не меняется
Никаких пятичасовых окон, недельных лимитов и коллективных исков о том, как их раскрывают. И локальный чекпойнт через год ведёт себя так же, как сегодня, — это важно, если вы построили рабочий процесс вокруг поведения модели.
4. Массовая, скучная, чётко определённая работа
Классификация тысяч обращений в поддержку, извлечение полей из счетов, конспектирование собственных заметок, перевод черновиков, разметка фотографий, генерация эмбеддингов для поиска по своим документам, расшифровка встреч с Whisper. Локальные модели среднего размера отлично с этим справляются, а миллион таких прогонов стоит только электричества.
5. Обучение и создание
Если вы делаете local-first приложения, тонко настраиваете небольшие модели или просто хотите понять, как это устроено, владение техникой — лучший учитель. (Если вам интересно создавать приложения с ИИ, весь процесс я описал в Как создать приложение с нуля с помощью ИИ в 2026 году.)
6. Вы и так собирались купить Mac
Тогда покупайте столько памяти, сколько нужно для моделей, которые вы реально будете запускать (см. часть 14), и считайте локальный ИИ бонусом, а не бизнес-кейсом.
Что хорошо работает локально
| Задача | Что запускать | Комфортный объём памяти |
|---|---|---|
| Приватный чат, черновики, переписывание | Qwen3.8 27B в 8-битном квантовании | 48–64 ГБ |
| Конспекты и вопросы-ответы по вашим документам | Qwen3.8 27B плюс модель эмбеддингов | 48–64 ГБ |
| Массовое извлечение и классификация | Модели поменьше (Gemma 4, gpt-oss-20b) | 16–32 ГБ |
| Речь в текст | Whisper | 8–16 ГБ |
| Генерация изображений | Draw Things или ComfyUI с моделями класса FLUX | 32 ГБ+ |
| Большая и быстрая чат-модель | gpt-oss-120b или Qwen3.5 122B | 128 ГБ |
Для локальной генерации видео Mac по-прежнему медленнее техники Nvidia или облачных GPU; моё руководство по M5 Pro 64 ГБ приводит цифры.
Часть 12 — Более дешёвые способы сократить счёт за ИИ на $200
Если вам на самом деле нужен меньший счёт за ИИ, есть способы дешевле, чем ноутбук за $7 000.
1. Перейдите на тариф ниже. Claude Max 5× и ChatGPT Pro 100 стоят $100, а AI Ultra от Google теперь начинается от $100. Если вы редко упираетесь в лимиты плана за $200, это экономит $1 200 в год вообще без потери качества.
2. Объедините два плана за $20. Claude Pro плюс ChatGPT Plus стоят $40 в месяц и дают два отдельных пула лимитов и два семейства фронтирных моделей, между которыми можно переключаться.
3. Платите за токены для открытых моделей. Те же модели с открытыми весами, которые вы запускали бы на Mac, и более крупные, которые туда никогда не поместятся, доступны по токенам у многих провайдеров — со скоростью дата-центра. DeepSeek V4.1 Flash, которая обходит все модели, помещающиеся в MacBook, стоит $0,15 за миллион входных токенов и $0,60 за миллион выходных токенов вне пиковых часов в собственном API DeepSeek (вдвое больше в пиковые часы). Qwen3.8 27B указана на OpenRouter от примерно $0,035 за миллион входных токенов. Для личных или клиентских данных используйте провайдера с хостингом в ЕС и соглашением об обработке данных, а не собственный API DeepSeek, который обрабатывает данные в Китае.
4. Используйте план кодинга с фиксированной ценой для открытых моделей. Z.ai GLM Coding Plan начинается от $18 в месяц и включает GLM-5.3, делящую первое место среди скачиваемых моделей в новом индексе, а также GLM-5.3-Flash, и работает в Claude Code, Codex, OpenCode и других инструментах. Скидка 10% на GLM Coding Plan по моей партнёрской ссылке. (Партнёрская ссылка — см. раскрытие информации в начале статьи.) Это не Opus 5.5, и индекс прямо это показывает, но стоит это меньше десятой части плана за $200. Я сравнил его с предложением MiniMax в GLM-5.3-Flash vs MiniMax M3.
5. Используйте Mac, который у вас уже есть. Если в вашем нынешнем Mac 16–32 ГБ, небольшие локальные модели бесплатно закрывают на удивление большую часть массовой работы из части 11.
6. Распределяйте по задачам. Схема, которая работает у большинства: локальная модель для приватных и массовых задач, дешёвый план или открытая модель по токенам для повседневной работы и доступ к фронтиру для сложных 10%. Моё сравнение harness для ИИ-кодинга содержит пять готовых схем под разные бюджеты.
Показать изображение Месячная стоимость каждого варианта в долларах США без НДС. Затраты при оплате за токены зависят от объёма использования; цены проверены 28 октября 2026 года.
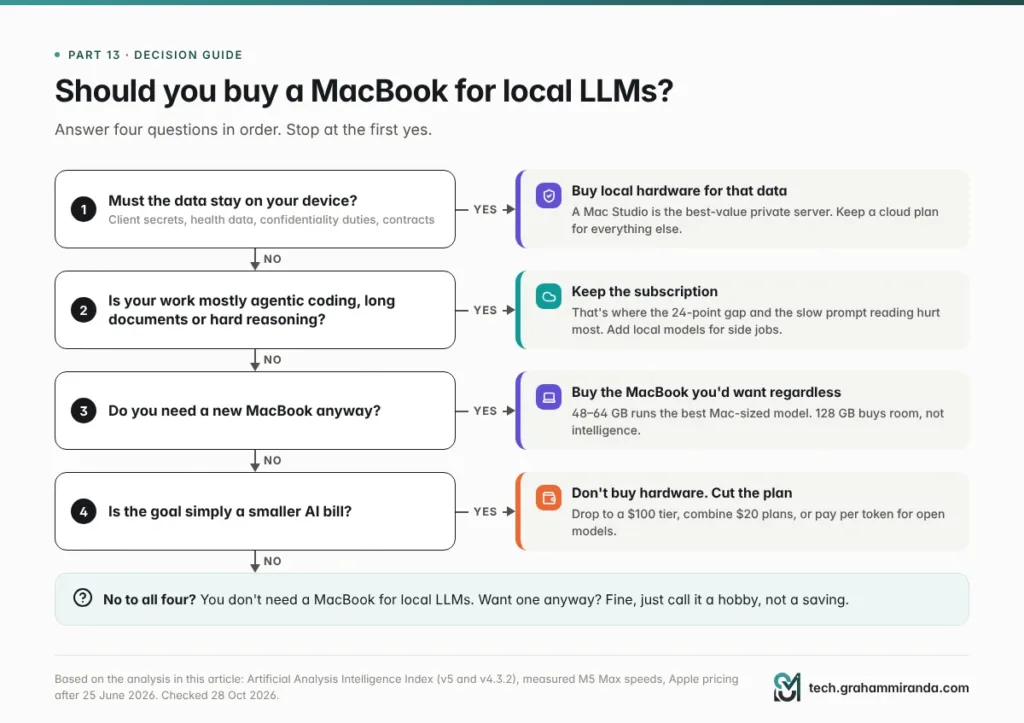
Часть 13 — Стоит ли покупать MacBook для локальных LLM? Руководство по решению
Показать изображение Начните сверху. Большинство путей заканчиваются словами “оставьте облачный план”, и в этом вся суть.
Пройдите четыре вопроса по порядку.
1. Должны ли данные оставаться на вашем устройстве? Если да — из-за конфиденциальности клиентов, медицинских данных или договора — покупайте локальную технику: этому требованию безразличны бенчмарки. Рассмотрите Mac Studio как частный сервер и оставьте облачный план для работы, где таких данных нет.
2. Состоит ли ваша работа в основном из агентского кодинга, длинных документов или сложных рассуждений? Если да, оставьте подписку. Именно здесь разрыв в 24 балла и время префилла бьют сильнее всего. Локальная модель всё равно может помогать с побочными задачами.
3. Нужен ли вам новый MacBook в любом случае? Если да, покупайте тот, который хотели бы и так. 48–64 ГБ хорошо тянут лучшую модель размера Mac. Переходите на 128 ГБ только если вам конкретно нужны модели класса 120B или несколько моделей одновременно — и понимайте, что платите $2 000 за место, а не за интеллект.
4. Цель — просто меньший счёт? Тогда не покупайте технику. Перейдите на тариф ниже, объедините планы за $20 или платите за токены открытых моделей (часть 12).
Если вы ответили «нет» на все четыре, MacBook для локальных LLM вам не нужен. Возможно, вы всё равно его хотите — и это нормально. Просто называйте это хобби, а не экономией.
Часть 14 — Если вы всё-таки его купили: как получить от него максимум
Выберите подходящую машину.
- Берите 16-дюймовый, а не 14-дюймовый, если M5 Max нужен для длительной работы с ИИ.
- Вместо этого рассмотрите Mac Studio. Тот же чип и та же память на $2 200 дешевле, лучшее охлаждение, и он может круглосуточно обслуживать ваш ноутбук и телефон.
- Не покупайте лишнюю память под сегодняшние модели. 48–64 ГБ позволяют запускать Qwen3.8 27B в 8-битном квантовании с длинными контекстами. Берите 128 ГБ ради моделей класса 120B, нескольких моделей одновременно или запаса под будущие релизы — понимая, сколько это стоит.
- Если вы покупаете на этой неделе, дождитесь сегодняшней вечерней презентации. Вы узнаете, что предлагает и сколько стоит OLED MacBook Pro, прежде чем решитесь.
Настройте как следует.
- Начните с LM Studio (MLX на Apple Silicon) — это самый простой путь, или Ollama если хотите один API для локальных и облачных моделей.
- Предпочитайте 8-бит для всего, на что будете полагаться; 4-бит используйте ради скорости в чате.
- Задавайте длину контекста осознанно. Многие среды исполнения по умолчанию используют маленькие контексты; агентам нужно гораздо больше.
- Поднимайте лимит памяти GPU только если понимаете компромисс, и оставляйте место для macOS.
- Оставьте облачный план за $20 для сложных 10%. Это дешевле вашего собственного времени.
Проверьте на своей работе. Возьмите 20 реальных промптов за прошлый месяц: письма, документы, задачи по кодингу — всё, чем вы действительно занимаетесь. Прогоните каждый через локальную и облачную модель, скройте, где какая, и оцените. Делайте это на языке, на котором работаете. Этот час скажет вам больше, чем любая таблица лидеров, включая те, что в этой статье.
Часто задаваемые вопросы
Может ли MacBook заменить подписку ChatGPT Pro или Claude Max?
Не за счёт качества. Модели, которые стоят за подпиской за $200, например Claude Opus 5.5 и GPT-6 Astra, скачать нельзя, а лучшим открытым моделям, которые скачать можно, нужно 375–460 ГБ памяти при 4 битах — намного больше, чем есть в любом MacBook. В индексе Artificial Analysis Opus 5.5 набирает 58; самая сильная модель, которую я нашёл для MacBook со 128 ГБ, Qwen3.8 27B, набирает 34 в той же версии. MacBook может заменить подписку для приватной, офлайновой работы или пакетных задач, но не для задач, где нужны передовые модели.
Какая лучшая локальная LLM для MacBook Pro с 128 ГБ в 2026 году?
Если важнее качество — Qwen3.8 27B: Artificial Analysis ставит её первой среди 141 сопоставимой модели с 34 баллами в Intelligence Index v4.3.2, и при 8 битах она помещается с запасом. Если важнее скорость — gpt-oss-120b и Qwen3.5 122B: это модели со смесью экспертов, которые выдают 55–88 токенов в секунду на M5 Max, но набирают меньше (12 и 16). Перед выбором проверьте Artificial Analysis: новые открытые модели меняют этот рейтинг каждые несколько недель.
Сколько сейчас стоит MacBook Pro с 128 ГБ?
16-дюймовый MacBook Pro с M5 Max (18-ядерный CPU, 40-ядерный GPU), 128 ГБ и 2 ТБ стоит $6 999 в США без налога с продаж. 25 июня 2026 года Apple подняла цены на Mac и удвоила стоимость апгрейда до 128 ГБ — с $1 000 до $2 000. В Германии та же конфигурация на старте стоила €6 249, а сейчас, по моей оценке, около €8 199. Mac Studio с тем же чипом и памятью стоил $4 799.
За сколько окупится MacBook по сравнению с подпиской на ИИ за $200?
Около 35 месяцев при цене $6 999 — если бы он полностью заменил подписку и ничего не стоил в работе. С электричеством примерно на $10 в месяц выходит около 37 месяцев, а если оставить подписку за $20 для самых сложных задач — около 41 месяца. Против подписки за $100 это больше шести лет. Mac Studio с тем же чипом окупается быстрее, примерно за 25–28 месяцев.
Достаточно ли быстр M5 Max для локальных LLM?
Для генерации ответов на моделях со смесью экспертов — да: при замере через MLX M5 Max со 128 ГБ выдавал 55–88 токенов в секунду, что близко к 98 у Claude Opus 5.5 в API Anthropic. Слабое место — чтение длинных промптов. Промпт на 32 000 токенов занял 13 секунд с gpt-oss-120b, 31 секунду с Qwen3.5 122B и 55 секунд с плотной моделью на 27B, а ИИ-агенты для кодинга перечитывают длинные промпты постоянно.
Так же ли хороши локальные LLM, как ChatGPT или Claude, сегодня?
Не те, что помещаются в ноутбук. В новом Intelligence Index v5 от Artificial Analysis, опубликованном 27 октября 2026 года, лучшие открытые модели, доступные для скачивания, набрали 32 против 58 у Claude Opus 5.5 и ниже 36 у Claude Haiku 5.5. Модели, достаточно компактные для MacBook, набрали максимум 34 в предыдущей версии индекса, где Opus 5.5 тоже набирал 58. На коротких простых задачах разница часто небольшая; на агентном кодинге, длинных документах и сложных рассуждениях она огромна.
Ухудшает ли квантование локальные модели?
Немного при 8 битах, больше при 4 битах, очень много ниже. Исследование более чем 500 000 оценок показало, что FP8 практически ничего не теряет, а 4-битная квантизация только весов на стандартных бенчмарках близка к 8-битной. Но на входах от 64 000 токенов и больше исследование EMNLP 2025 зафиксировало падение до 59% при 4 битах, хуже для текстов не на английском, а при 3 битах результат модели рассуждений по математике упал с 85,6% до 47,0%.
Могу ли я запустить DeepSeek V4.1 Flash или GLM-5.3 на MacBook?
Нет. У GLM-5.3 753 млрд параметров, у DeepSeek V4.1 Flash — 763 млрд с учётом памяти Engram, поэтому даже при 4 битах им нужно примерно 375–460 ГБ, намного больше максимума любого MacBook в 128 ГБ. Mac Studio с M5 Ultra и 512 ГБ смог бы их вместить. Практичный способ ими пользоваться — через API, в идеале у провайдера с хостингом в ЕС и соглашением об обработке данных.
Хватит ли 64 ГБ для локального ИИ или нужно 128 ГБ?
Большинству хватает 48–64 ГБ. Лучшая модель формата Mac в индексе Artificial Analysis, Qwen3.8 27B, помещается при 8 битах с запасом под длинные контексты. 128 ГБ позволяют запускать модели класса 120B, например gpt-oss-120b, держать загруженными несколько моделей и использовать более длинные контексты, но в сегодняшнем рейтинге эти крупные модели набирают меньше, так что апгрейд за $2 000 покупает место, а не интеллект.
Стоит ли купить Mac Studio вместо MacBook Pro для локальных LLM?
Если локальный ИИ — главная причина, то обычно да. Mac Studio с тем же M5 Max и 128 ГБ стоил $4 799, на $2 200 меньше 16-дюймового MacBook Pro, с лучшим длительным охлаждением и без батареи, о которой надо беспокоиться. Он может работать круглосуточно как приватный сервер моделей для вашего ноутбука и смартфона. Покупайте MacBook Pro, если портативность нужна вам по другим причинам.
Лучше ли запуск ИИ локально для конфиденциальности и GDPR?
Да, это его главное преимущество. С локальной моделью промпты и документы никогда не покидают ваше устройство, поэтому не нужно подписывать соглашение об обработке и нет трансграничной передачи данных. Это важно для данных клиентов, медицинской информации и профессий, связанных обязательством конфиденциальности, например для тех, кто подпадает под § 203 StGB в Германии. Выгода для конфиденциальности сохраняется независимо от того, насколько локальная модель сильна по сравнению с облачной. Это не юридическая консультация.
Могу ли я использовать Claude Code с локальной моделью?
Да. Ollama предоставляет API, совместимый с Anthropic, поэтому вы можете направить Claude Code на локальную модель, указав в ANTHROPIC_BASE_URL адрес http://localhost:11434. Учитывайте компромиссы: Ollama не поддерживает управление кешированием промптов от Anthropic, длинный системный промпт и описания инструментов Claude Code заставляют локальную модель много читать на каждом шаге, а сам Claude Code настроен под модели Claude. Открытые harness, такие как OpenCode, часто лучше подходят для локальных моделей.
Изменит ли что-то из этого новый OLED MacBook Pro?
Для локального ИИ, вероятно, немногое. Мероприятие Apple “Pro and Tell” проходит 28 октября 2026 года в 10:00 по тихоокеанскому времени, и, по сообщениям, ожидаемый там MacBook Pro с OLED-экраном использует те же чипы M5 Pro и M5 Max, что сохранит потолок в 128 ГБ и пропускную способность 614 ГБ/с. Анонсированный 27 октября 14-дюймовый MacBook Pro с M6 ограничен 32 ГБ.
Итог
В аргументе “отмените подписку за $200 и купите Mac” верны две вещи: подписки дороги, а локальный ИИ действительно полезен. Но главное в нём неверно. Подписка за $200 даёт вам лучшие модели мира, агентов, построенных вокруг них, и продукт, который улучшается каждый месяц. MacBook за $7 000 запускает лучшие модели, которые помещаются в 128 ГБ, а сегодня они набирают 34 против 58 у передовых, медленно читают длинные промпты и теряют качество именно там, где вы будете сжимать их сильнее всего.
Математика тоже не спасает. Даже в самом щедром случае MacBook выходит на окупаемость за три-четыре года, а за три года он стоит в пределах пары тысяч долларов от подписки — в зависимости от того, за сколько вы сможете его продать. Та же сумма за менее способный продукт.
Так что покупайте MacBook для локальных LLM, если ваши данные не могут покидать здание, если вы работаете офлайн, если вам нужны отсутствие лимитов и модель, которая никогда не меняется, или если вы и так собирались купить Mac. Это хорошие причины, и у многих они есть. Просто не покупайте его, чтобы отменить подписку. Держите облачный тариф для сложных 10%, перенесите приватные и скучные 90% на собственное железо и следите за рейтингами — они подскажут, когда этот баланс сместится.
Запускаете локальные модели для работы или получили результат, противоположный тому, что сказано в этой статье? Расскажите, какая модель, какая машина и какие задачи — с цифрами, если они у вас есть. Исправления и контраргументы приветствуются; статья обновляется, когда меняются рейтинги и цены, а в 2026 году это происходит часто.
Факты проверены: 28 октября 2026.