Español
 English
 Deutsch
 Italiano
 Français

El argumento es así. Una suscripción de IA de primera línea cuesta 200 $ al mes, o sea 2.400 $ al año. Un MacBook Pro con 128 GB de memoria unificada puede ejecutar modelos de lenguaje grandes en local, de forma privada y sin límites de uso. Así que cancela la suscripción, cómprate un MacBook para LLM locales y, en un año o dos, se habrá pagado solo.
Encontrarás versiones de este argumento por todas partes en 2026: en vídeos de YouTube que preguntan si deberías cancelar tu plan de IA de 200 $ y comprarte un Mac de 9.499 $, en posts de Medium que dividen el precio de un Mac entre 200, y en una columna de Forbes que echó las cuentas cuando Apple lanzó su nuevo Mac Studio en agosto. En el lanzamiento del MacBook Pro con M5 Max, John Ternus, responsable de hardware de Apple, dijo que las nuevas máquinas permiten a los profesionales “ejecutar LLM avanzados en el dispositivo”.
Comprar un MacBook para LLM locales es una idea perfectamente buena para algunas personas. Como sustituto de un plan de Claude o ChatGPT de 200 $, falla, y falla en lo único que el argumento nunca tiene en cuenta: la calidad. La suscripción te alquila los mejores modelos del mundo. El Mac ejecuta los mejores modelos que caben en 128 GB. Desde ayer podemos medir la distancia entre esas dos cosas con más precisión que nunca, y es mayor de lo que sugiere el hype.
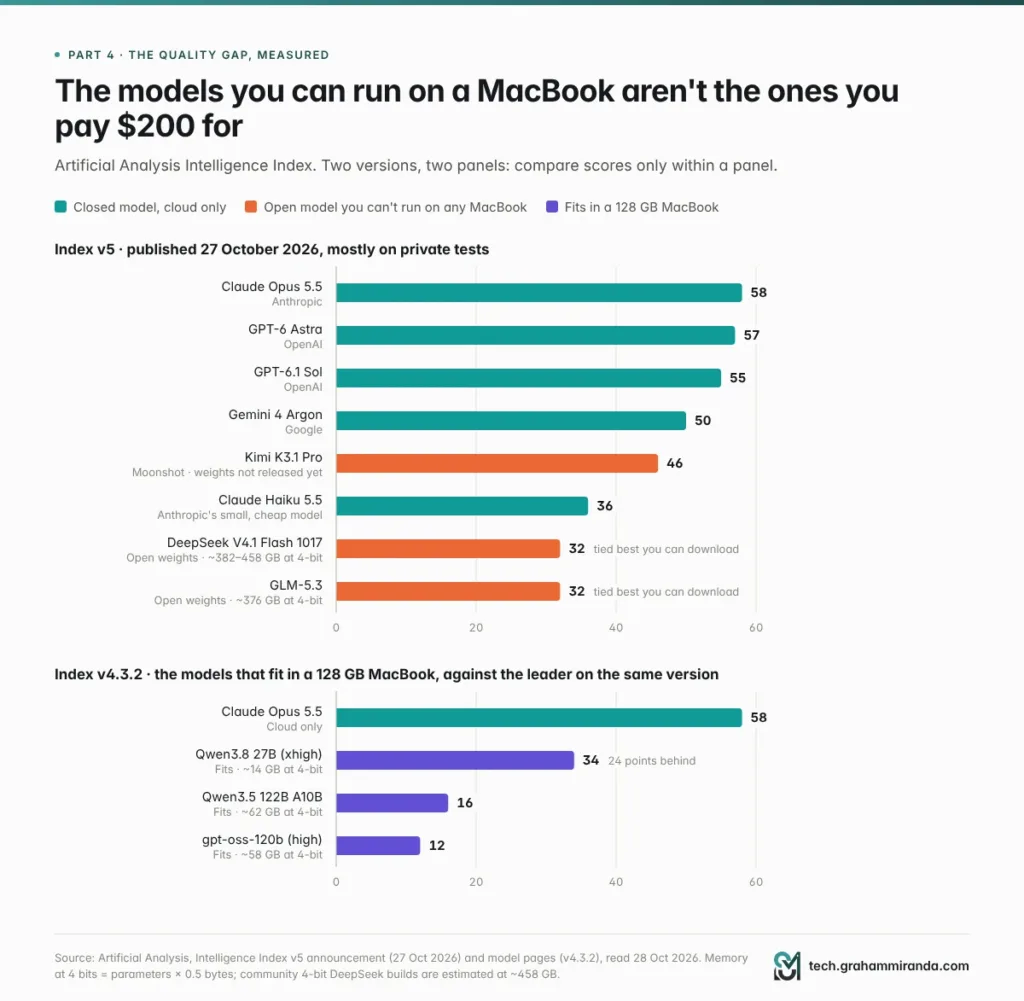
El 27 de octubre, Artificial Analysis reconstruyó su Intelligence Index en torno a pruebas mayoritariamente privadas. Claude Opus 5.5 lidera con 58. Los mejores modelos de pesos abiertos que puedes descargar de verdad, DeepSeek V4.1 Flash 1017 y GLM-5.3, obtienen 32, por debajo de Claude Haiku 5.5, el modelo pequeño y barato de Anthropic, que saca 36. Ninguno de esos modelos abiertos cabe en ningún MacBook: a 4 bits necesitan entre 375 y 460 GB. El modelo más potente que encontré que sí cabe en un MacBook de 128 GB, Qwen3.8 27B, obtiene 34 en la versión anterior del índice, en la que Opus 5.5 también saca 58.
Mientras tanto, el hardware se ha encarecido. En junio, Apple duplicó el precio de la ampliación de memoria a 128 GB en el M5 Max. Un MacBook Pro de 16 pulgadas con 128 GB cuesta ahora $6,999 en EE. UU. y, según mi cálculo, unos €8,199 en Alemania.
Así que esta es la versión honesta de las cuentas: qué compra de verdad un plan de 200 $ al mes, qué compra de verdad un desembolso de 7.000 $, qué tamaño tiene la brecha de calidad y por qué existe, cuánto corre de verdad un M5 Max, qué te cuesta la cuantización, cuándo sí tiene sentido comprar un Mac para IA local y qué formas más baratas hay de recortar una factura de 200 $ si es eso lo que buscas. Cada cifra se contrastó con su fuente el 28 de octubre de 2026.
TL;DR — La versión de 60 segundos
- Los modelos por los que pagas 200 $ no se pueden descargar, y los mejores que sí puedes descargar no caben en un MacBook. En el nuevo Intelligence Index v5 de Artificial Analysis, Claude Opus 5.5 saca 58. Los mejores modelos abiertos descargables, DeepSeek V4.1 Flash 1017 y GLM-5.3, sacan 32 y necesitan unos 375–460 GB de memoria a 4 bits.
- Lo que cabe saca mucho menos. El modelo más potente que encontré para un MacBook de 128 GB, Qwen3.8 27B, saca 34 frente a los 58 de Opus 5.5 en la misma versión del índice (v4.3.2). Los modelos de la clase 120B que sí necesitan la memoria extra sacan aún menos: 16 Qwen3.5 122B, 12 gpt-oss-120b.
- El MacBook de 128 GB se ha encarecido. Apple duplicó en junio la ampliación a 128 GB hasta 2.000 $, así que un M5 Max de 16 pulgadas con 128 GB cuesta ahora 6.999 $ (unos 8.199 € en Alemania, según mi estimación). El mismo chip y la misma memoria en un Mac Studio costaban 4.799 $.
- El punto de equilibrio está en tres o cuatro años, no en uno. Aunque el Mac sustituyera la suscripción por completo, tardaría unos 37 meses en superar a un plan de 200 $, 41 si mantienes un plan de 20 $ para el trabajo duro, y más de seis años frente a un plan de 100 $.
- Escribir es rápido; leer es lento. Un M5 Max genera 55–88 tokens por segundo con modelos de mezcla de expertos, no muy lejos de los 98 de Opus 5.5 en la API de Anthropic. Pero necesita de 13 a 55 segundos solo para leer un prompt de 32.000 tokens, y los agentes de IA releen prompts largos todo el día.
- Meter modelos grandes a la fuerza cuesta calidad. La cuantización a 4 bits es casi sin pérdidas en tareas cortas, pero en un estudio de EMNLP 2025 costó hasta un 59% en entradas largas, y más en idiomas distintos del inglés. A 3 bits, la nota de matemáticas de un modelo de razonamiento pequeño cayó del 85,6% al 47,0%.
- Los benchmarks públicos parecen favorecer a los modelos abiertos. Cuando Artificial Analysis pasó a pruebas mayoritariamente privadas, cuatro modelos abiertos destacados perdieron 13 puntos de media. Cuatro modelos cerrados destacados apenas se movieron.
- Lo local sigue ganando en privacidad, uso sin conexión, ausencia de límites de uso y trabajos masivos, y cuando ya ibas a comprar un Mac de todos modos. Cómpralo por esas razones, no para cancelar una suscripción.
- Hay formas más baratas de ahorrar. Baja a un nivel de 100 $ y ahorra 1.200 $ al año, paga por token los modelos abiertos (DeepSeek V4.1 Flash cuesta 0,60 $ por millón de tokens de salida fuera de horas punta) o usa un plan de programación desde 18 $ al mes.
El argumento frente a la realidad
| El argumento | La realidad, octubre de 2026 |
|---|---|
| “Se paga solo en un año” | Un MacBook Pro de 16 pulgadas con 128 GB cuesta 6.999 $. A 200 $ al mes son 35 meses antes de la electricidad, y 41 meses en cuanto añades el plan de 20 $ que mantendrás para las tareas difíciles |
| “Los modelos locales ya son casi tan buenos” | Opus 5.5 saca 58. El mejor modelo que cabe en 128 GB saca 34 (Qwen3.8 27B, índice v4.3.2). Los mejores modelos abiertos descargables sacan 32 en el nuevo v5 |
| “128 GB mueven los grandes modelos abiertos” | GLM-5.3 necesita unos 376 GB a 4 bits, DeepSeek V4.1 Flash unos 380–460 GB y Kimi K3 unos 1,5 TB. Ninguno cabe en un MacBook |
| “El M5 Max es rápido” | Al escribir, sí: 55–88 tokens por segundo con modelos de mezcla de expertos. Al leer un prompt de 32K tokens: de 13 a 55 segundos |
| “4 bits no pierden nada” | En benchmarks cortos, casi nada. En entradas de más de 64K tokens, hasta un 59% peor en un estudio, y peor aún fuera del inglés |
| “Sin límites, privacidad total” | Cierto. Esa es la verdadera razón para comprar uno |
Índice
- TL;DR — La versión de 60 segundos
- El argumento frente a la realidad
- Parte 1 — El argumento de “cancela tu plan de 200 $” y por qué resulta tan convincente
- Parte 2 — Qué compra de verdad un plan de 200 $ al mes en octubre de 2026
- Parte 3 — Cuánto cuesta ahora un MacBook de 128 GB
- Parte 4 — La brecha de calidad, medida
- Parte 5 — Por qué los modelos que quieres de verdad no caben
- Parte 6 — La cuantización: el impuesto de calidad que pagas por que quepa
- Parte 7 — Velocidad: rápido al escribir, lento al leer
- Parte 8 — El problema del portátil
- Parte 9 — La brecha de software: lo que tendrías que reconstruir
- Parte 10 — Las cuentas del punto de equilibrio, bien hechas
- Parte 11 — El caso justo: cuándo tiene sentido comprar un Mac para IA local
- Parte 12 — Formas más baratas de recortar una factura de IA de 200 $
- Parte 13 — ¿Deberías comprar un MacBook para LLM locales? Una guía de decisión
- Parte 14 — Si aun así compras uno: cómo sacarle el máximo partido
- Preguntas frecuentes
- ¿Puede un MacBook sustituir una suscripción ChatGPT Pro o Claude Max?
- ¿Cuál es el mejor LLM local para un MacBook Pro de 128 GB en 2026?
- ¿Cuánto cuesta ahora un MacBook Pro de 128 GB?
- ¿Cuánto tarda un MacBook en amortizarse frente a una suscripción de IA de 200 $?
- ¿Es el M5 Max lo bastante rápido para LLM locales?
- ¿Son los LLM locales tan buenos como ChatGPT o Claude ahora?
- ¿La cuantización empeora los modelos locales?
- ¿Puedo ejecutar DeepSeek V4.1 Flash o GLM-5.3 en un MacBook?
- ¿Bastan 64 GB para IA local o necesito 128 GB?
- ¿Debería comprar un Mac Studio en vez de un MacBook Pro para LLM locales?
- ¿Es mejor para la privacidad y el RGPD ejecutar la IA en local?
- ¿Puedo usar Claude Code con un modelo local?
- ¿Cambiará algo de esto el nuevo MacBook Pro con OLED?
- Conclusión
Parte 1 — El argumento de “cancela tu plan de 200 $” y por qué resulta tan convincente
Antes de nada, por qué este argumento cala tan bien: casi todo él es razonable.
Tres laboratorios convergieron en 200 $. El Claude Max 20× de Anthropic cuesta 200 $ al mes. El ChatGPT Pro de OpenAI llega en versiones de 100, 200 y 500 $. El AI Ultra de Google tiene un nivel de 100 $ y otro de 200 $. Paga eso cada mes y la cifra se queda: 2.400 $ al año, 7.200 $ en tres.
El hardware se puso serio. El MacBook Pro con M5 Max, a la venta desde marzo, admite hasta 128 GB de memoria unificada con 614 GB/s de ancho de banda, y Apple metió un Neural Accelerator, hardware dedicado a matemáticas matriciales, en cada núcleo de GPU. En agosto llegó el Mac Studio con una opción M5 Ultra homologada para hasta 512 GB. El marketing de Apple se apoya en la IA local más que nunca.
Las suscripciones se volvieron más mezquinas. Los límites semanales de Claude Max, añadidos meses después del lanzamiento del plan, son objeto de una demanda colectiva presentada el 8 de septiembre que sostiene que las etiquetas “5×” y “20×” no dejan lo bastante claros los topes semanales. Según se informa, OpenAI recortó la asignación de su plan Pro de 200 $ para nuevos suscriptores de 20 veces ChatGPT Plus a 10 veces. Cuando lo que alquilas no deja de encogerse, tenerlo empieza a parecer atractivo.
La privacidad es una preocupación real. Todo lo que pegas en un modelo en la nube sale de tu máquina. Para una empresa alemana que maneja datos de clientes, eso no es paranoia; es el RGPD.
Y la aritmética es fácil. La versión que más se comparte: un Mac Studio de 2.499 $ dividido entre 200 $ al mes son unos 12,5 meses. Forbes publicó en agosto una versión mucho más cuidadosa, con configuraciones reales y tres años de electricidad, y concluyó que un Mac probablemente no te dejará cancelar tu plan de Claude o ChatGPT si programas con agentes. Pero la versión corta es la que la gente recuerda.
Aquí está el fallo. El argumento compara un precio con un precio. Debería comparar un producto con un producto. Eso es lo que hace el resto de este artículo, empezando por lo que de verdad pagan los 200 $.
Parte 2 — Qué compra de verdad un plan de 200 $ al mes en octubre de 2026
| Proveedor | Nivel de 20 $ | Nivel de 100 $ | Nivel de 200 $ | Más de 200 $ |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: 20 $ (17 $ al mes con facturación anual) | Max 5×: 100 $ | Max 20×: 200 $ | Equipo y empresa |
| OpenAI (ChatGPT) | Plus: 20 $ (Go: 8 $) | Pro 100: 100 $ | Pro 200: 200 $ | Pro 500: 500 $ |
| Google (Gemini) | AI Pro: 20 $ | AI Ultra: 100 $ | AI Ultra: 200 $ | — |
Precios en EE. UU. por mes, sin IVA. Claude, de claude.com; ChatGPT, del rastreador de AI Business Weekly, actualizado el 4 de octubre; Google, del reportaje de Engadget sobre el relanzamiento de mayo. Los precios y las asignaciones cambian a menudo, así que compruébalo antes de suscribirte.
Para qué sirve de verdad el dinero
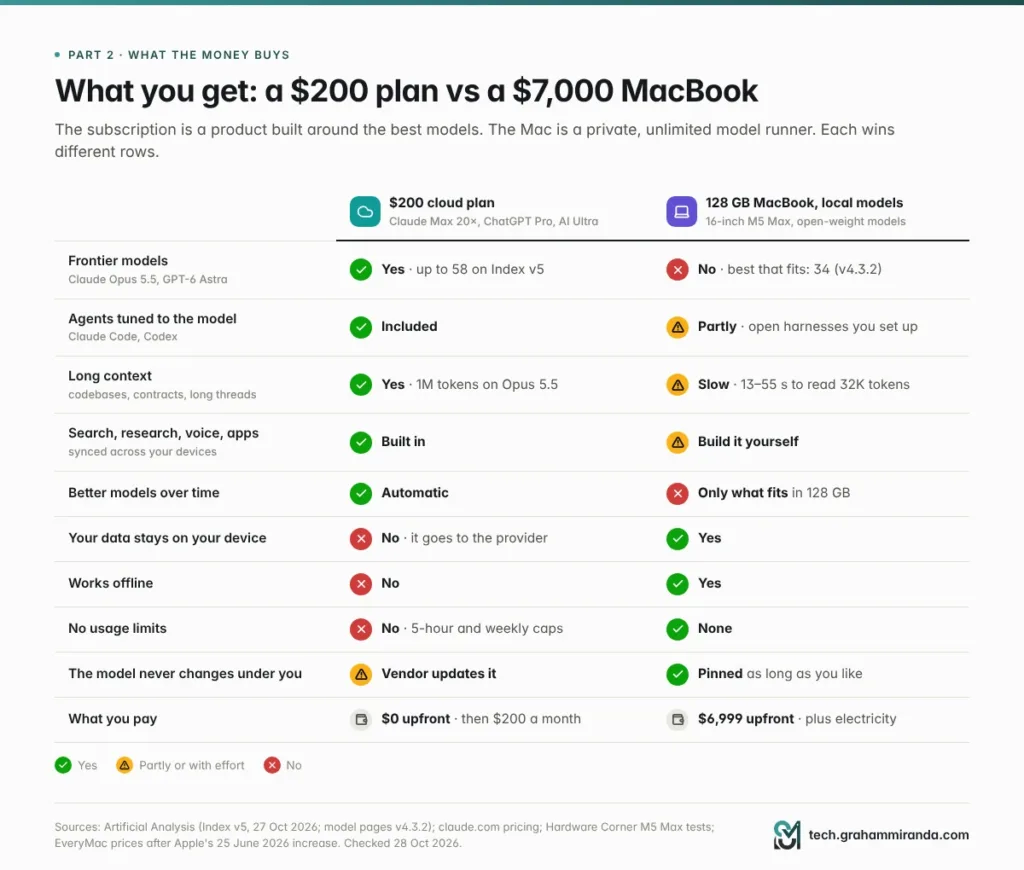
1. Los modelos de frontera, que no puedes conseguir en ningún otro sitio. En el nuevo índice de Artificial Analysis, Anthropic y OpenAI ocupan los cinco primeros puestos. Ninguno de esos modelos se puede descargar a ningún precio. La suscripción es la forma más barata en la que la mayoría de la gente llegará a usarlos.
2. Agentes construidos alrededor de esos modelos. Los planes de pago de Claude incluyen Claude Code; los de ChatGPT incluyen Codex. El harness y el modelo se ajustan juntos, lo que ayuda a explicar por qué están en lo más alto de las clasificaciones de programación con agentes. (Comparé 28 de estas herramientas en Todos los harness de programación con IA, comparados.)
3. Un contexto enorme. Claude Opus 5.5 admite una ventana de contexto de un millón de tokens, según Artificial Analysis: bases de código enteras, contratos enteros, trimestres enteros de correo.
4. El producto que rodea al modelo. Búsqueda web e investigación profunda, análisis de archivos, voz, memoria, generación de imágenes, conectores con tu correo y tus documentos, y apps que se sincronizan entre tu móvil, tu portátil y el navegador. Nada de eso viene con un archivo de modelo.
5. Actualizaciones que no tienes que instalar. El modelo que hay detrás de tu suscripción el trimestre que viene será mejor que el de hoy. El modelo de tu Mac solo cambia cuando descargas otro distinto, y solo si el nuevo cabe.
6. Algo del dinero de vuelta. La página de precios de Anthropic ya incluye créditos de API mensuales con Max: 100 $ en el plan 5× y 200 $ en el 20×.
Lo que no compra
Uso ilimitado. Los planes de Claude funcionan con ventanas deslizantes de cinco horas más topes semanales, y OpenAI y Google describen en general sus niveles superiores como múltiplos de los más baratos, cuando los describen. Control sobre dónde van tus datos, lo que importa mucho para los datos personales y de clientes. Y predictibilidad: las asignaciones han cambiado más de una vez este año.
Ten presentes esas tres cosas. Son el argumento honesto a favor de la IA local, y la parte 11 las examina a fondo.
Mostrar imagen La suscripción es un producto; el Mac es un ejecutor de modelos. Cada uno gana en filas distintas, y por eso la respuesta correcta para la mayoría de la gente es ambas.
Parte 3 — Cuánto cuesta ahora un MacBook de 128 GB
Solo un chip te lleva a 128 GB. En la generación M5, esa cantidad de memoria unificada solo viene con el M5 Max con la GPU de 40 núcleos, que tiene 614 GB/s de ancho de banda de memoria. El M5 Max con GPU de 32 núcleos está fijado en 36 GB y 460 GB/s, y el M5 Pro llega como máximo a 64 GB y 307 GB/s.
| Configuración | Precio en EE. UU. | Alemania |
|---|---|---|
| 16″ M5 Max (CPU de 18 núcleos, GPU de 40 núcleos), 48 GB, 2 TB | $4,999 | €5,699 |
| Ampliación a 128 GB | +2.000 $ (eran +1.000 $ hasta el 25 de junio) | unos +2.500 € (eran +1.250 € en el lanzamiento), estimado |
| 16″ con M5 Max, 128 GB, 2 TB | $6,999 | unos 8.199 € (estimado; 6.249 € en el lanzamiento) |
| Al máximo: 128 GB, 8 TB, pantalla nano-texturizada | $10,149 | — |
| Para comparar: Mac Studio, M5 Max, 128 GB | $4,799 | — |
Los precios en EE. UU. no incluyen impuesto de ventas; los de Alemania incluyen el 19% de IVA. El aumento alemán a 128 GB es una estimación mía: Apple cobraba 1.250 € por él en el lanzamiento, y el aumento en dólares se duplicó en junio. Consulta el configurador de Apple antes de comprar.
Tres cosas destacan.
La memoria es ahora la parte cara. Apple subió los precios de toda la gama Mac el 25 de junio y culpó a los costes de memoria y almacenamiento. Dijo a Reuters que “nunca había visto una subida de precio de un componente tan grande y tan rápida”. Las ampliaciones de 64 GB y 128 GB del M5 Max se duplicaron. El componente que más necesita la IA local es el que se ha vuelto el doble de caro.
La prima del portátil es de 2.200 $. El mismo M5 Max con los mismos 128 GB en un Mac Studio costaba 4.799 $ cuando Forbes lo valoró en agosto. Si quieres la memoria para IA, el formato portátil cuesta un 46% más.
El de 14 pulgadas es un compromiso. También puedes pedir el de 14 pulgadas con 128 GB, pero en el análisis de Notebookcheck su chasis tenía problemas para refrigerar el M5 Max bajo carga sostenida. Más sobre eso en la parte 8.
Nuevos Mac esta semana. El 27 de octubre Apple anunció un MacBook Pro de 14 pulgadas con el M6 de base: hasta 32 GB y 170 GB/s, desde 1.999 $. Es un buen portátil, no una máquina para LLM. Y esta noche (28 de octubre, 10:00 del Pacífico, 18:00 en Alemania) Apple celebra su evento “Pro and Tell”, donde se espera ampliamente un MacBook Pro con pantalla táctil OLED según los informes. Se dice que usa los mismos chips M5 Pro y M5 Max, lo que dejaría sin cambios el techo de 128 GB y los 614 GB/s.
Parte 4 — La brecha de calidad, medida
¿Cómo comparas un modelo en tu escritorio con uno en un centro de datos? No con sensaciones, ni con la tabla de benchmarks del propio fabricante. Artificial Analysis (AA) ejecuta la misma batería de pruebas en cientos de modelos, con el mismo harness, y condensa los resultados en un único Intelligence Index. Ningún índice es perfecto, pero el de AA es independiente, y es lo más parecido que tiene la industria a una vara de medir común.
El 27 de octubre, AA publicó la versión 5. El cambio principal: alrededor del 60% del índice se ejecuta ahora sobre conjuntos de pruebas privados o respuestas reservadas, así que un modelo no puede haber visto las preguntas durante el entrenamiento. El trabajo de conocimiento, la programación, la ciencia y el conocimiento general cuentan un cuarto cada uno.
La nueva clasificación
| Modelo | ¿Puedes descargarlo? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (máx) | No | 58 |
| GPT-6 Astra (máx) | No | 57 |
| GPT-6.1 Sol (máx) | No | 55 |
| Gemini 4 Argon (alto) | No | 50 |
| Kimi K3.1 Pro | Aún no; pesos sin publicar | 46 |
| Claude Haiku 5.5 (máx) | No | 36 |
| DeepSeek V4.1 Flash 1017 (máx) | Sí, licencia MIT | 32 |
| GLM-5.3 (máx) | Sí | 32 |
Fuente: Artificial Analysis, anuncio del Intelligence Index v5, 27 de octubre de 2026.
Hay tres cosas en esa tabla que importan si estás calculando el precio de un MacBook.
- Los cinco primeros puestos son todos de Anthropic y OpenAI, y ninguno de esos modelos se puede descargar a ningún precio.
- El mejor modelo abierto, Kimi K3.1 Pro, aún no ha publicado sus pesos. Entre los modelos que sí puedes descargar, la mejor puntuación es 32, lo que los deja 26 puntos por detrás del líder. En la versión anterior, la brecha entre el mejor modelo abierto y el mejor cerrado era de 3 puntos. Ahora es de 12, o de 26 si solo cuentas los pesos que puedes descargar.
- Claude Haiku 5.5 supera a cualquier modelo abierto descargable. Ese es el nivel pequeño, rápido y barato de Anthropic, no su buque insignia.
Programación, en concreto
El nuevo índice incluye FrontierCode 2.0, 132 tareas privadas de programación de Cognition. Claude Opus 5.5 resolvió el 46%; DeepSeek V4.1 Flash 1017, el más fuerte junto con otros entre los modelos descargables, resolvió el 28%. En Terminal-Bench-Science, 70 tareas de ciencia con agentes, saca un 59% frente a un 13%.
Para ser justos con los modelos abiertos: Kimi K3.1 Pro lidera Terminal-Bench 4.0 con un 67%, por delante de todos los modelos cerrados. Los modelos abiertos pueden ganar benchmarks concretos, y lo hacen. Pero ese aún no se puede descargar, y su predecesor, Kimi K3, tiene 2,8 billones de parámetros. No lo vas a ejecutar en un portátil.
Por qué la brecha acaba de crecer
El salto de v4.3 a v5 no trató a todos por igual.
| Modelo | Tipo | v4.3 | v5 | Cambio |
|---|---|---|---|---|
| Claude Opus 5.5 | Cerrado | 58 | 58 | 0 |
| GPT-6 Astra | Cerrado | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Cerrado | 56 | 54 | −2 |
| Gemini 4 Argon | Cerrado | 53 | 50 | −3 |
| Kimi K3.1 Pro | Abierto (sin publicar) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Recargar | 45 | 32 | −13 |
| Muse Spark Open, de Meta | Recargar | 39 | 25 | −14 |
| MiMo-V2.6-Pro, de Xiaomi | Recargar | 46 | 30 | −16 |
cifras de v4.3 y v5 según las publicó Trending Topics el 28 de octubre, y las puntuaciones de v5 coinciden con el anuncio de AA.
De media, esos cuatro modelos abiertos perdieron 13 puntos. Los cuatro cerrados se movieron un cuarto de punto.
AA no ha dicho por qué. La lectura obvia es que, cuando las preguntas de la prueba son secretas, un modelo no puede haberlas visto, y que los benchmarks públicos favorecen a los modelos entrenados a fondo con datos públicos. La réplica también es justa: las pruebas privadas no se pueden verificar desde fuera, y cómo ponderas las categorías mueve la clasificación. No te tomes ningún índice como el evangelio. Pero cuando cuatro modelos abiertos caen dos dígitos y cuatro cerrados no, es una señal que merece tomarse en serio: las tablas de benchmarks publicadas, y sobre todo las de los propios fabricantes, exageran lo cerca que están los modelos abiertos.
Y los modelos que sí caben en un MacBook
Los modelos que AA volvió a puntuar para su anuncio son en su mayoría demasiado grandes para un portátil. Para los que caben, las páginas de modelos de AA siguen mostrando Intelligence Index v4.3.2 puntuaciones, y en esa versión Opus 5.5 también saca 58. Así que aquí está la comparación en una escala consistente:
| Modelo | ¿Cabe en un MacBook de 128 GB? | v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (máx) | No, solo en la nube | 58 |
| Qwen3.8 27B (xhigh) | Sí, a 4 bits incluso en un Mac de 32 GB | 34 |
| Qwen3.5 122B A10B (razonamiento) | Sí, unos 70 GB a 4 bits | 16 |
| gpt-oss-120b (alto) | Sí, unos 64 GB | 12 |
Fuente: páginas de modelos de Artificial Analysis, consultadas el 28 de octubre de 2026.
AA sitúa a Qwen3.8 27B en primer lugar de 141 modelos comparables. Es realmente excelente para su tamaño, y un modelo abierto publicado bajo Apache 2.0. Aun así está 24 puntos por detrás.
Mostrar imagen Dos versiones del índice, dos paneles separados, nunca un solo eje. Arriba: Artificial Analysis Intelligence Index v5 (27 de octubre de 2026). Abajo: modelos que caben en un MacBook de 128 GB, en v4.3.2, la versión en la que se publican sus puntuaciones.
La paradoja de los 128 GB
Mira otra vez esa última tabla. El mejor modelo para un MacBook de 128 GB cabe en 32 GB. Los modelos que sí necesitan la memoria extra, mezclas de expertos de 120.000 millones de parámetros, sacan menos, sobre todo porque son más viejos: gpt-oss-120b salió en agosto de 2025, y Qwen3.5 122B ya se estaba midiendo en el M5 Max en marzo, meses antes de que llegara Qwen3.8 27B.
Entonces, ¿qué te compra hoy la ampliación de 48 GB a 128 GB por 2.000 $? Espacio: contextos más largos, precisión de 8 bits en vez de 4, varios modelos cargados a la vez y la opción de ejecutar un modelo potente de la clase 100.000 millones si aparece alguno. Son ventajas reales. Un modelo más listo no es una de ellas, al menos no en la clasificación de hoy. Consulta AA antes de comprar; este es el tipo de dato que cambia con un solo lanzamiento.
Cómo se siente un 34 frente a un 58 en la práctica
Los puntos del índice no son “porcentaje de inteligencia”, y no se reparten por igual entre tareas.
Para trabajos cortos y bien definidos, como reescribir un correo, resumir un documento que pegas o sacar campos de una factura, un buen modelo de 27B a menudo es indistinguible de uno de frontera. La brecha se abre en el trabajo largo y de varios pasos: un agente que tiene que leer una base de código, planificar, editar cinco archivos, ejecutar las pruebas y recuperarse de sus propios errores; una investigación que tiene que conciliar fuentes; un razonamiento en el que un paso en falso contamina el resto. Ese es justo el trabajo por el que la gente paga planes de 200 $.
La columna de Forbes de agosto puso un ejemplo concreto del propio artículo de investigación de Qwen: Qwen3-Coder-Next ejecutándose en Claude Code sacaba 30.9% en Terminal-Bench 2.0, frente a 53.9% de Claude Opus 4.5 en el mismo artículo. Son los modelos del año pasado, pero la forma no ha cambiado: en tareas con agentes, la configuración local fallaba mucho más a menudo.
Parte 5 — Por qué los modelos que quieres de verdad no caben
El tamaño de un modelo en memoria es fácil de calcular:
texto
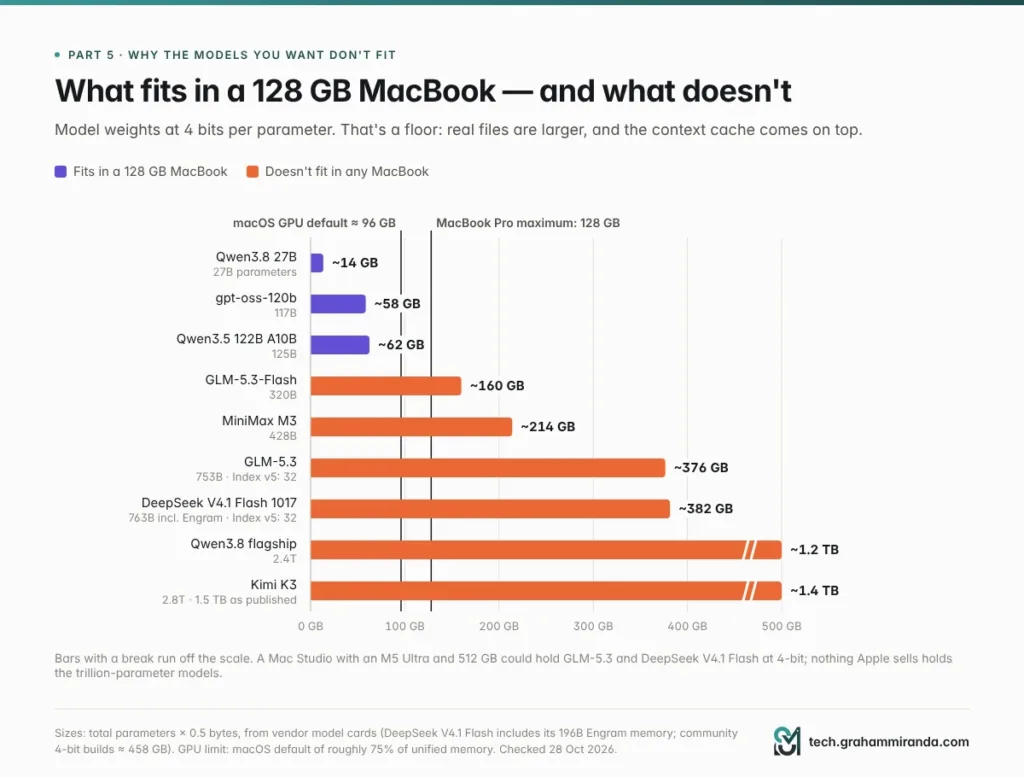
pesos (GB) ≈ parámetros (miles de millones) × bytes por parámetro 8 bits → × 1,0 4 bits → × 0,5 2 bits → × 0,25Después suma la caché KV, la memoria de trabajo del modelo para tu conversación, que crece con la longitud del contexto. Y recuerda que macOS no le entrega toda tu memoria unificada a la GPU: por defecto deja que la GPU fije más o menos 75% en los Macs con mucha memoria, unos 96 GB de una máquina de 128 GB. Puedes subir el límite con sudo sysctl iogpu.wired_limit_mb=…, bajo tu responsabilidad; todo lo que le des al modelo no lo tendrán tu navegador, tu editor y el sistema operativo.
Esto es lo que significa para los modelos de los que la gente habla de verdad:
| Modelo | Parámetros totales | Pesos a 4 bits (mínimo) | ¿Cabe en un MacBook de 128 GB? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ Sin problema |
| gpt-oss-120b | 117B | ~58 GB (archivo de 64 GB) | ✅ Sí |
| Qwen3.5 122B A10B (MoE) | 125B | ~62 GB (archivo de 69,6 GB) | ✅ Sí |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ No |
| MiniMax M3 | 428B | ~214 GB | ❌ No |
| GLM-5.3 | 753B | ~376 GB | ❌ No |
| DeepSeek V4.1 Flash 1017 | 763B, incluida la memoria Engram | ~382 GB (estimaciones de compilaciones 4 bits de la comunidad en ~458 GB) | ❌ No |
| Qwen3.8 insignia | 2,4 T | ~1,2 TB | ❌ No |
| Kimi K3 | 2,8 T | ~1,5 TB según lo publicado (MXFP4 nativo) | ❌ No |
La columna de 4 bits es parámetros × 0,5 bytes: solo pesos, antes de la caché KV y del sobrecargo del archivo, así que los archivos reales son más grandes. Los tamaños de archivo son de las pruebas de Hardware Corner con el M5 Max.
Los modelos que sacan 32 en el nuevo índice, los mejores que puedes descargar, necesitan de tres a cuatro veces lo que tiene un MacBook. Y los que están en medio tampoco entran. Si le dieras 100 de tus 128 GB a los pesos del modelo, esto es cuántos bits por peso te podrías permitir:
| Modelo | Bits por peso con un presupuesto de 100 GB |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Por debajo de unos tres bits, la calidad se desploma (la parte 6 tiene la investigación). Un bit por peso no es cuantización. Es amputación.
El contexto también cuesta memoria. En las pruebas de Hardware Corner, Qwen3-Coder-Next a 8 bits usaba 87,1 GB con un contexto de 4K y 92,6 GB con 64K: cinco gigabytes y medio extra solo para mantener una conversación más larga. Los agentes que leen repositorios enteros necesitan contextos largos, así que ese margen desaparece rápido.
¿Y un Mac Studio de 512 GB? Un Mac Studio con M5 Ultra y 512 GB podría alojar GLM-5.3 o DeepSeek V4.1 Flash a 4 bits. Apple dijo que esa configuración llegaría a finales de octubre; MacRumors espera que cueste muy por encima de 10.000 $, y Apple no había publicado un precio cuando lo comprobé. Estarías pagando cinco cifras por ejecutar modelos que sacan 32 en el nuevo índice, probablemente más despacio de lo que los sirven sus creadores. Mi Kimi K3 frente a Fable 5.1 frente a GLM-5.3 comparativa profundiza en lo que realmente hace falta para autoalojar los grandes modelos abiertos.
Mostrar imagen Solo los pesos, a 4 bits por parámetro; la caché de contexto va aparte. Todo lo que queda a la derecha de la línea de 128 GB necesita un Mac Studio o un servidor.
Parte 6 — La cuantización: el impuesto de calidad que pagas por que quepa
La cuantización guarda los pesos de un modelo en menos bits, 8 o 4 en vez de los 16 con los que se entrenó, así que ocupa menos memoria y corre más rápido. Todo modelo local que ejecutes en un Mac está cuantizado. La pregunta es cuánto cuesta, y la investigación da una respuesta clara y algo incómoda.
La buena noticia: 8 bits casi no cuestan nada y 4 bits van bien en general
- Uno de los mayores estudios hasta la fecha, de Eldar Kurtic y sus colegas, llevó a cabo más de 500.000 evaluaciones con modelos Llama 3.1 cuantizados. FP8 era prácticamente sin pérdidas en todos los tamaños; INT8 costaba un 1–3% con un ajuste cuidadoso; y la cuantización de 4 bits solo de pesos era “más competitiva de lo esperado”, cerca de 8 bits.
- En los modelos de razonamiento, un estudio de 2025 de Ruikang Liu y sus colegas encontró que los pesos y activaciones de 8 bits, o los pesos de 4 bits con activaciones de 16 bits, pueden no perder nada en benchmarks de matemáticas, ciencia y programación. Los anchos de bits menores traían lo que los autores llaman riesgos significativos de precisión, y la dificultad de la tarea afectaba mucho a cuánto se perdía.
Si solo haces preguntas cortas en inglés, un modelo de 4 bits se sentirá cercano al original.
La mala noticia: entradas largas, otros idiomas y todo lo que baje de 4 bits
- Contexto largo. Anmol Mekala y sus colegas probaron cinco métodos de cuantización en 9.700 ejemplos con entradas de 64.000 tokens o más (EMNLP 2025). 8 bits costaban alrededor de 0.8% de media. 4 bits costaban hasta un 59%, y el daño dependía mucho del modelo: con un método de 4 bits, Llama 3.1 70B caía un 32% en una tarea en la que Qwen 2.5 72B aguantaba.
- Idiomas distintos del inglés. El mismo estudio encontró que la degradación tendía a ser peor cuando la entrada no estaba en inglés. Si trabajas en alemán, prueba en alemán.
- Por debajo de 4 bits, el razonamiento se derrumba. Investigadores de Meta FAIR publicaron un estudio en junio de 2026 que muestra que los modelos de razonamiento cuantizados piensan demasiado. Con AWQ de 3 bits, la puntuación de un modelo de razonamiento de 1,5B en el benchmark MATH-500 cayó del 85,6% al 47,0%, y su cadena de pensamiento pasó de 5.200 a 23.400 tokens, 4,5 veces más larga. En un portátil que escribe a 20–80 tokens por segundo, un modelo que piensa cuatro veces más también es aproximadamente cuatro veces más lento.
Mostrar imagen Lo que la investigación dice que cuesta cada escalón de precisión. El apretón que metería un modelo más grande en 128 GB es justo el que más duele.
Qué significa eso para un MacBook de 128 GB
La cuantización que te puedes permitir para un modelo que querrías es la cuantización que más duele. Un modelo de 27B puede correr a 8 bits en un Mac con espacio de sobra, y debería. Los modelos de la clase 120B corren a 4 bits, lo que va bien para chat y es arriesgado con documentos largos. Y la única forma de meter algo de la clase 300B+ en un portátil son dos o tres bits por peso, donde los estudios anteriores dicen que el razonamiento se desmorona.
Mis reglas prácticas:
- Usa 8 bits para todo aquello de lo que vayas a fiarte, sobre todo documentos largos y trabajo con agentes.
- 4 bits van bien para chat, redacción y tareas cortas. Comprueba su comportamiento con contexto largo en tus propios documentos.
- No ejecutes modelos de razonamiento o programación por debajo de 4 bits salvo que estés experimentando.
- Prueba en el idioma en el que trabajas.
Parte 7 — Velocidad: rápido al escribir, lento al leer
Un LLM hace dos trabajos distintos a dos velocidades distintas. Prefill lee tu prompt, todo lo que has pegado más la conversación hasta ahora, y está limitado por la potencia de cálculo bruta. Generación escribe la respuesta token a token, y está limitada por el ancho de banda de memoria. Los propios investigadores de aprendizaje automático de Apple midieron ambas cosas en el M5: sus nuevos Neural Accelerators de GPU hicieron que el tiempo hasta el primer token fuera 3,3 a 4,1 veces más rápido que en el M4, mientras que la generación solo mejoró 1,19 a 1,27 veces, más o menos en línea con el ancho de banda extra.
Entonces, ¿qué hace de verdad un M5 Max con 128 GB? Hardware Corner publicó pruebas hechas con el framework MLX de Apple en un M5 Max de 14 pulgadas con 128 GB:
| Modelo | Contexto | Lectura (prefill), tok/s | Tiempo para leer todo el prompt | Escritura, tok/s |
|---|---|---|---|---|
| gpt-oss-120b (64 GB, MXFP4) | 4K | 1,325 | 3,1 s | 87.9 |
| 32K | 2,537 | 12,9 s | 64.5 | |
| Qwen3.5 122B A10B (4 bits) | 4K | 881 | 4,6 s | 65.9 |
| 32K | 1,068 | 30,7 s | 54.9 | |
| Qwen3.5 27B (denso, 6 bits) | 4K | 811 | 5,1 s | 23.6 |
| 32K | 591 | 55,4 s | 14.9 | |
| Qwen3-Coder-Next (8 bits) | 64K | 1,432 | 45,8 s | 48.2 |
Medido por el usuario de Reddit cryingneko y publicado por Hardware Corner. “Tiempo para leer todo el prompt” es la longitud del contexto dividida por la velocidad de prefill medida.
La velocidad de escritura ya está bien, al menos en modelos MoE
Los modelos de mezcla de expertos solo usan una fracción de sus pesos para cada token, así que escriben rápido: 55 a 88 tokens por segundo en el M5 Max. Para comparar, Artificial Analysis mide Claude Opus 5.5 en 98 tokens por segundo en la API de Anthropic. Para charlar con un modelo de la clase 120B, el M5 Max es realmente agradable. Los modelos densos son otra historia: un modelo de 27B que usa todos sus pesos para cada token escribe a 15–24 tokens por segundo.
También se acumulan dos efectos menores. La escritura se ralentiza a medida que crece la conversación: entre un 17% y un 37% más lenta a 32K que a 4K en esos tres modelos. Y los modelos de razonamiento se pasan cientos o miles de tokens pensando antes de responder.
Donde se espera es al leer
Mira otra vez la columna del tiempo de lectura. Un prompt de 32.000 tokens (unos cuantos archivos fuente, un contrato largo, un hilo de correo enorme) tarda de 13 a 55 segundos en leerse antes de que aparezca la primera palabra de la respuesta.
Eso importa sobre todo en justo el tipo de trabajo por el que se compra un plan de 200 $. Los agentes de programación con IA envían al modelo un prompt de sistema grande, las definiciones de cada herramienta, los archivos que han abierto y la conversación hasta ahora, y lo hacen en cada paso. Los servidores locales pueden reutilizar la parte del prompt que no ha cambiado, lo que ayuda mucho. Pero cada vez que cambia algo al principio del contexto, por ejemplo cuando el agente compacta su historial o cambias a una tarea nueva, todo lo que va después de ese punto hay que releerlo. Forbes citó a un desarrollador que esperó unos 90 segundos hasta el primer token en un M3 Ultra de 512 GB con un prompt de sistema de 16.000 tokens, y a otro que vio unos 20 segundos en frío en un portátil M4 Pro de 48 GB. Los chips de la generación M5 son mucho más rápidos en esto que los Mac antiguos, según las propias mediciones de Apple, pero la forma del problema es la misma.
Para ponerlo en perspectiva, las mismas pruebas de Hardware Corner se hicieron en una tarjeta de estación de trabajo Nvidia RTX Pro 6000, que cuesta unos 8.800 $ ella sola: leyó prompts 2 a 2,4 veces más rápido y escribió 1,7 a 2,8 veces más rápido que el M5 Max.
Mostrar imagen Medido con MLX en un M5 Max con 128 GB. Escribir es lo bastante rápido; leer prompts largos, que es lo que hacen los agentes constantemente, es donde se espera.
Parte 8 — El problema del portátil
Aunque los modelos fueran lo bastante buenos, un portátil es un sitio incómodo para ejecutarlos.
Calor. Ejecutar un modelo grande es carga sostenida: minutos u horas de la GPU y la memoria a pleno rendimiento, no un pico de diez segundos. El análisis de Notebookcheck del M5 Max de 14 pulgadas concluyó que su chasis y su refrigeración “sencillamente no pueden con el M5 Max”: el rendimiento en una prueba de estrés de CPU de 30 minutos cayó un 24%, y los ventiladores llegaron a 53,2 dB(A) en modo de alta potencia. Esa review medía cargas de CPU y gráficos, no LLM, y la propia Notebookcheck sugiere que el M5 Max pertenece al de 16 pulgadas. Si compras un MacBook para IA local, compra el de 16 pulgadas. Mi guía del MacBook Pro M5 Pro de 64 GB llegó a la misma conclusión sobre el trabajo sostenido en el chasis más pequeño.
También es tu ordenador de cada día. Carga un modelo de 70 GB más su contexto y aún te queda sitio para un navegador y un editor. Si te acercas a los aproximadamente 96 GB que la GPU recibe por defecto, o subes el límite para meter algo más grande, el resto de tu trabajo empieza a competir con el modelo por la memoria. Cada modelo que mantienes cargado es memoria que tus otras apps no tienen.
A las baterías no les gusta. La carga sostenida de la GPU agota rápido la batería de un portátil, así que las sesiones largas de inferencia local acaban con el cable enchufado, lo que más bien socava el argumento de “IA en cualquier sitio, sin conexión”.
Tu techo lo compras el primer día. La memoria unificada no se puede ampliar después de la compra. Si el mejor modelo abierto del año que viene necesita 160 GB, un MacBook de 128 GB simplemente no puede ejecutarlo.
Y se deprecia rápido. El especialista británico en equipos reacondicionados MacFinder analizó seis años de sus propios datos de compra y descubrió que la mayoría de los MacBook pierden alrededor de la mitad de su valor el primer año, y que los modelos de gama alta a menudo caen más: un MacBook Pro M4 de 16 pulgadas perdió hasta un 60% en un año. Una máquina de 6.999 $ es una apuesta de 6.999 $ a que el techo de memoria de hoy seguirá sirviendo dentro de tres años.
Un sobremesa es mejor caja para LLM. Si la IA local es el objetivo, un Mac Studio con el mismo M5 Max y 128 GB cuesta 2.200 $ menos, no tiene batería que cocer ni tapa que cerrar, y puede funcionar sin parar como servidor privado para tu portátil y tu móvil. Combínalo con el portátil que ya te guste.
Parte 9 — La brecha de software: lo que tendrías que reconstruir
Una suscripción es un modelo más un producto. Una configuración local te da el modelo y te deja el producto a ti.
| Qué hace la suscripción por ti | Qué harías en local |
|---|---|
| Aloja y actualiza el modelo | Descargar, convertir y actualizar los modelos tú mismo (LM Studio, Ollama o MLX) |
| Búsqueda web e investigación profunda | Montar una API de búsqueda o una búsqueda autoalojada, más un agente que la maneje |
| Lee PDF, hojas de cálculo e imágenes | Elegir modelos con visión y añadir análisis de documentos |
| Voz, memoria, generación de imágenes | Modelos y apps distintos para cada cosa (Whisper para voz, Draw Things o ComfyUI para imágenes) |
| Apps en todos tus dispositivos, sincronizadas | Ejecutar un servidor y un front-end, y exponerlo a tu móvil con seguridad |
| Claude Code o Codex, ajustados a sus propios modelos | Apunta un harness abierto, o el propio Claude Code, a un servidor local |
| Plantillas de chat, formatos de llamada a herramientas y seguridad resueltos | Depurarlos cuando aparece un modelo nuevo con una plantilla que tus herramientas no entienden |
Las herramientas son realmente buenas ahora. LM Studio es el comienzo más fácil en un Mac, Ollama te da una sola API para modelos locales y en la nube, y MLX de Apple suele ser lo más rápido. Ollama incluso expone una API compatible con Anthropic, así que puedes apuntar Claude Code a un modelo local definiendo ANTHROPIC_BASE_URL=http://localhost:11434. Su documentación es sincera sobre las carencias: los controles de caché de prompts, el recuento de tokens, los lotes y la entrada de PDF de Anthropic no son compatibles. Y Claude Code está ajustado para los modelos de Claude; un modelo local tiene que lidiar con el largo prompt de sistema y las definiciones de herramientas de Claude Code, que es donde más duelen los tiempos de prefill de la parte 7.
Nada de esto es imposible. Mi OpenCode v2 vs Hermes Agent vs OpenClaw artículo cubre agentes abiertos que funcionan con modelos locales. Pero es trabajo de verdad, y tus horas no son gratis. Calcula un fin de semana para montarlo y unas horas al mes para mantenerlo al día.
Parte 10 — Las cuentas del punto de equilibrio, bien hechas
Este es el cálculo que el argumento suele saltarse.
Paso 1: la versión ingenua
6.999 $ ÷ 200 $ al mes = 35 meses. No doce. Casi tres años, y esa es la versión más favorable.
Paso 2: añade la electricidad
Forbes estimó unos 10 $ al mes por un Mac ejecutando IA ocho horas al día a las tarifas medias de EE. UU. En Alemania, con la media de octubre de 29,68 céntimos por kWh, un portátil que consume de media 60–150 W durante ocho horas al día cuesta unos 4–11 € al mes. Poco, pero empuja el punto de equilibrio hasta unos 37 meses.
Paso 3: mantén un plan barato para lo difícil
Lo harás. Pocas personas que han usado un modelo de frontera para programar con agentes o para investigación seria vuelven a un modelo de 34 puntos para todo. Mantén un plan de 20 $ para el 10% difícil y el Mac te ahorra 170 $ al mes, no 200: unos 41 meses.
Paso 4: compara con aquello a lo que te bajarías de verdad
Si te preocupa lo suficiente la factura como para plantearte un portátil de 7.000 $, te preocupa lo suficiente como para bajar a un nivel de 100 $. Frente a 100 $ al mes, el punto de equilibrio está en unos 78 meses, más de seis años y medio, más de lo que mucha gente conserva un portátil.
| Escenario | Pago inicial | Sigues pagando | Ahorro mensual | Punto de equilibrio |
|---|---|---|---|---|
| MacBook frente a plan de 200 $, sin electricidad | $6,999 | — | $200 | 35 meses |
| MacBook frente a plan de 200 $, con electricidad | $6,999 | $10 | $190 | 37 meses |
| … y mantienes un plan de 20 $ | $6,999 | $30 | $170 | 41 meses |
| MacBook frente a plan de 100 $ | $6,999 | $10 | $90 | 78 meses |
| Mac Studio (128 GB) frente a plan de 200 $ | $4,799 | $10 | $190 | 25 meses |
| Mac Studio frente a plan de 200 $, manteniendo un plan de 20 $ | $4,799 | $30 | $170 | 28 meses |
Todos estos cálculos suponen que el Mac hace el trabajo de la suscripción por completo. Las partes 4 a 9 explican por qué no.
Mostrar imagen Coste acumulado en cuatro años, suponiendo que el Mac sustituye la suscripción por completo, cosa que no hace. Electricidad a unos 10 $ al mes.
Paso 5: tres años, con reventa
El hardware tiene valor de reventa, y ese es el argumento más fuerte para comprar. Supón que lo vendes a los tres años por el 35% del precio de compra. Es mi suposición, no una cita, informada por los datos de MacFinder que muestran que se pierde alrededor de la mitad del valor el primer año y que las pérdidas son más lentas después.
| Opción | Coste a 36 meses |
|---|---|
| Plan de 200 $ | $7,200 |
| MacBook (128 GB) + electricidad, vendido por el 35% | $4,909 |
| … más un plan de 20 $ para el trabajo de frontera | $5,629 |
| Mac Studio (128 GB) + electricidad + plan de 20 $, vendido por el 35% | $4,199 |
| Plan de 100 $ | $3,600 |
| Plan de 20 $ | $720 |
Así que sí: en tres años, un MacBook más un plan de 20 $ puede salir unos 1.600 $ más barato que un plan de 200 $, si lo vendes a buen precio. Pero mira lo que compra ese dinero. Por un lado, los mejores modelos del mundo con todas las herramientas a su alrededor. Por el otro, un modelo de 34 puntos, unos miles de dólares de depreciación y un plan barato para cuando necesites lo de verdad. El plan de 100 $ supera a cualquier opción de hardware en coste, y el plan de 20 $ supera a todo.
No ahorras mucho dinero con un MacBook para LLM locales. Te gastas una cantidad parecida en un producto distinto: privacidad, control y libertad frente a los límites, con menos inteligencia a cuestas.
La visión del coste marginal
Hay un planteamiento en el que comprar tiene más sentido: necesitas un MacBook nuevo de todos modos. Entonces el coste específico de la IA es solo la ampliación de memoria de 48 GB a 128 GB, 2.000 $, o diez meses de un plan de 200 $. No es una locura. Pero recuerda la paradoja de los 128 GB de la parte 4: en la clasificación de hoy, esa ampliación compra modelos más grandes, no más listos. Si compras un MacBook de todos modos, 48–64 GB mueven el mejor modelo del tamaño de un Mac a 8 bits y con contexto de sobra.
Qué compran en su lugar 6.999 $
- 35 meses de un plan de 200 $, 70 meses de un plan de 100 $, o 29 años de un plan de 20 $
- Aproximadamente 11.700 millones de tokens de salida de DeepSeek V4.1 Flash a su precio de API fuera de horas punta, un modelo que supera a todo lo que cabe en un MacBook
- Aproximadamente 350 millones de tokens de salida de Claude Opus 5.5 a través de la API de Anthropic, a los 20 $ por millón que indica Artificial Analysis
Parte 11 — El caso justo: cuándo tiene sentido comprar un Mac para IA local
Nada de esto significa que la IA local sea un truco. Escribo sobre ella constantemente en este blog porque es útil. Simplemente es útil por razones distintas de las que dice el argumento. Estas son las buenas.
1. Datos que no pueden salir de tu control
Si manejas archivos de clientes, información sanitaria, estados financieros sin publicar o cualquier cosa cubierta por un deber de confidencialidad, un modelo local significa que nada va a un tercero. Sin contrato de encargado del tratamiento, sin transferencia internacional, sin preguntarte por la configuración de entrenamiento. En Alemania, los profesionales sujetos al § 203 StGB, como abogados, médicos y asesores fiscales, necesitan garantías contractuales antes de que los datos de sus clientes vayan a cualquier proveedor externo, incluidos los de IA. Un modelo local esquiva esa cuestión por completo. Es la razón más fuerte para tener el hardware, y no depende de que el modelo local sea tan listo como Opus. Mi El estado de la IA en 2026 informe repasa con más detalle el coste y el cumplimiento normativo de ejecutar IA sin conexión.
2. Trabajo sin conexión
En un avión, en la sede de un cliente sin red, en una instalación donde la red es justo lo que está prohibido.
3. Sin límites, sin cambios de política, un modelo que nunca cambia
Sin ventanas de cinco horas, sin topes semanales, sin demandas colectivas sobre cómo se comunican. Y un checkpoint local se comporta igual dentro de un año que hoy, lo que importa si has construido un flujo de trabajo en torno a cómo se comporta un modelo.
4. Trabajo masivo, aburrido y bien definido
Clasificar miles de tickets de soporte, sacar campos de facturas, resumir tus propias notas, traducir borradores, etiquetar fotos, generar embeddings para buscar en tus propios documentos, transcribir reuniones con Whisper. Los modelos locales de tamaño medio son excelentes en esto, y ejecutar un millón de ellos no cuesta más que la electricidad.
5. Aprender y construir
Si construyes apps local-first, ajustas modelos pequeños o simplemente quieres entender cómo funciona todo esto, tener el hardware es el mejor profesor que hay. (Si lo tuyo es construir apps con IA, conté todo el proceso en Cómo construir una app desde cero con IA en 2026.)
6. Ya ibas a comprar un Mac de todos modos
Entonces compra memoria suficiente para los modelos que vas a ejecutar de verdad (ver la parte 14), y trata la IA local como un extra, no como un caso de negocio.
Qué funciona bien en local
| Trabajo | Qué ejecutar | Memoria cómoda |
|---|---|---|
| Chat privado, redacción, reescritura | Qwen3.8 27B a 8 bits | 48–64 GB |
| Resúmenes y Q&A sobre tus documentos | Qwen3.8 27B, más un modelo de embeddings | 48–64 GB |
| Extracción y clasificación masivas | Modelos más pequeños (Gemma 4, gpt-oss-20b) | 16–32 GB |
| Voz a texto | Whisper | 8–16 GB |
| Generación de imágenes | Draw Things o ComfyUI con modelos de la clase FLUX | 32 GB o más |
| Un modelo de chat grande y rápido | gpt-oss-120b o Qwen3.5 122B | 128 GB |
Para la generación de vídeo local, los Mac siguen siendo lentos comparados con el hardware de Nvidia o las GPU en la nube; mi guía del M5 Pro de 64 GB tiene los números.
Parte 12 — Formas más baratas de recortar una factura de IA de 200 $
Si lo que realmente quieres es una factura de IA más pequeña, hay rutas más baratas que un portátil de 7.000 $.
1. Baja un nivel. Claude Max 5× y ChatGPT Pro 100 cuestan 100 $, y el AI Ultra de Google ahora empieza en 100 $. Si rara vez llegas a tus límites con un plan de 200 $, esto ahorra 1.200 $ al año sin ninguna pérdida de calidad.
2. Combina dos planes de 20 $. Claude Pro más ChatGPT Plus cuesta 40 $ al mes y te da dos bolsas de límites separadas y dos familias de modelos de frontera entre las que cambiar.
3. Paga por token los modelos abiertos. Los mismos modelos de pesos abiertos que ejecutarías en un Mac, y otros más grandes que nunca cabrán, están disponibles por token en muchos proveedores, a la velocidad de un centro de datos. DeepSeek V4.1 Flash, que supera a todos los modelos que caben en un MacBook, cuesta 0,15 $ por millón de tokens de entrada y 0,60 $ por millón de tokens de salida fuera de horas punta en la propia API de DeepSeek (el doble en horas punta). Qwen3.8 27B aparece en OpenRouter desde unos 0,035 $ por millón de tokens de entrada. Para datos personales o de clientes, usa un proveedor con alojamiento en la UE y un contrato de encargado del tratamiento en vez de la propia API de DeepSeek, que procesa datos en China.
4. Usa un plan de programación de tarifa plana para modelos abiertos. El de Z.ai Plan de codificación GLM empieza en 18 $ al mes e incluye GLM-5.3, el mejor junto con otros entre los modelos descargables en el nuevo índice, además de GLM-5.3-Flash, y funciona en Claude Code, Codex, OpenCode y otras herramientas. Consigue un 10% de descuento en el GLM Coding Plan con mi enlace de afiliado. (Enlace de afiliado — consulta la divulgación al principio.) No es Opus 5.5, y el índice lo dice claramente, pero cuesta menos de una décima parte de un plan de 200 $. Lo comparé con la oferta de MiniMax en GLM-5.3-Flash frente a MiniMax M3.
5. Usa el Mac que ya tienes. Si tu Mac actual tiene entre 16 y 32 GB, los modelos locales pequeños se encargan gratis de una parte sorprendente del trabajo masivo de la parte 11.
6. Enruta según la tarea. La configuración que funciona para la mayoría: un modelo local para el trabajo privado y masivo, un plan barato o un modelo abierto por token para el día a día, y acceso a la frontera para el 10% difícil. Mi comparativa de harness de programación con IA tiene cinco configuraciones resueltas con presupuestos distintos.
Mostrar imagen Coste mensual de cada opción en dólares estadounidenses, antes de IVA. Los costes por token dependen de cuánto uses; precios comprobados el 28 de octubre de 2026.
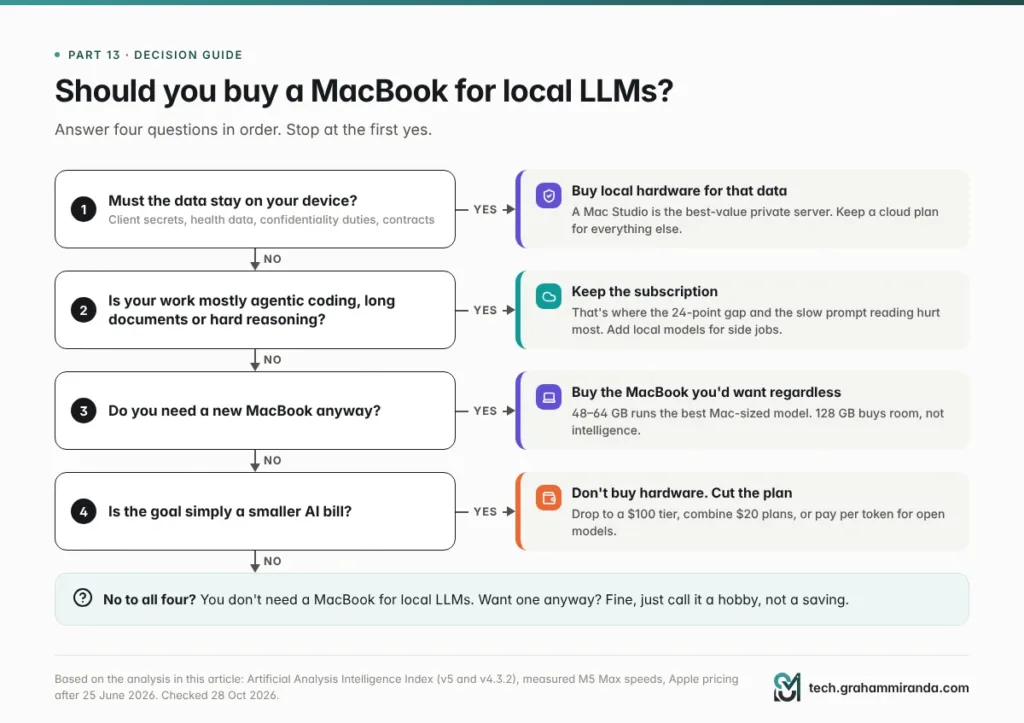
Parte 13 — ¿Deberías comprar un MacBook para LLM locales? Una guía de decisión
Mostrar imagen Empieza por arriba. Casi todos los caminos acaban en “mantén un plan en la nube”, y de eso se trata.
Responde cuatro preguntas en orden.
1. ¿Tienen los datos que quedarse en tu dispositivo? Si sí, por confidencialidad de clientes, datos de salud o un contrato, compra hardware local: ese requisito no entiende de benchmarks. Plantéate un Mac Studio como servidor privado, y mantén un plan en la nube para el trabajo que no implique esos datos.
2. ¿Es tu trabajo sobre todo programación con agentes, documentos largos o razonamiento difícil? Si sí, mantén la suscripción. Es justo donde más duelen la brecha de 24 puntos y los tiempos de prefill. Un modelo local aún puede ayudar con trabajos secundarios.
3. ¿Necesitas un MacBook nuevo de todos modos? Si sí, compra el que querrías de todos modos. 48–64 GB mueven bien el mejor modelo del tamaño de un Mac. Pasa a 128 GB solo si quieres específicamente modelos de la clase 120B o varios modelos cargados a la vez, y sabes que estás pagando 2.000 $ por espacio, no por inteligencia.
4. ¿El objetivo es simplemente una factura más pequeña? Entonces no compres hardware. Baja un nivel, combina planes de 20 $ o paga por token los modelos abiertos (parte 12).
Si has respondido no a las cuatro, no necesitas un MacBook para LLM locales. Puede que aun así quieras uno, y está bien. Llámalo afición, no ahorro.
Parte 14 — Si aun así compras uno: cómo sacarle el máximo partido
Elige la máquina correcta.
- Compra el de 16 pulgadas, no el de 14, si el M5 Max es para trabajo de IA sostenido.
- Plantéate un Mac Studio en su lugar. El mismo chip y la misma memoria por 2.200 $ menos, mejor refrigeración, y puede servir a tu portátil y tu móvil sin descanso.
- No compres memoria de más para los modelos de hoy. 48–64 GB mueven Qwen3.8 27B a 8 bits con contextos largos. Compra 128 GB para modelos de la clase 120B, varios modelos a la vez o margen para futuros lanzamientos, sabiendo lo que cuesta.
- Si vas a comprar esta semana, espera a que termine el evento de esta noche. Sabrás qué ofrece y cuánto cuesta el MacBook Pro OLED antes de decidirte.
Configúralo bien.
- Empieza con LM Studio (MLX en Apple Silicon) para el camino más fácil, o Ollama si quieres una sola API para modelos locales y en la nube.
- Prefiere 8 bits para todo aquello de lo que vayas a fiarte; usa 4 bits para velocidad en el chat.
- Fija la longitud de contexto a propósito. Muchos runtimes usan por defecto contextos pequeños; los agentes necesitan mucho más.
- Sube el límite de memoria de la GPU solo si entiendes el compromiso, y deja sitio para macOS.
- Mantén un plan en la nube de 20 $ para el 10% difícil. Es más barato que tu propio tiempo.
Pruébalo con tu propio trabajo. Coge 20 prompts reales del último mes: correos, documentos, tareas de programación, lo que hagas de verdad. Pásalos por tu modelo local y por tu modelo en la nube, oculta cuál es cuál y ponles nota. Hazlo en el idioma en el que trabajas. Esa hora te dirá más que cualquier clasificación, incluidas las de este artículo.
Preguntas frecuentes
¿Puede un MacBook sustituir una suscripción ChatGPT Pro o Claude Max?
No en calidad. Los modelos que hay detrás de un plan de 200 $, como Claude Opus 5.5 y GPT-6 Astra, no se pueden descargar, y los mejores modelos abiertos que sí se pueden descargar necesitan 375–460 GB de memoria a 4 bits, muy por encima de cualquier MacBook. En el índice de Artificial Analysis, Opus 5.5 saca 58; el modelo más potente que encontré que cabe en un MacBook de 128 GB, Qwen3.8 27B, saca 34 en la misma versión. Un MacBook puede sustituir una suscripción para trabajo privado, sin conexión o masivo, no para tareas de frontera.
¿Cuál es el mejor LLM local para un MacBook Pro de 128 GB en 2026?
En calidad, Qwen3.8 27B: Artificial Analysis lo sitúa primero de 141 modelos comparables, con 34 en el Intelligence Index v4.3.2, y entra sin problemas con 8 bits. En velocidad, gpt-oss-120b y Qwen3.5 122B son modelos de mezcla de expertos que escriben 55–88 tokens por segundo en un M5 Max, pero sacan menos (12 y 16). Consulta Artificial Analysis antes de elegir, porque los modelos abiertos nuevos cambian esta clasificación cada pocas semanas.
¿Cuánto cuesta ahora un MacBook Pro de 128 GB?
Un MacBook Pro de 16 pulgadas con un M5 Max (CPU de 18 núcleos, GPU de 40 núcleos), 128 GB y 2 TB cuesta 6.999 $ en EE. UU., antes de impuestos. Apple subió los precios de los Mac el 25 de junio de 2026 y duplicó la ampliación a 128 GB de 1.000 $ a 2.000 $. En Alemania, la misma configuración costaba 6.249 € en el lanzamiento y, según mi estimación, cuesta unos 8.199 € ahora. Un Mac Studio con el mismo chip y la misma memoria costaba 4.799 $.
¿Cuánto tarda un MacBook en amortizarse frente a una suscripción de IA de 200 $?
Unos 35 meses con 6.999 $, si sustituyera la suscripción por completo y no costara nada de ejecutar. Con unos 10 $ al mes de electricidad son unos 37 meses, y si mantienes un plan de 20 $ para tareas de frontera son unos 41 meses. Frente a un plan de 100 $ son más de seis años. Un Mac Studio con el mismo chip se amortiza antes, en unos 25 a 28 meses.
¿Es el M5 Max lo bastante rápido para LLM locales?
Para escribir respuestas con modelos de mezcla de expertos, sí: medido con MLX, un M5 Max con 128 GB generó 55–88 tokens por segundo, cerca de los 98 de Claude Opus 5.5 en la API de Anthropic. Leer prompts largos es el punto débil. Un prompt de 32.000 tokens tardó 13 segundos con gpt-oss-120b, 31 segundos con Qwen3.5 122B y 55 segundos con un modelo denso de 27B, y los agentes de programación con IA releen prompts largos constantemente.
¿Son los LLM locales tan buenos como ChatGPT o Claude ahora?
No los que caben en un portátil. En el nuevo Intelligence Index v5 de Artificial Analysis, publicado el 27 de octubre de 2026, los mejores modelos abiertos descargables sacaron 32 frente a los 58 de Claude Opus 5.5, y por debajo de Claude Haiku 5.5, con 36. Los modelos lo bastante pequeños para un MacBook sacaron 34 como máximo en la versión anterior del índice, donde Opus 5.5 también sacaba 58. Para tareas cortas y simples la diferencia suele ser pequeña; para programación con agentes, documentos largos y razonamiento difícil, es grande.
¿La cuantización empeora los modelos locales?
Poco a 8 bits, más a 4 bits, mucho por debajo de eso. Un estudio de más de 500.000 evaluaciones encontró que FP8 era prácticamente sin pérdidas y que la cuantización de 4 bits solo de pesos se acercaba a 8 bits en benchmarks estándar. Pero en entradas de 64.000 tokens o más, un estudio de EMNLP 2025 midió caídas de hasta el 59% a 4 bits, peores en texto no inglés, y a 3 bits la nota de matemáticas de un modelo de razonamiento cayó del 85,6% al 47,0%.
¿Puedo ejecutar DeepSeek V4.1 Flash o GLM-5.3 en un MacBook?
No. GLM-5.3 tiene 753.000 millones de parámetros y DeepSeek V4.1 Flash 763.000 millones incluida su memoria Engram, así que incluso a 4 bits necesitan unos 375–460 GB, mucho más que el máximo de 128 GB de cualquier MacBook. Un Mac Studio con M5 Ultra y 512 GB podría alojarlos. La forma práctica de usarlos es a través de una API, idealmente de un proveedor con alojamiento en la UE y un contrato de encargado del tratamiento.
¿Bastan 64 GB para IA local o necesito 128 GB?
Para la mayoría de la gente, 48–64 GB basta. El mejor modelo del tamaño de un Mac en el índice de Artificial Analysis, Qwen3.8 27B, entra con 8 bits y con sitio para contextos largos. 128 GB te permiten ejecutar modelos de la clase 120B como gpt-oss-120b, mantener varios modelos cargados y usar contextos más largos, pero en la clasificación de hoy esos modelos más grandes sacan menos, así que la ampliación de 2.000 $ compra espacio, no inteligencia.
¿Debería comprar un Mac Studio en vez de un MacBook Pro para LLM locales?
Si la IA local es el motivo principal, normalmente sí. Un Mac Studio con el mismo M5 Max y 128 GB costaba 4.799 $, 2.200 $ menos que el MacBook Pro de 16 pulgadas, con mejor refrigeración sostenida y sin batería de la que preocuparse. Puede funcionar sin parar como servidor de modelos privado para tu portátil y tu móvil. Compra un MacBook Pro si necesitas la portabilidad por otras razones.
¿Es mejor para la privacidad y el RGPD ejecutar la IA en local?
Sí, esa es su mayor ventaja. Con un modelo local, los prompts y los documentos nunca salen de tu dispositivo, así que no hay contrato de encargado del tratamiento que firmar ni transferencia internacional de datos. Eso importa para datos de clientes, información sanitaria y profesiones sujetas a confidencialidad, como las cubiertas por el § 203 StGB en Alemania. La ventaja de privacidad se mantiene tanto si el modelo local es tan capaz como uno en la nube como si no. Esto no es asesoramiento jurídico.
¿Puedo usar Claude Code con un modelo local?
Sí. Ollama ofrece una API compatible con Anthropic, así que puedes apuntar Claude Code a un modelo local definiendo ANTHROPIC_BASE_URL como http://localhost:11434. Espera contrapartidas: Ollama no admite los controles de caché de prompts de Anthropic, el largo prompt de sistema y las definiciones de herramientas de Claude Code hacen que el modelo local lea mucho en cada paso, y Claude Code está ajustado para los modelos de Claude. Los harness abiertos como OpenCode suelen encajar mejor con los modelos locales.
¿Cambiará algo de esto el nuevo MacBook Pro con OLED?
Probablemente no mucho para la IA local. El evento “Pro and Tell” de Apple se celebra el 28 de octubre de 2026 a las 10:00 del Pacífico, y se informa de que el MacBook Pro OLED con pantalla táctil que se espera usa los mismos chips M5 Pro y M5 Max, lo que mantendría el techo de 128 GB y 614 GB/s de ancho de banda. El MacBook Pro de 14 pulgadas con M6 anunciado el 27 de octubre llega como máximo a 32 GB.
Conclusión
El argumento de “cancela tu plan de 200 $ y cómprate un Mac” acierta en dos cosas: las suscripciones son caras y la IA local es realmente útil. Falla en lo importante. Un plan de 200 $ te alquila los mejores modelos del mundo, los agentes construidos a su alrededor y un producto que mejora cada mes. Un MacBook de 7.000 $ ejecuta los mejores modelos que caben en 128 GB, y hoy esos sacan 34 frente a los 58 de la frontera, leen los prompts largos despacio y pierden calidad justo en los puntos donde más los apretarías.
Las cuentas tampoco lo salvan. Incluso en el caso más generoso, el MacBook tarda de tres a cuatro años en amortizarse, y en tres años cuesta casi lo mismo que la suscripción, con una diferencia de un par de miles de dólares según por cuánto puedas venderlo. Es una factura parecida por un producto menos capaz.
Así que compra un MacBook para LLM locales si tus datos no pueden salir del edificio, si trabajas sin conexión, si quieres cero límites y un modelo que nunca cambia, o si ya ibas a comprar un Mac de todos modos. Son buenas razones, y mucha gente las tiene. Simplemente no lo compres para cancelar tu suscripción. Mantén un plan en la nube para el 10% difícil, pon el 90% privado y aburrido en tu propio hardware, y deja que las clasificaciones te digan cuándo cambia ese equilibrio.
¿Ejecutas modelos locales para trabajar o has encontrado lo contrario de lo que dice este artículo? Me gustaría saber qué modelo, qué máquina y qué tareas, con números si los tienes. Las correcciones y las pruebas en contra son bienvenidas; este artículo se actualiza cuando se mueven las clasificaciones y los precios, que en 2026 ocurre a menudo.
Datos comprobados: 28 de octubre de 2026.