
 العربية
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 हिन्दी

تتلخص حالة الذكاء الاصطناعي في 2026 في ثلاثة أمور حدثت خلال الأشهر الثمانية الأولى من العام — ولا يكاد أحد يجمعها في جملة واحدة.
تجاوز أحد النماذج نسبة 96% في SWE-bench Verified. ليس 96% في معيار لُعب — بل 96% على قضايا GitHub حقيقية من Django وFlask وscikit-learn، المعيار الذي كان يُفترض أن يستغرق سنوات. لقد انتهى دوره فعليًا كأداة تمييز، والنماذج الثلاثة في قمته تفصلها أقل من نقطة مئوية واحدة.
أفضل الأدلة المتاحة عمّا إذا كانت أدوات البرمجة بالذكاء الاصطناعي تجعل المطورين ذوي الخبرة أسرع تقول حتى الآن: لا. وجدت تجربة METR’s العشوائية المضبوطة تباطؤًا بنسبة 19%. وقد انهارت محاولتهم إعادة التجربة في 2026 لأن المطورين رفضوا العمل دون ذكاء اصطناعي، حتى مقابل 50 دولارًا في الساعة. من يستخدمون هذه الأدوات يعتقدون أنهم أسرع ثلاث مرات. أما بالقياس، فهم ليسوا كذلك.
وشحنت Microsoft نموذج استدلال بـ14 مليار معامل داخل Windows نفسه، وهي جملة كانت ستكون خيالًا علميًا في 2024 وأصبحت الآن حاشية في خطاب Build الرئيسي.
هذه الحقائق الثلاث هي كل حالة الذكاء الاصطناعي في 2026 بصورة مصغّرة. أصبحت النماذج استثنائية. لكن مكسب الإنتاجية المقاس لم يتبع ذلك. والحدود المثيرة للاهتمام انتقلت بهدوء من مركز البيانات إلى الجهاز في يدك.
هذه هي النسخة الطويلة من حالة الذكاء الاصطناعي في 2026. كُتبت لمن يتخذون قرارات مرتبطة بالمال — أي نموذج يوجّهون إليه المهام، وهل يسمحون للوكلاء بكتابة كود الإنتاج، وماذا يشترون، وماذا يقولون لعميل أو لمسؤول حماية بيانات. لقد فصلت ما شُحن فعليًا عمّا يُنقل من تقارير عمّا هو مجرد شائعة، لأن الخطأ الأغلى في هذا المجال هو التخطيط حول نموذج لا وجود له بعد.
آخر تحديث 3 سبتمبر 2026. وسيحتاج إلى تحديث آخر بحلول عيد الميلاد.
باختصار — حالة الذكاء الاصطناعي في 2026 خلال 90 ثانية
الحدود المتقدمة سباق بين أربعة، وAnthropic تتصدره حاليًا على مستوى المؤشر المجمّع. حتى 2 سبتمبر 2026، يسجل مؤشر الذكاء v4.1.1 من Artificial Analysis’s القيم التالية: Claude Fable 5.1 عند 65.7، وClaude Opus 5 عند 63.0، وGrok 4.6 عند 60.9، وGPT-5.6 Sol عند 58.9. لكن المتوسط المجمّع يخفي الجزء المثير: GPT-5.6 Sol يتصدر BrowseComp بنسبة 90.4%، وGemini 3.8 Flash يقدم 58.7 مقابل 0.75 دولار لكل مليون رمز إدخال، والنماذج العشرة الأولى تتباعد 8.2 نقطة فقط — نطاق ضيق بما يكفي لأن تغيّر فروق الهارنس والموجّه ترتيب نموذج عدة مراكز.
الأوزان المفتوحة متأخرة نحو جيل واحد وهي تقلّص الفجوة. GLM-5.3 (753B، مفتوح) عند 59.5 — السادس إجمالًا، متقدمًا على GPT-5.6 Sol. وDeepSeek V4 Pro شُحن بـ1.6 تريليون معامل بموجب ترخيص MIT فعلي. وسجل Ornith-1.5-397B نتيجة 86 في SWE-bench Verified وتجاوز بالكاد Claude Opus 4.8 في Terminal-Bench 2.1، بنتيجة 86.1 مقابل 85.0. فجوة القدرات الآن نحو ستة أشهر. أما فجوة الترخيص فهي المهمة.
“Vibe coding” كسبت حجة التبني وخسرت حجة الأدلة. 90% من المطورين يستخدمون أداة برمجة بالذكاء الاصطناعي واحدة على الأقل في العمل. وسوق وكلاء البرمجة في المؤسسات يعمل بنحو 10 مليارات دولار سنويًا. وثقة المطورين في مخرجات الذكاء الاصطناعي هبطت من 40% إلى 29% في عامين. الأدوات منتشرة عالميًا، ومن يستخدمونها يثقون بها أقل كل عام. وكلا الأمرين منطقي.
فاتورة الأمان وصلت، وهي مفصلة بندًا بندًا. وجدت Veracode أن 45% من عينات الكود المولدة بالذكاء الاصطناعي تُدخل ثغرة من قائمة OWASP Top 10. وقاس Apiiro المطورين المدعومين بالذكاء الاصطناعي وهم ينتجون عمليات commit أسرع بثلاث إلى أربع مرات، وملاحظات أمنية أسرع بعشر مرات. ونحو 20% من الكود المولد بالذكاء الاصطناعي يشير إلى حزم غير موجودة. هذا ليس حجة ضد الأدوات. بل حجة حول مكان إقامة البوابة.
أصبح الذكاء الاصطناعي دون اتصال مفيدًا حقًا هذا العام، على أجهزة يملكها الناس بالفعل. نموذج بـ2 مليار معامل يعمل بسرعة 61 رمزًا في الثانية على iPhone. ووضعت Microsoft نموذج استدلال بـ14B داخل Windows خلف شرط NPU بقدرة 40 TOPS. وتُقيّد Google أفضل نموذج لديها على الجهاز بـ12 GB من الذاكرة العشوائية، وكذلك تفعل Apple. المواصفة التي تحدد ما يمكنك تشغيله دون اتصال هي الذاكرة، لا القدرة الحاسوبية، والذاكرة هي ما أصبح نادرًا.
الخلاصة الصادقة في جملة واحدة عن حالة الذكاء الاصطناعي في 2026: هذا هو العام الذي توقفت فيه النماذج عن كونها عنق الزجاجة. أصبح التحقق هو عنق الزجاجة. كل قرار مهم في هذا المقال — أي نموذج، أي هارنس، أي جهاز، أي بوابة — ينبع من ذلك التغيير الواحد.
مقارنة سريعة: الحدود المتقدمة، سبتمبر 2026
يجمع مؤشر الذكاء v4.1.1 من Artificial Analysis تسعة تقييمات: GDPval-AA v2، وτ³-Banking، وTerminal-Bench v2.1، وSciCode، وHumanity’s Last Exam، وGPQA Diamond، وCritPt، وAA-Omniscience، وAA-LCR. والدرجات أدناه مأخوذة من لقطة 2 سبتمبر 2026.
| الطراز | المختبر | مؤشر AA | الأوزان | الإدخال / الإخراج لكل 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | مغلق | $10.00 / $50.00 |
| Claude Opus 5 | Anthropic | 63.0 | مغلق | $5.00 / $25.00 |
| Claude Fable 5 | Anthropic | 62.1 | مغلق | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | مغلق | — |
| Kimi K3 | Moonshot | 59.7 | أوزان مفتوحة | — |
| GLM-5.3 | Z.ai | 59.5 | أوزان مفتوحة | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | مغلق | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | مغلق | $0.75 / $3.75 | |
| Qwen3.8 Max Preview | Alibaba | 58.1 | مغلق | — |
| GLM-5.3-Flash | Z.ai | 57.5 | أوزان مفتوحة | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropic | 57.3 | مغلق | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | مغلق | — |
| GPT-5.5 | OpenAI | 56.3 | مغلق | — |
اقرأ العمود الرابع قبل الثالث. اثنان من أفضل عشرة نماذج لديهما أوزان قابلة للتنزيل، وأحدهما يكلف 0.15 دولار لكل مليون رمز إدخال.
مقارنة سريعة: حدود الأوزان المفتوحة
| الطراز | الإجمالي / النشط | السياق | الترخيص | تاريخ الإصدار |
|---|---|---|---|---|
| Kimi K3 | 2.8T / 104B | 1M | مرتّب حسب الإيرادات (مخصص) | July 2026 |
| Qwen3.8-2.4T-A95B | 2.4T / 95B | 262K (1M via YaRN) | Apache 2.0 | 14 Aug 2026 |
| DeepSeek V4 Pro | 1.6T / 49B | 1M | MIT | 12 Aug 2026 |
| GLM-5.3 | 753B / ~40B | 1M | مخصص (بوابة 10B دولار) | Aug 2026 |
| MiniMax M3 | 428B / 23B | 1M | مخصص (نسبة الإسناد) | 1 June 2026 |
| Ornith-1.5-397B | 397B MoE | 262K (1M via YaRN) | MIT | Aug 2026 |
| Gemma 4 31B | 31B كثيف | 256K | Apache 2.0 | 6 Apr 2026 |
| Qwen3.8-27B | 27B كثيف | 262K | Apache 2.0 | 14 Aug 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 Apr 2026 |
ثلاثة من تلك التسعة نظيفة حقًا وفق OSI. تلك هي القصة الحقيقية للأوزان المفتوحة في 2026، وسأعود إليها في الجزء الثالث.
الفصل الأول — النماذج
الجزء الأول: ما شُحن فعليًا في 2026
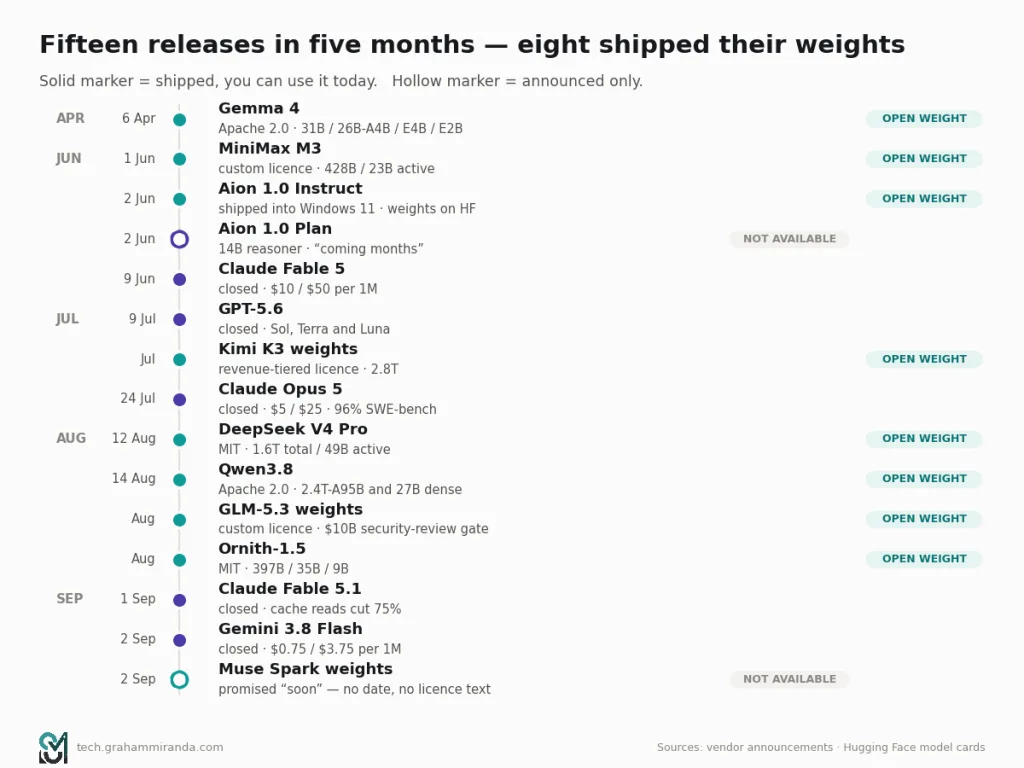
قبل أي جدال، السجل. أفصل هذا في ثلاث طبقات لأن الفرق بينها هو حيث يُهدر المال.
مؤكد ومُشحن
- 6 أبريل 2026 — Google تصدر Gemma 4 بموجب Apache 2.0، وهو تغيير في الترخيص عن الشروط المخصصة لـGemma 3. أربعة إصدارات: 31B كثيف، و26B مع 4B نشطة (MoE)، وE4B عند نحو 8B، وE2B بـ5.1B إجمالًا مع 2.3B نشطة. سياق 256K في النماذج الكبيرة، و128K في سلسلة E. وجميعها تدعم إدخال النص والصورة والفيديو؛ ويضيف E2B وE4B صوتًا أصليًا.
- 1 يونيو 2026 — MiniMax M3. 428B إجمالًا / 23B نشطة، وسياق 1M، وتعدد وسائط أصلي، ومشغّل انتباه متفرق جديد، والأوزان على Hugging Face. وقد غُطي بالتفصيل في مقالي السابق عن عتاد الذكاء الاصطناعي المحلي.
- 2 يونيو 2026 — Microsoft تعلن Aion 1.0 في Build. عائلة من النماذج على الجهاز شُحنت داخل Windows 11 نفسه: Aion 1.0 Instruct (قادر على العمل على CPU، في Edge Canary من 150.0.4070) وAion 1.0 Plan، وهو نموذج استدلال واستدعاء أدوات بـ14 مليار معامل مع نافذة سياق 32K.
- 9 يونيو 2026 — Claude Fable 5. الطبقة العليا من Anthropic’s، بسعر 10/50 دولارًا لكل مليون، وسياق 1M، وأقصى إخراج 128K.
- 9 يوليو 2026 — OpenAI تشحن GPT-5.6 بثلاثة إصدارات: Sol (5/30 دولارًا)، وTerra (2.50/15 دولارًا)، وLuna (1/6 دولارًا). القدرة السيبرانية مدمجة في Sol بدل بيعها كنموذج منفصل، مع وصول معزز عبر برنامج Trusted Access for Cyber التابع لـOpenAI’s.
- يوليو 2026 — Moonshot تفتح أوزان Kimi K3’s. 2.8 تريليون معامل، وسياق 1M، ودعم MXFP4 أصلي، بموجب ترخيص متدرج حسب الإيرادات.
- 24 يوليو 2026 — Claude Opus 5. 5/25 دولارًا، دون تغيير عن Opus 4.8. وتزعم Anthropic أنها “أكثر من ضعف أداء Opus 4.8’s” في Frontier-Bench v0.1 وتحقق ثلاثة أضعاف أفضل نموذج تالٍ في ARC-AGI 3.
- 12 أغسطس 2026 — DeepSeek V4 Pro يخرج من المعاينة بأوزان مرخصة بـMIT: 1.6T إجمالًا (بعض التغطية تقرّبها إلى 1.7T)، و49B نشطة، وسياق 1M، و893 GB من موترات BF16 وFP8، إضافة إلى وحدة فك تشفير استكشافية DSpark. Terminal-Bench 2.1 عند 87.9، وHLE-with-tools عند 60.0، وCyberGym عند 83.3. ورفعت DeepSeek أسعار API في الوقت نفسه.
- 14 أغسطس 2026 — أوزان Qwen3.8 المفتوحة بموجب Apache 2.0: نموذج متعدد الوسائط كثيف بـ27B وعملاق 2.4T-A95B، كلاهما على Hugging Face وModelScope، وسياق أصلي 262K قابل للتمديد إلى 1M باستخدام YaRN.
- أغسطس 2026 — أوزان GLM-5.3 تصل إلى Hugging Face بعد نحو أسبوعين من إطلاق API. 753B MoE، وسياق 1M، وإخراج 128K، وBF16 وFP8.
- أغسطس 2026 — Ornith-1.5. ثلاثة أحجام (397B MoE، و35B MoE مع 3B نشطة، و9B كثيف)، مبنية على Qwen3.5 وGemma 4 مع تدريب مسبق مستمر، ومرخصة بـMIT، وتزعم 86 في SWE-bench Verified.
- 1 سبتمبر 2026 — Claude Fable 5.1 وMythos 5.1. التفكير التكيفي مفعّل افتراضيًا، وسياق 1M، وإخراج 128K. التسعير الأساسي دون تغيير عند 10/50 دولارًا، لكن قراءات الذاكرة المؤقتة تنخفض 75%، من 1.00 إلى 0.25 دولار لكل مليون.
- 2 سبتمبر 2026 — Gemini 3.8 Flash بسعر 0.75/3.75 دولارًا، وسياق إدخال 1M، وإخراج 66K، وحد معرفة مارس 2026، مع إدخال نص وصورة وفيديو وصوت وPDF.
- 2 سبتمبر 2026 — Meta تشحن Muse Spark 1.3 وMuse Code CLI.
مُبلَّغ عنه، موثوق، غير مؤكد
- ستفتح Meta أوزان Muse Spark’s “قريبًا.” هذا Mark Zuckerberg على X، بلا تاريخ ولا عدد معاملات ولا تفاصيل معمارية ولا نص ترخيص. ولم تكشف Meta حجم النموذج في أي إصدار.
- Gemini Nano v4 يوصف بأنه قادم لأندرويد، مع أن Nano v3 مقتصر حاليًا على سلسلة Pixel 10.
- Aion 1.0 Plan متاح “في الأشهر القادمة” للإتاحة العامة؛ وInstruct فقط في المعاينة.
شائعة، مصدر واحد، تعامل معها على هذا الأساس
- كل ما قرأته عن الجيل الرائد القادم من Anthropic أو OpenAI أو Google. في سوق شحنت فيه أربعة مختبرات نموذجًا ضمن أفضل عشرة في نافذة تسعة أسابيع، عمر الشائعات المستقبلية نحو أسبوعين.
أمر آخر يستحق الإشارة، لأنه جديد ولا يكاد أحد خارج مجال الأمان يناقشه. يسجل Claude Mythos 5.1 نتيجة 60.9 في Terminal-Bench 4.0 — أعلى من 55.8 لـFable 5.1’s — و95.5% في SWE-bench Verified. لا يمكنك شراؤه.
تصف Anthropic نموذج Mythos بأنه “أقدر نموذج لديها في الأمن السيبراني وأبحاث الأحياء”، وهو متاح فقط لمدافعي الأمن السيبراني وعلماء الأحياء المدققين عبر برنامجين للوصول الموثوق: Cyber Verification Program وLife Sciences Verification Program. وبصياغة Anthropic’s نفسها، فإنها “قادرة فقط على إتاحته لمجموعة من المنظمات الأمريكية، لكننا نعمل على توسيع الوصول.” وقد بلغ مشروع Project Glasswing، وهو جهد توسيع الوصول، نحو 150 منظمة في أكثر من خمسة عشر بلدًا حتى يونيو 2026.
المنطق هو الاستخدام المزدوج — نموذج بارع في إيجاد الثغرات بارع في إيجادها لأي طرف — وأرى أنه دفاع ممكن. لكن لاحظ النتيجة البنيوية، لأنها جديدة حقًا: النموذج الأعلى تسجيلًا في معيار برمجة عام أصبح الآن نموذجًا لا يستطيع معظم العالم الوصول إليه بأي سعر. تقييد القدرات لأسباب أمان لا لأسباب تجارية سيصبح أكثر شيوعًا لا أقل، وإذا كنت خارج الولايات المتحدة فهو حجة للاهتمام بالأوزان المفتوحة لا علاقة لها بالتكلفة.
عرض الصورة تسعة أشهر، اثنا عشر إصدارًا مهمًا، أربعة منها بأوزان مفتوحة. الأشرطة الممتلئة شُحنت مع أوزان أو وصول API يمكنك شراؤه اليوم؛ والحدود المنقطة معلنة لكن غير متاحة.
الجزء الثاني: ما يفصل فعليًا نماذج الحدود المتقدمة الآن
إليك الحقيقة غير المريحة عن قمة ذلك التصنيف: في معظم العمل الذي ستقوم به فعليًا، النماذج الثمانية الأولى قابلة للتبادل.
لا أقول ذلك للمخالفة. أقوله لأن فارق المؤشر المجمّع بين Claude Fable 5.1 عند 65.7 وGLM-5.3-Flash عند 57.5 هو ثماني نقاط، وGLM-5.3-Flash يكلف 0.15 دولار لكل مليون رمز إدخال مقابل 10.00 دولارات لـFable’s. هذا فارق سعري 67× مقابل فارق قدرات 12% في درجة مركبة، والدرجات المركبة تضغط بالضبط الفروق المهمة لك وتضخم التي لا تهمك.
إذن السؤال المفيد ليس “أي نموذج أفضل.” بل “فيمَ يتفوق كل منها فعليًا، وهل يتقاطع ذلك مع أسبوعي.”
الأمور الأربعة التي تختلف فعليًا
1. الموثوقية الوكيلية على المدى الطويل. هذا هو الفارق الحقيقي في 2026 ويُقاس بشكل سيئ. يُقدَّم Opus 5 من Anthropic’s صراحةً بأنه “تحسن نوعي في طبقة Opus يشغّل وكلاء طويلين الأمد” — لا كنموذج أذكى، بل كنموذج لا يسقط في الساعة السادسة. والدليل على هذا النوع من التحسن يوجد في معايير الوكلاء (Terminal-Bench وOSWorld وFrontier-Bench) لا في معايير المعرفة، وتلك المعايير حديثة وصاخبة وحساسة للهارنس.
2. اقتصاديات الذاكرة المؤقتة. لم يكن التغيير الرئيسي في Fable 5.1’s قفزة في القدرات. كان تقليص قراءات الذاكرة المؤقتة 75%، من 1.00 إلى 0.25 دولار لكل مليون رمز — وهو ما يقدّره MarkTechPost بنحو 25% تكلفة أقل لسير العمل النموذجي وما يصل إلى 45% لسير عمل الوكلاء. لأي وكيل يعيد قراءة موجه نظام كبير أو قاعدة كود في كل دورة، تسعير الذاكرة المؤقتة رافعة أكبر على فاتورتك الشهرية من اختيار النموذج. لا أحد يضع ذلك في تصنيف.
3. التصفح واستخدام الأدوات. يسجل GPT-5.6 Sol نسبة 90.4% في BrowseComp — و92.2% عند إعداد الاستدلال Ultra. تلك قوة محددة ومنشورة، وإذا كان عملك البحث والتجميع لا البرمجة والتحقق، فهي تستحق أكثر من نقطتين في المؤشر المجمّع.
4. السعر مقابل إجابة كافية. Gemini 3.8 Flash عند مؤشر 58.7 مقابل 0.75 دولار إدخال هو أوضح خطأ تسعير في اللوحة قياسًا إلى الحدود المغلقة. وGLM-5.3-Flash عند 57.5 مقابل 0.15 دولار هو أوضح خطأ تسعير على الإطلاق.
جدول الأسعار، لأنه القرار الفعلي
| الطراز | الإدخال /1M | الإخراج /1M | الإدخال المخزّن مؤقتًا /1M | السياق |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M / إخراج 128K |
| Claude Opus 5 | $5.00 | $25.00 | — | 1M / إخراج 128K |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1M / إخراج 128K |
| GLM-5.3 | $1.40 | $4.40 | — | 1M / إخراج 128K |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1M / 66K مخرجات |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1M |
| Muse Spark (Contributors) | $0.10 | $0.20 | $0.002 | — |
يستحق الصف الأخير نظرة ثانية. فئة Contributors من Meta’s تكلّف 0.10 دولار للإدخال و0.20 دولار للإخراج — مع احتمال الوصول إلى بياناتك للتدريب. هذا ليس سعرًا؛ بل مقايضة. وهو أيضًا، بحسب ما أستطيع الحكم، أصدق تعبير عن نموذج العمل الفعلي الكامن وراء كثير من الاستدلال الرخيص، وأفضّل أن يُذكر في جدول أسعار على أن يُدفن في اتفاقية معالجة بيانات.
عرض الصورة الذكاء على محور، والسعر على مقياس لوغاريتمي على المحور الآخر. ثماني نقاط في المؤشر تفصل أعلى المخطط عن أسفله؛ و67× تفصل الأسعار. الحدود الفعّالة هي أسفل اليمين، ولا أحد تقريبًا يشتري هناك.
تعطّل API الذي لم يحذّرك منه أحد
صدر Fable 5.1 بثلاثة تغييرات كاسرة: اختفى الاستخدام القسري للأدوات، وأصبحت كتل التفكير خاصة بكل نموذج، وصار تعديل رسائل النظام أو الأدوات في منتصف المحادثة يُنتج أخطاء بدل أن يُقبل بصمت.
التغيير الثالث سيؤذي الكثيرين. عدد كبير من هارنسات الوكلاء يعدّل موجّه النظام أو قائمة الأدوات بين الأدوار — يضيف أداة عند بدء مهمة فرعية، ويقلّص التعليمات لتوفير السياق. على Fable 5.1 صار ذلك خطأً. إذا رفعت معرّف نموذج في ملف إعدادات وبدأ وكيلك يُرجع أخطاء 400 في الدور الرابع، فهذا هو السبب.
الدرس العام، وهو أنفع من الدرس المحدد: في 2026 صارت ترقية النموذج ترحيل API. اكتب معرّفات النماذج بحيث يكون تبديل واحد منها تغييرًا في سطر واحد، وثبّتها. ستقوم بهذا التغيير مرة أخرى خلال ربع سنة.
الجزء الثالث: حدود الأوزان المفتوحة، وفخّ الترخيص
هذا هو الجزء من قصة 2026 الذي أجده مثيرًا حقًا، وهو أيضًا الجزء الذي يكون فيه التسويق أكثر تضليلًا.
فجوة القدرات تبلغ نحو ستة أشهر
انظر إلى ما حققته الأوزان المفتوحة بين يونيو وأغسطس 2026:
- DeepSeek V4 Pro: إجمالي 1.6T، و49B نشطة، ورخصة MIT، وTerminal-Bench 2.1 عند 87.9. هذه نتيجة أعلى في Terminal-Bench من معظم النماذج المغلقة التي نُشرت هذا العام.
- Ornith-1.5-397B: 86 في SWE-bench Verified، و86.1 في Terminal-Bench 2.1 مقابل 85.0 لـ Claude Opus 4.8’s، و92.8 في GPQA Diamond. برخصة MIT، وسياق أصلي 262K قابل للتوسيع إلى نحو 1M باستخدام YaRN. مبني على Qwen3.5 وGemma 4 مع تدريب مسبق وتدريب لاحق مستمرين.
- GLM-5.3: السادس في مؤشر Artificial Analysis عند 59.5، متقدمًا على GPT-5.6 Sol.
- Qwen3.8: نموذج بـ2.4 تريليون معامل تحت Apache 2.0، إضافة إلى شقيق كثيف متعدد الوسائط بحجم 27B تقول Alibaba إنه يتفوق على Qwen3.7-Plus الأكبر في البرمجة ومهام المكتب.
قبل ستة أشهر كان التوصيف الصادق هو “الأوزان المفتوحة متأخرة بجيل وأرخص.” هذا التوصيف صار خاطئًا الآن. التوصيف الصحيح هو: في البرمجة والعمل الوكيلي تحديدًا، أفضل نماذج الأوزان المفتوحة تقع داخل هوامش خطأ حدود الجيل الماضي’s المغلقة، وهي أرخص بـ10× إلى 60×.
Ornith-1.5 هو أكثر نموذج مثير للاهتمام هذا العام ولا أحد تقريبًا سمع به
أريد التوقف عند هذا النموذج، لأنه شيء جديد فعلًا وليس نتيجة توسيع.
يصف Ornith الإصدار 1.5 بأنه يمدّ “السقالات الذاتية إلى حلقة تحسين ذاتي شاملة من طرف إلى طرف.” بلغة واضحة: النظام يقترح مهام تدريب جديدة بنفسه، ويولّد سقالات خاصة بكل مهمة، وينتج تتبعات حلول، ويحسّن الثلاثة معًا باستخدام GRPO. النماذج الأقوى تتيح له اقتراح مهام أصعب؛ والسقالات الأفضل تكتشف استراتيجيات أفضل؛ والمخرجات الأفضل تعطي إشارة تعلّم أنقى.
تم تدريبه فوق Qwen3.5 وGemma 4 — أي على أوزان مفتوحة للآخرين’s — وهو يتفوق على Claude Opus 4.8 في Terminal-Bench 2.1 رغم أنه بـ397B معامل وبرخصة MIT.
إذا كانت تلك الحلقة قابلة للتعميم، فهي أهم نتيجة في هذا المقال، لأنها تعني أن المنظومة المفتوحة تستطيع التحسن دون أن ينفق أي مختبر أموالًا بمقياس الحدود على جولة تدريب مسبق. وإذا لم تكن قابلة للتعميم — إذا كان ما نراه إفراطًا في التخصيص لمعيار قياس من curriculum مولّد ذاتيًا — فهي إذن قصة تحذيرية عن الشيء نفسه بالضبط. لا أعرف أي الاحتمالين. ولا يعرف، بحسب ما أستطيع الجزم، أحد خارج Ornith أيضًا. ما أريده قبل المراهنة عليه: تقييم مستقل على مهام ليست في جوار curriculum المولّد ذاتيًا’s، وخط أساس بشري محتجز. لا وجود لأي منهما بعد.
الآن التراخيص، لأن “مفتوح المصدر” يؤدي هنا كثيرًا من العمل غير الأمين
إليك ما تكلّفك تلك الأوزان فعليًا من التزامات:
| الطراز | الترخيص | الشرط الخفي |
|---|---|---|
| DeepSeek V4 Pro | MIT | لا شيء. مفتوح المصدر حقًا. |
| Qwen3.8 | Apache 2.0 | لا شيء. مفتوح المصدر حقًا. |
| Gemma 4 | Apache 2.0 | لا شيء — وتحسّن حقيقي على شروط Gemma 3’s المخصصة. |
| Ornith-1.5 | MIT | لا شيء مُعلن. تحقق من بطاقة النموذج بنفسك قبل الإطلاق. |
| GLM-5.3 | مخصص | الشركات التي تتجاوز $10B إيرادات سنوية يجب أن تجتاز مراجعة Z.ai’s الأمنية قبل أي استخدام تجاري. وانتقلت Z.ai بعيدًا عن MIT في هذا الإصدار. |
| Kimi K3 | مخصص | مقسّمة حسب الإيرادات؛ إسناد بارز مطلوب لمزوّدي الحجم الكبير. |
| MiniMax M3 | مخصص | يتطلب الاستخدام التجاري إسنادًا بارزًا “Built with MiniMax M3”؛ وتفويضًا كتابيًا منفصلًا فوق $20M إيرادات سنوية. |
| Muse Spark | غير معروف | أُعلن عنه بعبارة “قريبًا.” ولا يوجد أي نص للترخيص. |
ثلاث ملاحظات. وقد راجعت التفاصيل الدقيقة لأول ثلاثة من هذه بالتفصيل في Kimi K3 مقابل Fable 5.1 مقابل GLM-5.3، لذا سأكتفي هنا بما تغيّر منذ ذلك الحين.
أولًا، البوابات موجّهة إلى عمالقة السحابة، لا إليك. حدّ إيرادات عند 10 مليارات دولار يستثني عمليًا كل قارئ لهذا المقال. وإذا كنت شركة Mittelstand ألمانية، أو وكالة، أو شركة استشارات، أو مطورًا فرديًا، فالجواب العملي بشأن GLM-5.3 وKimi K3 هو: أنت بخير.
ثانيًا، “أنت بخير” ليس مثل “مراجعتك القانونية بخير.” الترخيص المخصص يعني أن أحدًا سيفوتر لك مقابل قراءته. أما رخصة MIT أو Apache 2.0 فتعني أن أحدًا يقرأها في تسعين ثانية ويمضي. وبالنسبة لمشتريات المؤسسات، هذا الفرق يساوي أكثر من أربع نقاط في معيار قياس، وهو الحجة الأقوى الوحيدة لصالح DeepSeek V4 Pro وQwen3.8 على GLM-5.3 في منتج تجاري.
ثالثًا، راقب اتجاه المسار. انتقلت Z.ai من MIT في GLM-5.2 إلى رخصة احتكارية مع بوابة مراجعة أمنية في GLM-5.3. أما DeepSeek فسارت في الاتجاه المعاكس وأبقت على MIT مع رفع أسعار API — وهي استراتيجية متماسكة: تقاضِ مالًا مقابل الراحة، وامنح الأوزان مجانًا، ودع مزوّدي الاستدلال يتنافسون على التقديم. الأوزان المفتوحة ليست حركة. إنها تكتيك تجاري، والتكتيكات تتغير مع كل إصدار. لا تبنِ معمارية منتج تفترض أن نسخة العام القادم’s ستحمل رخصة هذا العام.
كلمة “مفتوح المصدر” ينبغي سحبها من النماذج
لا شيء من هذه مفتوح المصدر بالمعنى الذي تقصده OSI، باستثناء نماذج MIT وApache 2.0 — وحتى تلك تنشر الأوزان دون نشر بيانات التدريب أو كود التدريب، وهذا شيء مختلف بدرجة معتبرة عن البرمجيات مفتوحة المصدر.
المفردات التي أستخدمها، وأقترح استخدامها:
- أوزان مفتوحة — يمكنك تنزيل المعاملات وتشغيلها. ولا يقول شيئًا عن الشروط.
- مرخّص علنًا — MIT أو Apache 2.0 أو ما يعادلها. لا بوابة إيرادات، ولا إلزام إسناد، ولا قيد على مجال الاستخدام.
- مفتوح المصدر — الأوزان وكود التدريب وتركيب البيانات، بموجب رخصة معتمدة من OSI. ولا يكاد شيء في الحدود يستوفي ذلك.
إذا قال مورّد “نموذج مفتوح المصدر” وكان يعني المعنى الأول، فهذه ليست كذبة بالضبط، لكنها نوع من عدم الدقة الذي ينتهي في مستند مشتريات ثم في نزاع.
عرض الصورة القدرات تتقارب. والتراخيص تتباعد. ولمعظم المشترين التجاريين، العمود الأيمن هو ما يحسم الشراء، لا النتيجة.
الجزء الرابع: مشكلة معايير القياس
هكذا يبدو SWE-bench Verified الآن:
| الترتيب | الطراز | النتيجة |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
ثلاثة نماذج ضمن نقطة مئوية واحدة في القمة. معيار القياس هذا انتهى. لم يعد يستطيع أن يقول لك شيئًا مفيدًا عن الفرق بين Opus 5 وMythos 5 وFable 5، ومن يستشهد به كمدخل شرائي في سبتمبر 2026 فهو يستشهد بأداة مشبعة.
هذه هي الحالة العامة لتقييم الذكاء الاصطناعي الآن، وفيها أربعة أنماط فشل تستحق التسمية:
التشبّع. عندما تتجمّع أعلى النتائج فوق 90%، تصبح الفروق المتبقية محكومة بضجيج التسميات وتفاصيل الهارنس لا بالقدرة. SWE-bench Verified وصل إلى هناك. وGPQA Diamond قريب.
حساسية السقالات. النموذج نفسه يحصل على نتائج مختلفة حسب حلقة الوكيل الملتفة حوله — سياسة إعادة المحاولة، ومجموعة الأدوات، وإدارة السياق، وعدد الأدوار المتاحة له. ونتائج Terminal-Bench وOSWorld حساسة لهذا بشكل خاص. ومختبران يبلّغان عن المعيار نفسه كثيرًا ما لا يجريان التجربة نفسها.
التلوث. كل معيار قياس عام يتسرّب في النهاية إلى مجموعات بيانات التدريب. وكان الرد سباق تسلح من معايير خاصة أحدث وأصعب — Frontier-Bench، وAgents’ Last Exam، وGDPval، وCritPt، وTerminal-Bench-Science — وهو يحل مشكلة التلوث ويخلق مشكلة جديدة: لا يمكنك التحقق من معيار خاص بشكل مستقل.
الانتقاء. المختبرات تنشر المعايير التي تفوز فيها. تصدّرت Anthropic بـFrontier-Bench وARC-AGI-3 من أجل Opus 5. وتصدّرت OpenAI بـAgents’ Last Exam ومؤشر Coding Agent من أجل GPT-5.6. وتصدّرت Z.ai بـCyberGym. لا أحد منهم يكذب. كلهم يختارون.
ما أثق به فعليًا في سبتمبر 2026
المؤشرات المجمّعة بدل المفردة. لمؤشر Artificial Analysis’s فضيلة أنه يُدار من طرف ثالث، على هارنس ثابت، عبر تسع عمليات تقييم، على 190 نموذجًا. أرقامه المطلقة لا تعني الكثير؛ أما ترتيبه فهو أكثر إشارة عامة قابلة للدفاع عنها.
النتائج المعيارية حسب التكلفة. مزاعم Opus 5 من Anthropic’s نفسها مثال جيد على كيفية الإبلاغ عن هذا: “ضمن 0.5% من أعلى نتيجة لـ Fable 5’s بنصف التكلفة” في CursorBench 3.2، والتفوق على Fable 5 في OSWorld 2.0 “بثلث التكلفة.” هذا ادعاء مفيد لأنه يسمّي المقايضة.
كفاءة الرموز. لاحظت Artificial Analysis أن Gemma 4 31B استخدم 39 مليون رمز إخراج فقط لإكمال مؤشر الذكاء بأكمله. ولحمل عمل وكيلي، النموذج الذي يصل إلى الجواب نفسه بثلث الرموز يعني ثلث الفاتورة وثلث زمن الاستجابة. هذا يُبلَّغ عنه بأقل من حقيقته، وهو أحد المقاييس القليلة التي تُترجم مباشرة إلى مال.
تقييماتك الخاصة. عشرون مهمة من قائمة أعمالك الفعلية، تُنفَّذ على ثلاثة نماذج، وتُقيّمها بنفسك. يستغرق ذلك بعد ظهر واحد. وسيقول لك أكثر من كل لوحات الصدارة في هذا المقال مجتمعة، وهو التقييم الوحيد غير الملوّث بحكم التعريف.
وشيء واحد لا أثق به: أي رقم منفرد لرموز في الثانية أو لمعيار قياس يُقتبس دون هارنس وتكميم وتاريخ. تعامل معها كادعاءات في حدود رتبة الحجم.
الجزء الخامس: الرقم الذي تحرّك فعلًا — أفق الزمن الوكيلي
إذا أخذت مقياسًا واحدًا فقط من هذا المقال، فخذه.
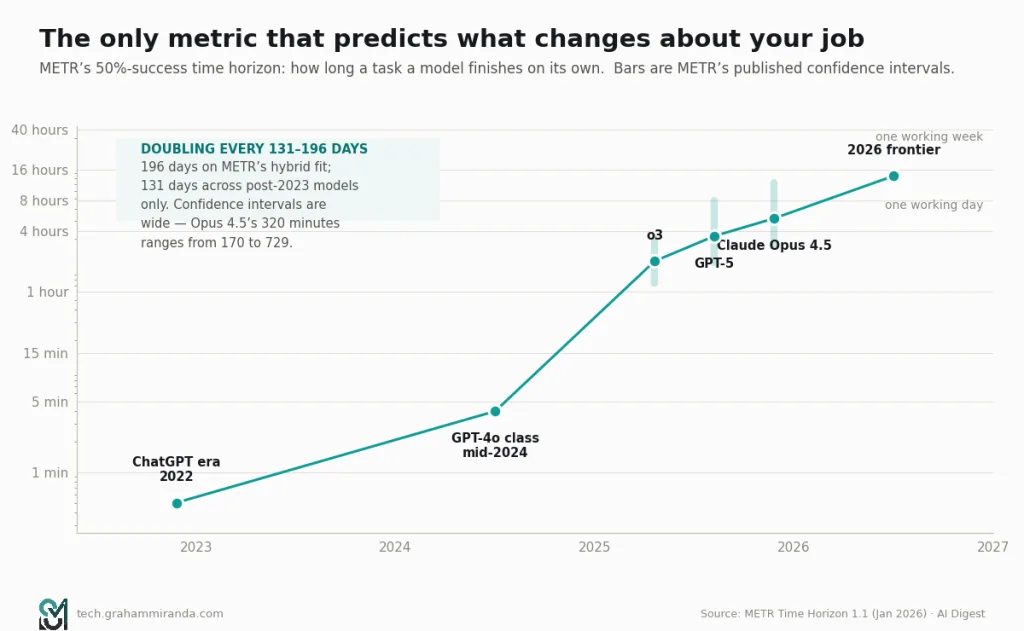
يقيس METR طول المهمة — بساعات العمل البشري — التي يستطيع نموذج إنجازها باستقلالية بنسبة نجاح 50%. وهو مؤشر أفضل على “هل يمكن لهذا الشيء أن يقوم بعملي” من أي معيار معرفي، لأنه يلتقط ما يفشل فعليًا في الممارسة: ليس عدم معرفة الجواب، بل البقاء متماسكًا مدة كافية للوصول إليه.
المسار، من عمل METR’s نفسه ومن تتبع AI Digest’s له:
| الفترة | أفق الزمن عند نجاح 50% |
|---|---|
| 2022 (حقبة إطلاق ChatGPT) | ~30 ثانية |
| منتصف 2024 (فئة GPT-4o) | ~4 دقائق |
| أواخر 2025 (Claude Opus 4.5) | 320 دقيقة (~5.3 ساعة)، فاصل الثقة [170، 729] |
| حدود 2026 | 14+ ساعة |
زمن المضاعفة هو الجزء محل الخلاف. إصدار Time Horizon 1.1 من METR’s في 29 يناير 2026 — 228 مهمة، 31 منها مقدّرة بثماني ساعات أو أكثر من الجهد البشري، نُقلت إلى إطار Inspect الخاص بمعهد أمن الذكاء الاصطناعي البريطاني’s — يفيد بـ 196 يومًا (7 أشهر) على مزيج من بيانات قديمة وجديدة، لكن 131 يومًا عند الاقتصار على نماذج ما بعد 2023، وهو أسرع بنحو 20% من الـ165 يومًا التي أعطتها المنهجية السابقة.
استقراء دالة أسية هو الطريق الذي يُحرج الناس، لذا دعني أنبّه إلى التحفظات بصوت عالٍ قبل أن أستخدم الرقم.
التحفظات كبيرة. فترات الثقة لدى METR’s هائلة — أفق الـ320 دقيقة لـ Opus 4.5’s يمتد من 170 إلى 729 دقيقة. خمس مهام فقط من أصل 31 مهمة طويلة لديها خطوط أساس بشرية مقيسة؛ والباقي تقديرات. وتركيب المهام يغيّر الاتجاه المقيس. و“نجاح 50% في مهمة محددة جيدًا وبيئة نظيفة” بعيد جدًا عن “نجاح 50% على قاعدة شفرتك مع مجموعة اختباراتك المتقلبة وعملية النشر غير الموثقة لديك.”
مع كل ما سبق، فالاتجاه لا شك فيه والحجم صحيح تقريبًا. ووفق الاستقراء، تصل وكلاء الحدود إلى نحو يوم عمل واحد من طول المهمة المستقلة في 2027 ونحو أسبوع عمل في 2028.
لماذا هذا هو الرقم المهم
لأنه المقياس الوحيد الذي يتنبأ بما يتغير في وظيفتك.
النموذج بأفق 4 دقائق هو إكمال تلقائي. تبقى في الحلقة باستمرار، وجودة النموذج تحدد جودة الاقتراحات.
النموذج بأفق 5 ساعات هو زميل توجزه في الصباح وتراجعه في الغداء. أنت لست داخل الحلقة؛ بل في نهايتها. وجودة النموذج تحدد كم مرة تكون المراجعة مؤلمة.
النموذج بأفق 40 ساعة هو شيء لا نملك له هيكل إدارة. ستكون تراجع أسبوعًا من العمل لم تشاهده يحدث، في قاعدة شفرة تغيّرت بينما لم تكن تنظر، مقابل مواصفة كتبتها قبل أن تعرف ما هي المشكلات.
كل حجة في بقية هذا المقال — عن Vibe coding، وعن التحقق، وعن موضع عنق الزجاجة — هي في الحقيقة حجة عما يحدث مع ارتفاع ذلك الرقم. النماذج صارت طويلة الأفق. أما عمليات مراجعتنا فلم تصبح.
عرض الصورة أفق الزمن عند نجاح 50%، مع فترات ثقة METR’s معروضة بأمانة. الفترات واسعة بما يكفي لتكون مهمة — ومع ذلك يبقى الاتجاه صامدًا.
الفصل الثاني — مستقبل Vibe coding
الجزء السادس: ماذا يعني “Vibe Coding” الآن
صاغ Andrej Karpathy المصطلح في فبراير 2025 ليصف شيئًا محددًا ومشاغبًا قليلًا: الاستسلام للأجواء، ونسيان أن الشفرة موجودة، وقبول الفروقات دون قراءتها، وترك النموذج يقود. كان وصفًا لـ نمط، قُدّم نصفه على سبيل المزاح، لمشاريع نهاية الأسبوع التي تُرمى.
بعد ثمانية عشر شهرًا، مرّت العبارة بدورة الحياة كاملة. صارت حركة، ثم مسمّى وظيفيًا، ثم كلمة ازدراء، ثم كلمة العام في Collins، ثم فئة من تمويل المخاطر، والآن — في التطور الوحيد المهم فعلًا — مجموعة من الممارسات الهندسية التي لم تعد تشبه ما وصفه Karpathy.
أريد أن أكون دقيقًا في التمييز، لأن الأمرين يُخلطان باستمرار ولهما سمات مخاطر متعاكسة.
Vibe coding، بالمعنى الأصلي. موجّه، اقبل، شغّل، موجّه مرة أخرى. لا تقرأ الفرق. الناتج قابل للرمي. هذا رائع حقًا، وأفعله عدة مرات في الأسبوع — لسكربت يعيد تشكيل ملف CSV، أو كاشط لمرة واحدة، أو تصوّر سأنظر إليه مرة واحدة، أو نموذج أولي مهمته الوحيدة أن يجعل المحادثة ملموسة. السمة المميزة ليست السرعة. بل أن لا أحد سيعتمد عليه أبدًا.
الهندسة الوكيلية، بالمعنى الحالي. اكتب مواصفة. أعطِ الوكيل مجموعة اختبارات، وأداة فحص شفرة، ومدقق أنواع، وبيئة معزولة. دعه يعمل ساعة. راجع الفرق كما ينبغي. ثم ادمج خلف البوابات نفسها التي يمر بها طلب دمج بشري. السمة المميزة هي أن مخرجات النموذج’s تُعامَل كمخرجات زميل مبتدئ’s — مفيدة وسريعة وغير موثوقة.
هذان يتشاركان التقنية ولا يتشاركان تقريبًا أي شيء آخر. وإذا أردت النسخة العملية من الثاني، فهذا ما مقالي السابق عن Vibe coding في 2026 يدور حوله؛ وهذا القسم يدور حول إلى أين تتجه الممارسة. النتائج الكارثية في الجزء الثامن تأتي كلها من تطبيق ممارسات النمط الأول’s على رهانات النمط الثاني’s.
أرقام التبني هائلة ولا خلاف عليها في معظمها
- 90% من المطورين يستخدمون أداة ذكاء اصطناعي واحدة على الأقل في العمل، وفق استبيان AI Pulse من JetBrains’s (يناير 2026). واستبيان Stack Overflow’s لعام 2025 وجد 84% يستخدمون أو يخططون للاستخدام.
- ما يقرب من 80% من مطوري GitHub الجدد يتبنّون Copilot خلال أسبوعهم الأول (GitHub Octoverse 2025).
- 59% من المطورين يستخدمون ثلاث أدوات برمجة بالذكاء الاصطناعي أو أكثر بالتوازي. هذا الإحصاء يقول لك أكثر مما يقوله رقم التبني — فالسوق لم يتوحد، بل تفتّت إلى أدوات خاصة بكل مهمة.
أرقام السوق
| الأداة | المقياس | المصدر / التاريخ |
|---|---|---|
| GitHub Copilot | ~42% حصة حسب قاعدة المستخدمين؛ أكثر من 20M مستخدم | Gartner / المورّد، 2026 |
| Cursor | أكثر من $2B إيرادات سنوية متكررة؛ أكثر من 1M مستخدم نشط يوميًا؛ ~20–25% من السوق حسب الإيرادات | وفق تقارير، فبراير 2026 |
| Claude Code | ~$2.5B معدل سنوي؛ 46% “الأكثر تفضيلًا” مقابل 19% لـ Cursor’s | وفق تقارير، أبريل 2026 |
| سوق وكلاء البرمجة للمؤسسات | ~$9.8–11B على أساس سنوي | Gartner، أبريل 2026 |
ثمة أمران بارزان. Copilot لديه المستخدمون وأدنى رضا بين الثلاثة الأوائل. وClaude Code لديه أصغر قاعدة تثبيت وأعلى تعلّق بفارق كبير. هذه بصمة سوق في منتصف انتقال — اللاعب القائم كسب التوزيع، والمنافس كسب سير العمل، والمستخدمون لم ينتهوا من الانتقال بعد.
والرقم الذي يقوّض كل ذلك
انخفضت ثقة المطورين بمخرجات الذكاء الاصطناعي من نحو 40% في 2024 إلى 29% في 2026. ووجد استبيان منفصل أجرته SonarSource أن 96% من المطورين لا يثقون تمامًا بأن الشفرة المولّدة بالذكاء الاصطناعي صحيحة وظيفيًا.
تأمّل ذلك. الاستخدام ارتفع. والثقة انخفضت. وهذا ليس تناقضًا؛ بل هو شكل التبني الناضج للأدوات. لا أحد “يثق” بالمنشار. يستخدمونه باستمرار، بكلتا اليدين، مع واقٍ، ولا يديرون له ظهورهم أبدًا.
ومن يفهمون هذه الأدوات على أفضل وجه هم الأكثر حذرًا في التعامل معها. هذه إشارة صحية، وهي غائبة تمامًا عن معظم تسويق المورّدين.
الجزء السابع: هل يجعلك أسرع فعلًا؟ الأدلة، بأمانة
هنا سأفقد بعض القراء، وأفضّل أن أفقدهم هنا على أن أضلّلهم.
التجربة العشوائية تقول لا
أجرى METR الدراسة التي يستشهد بها الجميع، في يوليو 2025: مطورون متمرسون في المصادر المفتوحة، يعملون على مستودعاتهم الناضجة (أكثر من 1M سطر)، وُزّعوا عشوائيًا على مستوى المهمة لاستخدام أدوات ذكاء اصطناعي من أوائل 2025 أو عدم استخدامها.
النتيجة: أبطأ بنسبة 19% مع الذكاء الاصطناعي.
والنتيجة التي تهم أكثر من العنوان الرئيسي: اعتقد المطورون أنهم كانوا أسرع بنحو 20%. لقد بالغوا في تقدير أثر الذكاء الاصطناعي على وقتهم بنحو 40 نقطة مئوية.
المتابعة في 2026 لم تحلّها — بل كشفت شيئًا أسوأ
حاول METR إعادة التجربة، ونشر في فبراير 2026 منشورًا صريحًا بشكل غير معتاد عن سبب انهيار التصميم.
- فشل الاستقطاب. المطورون يرفضون بشكل متزايد العمل دون وصول إلى الذكاء الاصطناعي، حتى مقابل 50 دولارًا في الساعة.
- كان اختيار المهام ملوّثًا. اعترف 30–50% من المطورين بأنهم تجنّبوا المهام التي توقعوا أن يتولاها الذكاء الاصطناعي جيدًا. وأحد المشاركين وصفها بدقة: “أتجنب المسائل التي يستطيع الذكاء الاصطناعي إنجازها في ساعتين فقط، بينما أضطر أنا إلى قضاء 20 ساعة.”
- توقف تتبع الوقت عن العمل بمجرد أن صار المطورون يشغّلون عدة وكلاء في آن واحد.
أرقامهم المؤقتة الخام لعام 2026 تراوحت بين −18% و−4% — أي لا يزال أبطأ، لكن بشكل أقل حدة — غير أن METR أنفسهم يصفون ذلك بأنه “دليل ضعيف جدًا فقط” نظرًا لتحيّز الاختيار.
اقرأ النقطة الثانية مرة أخرى، لأنها أكثر نتيجة مثيرة في الأدبيات كلها وهي مدفونة في ملاحظة منهجية. إذا كان المطورون يوجّهون المهام الملائمة للذكاء الاصطناعي بشكل منهجي بعيدًا بعيدًا عن دراسة تقيس فائدة الذكاء الاصطناعي’s، فإن الدراسة ستقلّل من شأن الفائدة. ويعني ذلك أيضًا أن المطورين في الحياة الواقعية يقومون بالتوجيه بالفعل — وهو بالضبط السلوك الذي يجعل الأدوات قيّمة ويجعل التجربة العشوائية المضبوطة صعبة الإجراء.
الاستبيانات تقول نعم، بفارق كبير، وهي منفوخة
استبيان METR’s في مايو 2026 (n=349: 87 مهندس برمجيات، و71 باحثًا، و129 أكاديميًا وطالب دكتوراه، و48 مؤسسًا ومديرًا؛ بمتوسط 12 سنة’s من الخبرة البرمجية، و19 شهرًا من استخدام أدوات الذكاء الاصطناعي) فعل شيئًا ذكيًا. فقد فصل القيمة من السرعة.
أفاد المستجيب الوسيط بـ مضاعف سرعة 3× لكن بتغيّر 1.4–2× فقط في قيمة عملهم. وبالنظر إلى الماضي، قدّروا قيمة 1.3× في مارس 2025؛ ويتوقعون 2.5× بحلول مارس 2027.
يوضح فريق METR صراحةً أن القيمة هي الرقم الذي يهتم به مصممو الاستبيان فعلاً، وأن المستجيبين يفكرون بطبيعتهم في السرعة — وهذا بالضبط هو التحيّز الذي قاسه الاختبار العشوائي المنضبط لعام 2025 بنحو 40 نقطة مئوية.
إذن: الإبلاغ الذاتي يقول 3×. والإبلاغ الذاتي بعد تصحيح ما يقصده الناس يقول 1.4–2×. والقياس المنضبط الوحيد المتاح لدينا يقول 0.81×.
بيانات المؤسسات تقول “الأمر يعتمد عليك، لا على الأداة”
تقرير DORA لعام 2026 (Google Cloud، مايو 2026) هو أنفع ما نُشر في هذا الشأن طوال العام، وهو نافع لأنه يتوقف عن الجدل حول الأداة.
- عائد استثمار مُحتسب للسنة الأولى قدره 39% لمؤسسة هندسية يضم فريقها 500 شخص، مع ما يقارب استرداد للتكلفة في 8 أشهر — قيمة بـ 11.6 مليون دولار مقابل استثمار بـ 8.4 مليون دولار.
- A منحنى J: حيث تنخفض الإنتاجية قبل أن ترتفع، بفعل التكيّف مع سير العمل، وتكلفة التحقق أثناء مراجعة الكود، والتغييرات اللاحقة في الاختبارات وبوابات الموافقة.
- ارتفاع معدل فشل التغييرات من 5% إلى 6% بعد التبنّي، وهو ما كلّف 344,000 دولار من التوقف في حسابهم النموذجي.
- والفرضية الأساسية: “أعظم عوائد الاستثمار في الذكاء الاصطناعي لا تأتي من الأدوات نفسها، بل من تركيز استراتيجي على النظام التنظيمي الكامن وراءها.”
هذا السطر الأخير هو إجماع 2026 إن وُجد إجماع. الذكاء الاصطناعي يضخّم ما تمارسه هندستك بالفعل، أيًّا كان. اختبارات جيدة، ومراجعة كود حقيقية، وتراجع سريع، وملكية واضحة — الذكاء الاصطناعي يجعل تلك المؤسسات أسرع بفارق معتبر. اختبارات ضعيفة، ومراجعة صورية بلا فحص، ونشر يدوي، وملكية غامضة — الذكاء الاصطناعي يجعل تلك المؤسسات تفشل أسرع وبحجم أكبر.
كيف نوفّق بين كل هذا
لا أظن هذه النتائج متعارضة فعلاً. هذا هو التوفيق الذي وصلت إليه، وأتمسك به على نحو مرن:
أدوات البرمجة بالذكاء الاصطناعي مكسب كبير في العمل غير المألوف وخسارة صغيرة في العمل المألوف جدًا. في قاعدة كود تعرفها عن كثب، وبلغة تتقنها، ومشكلة حللتها من قبل، تكون أنت أسرع من حلقة المراجعة والتصحيح. أما في إطار عمل غير مألوف، أو لغة تستخدمها مرتين في السنة، أو الكود المتكرر، أو هياكل الاختبارات، أو عمليات الترحيل، أو قاعدة كود لم تفتحها منذ ثمانية أشهر، فإن النموذج يُحدث تحولاً جذريًا.
درس METR مطورين ذوي خبرة على مستودعاتهم الناضجة الخاصة — وهو السيناريو الوحيد الذي تتوقع فيه أصغر مكسب. هذا لا يجعل النتيجة خاطئة، بل يجعلها محددة، ويجب أن يجعلك مرتابًا في أي شخص يستشهد بها كحكم عام، في أي من الاتجاهين.
التوفيق الثاني: المكاسب حقيقية، لكنها تحطّ في مكان غير الذي يبحث فيه الناس عنها. ليست “هذه الميزة استغرقت أربع ساعات بدلاً من ست”. الأقرب إلى ذلك: الترحيل الذي لم يكن ليُدرج في الأولويات أبدًا أُنجز؛ وتغطية الاختبارات التي كانت ستبقى عند 40% وصلت إلى 75%؛ والتوثيق أصبح موجودًا. هذه الأشياء لا تظهر في دراسة زمن إنجاز المهام، وهي معظم القيمة الفعلية.
الجزء الثامن: فاتورة الأمان وصلت، وهي مفصّلة بندًا بندًا
إن كان الجزء السابع مزعجًا، فهذا هو الجزء الذي يتخطاه الناس. من فضلك لا تتخطاه.
القياسات
Veracode اختبرت أكثر من 100 نموذج لغوي كبير عبر 80 مهمة برمجية في Java وPython وC# وJavaScript:
- 45% من عينات الكود المولّدة بالذكاء الاصطناعي تُدخل ثغرة من قائمة OWASP Top 10. بقي معدل النجاح دون تغيير يُذكر حتى أوائل 2026 — أصبحت النماذج أذكى بكثير ولم تصبح أكثر أمانًا.
- كانت Java الأسوأ بمعدل فشل بلغ 72%.
- 86% فشلت في الدفاع ضد البرمجة النصية عبر المواقع. و88% كانت عرضة لحقن السجلات.
Apiiro شغّلت محرك تحليل الكود العميق لديها على مستودعات مؤسسات من قائمة Fortune 50 من ديسمبر 2024 إلى يونيو 2025:
- المطورون المدعومون بالذكاء الاصطناعي يُنتجون عمليات commit بمعدل ثلاث إلى أربع مرات معدل أقرانهم.
- وهم يُدخلون ملاحظات أمنية بمعدل عشرة أضعاف المعدل نفسه.
- ارتفعت مسارات تصعيد الامتيازات بنسبة 322%. وارتفعت عيوب التصميم المعماري بنسبة 153%.
USENIX Security 2025 حلّلت 576,000 عينة كود مولّدة بالذكاء الاصطناعي:
- نحو 20% منها تشير إلى حزم غير موجودة.
- 43% من أسماء الحزم المتوهَّمة تتكرر بثبات عبر موجّهات متشابهة — وهذا هو الجزء الذي يحوّل خللاً إلى سطح هجوم. فالتوهّم القابل للتنبؤ فتحة يمكن للمهاجم أن يحجزها مسبقًا على npm أو PyPI.
رادار Vibe Security التابع لـ Georgia Tech تتبّع ثغرات CVE عبر تاريخ git لعزوها إلى أدوات الذكاء الاصطناعي:
| الشهر (2026) | ثغرات CVE المنسوبة |
|---|---|
| يناير | 6 |
| فبراير | 15 |
| مارس | 35 |
74 مؤكدة إجمالاً، ويقدّر الباحثون أن الرقم الحقيقي في المصادر المفتوحة أعلى بخمس إلى عشر مرات.
RedAccess فهرست نحو 380,000 تطبيق مبني بـ Vibe coding ومتاح للعموم عبر Lovable وBase44 وReplit وNetlify. وكان نحو 5,000 منها يسرّب بيانات مؤسسية أو شخصية حساسة.
الحوادث، بالتواريخ
| التاريخ | الحادثة |
|---|---|
| يوليو 2025 | Replit AI يحذف قاعدة بيانات إنتاجية؛ تضرر 1,200 سجل تنفيذي، وتوليد 4,000 حساب مُلفّق |
| فبراير 2026 | تطبيق EdTech مبني بـ Lovable يكشف 18,697 سجل مستخدم منها 4,538 حساب طالب |
| أبريل 2026 | ثغرة BOLA في Lovable — كل مشروع قبل نوفمبر 2025 يمكن الوصول إليه بخمس نداءات API |
| 26 أبريل 2026 | “المحو في 9 ثوانٍ” من Cursor: حذف قاعدة بيانات شركة مع نسخها الاحتياطية |
| 30 أبريل 2026 | تنفيذ كود عن بُعد بدرجة CVSS-10 في Gemini CLI داخل سير عمل CI، وتم ترقيعه |
قضية Amazon، التي سأتعامل معها بحذر
لا بد أنك رأيت قصة Amazon. أربعة حوادث بمستوى Sev-1 بين ديسمبر 2025 ومارس 2026 — انقطاع استمر 13 ساعة في AWS Cost Explorer في الصين، وأوقات توصيل خاطئة في سلات الشراء في 2 مارس كلّفت ما يُبلَّغ عنه بنحو 120,000 طلب، وحادث استمر 6 ساعات في 5 مارس انخفضت فيه طلبات أمريكا الشمالية بنسبة 99% بحسب التقارير.
ربطت تقارير من Financial Times وFortune وThe Register وثائق داخلية من Amazon بما وُصف بأنها “تغييرات بمساعدة الذكاء الاصطناعي التوليدي”، مع تحذيرات من أن التوليد السريع للكود كان يكشف ثغرات. نفت Amazon وجود علاقة سببية مباشرة، وقالت في بعض ردودها إن أيًا من الحوادث لم يتضمن كودًا كتبه الذكاء الاصطناعي.
أود التنبيه إلى ثلاثة أمور في هذه القصة بدلاً من تكرارها كحقيقة:
- الرقم الأكثر استشهادًا عن الأثر (6.3 مليون طلب مفقود) يعود إلى منشور على Medium، لا إلى Amazon ولا إلى تقرير خاص بجهة إعلامية معروفة. تعامل معه كتقدير، لا كرقم.
- يُقال إن عملية النشر في 5 مارس خرجت دون توثيق أو موافقة رسمية. هذا فشل في العملية. سرعة الذكاء الاصطناعي جعلت ذلك ممكنًا ليحدث أسرع؛ ولم تجعل بوابة الموافقة اختيارية.
- هذا التمييز هو جوهر الأمر، وهو سبب إدراجي القصة أصلاً. نمط الفشل لا يكون تقريبًا أبدًا “الذكاء الاصطناعي كتب كودًا سيئًا”. بل هو “الذكاء الاصطناعي كتب كودًا أسرع من العملية التي كان من المفترض أن تفحصه”.
ما يعنيه هذا فعلاً على مستوى الممارسة
ليس “توقف عن استخدام الأدوات”. لا أحد جاد يقول ذلك، ومذكرة البحث الخاصة بـ CSA — التي تجمع معظم ما سبق — تبدأ بالحوكمة لا بالامتناع.
الشكل العملي، بالترتيب الذي سأنفذه به:
- تعامل مع أي أداة ذكاء اصطناعي تملك وصولاً إلى بيانات الاعتماد كنظام ذي امتيازات. فهو كذلك. حدّد نطاق رموزه (tokens) وفقًا لذلك.
- SAST، وفحص التبعيات، وكشف الأسرار في كل commit. ليس ليلاً. في كل commit. فقد ارتفع معدل عمليات commit ثلاثة إلى أربعة أضعاف؛ والفحص الليلي أصبح الآن حلقة تغذية راجعة من ثلاثة أيام من حيث الأثر الفعلي.
- تحليل تركيب البرمجيات، وتحديدًا للحزم المتوهَّمة. هذا أرخص ضابط وأعلاها قيمة في القائمة، لأن نسبة 20% كبيرة جدًا والفشل صامت جدًا.
- سياسة مكتوبة بأن مساعدة الذكاء الاصطناعي لا تُستخدم دون مراجعة في كود المصادقة أو التشفير أو التخويل أو الدفع. هذه هي المجالات الأربعة التي يكون فيها الخطأ الدقيق محتملاً وكارثيًا في الوقت نفسه، والتي تكون فيها عين المراجع أغلى ما تكون.
- وسّع SBOM لديك لتسجيل مصدر أدوات الذكاء الاصطناعي. عندما تصل الدراسة التالية على غرار دراسة Georgia Tech إلى قاعدة الكود لديك، ستريد أن تكون قادرًا على الإجابة عن السؤال بنفسك.
- تعامل مع منصات Vibe coding الخارجية كموفري SaaS. أرقام RedAccess هي ما يحدث حين لا يفعل أحد ذلك.
لا شيء من ذلك غريب. معظمه هو ما كانت تفعله أي ورشة كفؤة في 2019. التغيير هو أن الحجم ارتفع بمقدار عشرة أضعاف، لذا يجب أن تكون الضوابط تلقائية لا ثقافية.
عرض الصورة بيانات الأمان، من Veracode وApiiro وUSENIX وGeorgia Tech. لاحظ الشكل: ارتفعت سرعة عمليات commit بمقدار 3–4 أضعاف، وارتفعت الملاحظات الأمنية عشرة أضعاف. والفجوة بين هذين المعاملين هي المشكلة كلها.
الجزء التاسع: ما حلّ محل Vibe coding
الممارسة التي تنجح فعلاً في 2026 لها اسم — بل أسماء عدة متنافسة، وهكذا تعرف أنها حقيقية — وهي تقريبًا نقيض الـ vibes.
سمِّها التطوير المدفوع بالمواصفات, الهندسة الوكيلية، أو هندسة السياق. البنية المشتركة:
1. المواصفة هي الكود المصدري الآن
ليست تذكرة Jira. بل وثيقة فعلية: ماذا يفعل الشيء، وما يجب ألا يفعله، وما هي الواجهات، وكيف يبدو “منتهيًا”، وما أنماط الفشل. تُودَع في المستودع، وتُدار بإصدارات، وتُراجَع.
يبدو هذا كرجوع إلى 1998، وهو ليس كذلك. الفرق أن المواصفة في 1998 كانت مُدخلاً لإنسان يعيد تفسيرها، فكانت تتعفن لحظة بدء البرمجة. في 2026 المواصفة مُدخل لعملية تعيد توليد التنفيذ بتكلفة زهيدة — أي أنك عندما تتغير المتطلبات تغيّر المواصفة وتعيد الاشتقاق، بدلاً من ترقيع كود لم يعد يطابق أي وصف مكتوب لنفسه.
انقلبت المعادلة الاقتصادية. حين كان التنفيذ مكلفًا والمواصفة رخيصة، كنت تكتب المواصفة بشكل غير صارم وتستثمر في الكود. وحين يصبح التنفيذ رخيصًا والمواصفة هي عنق الزجاجة، تستثمر في المواصفة.
2. مجموعة الاختبارات هي حدود الثقة
الوكيل القادر على تشغيل اختباراتك والتحسين عليها مختلف جذريًا عن وكيل لا يستطيع ذلك. هذا هو التغيير الأعلى مردودًا الذي يمكن لمعظم الفرق إجراؤه، ولا علاقة له بالذكاء الاصطناعي أصلاً — بل إن الذكاء الاصطناعي جعل أخيرًا عائد الاستثمار في تغطية الاختبارات واضحًا لأناس لم تكن حجج الحِرفية لتنال منهم.
النسخة العملية: يحصل الوكيل على بيئة معزولة، وأمر اختبار، وأمر lint، وفحص أنواع، ولا يُعد منتهيًا حتى تنجح الأربعة كلها. وكل ما عدا ذلك قابل للتفاوض.
3. انتقلت المراجعة من الأسطر إلى الفروقات إلى السلوك
المراجعة سطرًا بسطر لا تتوسع لتغطية فرق من ألف سطر يولّده وكيل، والتظاهر بغير ذلك هو كيف يبدأ الختم الصوري بلا فحص فعلي.
ما ينجح بدلاً من ذلك، بترتيب تقريبي حسب القيمة:
- راجع المواصفة، لا التنفيذ. إن كانت المواصفة صحيحة والاختبارات تنجح، فالتنفيذ تفصيل.
- راجع شكل الفرق (diff) — أي ملفات مُست، وأي تبعيات أُضيفت، وما الذي حُذف. معظم كوارث الوكلاء مرئية على هذا المستوى: ملف غير متوقع، أو تبعية جديدة، أو حذف لم يطلبه أحد.
- راجع الأسطر الحساسة أمنيًا تحديدًا. المصادقة، والتشفير، والتخويل، والمدفوعات، وأي شيء يمسّ البيانات الشخصية. هذه نسبة صغيرة من أي فرق.
- لا تراجع الكود المتكرر. فأنت لم تكن تراجعه فعلاً من الأصل.
4. الهارنس لا يقل أهمية عن النموذج
هذا غير مُقدَّر بما يكفي. النموذج نفسه، في حلقتَي وكيل مختلفتين، ينتج عملاً مختلف الجودة اختلافًا هائلاً — وهذا بالضبط سبب مراوغة مقارنات معايير القياس بين المختبرات.
الأجزاء المهمة: كيف تُدار السياق مع طول التشغيل، وهل يرى الوكيل إخفاقات اختباراته، وهل يستطيع تصفح المستودع أم يرى فقط ما تلصقه، وهل لديه خطوة تخطيط منفصلة عن خطوة التنفيذ، وهل يعرف متى يتوقف ويسأل.
ملاحظات إصدار Muse Spark 1.3 من Meta مثيرة للاهتمام في هذه النقطة بالضبط — فهي تصف النموذج بأنه أصبح يطرح أسئلة توضيحية على الموجّهات الغامضة، ويطلب المساعدة عند التعثر، ويؤكد قبل الإجراءات ذات العواقب. ليست هذه تحسينات في الذكاء. بل هي أدب، والأدب هو ما يجعل وكيلاً بعيد المدى قابلًا للاستمرار.
5. توجيه النماذج أصبح ممارسة قياسية
لا أحد جاد يشغّل نموذجًا واحدًا لكل شيء — وقد استعرضت نسخة بنموذجين من هذا في GLM-5.3-Flash مقابل MiniMax M3 في OpenCode. والنمط الذي استقر هو:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
      "description": "Architecture, root cause, anything where being wrong is expensive",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation — long-horizon, cost-sensitive",
      "model": "anthropic/claude-opus-5"
    },
    "bulk": {
      "description": "High-volume mechanical work where price dominates",
      "model": "zai/glm-5-3-flash"
    },
    "private": {
      "description": "Anything touching client data — runs on hardware we own",
      "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
      "description": "Renames, docstrings, lint fixes, test scaffolding",
      "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
المنطق، سطرًا بسطر:
- التخطيط يذهب إلى أقدر نموذج تستطيع تحمّل تكلفته. الخطة السيئة تكلّف من الرموز لاحقًا أكثر مما كلّفته الخطة نفسها.
- البناء يذهب إلى أفضل نموذج بعيد المدى بسعر معقول. Opus 5 بسعر 5/25 دولارًا مُوجّه صراحةً لهذا، وسعره نصف سعر Fable.
- العمل الميكانيكي الكمي يذهب إلى GLM-5.3-Flash بسعر 0.15/0.47 دولارًا، لأنه بهذا السعر لا يكون السؤال هل هو بنفس الجودة، بل هل هو جيد بما يكفي للمهمة المحددة. وغالبًا ما يكون كذلك.
- أي شيء خاص يذهب إلى المحلي، على نموذج يناسب جهازك.
- العمل الروتيني الشاق يذهب إلى نموذج محلي صغير، لأن إعادة تسمية رمز عبر أربعين ملفًا لا تحتاج استدلالاً من الحدود القصوى ولا تحتاج إلى مغادرة حاسوبك المحمول.
اكتب معرّفات النماذج بحيث يكون تبديل أحدها تغييرًا في سطر واحد. وبما أن أربعة مختبرات أطلقت نموذجًا ضمن العشرة الأوائل بين يونيو وسبتمبر، فستعيد هذا التغيير خلال الربع نفسه.
الجزء العاشر: مستقبل Vibe coding — ست تنبؤات مع درجة الثقة
التنبؤات بلا مستويات ثقة هي تسلية. هذه تنبؤاتي، مع مقدار ما أراهن به.
1. المصطلح يموت؛ والممارسة تنقسم انقسامًا دائمًا. ثقة عالية.
“Vibe coding” أصبح بالفعل مصطلحًا للذم في السياقات المهنية، ومصطلح فخر لا مكان له إلا في التسويق. وما يحل محله انقسام نظيف من طبقتين: مخرجات مولّدة بالذكاء الاصطناعي قابلة للرمي حيث لا يقرأ أحد الكود (لا بأس، صحيح، افعل المزيد منه)، وهندسة وكيلية خاضعة للمراجعة تمر فيها مخرجات النموذج عبر البوابات نفسها التي يمر بها عمل الإنسان (لا بأس أيضًا، وهو حيث توجد كل أموال المؤسسات).
الوسط الخطير — كود إنتاجي غير مقروء — هو ما تتكون منه قائمة حوادث 2026، وسيُخرَج من الوجود في السياقات التجارية بالتنظيم أو التأمين أو التدقيق. ليس لأن أحدًا يحظره، بل لأن استبيان أمان سيسأل عنه في النهاية.
2. التحقق يصبح عنق الزجاجة، وأموال الأدوات تتبعه. ثقة عالية.
نحن هناك بالفعل والسوق لم يعِد التسعير بعد. إن كان الوكلاء يستطيعون إنتاج أسبوع من العمل، فالقيد هو قدرة الإنسان على إثبات أن أسبوعًا من العمل صحيح.
توقّع أن تكون منتجات 2027 المثيرة للاهتمام عن الفحص بدلًا من التوليد: توليد الاختبارات القائمة على الخصائص، وأدوات الفروق الدلالية التي تصف تغيّر السلوك لا تغيّر الأسطر، والفحص الآلي لمطابقة المواصفات، والتحقق أثناء التشغيل من إجراءات الوكيل، و— وهذا ما كنت سأبنيه — أدوات تخبرك بأي 5% من فرق كبير يحتاج الإنسان فعلاً إلى قراءته.
3. الطرق الشكلية تنال لحظتها، متأخرة عشرين عامًا. ثقة متوسطة.
كان الاعتراض التاريخي على المواصفة الشكلية أن كتابة المواصفة تكلّف أكثر من كتابة الكود. هذا الاعتراض مات الآن، لأن كتابة الكود شبه مجانية وكتابة المواصفات هي عنق الزجاجة أصلاً.
أنظمة الأنواع، والعقود، والثوابت، واختبارات الخصائص، والتحقق الشكلي الخفيف، أصبحت فجأة لها حالة استخدام تغطي تكلفتها: فهي تصريحات نوايا قابلة للفحص الآلي يمكن للوكيل أن يكرّر عليها دون إنسان في الحلقة. وأتوقع أن يكون Rust والأنماط الأكثر صرامة في TypeScript ومكتبات العقود في Python من أكبر المستفيدين بشكل غير متناسب.
سبب أن ثقتي متوسطة فقط: المجال تنبأ بنهضة للطرق الشكلية كل سبع سنوات تقريبًا منذ 1985.
4. النماذج المحلية تلتهم طبقة العمل الشاق بالكامل. ثقة متوسطة إلى عالية.
انظر إلى ما يفعله نموذج بـ 27B برخصة Apache 2.0 الآن، أضف سنة أخرى، وضعه على جهاز بذاكرة موحدة سعتها 64 GB. إعادة التسمية، ووصف الدوال، وهياكل الاختبارات، ورسائل الـ commit، وإصلاحات lint، والترجمات الأولية، وتحليل السجلات — لا شيء من ذلك يحتاج نموذجًا في الحدود القصوى، وكله حجم كبير، وكله بالضبط العمل الذي تفضّل ألا ترسله إلى طرف ثالث من مستودع عميل.
تبقى الحدود القصوى في السحابة للتخطيط والاستدلال الصعب. أما الحجم فينتقل إلى المحلي. والجزء الحادي عشر وما بعده يتناول سبب أن ذلك أصبح ممكنًا ماديًا الآن.
5. دور المطور المبتدئ يتغير شكله بدلاً من أن يختفي. ثقة متوسطة، وهذا التنبؤ أتمسك به بأقل قدر.
الحالة المتشائمة واضحة: إن كان الوكلاء يؤدون العمل الذي كان المبتدئون يؤدونه، فلن يوظّف أحد المبتدئين، وبعد عشر سنوات لن يوجد مخضرمون.
أظن أن النتيجة الأرجح هي أن وظيفة المبتدئ تتغير من “اكتب الكود” إلى “تحقق من الكود وامتلك المواصفة” — وهي وظيفة أصعب للبدء فيها، لا أسهل، وستتطلب أن تعيد الصناعة بناء طريقة تدريبها للناس. والفرق التي تحل هذا ستملك ميزة توظيف هائلة على الفرق التي تتوقف عن التوظيف ببساطة.
التحفظ الصادق: هذا هو التنبؤ الذي تشير فيه حوافزي وتحليلي إلى الاتجاه نفسه، وهذا بالضبط هو الوقت الذي ينبغي أن ترتاب فيه بنفسك.
6. سيتعرض أحدهم لفشل كارثي فعلاً في البرمجة بالذكاء الاصطناعي، منسوب علنًا. ثقة عالية بالحدث، منخفضة بالتوقيت.
ليس قاعدة بيانات مسرّبة. بل شيء فيه جهة تنظيمية، وأثر مالي بمئات الملايين، وتحليل سبب جذري يقول إن وكيلاً فعل شيئًا لم يراجعه أي إنسان.
منحنى عزو ثغرات CVE — 6، ثم 15، ثم 35 في أشهر متتالية من 2026، مع تقدير الباحثين أن المعدل الحقيقي أعلى بخمس إلى عشر مرات — ليس منحنى يستوي من تلقاء نفسه. والسؤال هو: هل تشدّ الصناعة بواباتها أولاً، أم تنتظر الحادثة التي تفرض ذلك عليها؟
ما كنت سأفعله حيال الست جميعًا، في جملة واحدة: استثمر في الاختبارات والمواصفات وأدوات المراجعة، لا في تقنيات الموجّهات، لأن تقنية الموجّهات تفقد قيمتها مع كل إصدار نموذج، بينما تتراكم البنية التحتية للتحقق.
عرض الصورة الممارستان تشتركان في التقنية ولا شيء غيرها. الحلقة اليسرى صحيحة للعمل القابل للرمي وكارثية للإنتاج؛ والحلقة اليمنى هي ما كانت قائمة الحوادث في الجزء الثامن تفتقده.
الفصل الثالث — الذكاء الاصطناعي دون اتصال على أجهزة المستهلكين
الجزء الحادي عشر: الذكاء الاصطناعي دون اتصال لم يعد هواية هذا العام
لنحو عامين، كان “شغّله محليًا” حلًا وسطًا مبدئيًا. كنت تستطيع ذلك. وكان العرض الصادق هو: هذا نموذج بـ 7 مليارات معامل، أسوأ من الطبقة المجانية في كل شيء، على عتاد تملكه بالفعل، والسبب في استخدامه مبدئي.
تغيّر ذلك في 2026، وتغيّر لثلاثة أسباب منفصلة وصلت في الوقت نفسه.
النماذج الصغيرة أصبحت جيدة فعلاً. نموذج E4B من Gemma 4 يبلغ نحو 8 مليارات معامل، ويدعم 128K من السياق، ويتعامل مع النصوص والصور والفيديو والصوت الأصلي، ورخصته Apache 2.0. أما النسخة الكثيفة 31B فتحصل على 39 في مؤشر Artificial Analysis — ضمن النطاق الذي كان يمثل الحدود القصوى قبل ثمانية عشر شهرًا — وأجرت تشغيل المؤشر كله بـ 39 مليون رمز إخراج، وهو جزء يسير مما تستهلكه النماذج المماثلة. وQwen3.8-27B نموذج كثيف متعدد الوسائط برخصة Apache 2.0 وسياق أصلي 262K، وتقول Alibaba إنه يتفوق على Qwen3.7-Plus الأكبر منه بكثير في البرمجة ومهام المكتب.
أنظمة التشغيل شحنته. هذا هو التغيير المهم فعلاً، وقد حدث بهدوء. وضعت Microsoft نموذج Aion 1.0 داخل Windows 11. وتشحن Apple نموذجًا كثيفًا بـ 3 مليارات معامل إضافة إلى نموذج متناثر بـ 20 مليار معامل على هواتف iPhone. وتشحن Google نموذج Gemini Nano على أجهزة Pixel وأجهزة Samsung. الذكاء الاصطناعي على الجهاز لم يعد شيئًا تثبّته، بل أصبح شيئًا موجودًا بالفعل، وهذا هو الفرق بين تقنية يستخدمها المتحمسون وتقنية يستخدمها الجميع.
وأخيرًا صار العتاد يملك الذاكرة. ليس القدرة الحاسوبية — بل الذاكرة. وسأعود إلى سبب أن هذا التمييز هو القصة كلها.
ما يمنحك إياه “الذكاء الاصطناعي دون اتصال” فعلاً
دعني أكون محددًا، لأن هذا يُباع بشكل سيئ.
زمن الاستجابة. نموذج محلي بـ 4B يستجيب في عشرات المللي ثانية. أما رحلة الذهاب والعودة إلى السحابة فمئات في أفضل الأحوال. وفي أي شيء تفاعلي ومستمر — الإملاء، والترجمة الفورية، والإكمال التلقائي، والتلخيص أثناء الكتابة — يفوز المحلي في الإحساس، لا في الجودة، والإحساس هو ما يلاحظه الناس.
خصوصية معمارية لا تعاقدية. مع API، كل موجّه يغادر بنيتك التحتية، وتحتاج اتفاقية معالجة، وتقييم أثر النقل، وخريطة تدفق البيانات، وإجابة لمسؤول حماية البيانات لديك. أما مع نموذج يعمل على الجهاز، لا تنشأ مسألة نقل البيانات عبر الحدود، لأنه لا يوجد أي نقل. في الأعمال الألمانية والأوروبية تكون هذه غالبًا هي الحجة كاملة، وهي تُغلق صفقات لم يكن السعر ليُغلقها أبدًا.
التوافر. على متن طائرة. في موقع بلا تغطية. في منشأة يكون فيها الوصول إلى الشبكة هو الشيء المحظور. أثناء حادثة يعاني منها مزوّدك.
قابلية توقع التكلفة. ليس توفيرًا في التكلفة — سأجري تلك الحسابات في الجزء الخامس عشر، وهي لا تقول ما يريد الناس أن تقوله. لكن تكلفة عتاد ثابتة بتكلفة حدية صفرية لكل توكن هي بند في الميزانية مختلف تمامًا عن فاتورة قائمة على الاستخدام تتضاعف مع حماس الوكيل.
تثبيت الإصدار. نموذج API مغلق يُحدَّث خلف معرّف نموذج ثابت فينزلق سلوكه. أما نقطة حفظ محلية (checkpoint) فتبقى مطابقة بايتًا ببايت بعد عام. إن سبق أن توقّف لديك موجّه كان يعمل بهدوء، فأنت تعرف قيمة ذلك.
وما لا يمنحك إياه
قدرات الطليعة. الفجوة بين نموذج 4B على هاتفك وClaude Fable 5.1 ليست صغيرة ولن تُغلق. ومن يقول لك غير ذلك يبيعك شيئًا.
السرعة في النماذج الكبيرة. النموذج المحلي بحجم 400B يولّد التوكنات أبطأ من النموذج نفسه عبر API المزوّد، لأن المزوّد يشغّله على عتاد بعرض نطاق ذاكرة يزيد أربع إلى ست مرات على ما لديك. أنت تقايض الإنتاجية بالتحكم.
الجزء الثاني عشر: الهاتف في جيبك
المواصفة التي تحسم كل شيء هي ذاكرة الوصول العشوائي RAM
كل منصة كبرى رسمت الآن خطًا للذاكرة، وهذا الخط هو 12 GB.
| المنصة | النموذج على الجهاز | حد الذاكرة |
|---|---|---|
| Apple | AFM 3 Core (3B كثيف) + AFM 3 Core Advanced (20B متناثر، 1–4B نشط) | 12 GB لميزتين في iOS 27 |
| Gemini Nano v3 (Pixel 10 فقط)؛ Nano v2 على Pixel 9 والأقدم؛ Nano v4 قادم | 12 GB الحد الأدنى لـGemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 for Galaxy — معالج Oryon من الجيل الثالث، وNPU من Hexagon، +39% سعة NPU | يعتمد على الجهاز |
ترتيب Apple هو الأكثر إثارة للاهتمام تقنيًا. AFM 3 Core Advanced نموذج متناثر بـ20 مليار معامل يقيم في ذاكرة فلاش. الخبراء المشتركون يبقون مقيمين في الذاكرة؛ أما الخبراء الموجَّهون فيُبدَّلون إلى DRAM فقط عندما يحتاجهم طلب. بهذه الطريقة يمكن أصلًا وضع نموذج 20B على هاتف — تقايض عرض نطاق قراءة NAND بسعة DRAM.
لكن تبديل الخبراء إلى DRAM يحتاج مع ذلك إلى مساحة لتبديلها إليه، فوق نظام التشغيل والتطبيق العامل وخط معالجة الكاميرا. الفجوة بين 9 GB و12 GB ليست ثلاثة غيغابايت من تقسيم السوق. إنها مجموعة العمل اللازمة لتبديل الخبراء تحت ضغط ذاكرة حقيقي. يذكر Ming-Chi Kuo أن ميزتين في iOS 27 تتطلبان 12 GB: تعبيرات صوت Siri وتخصيص الإيقاع، وتحسينًا كبيرًا في دقة تحويل الكلام إلى نص. أما iPhone 18 الأساسي، المؤجَّل إلى ربيع 2027 بذاكرة يُقال إنها 9 GB، فلا يجتاز الحد.
لدى Google الفيزياء نفسها ومشكلة علاقات عامة أسوأ. Gemini Intelligence يحتاج Nano v3، وNano v3 حاليًا على Pixel 10 فقط، وأجهزة Pixel 9 — التي بِيعت تحت وعد تحديثات سبع سنوات — تعمل بـNano v2. كان الوعد يتعلق بالتحديثات. لم يكن قط يتعلق بالميزات، والفرق الذي كان منطقيًا لمدير منتج في 2023 لا معنى له إطلاقًا لدى عميل في 2026.
توقّع أن تكون هذه قصة الذكاء الاصطناعي الاستهلاكي في العامين المقبلين: وعد بدعم طويل يوصّل تحديثات أمنية إلى جهاز لا يستطيع تشغيل الميزات التي تُشحن التحديثات معها.
ما يستطيع الهاتف فعله حقًا، بالقياس
قياس معياري مستقل على iPhone 17 Pro (A19 Pro) عبر أربع بيئات تشغيل:
| الطراز | بيئة التشغيل | فك الترميز توكن/ث | ذروة الذاكرة |
|---|---|---|---|
| Gemma 4 E2B (4-bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-bit) | MLX | 47.5 | 2,900 MB |
| Gemma 4 E2B (4-bit) | llama.cpp | 37.8 | 3,156 MB |
| Gemma 4 E2B (4-bit) | CoreML / ANE | 33.4 | 1,187 MB |
| Qwen 3.5 2B (4-bit) | MLX | 61.2 | 1,279 MB |
| Qwen 3.5 2B (4-bit) | llama.cpp | 39.1 | 1,479 MB |
| Qwen 3.5 2B (4-bit) | CoreML / ANE | 27.9 | 241 MB |
نتيجتان تبرزان.
محرك الشبكة العصبية Neural Engine هو المسار الأبطأ والأكثر كفاءة في الذاكرة بفارق كبير. 27.9 توكن/ث عند 241 MB مقابل 61.2 توكن/ث لـMLX عند 1,279 MB — خمسة أضعاف السرعة مقابل خمسة أضعاف الذاكرة. هذه المقايضة تحديدًا هي سبب استخدام Apple للـANE في ميزات النظام الدائمة، وسبب تجاوز تطبيقات الطرف الثالث له في المحادثة التفاعلية.
ستون توكنًا في الثانية على نموذج 2B في جيبك أسرع من قراءة معظم الناس. ما يعني أن القيد على الذكاء الاصطناعي المحلي على الهاتف ليس السرعة. إنه القدرة، والقدرة دالة على عدد المعاملات، وعدد المعاملات دالة على الذاكرة — والذاكرة هي ما وضعه كل مزوّد للتو خلف بوابة.
الجزء الثالث عشر: الحاسوب الشخصي، ورهان Microsoft الهادئ
فعلت Microsoft شيئًا في Build 2026 في 2 يونيو أظنه سيبدو أهم بأثر رجعي مما بدا يومها: شحنت نماذج داخل Windows نفسه.
Aion 1.0 Instruct نموذج لغوي صغير للتلخيص وإعادة الصياغة والاستخراج. يحتاج معالجًا حديثًا وWindows 11 — بلا NPU وبلا GPU منفصل. وهو متاح الآن في Edge Canary من الإصدار 150.0.4070، ومكشوف لمطوري الويب عبر واجهات Prompt وSummarizer وWriter وRewriter، وقد وصلت أوزانه المفتوحة إلى Hugging Face في يوليو 2026.
Aion 1.0 Plan هو المثير للاهتمام: نموذج بـ14 مليار معامل للاستدلال واستدعاء الأدوات، بنافذة سياق 32K، مبني لسير عمل الوكيل وإدارة الملفات وتنسيق الوكلاء الفرعيين. “الأشهر المقبلة” وقت الكتابة.
كانت الصياغة التي استخدمتها Microsoft “ذكاء غير محدود لكل منزل وكل مكتب.” ضع التسويق جانبًا وانظر إلى قرار البنية: واجهة JavaScript في المتصفح تستدعي نموذجًا محليًا، بلا مفتاح وبلا فاتورة وبلا شبكة. إن أصبح ذلك هو المعتاد، ففئة هائلة من ميزات الذكاء الاصطناعي الصغيرة تتوقف عن كونها منتج SaaS وتصبح قدرة في المنصة. وهذا أهم بكثير لاقتصاديات صناعة الذكاء الاصطناعي من أي إصدار نموذج منفرد هذا العام.
الحد الأدنى للعتاد حقيقي ويستبعد كثيرًا من الأجهزة
يتطلب مسار NPU حاسوب Copilot+ بـ minimum 40-TOPS NPU:
| الشريحة | NPU | مؤهل؟ |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ العتاد؛ البرنامج “لاحقًا” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
وهذا هو الرقم الذي ينبغي أن يعيد ضبط التوقعات: على NPU بقوة 45 TOPS، يولّد نموذج 8B نحو 5 توكنات في الثانية. نموذج Plan بحجم 14B سيكون أبطأ.
خمسة توكنات في الثانية ليست تجربة محادثة. هي مقبولة لتلخيص في الخلفية أو إعادة صياغة أو تصنيف أو استخراج — وهي الأشياء التي صُمم Aion 1.0 Instruct لها فعلًا. أما أي شيء تجلس وتشاهده فليست مقبولة له.
لماذا هذا البطء مع 45 TOPS؟ لأن توليد التوكنات محدود بعرض نطاق الذاكرة، لا بقوة الحوسبة الخام. يستطيع NPU إجراء ضرب المصفوفات؛ المشكلة هي تمرير الأوزان من ذاكرة النظام مع كل توكن منفرد. هذا هو الجدار نفسه الذي يحكم كل جهاز في هذا المقال، وهو سبب أن “TOPS” رقم شبه عديم الفائدة عند الشراء.
أجهزة المكتب
إن أردت جهازًا مخصصًا للاستدلال المحلي، فقد استقرت فئة 128 GB على خيارين وشاذ واحد:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| الذاكرة | 128 GB موحدة | 128 GB LPDDR5X-8000 | حتى 512 GB موحدة |
| عرض النطاق الترددي | ~273 GB/s | ~256 GB/s | 1.2 TB/s |
| السعر | ~$3,999 | $2,300–$2,500 | من $5,499 |
| ملاحظات | منظومة CUDA | معالج قوي (1.6 TFLOPS في Linpack مقابل 708 GFLOPS لـSpark) | فئة 512 GB في أواخر أكتوبر، بلا سعر |
تلك الأسعار وأرقام Spark وStrix Halo مأخوذة من اختبارات نُشرت في أواخر ديسمبر 2025، فاعتبرها استرشادية لا راهنة — فقد تحركت أسعار الذاكرة منذ ذلك الحين. وDGX Spark وStrix Halo أقرب بكثير في توليد التوكنات مما توحي أرقام الحوسبة — لأن كليهما عالق عند نحو 256–273 GB/s من عرض النطاق، وهذا هو القيد الحاكم. ويتفوق Spark بفارق حاسم في توليد الصور (~120 TFLOPS مقابل ~46 على FLUX.1 Dev BF16) وفي توافق CUDA. أما Strix Halo فيتفوق في السعر والمعالج.
Mac Studio M5 Ultra في فئة مختلفة تمامًا في الذاكرة وعرض النطاق معًا، وقد كتبت عنه بإسهاب في مقال عتاد الذكاء الاصطناعي المحلي. الخلاصة: 512 GB عند 1.2 TB/s هي الآلة السائدة الوحيدة القادرة على استيعاب نموذج من فئة 400B في الذاكرة، وثمن هذا الامتياز يتراوح حول $16,000–$20,000 عند التجهيز.
النماذج التي تُشغّلها فعليًا
| الطراز | المعاملات | الترخيص | يعمل بارتياح في | مناسب لـ |
|---|---|---|---|---|
| Gemma 4 E2B | 5.1B / 2.3B نشط | Apache 2.0 | 4 GB | الهواتف، العمل الدائم، إدخال صوتي |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | الأعمال الروتينية على الحاسوب المحمول، والتلخيص |
| Aion 1.0 Instruct | نموذج لغوي صغير SLM | أوزان مفتوحة (HF، يوليو 2026) | CPU فقط | مهام نصية أصلية في Windows |
| Qwen3.8-27B | 27B كثيف | Apache 2.0 | 24–32 GB | أفضل نموذج محلي عام دون 32 GB |
| Gemma 4 26B-A4B | 26B / 4B نشط | Apache 2.0 | 24 GB | MoE سريع، تكلفة نشطة منخفضة |
| Gemma 4 31B | 31B كثيف | Apache 2.0 | 32 GB | أعلى جودة محلية دون 32 GB |
| Ornith-1.5 35B | 35B / 3B نشط | MIT | 32 GB | برمجة بالوكلاء، بصمة نشطة ضئيلة |
| gpt-oss-120b | 120B / 5.1B نشط | Apache 2.0 | 128 GB | النقطة المثلى عند 128 GB |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB+ | قريب من الطليعة، يحتاج جهازًا ضخمًا |
| MiniMax M3 | 428B / 23B نشط | مخصص | 512 GB | لا يتسع إلا على M5 Ultra |
| DeepSeek V4 Pro | 1.6T / 49B نشط | MIT | عنقود | ليس نموذجًا لجهاز استهلاكي |
| Kimi K3 | 2.8T / 104B نشط | مخصص | عنقود | لا يتسع على أي Mac تبيعه Apple |
إن كنت تختار جهاز Apple بالحجم المناسب تحديدًا، فقد استعرضت فئات الذاكرة بالتفصيل في دليل الذكاء الاصطناعي المحلي على MacBook Pro M5 Pro 64GB — والخلاصة أن 64 GB هي النقطة التي تكفّ عندها التنازلات عن الإزعاج.
إن أردت توصية واحدة: على جهاز بـ32 GB، شغّل Qwen3.8-27B أو Gemma 4 31B. كلاهما Apache 2.0، وكلاهما متعدد الوسائط، وكلاهما مفيد فعلًا، وكلاهما يتسع. هذا هو الافتراضي في 2026، وهو أفضل بكثير من الافتراضي الذي كان في 2025.
عرض الصورة ما يتسع فعلًا، حسب فئة الذاكرة. الخطوط العمودية هي أحجام الذاكرة التي يستطيع المستهلكون شراءها فعلًا؛ والنماذج التي تتجاوز الخط الأيمن هي سقف طليعة الذكاء الاصطناعي المحلي في 2026.
الجزء الرابع عشر: جدار الذاكرة هو القصة كلها
كل شيء في الفصل الثالث يعود إلى معادلة واحدة، فها هي صريحة.
هل سيتسع؟
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory × 0.75) − OS and app overhead − KV cache
ما مدى سرعة توليده؟
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenلاحظ أن المعادلة الثانية تستخدم المعاملات النشطة لا إجمالي المعاملات. هذا هو سبب تميّز نماذج خليط الخبراء (mixture-of-experts) بهذا القدر غير المتناسب على العتاد الاستهلاكي. فـGemma 4 26B-A4B لديه 26 مليار معامل من القدرة و4 مليارات معامل من التكلفة لكل توكن. وOrnith-1.5 35B يفعّل 3B. وMiniMax M3 لديه 428B إجمالًا و23B نشطة.
الكفاءة في تلك المعادلة تتراوح عمليًا بين 0.5 و0.8 حسب بيئة التشغيل والتكميم ومقدار عرض نطاق الذاكرة الذي يستهلكه بقية النظام.
الآن طبّقها. حاسوب محمول بـNPU بقوة 45 TOPS وذاكرة LPDDR5X عند، لنقل، 120 GB/s، يشغّل نموذج 8B بدقة 4-bit (4 GB أوزان نشطة): 120 × 0.6 ÷ 4 ≈ 18 توكنًا في الثانية نظريًا. أما الرقم المقاس فهو نحو 5. الفرق يعود إلى الجدولة وتنازع الذاكرة وتكاليف التعبئة المسبقة (prefill) وإلى أن سلاسل أدوات NPU غير ناضجة. في تلك الفجوة بين الحساب والقياس يسكن معظم خيبة الأمل في هذا المجال.
نقص DRAM هو المتغير الخفي وراء كل رقم في هذا المقال
أمضت شركات تصنيع الذاكرة عامي 2025 و2026 في إعادة توزيع الطاقة الإنتاجية نحو عملاء مراكز بيانات الذكاء الاصطناعي، الذين يوقعون عقودًا أكبر بهوامش أفضل من مصنّعي الأجهزة الاستهلاكية. والنتائج تظهر في كل مكان:
- رفعت Apple الأسعار على أجهزة Mac وiPad في يونيو 2026.
- تأخرت فئة 512 GB من Mac Studio إلى أواخر أكتوبر لأسباب تتعلق بالإمداد، ولا يزال سعرها غير معلن.
- يبلغ M6 من Apple سقفه عند 32 GB من الذاكرة الموحدة، وقد أُلغيت M6 Pro وMax وUltra إلغاءً تامًا.
- ذكر Ming-Chi Kuo أن Apple خفّضت شحنات عتاد 2026 بسبب إمداد الذاكرة.
كل سقف في هذا المقال يعود إلى النقص نفسه. بوابة 12 GB في الهواتف. سقف 32 GB في M6. حد 128 GB في الحواسيب المحمولة. فئة 512 GB المؤجلة. لا شيء من هذه قيد تقني في السيليكون؛ كلها قرارات توزيع في سوق تكون فيه الذاكرة نادرة ومكلفة.
إن كنت تنتظر عودة الأسعار إلى طبيعتها قبل شراء جهاز للاستدلال المحلي: لا أحد موثوق يتوقع متى يحدث ذلك.
الجزء الخامس عشر: الإعداد
القسم العملي. كل ما هنا شغّلته بنفسي؛ وحيث أنقل خبرًا بدل أن أشغّل، أقول ذلك.
أسهل طريق: LM Studio
واجهة رسومية، أصلية لـMLX على Apple Silicon، متصفح نماذج مدمج، وخادم متوافق مع OpenAI بمفتاح تبديل واحد. إن أردت تشغيل نموذج في عشر دقائق، ابدأ من هنا. وهو أيضًا الأداة التي تقيس Apple نفسها مقابلها في بياناتها الصحفية، وهذا يقول لك شيئًا عن مدى شيوع هذا الأمر.
الطريق الأكثر مرونة: Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
ذلك الأمر الثاني هو ما يفوته الناس. سياق Ollama الافتراضي مضبوط بتحفظ؛ وفي مهمة برمجية سيقتطع بصمت وستلوم النموذج.
أسرع طريق على Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
وجّه أي عميل متوافق مع OpenAI إلى http://localhost:8080/v1.
ارفع حد الذاكرة المثبتة قبل أن تشكو من الانهيارات
لا يسمح macOS للـGPU بتثبيت كل ذاكرتك الموحدة افتراضيًا. وعلى جهاز بذاكرة كبيرة، هذا هو الفرق بين تحميل النموذج وفشله:
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
لا تضبطه على حجم ذاكرتك الكامل. اترك لنظام التشغيل 12–16 GB على جهاز كبير، وإلا حصلت على ذعر في النواة (kernel panic) بدل استدلال سريع. وأعد التحقق بعد كل تحديث macOS، لأن التحديثات تعيد ضبطه.
على Windows، استخدم نماذج النظام أولًا
قبل تثبيت أي شيء، تحقق مما يمنحك Windows أصلًا. واجهات Prompt وSummarizer وWriter وRewriter في Edge تستدعي Aion 1.0 Instruct محليًا بلا مفتاح وبلا فاتورة. وللتلخيص وإعادة الصياغة والاستخراج داخل تطبيق ويب، هذا حل كامل بلا أي بنية تحتية.
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
إن احتجت أكثر من ذلك، فإن LM Studio وOllama يعملان جيدًا على Windows، وعلى جهاز بلا NPU مؤهل سيستخدمان GPU أو CPU، وهو أمر في نماذج فئة 8B غالبًا ما يكون أسرع من مسار NPU على أي حال.
إعداد هجين معقول
البنية التي سأبنيها فعليًا، وتقريبًا ما أشغّله:
- المستوى 1 — على الجهاز. نموذج صغير للتوجيه والتصنيف والاستخراج والتلخيص والإملاء. Gemma 4 E4B أو Aion 1.0 Instruct. متاح دائمًا، وبتكلفة حدية صفرية.
- المستوى 2 — عتادك الخاص. نموذج مفتوح الأوزان بحجم 27B–120B على جهاز تملكه، لأي عمل يمس بيانات العملاء التي يجب ألا تغادر الولاية القضائية. Qwen3.8-27B على 32 GB،
gpt-oss-120bعلى 128 GB. - المستوى 3 — الحدود المتقدمة عبر API. التخطيط والاستدلال الصعب والتشغيلات الوكيلية الطويلة، وأي شيء يكون فيه الخطأ مكلفًا.
الجدال لا يكون أبدًا حول “محلي أم سحابي.” بل حول أين ترسم الحدود، وقد تحركت الحدود كثيرًا هذا العام.
الجزء السادس عشر: حسابات التكلفة والامتثال
حجة التوفير لا تصمد أمام الآلة الحاسبة
خذ عبئًا واقعيًا لشركة صغيرة: شهر عمل من البرمجة الوكيلية المعتدلة، لنقل 40 مليون رمز إدخال و3 ملايين رمز إخراج.
| الخيار | التكلفة الشهرية |
|---|---|
| GLM-5.3-Flash API ($0.15 / $0.47) | ~$7.40 |
| Gemini 3.8 Flash API ($0.75 / $3.75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50، بدون تخزين مؤقت) | ~$550 |
| جهاز Strix Halo بـ$2,400، مستهلك على 3 سنوات | ~$67/شهر + الكهرباء |
لاحظ ما يقوله ذلك الجدول فعليًا. العتاد المحلي أرخص من قمة الحدود المتقدمة وأغلى من قاعها. مقابل GLM-5.3-Flash، لا يصل جهاز محلي أبدًا إلى نقطة التعادل في الرموز. ومقابل Fable 5.1 يعمل بدون تخزين مؤقت، يسدد ثمنه في خمسة أشهر — لكنك لا تقارن أشياء متكافئة، لأن Fable 5.1 نموذج أفضل بكثير من أي شيء يتسع في 128 GB.
لذا لا تشترِ عتادًا محليًا لتوفير المال. اشتره لأحد هذه الأسباب الخمسة، وكلها حقيقية:
- إقامة البيانات كقرار معماري لا كمشروع قانوني.
- لا حدود لمعدل الطلبات، ولا حصص، ولا حوادث سعة. جهازك لا يعرف ثلاثاء مزدحمًا.
- تثبيت الإصدار إلى الأبد. نقطة حفظ محلية تبقى متطابقة بايتًا ببايت بعد سنة.
- التشغيل دون اتصال.
- كنت بحاجة إلى محطة العمل على أي حال. هذه هي الحالة الأكثر شيوعًا التي يكون فيها الشراء صحيحًا ببساطة — إذا كنت ستنفق €2,500 على جهاز على أي حال، فالتكلفة الحدية لقدرة الذكاء الاصطناعي هي ترقية الذاكرة، لا الجهاز كله.
صورة الامتثال في الاتحاد الأوروبي، لأنها تغيرت في 2026
بالنسبة إلى القراء في ألمانيا والاتحاد الأوروبي، تحركت الأرضية التنظيمية هذا العام، وأصبحت المواعيد ثابتة لا مشروطة.
- 2 أغسطس 2025 — تولّى مقدّمو نماذج GPAI التزامات التوثيق وملخص محتوى التدريب وحقوق النشر.
- 2 أغسطس 2026 — دخلت صلاحيات الإنفاذ وواجبات الشفافية في المادة 50 حيز التنفيذ. أصبحت الغرامات قابلة للتطبيق الآن.
- 27 يوليو 2026 — دخل Digital Omnibus، اللائحة (EU) 2026/1744، حيز النفاذ، مستبدلًا الآلية المشروطة السابقة للأنظمة عالية المخاطر بمواعيد ثابتة.
- 2 ديسمبر 2026 — نهاية فترة السماح للعلامات المائية المقروءة آليًا على الأنظمة القائمة.
- 2 أغسطس 2027 — تُغلق نافذة الانتقال البالغة سنتين لنماذج GPAI الموجودة بالفعل في السوق.
- 2 ديسمبر 2027 — الأنظمة المستقلة عالية المخاطر بموجب الملحق الثالث (التوظيف، التقييم الائتماني، التعليم، البنية التحتية الحيوية).
- 2 أغسطس 2028 — الذكاء الاصطناعي عالي المخاطر المدمج في المنتجات الخاضعة للتنظيم بموجب الملحق الأول (الأجهزة الطبية، الآلات).
أضاف Digital Omnibus أيضًا حظرًا على الصور الحميمة غير الرضائية المولّدة بالذكاء الاصطناعي ومواد استغلال الأطفال جنسيًا، ووسّع صلاحيات الرقابة لمكتب الذكاء الاصطناعي الأوروبي.
ماذا يعني هذا عمليًا لقراء هذه المقالة. إذا كنت تبني فوق النماذج بدلًا من تدريبها، فإن معظم التزامات GPAI تقع على المزوّد لا عليك. ما يقع عليك هو الشفافية — إخبار الناس عندما يتفاعلون مع الذكاء الاصطناعي، ووسم المحتوى الاصطناعي — إضافة إلى مسألة تصنيف المخاطر العالية إذا كان نظامك يمس التوظيف أو الائتمان أو التعليم أو البنية التحتية الحيوية. موعد ديسمبر 2027 بعيد بما يكفي للتخطيط له وقريب بما يكفي لأن تصبح عبارة “سننظر في الأمر لاحقًا” لم تعد استراتيجية.
والنقطة الأكثر صلة بالفصل الثالث: نموذج على الجهاز يبسّط جوهريًا عدة من هذه المحادثات دفعة واحدة. لا نقل، ولا معالج، وخريطة تدفق بيانات أقصر بكثير. هذا ليس ثغرة — فالتزامات الشفافية ما زالت سارية — لكنه يزيل فئة كاملة من العمل.
لست محاميًا وهذه ليست استشارة قانونية. لأي أمر يتعلق بالمال، استعن بمستشار مؤهل ألماني أو في الاتحاد الأوروبي للنظر في نشرك المحدد.
الجزء السابع عشر: الحجة الصادقة ضد كل هذا
لو توقفت عند الجزء السادس عشر لكان هذا إعلانًا.
أدلة الإنتاجية المقاسة ما زالت لا تدعم هذا الحماس. تجربة عشوائية مضبوطة واحدة، أبطأ بنسبة 19%. متابعة تعذّر تنفيذها بشكل نظيف. تقارير ذاتية منفوخة بـ40 نقطة مئوية. الجميع في هذه الصناعة، وأنا منهم، يعمل إلى حد كبير على إحساس حول إحساس.
بيانات الأمان سيئة ولا تتحسن. ظل معدل فشل Veracode البالغ 45% في OWASP دون تغيير جوهري حتى أوائل 2026 بينما أصبحت النماذج أذكى بشكل هائل. هذه ليست مشكلة انتقالية يحلها التوسع. القدرة والأمان ليسا المحور نفسه، ولا أحد يحسّن بجدية من أجل الثاني.
معايير القياس مشبعة في القمة وغير قابلة للتحقق في الوسط. في SWE-bench Verified ثلاثة نماذج ضمن نقطة واحدة. ومعايير القياس التي تحل محله أصبحت خاصة أكثر فأكثر، وهذا يحل التلوث بجعل التحقق المستقل مستحيلًا.
الأوزان المفتوحة تفصلها مراجعة ترخيص واحدة عن ألا تكون مفتوحة. نقلت Z.ai نموذج GLM من MIT إلى ترخيص احتكاري مع بوابة مراجعة أمنية بين 5.2 و5.3. وعدت Meta بأوزان مفتوحة لـ Muse Spark دون تاريخ ولا حجم ولا نص ترخيص. إذا كانت معماريتك تفترض أوزانًا قابلة للتنزيل العام المقبل، فإن هذا الافتراض قرار تجاري لمورّد، لا قانون طبيعي.
الحدود المتقدمة ما زالت غير محلية، وأصبحت غير قابلة للشراء أيضًا بشكل متزايد. Mythos 5.1، الأعلى تسجيلًا في Terminal-Bench 4.0، مقيّد على مدافعي الأمن السيبراني وعلماء الحياة الخاضعين للتحقق، وهم حاليًا في الولايات المتحدة معظمهم. Kimi K3 وDeepSeek V4 Pro لا يتسعان على أي جهاز استهلاكي. ما يتسع على مكتبك نموذج من الطبقة الثانية ممتاز، وهو شيء مفيد حقًا أن تكون عليه، وليس الحدود المتقدمة.
الأداء على الجهاز أسوأ مما يوحي به التسويق. خمسة رموز في الثانية لنموذج 8B على NPU بقوة 45 TOPS. بوابة ذاكرة 12 GB تستبعد معظم الهواتف المتداولة. وعد تحديثات لسبع سنوات لا يغطي الميزات. الفجوة بين علامة “AI PC” وما يمكن للجهاز تشغيله فعليًا هائلة حاليًا.
والجغرافيا السياسية مدخل من مدخلات الشراء، سواء أردت ذلك أم لا. العديد من أفضل النماذج مفتوحة الأوزان — Kimi وGLM وDeepSeek وQwen وMiniMax — تأتي من مختبرات صينية. بالنسبة للقطاع العام والجهات القريبة من الدفاع وبعض العملاء الخاضعين للتنظيم، هذا مانع صارم بغض النظر عن مكان تشغيل الأوزان أو ما يقوله الترخيص. وفي الوقت نفسه، فإن أقدر نموذج برمجة من Anthropic مقيّد على منظمات أمريكية خاضعة للتحقق. يجري تمزيق المنظومة المفتوحة على أسس وطنية من الطرفين، وإن كنت في أوروبا فأنت لست في أي من طرفيها.
الجزء الثامن عشر: إطار القرار لوضع الذكاء الاصطناعي في 2026
عرض الصورة سبع حالات، سبع إجابات. اعثر على الصف الذي يشبه عامك.
سبع حالات، موضوعة على خريطة وضع الذكاء الاصطناعي في 2026 كما هو عليه اليوم فعليًا.
1. “أريد أفضل نموذج والتكلفة ليست مشكلة.”
Claude Fable 5.1 بـ65.7 على المؤشر الإجمالي، $10/$50، سياق 1M — وفعّل التخزين المؤقت، لأن خصم قراءة التخزين المؤقت البالغ 75% يساوي 25–45% من فاتورتك. أبقِ GPT-5.6 Sol متاحًا للبحث المكثف في التصفح عند 90.4% في BrowseComp. لا تتعذب؛ الفجوة بينهما أصغر من الفجوة بين أفضل موجّه لديك وأسوئه.
2. “أشغّل الكثير من الوكلاء والفاتورة أصبحت سخيفة.”
Claude Opus 5 بـ$5/$25 للأعمال طويلة الأفق، وGLM-5.3-Flash بـ$0.15/$0.47 للأعمال الميكانيكية الكبيرة، ونموذج محلي للأعمال الشاقة البسيطة. التوجيه هو أكبر رافعة تكلفة متاحة لك، وهو ملف إعدادات لا مشروع. قِس توزيع الرموز حسب دور الوكيل قبل أن تحسّن أي شيء — يكتشف معظم الناس أن 80% من إنفاقهم على مهام لم تكن بحاجة إلى نموذج من الحدود المتقدمة.
3. “GDPR وإقامة البيانات متطلبات صارمة لعمل العملاء.”
Qwen3.8-27B أو Gemma 4 31B على عتاد تملكه، كلاهما Apache 2.0 وكلاهما متعدد الوسائط. ارتقِ إلى gpt-oss-120b على جهاز 128 GB إذا احتاج العمل ذلك. الفكرة ليست السرعة — بل ألا يغادر أي موجّه المبنى، وأن تصبح مراجعتك القانونية قراءة ترخيص بدلًا من تقييم أثر النقل. اختر نماذج بتراخيص متسامحة تحديدًا حتى تكون تلك القراءة قصيرة.
4. “أريد تجربة الذكاء الاصطناعي المحلي دون إنفاق كثير.”
ما تملكه بالفعل، مع LM Studio وGemma 4 E4B. ثمانية غيغابايت من الذاكرة تكفي لتكون مفيدًا حقًا. اكتشف ما إذا كان الذكاء الاصطناعي المحلي يناسبك قبل أن تنفق عليه — يكتشف معظم الناس أنهم يريدون المستوى 1 والمستوى 3 ولم يحتاجوا المستوى 2 أبدًا.
5. “أشتري جهازًا خصيصًا للاستدلال المحلي.”
اشترِ على أساس عرض النطاق الترددي للذاكرة وسعتها، بهذا الترتيب، وتجاهل TOPS. في فئة 128 GB، يُعد Strix Halo بـ~$2,400 الخيار الأفضل قيمة، وDGX Spark بـ~$3,999 يشتري لك CUDA وتوليد صور أفضل بكثير. وما فوق ذلك، فإن Mac Studio M5 Ultra هو الشيء الوحيد الذي يستوعب نموذج 400B، بسعر لا يكون منطقيًا إلا إذا كنت بحاجة إلى محطة العمل على أي حال.
6. “فريقي يتبنى أدوات البرمجة بالذكاء الاصطناعي وأنا أتحمل المخاطر.”
افعل الأشياء المملة، بهذا الترتيب: SAST وكشف الأسرار في كل عملية commit؛ وتحليل تركيب البرمجيات للحزم المهلوسة؛ وسياسة مكتوبة تستبعد كود الذكاء الاصطناعي غير المراجع من المصادقة والتشفير والتفويض والمدفوعات؛ وبيانات اعتماد الوكيل بنطاق مميز؛ وSBOM يسجل مصدر الأداة. ثم توقع منحنى J — قاست DORA انخفاضًا حقيقيًا قبل المكسب — ولا تُصب بالذعر في الشهر الثالث.
7. “أي هاتف يجب أن أشتري للذكاء الاصطناعي؟”
أي طراز بذاكرة 12 GB. هذا هو الخط الذي رسمته كل منصة: iPhone 17 Pro و18 Pro بذاكرة 12 GB، وPixel 10 من أجل Nano v3، وGalaxy S26 Ultra على Snapdragon 8 Elite Gen 5. أما iPhone 18 الأساسي بذاكرة 9 GB حسب التقارير وPixel 9 وما قبله فستعمل الهواتف جيدًا ولن تحصل على الميزات. إذا كنت على جهاز بذاكرة 12 GB بالفعل، فترقية هذا العام تدريجية فيما يخص الذكاء الاصطناعي تحديدًا.
الجزء التاسع عشر: ما أراقبه في الربع القادم
هل ستشحن Meta أوزان Muse Spark فعليًا، وتحت أي ترخيص. كلمة “قريبًا” من مدير تنفيذي على X، بلا عدد معاملات ولا نص ترخيص، هي أضعف شكل من أشكال الالتزام في هذه المقالة. إذا شحنوها تحت Apache 2.0 فسيغيّر ذلك المنظومة المفتوحة جوهريًا. وإذا شحنوها تحت ترخيص مخصص ببوابة إيرادات، فذلك هو الافتراضي الصناعي الآن، وتصبح الأوزان المفتوحة فئة تسويقية لا خاصية.
هل تتكرر نتيجة التحسن الذاتي لـ Ornith-1.5. التقييم المستقل على مهام خارج المنهج المولّد ذاتيًا هو ما سيحسم الأمر. هذا هو البند الأعلى تباينًا في القائمة: إما أهم نتيجة في 2026 أو قصة تحذيرية عن معايير القياس المولّدة ذاتيًا، ولا أعرف حاليًا أيهما.
هل يُشحن Aion 1.0 Plan فعليًا، وبأي سرعة يعمل. نموذج استدلال 14B داخل Windows فئة جديدة حقًا. إذا عمل بـ3 رموز في الثانية على عتاد مؤهل، فهو عرض تجريبي. وإذا عمل بـ20، فإنه يغيّر ما يمكن لتطبيق سطح مكتب أن يفترضه.
منحنى إسناد CVE. 6، 15، 35 في أشهر متتالية. إذا استمر هذا المسار من أبريل إلى أغسطس، فستكون بيانات Georgia Tech أهم منشور أمني عن الذكاء الاصطناعي هذا العام حين تصدر.
هل يبني أحد أدوات المراجعة. الفجوة بين ما يستطيع الوكلاء إنتاجه وما يستطيع البشر التحقق منه هي مشكلة 2027 المحددة، وحتى اليوم ما زال معظم رأس المال الاستثماري يذهب إلى التوليد لا التحقق. ومن يشحن الأداة التي تخبرك بموثوقية أي 5% من الفرق يحتاج إلى عيون بشرية، سيكون من الصعب جدًا منافسته.
هل يخف نقص الذاكرة. إنه المتغير الخفي وراء بوابة 12 GB في الهواتف، وسقف 32 GB في M6، وتأخر فئة 512 GB في Mac، وارتفاع أسعار Apple في يونيو. لا أحد ذو مصداقية يتوقع انفراجًا.
وهل تبقى نماذج الحدود المتقدمة المقيّدة لأسباب أمان استثناءً. Mythos 5.1 مقيّد لأسباب الاستخدام المزدوج التي أجدها قابلة للدفاع، ومشروع Glasswing يوسّع الوصول بنشاط — نحو 150 منظمة في أكثر من خمسة عشر بلدًا بحلول يونيو 2026. لكن السابقة قد أُرسيت: الأعلى تسجيلًا في معيار برمجة عام أصبح شيئًا لا تستطيع معظم المنظمات شراؤه بأي ثمن. وإذا أصبح ذلك نمطًا لا حالة خاصة، فسيتحول سؤال “هل يمكن لمنظمتي اجتياز التحقق” إلى معيار لاختيار النموذج، وتتوقف الحجة لصالح الأوزان المفتوحة خارج الولايات المتحدة عن كونها مسألة تكلفة تمامًا.
الأسئلة الشائعة
ما أفضل LLM في سبتمبر 2026؟
على المستوى الإجمالي، يتصدر Claude Fable 5.1 مؤشر الذكاء v4.1.1 من Artificial Analysis بـ65.7، متقدمًا على Claude Opus 5 بـ63.0، وClaude Fable 5 بـ62.1، وGrok 4.6 بـ60.9، وGPT-5.6 Sol بـ58.9. لكن الإجمالي يضغط الفروق المهمة. يتصدر GPT-5.6 Sol التصفح بـ90.4% في BrowseComp؛ ويقدم Gemini 3.8 Flash 58.7 بـ$0.75 لكل مليون رمز إدخال؛ ويقدم GLM-5.3-Flash 57.5 بـ$0.15. بالنسبة لمعظم أعباء العمل الحقيقية، فإن أفضل ثمانية نماذج قابلة للتبادل، وينبغي أن يُتخذ القرار على أساس السعر وزمن الاستجابة واقتصاديات التخزين المؤقت والترخيص، لا على أساس الترتيب.
ما أفضل نموذج مفتوح الأوزان الآن؟
يعتمد على عتادك ومدى تحملك للترخيص. يسجل GLM-5.3 (753B) الأعلى بـ59.5 لكنه يحمل ترخيصًا مخصصًا مع بوابة مراجعة أمنية عند إيرادات 10 مليارات دولار. DeepSeek V4 Pro (1.6T إجماليًا، 49B نشطًا) مرخص بـMIT ويسجل 87.9 في Terminal-Bench 2.1، لكنه يحتاج إلى عنقود. أما لجهاز تملكه فعليًا، فإن Qwen3.8-27B أو Gemma 4 31B — وكلاهما Apache 2.0 — هما أفضل النماذج التي تتسع في 32 GB.
هل انتهى Vibe coding في 2026؟
الكلمة تحتضر؛ والممارسة انقسمت إلى اثنتين. Vibe coding بالمعنى الأصلي — موجّه، اقبل، لا تقرأ الفرق — يبقى صحيحًا للعمل القابل للتخلص منه: السكربتات والنماذج الأولية والتحليلات لمرة واحدة. وما حل محله لأي شيء يُشحن هو هندسة وكيلية مدفوعة بالمواصفات: مواصفة مكتوبة، وصندوق رمل، ومجموعة اختبارات يجب أن يجتازها الوكيل، ومراجعة حقيقية للفرق الناتج. الوسط الخطير — كود إنتاجي غير مراجع — هو مصدر كل حادثة موثقة في 2026.
هل تجعل البرمجة بالذكاء الاصطناعي المطورين أسرع فعليًا؟
التجربة العشوائية المضبوطة الوحيدة تقول لا. وجدت METR أن المطورين ذوي الخبرة كانوا أبطأ بنسبة 19% مع أدوات الذكاء الاصطناعي في أوائل 2025 على قواعد برمجية ناضجة، بينما كانوا يعتقدون أنهم أسرع بنسبة 20% — مبالغة بـ40 نقطة مئوية. ولم تتمكن متابعتهم في 2026 من التنفيذ بشكل نظيف لأن المطورين رفضوا العمل بدون الذكاء الاصطناعي. وتفيد الاستبيانات بمعامل سرعة 3× لكن بتغير 1.4–2× فقط في قيمة العمل. قراءتي: مكاسب كبيرة في العمل غير المألوف والنمط المتكرر والاختبارات والهجرات؛ ومكاسب صغيرة أو سلبية في قواعد برمجية تعرفها جيدًا.
ما مدى خطورة الكود المولّد بالذكاء الاصطناعي؟
خطير بشكل قابل للقياس ويتحسن ببطء. وجدت Veracode أن 45% من العينات المولّدة بالذكاء الاصطناعي تُدخل ثغرة من OWASP Top 10، وكانت Java الأسوأ بنسبة 72%. وقاست Apiiro أن المطورين بمساعدة الذكاء الاصطناعي ينتجون commits أسرع بـ3–4 مرات ونتائج أمنية أسرع بـ10 مرات، مع مسارات تصعيد الامتيازات بزيادة 322%. ونحو 20% من الكود المولّد بالذكاء الاصطناعي يشير إلى حزم غير موجودة، و43% من تلك الأسماء المهلوسة تتكرر بانتظام — وهذا سطح هجوم لسلسلة التوريد. الحل هو بوابات آلية في كل commit، لا الامتناع.
هل يمكنني تشغيل LLM جيد دون اتصال على حاسوبي؟
نعم، و2026 هي أول سنة يكون فيها ذلك صحيحًا بلا لبس. على 8 GB من الذاكرة، Gemma 4 E4B مفيد حقًا. وعلى 32 GB، فإن Qwen3.8-27B أو Gemma 4 31B نموذجان متعددَا الوسائط قويان تحت Apache 2.0. وعلى 128 GB، فإن gpt-oss-120b هو الخيار الأمثل. وما لا يتسع على أي جهاز استهلاكي هو الحدود المتقدمة الفعلية: Kimi K3 بـ2.8 تريليون معامل وDeepSeek V4 Pro بـ1.6 تريليون يحتاجان كلاهما إلى عنقود.
ما هو Microsoft Aion 1.0؟
عائلة من النماذج على الجهاز أُعلنت في Build في 2 يونيو 2026 وشُحنت إلى Windows 11. Aion 1.0 Instruct نموذج صغير للتلخيص وإعادة الصياغة والاستخراج يعمل على CPU حديث دون الحاجة إلى NPU، ويُتاح عبر واجهات JavaScript في Edge: Prompt وSummarizer وWriter وRewriter، مع أوزان مفتوحة على Hugging Face منذ يوليو 2026. Aion 1.0 Plan نموذج استدلال واستدعاء أدوات بـ14 مليار معامل ونافذة سياق 32K لسير عمل وكيلي، ويتطلب جهاز Copilot+ PC بحد أدنى 40 TOPS في NPU، وكان لا يزال “قادمًا في الأشهر المقبلة” في مطلع سبتمبر 2026.
لماذا تحتاج الهواتف إلى 12 GB من RAM لميزات الذكاء الاصطناعي؟
لأن النماذج على الجهاز محدودة بالذاكرة لا بالحوسبة. AFM 3 Core Advanced من Apple نموذج متناثر بـ20 مليار معامل يعيش في التخزين الوميضي ويبدّل الخبراء الموجّهين إلى DRAM عند الطلب — وهذا ما زال يحتاج إلى مكان يبدّلهم فيه، فوق نظام التشغيل والتطبيق وخط أنابيب الكاميرا. يذكر Ming-Chi Kuo ميزتين في iOS 27 تتطلبان 12 GB. ولدى Gemini Intelligence من Google الحد الأدنى نفسه البالغ 12 GB. الفجوة بين 9 GB و12 GB هي مجموعة العمل، لا تقسيم السوق.
هل يستحق NPU أن يكون لديك للذكاء الاصطناعي المحلي؟
أقل مما يوحي به التسويق. على NPU بقوة 45 TOPS، يولّد نموذج 8B نحو 5 رموز في الثانية، لأن توليد الرموز محدود بعرض النطاق الترددي للذاكرة لا بالحوسبة. NPU ممتازة للمهام الدائمة منخفضة الطاقة وقصيرة الاندفاع — تلك التي يشغلها نظام التشغيل باستمرار. أما للمحادثة التفاعلية على حاسوب محمول، فمسار GPU أو حتى CPU غالبًا أسرع. اشترِ على أساس عرض النطاق الترددي للذاكرة وسعتها؛ واعتبر TOPS شبه بلا معنى عند التسوق.
هل النماذج مفتوحة الأوزان مفتوحة المصدر فعليًا؟
غالبًا لا. DeepSeek V4 Pro (MIT) وQwen3.8 (Apache 2.0) وGemma 4 (Apache 2.0) وOrnith-1.5 (MIT) تحمل تراخيص متسامحة حقًا. GLM-5.3 يتطلب من الشركات التي تتجاوز إيراداتها 10 مليارات دولار اجتياز مراجعة Z.ai الأمنية؛ ويستخدم Kimi K3 ترخيصًا متدرجًا حسب الإيرادات؛ ويلزم MiniMax M3 بإسناد بارز “Built with MiniMax M3” لأي استخدام تجاري وبإذن كتابي فوق إيرادات 20 مليون دولار. ولا أحد منها ينشر بيانات التدريب أو كود التدريب. “الأوزان المفتوحة” هو المصطلح الدقيق؛ أما “مفتوح المصدر” فيؤدي عملًا غير صادق.
هل تشغيل النماذج محليًا أرخص من استخدام API؟
تقريبًا أبدًا على أساس تكلفة الرموز وحدها. شهر معتدل من العمل الوكيلي — 40 مليون رمز إدخال و3 ملايين رمز إخراج — يكلف نحو $7 على GLM-5.3-Flash ونحو $41 على Gemini 3.8 Flash. وجهاز محلي بـ$2,400 مستهلك على ثلاث سنوات يكلف نحو $67 شهريًا قبل الكهرباء. العتاد المحلي يتفوق على قمة الحدود المتقدمة في التكلفة ويخسر أمام قاعها. اشترِ محليًا لإقامة البيانات وحرية معدل الطلبات وتثبيت الإصدار والتشغيل دون اتصال — أو لأنك كنت بحاجة إلى محطة العمل على أي حال.
ماذا يتطلب قانون الذكاء الاصطناعي الأوروبي في 2026؟
اعتبارًا من 2 أغسطس 2026، تسري صلاحيات الإنفاذ وواجبات الشفافية في المادة 50 على الذكاء الاصطناعي للأغراض العامة، والغرامات متاحة الآن. دخل Digital Omnibus، اللائحة (EU) 2026/1744، حيز النفاذ في 27 يوليو 2026 وحدد مواعيد ثابتة: 2 ديسمبر 2026 تنتهي فترة السماح للعلامات المائية؛ 2 أغسطس 2027 يُغلق الانتقال لنماذج GPAI الموجودة بالفعل في السوق؛ 2 ديسمبر 2027 يسري على الأنظمة المستقلة عالية المخاطر بموجب الملحق الثالث؛ 2 أغسطس 2028 يغطي الذكاء الاصطناعي عالي المخاطر المدمج في المنتجات الخاضعة للتنظيم. إذا كنت تبني على النماذج بدلًا من تدريبها، فإن معظم التزامات GPAI تقع على المزوّد — والشفافية وتصنيف المخاطر العالية هما ما يقع عليك. هذه ليست استشارة قانونية.
إلى متى يمكن لوكيل ذكاء اصطناعي أن يعمل دون إشراف؟
تقيس METR طول المهمة التي يكملها النموذج ذاتيًا بنسبة نجاح 50%. ارتفع ذلك الرقم من نحو 30 ثانية في 2022 إلى أكثر من 14 ساعة للأنظمة الحدودية في 2026، بزمن مضاعفة نحو 196 يومًا على الملاءمة الهجينة لدى METR، أو 131 يومًا عند الاقتصار على نماذج ما بعد 2023. وفواصل الثقة واسعة جدًا — أفق الـ320 دقيقة لدى Claude Opus 4.5 يتراوح بين 170 و729 دقيقة — و5 فقط من أصل 31 مهمة طويلة لدى METR تستخدم خطوط أساس بشرية مقاسة. وبالاستقراء، فإن ذلك يعادل نحو يوم عمل من طول المهمة الذاتية في 2027.
أي نموذج يجب أن أستخدم للبرمجة تحديدًا؟
وجّه بدلًا من أن تختار. التخطيط والمعمارية إلى أقدر نموذج تستطيع تحمّل تكلفته (Claude Fable 5.1)؛ ومعظم التنفيذ طويل الأفق إلى Claude Opus 5 بنصف السعر؛ والعمل الميكانيكي عالي الحجم إلى GLM-5.3-Flash بـ$0.15/$0.47؛ وأي شيء يمس بيانات العملاء إلى نموذج محلي مفتوح الأوزان؛ وإعادة التسمية ونصوص التوثيق وإصلاحات lint إلى نموذج محلي صغير. اكتب معرّفات النماذج بحيث يكون تبديل أحدها تغييرًا في سطر واحد — فقد شحنت أربعة مختبرات نموذجًا ضمن العشرة الأوائل بين يونيو وسبتمبر 2026.
الخلاصة
قبل اثني عشر شهرًا، كان السؤال المثير في الذكاء الاصطناعي هو أي نموذج أذكى. أما وضع الذكاء الاصطناعي في 2026 فهو أن هذا السؤال أصبح قريبًا من غير المثير. أفضل عشرة نماذج تمتد على 8.2 نقطة في أفضل مؤشر إجمالي متاح، وأرخصها يكلف واحدًا على سبعة وستين من أغلاها.
ما حل محله أكثر فائدة وأقل إثارة: هل يمكنك التحقق من ما تنتجه هذه الأشياء بسرعة كافية لمواكبتها؟
هذا السؤال الواحد يفسر كل نتيجة في هذه المقالة. يفسر لماذا تشبع SWE-bench عند 96% وكف عن أن يكون مفيدًا. يفسر لماذا بلغ تبني أدوات البرمجة بالذكاء الاصطناعي 90% بينما هبطت الثقة إلى 29%. يفسر لماذا لم يتزحزح معدل الفشل الأمني لدى Veracode بينما ارتفعت القدرة، لأن القدرة وقابلية التحقق محوران مختلفان ويجري تحسين أحدهما فقط. يفسر لماذا وجدت DORA أن العوائد تأتي من المنظمة لا من الأداة. ويفسر لماذا تبدو الممارسة التي تعمل فعليًا في 2026 — المواصفة وصندوق الرمل وبوابة الاختبار والمراجعة الحقيقية — أقل سحرًا بكثير من العروض التجريبية.
أربعة أشياء سآخذها معي.
أصبحت الحدود المتقدمة سلعة أسرع مما توقع أي أحد، وفجوة الأوزان المفتوحة الآن نحو ستة أشهر. نموذج 397B مرخص بـMIT يتفوق على الحدود المتقدمة المغلقة للجيل الماضي في SWE-bench. ونموذج مفتوح الأوزان بـ753B يتقدم على GPT-5.6 Sol في المؤشر الإجمالي. خطط لعالم لا يكون فيه النموذج ميزتك التنافسية، لأنه لم يعد كذلك تقريبًا بالفعل.
اقرأ الترخيص قبل معيار القياس. القدرة تتقارب؛ والشروط تتباعد. ابتعدت Z.ai عن MIT بين إصدارين. وعدت Meta بأوزان دون نص ترخيص. وأفضل نموذج برمجة لدى Anthropic مقيّد بالجنسية. بالنسبة لمشترٍ تجاري، أربع نقاط في معيار القياس تساوي أقل من ترخيص يستطيع محاميك قراءته في تسعين ثانية.
التحقق هو اللعبة كلها الآن، ولا أحد تقريبًا يموله. يستطيع الوكلاء إنتاج يوم عمل؛ ونحن نراجعه بأدوات بُنيت لمراجعة ساعة عمل. إذا كنت تختار أين تصرف جهدك الهندسي في الاثني عشر شهرًا القادمة، فاصرفه على الاختبارات والمواصفات وأدوات المراجعة لا على تقنية الموجّهات. تقنية الموجّهات تستهلك مع كل إصدار نموذج. البنية التحتية للتحقق تتراكم.
وأصبح الذكاء الاصطناعي دون اتصال حقيقيًا، على ميزانية ذاكرة أصبحت مكلفة للتو. نموذج متعدد الوسائط بـ27 مليار معامل مرخص بـApache يعمل على جهاز يمكنك شراؤه بـ€2,500. ويشحن Windows نموذجًا داخل نظام التشغيل. وهاتفك يشغّل نموذجًا متناثرًا بـ20 مليار معامل من التخزين الوميضي. وكل سقف على ذلك — بوابة 12 GB في الهواتف، وسقف 32 GB في الحواسيب المحمولة، وحد 40 TOPS — هو قرار تخصيص ذاكرة في سوق تشح فيها DRAM، لا حد من حدود السيليكون.
الإعداد الذي كنت سأبنيه فعليًا اليوم: Gemma 4 E4B على الجهاز للمستوى الدائم؛ Qwen3.8-27B على عتادك الخاص لأي شيء يجب ألا يغادر المبنى؛ GLM-5.3-Flash بـ$0.15/$0.47 للوسط عالي الحجم؛ و Claude Opus 5 أو Fable 5.1 للتخطيط والمشكلات الصعبة حقًا، مع تفعيل التخزين المؤقت. وجّه بينها في ملف إعدادات، وتوقع إعادة كتابة ذلك الملف بعد ثلاثة أشهر.
عُد إلى هذا في ديسمبر. ستكون Meta قد شحنت الأوزان أو لا. وسيكون Aion 1.0 Plan حقيقيًا أو وهمًا. وستكون نتيجة التحسن الذاتي لـ Ornith قد تكررت أو اختفت بهدوء. وسيكون منحنى إسناد CVE قد أخبرنا ما إذا كانت 2026 هي السنة التي شددت فيها الصناعة بواباتها أم السنة التي انتظرت فيها شخصًا آخر.
هل تشغّل نماذج مفتوحة الأوزان في الإنتاج داخل الاتحاد الأوروبي، أم تشحن كودًا كتبه وكيل عبر عملية مراجعة تثق بها فعلًا؟ يهمني أمران تحديدًا: تقسيمات تكلفة الرموز المقاسة حسب دور الوكيل، وأي شيء ينجح في مراجعة فروق وكيل بألف سطر. التصحيحات والأدلة المضادة مرحب بها — تُحدَّث هذه المقالة عندما تتغير الصورة.
آخر تحديث: 3 سبتمبر 2026.


