ไทย
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 Bahasa Indonesia
 Русский
 العربية

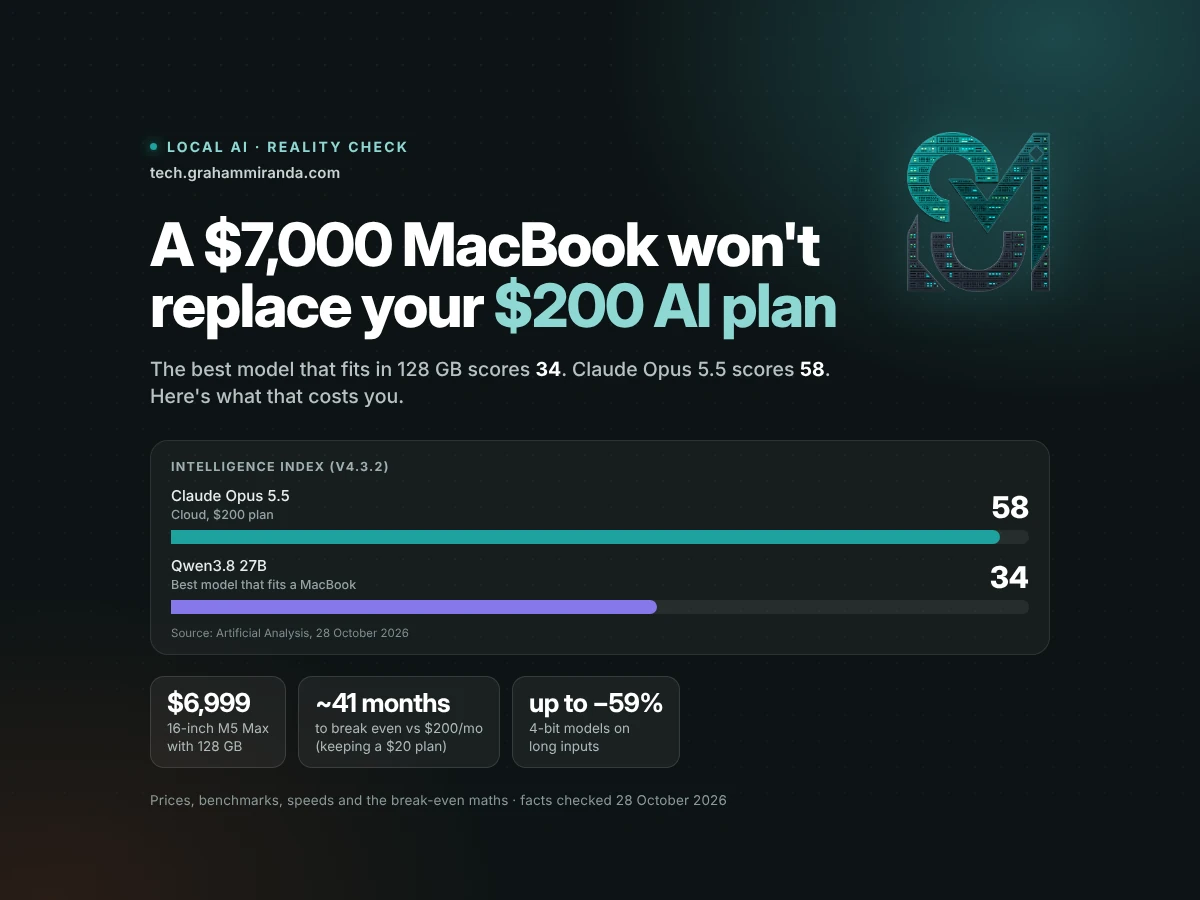
ข้อเสนอขายนี้พูดกันแบบนี้ การสมัครสมาชิก AI ระดับสูงสุดมีค่าใช้จ่าย $200 ต่อเดือน หรือ $2,400 ต่อปี MacBook Pro ที่มีหน่วยความจำแบบรวม 128 GB สามารถรันโมเดลภาษาขนาดใหญ่ได้ในเครื่อง อย่างเป็นส่วนตัว และไม่จำกัดการใช้งาน ดังนั้นยกเลิกการสมัครสมาชิกเสีย ซื้อ MacBook สำหรับ LLM ภายในเครื่องแทน แล้วอีกปีสองปีมันก็คุ้มทุนเอง
คุณจะเจอข้อเสนอนี้ในหลายรูปแบบตลอดปี 2026: ในวิดีโอ YouTube ที่ถามว่าคุณควรยกเลิกแผน AI ราคา $200 แล้วซื้อ Mac ราคา $9,499 หรือไม่ ในโพสต์ Medium ที่หาราคา Mac ด้วย $200 และในคอลัมน์ Forbes ที่คำนวณตัวเลขตอน Apple เปิดตัว Mac Studio รุ่นใหม่ในเดือนสิงหาคม ตอนเปิดตัว M5 Max MacBook Pro จอห์น เทอร์นัส หัวหน้าฝ่ายฮาร์ดแวร์ของ Apple กล่าวว่าเครื่องรุ่นใหม่ทำให้มืออาชีพ “รัน LLM ขั้นสูงบนอุปกรณ์ได้”
การซื้อ MacBook เพื่อรัน LLM ภายในเครื่องเป็นความคิดที่ดีมากสำหรับบางคน แต่ในฐานะสิ่งทดแทนแผน Claude หรือ ChatGPT ราคา $200 มันล้มเหลว และล้มเหลวในสิ่งเดียวที่ข้อเสนอนี้ไม่เคยคิดราคาเข้าไปด้วย: คุณภาพ. การสมัครสมาชิกให้คุณเช่าโมเดลที่ดีที่สุดในโลก ส่วน Mac รันโมเดลที่ดีที่สุดที่ใส่ลงใน 128 GB ได้ เมื่อวานนี้ เราเพิ่งวัดระยะห่างระหว่างสองสิ่งนี้ได้แม่นยำกว่าที่เคย และช่องว่างนั้นกว้างกว่าที่กระแส hype บอกไว้
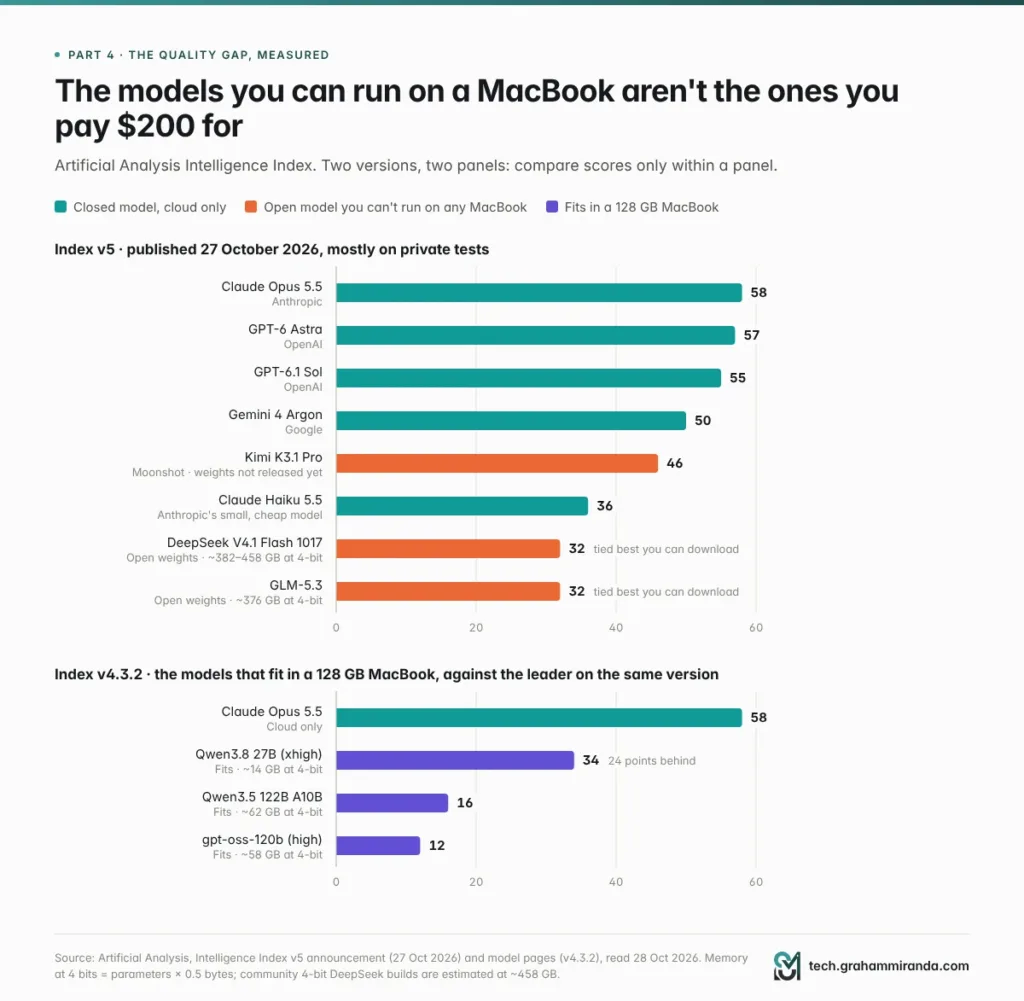
เมื่อวันที่ 27 ตุลาคม Artificial Analysis ได้สร้าง Intelligence Index ขึ้นใหม่โดยใช้การทดสอบแบบปิดเป็นหลัก Claude Opus 5.5 นำอยู่ที่ 58โมเดลโอเพนเวตที่ดีที่สุดที่คุณดาวน์โหลดได้จริง DeepSeek V4.1 Flash 1017 และ GLM-5.3 ได้คะแนน 32ต่ำกว่า Claude Haiku 5.5 โมเดลเล็กและราคาถูกของ Anthropic ที่ 36 ทั้งสองโมเดลเปิดนี้ไม่พอดีกับ MacBook เครื่องใดเลย: ที่ 4 บิต พวกมันต้องใช้หน่วยความจำระหว่าง 375 ถึง 460 GB โมเดลที่แข็งแกร่งที่สุดที่ผมพบว่าใส่ใน MacBook 128 GB ได้ คือ Qwen3.8 27B ได้คะแนน 34 ในเวอร์ชันก่อนของดัชนี ซึ่งเป็นเวอร์ชันที่ Opus 5.5 ก็ได้ 58 เช่นกัน
ระหว่างนี้ฮาร์ดแวร์ก็แพงขึ้น ในเดือนมิถุนายน Apple ขึ้นราคาอัปเกรดหน่วยความจำ 128 GB บน M5 Max เป็นสองเท่า ตอนนี้ MacBook Pro 16 นิ้วที่ความจุ 128 GB ราคา $6,999 ในสหรัฐฯ และจากประมาณการของผม ประมาณ €8,199 ในเยอรมนี
นี่คือคณิตศาสตร์ฉบับซื่อตรง: ว่า $200 ต่อเดือนซื้ออะไรได้จริง $7,000 ซื้ออะไรได้จริง ช่องว่างด้านคุณภาพกว้างแค่ไหนและทำไมจึงเป็นเช่นนั้น M5 Max เร็วแค่ไหนจริง ๆ การควอนไทซ์ทำให้คุณต้องเสียอะไรบ้าง เมื่อใดการซื้อ Mac เพื่อ AI ภายในเครื่องจึงสมเหตุสมผล และวิธีที่ถูกกว่าในการลดบิล $200 ถ้านั่นคือสิ่งที่คุณต้องการจริง ๆ ตัวเลขทุกตัวได้รับการตรวจสอบกับแหล่งที่มาเมื่อวันที่ 28 ตุลาคม 2026.
สรุปสั้น — ฉบับ 60 วินาที
- โมเดลที่คุณจ่าย $200 เพื่อใช้งานนั้นดาวน์โหลดไม่ได้ และโมเดลที่ดีที่สุดที่คุณดาวน์โหลดได้ก็ไม่พอดีกับ MacBook บน Intelligence Index v5 ใหม่ของ Artificial Analysis Claude Opus 5.5 ได้ 58 โมเดลเปิดชั้นนำที่ดาวน์โหลดได้ DeepSeek V4.1 Flash 1017 และ GLM-5.3 ได้ 32 และต้องใช้หน่วยความจำราว 375–460 GB ที่ 4 บิต
- รุ่นที่ใส่ได้คะแนนต่ำกว่ามาก โมเดลที่แข็งแกร่งที่สุดที่ผมพบสำหรับ MacBook 128 GB คือ Qwen3.8 27B ได้ 34 เทียบกับ 58 ของ Opus 5.5 บนดัชนีเวอร์ชันเดียวกัน (v4.3.2) ส่วนโมเดลระดับ 120B ที่ต้องใช้หน่วยความจำเพิ่มจริง ๆ ได้ต่ำกว่านั้นอีก: 16 สำหรับ Qwen3.5 122B และ 12 สำหรับ gpt-oss-120b
- MacBook 128 GB แพงขึ้น Apple ขึ้นราคาอัปเกรด 128 GB เป็นสองเท่าคือ $2,000 ในเดือนมิถุนายน ดังนั้น M5 Max 16 นิ้วความจุ 128 GB ตอนนี้ราคา $6,999 (ประมาณ €8,199 ในเยอรมนี ตามการประมาณของผม) ชิปและหน่วยความจำเดียวกันใน Mac Studio ราคา $4,799
- จุดคุ้มทุนคือสามถึงสี่ปี ไม่ใช่หนึ่งปี แม้ Mac จะแทนที่การสมัครสมาชิกได้ทั้งหมด ก็ต้องใช้เวลาราว 37 เดือนจึงจะชนะแพ็กเกจ $200, 41 เดือนหากคุณเก็บแพ็กเกจ $20 ไว้ทำงานยาก และมากกว่าหกปีเมื่อเทียบกับแพ็กเกจ $100
- การเขียนเร็ว แต่การอ่านช้า M5 Max สร้าง 55–88 โทเคนต่อวินาทีบนโมเดลแบบ mixture-of-experts ซึ่งไม่ห่างจาก 98 ของ Opus 5.5 บน API ของ Anthropic แต่มันต้องใช้เวลา 13–55 วินาทีเพียงเพื่ออ่านพรอมต์ 32,000 โทเคน และเอเจนต์ AI อ่านพรอมต์ยาว ๆ ซ้ำตลอดทั้งวัน
- การยัดโมเดลใหญ่ลงไปมีต้นทุนด้านคุณภาพ การควอนไทซ์ 4 บิตใกล้เคียงกับการไม่สูญเสียข้อมูลในงานสั้น ๆ แต่ในการศึกษา EMNLP 2025 มันสูญเสียคุณภาพถึง 59% กับอินพุตยาว และแย่ลงอีกในภาษาที่ไม่ใช่อังกฤษ ที่ 3 บิต คะแนนคณิตศาสตร์ของโมเดลเหตุผลขนาดเล็กตกจาก 85.6% เหลือ 47.0%
- ดูเหมือนเบนช์มาร์กสาธารณะจะเอื้อโมเดลเปิด เมื่อ Artificial Analysis เปลี่ยนไปใช้การทดสอบแบบปิดเป็นหลัก โมเดลโอเพนเวตชั้นนำสี่ตัวสูญเสียคะแนนเฉลี่ย 13 คะแนน ส่วนโมเดลปิดชั้นนำสี่ตัวแทบไม่ขยับ
- โลคอลยังชนะในเรื่องความเป็นส่วนตัว การใช้งานออฟไลน์ ไม่มีขีดจำกัดอัตราการใช้งาน และงานปริมาณมากและเมื่อคุณจะซื้อ Mac อยู่แล้ว ซื้อเพราะเหตุผลเหล่านั้น ไม่ใช่เพื่อยกเลิกการสมัครสมาชิก
- มีวิธีที่ถูกกว่าในการประหยัด ลดลงมาใช้ระดับ $100 และประหยัด $1,200 ต่อปี จ่ายตามโทเคนสำหรับโมเดลเปิด (DeepSeek V4.1 Flash ราคา $0.60 ต่อล้านโทเคนเอาต์พุตในช่วงนอกเวลาเร่งด่วน) หรือใช้แผนเขียนโค้ดเริ่มต้น $18 ต่อเดือน
ข้อเสนอขายกับความเป็นจริง
| ข้อเสนอขาย | ความเป็นจริง ตุลาคม 2026 |
|---|---|
| “คุ้มทุนเองภายในหนึ่งปี” | MacBook Pro 16 นิ้วความจุ 128 GB ราคา $6,999 ที่ $200 ต่อเดือน นั่นคือ 35 เดือนก่อนคิดค่าไฟฟ้า และ 41 เดือนเมื่อคุณบวกแพ็กเกจ $20 ที่คุณจะเก็บไว้ใช้งานยาก |
| “ตอนนี้โมเดลโลคอลดีพอ ๆ กันแล้ว” | Opus 5.5 ได้ 58 โมเดลที่ดีที่สุดที่ใส่ใน 128 GB ได้ 34 (Qwen3.8 27B, ดัชนี v4.3.2) โมเดลเปิดที่ดีที่สุดที่ดาวน์โหลดได้ได้ 32 บน v5 ใหม่ |
| “128 GB รันโมเดลเปิดขนาดใหญ่ได้” | GLM-5.3 ต้องใช้ราว 376 GB ที่ 4 บิต, DeepSeek V4.1 Flash ราว 380–460 GB, Kimi K3 ราว 1.5 TB ไม่มีตัวใดใส่ใน MacBook ได้ |
| “M5 Max เร็ว” | ด้านการเขียน ใช่: 55–88 โทเคนต่อวินาทีบนโมเดลแบบ mixture-of-experts ด้านการอ่านพรอมต์ 32K โทเคน: 13 ถึง 55 วินาที |
| “4 บิตไม่สูญเสียข้อมูล” | บนเบนช์มาร์กสั้น ๆ เกือบใช่ บนอินพุตเกิน 64K โทเคน แย่ลงถึง 59% ในการศึกษาหนึ่ง และแย่ลงอีกนอกภาษาอังกฤษ |
| “ไม่มีขีดจำกัด ความเป็นส่วนตัวเต็มที่” | จริง นั่นคือเหตุผลที่แท้จริงในการซื้อ |
สารบัญ
- สรุปสั้น — ฉบับ 60 วินาที
- ข้อเสนอขายกับความเป็นจริง
- ตอนที่ 1 — ข้อเสนอขาย “ยกเลิกแพ็กเกจ $200 ของคุณ” และทำไมมันจึงฟังดูถูกต้องนัก
- ตอนที่ 2 — $200 ต่อเดือนซื้ออะไรได้จริงในเดือนตุลาคม 2026
- ตอนที่ 3 — ตอนนี้ MacBook 128 GB ราคาเท่าไรจริง
- ตอนที่ 4 — ช่องว่างคุณภาพที่วัดได้
- ตอนที่ 5 — ทำไมโมเดลที่คุณต้องการจริง ๆ จึงใส่ไม่ได้
- ตอนที่ 6 — การควอนไทซ์: ภาษีคุณภาพที่คุณจ่ายเพื่อให้มันใส่ได้
- ตอนที่ 7 — ความเร็ว: เร็วตอนเขียน ช้าตอนอ่าน
- ตอนที่ 8 — ปัญหาแล็ปท็อป
- ตอนที่ 9 — ช่องว่างซอฟต์แวร์: สิ่งที่คุณต้องสร้างใหม่
- ตอนที่ 10 — คณิตศาสตร์จุดคุ้มทุน ฉบับซื่อตรง
- ตอนที่ 11 — กรณีที่ยุติธรรม: เมื่อใดการซื้อ Mac เพื่อ AI ภายในเครื่องสมเหตุสมผล
- ตอนที่ 12 — วิธีที่ถูกกว่าในการลดบิล AI $200
- ตอนที่ 13 — คุณควรซื้อ MacBook เพื่อรัน LLM ภายในเครื่องหรือไม่ คู่มือตัดสินใจ
- ตอนที่ 14 — ถ้าคุณซื้ออยู่ดี: วิธีใช้ให้คุ้มที่สุด
- คำถามที่พบบ่อย
- MacBook แทนการสมัครสมาชิก ChatGPT Pro หรือ Claude Max ได้ไหม
- LLM ภายในเครื่องที่ดีที่สุดสำหรับ MacBook Pro 128 GB ในปี 2026 คืออะไร
- ตอนนี้ MacBook Pro 128 GB ราคาเท่าไร
- MacBook ใช้เวลานานแค่ไหนจึงคุ้มทุนเมื่อเทียบกับการสมัครสมาชิก AI $200
- M5 Max เร็วพอสำหรับ LLM ภายในเครื่องหรือไม่
- ตอนนี้ LLM ภายในเครื่องดีเท่า ChatGPT หรือ Claude หรือยัง
- การควอนไทซ์ทำให้โมเดลโลคอลแย่ลงหรือไม่
- ผมรัน DeepSeek V4.1 Flash หรือ GLM-5.3 บน MacBook ได้ไหม
- 64 GB พอสำหรับ AI ภายในเครื่อง หรือต้องใช้ 128 GB
- ผมควรซื้อ Mac Studio แทน MacBook Pro สำหรับ LLM ภายในเครื่องหรือไม่
- การรัน AI ในเครื่องดีกว่าสำหรับความเป็นส่วนตัวและ GDPR หรือไม่
- ผมใช้ Claude Code กับโมเดลโลคอลได้ไหม
- MacBook Pro OLED รุ่นใหม่จะเปลี่ยนอะไรไหม
- บทสรุป
ตอนที่ 1 — ข้อเสนอขาย “ยกเลิกแพ็กเกจ $200 ของคุณ” และทำไมมันจึงฟังดูถูกต้องนัก
เริ่มจากทำไมข้อโต้แย้งนี้จึงแพร่หลายนัก เพราะส่วนใหญ่ของมันสมเหตุสมผล
สามห้องแล็บมาบรรจบที่ $200 Claude Max 20× ของ Anthropic ราคา $200 ต่อเดือน ChatGPT Pro ของ OpenAI มีรุ่น $100, $200 และ $500 AI Ultra ของ Google มีระดับ $100 และ $200 จ่ายแบบนี้ทุกเดือน ตัวเลขก็รวมกันได้: $2,400 ต่อปี, $7,200 ในสามปี
ฮาร์ดแวร์จริงจังขึ้น M5 Max MacBook Pro ที่วางขายตั้งแต่เดือนมีนาคม รองรับหน่วยความจำแบบรวมสูงสุด 128 GB พร้อมแบนด์วิดท์ 614 GB/s และ Apple ใส่ Neural Accelerator ซึ่งเป็นฮาร์ดแวร์คำนวณเมทริกซ์โดยเฉพาะ ไว้ในทุกคอร์ GPU ในเดือนสิงหาคม Mac Studio มาพร้อมตัวเลือก M5 Ultra ที่รองรับสูงสุด 512 GB การตลาดของ Apple เน้น AI ภายในเครื่องมากที่สุดเท่าที่เคยทำ
การสมัครสมาชิกกลายเป็นของขี้เหนียวขึ้น ขีดจำกัดรายสัปดาห์ของ Claude Max ที่เพิ่มเข้ามาหลายเดือนหลังเปิดตัวแพ็กเกจ เป็นหัวข้อของคดีกลุ่มที่ยื่นเมื่อวันที่ 8 กันยายน ซึ่งโต้แย้งว่าป้าย “5×” และ “20×” ไม่ได้ทำให้เพดานรายสัปดาห์ชัดเจนพอ มีรายงานว่า OpenAI ลดโควตาบนแพ็กเกจ Pro $200 สำหรับสมาชิกใหม่จาก 20 เท่าของ ChatGPT Plus เหลือ 10 เท่า เมื่อสิ่งที่คุณเช่าหดตัวลงเรื่อย ๆ การเป็นเจ้าของก็เริ่มดูน่าสนใจ
ความเป็นส่วนตัวเป็นข้อกังวลจริง อะไรก็ตามที่คุณวางลงในโมเดลบนคลาวด์จะออกจากเครื่องของคุณ สำหรับธุรกิจเยอรมันที่ถือข้อมูลลูกค้า นั่นไม่ใช่ความวิตกเกินเหตุ แต่คือ GDPR
และการคำนวณก็ง่าย เวอร์ชันที่ถูกแชร์มากที่สุด: Mac Studio ราคา $2,499 หารด้วย $200 ต่อเดือน ได้ประมาณ 12.5 เดือน Forbes ทำเวอร์ชันที่รอบคอบกว่ามากในเดือนสิงหาคม ด้วยการกำหนดค่าจริงและค่าไฟฟ้าสามปี และสรุปว่า Mac คงไม่ทำให้คุณยกเลิกแผน Claude หรือ ChatGPT ได้หากคุณเขียนโค้ดด้วยเอเจนต์ แต่เวอร์ชันสั้นคือสิ่งที่คนจำได้
นี่คือข้อบกพร่อง ข้อเสนอเปรียบเทียบราคากับราคา มันควรเปรียบเทียบสินค้ากับสินค้า นั่นคือสิ่งที่บทความที่เหลือทำ โดยเริ่มจากสิ่งที่ $200 จ่ายซื้อจริง
ตอนที่ 2 — $200 ต่อเดือนซื้ออะไรได้จริงในเดือนตุลาคม 2026
| ผู้ให้บริการ | ระดับ $20 | ระดับ $100 | ระดับ $200 | สูงกว่า $200 |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: $20 ($17 ต่อเดือนเมื่อจ่ายรายปี) | Max 5×: $100 | Max 20×: $200 | Team และ Enterprise |
| OpenAI (ChatGPT) | Plus: $20 (Go: $8) | Pro 100: $100 | Pro 200: $200 | Pro 500: $500 |
| Google (Gemini) | AI Pro: $20 | AI Ultra: $100 | AI Ultra: $200 | — |
ราคาสหรัฐฯ ต่อเดือน ไม่รวม VAT Claude จาก claude.com; ChatGPT จากตัวติดตามของ AI Business Weekly อัปเดต 4 ตุลาคม; Google จากรายงานของ Engadget เรื่องการเปิดตัวใหม่ในเดือนพฤษภาคม ราคาและโควตาเปลี่ยนบ่อย ดังนั้นตรวจสอบก่อนสมัครสมาชิก
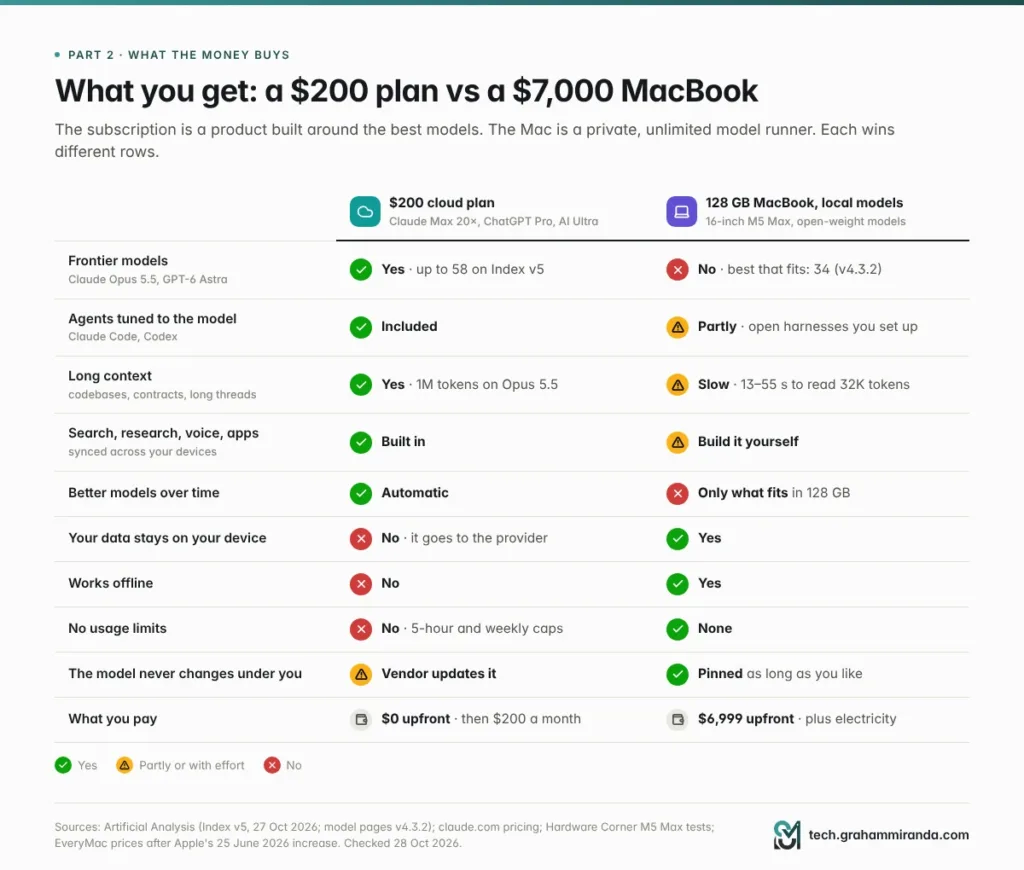
เงินนั้นจ่ายซื้ออะไรจริง ๆ
1. โมเดลแนวหน้า ซึ่งคุณหาไม่ได้จากที่อื่น บนดัชนีใหม่ของ Artificial Analysis Anthropic และ OpenAI ครองห้าอันดับแรกทั้งหมด ไม่มีโมเดลใดในนั้นที่ดาวน์โหลดได้ไม่ว่าจะจ่ายเท่าไร การสมัครสมาชิกเป็นวิธีที่ถูกที่สุดที่คนส่วนใหญ่จะได้ใช้มัน
2. เอเจนต์ที่สร้างขึ้นรอบโมเดลเหล่านั้น แพ็กเกจแบบเสียเงินของ Claude รวม Claude Code ไว้ ส่วนของ ChatGPT รวม Codex ไว้ harness และโมเดลถูกปรับแต่งมาด้วยกัน ซึ่งช่วยอธิบายว่าทำไมพวกมันจึงอยู่บนสุดของตารางอันดับการเขียนโค้ดด้วยเอเจนต์ (ผมเปรียบเทียบเครื่องมือ 28 ตัวนี้ใน เปรียบเทียบ AI coding harness ทุกตัว.)
3. บริบทมหาศาล Claude Opus 5.5 รองรับหน้าต่างบริบทหนึ่งล้านโทเคน ตามข้อมูลของ Artificial Analysis: ทั้งโค้ดเบส ทั้งสัญญา อีเมลทั้งไตรมาส
4. ผลิตภัณฑ์รอบ ๆ โมเดล การค้นหาเว็บและงานวิจัยเชิงลึก การวิเคราะห์ไฟล์ เสียง ความจำ การสร้างภาพ ตัวเชื่อมต่ออีเมลและเอกสารของคุณ และแอปที่ซิงก์ข้ามโทรศัพท์ แล็ปท็อป และเบราว์เซอร์ของคุณ ไม่มีสิ่งเหล่านี้มากับไฟล์โมเดล
5. การอัปเกรดที่ไม่ต้องติดตั้งเอง โมเดลที่อยู่เบื้องหลังการสมัครสมาชิกของคุณในไตรมาสหน้าจะดีกว่าวันนี้ โมเดลบน Mac ของคุณจะเปลี่ยนก็ต่อเมื่อคุณดาวน์โหลดตัวอื่นมา และเฉพาะเมื่อตัวใหม่ใส่ได้เท่านั้น
6. เงินคืนบางส่วน หน้าตาราคาของ Anthropic ตอนนี้ระบุเครดิต API รายเดือนพร้อม Max: $100 ในแพ็กเกจ 5× และ $200 ใน 20×
สิ่งที่มันไม่ได้ซื้อ
การใช้งานไม่จำกัด แพ็กเกจของ Claude ทำงานบนรอบห้าชั่วโมงแบบเลื่อนบวกเพดานรายสัปดาห์ ส่วน OpenAI และ Google ส่วนใหญ่อธิบายระดับสูงสุดของตนเป็นจำนวนเท่าของรุ่นที่ถูกกว่า เมื่อพวกเขาอธิบายเลย การควบคุมว่าข้อมูลของคุณไปที่ไหนซึ่งสำคัญมากสำหรับข้อมูลส่วนตัวและข้อมูลลูกค้า และ ความคาดเดาได้: โควตาเปลี่ยนมากกว่าหนึ่งครั้งในปีนี้
จำสามข้อนั้นไว้ นั่นคือกรณีที่ชอบธรรมของ AI ภายในเครื่อง และตอนที่ 11 จะพิจารณาอย่างเต็มที่
แสดงรูปภาพ การสมัครสมาชิกคือผลิตภัณฑ์ ส่วน Mac คือเครื่องรันโมเดล แต่ละอย่างชนะในด้านที่ต่างกัน ซึ่งเป็นเหตุผลว่าคำตอบที่ถูกสำหรับคนส่วนใหญ่คือทั้งสองอย่าง
ตอนที่ 3 — ตอนนี้ MacBook 128 GB ราคาเท่าไรจริง
มีเพียงชิปเดียวที่พาคุณไปถึง 128 GB ในรุ่น M5 หน่วยความจำแบบรวมขนาดนั้นมีเฉพาะกับ M5 Max พร้อม GPU 40 คอร์ซึ่งมีแบนด์วิดท์หน่วยความจำ 614 GB/s M5 Max แบบ GPU 32 คอร์ถูกจำกัดไว้ที่ 36 GB และ 460 GB/s ส่วน M5 Pro สูงสุดที่ 64 GB และ 307 GB/s
| การกำหนดค่า | ราคาที่สหรัฐฯ | เยอรมนี |
|---|---|---|
| 16″ M5 Max (CPU 18 คอร์, GPU 40 คอร์), 48 GB, 2 TB | $4,999 | €5,699 |
| อัปเกรดเป็น 128 GB | +$2,000 (เดิม +$1,000 ถึง 25 มิถุนายน) | ประมาณ +€2,500 (ตอนเปิดตัว +€1,250) เป็นการประเมิน |
| 16″ M5 Max, 128 GB, 2 TB | $6,999 | ประมาณ €8,199 (ประเมิน; €6,249 ตอนเปิดตัว) |
| สเปกเต็ม: 128 GB, 8 TB, จอ nano-texture | $10,149 | — |
| เพื่อเปรียบเทียบ: Mac Studio, M5 Max, 128 GB | $4,799 | — |
ราคาที่สหรัฐฯ ไม่รวมภาษีการขาย ส่วนราคาเยอรมนีรวม VAT 19% การอัปเกรด 128 GB ในเยอรมนีเป็นการประเมินของผม Apple คิด €1,250 ตอนเปิดตัว และราคาอัปเกรดเป็นดอลลาร์เพิ่มขึ้นเท่าตัวในเดือนมิถุนายน ตรวจสอบคอนฟิกูเรเตอร์ของ Apple ก่อนซื้อ
มีสามเรื่องที่เด่นชัด
ตอนนี้หน่วยความจำคือส่วนที่แพง Apple ขึ้นราคาไลน์ Mac ทั้งหมดเมื่อ 25 มิถุนายน และโทษต้นทุนหน่วยความจำกับที่เก็บข้อมูล บริษัทบอกกับ Reuters ว่า “ไม่เคยเห็นราคาชิ้นส่วนเพิ่มขึ้นมากและเร็วขนาดนี้มาก่อน” การอัปเกรด 64 GB และ 128 GB ของ M5 Max เพิ่มขึ้นเท่าตัวทั้งคู่ ชิ้นส่วนที่ AI ในเครื่องต้องการมากที่สุด คือชิ้นส่วนที่แพงขึ้นเป็นสองเท่า
ส่วนต่างราคาของแล็ปท็อปคือ $2,200 M5 Max ตัวเดียวกันกับ 128 GB เท่ากันใน Mac Studio ราคา $4,799 ตอนที่ Forbes เทียบราคาในเดือนสิงหาคม ถ้าคุณต้องการหน่วยความจำเพื่อ AI รูปแบบแล็ปท็อปมีราคาแพงกว่า 46%
รุ่น 14 นิ้วคือการประนีประนอม คุณสั่งรุ่น 14 นิ้วพร้อม 128 GB ได้เช่นกัน แต่ในรีวิวของ Notebookcheck ตัวเครื่องระบายความร้อน M5 Max ได้ยากเมื่อใช้งานต่อเนื่องเต็มที่ รายละเอียดเพิ่มเติมอยู่ในส่วนที่ 8
Mac รุ่นใหม่สัปดาห์นี้ เมื่อ 27 ตุลาคม Apple เปิดตัว MacBook Pro 14 นิ้วพร้อมชิป M6 : สูงสุด 32 GB และ 170 GB/s เริ่มต้นที่ $1,999 เป็นแล็ปท็อปที่ดี แต่ไม่ใช่เครื่องสำหรับ LLM และคืนนี้ (28 ตุลาคม 10:00 เวลาแปซิฟิก 18:00 เวลาเยอรมนี) Apple จัดงาน “Pro and Tell” และคาดว่าจะได้เห็น MacBook Pro จอสัมผัส OLED กันอย่างแพร่หลาย รายงานระบุว่าใช้ชิป M5 Pro และ M5 Max ตัวเดิม ซึ่งจะทำให้เพดาน 128 GB และ 614 GB/s ไม่เปลี่ยน
ตอนที่ 4 — ช่องว่างคุณภาพที่วัดได้
คุณจะเปรียบเทียบโมเดลบนโต๊ะของคุณกับโมเดลในศูนย์ข้อมูลได้อย่างไร ไม่ใช่ด้วยความรู้สึก และไม่ใช่ด้วยตารางเบนช์มาร์กของผู้ขายเอง Artificial Analysis (AA) รันชุดการทดสอบเดียวกันกับโมเดลหลายร้อยตัว ผ่าน harness เดียวกัน และสรุปผลเป็น Intelligence Index ค่าเดียว ไม่มี index ใดสมบูรณ์แบบ แต่ของ AA เป็นอิสระ และเป็นสิ่งที่ใกล้เคียงที่สุดที่อุตสาหกรรมมีในฐานะไม้บรรทัดร่วม
เมื่อ 27 ตุลาคม AA เผยแพร่ เวอร์ชัน 5. การเปลี่ยนแปลงหลักคือ ประมาณ 60% ของ index ตอนนี้รันบน ชุดทดสอบส่วนตัวหรือคำตอบที่ถูกกันไว้ดังนั้นโมเดลจึงไม่มีทางเห็นคำถามระหว่างการฝึก งานฐานความรู้ การเขียนโค้ด วิทยาศาสตร์ และความรู้ทั่วไปนับอย่างละหนึ่งในสี่
ตารางจัดอันดับใหม่
| รุ่น | ดาวน์โหลดได้ไหม | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | ไม่ใช่ | 58 |
| GPT-6 Astra (max) | ไม่ใช่ | 57 |
| GPT-6.1 Sol (max) | ไม่ใช่ | 55 |
| Gemini 4 Argon (high) | ไม่ใช่ | 50 |
| Kimi K3.1 Pro | ยังไม่ได้; ยังไม่เปิดเผยเวต | 46 |
| Claude Haiku 5.5 (max) | ไม่ใช่ | 36 |
| DeepSeek V4.1 Flash 1017 (max) | ใช่, สัญญาอนุญาต MIT | 32 |
| GLM-5.3 (max) | ใช่ | 32 |
ที่มา: Artificial Analysis, ประกาศ Intelligence Index v5, 27 ตุลาคม 2026
มีสามอย่างในตารางนั้นที่มีความสำคัญถ้าคุณกำลังคิดราคา MacBook
- ห้าอันดับแรกเป็นของ Anthropic และ OpenAI ทั้งหมดและไม่มีโมเดลใดในนั้นที่ดาวน์โหลดได้ ไม่ว่าจะจ่ายเท่าไร
- โมเดลโอเพนเวตที่ดีที่สุด คือ Kimi K3.1 Pro ยังไม่เปิดเผยเวต ในบรรดาโมเดลที่ดาวน์โหลดได้จริง คะแนนสูงสุดคือ 32 ซึ่งทำให้โมเดลเหล่านี้ ตามหลังผู้นำอยู่ 26 คะแนน. ในเวอร์ชันก่อนหน้า ช่องว่างระหว่างโมเดลโอเพนเวตที่ดีที่สุดกับโมเดลปิดที่ดีที่สุดคือ 3 คะแนน ตอนนี้คือ 12 หรือ 26 ถ้านับเฉพาะเวตที่ดาวน์โหลดได้
- Claude Haiku 5.5 ชนะโมเดลโอเพนเวตที่ดาวน์โหลดได้ทุกตัว นั่นคือรุ่นเล็ก เร็ว และราคาถูกของ Anthropic ไม่ใช่เรือธง
การเขียนโค้ดโดยเฉพาะ
index ใหม่มี FrontierCode 2.0, งานเขียนโค้ดส่วนตัว 132 งานจาก Cognition Claude Opus 5.5 แก้ได้ 46%; DeepSeek V4.1 Flash 1017 ซึ่งแรงที่สุดร่วมในบรรดาโมเดลที่ดาวน์โหลดได้ แก้ได้ 28% ใน Terminal-Bench-Scienceซึ่งมีงานวิทยาศาสตร์แบบเอเจนต์ 70 งาน ได้ 59% เทียบกับ 13%
พูดให้เป็นธรรมกับโมเดลโอเพนเวต: Kimi K3.1 Pro นำอยู่ Terminal-Bench 4.0 ด้วย 67% เหนือโมเดลปิดทุกตัว โมเดลโอเพนเวตชนะเบนช์มาร์กเดี่ยว ๆ ได้ และทำจริง แต่ตัวนั้นยังดาวน์โหลดไม่ได้ และรุ่นก่อนหน้าอย่าง Kimi K3 มีพารามิเตอร์ 2.8 ล้านล้าน คุณจะไม่ได้รันมันบนแล็ปท็อป
ทำไมช่องว่างจึงเพิ่งกว้างขึ้น
การก้าวจาก v4.3 ไป v5 ไม่ได้ปฏิบัติกับทุกคนเท่ากัน
| รุ่น | ประเภท | v4.3 | v5 | การเปลี่ยนแปลง |
|---|---|---|---|---|
| Claude Opus 5.5 | โมเดลปิด | 58 | 58 | 0 |
| GPT-6 Astra | โมเดลปิด | 53 | 57 | +4 |
| Claude Sonnet 5.5 | โมเดลปิด | 56 | 54 | −2 |
| Gemini 4 Argon | โมเดลปิด | 53 | 50 | −3 |
| Kimi K3.1 Pro | โอเพน (ยังไม่เปิดเผย) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | เปิด | 45 | 32 | −13 |
| Muse Spark Open (Meta) | เปิด | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | เปิด | 46 | 30 | −16 |
ตัวเลข v4.3 และ v5 ตามที่ Trending Topics รายงานเมื่อ 28 ตุลาคม โดยคะแนน v5 ตรงกับประกาศของ AA
โดยเฉลี่ยแล้ว สี่โมเดลโอเพนเวตนั้นเสียไป 13 คะแนน. ส่วนสี่โมเดลปิดขยับเพียงหนึ่งในสี่ของคะแนน
AA ไม่ได้บอกว่าเพราะอะไร คำอธิบายที่ชัดที่สุดคือ เมื่อคำถามทดสอบเป็นความลับ โมเดลก็ไม่มีทางเคยเห็นคำถามเหล่านั้น และเบนช์มาร์กสาธารณะมักทำให้โมเดลที่ฝึกกับข้อมูลสาธารณะหนัก ๆ ดูดีเกินจริง ข้อโต้แย้งอีกด้านก็ยุติธรรมเช่นกัน: การทดสอบแบบปิดตรวจสอบจากภายนอกไม่ได้ และการให้น้ำหนักแต่ละหมวดก็เปลี่ยนอันดับได้ อย่าถือว่า index ใดเพียงตัวเดียวเป็นความจริงทั้งหมด แต่เมื่อโมเดลโอเพนเวตสี่ตัวลดลงสองหลักและโมเดลปิดสี่ตัวแทบไม่ขยับ นั่นคือสัญญาณที่ควรจริงจัง: ตารางเบนช์มาร์กที่เผยแพร่ โดยเฉพาะของเจ้าของโมเดลเอง กล่าวเกินจริงว่าโมเดลโอเพนเวตใกล้เคียงแค่ไหน
และโมเดลที่ใส่ใน MacBook ได้จริง
โมเดลที่ AA ให้คะแนนใหม่สำหรับประกาศส่วนใหญ่ใหญ่เกินกว่าจะรันบนแล็ปท็อปมาก สำหรับตัวที่รันได้ หน้าโมเดลของ AA ยังแสดง v4.3.2 คะแนน และในเวอร์ชันนั้น Opus 5.5 ก็ได้ 58 เช่นกัน ดังนั้นนี่คือการเปรียบเทียบบนมาตรวัดเดียวที่สอดคล้องกัน:
| รุ่น | รันใน MacBook 128 GB ได้ไหม | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | ไม่ได้ ใช้บนคลาวด์เท่านั้น | 58 |
| Qwen3.8 27B (xhigh) | ได้ ที่ 4-bit แม้แต่บน Mac 32 GB | 34 |
| Qwen3.5 122B A10B (reasoning) | ได้ ประมาณ 70 GB ที่ 4-bit | 16 |
| gpt-oss-120b (high) | ได้ ประมาณ 64 GB | 12 |
ที่มา: หน้าโมเดลของ Artificial Analysis, อ่านเมื่อ 28 ตุลาคม 2026
AA จัดให้ Qwen3.8 27B อยู่อันดับหนึ่งจาก 141 โมเดลที่เทียบกันได้ มันยอดเยี่ยมจริง ๆ สำหรับขนาดของมัน และเป็นโมเดลโอเพนเวตที่เผยแพร่ภายใต้ Apache 2.0 แต่มันก็ยัง ตามหลังอยู่ 24 คะแนน.
แสดงรูปภาพ ดัชนีสองเวอร์ชัน สองแผงแยกกัน ไม่เคยใช้แกนเดียว แผงบน: Artificial Analysis Intelligence Index v5 (27 ตุลาคม 2026) แผงล่าง: โมเดลที่ใส่ใน MacBook 128 GB ได้ บน v4.3.2 ซึ่งเป็นเวอร์ชันที่เผยแพร่คะแนนของพวกมัน
ความขัดแย้งของ 128 GB
ลองดูตารางสุดท้ายนั้นอีกครั้ง โมเดลที่ดีที่สุดสำหรับ MacBook 128 GB จริง ๆ แล้วใส่ได้ใน 32 GB โมเดลที่ต้องใช้หน่วยความจำเพิ่มจริง ๆ คือ mixture of experts ขนาด 120,000 ล้านพารามิเตอร์ ได้คะแนนต่ำกว่า ส่วนใหญ่เพราะเก่ากว่า: gpt-oss-120b ออกในเดือนสิงหาคม 2025 และ Qwen3.5 122B ถูกทดสอบบน M5 Max ตั้งแต่เดือนมีนาคม หลายเดือนก่อน Qwen3.8 27B จะมา
แล้วการอัปเกรด $2,000 จาก 48 GB เป็น 128 GB ให้อะไรคุณในวันนี้? พื้นที่: บริบทยาวขึ้น ความละเอียด 8-bit แทน 4-bit โหลดหลายโมเดลพร้อมกัน และตัวเลือกในการรันโมเดลระดับ 100,000 ล้านพารามิเตอร์ที่แข็งแกร่งถ้ามีออกมา นั่นคือประโยชน์จริง แต่โมเดลที่ฉลาดกว่านั้นไม่ใช่หนึ่งในนั้น อย่างน้อยก็ไม่ใช่บนตารางอันดับวันนี้ ตรวจสอบ AA ก่อนซื้อ เพราะข้อเท็จจริงแบบนี้เปลี่ยนได้ด้วยการเปิดตัวเพียงครั้งเดียว
34 กับ 58 รู้สึกอย่างไรในทางปฏิบัติ
คะแนน index ไม่ได้หมายถึง “ฉลาดขึ้นเป็นเปอร์เซ็นต์” และไม่ได้กระจายเท่ากันในทุกงาน
งานสั้นและชัดเจน เช่น เขียนอีเมลใหม่ สรุปเอกสารที่คุณวางเข้ามา หรือดึงฟิลด์ออกจากใบแจ้งหนี้ โมเดล 27B ที่ดีมักแยกไม่ออกจากโมเดลระดับแนวหน้า ช่องว่างจะเปิดในงานยาวที่ต้องทำหลายขั้นตอน: เอเจนต์ที่ต้องอ่านโค้ดเบส วางแผน แก้ไฟล์ห้าไฟล์ รันเทสต์ และกู้คืนจากความผิดพลาดของตัวเอง งานวิจัยที่ต้องกระทบยอดแหล่งข้อมูล หรือการให้เหตุผลที่ก้าวผิดเพียงก้าวเดียวก็ทำให้ที่เหลือเสียทั้งหมด นั่นคืองานที่ผู้คนซื้อแผน $200 เพื่อทำจริง ๆ
คอลัมน์เดือนสิงหาคมของ Forbes ยกตัวอย่างชัดเจนจากงานวิจัยของ Qwen เอง: Qwen3-Coder-Next ที่รันใน Claude Code ได้คะแนน 30.9% บน Terminal-Bench 2.0 เทียบกับ 53.9% ของ Claude Opus 4.5 ในรายงานเดียวกัน นั่นคือโมเดลของปีที่แล้ว แต่รูปแบบยังไม่เปลี่ยน: ในงานแบบเอเจนต์ ชุดที่รันในเครื่องล้มเหลวบ่อยกว่ามาก
ตอนที่ 5 — ทำไมโมเดลที่คุณต้องการจริง ๆ จึงใส่ไม่ได้
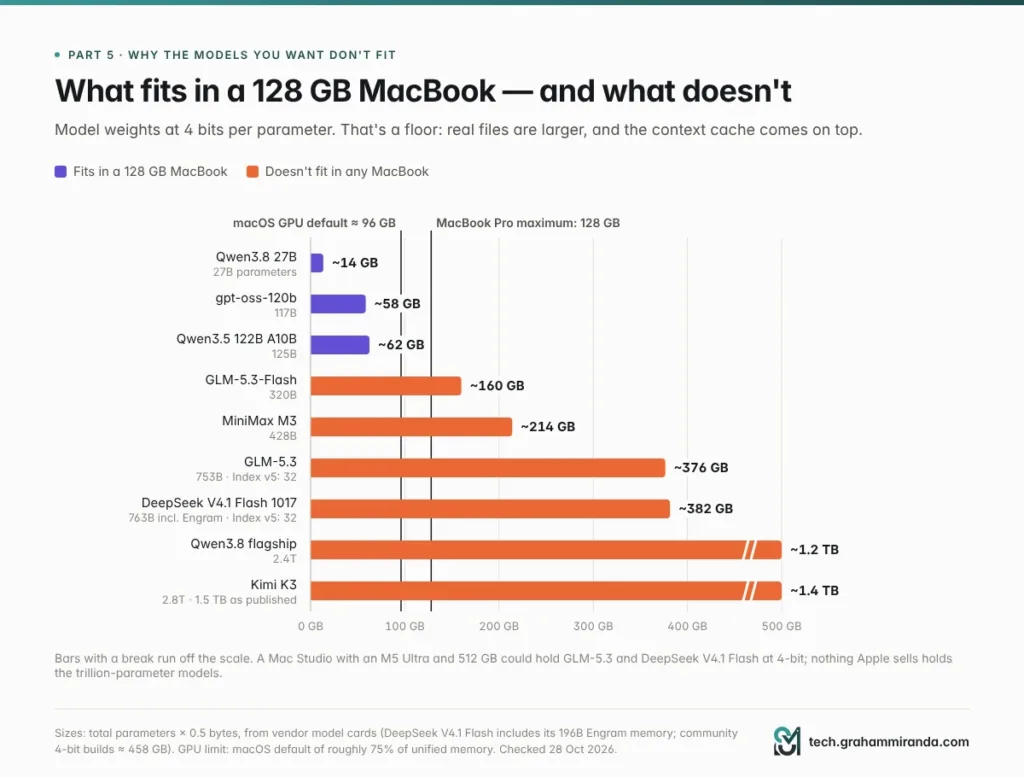
ขนาดของโมเดลในหน่วยความจำประมาณได้ง่าย ๆ:
text
เวต (GB) ≈ พารามิเตอร์ (พันล้าน) × ไบต์ต่อพารามิเตอร์
               8-bit → × 1.0     4-bit → × 0.5     2-bit → × 0.25
แล้วบวก KV cacheหน่วยความจำทำงานของโมเดลสำหรับบทสนทนาของคุณ ซึ่งโตตามความยาวบริบท และจำไว้ว่า macOS ไม่ได้ให้หน่วยความจำแบบรวมทั้งหมดแก่ GPU: โดยค่าเริ่มต้นอนุญาตให้ GPU ครอบครองประมาณ 75% บน Mac หน่วยความจำสูง ประมาณ 96 GB ของเครื่อง 128 GB คุณเพิ่มขีดจำกัดได้ด้วย sudo sysctl iogpu.wired_limit_mb=…ด้วยความเสี่ยงของคุณเอง อะไรก็ตามที่คุณให้โมเดล เบราว์เซอร์ เอดิเตอร์ และระบบปฏิบัติการของคุณจะไม่ได้
นี่คือความหมายสำหรับโมเดลที่คนพูดถึงจริง ๆ:
| รุ่น | พารามิเตอร์ทั้งหมด | เวต 4-bit (ขั้นต่ำ) | รันใน MacBook 128 GB ได้ไหม |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ สบายมาก |
| gpt-oss-120b | 117B | ~58 GB (ไฟล์ 64 GB) | ✅ ใช่ |
| Qwen3.5 122B A10B | 125B | ~62 GB (ไฟล์ 69.6 GB) | ✅ ใช่ |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ ไม่ใช่ |
| MiniMax M3 | 428B | ~214 GB | ❌ ไม่ใช่ |
| GLM-5.3 | 753B | ~376 GB | ❌ ไม่ใช่ |
| DeepSeek V4.1 Flash 1017 | 763B รวมหน่วยความจำ Engram | ~382 GB (บิลด์ 4-bit จากคอมมิวนิตี้ประเมินไว้ที่ ~458 GB) | ❌ ไม่ใช่ |
| Qwen3.8 รุ่นเรือธง | 2.4T | ~1.2 TB | ❌ ไม่ใช่ |
| Kimi K3 | 2.8T | ~1.5 TB ตามที่เผยแพร่ (MXFP4 แบบเนทีฟ) | ❌ ไม่ใช่ |
คอลัมน์ 4-bit คือพารามิเตอร์ × 0.5 ไบต์: เฉพาะเวต ก่อนรวม KV cache และโอเวอร์เฮดของไฟล์ ดังนั้นไฟล์จริงจึงใหญ่กว่านี้ ขนาดไฟล์มาจากการทดสอบ M5 Max ของ Hardware Corner
โมเดลที่ได้ 32 ใน index ใหม่ ซึ่งเป็นตัวที่ดีที่สุดที่ดาวน์โหลดได้ ต้องใช้ สามถึงสี่เท่า มากกว่าที่ MacBook มี และตัวที่อยู่ตรงกลางก็ยัดไม่ลงเช่นกัน ถ้าคุณให้เวตของโมเดล 100 GB จาก 128 GB ของคุณ นี่คือจำนวนบิตต่อเวตที่คุณจ่ายไหว:
| รุ่น | บิตต่อเวตในงบ 100 GB |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
ที่ประมาณสามบิตหรือต่ำกว่า คุณภาพดิ่งลงเหว (ส่วนที่ 6 มีงานวิจัย) หนึ่งบิตต่อเวตไม่ใช่การควอนไทซ์ แต่คือการตัดแขนขา
บริบทก็กินหน่วยความจำด้วย ในการทดสอบของ Hardware Corner, Qwen3-Coder-Next ที่ 8-bit ใช้ 87.1 GB ที่บริบท 4K และ 92.6 GB ที่ 64K เพิ่มมาห้ากว่า ๆ กิกะไบต์เพียงเพื่อถือบทสนทนาที่ยาวขึ้น เอเจนต์ที่อ่านทั้งรีโพซิทอรีต้องใช้บริบทยาว พื้นที่ว่างนั้นจึงหายไปอย่างรวดเร็ว
แล้ว Mac Studio 512 GB ล่ะ Mac Studio M5 Ultra พร้อม 512 GB จุ GLM-5.3 หรือ DeepSeek V4.1 Flash ที่ 4-bit ได้ Apple บอกว่าคอนฟิกูเรชันนั้นจะมาในปลายเดือนตุลาคม MacRumors คาดว่าราคาจะสูงกว่า $10,000 มาก และ Apple ยังไม่ประกาศราคาเมื่อผมตรวจสอบ คุณจะต้องจ่ายห้าหลักเพื่อรันโมเดลที่ได้ 32 ใน index ใหม่ และอาจช้ากว่าที่ผู้ผลิตให้บริการเสียอีก Kimi K3 เทียบ Fable 5.1 เทียบ GLM-5.3 การเปรียบเทียบของผมลงลึกกว่าว่าการโฮสต์โมเดลโอเพนเวตขนาดใหญ่ด้วยตัวเองต้องใช้อะไรจริง ๆ
แสดงรูปภาพ นับเฉพาะน้ำหนักโมเดล ที่ 4 บิตต่อพารามิเตอร์ ส่วนแคชบริบทนั้นเพิ่มเข้ามาอีก ทุกอย่างทางขวาของเส้น 128 GB ต้องใช้ Mac Studio หรือเซิร์ฟเวอร์
ตอนที่ 6 — การควอนไทซ์: ภาษีคุณภาพที่คุณจ่ายเพื่อให้มันใส่ได้
การควอนไทซ์เก็บเวตของโมเดลด้วยจำนวนบิตที่น้อยลง 8 หรือ 4 แทน 16 บิตที่ใช้ฝึก ดังนั้นจึงใช้หน่วยความจำน้อยลงและรันเร็วขึ้น ทุกโมเดลที่คุณรันบน Mac ล้วนผ่านการควอนไทซ์ คำถามคือมันแลกมาด้วยอะไร และงานวิจัยให้คำตอบที่ชัดเจนและชวนอึดอัดเล็กน้อย
ข่าวดี: 8 บิตแทบไม่มีต้นทุน ส่วน 4 บิตโดยมากก็ใช้ได้
- หนึ่งในการศึกษาที่ใหญ่ที่สุดจนถึงตอนนี้ โดย Eldar Kurtic และคณะ รันการประเมินกว่า 500,000 ครั้งกับโมเดล Llama 3.1 ที่ผ่านการควอนไทซ์ FP8 แทบไม่สูญเสียคุณภาพเลยในทุกขนาด; INT8 เสียประมาณ 1–3% เมื่อปรับมาดี; และการควอนไทซ์เฉพาะเวตที่ 4-bit “แข่งขันได้ดีกว่าที่คาด” ใกล้เคียง 8-bit
- สำหรับโมเดลที่ให้เหตุผล การศึกษาในปี 2025 โดย Ruikang Liu และคณะ พบว่าเวตและแอกติเวชัน 8-bit หรือเวต 4-bit กับแอกติเวชัน 16-bit อาจไม่สูญเสียคุณภาพเลยบนเบนช์มาร์กคณิตศาสตร์ วิทยาศาสตร์ และการเขียนโค้ด ความกว้างบิตที่ต่ำลงนำมาซึ่งสิ่งที่ผู้เขียนเรียกว่าความเสี่ยงต่อความแม่นยำอย่างมีนัยสำคัญ และความยากของงานมีผลอย่างมากต่อปริมาณที่สูญเสียไป
ถ้าคุณถามแต่คำถามสั้น ๆ เป็นภาษาอังกฤษ โมเดล 4-bit จะให้ความรู้สึกใกล้เคียงต้นฉบับ
ข่าวร้าย: อินพุตยาว ภาษาอื่น และอะไรที่ต่ำกว่า 4 บิต
- บริบทยาว Anmol Mekala และคณะ ทดสอบวิธีการควอนไทซ์ห้าวิธีกับตัวอย่าง 9,700 ตัวอย่างที่มีอินพุต 64,000 โทเคนขึ้นไป (EMNLP 2025) 8-bit เสียประมาณ 0.8% โดยเฉลี่ย ส่วน 4-bit เสีย มากถึง 59%และความเสียหายขึ้นกับโมเดลมาก: ภายใต้วิธี 4-bit วิธีหนึ่ง Llama 3.1 70B ตกลง 32% ในงานที่ Qwen 2.5 72B ยังทำได้ดี
- ภาษาที่ไม่ใช่อังกฤษ การศึกษาเดียวกันพบว่าการเสื่อมคุณภาพมักจะ แย่ลงเมื่ออินพุตไม่ใช่อังกฤษ. ถ้าคุณทำงานเป็นภาษาเยอรมัน ให้ทดสอบเป็นภาษาเยอรมัน
- ต่ำกว่า 4 บิต การให้เหตุผลพังทลาย นักวิจัยที่ Meta FAIR เผยแพร่การศึกษาในเดือนมิถุนายน 2026 แสดงว่าโมเดลที่ให้เหตุผลซึ่งผ่านการควอนไทซ์คิดมากเกินไป ภายใต้ AWQ 3-bit คะแนนของโมเดลให้เหตุผลขนาด 1.5B บนเบนช์มาร์ก MATH-500 ลดจาก 85.6% เหลือ 47.0%และสายการคิดของมันยาวขึ้นจาก 5,200 เป็น 23,400 โทเคน ยาวขึ้น 4.5 เท่า. บนแล็ปท็อปที่เขียนได้ 20 ถึง 80 โทเคนต่อวินาที โมเดลที่คิดนานขึ้นสี่เท่าก็ช้าลงประมาณสี่เท่าเช่นกัน
แสดงรูปภาพ งานวิจัยบอกว่าแต่ละขั้นที่ลดความละเอียดลงต้องแลกด้วยอะไร การบีบที่ทำให้โมเดลใหญ่ขึ้นใส่ใน 128 GB ได้ ก็คือการบีบที่เจ็บที่สุดนั่นเอง
นั่นหมายความอย่างไรกับ MacBook 128 GB
ระดับการควอนไทซ์ที่คุณจ่ายไหวสำหรับโมเดลที่คุณอยากได้ คือระดับที่เจ็บที่สุด โมเดล 27B รันที่ 8-bit บน Mac ได้แบบเหลือ ๆ และควรทำเช่นนั้น โมเดลระดับ 120B รันที่ 4-bit ซึ่งใช้แชตได้ดีแต่เสี่ยงกับเอกสารยาว และทางเดียวที่จะเอาโมเดลระดับ 300B ขึ้นไปมาใส่แล็ปท็อปได้คือสองหรือสามบิตต่อเวต ซึ่งการศึกษาข้างต้นบอกว่าการให้เหตุผลจะพังทลาย
กฎง่าย ๆ ของผม:
- ใช้ 8-bit กับทุกอย่างที่คุณต้องพึ่งพาโดยเฉพาะเอกสารยาวและงานแบบเอเจนต์
- 4-bit ใช้ได้ดีสำหรับแชต การร่าง และงานสั้น ๆ ตรวจสอบพฤติกรรมกับบริบทยาวบนเอกสารของคุณเอง
- อย่ารันโมเดลให้เหตุผลหรือเขียนโค้ดต่ำกว่า 4-bit เว้นแต่คุณกำลังทดลอง
- ทดสอบในภาษาที่คุณทำงาน
ตอนที่ 7 — ความเร็ว: เร็วตอนเขียน ช้าตอนอ่าน
LLM ทำงานสองอย่างที่ความเร็วต่างกัน Prefill อ่านพรอมต์ของคุณ ทุกอย่างที่คุณวางบวกกับบทสนทนาที่ผ่านมา และถูกจำกัดด้วยพลังประมวลผลล้วน ๆ Generation เขียนคำตอบทีละโทเคน และถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำ นักวิจัยแมชชีนเลิร์นนิงของ Apple เองวัดทั้งสองอย่างบน M5: GPU Neural Accelerators ตัวใหม่ทำให้เวลาถึงโทเคนแรก เร็วขึ้น 3.3 ถึง 4.1 เท่า เมื่อเทียบกับ M4 ขณะที่การสร้างคำตอบดีขึ้นเพียง 1.19 ถึง 1.27 เท่าซึ่งใกล้เคียงกับแบนด์วิดท์ที่เพิ่มขึ้น
แล้ว M5 Max พร้อม 128 GB ทำอะไรได้จริง Hardware Corner เผยแพร่การทดสอบที่รันด้วย MLX framework ของ Apple บน M5 Max 14 นิ้วพร้อม 128 GB:
| รุ่น | บริบท | การอ่าน (prefill), โทเคน/วินาที | เวลาที่ใช้อ่านพรอมต์ทั้งหมด | การเขียน, โทเคน/วินาที |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3.1 s | 87.9 |
| 32K | 2,537 | 12.9 s | 64.5 | |
| Qwen3.5 122B A10B (4-bit) | 4K | 881 | 4.6 s | 65.9 |
| 32K | 1,068 | 30.7 s | 54.9 | |
| Qwen3.5 27B (dense, 6-bit) | 4K | 811 | 5.1 s | 23.6 |
| 32K | 591 | 55.4 s | 14.9 | |
| Qwen3-Coder-Next (8-bit) | 64K | 1,432 | 45.8 s | 48.2 |
วัดโดยผู้ใช้ Reddit ชื่อ cryingneko และเผยแพร่โดย Hardware Corner “เวลาที่ใช้อ่านพรอมต์ทั้งหมด” คือความยาวบริบทหารด้วยความเร็ว prefill ที่วัดได้
ความเร็วในการเขียนตอนนี้โอเค อย่างน้อยบนโมเดล MoE
โมเดลแบบ mixture of experts ใช้เพียงเศษเสี้ยวของเวตในแต่ละโทเคน จึงเขียนได้เร็ว: 55 ถึง 88 โทเคนต่อวินาที บน M5 Max เพื่อเปรียบเทียบ Artificial Analysis วัด Claude Opus 5.5 ได้ 98 โทเคนต่อวินาที บน API ของ Anthropic สำหรับการแชตกับโมเดลระดับ 120B นั้น M5 Max ให้ประสบการณ์ที่ดีจริง ๆ ส่วนโมเดลแบบ dense เป็นอีกเรื่องหนึ่ง โมเดล 27B ที่ใช้ทุกพารามิเตอร์ในทุกโทเคนเขียนได้ 15 ถึง 24 โทเคนต่อวินาที
ยังมีผลกระทบเล็ก ๆ อีกสองอย่างที่ทบกัน การเขียนช้าลงเมื่อบทสนทนายาวขึ้น: ช้ากว่า 17% ถึง 37% ที่ 32K เมื่อเทียบกับ 4K ในทั้งสามโมเดล และโมเดลแบบ reasoning ใช้หลายร้อยหรือหลายพันโทเคนในการคิดก่อนจะตอบ
การอ่านคือจุดที่ต้องรอ
ลองดูคอลัมน์เวลาที่ใช้ในการอ่านอีกครั้ง พรอมต์ 32,000 โทเคน (ไฟล์ซอร์สสองสามไฟล์ สัญญายาว ๆ เธรดอีเมลขนาดใหญ่) ใช้เวลา 13 ถึง 55 วินาที ในการอ่านก่อนที่คำแรกของคำตอบจะปรากฏ
เรื่องนี้สำคัญที่สุดกับงานที่แผน $200 ถูกซื้อมาเพื่อทำพอดี เอเจนต์เขียนโค้ด AI ส่งพรอมต์ระบบขนาดใหญ่ นิยามของทุกเครื่องมือ ไฟล์ที่เปิดไว้ และบทสนทนาที่ผ่านมาให้โมเดลในทุกขั้นตอน เซิร์ฟเวอร์โลคอลสามารถใช้ส่วนของพรอมต์ที่ไม่เปลี่ยนแปลงซ้ำได้ ซึ่งช่วยได้มาก แต่เมื่อใดก็ตามที่มีบางอย่างช่วงต้นของบริบทเปลี่ยน เช่น เมื่อเอเจนต์ย่อประวัติของมัน หรือคุณสลับไปทำงานใหม่ ทุกอย่างหลังจากจุดนั้นต้องถูกอ่านใหม่ทั้งหมด Forbes อ้างคำพูดของนักพัฒนาคนหนึ่งที่รอประมาณ 90 วินาทีเพื่อให้ได้โทเคนแรกบน M3 Ultra 512 GB กับพรอมต์ระบบ 16,000 โทเคน และอีกคนที่เห็นประมาณ 20 วินาทีจากการเริ่มเย็นบนแล็ปท็อป M4 Pro 48 GB ชิปยุค M5 เร็วกว่านี้มากเมื่อเทียบกับ Mac รุ่นเก่า ตามการวัดของ Apple เอง แต่รูปร่างของปัญหายังเหมือนเดิม
เพื่อให้เห็นภาพ การทดสอบ Hardware Corner ชุดเดียวกันนี้รันบนการ์ดเวิร์กสเตชัน Nvidia RTX Pro 6000 ซึ่งมีราคาประมาณ $8,800 แค่ตัวการ์ด: มันอ่านพรอมต์ เร็วกว่า 2 ถึง 2.4 เท่า และเขียน เร็วกว่า 1.7 ถึง 2.8 เท่า เมื่อเทียบกับ M5 Max
แสดงรูปภาพ วัดด้วย MLX บน M5 Max ความจุ 128 GB การเขียนเร็วพอแล้ว ส่วนการอ่านพรอมต์ยาว ๆ ซึ่งเอเจนต์ทำตลอดเวลา คือจุดที่ต้องรอ
ตอนที่ 8 — ปัญหาแล็ปท็อป
ต่อให้โมเดลดีพอแล้ว แล็ปท็อปก็เป็นที่ที่รันโมเดลได้ไม่ค่อยสะดวก
ความร้อน การรันโมเดลขนาดใหญ่คือโหลดต่อเนื่อง: GPU และหน่วยความจำทำงานเต็มที่หลายนาทีหรือหลายชั่วโมง ไม่ใช่การระเบิดสิบวินาที รีวิวของ Notebookcheck ต่อ M5 Max ขนาด 14 นิ้วสรุปว่าโครงเครื่องและระบบระบายความร้อน “ไม่สามารถรับมือ M5 Max ได้อย่างเพียงพอ”: ประสิทธิภาพในการทดสอบ CPU stress 30 นาทีลดลง 24% และพัดลมดังถึง 53.2 dB(A) ในโหมด High Power รีวิวนั้นวัดโหลด CPU และกราฟิก ไม่ใช่ LLM และ Notebookcheck เองก็แนะนำว่า M5 Max ควรอยู่ในรุ่น 16 นิ้ว ถ้าคุณซื้อ MacBook เพื่อ AI โลคอลจริง ๆ ให้ซื้อรุ่น 16 นิ้ว ส่วน คู่มือ MacBook Pro M5 Pro 64 GB ได้ข้อสรุปเดียวกันเกี่ยวกับการทำงานต่อเนื่องบนตัวเครื่องที่เล็กกว่า
มันยังเป็นคอมพิวเตอร์ที่คุณใช้ทุกวันด้วย โหลดโมเดล 70 GB พร้อมบริบทของมัน แล้วคุณยังมีที่เหลือให้เบราว์เซอร์และเอดิเตอร์ ถ้าดันไปใกล้ ๆ 96 GB ที่ GPU ได้มาเป็นค่าเริ่มต้น หรือเพิ่มขีดจำกัดเพื่อยัดอะไรที่ใหญ่กว่า งานส่วนที่เหลือของคุณก็เริ่มแย่งหน่วยความจำกับโมเดล ทุกโมเดลที่คุณโหลดค้างไว้คือหน่วยความจำที่แอปอื่นไม่ได้รับ
แบตเตอรี่ไม่ชอบสิ่งนี้ โหลด GPU ต่อเนื่องทำให้แบตเตอรี่แล็ปท็อปหมดเร็ว เซสชันการอนุมานโลคอลที่ยาวนานจึงต้องเสียบปลั๊ก ซึ่งค่อนข้างหักล้างคำโฆษณา “AI ที่ไหนก็ได้ แบบออฟไลน์”
คุณซื้อเพดานของคุณตั้งแต่วันแรก หน่วยความจำแบบรวมอัปเกรดไม่ได้หลังซื้อ ถ้าโมเดลโอเพนซอร์สที่ดีที่สุดของปีหน้าต้องใช้ 160 GB MacBook 128 GB ก็รันมันไม่ได้เลย
และมูลค่าของมันลดเร็ว MacFinder ผู้ขายเครื่องรีเฟอร์บิชในสหราชอาณาจักร วิเคราะห์ข้อมูลการซื้อของตัวเองย้อนหลังหกปี และพบว่า MacBook ส่วนใหญ่สูญเสียมูลค่าประมาณครึ่งหนึ่งในปีแรก โดยรุ่นไฮเอนด์มักลดแรงกว่า: MacBook Pro M4 ขนาด 16 นิ้วลดลงถึง 60% ในหนึ่งปี เครื่องราคา $6,999 คือการเดิมพัน $6,999 ว่าเพดานหน่วยความจำของวันนี้จะยังมีประโยชน์ในอีกสามปี
เดสก์ท็อปเป็นเครื่องรัน LLM ที่ดีกว่า ถ้าเป้าหมายคือ AI โลคอล Mac Studio ที่ใช้ M5 Max เดียวกันและ 128 GB ราคาถูกกว่า $2,200 ไม่มีแบตเตอรี่ให้ร้อนและไม่มีฝาให้ปิด และรันได้ตลอด 24 ชั่วโมงเป็นเซิร์ฟเวอร์ส่วนตัวให้แล็ปท็อปและสมาร์ตโฟนของคุณ จับคู่กับแล็ปท็อปเครื่องไหนก็ได้ที่คุณชอบอยู่แล้ว
ตอนที่ 9 — ช่องว่างซอฟต์แวร์: สิ่งที่คุณต้องสร้างใหม่
การสมัครสมาชิกคือโมเดลบวกกับผลิตภัณฑ์ ส่วนการตั้งค่าแบบโลคอลให้โมเดลคุณ และปล่อยให้ผลิตภัณฑ์เป็นหน้าที่ของคุณ
| สิ่งที่การสมัครสมาชิกทำให้คุณ | สิ่งที่คุณต้องทำเองถ้าใช้โลคอล |
|---|---|
| โฮสต์และอัปเดตโมเดล | ดาวน์โหลด แปลง และอัปเดตโมเดลด้วยตัวเอง (LM Studio, Ollama หรือ MLX) |
| ค้นหาเว็บและค้นคว้าเชิงลึก | เชื่อมต่อ API ค้นหาหรือระบบค้นหาที่โฮสต์เอง พร้อมเอเจนต์มาขับเคลื่อน |
| อ่าน PDF สเปรดชีต และรูปภาพ | เลือกโมเดลที่รองรับภาพ และเพิ่มการแยกวิเคราะห์เอกสาร |
| เสียง ความจำ และการสร้างภาพ | แยกโมเดลและแอปสำหรับแต่ละอย่าง (Whisper สำหรับเสียง, Draw Things หรือ ComfyUI สำหรับภาพ) |
| แอปบนทุกอุปกรณ์ ซิงก์กัน | รันเซิร์ฟเวอร์และฟรอนต์เอนด์ แล้วเปิดให้สมาร์ตโฟนเข้าถึงอย่างปลอดภัย |
| Claude Code หรือ Codex ที่ปรับแต่งมาสำหรับโมเดลของตัวเอง | ชี้ harness แบบโอเพนซอร์ส หรือตัว Claude Code เอง ไปที่เซิร์ฟเวอร์โลคอล |
| เทมเพลตแชต รูปแบบการเรียกเครื่องมือ และความปลอดภัย ได้รับการจัดการให้แล้ว | ต้องดีบักเองเมื่อโมเดลใหม่ออกมาพร้อมเทมเพลตที่เครื่องมือของคุณไม่เข้าใจ |
เครื่องมือตอนนี้ดีจริง ๆ LM Studio เป็นจุดเริ่มต้นที่ง่ายที่สุดบน Mac, Ollama ให้ API เดียวสำหรับทั้งโมเดลโลคอลและคลาวด์ และ MLX ของ Apple มักเร็วที่สุด Ollama ยังเปิดให้ใช้ API ที่เข้ากันได้กับ Anthropicดังนั้นคุณจึงชี้ Claude Code ไปยังโมเดลโลคอลได้ด้วยการตั้งค่า ANTHROPIC_BASE_URL=http://localhost:11434เอกสารของมันก็พูดตรง ๆ ถึงช่องว่างที่มี: การควบคุม prompt caching ของ Anthropic, การนับโทเคน, batch และการป้อน PDF ไม่ได้รับการรองรับ และ Claude Code ถูกปรับแต่งมาสำหรับโมเดล Claude โมเดลโลคอลต้องรับมือกับพรอมต์ระบบยาว ๆ และนิยามเครื่องมือของ Claude Code ซึ่งเป็นจุดที่เวลา prefill ในส่วนที่ 7 สร้างปัญหา
ไม่มีอะไรในนี้ที่เป็นไปไม่ได้ บทความของผม OpenCode v2 เทียบ Hermes Agent เทียบ OpenClaw ครอบคลุมเอเจนต์โอเพนซอร์สที่ทำงานกับโมเดลโลคอล แต่มันเป็นงานจริงจัง และเวลาของคุณไม่ฟรี เผื่อเวลาสักสุดสัปดาห์ในการตั้งค่า และเดือนละไม่กี่ชั่วโมงในการอัปเดตให้ทันสมัย
ตอนที่ 10 — คณิตศาสตร์จุดคุ้มทุน ฉบับซื่อตรง
นี่คือการคำนวณที่คำโฆษณามักข้ามไป
ขั้นที่ 1: เวอร์ชันแบบง่าย
$6,999 ÷ $200 ต่อเดือน = 35 เดือนไม่ใช่สิบสองเดือน เกือบสามปี และนั่นคือเวอร์ชันที่ดูดีที่สุดแล้ว
ขั้นที่ 2: บวกค่าไฟฟ้า
Forbes ประเมินไว้ประมาณ $10 ต่อเดือน สำหรับ Mac ที่รัน AI วันละแปดชั่วโมงในอัตราค่าไฟเฉลี่ยของสหรัฐฯ ในเยอรมนี ที่ค่าเฉลี่ยเดือนตุลาคม 29.68 เซนต์ต่อ kWh แล็ปท็อปที่ใช้ไฟเฉลี่ย 60–150 W วันละแปดชั่วโมงมีค่าไฟประมาณ €4–11 ต่อเดือนน้อยนิด แต่ก็ดันจุดคุ้มทุนไปที่ ประมาณ 37 เดือน.
ขั้นที่ 3: เก็บแพ็กเกจราคาถูกไว้ทำงานยาก
คุณจะเก็บจริง คนที่เคยใช้โมเดลระดับแนวหน้าในการเขียนโค้ดแบบเอเจนต์หรือการวิจัยจริงจังน้อยคนที่จะกลับไปใช้โมเดล 34 คะแนนกับทุกงาน เก็บแผน $20 ไว้สำหรับงานยาก 10% แล้ว Mac จะประหยัดให้คุณเดือนละ $170 ไม่ใช่ $200: ประมาณ 41 เดือน.
ขั้นที่ 4: เทียบกับสิ่งที่คุณจะลดไปจริง ๆ
ถ้าคุณคิดเรื่องค่าใช้จ่ายมากพอที่จะพิจารณาแล็ปท็อปราคา $7,000 คุณก็คิดเรื่องค่าใช้จ่ายมากพอที่จะลดไปใช้แพ็กเกจ $100 เมื่อเทียบกับ $100 ต่อเดือน จุดคุ้มทุนคือ ประมาณ 78 เดือน หรือกว่าหกปีครึ่งซึ่งนานกว่าที่หลายคนใช้แล็ปท็อปหนึ่งเครื่อง
| สถานการณ์ | จ่ายล่วงหน้า | คุณยังจ่าย | ประหยัดต่อเดือน | จุดคุ้มทุน |
|---|---|---|---|---|
| MacBook เทียบกับแผน $200 ไม่รวมค่าไฟ | $6,999 | — | $200 | 35 เดือน |
| MacBook เทียบกับแผน $200 รวมค่าไฟ | $6,999 | $10 | $190 | 37 เดือน |
| … และคุณยังเก็บแผน $20 ไว้ | $6,999 | $30 | $170 | 41 เดือน |
| MacBook เทียบกับแผน $100 | $6,999 | $10 | $90 | 78 เดือน |
| Mac Studio (128 GB) เทียบกับแผน $200 | $4,799 | $10 | $190 | 25 เดือน |
| Mac Studio เทียบกับแผน $200 และยังเก็บแผน $20 | $4,799 | $30 | $170 | 28 เดือน |
ทั้งหมดนี้ตั้งสมมติฐานว่า Mac ทำงานแทนการสมัครสมาชิกได้ครบถ้วน ส่วนที่ 4 ถึง 9 อธิบายว่าทำไมมันทำไม่ได้
แสดงรูปภาพ ต้นทุนสะสมตลอดสี่ปี โดยสมมติว่า Mac แทนการสมัครสมาชิกได้ทั้งหมด ซึ่งไม่จริง ค่าไฟประมาณ $10 ต่อเดือน
ขั้นที่ 5: สามปี พร้อมการขายต่อ
ฮาร์ดแวร์มีมูลค่าขายต่อ และนั่นคือข้อโต้แย้งที่แข็งแรงที่สุดสำหรับการซื้อ สมมติว่าคุณขายต่อหลังจากสามปีในราคา 35% ของราคาซื้อนั่นคือสมมติฐานของผม ไม่ใช่ราคาเสนอซื้อ โดยอิงจากข้อมูลของ MacFinder ที่แสดงว่ามูลค่าหายไปประมาณครึ่งหนึ่งในปีแรก และลดช้าลงหลังจากนั้น
| ตัวเลือก | ต้นทุน 36 เดือน |
|---|---|
| แผน $200 | $7,200 |
| MacBook (128 GB) + ค่าไฟ ขายต่อในราคา 35% | $4,909 |
| … บวกแผน $20 สำหรับงานระดับแนวหน้า | $5,629 |
| Mac Studio (128 GB) + ค่าไฟ + แผน $20 ขายต่อในราคา 35% | $4,199 |
| แผน $100 | $3,600 |
| แผน $20 | $720 |
ดังนั้นใช่: ในสามปี MacBook บวกแผน $20 อาจถูกกว่าแผน $200 ประมาณ $1,600 ถ้าคุณขายต่อได้ในราคาที่เหมาะสม แต่ลองดูว่าเงินนั้นซื้ออะไรได้ ด้านหนึ่งคือโมเดลที่ดีที่สุดในโลกพร้อมเครื่องมือครบครัน อีกด้านคือโมเดล 34 คะแนน ค่าเสื่อมราคาหลายพันดอลลาร์ และแผนราคาถูกไว้ใช้เมื่อต้องการของจริง แผน $100 ชนะทุกทางเลือกฮาร์ดแวร์ในเรื่องต้นทุน และแผน $20 ชนะทุกอย่าง
คุณไม่ได้ประหยัดเงินมากนักด้วย MacBook สำหรับ LLM โลคอล คุณกำลังจ่ายในจำนวนที่ใกล้เคียงกันเพื่อ ผลิตภัณฑ์ที่ต่างออกไป: ความเป็นส่วนตัว การควบคุม และอิสระจากข้อจำกัด โดยมีความฉลาดน้อยกว่า
มุมมองต้นทุนส่วนเพิ่ม
มีกรอบความคิดหนึ่งที่การซื้อสมเหตุสมผลกว่า: คุณต้องซื้อ MacBook ใหม่อยู่แล้ว ต้นทุนที่เกี่ยวกับ AI ก็เหลือแค่การอัปเกรดหน่วยความจำจาก 48 GB เป็น 128 GB ราคา $2,000 หรือสิบเดือนของแผน $200 ซึ่งไม่ใช่เรื่องบ้า แต่จำความขัดแย้ง 128 GB จากส่วนที่ 4 ไว้: บนตารางอันดับของวันนี้ การอัปเกรดนั้นซื้อโมเดลที่ใหญ่ขึ้น ไม่ใช่โมเดลที่ฉลาดขึ้น ถ้าคุณจะซื้อ MacBook อยู่แล้ว 48–64 GB ก็รันโมเดลขนาด Mac ที่ดีที่สุดที่ 8-bit พร้อมบริบทเหลือเฟือ
$6,999 ซื้ออะไรได้แทน
- 35 เดือน ของแผน $200 70 เดือน ของแผน $100 หรือ 29 ปี ของแผน $20
- ประมาณ 11.7 พันล้านโทเคนเอาต์พุต จาก DeepSeek V4.1 Flash ในราคา API ช่วงนอกเวลาเร่งด่วน ซึ่งเป็นโมเดลที่ได้คะแนนสูงกว่าทุกโมเดลที่รันใน MacBook ได้
- ประมาณ 350 ล้านโทเคนเอาต์พุต ของ Claude Opus 5.5 ผ่าน API ของ Anthropic ในราคา $20 ต่อล้านโทเคนที่ Artificial Analysis ระบุไว้
ตอนที่ 11 — กรณีที่ยุติธรรม: เมื่อใดการซื้อ Mac เพื่อ AI ภายในเครื่องสมเหตุสมผล
ไม่มีสิ่งใดในนี้หมายความว่า AI โลคอลเป็นของเล่น ผมเขียนถึงมันบ่อยมากในบล็อกนี้เพราะมันมีประโยชน์ แค่ว่ามันมีประโยชน์ด้วยเหตุผลที่ต่างจากที่คำโฆษณาอ้าง นี่คือเหตุผลที่ดีจริง
1. ข้อมูลที่ไม่ควรออกจากการควบคุมของคุณ
ถ้าคุณจัดการไฟล์ลูกค้า ข้อมูลสุขภาพ งบการเงินที่ยังไม่เผยแพร่ หรืออะไรก็ตามที่อยู่ภายใต้หน้าที่รักษาความลับ โมเดลโลคอลหมายความว่าไม่มีอะไรถูกส่งไปยังบุคคลที่สาม ไม่ต้องมีสัญญาผู้ประมวลผลข้อมูล ไม่มีการโอนข้อมูลระหว่างประเทศ ไม่ต้องกังวลเรื่องการตั้งค่าการฝึกโมเดล ในเยอรมนี ผู้ประกอบวิชาชีพที่ผูกพันตาม § 203 StGBเช่น ทนายความ แพทย์ และที่ปรึกษาภาษี ต้องมีมาตรการคุ้มครองตามสัญญาก่อนที่ข้อมูลลูกค้าจะถูกส่งไปยังผู้ให้บริการภายนอกใด ๆ รวมถึงผู้ให้บริการ AI โมเดลโลคอลหลีกเลี่ยงคำถามนั้นไปโดยสิ้นเชิง นี่คือเหตุผลที่แข็งแรงที่สุดในการเป็นเจ้าของฮาร์ดแวร์ และมันไม่ขึ้นกับว่าโมเดลโลคอลจะฉลาดเท่า Opus หรือไม่ State of AI 2026 รายงานของผมลงรายละเอียดด้านต้นทุนและการปฏิบัติตามข้อกำหนดของการรัน AI แบบออฟไลน์มากกว่านี้
2. งานออฟไลน์
บนเครื่องบิน ที่ไซต์ลูกค้าที่ไม่มีเครือข่าย ในอาคารที่เครือข่ายคือสิ่งที่ถูกห้าม
3. ไม่มีขีดจำกัด ไม่มีนโยบายที่ผันแปร และโมเดลที่ไม่เคยเปลี่ยน
ไม่มีหน้าต่างใช้งานห้าชั่วโมง ไม่มีเพดานรายสัปดาห์ ไม่มีคดีฟ้องกลุ่มเกี่ยวกับวิธีเปิดเผยเพดานเหล่านั้น และเช็กพอยต์โลคอลให้ผลเหมือนเดิมในอีกหนึ่งปีเหมือนวันนี้ ซึ่งสำคัญถ้าคุณสร้างเวิร์กโฟลว์โดยอิงกับพฤติกรรมของโมเดล
4. งานปริมาณมาก น่าเบื่อ และมีขอบเขตชัดเจน
จำแนกตั๋วสนับสนุนหลายพันรายการ ดึงฟิลด์ออกจากใบแจ้งหนี้ สรุปโน้ตของคุณเอง แปลฉบับร่าง ติดแท็กรูปภาพ สร้าง embedding สำหรับค้นหาในเอกสารของคุณเอง ถอดเสียงการประชุมด้วย Whisper โมเดลโลคอลขนาดกลางทำสิ่งเหล่านี้ได้ดีเยี่ยม และการรันเป็นล้านครั้งไม่มีค่าใช้จ่ายใด ๆ นอกจากค่าไฟ
5. การเรียนรู้และการสร้าง
ถ้าคุณสร้างแอปแบบ local-first ไฟน์ทูนโมเดลเล็ก ๆ หรือแค่อยากเข้าใจว่าสิ่งนี้ทำงานอย่างไร การเป็นเจ้าของฮาร์ดแวร์คือครูที่ดีที่สุด (ถ้าการสร้างแอปด้วย AI คือสิ่งที่คุณสนใจ ผมเขียนกระบวนการทั้งหมดไว้ใน วิธีสร้างแอปตั้งแต่ต้นด้วย AI ในปี 2026.)
6. คุณจะซื้อ Mac อยู่แล้ว
ถ้าอย่างนั้นก็ซื้อหน่วยความจำให้พอสำหรับโมเดลที่คุณจะรันจริง (ดูส่วนที่ 14) และมอง AI โลคอลเป็นของแถม ไม่ใช่เหตุผลทางธุรกิจ
อะไรทำงานได้ดีในเครื่อง
| งาน | สิ่งที่ควรรัน | หน่วยความจำที่เพียงพอ |
|---|---|---|
| แชตส่วนตัว ร่างงาน เขียนใหม่ | Qwen3.8 27B ที่ 8-bit | 48–64 GB |
| สรุปและถาม-ตอบจากเอกสารของคุณ | Qwen3.8 27B พร้อมโมเดล embedding | 48–64 GB |
| การสกัดและจำแนกข้อมูลจำนวนมาก | โมเดลเล็กกว่า (Gemma 4, gpt-oss-20b) | 16–32 GB |
| การถอดเสียงเป็นข้อความ | Whisper | 8–16 GB |
| การสร้างภาพ | Draw Things หรือ ComfyUI กับโมเดลระดับ FLUX | 32 GB+ |
| โมเดลแชตขนาดใหญ่ที่เร็ว | gpt-oss-120b หรือ Qwen3.5 122B | 128 GB |
สำหรับการสร้างวิดีโอแบบโลคอล Mac ยังช้าเมื่อเทียบกับฮาร์ดแวร์ Nvidia หรือ GPU บนคลาวด์ คู่มือของผม รุ่น M5 Pro 64 GB มีตัวเลขให้ดู
ตอนที่ 12 — วิธีที่ถูกกว่าในการลดบิล AI $200
ถ้าสิ่งที่คุณต้องการจริง ๆ คือค่าใช้จ่าย AI ที่น้อยลง มีทางที่ถูกกว่าแล็ปท็อปราคา $7,000
1. ลดระดับแพ็กเกจ Claude Max 5× และ ChatGPT Pro 100 ราคา $100 และ AI Ultra ของ Google ตอนนี้เริ่มที่ $100 ถ้าคุณแทบไม่เคยชนขีดจำกัดของแผน $200 การทำแบบนี้ช่วยประหยัด $1,200 ต่อปี โดยไม่สูญเสียคุณภาพเลย
2. รวมแผน $20 สองแผนเข้าด้วยกัน Claude Pro บวก ChatGPT Plus ราคา $40 ต่อเดือน และให้โควตาขีดจำกัดสองชุดแยกกัน กับโมเดลระดับแนวหน้าสองตระกูลให้สลับใช้
3. จ่ายตามโทเคนสำหรับโมเดลโอเพนซอร์ส โมเดลโอเพนเวตแบบเดียวกับที่คุณจะรันบน Mac และโมเดลใหญ่กว่าที่ไม่มีทางรันได้ มีให้ใช้แบบจ่ายตามโทเคนจากผู้ให้บริการหลายราย ด้วยความเร็วระดับศูนย์ข้อมูล DeepSeek V4.1 Flashซึ่งได้คะแนนสูงกว่าทุกโมเดลที่รันใน MacBook ได้ มีราคา $0.15 ต่อล้านโทเคนอินพุต และ $0.60 ต่อล้านโทเคนเอาต์พุต ในช่วงนอกเวลาเร่งด่วนบน API ของ DeepSeek เอง (สองเท่าในช่วงเวลาเร่งด่วน) Qwen3.8 27B ถูกระบุบน OpenRouter เริ่มต้นที่ประมาณ $0.035 ต่อล้านโทเคนอินพุต สำหรับข้อมูลส่วนตัวหรือข้อมูลลูกค้า ให้ใช้ผู้ให้บริการที่โฮสต์ใน EU และมีข้อตกลงการประมวลผลข้อมูล แทน API ของ DeepSeek เอง ซึ่งประมวลผลข้อมูลในจีน
4. ใช้แผนเขียนโค้ดแบบเหมาจ่ายสำหรับโมเดลโอเพนซอร์ส ของ Z.ai GLM Coding Plan เริ่มต้นที่ $18 ต่อเดือน และรวม GLM-5.3 ซึ่งเป็นโมเดลที่คะแนนดีที่สุดร่วมในกลุ่มโมเดลที่ดาวน์โหลดได้บนดัชนีใหม่ พร้อม GLM-5.3-Flash และใช้ได้ใน Claude Code, Codex, OpenCode และเครื่องมืออื่น ๆ รับส่วนลด 10% สำหรับ GLM Coding Plan ผ่านลิงก์ affiliate ของผม. (ลิงก์พันธมิตร — ดูคำชี้แจงที่ด้านบน) มันไม่ใช่ Opus 5.5 และดัชนีก็บอกตรง ๆ อย่างนั้น แต่ราคาต่ำกว่าหนึ่งในสิบของแผน $200 ผมเปรียบเทียบกับข้อเสนอของ MiniMax ใน GLM-5.3-Flash เทียบ MiniMax M3.
5. ใช้ Mac ที่คุณมีอยู่แล้ว ถ้า Mac ปัจจุบันของคุณมีความจุ 16 ถึง 32 GB โมเดลโลคอลขนาดเล็กจัดการงานจำนวนมากในส่วนที่ 11 ได้ฟรีในระดับที่น่าประหลาดใจ
6. แยกเส้นทางตามงาน การตั้งค่าที่ได้ผลกับคนส่วนใหญ่: โมเดลโลคอลสำหรับงานส่วนตัวและงานปริมาณมาก แผนราคาถูกหรือโมเดลโอเพนซอร์สแบบจ่ายตามโทเคนสำหรับงานประจำวัน และการเข้าถึงโมเดลระดับแนวหน้าสำหรับงานยาก 10% การเปรียบเทียบ AI coding harness ของผม มีตัวอย่างการตั้งค่าห้าชุดในงบประมาณที่ต่างกัน
แสดงรูปภาพ ค่าใช้จ่ายรายเดือนของแต่ละตัวเลือกเป็นดอลลาร์สหรัฐ ก่อน VAT ค่าใช้จ่ายแบบจ่ายตามโทเคนขึ้นอยู่กับปริมาณการใช้งาน ตรวจสอบราคาเมื่อ 28 ตุลาคม 2026
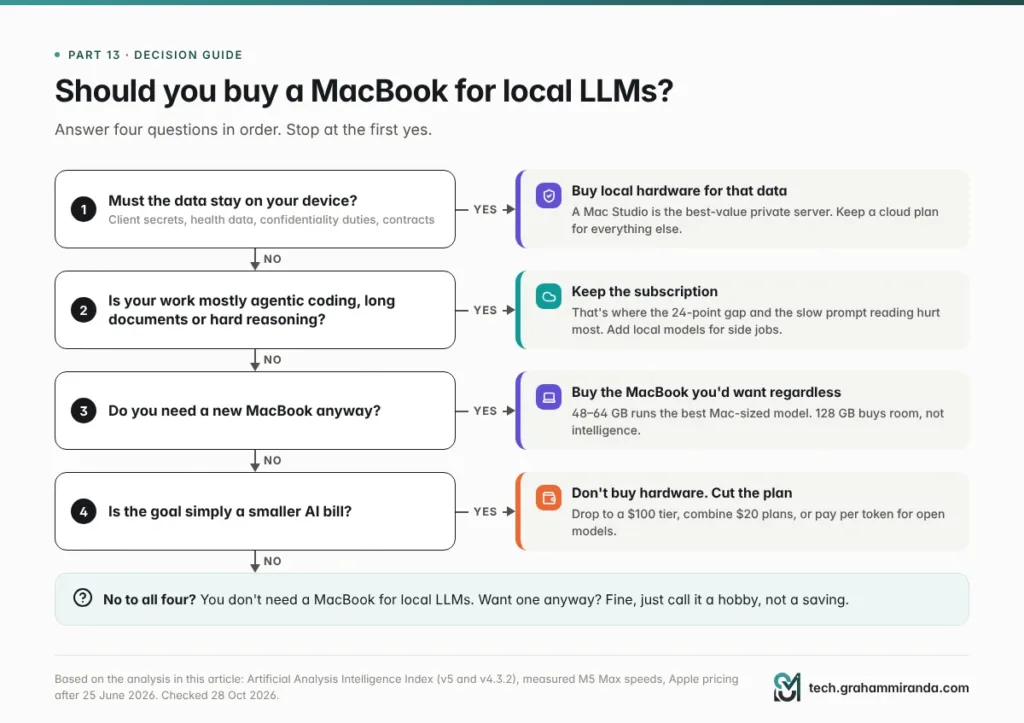
ตอนที่ 13 — คุณควรซื้อ MacBook เพื่อรัน LLM ภายในเครื่องหรือไม่ คู่มือตัดสินใจ
แสดงรูปภาพ เริ่มจากด้านบนสุด เส้นทางส่วนใหญ่จบลงที่ “เก็บแผนคลาวด์ไว้” และนั่นคือประเด็น
พิจารณาคำถามสี่ข้อตามลำดับ
1. ข้อมูลต้องอยู่ในอุปกรณ์ของคุณหรือไม่ ถ้าใช่ เพราะความลับของลูกค้า ข้อมูลสุขภาพ หรือสัญญา ให้ซื้อฮาร์ดแวร์โลคอล: ข้อกำหนดนั้นไม่สนใจผลเบนช์มาร์ก พิจารณา Mac Studio เป็นเซิร์ฟเวอร์ส่วนตัว และเก็บแผนคลาวด์ไว้สำหรับงานที่ไม่เกี่ยวข้องกับข้อมูลนั้น
2. งานของคุณส่วนใหญ่เป็นการเขียนโค้ดแบบเอเจนต์ เอกสารยาว หรือการให้เหตุผลยาก ๆ หรือไม่ ถ้าใช่ ให้เก็บการสมัครสมาชิกไว้ นั่นคือจุดที่ช่องว่าง 24 คะแนนและเวลา prefill สร้างปัญหาได้มากที่สุด โมเดลโลคอลยังช่วยงานรองได้
3. คุณต้องซื้อ MacBook ใหม่อยู่แล้วหรือไม่ ถ้าใช่ ให้ซื้อรุ่นที่คุณอยากได้อยู่แล้ว 48–64 GB รันโมเดลขนาด Mac ที่ดีที่สุดได้ดี ไปที่ 128 GB เฉพาะเมื่อคุณต้องการโมเดลระดับ 120B หรือโหลดหลายโมเดลพร้อมกันจริง ๆ และรู้ว่าคุณจ่าย $2,000 เพื่อพื้นที่ ไม่ใช่เพื่อความฉลาด
4. เป้าหมายคือแค่ค่าใช้จ่ายที่น้อยลงหรือไม่ ถ้าอย่างนั้นอย่าซื้อฮาร์ดแวร์ ลดระดับแพ็กเกจ รวมแผน $20 หรือจ่ายตามโทเคนสำหรับโมเดลโอเพนซอร์ส (ส่วนที่ 12)
ถ้าคุณตอบว่าไม่ทั้งสี่ข้อ คุณไม่จำเป็นต้องมี MacBook สำหรับ LLM โลคอล คุณอาจยังอยากได้ และนั่นก็ไม่เป็นไร แค่เรียกมันว่างานอดิเรก ไม่ใช่การประหยัด
ตอนที่ 14 — ถ้าคุณซื้ออยู่ดี: วิธีใช้ให้คุ้มที่สุด
เลือกเครื่องที่ใช่
- ซื้อรุ่น 16 นิ้ว ไม่ใช่ 14 นิ้ว ถ้า M5 Max มีไว้สำหรับงาน AI ต่อเนื่อง
- พิจารณา Mac Studio แทน ชิปและหน่วยความจำเดียวกันในราคาถูกกว่า $2,200 ระบายความร้อนได้ดีกว่า และเสิร์ฟแล็ปท็อปกับสมาร์ตโฟนของคุณได้ตลอด 24 ชั่วโมง
- อย่าซื้อหน่วยความจำเกินจำเป็นสำหรับโมเดลวันนี้ 48–64 GB รัน Qwen3.8 27B ที่ 8-bit พร้อมบริบทยาวได้ ซื้อ 128 GB สำหรับโมเดลระดับ 120B หลายโมเดลพร้อมกัน หรือเผื่อที่สำหรับรุ่นในอนาคต โดยรู้ว่าต้องจ่ายเท่าไร
- ถ้าคุณจะซื้อสัปดาห์นี้ ให้รอจนหลังงานเปิดตัวคืนนี้ คุณจะรู้ว่า OLED MacBook Pro มีอะไรบ้างและราคาเท่าไรก่อนตัดสินใจ
ตั้งค่าให้ถูกวิธี
- เริ่มจาก LM Studio (MLX บน Apple Silicon) สำหรับเส้นทางที่ง่ายที่สุด หรือ Ollama ถ้าคุณต้องการ API เดียวสำหรับโมเดลโลคอลและคลาวด์
- เลือก 8-bit สำหรับทุกอย่างที่คุณต้องพึ่งพา ใช้ 4-bit เพื่อความเร็วในการแชต
- ตั้งความยาวบริบทอย่างตั้งใจ รันไทม์หลายตัวตั้งค่าบริบทเล็กเป็นค่าเริ่มต้น เอเจนต์ต้องการมากกว่านั้นมาก
- เพิ่มขีดจำกัดหน่วยความจำ GPU เฉพาะเมื่อคุณเข้าใจข้อแลกเปลี่ยน และเผื่อที่ให้ macOS
- เก็บแผนคลาวด์ $20 ไว้ สำหรับงานยาก 10% มันถูกกว่าเวลาของคุณเอง
ทดสอบกับงานจริงของคุณ หยิบพรอมต์จริง 20 อันจากเดือนที่ผ่านมา: อีเมล เอกสาร งานเขียนโค้ด อะไรก็ตามที่คุณทำจริง รันแต่ละอันผ่านโมเดลโลคอลและโมเดลคลาวด์ของคุณ ซ่อนว่าอันไหนเป็นอันไหน แล้วให้คะแนน ทำเป็นภาษาที่คุณทำงานด้วย หนึ่งชั่วโมงนั้นจะบอกคุณได้มากกว่าตารางอันดับใด ๆ รวมถึงตารางในบทความนี้
คำถามที่พบบ่อย
MacBook แทนการสมัครสมาชิก ChatGPT Pro หรือ Claude Max ได้ไหม
ไม่ใช่ในเรื่องคุณภาพ โมเดลที่อยู่เบื้องหลังแผน $200 อย่าง Claude Opus 5.5 และ GPT-6 Astra ดาวน์โหลดไม่ได้ และโมเดลโอเพนซอร์สที่ดีที่สุดที่ดาวน์โหลดได้ต้องใช้หน่วยความจำ 375–460 GB ที่ 4-bit ซึ่งไกลเกินกว่า MacBook ทุกรุ่น ในดัชนีของ Artificial Analysis’s นั้น Opus 5.5 ได้ 58 ส่วนโมเดลที่แข็งแกร่งที่สุดที่ผมพบว่าพอดีกับ MacBook 128 GB อย่าง Qwen3.8 27B ได้ 34 ในเวอร์ชันเดียวกัน MacBook แทนการสมัครสมาชิกได้สำหรับงานส่วนตัว งานออฟไลน์ หรืองานปริมาณมาก แต่ไม่ใช่สำหรับงานระดับแนวหน้า
LLM ภายในเครื่องที่ดีที่สุดสำหรับ MacBook Pro 128 GB ในปี 2026 คืออะไร
ในเรื่องคุณภาพ Qwen3.8 27B: Artificial Analysis จัดอันดับให้เป็นที่หนึ่งจาก 141 โมเดลที่เทียบเคียงกัน ด้วยคะแนน 34 บน Intelligence Index v4.3.2 และรันที่ 8-bit ได้สบาย ๆ ในเรื่องความเร็ว gpt-oss-120b และ Qwen3.5 122B เป็นโมเดลแบบ mixture-of-experts ที่เขียนได้ 55–88 โทเคนต่อวินาทีบน M5 Max แต่ได้คะแนนต่ำกว่า (12 และ 16) ตรวจสอบ Artificial Analysis ก่อนเลือก เพราะโมเดลโอเพนซอร์สรุ่นใหม่เปลี่ยนอันดับนี้ทุกไม่กี่สัปดาห์
ตอนนี้ MacBook Pro 128 GB ราคาเท่าไร
MacBook Pro 16 นิ้วที่ใช้ M5 Max (CPU 18 คอร์, GPU 40 คอร์) หน่วยความจำ 128 GB และ 2 TB ราคา $6,999 ในสหรัฐฯ ก่อนภาษีขาย Apple ขึ้นราคา Mac เมื่อ 25 มิถุนายน 2026 และเพิ่มราคาอัปเกรดหน่วยความจำ 128 GB เป็นสองเท่า จาก $1,000 เป็น $2,000 ในเยอรมนี การกำหนดค่าเดียวกันราคา €6,249 ตอนเปิดตัว และจากที่ผมประเมิน ตอนนี้อยู่ที่ราว €8,199 Mac Studio ที่ใช้ชิปและหน่วยความจำเดียวกันราคา $4,799
MacBook ใช้เวลานานแค่ไหนจึงคุ้มทุนเมื่อเทียบกับการสมัครสมาชิก AI $200
ราว 35 เดือนที่ราคา $6,999 หากมันแทนการสมัครสมาชิกได้ทั้งหมดและไม่มีค่าใช้จ่ายในการใช้งาน เมื่อคิดค่าไฟราว $10 ต่อเดือนจะอยู่ที่ราว 37 เดือน และถ้าคุณยังเก็บแผน $20 ไว้สำหรับงานระดับแนวหน้า จะอยู่ที่ราว 41 เดือน เทียบกับแผน $100 ต้องใช้เวลากว่า 6 ปี Mac Studio ที่ใช้ชิปเดียวกันคืนทุนเร็วกว่า หลังราว 25 ถึง 28 เดือน
M5 Max เร็วพอสำหรับ LLM ภายในเครื่องหรือไม่
ใช่ สำหรับการเขียนคำตอบด้วยโมเดลแบบ mixture-of-experts วัดด้วย MLX พบว่า M5 Max หน่วยความจำ 128 GB สร้างได้ 55–88 โทเคนต่อวินาที ใกล้เคียงกับ 98 ของ Claude Opus 5.5 บน API ของ Anthropic การอ่านพรอมต์ยาวคือจุดอ่อน พรอมต์ 32,000 โทเคนใช้เวลา 13 วินาทีกับ gpt-oss-120b, 31 วินาทีกับ Qwen3.5 122B และ 55 วินาทีกับโมเดล dense 27B ขณะที่ AI coding agent อ่านพรอมต์ยาวซ้ำแล้วซ้ำอีกตลอดทั้งวัน
ตอนนี้ LLM ภายในเครื่องดีเท่า ChatGPT หรือ Claude หรือยัง
ไม่ใช่โมเดลที่พอดีกับแล็ปท็อป บน Intelligence Index v5 ใหม่ของ Artificial Analysis’s ที่เผยแพร่เมื่อ 27 ตุลาคม 2026 โมเดลโอเพนซอร์สที่ดาวน์โหลดได้ดีที่สุดได้ 32 เทียบกับ 58 ของ Claude Opus 5.5 และต่ำกว่า Claude Haiku 5.5 ที่ 36 โมเดลที่เล็กพอจะรันบน MacBook ได้สูงสุด 34 บนดัชนีเวอร์ชันก่อนหน้า ซึ่ง Opus 5.5 ก็ได้ 58 เช่นกัน สำหรับงานสั้นและง่าย ความต่างมักน้อย แต่สำหรับงาน agentic coding เอกสารยาว และการให้เหตุผลที่ยาก ความต่างนั้นมาก
การควอนไทซ์ทำให้โมเดลโลคอลแย่ลงหรือไม่
นิดหน่อยที่ 8-bit มากขึ้นที่ 4-bit และมากทีเดียวเมื่อต่ำกว่านั้น การศึกษาที่มีการประเมินมากกว่า 500,000 ครั้งพบว่า FP8 แทบไม่สูญเสียคุณภาพ และการควอนไทซ์แบบ weight-only ที่ 4-bit ใกล้เคียงกับ 8-bit บนเบนช์มาร์กมาตรฐาน แต่กับอินพุตตั้งแต่ 64,000 โทเคนขึ้นไป การศึกษาใน EMNLP 2025 วัดการลดลงได้ถึง 59% ที่ 4-bit และแย่ลงสำหรับข้อความที่ไม่ใช่ภาษาอังกฤษ ส่วนที่ 3 บิต คะแนนคณิตศาสตร์ของโมเดล reasoning ตัวหนึ่งลดจาก 85.6% เหลือ 47.0%
ผมรัน DeepSeek V4.1 Flash หรือ GLM-5.3 บน MacBook ได้ไหม
ไม่ GLM-5.3 มี 753 พันล้านพารามิเตอร์ และ DeepSeek V4.1 Flash มี 763 พันล้านพารามิเตอร์เมื่อรวมหน่วยความจำ Engram ดังนั้นแม้ที่ 4-bit ก็ต้องใช้ราว 375–460 GB ซึ่งมากกว่าขีดสูงสุด 128 GB ของ MacBook ทุกรุ่นมาก Mac Studio ที่ใช้ M5 Ultra และ 512 GB จึงจะรับไหว วิธีใช้จริงคือผ่าน API และควรเป็นผู้ให้บริการที่มีโฮสติ้งในสหภาพยุโรปและมีข้อตกลงการประมวลผลข้อมูล
64 GB พอสำหรับ AI ภายในเครื่อง หรือต้องใช้ 128 GB
สำหรับคนส่วนใหญ่ 48–64 GB ก็เพียงพอ โมเดลขนาด Mac ที่ดีที่สุดในดัชนีของ Artificial Analysis อย่าง Qwen3.8 27B รันที่ 8-bit ได้โดยยังเหลือที่ให้บริบทยาว 128 GB ทำให้รันโมเดลระดับ 120B อย่าง gpt-oss-120b ได้ เปิดโมเดลค้างไว้หลายตัว และใช้บริบทยาวขึ้น แต่บนลีดเดอร์บอร์ดวันนี้ โมเดลใหญ่เหล่านั้นได้คะแนนต่ำกว่า การอัปเกรดราคา $2,000 จึงซื้อพื้นที่มากกว่าซื้อความฉลาด
ผมควรซื้อ Mac Studio แทน MacBook Pro สำหรับ LLM ภายในเครื่องหรือไม่
ถ้า AI ในเครื่องเป็นเหตุผลหลัก ปกติคือใช่ Mac Studio ที่ใช้ M5 Max และ 128 GB เดียวกันราคา $4,799 ประหยัดกว่า MacBook Pro 16 นิ้ว $2,200 พร้อมระบบระบายความร้อนที่เสถียรกว่าและไม่มีแบตเตอรี่ให้กังวล มันเปิดทิ้งไว้ตลอดวันเป็นเซิร์ฟเวอร์โมเดลส่วนตัวให้แล็ปท็อปและมือถือของคุณได้ ซื้อ MacBook Pro ถ้าคุณต้องการความพกพาเพราะเหตุผลอื่น
การรัน AI ในเครื่องดีกว่าสำหรับความเป็นส่วนตัวและ GDPR หรือไม่
ใช่ นี่คือข้อได้เปรียบที่แข็งแกร่งที่สุด เมื่อใช้โมเดลในเครื่อง พรอมต์และเอกสารไม่เคยออกจากอุปกรณ์ของคุณ จึงไม่มีข้อตกลงผู้ประมวลผลให้ลงนามและไม่มีการโอนข้อมูลข้ามประเทศ เรื่องนี้สำคัญกับข้อมูลลูกค้า ข้อมูลสุขภาพ และวิชาชีพที่ผูกพันด้วยความลับ เช่นผู้ที่อยู่ภายใต้ § 203 StGB ในเยอรมนี ผลดีด้านความเป็นส่วนตัวยังคงอยู่ไม่ว่าโมเดลในเครื่องจะเก่งเท่าโมเดลบนคลาวด์หรือไม่ นี่ไม่ใช่คำแนะนำทางกฎหมาย
ผมใช้ Claude Code กับโมเดลโลคอลได้ไหม
ใช่ Ollama มี API ที่เข้ากันได้กับ Anthropic ดังนั้นคุณชี้ Claude Code ไปยังโมเดลในเครื่องได้โดยตั้งค่า ANTHROPIC_BASE_URL เป็น http://localhost:11434. คาดหวังการแลกเปลี่ยนบ้าง: Ollama ไม่รองรับตัวควบคุม prompt caching ของ Anthropic’s, system prompt และนิยามเครื่องมือที่ยาวของ Claude Code ทำให้โมเดลในเครื่องต้องอ่านข้อมูลจำนวนมากในทุกขั้นตอน และ Claude Code ถูกปรับแต่งมาสำหรับโมเดล Claude harness แบบเปิดอย่าง OpenCode มักเข้ากับโมเดลในเครื่องได้ลื่นกว่าอยู่แล้ว
MacBook Pro OLED รุ่นใหม่จะเปลี่ยนอะไรไหม
น่าจะไม่มากนักสำหรับ AI ในเครื่อง งานอีเวนต์ “Pro and Tell” ของ Apple จัดขึ้นวันที่ 28 ตุลาคม 2026 เวลา 10:00 ตามเวลาภาคพื้นแปซิฟิก และมีรายงานว่า MacBook Pro จอ OLED แบบทัชสกรีนที่คาดว่าจะเปิดตัวในงานใช้ชิป M5 Pro และ M5 Max เช่นเดิม ซึ่งจะทำให้เพดาน 128 GB และแบนด์วิดท์ 614 GB/s ยังคงอยู่ MacBook Pro 14 นิ้วที่ใช้ M6 ซึ่งประกาศเมื่อ 27 ตุลาคม สูงสุดที่ 32 GB
บทสรุป
ข้อเสนอ “ยกเลิกแผน $200 แล้วซื้อ Mac” พูดถูกสองเรื่อง คือการสมัครสมาชิกมีราคาแพง และ AI ในเครื่องมีประโยชน์จริง แต่มันผิดในเรื่องที่สำคัญ แผน $200 ให้คุณเช่าโมเดลที่ดีที่สุดในโลก พร้อม agent ที่สร้างขึ้นรอบ ๆ โมเดลเหล่านั้น และผลิตภัณฑ์ที่พัฒนาขึ้นทุกเดือน MacBook ราคา $7,000 รันโมเดลที่ดีที่สุดที่พอดีกับ 128 GB และวันนี้โมเดลเหล่านั้นได้ 34 เทียบกับ 58 ของกลุ่มแนวหน้า อ่านพรอมต์ยาวได้ช้า และสูญเสียคุณภาพในจุดที่คุณอยากบีบมันมากที่สุดพอดี
ตัวเลขก็ช่วยไม่ได้เช่นกัน แม้ในกรณีที่เอื้อที่สุด MacBook ต้องใช้เวลาสามถึงสี่ปีจึงจะคืนทุน และตลอดสามปีค่าใช้จ่ายต่างจากการสมัครสมาชิกเพียงไม่กี่พันดอลลาร์ ขึ้นอยู่กับว่าคุณขายต่อได้เท่าไร นั่นคือบิลที่ใกล้เคียงกันสำหรับผลิตภัณฑ์ที่ความสามารถน้อยกว่า
ดังนั้นซื้อ MacBook เพื่อรัน LLM ในเครื่อง ถ้าข้อมูลของคุณออกจากองค์กรไม่ได้ ถ้าคุณทำงานออฟไลน์ ถ้าคุณต้องการไม่มีขีดจำกัดและโมเดลที่ไม่เปลี่ยนแปลง หรือถ้าคุณจะซื้อ Mac อยู่แล้ว เหล่านั้นเป็นเหตุผลที่ดี และคนจำนวนมากมีเหตุผลแบบนี้ เพียงอย่าซื้อเพื่อยกเลิกการสมัครสมาชิก เก็บแผนบนคลาวด์ไว้สำหรับงานยาก 10% วางงานส่วนตัวและงานน่าเบื่อ 90% ไว้บนฮาร์ดแวร์ของคุณเอง และปล่อยให้ลีดเดอร์บอร์ดบอกคุณว่าสมดุลนั้นเปลี่ยนเมื่อไร
รันโมเดลในเครื่องเพื่องานของคุณอยู่ หรือพบสิ่งที่ตรงข้ามกับที่บทความนี้บอก? ผมอยากรู้ว่าโมเดลไหน เครื่องไหน และงานแบบไหน พร้อมตัวเลขถ้าคุณมี ข้อแก้ไขและหลักฐานที่โต้แย้งยินดีรับ บทความนี้จะอัปเดตเมื่อลีดเดอร์บอร์ดและราคาเปลี่ยน ซึ่งในปี 2026 หมายถึงบ่อยครั้ง
ตรวจสอบข้อเท็จจริง: 28 ตุลาคม 2026