हिन्दी
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 العربية

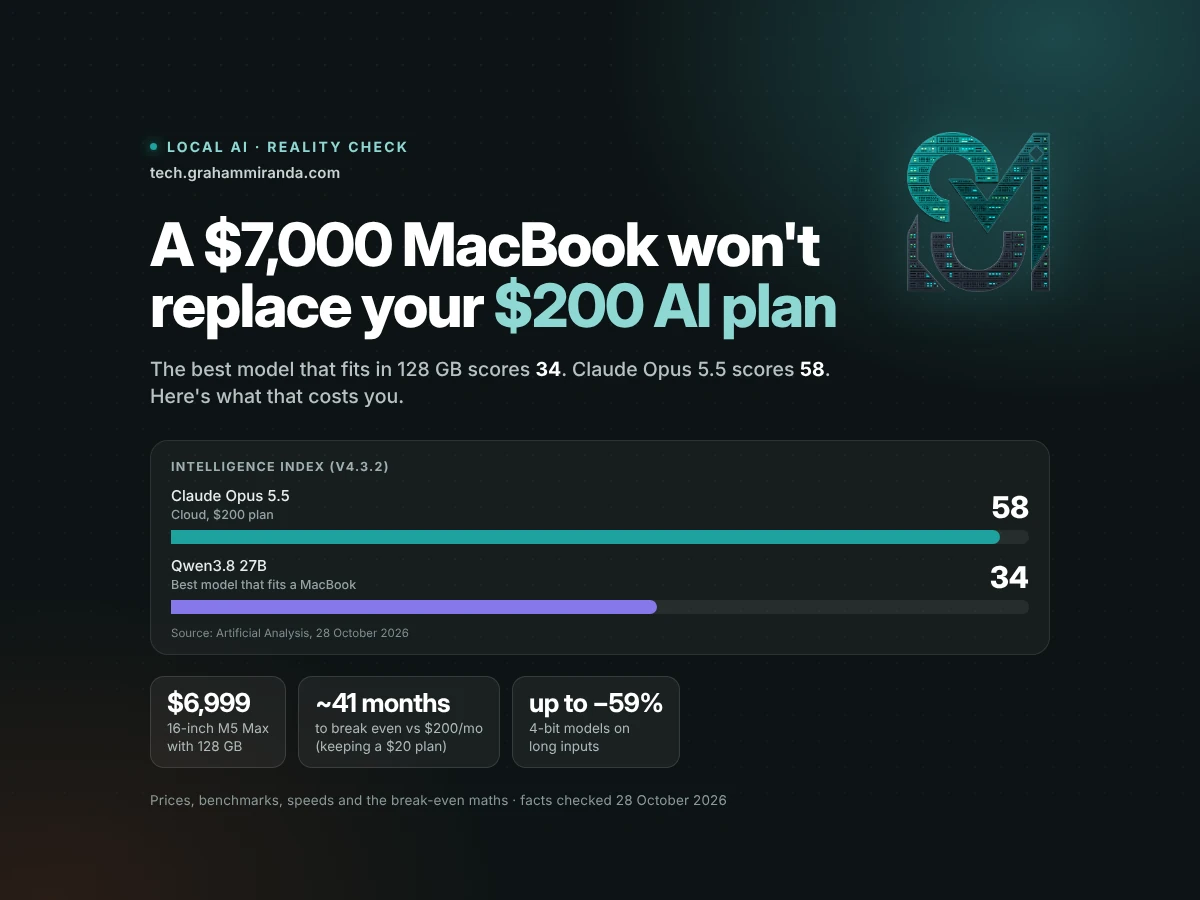
दलील कुछ इस तरह चलती है। सबसे ऊँचे दर्जे के AI सब्सक्रिप्शन की कीमत महीने $200 है, यानी साल में $2,400। 128 GB यूनिफ़ाइड मेमोरी वाला MacBook Pro बड़े भाषा मॉडल लोकली चला सकता है — प्राइवेसी के साथ और बिना किसी इस्तेमाल-सीमा के। तो सब्सक्रिप्शन बंद करें, बजाय इसके local LLM के लिए MacBook ख़रीदें, और एक-दो साल में उसकी लागत वसूल हो जाती है।
2026 में इसके संस्करण हर जगह मिलेंगे: उन YouTube वीडियो में जो पूछते हैं कि क्या आपको अपना $200 का AI प्लान बंद करके $9,499 का Mac ख़रीदना चाहिए, उन Medium पोस्ट में जो Mac’s कीमत को $200 से भाग देते हैं, और Forbes के उस कॉलम में जिसने अगस्त में Apple के नए Mac Studio के लॉन्च पर हिसाब लगाया। M5 Max MacBook Pro के लॉन्च पर Apple के हार्डवेयर प्रमुख John Ternus ने कहा कि नई मशीनें पेशेवरों को “डिवाइस पर एडवांस्ड LLM चलाने” देती हैं।
कुछ लोगों के लिए local LLM के लिए MacBook ख़रीदना बिल्कुल अच्छा आइडिया है। $200 वाले Claude या ChatGPT प्लान की जगह लेने के मामले में यह फ़ेल होता है, और फ़ेल उस एक चीज़ पर होता है जिसकी क़ीमत दलील में कभी नहीं जोड़ी जाती: क्वालिटी. सब्सक्रिप्शन आपको दुनिया के सबसे अच्छे मॉडल किराए पर देता है। Mac वे सबसे अच्छे मॉडल चलाता है जो 128 GB में फ़िट होते हैं। कल ही से हम इन दोनों के बीच की दूरी पहले से कहीं ज़्यादा सटीकता से नाप सकते हैं, और यह दूरी हाइप के दावों से कहीं ज़्यादा है।
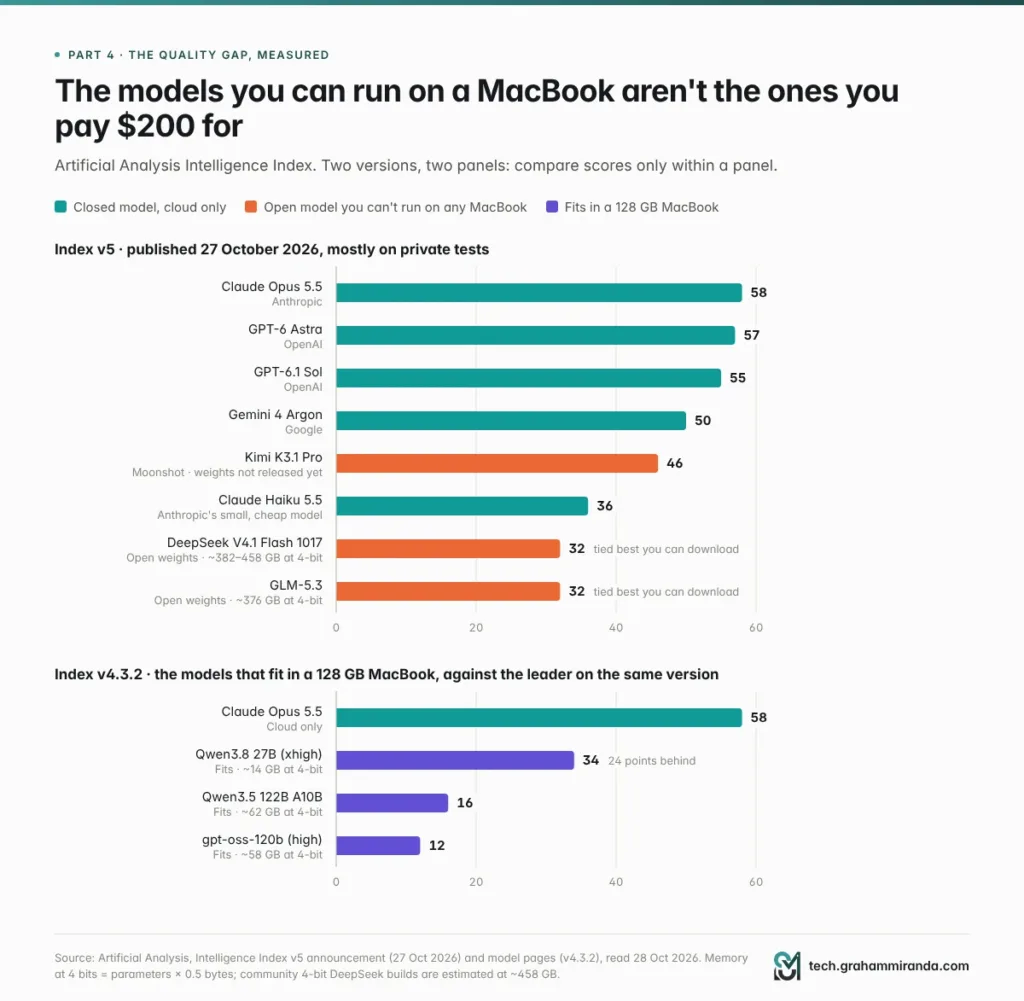
27 अक्टूबर को Artificial Analysis ने अपना Intelligence Index मुख्यतः प्राइवेट टेस्ट के आधार पर फिर से बनाया। Claude Opus 5.5 सबसे आगे है, स्कोर 58. जो सबसे अच्छे ओपन-वेट मॉडल आप असल में डाउनलोड कर सकते हैं — DeepSeek V4.1 Flash 1017 और GLM-5.3 — उनका स्कोर 32, जो Claude Haiku 5.5, Anthropic के छोटे और सस्ते मॉडल, के 36 से नीचे है। इनमें से कोई भी ओपन मॉडल किसी भी MacBook में फ़िट नहीं होता: 4-bit पर इन्हें 375 से 460 GB के बीच जगह चाहिए। 128 GB वाले MacBook में फ़िट होने वाला सबसे मज़बूत मॉडल जो मुझे मिला, Qwen3.8 27B, उसका स्कोर 34 इंडेक्स के पिछले संस्करण पर है, वही संस्करण जिस पर Opus 5.5 का स्कोर भी 58 है।
इस बीच हार्डवेयर और महंगा हो गया। जून में Apple ने M5 Max पर 128 GB मेमोरी अपग्रेड की कीमत दोगुनी कर दी। 128 GB वाले 16-इंच MacBook Pro की कीमत अब $6,999 अमेरिका में है और, मेरे अनुमान से, लगभग €8,199 जर्मनी में है।
तो यह है उस हिसाब का ईमानदार संस्करण: महीने के $200 असल में क्या ख़रीदते हैं, $7,000 असल में क्या ख़रीदते हैं, क्वालिटी का अंतर कितना बड़ा है और क्यों है, M5 Max असल में कितना तेज़ है, quantization आपसे कितनी क़ीमत वसूल करता है, local AI के लिए Mac ख़रीदना कब बनता है, और अगर आपको सच में $200 का बिल घटाना है तो उसके सस्ते रास्ते क्या हैं। हर आँकड़ा अपने स्रोत से मिलाकर जाँचा गया 28 अक्टूबर 2026.
TL;DR — 60 सेकंड में सार
- जिन मॉडलों के लिए आप $200 देते हैं, वे डाउनलोड नहीं किए जा सकते, और जो सबसे अच्छे मॉडल डाउनलोड किए जा सकते हैं वे MacBook में फ़िट नहीं होते। Artificial Analysis के नए Intelligence Index v5 पर Claude Opus 5.5 का स्कोर 58 है। सबसे ऊपर के डाउनलोड-योग्य ओपन मॉडल, DeepSeek V4.1 Flash 1017 और GLM-5.3, स्कोर 32 पर हैं और 4-bit पर इन्हें लगभग 375–460 GB मेमोरी चाहिए।
- जो फ़िट होते हैं उनका स्कोर कहीं कम है। 128 GB वाले MacBook के लिए मुझे जो सबसे मज़बूत मॉडल मिला, Qwen3.8 27B, उसका स्कोर उसी इंडेक्स संस्करण (v4.3.2) पर Opus 5.5 के 58 के मुक़ाबले 34 है। जिन 120B-श्रेणी के मॉडलों को असल में ज़्यादा मेमोरी चाहिए, उनका स्कोर और भी कम है: Qwen3.5 122B का 16, gpt-oss-120b का 12।
- 128 GB वाला MacBook महंगा हो गया। जून में Apple ने 128 GB अपग्रेड की कीमत दोगुनी करके $2,000 कर दी, इसलिए 128 GB वाला 16-इंच M5 Max अब $6,999 का है (जर्मनी में लगभग €8,199, मेरा अनुमान)। वही चिप और मेमोरी Mac Studio में $4,799 की पड़ती है।
- लागत वसूल होने में तीन से चार साल लगते हैं, एक नहीं। भले ही Mac सब्सक्रिप्शन की पूरी जगह ले ले, $200 के प्लान से आगे निकलने में लगभग 37 महीने लगेंगे, मुश्किल कामों के लिए $20 का प्लान रखने पर 41, और $100 के प्लान के मुक़ाबले छह साल से ज़्यादा।
- लिखना तेज़ है; पढ़ना धीमा। M5 Max मिश्रण-विशेषज्ञ (mixture-of-experts) मॉडलों पर 55–88 टोकन प्रति सेकंड बनाता है, जो Anthropic के API पर Opus 5.5 के 98 से बहुत दूर नहीं है। लेकिन 32,000-टोकन के प्रॉम्प्ट को सिर्फ़ पढ़ने में उसे 13–55 सेकंड लगते हैं, और AI एजेंट दिन भर लंबे प्रॉम्प्ट बार-बार पढ़ते हैं।
- बड़े मॉडलों को ज़बरदस्ती अंदर फ़िट करने पर क्वालिटी की क़ीमत चुकानी पड़ती है। छोटे कामों में 4-bit quantization लगभग बिना नुकसान के होता है, लेकिन EMNLP 2025 के एक अध्ययन में लंबे इनपुट पर इसकी क़ीमत 59% तक रही, और अंग्रेज़ी के अलावा दूसरी भाषाओं में उससे भी ज़्यादा। 3 bits पर एक छोटे reasoning मॉडल का गणित स्कोर 85.6% से गिरकर 47.0% हो गया।
- सार्वजनिक बेंचमार्क ओपन मॉडलों को बढ़ा-चढ़ाकर दिखाते लगते हैं। जब Artificial Analysis मुख्यतः प्राइवेट टेस्ट पर चला गया, तो चार प्रमुख ओपन-वेट मॉडलों के औसतन 13 अंक घट गए। चार प्रमुख क्लोज़्ड मॉडल लगभग वहीं रहे।
- लोकल अब भी प्राइवेसी, ऑफ़लाइन इस्तेमाल, बिना रेट लिमिट और थोक कामों में जीतता है, और तब भी जब आप वैसे भी Mac ख़रीद रहे थे। इन वजहों से ख़रीदें, सब्सक्रिप्शन बंद करने के लिए नहीं।
- बचाने के सस्ते तरीके भी हैं। $100 के टियर पर आ जाएँ और साल के $1,200 बचाएँ, ओपन मॉडलों के लिए प्रति टोकन भुगतान करें (DeepSeek V4.1 Flash का ऑफ़-पीक रेट आउटपुट के प्रति दस लाख टोकन $0.60 है), या $18 महीने से शुरू होने वाला कोडिंग प्लान लें।
दलील बनाम हक़ीक़त
| दलील | हक़ीक़त, अक्टूबर 2026 |
|---|---|
| “एक साल में इसकी लागत वसूल हो जाती है” | 128 GB वाला 16-इंच MacBook Pro $6,999 का है। महीने के $200 के हिसाब से यह बिजली को छोड़कर 35 महीने होते हैं, और मुश्किल कामों के लिए रखे जाने वाले $20 के प्लान को जोड़ दें तो 41 महीने |
| “लोकल मॉडल अब लगभग उतने ही अच्छे हैं” | Opus 5.5 का स्कोर 58 है। 128 GB में फ़िट होने वाले सबसे अच्छे मॉडल का स्कोर 34 है (Qwen3.8 27B, इंडेक्स v4.3.2)। सबसे अच्छे डाउनलोड-योग्य ओपन मॉडल नए v5 पर 32 पर हैं |
| “128 GB बड़े ओपन मॉडल चला देता है” | GLM-5.3 को 4-bit पर लगभग 376 GB चाहिए, DeepSeek V4.1 Flash को लगभग 380–460 GB, Kimi K3 को लगभग 1.5 TB। इनमें से कोई किसी भी MacBook में फ़िट नहीं होता |
| “M5 Max तेज़ है” | लिखने में हाँ: mixture-of-experts मॉडलों पर 55–88 टोकन प्रति सेकंड। 32K-टोकन का प्रॉम्प्ट पढ़ने में: 13 से 55 सेकंड |
| “4-bit बिना नुकसान है” | छोटे बेंचमार्क पर लगभग। 64K टोकन से बड़े इनपुट पर एक अध्ययन में 59% तक ख़राब, और अंग्रेज़ी के बाहर और भी ख़राब |
| “कोई सीमा नहीं, पूरी प्राइवेसी” | सच है। ख़रीदने की असली वजह यही है |
विषय-सूची
- TL;DR — 60 सेकंड में सार
- दलील बनाम हक़ीक़त
- भाग 1 — “अपना $200 का प्लान बंद कर दें” वाली दलील, और यह इतनी सही क्यों लगती है
- भाग 2 — अक्टूबर 2026 में महीने के $200 असल में क्या ख़रीदते हैं
- भाग 3 — 128 GB वाले MacBook की अब असल कीमत
- भाग 4 — क्वालिटी का अंतर, नापा हुआ
- भाग 5 — जो मॉडल आप असल में चाहते हैं वे फ़िट क्यों नहीं होते
- भाग 6 — Quantization: फ़िट कराने के लिए चुकाया जाने वाला क्वालिटी टैक्स
- भाग 7 — रफ़्तार: लिखने में तेज़, पढ़ने में धीमा
- भाग 8 — लैपटॉप की समस्या
- भाग 9 — सॉफ़्टवेयर का अंतर: आपको क्या-क्या फिर से बनाना पड़ेगा
- भाग 10 — लागत वसूली का हिसाब, ईमानदारी से
- भाग 11 — जायज़ पक्ष: local AI के लिए Mac ख़रीदना कब बनता है
- भाग 12 — $200 का AI बिल घटाने के सस्ते तरीके
- भाग 13 — क्या local LLM के लिए MacBook ख़रीदें? फ़ैसले की गाइड
- भाग 14 — अगर फिर भी ख़रीद लें: उससे सबसे ज़्यादा कैसे पाएँ
- अक्सर पूछे जाने वाले प्रश्न
- क्या MacBook ChatGPT Pro या Claude Max सब्सक्रिप्शन की जगह ले सकता है?
- 2026 में 128 GB वाले MacBook Pro के लिए सबसे अच्छा local LLM कौन है?
- 128 GB वाला MacBook Pro अब कितने का है?
- $200 के AI सब्सक्रिप्शन के मुक़ाबले MacBook कितने समय में अपनी लागत वसूल करता है?
- क्या M5 Max local LLM के लिए काफ़ी तेज़ है?
- क्या local LLM अब ChatGPT या Claude जितने अच्छे हैं?
- क्या quantization लोकल मॉडलों को ख़राब बनाता है?
- क्या मैं MacBook पर DeepSeek V4.1 Flash या GLM-5.3 चला सकता हूँ?
- क्या local AI के लिए 64 GB काफ़ी है, या 128 GB चाहिए?
- क्या मुझे local LLM के लिए MacBook Pro की जगह Mac Studio ख़रीदना चाहिए?
- क्या AI लोकल चलाना प्राइवेसी और GDPR के लिए बेहतर है?
- क्या मैं Claude Code को लोकल मॉडल के साथ इस्तेमाल कर सकता हूँ?
- क्या नया OLED MacBook Pro इसमें कुछ बदलेगा?
- मुख्य बात
भाग 1 — “अपना $200 का प्लान बंद कर दें” वाली दलील, और यह इतनी सही क्यों लगती है
पहले यह देखें कि यह दलील इतनी आसानी से क्यों फैलती है, क्योंकि इसका ज़्यादातर हिस्सा वाजिब है।
तीनों लैब $200 पर आ मिले। Anthropic’s Claude Max 20× महीने का $200 है। OpenAI’s ChatGPT Pro $100, $200 और $500 वाले संस्करणों में आता है। Google’s AI Ultra में $100 का टियर है और $200 वाला भी। हर महीने इतना देते रहें तो आँकड़ा याद रह जाता है: साल में $2,400, तीन साल में $7,200।
हार्डवेयर गंभीर हो गया। मार्च से बिक रहा M5 Max MacBook Pro 614 GB/s बैंडविड्थ के साथ 128 GB तक यूनिफ़ाइड मेमोरी लेता है, और Apple ने हर GPU कोर में Neural Accelerator, यानी मैट्रिक्स गणित के लिए समर्पित हार्डवेयर, डाला है। अगस्त में Mac Studio आया, जिसमें M5 Ultra विकल्प 512 GB तक का है। Apple’s मार्केटिंग पहले से कहीं ज़्यादा local AI पर टिकी है।
सब्सक्रिप्शन और कंजूस हो गए। प्लान लॉन्च होने के महीनों बाद जोड़ी गई Claude Max की साप्ताहिक सीमाएँ 8 सितंबर को दायर एक क्लास एक्शन का विषय हैं, जिसमें कहा गया है कि “5×” और “20×” लेबल साप्ताहिक कैप को काफ़ी स्पष्ट नहीं करते। कथित तौर पर OpenAI ने नए ग्राहकों के लिए अपने $200 वाले Pro प्लान का कोटा ChatGPT Plus के 20 गुना से घटाकर 10 गुना कर दिया। जब किराए की चीज़ लगातार सिकुड़ती रहे, तो अपना होना आकर्षक लगने लगता है।
प्राइवेसी एक असली चिंता है। क्लाउड मॉडल में आप जो कुछ भी पेस्ट करते हैं, वह आपकी मशीन से बाहर चला जाता है। क्लाइंट डेटा रखने वाले जर्मन कारोबार के लिए यह पैरानॉया नहीं; यह GDPR है।
और हिसाब आसान है। सबसे ज़्यादा शेयर होने वाला संस्करण: $2,499 का Mac Studio महीने के $200 से भाग दें तो लगभग 12.5 महीने। Forbes ने अगस्त में कहीं ज़्यादा सावधानी वाला संस्करण छापा, असली कॉन्फ़िगरेशन और तीन साल की बिजली के साथ, और नतीजा यह निकला कि अगर आप एजेंट के साथ कोडिंग करते हैं तो Mac शायद आपको अपना Claude या ChatGPT प्लान बंद करने नहीं देगा। लेकिन लोगों को छोटा संस्करण ही याद रहता है।
यहाँ ख़राबी यह है। दलील कीमत की तुलना कीमत से करती है। उसे प्रोडक्ट की तुलना प्रोडक्ट से करनी चाहिए। इस लेख का बाक़ी हिस्सा यही करता है, शुरुआत इससे कि $200 असल में किस चीज़ के लिए जाता है।
भाग 2 — अक्टूबर 2026 में महीने के $200 असल में क्या ख़रीदते हैं
| प्रोवाइडर | $20 टियर | $100 टियर | $200 टियर | $200 से ऊपर |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: $20 (सालाना बिलिंग पर महीने $17) | Max 5×: $100 | Max 20×: $200 | Team और Enterprise |
| OpenAI (ChatGPT) | Plus: $20 (Go: $8) | Pro 100: $100 | Pro 200: $200 | Pro 500: $500 |
| Google (Gemini) | AI Pro: $20 | AI Ultra: $100 | AI Ultra: $200 | — |
अमेरिकी कीमतें प्रति माह, VAT के बिना। Claude claude.com से; ChatGPT AI Business Weekly के ट्रैकर से, 4 अक्टूबर को अपडेट किया गया; Google मई में हुए री-लॉन्च पर Engadget की रिपोर्ट से। कीमतें और कोटा अक्सर बदलते हैं, इसलिए सब्सक्राइब करने से पहले जाँच लें।
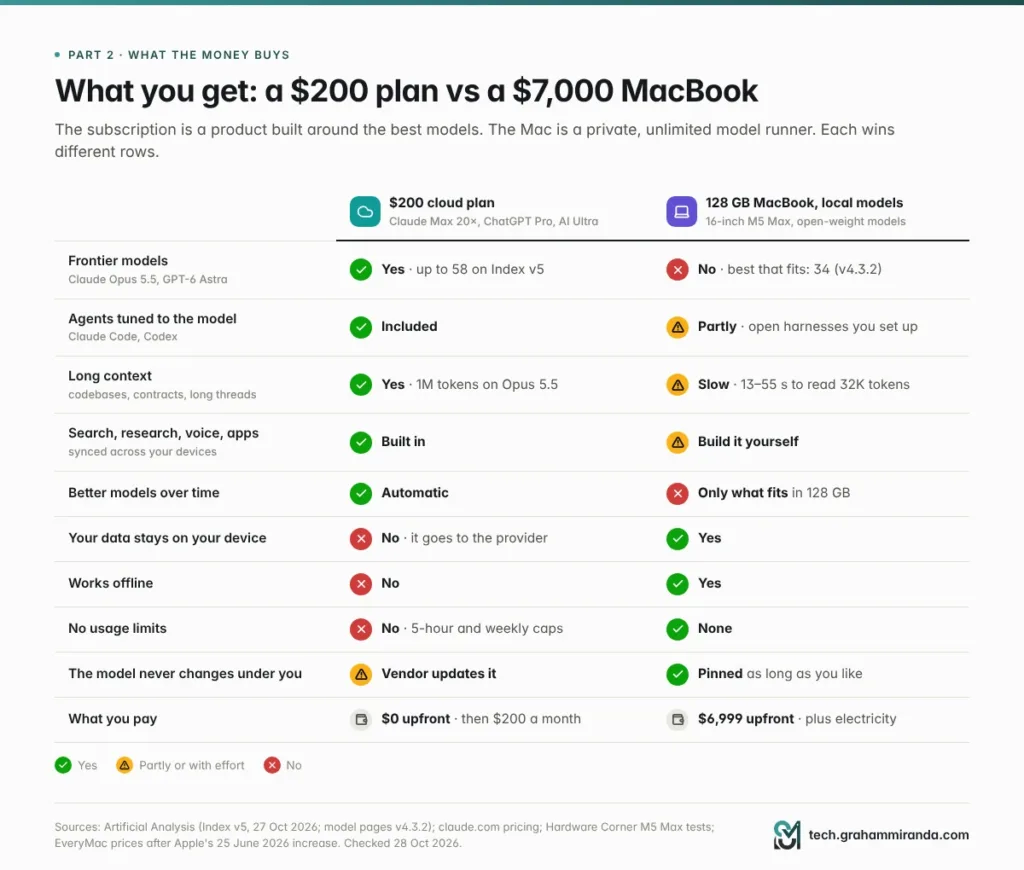
पैसा असल में किस चीज़ के लिए जाता है
1. फ़्रंटियर मॉडल, जो आपको कहीं और नहीं मिलते। Artificial Analysis के नए इंडेक्स पर टॉप पाँचों जगहें Anthropic और OpenAI के पास हैं। उनमें से कोई मॉडल किसी भी कीमत पर डाउनलोड नहीं किया जा सकता। ज़्यादातर लोगों के लिए इन्हें इस्तेमाल करने का सबसे सस्ता तरीका सब्सक्रिप्शन ही है।
2. उन मॉडलों के इर्द-गिर्द बने एजेंट। Claude के पेड प्लानों में Claude Code शामिल है; ChatGPT के प्लानों में Codex। हार्नेस और मॉडल साथ में ट्यून किए जाते हैं, जिससे समझ आता है कि ये एजेंटिक-कोडिंग लीडरबोर्ड पर सबसे ऊपर क्यों हैं। (मैंने ऐसे 28 टूल की तुलना हर AI कोडिंग हार्नेस की तुलना.)
3. बहुत बड़ा कॉन्टेक्स्ट। Artificial Analysis के मुताबिक़ Claude Opus 5.5 दस लाख टोकन की कॉन्टेक्स्ट विंडो लेता है: पूरे कोडबेस, पूरे कॉन्ट्रैक्ट, पूरी तिमाही की ईमेल।
4. मॉडल के इर्द-गिर्द का प्रोडक्ट। वेब सर्च और डीप रिसर्च, फ़ाइल एनालिसिस, वॉइस, मेमोरी, इमेज जनरेशन, आपकी मेल और दस्तावेज़ों से कनेक्टर, और ऐसे ऐप जो आपके फ़ोन, लैपटॉप और ब्राउज़र में सिंक रहते हैं। इनमें से कुछ भी मॉडल फ़ाइल के साथ नहीं आता।
5. वे अपग्रेड जो आपको इंस्टॉल नहीं करने पड़ते। अगली तिमाही में आपके सब्सक्रिप्शन के पीछे का मॉडल आज से बेहतर होगा। आपके Mac पर मॉडल तभी बदलता है जब आप कोई दूसरा डाउनलोड करें, और तभी जब नया वाला फ़िट हो जाए।
6. कुछ पैसा वापस। Anthropic के प्राइसिंग पेज पर अब Max के साथ मासिक API क्रेडिट दिए गए हैं: 5× प्लान पर $100 और 20× पर $200।
जो यह नहीं ख़रीदता
असीमित इस्तेमाल। Claude के प्लान रोलिंग पाँच-घंटे की विंडो और साप्ताहिक कैप पर चलते हैं, और OpenAI और Google अपने टॉप टियर को ज़्यादातर सस्ते टियरों के गुणकों के रूप में बताते हैं — जब बताते हैं तो। इस पर नियंत्रण कि आपका डेटा कहाँ जाता है, जो निजी और क्लाइंट डेटा के लिए बहुत मायने रखता है। और पूर्वानुमान: इस साल कोटा एक से ज़्यादा बार बदल चुका है।
इन तीनों को याद रखें। local AI का ईमानदार पक्ष यही है, और भाग 11 में इन्हें पूरा सुना जाता है।
छवि दिखाएँ सब्सक्रिप्शन एक प्रोडक्ट है; Mac एक मॉडल रनर। दोनों अलग-अलग पंक्तियों में जीतते हैं, इसलिए ज़्यादातर लोगों के लिए सही जवाब दोनों है।
भाग 3 — 128 GB वाले MacBook की अब असल कीमत
सिर्फ़ एक चिप आपको 128 GB तक ले जाती है। M5 पीढ़ी में इतनी यूनिफ़ाइड मेमोरी सिर्फ़ 40-कोर GPU वाला M5 Max ही देता है, जिसमें 614 GB/s मेमोरी बैंडविड्थ है। 32-कोर-GPU वाला M5 Max 36 GB और 460 GB/s पर तय है, और M5 Pro अधिकतम 64 GB और 307 GB/s तक जाता है।
| कॉन्फ़िगरेशन | अमेरिकी कीमत | जर्मनी |
|---|---|---|
| 16″ M5 Max (18-कोर CPU, 40-कोर GPU), 48 GB, 2 TB | $4,999 | €5,699 |
| 128 GB में अपग्रेड | +$2,000 (25 जून तक +$1,000 था) | लगभग +€2,500 (लॉन्च पर +€1,250 था), अनुमानित |
| 16″ M5 Max, 128 GB, 2 TB | $6,999 | लगभग €8,199 (अनुमानित; लॉन्च पर €6,249) |
| फ़ुल कॉन्फ़िगरेशन: 128 GB, 8 TB, नैनो-टेक्सचर डिस्प्ले | $10,149 | — |
| तुलना के लिए: Mac Studio, M5 Max, 128 GB | $4,799 | — |
अमेरिकी कीमतों में सेल्स टैक्स शामिल नहीं है; जर्मन कीमतों में 19% VAT शामिल है। जर्मन 128 GB अपग्रेड मेरा अनुमान है: लॉन्च पर Apple ने इसके लिए €1,250 लिए थे, और डॉलर वाला अपग्रेड जून में दोगुना हो गया। खरीदने से पहले Apple’s कॉन्फ़िगरेटर देख लें।
तीन बातें साफ़ उभरकर सामने आती हैं।
अब सबसे महँगा हिस्सा मेमोरी है। Apple ने 25 जून को पूरी Mac लाइन की कीमतें बढ़ाईं और इसके लिए मेमोरी और स्टोरेज की लागत को ज़िम्मेदार ठहराया। इसने Reuters से कहा कि उसने “किसी कल-पुर्ज़े की कीमत में इतनी तेज़ी से इतनी बड़ी बढ़ोतरी पहले कभी नहीं देखी”। M5 Max के 64 GB और 128 GB दोनों अपग्रेड दोगुने हो गए। लोकल AI को जिस कल-पुर्ज़े की सबसे ज़्यादा ज़रूरत है, वही दोगुना महँगा हो गया।
लैपटॉप का प्रीमियम $2,200 है। अगस्त में जब Forbes ने कीमत देखी, तब Mac Studio में वही M5 Max और वही 128 GB $4,799 का था। अगर आपको AI के लिए मेमोरी चाहिए, तो लैपटॉप फ़ॉर्म फ़ैक्टर 46% ज़्यादा महँगा पड़ता है।
14-इंच मॉडल एक समझौता है। आप 14-इंच को 128 GB के साथ भी ऑर्डर कर सकते हैं, लेकिन Notebookcheck’s समीक्षा में लगातार लोड के दौरान इसका चेसिस M5 Max को ठंडा रखने में संघर्ष करता दिखा। इस पर ज़्यादा बात भाग 8 में।
इस हफ़्ते नए Mac। 27 अक्टूबर को Apple ने बेस M6 चिप वाला 14-इंच MacBook Pro पेश किया: 32 GB और 170 GB/s तक, $1,999 से। यह अच्छा लैपटॉप है, LLM मशीन नहीं। और आज रात (28 अक्टूबर, 10:00 Pacific, जर्मनी में 18:00) Apple अपना “Pro and Tell” इवेंट रख रहा है, जहाँ एक OLED टचस्क्रीन MacBook Pro व्यापक रूप से अपेक्षित है। रिपोर्टों के मुताबिक़ इसमें वही M5 Pro और M5 Max चिप होंगे, जिससे 128 GB की सीमा और 614 GB/s में कोई बदलाव नहीं होगा।
भाग 4 — क्वालिटी का अंतर, नापा हुआ
आप अपने डेस्क पर रखे मॉडल की तुलना डेटा सेंटर वाले मॉडल से कैसे करेंगे? अंदाज़े से नहीं, और किसी वेंडर की अपनी बेंचमार्क तालिका से भी नहीं। Artificial Analysis (AA) सैकड़ों मॉडलों पर वही परीक्षण-समूह, उसी हार्नेस के ज़रिए चलाता है, और नतीजों को एक ही Intelligence Index में समेट देता है। कोई भी इंडेक्स परफ़ेक्ट नहीं है, लेकिन AA’s इंडेक्स स्वतंत्र है, और उद्योग के पास एक साझा पैमाने जैसा जो सबसे क़रीब है, वही है।
27 अक्टूबर को AA ने संस्करण 5जारी किया। सबसे बड़ा बदलाव यह है कि इंडेक्स का लगभग 60% अब निजी टेस्ट सेट या छिपाए गए जवाबोंपर चलता है, ताकि कोई मॉडल ट्रेनिंग के दौरान सवाल देख न चुका हो। नॉलेज वर्क, कोडिंग, साइंस और सामान्य ज्ञान — हर एक का हिस्सा एक-चौथाई है।
नई लीडरबोर्ड
| मॉडल | क्या आप इसे डाउनलोड कर सकते हैं? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | नहीं | 58 |
| GPT-6 Astra (max) | नहीं | 57 |
| GPT-6.1 Sol (max) | नहीं | 55 |
| Gemini 4 Argon (high) | नहीं | 50 |
| Kimi K3.1 Pro | अभी नहीं; वेट्स जारी नहीं हुए | 46 |
| Claude Haiku 5.5 (max) | नहीं | 36 |
| DeepSeek V4.1 Flash 1017 (max) | हाँ, MIT लाइसेंस | 32 |
| GLM-5.3 (max) | हाँ | 32 |
स्रोत: Artificial Analysis, Intelligence Index v5 की घोषणा, 27 अक्टूबर 2026।
अगर आप MacBook की कीमत का हिसाब लगा रहे हैं, तो उस तालिका की तीन बातें मायने रखती हैं।
- टॉप पाँचों जगह Anthropic और OpenAI के पास हैं, और उनमें से कोई भी मॉडल किसी भी कीमत पर डाउनलोड नहीं किया जा सकता।
- सबसे अच्छा ओपन मॉडल, Kimi K3.1 Pro, ने अपने वेट्स जारी नहीं किए हैं। जिन मॉडलों को आप सचमुच डाउनलोड कर सकते हैं, उनमें सबसे अच्छा स्कोर 32 है, यानी वे लीडर से 26 अंक पीछे रह जाते हैं। पिछले संस्करण पर सबसे अच्छे ओपन और सबसे अच्छे क्लोज़्ड मॉडल के बीच 3 अंक का अंतर था। अब यह 12 है, या 26 अगर आप केवल वे वेट्स गिनें जो आप डाउनलोड कर सकते हैं।
- Claude Haiku 5.5 हर डाउनलोडेबल ओपन मॉडल को पीछे छोड़ देता है। यह Anthropic का छोटा, तेज़ और सस्ता टियर है, उसका फ़्लैगशिप नहीं।
ख़ास तौर पर कोडिंग
नए इंडेक्स में शामिल हैं FrontierCode 2.0, Cognition की 132 प्राइवेट कोडिंग टास्क। Claude Opus 5.5 ने 46% हल किए; DeepSeek V4.1 Flash 1017, जो डाउनलोडेबल मॉडलों में संयुक्त रूप से सबसे मज़बूत है, ने 28% हल किए। जहाँ तक Terminal-Bench-Science, 70 एजेंटिक साइंस टास्क पर यह 59% बनाम 13% है।
ओपन मॉडलों के साथ न्याय करें तो: Kimi K3.1 Pro Terminal-Bench 4.0 67% के साथ आगे है, हर क्लोज़्ड मॉडल से आगे। ओपन मॉडल अलग-अलग बेंचमार्क जीत सकते हैं और जीतते हैं। लेकिन वह अभी डाउनलोडेबल नहीं है, और उसका पूर्ववर्ती, Kimi K3, 2.8 ट्रिलियन पैरामीटर का है। आप उसे लैपटॉप पर नहीं चलाएँगे।
अंतर अभी और क्यों बढ़ा
v4.3 से v5 की छलाँग ने सबके साथ एक जैसा व्यवहार नहीं किया।
| मॉडल | प्रकार | v4.3 | v5 | बदलाव |
|---|---|---|---|---|
| Claude Opus 5.5 | क्लोज़्ड | 58 | 58 | 0 |
| GPT-6 Astra | क्लोज़्ड | 53 | 57 | +4 |
| Claude Sonnet 5.5 | क्लोज़्ड | 56 | 54 | −2 |
| Gemini 4 Argon | क्लोज़्ड | 53 | 50 | −3 |
| Kimi K3.1 Pro | ओपन (वेट्स जारी नहीं) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | खोलें | 45 | 32 | −13 |
| Muse Spark Open (Meta) | खोलें | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | खोलें | 46 | 30 | −16 |
v4.3 और v5 के आँकड़े Trending Topics द्वारा 28 अक्टूबर को रिपोर्ट किए गए, जिनमें v5 के स्कोर AA’s घोषणा से मेल खाते हैं।
औसतन, वे चार ओपन मॉडल 13 अंकखो बैठे। चार क्लोज़्ड मॉडल एक-चौथाई अंक ही हिले।
AA ने इसका कारण नहीं बताया है। सीधा अर्थ यह है कि जब टेस्ट के सवाल गुप्त हों, तो कोई मॉडल उन्हें देख नहीं सकता, और पब्लिक बेंचमार्क उन मॉडलों को ज़्यादा अच्छा दिखाते हैं जिन्हें पब्लिक डेटा पर खूब ट्रेन किया गया हो। दूसरी बात भी जायज़ है: प्राइवेट टेस्ट बाहर से जाँचे नहीं जा सकते, और कैटेगरी को कितना वेट दें, इससे रैंकिंग बदल जाती है। किसी भी एक इंडेक्स को अंतिम सत्य न मानें। लेकिन जब चार ओपन मॉडल दोहरे अंकों में गिरें और चार क्लोज़्ड न गिरें, तो यह गंभीरता से लेने लायक संकेत है: प्रकाशित बेंचमार्क तालिकाएँ, और ख़ासकर वेंडरों की अपनी, ओपन मॉडलों के क़रीब होने को बढ़ा-चढ़ाकर दिखाती हैं।
और वे मॉडल जो असल में MacBook में फ़िट होते हैं
AA ने अपनी घोषणा के लिए जिन मॉडलों को दोबारा स्कोर किया, वे ज़्यादातर लैपटॉप के लिए कहीं ज़्यादा बड़े हैं। जो फ़िट होते हैं, उनके लिए AA’s मॉडल पेज अब भी v4.3.2 स्कोर दिखाते हैं, और उस संस्करण पर Opus 5.5 का स्कोर भी 58 है। तो यहाँ एक ही पैमाने पर तुलना है:
| मॉडल | 128 GB MacBook में फ़िट होता है? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | नहीं, केवल क्लाउड | 58 |
| Qwen3.8 27B (xhigh) | हाँ, 4-bit पर 32 GB Mac पर भी | 34 |
| Qwen3.5 122B A10B (reasoning) | हाँ, 4-bit पर लगभग 70 GB | 16 |
| gpt-oss-120b (high) | हाँ, लगभग 64 GB | 12 |
स्रोत: Artificial Analysis के मॉडल पेज, 28 अक्टूबर 2026 को देखे गए।
AA 141 तुलनीय मॉडलों में Qwen3.8 27B को पहले स्थान पर रखता है। अपने साइज़ के हिसाब से यह सचमुच बेहतरीन है, और Apache 2.0 के तहत जारी एक ओपन मॉडल है। फिर भी यह 24 अंक पीछे है।.
छवि दिखाएँ दो इंडेक्स संस्करण, दो अलग-अलग पैनल, कभी एक धुरी पर नहीं। ऊपर: Artificial Analysis Intelligence Index v5 (27 अक्टूबर 2026)। नीचे: 128 GB वाले MacBook में फ़िट होने वाले मॉडल, v4.3.2 पर, वही संस्करण जिस पर उनके स्कोर प्रकाशित होते हैं।
128 GB का विरोधाभास
उस पिछली तालिका को फिर से देखें। 128 GB MacBook के लिए सबसे अच्छा मॉडल 32 GB में फ़िट हो जाता है। जिन मॉडलों को सचमुच ज़्यादा मेमोरी चाहिए, यानी 120 अरब पैरामीटर वाले मिक्सचर-ऑफ़-एक्सपर्ट्स, उनका स्कोर कम है, मुख्य रूप से इसलिए कि वे पुराने हैं: gpt-oss-120b अगस्त 2025 में आया, और Qwen3.5 122B का M5 Max पर बेंचमार्क मार्च में ही हो रहा था, Qwen3.8 27B आने से महीनों पहले।
तो 48 GB से 128 GB वाला $2,000 का अपग्रेड आज आपको क्या देता है? जगह: लंबे कॉन्टेक्स्ट, 4-bit की जगह 8-bit प्रिसिज़न, एक साथ कई मॉडल लोड, और अगर 100 अरब श्रेणी का कोई मज़बूत मॉडल आए तो उसे चलाने का विकल्प। ये असली फ़ायदे हैं। ज़्यादा स्मार्ट मॉडल इनमें नहीं है, कम से कम आज की लीडरबोर्ड पर तो नहीं। खरीदने से पहले AA देख लें; यह ऐसा तथ्य है जो एक ही रिलीज़ में बदल जाता है।
34 बनाम 58 व्यवहार में कैसा लगता है
इंडेक्स के अंक “कितने प्रतिशत ज़्यादा स्मार्ट” नहीं होते, और हर काम पर एक जैसे नहीं उतरते।
छोटे, स्पष्ट कामों में, जैसे ईमेल फिर से लिखना, चिपकाए गए दस्तावेज़ का सार बनाना या किसी इनवॉइस से फ़ील्ड निकालना, एक अच्छा 27B मॉडल अक्सर फ्रंटियर मॉडल से अलग पहचाना नहीं जाता। अंतर लंबे, कई चरणों वाले काम में खुलता है: ऐसा एजेंट जिसे कोडबेस पढ़ना है, योजना बनानी है, पाँच फ़ाइलें बदलनी हैं, टेस्ट चलाने हैं और अपनी ही ग़लतियों से उबरना है; ऐसी रिसर्च जिसमें स्रोतों को मिलाना है; ऐसी रीज़निंग जहाँ एक ग़लत क़दम बाक़ी सब बिगाड़ देता है। लोग $200 वाले प्लान ठीक इसी काम के लिए खरीदते हैं।
Forbes’s अगस्त कॉलम ने Qwen के अपने रिसर्च पेपर से एक ठोस उदाहरण दिया: Claude Code में चल रहे Qwen3-Coder-Next ने 30.9% Terminal-Bench 2.0 पर स्कोर किया, जबकि 53.9% उसी पेपर में Claude Opus 4.5 के लिए यही आँकड़ा था। वे पिछले साल के मॉडल हैं, लेकिन तस्वीर नहीं बदली है: एजेंटिक कामों में लोकल सेटअप कहीं ज़्यादा बार फ़ेल हुआ।
भाग 5 — जो मॉडल आप असल में चाहते हैं वे फ़िट क्यों नहीं होते
मेमोरी में मॉडल का साइज़ अनुमान लगाना आसान है:
टेक्स्ट
वेट्स (GB) ≈ पैरामीटर (अरबों में) × प्रति पैरामीटर बाइट्स
               8-bit → × 1.0     4-bit → × 0.5     2-bit → × 0.25
फिर जोड़ें KV cache— यह आपकी बातचीत के लिए मॉडल की वर्किंग मेमोरी है, जो कॉन्टेक्स्ट की लंबाई के साथ बढ़ती है। और याद रखें, macOS आपकी पूरी यूनिफ़ाइड मेमोरी GPU को नहीं देता: डिफ़ॉल्ट रूप से यह GPU को 75% बड़ी मेमोरी वाले Mac पर लगभग 96 GB तक वायर करने देता है — 128 GB मशीन में से। आप सीमा बढ़ा सकते हैं sudo sysctl iogpu.wired_limit_mb=…, अपने जोखिम पर; मॉडल को आप जो भी देंगे, वह आपके ब्राउज़र, एडिटर और ऑपरेटिंग सिस्टम को नहीं मिलेगा।
इसका मतलब उन मॉडलों के लिए क्या है जिनकी लोग असल में बात करते हैं:
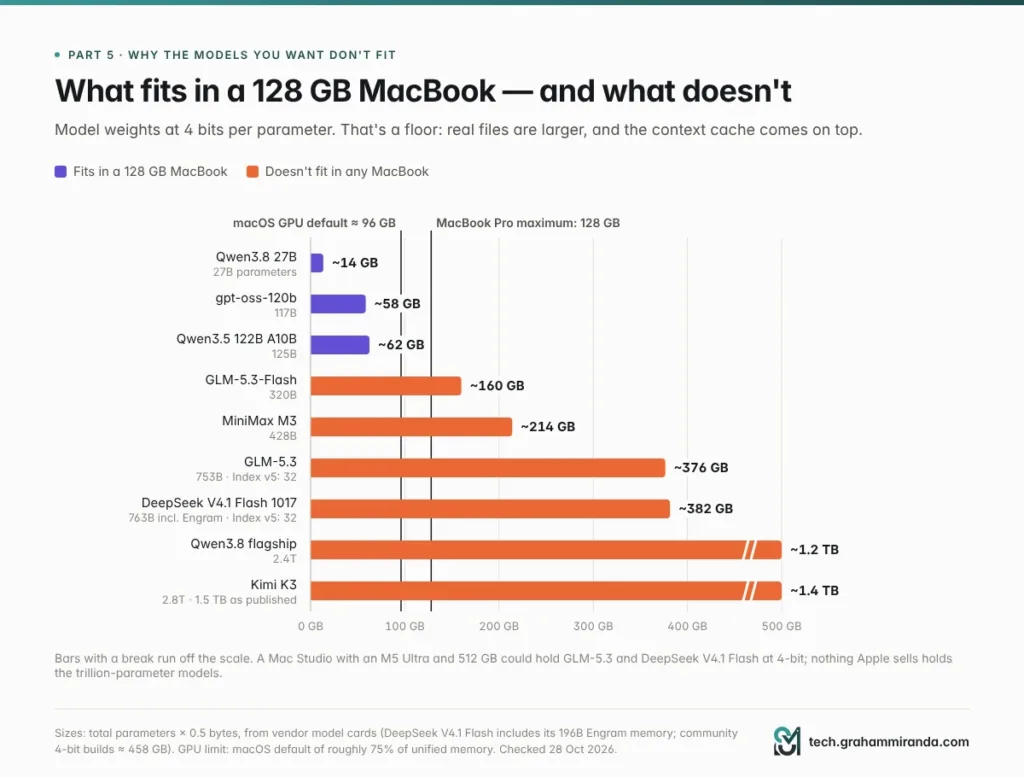
| मॉडल | कुल पैरामीटर | 4-bit वेट्स (न्यूनतम) | 128 GB MacBook में फ़िट होता है? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ आसानी से |
| gpt-oss-120b | 117B | ~58 GB (64 GB फ़ाइल) | ✅ हाँ |
| Qwen3.5 122B A10B | 125B | ~62 GB (69.6 GB फ़ाइल) | ✅ हाँ |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ नहीं |
| MiniMax M3 | 428B | ~214 GB | ❌ नहीं |
| GLM-5.3 | 753B | ~376 GB | ❌ नहीं |
| DeepSeek V4.1 Flash 1017 | 763B, Engram मेमोरी सहित | ~382 GB (कम्युनिटी 4-bit बिल्ड्स का अनुमान ~458 GB) | ❌ नहीं |
| Qwen3.8 फ़्लैगशिप | 2.4T | ~1.2 TB | ❌ नहीं |
| Kimi K3 | 2.8T | ~1.5 TB, जैसा प्रकाशित (नेटिव MXFP4) | ❌ नहीं |
4-bit कॉलम पैरामीटर × 0.5 बाइट्स है: सिर्फ़ वेट्स, KV cache और फ़ाइल ओवरहेड से पहले, इसलिए असली फ़ाइलें इससे बड़ी होती हैं। फ़ाइल साइज़ Hardware Corner’s M5 Max टेस्ट से हैं।
नए इंडेक्स पर 32 स्कोर करने वाले मॉडल, यानी जो सबसे अच्छे आप डाउनलोड कर सकते हैं, उन्हें ज़रूरत है तीन से चार गुना उससे कहीं ज़्यादा की, जो एक MacBook में है। और बीच वाले भी अंदर नहीं घुसते। अगर आप अपने 128 GB में से 100 GB मॉडल के वेट्स को दें, तो प्रति वेट कितने बिट दे सकते हैं:
| मॉडल | 100 GB के बजट में प्रति वेट बिट्स |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
लगभग तीन बिट और उससे नीचे, क्वालिटी खड़ी ढलान से गिरती है (भाग 6 में रिसर्च है)। प्रति वेट एक बिट क्वांटाइज़ेशन नहीं है। यह अंग काटना है।
कॉन्टेक्स्ट भी मेमोरी लेता है। Hardware Corner’s टेस्ट में, 8-bit पर Qwen3-Coder-Next ने 4K कॉन्टेक्स्ट पर 87.1 GB और 64K पर 92.6 GB लिया: लंबी बातचीत रखने भर के लिए साढ़े पाँच गीगाबाइट ज़्यादा। पूरी रिपॉज़िटरी पढ़ने वाले एजेंटों को लंबा कॉन्टेक्स्ट चाहिए, इसलिए वह खाली जगह तेज़ी से ख़त्म हो जाती है।
512 GB वाले Mac Studio का क्या? 512 GB वाला M5 Ultra Mac Studio 4-bit पर GLM-5.3 या DeepSeek V4.1 Flash रख सकता है। Apple ने कहा था कि वह कॉन्फ़िगरेशन अक्टूबर के अंत में आएगा; MacRumors को उम्मीद है कि इसकी कीमत $10,000 से काफ़ी ऊपर होगी, और जब मैंने देखा तब Apple ने कीमत जारी नहीं की थी। आप पाँच अंकों की रकम इसलिए दे रहे होंगे कि नए इंडेक्स पर 32 स्कोर करने वाले मॉडल चला सकें, और शायद उनके निर्माताओं के सर्वर से भी धीमे। मेरी Kimi K3 vs Fable 5.1 vs GLM-5.3 तुलना इस पर और गहराई से बताती है कि बड़े ओपन मॉडलों को सेल्फ-होस्ट करने में असल में क्या लगता है।
छवि दिखाएँ सिर्फ़ वेट, प्रति पैरामीटर 4 bits पर; कॉन्टेक्स्ट कैश इसके ऊपर अलग। 128 GB की रेखा के दाईं ओर की हर चीज़ के लिए Mac Studio या सर्वर चाहिए।
भाग 6 — Quantization: फ़िट कराने के लिए चुकाया जाने वाला क्वालिटी टैक्स
क्वांटाइज़ेशन मॉडल के वेट्स को कम बिट्स में रखता है, 16 की जगह 8 या 4, जिन पर उन्हें ट्रेन किया गया था, इसलिए कम मेमोरी लगती है और यह तेज़ चलता है। Mac पर आप जो भी लोकल मॉडल चलाएँगे, वह क्वांटाइज़्ड होगा। सवाल यह है कि इसकी क़ीमत क्या है, और रिसर्च इसका साफ़ और थोड़ा असहज जवाब देती है।
अच्छी ख़बर: 8-bit लगभग मुफ़्त है, 4-bit ज़्यादातर ठीक है
- अब तक के सबसे बड़े अध्ययनों में से एक, Eldar Kurtic और साथियों का, ने क्वांटाइज़्ड Llama 3.1 मॉडलों पर 500,000 से ज़्यादा मूल्यांकन चलाए। FP8 हर साइज़ पर व्यावहारिक रूप से लॉसलेस था; सावधानी से ट्यूनिंग करने पर INT8 की क़ीमत लगभग 1–3% थी; और 4-bit वेट-ओनली क्वांटाइज़ेशन “उम्मीद से ज़्यादा प्रतिस्पर्धी” था, 8-bit के क़रीब।
- रीज़निंग मॉडलों के लिए, Ruikang Liu और साथियों के 2025 के अध्ययन में पाया गया कि 8-bit वेट्स और एक्टिवेशन, या 16-bit एक्टिवेशन के साथ 4-bit वेट्स, गणित, विज्ञान और कोडिंग बेंचमार्क पर लॉसलेस हो सकते हैं। कम बिट चौड़ाई लेखकों के शब्दों में बड़े सटीकता-जोखिम लेकर आई, और काम की कठिनाई का साफ़ असर पड़ा कि कितना नुक़सान हुआ।
अगर आप हमेशा अंग्रेज़ी में छोटे सवाल ही पूछते हैं, तो 4-bit मॉडल मूल जैसा ही लगेगा।
बुरी ख़बर: लंबे इनपुट, दूसरी भाषाएँ और 4 bits से नीचे कुछ भी
- लंबा कॉन्टेक्स्ट। Anmol Mekala और साथियों ने पाँच क्वांटाइज़ेशन तरीक़ों को 9,700 उदाहरणों पर परखा, जिनमें इनपुट थे 64,000 टोकन या ज़्यादा (EMNLP 2025)। 8-bit की क़ीमत लगभग 0.8% औसतन रही। 4-bit की क़ीमत 59% तकरही, और नुक़सान मॉडल पर बहुत निर्भर था: एक 4-bit तरीक़े में Llama 3.1 70B उस काम पर 32% गिरा जहाँ Qwen 2.5 72B टिका रहा।
- अंग्रेज़ी के अलावा दूसरी भाषाएँ। उसी अध्ययन में पाया गया कि गिरावट तब ज़्यादा होती थी जब इनपुट अंग्रेज़ी में न हो। अगर आप जर्मन में काम करते हैं, तो जर्मन में ही टेस्ट करें।
- 4 बिट से नीचे रीज़निंग बिखर जाती है। Meta FAIR के शोधकर्ताओं ने जून 2026 में एक अध्ययन प्रकाशित किया जिसमें दिखा कि क्वांटाइज़्ड रीज़निंग मॉडल ज़रूरत से ज़्यादा सोचते हैं। 3-bit AWQ में MATH-500 बेंचमार्क पर एक 1.5B रीज़निंग मॉडल का स्कोर गिरा 85.6% से 47.0%तक, और उसकी चेन ऑफ़ थॉट 5,200 से 23,400 टोकन तक बढ़ गई, 4.5 गुना लंबी। ऐसे लैपटॉप पर जो 20 से 80 टोकन प्रति सेकंड लिखता है, चार गुना ज़्यादा सोचने वाला मॉडल लगभग चार गुना धीमा भी होता है।
छवि दिखाएँ रिसर्च के मुताबिक़ प्रिसिज़न में हर एक क़दम नीचे जाने की क़ीमत क्या है। बड़े मॉडल को 128 GB में फ़िट करने वाली सिकोड़न ही सबसे ज़्यादा नुक़सान देती है।
128 GB वाले MacBook के लिए इसका क्या मतलब है
जिस मॉडल को आप चाहेंगे, उसके लिए जो क्वांटाइज़ेशन आप वहन कर सकते हैं, वही सबसे ज़्यादा नुक़सान देता है। 27B मॉडल Mac पर 8-bit में खुली जगह के साथ चल सकता है, और चलना चाहिए। 120B श्रेणी के मॉडल 4-bit पर चलते हैं, जो चैट के लिए ठीक है और लंबे दस्तावेज़ों पर जोखिम भरा। और 300B से ऊपर की श्रेणी को लैपटॉप पर लाने का एकमात्र तरीक़ा प्रति वेट दो या तीन बिट है, जहाँ ऊपर के अध्ययनों के मुताबिक़ रीज़निंग बिखर जाती है।
मेरे अंगूठे के नियम:
- जिस पर आप भरोसा करेंगे, उसके लिए 8-bit इस्तेमाल करें, ख़ासकर लंबे दस्तावेज़ और एजेंट का काम।
- 4-bit चैट, ड्राफ़्टिंग और छोटे कामों के लिए ठीक है। अपने ही दस्तावेज़ों पर इसका लंबे कॉन्टेक्स्ट वाला व्यवहार जाँचें।
- रीज़निंग या कोडिंग मॉडल 4-bit से नीचे न चलाएँ , जब तक आप प्रयोग न कर रहे हों।
- जिस भाषा में आप काम करते हैं, उसी में टेस्ट करें।
भाग 7 — रफ़्तार: लिखने में तेज़, पढ़ने में धीमा
LLM दो अलग-अलग काम दो अलग-अलग रफ़्तार से करता है। Prefill आपका प्रॉम्प्ट पढ़ता है, यानी आपने जो चिपकाया और अब तक की बातचीत, और यह कच्ची कंप्यूटिंग शक्ति से सीमित है। Generation एक-एक टोकन करके जवाब लिखता है, और यह मेमोरी बैंडविड्थ से सीमित है। Apple’s ख़ुद के मशीन-लर्निंग शोधकर्ताओं ने M5 पर दोनों नापे: इसके नए GPU Neural Accelerators ने पहले टोकन तक का समय 3.3 से 4.1 गुना तेज़ M4 की तुलना में कर दिया, जबकि जनरेशन सिर्फ़ 1.19 से 1.27 गुनाबेहतर हुआ, लगभग अतिरिक्त बैंडविड्थ के अनुपात में।
तो 128 GB वाला M5 Max असल में क्या करता है? Hardware Corner ने 128 GB वाले 14-इंच M5 Max पर Apple’s MLX फ़्रेमवर्क से चलाए टेस्ट प्रकाशित किए:
| मॉडल | कॉन्टेक्स्ट | पढ़ना (prefill), tok/s | पूरा प्रॉम्प्ट पढ़ने का समय | लिखना, tok/s |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3.1 s | 87.9 |
| 32K | 2,537 | 12.9 s | 64.5 | |
| Qwen3.5 122B A10B (4-bit) | 4K | 881 | 4.6 s | 65.9 |
| 32K | 1,068 | 30.7 s | 54.9 | |
| Qwen3.5 27B (dense, 6-bit) | 4K | 811 | 5.1 s | 23.6 |
| 32K | 591 | 55.4 s | 14.9 | |
| Qwen3-Coder-Next (8-bit) | 64K | 1,432 | 45.8 s | 48.2 |
Reddit उपयोगकर्ता cryingneko द्वारा मापा गया और Hardware Corner द्वारा प्रकाशित। “पूरा प्रॉम्प्ट पढ़ने का समय” कॉन्टेक्स्ट की लंबाई को मापी गई prefill रफ़्तार से भाग देकर निकाला गया है।
लिखने की रफ़्तार अब ठीक है, कम से कम MoE मॉडलों पर
मिक्सचर-ऑफ़-एक्सपर्ट्स मॉडल हर टोकन के लिए अपने वेट्स का सिर्फ़ एक हिस्सा इस्तेमाल करते हैं, इसलिए तेज़ी से लिखते हैं: 55 से 88 टोकन प्रति सेकंड M5 Max पर। तुलना के लिए, Artificial Analysis Claude Opus 5.5 को 98 टोकन प्रति सेकंड Anthropic’s API पर। 120B-क्लास मॉडल के साथ चैट करने में M5 Max सचमुच सुखद है। Dense मॉडल दूसरी कहानी हैं: हर टोकन के लिए हर weight इस्तेमाल करने वाला 27B मॉडल 15 से 24 टोकन प्रति सेकंड लिखता है।
दो छोटे असर भी जुड़ जाते हैं। बातचीत जितनी लंबी होती है, लिखना उतना धीमा होता जाता है: उन तीनों मॉडलों में 4K के मुकाबले 32K पर 17% से 37% धीमा। और reasoning मॉडल जवाब देने से पहले सैकड़ों या हज़ारों टोकन सोचने में लगा देते हैं।
इंतज़ार पढ़ने में होता है
time-to-read कॉलम को फिर से देखें। 32,000 टोकन का प्रॉम्प्ट (कुछ source फ़ाइलें, एक लंबा contract, एक बड़ा email thread) पढ़ने में 13 से 55 सेकंड लेता है, इससे पहले कि जवाब का पहला शब्द सामने आए।
यह सबसे ज़्यादा उसी काम में मायने रखता है जिसके लिए $200 का प्लान खरीदा जाता है। AI कोडिंग एजेंट मॉडल को एक बड़ा system प्रॉम्प्ट, हर tool की परिभाषाएँ, खोली गई फ़ाइलें और अब तक की बातचीत भेजते हैं, और यह हर स्टेप पर करते हैं। लोकल सर्वर प्रॉम्प्ट के उस हिस्से को दोबारा इस्तेमाल कर सकते हैं जो बदला नहीं है, जिससे काफ़ी फ़ायदा होता है। लेकिन जब भी कॉन्टेक्स्ट में शुरुआत में कुछ बदलता है, जैसे जब एजेंट अपनी history compact करता है या आप नए काम पर जाते हैं, उसके बाद का सब कुछ दोबारा पढ़ना पड़ता है। Forbes ने एक डेवलपर का हवाला दिया जिसने 16,000-टोकन system प्रॉम्प्ट के साथ 512 GB M3 Ultra पर पहले टोकन के लिए क़रीब 90 सेकंड इंतज़ार किया, और एक और जिसने 48 GB M4 Pro लैपटॉप पर ठंडी शुरुआत से क़रीब 20 सेकंड देखे। Apple के अपने मापन के मुताबिक़ M5-जेनरेशन चिप्स इसमें पुराने Macs से काफ़ी तेज़ हैं, लेकिन समस्या का ढाँचा वही है।
तुलना के लिए, वही Hardware Corner टेस्ट एक Nvidia RTX Pro 6000 वर्कस्टेशन कार्ड पर भी चलाए गए, जिसकी अकेले क़ीमत क़रीब $8,800 है: उसने प्रॉम्प्ट 2 से 2.4 गुना तेज़ रफ़्तार से पढ़े और 1.7 से 2.8 गुना तेज़ रफ़्तार से M5 Max से लिखे।
छवि दिखाएँ MLX के साथ 128 GB वाले M5 Max पर मापा गया। लिखना काफ़ी तेज़ है; लंबे प्रॉम्प्ट पढ़ना, जो एजेंट लगातार करते हैं, वहीं इंतज़ार होता है।
भाग 8 — लैपटॉप की समस्या
मॉडल काफ़ी अच्छे होते तो भी, लैपटॉप उन्हें चलाने की अटपटी जगह है।
गर्मी। बड़ा मॉडल चलाना लगातार भार है: GPU और मेमोरी का मिनटों या घंटों तक पूरी ताक़त से काम, दस सेकंड का झटका नहीं। Notebookcheck की 14-इंच M5 Max समीक्षा ने नतीजा निकाला कि उसका chassis और cooling “M5 Max को ठीक से संभाल ही नहीं सकते”: 30 मिनट के CPU stress test में परफ़ॉर्मेंस 24% गिर गई, और High Power मोड में पंखे 53.2 dB(A) तक पहुँच गए। उस समीक्षा में CPU और graphics का भार मापा गया, LLM नहीं, और Notebookcheck ख़ुद कहता है कि M5 Max की जगह 16-इंच में है। अगर आप लोकल AI के लिए MacBook खरीदते हैं, तो 16-इंच खरीदें। मेरी MacBook Pro M5 Pro 64 GB गाइड छोटे chassis पर लगातार काम के बारे में भी वही नतीजा निकाला।
यह आपका रोज़मर्रा का कंप्यूटर भी है। 70 GB का मॉडल और उसका कॉन्टेक्स्ट लोड करें, तब भी browser और editor के लिए जगह बची रहती है। GPU को डिफ़ॉल्ट रूप से मिलने वाले क़रीब 96 GB की ओर बढ़ें, या कुछ बड़ा फ़िट करने के लिए सीमा बढ़ाएँ, तो आपका बाक़ी काम मॉडल से मेमोरी के लिए होड़ करने लगता है। आप जो भी मॉडल लोड रखते हैं, वह उतनी मेमोरी है जो आपके बाक़ी ऐप्स को नहीं मिलती।
बैटरी को यह रास नहीं आता। लगातार GPU लोड लैपटॉप की बैटरी जल्दी ख़त्म करता है, इसलिए लोकल इन्फ़रेंस के लंबे सेशन आख़िर में प्लग-इन ही होते हैं, जो “कहीं भी AI, ऑफ़लाइन” वाली पिच को काफ़ी कमज़ोर कर देता है।
आप अपनी ऊपरी सीमा पहले ही दिन खरीद लेते हैं। Unified memory खरीदने के बाद बढ़ाई नहीं जा सकती। अगर अगले साल का सबसे अच्छा ओपन मॉडल 160 GB माँगता है, तो 128 GB का MacBook उसे चला ही नहीं सकता।
और इसकी क़ीमत तेज़ी से गिरती है। UK के refurbisher MacFinder ने अपने छह साल के खरीद डेटा का विश्लेषण किया और पाया कि ज़्यादातर MacBook पहले साल में अपनी क़ीमत का क़रीब आधा खो देते हैं, और हाई-एंड मॉडल अक्सर ज़्यादा तेज़ी से गिरते हैं: 16-इंच M4 MacBook Pro एक साल में 60% तक गिर गया। $6,999 की मशीन एक $6,999 का दाँव है कि आज की मेमोरी सीमा तीन साल बाद भी काम आएगी।
LLM के लिए डेस्कटॉप बेहतर मशीन है। अगर लोकल AI ही मक़सद है, तो उसी M5 Max और 128 GB वाला Mac Studio $2,200 कम में मिलता है, पकाने के लिए बैटरी नहीं और बंद करने के लिए ढक्कन नहीं, और यह आपके लैपटॉप और फ़ोन के लिए निजी सर्वर की तरह चौबीसों घंटे चल सकता है। इसे अपने पसंदीदा लैपटॉप के साथ जोड़ लें।
भाग 9 — सॉफ़्टवेयर का अंतर: आपको क्या-क्या फिर से बनाना पड़ेगा
सब्सक्रिप्शन एक मॉडल प्लस एक प्रोडक्ट है। लोकल सेटअप आपको मॉडल देता है और प्रोडक्ट आप पर छोड़ देता है।
| सब्सक्रिप्शन आपके लिए क्या करता है | लोकल में आपको क्या करना होता |
|---|---|
| मॉडल को होस्ट और अपडेट करता है | मॉडल खुद डाउनलोड, कन्वर्ट और अपडेट करें (LM Studio, Ollama या MLX) |
| वेब सर्च और डीप रिसर्च | कोई search API या सेल्फ-होस्टेड सर्च जोड़ें, साथ में उसे चलाने वाला एजेंट |
| PDF, स्प्रेडशीट और इमेज पढ़ता है | vision वाले मॉडल चुनें, document parsing जोड़ें |
| वॉइस, मेमोरी, इमेज जनरेशन | हर एक के लिए अलग मॉडल और ऐप (बोली के लिए Whisper, इमेज के लिए Draw Things या ComfyUI) |
| हर डिवाइस पर ऐप, सिंक होते हुए | एक सर्वर और एक front-end चलाएँ, और उसे सुरक्षित तरीक़े से अपने फ़ोन तक पहुँचाएँ |
| Claude Code या Codex, अपने ही मॉडलों पर ट्यून किए हुए | किसी ओपन हार्नेस को, या Claude Code को ही, लोकल सर्वर की ओर इंगित करें |
| chat templates, tool-call फ़ॉर्मैट और safety संभाले हुए | इन्हें डीबग करें जब नया मॉडल ऐसे template के साथ आए जिसे आपके टूल समझते नहीं |
टूलिंग अब सचमुच अच्छी है। Mac पर शुरुआत के लिए LM Studio सबसे आसान है, Ollama आपको लोकल और cloud मॉडलों के लिए एक ही API देता है, और Apple’s MLX आमतौर पर सबसे तेज़ होता है। Ollama तो एक Anthropic-संगत APIभी देने लगा है, इसलिए आप सेटिंग के ज़रिए Claude Code को लोकल मॉडल की ओर भेज सकते हैं ANTHROPIC_BASE_URL=http://localhost:11434. फिर भी उसका दस्तावेज़ीकरण कमियों के बारे में साफ़गोई से बताता है: Anthropic के prompt-caching नियंत्रण, token counting, batches और PDF input समर्थित नहीं हैं। और Claude Code तो Claude मॉडलों के लिए ट्यून है; लोकल मॉडल को Claude Code का लंबा system प्रॉम्प्ट और tool परिभाषाएँ संभालनी पड़ती हैं, और यहीं Part 7 के prefill समय काटते हैं।
इनमें से कुछ भी असंभव नहीं है। मेरा OpenCode v2 बनाम Hermes Agent बनाम OpenClaw लेख उन ओपन एजेंट्स के बारे में है जो लोकल मॉडलों के साथ चलते हैं। लेकिन यह असली काम है, और आपके घंटे मुफ़्त नहीं हैं। सेटअप के लिए एक सप्ताहांत और उसे चालू रखने के लिए महीने में कुछ घंटे गिनकर रखें।
भाग 10 — लागत वसूली का हिसाब, ईमानदारी से
यहाँ वह हिसाब है जो यह पिच आमतौर पर छोड़ देती है।
स्टेप 1: सीधा-सादा हिसाब
$6,999 ÷ $200 प्रति माह = 35 महीने। बारह नहीं। क़रीब तीन साल, और यह सबसे उदार गणना है।
स्टेप 2: बिजली जोड़ें
Forbes ने अनुमान लगाया क़रीब $10 प्रति माह अमेरिका की औसत दरों पर रोज़ आठ घंटे AI चलाने वाले Mac के लिए। जर्मनी में, अक्टूबर की औसत 29.68 सेंट प्रति kWh दर पर, रोज़ आठ घंटे औसतन 60–150 W लेने वाले लैपटॉप का ख़र्च क़रीब €4–11 प्रति माह। छोटा है, लेकिन यह ब्रेक-ईवन को क़रीब 37 महीने.
स्टेप 3: मुश्किल कामों के लिए सस्ता प्लान रखें
तक धकेल देता है। आप रखेंगे ही। जिन लोगों ने agentic coding या गंभीर रिसर्च के लिए frontier मॉडल इस्तेमाल किया है, उनमें से कम ही हर काम के लिए 34-अंक वाले मॉडल पर लौटते हैं। मुश्किल 10% के लिए $20 का प्लान रखें, तो Mac आपको $200 नहीं, $170 प्रति माह बचाता है: क़रीब 41 महीने.
स्टेप 4: जिस पर आप असल में डाउनग्रेड करेंगे उससे तुलना करें
अगर आप इतने ख़र्च-सजग हैं कि $7,000 का लैपटॉप सोच रहे हैं, तो आप इतने ख़र्च-सजग हैं कि $100 वाले tier पर आ जाएँ। $100 प्रति माह के मुकाबले ब्रेक-ईवन है क़रीब 78 महीने, साढ़े छह साल से ज़्यादा, जितना लोग लैपटॉप रखते हैं उससे ज़्यादा।
| परिदृश्य | शुरुआती ख़र्च | आप फिर भी देते हैं | महीने की बचत | ब्रेक-ईवन |
|---|---|---|---|---|
| MacBook बनाम $200 प्लान, बिजली के बिना | $6,999 | — | $200 | 35 महीने |
| MacBook बनाम $200 प्लान, बिजली के साथ | $6,999 | $10 | $190 | 37 महीने |
| … और आप $20 का प्लान रखते हैं | $6,999 | $30 | $170 | 41 महीने |
| MacBook बनाम $100 प्लान | $6,999 | $10 | $90 | 78 महीने |
| Mac Studio (128 GB) बनाम $200 प्लान | $4,799 | $10 | $190 | 25 महीने |
| Mac Studio बनाम $200 प्लान, $20 का प्लान रखते हुए | $4,799 | $30 | $170 | 28 महीने |
इन सबमें मान लिया गया है कि Mac सब्सक्रिप्शन का काम पूरी तरह कर देता है। Part 4 से 9 बताते हैं कि ऐसा क्यों नहीं है।
छवि दिखाएँ चार साल का कुल ख़र्च, यह मानकर कि Mac सब्सक्रिप्शन की जगह पूरी तरह ले लेता है, जो वह नहीं लेता। बिजली क़रीब $10 प्रति माह।
स्टेप 5: तीन साल, रीसेल के साथ
हार्डवेयर की resale वैल्यू होती है, और खरीदने के पक्ष में यही सबसे मज़बूत तर्क है। मान लें आप तीन साल बाद उसे खरीद क़ीमत के 35% में बेच देते हैं। यह मेरा अनुमान है, कोई कोट नहीं, जो MacFinder के डेटा से प्रेरित है — पहले साल में क़रीब आधी क़ीमत जाना और उसके बाद धीमी गिरावट।
| विकल्प | 36 महीने का ख़र्च |
|---|---|
| $200 प्लान | $7,200 |
| MacBook (128 GB) + बिजली, 35% में बेचा गया | $4,909 |
| … साथ में frontier काम के लिए $20 का प्लान | $5,629 |
| Mac Studio (128 GB) + बिजली + $20 प्लान, 35% में बेचा गया | $4,199 |
| $100 प्लान | $3,600 |
| $20 प्लान | $720 |
तो हाँ: तीन साल में, MacBook और $20 का प्लान मिलाकर $200 के प्लान से क़रीब $1,600 सस्ता पड़ सकता है, अगर आप उसे ठीक क़ीमत पर बेच दें। लेकिन देखिए यह पैसा क्या खरीदता है। एक तरफ़ दुनिया के सबसे अच्छे मॉडल, अपने सारे टूल के साथ। दूसरी तरफ़ 34-अंक वाला मॉडल, कुछ हज़ार डॉलर का मूल्यह्रास, और असली चीज़ की ज़रूरत पड़ने पर एक सस्ता प्लान। ख़र्च के मामले में $100 का प्लान हर हार्डवेयर विकल्प से आगे है, और $20 का प्लान तो सबसे आगे।
MacBook लोकल LLM के लिए खरीदने से आप ज़्यादा पैसा नहीं बचा रहे। आप उतनी ही रक़म किसी अलग प्रोडक्टपर ख़र्च कर रहे हैं: प्राइवेसी, नियंत्रण और सीमाओं से आज़ादी, पर कम बुद्धि के साथ।
सीमांत लागत का नज़रिया
खरीदना एक ढाँचे में ज़्यादा समझ में आता है: आपको वैसे भी नया MacBook चाहिए। तब AI के लिए अतिरिक्त ख़र्च सिर्फ़ 48 GB से 128 GB की मेमोरी अपग्रेड है, $2,000, यानी $200 के प्लान के दस महीने। यह पागलपन नहीं है। लेकिन Part 4 का 128 GB विरोधाभास याद रखें: आज के लीडरबोर्ड पर वह अपग्रेड बड़े मॉडल देता है, समझदार नहीं। अगर आप वैसे भी MacBook खरीद रहे हैं, तो 48–64 GB सबसे अच्छे Mac-आकार के मॉडल को 8-bit पर भरपूर कॉन्टेक्स्ट के साथ चलाता है।
$6,999 से इसके बजाय क्या मिल सकता है
- 35 महीने $200 प्लान के, 70 महीने $100 प्लान के, या 29 साल $20 प्लान के
- क़रीब 11.7 अरब output टोकन DeepSeek V4.1 Flash से, उसकी off-peak API क़ीमत पर — एक ऐसा मॉडल जो MacBook में फ़िट होने वाले हर मॉडल से ज़्यादा अंक पाता है
- क़रीब 350 मिलियन output टोकन Claude Opus 5.5 के, Anthropic’s API के ज़रिए, Artificial Analysis के बताए $20 प्रति मिलियन पर
भाग 11 — जायज़ पक्ष: local AI के लिए Mac ख़रीदना कब बनता है
इसका मतलब यह नहीं कि लोकल AI कोई तमाशा है। मैं इस ब्लॉग पर लगातार इसके बारे में लिखता हूँ क्योंकि यह उपयोगी है। यह बस उन कारणों से उपयोगी है जिनकी पिच दावा करती है, वे नहीं। ये रहे अच्छे कारण।
1. ऐसा डेटा जो आपके नियंत्रण से बाहर नहीं जाना चाहिए
अगर आप client फ़ाइलें, स्वास्थ्य जानकारी, अप्रकाशित वित्तीय आँकड़े या गोपनीयता के दायित्व में आने वाली कोई भी चीज़ संभालते हैं, तो लोकल मॉडल का मतलब है कि कुछ भी किसी तीसरे पक्ष के पास नहीं जाता। कोई processor agreement नहीं, कोई अंतरराष्ट्रीय स्थानांतरण नहीं, training सेटिंग्स की चिंता नहीं। जर्मनी में, § 203 StGBसे बंधे पेशेवरों, जैसे वकील, डॉक्टर और कर सलाहकार, को client डेटा किसी बाहरी सेवा प्रदाता, AI प्रदाताओं समेत, के पास भेजने से पहले संविदात्मक सुरक्षा चाहिए। लोकल मॉडल उस सवाल को पूरी तरह बायपास कर देता है। हार्डवेयर रखने की यह सबसे मज़बूत वजह है, और यह इस पर निर्भर नहीं कि लोकल मॉडल Opus जितना स्मार्ट है या नहीं। मेरी AI की स्थिति 2026 रिपोर्ट ऑफ़लाइन AI चलाने के ख़र्च और अनुपालन पक्ष को और विस्तार से समझती है।
2. ऑफ़लाइन काम
हवाई जहाज़ में, बिना नेटवर्क वाली client साइट पर, ऐसी जगह जहाँ नेटवर्क ही मना है।
3. कोई सीमा नहीं, पॉलिसी नहीं बदलती, मॉडल कभी नहीं बदलता
न पाँच घंटे की खिड़कियाँ, न साप्ताहिक कैप, न यह बताने पर class actions कि इन्हें कैसे बताया जाता है। और लोकल checkpoint एक साल बाद वैसा ही व्यवहार करता है जैसा आज करता है, जो मायने रखता है अगर आपने किसी मॉडल के व्यवहार पर कोई वर्कफ़्लो बनाया है।
4. थोक, उबाऊ, साफ़ तौर पर तय काम
हज़ारों support टिकट classify करना, invoice से फ़ील्ड निकालना, अपने नोट्स का सारांश बनाना, ड्राफ़्ट का अनुवाद करना, फ़ोटो टैग करना, अपने ही दस्तावेज़ों पर search के लिए embeddings बनाना, Whisper से मीटिंग transcribe करना। मझोले लोकल मॉडल इनमें बेहतरीन हैं, और इनमें से दस लाख चलाने का ख़र्च सिर्फ़ बिजली है।
5. सीखना और बनाना
अगर आप लोकल-फ़स्ट ऐप बनाते हैं, छोटे मॉडलों की फाइन-ट्यूनिंग करते हैं या बस समझना चाहते हैं कि यह सब कैसे काम करता है, तो हार्डवेयर रखना सबसे अच्छा गुरु है। (अगर AI के साथ ऐप बनाना आपका काम है, तो मैंने पूरी प्रक्रिया 2026 में AI से शून्य से ऐप कैसे बनाएँ.)
6. आप वैसे भी Mac ख़रीद रहे थे
में लिखी है।) फिर जिन मॉडलों को आप सचमुच चलाएँगे उनके लिए पर्याप्त मेमोरी खरीदें (Part 14 देखें), और लोकल AI को बोनस मानें, business case नहीं।
लोकल पर क्या अच्छा चलता है
| काम | क्या चलाएँ | आरामदेह मेमोरी |
|---|---|---|
| निजी चैट, ड्राफ़्टिंग, दोबारा लिखना | Qwen3.8 27B, 8-bit पर | 48–64 GB |
| आपके दस्तावेज़ों पर सारांश और Q&A | Qwen3.8 27B, साथ में एक embedding मॉडल | 48–64 GB |
| बल्क निष्कर्षण और वर्गीकरण | छोटे मॉडल (Gemma 4, gpt-oss-20b) | 16–32 GB |
| स्पीच-टू-टेक्स्ट | Whisper | 8–16 GB |
| इमेज जनरेशन | Draw Things या ComfyUI, FLUX-क्लास मॉडलों के साथ | 32 GB+ |
| बड़ा, तेज़ चैट मॉडल | gpt-oss-120b या Qwen3.5 122B | 128 GB |
लोकल वीडियो जनरेशन के लिए Macs अब भी Nvidia हार्डवेयर या cloud GPUs के मुकाबले धीमे हैं; मेरी M5 Pro 64 GB गाइड में आँकड़े हैं।
भाग 12 — $200 का AI बिल घटाने के सस्ते तरीके
अगर आपको सचमुच छोटा AI बिल चाहिए, तो $7,000 के लैपटॉप से सस्ते रास्ते हैं।
1. एक tier नीचे आएँ। Claude Max 5× और ChatGPT Pro 100 की क़ीमत $100 है, और Google’s AI Ultra अब $100 से शुरू होता है। अगर $200 के प्लान पर आपकी सीमाएँ कभी-कभार ही लगती हैं, तो इससे $1,200 प्रति वर्ष बचते हैं, बिना किसी quality नुक़सान के।
2. दो $20 प्लान मिलाएँ। Claude Pro और ChatGPT Plus मिलाकर $40 प्रति माह होते हैं और आपको सीमाओं के दो अलग pool और स्विच करने के लिए frontier मॉडलों के दो परिवार मिलते हैं।
3. ओपन मॉडलों के लिए प्रति टोकन भुगतान करें। वही ओपन-वेट मॉडल जो आप Mac पर चलाते, और बड़े मॉडल जो कभी फ़िट नहीं होंगे, कई प्रदाताओं से प्रति टोकन, डेटा सेंटर की रफ़्तार पर मिलते हैं। DeepSeek V4.1 Flash, जो MacBook में फ़िट होने वाले हर मॉडल से ज़्यादा स्कोर करता है, की क़ीमत $0.15 प्रति मिलियन input टोकन और $0.60 प्रति मिलियन output टोकन है DeepSeek’s अपनी API पर off-peak (peak समय में दोगुनी)। Qwen3.8 27B OpenRouter पर क़रीब $0.035 प्रति मिलियन input टोकन से सूचीबद्ध है। व्यक्तिगत या client डेटा के लिए EU होस्टिंग और data processing agreement वाला प्रदाता चुनें, DeepSeek’s अपनी API नहीं, जो चीन में डेटा process करती है।
4. ओपन मॉडलों के लिए flat-rate कोडिंग प्लान लें। Z.ai’s GLM Coding Plan शुरू होता है $18 प्रति माह से और इसमें GLM-5.3 शामिल है, जो नए index पर डाउनलोड-योग्य मॉडलों में संयुक्त रूप से सर्वश्रेष्ठ है, साथ में GLM-5.3-Flash भी, और यह Claude Code, Codex, OpenCode और दूसरे टूल में चलता है। मेरे affiliate लिंक से GLM Coding Plan पर 10% छूट पाएँ. (एफ़िलिएट लिंक — ऊपर दिया गया डिस्क्लोज़र देखें।) यह Opus 5.5 नहीं है, और index यह साफ़ कहता है, लेकिन इसकी क़ीमत $200 के प्लान के दसवें हिस्से से भी कम है। मैंने इसकी तुलना MiniMax के ऑफ़र से GLM-5.3-Flash बनाम MiniMax M3.
5. जो Mac आपके पास पहले से है, उसी का इस्तेमाल करें। अगर आपके मौजूदा Mac में 16 से 32 GB है, तो छोटे लोकल मॉडल Part 11 के बल्क काम का हैरान करने वाला हिस्सा मुफ़्त में निपटा देते हैं।
6. काम के हिसाब से route करें। ज़्यादातर लोगों के लिए जो सेटअप काम करता है: निजी और बल्क कामों के लिए लोकल मॉडल, रोज़ के काम के लिए सस्ता प्लान या प्रति टोकन ओपन मॉडल, और मुश्किल 10% के लिए frontier एक्सेस। मेरी AI कोडिंग हार्नेस तुलना में अलग-अलग बजट के पाँच तैयार सेटअप हैं।
छवि दिखाएँ हर विकल्प का मासिक ख़र्च अमेरिकी डॉलर में, VAT से पहले। प्रति-टोकन ख़र्च इस पर निर्भर है कि आप कितना इस्तेमाल करते हैं; क़ीमतें 28 अक्टूबर 2026 को जाँची गईं।
भाग 13 — क्या local LLM के लिए MacBook ख़रीदें? फ़ैसले की गाइड
छवि दिखाएँ सबसे ऊपर से शुरू करें। ज़्यादातर रास्ते “cloud प्लान रखें” पर आकर खत्म होते हैं, और बात यही है।
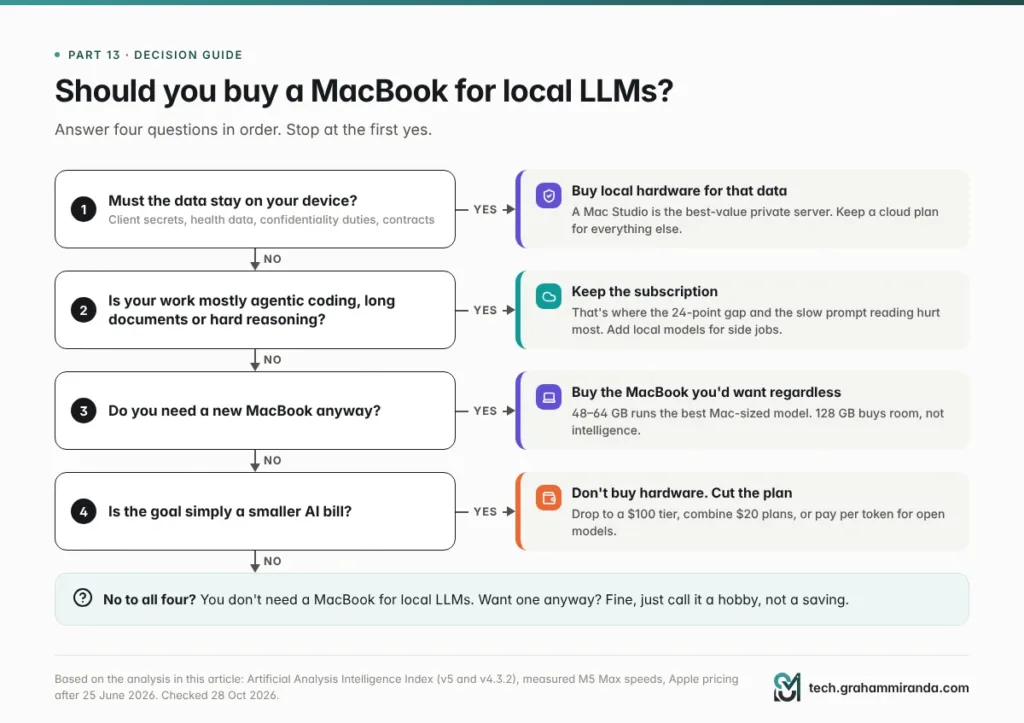
चार सवाल क्रम से निपटाएँ।
1. क्या डेटा आपके डिवाइस पर ही रहना चाहिए? अगर हाँ, client गोपनीयता, स्वास्थ्य डेटा या किसी contract की वजह से, तो लोकल हार्डवेयर खरीदें: उस शर्त को benchmarks से मतलब नहीं। Mac Studio को निजी सर्वर की तरह सोचें, और जो काम उस डेटा से जुड़ा नहीं उसके लिए cloud प्लान रखें।
2. क्या आपका काम ज़्यादातर agentic coding, लंबे दस्तावेज़ या मुश्किल reasoning है? अगर हाँ, तो सब्सक्रिप्शन रखें। यही वह जगह है जहाँ 24-अंक का अंतर और prefill समय सबसे ज़्यादा चुभते हैं। लोकल मॉडल साइड के कामों में फिर भी मदद कर सकता है।
3. क्या आपको वैसे भी नया MacBook चाहिए? अगर हाँ, तो वही खरीदें जो आप वैसे भी लेना चाहते थे। 48–64 GB सबसे अच्छे Mac-आकार के मॉडल को अच्छी तरह चलाता है। 128 GB पर सिर्फ़ तब जाएँ जब आपको ख़ास तौर पर 120B-क्लास मॉडल या एक साथ कई मॉडल चाहिए, और यह जानते हों कि आप $2,000 जगह के लिए दे रहे हैं, बुद्धि के लिए नहीं।
4. क्या मक़सद सिर्फ़ छोटा बिल है? तो हार्डवेयर मत खरीदें। एक tier नीचे आएँ, $20 के प्लान मिलाएँ, या ओपन मॉडलों के लिए प्रति टोकन भुगतान करें (Part 12)।
अगर आपने चारों का जवाब ना में दिया, तो आपको लोकल LLM के लिए MacBook की ज़रूरत नहीं है। आप फिर भी चाहें तो ले सकते हैं, इसमें कोई बुराई नहीं। बस इसे शौक़ कहिए, बचत नहीं।
भाग 14 — अगर फिर भी ख़रीद लें: उससे सबसे ज़्यादा कैसे पाएँ
सही मशीन चुनें।
- 16-इंच खरीदें, 14-इंच नहीं, अगर M5 Max लगातार AI काम के लिए है।
- इसके बजाय Mac Studio सोचें। वही चिप और मेमोरी $2,200 कम में, बेहतर कूलिंग, और यह आपके लैपटॉप और फ़ोन को चौबीसों घंटे सेवा दे सकता है।
- आज के मॉडलों के लिए ज़रूरत से ज़्यादा मेमोरी मत खरीदें। 48–64 GB, Qwen3.8 27B को 8-bit पर लंबे कॉन्टेक्स्ट के साथ चलाता है। 128 GB 120B-क्लास मॉडलों, एक साथ कई मॉडलों या आगे आने वाली रिलीज़ के लिए जगह के वास्ते खरीदें, यह जानते हुए कि इसका ख़र्च क्या है।
- अगर आप इस हफ़्ते खरीद रहे हैं, तो आज रात के इवेंट के बाद तक रुकें। इससे पहले कि आप commit करें, आपको पता होगा कि OLED MacBook Pro क्या देता है और कितने में।
इसे ठीक से सेट करें।
- LM Studio से शुरू करें (Apple Silicon पर MLX) सबसे आसान रास्ते के लिए, या Ollama अगर आप लोकल और cloud मॉडलों के लिए एक ही API चाहते हैं।
- 8-bit को प्राथमिकता दें जिस पर भी आप निर्भर हों उसके लिए; चैट में रफ़्तार के लिए 4-bit इस्तेमाल करें।
- कॉन्टेक्स्ट की लंबाई सोच-समझकर सेट करें। कई runtimes डिफ़ॉल्ट में छोटा कॉन्टेक्स्ट रखते हैं; एजेंट्स को उससे कहीं ज़्यादा चाहिए।
- GPU मेमोरी की सीमा तभी बढ़ाएँ जब आप इसमें लगने वाली क़ीमत समझते हों, और macOS के लिए जगह छोड़ें।
- $20 का cloud प्लान रखें मुश्किल 10% के लिए। यह आपके अपने समय से सस्ता है।
अपने ही काम पर इसे परखें। पिछले महीने के 20 असली प्रॉम्प्ट लें: ईमेल, दस्तावेज़, कोडिंग काम, जो भी आप सचमुच करते हैं। हर एक को अपने लोकल मॉडल और cloud मॉडल दोनों पर चलाएँ, छिपाएँ कि कौन सा कौन है, और अंक दें। यह उसी भाषा में करें जिसमें आप काम करते हैं। वह एक घंटा आपको किसी भी लीडरबोर्ड से ज़्यादा बताएगा, इस लेख वाले लीडरबोर्ड समेत।
अक्सर पूछे जाने वाले प्रश्न
क्या MacBook ChatGPT Pro या Claude Max सब्सक्रिप्शन की जगह ले सकता है?
गुणवत्ता पर नहीं। $200 वाले प्लान के पीछे के मॉडल, जैसे Claude Opus 5.5 और GPT-6 Astra, डाउनलोड नहीं किए जा सकते, और जो सबसे अच्छे ओपन मॉडल डाउनलोड हो सकते हैं, उन्हें 4-bit पर 375–460 GB मेमोरी चाहिए, जो किसी भी MacBook से बहुत ज़्यादा है। Artificial Analysis’s इंडेक्स पर Opus 5.5 का स्कोर 58 है; 128 GB MacBook में फ़िट होने वाला सबसे मज़बूत मॉडल जो मुझे मिला, Qwen3.8 27B, उसी वर्ज़न पर 34 अंक पाता है। MacBook निजी, ऑफ़लाइन या बल्क काम के लिए सब्सक्रिप्शन की जगह ले सकता है, फ़्रंटियर कामों के लिए नहीं।
2026 में 128 GB वाले MacBook Pro के लिए सबसे अच्छा local LLM कौन है?
गुणवत्ता के लिए, Qwen3.8 27B: Artificial Analysis इसे 141 तुलनीय मॉडलों में पहले स्थान पर रखता है, Intelligence Index v4.3.2 पर 34 अंक के साथ, और यह 8-bit पर आराम से फ़िट हो जाता है। गति के लिए, gpt-oss-120b और Qwen3.5 122B mixture-of-experts मॉडल हैं जो M5 Max पर 55–88 टोकन प्रति सेकंड लिखते हैं, लेकिन उनके स्कोर कम हैं (12 और 16)। चुनने से पहले Artificial Analysis देखें, क्योंकि नए ओपन मॉडल हर कुछ हफ़्ते में इस रैंकिंग को बदल देते हैं।
128 GB वाला MacBook Pro अब कितने का है?
एक 16-inch MacBook Pro, M5 Max (18-core CPU, 40-core GPU), 128 GB और 2 TB के साथ, अमेरिका में सेल्स टैक्स से पहले $6,999 का है। Apple ने 25 जून 2026 को Mac की कीमतें बढ़ाईं और 128 GB अपग्रेड को $1,000 से दोगुना कर $2,000 कर दिया। जर्मनी में वही कॉन्फ़िगरेशन लॉन्च पर €6,249 का था और मेरे अनुमान से अब लगभग €8,199 का है। उसी चिप और मेमोरी वाला Mac Studio $4,799 का था।
$200 के AI सब्सक्रिप्शन के मुक़ाबले MacBook कितने समय में अपनी लागत वसूल करता है?
$6,999 पर लगभग 35 महीने, अगर यह सब्सक्रिप्शन की पूरी जगह ले ले और चलाने में कुछ ख़र्च न हो। लगभग $10 प्रति माह बिजली के साथ यह लगभग 37 महीने है, और अगर आप मुश्किल कामों के लिए $20 का प्लान रखते हैं तो लगभग 41 महीने। $100 के प्लान की तुलना में यह छह साल से ज़्यादा है। उसी चिप वाला Mac Studio पहले, लगभग 25 से 28 महीनों में लागत निकाल लेता है।
क्या M5 Max local LLM के लिए काफ़ी तेज़ है?
mixture-of-experts मॉडलों के साथ जवाब लिखने के लिए, हाँ: MLX से मापा गया, 128 GB वाला M5 Max 55–88 टोकन प्रति सेकंड बनाता है, जो Anthropic’s API पर Claude Opus 5.5’s 98 के क़रीब है। लंबे प्रॉम्प्ट पढ़ना इसकी कमज़ोरी है। 32,000-टोकन का प्रॉम्प्ट gpt-oss-120b के साथ 13 सेकंड, Qwen3.5 122B के साथ 31 सेकंड और dense 27B मॉडल के साथ 55 सेकंड लिया, और AI कोडिंग एजेंट लंबे प्रॉम्प्ट बार-बार पढ़ते हैं।
क्या local LLM अब ChatGPT या Claude जितने अच्छे हैं?
लैपटॉप पर फ़िट होने वाले नहीं। Artificial Analysis’s नए Intelligence Index v5 पर, जो 27 अक्टूबर 2026 को प्रकाशित हुआ, सबसे अच्छे डाउनलोड-योग्य ओपन मॉडलों ने 32 अंक पाए, जबकि Claude Opus 5.5 के 58 थे, और Claude Haiku 5.5 के 36 से भी नीचे। MacBook में समाने लायक मॉडलों ने इंडेक्स के पिछले वर्ज़न पर अधिकतम 34 अंक पाए, जहाँ Opus 5.5 के भी 58 थे। छोटे, सरल कामों में फ़र्क अक्सर छोटा होता है; एजेंटिक कोडिंग, लंबे दस्तावेज़ों और मुश्किल तर्क में यह बड़ा है।
क्या quantization लोकल मॉडलों को ख़राब बनाता है?
8-bit पर थोड़ा, 4-bit पर ज़्यादा, उससे नीचे बहुत ज़्यादा। 500,000 से ज़्यादा मूल्यांकनों के एक अध्ययन में पाया गया कि FP8 व्यावहारिक रूप से लॉसलेस है और 4-bit weight-only क्वांटाइज़ेशन मानक बेंचमार्क पर 8-bit के क़रीब है। लेकिन 64,000 टोकन या उससे ज़्यादा के इनपुट पर, EMNLP 2025 के एक अध्ययन में 4-bit पर 59% तक गिरावट मापी गई, ग़ैर-अंग्रेज़ी टेक्स्ट के लिए और ख़राब, और 3 bits पर एक रीज़निंग मॉडल का गणित स्कोर 85.6% से 47.0% पर आ गया।
क्या मैं MacBook पर DeepSeek V4.1 Flash या GLM-5.3 चला सकता हूँ?
नहीं। GLM-5.3 में 753 बिलियन पैरामीटर हैं और DeepSeek V4.1 Flash में इसकी Engram मेमोरी सहित 763 बिलियन, इसलिए 4-bit पर भी उन्हें लगभग 375–460 GB चाहिए, जो किसी भी MacBook की 128 GB अधिकतम सीमा से बहुत ज़्यादा है। M5 Ultra और 512 GB वाला Mac Studio उन्हें रख सकता है। इन्हें इस्तेमाल करने का व्यावहारिक तरीका API है, बेहतर हो कि प्रोवाइडर के पास EU होस्टिंग और डेटा प्रोसेसिंग एग्रीमेंट हो।
क्या local AI के लिए 64 GB काफ़ी है, या 128 GB चाहिए?
ज़्यादातर लोगों के लिए, 48–64 GB काफ़ी है। Artificial Analysis’s इंडेक्स पर सबसे अच्छा Mac-आकार का मॉडल, Qwen3.8 27B, 8-bit पर लंबे कॉन्टेक्स्ट के लिए जगह के साथ फ़िट हो जाता है। 128 GB आपको gpt-oss-120b जैसे 120B-श्रेणी के मॉडल चलाने, कई मॉडल लोड रखने और लंबे कॉन्टेक्स्ट इस्तेमाल करने देता है, लेकिन आज के लीडरबोर्ड पर वे बड़े मॉडल कम स्कोर करते हैं, इसलिए $2,000 का अपग्रेड बुद्धि नहीं, जगह ख़रीदता है।
क्या मुझे local LLM के लिए MacBook Pro की जगह Mac Studio ख़रीदना चाहिए?
अगर लोकल AI मुख्य कारण है, तो आम तौर पर हाँ। उसी M5 Max और 128 GB वाला Mac Studio $4,799 का था, 16-inch MacBook Pro से $2,200 कम, बेहतर लगातार कूलिंग के साथ और बैटरी की चिंता के बिना। यह आपके लैपटॉप और फ़ोन के लिए निजी मॉडल सर्वर की तरह चौबीसों घंटे चल सकता है। अगर आपको पोर्टेबिलिटी दूसरे कारणों से चाहिए तो MacBook Pro ख़रीदें।
क्या AI लोकल चलाना प्राइवेसी और GDPR के लिए बेहतर है?
हाँ, यह इसका सबसे मज़बूत फ़ायदा है। लोकल मॉडल के साथ, प्रॉम्प्ट और दस्तावेज़ आपके डिवाइस से कभी बाहर नहीं जाते, इसलिए कोई प्रोसेसर एग्रीमेंट साइन करने की ज़रूरत नहीं और कोई अंतरराष्ट्रीय डेटा ट्रांसफ़र नहीं। यह क्लाइंट डेटा, स्वास्थ्य जानकारी और गोपनीयता से बंधे पेशों के लिए मायने रखता है, जैसे जर्मनी में § 203 StGB के अंतर्गत आने वाले। प्राइवेसी का फ़ायदा तब भी रहता है, चाहे लोकल मॉडल क्लाउड वाले जितना सक्षम हो या न हो। यह कानूनी सलाह नहीं है।
क्या मैं Claude Code को लोकल मॉडल के साथ इस्तेमाल कर सकता हूँ?
हाँ। Ollama एक Anthropic-संगत API देता है, इसलिए आप ANTHROPIC_BASE_URL सेट करके Claude Code को लोकल मॉडल की ओर इंगित कर सकते हैं http://localhost:11434. ट्रेड-ऑफ़ की उम्मीद रखें: Ollama Anthropic’s प्रॉम्प्ट-कैशिंग नियंत्रणों का समर्थन नहीं करता, Claude Code’s लंबा सिस्टम प्रॉम्प्ट और टूल परिभाषाएँ हर कदम पर लोकल मॉडल से बहुत कुछ पढ़वाते हैं, और Claude Code को Claude मॉडलों के लिए ट्यून किया गया है। OpenCode जैसे ओपन हार्नेस अक्सर लोकल मॉडलों के लिए ज़्यादा सहज होते हैं।
क्या नया OLED MacBook Pro इसमें कुछ बदलेगा?
शायद लोकल AI के लिए ज़्यादा कुछ नहीं। Apple’s “Pro and Tell” इवेंट 28 अक्टूबर 2026 को 10:00 Pacific पर है, और वहाँ अपेक्षित OLED टचस्क्रीन MacBook Pro के बारे में बताया जाता है कि वह भी वही M5 Pro और M5 Max चिप्स इस्तेमाल करेगा, जिससे 128 GB की सीमा और 614 GB/s बैंडविड्थ बनी रहेगी। 27 अक्टूबर को घोषित 14-inch MacBook Pro, M6 के साथ, अधिकतम 32 GB तक है।
मुख्य बात
“अपना $200 प्लान कैंसल करें और Mac ख़रीदें” वाली बात दो चीज़ों में सही है: सब्सक्रिप्शन महँगे हैं, और लोकल AI सचमुच उपयोगी है। यह अहम चीज़ में ग़लत है। $200 का प्लान आपको दुनिया के सबसे अच्छे मॉडल किराए पर देता है, उनके आसपास बने एजेंट और हर महीने बेहतर होता एक प्रोडक्ट। $7,000 का MacBook 128 GB में फ़िट होने वाले सबसे अच्छे मॉडल चलाता है, और आज वे फ़्रंटियर के 58 के मुक़ाबले 34 अंक पाते हैं, लंबे प्रॉम्प्ट धीरे पढ़ते हैं और ठीक उन जगहों पर गुणवत्ता खोते हैं जहाँ आप उन्हें सबसे ज़्यादा दबाते हैं।
गणित भी इसे नहीं बचाता। सबसे उदार स्थिति में भी, MacBook को लागत निकालने में तीन से चार साल लगते हैं, और तीन साल में यह सब्सक्रिप्शन के कुछ हज़ार डॉलर के भीतर ही रहता है, यह देखते हुए कि आप इसे कितने में बेच सकते हैं। यानी कम क्षमता वाले प्रोडक्ट के लिए लगभग उतना ही बिल।
इसलिए लोकल LLM के लिए MacBook तब ख़रीदें जब आपका डेटा इमारत से बाहर न जा सकता हो, जब आप ऑफ़लाइन काम करते हों, जब आपको कोई सीमा न चाहिए और ऐसा मॉडल चाहिए जो कभी न बदले, या जब आप वैसे भी Mac ख़रीद रहे हों। ये अच्छे कारण हैं, और बहुत से लोगों के पास ये हैं। बस सब्सक्रिप्शन कैंसल करने के लिए इसे न ख़रीदें। मुश्किल 10% के लिए क्लाउड प्लान रखें, निजी और उबाऊ 90% अपने हार्डवेयर पर रखें, और यह संतुलन कब बदलेगा, यह लीडरबोर्ड से देखें।
काम के लिए लोकल मॉडल चलाते हैं, या इस लेख में कही बात के उलट पाते हैं? मैं जानना चाहूँगा कि कौन-सा मॉडल, कौन-सी मशीन और कौन-से काम, और अगर आपके पास संख्याएँ हों तो उनके साथ। सुधार और विरोधी सबूत स्वागत हैं; यह लेख तब अपडेट होता है जब लीडरबोर्ड और कीमतें बदलती हैं, जिसका 2026 में मतलब है अक्सर।
तथ्य जाँचे गए: 28 अक्टूबर 2026।