
 العربية
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 हिन्दी

قبل ستة أسابيع كنت سأكتب هذا المقال بشكل مختلف.
في يوليو، وضعت Moonshot AI نموذجًا من فئة الحدود التقنية بـ 2.8 تريليون معامل على Hugging Face وسمحت لأي شخص بتنزيله. وفي 28 أغسطس، أصدرت Z.ai أخيرًا أوزان GLM-5.3 التي كانت تحتفظ بها لأسبوعين — بعد أن اكتشفت أن نموذجها نفسه قادر على ربط الثغرات ببعضها بطرق لم يطلبها أحد منه. وفي 1 سبتمبر، أطلقت Anthropic نموذج Claude Fable 5.1 وجعلت العمل الوكيلي أرخص بنسبة تصل إلى 45% دون تغيير السعر المعلن.
ثلاثة نماذج. ثلاث إجابات مختلفة تمامًا عن سؤال ما الذي يدين به مختبر ذكاء اصطناعي للجمهور. ولأول مرة منذ أن بدأ هذا كله، لم تعد خيارات الأوزان المفتوحة هي الحل الوسط.
هذه هي القصة الحقيقية لأواخر 2026، وتستحق نحو ثمانية آلاف كلمة، لأن التفاصيل هي مكان كل الأموال وكل الأخطاء.
لقد سحبت أوراق البنية وبطاقات النماذج ونصوص التراخيص — بشكل صحيح، سطرًا سطرًا، لأن اثنين من الثلاثة ليسا ما يسميه الناس به بشكل عابر — ومعايير قياس البائعين ودرجات المجمّعات المحايدة والأسعار الحقيقية لكل رمز، وقائمة أسعار Ollama’s الجديدة تمامًا. ثم حسبت تكلفة شهر عمل عادي بدلًا من سيناريو يوم الإطلاق.
وهذا ما خرجت به النتيجة.
باختصار — الحكم في 60 ثانية
GLM-5.3 هو أفضل قيمة في الذكاء الاصطناعي الآن، والفارق ليس بسيطًا. يمنحه Artificial Analysis درجة تفصله بنصف نقطة عن Kimi K3، ونحو ثلاث نقاط ونصف عن Claude Opus 5، بسعر $1.40 للإدخال و$4.40 للإخراج لكل مليون رمز. وفي المهمة الوكيلية نفسها، تبلغ تكلفته نحو سُدس تكلفة Fable 5.1. والأوزان قابلة للتنزيل. إذا أردت طرازًا واحدًا توجّه إليه وكيلك ولست تدير أعمالًا بإيرادات 10 مليارات دولار، فهذا هو.
Kimi K3 هو أقدر شيء يمكنك تنزيله قانونيًا. 2.8 تريليون معامل، و104 مليار معامل نشط، ونافذة سياق حقيقية تبلغ 1M، ورؤية أصلية، وأفضل درجة تصفح وكيلي نشرها أحد (BrowseComp 91.2)، و— الرقم الذي يجب أن ينهي حجة “النماذج المفتوحة متأخرة” — 88.3 في Terminal-Bench 2.1، مقابل 88.0 لـ Claude Fable 5’s و88.8 لـ GPT-5.6 Sol’s على الإصدار نفسه. كما تبلغ تكلفته $3/$15 — أكثر من ضعف GLM-5.3 — وأوزانه البالغة 1.5 تيرابايت تحتاج رفّ خوادم، لا محطة عمل. إنه الطراز الذي تستخدمه حين تكون المهمة صعبة وطويلة، والطراز الذي تستشهد به حين يقول لك أحد إن الأوزان المفتوحة متأخرة جيلًا.
لا يزال Claude Fable 5.1 هو الطراز الذي تلجأ إليه حين يكون الخطأ مكلفًا. يتصدر المجال في العمل الوكيلي المستمر لساعات طويلة، وفي التنقيح الفوضوي الذي لا يظهر أبدًا بشكل نظيف على لوحة ترتيب. خفّضت Anthropic قراءات الذاكرة المؤقتة بنسبة 75% في 1 سبتمبر، ما يجعل جلسات الوكيل الطويلة أرخص بكثير مما كانت. وهو أيضًا بستة أضعاف سعر GLM-5.3 لكل مهمة، ومغلق، ويحمل الآن قيودًا ضد التقطير تتعارض مع بعض عمليات التكامل القائمة.
الخلاصة الصادقة في سطر واحد: لقد قلّصت نماذج الأوزان المفتوحة فجوة القدرات إلى نحو ثلاثة إلى خمسة أشهر، ومحَت فجوة السعر تمامًا. ما تشتريه فعليًا من Anthropic في سبتمبر 2026 هو الموثوقية في أصعب 10% من العمل — وحقّ ألّا تفكر في أي من هذا.
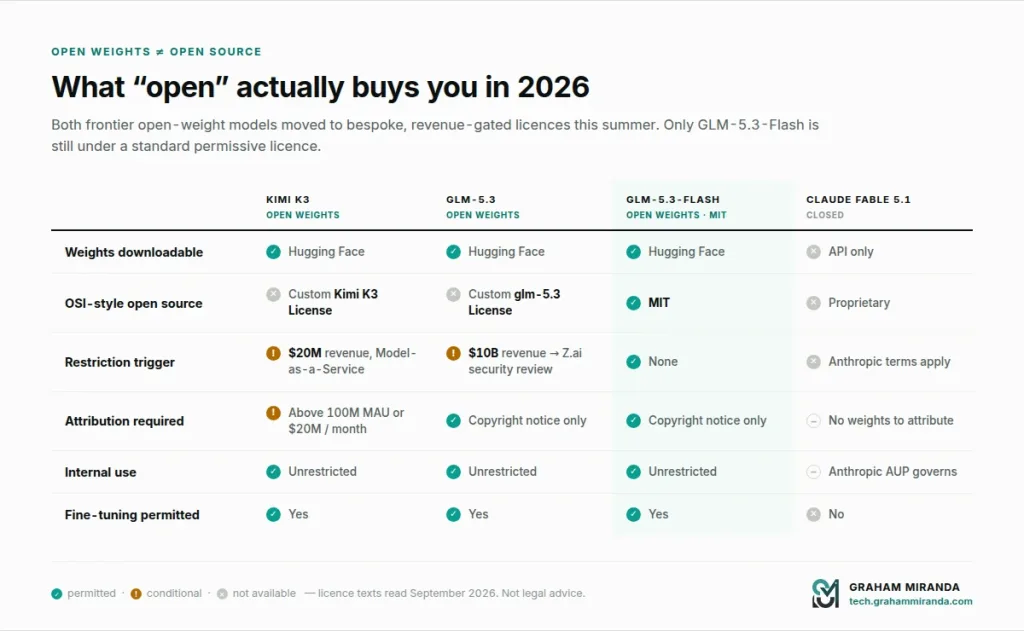
والمنعطف الذي لا يريد أحد قوله بصوت عالٍ: لم يعد Kimi K3 ولا GLM-5.3 يُوزَّع بموجب ترخيص مفتوح المصدر. انتقل كلاهما إلى شروط مخصّصة مشروطة بالإيرادات هذا الصيف. أوزان مفتوحة، نعم. مفتوح المصدر، لا. اقرأ قسم التراخيص قبل أن يقرأه فريقك القانوني.
جدول مقارنة سريع
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| المطوّر | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| تاريخ الإصدار | 16 يوليو 2026 (API) · 27 يوليو (الأوزان) | 14 أغسطس 2026 (API) · 28 أغسطس (الأوزان) | 1 سبتمبر 2026 |
| الأوزان متاحة | نعم | نعم | لا |
| الترخيص | ترخيص Kimi K3 (مخصّص، مشروط بالإيرادات) | ترخيص glm-5.3 (مخصّص، مشروط بالإيرادات) | احتكاري |
| إجمالي المعاملات | 2.8T | 753B | غير معلن |
| النشطة لكل رمز | 104B (16 من 896 خبيرًا) | ~40B (تقديري) | غير معلن |
| البنية | KDA + Attention Residuals، وStable LatentMoE، و69 طبقة KDA + 24 طبقة Gated MLA | MoE، القاعدة نفسها كـ GLM-5.2، والمكاسب من التدريب اللاحق فقط | غير معلن |
| نافذة السياق | 1,048,576 | 1,000,000 | 1,000,000 |
| أقصى إخراج | 131,072 افتراضيًا (حتى 1,048,576) | 128,000 | 128,000 |
| إدخال متعدد الوسائط | نص وصورة وفيديو (MoonViT-V2) | نص فقط | نص وصورة |
| التفكير | مفعّل دائمًا | مفعّل دائمًا، reasoning_effort low/high/max | مفعّل دائمًا، تكيّفي، جهد لكل رسالة (beta) |
| سعر الإدخال / 1M | $3.00 | $1.40 | $10.00 |
| الإدخال المخزّن مؤقتًا / 1M | $0.30 | $0.26 | $0.25 |
| سعر الإخراج / 1M | $15.00 | $4.40 | $50.00 |
| مؤشر AA للذكاء | 59.7 | 59.5 | لم يُقيَّم بعد (Fable 5: 62.1) |
| التكلفة لكل مهمة تقييم AA | $0.84 | $0.68 | — (Opus 5: $2.34) |
| بصمة الاستضافة الذاتية | ~1.5 تيرابايت (MXFP4 أصلي) | ~1.5 تيرابايت BF16 / ~750 غيغابايت FP8 | N/A |
| على Ollama | kimi-k3:cloud | glm-5.3:cloud | عبر Claude Code / Claude Desktop كعميل |
كل الأسعار هي أسعار القائمة من الجهة المطوّرة. أرقام Artificial Analysis مأخوذة من لقطة مؤشر سبتمبر 2026؛ وقد أُطلق Fable 5.1 في 1 سبتمبر ولم يكن قد قُيّم بشكل مستقل وقت الكتابة.
لماذا هذه المقارنة الثلاثية هي المقارنة المهمة
لمدة عامين كان لجدل المفتوح مقابل المغلق شكل مريح: النماذج المغلقة أفضل، والنماذج المفتوحة أرخص، وتختار موقعك على هذه المقايضة. كان الجميع يعرف أين يقف.
هذا الشكل انكسر هذا الصيف.
يقدّر Nathan Lambert، الذي يتابع هذا بعناية أكبر من أي شخص تقريبًا، الفجوة الحالية في القدرات بين نماذج الحدود ذات الأوزان المفتوحة ونماذج الحدود المغلقة بـ ثلاثة إلى خمسة أشهر — انخفاضًا من ستة إلى تسعة أشهر كان الناس يستشهدون بها قبل عام. وقت كتابته، كان Kimi K3 في المركز الثاني على مؤشر Vals AI وقريبًا من قمة مؤشر Artificial Analysis’s، ولم يتفوق عليه سوى Claude Fable وGPT-5.6 Sol Max. ولقطة مؤشر سبتمبر التي أستخدمها لاحقًا في هذا المقال تضعها رابعًا، خلف Grok 4.6. في كل الحالات: هذه ليست “نتيجة جيدة لنموذج مفتوح”. هذه نتيجة تصعد بها إلى منصة التتويج.
في هذه الأثناء، ذهبت بيانات الاستخدام إلى مكان مفاجئ حقًا. النماذج ذات الأصل الصيني استحوذت على نحو 61% من جميع الرموز الموجّهة عبر OpenRouter بحلول مايو 2026. وانخفضت حصة الولايات المتحدة من هذه الحركة من نحو 70% إلى نحو 30% خلال اثني عشر شهرًا. وLlama من Meta’s — النموذج الذي بدأ موجة الأوزان المفتوحة — هبط إلى أقل من 1% من الحجم الموجّه. وذهبت حصة Google’s من نحو 37% إلى 13%. ووجدت دراسة OpenRouter’s بـ 100 تريليون رمز مع a16z أن نماذج الأوزان المفتوحة تمثل نحو ثلث إجمالي حجم الرموز على المنصة.
يمكنك أن تجادل حول ما تمثله حركة OpenRouter. إنها تزيد من وزن المطورين والهواة وأعباء العمل الحساسة للتكلفة، وتقلل من وزن عقود المؤسسات التي لا تمر عبر أي موجّه أبدًا. حسنًا. لكنها أكبر مجموعة بيانات عامة لدينا عمّا يختاره الناس فعليًا حين تكون لديهم حرية الاختيار، والاتجاه لا لبس فيه.
إذن السؤال في سبتمبر 2026 لم يعد “هل النماذج المفتوحة جيدة بما يكفي بعد؟”. إنه أكثر حدة بكثير:
بوجود ثلاثة نماذج تجتاز الحد المطلوب جميعًا، أيّها توجّه إليه وكيلك — وكم يكلّفك الخطأ فعليًا؟
هذا سؤال عن معايير القياس والأسعار والتراخيص والبنية التحتية، بهذا الترتيب تقريبًا من حيث مقدار تفكير الناس فيها، وبالترتيب العكسي تمامًا من حيث أهميتها.
ما هو Kimi K3 فعليًا
أعلنت Moonshot AI عن Kimi K3 في 16 يوليو 2026 وأصدرت الأوزان الكاملة في 27 يوليو. وهو، بعدد المعاملات، أكبر نموذج مفتوح الأوزان نشره أحد على الإطلاق — 2.8 تريليون معامل إجمالًا، أي أكبر بنحو 75% من DeepSeek V4 Pro.
هذا الرقم أقل إثارة للإعجاب مما يبدو وأكثر إثارة للإعجاب مما يبدو، بهذا الترتيب.
البنية بلغة مبسطة
Kimi K3 نموذج خليط خبراء يفعّل 104 مليار معامل لكل رمز، باختيار 16 خبيرًا من مجموعة تضم 896. لذا، مع أن الإجمالي 2.8T، فإن أي تمرير أمامي يمس أقل من 4% من الأوزان. ومن هنا تأتي الجدوى الاقتصادية: معرفة مخزّنة هائلة، وتكلفة استدلال معتدلة.
الهندسة المثيرة للاهتمام في مجموعة طبقات الانتباه. يستخدم K3 93 طبقة مبنية من 69 طبقة KDA (Kimi Delta Attention) و24 طبقة Gated MLA — تصميم انتباه هجين من الخطي إلى الكامل بنسبة تداخل نحو 3:1. وKDA نسخة من الانتباه الخطي تعمل بزمن خطي بالنسبة لطول التسلسل بدلًا من زمن تربيعي، وهذا ما يجعل سياق 1M مجديًا اقتصاديًا وليس مجرد رقم مُعلن. وتذكر Moonshot تحقيق ما يصل إلى تقليل بنسبة 75% في ذاكرة KV المؤقتة وحتى 6× إنتاجية فك الترميز عند سياق 1M نتيجة لذلك.
وفوق ذلك يأتي Attention Residuals (AttnRes)، الذي تصفه Moonshot كبديل مباشر لوصلات البقايا القياسية، و Stable LatentMoE إطار لتوجيه. ويُقال إن الجمع بينهما يحقق نحو تحسين بمقدار 2.5× في كفاءة التوسيع الإجمالية مقارنة بـ Kimi K2.
تأتي الرؤية من MoonViT-V2، وهو مشفّر بـ 401M معامل، وهو أصلي وليس مضافًا لاحقًا — يتعامل K3 مع النص والصور والفيديو في نموذج واحد.
تفصيل آخر يهم كل من يفكر في الاستضافة الذاتية: دُرّب K3 باستخدام تدريب أصلي يراعي التكميم MXFP4، مع الخبراء في MXFP4 والتفعيلات في MXFP8. هذا ليس تكميمًا لاحقًا. نقطة الحفظ المنشورة هي النموذج المكمّم نفسه، ولهذا تبلغ 2.8 تريليون معامل نحو 1.5 تيرابايت على القرص بدلًا من ~5.6 تيرابايت التي تحتاجها نقطة حفظ BF16 بهذا الحجم.
حكاية معايير القياس
أرقام Moonshot’s المنشورة قوية في كل المجالات، وعلى نحو غير معتاد، صمدت عدة منها في التقييم المستقل:
- Terminal-Bench 2.1: 88.3 — أعلى درجة منشورة على هذا الإصدار من معيار القياس
- FrontierSWE: 81.2
- DeepSWE: 67.5
- BrowseComp: 91.2 — أفضل مستوى معروف في البحث الوكيلي على الويب
- GPQA Diamond: 93.5
- MMMU-Pro: 81.6 / 83.4 (الرؤية)
- SWE Marathon: 91.0
- OfficeQA Pro: 81.3
- AutomationBench: 30.8
- LMArena Frontend Code Arena: 1,679 Elo — المركز الأول، متقدمًا على Claude Fable 5 (1,631) وGPT-5.6 Sol (1,618)، وفاز في ستة من أصل سبعة مجالات للواجهات الأمامية
تستحق هذه الأخيرة توقفًا. نموذج بأوزان مفتوحة يمكنك تنزيله مجانًا احتل المركز الأول في ساحة تنافس لبرمجة الواجهات الأمامية تعتمد على تفضيل البشر، متقدمًا على النماذج المغلقة الرائدة من أفضل مختبرين تمويلًا في العالم. ومهما كان رأيك في معايير الساحات كمنهجية، فهذا عنوان كان من المستحيل تخيّله في 2025.
على المؤشرات المجمّعة يحلّ أدنى قليلًا: 59.7 على مؤشر الذكاء من Artificial Analysis، في المركز الثالث إجمالًا، خلف Claude Opus 5 (63.0) وClaude Fable 5 (62.1). وأرقام Moonshot الاستعراضية الخاصة — GDPval-AA v2 عند 1,687 و AA-Briefcase عند 1,527 — تضعه في المركز الثالث والثاني على التوالي في تقييمات العمل المعرفي تلك. وعلى Vals Index v2 يحلّ عند 57.8%، مقابل 67.2% لـ Claude Opus 5 و66.0% لـ Claude Fable 5 و63.7% لـ GPT-5.6 Sol — وهي أوسع فجوة بين المفتوح والمغلق في أي مؤشر وجدته، ويستحق إبقاءها في الذهن مقابل أرقام البرمجة.
العروض التوضيحية، وكيف تقرأها
نشرت Moonshot عرضين توضيحيين للاستقلالية على الأمد الطويل نالا اهتمامًا كبيرًا: تشغيل مستقل لمدة 48 ساعة يُكمل خط تصميم شريحة كاملًا (تصميم 4 نانومتر يُغلق التوقيت عند 100 ميغاهرتز، بمحاكاة تتجاوز 8,700 رمز/ثانية)، وإعادة إنتاج لـ علاقة I-Love-Q في نحو ساعتين، مقابل أسبوع إلى أسبوعين يحتاجهما باحث أول عادةً.
هذه عروض مبهرة حقًا، لكنني لن أبني عليها قرار شراء. العروض التي يديرها البائع ويبنيها البائع وينتقيها البائع تخبرك بما يستطيعه النموذج في يوم جيد تحت إشراف خبير، لا بما يفعله في مستودعك يوم ثلاثاء. اعتبرها دليل وجود على قدرة الأمد الطويل، لا مواصفة.
عرض الصورة معماريتان منشورتان وصندوق أسود واحد. النماذج المفتوحة تخبرك بالضبط كيف تعمل؛ والمغلق يخبرك بالنتيجة التي يحققها.
ما هو GLM-5.3 في الواقع
قصة إصدار GLM-5.3 هي الأغرب بين الثلاثة، وهي التي تستحق أن تُروى كاملة، لأنها المرة الأولى التي يتردد فيها مختبر كبير على نحو ظاهر في نشر الأوزان لأسباب غير تجارية.
أعلنت Z.ai عن GLM-5.3 في 14 أغسطس 2026 بشعار “Built to Code. Ready for Cyber Defense.” النموذج هو خليط خبراء بـ 753 مليار معامل، بنحو 40 مليار معامل نشطة لكل رمز وفق تقديرات المجتمع المستمدة من إعداد GLM-5.2. يحمل نافذة سياق بمليون رمز وحدًا أقصى للإخراج 128 ألفًا، و— خلافًا لـ GLM-5.3-Flash، الذي هو نموذج مختلف تمامًا — فهو نصي فقط.
“كل ما فعلناه هو التوسّع في التدريب اللاحق”
أكثر حقيقة تقنية تثير الاهتمام في GLM-5.3 هي أنه لا يوجد نموذج أساس جديد. فهو يعيد استخدام الأساس نفسه المدرب مسبقًا الخاص بـ GLM-5.2. وكل تحسّن جاء من تدريب لاحق موسّع بشكل كبير، لخصته Z.ai في: “كل ما فعلناه لـ GLM-5.3 هو التوسّع في التدريب اللاحق.”
الفروق ليست صغيرة:
| معيار القياس | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
تحسّن بستة أضعاف على Terminal-Bench وقفزة بعشرين نقطة على DeepSWE، انطلاقًا من الأوزان الأساسية نفسها، نتيجة مهمة فعلًا. تقول إن الحدود المتقدمة لا يزال أمامها مجال كبير في التدريب اللاحق، وهو النصف الأرخص بكثير من فاتورة التدريب. وهذا بالضبط سبب مواكبة المختبرات الصينية التي تعمل بـ“موارد أقل بمراتب”، كما يصفها Lambert، لنظيراتها الأمريكية.
الأسبوعان اللذان أمضتهما Z.ai دون إصدار
قالت Z.ai عند الإطلاق إن الأوزان ستأتي “على مراحل بعد تقييمات سلامة صارمة”، بهدف يقارب أسبوعين. وأدرج مستودعها على Hugging Face تاريخ 28 أغسطس. جاء ذلك التاريخ، ومضى بفارق ساعات، ثم ظهرت الأوزان مصحوبة بكتابة تقنية تشرح التأخير.
كان السبب هو القدرة السيبرانية. أثناء التقييم، أفادت Z.ai بأن GLM-5.3 حدّد 2,436 ثغرة في 269 مشروعًا مفتوح المصدر، منها 1,097 مصنّفة بالخطيرة أو العالية. والأهم من ذلك، أظهر النموذج استدلالًا على سلاسل استغلال متعددة المراحل — يربط خطوات الاستغلال ببعضها بشكل مستقل — وهو سلوك وصفته Z.ai بأنه “غير مقصود تمامًا” و“استمر في التراكم مع توسّع التدريب.”
أريد أن أكون حذرًا هنا، لأن هذا يسهل قراءته إما كتسويق أو كتهويل، وهو على الأرجح ليس أيًّا منهما. النموذج البارع في اكتشاف الثغرات بارع في اكتشاف الثغرات؛ فالاستخدامان الدفاعي والهجومي هما القدرة نفسها موجهة في اتجاهين مختلفين. وتوزيع المعايير عند Z.ai يعكس ذلك بصدق: CyberGym 84.5% (اكتشاف الثغرات، حيث يتقدم) مقابل ExploitBench 54.4% (الاستغلال، حيث يسجل Claude Fable 5 نسبة 78.0%). لقد حسّن المختبر عمدًا للنصف الدفاعي، وهذا يظهر.
الجدير بالملاحظة حقًا هو أن مختبرًا أوقف إصدارًا رئيسيًا أسبوعين ونشر منطقه. وسواء وجدت المنطق مقنعًا أم لا، فالسابقة جديدة.
أين يقف GLM-5.3 فعليًا
مخطط المقارنة الذي نشرته Z.ai لا يدّعي اكتساحًا كاملًا، وهذا منعش:
| معيار القياس | GLM-5.3 | أفضل مقارن |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3 يتقدم |
| CyberGym | 84.5% | GLM-5.3 يتقدم |
| GDPval-AA v2 | 1,769 | GLM-5.3 يتقدم |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34.6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72.7% |
| ExploitBench | 54.4% | Claude Fable 5: 78.0% |
| Code Bench (50 ألف رمز) | 31.4% | — |
وبشكل مستقل، تضعها Artificial Analysis عند 59.5 على مؤشر الذكاء — لا يمكن تمييزها إحصائيًا عن 59.7 لـ Kimi K3، من نموذج يملك نحو ربع المعاملات.
ثمة تحفّظ واحد من التقييم نفسه لا يذكره أحد في التسويق: أنتج GLM-5.3 170 مليون رمز إخراج عبر مجموعة Artificial Analysis مقابل وسيط 72 مليونًا لفئته. إنه مطوّل. reasoning_effort يفترض افتراضيًا أقصى ولا يمكن تعطيل التفكير، لذا تدفع مقابل قدر كبير من التروّي سواء استحقته المهمة أم لا. ومع ذلك، بلغت التكلفة الإجمالية لتشغيل التقييم الكامل 0.68 دولار لكل مهمة، مقابل 0.84 دولار لـ Kimi K3 و2.34 دولار لـ Claude Opus 5 — فالإطالة لا تمحو ميزة السعر، بل تضيّقها فقط.
ما هو Claude Fable 5.1 في الواقع
أصدرت Anthropic Claude Fable 5.1 في 1 سبتمبر 2026، إلى جانب Claude Mythos 5.1 — النموذج نفسه بإعداد ضمانات مختلف، متاح فقط عبر برامج الوصول الموثوق لأعمال الأمن السيبراني وعلوم الحياة.
التحديد دقيق، وأظنه صحيحًا: هذا هو “نموذج بُني لعمل لا ينتهي في موجّه واحد.” Anthropic لا تدّعي قفزة في الذكاء العام. بل تدّعي أن جلسات الوكلاء الممتدة على مدى ساعات تعمل بشكل أفضل.
الأرقام
| معيار القياس | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (جزئي) | 72.9% | 77.9% | — |
| Humanity’s Last Exam (بالأدوات) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
لسياق خارجي على المسطرة نفسها: يسجل GPT-5.6 Sol نسبة 52.3% على Terminal-Bench 4.0، فيتقدّم Fable 5.1 بنسبة 55.8% ويوسّعها Mythos 5.1 بنسبة 60.9%.
قفزة Terminal-Bench-Science — من 24.7% إلى 52.6%، أي مضاعفة نظيفة — هي التي سأزنها أكثر من غيرها إن كان عملك يتضمن حوسبة علمية أو خطوط بيانات. وعلى أصعب معيار لاستخدام الحاسوب لدى Browserbase’s، أكمل Fable 5.1 82% من المهام مقابل 74% لـ Claude Opus 5.
تذكر Anthropic أيضًا ما يقارب انخفاضًا بنسبة 60% في الإيجابيات الكاذبة للأمان السيبراني — أي رفض النموذج لعمل أمني مشروع لأنه طابق نمطيًا شيئًا خطيرًا. إن سبق أن رفض مساعد برمجة مساعدتك في كتابة محدّد معدل، فستفهم لماذا يهم هذا.
تغيير التسعير هو الخبر الحقيقي
الأسعار المعلنة لم تتحرك: 10 دولارات لكل مليون رمز إدخال، و50 دولارًا لكل مليون رمز إخراج. ما تغيّر هو مضاعف قراءة الذاكرة المؤقتة، وقد تغيّر كثيرًا.
| Fable 5 | Fable 5.1 | |
|---|---|---|
| المدخل | $10.00 | $10.00 |
| الإخراج | $50.00 | $50.00 |
| كتابة الذاكرة المؤقتة (5 دقائق) | $12.50 | $12.50 |
| كتابة الذاكرة المؤقتة (ساعة واحدة) | $20.00 | $20.00 |
| قراءة من الذاكرة المؤقتة | $1.00 | $0.25 |
هذا خفض بنسبة 75%، تحقق بنقل مضاعف قراءة الذاكرة المؤقتة من المعيار 0.1× من الإدخال الأساسي إلى 0.025×. وتذكر Anthropic ما يقارب 25% أرخص لأحمال العمل النموذجية وحتى 45% أرخص للعمل الوكيلي المكثف — والرقم الثاني حقيقي، لأن حلقات الوكلاء هي في الغالب قراءات للذاكرة المؤقتة. جلسة وكيل من 60 دورًا تعيد قراءة السياق المتراكم نفسه عشرات المرات. وتضاعف Batch API خفض الإدخال والإخراج فوق ذلك، لتصل إلى 5 دولارات/25 دولارًا.
هذا خفض سعر ذكي وموجّه. يجعل الشيء الذي يتفوق فيه Fable 5.1 — الجلسات الطويلة — أرخص بشكل ملموس دون تقليل قيمة النموذج عمومًا.
ثلاثة تغييرات كاسرة، وتراجع واحد
قبل ترقية تكامل في بيئة إنتاج، اقرأ هذه بعناية.
1. استخدام الأدوات القسري اختفى. الطلبات التي تستخدم tool_choice: "any" أو tool_choice: "tool" تُرجع الآن خطأ 400. التفكير دائمًا مفعّل ولا يمكن تجاوزه، وفرض استدعاء أداة سيتخطاه. عليك استخدام tool_choice: "auto".
2. كتل التفكير أحادية الاتجاه. يستطيع Fable 5.1 قراءة كتل التفكير التي أنتجتها نماذج Claude السابقة، لكن النماذج السابقة لا تستطيع قراءة كتل Fable 5.1. فقط Mythos 5.1 يستطيع. إذا كانت معماريتك تبدّل النماذج في منتصف المحادثة لتوفير المال، فإن هذا الاحتياطي يفرض الآن إعادة تخطيط.
3. تعديل السجل يُبطل كتل التفكير. بالنسبة للحسابات المنشأة بعد 31 أغسطس 2026، فإن تعديل الأدوار السابقة أو موجّه النظام أو مصفوفة الأدوات يُبطل كل كتل التفكير اللاحقة — أخطاء أو إسقاطات صامتة. هذا إجراء صريح ضد التقطير، وهو يكسر نمطًا شائعًا حيث تعيد أطر الوكلاء كتابة السياق بين الأدوار.
وثمة تراجع واحد يجدر معرفته: يُقال إن استدعاء الأدوات المتوازي أكثر تقلبًا في 5.1، فيصدر أحيانًا استدعاءً واحدًا في الدور حيث كان 5 يجمع عدة استدعاءات. وفي حلقة وكيل طويلة، يكلف ذلك وقتًا فعليًا.
ثمة أيضًا تفصيل في المُرمِّز يوقع الناس في فخ عند مقارنات التكلفة: يستخدم Fable 5.1 المُرمِّز نفسه الذي يستخدمه Claude Opus 4.7، والذي ينتج نحو 30% رموزًا أكثر من مُرمِّز نماذج Claude الأقدم للنص نفسه. إذا كنت تقيس التكلفة مقابل خط أساس من 2025، فعدّل ذلك قبل استنتاج أي شيء.
مشكلة المعايير: ثلاثة نماذج، ثلاث مساطر مختلفة
هنا الجزء الذي تخطئ فيه معظم مقالات المقارنة، ويستحق الصراحة.
لا يمكنك مقارنة هذه النماذج الثلاثة على Terminal-Bench. انظر:
- Kimi K3: 88.3 على Terminal-Bench 2.1
- GLM-5.3: 28.3 على Terminal-Bench 3.0
- Fable 5.1: 55.8 على Terminal-Bench 4.0
تلك ثلاثة معايير مختلفة تشترك في الاسم. كل إصدار أصبح أصعب بكثير من سابقه — وهذا هو الهدف كله من إصدار نسخة جديدة. وقراءة تلك الأرقام الثلاثة كترتيب ستخبرك أن Kimi K3 أفضل بثلاثة أضعاف من GLM-5.3 في العمل على الطرفية، وهذا هراء.
المشكلة نفسها تنطبق على AutomationBench، حيث تُذكر أرقام الإصدارات بشكل غير متسق، وعلى عائلة SWE-bench، حيث تقيس نسخ Verified وPro وMarathon أشياء مختلفة فعلًا. المختبرات لا تفعل ذلك لخداع أحد — بل يشغّلون التقييم الذي كان سائدًا حين درّبوا، والتقييمات تتغير كل بضعة أشهر الآن. لكن أثر ذلك على قارئ عادي هو أثر الخداع نفسه، لذا يستحق التنبيه إليه بصوت عالٍ.
ما يمكنك مقارنته بشكل مشروع، ضمن الإصدار نفسه:
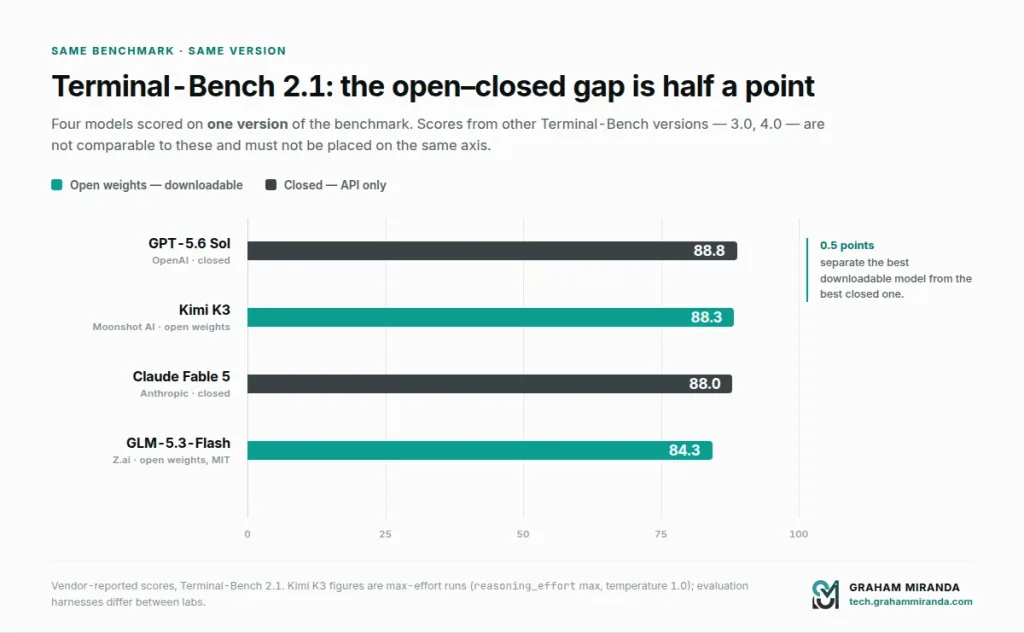
مفعّل Terminal-Bench 2.1: Kimi K3 (88.3) وGPT-5.6 Sol (88.8) وClaude Fable 5 (88.0) وGLM-5.3-Flash (84.3). أربعة نماذج، مسطرة واحدة. هذه هي المقارنة المهمة فعلًا، وقد خصصت لها جدولًا خاصًا في القسم التالي.
مفعّل Terminal-Bench 4.0: Fable 5.1 (55.8) مقابل GPT-5.6 Sol (52.3). Fable يفوز.
بعد ذلك، كن متشككًا في أي شخص يعرض عليك مخططًا شريطيًا واحدًا يضم النماذج الثلاثة الرئيسية في هذا المقال على محور Terminal-Bench. لا يمكن فعل ذلك بصدق.
حيث تلتقي فعليًا: الأرقام القابلة للمقارنة المتبادلة
إذا استبعدت اختلافات إصدارات المعايير، تبقى ثلاث مقارنات.
1. مؤشر الذكاء من Artificial Analysis (سبتمبر 2026)
يُدار بشكل مستقل، بالمنهجية نفسها عبر كل نموذج، دون مشاركة البائع في الاختيار.
| الترتيب | الطراز | النتيجة | أوزان مفتوحة |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | لا |
| 2 | Claude Fable 5 | 62.1 | لا |
| 3 | Grok 4.6 | 60.9 | لا |
| 4 | Kimi K3 | 59.7 | نعم |
| 5 | GLM-5.3 | 59.5 | نعم |
| 6 | GPT-5.6 Sol | 58.9 | لا |
| 7 | Qwen3.8 Max Preview | 58.1 | الأوزان قيد الانتظار |
| 8 | GLM-5.3-Flash | 57.5 | نعم (MIT) |
| 31 | MiniMax M3 | 45.4 | نعم |
لم يكن Fable 5.1 قد حصل على تقييم مستقل وقت الكتابة — فقد صدر في اليوم السابق. وبالنظر إلى فروق معايير 5.1 مقابل Fable 5، توقّع أن يحلّ عند 62.1 أو أعلى حين يُقيَّم.
ملاحظة على الدقة: اللقطات المختلفة لهذا المؤشر تقرّب بشكل مختلف — إحدى لقطات سبتمبر تضع Kimi K3 وGLM-5.3 عند 60 وGPT-5.6 Sol عند 61. الترتيب في القمة مستقر؛ أما الفجوات دون النقطة فليست كذلك. لا تبنِ حجة على نصف نقطة.
اقرأ ذلك الجدول بعناية. أفضل نموذج بأوزان مفتوحة متأخر 3.3 نقاط عن أفضل نموذج مغلق على أوسع مؤشر محايد متاح. قبل عام كانت تلك الفجوة بخانة عشرية مزدوجة.
2. Terminal-Bench 2.1 — الإصدار الوحيد الذي تلتقي فيه ثلاثة منها
هذا أنفع جدول في المقال، وكدت أفوّته. Kimi K3 وClaude Fable 5 وGPT-5.6 Sol حصلوا جميعًا على درجات على الإصدار نفسه من Terminal-Bench:
| الطراز | Terminal-Bench 2.1 | أوزان مفتوحة |
|---|---|---|
| GPT-5.6 Sol | 88.8 | لا |
| Kimi K3 | 88.3 | نعم |
| Claude Fable 5 | 88.0 | لا |
| GLM-5.3-Flash | 84.3 | نعم (MIT) |
نصف نقطة تفصل نموذجًا يمكنك تنزيله عن أفضل نموذج مغلق على المعيار نفسه، وفي الإصدار نفسه، وفي عمل وكيلي أصيل على الطرفية.
هذا هو الرقم الذي يجب تذكّره. لا تجميع المؤشر، ولا مخطط البائع — هذا. على شكل المهمة المحدد الذي هو البرمجة الوكيلية في الواقع، الفجوة داخل حدود الضجيج.
تحفّظ واحد، ذكره المصدر ويستحق التكرار: كل أرقام Kimi K3 المنشورة هي تشغيلات بأقصى جهد، عند reasoning_effort الحد الأقصى ودرجة حرارة 1.0. تستخدم المختبرات المختلفة هارنسات تقييم مختلفة وإعدادات جهد مختلفة، لذا حتى مقارنات الإصدار نفسه تحمل عدم يقين أكبر مما يوحي به جدول نظيف.
3. تكلفة تشغيل مجموعة التقييم نفسها
إن كان الجدول أعلاه أفضل مقارنة للقدرة، فهذه أفضل مقارنة للقيمة — لأنها الرقم الوحيد الذي يجمع القدرة والإطالة وكلفة الاستدلال والسعر في رقم واحد:
| الطراز | التكلفة لكل مهمة في مؤشر الذكاء |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
المهام نفسها، والتقييم نفسه، وفواتير حقيقية. يقدم GLM-5.3 نسبة 94% من نتيجة Opus 5 في المؤشر مقابل 29% من التكلفة.
4. GDPval-AA v2 (العمل المعرفي)
| الطراز | النتيجة |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
هذا يستحق التحفظ: إنه مجمّع من مخططات نشرها البائعون لا من تشغيل مستقل واحد، ولاحقات “Max” تشير إلى إعدادات جهد مختلفة. لكن الترتيب متسق عمومًا عبر المصادر، وهو يقول شيئًا حقيقيًا — في العمل المعرفي العام، خلافًا للبرمجة، لا تزال النماذج المغلقة تحتفظ بتقدم أوضح مما توحي به معايير البرمجة.
هذا هو النمط عبر المقارنات الثلاث. لقد لحقت النماذج المفتوحة أساسًا بالنماذج المغلقة في البرمجة والمهام الوكيلية. لكنها لا تزال متأخرة خطوة في العمل المعرفي الواسع. إن كان حمل عملك من النوع الأول، فحجة دفع أسعار النماذج المغلقة ضعيفة. وإن كان من النوع الثاني، فهي لا تزال قابلة للدفاع.
عرض الصورة ثلاث نقاط وبعض الشيء تفصل أفضل نموذج مغلق عن أفضل نموذج قابل للتنزيل. كانت تلك الفجوة بخانة عشرية مزدوجة قبل اثني عشر شهرًا.
حسابات التكلفة، بأرقام حقيقية
المعايير مجردة. الفواتير ليست كذلك.
السيناريو
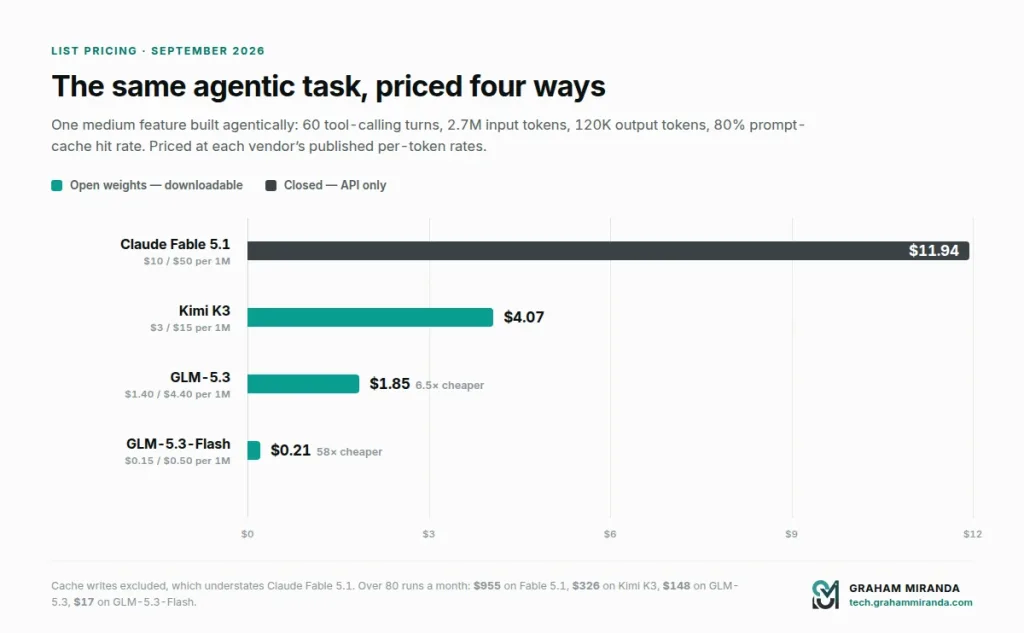
ميزة متوسطة واحدة، منفذة وكيليًا: نحو 60 دورة استدعاء أدوات، بمتوسط 45,000 رمز إدخال لكل دور مع تراكم السياق، و 2,000 رمز إخراج لكل دور.
- إجمالي الإدخال: 2.7 مليون رمز
- إجمالي الإخراج: 120 ألف رمز
- معدل إصابة ذاكرة التخزين المؤقت للموجّهات المفترض: 80% (2.16 مليون مخزّن مؤقتًا، 540 ألف جديد)
Claude Fable 5.1
| المكوّن | الرموز | السعر | التكلفة |
|---|---|---|---|
| إدخال جديد | 540K | $10.00/M | $5.40 |
| إدخال مخزّن مؤقتًا | 2.16M | $0.25/M | $0.54 |
| الإخراج | 120K | $50.00/M | $6.00 |
| الإجمالي | ≈ $11.94 |
Kimi K3
| المكوّن | الرموز | السعر | التكلفة |
|---|---|---|---|
| إدخال جديد | 540K | $3.00/M | $1.62 |
| إدخال مخزّن مؤقتًا | 2.16M | $0.30/M | $0.65 |
| الإخراج | 120K | $15.00/M | $1.80 |
| الإجمالي | ≈ $4.07 |
GLM-5.3
| المكوّن | الرموز | السعر | التكلفة |
|---|---|---|---|
| إدخال جديد | 540K | $1.40/M | $0.76 |
| إدخال مخزّن مؤقتًا | 2.16M | $0.26/M | $0.56 |
| الإخراج | 120K | $4.40/M | $0.53 |
| الإجمالي | ≈ $1.85 |
وللعلم — GLM-5.3-Flash
| المكوّن | الرموز | السعر | التكلفة |
|---|---|---|---|
| إدخال جديد | 540K | $0.15/M | $0.08 |
| إدخال مخزّن مؤقتًا | 2.16M | $0.03/M | $0.06 |
| الإخراج | 120K | $0.50/M | $0.06 |
| الإجمالي | ≈ $0.21 |
النسب
- GLM-5.3 أرخص بـ 6.5× من Fable 5.1 للعمل نفسه
- Kimi K3 أرخص بـ 2.9× من Fable 5.1
- GLM-5.3 أرخص بـ 2.2× من Kimi K3
- GLM-5.3-Flash أرخص بـ 58× من Fable 5.1، عند 57.5 على مؤشر الذكاء مقابل 62.1 لـ Fable 5
القياس على شهر عمل
أربع مهام كهذه يوميًا، عشرون يوم عمل — 80 تشغيلًا بالوكيل:
| الطراز | تكلفة الرموز الشهرية |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
ثلاث ملاحظات صادقة على هذه الأرقام
لا تُحتسب كتابات ذاكرة التخزين المؤقت. يتقاضى Fable 5.1 مبلغ $12.50 لكل مليون مقابل كتابات ذاكرة تخزين مؤقت لمدة 5 دقائق، والجلسة الطويلة تكتب ذاكرة التخزين المؤقت مرارًا. وإدراج الكتابات يرفع رقم Fable’ الحقيقي، لا يخفضه. كما أن معدل إصابة ذاكرة التخزين المؤقت 80% متفائل أيضًا للجلسات القصيرة.
توكنات الاستدلال تُحتسب كتوكنات مخرجات مفوترة. النماذج الثلاثة كلها تفكيرها دائم التشغيل. ويُوصف GLM-5.3 تحديدًا بأنه مطوّل — 170 مليون توكن مخرجات مقابل وسيط فئة يبلغ 72 مليونًا عبر مجموعة AA — لذا فإن حجم مخرجاته في العالم الحقيقي أعلى مما يوحي به عدّ الدورات الساذج. رقم $0.68 لكل مهمة يأخذ هذا في الحسبان بالفعل، ولهذا أثق به أكثر من نموذجي أعلاه.
مُجزِّئ كلمات Fable 5.1’ ينتج توكنات أكثر بنحو 30% من نماذج Claude الأقدم للنص نفسه. إذا كنت تقارن بفاتورة Claude سابقة، فعدّل الحساب.
حتى بعد التصحيحات الثلاثة كلها، لا يتغير الترتيب ولا يتغير المقدار إلا بالكاد. العمل بنماذج الحدود المغلقة يكلّف نحو ستة أضعاف ما يكلّفه أفضل نموذج بأوزان مفتوحة، لكل مهمة مكتملة.
عرض الصورة المهمة الوكيلية نفسها من 60 دورًا بأسعار القائمة لكل بائع. المحور الرأسي هو الحجة كاملة لصالح الأوزان المفتوحة.
التراخيص: ما الذي يمنحك إياه “المفتوح” فعليًا في 2026
هذا هو القسم الذي أتمنى أن يقرأه الناس أكثر من غيره، لأن المصطلحات انحرفت انحرافًا سيئًا، وسيكلّف ذلك شخصًا ما الكثير من المال.
لا Kimi K3 ولا GLM-5.3 مفتوح المصدر. كلاهما ينشر أوزانًا قابلة للتنزيل بموجب تراخيص مُصمّمة خصيصًا بشروط تُفعَّل عند بلوغ إيرادات معينة. هذا شيء مختلف جوهريًا عن MIT أو Apache 2.0، والفرق يقع مباشرة على نوع الأعمال التي ستستفيد أكثر من غيرها من الاستضافة الذاتية.
ترخيص Kimi K3
سترى عبارة “MIT معدّل” تتكرر في كل مكان على الإنترنت بشأن K3. هذا خطأ — فذلك كان يصف K2. يصدر K3 بموجب وثيقة مخصصة فيها بوابتان متميزتان:
بوابة النموذج كخدمة. إذا منحت أطرافًا ثالثة إمكانية الوصول إلى استدلال النموذج أو الضبط الدقيق — حيث تتحكم تلك الأطراف في المدخلات أو المعاملات أو بيانات التدريب — و “إجمالي إيرادات المرخَّص له والشركات التابعة له يتجاوز 20 مليون دولار أمريكي” على مدى أي 12 شهرًا متتالية، فيجب عليك التفاوض على اتفاق تجاري منفصل مع Moonshot. لاحظ إجمالي الإيرادات، عبر جميع الشركات التابعة، وليس الإيرادات المنسوبة إلى K3. شركة استشارات يبلغ حجم أعمالها €25 مليونًا وتعيد بيع الاستدلال تتجاوز الحد حتى لو كانت أعمال الذكاء الاصطناعي مجرد أثر هامشي في الحسابات.
بوابة الإسناد. المنتجات التي تتجاوز 100 مليون مستخدم نشط شهريًا أو إيرادات شهرية بقيمة $20 مليون يجب أن تعرض “Kimi K3” بشكل بارز في واجهة المنتج.
الإعفاء الأهم: الاستخدام الداخلي البحت غير مقيّد. تشغيل K3 لدعم مطوّريك أو باحثيك أو فريقك القانوني أو إنتاجية موظفيك العامة لا يفعّل أيًا من البوابتين. وبالنسبة للغالبية الساحقة من الشركات — بما في ذلك كل أعمالي تقريبًا — هذا هو البند ذو الصلة، والجواب هو أنك بخير.
البند الجديد مقارنةً بـ K2 هو بوابة النموذج كخدمة عند $20 مليون. كان K2 يشترط الإسناد فقط فوق حدوده. ويضيف K3 بوابة إيرادات أقل بكثير تستهدف تحديدًا معيدي بيع الاستدلال التجاري. لا تحاول Moonshot منعك من استخدام النموذج؛ بل تحاول منع مزودي السحابة من بناء أعمال تجارية عليه مجانًا.
ترخيص glm-5.3
اتخذ نموذج Z.ai’ الرائد اتجاهًا مختلفًا، وهو انقطاع عن السابقة أكبر مما اعترفت به معظم التغطيات.
صدر GLM-5.2 بموجب MIT. وصدر GLM-5.3-Flash بموجب MIT. أما GLM-5.3 فلم يصدر كذلك.
يسمح الترخيص المخصص للأفراد والشركات العادية بتشغيل النموذج ونشره وضبطه ضبطًا دقيقًا دون قيود إضافية. والبوابة الوحيدة موجهة إلى عمالقة السحابة: كيانٍ “إجمالي إيرادات المرخَّص له والشركات التابعة له يتجاوز 10 مليارات دولار أمريكي (أو ما يعادلها بعملات أخرى) إجمالًا على مدى أي 12 شهرًا متتالية” يجب يجتاز مراجعة Z.AI’ الأمنية قبل استخدام النموذج أو مشتقاته لأي غرض تجاري.
هذا حد قدره $10 مليارات. وهو يستبعد الجميع تقريبًا. لكن هناك تفصيلين في الشروط الدقيقة يستحقان الانتباه:
أولًا، يستثني الترخيص صراحةً مطوّري التطبيقات الذين يدمجون النموذج في ميزات، والبائعين الذين يمررون الطلبات فقط إلى مضيفين آخرين. الهدف ضيق ومحدد بوضوح: الشركات التي تريد أن تستضيف GLM-5.3 تجاريًا على نطاق واسع.
ثانيًا — وهذا هو الجزء المحرج حقًا — لا ينشر الترخيص أي معايير أو جدول زمني أو عملية استئناف لتلك المراجعة الأمنية. بل ينص فقط على أن “نطاقها وأسلوبها… يحددهما Z.AI بشكل معقول.” إذا كنت مؤسسة كبيرة، فهذا اعتماد غير محدود على تقدير مورّد أجنبي’، وسيقول فريق المشتريات لديك ذلك.
يجدر بالذكر أيضًا: رغم تعليق القدرات السيبرانية لأسبوعين الذي سبق الإصدار، لا يتضمن الترخيص أي قيود على الاستخدام المقبول، ولا استثناءات سيبرانية، ولا ادعاءات بملكية المخرجات. شكّل القلق الأمني توقيت الإصدار، لا شروطه..
إذن ما الذي لا يزال فعليًا تحت MIT؟
GLM-5.3-Flash. 320 مليار معامل، و18 مليارًا نشطة، ومتعدد الوسائط أصليًا، ومرخّص بموجب MIT، و57.5 على مؤشر الذكاء، و$0.15/$0.50 لكل مليون توكن — حاليًا نصف ذلك بموجب خصم ترويجي يستمر حتى 9 سبتمبر 2026. إذا كان شرطك ترخيصًا متسامحًا غير مقيّد حقًا وليس مجرد أوزان قابلة للتنزيل، فهذا هو مكان الحدود حاليًا، وهو مرتفع بشكل ملحوظ.
الملخص العملي
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| الأوزان قابلة للتنزيل | نعم | نعم | نعم | لا |
| مفتوح المصدر على طريقة OSI | لا | لا | نعم (MIT) | لا |
| شرط تفعيل القيد | إيرادات $20 مليون (MaaS) | إيرادات $10 مليارات (MaaS) | لا شيء | N/A |
| الإسناد مطلوب | فوق 100 مليون MAU / $20 مليون شهريًا | إشعار حقوق النشر فقط | إشعار حقوق النشر فقط | N/A |
| الاستخدام الداخلي مقيّد | لا | لا | لا | N/A |
| الضبط الدقيق مسموح | نعم | نعم | نعم | لا |
| سياسة الاستخدام المقبول | قياسي | لا يوجد في نص الترخيص | لا شيء | تنطبق سياسة الاستخدام المقبول من Anthropic |
بالنسبة لشركة ألمانية متوسطة نموذجية، أو وكالة، أو شركة استشارات تشغّل النماذج داخليًا أو تدمجها في منتج: الخيارات المفتوحة الثلاثة كلها قابلة للاستخدام دون التفاوض على أي شيء. البوابات موجودة لالتقاط AWS، لا أنت. لكن “اقرأ الترخيص” تحوّلت من نصيحة متحذلقة إلى نصيحة فعلية، وإذا كان حجم أعمالك يتجاوز نحو €20 مليونًا وكنت تعيد بيع الاستدلال بأي شكل، فاعرض الأمر على مستشار قانوني قبل النشر.
القضية الحقيقية للنماذج المفتوحة
أريد تقديم هذه الحجة بشكل صحيح لا كشعار، لأن “النماذج المفتوحة رائعة” ليست حجة، والأسباب الفعلية أكثر إثارة للاهتمام من الهتاف.
1. انهيار الأسعار ليس دعمًا، بل هو بنيوي
الاعتراض الغريزي على النماذج الصينية الرخيصة هو أن الأسعار تُحدَّد بخسارة وستعود إلى طبيعتها صعودًا. بعضها كذلك بالتأكيد. لكن النقطة البنيوية قائمة بذاتها: عندما تكون الأوزان عامة، يتحول الاستدلال إلى سوق سلع. عشرون مزود استضافة يتنافسون لتقديم النموذج نفسه، ولا يستطيع أي منهم تقاضي علاوة قدرات لأن لا أحد منهم يملك ميزة دفاعية في القدرات. لهذا يعمل GLM-5.3 بسعر $1.40/$4.40 ويعمل Fable 5.1 بسعر $10/$50 مقابل نتائج تفصلها ثلاث نقاط.
تشمل أسعار النماذج المغلقة استهلاك R&D، والهامش، وحقيقة وجود بائع واحد فقط. وتشمل أسعار الأوزان المفتوحة الكهرباء واستهلاك العتاد وهامشًا رفيعًا. هذان عملان مختلفان، ولن تُغلق الفجوة بأن تصبح النماذج المفتوحة أغلى.
الدليل على أن هذا حقيقي لا مؤقت: استحوذ DeepSeek على نحو 17% من استخدام التوكنات على Vercel بحلول مايو 2026 مع احتفاظه بنحو 1% من حصة الإيرادات. هذا ليس شذوذًا في الأسعار. هذا ما يبدو عليه التسليع على الرسم البياني.
2. حقوق الخروج تغيّر موقفك التفاوضي حتى لو لم تمارسها أبدًا
معظم الفرق التي تقرأ هذا لن تستضيف النموذج ذاتيًا. ويشرح قسم العتاد أدناه السبب — فإن Kimi K3 يحتاج رفًا. لكن الخيار له قيمة بغض النظر.
إذا رفعت Anthropic الأسعار، أو أوقفت النموذج الذي بنيت عليه، أو غيّرت سياسة الاستخدام المقبول لديها بطريقة تكسر منتجك، أو مرّت بربع سيئ، فإن سبيلك مع نموذج مغلق هو مشروع ترحيل. أما مع نموذج بأوزان مفتوحة فسبيلك هو تنزيل ملف كان يمكنك تنزيله في أي وقت. قد لا تفعل ذلك أبدًا. وحقيقة أنك تستطيع هي ما يجعل علاقة المورّد علاقة تجارية لا علاقة اعتماد.
هذا ليس نظريًا. صدر Fable 5.1 بثلاثة تغييرات كاسرة للتوافق في 1 سبتمبر، أحدها يبطل كتل التفكير عند تحرير سجل المحادثة للحسابات المنشأة بعد 31 أغسطس. إذا كان هذا النمط أساسيًا في معماريتك، فأنت تعيد الهندسة وفق جدول Anthropic’، لا جدولك.
3. إقامة البيانات تكف عن كونها مشروعًا
بالنسبة لأي شخص يعمل بموجب GDPR، هذه هي الحجة التي تُغلق الصفقات فعليًا.
مع API مغلق، يغادر كل موجّه بنيتك التحتية. تحتاج إلى اتفاقية معالج، وتقييم أثر نقل إذا كان المعالج خارج المنطقة الاقتصادية الأوروبية، وخريطة تدفق بيانات، وإجابة لمسؤول حماية البيانات لديك عن مصير البيانات المخزنة. كل ذلك قابل للتنفيذ. وهو أيضًا أسابيع من العمل لكل مورّد، تتكرر كلما غيّر المورّد أي شيء.
مع أوزان مفتوحة على بنية تحتية تتحكم بها — عتادك الخاص، أو مضيف GPU ألماني أو أوروبي — لا تنشأ مسألة النقل عبر الحدود، لأنه لا يوجد نقل. يعمل النموذج حيث تعيش بياناتك بالفعل. وتتحول المراجعة القانونية من تقييم نقل إلى قراءة ترخيص.
بالنسبة للعملاء الألمان والأوروبيين، هذا غالبًا هو العامل الحاسم، ويجدر بك أن تكون دقيقًا بشأن التحفظ: استخدام GLM-5.3 عبر API الخاص بـ Z.ai’ لا يمنحك هذا. تحصل عليه بتشغيل الأوزان بنفسك، أو من مزوّد يستضيفها في نطاق ولايتك القضائية. الترخيص يجعل ذلك قانونيًا؛ لكنه لا يجعله تلقائيًا.
4. قابلية الفحص حقيقية، وإن كانت قليلة الاستخدام
الأوزان المفتوحة تعني أنك تستطيع فحص المعمارية، وتشغيل تقييماتك على النموذج الفعلي بدلًا من نقطة نهاية قد تُحدَّث بصمت، وتكميمه ليلائم عتادك، وضبطه ضبطًا دقيقًا على مجالك، و— الأهم — تثبيت نسخة إلى الأبد.
هذه الأخيرة أقل تقديرًا مما تستحق. تُحدَّث واجهات API المغلقة خلف معرّفات نماذج ثابتة. وينزاح السلوك. وتتوقف الموجّهات التي كانت تعمل عن العمل، ولا يمكنك مقارنة التغيير لأنك لا تراه. أما نقطة حفظ محلية فتبقى مطابقة بايتًا ببايت بعد عام’.
5. الضغط التنافسي يفيد الجميع، بمن فيهم مستخدمو النماذج المغلقة
انظر إلى ما حدث هذا الصيف. نزل Kimi K3 في يوليو بسعر $3/$15 مع نتائج قريبة من الحدود. ونزل GLM-5.3 في أغسطس بسعر $1.40/$4.40 بفارق نصف نقطة عنه. وفي 1 سبتمبر، خفّضت Anthropic قراءات ذاكرة التخزين المؤقت بنسبة 75%.
لا أدّعي سببية مباشرة — فإن Anthropic لا تنشر مبررات الأسعار لديها، وخفض قراءات ذاكرة التخزين المؤقت تحسين طبيعي. لكن سوقًا فيها بدائل رخيصة ذات مصداقية تضع أسعارًا مختلفة عن سوق بلا بدائل، وقد أصبحت البدائل ذات مصداقية هذا العام. وإذا كنت تستخدم النماذج المغلقة حصريًا، فإن منظومة الأوزان المفتوحة لا تزال تجعل فواتيرك أصغر بهدوء.
6. المكاسب في التدريب اللاحق، وهو رخيص
نتيجة GLM-5.3 الرئيسية — تحسّن بستة أضعاف في Terminal-Bench من الأوزان الأساسية نفسها — هي أهم رقم استراتيجيًا في هذا المقال كله، وهي لا تتعلق بـ GLM.
تقول إن الجزء المكلف من بناء نموذج حدودي (التدريب المسبق) أصبح على نحو متزايد مدخلًا محلولًا ومُسلَّعًا، وأن الجزء المميّز (التدريب اللاحق، وبيئات RL، وتصميم المهام طويلة الأفق) ميسور نسبيًا. لهذا تواصل أربعة مختبرات صينية بقيمة مجمعة تبلغ نحو $159 مليار مواكبة مختبرات أمريكية تُقيَّم بأضعاف ذلك. وتقدير Lambert’ هو أن المختبرات الصينية تعمل بـ“رأس مال أقل بمراتب عدة.”
بالنسبة لأي طرف لاحق في السلسلة، الدلالة مباشرة: عدد موردي النماذج الموثوقين يزداد، لا ينقص. خطط معماريتك وفقًا لذلك.
7. آثار المنظومة تتراكم
تجاوز Qwen مليار تنزيل تراكمي على Hugging Face، متجاوزًا Llama، وهو الآن يرتكز عليه أكثر من 200,000 نموذج موسوم و113,000+ مشتق — نحو 40% من جميع مشتقات LLM الجديدة على المنصة مبنية على Qwen. هذه منظومة أدوات وتكميم وضبط دقيق ونشر لا توجد إلا لأن الأوزان عامة.
أنت تستفيد من تلك المنظومة سواء ساهمت فيها أم لا. تحويلات GGUF، ونوى vLLM، ومهايئات LoRA، ووصفات التكميم، وهارنسات التقييم — كل ذلك موجود لأن آلاف الأشخاص استطاعوا الوصول إلى الأوزان الفعلية.
8. إنه حيث ذهب المطورون بالفعل
النماذج ذات الأصل الصيني عند نحو 61% من توكنات OpenRouter. وانخفضت حصة النماذج الأمريكية من نحو 70% إلى نحو 30% في عام. وأربعة من النماذج الخمسة الأكثر استخدامًا على الموجّه من أصل صيني. ونماذج MiMo من Xiaomi’ وحدها تمثل نحو 21% من التوكنات الموجّهة وحوالي 22% من إجمالي حركة البرمجة.
سلوك المطورين مؤشر قائد. كان مؤشرًا قائدًا لـ Docker، ولـ Postgres، ولـ Linux. والمراهنة ضده لها سجل تاريخي ضعيف.
…والحجة الصادقة ضد
لو كتبت القسم أعلاه فقط، لكان هذا إعلانًا.
الأوزان المفتوحة ليست مفتوحة المصدر، وانحراف المصطلحات مشكلة حقيقية. اثنان من النماذج الثلاثة هنا يصدران بموجب تراخيص مخصصة مشروطة بالإيرادات دون موافقة OSI. وبند المراجعة الأمنية في GLM-5.3’ ليس له معايير منشورة ولا عملية استئناف. وإذا كان إطار الامتثال لديك يشترط ترخيصًا معتمدًا من OSI، فالجواب الصادق أن خياراتك هي GLM-5.3-Flash، ونماذج DeepSeek’ الرائدة المرخّصة بـ MIT، وقائمة تتقلص من غيرها.
معايير قياس المورّد تبقى معايير قياس المورّد. كل رقم رئيسي نشرته Moonshot وZ.ai مُبلَّغ عنه ذاتيًا ومُنتقى ذاتيًا. وحيث قاست مجمعات محايدة، تصمد الأرقام عمومًا — وهذا في رصيد المختبرين’ حقًا — لكن “تصمد عمومًا” تؤدي عملًا في تلك الجملة.
الاستضافة الذاتية وهم بالنسبة لمعظم الفرق. Kimi K3 بحجم 1.5 TB وتوصي Moonshot بـ 64+ مسرّعًا. ويحتاج GLM-5.3 إلى 8×H200 بدقة FP8 كحد أدنى. حق الخروج حقيقي؛ لكن تكلفة ممارسته مركز بيانات.
الدعم هو ما تصنعه بنفسك. حين يتعطل Fable 5.1، هناك شركة لديها اتفاقية مستوى خدمة. وحين ينتج نشر GLM-5.3 المستضاف ذاتيًا لديك هراءً عند نافذة سياق 300K في ليلة جمعة، فلن تجد سوى تذكرة GitHub وكفاءتك أنت.
الجيوسياسة مدخل حقيقي في المشتريات. كل الخيارات الثلاثة ذات الأوزان المفتوحة التي ناقشناها هنا تأتي من مختبرات صينية. وبالنسبة لبعض العملاء — القطاع العام، والمجالات القريبة من الدفاع، وبعض الصناعات المنظّمة — يشكّل ذلك مانعًا صلبًا بغض النظر عن شروط الترخيص أو مكان تشغيل الأوزان. ليس عملي أن أخبرك إن كان هذا القلق مبررًا. عملي أن أخبرك بأنه سيظهر في الاجتماع.
لا تزال النماذج المغلقة تتصدر العمل المعرفي العام. لدى GDPval-AA v2، يسجل Fable 5.1 نتيجة 1,853 مقابل 1,769 لـ GLM-5.3’ و1,687 لـ Kimi K3’. في البرمجة اختفت الفجوة. وفي العمل المعرفي المهني الواسع لم تختفِ.
عرض الصورة أوزان قابلة للتنزيل، وثلاث مجموعات مختلفة من الشروط. GLM-5.3-Flash وحده لا يزال بترخيص MIT.
Ollama في 2026: تغيير الأسعار الذي يهم فعلًا
أصبح Ollama بهدوء أهم قطعة بنية تحتية في هذه المحادثة، وفي 31 أغسطس 2026 غيّر طريقة تحصيله للرسوم بطريقة تستحق الفهم الجيد.
ما الذي تغيّر
نقل Ollama خطط Pro وMax وTeam من الفوترة بوقت GPU إلى أسعار قياسية في الصناعة لكل توكن، مع مجموعة أرصدة استخدام مشمولة في كل خطة. السبب المعلن للشركة’ ملموس بشكل منعش: نماذج مثل Kimi K3 جعلت مقاييس وقت GPU مستحيلة التنبؤ. عندما ينشّط نموذج 104 مليار معامل وينشّط آخر 3 مليارات، تتوقف “ساعة GPU” عن معنى أي شيء بالنسبة للشخص الذي يدفع.
الخطط الجديدة
| الخطة | السعر | الاستخدام الشهري المشمول | التزامن |
|---|---|---|---|
| مجاني | $0 | رصيد شهري صغير، نماذج للمبتدئين | طلب واحد |
| Pro | $20/شهر (أو $200/سنة) | استخدام بقيمة $60 | 3 طلبات |
| Max | $100/شهر | استخدام بقيمة $300 | 10 طلبات |
| Team | $500/شهر | استخدام مشترك بقيمة $1,000، مستخدمون بلا حد | 10 طلبات |
| المؤسسات | مخصص | مخصص | مخصص |
اقرأ صف Pro مرة أخرى. $20 تشتري توكنات بقيمة $60. هذا مضاعف 3× على الاستخدام المشمول، وعندما تنفد المجموعة تستمر بالسعر المنشور نفسه لكل توكن بالضبط — لا طبقة عقوبة ولا رسوم خدمة.
ما الذي أُزيل
هذا هو الجزء الذي لاحظه المطورون فعلًا: لا إعادة ضبط كل 5 ساعات ولا سقوف أسبوعية. أي شخص اصطدم بنافذة استخدام متجددة في منتصف إعادة هيكلة سيفهم لماذا كان ذلك أهم من السعر. تتجدد المجموعة الشهرية في تاريخ اشتراكك، والأهم من ذلك، لا تُرحَّل — لذا اختر حجم خطتك لشهرك العادي، لا لأكثر شهورك انشغالًا.
الشروط المهمة للعمل مع الاتحاد الأوروبي
ثلاثة التزامات في الإعلان ذات صلة مباشرة إذا كنت تتعامل مع بيانات العملاء:
- عدم الاحتفاظ بالبيانات. لا تُسجَّل الموجّهات والردود أبدًا ولا يُدرَّب عليها.
- الاستضافة في الولايات المتحدة وأوروبا، إضافة إلى سنغافورة لمجموعة محدودة من نماذج Qwen.
- وضوح تكلفة كل طلب في حسابك — يمكنك رؤية تكلفة كل استدعاء بالضبط.
بالنسبة لشركة استشارات ألمانية، هذه قصة امتثال أفضل ماديًا مما يقدمه معظم مزودي البوابة، رغم أن “الاستضافة في أوروبا” عبارة عن بيان توجيه لا ضمان تعاقدي لإقامة البيانات. وإذا كانت الإقامة شرطًا صلبًا لا تفضيلًا، فاطلبها من Ollama كتابةً قبل أن تفترضها.
الأسعار الفعلية لكل توكن
هنا يصبح الأمر مثيرًا. ينشر Ollama أسعارًا لكل نموذج، وهي تتبع أسعار الطرف الأول عن كثب:
| النموذج على Ollama | الإدخال / 1M | المخزّن مؤقتًا / 1M | الإخراج / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
طبّق حسابات الشهر السابقة على هذا. ثمانون تشغيلًا وكيليًا شهريًا على GLM-5.3 تكلف نحو $148 من التوكنات. خطة Max بسعر $100/شهر تغطي استخدامًا بقيمة $300 — لذا فإن عبء العمل نفسه الذي سيكلف نحو $955/شهر على Fable 5.1 يتسع بسهولة داخل اشتراك Ollama بقيمة $100 مع هامش إضافي.
هذه هي الحجة الاقتصادية كاملة للنماذج المفتوحة مضغوطة في سطر واحد على فاتورة.
عرض الصورة ثمانون تشغيلًا وكيليًا شهريًا على GLM-5.3 تتسع داخل خطة Ollama Max بقيمة $100 مع متبقٍّ. والعمل نفسه على Fable 5.1 فاتورة بقيمة $955.
ماذا أصدرت Ollama أيضًا في 2026
لم يحدث تغيير الأسعار بمعزل عن غيره. كانت الأشهر القليلة الماضية حافلة:
- 25 أغسطس — دعم Claude Desktop. تعمل Ollama الآن مزود بوابة طرف ثالث لـ Claude Desktop، فيمكنك تشغيل النماذج المفتوحة عبر عميل Anthropic’ نفسه.
- 26 أغسطس — v0.33.0. وصل تكامل بوابة Claude Desktop، واستُعيد استرجاع التعبئة المسبقة إلى ذاكرة التخزين المؤقت، وعطّلت Ollama رسالة النظام الخاصة بالعد التنازلي للتوكنات في Claude Code’، التي كانت تبطل ذاكرة KV المؤقتة في كل دورة. هذه الأخيرة إصلاح أداء هادئ لكن مهم.
- 26 أغسطس — v0.33.1. دعم MLX لـ Qwen3.8 Flash Next، ومخرجات منظمة، وإصلاح لمهلات GPU عند تحميل النماذج من تخزين أبطأ.
- 28 أغسطس — v0.33.2. استُعيد الوضع الداكن، وأُصلح Handoff في macOS، وأُبقيت طلبات وكيل Claude Desktop حية أثناء تحديثات كتالوج النماذج.
- 20 أغسطس — v0.32.15. إعداد أولي جديد لسطح المكتب، وتخزين مؤقت للبيانات الوصفية بين الطلبات خفض زمن الوصول إلى أول توكن إلى النصف تقريبًا.
- 11 أغسطس — NVIDIA Nemotron 3.5 Lightning، نموذج 30B مضبوط لسير عمل وكيلي مع استدعاء الأدوات على عتاد شخصي.
- 10 أغسطس — Muse Glimmer من Meta، نموذج متعدد الوسائط بحجم 30B تحت Apache 2.0، مسرَّع بمحرك MLX من Ollama. ويجدر الذكر نظرًا لانهيار Llama في الاستخدام الموجَّه — فلا تزال Meta تُطلق أوزانًا متسامحة بحق.
- 9 يوليو — جولة تمويل بقيمة 88 مليون دولار، مع إعلان Ollama عن 8.9 مليون مطوّر.
- 29 يونيو — Gemma 4 على MLX أسرع بنسبة تصل إلى 90% عبر التنبؤ متعدد الرموز، وهو ما يفيد وكلاء البرمجة على Apple Silicon بشكل غير متناسب.
- 5 يونيو — أضاف الإصدار v0.30 توافقًا مع GGUF عبر llama.cpp، مما يوسّع دعم العتاد إلى ما هو أبعد بكثير من Apple Silicon.
الخط العام هو أن Ollama لم تعد “الطريقة السهلة لتشغيل نموذج صغير على حاسوبك المحمول” بل أصبحت بوابة عامة الغرض تشغّل النماذج محليًا أيضًا. وتشمل قائمة الخدمة السحابية الآن kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 عبر سبعة أحجام، gpt-oss بأحجام 20b و120b، gemma4، وعائلة Nemotron 3 و mistral-large-3.
إعداد كل شيء: إعدادات جاهزة للنسخ واللصق
Ollama + Claude Code (أسرع طريق)
توفّر Ollama مشغّلًا بأمر واحد يتولى ربط البيئة عنك:
bash
ollama launch claudeإذا كنت تفضّل القيام بذلك يدويًا — وينبغي لك ذلك إن كنت تكتب سكربتًا — فثبّت Claude Code أولًا:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
ثم وجّهه إلى Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
وشغّله على النموذج الذي تريده:
bash
# A local model
claude --model qwen3.5

# A cloud model — note the :cloud suffix
claude --model kimi-k3:cloud
أو مباشرةً في السطر، دون تصدير أي شيء على مستوى النظام:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
أمران سيؤذيانك.
أولًا، لا تصدّر ANTHROPIC_BASE_URL بشكل دائم في ملف تعريف shell الخاص بك. إنه متغير عام وسيعيد توجيه كل أداة تتحدث لغة Anthropic على جهازك إلى Ollama بهدوء، بما فيها تلك التي أردتها أن تتحدث إلى Anthropic. فحدّد نطاقه لكل مشروع أو لكل استدعاء.
ثانيًا، اضبط طول السياق على 64k أو أكثر لأي عمل على مستودع حقيقي. القيمة الافتراضية في Ollama أصغر، ووكيل البرمجة الذي تنفد منه نافذة السياق بهدوء سيبدأ في نسيان الأشياء بدلًا من إظهار خطأ.
لتشغيلات CI أو Docker أو التشغيلات النصية، --yes يتخطى المطالبات التفاعلية:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "how does this repository work?"GLM-5.3 مباشرةً من Z.ai
إذا أردت توجيهًا من الجهة الأولى بدلًا من المرور عبر Ollama، فإن Z.ai تتيح ثلاث نقاط نهاية بروتوكولية:
| البروتوكول | عنوان URL الأساسي |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
كتلة موفّر OpenCode خاصة بـ GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3": {
          "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
          "options": { "reasoning_effort": "high", "temperature": 1 }
        }
      }
    }
  },
  "model": "zai/glm-5.3"
}
ملاحظة مهمة عند الترقية: يتطلب GLM-5.3 تفعيل الاستدلال. إذا كانت إعداداتك الحالية تضبط thinking.type: "disabled"، فسيفشل ذلك الآن. غيّره إلى "enabled" واضبط reasoning_effort: "low" إذا أردت استعادة ملف زمن الاستجابة القديم.
reasoning_effort هو مقبضك الرئيسي للموازنة بين الجودة والتكلفة: منخفض للاستدعاءات الحساسة لزمن الاستجابة، مرتفع للأعمال الجوهرية، أقصى (الافتراضي) للمشكلات التي هزمت فعلًا مرتفع. ونظرًا للإسهاب الموثّق، كنت سأشغّل مرتفع كإعداد يومي بدلًا من تركه أقصى مفعّلًا والتساؤل أين ذهبت رموز المخرجات.
إعداد التوجيه الذي سأوصي به فعلًا
لا شيء من هذا قرار “اختر واحدًا”. الإجابة الصحيحة لمعظم الفرق هي جدول توجيه من ثلاث طبقات، وكل هارنس وكلاء جدّي يدعم نماذج لكل وكيل.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
      "description": "Architecture, root-cause analysis, anything expensive to get wrong",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation work",
      "model": "zai/glm-5.3",
      "options": { "reasoning_effort": "high" }
    },
    "research": {
      "description": "Long-context reading, web research, multi-source synthesis",
      "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
      "description": "Renames, docstrings, test scaffolding, lint fixes",
      "model": "ollama/glm-5.3-flash"
    }
  }
}
المنطق وراء كل سطر:
- التخطيط يحصل على Fable 5.1. التخطيط هو المكان الذي يكلفك فيه القرار السيئ أكبر عدد من الرموز اللاحقة، والاتساق بعيد المدى هو بالضبط ما بُني 5.1 من أجله. وهو أيضًا المكان الذي تنفق فيه أقل عدد من الرموز، لذا ينطبق فرق السعر على أصغر شريحة من فاتورتك.
- البناء يحصل على GLM-5.3. أفضل قدرة لكل يورو في السوق، والجزء الأكبر من إنفاقك على الرموز يقع هنا.
- البحث يحصل على Kimi K3. نتيجة 91.2 في BrowseComp ونافذة سياق حقيقية بحجم 1M تجعلانه أفضل خيار متاح لقراءة الكثير من الأشياء وتجميعها.
- الأعمال الميكانيكية تحصل على GLM-5.3-Flash. بسعر $0.15/$0.50 يكون مجانيًا عمليًا، وإعادة تسمية رمز واحد في 40 ملفًا لا تحتاج استدلالًا من الطراز الأول.
small_modelيحصل على شيء صغير جدًا لأعمال الصيانة الداخلية للهارنس — توليد العناوين، والتلخيص، واستدعاءات الأدوات الداخلية.
أنت لا تختار فائزًا. أنت تبني صندوق تروس. واكتب معرّفات النماذج بحيث يكون استبدال أحدها تغييرًا في سطر واحد، لأنك في هذا السوق ستجري ذلك التغيير مرة أخرى خلال الربع.
ما يمكنك تشغيله محليًا فعليًا (واقع العتاد)
دعني أقتل افتراضًا قبل أن يكلف أحدًا مالًا.
لا يمكنك تشغيل Kimi K3 أو GLM-5.3 على محطة عمل. لا ببطاقة 5090. ولا ببطاقتين.
Kimi K3
- ~1.5 TB من الأوزان بصيغة MXFP4 الأصلية — وتذكّر أن ذلك هو نقطة حفظ مُكمَّمة، وليس نقطة انطلاق لضغط إضافي
- توصي Moonshot بـ 64 مسرّعًا على الأقل لخدمة تنافسية
- الاستضافة الذاتية الواقعية تبدأ من عناقيد متعددة العقد؛ ونشرات المرجع تستخدم رفوف GB300 NVL72
- لا يوجد أي إدخال رسمي في مكتبة Ollama لـ Kimi K3 المحلي، ولا تحويل GGUF موجّه للمستهلكين يستحق أن أرشدك إليه
- توجد تقارير عن تشغيله على عناقيد من بطاقات RTX 5090 الاستهلاكية، لكن “عنقود من بطاقات 5090” ليس حاسوبًا محمولًا والإنتاجية غير قابلة للمقارنة
GLM-5.3
- ~1.5 TB بصيغة BF16، أي نحو 750 GB بصيغة FP8
- أدنى عقدة واحدة قابلة للعمل: 8× H200 (1,128 GB من ذاكرة GPU) بصيغة FP8، مع ترك نحو 375 GB لذاكرة KV cache
- تتطلب BF16 عقدتين من 8×H200، أو عقدة واحدة 8×B300 (2,304 GB)
- عقدة واحدة من 8×H200 بصيغة BF16 أصغر من أن تتسع للأوزان مع الذاكرة المؤقتة
عرض الصورة نماذج الحدود المفتوحة تحتاج رفًا. فئة 24 GB هي حيث يعيش “يعمل على جهازي” فعليًا — وقد أصبحت جيدة جدًا.
إذن ماذا يعني “الذكاء الاصطناعي المحلي” فعليًا في سبتمبر 2026؟
إنه يعني فئة مختلفة من النماذج، وقد أصبحت تلك الفئة جيدة بحق:
| الطراز | VRAM | الغرض منه |
|---|---|---|
| Qwen3.8-27B | 24 GB بدقة Q4 | الأفضل في كل المهام على عتاد المستهلكين — 61.7% في SWE-bench |
| gpt-oss:20b | 16 GB | أفضل نموذج صغير، بجهد استدلال قابل للتعديل |
| Gemma 4 E4B | ~6 GB | الرؤية مع استدعاء الأدوات على حاسوب محمول حديث |
| Mistral 7B | 8 GB | أسرع خيار عام الغرض، 40–60 رمزًا/ثانية |
| DeepSeek-R1 7B | 5 GB | استدلال بسلسلة التفكير على GPU حاسوب محمول |
| Llama 4 Scout | ~55 GB بدقة Q4 | سياق 10M، متعدد الوسائط — أرض محطات العمل |
نموذج Qwen3.8-27B يسجّل 61.7% في SWE-bench، ويعمل بالكامل على GPU استهلاكية بسعة 24 GB دون أي اتصال بالشبكة، أمر لافت كان سيبدو خيالًا علميًا قبل ثمانية عشر شهرًا. إنه ليس GLM-5.3 ولا يدّعي أنه كذلك.
الصياغة الصادقة: الأوزان المفتوحة عند الحدود تشتري لك السيادة والسعر، لا التنفيذ المحلي. الأوزان المفتوحة في نطاق 7B–30B تشتري لك تنفيذًا محليًا حقيقيًا، بتكلفة قدرة حقيقية لكنها مقبولة، وتلك هي الفئة التي يكون فيها “يعمل على جهازي، ولا يرى الشبكة” متطلبًا قابلًا للتحقيق.
البنية التي تنجح مع معظم عملائي هي هذا التقسيم بالضبط: نموذج محلي صغير لأي شيء يمس بيانات حساسة فعلًا، ونموذج حدودي مفتوح الأوزان مستضاف لكل ما تبقى — مع إتاحة الأوزان كتأمين لا كخطة نشر.
أين ينكسر كل طراز فعليًا
بلا مبالغة. هذه هي نقاط الضعف بصدق.
نقاط ضعف Kimi K3
إنه مكلف بالنسبة لنموذج مفتوح. سعر $3/$15 يعادل 2.1× سعر الإدخال لدى GLM-5.3 و3.4× سعر الإخراج تقريبًا لنفس نتيجة مؤشر الذكاء. إذا كنت تختار K3 بدلًا من GLM-5.3، فكن واضحًا بشأن ما تشتريه بهذا الفارق — غالبًا منظومة الرؤية أو أداء التصفح.
الترخيص يفرض عتبة أدنى. عتبة إجمالي إيرادات بقيمة $20M لخدمات MaaS تشمل عددًا أكبر بكثير من المؤسسات مقارنة بعتبة $10B لدى GLM-5.3. إذا كان إعادة بيع الاستدلال موجودًا في أي مكان من نموذج عملك، فإن K3 هو الأكثر تقييدًا بين الاثنين.
الاستضافة الذاتية خارج متناول الجميع تقريبًا. 1.5 TB و64 مسرّعًا أو أكثر التزام بنيوي جدي. وحق الخروج هنا نظري أكثر منه مع أي نموذج آخر في هذه المقارنة.
أعمال المعرفة الواسعة متأخرة. نتيجة 1,687 في GDPval-AA v2 تضعه خلف GLM-5.3 وخلف كلا نموذجي Claude Fable وGPT-5.6 Sol Max. إنه متخصص في البرمجة والعمل الوكيلي، ويصادف أنه ضخم.
نقاط ضعف GLM-5.3
نص فقط. لا إدخال صور ولا فيديو. إذا كان سير عملك يتضمن تصحيح الأخطاء من لقطات الشاشة، أو التحويل من التصميم إلى الكود، أو رؤية المستندات، فإن GLM-5.3 لا يستطيع ذلك ببساطة وتحتاج بدلًا منه إلى GLM-5.3-Flash أو Kimi K3 أو Fable 5.1. هذا هو خطأ الإعداد الأكثر شيوعًا الذي أتوقع أن يقع فيه الناس، لأن معرّفات النماذج تبدو مترابطة وليست كذلك.
إنه مسهب، والإسهاب يُحتسب في الفاتورة. 170M رمز إخراج مقابل وسيط فئة 72M عبر مجموعة AA. reasoning_effort يفترض افتراضيًا أقصى، ولا يمكن إيقاف التفكير. فخطّط لرموز إخراج أكثر مما يوحي به عدد أدوارك.
الترخيص لم يعد MIT، وبند المراجعة الأمنية غير محدود. بالنسبة لمعظم القراء تجعل عتبة $10B هذا الأمر نظريًا. أما من يقترب منها، فإن “يُحدَّد النطاق والمنهج بشكل معقول من قبل Z.AI” ليس بندًا سيستمتع به فريقك القانوني.
نتيجة 28.3 في Terminal-Bench 3.0 تتأخر عن 34.6 لدى GPT-5.6 Sol. في المعيار الأقرب تحديدًا إلى البرمجة الوكيلية الأصلية في الطرفية، إنه خلف المنافسة المغلقة على المسطرة نفسها.
إنه جديد على الأوزان المفتوحة. صدر في 28 أغسطس. لم تحصل المجتمع إلا على أيام، لا أشهر. ولم تظهر بعد أخطاء النشر ذات الذيل الطويل.
نقاط ضعف Claude Fable 5.1
السعر. نحو 6.5× سعر GLM-5.3 لكل مهمة وكيلية مكتملة، حتى بعد خفض قراءة الذاكرة المؤقتة بنسبة 75%. ولمعظم الأعمال لم يعد هذا الفارق قابلًا للتبرير على أساس القدرة.
ثلاثة تغييرات كاسرة. استخدام الأدوات القسري يعيد 400. كتل التفكير لا تنتقل بالعكس إلى النماذج الأقدم. وتحرير سجل المحادثة يُبطل كتل التفكير في الحسابات المنشأة بعد 31 أغسطس 2026. وأي من هذه قد يكسر تكاملًا عاملًا عند الترقية.
تراجع استدعاء الأدوات المتوازي. تقارير عن استدعاء واحد لكل دور حيث كان Fable 5 يجمع عدة استدعاءات. وفي حلقة وكيل طويلة يعني ذلك وقتًا حقيقيًا تدفع ثمنه مرتين.
انعدام خيار الخروج. لا أوزان، ولا استضافة ذاتية، ولا تثبيت إصدار يتجاوز ما تقدمه Anthropic، ولا فحص. وعندما يتغير، تتكيف.
المُرمِّز يضخّم المقارنات. رموز أكثر بنحو 30% من نماذج Claude الأقدم للنص نفسه، مما يجعل مقارنات التكلفة التاريخية مضللة لصالح Anthropic إن لم تكن حذرًا.
إطار القرار: ستة سيناريوهات
عرض الصورة ستة سيناريوهات، ست إجابات. اعثر على الصف الذي يشبه أسبوعك.
1. “أريد نموذجًا واحدًا. أضبطه وأنساه وأبقي الفاتورة معقولة.”
GLM-5.3. على بُعد نصف نقطة من Kimi K3 ونحو ثلاث نقاط من أفضل نموذج مغلق على المؤشر المحايد، بسعر $1.40/$4.40. شغّله عبر Ollama على خطة Pro أو Max، واضبط reasoning_effort: high، ثم تابع عملك. والشيء الوحيد الذي يجب أن يدفعك بعيدًا عن هذه الإجابة هو حاجتك إلى إدخال الصور.
2. “عملي بصري — واجهات المستخدم، والتحويل من التصميم إلى الكود، وتصحيح الأخطاء من لقطات الشاشة، والمستندات.”
Kimi K3 أو GLM-5.3-Flash، لا GLM-5.3. يعالج MoonViT-V2 في K3 النصوص والصور والفيديو أصالةً ويسجّل 81.6/83.4 في MMMU-Pro. وGLM-5.3-Flash هو الخيار الاقتصادي بتعدد وسائط أصلي وترخيص MIT. أما GLM-5.3 فنصي فقط وسيرفض الإدخال ببساطة.
3. “جلسات مستقلة طويلة يكون فيها الخطأ مكلفًا.”
Claude Fable 5.1. هذا ما بُني من أجله، والمعايير تؤكد ذلك: تضاعفت نتيجة Terminal-Bench-Science، و82% في أصعب مهام استخدام الحاسوب لدى Browserbase مقابل 74% لـ Opus 5، وأكبر المكاسب المنشورة في العمل الوكيلي الممتد ساعات. وخفض قراءة الذاكرة المؤقتة بنسبة 75% يجعل هذا العبء بالضبط أرخص بنسبة تصل إلى 45% مما كان. ادفع الفارق حيث يكون الخطأ أغلى من الرموز.
4. “إقامة البيانات في الاتحاد الأوروبي متطلب صارم.”
GLM-5.3-Flash إذا كنت تحتاج MIT، وGLM-5.3 إذا كنت تحتاج القدرة. استضف ذاتيًا على عتادك أو لدى مزوّد GPU في الاتحاد الأوروبي، فتختفي مسألة النقل عبر الحدود. وخطّط لـ 8×H200 من أجل GLM-5.3 بصيغة FP8؛ أما Flash فهو أسهل بكثير عند 320B/18B. وإذا كانت الاستضافة الذاتية خارج الميزانية، فإن استضافة Ollama في أوروبا مع عدم الاحتفاظ بالبيانات هي الحل الوسط العملي — لكن احصل على التزام الإقامة كتابةً بدلًا من استنتاجه من صفحة تسويقية.
5. “فريق صغير، ميزانية ضيقة، وبرمجة طوال اليوم.”
GLM-5.3-Flash كخيار افتراضي، وGLM-5.3 للمشكلات الصعبة، وOllama Pro بسعر $20. يكلّف Flash سعر $0.15/$0.50 — ونصف ذلك حاليًا حتى 9 سبتمبر — ويسجّل 57.5 على مؤشر الذكاء. عشرون دولارًا تشتري ستين دولارًا من الرموز دون حدود أسبوعية. ولفريق من شخصين إلى أربعة يكاد هذا يكون غير قابل للمنافسة. وخطة GLM Coding بسعر $18 شهريًا (Lite) هي البديل إذا كنت تفضّل حصة ثابتة على رصيد متغيّر.
6. “أحتاج إلى تبرير هذا لفريق المشتريات أو الفريق القانوني.”
GLM-5.3-Flash. إنه النموذج الوحيد في هذه المقارنة تحت ترخيص معياري معتمد من OSI (MIT)، وهو متعدد الوسائط أصالةً، ويسجّل 57.5 على المؤشر المحايد، والأوزان على Hugging Face بلا بوابات إيرادات ولا شروط إسناد ولا بند مراجعة أمنية. وحين يكون السؤال “ما الذي يمكننا الدفاع عنه في مراجعة عقد،” فإن الترخيص المتسامح يتغلب على ثلاث نقاط في المعيار كل مرة.
ما سأراقبه خلال الربع القادم
هل تستقر Fable 5.1 فوق 62.1 على مؤشر Artificial Analysis. أُطلق في اليوم السابق لهذا المقال ولم يُقيَّم بشكل مستقل. وفروق نتائجه عن Fable 5 تشير إلى أنه ينبغي أن يكون كذلك، لكن “ينبغي” ليست “كان،” والفجوة إلى 59.7 لدى Kimi K3 هي الرقم الذي تدور عليه حجة المفتوح مقابل المغلق بأكملها.
هل يستمر انحراف الترخيص. في ثمانية أسابيع انتقلنا من GLM-5.2 تحت MIT إلى GLM-5.3 تحت ترخيص مخصص مع مراجعة أمنية تقديرية، ومن MIT المعدّل في Kimi K2 إلى شروط K3 المقيدة بالإيرادات. وإذا زاد GLM-6 وK4 تشديدًا، فسيصبح “الأوزان المفتوحة” مصطلحًا تسويقيًا لا فئة ذات معنى. وبقاء GLM-5.3-Flash على MIT هو الإشارة المضادة التي تستحق المتابعة.
هل تتبنى مختبرات أخرى نمط الإصدار المرحلي لدى Z.ai. تأخير لأسبوعين مع نشر مبرر السلامة هو عُرف جديد. فإن استمر، فهو عُرف جيد. وإن أصبح ذريعة لتأخير شحن الأوزان أكثر وأكثر، فهو مسار ناعم إلى عدم شحنها إطلاقًا.
تكرار مستقل لمزاعم القدرات السيبرانية. 2,436 ثغرة في 269 مشروعًا رقم استثنائي، وهو مُبلَّغ ذاتيًا بالكامل. ويحتاج طرف محايد إلى التحقق منه، لأن صحته تعيد تأطير محادثة السلامة الخاصة بالأوزان المفتوحة بأكملها، وإن لم يكن صحيحًا فقد كان تسويقًا فعالًا.
أسعار Ollama لكل رمز بعد ستة أشهر. عشرون دولارًا مقابل استخدام بقيمة ستين دولارًا موقف تمهيدي هجومي من شركة جمعت 88 مليون دولار في يوليو. وما إذا كانت هذه المضاعفات ستصمد أمام اقتصاديات الوحدة الحقيقية هو المتغير الأكبر في أطروحة “النماذج المفتوحة الرخيصة” للفرق الصغيرة.
هل تقترب النماذج المحلية في فئة 30B. نتيجة Qwen3.8-27B البالغة 61.7% في SWE-bench على 24 GB هي أكثر نتيجة لم تُناقش بما يكفي هذا العام. الحدود تحصل على العناوين؛ وفئة 24 GB هي التي تغيّر ما يمكن لشركة عادية فعله دون مفتاح API.
الأسئلة الشائعة
هل Kimi K3 مفتوح المصدر حقًا؟ لا. أوزان Kimi K3 قابلة للتنزيل مجانًا من Hugging Face، لكن بموجب ترخيص مخصص هو “Kimi K3 License،” لا ترخيص مفتوح المصدر معتمد من OSI. ومشغّلو النماذج كخدمة الذين تتجاوز إيراداتهم الإجمالية 20 مليون دولار خلال أي 12 شهرًا متتالية عليهم التفاوض على اتفاق تجاري منفصل مع Moonshot، والمنتجات التي يتجاوز عدد مستخدميها النشطين شهريًا 100 مليون أو إيراداتها الشهرية 20 مليون دولار يجب أن تعرض “Kimi K3” في واجهتها. أما الاستخدام الداخلي البحت فغير مقيّد.
هل GLM-5.3 أفضل من Kimi K3؟ إنهما متعادلان فعليًا على المؤشر التجميعي المحايد — 59.5 مقابل 59.7 على Artificial Analysis. وGLM-5.3 أرخص بـ 2.2× لكل مهمة وكيلية ويسجّل أعلى في أعمال المعرفة (GDPval-AA v2: 1,769 مقابل 1,687). أما Kimi K3 فهو متعدد الوسائط أصالةً، ويتقدم في التصفح الوكيلي (BrowseComp 91.2) وحلّ أولًا في ساحة كود الواجهات الأمامية لدى Arena.AI. اختر GLM-5.3 للتكلفة والبرمجة النصية؛ وKimi K3 للرؤية والتصفح والبحث بعيد المدى.
كم هي أرخص النماذج المفتوحة من Claude Fable 5.1؟ في مهمة وكيلية مُنمذجة من 60 دورًا، يكلّف GLM-5.3 نحو $1.85 مقابل $11.94 لـ Fable 5.1 — أرخص بنحو 6.5×. ويكلّف Kimi K3 نحو $4.07، أرخص بنحو 2.9×. ويكلّف GLM-5.3-Flash نحو $0.21، أرخص بنحو 58×. وعلى 80 تشغيلًا شهريًا يكون ذلك $148 مقابل $955.
هل يمكنني تشغيل Kimi K3 أو GLM-5.3 محليًا؟ ليس على عتاد المستهلكين. فـ Kimi K3 يبلغ نحو 1.5 TB حتى بصيغته الأصلية MXFP4 وتوصي Moonshot بـ 64 مسرّعًا أو أكثر. ويحتاج GLM-5.3 إلى 8×H200 (1,128 GB) على الأقل بصيغة FP8. وللتنفيذ المحلي الحقيقي، انظر إلى Qwen3.8-27B (24 GB بدقة Q4) أو gpt-oss:20b (16 GB) أو Gemma 4 E4B (~6 GB).
ما الذي تغيّر في Claude Fable 5.1؟ صدر في 1 سبتمبر 2026. انخفضت قراءة الذاكرة المؤقتة بنسبة 75% من $1.00 إلى $0.25 لكل مليون رمز، مما جعل أحمال العمل النموذجية أرخص بنحو 25% والأحمال الوكيلية أرخص بنسبة تصل إلى 45%؛ وبقي الإدخال والإخراج عند $10/$50. وارتفعت Terminal-Bench 4.0 من 42.0% إلى 55.8%، وTerminal-Bench-Science من 24.7% إلى 52.6%، وAutomationBench من 17.1% إلى 31.4%. وتؤثر ثلاثة تغييرات كاسرة على استخدام الأدوات القسري وقابلية نقل كتل التفكير وتحرير السجل.
ما هي أسعار Ollama الجديدة؟ اعتبارًا من 31 أغسطس 2026، تستخدم خطط Pro وMax وTeam تسعيرًا لكل توكن مع أرصدة مضمنة: Pro 20 دولارًا شهريًا مقابل استخدام بقيمة 60 دولارًا، وMax 100 دولار مقابل 300 دولار، وTeam 500 دولار مقابل 1,000 دولار مشتركة بين عدد غير محدود من المستخدمين. أُلغيت حدود الـ 5 ساعات والحدود الأسبوعية تمامًا، ولا توجد رسوم خدمة، ولا تُرحَّل الأرصدة إلى الفترة التالية، وتأتي جميع الخطط باحتفاظ صفري بالبيانات مع استضافة في الولايات المتحدة وأوروبا.
أي من هذه النماذج مرخّص فعليًا بـ MIT؟ GLM-5.3-Flash فقط — وهو نموذج منفصل بحجم 320B/18B متعدد الوسائط أصالةً صدر في 26 أغسطس 2026، ويسجّل 57.5 على مؤشر Artificial Analysis بسعر $0.15/$0.50 لكل مليون رمز. أما GLM-5.3 وKimi K3 فيستخدمان تراخيص مخصصة مقيدة بالإيرادات؛ وClaude Fable 5.1 مملوك بالكامل.
لماذا لا يمكنني مقارنة هذه النماذج على Terminal-Bench؟ لأن كلًا منها قُيِّم على إصدار مختلف. فنتيجة 88.3 لـ Kimi K3 على Terminal-Bench 2.1، و28.3 لـ GLM-5.3 على 3.0، و55.8 لـ Fable 5.1 على 4.0. وكل إصدار أصعب جوهريًا من سابقه، لذا فالأرقام ليست على المقياس نفسه. قارن داخل الإصدار نفسه فقط. على Terminal-Bench 2.1 مثلًا يسجّل Kimi K3 88.3 مقابل 88.0 لـ Claude Fable 5 و88.8 لـ GPT-5.6 Sol و84.3 لـ GLM-5.3-Flash — تلك المقارنة صحيحة، وهي التي تستحق الاقتباس.
هل أستخدم Ollama أم أتوجّه مباشرة إلى المورّد؟ استخدم Ollama إذا أردت علاقة فوترة واحدة وسطح API واحدًا وتبديلًا سهلًا بين النماذج واستضافة في الاتحاد الأوروبي أو الولايات المتحدة مع عدم الاحتفاظ بالبيانات — فأسعارها لكل رمز تتبع أسعار الطرف الأول عن قرب. واتجه مباشرةً إذا احتجت ميزات الطرف الأول مثل reasoning_effort الضوابط بكامل دقتها، أو اتفاقيات مستوى الخدمة من المورّد، أو خطط اشتراك مثل GLM Coding Plan. كثير من الفرق تشغّل الاثنين وتوزّع الطلبات حسب عبء العمل.
هل يدعم GLM-5.3 الصور؟ لا. GLM-5.3 نصّي فقط. أما GLM-5.3-Flash — وهو نموذج مختلف تمامًا رغم تشابه الاسم — فهو متعدد الوسائط أصالةً ويتعامل مع النص والصورة والفيديو وإدخال الملفات. وإرسال الصور إلى معرّف النموذج الخطأ هو أكثر أخطاء البداية شيوعًا في عائلة GLM.
الخلاصة
قبل اثني عشر شهرًا كان السؤال حول الأوزان المفتوحة هو ما إذا كانت هذه النماذج قابلة للاستخدام. وقبل ستة أشهر كان السؤال ما إذا كانت منافسة. وفي سبتمبر 2026 صار السؤال حقًا: ما الذي ما زلت تدفع مقابله علاوة النموذج المغلق؟
هناك إجابة حقيقية عن هذا السؤال، وهي أضيق مما كانت عليه. يتصدّر Claude Fable 5.1 أصعب الأعمال الوكيلة الممتدة، والعمل المعرفي العام، ونوع التنقيح الذي يحتاج فيه النموذج إلى إبقاء مشكلة معقّدة في ذهنه ساعات دون أن ينحرف. وخفض Anthropic لقراءات الذاكرة المؤقتة بنسبة 75% يستهدف هذا العبء بالضبط. إذا كانت كلفة خطئك تتجاوز كلفة الرموز، فالعلاوة منطقية.
أما في كل ما عدا ذلك، فقد تغيّرت الحسابات. يقدّم GLM-5.3 نسبة 94% من نتيجة Claude Opus 5 في المؤشر مقابل 29% من الكلفة. ويسجّل Kimi K3 نتيجة 88.3 في Terminal-Bench 2.1 مقابل 88.0 لـ Claude Fable 5 في الإصدار نفسه، وقد حلّ أولًا في Frontend Code Arena من LMArena متقدّمًا على النموذجين المغلقين الرائدين. وسيبيعك Ollama رموزًا بقيمة $60 مقابل $20، ويزيل حدود الاستخدام أثناء ذلك. هذا المزيج لم يكن موجودًا في الربيع.
لكن لا تدع الحماس يجعلك تتجاوز التفاصيل الدقيقة، فهناك تفصيلان وكلاهما مهم.
الأول هو الترخيص. لم يعد “الأوزان المفتوحة” و“المفتوح المصدر” يعنيان الشيء نفسه بصمت. فـ Kimi K3 و GLM-5.3 يصدران بتراخيص مُخصّصة مشروطة بالإيرادات. والعتبات مرتفعة بما يكفي ألّا يتأثر معظم القراء — لكن “معظم القراء لا يتأثرون” ليس مثل “بلا قيود”، وبند المراجعة الأمنية غير المحدّد في GLM-5.3 خطر مشتريات حقيقي للمؤسسات الكبيرة. و GLM-5.3-Flash بترخيص MIT هو آخر خيار قريب من الحدود يتمتع بسماحية كاملة، ولهذا بالضبط يستحق اهتمامًا أكبر مما يحصل عليه.
والثاني هو أن الاستضافة الذاتية أقرب إلى الطموح منها إلى الواقع. 1.5 TB من الأوزان و64 مسرّعًا ليست خطة خروج لشركة متوسطة الحجم. ما تشتريه الأوزان المفتوحة في هذه الفئة هو سوق استدلال تنافسي، وشفافية في الأسعار، وتثبيت للإصدارات، واختيار للولاية القضائية، وموقع تفاوضي. هذه أشياء قيمتها كبيرة. لكنها ليست مثل تشغيل النموذج في قبو منزلك.
الترتيب الذي كنت سأبنيه فعلًا: GLM-5.3 كخيار افتراضي، و Fable 5.1 في التخطيط والمشكلات الصعبة فعلًا، و Kimi K3 للرؤية والأبحاث طويلة المدى، و GLM-5.3-Flash للأعمال الشاقة الروتينية، ونموذج محلي بحجم 27B لكل ما يجب ألّا يخرج من المبنى أبدًا. وزّع الطلبات حسب عبء العمل، لا حسب الولاء. واكتب إعداداتك بحيث يكون تغيير معرّفات النماذج سطرًا واحدًا.
لأن التوقّع الوحيد الذي أثق به هو أن هذا المقال سيحتاج إلى تحديث قبل عيد الميلاد.
هل تشغّل أيًا من هذه الثلاثة في بيئة الإنتاج؟ يهمّني خصوصًا ما إذا كان إسهاب GLM-5.3 يظهر كمشكلة كلفة حقيقية على نطاق واسع، وما إذا كان أحد قد وضع ترخيص Kimi K3 فعلًا أمام مستشار قانوني وحصل على قراءة واضحة لتعريف MaaS. تواصل معي — التصحيحات والأدلة المضادة مرحّب بها، وسيُحدَّث هذا المقال عندما تتغيّر الصورة.
آخر تحديث: 2 سبتمبر 2026.


