العربية
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 हिन्दी

جدول المحتويات
- باختصار — الحكم
- أولًا: أجل، هذه الشريحة حقيقية
- مشكلة السعر (إصدار 2026)
- لماذا 64GB تحديدًا؟ حجة النقطة المثلى
- الخطوة 1: حرّر ذاكرتك (افعل هذا أولًا)
- الخطوة 2: ابنِ حزمتك
- الجزء 1: تشغيل LLM
- الجزء 2: توليد الصور
- الجزء 3: توليد الفيديو — القسم الصريح
- الجزء 4: سير عمل حقيقية تستحق البناء
- العيش معه: الحرارة والبطارية والضوضاء
- الحجج المضادة الصريحة
- حسابات التكلفة: المحلي مقابل السحابة
- دليل الشراء
- الأسئلة الشائعة
- ما يأتي بعد ذلك
- الخلاصة
هناك تكوين معيّن من Mac أصبح بهدوء الإجابة الافتراضية على سؤال “أي حاسوب محمول أشتري إذا أردت تشغيل طرازات الذكاء الاصطناعي بنفسي؟” إنه MacBook Pro 2026 بشريحة M5 Pro وذاكرة موحّدة سعتها 64GB.
ليس الأرخص. ولا الأسرع. لكنه الجهاز الذي تتحقق فيه المقايضات في المكان الصحيح لمعظم من يريدون فعلًا استخدام الطرازات المحلية بدلًا من مجرد قياسها.
يغطي هذا الدليل ما يمكن لذلك الجهاز فعله حقًا في ثلاثة أعباء عمل — طرازات اللغة الكبيرة وتوليد الصور وتوليد الفيديو — بأرقام حقيقية حيث توجد أرقام حقيقية، وتقديرات صادقة حيث لا توجد، وتعليمات إعداد خطوة بخطوة يمكنك اتباعها يوم يصل جهازك.
كما يغطي المواضع التي تنهار عندها حجة النقطة المثلى، لأنها تنهار فعلًا، ويجب أن تعرف أين بالضبط قبل أن تنفق ثلاثة آلاف دولار على ذاكرة لا يمكنك ترقيتها لاحقًا.
باختصار — الحكم
اشترِ M5 Pro بذاكرة 64GB إذا: كنت تريد جهازًا محمولًا يشغّل طرازات 8B–70B وطرازات Mixture-of-Experts بسرعة تكفي للعمل الحقيقي، ويولّد الصور في ثوانٍ لا دقائق، ويبقى لديه متسع لمتصفحك وبيئة IDE وحاويات Docker تعمل في الوقت نفسه. هذا هو أفضل حاسوب محمول للذكاء الاصطناعي المحلي في 2026.
انتقل إلى M5 Max بذاكرة 128GB إذا: كنت تحتاج تحديدًا إلى طرازات محلية من الفئة المتقدمة مثل
gpt-oss-120b(الذي لا لا يتسع في 64GB)، أو كنت تريد نحو ضعف سرعة توليد الرموز على الطرازات الكبيرة. يمتلك M5 Max بـ40 نواة 614 GB/s من النطاق الترددي للذاكرة مقابل 307 GB/s لدى M5 Pro’s، وفي فك ترميز LLM، النطاق الترددي هو كل شيء.ابحث عن غيره إذا: كان توليد الفيديو المحلي عبء عملك الأساسي. فكل جهاز Mac لا يزال أبطأ عدة مرات من RTX 5090 هنا، واستئجار السحابة أرخص بكثير لكل مقطع.
الأرقام الثلاثة التي تحدد هذا الجهاز:
| المقياس | M5 Pro (GPU بـ20 نواة) | لماذا يهم |
|---|---|---|
| 307 GB/s النطاق الترددي للذاكرة | ~2× من M5 الأساسي، ~½ من M5 Max بـ40 نواة | يحدد سقفك في الرموز/الثانية لطرازات LLM |
| 64GB أقصى ذاكرة موحّدة | ~48–52GB قابلة للاستخدام افتراضيًا | يحدد أي الطرازات يمكن تشغيلها أصلًا |
| 20 نواة GPU مع مسرّعات عصبية | قدرة حاسوبية للذكاء الاصطناعي 4×+ مقابل M4 Pro | يحدد سرعة معالجة الموجّه وسرعة انتشار الصور |
أولًا: أجل، هذه الشريحة حقيقية
كثير من الكتابات عن M5 Pro المنشورة في أواخر 2025 وأوائل 2026 كان تخمينًا. ولم يعد تخمينًا الآن.
أعلنت Apple عن M5 Pro و M5 Max في March 3, 2026، وطُرح كلاهما في MacBook Pro مقاس 14 بوصة و16 بوصة في March 11, 2026. وكان M5 الأساسي قد وصل قبل ذلك، في MacBook Pro مقاس 14 بوصة في 22 أكتوبر 2025، لكن تلك الشريحة أمر مختلف تمامًا — فهي تتوقف عند 32GB و153 GB/s، وهذا لا يكفي لأعباء العمل في هذا الدليل.
إليك ما أكدته Apple في صفحات غرفة الأخبار والمواصفات التقنية:
M5 Pro — المواصفات المؤكدة
| المكوّن | المواصفات |
|---|---|
| CPU | 18 نواة (6 “أنوية فائقة” حتى ~4.6 GHz + 12 نواة أداء حتى ~4.4 GHz). الفئة الأساسية: 15 نواة. أسرع بنسبة تصل إلى 30% في تعدد الخيوط من M4 Pro. |
| GPU | حتى 20 نواة، كل منها بمسرّع عصبي مخصص. تتبع الأشعة بالعتاد من الجيل الثالث. أكثر من 4× ذروة القدرة الحاسوبية لـ GPU في الذكاء الاصطناعي مقابل M4 Pro. |
| محرك عصبي | 16 نواة |
| ذاكرة موحّدة | 24GB / 48GB / 64GB — 64GB هو السقف |
| النطاق الترددي للذاكرة | حتى 307 GB/s (LPDDR5X) |
| عملية التصنيع | TSMC 3nm (N3P)، “Fusion Architecture” — شريحتان متصلتان عبر تغليف SoIC-mH |
| الإدخال/الإخراج & الوسائط | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW encode-decode, AV1 decode |
M5 Max — للمقارنة
يمتلك M5 Max المعالج CPU نفسه بـ18 نواة لكن بمعالج GPU يصل إلى 40 نواة، والأهم أنه يقدم قصة ذاكرة مختلفة: النسخة بـ32 نواة تعمل عند 460 GB/s، والنسخة بـ40 نواة عند 614 GB/s، وقابلة للتكوين حتى 128GB.
فجوة النطاق الترددي هذه ليست تفصيلًا ثانويًا في ورقة المواصفات. إنها العامل الأهم منفردًا في قرار M5 Pro مقابل M5 Max، وسنعود إليها مرارًا.
معايير قياس مستقلة
وحدة المراجعة لدى Notebookcheck’s — جهاز M5 Pro مقاس 16 بوصة بذاكرة 64GB — سجّلت درجات Geekbench 6.7 قدرها 4,295 للنواة الواحدة و28,436 لتعدد الأنوية، و2,347 في Cinebench 2024 لتعدد الأنوية، و9,481 في Cinebench 2026 لتعدد الأنوية.
وضع تحليلهم لـ GPU جهاز M5 Max في حدود مستوى RTX 5070 المكتبي تقريبًا، ومتقدمًا بسهولة على Strix Halo من AMD’s. أما GPU بـ20 نواة في M5 Pro’s فيقع أدنى من ذلك، ويستحق أن تستوعبه: هذا GPU قادر في حاسوب محمول، وليس بديلًا عن بطاقة مخصصة.
كما أشاروا إلى أمر أقل إطراءً، ويستحق الأخذ به بجدية: إن MacBook Pro 2026 يخفض تردده بشكل ملحوظ تحت الحمل المستمر، مع أداء CPU غير ثابت حتى في وضع High Power. المزيد عن ذلك في قسم الحرارة.
مشكلة السعر (إصدار 2026)
طُرح خط M5 Pro بسعر $2,199 للمقاس 14 بوصة و $2,699 للمقاس 16 بوصة. ثم جاءت أزمة الذاكرة العالمية.
في في يونيو 2026، رفعت Apple أسعار MacBook Pro بنحو $300 على كل الطرازات. بعد الزيادة، يستقر طراز M5 Pro 14 بوصة الأساسي حول $2,499، ويقع M5 Pro مقاس 14 بوصة بتكوين 64GB وSSD سعة 1TB في نطاق $2,799–$2,999 تقريبًا حسب اليوم والبائع. وقد خفّض B&H وبائعو تجزئة آخرون تكوينات M5 Pro بذاكرة 48GB و64GB بمقدار $300–$400، وهو أمر يستحق التحقق قبل الشراء المباشر.
في ألمانيا، يبدأ خط M5 Pro من €2,199، مع أسعار تعليمية ظهرت منخفضة حتى €1,979 لدى بائعي تجزئة مثل Edustore. أما تكوينات 64GB فترتفع بشكل ملموس عند احتساب ضريبة القيمة المضافة 19%.
فرقان يهمان في قرارك:
- من 48GB إلى 64GB في M5 Pro: كان تاريخيًا ترقية بـ$200–$400، لكن أسعار ترقية RAM تضخمت 50–67% في تكوينات كثيرة بعد زيادة يونيو.
- من M5 Pro بذاكرة 64GB إلى M5 Max بذاكرة 128GB: قفزة كبيرة. بدأ M5 Max من $3,599 (14 بوصة) و$3,899 (16 بوصة) قبل الزيادة، وتضاعفت أسعار ترقيات ذاكرة M5 Max إلى 64GB/128GB تقريبًا في يونيو. ونسخة 16 بوصة بأقصى تكوين تتجاوز الآن $10,000.
تحقق من كل سعر في هذا القسم قبل الشراء. سوق الذاكرة في 2026 يتحرك شهريًا، وكل ما هو مكتوب هنا عمره قصير.
لماذا 64GB تحديدًا؟ حجة النقطة المثلى
ادعاء “النقطة المثلى” ليس عن كون 64GB سحرًا. إنه عن الأشياء التي تمنعها كل فئة ذاكرة فعليًا.
ما لا يمكنك فعله في كل فئة
16GB / 24GB — يمكنك تشغيل طرازات 7B–8B بارتياح وطرازات 14B بتكميم عدواني. ولا يمكنك تشغيل أي شيء من فئة 30B+ بسياق ذي معنى. وستقضي وقتك في إدارة الذاكرة بدلًا من استخدام الطرازات.
32GB — قابل للعمل مع طرازات كثيفة 14B وبعض طرازات MoE الأصغر. لكن بمجرد إضافة ذاكرة KV المؤقتة لسياق 32K+، مع Chrome، مع بيئة IDE، مع خدمة Docker، تدخل منطقة ضغط الذاكرة. هذه هي الفئة التي يقنع فيها الناس أنفسهم بأن الذكاء الاصطناعي المحلي لا يعمل.
48GB — جيد حقًا. يشغّل طرازات كثيفة من فئة 32B بارتياح. المشكلة هي الهامش: طراز 70B بتكميم Q4 يبلغ نحو 40GB، وهو يتسع تقنيًا لكنه لا يترك شيئًا لبقية جهازك. وينتهي بك الأمر إلى إغلاق التطبيقات لتشغيل طراز، وهذا بالضبط هو الاحتكاك الذي يقتل سير العمل المحلي.
64GB — هذه هي النقطة التي يمكنك فيها الاحتفاظ بطراز 70B بتكميم Q4 أو أو طراز MoE بـ106 مليار معامل في الذاكرة و وتبقي بيئة عملك كاملة مقيمة في الذاكرة. لا إغلاق لـ Slack. لا إيقاف للحاويات. تفتح طرازًا وتواصل العمل.
128GB (نطاق M5 Max) — يفتح gpt-oss-120b وفئة 120B+. مفيد حقًا إذا كان هذا ما تحتاجه، ومكلف حقًا إن لم يكن.
حجة النقطة المثلى هي في الحقيقة حجة “شغّل طرازًا جادًا وكل شيء آخر معه”. وهذا هو الفرق بين أن يكون الذكاء الاصطناعي المحلي شيئًا تعرضه في عرض توضيحي وشيئًا تستخدمه.
لكن 64GB يأتي بسقف صلب، ويجب أن تعرفه الآن.
مشكلة gpt-oss-120b
gpt-oss-120b بتكميم MXFP4 يحتاج نحو 63GB للأوزان وحدها. وتُظهر قياسات مستقلة على M5 Max بذاكرة 128GB باستخدام MLX ذروة ذاكرة تبلغ نحو 64.4GB عند سياق 4,096 رمزًا و64.9GB عند سياق 16K.
على جهاز بذاكرة 64GB، حيث ميزانيتك الواقعية القابلة للاستخدام 52–60GB، فإن ذلك لا يتسع. ليس “يتسع بالكاد” — بل لا يتسع.
إذا رأيت ادعاءً بأن gpt-oss-120b يعمل على 64GB، فتعامل معه بارتياب. إنه طراز 128GB. هذه أوضح حجة منفردة للانتقال إلى M5 Max، وإذا كان ذلك الطراز يهمك، فلا شيء من حجج النقطة المثلى يغيّر الحساب.
الخطوة 1: حرّر ذاكرتك (افعل هذا أولًا)
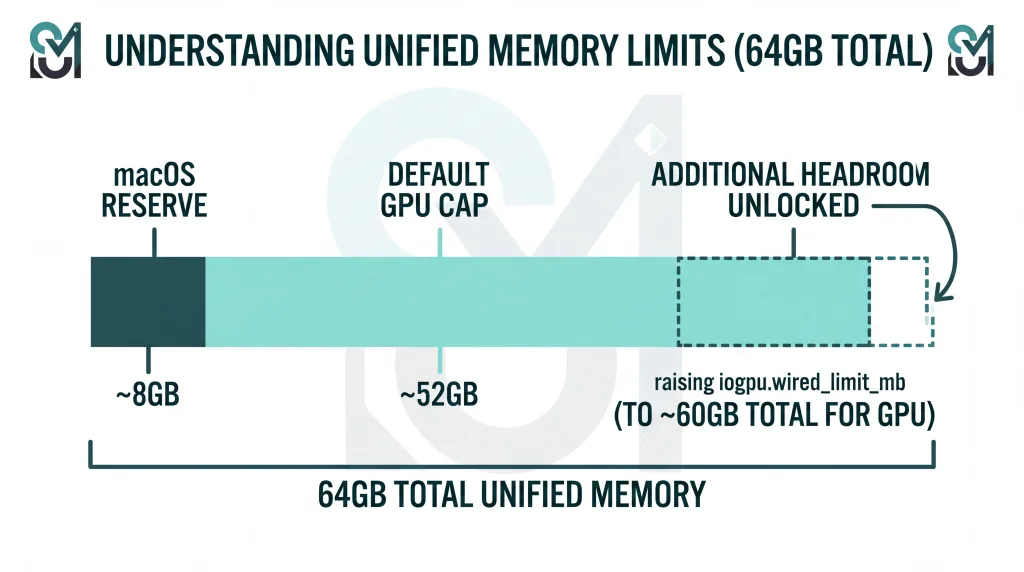
إليك شيئًا لا يعرفه معظم المشترين: macOS لا يسمح لـ GPU باستخدام كل ذاكرة RAM لديك.
افتراضيًا، يحدد macOS ذاكرة GPU المحجوزة عند نحو 75% من الإجمالي. وعلى جهاز بذاكرة 64GB يساوي ذلك نحو 51.84GB قابلة للاستخدام لأوزان الطراز، مع حجز الباقي للنظام.
يمكنك رفع هذا بأمر واحد. دون إعادة تشغيل، ودون تغييرات في System Integrity Protection.
ملاحظة: المفتاح الحديث هو
iogpu.wired_limit_mb. تشير الأدلة الأقدم إلىdebug.iogpu.wired_limit، وقد استُبدل. وإذا وجدت برنامجًا تعليميًا يستخدم المفتاح القديم، فهو قديم.
ارفع الحد
bash
# Set the GPU wired-memory limit to 60GB (60 × 1024 = 61440 MB)
sudo sysctl iogpu.wired_limit_mb=61440

# Verify it took effect
sysctl iogpu.wired_limit_mb

# Reset to the macOS default at any time
sudo sysctl iogpu.wired_limit_mb=0
اجعله دائمًا
يُعاد الإعداد إلى حالته عند إعادة التشغيل. لجعله دائمًا، أضفه إلى /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confبدلًا من ذلك، أنشئ LaunchDaemon أو أضف sysctl الاستدعاء إلى نص تسجيل الدخول إن كنت تفضل عدم لمس /etc/sysctl.conf.
إلى أي حدّ ترفعه؟
اترك 4–8GB لـ macOS. على جهاز بذاكرة 64GB، يُعد 60GB (61440 MB) جريئًا لكنه قابل للعمل إذا لم تكن تشغّل الكثير غيره. أما 56GB (57344 MB) فهو الإعداد اليومي الأكثر أمانًا.
لا تخصص 100%. ستحصل على مؤشر الانتظار الدوّار أو تجمّد التطبيقات أو إعادة تشغيل قسرية — وعلى جهاز في منتصف الاستدلال، يعني ذلك فقدان كل ما كنت تفعله.
الميزانية العملية على M5 Pro بذاكرة 64GB:
- افتراضيًا: ~48–52GB قابلة للاستخدام
- مرفوعة إلى 56GB: مريحة لطراز 70B بتكميم Q4 مع السياق
- مرفوعة إلى 60GB: الحد الأقصى، مع مساحة ضئيلة لتطبيقات أخرى
هذا الفرق — 48GB مقابل 58GB — هو غالبًا الفرق بين تشغيل الطراز على GPU وانتقاله إلى CPU، وهذا يدمّر الإنتاجية تمامًا. إنه أثمن خمس دقائق إعداد ستقضيها.
شرط مسبق آخر
يتطلب MLX نظام macOS 26.2 أو أحدث لاستخدام المسرّعات العصبية في M5’s فعليًا. إذا كنت على إصدار أقدم، فأنت تترك أكبر تحسين جيلي منفرد على الطاولة. تحقق من تحديث البرامج قبل أن تقيس أي شيء.
الخطوة 2: ابنِ حزمتك
إليك الإعداد الكامل بالترتيب. خصص نحو 30 دقيقة إضافة إلى وقت التنزيل.
2.1 — الأساسيات
bash
# ثبّت Homebrew إن لم يكن لديك
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# ثبّت uv — مدير حزم Python سريع، أفضل بكثير من pip لهذا الغرض
brew install uv

# اختياري لكنه مستحسن: مدير إصدارات Python
brew install [email protected]
2.2 — MLX (إطار عمل Apple’s الأصلي للتعلم الآلي)
MLX هو إطار المصفوفات الخاص بـ Apple’s، صُمم خصيصًا لمعمارية الذاكرة الموحّدة في Apple Silicon. وهو أسرع مسار لاستدلال LLM على Mac، ويجب أن يكون خيارك الافتراضي.
bash
# أنشئ بيئة مخصصة
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# ثبّت mlx-lm
uv pip install mlx-lm

# اختبره — هذا ينزّل نموذجًا ويشغّله
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Explain unified memory architecture in three sentences."
إذا أنتج ذلك نصًا، فحزمتك تعمل.
2.3 — LM Studio (الواجهة الرسومية)
نزّله من lmstudio.ai. هذه أسهل طريقة لتصفح النماذج وتنزيلها وتشغيلها، وقد استعرضتها Apple خلال إطلاق M5 Pro، وهذا يقول شيئًا عن مدى انتشار الاستدلال المحلي.
أبرز ميزة في LM Studio للمطوّرين هي الخادم المدمج المتوافق مع OpenAI. فعّله من تبويب المطور ويعرض نقطة نهاية على http://localhost:1234/v1 يمكن لأي عميل متوافق مع OpenAI التحدث إليها.
2.4 — Ollama (أداة CLI والخادم)
bash
brew install ollama

# ابدأ الخادم
ollama serve

# في طرفية أخرى، اسحب نموذجًا وشغّله
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
تحديث مهم لعام 2026: على March 30, 2026, Ollama 0.19 switched its Apple Silicon backend from llama.cpp to MLX. ضاعف هذا سرعة decode تقريبًا. وفي قياسات Ollama’s نفسها على M5 Max عند تشغيل Qwen3.5-35B-A3B، ارتفع prefill من 1,154 إلى 1,810 رمزًا/ثانية، وارتفع decode من 58 إلى 112 رمزًا/ثانية — ومع بناء int4 الخاص بها بلغ prefill نحو 1,851 وdecode نحو 134.
إذا كانت آخر تجربة لك مع Ollama على Mac قبل ذلك الإصدار، فنموذجك الذهني عن أدائه أصبح قديمًا.
2.5 — Draw Things (الصور والفيديو)
ثبّته من Mac App Store. إنه مجاني وأصلي ومحسّن لـ Metal، وهو حاليًا أفضل أداة لتوليد الصور على Apple Silicon. تنفيذ Metal FlashAttention v2.5 فيه يعمل أسرع بما يصل إلى 4.6× على M5 مقارنة بـ M4، ويدعم تدريب LoRA على الجهاز.
2.6 — ComfyUI (عندما تحتاج إلى مسارات معالجة)
bash
brew install comfyuiيمنحك ComfyUI تحكمًا في سير العمل قائمًا على العقد لا يستطيع Draw Things مجاراته. يعمل على خلفية MPS وهو أبطأ بنحو 20% من Draw Things على Apple Silicon للعمل نفسه، إضافة إلى مشكلات حقيقية مع نقاط فحص FP8 على Metal. استخدمه عندما تحتاج خطوط أنابيب معقدة؛ واستخدم Draw Things عندما تحتاج السرعة.
2.7 — تحقّق من كل شيء
bash
# تحقق من حد الذاكرة المثبّت
sysctl iogpu.wired_limit_mb

# تأكد أن MLX يرى وحدة GPU لديك
python -c "import mlx.core as mx; print(mx.default_device())"

# تأكد أن Ollama يقدّم الخدمة
curl http://localhost:11434/api/tags
الجزء 1: تشغيل LLM
هذا ما يتفوق فيه M5 Pro 64GB، ويستحق أن تفهمه لماذا قبل النظر إلى قائمة النماذج.
المفهوم الوحيد الذي يفسّر كل شيء: النطاق الترددي مقابل القدرة الحاسوبية
لاستدلال LLM مرحلتان، وكل منهما يضغط على جزء مختلف تمامًا من جهازك.
prefill (معالجة الموجّه) هو المرور على مدخلك قبل ظهور أول رمز. وهو مقيّد بالحوسبة. هذا هو سبب أن لصق ملف بـ 40,000 رمز في وكيل برمجة محلي كان يعني دقائق من الصمت على Mac بينما تنجزه بطاقة NVIDIA في ثوان.
decode (توليد الرموز) هو إنتاج كل رمز لاحق. وهو مقيّد بعرض نطاق الذاكرة. كل رمز يُولَّد يتطلب قراءة أوزان النموذج من الذاكرة. ذاكرة أسرع، رموز أسرع. الأمر بهذه البساطة تقريبًا.
هذا الانقسام يفسّر مقترح M5 Pro بأكمله:
- عرض نطاقه 307 GB/s يضع سقفًا صارمًا لسرعة decode. نحو ضعف سرعة M5’s الأساسية البالغة 153 GB/s، ونحو نصف سرعة M5 Max 40-core’s البالغة 614 GB/s.
- عرض نطاقه مسرّعات الشبكة العصبية — واحد داخل كل نواة GPU، وهو جديد في جيل M5 — يحسّن prefill بشكل كبير.
نشر فريق أبحاث MLX في Apple’s قياسات في نوفمبر 2025 تقارن M5 الأساسي بـ M4 الأساسي على Qwen3-14B-4bit: كان زمن الوصول إلى أول رمز أسرع بـ 4.06×، بينما تحسّن توليد الرموز بنسبة 1.19× فقط. هذه الزيادة المتواضعة في decode تطابق زيادة عرض النطاق تمامًا (120 GB/s → 153 GB/s). أما الزيادة الهائلة في prefill فتأتي كليًا من مسرّعات الشبكة العصبية.
تسوّق Apple لنسختي Pro وMax بأنهما تقدّمان معالجة موجّهات LLM أسرع بما يصل إلى 4× من M4 Pro وM4 Max. والآلية نفسها، لكن التأكيد المستقل على prefill في M5 Pro تحديدًا ما زال ضعيفًا.
ما يعنيه هذا عمليًا: إن M5 Pro ترقية نوعية عن أجهزة Mac السابقة لجيل M5 للعمل على السياقات الطويلة والبرمجة الوكيلية، حيث يهيمن prefill. وهو ترقية متواضعة لإنتاجية الدردشة الصرفة، حيث يهيمن decode.
ثورة MoE (لماذا أصبحت أجهزة Mac جيدة فجأة)
غيّرت معماريات Mixture-of-Experts الحسابات لأجهزة الذاكرة الموحّدة، وإن لم تفهم شيئًا آخر من هذا الدليل فافهم هذا.
نموذج MoE له إجمالي معاملات هائل لكنه يفعّل جزءًا صغيرًا فقط لكل رمز. gpt-oss-120b لديه 117 مليار معامل إجمالًا لكنه يفعّل نحو 5.1 مليار لكل رمز.
- إجمالي المعاملات تحدد الذاكرة متطلب الذاكرة — وهو ما تملكه أجهزة Mac بوفرة.
- المعاملات النشطة تحدد سرعة decode — وهي مقيّدة بعرض النطاق.
إذن نموذج MoE يحتاج المورد الذي تزخر به أجهزة Mac ويستهلك القليل من المورد الذي تفتقر إليه. ونموذج MoE مُختار جيدًا على Mac بـ 64GB يقدّم جودة قريبة من الحدود المتقدمة بسرعة decode لنموذج أصغر بكثير.
هذا سبب أن حاسوبًا محمولًا بـ 307 GB/s قد يبدو منافسًا لبطاقات تعمل بـ 1,700 GB/s في أحمال معينة. اختر نماذج MoE حيثما أمكن.
أي الطرازات تناسب فعلًا — الجدول
الأرقام المقيسة أدناه مأخوذة من قاعدة بيانات معايير مجتمع oMLX لـ M5 Pro بـ 20 نواة و64GB. والتقديرات موسومة بوضوح. لا تثق بأرقام رموز/ثانية غير موسومة تجدها في مكان آخر لهذه الشريحة — فقلة قليلة نشرت قياسات حقيقية لـ M5 Pro.
| الطراز | النوع | البصمة | decode (رمز/ثانية) | prefill (رمز/ثانية) | الحكم |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12GB | 66–80 ✅ مقيس | 1,500–2,200 ✅ | الخيار اليومي. سريع وقادر وصغير. |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20GB | ~55–70 (تقديري) | مرتفع | أفضل جودة لكل GB. خيار الكفاءة. |
| Qwen3.6-27B (4-bit) | كثيف | ~16GB | 17.8 ✅ مقيس | 470 ✅ | ممثل لفئة النماذج الكثيفة 27–35B. |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40GB+ | ~30 | مرتفع | استدلال قريب من الحدود المتقدمة ويدخل فعليًا في الذاكرة. |
| Llama 3.3 70B (Q4_K_M) | كثيف | ~40GB | ~7–12 (تقديري) | متوسط | صالح لأعمال الدُفعات؛ هامشي في الاستخدام التفاعلي. |
| Llama 3.3 70B (Q5_K_M) | كثيف | ~49GB | ~6–10 (تقديري) | متوسط | يدخل، لكن بضيق. ارفع حد الذاكرة أولًا. |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | كثيف | 8–24GB | 20–60+ | جيد | كلها مريحة. اختر حسب المهمة. |
| gpt-oss-120b (MXFP4) | MoE | ~63GB | — | — | ❌ لا يدخل في الذاكرة. يلزم جهاز بـ 128GB. |
| Qwen3-235B-A22B (1.58-bit ثلاثي) | MoE | ~53GB | ~5.6 | منخفض | يعمل تقنيًا. حيلة للعرض، لا سير عمل. |
ميزة الدُفعات: gpt-oss-20b على M5 Pro يتوسع إلى نحو 142 رمزًا/ثانية بحجم دُفعة 8. وإذا كنت تشغّل وكلاء أو حلقات تقييم أو أي حمل بطلبات متوازية، تتحسن الإنتاجية كثيرًا عن رقم المسار الواحد.
نظرة واقعية على طرازات 70B
لا يوجد رقم منشور ومقيس بشكل مستقل لـ decode على M5 Pro بالنسبة لـ Llama 3.3 70B. وتقدير 7–12 رمزًا/ثانية مستنبط من عرض النطاق.
للمعايرة: M4 Max 128GB بعرض 546 GB/s يقيس نحو 18–20 رمزًا/ثانية على النموذج نفسه. أما M5 Pro فعرضه 307 GB/s. والحساب غير مشجّع.
عند 7–12 رمزًا/ثانية تحصل على نحو 5–9 كلمات في الثانية — أبطأ من سرعة القراءة المريحة. هذا مقبول للمهام الخلفية ومعالجة المستندات والدُفعات الليلية. لكنه محبط في الدردشة التفاعلية.
التوصية الصادقة: على M5 Pro بـ 64GB، تعامل مع نماذج 70B الكثيفة كأدوات لأحمال الدُفعات، واستخدم نماذج MoE في كل ما هو تفاعلي.
التكميم: ماذا تختار فعليًا
| الصيغة | فقدان الجودة | متى تستخدمها |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | الافتراضي. أفضل نسبة سرعة إلى جودة. |
| MLX 4-bit | ~1–2% | الافتراضي على Mac. ذاكرة أقل بنحو 10% وسرعة أعلى بنسبة 15–30% من GGUF المكافئ. |
| Q5_K_M / MLX 6-bit | <1% | حين تكون لديك مساحة وتريد مخرجات شبه بلا فقدان. |
| Q6_K | ضئيل | أعمال حساسة للجودة مع ذاكرة فائضة. |
| Q8 / FP16 | لا شيء | نادرًا ما يستحق على حاسوب محمول. فهو ينصّف ميزانية حجم النموذج أو يقلّلها إلى الربع. |
| MXFP4 | أصلي | ليس خيارًا — فهذه طريقة gpt-oss في الشحن. |
| 1.58-bit ثلاثي | شديد | فقط لحشر نموذج لن يدخل في الذاكرة لولا ذلك. |
قاعدة عامة: 4-bit للسرعة والاتساع، و6-bit حين تهم الجودة وتتوفر المساحة، وتجاوز 8-bit على الحاسوب المحمول.
MLX مقابل llama.cpp — أي بيئة تشغيل؟
الجواب المختصر هو MLX، مع تحفظ واحد.
- تحت ~14B معامل: يتقدم MLX على llama.cpp بنسبة 20–87%. الفارق ليس بسيطًا.
- فوق ~27B: يتقارب الاثنان، لأن عرض نطاق الذاكرة يصبح عنق الزجاجة ويتوقف تأثير بيئة التشغيل.
- الذاكرة: يستخدم MLX نحو 10% أقل من GGUF عند التكميم المكافئ.
- التحفظ: في السياقات التي تتجاوز 30,000 رمز، قد يكون MLX أبطأ بنسبة 50% من llama.cpp مع تفعيل Flash Attention. وهذا يعتمد على النموذج والسياق.
إذا كنت تعمل بانتظام مع سياقات طويلة جدًا، فقِس الاثنين على حملك الفعلي. وإلا، فـ MLX.
تشغيل خادم API محلي
mlx-lm النسخة 0.18 وما بعدها تأتي بخادم متوافق مع OpenAI مع تجميع مستمر للدُفعات:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
الآن أي شيء يتحدث API الخاص بـ OpenAI يمكنه استخدام نموذجك المحلي:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Write a bash one-liner to find large files."}]
  }'
نقطة النهاية هذه هي أساس كل ما في قسم سير العمل أدناه.
الجزء 2: توليد الصور
توليد الصور هو المجال الذي يبدو فيه M5 Pro أفضل مما يوحي عرض نطاقه، لسبب واضح: الانتشار (diffusion) مقيّد بالحوسبةغير مقيّد بعرض النطاق، والنماذج صغيرة بما يكفي بحيث لا تكون الذاكرة قيدًا على جهاز بـ 64GB.
الأداء طرازًا بطراز
| الطراز | الحجم | الذاكرة | الوقت لكل صورة 1024×1024 | ملاحظات |
|---|---|---|---|---|
| SDXL | 3.5B | ~7GB | ~7 ثوانٍ عند 30 خطوة (M5 Max) | أسرع خيار عالي الجودة. منظومة LoRA هائلة. |
| FLUX.1 [schnell] | 12B | ~7GB (Q4) | ~20–25 ثانية عند 4 خطوات | مقطّر للسرعة. Apache-2.0. |
| FLUX.1 [dev] | 12B | ~10GB (Q6) | ~50 ثانية عند 20 خطوة (فئة M4) | معيار الجودة. |
| FLUX.2 [Klein] | 4B مقطّر | ~8GB | ~40 ثانية | أحدث وأصغر وأسرع. |
| FLUX.2 [dev] | كبير | 24GB+ | عدة دقائق | أفضل جودة، مع صبر حقيقي مطلوب. |
| SD 3.5 | يختلف | 10–20GB | عشرات الثواني | حل وسط متين. |
| Qwen-Image / Qwen-Image-Edit | يختلف | 15–25GB | عشرات الثواني | ممتاز لعرض النصوص وتحرير الصور. |
| HiDream, Chroma | يختلف | 10–20GB | يختلف | يستحق التجربة لتنوع الأنماط. |
قاس فريق أبحاث ML في Apple’s توليد FLUX-dev-4bit لصورة 1024×1024 أسرع بأكثر من 3.8× على M5 مقارنة بـ M4 باستخدام MLX. وتأتي هذه الزيادة من مسرّعات الشبكة العصبية، وتنطبق على عائلة M5 كلها.
لم يُنشر بعد أي معيار قياس لثوانٍ لكل صورة خاص بـ M5 Pro، لذا اعتبر الجدول أعلاه أرقام فئة M4 مع تحسّن ملموس متوقع من M5. عمليًا: توقّع FLUX.1 [schnell] في أقل من 20 ثانية بكثير وSDXL في ثوانٍ أحادية الرقم.
مع 64GB يمكنك تشغيل هذه النماذج بدقة FP16 دون تكميم، وهذه ميزة جودة حقيقية على أجهزة 16GB و24GB المُضطرة إلى Q4.
الأدوات: ماذا تستخدم
Draw Things — الخيار الافتراضي. Metal أصلي، ولا بيئة Python تتعطل، وMetal FlashAttention v2.5 يعمل أسرع بما يصل إلى 4.6× على M5 مقارنة بـ M4، وتدريب LoRA على الجهاز. مجاني على App Store.
ComfyUI — لخطوط الأنابيب القائمة على العقد وسلاسل ControlNet وسير العمل متعدد المراحل. أبطأ بنحو 20% من Draw Things على Apple Silicon. واحترس من نقاط فحص FP8 التي تفشل كثيرًا على Metal.
DiffusionKit — مجموعة أدوات الانتشار الخاصة بـ Apple’s، مدعومة بـ MLX. تستحق المتابعة.
Mochi Diffusion, InvokeAI — كلاهما قابل للاستخدام، وكلاهما جيد.
تجنّب: DiffusionBee مهجور فعليًا. يعمل Automatic1111 وForge تقنيًا عبر MPS، لكنهما بطيئان وسيّئا الصيانة على Mac.
خطوة بخطوة: أول صورة محلية لك
- ثبّت Draw Things من Mac App Store.
- افتحه وانتقل إلى مدير النماذج (الأيقونة أعلى اللوحة اليسرى).
- التنزيل FLUX.1 [schnell] — نحو 7GB بترميز Q4، أو خذ نسخة FP16 بما أن لديك الذاكرة الكافية.
- اضبط الخطوات على 4 (فقد قُطّرت schnell لهذا الغرض تحديدًا) و الحجم على 1024×1024.
- أدخل موجّهًا واضغط توليد.
- يتضمن تشغيلك الأول تحميل النموذج. أما التوليدات اللاحقة فأسرع بكثير.
تدريب LoRA على الجهاز
يمكن لجهاز بذاكرة 64GB إجراء ضبط دقيق لنماذج الصور محليًا، وهي قدرة تُقلَّل قيمتها حقًا. يدعم Draw Things تدريب LoRA مباشرة، كما يدعم MLX تقنيتي LoRA وQLoRA لنماذج الصور واللغة معًا.
تدريب LoRA صغير للأسلوب على 20–50 صورة مهمة تُنجز ليلًا على M5 Pro، ولا يغادر جهازك أبدًا. ولمن يعمل بمواد العملاء أو أصول مملوكة، هذا أهم من السرعة.
الجزء 3: توليد الفيديو — القسم الصريح
هنا يجب أن أكون صريحًا معك، لأن كثيرًا من المحتوى في هذا الموضوع ليس كذلك.
توليد الفيديو محليًا على أي Mac في 2026 بطيء. ليس بطيئًا بمعنى “أبطأ من 4090”. بل بطيء بما يكفي لتغيير طريقة عملك.
لماذا تعاني أجهزة Mac هنا تحديدًا
انتشار الفيديو يعتمد بشدة على مقيّد بالحوسبة. وعلى خلاف فك ترميز LLM، حيث يكون عرض النطاق الوافر للذاكرة في Mac هو المورد المعني، فإن توليد الفيديو يستهلك قدرة GPU الخام — وهو بالضبط المحور الذي يخسر فيه GPU حاسوب محمول بـ20 نواة أمام بطاقة مخصصة.
تساعد مسرّعات الشبكة العصبية في M5. لكنها لا تُغلق فجوة بهذا الحجم.
الأرقام كما هي دون تجميل
Wan 2.2 (Alibaba، برخصة Apache-2.0، متاح كنسخة MoE بحجم 14B ونسخة كثيفة 5B من نص/صورة إلى فيديو): على M1 Max بذاكرة 64GB يشغّل نسخة GGUF، استغرق مقطعًا مدته ثانيتان بدقة 832×480 وقتًا بلغ 82 دقيقة. أما مقطع مدته 5 ثوانٍ فسيتجاوز ثلاث ساعات.
للمقارنة، النموذج نفسه TI2V-5B على RTX 4090 بذاكرة 24GB ينتج 5 ثوانٍ بدقة 720p في نحو 9 دقائق.
M5 Pro أسرع بكثير من M1 Max، لكن رتبة الحجم هي المقصد.
قيد حاسم في Metal: لا تعمل نقاط حفظ FP8 على Metal — إذ إن نوع البيانات Float8_e4m3fn غير مدعوم. عليك استخدام نسخ GGUF. هذا يربك كثيرين ممن يتبعون برامج تعليمية موجّهة إلى NVIDIA، ويعني أيضًا قوالب FP8 في LTX-2 تفشل تمامًا على Mac.
الخبر الجيد: النماذج المقطّرة الأحدث تغيّر هذا. قاس Ivan Fioravanti النموذج المقطّر LTX 2.3 22B في Draw Things وهو ينتج فيديو مدته 5 ثوانٍ في نحو 121 ثانية على M5 Max بـ40 نواة — متجاوزًا فعليًا M3 Ultra بـ80 نواة، الذي استغرق 206 ثانية.
هذه نتيجة حقيقية وتحوّل فعلي. لكن انتبه إلى الشريحة: M5 Pro بـ20 نواة سيكون أبطأ بدرجة ملموسة من M5 Max بـ40 نواة في عمل محدود بالقدرة الحاسوبية كهذا. توقّع دقائق عدة بدلًا من دقيقتين.
نماذج أخرى — HunyuanVideo وMochi 1 وCogVideoX وFramePack وStable Video Diffusion — تتراوح بين البطء وعدم الجدوى على Mac. عدة منها موجّهة إلى CUDA أولًا وتحتاج حلولًا بديلة.
الحكم على الفيديو
الفيديو المحلي على M5 Pro 64GB ممكن للتجارب العرضية الصبورة — مقاطع قصيرة، ودقة أقل، ونماذج مقطّرة، عبر Draw Things. إنه يعمل. وستنتج أشياء.
لأي إنتاجية حقيقية، استأجر GPU. يشغّل RunPod وVast.ai وLambda بطاقة 5090 أو H100 ببضعة دولارات في الساعة، وينتجون في دقائق ما ينتجه حاسوبك المحمول في ساعة. وبالنسبة للفيديو تحديدًا، لا مجال للمقارنة اقتصاديًا.
إذا كان توليد الفيديو هو أساسي عبء عملك، فاشترِ جهاز NVIDIA أو خصّص ميزانية للسحابة. لا تشترِ Mac على أمل.
إذا أردت المحاولة رغم ذلك: خطوة بخطوة
- فتح Draw Things وانتقل إلى مدير نماذج الفيديو.
- نزّل نموذجًا مقطّرًا — LTX 2.3 أو نسخة Wan 2.2 GGUF. النماذج المقطّرة هي الفرق بين دقائق وساعات.
- ابدأ صغيرًا: 480p، ثانيتان، عدد خطوات منخفض. حدّد زمنك الأساسي قبل التوسّع.
- وصّل الكهرباء واستخدم وضع الطاقة العالية. سيعمل هذا على تشغيل مراوحك.
- لا ترفع الدقة والمدة إلا بعد أن تعرف كم يكلّفك المقطع القصير من الوقت الفعلي.
لا تستخدم نقاط حفظ FP8 على Mac أبدًا. GGUF أو لا شيء.
الجزء 4: سير عمل حقيقية تستحق البناء
معايير القياس ليست المقصد. إليك ما يفعله الناس فعليًا بهذا الجهاز.
سير العمل 1: وكيل برمجة محلي
هذا أعلى إعداد قيمةً في القائمة، ولا يستغرق سوى نحو عشر دقائق.
الخطوة 1 — شغّل خادم نموذج. إما تبويب Developer في LM Studio (نقطة النهاية على http://localhost:1234/v1) أو:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234الخطوة 2 — وجّه محرّرك إليه.
VS Code مع Cline أو Continue: أضف مزوّدًا متوافقًا مع OpenAI بعنوان أساس http://localhost:1234/v1، وأي مفتاح API غير فارغ، واسم نموذجك.
Zed: اضبط مزوّدًا مخصصًا متوافقًا مع OpenAI في الإعدادات.
Aider (الطرفية):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
الخطوة 3 — اختر النموذج المناسب. gpt-oss-20b وQwen3-Coder-30B-A3B كلاهما مبرمجان محليان قويان. كلاهما MoE، وهذا بالضبط ما تريده: فك ترميز سريع، وتحسينات التعبئة المسبقة في M5 تعني أن سياقات الملفات الكبيرة لم تعد تتعطل لدقائق.
ما الذي يمنحك إياه هذا: تكرار غير محدود بلا تكلفة لكل رمز، وبلا حدود معدل، وبشفرة لا تغادر جهازك أبدًا. وبالنسبة لقواعد الشيفرة المملوكة أو الخاصة بالعملاء، غالبًا ما تكون النقطة الأخيرة هي المبرر كله.
سير العمل 2: RAG خاص على مستنداتك
التضمينات المحلية مع نموذج بحجم 27B–70B تعني أن المستندات الحساسة — العقود والسجلات الطبية والبحوث الداخلية والبيانات المالية — قابلة للبحث والتلخيص دون أن يغادر بايت واحد حاسوبك المحمول.
فئة 64GB مهمة هنا تحديدًا لأن خطوط RAG تُبقي نموذج تضمين ومخزن متجهات ونموذج توليد في الذاكرة في آن واحد. عند 32GB أنت تتبادل باستمرار. وعند 64GB لا تفعل.
سير العمل 3: توليد دفعي طوال الليل
ضع بضع مئات من توليدات الصور في قائمة الانتظار في Draw Things، أو شغّل مهمة معالجة مستندات طويلة عبر mlx_lm.server، ودع الجهاز يعمل بينما تنام. وهو موصول بالكهرباء، تصبح نماذج 70B ودفعات الصور التي تبدو بطيئة جدًا تفاعليًا معقولة تمامًا خلال الليل.
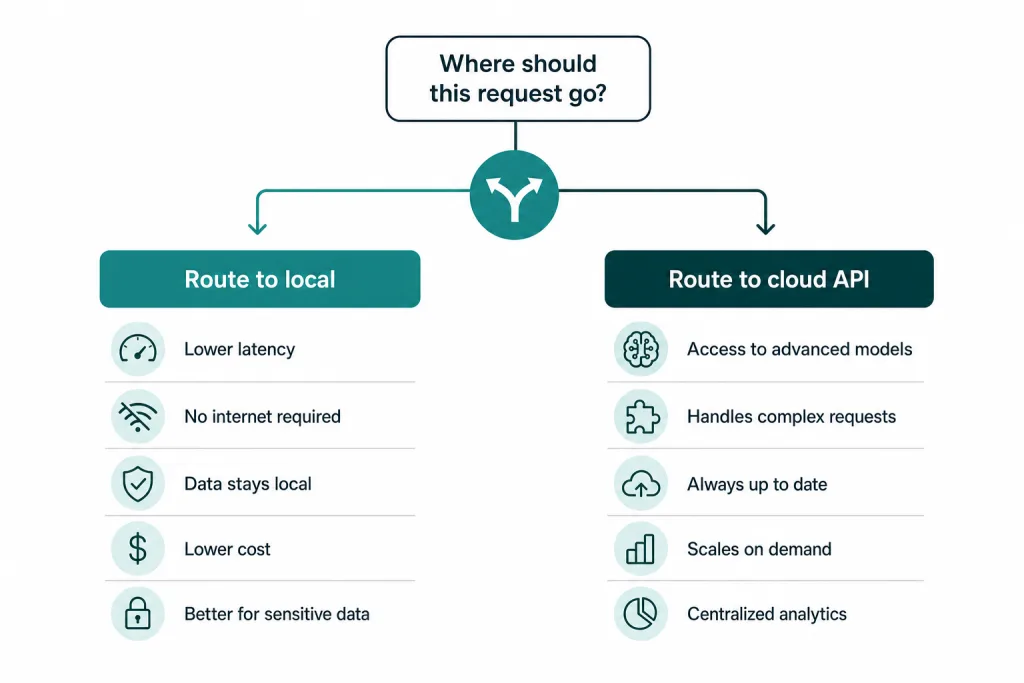
سير العمل 4: التوجيه الهجين (الاستراتيجية التي ينبغي لمعظم الناس تبنّيها)
لا تفكر في المحلي مقابل السحابي كخيارين حصريين. وزّع المهام:
| أرسل إلى المحلي | أرسل إلى API سحابي |
|---|---|
| أي شيء حساس من حيث الخصوصية | أصعب مهام الاستدلال |
| المعالجة بالجملة والدُّفعات | الحالات التي تحتاج جودة متقدمة حقيقية |
| حلقات الوكلاء ذات الاستدعاءات الكثيرة الرخيصة | المخرجات العرضية عالية المخاطر |
| التكرار والتجريب | العمل الذي يحتاج أحدث نموذج |
| العمل دون اتصال | نوافذ سياق طويلة جدًا |
هنا تكمن معظم القيمة. يتولى المحلي الحجم والتكرار والخصوصية. ويتولى السحابي النسبة الصعبة البالغة 5%.
حزمة Apple’s للذكاء الاصطناعي (تستحق المعرفة)
الـ إطار Foundation Models يمنح المطورين وصولًا مباشرًا عبر Swift إلى نموذج Apple على الجهاز — بنحو 3B معامل، مجانًا، وبخصوصية، ودون اتصال، مع توليد موجّه واستدعاء أدوات مدمجين.
تحديثات 2026 أهم من الإصدار الأصلي: إدخال بصري، وتنفيذ على الخادم، و LanguageModel بروتوكول يتيح لك إسناد جلسة إلى نموذج Apple أو نموذج سحابي، أو نموذج MLX محلي عبر MLXLanguageModel. إذا كنت تبني تطبيقات Mac أو iOS، فهذا مسار نظيف لميزات ذكاء اصطناعي هجينة على الجهاز.
Xcode 26 يأتي أيضًا بأدوات برمجة LLM مدمجة يمكنها استخدام ChatGPT، أو مزوّدين آخرين عبر مفتاح API، أو نموذج محلي يعمل على جهاز Mac لديك.
العيش معه: الحرارة والبطارية والضوضاء
المواصفات لا تخبرك كيف يكون استخدام الجهاز. بعض الملاحظات الصادقة.
مقاس 14 بوصة يخفض الأداء أكثر من 16 بوصة. أشار Notebookcheck إلى خفض حراري قوي في MacBook Pro 2026 تحت الحمل المستمر، مع سلوك غير متسق لوحدة CPU حتى في وضع الطاقة العالية. يتمتع مقاس 16 بوصة بهامش تبريد أكبر وبطارية أكبر. إذا كنت تخطط لجلسات استدلال مستمرة، فمقاس 16 بوصة هو الجهاز الأفضل — هذا فرق وظيفي حقيقي، وليس تفضيلًا شخصيًا.
ليست كل أعباء الذكاء الاصطناعي متساوية حراريًا. فك ترميز LLM معتدل نسبيًا — فهو محدود بالذاكرة، لذا لا يعمل GPU بكامل طاقته وتبقى المراوح هادئة غالبًا. أما انتشار الصور والفيديو فمحدود بالقدرة الحاسوبية وسيشغّل GPU بكامل طاقته، ويرفع سرعة المراوح إلى مستوى مسموع، ويستنزف البطارية سريعًا.
واقع البطارية: جلسات LLM القصيرة لا مشكلة فيها دون توصيل. أما عمل الانتشار المستمر فيستنزف البطارية في ساعتين وسيخفض الأداء حراريًا قبل ذلك. ابقَ موصولًا بالكهرباء لأي عمل جاد.
أوضاع الطاقة: يوفر مقاس 16 بوصة وضع الطاقة العالية، ويستحق تفعيله للمهام الطويلة. وضع الطاقة المنخفضة يقلل سرعة الاستدلال بدرجة ملموسة — تجنّبه أثناء تشغيل النماذج.
عادة عملية: دون توصيل للمحادثة والمساعدة في البرمجة. وموصولًا، بوضع الطاقة العالية، لدفعات الصور والفيديو.
الحجج المضادة الصريحة
الدليل الذي يعرض جانبًا واحدًا فقط هو تسويق. وهذه الحجة المضادة.
1. إن M5 Max أسرع فعليًا، والفرق ليس طفيفًا
307 GB/s مقابل 614 GB/s. وبما أن فك الترميز محدود بعرض النطاق، فإن M5 Max بـ40 نواة يولّد الرموز أسرع بنحو الضعف على النموذج نفسه. كما يستوعب gpt-oss-120b، وهو ما لا يستطيعه M5 Pro.
إذا كانت سرعة فك ترميز النماذج الكبيرة هي استخدامك الأساسي، فـM5 Max هو الجهاز الصحيح وM5 Pro حل وسط. والحجة المقابلة هي السعر: بعد يونيو 2026، أصبحت هذه الترقية قاسية.
2. قد يتفوق M4 Max المخفّض السعر على M5 Pro جديد
هذه هي الحجة التي يفوّتها معظم المشترين. يمتلك M4 Max نحو 546 GB/s من عرض نطاق الذاكرة — أكثر بكثير من 307 GB/s في M5 Pro. في فك ترميز LLM الخالص، سيتجاوز M4 Max 64GB عادةً M5 Pro 64GB.
ما تخسره: مسرّعات الشبكة العصبية في M5، أي تعبئة مسبقة أبطأ بكثير وتوليد صور أبطأ.
قاعدة القرار: إذا كنت تحادث النماذج الكبيرة غالبًا، فربما يكون M4 Max 64GB المخفّض الشراء الأفضل. وإذا كنت تمارس البرمجة بالوكلاء مع سياقات طويلة، أو تولّد الصور، فتفوز مزايا التعبئة المسبقة والانتشار في M5 Pro.
3. لا تزال NVIDIA تتفوق في القدرة الحاسوبية
يمتلك RTX 5090 ذاكرة VRAM بسعة 32GB بنحو 1,792 GB/s — أي نحو ستة أضعاف عرض النطاق في M5 Pro — إضافة إلى قدرة حاسوبية أكبر بكثير. لأي نموذج يتسع في 32GB، ولكل عمل محدود بالقدرة الحاسوبية (الفيديو، الصور، التعبئة المسبقة)، لا توجد منافسة.
تبدأ ميزة Mac بالضبط حيث تنتهي ذاكرة VRAM بسعة 32GB، وتشمل قابلية الحمل، والهدوء، وانخفاض استهلاك الطاقة، والقدرة على فعل هذا في قطار.
4. المنافسون بذاكرة موحّدة 128GB يلعبون على السعة لا على السرعة
NVIDIA DGX Spark / GB10: 128GB بنحو 273 GB/s، مع CUDA. على gpt-oss-120b MXFP4، وضعته الاختبارات المستقلة عند 34–39 tok/s.
AMD Strix Halo / Ryzen AI Max+ 395: 128GB بنحو 256 GB/s. وتذكر أرقام AMD نفسها ما يصل إلى 30 tok/s على النموذج نفسه عبر llama.cpp. والحواسيب الصغيرة المبنية عليه أرخص بوضوح من أي Mac.
لاحظ أن كليهما يمتلك عرض نطاق أقل من M5 Pro. إنها تشتري لك السعة، لا السرعة. إذا كان هدفك تشغيل نماذج كبيرة جدًا بسرعات مقبولة لا سريعة، فهي أرخص. وإذا أردت السرعة، فليست هي الجواب.
5. جهاز Mac المكتبي أفضل كجهاز ثابت
A يبلغ Mac Studio M3 Ultra 512GB عند 800 GB/s. إذا كان جهازك يقيم على مكتب، فهذا صندوق ذكاء اصطناعي محلي أفضل بكثير من أي MacBook Pro. قيمة الحاسوب المحمول تكمن في قابلية الحمل والبطارية والهدوء — وإذا لم تكن بحاجة إليها، فلا تدفع مقابلها.
6. لا يمكنك ترقية الذاكرة. أبدًا.
ذاكرة Apple Silicon مدمجة في الحزمة. وما تشتريه هو ما ستحصل عليه طوال عمر الجهاز.
بما أن إصدارات النماذج في 2026 تتجه باستمرار إلى بصمات MoE أكبر، فإن شراء ذاكرة RAM أقل من الحاجة هو الندم الكلاسيكي الدائم. إذا كنت تختار بين 48GB و64GB، فاختر 64GB.
حسابات التكلفة: المحلي مقابل السحابة
لنُجرِ الحساب بصدق، لأن “المحلي أرخص” غالبًا ما يُقال ونادرًا ما يُحسب.
الجهاز: نحو $2,800 لـM5 Pro 64GB، موزّعة على ثلاث إلى أربع سنوات.
أسعار API حتى أغسطس 2026 (لكل مليون رمز، إدخال/إخراج):
| الخدمة | المدخل | الإخراج |
|---|---|---|
| فئة Claude Sonnet | ~$3 | ~$15 |
| فئة GPT-5 | ~$1.75–$5 | ~$14–$30 |
| DeepSeek V4 Flash | ~$0.14 | ~$0.28 |
| نماذج مفتوحة مستضافة (gpt-oss، Llama) | أقل بعد | أقل بعد |
استئجار GPU سحابي: H100 بنحو $3/ساعة، وH200 بنحو $5/ساعة عند الطلب.
نقطة التعادل: تضع التحليلات المنشورة نقطة التقاطع لجهاز استهلاكي عند نحو 2–3 ملايين رمز يوميًا بشكل مستمر على مدى نحو اثني عشر شهرًا مقابل واجهات API مملوكة من الفئة المتوسطة.
هذا عدد كبير من الرموز. تحت هذا الحد، تتفوق واجهات API الرخيصة — وخاصة فئة DeepSeek — فعليًا على المحلي في تكلفة الرمز وحدها.
إذن لماذا تشتري الجهاز؟
لأن تكلفة الرمز ليست التكلفة الوحيدة:
- الخصوصية. بياناتك لا تغادر الجهاز أبدًا. في العمل القانوني أو الطبي أو المالي أو المتعلق بشيفرة مملوكة، غالبًا ما يكون هذا غير قابل للتنازل بصرف النظر عن السعر.
- بلا حدود معدل. لا خنق، ولا طوابير، ولا أخطاء سعة في الثانية صباحًا.
- دون اتصال. الطائرات، والقطارات، وشبكات wifi الفنادق السيئة، وانقطاعات الشبكة.
- تكلفة حدية صفرية. هذا يغيّر السلوك أكثر مما يتوقع الناس. عندما تكون كل تجربة مجانية، تجري عشر مرات أكثر. وغياب القلق بشأن كل رمز أثناء التكرار يستحق مالًا حقيقيًا في المخرجات.
- كنت بحاجة إلى حاسوب محمول على أي حال. التأطير الصادق ليس “$2,800 للذكاء الاصطناعي” — بل الفرق بين الجهاز الذي كنت ستشتريه وهذا الجهاز.
الخلاصة الصحيحة هي النهج الهجين. المحلي للحجم والخصوصية والتكرار وحلقات الوكلاء. والسحابي للمشكلات الصعبة. من يزعم أن المحلي يحل محل واجهات API المتقدمة تمامًا في 2026 يبالغ؛ ومن يزعم أن المحلي بلا جدوى لم يشغّل حلقة وكلاء على نطاق واسع.
دليل الشراء
| إذا كنت… | اشترِ هذا | لماذا |
|---|---|---|
| تريد الحاسوب المحمول الأكثر توازنًا للذكاء الاصطناعي المحلي | M5 Pro 64GB، 16 بوصة | يشغّل نماذج 8B–70B وMoE، ويولّد الصور بسرعة، ويتسع لكل شيء آخر. تبريد أفضل من مقاس 14 بوصة. |
تحتاج gpt-oss-120b أو نماذج 120B+ | M5 Max 128GB | الحاسوب المحمول الوحيد من Mac الذي يستوعبها. كما يضاعف سرعة فك الترميز تقريبًا. |
| تتحدث غالبًا مع النماذج الكبيرة، وتريد قيمة | M4 Max 64GB مخفّض | عرض نطاق أعلى (546 GB/s) يتفوق على M5 Pro في فك الترميز. |
| تمارس توليد الفيديو بجدية | NVIDIA (RTX 5090) أو السحابة | عمل محدود بالقدرة الحاسوبية؛ أجهزة Mac أبطأ عدة مرات. |
| تريد أقصى سعة بميزانية محدودة | حاسوب صغير Strix Halo 128GB | 128GB بتكلفة منخفضة، لكن بعرض نطاق أقل من M5 Pro. |
| تعمل على مكتب | يبلغ Mac Studio M3 Ultra | حتى 512GB بسرعة 800 GB/s. |
| لديك ميزانية محدودة | M5 Pro 48GB | يشغّل نماذج فئة 32B بسلاسة. تقبّل سقف 70B/MoE. |
ما لن أفعله: شراء جهاز بذاكرة 24GB أو 32GB للذكاء الاصطناعي المحلي الجاد. ستصطدم بالحد خلال أسابيع ولن تستطيع الترقية للخروج منه.
الأسئلة الشائعة
هل تكفي 64GB للذكاء الاصطناعي المحلي في 2026؟ نعم، لمعظم أعباء العمل. تشغّل ذاكرة 64GB بارتياح نماذج تصل إلى نحو 70B معامل بتكميم 4 بت، إضافة إلى نماذج Mixture-of-Experts مثل GLM-4.6 Air، مع ترك مساحة لنظام التشغيل وتطبيقاتك. الاستثناء الرئيسي هو gpt-oss-120b، وهو يحتاج نحو 63GB للأوزان وحدها ويتطلب جهازًا بذاكرة 128GB.
هل يستطيع M5 Pro تشغيل gpt-oss-120b؟ لا. يحتاج إصدار MXFP4 نحو 63GB للأوزان، وذروة الذاكرة المقاسة على M5 Max تبلغ 64.4–64.9GB حسب طول السياق. على جهاز بذاكرة 64GB وبميزانية استخدام واقعية تبلغ 52–60GB، لا يتسع. هذا نموذج يحتاج 128GB.
كم توكن في الثانية ينتج M5 Pro؟ يعتمد الأمر كثيرًا على النموذج. الأرقام المقاسة لـ M5 Pro بنسخة 20 نواة مع ذاكرة 64GB: gpt-oss-20b بمعدل 66–80 توكن/ثانية في فك الترميز مع 1,500–2,200 توكن/ثانية في prefill، وQwen3.6-27B بمعدل 17.8 توكن/ثانية في فك الترميز مع 470 توكن/ثانية في prefill. النماذج الكثيفة الأكبر مثل Llama 3.3 70B تُقدَّر بـ 7–12 توكن/ثانية.
M5 Pro أم M5 Max لنماذج LLM المحلية؟ M5 Max إذا كانت سرعة توليد التوكنات في النماذج الكبيرة أولويتك — فلديه عرض نطاق ذاكرة يبلغ 614 GB/s مقابل 307 GB/s في M5 Pro’s، ما يضاعف سرعة فك الترميز تقريبًا، ويدعم 128GB. وM5 Pro إذا أردت أفضل توازن بين السعر وسهولة الحمل والقدرة على تشغيل نماذج حتى 70B.
هل توليد الفيديو عملي على Mac؟ ليس حقًا، في 2026. انتشار الفيديو محدود بقدرة الحوسبة، وأجهزة Mac أبطأ عدة مرات من RTX 5090. النماذج المقطّرة تساعد — ينتج LTX 2.3 مقطعًا مدته 5 ثوانٍ في نحو 121 ثانية على M5 Max — لكن للإنتاجية الحقيقية، استئجار GPU سحابي أسرع وأرخص لكل مقطع بشكل كبير.
كيف أرفع حد ذاكرة GPU على macOS؟ التشغيل sudo sysctl iogpu.wired_limit_mb=61440 لتخصيص 60GB. تحقّق باستخدام sysctl iogpu.wired_limit_mb وأعد الضبط بقيمة 0. أضِفه إلى /etc/sysctl.conf ليلزم الإعداد بعد إعادة التشغيل. اترك دائمًا 4–8GB لـ macOS.
MLX أم llama.cpp على Apple Silicon؟ MLX في معظم الحالات. يتقدم على llama.cpp بنسبة 20–87% في النماذج دون 14B، ويستخدم ذاكرة أقل بنحو 10%، وهو ما تحوّل إليه Ollama 0.19 في مارس 2026. الاستثناء هو السياقات الطويلة جدًا — عند 30,000+ توكن، يمكن أن يكون llama.cpp مع Flash Attention أسرع بنسبة تصل إلى 50%.
هل أشتري مقاس 14 بوصة أم 16 بوصة؟ مقاس 16 بوصة للعمل المستمر في الذكاء الاصطناعي. لديه هامش حراري أفضل وبطارية أكبر ووضع High Power. أما مقاس 14 بوصة فيخفض أداءه بشكل ملحوظ تحت الحمل المستمر.
هل يتفوق M4 Max المخفّض السعر على M5 Pro الجديد؟ في فك ترميز LLM الخالص، غالبًا نعم — يمتلك M4 Max نحو 546 GB/s مقابل 307 GB/s في M5 Pro’s. ويتفوق M5 Pro في معالجة الموجّهات (أسرع حتى 4×) وتوليد الصور (أسرع أكثر من 3.8×) بفضل Neural Accelerators. اختر بناءً على عبء العمل الذي يغلب على استخدامك.
ما يأتي بعد ذلك
ثمة أمور قليلة تستحق المتابعة، لأنها قد تغيّر التوصية أعلاه.
معايير قياس مستقلة لـ M5 Pro على نماذج 70B. لم ينشر أحد رقمًا مقاسًا بدقة لفك الترميز بعد. إذا تجاوزت النتائج الواقعية 15 توكن/ثانية، فحجة “اشترِ الـ Max لفك الترميز” تضعف كثيرًا.
تكميمات gpt-oss-120b أصغر. إذا نزل إصدار دون 52GB، تضعف حجة سقف 64GB بين عشية وضحاها.
إعدادات macOS الافتراضية للذاكرة. إذا رفعت Apple التخصيص الافتراضي لذاكرة GPU فوق 75%، سيحصل كل من لديه جهاز بذاكرة 64GB على هامش إضافي مجاني.
استمرار تفوق MoE. الاتجاه نحو نماذج بإجمالي معاملات مرتفع ومعاملات نشطة منخفضة هو أفضل شيء حدث لأجهزة الذاكرة الموحدة. وكل إصدار MoE جديد يجعل أجهزة Mac أكثر تنافسية نسبيًا.
انخفاض أسعار API. أعد حساب نقطة التعادل بين المحلي والسحابي كل ستة أشهر. إنها تتغير.
الخلاصة
إن MacBook Pro M5 Pro بذاكرة 64GB ليس أسرع جهاز للذكاء الاصطناعي المحلي يمكنك شراؤه. بل ليس حتى أسرع جهاز Mac. ما هو عليه فعلًا هو التكوين الذي تتوقف فيه المقايضات عن التنازع.
يشغّل نماذج جيدة بما يكفي لتكون مفيدة فعلًا — gpt-oss-20b بسرعة 66–80 توكن/ثانية، وGLM-4.6 Air بنحو 30، وتوليد الصور في ثوانٍ — مع بقائه حاسوبًا محمولًا يمكنك حمله وتشغيله على البطارية واستخدامه حاسوبك الفعلي. أصلحت Neural Accelerators في جيل M5’s الضعف المحدد (بطء معالجة الموجّهات) الذي جعل أجهزة Mac السابقة محبطة للعمل الوكيلي وطويل السياق.
السقوف حقيقية وتستحق أن تعرفها: gpt-oss-120b لا يتسع، ونماذج 70B الكثيفة أدوات دفعية لا شركاء محادثة، وتوليد الفيديو مكانه السحابة.
إذا كانت هذه الحدود تناسب عملك، فهذا هو الجهاز. وإن لم تكن كذلك، فالأقسام أعلاه تخبرك بالضبط أي جهاز تشتري بدلًا منه — وهذا أنفع من مقال آخر يخبرك أن كل شيء على ما يرام.
تعكس الأسعار وإصدارات النماذج وأرقام معايير القياس في هذا المقال البيانات المتاحة في أغسطس 2026، وهي تتغير بسرعة — لا سيما أسعار Mac خلال نقص الذاكرة المستمر. تحقّق من المواصفات الحالية قبل الشراء.