
 ไทย
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

มีความเหนื่อยล้าในการตัดสินใจแบบเฉพาะเจาะจงมากที่จู่โจมคุณราว ๆ ห้าทุ่ม หลังดื่มกาแฟไปสามแก้ว ขณะจ้องอยู่ที่ตัวเลือกโมเดลของ OpenCode’s
คุณมีคีย์ Z.ai คุณมีคีย์ MiniMax ทั้งสองโมเดลอ้างว่ามีบริบทหนึ่งล้านโทเคน ทั้งคู่เป็นโอเพนเวต ทั้งคู่มีราคาแทบไม่มีนัยสำคัญเมื่อเทียบกับโมเดลปิดระดับแนวหน้า ทั้งคู่มีกราฟเบนช์มาร์กที่ตัวเองเป็นฝ่ายชนะ และคุณก็แค่อยากรู้ว่าจะตั้งตัวไหนเป็นค่าเริ่มต้นเพื่อกลับไปทำงานต่อ
บทความนี้คือคำตอบของคำถามนั้น — ฉบับยาว เพราะฉบับสั้น (“GLM-5.3-Flash น่าจะใช่”) ซ่อนข้อควรระวังราวหกข้อที่จะกัดคุณถ้าคุณข้ามมันไป
ผมได้รวบรวมรายละเอียดสถาปัตยกรรม เบนช์มาร์กจากผู้พัฒนา การประเมินจากฝ่ายกลาง ราคาต่อโทเคนจริงรวมถึงกับดักค่าบริการบริบทยาวแบบขั้นบันได เทเลเมทรีการใช้งานที่ OpenCode’s เผยแพร่เอง และไฟล์คอนฟิกจริงของทั้งสองโมเดล จากนั้นผมคำนวณต้นทุนสำหรับเดือนทำงานปกติ ไม่ใช่สถานการณ์ในข่าวประชาสัมพันธ์
นี่คือสิ่งที่ออกมา
TL;DR — คำตัดสินใน 30 วินาที
ใช้ GLM-5.3-Flash เป็นโมเดลเริ่มต้นใน OpenCode ของคุณ มันฉลาดกว่าในเกือบทุกเบนช์มาร์กด้านเอเจนต์และการเขียนโค้ดที่สำคัญ ราคาต่อโทเคนถูกกว่าประมาณครึ่งหนึ่ง ได้สัญญาอนุญาต MIT จริง ๆ และเป็นที่ที่ชุมชน OpenCode ไปกันจริง
เก็บ MiniMax M3 ไว้เป็นเลนความเร็วของคุณ มันสร้างข้อความได้เร็วกว่าประมาณสามเท่า และตอบถึงโทเคนแรกได้เร็วกว่าประมาณสองเท่า สำหรับลูปที่หมุนหลายรอบแต่ความยากต่ำ — เปลี่ยนชื่อไฟล์ ตั้งโครงเทสต์ สร้างเอกสาร รอบ lint-and-fix รีแฟกเตอร์ใหญ่แบบกลไก — ความต่างของความเร็วนั้นรู้สึกได้มากกว่าช่องว่างของความฉลาด
สรุปตรง ๆ ในบรรทัดเดียว: GLM-5.3-Flash คิดดีกว่า MiniMax M3 พิมพ์เร็วกว่า การเขียนโค้ดแบบเอเจนต์เป็นปัญหาการคิดเป็นหลัก GLM จึงได้ช่องค่าเริ่มต้น แต่ถ้าคุณไม่ได้ใช้ทั้งคู่ คุณก็ปล่อยทรูพุตทิ้งไปเปล่า ๆ และ OpenCode ทำให้การใช้ทั้งคู่ง่ายสุด ๆ
ตารางเปรียบเทียบแบบเร็ว
| GLM-5.3-Flash | MiniMax M3 | |
|---|---|---|
| ผู้พัฒนา | Z.ai (Zhipu AI) | MiniMax |
| เปิดตัว | 26 สิงหาคม 2026 | 1 มิถุนายน 2026 |
| พารามิเตอร์ทั้งหมด | 320B | ~428B |
| พารามิเตอร์ที่ใช้งานต่อโทเคน | 18B | ~23B |
| สถาปัตยกรรม | ไฮบริด KDA linear attention + NoPE sparse MLA, MoE (ผู้เชี่ยวชาญ 8 จาก 288 + แชร์ 1) | แกน GQA + MiniMax Sparse Attention (MSA), sparse MoE |
| หน้าต่างบริบท | 1M (1,048,576) | 1M (รับประกันพื้น 512K) |
| เอาต์พุตสูงสุด | 131,072 โทเคน | สูงสุด 262,144 โทเคน |
| อินพุตหลายรูปแบบ | ข้อความ รูปภาพ วิดีโอ ไฟล์ | ข้อความ รูปภาพ วิดีโอ |
| สัญญาอนุญาต | MIT | MiniMax Community License |
| ราคาอินพุต API | $0.15 / 1M (แคช $0.03) | $0.30 / 1M (แคช $0.06) |
| ราคาเอาต์พุต API | $0.50 / 1M | $1.20 / 1M |
| ค่าธรรมเนียมบริบทยาว | ไม่มีการประกาศ | 2× เมื่ออินพุตเกิน 512K |
| ความเร็วเอาต์พุต | ~48.6 โทเคน/วินาที | ~147.9 โทเคน/วินาที |
| เวลาถึงโทเคนแรก | ~1.51 วินาที | ~0.99 วินาที |
| Terminal-Bench 2.1 | 84.3 | 66.0 |
| Artificial Analysis Intelligence | 57 | 45 |
| ส่วนแบ่งโทเคนใน OpenCode | 10.3% | 1.12% |
| โหมดการคิด | เปิดตลอด (ปิดไม่ได้) | ปรับได้ |
| ราคาเริ่มต้นของการสมัครสมาชิก | $18/เดือน (GLM Coding Plan Lite) | $20/เดือน (MiniMax Plus) |
ราคาที่แสดงเป็นราคาตามรายการอย่างเป็นทางการจากแต่ละผู้ให้บริการ เกตเวย์แบบเราเตอร์อย่าง OpenRouter มักแสดงราคาที่ถูกกว่าจริง เพราะกระจายโหลดไปยังโฮสต์บุคคลที่สาม — มีรายละเอียดด้านล่าง เพราะเรื่องนี้สำคัญ
ทำไมการเปรียบเทียบนี้จึงสำคัญตอนนี้
สิบสองเดือนก่อน การพูดคุยเรื่องการเขียนโค้ดด้วยโมเดลโอเพนเวตเป็นเรื่องว่าโมเดลเหล่านี้ใช้งานได้เลยหรือไม่ คำถามนั้นจบไปแล้ว การพูดคุยในช่วงครึ่งหลังของปี 2026 แคบลงและน่าสนใจกว่า: คุณจะชี้ agent harness ของคุณไปที่โมเดลโอเพนเวตตัวไหน และถ้าเลือกผิดคุณต้องจ่ายเท่าไร?
OpenCode ทำให้คำถามนั้นคมขึ้น มันไม่ใช่หน้าต่างแชต — แต่เป็นเอเจนต์ที่อยู่ในเทอร์มินัล ซึ่งวางแผน อ่านไฟล์ แก้ไฟล์ รันคำสั่ง อ่านเอาต์พุต แล้ววนซ้ำ งานแบบนี้ลงโทษโมเดลในแบบที่เบนช์มาร์กแชตไม่เคยเผยให้เห็น โมเดลที่เขียนฟังก์ชันเดี่ยว ๆ ได้สวยงามยังใช้ไม่ได้ใน OpenCode ถ้ามันหลุดเธรดหลังเรียกเครื่องมือไปยี่สิบครั้ง หรือคิดค้นเส้นทางไฟล์ขึ้นมาเอง หรือเผาโทเคน 90,000 ตัวไปกับการตัดสินใจว่าจะทำอะไร
GLM-5.3-Flash และ MiniMax M3 เป็นโมเดลโอเพนเวตสองตัวที่เกี่ยวข้องกับบทสนทนานั้นอย่างน่าเชื่อถือที่สุดในตอนนี้ ทั้งคู่มาถึงห่างกันไม่เกินสามเดือน ทำงานเดียวกัน ราคาอยู่ในระดับเดียวกัน และเดินเดิมพันทางวิศวกรรมเกือบตรงข้ามกัน
ส่วนหลังนี่แหละที่น่าสนใจ
GLM-5.3-Flash คืออะไรกันแน่
GLM-5.3-Flash เป็นหนึ่งในการเปิดตัวที่ดีที่สุดของปี และมันไม่ใช่เรื่องบังเอิญ
ก่อนที่ Z.ai จะติดชื่อตัวเองลงบนสิ่งใด โมเดลนี้ปรากฏบน OpenRouter ภายใต้ชื่อรหัส “Ox Alpha.” ไม่มีการระบุแล็บ เข้าถึงได้เกือบฟรี ไม่มีการตลาด มันไต่ขึ้นไปอยู่อันดับต้นของชาร์ตการใช้งาน OpenRouter และ OpenCode อย่างเงียบ ๆ และอยู่ตรงนั้นราวหนึ่งสัปดาห์ระหว่างที่ชุมชนถกกันว่าใครสร้างมันขึ้นมา เมื่อวันที่ 26 สิงหาคม 2026 Z.ai ยืนยันว่าเป็นของตัวเอง และเปิดน้ำหนักโมเดลภายใต้ MIT
การปล่อยโมเดลออกสู่โลกและให้มันสร้างความน่าเชื่อถือก่อนจะอ้างว่าเป็นของตัวเองเป็นการเคลื่อนไหวที่ดีจริง และมันได้ผล — โมเดลมีข้อมูลการใช้งานจริงหนุนหลังก่อนที่ใครจะได้เห็นกราฟเบนช์มาร์ก
สถาปัตยกรรมในภาษาที่เข้าใจง่าย
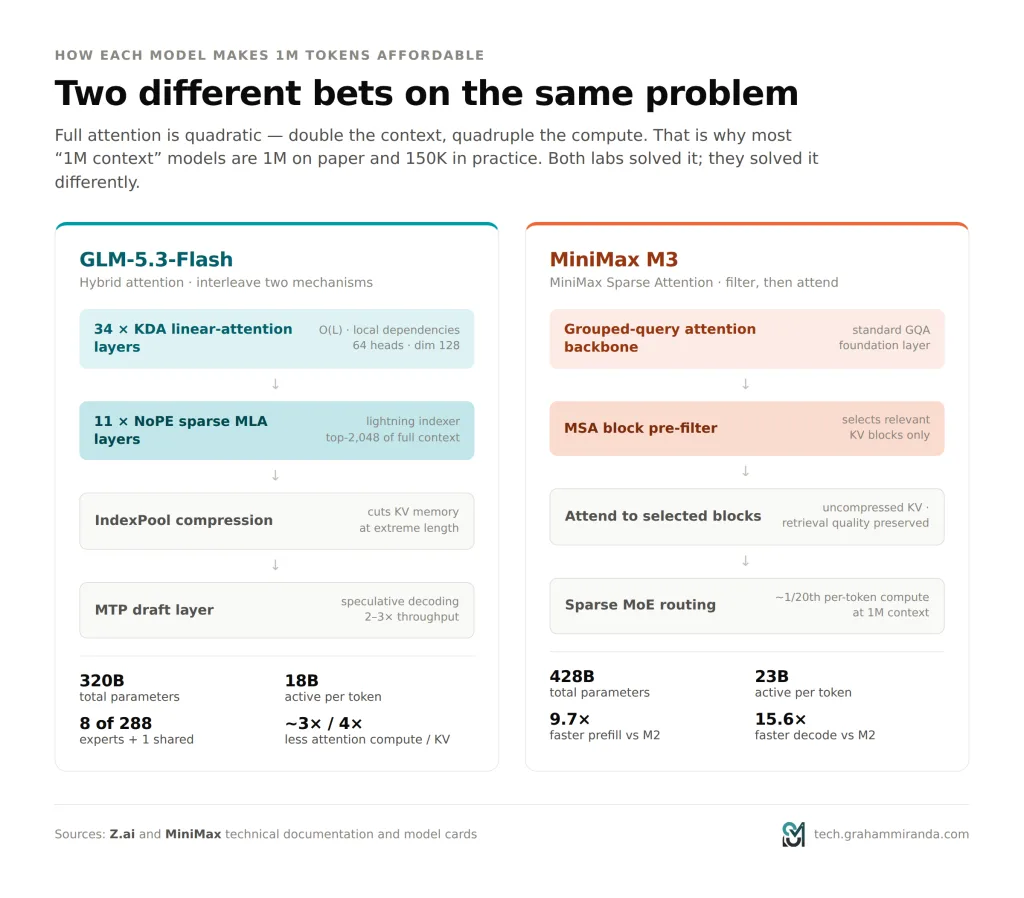
GLM-5.3-Flash เป็นโมเดล mixture-of-experts ขนาด 320 พันล้านพารามิเตอร์ที่เปิดใช้งานเพียงประมาณ 18 พันล้านพารามิเตอร์ต่อโทเคน มันส่งแต่ละโทเคนผ่านผู้เชี่ยวชาญแบบเราเตอร์ 8 จาก 288 ตัว บวกผู้เชี่ยวชาญที่แชร์กันอีก 1 ตัว — ประมาณ 2.8% ของน้ำหนักผู้เชี่ยวชาญจะทำงานในแต่ละฟอร์เวิร์ดพาส นั่นคือที่มาของเศรษฐศาสตร์แบบ “Flash”: ความรู้ระดับแนวหน้า ต้นทุนการอนุมานระดับโมเดลเล็ก
การออกแบบ attention คือส่วนใหม่จริง ๆ แทนที่จะใช้กลไก attention แบบเดียวกันหมด มันสลับสองแบบเข้าด้วยกัน:
- 34 เลเยอร์ KDA linear-attention เลเยอร์เหล่านี้ทำงานในเวลาเชิงเส้นเมื่อเทียบกับความยาวลำดับ แทนที่จะเป็นกำลังสอง พวกมันจัดการการพึ่งพาเฉพาะจุดได้ในราคาถูก และกันไม่ให้ทรูพุตทรุดลงเมื่อบริบทของคุณโตขึ้น
- 11 เลเยอร์ NoPE sparse MLA multi-head latent attention สไตล์ DeepSeek ที่ไม่มี positional embedding นำหน้าด้วย “lightning indexer” ที่เลือก 2,048 โทเคนที่เกี่ยวข้องที่สุดจากบริบททั้งหมด นี่คือสิ่งที่รักษาคุณภาพการดึงข้อมูลระยะไกล
นอกจากนี้ยังมี IndexPool ขั้นตอนบีบอัดที่รวมเวกเตอร์คีย์ของ indexer เพื่อลดภาระหน่วยความจำที่ความยาวบริบทสุดขั้ว และมี หัวทำนายหลายโทเคน สำหรับการถอดรหัสแบบคาดการณ์ — อิมพลีเมนเทชันใน vLLM ตั้งค่าเริ่มต้นไว้ที่ 5 โทเคนคาดการณ์ต่อขั้นตอนถอดรหัส ซึ่งให้ทรูพุต 2–3× ที่ขนาดแบตช์เล็ก
ผลสุทธิเมื่อเทียบกับ GLM-5.3 ตัวเต็ม: การคำนวณ attention ต่ำลงประมาณ 3× และ KV cache เล็กลงกว่า 4× นั่นคือเหตุผลว่าบริบท 1M โทเคนจึงใช้งานได้จริง ไม่ใช่แค่มีอยู่ในทางทฤษฎี
ทำไมมันสำคัญกับเอเจนต์เขียนโค้ด
สามเรื่องด้วยกัน
มันเป็นมัลติโมดัลโดยกำเนิด และนี่ไม่ใช่ลูกเล่นในบริบทนี้ โมเดลเขียนโค้ด GLM รุ่นก่อนมีจุดบอดกับทุกอย่างที่อ่านเป็นข้อความไม่ได้ ถ้าเอเจนต์ของคุณทำให้เลย์เอาต์พัง โมเดลที่รับได้แต่ข้อความก็ไม่มีทางรู้ GLM-5.3-Flash รับรูปภาพ วิดีโอ และไฟล์ได้โดยกำเนิด ซึ่งหมายความว่าการดีบั๊กด้วยภาพหน้าจอ การแปลงดีไซน์เป็นโค้ด และลูปตรวจสอบว่า “แบบนี้ดูถูกต้องจริงไหม” ล้วนเป็นไปได้
การคิดเป็นเรื่องบังคับ คุณปิดมันไม่ได้ คุณตั้งค่า reasoning_effort เพื่อ ต่ำ, สูง, หรือ สูงสุด (ค่าเริ่มต้นตามเอกสารคือ สูงสุด), แต่โมเดลคิดก่อนลงมือเสมอ สำหรับงานเอเจนต์ นี่คือค่าเริ่มต้นที่ถูกต้อง — โหมดล้มเหลวของโมเดลเขียนโค้ดราคาถูกคือการลงมืออย่างมั่นใจโดยไม่วางแผน และ Z.ai ได้ตัดตัวเลือกนั้นออกไป
การกระโดดข้ามรุ่นเป็นของจริง และมันมาจาก post-training GLM-5.3 ใช้โมเดลฐานเดียวกับ GLM-5.2 ทุกกำไรมาจากการขยาย post-training — มีรายงานว่าเพิ่มสภาพแวดล้อมงานระยะยาวขึ้นสิบเท่า ด้วยงานฝึกที่จำลองวงจรชีวิตซอฟต์แวร์ครบวงจรตั้งแต่ระบุบั๊ก ผ่านการทดสอบ ไปจนถึงดีพลอย บางงานมีขนาดเท่า “ภาระงานของวิศวกรอาวุโสหลายวัน” คะแนน DeepSWE v1.1 เพิ่มจาก 46.2 เป็น 63.4 ส่วน Terminal-Bench 3.0 เพิ่มจาก 4.6 เป็น 28.3 นั่นไม่ใช่ความต่างจากสัญญาณรบกวนของการปรับจูน
MiniMax M3 คืออะไรกันแน่
MiniMax M3 เปิดตัวเมื่อวันที่ 1 มิถุนายน 2026 และเดิมพันต่างออกไป: แทนที่จะปรับให้เก่งที่สุดด้านการให้เหตุผล กลับปรับให้เน้น เศรษฐศาสตร์ของลูปเอเจนต์ที่ทำงานต่อเนื่อง
มันเป็น sparse MoE ขนาด ~428B พารามิเตอร์ เปิดใช้งานประมาณ 23B พารามิเตอร์ต่อโทเคน สร้างบนแกน grouped-query-attention พร้อมกลไกของ MiniMax’s เอง MSA (MiniMax Sparse Attention) ที่วางทับด้านบน
เดิมพันของ MSA
attention แบบดั้งเดิมเป็นกำลังสอง: บริบทเพิ่มเป็นสองเท่า การคำนวณเพิ่มเป็นสี่เท่า นั่นคือเหตุผลที่โมเดล “บริบท 1M” ส่วนใหญ่มีบริบท 1M บนกระดาษ และมีบริบท 150K ในทางปฏิบัติ — คุณเติมหน้าต่างได้ในทางเทคนิค แต่คุณจะไม่อยากจ่าย
MSA แทน attention แบบเต็มด้วย การเลือกบล็อก KV. มันกรองบริบทล่วงหน้าเหลือเฉพาะบล็อกที่เกี่ยวข้อง แล้ว attend เฉพาะบล็อกเหล่านั้น โดยใช้ key-value ที่ไม่บีบอัด เพื่อให้คุณภาพการดึงข้อมูลอยู่รอดหลังการกรอง MiniMax รายงานผลลัพธ์ว่าอยู่ที่ประมาณ การคำนวณต่อโทเคนเพียง 1/20 ของรุ่นก่อนที่บริบท 1M พร้อมกับ prefill เร็วขึ้น 9.7× และถอดรหัสเร็วขึ้น 15.6× เทียบกับ M2
นี่เป็นงานวิศวกรรมที่ฉลาดจริง และมันปรากฏในตัวเลขที่คุณรู้สึกได้: เอาต์พุต ~148 โทเคน/วินาที และเวลาถึงโทเคนแรกต่ำกว่าหนึ่งวินาที เทียบกับ ~49 tok/sec และ TTFT ~1.5 วินาทีของ GLM-5.3-Flash แล้ว M3 ให้ความรู้สึกเหมือนเครื่องมือคนละคลาส ในลูปเอเจนต์ยาวที่มีหลายสิบรอบ ความต่างนั้นทบกันเป็นเวลาหลายนาทีต่อหนึ่งงาน
MiniMax ยังโปรโมต M3 ว่าทำ “เซสชันเขียนโค้ดอัตโนมัติ 8 ชั่วโมงขึ้นไป” ได้ มองนั่นเป็นคำกล่าวอ้าง ไม่ใช่สเปก — ยังไม่มีการตรวจสอบโดยอิสระ
จุดที่ M3 เก่งจริง ๆ
ด้านมัลติโมดัลและเอเจนต์เดสก์ท็อปของ M3 ถูกมองข้าม OSWorld-Verified ที่ 70.06% เป็นคะแนนที่จริงจังสำหรับงานเอเจนต์บนเดสก์ท็อป/GUI MCP Atlas ที่ 74.2% บอกว่าพฤติกรรมการเรียกใช้เครื่องมือของมันแข็งแรง GPQA Diamond ที่ 92.9% อยู่ใกล้ระดับแนวหน้าในการให้เหตุผลยาก และ SWE-bench Verified ที่ 80.5% เป็นตัวเลขพาดหัวที่แข็งแรง
ถ้างานของคุณคือ “ขับเบราว์เซอร์ อ่านวิดีโอ ใช้งาน UI เรียกเครื่องมือ MCP สิบสองตัวตามลำดับ” M3 ไม่ใช่การประนีประนอม อาจกล่าวได้ว่าเป็นเครื่องมือที่ดีกว่า
เบนช์มาร์ก — และสิ่งที่มันซ่อนไว้
ตรงนี้ผมต้องระวัง เพราะทั้งสองผู้พัฒนาปล่อยตัวเลขของตัวเอง และสองโมเดลนี้ถูกประเมินบน ชุดเบนช์มาร์กที่ต่างกัน. นั่นไม่ใช่เรื่องบังเอิญ แล็บเลือกการประเมินที่ตัวเองชนะ
จุดที่ทั้งคู่ทับซ้อนกันโดยตรง
| เบนช์มาร์ก | GLM-5.3-Flash | MiniMax M3 | สิ่งที่วัด |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 66.0 | งานเอเจนต์บนเชลล์/เทอร์มินัล |
| Artificial Analysis Intelligence Index | 57 | 45 | ความฉลาดโดยรวม |
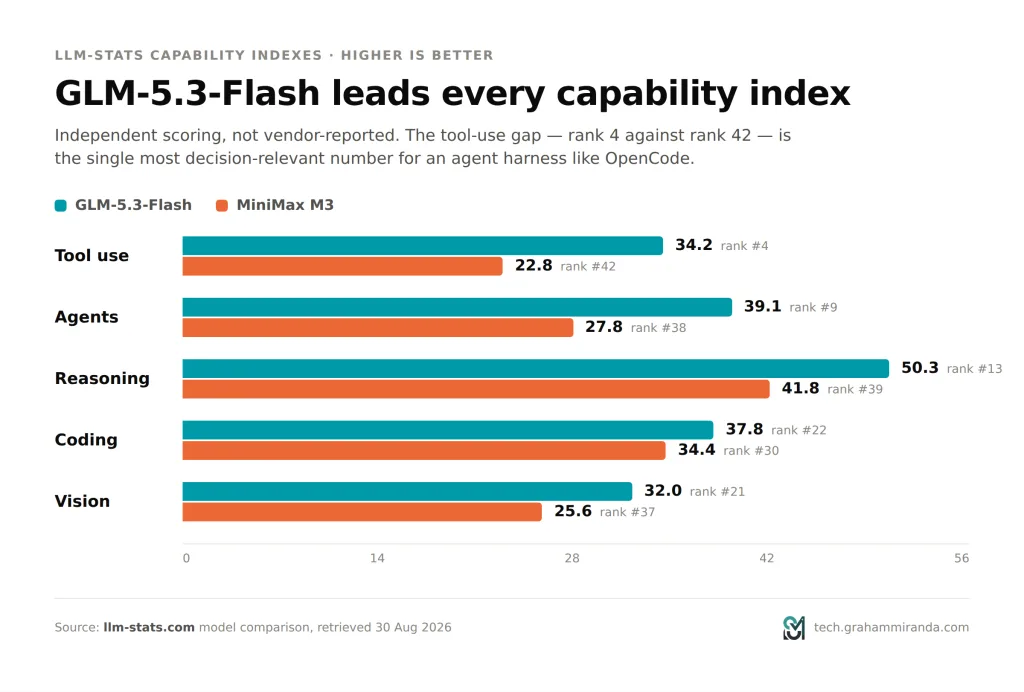
| ดัชนีการให้เหตุผล (llm-stats) | 50.3 (#13) | 41.8 (#39) | การให้เหตุผลหลายขั้นตอน |
| ดัชนีการเขียนโค้ด (llm-stats) | 37.8 (#22) | 34.4 (#30) | การสร้างโค้ด |
| ดัชนีเอเจนต์ (llm-stats) | 39.1 (#9) | 27.8 (#38) | การทำงานแบบเอเจนต์จนสำเร็จ |
| ดัชนีการใช้เครื่องมือ (llm-stats) | 34.2 (#4) | 22.8 (#42) | การเรียกฟังก์ชัน/เครื่องมือ |
| ดัชนีภาพ (llm-stats) | 32.0 (#21) | 25.6 (#37) | ความเข้าใจมัลติโมดัล |
Terminal-Bench 2.1 คือตัวที่ควรให้น้ำหนักมากที่สุดสำหรับ OpenCode เพราะเป็นตัวแทนสาธารณะที่ใกล้ที่สุดของสิ่งที่ OpenCode ทำจริง: เอเจนต์ในเทอร์มินัล รันคำสั่ง อ่านเอาต์พุต วนซ้ำ ช่องว่าง 18 คะแนนตรงนั้นไม่ใช่ความคลาดเคลื่อนจากการปัดเศษ
อันดับการใช้เครื่องมือเป็นอีกอันที่ผมไม่ข้าม GLM-5.3-Flash อยู่ที่ #4 โดยรวม เทียบกับ M3 ที่ #42 เป็นบรรทัดที่เกี่ยวกับการตัดสินใจมากที่สุดในบทความทั้งหมดนี้ agent harness คือเครื่องจักรเรียกเครื่องมือ โมเดลที่อยู่อันดับ 42 ด้านการใช้เครื่องมือจะสร้างการเรียกที่ผิดรูปแบบมากขึ้น ลองใหม่มากขึ้น รอบที่เสียเปล่ามากขึ้น — และทุกรอบที่เสียเปล่าต้องแลกด้วยโทเคนและ และ เวลาจริง ซึ่งลบข้อได้เปรียบด้านความเร็วของ M3’s อย่างเงียบ ๆ
จุดที่ GLM-5.3-Flash ยืนได้ด้วยตัวเอง
- Terminal-Bench 2.1: 84.3 — เทียบกับ Claude Opus 4.8 ที่ 85.0 ห่างจากโมเดลปิดระดับแนวหน้าไม่ถึงหนึ่งคะแนน ในราคาประมาณ 1/30
- DeepSWE v1.1: 63.4 — เพิ่มขึ้นจาก 46.2 ของ GLM-5.2’s
- AutomationBench v1.0.6: 48.8 — เทียบกับ Opus 4.8 ที่ 41.0 นี่คือช่องว่างที่กว้างที่สุดของมันเหนือโมเดลระดับแนวหน้า
- Z.ai Code Bench v1.0: 29.0 — Opus 4.8 ได้ 29.5
- GDPval-AA v2: 1773 — คะแนนสูงสุดในบรรดาโมเดลที่นำมาเทียบด้านความสามารถงานองค์ความรู้
- Toolathlon: 78.4 · OfficeQA Pro: 62.4 · CharXiv-R: 89.4% · MMVU: 80.5 · Chartography: 78.0
จุดที่ MiniMax M3 ยืนได้ด้วยตัวเอง
- SWE-bench Verified: 80.5%
- SWE-bench Pro: 59.0% — รีโปที่ยากกว่า รันด้วยโครง Claude Code
- MCP Atlas: 74.2% · OSWorld-Verified: 70.06% · GPQA Diamond: 92.9%
- KernelBench Hard: 28.8% · SWE-fficiency: 34.8%
ข้อควรระวังที่คุณควรนำมาใช้จริง
ตัวเลขเปิดตัวของทั้งสองแล็บ’ เป็นการรายงานตัวเอง ชุดเบนช์มาร์กของ MiniMax’s โดยเฉพาะยังไม่ปรากฏบนกระดานประเมินกลางตอนที่เปิดตัว และนักวิเคราะห์ของ Z.ai’s เองก็ตั้งข้อสังเกตว่า การเปลี่ยนเส้นทางอัตโนมัติจากโมเดลรุ่นเก่าบนแพลตฟอร์มของ Z.ai’s ทำให้การเปรียบเทียบ A/B แบบสะอาดเป็นเรื่องยากจริง ๆ
ในจุดที่ผู้รวบรวมคะแนนกลาง — Artificial Analysis และ llm-stats — ประเมินด้วยตัวเอง GLM-5.3-Flash ชนะทุกหมวดหมู่ นี่คือหลักฐานที่ผมให้น้ำหนักมากที่สุด เพราะไม่มีผู้ขายรายใดเป็นคนเลือกเบนช์มาร์กเหล่านั้นเอง
สัญญาณที่ไม่มีใครพูดถึง: ข้อมูลการใช้งานของ OpenCode เอง
นี่คือส่วนที่ผมเห็นว่าโน้มน้าวที่สุด และเป็นส่วนที่บทความเปรียบเทียบส่วนใหญ่ข้ามไปเสียสิ้น
OpenCode เผยแพร่ข้อมูลการใช้งานของโมเดลที่รันอยู่ภายใน ไม่ใช่คำกล่าวอ้างของผู้ขาย ไม่ใช่ชุดเบนช์มาร์ก แต่เป็นนักพัฒนาจริงที่ทำงานจริงและเลือกว่าจะใช้ตัวไหนต่อ
| เมตริก | GLM-5.3-Flash | MiniMax M3 |
|---|---|---|
| ผู้ใช้ไม่ซ้ำ | 566K | 436K |
| สัดส่วนโทเคนที่ประมวลผล | 10.3% | 1.12% |
| โทเคนในสองเดือน | 46T (+100%) | 5T (−51%) |
| ผู้ใช้ที่กลับมาในสัปดาห์แรก | รอดำเนินการ | 66% (32K ผู้ใช้-สัปดาห์) |
ลองอ่านตัวเลขสัดส่วนโทเคนสองตัวนั้นอีกครั้ง จำนวนผู้ใช้ใกล้เคียงกัน — GLM-5.3-Flash มีคนลองใช้มากกว่าประมาณ 30% — แต่ มีปริมาณโทเคนที่ประมวลผลมากกว่าเก้าเท่า
ช่องว่างนั้นไม่เกี่ยวกับว่าใครลองอะไร แต่เกี่ยวกับว่าใครเลือกใช้อะไรต่อเพื่องานจริง ผู้คนเปิดเซสชันกับ M3 และผู้คน อยู่ ในเซสชันที่ใช้ GLM-5.3-Flash
เส้นแนวโน้มบอกเรื่องเดียวกันชัดกว่า: GLM-5.3-Flash เพิ่มปริมาณโทเคนเป็นสองเท่าในสองเดือน ขณะที่ M3 สูญเสียไปครึ่งหนึ่ง
มีข้อแม้ที่ยุติธรรมอยู่สองข้อ ข้อแรก GLM-5.3-Flash ใหม่กว่าสามเดือน และโมเดลใหม่มักได้แรงหนุนจากความแปลกใหม่ เส้นกราฟของมันจะแบนลง ข้อสอง อัตราการกลับมาใช้ในสัปดาห์แรกของ M3 ที่ 66% เป็นตัวเลขที่ดี — คนที่เลือกมันไม่ได้ทิ้งมันไป แค่มีจำนวนน้อยกว่าและใช้มันเบากว่า และการลดลงของ M3 ส่วนหนึ่งมาจากการแย่งส่วนแบ่งกันเองของโมเดลรุ่นถัดไปของมันเอง และจังหวะการเปิดตัวแบบโอเพนเวตของจีนที่ถี่ขึ้น ไม่ใช่การถูกปฏิเสธล้วน ๆ
แต่ถ้าคุณกำลังถามว่า “ผู้ใช้ OpenCode ที่มีประสบการณ์รันอะไรอยู่จริง ๆ ทั้งวัน” ข้อมูลตอบได้อย่างไม่คลุมเครือ
ตั้งค่า MiniMax M3 ใน OpenCode
ให้เครดิตตามที่ควร: MiniMax ตั้งค่าง่ายกว่า, เพราะ OpenCode มีผู้ให้บริการ MiniMax ในตัว ไม่ต้องใช้ไฟล์คอนฟิก ไม่ต้องเขียน JSON ไม่ต้องตั้ง base URL
bash
# 1. Install OpenCode (skip if you already have it)
curl -fsSL https://opencode.ai/install | bash
# or: npm i -g opencode-ai

# 2. Authenticate
opencode auth login
# Select: "MiniMax Token Plan (minimax.io)"
# Paste your Subscription Key (starts sk-cp-...)

# 3. Go
opencode
จากนั้น /models ภายในเซสชัน แล้วเลือก MiniMax-M3.
กับดักชนิดของคีย์
ข้อนี้ทำให้คนเกือบทุกคนพลาด คีย์ MiniMax Token Plan (แบบสมัครสมาชิก) กับคีย์ API แบบจ่ายตามใช้งานใช้แทนกันไม่ได้ ทั้งสองแบบส่งคำขอคนละเส้นทางและคิดเงินคนละแบบ ถ้าคุณยืนยันตัวตนด้วยคีย์ PAYG กับผู้ให้บริการ Token Plan คุณจะเจอข้อผิดพลาดด้านการยืนยันตัวตนหรือยอดคงเหลือ ซึ่งดูเหมือนระบบล่ม แต่จริง ๆ แล้วคือการใช้คีย์ผิดประเภท
คีย์แบบสมัครสมาชิกขึ้นต้นด้วย sk-cp- และต้องมีการกำหนดที่นั่งหรือเครดิตให้ รับคีย์ของคุณได้จากหน้า Token Plan ในศูนย์ผู้ใช้ MiniMax ไม่ใช่หน้าคีย์ API ทั่วไป
ถ้าคุณต้องกำหนดบล็อกผู้ให้บริการเอง
ถ้าเวอร์ชัน OpenCode ของคุณเก่ากว่าผู้ให้บริการในตัว หรือคุณต้องการระบุคีย์ PAYG อย่างชัดเจน:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "minimax": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "MiniMax",
      "options": {
        "baseURL": "https://api.minimax.io/v1",
        "apiKey": "{env:MINIMAX_API_KEY}"
      },
      "models": {
        "MiniMax-M3": {
          "name": "MiniMax M3",
          "limit": {
            "context": 1000000,
            "output": 262144
          }
        }
      }
    }
  }
}
สังเกตค่า limit.contextที่ระบุไว้อย่างชัดเจน นั่นไม่ใช่ของประดับ — ดูหัวข้อถัดไป
กับดักหน้าต่างบริบทของ MiniMax (อ่านก่อนตัดสินใจ)
ถ้าคุณส่ง MiniMax M3 ผ่าน harness ที่รองรับ Anthropic — Claude Code หรือการตั้งค่า OpenCode ที่ใช้ @ai-sdk/anthropic กับ https://api.minimax.io/anthropic — มีบั๊กที่ถูกบันทึกไว้และยังไม่ปิด ซึ่งคุณต้องรู้
กรณี /anthropic ปลายทางรายงานหน้าต่างบริบท 200K แทนที่จะเป็น 1M ตามจริงของ M3
ดูเหมือนชั้นความเข้ากันได้จะสืบทอดเมทาดาทาของ Claude Sonnet แทนที่จะรายงานสเปกจริงของ M3 agent สำหรับเขียนโค้ดเชื่อเมทาดาทานั้นและกำหนดขนาดงบหน้าต่างบริบทตามนั้น — ซึ่งหมายความว่า การคอมแพ็กต์อัตโนมัติจะทำงานที่ราว 167K โทเคน ทั้งที่โมเดลรับได้สบาย ๆ ถึงห้าเท่าของจำนวนนั้น
นี่คือโหมดความล้มเหลวที่น่ารำคาญจริง ๆ เพราะมองไม่เห็น agent ของคุณไม่แสดงข้อผิดพลาด มันแค่เริ่มลืมสิ่งต่าง ๆ เงียบ ๆ เร็วเกินกว่าที่ควร และคุณจะเสียเวลาทั้งบ่ายสงสัยว่าทำไมโมเดลที่มีหน้าต่างโทเคนหนึ่งล้านถึงหลุดประเด็นตั้งแต่ไฟล์ที่สองของการรีแฟกเตอร์ ปัญหานี้ถูกแจ้งในวันเดียวกับที่ M3 เปิดตัวและยังเปิดอยู่
วิธีเลี่ยงปัญหา
ใน OpenCode: ให้ใช้ผู้ให้บริการ MiniMax ในตัว (เส้นทางที่เข้ากันได้กับ OpenAI) แทนเส้นทาง Anthropic และตั้งค่า limit.context อย่างชัดเจน ถ้าคุณกำหนดบล็อกผู้ให้บริการเอง
ใน Claude Code, ให้เขียนทับหน้าต่างการคอมแพ็กต์โดยตรง:
json
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.minimax.io/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "<YOUR_MINIMAX_SUBSCRIPTION_KEY>",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "MiniMax-M3[1m]"
  }
}
มีสองรายละเอียดที่สำคัญ คือ [1m] ต่อท้ายรหัสโมเดลเพื่อขอตัวแปรแบบบริบทเต็ม และ ตัวแปรสภาพแวดล้อมของเชลล์เขียนทับ settings.json ในพฤติกรรมตามเอกสารของ MiniMax ถ้าคุณมีค่า ANTHROPIC_BASE_URL ที่ export ไว้ใน .zshrc, มันจะชนะอย่างเงียบ ๆ และคุณจะเสียเวลาหาสาเหตุโดยเปล่าประโยชน์
อีกอย่าง — อย่าตั้งข้อมูลรับรองของผู้ให้บริการเป็นการ export ระดับ global ANTHROPIC_BASE_URL เป็นตัวแปรระดับ global การ export แบบถาวรจะเปลี่ยนเส้นทางทุกเครื่องมือที่พูดภาษา Anthropic บนเครื่องคุณไปยัง MiniMax อย่างเงียบ ๆ ให้จำกัดขอบเขตเป็นรายโปรเจกต์หรือรายครั้งที่เรียกใช้
ตั้งค่า GLM-5.3-Flash ใน OpenCode
OpenCode มีผู้ให้บริการ Z.AI ในตัวเช่นกัน ดังนั้นวิธีนี้ก็ง่ายพอ ๆ กัน — แต่มีทางแยกอยู่หนึ่งจุด
bash
# 1. Get a key from Z.ai — either a standard API key or a GLM Coding Plan key
# 2. Authenticate
opencode auth login
# Select "Z.AI" for a standard API key
# Select "Z.AI Coding Plan" for a Coding Plan subscription key

# 3. Start OpenCode, then pick your model
opencode
/models   # select GLM-5.3-Flash
เลือกผู้ให้บริการให้ตรงกับชนิดของคีย์ คีย์ API มาตรฐานกับคีย์ Coding Plan ใช้เส้นทางและวิธีคิดเงินคนละแบบ เลือกผิดจะเกิดข้อผิดพลาดด้านการยืนยันตัวตนหรือยอดคงเหลือ ซึ่งดูเหมือนบัญชีมีปัญหา
ปลายทางของ Coding Plan
ถ้าคุณต่อทุกอย่างเองหรือตั้งค่าเครื่องมืออื่น ชุดนักพัฒนาของ Z.ai เปิดให้ใช้สามแบบ:
| โปรโตคอล | Base URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
มีข้อจำกัดหนึ่งที่ควรบอกไว้: GLM Coding Plan ถูก จำกัดตามสัญญาให้ใช้กับเครื่องมือที่รองรับอย่างเป็นทางการเท่านั้น — Claude Code, OpenCode, Cline, Roo Code, Kilo Code, Cursor, Goose, Crush, OpenClaw และอื่น ๆ อีกไม่กี่ตัว ถ้าคุณวางแผนจะใช้คีย์ Coding Plan กับ harness ที่คุณสร้างเอง อ่านข้อกำหนดก่อน งานแบบนั้นให้ใช้ API มาตรฐาน
บล็อกผู้ให้บริการแบบกำหนดเอง
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3-flash": {
          "name": "GLM-5.3-Flash",
          "limit": {
            "context": 1048576,
            "output": 131072
          },
          "options": {
            "reasoning_effort": "high",
            "temperature": 1,
            "top_p": 0.95
          }
        }
      }
    }
  },
  "model": "zai/glm-5.3-flash"
}
การตั้งค่าการสุ่มตัวอย่างที่แนะนำ
คำแนะนำที่ Z.ai ระบุไว้ในเอกสารสำหรับ GLM-5.3-Flash ซึ่งผมจะไม่เบี่ยงจากมันถ้าไม่มีเหตุผล:
temperature: 1top_p: 0.95reasoning_effort: max(ค่าเริ่มต้นตามเอกสาร)thinking.clear_thinking: falsestream: trueและtool_stream: trueสำหรับคำขอแบบสตรีมมิง
reasoning_effort คือปุ่มหลักของคุณในการชั่งน้ำหนักคุณภาพกับความหน่วง ต่ำ สำหรับงานที่ไวต่อความหน่วง สูง สำหรับงานเขียนโค้ดขนาดใหญ่ สูงสุด สำหรับปัญหาที่ยากที่สุด เมื่อ GLM-5.3-Flash เป็นโมเดลที่ช้ากว่าในสองตัวอยู่แล้วที่ ~49 tok/sec สูง เป็นการตั้งค่าที่สมเหตุสมผลสำหรับใช้ทุกวัน และ สูงสุด คือสิ่งที่คุณหยิบมาใช้เมื่องานนั้นเอาชนะ สูง.
การตั้งค่าที่ผมแนะนำจริง ๆ: ใช้ทั้งสองตัว
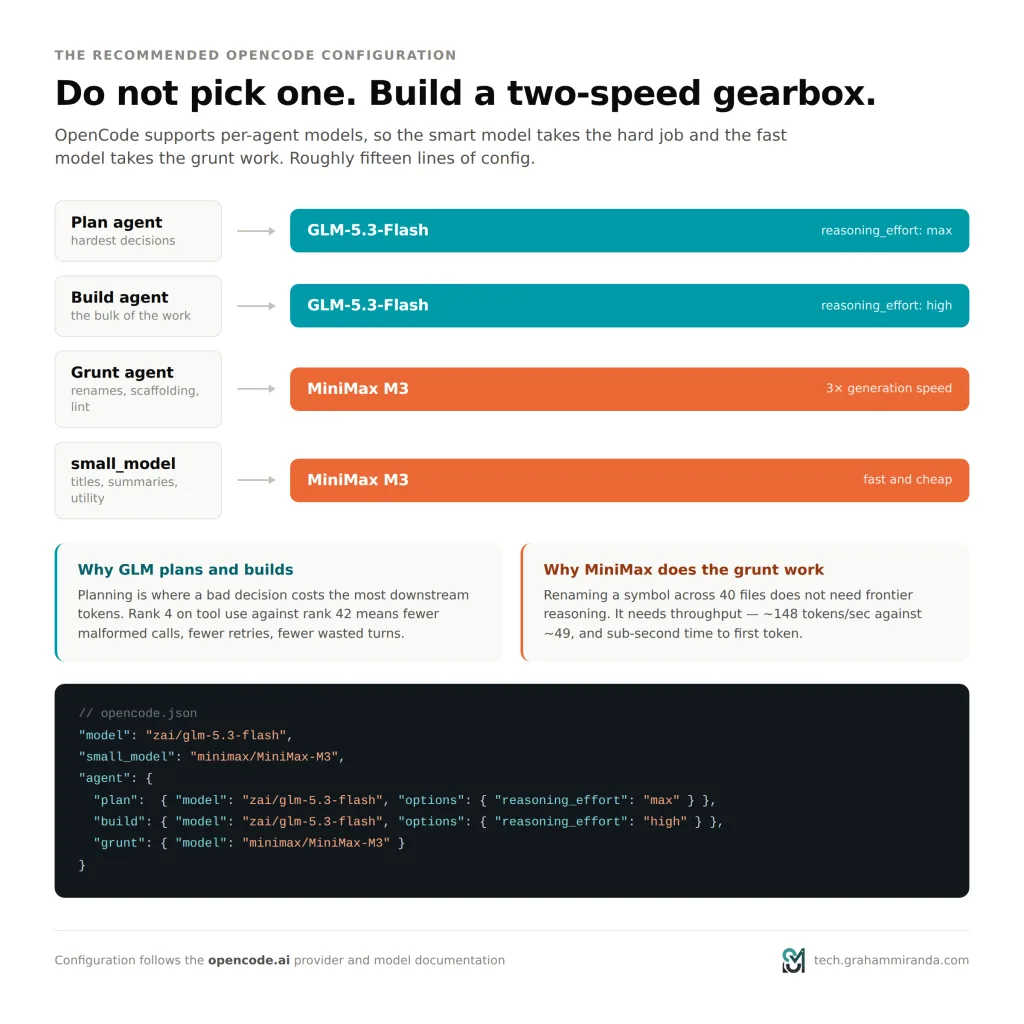
นี่คือจุดที่กรอบความคิดแบบ “ตัวต่อตัว” ใช้ไม่ได้ เพราะ OpenCode ไม่ได้บังคับให้คุณเลือกตัวเดียว คอนฟิกของมันรองรับโมเดลแยกตาม agent ซึ่งหมายความว่าคุณเอาโมเดลที่ฉลาดกว่าไปใช้งานยาก และโมเดลที่เร็วกว่าไปใช้งานหยาบ ๆ ได้
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3-flash",
  "small_model": "minimax/MiniMax-M3",
  "agent": {
    "build": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "high" }
    },
    "plan": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "max" }
    },
    "grunt": {
      "description": "Mechanical, high-volume edits: renames, test scaffolding, docstrings, lint fixes",
      "model": "minimax/MiniMax-M3"
    }
  }
}
เหตุผลคือ:
- งานวางแผนได้
reasoning_effort: maxGLM-5.3-Flash การวางแผนคือจุดที่การตัดสินใจผิดทำให้คุณเสียโทเคนปลายทางมากที่สุด จ่ายเพื่อความคิดที่ดีที่สุดที่คุณจ่ายไหวในขั้นนี้ - งานสร้างได้
สูง. สมดุลที่ดีระหว่างคุณภาพและความหน่วงสำหรับงานส่วนใหญ่ - งานกลไกยกให้ M3 การเปลี่ยนชื่อสัญลักษณ์ใน 40 ไฟล์ไม่จำเป็นต้องใช้โมเดลอันดับ 4 ด้านการใช้เครื่องมือ สิ่งที่ต้องใช้คือปริมาณงานที่ทำได้ต่อเวลา และ M3 เร็วกว่าสามเท่า
small_modelจัดการงานธุรการภายในของ OpenCode — การสร้างหัวข้อ การสรุป และการเรียกใช้ย่อยเล็ก ๆ ชี้ไปที่ตัวที่เร็วและถูก
คุณไม่ได้กำลังเลือกผู้ชนะ คุณกำลังสร้างชุดเกียร์สองความเร็ว
คำนวณต้นทุนด้วยตัวเลขจริง
เบนช์มาร์กเป็นเรื่องนามธรรม ใบแจ้งหนี้ไม่ใช่ ให้ผมลองจำลองงานแบบ agent ที่สมจริงแล้วคิดผ่านตารางราคาทั้งสอง
สถานการณ์
ฟีเจอร์ขนาดกลางหนึ่งตัว ทำแบบ agent ใน OpenCode: ประมาณ 60 รอบการเรียกเครื่องมือ, เฉลี่ย 45K โทเคนอินพุตต่อรอบ เมื่อบริบทสะสม และ 2K โทเคนเอาต์พุตต่อรอบ.
- อินพุตรวม: 2.7M โทเคน
- เอาต์พุตรวม: 120K โทเคน
- อัตราการแคชพรอมต์ที่สมมติไว้: 80% (แคช 2.16M, ใหม่ 540K)
GLM-5.3-Flash
| อุปกรณ์ | โทเคน | อัตรา | ค่าใช้จ่าย |
|---|---|---|---|
| อินพุตใหม่ | 540K | $0.15/M | $0.081 |
| อินพุตแคช | 2.16M | $0.03/M | $0.065 |
| เอาต์พุต | 120K | $0.50/M | $0.060 |
| รวม | ≈ $0.21 |
MiniMax M3 (ระดับมาตรฐาน, อินพุต ≤512K)
| อุปกรณ์ | โทเคน | อัตรา | ค่าใช้จ่าย |
|---|---|---|---|
| อินพุตใหม่ | 540K | $0.30/M | $0.162 |
| อินพุตแคช | 2.16M | $0.06/M | $0.130 |
| เอาต์พุต | 120K | $1.20/M | $0.144 |
| รวม | ≈ $0.44 |
GLM-5.3-Flash ถูกกว่าราว 2.1 เท่าสำหรับงานแบบเดียวกัน สอดคล้องกับการประเมินอิสระที่ว่าถูกกว่าราว 2.2 เท่าเมื่อคิดแบบผสมอินพุตต่อเอาต์พุต 3:1
ขยายเป็นหนึ่งเดือน
งานแบบนี้วันละสี่งาน ยี่สิบวันทำการ — 80 รอบการทำงานของเอเจนต์:
- GLM-5.3-Flash: ≈ $16.50/เดือน
- MiniMax M3: ≈ $35/เดือน
ค่าธรรมเนียมบริบทยาวที่ไม่มีใครพูดถึง
นี่คือกับดัก ราคาของ MiniMax M3 แบ่งระดับตามความยาวอินพุต, และเมื่อคำขอใดคำขอหนึ่งเกิน 512K โทเคนอินพุต อัตราจะเพิ่มเป็นสองเท่า:
| ระดับ | อินพุต | เอาต์พุต | อ่านแคช |
|---|---|---|---|
| อินพุต ≤512K | $0.30/M | $1.20/M | $0.06/M |
| อินพุต >512K | $0.60/M | $2.40/M | $0.12/M |
| ระดับลำดับความสำคัญ | 1.5 เท่าของมาตรฐาน | 1.5 เท่าของมาตรฐาน | 1.5 เท่าของมาตรฐาน |
ดังนั้นพาดหัวที่ว่า “บริบท 1M” มาพร้อมหมายเหตุท้าย: ครึ่งหลังของหน้าต่างนั้นมีค่าใช้จ่ายสองเท่า ถ้าเวิร์กโฟลว์ของคุณโหลดรีโพซิทอรีขนาดใหญ่เข้าบริบทจริง ๆ M3 จะเปลี่ยนจากแพงกว่า GLM-5.3-Flash 2 เท่าเป็นราว แพงกว่า 4 เท่า พอดีในเวลาที่คุณต้องการบริบทมากที่สุด
Z.ai ไม่ได้ประกาศค่าธรรมเนียมแบบเดียวกันสำหรับ GLM-5.3-Flash โทเคนหนึ่งล้านของมันคิดราคาแบบคงที่
การสมัครสมาชิกเทียบกับจ่ายตามใช้งาน
| GLM Coding Plan | MiniMax Token Plan | |
|---|---|---|
| ระดับเริ่มต้น | Lite $18/เดือน (~80 พรอมต์/5 ชม., ~400/สัปดาห์, 100 การเรียก MCP/เดือน) | Plus $20/เดือน (~3–4 agent) |
| ระดับกลาง | Pro $72/เดือน (~400 พรอมต์/5 ชม., ~2,000/สัปดาห์, 1,000 การเรียก MCP) | Max $50/เดือน (~4–5 agent, สร้างวิดีโอ 3 ครั้ง/วัน) |
| ระดับสูงสุด | Max $160/เดือน (~1,600 พรอมต์/5 ชม., ~8,000/สัปดาห์, 4,000 การเรียก MCP) | Ultra $120/เดือน (~6–7 agent, สร้างวิดีโอ 5 ครั้ง/วัน) |
| ส่วนลดรายปี | ลด ~30% | ไม่เปิดเผย |
| โมเดลที่รวมอยู่ | GLM-5.3, GLM-5.3-Flash, GLM-5.2, GLM-5-Turbo | ตระกูลโมเดล MiniMax |
สองรายละเอียดที่เปลี่ยนการคำนวณ
GLM-5.3-Flash ได้โควตา 3 เท่าใน Coding Plan เมื่อเทียบกับ GLM-5.3 และการใช้งานนอกช่วงพีคใช้คะแนนเพียง 50% ของปกติ การเลือก Flash แทน GLM-5.3 เต็มตัวจึงเพิ่มมูลค่าการสมัครสมาชิกของคุณเป็นสามเท่าโดยพฤตินัย และการย้ายงานหนักออกนอกช่วงพีค 14:00–18:00 UTC+8 จะยืดออกไปได้อีก
โควตาของ MiniMax ไม่ทบไปงวดถัดไป โควตาที่ไม่ได้ใช้จะหมดอายุเมื่อสิ้นสุดรอบบิลแต่ละรอบ และ MiniMax เองแนะนำให้ใช้แบบจ่ายตามใช้งานสำหรับการใช้งานจริงในโปรดักชัน มากกว่า Token Plan
ที่การใช้งานตามที่ผมจำลองไว้ (~$16–35 ต่อเดือนสำหรับโทเคน) การจ่ายตามใช้งานกับการสมัครสมาชิกระดับเริ่มต้นแทบจะเสมอกัน เมื่อใช้งานแบบ agent เกินราว 6–8 ชั่วโมงต่อวัน การสมัครสมาชิกชนะขาด — GLM Coding Plan Lite ราคา $18 ที่ครอบคลุม ~400 พรอมต์ต่อสัปดาห์นั้นเอาชนะได้ยากจริง ๆ
หมายเหตุเรื่องราคาผ่านเกตเวย์
คุณจะเห็นตัวเลขที่ต่างกันมากแล้วแต่ว่าดูที่ไหน OpenRouter ระบุ GLM-5.3-Flash ราว $0.05/M อินพุต และ $0.17/M เอาต์พุต ส่วนข้อมูลโมเดลของ OpenCode เองแสดง $0.07/M และ $0.25/M ทั้งสองต่ำกว่าราคาทางการของ Z.ai ที่ $0.15/$0.50
นั่นไม่ใช่ความขัดแย้ง เกตเวย์ที่ส่งต่อไปยังผู้ให้บริการหลายรายกระจายโหลดข้ามโฮสต์บุคคลที่สามกว่า 20 ราย — Baseten, DeepInfra, Novita, Cloudflare และอื่น ๆ — และโฮสต์เหล่านั้นแข่งขันกันที่ราคา คุณได้ GLM-5.3-Flash ถูกกว่าราคาปลีกผ่านเกตเวย์ได้แน่นอน แต่คุณแลกกับความสม่ำเสมอ ปริมาณงานบน OpenRouter อยู่ระหว่าง 8 ถึง 111 โทเคน/วินาที ขึ้นกับว่าคุณไปตกที่ผู้ให้บริการรายไหน ซึ่งสำหรับลูป agent ที่ยาวนานแล้ว นั่นคือความต่างระหว่างงานสองนาทีกับงานสิบห้านาที
สำหรับงานของเอเจนต์ ผมยอมจ่ายราคาตามรายการให้ผู้ให้บริการรายแรกโดยตรงเพื่อให้ได้แลตเทนซีที่คาดเดาได้ ใช้เกตเวย์สำหรับงานแบบแบตช์และการทดลอง
ไลเซนส์และการโฮสต์เอง: ส่วนที่ธุรกิจในยุโรปควรอ่านสองครั้ง
ถ้าคุณบริหารบริษัทในสหภาพยุโรป ไลเซนส์ไม่ใช่แค่หมายเหตุท้ายหน้า แต่เป็นคำถามด้านการจัดซื้อจัดจ้าง
GLM-5.3-Flash: MIT
น้ำหนักโมเดลอยู่บน Hugging Face ที่ zai-org/GLM-5.3-Flash ภายใต้ ไลเซนส์ MIT. นั่นคือความเปิดกว้างระดับสูงสุดที่ไลเซนส์ซอฟต์แวร์จะให้ได้: ใช้เชิงพาณิชย์ได้ แก้ไขได้ แจกจ่ายต่อได้ ฝังลงในผลิตภัณฑ์ได้ ไม่มีเกณฑ์รายได้ ไม่มีภาคผนวกข้อกำหนดการใช้งานที่ยอมรับได้ ไม่มีข้อจำกัดขอบเขตการใช้งาน เพียงเก็บประกาศลิขสิทธิ์ไว้ก็เสร็จ
สำหรับธุรกิจในเยอรมนีหรือสหภาพยุโรป การมี MIT บวกน้ำหนักโมเดลที่โฮสต์เองได้หมายความว่าคุณวางทั้งหมดไว้ในโครงสร้างพื้นฐานของคุณเองได้ และทำให้ถิ่นที่อยู่ของข้อมูลไม่เป็นประเด็นอีกต่อไป — ไม่ต้องประเมินการโอนข้อมูลข้ามพรมแดน ไม่ต้องทำข้อตกลงผู้ประมวลผลกับผู้ขายจีน ไม่ต้องพึ่งความพร้อมใช้งานของ’ระบบคนอื่น
MiniMax M3: MiniMax Community License
น้ำหนักของ M3’ เปิดให้ใช้บน Hugging Face เช่นกัน แต่ภายใต้ MiniMax Community License — ไลเซนส์ที่กำหนดเอง ไม่ใช่ไลเซนส์เปิดมาตรฐาน ปฏิกิริยาจากคอมมิวนิตี้เป็นไปในทางบวกโดยรวม (เปิดกว้างกว่าไลเซนส์ที่ M2.7 ใช้ตอนเปิดตัว) และหลายแหล่งระบุว่าการใช้งานเชิงพาณิชย์ในทางปฏิบัติไม่มีข้อจำกัด
แต่ “ถูกระบุว่าไม่มีข้อจำกัด” กับ “ผ่านการตรวจสอบโดยที่ปรึกษากฎหมายของคุณ” เป็นคนละเรื่องกัน ถ้า MiniMax M3 จะถูกนำไปใช้ในผลิตภัณฑ์เชิงพาณิชย์ ให้อ่านตัวบทไลเซนส์ด้วยตัวเองก่อนปล่อยสินค้า ไลเซนส์ที่กำหนดเองเพิ่มภาระในการตรวจสอบซึ่ง MIT ไม่มีเลย
เช็กความจริงเรื่องการโฮสต์เอง
ทั้งสองโมเดลเป็นโอเพนเวต แต่ไม่มีตัวไหนรันบนแล็ปท็อปของคุณ
GLM-5.3-Flash:
- เช็กพอยต์ FP8: 331 GB แบ่งเป็น 62 ชาร์ด (~306 GiB ของน้ำหนักก่อนรวม KV cache)
- เวอร์ชัน BF16: 640 GB แบ่งเป็น 120 ชาร์ด
- FP8 ที่ TP=4 บน GB200 เครื่องเดียว: ~386 GB VRAM
- BF16 ที่ TP=8: ~772 GB VRAM
- ต้องมี รุ่น Hopper หรือใหม่กว่า — H100/H200/B200/B300/GB200/GB300 หรือ AMD MI300X/MI325X/MI355X
- สแตก: vLLM 0.29.0+, FlashInfer 0.6.17+; รองรับ SGLang, TokenSpeed, KTransformers, Transformers, Unsloth ด้วย
MiniMax M3:
- ประมาณ 214 GB ที่การควอนไทซ์ 4 บิต — เล็กกว่า แต่ยังอยู่ในระดับเซิร์ฟเวอร์เต็มตัว
โครงสร้างพื้นฐานที่ Z.ai’ โฮสต์เองรายงานว่าได้เอาต์พุต ~48.7 โทเคน/วินาที โดยมี TTFT 1.52 วินาที และที่ TP=4 บน GB200 มี KV พูลขนาด 14.92M โทเคน รองรับคอนเคอร์เรนซีสูงสุด 113.81× ที่บริบท 128K นั่นคือขนาดฮาร์ดแวร์ที่ต้องใช้เพื่อให้บริการนี้ได้อย่างเหมาะสม
แปลให้เห็นภาพ: การโฮสต์โมเดลใดโมเดลหนึ่งเองหมายถึงการเช่าหรือซื้อ GPU สำหรับศูนย์ข้อมูลหลายตัว สำหรับทีมส่วนใหญ่ — รวมถึงลูกค้าส่วนใหญ่ของผม — คำตอบที่ถูกคือใช้ API โดยมีน้ำหนักแบบเปิดทำหน้าที่เป็น หลักประกัน. ถ้าผู้ขายขึ้นราคา ทำให้โมเดลแย่ลง หรือหายไป คุณยังมีทางออก ทางเลือกนั้นมีคุณค่าจริงแม้คุณจะไม่เคยใช้มันเลย
แต่ละโมเดลพลาดตรงไหนจริง ๆ
ไม่มีส่วนโฆษณาเกินจริง นี่คือจุดอ่อนตามจริง
จุดอ่อนของ GLM-5.3-Flash
มันช้า เอาต์พุต ~48.6 โทเคน/วินาที และใช้เวลา ~1.51 วินาทีถึงโทเคนแรก เทียบกับ M3’ ที่ ~148 โทก/วินาที และ ~0.99 วินาที คุณจะรู้สึกได้ทุกครั้งที่โมเดลสร้างข้อความยาว ในลูปเอเจนต์ 40 เทิร์น สิ่งนี้รวมกันเป็นเวลาหลายนาทีที่ต้องนั่งรอเปล่า ๆ
คุณปิดโหมดคิดไม่ได้ การบังคับให้ใช้การให้เหตุผลนั้นถูกต้องสำหรับงานเอเจนต์ที่ยาก และสิ้นเปลืองสำหรับคำสั่งง่าย ๆ ทุกคำขออย่าง “เพิ่ม docstring ให้ฟังก์ชันนี้” ต้องจ่ายภาษีการให้เหตุผล นี่คือเหตุผลที่คุณอยากต่อ M3 หรือโมเดลเล็กกว่าไว้ทำงานหนักซ้ำ ๆ
โทเคนการให้เหตุผลคือโทเคนที่ถูกคิดเงิน ด้วย reasoning_effort: max เป็นค่าเริ่มต้นตามเอกสาร ต้นทุนจริงต่องานจะสูงกว่าการประมาณแบบง่าย ๆ จากจำนวนอินพุต/เอาต์พุตเพียงอย่างเดียว ตั้งเป็น สูง เว้นแต่งานนั้นจะคุ้มค่า สูงสุด.
มันยังใหม่ เปิดตัว 26 สิงหาคม 2026 บั๊กการเชื่อมต่อปลายหางในระบบนิเวศของ harness ยังไม่ได้โผล่ขึ้นมาทั้งหมด และองค์ความรู้ของคอมมิวนิตี้ยังบางอยู่ ถ้าคุณเจอโหมดความล้มเหลวที่หาได้ยาก คุณอาจเป็นคนแรกที่รายงานมัน
อย่าสับสนกับ GLM-5.3 โมเดลทั้งสองเป็นโมเดลต่างกันที่มีความสามารถต่างกัน — ที่สำคัญคือ GLM-5.3 ที่ไม่ใช่ Flash รองรับข้อความเท่านั้น การส่งรูปภาพไปยัง ID โมเดลผิดเป็นความผิดพลาดช่วงแรกที่พบบ่อย
จุดอ่อนของ MiniMax M3
อันดับการใช้งานเครื่องมือคือปัญหาใหญ่จริง อยู่อันดับ #42 ในดัชนีการใช้เครื่องมือของ llm-stats’ เทียบกับ GLM-5.3-Flash ที่อันดับ #4 สำหรับ agent harness นี่คือความสามารถหลักที่แบกงานไว้ คาดว่าจะมีการเรียกเครื่องมือที่ผิดรูปแบบมากขึ้น รีทรายมากขึ้น และเสียเทิร์นไปกับการกู้คืนมากขึ้น — ซึ่งกินข้อได้เปรียบด้านความเร็วที่คุณจ่ายไป
บั๊กการรายงานขนาดบริบทยังไม่ถูกแก้ เปิดค้างตั้งแต่เปิดตัว หาทางเลี่ยงได้ แต่ก็เป็นบาดแผลเล็ก ๆ ที่ต้องแบกไว้
การตรวจสอบอิสระยังมีน้อย เบนช์มาร์กตอนเปิดตัวของ MiniMax’ ยังไม่ปรากฏบนกระดานที่เป็นกลาง และในจุดที่ผู้รวบรวมข้อมูลอิสระวัดได้ M3 อยู่อันดับกลางตาราง ไม่ใช่ใกล้หัวตาราง ช่องว่างระหว่างการนำเสนอของผู้ขายกับการวัดของบุคคลที่สามตรงนี้กว้างกว่าของ Z.ai
ราคาบริบทยาวเพิ่มเป็นสองเท่าเมื่อเกิน 512K ฟีเจอร์ที่เป็นจุดขายมีค่าใช้จ่ายส่วนเพิ่มพ่วงมาด้วย
ไลเซนส์ที่กำหนดเอง ต้องตรวจสอบทางกฎหมายเพิ่มเติมก่อนนำไปใช้เชิงพาณิชย์
การใช้งานลดลง ปริมาณโทเคนใน OpenCode ที่ลดลง 51% ในสองเดือนเป็นสัญญาณเกี่ยวกับโมเมนตัมของระบบนิเวศ ไม่ว่าสาเหตุคืออะไร ผู้ใช้ที่น้อยลงหมายถึงคนที่เจอและแก้บั๊กเดียวกับที่คุณจะเจอน้อยลง
กรอบการตัดสินใจ: ห้าสถานการณ์
1. “ผมอยากได้โมเดลเดียว ตั้งค่าแล้วลืมไปเลย”
GLM-5.3-Flash. ดีกว่าในทุกเบนช์มาร์กที่เป็นกลาง ราคาครึ่งเดียว มีไลเซนส์ MIT และเป็นที่ที่คอมมิวนิตี้ลงเอย ตั้งค่า reasoning_effort: high, เพิ่ม GLM Coding Plan Lite ราคา $18/เดือนถ้าคุณเขียนโค้ดทุกวัน แล้วไปทำอย่างอื่นต่อได้เลย
2. “ผมทำรีแฟกเตอร์เชิงกลขนาดใหญ่ข้ามโค้ดเบสยักษ์ใหญ่”
MiniMax M3 สำหรับรอบงานเชิงกล ส่วน GLM-5.3-Flash สำหรับการวางแผน MSA ทำให้ M3 ประหยัดจริงในบริบทยาว และความเร็วในการสร้างที่มากกว่า 3 เท่านั้นรู้สึกได้ชัดที่สุดกับงานแก้ไขปริมาณมากที่ระดับความยากต่ำ เพียงระวังหน้าผาราคาที่ 512K และให้ GLM วางแผนรีแฟกเตอร์ก่อนที่ M3 จะลงมือทำ
3. “งานของผมเป็นงานภาพ — UI, design-to-code, การดีบั๊กจากภาพหน้าจอ”
GLM-5.3-Flash เป็นตัวหลัก M3 เป็นตัวรองที่แข็งแกร่ง ความสามารถมัลติโมดัลแบบเนทีฟของ GLM’ ถูกออกแบบมาเพื่อสิ่งนี้โดยเฉพาะ และมีอันดับสูงกว่า M3 ในดัชนีด้านวิชัน (32.0 ต่อ 25.6) แต่คะแนน OSWorld-Verified ของ M3’ ที่ 70.06% ทำให้มันเป็นตัวเลือกที่ดีกว่าสำหรับ เอเจนต์เดสก์ท็อปและ GUI งาน — คือการขับเคลื่อนแอปจริง ไม่ใช่แค่อ่านภาพหน้าจอ
4. “ผมต้องโฮสต์เองเพราะถิ่นที่อยู่ของข้อมูลหรือการปฏิบัติตามกฎ”
GLM-5.3-Flash อย่างไม่ต้องสงสัย MIT กับไลเซนส์ชุมชนที่กำหนดเองไม่ใช่การเลือกที่สูสีเมื่อทีมกฎหมายของคุณเข้ามาเกี่ยว และการโฮสต์เองแบบ MIT ทำให้คำถามเรื่องการโอนข้อมูลข้ามพรมแดนทั้งหมดหมดไป ตั้งงบสำหรับฮาร์ดแวร์ระดับ Hopper หรือผู้ให้บริการ GPU ในยุโรป
5. “ผม’กำลังดูแลทีมเล็ก ๆ ด้วยงบที่จำกัด”
GLM Coding Plan Lite ราคา $18/เดือน โดยใช้ GLM-5.3-Flash เป็นค่าเริ่มต้น ตัวคูณโควตา 3 เท่าสำหรับ Flash ในแพ็กเกจทำให้มันเป็นตัวเลือกที่คุ้มค่าที่สุดต่อยูโรในตอนนี้ ตั้งเวลางานแบตช์หนัก ๆ ให้นอกช่วงพีค 14:00–18:00 UTC+8 เพื่อรับส่วนลด 50% ของคะแนน เพิ่ม MiniMax ภายหลังถ้าทรูพุตกลายเป็นคอขวด
สิ่งที่ผมจะจับตาในไตรมาสหน้า
ผลรัน Terminal-Bench และ SWE-bench Pro แบบอิสระสำหรับ GLM-5.3-Flash ตัวเลขจากผู้ขายยอดเยี่ยมมาก ผู้รวบรวมข้อมูลที่เป็นกลางยืนยันโดยรวม แต่ข้ออ้างเฉพาะที่ว่า “ห่างจาก Claude Opus 4.8 ไม่ถึงหนึ่งคะแนนบน Terminal-Bench 2.1” สมควรได้รับการทำซ้ำโดยบุคคลที่สามก่อนที่ใครจะสร้างกรณีทางธุรกิจบนข้ออ้างนั้น
ว่า MiniMax /anthropic บั๊กบริบทจะถูกแก้หรือไม่ มันเล็ก มีการบันทึกไว้ และเปิดค้างมาตั้งแต่เดือนมิถุนายน ความเร็วในการปิดบั๊กบอกอะไรบางอย่างเกี่ยวกับความเร็วในการดูแลรักษา
เส้นโค้งการคงอยู่ของผู้ใช้ GLM-5.3-Flash’ ใน OpenCode ตัวเลขส่วนแบ่งโทเคนนั้นน่าทึ่งแต่ยังใหม่ ประเด็นที่น่าสนใจคือมันจะคงอยู่ที่ 10%+ ได้หรือไม่เมื่อความแปลกใหม่จางลง ถ้าคงอยู่ได้ นี่ไม่ใช่แค่ช่วงเวลาหนึ่ง — แต่เป็นค่าเริ่มต้นใหม่
จังหวะการเปิดตัวจากแล็บโอเพนเวตของจีน Qwen3.8-Flash-Next เปิดตัวไล่ ๆ กับ GLM-5.3-Flash Kimi K3 เอาชนะ GLM-5.3 ได้แล้วใน DeepSWE (67.5 ต่อ 66.9) และ Toolathlon (76.5 ต่อ 73.0) ช่องว่างระหว่าง “โมเดลเขียนโค้ดโอเพนเวตที่ดีที่สุดในตอนนี้” กับ “อันดับสอง” วัดกันเป็นสัปดาห์แล้ว ออกแบบคอนฟิกให้การสลับสตริงโมเดลเป็นการแก้บรรทัดเดียว เพราะคุณจะต้องเปลี่ยนอีกแน่นอน
ว่า Z.ai จะประกาศราคา API แบบคงที่แยกเดี่ยวสำหรับ GLM-5.3 เต็มรูปแบบหรือไม่ ณ เวลาที่เขียน แถวราคาต่อโทเคนของ GLM-5.3 ยังหายไปจากหน้าราคาอย่างเป็นทางการ ขณะที่ GLM-5.3-Flash มีราคาครบแล้ว นั่นเป็นความไม่สมมาตรที่แปลกและน่าจับตา
คำถามที่พบบ่อย
GLM-5.3-Flash ดีกว่า MiniMax M3 สำหรับการเขียนโค้ดหรือไม่ จากหลักฐานที่มีอยู่ ใช่ GLM-5.3-Flash นำใน Terminal-Bench 2.1 (84.3 ต่อ 66.0) ในดัชนี Intelligence ของ Artificial Analysis’ (57 ต่อ 45) และในทุกดัชนีความสามารถของ llm-stats รวมถึงการเขียนโค้ด เอเจนต์ และการใช้เครื่องมือ อีกทั้งราคาต่อโทเคนยังถูกกว่าประมาณครึ่งหนึ่ง MiniMax M3 เร็วกว่า — ความเร็วเอาต์พุตประมาณ 3 เท่า — แต่การเขียนโค้ดแบบเอเจนต์ให้รางวัลกับคุณภาพการให้เหตุผลมากกว่าความเร็วในการสร้างดิบ ๆ
ตัวไหนถูกกว่า GLM-5.3-Flash หรือ MiniMax M3 GLM-5.3-Flash ประมาณ 2 เท่า ราคาอย่างเป็นทางการคือ $0.15/ล้านโทเคนอินพุต และ $0.50/ล้านโทเคนเอาต์พุตสำหรับ GLM-5.3-Flash เทียบกับ $0.30/ล้าน และ $1.20/ล้านสำหรับ MiniMax M3 ช่องว่างกว้างขึ้นเป็นประมาณ 4 เท่าสำหรับคำขอที่อินพุตเกิน 512K โทเคน ซึ่ง MiniMax เพิ่มราคาเป็นสองเท่าและ Z.ai ไม่มีค่าใช้จ่ายส่วนเพิ่ม
ผมรัน GLM-5.3-Flash ในเครื่องเองได้ไหม ได้เฉพาะบนฮาร์ดแวร์ระดับเซิร์ฟเวอร์ เช็กพอยต์ FP8 มีขนาด 331 GB และต้องใช้ VRAM ประมาณ 386 GB ที่ TP=4 บน GPU รุ่น Hopper หรือใหม่กว่า มันไม่ใช่โมเดลสำหรับฮาร์ดแวร์ผู้บริโภค ไลเซนส์ MIT ทำให้การโฮสต์เองถูกต้องตามกฎหมายได้ง่าย แต่ฮาร์ดแวร์ทำให้มันแพง
OpenCode รองรับทั้งสองโมเดลแบบเนทีฟหรือไม่ รองรับ OpenCode มีผู้ให้บริการในตัวสำหรับทั้ง Z.AI และ MiniMax รัน opencode auth login, เลือกผู้ให้บริการที่ตรงกับประเภทคีย์ของคุณ แล้ว /models เพื่อเลือกโมเดลของคุณ ไม่ต้อง opencode.json แก้ไขอะไรสำหรับการตั้งค่ามาตรฐาน
ทำไม MiniMax M3 ถึงแสดงบริบทแค่ 200K ใน Claude Code บั๊กที่รู้กันและยังเปิดอยู่ในเอนด์พอยต์ที่เข้ากันได้กับ Anthropic ของ MiniMax’ คือมันรายงานเมทาดาทาของ Claude Sonnet’ แทนสเปกจริงของ M3’ ทำให้เกิดการคอมแพ็กต์อัตโนมัติที่ราว 167K โทเคน ตั้งค่า CLAUDE_CODE_AUTO_COMPACT_WINDOW เพื่อ 1000000 ในการตั้งค่าของคุณ หรือใช้เส้นทางที่เข้ากันได้กับ OpenAI แทน
GLM-5.3’ กับ GLM-5.3-Flash ต่างกันอย่างไร คนละโมเดล GLM-5.3 เปิดตัว 14 สิงหาคม 2026 และรองรับข้อความเท่านั้น ใช้โมเดลฐานร่วมกับ GLM-5.2 ส่วน GLM-5.3-Flash เปิดตัว 26 สิงหาคม เป็นมัลติโมดัลแบบเนทีฟ ใช้สถาปัตยกรรม MoE แบบไฮบริดแอตเทนชันขนาด 320B/18B มีไลเซนส์ MIT พร้อมน้ำหนักแบบเปิด และมีราคาถูกกว่าประมาณหนึ่งในสิบ ภายใน GLM Coding Plan นั้น Flash ยังได้โควตา 3 เท่าด้วย
MiniMax M3 เป็นโอเพนซอร์สจริงหรือ น้ำหนักโมเดลดาวน์โหลดได้อย่างเปิดเผยจาก Hugging Face แต่ภายใต้ MiniMax Community License ที่กำหนดเอง ไม่ใช่ไลเซนส์เปิดมาตรฐานอย่าง MIT หรือ Apache 2.0 มีการระบุกันกว้าง ๆ ว่าการใช้งานเชิงพาณิชย์ไม่มีข้อจำกัด แต่ควรอ่านตัวบทไลเซนส์ก่อนปล่อยผลิตภัณฑ์เชิงพาณิชย์ที่ใช้มัน
ผมควรใช้แพ็กเกจสมัครสมาชิกหรือจ่ายตามการใช้งาน ต่ำกว่าค่าใช้จ่ายโทเคนประมาณ $20–30/เดือน ทั้งสองแบบใกล้เคียงกันจนเกือบเท่าทุน ถ้าเขียนโค้ดแบบเอเจนต์วันละ 6–8 ชั่วโมงขึ้นไป การสมัครสมาชิกชนะชัดเจน — GLM Coding Plan Lite ราคา $18/เดือนที่ครอบคลุมประมาณ 400 พรอมต์ต่อสัปดาห์เป็นตัวเลือกคุ้มค่าที่สุดในระดับเริ่มต้น โปรดทราบว่าโควตาของ MiniMax ไม่สะสมข้ามรอบ และ MiniMax เองแนะนำให้จ่ายตามการใช้งานสำหรับงานโปรดักชัน
บทสรุป
ถ้าจะเก็บสิ่งเดียวจากบทความนี้: GLM-5.3-Flash เป็นค่าเริ่มต้นที่ดีกว่าสำหรับ OpenCode ในปลายปี 2026, และข้อสรุปนี้ไม่ได้สูสีในมิติที่กำหนดผลลัพธ์ของการเขียนโค้ดแบบเอเจนต์ — คุณภาพการให้เหตุผล ความน่าเชื่อถือในการใช้เครื่องมือ และต้นทุนต่องานที่ทำเสร็จ
MiniMax M3 ไม่ใช่โมเดลที่แย่ มันเป็นโมเดลที่ปรับให้เหมาะกับคนละด้าน และสถาปัตยกรรม MSA ของมันเป็นคำตอบที่งดงามจริงสำหรับปัญหาด้านเศรษฐศาสตร์ของบริบทยาว มีงานจริง — การแก้ไขเชิงกลปริมาณมาก งานเอเจนต์เดสก์ท็อปและ GUI อะไรก็ตามที่ความเร็วในการสร้าง 3 เท่าเป็นปัจจัยสำคัญ — ที่มันเป็นเครื่องมือที่ถูกต้อง
แต่การเขียนโค้ดแบบเอเจนต์เป็นปัญหาการตัดสินใจเป็นพื้นฐาน ไม่ใช่ปัญหาความเร็วในการพิมพ์ โมเดลที่วางแผนได้ดีกว่า เรียกเครื่องมือได้น่าเชื่อถือกว่า และกู้คืนจากความล้มเหลวได้นุ่มนวลกว่าจะทำงานเสร็จมากกว่าต่อยูโร แม้จะสร้างโทเคนช้ากว่าสามเท่า
แนวทางปฏิบัติคือระบบเกียร์สองความเร็ว: GLM-5.3-Flash ใช้กับการวางแผนและการลงมือสร้าง ส่วน MiniMax M3 ใช้กับงานหนักซ้ำ ๆ small_model โดยให้ชี้ไปที่ตัวที่เร็ว OpenCode ทำให้เรื่องนี้เป็นการแก้คอนฟิกสิบห้าบรรทัด และทำให้คุณได้ความฉลาดในจุดที่สำคัญกับทรูพุตในจุดที่ไม่สำคัญ
และเขียนคอนฟิกนั้นให้สลับ ID โมเดลได้ง่าย ในตลาดนี้ คำตอบที่ชัดเจนของวันนี้มีอายุการใช้งานนับเป็นสัปดาห์
คุณเคยใช้ตัวใดตัวหนึ่งเป็นไดรเวอร์หลักใน OpenCode หรือยัง ผม’ สนใจเป็นพิเศษว่าตัวเลข Terminal-Bench ของ GLM-5.3-Flash’ จะยืนได้ในรีโพจริงหรือไม่ และมีใครหาทางเลี่ยงที่สะอาดกว่าสำหรับบั๊กการรายงานบริบทของ MiniMax’ ได้บ้าง ติดต่อมาได้เลย — ยินดีรับการแก้ไขและหลักฐานที่โต้แย้ง และบทความนี้จะอัปเดตเมื่อภาพรวมเปลี่ยน
อัปเดตล่าสุด: 30 สิงหาคม 2026


