ไทย
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

สารบัญ
- สรุปสั้น ๆ — คำตัดสิน
- ก่อนอื่น: ใช่ ชิปนี้มีจริง
- ปัญหาเรื่องราคา (ฉบับ 2026)
- ทำไมต้อง 64GB? เหตุผลของจุดลงตัว
- ขั้นที่ 1: ปลดล็อกหน่วยความจำ (ทำก่อนเลย)
- ขั้นที่ 2: ประกอบสแต็กของคุณ
- ตอนที่ 1: การรัน LLM
- ตอนที่ 2: การสร้างภาพ
- ตอนที่ 3: การสร้างวิดีโอ — ส่วนที่พูดตรง ๆ
- ตอนที่ 4: เวิร์กโฟลว์จริงที่คุ้มค่าสร้าง
- ใช้งานจริง: ความร้อน แบตเตอรี่ และเสียง
- ข้อโต้แย้งที่ตรงไปตรงมา
- คำนวณต้นทุน: โลคอลกับคลาวด์
- คู่มือการเลือกซื้อ
- คำถามที่พบบ่อย
- ก้าวต่อไป
- บทสรุป
มีคอนฟิกของ Mac รุ่นหนึ่งที่เงียบ ๆ กลายเป็นคำตอบมาตรฐานสำหรับคำถาม “ถ้าอยากรันโมเดล AI ด้วยตัวเองควรซื้อแล็ปท็อปตัวไหน?” นั่นคือ MacBook Pro ปี 2026 ที่ใช้ชิป M5 Pro พร้อมหน่วยความจำรวม 64GB
ไม่ใช่รุ่นที่ถูกที่สุด ไม่ใช่รุ่นที่เร็วที่สุด แต่เป็นรุ่นที่การแลกได้แลกเสียลงตัวพอดีสำหรับคนส่วนใหญ่ที่อยาก ใช้ โมเดลโลคอลจริง ๆ ไม่ใช่แค่เอามาเบนช์มาร์ก
คู่มือนี้ครอบคลุมว่าเครื่องนั้นทำอะไรได้จริงในสามงานหลัก — โมเดลภาษาขนาดใหญ่ การสร้างภาพ และการสร้างวิดีโอ — พร้อมตัวเลขจริงในจุดที่มีตัวเลขจริง ประมาณการอย่างตรงไปตรงมาในจุดที่ไม่มี และคำแนะนำการตั้งค่าทีละขั้นตอนที่คุณทำตามได้ในวันที่เครื่องมาถึง
นอกจากนี้ยังบอกด้วยว่าเหตุผลเรื่องจุดลงตัวนั้นพังตรงไหน เพราะมันพังจริง และคุณควรรู้ให้ชัดว่าตรงไหนก่อนจะจ่ายสามพันดอลลาร์กับหน่วยความจำที่อัปเกรดทีหลังไม่ได้
สรุปสั้น ๆ — คำตัดสิน
ซื้อ M5 Pro 64GB ถ้า: คุณต้องการเครื่องพกพาที่รันโมเดล 8B–70B และโมเดล Mixture-of-Experts ได้เร็วพอสำหรับงานจริง สร้างภาพได้ในไม่กี่วินาทีแทนที่จะเป็นนาที และยังมีที่ให้เบราว์เซอร์ IDE และคอนเทนเนอร์ Docker ทำงานพร้อมกันได้ นี่คือแล็ปท็อปที่ สมดุลที่สุด สำหรับ AI โลคอลในปี 2026
ขยับไป M5 Max 128GB ถ้า: คุณต้องการโมเดลโลคอลระดับแนวหน้าอย่าง
gpt-oss-120b(ซึ่ง ไม่ควร ไม่พอดีกับ 64GB) หรือคุณต้องการความเร็วในการสร้างโทเคนบนโมเดลใหญ่ราวสองเท่า M5 Max แบบ 40 คอร์มีแบนด์วิดท์หน่วยความจำ 614 GB/s เทียบกับ M5 Pro’s 307 GB/s และสำหรับการถอดรหัส LLM แบนด์วิดท์คือทุกสิ่งมองที่อื่นถ้า: การสร้างวิดีโอโลคอลคืองานหลักของคุณ Mac ทุกรุ่นยังช้ากว่า RTX 5090 หลายเท่าในส่วนนี้ และการเช่าคลาวด์ถูกกว่าต่อคลิปอย่างมาก
ตัวเลขสามตัวที่นิยามเครื่องนี้:
| เมตริก | M5 Pro (GPU 20 คอร์) | ทำไมเรื่องนี้สำคัญ |
|---|---|---|
| 307 GB/s แบนด์วิดท์หน่วยความจำ | ~2 เท่าของ M5 รุ่นพื้นฐาน, ~½ ของ M5 Max 40 คอร์ | กำหนดเพดานโทเคน/วินาทีสำหรับ LLM |
| 64GB หน่วยความจำรวมสูงสุด | ใช้ได้จริงประมาณ 48–52GB ตามค่าเริ่มต้น | กำหนดว่าโมเดลไหนรันได้บ้าง |
| GPU 20 คอร์ พร้อม Neural Accelerators | พลังประมวลผล AI มากกว่า 4 เท่าเทียบกับ M4 Pro | ขับเคลื่อนความเร็วในการประมวลผลพรอมต์และการแพร่ภาพ |
ก่อนอื่น: ใช่ ชิปนี้มีจริง
บทความจำนวนมากเกี่ยวกับ M5 Pro ที่ตีพิมพ์ช่วงปลายปี 2025 ถึงต้นปี 2026 เป็นการคาดเดา ตอนนี้ไม่ใช่การคาดเดาอีกต่อไป
Apple เปิดตัว M5 Pro และ M5 Max เมื่อ March 3, 2026และทั้งสองรุ่นเริ่มวางจำหน่ายใน MacBook Pro 14 นิ้วและ 16 นิ้วเมื่อ March 11, 2026ชิป M5 รุ่นพื้นฐานมาก่อนหน้านี้ ใน MacBook Pro 14 นิ้ว เมื่อวันที่ 22 ตุลาคม 2025 แต่ชิปนั้นเป็นเรื่องต่างกันโดยสิ้นเชิง — สูงสุดที่ 32GB และ 153 GB/s ซึ่งไม่พอสำหรับงานในคู่มือนี้
นี่คือสิ่งที่ Apple ยืนยันบนหน้า newsroom และหน้าข้อมูลทางเทคนิค:
M5 Pro — สเปกที่ยืนยันแล้ว
| อุปกรณ์ | ข้อมูลจำเพาะ |
|---|---|
| CPU | 18 คอร์ (6 “ซูเปอร์คอร์” สูงสุด ~4.6 GHz + 12 คอร์ประสิทธิภาพสูงสุด ~4.4 GHz) รุ่นฐาน: 15 คอร์ เร็วกว่า M4 Pro ในงานมัลติเธรดสูงสุดถึง 30% |
| GPU | สูงสุด 20 คอร์ แต่ละคอร์มี Neural Accelerator เฉพาะ รองรับฮาร์ดแวร์เรย์เทรซิงรุ่นที่สาม พลังประมวลผล GPU สูงสุดสำหรับ AI มากกว่า 4 เท่าเทียบกับ M4 Pro |
| Neural Engine | 16 คอร์ |
| หน่วยความจำรวม | 24GB / 48GB / 64GB — 64GB คือเพดาน |
| แบนด์วิดท์หน่วยความจำ | สูงสุด 307 GB/s (LPDDR5X) |
| กระบวนการผลิต | TSMC 3nm (N3P) “Fusion Architecture” — สองไดย์เชื่อมต่อกันด้วยแพ็กเกจ SoIC-mH |
| I/O & สื่อ | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW encode-decode, AV1 decode |
M5 Max — เพื่อเทียบเคียง
M5 Max ใช้ CPU 18 คอร์เดียวกัน แต่มี GPU สูงสุด 40 คอร์ และที่สำคัญคือเรื่องหน่วยความจำที่ต่างออกไป: รุ่น 32 คอร์ทำงานที่ 460 GB/s และรุ่น 40 คอร์ที่ 614 GB/s กำหนดค่าได้สูงสุด 128GB
ช่องว่างของแบนด์วิดท์นั้นไม่ใช่รายละเอียดเล็ก ๆ ในสเปก มันเป็นปัจจัยสำคัญที่สุดเพียงข้อเดียวในการตัดสินใจระหว่าง M5 Pro กับ M5 Max และเราจะกลับมาพูดถึงเรื่องนี้ซ้ำหลายครั้ง
เบนช์มาร์กจากแหล่งอิสระ
เครื่องรีวิวของ Notebookcheck — M5 Pro 16 นิ้ว พร้อม 64GB — ทำคะแนน Geekbench 6.7 ได้ 4,295 คอร์เดียว และ 28,436 หลายคอร์, Cinebench 2024 หลายคอร์ 2,347 และ Cinebench 2026 หลายคอร์ 9,481
การวิเคราะห์ GPU ของพวกเขาวาง M5 Max ไว้ใกล้เคียงกับ RTX 5070 สำหรับเดสก์ท็อป และนำ AMD Strix Halo อย่างสบาย GPU 20 คอร์ของ M5 Pro อยู่ต่ำกว่านั้น ซึ่งควรทำความเข้าใจไว้: นี่คือ GPU ที่เก่งในระดับแล็ปท็อป ไม่ใช่ตัวแทนการ์ดแยก
พวกเขายังชี้ถึงสิ่งที่ไม่ค่อยน่าชม และควรจริงจังด้วย: MacBook Pro ปี 2026 ลดความเร็วลงอย่างเห็นได้ชัดภายใต้โหลดต่อเนื่อง ประสิทธิภาพ CPU ไม่สม่ำเสมอแม้ในโหมด High Power จะมีรายละเอียดเพิ่มเติมในส่วนความร้อน
ปัญหาเรื่องราคา (ฉบับ 2026)
ไลน์ M5 Pro เปิดตัวที่ $2,199 สำหรับรุ่น 14 นิ้ว และ $2,699 สำหรับรุ่น 16 นิ้ว จากนั้นปัญหาขาดแคลนหน่วยความจำทั่วโลกก็เกิดขึ้น
ใน มิถุนายน 2026 Apple ขึ้นราคา MacBook Pro ราว $300 ทุกรุ่นหลังการขึ้นราคา M5 Pro 14 นิ้ว รุ่นเริ่มต้นอยู่ที่ราว $2,499 และ M5 Pro 14 นิ้วที่กำหนดค่า 64GB พร้อม SSD 1TB อยู่ในช่วง $2,799–$2,999 ขึ้นกับวันและร้านค้า B&H และผู้ขายรายอื่นลดราคารุ่น M5 Pro 48GB และ 64GB อยู่ที่ $300–$400 ควรเช็กก่อนซื้อตรง
ในเยอรมนี ไลน์ M5 Pro เริ่มที่ €2,199 โดยมีราคาสำหรับการศึกษาเห็นได้ต่ำถึง €1,979 ที่ร้านอย่าง Edustore รุ่น 64GB สูงขึ้นอย่างมีนัยสำคัญเมื่อรวม VAT 19%
มีส่วนต่างสองอย่างที่สำคัญต่อการตัดสินใจของคุณ:
- 48GB → 64GB บน M5 Pro: เดิมเป็นการอัปเกรด $200–$400 แต่ราคาอัปเกรด RAM พุ่งขึ้น 50–67% ในหลายคอนฟิกหลังการขึ้นราคาในเดือนมิถุนายน
- M5 Pro 64GB → M5 Max 128GB: เป็นการกระโดดที่มาก M5 Max เริ่มที่ $3,599 (14 นิ้ว) และ $3,899 (16 นิ้ว) ก่อนขึ้นราคา และการอัปเกรดหน่วยความจำ M5 Max 64GB/128GB มีราคาเพิ่มขึ้นราวสองเท่าในเดือนมิถุนายน รุ่น 16 นิ้วที่จัดเต็มตอนนี้เกิน $10,000.
ตรวจสอบราคาทุกตัวในส่วนนี้ก่อนซื้อ ตลาดหน่วยความจำปี 2026 ขยับทุกเดือน และสิ่งที่เขียนไว้ที่นี่มีอายุการใช้งานสั้น
ทำไมต้อง 64GB? เหตุผลของจุดลงตัว
ข้อกล่าวอ้างเรื่อง “จุดลงตัว” ไม่ได้อยู่ที่ 64GB เป็นเลขวิเศษ แต่อยู่ที่แต่ละระดับหน่วยความจำปิดกั้นอะไรจริง ๆ
สิ่งที่คุณทำไม่ได้ในแต่ละระดับ
16GB / 24GB — คุณรันโมเดล 7B–8B ได้สบาย และรันโมเดล 14B ด้วยการควอนไทซ์แบบหนักได้ แต่รันอะไรในระดับ 30B+ พร้อมบริบทที่มีความหมายไม่ได้ คุณจะเอาเวลาไปจัดการหน่วยความจำแทนการใช้โมเดล
32GB — พอใช้ได้กับโมเดล dense 14B และโมเดล MoE ขนาดเล็กบางตัว แต่พอเพิ่ม KV cache สำหรับบริบท 32K+ บวก Chrome บวก IDE บวก Docker daemon คุณก็เข้าสู่เขตแรงกดดันด้านหน่วยความจำ นี่คือระดับที่คนทำให้ตัวเองเชื่อว่า AI โลคอลใช้ไม่ได้
48GB — ดีจริง รันโมเดล dense ระดับ 32B ได้สบาย ปัญหาคือพื้นที่เหลือ: โมเดล 70B ที่ Q4 ใช้ราว 40GB ซึ่งในทางเทคนิคพอดี แต่ไม่เหลืออะไรให้ส่วนอื่นของเครื่อง คุณจะต้องปิดแอปเพื่อรันโมเดล ซึ่งเป็นแรงเสียดทานที่ฆ่าเวิร์กโฟลว์โลคอลพอดี
64GB — นี่คือจุดที่คุณเก็บโมเดล 70B Q4 ไว้ในหน่วยความจำได้ หรือ โมเดล MoE 106B พารามิเตอร์ไว้ในหน่วยความจำ และ เก็บสภาพแวดล้อมการทำงานทั้งหมดไว้ในหน่วยความจำ ไม่ต้องปิด Slack ไม่ต้องปิดคอนเทนเนอร์ คุณเปิดโมเดลแล้วทำงานต่อได้เลย
128GB (เขตของ M5 Max) — ปลดล็อก gpt-oss-120b และระดับ 120B+ มีประโยชน์จริงถ้านั่นคือสิ่งที่คุณต้องการ และแพงจริงถ้าไม่ใช่
เหตุผลเรื่องจุดลงตัวจริง ๆ แล้วคือเหตุผลของ “รันโมเดลจริงจัง และทำอย่างอื่นได้ทั้งหมด” นั่นคือความต่างระหว่าง AI โลคอลที่เป็นของสาธิตกับของที่คุณใช้จริง
แต่ 64GB มาพร้อมเพดานแข็ง และคุณควรรู้เรื่องนี้ตั้งแต่ตอนนี้
ปัญหา gpt-oss-120b
gpt-oss-120b ที่การควอนไทซ์ MXFP4 ใช้ราว 63GB แค่สำหรับน้ำหนัก การวัดอิสระบน M5 Max 128GB ด้วย MLX แสดงหน่วยความจำสูงสุดราว 64.4GB ที่บริบท 4,096 โทเคน และ 64.9GB ที่บริบท 16K.
บนเครื่อง 64GB ซึ่งงบที่ใช้ได้จริงคือ 52–60GB มันไม่พอดี ไม่ใช่ “พอดีแบบเบียด” — แต่ไม่พอดีเลย
ถ้าคุณเห็นคำกล่าวอ้างว่า gpt-oss-120b รันได้บน 64GB ให้สงสัยไว้ก่อน มันคือโมเดล 128GB นี่คือเหตุผลเดียวที่ชัดที่สุดในการขยับไป M5 Max และถ้าโมเดลนั้นสำคัญกับคุณ เหตุผลเรื่องจุดลงตัวไม่ว่าจะมากแค่ไหนก็เปลี่ยนตัวเลขไม่ได้
ขั้นที่ 1: ปลดล็อกหน่วยความจำ (ทำก่อนเลย)
มีสิ่งหนึ่งที่คนซื้อส่วนใหญ่ไม่รู้: macOS ไม่ให้ GPU ใช้ RAM ทั้งหมดของคุณ
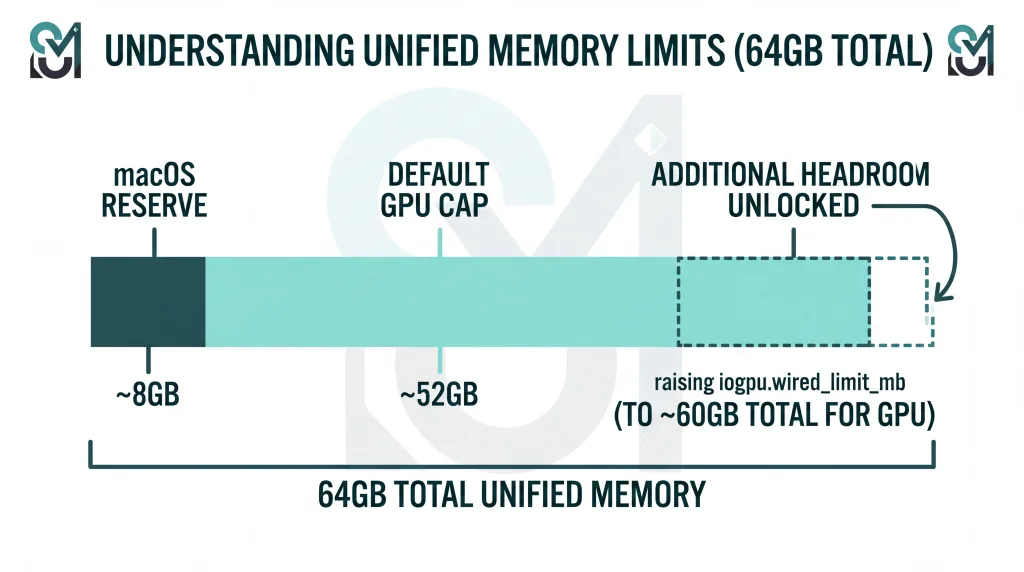
ตามค่าเริ่มต้น macOS จำกัดหน่วยความจำที่ผูกกับ GPU ไว้ราว 75% ของทั้งหมด บนเครื่อง 64GB คิดออกมาประมาณ 51.84GB ที่ใช้ได้สำหรับน้ำหนักโมเดล ส่วนที่เหลือสงวนไว้ให้ระบบ
คุณเพิ่มค่านี้ได้ด้วยคำสั่งเดียว ไม่ต้องรีบูต ไม่ต้องเปลี่ยน System Integrity Protection
หมายเหตุ: คีย์ปัจจุบันคือ
iogpu.wired_limit_mbคู่มือเก่าอ้างถึงdebug.iogpu.wired_limitซึ่งถูกแทนที่แล้ว ถ้าคุณเจอบทแนะนำที่ใช้คีย์เก่า แปลว่ามันล้าสมัยแล้ว
เพิ่มขีดจำกัด
bash
# Set the GPU wired-memory limit to 60GB (60 × 1024 = 61440 MB)
sudo sysctl iogpu.wired_limit_mb=61440

# Verify it took effect
sysctl iogpu.wired_limit_mb

# Reset to the macOS default at any time
sudo sysctl iogpu.wired_limit_mb=0
ทำให้คงอยู่ถาวร
การตั้งค่านี้รีเซ็ตเมื่อรีบูต หากต้องการให้คงอยู่ ให้เพิ่มลงใน /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confหรือจะสร้าง LaunchDaemon หรือเพิ่ม sysctl คำสั่งนี้ในสคริปต์ล็อกอิน ถ้าคุณไม่อยากแตะ /etc/sysctl.conf.
ควรดันไปไกลแค่ไหน?
เหลือ 4–8GB ไว้ให้ macOS บนเครื่อง 64GB การตั้ง 60GB (61440 MB) ถือว่าแรงแต่พอใช้ได้ถ้าคุณไม่ได้รันอย่างอื่นมาก 56GB (57344 MB) เป็นค่าที่ปลอดภัยกว่าสำหรับใช้ทุกวัน
อย่าจัดสรร 100% คุณจะเจอลูกบอลหมุน แอปค้าง หรือเครื่องรีเซ็ตหนัก — และบนเครื่องที่กำลังอนุมานอยู่ นั่นหมายถึงคุณเสียงานที่ทำอยู่ทั้งหมด
งบใช้งานจริงบน M5 Pro 64GB:
- ค่าเริ่มต้น: ใช้ได้ ~48–52GB
- เพิ่มเป็น 56GB: สบายสำหรับโมเดล 70B Q4 พร้อมบริบท
- เพิ่มเป็น 60GB: สูงสุด โดยเหลือที่ให้แอปอื่นน้อยมาก
ความต่างนั้น — 48GB กับ 58GB — บ่อยครั้งคือความต่างระหว่างโมเดลที่รันบน GPU กับที่ล้นไป CPU ซึ่งทำลายทรูพุตอย่างสิ้นเชิง นี่คือห้านาทีในการตั้งค่าที่คุ้มค่าที่สุดที่คุณจะทำ
ข้อกำหนดเบื้องต้นอีกหนึ่งอย่าง
MLX ต้องใช้ macOS 26.2 ขึ้นไปจึงจะใช้ M5’s Neural Accelerators ได้จริง ถ้าคุณใช้บิลด์เก่ากว่า คุณกำลังทิ้งการปรับปรุงครั้งใหญ่ที่สุดของรุ่นนี้ไป ตรวจสอบ Software Update ก่อนจะเบนช์มาร์กอะไรทั้งนั้น
ขั้นที่ 2: ประกอบสแต็กของคุณ
นี่คือการตั้งค่าทั้งหมดตามลำดับ เผื่อเวลาราว 30 นาทีบวกเวลา download
2.1 — พื้นฐาน
bash
# Install Homebrew if you don't have it
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# Install uv — a fast Python package manager, far better than pip for this
brew install uv

# Optional but recommended: a Python version manager
brew install [email protected]
2.2 — MLX (เฟรมเวิร์ก ML เนทีฟของ Apple)
MLX คือเฟรมเวิร์กอาร์เรย์ของ Apple’ เอง สร้างขึ้นเฉพาะสำหรับสถาปัตยกรรมหน่วยความจำแบบรวมของ Apple Silicon’ เป็นเส้นทางที่เร็วที่สุดสำหรับการอนุมาน LLM บน Mac และควรเป็นค่าตั้งต้นของคุณ
bash
# Create a dedicated environment
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# Install mlx-lm
uv pip install mlx-lm

# Test it — this downloads and runs a model
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Explain unified memory architecture in three sentences."
ถ้าคำสั่งนั้นให้ข้อความออกมา แปลว่าชุดเครื่องมือของคุณทำงานได้แล้ว
2.3 — LM Studio (ส่วนติดต่อกราฟิก)
ดาวน์โหลดได้ที่ lmstudio.ai. นี่คือวิธีที่เป็นมิตรที่สุดในการเรียกดู ดาวน์โหลด และรันโมเดล และ Apple ได้สาธิตมันตอนเปิดตัว M5 Pro ซึ่งบอกอะไรบางอย่างเกี่ยวกับระดับที่การอนุมานในเครื่องกลายเป็นเรื่องกระแสหลัก
ฟีเจอร์ที่มีประโยชน์ที่สุดของ LM Studio’ สำหรับนักพัฒนาคือเซิร์ฟเวอร์ที่รองรับ OpenAI ที่มีมาในตัว เปิดใช้งานได้ที่แท็บ นักพัฒนา แล้วมันจะเปิดปลายทางที่ http://localhost:1234/v1 ที่ไคลเอนต์ที่รองรับ OpenAI ทุกรายเชื่อมต่อได้
2.4 — Ollama (CLI และเซิร์ฟเวอร์)
bash
brew install ollama

# Start the server
ollama serve

# In another terminal, pull and run a model
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
อัปเดตสำคัญปี 2026: บน March 30, 2026, Ollama 0.19 switched its Apple Silicon backend from llama.cpp to MLX. สิ่งนี้ทำให้ความเร็ว decode เพิ่มขึ้นราวสองเท่า ในการวัดของ Ollama’ เองบน M5 Max ที่รัน Qwen3.5-35B-A3B นั้น prefill เพิ่มจาก 1,154 เป็น 1,810 โทเคน/วินาที และ decode จาก 58 เป็น 112 โทเคน/วินาที โดยบิลด์ int4 ของพวกเขาดัน prefill ไปถึง 1,851 และ decode ถึง 134
ถ้าครั้งสุดท้ายที่คุณลอง Ollama บน Mac เกิดก่อนรีลีสนั้น ภาพจำเรื่องประสิทธิภาพของมันในหัวคุณก็ล้าสมัยแล้ว
2.5 — Draw Things (ภาพและวิดีโอ)
ติดตั้งจาก Mac App Store ฟรี เป็นเนทีฟ ปรับแต่งเพื่อ Metal และตอนนี้เป็นเครื่องมือสร้างภาพที่ดีที่สุดบน Apple Silicon การทำงาน Metal FlashAttention v2.5 ของมันเร็วขึ้นถึง 4.6 เท่าบน M5 เมื่อเทียบกับ M4 และรองรับการฝึก LoRA บนเครื่อง
2.6 — ComfyUI (เมื่อคุณต้องใช้ไปป์ไลน์)
bash
brew install comfyuiComfyUI ให้การควบคุมเวิร์กโฟลว์แบบโหนดที่ Draw Things เทียบไม่ได้ มันทำงานบนแบ็กเอนด์ MPS และช้ากว่า Draw Things ราว 20% บน Apple Silicon สำหรับงานที่เท่ากัน อีกทั้งยังมีกับดักจริง ๆ กับเช็กพอยต์ FP8 บน Metal ใช้มันเมื่อคุณต้องการไปป์ไลน์ที่ซับซ้อน ใช้ Draw Things เมื่อคุณต้องการความเร็ว
2.7 — ตรวจสอบทุกอย่าง
bash
# Check your memory limit stuck
sysctl iogpu.wired_limit_mb

# Confirm MLX sees your GPU
python -c "import mlx.core as mx; print(mx.default_device())"

# Confirm Ollama is serving
curl http://localhost:11434/api/tags
ตอนที่ 1: การรัน LLM
นี่คือสิ่งที่ M5 Pro 64GB ทำได้ดีที่สุด และคุ้มค่าที่จะทำความเข้าใจ ทำไม ก่อนจะดูรายการโมเดล
แนวคิดเดียวที่อธิบายได้ทุกอย่าง: แบนด์วิดท์กับการประมวลผล
การอนุมาน LLM มีสองระยะ และสองระยะนี้กดดันคนละส่วนของเครื่องคุณโดยสิ้นเชิง
Prefill (การประมวลผลพรอมต์) คือการไล่ผ่านอินพุตของคุณก่อนที่โทเคนแรกจะปรากฏ มันเป็น ช่วงที่ถูกจำกัดด้วยพลังประมวลผล. นี่คือเหตุผลที่ว่าทำไมเมื่อก่อนการวางไฟล์ 40,000 โทเคนลงใน AI coding agent ในเครื่องจึงหมายถึงความเงียบหลายนาทีบน Mac ขณะที่การ์ด NVIDIA ย่อยมันเสร็จในไม่กี่วินาที
Decode (การสร้างโทเคน) คือการสร้างโทเคนถัดไปทีละตัว มันเป็น ช่วงที่ถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำ. ทุกโทเคนที่สร้างขึ้นต้องอ่านน้ำหนักของโมเดล’ จากหน่วยความจำ หน่วยความจำเร็วขึ้น โทเคนก็เร็วขึ้น เรียบง่ายประมาณนั้น
การแบ่งสองระยะนี้อธิบายข้อเสนอทั้งหมดของ M5 Pro:
- ของมัน 307 GB/s แบนด์วิดท์กำหนดเพดานตายตัวให้ความเร็ว decode ราวสองเท่าของ 153 GB/s ของ M5’ รุ่นพื้นฐาน และราวครึ่งหนึ่งของ 614 GB/s ของ M5 Max 40 คอร์’
- ของมัน Neural Accelerators — หนึ่งตัวในทุกคอร์ GPU เป็นของใหม่ในรุ่น M5 — ช่วยให้ prefill ดีขึ้นอย่างมาก
ทีมวิจัย MLX ของ Apple’ เองเผยแพร่ผลการวัดในเดือนพฤศจิกายน 2025 เปรียบเทียบ M5 รุ่นพื้นฐานกับ M4 รุ่นพื้นฐานบน Qwen3-14B-4bit: เวลาในการได้โทเคนแรกเร็วขึ้น 4.06 เท่าขณะที่การสร้างโทเคนดีขึ้นเพียง 1.19 เท่า การเพิ่มขึ้นเพียงเล็กน้อยของ decode นี้สอดคล้องกับการเพิ่มแบนด์วิดท์พอดี (120 GB/s → 153 GB/s) ส่วนการเพิ่มขึ้นมหาศาลของ prefill มาจาก Neural Accelerators ทั้งหมด
Apple ทำตลาดรุ่น Pro และ Max ว่าประมวลผลพรอมต์ LLM ได้เร็วขึ้นถึง 4 เท่าเมื่อเทียบกับ M4 Pro และ M4 Max กลไกนั้นเหมือนกัน แม้ว่าการยืนยัน prefill เฉพาะ M5 Pro จากผลทดสอบอิสระจะยังมีน้อยอยู่
สิ่งนี้หมายความในทางปฏิบัติว่า: M5 Pro เป็นการอัปเกรดที่พลิกโฉมเมื่อเทียบกับ Mac ก่อนยุค M5 สำหรับงานบริบทขนาดยาวและการเขียนโค้ดแบบเอเจนต์ ซึ่ง prefill เป็นตัวหลัก แต่เป็นการอัปเกรดเพียงเล็กน้อยสำหรับอัตราการทำงานของแชตล้วน ๆ ซึ่ง decode เป็นตัวหลัก
การปฏิวัติ MoE (ทำไม Mac ถึงดีขึ้นทันตา)
สถาปัตยกรรม Mixture-of-Experts เปลี่ยนสมการของเครื่องที่ใช้หน่วยความจำแบบรวม และถ้าคุณจะได้อะไรจากคู่มือนี้เพียงอย่างเดียว ก็จงเข้าใจสิ่งนี้
โมเดล MoE มีพารามิเตอร์รวมมหาศาล แต่เปิดใช้งานเพียงเศษเสี้ยวเล็กน้อยต่อโทเคน gpt-oss-120b มีพารามิเตอร์รวม 117 พันล้าน แต่เปิดใช้งานประมาณ 5.1 พันล้าน ต่อโทเคน
- พารามิเตอร์ทั้งหมด เป็นตัวกำหนด หน่วยความจำ ความต้องการ — ซึ่ง Mac มีอยู่อย่างเหลือเฟือ
- พารามิเตอร์ที่ใช้งาน เป็นตัวกำหนด ความเร็วถอดรหัส — ซึ่งถูกจำกัดด้วยแบนด์วิดท์
ดังนั้นโมเดล MoE จึงต้องการทรัพยากรที่ Mac มีมาก และใช้ทรัพยากรที่ Mac มีน้อยเพียงเล็กน้อย โมเดล MoE ที่เลือกมาอย่างดีบน Mac 64GB ให้คุณภาพใกล้ระดับแนวหน้า ด้วยความเร็วถอดรหัสของโมเดลที่เล็กกว่ามาก
นี่คือเหตุผลที่แล็ปท็อปที่มี 307 GB/s ให้ความรู้สึกว่าแข่งขันได้กับการ์ดที่ทำงาน 1,700 GB/s สำหรับบางงาน เลือกโมเดล MoE เมื่อทำได้
โมเดลไหนรันได้จริง — ตาราง
ตัวเลขที่วัดได้ด้านล่างมาจากฐานข้อมูลเบนช์มาร์กของชุมชน oMLX สำหรับ M5 Pro 20-core พร้อม 64GB ตัวเลขประมาณการถูกระบุไว้อย่างชัดเจน อย่าเชื่อตัวเลขโทเคน/วินาทีที่ไม่มีการระบุว่าเป็นตัวเลขประมาณการซึ่งคุณพบที่อื่นสำหรับชิปนี้ — มีคนไม่กี่คนเท่านั้นที่เผยแพร่การวัดค่า M5 Pro จริง
| รุ่น | ประเภท | พื้นที่หน่วยความจำที่ใช้ | ถอดรหัส (tok/s) | พรีฟิล (tok/s) | คำตัดสิน |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12GB | 66–80 ✅ วัดแล้ว | 1,500–2,200 ✅ | ตัวขับเคลื่อนประจำวัน เร็ว ความสามารถสูง เล็ก |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20GB | ~55–70 (ประมาณ) | สูง | คุณภาพต่อ GB ดีที่สุด ตัวเลือกที่คุ้มค่า |
| Qwen3.6-27B (4-bit) | Dense | ~16GB | 17.8 ✅ วัดแล้ว | 470 ✅ | ตัวแทนของคลาส Dense 27–35B |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40GB+ | ~30 | สูง | การให้เหตุผลใกล้ระดับแนวหน้าที่ใส่ได้จริง |
| Llama 3.3 70B (Q4_K_M) | Dense | ~40GB | ~7–12 (ประมาณ) | ปานกลาง | ใช้กับงานแบบแบตช์ได้ แต่แบบโต้ตอบทำได้แค่พอใช้ |
| Llama 3.3 70B (Q5_K_M) | Dense | ~49GB | ~6–10 (ประมาณ) | ปานกลาง | ใส่ได้แต่คับแคบ ควรเพิ่มขีดจำกัดหน่วยความจำก่อน |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | Dense | 8–24GB | 20–60+ | ดี | สบายทั้งหมด เลือกตามงาน |
| gpt-oss-120b (MXFP4) | MoE | ~63GB | — | — | ❌ ใส่ไม่ได้ ต้องใช้เครื่อง 128GB |
| Qwen3-235B-A22B (1.58-bit ternary) | MoE | ~53GB | ~5.6 | ต่ำ | รันได้ในทางเทคนิค แต่เป็นแค่ของโชว์ ไม่ใช่เวิร์กโฟลว์ |
โบนัสจากการแบตช์: gpt-oss-20b บน M5 Pro ขยายได้ประมาณ 142 tok/s ที่ขนาดแบตช์ 8. หากคุณรันเอเจนต์ ลูปประเมินผล หรือภาระงานใดที่มีคำขอแบบขนาน อัตราการประมวลผลจะดีขึ้นอย่างมากเมื่อเทียบกับตัวเลขแบบสตรีมเดียว
เช็กความจริงเรื่องโมเดล 70B
ยังไม่มีตัวเลข decode ของ M5 Pro สำหรับ Llama 3.3 70B ที่เผยแพร่และวัดโดยอิสระ ตัวเลขประมาณ 7–12 tok/s มาจากการคาดการณ์ตามแบนด์วิดท์
เพื่อเทียบเคียง: M4 Max 128GB ที่ 546 GB/s วัดได้ประมาณ 18–20 tok/s บนโมเดลเดียวกัน M5 Pro มี 307 GB/s ตัวเลขนี้ไม่น่าส่งเสริมเท่าไร
ที่ 7–12 tok/s คุณจะได้ประมาณ 5–9 คำต่อวินาที ซึ่งช้ากว่าความเร็วในการอ่านที่สบาย ใช้ได้ดีกับงานเบื้องหลัง การประมวลผลเอกสาร และแบตช์ข้ามคืน แต่น่ารำคาญสำหรับการแชทแบบโต้ตอบ
คำแนะนำตามจริง: บน M5 Pro 64GB ให้มองโมเดล dense 70B เป็นเครื่องมืองานแบบแบตช์ และใช้โมเดล MoE สำหรับทุกอย่างที่ต้องโต้ตอบ
ควอนไทซ์: ควรเลือกแบบไหนจริง ๆ
| รูปแบบ | การสูญเสียคุณภาพ | ใช้เมื่อใด |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | ค่าเริ่มต้น อัตราส่วนความเร็วต่อคุณภาพดีที่สุด |
| MLX 4-bit | ~1–2% | ค่าเริ่มต้นบน Mac ใช้หน่วยความจำน้อยลง ~10% และเร็วกว่า GGUF ที่เทียบกันได้ 15–30% |
| Q5_K_M / MLX 6-bit | <1% | เมื่อคุณมีพื้นที่เหลือและต้องการผลลัพธ์ที่แทบไม่สูญเสีย |
| Q6_K | แทบไม่มีผล | งานที่คุณภาพสำคัญและยังมีหน่วยความจำเหลือ |
| Q8 / FP16 | ไม่มี | แทบไม่คุ้มบนแล็ปท็อป เพราะกินงบขนาดโมเดลถึงครึ่งหรือหนึ่งในสี่ |
| MXFP4 | เนทีฟ | ไม่ใช่ตัวเลือก — เพราะมันคือวิธีที่โมเดล gpt-oss ถูกปล่อยออกมา |
| 1.58 บิตแบบ ternary | รุนแรง | ใช้เฉพาะเมื่อต้องยัดโมเดลที่ไม่งั้นใส่ไม่ลง |
หลักคร่าว ๆ: ใช้ 4 บิตเมื่อเน้นความเร็วและให้พอดีเครื่อง ใช้ 6 บิตเมื่อคุณภาพสำคัญและยังมีที่ว่าง และข้าม 8 บิตไปเลยบนแล็ปท็อป
MLX กับ llama.cpp — ใช้รันไทม์ไหน?
คำตอบสั้น ๆ คือ MLX แต่มีข้อแม้หนึ่งอย่าง
- ต่ำกว่าประมาณ 14B พารามิเตอร์: MLX นำหน้า llama.cpp อยู่ 20–87% ไม่ใช่สูสีเลย
- สูงกว่าประมาณ 27B: ทั้งสองตัวจะไล่มาบรรจบกัน เพราะแบนด์วิดท์หน่วยความจำกลายเป็นคอขวด และรันไทม์ไม่ใช่ปัจจัยอีกต่อไป
- หน่วยความจำ: MLX ใช้หน่วยความจำน้อยกว่า GGUF ประมาณ 10% ที่ระดับควอนไทซ์เดียวกัน
- ข้อแม้: ที่บริบท 30,000 โทเคนขึ้นไป MLX อาจช้าได้มากถึง 50% เมื่อเทียบกับ llama.cpp ที่เปิด Flash Attention ไว้ เรื่องนี้ขึ้นอยู่กับโมเดลและช่วงบริบท
ถ้าคุณทำงานกับบริบทที่ยาวมากเป็นประจำ ให้ทดสอบทั้งสองตัวกับงานจริงของคุณ ถ้าไม่ใช่ ก็ใช้ MLX
การรันเซิร์ฟเวอร์ API โลคอล
mlx-lm เวอร์ชัน 0.18 ขึ้นไปมีเซิร์ฟเวอร์ที่รองรับ OpenAI API พร้อม continuous batching:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
ตอนนี้ อะไรก็ตามที่พูดคุยผ่าน OpenAI API สามารถใช้โมเดลบนเครื่องคุณได้:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Write a bash one-liner to find large files."}]
  }'
ปลายทางนี้เป็นรากฐานของทุกอย่างในหัวข้อเวิร์กโฟลว์ด้านล่าง
ตอนที่ 2: การสร้างภาพ
การสร้างภาพคือจุดที่ M5 Pro ดูดีกว่าที่แบนด์วิดท์บอกไว้ ด้วยเหตุผลง่าย ๆ ว่า diffusion ช่วงที่ถูกจำกัดด้วยพลังประมวลผลไม่ได้ขึ้นอยู่กับแบนด์วิดท์ และโมเดลก็เล็กพอที่หน่วยความจำจะไม่เป็นข้อจำกัดบนเครื่อง 64GB
ประสิทธิภาพแยกตามโมเดล
| รุ่น | ขนาด | ความจำ | เวลาต่อภาพ 1024×1024 | หมายเหตุ |
|---|---|---|---|---|
| SDXL | 3.5B | ~7GB | ~7 วินาทีที่ 30 สเต็ป (M5 Max) | ตัวเลือกคุณภาพที่เร็วที่สุด มีระบบนิเวศ LoRA มหาศาล |
| FLUX.1 [schnell] | 12B | ~7GB (Q4) | ~20–25 วินาทีที่ 4 สเต็ป | กลั่นมาเพื่อความเร็ว Apache-2.0 |
| FLUX.1 [dev] | 12B | ~10GB (Q6) | ~50 วินาที ที่ 20 สเต็ป (ระดับ M4) | เบนช์มาร์กด้านคุณภาพ |
| FLUX.2 [Klein] | 4B แบบกลั่น | ~8GB | ~40 วินาที | ใหม่กว่า เล็กกว่า และเร็ว |
| FLUX.2 [dev] | ขนาดใหญ่ | 24GB+ | หลายนาที | คุณภาพดีที่สุด ต้องใช้ความอดทนจริง ๆ |
| SD 3.5 | แตกต่างกันไป | 10–20GB | หลายสิบวินาที | จุดกลางที่ลงตัว |
| Qwen-Image / Qwen-Image-Edit | แตกต่างกันไป | 15–25GB | หลายสิบวินาที | ยอดเยี่ยมสำหรับการเรนเดอร์ข้อความและการแก้ไข |
| HiDream, Chroma | แตกต่างกันไป | 10–20GB | แตกต่างกันไป | น่าลองหากต้องการสไตล์ที่หลากหลาย |
ทีม ML Research ของ Apple’s วัดว่า FLUX-dev-4bit สร้างภาพ 1024×1024 เร็วกว่า 3.8× บน M5 เทียบกับ M4 เมื่อใช้ MLX ผลที่ได้มาจาก Neural Accelerators และใช้ได้กับ M5 ทั้งตระกูล
ยังไม่มีเบนช์มาร์กวินาทีต่อภาพที่เฉพาะเจาะจงสำหรับ M5 Pro เผยแพร่ออกมา ดังนั้นให้ถือว่าตารางด้านบนเป็นตัวเลขระดับ M4 โดยคาดว่าจะได้แรงยกที่ชัดเจนจาก M5 ในโลกจริง คุณควรคาดว่า FLUX.1 [schnell] จะใช้เวลาต่ำกว่า 20 วินาทีอย่างชัดเจน และ SDXL ใช้เวลาเป็นเลขหลักเดียว
ที่ 64GB คุณรันโมเดลเหล่านี้ได้ที่ FP16 โดยไม่ต้องควอนไทซ์ซึ่งเป็นข้อได้เปรียบด้านคุณภาพจริง ๆ เหนือเครื่อง 16GB และ 24GB ที่ถูกบังคับให้ใช้ Q4
เครื่องมือ: ใช้อะไรดี
Draw Things — ตัวเลือกเริ่มต้น Native Metal ไม่มีสภาพแวดล้อม Python ให้พัง Metal FlashAttention v2.5 ทำงานเร็วขึ้นถึง 4.6× บน M5 เทียบกับ M4 และฝึก LoRA บนเครื่องได้ ฟรีบน App Store
ComfyUI — สำหรับไปป์ไลน์แบบโหนด เชน ControlNet และเวิร์กโฟลว์หลายขั้นตอน ช้ากว่า Draw Things ประมาณ 20% บน Apple Silicon ระวัง FP8 checkpoint ซึ่งมักล้มเหลวบน Metal
DiffusionKit — ชุดเครื่องมือดิฟฟิวชันของ Apple’s เอง ที่ใช้ MLX เป็นฐาน น่าจับตา
Mochi Diffusion, InvokeAI — ใช้ได้ทั้งคู่ ดีทั้งคู่
หลีกเลี่ยง: DiffusionBee ถือว่าถูกทิ้งไปแล้ว Automatic1111 และ Forge ทำงานได้จริงผ่าน MPS แต่ช้าและได้รับการดูแลไม่ดีบน Mac
ทีละขั้นตอน: ภาพโลคอลภาพแรกของคุณ
- ติดตั้ง Draw Things จาก Mac App Store
- เปิดขึ้นมาแล้วไปที่ตัวจัดการโมเดล (ไอคอนด้านบนของแผงซ้าย)
- ดาวน์โหลด FLUX.1 [schnell] — ประมาณ 7GB ที่ Q4 หรือจะเอาเวอร์ชัน FP16 ก็ได้ เพราะคุณมีหน่วยความจำเหลือ
- ตั้ง Steps เป็น 4 (schnell ถูกกลั่นมาเพื่อสิ่งนี้โดยเฉพาะ) และ ขนาด เป็น 1024×1024
- ใส่พรอมต์แล้วกด สร้าง.
- การรันครั้งแรกจะรวมเวลาโหลดโมเดลด้วย การสร้างครั้งถัด ๆ ไปจะเร็วขึ้นมาก
การเทรน LoRA บนเครื่อง
เครื่อง 64GB ไฟน์ทูนโมเดลภาพในเครื่องได้ ซึ่งเป็นความสามารถที่ถูกประเมินต่ำเกินไปจริง ๆ Draw Things รองรับการเทรน LoRA โดยตรง และ MLX รองรับ LoRA และ QLoRA ทั้งโมเดลภาพและโมเดลภาษา
LoRA สไตล์เล็ก ๆ จากภาพ 20–50 ภาพ เป็นงานข้ามคืนบน M5 Pro และข้อมูลไม่เคยออกจากเครื่องคุณ สำหรับใครที่ทำงานกับวัสดุของลูกค้าหรือทรัพย์สินที่เป็นกรรมสิทธิ์ เรื่องนี้สำคัญกว่าความเร็ว
ตอนที่ 3: การสร้างวิดีโอ — ส่วนที่พูดตรง ๆ
ตรงนี้ผมต้องพูดตรง ๆ กับคุณ เพราะเนื้อหาหลายชิ้นในหัวข้อนี้ไม่ได้ทำอย่างนั้น
การสร้างวิดีโอในเครื่องบน Mac ทุกรุ่นในปี 2026 นั้นช้า ไม่ใช่ช้าแบบ “ช้ากว่า 4090” แต่ช้าพอที่จะเปลี่ยนวิธีทำงานของคุณ
ทำไม Mac ถึงฝืดเป็นพิเศษในส่วนนี้
การดิฟฟิวชันวิดีโอกิน ช่วงที่ถูกจำกัดด้วยพลังประมวลผลพลังงานประมวลผลดิบของ GPU หนักมาก ต่างจากการถอดรหัส LLM ที่แบนด์วิดท์หน่วยความจำอันเหลือเฟือของ Mac เป็นทรัพยากรที่เกี่ยวข้อง — ซึ่งเป็นแกนเดียวกับที่ GPU แล็ปท็อป 20 คอร์แพ้การ์ดแยก
Neural Accelerators ของ M5 ช่วยได้ แต่ไม่ได้ปิดช่องว่างที่ใหญ่ขนาดนี้
ตัวเลขแบบไม่ปรุงแต่ง
Wan 2.2 (Alibaba, Apache-2.0 มีทั้งแบบ 14B MoE และแบบ dense 5B สำหรับข้อความ/ภาพเป็นวิดีโอ): บน M1 Max 64GB ที่รันบิลด์ GGUF คลิป ความยาว 2 วินาทีที่ 832×480 ใช้เวลา 82 นาทีคลิป 5 วินาทีจะเกินสามชั่วโมง
เทียบกันแล้ว โมเดล TI2V-5B เดียวกันบน RTX 4090 24GB สร้างวิดีโอ 5 วินาทีที่ 720p ได้ในราว 9 นาที.
M5 Pro เร็วกว่า M1 Max อย่างชัดเจน แต่ประเด็นอยู่ที่ลำดับของขนาด
ข้อจำกัดสำคัญของ Metal: เช็กพอยต์ FP8 ใช้ไม่ได้บน Metal — Float8_e4m3fn ไทป์ข้อมูลนี้ไม่รองรับ คุณต้องใช้บิลด์ GGUF เรื่องนี้ทำให้หลายคนที่ทำตามบทแนะนำซึ่งเน้น NVIDIA สะดุด และยังหมายความว่า เทมเพลต FP8 ของ LTX-2 ใช้ไม่ได้เลยบน Mac.
ข่าวดี: โมเดลกลั่นรุ่นใหม่กำลังเปลี่ยนเรื่องนี้ Ivan Fioravanti วัดค่า LTX 2.3 22B ใน Draw Things ที่สร้างวิดีโอ 5 วินาทีในราว 121 วินาที บน M5 Max 40 คอร์ — เอาชนะ M3 Ultra 80 คอร์ที่ใช้เวลา 206 วินาทีได้จริง
นั่นเป็นผลลัพธ์จริงและการเปลี่ยนแปลงจริง แต่สังเกตชิปไว้ด้วย: M5 Pro 20 คอร์จะช้ากว่าอย่างชัดเจนเมื่อเทียบกับ M5 Max 40 คอร์ในงานที่กินพลังประมวลผลแบบนี้ คาดว่าจะใช้เวลาหลายนาทีไม่ใช่สองนาที
โมเดลอื่น ๆ — HunyuanVideo, Mochi 1, CogVideoX, FramePack, Stable Video Diffusion — อยู่ในช่วงช้าถึงใช้จริงไม่ได้บน Mac หลายตัวเน้น CUDA ก่อนและต้องหาทางอ้อม
คำตัดสินเรื่องวิดีโอ
วิดีโอในเครื่องบน M5 Pro 64GB ทำได้สำหรับการทดลองเป็นครั้งคราวแบบใจเย็น — คลิปสั้น ความละเอียดต่ำลง โมเดลกลั่น ผ่าน Draw Things มันทำได้ คุณจะได้งานออกมา
ถ้าต้องการปริมาณงานจริงจัง ให้เช่า GPU RunPod, Vast.ai และ Lambda จะรัน 5090 หรือ H100 ในราคาไม่กี่ดอลลาร์ต่อชั่วโมง และสร้างงานในไม่กี่นาทีซึ่งแล็ปท็อปของคุณใช้เวลาหนึ่งชั่วโมง สำหรับวิดีโอโดยเฉพาะ ตัวเลขทางเศรษฐศาสตร์ไม่ได้ใกล้กันเลย
ถ้าการสร้างวิดีโอคือ หลัก งานหลักของคุณ ให้ซื้อเครื่อง NVIDIA หรือเผื่องบสำหรับคลาวด์ อย่าซื้อ Mac แล้วหวังเอา
ถ้าอยากลองอยู่ดี: ทีละขั้นตอน
- เปิด Draw Things แล้วสลับไปที่ตัวจัดการโมเดลวิดีโอ
- ดาวน์โหลด โมเดลแบบกลั่น — LTX 2.3 หรือบิลด์ Wan 2.2 GGUF โมเดลกลั่นคือความต่างระหว่างไม่กี่นาทีกับหลายชั่วโมง
- เริ่มจากเล็ก ๆ: 480p, 2 วินาที จำนวนสเต็ปต่ำ สร้างค่าฐานเวลาของคุณก่อนจะขยายขนาด
- เสียบปลั๊กและใช้ High Power Mode พัดลมจะทำงาน
- ค่อยเพิ่มความละเอียดและความยาว เมื่อคุณรู้แล้วว่าคลิปสั้นหนึ่งคลิปกินเวลาจริงเท่าไร
อย่าใช้เช็กพอยต์ FP8 บน Mac เด็ดขาด GGUF หรือไม่ก็ไม่ต้อง
ตอนที่ 4: เวิร์กโฟลว์จริงที่คุ้มค่าสร้าง
เบนช์มาร์กไม่ใช่ประเด็น นี่คือสิ่งที่คนทำจริง ๆ กับเครื่องนี้
เวิร์กโฟลว์ 1: เอเจนต์เขียนโค้ดโลคอล
นี่คือเซตอัปที่ให้ผลคุ้มค่าที่สุดในรายการ และใช้เวลาราวสิบนาที
ขั้นที่ 1 — เปิดเซิร์ฟเวอร์โมเดล ไม่ก็แท็บ Developer ของ LM Studio (ปลายทางที่ http://localhost:1234/v1) หรือ:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234ขั้นที่ 2 — ชี้เอดิเตอร์ของคุณไปที่มัน
VS Code กับ Cline หรือ Continue: เพิ่มผู้ให้บริการที่รองรับ OpenAI โดยใช้ base URL http://localhost:1234/v1และ API key อะไรก็ได้ที่ไม่ว่าง และชื่อโมเดลของคุณ
Zed: ตั้งค่าผู้ให้บริการที่รองรับ OpenAI แบบกำหนดเองในการตั้งค่า
Aider (เทอร์มินัล):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
ขั้นที่ 3 — เลือกโมเดลที่ใช่ gpt-oss-20b และ Qwen3-Coder-30B-A3B ต่างเป็นโมเดลเขียนโค้ดในเครื่องที่แข็งแรง ทั้งคู่เป็น MoE ซึ่งเป็นสิ่งที่คุณต้องการพอดี: ถอดรหัสเร็ว และการปรับปรุงด้าน prefill ของ M5 ทำให้บริบทไฟล์ขนาดใหญ่ไม่ต้องหยุดรอเป็นนาทีอีกต่อไป
สิ่งที่คุณได้: วนซ้ำได้ไม่จำกัดโดยไม่มีค่าใช้จ่ายต่อโทเคน ไม่มีอัตราจำกัด และโค้ดไม่เคยออกจากเครื่องคุณ สำหรับโค้ดเบสที่เป็นกรรมสิทธิ์หรือของลูกค้า ประเด็นหลังนี้มักเป็นเหตุผลทั้งหมด
เวิร์กโฟลว์ 2: RAG ส่วนตัวบนเอกสารของคุณ
embeddings ในเครื่องบวกกับโมเดล 27B–70B หมายความว่าเอกสารอ่อนไหว — สัญญา เวชระเบียน งานวิจัยภายใน ข้อมูลการเงิน — ค้นหาและสรุปได้โดยไม่มีแม้แต่ไบต์เดียวออกจากแล็ปท็อปของคุณ
ระดับ 64GB สำคัญตรงนี้เพราะไปป์ไลน์ RAG ต้องถือโมเดล embeddings, ที่เก็บเวกเตอร์ และโมเดลสร้างข้อความไว้ในหน่วยความจำพร้อมกัน ที่ 32GB คุณต้องสลับหน่วยความจำตลอดเวลา ที่ 64GB คุณไม่ต้อง
เวิร์กโฟลว์ 3: สร้างแบบเป็นชุดข้ามคืน
จัดคิวสร้างภาพหลายร้อยภาพใน Draw Things หรือรันงานประมวลผลเอกสารยาว ๆ ผ่าน mlx_lm.serverแล้วปล่อยให้เครื่องทำงานขณะคุณนอนหลับ เมื่อเสียบปลั๊ก โมเดล 70B และชุดภาพที่รู้สึกช้าเกินไปเมื่อใช้งานโต้ตอบ จะสมเหตุสมผลที่สุดในเวลาข้ามคืน
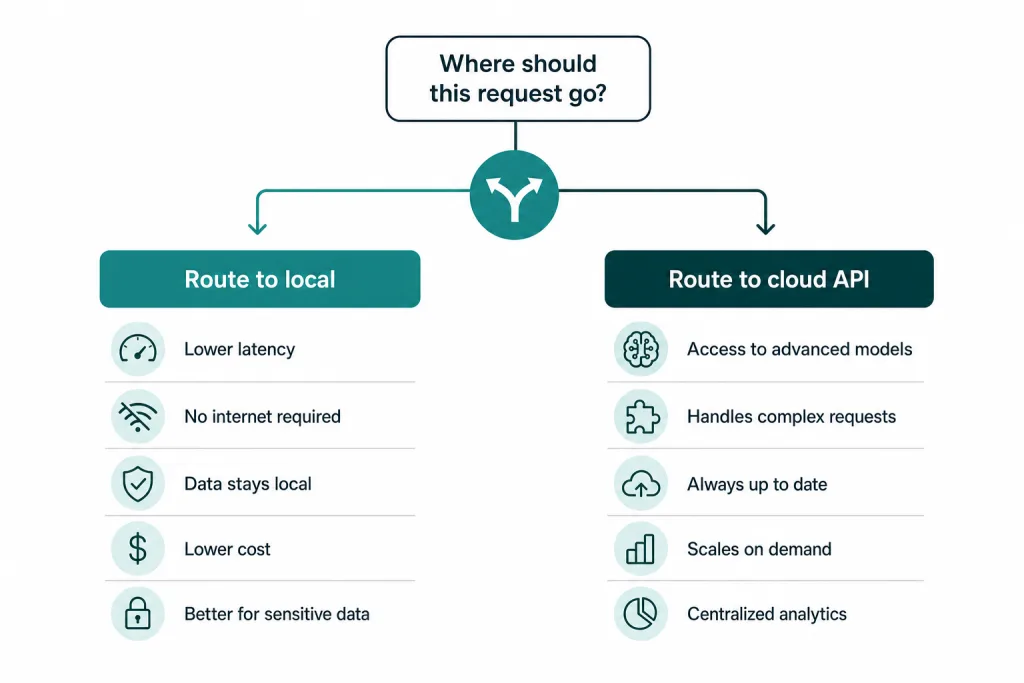
เวิร์กโฟลว์ 4: การกำหนดเส้นทางแบบไฮบริด (กลยุทธ์ที่คนส่วนใหญ่ควรใช้)
อย่ามองว่าในเครื่องกับคลาวด์เป็นสองขั้วที่ต้องเลือกข้าง จงเลือกเส้นทางตามงาน:
| ส่งไปที่ในเครื่อง | ส่งไปที่ API คลาวด์ |
|---|---|
| อะไรก็ตามที่อ่อนไหวด้านความเป็นส่วนตัว | งานใช้เหตุผลที่ยากที่สุด |
| งานประมวลผลจำนวนมากและการประมวลผลแบบแบตช์ | กรณีที่ต้องการคุณภาพระดับแนวหน้าจริง ๆ |
| ลูปเอเจนต์ที่มีการเรียกถูก ๆ หลายครั้ง | ผลลัพธ์ความเสี่ยงสูงที่ทำครั้งเดียว |
| การวนซ้ำและการทดลอง | งานที่ต้องใช้โมเดลล่าสุดจริง ๆ |
| งานออฟไลน์ | หน้าต่างบริบทที่ยาวมาก |
นี่คือที่ที่คุณค่าส่วนใหญ่อยู่ ในเครื่องรับผิดชอบปริมาณ การวนซ้ำ และความเป็นส่วนตัว คลาวด์รับผิดชอบ 5% ที่ยาก
สแต็ก AI ของ Apple เอง (ที่ควรรู้ไว้)
กรณี Foundation Models framework ให้นักพัฒนาที่ใช้ Swift เข้าถึงโมเดลบนเครื่องของ Apple ได้โดยตรง — ประมาณ 3B พารามิเตอร์ ฟรี เป็นส่วนตัว ออฟไลน์ พร้อมการสร้างแบบมีไกด์และการเรียกเครื่องมือในตัว
อัปเดตปี 2026 สำคัญกว่าการเปิดตัวครั้งแรก: อินพุตภาพ การทำงานฝั่งเซิร์ฟเวอร์ และ LanguageModel โปรโตคอลที่ให้คุณผูกเซสชันกับโมเดลของ Apple โมเดลบนคลาวด์ หรือโมเดล MLX ในเครื่อง ผ่าน MLXLanguageModelถ้าคุณสร้างแอป Mac หรือ iOS นี่คือเส้นทางที่สะอาดสู่ฟีเจอร์ AI แบบไฮบริดบนเครื่อง
Xcode 26 ยังมาพร้อมเครื่องมือเขียนโค้ดด้วย LLM ในตัวที่ใช้ ChatGPT ผู้ให้บริการรายอื่นผ่าน API key หรือโมเดลในเครื่องที่รันบน Mac ของคุณได้
ใช้งานจริง: ความร้อน แบตเตอรี่ และเสียง
สเปกไม่ได้บอกว่าใช้งานเครื่องจริง ๆ แล้วเป็นอย่างไร ต่อไปนี้คือข้อสังเกตตรง ๆ สองสามข้อ
รุ่น 14 นิ้วลดความเร็วมากกว่ารุ่น 16 นิ้ว Notebookcheck ชี้ว่ามีการลดความเร็วจากความร้อนอย่างหนักบน MacBook Pro ปี 2026 ภายใต้โหลดต่อเนื่อง โดยพฤติกรรมของ CPU ไม่สม่ำเสมอแม้ใน High Power Mode รุ่น 16 นิ้วมีช่องว่างในการระบายความร้อนมากกว่าและมีแบตเตอรี่ใหญ่กว่า ถ้าคุณวางแผนจะรันการอนุมานต่อเนื่องยาวนาน รุ่น 16 นิ้วคือเครื่องที่ดีกว่า — นี่คือความต่างเชิงการทำงานจริง ไม่ใช่ความชอบส่วนตัว
งาน AI ไม่ได้ร้อนเท่ากันทั้งหมด การถอดรหัส LLM ค่อนข้างเบา — มันผูกกับหน่วยความจำ GPU จึงไม่ได้ทำงานเต็มที่และพัดลมมักเงียบ การดิฟฟิวชันภาพและวิดีโอกินพลังประมวลผล จะดึง GPU ทำงานเต็มที่ พัดลมดังจนได้ยิน และแบตเตอรี่หมดเร็ว
ความจริงเรื่องแบตเตอรี่: เซสชัน LLM สั้น ๆ ใช้แบบไม่เสียบปลั๊กได้ งานดิฟฟิวชันต่อเนื่องจะกินแบตเตอรี่หมดในสองสามชั่วโมงและลดความเร็วจากความร้อนก่อนถึงตอนนั้น เสียบปลั๊กไว้สำหรับงานจริงจัง
โหมดพลังงาน: รุ่น 16 นิ้วมี High Power Mode ซึ่งคุ้มที่จะเปิดสำหรับงานยาว Low Power Mode ลดความเร็วการอนุมานอย่างมีนัยสำคัญ — หลีกเลี่ยงขณะรันโมเดล
นิสัยที่ใช้จริง: ไม่เสียบปลั๊กสำหรับแชตและช่วยเขียนโค้ด เสียบปลั๊กและเปิด High Power Mode สำหรับชุดภาพและวิดีโอ
ข้อโต้แย้งที่ตรงไปตรงมา
คู่มือที่เถียงข้างเดียวคือการตลาด นี่คือข้อโต้แย้ง
1. M5 Max เร็วกว่าจริง และไม่ได้ต่างกันนิดเดียว
307 GB/s เทียบกับ 614 GB/s เนื่องจากการถอดรหัสผูกกับแบนด์วิดท์ M5 Max 40 คอร์จึงสร้างโทเคนได้เร็วราวสองเท่า บนโมเดลเดียวกัน และยังใส่ gpt-oss-120bซึ่ง M5 Pro ทำไม่ได้
ถ้าความเร็วในการถอดรหัสโมเดลใหญ่คือการใช้งานหลักของคุณ M5 Max คือเครื่องที่ถูกต้อง และ M5 Pro คือการประนีประนอม ข้อโต้แย้งคือราคา: หลังเดือนมิถุนายน 2026 การอัปเกรดนั้นโหดมาก
2. M4 Max ที่ลดราคาอาจชนะ M5 Pro ใหม่
นี่คือข้อโต้แย้งที่ผู้ซื้อส่วนใหญ่พลาด M4 Max มีแบนด์วิดท์หน่วยความจำราว 546 GB/s — มากกว่า 307 GB/s ของ M5 Pro อย่างชัดเจน สำหรับการถอดรหัส LLM ล้วน ๆ M4 Max 64GB มักจะเร็วกว่า M5 Pro 64GB
สิ่งที่คุณแลกไป: Neural Accelerators ของ M5 ซึ่งหมายถึง prefill ที่ช้ากว่ามากและการสร้างภาพที่ช้ากว่า
กฎการตัดสินใจ: ถ้าคุณแชตกับโมเดลใหญ่เป็นหลัก M4 Max 64GB ที่ลดราคาน่าจะเป็นตัวเลือกที่ดีกว่า ถ้าคุณเขียนโค้ดแบบเอเจนต์กับบริบทที่ยาว หรือสร้างภาพ ข้อได้เปรียบด้าน prefill และดิฟฟิวชันของ M5 Pro จะชนะ
3. NVIDIA ยังชนะด้านการประมวลผล
RTX 5090 มี VRAM 32GB ที่ราว 1,792 GB/s — เกือบหกเท่าของแบนด์วิดท์ M5 Pro — บวกพลังประมวลผลที่มากกว่ามหาศาล สำหรับโมเดลใดก็ตามที่ใส่ใน 32GB ได้ และสำหรับงานที่กินพลังประมวลผลทั้งหมด (วิดีโอ ภาพ prefill) ไม่ใช่การแข่งขันกันเลย
ข้อได้เปรียบของ Mac เริ่มต้นตรงจุดที่ VRAM 32GB สิ้นสุดพอดี และรวมถึงความพกพา ความเงียบ การใช้ไฟต่ำ และความสามารถทำสิ่งนี้บนรถไฟ
4. คู่แข่งที่ใช้หน่วยความจำรวม 128GB เน้นความจุ ไม่ใช่ความเร็ว
NVIDIA DGX Spark / GB10: 128GB ที่ราว 273 GB/s พร้อม CUDA บน gpt-oss-120b MXFP4 การทดสอบอิสระวัดได้ 34–39 tok/s
AMD Strix Halo / Ryzen AI Max+ 395: 128GB ที่ราว 256 GB/s ตัวเลขของ AMD เองระบุว่าสูงถึง 30 tok/s บนโมเดลเดียวกันผ่าน llama.cpp มินิพีซีที่สร้างจากชิปนี้ถูกกว่า Mac รุ่นใด ๆ อย่างเห็นได้ชัด
สังเกตว่า ทั้งคู่มี แบนด์วิดท์ต่ำกว่า M5 Pro คุณได้ความจุ ไม่ใช่ความเร็ว ถ้าเป้าหมายคือรันโมเดลใหญ่ ๆ ในความเร็วที่ยอมรับได้ไม่ใช่เร็วจัด พวกมันถูกกว่า ถ้าคุณต้องการความเร็ว พวกมันไม่ใช่คำตอบ
5. Mac เดสก์ท็อปเหมาะกว่าในฐานะเครื่องตั้งโต๊ะ
A Mac Studio M3 Ultra ไปได้ถึง 512GB ที่ 800 GB/s ถ้าเครื่องของคุณอยู่บนโต๊ะตลอด นั่นคือกล่อง AI ในเครื่องที่ดีกว่าคุณ MacBook Pro รุ่นใด ๆ มาก คุณค่าของแล็ปท็อปคือความพกพา แบตเตอรี่ และความเงียบ — ถ้าคุณไม่ต้องการสิ่งเหล่านั้น ก็ไม่ต้องจ่าย
6. คุณอัปเกรดหน่วยความจำไม่ได้ ตลอดไป
หน่วยความจำ Apple Silicon อยู่บนแพ็กเกจ ซื้อมาเท่าไรก็ได้เท่านั้นตลอดอายุเครื่อง
เมื่อพิจารณาว่าโมเดลที่เปิดตัวในปี 2026 มีแนวโน้มขนาด MoE ใหญ่ขึ้นเรื่อย ๆ การซื้อ RAM น้อยเกินไปคือความเสียใจคลาสสิกที่แก้ไม่ได้ ถ้าคุณเลือกระหว่าง 48GB กับ 64GB ให้เอา 64GB
คำนวณต้นทุน: โลคอลกับคลาวด์
มาคิดเลขกันอย่างซื่อสัตย์ เพราะ “ในเครื่องถูกกว่า” มักถูกกล่าวอ้างและแทบไม่เคยถูกคำนวณ
เครื่อง: ราว $2,800 สำหรับ M5 Pro 64GB เฉลี่ยค่าเสื่อมในสามถึงสี่ปี
ราคา API ณ เดือนสิงหาคม 2026 (ต่อหนึ่งล้านโทเคน อินพุต/เอาต์พุต):
| บริการ | อินพุต | เอาต์พุต |
|---|---|---|
| ระดับ Claude Sonnet | ~$3 | ~$15 |
| ระดับ GPT-5 | ~$1.75–$5 | ~$14–$30 |
| DeepSeek V4 Flash | ~$0.14 | ~$0.28 |
| โมเดลโอเพนซอร์สที่ให้บริการโฮสต์ (gpt-oss, Llama) | ต่ำกว่านั้นอีก | ต่ำกว่านั้นอีก |
การเช่า GPU บนคลาวด์: H100 ราว $3/ชั่วโมง H200 ราว $5/ชั่วโมงแบบ on-demand
จุดคุ้มทุน: บทวิเคราะห์ที่เผยแพร่ระบุว่าจุดตัดข้ามสำหรับเครื่องสำหรับผู้ใช้ทั่วไปอยู่ที่ราว 2–3 ล้านโทเคนต่อวันต่อเนื่องราวสิบสองเดือน เมื่อเทียบกับ API ที่เป็นกรรมสิทธิ์ระดับกลาง
นั่นคือโทเคนจำนวนมาก ต่ำกว่าเกณฑ์นั้น API ราคาถูก — โดยเฉพาะระดับ DeepSeek — ให้ต้นทุนโทเคนถูกกว่าการรันในเครื่องจริง ๆ
แล้วทำไมต้องซื้อเครื่อง?
เพราะต้นทุนโทเคนไม่ใช่ต้นทุนเดียว:
- ความเป็นส่วนตัว ข้อมูลของคุณไม่เคยออกจากอุปกรณ์ สำหรับงานกฎหมาย การแพทย์ การเงิน หรือโค้ดที่เป็นกรรมสิทธิ์ เรื่องนี้มักต่อรองไม่ได้ไม่ว่าราคาจะเป็นเท่าไร
- ไม่มีอัตราจำกัด ไม่มีการหรี่ความเร็ว ไม่มีคิว ไม่มีข้อผิดพลาดเรื่องความจุตอนตีสอง
- ออฟไลน์ เครื่องบิน รถไฟ ไวไฟโรงแรมแย่ ๆ เน็ตดับ
- ต้นทุนส่วนเพิ่มเป็นศูนย์ เรื่องนี้เปลี่ยนพฤติกรรมมากกว่าที่คนคาด เมื่อการทดลองแต่ละครั้งฟรี คุณจะทำมากขึ้นสิบเท่า การไม่มีอาการกังวลเรื่องโทเคนระหว่างวนซ้ำมีค่ามหาศาลในแง่ผลงาน
- ยังไงคุณก็ต้องมีแล็ปท็อปอยู่แล้ว กรอบความคิดที่ซื่อสัตย์ไม่ใช่ “$2,800 เพื่อ AI” — แต่คือส่วนต่างระหว่างเครื่องที่คุณจะซื้ออยู่แล้วกับเครื่องนี้
ข้อสรุปที่ถูกต้องคือแบบไฮบริด ในเครื่องสำหรับปริมาณ ความเป็นส่วนตัว การวนซ้ำ และลูปเอเจนต์ คลาวด์สำหรับปัญหาที่ยาก ใครที่บอกว่าในเครื่องแทนที่ API ระดับแนวหน้าได้ทั้งหมดในปี 2026 กำลังขายเกินจริง ใครที่บอกว่าในเครื่องไม่มีประโยชน์ก็ยังไม่เคยรันลูปเอเจนต์ในระดับจริง
คู่มือการเลือกซื้อ
| ถ้าคุณ… | ซื้ออันนี้ | ทำไม |
|---|---|---|
| ต้องการแล็ปท็อป AI ในเครื่องที่สมดุลที่สุด | M5 Pro 64GB รุ่น 16 นิ้ว | รันโมเดล 8B–70B และ MoE สร้างภาพเร็ว มีที่เหลือให้อย่างอื่น ระบายความร้อนดีกว่ารุ่น 14 นิ้ว |
ต้องการ gpt-oss-120b หรือโมเดล 120B+ | M5 Max 128GB | แล็ปท็อป Mac รุ่นเดียวที่ใส่ได้ และความเร็วถอดรหัสราว 2 เท่า |
| แชตกับโมเดลใหญ่เป็นหลัก ต้องการความคุ้มค่า | M4 Max 64GB ที่ลดราคา | แบนด์วิดท์สูงกว่า (546 GB/s) ชนะ M5 Pro ในการถอดรหัส |
| ทำงานสร้างวิดีโอจริงจัง | NVIDIA (RTX 5090) หรือคลาวด์ | งานที่กินพลังประมวลผล Mac ช้ากว่าหลายเท่า |
| ต้องการความจุสูงสุดในงบจำกัด | มินิพีซี Strix Halo 128GB | 128GB ในราคาถูก แต่แบนด์วิดท์ต่ำกว่า M5 Pro |
| ทำงานที่โต๊ะ | Mac Studio M3 Ultra | สูงสุด 512GB ที่ 800 GB/s |
| มีงบจำกัด | M5 Pro 48GB | รันโมเดลระดับ 32B ได้สบาย ยอมรับเพดาน 70B/MoE ได้ก็พอ |
สิ่งที่ผมจะไม่ทำ: ซื้อเครื่อง 24GB หรือ 32GB เพื่อทำ local AI อย่างจริงจัง เพราะคุณจะชนกำแพงภายในไม่กี่สัปดาห์และอัปเกรดหนีไม่ได้
คำถามที่พบบ่อย
64GB พอสำหรับ local AI ในปี 2026 ไหม? พอ สำหรับงานส่วนใหญ่ 64GB รันโมเดลได้ถึงราว 70B พารามิเตอร์ที่การควอนไทซ์ 4-bit ได้อย่างสบาย รวมถึงโมเดลแบบ Mixture-of-Experts อย่าง GLM-4.6 Air โดยยังเหลือที่ให้ระบบปฏิบัติการและแอปของคุณ ข้อยกเว้นหลักคือ gpt-oss-120bซึ่งต้องใช้ราว 63GB สำหรับน้ำหนักโมเดลอย่างเดียว และต้องใช้เครื่อง 128GB
M5 Pro รัน gpt-oss-120b ได้ไหม? ไม่ได้ บิลด์ MXFP4 ต้องใช้ราว 63GB สำหรับน้ำหนักโมเดล และหน่วยความจำสูงสุดที่วัดได้บน M5 Max อยู่ที่ 64.4–64.9GB ขึ้นกับความยาวบริบท บนเครื่อง 64GB ที่ใช้ได้จริงราว 52–60GB มันไม่พอ นี่คือโมเดลสำหรับเครื่อง 128GB
M5 Pro สร้างได้กี่โทเคนต่อวินาที? ขึ้นกับโมเดลเป็นหลัก ตัวเลขที่วัดได้จาก M5 Pro 20-core พร้อม 64GB: gpt-oss-20b ที่ 66–80 tok/s สำหรับ decode พร้อม prefill 1,500–2,200 tok/s และ Qwen3.6-27B ที่ 17.8 tok/s decode พร้อม prefill 470 tok/s โมเดล dense ขนาดใหญ่ขึ้นอย่าง Llama 3.3 70B ประเมินไว้ที่ 7–12 tok/s
M5 Pro หรือ M5 Max สำหรับ LLM โลคอล? M5 Max ถ้าความเร็วในการสร้างโทเคนบนโมเดลใหญ่คือสิ่งที่คุณให้ความสำคัญ — มีแบนด์วิดท์หน่วยความจำ 614 GB/s เทียบกับ 307 GB/s ของ M5 Pro ทำให้ความเร็ว decode ราวสองเท่า และรองรับ 128GB เลือก M5 Pro ถ้าคุณต้องการสมดุลที่ดีที่สุดระหว่างราคา ความพกพา และความสามารถสำหรับโมเดลถึง 70B
การสร้างวิดีโอบน Mac ใช้ได้จริงไหม? ยังไม่จริงเท่าไรในปี 2026 การสร้างวิดีโอด้วย diffusion ติดขีดจำกัดที่พลังประมวลผล และ Mac ช้ากว่า RTX 5090 หลายเท่า โมเดลแบบ distilled ช่วยได้ — LTX 2.3 สร้างคลิป 5 วินาทีได้ในราว 121 วินาทีบน M5 Max — แต่ถ้าต้องการทรูพุตจริง การเช่า GPU บนคลาวด์เร็วกว่าและถูกกว่าต่อคลิปอย่างชัดเจน
จะเพิ่มขีดจำกัดหน่วยความจำ GPU บน macOS ได้อย่างไร? เรียกใช้ sudo sysctl iogpu.wired_limit_mb=61440 เพื่อจัดสรร 60GB ตรวจสอบด้วย sysctl iogpu.wired_limit_mb และรีเซ็ตด้วยค่า 0. เพิ่มลงใน /etc/sysctl.conf เพื่อให้คงอยู่ข้ามการรีบูต เสมอเว้น 4–8GB ให้ macOS
MLX หรือ llama.cpp บน Apple Silicon? MLX สำหรับกรณีส่วนใหญ่ นำหน้า llama.cpp อยู่ 20–87% บนโมเดลต่ำกว่า 14B ใช้หน่วยความจำน้อยกว่าราว 10% และเป็นสิ่งที่ Ollama 0.19 เปลี่ยนมาใช้ในเดือนมีนาคม 2026 ข้อยกเว้นคือบริบทที่ยาวมาก — ที่ 30,000+ โทเคน llama.cpp ที่ใช้ Flash Attention เร็วกว่าได้ถึง 50%
ควรซื้อรุ่น 14 นิ้วหรือ 16 นิ้ว? รุ่น 16 นิ้ว ถ้าทำงาน AI ต่อเนื่อง มีช่องว่างเรื่องความร้อนที่ดีกว่า แบตเตอรี่ใหญ่กว่า และมี High Power Mode ส่วนรุ่น 14 นิ้วลดความเร็วลงอย่างเห็นได้ชัดเมื่อรับโหลดต่อเนื่อง
M4 Max ที่ลดราคาเหนือกว่า M5 Pro เครื่องใหม่ไหม? ถ้าเทียบเฉพาะ decode ของ LLM บ่อยครั้งก็ใช่ — M4 Max มีราว 546 GB/s เทียบกับ 307 GB/s ของ M5 Pro แต่ M5 Pro ชนะด้านการประมวลผลพรอมต์ (เร็วกว่าถึง 4 เท่า) และการสร้างภาพ (เร็วกว่า 3.8 เท่าขึ้นไป) ด้วย Neural Accelerators เลือกตามงานที่คุณใช้เป็นหลัก
ก้าวต่อไป
มีบางเรื่องที่ควรจับตา เพราะอาจเปลี่ยนคำแนะนำข้างต้นได้
ผลเบนช์มาร์ก M5 Pro จากอิสระบนโมเดล 70B ยังไม่มีใครเผยแพร่ตัวเลข decode ที่วัดมาอย่างดี ถ้าผลในโลกจริงออกมาสูงกว่า 15 tok/s ข้อโต้แย้งที่ว่า “ซื้อ Max เพื่อ decode” จะอ่อนลงอย่างมาก
การควอนไทซ์ gpt-oss-120b ที่เล็กลง ถ้ามีบิลด์ที่ต่ำกว่า 52GB ข้อโต้แย้งเรื่องเพดาน 64GB ก็อ่อนลงในชั่วข้ามคืน
ค่าเริ่มต้นหน่วยความจำของ macOS ถ้า Apple เพิ่มการจัดสรร GPU เริ่มต้นขึ้นเกิน 75% ทุกคนที่ใช้เครื่อง 64GB จะได้ที่ว่างเพิ่มฟรี
MoE ยังชนะต่อไป เทรนด์ของโมเดลที่พารามิเตอร์รวมสูงแต่พารามิเตอร์ที่ใช้งานจริงต่ำคือสิ่งที่ดีที่สุดที่เกิดกับเครื่องหน่วยความจำแบบรวม ทุกการเปิดตัว MoE ใหม่ทำให้ Mac แข่งขันได้ดีขึ้นเมื่อเทียบกัน
ราคา API ที่ลดลง คำนวณจุดคุ้มทุนระหว่างเครื่องตัวเองกับคลาวด์ใหม่ทุกหกเดือน เพราะมันเปลี่ยนได้
บทสรุป
MacBook Pro M5 Pro พร้อม 64GB ไม่ใช่เครื่อง local AI ที่เร็วที่สุดที่ซื้อได้ ไม่ใช่แม้แต่ Mac ที่เร็วที่สุด สิ่งที่มันเป็นคือคอนฟิกที่ข้อแลกเปลี่ยนหยุดต่อสู้กันเอง
มันรันโมเดลที่ดีพอจะใช้งานได้จริง — gpt-oss-20b ที่ 66–80 tok/s, GLM-4.6 Air ราว 30, การสร้างภาพในไม่กี่วินาที — ในขณะที่ยังเป็นแล็ปท็อปที่พกพาได้ ใช้แบตเตอรี่ได้ และใช้เป็นคอมพิวเตอร์เครื่องจริงของคุณ Neural Accelerators ของรุ่น M5 แก้จุดอ่อนเฉพาะเจาะจง (การประมวลผลพรอมต์ที่ช้า) ที่ทำให้ Mac รุ่นก่อนน่ารำคาญสำหรับงานแบบ agentic และบริบทยาว
เพดานเหล่านี้มีจริงและควรรู้ไว้: gpt-oss-120b ไม่พอ โมเดล dense ขนาด 70B เป็นเครื่องมือแบบแบตช์มากกว่าคู่สนทนา และการสร้างวิดีโอควรอยู่บนคลาวด์
ถ้าข้อจำกัดเหล่านั้นสอดคล้องกับงานของคุณ นี่คือเครื่องที่ใช่ ถ้าไม่ หัวข้อข้างต้นบอกคุณชัดเจนว่าควรซื้อเครื่องไหนแทน — และนั่นมีประโยชน์กว่าบทความอีกชิ้นที่บอกว่าทุกอย่างเรียบร้อยดี
ราคา เวอร์ชันโมเดล และตัวเลขเบนช์มาร์กในบทความนี้สะท้อนข้อมูลที่มีในเดือนสิงหาคม 2026 และเปลี่ยนแปลงเร็ว — โดยเฉพาะราคา Mac ในช่วงที่หน่วยความจำขาดแคลนอยู่ ตรวจสอบสเปกปัจจุบันก่อนซื้อ