
 ไทย
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

หกสัปดาห์ก่อน ผมคงเขียนบทความนี้ต่างออกไป
ในเดือนกรกฎาคม Moonshot AI ปล่อยโมเดลระดับแนวหน้าที่มีพารามิเตอร์ 2.8 ล้านล้านตัวขึ้น Hugging Face และให้ใครก็ดาวน์โหลดได้ วันที่ 28 สิงหาคม Z.ai ปล่อยเวต GLM-5.3 ที่เก็บไว้นานสองสัปดาห์ในที่สุด — หลังจากพบว่าโมเดลของตัวเองสามารถเชื่อมช่องโหว่หลายอย่างเข้าด้วยกันในแบบที่ไม่มีใครสั่ง และวันที่ 1 กันยายน Anthropic ส่ง Claude Fable 5.1 ออกมาและทำให้งานเอเจนต์ถูกลงได้ถึง 45% โดยไม่แตะราคาที่ประกาศไว้
สามโมเดล สามคำตอบที่ต่างกันโดยสิ้นเชิงต่อคำถามว่าห้องแล็บ AI ควรให้อะไรกับสาธารณะ และเป็นครั้งแรกนับตั้งแต่เรื่องทั้งหมดนี้เริ่มขึ้น ตัวเลือกแบบโอเพนเวตไม่ใช่ตัวเลือกที่ต้องประนีประนอมอีกต่อไป
นั่นคือเรื่องจริงของปลายปี 2026 และมันคุ้มค่ากับประมาณแปดพันคำ เพราะรายละเอียดคือที่ที่เงินทั้งหมดและความผิดพลาดทั้งหมดอยู่
ผมดึงเอกสารสถาปัตยกรรม การ์ดโมเดล ข้อความสัญญาอนุญาต — อย่างจริงจัง ทีละบรรทัด เพราะสองในสามตัวไม่ใช่สิ่งที่คนพูดกันเล่น ๆ — เบนช์มาร์กจากผู้ขาย คะแนนจากผู้รวบรวมที่เป็นกลาง ราคาจริงต่อโทเคน และตารางราคาใหม่ล่าสุดของ Ollama’s แล้วผมคำนวณต้นทุนจากเดือนทำงานปกติ ไม่ใช่จากสถานการณ์วันเปิดตัว
นี่คือสิ่งที่ออกมา
สรุปสั้น — คำตัดสินใน 60 วินาที
GLM-5.3 ให้ความคุ้มค่าที่สุดในวงการ AI ตอนนี้ และไม่ได้คุ้มกว่าแค่นิดหน่อย Artificial Analysis ให้คะแนนห่างจาก Kimi K3 ภายในครึ่งคะแนน และตาม Claude Opus 5 อยู่ราวสามคะแนนครึ่ง ที่ราคาอินพุต $1.40 และเอาต์พุต $4.40 ต่อล้านโทเคน ในงานเอเจนต์เดียวกัน มันมีต้นทุนราวหนึ่งในหกของ Fable 5.1 เวตดาวน์โหลดได้ ถ้าคุณอยากได้โมเดลเดียวให้เอเจนต์ทำงานด้วย และคุณไม่ได้ทำธุรกิจรายได้หมื่นล้านดอลลาร์ นี่คือตัวนั้น
Kimi K3 คือสิ่งที่ทรงพลังที่สุดที่คุณดาวน์โหลดได้อย่างถูกกฎหมาย พารามิเตอร์ 2.8 ล้านล้านตัว ใช้งาน 104 พันล้านตัว หน้าต่างบริบท 1M จริง วิชันในตัว คะแนนการท่องเว็บแบบเอเจนต์ที่ดีที่สุดที่ใครเคยเผยแพร่ (BrowseComp 91.2) และ — ตัวเลขที่ควรยุติข้อโต้แย้งที่ว่า “โมเดลเปิดตามหลังอยู่” — 88.3 บน Terminal-Bench 2.1 เทียบกับ 88.0 ของ Claude Fable 5’s และ 88.8 ของ GPT-5.6 Sol’s ในเวอร์ชันเดียวกัน มันยังมีราคา $3/$15 — มากกว่าสองเท่าของ GLM-5.3 — และเวต 1.5 TB ต้องใช้ตู้แร็ก ไม่ใช่เวิร์กสเตชัน มันคือโมเดลที่คุณใช้เมื่องานยากและยาว และเป็นโมเดลที่คุณอ้างถึงเมื่อมีคนบอกว่าโอเพนเวตตามหลังอยู่หนึ่งรุ่น
Claude Fable 5.1 ยังเป็นโมเดลที่คุณหยิบมาใช้เมื่อการผิดพลาดมีราคาแพง มันนำในงานเอเจนต์ต่อเนื่องหลายชั่วโมง และในการดีบักที่ยุ่งเหยิงซึ่งไม่เคยโผล่ขึ้นมาสวย ๆ บนลีดเดอร์บอร์ด Anthropic ลดการอ่านแคชลง 75% เมื่อวันที่ 1 กันยายน ซึ่งทำให้เซสชันเอเจนต์ยาว ๆ ถูกลงอย่างมากเมื่อเทียบกับก่อนหน้านี้ มันยังมีราคาสูงกว่า GLM-5.3 ถึงหกเท่าต่องาน เป็นระบบปิด และตอนนี้มีข้อจำกัดต่อต้านการกลั่นโมเดลที่ทำให้การเชื่อมต่อบางอย่างที่มีอยู่ใช้ไม่ได้
สรุปตรง ๆ ในบรรทัดเดียว: โมเดลโอเพนเวตได้ปิดช่องว่างด้านความสามารถเหลือราวสามถึงห้าเดือน และพวกมันได้ทำลายช่องว่างด้านราคาจนหมดสิ้น สิ่งที่คุณกำลังซื้อจาก Anthropic ในเดือนกันยายน 2026 จริง ๆ คือความน่าเชื่อถือในงานยากที่สุด 10% — และสิทธิ์ที่จะไม่ต้องคิดเรื่องทั้งหมดนี้เลย
และจุดพลิกที่ไม่มีใครอยากพูดออกมา: ทั้ง Kimi K3 และ GLM-5.3 ไม่ได้ออกภายใต้สัญญาอนุญาตโอเพนซอร์สอีกต่อไป ทั้งคู่เปลี่ยนไปใช้เงื่อนไขเฉพาะที่ผูกกับรายได้ในช่วงฤดูร้อนนี้ โอเพนเวต ใช่ โอเพนซอร์ส ไม่ อ่านหัวข้อเรื่องสัญญาอนุญาตก่อนที่ทีมกฎหมายของคุณจะอ่าน
ตารางเปรียบเทียบแบบเร็ว
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| ผู้พัฒนา | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| เปิดตัว | 16 กรกฎาคม 2026 (API) · 27 กรกฎาคม (เวต) | 14 สิงหาคม 2026 (API) · 28 สิงหาคม (เวต) | 1 กันยายน 2026 |
| มีเวตให้ดาวน์โหลด | ใช่ | ใช่ | ไม่ใช่ |
| สัญญาอนุญาต | Kimi K3 License (กำหนดเอง ผูกกับรายได้) | glm-5.3 License (กำหนดเอง ผูกกับรายได้) | ลิขสิทธิ์ |
| พารามิเตอร์ทั้งหมด | 2.8T | 753B | ไม่เปิดเผย |
| พารามิเตอร์ที่ใช้งานต่อโทเคน | 104B (16 จาก 896 ผู้เชี่ยวชาญ) | ~40B (ประมาณ) | ไม่เปิดเผย |
| สถาปัตยกรรม | KDA + Attention Residuals, Stable LatentMoE, 69 ชั้น KDA + 24 ชั้น Gated MLA | MoE ใช้ฐานเดียวกับ GLM-5.2 ผล增益มาจากการฝึกหลังเทรนเท่านั้น | ไม่เปิดเผย |
| หน้าต่างบริบท | 1,048,576 | 1,000,000 | 1,000,000 |
| เอาต์พุตสูงสุด | ค่าเริ่มต้น 131,072 (สูงสุด 1,048,576) | 128,000 | 128,000 |
| อินพุตหลายรูปแบบ | ข้อความ รูปภาพ วิดีโอ (MoonViT-V2) | ข้อความเท่านั้น | ข้อความ รูปภาพ |
| การคิด | เปิดตลอด | เปิดตลอด, reasoning_effort low/high/max | เปิดตลอด ปรับตามงาน ระดับความพยายามต่อข้อความ (เบต้า) |
| ราคาอินพุต / 1M | $3.00 | $1.40 | $10.00 |
| อินพุตแคช / 1M | $0.30 | $0.26 | $0.25 |
| ราคาเอาต์พุต / 1M | $15.00 | $4.40 | $50.00 |
| AA Intelligence Index | 59.7 | 59.5 | ยังไม่ได้ให้คะแนน (Fable 5: 62.1) |
| ต้นทุนต่องานประเมิน AA | $0.84 | $0.68 | — (Opus 5: $2.34) |
| ขนาดเมื่อโฮสต์เอง | ~1.5 TB (native MXFP4) | ~1.5 TB BF16 / ~750 GB FP8 | N/A |
| บน Ollama | kimi-k3:cloud | glm-5.3:cloud | ผ่าน Claude Code / Claude Desktop ในฐานะไคลเอนต์ |
ราคาทั้งหมดเป็นราคาปลีกจากเจ้าของโดยตรง ตัวเลขของ Artificial Analysis มาจากภาพรวมดัชนีเดือนกันยายน 2026; Fable 5.1 เปิดตัวเมื่อวันที่ 1 กันยายน และยังไม่ได้รับการให้คะแนนอย่างอิสระในเวลาที่เขียน
ทำไมการเทียบสามตัวนี้จึงสำคัญ
เป็นเวลาสองปีที่บทสนทนาเรื่องเปิดกับปิดมีรูปร่างที่สบายใจ: โมเดลปิดดีกว่า โมเดลเปิดถูกกว่า และคุณเลือกจุดยืนของตัวเองบนการแลกเปลี่ยนนั้น ทุกคนรู้ว่าตัวเองยืนอยู่ตรงไหน
รูปร่างนั้นแตกสลายไปในช่วงฤดูร้อนนี้
Nathan Lambert ผู้ติดตามเรื่องนี้อย่างละเอียดกว่าคนเกือบทั้งหมด ประเมินช่องว่างความสามารถปัจจุบันระหว่างโอเพนเวตแนวหน้ากับโมเดลปิดแนวหน้าว่าอยู่ที่ สามถึงห้าเดือน — ลดลงจากหกถึงเก้าเดือนที่ผู้คนพูดถึงเมื่อปีที่แล้ว ตอนที่เขาเขียน Kimi K3 อยู่อันดับ #2 บนดัชนี Vals AI และใกล้จุดสูงสุดของ Artificial Analysis’s โดยแพ้ให้กับ Claude Fable และ GPT-5.6 Sol Max เท่านั้น ภาพรวมดัชนีเดือนกันยายนที่ผมใช้ต่อไปในบทความนี้จัดให้อยู่อันดับสี่ ตามหลัง Grok 4.6 ไม่ว่าจะทางไหน นั่นไม่ใช่ “ดีสำหรับโมเดลเปิด” นั่นคือการขึ้นโพเดียม
ขณะเดียวกัน ข้อมูลการใช้งานก็ไปในที่ที่เซอร์ไพรส์จริง ๆ โมเดลจากจีนคว้าไปราว 61% ของโทเคนทั้งหมดที่ผ่าน OpenRouter ภายในเดือนพฤษภาคม 2026 สัดส่วนของสหรัฐในทราฟฟิกนั้นดิ่งจากราว 70% เหลือราว 30% ในสิบสองเดือน Meta’s Llama — โมเดลที่เริ่มคลื่นโอเพนเวต — ตกลงต่ำกว่า 1% ของปริมาณที่กำหนดเส้นทาง Google’s ส่วนแบ่งไปจากราว 37% เหลือ 13% การศึกษาข้อมูลหนึ่งร้อยล้านล้านโทเคนของ OpenRouter’s ร่วมกับ a16z พบว่าโมเดลโอเพนเวตคิดเป็นราวหนึ่งในสามของปริมาณโทเคนทั้งหมดบนแพลตฟอร์ม
คุณโต้แย้งได้ว่าทราฟฟิกของ OpenRouter เป็นตัวแทนของอะไร มันเอียงไปทางนักพัฒนา คนสมัครเล่น และงานที่ไวต่อต้นทุน และนับธุรกิจองค์กรที่ไม่ได้ผ่านเราเตอร์ต่ำเกินไป ก็ได้ แต่มันคือชุดข้อมูลสาธารณะที่ใหญ่ที่สุดที่เรามีเกี่ยวกับสิ่งที่ผู้คนเลือกจริง ๆ เมื่อเลือกได้อย่างอิสระ และทิศทางก็ชัดเจนไม่มีข้อกังขา
ดังนั้นคำถามในเดือนกันยายน 2026 ไม่ใช่ “โมเดลเปิดดีพอหรือยัง” อีกต่อไป มันคมกว่าเดิมมาก:
เมื่อมีสามโมเดลที่ผ่านเกณฑ์ทั้งหมด คุณจะชี้เอเจนต์ไปที่ตัวไหน — และการเลือกผิดมีต้นทุนจริงเท่าไรกับคุณ?
นั่นเป็นคำถามเรื่องเบนช์มาร์ก ราคา สัญญาอนุญาต และโครงสร้างพื้นฐาน ตามลำดับที่ผู้คนคิดถึงมันประมาณนั้น และกลับกันพอดีกับลำดับที่มันสำคัญ
Kimi K3 คืออะไรกันแน่
Moonshot AI ประกาศ Kimi K3 เมื่อวันที่ 16 กรกฎาคม 2026 และปล่อยเวตเต็มในวันที่ 27 กรกฎาคม หากนับตามจำนวนพารามิเตอร์ มันเป็นโมเดลโอเพนเวตที่ใหญ่ที่สุดที่ใครเคยเผยแพร่ — พารามิเตอร์รวม 2.8 ล้านล้านตัว ใหญ่กว่า DeepSeek V4 Pro ราว 75%
ตัวเลขนั้นทั้งน่าประทับใจน้อยกว่าที่ฟังดู และน่าประทับใจมากกว่าที่ฟังดู ตามลำดับนั้น
สถาปัตยกรรมในภาษาที่เข้าใจง่าย
Kimi K3 เป็นโมเดลแบบ mixture-of-experts ที่เปิดใช้งาน พารามิเตอร์ 104 พันล้านตัวต่อโทเคนโดยเลือก 16 ผู้เชี่ยวชาญจากกลุ่ม 896 ตัว ดังนั้นแม้ยอดรวมจะเป็น 2.8T การส่งต่อข้อมูลแต่ละครั้งก็แตะเวตไม่ถึง 4% นั่นคือที่มาของเศรษฐศาสตร์: ความรู้ที่เก็บไว้มหาศาล ต้นทุนการอนุมานปานกลาง
วิศวกรรมที่น่าสนใจอยู่ที่ชั้นแอตเทนชัน K3 ใช้ 93 ชั้นที่สร้างจาก 69 ชั้น KDA (Kimi Delta Attention) และ 24 ชั้น Gated MLA — ดีไซน์แอตเทนชันแบบไฮบริดระหว่างเชิงเส้นกับเต็มที่อัตราสลับราว 3:1 KDA เป็นแอตเทนชันแบบเชิงเส้นที่ทำงานในเวลาเชิงเส้นตามความยาวลำดับ ไม่ใช่กำลังสอง ซึ่งเป็นสิ่งที่ทำให้บริบท 1M คุ้มค่าในเชิงเศรษฐกิจจริง ไม่ใช่แค่โฆษณา Moonshot รายงานว่าลดได้ถึง ลดแคช KV ได้ 75% และสูงถึง ปริมาณการถอดรหัส 6 เท่าที่บริบท 1M เป็นผลลัพธ์
ทับลงไปอีกชั้นคือ Attention Residuals (AttnRes)ซึ่ง Moonshot อธิบายว่าเป็นตัวแทนที่ใส่แทนที่ได้เลยสำหรับการเชื่อมต่อเรซิดิวแบบมาตรฐาน และ Stable LatentMoE กรอบการทำงานสำหรับการกำหนดเส้นทาง มีการอ้างว่าการรวมกันนี้ให้ ประสิทธิภาพการสเกลโดยรวมดีขึ้นราว 2.5 เท่า เมื่อเทียบกับ Kimi K2
ความสามารถด้านภาพมาจาก MoonViT-V2ตัวเข้ารหัส 401 ล้านพารามิเตอร์ และมันเป็นความสามารถในตัว ไม่ใช่ของที่ติดเพิ่มทีหลัง — K3 จัดการข้อความ รูปภาพ และวิดีโอในโมเดลเดียว
รายละเอียดอีกอย่างที่สำคัญสำหรับใครที่คิดจะโฮสต์เอง: K3 ถูกเทรนด้วย การเทรนแบบตระหนักถึงการควอนไทซ์ MXFP4 แบบเนทีฟโดยผู้เชี่ยวชาญอยู่ใน MXFP4 และแอคติเวชันอยู่ใน MXFP8 นี่ไม่ใช่การควอนไทซ์ทีหลัง เช็คพอยต์ที่เผยแพร่คือโมเดลที่ควอนไทซ์แล้ว ซึ่งเป็นเหตุให้พารามิเตอร์ 2.8 ล้านล้านตัวเหลือราว 1.5 TB บนดิสก์ แทนที่จะเป็นราว 5.6 TB ที่เช็คพอยต์ BF16 ขนาดนั้นต้องใช้
เรื่องของเบนช์มาร์ก
ตัวเลขที่ Moonshot’s เผยแพร่แข็งแรงในทุกด้าน และผิดปกติตรงที่มีหลายตัวยังยืนได้ภายใต้การประเมินอิสระ:
- Terminal-Bench 2.1: 88.3 — คะแนนสูงสุดที่เผยแพร่บนเบนช์มาร์กเวอร์ชันนั้น
- FrontierSWE: 81.2
- DeepSWE: 67.5
- BrowseComp: 91.2 — ระดับแนวหน้าสำหรับการค้นคว้าบนเว็บแบบเอเจนต์
- GPQA Diamond: 93.5
- MMMU-Pro: 81.6 / 83.4 (ภาพ)
- SWE Marathon: 91.0
- OfficeQA Pro: 81.3
- AutomationBench: 30.8
- LMArena Frontend Code Arena: 1,679 Elo — อันดับหนึ่ง, นำหน้า Claude Fable 5 (1,631) และ GPT-5.6 Sol (1,618) ชนะหกในเจ็ดหมวดฟรอนต์เอนด์
เรื่องสุดท้ายนั้นควรหยุดคิดสักครู่ โมเดลโอเพนเวตที่คุณดาวน์โหลดได้ฟรีคว้าอันดับหนึ่งบนอารีนาการเขียนโค้ดฟรอนต์เอนด์ที่ตัดสินด้วยความชอบของมนุษย์ นำหน้าโมเดลปิดระดับเรือธงจากห้องแล็บที่ได้เงินทุนมากที่สุดสองแห่งของโลก ไม่ว่าคุณจะคิดอย่างไรกับเบนช์มาร์กอารีนาในฐานะระเบียบวิธี นี่คือพาดหัวที่ไม่อาจจินตนาการได้ในปี 2025
บนดัชนีรวม คะแนนต่ำกว่าเล็กน้อย: 59.7 บน Artificial Analysis Intelligence Index, อันดับสามโดยรวม ตามหลัง Claude Opus 5 (63.0) และ Claude Fable 5 (62.1) ตัวเลขโชว์เคสของ Moonshot เอง — GDPval-AA v2 ที่ 1,687 และ AA-Briefcase ที่ 1,527 — จัดให้อยู่ในอันดับสามและสองตามลำดับในการประเมินงานความรู้เหล่านั้น บน Vals Index v2 อยู่ที่ 57.8%, เทียบกับ 67.2% ของ Claude Opus 5, 66.0% ของ Claude Fable 5 และ 63.7% ของ GPT-5.6 Sol — ช่องว่างระหว่างโอเพนกับปิดที่กว้างที่สุดในดัชนีใด ๆ ที่ผมพบ และควรค่าแก่การจดจำไว้เทียบกับตัวเลขด้านการเขียนโค้ด
เดโม และวิธีอ่านมัน
Moonshot เผยแพร่การสาธิตความเป็นอิสระระยะยาวสองชิ้นที่ได้รับความสนใจมาก: การ รันอัตโนมัติ 48 ชั่วโมงที่ทำไปป์ไลน์ออกแบบชิปครบทั้งวงจร (ดีไซน์ 4mm ที่ปิดทามิงได้ที่ 100 MHz จำลองที่ 8,700+ โทเคน/วินาที) และการทำซ้ำของ ความสัมพันธ์ I-Love-Q ในเวลาราวสองชั่วโมง, เทียบกับหนึ่งถึงสองสัปดาห์ที่นักวิจัยอาวุโสโดยทั่วไปต้องใช้
สิ่งเหล่านี้น่าประทับใจจริง และผมจะไม่ใช้มันเป็นฐานในการตัดสินใจซื้อ เดโมที่ผู้ขายรันเอง วางโครงเอง และคัดเลือกเอง บอกคุณได้ว่าโมเดลทำอะไรได้ในวันที่ดีภายใต้การดูแลของผู้เชี่ยวชาญ ไม่ใช่สิ่งที่มันทำในรีโพของคุณในวันอังคาร ให้มองมันเป็นหลักฐานว่าความสามารถระยะยาวมีอยู่จริง ไม่ใช่เป็นสเปก
แสดงรูปภาพ สถาปัตยกรรมที่เผยแพร่สองแบบกับกล่องดำหนึ่งใบ โมเดลโอเพนบอกคุณอย่างชัดเจนว่ามันทำงานอย่างไร ส่วนโมเดลปิดบอกคุณแค่ว่ามันได้คะแนนเท่าไร
GLM-5.3 คืออะไรกันแน่
GLM-5.3 มีเรื่องราวการเปิดตัวแปลกที่สุดในสามตัว และเป็นเรื่องที่ควรเล่าอย่างละเอียด เพราะเป็นครั้งแรกที่ห้องแล็บใหญ่แห่งหนึ่งลังเลอย่างเห็นได้ชัดในการเผยแพร่เวตด้วยเหตุผลที่ไม่ใช่เชิงพาณิชย์
Z.ai ประกาศ GLM-5.3 เมื่อ 14 สิงหาคม 2026 ด้วยสโลแกน “สร้างมาเพื่อเขียนโค้ด พร้อมสำหรับการป้องกันไซเบอร์” โมเดลนี้เป็น โมเดลผสมผู้เชี่ยวชาญขนาด 753 พันล้านพารามิเตอร์, โดยมีพารามิเตอร์ที่ทำงานจริงราว 40 พันล้านต่อโทเคนตามการประมาณของชุมชนที่อิงจากการตั้งค่า GLM-5.2 มีหน้าต่างบริบท 1M โทเคนและเอาต์พุตสูงสุด 128K และ — ต่างจาก GLM-5.3-Flash ซึ่งเป็นโมเดลคนละตัวโดยสิ้นเชิง — มันเป็น ข้อความล้วน.
“สิ่งที่เราทำมีแค่ขยายการฝึกหลังการเทรน”
ข้อเท็จจริงทางเทคนิคที่น่าสนใจที่สุดเกี่ยวกับ GLM-5.3 คือไม่มีโมเดลฐานใหม่เลย มันใช้ฐานที่ผ่านการพรีเทรนชุดเดียวกับ GLM-5.2 ทุกความก้าวหน้ามาจากการฝึกหลังการเทรนที่ขยายออกไปอย่างมาก ซึ่ง Z.ai สรุปไว้ว่า: “การขยายการฝึกหลังการเทรนคือทั้งหมดที่เราทำสำหรับ GLM-5.3”
ส่วนต่างไม่เล็กเลย:
| เบนช์มาร์ก | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
การพัฒนาขึ้นหกเท่าบน Terminal-Bench และการกระโดดยี่สิบจุดบน DeepSWE จากเวตฐานชุดเดียวกัน เป็นผลลัพธ์ที่สำคัญจริง ๆ มันบอกว่าพรมแดนยังมีช่องว่างให้ขยายอีกมากในการฝึกหลังการเทรน ซึ่งเป็นครึ่งที่ถูกกว่ามากของบิลการฝึก นั่นคือเหตุผลที่ห้องแล็บจีนซึ่งดำเนินงานด้วย “เงินทุนน้อยกว่าหลายสิบเท่า” ตามคำของ Lambert เมื่อเทียบกับของอเมริกา ยังรักษาจังหวะไว้ได้
สองสัปดาห์ที่ Z.ai ใช้ไปโดยไม่ปล่อยของ
Z.ai กล่าวตอนเปิดตัวว่าเวตจะตามมา “เป็นระยะ หลังการประเมินความปลอดภัยอย่างเข้มงวด” โดยตั้งเป้าไว้ราวสองสัปดาห์ รีโพ Hugging Face ของบริษัทระบุวันที่ 28 สิงหาคม วันนั้นมาถึง ผ่านไปเพียงไม่กี่ชั่วโมง แล้วเวตก็ปรากฏพร้อมบทเขียนเชิงเทคนิคที่อธิบายความล่าช้า
เหตุผลคือความสามารถด้านไซเบอร์ ระหว่างการประเมิน Z.ai รายงานว่า GLM-5.3 ตรวจพบ ช่องโหว่ 2,436 รายการใน 269 โครงการโอเพนซอร์ส, ซึ่งในจำนวนนี้ 1,097 รายการถูกจัดอยู่ในระดับวิกฤตหรือสูง. ที่สำคัญกว่านั้น โมเดลแสดงให้เห็น การให้เหตุผลแบบลูกโซ่การโจมตีหลายขั้นตอน — เชื่อมขั้นตอนการโจมตีเข้าด้วยกันเองโดยอัตโนมัติ — ซึ่ง Z.ai อธิบายว่าเป็นพฤติกรรมที่ “ไม่ได้ตั้งใจให้เกิดเต็มที่” และ “ยังทบต้นต่อเนื่องเมื่อขยายการฝึก”
ผมอยากระวังตรงนี้ เพราะเรื่องนี้อ่านเป็นการตลาดหรือการสร้างความตื่นตระหนกได้ง่าย และน่าจะไม่ใช่ทั้งสองอย่าง โมเดลที่เก่งในการหาช่องโหว่ก็คือเก่งในการหาช่องโหว่ การใช้เพื่อป้องกันและการใช้เพื่อโจมตีเป็นความสามารถเดียวกันที่ชี้ไปคนละทิศ ผลเบนช์มาร์กของ Z.ai สะท้อนเรื่องนี้อย่างตรงไปตรงมา: CyberGym 84.5% (การค้นพบช่องโหว่ ซึ่งเป็นจุดที่นำอยู่) เทียบกับ ExploitBench 54.4% (การโจมตี ซึ่ง Claude Fable 5 ได้ 78.0%) ห้องแล็บตั้งใจปรับแต่งให้เน้นครึ่งฝ่ายป้องกัน และเห็นผลชัด
สิ่งที่น่าสังเกตจริง ๆ คือห้องแล็บหนึ่งชะลอการเปิดตัวเรือธงไว้สองสัปดาห์และเผยแพร่เหตุผลของตน ไม่ว่าคุณจะเห็นว่าเหตุผลนั้นน่าเชื่อหรือไม่ บรรทัดฐานนี้ก็เป็นของใหม่
GLM-5.3 อยู่ตรงไหนจริง ๆ
แผนภูมิเปรียบเทียบที่ Z.ai เผยแพร่ไม่ได้อ้างว่าคว้าชัยขาด ซึ่งน่าสดชื่น:
| เบนช์มาร์ก | GLM-5.3 | ตัวเปรียบเทียบที่ดีที่สุด |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3 นำ |
| CyberGym | 84.5% | GLM-5.3 นำ |
| GDPval-AA v2 | 1,769 | GLM-5.3 นำ |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34.6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72.7% |
| ExploitBench | 54.4% | Claude Fable 5: 78.0% |
| Code Bench (50K โทเคน) | 31.4% | — |
โดยอิสระ Artificial Analysis จัดให้อยู่ที่ 59.5 บน Intelligence Index — แยกความต่างทางสถิติจาก 59.7 ของ Kimi K3 ไม่ได้ ทั้งที่มาจากโมเดลที่มีพารามิเตอร์ราวหนึ่งในสี่
ข้อควรระวังหนึ่งจากผลประเมินเดียวกันที่ไม่มีใครในการตลาดพูดถึง: GLM-5.3 สร้าง เอาต์พุต 170 ล้านโทเคนตลอดชุดทดสอบ Artificial Analysis เทียบกับค่ามัธยฐาน 72 ล้านโทเคนของรุ่นเดียวกัน มันพูดมาก reasoning_effort ค่าเริ่มต้นอยู่ที่ สูงสุด และปิดโหมดคิดไม่ได้ คุณจึงจ่ายค่าครุ่นคิดจำนวนมากไม่ว่างานจะคุ้มหรือไม่ ถึงอย่างนั้น ค่าใช้จ่ายรวมในการรันการประเมินทั้งหมดอยู่ที่ $0.68 ต่องาน, เทียบกับ $0.84 สำหรับ Kimi K3 และ $2.34 สำหรับ Claude Opus 5 — ดังนั้นการพูดมากไม่ได้ลบข้อได้เปรียบด้านราคา มันแค่ทำให้แคบลง
Claude Fable 5.1 คืออะไรกันแน่
Anthropic เปิดตัว Claude Fable 5.1 เมื่อ 1 กันยายน 2026, ควบคู่กับ Claude Mythos 5.1 — โมเดลเดียวกันแต่ตั้งค่าการป้องกันต่างกัน เปิดให้ใช้เฉพาะผ่านโครงการเข้าถึงแบบเชื่อถือได้สำหรับงานความมั่นคงปลอดภัยไซเบอร์และวิทยาศาสตร์ชีวภาพ
การวางตำแหน่งนั้นเจาะจง และผมคิดว่าถูกต้อง: นี่คือ “โมเดลที่สร้างขึ้นสำหรับงานซึ่งไม่จบในพรอมต์เดียว” Anthropic ไม่ได้อ้างว่าก้าวกระโดดทางสติปัญญาโดยทั่วไป บริษัทอ้างว่าเซสชันเอเจนต์ที่ยาวนานหลายชั่วโมงต่อเนื่องกันได้ผลดีขึ้น
ตัวเลข
| เบนช์มาร์ก | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (บางส่วน) | 72.9% | 77.9% | — |
| Humanity’s Last Exam (พร้อมเครื่องมือ) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
สำหรับบริบทภายนอกบนไม้บรรทัดเดียวกัน: GPT-5.6 Sol ได้ 52.3% บน Terminal-Bench 4.0, ดังนั้น 55.8% ของ Fable 5.1 จึงขึ้นนำ และ 60.9% ของ Mythos 5.1 ก็ต่อยอดออกไป
การกระโดดของ Terminal-Bench-Science — จาก 24.7% เป็น 52.6% เพิ่มเป็นสองเท่าพอดี — คือตัวที่ผมจะให้น้ำหนักมากที่สุดถ้างานของคุณเกี่ยวกับการคำนวณทางวิทยาศาสตร์หรือไปป์ไลน์ข้อมูล และบนเบนช์มาร์กการใช้คอมพิวเตอร์ที่ยากที่สุดของ Browserbase, Fable 5.1 ทำสำเร็จ 82% ของงาน เทียบกับ 74% ของ Claude Opus 5.
Anthropic ยังรายงานการลดลงราว 60% ในผลบวกลวงด้านความปลอดภัยไซเบอร์ — คือการที่โมเดลปฏิเสธงานความปลอดภัยที่ชอบด้วยกฎหมายเพราะไปจับคู่รูปแบบเข้ากับสิ่งที่เป็นอันตราย ถ้าคุณเคยเจอผู้ช่วยเขียนโค้ดปฏิเสธที่จะช่วยเขียน rate limiter คุณจะเข้าใจว่าทำไมเรื่องนี้สำคัญ
การเปลี่ยนราคาคือข่าวจริง ๆ
ราคาที่ประกาศไว้ไม่เปลี่ยน: $10 ต่อล้านโทเคนอินพุต, $50 ต่อล้านโทเคนเอาต์พุต สิ่งที่เปลี่ยนคือตัวคูณการอ่านแคช และเปลี่ยนไปมาก
| Fable 5 | Fable 5.1 | |
|---|---|---|
| อินพุต | $10.00 | $10.00 |
| เอาต์พุต | $50.00 | $50.00 |
| เขียนแคช (5 นาที) | $12.50 | $12.50 |
| เขียนแคช (1 ชั่วโมง) | $20.00 | $20.00 |
| อ่านแคช | $1.00 | $0.25 |
นั่นคือการลดลง 75% ทำได้โดยเลื่อนตัวคูณการอ่านแคชจากมาตรฐาน 0.1× ของอินพุตฐานลงมาเป็น 0.025× Anthropic ระบุตัวเลขราว ถูกลง 25% สำหรับงานทั่วไป และถูกลงถึง 45% สำหรับงานเอเจนต์เข้มข้น — และตัวเลขที่สองนั้นเป็นของจริง เพราะลูปเอเจนต์เกือบทั้งหมดคือการอ่านแคช เซสชันเอเจนต์ 60 เทิร์นอ่านบริบทสะสมชุดเดิมซ้ำหลายสิบครั้ง Batch API ลดอินพุตและเอาต์พุตลงครึ่งหนึ่งจากนั้นอีกชั้น ตกลงมาที่ $5/$25
นี่คือการลดราคาที่ฉลาดและเจาะจง มันทำให้สิ่งที่ Fable 5.1 ทำได้ดีที่สุด — เซสชันยาว — ถูกลงอย่างมีความหมาย โดยไม่ลดค่าของโมเดลโดยรวม
การเปลี่ยนแปลงที่ทำให้โค้ดเดิมพังสามข้อ และการถอยหลังหนึ่งข้อ
ก่อนอัปเกรดระบบที่ใช้งานจริง อ่านสิ่งเหล่านี้ให้ดี
1. การบังคับใช้เครื่องมือหายไปแล้ว คำขอที่ใช้ tool_choice: "any" หรือ tool_choice: "tool" ตอนนี้จะคืนค่า ข้อผิดพลาด 400. โหมดคิดเปิดตลอดและข้ามไม่ได้ การบังคับเรียกเครื่องมือจะข้ามมันไป คุณต้องใช้ tool_choice: "auto".
2. บล็อกการคิดเป็นทิศทางเดียว Fable 5.1 อ่านบล็อกการคิดที่โมเดล Claude รุ่นก่อนสร้างได้ แต่รุ่นก่อนอ่านของ Fable 5.1 ไม่ได้ มีเพียง Mythos 5.1 ที่อ่านได้ ถ้าสถาปัตยกรรมของคุณสลับโมเดลกลางบทสนทนาเพื่อประหยัดเงิน การถอยไปใช้ตัวสำรองนั้นตอนนี้บังคับให้ต้องวางแผนใหม่
3. การแก้ประวัติทำให้บล็อกการคิดใช้ไม่ได้ สำหรับบัญชีที่สร้างหลัง 31 สิงหาคม 2026 การแก้เทิร์นก่อนหน้า พรอมต์ระบบ หรืออาร์เรย์เครื่องมือ จะทำให้บล็อกการคิดที่ตามมาทั้งหมดใช้ไม่ได้ — ไม่ว่าจะเกิดข้อผิดพลาดหรือถูกทิ้งเงียบ ๆ นี่คือมาตรการต่อต้านการกลั่นความรู้จากโมเดลอย่างชัดเจน และมันทำลายรูปแบบที่พบบ่อยซึ่งเฟรมเวิร์กเอเจนต์เขียนบริบทใหม่ระหว่างเทิร์น
และอีกหนึ่งจุดถอยหลังที่ควรรู้: มีการรายงานว่าการเรียกเครื่องมือแบบขนานใน 5.1 แปรปรวนกว่าเดิม บางครั้งออกคำสั่งเดียวต่อเทิร์นทั้งที่ 5 จะรวมหลายคำสั่งไว้ด้วยกัน ในลูปเอเจนต์ยาว ๆ สิ่งนี้กินเวลาจริง
ยังมีรายละเอียดของตัวตัดคำที่ทำให้คนพลาดในการเปรียบเทียบต้นทุน: Fable 5.1 ใช้ตัวตัดคำเดียวกับ Claude Opus 4.7 ซึ่งสร้างโทเคน มากกว่า 30% เมื่อเทียบกับตัวตัดคำในโมเดล Claude รุ่นเก่าสำหรับข้อความเดียวกัน ถ้าคุณกำลังเปรียบเทียบต้นทุนกับฐานปี 2025 ให้ปรับค่านี้ก่อนสรุปอะไร
ปัญหาเบนช์มาร์ก: สามโมเดล สามไม้บรรทัดที่ต่างกัน
นี่คือส่วนที่บทความเปรียบเทียบส่วนใหญ่ทำผิด และควรพูดกันตรง ๆ
คุณเทียบสามโมเดลนี้บน Terminal-Bench ด้วยกันไม่ได้ ดูนี่:
- Kimi K3: 88.3 บน Terminal-Bench 2.1
- GLM-5.3: 28.3 บน Terminal-Bench 3.0
- Fable 5.1: 55.8 บน Terminal-Bench 4.0
นั่นคือเบนช์มาร์กสามตัวที่ต่างกันแต่ใช้ชื่อเดียวกัน แต่ละเวอร์ชันยากขึ้นมากกว่าเวอร์ชันก่อน — นั่นคือจุดประสงค์ทั้งหมดของการออกเวอร์ชันใหม่ การอ่านตัวเลขสามตัวนั้นเป็นการจัดอันดับจะบอกคุณว่า Kimi K3 เก่งกว่า GLM-5.3 ถึงสามเท่าในงานเทอร์มินัล ซึ่งเป็นเรื่องไร้สาระ
ปัญหาเดียวกันใช้กับ AutomationBench ซึ่งมีการรายงานเลขเวอร์ชันไม่สม่ำเสมอ และกับตระกูล SWE-bench ซึ่งตัวแปร Verified, Pro และ Marathon วัดสิ่งที่ต่างกันจริง ๆ ห้องแล็บไม่ได้ทำแบบนี้เพื่อหลอกใคร — พวกเขารันการประเมินที่เป็นมาตรฐานตอนที่ฝึกโมเดล และตอนนี้การประเมินเปลี่ยนรุ่นทุกไม่กี่เดือน แต่ผลต่อผู้อ่านทั่วไปก็เหมือนกับการหลอกลวง จึงควรชี้ให้ชัดดัง ๆ
สิ่งที่คุณเปรียบเทียบได้อย่างชอบธรรม ภายในเวอร์ชันเดียวกัน:
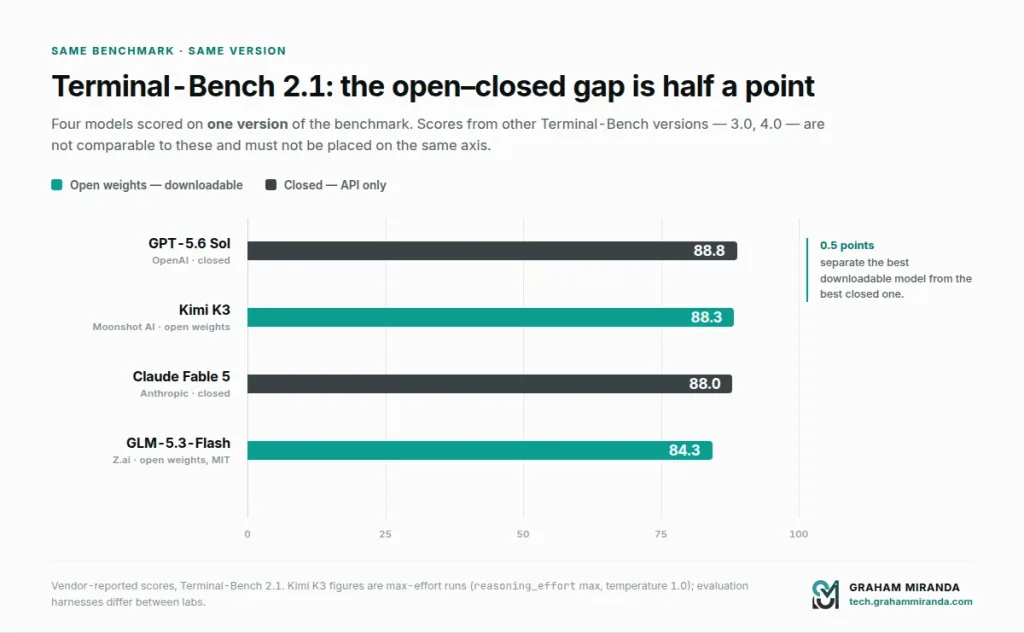
บน Terminal-Bench 2.1: Kimi K3 (88.3), GPT-5.6 Sol (88.8), Claude Fable 5 (88.0) และ GLM-5.3-Flash (84.3) สี่โมเดล หนึ่งไม้บรรทัด นี่คือการเปรียบเทียบที่สำคัญจริง และผมได้ทำตารางแยกให้ในหัวข้อถัดไป
บน Terminal-Bench 4.0: Fable 5.1 (55.8) เทียบกับ GPT-5.6 Sol (52.3) Fable ชนะ
นอกจากนั้น จงระแวงใครก็ตามที่โชว์แผนภูมิแท่งเดียวที่มีโมเดลหลักทั้งสามตัวของบทความนี้บนแกน Terminal-Bench มันทำอย่างซื่อสัตย์ไม่ได้
จุดที่พวกมันเจอกันจริง: ตัวเลขที่เปรียบข้ามได้
ตัดปัญหาเวอร์ชันเบนช์มาร์กที่ไม่ตรงกันออกไป แล้วจะเหลือการเปรียบเทียบที่ใช้ได้สามชุด
1. Artificial Analysis Intelligence Index (กันยายน 2026)
รันโดยอิสระ ระเบียบวิธีเดียวกันกับทุกโมเดล ไม่มีผู้ขายเกี่ยวข้องในการคัดเลือก
| อันดับ | รุ่น | คะแนน | โอเพนเวต |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | ไม่ใช่ |
| 2 | Claude Fable 5 | 62.1 | ไม่ใช่ |
| 3 | Grok 4.6 | 60.9 | ไม่ใช่ |
| 4 | Kimi K3 | 59.7 | ใช่ |
| 5 | GLM-5.3 | 59.5 | ใช่ |
| 6 | GPT-5.6 Sol | 58.9 | ไม่ใช่ |
| 7 | Qwen3.8 Max Preview | 58.1 | เวตยังไม่เปิด |
| 8 | GLM-5.3-Flash | 57.5 | มี (MIT) |
| 31 | MiniMax M3 | 45.4 | ใช่ |
Fable 5.1 ยังไม่ถูกให้คะแนนโดยอิสระในเวลาที่เขียน — มันเปิดตัวเมื่อวันก่อน จากส่วนต่างเบนช์มาร์กของ 5.1 เมื่อเทียบกับ Fable 5 คาดว่ามันจะอยู่ที่ 62.1 หรือสูงกว่าเมื่อได้คะแนน
หมายเหตุเรื่องความละเอียด: สแนปช็อตต่าง ๆ ของดัชนีนี้ปัดเศษไม่เหมือนกัน — การดึงข้อมูลครั้งหนึ่งในเดือนกันยายนให้ Kimi K3 และ GLM-5.3 อยู่ที่ 60 ทั้งคู่ และ GPT-5.6 Sol ที่ 61 ลำดับบนสุดนั้นคงที่ แต่ช่องว่างระดับเศษจุดนั้นไม่คงที่ อย่าสร้างข้อโต้แย้งจากครึ่งคะแนน
อ่านตารางนั้นให้ดี โมเดลโอเพนเวตที่ดีที่สุดตามหลังโมเดลปิดที่ดีที่สุด 3.3 จุดบนดัชนีกลางที่ครอบคลุมที่สุดเท่าที่มี เมื่อปีที่แล้วช่องว่างนั้นเป็นเลขสองหลัก
2. Terminal-Bench 2.1 — เวอร์ชันเดียวที่ทั้งสามตัวมาเจอกัน
นี่คือตารางที่มีประโยชน์ที่สุดในบทความ และผมเกือบพลาดมันไป Kimi K3, Claude Fable 5 และ GPT-5.6 Sol ถูกให้คะแนนบน เวอร์ชันเดียวกัน ของ Terminal-Bench:
| รุ่น | Terminal-Bench 2.1 | โอเพนเวต |
|---|---|---|
| GPT-5.6 Sol | 88.8 | ไม่ใช่ |
| Kimi K3 | 88.3 | ใช่ |
| Claude Fable 5 | 88.0 | ไม่ใช่ |
| GLM-5.3-Flash | 84.3 | มี (MIT) |
ครึ่งคะแนนคือช่องว่างระหว่างโมเดลที่คุณดาวน์โหลดได้กับโมเดลปิดที่ดีที่สุด บนเบนช์มาร์กเดียวกัน เวอร์ชันเดียวกัน ในงานเอเจนต์แบบเทอร์มินัลโดยกำเนิด
นั่นคือตัวเลขที่ควรจำ ไม่ใช่ค่าดัชนีรวม ไม่ใช่แผนภูมิผู้ขาย — ตัวนี้ บนรูปร่างงานเฉพาะที่งานเขียนโค้ดแบบเอเจนต์เป็นจริง ๆ ช่องว่างอยู่ในระดับที่ไม่ต่างจากความคลาดเคลื่อน
ข้อควรระวังหนึ่งที่แหล่งข้อมูลระบุเองและควรพูดซ้ำ: ตัวเลขที่เผยแพร่ทั้งหมดของ Kimi K3 เป็นการรันที่ใช้ความพยายามสูงสุด ที่ reasoning_effort ระดับ maximum และ temperature 1.0 ห้องแล็บต่าง ๆ ใช้ฮาร์เนสการประเมินและระดับความพยายามต่างกัน ดังนั้นแม้การเปรียบเทียบในเวอร์ชันเดียวกันก็มีความไม่แน่นอนมากกว่าที่ตารางเรียบร้อยบ่งบอก
3. ต้นทุนในการรันชุดการประเมินเดียวกัน
ถ้าตารางข้างบนคือการเปรียบเทียบความสามารถที่ดีที่สุด นี่คือการเปรียบเทียบความคุ้มค่าที่ดีที่สุด — เพราะมันเป็นตัวเลขเดียวที่รวมความสามารถ การพูดมาก ค่าใช้จ่ายในการคิด และราคาไว้ด้วยกัน:
| รุ่น | ต้นทุนต่องานใน Intelligence Index |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
งานเดียวกัน การให้คะแนนเดียวกัน ใบแจ้งหนี้จริง GLM-5.3 ให้คะแนนดัชนี 94% ของ Opus 5 ด้วยต้นทุน 29%
4. GDPval-AA v2 (งานความรู้)
| รุ่น | คะแนน |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
อันนี้ควรมีข้อกำกับ: มันประกอบขึ้นจากแผนภูมิที่ผู้ขายเผยแพร่ ไม่ใช่การรันโดยอิสระครั้งเดียว และคำต่อท้าย “Max” บ่งบอกการตั้งค่าระดับความพยายามที่ต่างกัน แต่ลำดับโดยรวมสอดคล้องกันในหลายแหล่ง และมันบอกสิ่งที่เป็นจริง — ในงานความรู้ทั่วไป ซึ่งต่างจากการเขียนโค้ด โมเดลปิดยังนำอยู่ชัดเจนกว่าที่เบนช์มาร์กการเขียนโค้ดบ่งบอก
นั่นคือรูปแบบที่พบในการเปรียบเทียบทั้งสามชุด โมเดลโอเพนไล่ทันในงานเขียนโค้ดและงานเอเจนต์ได้แล้วเป็นหลัก แต่ยังตามอยู่หนึ่งก้าวในงานความรู้กว้าง ๆ ถ้างานของคุณเป็นแบบแรก เหตุผลในการจ่ายราคาโมเดลปิดนั้นอ่อน ถ้าเป็นแบบหลัง ก็ยังป้องกันได้
แสดงรูปภาพ สามจุดกว่านิดหน่อยคือช่องว่างระหว่างโมเดลปิดที่ดีที่สุดกับโมเดลที่ดาวน์โหลดได้ดีที่สุด ช่องว่างนั้นเป็นเลขสองหลักเมื่อสิบสองเดือนก่อน
คณิตศาสตร์ต้นทุน ด้วยตัวเลขจริง
เบนช์มาร์กเป็นนามธรรม ใบแจ้งหนี้ไม่ใช่
สถานการณ์
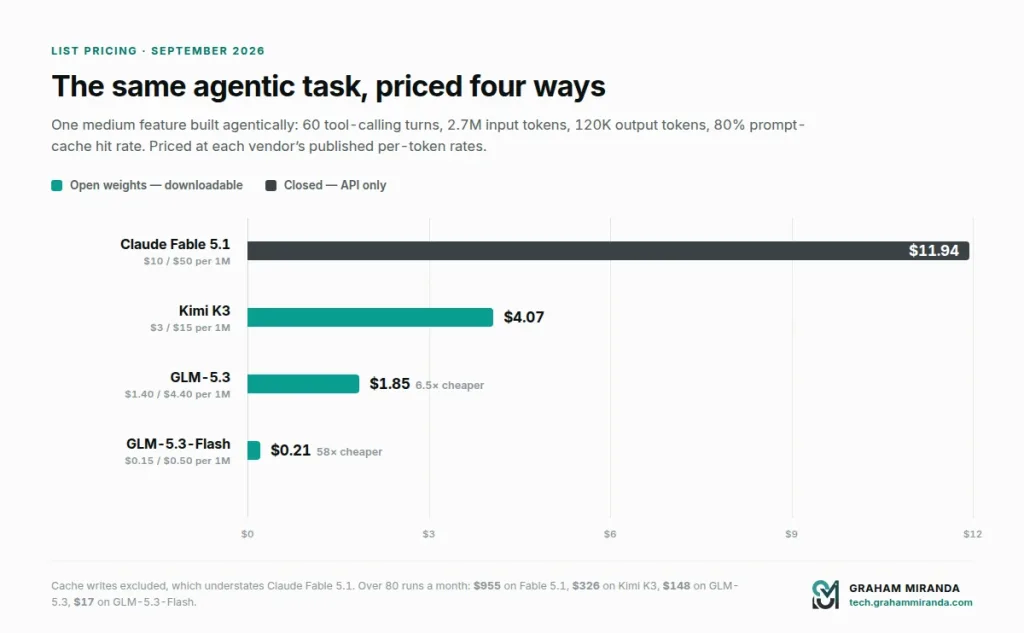
หนึ่งฟีเจอร์ขนาดกลาง ทำแบบเอเจนต์: ประมาณ 60 รอบการเรียกเครื่องมือ, เฉลี่ย โทเคนอินพุต 45,000 ต่อเทิร์น เมื่อบริบทสะสม และ โทเคนเอาต์พุต 2,000 ต่อเทิร์น.
- อินพุตรวม: 2.7M โทเคน
- เอาต์พุตรวม: 120K โทเคน
- อัตราการแคชพรอมต์ที่สมมติไว้: 80% (แคช 2.16M, ใหม่ 540K)
Claude Fable 5.1
| อุปกรณ์ | โทเคน | อัตรา | ค่าใช้จ่าย |
|---|---|---|---|
| อินพุตใหม่ | 540K | $10.00/M | $5.40 |
| อินพุตแคช | 2.16M | $0.25/M | $0.54 |
| เอาต์พุต | 120K | $50.00/M | $6.00 |
| รวม | ≈ $11.94 |
Kimi K3
| อุปกรณ์ | โทเคน | อัตรา | ค่าใช้จ่าย |
|---|---|---|---|
| อินพุตใหม่ | 540K | $3.00/M | $1.62 |
| อินพุตแคช | 2.16M | $0.30/M | $0.65 |
| เอาต์พุต | 120K | $15.00/M | $1.80 |
| รวม | ≈ $4.07 |
GLM-5.3
| อุปกรณ์ | โทเคน | อัตรา | ค่าใช้จ่าย |
|---|---|---|---|
| อินพุตใหม่ | 540K | $1.40/M | $0.76 |
| อินพุตแคช | 2.16M | $0.26/M | $0.56 |
| เอาต์พุต | 120K | $4.40/M | $0.53 |
| รวม | ≈ $1.85 |
และเพื่ออ้างอิง — GLM-5.3-Flash
| อุปกรณ์ | โทเคน | อัตรา | ค่าใช้จ่าย |
|---|---|---|---|
| อินพุตใหม่ | 540K | $0.15/M | $0.08 |
| อินพุตแคช | 2.16M | $0.03/M | $0.06 |
| เอาต์พุต | 120K | $0.50/M | $0.06 |
| รวม | ≈ $0.21 |
อัตราส่วน
- GLM-5.3 ถูกกว่า Fable 5.1 6.5 เท่า สำหรับงานที่เหมือนกัน
- Kimi K3 ถูกกว่า Fable 5.1 2.9 เท่า
- GLM-5.3 ถูกกว่า Kimi K3 2.2 เท่า
- GLM-5.3-Flash ถูกกว่า Fable 5.1 58 เท่า, ที่ 57.5 บนดัชนีสติปัญญา เทียบกับ 62.1 ของ Fable 5
ขยายเป็นหนึ่งเดือนทำงาน
งานแบบนี้วันละสี่งาน ยี่สิบวันทำการ — 80 รอบการทำงานของเอเจนต์:
| รุ่น | ต้นทุนโทเคนรายเดือน |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
ข้อแม้ตรงไปตรงมา 3 ประการเกี่ยวกับตัวเลขเหล่านี้
ไม่รวมการเขียนแคช Fable 5.1 คิด $12.50 ต่อล้านโทเคนสำหรับการเขียนแคช 5 นาที และเซสชันยาวจะเขียนแคชซ้ำหลายครั้ง การรวมการเขียนแคชทำให้ตัวเลขจริงของ Fable’สูงขึ้น ไม่ใช่ต่ำลง อัตราการเข้าถึงแคช 80% ก็ยังมองโลกในแง่ดีเกินไปสำหรับเซสชันสั้น
โทเคนการให้เหตุผลคือโทเคนเอาต์พุตที่ถูกคิดเงิน ทั้งสามโมเดลมีโหมดคิดตลอดเวลา โดยเฉพาะ GLM-5.3 ที่มีบันทึกว่าเขียนเยอะ — 170 ล้านโทเคนเอาต์พุต เทียบกับค่ามัธยฐานของกลุ่มที่ 72 ล้านในการทดสอบ AA ทั้งชุด — ดังนั้นปริมาณเอาต์พุตในโลกจริงจึงสูงกว่าที่การนับรอบแบบง่าย ๆ บอก ตัวเลข $0.68 ต่องานได้คำนึงถึงเรื่องนี้แล้ว ซึ่งเป็นเหตุผลที่ผมเชื่อถือมันมากกว่าแบบจำลองของผมเองด้านบน
ตัวตัดคำของ Fable 5.1 ให้โทเคนมากกว่าประมาณ 30% เมื่อเทียบกับโมเดล Claude รุ่นเก่าสำหรับข้อความเดียวกัน หากคุณกำลังเทียบกับบิล Claude ในอดีต ให้ปรับตัวเลข
แม้หลังการแก้ไขทั้งสามข้อ ลำดับยังไม่เปลี่ยน และขนาดก็แทบไม่เปลี่ยน งานกับโมเดลปิดระดับแนวหน้ามีค่าใช้จ่ายประมาณหกเท่าของโมเดลโอเพนเวตที่ดีที่สุด ต่อหนึ่งงานที่ทำเสร็จ
แสดงรูปภาพ งานเอเจนต์ 60 เทิร์นเดียวกันในราคาตามรายการของแต่ละผู้ขาย แกนตั้งคือข้อโต้แย้งทั้งหมดเพื่อโอเพนเวต
สัญญาอนุญาต: “โอเพน” ให้อะไรคุณจริง ๆ ในปี 2026
นี่คือส่วนที่ผมอยากให้คนอ่านมากที่สุด เพราะคำศัพท์เริ่มเพี้ยนไปมาก และมันจะทำให้ใครบางคนต้องเสียเงินก้อนใหญ่
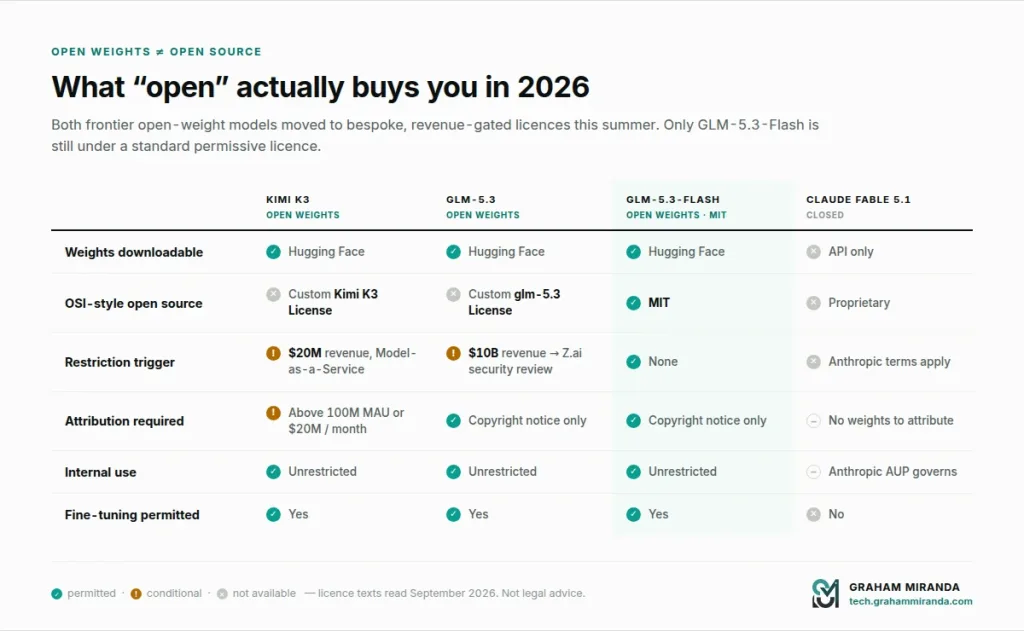
ทั้ง Kimi K3 และ GLM-5.3 ไม่ใช่โอเพนซอร์ส ทั้งคู่เผยแพร่เวตที่ดาวน์โหลดได้ภายใต้สัญญาอนุญาตเฉพาะกิจที่มีเงื่อนไขผูกกับรายได้ ซึ่งแตกต่างอย่างมีนัยสำคัญจาก MIT หรือ Apache 2.0 และความแตกต่างนั้นตกอยู่กับธุรกิจประเภทที่ได้ประโยชน์มากที่สุดจากการโฮสต์เอง
สัญญาอนุญาต Kimi K3
คุณจะเห็น “Modified MIT” ถูกพูดซ้ำทั่วอินเทอร์เน็ตเกี่ยวกับ K3 นั่นผิด — คำนั้นใช้กับ K2 K3 ออกภายใต้เอกสารเฉพาะกิจที่มีเงื่อนไขกั้นสองข้อ:
เงื่อนไขการให้บริการโมเดล (Model-as-a-Service) หากคุณให้บุคคลภายนอกเข้าถึงการอนุมานหรือการไฟน์ทูนโมเดล — โดยบุคคลภายนอกเหล่านั้นควบคุมอินพุต พารามิเตอร์ หรือข้อมูลฝึก — และ “รายได้รวมของผู้รับใบอนุญาตและบริษัทในเครือเกิน 20 ล้านดอลลาร์สหรัฐ” ในช่วง 12 เดือนติดต่อกันใด ๆ คุณต้องเจรจาข้อตกลงเชิงพาณิชย์แยกต่างหากกับ Moonshot โปรดทราบ รวม รายได้ จากทุกบริษัทในเครือ ไม่ใช่รายได้ที่เกิดจาก K3 ที่ปรึกษาที่มีรายได้ 25 ล้านยูโรซึ่งขายต่อการอนุมานก็ข้ามเส้นแล้ว แม้ว่าธุรกิจ AI จะเป็นเพียงเศษเสี้ยวก็ตาม
เงื่อนไขการระบุที่มา ผลิตภัณฑ์ที่มี ผู้ใช้งานรายเดือนที่ใช้งานจริง 100 ล้านคน หรือรายได้ต่อเดือน 20 ล้านดอลลาร์ ต้องแสดง “Kimi K3” อย่างเด่นชัดในอินเทอร์เฟซของผลิตภัณฑ์
ข้อยกเว้นที่สำคัญที่สุด: การใช้ภายในล้วน ๆ ไม่มีข้อจำกัด การรัน K3 เพื่อสนับสนุนนักพัฒนา ทีมวิจัย ทีมกฎหมาย หรือผลิตภาพพนักงานทั่วไปของคุณ ไม่กระตุ้นเงื่อนไขใด ๆ สำหรับธุรกิจส่วนใหญ่ท่วมท้น — รวมถึงธุรกิจของผมเกือบทั้งหมด — นั่นคือข้อที่เกี่ยวข้อง และคำตอบคือคุณไม่มีปัญหา
ข้อที่ใหม่เมื่อเทียบกับ K2 คือเงื่อนไข MaaS ที่ 20 ล้านดอลลาร์ K2 กำหนดเพียงการระบุที่มาเมื่อเกินเกณฑ์ ส่วน K3 เพิ่มเงื่อนไขรายได้ที่ต่ำกว่ามากซึ่งมุ่งเป้าไปที่ผู้ขายต่อการอนุมานเชิงพาณิชย์โดยเฉพาะ Moonshot ไม่ได้พยายามหยุดคุณไม่ให้ใช้โมเดล แต่พยายามหยุดผู้ให้บริการคลาวด์ไม่ให้สร้างธุรกิจบนโมเดลนี้ฟรี
สัญญาอนุญาต glm-5.3
เรือธงของ Z.ai ไปคนละทิศ และเป็นการแตกแยกจากแนวปฏิบัติเดิมมากกว่าที่สื่อส่วนใหญ่ยอมรับ
GLM-5.2 ออกภายใต้ MIT GLM-5.3-Flash ออกภายใต้ MIT แต่ GLM-5.3 ไม่ใช่
สัญญาอนุญาตเฉพาะกิจอนุญาตให้บุคคลและธุรกิจทั่วไปรัน ติดตั้งใช้งาน และไฟน์ทูนโมเดลได้โดยไม่มีข้อจำกัดเพิ่มเติม เงื่อนไขเดียวมุ่งเป้าไปที่ผู้ให้บริการคลาวด์ขนาดยักษ์: องค์กรที่มี “รายได้รวมของผู้รับใบอนุญาตและบริษัทในเครือเกิน 1 หมื่นล้านดอลลาร์สหรัฐ (หรือเทียบเท่าในสกุลอื่น) รวมกันในช่วง 12 เดือนติดต่อกันใด ๆ” ต้อง ผ่านการตรวจสอบความปลอดภัยของ Z.AI ก่อนใช้โมเดลหรือสิ่งที่พัฒนาต่อจากโมเดลเพื่อวัตถุประสงค์เชิงพาณิชย์ใด ๆ
นั่นคือเกณฑ์ 1 หมื่นล้านดอลลาร์ ซึ่งกันคนเกือบทั้งหมดออก แต่มีรายละเอียดสองข้อในตัวอักษรเล็กที่ควรค่าแก่การใส่ใจ:
ข้อแรก สัญญาอนุญาตยกเว้นชัดเจนสำหรับนักพัฒนาแอปที่ฝังโมเดลไว้ในฟีเจอร์ และผู้ขายต่อที่เพียงส่งต่อคำขอไปยังโฮสต์อื่น เป้าหมายแคบและระบุชัดเจน: บริษัทที่ต้องการ โฮสต์ GLM-5.3 เชิงพาณิชย์ในระดับใหญ่
ข้อสอง — และนี่คือส่วนที่อึดอัดจริง ๆ — สัญญาอนุญาตไม่ได้เผยแพร่เกณฑ์ กรอบเวลา หรือกระบวนการอุทธรณ์สำหรับการตรวจสอบความปลอดภัยนั้น ระบุเพียงว่า “ขอบเขตและวิธีการ… จะถูกกำหนดอย่างสมเหตุสมผลโดย Z.AI” หากคุณเป็นองค์กรขนาดใหญ่ นั่นคือการพึ่งพาโดยไม่มีขอบเขตกับดุลยพินิจของผู้ขายต่างชาติ และทีมจัดซื้อของคุณจะบอกเช่นนั้น
น่าสังเกตด้วยว่า แม้จะมีการระงับการเปิดตัวสองสัปดาห์เพราะความสามารถด้านไซเบอร์ก่อนการเผยแพร่ สัญญาอนุญาตไม่มีข้อจำกัดการใช้งานที่ยอมรับได้ ไม่มีการยกเว้นด้านไซเบอร์ และไม่มีการอ้างความเป็นเจ้าของเอาต์พุต ความกังวลด้านความปลอดภัยมีผลต่อ จังหวะเวลาของการเปิดตัว ไม่ใช่ ข้อกำหนด.
แล้วอะไรที่ยังเป็น MIT จริง ๆ?
GLM-5.3-Flash. 320B พารามิเตอร์ 18B ที่ใช้งานจริง มัลติโหมดโดยกำเนิด อนุญาตแบบ MIT 57.5 บนดัชนีความฉลาด และ $0.15/$0.50 ต่อล้านโทเคน — ปัจจุบันเหลือครึ่งหนึ่งภายใต้ส่วนลดโปรโมชันถึง 9 กันยายน 2026 หากสิ่งที่คุณต้องการคือสัญญาอนุญาตแบบเปิดกว้างไม่มีข้อจำกัดจริง ๆ ไม่ใช่แค่เวตที่ดาวน์โหลดได้ นั่นคือจุดที่แนวหน้าอยู่ในตอนนี้ และมันสูงอย่างน่าทึ่ง
สรุปภาคปฏิบัติ
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| ดาวน์โหลดเวตได้ | ใช่ | ใช่ | ใช่ | ไม่ใช่ |
| โอเพนซอร์สแบบ OSI | ไม่ใช่ | ไม่ใช่ | มี (MIT) | ไม่ใช่ |
| เงื่อนไขที่กระตุ้นข้อจำกัด | รายได้ 20 ล้านดอลลาร์ (MaaS) | รายได้ 1 หมื่นล้านดอลลาร์ (MaaS) | ไม่มี | N/A |
| ต้องระบุที่มา | เกิน 100 ล้าน MAU / 20 ล้านดอลลาร์ต่อเดือน | เพียงประกาศลิขสิทธิ์ | เพียงประกาศลิขสิทธิ์ | N/A |
| จำกัดการใช้ภายใน | ไม่ใช่ | ไม่ใช่ | ไม่ใช่ | N/A |
| อนุญาตให้ไฟน์ทูน | ใช่ | ใช่ | ใช่ | ไม่ใช่ |
| นโยบายการใช้งานที่ยอมรับได้ | มาตรฐาน | ไม่มีในข้อความสัญญาอนุญาต | ไม่มี | ใช้ AUP ของ Anthropic |
สำหรับธุรกิจ Mittelstand เยอรมันทั่วไป เอเจนซี หรือที่ปรึกษาที่รันโมเดลภายในหรือฝังไว้ในผลิตภัณฑ์: ตัวเลือกโอเพนทั้งสามแบบใช้งานได้โดยไม่ต้องเจรจาใด ๆ เงื่อนไขเหล่านั้นมีไว้จับ AWS ไม่ใช่คุณ แต่ “อ่านสัญญาอนุญาต” เปลี่ยนจากคำแนะนำจู้จี้เป็นคำแนะนำจริงจังแล้ว และหากคุณมีรายได้เกินประมาณ 20 ล้านยูโรและขายต่อการอนุมานในรูปแบบใด ๆ ให้เอาไปให้ที่ปรึกษากฎหมายดูก่อนใช้งาน
เหตุผลจริง ๆ ของโมเดลโอเพน
ผมอยากเสนอเหตุผลนี้อย่างจริงจัง ไม่ใช่แบบสโลแกน เพราะ “โมเดลโอเพนเจ๋ง” ไม่ใช่เหตุผล และเหตุผลจริง ๆ น่าสนใจกว่าการเชียร์
1. ราคาที่ดิ่งลงไม่ใช่เงินอุดหนุน แต่เป็นเรื่องเชิงโครงสร้าง
ข้อโต้แย้งโดยสัญชาตญาณต่อโมเดลจีนราคาถูกคือการตั้งราคาแบบขาดทุนเพื่อช่วงชิงตลาดและจะปรับขึ้นในภายหลัง บางส่วนเป็นเช่นนั้นจริง แต่ประเด็นเชิงโครงสร้างยังยืนอยู่โดยอิสระ: เมื่อเวตเป็นสาธารณะ การอนุมานกลายเป็นตลาดสินค้าโภคภัณฑ์ ผู้ให้บริการโฮสต์ยี่สิบรายแข่งขันกันให้บริการโมเดลเดียวกัน และไม่มีใครเรียกพรีเมียมด้านความสามารถได้ เพราะไม่มีใครมีคูน้ำป้องกันคู่แข่งด้านความสามารถ นั่นคือเหตุผลที่ GLM-5.3 อยู่ที่ $1.40/$4.40 และ Fable 5.1 อยู่ที่ $10/$50 ทั้งที่คะแนนต่างกันสามจุด
ราคาโมเดลปิดรวมการตัดค่าใช้จ่าย R&D กำไร และความจริงที่มีผู้ขายเพียงรายเดียว ราคาโอเพนเวตรวมค่าไฟฟ้า ค่าเสื่อมฮาร์ดแวร์ และกำไรบาง ๆ สิ่งเหล่านี้เป็นธุรกิจที่ต่างกัน และช่องว่างจะไม่ปิดลงเพราะโมเดลโอเพนมีราคาแพงขึ้น
หลักฐานว่านี่เป็นเรื่องจริงไม่ใช่เรื่องชั่วคราว: DeepSeek ครองส่วนแบ่งประมาณ 17% ของการใช้โทเคนบน Vercel ภายในเดือนพฤษภาคม 2026 ขณะที่มีส่วนแบ่งรายได้เพียงประมาณ 1% นั่นไม่ใช่ความผิดปกติด้านราคา นั่นคือหน้าตาของการกลายเป็นสินค้าโภคภัณฑ์บนกราฟ
2. สิทธิ์ในการออกเปลี่ยนอำนาจต่อรองของคุณ แม้คุณจะไม่เคยใช้มันเลย
ทีมส่วนใหญ่ที่อ่านถึงตรงนี้จะไม่โฮสต์เอง ส่วนฮาร์ดแวร์ด้านล่างอธิบายว่าทำไม — Kimi K3 ต้องใช้ตู้แร็ค แต่ตัวเลือกนี้มีคุณค่าไม่ว่าจะอย่างไร
หาก Anthropic ขึ้นราคา เลิกใช้โมเดลที่คุณสร้างบนนั้น เปลี่ยนนโยบายการใช้งานที่ยอมรับได้จนทำให้ผลิตภัณฑ์คุณพัง หรือมีไตรมาสที่แย่ ทางออกของคุณกับโมเดลปิดคือโปรเจกต์ย้ายระบบ กับโมเดลโอเพนเวต ทางออกของคุณคือดาวน์โหลดไฟล์ที่คุณดาวน์โหลดได้ทุกเมื่อ คุณอาจไม่เคยทำ ข้อเท็จจริงที่ว่าคุณ สามารถ ทำได้ คือสิ่งที่ทำให้ความสัมพันธ์กับผู้ขายเป็นความสัมพันธ์เชิงพาณิชย์ ไม่ใช่การพึ่งพา
นี่ไม่ใช่ทฤษฎี Fable 5.1 เปิดตัวพร้อมการเปลี่ยนแปลงที่ทำให้ระบบพังสามอย่างในวันที่ 1 กันยายน หนึ่งในนั้นทำให้บล็อกการคิดใช้ไม่ได้เมื่อคุณแก้ไขประวัติบทสนทนาสำหรับบัญชีที่สร้างหลัง 31 สิงหาคม หากรูปแบบนั้นเป็นโครงรับน้ำหนักในสถาปัตยกรรมของคุณ คุณกำลังวิศวกรรมใหม่ตามตารางของ Anthropic’ ไม่ใช่ของคุณ
3. การพำนักของข้อมูลเลิกเป็นโปรเจกต์
สำหรับใครก็ตามที่ดำเนินงานภายใต้ GDPR นี่คือเหตุผลที่ปิดดีลได้จริง
กับ API ปิด ทุกพรอมต์ออกจากโครงสร้างพื้นฐานของคุณ คุณต้องมีข้อตกลงผู้ประมวลผล การประเมินผลกระทบการโอนข้อมูลหากผู้ประมวลผลอยู่นอก EEA แผนผังการไหลของข้อมูล และคำตอบให้ DPO ว่าข้อมูลที่พักอยู่นั้นเกิดอะไรขึ้น ทั้งหมดนี้ทำได้ และยังใช้เวลาหลายสัปดาห์ต่อผู้ขายหนึ่งราย ซ้ำทุกครั้งที่ผู้ขายเปลี่ยนอะไร
กับโอเพนเวตบนโครงสร้างพื้นฐานที่คุณควบคุม — ฮาร์ดแวร์ของคุณเอง หรือผู้ให้บริการ GPU เยอรมันหรือ EU — คำถามเรื่องการโอนข้ามพรมแดนไม่เกิดขึ้น เพราะไม่มีการโอน โมเดลรันที่ที่ข้อมูลของคุณอยู่แล้ว การตรวจสอบทางกฎหมายเปลี่ยนจากการประเมินการโอนเป็นการอ่านสัญญาอนุญาต
สำหรับลูกค้าเยอรมันและ EU นี่มักเป็นปัจจัยชี้ขาด และควรพูดข้อแม้ให้ชัด: การใช้ GLM-5.3 ผ่าน API ของ Z.ai’ ไม่ให้สิ่งนี้แก่คุณ คุณได้สิ่งนี้จากการรันเวตเอง หรือจากผู้ให้บริการที่โฮสต์เวตในเขตอำนาจของคุณ สัญญาอนุญาตทำให้สิ่งนั้นถูกกฎหมาย แต่มันไม่ได้ทำให้เกิดขึ้นเอง
4. ความสามารถในการตรวจสอบมีจริง แม้จะถูกใช้น้อย
โอเพนเวตหมายความว่าคุณตรวจสอบสถาปัตยกรรมได้ รันการประเมินของคุณเองบนโมเดลจริงแทนที่จะเป็นปลายทางที่อาจถูกอัปเดตเงียบ ๆ ควอนไทซ์ให้พอดีฮาร์ดแวร์ ไฟน์ทูนบนโดเมนของคุณ และ — ที่สำคัญ — ปักหมุดเวอร์ชันไว้ตลอดไป
ข้อสุดท้ายนั้นถูกมองข้าม API ปิดถูกอัปเดตเบื้องหลัง ID โมเดลที่คงที่ พฤติกรรมค่อย ๆ เปลี่ยน พรอมต์ที่เคยใช้ได้ก็ใช้ไม่ได้ และคุณเทียบความแตกต่างไม่ได้เพราะมองไม่เห็น เช็กพอยต์ในเครื่องจะเหมือนเดิมทุกไบต์ในอีกหนึ่งปี’
5. แรงกดดันจากการแข่งขันเป็นประโยชน์กับทุกคน รวมถึงผู้ใช้โมเดลปิด
ดูสิ่งที่เกิดขึ้นฤดูร้อนนี้ Kimi K3 เปิดตัวในเดือนกรกฎาคมที่ $3/$15 พร้อมคะแนนใกล้เคียงแนวหน้า GLM-5.3 เปิดตัวในเดือนสิงหาคมที่ $1.40/$4.40 ห่างกันครึ่งจุด และในวันที่ 1 กันยายน Anthropic ลดการอ่านแคชลง 75%
ผมไม่ได้อ้างว่าเป็นเหตุโดยตรง — Anthropic ไม่ได้เผยเหตุผลการตั้งราคา และการลดการอ่านแคชเป็นการปรับให้เหมาะสมตามธรรมชาติ แต่ตลาดที่มีทางเลือกถูกที่น่าเชื่อถือย่อมตั้งราคาต่างจากตลาดที่ไม่มี และทางเลือกเหล่านั้นน่าเชื่อถือขึ้นในปีนี้ หากคุณใช้โมเดลปิดเพียงอย่างเดียว ระบบนิเวศโอเพนเวตก็ยังค่อย ๆ ทำให้บิลคุณเล็กลง
6. การฝึกหลังการฝึก (post-training) คือจุดที่ได้กำไร และมันถูก
ผลลัพธ์เด่นของ GLM-5.3’ — การปรับปรุง Terminal-Bench หกเท่าจากเวตฐานเดียวกัน — เป็นตัวเลขที่สำคัญเชิงกลยุทธ์ที่สุดในบทความทั้งหมดนี้ และมันไม่เกี่ยวกับ GLM
มันบอกว่าส่วนที่แพงของการสร้างโมเดลแนวหน้า (การฝึกก่อน) กลายเป็นอินพุตที่แก้ปัญหาแล้วและเป็นสินค้าโภคภัณฑ์มากขึ้นเรื่อย ๆ ส่วนที่สร้างความแตกต่าง (การฝึกหลังการฝึก สภาพแวดล้อม RL การออกแบบงานระยะยาว) มีราคาจับต้องได้กว่าเมื่อเทียบกัน นั่นคือเหตุผลที่ห้องแล็บจีนสี่แห่งที่มีมูลค่ารวมประมาณ 159 พันล้านดอลลาร์ก้าวทันห้องแล็บอเมริกาที่มีมูลค่าหลายเท่า การประเมินของ Lambert’ คือห้องแล็บจีนกำลังทำงานด้วย “เงินทุนน้อยกว่าหลายอันดับขนาด”
สำหรับใครก็ตามที่อยู่ปลายน้ำ นัยนั้นตรงไปตรงมา: จำนวนผู้ขายโมเดลที่น่าเชื่อถือกำลังเพิ่มขึ้น ไม่ใช่ลดลง วางสถาปัตยกรรมของคุณให้สอดคล้อง
7. ผลกระทบของระบบนิเวศทบทวี
Qwen ทะลุ หนึ่งพันล้านดาวน์โหลดสะสมบน Hugging Faceแซง Llama และตอนนี้เป็นฐานของโมเดลที่ติดแท็กกว่า 200,000 โมเดลและอนุพันธ์กว่า 113,000 รายการ — ประมาณ 40% ของอนุพันธ์ LLM ใหม่ทั้งหมด บนแพลตฟอร์มอิง Qwen นั่นคือระบบนิเวศเครื่องมือ การควอนไทซ์ การไฟน์ทูน และการติดตั้งใช้งานที่มีอยู่เพียงเพราะเวตเป็นสาธารณะ
คุณได้ประโยชน์จากระบบนิเวศนั้นไม่ว่าคุณจะร่วมสร้างหรือไม่ การแปลง GGUF เคอร์เนล vLLM อะแดปเตอร์ LoRA สูตรควอนไทซ์ ชุดทดสอบประเมิน — ทั้งหมดมีอยู่เพราะคนหลายพันคนเข้าถึงเวตจริงได้
8. มันคือที่ที่นักพัฒนาไปกันแล้ว
โมเดลต้นกำเนิดจีนที่ ~61% ของโทเคนบน OpenRouterส่วนแบ่งโมเดลสหรัฐลดจาก ~70% เหลือ ~30% ในหนึ่งปี สี่ในห้าโมเดลที่ใช้มากที่สุดบนเราเตอร์มีต้นกำเนิดจีน MiMo ของ Xiaomi’ เพียงอย่างเดียวคิดเป็นประมาณ 21% ของโทเคนที่ถูกส่งต่อ และประมาณ 22% ของทราฟฟิกเขียนโค้ดทั้งหมด
พฤติกรรมนักพัฒนาเป็นตัวชี้วัดล่วงหน้า มันเป็นตัวชี้วัดล่วงหน้าสำหรับ Docker, Postgres และ Linux การเดิมพันสวนทางกับมันมีประวัติที่แย่
…และข้อโต้แย้งที่ตรงไปตรงมา
ถ้าผมเขียนแค่ส่วนข้างบน นี่จะกลายเป็นโฆษณา
โอเพนเวตไม่ใช่โอเพนซอร์ส และการเพี้ยนของคำศัพท์เป็นปัญหาจริง สองในสามโมเดลนี้ออกภายใต้สัญญาอนุญาตเฉพาะกิจที่ผูกกับรายได้โดยไม่มีการรับรองจาก OSI ข้อการตรวจสอบความปลอดภัยของ GLM-5.3’ ไม่มีเกณฑ์หรือกระบวนการอุทธรณ์ที่เผยแพร่ หากกรอบการปฏิบัติตามกฎของคุณต้องการสัญญาอนุญาตที่ OSI รับรอง คำตอบตรงไปตรงมาคือตัวเลือกของคุณคือ GLM-5.3-Flash เรือธงของ DeepSeek’ ที่อนุญาตแบบ MIT และรายชื่ออื่น ๆ ที่หดลงเรื่อย ๆ
เบนช์มาร์กของผู้ขายก็ยังเป็นเบนช์มาร์กของผู้ขาย ตัวเลขพาดหัวทุกตัวที่ Moonshot และ Z.ai เผยแพร่เป็นตัวเลขที่รายงานเองและเลือกเอง ในจุดที่ผู้รวบรวมข้อมูลเป็นกลางได้วัด ตัวเลขส่วนใหญ่ยืนยันได้ — ซึ่งเป็นเครดิตของทั้งสองแล็บ’ จริง ๆ — แต่ “ส่วนใหญ่ยืนยันได้” ทำหน้าที่หนักในประโยคนั้น
การโฮสต์เองเป็นเรื่องเพ้อฝันสำหรับทีมส่วนใหญ่ Kimi K3 มีขนาด 1.5 TB และ Moonshot แนะนำตัวเร่งความเร็ว 64 ตัวขึ้นไป GLM-5.3 ต้องใช้ 8×H200 ที่ FP8 เป็นอย่างน้อย สิทธิ์ในการออกมีจริง แต่ต้นทุนในการใช้มันคือศูนย์ข้อมูล
การสนับสนุนคือสิ่งที่คุณสร้างขึ้นเอง เมื่อ Fable 5.1 พัง มีบริษัทที่มี SLA รับผิดชอบ เมื่อการติดตั้ง GLM-5.3 ที่คุณโฮสต์เองสร้างขยะที่บริบท 300K ในคืนวันศุกร์ สิ่งที่มีคือ GitHub issue และความสามารถของคุณเอง
ภูมิรัฐศาสตร์เป็นปัจจัยจริงในการจัดซื้อ ตัวเลือกโอเพนเวตทั้งสามแบบที่พูดถึงที่นี่มาจากห้องแล็บจีน สำหรับลูกค้าบางราย — ภาครัฐ หน่วยงานใกล้ชิดกลาโหม อุตสาหกรรมที่มีการกำกับบางประเภท — นั่นเป็นอุปสรรคตายตัวไม่ว่าข้อกำหนดสัญญาจะเป็นอย่างไรหรือเวตจะรันที่ไหน ไม่ใช่หน้าที่ผมที่จะบอกว่าความกังวลนั้นมีมูลหรือไม่ หน้าที่ผมคือบอกคุณว่ามันจะถูกยกขึ้นมาในการประชุม
โมเดลปิดยังนำอยู่ในงานความรู้ทั่วไป GDPval-AA v2 ให้ Fable 5.1 ที่ 1,853 เทียบกับ GLM-5.3’ ที่ 1,769 และ Kimi K3’ ที่ 1,687 ด้านการเขียนโค้ดช่องว่างหายไปแล้ว ด้านงานความรู้วิชาชีพกว้าง ๆ ยังไม่หาย
แสดงรูปภาพ เวตดาวน์โหลดได้ แต่มีเงื่อนไขสามชุดที่ต่างกัน มีเพียง GLM-5.3-Flash ที่ยังเป็น MIT
Ollama ในปี 2026: การเปลี่ยนราคาที่สำคัญจริง ๆ
Ollama ค่อย ๆ กลายเป็นโครงสร้างพื้นฐานที่สำคัญที่สุดในการพูดคุยนี้ และเมื่อ 31 สิงหาคม 2026 มันเปลี่ยนวิธีคิดเงินในแบบที่ควรค่าแก่การทำความเข้าใจอย่างถูกต้อง
อะไรเปลี่ยนไป
Ollama เปลี่ยนแผน Pro, Max และ Team จากการคิดตามเวลา GPU เป็น การคิดราคาต่อโทเคนแบบมาตรฐานอุตสาหกรรม พร้อมเครดิตการใช้งานจำนวนหนึ่งรวมอยู่ในทุกแผน เหตุผลที่บริษัท’ ระบุชัดเจนจนสดชื่น: โมเดลอย่าง Kimi K3 ทำให้ตัวชี้วัดเวลาจีพียูคาดเดาไม่ได้ เมื่อโมเดลหนึ่งเปิดใช้พารามิเตอร์ 104B และอีกโมเดลเปิดใช้ 3B “หนึ่งชั่วโมงของ GPU” ก็ไม่มีความหมายอะไรกับคนที่จ่ายเงิน
แผนใหม่
| แผน | ราคา | การใช้งานรายเดือนที่รวมอยู่ | การทำงานพร้อมกัน |
|---|---|---|---|
| ฟรี | $0 | เครดิตเล็กน้อยรายเดือน โมเดลเริ่มต้น | 1 คำขอ |
| Pro | $20/เดือน (หรือ $200/ปี) | การใช้งาน $60 | 3 คำขอ |
| Max | $100/เดือน | การใช้งาน $300 | 10 คำขอ |
| Team | $500/เดือน | $1,000 ใช้ร่วมกัน ผู้ใช้ไม่จำกัด | 10 คำขอ |
| องค์กร | Custom | Custom | Custom |
อ่านแถว Pro อีกครั้ง $20 ซื้อโทเคนได้ $60 นั่นคือตัวคูณ 3 เท่าของการใช้งานที่รวมอยู่ และเมื่อเครดิตหมด คุณใช้ต่อในอัตราต่อโทเคนที่ประกาศไว้เดิมทุกประการ — ไม่มีขั้นปรับโทษ ไม่มีค่าบริการ
สิ่งที่ถูกตัดออก
นี่คือส่วนที่นักพัฒนาสังเกตเห็นจริง ๆ: ไม่มีการรีเซ็ตทุก 5 ชั่วโมง และไม่มีการจำกัดรายสัปดาห์ ใครก็ตามที่เคยชนกำแพงหน้าต่างการใช้งานแบบหมุนเวียนกลางการรีแฟกเตอร์จะเข้าใจว่าทำไมเรื่องนี้สำคัญกว่าราคา เครดิตก้อนรายเดือนรีเฟรชในวันสมัครสมาชิกของคุณ และที่สำคัญ ไม่ทบไปเดือนถัดไป — ดังนั้นเลือกขนาดแผนให้พอดีเดือนปกติของคุณ ไม่ใช่เดือนที่ยุ่งที่สุด
ข้อกำหนดที่สำคัญสำหรับงานใน EU
คำมั่นสามข้อในประกาศเกี่ยวข้องโดยตรงหากคุณจัดการข้อมูลลูกค้า:
- ไม่เก็บข้อมูลใด ๆ พรอมต์และคำตอบไม่ถูกบันทึกและไม่ถูกนำไปฝึก
- โฮสต์ในสหรัฐและยุโรปบวกสิงคโปร์สำหรับโมเดล Qwen จำนวนจำกัด
- การมองเห็นต้นทุนต่อคำขอ ในบัญชีของคุณ — คุณเห็นได้ว่าการเรียกแต่ละครั้งมีค่าใช้จ่ายเท่าไร
สำหรับที่ปรึกษาเยอรมัน นั่นเป็นเรื่องราวการปฏิบัติตามกฎที่ดีกว่าที่ผู้ให้บริการเกตเวย์ส่วนใหญ่เสนออย่างมีนัยสำคัญ แม้ว่า “โฮสต์ในยุโรป” จะเป็นคำกล่าวเรื่องเส้นทางมากกว่าการรับประกันการพำนักข้อมูลตามสัญญา หากการพำนักข้อมูลเป็นข้อกำหนดตายตัวไม่ใช่ความชอบ ให้ขอจาก Ollama เป็นลายลักษณ์อักษรก่อนที่คุณจะถือว่ามี
อัตราต่อโทเคนจริง
ตรงนี้เริ่มน่าสนใจ Ollama ประกาศอัตราต่อโมเดล และใกล้เคียงกับราคาจากเจ้าของโมเดลมาก:
| โมเดลบน Ollama | อินพุต / 1M | แคช / 1M | เอาต์พุต / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
ลองคำนวณรายเดือนจากข้างต้นกับตัวเลขนี้ การรันเอเจนต์แปดสิบครั้งต่อเดือนบน GLM-5.3 มีค่าโทเคนประมาณ $148 แผน Max ที่ $100/เดือนครอบคลุมการใช้งาน $300 — ดังนั้นภาระงานเดียวกันที่เคยมีค่าใช้จ่ายประมาณ $955/เดือนบน Fable 5.1 จึงพอดีอยู่ในการสมัครสมาชิก Ollama มูลค่า $100 อย่างสบาย ๆ และยังมีเหลือ
นั่นคือข้อโต้แย้งเชิงเศรษฐกิจทั้งหมดของโมเดลโอเพนที่บีบอัดเหลือบรรทัดเดียวบนใบแจ้งหนี้
แสดงรูปภาพ การรันเอเจนต์แปดสิบครั้งต่อเดือนบน GLM-5.3 พอดีอยู่ในแผน Ollama Max $100 และยังเหลือเงินทอน งานเดียวกันบน Fable 5.1 คือใบแจ้งหนี้ $955
Ollama ปล่อยอะไรอีกในปี 2026
การเปลี่ยนราคาไม่ได้เกิดขึ้นโดด ๆ ไม่กี่เดือนที่ผ่านมาคึกคัก:
- 25 สิงหาคม — รองรับ Claude Desktop ตอนนี้ Ollama ทำงานเป็นผู้ให้บริการเกตเวย์บุคคลที่สามสำหรับ Claude Desktop คุณจึงขับเคลื่อนโมเดลโอเพนผ่านไคลเอนต์ของ Anthropic’ เองได้
- 26 สิงหาคม — v0.33.0 การผสานรวมเกตเวย์ Claude Desktop มาถึง การกู้คืนพรีฟิลถูกนำกลับเข้าแคช และ Ollama ปิดข้อความระบบนับถอยหลังโทเคนของ Claude Code ซึ่งทำให้แคช KV ใช้ไม่ได้ในทุกเทิร์น ข้อสุดท้ายเป็นการแก้ประสิทธิภาพที่เงียบแต่สำคัญ
- 26 สิงหาคม — v0.33.1 รองรับ MLX สำหรับ Qwen3.8 Flash Next เอาต์พุตแบบมีโครงสร้าง และแก้ไขปัญหา GPU หมดเวลาเมื่อโหลดโมเดลจากที่เก็บข้อมูลที่ช้ากว่า
- 28 สิงหาคม — v0.33.2 โหมดมืดกลับมา แก้ไข handoff บน macOS และคงคำขอพร็อกซีของ Claude Desktop ให้ทำงานอยู่ระหว่างการอัปเดตแค็ตตาล็อกโมเดล
- 20 สิงหาคม — v0.32.15 การเริ่มต้นใช้งานเดสก์ท็อปแบบใหม่ และการแคชเมทาดาทาระหว่างคำขอที่ ลดเวลาถึงโทเคนแรกได้ประมาณครึ่งหนึ่ง
- 11 สิงหาคม — NVIDIA Nemotron 3.5 Lightningโมเดลขนาด 30B ที่ปรับแต่งสำหรับเวิร์กโฟลว์เอเจนต์พร้อมการเรียกใช้เครื่องมือบนฮาร์ดแวร์ส่วนตัว
- 10 สิงหาคม — Muse Glimmer ของ Meta, โมเดลมัลติโมดัลขนาด 30B ภายใต้ Apache 2.0, เร่งความเร็วด้วย MLX engine ของ Ollama น่าจดจำเพราะการล่มสลายของการใช้งาน Llama ในเส้นทางการเรียกใช้ — Meta ยังคงปล่อยเวตที่เปิดกว้างจริง ๆ
- 9 กรกฎาคม — การระดมทุนรอบ 88 ล้านดอลลาร์, โดย Ollama รายงานว่า นักพัฒนา 8.9 ล้านคน.
- 29 มิถุนายน — Gemma 4 บน MLX เร็วขึ้นถึง 90% ด้วยการทำนายหลายโทเคนพร้อมกัน ซึ่งช่วยเอเจนต์เขียนโค้ดบน Apple Silicon มากเป็นพิเศษ
- 5 มิถุนายน — v0.30 เพิ่มความเข้ากันได้กับ GGUF ผ่าน llama.cpp ขยายการรองรับฮาร์ดแวร์ออกไปไกลกว่า Apple Silicon มาก
เส้นเรื่องหลักคือ Ollama เลิกเป็น “วิธีง่าย ๆ ในการรันโมเดลเล็กบนแล็ปท็อป” และกลายเป็นเกตเวย์อเนกประสงค์ที่บังเอิญรันโมเดลในเครื่องได้ด้วย ตอนนี้แค็ตตาล็อกบนคลาวด์มี kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 ในเจ็ดขนาด, gpt-oss ที่ 20b และ 120b, gemma4, ตระกูล Nemotron 3 และ mistral-large-3.
ตั้งค่าทั้งหมด: คอนฟิกที่คัดลอกวางได้
Ollama + Claude Code (เส้นทางที่เร็วที่สุด)
Ollama มีตัวเรียกใช้งานที่ใช้คำสั่งเดียว ซึ่งจัดการเชื่อมต่อสภาพแวดล้อมให้คุณ:
bash
ollama launch claudeถ้าคุณอยากทำเองด้วยมือ — ซึ่งควรทำถ้าคุณจะเขียนสคริปต์ — ให้ติดตั้ง Claude Code ก่อน:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
จากนั้นชี้มันไปที่ Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
แล้วรันกับโมเดลที่คุณต้องการ:
bash
# A local model
claude --model qwen3.5

# A cloud model — note the :cloud suffix
claude --model kimi-k3:cloud
หรือใส่ในบรรทัดคำสั่ง โดยไม่ต้อง export อะไรในระดับ global:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
มีสองเรื่องที่อาจทำให้คุณเจ็บตัว
ข้อแรก, อย่า export ANTHROPIC_BASE_URL ไว้ถาวรใน shell profile ของคุณ มันเป็นตัวแปรระดับ global และจะเปลี่ยนเส้นทางเครื่องมือทุกตัวที่พูดภาษา Anthropic บนเครื่องคุณไปยัง Ollama อย่างเงียบ ๆ รวมถึงตัวที่คุณอยากให้คุยกับ Anthropic จำกัดขอบเขตให้ใช้เฉพาะโปรเจกต์หรือเฉพาะการเรียกครั้งนั้น
ข้อที่สอง, ตั้งความยาวบริบทไว้ที่ 64k หรือสูงกว่า สำหรับงานใดก็ตามที่ทำกับรีโพจริง ค่าเริ่มต้นของ Ollama นั้นเล็กกว่า และเอเจนต์เขียนโค้ดที่หน้าต่างบริบทหมดอย่างเงียบ ๆ จะเริ่มลืมสิ่งต่าง ๆ แทนที่จะแจ้งข้อผิดพลาด
สำหรับงาน CI, Docker หรือการรันด้วยสคริปต์, --yes จะข้ามคำถามแบบอินเทอร์แอกทีฟ:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "how does this repository work?"GLM-5.3 ตรงจาก Z.ai
ถ้าคุณอยากใช้เส้นทางของเจ้าของโดยตรงแทนที่จะผ่าน Ollama, Z.ai เปิด endpoint สามโปรโตคอล:
| โปรโตคอล | Base URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
บล็อก provider ของ OpenCode สำหรับ GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3": {
          "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
          "options": { "reasoning_effort": "high", "temperature": 1 }
        }
      }
    }
  },
  "model": "zai/glm-5.3"
}
หมายเหตุสำคัญสำหรับการอัปเกรด: GLM-5.3 ต้องเปิดการให้เหตุผลไว้ ถ้าคอนฟิกเดิมของคุณตั้งค่า thinking.type: "disabled", ตอนนี้จะล้มเหลว เปลี่ยนเป็น "enabled" และตั้งค่า reasoning_effort: "low" ถ้าคุณอยากได้ความหน่วงแบบเดิมกลับมา
reasoning_effort คือปุ่มหลักของคุณในการชั่งคุณภาพกับต้นทุน: ต่ำ สำหรับการเรียกที่ไวต่อความหน่วง, สูง สำหรับงานหนัก, สูงสุด (ค่าเริ่มต้น) สำหรับปัญหาที่ยากและเอาชนะได้ยากจริง ๆ สูง. เมื่อพิจารณาความพูดเยอะที่มีบันทึกไว้ ผมจะรัน สูง เป็นค่าใช้ทุกวันแทนที่จะปล่อยให้ สูงสุด เปิดไว้แล้วสงสัยว่าโทเคนเอาต์พุตหายไปไหน
การตั้งค่า routing ที่ผมแนะนำจริง ๆ
นี่ไม่ใช่การตัดสินใจแบบ “เลือกสักตัว” คำตอบที่ถูกสำหรับทีมส่วนใหญ่คือตาราง routing สามชั้น และ agent harness จริงจังทุกรองรับโมเดลแยกตามเอเจนต์
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
      "description": "Architecture, root-cause analysis, anything expensive to get wrong",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation work",
      "model": "zai/glm-5.3",
      "options": { "reasoning_effort": "high" }
    },
    "research": {
      "description": "Long-context reading, web research, multi-source synthesis",
      "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
      "description": "Renames, docstrings, test scaffolding, lint fixes",
      "model": "ollama/glm-5.3-flash"
    }
  }
}
เหตุผลเบื้องหลังแต่ละบรรทัด:
- ขั้นวางแผนใช้ Fable 5.1 ขั้นวางแผนคือที่ที่การตัดสินใจผิดจะทำให้คุณเสียโทเคนปลายทางมากที่สุด และความต่อเนื่องในระยะยาวคือสิ่งที่ 5.1 ถูกสร้างมาเพื่อสิ่งนี้พอดี อีกทั้งยังเป็นขั้นที่คุณใช้โทเคนน้อยที่สุด ดังนั้นส่วนต่างราคาจึงตกกับส่วนที่เล็กที่สุดในบิลของคุณ
- ขั้นลงมือสร้างใช้ GLM-5.3 ความสามารถต่อยูโรดีที่สุดในตลาด และค่าโทเคนส่วนใหญ่ของคุณตกอยู่ที่นี่
- ขั้นค้นคว้าใช้ Kimi K3 BrowseComp 91.2 และหน้าต่างบริบท 1M จริง ๆ ทำให้มันเป็นตัวเลือกที่ดีที่สุดที่มีสำหรับการอ่านหลายอย่างแล้วสังเคราะห์เข้าด้วยกัน
- งานซ้ำ ๆ ใช้ GLM-5.3-Flash ที่ $0.15/$0.50 ถือว่าฟรีเลย และการเปลี่ยนชื่อสัญลักษณ์ใน 40 ไฟล์ไม่ต้องใช้การให้เหตุผลระดับแนวหน้า
small_modelใช้ตัวเล็ก ๆ สำหรับงานธุรการของ harness เอง — การสร้างชื่อเรื่อง การสรุป การเรียกยูทิลิตี้ภายใน
คุณไม่ได้กำลังเลือกผู้ชนะ คุณกำลังสร้างชุดเกียร์ และเขียน ID โมเดลให้การสลับตัวหนึ่งเป็นการแก้บรรทัดเดียว เพราะในตลาดนี้คุณจะต้องเปลี่ยนอีกครั้งภายในไตรมาส
สิ่งที่คุณรันในเครื่องได้จริง (ความจริงเรื่องฮาร์ดแวร์)
ขอผมฆ่าข้อสันนิษฐานหนึ่งก่อนที่มันจะทำให้ใครบางคนเสียเงิน
คุณรัน Kimi K3 หรือ GLM-5.3 บนเวิร์กสเตชันไม่ได้ ไม่ว่าจะมี 5090 ตัวเดียว หรือสองตัวก็ไม่
Kimi K3
- ~1.5 TB ของเวตใน MXFP4 แบบเนทีฟ — และจำไว้ว่านั่นคือ เปิดใช้งานอยู่ เช็กพอยต์ที่ผ่านการควอนไทซ์แล้ว ไม่ใช่จุดเริ่มต้นสำหรับการบีบอัดต่อ
- Moonshot แนะนำ อย่างน้อย 64 accelerator สำหรับการให้บริการที่แข่งขันได้
- การโฮสต์เองที่สมจริงเริ่มต้นที่คลัสเตอร์หลายโหนด การติดตั้งอ้างอิงใช้แร็ก GB300 NVL72
- ไม่มี รายการอย่างเป็นทางการในไลบรารี Ollama สำหรับ Kimi K3 ในเครื่อง และไม่มีการแปลง GGUF สำหรับผู้ใช้ทั่วไปที่คุ้มค่าจะชี้นำให้คุณ
- มีรายงานว่ามันรันบนคลัสเตอร์ของ RTX 5090 สำหรับผู้ใช้ทั่วไปได้ แต่ “คลัสเตอร์ของ 5090” ไม่ใช่แล็ปท็อป และทรูพุตเทียบกันไม่ได้
GLM-5.3
- ~1.5 TB ใน BF16, ประมาณ 750 GB ที่ FP8
- โหนดเดียวขั้นต่ำที่ใช้งานได้: 8× H200 (หน่วยความจำ GPU 1,128 GB) ที่ FP8 เหลือประมาณ 375 GB สำหรับ KV cache
- BF16 ต้องใช้สองโหนด 8×H200 หรือโหนด 8×B300 เดียว (2,304 GB)
- โหนด 8×H200 เดียวใน BF16 เล็กเกินไปสำหรับเวตบวกแคช
แสดงรูปภาพ โมเดลเปิดระดับแนวหน้าต้องใช้แร็ก ชั้น 24 GB คือที่ที่ “รันบนเครื่องผมได้” อยู่จริง — และมันเก่งขึ้นมากแล้ว
แล้ว “AI ในเครื่อง” หมายถึงอะไรจริง ๆ ในกันยายน 2026?
มันหมายถึงโมเดลอีกระดับหนึ่ง และระดับนั้นเก่งขึ้นจริง ๆ แล้ว:
| รุ่น | VRAM | ใช้ทำอะไร |
|---|---|---|
| Qwen3.8-27B | 24 GB ที่ Q4 | รอบด้านที่สุดบนฮาร์ดแวร์ผู้ใช้ทั่วไป — SWE-bench 61.7% |
| gpt-oss:20b | 16 GB | โมเดลเล็กที่ดีที่สุด ปรับความเข้มของการให้เหตุผลได้ |
| Gemma 4 E4B | ~6 GB | ความสามารถด้านภาพบวกการเรียกใช้เครื่องมือบนแล็ปท็อปสมัยใหม่ |
| Mistral 7B | 8 GB | ตัวเลือกอเนกประสงค์ที่เร็วที่สุด 40–60 tok/วินาที |
| DeepSeek-R1 7B | 5 GB | การให้เหตุผลแบบลูกโซ่ความคิดบน GPU ของแล็ปท็อป |
| Llama 4 Scout | ~55 GB ที่ Q4 | บริบท 10M, มัลติโมดัล — อาณาเขตของเวิร์กสเตชัน |
Qwen3.8-27B ที่ได้ 61.7% บน SWE-bench โดยรันทั้งหมดบน GPU ผู้ใช้ทั่วไปขนาด 24 GB ที่ไม่มีการเชื่อมต่อเครือข่าย เป็นเรื่องน่าทึ่งที่สิบแปดเดือนก่อนคงฟังดูเหมือนนิยายวิทยาศาสตร์ มันไม่ใช่ GLM-5.3 และมันไม่ได้แกล้งทำเป็นเช่นนั้น
กรอบความคิดที่ตรงไปตรงมา: เวตเปิดระดับแนวหน้าซื้อให้คุณ อธิปไตยและราคาไม่ใช่ การรันในเครื่อง. เวตเปิดในช่วง 7B–30B ซื้อการรันในเครื่องจริง ๆ ให้คุณ ในราคาความสามารถที่ลดลงจริงแต่ยอมรับได้ และนั่นคือระดับที่ “รันบนเครื่องผม ไม่เห็นเครือข่าย” เป็นข้อกำหนดที่ทำได้จริง
สถาปัตยกรรมที่ได้ผลกับลูกค้าส่วนใหญ่ของผมคือการแยกแบบนั้นเป๊ะ ๆ: โมเดลเล็กในเครื่องสำหรับทุกอย่างที่แตะข้อมูลอ่อนไหวจริง ๆ และโมเดลโอเพนเวตระดับแนวหน้าที่โฮสต์ให้บริการสำหรับอย่างอื่นทั้งหมด — โดยมีเวตพร้อมใช้เป็นหลักประกันมากกว่าเป็นแผนการติดตั้งใช้งาน
แต่ละโมเดลพลาดตรงไหนจริง ๆ
ไม่มีคำโฆษณาเกินจริง นี่คือจุดอ่อนตามจริง
จุดอ่อนของ Kimi K3
มันแพงสำหรับโมเดลเปิด $3/$15 คือ 2.1 เท่าของราคาอินพุต GLM-5.3 และ 3.4 เท่าของราคาเอาต์พุต โดยได้คะแนนดัชนีความฉลาดพอ ๆ กัน ถ้าคุณเลือก K3 แทน GLM-5.3 ให้ชัดเจนว่าคุณซื้ออะไรด้วยส่วนต่างนั้น — ปกติคือชุดความสามารถด้านภาพหรือประสิทธิภาพการท่องเว็บ
สัญญาอนุญาตมีเกณฑ์ที่ต่ำกว่า เกณฑ์ MaaS ที่รายได้รวม 20 ล้านดอลลาร์ครอบคลุมองค์กรได้มากกว่าเกณฑ์ 10 พันล้านดอลลาร์ของ GLM-5.3 มาก ถ้าการขายต่อบริการอนุมานอยู่ในโมเดลธุรกิจของคุณที่ใดก็ตาม K3 คือตัวที่ถูกจำกัดมากกว่าของทั้งสอง
การโฮสต์เองอยู่นอกเอื้อมของเกือบทุกคน 1.5 TB กับ accelerator 64 ตัวขึ้นไปเป็นการลงทุนโครงสร้างพื้นฐานที่จริงจัง สิทธิ์ในการออกไปใช้ได้จริงในทางทฤษฎีมากกว่าโมเดลอื่นใดในการเปรียบเทียบนี้
งานความรู้แบบกว้างตามหลังอยู่ GDPval-AA v2 ที่ 1,687 ทำให้มันตามหลัง GLM-5.3, Claude Fable ทั้งสองรุ่น และ GPT-5.6 Sol Max มันเป็นผู้เชี่ยวชาญด้านการเขียนโค้ดและงานเอเจนต์ที่บังเอิญมีขนาดมหึมา
จุดอ่อนของ GLM-5.3
ข้อความเท่านั้น ไม่มีอินพุตรูปภาพ ไม่มีวิดีโอ ถ้าเวิร์กโฟลว์ของคุณมีการดีบักจากภาพหน้าจอ การแปลงดีไซน์เป็นโค้ด หรือการอ่านเอกสารด้วยภาพ GLM-5.3 ทำไม่ได้เลย และคุณต้องใช้ GLM-5.3-Flash, Kimi K3 หรือ Fable 5.1 แทน นี่คือความผิดพลาดในการตั้งค่าที่พบบ่อยที่สุดที่ผมคาดว่าคนจะทำ เพราะ ID ของโมเดลดูเกี่ยวข้องกันแต่ไม่ใช่
มันพูดเยอะ และความพูดเยอะถูกคิดเงิน โทเคนเอาต์พุต 170M เทียบกับค่ามัธยฐานระดับ 72M ในชุดทดสอบ AA reasoning_effort ค่าเริ่มต้นอยู่ที่ สูงสุด, และการคิดไม่สามารถปิดได้ เผื่อโทเคนเอาต์พุตไว้มากกว่าที่จำนวนรอบของคุณบอกเป็นนัย
สัญญาอนุญาตไม่ใช่ MIT แล้ว และข้อกำหนดการตรวจสอบความปลอดภัยไม่มีขอบเขต สำหรับผู้อ่านส่วนใหญ่ เกณฑ์ 10 พันล้านดอลลาร์ทำให้เรื่องนี้เป็นเพียงทฤษฎี สำหรับใครก็ตามที่ใกล้เกณฑ์นั้น “ขอบเขตและวิธีการจะถูกกำหนดอย่างสมเหตุสมผลโดย Z.AI” ไม่ใช่ข้อกำหนดที่ทีมกฎหมายของคุณจะชอบ
Terminal-Bench 3.0 ที่ 28.3 ตามหลัง GPT-5.6 Sol ที่ 34.6 บนเบนช์มาร์กเฉพาะที่ใกล้ที่สุดกับการเขียนโค้ดแบบเอเจนต์ในเทอร์มินัล มันตามหลังคู่แข่งแบบปิดเมื่อวัดด้วยไม้บรรทัดเดียวกัน
มันเพิ่งมาอยู่ในโลกเวตเปิด เปิดตัว 28 สิงหาคม ชุมชนมีเวลาแค่วัน ไม่ใช่เดือน บั๊กในการติดตั้งใช้งานที่พบได้น้อยยังไม่โผล่ขึ้นมา
จุดอ่อนของ Claude Fable 5.1
ราคา ประมาณ 6.5 เท่าของ GLM-5.3 ต่องานเอเจนต์ที่ทำสำเร็จหนึ่งงาน แม้หลังลดราคาการอ่านแคช 75% แล้ว สำหรับงานส่วนใหญ่ ช่องว่างนั้นไม่สามารถปกป้องได้ด้วยเหตุผลด้านความสามารถอีกต่อไป
การเปลี่ยนแปลงที่ทำให้ของเดิมพังสามข้อ การบังคับใช้เครื่องมือคืนค่า 400 บล็อกการคิดไม่ส่งย้อนกลับไปยังโมเดลรุ่นเก่า การแก้ประวัติบทสนทนาทำให้บล็อกการคิดใช้ไม่ได้บนบัญชีที่สร้างหลัง 31 สิงหาคม 2026 ข้อใดข้อหนึ่งในนี้ทำให้การเชื่อมต่อที่ทำงานอยู่พังเมื่ออัปเกรดได้
การเรียกใช้เครื่องมือแบบขนานถอยหลังลง มีรายงานว่ามีการเรียกครั้งละหนึ่งครั้งต่อรอบ ในขณะที่ Fable 5 รวมหลายครั้งไว้ด้วยกัน ในลูปเอเจนต์ยาว ๆ นั่นคือเวลาจริงที่คุณจ่ายสองต่อ
ไม่มีทางออกเลย ไม่มีเวต ไม่มีการโฮสต์เอง ไม่มีการปักหมุดเวอร์ชันเกินกว่าที่ Anthropic มีให้ ไม่มีการตรวจสอบภายใน เมื่อมันเปลี่ยน คุณก็ต้องปรับตาม
ตัวแบ่งโทเคนทำให้การเปรียบเทียบตัวเลขดูสูงเกินจริง มากกว่าโมเดล Claude รุ่นเก่าถึง ~30% สำหรับข้อความเดียวกัน ซึ่งทำให้การเปรียบเทียบต้นทุนในอดีตเข้าใจผิดไปในทางที่เป็นประโยชน์กับ Anthropic ถ้าคุณไม่ระวัง
กรอบการตัดสินใจ: หกสถานการณ์
แสดงรูปภาพ หกสถานการณ์ หกคำตอบ หาแถวที่ฟังดูเหมือนสัปดาห์ของคุณ
1. “ผมอยากได้โมเดลเดียว ตั้งแล้วลืม แล้วให้บิลอยู่ในระดับที่สมเหตุสมผล”
GLM-5.3 ห่างจาก Kimi K3 ไม่ถึงครึ่งคะแนน และห่างจากโมเดลปิดที่ดีที่สุดประมาณสามคะแนนบนดัชนีเป็นกลาง ที่ $1.40/$4.40 รันผ่าน Ollama บนแพ็กเกจ Pro หรือ Max ตั้ง reasoning_effort: high, แล้วไปทำงานของคุณต่อ สิ่งเดียวที่ควรทำให้คุณเปลี่ยนจากคำตอบนี้คือความจำเป็นในการป้อนรูปภาพ
2. “งานของผมเป็นงานภาพ — UI, การแปลงดีไซน์เป็นโค้ด, การดีบักจากภาพหน้าจอ, เอกสาร”
Kimi K3 หรือ GLM-5.3-Flash ไม่ใช่ GLM-5.3 MoonViT-V2 ของ K3 จัดการข้อความ รูปภาพ และวิดีโอได้เองตามธรรมชาติ และได้ 81.6/83.4 บน MMMU-Pro ส่วน GLM-5.3-Flash คือตัวเลือกประหยัดที่มีมัลติโมดัลیتیในตัวและสัญญาอนุญาต MIT GLM-5.3 รองรับข้อความเท่านั้นและจะปฏิเสธอินพุตนั้นไปเลย
3. “เซสชันอัตโนมัติยาว ๆ ที่การตัดสินใจผิดมีราคาแพง”
Claude Fable 5.1 นี่คือสิ่งที่มันถูกสร้างมาเพื่อ และเบนช์มาร์กสนับสนุน: Terminal-Bench-Science เพิ่มเป็นสองเท่า, 82% บนงานใช้คอมพิวเตอร์ที่ยากที่สุดของ Browserbase เทียบกับ 74% ของ Opus 5 และการเพิ่มขึ้นมากที่สุดที่มีการเผยแพร่ในงานเอเจนต์ที่ใช้เวลาหลายชั่วโมง การลดราคาการอ่านแคช 75% ทำให้ภาระงานแบบนี้ถูกลงถึง 45% จากเดิม จ่ายส่วนต่างในจุดที่ความผิดพลาดแพงกว่าโทเคน
4. “การเก็บข้อมูลใน EU เป็นข้อกำหนดที่ขาดไม่ได้”
GLM-5.3-Flash ถ้าคุณต้องการ MIT, GLM-5.3 ถ้าคุณต้องการความสามารถ โฮสต์เองบนฮาร์ดแวร์ของคุณหรือผู้ให้บริการ GPU ใน EU แล้วคำถามเรื่องการโอนข้ามพรมแดนก็หมดไป เตรียมงบ 8×H200 สำหรับ GLM-5.3 ที่ FP8 ส่วน Flash จัดการได้ง่ายกว่ามากที่ 320B/18B ถ้าการโฮสต์เองเกินงบ การโฮสต์ในยุโรปของ Ollama ที่ไม่เก็บข้อมูลเลยคือทางสายกลางที่ใช้ได้จริง — แต่ขอคำมั่นเรื่องถิ่นที่อยู่เป็นลายลักษณ์อักษร อย่าเดาจากหน้าโฆษณา
5. “ทีมเล็ก งบตึง เขียนโค้ดทั้งวัน”
GLM-5.3-Flash เป็นค่าเริ่มต้น, GLM-5.3 สำหรับปัญหายาก, Ollama Pro ที่ $20 Flash ราคา $0.15/$0.50 — ตอนนี้ลดครึ่งหนึ่งถึง 9 กันยายน — และได้ 57.5 บนดัชนีความฉลาด ยี่สิบดอลลาร์ซื้อโทเคนได้หกสิบดอลลาร์โดยไม่มีเพดานรายสัปดาห์ สำหรับทีมสองถึงสี่คนนี่แทบจะเอาชนะไม่ได้เลย แพ็กเกจ GLM Coding Plan ที่ $18/เดือน (Lite) เป็นทางเลือกถ้าคุณชอบโควตาคงที่มากกว่าสระเครดิต
6. “ผมต้องอธิบายเรื่องนี้ให้ทีมจัดซื้อหรือทีมกฎหมายเห็นชอบ”
GLM-5.3-Flash. มันเป็นโมเดลเดียวในการเปรียบเทียบนี้ที่อยู่ใต้สัญญาอนุญาตมาตรฐานที่ OSI รับรอง (MIT) รองรับมัลติโมดัลในตัว ได้ 57.5 บนดัชนีเป็นกลาง และเวตอยู่บน Hugging Face โดยไม่มีเกณฑ์รายได้ ไม่มีข้อบังคับเรื่องการระบุที่มา และไม่มีข้อกำหนดการตรวจสอบความปลอดภัย เมื่อคำถามคือ “เราจะปกป้องอะไรได้ในการตรวจสัญญา” สัญญาอนุญาตแบบเปิดกว้างชนะสามคะแนนเบนช์มาร์กได้ทุกครั้ง
สิ่งที่ผมจะจับตาในไตรมาสหน้า
ว่า Fable 5.1 จะได้สูงกว่า 62.1 บนดัชนี Artificial Analysis หรือไม่ มันเปิดตัวก่อนบทความนี้หนึ่งวันและยังไม่ถูกให้คะแนนอย่างเป็นอิสระ ส่วนต่างเบนช์มาร์กเหนือ Fable 5 บอกว่ามันน่าจะทำได้ แต่ “น่าจะ” ไม่ใช่ “ทำได้แล้ว” และช่องว่างกับ 59.7 ของ Kimi K3 คือตัวเลขที่การโต้เถียงเรื่องเปิดกับปิดทั้งหมดขึ้นอยู่กับมัน
ว่าการเลื่อนไถลของสัญญาอนุญาตจะดำเนินต่อไปหรือไม่ ในแปดสัปดาห์ เราผ่านจาก GLM-5.2 ใต้ MIT ไปสู่ GLM-5.3 ใต้สัญญาอนุญาตเฉพาะพร้อมการตรวจสอบความปลอดภัยตามดุลพินิจ และจาก MIT ดัดแปลงของ Kimi K2 ไปสู่เงื่อนไขที่กั้นด้วยรายได้ของ K3 ถ้า GLM-6 และ K4 เข้มงวดขึ้นอีก “โอเพนเวต” จะกลายเป็นคำโฆษณามากกว่าหมวดหมู่ที่มีความหมาย การที่ GLM-5.3-Flash ยังคงเป็น MIT คือสัญญาณสวนทางที่ควรจับตา
ว่าแล็บอื่นจะนำรูปแบบการปล่อยเป็นขั้น ๆ ของ Z.ai ไปใช้หรือไม่ การหน่วงสองสัปดาห์พร้อมเหตุผลด้านความปลอดภัยที่เผยแพร่เป็นบรรทัดฐานใหม่ ถ้ามันคงอยู่ ก็เป็นบรรทัดฐานที่ดี ถ้ามันกลายเป็นเหตุผลให้ปล่อยเวตช้าลงเรื่อย ๆ นั่นคือทางลาดเอียงไปสู่การไม่ปล่อยเลย
การทำซ้ำอย่างเป็นอิสระต่อข้ออ้างเรื่องความสามารถด้านไซเบอร์ ช่องโหว่ 2,436 รายการใน 269 โปรเจกต์เป็นตัวเลขที่น่าทึ่ง และเป็นการรายงานเองทั้งหมด ต้องมีคนที่เป็นกลางตรวจสอบ เพราะถ้าแม่นยำ มันเปลี่ยนกรอบการถกเถียงเรื่องความปลอดภัยของโอเพนเวตทั้งหมด และถ้าไม่ใช่ มันก็เป็นการตลาดที่ได้ผล
อัตราต่อโทเคนของ Ollama ในอีกหกเดือนข้างหน้า $20 สำหรับการใช้งาน $60 เป็นท่าทีเปิดตัวที่ดุดันจากบริษัทที่ระดมทุนได้ 88 ล้านดอลลาร์ในเดือนกรกฎาคม การที่ตัวคูณเหล่านั้นจะอยู่รอดเมื่อเจอเศรษฐศาสตร์ต่อหน่วยจริงหรือไม่ คือตัวแปรใหญ่ที่สุดในข้อเสนอ “โมเดลเปิดราคาถูก” สำหรับทีมเล็ก
ว่าโมเดลในเครื่องจะไล่ทันในระดับ 30B หรือไม่ Qwen3.8-27B ที่ 61.7% บน SWE-bench บน 24 GB คือผลลัพธ์ที่ถูกพูดถึงน้อยที่สุดของปี ระดับแนวหน้าได้พาดหัวข่าว แต่ระดับ 24 GB คือสิ่งที่เปลี่ยนว่าธุรกิจธรรมดาทำอะไรได้บ้างโดยไม่ต้องมี API key
คำถามที่พบบ่อย
Kimi K3 เป็นโอเพนซอร์สจริงหรือ? ไม่ใช่ เวตของ Kimi K3 ดาวน์โหลดได้ฟรีจาก Hugging Face แต่ภายใต้ “Kimi K3 License” ที่กำหนดเอง ไม่ใช่สัญญาอนุญาตโอเพนซอร์สที่ OSI รับรอง ผู้ให้บริการ Model-as-a-Service ที่มีรายได้รวมเกิน 20 ล้านดอลลาร์ในช่วง 12 เดือนติดต่อกันใด ๆ ต้องเจรจาข้อตกลงเชิงพาณิชย์แยกกับ Moonshot และผลิตภัณฑ์ที่มีผู้ใช้ต่อเดือนเกิน 100 ล้านคนหรือรายได้ต่อเดือนเกิน 20 ล้านดอลลาร์ต้องแสดง “Kimi K3” ในอินเทอร์เฟซ การใช้ภายในองค์กรล้วน ๆ ไม่มีข้อจำกัด
GLM-5.3 ดีกว่า Kimi K3 หรือไม่? ทั้งสองเสมอกันในทางปฏิบัติบนดัชนีรวมแบบเป็นกลาง — 59.5 ต่อ 59.7 บน Artificial Analysis GLM-5.3 ถูกกว่าต่องานเอเจนต์ 2.2 เท่า และได้คะแนนสูงกว่าในงานความรู้ (GDPval-AA v2: 1,769 ต่อ 1,687) Kimi K3 รองรับมัลติโมดัลในตัว นำด้านการท่องเว็บแบบเอเจนต์ (BrowseComp 91.2) และได้ที่หนึ่งใน frontend code arena ของ Arena.AI เลือก GLM-5.3 เพื่อต้นทุนและการเขียนโค้ดจากข้อความ เลือก Kimi K3 เพื่อความสามารถด้านภาพ การท่องเว็บ และการวิจัยระยะยาว
โมเดลเปิดถูกกว่า Claude Fable 5.1 แค่ไหน? ในงานเอเจนต์ 60 รอบตามแบบจำลอง GLM-5.3 มีต้นทุนประมาณ $1.85 เทียบกับ $11.94 ของ Fable 5.1 — ถูกกว่าประมาณ 6.5 เท่า Kimi K3 มีต้นทุนประมาณ $4.07 ถูกกว่าประมาณ 2.9 เท่า GLM-5.3-Flash มีต้นทุนประมาณ $0.21 ถูกกว่าประมาณ 58 เท่า ถ้ารัน 80 ครั้งต่อเดือน นั่นคือ $148 เทียบกับ $955
ผมรัน Kimi K3 หรือ GLM-5.3 ในเครื่องได้ไหม? ไม่ได้บนฮาร์ดแวร์ผู้ใช้ทั่วไป Kimi K3 มีขนาดประมาณ 1.5 TB แม้ในรูปแบบ MXFP4 ดั้งเดิม และ Moonshot แนะนำ accelerator 64 ตัวขึ้นไป GLM-5.3 ต้องใช้อย่างน้อย 8×H200 (1,128 GB) ที่ FP8 สำหรับการรันในเครื่องจริง ๆ ให้ดู Qwen3.8-27B (24 GB ที่ Q4), gpt-oss:20b (16 GB) หรือ Gemma 4 E4B (~6 GB)
Claude Fable 5.1 เปลี่ยนอะไรบ้าง? เปิดตัว 1 กันยายน 2026 การอ่านแคชลดลง 75% จาก $1.00 เหลือ $0.25 ต่อล้านโทเคน ทำให้ภาระงานทั่วไปถูกลงประมาณ 25% และภาระงานแบบเอเจนต์ถูกลงถึง 45% ส่วนอินพุตและเอาต์พุตยังอยู่ที่ $10/$50 Terminal-Bench 4.0 เพิ่มจาก 42.0% เป็น 55.8%, Terminal-Bench-Science จาก 24.7% เป็น 52.6%, AutomationBench จาก 17.1% เป็น 31.4% การเปลี่ยนแปลงที่ทำให้ของเดิมพังสามข้อส่งผลต่อการบังคับใช้เครื่องมือ การพาบล็อกการคิดข้ามรุ่น และการแก้ประวัติ
ราคาใหม่ของ Ollama คืออะไร? ตั้งแต่ 31 สิงหาคม 2026 แพ็กเกจ Pro, Max และ Team ใช้ราคาตามจำนวนโทเคนพร้อมเครดิตที่รวมมาให้: Pro $20/เดือน สำหรับการใช้งานมูลค่า $60, Max $100 สำหรับ $300, Team $500 สำหรับ $1,000 ที่แชร์ได้ไม่จำกัดจำนวนผู้ใช้ เพดาน 5 ชั่วโมงและรายสัปดาห์ถูกยกเลิกทั้งหมด ไม่มีค่าบริการ เครดิตไม่สามารถยกยอดไปใช้ต่อ และทุกแพ็กเกจไม่มีการเก็บข้อมูลเลย โดยโฮสต์อยู่ในสหรัฐอเมริกาและยุโรป
โมเดลใดในนี้ใช้สัญญาอนุญาต MIT จริง ๆ? มีเพียง GLM-5.3-Flash — โมเดลแยกต่างหากขนาด 320B/18B ที่รองรับมัลติโมดัลในตัว เปิดตัว 26 สิงหาคม 2026 ได้ 57.5 บนดัชนี Artificial Analysis ที่ $0.15/$0.50 ต่อล้านโทเคน GLM-5.3 และ Kimi K3 ต่างใช้สัญญาอนุญาตเฉพาะที่กั้นด้วยรายได้ ส่วน Claude Fable 5.1 เป็นกรรมสิทธิ์ปิดทั้งหมด
ทำไมผมเปรียบเทียบโมเดลเหล่านี้บน Terminal-Bench ไม่ได้? เพราะแต่ละตัวถูกประเมินบนเวอร์ชันที่ต่างกัน 88.3 ของ Kimi K3 อยู่บน Terminal-Bench 2.1, 28.3 ของ GLM-5.3 อยู่บน 3.0 และ 55.8 ของ Fable 5.1 อยู่บน 4.0 แต่ละเวอร์ชันยากขึ้นมากกว่ารุ่นก่อน ดังนั้นตัวเลขไม่ได้อยู่ในมาตราเดียวกัน เปรียบเทียบภายในเวอร์ชันเดียวกันเท่านั้น ตัวอย่างเช่น บน Terminal-Bench 2.1 Kimi K3 ได้ 88.3 เทียบกับ 88.0 ของ Claude Fable 5, 88.8 ของ GPT-5.6 Sol และ 84.3 ของ GLM-5.3-Flash — การเปรียบเทียบนั้นใช้ได้ และเป็นอันที่ควรอ้างอิง
ควรใช้ Ollama หรือต่อตรงกับผู้ให้บริการเองดี ใช้ Ollama หากคุณต้องการการเรียกเก็บเงินรายเดียว พื้นผิว API เดียว สลับโมเดลได้ง่าย และโฮสติ้งใน EU/US ที่ไม่เก็บข้อมูลเลย — อัตราต่อโทเคนของมันใกล้เคียงกับราคาจากเจ้าของโมเดลมาก ต่อตรงหากคุณต้องการฟีเจอร์จากเจ้าของโมเดล เช่นของ Z.ai’ reasoning_effort การควบคุมอย่างเต็มรูปแบบ SLA จากผู้ขาย หรือแผนการสมัครสมาชิกอย่าง GLM Coding Plan หลายทีมใช้ทั้งสองทางและเลือกเส้นทางตามลักษณะงาน
GLM-5.3 รองรับรูปภาพหรือไม่ ไม่ GLM-5.3 รองรับข้อความเท่านั้น GLM-5.3-Flash — โมเดลที่แตกต่างไปคนละตัวแม้ชื่อจะคล้ายกัน — เป็นมัลติโหมดโดยกำเนิดและรองรับอินพุตทั้งข้อความ รูปภาพ วิดีโอ และไฟล์ การส่งรูปภาพไปยัง ID โมเดลผิดคือความผิดพลาดช่วงแรกที่พบบ่อยที่สุดกับตระกูล GLM
บทสรุป
สิบสองเดือนก่อน คำถามเรื่องโอเพนเวตคือโมเดลเหล่านี้ใช้งานได้หรือไม่ หกเดือนก่อนคือแข่งขันได้หรือไม่ ในกันยายน 2026 คำถามกลายเป็นเรื่องจริงจังว่า คุณยังจ่ายเงินพรีเมียมให้โมเดลปิดอยู่เพื่ออะไร
คำถามนั้นมีคำตอบจริง และมันแคบกว่าเมื่อก่อน Claude Fable 5.1 นำในงานเอเจนต์ต่อเนื่องที่ยากที่สุด งานความรู้ทั่วไป และการดีบักประเภทที่โมเดลต้องถือปัญหาที่วุ่นวายไว้ในหัวเป็นชั่วโมงโดยไม่หลุด การลดค่าอ่านแคช 75% ของ Anthropic ตั้งเป้าที่ภาระงานนั้นพอดี หากต้นทุนความผิดพลาดของคุณสูงกว่าต้นทุนโทเคน พรีเมียมนั้นก็สมเหตุสมผล
สำหรับอย่างอื่น ตัวเลขได้ขยับไปแล้ว GLM-5.3 ให้คะแนนดัชนี 94% ของ Claude Opus 5 ในต้นทุน 29% Kimi K3 ได้ 88.3 บน Terminal-Bench 2.1 เทียบกับ 88.0 ของ Claude Fable 5 ในเวอร์ชันเดียวกัน และคว้าอันดับหนึ่งบน Frontend Code Arena ของ LMArena เหนือโมเดลปิดระดับเรือธงทั้งสองตัว Ollama จะขายโทเคนให้คุณ $60 ในราคา $20 และยกเลิกเพดานการใช้งานไปด้วย การผสมแบบนั้นไม่มีอยู่ในช่วงฤดูใบไม้ผลิ
แต่อย่าให้ความตื่นเต้นทำให้ข้ามตัวอักษรตัวเล็กไป เพราะมีอยู่สองข้อและทั้งสองข้อสำคัญ
ข้อแรกคือสัญญาอนุญาต “โอเพนเวต” กับ “โอเพนซอร์ส” เลิกมีความหมายเดียวกันไปอย่างเงียบ ๆ แล้ว Kimi K3 และ GLM-5.3 ต่างออกภายใต้สัญญาอนุญาตเฉพาะกิจที่กั้นด้วยรายได้ ประตูนั้นสูงพอที่ผู้อ่านส่วนใหญ่จะไม่ได้รับผลกระทบ — แต่ “ผู้อ่านส่วนใหญ่ไม่ได้รับผลกระทบ” ไม่เหมือนกับ “ไม่มีข้อจำกัด,” และข้อกำหนดการตรวจสอบความปลอดภัยที่ไม่ได้นิยามของ GLM-5.3 ก็เป็นความเสี่ยงด้านการจัดซื้อจริงสำหรับองค์กรขนาดใหญ่ GLM-5.3-Flash ภายใต้ MIT คือตัวเลือกสุดท้ายที่อนุญาตเต็มรูปแบบและใกล้เคียงชายแดน ซึ่งเป็นเหตุผลพอดีที่มันควรได้รับความสนใจมากกว่าที่เป็นอยู่
ข้อที่สองคือการโฮสต์เองส่วนใหญ่เป็นเพียงความฝัน น้ำหนักโมเดล 1.5 TB กับตัวเร่ง 64 ตัวไม่ใช่แผนถอนตัวสำหรับธุรกิจขนาดกลาง สิ่งที่โอเพนเวตซื้อให้คุณในระดับนี้คือตลาดการอนุมานที่แข่งขันได้ ความโปร่งใสด้านราคา การปักหมุดเวอร์ชัน การเลือกเขตอำนาจศาล และจุดยืนในการเจรจา สิ่งเหล่านี้มีค่ามหาศาล แต่ไม่เหมือนกับการรันมันในห้องใต้ดินของคุณ
ชุดที่ผมจะสร้างจริง ๆ คือ GLM-5.3 เป็นค่าเริ่มต้น, Fable 5.1 สำหรับการวางแผนและปัญหาที่ยากจริง, Kimi K3 สำหรับงานภาพและการวิจัยระยะยาว, GLM-5.3-Flash สำหรับงานหยาบ และโมเดลโลคัล 27B สำหรับอะไรก็ตามที่ห้ามออกจากอาคารเด็ดขาด เลือกเส้นทางตามลักษณะงาน ไม่ใช่ตามความภักดี เขียนคอนฟิกของคุณให้ ID โมเดลเปลี่ยนได้ในบรรทัดเดียว
เพราะการคาดการณ์เดียวที่ผมมั่นใจคือบทความนี้จะต้องอัปเดตก่อนคริสต์มาส
คุณรันหนึ่งในสามตัวนี้ในโปรดักชันอยู่หรือไม่ ผมสนใจเป็นพิเศษว่าความเยิ่นเย้อของ GLM-5.3 จะกลายเป็นปัญหาต้นทุนจริงในระดับสเกลหรือไม่ และมีใครเอาสัญญาอนุญาต Kimi K3 ไปให้ที่ปรึกษากฎหมายดูแล้วได้ความชัดเจนเรื่องนิยาม MaaS บ้างหรือยัง ติดต่อมาได้ — ยินดีรับคำแก้ไขและหลักฐานโต้แย้ง และบทความนี้จะอัปเดตเมื่อภาพเปลี่ยนไป
อัปเดตล่าสุด: 2 กันยายน 2026


