
 ไทย
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

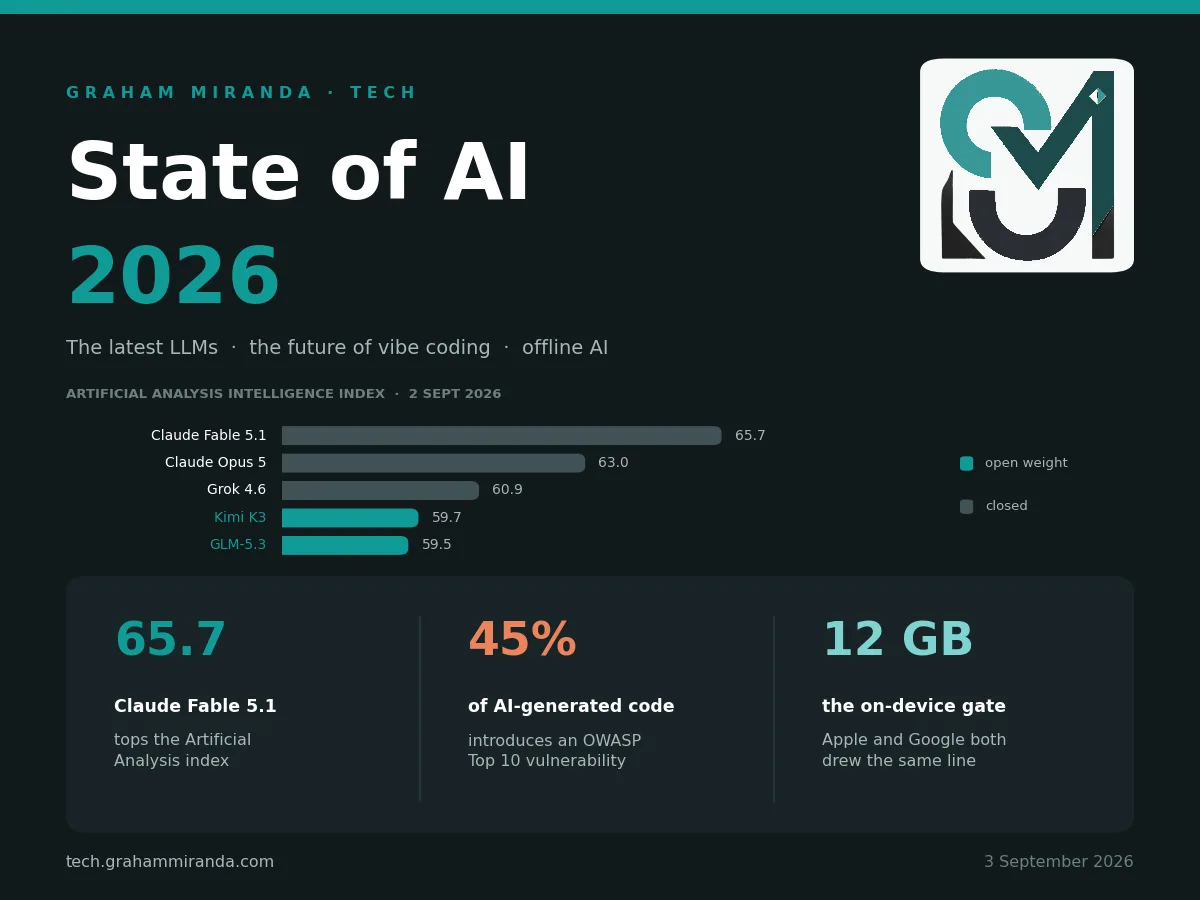
สถานะของ AI ในปี 2026 สรุปได้เป็นสามเรื่องที่เกิดขึ้นในช่วงแปดเดือนแรกของปี — และแทบไม่มีใครพูดทั้งสามเรื่องนี้ในประโยคเดียวกัน
มีโมเดลหนึ่งทำคะแนนเกิน 96% บน SWE-bench Verified ไม่ใช่ 96% บนเบนช์มาร์กเล่น ๆ — แต่เป็น 96% บน issue จริงใน GitHub จาก Django, Flask และ scikit-learn ซึ่งเป็นเบนช์มาร์กที่เคยคาดกันว่าต้องใช้เวลาหลายปี ตอนนี้มันถือว่าจบหน้าที่ในฐานะตัวแยกความสามารถแล้ว และสามโมเดลอันดับต้นถูกคั่นด้วยคะแนนต่างกันไม่ถึงหนึ่งเปอร์เซ็นต์
หลักฐานที่ดีที่สุดเท่าที่มีอยู่เกี่ยวกับคำถามว่าเครื่องมือเขียนโค้ด AI ทำให้นักพัฒนาที่มีประสบการณ์เร็วขึ้นหรือไม่ ยังคงตอบว่าไม่ การทดลองแบบสุ่มที่มีกลุ่มควบคุมของ METR’s พบว่าช้าลง 19% ความพยายามของพวกเขาเองที่จะรันซ้ำในปี 2026 ล้มเหลว เพราะนักพัฒนาปฏิเสธที่จะทำงานโดยไม่มี AI แม้จะได้ค่าตอบแทนชั่วโมงละ $50 คนที่ใช้เครื่องมือเหล่านี้เชื่อว่าตัวเองเร็วขึ้นสามเท่า แต่เมื่อวัดจริงกลับไม่ใช่
และ Microsoft ได้ส่งโมเดลการให้เหตุผลขนาด 1.4 หมื่นล้านพารามิเตอร์เข้าไปอยู่ใน Windows เอง, ซึ่งเป็นประโยคที่จะเป็นนิยายวิทยาศาสตร์ในปี 2024 และตอนนี้กลายเป็นเพียงเชิงอรรถในคีย์โนต Build
ข้อเท็จจริงสามข้อนั้นคือทั้งหมดของ สถานะของ AI 2026 ในภาพย่อ โมเดลกลายเป็นสิ่งที่ไม่ธรรมดา ผลผลิตที่วัดได้กลับไม่ได้เพิ่มตาม และพรมแดนที่น่าสนใจก็ย้ายออกจากศูนย์ข้อมูลไปยังอุปกรณ์ในมือคุณอย่างเงียบ ๆ
นี่คือฉบับยาวของสถานะ AI 2026 เขียนขึ้นสำหรับคนที่ต้องตัดสินใจโดยมีเงินเกี่ยวข้อง — จะเลือกส่งงานไปยังโมเดลไหน จะให้เอเจนต์เขียนโค้ดโปรดักชันหรือไม่ จะซื้ออะไร และจะบอกลูกค้าหรือเจ้าหน้าที่คุ้มครองข้อมูลว่าอย่างไร ผมแยกสิ่งที่วางจำหน่ายจริงออกจากสิ่งที่ได้รับการรายงาน และจากสิ่งที่เป็นข่าวลือ เพราะความผิดพลาดที่แพงที่สุดเพียงเรื่องเดียวในสาขานี้คือการวางแผนโดยอิงโมเดลที่ยังไม่มีอยู่จริง
อัปเดตล่าสุด 3 กันยายน 2026 ต้องอัปเดตอีกครั้งก่อนคริสต์มาส
สรุปย่อ — สถานะ AI 2026 ใน 90 วินาที
พรมแดน AI เป็นการแข่งม้าสี่ตัว และตอนนี้ Anthropic กำลังชนะในภาพรวม ณ วันที่ 2 กันยายน 2026 Artificial Analysis’s Intelligence Index v4.1.1 ให้ Claude Fable 5.1 อยู่ที่ 65.7, Claude Opus 5 ที่ 63.0, Grok 4.6 ที่ 60.9 และ GPT-5.6 Sol ที่ 58.9 แต่ค่าภาพรวมซ่อนส่วนที่น่าสนใจไว้: GPT-5.6 Sol นำ BrowseComp ที่ 90.4%, Gemini 3.8 Flash ทำได้ 58.7 ในราคา $0.75 ต่อล้านโทเคนอินพุต และสิบโมเดลอันดับแรกมีช่วงคะแนนห่างกันเพียง 8.2 คะแนน — ช่วงที่แคบพอจนความแตกต่างของ harness และพรอมต์สามารถเลื่อนโมเดลได้หลายอันดับ
โอเพนเวตตามหลังอยู่ประมาณหนึ่งรุ่นและกำลังไล่ตาม GLM-5.3 (753B, open) อยู่ที่ 59.5 — อันดับหกโดยรวม นำหน้า GPT-5.6 Sol ส่วน DeepSeek V4 Pro เปิดตัวด้วยพารามิเตอร์ 1.6 ล้านล้านภายใต้สัญญาอนุญาต MIT จริง ๆ Ornith-1.5-397B ทำได้ 86 บน SWE-bench Verified และแซง Claude Opus 4.8 บน Terminal-Bench 2.1 ด้วย 86.1 ต่อ 85.0 ช่องว่างด้านความสามารถตอนนี้อยู่ที่ประมาณหกเดือน ช่องว่างด้านสัญญาอนุญาตคือสิ่งที่สำคัญ
“ไวบ์โคดิง” ชนะข้อโต้แย้งเรื่องการนำไปใช้ แต่แพ้ข้อโต้แย้งด้านหลักฐาน 90% ของนักพัฒนาใช้เครื่องมือเขียนโค้ด AI อย่างน้อยหนึ่งตัวในการทำงาน ตลาดเอเจนต์เขียนโค้ดระดับองค์กรมีมูลค่าประมาณ 1 หมื่นล้านดอลลาร์ต่อปี และความไว้วางใจของนักพัฒนาต่อผลลัพธ์จาก AI ลดลงจาก 40% เหลือ 29% ในสองปี เครื่องมือกลายเป็นเรื่องสากล และคนที่ใช้มันก็ไว้วางใจน้อยลงทุกปี ทั้งสองเรื่องนั้นสมเหตุสมผล
บิลด้านความปลอดภัยมาถึงแล้ว และแจกแจงเป็นรายการ Veracode พบว่า 45% ของตัวอย่างโค้ดที่สร้างโดย AI นำช่องโหว่ใน OWASP Top 10 เข้ามา Apiiro วัดได้ว่านักพัฒนาที่ใช้ AI ช่วยสร้าง commit เร็วขึ้นสามถึงสี่เท่า และพบปัญหาความปลอดภัยเร็วขึ้นสิบเท่า ประมาณ 20% ของโค้ดที่สร้างโดย AI อ้างถึงแพ็กเกจที่ไม่มีอยู่จริง นี่ไม่ใช่ข้อโต้แย้งต่อเครื่องมือเหล่านี้ แต่เป็นข้อโต้แย้งว่าเราควรวางด่านตรวจไว้ตรงไหน
AI ออฟไลน์กลายเป็นประโยชน์จริง ๆ ในปีนี้ บนฮาร์ดแวร์ที่ผู้คนมีอยู่แล้ว โมเดลขนาด 2 พันล้านพารามิเตอร์ทำงานที่ 61 โทเคนต่อวินาทีบน iPhone Microsoft ใส่โมเดลให้เหตุผลขนาด 14B ไว้ใน Windows โดยมีข้อกำหนด NPU 40 TOPS Google จำกัดโมเดลบนอุปกรณ์ที่ดีที่สุดไว้ที่ RAM 12 GB และ Apple ก็เช่นกัน สเปกที่กำหนดว่าคุณรันอะไรได้แบบออฟไลน์คือหน่วยความจำ ไม่ใช่พลังประมวลผล และหน่วยความจำคือสิ่งที่ขาดแคลน
ประโยคเดียวที่ตรงไปตรงมาเกี่ยวกับสถานะ AI 2026: นี่คือปีที่โมเดลหยุดเป็นคอขวด การตรวจสอบกลายเป็นคอขวด การตัดสินใจสำคัญทุกอย่างในบทความนี้ — จะใช้โมเดลไหน harness ไหน อุปกรณ์ไหน ด่านไหน — ล้วนเป็นผลสืบเนื่องจากการเปลี่ยนแปลงครั้งนั้น
เปรียบเทียบเร็ว: พรมแดน AI กันยายน 2026
Artificial Analysis Intelligence Index v4.1.1 รวมการประเมินเก้าชุด: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience และ AA-LCR คะแนนด้านล่างเป็นภาพ ณ วันที่ 2 กันยายน 2026
| รุ่น | แล็บ | ดัชนี AA | น้ำหนัก | อินพุต / เอาต์พุตต่อ 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | โมเดลปิด | $10.00 / $50.00 |
| Claude Opus 5 | Anthropic | 63.0 | โมเดลปิด | $5.00 / $25.00 |
| Claude Fable 5 | Anthropic | 62.1 | โมเดลปิด | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | โมเดลปิด | — |
| Kimi K3 | Moonshot | 59.7 | โอเพนเวต | — |
| GLM-5.3 | Z.ai | 59.5 | โอเพนเวต | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | โมเดลปิด | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | โมเดลปิด | $0.75 / $3.75 | |
| Qwen3.8 Max Preview | Alibaba | 58.1 | โมเดลปิด | — |
| GLM-5.3-Flash | Z.ai | 57.5 | โอเพนเวต | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropic | 57.3 | โมเดลปิด | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | โมเดลปิด | — |
| GPT-5.5 | OpenAI | 56.3 | โมเดลปิด | — |
อ่านคอลัมน์ที่สี่ก่อนคอลัมน์ที่สาม สองในสิบโมเดลอันดับแรกมีน้ำหนักที่ดาวน์โหลดได้, และหนึ่งในนั้นมีราคา $0.15 ต่อล้านโทเคนอินพุต
เปรียบเทียบเร็ว: พรมแดนโอเพนเวต
| รุ่น | ทั้งหมด / ใช้งานจริง | บริบท | สัญญาอนุญาต | เปิดตัว |
|---|---|---|---|---|
| Kimi K3 | 2.8T / 104B | 1M | แบ่งตามรายได้ (กำหนดเอง) | กรกฎาคม 2026 |
| Qwen3.8-2.4T-A95B | 2.4T / 95B | 262K (1M ผ่าน YaRN) | Apache 2.0 | 14 สิงหาคม 2026 |
| DeepSeek V4 Pro | 1.6T / 49B | 1M | MIT | 12 สิงหาคม 2026 |
| GLM-5.3 | 753B / ~40B | 1M | กำหนดเอง (เกณฑ์ $10B) | สิงหาคม 2026 |
| MiniMax M3 | 428B / 23B | 1M | กำหนดเอง (ระบุที่มา) | 1 มิถุนายน 2026 |
| Ornith-1.5-397B | 397B MoE | 262K (1M ผ่าน YaRN) | MIT | สิงหาคม 2026 |
| Gemma 4 31B | 31B แบบ dense | 256K | Apache 2.0 | 6 เมษายน 2026 |
| Qwen3.8-27B | 27B dense | 262K | Apache 2.0 | 14 สิงหาคม 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 เมษายน 2026 |
สามในเก้านั้นมีสัญญาอนุญาตที่ผ่านเกณฑ์ OSI อย่างแท้จริง นั่นคือเรื่องจริงของโอเพนเวตในปี 2026 และผมจะกลับมาพูดถึงในภาคสาม
ภาคหนึ่ง — โมเดล
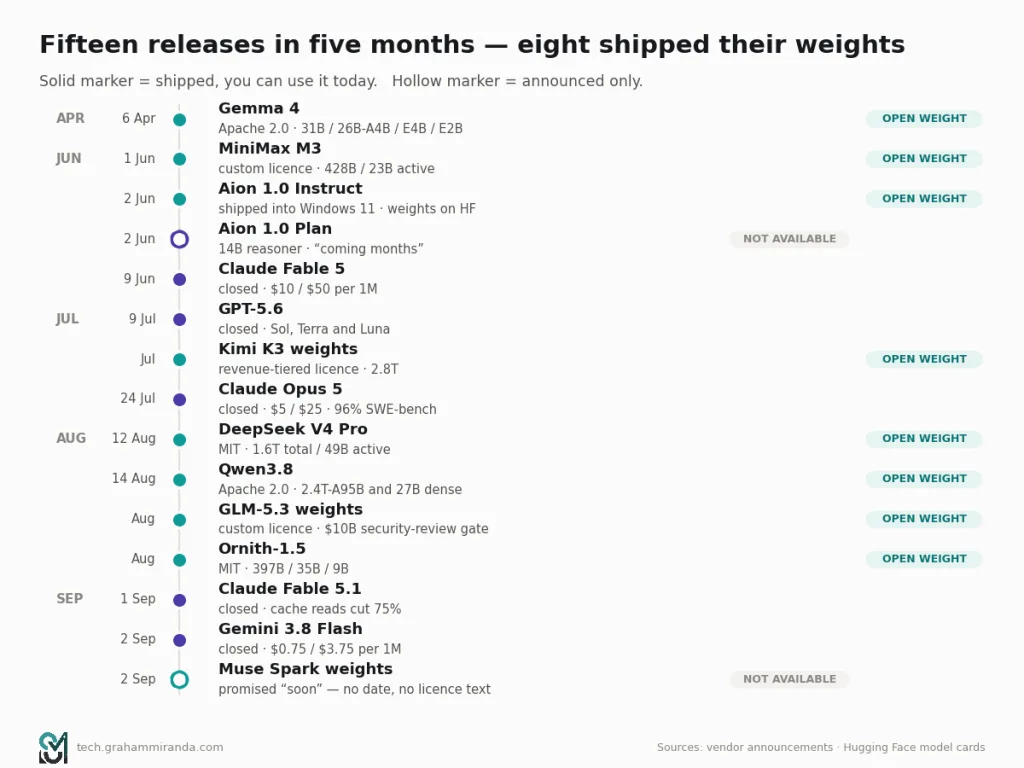
ตอนที่หนึ่ง: สิ่งที่เปิดตัวจริงในปี 2026
ก่อนจะโต้แย้งอะไร นี่คือบัญชี ผมแบ่งเป็นสามชั้น เพราะความแตกต่างระหว่างชั้นเหล่านั้นคือจุดที่เงินรั่วไหล
ยืนยันแล้วและกำลังส่งมอบ
- 6 เมษายน 2026 — Google เปิดตัว Gemma 4 ภายใต้ Apache 2.0 ซึ่งเป็นการเปลี่ยนสัญญาอนุญาตจากเงื่อนไขเฉพาะของ Gemma 3’s มีสี่รุ่น: 31B dense, 26B ที่มี 4B ใช้งานจริง (MoE), E4B ที่ประมาณ 8B และ E2B ที่รวม 5.1B โดยใช้งานจริง 2.3B บริบท 256K บนโมเดลใหญ่ และ 128K บนซีรีส์ E ทั้งหมดรองรับอินพุตข้อความ รูปภาพ และวิดีโอ ส่วน E2B และ E4B เพิ่มเสียงแบบเนทีฟ
- 1 มิถุนายน 2026 — MiniMax M3 428B ทั้งหมด / 23B ใช้งานจริง บริบท 1M มัลติโมดัลแบบเนทีฟ ตัวดำเนินการ attention แบบ sparse ใหม่ น้ำหนักอยู่บน Hugging Face ครอบคลุมเชิงลึกใน บทความก่อนหน้านี้ของผมเกี่ยวกับฮาร์ดแวร์ AI ภายในเครื่อง.
- 2 มิถุนายน 2026 — Microsoft ประกาศ Aion 1.0 ที่งาน Build ตระกูลโมเดลบนอุปกรณ์ที่ส่งเข้าไปใน Windows 11 เอง: Aion 1.0 Instruct (ใช้ CPU ได้ อยู่ใน Edge Canary ตั้งแต่ 150.0.4070) และ Aion 1.0 Plan ซึ่งเป็นโมเดลให้เหตุผลและเรียกใช้เครื่องมือขนาด 1.4 หมื่นล้านพารามิเตอร์พร้อมหน้าต่างบริบท 32K
- 9 มิถุนายน 2026 — Claude Fable 5 ระดับสูงสุดของ Anthropic’s ที่ $10/$50 ต่อล้าน บริบท 1M เอาต์พุตสูงสุด 128K
- 9 กรกฎาคม 2026 — OpenAI เปิดตัว GPT-5.6 ในสามรุ่น: Sol ($5/$30), Terra ($2.50/$15) และ Luna ($1/$6) ความสามารถด้านไซเบอร์ถูกสร้างไว้ใน Sol แทนที่จะขายเป็นโมเดลแยก พร้อมการเข้าถึงเพิ่มเติมผ่านโครงการ Trusted Access for Cyber ของ OpenAI’s
- กรกฎาคม 2026 — Moonshot เปิดน้ำหนักของ Kimi K3’s พารามิเตอร์ 2.8 ล้านล้าน บริบท 1M MXFP4 แบบเนทีฟ ภายใต้สัญญาอนุญาตแบบแบ่งชั้นตามรายได้
- 24 กรกฎาคม 2026 — Claude Opus 5 ราคา $5/$25 ไม่เปลี่ยนแปลงจาก Opus 4.8 ส่วน Anthropic อ้างว่ามัน “เพิ่มประสิทธิภาพของ Opus 4.8’s มากกว่าสองเท่า” บน Frontier-Bench v0.1 และทำคะแนนได้สามเท่าของโมเดลที่ดีที่สุดรองลงมาบน ARC-AGI 3
- 12 สิงหาคม 2026 — DeepSeek V4 Pro ออกจากโหมดพรีวิว พร้อมน้ำหนักภายใต้สัญญาอนุญาต MIT: 1.6T ทั้งหมด (บางรายงานปัดเป็น 1.7T), 49B ใช้งานจริง, บริบท 1M, เทนเซอร์ BF16 และ FP8 ขนาด 893 GB พร้อมโมดูลถอดรหัสแบบคาดเดา DSpark ส่วน Terminal-Bench 2.1 อยู่ที่ 87.9, HLE-with-tools ที่ 60.0 และ CyberGym ที่ 83.3 DeepSeek ขึ้นราคา API ในเวลาเดียวกัน
- 14 สิงหาคม 2026 — น้ำหนักเปิดของ Qwen3.8 ภายใต้ Apache 2.0: โมเดลมัลติโมดัลแบบ dense ขนาด 27B และยักษ์ 2.4T-A95B ทั้งคู่อยู่บน Hugging Face และ ModelScope บริบทเนทีฟ 262K ขยายได้ถึง 1M ด้วย YaRN
- สิงหาคม 2026 — น้ำหนัก GLM-5.3 ขึ้น Hugging Face ประมาณสองสัปดาห์หลังเปิด API 753B MoE บริบท 1M เอาต์พุต 128K BF16 และ FP8
- สิงหาคม 2026 — Ornith-1.5 สามขนาด (397B MoE, 35B MoE ที่ใช้งานจริง 3B, 9B dense) สร้างบน Qwen3.5 และ Gemma 4 ด้วยการฝึกเพิ่มเติมต่อเนื่อง ใช้สัญญาอนุญาต MIT และอ้างว่าทำได้ 86 บน SWE-bench Verified
- 1 กันยายน 2026 — Claude Fable 5.1 และ Mythos 5.1 เปิดการใช้ความคิดแบบปรับได้เป็นค่าเริ่มต้น บริบท 1M เอาต์พุต 128K ราคาพื้นฐานไม่เปลี่ยนที่ $10/$50 แต่การอ่านแคชลดลง 75% จาก $1.00 เหลือ $0.25 ต่อล้าน
- 2 กันยายน 2026 — Gemini 3.8 Flash ที่ $0.75/$3.75 บริบทอินพุต 1M เอาต์พุต 66K ความรู้ถึงมีนาคม 2026 พร้อมอินพุตข้อความ รูปภาพ วิดีโอ เสียง และ PDF
- 2 กันยายน 2026 — Meta เปิดตัว Muse Spark 1.3 และ Muse Code CLI
มีรายงาน น่าเชื่อถือ แต่ยังไม่ยืนยัน
- Meta จะเปิดน้ำหนักของ Muse Spark’s “เร็ว ๆ นี้” นั่นคือ Mark Zuckerberg บน X โดยไม่มีวันที่ ไม่มีจำนวนพารามิเตอร์ ไม่มีรายละเอียดสถาปัตยกรรม และไม่มีข้อความสัญญาอนุญาต Meta ไม่ได้เปิดเผยขนาดของโมเดล’s ในทุกรุ่น
- Gemini Nano v4 ถูกอธิบายว่ากำลังจะมาใน Android โดย Nano v3 ปัจจุบันจำกัดอยู่ที่ซีรีส์ Pixel 10
- Aion 1.0 Plan มีกำหนด “อีกไม่กี่เดือน” สำหรับการเปิดให้ใช้ทั่วไป มีเพียง Instruct ที่อยู่ในพรีวิว
ข่าวลือ แหล่งเดียว ควรรับฟังตามนั้น
- ทุกสิ่งที่คุณอ่านเกี่ยวกับเรือธงลำถัดไปของ Anthropic, OpenAI หรือ Google ในตลาดที่สี่แล็บเปิดตัวโมเดลติดสิบอันดับภายในเก้าสัปดาห์ ข่าวลือไปข้างหน้ามีครึ่งชีวิตประมาณสองสัปดาห์
อีกเรื่องที่ควรระบุไว้ เพราะมันใหม่และแทบไม่มีใครนอกวงความปลอดภัยพูดถึง Claude Mythos 5.1 ทำได้ 60.9 บน Terminal-Bench 4.0 — สูงกว่า 55.8 ของ Fable 5.1 — และ 95.5% บน SWE-bench Verified คุณซื้อมันไม่ได้
Anthropic อธิบาย Mythos ว่าเป็น “โมเดลที่ความสามารถสูงสุดสำหรับการวิจัยไซเบอร์ซีเคียวริตี้และชีววิทยา” และมีให้เฉพาะนักป้องกันไซเบอร์และนักวิทยาศาสตร์ชีวภาพที่ผ่านการตรวจสอบ ผ่านสองโครงการเข้าถึงแบบเชื่อถือได้: Cyber Verification Program และ Life Sciences Verification Program ถ้อยคำของ Anthropic’s เองคือพวกเขา “สามารถให้บริการได้เฉพาะกับองค์กรในสหรัฐฯ ชุดหนึ่ง แม้เรา’กำลังพยายามขยายการเข้าถึง” Project Glasswing ความพยายามขยายการเข้าถึง ได้ไปถึงประมาณ 150 องค์กรในกว่าสิบห้าประเทศ ณ เดือนมิถุนายน 2026
เหตุผลคือมันใช้ได้สองทาง — โมเดลที่เก่งในการหาช่องโหว่ก็เก่งในการหาช่องโหว่ให้ทั้งสองฝ่าย — และผมคิดว่ามันป้องกันได้ แต่สังเกตผลเชิงโครงสร้าง เพราะมันใหม่จริง ๆ: โมเดลที่คะแนนสูงสุดบนเบนช์มาร์กเขียนโค้ดสาธารณะตอนนี้คือโมเดลที่คนส่วนใหญ่ของโลกเข้าถึงไม่ได้ไม่ว่าจะจ่ายเท่าไร การจำกัดความสามารถด้วยเหตุผลด้านความปลอดภัยแทนเหตุผลเชิงพาณิชย์จะกลายเป็นเรื่องปกติมากขึ้น ไม่ใช่น้อยลง และถ้าคุณอยู่นอกสหรัฐฯ นี่เป็นเหตุผลให้ใส่ใจโอเพนเวตที่ไม่เกี่ยวกับต้นทุนเลย
แสดงรูปภาพ เก้าเดือน การเปิดตัวสำคัญสิบสองรายการ สี่รายการเป็นโอเพนเวต แท่งทึบคือเปิดตัวพร้อมน้ำหนักหรือ API ที่ซื้อได้วันนี้ เส้นประคือประกาศแล้วแต่ยังไม่มีให้ใช้
ตอนที่สอง: อะไรแยกโมเดลพรมแดนออกจากกันจริง ๆ ตอนนี้
ความจริงที่ไม่สบายใจเกี่ยวกับหัวตารางอันดับนั้นคือ: ในงานส่วนใหญ่ที่คุณจะทำจริง แปดโมเดลอันดับแรกใช้แทนกันได้
ผมไม่ได้พูดแบบนี้เพื่อให้ขัดกับคนอื่น ผมพูดเพราะช่องว่างดัชนีรวมระหว่าง Claude Fable 5.1 ที่ 65.7 กับ GLM-5.3-Flash ที่ 57.5 คือแปดคะแนน และ GLM-5.3-Flash ราคา $0.15 ต่อล้านโทเคนอินพุต เทียบกับ $10.00 ของ Fable’s นั่นคือ ส่วนต่างราคา 67 เท่าสำหรับส่วนต่างความสามารถ 12% บนคะแนนรวม, และคะแนนรวมบีบอัดความแตกต่างที่มีความหมายกับคุณพอดี ขณะที่ขยายความแตกต่างที่ไม่มี
ดังนั้นคำถามที่มีประโยชน์ไม่ใช่ “โมเดลไหนดีที่สุด” แต่เป็น “แต่ละตัวเก่งจริง ๆ เรื่องอะไร และสิ่งนั้นทับซ้อนกับสัปดาห์ทำงานของผมหรือไม่”
สี่สิ่งที่แตกต่างกันจริง ๆ
1. ความน่าเชื่อถือของเอเจนต์ในงานระยะยาว นี่คือตัวแยกความแตกต่างจริงของปี 2026 และมันถูกวัดได้แย่มาก Opus 5 ของ Anthropic ถูกวางตำแหน่งชัดเจนว่าเป็น “การปรับปรุงครั้งใหญ่สำหรับระดับ Opus ที่ขับเคลื่อนเอเจนต์ทำงานยาวนาน” — ไม่ใช่โมเดลที่ฉลาดกว่า แต่เป็นโมเดลที่ไม่ล้มตอนชั่วโมงที่หก หลักฐานสำหรับการปรับปรุงประเภทนี้อยู่ในเบนช์มาร์กเชิงเอเจนต์ (Terminal-Bench, OSWorld, Frontier-Bench) มากกว่าในเบนช์มาร์กความรู้ และเบนช์มาร์กเหล่านั้นยังเด็ก มีสัญญาณรบกวน และไวต่อโครงสร้างทดสอบ
2. เศรษฐศาสตร์ของแคช การเปลี่ยนแปลงพาดหัวของ Fable 5.1’s ไม่ใช่การกระโดดของความสามารถ แต่คือการลดการอ่านแคชลง 75% จาก $1.00 เหลือ $0.25 ต่อล้านโทเคน — ซึ่ง MarkTechPost ประเมินว่าลดต้นทุนได้ประมาณ 25% สำหรับเวิร์กโฟลว์ทั่วไป และสูงถึง 45% สำหรับงานเอเจนต์ สำหรับเอเจนต์ใดก็ตามที่อ่านพรอมต์ระบบหรือโค้ดเบสขนาดใหญ่ซ้ำทุกเทิร์น ราคาแคชเป็นคันโยกที่ใหญ่กว่าการเลือกโมเดลต่อบิลรายเดือนของคุณ ไม่มีใครเอาสิ่งนั้นขึ้นตารางอันดับ
3. การท่องเว็บและการใช้เครื่องมือ GPT-5.6 Sol ทำได้ 90.4% บน BrowseComp — 92.2% ที่การตั้งค่าการให้เหตุผลระดับ Ultra นั่นคือจุดแข็งที่เฉพาะเจาะจงและเปิดเผยแล้ว และถ้างานของคุณคือการวิจัยและสังเคราะห์มากกว่าเขียนโค้ดและตรวจสอบ มันมีค่ามากกว่าดัชนีรวมสองคะแนน
4. ราคาต่อคำตอบที่เพียงพอ Gemini 3.8 Flash ที่ดัชนี 58.7 ในราคาอินพุต $0.75 เป็นสิ่งที่ตั้งราคาผิดชัดที่สุดบนกระดานเมื่อเทียบกับพรมแดนแบบปิด GLM-5.3-Flash ที่ 57.5 ในราคา $0.15 คือสิ่งที่ตั้งราคาผิดชัดที่สุดอย่างไม่ต้องเถียง
ตารางราคา เพราะนั่นคือการตัดสินใจจริง
| รุ่น | อินพุต /1M | เอาต์พุต /1M | อินพุตแคช /1M | บริบท |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M / เอาต์พุต 128K |
| Claude Opus 5 | $5.00 | $25.00 | — | 1M / เอาต์พุต 128K |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1M / เอาต์พุต 128K |
| GLM-5.3 | $1.40 | $4.40 | — | 1M / เอาต์พุต 128K |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1M / 66K ขาออก |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1M |
| Muse Spark (Contributors) | $0.10 | $0.20 | $0.002 | — |
แถวสุดท้ายนั้นควรค่าแก่การมองอีกครั้ง ระดับ Contributors ของ Meta’s อยู่ที่ $0.10 ขาเข้า และ $0.20 ขาออก — พร้อมการเข้าถึงข้อมูลของคุณเพื่อใช้ฝึกโมเดล นั่นไม่ใช่ราคา มันคือการแลกเปลี่ยน และเท่าที่ผมดูออก นี่คือการเปิดเผยรูปแบบธุรกิจจริงที่อยู่ใต้การอนุมานราคาถูกจำนวนมากอย่างตรงไปตรงมาที่สุด และผมยอมให้มันเขียนอยู่ในตารางราคามากกว่าจะถูกซุกไว้ใน DPA
แสดงรูปภาพ ความฉลาดบนแกนหนึ่ง ราคาแบบลอการิทึมบนอีกแกน ห่างกันแปดคะแนนดัชนีระหว่างบนสุดกับล่างสุดของกราฟ แต่ราคาห่างกัน 67 เท่า พรมแดนประสิทธิภาพอยู่ที่มุมขวาล่าง และแทบไม่มีใครซื้อตรงนั้น
การเปลี่ยนแปลง API ที่ไม่มีใครเตือนคุณ
Fable 5.1 เปิดตัวพร้อมการเปลี่ยนแปลงที่ทำให้ของเดิมพังสามอย่าง: การบังคับใช้เครื่องมือหายไปแล้ว บล็อกความคิดตอนนี้จำเพาะต่อรุ่น และการแก้ไขข้อความระบบหรือเครื่องมือกลางบทสนทนาตอนนี้ทำให้เกิดข้อผิดพลาดแทนที่จะถูกยอมรับเงียบ ๆ
ข้อที่สามจะกัดคนจำนวนมาก agent harness จำนวนมากแก้ไข system prompt หรือรายการเครื่องมือระหว่างเทิร์น — เพิ่มเครื่องมือเมื่อเริ่มงานย่อย ตัดคำสั่งเพื่อประหยัดบริบท บน Fable 5.1 ตอนนี้นั่นคือข้อผิดพลาด ถ้าคุณอัปเกรด model ID ในไฟล์ config แล้วเอเจนต์ของคุณเริ่มโยน 400 ในเทิร์นที่สี่ นั่นคือสาเหตุ
บทเรียนทั่วไป ซึ่งมีค่ามากกว่าบทเรียนเฉพาะ: ในปี 2026 การอัปเกรดโมเดลคือการย้าย API เขียน model ID ของคุณให้การสลับรุ่นเป็นการแก้บรรทัดเดียว และปักหมุดไว้ คุณจะต้องเปลี่ยนอีกครั้งภายในไตรมาสเดียว
ภาคสาม: พรมแดนโอเพนเวต และกับดักใบอนุญาต
นี่คือส่วนของเรื่องราวปี 2026 ที่ผมรู้สึกตื่นเต้นจริง ๆ และเป็นส่วนที่การตลาดทำให้เข้าใจผิดมากที่สุดด้วย
ช่องว่างด้านความสามารถอยู่ที่ประมาณหกเดือน
ดูสิ่งที่โอเพนเวตทำได้ระหว่างมิถุนายนถึงสิงหาคม 2026:
- DeepSeek V4 Pro: รวม 1.6T, แอ็กทีฟ 49B, สัญญาอนุญาต MIT, Terminal-Bench 2.1 ที่ 87.9 นั่นเป็นตัวเลข Terminal-Bench ที่สูงกว่าที่โมเดลปิดส่วนใหญ่ประกาศในปีนี้
- Ornith-1.5-397B: 86 บน SWE-bench Verified, 86.1 บน Terminal-Bench 2.1 เทียบกับ 85.0 ของ Claude Opus 4.8’s และ 92.8 บน GPQA Diamond ใบอนุญาต MIT บริบทเนทีฟ 262K ขยายได้ถึงประมาณ 1M ด้วย YaRN สร้างต่อยอดบน Qwen3.5 และ Gemma 4 ด้วยการพรีเทรนและการโพสต์เทรนต่อเนื่อง
- GLM-5.3: อันดับหกบนดัชนี Artificial Analysis ที่ 59.5 นำหน้า GPT-5.6 Sol
- Qwen3.8: โมเดล 2.4 ล้านล้านพารามิเตอร์ภายใต้ Apache 2.0 พร้อมรุ่นพี่น้องมัลติโมดัลแบบเดนส์ 27B ที่ Alibaba บอกว่าเอาชนะ Qwen3.7-Plus ที่ใหญ่กว่าได้ในงานเขียนโค้ดและงานสำนักงาน
หกเดือนก่อน กรอบที่ตรงไปตรงมาคือ “โอเพนเวตตามหลังอยู่หนึ่งรุ่นและถูกกว่า” กรอบนั้นตอนนี้ผิดแล้ว กรอบที่ถูกต้องคือ: สำหรับงานเขียนโค้ดและงานเอเจนต์โดยเฉพาะ โมเดลโอเพนเวตที่ดีที่สุดอยู่ในช่วงความคลาดเคลื่อนของพรมแดนโมเดลปิดรุ่นก่อน และถูกกว่า 10 ถึง 60 เท่า
Ornith-1.5 เป็นโมเดลที่น่าสนใจที่สุดของปี และแทบไม่มีใครเคยได้ยินชื่อ
ผมอยากพูดถึงตัวนี้ให้ละเอียด เพราะมันเป็นสิ่งใหม่จริง ๆ ไม่ใช่แค่ผลจากการขยายขนาด
Ornith อธิบายว่า 1.5 ต่อยอด “self-scaffolding ไปสู่วงจรการพัฒนาตนเองแบบครบวงจร” พูดง่าย ๆ คือ ระบบเสนองานฝึกใหม่ของตัวเอง สร้างสแคฟโฟลด์เฉพาะงานสำหรับงานเหล่านั้น สร้างโรลเอาต์ของคำตอบ และปรับทั้งสามอย่างพร้อมกันด้วย GRPO โมเดลที่แข็งแรงกว่าทำให้มันเสนองานที่ยากขึ้นได้ สแคฟโฟลด์ที่ดีกว่าค้นพบกลยุทธ์ที่ดีกว่า และเอาต์พุตที่ดีกว่าให้สัญญาณการเรียนรู้ที่สะอาดกว่า
มันถูกฝึกต่อยอดบน Qwen3.5 และ Gemma 4 — คือบนโอเพนเวตของคนอื่น’s — และเอาชนะ Claude Opus 4.8 บน Terminal-Bench 2.1 ทั้งที่มีพารามิเตอร์ 397B และใช้สัญญาอนุญาต MIT
ถ้าวงจรนั้นใช้ได้ทั่วไป นี่คือผลลัพธ์ที่ส่งผลกว้างที่สุดในบทความนี้, เพราะมันหมายความว่าระบบนิเวศเปิดสามารถพัฒนาได้โดยไม่ต้องมีห้องแล็บใดใช้เงินระดับพรมแดนกับการพรีเทรน ถ้ามันใช้ไม่ได้ทั่วไป — ถ้าสิ่งที่เราเห็นคือการโอเวอร์ฟิตเฉพาะเบนช์มาร์กจากหลักสูตรที่สร้างเอง — มันก็เป็นอุทาหรณ์เกี่ยวกับสิ่งเดียวกันนั้นพอดี ผมไม่รู้ว่าอันไหน จนถึงตอนนี้เท่าที่ผมบอกได้ ก็ไม่มีใครนอก Ornith ที่รู้ สิ่งที่ผมอยากเห็นก่อนจะเดิมพันกับมันคือ การประเมินอิสระบนงานที่ไม่อยู่ในละแวกของหลักสูตรที่สร้างเอง และเส้นฐานมนุษย์ที่เก็บแยกไว้ต่างหาก ทั้งสองอย่างยังไม่มี
ทีนี้เรื่องสัญญาอนุญาต เพราะ “โอเพนซอร์ส” กำลังทำงานที่ไม่ซื่อตรงหลายอย่าง
นี่คือสิ่งที่น้ำหนักเหล่านั้นทำให้คุณต้องแบกรับในแง่พันธะจริง ๆ:
| รุ่น | สัญญาอนุญาต | ข้อแม้ |
|---|---|---|
| DeepSeek V4 Pro | MIT | ไม่มีเลย โอเพนซอร์สจริง ๆ |
| Qwen3.8 | Apache 2.0 | ไม่มีเลย โอเพนซอร์สจริง ๆ |
| Gemma 4 | Apache 2.0 | ไม่มี — และเป็นการปรับปรุงจริงจากข้อกำหนดเฉพาะของ Gemma 3’s |
| Ornith-1.5 | MIT | ไม่ระบุ ตรวจสอบ model card ด้วยตัวเองก่อนนำไปใช้จริง |
| GLM-5.3 | Custom | บริษัทที่มีรายได้เกิน รายได้ต่อปี $10B ต้องผ่าน Z.ai’s การตรวจสอบความปลอดภัย ก่อนการใช้งานเชิงพาณิชย์ใด ๆ Z.ai ย้าย ออกไป จาก MIT ในรุ่นนี้ |
| Kimi K3 | Custom | แบ่งตามระดับรายได้; ผู้ให้บริการปริมาณสูงต้องแสดงเครดิตอย่างเด่นชัด |
| MiniMax M3 | Custom | การใช้เชิงพาณิชย์ต้องแสดงเครดิต “Built with MiniMax M3” อย่างเด่นชัด; ต้องมีหนังสืออนุญาตแยกต่างหากเมื่อเกิน $20M รายได้ต่อปี |
| Muse Spark | ไม่ทราบ | ประกาศว่า “เร็ว ๆ นี้” ยังไม่มีข้อความสัญญาอนุญาต |
ข้อสังเกตสามข้อ ผมไล่ตัวอักษรเล็ก ๆ ของสามตัวแรกอย่างละเอียดใน Kimi K3 เทียบ Fable 5.1 เทียบ GLM-5.3, ดังนั้นตรงนี้ผมจะพูดถึงเฉพาะสิ่งที่เปลี่ยนไปนับจากนั้น
ข้อแรก ประตูเหล่านั้นเล็งไปที่บริษัทไฮเปอร์สเกล ไม่ได้เล็งมาที่คุณ เกณฑ์รายได้ $10 พันล้านกันผู้อ่านบทความนี้แทบทุกคนออกไป ถ้าคุณเป็นธุรกิจ Mittelstand ของเยอรมัน เอเจนซี ที่ปรึกษา หรือนักพัฒนาคนเดียว คำตอบในทางปฏิบัติสำหรับ GLM-5.3 และ Kimi K3 คือ: คุณไม่เป็นไร
ข้อสอง “คุณไม่เป็นไร” ไม่เหมือนกับ “การตรวจสอบทางกฎหมายของคุณไม่เป็นไร” สัญญาอนุญาตเฉพาะกิจหมายความว่ามีคนเก็บเงินคุณเพื่ออ่านมัน สัญญา MIT หรือ Apache 2.0 หมายความว่ามีคนอ่านเก้าสิบวินาทีแล้วไปต่อ สำหรับการจัดซื้อในองค์กร ความต่างนั้นมีค่ามากกว่าสี่คะแนนเบนช์มาร์ก และเป็นข้อโต้แย้งที่แข็งแรงที่สุดเพียงข้อเดียวที่สนับสนุน DeepSeek V4 Pro และ Qwen3.8 เหนือ GLM-5.3 ในผลิตภัณฑ์เชิงพาณิชย์
ข้อสาม จับตาทิศทางการเคลื่อนไป Z.ai เปลี่ยนจาก MIT บน GLM-5.2 มาเป็นสัญญาอนุญาตแบบกรรมสิทธิ์พร้อมประตูตรวจสอบความปลอดภัยบน GLM-5.3 DeepSeek ไปอีกทางและคง MIT ไว้พร้อมขึ้นราคา API — ซึ่งเป็นกลยุทธ์ที่สอดคล้องกัน: เก็บเงินกับความสะดวก ให้โมเดลไปฟรี และปล่อยให้ผู้ให้บริการการอนุมานแข่งขันกันด้านการให้บริการ โอเพนเวตไม่ใช่ขบวนการเคลื่อนไหว มันเป็นกลยุทธ์เชิงพาณิชย์ และกลยุทธ์เปลี่ยนทุกรุ่นที่ออก อย่าสร้างสถาปัตยกรรมผลิตภัณฑ์ที่ตั้งสมมติฐานว่าเวอร์ชันปีหน้าจะใช้สัญญาอนุญาตของปีนี้
คำว่า “โอเพนซอร์ส” ควรเลิกใช้กับโมเดล
ไม่มีตัวไหนในนี้เป็นโอเพนซอร์สในความหมายที่ OSI หมายถึง ยกเว้นตัวที่ใช้ MIT และ Apache 2.0 — และแม้แต่พวกนั้นก็ปล่อยน้ำหนักโดยไม่ปล่อยข้อมูลฝึกหรือโค้ดฝึก ซึ่งเป็นสิ่งที่ต่างจากซอฟต์แวร์โอเพนซอร์สอย่างมีนัยสำคัญ
คำศัพท์ที่ผมใช้ และอยากแนะนำ:
- โอเพนเวต — คุณดาวน์โหลดและรันพารามิเตอร์ได้ ไม่ได้บอกอะไรเกี่ยวกับข้อกำหนด
- มีสัญญาอนุญาตเปิด — MIT, Apache 2.0 หรือเทียบเท่า ไม่มีเกณฑ์รายได้ ไม่มีข้อบังคับการแสดงเครดิต ไม่มีข้อจำกัดขอบเขตการใช้งาน
- โอเพนซอร์ส — น้ำหนัก โค้ดฝึก และองค์ประกอบข้อมูล ภายใต้สัญญาอนุญาตที่ OSI รับรอง แทบไม่มีอะไรที่พรมแดนเข้าเกณฑ์นี้
ถ้าผู้ขายพูดว่า “โมเดลโอเพนซอร์ส” และหมายถึงอย่างแรก นั่นไม่ใช่การโกหกเสียทีเดียว แต่มันเป็นความคลุมเครือแบบที่ไปจบในเอกสารจัดซื้อแล้วก็กลายเป็นข้อพิพาท
แสดงรูปภาพ ความสามารถกำลังบรรจบกัน สัญญาอนุญาตกำลังแยกจากกัน สำหรับผู้ซื้อเชิงพาณิชย์ส่วนใหญ่ คอลัมน์ขวามือคือคอลัมน์ที่ตัดสินการซื้อ ไม่ใช่คะแนน
ภาคสี่: ปัญหาเบนช์มาร์ก
ตอนนี้ SWE-bench Verified หน้าตาเป็นแบบนี้:
| อันดับ | รุ่น | คะแนน |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
สามโมเดลห่างกันไม่ถึงหนึ่งเปอร์เซ็นต์ี่หัวตาราง เบนช์มาร์กนั้นจบแล้ว มันบอกอะไรที่เป็นประโยชน์เกี่ยวกับความต่างระหว่าง Opus 5, Mythos 5 และ Fable 5 ไม่ได้ และใครก็ตามที่อ้างมันเป็นข้อมูลประกอบการซื้อในเดือนกันยายน 2026 กำลังอ้างเครื่องมือที่อิ่มตัวแล้ว
นี่คือสภาพทั่วไปของการประเมิน AI ตอนนี้ และมีโหมดล้มเหลวสี่แบบที่ควรเอ่ยถึง:
ความอิ่มตัว เมื่อคะแนนสูงสุดกระจุกอยู่เหนือ 90% ความต่างที่เหลือถูกครอบงำด้วยสัญญาณรบกวนของเลเบลและรายละเอียดของ harness มากกว่าความสามารถ SWE-bench Verified ถึงจุดนั้นแล้ว GPQA Diamond ใกล้แล้ว
ความอ่อนไหวต่อสแคฟโฟลด์ โมเดลเดียวกันได้คะแนนต่างกันขึ้นอยู่กับลูปเอเจนต์ที่ห่อหุ้มมัน — นโยบายลองใหม่ ชุดเครื่องมือ การจัดการบริบท จำนวนเทิร์นที่ได้ ผล Terminal-Bench และ OSWorld อ่อนไหวต่อสิ่งนี้เป็นพิเศษ สองห้องแล็บที่รายงานเบนช์มาร์กเดียวกันบ่อยครั้งไม่ได้ทำการทดลองเดียวกัน
การปนเปื้อน เบนช์มาร์กสาธารณะทุกรายสุดท้ายก็รั่วเข้าคลังข้อมูลฝึก คำตอบคือการแข่งสะสมเบนช์มาร์กใหม่กว่า ยากกว่า และเป็นส่วนตัว — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science — ซึ่งแก้ปัญหาการปนเปื้อนและสร้างปัญหาใหม่: คุณตรวจสอบเบนช์มาร์กส่วนตัวโดยอิสระไม่ได้
การคัดเลือก ห้องแล็บเผยแพร่เบนช์มาร์กที่ตัวเองชนะ Anthropic นำด้วย Frontier-Bench และ ARC-AGI-3 สำหรับ Opus 5 OpenAI นำด้วย Agents’ Last Exam และ Coding Agent Index สำหรับ GPT-5.6 Z.ai นำด้วย CyberGym ไม่มีใครโกหก ทุกคนกำลังเลือก
สิ่งที่ผมเชื่อถือจริง ๆ ในเดือนกันยายน 2026
ภาพรวมดีกว่าตัวเดียว ดัชนี Artificial Analysis’s มีคุณสมบัติที่ดีคือดำเนินการโดยบุคคลที่สาม บน harness คงที่ ครอบคลุมการประเมินเก้าชุด บน 190 โมเดล ตัวเลขสัมบูรณ์ของมันไม่มีความหมายมากนัก ส่วน การจัดอันดับ คือสัญญาณสาธารณะที่ปกป้องได้มากที่สุดเท่าที่มีอยู่
ผลลัพธ์ที่ปรับตามต้นทุน คำกล่าวอ้างของ Anthropic’s เองเกี่ยวกับ Opus 5 เป็นตัวอย่างที่ดีของการรายงานแบบนี้: “ห่างจากคะแนนสูงสุดของ Fable 5’s ไม่เกิน 0.5% ด้วยต้นทุนครึ่งเดียว” บน CursorBench 3.2 และเอาชนะ Fable 5 บน OSWorld 2.0 “ด้วยต้นทุนหนึ่งในสาม” นั่นเป็นการกล่าวอ้างที่มีประโยชน์เพราะมันระบุการแลกเปลี่ยนออกมา
ประสิทธิภาพของโทเคน Artificial Analysis ตั้งข้อสังเกตว่า Gemma 4 31B ใช้เพียง 39 ล้านโทเคนเอาต์พุตในการทำ Intelligence Index ทั้งชุดให้เสร็จ สำหรับงานเอเจนต์ โมเดลที่ได้คำตอบเดียวกันด้วยโทเคนหนึ่งในสามคือบิลหนึ่งในสามและความหน่วงหนึ่งในสาม นี่ถูกรายงานน้อยเกินไป และเป็นหนึ่งในไม่กี่ตัวชี้วัดที่แปลงเป็นเงินได้โดยตรง
การประเมินของคุณเอง ยี่สิบงานจาก backlog จริงของคุณ รันกับสามโมเดล ให้คะแนนโดยคุณ ใช้เวลาบ่ายเดียว มันจะบอกคุณได้มากกว่าทุกกระดานอันดับในบทความนี้รวมกัน และเป็นการประเมินเดียวที่นิยามได้ว่าไม่มีการปนเปื้อนอย่างแน่นอน
และมีสิ่งหนึ่งที่ผมไม่เชื่อถือ: ตัวเลขโทเคนต่อวินาทีหรือตัวเลขเบนช์มาร์กใด ๆ ที่อ้างโดยไม่มี harness ไม่ระบุการควอนไทซ์ และไม่มีวันที่ ให้ถือว่าสิ่งเหล่านั้นเป็นการอ้างระดับขนาดคร่าว ๆ
ภาคห้า: ตัวเลขที่ขยับจริง — ขอบเวลาแบบเอเจนต์
ถ้าคุณจะเอาตัวชี้วัดจากบทความนี้ไปเพียงตัวเดียว เอาตัวนี้
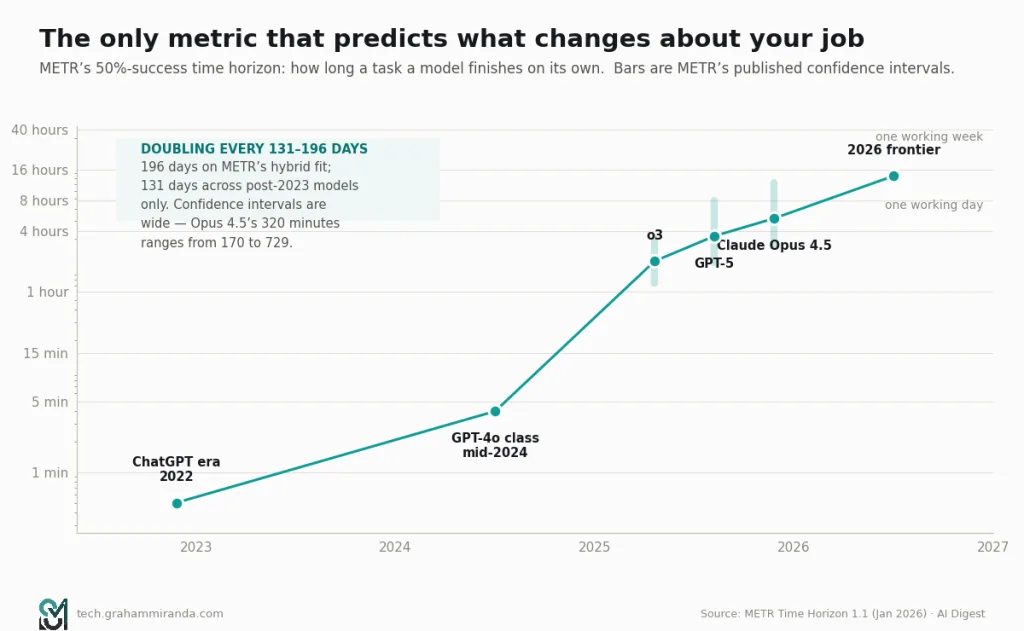
METR วัดความยาวของงาน — เป็นชั่วโมงการทำงานของมนุษย์ — ที่โมเดลทำได้เองโดยสำเร็จ 50% มันเป็นตัวแทนที่ดีกว่าสำหรับคำถาม “สิ่งนี้ทำงานของผมได้ไหม” กว่าเบนช์มาร์กความรู้ใด ๆ เพราะมันจับสิ่งที่ล้มเหลวจริงในทางปฏิบัติ: ไม่ใช่การไม่รู้คำตอบ แต่คือการคงความสอดคล้องได้นานพอจะไปถึงคำตอบ
เส้นทางการเปลี่ยนแปลง จากงานของ METR’s เองและการติดตามของ AI Digest’s:
| ช่วงเวลา | ขอบเวลาที่สำเร็จ 50% |
|---|---|
| 2022 (ยุคเปิดตัว ChatGPT) | ~30 วินาที |
| กลางปี 2024 (ระดับ GPT-4o) | ~4 นาที |
| ปลายปี 2025 (Claude Opus 4.5) | 320 นาที (~5.3 ชั่วโมง), CI [170, 729] |
| พรมแดนปี 2026 | 14+ ชั่วโมง |
เวลาที่ใช้ในการเพิ่มเป็นสองเท่าคือส่วนที่ยังโต้แย้งกัน การเปิดตัว Time Horizon 1.1 ของ METR’s เมื่อ 29 มกราคม 2026 — 228 งาน โดย 31 งานประเมินว่าต้องใช้แรงงานมนุษย์แปดชั่วโมงขึ้นไป ย้ายมาอยู่บนกรอบ Inspect ของ UK AI Security Institute’s — รายงานว่า 196 วัน (7 เดือน) บนข้อมูลผสมระหว่างเก่าและใหม่ แต่ 131 วัน เมื่อจำกัดเฉพาะโมเดลหลังปี 2023 ซึ่งเร็วกว่าประมาณ 20% เมื่อเทียบกับ 165 วันที่ระเบียบวิธีเดิมให้ไว้
การคาดการณ์ต่อจากเส้นโค้งเลขชี้กำลังคือวิธีที่คนทำให้ตัวเองขายหน้า ผมจึงขอเตือนข้อแม้ให้ดัง ๆ ก่อนจะใช้ตัวเลขนั้น
ข้อแม้นั้นใหญ่หลวง ช่วงความเชื่อมั่นของ METR’s เองกว้างมหาศาล — ขอบเวลา 320 นาทีของ Opus 4.5’s มีช่วงตั้งแต่ 170 ถึง 729 นาที มีเพียง 5 จาก 31 งานยาวของพวกเขาที่มีเส้นฐานมนุษย์ที่วัดไว้ ส่วนที่เหลือเป็นการประเมิน องค์ประกอบของงานเปลี่ยนแนวโน้มที่วัดได้ และ “สำเร็จ 50% บนงานที่กำหนดชัดเจนในสภาพแวดล้อมสะอาด” ห่างไกลจาก “สำเร็จ 50% บนโค้ดเบสของคุณกับชุดทดสอบที่ขึ้น ๆ ลง ๆ และกระบวนการดีพลอยที่ไม่มีเอกสารของคุณ”
แม้จะพูดอย่างนั้นทั้งหมด, ทิศทางไม่ต้องสงสัยและขนาดก็ประมาณถูกต้อง ตามการคาดการณ์ต่อ เอเจนต์ระดับพรมแดนจะทำความยาวงานอัตโนมัติได้ราวหนึ่งวันทำการในปี 2027 และราวหนึ่งสัปดาห์ทำการในปี 2028
ทำไมตัวเลขนี้จึงสำคัญ
เพราะ มันเป็นตัวชี้วัดเดียวที่ทำนายว่าอะไรจะเปลี่ยนไปในงานของคุณ
โมเดลที่มีขอบเวลา 4 นาทีคือออโตคอมพลีต คุณอยู่ในลูปตลอดเวลา และคุณภาพของโมเดลกำหนดว่าคำแนะนำดีแค่ไหน
โมเดลที่มีขอบเวลา 5 ชั่วโมงคือเพื่อนร่วมงานที่คุณบรีฟตอนเช้าและรีวิวตอนเที่ยง คุณไม่ได้อยู่ในลูป คุณอยู่ปลายลูป คุณภาพของโมเดลกำหนดว่าการรีวิวจะเจ็บปวดบ่อยแค่ไหน
โมเดลที่มีขอบเวลา 40 ชั่วโมงเป็นสิ่งที่เรายังไม่มีโครงสร้างการจัดการรองรับ คุณจะต้องรีวิวงานทั้งสัปดาห์ที่คุณไม่ได้เห็นมันเกิดขึ้น ในโค้ดเบสที่เปลี่ยนไปตอนคุณไม่ได้มอง เทียบกับสเปกที่คุณเขียนไว้ก่อนรู้ว่าปัญหาคืออะไร
ทุกข้อโต้แย้งในส่วนที่เหลือของบทความนี้ — เกี่ยวกับไวบ์โคดิง เกี่ยวกับการตรวจสอบยืนยัน เกี่ยวกับว่าคอขวดอยู่ตรงไหน — จริง ๆ แล้วเป็นข้อโต้แย้งเกี่ยวกับสิ่งที่จะเกิดขึ้นเมื่อตัวเลขนั้นสูงขึ้น โมเดลมีขอบเขตยาวขึ้นแล้ว กระบวนการรีวิวของเราไม่ได้เป็นเช่นนั้น
แสดงรูปภาพ ขอบเวลาที่ประสบความสำเร็จ 50% พร้อมช่วงความเชื่อมั่นของ METR’s ที่แสดงอย่างตรงไปตรงมา ช่วงนั้นกว้างพอที่จะมีนัยสำคัญ — และแนวโน้มก็ยังอยู่รอดแม้มีช่วงกว้างนั้น
องก์ที่สอง — อนาคตของไวบ์โคดิง
ภาคหก: “ไวบ์โคดิง” หมายถึงอะไรตอนนี้
Andrej Karpathy บัญญัติคำนี้ในเดือนกุมภาพันธ์ 2025 เพื่ออธิบายบางสิ่งที่เฉพาะเจาะจงและแอบซุกซนเล็กน้อย: ยอมปล่อยตามฟีล ลืมไปว่าโค้ดมีอยู่ ยอมรับดิฟโดยไม่อ่าน และปล่อยให้โมเดลขับเคลื่อน มันเป็นการบรรยาย โหมด, ที่เสนอแบบครึ่งเล่นครึ่งจริง สำหรับโปรเจกต์สุดสัปดาห์ที่ใช้แล้วทิ้ง
สิบแปดเดือนต่อมา วลีนี้ผ่านวงจรชีวิตมาครบแล้ว มันกลายเป็นขบวนการเคลื่อนไหว แล้วเป็นชื่อตำแหน่งงาน แล้วเป็นคำดูถูก แล้วเป็นคำแห่งปีของ Collins แล้วเป็นหมวดหมู่ของการระดมทุน และตอนนี้ — ในพัฒนาการเดียวที่สำคัญจริง ๆ — มันกลายเป็นชุดแนวปฏิบัติทางวิศวกรรมที่ไม่เหมือนสิ่งที่ Karpathy บรรยายไว้อีกต่อไป
ผมอยากแยกให้ชัด เพราะสองสิ่งนี้ถูกรวมเข้าด้วยกันตลอด และมีโปรไฟล์ความเสี่ยงตรงกันข้าม
ไวบ์โคดิง ในความหมายเดิม พรอมต์ ยอมรับ รัน พรอมต์อีกครั้ง ไม่อ่านดิฟ ชิ้นงานใช้แล้วทิ้งได้ นี่ดีจริง ๆ และผมทำสัปดาห์ละหลายครั้ง — สำหรับสคริปต์ที่จัดรูป CSV ใหม่ สแครปเปอร์ใช้ครั้งเดียว วิชวลไลเซชันที่ผมจะดูครั้งเดียว หรือต้นแบบที่มีหน้าที่เดียวคือทำให้บทสนทนาเป็นรูปธรรม คุณสมบัติที่นิยามมันไม่ใช่ความเร็ว แต่คือจะไม่มีใครต้องพึ่งมันเลย
วิศวกรรมแบบเอเจนต์ ในความหมายปัจจุบัน เขียนสเปก ให้ชุดทดสอบ ตัวตรวจ lint ตัวตรวจชนิด และแซนด์บ็อกซ์แก่เอเจนต์ ปล่อยให้มันรันหนึ่งชั่วโมง รีวิวดิฟอย่างจริงจัง รวมโค้ดผ่านประตูเดียวกันกับ PR ของมนุษย์ คุณสมบัติที่นิยามมันคือเอาต์พุตของโมเดลถูกมองเป็นเอาต์พุตของเพื่อนร่วมงานระดับจูเนียร์ — มีประโยชน์ เร็ว และไม่ไว้วางใจ
สองสิ่งนี้ใช้เทคโนโลยีร่วมกันและแทบไม่มีอะไรอื่นร่วมกันเลย ถ้าคุณต้องการฉบับระดับผู้ปฏิบัติของอย่างที่สอง นั่นคือสิ่งที่ บทความก่อนหน้าของผมเกี่ยวกับไวบ์โคดิงในปี 2026 พูดถึง; ส่วนนี้พูดถึงว่าการปฏิบัติกำลังมุ่งไปทางไหน ผลลัพธ์หายนะในภาคแปดล้วนมาจากการนำแนวปฏิบัติของโหมดแรกไปใช้กับเดิมพันของโหมดที่สอง
ตัวเลขการนำไปใช้มหาศาลและส่วนใหญ่ไม่มีการโต้แย้ง
- นักพัฒนา 90% ใช้เครื่องมือ AI อย่างน้อยหนึ่งตัวในการทำงาน จากแบบสำรวจ AI Pulse ของ JetBrains’ (มกราคม 2026) แบบสำรวจปี 2025 ของ Stack Overflow’s พบว่า 84% ใช้หรือวางแผนจะใช้
- นักพัฒนา GitHub ใหม่เกือบ 80% เริ่มใช้ Copilot ภายในสัปดาห์แรก (GitHub Octoverse 2025)
- นักพัฒนา 59% ใช้เครื่องมือเขียนโค้ด AI สามตัวขึ้นไปพร้อมกัน สถิตินั้นบอกคุณได้มากกว่าตัวเลขการนำไปใช้ — ตลาดไม่ได้รวมตัวกัน แต่แตกออกเป็นเครื่องมือเฉพาะงาน
ตัวเลขตลาด
| เครื่องมือ | เมตริก | แหล่งที่มา / วันที่ |
|---|---|---|
| GitHub Copilot | ส่วนแบ่ง ~42% ตามฐานผู้ใช้; ผู้ใช้ 20M+ | Gartner / ผู้ขาย, 2026 |
| Cursor | ARR $2B+; ผู้ใช้ที่ใช้งานจริงต่อวัน 1M+; ~20–25% ของตลาดตามรายได้ | รายงานเมื่อกุมภาพันธ์ 2026 |
| Claude Code | run-rate ~$2.5B; 46% “ชอบที่สุด” เทียบกับ 19% ของ Cursor’s | รายงานเมื่อเมษายน 2026 |
| ตลาดเอเจนต์เขียนโค้ดในองค์กร | ~$9.8–11B ต่อปี | Gartner, เมษายน 2026 |
มีสองสิ่งเด่นชัด Copilot มีผู้ใช้และความพึงพอใจต่ำที่สุดในสามอันดับแรก Claude Code มีฐานผู้ติดตั้งเล็กที่สุดและได้รับความนิยมสูงที่สุดอย่างท่วมท้น นั่นคือลายเซ็นของตลาดที่กำลังอยู่กลางการเปลี่ยนผ่าน — ผู้ครองตลาดเดิมชนะด้านการกระจาย ผู้ท้าชิงชนะเวิร์กโฟลว์ และผู้ใช้ยังย้ายไม่เสร็จ
และตัวเลขที่บั่นทอนทั้งหมดนั้น
ความไว้วางใจของนักพัฒนาต่อเอาต์พุต AI ลดจากประมาณ 40% ในปี 2024 เหลือ 29% ในปี 2026 แบบสำรวจแยกของ SonarSource พบว่านักพัฒนา 96% ไม่ได้ไว้วางใจเต็มที่ว่าโค้ดที่ AI สร้างจะทำงานถูกต้อง
ลองคิดดู การใช้งานเพิ่มขึ้น ความไว้วางใจลดลง สองอย่างนี้ไม่ได้ขัดกัน มันคือหน้าตาของการนำเครื่องมือมาใช้อย่างโตเต็มที่ ไม่มีใคร “ไว้วางใจ” เลื่อยโซ่ พวกเขาใช้มันตลอดเวลา ด้วยสองมือ สวมอุปกรณ์ป้องกัน และไม่เคยหันหลังให้มัน
คนที่เข้าใจเครื่องมือเหล่านี้ดีที่สุดคือคนที่ระวังกับมันมากที่สุด นั่นเป็นสัญญาณที่ดี และมันหายไปทั้งหมดจากการตลาดของผู้ขายส่วนใหญ่
ภาคเจ็ด: มันทำให้คุณเร็วขึ้นจริงหรือ? หลักฐานตามจริง
ตรงนี้ผมจะทำผู้อ่านบางคนหลุดไป และผมยอมให้เขาหลุดตรงนี้มากกว่าทำให้เขาเข้าใจผิด
การทดลองแบบสุ่มบอกว่าไม่
METR ทำการศึกษาที่ทุกคนอ้างถึงในเดือนกรกฎาคม 2025: นักพัฒนาโอเพนซอร์สที่มีประสบการณ์ ทำงานบนรีโพของตัวเองที่โตเต็มที่ (1M+ บรรทัด) สุ่มระดับงานว่าจะใช้หรือไม่ใช้เครื่องมือ AI ต้นปี 2025
ผล: ช้ากว่า 19% เมื่อใช้ AI
และข้อค้นพบที่สำคัญกว่าพาดหัว: นักพัฒนาเชื่อว่าพวกเขาทำได้เร็วขึ้นประมาณ 20% พวกเขาประเมินผลของ AI’s ต่อเวลาของตัวเองสูงเกินไปประมาณ 40 เปอร์เซ็นต์
การติดตามผลในปี 2026 ไม่ได้ไขข้อข้องใจ — มันเผยสิ่งที่แย่กว่า
METR พยายามทำการทดลองซ้ำ และในเดือนกุมภาพันธ์ 2026 เผยแพร่บทความที่ตรงไปตรงมาอย่างผิดปกติว่าทำไมการออกแบบจึงพัง
- การรับสมัครล้มเหลว นักพัฒนาปฏิเสธที่จะทำงานโดยไม่มี AI มากขึ้นเรื่อย ๆ แม้จะได้ค่าตอบแทน $50 ต่อชั่วโมง
- การเลือกงานถูกปนเปื้อน นักพัฒนา 30–50% ยอมรับว่าหลีกเลี่ยงงานที่พวกเขาคาดว่า AI จะทำได้ดี ผู้เข้าร่วมคนหนึ่งพูดได้ตรงเป๊ะ: “ผมหลีกเลี่ยงงานแบบที่ AI ทำเสร็จได้ใน 2 ชั่วโมง แต่ผมต้องใช้ 20 ชั่วโมง”
- การจับเวลาใช้ไม่ได้อีกต่อไป เมื่อนักพัฒนาเริ่มรันเอเจนต์หลายตัวพร้อมกัน
ตัวเลขชั่วคราวดิบปี 2026 ของพวกเขาอยู่ระหว่าง −18% ถึง −4% — ยังช้าอยู่ แต่น้อยลงอย่างเห็นได้ชัด — แต่ METR เองอธิบายว่านี่เป็น “หลักฐานที่อ่อนมากเท่านั้น” เมื่อคำนึงถึงอคติจากการเลือก
อ่านข้อที่สองอีกครั้ง เพราะมันเป็นข้อค้นพบที่น่าสนใจที่สุดในวรรณกรรมทั้งหมด และมันถูกฝังอยู่ในหมายเหตุระเบียบวิธี ถ้านักพัฒนาจัดเส้นทางงานที่เป็นมิตรกับ AI อย่างเป็นระบบ ออกไป ออกจากการศึกษาที่วัดประโยชน์ของ AI’s การศึกษาจะประเมินประโยชน์ต่ำไป นอกจากนี้ยังบอกเป็นนัยว่าในชีวิตจริง นักพัฒนาได้จัดเส้นทางอยู่แล้ว — ซึ่งเป็นพฤติกรรมที่ทำให้เครื่องมือมีค่าและทำให้ RCT ทำได้ยากพอดี
แบบสำรวจบอกว่าใช่ มากด้วย และตัวเลขนั้นพองเกินจริง
แบบสำรวจของ METR’s ในเดือนพฤษภาคม 2026 (n=349: วิศวกรซอฟต์แวร์ 87 คน นักวิจัย 71 คน นักวิชาการและนักศึกษาเอก 129 คน ผู้ก่อตั้งและผู้จัดการ 48 คน; ประสบการณ์เขียนโปรแกรมเฉลี่ย 12 ปี’ ใช้เครื่องมือ AI 19 เดือน) ทำอะไรที่ฉลาดอย่างหนึ่ง มันแยก คุณค่า จาก ความเร็ว.
ผู้ตอบมัธยฐานรายงานว่า ตัวคูณความเร็ว 3 เท่า แต่มีเพียง การเปลี่ยนแปลง 1.4–2 เท่าในมูลค่างานของพวกเขา เมื่อมองย้อนกลับ พวกเขาประเมินคุณค่า 1.3 เท่าในเดือนมีนาคม 2025 และคาดการณ์ 2.5 เท่าภายในเดือนมีนาคม 2027
METR ระบุชัดเจนว่ามูลค่าคือตัวเลขที่ผู้ออกแบบแบบสำรวจสนใจจริง และผู้ตอบแบบสำรวจมักคิดในแง่ความเร็วโดยธรรมชาติ ซึ่งเป็นอคติแบบเดียวกับที่ RCT ปี 2025 วัดได้ถึง 40 เปอร์เซ็นต์
สรุปคือ การรายงานตนเองบอกว่า 3 เท่า เมื่อปรับการรายงานตนเองตามสิ่งที่ผู้คนหมายถึงจริงจะได้ 1.4–2 เท่า และการวัดแบบควบคุมได้เพียงครั้งเดียวที่เรามีบอกว่า 0.81 เท่า
ข้อมูลระดับองค์กรบอกว่า “มันขึ้นอยู่กับคุณ ไม่ใช่ที่เครื่องมือ”
รายงานปี 2026 ของ DORA’s (Google Cloud, พฤษภาคม 2026) เป็นสิ่งที่ถูกตีพิมพ์ในปีนี้แล้วมีประโยชน์ที่สุด และมีประโยชน์เพราะมันเลิกเถียงกันเรื่องเครื่องมือ
- ROI ที่จำลองขึ้นในปีแรกของ 39% สำหรับองค์กรวิศวกรรมขนาด 500 คน โดยมีระยะคืนทุนประมาณ 8 เดือน — มูลค่า 11.6 ล้านดอลลาร์ เทียบกับการลงทุน 8.4 ล้านดอลลาร์
- A เส้นโค้ง J: ผลผลิตลดลงก่อนจะเพิ่มขึ้น จากแรงขับของการปรับตัวของเวิร์กโฟลว์ ต้นทุนการตรวจสอบจากการรีวิวโค้ด และการเปลี่ยนแปลงปลายน้ำในด่านการทดสอบและการอนุมัติ
- อัตราความล้มเหลวของการเปลี่ยนแปลงเพิ่มจาก 5% เป็น 6% หลังการนำมาใช้ ซึ่งคิดเป็นค่าเสียเวลาระบบล่ม 344,000 ดอลลาร์ในการคำนวณตัวอย่างของพวกเขา
- และข้อสรุปหลักคือ: “ผลตอบแทนที่ยิ่งใหญ่ที่สุดจากการลงทุนใน AI ไม่ได้มาจากตัวเครื่องมือ แต่มาจากการให้ความสำคัญเชิงกลยุทธ์กับระบบองค์กรที่เป็นรากฐาน”
ประโยคสุดท้ายนั้นคือฉันทามติของปี 2026 ถ้ามีฉันทามติอยู่จริง AI ขยายสิ่งที่แนวปฏิบัติทางวิศวกรรมของคุณเป็นอยู่แล้วให้ชัดขึ้น การทดสอบที่ดี การรีวิวโค้ดจริง การย้อนกลับที่รวดเร็ว ความเป็นเจ้าของที่ชัดเจน — AI ทำให้องค์กรเหล่านี้เร็วขึ้นอย่างมีความหมาย ส่วนการทดสอบที่อ่อนแอ การรีวิวแบบประทับตราผ่าน การดีพลอยด้วยมือ ความเป็นเจ้าของที่ไม่ชัดเจน — AI ทำให้องค์กรเหล่านี้ล้มเหลวเร็วขึ้นและในปริมาณที่มากขึ้น
จะประสานเรื่องทั้งหมดนี้เข้าด้วยกันอย่างไร
ผมไม่คิดว่าข้อค้นพบเหล่านี้ขัดแย้งกันจริง นี่คือข้อสรุปที่ผมลงเอย และผมยึดมันอย่างหลวม ๆ:
เครื่องมือเขียนโค้ด AI ให้ผลดีมากกับงานที่ไม่คุ้นเคย และขาดทุนเล็กน้อยกับงานที่คุ้นเคยลึกซึ้ง บนโค้ดเบสที่คุณรู้จักดี ในภาษาที่คุณคล่อง ในปัญหาที่คุณเคยแก้มาก่อน คุณเร็วกว่าลูปการรีวิวและแก้ไข บนเฟรมเวิร์กที่ไม่คุ้นเคย ภาษาที่คุณใช้ปีละสองครั้ง โค้ดซ้ำ ๆ โครงทดสอบ การย้ายข้อมูล หรือโค้ดเบสที่คุณไม่ได้เปิดมาสองเดือน โมเดลเปลี่ยนแปลงทุกอย่าง
METR ศึกษานักพัฒนาที่มีประสบการณ์บนรีโพที่โตเต็มที่ของพวกเขาเอง ซึ่งเป็นสถานการณ์เดียวที่คุณจะคาดการณ์ว่าผลตอบแทนจะน้อยที่สุด นั่นไม่ได้ทำให้ข้อค้นพบผิด แต่ทำให้มันเจาะจง และควรทำให้คุณระแวงใครก็ตามที่อ้างมันเป็นคำตัดสินทั่วไป ไม่ว่าจะในทิศทางไหน
ข้อสรุปที่สอง: ผลตอบแทนนั้นมีจริง แต่มันไปตกอยู่ในที่ที่ต่างจากที่ผู้คนมองหา ไม่ใช่ “ฟีเจอร์นี้ใช้เวลาสี่ชั่วโมงแทนที่จะเป็นหกชั่วโมง” แต่เป็นแบบนี้มากกว่า: การย้ายข้อมูลที่ไม่เคยจะได้ความสำคัญกลับถูกทำจนเสร็จ ความครอบคลุมการทดสอบที่จะคงอยู่ที่ 40% ตลอดไปกลับขึ้นไปถึง 75% เอกสารมีอยู่จริง สิ่งเหล่านี้ไม่ปรากฏในการศึกษาเวลาการทำงานให้เสร็จ และมันคือคุณค่าที่แท้จริงเสียส่วนใหญ่
ตอนที่แปด: บิลด้านความปลอดภัยมาถึงแล้ว และมันแจกแจงเป็นรายการ
ถ้าตอนที่เจ็ดทำให้อึดอัด ตอนนี้คือตอนที่คนข้ามไป กรุณาอย่าข้าม
ตัวเลขที่วัดได้
Veracode ทดสอบโมเดลภาษาขนาดใหญ่กว่า 100 ตัวในงานเขียนโค้ด 80 งาน ด้วย Java, Python, C# และ JavaScript:
- 45% ของตัวอย่างโค้ดที่ AI สร้างขึ้นนำมาซึ่งช่องโหว่ใน OWASP Top 10 อัตราการผ่านแทบไม่เปลี่ยนตลอดต้นปี 2026 โมเดลฉลาดขึ้นมากแต่ไม่ได้ปลอดภัยขึ้นเลย
- Java แย่ที่สุดด้วยอัตราความล้มเหลว 72%
- 86% ล้มเหลวในการป้องกัน cross-site scripting ส่วน 88% มีช่องโหว่ต่อ log injection
Apiiro รันเอนจิน Deep Code Analysis ทั่วรีโพขององค์กรใน Fortune 50 ตั้งแต่ธันวาคม 2024 ถึงมิถุนายน 2025:
- นักพัฒนาที่ใช้ AI ช่วยสร้างคอมมิตในอัตรา สามถึงสี่เท่า ของเพื่อนร่วมงาน
- พวกเขาสร้างข้อค้นพบด้านความปลอดภัยในอัตรา สิบเท่า ของอัตราปกติ
- เส้นทางการยกระดับสิทธิ์เพิ่มขึ้น 322% ความบกพร่องในการออกแบบสถาปัตยกรรมเพิ่มขึ้น 153%
USENIX Security 2025 วิเคราะห์ตัวอย่างโค้ดที่ AI สร้างขึ้น 576,000 ตัวอย่าง:
- ราว 20% อ้างถึงแพ็กเกจที่ไม่มีอยู่จริง
- 43% ของชื่อแพ็กเกจที่ถูกสร้างขึ้นแบบหลอน ๆ ปรากฏซ้ำอย่างสม่ำเสมอในพรอมต์ที่คล้ายกัน — ซึ่งเป็นส่วนที่เปลี่ยนบั๊กให้กลายเป็นพื้นผิวการโจมตี การหลอนที่คาดเดาได้คือช่องที่ผู้โจมตีจองล่วงหน้าบน npm หรือ PyPI ได้
Georgia Tech’s Vibe Security Radar ไล่ตาม CVE ย้อนผ่านประวัติ git เพื่อระบุว่าเกิดจากเครื่องมือ AI:
| เดือน (2026) | CVE ที่ระบุได้ |
|---|---|
| มกราคม | 6 |
| กุมภาพันธ์ | 15 |
| มีนาคม | 35 |
ยืนยันแล้วทั้งหมด 74 รายการ โดยนักวิจัยประเมินว่าตัวเลขจริงทั่วทั้งโอเพนซอร์สอยู่ที่ สูงกว่าห้าเท่าถึงสิบเท่า.
RedAccess จัดทำดัชนีราว แอปพลิเคชันที่เขียนแบบไวบ์โคดิงซึ่งเข้าถึงได้สาธารณะ 380,000 รายการ บน Lovable, Base44, Replit และ Netlify ประมาณ 5,000 รายการกำลังรั่วไหลข้อมูลองค์กรหรือข้อมูลส่วนบุคคลที่ละเอียดอ่อน
เหตุการณ์ต่าง ๆ เรียงตามวันที่
| วันที่ | เหตุการณ์ |
|---|---|
| ก.ค. 2025 | Replit AI ลบฐานข้อมูลโปรดักชัน มีบันทึกของผู้บริหาร 1,200 รายการได้รับผลกระทบ และสร้างบัญชีปลอมขึ้น 4,000 บัญชี |
| ก.พ. 2026 | แอป EdTech ที่สร้างด้วย Lovable เปิดเผยบันทึกผู้ใช้ 18,697 รายการ รวมถึงบัญชีนักเรียน 4,538 บัญชี |
| เม.ย. 2026 | ช่องโหว่ BOLA ของ Lovable — ทุกโปรเจกต์ก่อนพฤศจิกายน 2025 เข้าถึงได้ด้วยการเรียก API ห้าครั้ง |
| 26 เม.ย. 2026 | Cursor “ล้างใน 9 วินาที”: ฐานข้อมูลของบริษัทถูกลบพร้อมกับแบ็กอัป |
| 30 เม.ย. 2026 | Gemini CLI ช่องโหว่รันโค้ดจากระยะไกลระดับ CVSS-10 ในเวิร์กโฟลว์ CI แก้ไขแล้ว |
กรณี Amazon ซึ่งผมจะจัดการอย่างระมัดระวัง
คุณคงเห็นเรื่องราวของ Amazon แล้ว เหตุการณ์ระดับ Sev-1 สี่ครั้งระหว่างธันวาคม 2025 ถึงมีนาคม 2026 — AWS Cost Explorer ล่ม 13 ชั่วโมงในจีน เวลาจัดส่งผิดในตะกร้าสินค้าเมื่อ 2 มีนาคม ซึ่งมีรายงานว่ากระทบออร์เดอร์ราว 120,000 รายการ และเหตุการณ์ 6 ชั่วโมงเมื่อ 5 มีนาคม ซึ่งมีรายงานว่าออร์เดอร์ในอเมริกาเหนือลดลง 99%
รายงานจาก Financial Times, Fortune และ The Register เชื่อมโยงเอกสารภายในของ Amazon เข้ากับสิ่งที่ถูกเรียกว่า “การเปลี่ยนแปลงที่ได้รับความช่วยเหลือจาก Gen-AI” พร้อมคำเตือนว่าการสร้างโค้ดอย่างรวดเร็วกำลังเปิดเผยช่องโหว่ Amazon โต้แย้งความสัมพันธ์เชิงเหตุโดยตรง โดยระบุในบางคำตอบว่าไม่มีเหตุการณ์ใดเกี่ยวข้องกับโค้ดที่ AI เขียน
ผมขอยกสามประเด็นเกี่ยวกับเรื่องนี้แทนที่จะเล่าซ้ำเป็นข้อเท็จจริง:
- ตัวเลขผลกระทบที่ถูกอ้างถึงมากที่สุด (ออร์เดอร์ที่หายไป 6.3 ล้านรายการ) ย้อนกลับไปถึงโพสต์บน Medium ไม่ใช่ Amazon และไม่ใช่การรายงานของ outlet’s ที่ระบุชื่อ ให้ถือเป็นประมาณการ ไม่ใช่ตัวเลขจริง
- การดีพลอยเมื่อ 5 มีนาคม มีรายงานว่าออกไป โดยไม่มีเอกสารหรือการอนุมัติอย่างเป็นทางการ. นั่นคือความล้มเหลวของกระบวนการ ความเร็วของ AI ทำให้มัน เป็นไปได้ เกิดขึ้นเร็วขึ้น แต่ไม่ได้ทำให้ด่านการอนุมัติกลายเป็นเรื่องทางเลือก
- ความแตกต่างนั้นคือประเด็นทั้งหมด และเป็นเหตุผลที่ผมเล่าเรื่องนี้ขึ้นมา รูปแบบความล้มเหลวแทบไม่เคยเป็น “AI เขียนโค้ดแย่” แต่เป็น “AI เขียนโค้ดเร็วกว่ากระบวนการที่ควรตรวจสอบมัน”
สิ่งนี้หมายความจริง ๆ ต่อการปฏิบัติ
ไม่ใช่ “เลิกใช้เครื่องมือ” ไม่มีใครที่จริงจังเถียงแบบนั้น และบันทึกวิจัยของ CSA’s เอง ซึ่งรวบรวมข้อมูลส่วนใหญ่ข้างต้น เริ่มต้นด้วยการกำกับดูแล ไม่ใช่การหักดิบเลิกใช้
รูปแบบในทางปฏิบัติ ตามลำดับที่ผมจะลงมือทำ:
- ปฏิบัติกับเครื่องมือ AI ใดก็ตามที่เข้าถึงข้อมูลรับรองราวกับเป็นระบบสิทธิ์พิเศษ มันเป็นเช่นนั้นจริง กำหนดขอบเขตโทเค็นของมันให้สอดคล้อง
- SAST การสแกนดีเพนเดนซี และการตรวจจับซีเคร็ตในทุกคอมมิต ไม่ใช่คืนละครั้ง แต่ทุกคอมมิต อัตราคอมมิตเพิ่มขึ้นสามถึงสี่เท่า การสแกนคืนละครั้งตอนนี้เทียบเท่าลูปป้อนกลับสามวัน
- การวิเคราะห์องค์ประกอบซอฟต์แวร์ โดยเฉพาะสำหรับแพ็กเกจที่ถูกสร้างขึ้นแบบหลอน นี่คือมาตรการควบคุมที่ถูกที่สุดและให้คุณค่าสูงที่สุดในรายการ เพราะตัวเลข 20% นั้นสูงมากและความล้มเหลวเงียบมาก
- นโยบายเป็นลายลักษณ์อักษรว่าความช่วยเหลือจาก AI จะไม่ถูกใช้โดยไม่มีการรีวิวกับโค้ดการยืนยันตัวตน การเข้ารหัส การอนุญาต หรือการชำระเงิน นี่คือสี่พื้นที่ที่ข้อผิดพลาดเล็ก ๆ น้อย ๆ มีโอกาสเกิดและเป็นหายนะทั้งคู่ และเป็นที่ที่สายตาของ reviewer’s มีค่าที่สุด
- ขยาย SBOM ของคุณให้บันทึกที่มาของเครื่องมือ AI เมื่อการศึกษาระบุที่มาแบบ Georgia-Tech ครั้งหน้าลงมาที่โค้ดเบสของคุณ คุณจะอยากตอบคำถามนั้นได้ด้วยตัวเอง
- ปฏิบัติกับแพลตฟอร์มไวบ์โคดิงของบุคคลที่สามเหมือนผู้ขาย SaaS ตัวเลขของ RedAccess คือสิ่งที่เกิดขึ้นเมื่อไม่มีใครทำแบบนั้น
ไม่มีอะไรแปลกประหลาดในนั้น ส่วนใหญ่คือสิ่งที่ทีมงานที่มีความสามารถทำกันในปี 2019 สิ่งที่เปลี่ยนไปคือปริมาณเพิ่มขึ้นหนึ่งหลัก ดังนั้นมาตรการควบคุมต้องเป็นแบบอัตโนมัติ ไม่ใช่แบบวัฒนธรรม
แสดงรูปภาพ ข้อมูลด้านความปลอดภัยจาก Veracode, Apiiro, USENIX และ Georgia Tech สังเกตรูปทรง: ความเร็วคอมมิตเพิ่มขึ้น 3–4 เท่า ข้อค้นพบด้านความปลอดภัยเพิ่มขึ้น 10 เท่า ช่องว่างระหว่างตัวคูณสองตัวนั้นคือปัญหาทั้งหมด
ตอนที่เก้า: อะไรเข้ามาแทนไวบ์โคดิง
แนวปฏิบัติที่ได้ผลจริงในปี 2026 มีชื่อ — หลายชื่อที่แข่งขันกัน ซึ่งนั่นคือวิธีที่คุณรู้ว่ามันเป็นของจริง — และมันตรงข้ามกับไวบ์โดยประมาณ
เรียกมันว่า การพัฒนาที่ขับเคลื่อนด้วยสเปก, วิศวกรรมแบบเอเจนต์, หรือ วิศวกรรมบริบท. โครงสร้างร่วมคือ:
1. สเปกคือซอร์สโค้ดในตอนนี้
ไม่ใช่ตั๋ว Jira แต่เป็นเอกสารจริง: สิ่งนั้นทำอะไร อะไรที่มันต้องไม่ทำ อินเทอร์เฟซเป็นอย่างไร “เสร็จ” หน้าตาเป็นแบบไหน โหมดความล้มเหลวมีอะไรบ้าง คอมมิตเข้าไปในรีโพ มีเวอร์ชัน และผ่านการรีวิว
สิ่งนี้รู้สึกเหมือนถอยหลังกลับไปปี 1998 แต่มันไม่ใช่ ความต่างคือในปี 1998 สเปกเป็นข้อมูลเข้าสำหรับมนุษย์ที่จะตีความใหม่ และมันเน่าไปทันทีที่เริ่มเขียนโค้ด ในปี 2026 สเปกเป็นข้อมูลเข้าสำหรับกระบวนการที่สร้าง implementation ขึ้นใหม่ได้ในราคาถูก ซึ่งหมายความว่าเมื่อความต้องการเปลี่ยน คุณเปลี่ยนสเปกแล้วสร้างใหม่ แทนที่จะแพตช์โค้ดที่ไม่ตรงกับคำอธิบายเป็นลายลักษณ์อักษรของตัวมันเองอีกต่อไป
เศรษฐศาสตร์พลิกกลับ เมื่อ implementation แพงและสเปกถูก คุณเขียนสเปกแบบหลวม ๆ และลงทุนในโค้ด เมื่อ implementation ถูกและสเปกคือคอขวด คุณลงทุนในสเปก
2. ชุดทดสอบคือขอบเขตของความไว้วางใจ
เอเจนต์ที่รันการทดสอบของคุณและวนซ้ำกับมันได้เป็นเครื่องมือที่ต่างโดยพื้นฐานจากตัวที่ทำไม่ได้ นี่คือการเปลี่ยนแปลงที่ให้ผลสูงสุดเพียงอย่างเดียวที่ทีมส่วนใหญ่ทำได้ และมันไม่เกี่ยวกับ AI เลย คือ AI ทำให้ผลตอบแทนจากการลงทุนในความครอบคลุมการทดสอบชัดเจนในที่สุด สำหรับคนที่ไม่เคยจะเชื่อด้วยเหตุผลเรื่องฝีมือ
ฉบับปฏิบัติ: เอเจนต์ได้แซนด์บ็อกซ์ คำสั่งทดสอบ คำสั่ง lint และการตรวจชนิด และมันยังไม่เสร็จจนกว่าทั้งสี่อย่างจะเขียว อย่างอื่นต่อรองได้
3. การรีวิวเปลี่ยนจากรายบรรทัดไปที่ดิฟฟ์ แล้วไปที่พฤติกรรม
การรีวิวทีละบรรทัดขยายไม่ถึงดิฟฟ์ที่เอเจนต์สร้างขึ้นเป็นพันบรรทัด และการทำเป็นว่าไม่ใช่คือจุดเริ่มของการรีวิวแบบประทับตราผ่าน
สิ่งที่ได้ผลแทน โดยเรียงตามคุณค่าคร่าว ๆ:
- รีวิวสเปก ไม่ใช่ implementation ถ้าสเปกถูกและการทดสอบผ่าน implementation เป็นเพียงรายละเอียด
- รีวิวรูปทรงของ diff’s — ไฟล์ไหนถูกแตะ มีดีเพนเดนซีอะไรถูกเพิ่ม อะไรถูกลบ หายนะของเอเจนต์ส่วนใหญ่เห็นได้ในระดับนี้: ไฟล์ที่ไม่คาดคิด ดีเพนเดนซีใหม่ การลบที่ไม่มีใครขอ
- รีวิวบรรทัดที่อ่อนไหวต่อความปลอดภัยโดยเฉพาะ การยืนยันตัวตน การเข้ารหัส การอนุญาต การชำระเงิน อะไรก็ตามที่แตะ PII นี่เป็นสัดส่วนเล็ก ๆ ของดิฟฟ์ใด ๆ
- อย่ารีวิวโค้ดโครงซ้ำ ๆ ยังไงคุณก็ไม่เคยรีวิวมันจริง ๆ อยู่แล้ว
4. harness สำคัญพอ ๆ กับโมเดล
เรื่องนี้ถูกให้ค่าน้อยเกินไป โมเดลเดียวกัน ในลูปเอเจนต์ที่ต่างกันสองแบบ ให้งานคุณภาพต่างกันสุดขั้ว ซึ่งเป็นเหตุผลว่าทำไมการเปรียบเทียบเบนช์มาร์กระหว่างแล็บจึงลื่นไหลนัก
ส่วนประกอบที่สำคัญ: หน้าต่างบริบทถูกจัดการอย่างไรเมื่อการรันยาวขึ้น เอเจนต์เห็นการทดสอบที่ล้มเหลวของตัวเองได้หรือไม่ มันเรียกดูรีโพได้หรือเห็นแค่สิ่งที่คุณวางไป มีขั้นวางแผนแยกจากขั้นลงมือหรือไม่ และมันรู้หรือไม่ว่าเมื่อไรควรหยุดแล้วถาม
บันทึกการเปิดตัว Muse Spark 1.3 ของ Meta’s น่าสนใจในประเด็นนี้พอดี พวกเขาอธิบายว่าโมเดลตอนนี้ถามคำถามเพื่อความชัดเจนเมื่อพรอมต์กำกวม ขอความช่วยเหลือเมื่อติด และยืนยันก่อนการกระทำที่มีผลสำคัญ สิ่งเหล่านั้นไม่ใช่การพัฒนาความฉลาด แต่มันคือมารยาทและมารยาทคือสิ่งที่ทำให้เอเจนต์ระยะยาวอยู่รอดได้
5. การเราเตอร์โมเดลกลายเป็นแนวปฏิบัติมาตรฐานแล้ว
ไม่มีใครที่จริงจังใช้โมเดลเดียวทำทุกอย่าง ผมอธิบายฉบับสองโมเดลของเรื่องนี้ไว้ใน GLM-5.3-Flash กับ MiniMax M3 ใน OpenCode. รูปแบบที่ลงตัวแล้ว:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
      "description": "Architecture, root cause, anything where being wrong is expensive",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation — long-horizon, cost-sensitive",
      "model": "anthropic/claude-opus-5"
    },
    "bulk": {
      "description": "High-volume mechanical work where price dominates",
      "model": "zai/glm-5-3-flash"
    },
    "private": {
      "description": "Anything touching client data — runs on hardware we own",
      "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
      "description": "Renames, docstrings, lint fixes, test scaffolding",
      "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
เหตุผล ทีละบรรทัด:
- การวางแผนไปที่โมเดลที่เก่งที่สุดเท่าที่คุณจ่ายไหว แผนที่แย่กินโทเค็นปลายน้ำมากกว่าต้นทุนของแผนนั้นเอง
- การสร้างไปที่โมเดลระยะยาวที่ดีที่สุดในราคาที่สมเหตุสมผล Opus 5 ที่ $5/$25 ถูกวางตำแหน่งไว้เพื่อสิ่งนี้โดยชัดเจน และเป็นครึ่งหนึ่งของราคา Fable’s
- งานกลไกปริมาณมากไปที่ GLM-5.3-Flash ที่ $0.15/$0.47เพราะในราคานั้น คำถามไม่ใช่ว่ามันดีเท่าหรือไม่ แต่คือมันดีพอสำหรับงานนั้นหรือไม่ และบ่อยครั้งมันก็ดีพอ
- อะไรที่เป็นส่วนตัวไปที่เครื่องโลคอลบนโมเดลที่พอดีกับเครื่องของคุณ
- งานจุกจิกไปที่โมเดลโลคอลขนาดเล็กเพราะการเปลี่ยนชื่อสัญลักษณ์ในสี่สิบไฟล์ไม่ต้องใช้การให้เหตุผลระดับแนวหน้า และไม่ต้องออกจากแล็ปท็อปคุณ
เขียน ID ของโมเดลให้การสลับตัวหนึ่งเป็นการแก้บรรทัดเดียว เมื่อพิจารณาว่ามีสี่แล็บที่ส่งโมเดลติดท็อปสิบระหว่างมิถุนายนถึงกันยายน คุณจะต้องเปลี่ยนอีกครั้งภายในไตรมาสนี้
ตอนที่สิบ: อนาคตของไวบ์โคดิง — หกคำทำนาย พร้อมระดับความมั่นใจ
คำทำนายที่ไม่ระบุระดับความมั่นใจเป็นเพียงความบันเทิง นี่คือของผม พร้อมจำนวนที่ผมกล้าเดิมพัน
1. คำนี้ตาย แนวปฏิบัติแยกออกจากกันอย่างถาวร ความมั่นใจสูง
“ไวบ์โคดิง” กำลังกลายเป็นคำที่ใช้ดูถูกในสภาพแวดล้อมวิชาชีพ และไม่เคยเป็นคำที่ภาคภูมิใจที่ไหนนอกจากงานการตลาด สิ่งที่มาแทนคือการแยกสองชั้นที่ชัดเจน: ชิ้นงานที่ AI สร้างขึ้นแบบใช้แล้วทิ้งซึ่งไม่มีใครอ่านโค้ด (ก็ดี ถูกต้อง ทำมากขึ้นได้) และงานวิศวกรรมแบบเอเจนต์ที่มีการรีวิว ซึ่งผลลัพธ์ของโมเดล’s ต้องผ่านด่านเดียวกับของ human’s (ก็ดีเช่นกัน และเป็นที่ที่เงินระดับองค์กรทั้งหมดอยู่)
ตรงกลางที่อันตราย — โค้ดโปรดักชันที่ไม่มีใครอ่าน — คือสิ่งที่ประกอบขึ้นเป็นรายการเหตุการณ์ปี 2026 และมันจะถูกกำกับดูแล ทำประกัน หรือตรวจสอบจนหมดไปในบริบทเชิงพาณิชย์ ไม่ใช่เพราะมีใครสั่งห้าม แต่เพราะแบบสอบถามด้านความปลอดภัยจะถามถึงมันในที่สุด
2. การตรวจสอบกลายเป็นคอขวด และเงินลงทุนเครื่องมือจะตามมา ความมั่นใจสูง
เราอยู่ตรงนั้นแล้วและตลาดยังไม่ปรับราคา ถ้าเอเจนต์ผลิตงานได้หนึ่งสัปดาห์ ข้อจำกัดคือความสามารถของ human’s ในการยืนยันว่างานหนึ่งสัปดาห์นั้นถูกต้อง
คาดว่าผลิตภัณฑ์ที่น่าสนใจของปี 2027 จะเกี่ยวกับ การตรวจสอบ แทนที่จะ การสร้าง: การสร้างการทดสอบแบบอิงคุณสมบัติ เครื่องมือดิฟฟ์เชิงความหมายที่อธิบายการเปลี่ยนพฤติกรรมแทนการเปลี่ยนบรรทัด การตรวจสอบความสอดคล้องกับสเปกอัตโนมัติ การตรวจสอบการกระทำของเอเจนต์ขณะรัน และ — นี่คือสิ่งที่ผมจะสร้าง — เครื่องมือที่บอกคุณว่า 5% ใดของดิฟฟ์ขนาดใหญ่ที่มนุษย์ต้องอ่านจริง ๆ
3. ระเบียบวิธีเชิงรูปแบบได้ช่วงเวลาของมัน ในอีกยี่สิบปีให้หลัง ความมั่นใจปานกลาง
ข้อโต้แย้งในอดีตต่อสเปกเชิงรูปแบบคือการเขียนสเปกแพงกว่าเขียนโค้ด ข้อโต้แย้งนั้นตายแล้ว เพราะการเขียนโค้ดแทบไม่มีต้นทุน และการเขียนสเปกคือคอขวดอยู่แล้ว
ระบบชนิด สัญญา ค่าคงที่ การทดสอบแบบอิงคุณสมบัติ และการตรวจสอบเชิงรูปแบบแบบเบา จู่ ๆ ก็มีกรณีการใช้งานที่คุ้มทุนเอง: มันคือข้อความแสดงเจตนาที่เครื่องตรวจสอบได้ ซึ่งเอเจนต์สามารถวนซ้ำได้โดยไม่ต้องมีมนุษย์อยู่ในลูป ผมคาดว่า Rust โหมดที่เข้มงวดขึ้นของ TypeScript’s และไลบรารีสัญญาใน Python จะเป็นผู้ได้ประโยชน์มากเกินสัดส่วน
เหตุผลที่ความมั่นใจของผมแค่ปานกลาง: วงการนี้ทำนายการฟื้นตัวของระเบียบวิธีเชิงรูปแบบราวทุกเจ็ดปีตั้งแต่ปี 1985
4. โมเดลโลคอลกลืนชั้นงานจุกจิกไปทั้งหมด ความมั่นใจค่อนข้างสูง
ดูว่าโมเดล 27B ภายใต้ Apache 2.0 ทำอะไรได้ตอนนี้ แล้วบวกอีกหนึ่งปี และวางมันบนเครื่องที่มีหน่วยความจำแบบรวม 64 GB การเปลี่ยนชื่อ docstring โครงทดสอบ ข้อความคอมมิต การแก้ lint การแปลฉบับร่างแรก การวิเคราะห์ล็อก ไม่มีสิ่งใดต้องใช้โมเดลระดับแนวหน้า ทั้งหมดเป็นปริมาณมาก และทั้งหมดเป็นงานที่คุณไม่อยากส่งให้บุคคลที่สามจาก client’s repository
แนวหน้ายังอยู่ในคลาวด์สำหรับการวางแผนและการให้เหตุผลยาก ปริมาณงานย้ายไปที่เครื่องโลคอล ตั้งแต่ตอนที่สิบเอ็ดเป็นต้นไปคือเหตุผลว่าทำไมตอนนี้มันเป็นไปได้ในทางกายภาพ
5. บทบาทนักพัฒนาระดับจูเนียร์เปลี่ยนรูปทรง ไม่ใช่หายไป ความมั่นใจปานกลาง และผมยึดข้อนี้หลวมที่สุด
กรณีมองร้ายนั้นตรงไปตรงมา: ถ้าเอเจนต์ทำงานที่จูเนียร์เคยทำ ไม่มีใครจ้างจูเนียร์ และในสิบปีจะไม่มีซีเนียร์
ผมคิดว่าผลลัพธ์ที่น่าจะเป็นไปได้มากกว่าคืองานระดับเริ่มต้นเปลี่ยนจาก “เขียนโค้ด” เป็น “ตรวจสอบโค้ดและเป็นเจ้าของสเปก” — ซึ่งเป็นงานที่เริ่มต้นได้ยากกว่า ไม่ใช่ง่ายกว่า และจะทำให้วงการต้องสร้างวิธีฝึกคนขึ้นใหม่ ทีมที่คิดเรื่องนี้ออกจะได้เปรียบในการจ้างงานอย่างมหาศาลเหนือทีมที่แค่หยุดจ้าง
ข้อแม้ตามจริง: นี่คือคำทำนายที่แรงจูงใจและบทวิเคราะห์ของผมชี้ไปทางเดียวกัน ซึ่งเป็นตอนที่คุณควรระแวงตัวเองพอดี
6. จะมีใครสักคนประสบความล้มเหลวจากการเขียนโค้ดด้วย AI ที่เป็นหายนะจริง ๆ และถูกระบุต่อสาธารณะ ความมั่นใจสูงต่อเหตุการณ์ ต่ำต่อกำหนดเวลา
ไม่ใช่ฐานข้อมูลรั่ว แต่เป็นอะไรที่มีหน่วยงานกำกับดูแล ผลกระทบทางการเงินระดับเก้าหลัก และการวิเคราะห์สาเหตุรากที่บอกว่าเอเจนต์ทำสิ่งที่ไม่มีมนุษย์รีวิว
เส้นโค้งการระบุที่มาของ CVE — 6 จากนั้น 15 จากนั้น 35 ในเดือนติดกันของปี 2026 โดยนักวิจัยประเมินอัตราจริงสูงกว่าห้าเท่าถึงสิบเท่า — ไม่ใช่เส้นโค้งที่แบนลงเอง คำถามคือวงการจะรัดด่านของตัวเองก่อน หรือรอให้เกิดเหตุการณ์ที่บังคับให้ต้องทำ
สิ่งที่ผมจะทำกับทั้งหกข้อในประโยคเดียว: ลงทุนในการทดสอบ สเปก และเครื่องมือรีวิว มากกว่าในเทคนิคพรอมต์ เพราะเทคนิคพรอมต์เสื่อมค่าทุกครั้งที่มีโมเดลออกใหม่ ขณะที่โครงสร้างพื้นฐานการตรวจสอบทบต้น
แสดงรูปภาพ แนวปฏิบัติทั้งสองใช้เทคโนโลยีร่วมกันและไม่มีอะไรอย่างอื่นร่วม ลูปซ้ายมือถูกต้องสำหรับงานใช้แล้วทิ้งและเป็นหายนะสำหรับโปรดักชัน ลูปขวามือคือสิ่งที่รายการเหตุการณ์ในตอนที่แปดขาดไป
ภาคที่ 3 — AI ออฟไลน์บนอุปกรณ์สำหรับผู้บริโภค
ตอนที่สิบเอ็ด: AI ออฟไลน์เลิกเป็นงานอดิเรกในปีนี้
เป็นเวลาราวสองปี “รันบนเครื่องตัวเอง” เป็นการประนีประนอมบนหลักการ คุณทำได้ คำขายตามจริงคือ: นี่คือโมเดล 7 พันล้านพารามิเตอร์ที่แย่กว่าชั้นฟรีของทุกเจ้า บนฮาร์ดแวร์ที่คุณมีอยู่แล้ว และเหตุผลที่ทำคือหลักการ
สิ่งนั้นเปลี่ยนในปี 2026 และเปลี่ยนด้วยเหตุผลสามข้อแยกกันที่มาถึงพร้อมกัน
โมเดลเล็กเก่งขึ้นจริง ๆ E4B ของ Gemma 4’s มีขนาดราว 8 พันล้านพารามิเตอร์ รองรับบริบท 128K จัดการข้อความ ภาพ วิดีโอ และเสียงแบบเนทีฟ และอยู่ภายใต้ Apache 2.0 ตัวแปร dense 31B ได้ 39 คะแนนในดัชนี Artificial Analysis — อยู่ในช่วงที่เป็นแนวหน้าเมื่อสิบแปดเดือนก่อน — และรันดัชนีทั้งหมดด้วยโทเค็นเอาต์พุต 39 ล้าน ซึ่งเป็นเศษเสี้ยวของที่โมเดลเทียบเคียงเผาไป Qwen3.8-27B เป็นโมเดลมัลติโหมดัลแบบ dense ภายใต้ Apache 2.0 ที่มีบริบทเนทีฟ 262K ซึ่ง Alibaba อ้างว่าเอาชนะ Qwen3.7-Plus ที่ใหญ่กว่ามากในงานเขียนโค้ดและงานออฟฟิศ
ระบบปฏิบัติการใส่มันมาให้แล้ว นี่คือการเปลี่ยนแปลงที่สำคัญจริงและมันเกิดขึ้นเงียบ ๆ Microsoft ใส่ Aion 1.0 ไว้ใน Windows 11 Apple ส่งโมเดล dense 3 พันล้านพารามิเตอร์พร้อมโมเดล sparse 20 พันล้านพารามิเตอร์บน iPhone Google ส่ง Gemini Nano บน Pixel และอุปกรณ์ Samsung AI บนอุปกรณ์เลิกเป็นสิ่งที่คุณต้องติดตั้ง และกลายเป็นสิ่งที่มีอยู่แล้วซึ่งเป็นความต่างระหว่างเทคโนโลยีที่คนคลั่งไคล้ใช้ กับเทคโนโลยีที่ทุกคนใช้
และในที่สุดฮาร์ดแวร์ก็มีหน่วยความจำพอ ไม่ใช่พลังประมวลผล แต่เป็นหน่วยความจำ ผมจะกลับมาที่เหตุผลว่าทำไมความต่างนั้นคือเรื่องทั้งหมด
“AI ออฟไลน์” ให้อะไรคุณจริง ๆ
ผมจะพูดให้ชัด เพราะเรื่องนี้ถูกขายไม่ดี
ความหน่วง โมเดลโลคอลขนาด 4B ตอบสนองในหลักสิบมิลลิวินาที การไปกลับคลาวด์อย่างดีที่สุดคือหลักร้อย สำหรับอะไรที่โต้ตอบและต่อเนื่อง — การเขียนตามคำบอก การแปลสด การเติมข้อความอัตโนมัติ การสรุปขณะพิมพ์ — โลคอลชนะด้านความรู้สึก ไม่ใช่ด้านคุณภาพ และความรู้สึกคือสิ่งที่ผู้คนสังเกตเห็น
ความเป็นส่วนตัวที่เป็นเรื่องสถาปัตยกรรม ไม่ใช่สัญญา เมื่อใช้ API ทุกพรอมต์ออกจากโครงสร้างพื้นฐานของคุณ และคุณต้องมีข้อตกลงผู้ประมวลผล การประเมินผลกระทบการโอนย้าย แผนผังการไหลของข้อมูล และคำตอบสำหรับเจ้าหน้าที่คุ้มครองข้อมูลของคุณ เมื่อใช้โมเดลที่รันบนอุปกรณ์ คำถามเรื่องการโอนข้อมูลข้ามพรมแดนจึงไม่เกิดขึ้น เพราะไม่มีการโอนข้อมูลเลย สำหรับงานในเยอรมนีและสหภาพยุโรป นี่มักเป็นข้อโต้แย้งทั้งหมด และปิดดีลได้ในแบบที่ราคาไม่มีทางทำได้
ความพร้อมใช้งาน บนเครื่องบิน บนพื้นที่ที่ไม่มีสัญญาณ ในสถานที่ซึ่งการเข้าถึงเครือข่ายคือสิ่งที่ถูกห้าม ระหว่างที่ผู้ให้บริการ’ของคุณเกิดเหตุขัดข้อง
การคาดการณ์ต้นทุนได้ ไม่ใช่การประหยัดต้นทุน — ผมจะคำนวณเรื่องนั้นในภาคที่สิบห้า และผลที่ได้ไม่ตรงกับที่คนอยากให้เป็น แต่ต้นทุนฮาร์ดแวร์คงที่ที่มีต้นทุนส่วนเพิ่มเป็นศูนย์ต่อโทเคนนั้นเป็นรายการงบประมาณที่ต่างออกไปมากจากบิลแบบใช้เท่าไรจ่ายเท่านั้น ซึ่งบวมตามความกระตือรือร้นของเอเจนต์’
การล็อกเวอร์ชัน โมเดล API แบบปิดถูกอัปเดตอยู่เบื้องหลัง ID โมเดลที่คงที่ และพฤติกรรมก็ค่อย ๆ เลื่อนไป เช็กพอยต์ในเครื่องยังเหมือนเดิมทุกไบต์แม้ผ่านไปหนึ่งปี ถ้าคุณเคยมีพรอมต์ที่ใช้งานได้แล้วจู่ ๆ ก็เลิกทำงาน คุณก็รู้ว่าสิ่งนั้นมีค่าแค่ไหน
และสิ่งที่มันไม่ได้ให้คุณ
ความสามารถระดับแนวหน้า ช่องว่างระหว่างโมเดล 4B บนโทรศัพท์ของคุณกับ Claude Fable 5.1 ไม่ใช่ช่องว่างเล็ก ๆ และจะไม่ปิดลง ใครที่บอกเป็นอย่างอื่นกำลังขายอะไรบางอย่างอยู่
ความเร็วกับโมเดลขนาดใหญ่ โมเดล 400B ในเครื่องสร้างโทเคนได้ช้ากว่าโมเดลเดียวกันบน API ของผู้ให้บริการ เพราะผู้ให้บริการรันมันบนฮาร์ดแวร์ที่มีแบนด์วิดท์หน่วยความจำมากกว่าคุณสี่ถึงหกเท่า คุณแลกปริมาณงานกับอำนาจควบคุม
ภาคที่สิบสอง: โทรศัพท์ในกระเป๋าคุณ
สเปกที่กำหนดทุกอย่างคือ RAM
ทุกแพลตฟอร์มหลักได้ลากเส้นแบ่งเรื่องหน่วยความจำแล้ว และเส้นนั้นอยู่ที่ 12 GB
| แพลตฟอร์ม | โมเดลบนอุปกรณ์ | เกณฑ์หน่วยความจำ |
|---|---|---|
| Apple | AFM 3 Core (แบบ dense 3B) + AFM 3 Core Advanced (แบบ sparse 20B, ทำงานจริง 1–4B) | 12 GB สำหรับฟีเจอร์ iOS 27 สองอย่าง |
| Gemini Nano v3 (เฉพาะ Pixel 10); Nano v2 บน Pixel 9 และรุ่นเก่ากว่า; Nano v4 กำลังจะมา | 12 GB ขั้นต่ำสำหรับ Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 for Galaxy — CPU Oryon เจนที่ 3, NPU Hexagon, ความจุ NPU +39% | ขึ้นอยู่กับอุปกรณ์ |
การจัดวางของ Apple คือสิ่งที่น่าสนใจในเชิงเทคนิค AFM 3 Core Advanced เป็นโมเดลแบบ sparse ขนาด 20,000 ล้านพารามิเตอร์ที่อาศัยอยู่ในที่จัดเก็บแบบแฟลช ผู้เชี่ยวชาญที่ใช้ร่วมกันจะพักอยู่ในหน่วยความจำ ส่วนผู้เชี่ยวชาญที่ถูกเลือกเส้นทางจะถูกสลับเข้า DRAM เฉพาะเมื่อคำขอต้องการมัน นั่นคือวิธีที่ทำให้โมเดล 20B ใส่ลงในโทรศัพท์ได้เลย — คุณแลกแบนด์วิดท์การอ่าน NAND กับความจุ DRAM
แต่การสลับผู้เชี่ยวชาญเข้า DRAM ยังต้องมีที่ให้สลับมัน เข้าไป, นอกเหนือจากระบบปฏิบัติการ แอปที่กำลังทำงาน และไปป์ไลน์ของกล้อง ช่องว่างระหว่าง 9 GB กับ 12 GB ไม่ใช่การแบ่งตลาดสามกิกะไบต์ แต่เป็นชุดการทำงานสำหรับการสลับผู้เชี่ยวชาญภายใต้แรงกดดันหน่วยความจำจริง Ming-Chi Kuo รายงานว่าฟีเจอร์สองอย่างของ iOS 27 ต้องใช้ 12 GB ได้แก่ การแสดงอารมณ์และปรับจังหวะเสียงของ Siri และการปรับปรุงความแม่นยำในการแปลงเสียงเป็นข้อความอย่างมีนัยสำคัญ iPhone 18 รุ่นพื้นฐาน ซึ่งเลื่อนไปเป็นฤดูใบไม้ผลิ 2027 พร้อมหน่วยความจำที่รายงานว่า 9 GB ไม่ผ่านเกณฑ์นี้
Google เจอฟิสิกส์เดียวกันและมีปัญหาภาพลักษณ์สาธารณะที่แย่กว่า Gemini Intelligence ต้องใช้ Nano v3, Nano v3 ตอนนี้มีเฉพาะ Pixel 10 และอุปกรณ์ Pixel 9 — ที่ขายภายใต้ คำสัญญาอัปเดตเจ็ดปี — ยังใช้ Nano v2 คำสัญญานั้นเกี่ยวกับการอัปเดต ไม่เคยเกี่ยวกับฟีเจอร์ และความแตกต่างที่สมเหตุสมผลสำหรับผู้จัดการผลิตภัณฑ์ในปี 2023 ก็ไม่สมเหตุสมผลเลยสำหรับลูกค้าในปี 2026
คาดว่านี่จะเป็นเรื่องราว AI ของผู้บริโภคในสองปีข้างหน้า: คำสัญญาการสนับสนุนระยะยาวที่ส่งแพตช์ความปลอดภัยให้อุปกรณ์ที่ไม่สามารถรันฟีเจอร์ที่มาพร้อมกับแพตช์เหล่านั้น
สิ่งที่โทรศัพท์ทำได้จริง เมื่อวัดออกมา
การเบนช์มาร์กอิสระบน iPhone 17 Pro (A19 Pro) ในสี่รันไทม์:
| รุ่น | รันไทม์ | โทเคน/วินาที (decode) | หน่วยความจำสูงสุด |
|---|---|---|---|
| Gemma 4 E2B (4-bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-bit) | MLX | 47.5 | 2,900 MB |
| Gemma 4 E2B (4-bit) | llama.cpp | 37.8 | 3,156 MB |
| Gemma 4 E2B (4-bit) | CoreML / ANE | 33.4 | 1,187 MB |
| Qwen 3.5 2B (4-bit) | MLX | 61.2 | 1,279 MB |
| Qwen 3.5 2B (4-bit) | llama.cpp | 39.1 | 1,479 MB |
| Qwen 3.5 2B (4-bit) | CoreML / ANE | 27.9 | 241 MB |
มีสองสิ่งที่เด่นขึ้นมา
Neural Engine เป็นเส้นทางที่ช้าที่สุด และประหยัดหน่วยความจำที่สุดอย่างมาก 27.9 tok/s ที่ 241 MB เทียบกับ 61.2 tok/s ของ MLX’ ที่ 1,279 MB — ความเร็วห้าเท่าแลกกับหน่วยความจำห้าเท่า การแลกเปลี่ยนนี้คือเหตุผลที่ Apple ใช้ ANE สำหรับฟีเจอร์ระบบที่ทำงานตลอดเวลา และเป็นเหตุผลที่แอปของบุคคลที่สามข้ามมันไปสำหรับแชตแบบโต้ตอบ
หกสิบโทเคนต่อวินาทีบนโมเดล 2B ในกระเป๋าคุณนั้นเร็วกว่าความเร็วอ่านของคนส่วนใหญ่ ซึ่งหมายความว่าข้อจำกัดของ AI ที่รันในโทรศัพท์ไม่ใช่ความเร็ว แต่คือความสามารถ ความสามารถเป็นฟังก์ชันของจำนวนพารามิเตอร์ พารามิเตอร์เป็นฟังก์ชันของหน่วยความจำ — และหน่วยความจำคือสิ่งที่ผู้ผลิตทุกรายเพิ่งเอามาตั้งเป็นเกณฑ์
ภาคที่สิบสาม: พีซี และการเดิมพันเงียบ ๆ ของ Microsoft
Microsoft ทำบางอย่างที่ Build 2026 เมื่อวันที่ 2 มิถุนายน ซึ่งผมคิดว่าเมื่อมองย้อนหลังจะดูสำคัญกว่าที่มันดูในวันนั้น: มันส่งโมเดลเข้าไปใน Windows เอง
Aion 1.0 Instruct เป็นโมเดลภาษาขนาดเล็กสำหรับการสรุป การเขียนใหม่ และการสกัดข้อมูล ต้องใช้ CPU สมัยใหม่และ Windows 11 — ไม่ต้องมี NPU ไม่ต้องมี GPU แยก ตอนนี้ใช้ได้ใน Edge Canary ตั้งแต่บิลด์ 150.0.4070 เปิดให้นักพัฒนาเว็บเข้าถึงผ่าน API Prompt, Summarizer, Writer และ Rewriter และน้ำหนักแบบเปิดของมันขึ้นบน Hugging Face เมื่อกรกฎาคม 2026
Aion 1.0 Plan คือตัวที่น่าสนใจ: โมเดลการให้เหตุผลและการเรียกใช้เครื่องมือขนาด 14,000 ล้านพารามิเตอร์ที่มีหน้าต่างบริบท 32Kสร้างมาสำหรับเวิร์กโฟลว์ของเอเจนต์ การจัดการไฟล์ และการประสานงานเอเจนต์ย่อย “อีกไม่กี่เดือน” ณ เวลาที่เขียน
กรอบที่ Microsoft ใช้คือ “สติปัญญาแบบไม่จำกัดปริมาณสำหรับทุกบ้านและทุกโต๊ะทำงาน” วางเรื่องการตลาดไว้ก่อนแล้วดูการตัดสินใจด้านสถาปัตยกรรม: API JavaScript ในเบราว์เซอร์ที่เรียกโมเดลในเครื่อง โดยไม่ต้องใช้คีย์ ไม่มีบิล และไม่ต้องใช้เครือข่าย ถ้าสิ่งนั้นกลายเป็นเรื่องปกติ ฟีเจอร์ AI ขนาดเล็กกลุ่มใหญ่จะเลิกเป็นผลิตภัณฑ์ SaaS และกลายเป็นความสามารถของแพลตฟอร์ม นั่นเป็นเรื่องใหญ่กว่ามากสำหรับเศรษฐศาสตร์ของอุตสาหกรรม AI เทียบกับการเปิดตัวโมเดลใด ๆ ในปีนี้
พื้นขั้นต่ำของฮาร์ดแวร์เป็นเรื่องจริง และมันกันเครื่องจำนวนมากออกไป
เส้นทาง NPU ต้องใช้ Copilot+ PC ที่มี minimum 40-TOPS NPU:
| ซิลิคอน | NPU | ผ่านเกณฑ์? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ ฮาร์ดแวร์; ซอฟต์แวร์ “มาทีหลัง” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
และนี่คือตัวเลขที่ควรทำให้คุณปรับความคาดหวังใหม่: บน NPU 45 TOPS โมเดล 8B สร้างได้ราว 5 โทเคนต่อวินาที โมเดล Plan ขนาด 14B จะช้ากว่านั้น
ห้าโทเคนต่อวินาทีไม่ใช่ประสบการณ์แชต แต่ใช้ได้ดีกับการสรุปเบื้องหลัง การเขียนใหม่ การจำแนก และการสกัดข้อมูล — สิ่งที่ Aion 1.0 Instruct มีไว้ทำจริง ๆ แต่ใช้ไม่ได้กับอะไรก็ตามที่คุณต้องนั่งเฝ้าดู
ทำไมช้าจังบน 45 TOPS? เพราะการสร้างโทเคนถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำ ไม่ใช่พลังประมวลผลดิบ NPU คูณเมทริกซ์ได้ ปัญหาคือการสตรีมน้ำหนักออกจากหน่วยความจำระบบในทุก ๆ โทเคน นี่คือกำแพงเดียวกันที่กำหนดอุปกรณ์ทุกเครื่องในบทความนี้ และเป็นเหตุผลว่าทำไม “TOPS” จึงเป็นตัวเลขที่แทบไม่มีประโยชน์เวลาเลือกซื้อ
เครื่องเดสก์ท็อป
ถ้าคุณต้องการเครื่องสำหรับการอนุมานในเครื่องโดยเฉพาะ ชั้น 128 GB ได้ลงตัวเป็นสองตัวเลือกและหนึ่งข้อยกเว้น:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| ความจำ | 128 GB แบบ unified | 128 GB LPDDR5X-8000 | สูงสุด 512 GB unified |
| แบนด์วิดท์ | ~273 GB/s | ~256 GB/s | 1.2 TB/s |
| ราคา | ~$3,999 | $2,300–$2,500 | เริ่มต้น $5,499 |
| หมายเหตุ | ระบบนิเวศ CUDA | CPU แรง (1.6 TFLOPS Linpack เทียบกับ 708 GFLOPS ของ Spark’) | รุ่น 512 GB ปลายเดือน ต.ค. ยังไม่ตั้งราคา |
ราคาเหล่านั้นและตัวเลขของ Spark กับ Strix Halo มาจากการทดสอบที่เผยแพร่ปลายธันวาคม 2025 ดังนั้นให้ถือเป็นตัวเลขบ่งชี้มากกว่าตัวเลขปัจจุบัน — ราคาหน่วยความจำเปลี่ยนไปแล้วนับจากนั้น DGX Spark กับ Strix Halo ใกล้กันมากในเรื่องการสร้างโทเคนกว่าที่ตัวเลขพลังประมวลผลบ่งบอก — เพราะทั้งคู่อยู่ที่ราว 256–273 GB/s ของแบนด์วิดท์ และนั่นคือข้อจำกัดที่แท้จริง Spark ชนะขาดในเรื่องการสร้างภาพ (~120 TFLOPS เทียบกับ ~46 บน FLUX.1 Dev BF16) และเรื่องความเข้ากันได้กับ CUDA ส่วน Strix Halo ชนะเรื่องราคาและ CPU
Mac Studio M5 Ultra อยู่ในหมวดหมู่ที่ต่างออกไปโดยสิ้นเชิงทั้งเรื่องหน่วยความจำและแบนด์วิดท์ และผมเขียนเกี่ยวกับมันไว้อย่างละเอียดใน บทความเรื่องฮาร์ดแวร์สำหรับ AI ในเครื่องฉบับย่อ: 512 GB ที่ 1.2 TB/s เป็นเครื่องกระแสหลักรุ่นเดียวที่จุโมเดลระดับ 400B ไว้ในหน่วยความจำได้ และราคาของสิทธิพิเศษนั้นอยู่ราว $16,000–$20,000 เมื่อตั้งค่าครบ
โมเดลที่ควรเอามารันจริง
| รุ่น | พารามิเตอร์ | สัญญาอนุญาต | รันได้สบายใน | เหมาะกับ |
|---|---|---|---|---|
| Gemma 4 E2B | 5.1B / ใช้งาน 2.3B | Apache 2.0 | 4 GB | โทรศัพท์ ทำงานตลอดเวลา อินพุตเสียง |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | งานพื้นฐานบนแล็ปท็อป การสรุป |
| Aion 1.0 Instruct | SLM ขนาดเล็ก | น้ำหนักแบบเปิด (HF, ก.ค. 2026) | CPU เท่านั้น | งานข้อความแบบเนทีฟบน Windows |
| Qwen3.8-27B | 27B dense | Apache 2.0 | 24–32 GB | โมเดลในเครื่องอเนกประสงค์ที่ดีที่สุดต่ำกว่า 32 GB |
| Gemma 4 26B-A4B | 26B / ใช้งาน 4B | Apache 2.0 | 24 GB | MoE เร็ว ต้นทุนการใช้งานต่ำ |
| Gemma 4 31B | 31B แบบ dense | Apache 2.0 | 32 GB | คุณภาพในเครื่องสูงสุดต่ำกว่า 32 GB |
| Ornith-1.5 35B | 35B / ใช้งาน 3B | MIT | 32 GB | การเขียนโค้ดแบบเอเจนต์ ใช้งานจริงน้อยมาก |
| gpt-oss-120b | 120B / ใช้งาน 5.1B | Apache 2.0 | 128 GB | จุดพอดีที่ 128 GB |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB+ | ใกล้ระดับแนวหน้า ต้องใช้เครื่องใหญ่ |
| MiniMax M3 | 428B / ใช้งาน 23B | Custom | 512 GB | ใส่ได้เฉพาะบน M5 Ultra |
| DeepSeek V4 Pro | 1.6T / ใช้งาน 49B | MIT | คลัสเตอร์ | ไม่ใช่โมเดลสำหรับอุปกรณ์ผู้บริโภค |
| Kimi K3 | 2.8T / ใช้งาน 104B | Custom | คลัสเตอร์ | ใส่ไม่ได้บน Mac รุ่นใดที่ Apple ขาย |
ถ้าคุณกำลังเลือกสเปกเครื่อง Apple โดยเฉพาะ ผมไล่ดูระดับหน่วยความจำอย่างละเอียดใน คู่มือ AI ในเครื่องสำหรับ MacBook Pro M5 Pro 64GB — ฉบับย่อคือ 64 GB เป็นจุดที่การประนีประนอมเลิกน่ารำคาญ
ถ้าอยากได้คำแนะนำเดียว: บนเครื่อง 32 GB ให้รัน Qwen3.8-27B หรือ Gemma 4 31Bทั้งคู่เป็น Apache 2.0 ทั้งคู่รองรับหลายรูปแบบ ทั้งคู่มีประโยชน์จริง ทั้งคู่ใส่ได้ นั่นคือค่าเริ่มต้นของปี 2026 และเป็นค่าเริ่มต้นที่ดีกว่าของปี 2025 มาก
แสดงรูปภาพ สิ่งที่ใส่ได้จริง แยกตามระดับหน่วยความจำ เส้นแนวตั้งคือขนาดหน่วยความจำที่ผู้บริโภคซื้อได้จริง ส่วนโมเดลที่ล้นเลยเส้นขวาสุดคือเพดานของ AI ระดับแนวหน้าในเครื่องของปี 2026
ภาคที่สิบสี่: กำแพงหน่วยความจำคือเรื่องทั้งหมด
ทุกอย่างในองก์ที่สามย้อนกลับมาที่สมการเดียว ดังนั้นนี่คือสมการนั้นอย่างชัดเจน
มันจะใส่ได้ไหม?
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory × 0.75) − OS and app overhead − KV cache
มันจะสร้างได้เร็วแค่ไหน?
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenสังเกตว่าสูตรที่สองใช้ พารามิเตอร์ที่ใช้งานจริง พารามิเตอร์ ไม่ใช่ทั้งหมด นี่คือเหตุผลที่โมเดล mixture-of-experts เก่งเกินสัดส่วนบนฮาร์ดแวร์สำหรับผู้บริโภคขนาดนี้ Gemma 4’ รุ่น 26B-A4B มีความสามารถจาก 26,000 ล้านพารามิเตอร์ และมีต้นทุนต่อโทเคนที่ 4,000 ล้านพารามิเตอร์ Ornith-1.5’ ขนาด 35B เปิดใช้งาน 3B ส่วน MiniMax M3 มีทั้งหมด 428B และใช้งาน 23B
ในทางปฏิบัติ ประสิทธิภาพในสูตรนั้นอยู่ราว 0.5 ถึง 0.8 ขึ้นอยู่กับรันไทม์ การควอนไทซ์ และสัดส่วนแบนด์วิดท์หน่วยความจำที่ส่วนอื่นของระบบกำลังใช้อยู่
ทีนี้ลองใช้ดู แล็ปท็อป NPU 45 TOPS ที่ใช้ LPDDR5X ราว 120 GB/s รันโมเดล 8B แบบ 4-bit (น้ำหนักที่ใช้งาน 4 GB): 120 × 0.6 ÷ 4 ≈ 18 โทเคน/วินาที ในทางทฤษฎี แต่ตัวเลขที่วัดได้จริงอยู่ราว 5 ความต่างมาจากการจัดตาราง การแย่งชิงหน่วยความจำ ต้นทุนการ prefill และความจริงที่ว่า toolchain ของ NPU ยังไม่พัฒนาเต็มที่ ช่องว่างระหว่างการคำนวณกับการวัดค่านั้นคือที่อยู่ของความผิดหวังส่วนใหญ่ในวงการนี้
การขาดแคลน DRAM คือตัวแปรที่ซ่อนอยู่เบื้องหลังทุกตัวเลขในบทความนี้
ผู้ผลิตหน่วยความจำใช้ปี 2025 และ 2026 จัดสรรกำลังการผลิตใหม่ให้กับลูกค้าศูนย์ข้อมูล AI ซึ่งเซ็นสัญญาใหญ่กว่าและได้กำไรต่อหน่วยดีกว่าผู้ผลิตอุปกรณ์สำหรับผู้บริโภค ผลที่ตามมาปรากฏให้เห็นทุกที่:
- Apple ขึ้นราคา Mac และ iPad ทั้งไลน์เมื่อมิถุนายน 2026
- รุ่น 512 GB ของ Mac Studio เลื่อนไปปลายเดือนตุลาคมเพราะเหตุด้านอุปทาน และยังไม่มีการตั้งราคา
- M6 ของ Apple’ จำกัดที่หน่วยความจำแบบ unified 32 GB และ M6 Pro, Max และ Ultra ถูกยกเลิกไปเลย
- Ming-Chi Kuo รายงานว่า Apple ลดการส่งมอบฮาร์ดแวร์ปี 2026 เพราะอุปทานหน่วยความจำ
เพดานทุกอันในบทความนี้ย้อนกลับไปที่การขาดแคลนเดียวกัน เกณฑ์ 12 GB ของโทรศัพท์ เพดาน 32 GB ของ M6 เพดาน 128 GB ของแล็ปท็อป รุ่น 512 GB ที่ล่าช้า ไม่มีสักข้อที่เป็นขีดจำกัดทางเทคนิคของซิลิคอน ทั้งหมดเป็นการตัดสินใจจัดสรรในตลาดที่หน่วยความจำหายากและมีราคาแพง
ถ้าคุณรอให้ราคากลับสู่ปกติก่อนซื้อเครื่องสำหรับการอนุมานในเครื่อง: ไม่มีใครที่น่าเชื่อถือกำลังพยากรณ์ว่าจะเกิดขึ้นเมื่อไร
ภาคที่สิบห้า: การตั้งค่าให้ใช้งาน
ส่วนปฏิบัติ ทุกอย่างที่นี่ผมรันมาแล้ว ที่ไหนที่ผมรายงานแทนที่จะรันเอง ผมบอกไว้
เส้นทางที่ง่ายที่สุด: LM Studio
มี GUI เป็น MLX-native บน Apple Silicon มีตัวเรียกดูโมเดลในตัว มีเซิร์ฟเวอร์ที่เข้ากันได้กับ OpenAI ด้วยสวิตช์เดียว ถ้าคุณอยากให้มีโมเดลรันอยู่ภายในสิบนาที เริ่มที่นี่ มันยังเป็นเครื่องมือที่ Apple ใช้เปรียบเทียบในข่าวประชาสัมพันธ์ของตัวเอง ซึ่งบอกอะไรบางอย่างเกี่ยวกับว่าสิ่งนี้กลายเป็นกระแสหลักแค่ไหน
เส้นทางที่ยืดหยุ่นที่สุด: Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
คำสั่งที่สองคือสิ่งที่คนมักมองข้าม บริบทเริ่มต้นของ Ollama ตั้งไว้ค่อนข้างต่ำ บนงานเขียนโค้ดมันจะตัดข้อมูลทิ้งเงียบ ๆ แล้วคุณจะโทษโมเดล
เส้นทางที่เร็วที่สุดบน Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
ชี้ไคลเอนต์ที่เข้ากันได้กับ OpenAI ตัวใดก็ได้ไปที่ http://localhost:8080/v1.
เพิ่มขีดจำกัดหน่วยความจำแบบ wired ก่อนที่คุณจะบ่นเรื่องการแครช
โดยค่าเริ่มต้น macOS จะไม่ยอมให้ GPU ยึดหน่วยความจำ unified ทั้งหมดของคุณไว้ บนเครื่องหน่วยความจำใหญ่ นี่คือความต่างระหว่างโมเดลที่โหลดขึ้นกับโมเดลที่โหลดไม่ขึ้น:
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
อย่าตั้งค่านี้เป็นขนาดหน่วยความจำเต็มของคุณ เผื่อให้ระบบปฏิบัติการ 12–16 GB บนเครื่องใหญ่ ไม่อย่างนั้นคุณจะเจอ kernel panic แทนที่จะได้การอนุมานที่เร็ว และตรวจซ้ำทุกครั้งหลังอัปเดต macOS เพราะการอัปเดตรีเซ็ตค่านี้
บน Windows ให้ใช้โมเดลของระบบปฏิบัติการก่อน
ก่อนจะติดตั้งอะไร ให้ดูว่า Windows ให้อะไรคุณอยู่แล้ว API Prompt, Summarizer, Writer และ Rewriter ใน Edge เรียก Aion 1.0 Instruct ในเครื่องโดยไม่ต้องใช้คีย์และไม่มีบิล สำหรับการสรุป การเขียนใหม่ และการสกัดข้อมูลภายในเว็บแอป นั่นคือโซลูชันที่สมบูรณ์โดยไม่ต้องมีโครงสร้างพื้นฐานใด ๆ
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
ถ้าต้องการมากกว่านั้น LM Studio และ Ollama ทำงานได้ดีบน Windows และบนเครื่องที่ไม่มี NPU ที่ผ่านเกณฑ์ พวกมันจะใช้ GPU หรือ CPU ซึ่งสำหรับโมเดลระดับ 8B มักจะ เร็วกว่า เส้นทาง NPU เสียอีก
การตั้งค่าแบบไฮบริดที่สมเหตุสมผล
สถาปัตยกรรมที่ผมจะสร้างจริง และสิ่งที่ผมรันอยู่คร่าว ๆ:
- ระดับ 1 — บนอุปกรณ์ โมเดลขนาดเล็กสำหรับการจัดเส้นทาง การจำแนกประเภท การดึงข้อมูล การสรุป และการเขียนตามคำบอก ใช้ Gemma 4 E4B หรือ Aion 1.0 Instruct พร้อมใช้งานเสมอ ไม่มีต้นทุนส่วนเพิ่ม
- ระดับ 2 — ฮาร์ดแวร์ของคุณเอง โมเดลโอเพนเวตขนาด 27B–120B บนเครื่องที่คุณเป็นเจ้าของ สำหรับงานใดก็ตามที่แตะข้อมูลลูกค้าซึ่งห้ามออกนอกเขตอำนาจศาล Qwen3.8-27B บน 32 GB,
gpt-oss-120bหรือ 128 GB - ระดับ 3 — ฟรอนเทียร์ผ่าน API การวางแผน การให้เหตุผลยาก ๆ การรันเอเจนต์แบบยาวนาน และงานใดก็ตามที่ผิดพลาดแล้วมีต้นทุนสูง
การถกเถียงไม่เคยเป็นเรื่อง “โลคอลหรือคลาวด์” แต่เป็นเรื่องว่าจะลากเส้นแบ่งตรงไหน และปีนี้เส้นแบ่งนั้นขยับไปไกลมาก
ตอนที่ 16: ตัวเลขต้นทุนและการปฏิบัติตามข้อกำหนด
ข้อโต้แย้งเรื่องการประหยัดต้นทุนไปไม่รอดเมื่อลองกดเครื่องคิดเลข
ลองดูปริมาณงานจริงของธุรกิจขนาดเล็กสักหนึ่งเดือน: การใช้เอเจนต์เขียนโค้ดระดับปานกลางหนึ่งเดือนทำงาน สมมติว่า 40 ล้านโทเคนอินพุตและ 3 ล้านโทเคนเอาต์พุต
| ตัวเลือก | ต้นทุนต่อเดือน |
|---|---|
| GLM-5.3-Flash API ($0.15 / $0.47) | ~$7.40 |
| Gemini 3.8 Flash API ($0.75 / $3.75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50 แบบไม่ใช้แคช) | ~$550 |
| เครื่อง Strix Halo ราคา $2,400 ตัดค่าเสื่อมราคา 3 ปี | ~$67/เดือน + ค่าไฟ |
สังเกตว่าตารางนั้นบอกอะไรจริง ๆ ฮาร์ดแวร์โลคอลถูกกว่าสุดยอดของฟรอนเทียร์ และแพงกว่าฐานล่างของมัน เมื่อเทียบกับ GLM-5.3-Flash เครื่องโลคอลไม่เคยคุ้มทุนในแง่โทเคนเลย เมื่อเทียบกับ Fable 5.1 แบบไม่ใช้แคช มันคืนทุนในห้าเดือน — แต่คุณกำลังเทียบของที่ไม่เหมือนกัน เพราะ Fable 5.1 เป็นโมเดลที่ดีกว่าอะไรก็ตามที่ใส่ได้ใน 128 GB มาก
ดังนั้นอย่าซื้อฮาร์ดแวร์โลคอลเพื่อประหยัดเงิน ซื้อเพราะเหตุผลห้าข้อนี้ ซึ่งล้วนเป็นเหตุผลจริง:
- การเก็บข้อมูลในเขตอำนาจศาลที่กำหนด ซึ่งเป็นการตัดสินใจด้านสถาปัตยกรรม ไม่ใช่โครงการด้านกฎหมาย
- ไม่มีเรตลิมิต ไม่มีโควตา ไม่มีเหตุการณ์ความจุไม่พอ เครื่องของคุณไม่มีวันอังคารที่งานล้น
- ปักหมุดเวอร์ชันได้ตลอดไป เช็กพอยต์ในเครื่องยังเหมือนเดิมทุกไบต์ในอีกหนึ่งปี
- การทำงานแบบออฟไลน์
- ยังไงคุณก็ต้องใช้เวิร์กสเตชันอยู่แล้ว นี่คือกรณีที่พบบ่อยที่สุดซึ่งการซื้อถูกต้องตรง ๆ — ถ้าคุณจะซื้อเครื่องในราคา €2,500 อยู่แล้ว ต้นทุนส่วนเพิ่มของความสามารถ AI คือการอัปเกรดหน่วยความจำ ไม่ใช่ตัวเครื่องทั้งเครื่อง
ภาพรวมการปฏิบัติตามข้อกำหนดของ EU เพราะมันเปลี่ยนไปในปี 2026
สำหรับผู้อ่านในเยอรมนีและ EU พื้นฐานกฎระเบียบขยับในปีนี้ และกำหนดการต่าง ๆ ตอนนี้ตายตัวแล้ว ไม่ใช่แบบมีเงื่อนไข
- 2 สิงหาคม 2025 — ผู้ให้บริการโมเดล GPAI มีหน้าที่ด้านเอกสาร สรุปเนื้อหาที่ใช้ฝึก และลิขสิทธิ์
- 2 สิงหาคม 2026 — อำนาจบังคับใช้กฎหมายและหน้าที่ความโปร่งใสตามมาตรา 50 มีผลบังคับใช้ ตอนนี้สามารถปรับได้แล้ว
- 27 กรกฎาคม 2026 — Digital Omnibus หรือ Regulation (EU) 2026/1744 มีผลบังคับใช้ แทนกลไกแบบมีเงื่อนไขเดิมสำหรับระบบความเสี่ยงสูงด้วยกำหนดการที่ตายตัว
- 2 ธันวาคม 2026 — สิ้นสุดระยะผ่อนผันสำหรับการใส่ลายน้ำที่เครื่องอ่านได้บนระบบที่มีอยู่เดิม
- 2 สิงหาคม 2027 — หน้าต่างเปลี่ยนผ่านสองปีปิดลงสำหรับโมเดล GPAI ที่อยู่ในตลาดแล้ว
- 2 ธันวาคม 2027 — ระบบความเสี่ยงสูงแบบเดี่ยวภายใต้ภาคผนวก III (การจ้างงาน การให้คะแนนเครดิต การศึกษา โครงสร้างพื้นฐานสำคัญ)
- 2 สิงหาคม 2028 — AI ความเสี่ยงสูงที่ฝังอยู่ในผลิตภัณฑ์ที่มีการกำกับดูแลภายใต้ภาคผนวก I (อุปกรณ์การแพทย์ เครื่องจักร)
Digital Omnibus ยังเพิ่มข้อห้ามเกี่ยวกับภาพอนาจารที่ AI สร้างขึ้นโดยไม่ได้รับความยินยอมและ CSAM พร้อมขยายอำนาจกำกับดูแลของ EU AI Office
สิ่งนี้หมายความในทางปฏิบัติอย่างไรสำหรับผู้อ่านบทความนี้ ถ้าคุณสร้างบนโมเดลสำเร็จรูปแทนการฝึกโมเดลเอง ภาระผูกพัน GPAI ส่วนใหญ่อยู่ที่ผู้ให้บริการ ไม่ใช่ที่คุณ สิ่งที่ตกมาถึงคุณคือความโปร่งใส — การบอกผู้ใช้ว่าพวกเขากำลังโต้ตอบกับ AI และการทำเครื่องหมายเนื้อหาสังเคราะห์ — บวกกับคำถามเรื่องการจัดชั้นความเสี่ยงสูง หากระบบของคุณเกี่ยวข้องกับการจ้างงาน เครดิต การศึกษาหรือโครงสร้างพื้นฐานสำคัญ กำหนดการธันวาคม 2027 ห่างพอที่จะวางแผนได้ และใกล้พอที่ “เดี๋ยวค่อยไปดู” จะไม่ใช่กลยุทธ์อีกต่อไป
และประเด็นที่เกี่ยวข้องมากที่สุดกับ Act III: โมเดลที่ทำงานบนอุปกรณ์ช่วยให้บทสนทนาเหล่านี้หลายเรื่องง่ายขึ้นอย่างมีนัยสำคัญในคราวเดียว ไม่มีการโอนข้อมูล ไม่มีผู้ประมวลผล แผนผังการไหลของข้อมูลสั้นลงมาก นี่ไม่ใช่ช่องโหว่ — หน้าที่ด้านความโปร่งใสยังใช้อยู่ — แต่มันตัดงานออกไปทั้งหมวด
ผมไม่ใช่นักกฎหมายและนี่ไม่ใช่คำแนะนำทางกฎหมาย สำหรับเรื่องใดก็ตามที่มีเงินเกี่ยวข้อง ควรให้ที่ปรึกษาที่ผ่านคุณสมบัติในเยอรมนีหรือ EU ตรวจดูการใช้งานจริงของคุณ
ตอนที่ 17: ข้อโต้แย้งตรง ๆ ต่อทั้งหมดนี้
ถ้าผมหยุดที่ตอนที่ 16 นี่คงเป็นโฆษณา
หลักฐานที่วัดได้เรื่องผลิตภาพยังไม่สนับสนุนความกระตือรือร้นนั้น การทดลองแบบสุ่มควบคุมเพียงชิ้นเดียว ช้ากว่า 19% การทดลองซ้ำที่ทำได้ไม่สะอาด รายงานจากผู้ใช้เองที่พองเกินจริงไป 40 เปอร์เซ็นต์ ทุกคนในอุตสาหกรรมนี้ รวมถึงตัวผม กำลังทำงานโดยอิงกับความเชื่อเชิงความรู้สึกที่ต่อยอดจากความรู้สึกอีกชั้นเป็นหลัก
ข้อมูลด้านความปลอดภัยแย่และไม่ได้ดีขึ้น อัตราความล้มเหลว OWASP 45% ของ Veracode แทบไม่เปลี่ยนเลยจนถึงต้นปี 2026 ในขณะที่โมเดลฉลาดขึ้นอย่างมาก นั่นไม่ใช่ปัญหาช่วงเปลี่ยนผ่านที่การขยายขนาดจะแก้ได้ ความสามารถและความปลอดภัยไม่ใช่แกนเดียวกัน และไม่มีใครกำลังปรับแต่งอย่างหนักเพื่อแกนที่สอง
เบนช์มาร์กอิ่มตัวที่ระดับบน และตรวจสอบไม่ได้ที่ระดับกลาง SWE-bench Verified มีสามโมเดลที่ห่างกันไม่ถึงหนึ่งคะแนน เบนช์มาร์กที่มาแทนนั้นเป็นแบบปิดมากขึ้นเรื่อย ๆ ซึ่งแก้ปัญหาการปนเปื้อนด้วยการทำให้การตรวจสอบอิสระเป็นไปไม่ได้
น้ำหนักแบบเปิดห่างจากการไม่เปิดเพียงการแก้สัญญาอนุญาตครั้งเดียว Z.ai เปลี่ยน GLM จาก MIT เป็นสัญญาอนุญาตแบบกรรมสิทธิ์ที่มีด่านตรวจความปลอดภัยระหว่าง 5.2 กับ 5.3 Meta สัญญาว่าจะเปิดน้ำหนักของ Muse Spark โดยไม่มีกำหนด ไม่มีขนาด และไม่มีข้อความสัญญาอนุญาต ถ้าสถาปัตยกรรมของคุณตั้งสมมติฐานว่าจะมีน้ำหนักให้ดาวน์โหลดได้ในปีหน้า สมมติฐานนั้นคือการตัดสินใจทางธุรกิจของผู้ขาย ไม่ใช่กฎธรรมชาติ
ฟรอนเทียร์ยังไม่ใช่ของโลคอล และยิ่งซื้อไม่ได้มากขึ้นเรื่อย ๆ Mythos 5.1 ซึ่งทำคะแนนสูงสุดใน Terminal-Bench 4.0 ถูกจำกัดให้เฉพาะนักป้องกันไซเบอร์และนักวิทยาศาสตร์ชีวภาพที่ผ่านการตรวจสอบ ซึ่งตอนนี้ส่วนใหญ่อยู่ในสหรัฐฯ Kimi K3 และ DeepSeek V4 Pro ไม่พอดีกับเครื่องของผู้บริโภคใด ๆ สิ่งที่พอดีกับโต๊ะของคุณคือโมเดลระดับสองที่ยอดเยี่ยม ซึ่งเป็นสถานะที่มีประโยชน์จริง ๆ และไม่ใช่ฟรอนเทียร์
ประสิทธิภาพบนอุปกรณ์แย่กว่าที่การตลาดบอกไว้ ห้าโทเคนต่อวินาทีสำหรับโมเดล 8B บน NPU 45 TOPS ด่านหน่วยความจำ 12 GB ที่กีดกันโทรศัพท์ส่วนใหญ่ที่ใช้งานอยู่ คำสัญญาอัปเดตเจ็ดปีที่ไม่ครอบคลุมฟีเจอร์ ช่องว่างระหว่างแบรนด์ “AI PC” กับสิ่งที่เครื่องรันได้จริงตอนนี้มหาศาล
และภูมิรัฐศาสตร์เป็นปัจจัยในการจัดซื้อ ไม่ว่าคุณจะคิดว่ามันควรเป็นหรือไม่ โมเดลโอเพนเวตที่ดีที่สุดหลายตัว — Kimi, GLM, DeepSeek, Qwen, MiniMax — มาจากแล็บจีน สำหรับภาครัฐ ลูกค้าที่เกี่ยวข้องกับกลาโหม และลูกค้าที่อยู่ภายใต้การกำกับดูแลบางราย นี่คืออุปสรรคตายตัว ไม่ว่าน้ำหนักจะรันที่ไหนหรือสัญญาอนุญาตจะเขียนว่าอะไร ในขณะเดียวกันโมเดลเขียนโค้ดที่เก่งที่สุดของ Anthropic ก็ถูกจำกัดให้เฉพาะองค์กรในสหรัฐฯ ที่ผ่านการตรวจสอบ ระบบนิเวศแบบเปิดกำลังถูกฉีกออกตามแนวชาติจากทั้งสองด้านและถ้าคุณอยู่ในยุโรป คุณไม่ได้อยู่ปลายด้านใดด้านหนึ่งเลย
ตอนที่ 18: กรอบการตัดสินใจสำหรับสถานะของ AI ปี 2026
แสดงรูปภาพ เจ็ดสถานการณ์ เจ็ดคำตอบ หาแถวที่ฟังดูเหมือนปีของคุณ
เจ็ดสถานการณ์ที่จับคู่กับสถานะของ AI ปี 2026 ตามที่มันเป็นจริงในวันนี้
1. “อยากได้โมเดลที่ดีที่สุด และเรื่องต้นทุนไม่ใช่ปัญหา”
Claude Fable 5.1 ที่ 65.7 บนดัชนีรวม $10/$50 บริบท 1M — และเปิดแคชไว้ เพราะการลดค่าอ่านแคช 75% คิดเป็น 25–45% ของบิลคุณ เก็บ GPT-5.6 Sol ไว้ใช้สำหรับงานวิจัยที่เน้นการท่องเว็บ ที่ 90.4% บน BrowseComp อย่าคิดมาก ช่องว่างระหว่างสองตัวเล็กกว่าช่องว่างระหว่างพรอมต์ที่ดีที่สุดกับแย่ที่สุดของคุณ
2. “รันเอเจนต์เยอะมากจนบิลเริ่มไม่ไหวแล้ว”
Claude Opus 5 ที่ $5/$25 สำหรับงานระยะยาว GLM-5.3-Flash ที่ $0.15/$0.47 สำหรับงานซ้ำ ๆ ปริมาณมาก และโมเดลโลคอลสำหรับงานหยาบ การจัดเส้นทางคือคันโยกต้นทุนที่ใหญ่ที่สุดที่คุณมี และมันคือไฟล์คอนฟิก ไม่ใช่โครงการ วัดสัดส่วนโทเคนแยกตามบทบาทของเอเจนต์ก่อนจะปรับอะไร — คนส่วนใหญ่พบว่า 80% ของค่าใช้จ่ายหมดไปกับงานที่ไม่จำเป็นต้องใช้โมเดลฟรอนเทียร์
3. “GDPR และการเก็บข้อมูลในเขตอำนาจศาลเป็นข้อกำหนดตายตัวสำหรับงานลูกค้า”
Qwen3.8-27B หรือ Gemma 4 31B บนฮาร์ดแวร์ที่คุณเป็นเจ้าของทั้งคู่ใช้ Apache 2.0 ทั้งคู่รองรับหลายรูปแบบข้อมูล ขยับไปใช้ gpt-oss-120b เครื่อง 128 GB ถ้างานต้องการ จุดสำคัญไม่ใช่ความเร็ว — แต่คือไม่มีพรอมต์ใดออกจากอาคาร และการตรวจสอบทางกฎหมายของคุณกลายเป็นการอ่านสัญญาอนุญาตแทนการประเมินผลกระทบของการโอนข้อมูล เลือกโมเดลที่สัญญาอนุญาตเปิดกว้างโดยเฉพาะ เพื่อให้การอ่านนั้นสั้น
4. “อยากลอง AI โลคอลโดยไม่ต้องจ่ายมาก”
อะไรก็ตามที่คุณมีอยู่แล้ว บวก LM Studio บวก Gemma 4 E4B หน่วยความจำแปดกิกะไบต์ก็เพียงพอที่จะมีประโยชน์จริง ดูให้รู้ตัวก่อนว่า AI โลคอลเหมาะกับคุณไหมก่อนจะลงเงินกับมัน — คนส่วนใหญ่พบว่าตัวเองอยากได้ระดับ 1 กับระดับ 3 และไม่เคยต้องการระดับ 2 เลย
5. “กำลังจะซื้อเครื่องมาเพื่อการอนุมานในเครื่องโดยเฉพาะ”
เลือกซื้อจากแบนด์วิดท์หน่วยความจำและความจุ ตามลำดับนั้น และไม่ต้องสน TOPS ในกลุ่ม 128 GB Strix Halo ที่ราคา ~$2,400 คือตัวที่คุ้มค่า และ DGX Spark ที่ ~$3,999 ให้ CUDA และการสร้างภาพที่ดีกว่ามาก เหนือขึ้นไป Mac Studio M5 Ultra เป็นเพียงสิ่งเดียวที่รับโมเดล 400B ได้ ในราคาที่สมเหตุสมผลเฉพาะเมื่อคุณต้องใช้เวิร์กสเตชันอยู่แล้ว
6. “ทีมของผมกำลังนำเครื่องมือเขียนโค้ด AI มาใช้ และผมเป็นคนรับความเสี่ยง”
ทำเรื่องน่าเบื่อเหล่านี้ ตามลำดับนี้: SAST และการตรวจจับความลับทุกคอมมิต; การวิเคราะห์องค์ประกอบซอฟต์แวร์สำหรับแพ็กเกจที่โมเดลคิดขึ้นเอง; นโยบายเป็นลายลักษณ์อักษรที่ห้ามโค้ด AI ที่ยังไม่ผ่านการรีวิวในส่วน auth, crypto, authz และการชำระเงิน; ข้อมูลรับรองของเอเจนต์ที่จำกัดขอบเขตแบบสิทธิ์พิเศษ; และ SBOM ที่บันทึกที่มาของเครื่องมือ จากนั้นคาดว่าจะมี เส้นโค้ง J — DORA วัดพบว่ามีการตกจริงก่อนจะได้ผลตอบแทน — และอย่าตกใจในเดือนที่สาม
7. “ควรซื้อโทรศัพท์รุ่นไหนเพื่อใช้ AI?”
รุ่นไหนก็ได้ที่มี 12 GB นั่นคือเส้นที่ทุกแพลตฟอร์มลากไว้: iPhone 17 Pro และ 18 Pro ที่ 12 GB, Pixel 10 สำหรับ Nano v3, Galaxy S26 Ultra บน Snapdragon 8 Elite Gen 5 ส่วน iPhone 18 รุ่นพื้นฐานที่มีรายงานว่า 9 GB กับ Pixel 9 และรุ่นเก่ากว่าจะใช้งานโทรศัพท์ได้ปกติ แต่จะไม่ได้ฟีเจอร์เหล่านี้ ถ้าคุณใช้เครื่อง 12 GB อยู่แล้ว การอัปเกรดปีนี้เป็นเพียงการขยับเล็กน้อยในแง่ AI โดยเฉพาะ
ตอนที่ 19: สิ่งที่ผมจับตาดูในไตรมาสหน้า
ว่า Meta จะปล่อยน้ำหนักของ Muse Spark จริงหรือไม่ และภายใต้สัญญาอนุญาตอะไร คำว่า “เร็ว ๆ นี้” จากซีอีโอบน X โดยไม่มีจำนวนพารามิเตอร์และไม่มีข้อความสัญญาอนุญาต คือรูปแบบคำมั่นที่อ่อนแอที่สุดในบทความนี้ ถ้าพวกเขาปล่อยภายใต้ Apache 2.0 มันจะเปลี่ยนระบบนิเวศแบบเปิดอย่างมีนัยสำคัญ ถ้าปล่อยภายใต้สัญญาอนุญาตเฉพาะกิจที่มีด่านรายได้ นั่นคือค่ามาตรฐานของอุตสาหกรรมตอนนี้ และน้ำหนักแบบเปิดก็กลายเป็นหมวดทางการตลาดมากกว่าคุณสมบัติจริง
ว่าผลการพัฒนาตัวเองของ Ornith-1.5 จะทำซ้ำได้หรือไม่ การประเมินอิสระบนงานที่อยู่นอกหลักสูตรที่โมเดลสร้างเองคือสิ่งที่จะตอบคำถามนี้ได้ นี่คือรายการที่มีความแปรปรวนสูงสุดในลิสต์: มันอาจเป็นผลลัพธ์ที่สำคัญที่สุดของปี 2026 หรือเป็นนิทานเตือนใจเกี่ยวกับเบนช์มาร์กที่โมเดลสร้างเอง และตอนนี้ผมยังไม่รู้ว่าอันไหน
ว่า Aion 1.0 Plan จะออกจริงหรือไม่ และรันได้เร็วแค่ไหน โมเดลให้เหตุผลขนาด 14B ใน Windows เป็นหมวดใหม่จริง ๆ ถ้ามันรันที่ 3 โทเคนต่อวินาทีบนฮาร์ดแวร์ที่เข้าเกณฑ์ ก็เป็นแค่เดโม ถ้ารันได้ 20 มันจะเปลี่ยนสิ่งที่แอปเดสก์ท็อปตั้งสมมติฐานได้
เส้นโค้งการระบุที่มาของ CVE 6, 15, 35 ในแต่ละเดือนติดกัน ถ้าเดือนเมษายนถึงสิงหาคมยังคงวิถีนั้น ข้อมูลของ Georgia Tech จะเป็นงานตีพิมพ์ด้านความปลอดภัย AI ที่มีผลกระทบมากที่สุดของปีเมื่อออกมา
ว่าจะมีใครสร้างเครื่องมือสำหรับการรีวิวขึ้นมาหรือไม่ ช่องว่างระหว่างสิ่งที่เอเจนต์ผลิตได้กับสิ่งที่มนุษย์ตรวจสอบได้คือปัญหาที่เป็นตัวกำหนดของปี 2027 และ ณ วันนี้เงินทุนร่วมลงทุนเกือบทั้งหมดยังไหลไปที่การสร้างมากกว่าการตรวจสอบ ใครก็ตามที่ส่งเครื่องมือที่บอกได้อย่างน่าเชื่อถือว่า diff ส่วนไหน 5% ที่ต้องใช้สายตามนุษย์ จะเป็นคู่แข่งที่เอาชนะได้ยากมาก
ว่าการขาดแคลนหน่วยความจำจะคลี่คลายหรือไม่ มันคือตัวแปรที่ซ่อนอยู่เบื้องหลังด่าน 12 GB ของโทรศัพท์ เพดาน 32 GB ของ M6 ชั้น 512 GB ของ Mac ที่ล่าช้าออกไป และการขึ้นราคาของ Apple ในเดือนมิถุนายน ไม่มีใครที่น่าเชื่อถือพยากรณ์ว่าจะผ่อนคลาย
และว่าโมเดลฟรอนเทียร์ที่ถูกจำกัดด้วยเหตุผลด้านความปลอดภัยจะยังเป็นข้อยกเว้นหรือไม่ Mythos 5.1 ถูกจำกัดด้วยเหตุผลเรื่องการใช้ได้สองทาง ซึ่งผมเห็นว่าป้องกันได้ และ Project Glasswing กำลังขยายการเข้าถึงอย่างจริงจัง — ราว 150 องค์กรในกว่าสิบห้าประเทศภายในเดือนมิถุนายน 2026 แต่แบบอย่างถูกตั้งไว้แล้ว: ผู้ทำคะแนนสูงสุดบนเบนช์มาร์กการเขียนโค้ดสาธารณะตอนนี้กลายเป็นสิ่งที่องค์กรส่วนใหญ่ซื้อไม่ได้ไม่ว่าจะราคาเท่าไร ถ้าสิ่งนั้นกลายเป็นรูปแบบที่เกิดซ้ำไม่ใช่กรณีพิเศษ “องค์กรของฉันผ่านการตรวจสอบได้ไหม” จะกลายเป็นเกณฑ์เลือกโมเดล และข้อโต้แย้งเพื่อน้ำหนักแบบเปิดนอกสหรัฐฯ จะเลิกเป็นเรื่องของต้นทุนไปเลย
คำถามที่พบบ่อย
LLM ตัวไหนดีที่สุดในเดือนกันยายน 2026?
ในภาพรวม Claude Fable 5.1 นำ Artificial Analysis Intelligence Index v4.1.1 ที่ 65.7 เหนือกว่า Claude Opus 5 ที่ 63.0, Claude Fable 5 ที่ 62.1, Grok 4.6 ที่ 60.9 และ GPT-5.6 Sol ที่ 58.9 แต่ค่าภาพรวมบีบความแตกต่างที่สำคัญให้แบนลง GPT-5.6 Sol นำด้านการท่องเว็บที่ 90.4% บน BrowseComp; Gemini 3.8 Flash ทำได้ 58.7 ที่ $0.75 ต่อโทเคนอินพุตหนึ่งล้านโทเคน; GLM-5.3-Flash ทำได้ 57.5 ที่ $0.15 สำหรับงานจริงส่วนใหญ่ โมเดลแปดอันดับแรกใช้แทนกันได้ และควรตัดสินใจจากราคา ความหน่วง ความคุ้มค่าของแคช และสัญญาอนุญาต มากกว่าอันดับ
ตอนนี้โมเดลโอเพนเวตตัวไหนดีที่สุด?
ขึ้นอยู่กับฮาร์ดแวร์และระดับความอดทนต่อสัญญาอนุญาตของคุณ GLM-5.3 (753B) ทำคะแนนสูงสุดที่ 59.5 แต่มาพร้อมสัญญาอนุญาตเฉพาะกิจที่มีด่านตรวจความปลอดภัยด้านรายได้ 1 หมื่นล้านดอลลาร์ DeepSeek V4 Pro (รวม 1.6T, แอ็กทีฟ 49B) ใช้สัญญาอนุญาต MIT และทำได้ 87.9 บน Terminal-Bench 2.1 แต่ต้องใช้คลัสเตอร์ สำหรับเครื่องที่คุณเป็นเจ้าของจริง ๆ Qwen3.8-27B หรือ Gemma 4 31B — ทั้งคู่ Apache 2.0 — เป็นโมเดลที่ดีที่สุดที่ใส่ได้ใน 32 GB
ไวบ์โคดิงตายแล้วในปี 2026 หรือ?
คำนี้กำลังตาย แต่การปฏิบัติแยกออกเป็นสองทาง ไวบ์โคดิงในความหมายเดิม — พรอมต์ ยอมรับ ไม่ต้องอ่าน diff — ยังใช้ได้กับงานใช้แล้วทิ้ง: สคริปต์ ต้นแบบ การวิเคราะห์ครั้งเดียว สิ่งที่มาแทนสำหรับงานที่ต้องส่งมอบจริงคือวิศวกรรมเอเจนต์ที่ขับด้วยสเปก: สเปกเป็นลายลักษณ์อักษร แซนด์บ็อกซ์ ชุดทดสอบที่เอเจนต์ต้องผ่าน และการรีวิว diff ที่ได้จริง ๆ ตรงกลางที่อันตราย — โค้ดโปรดักชันที่ไม่ได้รีวิว — คือที่มาของทุกเหตุการณ์ที่บันทึกไว้ในปี 2026
การเขียนโค้ดด้วย AI ทำให้ developers เร็วขึ้นจริงหรือ?
การทดลองแบบสุ่มควบคุมเพียงชิ้นเดียวบอกว่าไม่ METR พบว่านักพัฒนาที่มีประสบการณ์ช้ากว่า 19% เมื่อใช้เครื่องมือ AI ต้นปี 2025 บนโค้ดเบสที่โตเต็มที่ ขณะที่เชื่อว่าตัวเองเร็วขึ้น 20% — ประเมินเกินจริงไป 40 เปอร์เซ็นต์ การทดลองซ้ำในปี 2026 ของพวกเขาทำได้ไม่สะอาด เพราะนักพัฒนาปฏิเสธที่จะทำงานโดยไม่มี AI แบบสำรวจรายงานว่าความเร็วคูณ 3 แต่การเปลี่ยนแปลงของมูลค่างานมีเพียง 1.4–2 เท่า ข้ออ่านของผม: ได้ประโยชน์มากกับงานที่ไม่คุ้นเคย โค้ดสำเร็จรูป การทดสอบ และการย้ายระบบ; ได้น้อยหรือติดลบกับโค้ดเบสที่คุณรู้ดีอยู่แล้ว
โค้ดที่ AI สร้างขึ้นเสี่ยงแค่ไหน?
วัดได้ว่าเสี่ยง และดีขึ้นช้า ๆ Veracode พบว่า 45% ของตัวอย่างที่ AI สร้างขึ้นแนะนำช่องโหว่ OWASP Top 10 โดย Java แย่ที่สุดที่ 72% Apiiro วัดพบว่านักพัฒนาที่ใช้ AI ช่วยผลิตคอมมิตเร็วขึ้น 3–4 เท่า และพบประเด็นด้านความปลอดภัยเร็วขึ้น 10 เท่า โดยเส้นทางการยกระดับสิทธิ์เพิ่มขึ้น 322% ประมาณ 20% ของโค้ดที่ AI สร้างอ้างถึงแพ็กเกจที่ไม่มีอยู่จริง และ 43% ของชื่อที่โมเดลคิดขึ้นเหล่านั้นปรากฏซ้ำอย่างสม่ำเสมอ — ซึ่งเป็นพื้นผิวการโจมตีในห่วงโซ่อุปทาน ทางแก้คือด่านอัตโนมัติทุกคอมมิต ไม่ใช่การเลิกใช้
รัน LLM ดี ๆ แบบออฟไลน์บนคอมพิวเตอร์ของตัวเองได้ไหม?
ได้ และปี 2026 เป็นปีแรกที่เรื่องนี้เป็นจริงอย่างไม่ต้องสงสัย บนหน่วยความจำ 8 GB Gemma 4 E4B มีประโยชน์จริง บน 32 GB Qwen3.8-27B หรือ Gemma 4 31B เป็นโมเดลหลายรูปแบบที่แข็งแกร่งภายใต้ Apache 2.0 บน 128 GB gpt-oss-120b คือจุดที่ลงตัว สิ่งที่ไม่พอดีกับเครื่องผู้บริโภคใด ๆ คือฟรอนเทียร์จริง ๆ: Kimi K3 ที่ 2.8 ล้านล้านพารามิเตอร์ และ DeepSeek V4 Pro ที่ 1.6 ล้านล้านพารามิเตอร์ ต่างต้องใช้คลัสเตอร์
Microsoft Aion 1.0 คืออะไร?
กลุ่มโมเดลบนอุปกรณ์ที่ประกาศในงาน Build วันที่ 2 มิถุนายน 2026 และส่งมอบใน Windows 11 Aion 1.0 Instruct เป็นโมเดลเล็กสำหรับการสรุป การเขียนใหม่ และการดึงข้อมูล ซึ่งรันบน CPU สมัยใหม่โดยไม่ต้องมี NPU เปิดให้ใช้ผ่าน JavaScript API ของ Edge ได้แก่ Prompt, Summarizer, Writer และ Rewriter โดยมีน้ำหนักแบบเปิดบน Hugging Face ตั้งแต่เดือนกรกฎาคม 2026 Aion 1.0 Plan เป็นโมเดลให้เหตุผลและเรียกใช้เครื่องมือขนาด 1.4 หมื่นล้านพารามิเตอร์ มีหน้าต่างบริบท 32K สำหรับเวิร์กโฟลว์แบบเอเจนต์ ต้องใช้ Copilot+ PC ที่มี NPU ขั้นต่ำ 40 TOPS และยังคงเป็น “อีกหลายเดือนข้างหน้า” ณ ต้นเดือนกันยายน 2026
ทำไมโทรศัพท์ต้องมี RAM 12 GB สำหรับฟีเจอร์ AI?
เพราะโมเดลบนอุปกรณ์ถูกจำกัดด้วยหน่วยความจำ ไม่ใช่ด้วยพลังประมวลผล AFM 3 Core Advanced ของ Apple เป็นโมเดลแบบกระจายขนาด 2 หมื่นล้านพารามิเตอร์ที่อยู่ในที่เก็บแฟลชและสลับ routed experts เข้า DRAM ตามต้องการ — ซึ่งยังต้องมีที่ให้สลับเข้า นอกเหนือจากระบบปฏิบัติการ แอป และไปป์ไลน์กล้อง Ming-Chi Kuo รายงานว่าฟีเจอร์ iOS 27 สองตัวต้องใช้ 12 GB Gemini Intelligence ของ Google ก็กำหนดขั้นต่ำ 12 GB เช่นกัน ช่องว่างระหว่าง 9 GB กับ 12 GB คือชุดทำงาน ไม่ใช่การแบ่งตลาด
NPU คุ้มที่จะมีไว้สำหรับ AI โลคอลไหม?
น้อยกว่าที่การตลาดบอก บน NPU 45 TOPS โมเดล 8B สร้างราว 5 โทเคนต่อวินาที เพราะการสร้างโทเคนถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำมากกว่าพลังประมวลผล NPU ยอดเยี่ยมสำหรับงานเปิดตลอดเวลา ใช้พลังงานต่ำ และทำงานสั้น ๆ — งานที่ระบบปฏิบัติการรันตลอด สำหรับแชตโต้ตอบบนแล็ปท็อป เส้นทาง GPU หรือแม้แต่ CPU มักเร็วกว่า เลือกซื้อจากแบนด์วิดท์และความจุหน่วยความจำ และถือว่า TOPS แทบไม่มีความหมายในการช้อปปิ้ง
โมเดลโอเพนเวตเป็นโอเพนซอร์สจริงหรือ?
ส่วนใหญ่ไม่ DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) และ Ornith-1.5 (MIT) มีสัญญาอนุญาตที่เปิดกว้างจริง GLM-5.3 กำหนดให้บริษัทที่มีรายได้เกิน 1 หมื่นล้านดอลลาร์ต้องผ่านการตรวจสอบความปลอดภัยของ Z.ai; Kimi K3 ใช้สัญญาอนุญาตแบ่งตามระดับรายได้; MiniMax M3 บังคับให้ระบุเครดิต “Built with MiniMax M3” อย่างชัดเจนสำหรับการใช้งานเชิงพาณิชย์ใด ๆ และต้องขออนุญาตเป็นลายลักษณ์อักษรเมื่อรายได้เกิน 20 ล้านดอลลาร์ ไม่มีตัวใดเปิดเผยข้อมูลฝึกหรือโค้ดฝึก “โอเพนเวต” คือคำที่ถูกต้อง ส่วน “โอเพนซอร์ส” กำลังทำงานแบบไม่ซื่อสัตย์
รันโมเดลในเครื่องถูกกว่าการใช้ API ไหม?
แทบไม่เคยถูกถ้าคิดแค่ต้นทุนโทเคน งานเอเจนต์ปานกลางหนึ่งเดือน — อินพุต 40M และเอาต์พุต 3M โทเคน — มีต้นทุนราว $7 บน GLM-5.3-Flash และราว $41 บน Gemini 3.8 Flash เครื่องโลคอลราคา $2,400 ตัดค่าเสื่อม 3 ปีคิดเป็นราว $67 ต่อเดือนก่อนค่าไฟ ฮาร์ดแวร์โลคอลชนะสุดยอดฟรอนเทียร์เรื่องต้นทุน และแพ้ฐานล่างของมัน ซื้อโลคอลเพื่อการเก็บข้อมูลในเขตอำนาจศาล อิสระจากเรตลิมิต การปักหมุดเวอร์ชัน และการทำงานออฟไลน์ — หรือเพราะคุณต้องใช้เวิร์กสเตชันอยู่แล้ว
EU AI Act กำหนดอะไรบ้างในปี 2026?
ตั้งแต่ 2 สิงหาคม 2026 อำนาจบังคับใช้และหน้าที่ความโปร่งใสตามมาตรา 50 ใช้กับ AI เพื่อวัตถุประสงค์ทั่วไป และสามารถปรับได้แล้ว Digital Omnibus หรือ Regulation (EU) 2026/1744 มีผลบังคับใช้เมื่อ 27 กรกฎาคม 2026 และกำหนดวันที่ตายตัว: 2 ธันวาคม 2026 สิ้นสุดระยะผ่อนผันการใส่ลายน้ำ; 2 สิงหาคม 2027 ปิดการเปลี่ยนผ่านสำหรับโมเดล GPAI ที่อยู่ในตลาดแล้ว; 2 ธันวาคม 2027 ใช้กับระบบความเสี่ยงสูงแบบเดี่ยวภายใต้ภาคผนวก III; 2 สิงหาคม 2028 ครอบคลุม AI ความเสี่ยงสูงที่ฝังในผลิตภัณฑ์ที่มีการกำกับดูแล ถ้าคุณสร้างบนโมเดลแทนการฝึกเอง ภาระ GPAI ส่วนใหญ่อยู่ที่ผู้ให้บริการ — ความโปร่งใสและการจัดชั้นความเสี่ยงสูงคือสิ่งที่ตกมาถึงคุณ นี่ไม่ใช่คำแนะนำทางกฎหมาย
เอเจนต์ AI ทำงานโดยไม่มีคนดูแลได้นานแค่ไหน?
METR วัดความยาวงานที่โมเดลทำเสร็จด้วยตัวเองโดยมีอัตราความสำเร็จ 50% ตัวเลขนั้นขยับจากราว 30 วินาทีในปี 2022 เป็นกว่าสิบสี่ชั่วโมงสำหรับระบบฟรอนเทียร์ในปี 2026 โดยมีเวลาในการเพิ่มเป็นสองเท่าราว 196 วันตามการฟิตแบบผสมของ METR หรือ 131 วันเมื่อจำกัดเฉพาะโมเดลหลังปี 2023 ช่วงความเชื่อมั่นกว้างมาก — ขอบเขต 320 นาทีของ Claude Opus 4.5 อยู่ในช่วง 170 ถึง 729 นาที — และมีเพียง 5 จาก 31 งานยาวของ METR ที่ใช้ค่าพื้นฐานจากมนุษย์ที่วัดได้ เมื่อคาดการณ์ต่อ นั่นคือความยาวงานอัตโนมัติราวหนึ่งวันทำงานในปี 2027
ควรใช้โมเดลไหนสำหรับการเขียนโค้ดโดยเฉพาะ?
จัดเส้นทางดีกว่าเลือกตัวเดียว การวางแผนและสถาปัตยกรรมให้โมเดลที่เก่งที่สุดที่คุณจ่ายไหว (Claude Fable 5.1); งานลงมือทำระยะยาวส่วนใหญ่ให้ Claude Opus 5 ในราคาครึ่งเดียว; งานซ้ำ ๆ ปริมาณมากให้ GLM-5.3-Flash ที่ $0.15/$0.47; งานใดที่แตะข้อมูลลูกค้าให้โมเดลโอเพนเวตโลคอล; และการเปลี่ยนชื่อ เอกสารโค้ด และการแก้ lint ให้โมเดลโลคอลเล็ก เขียน ID ของโมเดลให้การสลับตัวเป็นการแก้บรรทัดเดียว — สี่แล็บส่งโมเดลระดับท็อปเทนออกมาระหว่างมิถุนายนถึงกันยายน 2026
บทสรุป
สิบสองเดือนก่อน คำถามที่น่าสนใจในวงการ AI คือโมเดลไหนฉลาดที่สุด สถานะของ AI ปี 2026 คือคำถามนี้กลายเป็นเรื่องไม่น่าสนใจไปแล้ว โมเดลสิบบนสุดห่างกัน 8.2 คะแนนบนดัชนีรวมที่ดีที่สุดที่มี และตัวที่ถูกที่สุดมีราคาหนึ่งในหกสิบเจ็ดของตัวที่แพงที่สุด
สิ่งที่มาแทนนั้นมีประโยชน์กว่าและน่าตื่นเต้นน้อยกว่า: คุณตรวจสอบสิ่งที่พวกมันผลิตออกมาได้เร็วพอที่จะตามทันพวกมันไหม?
คำถามเดียวนั้นอธิบายทุกสิ่งที่พบในบทความนี้ มันอธิบายว่าทำไม SWE-bench อิ่มตัวที่ 96% และเลิกให้ข้อมูลที่เป็นประโยชน์ มันอธิบายว่าทำไมการนำเครื่องมือเขียนโค้ด AI ไปใช้แตะ 90% ในขณะที่ความเชื่อมั่นลดลงเหลือ 29% มันอธิบายว่าทำไมอัตราความล้มเหลวด้านความปลอดภัยของ Veracode ไม่ขยับเลยในขณะที่ความสามารถพุ่งสูง เพราะความสามารถและความสามารถในการตรวจสอบเป็นคนละแกน และมีเพียงแกนเดียวที่ถูกปรับแต่ง มันอธิบายว่าทำไม DORA พบว่าผลตอบแทนมาจากองค์กร ไม่ใช่จากเครื่องมือ และมันอธิบายว่าทำไมวิธีปฏิบัติที่ได้ผลจริงในปี 2026 — สเปก แซนด์บ็อกซ์ ด่านทดสอบ การรีวิวจริง — ดูมหัศจรรย์น้อยกว่าเดโมมาก
สี่สิ่งที่ผมอยากให้ติดไป
ฟรอนเทียร์กลายเป็นสินค้าโภคภัณฑ์เร็วกว่าที่ใครคาด และช่องว่างของโอเพนเวตตอนนี้ราวหกเดือน โมเดล 397B ที่ใช้สัญญาอนุญาต MIT ชนะฟรอนเทียร์แบบปิดของรุ่นก่อนบน SWE-bench โมเดลโอเพนเวต 753B มีอันดับเหนือ GPT-5.6 Sol บนดัชนีรวม วางแผนสำหรับโลกที่โมเดลไม่ใช่ความได้เปรียบของคุณ เพราะมันเกือบจะไม่ใช่แล้วในตอนนี้
อ่านสัญญาอนุญาตก่อนดูเบนช์มาร์ก ความสามารถกำลังบรรจบกัน ส่วนเงื่อนไขกำลังแยกจากกัน Z.ai ย้ายออกจาก MIT ระหว่างรุ่น Meta สัญญาว่าจะปล่อยน้ำหนักโดยไม่มีข้อความสัญญาอนุญาต โมเดลเขียนโค้ดที่ดีที่สุดของ Anthropic ถูกจำกัดตามสัญชาติ สำหรับผู้ซื้อเชิงพาณิชย์ คะแนนเบนช์มาร์กที่นำอยู่สี่คะแนนมีค่าน้อยกว่าสัญญาอนุญาตที่ทนายของคุณอ่านจบได้ในเก้าสิบวินาที
ตอนนี้การตรวจสอบคือเกมทั้งหมด และแทบไม่มีใครลงทุนกับมัน เอเจนต์ผลิตงานได้หนึ่งวัน แต่เรารีวิวด้วยเครื่องมือที่สร้างมาสำหรับรีวิวงานหนึ่งชั่วโมง ถ้าคุณกำลังเลือกว่าจะลงแรงวิศวกรรมตรงไหนในสิบสองเดือนข้างหน้า ให้ลงกับการทดสอบ สเปก และเครื่องมือรีวิว มากกว่าเทคนิคการเขียนพรอมต์ เทคนิคพรอมต์เสื่อมค่าลงทุกครั้งที่โมเดลออกรุ่นใหม่ โครงสร้างพื้นฐานการตรวจสอบกลับทบต้น
และ AI ออฟไลน์ก็กลายเป็นของจริง บนงบหน่วยความจำที่เพิ่งแพงขึ้น โมเดลหลายรูปแบบขนาด 2.7 หมื่นล้านพารามิเตอร์ภายใต้สัญญาอนุญาต Apache รันบนเครื่องที่ซื้อได้ในราคา €2,500 Windows มีโมเดลอยู่ในระบบปฏิบัติการ โทรศัพท์ของคุณรันโมเดลแบบกระจาย 2 หมื่นล้านพารามิเตอร์จากแฟลช ทุกเพดานของเรื่องนี้ — ด่าน 12 GB ของโทรศัพท์ เพดาน 32 GB ของแล็ปท็อป พื้น 40 TOPS — คือการตัดสินใจจัดสรรหน่วยความจำในตลาดที่ DRAM ขาดแคลน ไม่ใช่ขีดจำกัดของซิลิคอน
ชุดที่ผมจะสร้างจริง ๆ วันนี้: Gemma 4 E4B บนอุปกรณ์ สำหรับระดับที่เปิดตลอดเวลา; Qwen3.8-27B บนฮาร์ดแวร์ของคุณเอง สำหรับงานใดก็ตามที่ห้ามออกจากอาคาร; GLM-5.3-Flash ที่ $0.15/$0.47 สำหรับระดับกลางที่ปริมาณมาก; และ Claude Opus 5 หรือ Fable 5.1 สำหรับการวางแผนและปัญหาที่ยากจริง ๆ โดยเปิดแคชไว้ จัดเส้นทางระหว่างพวกมันในไฟล์คอนฟิก และคาดว่าคุณจะต้องเขียนไฟล์นั้นใหม่ในสามเดือน
กลับมาดูเรื่องนี้ในเดือนธันวาคม Meta จะปล่อยน้ำหนักหรือไม่ปล่อยก็ได้ Aion 1.0 Plan จะเป็นของจริงหรือแค่ไอระเหย ผลการพัฒนาตัวเองของ Ornith จะทำซ้ำได้หรือหายไปเงียบ ๆ และเส้นโค้งการระบุที่มาของ CVE จะบอกเราว่าปี 2026 เป็นปีที่อุตสาหกรรมกระชับด่านของตัวเอง หรือเป็นปีที่มันรอให้คนอื่นทำ
คุณกำลังรันโมเดลโอเพนเวตในโปรดักชันใน EU อยู่หรือเปล่า หรือส่งโค้ดที่เอเจนต์เขียนผ่านกระบวนการรีวิวที่คุณเชื่อถือได้จริง ๆ? ผมสนใจเป็นพิเศษสองเรื่อง: สัดส่วนต้นทุนโทเคนที่วัดได้แยกตามบทบาทของเอเจนต์ และอะไรก็ตามที่ใช้รีวิว diff ของเอเจนต์ยาวเป็นพันบรรทัดได้ผล ยินดีรับคำแก้ไขและหลักฐานโต้แย้ง — บทความนี้จะได้รับการอัปเดตเมื่อภาพเปลี่ยน
อัปเดตล่าสุด: 3 กันยายน 2026


