Português do Brasil
 English
 Deutsch
 Español
 Italiano
 Français

Índice
- TL;DR — O veredito
- Primeiro: sim, este chip é real
- O problema do preço (edição 2026)
- Por que 64GB especificamente? O argumento do ponto ideal
- Passo 1: libere sua memória (faça isso primeiro)
- Passo 2: monte seu stack
- Parte 1: executando LLMs
- O único conceito que explica tudo: largura de banda vs poder de computação
- A revolução do MoE (por que os Macs de repente ficaram bons)
- Quais modelos realmente cabem — a tabela
- Um teste de realidade sobre modelos 70B
- Quantização: o que realmente escolher
- MLX vs llama.cpp — qual runtime?
- Executando um servidor de API local
- Parte 2: geração de imagens
- Parte 3: geração de vídeo — a seção honesta
- Parte 4: fluxos de trabalho reais que valem a pena construir
- Fluxo de trabalho 1: um agente de codificação local
- Fluxo de trabalho 2: RAG privado sobre seus documentos
- Fluxo de trabalho 3: geração em lote durante a noite
- Fluxo de trabalho 4: roteamento híbrido (a estratégia que a maioria das pessoas deveria adotar)
- O stack de IA da própria Apple’s (vale a pena conhecer)
- Convivendo com ele: temperatura, bateria e ruído
- Os contrapontos honestos
- 1. O M5 Max é genuinamente mais rápido, e não é sutil
- 2. Um M4 Max com desconto pode superar um M5 Pro novo
- 3. A NVIDIA ainda vence em poder de computação
- 4. Os concorrentes com 128GB de memória unificada apostam em capacidade, não em velocidade
- 5. Um Mac de mesa é uma máquina fixa melhor
- 6. Você não pode atualizar a memória. Nunca.
- A conta do custo: local vs nuvem
- O guia de compra
- Perguntas frequentes
- O que vem a seguir
- A conclusão
Há uma configuração específica de Mac que, sem alarde, se tornou a resposta padrão para “qual notebook devo comprar se quiser rodar modelos de IA por conta própria?” É o MacBook Pro de 2026 com o chip M5 Pro e 64GB de memória unificada.
Não é o mais barato. Nem o mais rápido. Mas é aquele em que os trade-offs se encaixam no lugar certo para a maioria das pessoas que realmente quer usar modelos locais em vez de apenas fazer benchmark deles.
Este guia cobre o que essa máquina consegue fazer de verdade em três tipos de carga de trabalho — grandes modelos de linguagem, geração de imagens e geração de vídeo — com números reais onde eles existem, estimativas honestas onde não existem, e instruções de configuração passo a passo que você pode seguir no dia em que sua máquina chegar.
Ele também cobre onde o argumento do ponto ideal falha, porque ele de fato falha, e você deve saber exatamente onde antes de gastar três mil dólares em memória que não poderá atualizar depois.
TL;DR — O veredito
Compre o M5 Pro de 64GB se: você quer uma máquina portátil que roda modelos de 8B a 70B e modelos Mixture-of-Experts rápido o suficiente para trabalho real, gera imagens em segundos e não em minutos, e ainda tem espaço para seu navegador, IDE e contêineres Docker rodando ao mesmo tempo. Este é o notebook mais equilibrado notebook para IA local em 2026.
Passe para o M5 Max de 128GB se: você precisa especificamente de modelos locais de ponta como
gpt-oss-120b(que não não cabe em 64GB), ou você quer aproximadamente o dobro da velocidade de geração de tokens em modelos grandes. O M5 Max de 40 núcleos tem 614 GB/s de largura de banda de memória contra os 307 GB/s do M5 Pro’s, e para decodificação de LLM, largura de banda é tudo.Procure outra opção se: a geração local de vídeo é sua principal carga de trabalho. Todo Mac ainda é várias vezes mais lento que uma RTX 5090 aqui, e o aluguel na nuvem é drasticamente mais barato por clipe.
Os três números que definem esta máquina:
| Métrica | M5 Pro (GPU de 20 núcleos) | Por que isso importa |
|---|---|---|
| 307 GB/s largura de banda de memória | ~2× o M5 base, ~½ do M5 Max de 40 núcleos | Define seu teto de tokens/s para LLMs |
| 64GB memória unificada máxima | ~48–52GB utilizáveis por padrão | Determina quais modelos cabem |
| 20 núcleos de GPU com Neural Accelerators | 4×+ de computação de IA vs M4 Pro | Impulsiona o processamento de prompt e a velocidade de difusão |
Primeiro: sim, este chip é real
Muito do que se escreveu sobre o M5 Pro no final de 2025 e início de 2026 era especulação. Não é mais especulação.
A Apple anunciou o M5 Pro e o M5 Max em March 3, 2026, e ambos chegaram ao MacBook Pro de 14 e 16 polegadas em March 11, 2026. O M5 base havia chegado antes, no MacBook Pro de 14 polegadas em 22 de outubro de 2025, mas esse chip é uma proposta completamente diferente — ele chega no máximo a 32GB e 153 GB/s, o que não é suficiente para as cargas de trabalho deste guia.
Veja o que a Apple confirmou nas páginas do Newsroom e de especificações técnicas:
M5 Pro — especificações confirmadas
| Componente | Especificação |
|---|---|
| CPU | 18 núcleos (6 “super núcleos” de até ~4,6 GHz + 12 núcleos de desempenho de até ~4,4 GHz). Bin base: 15 núcleos. Até 30% mais rápido em multithread que o M4 Pro. |
| GPU | Até 20 núcleos, cada um com um Neural Accelerator dedicado. Ray tracing por hardware de terceira geração. Mais de 4× o pico de computação de GPU para IA vs M4 Pro. |
| Neural Engine | 16 núcleos |
| Memória unificada | 24GB / 48GB / 64GB — 64GB é o teto |
| Largura de banda de memória | Até 307 GB/s (LPDDR5X) |
| Processo | TSMC 3nm (N3P), “Fusion Architecture” — dois dies unidos via empacotamento SoIC-mH |
| E/S & mídia | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW encode-decode, AV1 decode |
M5 Max — para comparar
O M5 Max tem a mesma CPU de 18 núcleos, mas até uma GPU de 40 núcleos e, crucialmente, uma história de memória diferente: a variante de 32 núcleos roda a 460 GB/s, e a de 40 núcleos a 614 GB/s, configurável até 128GB.
Essa diferença de largura de banda não é um detalhe menor de ficha técnica. É o fator mais importante na decisão entre M5 Pro e M5 Max, e voltaremos a ele repetidamente.
Benchmarks independentes
A unidade de análise da Notebookcheck’s — um M5 Pro de 16 polegadas com 64GB — registrou pontuações de 4.295 em single-core e 28.436 em multi-core no Geekbench 6.7, 2.347 em multi-core no Cinebench 2024 e 9.481 em multi-core no Cinebench 2026.
A análise de GPU deles colocou o M5 Max mais ou menos no nível de uma RTX 5070 de mesa e confortavelmente à frente do Strix Halo da AMD’s. A GPU de 20 núcleos do M5 Pro’s fica abaixo disso, o que vale internalizar: é uma GPU capaz para um notebook, não um substituto para uma placa dedicada.
Eles também apontaram algo menos lisonjeiro, e que vale levar a sério: o MacBook Pro de 2026 sofre throttling perceptível sob carga sustentada, com desempenho de CPU inconsistente mesmo no modo de alta potência. Mais sobre isso na seção de temperatura.
O problema do preço (edição 2026)
A linha M5 Pro foi lançada a US$ 2.199 para o de 14 polegadas e US$ 2.699 para o de 16 polegadas. Então veio a escassez global de memória.
Em junho de 2026, a Apple aumentou os preços do MacBook Pro em cerca de US$ 300 em toda a linha. Depois do aumento, o M5 Pro de 14 polegadas de entrada fica em torno de US$ 2.499, e um M5 Pro de 14 polegadas com 64GB e SSD de 1TB fica na faixa de US$ 2.799–US$ 2.999, dependendo do dia e da loja. A B&H e outros revendedores vêm dando descontos de US$ 300–US$ 400 nas configurações M5 Pro de 48GB e 64GB, o que vale conferir antes de comprar direto.
Na Alemanha, a linha M5 Pro começa em € 2.199, com preços educacionais vistos a partir de € 1.979 em revendedores como a Edustore. As configurações de 64GB sobem bastante quando se inclui o IVA de 19%.
Duas diferenças importam para sua decisão:
- 48GB → 64GB no M5 Pro: historicamente um upgrade de US$ 200–US$ 400, mas os preços de upgrade de RAM subiram 50–67% em muitas configurações depois do aumento de junho.
- M5 Pro 64GB → M5 Max 128GB: um salto considerável. O M5 Max começava em US$ 3.599 (14 polegadas) e US$ 3.899 (16 polegadas) antes do aumento, e os upgrades de memória de 64GB/128GB do M5 Max quase dobraram de preço em junho. Um modelo de 16 polegadas no máximo agora passa de US$ 10.000.
Confira cada preço desta seção antes de comprar. O mercado de memória de 2026 se move mês a mês, e qualquer coisa escrita aqui tem vida curta.
Por que 64GB especificamente? O argumento do ponto ideal
A alegação de “ponto ideal” não é sobre 64GB ser mágico. É sobre o que cada faixa de memória realmente inviabiliza.
O que você não pode fazer em cada faixa
16GB / 24GB — Você roda modelos de 7B a 8B com conforto e modelos de 14B com quantização agressiva. Não roda nada da classe 30B+ com contexto significativo. Você vai passar o tempo gerenciando memória em vez de usar modelos.
32GB — Viável para modelos densos de 14B e alguns modelos MoE menores. Mas quando você adiciona um cache KV para contexto de 32K+, mais o Chrome, mais sua IDE, mais um daemon Docker, você entra em território de pressão de memória. É nesta faixa que as pessoas se convencem de que a IA local não funciona.
48GB — Genuinamente bom. Roda modelos densos da classe 32B com conforto. O problema é a folga: um modelo de 70B em Q4 tem cerca de 40GB, o que tecnicamente cabe, mas não deixa nada para o resto da máquina. Você acaba fechando aplicativos para rodar um modelo, que é exatamente o atrito que mata os fluxos de trabalho locais.
64GB — Este é o ponto em que você consegue manter um modelo de 70B em Q4 ou um modelo MoE de 106 bilhões de parâmetros na memória e e manter todo o seu ambiente de trabalho residente. Sem fechar o Slack. Sem desligar contêineres. Você abre um modelo e continua trabalhando.
128GB (território do M5 Max) — Desbloqueia gpt-oss-120b e a classe 120B+. Genuinamente útil se é disso que você precisa, e genuinamente caro se não for.
O argumento do ponto ideal é, na verdade, o argumento de “rodar um modelo sério E todo o resto”. É a diferença entre a IA local ser algo que você demonstra e algo que você usa.
Mas 64GB vem com um teto rígido, e você deve saber disso agora.
O problema do gpt-oss-120b
gpt-oss-120b na quantização MXFP4 precisa de cerca de 63GB só para os pesos. Medições independentes em um M5 Max de 128GB usando MLX mostram pico de memória de cerca de 64,4GB com contexto de 4.096 tokens e 64,9GB com contexto de 16K.
Em uma máquina de 64GB, onde seu orçamento utilizável realista é de 52 a 60GB, isso não cabe. Não é “cabe apertado” — não cabe.
Se você vê uma alegação de que gpt-oss-120b roda em 64GB, desconfie. É um modelo de 128GB. Este é o argumento mais claro para subir para o M5 Max, e se esse modelo importa para você, nenhuma quantidade de raciocínio sobre ponto ideal muda a aritmética.
Passo 1: libere sua memória (faça isso primeiro)
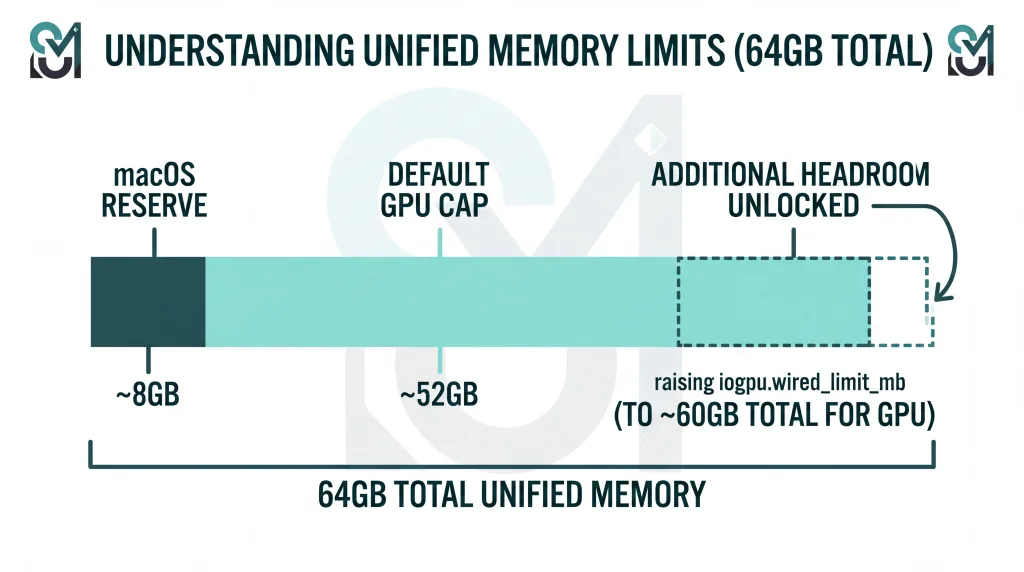
Eis algo que a maioria dos compradores não sabe: o macOS não deixa a GPU usar toda a sua RAM.
Por padrão, o macOS limita a memória wired da GPU a cerca de 75% do total. Em uma máquina de 64GB, isso dá cerca de 51,84GB utilizáveis para os pesos do modelo, com o restante reservado para o sistema.
Você pode aumentar isso com um único comando. Sem reiniciar, sem alterar o System Integrity Protection.
Nota: a chave moderna é
iogpu.wired_limit_mb. Guias mais antigos citamdebug.iogpu.wired_limit, que foi substituída. Se você encontrar um tutorial usando a chave antiga, ele está desatualizado.
Aumente o limite
bash
# Set the GPU wired-memory limit to 60GB (60 × 1024 = 61440 MB)
sudo sysctl iogpu.wired_limit_mb=61440

# Verify it took effect
sysctl iogpu.wired_limit_mb

# Reset to the macOS default at any time
sudo sysctl iogpu.wired_limit_mb=0
Torne permanente
A configuração é redefinida ao reiniciar. Para torná-la permanente, adicione-a ao /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confComo alternativa, crie um LaunchDaemon ou adicione a sysctl chamada a um script de login se você preferir não mexer em /etc/sysctl.conf.
Até onde você deve forçar?
Deixe 4 a 8GB para o macOS. Em uma máquina de 64GB, 60GB (61440 MB) é agressivo, mas viável se você não estiver rodando muita coisa além disso. 56GB (57344 MB) é a configuração diária mais segura.
Não aloque 100%. Você vai ver a bolinha giratória, travamentos de aplicativos ou um reset forçado — e, em uma máquina no meio de uma inferência, isso significa perder o que estava fazendo.
Orçamento prático em um M5 Pro de 64GB:
- Padrão: ~48–52GB utilizáveis
- Aumentado para 56GB: confortável para um modelo 70B Q4 mais contexto
- Aumentado para 60GB: máximo, com espaço mínimo para outros aplicativos
Essa diferença — 48GB versus 58GB — muitas vezes é a diferença entre um modelo rodar na GPU e transbordar para a CPU, o que destrói completamente a vazão. São os cinco minutos de configuração de maior valor que você vai fazer.
Mais um pré-requisito
O MLX exige macOS 26.2 ou posterior para realmente usar os Neural Accelerators do M5’s. Se você está em uma versão anterior, está deixando de lado a maior melhoria geracional. Verifique o Software Update antes de fazer qualquer benchmark.
Passo 2: monte seu stack
Aqui está a configuração completa, na ordem. Reserve cerca de 30 minutos, mais o tempo de download.
2.1 — Fundamentos
bash
# Install Homebrew if you don't have it
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# Install uv — a fast Python package manager, far better than pip for this
brew install uv

# Optional but recommended: a Python version manager
brew install [email protected]
2.2 — MLX (o framework nativo de ML da Apple’s)
O MLX é o framework de arrays da própria Apple, criado especificamente para a arquitetura de memória unificada do Apple Silicon. É o caminho mais rápido para inferência de LLM em um Mac e deve ser o seu padrão.
bash
# Create a dedicated environment
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# Install mlx-lm
uv pip install mlx-lm

# Test it — this downloads and runs a model
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Explain unified memory architecture in three sentences."
Se isso gerar texto, sua stack funciona.
2.3 — LM Studio (a interface gráfica)
Baixe em lmstudio.ai. É a forma mais amigável de navegar, baixar e executar modelos, e a Apple o demonstrou no lançamento do M5 Pro, o que diz algo sobre como a inferência local se tornou comum.
O recurso mais útil do LM Studio para desenvolvedores é o servidor compatível com OpenAI integrado. Ative-o na Desenvolvedor aba e ele expõe um endpoint em http://localhost:1234/v1 que qualquer cliente compatível com OpenAI pode usar.
2.4 — Ollama (a CLI e o servidor)
bash
brew install ollama

# Start the server
ollama serve

# In another terminal, pull and run a model
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Atualização importante de 2026: em March 30, 2026, Ollama 0.19 switched its Apple Silicon backend from llama.cpp to MLX. Isso praticamente dobrou a velocidade de decodificação. Nas próprias medições da Ollama no M5 Max com o Qwen3.5-35B-A3B, o prefill passou de 1.154 para 1.810 tokens/s e a decodificação de 58 para 112 tokens/s — e a build int4 deles levou o prefill a 1.851 e a decodificação a 134.
Se a última vez que você testou o Ollama em um Mac foi antes desse lançamento, seu modelo mental de desempenho está desatualizado.
2.5 — Draw Things (imagens e vídeo)
Instale pela Mac App Store. É gratuito, nativo, otimizado para Metal e atualmente a melhor ferramenta de geração de imagens no Apple Silicon. Sua implementação do Metal FlashAttention v2.5 roda até 4,6× mais rápido no M5 do que no M4, e ele suporta treinamento de LoRA no dispositivo.
2.6 — ComfyUI (quando você precisa de pipelines)
bash
brew install comfyuiO ComfyUI oferece controle de fluxo de trabalho baseado em nós que o Draw Things não iguala. Ele roda no backend MPS e é cerca de 20% mais lento que o Draw Things no Apple Silicon para o mesmo trabalho, além de ter armadilhas reais com checkpoints FP8 no Metal. Use quando precisar de pipelines complexos; use o Draw Things quando precisar de velocidade.
2.7 — Verifique tudo
bash
# Check your memory limit stuck
sysctl iogpu.wired_limit_mb

# Confirm MLX sees your GPU
python -c "import mlx.core as mx; print(mx.default_device())"

# Confirm Ollama is serving
curl http://localhost:11434/api/tags
Parte 1: executando LLMs
É nisso que o M5 Pro de 64GB se destaca, e vale a pena entender por que antes de olhar a lista de modelos.
O único conceito que explica tudo: largura de banda vs poder de computação
A inferência de LLM tem duas fases, e elas exigem partes completamente diferentes da sua máquina.
Prefill (processamento do prompt) é a passagem pela sua entrada antes de o primeiro token aparecer. É limitada por computação. É por isso que colar um arquivo de 40.000 tokens em um agente de codificação local costumava significar minutos de silêncio em um Mac, enquanto uma placa NVIDIA dava conta em segundos.
Decode (geração de tokens) é produzir cada token seguinte. É limitada pela largura de banda de memória. Cada token gerado exige ler os pesos do modelo na memória. Memória mais rápida, tokens mais rápidos. É quase tão simples assim.
Essa divisão explica toda a proposta do M5 Pro:
- Sua 307 GB/s largura de banda define um teto rígido para a velocidade de decodificação. Cerca do dobro dos 153 GB/s do M5 base, cerca da metade dos 614 GB/s do M5 Max de 40 núcleos.
- Sua Aceleradores Neurais — um em cada núcleo da GPU, novidade da geração M5 — melhoram drasticamente o prefill.
A própria equipe de pesquisa do MLX da Apple publicou medições em novembro de 2025 comparando o M5 base com o M4 base no Qwen3-14B-4bit: o tempo até o primeiro token foi 4,06× mais rápido, enquanto a geração de tokens melhorou apenas 1,19×. Esse ganho modesto na decodificação acompanha exatamente o aumento de largura de banda (120 GB/s → 153 GB/s). O enorme ganho no prefill vem inteiramente dos Aceleradores Neurais.
A Apple anuncia as variantes Pro e Max como até 4× mais rápidas no processamento de prompts de LLM do que o M4 Pro e o M4 Max. O mecanismo é idêntico, embora a confirmação independente de prefill específica para o M5 Pro ainda seja escassa.
O que isso significa na prática: o M5 Pro é um upgrade transformador em relação aos Macs anteriores ao M5 para trabalho com contexto longo e codificação agêntica, onde o prefill domina. É um upgrade modesto para vazão de chat puro, onde a decodificação domina.
A revolução do MoE (por que os Macs de repente ficaram bons)
Arquiteturas Mixture-of-Experts mudaram o cálculo para máquinas de memória unificada, e se você não entender mais nada deste guia, entenda isto.
Um modelo MoE tem um total enorme de parâmetros, mas ativa apenas uma pequena fração por token. gpt-oss-120b tem 117 bilhões de parâmetros totais, mas ativa cerca de 5,1 bilhões por token.
- Parâmetros totais determinam seu memória requisito — que os Macs têm de sobra.
- Parâmetros ativos determinam seu velocidade de decodificação — que é limitada por largura de banda.
Então um modelo MoE precisa do recurso em que os Macs são ricos e consome pouco do recurso em que eles são pobres. Um modelo MoE bem escolhido em um Mac de 64GB entrega qualidade quase de fronteira na velocidade de decodificação de um modelo muito menor.
É por isso que um notebook com 307 GB/s pode parecer competitivo com placas de 1.700 GB/s em certas cargas de trabalho. Escolha modelos MoE sempre que puder.
Quais modelos realmente cabem — a tabela
Os números medidos abaixo vêm do banco de benchmarks da comunidade oMLX para o M5 Pro de 20 núcleos com 64GB. As estimativas estão claramente sinalizadas. Não confie em números de tokens/s não sinalizados que você encontrar por aí para este chip — pouquíssimas pessoas publicaram medições reais do M5 Pro.
| Modelo | Tipo | Pegada | Decodificação (tok/s) | Prefill (tok/s) | Veredito |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12GB | 66–80 ✅ medido | 1.500–2.200 ✅ | O cavalo de batalha do dia a dia. Rápido, capaz, minúsculo. |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20GB | ~55–70 (est.) | Alto | Melhor qualidade por GB. A escolha da eficiência. |
| Qwen3.6-27B (4 bits) | Denso | ~16GB | 17.8 ✅ medido | 470 ✅ | Representativo da classe densa de 27–35B. |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40GB+ | ~30 | Alto | Raciocínio quase de fronteira que realmente cabe. |
| Llama 3.3 70B (Q4_K_M) | Denso | ~40GB | ~7–12 (est.) | Moderado | Utilizável para trabalho em lote; marginal no uso interativo. |
| Llama 3.3 70B (Q5_K_M) | Denso | ~49GB | ~6–10 (est.) | Moderado | Cabe, mas apertado. Aumente seu limite de memória primeiro. |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | Denso | 8–24GB | 20–60+ | Bom | Todos confortáveis. Escolha pela tarefa. |
| gpt-oss-120b (MXFP4) | MoE | ~63GB | — | — | ❌ Não cabe. Requer uma máquina de 128GB. |
| Qwen3-235B-A22B (ternário de 1,58 bit) | MoE | ~53GB | ~5.6 | Baixo | Tecnicamente roda. Um truque de festa, não um fluxo de trabalho. |
O bônus do batching: gpt-oss-20b no M5 Pro escala para cerca de 142 tok/s com batch size 8. Se você executa agentes, loops de avaliação ou qualquer carga com requisições paralelas, a vazão melhora bastante em relação ao número de fluxo único.
Um teste de realidade sobre modelos 70B
Não existe nenhum número publicado de decodificação do M5 Pro para o Llama 3.3 70B medido de forma independente. A estimativa de 7–12 tok/s é extrapolada da largura de banda.
Para calibrar: um M4 Max de 128GB a 546 GB/s mede cerca de 18–20 tok/s no mesmo modelo. O M5 Pro tem 307 GB/s. A aritmética não é animadora.
A 7–12 tok/s você obtém cerca de 5–9 palavras por segundo — mais lento que uma velocidade de leitura confortável. Isso serve para trabalhos em segundo plano, processamento de documentos e lotes noturnos. É frustrante para chat interativo.
A recomendação honesta: em um M5 Pro de 64GB, trate modelos densos de 70B como ferramentas para cargas em lote e use modelos MoE para qualquer coisa interativa.
Quantização: o que realmente escolher
| Formato | Perda de qualidade | Quando usar |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | Padrão. Melhor relação velocidade-qualidade. |
| MLX 4 bits | ~1–2% | Padrão no Mac. ~10% menos memória e 15–30% mais rápido que o GGUF equivalente. |
| Q5_K_M / MLX 6 bits | <1% | Quando você tem folga e quer saída quase sem perdas. |
| Q6_K | Desprezível | Trabalho crítico em qualidade com memória de sobra. |
| Q8 / FP16 | Nenhum | Raramente vale a pena em um notebook. Reduz seu orçamento de tamanho de modelo pela metade ou a um quarto. |
| MXFP4 | Nativo | Não é uma escolha — é como o gpt-oss é distribuído. |
| ternário de 1,58 bit | Grave | Só para encaixar um modelo que de outra forma não caberia. |
Regra geral: 4 bits para velocidade e encaixe, 6 bits quando a qualidade importa e há espaço, e pule os 8 bits no notebook.
MLX vs llama.cpp — qual runtime?
A resposta curta é MLX, com uma ressalva.
- Abaixo de ~14B de parâmetros: O MLX supera o llama.cpp em 20–87%. Sem comparação.
- Acima de ~27B: os dois convergem, porque a largura de banda de memória se torna o gargalo e o runtime deixa de importar.
- Memória: O MLX usa cerca de 10% menos que o GGUF na mesma quantização.
- A ressalva: em contextos de 30.000+ tokens, o MLX pode ser até 50% mais lento que o llama.cpp com Flash Attention ativado. Isso depende do modelo e do contexto.
Se você trabalha rotineiramente com contextos muito longos, faça benchmark dos dois na sua carga real. Caso contrário, MLX.
Executando um servidor de API local
mlx-lm A versão 0.18 e posteriores trazem um servidor compatível com OpenAI com batching contínuo:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
Agora qualquer coisa que fale a API da OpenAI pode usar seu modelo local:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Write a bash one-liner to find large files."}]
  }'
Esse endpoint é a base de tudo na seção de fluxos de trabalho abaixo.
Parte 2: geração de imagens
A geração de imagens é onde o M5 Pro parece melhor do que sua largura de banda sugere, por um motivo simples: a difusão é limitada por computação, não limitada por largura de banda, e os modelos são pequenos o bastante para que a memória nunca seja a restrição em uma máquina de 64GB.
Desempenho modelo por modelo
| Modelo | Tamanho | Memória | Tempo por imagem de 1024×1024 | Notas |
|---|---|---|---|---|
| SDXL | 3.5B | ~7GB | ~7s em 30 passos (M5 Max) | Opção de qualidade mais rápida. Ecossistema enorme de LoRA. |
| FLUX.1 [schnell] | 12B | ~7GB (Q4) | ~20–25s em 4 passos | Destilado para velocidade. Apache-2.0. |
| FLUX.1 [dev] | 12B | ~10GB (Q6) | ~50s em 20 passos (classe M4) | A referência de qualidade. |
| FLUX.2 [Klein] | 4B destilado | ~8GB | ~40s | Mais novo, menor, rápido. |
| FLUX.2 [dev] | Grande | 24GB+ | Vários minutos | Melhor qualidade, exige paciência de verdade. |
| SD 3.5 | Varia | 10–20GB | Dezenas de segundos | Um bom meio-termo. |
| Qwen-Image / Qwen-Image-Edit | Varia | 15–25GB | Dezenas de segundos | Excelente para renderização de texto e edição. |
| HiDream, Chroma | Varia | 10–20GB | Varia | Vale explorar pela variedade de estilos. |
A equipe de ML Research da Apple mediu o FLUX-dev-4bit gerando uma imagem de 1024×1024 mais de 3,8× mais rápido no M5 do que no M4 usando MLX. Esse ganho vem dos Aceleradores Neurais e vale para toda a família M5.
Nenhum benchmark de segundos por imagem específico do M5 Pro foi publicado ainda, então trate a tabela acima como números da classe M4 com um ganho realista no M5. Na prática: espere o FLUX.1 [schnell] bem abaixo de 20 segundos e o SDXL em um dígito de segundos.
Com 64GB você pode rodar esses modelos em FP16 sem quantização, o que é uma vantagem real de qualidade sobre máquinas de 16GB e 24GB que são forçadas ao Q4.
Ferramentas: o que usar
Draw Things — a escolha padrão. Metal nativo, nenhum ambiente Python para quebrar, Metal FlashAttention v2.5 rodando até 4,6× mais rápido no M5 do que no M4 e treinamento de LoRA no dispositivo. Grátis na App Store.
ComfyUI — para pipelines baseados em nós, cadeias de ControlNet e fluxos de trabalho em várias etapas. Cerca de 20% mais lento que o Draw Things no Apple Silicon. Cuidado com checkpoints FP8, que frequentemente falham no Metal.
DiffusionKit — o kit de difusão da própria Apple, com MLX por baixo. Vale acompanhar.
Mochi Diffusion, InvokeAI — ambos viáveis, ambos funcionam.
Evite: O DiffusionBee está efetivamente abandonado. Automatic1111 e Forge funcionam tecnicamente via MPS, mas são lentos e mal mantidos no Mac.
Passo a passo: sua primeira imagem local
- Instale Draw Things pela Mac App Store.
- Abra o app e vá ao gerenciador de modelos (o ícone no topo do painel esquerdo).
- Download FLUX.1 [schnell] — cerca de 7 GB em Q4, ou pegue a versão FP16, já que você tem memória.
- Defina Etapas como 4 (o schnell é destilado exatamente para isso) e Tamanho para 1024×1024.
- Digite um prompt e clique em Generate.
- A primeira execução inclui o carregamento do modelo. As gerações seguintes são bem mais rápidas.
Treinamento de LoRA no dispositivo
Uma máquina de 64 GB consegue fazer ajuste fino de modelos de imagem localmente, uma capacidade genuinamente subestimada. O Draw Things suporta treinamento de LoRA diretamente, e o MLX suporta LoRA e QLoRA tanto para modelos de imagem quanto de linguagem.
Um LoRA de estilo pequeno, com 20–50 imagens, roda durante a noite em um M5 Pro, e nunca sai da sua máquina. Para quem trabalha com material de clientes ou ativos proprietários, isso importa mais que a velocidade.
Parte 3: geração de vídeo — a seção honesta
Aqui eu preciso ser direto com você, porque muito conteúdo sobre este tema não é.
A geração de vídeo local em qualquer Mac em 2026 é lenta. Não no sentido de “mais lento que uma 4090”. Lento o suficiente para mudar como você trabalha.
Por que os Macs sofrem especificamente aqui
A difusão de vídeo é fortemente limitada por computação. Diferente da decodificação de LLM, em que a banda de memória abundante do Mac é o recurso relevante, a geração de vídeo martela o poder bruto de GPU — exatamente o eixo em que uma GPU de notebook de 20 núcleos perde para uma placa dedicada.
Os Neural Accelerators do M5 ajudam. Mas não fecham uma lacuna desse tamanho.
Os números, sem rodeios
Wan 2.2 (Alibaba, Apache-2.0, disponível como MoE de 14B e como variante densa de 5B texto/imagem-para-vídeo): em um M1 Max de 64 GB rodando um build GGUF, um clipe de 2 segundos em 832×480 levou 82 minutos. Um clipe de 5 segundos passaria de três horas.
Para comparar, o mesmo modelo TI2V-5B em uma RTX 4090 de 24 GB produz 5 segundos em 720p em cerca de 9 minutos.
Um M5 Pro é bem mais rápido que um M1 Max, mas a ordem de grandeza é o que importa.
Uma limitação crítica do Metal: Checkpoints FP8 não funcionam no Metal — o Float8_e4m3fn tipo de dado não é suportado. Você precisa usar builds GGUF. Isso derruba muita gente que segue tutoriais voltados para NVIDIA, e também significa que os templates FP8 do LTX-2 falham de vez no Mac.
A boa notícia: modelos destilados mais novos estão mudando isso. Ivan Fioravanti mediu o destilado LTX 2.3 22B no Draw Things gerando um vídeo de 5 segundos em cerca de 121 segundos em um M5 Max de 40 núcleos — superando de fato um M3 Ultra de 80 núcleos, que levou 206 segundos.
É um resultado real e uma mudança de verdade. Mas repare no chip: um M5 Pro de 20 núcleos será bem mais lento que um M5 Max de 40 núcleos em trabalho limitado por computação como esse. Espere vários minutos, não dois.
Outros modelos — HunyuanVideo, Mochi 1, CogVideoX, FramePack, Stable Video Diffusion — vão de lentos a inviáveis no Mac. Vários são CUDA-first e exigem contornos.
O veredito sobre vídeo
Vídeo local em um M5 Pro de 64 GB é viável para experimentação ocasional e paciente — clipes curtos, resoluções menores, modelos destilados, via Draw Things. Funciona. Você vai criar coisas.
Para qualquer vazão real, alugue uma GPU. RunPod, Vast.ai e Lambda rodam uma 5090 ou uma H100 por alguns dólares a hora e produzem em minutos o que seu notebook produz em uma hora. Para vídeo especificamente, a economia não chega perto.
Se a geração de vídeo é a sua primária carga de trabalho, compre uma máquina NVIDIA ou reserve orçamento para a nuvem. Não compre um Mac esperando que dê certo.
Se você quiser tentar mesmo assim: passo a passo
- Abrir Draw Things e mude para o gerenciador de modelos de vídeo.
- Baixe um destilado modelo — LTX 2.3 ou um build GGUF do Wan 2.2. Modelos destilados são a diferença entre minutos e horas.
- Comece pequeno: 480p, 2 segundos, poucas etapas. Estabeleça seu tempo de referência antes de aumentar.
- Ligue na tomada e use o High Power Mode. Isso vai fazer as ventoinhas girarem.
- Aumente resolução e duração só depois de saber quanto um clipe curto custa em tempo real.
Nunca use checkpoints FP8 em um Mac. GGUF ou nada.
Parte 4: fluxos de trabalho reais que valem a pena construir
Benchmarks não são o ponto. Veja o que as pessoas realmente fazem com esta máquina.
Fluxo de trabalho 1: um agente de codificação local
Esta é a configuração de maior valor da lista, e leva uns dez minutos.
Passo 1 — Inicie um servidor de modelos. Use a aba Developer do LM Studio (endpoint em http://localhost:1234/v1) ou:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234Passo 2 — Aponte seu editor para ele.
VS Code com Cline ou Continue: adicione um provedor compatível com OpenAI com a URL base http://localhost:1234/v1, qualquer chave de API não vazia e o nome do seu modelo.
Zed: configure um provedor personalizado compatível com OpenAI nas configurações.
Aider (terminal):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
Passo 3 — Escolha o modelo certo. gpt-oss-20b e o Qwen3-Coder-30B-A3B são bons programadores locais. Ambos são MoE, que é exatamente o que você quer: decodificação rápida, e as melhorias de prefill do M5 fazem com que contextos grandes de arquivos não travem mais por minutos.
O que você ganha com isso: iteração ilimitada sem custo por token, sem limites de taxa e com código que nunca sai da sua máquina. Para bases de código proprietárias ou de clientes, esse último ponto costuma ser a justificativa inteira.
Fluxo de trabalho 2: RAG privado sobre seus documentos
Embeddings locais mais um modelo de 27B–70B significa que documentos sensíveis — contratos, prontuários médicos, pesquisas internas, dados financeiros — ficam pesquisáveis e resumíveis sem que um único byte saia do seu notebook.
A faixa de 64 GB importa aqui justamente porque pipelines de RAG mantêm um modelo de embedding, um vector store e um modelo de geração na memória ao mesmo tempo. Com 32 GB você fica trocando de página o tempo todo. Com 64 GB, não.
Fluxo de trabalho 3: geração em lote durante a noite
Coloque algumas centenas de gerações de imagem na fila no Draw Things, ou rode um longo trabalho de processamento de documentos via mlx_lm.server, e deixe a máquina trabalhar enquanto você dorme. Na tomada, modelos de 70B e lotes de imagens que parecem lentos demais no uso interativo são perfeitamente razoáveis durante a noite.
Fluxo de trabalho 4: roteamento híbrido (a estratégia que a maioria das pessoas deveria adotar)
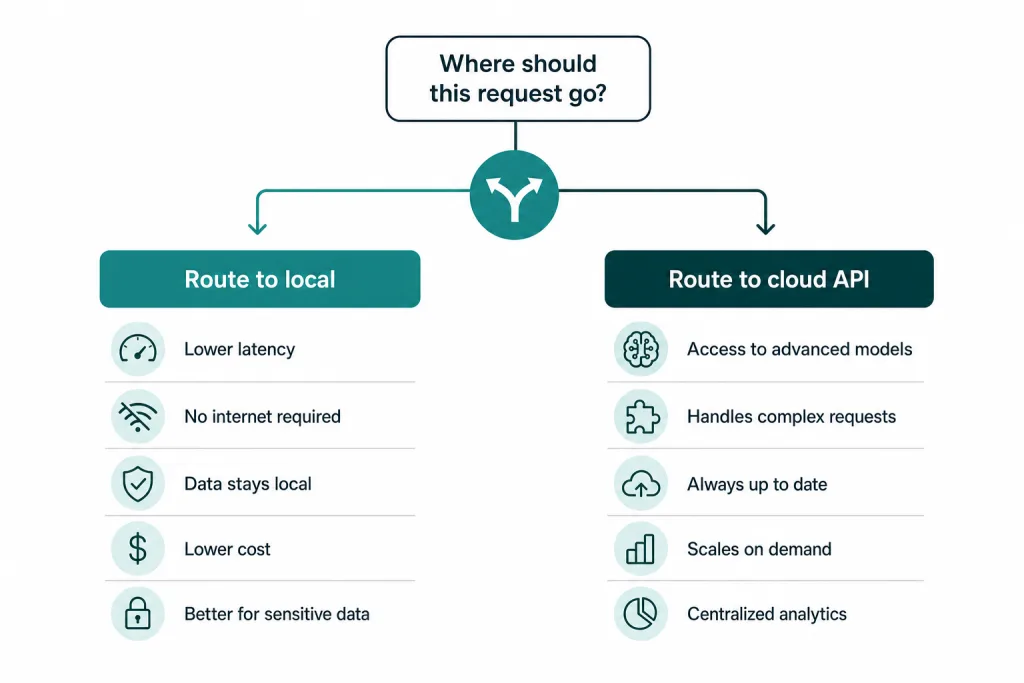
Não pense em local versus nuvem como binário. Roteie por tarefa:
| Envie para o local | Envie para a API na nuvem |
|---|---|
| Qualquer coisa sensível à privacidade | As tarefas de raciocínio mais difíceis |
| Processamento em massa e em lote | Casos que exigem qualidade de fronteira de verdade |
| Loops de agentes com muitas chamadas baratas | Saídas pontuais de alto risco |
| Iteração e experimentação | Trabalho que precisa do modelo mais recente |
| Trabalho offline | Janelas de contexto muito longas |
É aqui que está a maior parte do valor. O local cuida do volume, da iteração e da privacidade. A nuvem cuida dos 5% difíceis.
O stack de IA da própria Apple’s (vale a pena conhecer)
O Foundation Models framework dá aos desenvolvedores acesso direto em Swift ao modelo no dispositivo da Apple — cerca de 3B parâmetros, gratuito, privado, offline, com geração guiada e chamada de ferramentas integradas.
As atualizações de 2026 importam mais que o lançamento original: entrada de visão, execução no lado do servidor e um LanguageModel protocolo que permite basear uma sessão no modelo da Apple, em um modelo na nuvem ou em um modelo MLX local via MLXLanguageModel. Se você cria apps para Mac ou iOS, esse é um caminho limpo para recursos de IA híbridos no dispositivo.
Xcode 26 também vem com ferramentas de codificação com LLM integradas que podem usar o ChatGPT, outros provedores via chave de API ou um modelo local rodando no seu Mac.
Convivendo com ele: temperatura, bateria e ruído
Especificações não dizem como é usar uma máquina. Algumas observações honestas.
O de 14 polegadas reduz o desempenho mais que o de 16. O Notebookcheck apontou throttling térmico forte no MacBook Pro de 2026 sob carga sustentada, com comportamento de CPU inconsistente até no High Power Mode. O de 16 polegadas tem mais margem de refrigeração e bateria maior. Se você planeja sessões de inferência longas, o de 16 polegadas é a máquina melhor — é uma diferença funcional real, não uma preferência.
Nem todas as cargas de trabalho de IA se comportam igual termicamente. A decodificação de LLM é relativamente tranquila — é limitada por memória, então a GPU não fica saturada e as ventoinhas costumam ficar silenciosas. Difusão de imagem e vídeo é limitada por computação: prende sua GPU, faz as ventoinhas ficarem audíveis e consome bateria rápido.
A realidade da bateria: sessões curtas de LLM funcionam bem fora da tomada. Trabalho de difusão sustentado acaba com a bateria em algumas horas e sofre throttling térmico antes disso. Fique na tomada para qualquer coisa séria.
Modos de energia: o de 16 polegadas oferece o High Power Mode, que vale ativar para trabalhos longos. O Low Power Mode reduz de forma significativa a velocidade de inferência — evite enquanto roda modelos.
Hábito prático: fora da tomada para conversa e assistência de código. Na tomada, em High Power Mode, para lotes de imagens e vídeo.
Os contrapontos honestos
Um guia que só defende um lado é marketing. Aqui está o argumento contrário.
1. O M5 Max é genuinamente mais rápido, e não é sutil
307 GB/s contra 614 GB/s. Como a decodificação é limitada por banda, um M5 Max de 40 núcleos gera tokens cerca de duas vezes mais rápido no mesmo modelo. Ele também comporta gpt-oss-120b, o que o M5 Pro não consegue.
Se a velocidade de decodificação de modelos grandes é seu caso de uso principal, o M5 Max é a máquina certa e o M5 Pro é um meio-termo. O contrapeso é o preço: depois de junho de 2026, esse upgrade é brutal.
2. Um M4 Max com desconto pode superar um M5 Pro novo
Este é o argumento que a maioria dos compradores perde. O M4 Max tem cerca de 546 GB/s de banda de memória — bem mais que os 307 GB/s do M5 Pro. Para decodificação pura de LLM, um M4 Max de 64 GB normalmente supera um M5 Pro de 64 GB.
O que você abre mão: os Neural Accelerators do M5, o que significa prefill bem mais lento e geração de imagens mais lenta.
A regra de decisão: se você conversa principalmente com modelos grandes, um M4 Max de 64 GB com desconto é provavelmente a melhor compra. Se você faz codificação agêntica com contextos longos ou gera imagens, as vantagens de prefill e difusão do M5 Pro vencem.
3. A NVIDIA ainda vence em poder de computação
Uma RTX 5090 tem 32 GB de VRAM a cerca de 1.792 GB/s — quase seis vezes a banda do M5 Pro — além de muito mais poder de computação. Para qualquer modelo que caiba em 32 GB, e para todo trabalho limitado por computação (vídeo, imagem, prefill), não há disputa.
A vantagem do Mac começa exatamente onde os 32 GB de VRAM acabam, e inclui portabilidade, silêncio, baixo consumo e a possibilidade de fazer isso no trem.
4. Os concorrentes com 128GB de memória unificada apostam em capacidade, não em velocidade
NVIDIA DGX Spark / GB10: 128 GB a cerca de 273 GB/s, com CUDA. Em gpt-oss-120b MXFP4, testes independentes o colocam em 34–39 tok/s.
AMD Strix Halo / Ryzen AI Max+ 395: 128 GB a cerca de 256 GB/s. Os próprios números da AMD citam até 30 tok/s no mesmo modelo via llama.cpp. Mini-PCs construídos em torno dele são bem mais baratos que qualquer Mac.
Observe que ambos têm menor banda de memória que o M5 Pro. Eles compram capacidade, não velocidade. Se seu objetivo é rodar modelos muito grandes em velocidades aceitáveis, não rápidas, eles são mais baratos. Se você quer velocidade, eles não são a resposta.
5. Um Mac de mesa é uma máquina fixa melhor
A Mac Studio M3 Ultra vai até 512 GB a 800 GB/s. Se sua máquina fica em uma mesa, é uma caixa de IA local muito melhor que qualquer MacBook Pro. A proposta de valor do notebook é portabilidade, bateria e silêncio — se você não precisa disso, não pague por isso.
6. Você não pode atualizar a memória. Nunca.
A memória do Apple Silicon é on-package. O que você comprar é o que terá por toda a vida da máquina.
Como os lançamentos de modelos de 2026 seguem a tendência de pegadas MoE maiores, comprar RAM de menos é o arrependimento clássico e permanente. Se você está escolhendo entre 48 GB e 64 GB, fique com os 64 GB.
A conta do custo: local vs nuvem
Vamos fazer a conta com honestidade, porque “local é mais barato” é muito afirmado e pouco calculado.
Máquina: cerca de US$ 2.800 por um M5 Pro de 64GB, amortizados em três a quatro anos.
Preços de API em agosto de 2026 (por milhão de tokens, entrada/saída):
| Serviço | Entrada | Saída |
|---|---|---|
| Classe Claude Sonnet | ~US$ 3 | ~US$ 15 |
| Classe GPT-5 | ~US$ 1,75–US$ 5 | ~US$ 14–US$ 30 |
| DeepSeek V4 Flash | ~US$ 0,14 | ~US$ 0,28 |
| Modelos abertos hospedados (gpt-oss, Llama) | Ainda mais baixo | Ainda mais baixo |
Aluguel de GPU na nuvem: H100 em torno de US$ 3/hora, H200 em torno de US$ 5/hora sob demanda.
O ponto de equilíbrio: análises publicadas colocam o ponto de virada para uma máquina de consumo em cerca de 2–3 milhões de tokens por dia, mantidos por cerca de doze meses em relação a APIs proprietárias de faixa intermediária.
São muitos tokens. Abaixo desse limite, APIs baratas — da classe DeepSeek especialmente — realmente saem mais em conta que o local no custo puro por token.
Então por que comprar a máquina?
Porque custo por token não é o único custo:
- Privacidade. Seus dados nunca saem do dispositivo. Para trabalho jurídico, médico, financeiro ou com código proprietário, isso muitas vezes não é negociável, independentemente do preço.
- Sem limites de taxa. Sem throttling, sem filas, sem erros de capacidade às 2 da manhã.
- Offline. Aviões, trens, Wi-Fi ruim de hotel, quedas de rede.
- Custo marginal zero. Isso muda o comportamento mais do que as pessoas esperam. Quando cada experimento é grátis, você faz dez vezes mais. A ausência de ansiedade por token enquanto itera vale dinheiro de verdade em resultado.
- Você precisava de um notebook de qualquer forma. A forma honesta de enquadrar isso não é “US$ 2.800 por IA” — é o delta entre a máquina que você teria comprado e esta.
A conclusão correta é híbrida. Local para volume, privacidade, iteração e loops de agentes. Nuvem para os problemas difíceis. Quem afirma que o local substitui totalmente as APIs de fronteira em 2026 está vendendo demais; quem afirma que o local não serve para nada nunca rodou um loop de agentes em escala.
O guia de compra
| Se você… | Compre isto | Por que |
|---|---|---|
| Quer o notebook de IA local mais equilibrado | M5 Pro 64 GB, 16 polegadas | Roda modelos de 8B–70B e MoE, geração de imagem rápida e espaço para todo o resto. Melhor refrigeração que o de 14 polegadas. |
Precisa gpt-oss-120b ou de modelos 120B+ | M5 Max 128 GB | O único notebook Mac que comporta. Também ~2× a velocidade de decodificação. |
| Conversa principalmente com modelos grandes e quer custo-benefício | M4 Max 64 GB com desconto | Banda maior (546 GB/s) supera o M5 Pro na decodificação. |
| Faz geração de vídeo a sério | NVIDIA (RTX 5090) ou nuvem | Trabalho limitado por computação; os Macs são várias vezes mais lentos. |
| Quer capacidade máxima com orçamento limitado | mini-PC Strix Halo 128 GB | 128GB com economia, mas com largura de banda menor que a do M5 Pro. |
| Trabalha em uma mesa | Mac Studio M3 Ultra | Até 512GB a 800 GB/s. |
| Está com o orçamento apertado | M5 Pro 48GB | Roda bem modelos da classe 32B. Aceite o teto de 70B/MoE. |
O que eu não faria: comprar uma máquina de 24GB ou 32GB para IA local séria. Você vai bater no limite em poucas semanas e não consegue sair dele com um upgrade.
Perguntas frequentes
64GB bastam para IA local em 2026? Sim, para a maioria das cargas de trabalho. 64GB rodam com folga modelos de até cerca de 70B parâmetros em quantização de 4 bits, além de modelos Mixture-of-Experts como o GLM-4.6 Air, e ainda sobra espaço para o sistema operacional e os aplicativos. A principal exceção é gpt-oss-120b, que precisa de cerca de 63GB só para os pesos e exige uma máquina de 128GB.
O M5 Pro consegue rodar o gpt-oss-120b? Não. A versão MXFP4 precisa de cerca de 63GB para os pesos, e o pico de memória medido em um M5 Max é de 64,4–64,9GB dependendo do comprimento do contexto. Em uma máquina de 64GB com um orçamento realista de 52–60GB utilizáveis, não cabe. Este é um modelo para 128GB.
Quantos tokens por segundo o M5 Pro produz? Depende muito do modelo. Números medidos para o M5 Pro de 20 núcleos com 64GB: gpt-oss-20b a 66–80 tok/s de decodificação com 1.500–2.200 tok/s de prefill, e o Qwen3.6-27B a 17,8 tok/s de decodificação com 470 tok/s de prefill. Modelos densos maiores, como o Llama 3.3 70B, são estimados em 7–12 tok/s.
M5 Pro ou M5 Max para LLMs locais? M5 Max se a velocidade de geração de tokens em modelos grandes for sua prioridade — ele tem 614 GB/s de largura de banda de memória contra os 307 GB/s do M5 Pro’s, praticamente dobrando a velocidade de decodificação, e suporta 128GB. M5 Pro se você quer o melhor equilíbrio entre preço, portabilidade e capacidade para modelos de até 70B.
Gerar vídeo é viável em um Mac? Na prática, não, em 2026. A difusão de vídeo é limitada pelo poder de processamento, e os Macs são várias vezes mais lentos que uma RTX 5090. Modelos destilados ajudam — o LTX 2.3 gera um clipe de 5 segundos em cerca de 121 segundos em um M5 Max —, mas, para vazão de verdade, alugar GPU na nuvem é muito mais rápido e mais barato por clipe.
Como aumento o limite de memória da GPU no macOS? Executar sudo sysctl iogpu.wired_limit_mb=61440 para alocar 60GB. Confirme com sysctl iogpu.wired_limit_mb e redefina com um valor de 0. Adicione ao /etc/sysctl.conf para persistir entre reinicializações. Sempre deixe 4–8GB para o macOS.
MLX ou llama.cpp no Apple Silicon? MLX na maioria dos casos. Ele supera o llama.cpp em 20–87% nos modelos abaixo de 14B, usa cerca de 10% menos memória e é para onde o Ollama 0.19 migrou em março de 2026. A exceção são contextos muito longos — com 30.000+ tokens, o llama.cpp com Flash Attention pode ser até 50% mais rápido.
Devo comprar o de 14 polegadas ou o de 16? O de 16 polegadas para trabalho de IA sustentado. Ele tem mais margem térmica, bateria maior e o High Power Mode. O de 14 polegadas reduz a frequência de forma perceptível sob carga prolongada.
Um M4 Max com desconto supera um M5 Pro novo? Para decodificação pura de LLM, muitas vezes sim — o M4 Max tem cerca de 546 GB/s contra os 307 GB/s do M5 Pro’s. O M5 Pro ganha no processamento de prompt (até 4× mais rápido) e na geração de imagens (mais de 3,8× mais rápido) graças aos seus Neural Accelerators. Escolha com base em qual carga de trabalho domina seu uso.
O que vem a seguir
Alguns pontos que vale acompanhar, porque podem mudar a recomendação acima.
Benchmarks independentes do M5 Pro em modelos de 70B. Ninguém publicou ainda um número de decodificação medido de forma adequada. Se os resultados reais ficarem acima de 15 tok/s, o argumento “compre o Max pela decodificação” enfraquece bastante.
Menores gpt-oss-120b quantizações. Se um build chegar abaixo de 52GB, o argumento do teto de 64GB perde força da noite para o dia.
Padrões de memória do macOS. Se a Apple aumentar a alocação padrão de GPU para acima de 75%, todo mundo com uma máquina de 64GB ganha folga de graça.
O MoE continua vencendo. A tendência de modelos com total alto e poucos parâmetros ativos é a melhor coisa que aconteceu com máquinas de memória unificada. Cada novo lançamento de MoE torna os Macs relativamente mais competitivos.
Queda nos preços de API. Refaça o cálculo de equilíbrio entre local e nuvem a cada seis meses. Ele muda.
A conclusão
O MacBook Pro M5 Pro com 64GB não é a máquina de IA local mais rápida que você pode comprar. Nem é o Mac mais rápido. O que ele é: a configuração em que os trade-offs param de brigar entre si.
Ele roda modelos bons o suficiente para serem realmente úteis — gpt-oss-20b a 66–80 tok/s, o GLM-4.6 Air em torno de 30, geração de imagens em segundos — e continua sendo um notebook que você pode carregar, usar na bateria e adotar como seu computador de verdade. Os Neural Accelerators da geração M5’s resolveram a fraqueza específica (processamento de prompt lento) que tornava os Macs anteriores frustrantes para trabalho agêntico e de contexto longo.
Os tetos são reais e vale conhecê-los: gpt-oss-120b não cabe, modelos densos de 70B são ferramentas de processamento em lote e não parceiros de conversa, e a geração de vídeo pertence à nuvem.
Se esses limites se encaixam no seu trabalho, esta é a máquina. Se não, as seções acima dizem exatamente qual comprar em vez dela — e isso é mais útil do que mais um artigo dizendo que está tudo bem.
Os preços, as versões de modelos e os números de benchmark deste artigo refletem os dados disponíveis em agosto de 2026 e mudam rápido — especialmente os preços dos Macs durante a atual escassez de memória. Verifique as especificações atuais antes de comprar.