Русский
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 العربية
 हिन्दी

Содержание
- Кратко — вердикт
- Сначала: да, этот чип существует
- Проблема цены (версия 2026 года)
- Почему именно 64 ГБ? Аргумент оптимального варианта
- Шаг 1: разблокируйте память (сделайте это первым)
- Шаг 2: соберите стек
- Часть 1: запуск LLM
- Один принцип, который объясняет всё: пропускная способность против вычислений
- Революция MoE (почему Mac внезапно стали хороши)
- Какие модели реально помещаются — таблица
- Проверка реальностью: модели на 70B
- Квантование: что выбрать на практике
- MLX против llama.cpp — какая среда выполнения?
- Запуск локального API-сервера
- Часть 2: генерация изображений
- Часть 3: генерация видео — честный раздел
- Часть 4: рабочие процессы, которые стоит построить
- Жизнь с ним: нагрев, батарея и шум
- Честные контраргументы
- 1. M5 Max действительно быстрее, и это заметно
- 2. M4 Max со скидкой может оказаться лучше нового M5 Pro
- 3. NVIDIA по-прежнему выигрывает в вычислениях
- 4. Конкуренты с 128 ГБ объединённой памяти играют на объёме, а не на скорости
- 5. Настольный Mac лучше как стационарная машина
- 6. Память увеличить нельзя. Никогда.
- Расчёт затрат: локально против облака
- Руководство по покупке
- Часто задаваемые вопросы
- Что дальше
- Итог
Есть одна конкретная конфигурация Mac, которая тихо стала ответом по умолчанию на вопрос “какой ноутбук купить, если я хочу запускать модели ИИ сам?” Это MacBook Pro 2026 года с чипом M5 Pro и 64 ГБ объединённой памяти.
Не самый дешёвый. Не самый быстрый. Но именно тот, где компромиссы складываются правильно для большинства, кто действительно хочет использование локальные модели, а не только замерять их в бенчмарках.
Это руководство описывает, что эта машина действительно умеет в трёх задачах — большие языковые модели, генерация изображений и генерация видео — с реальными цифрами там, где они есть, честными оценками там, где их нет, и пошаговыми инструкциями по настройке, которым можно следовать в день, когда машина приедет.
Оно также показывает, где аргумент об оптимальном варианте ломается, потому что он действительно ломается, и вам стоит точно знать где — до того, как вы потратите три тысячи долларов на память, которую потом нельзя будет увеличить.
Кратко — вердикт
Берите M5 Pro 64 ГБ, если: нужна портативная машина, которая запускает модели 8B–70B и модели Mixture-of-Experts достаточно быстро для реальной работы, генерирует изображения за секунды, а не за минуты, и при этом оставляет место для браузера, IDE и контейнеров Docker одновременно. Это самый сбалансированный ноутбук для локального ИИ в 2026 году.
Переходите на M5 Max 128 ГБ, если: вам нужны именно локальные модели передового класса, такие как
gpt-oss-120b(которая не не помещается на 64 ГБ), или вам нужна примерно вдвое большая скорость генерации токенов на больших моделях. У M5 Max с 40 ядрами 614 ГБ/с пропускной способности памяти против 307 ГБ/с у M5 Pro, а при декодировании LLM пропускная способность решает всё.Ищите другое, если: генерация видео локально — ваша основная задача. Любой Mac здесь всё ещё в несколько раз медленнее RTX 5090, а аренда в облаке заметно дешевле в расчёте на клип.
Три цифры, которые определяют эту машину:
| Метрика | M5 Pro (GPU на 20 ядер) | Почему это важно |
|---|---|---|
| 307 ГБ/с пропускная способность памяти | ~2× базового M5, ~½ M5 Max с 40 ядрами | Задаёт потолок токенов/с для LLM |
| 64 ГБ максимум объединённой памяти | ~48–52 ГБ доступно по умолчанию | Определяет, какие модели вообще помещаются |
| 20 ядер GPU с Neural Accelerators | 4×+ вычислений для ИИ по сравнению с M4 Pro | Определяет скорость обработки промпта и диффузии |
Сначала: да, этот чип существует
Многое из написанного про M5 Pro в конце 2025 и начале 2026 года было домыслами. Теперь это не домыслы.
Apple представила M5 Pro и M5 Max March 3, 2026, и обе вышли в 14- и 16-дюймовом MacBook Pro March 11, 2026. Базовый M5 появился раньше, в 14-дюймовом MacBook Pro 22 октября 2025 года, но этот чип — совсем другая история: его максимум — 32 ГБ и 153 ГБ/с, чего недостаточно для задач из этого руководства.
Вот что Apple подтвердила на страницах новостей и технических характеристик:
M5 Pro — подтверждённые характеристики
| Компонент | Характеристика |
|---|---|
| CPU | 18 ядер (6 “суперъядер” до ~4,6 ГГц + 12 производительных ядер до ~4,4 ГГц). Базовая конфигурация: 15 ядер. До 30% быстрее в многопоточных задачах, чем M4 Pro. |
| GPU | До 20 ядер, каждое с выделенным Neural Accelerator. Аппаратная трассировка лучей третьего поколения. Более 4× пиковой производительности GPU в задачах ИИ по сравнению с M4 Pro. |
| Neural Engine | 16 ядер |
| Объединённая память | 24 ГБ / 48 ГБ / 64 ГБ — максимум 64 ГБ |
| Пропускная способность памяти | До 307 ГБ/с (LPDDR5X) |
| Техпроцесс | TSMC 3 нм (N3P), “Fusion Architecture” — два кристалла, соединённых упаковкой SoIC-mH |
| Ввод-вывод и медиа | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW encode-decode, AV1 decode |
M5 Max — для сравнения
M5 Max — тот же 18-ядерный CPU, но с GPU до 40 ядер и, что важнее, с другой памятью: вариант с 32 ядрами работает на 460 ГБ/с, а с 40 ядрами — на 614 ГБ/с, с конфигурацией до 128 ГБ.
Этот разрыв в пропускной способности — не мелкая деталь из спецификации. Это самый важный фактор при выборе между M5 Pro и M5 Max, и мы будем возвращаться к нему не раз.
Независимые бенчмарки
Тестовый экземпляр Notebookcheck — 16-дюймовый M5 Pro с 64 ГБ — показал в Geekbench 6.7 результаты 4 295 в одноядерном и 28 436 в многоядерном тесте, 2 347 в многоядерном Cinebench 2024 и 9 481 в многоядерном Cinebench 2026.
Их анализ GPU поставил M5 Max примерно на уровень настольной RTX 5070 и уверенно выше AMD Strix Halo. 20-ядерный GPU M5 Pro находится ниже, и это стоит усвоить: это мощный GPU для ноутбука, но не замена дискретной карте.
Они также отметили кое-что не столь лестное, и к этому стоит отнестись серьёзно: MacBook Pro 2026 года заметно сбрасывает частоты при длительной нагрузке, а производительность CPU нестабильна даже в режиме High Power. Подробнее об этом в разделе про нагрев.
Проблема цены (версия 2026 года)
Линейка M5 Pro стартовала по цене $2,199 за 14-дюймовую версию и $2,699 за 16-дюймовую. Затем ударил глобальный дефицит памяти.
В в июне 2026 года Apple подняла цены на MacBook Pro примерно на $300 по всей линейке. После повышения базовая 14-дюймовая модель M5 Pro стоит около $2 499, а 14-дюймовый M5 Pro с 64 ГБ и SSD на 1 ТБ попадает в диапазон $2 799–$2 999 в зависимости от дня и продавца. B&H и другие реселлеры дают скидки $300–$400 на конфигурации M5 Pro с 48 ГБ и 64 ГБ — это стоит проверить, прежде чем покупать напрямую.
В Германии линейка M5 Pro начинается с €2 199, а образовательные цены у реселлеров вроде Edustore опускаются до €1 979. Конфигурации с 64 ГБ заметно дороже, если учесть НДС 19%.
Для вашего решения важны две разницы:
- 48 ГБ → 64 ГБ на M5 Pro: исторически апгрейд за $200–$400, но после июньского повышения цены на апгрейд памяти выросли на 50–67% во многих конфигурациях.
- M5 Pro 64 ГБ → M5 Max 128 ГБ: существенный скачок. M5 Max до повышения стоил от $3 599 (14 дюймов) и $3 899 (16 дюймов), а апгрейды памяти до 64/128 ГБ для M5 Max в июне подорожали примерно вдвое. Максимально укомплектованный 16-дюймовый теперь превышает $10,000.
Проверьте каждую цену в этом разделе перед покупкой. Рынок памяти в 2026 году меняется ежемесячно, и всё написанное здесь быстро устаревает.
Почему именно 64 ГБ? Аргумент оптимального варианта
Утверждение об “оптимальном варианте” не в том, что 64 ГБ — это магия. Оно в том, что каждый уровень памяти реально закрывает.
Что недоступно на каждом уровне
16 ГБ / 24 ГБ — Модели 7B–8B идут комфортно, 14B — при агрессивном квантовании. Ничего из класса 30B+ с осмысленным контекстом запустить нельзя. Вы будете тратить время на управление памятью вместо работы с моделями.
32 ГБ — Работоспособно для плотных моделей 14B и некоторых MoE поменьше. Но как только добавится KV-кэш для контекста 32K+, плюс Chrome, плюс IDE, плюс демон Docker, вы оказываетесь в зоне нехватки памяти. Именно на этом уровне люди убеждают себя, что локальный ИИ не работает.
48 ГБ — Действительно хорошо. Плотные модели класса 32B идут комфортно. Проблема в запасе: модель 70B в Q4 — это примерно 40 ГБ, что технически помещается, но не оставляет ничего для остальной машины. В итоге вы закрываете приложения, чтобы запустить модель, — и именно это трение убивает локальные процессы.
64 ГБ — Здесь вы можете держать в памяти модель 70B в Q4 или и MoE-модель на 106 млрд параметров и и сохранять всю рабочую среду в памяти. Не нужно закрывать Slack. Не нужно останавливать контейнеры. Вы открываете модель и продолжаете работать.
128 ГБ (территория M5 Max) — Открывает gpt-oss-120b и класс 120B+. Действительно полезно, если вам это нужно, и действительно дорого, если нет.
Аргумент об оптимальном варианте на самом деле про “запустить серьёзную модель И всё остальное”. Это разница между локальным ИИ как демонстрацией и локальным ИИ как рабочим инструментом.
Но у 64 ГБ есть жёсткий потолок, и о нём стоит знать заранее.
Проблема gpt-oss-120b
gpt-oss-120b при квантовании MXFP4 требует примерно 63 ГБ только на веса. Независимые замеры на M5 Max 128 ГБ с MLX показывают пиковое потребление памяти около 64,4 ГБ при контексте 4 096 токенов и 64,9 ГБ при контексте 16K.
На машине с 64 ГБ, где реальный доступный бюджет — 52–60 ГБ, это не помещается. Не “помещается впритык” — не помещается.
Если вы увидите утверждение, что gpt-oss-120b работает на 64 ГБ, отнеситесь к нему с подозрением. Это модель для 128 ГБ. Это самый ясный аргумент в пользу перехода на M5 Max, и если эта модель вам важна, никакие рассуждения об оптимальном варианте арифметику не изменят.
Шаг 1: разблокируйте память (сделайте это первым)
Вот что большинство покупателей не знает: macOS не позволяет GPU использовать всю оперативную память.
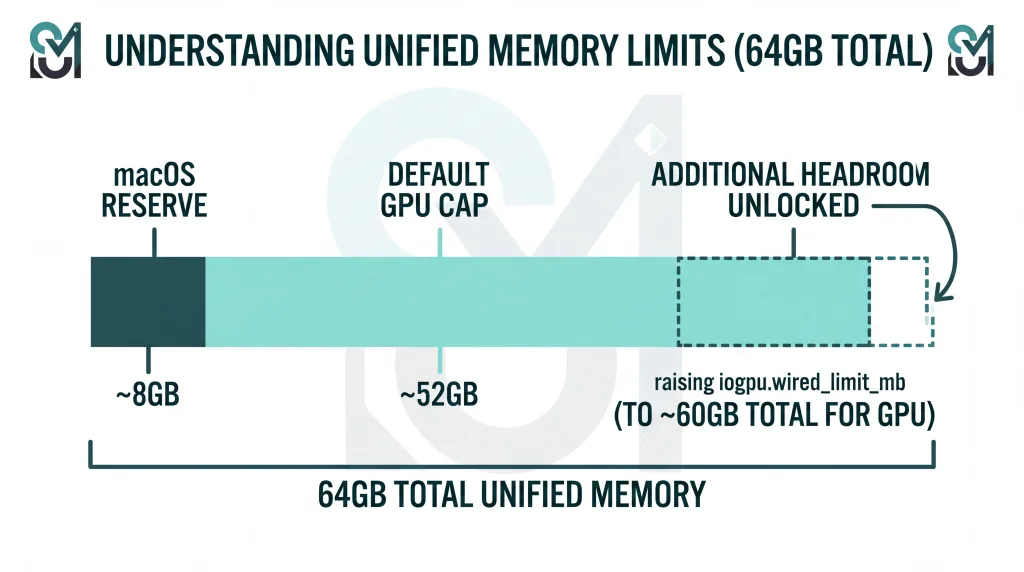
По умолчанию macOS ограничивает память, закреплённую за GPU, примерно 75% от общего объёма. На машине с 64 ГБ это около 51,84 ГБ доступно для весов модели, а остальное зарезервировано для системы.
Это можно поднять одной командой. Без перезагрузки и без изменений System Integrity Protection.
Примечание: современный ключ —
iogpu.wired_limit_mb. Старые руководства ссылаются наdebug.iogpu.wired_limit, который был заменён. Если вам попадётся руководство со старым ключом, оно устарело.
Поднимите лимит
bash
# Установить лимит закреплённой за GPU памяти в 60 ГБ (60 × 1024 = 61440 МБ)
sudo sysctl iogpu.wired_limit_mb=61440

# Проверить, что применилось
sysctl iogpu.wired_limit_mb

# Сбросить к значению macOS по умолчанию в любой момент
sudo sysctl iogpu.wired_limit_mb=0
Сделайте настройку постоянной
Настройка сбрасывается при перезагрузке. Чтобы она сохранилась, добавьте её в /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confКак вариант, создайте LaunchDaemon или добавьте sysctl вызов в скрипт входа, если не хотите трогать /etc/sysctl.conf.
Насколько можно зайти?
Оставьте 4–8 ГБ для macOS. На машине с 64 ГБ значение 60 ГБ (61440 МБ) агрессивно, но работоспособно, если больше ничего тяжёлого не запущено. 56 ГБ (57344 МБ) — более безопасная повседневная настройка.
Не выделяйте 100%. Вы получите «пляшущий шарик», зависания приложений или жёсткую перезагрузку, а на машине посреди инференса это значит потерять всё, чем вы занимались.
Практический бюджет на M5 Pro с 64 ГБ:
- По умолчанию: ~48–52 ГБ доступно
- С поднятием до 56 ГБ: комфортно для модели 70B Q4 плюс контекст
- С поднятием до 60 ГБ: максимум, но почти не остаётся места другим приложениям
Эта разница — 48 ГБ против 58 ГБ — часто определяет, будет модель работать на GPU или частично уйдёт на CPU, что полностью убивает пропускную способность. Это самые ценные пять минут настройки из всех.
Ещё одно требование
MLX требует macOS 26.2 или новее, чтобы действительно использовать Neural Accelerators в M5’s Если у вас более ранняя сборка, вы не используете самое крупное улучшение поколения. Проверьте «Обновление ПО», прежде чем что-либо замерять.
Шаг 2: соберите стек
Вот полная настройка по порядку. Заложите около 30 минут плюс время на загрузку.
2.1 — основы
bash
# Install Homebrew if you don't have it
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# Install uv — a fast Python package manager, far better than pip for this
brew install uv

# Optional but recommended: a Python version manager
brew install [email protected]
2.2 — MLX (нативный ML-фреймворк Apple’s)
MLX — это собственный фреймворк массивов от Apple, созданный специально под архитектуру объединённой памяти Apple Silicon. Это самый быстрый путь для инференса LLM на Mac, и именно его стоит выбирать по умолчанию.
bash
# Create a dedicated environment
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# Install mlx-lm
uv pip install mlx-lm

# Test it — this downloads and runs a model
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Explain unified memory architecture in three sentences."
Если на выходе появился текст, ваш стек работает.
2.3 — LM Studio (графический интерфейс)
Скачайте с lmstudio.ai. Это самый удобный способ просматривать, скачивать и запускать модели, и Apple показала его на презентации M5 Pro — это кое-что говорит о том, насколько массовым стал локальный инференс.
Самая полезная для разработчиков функция LM Studio — встроенный сервер, совместимый с OpenAI. Включите его во вкладке Разработчик tab — и он открывает эндпоинт по адресу http://localhost:1234/v1 с которым может работать любой клиент, совместимый с OpenAI.
2.4 — Ollama (CLI и сервер)
bash
brew install ollama

# Start the server
ollama serve

# In another terminal, pull and run a model
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Важное обновление 2026 года: на March 30, 2026, Ollama 0.19 switched its Apple Silicon backend from llama.cpp to MLX. Это примерно вдвое увеличило скорость декодирования. По собственным замерам Ollama на M5 Max при запуске Qwen3.5-35B-A3B префилл вырос с 1 154 до 1 810 токенов/с, а декодирование — с 58 до 112 токенов/с; сборка с int4 подняла префилл до 1 851, а декодирование — до 134.
Если вы последний раз пробовали Ollama на Mac до этого релиза, ваше представление о её производительности устарело.
2.5 — Draw Things (изображения и видео)
Установите из Mac App Store. Программа бесплатна, нативна, оптимизирована под Metal и сейчас это лучший инструмент генерации изображений на Apple Silicon. Её реализация Metal FlashAttention v2.5 работает на M5 до 4,6× быстрее, чем на M4, и поддерживает обучение LoRA прямо на устройстве.
2.6 — ComfyUI (когда нужны пайплайны)
bash
brew install comfyuiComfyUI даёт управление рабочими процессами на основе узлов, с которым Draw Things не сравнится. Он работает на бэкенде MPS и на Apple Silicon примерно на 20 % медленнее Draw Things при той же работе, плюс есть реальные подводные камни с FP8-чекпойнтами на Metal. Используйте его, когда нужны сложные конвейеры; Draw Things — когда нужна скорость.
2.7 — проверьте всё
bash
# Check your memory limit stuck
sysctl iogpu.wired_limit_mb

# Confirm MLX sees your GPU
python -c "import mlx.core as mx; print(mx.default_device())"

# Confirm Ollama is serving
curl http://localhost:11434/api/tags
Часть 1: запуск LLM
Именно в этом M5 Pro 64GB особенно хорош, и это стоит понять зачем прежде чем смотреть на список моделей.
Один принцип, который объясняет всё: пропускная способность против вычислений
Инференс LLM состоит из двух фаз, и они нагружают совершенно разные части вашей машины.
Префилл (обработка промпта) — это проход по вашему вводу до появления первого токена. Он ограничен вычислениями. Именно поэтому вставка файла на 40 000 токенов в локальный агент для кодинга раньше означала минуты тишины на Mac, тогда как карта NVIDIA прожёвывала его за секунды.
Декодирование (генерация токенов) — это генерация каждого следующего токена. Оно ограничено пропускной способностью памяти. Каждый сгенерированный токен требует чтения весов модели из памяти. Быстрее память — быстрее токены. Всё почти так просто.
Это разделение объясняет всё предложение M5 Pro:
- Его 307 ГБ/с пропускная способность задаёт жёсткий потолок скорости декодирования. Примерно вдвое больше базового M5 с 153 ГБ/с и примерно вдвое меньше, чем у 40-ядерного M5 Max с 614 ГБ/с.
- Его Нейронные ускорители — по одному в каждом ядре GPU, новинка поколения M5 — резко ускоряют префилл.
Собственная исследовательская команда Apple по MLX опубликовала в ноябре 2025 года замеры, сравнивающие базовый M5 с базовым M4 на Qwen3-14B-4bit: время до первого токена оказалось в 4,06 раза меньше, тогда как генерация токенов ускорилась лишь в 1,19 раза. Этот скромный прирост декодирования точно совпадает с приростом пропускной способности (120 ГБ/с → 153 ГБ/с). Огромный выигрыш в префилле целиком обеспечивают нейронные ускорители.
Apple рекламирует варианты Pro и Max как обеспечивающие до 4× более быструю обработку промптов LLM, чем M4 Pro и M4 Max. Механизм тот же, хотя независимых подтверждений префилла именно на M5 Pro пока мало.
Что это значит на практике: для работы с длинным контекстом и агентного кодинга, где доминирует префилл, M5 Pro — преображающий апгрейд по сравнению с Mac до M5. Для чистой пропускной способности чата, где доминирует декодирование, это скромное улучшение.
Революция MoE (почему Mac внезапно стали хороши)
Архитектуры Mixture-of-Experts изменили расклад для машин с объединённой памятью, и если вы не вынесете из этого руководства ничего другого, вынесите вот это.
У MoE-модели огромное общее число параметров, но на каждый токен активируется лишь малая их доля. gpt-oss-120b имеет 117 миллиардов общих параметров, но активирует примерно 5,1 миллиарда на токен.
- Всего параметров определяют вашу память потребность — а её у Mac в избытке.
- Активные параметры определяют вашу скорость декодирования — а она ограничена пропускной способностью памяти.
Итак, MoE-модели нужен тот ресурс, которого у Mac в избытке, и она почти не расходует ресурс, которого у Mac мало. Хорошо выбранная MoE-модель на Mac с 64 ГБ даёт качество почти уровня фронтира на скорости декодирования куда меньшей модели.
Именно поэтому на некоторых задачах ноутбук с 307 ГБ/с ощущается конкурентом карт с 1 700 ГБ/с. Где можете, выбирайте MoE-модели.
Какие модели реально помещаются — таблица
Измеренные цифры ниже взяты из базы бенчмарков сообщества oMLX для M5 Pro с 20 ядрами и 64 ГБ. Оценки явно помечены. Не доверяйте непомеченным цифрам токенов/с для этого чипа, которые встретите в других местах — очень немногие публиковали реальные замеры M5 Pro.
| Модель | Тип | Потребление | Декодирование (ток/с) | Префилл (ток/с) | Вердикт |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12 ГБ | 66–80 ✅ измерено | 1 500–2 200 ✅ | Рабочая лошадка на каждый день. Быстрая, способная, компактная. |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20 ГБ | ~55–70 (оценка) | Высоко | Лучшее качество на ГБ. Выбор по эффективности. |
| Qwen3.6-27B (4-бит) | Плотная | ~16 ГБ | 17.8 ✅ измерено | 470 ✅ | Представитель класса плотных моделей 27–35B. |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40 ГБ+ | ~30 | Высоко | Рассуждения почти уровня фронтира, которые действительно помещаются. |
| Llama 3.3 70B (Q4_K_M) | Плотная | ~40GB | ~7–12 (оценка) | Средне | Годится для пакетной работы; в интерактиве — на грани. |
| Llama 3.3 70B (Q5_K_M) | Плотная | ~49GB | ~6–10 (оценка) | Средне | Влезает, но впритык. Сначала поднимите лимит памяти. |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | Плотная | 8–24GB | 20–60+ | Хорошо | Всё комфортно. Выбирайте под задачу. |
| gpt-oss-120b (MXFP4) | MoE | ~63GB | — | — | ❌ Не влезает. Нужна машина с 128GB. |
| Qwen3-235B-A22B (1,58-битный тернарный) | MoE | ~53GB | ~5.6 | Низкий | Технически работает. Фокус, а не рабочий процесс. |
Бонус пакетной обработки: gpt-oss-20b на M5 Pro масштабируется примерно до 142 tok/s при размере пакета 8. Если вы запускаете агентов, циклы оценки или любую нагрузку с параллельными запросами, пропускная способность заметно выше, чем в однопоточном режиме.
Проверка реальностью: модели на 70B
Опубликованных независимо измеренных значений скорости декодирования на M5 Pro для Llama 3.3 70B нет. Оценка 7–12 tok/s получена экстраполяцией по пропускной способности памяти.
Для калибровки: M4 Max 128GB при 546 GB/s показывает примерно 18–20 tok/s на той же модели. У M5 Pro — 307 GB/s. Арифметика не обнадёживает.
При 7–12 tok/s вы получаете примерно 5–9 слов в секунду — медленнее комфортной скорости чтения. Это нормально для фоновых задач, обработки документов и ночных пакетов. Для интерактивного чата это раздражает.
Честная рекомендация: на M5 Pro с 64GB относитесь к плотным моделям на 70B как к инструментам пакетной обработки, а для всего интерактивного используйте MoE-модели.
Квантование: что выбрать на практике
| Формат | Потеря качества | Когда использовать |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | По умолчанию. Лучшее соотношение скорости и качества. |
| MLX 4-bit | ~1–2% | По умолчанию на Mac. Примерно на 10% меньше памяти и на 15–30% быстрее, чем эквивалентный GGUF. |
| Q5_K_M / MLX 6-bit | <1% | Когда есть запас памяти и нужен вывод почти без потерь. |
| Q6_K | Незначительно | Работа, где критично качество, при наличии запаса памяти. |
| Q8 / FP16 | Нет | На ноутбуке почти никогда не оправдано. Вдвое или вчетверо сокращает ваш бюджет по размеру модели. |
| MXFP4 | Нативно | Не выбор — так gpt-oss и поставляется. |
| троичное, 1,58 бита | Существенно | Только чтобы втиснуть модель, которая иначе не поместится. |
Практическое правило: 4 бита — для скорости и чтобы влезло, 6 бит — когда важно качество и есть запас, а 8 бит на ноутбуке пропускайте.
MLX против llama.cpp — какая среда выполнения?
Короткий ответ — MLX, но с одной оговоркой.
- До ~14B параметров: MLX опережает llama.cpp на 20–87 %. Даже не близко.
- Свыше ~27B: они сближаются, потому что узким местом становится пропускная способность памяти, и среда выполнения перестаёт иметь значение.
- Память: При том же квантовании MLX занимает примерно на 10 % меньше, чем GGUF.
- Оговорка: на контекстах от 30 000 токенов MLX может быть вплоть до на 50 % медленнее чем llama.cpp с включённым Flash Attention. Это зависит от модели и контекста.
Если вы постоянно работаете с очень длинными контекстами, сравните оба варианта на своей реальной нагрузке. В остальных случаях — MLX.
Запуск локального API-сервера
mlx-lm Начиная с 0.18 в комплекте идёт сервер, совместимый с OpenAI, с непрерывным батчингом:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
Теперь всё, что работает через OpenAI API, может использовать вашу локальную модель:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Write a bash one-liner to find large files."}]
  }'
Эта точка доступа — основа всего в разделе о рабочих процессах ниже.
Часть 2: генерация изображений
Генерация изображений — та область, где M5 Pro выглядит лучше, чем можно предположить по его пропускной способности памяти, и причина простая: диффузия ограничен вычислениями, а не ограничена пропускной способностью памяти, и модели достаточно малы, чтобы память вообще становилась ограничением на машине с 64 ГБ.
Производительность по моделям
| Модель | Размер | Память | Время на одно изображение 1024×1024 | Примечания |
|---|---|---|---|---|
| SDXL | 3.5B | ~7GB | ~7 с при 30 шагах (M5 Max) | Самый быстрый из качественных вариантов. Огромная экосистема LoRA. |
| FLUX.1 [schnell] | 12B | ~7GB (Q4) | ~20–25 с при 4 шагах | Дистиллированная версия для скорости. Apache-2.0. |
| FLUX.1 [dev] | 12B | ~10 ГБ (Q6) | ~50 с при 20 шагах (уровень M4) | Эталон качества. |
| FLUX.2 [Klein] | 4B, дистиллированная | ~8 ГБ | ~40 с | Новее, меньше, быстрее. |
| FLUX.2 [dev] | Большая | 24 ГБ+ | Несколько минут | Лучшее качество, требуется настоящее терпение. |
| SD 3.5 | По-разному | 10–20 ГБ | Десятки секунд | Крепкая золотая середина. |
| Qwen-Image / Qwen-Image-Edit | По-разному | 15–25 ГБ | Десятки секунд | Отлично подходит для рендеринга текста и редактирования. |
| HiDream, Chroma | По-разному | 10–20 ГБ | По-разному | Стоит изучить ради разнообразия стилей. |
Команда Apple’s ML Research измерила, как FLUX-dev-4bit генерирует изображение 1024×1024 более чем в 3,8 раза быстрее на M5, чем на M4 с помощью MLX. Этот прирост дают Neural Accelerators, и он распространяется на всё семейство M5.
Специфичного для M5 Pro бенчмарка секунд на изображение пока не опубликовано, поэтому считайте таблицу выше показателями уровня M4 с ожидаемым заметным приростом на M5. На практике: ожидайте FLUX.1 [schnell] заметно быстрее 20 секунд, а SDXL — за однозначные секунды.
При 64 ГБ вы можете запускать эти модели в FP16 без квантования, что даёт настоящее преимущество в качестве перед машинами с 16 ГБ и 24 ГБ, которые вынуждены переходить на Q4.
Инструменты: что использовать
Draw Things — выбор по умолчанию. Нативный Metal, никакого окружения Python, которое может сломаться, Metal FlashAttention v2.5 работает до 4,6 раза быстрее на M5, чем на M4, и обучение LoRA на устройстве. Бесплатно в App Store.
ComfyUI — для узловых пайплайнов, цепочек ControlNet и многоэтапных рабочих процессов. Примерно на 20 % медленнее Draw Things на Apple Silicon. Осторожно с FP8-чекпоинтами: они часто не работают на Metal.
DiffusionKit — собственный набор инструментов Apple для диффузии на базе MLX. Стоит присмотреться.
Mochi Diffusion, InvokeAI — оба варианта жизнеспособны, оба хороши.
Избегайте: DiffusionBee фактически заброшен. Automatic1111 и Forge технически работают через MPS, но на Mac они медленны и плохо поддерживаются.
Пошагово: ваше первое локальное изображение
- Установите Draw Things из Mac App Store.
- Откройте его и перейдите в менеджер моделей (значок в верхней части левой панели).
- Скачать FLUX.1 [schnell] — около 7 ГБ в Q4 или возьмите версию FP16, раз у вас достаточно памяти.
- Задайте число шагов равным 4 (schnell дистиллирована именно для этого) и Размер разрешение — 1024×1024.
- Введите промпт и нажмите Сгенерировать.
- Первый запуск включает загрузку модели. Последующие генерации проходят намного быстрее.
Обучение LoRA на устройстве
Машина с 64 ГБ может тонко настраивать модели изображений локально — это по-настоящему недооценённая возможность. Draw Things поддерживает обучение LoRA напрямую, а MLX поддерживает LoRA и QLoRA как для моделей изображений, так и для языковых моделей.
Небольшая LoRA стиля на 20–50 изображениях — это задача на ночь для M5 Pro, и она никогда не покидает вашу машину. Для тех, кто работает с клиентскими материалами или проприетарными активами, это важнее скорости.
Часть 3: генерация видео — честный раздел
Здесь мне придётся быть с вами прямым, потому что многие материалы на эту тему не отличаются прямотой.
Локальная генерация видео на любом Mac в 2026 году медленна. Это не “медленнее, чем 4090”. Это настолько медленно, что меняет то, как вы работаете.
Почему Mac здесь особенно тяжело
Диффузия видео очень требовательна ограничен вычислениями. В отличие от декодирования LLM, где нужный ресурс — обильная пропускная способность памяти Mac’s, генерация видео нагружает вычислительную мощность GPU в чистом виде — именно ту ось, где 20-ядерный GPU ноутбука уступает дискретной видеокарте.
Нейронные ускорители M5’s помогают. Они не закрывают настолько большой разрыв.
Цифры без прикрас
Wan 2.2 (Alibaba, Apache-2.0, доступна как 14B MoE и как плотная 5B-версия текст/изображение-в-видео): на M1 Max 64 ГБ с GGUF-сборкой, 2-секундный клип в 832×480 занял 82 минуты. 5-секундный клип занял бы больше трёх часов.
Для сравнения: та же модель TI2V-5B на 24 ГБ RTX 4090 выдаёт 5 секунд в 720p примерно за 9 минут.
M5 Pro заметно быстрее M1 Max, но суть именно в порядке величины.
Критическое ограничение Metal: FP8-чекпоинты не работают на Metal — Float8_e4m3fn не поддерживается как тип данных. Нужно использовать GGUF-сборки. Это сбивает с толку многих, кто следует руководствам, ориентированным на NVIDIA, и также означает, FP8-шаблоны LTX-2’s вообще не работают на Mac.
Хорошая новость: более новые дистиллированные модели меняют это. Ivan Fioravanti измерил дистиллированную LTX 2.3 22B в Draw Things, создающую 5-секундное видео примерно за 121 секунду на M5 Max с 40 ядрами — и она фактически обогнала M3 Ultra с 80 ядрами, которому потребовалось 206 секунд.
Это реальный результат и настоящий сдвиг. Но обратите внимание на чип: M5 Pro с 20 ядрами будет существенно медленнее M5 Max с 40 ядрами на таких задачах, упирающихся в вычисления. Ожидайте несколько минут, а не две.
Другие модели — HunyuanVideo, Mochi 1, CogVideoX, FramePack, Stable Video Diffusion — на Mac работают от медленно до неприемлемо. Многие заточены под CUDA и требуют обходных путей.
Вердикт по видео
Локальное видео на M5 Pro 64GB реально для редких и терпеливых экспериментов — короткие ролики, пониженное разрешение, дистиллированные модели, через Draw Things. Это работает. Вы будете создавать.
Для сколько-нибудь реальной производительности арендуйте GPU. RunPod, Vast.ai и Lambda запустят 5090 или H100 за несколько долларов в час и сделают за минуты то, на что вашему ноутбуку нужен час. Именно в видео экономика несопоставима.
Если генерация видео — ваша основной основная задача, покупайте машину на NVIDIA или закладывайте бюджет на облако. Не покупайте Mac в надежде.
Если всё равно хотите попробовать: пошагово
- Открыть Draw Things и переключитесь на менеджер видеомоделей.
- Скачайте дистиллированную модель — LTX 2.3 или сборку Wan 2.2 GGUF. Дистиллированные модели — это разница между минутами и часами.
- Начните с малого: 480p, 2 секунды, небольшое число шагов. Замерьте базовое время, прежде чем масштабировать.
- Подключите питание и включите High Power Mode. Вентиляторы будут работать.
- Повышайте разрешение и длительность только после того, как узнаете, сколько реального времени у вас занимает короткий ролик.
Никогда не используйте FP8-чекпойнты на Mac. GGUF или ничего.
Часть 4: рабочие процессы, которые стоит построить
Бенчмарки — не главное. Вот что люди на самом деле делают на этой машине.
Процесс 1: локальный агент для кодинга
Это самая полезная настройка в списке, и она занимает около десяти минут.
Шаг 1 — запустите сервер модели. Либо вкладка Developer в LM Studio’s (эндпоинт по адресу http://localhost:1234/v1) либо:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234Шаг 2 — направьте редактор на него.
VS Code с Cline или Continue: добавьте провайдера, совместимого с OpenAI, с базовым URL http://localhost:1234/v1, любой непустой API-ключ и имя вашей модели.
Zed: настройте в параметрах собственного провайдера, совместимого с OpenAI.
Aider (терминал):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
Шаг 3 — выберите подходящую модель. gpt-oss-20b и Qwen3-Coder-30B-A3B — оба сильные локальные модели для кода. Обе — MoE, а это именно то, что нужно: быстрый декод, а улучшения prefill в M5’s означают, что крупные файловые контексты больше не встают на минуты.
Что это вам даёт: неограниченные итерации без оплаты за токены, без лимитов и с кодом, который никогда не покидает вашу машину. Для проприетарных или клиентских кодовых баз последний пункт часто и есть всё обоснование.
Процесс 2: приватный RAG по вашим документам
Локальные эмбеддинги плюс модель на 27B–70B означают, что конфиденциальные документы — договоры, медицинские записи, внутренние исследования, финансы — можно искать и суммировать, и при этом ни один байт не покидает ваш ноутбук.
Уровень 64GB важен здесь именно потому, что конвейеры RAG держат в памяти одновременно модель эмбеддингов, векторное хранилище и генеративную модель. При 32GB вы постоянно уходите в swap. При 64GB — нет.
Процесс 3: пакетная генерация за ночь
Поставьте в очередь несколько сотен генераций изображений в Draw Things или запустите долгую обработку документов через mlx_lm.server, а машина пусть работает, пока вы спите. С подключённым питанием модели на 70B и пакеты изображений, которые интерактивно кажутся слишком медленными, за ночь вполне разумны.
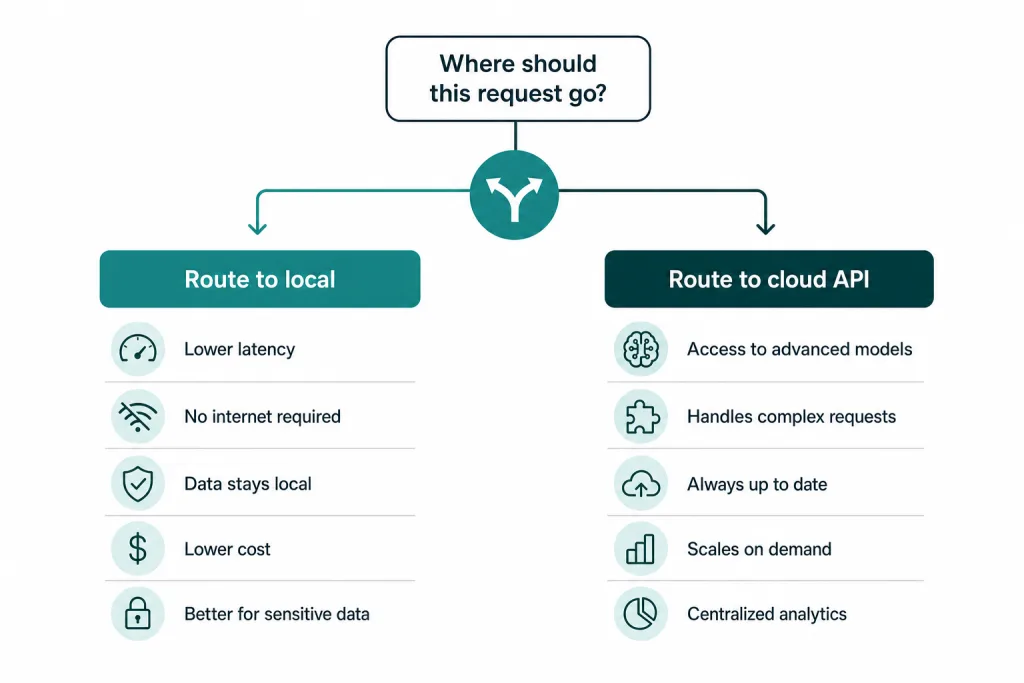
Процесс 4: гибридная маршрутизация (стратегия, которую стоит принять большинству)
Не рассматривайте выбор между локальным и облачным как бинарный. Распределяйте по задачам:
| Отправляйте локально | Отправляйте в облачный API |
|---|---|
| Всё, что касается конфиденциальности | Самые сложные задачи на рассуждение |
| Массовая и пакетная обработка | Случаи, требующие по-настоящему передового качества |
| Циклы агентов с множеством дешёвых вызовов | Разовые ответы с высокой ценой ошибки |
| Итерации и эксперименты | Работа, которой нужна самая свежая модель |
| Работа офлайн | Очень длинные контекстные окна |
Именно здесь и живёт основная ценность. Локально — объём, итерации и конфиденциальность. Облако — сложные 5%.
Собственный ИИ-стек Apple (о нём стоит знать)
Этот Фреймворк Foundation Models даёт разработчикам прямой доступ из Swift к Apple’s модели на устройстве — примерно 3 млрд параметров, бесплатно, приватно, офлайн, со встроенными управляемой генерацией и вызовом инструментов.
Обновления 2026 года важнее первоначального релиза: ввод изображений, выполнение на стороне сервера и LanguageModel протокол, который позволяет привязать сессию к Apple’s модели, облачной модели, или к локальной модели MLX через MLXLanguageModel. Если вы делаете приложения для Mac или iOS, это чистый путь к гибридным ИИ-функциям на устройстве.
Xcode 26 также включает встроенные инструменты кодинга на основе LLM, которые могут использовать ChatGPT, других провайдеров по API-ключу или локальную модель на вашем Mac.
Жизнь с ним: нагрев, батарея и шум
Характеристики не расскажут, каково это — пользоваться машиной. Несколько честных наблюдений.
14-дюймовая модель троттлит сильнее, чем 16-дюймовая. Notebookcheck отметил сильный тепловой троттлинг у MacBook Pro 2026 года под длительной нагрузкой и непоследовательное поведение CPU даже в режиме High Power Mode. У 16-дюймовой модели больше запаса охлаждения и крупнее батарея. Если вы планируете длительные сессии инференса, 16-дюймовая модель — лучший выбор — это реальная функциональная разница, а не предпочтение.
Не все ИИ-нагрузки одинаковы с точки зрения тепла. Декодирование LLM относительно мягкое — оно ограничено памятью, поэтому GPU не загружен полностью и вентиляторы часто остаются тихими. Диффузия изображений и видео ограничена вычислениями: она загрузит GPU по полной, раскрутит вентиляторы до слышимости и быстро посадит батарею.
Реальность батареи: короткие сессии с LLM нормально проходят без питания. Длительная работа с диффузией посадит батарею за пару часов и раньше упрётся в тепловой троттлинг. Для всего серьёзного держите питание подключённым.
Режимы питания: 16-дюймовая модель предлагает High Power Mode, который стоит включать для долгих задач. Low Power Mode заметно снижает скорость инференса — не используйте его во время работы с моделями.
Полезная привычка: без питания — для чата и помощи в кодинге. С питанием и в High Power Mode — для пакетов изображений и видео.
Честные контраргументы
Руководство, которое доказывает только одну сторону, — это маркетинг. Вот аргументы против.
1. M5 Max действительно быстрее, и это заметно
307 ГБ/с против 614 ГБ/с. Поскольку декодирование упирается в пропускную способность, M5 Max с 40 ядрами генерирует токены примерно вдвое быстрее на той же модели. Он также вмещает gpt-oss-120b, чего M5 Pro не может.
Если скорость декодирования больших моделей — ваш основной сценарий, то правильная машина — M5 Max, а M5 Pro это компромисс. Контраргумент — цена: после июня 2026 года такой апгрейд обходится очень дорого.
2. M4 Max со скидкой может оказаться лучше нового M5 Pro
Вот аргумент, который упускает большинство покупателей. У M4 Max примерно 546 ГБ/с пропускной способности памяти — заметно больше, чем 307 ГБ/с у M5 Pro. В чистом декодировании LLM M4 Max 64 ГБ обычно обгоняет M5 Pro 64 ГБ.
Чем вы жертвуете: Neural Accelerators у M5, а значит, гораздо более медленной обработкой промпта и более медленной генерацией изображений.
Правило выбора: если вы в основном общаетесь с большими моделями, M4 Max 64 ГБ со скидкой, пожалуй, будет выгоднее. Если вы занимаетесь агентным кодингом с длинными контекстами или генерируете изображения, побеждают преимущества M5 Pro в обработке промпта и диффузии.
3. NVIDIA по-прежнему выигрывает в вычислениях
У RTX 5090 32 ГБ видеопамяти при примерно 1 792 ГБ/с — почти в шесть раз больше пропускной способности M5 Pro — плюс несравнимо больше вычислений. Для любой модели, которая помещается в 32 ГБ, и для любой работы, ограниченной вычислениями (видео, изображения, обработка промпта), это не соревнование.
Преимущество Mac начинается ровно там, где заканчиваются 32 ГБ видеопамяти, и включает портативность, тишину, низкое энергопотребление и возможность заниматься этим в поезде.
4. Конкуренты с 128 ГБ объединённой памяти играют на объёме, а не на скорости
NVIDIA DGX Spark / GB10: 128 ГБ при примерно 273 ГБ/с, с CUDA. На gpt-oss-120b MXFP4 независимые тесты дают ему 34–39 ток/с.
AMD Strix Halo / Ryzen AI Max+ 395: 128 ГБ при примерно 256 ГБ/с. Сама AMD приводит цифру до 30 ток/с на той же модели через llama.cpp. Мини-ПК на этой платформе заметно дешевле любого Mac.
Учтите, что у обоих ниже пропускная способность, чем у M5 Pro. Они дают объём, а не скорость. Если ваша цель — запускать очень большие модели с приемлемой, а не высокой скоростью, они дешевле. Если вам нужна скорость, это не ваш выбор.
5. Настольный Mac лучше как стационарная машина
A Mac Studio M3 Ultra доходит до 512 ГБ при 800 ГБ/с. Если ваша машина стоит на столе, это гораздо лучший аппарат для локального ИИ, чем любой MacBook Pro. Ценность ноутбука — портативность, батарея и тишина; если вам это не нужно, не платите за это.
6. Память увеличить нельзя. Никогда.
Память Apple Silicon распаяна в корпусе чипа. Что купили — с тем и будете жить весь срок службы машины.
Учитывая, что модели, выходящие в 2026 году, становятся всё крупнее по объёму MoE, экономия на оперативной памяти — это классическое и уже непоправимое сожаление. Если выбираете между 48 и 64 ГБ, берите 64 ГБ.
Расчёт затрат: локально против облака
Давайте честно посчитаем, потому что “локально дешевле” часто утверждают и редко считают.
Машина: примерно $2 800 за M5 Pro 64 ГБ, амортизированные за три-четыре года.
цены API по состоянию на август 2026 года (за миллион токенов, ввод/вывод):
| Служба | Ввод | Вывод |
|---|---|---|
| Класс Claude Sonnet | ~$3 | ~$15 |
| Класс GPT-5 | ~$1,75–$5 | ~$14–$30 |
| DeepSeek V4 Flash | ~$0.14 | ~$0.28 |
| Открытые модели на хостинге (gpt-oss, Llama) | Ещё ниже | Ещё ниже |
Аренда облачных GPU: H100 около $3 в час, H200 около $5 в час по требованию.
Точка безубыточности: в опубликованных анализах точка окупаемости для потребительской машины оценивается примерно в 2–3 млн токенов в день, устойчиво на протяжении примерно двенадцати месяцев по сравнению с проприетарными API среднего уровня.
Это очень много токенов. Ниже этого порога дешёвые API — особенно уровня DeepSeek — действительно обходят локальные модели по чистой стоимости токена.
Так зачем покупать эту машину?
Потому что стоимость токенов — не единственная стоимость:
- Конфиденциальность. Ваши данные не покидают устройство. Для юридической, медицинской, финансовой работы или работы с проприетарным кодом это часто не обсуждается, какова бы ни была цена.
- Никаких лимитов на запросы. Никакого троттлинга, очередей и ошибок нехватки мощности в два часа ночи.
- Офлайн. Самолёты, поезда, плохой wi-fi в отеле, сбои сети.
- Нулевые предельные издержки. Это меняет поведение сильнее, чем ожидают. Когда каждый эксперимент бесплатен, вы проводите их в десять раз больше. Отсутствие тревоги за каждый токен при итерациях реально окупается в результатах.
- Ноутбук вам был нужен и так. Честно говоря, речь не о “$2 800 за ИИ” — а о разнице между машиной, которую вы купили бы, и этой.
Правильный вывод — гибридный подход. Локально — для объёма, конфиденциальности, итераций и агентных циклов. Облако — для сложных задач. Кто утверждает, что в 2026 году локальные модели полностью заменяют frontier-API, тот преувеличивает; кто говорит, что локальные модели бесполезны, тот не запускал агентный цикл в масштабе.
Руководство по покупке
| Если вы… | Покупайте это | Почему |
|---|---|---|
| Хотите максимально сбалансированный ноутбук для локального ИИ | M5 Pro 64GB, 16 дюймов | Запускает модели 8B–70B и MoE, быстрая генерация изображений, место для всего остального. Лучший отвод тепла, чем у 14-дюймовой модели. |
Нужны gpt-oss-120b или модели от 120B | M5 Max 128GB | Единственный ноутбук Mac, куда они помещаются. Ещё и ~2× скорость декодирования. |
| В основном общаетесь с большими моделями и хотите выгоду | M4 Max 64GB со скидкой | Более высокая пропускная способность (546 GB/s) обгоняет M5 Pro при декодировании. |
| Серьёзно занимаетесь генерацией видео | NVIDIA (RTX 5090) или облако | Работа упирается в вычисления; Mac в разы медленнее. |
| Нужен максимальный объём за скромные деньги | Strix Halo 128GB мини-ПК | 128 ГБ дёшево, но пропускная способность памяти ниже, чем у M5 Pro. |
| Работаете за письменным столом | Mac Studio M3 Ultra | До 512 ГБ при 800 ГБ/с. |
| Ограничены в бюджете | M5 Pro 48 ГБ | Модели класса 32B идут нормально. Смиритесь с потолком 70B/MoE. |
Чего бы я не делал: покупать машину на 24 или 32 ГБ для серьёзного локального ИИ. Вы упрётесь в стену за считаные недели, и обойти её апгрейдом не получится.
Часто задаваемые вопросы
Хватает ли 64 ГБ для локального ИИ в 2026 году? Да, для большинства задач. 64 ГБ спокойно тянут модели до примерно 70 млрд параметров при 4-битном квантовании, а также MoE-модели вроде GLM-4.6 Air, и при этом остаётся место для операционной системы и приложений. Главное исключение — gpt-oss-120b, для которого только веса занимают около 63 ГБ и нужна машина на 128 ГБ.
Потянет ли M5 Pro gpt-oss-120b? Нет. Сборка MXFP4 требует около 63 ГБ только под веса, а измеренный пик памяти на M5 Max составляет 64,4–64,9 ГБ в зависимости от длины контекста. На машине с 64 ГБ, где реально доступно 52–60 ГБ, она не помещается. Это модель для 128 ГБ.
Сколько токенов в секунду выдаёт M5 Pro? Это сильно зависит от модели. Измеренные значения для M5 Pro с 20 ядрами и 64 ГБ: gpt-oss-20b на уровне 66–80 ток/с при декодировании и 1 500–2 200 ток/с при префилле, а Qwen3.6-27B — 17,8 ток/с при декодировании и 470 ток/с при префилле. Для более крупных плотных моделей вроде Llama 3.3 70B оценка — 7–12 ток/с.
M5 Pro или M5 Max для локальных LLM? M5 Max — если приоритет скорость генерации токенов на крупных моделях: у него 614 ГБ/с пропускной способности памяти против 307 ГБ/с у M5 Pro’s, то есть декодирование идёт примерно вдвое быстрее, и он поддерживает 128 ГБ. M5 Pro — если вам нужен лучший баланс цены, портативности и возможностей для моделей до 70B.
Практично ли генерировать видео на Mac? В 2026 году — не особо. Видеодиффузия упирается в вычисления, а Mac в несколько раз медленнее RTX 5090. Дистиллированные модели помогают: LTX 2.3 делает пятисекундный клип примерно за 121 секунду на M5 Max, но для реальной производительности аренда GPU в облаке заметно быстрее и дешевле в расчёте на клип.
Как увеличить лимит памяти GPU в macOS? Запуск sudo sysctl iogpu.wired_limit_mb=61440 чтобы выделить 60 ГБ. Проверьте командой sysctl iogpu.wired_limit_mb и сбросьте, задав значение 0. Добавьте её в /etc/sysctl.conf чтобы настройка сохранялась после перезагрузки. Всегда оставляйте 4–8 ГБ для macOS.
MLX или llama.cpp на Apple Silicon? В большинстве случаев — MLX. На моделях до 14B он опережает llama.cpp на 20–87%, расходует примерно на 10% меньше памяти, и именно на него перешёл Ollama 0.19 в марте 2026 года. Исключение — очень длинные контексты: при 30 000+ токенов llama.cpp с Flash Attention может быть до 50% быстрее.
Брать 14-дюймовый или 16-дюймовый? 16-дюймовый — для длительной работы с ИИ. У него лучше запас по охлаждению, батарея больше и есть режим высокой мощности. 14-дюймовый заметно сбрасывает частоты под длительной нагрузкой.
Обгонит ли M4 Max со скидкой новый M5 Pro? В чистом декодировании LLM — часто да: у M4 Max примерно 546 ГБ/с против 307 ГБ/с у M5 Pro’s. Зато M5 Pro выигрывает в обработке промптов (до 4× быстрее) и генерации изображений (более 3,8× быстрее) благодаря Neural Accelerators. Выбирайте по тому, какая нагрузка у вас преобладает.
Что дальше
Несколько вещей, за которыми стоит следить: они могут изменить рекомендацию выше.
Независимые бенчмарки M5 Pro на моделях 70B. Пока никто не опубликовал корректно измеренную цифру декодирования. Если реальные результаты окажутся выше 15 ток/с, аргумент “берите Max ради декодирования” заметно ослабнет.
Меньшие gpt-oss-120b квантования. Если сборка окажется меньше 52 ГБ, аргумент про потолок 64 ГБ размягчится за одну ночь.
Значения памяти macOS по умолчанию. Если Apple поднимет выделение памяти GPU по умолчанию выше 75%, все владельцы машин с 64 ГБ получат бесплатный запас.
MoE продолжает побеждать. Тренд на модели с большим общим и малым числом активных параметров — лучшее, что случилось с машинами с унифицированной памятью. Каждый новый релиз MoE делает Mac относительно более конкурентоспособными.
Падающие цены API. Пересчитывайте точку безубыточности локально-против-облака каждые полгода. Она сдвигается.
Итог
MacBook Pro M5 Pro с 64 ГБ — не самая быстрая машина для локального ИИ, которую можно купить. И даже не самый быстрый Mac. Это конфигурация, в которой компромиссы перестают бороться друг с другом.
Она запускает модели, достаточно хорошие, чтобы быть по-настоящему полезными, — gpt-oss-20b на уровне 66–80 ток/с, GLM-4.6 Air — около 30, генерация изображений за секунды, — и при этом остаётся ноутбуком, который можно носить с собой, работать от батареи и использовать как свой основной компьютер. Neural Accelerators поколения M5’s устранили конкретную слабость (медленную обработку промптов), из-за которой ранние Mac раздражали в агентных задачах и работе с длинным контекстом.
Потолки реальны, и о них стоит знать: gpt-oss-120b не помещается, плотные модели 70B — инструменты пакетной обработки, а не собеседники, а генерации видео место в облаке.
Если эти ограничения укладываются в вашу работу, это ваша машина. Если нет — в разделах выше сказано, какую машину купить вместо неё, и это полезнее очередной статьи о том, что всё в порядке.
Цены, версии моделей и цифры бенчмарков в этой статье отражают данные, доступные в августе 2026 года, и быстро меняются — особенно цены на Mac в условиях продолжающегося дефицита памяти. Проверяйте актуальные характеристики перед покупкой.