Bahasa Indonesia
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Русский
 العربية
 हिन्दी

Daftar isi
- TL;DR — Putusan
- Pertama: ya, chip ini nyata
- Masalah harga (edisi 2026)
- Kenapa tepatnya 64GB? Argumen titik ideal
- Langkah 1: buka batas memorimu (lakukan ini dulu)
- Langkah 2: susun stack-mu
- Bagian 1: menjalankan LLM
- Bagian 2: pembuatan gambar
- Bagian 3: pembuatan video — bagian yang jujur
- Bagian 4: alur kerja nyata yang layak dibangun
- Memakainya sehari-hari: panas, baterai, dan kebisingan
- Argumen tandingan yang jujur
- 1. M5 Max memang lebih cepat, dan bedanya tidak tipis
- 2. M4 Max yang didiskon bisa mengalahkan M5 Pro baru
- 3. NVIDIA tetap menang soal komputasi
- 4. Pesaing memori terpadu 128GB bermain di kapasitas, bukan kecepatan
- 5. Mac desktop lebih cocok sebagai mesin tetap
- 6. Kamu tidak bisa menambah memori. Selamanya.
- Hitungan biaya: lokal vs cloud
- Panduan membeli
- Pertanyaan yang sering diajukan
- Apa yang berikutnya
- Kesimpulan
Ada satu konfigurasi Mac yang diam-diam jadi jawaban default untuk “laptop apa yang harus aku beli kalau ingin menjalankan model AI sendiri?” Itu MacBook Pro 2026 dengan chip M5 Pro dan memori terpadu 64GB.
Bukan yang termurah. Bukan yang tercepat. Tapi yang komprominya mendarat di titik tepat bagi kebanyakan orang yang benar-benar ingin memakai model lokal, bukan sekadar mengetesnya di benchmark.
Panduan ini membahas apa yang benar-benar bisa dilakukan mesin itu pada tiga jenis beban kerja — model bahasa besar, pembuatan gambar, dan pembuatan video — dengan angka nyata di tempat angka nyata tersedia, perkiraan jujur di tempat angka tidak ada, dan instruksi penyiapan langkah demi langkah yang bisa kamu ikuti pada hari mesinmu tiba.
Panduan ini juga membahas di mana argumen titik ideal patah, karena memang patah, dan kamu sebaiknya tahu persis di mana sebelum menghabiskan tiga ribu dolar untuk memori yang tidak bisa kamu upgrade nanti.
TL;DR — Putusan
Beli M5 Pro 64GB kalau: kamu ingin mesin portabel yang menjalankan model 8B–70B dan model Mixture-of-Experts cukup cepat untuk kerja nyata, menghasilkan gambar dalam hitungan detik bukan menit, dan masih punya ruang untuk browser, IDE, serta kontainer Docker yang berjalan bersamaan. Ini laptop paling seimbang laptop untuk AI lokal pada 2026.
Naik ke M5 Max 128GB kalau: kamu secara khusus butuh model lokal kelas terdepan seperti
gpt-oss-120b(yang tidak bukan muat di 64GB), atau kamu ingin kecepatan pembuatan token kira-kira dua kali lipat pada model besar. M5 Max 40-core punya bandwidth memori 614 GB/s dibanding 307 GB/s pada M5 Pro’s, dan untuk decode LLM, bandwidth adalah segalanya.Cari di tempat lain kalau: pembuatan video lokal adalah beban kerja utamamu. Setiap Mac masih beberapa kali lebih lambat daripada RTX 5090 di sini, dan sewa cloud jauh lebih murah per klip.
Tiga angka yang mendefinisikan mesin ini:
| Metrik | M5 Pro (GPU 20-core) | Mengapa ini penting |
|---|---|---|
| 307 GB/s bandwidth memori | ~2× M5 dasar, ~½ M5 Max 40-core | Menentukan batas atas token/detik untuk LLM |
| 64GB memori terpadu maksimum | ~48–52GB bisa dipakai secara default | Menentukan model mana yang bisa muat sama sekali |
| 20 core GPU dengan Neural Accelerator | Komputasi AI 4×+ dibanding M4 Pro | Menentukan kecepatan pemrosesan prompt dan difusi |
Pertama: ya, chip ini nyata
Banyak tulisan soal M5 Pro yang terbit akhir 2025 dan awal 2026 masih spekulasi. Sekarang bukan spekulasi lagi.
Apple mengumumkan M5 Pro dan M5 Max pada March 3, 2026, dan keduanya mulai dikirim dalam MacBook Pro 14 inci dan 16 inci pada March 11, 2026. M5 dasar sudah hadir lebih dulu, di MacBook Pro 14 inci pada 22 Oktober 2025, tapi chip itu sama sekali lain ceritanya — puncaknya 32GB dan 153 GB/s, yang tidak cukup untuk beban kerja dalam panduan ini.
Inilah yang dikonfirmasi Apple di halaman newsroom dan tech-specs:
M5 Pro — spesifikasi yang dikonfirmasi
| Komponen | Spesifikasi |
|---|---|
| CPU | 18-core (6 “super core” hingga ~4.6 GHz + 12 performance core hingga ~4.4 GHz). Bin dasar: 15-core. Hingga 30% lebih cepat multithread dibanding M4 Pro. |
| GPU | Hingga 20 core, masing-masing dengan Neural Accelerator khusus. Ray tracing hardware generasi ketiga. Lebih dari 4× komputasi GPU puncak untuk AI dibanding M4 Pro. |
| Neural Engine | 16-core |
| Memori terpadu | 24GB / 48GB / 64GB — 64GB adalah batas atasnya |
| Bandwidth memori | Hingga 307 GB/s (LPDDR5X) |
| Proses | TSMC 3nm (N3P), “Fusion Architecture” — dua die disatukan lewat kemasan SoIC-mH |
| I/O & media | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW encode-decode, AV1 decode |
M5 Max — sebagai pembanding
M5 Max memakai CPU 18-core yang sama tapi GPU hingga 40 core, dan yang penting, cerita memorinya berbeda: varian 32-core berjalan di 460 GB/s, dan varian 40-core di 614 GB/s, bisa dikonfigurasi hingga 128GB.
Celah bandwidth itu bukan detail kecil di lembar spesifikasi. Itu faktor paling penting dalam keputusan M5 Pro versus M5 Max, dan kita akan kembali ke sana berulang kali.
Benchmark independen
Unit review Notebookcheck’s — MacBook Pro 16 inci dengan M5 Pro dan 64GB — mencatat skor Geekbench 6.7 sebesar 4.295 single-core dan 28.436 multi-core, Cinebench 2024 multi-core 2.347, dan Cinebench 2026 multi-core 9.481.
Analisis GPU mereka menempatkan M5 Max kira-kira setara RTX 5070 desktop dan nyaman unggul atas AMD’s Strix Halo. GPU 20-core pada M5 Pro berada di bawah itu, dan itu layak diresapi: ini GPU yang mumpuni untuk laptop, bukan pengganti kartu khusus.
Mereka juga menandai sesuatu yang kurang menyenangkan, dan layak dianggap serius: MacBook Pro 2026 mengalami throttling yang terasa di bawah beban terus-menerus, dengan performa CPU yang tidak konsisten bahkan dalam High Power Mode. Lebih lanjut di bagian panas.
Masalah harga (edisi 2026)
Jajaran M5 Pro diluncurkan pada $2,199 untuk 14 inci dan $2,699 untuk 16 inci. Lalu kelangkaan memori global menghantam.
Di Juni 2026, Apple menaikkan harga MacBook Pro sekitar $300 di semua lini. Setelah kenaikan, M5 Pro 14 inci entry-level ada di sekitar $2.499, dan M5 Pro 14 inci dengan 64GB plus SSD 1TB berada di kisaran $2.799–$2.999 tergantung hari dan penjual. B&H dan reseller lain mendiskon konfigurasi M5 Pro 48GB dan 64GB sebesar $300–$400, jadi cek dulu sebelum membeli langsung.
Di Jerman, jajaran M5 Pro mulai dari €2.199, dengan harga edukasi serendah €1.979 di reseller seperti Edustore. Konfigurasi 64GB jauh lebih tinggi setelah PPN 19% dimasukkan.
Dua selisih penting untuk keputusanmu:
- 48GB → 64GB di M5 Pro: dulu peningkatan seharga $200–$400, tapi harga upgrade RAM naik 50–67% di banyak konfigurasi setelah kenaikan Juni.
- M5 Pro 64GB → M5 Max 128GB: lompatan besar. M5 Max mulai dari $3.599 (14 inci) dan $3.899 (16 inci) sebelum kenaikan, dan upgrade memori M5 Max 64GB/128GB kurang lebih dua kali lipat harganya pada Juni. Model 16 inci spek penuh sekarang melewati $10,000.
Cek ulang setiap harga di bagian ini sebelum membeli. Pasar memori 2026 bergerak tiap bulan, dan apa pun yang ditulis di sini cepat kedaluwarsa.
Kenapa tepatnya 64GB? Argumen titik ideal
Klaim “sweet spot” bukan soal 64GB itu ajaib. Ini soal apa yang sebenarnya tertutup di tiap tingkatan memori.
Yang tidak bisa kamu lakukan di tiap tingkatan
16GB / 24GB — Kamu bisa menjalankan model 7B–8B dengan nyaman dan model 14B pada kuantisasi agresif. Kamu tidak bisa menjalankan apa pun di kelas 30B+ dengan konteks yang berarti. Waktumu habis untuk mengatur memori, bukan memakai model.
32GB — Bisa untuk model dense 14B dan sebagian model MoE yang lebih kecil. Tapi begitu kamu menambah KV cache untuk konteks 32K+, plus Chrome, plus IDE, plus daemon Docker, kamu sudah masuk wilayah tekanan memori. Di tingkatan inilah orang meyakinkan diri bahwa AI lokal tidak berfungsi.
48GB — Benar-benar bagus. Menjalankan model dense kelas 32B dengan nyaman. Masalahnya headroom: model 70B pada Q4 sekitar 40GB, secara teknis muat tapi tidak menyisakan apa pun untuk bagian lain mesinmu. Kamu akhirnya menutup aplikasi untuk menjalankan model, dan itulah friksi yang mematikan alur kerja lokal.
64GB — Di sinilah kamu bisa menampung model 70B Q4 atau model MoE 106B parameter di memori dan dan menjaga seluruh lingkungan kerjamu tetap tinggal. Tidak perlu menutup Slack. Tidak perlu mematikan kontainer. Kamu buka model dan terus bekerja.
128GB (wilayah M5 Max) — Membuka gpt-oss-120b dan kelas 120B+. Benar-benar berguna kalau itu yang kamu butuhkan, dan benar-benar mahal kalau bukan.
Argumen titik ideal sebenarnya adalah argumen “jalankan model serius DAN semua hal lain”. Itulah bedanya antara AI lokal sebagai hal yang kamu demokan dan hal yang kamu pakai.
Tapi 64GB punya batas atas yang keras, dan kamu sebaiknya tahu soal itu sekarang.
Masalah gpt-oss-120b
gpt-oss-120b pada kuantisasi MXFP4 butuh sekitar 63GB hanya untuk bobot. Pengukuran independen pada M5 Max 128GB dengan MLX menunjukkan memori puncak sekitar 64,4GB pada konteks 4.096 token dan 64,9GB pada konteks 16K.
Di mesin 64GB, dengan anggaran realistis 52–60GB, itu tidak muat. Bukan “muat mepet” — tidak muat.
Kalau kamu melihat klaim bahwa gpt-oss-120b berjalan di 64GB, curigai. Itu model 128GB. Ini argumen tunggal paling jelas untuk naik ke M5 Max, dan kalau model itu penting bagimu, sebanyak apa pun alasan titik ideal tidak mengubah hitungannya.
Langkah 1: buka batas memorimu (lakukan ini dulu)
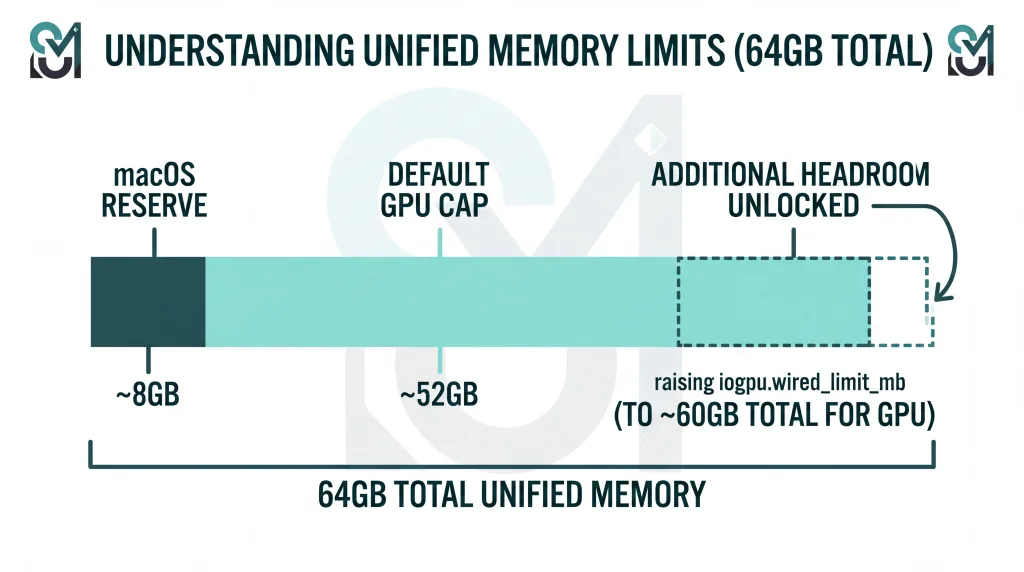
Ada satu hal yang tidak diketahui banyak pembeli: macOS tidak membiarkan GPU memakai seluruh RAM-mu.
Secara default, macOS membatasi memori wired GPU pada sekitar 75% dari total. Di mesin 64GB itu berarti sekitar 51,84GB yang bisa dipakai untuk bobot model, dengan sisanya dicadangkan untuk sistem.
Kamu bisa menaikkannya dengan satu perintah. Tanpa reboot, tanpa mengubah System Integrity Protection.
Catatan: kunci modernnya adalah
iogpu.wired_limit_mb. Panduan lama menyebutdebug.iogpu.wired_limit, yang sudah diganti. Kalau kamu menemukan tutorial yang memakai kunci lama, itu sudah kedaluwarsa.
Naikkan batasnya
bash
# Set the GPU wired-memory limit to 60GB (60 × 1024 = 61440 MB)
sudo sysctl iogpu.wired_limit_mb=61440

# Verify it took effect
sysctl iogpu.wired_limit_mb

# Reset to the macOS default at any time
sudo sysctl iogpu.wired_limit_mb=0
Buat agar permanen
Setelan ini kembali ke default saat reboot. Agar permanen, tambahkan ke /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confAlternatifnya, buat LaunchDaemon atau tambahkan sysctl panggilan ke skrip login kalau kamu tidak ingin menyentuh /etc/sysctl.conf.
Sejauh mana sebaiknya kamu mendorongnya?
Sisakan 4–8GB untuk macOS. Di mesin 64GB, 60GB (61440 MB) agresif tapi masih bisa dipakai kalau kamu tidak menjalankan banyak hal lain. 56GB (57344 MB) adalah setelan sehari-hari yang lebih aman.
Jangan alokasikan 100%. Kamu akan kena beachball, aplikasi macet, atau hard reset — dan di mesin yang sedang inferensi, itu berarti kehilangan apa pun yang sedang kamu kerjakan.
Anggaran praktis di M5 Pro 64GB:
- Default: ~48–52GB bisa dipakai
- Dinaikkan ke 56GB: nyaman untuk model 70B Q4 plus konteks
- Dinaikkan ke 60GB: maksimum, dengan ruang minim untuk aplikasi lain
Selisih itu — 48GB versus 58GB — sering menjadi pembeda antara model yang berjalan di GPU dan model yang tumpah ke CPU, yang benar-benar menghancurkan throughput. Ini lima menit penyiapan paling berharga yang akan kamu lakukan.
Satu prasyarat lagi
MLX butuh macOS 26.2 atau lebih baru untuk benar-benar memakai M5’s Neural Accelerators. Kalau kamu masih di build lebih lama, kamu meninggalkan peningkatan generasional terbesar begitu saja. Periksa Software Update sebelum mengetes apa pun.
Langkah 2: susun stack-mu
Berikut penyiapan lengkapnya, berurutan. Sediakan sekitar 30 menit plus waktu unduh.
2.1 — Dasar-dasar
bash
# Install Homebrew if you don't have it
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# Install uv — a fast Python package manager, far better than pip for this
brew install uv

# Optional but recommended: a Python version manager
brew install [email protected]
2.2 — MLX (framework ML native Apple’s)
MLX adalah framework array milik Apple sendiri, dibuat khusus untuk arsitektur memori terpadu Apple Silicon. Ini jalur tercepat untuk inferensi LLM di Mac dan sebaiknya jadi pilihan default-mu.
bash
# Create a dedicated environment
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# Install mlx-lm
uv pip install mlx-lm

# Test it — this downloads and runs a model
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Explain unified memory architecture in three sentences."
Kalau perintah itu menghasilkan teks, berarti susunan alatmu sudah jalan.
2.3 — LM Studio (antarmuka grafis)
Unduh dari lmstudio.ai. Ini cara paling ramah untuk menjelajah, mengunduh, dan menjalankan model, dan Apple mendemonstrasikannya saat peluncuran M5 Pro — yang menunjukkan seberapa arus utama inferensi lokal sekarang.
Fitur LM Studio yang paling berguna bagi pengembang adalah server kompatibel OpenAI bawaan. Aktifkan di Pengembang tab dan endpoint-nya tersedia di http://localhost:1234/v1 yang bisa dipakai klien apa pun yang kompatibel dengan OpenAI.
2.4 — Ollama (CLI dan server)
bash
brew install ollama

# Start the server
ollama serve

# In another terminal, pull and run a model
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Pembaruan penting 2026: pada March 30, 2026, Ollama 0.19 switched its Apple Silicon backend from llama.cpp to MLX. Ini kurang lebih menggandakan kecepatan decode. Pada pengukuran Ollama sendiri di M5 Max dengan Qwen3.5-35B-A3B, prefill naik dari 1.154 ke 1.810 token/detik dan decode dari 58 ke 112 token/detik — dengan build int4 mereka mendorong prefill ke 1.851 dan decode ke 134.
Kalau terakhir kali kamu mencoba Ollama di Mac sebelum rilis itu, gambaran performanya di kepalamu sudah kedaluwarsa.
2.5 — Draw Things (gambar dan video)
Pasang dari Mac App Store. Gratis, native, dioptimalkan untuk Metal, dan saat ini alat pembuatan gambar terbaik di Apple Silicon. Implementasi Metal FlashAttention v2.5-nya berjalan hingga 4,6× lebih cepat di M5 daripada di M4, dan mendukung pelatihan LoRA di perangkat.
2.6 — ComfyUI (saat butuh pipeline)
bash
brew install comfyuiComfyUI memberi kontrol alur kerja berbasis node yang tidak bisa disamai Draw Things. Ia berjalan di backend MPS dan sekitar 20% lebih lambat daripada Draw Things di Apple Silicon untuk pekerjaan setara, plus ada jebakan nyata dengan checkpoint FP8 di Metal. Pakai saat kamu butuh pipeline rumit; pakai Draw Things saat kamu butuh kecepatan.
2.7 — Verifikasi semuanya
bash
# Check your memory limit stuck
sysctl iogpu.wired_limit_mb

# Confirm MLX sees your GPU
python -c "import mlx.core as mx; print(mx.default_device())"

# Confirm Ollama is serving
curl http://localhost:11434/api/tags
Bagian 1: menjalankan LLM
Inilah keunggulan utama M5 Pro 64GB, dan layak dipahami mengapa sebelum melihat daftar model.
Satu konsep yang menjelaskan semuanya: bandwidth vs komputasi
Inferensi LLM punya dua fase, dan keduanya membebani bagian mesinmu yang benar-benar berbeda.
Prefill (pemrosesan prompt) adalah pembacaan input sebelum token pertama muncul. Proses ini dibatasi komputasi. Karena inilah menempelkan berkas 40.000 token ke agen coding lokal dulu berarti hening bermenit-menit di Mac, sementara kartu NVIDIA menelannya dalam hitungan detik.
Decode (pembuatan token) adalah menghasilkan setiap token berikutnya. Proses ini dibatasi bandwidth memori. Setiap token yang dihasilkan butuh membaca bobot model dari memori. Memori lebih cepat, token lebih cepat. Kurang lebih sesederhana itu.
Pembagian ini menjelaskan seluruh proposisi M5 Pro:
- Bandwidth-nya 307 GB/s menetapkan batas atas keras untuk kecepatan decode. Kira-kira dua kali 153 GB/s milik M5 dasar, kira-kira setengah 614 GB/s milik M5 Max 40-core.
- Bandwidth-nya Neural Accelerators — satu di setiap inti GPU, baru di generasi M5 — meningkatkan prefill secara drastis.
Tim riset MLX Apple sendiri menerbitkan pengukuran pada November 2025 yang membandingkan M5 dasar dengan M4 dasar pada Qwen3-14B-4bit: waktu ke token pertama 4,06× lebih cepat, sementara pembuatan token hanya membaik 1,19×. Kenaikan decode yang sederhana itu persis mengikuti kenaikan bandwidth (120 GB/s → 153 GB/s). Lonjakan prefill yang sangat besar sepenuhnya berasal dari Neural Accelerators.
Apple memasarkan varian Pro dan Max sebagai hingga 4× lebih cepat dalam pemrosesan prompt LLM dibanding M4 Pro dan M4 Max. Mekanismenya identik, meski konfirmasi prefill khusus M5 Pro dari pihak independen masih tipis.
Artinya dalam praktik: M5 Pro adalah peningkatan transformatif dibanding Mac pra-M5 untuk pekerjaan konteks panjang dan coding agentik, tempat prefill mendominasi. Ia peningkatan yang moderat untuk throughput chat murni, tempat decode mendominasi.
Revolusi MoE (kenapa Mac tiba-tiba jadi bagus)
Arsitektur Mixture-of-Experts mengubah hitungan untuk mesin memori terpadu, dan kalau kamu tidak menangkap apa pun dari panduan ini, tangkaplah ini.
Model MoE punya total parameter yang sangat besar tetapi hanya mengaktifkan sebagian kecil per token. gpt-oss-120b memiliki total 117 miliar parameter tetapi hanya mengaktifkan sekitar 5,1 miliar per token.
- Total parameter menentukan memori kebutuhan — yang berlimpah di Mac.
- Parameter aktif menentukan kecepatan decode — yang dibatasi bandwidth.
Jadi model MoE membutuhkan sumber daya yang berlimpah di Mac dan hanya sedikit memakai sumber daya yang langka di Mac. Model MoE yang dipilih dengan baik di Mac 64GB memberi kualitas nyaris terdepan dengan kecepatan decode model yang jauh lebih kecil.
Inilah sebabnya laptop dengan 307 GB/s bisa terasa kompetitif dengan kartu yang berjalan 1.700 GB/s untuk beban kerja tertentu. Pilih model MoE bila bisa.
Model mana yang benar-benar muat — tabelnya
Angka terukur di bawah berasal dari basis data benchmark komunitas oMLX untuk M5 Pro 20-core dengan 64GB. Estimasi ditandai dengan jelas. Jangan percaya angka token/detik tanpa tanda yang kamu temukan di tempat lain untuk chip ini — sangat sedikit orang yang menerbitkan pengukuran M5 Pro sungguhan.
| Model | Jenis | Jejak memori | Decode (tok/s) | Prefill (tok/s) | Kesimpulan |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12GB | 66–80 ✅ terukur | 1.500–2.200 ✅ | Penggerak sehari-hari. Cepat, mumpuni, kecil. |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20GB | ~55–70 (estimasi) | Tinggi | Kualitas terbaik per GB. Pilihan paling efisien. |
| Qwen3.6-27B (4-bit) | Dense | ~16GB | 17.8 ✅ terukur | 470 ✅ | Mewakili kelas dense 27–35B. |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40GB+ | ~30 | Tinggi | Penalaran nyaris terdepan yang benar-benar muat. |
| Llama 3.3 70B (Q4_K_M) | Dense | ~40GB | ~7–12 (estimasi) | Sedang | Bisa dipakai untuk kerja batch; pas-pasan untuk interaktif. |
| Llama 3.3 70B (Q5_K_M) | Dense | ~49GB | ~6–10 (estimasi) | Sedang | Muat, tapi mepet. Naikkan batas memori dulu. |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | Dense | 8–24GB | 20–60+ | Baik | Semua nyaman. Pilih sesuai tugas. |
| gpt-oss-120b (MXFP4) | MoE | ~63GB | — | — | ❌ Tidak muat. Perlu mesin 128GB. |
| Qwen3-235B-A22B (1.58-bit ternary) | MoE | ~53GB | ~5.6 | Rendah | Secara teknis bisa jalan. Trik pamer, bukan alur kerja. |
Bonus batching: gpt-oss-20b di M5 Pro naik menjadi sekitar 142 tok/s pada ukuran batch 8. Kalau kamu menjalankan agen, loop evaluasi, atau beban kerja apa pun dengan permintaan paralel, throughput meningkat cukup besar dibanding angka satu aliran.
Cek realitas soal model 70B
Tidak ada angka decode Llama 3.3 70B untuk M5 Pro yang diterbitkan dan diukur secara independen. Estimasi 7–12 tok/s diekstrapolasi dari bandwidth.
Sebagai kalibrasi: M4 Max 128GB pada 546 GB/s terukur sekitar 18–20 tok/s pada model yang sama. M5 Pro punya 307 GB/s. Aritmetikanya tidak menggembirakan.
Pada 7–12 tok/s kamu dapat sekitar 5–9 kata per detik — lebih lambat dari kecepatan baca yang nyaman. Itu tidak masalah untuk tugas latar belakang, pemrosesan dokumen, dan batch semalam. Melelahkan untuk chat interaktif.
Rekomendasi jujurnya: di M5 Pro 64GB, perlakukan model dense 70B sebagai alat kerja batch dan pakai model MoE untuk apa pun yang interaktif.
Kuantisasi: mana yang sebaiknya dipilih
| Format | Kehilangan kualitas | Kapan dipakai |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | Default. Rasio kecepatan-terhadap-kualitas terbaik. |
| MLX 4-bit | ~1–2% | Default di Mac. Memori ~10% lebih hemat dan 15–30% lebih cepat daripada GGUF setara. |
| Q5_K_M / MLX 6-bit | <1% | Saat masih ada ruang dan kamu ingin hasil nyaris tanpa kehilangan. |
| Q6_K | Diabaikan | Pekerjaan yang kritis kualitas dengan memori sisa. |
| Q8 / FP16 | Tidak ada | Jarang sepadan di laptop. Memangkas separuh atau seperempat anggaran ukuran modelmu. |
| MXFP4 | Native | Bukan pilihan — memang begitulah cara gpt-oss dirilis. |
| 1.58-bit ternary | Parah | Hanya untuk memaksa model yang kalau tidak begitu tidak akan muat. |
Aturan praktis: 4-bit untuk kecepatan dan agar muat, 6-bit saat kualitas penting dan masih ada ruang, dan lewati 8-bit di laptop.
MLX vs llama.cpp — runtime mana?
Jawaban singkatnya MLX, dengan satu catatan.
- Di bawah ~14B parameter: MLX unggul 20–87% atas llama.cpp. Bukan selisih tipis.
- Di atas ~27B: keduanya menyatu, karena bandwidth memori jadi hambatan dan runtime tidak lagi berpengaruh.
- Memori: MLX memakai sekitar 10% lebih sedikit daripada GGUF pada kuantisasi setara.
- Catatannya: pada konteks 30.000+ token, MLX bisa sampai 50% lebih lambat daripada llama.cpp dengan Flash Attention aktif. Ini tergantung model dan konteks.
Kalau kamu rutin bekerja dengan konteks sangat panjang, benchmark keduanya pada beban kerja nyatamu. Kalau tidak, MLX.
Menjalankan server API lokal
mlx-lm 0.18 dan setelahnya menyertakan server kompatibel OpenAI dengan batching berkelanjutan:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
Sekarang apa pun yang berbicara bahasa API OpenAI bisa memakai model lokalmu:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Write a bash one-liner to find large files."}]
  }'
Endpoint itu adalah fondasi untuk semua yang ada di bagian alur kerja di bawah.
Bagian 2: pembuatan gambar
Pembuatan gambar adalah area tempat M5 Pro tampil lebih baik daripada yang disarankan bandwidth-nya, karena alasan sederhana: difusi itu dibatasi komputasi, bukan dibatasi bandwidth, dan modelnya cukup kecil sehingga memori tidak pernah menjadi kendala di mesin 64GB.
Performa per model
| Model | Ukuran | Memori | Waktu per gambar 1024×1024 | Catatan |
|---|---|---|---|---|
| SDXL | 3.5B | ~7GB | ~7 detik pada 30 langkah (M5 Max) | Opsi kualitas tercepat. Ekosistem LoRA sangat besar. |
| FLUX.1 [schnell] | 12B | ~7GB (Q4) | ~20–25 detik pada 4 langkah | Didistilasi untuk kecepatan. Apache-2.0. |
| FLUX.1 [dev] | 12B | ~10GB (Q6) | ~50 detik pada 20 langkah (kelas M4) | Tolok ukur kualitas. |
| FLUX.2 [Klein] | 4B didistilasi | ~8GB | ~40 detik | Lebih baru, lebih kecil, cepat. |
| FLUX.2 [dev] | Besar | 24GB+ | Beberapa menit | Kualitas terbaik, butuh kesabaran sungguhan. |
| SD 3.5 | Bervariasi | 10–20GB | Puluhan detik | Jalan tengah yang mantap. |
| Qwen-Image / Qwen-Image-Edit | Bervariasi | 15–25GB | Puluhan detik | Sangat baik untuk render teks dan penyuntingan. |
| HiDream, Chroma | Bervariasi | 10–20GB | Bervariasi | Layak dijelajahi untuk variasi gaya. |
Tim ML Research Apple mengukur FLUX-dev-4bit menghasilkan gambar 1024×1024 lebih dari 3,8× lebih cepat di M5 daripada di M4 memakai MLX. Keuntungan itu datang dari Neural Accelerators, dan berlaku untuk seluruh keluarga M5.
Belum ada benchmark detik-per-gambar khusus M5 Pro yang diterbitkan, jadi anggap tabel di atas sebagai angka kelas M4 dengan kenaikan M5 yang berarti. Di dunia nyata: kamu semestinya mendapat FLUX.1 [schnell] jauh di bawah 20 detik dan SDXL dalam hitungan detik satu digit.
Dengan 64GB kamu bisa menjalankan model-model ini pada FP16 tanpa kuantisasi, yang jadi keunggulan kualitas nyata dibanding mesin 16GB dan 24GB yang terpaksa memakai Q4.
Perkakas: apa yang dipakai
Draw Things — pilihan default. Metal native, tidak ada lingkungan Python yang bisa rusak, Metal FlashAttention v2.5 berjalan hingga 4,6× lebih cepat di M5 daripada M4, dan pelatihan LoRA di perangkat. Gratis di App Store.
ComfyUI — untuk pipeline berbasis node, rangkaian ControlNet, dan alur kerja bertahap. Sekitar 20% lebih lambat daripada Draw Things di Apple Silicon. Waspadai checkpoint FP8, yang sering gagal di Metal.
DiffusionKit — toolkit difusi milik Apple sendiri, berbasis MLX. Layak dipantau.
Mochi Diffusion, InvokeAI — keduanya layak, keduanya baik-baik saja.
Hindari: DiffusionBee praktis sudah ditinggalkan. Automatic1111 dan Forge secara teknis berjalan lewat MPS tetapi lambat dan kurang terawat di Mac.
Langkah demi langkah: gambar lokal pertamamu
- Pasang Draw Things dari Mac App Store.
- Buka dan masuk ke pengelola model (ikon di bagian atas panel kiri).
- Unduhan FLUX.1 [schnell] — sekitar 7GB pada Q4, atau ambil versi FP16 karena memorimu mencukupi.
- Atur Langkah ke 4 (schnell didistilasi tepat untuk ini) dan Ukuran ke 1024×1024.
- Masukkan prompt dan tekan Buat.
- Proses pertama mencakup pemuatan model. Pembuatan berikutnya jauh lebih cepat.
Latihan LoRA di perangkat
Mesin 64GB dapat melakukan fine-tuning model gambar secara lokal, kemampuan yang sungguh diremehkan. Draw Things mendukung pelatihan LoRA langsung, dan MLX mendukung LoRA serta QLoRA untuk model gambar maupun bahasa.
LoRA gaya kecil pada 20–50 gambar adalah pekerjaan semalam di M5 Pro, dan tidak pernah meninggalkan mesinmu. Bagi siapa pun yang bekerja dengan materi klien atau aset milik sendiri, itu lebih penting daripada kecepatan.
Bagian 3: pembuatan video — bagian yang jujur
Di sinilah saya harus terus terang kepadamu, karena banyak konten tentang topik ini tidak.
Pembuatan video lokal di Mac mana pun pada 2026 itu lambat. Bukan lambat “lebih lambat dari 4090”. Cukup lambat untuk mengubah cara kerjamu.
Kenapa Mac khususnya kesulitan di sini
Difusi video sangat dibatasi komputasi. Berbeda dengan decode LLM, di mana bandwidth memori Mac yang melimpah menjadi sumber daya yang relevan, pembuatan video menghantam komputasi GPU mentah — tepat pada sumbu di mana GPU laptop 20-core kalah dari kartu khusus.
Neural Accelerator M5 membantu. Tetapi tidak menutup celah sebesar ini.
Angkanya, apa adanya
Wan 2.2 (Alibaba, Apache-2.0, tersedia sebagai MoE 14B dan varian teks/gambar-ke-video dense 5B): pada M1 Max 64GB yang menjalankan build GGUF, sebuah klip 2 detik pada 832×480 memakan waktu 82 menit. Klip 5 detik akan melebihi tiga jam.
Sebagai perbandingan, model TI2V-5B yang sama pada RTX 4090 24GB menghasilkan 5 detik pada 720p dalam sekitar 9 menit.
M5 Pro jauh lebih cepat daripada M1 Max, tetapi perbedaan skalanya itulah intinya.
Batasan Metal yang krusial: Checkpoint FP8 tidak berfungsi di Metal — Float8_e4m3fn tipe data tidak didukung. Kamu harus menggunakan build GGUF. Ini menjebak banyak orang yang mengikuti tutorial berorientasi NVIDIA, dan itu juga berarti Template FP8 LTX-2 gagal total di Mac.
Kabar baiknya: model terdistilasi yang lebih baru mengubah ini. Ivan Fioravanti mengukur LTX 2.3 22B di Draw Things menghasilkan video 5 detik dalam sekitar 121 detik pada M5 Max 40-core — bahkan mengalahkan M3 Ultra 80-core, yang memakan 206 detik.
Itu hasil nyata dan pergeseran sungguhan. Tetapi perhatikan chipnya: M5 Pro 20-core akan jauh lebih lambat daripada M5 Max 40-core pada pekerjaan yang dibatasi komputasi seperti ini. Perkirakan beberapa menit, bukan dua.
Model lain — HunyuanVideo, Mochi 1, CogVideoX, FramePack, Stable Video Diffusion — berkisar dari lambat hingga tidak praktis di Mac. Beberapa mengutamakan CUDA dan memerlukan penyesuaian khusus.
Putusan soal video
Video lokal pada M5 Pro 64GB layak untuk eksperimen sesekali yang sabar — klip pendek, resolusi lebih rendah, model terdistilasi, lewat Draw Things. Ini berhasil. Kamu akan membuat sesuatu.
Untuk throughput yang sungguh-sungguh, sewa GPU. RunPod, Vast.ai, dan Lambda akan menjalankan 5090 atau H100 dengan beberapa dolar per jam dan menghasilkan dalam beberapa menit apa yang laptopmu hasilkan dalam satu jam. Khusus untuk video, selisih ekonominya sangat jauh.
Jika pembuatan video adalah utama beban kerjamu, beli mesin NVIDIA atau siapkan anggaran untuk cloud. Jangan beli Mac lalu berharap.
Kalau tetap ingin mencoba: langkah demi langkah
- Buka Draw Things dan beralih ke pengelola model video.
- Unduh model terdistilasi — LTX 2.3 atau build GGUF Wan 2.2. Model terdistilasi adalah perbedaan antara menit dan jam.
- Mulai kecil: 480p, 2 detik, jumlah langkah rendah. Tetapkan waktu dasarmu sebelum menaikkan skala.
- Colokkan dan gunakan Mode Daya Tinggi. Ini akan menyalakan kipas.
- Tingkatkan resolusi dan durasi hanya setelah kamu tahu berapa biaya waktu nyata sebuah klip pendek.
Jangan pernah menggunakan checkpoint FP8 di Mac. GGUF atau tidak sama sekali.
Bagian 4: alur kerja nyata yang layak dibangun
Benchmark bukan intinya. Inilah yang sebenarnya dilakukan orang dengan mesin ini.
Alur kerja 1: agen coding lokal
Ini adalah penyiapan dengan nilai tertinggi dalam daftar, dan hanya memakan sekitar sepuluh menit.
Langkah 1 — Jalankan server model. Baik tab Developer LM Studio (endpoint di http://localhost:1234/v1) atau:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234Langkah 2 — Arahkan editormu ke sana.
VS Code dengan Cline atau Continue: tambahkan penyedia yang kompatibel dengan OpenAI dengan base URL http://localhost:1234/v1, API key apa pun yang tidak kosong, dan nama modelmu.
Zed: konfigurasikan penyedia khusus yang kompatibel dengan OpenAI di pengaturan.
Aider (terminal):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
Langkah 3 — Pilih model yang tepat. gpt-oss-20b dan Qwen3-Coder-30B-A3B sama-sama pengode lokal yang kuat. Keduanya MoE, tepat seperti yang kamu inginkan: decode cepat, dan peningkatan prefill M5 berarti konteks berkas besar tidak lagi tersendat sampai beberapa menit.
Apa yang kamu dapatkan: iterasi tanpa batas tanpa biaya per token, tanpa batas laju, dan kode yang tidak pernah meninggalkan mesinmu. Untuk basis kode milik sendiri atau klien, poin terakhir itu sering menjadi seluruh pembenarannya.
Alur kerja 2: RAG privat atas dokumenmu
Embedding lokal ditambah model 27B–70B berarti dokumen sensitif — kontrak, catatan medis, riset internal, laporan keuangan — dapat dicari dan diringkas tanpa satu byte pun meninggalkan laptopmu.
Tingkat 64GB penting di sini justru karena pipeline RAG menyimpan model embedding, penyimpanan vektor, dan model generasi di memori secara bersamaan. Pada 32GB kamu terus-menerus melakukan swap. Pada 64GB tidak.
Alur kerja 3: pembuatan batch semalam
Antrekan beberapa ratus pembuatan gambar di Draw Things, atau jalankan pekerjaan pemrosesan dokumen yang panjang lewat mlx_lm.server, dan biarkan mesin bekerja saat kamu tidur. Saat dicolokkan, model 70B dan batch gambar yang terasa terlalu lambat secara interaktif sangat wajar untuk semalam.
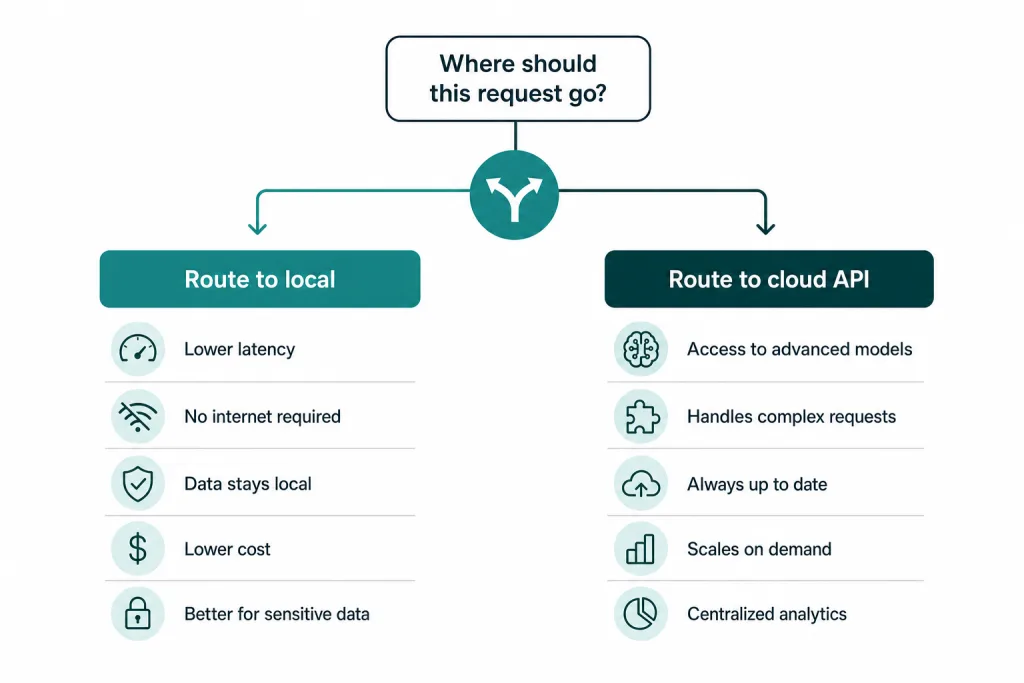
Alur kerja 4: routing hibrida (strategi yang sebaiknya diadopsi kebanyakan orang)
Jangan anggap lokal versus cloud sebagai pilihan biner. Rutekan berdasarkan tugas:
| Kirim ke lokal | Kirim ke API cloud |
|---|---|
| Apa pun yang sensitif privasi | Tugas penalaran tersulit |
| Pemrosesan massal dan batch | Kasus yang membutuhkan kualitas terdepan sungguhan |
| Loop agen dengan banyak panggilan murah | Keluaran sekali jalan dengan taruhan tinggi |
| Iterasi dan eksperimen | Pekerjaan yang membutuhkan model paling mutakhir |
| Pekerjaan offline | Jendela konteks sangat panjang |
Di sinilah sebagian besar nilainya berada. Lokal menangani volume, iterasi, dan privasi. Cloud menangani 5% yang sulit.
Stack AI Apple’s sendiri (layak diketahui)
The Framework Foundation Models memberi pengembang akses Swift langsung ke model on-device Apple — sekitar 3B parameter, gratis, privat, offline, dengan generasi terpandu dan pemanggilan alat bawaan.
Pembaruan 2026 lebih penting daripada rilis aslinya: input visi, eksekusi sisi server, dan protokol LanguageModel yang memungkinkanmu mendukung sesi dengan model Apple, model cloud, atau model MLX lokal lewat MLXLanguageModel. Jika kamu membangun aplikasi Mac atau iOS, itu jalur bersih menuju fitur AI on-device hibrida.
Xcode 26 juga hadir dengan alat coding LLM bawaan yang dapat memakai ChatGPT, penyedia lain lewat API key, atau model lokal yang berjalan di Macmu.
Memakainya sehari-hari: panas, baterai, dan kebisingan
Spesifikasi tidak memberitahumu bagaimana rasanya memakai sebuah mesin. Beberapa pengamatan jujur.
Model 14 inci lebih sering melakukan throttle daripada 16 inci. Notebookcheck menandai throttling termal yang parah pada MacBook Pro 2026 di bawah beban berkelanjutan, dengan perilaku CPU yang tidak konsisten bahkan dalam Mode Daya Tinggi. Model 16 inci memiliki ruang pendinginan lebih besar dan baterai lebih besar. Jika kamu merencanakan sesi inferensi berkelanjutan, model 16 inci adalah mesin yang lebih baik — ini perbedaan fungsional nyata, bukan preferensi.
Tidak semua beban kerja AI setara secara termal. Decode LLM relatif ringan — terikat memori, jadi GPU tidak sepenuhnya jenuh dan kipas sering tetap tenang. Difusi gambar dan video terikat komputasi dan akan membebani GPU-mu, membuat kipas terdengar, dan menguras baterai dengan cepat.
Realitas baterai: sesi LLM pendek aman tanpa colokan. Pekerjaan difusi berkelanjutan akan menguras baterai dalam beberapa jam dan mengalami throttle termal sebelum itu. Tetap dicolokkan untuk apa pun yang serius.
Mode daya: model 16 inci menawarkan Mode Daya Tinggi, layak diaktifkan untuk pekerjaan panjang. Mode Daya Rendah secara signifikan menurunkan kecepatan inferensi — hindari saat menjalankan model.
Kebiasaan praktis: tanpa colokan untuk obrolan dan bantuan coding. Dicolokkan, dengan Mode Daya Tinggi, untuk batch gambar dan video.
Argumen tandingan yang jujur
Panduan yang hanya membela satu sisi adalah pemasaran. Inilah argumen sebaliknya.
1. M5 Max memang lebih cepat, dan bedanya tidak tipis
307 GB/s versus 614 GB/s. Karena decode terikat bandwidth, M5 Max 40-core menghasilkan token sekitar dua kali lebih cepat pada model yang sama. Ia juga memuat gpt-oss-120b, yang tidak bisa dilakukan M5 Pro.
Jika kecepatan decode model besar adalah kasus penggunaan utamamu, M5 Max adalah mesin yang tepat dan M5 Pro adalah kompromi. Penawarnya adalah harga: setelah Juni 2026, peningkatan itu brutal.
2. M4 Max yang didiskon bisa mengalahkan M5 Pro baru
Ini argumen yang paling sering terlewat oleh pembeli. M4 Max memiliki bandwidth memori sekitar 546 GB/s — jauh lebih besar daripada 307 GB/s milik M5 Pro. Untuk decode LLM murni, M4 Max 64GB biasanya akan lebih cepat daripada M5 Pro 64GB.
Yang kamu korbankan: Neural Accelerator M5, yang berarti prefill jauh lebih lambat dan pembuatan gambar lebih lambat.
Aturan keputusan: jika kamu sebagian besar mengobrol dengan model besar, M4 Max 64GB yang didiskon bisa dibilang pembelian yang lebih baik. Jika kamu melakukan coding agen dengan konteks panjang, atau membuat gambar, keunggulan prefill dan difusi M5 Pro menang.
3. NVIDIA tetap menang soal komputasi
RTX 5090 memiliki 32GB VRAM pada sekitar 1.792 GB/s — hampir enam kali bandwidth M5 Pro — ditambah komputasi yang jauh lebih besar. Untuk model apa pun yang muat dalam 32GB, dan untuk semua pekerjaan terikat komputasi (video, gambar, prefill), ini bukan pertandingan.
Keunggulan Mac dimulai tepat di tempat 32GB VRAM berakhir, dan mencakup portabilitas, kesenyapan, konsumsi daya rendah, dan kemampuan melakukan ini di kereta.
4. Pesaing memori terpadu 128GB bermain di kapasitas, bukan kecepatan
NVIDIA DGX Spark / GB10: 128GB pada sekitar 273 GB/s, dengan CUDA. Pada gpt-oss-120b MXFP4, uji independen menempatkannya pada 34–39 tok/s.
AMD Strix Halo / Ryzen AI Max+ 395: 128GB pada sekitar 256 GB/s. Angka AMD sendiri menyebut hingga 30 tok/s pada model yang sama lewat llama.cpp. Mini-PC yang dibangun di sekitarnya jauh lebih murah daripada Mac mana pun.
Perhatikan bahwa keduanya memiliki lebih rendah bandwidth daripada M5 Pro. Mereka memberimu kapasitas, bukan kecepatan. Jika tujuanmu menjalankan model yang sangat besar pada kecepatan yang bisa diterima ketimbang cepat, mereka lebih murah. Jika kamu ingin kecepatan, mereka bukan jawabannya.
5. Mac desktop lebih cocok sebagai mesin tetap
A Mac Studio M3 Ultra mencapai 512GB pada 800 GB/s. Jika mesinmu tinggal di meja, itu kotak AI lokal yang jauh lebih baik daripada MacBook Pro mana pun. Proposisi nilai laptop adalah portabilitas, baterai, dan kesenyapan — jika kamu tidak membutuhkannya, jangan bayar untuk itu.
6. Kamu tidak bisa menambah memori. Selamanya.
Memori Apple Silicon ada di dalam paket. Apa pun yang kamu beli itulah yang kamu miliki sepanjang usia mesin.
Mengingat rilis model 2026 terus mengarah ke jejak MoE yang lebih besar, membeli RAM terlalu kecil adalah penyesalan klasik dan permanen. Jika kamu memilih antara 48GB dan 64GB, ambil 64GB.
Hitungan biaya: lokal vs cloud
Mari kita berhitung dengan jujur, karena “lokal lebih murah” sering diklaim dan jarang dihitung.
Mesin: sekitar $2.800 untuk M5 Pro 64GB, diamortisasi selama tiga sampai empat tahun.
Harga API per Agustus 2026 (per juta token, input/output):
| Layanan | Masukan | Output |
|---|---|---|
| Kelas Claude Sonnet | ~$3 | ~$15 |
| Kelas GPT-5 | ~$1,75–$5 | ~$14–$30 |
| DeepSeek V4 Flash | ~$0.14 | ~$0.28 |
| Model terbuka yang dihosting (gpt-oss, Llama) | Bahkan lebih rendah | Bahkan lebih rendah |
Sewa GPU cloud: H100 sekitar $3/jam, H200 sekitar $5/jam sesuai permintaan.
Titik impasnya: analisis yang telah dipublikasikan menempatkan titik persilangan untuk mesin konsumen pada sekitar 2–3 juta token per hari yang bertahan selama sekitar dua belas bulan dibandingkan API proprietary kelas menengah.
Itu banyak token. Di bawah ambang itu, API murah — terutama kelas DeepSeek — benar-benar lebih murah daripada lokal dalam biaya token murni.
Jadi mengapa membeli mesinnya?
Karena biaya token bukan satu-satunya biaya:
- Privasi. Datamu tidak pernah meninggalkan perangkat. Untuk pekerjaan hukum, medis, keuangan, atau kode milik sendiri, ini sering kali tidak bisa ditawar berapa pun harganya.
- Tanpa batas laju. Tanpa throttle, tanpa antrean, tanpa galat kapasitas pada jam 2 pagi.
- Offline. Pesawat, kereta, wifi hotel buruk, gangguan jaringan.
- Tanpa biaya marginal. Ini mengubah perilaku lebih dari yang orang duga. Ketika setiap eksperimen gratis, kamu menjalankannya sepuluh kali lebih banyak. Tidak adanya kecemasan per token saat beriterasi bernilai uang nyata dalam hal hasil.
- Lagipula kamu memang butuh laptop. Kerangka jujurnya bukan “$2.800 untuk AI” — melainkan selisih antara mesin yang akan kamu beli dan mesin ini.
Kesimpulan yang tepat adalah hibrida. Lokal untuk volume, privasi, iterasi, dan loop agen. Cloud untuk masalah-masalah sulit. Siapa pun yang mengklaim lokal sepenuhnya menggantikan API terdepan pada 2026 sedang melebih-lebihkan; siapa pun yang mengklaim lokal tidak berguna belum pernah menjalankan loop agen dalam skala besar.
Panduan membeli
| Jika kamu… | Beli ini | Mengapa |
|---|---|---|
| Ingin laptop AI lokal paling seimbang | M5 Pro 64GB, 16 inci | Menjalankan model 8B–70B dan MoE, pembuatan gambar cepat, ruang untuk hal lain. Termal lebih baik daripada 14 inci. |
Butuh gpt-oss-120b atau model 120B+ | M5 Max 128GB | Satu-satunya laptop Mac yang memuatnya. Juga kecepatan decode ~2×. |
| Sebagian besar mengobrol dengan model besar, ingin nilai | M4 Max 64GB diskon | Bandwidth lebih tinggi (546 GB/s) mengalahkan M5 Pro pada decode. |
| Serius dalam pembuatan video | NVIDIA (RTX 5090) atau cloud | Pekerjaan terikat komputasi; Mac beberapa kali lebih lambat. |
| Ingin kapasitas maksimum dengan anggaran terbatas | Strix Halo 128GB mini-PC | 128GB dengan harga murah, tetapi bandwidth lebih rendah daripada M5 Pro. |
| Kerja di meja | Mac Studio M3 Ultra | Hingga 512GB pada 800 GB/s. |
| Punya anggaran terbatas | M5 Pro 48GB | Kelas 32B berjalan lancar. Terima saja batas 70B/MoE. |
Yang tidak akan saya lakukan: membeli mesin 24GB atau 32GB untuk AI lokal yang serius. Dalam hitungan minggu kamu akan menabrak batas dan tidak bisa keluar lewat upgrade.
Pertanyaan yang sering diajukan
Apakah 64GB cukup untuk AI lokal di 2026? Ya, untuk sebagian besar beban kerja. 64GB dengan nyaman menjalankan model hingga sekitar 70B parameter pada kuantisasi 4-bit, plus model Mixture-of-Experts seperti GLM-4.6 Air, sambil menyisakan ruang untuk sistem operasi dan aplikasimu. Pengecualian utamanya adalah gpt-oss-120b, yang butuh sekitar 63GB hanya untuk bobotnya dan memerlukan mesin 128GB.
Bisakah M5 Pro menjalankan gpt-oss-120b? Tidak. Build MXFP4 butuh sekitar 63GB hanya untuk bobot, dan memori puncak terukur pada M5 Max adalah 64,4–64,9GB tergantung panjang konteks. Pada mesin 64GB dengan anggaran terpakai realistis 52–60GB, model itu tidak muat. Ini model untuk 128GB.
Berapa token per detik yang dihasilkan M5 Pro? Sangat bergantung pada modelnya. Angka terukur untuk M5 Pro 20-core dengan 64GB: gpt-oss-20b pada 66–80 tok/s decode dengan prefill 1.500–2.200 tok/s, dan Qwen3.6-27B pada 17,8 tok/s decode dengan prefill 470 tok/s. Model dense yang lebih besar seperti Llama 3.3 70B diperkirakan 7–12 tok/s.
M5 Pro atau M5 Max untuk LLM lokal? M5 Max jika kecepatan generasi token pada model besar jadi prioritasmu — bandwidth memorinya 614 GB/s versus M5 Pro’s 307 GB/s, kurang lebih dua kali lipat kecepatan decode, dan mendukung 128GB. M5 Pro jika kamu ingin keseimbangan terbaik antara harga, portabilitas, dan kemampuan untuk model sampai 70B.
Apakah pembuatan video praktis di Mac? Tidak juga, pada 2026. Difusi video terikat komputasi, dan Mac beberapa kali lebih lambat daripada RTX 5090. Model distilled membantu — LTX 2.3 menghasilkan klip 5 detik dalam sekitar 121 detik di M5 Max — tetapi untuk throughput nyata, sewa GPU cloud jauh lebih cepat dan lebih murah per klip.
Bagaimana cara menaikkan batas memori GPU di macOS? Jalankan sudo sysctl iogpu.wired_limit_mb=61440 untuk mengalokasikan 60GB. Verifikasi dengan sysctl iogpu.wired_limit_mb dan reset dengan nilai 0. Tambahkan ke /etc/sysctl.conf agar bertahan setelah reboot. Selalu sisakan 4–8GB untuk macOS.
MLX atau llama.cpp di Apple Silicon? MLX untuk sebagian besar kasus. Ia unggul 20–87% atas llama.cpp pada model di bawah 14B, memakai memori sekitar 10% lebih sedikit, dan inilah yang dipakai Ollama 0.19 sejak Maret 2026. Pengecualiannya konteks yang sangat panjang — pada 30.000+ token, llama.cpp dengan Flash Attention bisa sampai 50% lebih cepat.
Sebaiknya beli yang 14 inci atau 16 inci? Yang 16 inci untuk kerja AI berkelanjutan. Ruang termalnya lebih baik, baterainya lebih besar, dan ada High Power Mode. Yang 14 inci mengalami throttle yang cukup terasa di bawah beban terus-menerus.
Apakah M4 Max diskon mengalahkan M5 Pro baru? Untuk decode LLM murni, sering ya — M4 Max punya sekitar 546 GB/s versus M5 Pro’s 307 GB/s. M5 Pro menang pada pemrosesan prompt (hingga 4× lebih cepat) dan pembuatan gambar (lebih dari 3,8× lebih cepat) berkat Neural Accelerators-nya. Pilih berdasarkan beban kerja mana yang dominan dalam pemakaianmu.
Apa yang berikutnya
Beberapa hal yang layak dipantau, karena bisa mengubah rekomendasi di atas.
Benchmark independen M5 Pro pada model 70B. Belum ada yang menerbitkan angka decode yang benar-benar terukur. Jika hasil dunia nyata berada di atas 15 tok/s, argumen “beli Max untuk decode” melemah cukup jauh.
Kuantisasi gpt-oss-120b lebih kecil. Jika ada build yang berada di bawah 52GB, argumen batas 64GB melemah dalam semalam.
default memori macOS. Jika Apple menaikkan alokasi GPU default di atas 75%, semua orang dengan mesin 64GB mendapat ruang ekstra gratis.
MoE yang terus menang. Tren menuju model dengan total parameter besar tapi parameter aktif sedikit adalah hal terbaik yang pernah terjadi pada mesin memori terpadu. Setiap rilis MoE baru membuat Mac relatif lebih kompetitif.
Harga API yang turun. Hitung ulang titik impas lokal versus cloud setiap enam bulan. Angkanya bergerak.
Kesimpulan
MacBook Pro M5 Pro dengan 64GB bukan mesin AI lokal tercepat yang bisa kamu beli. Bahkan bukan Mac tercepat. Yang ia adalah: konfigurasi di mana kompromi-komprominya berhenti saling bertabrakan.
Ia menjalankan model yang cukup bagus untuk benar-benar berguna — gpt-oss-20b pada 66–80 tok/s, GLM-4.6 Air di sekitar 30, pembuatan gambar dalam hitungan detik — sambil tetap menjadi laptop yang bisa kamu bawa, jalankan dengan baterai, dan pakai sebagai komputermu sehari-hari. Neural Accelerators generasi M5’s memperbaiki kelemahan spesifik (pemrosesan prompt yang lambat) yang membuat Mac-Mac sebelumnya menjengkelkan untuk pekerjaan agentic dan konteks panjang.
Batas-batasnya nyata dan perlu diketahui: gpt-oss-120b tidak muat, model dense 70B adalah alat batch bukan teman mengobrol, dan pembuatan video tempatnya di cloud.
Jika batas-batas itu cocok dengan pekerjaanmu, inilah mesinnya. Jika tidak, bagian-bagian di atas memberi tahu persis mana yang sebaiknya kamu beli — dan itu lebih berguna daripada artikel lain yang bilang semuanya baik-baik saja.
Harga, versi model, dan angka benchmark dalam artikel ini mencerminkan data yang tersedia pada Agustus 2026 dan bergerak cepat — terutama harga Mac selama kelangkaan memori yang masih berlangsung. Verifikasi spesifikasi terkini sebelum membeli.