हिन्दी
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 العربية

विषय-सूची
- संक्षेप में — फ़ैसला
- पहले: हाँ, यह चिप असली है
- कीमत की समस्या (2026 संस्करण)
- खास तौर पर 64GB क्यों? स्वीट स्पॉट का तर्क
- स्टेप 1: अपनी मेमोरी अनलॉक करें (यह पहले करें)
- स्टेप 2: अपना स्टैक बनाएँ
- भाग 1: LLM चलाना
- भाग 2: इमेज जनरेशन
- भाग 3: वीडियो जनरेशन — ईमानदारी वाला हिस्सा
- भाग 4: बनाने लायक असली वर्कफ़्लो
- इसके साथ रहना: गर्मी, बैटरी और शोर
- ईमानदार विरोधी तर्क
- लागत का गणित: लोकल बनाम क्लाउड
- खरीदने की गाइड
- अक्सर पूछे जाने वाले प्रश्न
- आगे क्या आता है
- मुख्य बात
Mac का एक खास कॉन्फ़िगरेशन चुपचाप इस सवाल का डिफ़ॉल्ट जवाब बन गया है: “अगर मुझे खुद AI मॉडल चलाने हैं तो कौन सा लैपटॉप खरीदूँ?” वह है 2026 का MacBook Pro, M5 Pro चिप और 64GB यूनिफ़ाइड मेमोरी के साथ।
सबसे सस्ता नहीं। सबसे तेज़ नहीं। लेकिन वह जिसमें ज़्यादातर लोगों के लिए समझौते सही जगह बैठते हैं, जो असल में उपयोग लोकल मॉडल चाहते हैं, सिर्फ़ उन्हें बेंचमार्क करना नहीं।
यह गाइड बताती है कि वह मशीन तीन तरह के कामों में असल में क्या कर सकती है — बड़े लैंग्वेज मॉडल, इमेज जनरेशन और वीडियो जनरेशन — जहाँ असली आँकड़े हैं वहाँ असली आँकड़ों के साथ, जहाँ नहीं हैं वहाँ ईमानदार अनुमानों के साथ, और स्टेप बाय स्टेप सेटअप निर्देश जिन्हें आप अपनी मशीन आने के दिन ही फ़ॉलो कर सकते हैं।
यह यह भी बताती है कि स्वीट स्पॉट का तर्क कहाँ टूटता है, क्योंकि वह टूटता है, और तीन हज़ार डॉलर ऐसी मेमोरी पर खर्च करने से पहले आपको ठीक-ठीक पता होना चाहिए कि कहाँ — जिसे बाद में अपग्रेड नहीं किया जा सकता।
संक्षेप में — फ़ैसला
M5 Pro 64GB खरीदें अगर: आपको एक पोर्टेबल मशीन चाहिए जो 8B–70B मॉडल और Mixture-of-Experts मॉडल असली काम के लिए काफ़ी तेज़ी से चलाए, इमेज मिनटों के बजाय सेकंडों में बनाए, और साथ ही आपके ब्राउज़र, IDE और एक साथ चल रहे Docker कंटेनर के लिए जगह भी बची रहे। यह 2026 में लोकल AI के लिए सबसे संतुलित लैपटॉप 2026 में लोकल AI के लिए है।
M5 Max 128GB पर जाएँ अगर: आपको खास तौर पर फ़्रंटियर-क्लास लोकल मॉडल चाहिए जैसे
gpt-oss-120b(जो नहीं 64GB पर फ़िट नहीं होता), या आपको बड़े मॉडलों पर लगभग दोगुनी टोकन जनरेशन स्पीड चाहिए। M5 Max 40-कोर में 614 GB/s मेमोरी बैंडविड्थ है जबकि M5 Pro’s 307 GB/s, और LLM डिकोड के लिए बैंडविड्थ ही सब कुछ है।कहीं और देखें अगर: लोकल वीडियो जनरेशन आपका मुख्य काम है। यहाँ हर Mac अब भी RTX 5090 से कई गुना धीमा है, और क्लाउड किराए पर हर क्लिप काफ़ी सस्ती पड़ती है।
इस मशीन को परिभाषित करने वाले तीन आँकड़े:
| मीट्रिक | M5 Pro (20-कोर GPU) | यह क्यों मायने रखता है |
|---|---|---|
| 307 GB/s मेमोरी बैंडविड्थ | ~2× बेस M5, ~½ M5 Max 40-कोर | LLM के लिए tokens/sec की आपकी ऊपरी सीमा तय करता है |
| 64GB अधिकतम यूनिफ़ाइड मेमोरी | डिफ़ॉल्ट रूप से ~48–52GB उपयोगी | तय करता है कि कौन से मॉडल फ़िट होंगे ही |
| 20 GPU कोर Neural Accelerators के साथ | M4 Pro की तुलना में 4×+ AI कंप्यूट | प्रॉम्प्ट प्रोसेसिंग और डिफ़्यूज़न स्पीड चलाता है |
पहले: हाँ, यह चिप असली है
2025 के आख़िर और 2026 की शुरुआत में M5 Pro पर छपी बहुत सी बातें अटकलें थीं। अब अटकलें नहीं हैं।
Apple ने M5 Pro और M5 Max की घोषणा की March 3, 2026, और दोनों 14-इंच और 16-इंच MacBook Pro में आए March 11, 2026. बेस M5 पहले ही आ चुका था, 22 अक्टूबर 2025 को 14-इंच MacBook Pro में, लेकिन वह चिप पूरी तरह अलग मामला है — उसकी सीमा 32GB और 153 GB/s है, जो इस गाइड के वर्कलोड के लिए काफ़ी नहीं है।
Apple ने न्यूज़रूम और टेक-स्पेक्स पेजों पर यह पुष्टि की:
M5 Pro — पुष्ट स्पेसिफ़िकेशन
| घटक | स्पेसिफ़िकेशन |
|---|---|
| CPU | 18-कोर (6 “सुपर कोर” ~4.6 GHz तक + 12 परफ़ॉर्मेंस कोर ~4.4 GHz तक)। बेस बिन: 15-कोर। M4 Pro से मल्टीथ्रेडेड में 30% तक तेज़। |
| GPU | 20 कोर तक, हर एक में समर्पित Neural Accelerator। तीसरी पीढ़ी का हार्डवेयर रे ट्रेसिंग। M4 Pro की तुलना में AI के लिए 4× से ज़्यादा पीक GPU कंप्यूट। |
| Neural Engine | 16-कोर |
| यूनिफ़ाइड मेमोरी | 24GB / 48GB / 64GB — 64GB अधिकतम है |
| मेमोरी बैंडविड्थ | 307 GB/s तक (LPDDR5X) |
| प्रोसेस | TSMC 3nm (N3P), “Fusion Architecture” — SoIC-mH पैकेजिंग से जुड़े दो डाइ |
| I/O & मीडिया | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW encode-decode, AV1 decode |
M5 Max — तुलना के लिए
M5 Max में वही 18-कोर CPU है लेकिन 40-कोर GPU तक, और सबसे ज़रूरी बात, मेमोरी की कहानी अलग है: 32-कोर वेरिएंट 460 GB/s पर चलता है, और 40-कोर वेरिएंट 614 GB/s पर, 128GB तक कॉन्फ़िगर हो सकता है।
वह बैंडविड्थ का अंतर स्पेक-शीट का कोई छोटा विवरण नहीं है। M5 Pro बनाम M5 Max के फ़ैसले में यह सबसे अहम एकमात्र कारक है, और हम इस पर बार-बार लौटेंगे।
स्वतंत्र बेंचमार्क
Notebookcheck’s के रिव्यू यूनिट — 64GB वाला 16-इंच M5 Pro — ने Geekbench 6.7 में 4,295 सिंगल-कोर और 28,436 मल्टी-कोर, Cinebench 2024 मल्टी-कोर में 2,347, और Cinebench 2026 मल्टी-कोर में 9,481 स्कोर किए।
उनके GPU विश्लेषण ने M5 Max को लगभग डेस्कटॉप RTX 5070 के बराबर और AMD’s Strix Halo से आराम से आगे रखा। M5 Pro’s 20-कोर GPU उससे नीचे बैठता है, जिसे मन में बैठा लेना चाहिए: यह लैपटॉप के लिए एक सक्षम GPU है, किसी डेडिकेटेड कार्ड का विकल्प नहीं।
उन्होंने कुछ कम चापलूसी वाला भी बताया, और उसे गंभीरता से लेना चाहिए: 2026 का MacBook Pro लगातार लोड में साफ़ तौर पर थ्रॉटल करता है, High Power Mode में भी CPU परफ़ॉर्मेंस असंगत रहती है। इस पर थर्मल्स वाले हिस्से में और बात होगी।
कीमत की समस्या (2026 संस्करण)
M5 Pro लाइन शुरू हुई $2,199 14-इंच के लिए और $2,699 16-इंच के लिए। फिर वैश्विक मेमोरी की कमी आई।
में जून 2026 में Apple ने MacBook Pro की कीमतें लगभग $300 बढ़ा दीं, सभी मॉडलों में. बढ़ोतरी के बाद एंट्री-लेवल M5 Pro 14-इंच लगभग $2,499 पर है, और 64GB तथा 1TB SSD के साथ कॉन्फ़िगर किया गया 14-इंच M5 Pro दिन और विक्रेता के हिसाब से $2,799–$2,999 की रेंज में पड़ता है। B&H और दूसरे रीसेलर 48GB और 64GB वाले M5 Pro कॉन्फ़िगरेशन पर $300–$400 की छूट दे रहे हैं, जिसे सीधे खरीदने से पहले जाँच लेना चाहिए।
जर्मनी में M5 Pro लाइन €2,199 से शुरू होती है, Edustore जैसे रीसेलर पर एजुकेशन प्राइसिंग €1,979 तक देखी गई है। 19% VAT जोड़ने पर 64GB कॉन्फ़िगरेशन काफ़ी ज़्यादा हो जाते हैं।
आपके फ़ैसले के लिए दो अंतर मायने रखते हैं:
- M5 Pro पर 48GB → 64GB: पहले $200–$400 का अपग्रेड था, लेकिन जून की बढ़ोतरी के बाद कई कॉन्फ़िगरेशन में RAM अपग्रेड की कीमत 50–67% बढ़ गई।
- M5 Pro 64GB → M5 Max 128GB: एक बड़ी छलांग। M5 Max बढ़ोतरी से पहले $3,599 (14-इंच) और $3,899 (16-इंच) से शुरू होता था, और जून में 64GB/128GB M5 Max मेमोरी अपग्रेड की कीमत लगभग दोगुनी हो गई। पूरी तरह लैस 16-इंच अब पार कर जाता है $10,000.
खरीदने से पहले इस हिस्से की हर कीमत जाँच लें। 2026 का मेमोरी बाज़ार हर महीने बदल रहा है, और यहाँ लिखी कोई भी बात कुछ ही समय में पुरानी हो जाती है।
खास तौर पर 64GB क्यों? स्वीट स्पॉट का तर्क
“स्वीट स्पॉट” का दावा यह नहीं है कि 64GB जादुई है। यह इस बारे में है कि हर मेमोरी टियर असल में क्या बंद कर देता है।
हर टियर पर आप क्या नहीं कर सकते
16GB / 24GB — आप 7B–8B मॉडल आराम से चला सकते हैं और 14B मॉडल आक्रामक क्वांटाइज़ेशन पर। 30B+ क्लास में कुछ भी काम का कॉन्टेक्स्ट देकर नहीं चला सकते। आपका समय मॉडल इस्तेमाल करने के बजाय मेमोरी मैनेज करने में जाएगा।
32GB — 14B डेंस मॉडल और कुछ छोटे MoE मॉडल के लिए काम चलाऊ। लेकिन एक बार 32K+ कॉन्टेक्स्ट के लिए KV कैश, साथ में Chrome, साथ में आपका IDE, साथ में Docker डेमन जोड़ दें, तो आप मेमोरी प्रेशर के इलाके में पहुँच जाते हैं। यही वह टियर है जहाँ लोग खुद को यकीन दिला लेते हैं कि लोकल AI काम नहीं करता।
48GB — सचमुच अच्छा। 32B-क्लास डेंस मॉडल आराम से चलाता है। दिक्कत हेडरूम की है: Q4 पर 70B मॉडल लगभग 40GB का होता है, जो तकनीकी रूप से फ़िट तो होता है पर आपकी बाकी मशीन के लिए कुछ नहीं छोड़ता। आप मॉडल चलाने के लिए ऐप्लिकेशन बंद करने लगते हैं, और यही वह रगड़ है जो लोकल वर्कफ़्लो को मार देती है।
64GB — यही वह बिंदु है जहाँ आप 70B Q4 मॉडल या 106B-पैरामीटर MoE मॉडल को मेमोरी में और रख सकते हैं और अपना पूरा कामकाजी माहौल लोडेड रख सकते हैं। Slack बंद करने की ज़रूरत नहीं। कंटेनर बंद करने की ज़रूरत नहीं। आप मॉडल खोलते हैं और काम करते रहते हैं।
128GB (M5 Max का इलाका) — खोलता है gpt-oss-120b और 120B+ क्लास को। सचमुच उपयोगी अगर आपको यही चाहिए, और सचमुच महँगा अगर नहीं।
स्वीट स्पॉट का तर्क असल में “एक गंभीर मॉडल चलाएँ और बाकी सब भी” का तर्क है। यही अंतर है लोकल AI के डेमो में दिखाने वाली चीज़ और इस्तेमाल करने वाली चीज़ के बीच।
लेकिन 64GB के साथ एक सख़्त सीमा आती है, और यह आपको अभी जान लेनी चाहिए।
gpt-oss-120b की समस्या
gpt-oss-120b MXFP4 क्वांटाइज़ेशन पर सिर्फ़ वेट के लिए लगभग 63GB चाहिए। M5 Max 128GB पर MLX का इस्तेमाल करते हुए स्वतंत्र माप लगभग 4,096-टोकन कॉन्टेक्स्ट पर 64.4GB और 16K कॉन्टेक्स्ट पर 64.9GB पीक मेमोरी दिखाते हैं.
64GB की मशीन पर, जहाँ आपका असल उपयोगी बजट 52–60GB है, वह फ़िट नहीं होता। “तंगी से फ़िट होता है” नहीं — फ़िट नहीं होता।
अगर आप कोई दावा देखें कि gpt-oss-120b 64GB पर चलता है, तो उसे शक की नज़र से देखें। यह 128GB का मॉडल है। M5 Max पर जाने का यह सबसे साफ़ एकल तर्क है, और अगर वह मॉडल आपके लिए मायने रखता है, तो स्वीट स्पॉट की कोई भी दलील गणित नहीं बदलती।
स्टेप 1: अपनी मेमोरी अनलॉक करें (यह पहले करें)
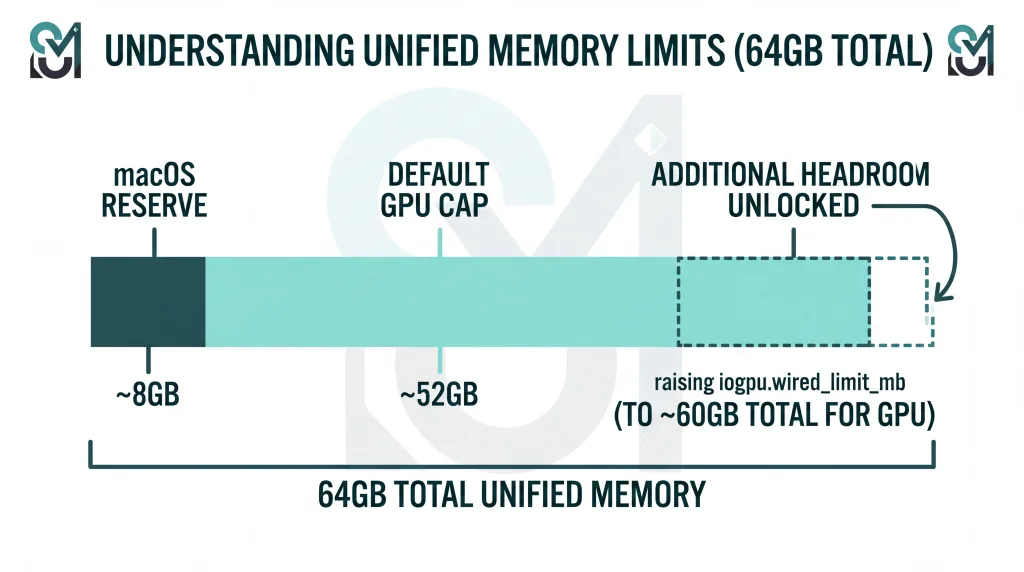
यह बात ज़्यादातर खरीदार नहीं जानते: macOS GPU को आपकी पूरी RAM इस्तेमाल नहीं करने देता।
डिफ़ॉल्ट रूप से macOS GPU-वायर्ड मेमोरी को कुल का लगभग 75% पर सीमित करता है। 64GB की मशीन पर यह लगभग 51.84GB मॉडल वेट के लिए उपयोगी बनता है, बाकी सिस्टम के लिए आरक्षित रहता है।
आप इसे एक ही कमांड से बढ़ा सकते हैं। न रीबूट, न System Integrity Protection में बदलाव।
नोट: आधुनिक की है
iogpu.wired_limit_mb. पुरानी गाइडdebug.iogpu.wired_limitका ज़िक्र करती हैं, जिसे बदल दिया गया है। अगर आपको पुरानी की इस्तेमाल करने वाला कोई ट्यूटोरियल मिले, तो वह पुराना है।
सीमा बढ़ाएँ
bash
# Set the GPU wired-memory limit to 60GB (60 × 1024 = 61440 MB)
sudo sysctl iogpu.wired_limit_mb=61440

# Verify it took effect
sysctl iogpu.wired_limit_mb

# Reset to the macOS default at any time
sudo sysctl iogpu.wired_limit_mb=0
इसे स्थायी बनाएँ
यह सेटिंग रीबूट पर रीसेट हो जाती है। इसे बनाए रखने के लिए इसे यहाँ जोड़ें /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confवैकल्पिक रूप से, LaunchDaemon बनाएँ या sysctl कॉल लॉगिन स्क्रिप्ट में जोड़ें अगर आप बदलना नहीं चाहते /etc/sysctl.conf.
इसे कितना आगे बढ़ाएँ?
macOS के लिए 4–8GB छोड़ें। 64GB की मशीन पर 60GB (61440 MB) आक्रामक है पर काम चलाऊ अगर आप ज़्यादा कुछ और नहीं चला रहे। 56GB (57344 MB) रोज़ के लिए ज़्यादा सुरक्षित सेटिंग है।
100% आवंटित न करें। आपको बीचबॉल, ऐप्लिकेशन लॉकअप या हार्ड रीसेट मिलेगा — और इन्फ़रेंस के बीच में मशीन पर इसका मतलब है आप जो कर रहे थे वह खो जाना।
64GB M5 Pro पर व्यावहारिक बजट:
- डिफ़ॉल्ट: ~48–52GB उपयोगी
- 56GB तक बढ़ाया: 70B Q4 मॉडल और कॉन्टेक्स्ट के लिए आरामदायक
- 60GB तक बढ़ाया: अधिकतम, दूसरे ऐप्लिकेशन के लिए बहुत कम जगह
वह अंतर — 48GB बनाम 58GB — अक्सर मॉडल के GPU पर चलने और CPU पर गिर जाने के बीच का अंतर होता है, जो थ्रूपुट को पूरी तरह तबाह कर देता है। यह सेटअप के सबसे कीमती पाँच मिनट हैं जो आप देंगे।
एक और ज़रूरी शर्त
M5’s Neural Accelerators का असल में इस्तेमाल करने के लिए MLX को macOS 26.2 या उसके बाद का वर्ज़न चाहिए। अगर आप पुराने बिल्ड पर हैं, तो आप पीढ़ी का सबसे बड़ा सुधार छोड़ रहे हैं। कुछ भी बेंचमार्क करने से पहले Software Update देखें।
स्टेप 2: अपना स्टैक बनाएँ
यह पूरा सेटअप है, क्रम में। लगभग 30 मिनट और डाउनलोड का समय जोड़ लें।
2.1 — बुनियाद
bash
# Install Homebrew if you don't have it
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# Install uv — a fast Python package manager, far better than pip for this
brew install uv

# Optional but recommended: a Python version manager
brew install [email protected]
2.2 — MLX (Apple’s नेटिव ML फ़्रेमवर्क)
MLX Apple’s अपना array framework है, जिसे खास तौर पर Apple Silicon की unified memory architecture के लिए बनाया गया है। Mac पर LLM इन्फ़रेंस के लिए यह सबसे तेज़ रास्ता है और इसे ही आपका डिफ़ॉल्ट होना चाहिए।
bash
# Create a dedicated environment
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# Install mlx-lm
uv pip install mlx-lm

# Test it — this downloads and runs a model
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Explain unified memory architecture in three sentences."
अगर इससे टेक्स्ट बनता है, तो आपका स्टैक काम कर रहा है।
2.3 — LM Studio (GUI)
यहाँ से डाउनलोड करें lmstudio.ai. मॉडल ब्राउज़ करने, डाउनलोड करने और चलाने का यह सबसे आसान तरीका है, और Apple ने M5 Pro लॉन्च के दौरान इसे दिखाया भी, जिससे अंदाज़ा होता है कि लोकल इन्फ़रेंस कितना आम हो चुका है।
डेवलपर्स के लिए LM Studio’s सबसे उपयोगी फ़ीचर बिल्ट-इन OpenAI-संगत सर्वर है। इसे इस डेवलपर टैब में चालू करें और यह इस पते पर एक एंडपॉइंट देता है http://localhost:1234/v1 जिससे कोई भी OpenAI-संगत क्लाइंट बात कर सकता है।
2.4 — Ollama (CLI और सर्वर)
bash
brew install ollama

# Start the server
ollama serve

# In another terminal, pull and run a model
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
2026 का ज़रूरी अपडेट: पर March 30, 2026, Ollama 0.19 switched its Apple Silicon backend from llama.cpp to MLX. इससे डिकोड गति लगभग दोगुनी हो गई। Ollama’s के अपने M5 Max मापनों में Qwen3.5-35B-A3B चलाते हुए prefill 1,154 से बढ़कर 1,810 tokens/sec और decode 58 से 112 tokens/sec हो गया — और उनके int4 बिल्ड में prefill 1,851 तथा decode 134 तक पहुँच गया।
अगर आपने Mac पर Ollama आखिरी बार उस रिलीज़ से पहले आज़माया था, तो इसकी परफ़ॉर्मेंस के बारे में आपकी समझ अब पुरानी है।
2.5 — Draw Things (इमेज और वीडियो)
Mac App Store से इंस्टॉल करें। यह मुफ़्त, नेटिव और Metal के लिए ऑप्टिमाइज़्ड है, और फ़िलहाल Apple Silicon पर सबसे अच्छा इमेज जनरेशन टूल है। इसका Metal FlashAttention v2.5 कार्यान्वयन M5 पर M4 की तुलना में 4.6× तक तेज़ चलता है, और यह डिवाइस पर LoRA ट्रेनिंग भी सपोर्ट करता है।
2.6 — ComfyUI (जब आपको पाइपलाइन चाहिए)
bash
brew install comfyuiComfyUI आपको नोड-आधारित वर्कफ़्लो कंट्रोल देता है, जिसकी बराबरी Draw Things नहीं कर सकता। यह MPS बैकएंड पर चलता है और Apple Silicon पर समान काम के लिए Draw Things से लगभग 20% धीमा है; साथ ही Metal पर FP8 चेकपॉइंट के साथ इसमें असली दिक्कतें आती हैं। जटिल पाइपलाइन चाहिए तो इसे इस्तेमाल करें; रफ़्तार चाहिए तो Draw Things।
2.7 — सब कुछ जाँचें
bash
# Check your memory limit stuck
sysctl iogpu.wired_limit_mb

# Confirm MLX sees your GPU
python -c "import mlx.core as mx; print(mx.default_device())"

# Confirm Ollama is serving
curl http://localhost:11434/api/tags
भाग 1: LLM चलाना
M5 Pro 64GB इसमें सबसे बेहतर है, और इसे समझना फ़ायदेमंद है क्यों मॉडल सूची देखने से पहले।
वह एक कॉन्सेप्ट जो सब समझाता है: बैंडविड्थ बनाम कंप्यूट
LLM इन्फ़रेंस के दो चरण होते हैं, और वे आपकी मशीन के बिल्कुल अलग-अलग हिस्सों पर ज़ोर डालते हैं।
Prefill (प्रॉम्प्ट प्रोसेसिंग) पहला टोकन आने से पहले आपके इनपुट पर एक पास है। यह कंप्यूट-बाउंड. यही वजह है कि पहले Mac पर लोकल कोडिंग एजेंट में 40,000-टोकन की फ़ाइल पेस्ट करने का मतलब मिनटों की ख़ामोशी होता था, जबकि NVIDIA कार्ड उसे सेकंडों में निपटा देता था।
Decode (टोकन जनरेशन) हर अगला टोकन बनाना है। यह मेमोरी-बैंडविड्थ-बाउंड. हर जनरेट किए गए टोकन के लिए मॉडल’s वेट्स को मेमोरी से पढ़ना पड़ता है। तेज़ मेमोरी, तेज़ टोकन। बात लगभग इतनी ही सीधी है।
यही बँटवारा M5 Pro की पूरी पेशकश समझाता है:
- इसकी 307 GB/s बैंडविड्थ डिकोड गति की सख़्त ऊपरी सीमा तय करती है। बेस M5’s 153 GB/s से लगभग दोगुनी, M5 Max 40-core’s 614 GB/s से लगभग आधी।
- इसकी Neural Accelerators — हर GPU कोर में एक, M5 जनरेशन में नया — prefill को नाटकीय रूप से बेहतर करते हैं।
Apple’s MLX रिसर्च टीम ने नवंबर 2025 में बेस M5 की बेस M4 से तुलना करते हुए Qwen3-14B-4bit पर मापन प्रकाशित किए: time-to-first-token 4.06× तेज़ था, जबकि टोकन जनरेशन सिर्फ़ 1.19× सुधरा। डिकोड में यह छोटा-सा फ़ायदा बैंडविड्थ की बढ़ोतरी से ठीक-ठीक मेल खाता है (120 GB/s → 153 GB/s)। prefill का ज़बरदस्त फ़ायदा पूरी तरह Neural Accelerators से आता है।
Apple, Pro और Max वेरिएंट को M4 Pro और M4 Max से 4× तक तेज़ LLM प्रॉम्प्ट प्रोसेसिंग देने वाला बताता है। तंत्र वही है, हालाँकि M5 Pro के लिए खास तौर पर स्वतंत्र prefill पुष्टि अभी कम है।
व्यवहार में इसका मतलब: लंबे कॉन्टेक्स्ट वाले काम और एजेंटिक कोडिंग के लिए M5 Pro, M5 से पहले के Macs की तुलना में बड़ा बदलाव है, क्योंकि वहाँ prefill हावी होता है। सिर्फ़ चैट थ्रूपुट के लिए यह छोटा-सा अपग्रेड है, क्योंकि वहाँ decode हावी होता है।
MoE क्रांति (Mac अचानक अच्छे क्यों हो गए)
Mixture-of-Experts आर्किटेक्चर ने unified-memory मशीनों का पूरा गणित बदल दिया है, और अगर इस गाइड से आप कुछ और न समझें, तो यह समझ लें।
MoE मॉडल के कुल पैरामीटर बहुत बड़े होते हैं, लेकिन प्रति टोकन उसका सिर्फ़ छोटा हिस्सा सक्रिय होता है। gpt-oss-120b के कुल 117 अरब पैरामीटर हैं, लेकिन सक्रिय होते हैं लगभग 5.1 अरब प्रति टोकन।
- कुल पैरामीटर तय करते हैं आपकी मेमोरी ज़रूरत — जो Macs में भरपूर है।
- सक्रिय पैरामीटर तय करते हैं आपकी डिकोड गति — जो बैंडविड्थ-बाउंड है।
तो MoE मॉडल को वह संसाधन चाहिए जिसमें Macs मालामाल हैं, और उस संसाधन का बहुत कम इस्तेमाल करता है जिसमें Macs कमज़ोर हैं। 64GB के Mac पर सही चुना गया MoE मॉडल लगभग फ्रंटियर-स्तर की क्वालिटी देता है, और उसी डिकोड गति पर जो बहुत छोटा मॉडल देता है।
यही वजह है कि 307 GB/s वाला लैपटॉप कुछ खास वर्कलोड में 1,700 GB/s पर चलने वाले कार्ड्स के मुकाबले टक्कर देता महसूस होता है। जहाँ हो सके, MoE मॉडल चुनें।
कौन से मॉडल असल में फ़िट होते हैं — टेबल
नीचे दिए मापे गए आँकड़े 64GB वाले M5 Pro 20-core के लिए oMLX कम्युनिटी बेंचमार्क डेटाबेस से हैं। अनुमान साफ़ तौर पर चिह्नित हैं। इस चिप के लिए कहीं और मिलने वाले बिना-चिह्नित tokens/sec आँकड़ों पर भरोसा न करें — बहुत कम लोगों ने M5 Pro के असली मापन प्रकाशित किए हैं।
| मॉडल | प्रकार | फ़ुटप्रिंट | Decode (tok/s) | Prefill (tok/s) | नतीजा |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12GB | 66–80 ✅ मापा गया | 1,500–2,200 ✅ | रोज़मर्रा का साथी। तेज़, काबिल, छोटा। |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20GB | ~55–70 (अनु.) | उच्च | हर GB पर सबसे अच्छी क्वालिटी। एफ़िशिएंसी की पसंद। |
| Qwen3.6-27B (4-bit) | Dense | ~16GB | 17.8 ✅ मापा गया | 470 ✅ | dense 27–35B श्रेणी का प्रतिनिधि। |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40GB+ | ~30 | उच्च | लगभग फ्रंटियर-स्तर की रीज़निंग जो सचमुच फ़िट होती है। |
| Llama 3.3 70B (Q4_K_M) | Dense | ~40GB | ~7–12 (अनु.) | मध्यम | बैच काम के लिए काम का; इंटरैक्टिव में सीमांत। |
| Llama 3.3 70B (Q5_K_M) | Dense | ~49GB | ~6–10 (अनु.) | मध्यम | फ़िट होता है, पर तंगी से। पहले अपनी मेमोरी सीमा बढ़ाएँ। |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | Dense | 8–24GB | 20–60+ | अच्छा | सब आराम से। काम के हिसाब से चुनें। |
| gpt-oss-120b (MXFP4) | MoE | ~63GB | — | — | ❌ फ़िट नहीं होता। 128GB मशीन ज़रूरी। |
| Qwen3-235B-A22B (1.58-bit ternary) | MoE | ~53GB | ~5.6 | कम | तकनीकी रूप से चलता है। पार्टी का करतब, वर्कफ़्लो नहीं। |
बैचिंग का बोनस: gpt-oss-20b M5 Pro पर बढ़कर लगभग batch size 8 पर 142 tok/s. अगर आप एजेंट, इवैल्यूएशन लूप या समानांतर रिक्वेस्ट वाला कोई भी काम चला रहे हैं, तो थ्रूपुट सिंगल-स्ट्रीम आँकड़े से काफ़ी बेहतर होता है।
70B मॉडल पर वास्तविकता की जाँच
Llama 3.3 70B के लिए M5 Pro का कोई प्रकाशित, स्वतंत्र रूप से मापा गया decode आँकड़ा नहीं है। 7–12 tok/s का अनुमान बैंडविड्थ से निकाला गया है।
तुलना के लिए: 546 GB/s वाला M4 Max 128GB उसी मॉडल पर लगभग 18–20 tok/s देता है। M5 Pro में 307 GB/s है। गणित उत्साहजनक नहीं है।
7–12 tok/s पर आपको लगभग 5–9 शब्द प्रति सेकंड मिलते हैं — आराम से पढ़ने की गति से धीमा। बैकग्राउंड जॉब, दस्तावेज़ प्रोसेसिंग और रातभर चलने वाले बैच के लिए यह ठीक है। इंटरैक्टिव चैट के लिए यह चिढ़ाने वाला है।
ईमानदार सलाह: 64GB के M5 Pro पर 70B dense मॉडलों को बैच-वर्कलोड टूल मानें और जो भी इंटरैक्टिव हो, उसके लिए MoE मॉडल इस्तेमाल करें।
क्वांटाइज़ेशन: असल में क्या चुनें
| फ़ॉर्मैट | क्वालिटी की हानि | कब इस्तेमाल करें |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | डिफ़ॉल्ट। गति और क्वालिटी का सबसे अच्छा अनुपात। |
| MLX 4-bit | ~1–2% | Mac पर डिफ़ॉल्ट। बराबर GGUF से ~10% कम मेमोरी और 15–30% तेज़। |
| Q5_K_M / MLX 6-bit | <1% | जब मेमोरी में जगह हो और लगभग बिना नुकसान वाला आउटपुट चाहिए। |
| Q6_K | नगण्य | क्वालिटी-क्रिटिकल काम, जब मेमोरी बची हो। |
| Q8 / FP16 | कोई नहीं | लैपटॉप पर शायद ही फ़ायदेमंद। आपके मॉडल साइज़ बजट को आधा या चौथाई कर देता है। |
| MXFP4 | नेटिव | कोई विकल्प नहीं — यह इसी तरह gpt-oss आता है। |
| 1.58-bit ternary | गंभीर | सिर्फ़ ऐसे मॉडल को जैसे-तैसे फ़िट करने के लिए जो वरना फ़िट ही नहीं होगा। |
मोटा नियम: गति और फ़िट के लिए 4-bit, जब क्वालिटी मायने रखे और जगह हो तो 6-bit, और लैपटॉप पर 8-bit छोड़ दें।
MLX बनाम llama.cpp — कौन सा रनटाइम?
छोटा जवाब है MLX, बस एक शर्त के साथ।
- ~14B पैरामीटर से नीचे: MLX, llama.cpp से 20–87% आगे है। मुकाबला ही नहीं।
- ~27B से ऊपर: दोनों एक स्तर पर आ जाते हैं, क्योंकि मेमोरी बैंडविड्थ अड़चन बन जाती है और रनटाइम का महत्व ख़त्म हो जाता है।
- मेमोरी: बराबर क्वांटाइज़ेशन पर MLX, GGUF से लगभग 10% कम इस्तेमाल करता है।
- शर्त: 30,000+ टोकन के कॉन्टेक्स्ट में MLX अधिकतम 50% धीमा llama.cpp की तुलना में, जब Flash Attention चालू हो। यह मॉडल और कॉन्टेक्स्ट पर निर्भर है।
अगर आप नियमित रूप से बहुत लंबे कॉन्टेक्स्ट पर काम करते हैं, तो अपने असली वर्कलोड पर दोनों का बेंचमार्क लें। वरना MLX।
लोकल API सर्वर चलाना
mlx-lm 0.18 और उसके बाद के वर्ज़न continuous batching वाला OpenAI-संगत सर्वर देते हैं:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
अब जो भी OpenAI API से बात करता है, वह आपका लोकल मॉडल इस्तेमाल कर सकता है:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Write a bash one-liner to find large files."}]
  }'
यही एंडपॉइंट नीचे वर्कफ़्लो सेक्शन में बताई हर चीज़ की बुनियाद है।
भाग 2: इमेज जनरेशन
इमेज जनरेशन वह जगह है जहाँ M5 Pro अपनी बैंडविड्थ के हिसाब से बेहतर दिखता है, और वजह सीधी है: diffusion कंप्यूट-बाउंडबैंडविड्थ-बाउंड नहीं है, और मॉडल इतने छोटे हैं कि 64GB मशीन पर मेमोरी कभी रुकावट नहीं बनती।
मॉडल-दर-मॉडल परफ़ॉर्मेंस
| मॉडल | साइज़ | मेमोरी | प्रति 1024×1024 इमेज समय | नोट्स |
|---|---|---|---|---|
| SDXL | 3.5B | ~7GB | 30 steps पर ~7s (M5 Max) | सबसे तेज़ क्वालिटी विकल्प। विशाल LoRA इकोसिस्टम। |
| FLUX.1 [schnell] | 12B | ~7GB (Q4) | 4 steps पर ~20–25s | गति के लिए डिस्टिल्ड। Apache-2.0। |
| FLUX.1 [dev] | 12B | ~10GB (Q6) | 20 steps पर ~50s (M4-श्रेणी) | क्वालिटी का बेंचमार्क। |
| FLUX.2 [Klein] | 4B डिस्टिल्ड | ~8GB | ~40s | नया, छोटा, तेज़। |
| FLUX.2 [dev] | बड़ा | 24GB+ | कई मिनट | सबसे अच्छी क्वालिटी, सच में सब्र चाहिए। |
| SD 3.5 | अलग-अलग | 10–20GB | दसियों सेकंड | ठोस बीच का रास्ता। |
| Qwen-Image / Qwen-Image-Edit | अलग-अलग | 15–25GB | दसियों सेकंड | टेक्स्ट रेंडरिंग और एडिटिंग के लिए बढ़िया। |
| HiDream, Chroma | अलग-अलग | 10–20GB | अलग-अलग | स्टाइल की विविधता के लिए देखने लायक। |
Apple’s ML Research टीम ने मापा कि FLUX-dev-4bit एक 1024×1024 इमेज बनाता है M5 पर M4 से 3.8× से भी ज़्यादा तेज़ MLX का उपयोग करते हुए। यह फ़ायदा Neural Accelerators से आता है, और पूरे M5 परिवार पर लागू होता है।
M5 Pro के लिए खास seconds-per-image बेंचमार्क अभी प्रकाशित नहीं हुआ है, इसलिए ऊपर की तालिका को M4-श्रेणी के आँकड़े मानें, जिनमें M5 से अच्छा-खासा सुधार अपेक्षित है। असल दुनिया में: FLUX.1 [schnell] 20 सेकंड से काफ़ी कम में और SDXL एक अंक वाले सेकंडों में मिलने चाहिए।
64GB पर आप इन मॉडलों को चला सकते हैं बिना क्वांटाइज़ेशन के FP16 में, जो 16GB और 24GB मशीनों पर सचमुच क्वालिटी का फ़ायदा है, जिन्हें Q4 पर मजबूर होना पड़ता है।
टूलिंग: क्या इस्तेमाल करें
Draw Things — डिफ़ॉल्ट पसंद। नेटिव Metal, टूटने वाला कोई Python एनवायरनमेंट नहीं, Metal FlashAttention v2.5 जो M5 पर M4 से 4.6× तक तेज़ चलता है, और डिवाइस पर LoRA ट्रेनिंग। App Store पर मुफ़्त।
ComfyUI — नोड-आधारित पाइपलाइन, ControlNet चेन और मल्टी-स्टेज वर्कफ़्लो के लिए। Apple Silicon पर Draw Things से लगभग 20% धीमा। FP8 चेकपॉइंट से सावधान, जो Metal पर अक्सर फ़ेल होते हैं।
DiffusionKit — Apple’s अपना diffusion टूलकिट, MLX पर आधारित। नज़र रखने लायक।
Mochi Diffusion, InvokeAI — दोनों व्यावहारिक हैं, दोनों ठीक हैं।
इनसे बचें: DiffusionBee को व्यावहारिक रूप से छोड़ दिया गया है। Automatic1111 और Forge तकनीकी रूप से MPS के ज़रिए चलते हैं, लेकिन Mac पर वे धीमे हैं और उनका रखरखाव ढीला है।
स्टेप बाय स्टेप: आपकी पहली लोकल इमेज
- इंस्टॉल करें Draw Things Mac App Store से।
- इसे खोलें और मॉडल मैनेजर पर जाएँ (बाएँ पैनल के ऊपर वाला आइकन)।
- डाउनलोड FLUX.1 [schnell] — Q4 में लगभग 7GB, या FP16 वर्ज़न ले लें क्योंकि आपके पास मेमोरी है।
- सेट करें: Steps को 4 पर (schnell ठीक इसी के लिए डिस्टिल्ड है) और साइज़ को 1024×1024 पर।
- प्रॉम्प्ट लिखें और दबाएँ जनरेट.
- पहली बार चलाने में मॉडल लोड होता है। इसके बाद के जनरेशन बहुत तेज़ होते हैं।
डिवाइस पर LoRA ट्रेनिंग
64GB की मशीन इमेज मॉडल को लोकली फाइन-ट्यून कर सकती है, और यह क्षमता वाकई कम आँकी जाती है। Draw Things सीधे LoRA ट्रेनिंग सपोर्ट करता है, और MLX इमेज तथा लैंग्वेज दोनों तरह के मॉडल के लिए LoRA और QLoRA सपोर्ट करता है।
20–50 इमेज पर एक छोटा स्टाइल LoRA, M5 Pro पर रात भर का काम है, और वह कभी आपकी मशीन से बाहर नहीं जाता। जो लोग क्लाइंट की सामग्री या प्रोप्राइटरी एसेट्स के साथ काम करते हैं, उनके लिए यह स्पीड से ज़्यादा मायने रखता है।
भाग 3: वीडियो जनरेशन — ईमानदारी वाला हिस्सा
यहाँ मुझे आपसे सीधे बात करनी है, क्योंकि इस विषय पर बहुत सी सामग्री सीधी नहीं है।
2026 में किसी भी Mac पर लोकल वीडियो जनरेशन धीमा है। “4090 से धीमा” जितना धीमा नहीं। इतना धीमा कि आपके काम करने का तरीका ही बदल जाए।
Mac यहाँ खास तौर पर क्यों संघर्ष करते हैं
वीडियो डिफ़्यूज़न भारी रूप से कंप्यूट-बाउंड. LLM डीकोड में Mac की भरपूर मेमोरी बैंडविड्थ ही काम की रिसोर्स होती है, लेकिन वीडियो जनरेशन सीधे GPU कंप्यूट पर ज़ोर डालता है — ठीक उसी मोर्चे पर जहाँ 20-कोर का लैपटॉप GPU एक डेडिकेटेड कार्ड से हार जाता है।
M5 के Neural Accelerators मदद करते हैं। इतना बड़ा अंतर वे नहीं पाट पाते।
आँकड़े, बिना लाग-लपेट
Wan 2.2 (Alibaba, Apache-2.0, 14B MoE और डेंस 5B text/image-to-video वेरिएंट में उपलब्ध): M1 Max 64GB पर GGUF बिल्ड चलाने पर 832×480 पर 2 सेकंड की क्लिप में 82 मिनट लगे. 5 सेकंड की क्लिप पर तीन घंटे से ज़्यादा लग जाते।
तुलना के लिए, वही TI2V-5B मॉडल 24GB RTX 4090 पर 720p में 5 सेकंड का वीडियो लगभग 9 मिनट में बनाता है।.
M5 Pro, M1 Max से काफ़ी तेज़ है, लेकिन असली बात यह है कि अंतर का पैमाना वही कई गुना का रहता है।
Metal की एक अहम सीमा: FP8 चेकपॉइंट Metal पर काम नहीं करते — Float8_e4m3fn डेटाटाइप सपोर्टेड नहीं है। आपको GGUF बिल्ड इस्तेमाल करने होंगे। NVIDIA-केंद्रित ट्यूटोरियल फ़ॉलो करने वाले बहुत लोग यहीं अटकते हैं, और इसका मतलब यह भी है कि LTX-2’s FP8 टेम्पलेट Mac पर सीधे फ़ेल हो जाते हैं.
अच्छी ख़बर: नए डिस्टिल्ड मॉडल इसे बदल रहे हैं। Ivan Fioravanti ने डिस्टिल्ड LTX 2.3 22B को Draw Things में, M5 Max 40-कोर पर लगभग 121 सेकंड में 5 सेकंड का वीडियो बनाते हुए मापा — जो असल में M3 Ultra 80-कोर से बेहतर निकला, जिसने 206 सेकंड लिए।
यह एक असली नतीजा है और सचमुच एक बदलाव भी। लेकिन चिप पर ध्यान दें: ऐसे कंप्यूट-बाउंड काम में M5 Pro 20-कोर, M5 Max 40-कोर से साफ़ तौर पर धीमा रहेगा। दो मिनट नहीं, कई मिनट की उम्मीद रखें।
अन्य मॉडल — HunyuanVideo, Mochi 1, CogVideoX, FramePack, Stable Video Diffusion — Mac पर धीमे से लेकर अव्यावहारिक तक हैं। इनमें से कई CUDA-first हैं और इनके लिए वर्कअराउंड चाहिए।
वीडियो पर फ़ैसला
M5 Pro 64GB पर लोकल वीडियो कभी-कभार के धैर्यपूर्ण प्रयोगों के लिए व्यावहारिक है — छोटे क्लिप, कम रेज़ोल्यूशन, डिस्टिल्ड मॉडल, Draw Things के ज़रिए। यह काम करता है। आप चीज़ें बनाएँगे।
किसी भी वास्तविक थ्रूपुट के लिए, GPU किराए पर लें। RunPod, Vast.ai और Lambda कुछ डॉलर प्रति घंटे में 5090 या H100 चलाएँगे और मिनटों में वह बना देंगे जो आपका लैपटॉप एक घंटे में बनाता है। ख़ासकर वीडियो के लिए, लागत की कोई तुलना नहीं है।
अगर वीडियो जनरेशन आपका प्राइमरी वर्कलोड है, तो NVIDIA मशीन खरीदें या क्लाउड का बजट रखें। Mac खरीदकर उम्मीद मत पालिए।
अगर फिर भी आज़माना चाहें: स्टेप बाय स्टेप
- खोलें Draw Things और वीडियो मॉडल मैनेजर पर स्विच करें।
- डाउनलोड करें एक डिस्टिल्ड मॉडल — LTX 2.3 या Wan 2.2 GGUF बिल्ड। डिस्टिल्ड मॉडल ही मिनट और घंटों का फ़र्क़ हैं।
- छोटे से शुरू करें: 480p, 2 सेकंड, कम स्टेप संख्या। बड़ा करने से पहले अपनी बेसलाइन टाइमिंग तय करें।
- प्लग इन करें और High Power Mode इस्तेमाल करें। इससे पंखे चलेंगे।
- रेज़ोल्यूशन और अवधि तभी बढ़ाएँ जब आप जान जाएँ कि एक छोटा क्लिप आपका कितना वक़्त लेता है।
Mac पर कभी FP8 चेकपॉइंट इस्तेमाल न करें। GGUF या कुछ नहीं।
भाग 4: बनाने लायक असली वर्कफ़्लो
बेंचमार्क मुद्दा नहीं हैं। लोग वास्तव में इस मशीन से क्या करते हैं, यह रहा।
वर्कफ़्लो 1: एक लोकल कोडिंग एजेंट
यह सूची में सबसे ज़्यादा मूल्यवान सेटअप है, और इसमें लगभग दस मिनट लगते हैं।
स्टेप 1 — मॉडल सर्वर शुरू करें। या तो LM Studio’s Developer टैब (endpoint यहाँ http://localhost:1234/v1) या:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234स्टेप 2 — अपने एडिटर को इससे जोड़ें।
Cline या Continue के साथ VS Code: base URL के साथ OpenAI-संगत प्रोवाइडर जोड़ें http://localhost:1234/v1, कोई भी ख़ाली न होने वाली API key, और आपका मॉडल नाम।
Zed: सेटिंग में कस्टम OpenAI-संगत प्रोवाइडर कॉन्फ़िगर करें।
Aider (टर्मिनल):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
स्टेप 3 — सही मॉडल चुनें। gpt-oss-20b और Qwen3-Coder-30B-A3B दोनों मज़बूत लोकल कोडर हैं। दोनों MoE हैं, जो बिल्कुल वही है जो आप चाहते हैं: तेज़ डिकोड, और M5’s prefill सुधारों का मतलब है कि बड़े फ़ाइल कॉन्टेक्स्ट अब मिनटों तक नहीं अटकते।
इससे आपको क्या मिलता है: बिना प्रति-टोकन लागत, बिना रेट लिमिट के असीमित इटरेशन, और ऐसा कोड जो कभी आपकी मशीन से बाहर नहीं जाता। प्रोप्राइटरी या क्लाइंट कोडबेस के लिए, वह आख़िरी बिंदु अक्सर पूरा औचित्य होता है।
वर्कफ़्लो 2: आपके डॉक्यूमेंट्स पर प्राइवेट RAG
लोकल एम्बेडिंग्स और 27B–70B मॉडल का मतलब है कि संवेदनशील दस्तावेज़ — अनुबंध, मेडिकल रिकॉर्ड, आंतरिक शोध, वित्तीय डेटा — आपके लैपटॉप से एक बाइट भी बाहर गए बिना खोजे और सारांशित किए जा सकते हैं।
64GB टियर यहाँ ख़ास तौर पर मायने रखता है क्योंकि RAG पाइपलाइन एक साथ मेमोरी में एम्बेडिंग मॉडल, वेक्टर स्टोर और जनरेशन मॉडल रखती हैं। 32GB पर आप लगातार स्वैप करते रहते हैं। 64GB पर नहीं।
वर्कफ़्लो 3: रात भर में बैच जनरेशन
Draw Things में कुछ सौ इमेज जनरेशन कतार में लगाएँ, या कोई लंबा दस्तावेज़-प्रोसेसिंग काम चलाएँ mlx_lm.server, और मशीन को आपके सोने के दौरान काम करने दें। प्लग इन रहने पर, 70B मॉडल और इमेज बैच जो इंटरैक्टिव तौर पर बहुत धीमे लगते हैं, रात भर के लिए बिल्कुल उचित हैं।
वर्कफ़्लो 4: हाइब्रिड राउटिंग (वह रणनीति जो ज़्यादातर लोगों को अपनानी चाहिए)
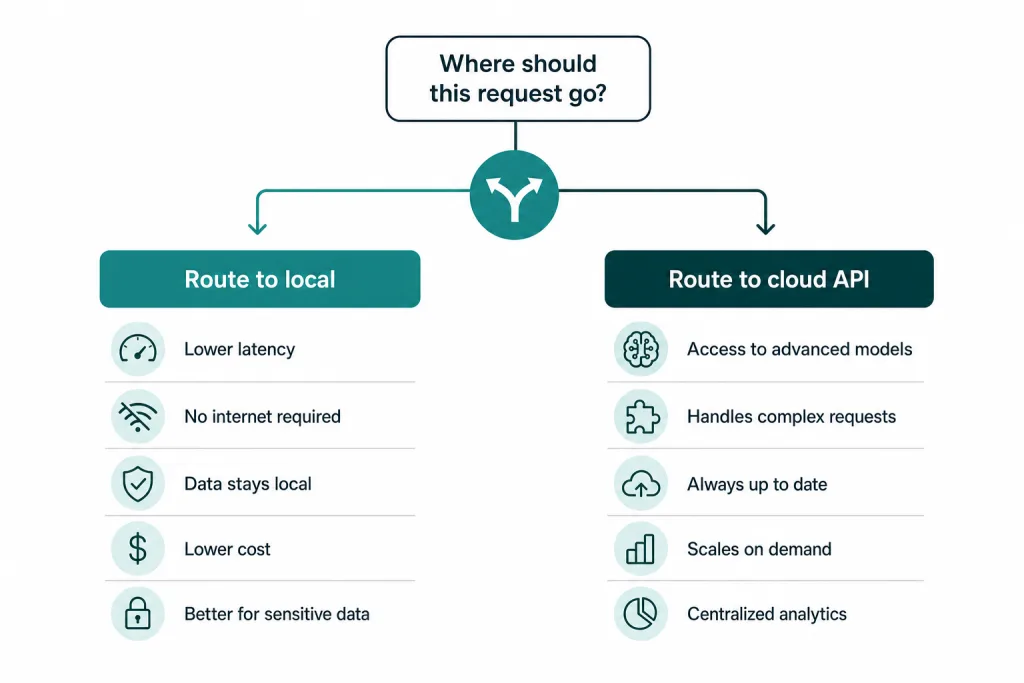
लोकल बनाम क्लाउड को दो-में-से-एक का चुनाव न समझें। काम के हिसाब से रूट करें:
| लोकल पर भेजें | क्लाउड API पर भेजें |
|---|---|
| प्राइवेसी से जुड़ी कोई भी चीज़ | सबसे कठिन रीज़निंग टास्क |
| बल्क और बैच प्रोसेसिंग | जिन मामलों में असली फ्रंटियर गुणवत्ता चाहिए |
| कई सस्ते कॉल वाले एजेंट लूप | एक-बार के ज़्यादा जोखिम वाले आउटपुट |
| इटरेशन और प्रयोग | जिस काम के लिए सबसे नया मॉडल चाहिए |
| ऑफ़लाइन काम | बहुत लंबी कॉन्टेक्स्ट विंडो |
यहीं सबसे ज़्यादा फ़ायदा है। लोकल वॉल्यूम, इटरेशन और प्राइवेसी संभालता है। क्लाउड मुश्किल 5% संभालता है।
Apple’s अपना AI स्टैक (जिसके बारे में जानना ज़रूरी है)
यह Foundation Models फ़्रेमवर्क डेवलपर्स को Apple’s ऑन-डिवाइस मॉडल तक सीधी Swift पहुँच देता है — लगभग 3B पैरामीटर, मुफ़्त, निजी, ऑफ़लाइन, साथ में गाइडेड जनरेशन और टूल कॉलिंग पहले से मौजूद।
2026 के अपडेट मूल रिलीज़ से ज़्यादा मायने रखते हैं: विज़न इनपुट, सर्वर-साइड एग्ज़िक्यूशन, और एक LanguageModel प्रोटोकॉल जो आपको Apple’s मॉडल, किसी क्लाउड मॉडल, या किसी लोकल MLX मॉडल के ज़रिए MLXLanguageModelसे जोड़ने देता है। अगर आप Mac या iOS ऐप बनाते हैं, तो यह हाइब्रिड ऑन-डिवाइस AI फ़ीचर्स के लिए साफ़ रास्ता है।
Xcode 26 में बिल्ट-इन LLM कोडिंग टूल्स भी आते हैं जो ChatGPT, API key के ज़रिए दूसरे प्रोवाइडर, या आपके Mac पर चल रहे किसी लोकल मॉडल का इस्तेमाल कर सकते हैं।
इसके साथ रहना: गर्मी, बैटरी और शोर
स्पेक्स से यह नहीं पता चलता कि मशीन का इस्तेमाल करना कैसा लगता है। कुछ ईमानदार टिप्पणियाँ।
14-इंच मॉडल 16-इंच से ज़्यादा थ्रॉटल करता है। Notebookcheck ने 2026 MacBook Pro में लगातार लोड के दौरान तेज़ थर्मल थ्रॉटलिंग की ओर ध्यान दिलाया, और High Power Mode में भी CPU का व्यवहार असंगत रहा। 16-इंच मॉडल में कूलिंग के लिए ज़्यादा गुंजाइश और बड़ी बैटरी है। अगर आप लंबे इन्फ़रेंस सेशन चलाने की सोच रहे हैं, तो 16-इंच बेहतर मशीन है — यह असली कार्यात्मक अंतर है, पसंद का मामला नहीं।
थर्मल के लिहाज़ से सारे AI वर्कलोड एक जैसे नहीं होते। LLM डिकोड तुलनात्मक रूप से हल्का है — यह मेमोरी-बाउंड है, इसलिए GPU पूरी तरह लोड नहीं होता और पंखे अक्सर शांत रहते हैं। इमेज और वीडियो डिफ़्यूज़न कंप्यूट-बाउंड होते हैं और आपके GPU को पूरी तरह लगा देंगे, पंखों को सुनाई देने लायक तेज़ कर देंगे, और बैटरी तेज़ी से खत्म करेंगे।
बैटरी की हकीकत: छोटे LLM सेशन बिना प्लग इन किए ठीक चलते हैं। लगातार डिफ़्यूज़न का काम बैटरी को कुछ ही घंटों में खत्म कर देगा और उससे पहले थर्मल थ्रॉटलिंग शुरू हो जाएगी। कुछ भी गंभीर करना हो तो प्लग इन रहें।
पावर मोड: 16-इंच में High Power Mode मिलता है, जिसे लंबे कामों के लिए चालू करना फ़ायदेमंद है। Low Power Mode इन्फ़रेंस की गति को साफ़ तौर पर कम कर देता है — मॉडल चलाते समय इसे टालें।
काम की आदत: चैट और कोडिंग सहायता के लिए बिना प्लग इन किए। इमेज बैच और वीडियो के लिए प्लग इन करके, High Power Mode में।
ईमानदार विरोधी तर्क
जो गाइड सिर्फ़ एक पक्ष की वकालत करे, वह मार्केटिंग है। यह रहे इसके विपक्ष में तर्क।
1. M5 Max असल में तेज़ है, और यह फ़र्क़ साफ़ है
307 GB/s बनाम 614 GB/s। चूँकि डिकोड बैंडविड्थ-बाउंड है, M5 Max 40-core लगभग दोगुनी रफ़्तार से टोकन जनरेट करता है उसी मॉडल पर। यह भी फ़िट हो जाता है gpt-oss-120b, जो M5 Pro नहीं कर सकता।
अगर बड़े मॉडल की डिकोड स्पीड आपका मुख्य उपयोग है, तो M5 Max सही मशीन है और M5 Pro एक समझौता। इसके विपरीत कीमत है: जून 2026 के बाद वह अपग्रेड बहुत भारी पड़ता है।
2. छूट पर मिला M4 Max नए M5 Pro को पीछे छोड़ सकता है
यही वह तर्क है जो ज़्यादातर खरीदार चूक जाते हैं। M4 Max में मोटे तौर पर 546 GB/s मेमोरी बैंडविड्थ है — M5 Pro’s 307 GB/s से काफ़ी ज़्यादा। शुद्ध LLM डिकोड के लिए, M4 Max 64GB आम तौर पर M5 Pro 64GB से आगे रहेगा।
आप क्या छोड़ते हैं: M5’s Neural Accelerators, यानी काफ़ी धीमा prefill और धीमी इमेज जनरेशन।
फ़ैसले का नियम: अगर आप ज़्यादातर बड़े मॉडलों से चैट करते हैं, तो छूट पर मिला M4 Max 64GB शायद बेहतर खरीद है। अगर आप लंबे कॉन्टेक्स्ट के साथ एजेंटिक कोडिंग करते हैं, या इमेज जनरेट करते हैं, तो M5 Pro’s prefill और diffusion फ़ायदे जीतते हैं।
3. कंप्यूट में NVIDIA अब भी आगे है
RTX 5090 में 32GB VRAM है, लगभग 1,792 GB/s — M5 Pro’s बैंडविड्थ से लगभग छह गुना — साथ में कहीं ज़्यादा कंप्यूट। 32GB में फ़िट होने वाले किसी भी मॉडल के लिए, और सभी कंप्यूट-बाउंड कामों (वीडियो, इमेज, prefill) के लिए, यह मुक़ाबला ही नहीं है।
Mac’s बढ़त ठीक वहीं शुरू होती है जहाँ 32GB VRAM ख़त्म होती है, और इसमें पोर्टेबिलिटी, ख़ामोशी, कम बिजली खपत, और ट्रेन में बैठकर यह सब कर पाने की क्षमता शामिल है।
4. 128GB यूनिफ़ाइड-मेमोरी वाले मुकाबिले क्षमता का दाँव हैं, रफ़्तार का नहीं
NVIDIA DGX Spark / GB10: 128GB, लगभग 273 GB/s पर, CUDA के साथ। gpt-oss-120b MXFP4 पर, स्वतंत्र टेस्ट इसे 34–39 tok/s पर रखते हैं।
AMD Strix Halo / Ryzen AI Max+ 395: 128GB, लगभग 256 GB/s पर। AMD’s अपने आँकड़ों में उसी मॉडल पर llama.cpp के ज़रिए 30 tok/s तक का ज़िक्र है। इस पर बने Mini-PC किसी भी Mac से काफ़ी सस्ते हैं।
ध्यान दें कि दोनों में कम बैंडविड्थ है M5 Pro की तुलना में। ये आपको कैपेसिटी देते हैं, स्पीड नहीं। अगर आपका लक्ष्य बहुत बड़े मॉडल तेज़ की बजाय स्वीकार्य गति पर चलाना है, तो ये सस्ते हैं। अगर आपको स्पीड चाहिए, तो ये जवाब नहीं हैं।
5. डेस्कटॉप Mac एक बेहतर स्थिर मशीन है
A Mac Studio M3 Ultra 512GB तक जाता है, 800 GB/s पर। अगर आपकी मशीन डेस्क पर रहती है, तो वह किसी भी MacBook Pro से कहीं बेहतर लोकल-AI बॉक्स है। लैपटॉप की वैल्यू पोर्टेबिलिटी, बैटरी और ख़ामोशी में है — अगर आपको इनकी ज़रूरत नहीं, तो इनके पैसे न दें।
6. आप मेमोरी अपग्रेड नहीं कर सकते। कभी नहीं।
Apple Silicon की मेमोरी ऑन-पैकेज होती है। जो खरीदेंगे, वही मशीन की पूरी उम्र आपके पास रहेगा।
यह देखते हुए कि 2026 के मॉडल रिलीज़ बड़े MoE फ़ुटप्रिंट की ओर बढ़ते जा रहे हैं, कम RAM खरीदना क्लासिक और स्थायी पछतावा है। अगर आप 48GB और 64GB के बीच चुन रहे हैं, तो 64GB लें।
लागत का गणित: लोकल बनाम क्लाउड
आइए गणित ईमानदारी से करें, क्योंकि “लोकल सस्ता है” अक्सर कहा जाता है और शायद ही कभी जोड़ा जाता है।
मशीन: M5 Pro 64GB के लिए लगभग $2,800, तीन से चार सालों में परिशोधित।
अगस्त 2026 तक API प्राइसिंग (प्रति मिलियन टोकन, इनपुट/आउटपुट):
| सेवा | इनपुट | आउटपुट |
|---|---|---|
| Claude Sonnet–श्रेणी | ~$3 | ~$15 |
| GPT-5–श्रेणी | ~$1.75–$5 | ~$14–$30 |
| DeepSeek V4 Flash | ~$0.14 | ~$0.28 |
| होस्टेड ओपन मॉडल (gpt-oss, Llama) | और भी कम | और भी कम |
क्लाउड GPU किराया: H100 लगभग $3/घंटा, H200 लगभग $5/घंटा ऑन-डिमांड।
ब्रेक-ईवन: प्रकाशित विश्लेषणों के अनुसार उपभोक्ता मशीन के लिए क्रॉसओवर लगभग लगभग बारह महीनों तक लगातार रोज़ 2–3 मिलियन टोकन मिड-टियर प्रोप्राइटरी APIs की तुलना में।
यह काफ़ी ज़्यादा टोकन है। इस सीमा से नीचे सस्ते APIs — विशेषकर DeepSeek-स्तर के — शुद्ध टोकन लागत पर लोकल से सचमुच सस्ते पड़ते हैं।
तो मशीन खरीदें ही क्यों?
क्योंकि टोकन लागत ही एकमात्र लागत नहीं है:
- प्राइवेसी। आपका डेटा कभी डिवाइस से बाहर नहीं जाता। कानूनी, चिकित्सा, वित्तीय या प्रोप्राइटरी कोड के काम में यह अक्सर कीमत की परवाह किए बिना अनिवार्य होता है।
- कोई रेट लिमिट नहीं। रात 2 बजे कोई थ्रॉटलिंग नहीं, कोई कतार नहीं, कोई क्षमता त्रुटि नहीं।
- ऑफ़लाइन। हवाई जहाज़, ट्रेनें, होटल का खराब wifi, नेटवर्क बंद।
- शून्य सीमांत लागत। यह लोगों की अपेक्षा से ज़्यादा व्यवहार बदलता है। जब हर प्रयोग मुफ़्त हो, आप दस गुना ज़्यादा करते हैं। पुनरावृत्ति के दौरान प्रति-टोकन की चिंता न होना आउटपुट में असली पैसों के बराबर है।
- आपको वैसे भी लैपटॉप चाहिए था। ईमानदार ढंग से देखें तो यह “AI के लिए $2,800” नहीं है — यह उस मशीन और इस मशीन के बीच का अंतर है जो आप वैसे भी खरीदते।
सही निष्कर्ष हाइब्रिड है। वॉल्यूम, प्राइवेसी, पुनरावृत्ति और एजेंट लूप के लिए लोकल। मुश्किल समस्याओं के लिए क्लाउड। जो कहता है कि 2026 में लोकल फ्रंटियर APIs को पूरी तरह बदल देता है, वह बढ़ा-चढ़ा कर बता रहा है; जो कहता है कि लोकल बेकार है, उसने बड़े पैमाने पर एजेंट लूप कभी नहीं चलाया।
खरीदने की गाइड
| अगर आप… | यह खरीदें | क्यों |
|---|---|---|
| सबसे संतुलित लोकल-AI लैपटॉप चाहिए | M5 Pro 64GB, 16-इंच | 8B–70B और MoE मॉडल चलाता है, तेज़ इमेज जनरेशन, बाकी सब के लिए जगह। 14-इंच से बेहतर थर्मल्स। |
चाहिए gpt-oss-120b या 120B+ मॉडल | M5 Max 128GB | ऐसे मॉडल फ़िट करने वाला एकमात्र Mac लैपटॉप। साथ ही ~2× डिकोड स्पीड। |
| ज़्यादातर बड़े मॉडल से चैट, वैल्यू चाहिए | डिस्काउंट वाला M4 Max 64GB | ज़्यादा बैंडविड्थ (546 GB/s) डिकोड में M5 Pro से आगे है। |
| वीडियो जनरेशन गंभीरता से करते हैं | NVIDIA (RTX 5090) या क्लाउड | कंप्यूट-बाउंड काम; Mac कई गुना धीमे हैं। |
| कम बजट में अधिकतम क्षमता चाहिए | Strix Halo 128GB mini-PC | सस्ते में 128GB, लेकिन M5 Pro से कम बैंडविड्थ। |
| डेस्क पर काम करते हैं | Mac Studio M3 Ultra | 800 GB/s पर 512GB तक। |
| बजट सीमित है | M5 Pro 48GB | 32B-श्रेणी के मॉडल ठीक चलते हैं। 70B/MoE की सीमा मान लें। |
जो मैं नहीं करूँगा: गंभीर लोकल AI के लिए 24GB या 32GB की मशीन खरीदना। कुछ ही हफ़्तों में दीवार आ जाएगी और आप उसे अपग्रेड करके बाहर नहीं निकल सकते।
अक्सर पूछे जाने वाले प्रश्न
क्या 2026 में लोकल AI के लिए 64GB काफ़ी है? हाँ, ज़्यादातर वर्कलोड के लिए। 64GB, 4-बिट क्वांटाइज़ेशन पर लगभग 70B पैरामीटर तक के मॉडल और GLM-4.6 Air जैसे Mixture-of-Experts मॉडल आराम से चला देता है, और आपके ऑपरेटिंग सिस्टम व ऐप्स के लिए जगह भी बची रहती है। मुख्य अपवाद है gpt-oss-120b, जिसे अकेले वेट्स के लिए ही लगभग 63GB चाहिए और 128GB की मशीन ज़रूरी है।
क्या M5 Pro gpt-oss-120b चला सकता है? नहीं। MXFP4 बिल्ड को वेट्स के लिए लगभग 63GB चाहिए, और M5 Max पर मापी गई पीक मेमोरी कॉन्टेक्स्ट लंबाई के हिसाब से 64.4–64.9GB है। 64GB की मशीन पर, जहाँ वास्तव में 52–60GB उपयोगी मिलते हैं, यह फ़िट नहीं होता। यह 128GB का मॉडल है।
M5 Pro प्रति सेकंड कितने टोकन देता है? यह मॉडल पर बहुत निर्भर करता है। 64GB वाले M5 Pro 20-core के मापे गए आँकड़े: gpt-oss-20b decode में 66–80 tok/s और prefill में 1,500–2,200 tok/s, तथा Qwen3.6-27B decode में 17.8 tok/s और prefill में 470 tok/s। Llama 3.3 70B जैसे बड़े dense मॉडल का अनुमान 7–12 tok/s है।
लोकल LLM के लिए M5 Pro या M5 Max? M5 Max, अगर बड़े मॉडलों पर टोकन जनरेशन की रफ़्तार आपकी प्राथमिकता है — इसमें M5 Pro’s 307 GB/s के मुक़ाबले 614 GB/s मेमोरी बैंडविड्थ है, जो decode की रफ़्तार लगभग दोगुनी कर देती है, और यह 128GB तक सपोर्ट करता है। M5 Pro, अगर आप 70B तक के मॉडलों के लिए क़ीमत, पोर्टेबिलिटी और क्षमता का सबसे अच्छा संतुलन चाहते हैं।
क्या Mac पर वीडियो जनरेशन व्यावहारिक है? 2026 में ज़्यादातर नहीं। वीडियो डिफ़्यूज़न compute-bound है, और Mac RTX 5090 से कई गुना धीमे हैं। distilled मॉडल मदद करते हैं — LTX 2.3 M5 Max पर 5 सेकंड की क्लिप लगभग 121 सेकंड में बनाता है — लेकिन असली throughput के लिए क्लाउड GPU किराए पर लेना हर क्लिप के हिसाब से बहुत तेज़ और सस्ता है।
macOS पर GPU मेमोरी की सीमा कैसे बढ़ाएँ? चलाएँ sudo sysctl iogpu.wired_limit_mb=61440 60GB आवंटित करने के लिए। इससे जाँचें sysctl iogpu.wired_limit_mb और इस मान से रीसेट करें 0. इसे इसमें जोड़ें /etc/sysctl.conf ताकि रीबूट के बाद भी बना रहे। macOS के लिए हमेशा 4–8GB छोड़ें।
Apple Silicon पर MLX या llama.cpp? ज़्यादातर मामलों में MLX। 14B से छोटे मॉडलों पर यह llama.cpp से 20–87% आगे है, लगभग 10% कम मेमोरी लेता है, और Ollama 0.19 ने मार्च 2026 में इसी पर स्विच किया। अपवाद है बहुत लंबा कॉन्टेक्स्ट — 30,000+ टोकन पर Flash Attention वाला llama.cpp 50% तक तेज़ हो सकता है।
14-इंच खरीदूँ या 16-इंच? लगातार AI काम के लिए 16-इंच। इसमें बेहतर थर्मल हेडरूम, बड़ी बैटरी और High Power Mode है। 14-इंच लगातार लोड में साफ़ नज़र आने वाली थ्रॉटलिंग करता है।
क्या सस्ता मिल रहा M4 Max नए M5 Pro से बेहतर है? सिर्फ़ LLM decode के लिए अक्सर हाँ — M4 Max में M5 Pro’s 307 GB/s के मुक़ाबले लगभग 546 GB/s है। M5 Pro अपने Neural Accelerators की वजह से prompt processing (4× तक तेज़) और इमेज जनरेशन (3.8× से ज़्यादा तेज़) में आगे है। चुनाव इस बात पर करें कि आपके इस्तेमाल में कौन-सा वर्कलोड हावी है।
आगे क्या आता है
कुछ बातें ध्यान देने लायक हैं, क्योंकि वे ऊपर की सिफ़ारिश बदल सकती हैं।
70B मॉडलों पर स्वतंत्र M5 Pro बेंचमार्क। अभी तक किसी ने ठीक से मापा गया decode आँकड़ा प्रकाशित नहीं किया है। अगर वास्तविक नतीजे 15 tok/s से ऊपर आते हैं, तो “decode के लिए Max खरीदें” वाली दलील काफ़ी कमज़ोर पड़ जाती है।
छोटे gpt-oss-120b क्वांटाइज़ेशन। अगर कोई बिल्ड 52GB से नीचे आ जाता है, तो 64GB की सीमा वाली दलील रातों-रात कमज़ोर हो जाती है।
macOS की मेमोरी डिफ़ॉल्ट। अगर Apple डिफ़ॉल्ट GPU आवंटन 75% से ऊपर कर देता है, तो 64GB मशीन वाले सभी लोगों को मुफ़्त हेडरूम मिल जाता है।
MoE का जीतते रहना। ज़्यादा कुल पैरामीटर और कम सक्रिय पैरामीटर वाले मॉडलों की दिशा यूनिफ़ाइड-मेमोरी मशीनों के साथ हुई सबसे अच्छी चीज़ है। हर नया MoE रिलीज़ Mac को तुलनात्मक रूप से ज़्यादा प्रतिस्पर्धी बनाता है।
गिरती API क़ीमतें। लोकल बनाम क्लाउड का break-even हर छह महीने में दोबारा निकालें। यह बदलता रहता है।
मुख्य बात
64GB वाला MacBook Pro M5 Pro सबसे तेज़ लोकल-AI मशीन नहीं है जो आप खरीद सकते हैं। यह सबसे तेज़ Mac भी नहीं है। यह वह कॉन्फ़िगरेशन है जहाँ समझौते एक-दूसरे से लड़ना बंद कर देते हैं।
यह ऐसे मॉडल चलाता है जो सचमुच उपयोगी होने लायक अच्छे हैं — gpt-oss-20b 66–80 tok/s पर, GLM-4.6 Air लगभग 30 पर, इमेज जनरेशन सेकंडों में — और साथ ही यह ऐसा लैपटॉप बना रहता है जिसे आप साथ ले जा सकते हैं, बैटरी पर चला सकते हैं और अपने असली कंप्यूटर की तरह इस्तेमाल कर सकते हैं। M5 पीढ़ी के Neural Accelerators ने उस ख़ास कमज़ोरी (धीमा prompt processing) को ठीक किया जो पहले के Mac को एजेंटिक और लंबे कॉन्टेक्स्ट वाले काम के लिए निराशाजनक बनाती थी।
सीमाएँ असली हैं और जानने लायक हैं: gpt-oss-120b फ़िट नहीं होता, 70B dense मॉडल चैट साथी नहीं बल्कि बैच टूल हैं, और वीडियो जनरेशन क्लाउड में ही जँचता है।
अगर ये सीमाएँ आपके काम के साथ बैठ जाती हैं, तो यही मशीन है। अगर नहीं, तो ऊपर के हिस्से आपको ठीक-ठीक बताते हैं कि इसके बजाय कौन-सी खरीदें — और यह किसी ऐसे लेख से ज़्यादा उपयोगी है जो कहे कि सब कुछ ठीक है।
इस लेख में क़ीमतें, मॉडल संस्करण और बेंचमार्क आँकड़े अगस्त 2026 में उपलब्ध डेटा पर आधारित हैं और तेज़ी से बदलते हैं — ख़ासकर जारी मेमोरी की कमी के दौरान Mac की क़ीमतें। खरीदने से पहले मौजूदा स्पेसिफ़िकेशन जाँच लें।