Tiếng Việt
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 ไทย
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

Mục lục
- Tóm tắt — Kết luận
- Trước tiên: đúng, con chip này là thật
- Vấn đề giá (bản 2026)
- Vì sao lại là 64GB? Lập luận về điểm tối ưu
- Bước 1: mở khóa bộ nhớ (làm việc này trước)
- Bước 2: dựng bộ công cụ
- Phần 1: chạy LLM
- Phần 2: tạo ảnh
- Phần 3: tạo video — phần nói thật
- Phần 4: quy trình làm việc thật đáng xây
- Sống cùng nó: nhiệt độ, pin và tiếng ồn
- Những phản biện trung thực
- 1. M5 Max thực sự nhanh hơn, và không phải chênh lệch nhỏ
- 2. M4 Max giảm giá có thể hơn M5 Pro mới
- 3. NVIDIA vẫn thắng về năng lực tính toán
- 4. Các đối thủ bộ nhớ hợp nhất 128GB là cuộc chơi dung lượng, không phải tốc độ
- 5. Mac để bàn là máy cố định tốt hơn
- 6. Bạn không thể nâng cấp bộ nhớ. Không bao giờ.
- Bài toán chi phí: cục bộ so với đám mây
- Hướng dẫn mua
- Câu hỏi thường gặp
- Điều gì tiếp theo
- Điểm mấu chốt
Có một cấu hình Mac đã lặng lẽ trở thành câu trả lời mặc định cho câu hỏi “tôi nên mua laptop nào nếu muốn tự chạy mô hình AI?” Đó là MacBook Pro 2026 với chip M5 Pro và 64GB bộ nhớ hợp nhất.
Không phải rẻ nhất. Không phải nhanh nhất. Nhưng là chiếc máy mà những đánh đổi rơi đúng chỗ với hầu hết những người thực sự muốn dùng mô hình cục bộ chứ không chỉ để benchmark chúng.
Hướng dẫn này trình bày chiếc máy đó thực sự làm được gì trong ba khối công việc — mô hình ngôn ngữ lớn, tạo ảnh và tạo video — với con số thật ở nơi có con số thật, ước lượng trung thực ở nơi không có, và hướng dẫn cài đặt từng bước để bạn làm theo ngay ngày máy về.
Nó cũng nói rõ chỗ nào lập luận về điểm tối ưu không còn đúng, vì nó thật sự có chỗ sai, và bạn nên biết chính xác chỗ đó trước khi bỏ ba nghìn đô cho bộ nhớ không thể nâng cấp về sau.
Tóm tắt — Kết luận
Mua M5 Pro 64GB nếu: bạn muốn một chiếc máy di động chạy mô hình 8B–70B và mô hình Mixture-of-Experts đủ nhanh cho công việc thật, tạo ảnh trong vài giây thay vì vài phút, và vẫn còn chỗ cho trình duyệt, IDE và các vùng chứa Docker chạy cùng lúc. Đây là chiếc laptop cân bằng nhất cho AI cục bộ năm 2026.
Nâng lên M5 Max 128GB nếu: bạn đặc biệt cần những mô hình cục bộ tầm tiên phong như
gpt-oss-120b(vốn không không vừa trên 64GB), hoặc bạn muốn tốc độ sinh token trên mô hình lớn nhanh gấp đôi. M5 Max 40 nhân có băng thông bộ nhớ 614 GB/s so với 307 GB/s của M5 Pro’s, và với giải mã LLM, băng thông là tất cả.Hãy tìm chỗ khác nếu: tạo video cục bộ là công việc chính của bạn. Mọi chiếc Mac vẫn chậm hơn RTX 5090 vài lần ở đây, và thuê đám mây rẻ hơn nhiều cho mỗi clip.
Ba con số định nghĩa chiếc máy này:
| Chỉ số | M5 Pro (GPU 20 nhân) | Vì sao điều này quan trọng |
|---|---|---|
| 307 GB/s băng thông bộ nhớ | ~2× M5 cơ sở, ~½ M5 Max 40 nhân | Đặt trần tốc độ token/giây cho LLM |
| 64GB bộ nhớ hợp nhất tối đa | ~48–52GB dùng được mặc định | Quyết định mô hình nào vừa được |
| 20 nhân GPU với Neural Accelerator | Năng lực tính toán AI gấp hơn 4× so với M4 Pro | Tăng tốc xử lý prompt và tốc độ diffusion |
Trước tiên: đúng, con chip này là thật
Nhiều bài viết về M5 Pro xuất bản cuối 2025 và đầu 2026 chỉ là phỏng đoán. Giờ thì không còn là phỏng đoán nữa.
Apple công bố M5 Pro và M5 Max ngày March 3, 2026, và cả hai lên kệ trên MacBook Pro 14 inch và 16 inch ngày March 11, 2026. M5 bản cơ sở đến trước đó, trên MacBook Pro 14 inch ngày 22 tháng 10 năm 2025, nhưng con chip đó là câu chuyện hoàn toàn khác — tối đa 32GB và 153 GB/s, không đủ cho các khối công việc trong hướng dẫn này.
Đây là những gì Apple xác nhận trên trang newsroom và trang thông số kỹ thuật:
M5 Pro — thông số đã xác nhận
| Thành phần | Thông số |
|---|---|
| CPU | 18 nhân (6 “nhân siêu” lên tới ~4.6 GHz + 12 nhân hiệu năng lên tới ~4.4 GHz). Cấu hình cơ sở: 15 nhân. Nhanh hơn tới 30% khi chạy đa luồng so với M4 Pro. |
| GPU | Tối đa 20 nhân, mỗi nhân có một Neural Accelerator riêng. Ray tracing phần cứng thế hệ thứ ba. Năng lực tính toán GPU đỉnh cao hơn 4× cho AI so với M4 Pro. |
| Neural Engine | 16 nhân |
| Bộ nhớ hợp nhất | 24GB / 48GB / 64GB — 64GB là mức trần |
| Băng thông bộ nhớ | Tối đa 307 GB/s (LPDDR5X) |
| Tiến trình sản xuất | TSMC 3nm (N3P), “Fusion Architecture” — hai die ghép bằng đóng gói SoIC-mH |
| I/O & đa phương tiện | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW encode-decode, AV1 decode |
M5 Max — để so sánh
M5 Max dùng cùng CPU 18 nhân nhưng GPU tối đa 40 nhân, và quan trọng là câu chuyện bộ nhớ khác: bản 32 nhân chạy ở 460 GB/s, bản 40 nhân ở 614 GB/s, cấu hình tối đa 128GB.
Khoảng cách băng thông đó không phải chi tiết nhỏ trên bảng thông số. Đó là yếu tố quan trọng nhất trong quyết định M5 Pro hay M5 Max, và chúng ta sẽ quay lại nhiều lần.
Benchmark độc lập
Máy review của Notebookcheck’s — một chiếc M5 Pro 16 inch với 64GB — đạt điểm Geekbench 6.7 là 4.295 đơn nhân và 28.436 đa nhân, Cinebench 2024 đa nhân 2.347, và Cinebench 2026 đa nhân 9.481.
Phân tích GPU của họ đặt M5 Max ngang với RTX 5070 để bàn và vượt khá xa Strix Halo AMD’s. GPU 20 nhân M5 Pro’s nằm dưới mức đó, điều này đáng để ghi nhớ: đây là GPU khá cho laptop, không phải thứ thay thế card rời.
Họ cũng chỉ ra một điều kém đẹp hơn, và đáng để coi trọng: MacBook Pro 2026 giảm xung rõ rệt khi tải kéo dài, hiệu năng CPU không ổn định ngay cả ở High Power Mode. Sẽ nói thêm ở phần nhiệt độ.
Vấn đề giá (bản 2026)
Dòng M5 Pro ra mắt ở mức $2,199 cho bản 14 inch và $2,699 cho bản 16 inch. Rồi cuộc thiếu hụt bộ nhớ toàn cầu ập tới.
Trong tháng 6 năm 2026, Apple tăng giá MacBook Pro khoảng $300 trên toàn dòng. Sau đợt tăng, M5 Pro 14 inch bản cơ sở vào khoảng $2.499, còn M5 Pro 14 inch cấu hình 64GB và SSD 1TB rơi vào khoảng $2.799–$2.999 tuỳ ngày và tuỳ nhà bán. B&H và các nhà bán lại khác đã giảm $300–$400 cho cấu hình M5 Pro 48GB và 64GB, nên kiểm tra trước khi mua trực tiếp.
Ở Đức, dòng M5 Pro khởi điểm từ €2.199, giá cho giáo dục có lúc xuống €1.979 tại các nhà bán lại như Edustore. Cấu hình 64GB cao hơn đáng kể khi đã gồm 19% VAT.
Hai mức chênh quan trọng cho quyết định của bạn:
- 48GB → 64GB trên M5 Pro: trước đây là khoản nâng cấp $200–$400, nhưng giá nâng RAM đã tăng 50–67% ở nhiều cấu hình sau đợt tăng giá tháng 6.
- M5 Pro 64GB → M5 Max 128GB: một bước nhảy lớn. M5 Max khởi điểm $3.599 (14 inch) và $3.899 (16 inch) trước đợt tăng, và giá nâng bộ nhớ M5 Max 64GB/128GB gần như gấp đôi vào tháng 6. Một chiếc 16 inch full cấu hình giờ vượt $10,000.
Hãy kiểm tra lại từng mức giá trong phần này trước khi mua. Thị trường bộ nhớ 2026 biến động theo tháng, và mọi thứ viết ở đây đều nhanh lỗi thời.
Vì sao lại là 64GB? Lập luận về điểm tối ưu
Lập luận “điểm tối ưu” không phải vì 64GB là con số kỳ diệu. Nó nói về việc mỗi mức bộ nhớ thực sự chặn mất điều gì.
Bạn không thể làm gì ở từng mức
16GB / 24GB — Bạn chạy thoải mái mô hình 7B–8B và mô hình 14B ở mức lượng tử hóa mạnh. Bạn không thể chạy bất cứ thứ gì thuộc lớp 30B+ với ngữ cảnh có ý nghĩa. Bạn sẽ dành thời gian quản lý bộ nhớ thay vì dùng mô hình.
32GB — Dùng được cho mô hình dense 14B và vài mô hình MoE nhỏ hơn. Nhưng khi bạn thêm KV cache cho ngữ cảnh 32K+, cộng Chrome, cộng IDE, cộng một Docker daemon, bạn đã bước vào vùng áp lực bộ nhớ. Đây là mức khiến người ta tự thuyết phục rằng AI cục bộ không hoạt động.
48GB — Thực sự tốt. Chạy thoải mái mô hình dense lớp 32B. Vấn đề là dư địa: mô hình 70B ở Q4 nặng khoảng 40GB, về mặt kỹ thuật là vừa nhưng không còn gì cho phần còn lại của máy. Bạn sẽ phải thoát ứng dụng để chạy mô hình, và đó chính là ma sát giết chết quy trình làm việc cục bộ.
64GB — Đây là mức mà bạn có thể giữ một mô hình 70B Q4 hoặc một mô hình MoE 106 tỷ tham số trong bộ nhớ và và giữ toàn bộ môi trường làm việc thường trú. Không phải thoát Slack. Không phải tắt vùng chứa. Bạn mở mô hình và làm việc tiếp.
128GB (lãnh địa M5 Max) — Mở ra gpt-oss-120b và lớp 120B trở lên. Thực sự hữu ích nếu bạn cần, và thực sự đắt nếu không cần.
Lập luận về điểm tối ưu thực chất là lập luận “chạy được một mô hình nghiêm túc VÀ mọi thứ khác”. Đó là khác biệt giữa AI cục bộ như thứ để demo và thứ để dùng.
Nhưng 64GB đi kèm một giới hạn cứng, và bạn nên biết ngay bây giờ.
Vấn đề gpt-oss-120b
gpt-oss-120b ở mức lượng tử hóa MXFP4 cần khoảng 63GB chỉ cho trọng số. Các đo đạc độc lập trên M5 Max 128GB dùng MLX cho thấy bộ nhớ đỉnh khoảng 64,4GB ở ngữ cảnh 4.096 token và 64,9GB ở ngữ cảnh 16K.
Trên một chiếc máy 64GB, nơi ngân sách dùng được thực tế là 52–60GB, thì không vừa. Không phải “vừa sát” — mà là không vừa.
Nếu bạn thấy ai đó nói rằng gpt-oss-120b chạy được trên 64GB, hãy nghi ngờ. Đây là mô hình 128GB. Đây là lý lẽ rõ ràng nhất để nâng lên M5 Max, và nếu mô hình đó quan trọng với bạn thì mọi lập luận về điểm tối ưu cũng không đổi được phép tính.
Bước 1: mở khóa bộ nhớ (làm việc này trước)
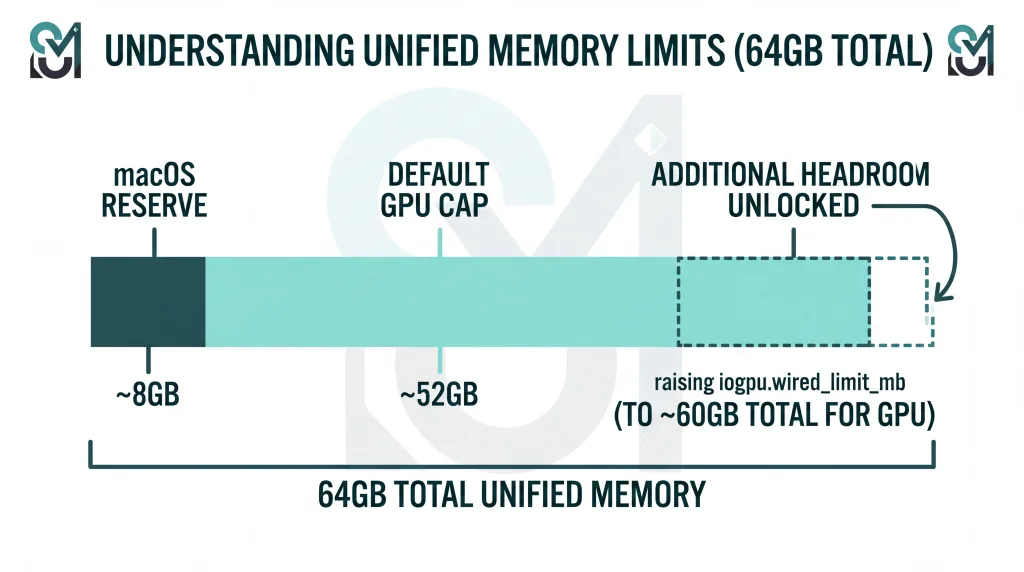
Có một điều mà hầu hết người mua không biết: macOS không cho GPU dùng toàn bộ RAM của bạn.
Mặc định, macOS giới hạn bộ nhớ dành cho GPU ở khoảng 75% tổng dung lượng. Trên máy 64GB, con số đó là khoảng 51,84GB dùng được cho trọng số mô hình, phần còn lại để dành cho hệ thống.
Bạn có thể nâng giới hạn này bằng một lệnh. Không cần khởi động lại, không cần đổi System Integrity Protection.
Lưu ý: khóa hiện hành là
iogpu.wired_limit_mb. Các hướng dẫn cũ nhắc tớidebug.iogpu.wired_limit, đã bị thay thế. Nếu bạn thấy một hướng dẫn dùng khóa cũ thì hướng dẫn đó đã lỗi thời.
Nâng giới hạn
bash
# Đặt giới hạn bộ nhớ dành cho GPU là 60GB (60 × 1024 = 61440 MB)
sudo sysctl iogpu.wired_limit_mb=61440

# Kiểm tra xem đã có hiệu lực chưa
sysctl iogpu.wired_limit_mb

# Đặt lại về mặc định của macOS bất cứ lúc nào
sudo sysctl iogpu.wired_limit_mb=0
Lưu vĩnh viễn
Thiết lập này mất sau khi khởi động lại. Để giữ lâu dài, thêm nó vào /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confHoặc tạo một LaunchDaemon hoặc thêm lệnh sysctl gọi vào script đăng nhập nếu bạn không muốn động vào /etc/sysctl.conf.
Nên đẩy tới đâu?
Để 4–8GB cho macOS. Trên máy 64GB, 60GB (61440 MB) là mức mạnh tay nhưng vẫn dùng được nếu bạn không chạy nhiều thứ khác. 56GB (57344 MB) là mức an toàn hơn cho mỗi ngày.
Đừng cấp 100%. Bạn sẽ gặp bánh xe xoay, ứng dụng treo, hoặc phải khởi động lại cứng — và trên máy đang suy luận, điều đó nghĩa là mất mọi thứ đang làm.
Ngân sách thực tế trên M5 Pro 64GB:
- Mặc định: dùng được ~48–52GB
- Nâng lên 56GB: thoải mái cho mô hình 70B Q4 cộng ngữ cảnh
- Nâng lên 60GB: tối đa, gần như không còn chỗ cho ứng dụng khác
Khác biệt đó — 48GB so với 58GB — thường là khác biệt giữa việc mô hình chạy trên GPU và việc tràn sang CPU, điều tuyệt đối phá hủy thông lượng. Đây là năm phút thiết lập giá trị nhất bạn sẽ làm.
Một điều kiện tiên quyết nữa
MLX cần macOS 26.2 trở lên để thực sự dùng M5’s Neural Accelerators. Nếu bạn đang ở bản cũ hơn, bạn đang bỏ qua cải tiến thế hệ lớn nhất. Hãy kiểm tra Software Update trước khi benchmark bất cứ thứ gì.
Bước 2: dựng bộ công cụ
Đây là toàn bộ quá trình cài đặt, theo thứ tự. Dành khoảng 30 phút cộng thời gian tải.
2.1 — Nền tảng
bash
# Install Homebrew if you don't have it
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# Install uv — a fast Python package manager, far better than pip for this
brew install uv

# Optional but recommended: a Python version manager
brew install [email protected]
2.2 — MLX (framework học máy gốc Apple’s)
MLX là framework mảng của chính Apple, được xây dựng riêng cho kiến trúc bộ nhớ hợp nhất của Apple Silicon. Đây là con đường nhanh nhất để suy luận LLM trên máy Mac và nên là lựa chọn mặc định của bạn.
bash
# Create a dedicated environment
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# Install mlx-lm
uv pip install mlx-lm

# Test it — this downloads and runs a model
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Explain unified memory architecture in three sentences."
Nếu lệnh đó sinh ra văn bản, stack của bạn đã hoạt động.
2.3 — LM Studio (giao diện đồ họa)
Tải từ lmstudio.ai. Đây là cách thân thiện nhất để duyệt, tải và chạy mô hình, và Apple đã trình diễn nó trong buổi ra mắt M5 Pro — điều đó cho thấy suy luận cục bộ đã trở nên phổ biến đến mức nào.
Tính năng hữu ích nhất của LM Studio với lập trình viên là máy chủ tương thích OpenAI tích hợp sẵn. Bật nó trong tab Nhà phát triển và nó mở một endpoint tại http://localhost:1234/v1 mà bất kỳ client tương thích OpenAI nào cũng có thể kết nối.
2.4 — Ollama (CLI và máy chủ)
bash
brew install ollama

# Start the server
ollama serve

# In another terminal, pull and run a model
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Cập nhật quan trọng năm 2026: trên March 30, 2026, Ollama 0.19 switched its Apple Silicon backend from llama.cpp to MLX. Điều này gần như nhân đôi tốc độ giải mã. Trong các đo đạc của chính Ollama trên M5 Max khi chạy Qwen3.5-35B-A3B, prefill tăng từ 1.154 lên 1.810 token/giây và decode từ 58 lên 112 token/giây — bản build int4 của họ đẩy prefill lên 1.851 và decode lên 134.
Nếu lần cuối bạn thử Ollama trên Mac là trước bản phát hành đó, mô hình tinh thần của bạn về hiệu năng của nó đã lỗi thời.
2.5 — Draw Things (ảnh và video)
Cài từ Mac App Store. Nó miễn phí, native, tối ưu cho Metal, và hiện là công cụ tạo ảnh tốt nhất trên Apple Silicon. Triển khai Metal FlashAttention v2.5 của nó chạy nhanh hơn tới 4,6× trên M5 so với M4, và nó hỗ trợ tinh chỉnh LoRA ngay trên máy.
2.6 — ComfyUI (khi bạn cần pipeline)
bash
brew install comfyuiComfyUI cho bạn khả năng điều khiển quy trình làm việc dựa trên node mà Draw Things không có. Nó chạy trên backend MPS và chậm hơn Draw Things khoảng 20% trên Apple Silicon với cùng khối lượng việc, cộng thêm những cạm bẫy thật sự với checkpoint FP8 trên Metal. Dùng nó khi bạn cần pipeline phức tạp; dùng Draw Things khi bạn cần tốc độ.
2.7 — Kiểm tra mọi thứ
bash
# Check your memory limit stuck
sysctl iogpu.wired_limit_mb

# Confirm MLX sees your GPU
python -c "import mlx.core as mx; print(mx.default_device())"

# Confirm Ollama is serving
curl http://localhost:11434/api/tags
Phần 1: chạy LLM
Đây là điểm mạnh nhất của M5 Pro 64GB, và đáng để hiểu vì sao trước khi xem danh sách mô hình.
Một khái niệm giải thích mọi thứ: băng thông so với năng lực tính toán
Suy luận LLM có hai giai đoạn, và chúng gây áp lực lên những phần hoàn toàn khác nhau của máy.
Prefill (xử lý prompt) là lượt chạy qua toàn bộ đầu vào trước khi token đầu tiên xuất hiện. Nó bị phụ thuộc vào tính toán. Đây là lý do trước kia việc dán một tệp 40.000 token vào tác nhân coding cục bộ có nghĩa là vài phút im lặng trên Mac, trong khi một card NVIDIA xử lý xong trong vài giây.
Decode (sinh token) là việc sinh ra từng token tiếp theo. Nó bị phụ thuộc vào băng thông bộ nhớ. Mỗi token được sinh ra đều cần đọc trọng số của mô hình từ bộ nhớ. Bộ nhớ nhanh hơn thì token nhanh hơn. Gần như đơn giản vậy.
Sự phân chia này giải thích toàn bộ đề xuất của M5 Pro:
- Băng thông của nó 307 GB/s đặt mức trần cứng cho tốc độ decode. Gấp đôi 153 GB/s của M5 cơ bản, và khoảng một nửa 614 GB/s của M5 Max 40 lõi.
- Băng thông của nó Neural Accelerators — một cái trong mỗi lõi GPU, mới ở thế hệ M5 — cải thiện đáng kể prefill.
Nhóm nghiên cứu MLX của chính Apple đã công bố các đo đạc vào tháng 11 năm 2025, so sánh M5 cơ bản với M4 cơ bản trên Qwen3-14B-4bit: thời gian đến token đầu tiên nhanh hơn 4,06×, trong khi sinh token chỉ cải thiện 1,19×. Mức tăng decode khiêm tốn đó khớp chính xác với mức tăng băng thông (120 GB/s → 153 GB/s). Mức tăng prefill khổng lồ đến hoàn toàn từ Neural Accelerators.
Apple quảng cáo các biến thể Pro và Max đạt tốc độ xử lý prompt LLM nhanh hơn tới 4× so với M4 Pro và M4 Max. Cơ chế là như nhau, dù xác nhận độc lập về prefill riêng cho M5 Pro vẫn còn ít.
Điều này có nghĩa trên thực tế: M5 Pro là một nâng cấp mang tính thay đổi so với các máy Mac trước M5 cho công việc ngữ cảnh dài và coding dạng tác nhân, nơi prefill chiếm ưu thế. Nó là nâng cấp khiêm tốn cho thông lượng chat thuần, nơi decode chiếm ưu thế.
Cuộc cách mạng MoE (vì sao Mac bỗng trở nên tốt)
Kiến trúc Mixture-of-Experts đã thay đổi bài toán cho các máy bộ nhớ hợp nhất, và nếu bạn không học được gì khác từ hướng dẫn này, hãy hiểu điều này.
Một mô hình MoE có tổng số tham số khổng lồ nhưng chỉ kích hoạt một phần nhỏ trong mỗi token. gpt-oss-120b có 117 tỷ tổng tham số nhưng chỉ kích hoạt khoảng 5,1 tỷ mỗi token.
- Tổng số tham số quyết định yêu cầu bộ nhớ bộ nhớ của bạn — thứ mà máy Mac có rất nhiều.
- Tham số hoạt động quyết định yêu cầu tốc độ decode — thứ bị giới hạn bởi băng thông.
Vậy một mô hình MoE cần nguồn tài nguyên mà máy Mac có nhiều và tiêu thụ ít nguồn tài nguyên mà máy Mac yếu. Một mô hình MoE được chọn tốt trên máy Mac 64GB cho chất lượng gần mức tiên tiến với tốc độ decode của một mô hình nhỏ hơn nhiều.
Đây là lý do một laptop 307 GB/s có thể có cảm giác cạnh tranh với các card chạy 1.700 GB/s trong một số khối lượng việc nhất định. Hãy chọn mô hình MoE khi có thể.
Mô hình nào thực sự vừa — bảng
Các số liệu đo được bên dưới đến từ cơ sở dữ liệu benchmark cộng đồng oMLX cho M5 Pro 20 lõi với 64GB. Các ước tính được đánh dấu rõ ràng. Đừng tin những con số token/giây không được đánh dấu mà bạn thấy ở nơi khác cho chip này — rất ít người đã công bố đo đạc thực tế về M5 Pro.
| Mô hình | Loại | Mức chiếm dụng | Decode (token/giây) | Prefill (token/giây) | Kết luận |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12GB | 66–80 ✅ đo được | 1.500–2.200 ✅ | Mẫu chạy hằng ngày. Nhanh, đủ sức, nhỏ gọn. |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20GB | ~55–70 (ước tính) | Cao | Chất lượng tốt nhất trên mỗi GB. Lựa chọn hiệu quả. |
| Qwen3.6-27B (4-bit) | Dense | ~16GB | 17.8 ✅ đo được | 470 ✅ | Đại diện cho lớp dense 27–35B. |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40GB+ | ~30 | Cao | Suy luận gần mức tiên tiến mà thực sự vừa. |
| Llama 3.3 70B (Q4_K_M) | Dense | ~40GB | ~7–12 (ước tính) | Trung bình | Dùng được cho việc chạy theo lô; tương tác thì chật vật. |
| Llama 3.3 70B (Q5_K_M) | Dense | ~49GB | ~6–10 (ước tính) | Trung bình | Vừa, nhưng sát. Hãy nâng giới hạn bộ nhớ trước. |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | Dense | 8–24GB | 20–60+ | Tốt | Tất cả đều thoải mái. Chọn theo tác vụ. |
| gpt-oss-120b (MXFP4) | MoE | ~63GB | — | — | ❌ Không vừa. Cần máy 128GB. |
| Qwen3-235B-A22B (1.58-bit ternary) | MoE | ~53GB | ~5.6 | Thấp | Chạy được về mặt kỹ thuật. Một trò biểu diễn, không phải quy trình làm việc. |
Điểm cộng từ batch: gpt-oss-20b trên M5 Pro mở rộng tới khoảng 142 tok/s ở batch size 8. Nếu bạn chạy tác nhân, vòng đánh giá, hay bất kỳ khối lượng việc nào có yêu cầu song song, thông lượng cải thiện đáng kể so với con số một luồng.
Kiểm tra thực tế với mô hình 70B
Không có con số decode nào cho Llama 3.3 70B trên M5 Pro được công bố và đo độc lập. Ước tính 7–12 tok/s được ngoại suy từ băng thông.
Để tham chiếu: một M4 Max 128GB ở 546 GB/s đo được khoảng 18–20 tok/s trên cùng mô hình. M5 Pro có 307 GB/s. Phép tính không mấy khích lệ.
Ở 7–12 tok/s bạn được khoảng 5–9 từ mỗi giây — chậm hơn tốc độ đọc thoải mái. Điều đó ổn cho tác vụ nền, xử lý tài liệu và các lô chạy qua đêm. Nó gây bực bội khi chat tương tác.
Khuyến nghị trung thực: trên M5 Pro 64GB, hãy coi các mô hình dense 70B là công cụ cho khối lượng việc theo lô và dùng mô hình MoE cho mọi thứ mang tính tương tác.
Lượng tử hóa: nên chọn loại nào
| Định dạng | Mất chất lượng | Khi nào dùng |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | Mặc định. Tỷ lệ tốc độ trên chất lượng tốt nhất. |
| MLX 4-bit | ~1–2% | Mặc định trên Mac. Ít hơn khoảng 10% bộ nhớ và nhanh hơn 15–30% so với GGUF tương đương. |
| Q5_K_M / MLX 6-bit | <1% | Khi bạn còn dư bộ nhớ và muốn đầu ra gần như không mất mát. |
| Q6_K | Không đáng kể | Việc quan trọng về chất lượng với bộ nhớ còn dư. |
| Q8 / FP16 | Không có | Hiếm khi đáng trên laptop. Cắt một nửa hoặc một phần tư ngân sách kích thước mô hình của bạn. |
| MXFP4 | Gốc | Không phải lựa chọn — đó là cách gpt-oss được phát hành. |
| 1.58-bit ternary | Nghiêm trọng | Chỉ để nhét vừa một mô hình mà nếu không thì không thể vừa. |
Quy tắc chung: 4-bit cho tốc độ và độ vừa, 6-bit khi chất lượng quan trọng và bạn còn chỗ, và bỏ qua 8-bit trên laptop.
MLX và llama.cpp — dùng runtime nào?
Câu trả lời ngắn là MLX, với một lưu ý.
- Dưới ~14B tham số: MLX dẫn trước llama.cpp 20–87%. Cách biệt không nhỏ.
- Trên ~27B: hai bên hội tụ, vì băng thông bộ nhớ trở thành điểm nghẽn và runtime không còn quan trọng.
- Bộ nhớ: MLX dùng ít hơn GGUF khoảng 10% ở cùng mức lượng tử hóa.
- Lưu ý: ở ngữ cảnh 30.000+ token, MLX có thể chậm hơn tới 50% so với llama.cpp khi bật Flash Attention. Điều này phụ thuộc vào mô hình và ngữ cảnh.
Nếu bạn thường xuyên làm việc với ngữ cảnh rất dài, hãy benchmark cả hai trên khối lượng việc thực tế của bạn. Nếu không, dùng MLX.
Chạy máy chủ API cục bộ
mlx-lm 0.18 và mới hơn có sẵn máy chủ tương thích OpenAI với continuous batching:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
Giờ đây bất cứ thứ gì nói được API OpenAI đều có thể dùng mô hình cục bộ của bạn:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Write a bash one-liner to find large files."}]
  }'
Endpoint đó là nền tảng cho mọi thứ trong phần quy trình làm việc bên dưới.
Phần 2: tạo ảnh
Tạo ảnh là nơi M5 Pro trông tốt hơn so với mức băng thông của nó, vì một lý do đơn giản: diffusion phụ thuộc vào tính toánphụ thuộc vào tính toán, không phải băng thông, và các mô hình đủ nhỏ để bộ nhớ không bao giờ là ràng buộc trên máy 64GB.
Hiệu năng theo từng mô hình
| Mô hình | Kích thước | Bộ nhớ | Thời gian cho ảnh 1024×1024 | Ghi chú |
|---|---|---|---|---|
| SDXL | 3.5B | ~7GB | ~7 giây ở 30 bước (M5 Max) | Lựa chọn chất lượng nhanh nhất. Hệ sinh thái LoRA khổng lồ. |
| FLUX.1 [schnell] | 12B | ~7GB (Q4) | ~20–25 giây ở 4 bước | Được chưng cất cho tốc độ. Apache-2.0. |
| FLUX.1 [dev] | 12B | ~10GB (Q6) | ~50 giây ở 20 bước (lớp M4) | Chuẩn mực về chất lượng. |
| FLUX.2 [Klein] | 4B chưng cất | ~8GB | ~40 giây | Mới hơn, nhỏ hơn, nhanh. |
| FLUX.2 [dev] | Lớn | 24GB+ | Vài phút | Chất lượng tốt nhất, cần kiên nhẫn thật sự. |
| SD 3.5 | Khác nhau | 10–20GB | Hàng chục giây | Mức trung dung vững chắc. |
| Qwen-Image / Qwen-Image-Edit | Khác nhau | 15–25GB | Hàng chục giây | Xuất sắc cho render và chỉnh sửa văn bản. |
| HiDream, Chroma | Khác nhau | 10–20GB | Khác nhau | Đáng khám phá vì dải phong cách rộng. |
Nhóm nghiên cứu ML của Apple đo FLUX-dev-4bit tạo ảnh 1024×1024 nhanh hơn 3,8× trên M5 so với M4 bằng MLX. Mức tăng đó đến từ Neural Accelerators và áp dụng cho toàn bộ dòng M5.
Chưa có benchmark số giây mỗi ảnh riêng cho M5 Pro được công bố, nên hãy coi bảng trên là số liệu lớp M4 với mức tăng M5 đáng kể được kỳ vọng. Thực tế: bạn nên kỳ vọng FLUX.1 [schnell] dưới 20 giây và SDXL trong vài giây.
Ở 64GB bạn có thể chạy các mô hình này ở FP16 không lượng tử hóa, đây là lợi thế chất lượng thật sự so với máy 16GB và 24GB buộc phải dùng Q4.
Công cụ: dùng gì
Draw Things — lựa chọn mặc định. Metal native, không có môi trường Python để hỏng, Metal FlashAttention v2.5 chạy nhanh hơn tới 4,6× trên M5 so với M4, và tinh chỉnh LoRA ngay trên máy. Miễn phí trên App Store.
ComfyUI — cho pipeline dựa trên node, chuỗi ControlNet và quy trình làm việc nhiều giai đoạn. Chậm hơn Draw Things khoảng 20% trên Apple Silicon. Coi chừng checkpoint FP8, thứ thường xuyên lỗi trên Metal.
DiffusionKit — bộ công cụ diffusion của chính Apple, nền MLX. Đáng theo dõi.
Mochi Diffusion, InvokeAI — cả hai đều khả thi, cả hai đều ổn.
Tránh: DiffusionBee coi như đã bị bỏ rơi. Automatic1111 và Forge về mặt kỹ thuật vẫn chạy qua MPS nhưng chậm và ít được bảo trì trên Mac.
Từng bước: ảnh cục bộ đầu tiên của bạn
- Cài đặt Draw Things từ Mac App Store.
- Mở ứng dụng và vào trình quản lý mô hình (biểu tượng ở trên cùng của bảng bên trái).
- Tải xuống FLUX.1 [schnell] — khoảng 7GB ở Q4, hoặc lấy bản FP16 vì bạn đủ bộ nhớ.
- Đặt Số bước thành 4 (schnell được tinh chỉnh chính xác cho việc này) và Kích thước thành 1024×1024.
- Nhập prompt và nhấn Tạo.
- Lần chạy đầu tiên bao gồm việc tải mô hình. Những lần tạo sau nhanh hơn nhiều.
Huấn luyện LoRA trên máy
Một chiếc máy 64GB có thể tinh chỉnh mô hình hình ảnh ngay trên máy, một khả năng thực sự bị đánh giá thấp. Draw Things hỗ trợ huấn luyện LoRA trực tiếp, và MLX hỗ trợ LoRA cùng QLoRA cho cả mô hình hình ảnh lẫn mô hình ngôn ngữ.
Một LoRA phong cách nhỏ trên 20–50 ảnh là công việc qua đêm trên M5 Pro, và nó không bao giờ rời khỏi máy bạn. Với ai làm việc với tài liệu của khách hàng hoặc tài sản độc quyền, điều đó quan trọng hơn tốc độ.
Phần 3: tạo video — phần nói thật
Đến đây tôi phải nói thẳng với bạn, vì nhiều nội dung về chủ đề này thì không như vậy.
Tạo video cục bộ trên bất kỳ máy Mac nào vào năm 2026 đều chậm. Không phải kiểu chậm “chậm hơn 4090”. Chậm đến mức thay đổi cách bạn làm việc.
Vì sao Mac đặc biệt chật vật ở đây
Khuếch tán video phụ thuộc rất nặng vào sức tính toán phụ thuộc vào tính toán. Không như giải mã LLM, nơi băng thông bộ nhớ dồi dào của Mac là tài nguyên quyết định, tạo video bào mòn sức tính toán thô của GPU — đúng trục mà GPU laptop 20 nhân thua card đồ họa chuyên dụng.
Neural Accelerator của M5 có giúp ích. Nhưng chúng không thu hẹp được khoảng cách lớn đến vậy.
Những con số, không tô vẽ
Wan 2.2 (Alibaba, Apache-2.0, có dạng 14B MoE và một biến thể 5B dense văn bản/hình ảnh sang video): trên một M1 Max 64GB chạy bản dựng GGUF, một clip 2 giây ở 832×480 mất 82 phút. Một clip 5 giây sẽ vượt quá ba giờ.
Để so sánh, cùng mô hình TI2V-5B trên một RTX 4090 24GB tạo 5 giây ở 720p trong khoảng 9 phút.
M5 Pro nhanh hơn M1 Max đáng kể, nhưng điều đáng nói là khoảng cách về bậc độ lớn.
Một giới hạn quan trọng của Metal: Checkpoint FP8 không chạy trên Metal — kiểu dữ liệu Float8_e4m3fn không được hỗ trợ. Bạn phải dùng bản dựng GGUF. Điều này khiến nhiều người làm theo các hướng dẫn thiên về NVIDIA vấp phải, và nó cũng có nghĩa các mẫu FP8 của LTX-2’s thất bại hoàn toàn trên Mac.
Tin tốt: các mô hình tinh chỉnh mới hơn đang thay đổi điều này. Ivan Fioravanti đã đo mô hình tinh chỉnh LTX 2.3 22B trong Draw Things tạo video 5 giây trong khoảng 121 giây trên M5 Max 40 nhân — thực sự vượt M3 Ultra 80 nhân, vốn mất 206 giây.
Đó là một kết quả thật và một sự thay đổi thật. Nhưng hãy để ý con chip: M5 Pro 20 nhân sẽ chậm hơn rõ rệt so với M5 Max 40 nhân với những công việc giới hạn bởi tính toán như thế này. Hãy chờ vài phút chứ không phải hai phút.
Các mô hình khác — HunyuanVideo, Mochi 1, CogVideoX, FramePack, Stable Video Diffusion — từ chậm đến không thực tế trên Mac. Một số được làm cho CUDA trước tiên và cần các cách xử lý vòng.
Kết luận về video
Video cục bộ trên M5 Pro 64GB là khả thi cho những lần thử nghiệm thỉnh thoảng và kiên nhẫn — clip ngắn, độ phân giải thấp hơn, mô hình tinh chỉnh, qua Draw Things. Nó chạy được. Bạn sẽ tạo ra được đồ.
Với bất kỳ thông lượng thực sự nào, hãy thuê GPU. RunPod, Vast.ai và Lambda sẽ chạy 5090 hoặc H100 với vài đô một giờ và tạo ra trong vài phút thứ mà laptop của bạn tạo trong một giờ. Riêng với video, bài toán kinh tế không có gì để so sánh.
Nếu tạo video là chính công việc chính của bạn, hãy mua máy NVIDIA hoặc dự trù ngân sách cho cloud. Đừng mua Mac rồi hy vọng.
Nếu bạn vẫn muốn thử: từng bước
- Mở Draw Things và chuyển sang trình quản lý mô hình video.
- Tải một mô hình tinh chỉnh — LTX 2.3 hoặc một bản dựng Wan 2.2 GGUF. Mô hình tinh chỉnh chính là khác biệt giữa vài phút và vài giờ.
- Bắt đầu nhỏ: 480p, 2 giây, số bước thấp. Xác lập thời gian cơ sở trước khi tăng quy mô.
- Cắm điện và dùng High Power Mode. Quạt sẽ chạy.
- Chỉ tăng độ phân giải và thời lượng sau khi bạn biết một clip ngắn tốn bao nhiêu thời gian thực.
Đừng bao giờ dùng checkpoint FP8 trên Mac. GGUF hoặc không gì cả.
Phần 4: quy trình làm việc thật đáng xây
Benchmark không phải là điểm chính. Đây là những gì người ta thực sự làm với chiếc máy này.
Quy trình 1: tác nhân viết mã cục bộ
Đây là thiết lập giá trị nhất trong danh sách, và chỉ mất khoảng mười phút.
Bước 1 — Khởi động máy chủ mô hình. Dùng tab Developer của LM Studio’s (endpoint tại http://localhost:1234/v1) hoặc:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234Bước 2 — Trỏ trình soạn thảo của bạn vào đó.
VS Code với Cline hoặc Continue: thêm một nhà cung cấp tương thích OpenAI với base URL http://localhost:1234/v1, một API key bất kỳ không rỗng, và tên mô hình của bạn.
Zed: cấu hình một nhà cung cấp tùy chỉnh tương thích OpenAI trong phần cài đặt.
Aider (terminal):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
Bước 3 — Chọn đúng mô hình. gpt-oss-20b và Qwen3-Coder-30B-A3B đều là những mô hình lập trình cục bộ mạnh. Cả hai đều là MoE, đúng thứ bạn muốn: giải mã nhanh, và những cải thiện prefill của M5’s nghĩa là ngữ cảnh tệp lớn không còn bị treo hàng phút nữa.
Điều này mang lại gì: lặp không giới hạn mà không tốn chi phí theo token, không giới hạn tốc độ, và mã không bao giờ rời khỏi máy bạn. Với các cơ sở mã độc quyền hoặc của khách hàng, điểm cuối đó thường chính là toàn bộ lý do.
Quy trình 2: RAG riêng tư trên tài liệu của bạn
Embedding cục bộ cộng với một mô hình 27B–70B nghĩa là các tài liệu nhạy cảm — hợp đồng, hồ sơ y tế, nghiên cứu nội bộ, tài chính — có thể tìm kiếm và tóm tắt mà không một byte nào rời khỏi laptop của bạn.
Mức 64GB đặc biệt quan trọng ở đây vì các pipeline RAG giữ đồng thời một mô hình embedding, một kho vector và một mô hình sinh trong bộ nhớ. Ở 32GB bạn liên tục phải hoán đổi. Ở 64GB thì không.
Quy trình 3: tạo hàng loạt qua đêm
Xếp hàng vài trăm lần tạo hình ảnh trong Draw Things, hoặc chạy một tác vụ xử lý tài liệu dài qua mlx_lm.server, và để máy làm việc trong lúc bạn ngủ. Khi cắm điện, các mô hình 70B và lô hình ảnh vốn cảm thấy quá chậm khi tương tác lại hoàn toàn hợp lý nếu chạy qua đêm.
Quy trình 4: định tuyến lai (chiến lược mà hầu hết mọi người nên áp dụng)
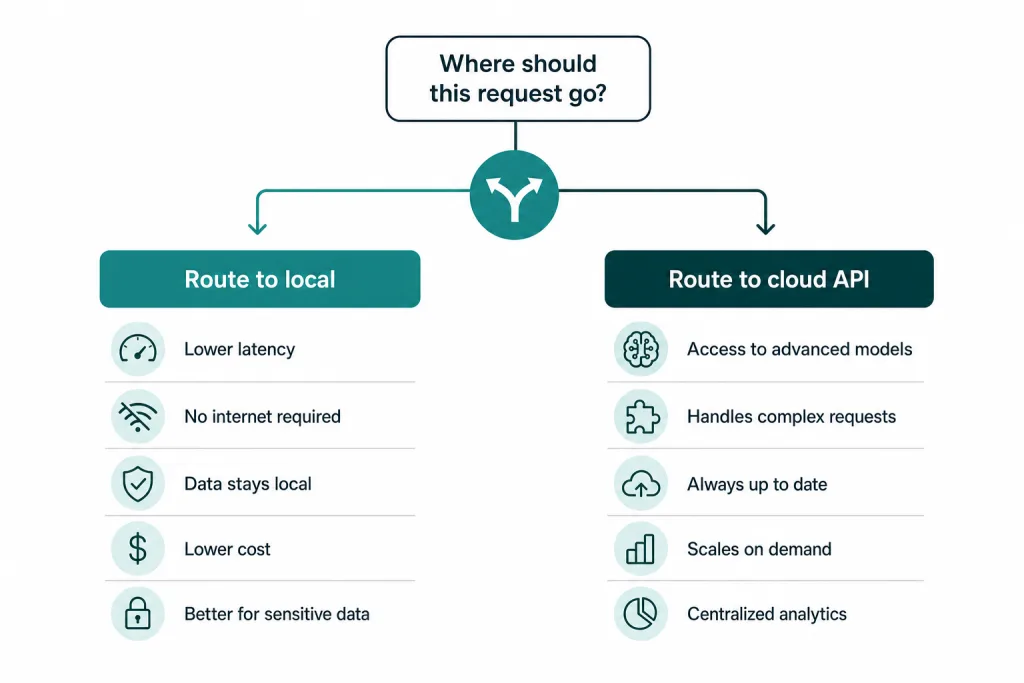
Đừng xem cục bộ với cloud là hai lựa chọn nhị phân. Hãy định tuyến theo tác vụ:
| Gửi cục bộ | Gửi tới API cloud |
|---|---|
| Mọi thứ nhạy cảm về quyền riêng tư | Các tác vụ suy luận khó nhất |
| Xử lý hàng loạt và theo lô | Những trường hợp cần chất lượng tiên phong thực sự |
| Vòng lặp tác nhân với nhiều lệnh gọi rẻ | Đầu ra quan trọng chạy một lần |
| Lặp và thử nghiệm | Công việc cần mô hình mới nhất |
| Làm việc ngoại tuyến | Cửa sổ ngữ cảnh rất dài |
Đây là nơi phần lớn giá trị nằm ở đó. Cục bộ xử lý khối lượng, lặp và quyền riêng tư. Cloud xử lý 5% khó.
Bộ công cụ AI riêng Apple’s (đáng để biết)
Việc Khung Foundation Models cho nhà phát triển truy cập trực tiếp bằng Swift vào mô hình trên thiết bị của Apple’s — khoảng 3B tham số, miễn phí, riêng tư, ngoại tuyến, có sẵn tạo có hướng dẫn và gọi công cụ.
Các bản cập nhật năm 2026 quan trọng hơn bản phát hành gốc: đầu vào hình ảnh, thực thi phía máy chủ, và một LanguageModel giao thức cho phép bạn gắn một phiên với mô hình của Apple’s, một mô hình cloud, hoặc một mô hình MLX cục bộ qua MLXLanguageModel. Nếu bạn xây dựng ứng dụng Mac hoặc iOS, đó là một con đường gọn gàng để có các tính năng AI lai trên thiết bị.
Xcode 26 cũng có sẵn các công cụ lập trình LLM tích hợp, có thể dùng ChatGPT, các nhà cung cấp khác qua API key, hoặc một mô hình cục bộ chạy trên Mac của bạn.
Sống cùng nó: nhiệt độ, pin và tiếng ồn
Thông số không cho bạn biết cảm giác dùng một chiếc máy. Vài nhận xét thẳng thắn.
Bản 14 inch bị bóp hiệu năng nhiều hơn bản 16 inch. Notebookcheck ghi nhận hiện tượng bóp hiệu năng do nhiệt mạnh trên MacBook Pro 2026 khi chịu tải liên tục, với hành vi CPU không ổn định ngay cả ở High Power Mode. Bản 16 inch có nhiều dư địa tản nhiệt hơn và pin lớn hơn. Nếu bạn dự định chạy các phiên suy luận liên tục, bản 16 inch là chiếc máy tốt hơn — đây là khác biệt chức năng thật, không phải sở thích.
Không phải mọi khối lượng công việc AI đều như nhau về nhiệt. Giải mã LLM tương đối nhẹ — nó bị giới hạn bởi bộ nhớ, nên GPU không bị dùng hết và quạt thường im. Khuếch tán hình ảnh và video bị giới hạn bởi tính toán, sẽ ép GPU chạy hết công suất, quạt kêu to và pin tụt nhanh.
Thực tế về pin: các phiên LLM ngắn thì không sao khi không cắm điện. Làm khuếch tán liên tục sẽ hút cạn pin trong vài giờ và bị bóp hiệu năng do nhiệt trước đó. Hãy cắm điện cho bất cứ việc gì nghiêm túc.
Chế độ nguồn: bản 16 inch có High Power Mode, đáng bật cho các tác vụ dài. Low Power Mode làm giảm tốc độ suy luận đáng kể — tránh dùng khi chạy mô hình.
Thói quen thực tế: không cắm điện khi trò chuyện và hỗ trợ lập trình. Cắm điện, bật High Power Mode, khi chạy lô hình ảnh và video.
Những phản biện trung thực
Một hướng dẫn chỉ nói một phía là tiếp thị. Đây là phía ngược lại.
1. M5 Max thực sự nhanh hơn, và không phải chênh lệch nhỏ
307 GB/s so với 614 GB/s. Vì giải mã bị giới hạn bởi băng thông, M5 Max 40 nhân tạo token nhanh gấp khoảng hai lần trên cùng một mô hình. Nó cũng chứa được gpt-oss-120b, điều mà M5 Pro không làm được.
Nếu tốc độ giải mã mô hình lớn là mục đích chính của bạn, M5 Max mới là chiếc máy đúng và M5 Pro là một thỏa hiệp. Đối trọng là giá: sau tháng 6 năm 2026, việc nâng cấp đó rất chát.
2. M4 Max giảm giá có thể hơn M5 Pro mới
Đây là lập luận mà phần lớn người mua bỏ qua. M4 Max có băng thông bộ nhớ khoảng 546 GB/s — nhiều hơn đáng kể so với 307 GB/s của M5 Pro’s. Với giải mã LLM thuần túy, M4 Max 64GB thường sẽ nhanh hơn M5 Pro 64GB.
Cái bạn đánh đổi: Neural Accelerator của M5’s, nghĩa là prefill chậm hơn nhiều và tạo hình ảnh chậm hơn.
Quy tắc quyết định: nếu bạn chủ yếu trò chuyện với các mô hình lớn, một chiếc M4 Max 64GB giảm giá có lẽ là lựa chọn tốt hơn. Nếu bạn làm lập trình tác nhân với ngữ cảnh dài, hoặc tạo hình ảnh, lợi thế prefill và khuếch tán của M5 Pro’s sẽ thắng.
3. NVIDIA vẫn thắng về năng lực tính toán
Một chiếc RTX 5090 có 32GB VRAM với khoảng 1.792 GB/s — gần sáu lần băng thông của M5 Pro’s — cộng thêm sức tính toán lớn hơn nhiều. Với bất kỳ mô hình nào vừa 32GB, và với mọi công việc giới hạn bởi tính toán (video, hình ảnh, prefill), không có gì để so.
Lợi thế của Mac’s bắt đầu đúng ở nơi 32GB VRAM kết thúc, và bao gồm tính di động, sự yên tĩnh, mức tiêu thụ điện thấp, và khả năng làm việc này trên tàu.
4. Các đối thủ bộ nhớ hợp nhất 128GB là cuộc chơi dung lượng, không phải tốc độ
NVIDIA DGX Spark / GB10: 128GB với khoảng 273 GB/s, có CUDA. Với gpt-oss-120b MXFP4, các thử nghiệm độc lập đặt nó ở 34–39 tok/s.
AMD Strix Halo / Ryzen AI Max+ 395: 128GB với khoảng 256 GB/s. Số liệu của chính AMD’s nêu tới 30 tok/s trên cùng mô hình qua llama.cpp. Các máy mini-PC dựng quanh nó rẻ hơn đáng kể so với bất kỳ máy Mac nào.
Lưu ý rằng cả hai đều có băng thông thấp hơn so với M5 Pro. Chúng cho bạn dung lượng, không phải tốc độ. Nếu mục tiêu của bạn là chạy những mô hình rất lớn ở mức chấp nhận được thay vì nhanh, chúng rẻ hơn. Nếu bạn muốn tốc độ, chúng không phải câu trả lời.
5. Mac để bàn là máy cố định tốt hơn
A Mac Studio M3 Ultra lên tới 512GB ở 800 GB/s. Nếu máy của bạn nằm trên bàn, đó là một cỗ máy AI cục bộ tốt hơn nhiều so với bất kỳ MacBook Pro nào. Giá trị của laptop là tính di động, pin và sự yên tĩnh — nếu bạn không cần những thứ đó, đừng trả tiền cho chúng.
6. Bạn không thể nâng cấp bộ nhớ. Không bao giờ.
Bộ nhớ Apple Silicon nằm ngay trong gói chip. Bạn mua bao nhiêu thì có bấy nhiêu trong suốt vòng đời của máy’s.
Vì các mô hình ra mắt năm 2026 có xu hướng ngày càng có dấu chân MoE lớn hơn, mua thiếu RAM là nỗi hối tiếc kinh điển và vĩnh viễn. Nếu bạn đang chọn giữa 48GB và 64GB, hãy lấy 64GB.
Bài toán chi phí: cục bộ so với đám mây
Hãy tính toán một cách trung thực, vì “cục bộ rẻ hơn” thường được khẳng định mà ít khi được tính.
Máy: khoảng $2.800 cho một chiếc M5 Pro 64GB, phân bổ trong ba đến bốn năm.
Giá API tính đến tháng 8 năm 2026 (trên một triệu token, đầu vào/đầu ra):
| Dịch vụ | Đầu vào | Đầu ra |
|---|---|---|
| Hạng Claude Sonnet | ~$3 | ~$15 |
| Hạng GPT-5 | ~$1,75–$5 | ~$14–$30 |
| DeepSeek V4 Flash | ~$0.14 | ~$0.28 |
| Mô hình mở do dịch vụ lưu trữ (gpt-oss, Llama) | Còn thấp hơn nữa | Còn thấp hơn nữa |
Thuê GPU trên cloud: H100 khoảng $3/giờ, H200 khoảng $5/giờ theo yêu cầu.
Điểm hòa vốn: các phân tích đã công bố đặt điểm giao nhau cho một máy tiêu dùng ở khoảng 2–3 triệu token mỗi ngày, duy trì trong khoảng mười hai tháng so với các API độc quyền tầm trung.
Đó là một lượng token rất lớn. Dưới ngưỡng đó, các API rẻ — đặc biệt là hạng DeepSeek — thực sự rẻ hơn cục bộ nếu chỉ tính chi phí token.
Vậy tại sao vẫn mua máy?
Vì chi phí token không phải chi phí duy nhất:
- Quyền riêng tư. Dữ liệu của bạn không bao giờ rời khỏi thiết bị. Với công việc pháp lý, y tế, tài chính hoặc mã nguồn độc quyền, điều này thường là không thể thương lượng bất kể giá.
- Không giới hạn tốc độ. Không bóp băng thông, không xếp hàng, không lỗi hết dung lượng lúc 2 giờ sáng.
- Ngoại tuyến. Máy bay, tàu hỏa, wifi khách sạn tệ, mạng mất kết nối.
- Chi phí biên bằng không. Điều này thay đổi hành vi nhiều hơn người ta tưởng. Khi mỗi thử nghiệm miễn phí, bạn chạy nhiều gấp mười lần. Việc không phải lo lắng về từng token khi lặp đáng giá bằng tiền thật trong kết quả.
- Dù sao bạn cũng cần một chiếc laptop. Cách nhìn trung thực không phải là “$2.800 cho AI” — mà là phần chênh lệch giữa chiếc máy bạn vốn định mua và chiếc này.
Kết luận đúng là kết hợp. Cục bộ cho khối lượng, quyền riêng tư, lặp và vòng lặp tác nhân. Cloud cho những bài toán khó. Ai nói cục bộ thay thế hoàn toàn các API tiên phong năm 2026 là nói quá; ai nói cục bộ vô nghĩa thì chưa từng chạy vòng lặp tác nhân ở quy mô lớn.
Hướng dẫn mua
| Nếu bạn… | Mua cái này | Tại sao |
|---|---|---|
| Muốn chiếc laptop AI cục bộ cân bằng nhất | M5 Pro 64GB, 16 inch | Chạy mô hình 8B–70B và MoE, tạo hình ảnh nhanh, còn chỗ cho mọi thứ khác. Tản nhiệt tốt hơn bản 14 inch. |
Cần gpt-oss-120b hoặc mô hình 120B+ | M5 Max 128GB | Chiếc laptop Mac duy nhất chứa được chúng. Tốc độ giải mã cũng gấp ~2 lần. |
| Chủ yếu trò chuyện với mô hình lớn, muốn đáng tiền | M4 Max 64GB giảm giá | Băng thông cao hơn (546 GB/s) đánh bại M5 Pro khi giải mã. |
| Làm video một cách nghiêm túc | NVIDIA (RTX 5090) hoặc cloud | Công việc giới hạn bởi tính toán; Mac chậm hơn vài lần. |
| Muốn dung lượng tối đa với ngân sách hạn chế | mini-PC Strix Halo 128GB | 128GB với giá rẻ, nhưng băng thông thấp hơn M5 Pro. |
| Làm việc tại bàn | Mac Studio M3 Ultra | Lên đến 512GB ở 800 GB/s. |
| Có ngân sách eo hẹp | M5 Pro 48GB | Chạy tốt các mô hình cỡ 32B. Chấp nhận giới hạn 70B/MoE. |
Điều tôi sẽ không làm: mua máy 24GB hoặc 32GB cho AI cục bộ nghiêm túc. Bạn sẽ chạm trần trong vài tuần và không thể nâng cấp để thoát ra.
Câu hỏi thường gặp
64GB có đủ cho AI cục bộ vào năm 2026? Đủ, với hầu hết tác vụ. 64GB chạy thoải mái các mô hình lên tới khoảng 70B tham số ở lượng tử hóa 4-bit, cùng các mô hình Mixture-of-Experts như GLM-4.6 Air, mà vẫn còn chỗ cho hệ điều hành và ứng dụng. Ngoại lệ chính là gpt-oss-120b, mô hình này cần khoảng 63GB chỉ riêng trọng số và đòi hỏi máy 128GB.
M5 Pro có chạy được gpt-oss-120b không? Không. Bản MXFP4 cần khoảng 63GB cho trọng số, và bộ nhớ đỉnh đo được trên M5 Max là 64,4–64,9GB tùy độ dài ngữ cảnh. Trên máy 64GB với ngân sách khả dụng thực tế 52–60GB, nó không vừa. Đây là mô hình dành cho máy 128GB.
M5 Pro tạo ra bao nhiêu token mỗi giây? Phụ thuộc rất nhiều vào mô hình. Số liệu đo được cho M5 Pro 20 nhân với 64GB: gpt-oss-20b ở 66–80 tok/s giải mã với 1.500–2.200 tok/s tiền xử lý, và Qwen3.6-27B ở 17,8 tok/s giải mã với 470 tok/s tiền xử lý. Các mô hình dense lớn hơn như Llama 3.3 70B được ước tính 7–12 tok/s.
M5 Pro hay M5 Max cho LLM cục bộ? M5 Max nếu ưu tiên của bạn là tốc độ tạo token trên các mô hình lớn — máy có 614 GB/s băng thông bộ nhớ so với 307 GB/s của M5 Pro’, tốc độ giải mã gần gấp đôi, và hỗ trợ 128GB. Chọn M5 Pro nếu bạn muốn sự cân bằng tốt nhất giữa giá, tính di động và khả năng cho các mô hình tới 70B.
Tạo video trên Mac có thực tế không? Không hẳn, vào năm 2026. Khuếch tán video bị giới hạn bởi sức tính toán, và Mac chậm hơn RTX 5090 vài lần. Các mô hình chưng cất có giúp ích — LTX 2.3 tạo một clip 5 giây trong khoảng 121 giây trên M5 Max — nhưng để có thông lượng thực sự, thuê GPU đám mây nhanh và rẻ hơn nhiều trên mỗi clip.
Làm thế nào để tăng giới hạn bộ nhớ GPU trên macOS? Chạy sudo sysctl iogpu.wired_limit_mb=61440 để cấp phát 60GB. Kiểm tra bằng sysctl iogpu.wired_limit_mb và đặt lại với giá trị 0. Thêm dòng đó vào /etc/sysctl.conf để duy trì qua các lần khởi động lại. Luôn để lại 4–8GB cho macOS.
MLX hay llama.cpp trên Apple Silicon? MLX cho hầu hết trường hợp. Nó dẫn trước llama.cpp 20–87% trên các mô hình dưới 14B, dùng ít bộ nhớ hơn khoảng 10%, và là thứ Ollama 0.19 chuyển sang vào tháng 3 năm 2026. Ngoại lệ là ngữ cảnh rất dài — ở 30.000+ token, llama.cpp với Flash Attention có thể nhanh hơn tới 50%.
Nên mua bản 14 inch hay 16 inch? Bản 16 inch cho công việc AI kéo dài. Máy có dư địa tản nhiệt tốt hơn, pin lớn hơn và chế độ High Power. Bản 14 inch bị giảm hiệu năng rõ rệt khi tải liên tục.
M4 Max giảm giá có đánh bại M5 Pro mới không? Với giải mã LLM thuần túy, thường là có — M4 Max có khoảng 546 GB/s so với 307 GB/s của M5 Pro’. M5 Pro thắng ở xử lý prompt (nhanh hơn tới 4 lần) và tạo ảnh (nhanh hơn 3,8 lần) nhờ Neural Accelerators. Hãy chọn dựa trên tác vụ nào chiếm phần lớn việc bạn làm.
Điều gì tiếp theo
Vài điều đáng theo dõi, vì chúng có thể thay đổi khuyến nghị ở trên.
Các benchmark độc lập cho M5 Pro trên mô hình 70B. Chưa ai công bố con số giải mã được đo đạc tử tế. Nếu kết quả thực tế vượt 15 tok/s, lập luận “mua bản Max để giải mã” yếu đi đáng kể.
Nhỏ hơn gpt-oss-120b các bản lượng tử hóa. Nếu một bản build xuống dưới 52GB, lập luận về giới hạn 64GB sẽ dịu đi chỉ sau một đêm.
Mặc định bộ nhớ của macOS. Nếu Apple nâng mức cấp phát GPU mặc định lên trên 75%, mọi người dùng máy 64GB sẽ có thêm dư địa miễn phí.
MoE tiếp tục thắng thế. Xu hướng mô hình tổng tham số lớn, tham số hoạt động thấp là điều tốt nhất từng xảy ra với các máy bộ nhớ hợp nhất. Mỗi bản phát hành MoE mới lại khiến Mac cạnh tranh hơn.
Giá API giảm. Hãy tính lại điểm hòa vốn giữa cục bộ và đám mây sáu tháng một lần. Nó thay đổi.
Điểm mấu chốt
MacBook Pro M5 Pro với 64GB không phải máy AI cục bộ nhanh nhất bạn có thể mua. Nó thậm chí không phải chiếc Mac nhanh nhất. Điều nó là: cấu hình mà ở đó các đánh đổi thôi chống lại nhau.
Nó chạy những mô hình đủ tốt để thực sự hữu ích — gpt-oss-20b ở 66–80 tok/s, GLM-4.6 Air khoảng 30, tạo ảnh trong vài giây — mà vẫn là chiếc laptop bạn có thể mang theo, chạy bằng pin và dùng làm máy tính thực sự của mình. Neural Accelerators của thế hệ M5’ đã khắc phục điểm yếu cụ thể (xử lý prompt chậm) khiến các Mac trước đây gây ức chế với công việc dạng tác nhân và ngữ cảnh dài.
Các giới hạn là thật và đáng để biết: gpt-oss-120b không vừa, các mô hình dense 70B là công cụ chạy theo lô chứ không phải bạn trò chuyện, và tạo video thuộc về đám mây.
Nếu những giới hạn đó phù hợp với công việc của bạn, đây là chiếc máy dành cho bạn. Nếu không, các phần trên nói rõ bạn nên mua chiếc nào thay thế — và điều đó hữu ích hơn một bài viết khác bảo rằng mọi thứ đều ổn.
Giá, phiên bản mô hình và số liệu benchmark trong bài phản ánh dữ liệu có vào tháng 8 năm 2026 và thay đổi nhanh — đặc biệt là giá Mac trong tình trạng thiếu hụt bộ nhớ đang diễn ra. Hãy kiểm tra thông số hiện tại trước khi mua.