
 हिन्दी
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 العربية

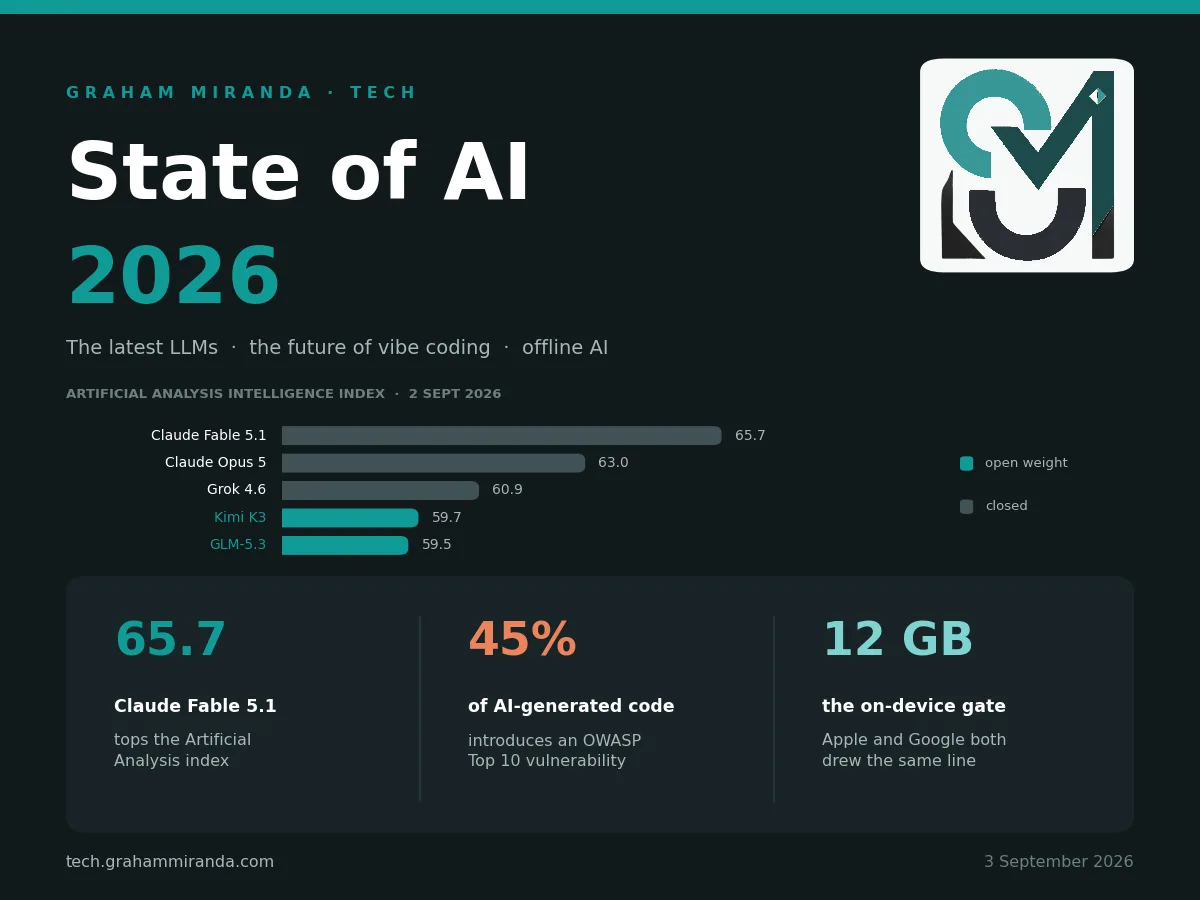
AI 2026 की स्थिति इस साल के पहले आठ महीनों में हुई तीन बातों पर टिकी है — और लगभग किसी ने भी उन्हें एक ही वाक्य में नहीं रखा है।
एक मॉडल SWE-bench Verified पर 96% से आगे निकल गया। किसी खिलौना बेंचमार्क पर 96% नहीं — Django, Flask और scikit-learn के असली GitHub issues पर 96%, वह बेंचमार्क जिसे सालों लगने थे। अब यह विभाजक के तौर पर व्यावहारिक रूप से ख़त्म हो चुका है, और इसके शीर्ष पर मौजूद तीन मॉडलों के बीच एक प्रतिशत अंक से भी कम का अंतर है।
AI कोडिंग टूल्स अनुभवी डेवलपर्स को तेज़ बनाते हैं या नहीं, इस पर उपलब्ध सबसे अच्छा सबूत अब भी 'नहीं' कहता है। METR’s रैंडमाइज़्ड कंट्रोल्ड ट्रायल में 19% की सुस्ती मिली। 2026 में इसे दोबारा चलाने की उनकी खुद की कोशिश इसलिए ढह गई क्योंकि डेवलपर्स ने $50 प्रति घंटे पर भी AI के बिना काम करने से मना कर दिया। इन टूल्स का इस्तेमाल करने वाले मानते हैं कि वे तीन गुना तेज़ हैं। नापने पर वे नहीं हैं।
और Microsoft ने 14 अरब पैरामीटर वाला रीज़निंग मॉडल सीधे Windows में भेज दिया, जो 2024 में साइंस फ़िक्शन जैसा लगता और अब किसी Build कीनोट में बस एक फ़ुटनोट है।
ये तीन तथ्य पूरी AI 2026 की स्थिति का लघु चित्र हैं। मॉडल असाधारण हो गए। नापी गई उत्पादकता में वह बढ़त नहीं आई। और दिलचस्प फ़्रंटियर चुपचाप डेटा सेंटर से हटकर आपके हाथ में मौजूद डिवाइस पर पहुँच गया।
यह AI 2026 की स्थिति का विस्तृत संस्करण है। यह उन लोगों के लिए लिखा गया है जिन्हें पैसे से जुड़े फ़ैसले लेने होते हैं — किस मॉडल पर रूट करना है, एजेंट्स को प्रोडक्शन कोड लिखने देना है या नहीं, क्या ख़रीदना है, और किसी क्लाइंट या डेटा प्रोटेक्शन अधिकारी को क्या बताना है। मैंने जो शिप हुआ, जो रिपोर्ट हुआ और जो अफ़वाह है, उन्हें अलग-अलग रखा है, क्योंकि इस क्षेत्र की सबसे महँगी ग़लती ऐसे मॉडल के इर्द-गिर्द योजना बनाना है जो अभी मौजूद ही नहीं है।
अंतिम अपडेट 3 September 2026। इसे क्रिसमस तक फिर अपडेट करना पड़ेगा।
TL;DR — 90 सेकंड में AI 2026 की स्थिति
फ़्रंटियर चार घोड़ों की दौड़ है और फ़िलहाल एग्रीगेट पर Anthropic जीत रहा है। 2 September 2026 तक, Artificial Analysis’s Intelligence Index v4.1.1 में Claude Fable 5.1 65.7 पर, Claude Opus 5 63.0 पर, Grok 4.6 60.9 पर और GPT-5.6 Sol 58.9 पर है। लेकिन एग्रीगेट दिलचस्प हिस्से को छिपाता है: GPT-5.6 Sol BrowseComp पर 90.4% के साथ आगे है, Gemini 3.8 Flash प्रति मिलियन इनपुट टोकन $0.75 पर 58.7 देता है, और टॉप दस मॉडलों के बीच सिर्फ़ 8.2 अंकों का फ़ासला है — इतनी कम दूरी कि हार्नेस और प्रॉम्प्ट के अंतर से कोई मॉडल कई स्थान ऊपर-नीचे हो सकता है।
ओपन-वेट मॉडल लगभग एक जनरेशन पीछे हैं और अंतर पाट रहे हैं। GLM-5.3 (753B, ओपन) 59.5 पर है — कुल छठे स्थान पर, GPT-5.6 Sol से आगे। DeepSeek V4 Pro असली MIT लाइसेंस के तहत 1.6 ट्रिलियन पैरामीटर के साथ आया। Ornith-1.5-397B ने SWE-bench Verified पर 86 हासिल किया और Terminal-Bench 2.1 पर 86.1 बनाम 85.0 से Claude Opus 4.8 को पीछे छोड़ा। क्षमता का अंतर अब लगभग छह महीने का है। लाइसेंस का अंतर ही मायने रखता है।
“वाइब कोडिंग” ने अपनाए जाने की बहस जीत ली और सबूत की बहस हार गई। 90% डेवलपर्स काम पर कम से कम एक AI कोडिंग टूल इस्तेमाल करते हैं। एंटरप्राइज़ कोडिंग-एजेंट बाज़ार सालाना लगभग $10 अरब पर चल रहा है। और AI आउटपुट पर डेवलपर्स का भरोसा दो साल में 40% से 29% पर गिर गया। टूल्स सर्वव्यापी हैं, और उन्हें इस्तेमाल करने वाले हर साल उन पर कम भरोसा करते हैं। ये दोनों बातें तर्कसंगत हैं।
सुरक्षा का बिल आ चुका है और उसमें हर मद अलग-अलग लिखी है। Veracode ने पाया कि AI से बने 45% कोड सैंपल में OWASP Top 10 की कोई कमज़ोरी आती है। Apiiro ने नापा कि AI की मदद लेने वाले डेवलपर्स तीन से चार गुना तेज़ी से कमिट बनाते हैं और सुरक्षा संबंधी खामियाँ दस गुना तेज़ी से मिलती हैं। AI से बना लगभग 20% कोड ऐसे पैकेजों का ज़िक्र करता है जो मौजूद ही नहीं हैं। यह टूल्स के ख़िलाफ़ दलील नहीं है। यह इस बात की दलील है कि आप गेट कहाँ लगाते हैं।
ऑफ़लाइन AI इस साल उन हार्डवेयर पर सचमुच उपयोगी हो गया जो लोगों के पास पहले से है। एक 2 अरब पैरामीटर वाला मॉडल iPhone पर 61 टोकन प्रति सेकंड चलता है। Microsoft ने 14B का रीज़नर Windows में 40-TOPS NPU की शर्त के पीछे रखा। Google अपने सबसे अच्छे ऑन-डिवाइस मॉडल को 12 GB RAM की शर्त के पीछे रखता है, और Apple भी। ऑफ़लाइन क्या चला सकते हैं, यह तय करने वाली स्पेसिफ़िकेशन मेमोरी है, कंप्यूट नहीं, और मेमोरी ही वह चीज़ है जो कम पड़ गई।
AI 2026 की स्थिति पर ईमानदार एक पंक्ति: यह वह साल है जब मॉडल अब अड़चन नहीं रहे। अड़चन वेरिफ़िकेशन बन गया। इस लेख का हर अहम फ़ैसला — कौन सा मॉडल, कौन सा हार्नेस, कौन सा डिवाइस, कौन सा गेट — उसी एक बदलाव का नतीजा है।
तुरंत तुलना: फ़्रंटियर, September 2026
Artificial Analysis Intelligence Index v4.1.1 नौ मूल्यांकनों को जोड़ता है: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience और AA-LCR। नीचे दिए स्कोर 2 September 2026 के स्नैपशॉट हैं।
| मॉडल | लैब | AA इंडेक्स | वेट | प्रति 1M इनपुट / आउटपुट |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | क्लोज़्ड | $10.00 / $50.00 |
| Claude Opus 5 | Anthropic | 63.0 | क्लोज़्ड | $5.00 / $25.00 |
| Claude Fable 5 | Anthropic | 62.1 | क्लोज़्ड | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | क्लोज़्ड | — |
| Kimi K3 | Moonshot | 59.7 | ओपन वेट | — |
| GLM-5.3 | Z.ai | 59.5 | ओपन वेट | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | क्लोज़्ड | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | क्लोज़्ड | $0.75 / $3.75 | |
| Qwen3.8 Max Preview | Alibaba | 58.1 | क्लोज़्ड | — |
| GLM-5.3-Flash | Z.ai | 57.5 | ओपन वेट | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropic | 57.3 | क्लोज़्ड | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | क्लोज़्ड | — |
| GPT-5.5 | OpenAI | 56.3 | क्लोज़्ड | — |
तीसरे से पहले चौथा कॉलम पढ़ें। टॉप दस में से दो मॉडलों के वेट डाउनलोड करने लायक हैं, और उनमें से एक की क़ीमत प्रति मिलियन इनपुट टोकन $0.15 है।
तुरंत तुलना: ओपन-वेट फ़्रंटियर
| मॉडल | कुल / सक्रिय | कॉन्टेक्स्ट | लाइसेंस | रिलीज़ |
|---|---|---|---|---|
| Kimi K3 | 2.8T / 104B | 1M | रेवेन्यू-टियर वाला (कस्टम) | July 2026 |
| Qwen3.8-2.4T-A95B | 2.4T / 95B | 262K (YaRN के ज़रिए 1M) | Apache 2.0 | 14 Aug 2026 |
| DeepSeek V4 Pro | 1.6T / 49B | 1M | MIT | 12 Aug 2026 |
| GLM-5.3 | 753B / ~40B | 1M | कस्टम ($10B गेट) | Aug 2026 |
| MiniMax M3 | 428B / 23B | 1M | कस्टम (एट्रिब्यूशन) | 1 जून 2026 |
| Ornith-1.5-397B | 397B MoE | 262K (YaRN के ज़रिए 1M) | MIT | Aug 2026 |
| Gemma 4 31B | 31B डेंस | 256K | Apache 2.0 | 6 Apr 2026 |
| Qwen3.8-27B | 27B डेंस | 262K | Apache 2.0 | 14 Aug 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 Apr 2026 |
उन नौ में से तीन सचमुच OSI-क्लीन हैं। 2026 में ओपन वेट की असली कहानी यही है, और मैं भाग तीन में इस पर लौटूँगा।
भाग I — मॉडल
भाग एक: 2026 में असल में क्या शिप हुआ
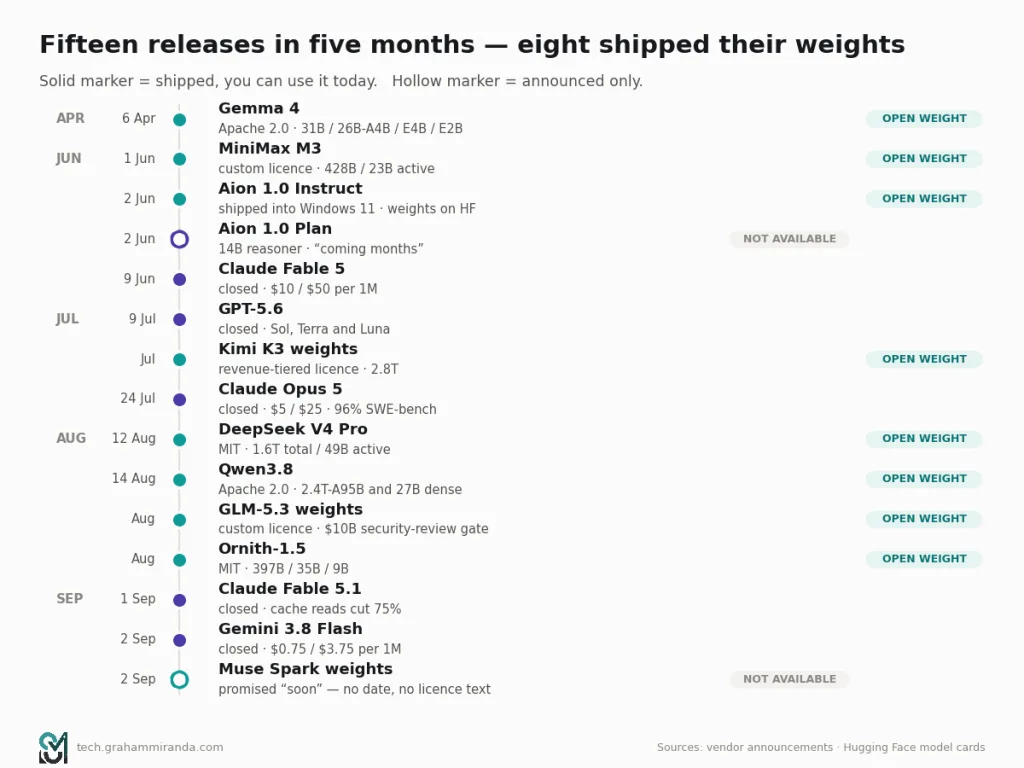
किसी भी दलील से पहले, बहीखाता। मैं इसे तीन श्रेणियों में बाँट रहा हूँ क्योंकि इनके बीच का अंतर ही वह जगह है जहाँ पैसा बर्बाद होता है।
पुष्ट और शिप हो रहा
- 6 April 2026 — Google ने Gemma 4 जारी किया Apache 2.0 के तहत, जो Gemma 3’s के अलग-थलग नियमों से लाइसेंस बदलाव है। चार वेरिएंट: 31B डेंस, 4B सक्रिय के साथ 26B (MoE), ~8B पर E4B, और 5.1B कुल में 2.3B सक्रिय के साथ E2B। बड़े मॉडलों पर 256K कॉन्टेक्स्ट, E-सीरीज़ पर 128K। सभी टेक्स्ट, इमेज और वीडियो इनपुट का समर्थन करते हैं; E2B और E4B नेटिव ऑडियो जोड़ते हैं।
- 1 June 2026 — MiniMax M3। 428B कुल / 23B सक्रिय, 1M कॉन्टेक्स्ट, नेटिव मल्टीमॉडैलिटी, एक नया स्पार्स अटेंशन ऑपरेटर, Hugging Face पर वेट। इसकी विस्तृत चर्चा मेरे लोकल AI हार्डवेयर पर पहले के लेख में है।.
- 2 June 2026 — Microsoft ने Build में Aion 1.0 की घोषणा की। ऑन-डिवाइस मॉडलों का एक परिवार सीधे Windows 11 में शिप हुआ: Aion 1.0 Instruct (CPU पर चलने योग्य, Edge Canary में 150.0.4070 से) और Aion 1.0 Plan, 32K कॉन्टेक्स्ट विंडो वाला 14 अरब पैरामीटर का रीज़निंग और टूल-कॉलिंग मॉडल।
- 9 June 2026 — Claude Fable 5। Anthropic’s टॉप टियर, प्रति मिलियन $10/$50, 1M कॉन्टेक्स्ट, 128K अधिकतम आउटपुट।
- 9 July 2026 — OpenAI ने GPT-5.6 शिप किया तीन वेरिएंट में: Sol ($5/$30), Terra ($2.50/$15) और Luna ($1/$6)। साइबर क्षमता अलग मॉडल के रूप में बेचने के बजाय Sol में बनाई गई है, और OpenAI’s Trusted Access for Cyber कार्यक्रम के ज़रिए बेहतर पहुँच मिलती है।
- July 2026 — Moonshot ने Kimi K3’s के वेट खोले। 2.8 ट्रिलियन पैरामीटर, 1M कॉन्टेक्स्ट, नेटिव MXFP4, रेवेन्यू-टियर वाले लाइसेंस के तहत।
- 24 July 2026 — Claude Opus 5। $5/$25, Opus 4.8 से अपरिवर्तित। Anthropic का दावा है कि यह Frontier-Bench v0.1 पर Opus 4.8’s के प्रदर्शन को “दोगुने से भी अधिक” करता है और ARC-AGI 3 पर अगले सबसे अच्छे मॉडल से तीन गुना स्कोर करता है।
- 12 August 2026 — DeepSeek V4 Pro प्रीव्यू से बाहर आया MIT-लाइसेंस वाले वेट के साथ: 1.6T कुल (कुछ कवरेज इसे 1.7T तक गोल करते हैं), 49B सक्रिय, 1M कॉन्टेक्स्ट, BF16 और FP8 टेंसर में 893 GB, साथ में एक DSpark स्पेक्युलेटिव डिकोडिंग मॉड्यूल। Terminal-Bench 2.1 पर 87.9, HLE-with-tools पर 60.0, CyberGym पर 83.3। DeepSeek ने साथ ही API की क़ीमतें बढ़ा दीं।
- 14 August 2026 — Qwen3.8 के ओपन वेट Apache 2.0 के तहत: एक 27B डेंस मल्टीमॉडल मॉडल और एक 2.4T-A95B विशाल मॉडल, दोनों Hugging Face और ModelScope पर, 262K नेटिव कॉन्टेक्स्ट जो YaRN के साथ 1M तक बढ़ाया जा सकता है।
- August 2026 — GLM-5.3 के वेट API लॉन्च के लगभग दो हफ़्ते बाद Hugging Face पर आते हैं। 753B MoE, 1M कॉन्टेक्स्ट, 128K आउटपुट, BF16 और FP8।
- August 2026 — Ornith-1.5। तीन स्केल (397B MoE, 3B सक्रिय के साथ 35B MoE, 9B डेंस), Qwen3.5 और Gemma 4 पर निरंतर प्रीट्रेनिंग के साथ बने, MIT लाइसेंस वाले, और SWE-bench Verified पर 86 का दावा करते हैं।
- 1 September 2026 — Claude Fable 5.1 और Mythos 5.1। डिफ़ॉल्ट रूप से एडाप्टिव थिंकिंग चालू, 1M कॉन्टेक्स्ट, 128K आउटपुट। बेस प्राइसिंग $10/$50 पर अपरिवर्तित, लेकिन कैश रीड्स 75% घटकर प्रति मिलियन $1.00 से $0.25 हो गईं।
- 2 September 2026 — Gemini 3.8 Flash $0.75/$3.75 पर, 1M इनपुट कॉन्टेक्स्ट, 66K आउटपुट, March 2026 ज्ञान कटऑफ़, टेक्स्ट, इमेज, वीडियो, ऑडियो और PDF इनपुट के साथ।
- 2 September 2026 — Meta ने Muse Spark 1.3 शिप किया और Muse Code CLI।
रिपोर्टेड, विश्वसनीय, अपुष्ट
- Meta Muse Spark’s के वेट “जल्द ही।” खोलेगा। यह X पर Mark Zuckerberg का बयान है, जिसमें कोई तारीख़, पैरामीटर संख्या, आर्किटेक्चर का ब्यौरा या लाइसेंस टेक्स्ट नहीं है। Meta ने किसी भी वर्ज़न में मॉडल का आकार नहीं बताया है।
- Gemini Nano v4 को Android के लिए आने वाला बताया गया है, जबकि Nano v3 फ़िलहाल Pixel 10 सीरीज़ तक सीमित है।
- Aion 1.0 Plan सामान्य उपलब्धता के लिए “आने वाले महीनों में” है; सिर्फ़ Instruct प्रीव्यू में है।
अफ़वाह, एक ही स्रोत, उसी हिसाब से लें
- अगले Anthropic, OpenAI या Google फ़्लैगशिप के बारे में आपने जो कुछ पढ़ा है। ऐसे बाज़ार में जहाँ चार लैब्स ने नौ हफ़्तों की अवधि में टॉप-टेन मॉडल शिप किया, आगे की अफ़वाहों की हाफ़-लाइफ़ लगभग दो हफ़्ते होती है।
एक और बात ध्यान देने योग्य है, क्योंकि यह नई है और सुरक्षा क्षेत्र के बाहर लगभग कोई इस पर चर्चा नहीं कर रहा। Claude Mythos 5.1 Terminal-Bench 4.0 पर 60.9 स्कोर करता है — Fable 5.1’s के 55.8 से ज़्यादा — और SWE-bench Verified पर 95.5%। इसे आप ख़रीद नहीं सकते।
Anthropic Mythos को “साइबरसुरक्षा और जीव विज्ञान अनुसंधान के लिए अपना सबसे सक्षम मॉडल” बताता है, और यह केवल सत्यापित साइबरडिफ़ेंडर्स और जीव वैज्ञानिकों को दो ट्रस्टेड-एक्सेस कार्यक्रमों के ज़रिए उपलब्ध है: Cyber Verification Program और Life Sciences Verification Program। Anthropic के अपने शब्दों में वे “इसे केवल अमेरिकी संगठनों के एक सेट को उपलब्ध करा सकते हैं, हालाँकि हम पहुँच बढ़ाने पर काम कर रहे हैं।” पहुँच बढ़ाने वाली परियोजना Project Glasswing लगभग पंद्रह से ज़्यादा देशों के 150 संगठनों तक June 2026 तक पहुँच चुकी थी।
तर्क यह है कि यह डुअल-यूज़ है — जो मॉडल कमज़ोरियाँ खोजने में शानदार है, वह दोनों पक्षों के लिए उन्हें खोजने में शानदार है — और मुझे लगता है कि यह उचित है। लेकिन इसका ढाँचागत नतीजा देखें, क्योंकि यह सचमुच नया है: किसी सार्वजनिक कोडिंग बेंचमार्क पर सबसे ज़्यादा स्कोर करने वाला मॉडल अब वह है जिस तक दुनिया का ज़्यादातर हिस्सा किसी भी क़ीमत पर पहुँच नहीं सकता। व्यावसायिक कारणों के बजाय सुरक्षा कारणों से क्षमता को गेट करना कम नहीं, ज़्यादा आम होगा, और अगर आप अमेरिका से बाहर हैं तो यह ओपन वेट की परवाह करने की ऐसी दलील है जिसका लागत से कोई लेना-देना नहीं।
छवि दिखाएँ नौ महीने, बारह अहम रिलीज़ें, जिनमें चार ओपन वेट। ठोस बार वेट या API एक्सेस के साथ शिप हो चुके हैं जो आप आज ख़रीद सकते हैं; बिंदुदार रूपरेखाएँ घोषित लेकिन अनुपलब्ध हैं।
भाग दो: अब फ़्रंटियर मॉडलों को असल में क्या अलग करता है
उस लीडरबोर्ड के शीर्ष के बारे में असहज सच यह है: ज़्यादातर असली काम में, टॉप आठ मॉडल एक-दूसरे की जगह ले सकते हैं।
मैं यह बात उलटी राय जताने के लिए नहीं कह रहा। मैं यह इसलिए कह रहा हूँ क्योंकि Claude Fable 5.1 के 65.7 और GLM-5.3-Flash के 57.5 के बीच एग्रीगेट इंडेक्स का अंतर आठ अंक है, और GLM-5.3-Flash की क़ीमत प्रति मिलियन इनपुट टोकन $0.15 है जबकि Fable’s की $10.00 है। यह कंपोज़िट स्कोर पर 12% क्षमता अंतर के लिए 67× क़ीमत का अंतर है, और कंपोज़िट स्कोर ठीक उन्हीं अंतरों को दबा देते हैं जो आपके लिए मायने रखते हैं और जो नहीं रखते उन्हें बढ़ा-चढ़ा दिखाते हैं।
तो काम का सवाल यह नहीं है कि “कौन सा मॉडल सबसे अच्छा है।” सवाल यह है कि “हर एक असल में किसमें सबसे अच्छा है, और क्या वह मेरे हफ़्ते से मेल खाता है।”
चार बातें जो सचमुच अलग हैं
1. लंबी अवधि की एजेंटिक विश्वसनीयता। यह 2026 का असली विभेदक है और इसे बुरी तरह नापा जाता है। Anthropic’s Opus 5 को स्पष्ट रूप से “लंबे समय तक चलने वाले एजेंट्स को चलाने वाले Opus टियर के लिए एक बड़े कदम जैसा सुधार” बताया गया है — ज़्यादा स्मार्ट मॉडल के रूप में नहीं, बल्कि ऐसे मॉडल के रूप में जो छठे घंटे पर नहीं गिरता। इस तरह के सुधार का सबूत ज्ञान के बेंचमार्कों के बजाय एजेंटिक बेंचमार्कों (Terminal-Bench, OSWorld, Frontier-Bench) में है, और वे बेंचमार्क नए, शोरगुल वाले और स्कैफ़ोल्ड के प्रति संवेदनशील हैं।
2. कैश की अर्थव्यवस्था। Fable 5.1’s की मुख्य बदलाव क्षमता में छलांग नहीं था। वह कैश रीड्स को 75% घटाना था, प्रति मिलियन टोकन $1.00 से $0.25 तक — जिसे MarkTechPost आम वर्कफ़्लो के लिए लगभग 25% और एजेंटिक वर्कफ़्लो के लिए 45% तक कम लागत बताता है। जो भी एजेंट हर टर्न पर बड़ा सिस्टम प्रॉम्प्ट या कोडबेस दोबारा पढ़ता है, उसके लिए मासिक बिल पर मॉडल के चुनाव से बड़ा लीवर कैश प्राइसिंग है। कोई इसे लीडरबोर्ड पर नहीं रखता।
3. ब्राउज़िंग और टूल का इस्तेमाल। GPT-5.6 Sol BrowseComp पर 90.4% स्कोर करता है — Ultra रीज़निंग सेटिंग पर 92.2%। यह एक ख़ास, प्रकाशित ताकत है, और अगर आपका वर्कलोड कोड-और-वेरिफ़ाई के बजाय रिसर्च-और-सिंथेसिस है, तो यह एग्रीगेट इंडेक्स के दो अंकों से ज़्यादा क़ीमती है।
4. पर्याप्त जवाब की क़ीमत। Gemini 3.8 Flash का $0.75 इनपुट पर 58.7 इंडेक्स, क्लोज़्ड फ़्रंटियर के मुक़ाबले बोर्ड पर सबसे स्पष्ट रूप से ग़लत क़ीमत वाली चीज़ है। GLM-5.3-Flash का $0.15 पर 57.5 तो बिल्कुल ही सबसे स्पष्ट ग़लत क़ीमत वाली चीज़ है।
प्राइसिंग टेबल, क्योंकि असली फ़ैसला यही है
| मॉडल | इनपुट /1M | आउटपुट /1M | कैश्ड इनपुट /1M | कॉन्टेक्स्ट |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M / 128K आउट |
| Claude Opus 5 | $5.00 | $25.00 | — | 1M / 128K आउट |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1M / 128K आउट |
| GLM-5.3 | $1.40 | $4.40 | — | 1M / 128K आउट |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1M / 66K आउटपुट |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1M |
| Muse Spark (Contributors) | $0.10 | $0.20 | $0.002 | — |
आखिरी पंक्ति पर एक बार फिर नज़र डालनी चाहिए। Meta’s Contributors टियर की कीमत इनपुट $0.10 और आउटपुट $0.20 है — साथ में ट्रेनिंग के लिए आपके डेटा तक संभावित पहुँच। यह कीमत नहीं, एक सौदा है। और जहाँ तक मैं बता सकता हूँ, बहुत सारे सस्ते इन्फ़रेंस के नीचे जो असली बिज़नेस मॉडल है, उसकी यह सबसे ईमानदार अभिव्यक्ति है — और मुझे यह किसी DPA में दबे होने से बेहतर प्राइसिंग टेबल में लिखी हुई लगती है।
छवि दिखाएँ एक अक्ष पर इंटेलिजेंस, दूसरे पर लॉग स्केल में कीमत। चार्ट के ऊपर और नीचे के बीच सिर्फ़ आठ इंडेक्स अंक हैं; कीमतों के बीच 67× का फ़ासला है। एफ़िशिएंट फ़्रंटियर नीचे-दाएँ कोने में है, और वहाँ लगभग कोई नहीं खरीदता।
वह API ब्रेकेज जिसकी चेतावनी किसी ने नहीं दी
Fable 5.1 तीन ब्रेकिंग बदलावों के साथ आया: फ़ोर्स्ड टूल यूज़ हट गया, थिंकिंग ब्लॉक अब हर मॉडल के लिए अलग हैं, और बातचीत के बीच में सिस्टम मैसेज या टूल्स में किया गया बदलाव अब चुपचाप स्वीकार होने की जगह एरर देता है।
तीसरा बदलाव बहुतों को चुभेगा। बहुत सारे एजेंट हार्नेस टर्न के बीच सिस्टम प्रॉम्प्ट या टूल की सूची बदल देते हैं — कोई सबटास्क शुरू होने पर टूल जोड़ना, कॉन्टेक्स्ट बचाने के लिए निर्देश छोटे करना। Fable 5.1 पर यह अब एरर है। अगर आप किसी कॉन्फ़िग फ़ाइल में मॉडल ID अपग्रेड करते हैं और आपका एजेंट चौथे टर्न पर 400 एरर देने लगे, तो वजह यही है।
आम सबक, जो इस खास सबक से ज़्यादा क़ीमती है: 2026 में मॉडल अपग्रेड एक API माइग्रेशन है। अपनी मॉडल ID ऐसे लिखें कि एक बदलना एक लाइन का काम हो, और उन्हें पिन कर दें। एक तिमाही के अंदर आपको यह बदलाव फिर करना पड़ेगा।
भाग तीन: ओपन-वेट फ़्रंटियर, और लाइसेंस का जाल
2026 की कहानी का यह हिस्सा मुझे सचमुच रोमांचक लगता है, और यही वह हिस्सा भी है जहाँ मार्केटिंग सबसे ज़्यादा भटकाती है।
क्षमता का अंतर लगभग छह महीने का है
देखिए जून और अगस्त 2026 के बीच ओपन वेट ने क्या हासिल किया:
- DeepSeek V4 Pro: कुल 1.6T, सक्रिय 49B, MIT लाइसेंस, Terminal-Bench 2.1 पर 87.9। यह इस साल प्रकाशित ज़्यादातर क्लोज़्ड मॉडल्स के आँकड़े से ऊँचा Terminal-Bench आँकड़ा है।
- Ornith-1.5-397B: SWE-bench Verified पर 86, Terminal-Bench 2.1 पर Claude Opus 4.8 के 85.0 के मुक़ाबले 86.1, और GPQA Diamond पर 92.8। MIT लाइसेंस, 262K नेटिव कॉन्टेक्स्ट जिसे YaRN के साथ लगभग 1M तक बढ़ाया जा सकता है। Qwen3.5 और Gemma 4 के ऊपर कंटीन्यूड प्री-ट्रेनिंग और पोस्ट-ट्रेनिंग के साथ बनाया गया।
- GLM-5.3: Artificial Analysis इंडेक्स पर 59.5 के साथ छठे स्थान पर, GPT-5.6 Sol से आगे।
- Qwen3.8: Apache 2.0 के तहत 2.4 ट्रिलियन पैरामीटर वाला मॉडल, साथ में 27B का डेंस मल्टीमॉडल सिबलिंग जिसके बारे में Alibaba का कहना है कि वह कोडिंग और ऑफ़िस के कामों में बड़े Qwen3.7-Plus से बेहतर है।
छह महीने पहले ईमानदार ढाँचा यह था कि “ओपन वेट एक पीढ़ी पीछे हैं और सस्ते हैं।” वह ढाँचा अब ग़लत है। सही ढाँचा यह है: खास तौर पर कोडिंग और एजेंटिक काम के लिए, सबसे अच्छे ओपन-वेट मॉडल पिछली पीढ़ी के क्लोज़्ड फ़्रंटियर के एरर बार्स के भीतर हैं, और वे 10× से 60× तक सस्ते हैं।
Ornith-1.5 इस साल का सबसे दिलचस्प मॉडल है और लगभग किसी ने इसका नाम नहीं सुना
मैं इस पर थोड़ा रुकना चाहता हूँ, क्योंकि यह सिर्फ़ स्केलिंग का नतीजा नहीं, सचमुच नई चीज़ है।
Ornith, 1.5 को “सेल्फ़-स्कैफ़ोल्डिंग को एंड-टू-एंड सेल्फ़-इम्प्रूवमेंट लूप तक बढ़ाने” के रूप में बताता है। सीधे शब्दों में: सिस्टम खुद अपने नए ट्रेनिंग टास्क सुझाता है, उनके लिए टास्क-विशेष स्कैफ़ोल्ड बनाता है, सॉल्यूशन रोलआउट तैयार करता है, और तीनों को GRPO के साथ मिलकर ऑप्टिमाइज़ करता है। ज़्यादा मज़बूत मॉडल इसे और कठिन टास्क सुझाने देते हैं; बेहतर स्कैफ़ोल्ड बेहतर रणनीतियाँ खोजते हैं; बेहतर आउटपुट साफ़ लर्निंग सिग्नल देते हैं।
इसे Qwen3.5 और Gemma 4 के ऊपर ट्रेन किया गया है — यानी दूसरों के ओपन वेट पर — और यह Terminal-Bench 2.1 पर Claude Opus 4.8 को हराता है, जबकि खुद 397B पैरामीटर का और MIT लाइसेंस वाला है।
अगर वह लूप आम हो जाता है, तो यह इस लेख का सबसे असरदार नतीजा है, क्योंकि इसका मतलब है कि ओपन इकोसिस्टम बिना किसी लैब के प्री-ट्रेनिंग रन पर फ़्रंटियर-स्तर का पैसा ख़र्च किए बेहतर हो सकता है। अगर यह आम नहीं होता — अगर जो हम देख रहे हैं वह खुद से बनाए गए करिकुलम से आई बेंचमार्क-विशेष ओवरफ़िटिंग है — तो यह ठीक उसी चीज़ के बारे में एक चेतावनी-कथा है। मुझे नहीं पता कि इनमें से कौन-सा है। और जहाँ तक मैं बता सकता हूँ, Ornith के बाहर किसी को भी नहीं पता। इस पर दाँव लगाने से पहले मैं जो चाहूँगा: ऐसे टास्क पर स्वतंत्र मूल्यांकन जो खुद से बने करिकुलम के आसपास के भी न हों, और एक अलग रखा गया मानव बेसलाइन। इनमें से कुछ भी अभी मौजूद नहीं है।
अब लाइसेंस, क्योंकि “ओपन सोर्स” यहाँ बहुत बेईमानी का काम कर रहा है
यहाँ यह है कि वे वेट आपसे दायित्वों के रूप में असल में क्या माँगते हैं:
| मॉडल | लाइसेंस | पेच |
|---|---|---|
| DeepSeek V4 Pro | MIT | कोई नहीं। सचमुच ओपन सोर्स। |
| Qwen3.8 | Apache 2.0 | कोई नहीं। सचमुच ओपन सोर्स। |
| Gemma 4 | Apache 2.0 | कोई नहीं — और Gemma 3 की अलग बनी शर्तों के मुक़ाबले सचमुच सुधार। |
| Ornith-1.5 | MIT | कोई शर्त नहीं बताई गई। शिप करने से पहले मॉडल कार्ड खुद जाँचें। |
| GLM-5.3 | Custom | जिन कंपनियों की सालाना कमाई $10B से ज़्यादा है, उन्हें Z.ai का पास करना होगा सिक्योरिटी रिव्यू किसी भी कमर्शियल इस्तेमाल से पहले। Z.ai हट गए इस रिलीज़ में MIT से। |
| Kimi K3 | Custom | कमाई के स्तर के हिसाब से; हाई-वॉल्यूम प्रोवाइडर्स के लिए स्पष्ट एट्रिब्यूशन ज़रूरी। |
| MiniMax M3 | Custom | कमर्शियल इस्तेमाल के लिए स्पष्ट “Built with MiniMax M3” एट्रिब्यूशन ज़रूरी; इससे ऊपर अलग लिखित अनुमति $20M सालाना कमाई। |
| Muse Spark | अज्ञात | “जल्द आ रहा है” के रूप में घोषित। कोई लाइसेंस टेक्स्ट मौजूद नहीं है। |
तीन बातें। इनमें से पहले तीन की बारीक शर्तें मैंने विस्तार से यहाँ देखी थीं Kimi K3 vs Fable 5.1 vs GLM-5.3, इसलिए यहाँ मैं सिर्फ़ उसी पर रहूँगा जो तब से बदला है।
पहली बात, ये गेट्स हाइपरस्केलर्स के लिए हैं, आपके लिए नहीं। $10 अरब कमाई की सीमा इस लेख के लगभग हर पाठक को बाहर रखती है। अगर आप जर्मन Mittelstand व्यवसाय, कोई एजेंसी, कंसल्टेंसी या अकेले डेवलपर हैं, तो GLM-5.3 और Kimi K3 के लिए व्यावहारिक जवाब है: आप ठीक हैं।
दूसरी बात, “आप ठीक हैं” और “आपकी कानूनी समीक्षा ठीक है” एक बात नहीं है। कस्टम लाइसेंस का मतलब है कि इसे पढ़ने के लिए कोई आपसे बिल करता है। MIT या Apache 2.0 लाइसेंस का मतलब है कि कोई इसे नब्बे सेकंड में पढ़कर आगे बढ़ जाता है। एंटरप्राइज़ खरीद में यह अंतर बेंचमार्क के चार अंकों से ज़्यादा क़ीमती है, और किसी कमर्शियल प्रोडक्ट में GLM-5.3 की जगह DeepSeek V4 Pro और Qwen3.8 चुनने की यह सबसे मज़बूत एकल दलील है।
तीसरी बात, रुझान की दिशा देखें। Z.ai GLM-5.2 पर MIT से हटकर GLM-5.3 पर सिक्योरिटी-रिव्यू गेट वाले मालिकाना लाइसेंस पर आ गया। DeepSeek उलटी दिशा में गया और API कीमतें बढ़ाने के साथ MIT बनाए रखा — जो एक सुसंगत रणनीति है: सुविधा का पैसा लो, वेट मुफ़्त दो, और इन्फ़रेंस प्रोवाइडर्स को सर्विंग में मुक़ाबला करने दो। ओपन वेट कोई आंदोलन नहीं हैं। वे एक कमर्शियल रणनीति हैं, और रणनीतियाँ हर रिलीज़ के साथ बदलती हैं। ऐसी प्रोडक्ट आर्किटेक्चर मत बनाइए जो मान ले कि अगले साल का वर्ज़न इस साल वाला लाइसेंस लेकर आएगा।
मॉडल्स के लिए “ओपन सोर्स” शब्द को रिटायर कर देना चाहिए
इनमें से कोई भी उस अर्थ में ओपन सोर्स नहीं है जो OSI का है, सिवाय MIT और Apache 2.0 वालों के — और वे भी ट्रेनिंग डेटा या ट्रेनिंग कोड जारी किए बिना सिर्फ़ वेट जारी करते हैं, जो ओपन-सोर्स सॉफ़्टवेयर से बहुत अलग बात है।
मैं जो शब्दावली इस्तेमाल करता हूँ, और जिसका सुझाव दूँगा:
- ओपन वेट — आप पैरामीटर डाउनलोड कर सकते हैं और चला सकते हैं। शर्तों के बारे में कुछ नहीं कहता।
- खुला लाइसेंस — MIT, Apache 2.0 या बराबर का। कोई कमाई-गेट नहीं, एट्रिब्यूशन की कोई अनिवार्यता नहीं, इस्तेमाल के क्षेत्र पर कोई रोक नहीं।
- ओपन सोर्स — वेट, ट्रेनिंग कोड और डेटा की संरचना, OSI-स्वीकृत लाइसेंस के तहत। फ़्रंटियर पर लगभग कुछ भी इस कसौटी पर खरा नहीं उतरता।
अगर कोई विक्रेता “ओपन सोर्स मॉडल” कहता है और उसका मतलब पहला ही हो, तो वह ठीक-ठीक झूठ नहीं है, लेकिन यह वैसी ढीली बात है जो खरीद दस्तावेज़ में पहुँचकर फिर विवाद बन जाती है।
छवि दिखाएँ क्षमता एक-दूसरे के क़रीब आ रही है। लाइसेंस दूर जा रहे हैं। ज़्यादातर कमर्शियल खरीदारों के लिए खरीद का फ़ैसला दाएँ वाला कॉलम करता है, स्कोर नहीं।
भाग चार: बेंचमार्क की समस्या
SWE-bench Verified अब ऐसा दिखता है:
| रैंक | मॉडल | स्कोर |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
ऊपर तीन मॉडल एक प्रतिशत अंक के भीतर हैं। वह बेंचमार्क ख़त्म हो चुका है। यह Opus 5, Mythos 5 और Fable 5 के बीच के फ़र्क़ के बारे में कुछ काम का नहीं बता सकता, और सितंबर 2026 में इसे खरीदारी का आधार बताने वाला कोई भी व्यक्ति एक संतृप्त औज़ार का हवाला दे रहा है।
अभी AI मूल्यांकन की आम हालत यही है, और इसमें चार विफलताएँ हैं जिनके नाम लेने लायक हैं:
संतृप्ति। जब शीर्ष स्कोर 90% से ऊपर झुंड बना लेते हैं, तो बचे हुए अंतर पर क्षमता से ज़्यादा लेबल के शोर और हार्नेस की बारीकियों का राज होता है। SWE-bench Verified वहाँ पहुँच चुका है। GPQA Diamond भी क़रीब है।
स्कैफ़ोल्ड के प्रति संवेदनशीलता। वही मॉडल इस पर अलग स्कोर करता है कि उसके चारों ओर कौन-सा एजेंट लूप लपेटा गया है — रीट्राई नीति, टूल सेट, कॉन्टेक्स्ट मैनेजमेंट, उसे कितने टर्न मिलते हैं। Terminal-Bench और OSWorld के नतीजे इसके प्रति खास तौर पर संवेदनशील हैं। एक ही बेंचमार्क की रिपोर्ट करने वाली दो लैब्स अक्सर एक ही प्रयोग नहीं चला रही होतीं।
संदूषण। हर सार्वजनिक बेंचमार्क आख़िरकार ट्रेनिंग कॉर्पोरा में रिस जाता है। जवाब नए, कठिन, निजी बेंचमार्क की होड़ रहा है — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science — जो संदूषण सुलझाता है और नई समस्या बनाता है: किसी निजी बेंचमार्क को आप स्वतंत्र रूप से सत्यापित नहीं कर सकते।
चयन। लैब्स वही बेंचमार्क प्रकाशित करती हैं जिनमें वे जीतती हैं। Anthropic ने Opus 5 के लिए Frontier-Bench और ARC-AGI-3 को आगे रखा। OpenAI ने GPT-5.6 के लिए Agents’ Last Exam और Coding Agent Index को आगे रखा। Z.ai ने CyberGym को आगे रखा। उनमें से कोई झूठ नहीं बोल रहा। सब चुन रहे हैं।
सितंबर 2026 में मैं असल में किस पर भरोसा करता हूँ
एकल के बजाय समग्र। Artificial Analysis के इंडेक्स की खूबी यह है कि इसे कोई तीसरा पक्ष चलाता है, एक तय हार्नेस पर, नौ मूल्यांकनों में, 190 मॉडल्स पर। इसके पूर्ण आँकड़ों का अर्थ कम है; इसकी क्रम-व्यवस्था उपलब्ध सबसे ठोस सार्वजनिक संकेत है।
लागत के हिसाब से सामान्यीकृत नतीजे। इसे कैसे पेश करना चाहिए, इसका अच्छा उदाहरण Anthropic के खुद के Opus 5 दावे हैं: CursorBench 3.2 पर “आधी लागत में Fable 5 के शिखर स्कोर के 0.5% के भीतर”, और OSWorld 2.0 पर Fable 5 को “एक-तिहाई लागत में” हराना। यह काम का दावा है क्योंकि यह सौदे का नाम लेता है।
टोकन दक्षता। Artificial Analysis ने नोट किया कि Gemma 4 31B ने पूरा Intelligence Index पूरा करने में सिर्फ़ 39 मिलियन आउटपुट टोकन लिए। एजेंटिक काम के लिए, जो मॉडल एक-तिहाई टोकन में वही जवाब देता है, उसका बिल भी एक-तिहाई और लेटेंसी भी एक-तिहाई है। इस पर कम रिपोर्टिंग होती है और यह उन गिने-चुने मीट्रिक्स में से है जो सीधे पैसे में बदलता है।
आपके अपने इवैल्स। आपके असली बैकलॉग से बीस टास्क, तीन मॉडल्स पर चलाए गए, और आपके द्वारा स्कोर किए गए। इसमें एक दोपहर लगती है। यह इस लेख के सारे लीडरबोर्ड्स से मिलाकर ज़्यादा बताएगा, और यही एकमात्र मूल्यांकन है जो परिभाषा से ही असंदूषित है।
और एक चीज़ जिस पर मैं भरोसा नहीं करता: बिना हार्नेस, बिना क्वांटाइज़ेशन और बिना तारीख़ बताया गया कोई भी अकेला टोकन-प्रति-सेकंड या बेंचमार्क आँकड़ा। इन्हें परिमाण-क्रम के दावे मानें।
भाग पाँच: वह आँकड़ा जो असल में हिला — एजेंटिक टाइम होराइज़न
अगर इस लेख से आप सिर्फ़ एक मीट्रिक लें, तो यही लें।
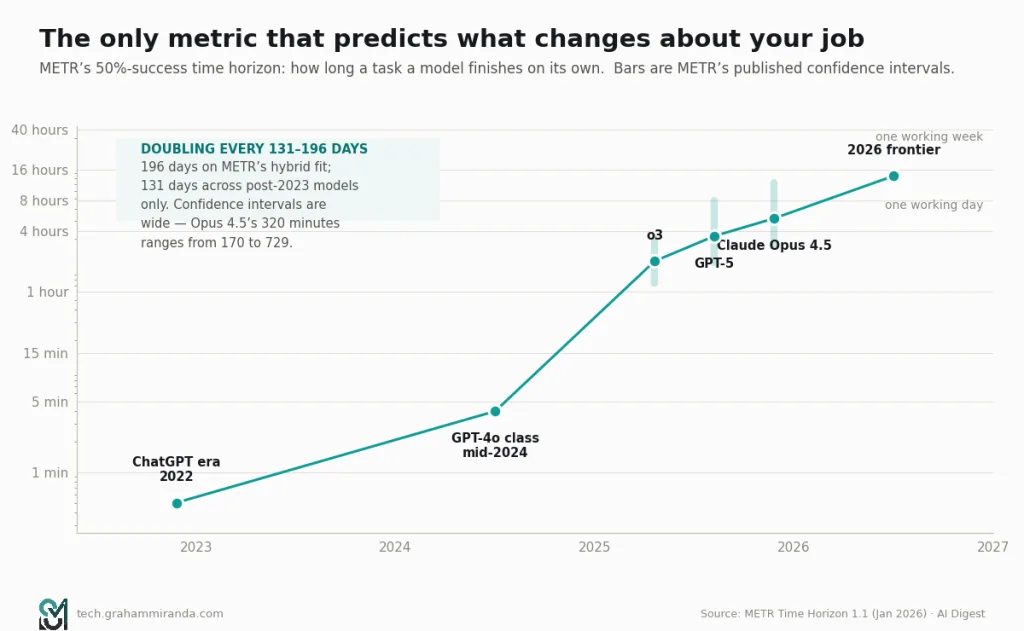
METR उस टास्क की लंबाई नापता है — इंसानी घंटों में — जिसे कोई मॉडल 50% सफलता के साथ खुद पूरा कर सकता है। “क्या यह चीज़ मेरा काम कर सकती है” का यह किसी भी ज्ञान-बेंचमार्क से बेहतर अनुमान है, क्योंकि यह उस चीज़ को पकड़ता है जो असल में विफल होती है: जवाब न आना नहीं, बल्कि वहाँ तक पहुँचने के लिए ज़रूरत भर देर तक एकसाथ जुड़े रहना।
प्रक्षेप, METR के खुद के काम और AI Digest की उसकी ट्रैकिंग से:
| अवधि | 50% सफलता वाला टाइम होराइज़न |
|---|---|
| 2022 (ChatGPT लॉन्च के दौर) | ~30 सेकंड |
| 2024 का मध्य (GPT-4o श्रेणी) | ~4 मिनट |
| 2025 का अंत (Claude Opus 4.5) | 320 मिनट (~5.3 घंटे), CI [170, 729] |
| 2026 फ़्रंटियर | 14+ घंटे |
डबलिंग टाइम ही विवादित हिस्सा है। 29 जनवरी 2026 को METR की Time Horizon 1.1 रिलीज़ — 228 टास्क, जिनमें 31 का अनुमान इंसानी मेहनत के आठ या अधिक घंटे, जिन्हें UK AI Security Institute के Inspect फ़्रेमवर्क पर ले जाया गया — बताती है 196 दिन (7 महीने) पुराने और नए डेटा के मिश्रण पर, लेकिन 131 दिन जब सिर्फ़ 2023 के बाद के मॉडल्स पर सीमित किया जाए, जो पिछली कार्यप्रणाली के 165 दिनों से लगभग 20% तेज़ है।
एक्सपोनेंशियल का एक्सट्रापोलेशन करना ही लोगों के शर्मिंदा होने का तरीका है, इसलिए इस आँकड़े का इस्तेमाल करने से पहले मैं सावधानियाँ ज़ोर से बता देता हूँ।
सावधानियाँ बड़ी हैं। METR के खुद के कॉन्फ़िडेंस इंटरवल बहुत बड़े हैं — Opus 4.5 के 320 मिनट के होराइज़न की सीमा 170 से 729 मिनट है। उनके 31 लंबे टास्क में से सिर्फ़ 5 के इंसानी बेसलाइन मापे गए हैं; बाकी अनुमान हैं। टास्क की संरचना नापे गए ट्रेंड को बदल देती है। और “साफ़ माहौल में अच्छी तरह तय किए गए टास्क पर 50% सफलता” और “आपके कोडबेस पर, आपके कभी-कभी फ़ेल होने वाले टेस्ट सूट और आपकी बिना दस्तावेज़ वाली डिप्लॉयमेंट प्रक्रिया के साथ 50% सफलता” में बहुत फ़ासला है।
यह सब कहने के बाद भी, दिशा पर संदेह नहीं है और परिमाण लगभग सही है। एक्सट्रापोलेशन के हिसाब से, फ़्रंटियर एजेंट 2027 में लगभग एक कार्यदिवस की स्वायत्त टास्क-लंबाई और 2028 में लगभग एक कार्य-सप्ताह तक पहुँचते हैं।
यही आँकड़ा क्यों मायने रखता है
क्योंकि यही एकमात्र मीट्रिक है जो बताता है कि आपकी नौकरी में क्या बदलेगा।
4 मिनट के होराइज़न वाला मॉडल ऑटोकम्प्लीट है। आप लगातार लूप में रहते हैं, और मॉडल की गुणवत्ता तय करती है कि सुझाव कितने अच्छे होंगे।
5 घंटे के होराइज़न वाला मॉडल वह सहकर्मी है जिसे आप सुबह ब्रीफ़ करते हैं और दोपहर के खाने के समय रिव्यू करते हैं। आप लूप में नहीं हैं; आप उसके अंत में हैं। मॉडल की गुणवत्ता तय करती है कि रिव्यू कितनी बार तकलीफ़देह होगा।
40 घंटे के होराइज़न वाला मॉडल ऐसी चीज़ है जिसके लिए हमारे पास कोई मैनेजमेंट ढाँचा नहीं है। आप एक हफ़्ते के ऐसे काम का रिव्यू कर रहे होंगे जो होते हुए आपने नहीं देखा, ऐसे कोडबेस में जो आपके देखते-देखते बदल गया, उस स्पेसिफ़िकेशन के ख़िलाफ़ जो आपने तब लिखा था जब आपको पता भी नहीं था कि समस्याएँ क्या होंगी।
इस लेख के बाकी हिस्से की हर बहस — वाइब कोडिंग पर, वेरिफ़िकेशन पर, यह कि बाधा कहाँ है — असल में इसी पर है कि वह आँकड़ा जैसे-जैसे चढ़ेगा, क्या होगा। मॉडल्स लॉन्ग-होराइज़न हो गए। हमारी रिव्यू प्रक्रियाएँ नहीं हुईं।
छवि दिखाएँ 50% सफलता वाला टाइम होराइज़न, जिसमें METR के कॉन्फ़िडेंस इंटरवल ईमानदारी से दिखाए गए हैं। ये इंटरवल इतने चौड़े हैं कि मायने रखते हैं — और ट्रेंड फिर भी इनके पार बना रहता है।
अध्याय दो — वाइब कोडिंग का भविष्य
भाग छह: “वाइब कोडिंग” का अब क्या मतलब है
Andrej Karpathy ने यह शब्द फ़रवरी 2025 में कुछ खास और थोड़ा शरारती अर्थ में गढ़ा था: वाइब्स के आगे हार मान लेना, भूल जाना कि कोड मौजूद है, बिना पढ़े diffs स्वीकार करना, और मॉडल को गाड़ी चलाने देना। यह एक ऐसा मोडथा, जो आधे मज़ाक में, उन फेंकने लायक वीकेंड प्रोजेक्ट्स के लिए पेश किया गया।
अठारह महीने बाद यह वाक्यांश पूरा जीवनचक्र देख चुका है। यह पहले आंदोलन बना, फिर नौकरी का पद, फिर गाली, फिर Collins का वर्ड ऑफ़ द ईयर, फिर वेंचर फ़ंडिंग की एक श्रेणी, और अब — जो एकमात्र बदलाव असल में मायने रखता है — इंजीनियरिंग प्रैक्टिसेस का एक ऐसा समूह, जो अब Karpathy के बताए से मेल नहीं खाता।
मैं इस बँटवारे पर साफ़ रहना चाहता हूँ, क्योंकि ये दोनों चीज़ें लगातार एक में मिला दी जाती हैं और इनके जोखिम बिल्कुल उलटे हैं।
वाइब कोडिंग, मूल अर्थ में। प्रॉम्प्ट दें, स्वीकारें, चलाएँ, फिर प्रॉम्प्ट दें। diff मत पढ़ें। नतीजा फेंकने लायक है। यह सचमुच शानदार है, और मैं हफ़्ते में कई बार करता हूँ — किसी CSV को नया आकार देने वाली स्क्रिप्ट, एक बार चलने वाले स्क्रैपर, ऐसी विज़ुअलाइज़ेशन जिसे मैं एक ही बार देखूँगा, या ऐसे प्रोटोटाइप के लिए जिसका एकमात्र काम किसी बातचीत को ठोस बनाना है। इसकी पहचान रफ़्तार नहीं है। पहचान यह है कि इस पर कभी कोई निर्भर नहीं होगा।
एजेंटिक इंजीनियरिंग, मौजूदा अर्थ में। स्पेसिफ़िकेशन लिखें। एजेंट को टेस्ट सूट, लिंटर, टाइप चेकर और सैंडबॉक्स दें। उसे एक घंटे चलने दें। diff ठीक से रिव्यू करें। किसी इंसानी PR जैसे ही गेट्स के पीछे मर्ज करें। पहचान यह है कि मॉडल के आउटपुट को किसी जूनियर सहकर्मी के आउटपुट की तरह माना जाता है — काम का, तेज़, और भरोसेमंद नहीं।
इन दोनों में तकनीक एक है और लगभग कुछ और साझा नहीं। अगर आपको दूसरे का प्रैक्टिशनर-स्तर वाला संस्करण चाहिए, तो वह 2026 में वाइब कोडिंग पर मेरा पुराना लेख इसी पर है; यह हिस्सा इस बारे में है कि यह प्रैक्टिस किस दिशा में जा रही है। भाग आठ के विनाशकारी नतीजे सब इसी से आते हैं कि पहले मोड की आदतें दूसरे मोड के दाँव पर लगा दी जाएँ।
अपनाने के आँकड़े बहुत बड़े हैं और ज़्यादातर विवाद में नहीं हैं
- 90% डेवलपर्स काम पर कम से कम एक AI टूल इस्तेमाल करते हैं, JetBrains के AI Pulse सर्वे (जनवरी 2026) के मुताबिक़। Stack Overflow के 2025 सर्वे में 84% इस्तेमाल कर रहे थे या करने की योजना बना रहे थे।
- लगभग 80% नए GitHub डेवलपर्स अपने पहले हफ़्ते में Copilot अपना लेते हैं (GitHub Octoverse 2025)।
- 59% डेवलपर्स तीन या ज़्यादा AI कोडिंग टूल एक साथ इस्तेमाल करते हैं। यह आँकड़ा आपको अपनाने के आँकड़े से ज़्यादा बताता है — बाज़ार एकजुट नहीं हुआ, वह टास्क-विशेष टूल्स में बिखर गया है।
बाज़ार के आँकड़े
| टूल | मीट्रिक | स्रोत / तारीख़ |
|---|---|---|
| GitHub Copilot | यूज़र बेस के हिसाब से ~42% हिस्सा; 20M+ यूज़र | Gartner / विक्रेता, 2026 |
| Cursor | $2B+ ARR; 1M+ डेली एक्टिव यूज़र; कमाई के हिसाब से बाज़ार का ~20–25% | रिपोर्ट किया गया, फ़रवरी 2026 |
| Claude Code | ~$2.5B रन-रेट; 46% “सबसे पसंदीदा” बनाम Cursor के 19% | रिपोर्ट किया गया, अप्रैल 2026 |
| एंटरप्राइज़ कोडिंग-एजेंट बाज़ार | ~$9.8–11B सालाना | Gartner, अप्रैल 2026 |
दो बातें उभरकर सामने आती हैं। Copilot के पास यूज़र हैं और शीर्ष तीन में सबसे कम संतुष्टि। Claude Code का इंस्टॉल बेस सबसे छोटा है और स्नेह सबसे ज़्यादा। यह बदलाव के बीच में खड़े बाज़ार की पहचान है — मौजूदा खिलाड़ी ने डिस्ट्रिब्यूशन जीता, चैलेंजर ने वर्कफ़्लो जीता, और यूज़र अभी पूरी तरह पलटे नहीं हैं।
और वह आँकड़ा जो इस सब को काट देता है
AI आउटपुट पर डेवलपर्स का भरोसा 2024 के लगभग 40% से गिरकर 2026 में 29% हो गया। SonarSource के एक अलग सर्वे में पाया गया कि 96% डेवलपर्स AI से बने कोड को कार्यात्मक रूप से सही होने पर पूरा भरोसा नहीं करते।
इस पर ठहरकर सोचें। इस्तेमाल बढ़ा। भरोसा घटा। ये विरोधाभासी नहीं हैं; परिपक्व टूल अपनाने की तस्वीर ऐसी ही होती है। कोई चेनसॉ पर “भरोसा” नहीं करता। लोग उसे लगातार इस्तेमाल करते हैं, दोनों हाथों से, सुरक्षा पहनकर, और कभी उसकी ओर पीठ नहीं करते।
इन टूल्स को सबसे अच्छी तरह समझने वाले ही इनसे सबसे ज़्यादा सतर्क रहते हैं। यह एक स्वस्थ संकेत है, और ज़्यादातर विक्रेता मार्केटिंग में यह पूरी तरह ग़ायब है।
भाग सात: क्या यह सचमुच आपको तेज़ बनाता है? सबूत, ईमानदारी से
यहीं मैं कुछ पाठक खो देता हूँ, और मैं उन्हें यहाँ खोना बेहतर समझता हूँ बजाय उन्हें भटकाने के।
रैंडमाइज़्ड ट्रायल कहता है नहीं
METR ने जुलाई 2025 में वही अध्ययन किया जिसका सब हवाला देते हैं: अनुभवी ओपन-सोर्स डेवलपर्स, अपनी ही परिपक्व रिपॉज़िटरीज़ (1M+ लाइनें) पर काम करते हुए, टास्क के स्तर पर रैंडमाइज़ किए गए कि 2025 की शुरुआत के AI टूल्स इस्तेमाल करें या न करें।
नतीजा: AI के साथ 19% धीमे।
और सुर्ख़ी से ज़्यादा मायने रखने वाली बात: डेवलपर्स का मानना था कि वे लगभग 20% तेज़ हुए थे। उन्होंने अपने समय पर AI के असर का आकलन लगभग 40 प्रतिशत अंक ज़्यादा लगाया।
2026 के फ़ॉलो-अप ने इसे सुलझाया नहीं — उसने कुछ और बुरा दिखाया
METR ने प्रयोग दोबारा चलाने की कोशिश की और फ़रवरी 2026 में एक असामान्य रूप से साफ़दिल पोस्ट प्रकाशित की कि डिज़ाइन क्यों टूटा।
- भर्ती विफल रही। डेवलपर्स बढ़ती संख्या में AI की पहुँच के बिना काम करने से मना कर रहे हैं, $50 प्रति घंटा मिलने पर भी।
- टास्क का चयन संदूषित था। 30–50% डेवलपर्स ने माना कि वे ऐसे टास्क से बचते रहे जिन्हें AI अच्छी तरह कर लेगा ऐसा उन्हें लगता था। एक प्रतिभागी ने इसे बिल्कुल सही कहा: “मैं ऐसे इश्यू से बचता हूँ जहाँ AI चीज़ें सिर्फ़ 2 घंटे में ख़त्म कर सकता है, लेकिन मुझे 20 घंटे लगाने पड़ते हैं।”
- समय की ट्रैकिंग काम करनी बंद हो गई जब डेवलपर्स एक साथ कई एजेंट चलाने लगे।
उनके 2026 के कच्चे अंतरिम आँकड़े −18% से −4% तक थे — अब भी धीमे, पर कम नाटकीय ढंग से — लेकिन METR खुद इसे चयन-पूर्वाग्रह को देखते हुए “सिर्फ़ बहुत कमज़ोर सबूत” बताते हैं।
दूसरे बिंदु को फिर पढ़ें, क्योंकि पूरी साहित्य-सामग्री में सबसे दिलचस्प निष्कर्ष वही है और वह एक कार्यप्रणाली-टिप्पणी में दबा हुआ है। अगर डेवलपर्स व्यवस्थित रूप से AI-अनुकूल टास्क को हट गए AI के फ़ायदे को नापने वाले अध्ययन से बाहर कर देते हैं, तो अध्ययन फ़ायदे को कम आँकेगा। इसका यह भी मतलब है कि असल ज़िंदगी में डेवलपर्स यह रूटिंग पहले से कर रहे हैं — और यही व्यवहार इन टूल्स को क़ीमती बनाता है और RCT चलाना मुश्किल।
सर्वे कहते हैं हाँ, बहुत ज़्यादा, और वे बढ़ा-चढ़ाकर हैं
METR के मई 2026 सर्वे (n=349: 87 सॉफ़्टवेयर इंजीनियर, 71 शोधकर्ता, 129 शिक्षाविद और पीएचडी छात्र, 48 फ़ाउंडर और मैनेजर; औसतन 12 साल का प्रोग्रामिंग अनुभव, 19 महीने का AI टूल इस्तेमाल) ने एक चतुर काम किया। उसने यह अंतर निकाला — मूल्य से रफ़्तार.
औसत उत्तरदाता ने बताया 3× रफ़्तार गुणक लेकिन सिर्फ़ अपने काम के मूल्य में 1.4–2× बदलाव। पीछे मुड़कर देखने पर उन्होंने मार्च 2025 में 1.3× मूल्य का अनुमान लगाया; वे मार्च 2027 तक 2.5× का पूर्वानुमान करते हैं।
METR साफ़ कहता है कि सर्वे डिज़ाइनरों को असल में value वाली संख्या से ही मतलब होता है, और जवाब देने वाले स्वाभाविक रूप से गति में सोचते हैं — और यही वह पूर्वाग्रह है जिसे 2025 के RCT ने 40 प्रतिशत अंकों में मापा।
तो: स्व-रिपोर्ट 3× कहती है। लोग असल में क्या कहना चाहते हैं, उसके हिसाब से सुधारी गई स्व-रिपोर्ट 1.4–2× कहती है। हमारे पास जो एक नियंत्रित माप है, वह 0.81× कहता है।
संगठनात्मक डेटा कहता है “यह आप पर निर्भर है, टूल पर नहीं”
DORA की 2026 रिपोर्ट (Google Cloud, मई 2026) इस साल इस विषय पर छपी सबसे उपयोगी चीज़ है, और यह इसलिए उपयोगी है कि यह टूल पर बहस करना बंद कर देती है।
- पहले साल का अनुमानित ROI 39% 500 लोगों की इंजीनियरिंग संस्था के लिए, लगभग 8 महीने में निवेश वसूली के साथ — $8.4M के निवेश के मुकाबले $11.6M का मूल्य।
- A J-कर्व: उत्पादकता बढ़ने से पहले गिरती है, जिसकी वजह वर्कफ़्लो में अनुकूलन, कोड रिव्यू में सत्यापन की लागत, और टेस्टिंग तथा अप्रूवल गेट में आगे होने वाले बदलाव हैं।
- चेंज फेल्योर रेट 5% से 6% तक बढ़ना अपनाने के बाद, जिससे उनके नमूना गणना में $344,000 की डाउनटाइम लागत आई।
- और मुख्य तर्क: “AI निवेश पर सबसे बड़ा रिटर्न टूल से नहीं, बल्कि उसके पीछे के संगठनात्मक सिस्टम पर रणनीतिक ध्यान देने से आता है।”
अगर 2026 में कोई आम सहमति है, तो वह वही आख़िरी पंक्ति है। AI आपकी इंजीनियरिंग प्रैक्टिस जो भी है, उसी को बढ़ाता है। अच्छे टेस्ट, सच्चा कोड रिव्यू, तेज़ रोलबैक, साफ़ जवाबदेही — AI ऐसे संगठनों को वाकई तेज़ बनाता है। कमज़ोर टेस्ट, नाममात्र का रिव्यू, मैन्युअल डिप्लॉय, धुँधली जवाबदेही — AI ऐसे संगठनों को और तेज़ी से और ज़्यादा मात्रा में फेल कराता है।
इन सबको कैसे साथ मिलाएँ
मुझे नहीं लगता कि ये निष्कर्ष वाकई आपस में टकराते हैं। मैं जिस तालमेल पर पहुँचा हूँ वह यह है, और मैं इसे ढीले ढंग से थामे हुए हूँ:
AI कोडिंग टूल अपरिचित काम में बड़ा फ़ायदा और गहराई से जाने-पहचाने काम में छोटा नुकसान हैं। जिस कोडबेस को आप अंदर तक जानते हैं, जिस भाषा में आप धाराप्रवाह हैं, और जो समस्या आप पहले हल कर चुके हैं, वहाँ आप रिव्यू-और-सुधार के लूप से तेज़ हैं। किसी अपरिचित फ़्रेमवर्क पर, साल में दो बार इस्तेमाल होने वाली भाषा पर, बॉयलरप्लेट पर, टेस्ट स्कैफ़ोल्डिंग पर, माइग्रेशन पर, या ऐसे कोडबेस पर जिसे आपने आठ महीने से नहीं खोला — वहाँ मॉडल कायापलट कर देता है।
METR ने अनुभवी डेवलपर्स को उनके ही परिपक्व रिपॉज़िटरी में पढ़ा — यानी ठीक वही परिदृश्य जहाँ आप सबसे कम फ़ायदे का अनुमान लगाते। इससे निष्कर्ष ग़लत नहीं हो जाता। यह बस विशिष्ट हो जाता है, और इससे आपको उन लोगों पर शक करना चाहिए जो इसे किसी भी दिशा में सामान्य फ़ैसला बताकर पेश करते हैं।
दूसरा तालमेल: फ़ायदे असली हैं, पर वे वहाँ नहीं पड़ते जहाँ लोग उन्हें ढूँढते हैं। यह नहीं कि “यह फ़ीचर छह के बजाय चार घंटे में बन गया।” बल्कि कुछ ऐसा: जिस माइग्रेशन को प्राथमिकता कभी नहीं मिलनी थी, वह हो गया; जो टेस्ट कवरेज हमेशा 40% पर अटका रहने वाला था, वह 75% हो गया; डॉक्युमेंटेशन मौजूद है। ये बातें टास्क पूरा होने के समय वाले अध्ययन में नहीं दिखतीं, और असली मूल्य का बड़ा हिस्सा यही है।
भाग आठ: सुरक्षा का बिल आ चुका है, और वह मद-वार है
अगर भाग सात असहज था, तो यह वह भाग है जिसे लोग छोड़ देते हैं। कृपया इसे न छोड़ें।
मापन
Veracode ने Java, Python, C# और JavaScript के 80 कोडिंग टास्क पर 100 से ज़्यादा लार्ज लैंग्वेज मॉडल जाँचे:
- 45% AI-जनित कोड नमूनों में OWASP Top 10 की कोई कमज़ोरी आती है। 2026 की शुरुआत तक पास रेट लगभग वही रहा — मॉडल बहुत होशियार हुए, ज़्यादा सुरक्षित नहीं।
- Java सबसे ख़राब रहा, 72% फेल्योर रेट के साथ।
- 86% क्रॉस-साइट स्क्रिप्टिंग से बचाव में फेल हुए। 88% लॉग इंजेक्शन के प्रति संवेदनशील थे।
Apiiro ने दिसंबर 2024 से जून 2025 तक Fortune 50 के एंटरप्राइज़ रिपॉज़िटरी पर अपना Deep Code Analysis इंजन चलाया:
- AI की मदद लेने वाले डेवलपर्स अपने साथियों की तुलना में तीन से चार गुना ज़्यादा दर से कमिट करते हैं।
- वे सुरक्षा समस्याएँ दस गुना ज़्यादा दर से पैदा करते हैं।
- प्रिविलेज एस्केलेशन के रास्ते 322% बढ़े। आर्किटेक्चरल डिज़ाइन की खामियाँ 153% बढ़ीं।
USENIX Security 2025 ने 576,000 AI-जनित कोड नमूनों का विश्लेषण किया:
- करीब 20% ऐसे पैकेजों का ज़िक्र करते हैं जो मौजूद ही नहीं हैं।
- 43% हैलुसिनेटेड पैकेज नाम मिलते-जुलते प्रॉम्प्ट पर लगातार दोहराए जाते हैं — और यही वह हिस्सा है जो एक बग को हमले की सतह बना देता है। अनुमान लगाने लायक हैलुसिनेशन एक ऐसा स्लॉट है जिसे हमलावर npm या PyPI पर पहले से रजिस्टर कर सकता है।
Georgia Tech का Vibe Security Radar ने git इतिहास से पीछे जाकर CVEs ट्रेस किए और उन्हें AI टूलिंग से जोड़ा:
| महीना (2026) | जोड़े गए CVEs |
|---|---|
| जनवरी | 6 |
| फ़रवरी | 15 |
| मार्च | 35 |
कुल 74 पुष्ट, और शोधकर्ताओं का अनुमान है कि ओपन सोर्स में असली आँकड़ा पाँच से दस गुना ज़्यादा है.
RedAccess ने लगभग इनकी पहचान की — 380,000 सार्वजनिक रूप से सुलभ वाइब-कोडेड एप्लिकेशन Lovable, Base44, Replit और Netlify पर। इनमें से करीब 5,000 संवेदनशील कॉर्पोरेट या निजी डेटा लीक कर रहे थे।
घटनाएँ, तारीख़ के साथ
| तारीख़ | इंसीडेंट |
|---|---|
| जुलाई 2025 | Replit AI ने प्रोडक्शन डेटाबेस मिटा दिया; 1,200 एग्ज़ीक्यूटिव रिकॉर्ड प्रभावित, 4,000 फ़र्ज़ी अकाउंट बन गए |
| फ़रवरी 2026 | Lovable से बने EdTech ऐप ने 18,697 यूज़र रिकॉर्ड उजागर किए, जिनमें 4,538 छात्र अकाउंट शामिल |
| अप्रैल 2026 | Lovable में BOLA कमज़ोरी — नवंबर 2025 से पहले का हर प्रोजेक्ट पाँच API कॉल में पहुँच में |
| 26 अप्रैल 2026 | Cursor की “9 सेकंड में सफ़ाया”: कंपनी का डेटाबेस उसके बैकअप समेत मिट गया |
| 30 अप्रैल 2026 | CI वर्कफ़्लो में Gemini CLI की CVSS-10 रिमोट कोड एग्ज़ीक्यूशन, पैच हो गई |
Amazon का मामला, जिसे मैं सावधानी से संभालूँगा
आपने Amazon की ख़बर देखी होगी। दिसंबर 2025 से मार्च 2026 के बीच चार Sev-1 घटनाएँ — चीन में 13 घंटे की AWS Cost Explorer आउटेज, 2 मार्च को शॉपिंग कार्ट में ग़लत डिलीवरी समय जिससे कथित तौर पर करीब 120,000 ऑर्डर प्रभावित हुए, और 5 मार्च की 6 घंटे की घटना जिसमें उत्तर अमेरिकी ऑर्डर कथित रूप से 99% गिर गए।
Financial Times, Fortune और The Register की रिपोर्टिंग ने Amazon के आंतरिक दस्तावेज़ों को उन चीज़ों से जोड़ा जिन्हें “Gen-AI assisted changes” कहा गया, साथ में चेतावनी कि तेज़ कोड जनरेशन कमज़ोरियाँ उजागर कर रहा था। Amazon ने सीधे कारण-संबंध को चुनौती दी है, और कुछ जवाबों में कहा है कि किसी भी घटना में AI से लिखा कोड शामिल नहीं था।
मैं इस ख़बर को तथ्य की तरह दोहराने के बजाय इसके तीन पहलू रेखांकित कर रहा हूँ:
- सबसे ज़्यादा उद्धृत प्रभाव आँकड़ा (63 लाख खोए ऑर्डर) किसी Medium पोस्ट से आता है, Amazon या किसी नामित मीडिया की अपनी रिपोर्टिंग से नहीं। इसे अनुमान मानें, संख्या नहीं।
- 5 मार्च का डिप्लॉयमेंट कथित तौर पर बिना औपचारिक डॉक्युमेंटेशन या अप्रूवल के चला गया. यह प्रोसेस की विफलता है। AI की गति ने इसे संभव बनाया तेज़ी से होने दिया; अप्रूवल गेट को वैकल्पिक नहीं बनाया।
- यही अंतर पूरी बात है, और इसीलिए मैं इस ख़बर को शामिल कर रहा हूँ। विफलता की वजह लगभग कभी “AI ने ख़राब कोड लिखा” नहीं होती। वह यह होती है कि “AI ने कोड उस प्रोसेस से तेज़ लिखा जिसे उसे जाँचना था।”
इसका प्रैक्टिस पर असल में क्या मतलब है
“टूल इस्तेमाल करना बंद कर दें” नहीं। कोई गंभीर आदमी ऐसा नहीं कह रहा, और CSA का अपना रिसर्च नोट — जो ऊपर की ज़्यादातर बातें जमा करता है — परहेज़ के बजाय गवर्नेंस से शुरू होता है।
व्यवहारिक रूप, उसी क्रम में जिसमें मैं इसे लागू करूँगा:
- क्रेडेंशियल तक पहुँच रखने वाले किसी भी AI टूल को प्रिविलेज्ड सिस्टम मानें। वह है भी। उसके टोकन उसी हिसाब से सीमित रखें।
- हर कमिट पर SAST, डिपेंडेंसी स्कैनिंग और सीक्रेट डिटेक्शन। रात में एक बार नहीं। हर कमिट पर। कमिट दर तीन से चार गुना बढ़ गई है; अब रात में होने वाला स्कैन असल में तीन दिन का फ़ीडबैक लूप बन जाता है।
- सॉफ़्टवेयर कंपोज़िशन एनालिसिस, ख़ास तौर पर हैलुसिनेटेड पैकेजों के लिए। यह सूची का सबसे सस्ता और सबसे ज़्यादा मूल्य देने वाला नियंत्रण है, क्योंकि 20% का आँकड़ा बहुत बड़ा है और विफलता बहुत ख़ामोश होती है।
- एक लिखित नीति कि ऑथेंटिकेशन, क्रिप्टोग्राफ़ी, ऑथराइज़ेशन या पेमेंट कोड में AI की मदद बिना रिव्यू के इस्तेमाल नहीं होगी। ये चार ऐसे क्षेत्र हैं जहाँ बारीक ग़लती की संभावना भी है और वह तबाही भी लाती है, और जहाँ रिव्यूअर की नज़र सबसे ज़्यादा काम आती है।
- अपने SBOM को बढ़ाएँ ताकि वह AI टूल की उत्पत्ति दर्ज करे। जब अगला Georgia-Tech जैसा एट्रिब्यूशन अध्ययन आपके कोडबेस पर आए, तो आप ख़ुद उस सवाल का जवाब दे पाना चाहेंगे।
- तृतीय-पक्ष वाइब-कोडिंग प्लेटफ़ॉर्म को SaaS वेंडर मानें। RedAccess के आँकड़े वही हैं जो तब होता है जब कोई यह नहीं करता।
इसमें कुछ भी अनोखा नहीं है। इसका ज़्यादातर हिस्सा वही है जो 2019 में एक सक्षम टीम कर रही थी। बदलाव यह है कि मात्रा एक ऑर्डर ऑफ़ मैग्निट्यूड बढ़ गई, इसलिए नियंत्रण सांस्कृतिक नहीं, अपने-आप चलने वाले होने चाहिए।
छवि दिखाएँ सुरक्षा डेटा — Veracode, Apiiro, USENIX और Georgia Tech से। आकार पर ध्यान दें: कमिट की रफ़्तार 3–4× बढ़ी, सुरक्षा समस्याएँ 10× बढ़ीं। इन दो गुणकों के बीच का अंतर ही पूरी समस्या है।
भाग नौ: वाइब कोडिंग की जगह क्या आया
2026 में जो प्रैक्टिस वाकई काम करती है, उसका एक नाम है — कई मुकाबिल नाम, और इसी से पता चलता है कि यह असली है — और यह लगभग वाइब्स के उलट है।
इसे कहें स्पेक-ड्रिवन डेवलपमेंट, एजेंटिक इंजीनियरिंग, या कॉन्टेक्स्ट इंजीनियरिंग. आम ढाँचा:
1. अब स्पेसिफ़िकेशन ही सोर्स कोड है
कोई Jira टिकट नहीं। एक असली दस्तावेज़: चीज़ क्या करती है, क्या नहीं करनी चाहिए, इंटरफ़ेस क्या हैं, “पूरा होना” कैसा दिखता है, विफलता के तरीके क्या हैं। रिपॉज़िटरी में कमिट, वर्ज़न किया हुआ, रिव्यू किया हुआ।
यह 1998 की ओर वापसी लगती है, पर है नहीं। फ़र्क यह है कि 1998 में स्पेक किसी इंसान के लिए इनपुट होता था जो उसे फिर से अपने ढंग से समझता, और कोडिंग शुरू होते ही वह सड़ने लगता। 2026 में स्पेक ऐसी प्रोसेस का इनपुट है जो लागू करने का हिस्सा सस्ते में फिर से बना देती है — यानी ज़रूरतें बदलें तो आप स्पेक बदलते हैं और दोबारा निकाल लेते हैं, न कि ऐसे कोड को पैच करते हैं जो अब अपने किसी लिखित विवरण से मेल नहीं खाता।
अर्थशास्त्र पलट गया। जब लागू करना महँगा और स्पेक सस्ता था, तो आप ढीला स्पेक लिखते और कोड में निवेश करते थे। जब लागू करना सस्ता है और स्पेक ही अड़चन है, तो आप स्पेक में निवेश करते हैं।
2. टेस्ट सूट ही भरोसे की सीमा है
जो एजेंट आपके टेस्ट चला सकता है और उनके हिसाब से दोहरा सकता है, वह उस एजेंट से मूल रूप से अलग टूल है जो ऐसा नहीं कर सकता। यह वह एक बदलाव है जिसका सबसे ज़्यादा लाभ ज़्यादातर टीमें उठा सकती हैं, और इसका AI से कोई लेना-देना नहीं — बात यह है कि AI ने आख़िरकार उन लोगों को भी टेस्ट कवरेज के ROI का एहसास करा दिया जिन्हें कारीगरी वाली दलीलों से कभी क़ायल नहीं किया जा सकता था।
व्यवहारिक रूप: एजेंट को एक सैंडबॉक्स, एक टेस्ट कमांड, एक lint कमांड और एक टाइप चेक मिलता है, और जब तक चारों हरे न हों, काम पूरा नहीं माना जाता। बाक़ी सब पर बात हो सकती है।
3. रिव्यू लाइनों से डिफ़्स और फिर व्यवहार तक पहुँच गया
लाइन-दर-लाइन रिव्यू एजेंट के बनाए हज़ार लाइन के डिफ़ पर लागू नहीं होता, और इसके उलट दिखावा करना ही रबर-स्टैंपिंग की शुरुआत है।
इसके बजाय क्या काम करता है, लगभग मूल्य के क्रम में:
- स्पेक का रिव्यू करें, लागू करने का नहीं। अगर स्पेक सही है और टेस्ट पास हैं, तो लागू करना एक बारीकी है।
- डिफ़ का आकार देखें — कौन सी फ़ाइलें छुई गईं, कौन सी डिपेंडेंसी जोड़ी गईं, क्या मिटाया गया। एजेंट की ज़्यादातर आफ़तें इसी स्तर पर दिखती हैं: एक अनचाही फ़ाइल, एक नई डिपेंडेंसी, एक ऐसा डिलीशन जो किसी ने नहीं माँगा।
- सुरक्षा से जुड़ी लाइनों का ख़ास तौर पर रिव्यू करें। Auth, crypto, authz, पेमेंट, और PII को छूने वाली कोई भी चीज़। यह किसी भी डिफ़ का छोटा हिस्सा होता है।
- बॉयलरप्लेट का रिव्यू न करें। आप उसका रिव्यू वैसे भी कभी ठीक से करते ही नहीं थे।
4. हार्नेस उतना ही मायने रखता है जितना मॉडल
यह कम आँका जाता है। वही मॉडल, दो अलग एजेंट लूप में, बिल्कुल अलग गुणवत्ता का काम देता है — और इसीलिए लैब्स के बीच बेंचमार्क तुलनाएँ इतनी फिसलन भरी हैं।
मायने रखने वाले हिस्से: रन लंबा होने पर कॉन्टेक्स्ट कैसे संभाला जाता है, एजेंट अपने टेस्ट फेल्योर देख सकता है या नहीं, वह रिपॉज़िटरी ख़ुद देख सकता है या सिर्फ़ वही जो आप पेस्ट करें, उसके पास प्लान का चरण execution के चरण से अलग है या नहीं, और उसे पता है कि कब रुककर पूछना है।
Meta के Muse Spark 1.3 के रिलीज़ नोट्स ठीक इसी मुद्दे पर दिलचस्प हैं — वे बताते हैं कि मॉडल अब अस्पष्ट प्रॉम्प्ट पर स्पष्ट करने वाले सवाल पूछता है, अटकने पर मदद माँगता है, और बड़े नतीजे वाले कामों से पहले पुष्टि करता है। ये बुद्धिमत्ता में सुधार नहीं हैं। ये तमीज़ हैं, और तमीज़ ही वह चीज़ है जो लंबे समय तक चलने वाले एजेंट को टिकाऊ बनाती है।
5. मॉडल रूटिंग अब मानक प्रैक्टिस है
कोई गंभीर आदमी सब कुछ एक ही मॉडल से नहीं चलाता — मैंने इसका दो-मॉडल वाला रूप यहाँ समझाया था OpenCode में GLM-5.3-Flash बनाम MiniMax M3. जो पैटर्न अब तय हो चुका है:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
      "description": "Architecture, root cause, anything where being wrong is expensive",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation — long-horizon, cost-sensitive",
      "model": "anthropic/claude-opus-5"
    },
    "bulk": {
      "description": "High-volume mechanical work where price dominates",
      "model": "zai/glm-5-3-flash"
    },
    "private": {
      "description": "Anything touching client data — runs on hardware we own",
      "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
      "description": "Renames, docstrings, lint fixes, test scaffolding",
      "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
तर्क, एक-एक पंक्ति में:
- प्लानिंग सबसे सक्षम मॉडल को जाती है जो आप वहन कर सकते हैं। ख़राब प्लान आगे के टोकन में उससे ज़्यादा महँगा पड़ता है जितना वह प्लान ख़ुद कभी था।
- बनाने का काम सही दाम पर सबसे अच्छे लंबे-क्षितिज वाले मॉडल को जाता है। Opus 5, $5/$25 पर, साफ़ तौर पर इसी के लिए बनाया गया है और Fable के दाम का आधा है।
- थोक का यांत्रिक काम GLM-5.3-Flash को जाता है, $0.15/$0.47 पर, क्योंकि उस दाम पर सवाल यह नहीं कि वह उतना अच्छा है या नहीं, बल्कि यह कि वह उस ख़ास काम के लिए काफ़ी अच्छा है या नहीं। अक्सर होता है।
- जो भी निजी हो, लोकल जाता है, ऐसे मॉडल पर जो आपकी मशीन में फ़िट बैठे।
- छोटा-मोटा काम छोटे लोकल मॉडल को जाता है, क्योंकि चालीस फ़ाइलों में किसी सिंबल का नाम बदलने के लिए फ़्रंटियर रीज़निंग की ज़रूरत नहीं, और न ही उसे आपके लैपटॉप से बाहर जाने की ज़रूरत है।
मॉडल IDs ऐसे लिखें कि एक बदलना एक पंक्ति का काम हो। चूँकि जून और सितंबर के बीच चार लैब्स ने टॉप-10 मॉडल भेजे, आप यह बदलाव तिमाही के भीतर फिर करेंगे।
भाग दस: वाइब कोडिंग का भविष्य — छह भविष्यवाणियाँ, भरोसे के स्तर के साथ
भरोसे का स्तर बताए बिना भविष्यवाणियाँ मनोरंजन हैं। ये मेरी हैं, और साथ में यह कि मैं कितना दाँव लगाऊँगा।
1. शब्द मर जाएगा; प्रैक्टिस हमेशा के लिए दो हिस्सों में बँट जाएगी। ज़्यादा भरोसा।
“Vibe coding” पेशेवर माहौल में पहले ही गाली बनने लगा है और मार्केटिंग के सिवा कहीं गर्व का शब्द नहीं है। इसकी जगह एक साफ़ दो-स्तरीय बँटवारा आ रहा है: फेंकने लायक AI-जनित चीज़ें जिनमें कोई कोड पढ़ता ही नहीं (ठीक है, सही है, और करते रहें), और रिव्यू किया गया एजेंटिक इंजीनियरिंग जहाँ मॉडल का आउटपुट उन्हीं गेट्स से गुज़रता है जिनसे इंसान का (यह भी ठीक है, और सारा एंटरप्राइज़ पैसा यहीं है)।
ख़तरनाक बीच वाला हिस्सा — प्रोडक्शन कोड, बिना पढ़ा हुआ — वही है जिससे 2026 की घटनाओं की सूची बनी है, और व्यावसायिक संदर्भों में यह नियमों, बीमा या ऑडिट के दबाव में ख़त्म हो जाएगा। इसलिए नहीं कि कोई इसे बैन करता है, बल्कि इसलिए कि आख़िर में कोई सुरक्षा प्रश्नावली यह पूछ ही लेती है।
2. सत्यापन ही अड़चन बनेगा, और टूलिंग का पैसा उसी के पीछे जाएगा। ज़्यादा भरोसा।
हम वहाँ पहुँच चुके हैं और बाज़ार ने अभी दाम नहीं बदले। अगर एजेंट एक हफ़्ते का काम बना सकते हैं, तो अड़चन इंसान की यह क्षमता है कि वह साबित कर सके कि एक हफ़्ते का काम सही है।
2027 के दिलचस्प प्रोडक्ट इस बारे में होंगे जाँचने के बजाय बनाने: प्रॉपर्टी-आधारित टेस्ट जनरेशन, ऐसे सिमैंटिक डिफ़ टूल जो लाइन बदलने के बजाय व्यवहार बदलने का बखान करें, स्वचालित स्पेक-अनुपालन जाँच, एजेंट के कामों का रनटाइम सत्यापन, और — यही मैं बनाता — ऐसे टूल जो बताएँ कि बड़े डिफ़ का कौन सा 5% इंसान को सचमुच पढ़ना है।
3. फ़ॉर्मल मेथड्स का समय आएगा, बीस साल देर से। मध्यम भरोसा।
फ़ॉर्मल स्पेसिफ़िकेशन पर ऐतिहासिक आपत्ति यह थी कि स्पेक लिखना कोड लिखने से महँगा पड़ता है। वह आपत्ति अब ख़त्म है, क्योंकि कोड लिखना लगभग मुफ़्त है और स्पेक लिखना वैसे भी अड़चन है।
टाइप सिस्टम, कॉन्ट्रैक्ट, इनवेरिएंट, प्रॉपर्टी टेस्ट और हल्का फ़ॉर्मल वेरिफ़िकेशन — अचानक इनके पास एक ऐसा उपयोग है जो अपनी लागत निकाल देता है: ये मंशा के ऐसे बयान हैं जिन्हें मशीन जाँच सकती है और एजेंट उनके हिसाब से बिना इंसान के लूप में आए दोहरा सकता है। मुझे उम्मीद है कि Rust, TypeScript के सख़्त मोड और Python की कॉन्ट्रैक्ट लाइब्रेरी को इसका असामान्य रूप से ज़्यादा फ़ायदा मिलेगा।
मेरा भरोसा सिर्फ़ मध्यम क्यों है: यह क्षेत्र 1985 से लगभग हर सात साल में फ़ॉर्मल मेथड्स के पुनर्जागरण की भविष्यवाणी करता आया है।
4. लोकल मॉडल छोटे-मोटे काम की पूरी परत खा जाएँगे। मध्यम-से-ज़्यादा भरोसा।
देखें कि Apache 2.0 पर एक 27B मॉडल अब क्या करता है, एक और साल जोड़ें, और उसे 64 GB यूनिफ़ाइड मेमोरी वाली मशीन पर बैठा दें। नाम बदलना, डॉकस्ट्रिंग, टेस्ट स्कैफ़ोल्डिंग, कमिट संदेश, lint सुधार, पहला ड्राफ़्ट अनुवाद, लॉग विश्लेषण — इनमें से किसी के लिए फ़्रंटियर मॉडल की ज़रूरत नहीं, यह सब बड़ी मात्रा में है, और यही वह काम है जिसे आप किसी क्लाइंट की रिपॉज़िटरी से किसी तीसरे पक्ष को भेजना पसंद नहीं करेंगे।
फ़्रंटियर प्लानिंग और मुश्किल रीज़निंग के लिए क्लाउड में रहेगा। मात्रा लोकल चली जाएगी। भाग ग्यारह से आगे इस बारे में है कि यह अब भौतिक रूप से कैसे मुमकिन है।
5. जूनियर डेवलपर की भूमिका ख़त्म नहीं होगी, बदल जाएगी। मध्यम भरोसा, और इसे मैं सबसे ढीले ढंग से थामे हूँ।
निराशावादी पक्ष सीधा है: अगर एजेंट वह काम करेंगे जो पहले जूनियर करते थे, तो कोई जूनियर नहीं रखेगा, और दस साल में सीनियर ही नहीं बचेंगे।
मुझे लगता है कि ज़्यादा संभावित नतीजा यह है कि एंट्री-लेवल नौकरी “कोड लिखो” से बदलकर “कोड सत्यापित करो और स्पेक की ज़िम्मेदारी लो” हो जाएगी — शुरुआत करने के लिए यह ज़्यादा मुश्किल नौकरी है, आसान नहीं, और इसके लिए उद्योग को यह दोबारा बनाना होगा कि वह लोगों को कैसे प्रशिक्षित करता है। जो टीमें इसे समझ लेंगी, उन्हें उन टीमों पर बहुत बड़ा हायरिंग फ़ायदा होगा जो बस हायरिंग बंद कर देंगी।
ईमानदार चेतावनी: यह वह भविष्यवाणी है जहाँ मेरे हित और मेरा विश्लेषण एक ही दिशा में इशारा करते हैं, और ठीक तभी अपने आप पर शक करना चाहिए।
6. किसी की सचमुच तबाही वाली, सार्वजनिक रूप से AI-कोडिंग से जोड़ी गई विफलता होगी। घटना पर ज़्यादा भरोसा, समय पर कम।
लीक हुआ डेटाबेस नहीं। कुछ ऐसा जिसमें कोई रेगुलेटर हो, नौ अंकों का वित्तीय नुक़सान हो, और रूट कॉज़ एनालिसिस कहे कि एजेंट ने कुछ ऐसा किया जिसे किसी इंसान ने रिव्यू ही नहीं किया।
CVE एट्रिब्यूशन का वक्र — 2026 के लगातार महीनों में 6, फिर 15, फिर 35, जबकि शोधकर्ता असली दर पाँच से दस गुना ज़्यादा आँकते हैं — अपने आप सपाट नहीं होगा। सवाल यह है कि उद्योग पहले अपने गेट कसेगा या उस घटना का इंतज़ार करेगा जो उसे मजबूर करे।
इन छहों के बारे में मैं क्या करूँगा, एक वाक्य में: प्रॉम्प्ट तकनीक में नहीं, टेस्ट, स्पेक और रिव्यू टूलिंग में निवेश करें, क्योंकि हर नए मॉडल के आने पर प्रॉम्प्ट तकनीक की क़ीमत घटती है और सत्यापन का ढाँचा चक्रवृद्धि रूप से बढ़ता है।
छवि दिखाएँ दोनों प्रैक्टिस एक ही तकनीक साझा करती हैं, बस। बाईं ओर का लूप फेंकने लायक काम के लिए सही है और प्रोडक्शन के लिए तबाही है; दाईं ओर का लूप वही है जो भाग आठ की घटनाओं की सूची में ग़ायब था।
अध्याय III — कंज़्यूमर डिवाइस पर ऑफ़लाइन AI
भाग ग्यारह: इस साल ऑफ़लाइन AI शौक़ नहीं रहा
करीब दो साल तक “इसे लोकल चलाओ” एक सिद्धांतवाला समझौता था। आप कर सकते थे। ईमानदार पिच यह थी: यह 7 अरब पैरामीटर का मॉडल है जो हर चीज़ के मुफ़्त टियर से ख़राब है, आपके पास पहले से मौजूद हार्डवेयर पर, और इसे करने की वजह सिद्धांत है।
यह 2026 में बदला, और तीन अलग-अलग वजहों से बदला जो एक साथ आईं।
छोटे मॉडल सचमुच अच्छे हो गए। Gemma 4 का E4B लगभग 8 अरब पैरामीटर का है, 128K कॉन्टेक्स्ट सपोर्ट करता है, टेक्स्ट, इमेज, वीडियो और नेटिव ऑडियो संभालता है, और Apache 2.0 है। 31B डेंस वेरिएंट Artificial Analysis इंडेक्स पर 39 अंक लाता है — यानी उस दायरे में जो अठारह महीने पहले फ़्रंटियर था — और पूरा इंडेक्स रन 3.9 करोड़ आउटपुट टोकन में किया, जो तुलनीय मॉडलों के जलाए टोकन का एक छोटा हिस्सा है। Qwen3.8-27B Apache 2.0 के तहत एक डेंस मल्टीमॉडल मॉडल है जिसका 262K नेटिव कॉन्टेक्स्ट है और Alibaba का दावा है कि वह कोडिंग और ऑफ़िस के कामों में कहीं बड़े Qwen3.7-Plus को पीछे छोड़ता है।
ऑपरेटिंग सिस्टम्स ने इसे शिप कर दिया। यही वह बदलाव है जो वाकई मायने रखता है, और वह ख़ामोशी से हुआ। Microsoft ने Aion 1.0 को Windows 11 में डाल दिया। Apple iPhones पर 3 अरब पैरामीटर का डेंस मॉडल और 20 अरब पैरामीटर का स्पार्स मॉडल भेजती है। Google Pixel और Samsung डिवाइस पर Gemini Nano भेजता है। ऑन-डिवाइस AI वह चीज़ नहीं रही जिसे आप इंस्टॉल करते हैं; वह वह चीज़ बन गई जो पहले से मौजूद है, और यही फ़र्क है किसी तकनीक को शौक़ीनों के इस्तेमाल करने और सबके इस्तेमाल करने में।
और हार्डवेयर में आख़िरकार मेमोरी आ गई है। कंप्यूट नहीं — मेमोरी। मैं बाद में बताऊँगा कि यही फ़र्क पूरी कहानी क्यों है।
“ऑफ़लाइन AI” से आपको असल में क्या मिलता है
ठोस होकर बताता हूँ, क्योंकि इसे बहुत बुरी तरह बेचा जाता है।
लेटेंसी। लोकल 4B मॉडल दसियों मिलीसेकंड में जवाब देता है। क्लाउड का राउंड ट्रिप सबसे अच्छे हाल में सैकड़ों में होता है। जो भी इंटरैक्टिव और लगातार चलने वाला हो — डिक्टेशन, लाइव अनुवाद, ऑटोकम्प्लीट, टाइप करते हुए सारांश — वहाँ लोकल अनुभव पर जीतता है, गुणवत्ता पर नहीं, और लोग अनुभव ही नोटिस करते हैं।
प्राइवेसी जो अनुबंध की नहीं, आर्किटेक्चर की चीज़ है। API के साथ हर प्रॉम्प्ट आपके ढाँचे से बाहर जाता है और आपको प्रोसेसर एग्रीमेंट, ट्रांसफ़र इम्पैक्ट असेसमेंट, डेटा फ़्लो मैप और अपने डेटा प्रोटेक्शन ऑफ़िसर के लिए जवाब चाहिए होता है। डिवाइस पर चलने वाले मॉडल के साथ, सीमा-पार स्थानांतरण का सवाल ही नहीं उठता, क्योंकि कोई स्थानांतरण होता ही नहीं। जर्मन और EU काम के लिए अक्सर यही पूरी दलील होती है, और यह ऐसे सौदे बंद कर देती है जो कीमत कभी नहीं कर पाती।
उपलब्धता। हवाई जहाज़ में। ऐसी जगह जहाँ नेटवर्क कवरेज नहीं है। ऐसी सुविधा में जहाँ नेटवर्क एक्सेस ही मना है। आपके प्रोवाइडर’ की घटना के दौरान।
लागत की पूर्वानुमेयता। लागत बचत नहीं — वह गणना मैं पंद्रहवें भाग में करूँगा और वह वह नहीं कहती जो लोग सुनना चाहते हैं। लेकिन प्रति टोकन शून्य सीमांत लागत वाली तय हार्डवेयर लागत, एजेंट’ के उत्साह के साथ बढ़ने वाले उपयोग-आधारित बिल से बहुत अलग बजट मद है।
वर्ज़न पिनिंग। एक बंद API मॉडल स्थिर मॉडल ID के पीछे अपडेट होता रहता है और व्यवहार बदलता रहता है। एक लोकल चेकपॉइंट साल भर बाद भी बाइट-दर-बाइट वही रहता है। अगर कभी आपका कोई चलता हुआ प्रॉम्प्ट चुपचाप काम करना बंद कर चुका है, तो आप जानते हैं कि उसकी क्या कीमत है।
और यह आपको क्या नहीं दिलाता
फ्रंटियर क्षमता। आपके फ़ोन पर चलने वाले 4B मॉडल और Claude Fable 5.1 के बीच का अंतर छोटा नहीं है और घटेगा नहीं। जो कोई आपको इसके उलट बताए, वह कुछ बेच रहा है।
बड़े मॉडल पर गति। लोकल 400B मॉडल टोकन उत्पन्न करने में उसी मॉडल की तुलना में धीमा है जो विक्रेता’ के API पर चलता है, क्योंकि विक्रेता उसे आपकी मेमोरी बैंडविड्थ से चार से छह गुना ज़्यादा वाले हार्डवेयर पर चलाता है। आप नियंत्रण के लिए थ्रूपुट की अदला-बदली करते हैं।
भाग बारह: आपकी जेब का फ़ोन
हर चीज़ तय करने वाला स्पेसिफिकेशन RAM है
हर प्रमुख प्लेटफ़ॉर्म ने अब मेमोरी की एक रेखा खींच दी है, और वह रेखा 12 GB पर है।
| प्लेटफ़ॉर्म | ऑन-डिवाइस मॉडल | मेमोरी गेट |
|---|---|---|
| Apple | AFM 3 Core (3B डेंस) + AFM 3 Core Advanced (20B स्पार्स, 1–4B सक्रिय) | 12 GB iOS 27 की दो सुविधाओं के लिए |
| Gemini Nano v3 (सिर्फ़ Pixel 10 पर); Pixel 9 और उससे पुराने पर Nano v2; Nano v4 जल्द आने वाला है | 12 GB Gemini Intelligence के लिए न्यूनतम | |
| Qualcomm / Samsung | Galaxy के लिए Snapdragon 8 Elite Gen 5 — तीसरी पीढ़ी का Oryon CPU, Hexagon NPU, +39% NPU क्षमता | डिवाइस पर निर्भर |
Apple’ की व्यवस्था तकनीकी रूप से दिलचस्प है। AFM 3 Core Advanced एक 20 अरब पैरामीटर वाला स्पार्स मॉडल है जो फ़्लैश स्टोरेज में रहता है। साझा एक्सपर्ट मेमोरी में बने रहते हैं; रूटेड एक्सपर्ट को DRAM में तभी स्वैप किया जाता है जब किसी रिक्वेस्ट को उनकी ज़रूरत होती है। किसी 20B मॉडल को फ़ोन पर फ़िट करने का तरीका यही है — आप DRAM क्षमता के बदले NAND रीड बैंडविड्थ की अदला-बदली करते हैं।
लेकिन एक्सपर्ट को DRAM में स्वैप करने के लिए फिर भी ऐसी जगह चाहिए जहाँ उन्हें स्वैप किया जा सके — और वह जगह, जो ऑपरेटिंग सिस्टम, चल रहे ऐप और कैमरा पाइपलाइन के ऊपर होनी चाहिए। 9 GB और 12 GB के बीच का अंतर तीन गीगाबाइट की मार्केट सेगमेंटेशन नहीं है। यह असली मेमोरी दबाव में एक्सपर्ट स्वैपिंग के लिए ज़रूरी वर्किंग सेट है। Ming-Chi Kuo रिपोर्ट करते हैं कि iOS 27 की दो सुविधाओं के लिए 12 GB चाहिए: Siri की आवाज़ की अभिव्यक्ति और बोलने की गति की कस्टमाइज़ेशन, और स्पीच-टू-टेक्स्ट सटीकता में बड़ा सुधार। बेस iPhone 18, जो वसंत 2027 तक देर से आ रहा है और कथित तौर पर 9 GB के साथ है, यह शर्त पूरी नहीं करता।
Google के पास वही भौतिकी है और PR की समस्या उससे भी बदतर है। Gemini Intelligence को Nano v3 चाहिए, Nano v3 फ़िलहाल सिर्फ़ Pixel 10 पर है, और Pixel 9 डिवाइस — जो एक सात साल के अपडेट के वादे के तहत बेचे गए थे — और वे Nano v2 पर हैं। वादा अपडेट के बारे में था। यह कभी सुविधाओं के बारे में नहीं था, और 2023 में किसी प्रोडक्ट मैनेजर को जो अंतर समझ आता था, वह 2026 के ग्राहक को बिल्कुल भी समझ नहीं आता।
अगले दो सालों की उपभोक्ता AI कहानी यही होने की उम्मीद करें: लंबे सपोर्ट का एक वादा जो ऐसे डिवाइस तक सुरक्षा पैच पहुँचाता है जो उन सुविधाओं को चला ही नहीं सकता जिनके साथ ये पैच भेजे जाते हैं।
फ़ोन असल में क्या कर सकता है, मापा गया
iPhone 17 Pro (A19 Pro) पर चार रनटाइम में स्वतंत्र बेंचमार्किंग:
| मॉडल | रनटाइम | डिकोड tok/s | अधिकतम मेमोरी |
|---|---|---|---|
| Gemma 4 E2B (4-बिट) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-बिट) | MLX | 47.5 | 2,900 MB |
| Gemma 4 E2B (4-बिट) | llama.cpp | 37.8 | 3,156 MB |
| Gemma 4 E2B (4-बिट) | CoreML / ANE | 33.4 | 1,187 MB |
| Qwen 3.5 2B (4-बिट) | MLX | 61.2 | 1,279 MB |
| Qwen 3.5 2B (4-बिट) | llama.cpp | 39.1 | 1,479 MB |
| Qwen 3.5 2B (4-बिट) | CoreML / ANE | 27.9 | 241 MB |
दो नतीजे साफ़ दिखते हैं।
Neural Engine सबसे धीमा रास्ता है और अब तक सबसे कम मेमोरी लेने वाला। 241 MB पर 27.9 tok/s बनाम MLX’s 1,279 MB पर 61.2 tok/s — पाँच गुना गति, पाँच गुना मेमोरी। यही सौदा वह कारण है कि Apple हमेशा चालू रहने वाले सिस्टम फ़ीचर के लिए ANE इस्तेमाल करता है और थर्ड-पार्टी ऐप इंटरैक्टिव चैट के लिए इसे छोड़ देते हैं।
आपकी जेब में 2B मॉडल पर साठ टोकन प्रति सेकंड ज़्यादातर लोगों के पढ़ने की गति से तेज़ है। यानी फ़ोन-लोकल AI पर सीमा गति नहीं है। वह क्षमता है, क्षमता पैरामीटर का फलन है, पैरामीटर मेमोरी का फलन हैं — और मेमोरी वही चीज़ है जिसे हर विक्रेता ने अभी सीमित किया है।
भाग तेरह: PC, और Microsoft’s ख़ामोश दाँव
Microsoft ने 2 जून को Build 2026 में कुछ किया जो मुझे लगता है कि पीछे मुड़कर देखने पर उस दिन से कहीं ज़्यादा अहम लगेगा: उसने Windows में ही मॉडल भेज दिए।
Aion 1.0 Instruct सारांश बनाने, फिर से लिखने और जानकारी निकालने के लिए एक छोटा भाषा मॉडल है। इसे आधुनिक CPU और Windows 11 चाहिए — कोई NPU नहीं, कोई अलग GPU नहीं। यह अब Edge Canary में build 150.0.4070 से उपलब्ध है, Prompt, Summarizer, Writer और Rewriter API के ज़रिए वेब डेवलपर्स के लिए खुला है, और इसके ओपन-वेट जुलाई 2026 में Hugging Face पर आए।
Aion 1.0 Plan दिलचस्प वाला है: एक 14 अरब पैरामीटर वाला रीज़निंग और टूल-कॉलिंग मॉडल, 32K कॉन्टेक्स्ट विंडो के साथ, जो एजेंटिक वर्कफ़्लो, फ़ाइल प्रबंधन और सब-एजेंट ऑर्केस्ट्रेशन के लिए बनाया गया है। लिखने के समय “आने वाले महीनों में”।
Microsoft ने जो ढाँचा इस्तेमाल किया वह था “हर घर और हर डेस्क तक बिना मीटर वाली इंटेलिजेंस।” मार्केटिंग को एक तरफ़ रखिए और आर्किटेक्चर का फ़ैसला देखिए: ब्राउज़र में एक JavaScript API जो लोकल मॉडल को कॉल करती है, बिना कुंजी, बिना बिल और बिना नेटवर्क। अगर यह सामान्य हो जाए, तो छोटे AI फ़ीचर की एक बहुत बड़ी श्रेणी SaaS उत्पाद होना बंद करके प्लेटफ़ॉर्म क्षमता बन जाती है। AI उद्योग’s अर्थशास्त्र के लिए यह इस साल के किसी भी एकल मॉडल रिलीज़ से कहीं बड़ी बात है।
हार्डवेयर की न्यूनतम सीमा असली है और यह बहुत सारी मशीनों को बाहर कर देती है
NPU वाले रास्ते के लिए Copilot+ PC चाहिए जिसमें हो minimum 40-TOPS NPU:
| सिलिकॉन | NPU | योग्य? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ हार्डवेयर; सॉफ़्टवेयर “बाद में आएगा” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
और यह वह आँकड़ा है जो उम्मीदें नए सिरे से तय कर देगा: 45 TOPS के NPU पर, एक 8B मॉडल लगभग 5 टोकन प्रति सेकंड जनरेट करता है। 14B Plan मॉडल धीमा होगा।
पाँच टोकन प्रति सेकंड कोई चैट अनुभव नहीं है। यह बैकग्राउंड सारांश, रीराइट, क्लासिफ़िकेशन, एक्सट्रैक्शन — यानी वे काम जिनके लिए Aion 1.0 Instruct वास्तव में बना है — के लिए ठीक है। जिस चीज़ को आप बैठकर देखते हैं, उसके लिए यह ठीक नहीं है।
45 TOPS पर इतनी धीमी गति क्यों? क्योंकि टोकन जनरेशन मेमोरी बैंडविड्थ से सीमित है, कच्ची कंप्यूट पावर से नहीं। NPU मैट्रिक्स गुणा कर सकता है; समस्या यह है कि हर एक टोकन के लिए वेट्स को सिस्टम मेमोरी से स्ट्रीम करना पड़ता है। यही वह दीवार है जो इस लेख के हर डिवाइस पर लागू होती है, और इसी वजह से खरीदारी के लिए “TOPS” लगभग बेकार आँकड़ा है।
डेस्कटॉप बॉक्स
अगर आपको खास तौर पर लोकल इन्फ़रेंस के लिए मशीन चाहिए, तो 128 GB वाला वर्ग दो विकल्पों और एक अपवाद पर आकर ठहर गया है:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| मेमोरी | 128 GB यूनिफ़ाइड | 128 GB LPDDR5X-8000 | अधिकतम 512 GB यूनिफ़ाइड |
| बैंडविड्थ | ~273 GB/s | ~256 GB/s | 1.2 TB/s |
| क़ीमत | ~$3,999 | $2,300–$2,500 | $5,499 से |
| नोट्स | CUDA इकोसिस्टम | मज़बूत CPU (1.6 TFLOPS Linpack बनाम Spark का 708 GFLOPS) | 512 GB टियर अक्टूबर के अंत में, कीमत तय नहीं |
वे कीमतें और Spark तथा Strix Halo के आँकड़े दिसंबर 2025 के अंत में प्रकाशित टेस्टिंग से हैं, इसलिए इन्हें मौजूदा नहीं, बल्कि सांकेतिक मानें — तब से मेमोरी की कीमतें बदल चुकी हैं। DGX Spark और Strix Halo टोकन जनरेशन पर अपने कंप्यूट आँकड़ों से कहीं ज़्यादा करीब हैं — क्योंकि दोनों लगभग 256–273 GB/s बैंडविड्थ पर अटके हुए हैं और वही असली सीमा है। Spark इमेज जनरेशन (~120 TFLOPS बनाम FLUX.1 Dev BF16 पर ~46) और CUDA संगतता पर निर्णायक रूप से जीतता है। Strix Halo कीमत और CPU पर जीतता है।
Mac Studio M5 Ultra मेमोरी और बैंडविड्थ, दोनों पर पूरी तरह अलग श्रेणी की मशीन है, और मैंने इस पर विस्तार से लिखा है — लोकल AI हार्डवेयर वाला लेख। संक्षेप में: 1.2 TB/s पर 512 GB मेमोरी वाली यह अकेली मुख्यधारा की मशीन है जो 400B श्रेणी का मॉडल मेमोरी में समेट सकती है, और कॉन्फ़िगर कराने पर इस सुविधा की कीमत लगभग $16,000–$20,000 पड़ती है।
असल में चलाने लायक मॉडल
| मॉडल | पैरामीटर | लाइसेंस | आराम से चलता है | किसके लिए अच्छा |
|---|---|---|---|---|
| Gemma 4 E2B | 5.1B / 2.3B सक्रिय | Apache 2.0 | 4 GB | फ़ोन, हमेशा चालू, ऑडियो इनपुट |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | लैपटॉप पर भारी काम, सारांश बनाना |
| Aion 1.0 Instruct | छोटा SLM | ओपन-वेट (HF, जुलाई 2026) | केवल CPU | Windows-नेटिव टेक्स्ट कार्य |
| Qwen3.8-27B | 27B डेंस | Apache 2.0 | 24–32 GB | 32 GB से कम में सबसे अच्छा सामान्य लोकल मॉडल |
| Gemma 4 26B-A4B | 26B / 4B सक्रिय | Apache 2.0 | 24 GB | तेज़ MoE, कम सक्रिय लागत |
| Gemma 4 31B | 31B डेंस | Apache 2.0 | 32 GB | 32 GB से कम में सर्वोच्च लोकल गुणवत्ता |
| Ornith-1.5 35B | 35B / 3B सक्रिय | MIT | 32 GB | एजेंटिक कोडिंग, बहुत छोटा सक्रिय फ़ुटप्रिंट |
| gpt-oss-120b | 120B / 5.1B सक्रिय | Apache 2.0 | 128 GB | 128 GB का आदर्श बिंदु |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB+ | फ़्रंटियर के करीब, बड़ी मशीन चाहिए |
| MiniMax M3 | 428B / 23B सक्रिय | Custom | 512 GB | सिर्फ़ M5 Ultra पर ही फ़िट होता है |
| DeepSeek V4 Pro | 1.6T / 49B सक्रिय | MIT | क्लस्टर | उपभोक्ता डिवाइस का मॉडल नहीं |
| Kimi K3 | 2.8T / 104B सक्रिय | Custom | क्लस्टर | Apple जो भी Mac बेचता है, किसी पर फ़िट नहीं होता |
अगर आप ख़ास तौर पर Apple मशीन का साइज़ तय कर रहे हैं, तो मैंने मेमोरी टियर पर विस्तार से लिखा है MacBook Pro M5 Pro 64GB लोकल AI गाइड में — संक्षेप में, 64 GB वह बिंदु है जहाँ समझौते परेशान करना बंद कर देते हैं।
अगर आपको एक सुझाव चाहिए: 32 GB की मशीन पर, चलाएँ Qwen3.8-27B या Gemma 4 31B. दोनों Apache 2.0, दोनों मल्टीमॉडल, दोनों सचमुच उपयोगी, दोनों फ़िट होते हैं। यही 2026 का डिफ़ॉल्ट है और 2025 के डिफ़ॉल्ट से कहीं बेहतर है।
छवि दिखाएँ मेमोरी टियर के हिसाब से असल में क्या फ़िट होता है। खड़ी रेखाएँ वे मेमोरी साइज़ हैं जो उपभोक्ता सचमुच खरीद सकते हैं; दाईं ओर की रेखा से आगे निकलने वाले मॉडल 2026 में लोकल फ़्रंटियर AI की ऊपरी सीमा हैं।
भाग चौदह: पूरी कहानी मेमोरी की दीवार है
एक्ट III की हर बात एक ही समीकरण पर आकर रुकती है, तो इसे साफ़ तौर पर लिखते हैं।
क्या यह फ़िट होगा?
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory × 0.75) − OS and app overhead − KV cache
यह कितनी तेज़ी से जनरेट करेगा?
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenध्यान दें कि दूसरा फ़ॉर्मूला सक्रिय पैरामीटर लेता है, कुल नहीं। यही कारण है कि मिक्सचर-ऑफ़-एक्सपर्ट्स मॉडल उपभोक्ता हार्डवेयर पर अनुपात से कहीं अधिक अच्छे होते हैं। Gemma 4’s 26B-A4B में 26 अरब पैरामीटर की क्षमता और 4 अरब पैरामीटर की प्रति-टोकन लागत है। Ornith-1.5’s 35B, 3B को सक्रिय करता है। MiniMax M3 में कुल 428B और सक्रिय 23B हैं।
उस फ़ॉर्मूले में दक्षता व्यवहार में लगभग 0.5 से 0.8 होती है जो रनटाइम, क्वांटाइज़ेशन और इस बात पर निर्भर करता है कि सिस्टम का बाकी हिस्सा मेमोरी बैंडविड्थ का कितना उपयोग कर रहा है।
अब इसे लागू करें। LPDDR5X के साथ 45-TOPS NPU वाला लैपटॉप, मान लीजिए 120 GB/s पर, 8B मॉडल को 4-bit पर चला रहा है (4 GB सक्रिय वेट्स): 120 × 0.6 ÷ 4 ≈ 18 टोकन/सेकंड सिद्धांत में। मापा गया आँकड़ा लगभग 5 है। अंतर शेड्यूलिंग, मेमोरी कंटेंशन, प्रीफ़िल लागत और इस तथ्य से आता है कि NPU टूलचेन अभी अपरिपक्व हैं। अंकगणित और वास्तविक माप के बीच का यही अंतर इस क्षेत्र की अधिकांश निराशा की जड़ है।
इस लेख के हर आँकड़े के पीछे DRAM की कमी एक छिपा हुआ चर है
मेमोरी निर्माताओं ने 2025 और 2026 का समय AI डेटा सेंटर ग्राहकों की ओर क्षमता पुनः आवंटित करने में लगाया, जो उपभोक्ता उपकरण निर्माताओं की तुलना में बेहतर मार्जिन पर बड़े अनुबंध करते हैं। इसके परिणाम हर जगह दिखते हैं:
- Apple ने जून 2026 में Macs और iPads की कीमतें बढ़ा दीं।
- 512 GB Mac Studio वेरिएंट आपूर्ति के कारण अक्टूबर के अंत तक खिसक गया और अभी भी बिना कीमत का है।
- Apple’s M6 अधिकतम 32 GB यूनिफ़ाइड मेमोरी तक सीमित है, और M6 Pro, Max और Ultra को पूरी तरह रद्द कर दिया गया।
- Ming-Chi Kuo ने बताया कि Apple ने मेमोरी आपूर्ति के कारण 2026 की हार्डवेयर शिपमेंट में कटौती की।
इस लेख में हर सीमा उसी कमी से जुड़ी है। 12 GB फ़ोन की सीमा। 32 GB M6 की अधिकतम सीमा। 128 GB लैपटॉप की अधिकतम सीमा। देर से आया 512 GB वेरिएंट। इनमें से कोई भी सिलिकॉन की तकनीकी सीमा नहीं है; ये सभी ऐसे बाज़ार में आवंटन के फ़ैसले हैं जहाँ मेमोरी दुर्लभ और महँगी है।
यदि आप लोकल इन्फ़रेंस के लिए मशीन खरीदने से पहले कीमतों के सामान्य होने का इंतज़ार कर रहे हैं: कोई विश्वसनीय व्यक्ति यह पूर्वानुमान नहीं लगा रहा कि ऐसा कब होगा।
भाग पंद्रह: सेटअप करना
व्यावहारिक हिस्सा। यहाँ जो कुछ है, वह मैंने चलाया है; जहाँ मैं चलाने के बजाय रिपोर्ट कर रहा हूँ, वहाँ मैं स्पष्ट कहता हूँ।
सबसे आसान रास्ता: LM Studio
एक GUI, Apple Silicon पर MLX-नेटिव, मॉडल ब्राउज़र अंतर्निहित, एक टॉगल से OpenAI-संगत सर्वर। अगर आप दस मिनट में मॉडल चलाना चाहते हैं, तो यहीं से शुरू करें। Apple अपने प्रेस रिलीज़ में भी इसी टूल के ख़िलाफ़ बेंचमार्क करता है, जो बताता है कि यह कितना मुख्यधारा में आ गया है।
सबसे लचीला रास्ता: Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
वही दूसरा कमांड वह है जिसे लोग चूक जाते हैं। Ollama’s डिफ़ॉल्ट कॉन्टेक्स्ट रूढ़िवादी ढंग से सेट है; किसी कोड कार्य पर यह चुपचाप काट देगा और आप मॉडल को दोष देंगे।
Apple Silicon पर सबसे तेज़ रास्ता: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
किसी भी OpenAI-संगत क्लाइंट को यहाँ पॉइंट करें http://localhost:8080/v1.
क्रैश की शिकायत करने से पहले वायर्ड मेमोरी सीमा बढ़ाएँ
macOS डिफ़ॉल्ट रूप से GPU को आपकी पूरी यूनिफ़ाइड मेमोरी वायर करने नहीं देता। बड़ी मेमोरी वाली मशीन पर यही तय करता है कि मॉडल लोड होगा या विफल होगा:
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
इसे अपनी पूरी मेमोरी साइज़ पर सेट न करें। बड़ी मशीन पर OS के लिए 12–16 GB छोड़ दें, वरना तेज़ इन्फ़रेंस के बजाय आपको कर्नल पैनिक मिलेंगे। और हर macOS अपडेट के बाद इसे दोबारा जाँचें, क्योंकि अपडेट इसे रीसेट कर देते हैं।
Windows पर पहले OS के मॉडल इस्तेमाल करें
कुछ भी इंस्टॉल करने से पहले देखें कि Windows आपको पहले से क्या देता है। Edge में Prompt, Summarizer, Writer और Rewriter API स्थानीय रूप से Aion 1.0 Instruct को कॉल करते हैं, बिना किसी कुंजी और बिना किसी बिल के। किसी वेब ऐप के भीतर सारांश, रीराइटिंग और एक्सट्रैक्शन के लिए, यह शून्य इन्फ्रास्ट्रक्चर वाला एक पूरा समाधान है।
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
अगर आपको इससे अधिक चाहिए, तो LM Studio और Ollama दोनों Windows पर ठीक चलते हैं, और बिना योग्य NPU वाली मशीन पर वे GPU या CPU का उपयोग करेंगे, जो 8B श्रेणी के मॉडल के लिए अक्सर तेज़ NPU पाथ की तुलना में, वैसे भी।
एक समझदार हाइब्रिड सेटअप
जो आर्किटेक्चर मैं असल में बनाऊँगा, और मोटे तौर पर जो मैं चलाता हूँ:
- टियर 1 — डिवाइस पर। रूटिंग, क्लासिफ़िकेशन, एक्सट्रैक्शन, सारांश और डिक्टेशन के लिए एक छोटा मॉडल। Gemma 4 E4B या Aion 1.0 Instruct। हमेशा उपलब्ध, शून्य सीमांत लागत।
- टियर 2 — आपका अपना हार्डवेयर। आपकी अपनी मशीन पर 27B–120B का ओपन-वेट मॉडल, उस हर काम के लिए जो क्लाइंट डेटा को छूता है और जिसे अधिकार-क्षेत्र से बाहर नहीं जाना चाहिए। 32 GB पर Qwen3.8-27B,
gpt-oss-120b128 GB पर। - टियर 3 — API के ज़रिए फ़्रंटियर। प्लानिंग, कठिन रीज़निंग, लंबे एजेंटिक रन, और वह सब जहाँ ग़लत होना महँगा पड़ता है।
यह बहस कभी “लोकल या क्लाउड” की नहीं होती। यह सवाल है कि आप रेखाएँ कहाँ खींचते हैं, और इस साल वे रेखाएँ बहुत आगे खिसक गई हैं।
भाग सोलह: लागत और अनुपालन का गणित
बचत का तर्क कैलकुलेटर पर खरा नहीं उतरता
एक वास्तविक छोटे कारोबार का वर्कलोड लें: मध्यम एजेंटिक कोडिंग का एक कामकाजी महीना, मान लीजिए 40 मिलियन इनपुट और 3 मिलियन आउटपुट टोकन।
| विकल्प | मासिक लागत |
|---|---|
| GLM-5.3-Flash API ($0.15 / $0.47) | ~$7.40 |
| Gemini 3.8 Flash API ($0.75 / $3.75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50, बिना कैश) | ~$550 |
| तीन साल में परिशोधित $2,400 का Strix Halo बॉक्स | ~$67/महीना + बिजली |
ध्यान दें कि वह तालिका असल में क्या कहती है। लोकल हार्डवेयर फ़्रंटियर के शीर्ष से सस्ता है और उसके निचले सिरे से महँगा। GLM-5.3-Flash के मुक़ाबले लोकल बॉक्स टोकन पर कभी लागत नहीं निकाल पाता। बिना कैश चल रहे Fable 5.1 के मुक़ाबले यह पाँच महीनों में अपनी लागत निकाल लेता है — लेकिन यहाँ तुलना बराबर की नहीं है, क्योंकि Fable 5.1 उस हर मॉडल से बहुत बेहतर है जो 128 GB में समाता है।
तो पैसे बचाने के लिए लोकल हार्डवेयर न ख़रीदें। इसे इन पाँच कारणों में से किसी एक के लिए ख़रीदें, और ये सभी असली हैं:
- ऐसी डेटा रेज़िडेंसी जो कानूनी प्रोजेक्ट के बजाय आर्किटेक्चर का फ़ैसला हो।
- कोई रेट लिमिट नहीं, कोई कोटा नहीं, क्षमता की कोई घटना नहीं। आपकी मशीन पर कोई व्यस्त मंगलवार नहीं होता।
- वर्ज़न पिनिंग हमेशा के लिए। लोकल चेकपॉइंट एक साल बाद भी बाइट-दर-बाइट वही रहता है।
- ऑफ़लाइन संचालन।
- आपको वर्कस्टेशन वैसे भी चाहिए था। यह सबसे आम मामला है जहाँ ख़रीदना सीधे तौर पर सही है — अगर आप वैसे भी मशीन पर €2,500 खर्च करने वाले थे, तो AI क्षमता की अतिरिक्त लागत मेमोरी अपग्रेड है, पूरा बॉक्स नहीं।
EU अनुपालन की तस्वीर, क्योंकि 2026 में यह बदल गई
जर्मनी और EU के पाठकों के लिए, इस साल नियामक ज़मीन बदल गई और तारीखें अब सशर्त नहीं, तय हैं।
- 2 अगस्त 2025 — GPAI मॉडल प्रदाताओं पर दस्तावेज़ीकरण, प्रशिक्षण-सामग्री-सारांश और कॉपीराइट के दायित्व आए।
- 2 अगस्त 2026 — प्रवर्तन शक्तियाँ और अनुच्छेद 50 की पारदर्शिता ड्यूटी लागू हुईं। अब जुर्माने लगाए जा सकते हैं।
- 27 जुलाई 2026 — डिजिटल ऑम्निबस, रेगुलेशन (EU) 2026/1744, लागू हुआ, जिसने उच्च-जोखिम वाले सिस्टमों के लिए पिछली सशर्त व्यवस्था को तय तारीखों से बदल दिया।
- 2 दिसंबर 2026 — मौजूदा सिस्टमों पर मशीन-पठनीय वॉटरमार्किंग के लिए छूट अवधि का अंत।
- 2 अगस्त 2027 — बाज़ार में पहले से मौजूद GPAI मॉडलों के लिए दो साल की संक्रमण खिड़की बंद होती है।
- 2 December 2027 — अनुलग्नक III के तहत स्वतंत्र उच्च-जोखिम सिस्टम (भर्ती, क्रेडिट स्कोरिंग, शिक्षा, महत्वपूर्ण अवसंरचना)।
- 2 अगस्त 2028 — अनुलग्नक I के तहत नियामित उत्पादों (चिकित्सा उपकरण, मशीनरी) में अंतर्निहित उच्च-जोखिम AI।
डिजिटल ऑम्निबस ने AI-निर्मित, बिना सहमति वाली अंतरंग तस्वीरों और CSAM पर प्रतिबंध भी जोड़े, और EU AI Office’ की पर्यवेक्षी शक्तियाँ बढ़ाईं।
इस लेख के पाठकों के लिए इसका व्यावहारिक अर्थ क्या है। अगर आप मॉडलों को प्रशिक्षित करने के बजाय उनके ऊपर निर्माण कर रहे हैं, तो GPAI के ज़्यादातर दायित्व प्रदाता के पास हैं, आपके पास नहीं। आप पर पारदर्शिता आती है — लोगों को बताना कि वे AI के साथ बातचीत कर रहे हैं, और सिंथेटिक सामग्री को चिह्नित करना — साथ ही उच्च-जोखिम वर्गीकरण का सवाल, अगर आपका सिस्टम भर्ती, क्रेडिट, शिक्षा या महत्वपूर्ण अवसंरचना को छूता है। दिसंबर 2027 की तारीख योजना बनाने के लिए इतनी दूर है और इतनी पास भी कि “हम बाद में देखेंगे” अब कोई रणनीति नहीं रही।
और भाग III से सबसे प्रासंगिक बात: ऑन-डिवाइस मॉडल इनमें से कई बातचीतों को एक साथ काफ़ी आसान बना देता है। कोई ट्रांसफ़र नहीं, कोई प्रोसेसर नहीं, डेटा फ़्लो का नक्शा बहुत छोटा। यह कोई खामी नहीं है — पारदर्शिता के दायित्व फिर भी लागू हैं — लेकिन यह काम की एक पूरी श्रेणी हटा देता है।
मैं वकील नहीं हूँ और यह कानूनी सलाह नहीं है। जहाँ पैसा जुड़ा है, वहाँ जर्मन या EU-योग्य सलाहकार से अपनी विशिष्ट डिप्लॉयमेंट देखवाएँ।
भाग सत्रह: इन सबके विरुद्ध ईमानदार पक्ष
अगर मैं भाग सोलह पर रुक जाता, तो यह एक विज्ञापन होता।
मापी गई उत्पादकता का सबूत अब भी इस उत्साह का समर्थन नहीं करता। एक रैंडमाइज़्ड कंट्रोल्ड ट्रायल, 19% धीमा। एक फ़ॉलो-अप जो साफ़-सुथरे ढंग से चलाया नहीं जा सका। स्व-रिपोर्ट 40 प्रतिशत अंक तक बढ़ा-चढ़ाकर बताई गईं। इस उद्योग में हर कोई, मैं भी शामिल, काफ़ी हद तक वाइब्स के बारे में वाइब्स पर चल रहा है।
सुरक्षा का डेटा ख़राब है और सुधर नहीं रहा। Veracode’ की 45% OWASP विफलता दर 2026 की शुरुआत तक लगभग अपरिवर्तित रही, जबकि मॉडल नाटकीय रूप से होशियार हो गए। यह ऐसी संक्रमणकालीन समस्या नहीं है जिसे स्केल ठीक कर देगा। क्षमता और सुरक्षा एक ही अक्ष नहीं हैं, और कोई भी दूसरे पर ज़ोर से अनुकूलन नहीं कर रहा।
बेंचमार्क शीर्ष पर संतृप्त हैं और बीच में असत्यापनीय। SWE-bench Verified में तीन मॉडल एक अंक के भीतर हैं। इसकी जगह लेने वाले बेंचमार्क तेज़ी से निजी हो रहे हैं, जो संदूषण की समस्या को स्वतंत्र सत्यापन असंभव बनाकर हल करते हैं।
ओपन वेट एक लाइसेंस संशोधन की दूरी पर हैं कि वे ओपन न रह जाएँ। Z.ai ने 5.2 और 5.3 के बीच GLM को MIT से मालिकाना लाइसेंस पर ले जाया, जिसमें सुरक्षा-समीक्षा द्वार है। Meta ने Muse Spark के लिए ओपन वेट का वादा किया है, बिना तारीख, बिना आकार और बिना लाइसेंस पाठ। अगर आपकी आर्किटेक्चर अगले साल डाउनलोड-योग्य वेट मानकर चलती है, तो वह धारणा विक्रेता’ का कारोबारी फ़ैसला है, प्रकृति का नियम नहीं।
फ़्रंटियर अब भी लोकल नहीं है, और तेज़ी से ख़रीदने योग्य भी नहीं रहा। Mythos 5.1, जो Terminal-Bench 4.0 पर सर्वोच्च स्कोरर है, सिर्फ़ जाँचे गए साइबर-रक्षकों और जीवन-वैज्ञानिकों तक सीमित है, फ़िलहाल मुख्यतः अमेरिका में। Kimi K3 और DeepSeek V4 Pro किसी भी उपभोक्ता मशीन पर नहीं समाते। आपकी मेज़ पर जो समाता है वह एक बेहतरीन दूसरे दर्जे का मॉडल है, जो होना वाकई उपयोगी बात है और फ़्रंटियर नहीं है।
ऑन-डिवाइस प्रदर्शन मार्केटिंग जितना बताती है उससे ख़राब है। 45-TOPS NPU पर 8B मॉडल के लिए पाँच टोकन प्रति सेकंड। 12 GB मेमोरी की सीमा जो ज़्यादातर उपलब्ध फ़ोनों को बाहर कर देती है। सात साल के अपडेट का वादा जो फ़ीचरों को कवर नहीं करता। “AI PC” ब्रांडिंग और मशीन असल में जो चला सकती है, उसके बीच की खाई फ़िलहाल बहुत बड़ी है।
और भू-राजनीति ख़रीद का एक कारक है, चाहे आप मानें या न मानें कि उसे होना चाहिए। सबसे अच्छे ओपन-वेट मॉडलों में से कई — Kimi, GLM, DeepSeek, Qwen, MiniMax — चीनी लैब से आते हैं। सार्वजनिक क्षेत्र, रक्षा से जुड़े और कुछ नियमित क्लाइंटों के लिए यह सख़्त बाधा है, चाहे वेट कहाँ चलें या लाइसेंस क्या कहे। इस बीच Anthropic का सबसे सक्षम कोडिंग मॉडल जाँचे गए अमेरिकी संगठनों तक सीमित है। ओपन इकोसिस्टम को दोनों सिरों से राष्ट्रीय रेखाओं पर खींचा जा रहा है, और अगर आप यूरोप में हैं तो आप इसके किसी भी सिरे पर नहीं हैं।
भाग अठारह: AI 2026 की स्थिति के लिए निर्णय ढाँचा
छवि दिखाएँ सात स्थितियाँ, सात जवाब। वह पंक्ति ढूँढ़ें जो आपके साल जैसी लगे।
सात स्थितियाँ, जो आज AI 2026 की वास्तविक स्थिति पर मैप की गई हैं।
1. “मुझे सबसे अच्छा मॉडल चाहिए और लागत मायने नहीं रखती।”
Claude Fable 5.1 एग्रीगेट इंडेक्स पर 65.7, $10/$50, 1M कॉन्टेक्स्ट — और कैशिंग चालू करें, क्योंकि 75% कैश रीड कटौती आपके बिल का 25–45% बचाती है। रखें GPT-5.6 Sol ब्राउज़िंग-भारी रिसर्च के लिए 90.4% BrowseComp पर उपलब्ध। ज़्यादा माथापच्ची न करें; उनके बीच का अंतर आपके सबसे अच्छे और सबसे ख़राब प्रॉम्प्ट के अंतर से छोटा है।
2. “मैं बहुत सारे एजेंट चलाता हूँ और बिल बेतुका होता जा रहा है।”
लंबे समय तक चलने वाले काम के लिए Claude Opus 5 $5/$25 पर, थोक यांत्रिक काम के लिए GLM-5.3-Flash $0.15/$0.47 पर, और साधारण काम के लिए एक लोकल मॉडल। रूटिंग आपके पास उपलब्ध सबसे बड़ा लागत-लीवर है और यह एक कॉन्फ़िग फ़ाइल है, कोई प्रोजेक्ट नहीं। कुछ भी ऑप्टिमाइज़ करने से पहले एजेंट भूमिका के हिसाब से अपना टोकन बँटवारा मापें — ज़्यादातर लोग पाते हैं कि उनका 80% ख़र्च ऐसे कामों पर है जिन्हें फ़्रंटियर मॉडल की ज़रूरत नहीं थी।
3. “GDPR और डेटा रेज़िडेंसी क्लाइंट काम के लिए सख़्त शर्तें हैं।”
अपने हार्डवेयर पर Qwen3.8-27B या Gemma 4 31B, दोनों Apache 2.0, दोनों मल्टीमॉडल। आगे बढ़ें gpt-oss-120b 128 GB मशीन पर, अगर काम को ज़रूरत हो। मुद्दा गति नहीं है — मुद्दा यह है कि कोई प्रॉम्प्ट इमारत से बाहर नहीं जाता और आपकी कानूनी समीक्षा ट्रांसफ़र इम्पैक्ट असेसमेंट के बजाय लाइसेंस पढ़ने भर की रह जाती है। ख़ास तौर पर अनुमतिपूर्ण लाइसेंस वाले मॉडल चुनें ताकि वह पढ़ाई छोटी रहे।
4. “मैं ज़्यादा ख़र्च किए बिना लोकल AI आज़माना चाहता हूँ।”
जो आपके पास पहले से है, साथ में LM Studio, साथ में Gemma 4 E4B। आठ गीगाबाइट मेमोरी वाकई उपयोगी होने के लिए काफ़ी है। पैसा ख़र्च करने से पहले पता करें कि लोकल AI आपके लिए है या नहीं — ज़्यादातर लोग पाते हैं कि उन्हें टियर 1 और टियर 3 चाहिए और टियर 2 की ज़रूरत ही नहीं थी।
5. “मैं ख़ास तौर पर लोकल इन्फ़रेंस के लिए मशीन ख़रीद रहा हूँ।”
मेमोरी बैंडविड्थ और क्षमता के आधार पर ख़रीदें, इसी क्रम में, और TOPS को नज़रअंदाज़ करें। 128 GB वर्ग में, ~$2,400 पर Strix Halo सबसे अच्छा मूल्य है और ~$3,999 पर DGX Spark आपको CUDA और बहुत बेहतर इमेज जनरेशन देता है। उससे ऊपर, Mac Studio M5 Ultra ही एकमात्र चीज़ है जो 400B मॉडल संभालती है, ऐसी क़ीमत पर जो तभी समझ आती है जब आपको वर्कस्टेशन वैसे भी चाहिए था।
6. “मेरी टीम AI कोडिंग टूल अपना रही है और जोखिम मेरे पास है।”
उबाऊ काम करें, इसी क्रम में: हर कमिट पर SAST और सीक्रेट डिटेक्शन; हॉलुसिनेटेड पैकेजों के लिए सॉफ़्टवेयर कंपोज़िशन एनालिसिस; एक लिखित नीति जो बिना समीक्षा वाले AI कोड को auth, crypto, authz और भुगतान से बाहर रखे; एजेंट क्रेडेंशियल्स को विशेषाधिकार प्राप्त के रूप में सीमित; और एक SBOM जो टूल की उत्पत्ति दर्ज करे। फिर उम्मीद रखें J-कर्व — DORA ने लाभ से पहले असली गिरावट मापी — और तीसरे महीने में घबराएँ नहीं।
7. “AI के लिए कौन-सा फ़ोन ख़रीदूँ?”
कोई भी 12 GB मॉडल। यही वह रेखा है जो हर प्लेटफ़ॉर्म ने खींची है: iPhone 17 Pro और 18 Pro 12 GB पर, Nano v3 के लिए Pixel 10, Snapdragon 8 Elite Gen 5 पर Galaxy S26 Ultra। बेस iPhone 18 कथित 9 GB पर और Pixel 9 तथा उससे पुराने फ़ोन ठीक चलेंगे और उन्हें ये फ़ीचर नहीं मिलेंगे। अगर आपके पास पहले से 12 GB डिवाइस है, तो इस साल’ का अपग्रेड ख़ास तौर पर AI के लिए सीमित है।
भाग उन्नीस: अगली तिमाही में मैं क्या देख रहा हूँ
क्या Meta असल में Muse Spark’ के वेट भेजती है, और किस लाइसेंस के तहत। X पर किसी CEO का “जल्द ही”, बिना पैरामीटर संख्या और बिना लाइसेंस पाठ, इस लेख में प्रतिबद्धता का सबसे कमज़ोर रूप है। अगर वे Apache 2.0 के तहत भेजते हैं तो यह ओपन इकोसिस्टम को बहुत बदल देता है। अगर वे राजस्व द्वार वाले अनोखे लाइसेंस के तहत भेजते हैं, तो यही अब उद्योग का डिफ़ॉल्ट है और ओपन वेट एक गुण के बजाय मार्केटिंग श्रेणी बन जाते हैं।
क्या Ornith-1.5 का स्व-सुधार परिणाम दोहराया जाता है। स्व-निर्मित पाठ्यक्रम से बाहर के कामों पर एक स्वतंत्र मूल्यांकन ही इसे तय करेगा। यह सूची में सबसे ज़्यादा अस्थिरता वाला मद है: यह या तो 2026 का सबसे महत्वपूर्ण परिणाम है या स्व-निर्मित बेंचमार्कों के बारे में एक चेतावनी-कथा, और मुझे फ़िलहाल नहीं पता कि कौन-सा।
क्या Aion 1.0 Plan असल में आता है और किस गति पर चलता है। Windows में 14B रीज़निंग मॉडल वाकई एक नई श्रेणी है। अगर यह योग्य हार्डवेयर पर 3 टोकन प्रति सेकंड चलता है, तो यह डेमो है। अगर 20 पर चलता है, तो यह बदल देता है कि डेस्कटॉप एप्लिकेशन क्या मान सकता है।
CVE एट्रिब्यूशन कर्व। लगातार महीनों में 6, 15, 35। अगर अप्रैल से अगस्त तक यही रफ़्तार रही, तो जॉर्जिया टेक का डेटा साल का सबसे असरदार AI सुरक्षा प्रकाशन होगा जब वह आएगा।
क्या कोई समीक्षा टूलिंग बनाता है। एजेंट जो बना सकते हैं और इंसान जो सत्यापित कर सकते हैं, उनके बीच की खाई 2027 की परिभाषित समस्या है, और आज तकरीबन सारा वेंचर पैसा जनरेशन में जा रहा है, सत्यापन में नहीं। जो भी वह टूल भेजेगा जो भरोसे से बताए कि किसी डिफ़ के किस 5% हिस्से पर इंसानी नज़र चाहिए, उससे मुक़ाबला करना बहुत मुश्किल होगा।
क्या मेमोरी की कमी में राहत आती है। यह 12 GB फ़ोन द्वार, 32 GB M6 कैप, देर से आए 512 GB Mac टियर और जून में Apple की क़ीमत बढ़ोतरी के पीछे का छिपा चर है। कोई विश्वसनीय व्यक्ति राहत का अनुमान नहीं दे रहा।
और क्या सुरक्षा-सीमा वाले फ़्रंटियर मॉडल अपवाद बने रहते हैं। Mythos 5.1 दोहरे उपयोग के कारणों से सीमित है जिन्हें मैं उचित मानता हूँ, और Project Glasswing सक्रिय रूप से पहुँच बढ़ा रहा है — जून 2026 तक पंद्रह से ज़्यादा देशों में क़रीब 150 संगठन। लेकिन मिसाल क़ायम हो चुकी है: किसी सार्वजनिक कोडिंग बेंचमार्क का सर्वोच्च स्कोरर अब ऐसी चीज़ है जिसे ज़्यादातर संगठन किसी भी क़ीमत पर नहीं ख़रीद सकते। अगर यह विशेष मामला नहीं बल्कि पैटर्न बन जाए, तो “क्या मेरा संगठन जाँचा जा सकता है” मॉडल चुनने का मानदंड बन जाता है, और अमेरिका से बाहर ओपन वेट का तर्क लागत का मामला ही नहीं रह जाता।
अक्सर पूछे जाने वाले प्रश्न
सितंबर 2026 में सबसे अच्छा LLM कौन-सा है?
एग्रीगेट पर, Claude Fable 5.1 Artificial Analysis’ के Intelligence Index v4.1.1 में 65.7 के साथ शीर्ष पर है, Claude Opus 5 63.0 पर, Claude Fable 5 62.1 पर, Grok 4.6 60.9 पर और GPT-5.6 Sol 58.9 पर। लेकिन एग्रीगेट उन अंतरों को दबा देता है जो मायने रखते हैं। GPT-5.6 Sol ब्राउज़िंग में BrowseComp पर 90.4% के साथ आगे है; Gemini 3.8 Flash प्रति मिलियन इनपुट टोकन $0.75 पर 58.7 देता है; GLM-5.3-Flash $0.15 पर 57.5 देता है। ज़्यादातर वास्तविक वर्कलोड के लिए शीर्ष आठ मॉडल आपस में बदले जा सकते हैं और फ़ैसला रैंकिंग के बजाय क़ीमत, लेटेंसी, कैश अर्थशास्त्र और लाइसेंस पर होना चाहिए।
फ़िलहाल सबसे अच्छा ओपन-वेट मॉडल कौन-सा है?
यह आपके हार्डवेयर और लाइसेंस सहनशीलता पर निर्भर है। GLM-5.3 (753B) 59.5 के साथ सबसे ऊँचा स्कोर करता है लेकिन $10 अरब राजस्व वाले सुरक्षा-समीक्षा द्वार के साथ मालिकाना लाइसेंस लाता है। DeepSeek V4 Pro (कुल 1.6T, सक्रिय 49B) MIT लाइसेंस वाला है और Terminal-Bench 2.1 पर 87.9 स्कोर करता है, लेकिन क्लस्टर चाहिए। ऐसी मशीन जो वाकई आपकी हो, उसके लिए Qwen3.8-27B या Gemma 4 31B — दोनों Apache 2.0 — 32 GB में समाने वाले सबसे अच्छे मॉडल हैं।
क्या 2026 में वाइब कोडिंग ख़त्म हो गई है?
शब्द मर रहा है; व्यवहार दो हिस्सों में बँट गया। मूल अर्थ में वाइब कोडिंग — प्रॉम्प्ट करें, स्वीकारें, डिफ़ न पढ़ें — फेंकने लायक काम के लिए सही बनी हुई है: स्क्रिप्ट, प्रोटोटाइप, एक-बार के विश्लेषण। जो कुछ भी शिप होता है, उसके लिए इसकी जगह स्पेक-चालित एजेंटिक इंजीनियरिंग ने ली है: लिखित स्पेसिफ़िकेशन, सैंडबॉक्स, एक टेस्ट सूट जो एजेंट को पास करना है, और नतीजे के डिफ़ की असली समीक्षा। ख़तरनाक बीच वाला हिस्सा — बिना समीक्षा वाला प्रोडक्शन कोड — वही है जहाँ से 2026 की हर दर्ज घटना आई।
क्या AI कोडिंग असल में डेवलपर्स को तेज़ करती है?
अकेला रैंडमाइज़्ड कंट्रोल्ड ट्रायल कहता है नहीं। METR ने पाया कि परिपक्व कोडबेस पर 2025 की शुरुआती AI टूल के साथ अनुभवी डेवलपर 19% धीमे थे, जबकि उन्हें लगा कि वे 20% तेज़ हुए — 40 प्रतिशत अंक की अधिक आँकी गई। उनका 2026 का फ़ॉलो-अप साफ़-सुथरे ढंग से नहीं चलाया जा सका क्योंकि डेवलपर्स ने AI के बिना काम करने से इनकार कर दिया। सर्वे 3× गति गुणक बताते हैं लेकिन काम के मूल्य में सिर्फ़ 1.4–2× बदलाव। मेरी राय: अनजान काम, बॉयलरप्लेट, टेस्ट और माइग्रेशन पर बड़े लाभ; जिन कोडबेस को आप अंदर से जानते हैं उन पर छोटे या नकारात्मक लाभ।
AI-जनित कोड कितना जोखिम भरा है?
मापने योग्य जोखिम भरा और धीरे सुधरता हुआ। Veracode ने पाया कि AI-जनित 45% सैंपल OWASP Top 10 की कोई कमज़ोरी लाते हैं, जिसमें Java सबसे ख़राब 72% पर है। Apiiro ने मापा कि AI-सहायता पाने वाले डेवलपर 3–4× तेज़ी से कमिट बनाते हैं और सुरक्षा निष्कर्ष 10× तेज़ी से निकलते हैं, जिसमें विशेषाधिकार-वृद्धि के रास्ते 322% बढ़े। AI-जनित कोड का लगभग 20% ऐसे पैकेजों का ज़िक्र करता है जो मौजूद नहीं हैं, और उनमें से 43% हॉलुसिनेटेड नाम लगातार दोहराए जाते हैं — जो आपूर्ति श्रृंखला हमले की सतह है। हल हर कमिट पर स्वचालित गेट हैं, परहेज़ नहीं।
क्या मैं अपने ही कंप्यूटर पर ऑफ़लाइन अच्छा LLM चला सकता हूँ?
हाँ, और 2026 पहला साल है जब यह बिना किसी शक के सच है। 8 GB मेमोरी पर Gemma 4 E4B वाकई उपयोगी है। 32 GB पर Qwen3.8-27B या Gemma 4 31B Apache 2.0 के तहत मज़बूत मल्टीमॉडल मॉडल हैं। 128 GB पर gpt-oss-120b सबसे अच्छा संतुलन है। जो किसी भी उपभोक्ता मशीन पर नहीं समाता वह असली फ़्रंटियर है: Kimi K3 2.8 ट्रिलियन पैरामीटर और DeepSeek V4 Pro 1.6 ट्रिलियन, दोनों को क्लस्टर चाहिए।
Microsoft Aion 1.0 क्या है?
2 जून 2026 को Build में घोषित और Windows 11 में भेजे गए ऑन-डिवाइस मॉडलों का एक परिवार। Aion 1.0 Instruct सारांश, पुनर्लेखन और एक्सट्रैक्शन के लिए एक छोटा मॉडल है जो आधुनिक CPU पर बिना NPU के चलता है, Edge’ के Prompt, Summarizer, Writer और Rewriter JavaScript APIs के ज़रिए उपलब्ध है, और जुलाई 2026 से Hugging Face पर ओपन वेट के साथ है। Aion 1.0 Plan 14 अरब पैरामीटर वाला रीज़निंग और टूल-कॉलिंग मॉडल है जिसकी 32K कॉन्टेक्स्ट विंडो एजेंटिक वर्कफ़्लो के लिए है, जिसके लिए 40-TOPS न्यूनतम NPU वाला Copilot+ PC चाहिए, और सितंबर 2026 की शुरुआत में यह अब भी “आने वाले महीनों में” था।
AI फ़ीचरों के लिए फ़ोनों को 12 GB RAM क्यों चाहिए?
क्योंकि ऑन-डिवाइस मॉडल कंप्यूट-बाउंड नहीं, मेमोरी-बाउंड होते हैं। Apple’ का AFM 3 Core Advanced 20 अरब पैरामीटर वाला स्पार्स मॉडल है जो फ़्लैश स्टोरेज में रहता है और ज़रूरत पर राउटेड एक्सपर्ट्स को DRAM में स्वैप करता है — जिसके लिए जगह चाहिए, OS, ऐप और कैमरा पाइपलाइन के ऊपर। Ming-Chi Kuo बताते हैं कि iOS 27 के दो फ़ीचर 12 GB माँगते हैं। Google’ की Gemini Intelligence की भी वही 12 GB न्यूनतम है। 9 GB और 12 GB के बीच का अंतर वर्किंग सेट है, बाज़ार विभाजन नहीं।
क्या लोकल AI के लिए NPU रखना फ़ायदेमंद है?
मार्केटिंग के दावे से कम। 45-TOPS NPU पर 8B मॉडल लगभग 5 टोकन प्रति सेकंड बनाता है, क्योंकि टोकन जनरेशन कंप्यूट के बजाय मेमोरी बैंडविड्थ से सीमित है। NPU हमेशा-चालू, कम बिजली, छोटे-बर्स्ट कामों के लिए उत्कृष्ट हैं — वही जो ऑपरेटिंग सिस्टम लगातार चलाता है। लैपटॉप पर इंटरैक्टिव चैट के लिए GPU या CPU रास्ता अक्सर तेज़ होता है। मेमोरी बैंडविड्थ और क्षमता पर ख़रीदें; ख़रीदारी में TOPS को लगभग अर्थहीन मानें।
क्या ओपन-वेट मॉडल असल में ओपन सोर्स हैं?
ज़्यादातर नहीं। DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) और Ornith-1.5 (MIT) वाकई उदार लाइसेंस लाते हैं। GLM-5.3 के लिए $10 अरब से ज़्यादा राजस्व वाली कंपनियों को Z.ai’ की सुरक्षा समीक्षा पास करनी होती है; Kimi K3 राजस्व-स्तरीय लाइसेंस का इस्तेमाल करता है; MiniMax M3 किसी भी व्यावसायिक उपयोग पर स्पष्ट “Built with MiniMax M3” एट्रिब्यूशन और $20 मिलियन से ज़्यादा राजस्व पर लिखित अनुमति अनिवार्य करता है। इनमें से कोई भी प्रशिक्षण डेटा या प्रशिक्षण कोड नहीं छोड़ता। “ओपन वेट” सही शब्द है; “ओपन सोर्स” बेईमानी कर रहा है।
क्या API के बजाय मॉडल लोकल चलाना सस्ता है?
सिर्फ़ टोकन लागत पर लगभग कभी नहीं। एजेंटिक काम का एक सामान्य महीना — 40M इनपुट और 3M आउटपुट टोकन — GLM-5.3-Flash पर लगभग $7 और Gemini 3.8 Flash पर लगभग $41 का पड़ता है। तीन साल में परिशोधित $2,400 का लोकल बॉक्स बिजली से पहले लगभग $67 महीना है। लोकल हार्डवेयर लागत पर फ़्रंटियर के शीर्ष को हराता है और उसके निचले सिरे से हारता है। लोकल डेटा रेज़िडेंसी, रेट-लिमिट की आज़ादी, वर्ज़न पिनिंग और ऑफ़लाइन संचालन के लिए ख़रीदें — या इसलिए कि आपको वर्कस्टेशन वैसे भी चाहिए था।
2026 में EU AI Act क्या माँगता है?
2 अगस्त 2026 से, प्रवर्तन शक्तियाँ और अनुच्छेद 50 की पारदर्शिता ड्यूटी सामान्य-प्रयोजन AI पर लागू होती हैं, और जुर्माने अब लगाए जा सकते हैं। डिजिटल ऑम्निबस, रेगुलेशन (EU) 2026/1744, 27 जुलाई 2026 को लागू हुआ और तय तारीखें दे गया: 2 दिसंबर 2026 वॉटरमार्किंग छूट अवधि ख़त्म करता है; 2 अगस्त 2027 बाज़ार में पहले से मौजूद GPAI मॉडलों के संक्रमण को बंद करता है; 2 दिसंबर 2027 अनुलग्नक III के तहत स्वतंत्र उच्च-जोखिम सिस्टम पर लागू है; 2 अगस्त 2028 नियामित उत्पादों में अंतर्निहित उच्च-जोखिम AI को कवर करता है। अगर आप मॉडलों को प्रशिक्षित नहीं बल्कि उनके ऊपर बनाते हैं, तो GPAI के ज़्यादातर दायित्व प्रदाता के पास हैं — आप पर पारदर्शिता और उच्च-जोखिम वर्गीकरण आते हैं। यह कानूनी सलाह नहीं है।
AI एजेंट बिना निगरानी कितनी देर काम कर सकता है?
METR उस काम की अवधि मापता है जो मॉडल 50% सफलता के साथ स्वायत्त रूप से पूरा करता है। यह आँकड़ा 2022 में लगभग 30 सेकंड से बढ़कर 2026 में फ़्रंटियर सिस्टमों के लिए 14 घंटे से ज़्यादा हो गया, METR’ के हाइब्रिड फ़िट पर लगभग 196 दिन की दोगुनी होने की दर, या 2023 के बाद के मॉडलों तक सीमित करने पर 131 दिन। भरोसा अंतराल बहुत चौड़े हैं — Claude Opus 4.5’ का 320-मिनट का दायरा 170 से 729 मिनट तक है — और METR’ के 31 लंबे कामों में सिर्फ़ 5 में मापे गए मानवीय बेसलाइन हैं। बढ़ा-चढ़ाकर देखें तो यह 2027 में लगभग एक कामकाजी दिन की स्वायत्त कार्य अवधि है।
कोडिंग के लिए ख़ास तौर पर कौन-सा मॉडल इस्तेमाल करूँ?
चुनें नहीं, रूट करें। प्लानिंग और आर्किटेक्चर उस सबसे सक्षम मॉडल को जिसका ख़र्च आप उठा सकें (Claude Fable 5.1); लंबी अवधि के कार्यान्वयन का बड़ा हिस्सा आधी क़ीमत पर Claude Opus 5 को; ज़्यादा मात्रा का यांत्रिक काम $0.15/$0.47 पर GLM-5.3-Flash को; क्लाइंट डेटा को छूने वाला सब कुछ लोकल ओपन-वेट मॉडल को; और नाम बदलना, डॉकस्ट्रिंग और lint फ़िक्स एक छोटे लोकल मॉडल को। मॉडल IDs ऐसे लिखें कि एक बदलना एक पंक्ति का बदलाव हो — जून और सितंबर 2026 के बीच चार लैब ने शीर्ष-दस का मॉडल भेजा।
मुख्य बात
बारह महीने पहले, AI में दिलचस्प सवाल यह था कि कौन-सा मॉडल सबसे होशियार है। AI 2026 की स्थिति यह है कि यह सवाल लगभग नीरस हो चुका है। सबसे अच्छे उपलब्ध एग्रीगेट पर शीर्ष दस मॉडल 8.2 अंकों में फैले हैं, और उनमें सबसे सस्ता सबसे महँगे के ख़र्च का सिर्फ़ एक-सत्तरवाँ हिस्सा है।
उसकी जगह जो आया है वह ज़्यादा उपयोगी और कम रोमांचक है: क्या आप यह सत्यापित कर सकते हैं कि ये चीज़ें क्या बनाती हैं, इतनी तेज़ी से कि उनके साथ बने रहें?
यही एक सवाल इस लेख के हर निष्कर्ष को समझाता है। यह समझाता है कि SWE-bench 96% पर क्यों संतृप्त हुआ और जानकारी देने से क्यों रुक गया। यह समझाता है कि AI कोडिंग टूल अपनाने का आँकड़ा 90% तक क्यों पहुँचा जबकि भरोसा 29% पर गिरा। यह समझाता है कि Veracode’ की सुरक्षा विफलता दर क्यों नहीं हिली जबकि क्षमता आसमान छू रही थी, क्योंकि क्षमता और सत्यापन-योग्यता अलग-अलग अक्ष हैं और सिर्फ़ एक पर अनुकूलन हो रहा है। यह समझाता है कि DORA ने क्यों पाया कि लाभ टूल से नहीं, संगठन से आता है। और यह समझाता है कि 2026 में जो तरीक़ा असल में काम करता है — स्पेसिफ़िकेशन, सैंडबॉक्स, टेस्ट गेट, असली समीक्षा — वह डेमो से इतना कम जादुई क्यों लगता है।
चार बातें जो मैं साथ ले जाऊँगा।
फ़्रंटियर किसी की भी उम्मीद से तेज़ी से कमोडिटी बन गया, और ओपन-वेट का अंतर अब लगभग छह महीने का है। MIT लाइसेंस वाला 397B मॉडल SWE-bench पर पिछली जेनरेशन’ के बंद फ़्रंटियर को हरा देता है। 753B का ओपन-वेट मॉडल एग्रीगेट इंडेक्स पर GPT-5.6 Sol से आगे है। ऐसी दुनिया की तैयारी करें जहाँ मॉडल आपका विभेदक न हो, क्योंकि अभी तो वह लगभग है ही नहीं।
बेंचमार्क से पहले लाइसेंस पढ़ें। क्षमता अभिसरित हो रही है; शर्तें अलग हो रही हैं। Z.ai रिलीज़ों के बीच MIT से दूर चला गया। Meta ने बिना लाइसेंस पाठ वेट का वादा किया है। Anthropic’ का सबसे अच्छा कोडिंग मॉडल राष्ट्रीयता से सीमित है। किसी व्यावसायिक ख़रीदार के लिए, चार अंक का बेंचमार्क उस लाइसेंस से कम क़ीमती है जिसे उसका वकील नब्बे सेकंड में पढ़ सके।
सत्यापन ही अब पूरा खेल है, और उसमें लगभग कोई पैसा नहीं लगा रहा। एजेंट एक दिन का काम बना सकते हैं; हम उसे ऐसे टूल से समीक्षा करते हैं जो एक घंटे का काम समीक्षा करने के लिए बने हैं। अगर आप अगले बारह महीनों में इंजीनियरिंग मेहनत कहाँ लगानी है चुन रहे हैं, तो प्रॉम्प्ट तकनीक के बजाय टेस्ट, स्पेसिफ़िकेशन और समीक्षा टूलिंग पर लगाएँ। प्रॉम्प्ट तकनीक हर मॉडल रिलीज़ के साथ मूल्य खोती है। सत्यापन का ढाँचा चक्रवृद्धि रूप से बढ़ता है।
और ऑफ़लाइन AI असली हो गया, ऐसे मेमोरी बजट पर जो अभी महँगा हो गया है। 27 अरब पैरामीटर वाला Apache लाइसेंस वाला मल्टीमॉडल मॉडल उस मशीन पर चलता है जिसे आप €2,500 में ख़रीद सकते हैं। Windows ऑपरेटिंग सिस्टम में मॉडल भेजता है। आपका फ़ोन फ़्लैश से 20 अरब पैरामीटर वाला स्पार्स मॉडल चलाता है। इस पर हर सीमा — 12 GB फ़ोन द्वार, 32 GB लैपटॉप कैप, 40-TOPS की न्यूनतम सीमा — ऐसे बाज़ार में मेमोरी आवंटन का फ़ैसला है जहाँ DRAM की कमी है, सिलिकॉन की सीमा नहीं।
आज मैं असल में जो सेटअप बनाऊँगा: डिवाइस पर Gemma 4 E4B हमेशा-चालू टियर के लिए; अपने हार्डवेयर पर Qwen3.8-27B उस हर चीज़ के लिए जो इमारत से बाहर नहीं जानी चाहिए; $0.15/$0.47 पर GLM-5.3-Flash ज़्यादा मात्रा वाले बीच के हिस्से के लिए; और Claude Opus 5 या Fable 5.1 प्लानिंग और वाकई कठिन समस्याओं के लिए, कैशिंग चालू करके। इनके बीच रूटिंग एक कॉन्फ़िग फ़ाइल में करें, और उम्मीद रखें कि वह फ़ाइल तीन महीने में फिर लिखनी पड़ेगी।
दिसंबर में इसे फिर देखें। Meta ने या तो वेट भेजे होंगे या नहीं। Aion 1.0 Plan या तो असली होगा या भाप। Ornith का स्व-सुधार परिणाम या तो दोहराया जा चुका होगा या चुपचाप ग़ायब हो चुका होगा। और CVE एट्रिब्यूशन कर्व हमें बता चुका होगा कि 2026 वह साल था जब उद्योग ने अपने द्वार ख़ुद कसे, या वह साल जब उसने किसी और के कसे जाने का इंतज़ार किया।
क्या आप EU में प्रोडक्शन में ओपन-वेट मॉडल चला रहे हैं, या एजेंट-लिखित कोड को ऐसी समीक्षा प्रक्रिया से भेज रहे हैं जिस पर आपको वाकई भरोसा है? मुझे ख़ास तौर पर दो चीज़ों में दिलचस्पी है: एजेंट भूमिका के हिसाब से मापा गया टोकन-लागत बँटवारा, और ऐसा कुछ भी जो हज़ार पंक्तियों के एजेंट डिफ़ की समीक्षा में काम करे। सुधार और विरोधी सबूत स्वागत योग्य हैं — तस्वीर बदलने पर यह लेख अपडेट होता है।
अंतिम अपडेट: 3 सितंबर 2026।


