
 हिन्दी
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 العربية

रात क़रीब 11 बजे, तीन कॉफ़ी पी चुकने के बाद, OpenCode’s मॉडल पिकर को घूरते हुए एक बहुत ख़ास किस्म की डिसीज़न फ़टीग होती है।
आपके पास Z.ai की कुंजी है। आपके पास MiniMax की कुंजी है। दोनों मॉडल दस लाख टोकन के कॉन्टेक्स्ट का दावा करते हैं। दोनों ओपन-वेट हैं। फ्रंटियर क्लोज़्ड मॉडल के मुक़ाबले दोनों की लागत लगभग कुछ भी नहीं है। दोनों के पास एक बेंचमार्क चार्ट है जिसमें वे जीत रहे हैं। और आप बस यह जानना चाहते हैं कि किसे अपना डिफ़ॉल्ट बनाएँ ताकि आप काम पर लौट सकें।
यह लेख उसी सवाल का जवाब है — लंबा वाला, क्योंकि छोटा जवाब (“GLM-5.3-Flash, शायद”) क़रीब छह ऐसी चेतावनियाँ छिपाता है जो उन्हें छोड़ने पर आपको भारी पड़ेंगी।
मैंने आर्किटेक्चर का ब्यौरा, विक्रेताओं के बेंचमार्क, निष्पक्ष मूल्यांकन, टियर वाले लॉन्ग-कॉन्टेक्स्ट जाल सहित असली प्रति-टोकन प्राइसिंग, OpenCode’s खुद की प्रकाशित उपयोग टेलीमेट्री, और दोनों की असली कॉन्फ़िगरेशन फ़ाइलें निकाली हैं। फिर मैंने प्रेस-रिलीज़ के परिदृश्य के बजाय एक सामान्य कामकाजी महीने का लागत-गणित किया।
नतीजा यह रहा।
TL;DR — 30 सेकंड का फ़ैसला
GLM-5.3-Flash को अपना डिफ़ॉल्ट OpenCode मॉडल बनाएँ। यह लगभग हर उस एजेंटिक और कोडिंग बेंचमार्क पर ज़्यादा स्मार्ट है जो मायने रखता है, प्रति टोकन इसकी लागत लगभग आधी है, यह वाक़ई MIT-लाइसेंस्ड है, और OpenCode कम्युनिटी असल में यहीं गई है।
MiniMax M3 को अपनी स्पीड लेन के रूप में रखें। यह लगभग तीन गुना तेज़ जनरेट करता है और पहले टोकन पर लगभग दोगुनी तेज़ी से जवाब देता है। ज़्यादा टर्न वाले, कम कठिनाई वाले लूप में — फ़ाइलों के नाम बदलना, टेस्ट स्कैफ़ोल्डिंग, डॉक जनरेशन, लिंट-और-फ़िक्स पास, बड़े मशीनी रिफ़ैक्टर — वह गति का अंतर इंटेलिजेंस के अंतर से ज़्यादा महसूस होता है।
ईमानदार बात, एक लाइन में: GLM-5.3-Flash बेहतर सोचता है, MiniMax M3 तेज़ टाइप करता है। एजेंटिक कोडिंग ज़्यादातर सोचने की समस्या है, इसलिए डिफ़ॉल्ट जगह GLM की है। लेकिन अगर आप दोनों नहीं चला रहे, तो आप थ्रूपुट बेकार छोड़ रहे हैं, और OpenCode दोनों को चलाना बेहद आसान बना देता है।
त्वरित तुलना तालिका
| GLM-5.3-Flash | MiniMax M3 | |
|---|---|---|
| निर्माता | Z.ai (Zhipu AI) | MiniMax |
| रिलीज़ | 26 अगस्त 2026 | 1 जून 2026 |
| कुल पैरामीटर | 320B | ~428B |
| प्रति टोकन सक्रिय | 18B | ~23B |
| आर्किटेक्चर | हाइब्रिड KDA लीनियर अटेंशन + NoPE स्पार्स MLA, MoE (288 में से 8 एक्सपर्ट + 1 शेयर्ड) | GQA बैकबोन + MiniMax Sparse Attention (MSA), स्पार्स MoE |
| कॉन्टेक्स्ट विंडो | 1M (1,048,576) | 1M (512K गारंटीड फ़्लोर) |
| अधिकतम आउटपुट | 131,072 टोकन | 262,144 टोकन तक |
| मल्टीमॉडल इनपुट | टेक्स्ट, इमेज, वीडियो, फ़ाइल | टेक्स्ट, इमेज, वीडियो |
| लाइसेंस | MIT | MiniMax Community License |
| API इनपुट कीमत | $0.15 / 1M ($0.03 कैश्ड) | $0.30 / 1M ($0.06 कैश्ड) |
| API आउटपुट कीमत | $0.50 / 1M | $1.20 / 1M |
| लॉन्ग-कॉन्टेक्स्ट सरचार्ज | कोई प्रकाशित नहीं | 512K इनपुट से ऊपर 2× |
| आउटपुट गति | ~48.6 tok/sec | ~147.9 tok/sec |
| पहले टोकन तक का समय | ~1.51s | ~0.99s |
| Terminal-Bench 2.1 | 84.3 | 66.0 |
| Artificial Analysis Intelligence | 57 | 45 |
| OpenCode टोकन हिस्सा | 10.3% | 1.12% |
| थिंकिंग मोड | हमेशा चालू (बंद नहीं कर सकते) | कॉन्फ़िगर करने योग्य |
| सब्सक्रिप्शन एंट्री प्राइस | $18/mo (GLM Coding Plan Lite) | $20/mo (MiniMax Plus) |
प्राइसिंग हर विक्रेता की आधिकारिक लिस्ट प्राइसिंग है। OpenRouter जैसे राउटेड गेटवे अक्सर कम प्रभावी कीमतें दिखाते हैं क्योंकि वे थर्ड-पार्टी होस्ट्स के बीच लोड-बैलेंस करते हैं — इस पर नीचे और बात होगी, क्योंकि यह मायने रखता है।
अभी यही तुलना क्यों मायने रखती है
बारह महीने पहले ओपन-वेट कोडिंग की बहस इस बात पर थी कि ये मॉडल आख़िर काम के लायक हैं भी या नहीं। वह सवाल तय हो चुका है। 2026 की दूसरी छमाही की बहस ज़्यादा सीमित और ज़्यादा दिलचस्प है: आप अपना एजेंट हार्नेस किस ओपन-वेट मॉडल पर लगाते हैं, और ग़लत चुनने पर आपको क्या कीमत चुकानी पड़ती है?
OpenCode ने उस सवाल को और पैना कर दिया। यह कोई चैट विंडो नहीं है — यह टर्मिनल में चलने वाला एजेंट है जो योजना बनाता है, फ़ाइलें पढ़ता है, उन्हें संपादित करता है, कमांड चलाता है, आउटपुट पढ़ता है और दोहराता है। यह वर्कलोड मॉडलों को ऐसे तरीक़ों से परखता है जो चैट बेंचमार्क कभी सामने नहीं लाता। जो मॉडल सुंदर, अलग-थलग फ़ंक्शन लिख लेता है, वह OpenCode में बेकार साबित हो सकता है अगर वह बीस टूल कॉल के बाद धागा खो दे, या फ़ाइल पाथ का भ्रम पैदा करे, या यह तय करने में 90,000 टोकन जला दे कि क्या करना है।
GLM-5.3-Flash और MiniMax M3 इस समय उस बहस में सबसे भरोसेमंद तरीक़े से मौजूद दो ओपन-वेट मॉडल हैं। ये एक-दूसरे से तीन महीने के भीतर आए, इनका लक्ष्य एक ही काम है, इनकी कीमतें एक ही परिमाण के दायरे में हैं, और इन्होंने लगभग उलटे इंजीनियरिंग दाँव लगाए हैं।
दिलचस्प बात वही आख़िरी हिस्सा है।
GLM-5.3-Flash असल में क्या है
GLM-5.3-Flash की लॉन्चिंग साल की बेहतरीन लॉन्चिंग में से एक रही, और यह संयोग नहीं था।
Z.ai ने किसी चीज़ पर अपना नाम लगाने से पहले, यह मॉडल OpenRouter पर इस कोडनेम से आया “Ox Alpha.” कोई लैब का नाम नहीं, लगभग मुफ़्त एक्सेस, कोई मार्केटिंग नहीं। यह चुपचाप OpenRouter और OpenCode के उपयोग चार्ट में शीर्ष पर पहुँचा और क़रीब एक हफ़्ते वहीं रहा, जबकि कम्युनिटी में बहस चलती रही कि इसे किसने बनाया। 26 अगस्त 2026 को Z.ai ने पुष्टि की कि यह उनका है और वेट्स को MIT के तहत ओपन-सोर्स कर दिया।
किसी मॉडल को खुले में उतारना और दावा करने से पहले उसे भरोसा कमाने देना सचमुच अच्छा क़दम है, और यह काम कर गया — बेंचमार्क चार्ट किसी के देखने से पहले ही मॉडल के पीछे असली उपयोग डेटा था।
आर्किटेक्चर, आसान भाषा में
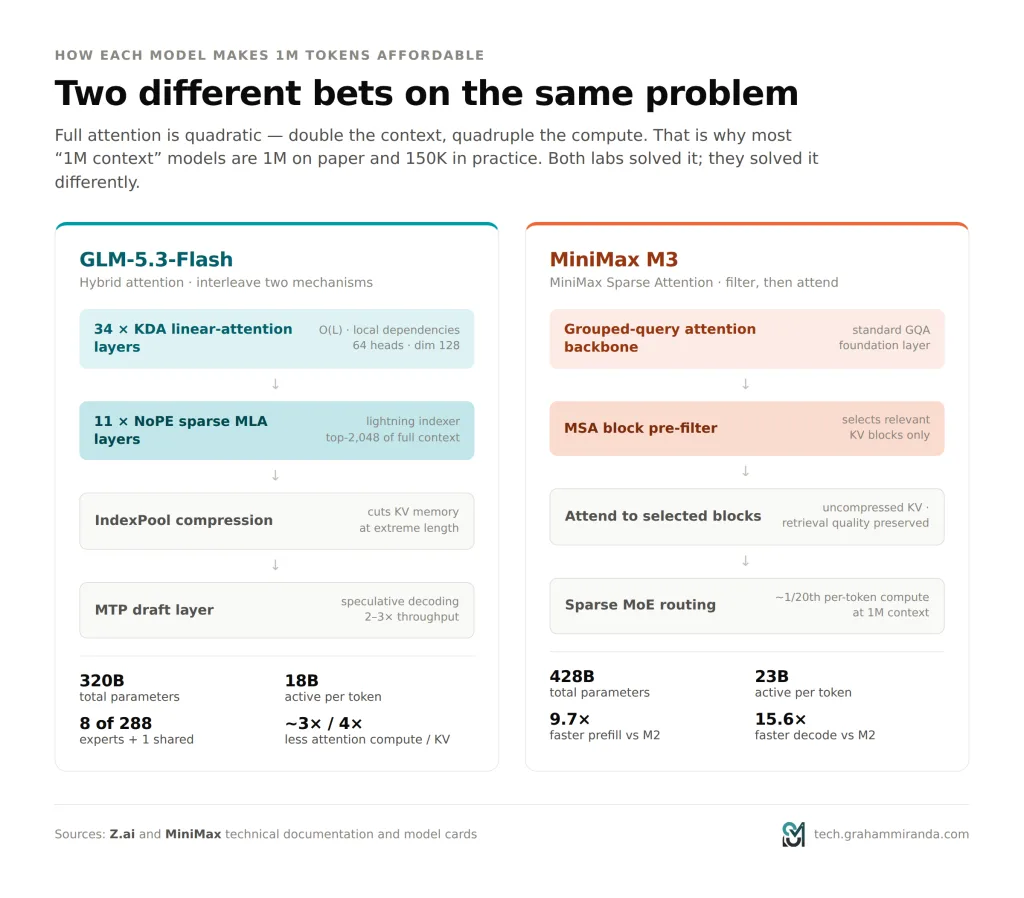
GLM-5.3-Flash 320 अरब पैरामीटर का मिक्सचर-ऑफ़-एक्सपर्ट्स मॉडल है जो प्रति टोकन केवल क़रीब 18 अरब पैरामीटर सक्रिय करता है। यह हर टोकन को 288 राउटेड एक्सपर्ट्स में से 8 और एक शेयर्ड एक्सपर्ट से गुज़ारता है — किसी भी फ़ॉरवर्ड पास पर एक्सपर्ट वेट्स का लगभग 2.8% चलता है। “Flash” का अर्थशास्त्र यहीं से आता है: फ्रंटियर स्तर का ज्ञान, छोटे मॉडल की इन्फ़रेंस लागत।
अटेंशन डिज़ाइन ही वाक़ई नया हिस्सा है। एक समान अटेंशन मेकैनिज़्म के बजाय यह दो को मिलाकर चलाता है:
- 34 KDA लीनियर-अटेंशन लेयर। ये सीक्वेंस लंबाई के अनुपात में क्वाड्रेटिक के बजाय लीनियर समय में चलती हैं। ये लोकल निर्भरताओं को सस्ते में संभालती हैं और आपका कॉन्टेक्स्ट बढ़ने पर थ्रूपुट को धराशायी होने से रोकती हैं।
- 11 NoPE स्पार्स MLA लेयर। बिना पोज़िशनल एम्बेडिंग के DeepSeek-शैली का मल्टी-हेड लेटेंट अटेंशन, जिसके आगे एक “लाइटनिंग इंडेक्सर” है जो पूरे कॉन्टेक्स्ट में से सबसे प्रासंगिक 2,048 टोकन चुनता है। यही लंबी दूरी की रिट्रीवल गुणवत्ता बचाता है।
यहाँ एक IndexPool कम्प्रेशन स्टेप भी है जो अत्यधिक कॉन्टेक्स्ट लंबाई पर मेमोरी ओवरहेड घटाने के लिए इंडेक्सर key वेक्टरों को समेटता है, और एक मल्टी-टोकन प्रेडिक्शन हेड स्पेक्युलेटिव डिकोडिंग के लिए — vLLM इम्प्लीमेंटेशन डिफ़ॉल्ट रूप से प्रति डिकोड स्टेप 5 स्पेक्युलेटिव टोकन लेता है, जो छोटे बैच साइज़ पर 2–3× थ्रूपुट के बराबर है।
पूरे GLM-5.3 के मुक़ाबले कुल असर: लगभग 3× कम अटेंशन कंप्यूट और 4× से ज़्यादा छोटा KV कैश। इसीलिए 1M-टोकन का कॉन्टेक्स्ट सिर्फ़ सैद्धांतिक रूप से उपलब्ध नहीं, बल्कि असल में काम का है।
कोडिंग एजेंट्स के लिए यह क्यों मायने रखता है
ख़ास तौर पर तीन बातें।
यह मूल रूप से मल्टीमॉडल है, और यहाँ यह कोई दिखावा नहीं है। पहले के GLM कोडिंग मॉडलों की हर उस चीज़ पर पकड़ नहीं थी जिसे वे टेक्स्ट के रूप में नहीं पढ़ सकते थे। अगर आपका एजेंट लेआउट बिगाड़ देता है, तो सिर्फ़ टेक्स्ट वाले मॉडल को पता लगाने का कोई तरीक़ा नहीं है। GLM-5.3-Flash इमेज, वीडियो और फ़ाइलें मूल रूप से लेता है, जिसका मतलब है कि स्क्रीनशॉट से डीबगिंग, डिज़ाइन-टू-कोड, और “क्या यह देखने में सही लगता है” वाले वेरिफ़िकेशन लूप अब मुमकिन हैं।
सोचना अनिवार्य है। आप इसे बंद नहीं कर सकते। आप reasoning_effort को कम, उच्च, या अधिकतम (दस्तावेज़ में डिफ़ॉल्ट है अधिकतम), लेकिन मॉडल काम करने से पहले हमेशा सोचता है। एजेंटिक काम के लिए यही सही डिफ़ॉल्ट है — सस्ते कोडिंग मॉडलों की विफलता यही होती है कि वे योजना बनाए बिना आत्मविश्वास से काम कर देते हैं, और Z.ai ने वह विकल्प हटा दिया है।
पीढ़ीगत छलांग असली है, और वह पोस्ट-ट्रेनिंग से आई है। GLM-5.3 वही बेस मॉडल दोबारा इस्तेमाल करता है जो GLM-5.2 का था। हर बढ़त पोस्ट-ट्रेनिंग को स्केल करने से आई — कथित तौर पर दस गुना ज़्यादा लंबे-क्षितिज वाले टास्क एनवायरनमेंट, जिनमें प्रशिक्षण टास्क बग की पहचान से लेकर टेस्टिंग और डिप्लॉयमेंट तक पूरा सॉफ़्टवेयर जीवन-चक्र सिम्युलेट करते थे, कुछ तो “एक सीनियर इंजीनियर के कई दिनों के काम” के आकार के। DeepSWE v1.1 स्कोर 46.2 से 63.4 हो गया। Terminal-Bench 3.0 4.6 से 28.3 हो गया। ये ट्यूनिंग-शोर वाले अंतर नहीं हैं।
MiniMax M3 असल में क्या है
MiniMax M3 1 जून 2026 को आया और इसने अलग दाँव लगाया: चरम रीज़निंग के लिए ऑप्टिमाइज़ करने के बजाय ऑप्टिमाइज़ करो लगातार चलने वाले एजेंट लूप के अर्थशास्त्र के लिए।
यह ~428B पैरामीटर का स्पार्स MoE है जिसमें प्रति टोकन लगभग 23B पैरामीटर सक्रिय रहते हैं, और यह ग्रुप्ड-क्वेरी-अटेंशन बैकबोन पर बना है जिसके ऊपर MiniMax’s खुद का MSA (MiniMax Sparse Attention) लगा है।
MSA का दाँव
पारंपरिक अटेंशन क्वाड्रेटिक है: कॉन्टेक्स्ट दोगुना, कंप्यूट चार गुना। यही कारण है कि ज़्यादातर “1M कॉन्टेक्स्ट” मॉडल काग़ज़ पर 1M कॉन्टेक्स्ट हैं और व्यवहार में 150K — तकनीकी रूप से आप विंडो भर सकते हैं, पर उसकी कीमत चुकाना आपको पसंद नहीं आएगा।
MSA पूरे अटेंशन की जगह यह लाता है: KV-ब्लॉक सिलेक्शन। यह कॉन्टेक्स्ट को पहले छानकर सिर्फ़ प्रासंगिक ब्लॉक तक लाता है और केवल उन्हीं पर अटेंशन देता है, बिना कम्प्रेस किए key-values इस्तेमाल करता है ताकि फ़िल्टरिंग के बाद भी रिट्रीवल गुणवत्ता बनी रहे। MiniMax नतीजे को लगभग प्रति-टोकन कंप्यूट का 1/20वाँ हिस्सा 1M कॉन्टेक्स्ट पर पिछली पीढ़ी के मुक़ाबले, साथ में 9.7× तेज़ प्रीफ़िल और 15.6× तेज़ डिकोडिंग M2 के मुक़ाबले।
यह सचमुच समझदारी भरा इंजीनियरिंग है, और यह उन आँकड़ों में दिखता है जो आप महसूस करते हैं: ~148 टोकन/सेकंड आउटपुट और पहले टोकन तक एक सेकंड से कम समय। GLM-5.3-Flash’s ~49 tok/sec और ~1.5s TTFT के मुक़ाबले M3 अलग ही श्रेणी का औज़ार लगता है। दर्जनों टर्न वाले लंबे एजेंट लूप में यह हर टास्क पर कई मिनट की घड़ी-समय की दूरी बना देता है।
MiniMax M3 को “8+ घंटे के स्वायत्त कोडिंग सेशन” में सक्षम बताकर मार्केट भी करता है। इसे दावा मानें, स्पेक नहीं — इसकी स्वतंत्र रूप से पुष्टि नहीं हुई है।
M3 असल में कहाँ मज़बूत है
M3 का मल्टीमॉडल और डेस्कटॉप-एजेंट पक्ष कम आँका जाता है। OSWorld-Verified पर 70.06% डेस्कटॉप/GUI एजेंट टास्क के लिए गंभीर स्कोर है। MCP Atlas पर 74.2% बताता है कि इसका टूल-इन्वोकेशन व्यवहार ठोस है। GPQA Diamond पर 92.9% कठिन रीज़निंग में फ्रंटियर के करीब है। और SWE-bench Verified पर 80.5% मज़बूत हेडलाइन आँकड़ा है।
अगर आपका वर्कलोड “ब्राउज़र चलाना, वीडियो पढ़ना, UI चलाना, एक के बाद एक बारह MCP टूल कॉल करना” है, तो M3 कोई समझौता नहीं है। यह शायद बेहतर औज़ार है।
बेंचमार्क — और वे क्या छिपा रहे हैं
यहाँ मुझे सावधान रहना है, क्योंकि दोनों विक्रेता अपने-अपने आँकड़े छापते हैं और दोनों मॉडलों का मूल्यांकन ज़्यादातर अलग-अलग बेंचमार्क सेटों पर। यह संयोग नहीं है। लैब वही मूल्यांकन चुनती हैं जिनमें वे जीतती हैं।
जहाँ वे सीधे ओवरलैप करते हैं
| बेंचमार्क | GLM-5.3-Flash | MiniMax M3 | यह क्या मापता है |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 66.0 | शेल/टर्मिनल एजेंट टास्क |
| Artificial Analysis Intelligence Index | 57 | 45 | समग्र इंटेलिजेंस |
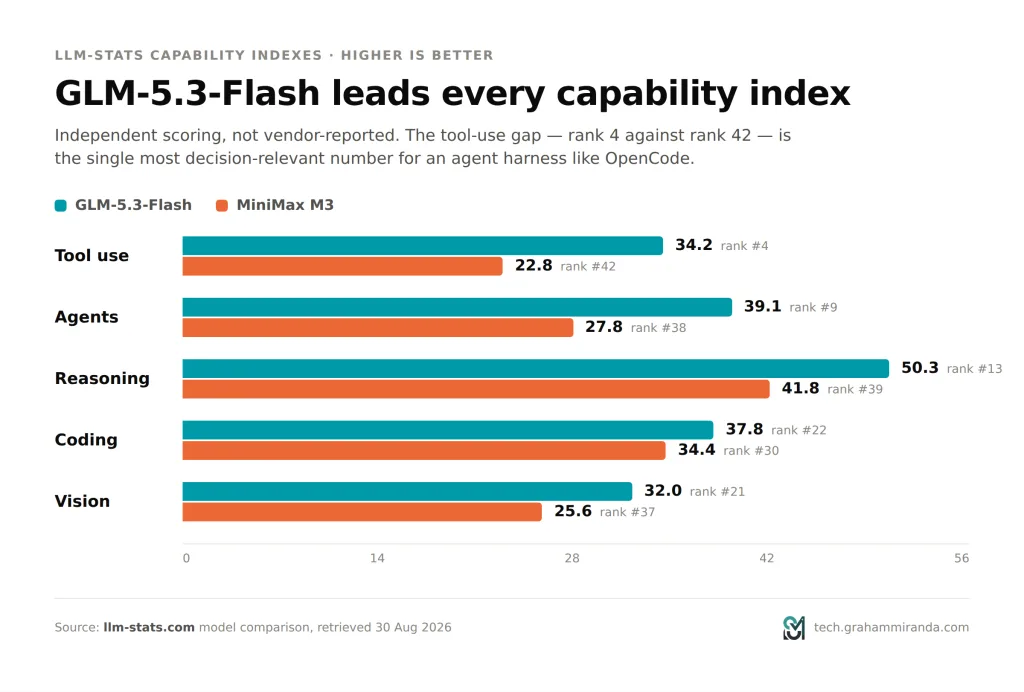
| रीज़निंग इंडेक्स (llm-stats) | 50.3 (#13) | 41.8 (#39) | मल्टी-स्टेप रीज़निंग |
| कोडिंग इंडेक्स (llm-stats) | 37.8 (#22) | 34.4 (#30) | कोड जनरेशन |
| एजेंट्स इंडेक्स (llm-stats) | 39.1 (#9) | 27.8 (#38) | एजेंटिक टास्क पूर्णता |
| टूल यूज़ इंडेक्स (llm-stats) | 34.2 (#4) | 22.8 (#42) | फ़ंक्शन/टूल कॉलिंग |
| विज़न इंडेक्स (llm-stats) | 32.0 (#21) | 25.6 (#37) | मल्टीमॉडल समझ |
OpenCode के लिए Terminal-Bench 2.1 को सबसे ज़्यादा वज़न देना चाहिए, क्योंकि यह सार्वजनिक रूप से इस बात का सबसे करीबी प्रॉक्सी है कि OpenCode असल में क्या करता है: टर्मिनल में एक एजेंट, कमांड चलाते हुए, आउटपुट पढ़ते हुए, दोहराते हुए। वहाँ 18 अंकों का अंतर कोई राउंडिंग एरर नहीं है।
टूल यूज़ रैंकिंग वह दूसरी चीज़ है जिसे मैं नहीं छोड़ूँगा। GLM-5.3-Flash कुल मिलाकर #4 बनाम M3 #42 इस पूरे लेख की सबसे निर्णायक पंक्ति है। एजेंट हार्नेस एक टूल-कॉलिंग मशीन है। जो मॉडल टूल यूज़ में #42 है, वह ज़्यादा ग़लत कॉल, ज़्यादा रीट्राई, ज़्यादा बर्बाद टर्न पैदा करेगा — और हर बर्बाद टर्न आपको टोकन का खर्चा और और घड़ी का समय लेता है, जो चुपचाप M3’s गति का फ़ायदा मिटा देता है।
GLM-5.3-Flash अकेले में कहाँ खड़ा है
- Terminal-Bench 2.1: 84.3 — Claude Opus 4.8 के 85.0 के मुक़ाबले। एक फ्रंटियर क्लोज़्ड मॉडल से एक अंक के भीतर, लगभग 1/30वीं कीमत पर।
- DeepSWE v1.1: 63.4 — GLM-5.2’s 46.2 से ऊपर।
- AutomationBench v1.0.6: 48.8 — Opus 4.8 के 41.0 के मुक़ाबले। किसी फ्रंटियर मॉडल पर यह इसकी सबसे बड़ी बढ़त है।
- Z.ai Code Bench v1.0: 29.0 — Opus 4.8 का स्कोर 29.5 है।
- GDPval-AA v2: 1773 — ज्ञान-कार्य क्षमता पर तुलना किए गए मॉडलों में सर्वोच्च स्कोर।
- Toolathlon: 78.4 · OfficeQA Pro: 62.4 · CharXiv-R: 89.4% · MMVU: 80.5 · Chartography: 78.0
MiniMax M3 अकेले में कहाँ खड़ा है
- SWE-bench Verified: 80.5%
- SWE-bench Pro: 59.0% — कठिन रेपो, Claude Code स्कैफ़ोल्डिंग के साथ चलाए गए
- MCP Atlas: 74.2% · OSWorld-Verified: 70.06% · GPQA Diamond: 92.9%
- KernelBench Hard: 28.8% · SWE-fficiency: 34.8%
वह चेतावनी जो आपको सचमुच लगानी चाहिए
दोनों लैब्स के लॉन्च आँकड़े स्वयं-रिपोर्टेड हैं। ख़ास तौर पर MiniMax’s बेंचमार्क सूट अपनी रिलीज़ के समय निष्पक्ष मूल्यांकन बोर्डों पर नहीं आया था, और Z.ai’s के अपने विश्लेषकों ने नोट किया कि Z.ai’s प्लेटफ़ॉर्म पर पुराने मॉडल वर्ज़न से होने वाले स्वचालित रीडायरेक्ट साफ़ A/B तुलना को सचमुच मुश्किल बनाते हैं।
जहाँ निष्पक्ष एग्रीगेटर — Artificial Analysis और llm-stats — ने अपने मूल्यांकन चलाए हैं, GLM-5.3-Flash हर श्रेणी में जीतता है। यही वह सबूत है जिसे मैं सबसे अधिक महत्व देता हूँ, क्योंकि उन बेंचमार्क को किसी भी विक्रेता ने नहीं चुना था।
वह संकेत जिस पर कोई बात नहीं करता: OpenCode’ का अपना उपयोग डेटा
यही वह हिस्सा है जो मुझे सबसे अधिक प्रभावी लगा, और यही वह हिस्सा है जिसे ज़्यादातर तुलना लेख पूरी तरह छोड़ देते हैं।
OpenCode उन मॉडलों के उपयोग का टेलीमेट्री डेटा प्रकाशित करता है जो उसके अंदर चलते हैं। विक्रेता के दावे नहीं। बेंचमार्क सूट नहीं। असली डेवलपर्स, असली काम करते हुए, यह चुनते हुए कि किसे इस्तेमाल करना जारी रखना है।
| मीट्रिक | GLM-5.3-Flash | MiniMax M3 |
|---|---|---|
| यूनिक उपयोगकर्ता | 566K | 436K |
| प्रोसेस किए गए टोकन का हिस्सा | 10.3% | 1.12% |
| दो महीनों में टोकन | 46T (+100%) | 5T (−51%) |
| पहले हफ़्ते लौटने वाले उपयोगकर्ता | लंबित | 66% (32K उपयोगकर्ता-सप्ताह) |
उन दो टोकन-हिस्से वाले आँकड़ों को फिर से पढ़ें। उपयोगकर्ताओं की संख्या लगभग बराबर है — GLM-5.3-Flash को आज़माने वाले लोग लगभग 30% अधिक हैं — लेकिन नौ गुना से अधिक टोकन थ्रूपुट।
यह अंतर इस बात का नहीं है कि किसने क्या आज़माया। यह इस बात का है कि कौन असली काम के लिए किसके साथ टिका। लोग M3 के साथ सेशन खोलते हैं, और लोग रहते हैं GLM-5.3-Flash के सेशन में।
ट्रेंड लाइन यही बात और ज़ोर से कहती है: GLM-5.3-Flash ने दो महीनों में अपना टोकन वॉल्यूम दोगुना कर लिया, जबकि M3 ने अपना आधा खो दिया।
दो वाजिब चेतावनियाँ। पहली, GLM-5.3-Flash तीन महीने नया है, और नए मॉडलों को नई चीज़ का फ़ायदा मिलता है; इसका कर्व आगे चपटा हो जाएगा। दूसरी, M3’ का पहले हफ़्ते में 66% रिटेंशन एक स्वस्थ आँकड़ा है — जिन लोगों ने इसे चुना है वे इसे छोड़ नहीं रहे, बस उनकी संख्या कम है और वे इसे हल्के ढंग से इस्तेमाल करते हैं। और M3’ की गिरावट कुछ हद तक उसके अपने उत्तराधिकारियों और चीनी ओपन-वेट रिलीज़ की व्यापक गति के कारण है, सिर्फ़ अस्वीकृति नहीं।
लेकिन अगर आप पूछ रहे हैं कि “अनुभवी OpenCode उपयोगकर्ता असल में पूरे दिन क्या चला रहे हैं,” तो डेटा इसका स्पष्ट जवाब देता है।
OpenCode में MiniMax M3 सेट करना
जहाँ श्रेय बनता है, वहाँ देना चाहिए: MiniMax को सेट करना ज़्यादा आसान है, क्योंकि OpenCode में बिल्ट-इन MiniMax प्रोवाइडर आता है। कोई कॉन्फ़िग फ़ाइल नहीं, कोई JSON नहीं, कोई base URL नहीं।
bash
# 1. Install OpenCode (skip if you already have it)
curl -fsSL https://opencode.ai/install | bash
# or: npm i -g opencode-ai

# 2. Authenticate
opencode auth login
# Select: "MiniMax Token Plan (minimax.io)"
# Paste your Subscription Key (starts sk-cp-...)

# 3. Go
opencode
फिर /models सेशन के अंदर चलाएँ और चुनें MiniMax-M3.
की-टाइप का जाल
यह जाल लगभग सभी को फँसाता है। MiniMax Token Plan (सब्सक्रिप्शन) की और पे-एज़-यू-गो API की, ये एक-दूसरे की जगह नहीं चलतीं। इनका रूटिंग और बिलिंग तरीका अलग है। अगर आप Token Plan प्रोवाइडर के साथ PAYG की इस्तेमाल करके ऑथेंटिकेट करते हैं, तो आपको ऑथेंटिकेशन या बैलेंस की गड़बड़ियाँ दिखेंगी जो आउटेज जैसी लगती हैं, जबकि असल में वे की का मेल न होना हैं।
सब्सक्रिप्शन की शुरू होती हैं sk-cp- और इनके लिए असाइन की गई सीट या क्रेडिट ज़रूरी होते हैं। अपनी की MiniMax यूज़र सेंटर के Token Plan पेज से लें, सामान्य API key पेज से नहीं।
अगर आपको मैन्युअल प्रोवाइडर ब्लॉक चाहिए
अगर आपका OpenCode बिल्ड बिल्ट-इन प्रोवाइडर से पुराना है, या आप साफ़ तौर पर PAYG की की ओर इशारा करना चाहते हैं:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "minimax": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "MiniMax",
      "options": {
        "baseURL": "https://api.minimax.io/v1",
        "apiKey": "{env:MINIMAX_API_KEY}"
      },
      "models": {
        "MiniMax-M3": {
          "name": "MiniMax M3",
          "limit": {
            "context": 1000000,
            "output": 262144
          }
        }
      }
    }
  }
}
स्पष्ट limit.contextपर ध्यान दें। यह सजावट नहीं है — अगला सेक्शन देखें।
MiniMax कॉन्टेक्स्ट विंडो का जाल (इस पर आगे बढ़ने से पहले पढ़ें)
अगर आप MiniMax M3 को Anthropic-संगत हार्नेस से रूट करते हैं — Claude Code, या ऐसा OpenCode सेटअप जो @ai-sdk/anthropic के साथ https://api.minimax.io/anthropic इस्तेमाल करता है — तो एक दर्ज बग मौजूद है जो अब भी खुला है और जिसके बारे में आपको जानना चाहिए।
यह /anthropic एंडपॉइंट M3’ की असली 1M की जगह 200K कॉन्टेक्स्ट विंडो बताता है।
लगता है कि compatibility लेयर M3’ का असली स्पेसिफ़िकेशन बताने के बजाय Claude Sonnet’ का मेटाडेटा विरासत में ले लेती है। कोडिंग एजेंट उस मेटाडेटा पर भरोसा करते हैं और उसी हिसाब से अपना कॉन्टेक्स्ट बजट तय करते हैं — जिसका मतलब है ऑटो-कम्पैक्शन लगभग 167K टोकन पर चलता है जबकि मॉडल आराम से उससे पाँच गुना रख सकता है।
यह सचमुच चिढ़ाने वाली विफलता है, क्योंकि यह अदृश्य है। आपका एजेंट कोई एरर नहीं देता। वह बस चुपचाप उन चीज़ों को बहुत पहले भूलने लगता है जो उसे याद रहनी चाहिए, और आप पूरी दोपहर यह सोचते रह जाते हैं कि दस लाख टोकन वाली विंडो वाला मॉडल रिफ़ैक्टर की दो फ़ाइलों बाद ही धागा क्यों खो देता है। यह समस्या M3’ के रिलीज़ के दिन दर्ज हुई थी और अब भी खुली है।
इसका उपाय
OpenCode में: Anthropic रूट की जगह बिल्ट-इन MiniMax प्रोवाइडर (OpenAI-संगत रूट) इस्तेमाल करें, और सेट करें limit.context limit.context को स्पष्ट रूप से, अगर आप मैन्युअल प्रोवाइडर ब्लॉक बनाते हैं।
Claude Code में, कम्पैक्शन विंडो को सीधे ओवरराइड करें:
json
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.minimax.io/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "<YOUR_MINIMAX_SUBSCRIPTION_KEY>",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "MiniMax-M3[1m]"
  }
}
दो बातें मायने रखती हैं: मॉडल ID पर [1m] सफ़िक्स full-context वेरिएंट माँगता है, और शेल एनवायरनमेंट वेरिएबल ओवरराइड कर देते हैं settings.json को, MiniMax’ के दर्ज व्यवहार के अनुसार। अगर आपके पास पुराना ANTHROPIC_BASE_URL आपके .zshrcमें एक्सपोर्ट किया हुआ है, तो वह चुपचाप जीत जाता है और आप बेवजह भागदौड़ करते रहेंगे।
साथ ही — प्रोवाइडर क्रेडेंशियल्स को ग्लोबल एक्सपोर्ट के रूप में सेट न करें। ANTHROPIC_BASE_URL एक ग्लोबल वेरिएबल है; इसे स्थायी रूप से एक्सपोर्ट करने पर आपकी मशीन का हर Anthropic-से बात करने वाला टूल चुपचाप MiniMax की ओर मुड़ जाएगा। इसे हर प्रोजेक्ट या हर इनवोकेशन के लिए अलग रखें।
OpenCode में GLM-5.3-Flash सेट करना
OpenCode में बिल्ट-इन Z.AI प्रोवाइडर भी आता है, इसलिए यह लगभग उतना ही आसान है — बस रास्ते में एक मोड़ है।
bash
# 1. Get a key from Z.ai — either a standard API key or a GLM Coding Plan key
# 2. Authenticate
opencode auth login
# Select "Z.AI" for a standard API key
# Select "Z.AI Coding Plan" for a Coding Plan subscription key

# 3. Start OpenCode, then pick your model
opencode
/models   # select GLM-5.3-Flash
प्रोवाइडर को की के टाइप से मिलाएँ। स्टैंडर्ड API की और Coding Plan की अलग-अलग रूट और अलग बिलिंग इस्तेमाल करती हैं। ग़लत चुनने पर ऑथ या बैलेंस की गड़बड़ियाँ आती हैं जो टूटे हुए अकाउंट जैसी लगती हैं।
Coding Plan के एंडपॉइंट
अगर आप चीज़ें मैन्युअली जोड़ रहे हैं या किसी और टूल को कॉन्फ़िगर कर रहे हैं, तो Z.ai’ के डेवलपर पैक में तीन दिए गए हैं:
| प्रोटोकॉल | बेस URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
एक पाबंदी जिसका ज़िक्र ज़रूरी है: GLM Coding Plan अनुबंध के तहत सिर्फ़ आधिकारिक रूप से समर्थित टूल तक सीमित है — Claude Code, OpenCode, Cline, Roo Code, Kilo Code, Cursor, Goose, Crush, OpenClaw और कुछ अन्य। अगर आप Coding Plan की को अपने खुद के बनाए हार्नेस पर इस्तेमाल करने की सोच रहे हैं, तो पहले शर्तें पढ़ें। उसके लिए स्टैंडर्ड API इस्तेमाल करें।
मैन्युअल प्रोवाइडर ब्लॉक
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3-flash": {
          "name": "GLM-5.3-Flash",
          "limit": {
            "context": 1048576,
            "output": 131072
          },
          "options": {
            "reasoning_effort": "high",
            "temperature": 1,
            "top_p": 0.95
          }
        }
      }
    }
  },
  "model": "zai/glm-5.3-flash"
}
सुझाए गए सैंपलिंग सेटिंग
GLM-5.3-Flash के लिए Z.ai’ की दर्ज सिफ़ारिशें, जिनसे मैं बिना कारण हटूँगा नहीं:
temperature: 1top_p: 0.95reasoning_effort: max(दर्ज डिफ़ॉल्ट)thinking.clear_thinking: falsestream: trueऔरtool_stream: trueस्ट्रीमिंग रिक्वेस्ट के लिए
reasoning_effort गुणवत्ता और लेटेंसी के बीच आपका मुख्य समायोजन है। कम लेटेंसी-संवेदी काम के लिए, उच्च बड़े कोडिंग काम के लिए, अधिकतम सबसे कठिन समस्याओं के लिए। चूँकि GLM-5.3-Flash पहले से ही दोनों मॉडलों में धीमा है — लगभग 49 tok/sec — उच्च रोज़मर्रा के लिए समझदारी भरा सेटिंग है और अधिकतम उस समय काम आता है जब कोई काम सचमुच आपको हरा दे उच्च.
मेरी असल सिफ़ारिश वाला सेटअप: दोनों चलाएँ
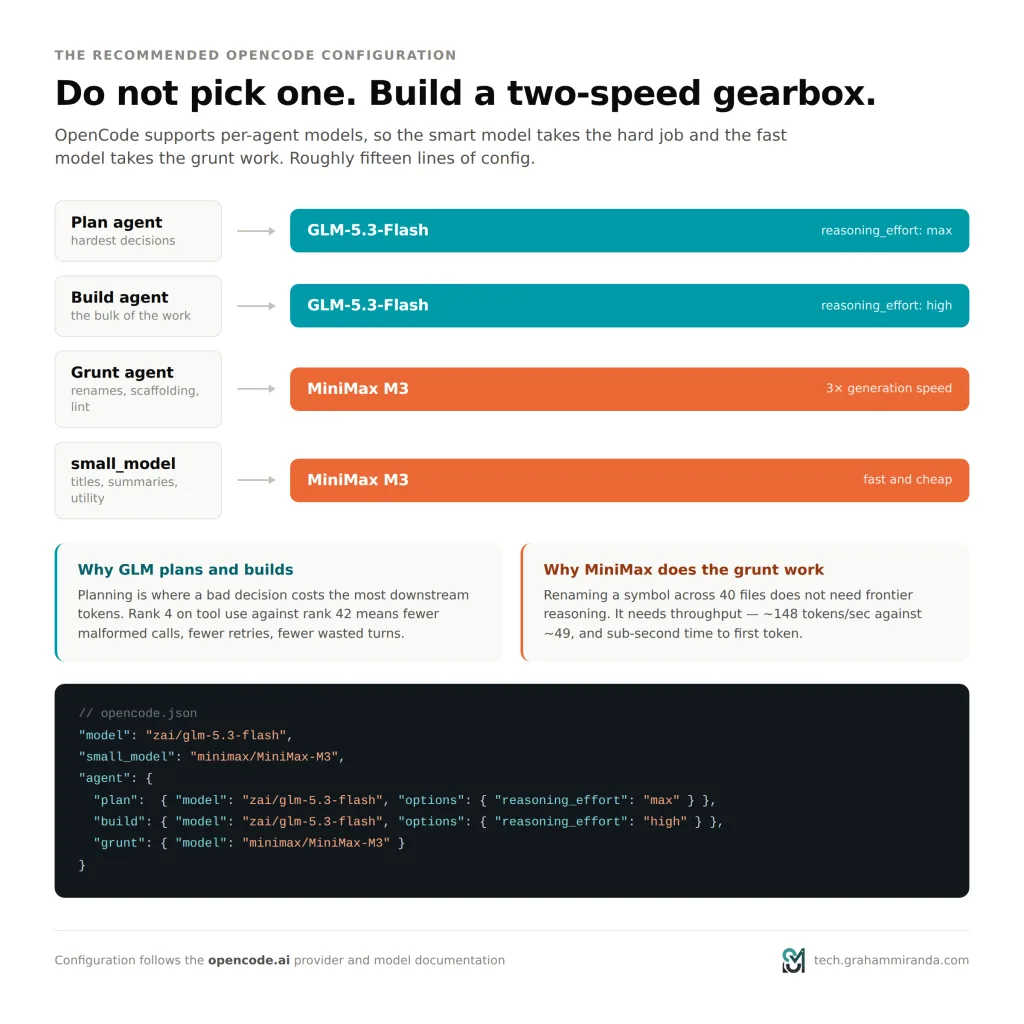
यहीं “बनाम” वाली सोच टूट जाती है, क्योंकि OpenCode आपको एक चुनने पर मजबूर नहीं करता। इसका कॉन्फ़िग हर एजेंट के लिए अलग मॉडल का समर्थन करता है, यानी आप मुश्किल काम पर स्मार्ट मॉडल और मामूली काम पर तेज़ मॉडल रख सकते हैं।
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3-flash",
  "small_model": "minimax/MiniMax-M3",
  "agent": {
    "build": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "high" }
    },
    "plan": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "max" }
    },
    "grunt": {
      "description": "Mechanical, high-volume edits: renames, test scaffolding, docstrings, lint fixes",
      "model": "minimax/MiniMax-M3"
    }
  }
}
तर्क यह है:
- प्लानिंग के लिए
reasoning_effort: maxGLM-5.3-Flash मिलता है। प्लानिंग वह जगह है जहाँ एक ग़लत फ़ैसला आगे में सबसे ज़्यादा टोकन खर्च कराता है। इस कदम पर जितनी अच्छी सोच आप वहन कर सकते हैं, वह खरीदें। - बिल्डिंग के लिए
उच्च. काम के बड़े हिस्से के लिए गुणवत्ता और लेटेंसी का अच्छा संतुलन। - मशीनी काम M3 को जाता है। 40 फ़ाइलों में किसी सिंबल का नाम बदलने के लिए #4 रैंक वाला टूल-यूज़ मॉडल ज़रूरी नहीं। इसके लिए थ्रूपुट चाहिए, और M3 तीन गुना तेज़ है।
small_modelOpenCode’ के अंदरूनी काम संभालता है — टाइटल बनाना, सारांश बनाना, छोटी यूटिलिटी कॉल्स। इसे तेज़ और सस्ते वाले पर सेट करें।
आप विजेता नहीं चुन रहे। आप दो-स्पीड वाला गियरबॉक्स बना रहे हैं।
असली आँकड़ों के साथ लागत का हिसाब
बेंचमार्क अमूर्त होते हैं। इनवॉइस नहीं होते। आइए एक वास्तविक एजेंटिक टास्क का मॉडल बनाऊँ और उसे दोनों प्राइस शीट पर चलाऊँ।
परिदृश्य
OpenCode में एजेंटिक तरीके से किया गया एक मध्यम आकार का फ़ीचर: लगभग 60 टूल-कॉलिंग टर्न, औसतन प्रति टर्न 45K इनपुट टोकन क्योंकि कॉन्टेक्स्ट बढ़ता जाता है, और प्रति टर्न 2K आउटपुट टोकन.
- कुल इनपुट: 2.7M टोकन
- कुल आउटपुट: 120K टोकन
- माना गया प्रॉम्प्ट कैश हिट रेट: 80% (2.16M कैश्ड, 540K फ़्रेश)
GLM-5.3-Flash
| घटक | टोकन | दर | लागत |
|---|---|---|---|
| फ़्रेश इनपुट | 540K | $0.15/M | $0.081 |
| कैश्ड इनपुट | 2.16M | $0.03/M | $0.065 |
| आउटपुट | 120K | $0.50/M | $0.060 |
| कुल | ≈ $0.21 |
MiniMax M3 (स्टैंडर्ड टियर, ≤512K इनपुट)
| घटक | टोकन | दर | लागत |
|---|---|---|---|
| फ़्रेश इनपुट | 540K | $0.30/M | $0.162 |
| कैश्ड इनपुट | 2.16M | $0.06/M | $0.130 |
| आउटपुट | 120K | $1.20/M | $0.144 |
| कुल | ≈ $0.44 |
एक जैसे काम पर GLM-5.3-Flash लगभग 2.1× सस्ता है। यह 3:1 इनपुट/आउटपुट के मिश्रित आधार पर ~2.2× सस्ते होने के स्वतंत्र अनुमान से मेल खाता है।
एक महीने तक बढ़ाने पर
रोज़ चार ऐसे टास्क, बीस कार्यदिवस — 80 एजेंटिक रन:
- GLM-5.3-Flash: ≈ $16.50/महीना
- MiniMax M3: ≈ $35/महीना
लंबे कॉन्टेक्स्ट का वह अतिरिक्त शुल्क जिसका कोई ज़िक्र नहीं करता
यहाँ जाल है। MiniMax M3’ की प्राइसिंग इनपुट लंबाई के हिसाब से टियर में बँटी है, और जैसे ही कोई एक रिक्वेस्ट 512K इनपुट टोकन से ऊपर जाती है, रेट दोगुना हो जाता है:
| टियर | इनपुट | आउटपुट | कैश रीड |
|---|---|---|---|
| ≤512K इनपुट | $0.30/M | $1.20/M | $0.06/M |
| >512K इनपुट | $0.60/M | $2.40/M | $0.12/M |
| प्रायोरिटी टियर | स्टैंडर्ड का 1.5× | स्टैंडर्ड का 1.5× | स्टैंडर्ड का 1.5× |
तो हेडलाइन वाला “1M कॉन्टेक्स्ट” एक फुटनोट के साथ आता है: उस विंडो का दूसरा आधा हिस्सा दोगुना महँगा पड़ता है। अगर आपके वर्कफ़्लो में सचमुच बहुत बड़े रिपॉज़िटरी कॉन्टेक्स्ट में लोड होते हैं, तो M3 GLM-5.3-Flash से 2× महँगा होने से लगभग 4× महँगा हो जाता है — ठीक उस समय जब आपको कॉन्टेक्स्ट की सबसे ज़्यादा ज़रूरत हो।
Z.ai GLM-5.3-Flash के लिए ऐसा कोई अतिरिक्त शुल्क नहीं बताता। इसके दस लाख टोकन एक ही फ़्लैट दर पर हैं।
सब्सक्रिप्शन बनाम पे-एज़-यू-गो
| GLM Coding Plan | MiniMax Token Plan | |
|---|---|---|
| एंट्री | Lite $18/महीना (~80 प्रॉम्प्ट/5 घंटे, ~400/हफ़्ता, 100 MCP कॉल/महीना) | Plus $20/महीना (~3–4 एजेंट) |
| मिड | Pro $72/महीना (~400 प्रॉम्प्ट/5 घंटे, ~2,000/हफ़्ता, 1,000 MCP कॉल) | Max $50/महीना (~4–5 एजेंट, रोज़ 3 वीडियो जनरेशन) |
| टॉप | Max $160/महीना (~1,600 प्रॉम्प्ट/5 घंटे, ~8,000/हफ़्ता, 4,000 MCP कॉल) | Ultra $120/महीना (~6–7 एजेंट, रोज़ 5 वीडियो जनरेशन) |
| सालाना छूट | ~30% छूट | प्रकाशित नहीं |
| शामिल मॉडल | GLM-5.3, GLM-5.3-Flash, GLM-5.2, GLM-5-Turbo | MiniMax मॉडल परिवार |
दो बातें जो हिसाब बदल देती हैं।
Coding Plan के अंदर GLM-5.3-Flash को 3× कोटा मिलता है GLM-5.3 की तुलना में, और ऑफ़-पीक उपयोग स्टैंडर्ड पॉइंट्स का 50% खर्च करता है। पूरे GLM-5.3 की जगह Flash चुनने से आपके सब्सक्रिप्शन’ का मूल्य व्यावहारिक रूप से तीन गुना हो जाता है, और भारी रन को 14:00–18:00 UTC+8 की पीक विंडो से बाहर करने पर यह और बढ़ जाता है।
MiniMax कोटा आगे नहीं बढ़ता। बिना इस्तेमाल हुआ कोटा हर बिलिंग साइकल के अंत में समाप्त हो जाता है, और MiniMax खुद प्रोडक्शन डिप्लॉयमेंट के लिए Token Plan की जगह पे-एज़-यू-गो की सलाह देता है।
मेरे अनुमानित उपयोग (~$16–35/महीना टोकन) पर पे-एज़-यू-गो और एंट्री सब्सक्रिप्शन लगभग बराबर हैं। रोज़ करीब 6–8 घंटे एजेंटिक काम से आगे सब्सक्रिप्शन साफ़ जीतते हैं — $18 का GLM Coding Plan Lite जो ~400 साप्ताहिक प्रॉम्प्ट देता है, उसे हराना सचमुच मुश्किल है।
गेटवे प्राइसिंग पर एक टिप्पणी
आपको जहाँ देखेंगे, वहाँ बहुत अलग आँकड़े दिखेंगे। OpenRouter पर GLM-5.3-Flash लगभग $0.05/M इनपुट और $0.17/M आउटपुट पर सूचीबद्ध है; OpenCode’ के अपने मॉडल डेटा में $0.07/M और $0.25/M दिखता है। दोनों Z.ai’ की आधिकारिक $0.15/$0.50 से कम हैं।
यह विरोधाभास नहीं है। राउटेड गेटवे 20+ थर्ड-पार्टी होस्ट — Baseten, DeepInfra, Novita, Cloudflare और अन्य — पर लोड-बैलेंस करते हैं, और वे होस्ट कीमत पर मुकाबला करते हैं। आप गेटवे के ज़रिए GLM-5.3-Flash को लिस्ट प्राइस से सस्ते में बिल्कुल पा सकते हैं। लेकिन आप निरंतरता छोड़ देते हैं: OpenRouter पर थ्रूपुट 8 से 111 टोकन/सेकंड तक होता है, यह इस पर निर्भर करता है कि आप किस प्रोवाइडर पर पहुँचते हैं, और लंबे एजेंट लूप के लिए यह दो मिनट के काम और पंद्रह मिनट के काम के बीच का फ़र्क़ है।
एजेंट के काम के लिए मैं सीधे मूल विक्रेता को लिस्ट प्राइस देना और अनुमानित लेटेंसी पाना बेहतर मानूँगा। बैच और प्रयोग के लिए गेटवे इस्तेमाल करें।
लाइसेंसिंग और सेल्फ-होस्टिंग: यूरोपीय कारोबारों को जो हिस्सा दो बार पढ़ना चाहिए
अगर आप EU के भीतर कंपनी चला रहे हैं, तो लाइसेंस कोई फ़ुटनोट नहीं है। यह खरीद से जुड़ा सवाल है।
GLM-5.3-Flash: MIT
वेट्स Hugging Face पर यहाँ उपलब्ध हैं: zai-org/GLM-5.3-Flash …के अंतर्गत MIT लाइसेंस। सॉफ़्टवेयर लाइसेंसिंग में इससे ज़्यादा उदारता आम तौर पर नहीं मिलती: इसे व्यावसायिक रूप से इस्तेमाल करें, इसमें बदलाव करें, दोबारा बाँटें, किसी प्रोडक्ट में शामिल करें — कोई रेवेन्यू सीमा नहीं, कोई स्वीकार्य-उपयोग परिशिष्ट नहीं, कोई उपयोग-क्षेत्र प्रतिबंध नहीं। कॉपीराइट नोटिस बनाए रखें और बात ख़त्म।
किसी जर्मन या EU कारोबार के लिए MIT लाइसेंस और सेल्फ-होस्ट करने योग्य वेट्स का मतलब है कि आप पूरी चीज़ अपनी ही इन्फ़्रास्ट्रक्चर में रख सकते हैं और data residency कोई मुद्दा ही नहीं रहता — सीमा-पार ट्रांसफ़र का आकलन नहीं, किसी चीनी विक्रेता के साथ processor agreement नहीं, किसी और’s uptime पर निर्भरता नहीं।
MiniMax M3: MiniMax Community License
M3 के वेट्स भी Hugging Face पर खुले हैं, लेकिन MiniMax Community License — कस्टम लाइसेंस के तहत, किसी मानक उदार लाइसेंस के तहत नहीं। कम्युनिटी की प्रतिक्रिया कुल मिलाकर सकारात्मक रही (यह उस लाइसेंस से ज़्यादा उदार है जिसके तहत M2.7 आया था), और कई स्रोत व्यावसायिक उपयोग को व्यवहार में अप्रतिबंधित बताते हैं।
लेकिन “अप्रतिबंधित बताया गया” और “आपके कानूनी सलाहकार द्वारा जाँचा गया” — दोनों अलग बातें हैं। अगर MiniMax M3 किसी व्यावसायिक प्रोडक्ट में जा रहा है, तो शिप करने से पहले लाइसेंस का पाठ सीधे पढ़ें। कस्टम लाइसेंस समीक्षा का अतिरिक्त बोझ जोड़ता है, जो MIT में बिल्कुल नहीं है।
सेल्फ-होस्टिंग की ज़मीनी हक़ीक़त
दोनों मॉडल ओपन-वेट हैं। इनमें से कोई भी आपके लैपटॉप पर नहीं चलेगा।
GLM-5.3-Flash:
- FP8 चेकपॉइंट: 331 GB 62 शार्ड्स में (~306 GiB वेट्स, KV cache से पहले)
- BF16 वेरिएंट: 640 GB 120 शार्ड्स में
- एक ही GB200 पर TP=4 में FP8: ~386 GB VRAM
- TP=8 पर BF16: ~772 GB VRAM
- ज़रूरी Hopper जनरेशन या उससे नया — H100/H200/B200/B300/GB200/GB300, या AMD MI300X/MI325X/MI355X
- स्टैक: vLLM 0.29.0+, FlashInfer 0.6.17+; साथ ही SGLang, TokenSpeed, KTransformers, Transformers, Unsloth
MiniMax M3:
- लगभग 4-bit क्वांटाइज़ेशन पर 214 GB — छोटा, लेकिन फिर भी पक्का सर्वर-क्लास
Z.ai’s की अपनी होस्टेड इन्फ़्रास्ट्रक्चर ~48.7 आउटपुट टोकन/सेकंड और 1.52s TTFT की रिपोर्ट देती है, और GB200 पर TP=4 में 14.92M-टोकन का KV पूल, जो 128K कॉन्टेक्स्ट पर 113.81× अधिकतम concurrency संभालता है। इस मॉडल को ठीक से सर्व करने के लिए इसी आकार का हार्डवेयर चाहिए।
व्यवहार में इसका मतलब: इनमें से कोई भी मॉडल सेल्फ-होस्ट करने का मतलब है कई डेटा सेंटर GPU किराए पर लेना या खरीदना। ज़्यादातर टीमों के लिए — मेरे अधिकांश क्लाइंट्स सहित — सही जवाब API है, और ओपन वेट्स एक तरह का बीमा। अगर विक्रेता दाम बढ़ाता है, मॉडल की गुणवत्ता घटाता है या पूरी तरह गायब हो जाता है, तो आपके पास निकलने का विकल्प रहता है। यह विकल्प असली कीमत रखता है, भले ही आप इसे कभी इस्तेमाल न करें।
हर मॉडल असल में कहाँ फेल होता है
कोई हाइप सेक्शन नहीं। ये रहीं ईमानदार कमज़ोरियाँ।
GLM-5.3-Flash की कमज़ोरियाँ
यह धीमा है। ~48.6 टोकन/सेकंड आउटपुट और पहले टोकन तक ~1.51s। M3 के ~148 टोकन/सेकंड और ~0.99s के मुकाबले हर लंबा जनरेशन खलता है। 40-टर्न के एजेंट लूप में यह कई असली मिनटों में बदल जाता है।
आप सोच बंद नहीं कर सकते। मुश्किल एजेंट वाले काम में अनिवार्य रीज़निंग सही है और छोटे-मोटे कॉल्स में फ़िज़ूल। हर “इस फ़ंक्शन में डॉकस्ट्रिंग जोड़ें” अनुरोध रीज़निंग टैक्स चुकाता है। ठीक इसीलिए रट्टू-मेहनत के लिए M3 या किसी छोटे मॉडल को जोड़ना चाहिए।
रीज़निंग टोकन भी बिल किए जाने वाले टोकन होते हैं। जब reasoning_effort: max डॉक्युमेंटेड डिफ़ॉल्ट के तौर पर रहता है, तो प्रति टास्क वास्तविक लागत केवल input/output की गिनती से निकाले गए सीधे अनुमानों से ऊपर रहती है। इसे उच्च पर सेट करें, सिवाय उन कामों के जो अधिकतम.
यह नया है। 26 अगस्त 2026 को रिलीज़ हुआ। हार्नेस इकोसिस्टम में लंबी-पूँछ वाले इंटीग्रेशन बग अभी सब सामने नहीं आए हैं, और कम्युनिटी का ज्ञान अभी पतला है। अगर आप किसी अनोखी फेलियर स्थिति से टकराते हैं, तो शायद इसे सबसे पहले आप ही रिपोर्ट करेंगे।
इसे GLM-5.3 से न मिलाएँ। ये अलग मॉडल हैं, अलग क्षमताओं के साथ — ख़ास तौर पर, बिना Flash वाला GLM-5.3 सिर्फ़ टेक्स्ट संभालता है। गलत मॉडल ID पर इमेज भेजना शुरुआत में होने वाली आम ग़लती है।
MiniMax M3 की कमज़ोरियाँ
असली समस्या tool-use रैंकिंग है। llm-stats’ के tool-use इंडेक्स पर #42, जबकि GLM-5.3-Flash #4 पर। एजेंट हार्नेस के लिए यही सबसे ज़रूरी क्षमता है। उम्मीद रखें कि tool calls ज़्यादा बिगड़ेंगे, ज़्यादा रीट्राई होंगे, सँभलने में ज़्यादा टर्न जाएँगे — और यह उस स्पीड का फ़ायदा खा जाता है जिसके लिए आपने कीमत चुकाई।
कॉन्टेक्स्ट रिपोर्टिंग वाला बग अब तक अनसुलझा है। रिलीज़ के बाद से खुला है। इसके आस-पास काम चलाया जा सकता है, लेकिन यह एक छोटी-सी चुभन है जो साथ चलती है।
स्वतंत्र सत्यापन बहुत कम है। MiniMax’s के लॉन्च बेंचमार्क न्यूट्रल बोर्ड्स पर नहीं दिखे थे, और जहाँ न्यूट्रल एग्रीगेटर्स ने मापा है, वहाँ M3 टेबल के बीच में बैठता है, ऊपर के पास नहीं। विक्रेता की प्रस्तुति और तीसरे पक्ष के मापन के बीच की खाई यहाँ Z.ai के मुकाबले ज़्यादा चौड़ी है।
512K से ऊपर लॉन्ग-कॉन्टेक्स्ट प्राइसिंग दोगुनी हो जाती है। मुख्य विशेषता के साथ अतिरिक्त शुल्क जुड़ा है।
कस्टम लाइसेंस। व्यावसायिक डिप्लॉयमेंट से पहले अतिरिक्त कानूनी समीक्षा।
घटता उपयोग। दो महीनों में OpenCode टोकन वॉल्यूम में 51% गिरावट इकोसिस्टम की गति का संकेत है, वजह जो भी हो। कम यूज़र का मतलब है कि जो बग आपको मिलेंगे, उनसे टकराने और उन्हें ठीक करने वाले लोग भी कम होंगे।
फ़ैसले का ढाँचा: पाँच परिदृश्य
1. “मुझे एक मॉडल चाहिए — सेट करो और भूल जाओ।”
GLM-5.3-Flash. हर न्यूट्रल बेंचमार्क पर बेहतर, आधी कीमत, MIT लाइसेंस, और कम्युनिटी भी यहीं आकर रुकी है। सेट करें reasoning_effort: high, अगर आप रोज़ कोड करते हैं तो $18/महीने का GLM Coding Plan Lite जोड़ें और अपनी ज़िंदगी आगे बढ़ाएँ।
2. “मैं बहुत बड़े कोडबेस पर भारी-भरकम, यांत्रिक रिफ़ैक्टर चलाता हूँ।”
यांत्रिक पास के लिए MiniMax M3, और प्लान के लिए GLM-5.3-Flash। MSA लंबे कॉन्टेक्स्ट में M3 को सचमुच किफ़ायती बनाता है, और 3× जनरेशन स्पीड सबसे ज़्यादा ऊँचे वॉल्यूम, आसान एडिट्स में महसूस होती है। बस 512K की प्राइसिंग खड़ी चट्टान का ध्यान रखें, और M3 के अमल में उतारने से पहले GLM से रिफ़ैक्टर की योजना बनवाएँ।
3. “मेरा काम दिखने वाला है — UI, डिज़ाइन-टू-कोड, स्क्रीनशॉट डीबगिंग।”
पहले GLM-5.3-Flash, और मज़बूत दूसरे विकल्प के तौर पर M3। GLM’s की नेटिव मल्टीमॉडैलिटी ठीक इसी के लिए बनी है और विज़न इंडेक्स पर यह M3 से आगे है (32.0 बनाम 25.6)। लेकिन M3 का OSWorld-Verified स्कोर 70.06% इसे ख़ास तौर पर इसके लिए बेहतर विकल्प बनाता है: डेस्कटॉप और GUI एजेंट काम के लिए — स्क्रीनशॉट पढ़ने के बजाय असली ऐप्स चलाना।
4. “मुझे data residency या अनुपालन के लिए सेल्फ-होस्ट करना है।”
बिना किसी संदेह के GLM-5.3-Flash। जब आपकी कानूनी टीम शामिल हो, तो MIT बनाम कस्टम कम्युनिटी लाइसेंस कोई काँटे का फ़ैसला नहीं है, और MIT सेल्फ-होस्टिंग सीमा-पार डेटा ट्रांसफ़र का पूरा सवाल ही मेज़ से हटा देती है। Hopper-क्लास हार्डवेयर या किसी यूरोपीय GPU होस्ट के लिए बजट रखें।
5. “मैं सीमित बजट पर छोटी टीम चला रहा हूँ।”
$18/महीने का GLM Coding Plan Lite, और डिफ़ॉल्ट GLM-5.3-Flash। प्लान के अंदर Flash के लिए 3× कोटा मल्टीप्लायर इसे अभी उपलब्ध सबसे ज़्यादा वैल्यू-प्रति-यूरो विकल्प बनाता है। 50% पॉइंट्स छूट के लिए भारी बैच रन 14:00–18:00 UTC+8 की पीक विंडो से बाहर रखें। अगर थ्रूपुट बाधा बने तो बाद में MiniMax जोड़ लें।
अगली तिमाही में मैं किन बातों पर नज़र रखूँगा
GLM-5.3-Flash के लिए स्वतंत्र Terminal-Bench और SWE-bench Pro रन। विक्रेता के आँकड़े बेहतरीन हैं। न्यूट्रल एग्रीगेटर्स मोटे तौर पर इनकी पुष्टि करते हैं। लेकिन “Terminal-Bench 2.1 पर Claude Opus 4.8 से एक अंक के भीतर” वाला ख़ास दावा तीसरे पक्ष से दोहराए जाने लायक है, इससे पहले कि कोई उस पर बिज़नेस केस बनाए।
क्या MiniMax का /anthropic कॉन्टेक्स्ट बग ठीक होता है। यह छोटा है, दर्ज है, और जून से खुला पड़ा है। यह कितनी जल्दी बंद होता है, इससे रखरखाव की रफ़्तार के बारे में कुछ पता चलता है।
OpenCode में GLM-5.3-Flash’s रिटेंशन कर्व। टोकन-शेयर का आँकड़ा शानदार है, पर नया है। दिलचस्प बात यह है कि नयापन ख़त्म होने के बाद यह 10%+ पर टिकता है या नहीं। अगर टिकता है, तो यह कोई क्षणिक लहर नहीं — यह नया डिफ़ॉल्ट है।
चीनी ओपन-वेट लैब्स की रिलीज़ रफ़्तार। Qwen3.8-Flash-Next लगभग GLM-5.3-Flash के साथ ही आया। Kimi K3 पहले ही DeepSWE (67.5 बनाम 66.9) और Toolathlon (76.5 बनाम 73.0) पर GLM-5.3 को पीछे छोड़ चुका है। “मौजूदा सबसे अच्छा ओपन-वेट कोडिंग मॉडल” और “दूसरे नंबर का” के बीच का फ़ासला अब हफ़्तों में नापा जाता है। अपनी कॉन्फ़िग ऐसी बनाएँ कि मॉडल स्ट्रिंग बदलना एक लाइन का काम हो, क्योंकि यह बदलाव आपको फिर करना पड़ेगा।
क्या Z.ai पूरे GLM-5.3 के लिए सपाट, अलग API प्राइसिंग प्रकाशित करता है। लिखते समय तक आधिकारिक प्राइसिंग पेज पर GLM-5.3 की प्रति-टोकन पंक्ति अब भी गायब थी, जबकि GLM-5.3-Flash की पूरी कीमत दर्ज थी। यह अजीब असमानता है और नज़र रखने लायक है।
अक्सर पूछे जाने वाले प्रश्न
कोडिंग के लिए GLM-5.3-Flash, MiniMax M3 से बेहतर है? उपलब्ध सबूतों के आधार पर, हाँ। GLM-5.3-Flash Terminal-Bench 2.1 (84.3 बनाम 66.0), Artificial Analysis’ Intelligence Index (57 बनाम 45), और llm-stats के हर क्षमता इंडेक्स — कोडिंग, एजेंट्स और tool use सहित — में आगे है। प्रति टोकन यह लगभग आधी कीमत पर भी है। MiniMax M3 तेज़ है — आउटपुट स्पीड लगभग 3× — लेकिन एजेंटिक कोडिंग में कच्ची जनरेशन स्पीड से ज़्यादा रीज़निंग की गुणवत्ता मायने रखती है।
कौन सस्ता है, GLM-5.3-Flash या MiniMax M3? GLM-5.3-Flash, लगभग 2× से। आधिकारिक प्राइसिंग GLM-5.3-Flash के लिए $0.15/M इनपुट और $0.50/M आउटपुट है, जबकि MiniMax M3 के लिए $0.30/M और $1.20/M। 512K इनपुट टोकन से ऊपर के अनुरोधों में यह अंतर लगभग 4× तक बढ़ जाता है, जहाँ MiniMax अपने रेट दोगुने कर देता है और Z.ai कोई अतिरिक्त शुल्क नहीं लेता।
क्या मैं GLM-5.3-Flash लोकल पर चला सकता हूँ? सिर्फ़ सर्वर-क्लास हार्डवेयर पर। FP8 चेकपॉइंट 331 GB का है और TP=4 पर लगभग 386 GB VRAM चाहता है, Hopper जनरेशन या उससे नए GPU पर। यह कंज़्यूमर हार्डवेयर वाला मॉडल नहीं है। MIT लाइसेंस सेल्फ-होस्टिंग को कानूनी तौर पर आसान बनाता है; हार्डवेयर इसे महँगा बनाता है।
क्या OpenCode दोनों मॉडल को नेटिव रूप से सपोर्ट करता है? हाँ। OpenCode में Z.AI और MiniMax दोनों के लिए बिल्ट-इन प्रोवाइडर आते हैं। चलाएँ opencode auth login, अपनी key के टाइप से मेल खाता प्रोवाइडर चुनें, फिर /models से अपना मॉडल चुनें। कोई opencode.json में एडिट करने की ज़रूरत नहीं — सामान्य सेटअप के लिए।
Claude Code में MiniMax M3 सिर्फ़ 200K कॉन्टेक्स्ट क्यों दिखाता है? MiniMax’s के Anthropic-संगत endpoint में एक जाना-पहचाना, अब भी खुला बग: यह M3 के असली स्पेसिफ़िकेशन की जगह Claude Sonnet’s मेटाडेटा बताता है, जिससे लगभग 167K टोकन पर ऑटो-कॉम्पैक्शन शुरू हो जाता है। सेट करें CLAUDE_CODE_AUTO_COMPACT_WINDOW को 1000000 को अपनी सेटिंग्स में रखें, या इसके बजाय OpenAI-संगत रूट इस्तेमाल करें।
GLM-5.3 और GLM-5.3-Flash में क्या फ़र्क है? अलग-अलग मॉडल। GLM-5.3 14 अगस्त 2026 को आया और सिर्फ़ टेक्स्ट संभालता है, इसका बेस मॉडल GLM-5.2 के साथ साझा है। GLM-5.3-Flash 26 अगस्त को आया, नेटिव रूप से मल्टीमॉडल है, 320B/18B हाइब्रिड-अटेंशन MoE आर्किटेक्चर पर चलता है, MIT लाइसेंस के साथ ओपन वेट्स है, और लगभग दसवें हिस्से की कीमत पर पड़ता है। GLM Coding Plan के अंदर Flash को 3× कोटा भी मिलता है।
क्या MiniMax M3 सचमुच ओपन सोर्स है? वेट्स Hugging Face से खुलकर डाउनलोड हो सकते हैं, लेकिन MIT या Apache 2.0 जैसे मानक उदार लाइसेंस के बजाय कस्टम MiniMax Community License के तहत। व्यावसायिक उपयोग को व्यापक रूप से अप्रतिबंधित बताया जाता है, पर उस पर व्यावसायिक प्रोडक्ट शिप करने से पहले लाइसेंस का पाठ पढ़ें।
मैं सब्सक्रिप्शन प्लान लूँ या pay-as-you-go? महीने के लगभग $20–30 के टोकन खर्च तक दोनों लगभग बराबर पड़ते हैं। रोज़ 6–8 घंटे से ज़्यादा एजेंटिक कोडिंग पर सब्सक्रिप्शन साफ़ जीतते हैं — $18/महीने का GLM Coding Plan Lite, जो हफ़्ते में लगभग 400 प्रॉम्प्ट कवर करता है, अभी उपलब्ध सबसे मज़बूत एंट्री-लेवल वैल्यू है। ध्यान रखें कि MiniMax का कोटा अगले महीने में नहीं जुड़ता, और MiniMax ख़ुद प्रोडक्शन वर्कलोड के लिए pay-as-you-go की सलाह देता है।
मुख्य बात
अगर इससे एक ही बात लेनी हो: 2026 के अंत में OpenCode के लिए GLM-5.3-Flash बेहतर डिफ़ॉल्ट है, और जिन आयामों पर एजेंटिक कोडिंग का नतीजा तय होता है — रीज़निंग की गुणवत्ता, tool-use की भरोसेमंदी और प्रति पूर्ण टास्क लागत — उन पर मुक़ाबला क़रीब भी नहीं है।
MiniMax M3 बुरा मॉडल नहीं है। यह अलग तरह से ऑप्टिमाइज़ किया गया मॉडल है, और इसका MSA आर्किटेक्चर लॉन्ग-कॉन्टेक्स्ट की अर्थशास्त्र-समस्या का सचमुच सुंदर जवाब है। कुछ असली वर्कलोड ऐसे हैं — ऊँचे वॉल्यूम के यांत्रिक एडिट्स, डेस्कटॉप और GUI एजेंट के काम, जहाँ 3× जनरेशन स्पीड हावी होती है — जहाँ यह सही औज़ार है।
लेकिन एजेंटिक कोडिंग बुनियादी तौर पर फ़ैसले लेने की समस्या है, टाइपिंग की रफ़्तार की नहीं। जो मॉडल बेहतर योजना बनाता है, ज़्यादा भरोसे से टूल कॉल करता है और नाकामी से ज़्यादा संभली हुई तरह उबरता है, वह तीन गुना धीमे टोकन बनाने पर भी प्रति यूरो ज़्यादा टास्क पूरे करेगा।
व्यवहारिक रास्ता दो-गति वाला गियरबॉक्स है: योजना और निर्माण पर GLM-5.3-Flash, रट्टू-मेहनत पर MiniMax M3, small_model और तेज़ वाले की ओर भेजा गया काम। OpenCode में यह पंद्रह पंक्तियों का कॉन्फ़िग बदलाव है, और इससे आपको जहाँ अक्ल चाहिए वहाँ अक्ल मिलती है, और जहाँ नहीं चाहिए वहाँ थ्रूपुट।
और वह कॉन्फ़िग ऐसा लिखें कि मॉडल ID बदलना आसान हो। इस बाज़ार में today’s obvious answer की उम्र हफ़्तों में नापी जाती है।
क्या आपने इनमें से कोई एक OpenCode के रोज़मर्रा के मॉडल के तौर पर चलाया है? मुझे ख़ास तौर पर यह जानने में दिलचस्पी है कि GLM-5.3-Flash’s Terminal-Bench आँकड़े असली रिपॉज़िटरी में टिकते हैं या नहीं, और क्या किसी ने MiniMax’s कॉन्टेक्स्ट-रिपोर्टिंग बग का कोई साफ़-सुथरा वर्कअराउंड खोजा है। संपर्क करें — सुधार और उलटे सबूत दोनों का स्वागत है, और तस्वीर बदलने पर यह लेख अपडेट होता रहता है।
अंतिम अपडेट: 30 अगस्त 2026।


