Bahasa Indonesia
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Русский
 العربية
 हिन्दी

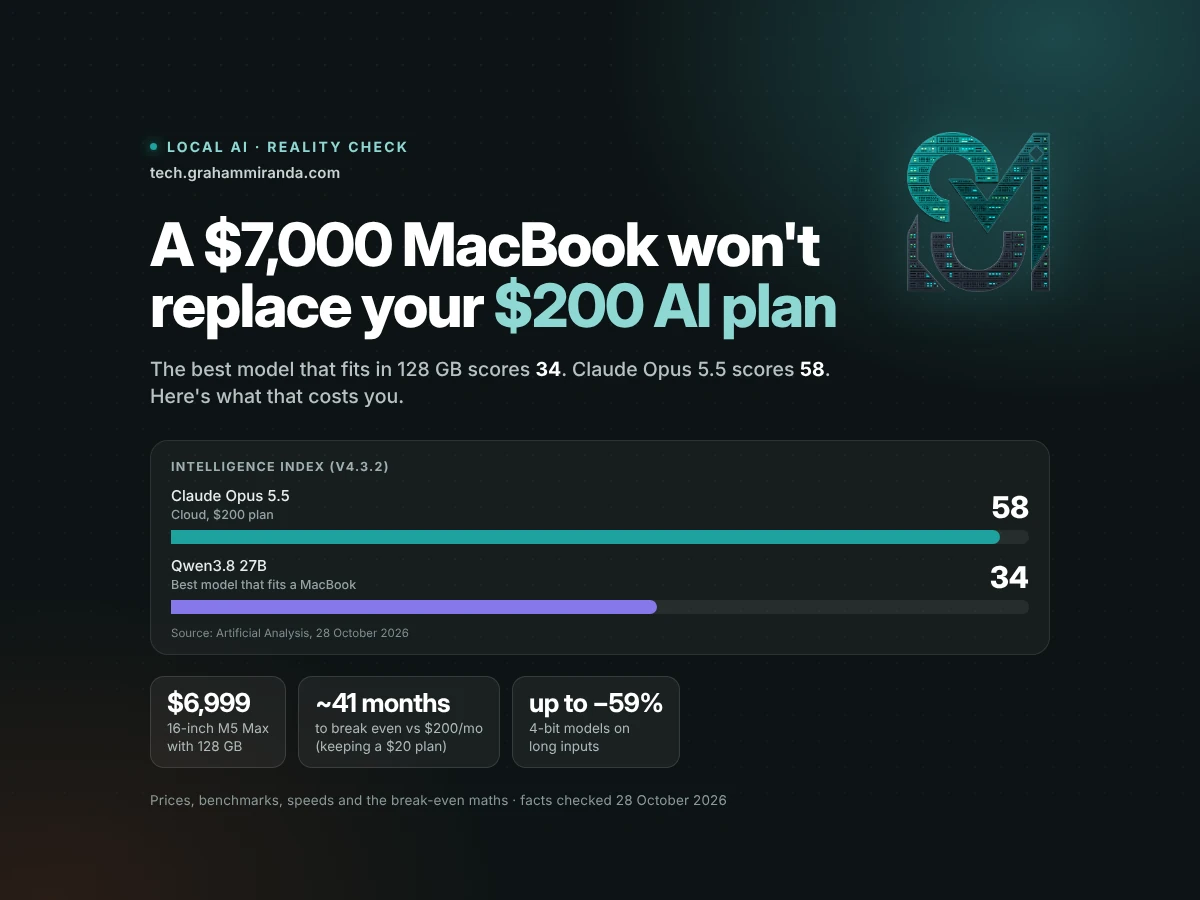
Gagasannya begini. Langganan AI kelas atas berharga $200 sebulan, yaitu $2.400 setahun. MacBook Pro dengan 128 GB memori terpadu bisa menjalankan model bahasa besar (LLM) secara lokal, privat, dan tanpa batas pemakaian. Jadi batalkan langganannya, beli MacBook untuk LLM lokal sebagai gantinya, dan dalam satu atau dua tahun perangkat itu sudah balik modal.
Kamu akan menemukan versi gagasan ini sepanjang 2026: di video YouTube yang menanyakan apakah sebaiknya kamu membatalkan paket AI $200 dan membeli Mac $9.499, di pos Medium yang membagi harga Mac dengan $200, dan di kolom Forbes yang menghitung angkanya saat Apple meluncurkan Mac Studio baru pada Agustus. Pada peluncuran MacBook Pro M5 Max, kepala perangkat keras Apple John Ternus mengatakan mesin baru itu memungkinkan para profesional “menjalankan LLM canggih di perangkat”.
Membeli MacBook untuk LLM lokal adalah ide yang sepenuhnya masuk akal bagi sebagian orang. Sebagai pengganti paket Claude atau ChatGPT $200, gagasan itu gagal, dan gagal pada satu hal yang tidak pernah dihitung oleh gagasan itu: mutu. Langganan menyewakan model terbaik di dunia untukmu. Mac menjalankan model terbaik yang muat di 128 GB. Sejak kemarin, kita bisa mengukur jarak antara kedua hal itu lebih tepat daripada sebelumnya, dan jaraknya lebih lebar daripada yang disiratkan hype.
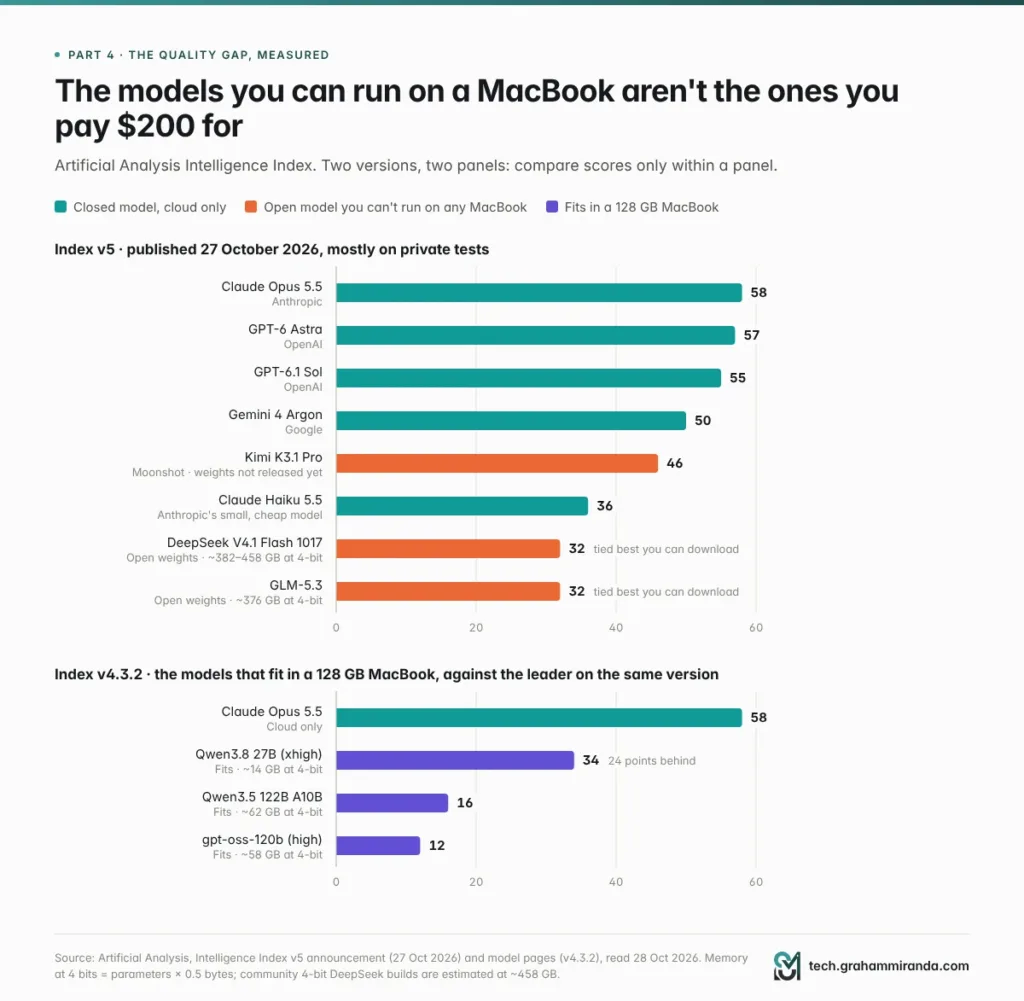
Pada 27 Oktober, Artificial Analysis menyusun ulang Intelligence Index-nya berdasarkan tes yang sebagian besar bersifat privat. Claude Opus 5.5 memimpin dengan 58. Model bobot terbuka terbaik yang benar-benar bisa kamu unduh, DeepSeek V4.1 Flash 1017 dan GLM-5.3, mendapat skor 32, di bawah Claude Haiku 5.5, model kecil dan murah buatan Anthropic, yang berada di 36. Tak satu pun model terbuka itu muat di MacBook mana pun: pada 4-bit keduanya butuh sekitar 375 sampai 460 GB. Model terkuat yang bisa kutama temukan dan benar-benar muat di MacBook 128 GB, Qwen3.8 27B, mendapat skor 34 pada versi indeks sebelumnya, versi yang juga memberi Opus 5.5 skor 58.
Sementara itu perangkat kerasnya makin mahal. Pada Juni, Apple menggandakan harga peningkatan memori 128 GB pada M5 Max. MacBook Pro 16 inci dengan 128 GB sekarang berharga $6,999 di AS dan, menurut perkiraanku, sekitar €8,199 di Jerman.
Jadi inilah versi jujur dari hitungannya: apa yang sebenarnya dibeli dengan $200 sebulan, apa yang sebenarnya dibeli dengan $7.000, sebesar apa jarak mutunya dan kenapa jarak itu ada, secepat apa M5 Max sebenarnya, berapa biaya kuantisasi bagimu, kapan membeli Mac untuk AI lokal memang masuk akal, dan cara yang lebih murah untuk memangkas tagihan $200 kalau itu yang sebenarnya kamu cari. Setiap angka sudah dicek ke sumbernya pada 28 Oktober 2026.
TL;DR — versi 60 detik
- Model yang kamu bayar $200 tidak bisa diunduh, dan model terbaik yang bisa kamu unduh tidak muat di MacBook. Pada Intelligence Index v5 yang baru dari Artificial Analysis, Claude Opus 5.5 mendapat skor 58. Model terbuka teratas yang bisa diunduh, DeepSeek V4.1 Flash 1017 dan GLM-5.3, mendapat skor 32 dan butuh sekitar 375–460 GB memori pada 4-bit.
- Yang muat skornya jauh lebih rendah. Model terkuat yang kutama temukan untuk MacBook 128 GB, Qwen3.8 27B, mendapat skor 34, sedangkan Opus 5.5 mendapat 58 pada versi indeks yang sama (v4.3.2). Model kelas 120B yang justru butuh memori ekstra itu skornya lebih rendah lagi: 16 untuk Qwen3.5 122B, 12 untuk gpt-oss-120b.
- MacBook 128 GB jadi lebih mahal. Apple menggandakan harga peningkatan 128 GB menjadi $2.000 pada Juni, jadi M5 Max 16 inci dengan 128 GB sekarang $6.999 (sekitar €8.199 di Jerman, menurut perkiraanku). Chip dan memori yang sama di Mac Studio berharga $4.799.
- Titik impasnya tiga sampai empat tahun, bukan satu tahun. Bahkan kalau Mac sepenuhnya menggantikan langganan, butuh sekitar 37 bulan untuk mengalahkan paket $200, 41 bulan kalau kamu tetap memakai paket $20 untuk pekerjaan berat, dan lebih dari enam tahun dibanding paket $100.
- Menulis itu cepat; membaca itu lambat. M5 Max menghasilkan 55–88 token per detik pada model mixture-of-experts, tidak jauh dari 98 milik Opus 5.5 di API Anthropic. Tapi perangkat ini butuh 13–55 detik hanya untuk membaca prompt 32.000 token, sedangkan agen AI membaca ulang prompt panjang sepanjang hari.
- Memaksakan model besar agar muat berbiaya mutu. Kuantisasi 4-bit hampir tanpa kehilangan pada tugas pendek, tapi dalam studi EMNLP 2025 biayanya mencapai 59% pada input panjang, dan lebih besar lagi di bahasa selain Inggris. Pada 3 bit, skor matematika sebuah model penalaran kecil turun dari 85,6% menjadi 47,0%.
- Benchmark publik tampaknya membuat model terbuka terlihat lebih baik. Ketika Artificial Analysis beralih ke tes yang sebagian besar privat, empat model bobot terbuka terkemuka kehilangan rata-rata 13 poin. Empat model tertutup terkemuka nyaris tidak bergerak.
- Lokal tetap menang soal privasi, pemakaian offline, tanpa batas permintaan, dan pekerjaan massal, dan ketika kamu memang sudah akan membeli Mac. Beli karena alasan-alasan itu, bukan untuk membatalkan langganan.
- Ada cara yang lebih murah untuk berhemat. Turun ke paket $100 dan hemat $1.200 setahun, bayar per token untuk model terbuka (DeepSeek V4.1 Flash berharga $0,60 per juta token output di luar jam sibuk), atau pakai paket coding mulai $18 sebulan.
Gagasan versus kenyataan
| Gagasannya | Kenyataannya, Oktober 2026 |
|---|---|
| “Balik modal dalam setahun” | MacBook Pro 16 inci dengan 128 GB berharga $6.999. Dengan $200 sebulan, itu 35 bulan sebelum listrik, dan 41 bulan begitu kamu tambahkan paket $20 yang akan tetap kamu pakai untuk tugas berat |
| “Model lokal sekarang pada dasarnya sama bagusnya” | Opus 5.5 mendapat skor 58. Model terbaik yang muat di 128 GB mendapat skor 34 (Qwen3.8 27B, indeks v4.3.2). Model terbuka terbaik yang bisa diunduh mendapat skor 32 pada v5 yang baru |
| “128 GB bisa menjalankan model terbuka besar” | GLM-5.3 butuh sekitar 376 GB pada 4-bit, DeepSeek V4.1 Flash sekitar 380–460 GB, Kimi K3 sekitar 1,5 TB. Tak satu pun muat di MacBook mana pun |
| “M5 Max itu cepat” | Untuk menulis, ya: 55–88 token per detik pada model mixture-of-experts. Untuk membaca prompt 32K token: 13 sampai 55 detik |
| “4-bit tanpa kehilangan mutu” | Pada benchmark pendek, hampir. Pada input di atas 64K token, hingga 59% lebih buruk dalam satu studi, dan lebih buruk lagi di luar bahasa Inggris |
| “Tanpa batas, privasi total” | Benar. Itulah alasan sebenarnya untuk membelinya |
Daftar isi
- TL;DR — versi 60 detik
- Gagasan versus kenyataan
- Bagian 1 — Gagasan “Batalkan paket $200-mu”, dan kenapa terdengar begitu masuk akal
- Bagian 2 — Apa yang sebenarnya dibeli $200 sebulan pada Oktober 2026
- Bagian 3 — Berapa harga MacBook 128 GB sekarang
- Bagian 4 — Jarak mutu, diukur
- Bagian 5 — Kenapa model yang sebenarnya kamu inginkan tidak muat
- Bagian 6 — Kuantisasi: pajak mutu yang kamu bayar agar model muat
- Bagian 7 — Kecepatan: cepat saat menulis, lambat saat membaca
- Bagian 8 — Masalah laptop
- Bagian 9 — Jarak perangkat lunak: apa yang harus kamu bangun ulang
- Bagian 10 — Hitungan titik impas, dikerjakan dengan jujur
- Bagian 11 — Sisi yang adil: kapan membeli Mac untuk AI lokal masuk akal
- Bagian 12 — Cara lebih murah memangkas tagihan AI $200
- Bagian 13 — Haruskah kamu membeli MacBook untuk LLM lokal? Panduan keputusan
- Bagian 14 — Kalau tetap membelinya: cara memaksimalkannya
- Pertanyaan yang sering diajukan
- Bisakah MacBook menggantikan langganan ChatGPT Pro atau Claude Max?
- Apa LLM lokal terbaik untuk MacBook Pro 128 GB pada 2026?
- Berapa harga MacBook Pro 128 GB sekarang?
- Berapa lama MacBook balik modal dibanding langganan AI $200?
- Apakah M5 Max cukup cepat untuk LLM lokal?
- Apakah LLM lokal sekarang sebaik ChatGPT atau Claude?
- Apakah kuantisasi membuat model lokal lebih buruk?
- Bisakah aku menjalankan DeepSeek V4.1 Flash atau GLM-5.3 di MacBook?
- Apakah 64 GB cukup untuk AI lokal, atau aku perlu 128 GB?
- Sebaiknya aku membeli Mac Studio daripada MacBook Pro untuk LLM lokal?
- Apakah menjalankan AI secara lokal lebih baik untuk privasi dan GDPR?
- Bisakah aku memakai Claude Code dengan model lokal?
- Apakah MacBook Pro OLED baru akan mengubah semua ini?
- Kesimpulan
Bagian 1 — Gagasan “Batalkan paket $200-mu”, dan kenapa terdengar begitu masuk akal
Mulai dari kenapa argumen ini begitu mudah menyebar, karena sebagian besar isinya masuk akal.
Tiga lab bertemu di angka $200. Claude Max 20× dari Anthropic berharga $200 sebulan. ChatGPT Pro dari OpenAI tersedia dalam versi $100, $200, dan $500. AI Ultra dari Google punya paket $100 dan paket $200. Bayar itu setiap bulan dan angkanya menempel: $2.400 setahun, $7.200 dalam tiga tahun.
Perangkat kerasnya jadi serius. MacBook Pro M5 Max, yang dijual sejak Maret, menampung hingga 128 GB memori terpadu dengan bandwidth 614 GB/s, dan Apple menanamkan Neural Accelerator, perangkat keras khusus matematika matriks, di setiap inti GPU. Pada Agustus, Mac Studio hadir dengan opsi M5 Ultra yang mendukung hingga 512 GB. Pemasaran Apple sekarang lebih banyak mengandalkan AI lokal daripada sebelumnya.
Langganannya jadi makin pelit. Batas mingguan Claude Max, yang ditambahkan beberapa bulan setelah paket itu diluncurkan, menjadi pokok gugatan kelompok yang diajukan pada 8 September, yang berpendapat bahwa label “5×” dan “20×” tidak cukup menjelaskan batas mingguannya. OpenAI dilaporkan memotong jatah paket Pro $200 bagi pelanggan baru dari 20 kali ChatGPT Plus menjadi 10 kali. Ketika barang yang kamu sewa terus menyusut, memiliki mulai terlihat menarik.
Privasi memang masalah nyata. Apa pun yang kamu tempel ke model cloud meninggalkan mesinmu. Bagi bisnis Jerman yang memegang data klien, itu bukan paranoia; itu GDPR.
Dan hitungannya mudah. Versi yang paling banyak dibagikan: Mac Studio $2.499 dibagi $200 sebulan adalah sekitar 12,5 bulan. Forbes menjalankan versi yang jauh lebih cermat pada Agustus, dengan konfigurasi nyata dan tiga tahun listrik, dan menyimpulkan bahwa Mac mungkin tidak akan membuatmu bisa membatalkan paket Claude atau ChatGPT kalau kamu coding dengan agen. Tapi versi pendeknya yang diingat orang.
Inilah cacatnya. Gagasan itu membandingkan harga dengan harga. Seharusnya membandingkan produk dengan produk. Itulah yang dilakukan sisa artikel ini, dimulai dari apa yang sebenarnya dibayar oleh $200.
Bagian 2 — Apa yang sebenarnya dibeli $200 sebulan pada Oktober 2026
| Penyedia | Paket $20 | Paket $100 | Paket $200 | Di atas $200 |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: $20 ($17 per bulan bila ditagih tahunan) | Max 5×: $100 | Max 20×: $200 | Tim dan Enterprise |
| OpenAI (ChatGPT) | Plus: $20 (Go: $8) | Pro 100: $100 | Pro 200: $200 | Pro 500: $500 |
| Google (Gemini) | AI Pro: $20 | AI Ultra: $100 | AI Ultra: $200 | — |
Harga AS per bulan, tidak termasuk PPN. Claude dari claude.com; ChatGPT dari pelacak AI Business Weekly, diperbarui 4 Oktober; Google dari laporan Engadget soal peluncuran ulang Mei. Harga dan jatah sering berubah, jadi periksa sebelum berlangganan.
Untuk apa uangnya sebenarnya dibayarkan
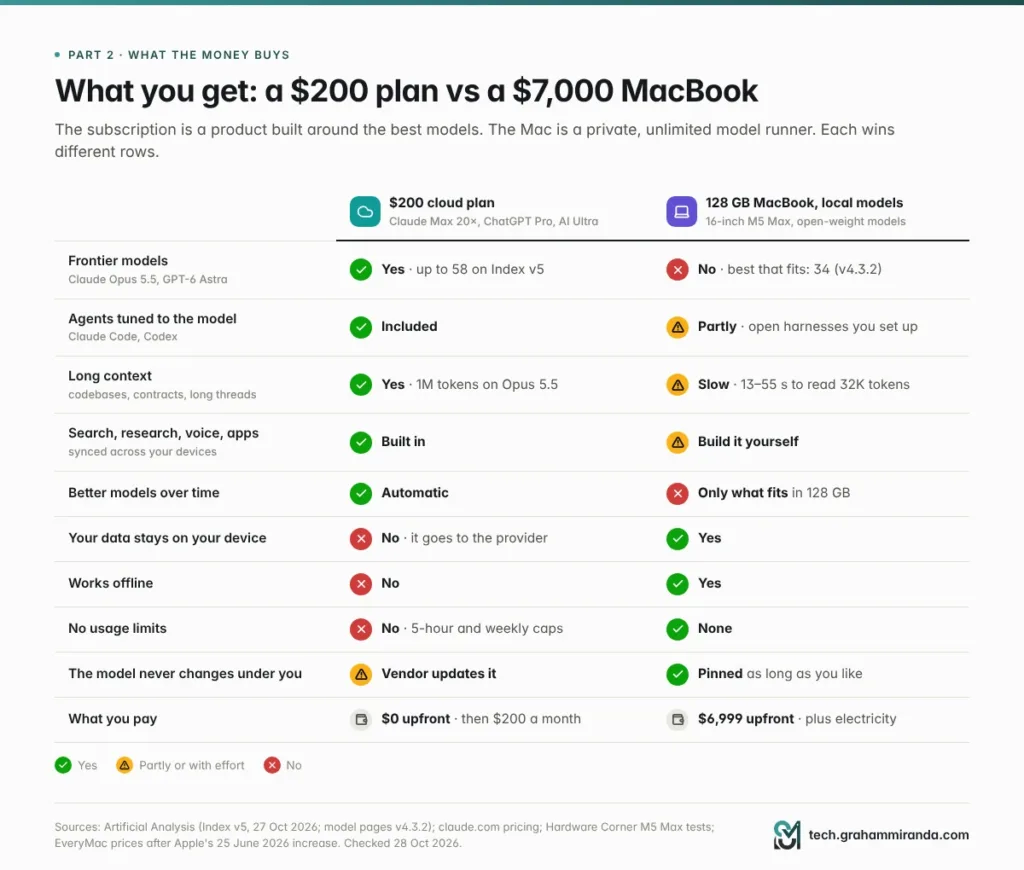
1. Model terdepan, yang tidak bisa kamu dapatkan di tempat lain. Pada indeks baru Artificial Analysis, Anthropic dan OpenAI mengisi kelima posisi teratas. Tak satu pun model itu bisa diunduh dengan harga berapa pun. Langganan adalah cara termurah bagi sebagian besar orang untuk bisa memakainya.
2. Agen yang dibangun di sekitar model-model itu. Paket berbayar Claude menyertakan Claude Code; paket ChatGPT menyertakan Codex. Harness dan modelnya disetel bersama, yang membantu menjelaskan kenapa keduanya duduk di puncak papan peringkat coding agentik. (Aku membandingkan 28 alat semacam ini di Perbandingan semua harness coding AI.)
3. Konteks yang sangat besar. Claude Opus 5.5 punya jendela konteks satu juta token, menurut Artificial Analysis: seluruh basis kode, seluruh kontrak, email seperempat tahun penuh.
4. Produk di sekitar modelnya. Pencarian web dan riset mendalam, analisis berkas, suara, memori, pembuatan gambar, konektor ke email dan dokumenmu, serta aplikasi yang tersinkron di ponsel, laptop, dan browser. Tak satu pun dari itu ikut dalam berkas model.
5. Peningkatan yang tidak perlu kamu pasang. Model di balik langgananmu kuartal depan akan lebih baik daripada yang sekarang. Model di Mac-mu hanya berubah kalau kamu mengunduh yang berbeda, dan hanya jika yang baru muat.
6. Sedikit uang yang kembali. Halaman harga Anthropic sekarang mencantumkan kredit API bulanan pada Max: $100 di paket 5× dan $200 di paket 20×.
Apa yang tidak dibelinya
Pemakaian tanpa batas. Paket Claude berjalan dengan jendela lima jam bergulir plus batas mingguan, sedangkan OpenAI dan Google umumnya menggambarkan paket teratas mereka sebagai kelipatan dari paket yang lebih murah, kalau pun menggambarkannya. Kendali atas ke mana datamu pergi, yang sangat penting bagi data pribadi dan data klien. Dan prediktabilitas: jatahnya sudah berubah lebih dari sekali tahun ini.
Ingat tiga hal itu. Itulah dasar yang jujur untuk AI lokal, dan Bagian 11 membahasnya tuntas.
Tampilkan gambar Langganan adalah sebuah produk; Mac adalah penjalan model. Keduanya menang di baris yang berbeda, dan itulah sebabnya jawaban yang tepat bagi sebagian besar orang adalah keduanya.
Bagian 3 — Berapa harga MacBook 128 GB sekarang
Hanya satu chip yang membawamu ke 128 GB. Pada generasi M5, memori terpadu sebesar itu hanya tersedia dengan M5 Max dengan GPU 40 inti, yang punya bandwidth memori 614 GB/s. M5 Max dengan GPU 32 inti terkunci di 36 GB dan 460 GB/s, sedangkan M5 Pro mentok di 64 GB dan 307 GB/s.
| Konfigurasi | Harga AS | Jerman |
|---|---|---|
| M5 Max 16″ (CPU 18 inti, GPU 40 inti), 48 GB, 2 TB | $4,999 | €5,699 |
| Upgrade ke 128 GB | +$2.000 (sebelumnya +$1.000 sampai 25 Juni) | sekitar +€2.500 (sebelumnya +€1.250 saat peluncuran), perkiraan |
| M5 Max 16″, 128 GB, 2 TB | $6,999 | sekitar €8.199 (perkiraan; €6.249 saat peluncuran) |
| Spek penuh: 128 GB, 8 TB, layar nano-texture | $10,149 | — |
| Sebagai pembanding: Mac Studio, M5 Max, 128 GB | $4,799 | — |
Harga AS tidak termasuk pajak penjualan; harga Jerman termasuk PPN 19%. Upgrade 128 GB versi Jerman adalah perkiraan saya: Apple mematok €1.250 saat peluncuran, dan upgrade dalam dolar berlipat dua pada Juni. Periksa konfigurator Apple sebelum membeli.
Ada tiga hal yang menonjol.
Memori kini jadi bagian yang mahal. Apple menaikkan harga seluruh lini Mac pada 25 Juni dan menyalahkan biaya memori serta penyimpanan. Kepada Reuters, Apple menyatakan pihaknya “belum pernah melihat kenaikan harga komponen sebesar ini, secepat ini”. Upgrade 64 GB dan 128 GB pada M5 Max sama-sama berlipat dua. Komponen yang paling dibutuhkan AI lokal justru yang harganya berlipat dua.
Premi laptopnya $2.200. M5 Max yang sama dengan 128 GB yang sama di Mac Studio berharga $4.799 saat Forbes menghitungnya pada Agustus. Jika kamu menginginkan memori untuk AI, bentuk laptop membuatnya 46% lebih mahal.
Versi 14 inci adalah kompromi. Kamu juga bisa memesan versi 14 inci dengan 128 GB, tetapi dalam ulasan Notebookcheck sasisnya kesulitan mendinginkan M5 Max saat beban berkelanjutan. Lebih lanjut di Bagian 8.
Mac baru minggu ini. Pada 27 Oktober Apple mengumumkan MacBook Pro 14 inci dengan chip dasar M6 : hingga 32 GB dan 170 GB/s, mulai $1.999. Laptop yang bagus, bukan mesin LLM. Dan malam ini (28 Oktober, 10.00 waktu Pasifik, 18.00 di Jerman) Apple menggelar acara “Pro and Tell”, di mana MacBook Pro layar sentuh OLED diharapkan luas. Laporan menyebut perangkat itu memakai chip M5 Pro dan M5 Max yang sama, sehingga batas 128 GB dan 614 GB/s tidak berubah.
Bagian 4 — Jarak mutu, diukur
Bagaimana membandingkan model di meja kerjamu dengan model di pusat data? Bukan dengan firasat, dan bukan dengan tabel benchmark milik vendor. Artificial Analysis (AA) menjalankan rangkaian tes yang sama pada ratusan model, melalui harness yang sama, lalu meringkas hasilnya menjadi satu Intelligence Index. Tidak ada indeks yang sempurna, tetapi indeks AA independen, dan itulah yang paling mendekati tolok ukur bersama di industri ini.
Pada 27 Oktober, AA menerbitkan versi 5. Perubahan utamanya: sekitar 60% indeks kini berjalan pada set tes privat atau jawaban yang disisihkan, sehingga model tidak mungkin sudah melihat pertanyaannya saat pelatihan. Pekerjaan berbasis pengetahuan, coding, sains, dan pengetahuan umum masing-masing berbobot seperempat.
Papan peringkat baru
| Model | Bisakah diunduh? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | Tidak | 58 |
| GPT-6 Astra (max) | Tidak | 57 |
| GPT-6.1 Sol (max) | Tidak | 55 |
| Gemini 4 Argon (high) | Tidak | 50 |
| Kimi K3.1 Pro | Belum; bobotnya belum dirilis | 46 |
| Claude Haiku 5.5 (max) | Tidak | 36 |
| DeepSeek V4.1 Flash 1017 (max) | Ya, lisensi MIT | 32 |
| GLM-5.3 (max) | Ya | 32 |
Sumber: Artificial Analysis, pengumuman Intelligence Index v5, 27 Oktober 2026.
Ada tiga hal di tabel itu yang penting jika kamu menghitung harga MacBook.
- Lima peringkat teratas semuanya milik Anthropic dan OpenAI, dan tak satu pun model itu bisa diunduh berapa pun harganya.
- Model terbuka terbaik, Kimi K3.1 Pro, belum merilis bobotnya. Di antara model yang benar-benar bisa diunduh, skor terbaik adalah 32, yang membuatnya tertinggal 26 poin dari pemimpin. Pada versi sebelumnya selisih antara model terbuka terbaik dan model tertutup terbaik adalah 3 poin. Sekarang 12, atau 26 jika kamu hanya menghitung bobot yang bisa diunduh.
- Claude Haiku 5.5 mengalahkan semua model terbuka yang bisa diunduh. Itu kelas kecil, cepat, dan murah milik Anthropic, bukan model andalannya.
Khususnya coding
Indeks baru mencakup FrontierCode 2.0, 132 tugas coding privat dari Cognition. Claude Opus 5.5 menyelesaikan 46%; DeepSeek V4.1 Flash 1017, terkuat bersama di antara model yang bisa diunduh, menyelesaikan 28%. Pada Terminal-Bench-Science, 70 tugas sains agentik, hasilnya 59% berbanding 13%.
Agar adil pada model terbuka: Kimi K3.1 Pro memimpin Terminal-Bench 4.0 dengan 67%, di atas semua model tertutup. Model terbuka bisa dan memang menang di benchmark individual. Tapi model itu belum bisa diunduh, dan pendahulunya, Kimi K3, punya 2,8 triliun parameter. Kamu tidak akan menjalankannya di laptop.
Kenapa jaraknya makin lebar
Lompatan dari v4.3 ke v5 tidak memperlakukan semua model sama.
| Model | Jenis | v4.3 | v5 | Perubahan |
|---|---|---|---|---|
| Claude Opus 5.5 | Tertutup | 58 | 58 | 0 |
| GPT-6 Astra | Tertutup | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Tertutup | 56 | 54 | −2 |
| Gemini 4 Argon | Tertutup | 53 | 50 | −3 |
| Kimi K3.1 Pro | Terbuka (belum dirilis) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Buka | 45 | 32 | −13 |
| Muse Spark Open (Meta) | Buka | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | Buka | 46 | 30 | −16 |
Angka v4.3 dan v5 seperti dilaporkan Trending Topics pada 28 Oktober, dengan skor v5 sesuai pengumuman AA.
Rata-rata, empat model terbuka itu kehilangan 13 poin. Empat model tertutup hanya bergeser seperempat poin.
AA belum menjelaskan alasannya. Bacaan yang jelas: ketika pertanyaan tes dirahasiakan, model tidak mungkin sudah melihatnya, dan benchmark publik cenderung menyanjung model yang dilatih berat pada data publik. Bantahannya juga sah: tes privat tidak bisa diperiksa dari luar, dan cara membobot kategori mengubah peringkat. Jangan menganggap indeks mana pun sebagai kitab suci. Tapi ketika empat model terbuka turun dua digit dan empat model tertutup tidak, itu sinyal yang layak dipertimbangkan: tabel benchmark yang dipublikasikan, terutama milik vendor sendiri, membesar-besarkan seberapa dekat model terbuka.
Dan model yang benar-benar muat di MacBook
Model yang dinilai ulang AA untuk pengumumannya sebagian besar jauh terlalu besar untuk laptop. Untuk model yang muat, halaman model AA masih menampilkan skor v4.3.2 , dan pada versi itu Opus 5.5 juga mencetak 58. Jadi ini perbandingan pada satu skala yang konsisten:
| Model | Muat di MacBook 128 GB? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | Tidak, hanya cloud | 58 |
| Qwen3.8 27B (xhigh) | Ya, pada 4-bit bahkan di Mac 32 GB | 34 |
| Qwen3.5 122B A10B (reasoning) | Ya, sekitar 70 GB pada 4-bit | 16 |
| gpt-oss-120b (high) | Ya, sekitar 64 GB | 12 |
Sumber: halaman model Artificial Analysis, dibaca pada 28 Oktober 2026.
AA menempatkan Qwen3.8 27B di peringkat pertama dari 141 model sebanding. Model ini benar-benar unggul untuk ukurannya, dan merupakan model terbuka dengan lisensi Apache 2.0. Tetap saja tertinggal 24 poin.
Tampilkan gambar Dua versi indeks, dua panel terpisah, tidak pernah satu sumbu. Atas: Artificial Analysis Intelligence Index v5 (27 Oktober 2026). Bawah: model yang muat di MacBook 128 GB, pada v4.3.2, versi tempat skor mereka diterbitkan.
Paradoks 128 GB
Lihat lagi tabel terakhir itu. Model terbaik untuk MacBook 128 GB muat di 32 GB. Model yang benar-benar membutuhkan memori ekstra, mixture-of-experts 120 miliar parameter, skornya lebih rendah, terutama karena lebih tua: gpt-oss-120b keluar pada Agustus 2025, dan Qwen3.5 122B sudah di-benchmark di M5 Max pada Maret, berbulan-bulan sebelum Qwen3.8 27B hadir.
Jadi apa yang kamu dapat hari ini dari upgrade $2.000 dari 48 GB ke 128 GB? Ruang: konteks lebih panjang, presisi 8-bit alih-alih 4-bit, beberapa model dimuat sekaligus, dan opsi menjalankan model kelas 100 miliar yang kuat jika nanti rilis. Itu manfaat nyata. Model yang lebih pintar bukan salah satunya, setidaknya tidak di papan peringkat hari ini. Periksa AA sebelum membeli; fakta seperti ini bisa berubah dengan satu rilis.
Bagaimana rasanya 34 versus 58 dalam praktik
Poin indeks bukan “persen lebih pintar”, dan tidak tersebar merata di semua tugas.
Untuk pekerjaan pendek yang jelas batasnya, seperti menulis ulang email, meringkas dokumen yang kamu tempel, atau menarik kolom dari faktur, model 27B yang bagus sering tak bisa dibedakan dari model terdepan. Celahnya terbuka pada pekerjaan panjang dan bertahap: agen yang harus membaca basis kode, merencanakan, mengubah lima berkas, menjalankan tes, dan pulih dari kesalahannya sendiri; riset yang harus merekonsiliasi sumber; penalaran di mana satu langkah salah merusak sisanya. Itulah persis pekerjaan yang orang bayar $200 sebulan untuknya.
Kolom Forbes edisi Agustus memberi contoh konkret dari makalah riset Qwen sendiri: Qwen3-Coder-Next yang berjalan di Claude Code mencetak 30.9% pada Terminal-Bench 2.0, berbanding 53.9% untuk Claude Opus 4.5 dalam makalah yang sama. Itu model tahun lalu, tapi polanya belum berubah: pada tugas agentik, penyiapan lokal jauh lebih sering gagal.
Bagian 5 — Kenapa model yang sebenarnya kamu inginkan tidak muat
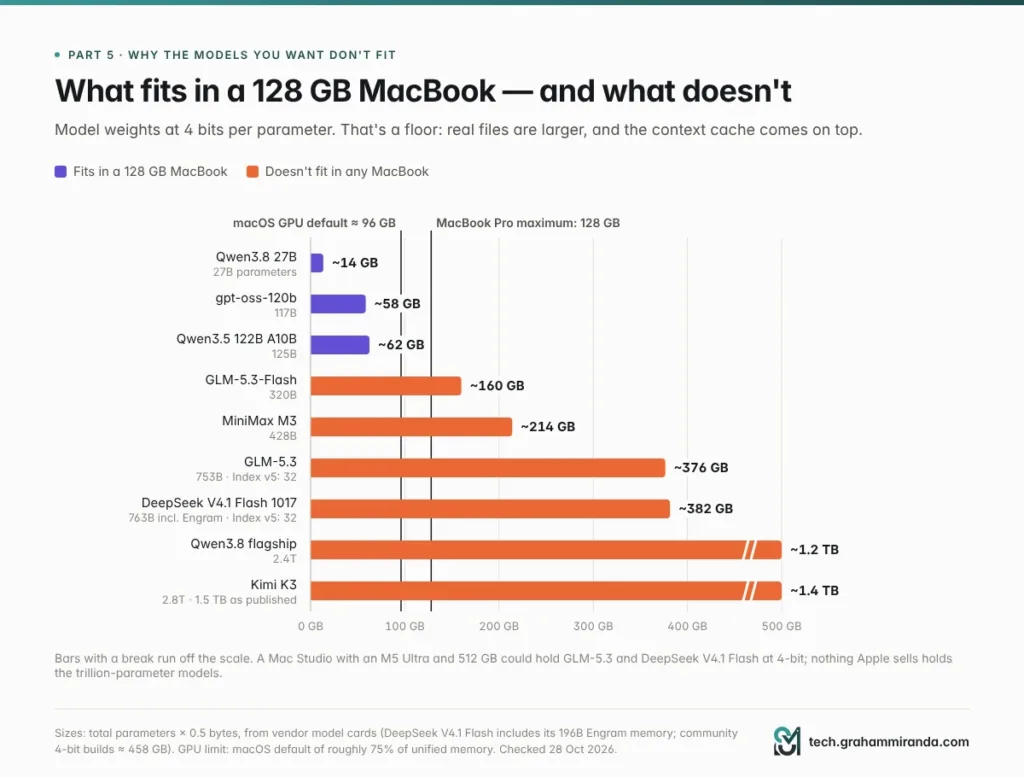
Ukuran model di memori mudah diperkirakan:
teks
bobot (GB) ≈ parameter (miliar) × byte per parameter
               8-bit → × 1,0     4-bit → × 0,5     2-bit → × 0,25
Lalu tambahkan KV cache, memori kerja model untuk percakapanmu, yang tumbuh seiring panjang konteks. Dan ingat, macOS tidak menyerahkan seluruh memori terpadu ke GPU: secara default GPU boleh mematok sekitar 75% di Mac bermemori besar, sekitar 96 GB dari mesin 128 GB. Kamu bisa menaikkan batasnya dengan sudo sysctl iogpu.wired_limit_mb=…, dengan risiko sendiri; apa pun yang kamu berikan ke model tidak didapat browser, editor, dan sistem operasimu.
Inilah artinya untuk model yang benar-benar dibicarakan orang:
| Model | Total parameter | Bobot 4-bit (batas bawah) | Muat di MacBook 128 GB? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ Mudah |
| gpt-oss-120b | 117B | ~58 GB (berkas 64 GB) | ✅ Ya |
| Qwen3.5 122B A10B | 125B | ~62 GB (berkas 69,6 GB) | ✅ Ya |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ Tidak |
| MiniMax M3 | 428B | ~214 GB | ❌ Tidak |
| GLM-5.3 | 753B | ~376 GB | ❌ Tidak |
| DeepSeek V4.1 Flash 1017 | 763B termasuk memori Engram | ~382 GB (build 4-bit komunitas diperkirakan ~458 GB) | ❌ Tidak |
| Qwen3.8 andalan | 2.4T | ~1,2 TB | ❌ Tidak |
| Kimi K3 | 2.8T | ~1,5 TB sesuai publikasi (MXFP4 native) | ❌ Tidak |
Kolom 4-bit adalah parameter × 0,5 byte: hanya bobot, sebelum KV cache dan overhead berkas, jadi berkas sebenarnya lebih besar. Ukuran berkas diambil dari pengujian M5 Max oleh Hardware Corner.
Model yang mencetak 32 pada indeks baru, yang terbaik yang bisa kamu unduh, butuh tiga sampai empat kali lebih dari kapasitas MacBook. Dan model di antaranya juga tidak muat. Jika kamu memberi 100 GB dari 128 GB untuk bobot model, ini jumlah bit per bobot yang bisa kamu dapat:
| Model | Bit per bobot dalam anggaran 100 GB |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Di sekitar tiga bit ke bawah, kualitas jatuh drastis (Bagian 6 memuat risetnya). Satu bit per bobot bukan kuantisasi. Itu amputasi.
Konteks juga memakan memori. Dalam pengujian Hardware Corner, Qwen3-Coder-Next 8-bit memakai 87,1 GB pada konteks 4K dan 92,6 GB pada 64K: tambahan lima setengah gigabyte hanya untuk menampung percakapan yang lebih panjang. Agen yang membaca seluruh repositori butuh konteks panjang, jadi sisa ruang itu cepat habis.
Bagaimana dengan Mac Studio 512 GB? Mac Studio M5 Ultra dengan 512 GB bisa menampung GLM-5.3 atau DeepSeek V4.1 Flash pada 4-bit. Apple bilang konfigurasi itu akan hadir akhir Oktober; MacRumors memperkirakan harganya jauh di atas $10.000, dan Apple belum menerbitkan harga saat saya cek. Kamu akan membayar lima digit untuk menjalankan model yang mencetak 32 pada indeks baru, kemungkinan lebih lambat daripada cara pembuatnya menyajikannya. Perbandingan Kimi K3 versus Fable 5.1 versus GLM-5.3 saya membahas lebih dalam soal apa yang sebenarnya dibutuhkan untuk menghosting sendiri model terbuka besar.
Tampilkan gambar Hanya bobot, pada 4 bit per parameter; cache konteks dihitung di atasnya. Semua yang berada di kanan garis 128 GB butuh Mac Studio atau server.
Bagian 6 — Kuantisasi: pajak mutu yang kamu bayar agar model muat
Kuantisasi menyimpan bobot model dalam bit lebih sedikit, 8 atau 4 alih-alih 16 seperti saat dilatih, sehingga memori lebih hemat dan berjalan lebih cepat. Semua model lokal yang kamu jalankan di Mac terkuantisasi. Pertanyaannya berapa biayanya, dan riset memberi jawaban yang jelas sekaligus agak tidak nyaman.
Kabar baiknya: 8-bit nyaris gratis, 4-bit sebagian besar masih oke
- Salah satu studi terbesar sejauh ini, oleh Eldar Kurtic dan rekan-rekannya, menjalankan lebih dari 500.000 evaluasi pada model Llama 3.1 terkuantisasi. FP8 praktis tanpa kehilangan di semua ukuran; INT8 berkurang sekitar 1–3% dengan penyetelan cermat; dan kuantisasi 4-bit khusus bobot “lebih kompetitif dari perkiraan”, mendekati 8-bit.
- Untuk model penalaran, studi 2025 oleh Ruikang Liu dan rekan-rekannya menemukan bahwa bobot dan aktivasi 8-bit, atau bobot 4-bit dengan aktivasi 16-bit, bisa tanpa kehilangan pada benchmark matematika, sains, dan coding. Lebar bit yang lebih rendah membawa apa yang penulis sebut risiko akurasi signifikan, dan tingkat kesulitan tugas sangat memengaruhi besarnya penurunan.
Jika kamu hanya bertanya hal pendek dalam bahasa Inggris, model 4-bit akan terasa mirip aslinya.
Kabar buruknya: input panjang, bahasa lain, dan apa pun di bawah 4 bit
- Konteks panjang. Anmol Mekala dan rekan-rekannya menguji lima metode kuantisasi pada 9.700 contoh dengan input 64.000 token atau lebih (EMNLP 2025). 8-bit berkurang sekitar 0.8% rata-rata. 4-bit berkurang hingga 59%, dan kerusakannya sangat bergantung pada model: dengan salah satu metode 4-bit, Llama 3.1 70B turun 32% pada tugas di mana Qwen 2.5 72B bertahan.
- Bahasa selain Inggris. Studi yang sama menemukan penurunan cenderung lebih buruk bila input bukan bahasa Inggris. Jika kamu bekerja dalam bahasa Jerman, uji dalam bahasa Jerman.
- Di bawah 4 bit, penalaran runtuh. Peneliti di Meta FAIR menerbitkan studi pada Juni 2026 yang menunjukkan model penalaran terkuantisasi berpikir berlebihan. Pada AWQ 3-bit, skor model penalaran 1,5B di benchmark MATH-500 turun dari 85,6% ke 47,0%, dan rantai berpikirnya tumbuh dari 5.200 ke 23.400 token, 4,5 kali lebih panjang. Di laptop yang menulis 20 sampai 80 token per detik, model yang berpikir empat kali lebih lama juga sekitar empat kali lebih lambat.
Tampilkan gambar Apa kata riset tentang biaya setiap penurunan presisi. Pemerasan yang bisa memuat model lebih besar ke 128 GB justru yang paling menyakitkan.
Artinya bagi MacBook 128 GB
Kuantisasi yang mampu kamu tanggung untuk model yang kamu inginkan adalah kuantisasi yang paling menyakitkan. Model 27B bisa berjalan 8-bit di Mac dengan ruang sisa, dan sebaiknya begitu. Model kelas 120B berjalan 4-bit, cukup untuk chat dan berisiko pada dokumen panjang. Dan satu-satunya cara menaruh sesuatu dari kelas 300B ke atas di laptop adalah dua atau tiga bit per bobot, di mana studi di atas menyebut penalaran berantakan.
Pedoman praktis saya:
- Pakai 8-bit untuk apa pun yang akan kamu andalkan, terutama dokumen panjang dan pekerjaan agen.
- 4-bit cukup untuk chat, penyusunan draf, dan tugas pendek. Periksa perilakunya pada konteks panjang dengan dokumenmu sendiri.
- Jangan jalankan model penalaran atau coding di bawah 4-bit kecuali kamu sedang bereksperimen.
- Uji dalam bahasa yang kamu pakai bekerja.
Bagian 7 — Kecepatan: cepat saat menulis, lambat saat membaca
LLM melakukan dua pekerjaan berbeda dengan dua kecepatan berbeda. Prefill membaca prompt-mu, semua yang kamu tempel plus percakapan sejauh itu, dan dibatasi oleh daya komputasi mentah. Generasi menulis jawaban satu token demi satu token, dan dibatasi oleh bandwidth memori. Peneliti machine learning Apple sendiri mengukur keduanya di M5: GPU Neural Accelerators barunya membuat waktu ke token pertama 3,3 sampai 4,1 kali lebih cepat daripada di M4, sementara generasi hanya meningkat 1,19 sampai 1,27 kali, kira-kira sejalan dengan tambahan bandwidth.
Jadi apa yang sebenarnya bisa dilakukan M5 Max 128 GB? Hardware Corner menerbitkan pengujian dengan framework MLX Apple pada M5 Max 14 inci 128 GB:
| Model | Konteks | Membaca (prefill), tok/s | Waktu membaca seluruh prompt | Menulis, tok/s |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3,1 dtk | 87.9 |
| 32K | 2,537 | 12,9 dtk | 64.5 | |
| Qwen3.5 122B A10B (4-bit) | 4K | 881 | 4,6 dtk | 65.9 |
| 32K | 1,068 | 30,7 dtk | 54.9 | |
| Qwen3.5 27B (dense, 6-bit) | 4K | 811 | 5,1 dtk | 23.6 |
| 32K | 591 | 55,4 dtk | 14.9 | |
| Qwen3-Coder-Next (8-bit) | 64K | 1,432 | 45,8 dtk | 48.2 |
Diukur oleh pengguna Reddit cryingneko dan diterbitkan Hardware Corner. “Waktu membaca seluruh prompt” adalah panjang konteks dibagi kecepatan prefill yang terukur.
Kecepatan menulis sekarang sudah oke, setidaknya pada model MoE
Model mixture-of-experts hanya memakai sebagian kecil bobotnya untuk setiap token, jadi menulisnya cepat: 55 sampai 88 token per detik di M5 Max. Sebagai pembanding, Artificial Analysis mengukur Claude Opus 5.5 pada 98 token per detik di API Anthropic. Untuk mengobrol dengan model kelas 120B, M5 Max benar-benar nyaman. Model dense lain ceritanya: model 27B yang memakai setiap bobot untuk setiap token menulis 15 hingga 24 token per detik.
Dua efek yang lebih kecil juga menumpuk. Menulis melambat seiring percakapan bertambah panjang: 17% hingga 37% lebih lambat pada 32K dibanding 4K di ketiga model itu. Dan model penalaran menghabiskan ratusan atau ribuan token untuk berpikir sebelum menjawab.
Menunggunya ada di bagian membaca
Lihat lagi kolom waktu baca. Prompt 32.000 token (beberapa berkas sumber, kontrak panjang, utas email besar) butuh 13 hingga 55 detik untuk dibaca sebelum kata pertama jawaban muncul.
Itu paling berpengaruh justru pada pekerjaan yang menjadi alasan orang membeli paket $200. Agen coding AI mengirimkan prompt sistem yang besar, definisi setiap alat, berkas yang telah dibuka, dan percakapan sejauh ini, dan mereka melakukannya pada setiap langkah. Server lokal dapat menggunakan ulang bagian prompt yang tidak berubah, dan itu sangat membantu. Tetapi setiap kali sesuatu di awal konteks berubah, misalnya ketika agen memadatkan riwayatnya atau kamu beralih ke tugas baru, semua yang setelah titik itu harus dibaca ulang. Forbes mengutip seorang developer yang menunggu sekitar 90 detik untuk token pertama pada M3 Ultra 512 GB dengan prompt sistem 16.000 token, dan developer lain yang melihat sekitar 20 detik dari kondisi dingin pada laptop M4 Pro 48 GB. Chip generasi M5 jauh lebih cepat dalam hal ini dibanding Mac lama, menurut pengukuran Apple sendiri, tetapi bentuk masalahnya tetap sama.
Sebagai perbandingan, tes Hardware Corner yang sama dijalankan pada kartu workstation Nvidia RTX Pro 6000, yang harganya sekitar $8.800 sendiri: kartu itu membaca prompt 2 hingga 2,4 kali lebih cepat dan menulis 1,7 hingga 2,8 kali lebih cepat daripada M5 Max.
Tampilkan gambar Diukur dengan MLX pada M5 Max 128 GB. Menulis cukup cepat; membaca prompt panjang, yang terus dilakukan agen, adalah tempat penantian terjadi.
Bagian 8 — Masalah laptop
Bahkan jika modelnya cukup baik, laptop adalah tempat yang canggung untuk menjalankannya.
Panas. Menjalankan model besar adalah beban terus-menerus: GPU dan memori bekerja penuh selama menit atau jam, bukan ledakan sepuluh detik. Ulasan Notebookcheck tentang M5 Max 14 inci menyimpulkan bahwa sasis dan pendinginannya “tidak mampu menangani M5 Max secara memadai”: performa dalam uji stres CPU 30 menit turun 24%, dan kipas mencapai 53,2 dB(A) dalam mode High Power. Ulasan itu mengukur beban CPU dan grafis, bukan LLM, dan Notebookcheck sendiri menyarankan M5 Max sebaiknya ada di model 16 inci. Jika kamu memang membeli MacBook untuk AI lokal, belilah yang 16 inci. Panduan Panduan MacBook Pro M5 Pro 64 GB saya sampai pada kesimpulan yang sama tentang kerja terus-menerus di sasis yang lebih kecil.
Ini juga komputer sehari-harimu. Muat model 70 GB plus konteksnya dan kamu masih punya ruang untuk browser dan editor. Dorong ke sekitar 96 GB yang didapat GPU secara default, atau naikkan batasnya untuk memuat sesuatu yang lebih besar, dan sisa pekerjaanmu mulai bersaing dengan model untuk memori. Setiap model yang kamu biarkan termuat adalah memori yang tidak didapat aplikasi lain.
Baterai tidak suka itu. Beban GPU terus-menerus cepat menguras baterai laptop, jadi sesi inferensi lokal yang panjang akhirnya dilakukan sambil tercolok, yang agak melemahkan tawaran “AI di mana saja, offline”.
Kamu membeli batas atasmu di hari pertama. Memori terpadu tidak bisa ditingkatkan setelah dibeli. Jika model terbuka terbaik tahun depan butuh 160 GB, MacBook 128 GB tidak akan bisa menjalankannya.
Dan nilainya turun cepat. MacFinder, penjual barang rekondisi asal Inggris, menganalisis data pembeliannya sendiri selama enam tahun dan menemukan sebagian besar MacBook kehilangan sekitar setengah nilainya pada tahun pertama, dengan model kelas atas sering turun lebih dalam: MacBook Pro M4 16 inci kehilangan hingga 60% dalam setahun. Mesin seharga $6.999 adalah taruhan $6.999 bahwa batas memori hari ini masih berguna dalam tiga tahun.
Desktop adalah mesin LLM yang lebih baik. Jika AI lokal adalah tujuannya, Mac Studio dengan M5 Max dan 128 GB yang sama berharga $2.200 lebih murah, tidak punya baterai yang bisa kepanasan dan tidak punya tutup untuk ditutup, dan bisa berjalan sepanjang waktu sebagai server pribadi untuk laptop dan ponselmu. Pasangkan dengan laptop apa pun yang sudah kamu suka.
Bagian 9 — Jarak perangkat lunak: apa yang harus kamu bangun ulang
Langganan adalah model plus produk. Penyiapan lokal memberimu modelnya dan menyerahkan produknya kepadamu.
| Apa yang dilakukan langganan untukmu | Apa yang akan kamu lakukan secara lokal |
|---|---|
| Menghosting dan memperbarui model | Mengunduh, mengonversi, dan memperbarui model sendiri (LM Studio, Ollama, atau MLX) |
| Pencarian web dan riset mendalam | Menyiapkan API pencarian atau pencarian yang dihosting sendiri, plus agen untuk menggerakkannya |
| Membaca PDF, spreadsheet, dan gambar | Pilih model dengan kemampuan visual, tambahkan penguraian dokumen |
| Suara, memori, pembuatan gambar | Model dan aplikasi terpisah untuk masing-masing (Whisper untuk suara, Draw Things atau ComfyUI untuk gambar) |
| Aplikasi di setiap perangkat, tersinkron | Jalankan server dan front-end, lalu ekspos ke ponselmu dengan aman |
| Claude Code atau Codex, disesuaikan dengan model mereka sendiri | Arahkan harness terbuka, atau Claude Code itu sendiri, ke server lokal |
| Template chat, format pemanggilan alat, dan keamanan ditangani | Debug saat model baru dirilis dengan template yang tidak dipahami alatmu |
Perkakasnya sekarang benar-benar bagus. LM Studio adalah awal termudah di Mac, Ollama memberimu satu API untuk model lokal dan cloud, dan MLX dari Apple biasanya paling cepat. Ollama bahkan mengekspos API yang kompatibel dengan Anthropic, jadi kamu bisa mengarahkan Claude Code ke model lokal dengan mengatur ANTHROPIC_BASE_URL=http://localhost:11434. Dokumentasinya blak-blakan soal celahnya: kontrol caching prompt Anthropic, penghitungan token, batch, dan input PDF tidak didukung. Dan Claude Code disesuaikan untuk model Claude; model lokal harus menangani prompt sistem dan definisi alat Claude Code yang panjang, dan di situlah waktu prefill dari Bagian 7 mulai terasa.
Tidak ada yang mustahil. Tulisan OpenCode v2 versus Hermes Agent versus OpenClaw saya membahas agen terbuka yang bekerja dengan model lokal. Tapi itu kerja nyata, dan waktumu tidak gratis. Sisihkan satu akhir pekan untuk menyiapkannya dan beberapa jam sebulan untuk menjaganya tetap mutakhir.
Bagian 10 — Hitungan titik impas, dikerjakan dengan jujur
Inilah perhitungan yang biasanya dilewatkan tawaran itu.
Langkah 1: versi naif
$6.999 ÷ $200 per bulan = 35 bulan. Bukan dua belas. Hampir tiga tahun, dan itu versi yang paling menguntungkan.
Langkah 2: tambahkan listrik
Forbes memperkirakan sekitar $10 per bulan untuk Mac yang menjalankan AI delapan jam sehari dengan tarif rata-rata AS. Di Jerman, dengan rata-rata Oktober 29,68 sen per kWh, laptop yang rata-rata memakai 60–150 W selama delapan jam sehari menghabiskan sekitar €4–11 per bulan. Kecil, tapi itu mendorong titik impas ke sekitar 37 bulan.
Langkah 3: pertahankan paket murah untuk hal-hal berat
Kamu akan tetap memakainya. Sedikit orang yang pernah memakai model terdepan untuk coding agentik atau riset serius kembali ke model 34 poin untuk segala hal. Pertahankan paket $20 untuk 10% pekerjaan sulit dan Mac menghemat $170 per bulan, bukan $200: sekitar 41 bulan.
Langkah 4: bandingkan dengan paket yang benar-benar akan kamu turuni
Jika kamu cukup sadar biaya untuk mempertimbangkan laptop $7.000, kamu juga cukup sadar biaya untuk turun ke tingkat $100. Dibanding $100 per bulan, titik impasnya adalah sekitar 78 bulan, lebih dari enam setengah tahun, lebih lama daripada yang banyak orang pertahankan laptopnya.
| Skenario | Di muka | Kamu tetap membayar | Penghematan bulanan | Titik impas |
|---|---|---|---|---|
| MacBook vs paket $200, tanpa listrik | $6,999 | — | $200 | 35 bulan |
| MacBook vs paket $200, dengan listrik | $6,999 | $10 | $190 | 37 bulan |
| … dan kamu tetap pakai paket $20 | $6,999 | $30 | $170 | 41 bulan |
| MacBook vs paket $100 | $6,999 | $10 | $90 | 78 bulan |
| Mac Studio (128 GB) vs paket $200 | $4,799 | $10 | $190 | 25 bulan |
| Mac Studio vs paket $200, tetap pakai paket $20 | $4,799 | $30 | $170 | 28 bulan |
Semua ini mengasumsikan Mac sepenuhnya menjalankan tugas langganan. Bagian 4 sampai 9 menjelaskan mengapa tidak.
Tampilkan gambar Biaya kumulatif selama empat tahun, dengan asumsi Mac sepenuhnya menggantikan langganan, padahal tidak. Listrik sekitar $10 per bulan.
Langkah 5: tiga tahun, dengan nilai jual kembali
Perangkat keras punya nilai jual kembali, dan itu argumen terkuat untuk membeli. Asumsikan kamu menjualnya setelah tiga tahun seharga 35% dari harga beli. Itu asumsiku, bukan kutipan, berdasarkan data MacFinder yang menunjukkan sekitar setengah nilainya hilang pada tahun pertama dan kerugian melambat setelahnya.
| Opsi | Biaya 36 bulan |
|---|---|
| Paket $200 | $7,200 |
| MacBook (128 GB) + listrik, dijual 35% | $4,909 |
| … plus paket $20 untuk pekerjaan terdepan | $5,629 |
| Mac Studio (128 GB) + listrik + paket $20, dijual 35% | $4,199 |
| Paket $100 | $3,600 |
| Paket $20 | $720 |
Jadi ya: selama tiga tahun, MacBook plus paket $20 bisa keluar sekitar $1.600 lebih murah daripada paket $200, jika kamu menjualnya dengan harga layak. Tapi lihat apa yang dibeli uang itu. Di satu sisi, model terbaik di dunia dengan semua alat di sekitarnya. Di sisi lain, model 34 poin, beberapa ribu dolar depresiasi, dan paket murah untuk saat kamu butuh yang asli. Paket $100 mengalahkan semua opsi perangkat keras dalam biaya, dan paket $20 mengalahkan semuanya.
Kamu tidak menghemat banyak uang dengan MacBook untuk LLM lokal. Kamu membelanjakan jumlah yang mirip untuk produk yang berbeda: privasi, kendali, dan kebebasan dari batasan, dengan kecerdasan yang lebih rendah.
Sudut pandang biaya marginal
Ada satu kerangka berpikir di mana membeli lebih masuk akal: kamu memang butuh MacBook baru. Maka biaya khusus AI-nya hanyalah peningkatan memori dari 48 GB ke 128 GB, $2.000, atau sepuluh bulan paket $200. Itu tidak gila. Tapi ingat paradoks 128 GB dari Bagian 4: di papan peringkat hari ini, peningkatan itu membeli model yang lebih besar, bukan yang lebih pintar. Jika kamu tetap membeli MacBook, 48–64 GB menjalankan model terbaik seukuran Mac pada 8-bit dengan konteks yang cukup.
Apa yang bisa dibeli dengan $6.999 sebagai gantinya
- 35 bulan dari paket $200, 70 bulan dari paket $100, atau 29 tahun dari paket $20
- Sekitar 11,7 miliar token keluaran dari DeepSeek V4.1 Flash pada harga API off-peak-nya, model yang mengungguli semua yang muat di MacBook
- Sekitar 350 juta token keluaran dari Claude Opus 5.5 melalui API Anthropic, pada $20 per juta token keluaran yang tercantum di Artificial Analysis
Bagian 11 — Sisi yang adil: kapan membeli Mac untuk AI lokal masuk akal
Semua ini tidak berarti AI lokal itu gimmick. Saya sering menulisnya di blog ini karena berguna. Hanya saja berguna karena alasan yang berbeda dari yang diklaim tawaran itu. Ini alasan-alasan yang bagus.
1. Data yang tidak boleh lepas dari kendalimu
Jika kamu menangani berkas klien, informasi kesehatan, laporan keuangan yang belum terbit, atau apa pun yang tercakup kewajiban kerahasiaan, model lokal berarti tidak ada yang dikirim ke pihak ketiga. Tidak ada perjanjian pemrosesan data, tidak ada transfer internasional, tidak ada keharusan memikirkan pengaturan pelatihan. Di Jerman, profesional yang terikat § 203 StGB, seperti pengacara, dokter, dan penasihat pajak, memerlukan pengamanan kontraktual sebelum data klien dikirim ke penyedia layanan luar mana pun, termasuk penyedia AI. Model lokal menghindari pertanyaan itu sepenuhnya. Ini alasan terkuat untuk memiliki perangkat kerasnya, dan tidak bergantung pada apakah model lokal sepintar Opus. Laporan Kondisi AI 2026 saya membahas sisi biaya dan kepatuhan menjalankan AI offline lebih detail.
2. Kerja offline
Di pesawat, di lokasi klien tanpa jaringan, di fasilitas tempat jaringan justru hal yang dilarang.
3. Tanpa batas, tanpa pergeseran kebijakan, model yang tak pernah berubah
Tidak ada jendela lima jam, tidak ada batas mingguan, tidak ada gugatan kelompok tentang bagaimana hal itu diungkapkan. Dan checkpoint lokal berperilaku sama dalam setahun seperti hari ini, yang penting jika kamu membangun alur kerja di sekitar perilaku suatu model.
4. Pekerjaan massal, membosankan, dan jelas cakupannya
Mengklasifikasikan ribuan tiket dukungan, menarik kolom dari faktur, merangkum catatanmu sendiri, menerjemahkan draf, menandai foto, menghasilkan embedding untuk pencarian atas dokumenmu sendiri, mentranskripsikan rapat dengan Whisper. Model lokal ukuran menengah sangat baik untuk ini, dan menjalankan sejuta tugas seperti itu tidak memakan biaya apa pun selain listrik.
5. Belajar dan membangun
Jika kamu membangun aplikasi local-first, melakukan fine-tuning model kecil, atau hanya ingin memahami cara kerja semua ini, memiliki perangkat kerasnya adalah guru terbaik. (Jika membangun aplikasi dengan AI adalah minatmu, saya menulis seluruh prosesnya di Cara Membuat Aplikasi dari Nol dengan AI pada 2026.)
6. Kamu memang sudah mau membeli Mac
Lalu beli memori yang cukup untuk model yang benar-benar akan kamu jalankan (lihat Bagian 14), dan anggap AI lokal sebagai bonus, bukan kasus bisnis.
Apa yang berjalan baik secara lokal
| Pekerjaan | Yang dijalankan | Memori yang nyaman |
|---|---|---|
| Chat pribadi, penyusunan draf, penulisan ulang | Qwen3.8 27B pada 8-bit | 48–64 GB |
| Ringkasan dan tanya jawab atas dokumenmu | Qwen3.8 27B, plus model embedding | 48–64 GB |
| Ekstraksi dan klasifikasi massal | Model lebih kecil (Gemma 4, gpt-oss-20b) | 16–32 GB |
| Ucapan ke teks | Whisper | 8–16 GB |
| Pembuatan gambar | Draw Things atau ComfyUI dengan model kelas FLUX | 32 GB+ |
| Model chat besar dan cepat | gpt-oss-120b atau Qwen3.5 122B | 128 GB |
Untuk pembuatan video lokal, Mac tetap lambat dibandingkan perangkat keras Nvidia atau GPU cloud; panduan M5 Pro 64 GB saya punya angkanya.
Bagian 12 — Cara lebih murah memangkas tagihan AI $200
Jika yang benar-benar kamu inginkan adalah tagihan AI yang lebih kecil, ada rute yang lebih murah daripada laptop $7.000.
1. Turun satu tingkat. Claude Max 5× dan ChatGPT Pro 100 berharga $100, dan AI Ultra dari Google sekarang mulai dari $100. Jika kamu jarang mencapai batas pada paket $200, ini menghemat $1.200 per tahun tanpa kehilangan kualitas sama sekali.
2. Gabungkan dua paket $20. Claude Pro plus ChatGPT Plus berharga $40 per bulan dan memberimu dua kumpulan batas terpisah serta dua keluarga model terdepan untuk dipilih.
3. Bayar per token untuk model terbuka. Model bobot terbuka yang sama yang akan kamu jalankan di Mac, dan model lebih besar yang tidak akan pernah muat, tersedia per token dari banyak penyedia, dengan kecepatan pusat data. DeepSeek V4.1 Flash, yang mengungguli setiap model yang muat di MacBook, berharga $0,15 per juta token masukan dan $0,60 per juta token keluaran off-peak di API DeepSeek sendiri (dua kali lipat pada jam sibuk). Qwen3.8 27B tercantum di OpenRouter mulai sekitar $0,035 per juta token masukan. Untuk data pribadi atau klien, gunakan penyedia dengan hosting UE dan perjanjian pemrosesan data, bukan API DeepSeek sendiri, yang memproses data di Tiongkok.
4. Gunakan paket coding tarif tetap untuk model terbuka. Z.ai GLM Coding Plan mulai dari $18 per bulan dan mencakup GLM-5.3, sama-sama terbaik di antara model yang dapat diunduh pada indeks baru, plus GLM-5.3-Flash, dan berfungsi di Claude Code, Codex, OpenCode, dan alat lain. Dapatkan diskon 10% untuk GLM Coding Plan melalui tautan afiliasi saya. (Tautan afiliasi — lihat pengungkapan di bagian atas.) Ini bukan Opus 5.5, dan indeksnya mengatakan itu dengan jelas, tetapi biayanya kurang dari sepersepuluh paket $200. Saya membandingkannya dengan tawaran MiniMax di GLM-5.3-Flash versus MiniMax M3.
5. Gunakan Mac yang sudah kamu punya. Jika Mac-mu saat ini punya 16 hingga 32 GB, model lokal kecil menangani banyak sekali pekerjaan massal di Bagian 11 secara gratis.
6. Arahkan sesuai tugas. Penyiapan yang berhasil untuk sebagian besar orang: model lokal untuk pekerjaan pribadi dan massal, paket murah atau model terbuka per token untuk pekerjaan sehari-hari, dan akses model terdepan untuk 10% yang sulit. Perbandingan perbandingan harness coding AI saya punya lima contoh penyiapan dengan anggaran berbeda.
Tampilkan gambar Biaya bulanan setiap opsi dalam dolar AS, sebelum PPN. Biaya bayar per token bergantung pada seberapa banyak kamu memakainya; harga diperiksa 28 Oktober 2026.
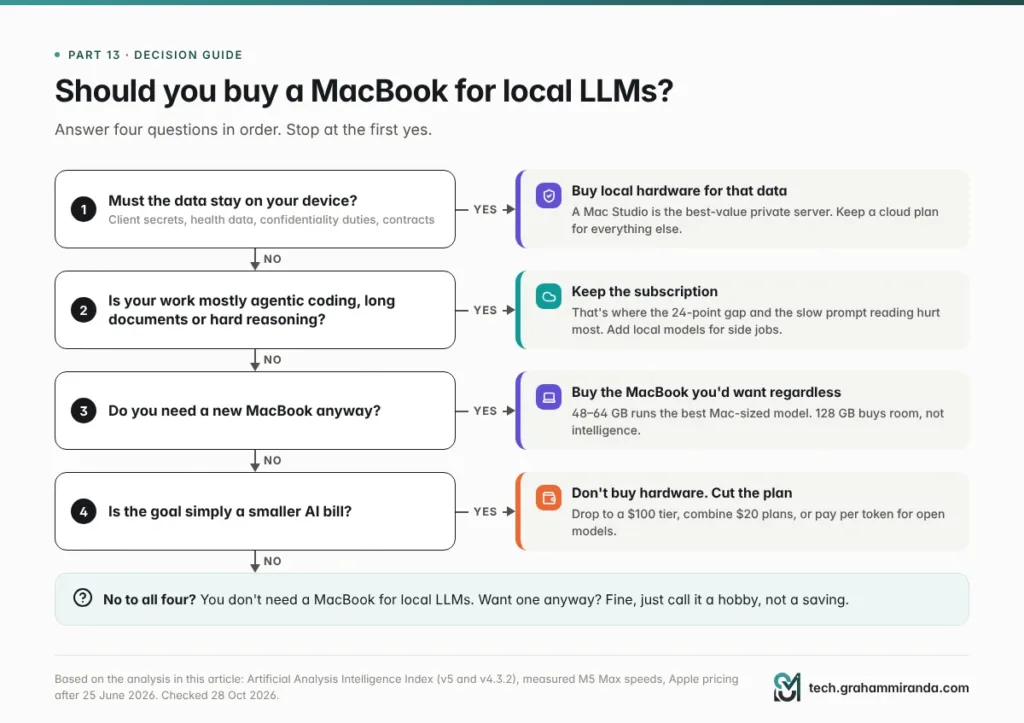
Bagian 13 — Haruskah kamu membeli MacBook untuk LLM lokal? Panduan keputusan
Tampilkan gambar Mulai dari atas. Sebagian besar jalur berakhir dengan “tetap pakai paket cloud”, dan itulah intinya.
Jawab empat pertanyaan secara berurutan.
1. Apakah data harus tetap di perangkatmu? Jika ya, karena kerahasiaan klien, data kesehatan, atau kontrak, beli perangkat keras lokal: persyaratan itu tidak peduli pada benchmark. Pertimbangkan Mac Studio sebagai server pribadi, dan pertahankan paket cloud untuk pekerjaan yang tidak melibatkan data tersebut.
2. Apakah pekerjaanmu sebagian besar coding agentik, dokumen panjang, atau penalaran sulit? Jika ya, pertahankan langganan. Di situlah celah 24 poin dan waktu prefill paling terasa. Model lokal tetap bisa membantu untuk pekerjaan sampingan.
3. Apakah kamu tetap butuh MacBook baru? Jika ya, beli yang memang kamu inginkan. 48–64 GB menjalankan model terbaik seukuran Mac dengan baik. Naik ke 128 GB hanya jika kamu secara khusus ingin model kelas 120B atau beberapa model termuat sekaligus, dan sadar kamu membayar $2.000 untuk ruang, bukan untuk kecerdasan.
4. Apakah tujuannya sekadar tagihan yang lebih kecil? Kalau begitu jangan beli perangkat keras. Turun satu tingkat, gabungkan paket $20, atau bayar per token untuk model terbuka (Bagian 12).
Jika kamu menjawab tidak untuk keempatnya, kamu tidak perlu MacBook untuk LLM lokal. Kamu mungkin tetap ingin, dan itu tidak masalah. Sebut saja hobi, bukan penghematan.
Bagian 14 — Kalau tetap membelinya: cara memaksimalkannya
Pilih mesin yang tepat.
- Beli yang 16 inci, bukan 14 inci, jika M5 Max untuk kerja AI terus-menerus.
- Pertimbangkan Mac Studio sebagai gantinya. Chip dan memori yang sama, $2.200 lebih murah, pendinginan lebih baik, dan bisa melayani laptop serta ponselmu sepanjang waktu.
- Jangan membeli memori berlebihan untuk model hari ini. 48–64 GB menjalankan Qwen3.8 27B pada 8-bit dengan konteks panjang. Beli 128 GB untuk model kelas 120B, beberapa model sekaligus, atau ruang cadangan untuk rilis mendatang, dengan memahami biayanya.
- Jika kamu membeli minggu ini, tunggu sampai acara malam ini selesai. Kamu akan tahu apa yang ditawarkan dan berapa biaya MacBook Pro OLED sebelum memutuskan.
Siapkan dengan benar.
- Mulai dengan LM Studio (MLX di Apple Silicon) untuk jalur termudah, atau Ollama jika kamu ingin satu API untuk model lokal dan cloud.
- Utamakan 8-bit untuk apa pun yang akan kamu andalkan; gunakan 4-bit untuk kecepatan pada chat.
- Atur panjang konteks dengan sengaja. Banyak runtime default ke konteks kecil; agen butuh jauh lebih banyak.
- Naikkan batas memori GPU hanya jika kamu memahami trade-off-nya, dan sisakan ruang untuk macOS.
- Pertahankan paket cloud $20 untuk 10% yang sulit. Itu lebih murah daripada waktumu sendiri.
Uji pada pekerjaanmu sendiri. Ambil 20 prompt nyata dari bulan lalu: email, dokumen, tugas coding, apa pun yang benar-benar kamu lakukan. Jalankan masing-masing melalui model lokal dan model cloud-mu, sembunyikan mana yang mana, lalu nilai. Lakukan dalam bahasa yang kamu gunakan untuk bekerja. Satu jam itu akan memberitahumu lebih banyak daripada papan peringkat mana pun, termasuk yang ada di artikel ini.
Pertanyaan yang sering diajukan
Bisakah MacBook menggantikan langganan ChatGPT Pro atau Claude Max?
Bukan soal kualitas. Model di balik paket $200, seperti Claude Opus 5.5 dan GPT-6 Astra, tidak bisa diunduh, dan model terbuka terbaik yang bisa diunduh butuh 375–460 GB memori pada 4-bit, jauh melebihi MacBook mana pun. Pada indeks Artificial Analysis, Opus 5.5 mencetak 58; model terkuat yang saya temukan yang muat di MacBook 128 GB, Qwen3.8 27B, mencetak 34 pada versi yang sama. MacBook bisa menggantikan langganan untuk pekerjaan privat, offline, atau massal, tetapi bukan untuk tugas terdepan.
Apa LLM lokal terbaik untuk MacBook Pro 128 GB pada 2026?
Untuk kualitas, Qwen3.8 27B: Artificial Analysis menempatkannya di peringkat pertama dari 141 model sebanding, dengan 34 pada Intelligence Index v4.3.2, dan model ini muat dengan lega pada 8-bit. Untuk kecepatan, gpt-oss-120b dan Qwen3.5 122B adalah model mixture-of-experts yang menulis 55–88 token per detik di M5 Max, tetapi skornya lebih rendah (12 dan 16). Periksa Artificial Analysis sebelum memilih, karena model terbuka baru mengubah peringkat ini tiap beberapa minggu.
Berapa harga MacBook Pro 128 GB sekarang?
MacBook Pro 16 inci dengan M5 Max (CPU 18 inti, GPU 40 inti), 128 GB dan 2 TB berharga $6.999 di AS, sebelum pajak penjualan. Apple menaikkan harga Mac pada 25 Juni 2026 dan menggandakan harga upgrade 128 GB dari $1.000 menjadi $2.000. Di Jerman konfigurasi yang sama berharga €6.249 saat peluncuran dan kini, menurut perkiraan saya, sekitar €8.199. Mac Studio dengan chip dan memori yang sama berharga $4.799.
Berapa lama MacBook balik modal dibanding langganan AI $200?
Sekitar 35 bulan dengan $6.999, jika MacBook sepenuhnya menggantikan langganan dan tidak ada biaya operasional. Dengan listrik sekitar $10 per bulan, jadi sekitar 37 bulan, dan jika kamu tetap memakai paket $20 untuk tugas terdepan, sekitar 41 bulan. Dibanding paket $100, lebih dari enam tahun. Mac Studio dengan chip yang sama mencapai titik impas lebih cepat, setelah sekitar 25 sampai 28 bulan.
Apakah M5 Max cukup cepat untuk LLM lokal?
Untuk menulis jawaban dengan model mixture-of-experts, ya: diukur dengan MLX, M5 Max dengan 128 GB menghasilkan 55–88 token per detik, mendekati 98 milik Claude Opus 5.5 di API Anthropic. Membaca prompt panjang adalah titik lemahnya. Prompt 32.000 token butuh 13 detik dengan gpt-oss-120b, 31 detik dengan Qwen3.5 122B dan 55 detik dengan model dense 27B, sementara agen coding AI membaca ulang prompt panjang terus-menerus.
Apakah LLM lokal sekarang sebaik ChatGPT atau Claude?
Bukan yang muat di laptop. Pada Intelligence Index v5 baru dari Artificial Analysis, yang terbit 27 Oktober 2026, model terbuka terbaik yang bisa diunduh mencetak 32 dibanding 58 untuk Claude Opus 5.5, dan di bawah Claude Haiku 5.5 dengan 36. Model yang cukup kecil untuk MacBook mencetak paling tinggi 34 pada versi indeks sebelumnya, tempat Opus 5.5 juga mencetak 58. Untuk tugas pendek dan sederhana selisihnya sering kecil; untuk coding agentic, dokumen panjang dan penalaran sulit, selisihnya besar.
Apakah kuantisasi membuat model lokal lebih buruk?
Sedikit pada 8-bit, lebih banyak pada 4-bit, banyak sekali di bawah itu. Studi atas lebih dari 500.000 evaluasi menemukan FP8 praktis tanpa kehilangan dan kuantisasi weight-only 4-bit mendekati 8-bit pada benchmark standar. Tetapi pada input 64.000 token atau lebih, studi EMNLP 2025 mengukur penurunan hingga 59% pada 4-bit, lebih buruk untuk teks non-Inggris, dan pada 3 bit skor matematika sebuah model penalaran jatuh dari 85,6% ke 47,0%.
Bisakah aku menjalankan DeepSeek V4.1 Flash atau GLM-5.3 di MacBook?
Tidak. GLM-5.3 punya 753 miliar parameter dan DeepSeek V4.1 Flash 763 miliar termasuk memori Engram-nya, jadi bahkan pada 4-bit keduanya butuh sekitar 375–460 GB, jauh melebihi batas 128 GB MacBook mana pun. Mac Studio dengan M5 Ultra dan 512 GB bisa memuatnya. Cara praktis memakainya adalah lewat API, idealnya penyedia dengan hosting di UE dan perjanjian pemrosesan data.
Apakah 64 GB cukup untuk AI lokal, atau aku perlu 128 GB?
Bagi sebagian besar orang, 48–64 GB sudah cukup. Model seukuran Mac terbaik pada indeks Artificial Analysis, Qwen3.8 27B, muat pada 8-bit dengan sisa ruang untuk konteks panjang. 128 GB memungkinkanmu menjalankan model kelas 120B seperti gpt-oss-120b, memuat beberapa model sekaligus dan memakai konteks lebih panjang, tetapi di papan peringkat hari ini model yang lebih besar itu mencetak lebih rendah, jadi upgrade $2.000 membeli ruang, bukan kecerdasan.
Sebaiknya aku membeli Mac Studio daripada MacBook Pro untuk LLM lokal?
Jika AI lokal adalah alasan utamanya, biasanya ya. Mac Studio dengan M5 Max dan 128 GB yang sama berharga $4.799, $2.200 lebih murah daripada MacBook Pro 16 inci, dengan pendinginan berkelanjutan yang lebih baik dan tanpa baterai yang perlu dipikirkan. Ia bisa berjalan terus sebagai server model privat untuk laptop dan ponselmu. Beli MacBook Pro jika kamu butuh portabilitas untuk alasan lain.
Apakah menjalankan AI secara lokal lebih baik untuk privasi dan GDPR?
Ya, itu keunggulan terkuatnya. Dengan model lokal, prompt dan dokumen tidak pernah meninggalkan perangkatmu, jadi tidak ada perjanjian pemroses yang perlu ditandatangani dan tidak ada transfer data internasional. Itu penting untuk data klien, informasi kesehatan dan profesi yang terikat kerahasiaan, seperti yang diatur § 203 StGB di Jerman. Manfaat privasi tetap ada, entah model lokal itu sekuat model cloud atau tidak. Ini bukan nasihat hukum.
Bisakah aku memakai Claude Code dengan model lokal?
Ya. Ollama menyediakan API yang kompatibel dengan Anthropic, jadi kamu bisa mengarahkan Claude Code ke model lokal dengan menyetel ANTHROPIC_BASE_URL ke http://localhost:11434. Perkirakan trade-off: Ollama tidak mendukung kontrol prompt-caching Anthropic, system prompt panjang dan definisi tool Claude Code membuat model lokal membaca banyak hal di setiap langkah, dan Claude Code disetel untuk model Claude. Harness terbuka seperti OpenCode sering lebih pas untuk model lokal.
Apakah MacBook Pro OLED baru akan mengubah semua ini?
Mungkin tidak banyak untuk AI lokal. Acara “Pro and Tell” Apple berlangsung pada 28 Oktober 2026 pukul 10.00 waktu Pasifik, dan MacBook Pro layar sentuh OLED yang diharapkan muncul di sana dilaporkan memakai chip M5 Pro dan M5 Max yang sama, yang akan mempertahankan batas 128 GB dan bandwidth 614 GB/s. MacBook Pro 14 inci dengan M6 yang diumumkan pada 27 Oktober puncaknya 32 GB.
Kesimpulan
Pitch “batalkan paket $200-mu dan beli Mac” benar dalam dua hal: langganan memang mahal, dan AI lokal memang berguna. Yang penting justru salah. Paket $200 menyewakan model terbaik di dunia, agen yang dibangun di sekitarnya dan produk yang membaik setiap bulan. MacBook $7.000 menjalankan model terbaik yang muat di 128 GB, dan hari ini model itu mencetak 34 dibanding 58 di garis terdepan, membaca prompt panjang dengan lambat dan kehilangan kualitas tepat di tempat kamu paling memaksanya.
Matematikanya juga tidak menyelamatkannya. Bahkan dalam kasus paling longgar, MacBook butuh tiga sampai empat tahun untuk balik modal, dan selama tiga tahun biayanya hanya berselisih beberapa ribu dolar dari langganan, tergantung berapa harga jualnya. Tagihan yang mirip untuk produk yang kurang mampu.
Jadi beli MacBook untuk LLM lokal jika datamu tidak boleh keluar gedung, jika kamu bekerja offline, jika kamu ingin tanpa batas dan model yang tidak pernah berubah, atau jika kamu memang sudah akan membeli Mac. Itu alasan yang bagus, dan banyak orang punya alasan itu. Hanya saja, jangan membelinya untuk membatalkan langgananmu. Pertahankan paket cloud untuk 10% yang sulit, taruh 90% yang privat dan membosankan di perangkatmu sendiri, dan biarkan papan peringkat memberitahumu kapan keseimbangan itu bergeser.
Menjalankan model lokal untuk pekerjaan, atau menemukan hal yang berlawanan dengan artikel ini? Saya ingin mendengar model mana, mesin mana dan tugas mana, dengan angka jika kamu punya. Koreksi dan bukti tandingan diterima; artikel ini diperbarui ketika papan peringkat dan harga bergerak, yang pada 2026 berarti sering.
Fakta diperiksa: 28 Oktober 2026.