
 Bahasa Indonesia
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Русский
 العربية
 हिन्दी

Ada satu jenis kelelahan mengambil keputusan yang sangat khas yang menghampirimu sekitar pukul 23.00, setelah tiga cangkir kopi, sambil menatap pemilih model OpenCode’nya.
Kamu punya kunci Z.ai. Kamu punya kunci MiniMax. Kedua model mengklaim konteks sejuta token. Keduanya bobot terbuka. Keduanya nyaris tanpa biaya dibanding model tertutup kelas terdepan. Keduanya punya grafik benchmark yang menunjukkan mereka sedang menang. Dan kamu cuma ingin tahu mana yang harus dijadikan default supaya bisa kembali bekerja.
Artikel ini adalah jawaban untuk pertanyaan itu — versi panjangnya, karena versi pendek (“GLM-5.3-Flash, mungkin”) menyembunyikan sekitar enam catatan yang akan menggigitmu kalau kamu melewatinya.
Saya sudah mengumpulkan detail arsitektur, benchmark dari vendor, evaluasi netral, harga per token yang sebenarnya termasuk jebakan tarif berlapis untuk konteks panjang, telemetri penggunaan OpenCode’nya sendiri yang sudah dipublikasikan, dan berkas konfigurasi asli keduanya. Lalu saya menghitung biaya untuk satu bulan kerja normal, bukan skenario siaran pers.
Inilah hasilnya.
TL;DR — Vonis 30 detik
Jalankan GLM-5.3-Flash sebagai model default OpenCode kamu. Model ini lebih pintar di hampir setiap benchmark agentic dan coding yang penting, biayanya sekitar setengahnya per token, benar-benar berlisensi MIT, dan ke sanalah komunitas OpenCode sebenarnya pergi.
Simpan MiniMax M3 sebagai jalur cepatmu. Model ini menghasilkan sekitar tiga kali lebih cepat dan menjawab sekitar dua kali lebih cepat pada token pertama. Untuk putaran dengan banyak giliran dan kesulitan rendah — mengganti nama berkas, menyusun kerangka tes, membuat dokumentasi, lint-and-fix, refactor mekanis besar — selisih kecepatan itu lebih terasa daripada selisih kecerdasannya.
Ringkasan jujurnya: GLM-5.3-Flash berpikir lebih baik, MiniMax M3 mengetik lebih cepat. Coding agentic sebagian besar adalah masalah berpikir, jadi GLM menang di slot default. Tapi kalau kamu tidak menjalankan keduanya, kamu meninggalkan throughput percuma, dan OpenCode membuat menjalankan keduanya sangat mudah.
Tabel perbandingan singkat
| GLM-5.3-Flash | MiniMax M3 | |
|---|---|---|
| Pembuat | Z.ai (Zhipu AI) | MiniMax |
| Dirilis | 26 Agustus 2026 | 1 Juni 2026 |
| Total parameter | 320B | ~428B |
| Aktif per token | 18B | ~23B |
| Arsitektur | Attention linear KDA hibrida + MLA sparse NoPE, MoE (8 dari 288 expert + 1 bersama) | Backbone GQA + MiniMax Sparse Attention (MSA), MoE sparse |
| Jendela konteks | 1M (1.048.576) | 1M (512K minimum yang dijamin) |
| Output maksimum | 131.072 token | hingga 262.144 token |
| Input multimodal | Teks, gambar, video, berkas | Teks, gambar, video |
| Lisensi | MIT | MiniMax Community License |
| Harga input API | $0.15 / 1M ($0.03 cache) | $0.30 / 1M ($0.06 cache) |
| Harga output API | $0.50 / 1M | $1.20 / 1M |
| Biaya tambahan konteks panjang | Tidak ada yang dipublikasikan | 2× di atas input 512K |
| Kecepatan output | ~48,6 tok/detik | ~147,9 tok/detik |
| Waktu ke token pertama | ~1,51s | ~0,99s |
| Terminal-Bench 2.1 | 84.3 | 66.0 |
| Artificial Analysis Intelligence | 57 | 45 |
| Pangsa token OpenCode | 10.3% | 1.12% |
| Mode berpikir | Selalu aktif (tidak bisa dimatikan) | Dapat diatur |
| Harga masuk langganan | $18/bln (GLM Coding Plan Lite) | $20/bln (MiniMax Plus) |
Harga di sini adalah harga daftar resmi dari masing-masing vendor. Gateway perantara seperti OpenRouter sering menampilkan harga efektif lebih rendah karena mereka menyeimbangkan beban di antara host pihak ketiga — ini dibahas lebih lanjut di bawah, karena penting.
Kenapa perbandingan ini yang paling relevan sekarang
Dua belas bulan lalu, perdebatan coding bobot terbuka adalah soal apakah model-model ini bisa dipakai sama sekali. Pertanyaan itu sudah selesai. Perdebatan di paruh kedua 2026 lebih sempit dan lebih menarik: model bobot terbuka mana yang kamu arahkan ke harness agenmu, dan berapa biayanya kalau kamu salah?
OpenCode mempertajam pertanyaan itu. Ini bukan jendela chat — ini agen native terminal yang merencanakan, membaca berkas, menyuntingnya, menjalankan perintah, membaca output, lalu mengulanginya. Beban kerja itu menghukum model dengan cara yang tidak pernah muncul di benchmark chat. Model yang menulis fungsi terisolasi dengan indah tetap bisa tidak berguna di OpenCode kalau kehilangan alur setelah dua puluh panggilan tool, atau berhalusinasi soal path berkas, atau membakar 90.000 token untuk memutuskan apa yang harus dilakukan.
GLM-5.3-Flash dan MiniMax M3 adalah dua model bobot terbuka yang paling kredibel dalam perdebatan itu saat ini. Keduanya hadir dalam jarak tiga bulan, menyasar pekerjaan yang sama, harganya berada dalam orde yang sama, dan keduanya mengambil taruhan rekayasa yang hampir berlawanan.
Bagian terakhir itulah yang menarik.
Apa sebenarnya GLM-5.3-Flash
GLM-5.3-Flash punya salah satu peluncuran terbaik tahun ini, dan itu bukan kebetulan.
Sebelum Z.ai mencantumkan namanya pada apa pun, model ini muncul di OpenRouter dengan nama kode “Ox Alpha.” Tanpa atribusi lab, akses nyaris gratis, tanpa pemasaran. Model ini diam-diam naik ke puncak tangga penggunaan OpenRouter dan OpenCode dan bertahan di sana sekitar seminggu sementara komunitas berdebat soal siapa yang membuatnya. Pada 26 Agustus 2026, Z.ai mengonfirmasi bahwa itu miliknya dan membuka bobotnya dengan lisensi MIT.
Melepas model ke alam bebas dan membiarkannya membangun kredibilitas sebelum mengklaimnya adalah langkah yang benar-benar bagus, dan itu berhasil — model tersebut punya data penggunaan nyata sebelum ada yang melihat grafik benchmark.
Arsitekturnya, dengan bahasa sederhana
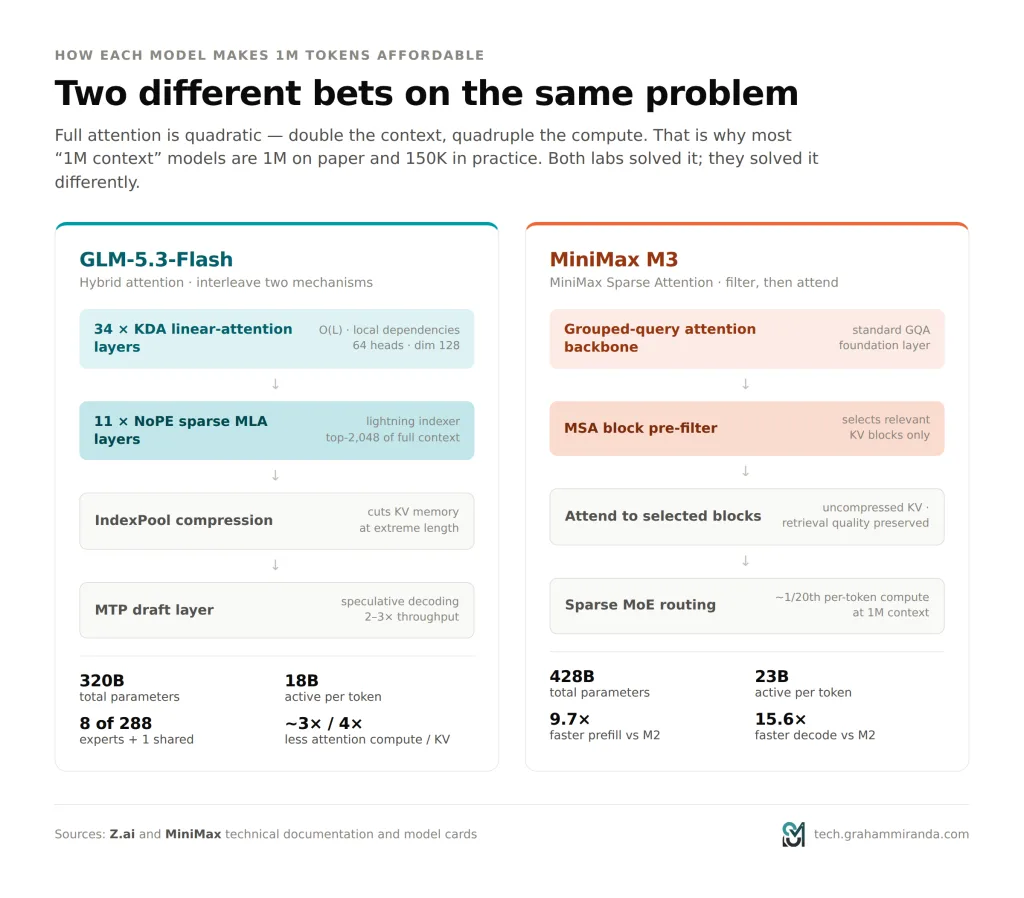
GLM-5.3-Flash adalah model mixture-of-experts 320 miliar parameter yang hanya mengaktifkan sekitar 18 miliar parameter per token. Setiap token dilewatkan melalui 8 dari 288 expert yang dirutekan plus satu expert bersama — sekitar 2,8% bobot expert menyala pada setiap forward pass. Dari situlah ekonomi “Flash” berasal: pengetahuan sekelas model terdepan, biaya inferensi model kecil.
Desain attention-nya adalah bagian yang benar-benar baru. Alih-alih satu mekanisme attention yang seragam, ia menyelang dua:
- 34 lapisan linear-attention KDA. Lapisan ini berjalan dalam waktu linear terhadap panjang sekuens, bukan kuadratik. Lapisan ini menangani dependensi lokal dengan murah dan menjaga throughput agar tidak runtuh saat konteksmu bertambah.
- 11 lapisan MLA sparse NoPE. Multi-head latent attention bergaya DeepSeek tanpa positional embedding, didahului oleh “lightning indexer” yang memilih 2.048 token paling relevan dari seluruh konteks. Inilah yang menjaga kualitas pengambilan jarak jauh.
Ada juga IndexPool langkah kompresi yang mengagregasi vektor key indexer untuk memangkas overhead memori pada panjang konteks ekstrem, dan sebuah kepala prediksi multi-token untuk speculative decoding — implementasi vLLM default ke 5 token spekulatif per langkah dekode, bernilai 2–3× throughput pada ukuran batch kecil.
Efek bersihnya dibanding GLM-5.3 penuh: komputasi attention sekitar 3× lebih rendah dan KV cache lebih dari 4× lebih kecil. Itulah sebabnya konteks 1 juta token benar-benar bisa dipakai, bukan hanya tersedia secara teori.
Kenapa ini penting untuk agen coding
Tiga hal, spesifiknya.
Model ini multimodal secara native, dan di sini itu bukan gimmick. Model coding GLM sebelumnya punya titik buta untuk apa pun yang tidak bisa dibaca sebagai teks. Kalau agenmu merusak tata letak, model yang hanya bisa teks tidak punya cara untuk mengetahuinya. GLM-5.3-Flash menerima gambar, video, dan berkas secara native, artinya debugging berbasis screenshot, design-to-code, dan loop verifikasi “apakah ini benar-benar terlihat benar” kini mungkin dilakukan.
Berpikir itu wajib. Kamu tidak bisa mematikannya. Kamu bisa mengatur reasoning_effort untuk rendah, tinggi, atau maks (default yang terdokumentasi adalah maks), tapi model selalu bernalar sebelum bertindak. Untuk pekerjaan agentic ini default yang tepat — mode kegagalan model coding murah adalah bertindak dengan percaya diri tanpa perencanaan, dan Z.ai sudah menghapus opsi itu.
Lompatan antargenerasi ini nyata, dan berasal dari post-training. GLM-5.3 memakai base model yang sama dengan GLM-5.2. Semua peningkatan datang dari penskalaan post-training — dilaporkan sepuluh kali lebih banyak lingkungan tugas berhorizon panjang, dengan tugas latihan yang mensimulasikan siklus hidup perangkat lunak lengkap dari identifikasi bug sampai pengujian dan deployment, sebagian berukuran “beban kerja seorang senior engineer selama beberapa hari.” Skor DeepSWE v1.1 naik dari 46,2 ke 63,4. Terminal-Bench 3.0 naik dari 4,6 ke 28,3. Itu bukan selisih akibat noise tuning.
Apa sebenarnya MiniMax M3
MiniMax M3 hadir pada 1 Juni 2026 dan mengambil taruhan berbeda: alih-alih mengoptimalkan penalaran puncak, ia mengoptimalkan ekonomi loop agen yang berkelanjutan.
Ini adalah MoE sparse berparameter ~428B dengan sekitar 23B parameter aktif per token, dibangun di atas backbone grouped-query-attention dengan MSA (MiniMax Sparse Attention) milik MiniMax’nya di atasnya.
Taruhan MSA
Attention tradisional bersifat kuadratik: konteks dua kali lipat, komputasi empat kali lipat. Itulah sebabnya sebagian besar model “konteks 1M” hanya 1M di atas kertas dan 150K dalam praktik — secara teknis kamu bisa mengisi jendelanya, tapi kamu tidak akan mau membayarnya.
MSA menggantikan attention penuh dengan seleksi blok KV. MSA menyaring konteks lebih dulu menjadi blok yang relevan dan hanya memperhatikan blok itu, memakai key-value yang tidak dikompresi agar kualitas pengambilan tetap bertahan setelah penyaringan. MiniMax melaporkan hasilnya sebagai sekitar 1/20 komputasi per token dari generasi sebelumnya pada konteks 1M, dengan prefill 9,7× lebih cepat dan decoding 15,6× lebih cepat dibanding M2.
Ini rekayasa yang benar-benar cerdas, dan itu terlihat pada angka yang kamu rasakan: output ~148 token/detik dan waktu ke token pertama di bawah satu detik. Dibanding GLM-5.3-Flash’nya yang ~49 token/detik dan TTFT ~1,5 detik, M3 terasa seperti kelas tool yang berbeda. Dalam loop agen panjang dengan puluhan giliran, itu menumpuk menjadi selisih beberapa menit waktu nyata per tugas.
MiniMax juga memasarkan M3 sebagai mampu menjalani “sesi coding otonom 8+ jam.” Anggap itu klaim, bukan spesifikasi — belum divalidasi secara independen.
Di mana M3 benar-benar kuat
Sisi multimodal dan agen desktop M3 kurang dihargai. OSWorld-Verified di 70,06% adalah skor serius untuk tugas agen desktop/GUI. MCP Atlas di 74,2% menunjukkan perilaku pemanggilan tool-nya solid. GPQA Diamond di 92,9% berada dekat level terdepan pada penalaran sulit. Dan SWE-bench Verified di 80,5% adalah angka utama yang kuat.
Kalau beban kerjamu adalah “menjalankan browser, membaca video, mengoperasikan UI, memanggil dua belas tool MCP berurutan,” M3 bukan kompromi. Bisa dibilang ini tool yang lebih baik.
Benchmark — dan apa yang disembunyikannya
Di sinilah saya harus berhati-hati, karena kedua vendor menerbitkan angka mereka sendiri dan kedua model sebagian besar dievaluasi pada set benchmark yang berbeda. Itu bukan kebetulan. Lab memilih evaluasi yang mereka menangi.
Di mana keduanya bertumpang tindih langsung
| Benchmark | GLM-5.3-Flash | MiniMax M3 | Apa yang diukur |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 66.0 | Tugas agen shell/terminal |
| Artificial Analysis Intelligence Index | 57 | 45 | Kecerdasan agregat |
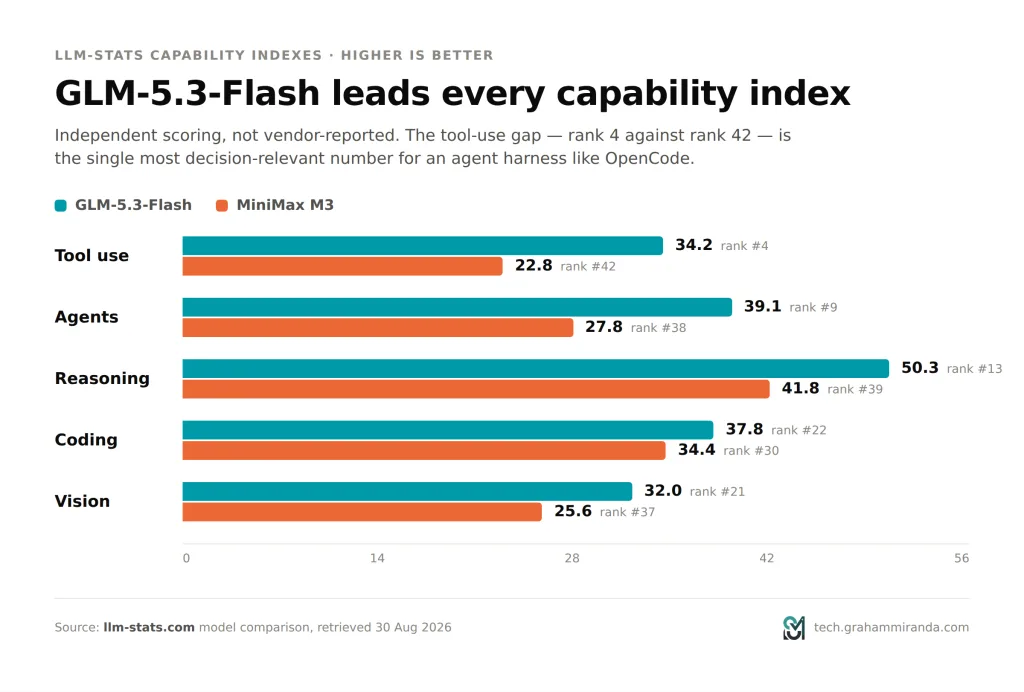
| Indeks penalaran (llm-stats) | 50.3 (#13) | 41.8 (#39) | Penalaran bertahap |
| Indeks coding (llm-stats) | 37.8 (#22) | 34.4 (#30) | Pembuatan kode |
| Indeks agen (llm-stats) | 39.1 (#9) | 27.8 (#38) | Penyelesaian tugas agentic |
| Indeks penggunaan tool (llm-stats) | 34.2 (#4) | 22.8 (#42) | Pemanggilan fungsi/tool |
| Indeks visi (llm-stats) | 32.0 (#21) | 25.6 (#37) | Pemahaman multimodal |
Terminal-Bench 2.1 adalah yang paling perlu diberi bobot untuk OpenCode, karena itu proksi publik terdekat dengan apa yang sebenarnya dilakukan OpenCode: agen di terminal, menjalankan perintah, membaca output, mengulang. Selisih 18 poin di sana bukan kesalahan pembulatan.
Peringkat Penggunaan Tool adalah satu lagi yang tidak akan saya lewati. GLM-5.3-Flash di #4 keseluruhan versus M3 di #42 adalah baris paling relevan untuk keputusan di seluruh artikel ini. Harness agen adalah mesin pemanggil tool. Model yang ada di #42 untuk penggunaan tool akan menghasilkan lebih banyak panggilan cacat, lebih banyak percobaan ulang, lebih banyak giliran terbuang — dan setiap giliran terbuang memakan token dan dan waktu nyata, yang diam-diam menghapus keunggulan kecepatan M3’nya.
Posisi GLM-5.3-Flash sendiri
- Terminal-Bench 2.1: 84,3 — dibanding Claude Opus 4.8 di 85,0. Selisih kurang dari satu poin dari model tertutup terdepan, dengan harga sekitar 1/30nya.
- DeepSWE v1.1: 63,4 — naik dari 46,2 milik GLM-5.2’nya.
- AutomationBench v1.0.6: 48,8 — versus Opus 4.8 di 41,0. Ini keunggulan terbesarnya atas model terdepan.
- Z.ai Code Bench v1.0: 29,0 — Opus 4.8 mencetak 29,5.
- GDPval-AA v2: 1.773 — skor tertinggi di antara model yang dibandingkan untuk kemampuan kerja pengetahuan.
- Toolathlon: 78,4 · OfficeQA Pro: 62,4 · CharXiv-R: 89,4% · MMVU: 80,5 · Chartography: 78,0
Posisi MiniMax M3 sendiri
- SWE-bench Verified: 80,5%
- SWE-bench Pro: 59,0% — repo lebih sulit, dijalankan dengan scaffolding Claude Code
- MCP Atlas: 74,2% · OSWorld-Verified: 70,06% · GPQA Diamond: 92,9%
- KernelBench Hard: 28,8% · SWE-fficiency: 34,8%
Catatan yang sebenarnya perlu kamu terapkan
Angka peluncuran kedua lab’nya adalah hasil pelaporan sendiri. Suite benchmark MiniMax’nya khususnya belum muncul di papan evaluasi netral saat dirilis, dan analis Z.ai’nya sendiri mencatat bahwa pengalihan otomatis dari versi model lama di platform Z.ai’nya membuat perbandingan A/B yang bersih benar-benar sulit.
Di mana agregator netral — Artificial Analysis dan llm-stats — menjalankan evaluasi mereka sendiri, GLM-5.3-Flash menang di setiap kategori. Itulah bukti yang paling saya utamakan, karena tak satu pun vendor memilih benchmark tersebut.
Sinyal yang tidak dibicarakan siapa pun: data penggunaan OpenCode sendiri
Inilah bagian yang paling meyakinkan bagi saya, dan justru bagian inilah yang dilewati sepenuhnya oleh sebagian besar artikel perbandingan.
OpenCode menerbitkan telemetri penggunaan untuk model yang berjalan di dalamnya. Bukan klaim vendor. Bukan kumpulan benchmark. Pengembang sungguhan, yang mengerjakan pekerjaan sungguhan, memilih apa yang terus mereka pakai.
| Metrik | GLM-5.3-Flash | MiniMax M3 |
|---|---|---|
| Pengguna unik | 566K | 436K |
| Porsi token yang diproses | 10.3% | 1.12% |
| Token selama dua bulan | 46T (+100%) | 5T (−51%) |
| Pengguna yang kembali di minggu pertama | tertunda | 66% (32K pengguna-minggu) |
Baca lagi dua angka porsi token itu. Jumlah penggunanya kurang lebih sebanding — GLM-5.3-Flash punya sekitar 30% lebih banyak orang yang pernah mencobanya — tetapi lebih dari sembilan kali lipat throughput tokennya.
Kesenjangan itu bukan soal siapa mencoba apa. Ini soal siapa yang bertahan dengan apa untuk pekerjaan nyata. Orang membuka sesi dengan M3, dan orang menetap di sesi dengan GLM-5.3-Flash.
Garis trennya mengatakan hal yang sama dengan lebih keras: GLM-5.3-Flash menggandakan volume tokennya dalam dua bulan sementara M3 kehilangan separuhnya.
Ada dua catatan yang adil. Pertama, GLM-5.3-Flash tiga bulan lebih baru, dan model baru mendapat lonjakan karena kebaruan; kurvanya akan mendatar. Kedua, retensi minggu pertama M3 sebesar 66% adalah angka yang sehat — orang yang memilihnya tidak meninggalkannya, hanya jumlahnya lebih sedikit dan mereka memakainya lebih ringan. Dan penurunan M3 sebagian karena kanibalisasi oleh penerusnya sendiri dan ritme rilis model bobot terbuka Tiongkok yang lebih luas, bukan semata-mata penolakan.
Tetapi jika kamu bertanya “apa yang sebenarnya dijalankan pengguna OpenCode berpengalaman sepanjang hari,” datanya menjawab tanpa keraguan.
Menyiapkan MiniMax M3 di OpenCode
Pujian pada tempatnya: MiniMax lebih mudah disiapkan, karena OpenCode sudah menyertakan provider MiniMax bawaan. Tanpa berkas konfigurasi, tanpa JSON, tanpa base URL.
bash
# 1. Install OpenCode (skip if you already have it)
curl -fsSL https://opencode.ai/install | bash
# or: npm i -g opencode-ai

# 2. Authenticate
opencode auth login
# Select: "MiniMax Token Plan (minimax.io)"
# Paste your Subscription Key (starts sk-cp-...)

# 3. Go
opencode
Lalu /models di dalam sesi lalu pilih MiniMax-M3.
Jebakan jenis kunci
Yang ini menjerat hampir semua orang. Kunci MiniMax Token Plan (langganan) dan kunci API bayar sesuai pemakaian tidak bisa saling ditukar. Rutenya berbeda dan penagihannya berbeda. Jika kamu mengautentikasi dengan kunci PAYG pada provider Token Plan, kamu akan mendapat galat autentikasi atau saldo yang terlihat seperti gangguan layanan padahal sebenarnya ketidakcocokan.
Kunci langganan dimulai dengan sk-cp- dan memerlukan seat atau kredit yang diberikan. Dapatkan milikmu dari halaman Token Plan di pusat pengguna MiniMax, bukan dari halaman kunci API umum.
Jika kamu perlu blok provider manual
Jika build OpenCode-mu lebih lama daripada provider bawaan, atau kamu ingin menunjuk kunci PAYG secara eksplisit:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "minimax": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "MiniMax",
      "options": {
        "baseURL": "https://api.minimax.io/v1",
        "apiKey": "{env:MINIMAX_API_KEY}"
      },
      "models": {
        "MiniMax-M3": {
          "name": "MiniMax M3",
          "limit": {
            "context": 1000000,
            "output": 262144
          }
        }
      }
    }
  }
}
Perhatikan penyebutan eksplisit limit.context. Itu bukan hiasan — lihat bagian berikutnya.
Jebakan jendela konteks MiniMax (baca ini sebelum berkomitmen)
Jika kamu merutekan MiniMax M3 melalui harness yang kompatibel dengan Anthropic — Claude Code, atau setup OpenCode yang memakai @ai-sdk/anthropic terhadap https://api.minimax.io/anthropic — ada bug yang terdokumentasi dan masih terbuka yang perlu kamu ketahui.
The /anthropic endpoint melaporkan jendela konteks 200K, bukan 1M milik M3 yang sebenarnya.
Lapisan kompatibilitas tampaknya mewarisi metadata Claude Sonnet alih-alih melaporkan spesifikasi asli M3. Agen coding memercayai metadata itu dan menyesuaikan anggaran konteksnya — yang berarti pemadatan otomatis terpicu di sekitar 167K token padahal modelnya bisa menampung lima kali lipat itu dengan nyaman.
Ini mode kegagalan yang benar-benar menjengkelkan, karena tidak terlihat. Agenmu tidak memberikan galat. Ia hanya diam-diam mulai melupakan hal-hal jauh lebih awal dari seharusnya, dan kamu menghabiskan satu sore bertanya-tanya kenapa model dengan jendela sejuta token terus kehilangan alur dua berkas setelah mulai melakukan refactor. Isu ini dilaporkan pada hari rilis M3 dan masih terbuka.
Cara menyiasatinya
Di OpenCode: gunakan provider MiniMax bawaan (rute yang kompatibel dengan OpenAI), bukan rute Anthropic, lalu set limit.context secara eksplisit jika kamu menentukan blok provider manual.
Di Claude Code, timpa jendela pemadatan secara langsung:
json
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.minimax.io/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "<YOUR_MINIMAX_SUBSCRIPTION_KEY>",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "MiniMax-M3[1m]"
  }
}
Ada dua detail yang penting: akhiran [1m] pada ID model meminta varian konteks penuh, dan variabel lingkungan shell menimpa settings.json dalam perilaku yang didokumentasikan MiniMax. Jika kamu punya ANTHROPIC_BASE_URL yang di-export di .zshrc, ia menang tanpa suara dan kamu akan berputar-putar tanpa hasil.
Juga — jangan set kredensial provider sebagai export global. ANTHROPIC_BASE_URL adalah variabel global; meng-export-nya secara permanen akan diam-diam mengalihkan setiap tool berbahasa Anthropic di mesinmu ke MiniMax. Batasi cakupannya per proyek atau per pemanggilan.
Menyiapkan GLM-5.3-Flash di OpenCode
OpenCode juga menyertakan provider Z.AI bawaan, jadi ini hampir sama mudahnya — dengan satu persimpangan.
bash
# 1. Get a key from Z.ai — either a standard API key or a GLM Coding Plan key
# 2. Authenticate
opencode auth login
# Select "Z.AI" for a standard API key
# Select "Z.AI Coding Plan" for a Coding Plan subscription key

# 3. Start OpenCode, then pick your model
opencode
/models   # select GLM-5.3-Flash
Cocokkan provider dengan jenis kuncinya. Kunci API standar dan kunci Coding Plan memakai rute dan penagihan yang berbeda. Memilih yang salah menghasilkan galat autentikasi atau saldo yang terlihat seperti akun bermasalah.
Endpoint Coding Plan
Jika kamu menyambungkan secara manual atau mengonfigurasi tool lain, paket developer Z.ai menyediakan tiga:
| Protokol | URL dasar |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
Satu batasan yang perlu diperhatikan: GLM Coding Plan dibatasi secara kontrak hanya untuk tool yang didukung resmi — Claude Code, OpenCode, Cline, Roo Code, Kilo Code, Cursor, Goose, Crush, OpenClaw dan beberapa lainnya. Jika kamu berencana memakai kunci Coding Plan pada harness buatanmu sendiri, baca dulu ketentuannya. Untuk itu, gunakan API standar.
Blok provider manual
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3-flash": {
          "name": "GLM-5.3-Flash",
          "limit": {
            "context": 1048576,
            "output": 131072
          },
          "options": {
            "reasoning_effort": "high",
            "temperature": 1,
            "top_p": 0.95
          }
        }
      }
    }
  },
  "model": "zai/glm-5.3-flash"
}
Pengaturan sampling yang disarankan
Rekomendasi terdokumentasi Z.ai untuk GLM-5.3-Flash, yang tidak akan saya ubah tanpa alasan:
temperature: 1top_p: 0.95reasoning_effort: max(default terdokumentasi)thinking.clear_thinking: falsestream: truedantool_stream: trueuntuk permintaan streaming
reasoning_effort adalah tombol utama kualitas versus latensi. rendah untuk pekerjaan yang sensitif latensi, tinggi untuk coding yang substansial, maks untuk masalah tersulit. Karena GLM-5.3-Flash sudah menjadi yang lebih lambat dari kedua model dengan ~49 tok/sec, tinggi adalah pengaturan harian yang masuk akal dan maks adalah yang kamu pakai ketika sebuah tugas benar-benar mengalahkan tinggi.
Setup yang benar-benar saya rekomendasikan: jalankan keduanya
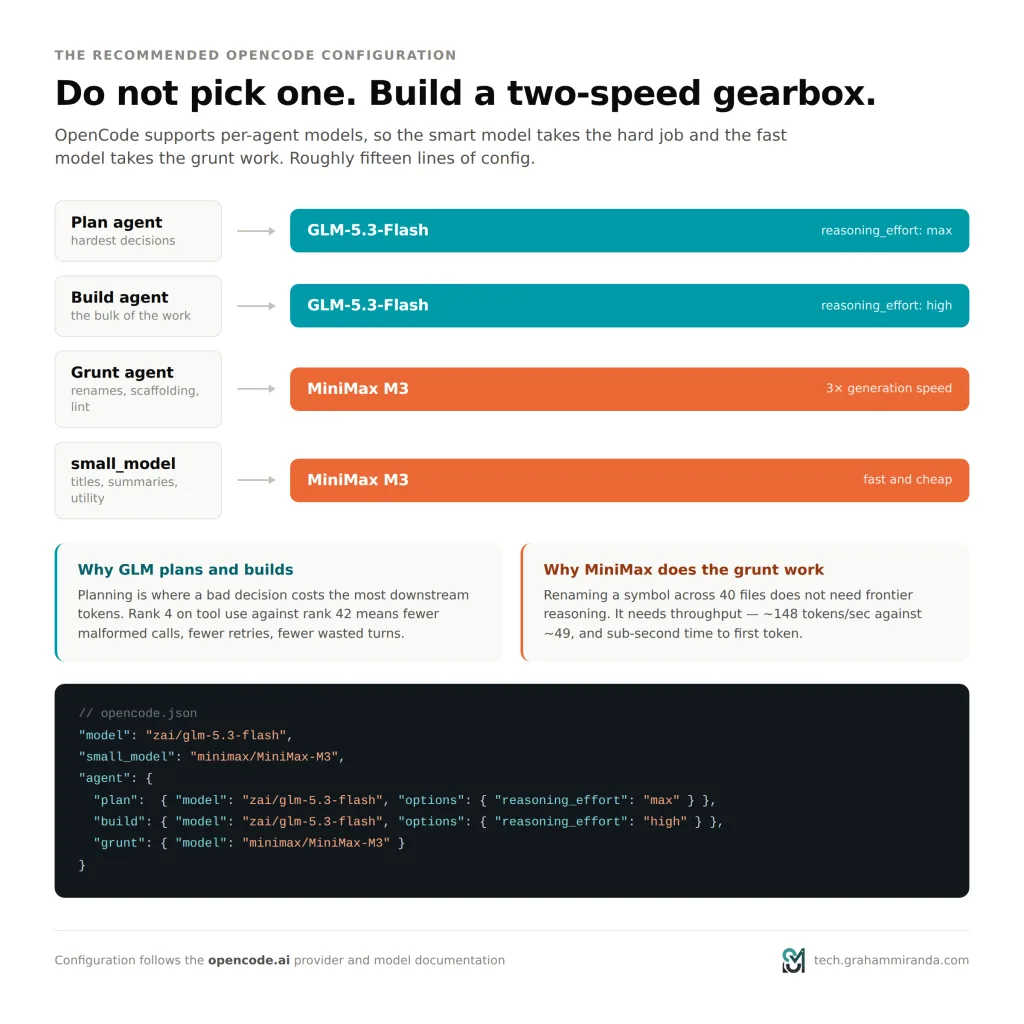
Di sinilah kerangka “versus” itu runtuh, karena OpenCode tidak memaksamu memilih satu. Konfigurasinya mendukung model per agen, yang berarti kamu bisa menaruh model pintar pada pekerjaan sulit dan model cepat pada kerja kasar.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3-flash",
  "small_model": "minimax/MiniMax-M3",
  "agent": {
    "build": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "high" }
    },
    "plan": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "max" }
    },
    "grunt": {
      "description": "Mechanical, high-volume edits: renames, test scaffolding, docstrings, lint fixes",
      "model": "minimax/MiniMax-M3"
    }
  }
}
Logikanya:
- Perencanaan menggunakan
reasoning_effort: maxGLM-5.3-Flash. Perencanaan adalah tempat keputusan buruk paling banyak memakan token di hilir. Beli pemikiran terbaik yang mampu kamu bayar pada langkah ini. - Pembangunan menggunakan
tinggi. Keseimbangan kualitas dan latensi yang baik untuk sebagian besar pekerjaan. - Pekerjaan mekanis diberikan ke M3. Mengganti nama simbol di 40 berkas tidak memerlukan model tool-use peringkat #4. Yang dibutuhkan adalah throughput, dan M3 tiga kali lebih cepat.
small_modelmenangani pekerjaan internal OpenCode — pembuatan judul, ringkasan, panggilan utilitas kecil. Arahkan ke model yang cepat dan murah.
Kamu tidak sedang memilih pemenang. Kamu sedang membangun gir dua kecepatan.
Hitungan biaya dengan angka nyata
Benchmark itu abstrak. Faktur tidak. Mari saya modelkan tugas agentic yang realistis dan menghitungnya dengan kedua daftar harga.
Skenarionya
Satu fitur berukuran sedang, dikerjakan secara agentic di OpenCode: sekitar 60 giliran pemanggilan tool, rata-rata 45K token input per putaran seiring konteks menumpuk, dan 2K token output per putaran.
- Total input: 2,7 juta token
- Total output: 120 ribu token
- Asumsi tingkat cache prompt yang terpakai: 80% (2,16 juta dari cache, 540 ribu baru)
GLM-5.3-Flash
| Komponen | Token | Tarif | Biaya |
|---|---|---|---|
| Input baru | 540 ribu | $0.15/M | $0.081 |
| Input cache | 2,16 juta | $0.03/M | $0.065 |
| Output | 120 ribu | $0.50/M | $0.060 |
| Total | ≈ $0.21 |
MiniMax M3 (tier standar, input ≤512K)
| Komponen | Token | Tarif | Biaya |
|---|---|---|---|
| Input baru | 540 ribu | $0.30/M | $0.162 |
| Input cache | 2,16 juta | $0,06/M | $0.130 |
| Output | 120 ribu | $1,20/M | $0.144 |
| Total | ≈ $0,44 |
GLM-5.3-Flash sekitar 2,1× lebih murah untuk pekerjaan yang sama. Itu sejalan dengan perkiraan independen ~2,2× lebih murah pada campuran input/output 3:1.
Menghitung untuk sebulan
Empat tugas seperti itu sehari, dua puluh hari kerja — 80 kali jalan agen:
- GLM-5.3-Flash: ≈ $16,50/bulan
- MiniMax M3: ≈ $35/bulan
Biaya tambahan konteks panjang yang tidak disebut siapa pun
Inilah jebakannya. Harga MiniMax M3 bertingkat menurut panjang input, dan begitu satu permintaan melewati 512K token input, tarifnya berlipat dua:
| Tier | Masukan | Output | Baca cache |
|---|---|---|---|
| input ≤512K | $0.30/M | $1,20/M | $0,06/M |
| input >512K | $0,60/M | $2,40/M | $0,12/M |
| Tier prioritas | 1,5× standar | 1,5× standar | 1,5× standar |
Jadi angka utama “konteks 1M” itu disertai catatan kaki: separuh kedua jendela tersebut berbiaya dua kali lipat. Jika alur kerjamu benar-benar memuat repositori raksasa ke dalam konteks, M3 berubah dari 2× lebih mahal daripada GLM-5.3-Flash menjadi sekitar 4× lebih mahal tepat saat kamu paling membutuhkan konteks.
Z.ai tidak menerbitkan biaya tambahan serupa untuk GLM-5.3-Flash. Sejuta tokennya diberi harga rata.
Langganan versus bayar sesuai pemakaian
| GLM Coding Plan | MiniMax Token Plan | |
|---|---|---|
| Entry | Lite $18/bln (~80 prompt/5 jam, ~400/minggu, 100 panggilan MCP/bln) | Plus $20/bln (~3–4 agen) |
| Mid | Pro $72/bln (~400 prompt/5 jam, ~2.000/minggu, 1.000 panggilan MCP) | Max $50/bln (~4–5 agen, 3 video/hari) |
| Top | Max $160/bln (~1.600 prompt/5 jam, ~8.000/minggu, 4.000 panggilan MCP) | Ultra $120/bln (~6–7 agen, 5 video/hari) |
| Diskon tahunan | diskon ~30% | Tidak dipublikasikan |
| Model yang disertakan | GLM-5.3, GLM-5.3-Flash, GLM-5.2, GLM-5-Turbo | keluarga model MiniMax |
Dua detail yang mengubah hitungan.
GLM-5.3-Flash mendapat kuota 3× di dalam Coding Plan dibandingkan GLM-5.3, dan pemakaian di luar jam sibuk hanya memakan 50% poin standar. Memilih Flash alih-alih GLM-5.3 penuh secara efektif melipattigakan nilai langgananmu, dan memindahkan proses berat ke luar jendela sibuk 14:00–18:00 UTC+8 membuatnya makin panjang.
Kuota MiniMax tidak bisa dibawa ke siklus berikutnya. Jatah yang tidak terpakai hangus di akhir setiap siklus penagihan, dan MiniMax sendiri menyarankan bayar sesuai pemakaian untuk deployment produksi ketimbang Token Plan.
Pada pemakaian yang saya modelkan (~$16–35/bulan untuk token), bayar sesuai pemakaian dan langganan entry kurang lebih impas. Lewat sekitar 6–8 jam kerja agentic per hari, langganan menang telak — GLM Coding Plan Lite seharga $18 yang mencakup ~400 prompt per minggu benar-benar sulit dikalahkan.
Catatan tentang harga gateway
Kamu akan melihat angka yang sangat berbeda tergantung di mana kamu melihat. OpenRouter mencantumkan GLM-5.3-Flash sekitar $0,05/M input dan $0,17/M output; data model OpenCode sendiri menunjukkan $0,07/M dan $0,25/M. Keduanya di bawah harga resmi Z.ai $0,15/$0,50.
Itu bukan kontradiksi. Gateway berute melakukan load balancing ke 20+ host pihak ketiga — Baseten, DeepInfra, Novita, Cloudflare dan lainnya — dan host-host itu bersaing harga. Kamu benar-benar bisa mendapatkan GLM-5.3-Flash lebih murah daripada harga list lewat gateway. Yang kamu tukar adalah konsistensi: throughput di OpenRouter berkisar dari 8 sampai 111 token/detik tergantung provider mana yang kamu dapat, yang untuk loop agen panjang adalah beda antara tugas dua menit dan tugas lima belas menit.
Untuk pekerjaan agen, saya lebih memilih membayar harga resmi ke pihak pertama dan mendapat latensi yang bisa diprediksi. Gunakan gateway untuk batch dan eksperimen.
Lisensi dan hosting sendiri: bagian yang perlu dibaca dua kali oleh bisnis Eropa
Kalau kamu menjalankan perusahaan di dalam UE, lisensi bukan sekadar catatan kaki. Ini pertanyaan pengadaan.
GLM-5.3-Flash: MIT
Bobotnya ada di Hugging Face di zai-org/GLM-5.3-Flash di bawah lisensi MIT. Itu kurang lebih selonggar-longgarnya lisensi perangkat lunak: pakai secara komersial, ubah, sebarkan ulang, tanamkan dalam produk, tanpa ambang pendapatan, tanpa lampiran penggunaan yang diperbolehkan, tanpa batasan bidang penggunaan. Pertahankan pemberitahuan hak cipta dan selesai.
Bagi bisnis Jerman atau UE, MIT plus bobot yang bisa dihosting sendiri berarti kamu bisa menaruh semuanya di infrastruktur sendiri dan membuat residensi data bukan masalah — tanpa penilaian transfer lintas negara, tanpa perjanjian prosesor dengan vendor Tiongkok, tanpa ketergantungan pada uptime orang lain.
MiniMax M3: MiniMax Community License
Bobot M3 juga terbuka di Hugging Face, tetapi di bawah MiniMax Community License — lisensi khusus, bukan lisensi permisif standar. Sambutan komunitas secara umum positif (lebih permisif daripada lisensi yang dipakai M2.7), dan beberapa sumber menyebut penggunaan komersial tidak dibatasi dalam praktik.
Tapi “disebut tidak dibatasi” dan “diaudit oleh penasihat hukummu” adalah dua hal berbeda. Kalau MiniMax M3 akan masuk ke produk komersial, baca langsung teks lisensinya sebelum merilis. Lisensi khusus menimbulkan beban tinjauan yang tidak ada pada MIT.
Kenyataan menghosting sendiri
Kedua model berbobot terbuka. Tidak ada yang berjalan di laptopmu.
GLM-5.3-Flash:
- Checkpoint FP8: 331 GB dalam 62 shard (~306 GiB bobot sebelum KV cache)
- Varian BF16: 640 GB dalam 120 shard
- FP8 dengan TP=4 pada satu GB200: ~386 GB VRAM
- BF16 dengan TP=8: ~772 GB VRAM
- Membutuhkan generasi Hopper atau lebih baru — H100/H200/B200/B300/GB200/GB300, atau AMD MI300X/MI325X/MI355X
- Stack: vLLM 0.29.0+, FlashInfer 0.6.17+; juga SGLang, TokenSpeed, KTransformers, Transformers, Unsloth
MiniMax M3:
- Sekitar 214 GB pada kuantisasi 4-bit — lebih kecil, tetapi tetap kelas server
Infrastruktur hosting milik Z.ai melaporkan ~48,7 token output/detik dengan TTFT 1,52 detik, dan pada TP=4 di GB200 sebuah pool KV 14,92 juta token yang mendukung konkurensi maksimum 113,81× pada konteks 128K. Itulah bentuk perangkat keras yang dibutuhkan untuk melayani model ini dengan benar.
Terjemahan praktisnya: menghosting sendiri salah satu model berarti menyewa atau membeli beberapa GPU pusat data. Bagi sebagian besar tim — termasuk sebagian besar klien saya — jawaban yang tepat adalah API, dengan bobot terbuka berfungsi sebagai asuransi. Kalau vendor menaikkan harga, menurunkan kualitas model, atau hilang, kamu punya jalan keluar. Opsi itu punya nilai nyata meski tidak pernah kamu pakai.
Di mana setiap model sebenarnya jebol
Tanpa bagian promosi. Ini kelemahan yang sebenarnya.
Kelemahan GLM-5.3-Flash
Model ini lambat. ~48,6 token/detik output dan ~1,51 detik ke token pertama. Dibanding ~148 tok/detik dan ~0,99 detik milik M3, setiap generasi panjang terasa. Dalam loop agen 40 giliran, itu menumpuk jadi beberapa menit menunggu.
Kamu tidak bisa mematikan mode berpikir. Penalaran wajib tepat untuk pekerjaan agen yang sulit dan boros untuk panggilan sepele. Setiap permintaan “tambahkan docstring ke fungsi ini” membayar pajak penalaran. Justru karena itu kamu ingin M3 atau model lebih kecil dipasang untuk kerja kasar.
Token penalaran adalah token yang ditagih. Dengan reasoning_effort: max sebagai default yang didokumentasikan, biaya nyata per tugas lebih tinggi daripada perkiraan naif dari hitungan input/output saja. Setel ke tinggi kecuali tugasnya memang layak maks.
Model ini masih baru. Dirilis 26 Agustus 2026. Bug integrasi berekor panjang di ekosistem harness belum semuanya muncul, dan pengetahuan komunitas masih tipis. Kalau kamu kena mode kegagalan yang langka, kamu mungkin orang pertama yang melaporkannya.
Jangan tertukar dengan GLM-5.3. Keduanya model berbeda dengan kemampuan berbeda — terutama, GLM-5.3 non-Flash hanya teks. Mengirim gambar ke ID model yang salah adalah kesalahan awal yang umum.
Kelemahan MiniMax M3
Peringkat penggunaan alat adalah masalah sebenarnya. #42 pada indeks penggunaan alat llm-stats, sementara GLM-5.3-Flash di #4. Untuk harness agen, itu kemampuan yang menanggung beban. Perkirakan lebih banyak panggilan alat cacat, lebih banyak percobaan ulang, lebih banyak giliran terbuang untuk pemulihan — yang memakan keunggulan kecepatan yang kamu bayar.
Bug pelaporan konteks belum terpecahkan. Terbuka sejak rilis. Bisa diakali, tapi tetap luka kecil yang kamu bawa.
Verifikasi independen masih tipis. Benchmark peluncuran MiniMax belum muncul di papan netral, dan di tempat agregator netral mengukur, M3 berada di papan tengah, bukan dekat puncak. Jarak antara framing vendor dan pengukuran pihak ketiga di sini lebih lebar daripada untuk Z.ai.
Harga konteks panjang dua kali lipat di atas 512K. Fitur andalan itu punya biaya tambahan.
Lisensi khusus. Tinjauan hukum tambahan sebelum penerapan komersial.
Penggunaan menurun. Penurunan 51% volume token OpenCode dalam dua bulan adalah sinyal momentum ekosistem, apa pun penyebabnya. Pengguna lebih sedikit berarti lebih sedikit orang yang mengalami dan memperbaiki bug yang sama denganmu.
Kerangka keputusan: lima skenario
1. “Saya mau satu model, pasang, lalu lupakan.”
GLM-5.3-Flash. Lebih baik di setiap benchmark netral, separuh harga, berlisensi MIT, dan tempat komunitas berpijak. Setel reasoning_effort: high, tambahkan GLM Coding Plan Lite seharga $18/bulan kalau kamu ngoding setiap hari, lalu lanjutkan hidupmu.
2. “Saya menjalankan refactor mekanis besar di codebase raksasa.”
MiniMax M3 untuk lintasan mekanis, GLM-5.3-Flash untuk rencananya. MSA membuat M3 benar-benar ekonomis pada konteks panjang, dan kecepatan generasi 3× paling terasa pada suntingan bervolume tinggi dengan kesulitan rendah. Perhatikan tebing harga 512K, dan biarkan GLM merencanakan refactor sebelum M3 menjalankannya.
3. “Pekerjaan saya visual — UI, design-to-code, debugging lewat screenshot.”
GLM-5.3-Flash dulu, M3 sebagai pilihan kedua yang kuat. Multimodalitas asli GLM dirancang tepat untuk ini dan peringkatnya di atas M3 pada indeks visi (32,0 vs 25,6). Tapi skor OSWorld-Verified M3 sebesar 70,06% membuatnya pilihan lebih baik khusus untuk agen desktop dan GUI pekerjaan — menjalankan aplikasi sungguhan, bukan membaca screenshot.
4. “Saya perlu hosting sendiri untuk residensi data atau kepatuhan.”
GLM-5.3-Flash, tanpa keraguan. MIT versus lisensi komunitas khusus bukan pilihan yang tipis ketika tim hukummu terlibat, dan hosting sendiri dengan MIT menyingkirkan seluruh pertanyaan transfer data lintas negara. Siapkan anggaran untuk perangkat keras kelas Hopper atau host GPU Eropa.
5. “Saya memimpin tim kecil dengan anggaran ketat.”
GLM Coding Plan Lite seharga $18/bulan, dengan default GLM-5.3-Flash. Pengali kuota 3× untuk Flash di dalam paket menjadikannya opsi dengan nilai per euro tertinggi saat ini. Jadwalkan batch berat di luar jendela sibuk 14.00–18.00 UTC+8 untuk diskon poin 50%. Tambahkan MiniMax nanti kalau throughput jadi hambatan.
Yang akan saya pantau pada kuartal berikutnya
Uji Terminal-Bench dan SWE-bench Pro independen untuk GLM-5.3-Flash. Angka vendor sangat bagus. Agregator netral secara luas menguatkannya. Tapi klaim spesifik “dalam selisih satu poin dari Claude Opus 4.8 pada Terminal-Bench 2.1” layak direplikasi pihak ketiga sebelum ada yang membangun kasus bisnis di atasnya.
Apakah MiniMax /anthropic bug konteksnya akan diperbaiki. Bug ini kecil, sudah terdokumentasi, dan terbuka sejak Juni. Seberapa cepat ditutup memberi tahu sesuatu tentang kecepatan pemeliharaan.
Kurva retensi GLM-5.3-Flash di OpenCode. Angka pangsa tokennya spektakuler tapi masih muda. Datapoin yang menarik adalah apakah angka itu bertahan di 10%+ setelah kebaruannya memudar. Kalau iya, ini bukan sekadar momen — ini default baru.
Irama rilis dari lab bobot terbuka Tiongkok. Qwen3.8-Flash-Next diluncurkan kurang lebih bersamaan dengan GLM-5.3-Flash. Kimi K3 sudah mengalahkan GLM-5.3 pada DeepSWE (67,5 vs 66,9) dan Toolathlon (76,5 vs 73,0). Jarak antara “model coding bobot terbuka terbaik saat ini” dan “terbaik kedua” kini diukur dalam minggu. Susun konfigurasimu agar menukar string model hanya perubahan satu baris, karena kamu akan melakukannya lagi.
Apakah Z.ai menerbitkan harga API tunggal untuk GLM-5.3 penuh. Saat tulisan ini dibuat, baris per-token untuk GLM-5.3 masih belum ada di halaman harga resmi sementara GLM-5.3-Flash sudah lengkap harganya. Asimetri yang aneh dan layak dipantau.
Pertanyaan yang sering diajukan
Apakah GLM-5.3-Flash lebih baik daripada MiniMax M3 untuk coding? Berdasarkan bukti yang ada, ya. GLM-5.3-Flash unggul pada Terminal-Bench 2.1 (84,3 vs 66,0), pada Intelligence Index Artificial Analysis (57 vs 45), dan pada setiap indeks kemampuan llm-stats termasuk coding, agen, dan penggunaan alat. Harganya juga sekitar separuh per token. MiniMax M3 lebih cepat — sekitar 3× kecepatan output — tetapi coding agentic lebih menghargai kualitas penalaran daripada kecepatan generasi mentah.
Mana yang lebih murah, GLM-5.3-Flash atau MiniMax M3? GLM-5.3-Flash, sekitar 2×. Harga resminya $0,15/juta input dan $0,50/juta output untuk GLM-5.3-Flash, dibanding $0,30/juta dan $1,20/juta untuk MiniMax M3. Jaraknya melebar jadi sekitar 4× untuk permintaan di atas 512K token input, tempat MiniMax menggandakan tarif dan Z.ai tidak menerbitkan biaya tambahan.
Bisakah saya menjalankan GLM-5.3-Flash secara lokal? Hanya di perangkat keras kelas server. Checkpoint FP8-nya 331 GB dan butuh sekitar 386 GB VRAM pada TP=4, di GPU generasi Hopper atau lebih baru. Ini bukan model untuk perangkat keras konsumen. Lisensi MIT membuat hosting sendiri sederhana secara hukum; perangkat kerasnya yang membuatnya mahal.
Apakah OpenCode mendukung kedua model secara bawaan? Ya. OpenCode menyertakan penyedia bawaan untuk Z.AI dan MiniMax. Jalankan opencode auth login, pilih penyedia yang cocok dengan jenis kuncimu, lalu /models untuk memilih modelmu. Tidak perlu opencode.json diedit untuk pengaturan standar.
Mengapa MiniMax M3 hanya menampilkan konteks 200K di Claude Code? Bug yang sudah diketahui dan masih terbuka di endpoint kompatibel-Anthropic milik MiniMax: ia melaporkan metadata Claude Sonnet alih-alih spesifikasi asli M3, memicu pemadatan otomatis sekitar 167K token. Setel CLAUDE_CODE_AUTO_COMPACT_WINDOW untuk 1000000 di pengaturanmu, atau gunakan rute kompatibel-OpenAI sebagai gantinya.
Apa bedanya GLM-5.3 dan GLM-5.3-Flash? Model yang berbeda. GLM-5.3 diluncurkan 14 Agustus 2026 dan hanya teks, berbagi model dasar dengan GLM-5.2. GLM-5.3-Flash diluncurkan 26 Agustus, multimodal secara bawaan, memakai arsitektur MoE hybrid-attention 320B/18B, berlisensi MIT dengan bobot terbuka, dan harganya sekitar sepersepuluhnya. Di dalam GLM Coding Plan, Flash juga mendapat kuota 3×.
Apakah MiniMax M3 benar-benar sumber terbuka? Bobotnya bisa diunduh terbuka dari Hugging Face, tetapi di bawah MiniMax Community License yang khusus, bukan lisensi permisif standar seperti MIT atau Apache 2.0. Penggunaan komersial secara luas disebut tidak dibatasi, tapi baca teks lisensinya sebelum merilis produk komersial di atasnya.
Sebaiknya pakai paket langganan atau bayar sesuai pemakaian? Di bawah pengeluaran token sekitar $20–30/bulan, keduanya hampir impas. Di atas 6–8 jam coding agentic per hari, langganan menang jelas — GLM Coding Plan Lite seharga $18/bulan yang mencakup sekitar 400 prompt per minggu adalah nilai tingkat awal terkuat yang tersedia. Catat bahwa kuota MiniMax tidak terbawa ke periode berikutnya, dan MiniMax sendiri menyarankan bayar sesuai pemakaian untuk beban kerja produksi.
Kesimpulan
Kalau kamu hanya mengambil satu hal dari ini: GLM-5.3-Flash adalah default yang lebih baik untuk OpenCode pada akhir 2026, dan perbandingannya tidak tipis pada dimensi yang menentukan hasil coding agentic — kualitas penalaran, keandalan penggunaan alat, dan biaya per tugas yang selesai.
MiniMax M3 bukan model buruk. Ia dioptimalkan secara berbeda, dan arsitektur MSA-nya adalah jawaban yang sungguh elegan untuk masalah ekonomi konteks panjang. Ada beban kerja nyata — suntingan mekanis bervolume tinggi, tugas agen desktop dan GUI, apa pun yang didominasi kecepatan generasi 3× — di mana ia adalah alat yang tepat.
Tapi coding agentic pada dasarnya adalah masalah pengambilan keputusan, bukan masalah kecepatan mengetik. Model yang merencanakan lebih baik, memanggil alat lebih andal, dan pulih dari kegagalan lebih rapi akan menyelesaikan lebih banyak tugas per euro, meski menghasilkan token tiga kali lebih lambat.
Langkah pragmatisnya adalah gir dua kecepatan: GLM-5.3-Flash untuk perencanaan dan pembangunan, MiniMax M3 untuk kerja kasar, small_model diarahkan ke yang cepat. OpenCode membuatnya jadi perubahan konfigurasi lima belas baris, dan kamu mendapat kecerdasan di tempat yang penting serta throughput di tempat yang tidak.
Dan tulis konfigurasi itu agar ID model mudah ditukar. Di pasar ini, jawaban paling jelas hari ini punya masa berlaku yang diukur dalam minggu.
Pernahkah kamu menjalankan salah satunya sebagai pemakaian harian OpenCode? Saya terutama ingin tahu apakah angka Terminal-Bench GLM-5.3-Flash bertahan di repositori nyata, dan apakah ada yang menemukan solusi sementara yang lebih bersih untuk bug pelaporan konteks MiniMax. Hubungi saya — koreksi dan bukti tandingan diterima, dan artikel ini diperbarui ketika gambarannya berubah.
Terakhir diperbarui: 30 Agustus 2026.


