
 Bahasa Indonesia
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Русский
 العربية
 हिन्दी

Enam minggu lalu, saya akan menulis artikel ini dengan cara berbeda.
Pada Juli, Moonshot AI menaruh model kelas garis depan berparameter 2,8 triliun di Hugging Face dan membiarkan siapa pun mengunduhnya. Pada 28 Agustus, Z.ai akhirnya merilis bobot GLM-5.3 yang sudah dua minggu mereka simpan — setelah menemukan bahwa modelnya sendiri bisa merangkai eksploitasi dengan cara yang tidak pernah diminta. Dan pada 1 September, Anthropic merilis Claude Fable 5.1 dan membuat pekerjaan agenik hingga 45% lebih murah tanpa menyentuh harga utamanya.
Tiga model. Tiga jawaban yang benar-benar berbeda atas pertanyaan tentang apa yang harus diberikan sebuah lab AI kepada publik. Dan untuk pertama kalinya sejak semua ini dimulai, opsi bobot terbuka bukan lagi pilihan kompromi.
Itulah cerita sebenarnya di akhir 2026, dan layak ditulis sekitar delapan ribu kata, karena di detail itulah semua uang dan semua kesalahan berada.
Saya sudah membuka makalah arsitektur, kartu model, teks lisensi — dengan benar, baris demi baris, karena dua dari tiga itu bukan seperti yang orang sebut secara santai — benchmark vendor, skor agregator netral, tarif per token yang sebenarnya, dan daftar harga terbaru Ollama’s. Lalu saya hitung biayanya untuk satu bulan kerja normal, bukan skenario hari peluncuran.
Inilah hasilnya.
TL;DR — Putusan 60 detik
GLM-5.3 adalah nilai terbaik di AI saat ini, dan selisihnya jauh. Artificial Analysis menilainya dalam selisih setengah poin dari Kimi K3 dan sekitar tiga setengah poin di belakang Claude Opus 5, dengan harga $1,40 masuk dan $4,40 keluar per juta token. Pada tugas agenik yang sama, biayanya kira-kira seperenam dari biaya Fable 5.1. Bobotnya bisa diunduh. Kalau kamu ingin satu model untuk dijadikan tujuan agenmu dan kamu tidak menjalankan bisnis berpendapatan $10 miliar, inilah pilihannya.
Kimi K3 adalah hal paling mumpuni yang bisa kamu unduh secara legal. 2,8 triliun parameter, 104 miliar aktif, konteks 1M yang sungguhan, visi bawaan, skor penjelajahan agenik terbaik yang pernah dipublikasikan siapa pun (BrowseComp 91.2), dan — angka yang seharusnya mengakhiri argumen “model terbuka tertinggal” — 88,3 pada Terminal-Bench 2.1, dibandingkan Claude Fable 5’s 88,0 dan GPT-5.6 Sol’s 88,8 pada versi yang sama. Model ini juga berbiaya $3/$15 — lebih dari dua kali GLM-5.3 — dan 1,5 TB bobotnya butuh rak, bukan workstation. Ini model yang kamu pakai saat tugasnya sulit dan panjang, dan model yang kamu kutip saat seseorang bilang bobot terbuka tertinggal satu generasi.
Claude Fable 5.1 tetap model yang kamu jangkau saat salah itu mahal. Model ini memimpin di pekerjaan agenik berjam-jam yang berkelanjutan dan di debugging berantakan yang tidak pernah muncul rapi di papan peringkat. Anthropic memotong baca cache sebesar 75% pada 1 September, yang membuat sesi agen panjang jauh lebih murah dari sebelumnya. Harganya juga enam kali GLM-5.3 per tugas, tertutup, dan sekarang membawa pembatasan anti-distilasi yang merusak beberapa integrasi yang sudah ada.
Ringkasan jujurnya: model bobot terbuka telah menutup celah kemampuan menjadi sekitar tiga sampai lima bulan, dan mereka telah menghancurkan celah harga. Yang sebenarnya kamu beli dari Anthropic pada September 2026 adalah keandalan pada 10% pekerjaan tersulit — dan hak untuk tidak memikirkan semua ini.
Dan twist yang tidak ada yang mau katakan terang-terangan: Kimi K3 maupun GLM-5.3 tidak lagi dirilis di bawah lisensi sumber terbuka. Keduanya beralih ke syarat khusus yang dibatasi pendapatan musim panas ini. Bobot terbuka, ya. Sumber terbuka, tidak. Baca bagian tentang lisensi sebelum tim legalmu melakukannya.
Tabel perbandingan singkat
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Pembuat | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| Dirilis | 16 Juli 2026 (API) · 27 Juli (bobot) | 14 Agustus 2026 (API) · 28 Agustus (bobot) | 1 September 2026 |
| Bobot tersedia | Ya | Ya | Tidak |
| Lisensi | Kimi K3 License (khusus, dibatasi pendapatan) | glm-5.3 License (khusus, dibatasi pendapatan) | Proprietary |
| Total parameter | 2.8T | 753B | Tidak diungkapkan |
| Aktif per token | 104B (16 dari 896 pakar) | ~40B (perkiraan) | Tidak diungkapkan |
| Arsitektur | KDA + Attention Residuals, Stable LatentMoE, 69 lapisan KDA + 24 lapisan Gated MLA | MoE, basis sama dengan GLM-5.2, peningkatan hanya dari pasca-pelatihan | Tidak diungkapkan |
| Jendela konteks | 1,048,576 | 1,000,000 | 1,000,000 |
| Output maksimum | 131.072 bawaan (hingga 1.048.576) | 128,000 | 128,000 |
| Input multimodal | Teks, gambar, video (MoonViT-V2) | Hanya teks | Teks, gambar |
| Berpikir | Selalu aktif | Selalu aktif, reasoning_effort low/high/max | Selalu aktif, adaptif, upaya per pesan (beta) |
| Harga input / 1M | $3.00 | $1.40 | $10.00 |
| Input cache / 1M | $0.30 | $0.26 | $0.25 |
| Harga output / 1M | $15.00 | $4.40 | $50.00 |
| Indeks Kecerdasan AA | 59.7 | 59.5 | Belum dinilai (Fable 5: 62,1) |
| Biaya per tugas evaluasi AA | $0.84 | $0.68 | — (Opus 5: $2,34) |
| Kebutuhan dihosting sendiri | ~1,5 TB (MXFP4 bawaan) | ~1,5 TB BF16 / ~750 GB FP8 | N/A |
| Di Ollama | kimi-k3:cloud | glm-5.3:cloud | Lewat Claude Code / Claude Desktop sebagai klien |
Semua harga adalah harga daftar pihak pertama. Angka Artificial Analysis berasal dari snapshot indeks September 2026; Fable 5.1 diluncurkan pada 1 September dan belum dinilai secara independen saat artikel ini ditulis.
Mengapa perbandingan tiga arah ini yang penting
Selama dua tahun, percakapan terbuka-versus-tertutup punya bentuk yang nyaman: model tertutup lebih baik, model terbuka lebih murah, dan kamu memilih posisimu pada trade-off itu. Semua orang tahu di mana posisinya.
Bentuk itu patah musim panas ini.
Nathan Lambert, yang mengikuti ini lebih teliti daripada hampir siapa pun, menempatkan celah kemampuan saat ini antara model bobot terbuka garis depan dan model tertutup garis depan pada tiga sampai lima bulan — turun dari enam sampai sembilan bulan yang dikutip orang setahun lalu. Saat dia menulis, Kimi K3 berada di #2 pada indeks Vals AI dan dekat puncak Artificial Analysis’s, hanya dikalahkan Claude Fable dan GPT-5.6 Sol Max. Snapshot indeks September yang saya pakai nanti di artikel ini menempatkannya di posisi keempat, di belakang Grok 4.6. Apa pun itu: bukan “bagus untuk model terbuka.” Itu finis podium.
Sementara itu data penggunaan telah bergerak ke tempat yang benar-benar mengejutkan. Model asal Tiongkok menangkap sekitar 61% dari semua token yang dirutekan lewat OpenRouter pada Mei 2026. Pangsa AS dari lalu lintas itu runtuh dari sekitar 70% menjadi sekitar 30% dalam dua belas bulan. Meta’s Llama — model yang memulai gelombang bobot terbuka — jatuh di bawah 1% volume yang dirutekan. Pangsa Google turun dari sekitar 37% menjadi 13%. Studi 100 triliun token OpenRouter sendiri bersama a16z menemukan model bobot terbuka menyumbang sekitar sepertiga dari seluruh volume token di platform.
Kamu bisa berdebat tentang apa yang diwakili lalu lintas OpenRouter. Ini terlalu banyak mewakili pengembang, penghobi, dan beban kerja yang peka biaya, dan kurang menghitung kontrak perusahaan yang tidak pernah menyentuh router. Tidak apa-apa. Tapi ini adalah kumpulan data publik terbesar yang kita miliki tentang apa yang benar-benar dipilih orang saat mereka bisa memilih dengan bebas, dan arahnya tidak ambigu.
Jadi pertanyaan pada September 2026 bukan lagi “apakah model terbuka sudah cukup bagus.” Pertanyaannya jauh lebih tajam:
Dengan tiga model yang semuanya lolos standar, ke mana kamu mengarahkan agenmu — dan berapa biaya sebenarnya kalau kamu salah?
Itu pertanyaan tentang benchmark, harga, lisensi, dan infrastruktur, kira-kira dalam urutan seberapa sering orang memikirkannya dan persis kebalikan dari seberapa penting itu.
Apa sebenarnya Kimi K3
Moonshot AI mengumumkan Kimi K3 pada 16 Juli 2026 dan merilis bobot lengkapnya pada 27 Juli. Berdasarkan jumlah parameter, ini model bobot terbuka terbesar yang pernah diterbitkan siapa pun — 2,8 triliun parameter total, sekitar 75% lebih besar dari DeepSeek V4 Pro.
Angka itu kurang mengesankan daripada kedengarannya dan lebih mengesankan daripada kedengarannya, dalam urutan itu.
Arsitekturnya, dengan bahasa sederhana
Kimi K3 adalah model mixture-of-experts yang mengaktifkan 104 miliar parameter per token, memilih 16 pakar dari kumpulan 896. Jadi meskipun totalnya 2,8T, setiap forward pass hanya menyentuh di bawah 4% bobot. Dari situlah ekonominya berasal: pengetahuan tersimpan yang sangat besar, biaya inferensi yang moderat.
Rekayasa yang menarik ada di susunan attention. K3 memakai 93 lapisan yang dibangun dari 69 lapisan KDA (Kimi Delta Attention) dan 24 lapisan Gated MLA — desain attention hibrida linear-ke-penuh dengan rasio interleave sekitar 3:1. KDA adalah varian linear-attention yang berjalan dalam waktu linear terhadap panjang urutan, bukan kuadratik, dan itulah yang membuat konteks 1M layak secara ekonomi, bukan sekadar diklaim. Moonshot melaporkan hingga pengurangan cache KV hingga 75% dan hingga 6× throughput decode pada konteks 1M sebagai hasilnya.
Di atasnya ada Attention Residuals (AttnRes), yang oleh Moonshot disebut pengganti langsung untuk koneksi residual standar, dan Stable LatentMoE kerangka untuk routing. Kombinasinya diklaim memberikan sekitar peningkatan 2,5× dalam efisiensi scaling keseluruhan dibanding Kimi K2.
Visi berasal dari MoonViT-V2, encoder 401 juta parameter, dan sifatnya bawaan, bukan tambalan — K3 menangani teks, gambar, dan video dalam satu model.
Satu detail lagi yang penting bagi siapa pun yang mempertimbangkan hosting sendiri: K3 dilatih dengan pelatihan sadar-kuantisasi MXFP4 bawaan, dengan pakar dalam MXFP4 dan aktivasi dalam MXFP8. Ini bukan kuantisasi pasca-hoc. Checkpoint yang diterbitkan adalah model terkuantisasi, itulah sebabnya 2,8 triliun parameter mendarat di sekitar 1,5 TB di disk bukan ~5,6 TB yang dibutuhkan checkpoint BF16 sebesar itu.
Kisah benchmark
Angka terbitan Moonshot’s kuat di semua bidang, dan tidak biasanya, beberapa bertahan dalam evaluasi independen:
- Terminal-Bench 2.1: 88.3 — skor terbitan tertinggi pada versi benchmark tersebut
- FrontierSWE: 81.2
- DeepSWE: 67.5
- BrowseComp: 91.2 — yang terbaik saat ini untuk riset web agenik
- GPQA Diamond: 93.5
- MMMU-Pro: 81.6 / 83.4 (visi)
- SWE Marathon: 91.0
- OfficeQA Pro: 81.3
- AutomationBench: 30.8
- LMArena Frontend Code Arena: 1.679 Elo — peringkat pertama, di atas Claude Fable 5 (1.631) dan GPT-5.6 Sol (1.618), menang di enam dari tujuh domain frontend
Yang terakhir itu patut direnungkan sejenak. Model bobot terbuka yang bisa kamu unduh gratis menduduki peringkat pertama di arena coding frontend berbasis preferensi manusia, di atas model tertutup unggulan dari dua lab dengan pendanaan terbesar di dunia. Apa pun pendapatmu soal benchmark arena sebagai metodologi, itu judul yang tak terbayangkan pada 2025.
Di indeks agregat, posisinya sedikit lebih rendah: 59,7 di Artificial Analysis Intelligence Index, ketiga secara keseluruhan, di belakang Claude Opus 5 (63,0) dan Claude Fable 5 (62,1). Angka unggulan Moonshot sendiri — GDPval-AA v2 di 1.687 dan AA-Briefcase di 1.527 — menempatkannya ketiga dan kedua dalam evaluasi kerja pengetahuan itu. Di Vals Index v2 posisinya di 57.8%, dibandingkan 67,2% milik Claude Opus 5, 66,0% milik Claude Fable 5, dan 63,7% milik GPT-5.6 Sol — selisih terbuka-versus-tertutup terlebar di indeks mana pun yang saya temukan, dan layak diingat saat melihat angka coding.
Demo-demonya, dan cara membacanya
Moonshot menerbitkan dua demonstrasi otonomi jangka panjang yang banyak diperhatikan, yaitu proses desain chip lengkap secara otonom selama 48 jam (desain 4mm yang menutup timing pada 100 MHz, dengan simulasi 8.700+ token/detik), dan reproduksi relasi I-Love-Q dalam sekitar dua jam, dibandingkan satu sampai dua minggu yang biasanya dibutuhkan seorang peneliti senior.
Ini benar-benar mengesankan, dan saya tidak akan mendasarkan keputusan pembelian pada ini. Demonstrasi yang dijalankan, dirangkai, dan dipilih vendor memberitahumu apa yang bisa dilakukan model pada hari baik dengan pengawasan ahli, bukan apa yang dilakukannya di repositorimu pada hari Selasa. Anggap ini bukti keberadaan untuk kapabilitas jangka panjang, bukan spesifikasi.
Tampilkan gambar Dua arsitektur yang diterbitkan dan satu kotak hitam. Model terbuka memberitahumu persis cara kerjanya; yang tertutup memberitahumu skornya.
Apa sebenarnya GLM-5.3
GLM-5.3 punya kisah rilis paling aneh di antara ketiganya, dan itu layak diceritakan dengan benar, karena inilah pertama kalinya sebuah lab besar terlihat ragu menerbitkan bobot karena alasan selain komersial.
Z.ai mengumumkan GLM-5.3 pada 14 Agustus 2026 dengan tagline “Dibuat untuk Coding. Siap untuk Pertahanan Siber.” Model ini adalah mixture of experts 753 miliar parameter, dengan sekitar 40 miliar parameter aktif per token menurut estimasi komunitas yang diturunkan dari konfigurasi GLM-5.2. Model ini membawa jendela konteks 1 juta token dan output maksimum 128K, dan — tidak seperti GLM-5.3-Flash, yang merupakan model yang sama sekali berbeda — model ini hanya teks.
“Scaling post-training adalah semua yang kami lakukan”
Fakta teknis paling menarik tentang GLM-5.3 adalah tidak ada model dasar baru. Model ini memakai ulang fondasi terlatih yang sama dengan GLM-5.2. Semua peningkatan datang dari post-training yang diperpanjang drastis, yang diringkas Z.ai sebagai: “Scaling post-training adalah semua yang kami lakukan untuk GLM-5.3.”
Selisihnya tidak kecil:
| Benchmark | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Peningkatan enam kali lipat di Terminal-Bench dan lonjakan dua puluh poin di DeepSWE, dari bobot dasar yang sama, adalah hasil yang benar-benar penting. Itu menunjukkan frontier masih punya banyak ruang di post-training, separuh tagihan pelatihan yang jauh lebih murah. Justru karena itu lab-lab Tiongkok yang beroperasi dengan, seperti kata Lambert, “modal beberapa orde besaran lebih kecil” daripada lab Amerika tetap bisa mengejar.
Dua minggu Z.ai menunda rilis
Z.ai mengatakan saat peluncuran bahwa bobotnya akan menyusul “secara bertahap setelah evaluasi keselamatan yang ketat,” dengan target sekitar dua minggu. Repositori Hugging Face-nya mencantumkan 28 Agustus. Tanggal itu datang, lewat beberapa jam, lalu bobotnya muncul bersama tulisan teknis yang menjelaskan penundaan.
Alasannya adalah kapabilitas siber. Saat evaluasi, Z.ai melaporkan bahwa GLM-5.3 mengidentifikasi 2.436 kerentanan di 269 proyek sumber terbuka, di antaranya 1.097 dinilai kritis atau berkeparahan tinggi. Lebih penting lagi, model itu menunjukkan penalaran rantai eksploitasi bertahap — merangkai langkah eksploitasi secara otonom — yang Z.ai gambarkan sebagai perilaku yang “tidak sepenuhnya disengaja” dan “terus menguat seiring skala pelatihan.”
Saya ingin berhati-hati di sini, karena ini mudah dibaca sebagai pemasaran atau alarmisme, dan kemungkinan besar bukan keduanya. Model yang bagus menemukan kerentanan memang bagus dalam menemukan kerentanan; penggunaan defensif dan ofensif adalah kapabilitas yang sama yang diarahkan ke arah berbeda. Sebaran benchmark Z.ai mencerminkan itu dengan jujur: CyberGym 84,5% (penemuan kerentanan, di mana model ini memimpin) dibandingkan ExploitBench 54,4% (eksploitasi, di mana Claude Fable 5 mencetak 78,0%). Lab itu sengaja mengoptimalkan separuh sisi defensif dan hasilnya terlihat.
Yang benar-benar mencolok adalah sebuah lab menahan rilis unggulan selama dua minggu dan menerbitkan alasannya. Entah kamu menganggap alasannya meyakinkan atau tidak, presedennya baru.
Posisi GLM-5.3 sebenarnya
Bagan perbandingan terbitan Z.ai tidak mengklaim kemenangan mutlak, dan itu menyegarkan:
| Benchmark | GLM-5.3 | Pembanding terbaik |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3 unggul |
| CyberGym | 84.5% | GLM-5.3 unggul |
| GDPval-AA v2 | 1,769 | GLM-5.3 unggul |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34,6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72,7% |
| ExploitBench | 54.4% | Claude Fable 5: 78,0% |
| Code Bench (50K token) | 31.4% | — |
Secara independen, Artificial Analysis menempatkannya di 59,5 di Intelligence Index — secara statistik tak terbedakan dari 59,7 milik Kimi K3, dari model dengan parameter sekitar seperempatnya.
Satu catatan dari evaluasi yang sama yang tak disebut siapa pun di materi pemasaran: GLM-5.3 menghasilkan 170 juta token output di seluruh rangkaian Artificial Analysis, dibandingkan median 72 juta untuk kelasnya. Model ini banyak bicara. reasoning_effort default-nya adalah maks dan thinking tidak bisa dimatikan, jadi kamu membayar banyak deliberasi entah tugasnya layak atau tidak. Meski begitu, total biaya menjalankan evaluasi penuh mencapai $0,68 per tugas, dibandingkan $0,84 untuk Kimi K3 dan $2,34 untuk Claude Opus 5 — jadi verbositasnya tidak menghapus keunggulan harga. Hanya mempersempitnya.
Apa sebenarnya Claude Fable 5.1
Anthropic merilis Claude Fable 5.1 pada 1 September 2026, bersama Claude Mythos 5.1 — model yang sama dengan konfigurasi pengaman berbeda, tersedia hanya lewat program akses tepercaya untuk pekerjaan keamanan siber dan ilmu hayati.
Positioningnya spesifik dan, menurut saya, tepat: ini adalah “model yang dibangun untuk pekerjaan yang tidak selesai dalam satu prompt.” Anthropic tidak mengklaim lompatan kecerdasan umum. Yang diklaim adalah sesi agentic berjam-jam yang berkelanjutan berjalan lebih baik.
Angkanya
| Benchmark | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (sebagian) | 72.9% | 77.9% | — |
| Humanity’s Last Exam (dengan alat) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Untuk konteks eksternal pada penggaris yang sama: GPT-5.6 Sol mencetak 52,3% di Terminal-Bench 4.0, jadi 55,8% milik Fable 5.1 mengambil pimpinan dan 60,9% milik Mythos 5.1 memperlebarnya.
Lonjakan Terminal-Bench-Science — 24,7% ke 52,6%, tepat dua kali lipat — adalah yang paling saya bobot kalau pekerjaanmu melibatkan komputasi ilmiah atau pipeline data. Dan di benchmark penggunaan komputer tersulit dari Browserbase, Fable 5.1 menyelesaikan 82% tugas dibandingkan 74% milik Claude Opus 5.
Anthropic juga melaporkan sekitar penurunan 60% pada positif palsu keamanan siber — model menolak pekerjaan keamanan yang sah karena mencocokkan pola ke sesuatu yang berbahaya. Kalau kamu pernah mengalami asisten coding menolak membantumu menulis rate limiter, kamu akan paham kenapa itu penting.
Perubahan harga itulah berita sebenarnya
Tarif utama tidak berubah: $10 per juta token input, $50 per juta output. Yang berubah adalah pengali pembacaan cache, dan perubahannya besar.
| Fable 5 | Fable 5.1 | |
|---|---|---|
| Masukan | $10.00 | $10.00 |
| Output | $50.00 | $50.00 |
| Penulisan cache (5 menit) | $12.50 | $12.50 |
| Penulisan cache (1 jam) | $20.00 | $20.00 |
| Baca cache | $1.00 | $0.25 |
Itu pemotongan 75%, dicapai dengan menggeser pengali pembacaan cache dari standar 0,1× input dasar ke 0,025×. Anthropic menyebut sekitar 25% lebih murah untuk beban kerja tipikal dan hingga 45% lebih murah untuk pekerjaan yang sangat agentic — dan angka kedua itu nyata, karena loop agentic sebagian besar adalah pembacaan cache. Sesi agen 60 putaran membaca ulang konteks terakumulasi yang sama puluhan kali. Batch API memotong input dan output separuh di atas itu, menjadi $5/$25.
Ini pemotongan harga yang cerdas dan tepat sasaran. Hal spesifik yang paling dikuasai Fable 5.1 — sesi panjang — jadi jauh lebih murah tanpa menurunkan nilai model secara umum.
Tiga perubahan yang memutus kompatibilitas, satu regresi
Sebelum kamu meningkatkan integrasi produksi, baca ini dengan saksama.
1. Penggunaan tool secara paksa sudah dihapus. Permintaan yang memakai tool_choice: "any" atau tool_choice: "tool" sekarang mengembalikan error 400. Thinking selalu aktif dan tidak bisa dilewati, dan memaksa pemanggilan tool akan melewatinya. Kamu harus memakai tool_choice: "auto".
2. Blok thinking bersifat satu arah. Fable 5.1 bisa membaca blok thinking yang dihasilkan model Claude sebelumnya, tapi model sebelumnya tidak bisa membaca milik Fable 5.1. Hanya Mythos 5.1 yang bisa. Jika arsitekturmu berganti model di tengah percakapan untuk menghemat biaya, fallback itu sekarang memaksa perencanaan ulang.
3. Mengedit riwayat membatalkan blok thinking. Untuk akun yang dibuat setelah 31 Agustus 2026, mengedit giliran sebelumnya, system prompt, atau array tool membatalkan semua blok thinking berikutnya — error atau dibuang diam-diam. Ini tindakan anti-distilasi yang eksplisit dan mematahkan pola umum di mana framework agen menulis ulang konteks antar giliran.
Dan satu regresi yang perlu diketahui: pemanggilan tool secara paralel dilaporkan lebih bervariasi di 5.1, kadang hanya mengeluarkan satu panggilan per putaran padahal 5 mengelompokkan beberapa sekaligus. Pada loop agen yang panjang itu memakan waktu nyata.
Ada juga detail tokenizer yang menjebak orang dalam perbandingan biaya: Fable 5.1 memakai tokenizer yang sama dengan Claude Opus 4.7, yang menghasilkan sekitar 30% lebih banyak token daripada tokenizer di model Claude lama untuk teks yang sama. Jika kamu membandingkan biaya dengan baseline 2025, sesuaikan dulu sebelum menyimpulkan apa pun.
Masalah benchmark: tiga model, tiga penggaris berbeda
Inilah bagian yang paling sering salah dipahami artikel perbandingan, dan perlu dikatakan terus terang.
Kamu tidak bisa menyandingkan ketiga model ini di Terminal-Bench. Coba lihat:
- Kimi K3: 88.3 di Terminal-Bench 2.1
- GLM-5.3: 28.3 di Terminal-Bench 3.0
- Fable 5.1: 55.8 di Terminal-Bench 4.0
Itu tiga benchmark berbeda yang berbagi satu nama. Tiap versi menjadi jauh lebih sulit dari sebelumnya — itulah inti merilis versi baru. Membaca ketiga angka itu sebagai peringkat akan memberitahumu Kimi K3 tiga kali lebih baik dari GLM-5.3 dalam pekerjaan terminal, yang tidak masuk akal.
Masalah yang sama berlaku pada AutomationBench, di mana nomor versi dilaporkan tidak konsisten, dan pada keluarga SWE-bench, di mana varian Verified, Pro, dan Marathon mengukur hal yang benar-benar berbeda. Lab tidak melakukan ini untuk menipu siapa pun — mereka menjalankan evaluasi yang berlaku saat mereka melatih, dan evaluasi berganti setiap beberapa bulan sekarang. Tapi efeknya bagi pembaca awam sama dengan penipuan, jadi layak ditandai dengan lantang.
Yang bisa kamu bandingkan secara sah, dalam versi yang sama:
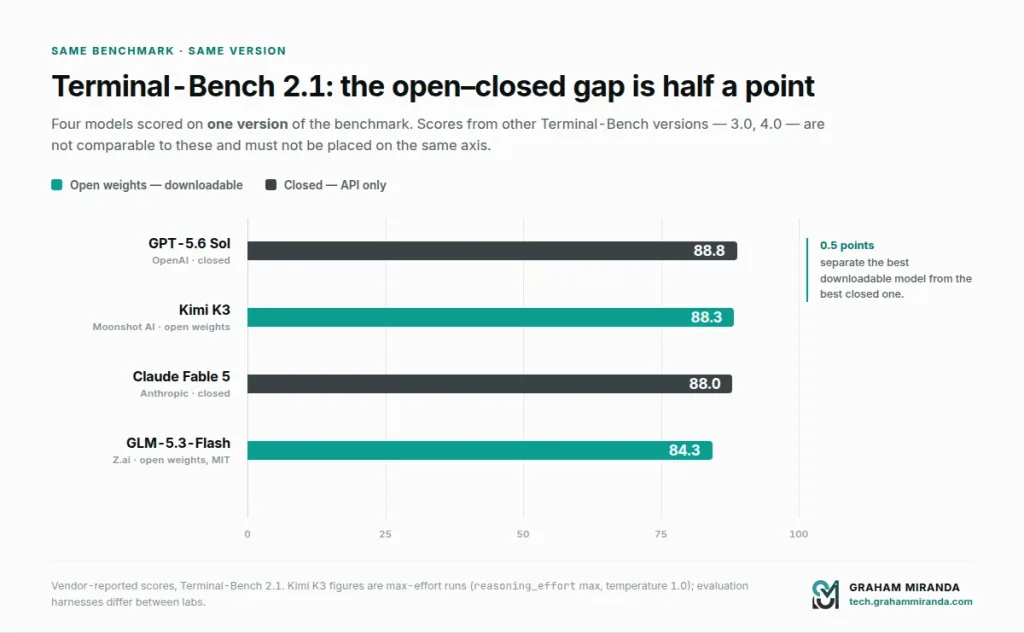
Aktif Terminal-Bench 2.1: Kimi K3 (88,3), GPT-5.6 Sol (88,8), Claude Fable 5 (88,0), dan GLM-5.3-Flash (84,3). Empat model, satu penggaris. Inilah perbandingan yang benar-benar penting dan saya memberinya tabel sendiri di bagian berikutnya.
Aktif Terminal-Bench 4.0: Fable 5.1 (55,8) melawan GPT-5.6 Sol (52,3). Fable menang.
Selain itu, bersikap skeptis pada siapa pun yang menunjukkan satu grafik batang berisi ketiga model utama artikel ini pada sumbu Terminal-Bench. Itu tidak bisa dilakukan dengan jujur.
Titik temu sebenarnya: angka yang bisa dibandingkan lintas model
Singkirkan ketidakcocokan versi benchmark dan tiga perbandingan tetap bertahan.
1. Artificial Analysis Intelligence Index (September 2026)
Dijalankan independen, metodologi sama untuk setiap model, tanpa keterlibatan vendor dalam pemilihan.
| Peringkat | Model | Skor | Bobot terbuka |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | Tidak |
| 2 | Claude Fable 5 | 62.1 | Tidak |
| 3 | Grok 4.6 | 60.9 | Tidak |
| 4 | Kimi K3 | 59.7 | Ya |
| 5 | GLM-5.3 | 59.5 | Ya |
| 6 | GPT-5.6 Sol | 58.9 | Tidak |
| 7 | Qwen3.8 Max Preview | 58.1 | Bobot menyusul |
| 8 | GLM-5.3-Flash | 57.5 | Ya (MIT) |
| 31 | MiniMax M3 | 45.4 | Ya |
Fable 5.1 belum dinilai secara independen saat artikel ini ditulis — model ini baru dirilis sehari sebelumnya. Mengingat selisih benchmark 5.1 dibanding Fable 5, perkirakan skornya mendarat di atau di atas 62,1 saat dinilai.
Catatan soal presisi: snapshot indeks ini membulatkan dengan cara berbeda-beda — satu tarikan September menempatkan Kimi K3 dan GLM-5.3 sama-sama di 60 dan GPT-5.6 Sol di 61. Urutan di puncak stabil; selisih di bawah satu poin tidak. Jangan membangun argumen di atas setengah poin.
Baca tabel itu dengan cermat. Model bobot terbuka terbaik tertinggal 3,3 poin dari model tertutup terbaik pada indeks netral terluas yang tersedia. Setahun lalu selisih itu dua digit.
2. Terminal-Bench 2.1 — satu-satunya versi tempat ketiganya bertemu
Ini tabel paling berguna di seluruh artikel, dan saya hampir melewatkannya. Kimi K3, Claude Fable 5, dan GPT-5.6 Sol semuanya dinilai pada versi yang sama dari Terminal-Bench:
| Model | Terminal-Bench 2.1 | Bobot terbuka |
|---|---|---|
| GPT-5.6 Sol | 88.8 | Tidak |
| Kimi K3 | 88.3 | Ya |
| Claude Fable 5 | 88.0 | Tidak |
| GLM-5.3-Flash | 84.3 | Ya (MIT) |
Setengah poin memisahkan model yang bisa kamu unduh dari model tertutup terbaik pada benchmark yang sama, versi yang sama, untuk pekerjaan agentic yang native di terminal.
Itulah angka yang perlu diingat. Bukan agregat indeks, bukan bagan vendor — yang ini. Pada bentuk tugas yang sebenarnya adalah coding agentic, selisihnya berada di dalam noise.
Satu catatan, dinyatakan oleh sumbernya dan layak diulang: semua angka terbitan Kimi K3 adalah eksekusi dengan effort maksimum, pada reasoning_effort maximum dan temperature 1,0. Lab berbeda memakai harness evaluasi dan pengaturan effort yang berbeda, jadi bahkan perbandingan versi yang sama membawa lebih banyak ketidakpastian daripada yang disiratkan tabel yang rapi.
3. Biaya menjalankan rangkaian evaluasi yang sama
Jika tabel di atas adalah perbandingan kapabilitas terbaik, ini perbandingan nilai terbaik — karena ini satu-satunya angka yang menggabungkan kapabilitas, verbositas, biaya penalaran, dan harga dalam satu angka:
| Model | Biaya per tugas Intelligence Index |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
Tugas sama, penilaian sama, tagihan nyata. GLM-5.3 memberikan 94% skor indeks Opus 5 dengan 29% biayanya.
4. GDPval-AA v2 (kerja pengetahuan)
| Model | Skor |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
Yang ini perlu catatan: tabel ini disusun dari bagan terbitan vendor, bukan satu proses independen, dan sufiks “Max” menandakan pengaturan effort yang berbeda. Tapi urutannya secara umum konsisten di berbagai sumber, dan itu mengatakan sesuatu yang nyata — pada kerja pengetahuan umum, berbeda dengan coding, model tertutup masih memimpin lebih jelas daripada yang disiratkan benchmark coding.
Itulah polanya di ketiga perbandingan. Model terbuka pada dasarnya sudah menyusul di tugas coding dan agentic. Mereka masih selangkah di belakang pada kerja pengetahuan yang luas. Jika beban kerjamu yang pertama, alasan membayar harga model tertutup lemah. Jika yang kedua, itu masih bisa dibela.
Tampilkan gambar Tiga koma sekian poin memisahkan model tertutup terbaik dari model terbaik yang bisa diunduh. Dua belas bulan lalu selisih itu dua digit.
Hitungan biaya, dengan angka nyata
Benchmark itu abstrak. Tagihan tidak.
Skenarionya
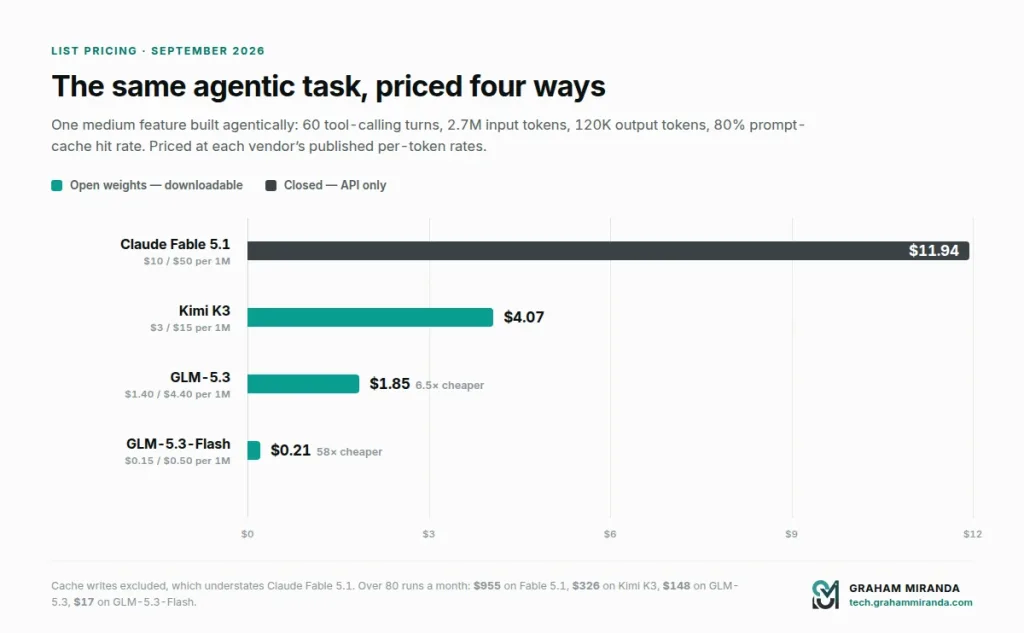
Satu fitur ukuran sedang, dikerjakan secara agentic: sekitar 60 giliran pemanggilan tool, rata-rata 45.000 token input per putaran seiring konteks menumpuk, dan 2.000 token output per putaran.
- Total input: 2,7 juta token
- Total output: 120 ribu token
- Asumsi tingkat cache prompt yang terpakai: 80% (2,16 juta dari cache, 540 ribu baru)
Claude Fable 5.1
| Komponen | Token | Tarif | Biaya |
|---|---|---|---|
| Input baru | 540 ribu | $10,00/M | $5.40 |
| Input cache | 2,16 juta | $0,25/M | $0.54 |
| Output | 120 ribu | $50,00/M | $6.00 |
| Total | ≈ $11,94 |
Kimi K3
| Komponen | Token | Tarif | Biaya |
|---|---|---|---|
| Input baru | 540 ribu | $3,00/M | $1.62 |
| Input cache | 2,16 juta | $0.30/M | $0.65 |
| Output | 120 ribu | $15,00/M | $1.80 |
| Total | ≈ $4,07 |
GLM-5.3
| Komponen | Token | Tarif | Biaya |
|---|---|---|---|
| Input baru | 540 ribu | $1,40/M | $0.76 |
| Input cache | 2,16 juta | $0,26/M | $0.56 |
| Output | 120 ribu | $4,40/M | $0.53 |
| Total | ≈ $1,85 |
Dan sebagai rujukan — GLM-5.3-Flash
| Komponen | Token | Tarif | Biaya |
|---|---|---|---|
| Input baru | 540 ribu | $0.15/M | $0.08 |
| Input cache | 2,16 juta | $0.03/M | $0.06 |
| Output | 120 ribu | $0.50/M | $0.06 |
| Total | ≈ $0.21 |
Rasionya
- GLM-5.3 6,5× lebih murah daripada Fable 5.1 untuk pekerjaan yang sama
- Kimi K3 2,9× lebih murah daripada Fable 5.1
- GLM-5.3 2,2× lebih murah daripada Kimi K3
- GLM-5.3-Flash 58× lebih murah daripada Fable 5.1, pada 57,5 di indeks kecerdasan dibandingkan 62,1 milik Fable 5
Diskalakan ke satu bulan kerja
Empat tugas seperti itu sehari, dua puluh hari kerja — 80 kali jalan agen:
| Model | Biaya token bulanan |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
Tiga catatan jujur soal angka-angka ini
Penulisan cache tidak dihitung. Fable 5.1 menagih $12.50/M untuk penulisan cache 5 menit, dan sesi panjang menulis cache berulang kali. Memasukkan penulisan cache justru menaikkan angka nyata Fable, bukan menurunkannya. Tingkat hit 80% juga terlalu optimistis untuk sesi singkat.
Token penalaran adalah token keluaran yang ditagih. Ketiga model punya thinking yang selalu aktif. GLM-5.3 khususnya tercatat cerewet — 170M token keluaran dibanding median kelas 72M di seluruh suite AA — jadi volume keluarannya di dunia nyata lebih tinggi daripada yang disarankan hitungan giliran secara naif. Angka $0.68 per tugas sudah memperhitungkan ini, makanya saya lebih percaya angka itu daripada model hitungan saya sendiri di atas.
tokenizer Fable 5.1 menghasilkan ~30% lebih banyak token dibanding model Claude yang lebih lama untuk teks yang sama. Kalau kamu membandingkan dengan tagihan Claude historis, sesuaikan.
Bahkan setelah ketiga koreksi itu, urutannya tidak berubah dan besarnya selisih hampir tidak berubah. Pekerjaan frontier tertutup menelan biaya sekitar enam kali lipat model bobot terbuka terbaik, per tugas yang selesai.
Tampilkan gambar Tugas agentic 60 putaran yang sama dengan harga daftar tiap vendor. Sumbu vertikalnya adalah seluruh argumen untuk bobot terbuka.
Lisensi: apa yang sebenarnya kamu dapat dari “terbuka” di 2026
Ini bagian yang paling ingin saya orang baca, karena kosakatanya sudah melenceng jauh dan itu akan membuat seseorang kehilangan banyak uang.
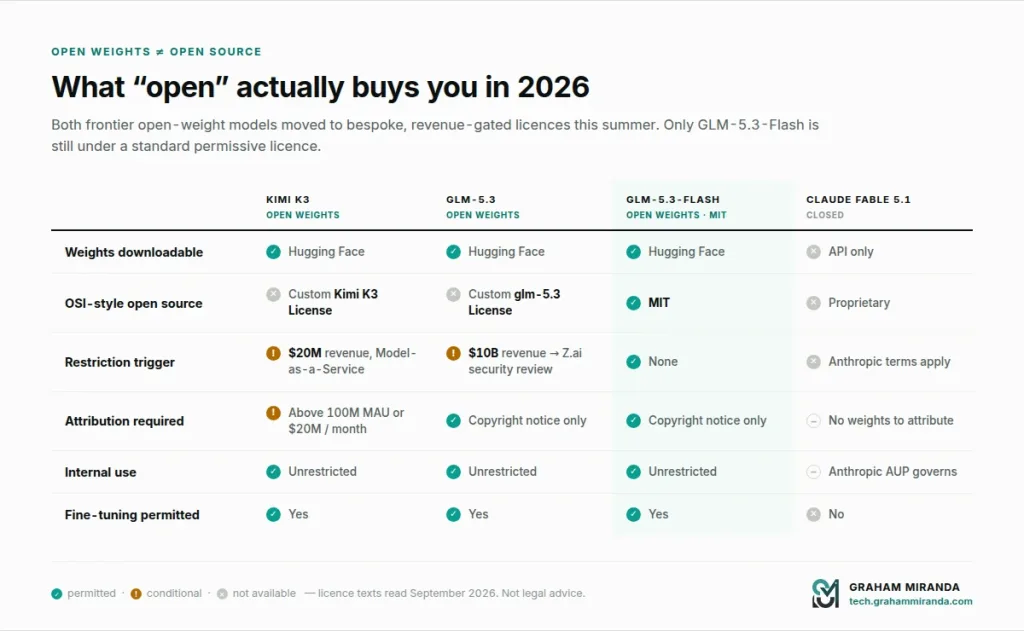
Kimi K3 dan GLM-5.3 bukan sumber terbuka. Keduanya menerbitkan bobot yang bisa diunduh di bawah lisensi khusus dengan syarat yang dipicu pendapatan. Itu berbeda secara berarti dari MIT atau Apache 2.0, dan perbedaannya tepat mengenai jenis bisnis yang paling diuntungkan oleh dihosting sendiri.
Lisensi Kimi K3
Kamu akan melihat “Modified MIT” disebut berulang di seluruh internet untuk K3. Itu salah — itu untuk K2. K3 dirilis di bawah dokumen khusus dengan dua gerbang berbeda:
Gerbang Model-as-a-Service. Kalau kamu memberi pihak ketiga akses ke inferensi atau fine-tuning model — di mana pihak ketiga itu mengendalikan input, parameter, atau data latih — dan “pendapatan agregat Penerima Lisensi dan afiliasinya melebihi 20 juta dolar AS” selama 12 bulan berturut-turut mana pun, kamu harus menegosiasikan perjanjian komersial terpisah dengan Moonshot. Perhatikan agregat pendapatan, di semua afiliasi, bukan pendapatan yang berasal dari K3. Konsultan dengan omzet €25M yang menjual ulang inferensi sudah melewati batas meskipun bisnis AI-nya hanya sisa pembulatan.
Gerbang atribusi. Produk yang melebihi 100 juta pengguna aktif bulanan atau pendapatan bulanan $20 juta wajib menampilkan “Kimi K3” secara mencolok di antarmuka produk.
Pengecualian yang paling penting: penggunaan internal murni tidak dibatasi. Menjalankan K3 untuk mendukung developer, peneliti, tim hukum, atau produktivitas karyawan kamu sendiri tidak memicu salah satu gerbang. Bagi sebagian besar bisnis — termasuk hampir semua milik saya — itulah klausul yang relevan, dan jawabannya kamu aman.
Klausul yang baru dibanding K2 adalah gerbang MaaS $20M. K2 hanya mewajibkan atribusi di atas ambangnya. K3 menambahkan gerbang pendapatan yang jauh lebih rendah yang khusus menyasar penjual ulang inferensi komersial. Moonshot bukan berusaha menghentikan kamu memakai modelnya; mereka berusaha menghentikan penyedia cloud membangun bisnis di atasnya secara gratis.
Lisensi glm-5.3
Produk unggulan Z.ai mengambil arah berbeda, dan itu pemutusan dari preseden yang lebih besar daripada yang diakui sebagian besar liputan.
GLM-5.2 dirilis di bawah MIT. GLM-5.3-Flash dirilis di bawah MIT. GLM-5.3 tidak.
Lisensi khusus ini mengizinkan individu dan bisnis biasa menjalankan, menerapkan, dan melakukan fine-tuning model tanpa batasan tambahan. Satu-satunya gerbang menyasar hyperscaler: entitas yang “pendapatan agregat Penerima Lisensi dan afiliasinya melebihi 10 miliar dolar AS (atau setara dalam mata uang lain) secara total selama 12 bulan berturut-turut mana pun” harus lolos tinjauan keamanan Z.AI sebelum menggunakan model atau turunannya untuk tujuan komersial apa pun.
Itu ambang $10 miliar. Hampir semua orang dikecualikan. Tapi dua detail di bagian kecilnya layak diperhatikan:
Pertama, lisensi secara eksplisit mengecualikan pengembang aplikasi yang menyematkan model ke dalam fitur, dan penjual ulang yang sekadar meneruskan permintaan ke host lain. Sasarannya sempit dan jelas: perusahaan yang ingin menghosting GLM-5.3 secara komersial dalam skala besar.
Kedua — dan ini bagian yang benar-benar canggung — lisensi tidak menerbitkan kriteria, jadwal, atau proses banding untuk tinjauan keamanan itu. Isinya hanya menyatakan bahwa “ruang lingkup dan metodenya… akan ditentukan secara wajar oleh Z.AI.” Kalau kamu perusahaan besar, itu ketergantungan tanpa batas pada kebijaksanaan vendor asing, dan tim pengadaanmu akan mengatakan itu.
Juga layak dicatat: meskipun ada penundaan dua minggu karena kapabilitas siber sebelum rilis, lisensi tidak memuat batasan penggunaan yang dapat diterima, tidak ada pengecualian siber, dan tidak ada klaim kepemilikan atas keluaran. Kekhawatiran soal keamanan membentuk waktu peluncuran, bukan ketentuan rilisnya..
Jadi apa yang sebenarnya masih MIT?
GLM-5.3-Flash. 320B parameter, 18B aktif, multimodal asli, berlisensi MIT, 57,5 pada indeks kecerdasan, dan $0.15/$0.50 per juta token — saat ini setengahnya lewat diskon promosi yang berlaku sampai 9 September 2026. Kalau kebutuhanmu adalah lisensi permisif tanpa batasan yang sungguh-sungguh, bukan sekadar bobot yang bisa diunduh, di situlah posisi frontier sekarang, dan itu luar biasa tinggi.
Ringkasan praktis
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Bobot bisa diunduh | Ya | Ya | Ya | Tidak |
| Sumber terbuka gaya OSI | Tidak | Tidak | Ya (MIT) | Tidak |
| Pemicu pembatasan | Pendapatan $20M (MaaS) | Pendapatan $10B (MaaS) | Tidak ada | N/A |
| Wajib atribusi | Di atas 100M MAU / $20M-bulan | Hanya pemberitahuan hak cipta | Hanya pemberitahuan hak cipta | N/A |
| Penggunaan internal dibatasi | Tidak | Tidak | Tidak | N/A |
| Fine-tuning diizinkan | Ya | Ya | Ya | Tidak |
| Kebijakan penggunaan yang dapat diterima | Standar | Tidak ada di teks lisensi | Tidak ada | AUP Anthropic berlaku |
Bagi bisnis Mittelstand Jerman pada umumnya, agensi, atau konsultan yang menjalankan model secara internal atau menyematkannya ke produk: ketiga opsi terbuka bisa dipakai tanpa menegosiasikan apa pun. Gerbang-gerbang itu ada untuk menangkap AWS, bukan kamu. Tapi “baca lisensinya” sudah berubah dari nasihat cerewet menjadi nasihat sungguhan, dan kalau omzetmu di atas sekitar €20M dan kamu menjual ulang inferensi dalam bentuk apa pun, bawa ke penasihat hukum sebelum deploy.
Alasan sesungguhnya untuk model terbuka
Saya ingin menyampaikan argumen ini dengan benar, bukan sebagai slogan, karena “model terbuka itu hebat” bukan argumen dan alasan sebenarnya lebih menarik daripada sorak-sorainya.
1. Runtuhnya harga bukan subsidi, tapi struktural
Keberatan refleks terhadap model Cina yang murah adalah bahwa harganya merugi dulu dan akan kembali normal ke atas. Sebagian memang begitu. Tapi poin strukturalnya tetap berdiri sendiri: ketika bobot dipublikasikan, inferensi menjadi pasar komoditas. Dua puluh penyedia hosting bersaing melayani model yang sama, dan tidak ada yang bisa menagih premi kapabilitas karena tidak ada yang punya parit kapabilitas. Itulah sebabnya GLM-5.3 berjalan di $1.40/$4.40 dan Fable 5.1 di $10/$50 untuk skor yang selisih tiga poin.
Harga model tertutup mencakup amortisasi R&D, margin, dan fakta bahwa penjualnya hanya satu. Harga bobot terbuka mencakup listrik, amortisasi perangkat keras, dan margin tipis. Itu bisnis yang berbeda, dan selisihnya tidak akan menutup karena model terbuka jadi lebih mahal.
Bukti bahwa ini nyata dan bukan sementara: DeepSeek menguasai sekitar 17% penggunaan token di Vercel pada Mei 2026 sambil memegang sekitar 1% pangsa pendapatan. Itu bukan anomali harga. Itulah bentuk komoditisasi di dalam grafik.
2. Hak keluar mengubah posisi negosiasimu meskipun tidak pernah kamu pakai
Sebagian besar tim yang membaca ini tidak akan menghosting sendiri. Bagian perangkat keras di bawah menjelaskan alasannya — Kimi K3 butuh rak. Tapi opsinya tetap bernilai.
Kalau Anthropic menaikkan harga, menghentikan model yang kamu bangun di atasnya, mengubah kebijakan penggunaan yang dapat diterimanya sampai merusak produkmu, atau mengalami kuartal buruk, jalan keluarmu dengan model tertutup adalah proyek migrasi. Dengan model bobot terbuka, jalan keluarnya adalah mengunduh berkas yang seharusnya bisa kamu unduh kapan saja. Mungkin kamu tidak akan pernah melakukannya. Fakta bahwa kamu bisa adalah yang membuat hubungan dengan vendor ini komersial, bukan sebuah ketergantungan.
Ini bukan teori. Fable 5.1 dirilis dengan tiga perubahan yang memutus kompatibilitas pada 1 September, salah satunya membatalkan blok thinking saat kamu menyunting riwayat percakapan untuk akun yang dibuat setelah 31 Agustus. Kalau pola itu menopang arsitekturmu, kamu merekayasa ulang sesuai jadwal Anthropic, bukan jadwalmu.
3. Residensi data tidak lagi jadi proyek
Bagi siapa pun yang beroperasi di bawah GDPR, inilah argumen yang benar-benar menutup kesepakatan.
Dengan API tertutup, setiap prompt meninggalkan infrastrukturmu. Kamu butuh perjanjian pemroses, penilaian dampak transfer kalau pemrosesnya di luar EEA, peta aliran data, dan jawaban untuk DPO kamu tentang apa yang terjadi pada data saat tersimpan. Semua itu bisa dilakukan. Tapi juga butuh berminggu-minggu kerja per vendor, diulang setiap kali vendor mengubah apa pun.
Dengan bobot terbuka di infrastruktur yang kamu kendalikan — perangkat keras sendiri, atau host GPU Jerman atau UE — pertanyaan transfer lintas batas tidak muncul, karena tidak ada transfer. Model berjalan di tempat data kamu sudah berada. Tinjauan hukum berubah dari penilaian transfer menjadi membaca lisensi.
Bagi klien Jerman dan UE ini sering jadi faktor penentu, dan ada baiknya kita tepat soal pengecualiannya: memakai GLM-5.3 lewat API Z.ai tidak memberimu ini. Kamu mendapatkannya dengan menjalankan bobotnya sendiri, atau dari penyedia yang menghostingnya di yurisdiksimu. Lisensinya membuat itu legal; lisensi tidak membuatnya otomatis.
4. Kemampuan memeriksa itu nyata, meski jarang dipakai
Bobot terbuka berarti kamu bisa memeriksa arsitekturnya, menjalankan evaluasi sendiri pada model sesungguhnya dan bukan pada endpoint yang mungkin diperbarui diam-diam, mengkuantisasinya agar pas di perangkatmu, melakukan fine-tuning untuk domainmu, dan — yang penting — mengunci satu versi selamanya.
Yang terakhir itu kurang dihargai. API tertutup diperbarui di balik ID model yang stabil. Perilakunya bergeser. Prompt yang dulu bekerja berhenti bekerja, dan kamu tidak bisa membandingkan perubahannya karena kamu tidak bisa melihatnya. Checkpoint lokal tetap identik byte demi byte setahun kemudian.
5. Tekanan kompetisi menguntungkan semua orang, termasuk pengguna model tertutup
Lihat apa yang terjadi musim panas ini. Kimi K3 hadir Juli di $3/$15 dengan skor yang mendekati frontier. GLM-5.3 hadir Agustus di $1.40/$4.40 dengan selisih setengah poin. Dan pada 1 September, Anthropic memotong pembacaan cache 75%.
Saya tidak mengklaim sebab-akibat langsung — Anthropic tidak menerbitkan alasan penetapan harganya dan pemotongan pembacaan cache adalah optimasi yang wajar. Tapi pasar dengan substitusi murah yang kredibel menetapkan harga berbeda dari pasar tanpa itu, dan tahun ini substitusinya menjadi kredibel. Kalau kamu hanya memakai model tertutup, ekosistem bobot terbuka tetap diam-diam membuat tagihanmu lebih kecil.
6. Keuntungan ada di post-training, dan itu murah
Hasil utama GLM-5.3 — peningkatan Terminal-Bench enam kali lipat dari bobot dasar yang sama — adalah angka paling penting secara strategis di seluruh artikel ini, dan itu bukan soal GLM.
Itu berarti bagian mahal dari membangun model frontier (pretraining) makin menjadi input yang sudah terpecahkan dan terkomoditisasi, sedangkan bagian yang membedakan (post-training, lingkungan RL, desain tugas jangka panjang) relatif terjangkau. Itulah sebabnya empat lab Cina dengan valuasi gabungan sekitar $159 miliar bisa mengejar lab Amerika yang nilainya berkali-kali lipat. Penilaian Lambert: lab-lab Cina berjalan dengan “modal yang lebih kecil beberapa orde besaran.”
Bagi siapa pun di hilir, implikasinya lugas: jumlah vendor model yang kredibel bertambah, bukan berkurang. Rencanakan arsitekturmu sesuai itu.
7. Efek ekosistemnya berlipat
Qwen melewati satu miliar unduhan kumulatif di Hugging Face, menyalip Llama, dan kini menjadi jangkar bagi lebih dari 200.000 model bertag dan 113.000+ turunan — sekitar 40% dari semua turunan LLM baru di platform itu berbasis Qwen. Itu ekosistem perkakas, kuantisasi, fine-tuning, dan deployment yang ada hanya karena bobotnya publik.
Kamu mendapat manfaat dari ekosistem itu entah kamu berkontribusi atau tidak. Konversi GGUF, kernel vLLM, adapter LoRA, resep kuantisasi, harness evaluasi — semua itu ada karena ribuan orang bisa memegang bobot sesungguhnya.
8. Di situlah para developer sudah pergi
Model asal Cina di ~61% token OpenRouter. Pangsa model AS turun dari ~70% ke ~30% dalam setahun. Empat dari lima model yang paling banyak dipakai di router itu berasal dari Cina. Model MiMo dari Xiaomi saja menyumbang sekitar 21% token yang dirutekan dan sekitar 22% dari seluruh lalu lintas coding.
Perilaku developer adalah indikator awal. Itu jadi indikator awal untuk Docker, Postgres, dan Linux. Bertaruh melawannya punya rekam jejak historis yang buruk.
…Dan argumen jujur yang menentangnya
Kalau saya hanya menulis bagian di atas, ini akan jadi iklan.
Bobot terbuka bukan sumber terbuka, dan pergeseran kosakatanya masalah nyata. Dua dari tiga model di sini dirilis di bawah lisensi khusus yang dibatasi pendapatan tanpa persetujuan OSI. Klausul tinjauan keamanan GLM-5.3 tidak punya kriteria atau proses banding yang diterbitkan. Kalau kerangka kepatuhanmu mewajibkan lisensi yang disetujui OSI, jawaban jujurnya adalah pilihanmu tinggal GLM-5.3-Flash, model unggulan DeepSeek yang berlisensi MIT, dan daftar lain yang makin pendek.
Benchmark vendor tetap benchmark vendor. Setiap angka utama yang diterbitkan Moonshot dan Z.ai adalah laporan sendiri dan pilihan sendiri. Di tempat agregator netral mengukur, angkanya secara luas bertahan — dan itu benar-benar kredit untuk kedua lab — tapi “secara luas bertahan” memikul beban penting di kalimat itu.
Menghosting sendiri adalah fantasi bagi sebagian besar tim. Kimi K3 berukuran 1,5 TB dan Moonshot merekomendasikan 64+ akselerator. GLM-5.3 butuh 8×H200 pada FP8 sebagai minimum mutlak. Hak keluarnya nyata; biaya menjalankannya adalah pusat data.
Dukungan tergantung apa yang kamu siapkan. Kalau Fable 5.1 rusak, ada perusahaan dengan SLA. Kalau deployment GLM-5.3 yang kamu hosting sendiri menghasilkan sampah pada konteks 300K di Jumat malam, yang ada hanya issue di GitHub dan kompetensimu sendiri.
Geopolitik adalah input pengadaan yang nyata. Ketiga opsi bobot terbuka yang dibahas di sini berasal dari lab Cina. Bagi sebagian klien — sektor publik, yang bersinggungan dengan pertahanan, industri teregulasi tertentu — itu penghalang mutlak terlepas dari syarat lisensi atau di mana bobotnya dijalankan. Bukan tugas saya memberi tahu apakah kekhawatiran itu berdasar. Tugas saya memberi tahu bahwa itu akan muncul dalam rapat.
Model tertutup masih unggul dalam pekerjaan pengetahuan umum. GDPval-AA v2 menempatkan Fable 5.1 di 1.853, dibanding GLM-5.3 pada 1.769 dan Kimi K3 pada 1.687. Dalam coding selisihnya hilang. Dalam pekerjaan pengetahuan profesional yang luas, tidak.
Tampilkan gambar Bobot yang bisa diunduh, tiga set ketentuan yang berbeda. Hanya GLM-5.3-Flash yang masih MIT.
Ollama di 2026: perubahan harga yang benar-benar penting
Ollama diam-diam menjadi infrastruktur paling penting dalam percakapan ini, dan pada 31 Agustus 2026 mereka mengubah cara menagih dengan cara yang layak dipahami dengan benar.
Apa yang berubah
Ollama memindahkan paket Pro, Max, dan Team dari penagihan waktu GPU ke harga per token standar industri, dengan kumpulan kredit pemakaian yang disertakan di setiap paket. Alasan yang dinyatakan perusahaan itu segar karena konkret: model seperti Kimi K3 membuat metrik waktu GPU mustahil diprediksi. Ketika satu model mengaktifkan 104B parameter dan yang lain 3B, “satu jam GPU” tidak lagi berarti apa pun bagi orang yang membayar.
Paket baru
| Paket | Harga | Pemakaian bulanan yang disertakan | Konkurensi |
|---|---|---|---|
| Gratis | $0 | Kredit bulanan kecil, model pemula | 1 permintaan |
| Pro | $20/bln (atau $200/thn) | Pemakaian senilai $60 | 3 permintaan |
| Max | $100/bln | Pemakaian senilai $300 | 10 permintaan |
| Team | $500/bln | $1.000 dibagi, pengguna tanpa batas | 10 permintaan |
| Perusahaan | Khusus | Khusus | Khusus |
Baca lagi baris Pro. $20 membeli token senilai $60. Itu pengali 3× pada pemakaian yang disertakan, dan saat kuotanya habis kamu lanjut dengan tarif per token yang diterbitkan persis sama — tanpa tingkatan denda, tanpa biaya layanan.
Apa yang dihapus
Ini bagian yang benar-benar diperhatikan para developer: tidak ada reset 5 jam dan tidak ada batas mingguan. Siapa pun yang pernah menabrak jendela pemakaian bergulir di tengah refactor akan paham kenapa itu lebih penting daripada harganya. Kuota bulanan disegarkan pada tanggal langgananmu dan, yang penting, tidak digulirkan — jadi sesuaikan paketmu dengan bulan normalmu, bukan bulan tersibukmu.
Syarat yang penting untuk pekerjaan di UE
Tiga komitmen dalam pengumuman itu langsung relevan kalau kamu menangani data klien:
- Tanpa penyimpanan data. Prompt dan respons tidak pernah dicatat dan tidak pernah dipakai untuk pelatihan.
- Hosting di AS dan Eropa, plus Singapura untuk sebagian kecil model Qwen.
- Visibilitas biaya per permintaan di akunmu — kamu bisa melihat persis berapa biaya setiap panggilan.
Bagi konsultan Jerman itu kisah kepatuhan yang jauh lebih baik daripada yang ditawarkan sebagian besar penyedia gateway, meskipun “dihosting di Eropa” adalah pernyataan rute, bukan jaminan residensi data secara kontrak. Kalau residensi jadi syarat mutlak dan bukan preferensi, mintalah tertulis dari Ollama sebelum kamu menganggapnya ada.
Tarif per token yang sebenarnya
Di sinilah jadi menarik. Ollama menerbitkan tarif per model, dan tarifnya mengikuti harga pihak pertama dengan rapat:
| Model di Ollama | Input / 1M | Cache / 1M | Output / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
Jalankan hitungan bulanan dari tadi lewat angka ini. Delapan puluh agentic run sebulan di GLM-5.3 memakan sekitar $148 token. Paket Max seharga $100/bulan menutupi pemakaian $300 — jadi beban kerja yang sama yang akan menelan sekitar $955/bulan di Fable 5.1 muat dengan nyaman di langganan Ollama $100 dengan sisa ruang.
Itulah seluruh argumen ekonomi model terbuka yang dipadatkan ke satu baris di faktur.
Tampilkan gambar Delapan puluh agentic run sebulan di GLM-5.3 muat di paket Ollama Max $100 dengan kembalian. Pekerjaan yang sama di Fable 5.1 adalah faktur $955.
Apa lagi yang dirilis Ollama di 2026
Perubahan harga itu tidak terjadi sendirian. Beberapa bulan terakhir sibuk:
- 25 Agustus — dukungan Claude Desktop. Ollama kini berfungsi sebagai penyedia gateway pihak ketiga untuk Claude Desktop, jadi kamu bisa menjalankan model terbuka lewat klien milik Anthropic sendiri.
- 26 Agustus — v0.33.0. Integrasi gateway Claude Desktop masuk, pemulihan prefill dikembalikan ke cache, dan Ollama menonaktifkan pesan sistem hitung mundur token Claude Code, yang membatalkan cache KV di setiap giliran. Yang terakhir itu perbaikan performa yang senyap tapi penting.
- 26 Agustus — v0.33.1. Dukungan MLX untuk Qwen3.8 Flash Next, keluaran terstruktur, dan perbaikan timeout GPU saat memuat model dari penyimpanan yang lebih lambat.
- 28 Agustus — v0.33.2. Mode gelap dikembalikan, handoff macOS diperbaiki, dan permintaan proxy Claude Desktop tetap hidup selama pembaruan katalog model.
- 20 Agustus — v0.32.15. Onboarding desktop baru, dan caching metadata antarpermintaan yang memangkas waktu ke token pertama sekitar setengahnya.
- 11 Agustus — NVIDIA Nemotron 3.5 Lightning, model 30B yang disetel untuk alur kerja agentic dengan pemanggilan tool di perangkat pribadi.
- 10 Agustus — Muse Glimmer dari Meta, model multimodal 30B di bawah Apache 2.0, dipercepat oleh mesin MLX Ollama. Perlu dicatat mengingat keruntuhan Llama dalam penggunaan yang dirutekan — Meta masih merilis bobot yang benar-benar permisif.
- 9 Juli — putaran pendanaan $88M, dengan Ollama melaporkan 8,9 juta pengembang.
- 29 Juni — Gemma 4 di MLX hingga 90% lebih cepat lewat prediksi multi-token, yang sangat menguntungkan agen coding di Apple Silicon.
- 5 Juni — v0.30 menambah kompatibilitas GGUF lewat llama.cpp, memperluas dukungan perangkat keras jauh melampaui Apple Silicon.
Benang merahnya adalah Ollama bukan lagi “cara mudah menjalankan model kecil di laptopmu” dan sudah menjadi gateway serbaguna yang kebetulan juga menjalankan model secara lokal. Katalog cloud-nya sekarang mencakup kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 dalam tujuh ukuran, gpt-oss pada 20b dan 120b, gemma4, keluarga Nemotron 3 dan mistral-large-3.
Menyiapkan semuanya: konfigurasi siap tempel
Ollama + Claude Code (jalur tercepat)
Ollama menyertakan peluncur satu perintah yang mengurus penyambungan environment untukmu:
bash
ollama launch claudeKalau kamu lebih suka melakukannya manual — dan sebaiknya begitu kalau kamu membuat skrip — pasang Claude Code dulu:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
Lalu arahkan ke Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
Lalu jalankan dengan model mana pun yang kamu mau:
bash
# A local model
claude --model qwen3.5

# A cloud model — note the :cloud suffix
claude --model kimi-k3:cloud
Atau inline, tanpa mengekspor apa pun secara global:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Dua hal yang akan menggigitmu.
Pertama, jangan ekspor ANTHROPIC_BASE_URL secara permanen di profil shell-mu. Ini variabel global dan diam-diam akan mengalihkan setiap alat yang berbicara protokol Anthropic di mesinmu ke Ollama, termasuk yang tadi ingin kamu hubungkan ke Anthropic. Batasi cakupannya per proyek atau per pemanggilan.
Kedua, setel panjang konteks ke 64k atau lebih tinggi untuk apa pun yang bekerja pada repositori sungguhan. Bawaan Ollama lebih kecil, dan agen coding yang diam-diam kehabisan jendela konteks akan mulai melupakan hal-hal alih-alih memunculkan galat.
Untuk CI, Docker, atau eksekusi berskrip, --yes melewati prompt interaktif:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "how does this repository work?"GLM-5.3 langsung dari Z.ai
Kalau kamu ingin perutean pihak pertama alih-alih lewat Ollama, Z.ai menyediakan tiga endpoint protokol:
| Protokol | URL dasar |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
Blok provider OpenCode untuk GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3": {
          "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
          "options": { "reasoning_effort": "high", "temperature": 1 }
        }
      }
    }
  },
  "model": "zai/glm-5.3"
}
Catatan penting untuk upgrade: GLM-5.3 mewajibkan reasoning dalam keadaan aktif. Jika konfigurasi lamamu menyetel thinking.type: "disabled", itu sekarang akan gagal. Ubah menjadi "enabled" dan setel reasoning_effort: "low" kalau kamu ingin profil latensi lama kembali.
reasoning_effort adalah tombol utama kualitas versus biaya: rendah untuk panggilan yang sensitif latensi, tinggi untuk pekerjaan besar, maks (bawaan) untuk masalah yang benar-benar telah mengalahkan tinggi. Mengingat verbositas yang terdokumentasi, saya akan menjalankan tinggi sebagai setelan sehari-hari alih-alih membiarkan maks menyala dan bertanya-tanya ke mana token output pergi.
Setelan perutean yang benar-benar saya rekomendasikan
Semua ini bukan keputusan “pilih satu”. Jawaban yang tepat untuk sebagian besar tim adalah tabel perutean tiga lapis, dan setiap harness agen yang serius mendukung model per agen.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
      "description": "Architecture, root-cause analysis, anything expensive to get wrong",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation work",
      "model": "zai/glm-5.3",
      "options": { "reasoning_effort": "high" }
    },
    "research": {
      "description": "Long-context reading, web research, multi-source synthesis",
      "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
      "description": "Renames, docstrings, test scaffolding, lint fixes",
      "model": "ollama/glm-5.3-flash"
    }
  }
}
Alasan di balik setiap baris:
- Perencanaan pakai Fable 5.1. Perencanaan adalah tempat keputusan buruk paling banyak memakan token di hilir, dan koherensi jangka panjang justru yang menjadi alasan 5.1 dibuat. Di sini juga kamu menghabiskan token paling sedikit, jadi premi harganya hanya berlaku pada potongan tagihanmu yang paling kecil.
- Pembangunan pakai GLM-5.3. Kemampuan per euro terbaik di pasar, dan sebagian besar belanja tokenmu jatuh di sini.
- Riset pakai Kimi K3. BrowseComp 91.2 dan konteks 1M sungguhan menjadikannya opsi terbaik untuk membaca banyak hal lalu menyintesisnya.
- Pekerjaan mekanis pakai GLM-5.3-Flash. Dengan $0.15/$0.50 praktis gratis, dan mengganti nama simbol di 40 berkas tidak butuh penalaran frontier.
small_modeldapat model mungil untuk keperluan internal harness — pembuatan judul, ringkasan, panggilan utilitas internal.
Kamu tidak sedang memilih pemenang. Kamu sedang membangun kotak persneling. Dan tulis ID model sedemikian rupa sehingga menggantinya cukup satu baris, karena di pasar ini kamu akan menggantinya lagi dalam kuartal yang sama.
Yang benar-benar bisa kamu jalankan secara lokal (realitas perangkat keras)
Biar saya bunuh satu asumsi sebelum ia memakan uang seseorang.
Kamu tidak bisa menjalankan Kimi K3 atau GLM-5.3 di workstation. Bukan dengan satu 5090. Bukan dengan dua.
Kimi K3
- ~1.5 TB bobot dalam MXFP4 native — dan ingat, itu adalah checkpoint terkuantisasi, bukan titik awal untuk kompresi lanjutan
- Moonshot merekomendasikan minimal 64 akselerator untuk penyajian yang kompetitif
- Self-hosting yang realistis dimulai dari klaster multi-node; deployment referensi memakai rak GB300 NVL72
- Tidak ada entri resmi di pustaka Ollama untuk Kimi K3 lokal, dan tidak ada konversi GGUF konsumen yang layak untuk kamu coba
- Ada laporan bahwa model ini berjalan di klaster RTX 5090 konsumen, tetapi “klaster 5090” bukan laptop dan throughput-nya tidak sebanding
GLM-5.3
- ~1.5 TB dalam BF16, kira-kira 750 GB pada FP8
- Node tunggal minimum yang layak: 8× H200 (1,128 GB memori GPU) pada FP8, menyisakan sekitar 375 GB untuk KV cache
- BF16 butuh dua node 8×H200, atau satu node 8×B300 (2,304 GB)
- Satu node 8×H200 dengan BF16 terlalu kecil untuk bobot plus cache
Tampilkan gambar Model open frontier butuh rak. Kelas 24 GB adalah tempat “jalan di mesin saya” benar-benar hidup — dan kelas itu sudah menjadi sangat bagus.
Jadi apa arti “AI lokal” sebenarnya pada September 2026?
Artinya kelas model yang berbeda, dan kelas itu sudah benar-benar bagus:
| Model | VRAM | Untuk apa |
|---|---|---|
| Qwen3.8-27B | 24 GB pada Q4 | Serba bisa terbaik di perangkat keras konsumen — SWE-bench 61.7% |
| gpt-oss:20b | 16 GB | Model kecil terbaik, effort penalaran bisa diatur |
| Gemma 4 E4B | ~6 GB | Visi plus pemanggilan tool di laptop modern |
| Mistral 7B | 8 GB | Opsi serbaguna tercepat, 40–60 tok/detik |
| DeepSeek-R1 7B | 5 GB | Penalaran chain-of-thought di GPU laptop |
| Llama 4 Scout | ~55 GB pada Q4 | Konteks 10M, multimodal — wilayah workstation |
Qwen3.8-27B yang mencetak 61.7% di SWE-bench, berjalan sepenuhnya di GPU konsumen 24 GB tanpa koneksi jaringan, adalah hal luar biasa yang delapan belas bulan lalu akan terdengar seperti fiksi ilmiah. Model ini bukan GLM-5.3 dan tidak berpura-pura menjadi GLM-5.3.
Rumusan jujurnya: bobot terbuka di garis depan memberimu kedaulatan dan harga, bukan eksekusi lokal. Bobot terbuka di rentang 7B–30B memberimu eksekusi lokal sungguhan, dengan biaya kemampuan yang nyata tetapi bisa diterima, dan di kelas itulah “jalan di mesin saya, tidak melihat jaringan” menjadi syarat yang bisa dicapai.
Arsitektur yang berhasil untuk sebagian besar klien saya persis pembagian itu: model lokal kecil untuk apa pun yang menyentuh data yang benar-benar sensitif, dan model frontier bobot terbuka yang dihosting untuk sisanya — dengan bobot tersedia sebagai asuransi, bukan sebagai rencana deployment.
Di mana setiap model sebenarnya jebol
Tanpa gembar-gembor. Ini kelemahan yang jujur.
Kelemahan Kimi K3
Mahal untuk ukuran model terbuka. $3/$15 adalah 2.1× tarif input GLM-5.3 dan 3.4× tarif outputnya untuk skor indeks kecerdasan yang praktis sama. Kalau kamu memilih K3 ketimbang GLM-5.3, jelaskan pada dirimu apa yang kamu beli dengan premi itu — biasanya tumpukan visi atau performa browsing-nya.
Lisensinya punya ambang yang lebih rendah. Ambang pendapatan agregat MaaS $20M menjaring jauh lebih banyak organisasi daripada $10B milik GLM-5.3. Kalau penjualan ulang inferensi ada di mana pun dalam model bisnismu, K3 yang lebih terbatas di antara keduanya.
Self-hosting di luar jangkauan hampir semua orang. 1.5 TB dan 64+ akselerator adalah komitmen infrastruktur yang serius. Hak keluar di sini lebih teoretis dibanding model lain mana pun dalam perbandingan ini.
Pekerjaan pengetahuan yang luas tertinggal. GDPval-AA v2 di 1,687 menempatkannya di belakang GLM-5.3, kedua Claude Fable, dan GPT-5.6 Sol Max. Ini spesialis coding dan agentic yang kebetulan berukuran raksasa.
Kelemahan GLM-5.3
Hanya teks. Tidak ada input gambar, tidak ada video. Kalau alur kerjamu mencakup debugging lewat tangkapan layar, design-to-code, atau visi dokumen, GLM-5.3 tidak bisa melakukannya dan kamu perlu GLM-5.3-Flash, Kimi K3, atau Fable 5.1. Ini kesalahan konfigurasi paling umum yang saya perkirakan akan orang lakukan, karena ID modelnya terlihat berkerabat padahal tidak.
Model ini bertele-tele, dan kebanyakan bicara itu ditagih. 170M token output dibanding median kelas 72M di seluruh suite AA. reasoning_effort default-nya adalah maks, dan thinking tidak bisa dimatikan. Anggarkan token output lebih banyak daripada yang tersirat oleh jumlah giliranmu.
Lisensinya bukan lagi MIT, dan klausul tinjauan keamanannya tidak berbatas. Bagi sebagian besar pembaca, ambang $10B membuat ini sekadar urusan akademis. Bagi siapa pun yang mendekatinya, “ruang lingkup dan metode akan ditentukan secara wajar oleh Z.AI” bukan klausul yang akan disukai tim legalmu.
Terminal-Bench 3.0 di 28.3 tertinggal dari 34.6 milik GPT-5.6 Sol. Pada benchmark spesifik yang paling dekat dengan coding agentic asli terminal, ia tertinggal dari pesaing tertutup pada penggaris yang sama.
Ini pendatang baru di dunia bobot terbuka. Dirilis 28 Agustus. Komunitas baru punya hitungan hari, bukan bulan. Bug deployment ekor panjang belum muncul ke permukaan.
Kelemahan Claude Fable 5.1
Harganya. Sekitar 6.5× GLM-5.3 per tugas agentic yang selesai, bahkan setelah pemotongan 75% pada cache read. Untuk sebagian besar pekerjaan, selisih itu tidak lagi bisa dibela dengan alasan kemampuan.
Tiga perubahan yang memutus kompatibilitas. Pemaksaan penggunaan tool mengembalikan 400. Blok thinking tidak bisa dibawa mundur ke model yang lebih lama. Mengedit riwayat percakapan membatalkan blok thinking pada akun yang dibuat setelah 31 Agustus 2026. Salah satu dari ini bisa memutus integrasi yang tadinya berjalan saat upgrade.
Pemanggilan tool paralel mundur. Ada laporan hanya satu panggilan per giliran, padahal Fable 5 menggabungkan beberapa. Pada loop agen yang panjang, itu waktu nyata yang kamu bayar dua kali.
Nol opsi keluar. Tidak ada bobot, tidak ada self-hosting, tidak ada penyematan versi di luar yang ditawarkan Anthropic, tidak ada inspeksi. Saat berubah, kamu yang menyesuaikan.
Tokenizernya membesarkan perbandingan. ~30% lebih banyak token dibanding model Claude yang lebih lama untuk teks yang sama, yang membuat perbandingan biaya historis menyesatkan dan menguntungkan Anthropic kalau kamu tidak berhati-hati.
Kerangka keputusan: enam skenario
Tampilkan gambar Enam skenario, enam jawaban. Temukan baris yang terdengar seperti mingguanmu.
1. “Saya mau satu model. Setel, lupakan, tagihan tetap waras.”
GLM-5.3. Dalam selisih setengah poin dari Kimi K3 dan sekitar tiga poin dari model tertutup terbaik pada indeks netral, dengan $1.40/$4.40. Jalankan lewat Ollama di paket Pro atau Max, setel reasoning_effort: high, dan lanjutkan pekerjaanmu. Satu-satunya hal yang seharusnya menjauhkanmu dari jawaban ini adalah kebutuhan input gambar.
2. “Pekerjaan saya visual — UI, design-to-code, debugging lewat tangkapan layar, dokumen.”
Kimi K3 atau GLM-5.3-Flash, bukan GLM-5.3. MoonViT-V2 milik K3 menangani teks, gambar, dan video secara native serta mencetak 81.6/83.4 di MMMU-Pro. GLM-5.3-Flash adalah opsi hemat dengan multimodalitas native dan lisensi MIT. GLM-5.3 hanya teks dan akan menolak input tersebut begitu saja.
3. “Sesi otonom panjang di mana kesalahan itu mahal.”
Claude Fable 5.1. Inilah tujuan model ini dibuat dan benchmark mendukungnya: Terminal-Bench-Science dua kali lipat, 82% pada tugas computer-use tersulit Browserbase dibanding 74% milik Opus 5, dan kenaikan terbesar yang dipublikasikan pada pekerjaan agentic berjam-jam. Pemotongan 75% pada cache read membuat justru beban kerja inilah yang hingga 45% lebih murah daripada sebelumnya. Bayar preminya di tempat kesalahan lebih mahal daripada token.
4. “Residensi data UE adalah syarat mutlak.”
GLM-5.3-Flash kalau kamu butuh MIT, GLM-5.3 kalau kamu butuh kemampuan. Self-host di perangkat kerasmu sendiri atau di penyedia GPU UE dan pertanyaan transfer lintas batas tidak lagi ada. Anggarkan 8×H200 untuk GLM-5.3 pada FP8; Flash jauh lebih ringan di 320B/18B. Kalau self-hosting di luar anggaran, hosting Ollama di Eropa dengan retensi data nol adalah jalan tengah yang pragmatis — tetapi mintalah komitmen residensi secara tertulis, bukan menyimpulkannya dari halaman pemasaran.
5. “Tim kecil, anggaran ketat, coding sepanjang hari.”
GLM-5.3-Flash sebagai bawaan, GLM-5.3 untuk masalah sulit, Ollama Pro $20. Flash berbiaya $0.15/$0.50 — saat ini setengahnya sampai 9 September — dan mencetak 57.5 pada indeks kecerdasan. Dua puluh dolar membeli token senilai enam puluh dolar tanpa batas mingguan. Untuk tim dua sampai empat orang ini hampir tak terkalahkan. GLM Coding Plan $18/bulan (Lite) adalah alternatifnya kalau kamu lebih suka kuota tetap daripada kumpulan kredit.
6. “Saya harus bisa menjelaskan ini ke tim pengadaan atau legal.”
GLM-5.3-Flash. Ini satu-satunya model dalam perbandingan ini di bawah lisensi standar yang disetujui OSI (MIT), multimodal secara native, mencetak 57.5 pada indeks netral, dan bobotnya ada di Hugging Face tanpa ambang pendapatan, tanpa kewajiban atribusi, dan tanpa klausul tinjauan keamanan. Ketika pertanyaannya adalah “apa yang bisa kami pertahankan dalam tinjauan kontrak”, lisensi permisif selalu menang atas tiga poin benchmark.
Yang akan saya pantau pada kuartal berikutnya
Apakah Fable 5.1 mendarat di atas 62.1 pada indeks Artificial Analysis. Model ini diluncurkan sehari sebelum artikel ini dan belum dinilai secara independen. Selisih benchmark-nya terhadap Fable 5 menunjukkan seharusnya begitu, tetapi “seharusnya” bukan “sudah”, dan jarak ke 59.7 milik Kimi K3 adalah angka yang menjadi poros seluruh argumen terbuka versus tertutup.
Apakah pergeseran lisensi berlanjut. Dalam delapan minggu kita beralih dari GLM-5.2 di bawah MIT ke GLM-5.3 di bawah lisensi pesanan dengan tinjauan keamanan yang diskresioner, dan dari modified-MIT milik Kimi K2 ke ketentuan berbasis pendapatan milik K3. Kalau GLM-6 dan K4 makin ketat, “bobot terbuka” jadi istilah pemasaran alih-alih kategori yang bermakna. GLM-5.3-Flash yang tetap MIT adalah sinyal lawan yang layak dipantau.
Apakah lab lain mengadopsi pola rilis bertahap Z.ai. Penahanan dua minggu dengan alasan keselamatan yang dipublikasikan adalah norma baru. Kalau bertahan, itu norma yang baik. Kalau ia menjadi alasan bobot dikirim makin lama makin lambat, itu jalan halus menuju tidak mengirimkannya sama sekali.
Replikasi independen atas klaim kemampuan siber. 2,436 kerentanan di 269 proyek adalah angka yang luar biasa dan seluruhnya dilaporkan sendiri. Seseorang yang netral perlu memeriksanya, karena kalau akurat itu mengubah kerangka seluruh percakapan keselamatan bobot terbuka, dan kalau tidak, itu pemasaran yang efektif.
Tarif per token Ollama enam bulan dari sekarang. $20 untuk pemakaian senilai $60 adalah sikap pengenalan yang agresif dari perusahaan yang menggalang $88M pada Juli. Apakah pengali itu bertahan saat bersentuhan dengan ekonomi unit nyata adalah variabel terbesar dalam tesis “model terbuka yang murah” bagi tim kecil.
Apakah model lokal menyusul di kelas 30B. Qwen3.8-27B dengan SWE-bench 61.7% di 24 GB adalah hasil paling kurang dibicarakan tahun ini. Garis depan yang dapat headline; kelas 24 GB-lah yang mengubah apa yang bisa dilakukan bisnis biasa tanpa API key.
Pertanyaan yang sering diajukan
Apakah Kimi K3 benar-benar sumber terbuka? Tidak. Bobot Kimi K3 bisa diunduh bebas dari Hugging Face, tetapi di bawah “Kimi K3 License” pesanan, bukan lisensi sumber terbuka yang disetujui OSI. Operator Model-as-a-Service dengan pendapatan agregat melebihi $20 juta dalam 12 bulan berturut-turut mana pun harus menegosiasikan perjanjian komersial terpisah dengan Moonshot, dan produk dengan lebih dari 100 juta pengguna aktif bulanan atau pendapatan bulanan $20 juta harus menampilkan “Kimi K3” di antarmukanya. Penggunaan murni internal tidak dibatasi.
Apakah GLM-5.3 lebih baik daripada Kimi K3? Keduanya praktis seri pada indeks agregat netral — 59.5 melawan 59.7 di Artificial Analysis. GLM-5.3 2.2× lebih murah per tugas agentic dan mencetak lebih tinggi pada pekerjaan pengetahuan (GDPval-AA v2: 1,769 vs 1,687). Kimi K3 multimodal secara native, memimpin pada browsing agentic (BrowseComp 91.2), dan menempati peringkat pertama di arena kode frontend Arena.AI. Pilih GLM-5.3 untuk biaya dan coding berbasis teks; Kimi K3 untuk visi, browsing, dan riset jangka panjang.
Seberapa lebih murah model terbuka dibanding Claude Fable 5.1? Pada tugas agentic 60 giliran yang dimodelkan, GLM-5.3 berbiaya sekitar $1.85 dibanding $11.94 milik Fable 5.1 — sekitar 6.5× lebih murah. Kimi K3 sekitar $4.07, sekitar 2.9× lebih murah. GLM-5.3-Flash sekitar $0.21, sekitar 58× lebih murah. Selama 80 kali jalan sebulan itu $148 versus $955.
Bisakah saya menjalankan Kimi K3 atau GLM-5.3 secara lokal? Tidak di perangkat keras konsumen. Kimi K3 sekitar 1.5 TB bahkan dalam format MXFP4 native-nya dan Moonshot merekomendasikan 64+ akselerator. GLM-5.3 butuh minimal 8×H200 (1,128 GB) pada FP8. Untuk eksekusi lokal sungguhan, lihat Qwen3.8-27B (24 GB pada Q4), gpt-oss:20b (16 GB), atau Gemma 4 E4B (~6 GB).
Apa yang berubah di Claude Fable 5.1? Dirilis 1 September 2026. Cache read turun 75% dari $1.00 ke $0.25 per juta token, membuat beban kerja biasa sekitar 25% lebih murah dan beban kerja agentic hingga 45% lebih murah; input dan output tetap $10/$50. Terminal-Bench 4.0 naik dari 42.0% ke 55.8%, Terminal-Bench-Science dari 24.7% ke 52.6%, AutomationBench dari 17.1% ke 31.4%. Tiga perubahan yang memutus kompatibilitas memengaruhi pemaksaan penggunaan tool, portabilitas blok thinking, dan pengeditan riwayat.
Bagaimana harga baru Ollama? Mulai 31 Agustus 2026, paket Pro, Max dan Team memakai harga per token dengan kredit yang disertakan: Pro $20/bulan untuk pemakaian $60, Max $100 untuk $300, Team $500 untuk $1,000 yang dibagi ke pengguna tanpa batas. Batas 5 jam dan batas mingguan dihapus sepenuhnya, tidak ada biaya layanan, kredit tidak terbawa ke periode berikutnya, dan semua paket menerapkan retensi data nol dengan hosting di AS dan Eropa.
Model mana di antaranya yang benar-benar berlisensi MIT? Hanya GLM-5.3-Flash — model terpisah 320B/18B yang multimodal secara native, dirilis 26 Agustus 2026, mencetak 57.5 pada indeks Artificial Analysis dengan $0.15/$0.50 per juta token. GLM-5.3 dan Kimi K3 sama-sama memakai lisensi pesanan berbasis pendapatan; Claude Fable 5.1 sepenuhnya proprietary.
Mengapa saya tidak bisa membandingkan model-model ini di Terminal-Bench? Karena masing-masing dievaluasi pada versi yang berbeda. 88.3 milik Kimi K3 ada di Terminal-Bench 2.1, 28.3 milik GLM-5.3 di 3.0, dan 55.8 milik Fable 5.1 di 4.0. Setiap versi jauh lebih sulit daripada versi sebelumnya, jadi angkanya tidak berada pada skala yang sama. Bandingkan hanya dalam versi yang sama. Pada Terminal-Bench 2.1, misalnya, Kimi K3 mencetak 88.3 melawan 88.0 milik Claude Fable 5, 88.8 milik GPT-5.6 Sol, dan 84.3 milik GLM-5.3-Flash — perbandingan itu sah, dan itulah yang layak dikutip.
Sebaiknya pakai Ollama atau langsung ke vendornya? Ollama kalau kamu mau satu hubungan penagihan, satu antarmuka API, pergantian model yang mudah, dan hosting di UE/AS dengan retensi data nol — tarif per tokennya mengikuti harga pihak pertama dengan cukup ketat. Langsung ke vendor kalau kamu butuh fitur pihak pertama seperti Z.ai’s reasoning_effort kontrol fitur secara utuh, SLA vendor, atau paket langganan seperti GLM Coding Plan. Banyak tim memakai keduanya dan mengarahkan berdasarkan beban kerja.
Apakah GLM-5.3 mendukung gambar? Tidak. GLM-5.3 hanya teks. GLM-5.3-Flash — model yang sama sekali berbeda meskipun namanya mirip — bersifat multimodal secara bawaan dan menangani input teks, gambar, video, dan berkas. Mengirim gambar ke ID model yang salah adalah kesalahan awal paling umum dengan keluarga GLM.
Kesimpulan
Dua belas bulan lalu, pertanyaan soal bobot terbuka adalah apakah model-model ini bisa dipakai. Enam bulan lalu, pertanyaannya apakah model-model itu kompetitif. Pada September 2026, pertanyaannya benar-benar: untuk apa kamu masih membayar harga lebih untuk model tertutup?
Ada jawaban nyata untuk pertanyaan itu, dan cakupannya lebih sempit dari sebelumnya. Claude Fable 5.1 unggul dalam pekerjaan agen berkelanjutan yang paling sulit, pekerjaan pengetahuan umum, dan jenis debugging ketika model harus menyimpan masalah rumit di kepalanya selama berjam-jam tanpa melenceng. Pemotongan 75% pada pembacaan cache Anthropic’s menyasar tepat beban kerja itu. Kalau biaya kegagalanmu melebihi biaya tokenmu, harga lebih itu rasional.
Untuk semua hal lain, hitungannya sudah bergeser. GLM-5.3 memberikan 94% skor indeks Claude Opus 5’s dengan biaya 29%. Kimi K3 mencetak 88,3 di Terminal-Bench 2.1 melawan 88,0 milik Claude Fable 5’s pada versi yang sama, dan meraih tempat pertama di Frontend Code Arena LMArena’s di atas kedua model tertutup unggulan. Ollama akan menjual token senilai $60 seharga $20 sekaligus menghapus batas penggunaan. Kombinasi itu tidak ada pada musim semi.
Tapi jangan biarkan antusiasme membuatmu melewatkan detail kecilnya, karena ada dua dan keduanya penting.
Yang pertama adalah lisensi. “Bobot terbuka” dan “sumber terbuka” diam-diam berhenti berarti hal yang sama. Kimi K3 dan GLM-5.3 keduanya dirilis dengan lisensi khusus yang dibatasi berdasarkan pendapatan. Ambangnya cukup tinggi sehingga sebagian besar pembaca tidak terpengaruh — tetapi “sebagian besar pembaca tidak terpengaruh” tidak sama dengan “tanpa batasan,” dan klausul tinjauan keamanan GLM-5.3’s yang tidak terdefinisi merupakan risiko pengadaan nyata bagi perusahaan besar. GLM-5.3-Flash dengan MIT adalah opsi terakhir yang sepenuhnya permisif dan berdekatan dengan garis depan, yang justru membuatnya layak mendapat lebih banyak perhatian daripada yang didapatnya.
Yang kedua adalah bahwa menghosting sendiri sebagian besar hanya angan-angan. 1,5 TB bobot dan 64 akselerator bukan rencana keluar bagi bisnis menengah. Yang dibeli bobot terbuka pada tingkat ini adalah pasar inferensi yang kompetitif, transparansi harga, penyematan versi, pilihan yurisdiksi, dan posisi negosiasi. Semua itu sangat berharga. Itu tidak sama dengan menjalankannya di ruang bawah tanahmu.
Konfigurasi yang benar-benar akan saya bangun: GLM-5.3 sebagai pilihan bawaan, Fable 5.1 untuk perencanaan dan masalah yang benar-benar sulit, Kimi K3 untuk visi dan riset jangka panjang, GLM-5.3-Flash untuk pekerjaan kasar, dan model lokal 27B untuk apa pun yang tidak boleh keluar dari gedung. Arahkan berdasarkan beban kerja, bukan loyalitas. Tulis konfigurasimu agar ID model cukup diubah dalam satu baris.
Karena satu-satunya prediksi yang saya yakini adalah artikel ini perlu diperbarui sebelum Natal.
Apakah kamu menjalankan salah satu dari ketiganya di produksi? Saya sangat tertarik apakah verbositas GLM-5.3’s muncul sebagai masalah biaya nyata dalam skala besar, dan apakah ada yang benar-benar membawa lisensi Kimi K3 ke penasihat hukum dan mendapat pemahaman yang jelas tentang definisi MaaS. Hubungi saya — koreksi dan bukti yang berlawanan diterima, dan artikel ini diperbarui ketika keadaan berubah.
Terakhir diperbarui: 2 September 2026.


