 Français
 English
 Deutsch
 Español
 Italiano

L'état des lieux de l'IA en 2026 se résume à trois événements survenus au cours des huit premiers mois de l'année — et presque personne ne les a mentionnés dans la même phrase.
Un modèle a franchi le seuil 96% sur SWE-bench. Vérifié. Il ne s'agit pas du 96% sur un benchmark fictif, mais bien du 96% appliqué à de véritables tickets GitHub issus de Django, Flask et scikit-learn : ce benchmark, qui devait initialement prendre des années, est désormais pratiquement achevé en tant que discriminateur, et les trois modèles en tête se distinguent par un écart inférieur à un point de pourcentage.
Les meilleures données disponibles permettant de déterminer si les outils de codage basés sur l'IA permettent aux développeurs expérimentés de gagner en rapidité indiquent toujours que ce n'est pas le cas. L'essai contrôlé randomisé mené par METR a mis en évidence un ralentissement de 19%. Leur tentative de le reproduire en 2026 a échoué, car les développeurs ont refusé de travailler sans IA, même à un rythme de $50 par heure. Les utilisateurs de ces outils estiment qu'ils sont trois fois plus rapides. Or, d'après les mesures effectuées, ce n'est pas le cas.
Et Microsoft a intégré un modèle de raisonnement comptant 14 milliards de paramètres directement dans Windows, une phrase qui aurait relevé de la science-fiction en 2024 et qui n'est aujourd'hui qu'une note de bas de page dans un discours d'ouverture de la conférence Build.
Ces trois faits constituent l'ensemble État des lieux de l'IA en 2026 en miniature. Les modèles se sont révélés extraordinaires. Mais les gains de productivité escomptés ne se sont pas concrétisés. Et la frontière de l’innovation s’est discrètement déplacée du centre de données vers l’appareil que vous tenez entre vos mains.
Voici la version détaillée du rapport « État des lieux de l’IA en 2026 ». Elle s’adresse aux personnes amenées à prendre des décisions ayant des implications financières : quel modèle choisir, faut-il laisser les agents écrire du code de production, quoi acheter, et que dire à un client ou à un délégué à la protection des données ? J’ai fait la distinction entre ce qui a été commercialisé, ce qui a été annoncé et ce qui relève de la rumeur, car l’erreur la plus coûteuse dans ce domaine est de baser sa planification sur un modèle qui n’existe pas encore.
Dernière mise à jour le 3 septembre 2026. Il faudra la mettre à jour à nouveau d'ici Noël.
En bref — L'état des lieux de l'IA en 2026 en 90 secondes
La course fait l'objet d'une lutte à quatre, et Anthropic est actuellement en tête au classement général. Au 2 septembre 2026, l’indice d’intelligence v4.1.1 d’Artificial Analysis attribue à Claude Fable 5.1 un score de 65,7, à Claude Opus 5 un score de 63,0, Grok 4.6 à 60,9 et GPT-5.6 Sol à 58,9. Mais cette moyenne masque l’aspect le plus intéressant : GPT-5.6 Sol devance BrowseComp avec un score de 90,41 TP3T, Gemini 3.8 Flash affiche 58,7 à $0,75 par million de jetons d’entrée, et les dix meilleurs modèles ne se répartissent que sur 8,2 points — un écart suffisamment faible pour que des différences au niveau de l’architecture et des prompts puissent faire gagner ou perdre plusieurs places à un modèle.
Les poids ouverts ont environ une génération de retard, mais ils rattrapent leur retard. GLM-5.3 (753B, en version ouverte) affiche un score de 59,5 — sixième au classement général, devant GPT-5.6 Sol. DeepSeek V4 Pro est distribué avec 1 600 milliards de paramètres sous une licence MIT authentique. Ornith-1.5-397B a atteint 86 sur SWE-bench Verified et a devancé de justesse Claude Opus 4.8 sur Terminal-Bench 2.1, avec un score de 86,1 contre 85,0. Le retard en termes de capacités est désormais d'environ six mois. C'est le retard en matière de licences qui est déterminant.
“Le ” Vibe coding » a remporté le débat sur l'adoption, mais a perdu celui sur les preuves. 90% de développeurs utilisent au moins un outil de codage basé sur l'IA dans le cadre de leur travail. Le marché des agents de codage d’entreprise représente environ $10 milliards en chiffre d’affaires annualisé. Et la confiance des développeurs dans les résultats générés par l’IA est passée de 40% à 29% en deux ans. Ces outils sont universels, et les personnes qui les utilisent leur font de moins en moins confiance chaque année. Ces deux constatations sont tout à fait rationnelles.
La facture de sécurité est arrivée et elle est détaillée. Veracode a constaté que 45% d'exemples de code générés par l'IA présentaient une vulnérabilité figurant dans le Top 10 de l'OWASP. Apiiro a mesuré que les développeurs assistés par l'IA effectuaient leurs commits trois à quatre fois plus rapidement et identifiaient les failles de sécurité dix fois plus vite. Environ 20% de code généré par l’IA fait référence à des paquets qui n’existent pas. Ce n’est pas un argument contre ces outils. C’est une question de savoir où placer la barrière.
Cette année, l'IA hors ligne est devenue véritablement utile, sur du matériel que les utilisateurs possèdent déjà. Un modèle de 2 milliards de paramètres fonctionne à une vitesse de 61 tokens par seconde sur un iPhone. Microsoft a intégré à Windows un moteur de raisonnement de 14 milliards de paramètres, qui nécessite une NPU d’une puissance de 40 TOPS. Google réserve son meilleur modèle embarqué aux appareils dotés de 12 Go de RAM, tout comme Apple. C'est la mémoire, et non la puissance de calcul, qui détermine ce que vous pouvez exécuter hors ligne, et c'est justement la mémoire qui vient à manquer.
Une phrase qui résume avec honnêteté l'état de l'IA en 2026 : C'est cette année-là que les modèles ont cessé d'être le goulot d'étranglement. C'est la vérification qui est devenue le goulot d'étranglement. Chaque décision importante évoquée dans cet article — quel modèle, quel harnais, quel appareil, quelle porte — découle de ce seul changement.
Comparaison rapide : The Frontier, septembre 2026
L'indice « Artificial Analysis Intelligence » v4.1.1 regroupe neuf évaluations : GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience et AA-LCR. Les scores ci-dessous correspondent à un instantané du 2 septembre 2026.
| Modèle | Laboratoire | Index AA | Poids | Entrées / Sorties par 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropique | 65.7 | Fermé | $10.00 / $50.00 |
| Claude, opus 5 | Anthropique | 63.0 | Fermé | $5.00 / $25.00 |
| Claude Fable 5 | Anthropique | 62.1 | Fermé | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | Fermé | — |
| Kimi K3 | Moonshot | 59.7 | Poids libre | — |
| GLM-5.3 | Z.ai | 59.5 | Poids libre | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Fermé | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | Fermé | $0.75 / $3.75 | |
| Aperçu de Qwen 3.8 Max | Alibaba | 58.1 | Fermé | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Poids libre | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropique | 57.3 | Fermé | $5.00 / $25.00 |
| Muse Spark 1.2 | Méta | 56.8 | Fermé | — |
| GPT-5.5 | OpenAI | 56.3 | Fermé | — |
Lisez la quatrième colonne avant la troisième. Deux des dix meilleurs modèles proposent des poids téléchargeables, et l'un d'entre eux coûte $0,15 par million de jetons d'entrée.
Comparaison rapide : la catégorie « Open-Weight »
| Modèle | Total / Actifs | Contexte | Licence | Publié |
|---|---|---|---|---|
| Kimi K3 | 2,8 T / 104 milliards | 1 million | Par tranche de chiffre d'affaires (personnalisé) | juillet 2026 |
| Qwen3.8-2.4T-A95B | 2,4 T / 95 B | 262 000 (1 million via YaRN) | Apache 2.0 | 14 août 2026 |
| DeepSeek V4 Pro | 1,6 T / 49 B | 1 million | MIT | 12 août 2026 |
| GLM-5.3 | 753B / ~40B | 1 million | Personnalisé (grille $10B) | août 2026 |
| MiniMax M3 | 428B / 23B | 1 million | Personnalisé (mention de source) | 1er juin 2026 |
| Ornith-1.5-397B | 397B Ministère de l'Éducation | 262 000 (1 million via YaRN) | MIT | août 2026 |
| Gemma 4 31B | 31B dense | 256 Ko | Apache 2.0 | 6 avril 2026 |
| Qwen3.8-27B | 27B dense | 262 000 | Apache 2.0 | 14 août 2026 |
| Gemma 4 E4B | ~8 milliards | 128 K | Apache 2.0 | 6 avril 2026 |
Trois de ces neuf sont véritablement « OSI-clean ». C'est là la véritable histoire des catégories de poids ouvertes en 2026, et j'y reviendrai dans la troisième partie.
ACTE I — LES MANNEQUINS
Première partie : Ce qui a réellement été commercialisé en 2026
Avant toute discussion, voyons d'abord les comptes. Je classe cela en trois catégories, car c'est précisément dans ces différences que l'argent est gaspillé.
Commande validée et en cours d'expédition
- 6 avril 2026 — Google lance Gemma 4 sous licence Apache 2.0, ce qui marque un changement par rapport aux conditions spécifiques de Gemma 3. Quatre variantes : 31 milliards de mots denses, 26 milliards avec 4 milliards de mots actifs (MoE), E4B à environ 8 milliards, et E2B à 5,1 milliards au total avec 2,3 milliards de mots actifs. Contexte de 256K pour les grands modèles, 128K pour la série E. Tous prennent en charge les entrées texte, image et vidéo ; les modèles E2B et E4B ajoutent la prise en charge native de l’audio.
- 1er juin 2026 — MiniMax M3. 428 milliards au total / 23 milliards actifs, 1 million de contextes, multimodalité native, un nouvel opérateur d’attention clairsemée, poids disponibles sur Hugging Face. Ce sujet est abordé en détail dans mon article précédent sur le matériel d'IA local.
- 2 juin 2026 — Microsoft annonce Aion 1.0 lors de la conférence Build. Une famille de modèles intégrés directement dans Windows 11 : Aion 1.0 Instruct (compatible avec le processeur, disponible dans Edge Canary à partir de la version 150.0.4070) et Aion 1.0 Plan, un modèle de raisonnement et d’appel d’outils comptant 14 milliards de paramètres et doté d’une fenêtre de contexte de 32 Ko.
- 9 juin 2026 — Claude Fable 5. Le modèle haut de gamme d'Anthropic : $10/$50 par million, contexte de 1 million, sortie maximale de 128K.
- 9 juillet 2026 — OpenAI lance GPT-5.6 en trois versions : Sol ($5/$30), Terra ($2,50/$15) et Luna ($1/$6). La fonctionnalité cyber est intégrée à Sol plutôt que vendue sous forme de modèle distinct, avec un accès amélioré via le programme « Trusted Access for Cyber » d’OpenAI.
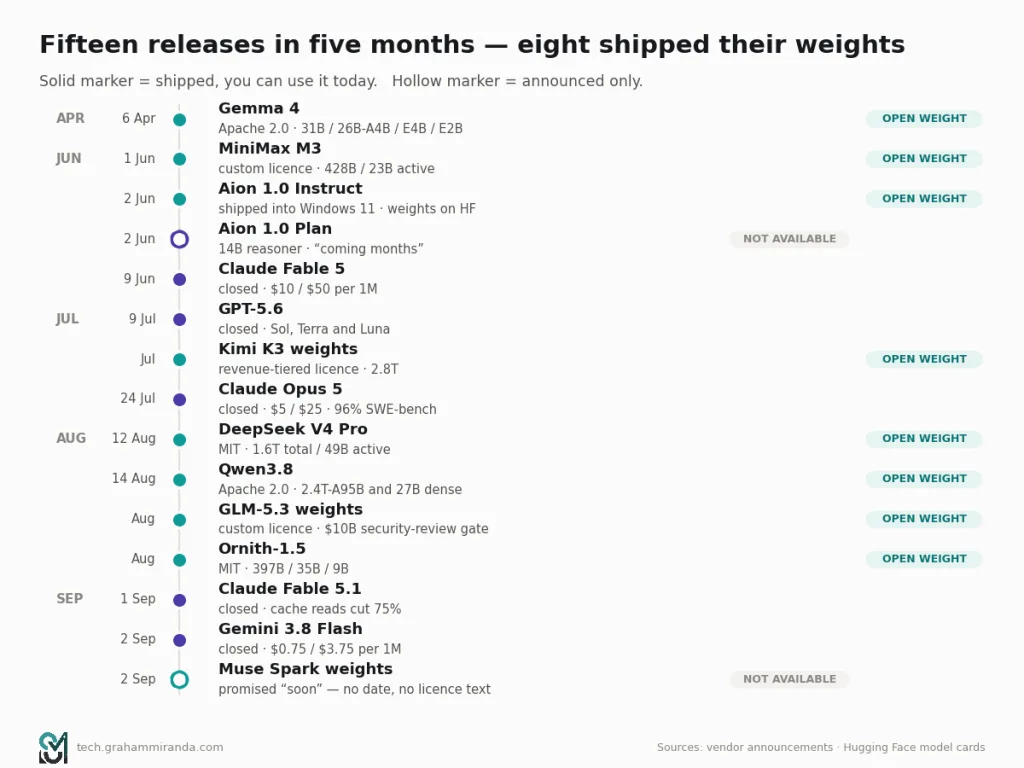
- Juillet 2026 — Moonshot dévoile les poids de la Kimi K3. 2 800 milliards de paramètres, 1 million de contextes, MXFP4 natif, sous licence à plusieurs niveaux en fonction du chiffre d'affaires.
- 24 juillet 2026 — Claude Opus 5. $5/$25, inchangé par rapport à Opus 4.8. Anthropic affirme qu’il “ double largement les performances d’Opus 4.8 ’ sur Frontier-Bench v0.1 et obtient un score trois fois supérieur à celui du deuxième meilleur modèle sur ARC-AGI 3.
- 12 août 2026 — DeepSeek V4 Pro sort de la phase de préversion avec des poids sous licence MIT : 1,6 T au total (certaines sources arrondissent ce chiffre à 1,7 T), 49 milliards de poids actifs, 1 million de poids de contexte, 893 Go de tenseurs BF16 et FP8, ainsi qu’un module de décodage spéculatif DSpark. Terminal-Bench 2.1 à 87,9, HLE-with-tools à 60,0, CyberGym à 83,3. DeepSeek a augmenté les tarifs de son API au même moment.
- 14 août 2026 — Qwen 3.8, toutes catégories de poids sous licence Apache 2.0 : un modèle multimodal dense de 27 milliards de paramètres et un modèle géant de 2,4 T-A95B, tous deux disponibles sur Hugging Face et ModelScope, avec un contexte natif de 262 000 éléments extensible à 1 million grâce à YaRN.
- Août 2026 — Coefficients de pondération GLM-5.3 publié sur Hugging Face environ deux semaines après le lancement de l'API. 753 milliards de MoE, 1 million de contextes, 128 000 sorties, BF16 et FP8.
- Août 2026 — Ornith-1.5. Trois modèles (397B MoE, 35B MoE avec 3B actifs, 9B denses), développés à partir de Qwen3.5 et Gemma 4 avec un pré-entraînement continu, sous licence MIT, et affichant un score de 86 sur SWE-bench Verified.
- 1er septembre 2026 — Claude Fable 5.1 et Mythos 5.1. Mode « Adaptive Thinking » activé par défaut, contexte de 1 M, sortie de 128 K. Tarification de base inchangée à 1 TP 4 T 10/1 TP 4 T 50, mais les lectures en cache baissent de 751 TP 3 T, passant de 1 TP 4 T 1,00 à 1 TP 4 T 0,25 par million.
- 2 septembre 2026 — Gemini 3.8 Flash à $0,75/$3,75, contexte d'entrée de 1 Mo, sortie de 66 Ko, date de mise à jour des connaissances : mars 2026, avec des données d'entrée sous forme de texte, d'images, de vidéos, de fichiers audio et de PDF.
- 2 septembre 2026 — Meta commercialise le Muse Spark 1.3 et l'interface en ligne de commande de Muse Code.
Signalé, crédible, non confirmé
- Meta rendra “ prochainement ” publics les paramètres de Muse Spark.” Il s'agit de Mark Zuckerberg sur X, sans date, sans nombre de paramètres, sans détails sur l'architecture et sans texte de licence. Meta n'a communiqué aucune information sur la taille du modèle, quelle que soit la version.
- Gemini Nano v4 est annoncé pour Android, Nano v3 étant pour l'instant réservé à la gamme Pixel 10.
- Plan Aion 1.0 sera disponible “ dans les prochains mois ” ; seul Instruct est actuellement en version préliminaire.
Rumeur, source unique, à prendre avec des pincettes
- Tout ce que vous avez lu sur le prochain produit phare d'Anthropic, d'OpenAI ou de Google. Sur un marché où quatre laboratoires ont lancé un modèle classé parmi les dix meilleurs en l'espace de neuf semaines, les rumeurs ont une demi-vie d'environ deux semaines.
Il y a encore un point qui mérite d'être souligné, car c'est une nouveauté dont presque personne ne parle en dehors du milieu de la sécurité. Claude Mythos 5.1 obtient un score de 60,9 sur Terminal-Bench 4.0 — supérieur aux 55,8 de Fable 5.1 — et de 95,51 TP3T sur SWE-bench Verified. Il n'est pas disponible à la vente.
Anthropic décrit Mythos comme son “ modèle le plus performant pour la recherche en cybersécurité et en biologie ”, et celui-ci n’est accessible qu’aux cyberdéfenseurs et aux chercheurs en sciences de la vie ayant fait l’objet d’une vérification préalable, par le biais de deux programmes d’accès sécurisé : le “ Cyber Verification Program ” et le « Life Sciences Verification Program ». Selon les propres termes d’Anthropic, l’entreprise « ne peut le mettre à la disposition que d’un ensemble d’organisations américaines, bien que nous nous efforcions d’élargir l’accès ». Le projet Glasswing, qui vise à élargir cet accès, avait atteint environ 150 organisations dans plus de quinze pays à compter de juin 2026.
Le raisonnement repose sur le principe du « double usage » : un modèle particulièrement efficace pour détecter des vulnérabilités l'est tout autant pour les deux camps, et je pense que cela se justifie. Mais il faut noter la conséquence structurelle, car elle est véritablement nouvelle : Le modèle qui obtient les meilleurs résultats dans un benchmark public de programmation est désormais inaccessible à la plupart des gens dans le monde, quel que soit le prix. Les restrictions d'accès fondées sur des motifs de sécurité plutôt que sur des considérations commerciales vont se généraliser, et non au contraire, et si vous résidez en dehors des États-Unis, c'est là un argument en faveur de l'importance accordée à la transparence des poids, qui n'a rien à voir avec les coûts.
Afficher l'image Neuf mois, douze versions majeures, dont quatre en « open weight ». Les barres pleines correspondent à des versions déjà disponibles ou à un accès API que vous pouvez acheter dès aujourd’hui ; les contours en pointillés indiquent des versions annoncées mais non encore disponibles.
Deuxième partie : Qu'est-ce qui distingue réellement les modèles Frontier aujourd'hui ?
Voici la vérité dérangeante concernant le haut de ce classement : Pour la plupart des tâches que vous aurez à effectuer, les huit meilleurs modèles sont en réalité interchangeables.
Je ne dis pas cela pour faire le contre-courant. Je le dis parce que l'écart global entre l'indice Claude Fable 5.1, à 65,7, et l'indice GLM-5.3-Flash, à 57,5, est de huit points, et que le GLM-5.3-Flash coûte $0,15 par million de jetons d’entrée, contre $10,00 pour le Fable. Cela représente un Une différence de prix de 67 fois pour une différence de performances de 12% sur un score composite, et les notes composites minimisent justement les différences qui comptent pour vous tout en amplifiant celles qui n'ont pas d'importance.
La question pertinente n'est donc pas “ quel est le meilleur modèle ? ”, mais “ en quoi chacun d'entre eux excelle-t-il réellement, et cela correspond-il à mon emploi du temps hebdomadaire ? ”.”
Les quatre éléments qui se distinguent véritablement
1. Fiabilité agentique à long terme. C’est là le véritable facteur de différenciation pour 2026, et il est très mal mesuré. Opus 5 d’Anthropic est explicitement présenté comme “ une amélioration radicale pour la gamme Opus qui alimente les agents fonctionnant sur le long terme ” — non pas comme un modèle plus intelligent, mais comme un modèle qui ne tombe pas en panne au bout de six heures. Les preuves de ce type d’amélioration se trouvent dans les benchmarks d’agentique (Terminal-Bench, OSWorld, Frontier-Bench) plutôt que dans les benchmarks de connaissances, et ces benchmarks sont récents, bruyants et sensibles à la structure d’apprentissage.
2. L'économie de la mémoire cache. Le changement le plus marquant de Fable 5.1 n'était pas une avancée en termes de performances. Il s’agissait de réduire les lectures de cache de 751 TP3T, passant de 1 TP4T1,00 à 1 TP4T0,25 par million de jetons — ce qui, selon MarkTechPost, représente une réduction des coûts d’environ 251 TP3T pour les flux de travail classiques et pouvant atteindre 451 TP3T pour les flux de travail ’ agentic ». Pour tout agent qui relit à chaque tour une invite système volumineuse ou une base de code importante, le coût de la mise en cache a une incidence plus importante sur votre facture mensuelle que le choix du modèle. Personne ne met ça dans un classement.
3. Navigation et utilisation des outils. GPT-5.6 Sol obtient un score de 90,41 TP3T sur BrowseComp — et de 92,21 TP3T avec le paramètre de raisonnement « Ultra ». Il s'agit là d'un point fort spécifique et avéré, et si votre charge de travail relève davantage de la recherche et de la synthèse que du codage et de la vérification, cela vaut plus de deux points d'indice global.
4. Prix par réponse satisfaisante. Le Gemini 3.8 Flash, avec un indice de 58,7 pour une configuration $0,75, est le produit dont la valorisation est manifestement la plus erronée du tableau par rapport à la frontière fermée. Le GLM-5.3-Flash, avec un indice de 57,5 pour une configuration $0,15, est tout simplement le produit dont la valorisation est manifestement la plus erronée, point final.
Le tableau des tarifs, car c'est lui qui détermine réellement la décision
| Modèle | Entrée /1M | Sortie /1M | Données mises en cache /1M | Contexte |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1 Mo / 128 Ko en sortie |
| Claude, opus 5 | $5.00 | $25.00 | — | 1 Mo / 128 Ko en sortie |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1 Mo / 128 Ko en sortie |
| GLM-5.3 | $1.40 | $4.40 | — | 1 Mo / 128 Ko en sortie |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1 million / 66 000 sortis |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1 million |
| Muse Spark (Contributeurs) | $0.10 | $0.20 | $0.002 | — |
Cette dernière ligne mérite qu'on s'y attarde un peu plus. Le niveau « Contributeurs » de Meta correspond à $0.10 en entrée et $0.20 en sortie — avec un accès potentiel à vos données à des fins d’entraînement. Ce n'est pas un prix, c'est un échange. C'est aussi, pour autant que je puisse en juger, l'expression la plus honnête du véritable modèle économique qui se cache derrière bien des déductions simplistes, et je préfère que cela soit clairement indiqué dans un tableau tarifaire plutôt que dissimulé dans un accord de traitement des données (DPA).
Afficher l'image L'intelligence sur un axe, le prix sur une échelle logarithmique sur l'autre. Huit points d'indice séparent le haut du graphique du bas ; les prix sont séparés par un facteur de 67×. La frontière d'efficacité se trouve en bas à droite, et presque personne n'achète à cet endroit.
La rupture d'API dont personne ne vous a prévenu
La version 5.1 de Fable comporte trois changements majeurs : l'utilisation forcée des outils a été supprimée, les blocs de réflexion sont désormais spécifiques à chaque modèle, et les modifications apportées en cours de conversation aux messages système ou aux outils génèrent désormais des erreurs au lieu d'être acceptées sans avertissement.
Ce troisième point va poser problème. Un grand nombre de harnais d’agents modifient l’invite du système ou la liste d’outils entre deux tours : ils ajoutent un outil au début d’une sous-tâche ou raccourcissent les instructions pour économiser du contexte. Dans Fable 5.1, cela génère désormais une erreur. Si vous mettez à jour l’ID d’un modèle dans un fichier de configuration et que votre agent commence à renvoyer des codes d’erreur 400 au quatrième tour, c’est pour cette raison.
La leçon générale, qui vaut plus que la leçon particulière : En 2026, la mise à jour d'un modèle consistera en une migration d'API. Écrivez les identifiants de vos modèles de manière à ce que le remplacement de l'un d'entre eux ne nécessite qu'une seule ligne de code, puis verrouillez-les. Vous devrez effectuer cette modification à nouveau d'ici un trimestre.
Troisième partie : La frontière du poids libre et le piège de la licence
C'est la partie de l'histoire de 2026 qui me passionne vraiment, mais c'est aussi celle où le marketing est le plus trompeur.
L'écart de capacités est d'environ six mois
Découvrez les résultats obtenus par la catégorie « poids libres » entre juin et août 2026 :
- DeepSeek V4 Pro: 1,6 T au total, 49 milliards actifs, licence MIT, score Terminal-Bench de 2,1 à 87,9. Ce score Terminal-Bench est supérieur à celui de la plupart des modèles fermés publiés cette année.
- Ornith-1.5-397B: 86 sur SWE-bench (vérifié), 86,1 sur Terminal-Bench 2.1 (contre 85,0 pour Claude Opus 4.8) et 92,8 sur GPQA Diamond. Sous licence MIT, 262 Ko de contexte natif extensible à environ 1 Mo avec YaRN. Construit sur la base de Qwen 3.5 et Gemma 4 avec pré-entraînement et post-entraînement continus.
- GLM-5.3: sixième de l'indice « Artificial Analysis » avec un score de 59,5, devant le GPT-5.6 Sol.
- Qwen 3.8: un modèle de 2 400 milliards de paramètres sous licence Apache 2.0, ainsi qu'un modèle multimodal dense de 27 milliards de paramètres qui, selon Alibaba, surpasse le Qwen3.7-Plus, pourtant plus volumineux, dans les tâches de codage et de bureautique.
Il y a six mois, on disait en toute honnêteté que “ les systèmes à poids ouverts ont une génération de retard et sont moins chers ”. Ce point de vue est désormais erroné. Le point de vue correct est le suivant : En ce qui concerne plus particulièrement le codage et les tâches agentiques, les meilleurs modèles à poids ouverts se situent dans les limites des marges d’erreur de la frontière fermée de la dernière génération, et leur coût est de 10 à 60 fois inférieur.
Ornith-1.5 est le modèle le plus intéressant de l'année, et pourtant presque personne n'en a entendu parler
Je voudrais m'attarder sur ce point, car il s'agit d'une véritable innovation et non d'un simple résultat d'extrapolation.
Ornith décrit la version 1.5 comme étendant “ l’auto-échafaudage à une boucle d’auto-amélioration de bout en bout ”. En termes simples : le système propose ses propres nouvelles tâches d’entraînement, génère pour celles-ci des échafaudages spécifiques, produit des déploiements de solutions et optimise ces trois éléments conjointement grâce au GRPO. Des modèles plus performants lui permettent de proposer des tâches plus difficiles ; de meilleurs échafaudages permettent de découvrir de meilleures stratégies ; de meilleurs résultats fournissent un signal d’apprentissage plus clair.
Il a été entraîné à partir de Qwen 3.5 et de Gemma 4 — c'est-à-dire à partir de poids ouverts développés par d'autres — et il surpasse Claude Opus 4.8 sur Terminal-Bench 2.1, tout en comptant 397 milliards de paramètres et en étant sous licence MIT.
Si cette boucle se généralise, il s'agit du résultat le plus important de cet article., car cela signifie que l’écosystème ouvert peut s’améliorer sans qu’aucun laboratoire n’ait à dépenser des sommes colossales pour un cycle de pré-entraînement. Si la généralisation ne se fait pas — si ce à quoi nous assistons n’est qu’un surapprentissage spécifique à un benchmark issu d’un programme d’apprentissage auto-généré —, alors cela constitue un avertissement concernant exactement la même chose. Je ne sais pas de quoi il s’agit. Et, pour autant que je sache, personne en dehors d’Ornith ne le sait non plus. Ce que j’aimerais voir avant de parier là-dessus : une évaluation indépendante sur des tâches qui ne font pas partie de l’environnement du programme d’apprentissage auto-généré, et une référence humaine non utilisée lors de l’entraînement. Aucune de ces deux choses n’existe encore.
Parlons maintenant des licences, car le “ logiciel libre ” est à l'origine de nombreuses pratiques malhonnêtes
Voici ce que ces poids vous coûtent réellement en termes d'obligations :
| Modèle | Licence | Le hic |
|---|---|---|
| DeepSeek V4 Pro | MIT | Aucun. Véritablement open source. |
| Qwen 3.8 | Apache 2.0 | Aucun. Véritablement open source. |
| Gemma 4 | Apache 2.0 | Aucune — et une réelle amélioration par rapport aux conditions sur mesure de Gemma 3. |
| Ornith-1.5 | MIT | Non indiqué. Vérifiez vous-même la fiche technique avant l'expédition. |
| GLM-5.3 | Personnalisé | Entreprises de plus de Chiffre d'affaires annuel de $10B doit réussir l'examen de Z.ai examen de sécurité avant toute utilisation commerciale. Z.ai a déménagé loin du MIT pour cette version. |
| Kimi K3 | Personnalisé | Barème basé sur le chiffre d'affaires ; attribution claire requise pour les prestataires à fort volume. |
| MiniMax M3 | Personnalisé | Toute utilisation commerciale nécessite la mention bien visible “ Conçu avec MiniMax M3 ” ; une autorisation écrite distincte est requise, comme indiqué ci-dessus. $20M chiffre d'affaires annuel. |
| Muse Spark | Inconnu | Annoncé comme “ à venir ”. Il n'existe aucun texte de licence. |
Trois remarques. J'ai examiné en détail les clauses en petits caractères des trois premières d'entre elles dans Kimi K3 vs Fable 5.1 vs GLM-5.3, je vais donc m'en tenir ici à ce qui a changé depuis.
Tout d'abord, ces passerelles s'adressent aux hyperscalers, pas à vous. Un seuil de chiffre d'affaires de $10 milliards exclut pratiquement tous les lecteurs de cet article. Si vous êtes une PME allemande, une agence, un cabinet de conseil ou un développeur indépendant, la réponse concrète concernant GLM-5.3 et Kimi K3 est la suivante : vous n'avez rien à craindre.
Deuxièmement, “ tout va bien pour vous ” n'est pas la même chose que “ votre analyse juridique est correcte ”.” Une licence sur mesure, c'est quand quelqu'un vous facture pour la lire. Une licence MIT ou Apache 2.0 signifie que quelqu’un la lit en quatre-vingt-dix secondes et passe à autre chose. Pour les achats d’entreprise, cette différence vaut plus de quatre points de référence, et c’est l’argument le plus convaincant en faveur de DeepSeek V4 Pro et Qwen3.8 par rapport à GLM-5.3 dans un produit commercial.
Troisièmement, surveillez le sens de la marche. Z.ai est passé d’une licence MIT pour GLM-5.2 à une licence propriétaire assortie d’un contrôle de sécurité pour GLM-5.3. DeepSeek a suivi le chemin inverse : l’entreprise a conservé la licence MIT tout en augmentant les tarifs de son API — ce qui constitue une stratégie cohérente : faire payer la commodité, fournir gratuitement les poids et laisser les fournisseurs de services d’inférence se faire concurrence sur la qualité du service. Les « poids ouverts » ne constituent pas un mouvement. Il s'agit d'une stratégie commerciale, et ces stratégies évoluent à chaque nouvelle version. Ne concevez pas une architecture de produit en partant du principe que la version de l'année prochaine utilisera la licence de cette année.
Le terme “ open source ” devrait être abandonné pour les modèles
Aucune de ces licences n'est open source au sens où l'entend l'OSI, à l'exception des licences MIT et Apache 2.0 — et même celles-ci ne fournissent que les modèles sans divulguer les données d'entraînement ni le code d'entraînement, ce qui est très différent d'un logiciel open source.
Le vocabulaire que j'utilise et que je recommande :
- Poids libre — vous pouvez télécharger et exécuter les paramètres. Cela ne dit rien sur les conditions.
- Sous licence libre — MIT, Apache 2.0 ou équivalent. Aucune condition de revenus, aucune obligation de mention de la source, aucune restriction quant au domaine d'utilisation.
- Open source — les poids, le code d’entraînement et la composition des données, sous une licence approuvée par l’OSI. Presque rien dans ce domaine de pointe ne répond à ces critères.
Si un fournisseur parle de “ modèle open source ” et fait référence à la première définition, ce n'est pas tout à fait un mensonge, mais c'est le genre d'imprécision qui finit par se retrouver dans un cahier des charges, puis donne lieu à un litige.
Afficher l'image Les fonctionnalités tendent à s'uniformiser. Les licences, en revanche, divergent. Pour la plupart des acheteurs professionnels, c'est la colonne de droite qui détermine l'achat, et non la note attribuée.
Quatrième partie : Le problème des indices de référence
SWE-bench Verified se présente désormais comme suit :
| Classement | Modèle | Score |
|---|---|---|
| 1 | Claude, opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptative) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
Trois modèles se situent à moins d'un point de pourcentage les uns des autres en tête du classement. Ce test de référence n'a plus de valeur. Il ne permet pas de tirer des conclusions utiles sur les différences entre l'Opus 5, le Mythos 5 et le Fable 5, et quiconque s'y référera pour justifier un achat en septembre 2026 s'appuiera sur un outil qui a fait son temps.
Telle est la situation générale actuelle en matière d'évaluation de l'IA, et elle présente quatre types d'échecs qu'il convient de mentionner :
Saturation. Lorsque les meilleurs scores se regroupent au-dessus de 90%, les différences restantes sont principalement dues au bruit des étiquettes et aux détails du harnais plutôt qu’aux capacités. SWE-bench Verified se situe à ce niveau. GPQA Diamond s’en approche.
Sensibilité de l'échafaudage. Un même modèle obtient des résultats différents selon la boucle d'agent qui l'entoure : politique de réessai, ensemble d'outils, gestion du contexte, nombre de tours dont il dispose. Les résultats de Terminal-Bench et d'OSWorld y sont particulièrement sensibles. Il arrive souvent que deux laboratoires publiant les résultats d'un même benchmark n'aient pas mené la même expérience.
Contamination. Tout benchmark public finit par se retrouver dans les corpus d'entraînement. Cela a donné lieu à une course à l'armement consistant à créer des benchmarks privés toujours plus récents et plus complexes — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science —, ce qui résout certes le problème de la contamination, mais en engendre un nouveau : il est impossible de vérifier de manière indépendante un benchmark privé.
Sélection. Les laboratoires publient les tests de performance qu’ils remportent. Anthropic s’est distingué avec Frontier-Bench et ARC-AGI-3 pour Opus 5. OpenAI s’est distingué avec ’ Agents’ Last Exam » et un « Coding Agent Index » pour GPT-5.6. Z.ai s’est distingué avec CyberGym. Aucun d'entre eux ne ment. Tous font un choix.
Ce en quoi j'ai vraiment confiance en septembre 2026
Les tournois par équipes plutôt que les tournois individuels. L’indice d’Artificial Analysis présente l’avantage d’être géré par un tiers, selon une méthodologie fixe, sur la base de neuf évaluations portant sur 190 modèles. Ses chiffres absolus n’ont guère de signification ; son commande est le signal public le plus facile à justifier qui soit.
Résultats normalisés en fonction des coûts. Les affirmations d’Anthropic concernant son Opus 5 illustrent parfaitement la manière de présenter ces informations : “ à moins de 0,51 TP3T du score maximal de Fable 5 pour la moitié du coût ’ sur CursorBench 3.2, et en surpassant Fable 5 sur OSWorld 2.0 ” pour un tiers du coût “. Il s’agit là d’une affirmation utile, car elle précise clairement le compromis.
Efficacité des jetons. Artificial Analysis a relevé que Gemma 4 31B n'avait utilisé que 39 millions de tokens de sortie pour générer l'intégralité de l'Intelligence Index. Pour une charge de travail agentique, un modèle qui parvient à la même réponse en un tiers du nombre de jetons représente un tiers du coût et un tiers de la latence. Cet aspect est sous-estimé, alors qu’il s’agit de l’un des rares indicateurs qui se traduisent directement en termes financiers.
Vos propres évaluations. Vingt tâches issues de votre backlog actuel, testées sur trois modèles, notées par vos soins. Cela prend un après-midi. Cela vous en apprendra davantage que tous les classements présentés dans cet article réunis, et c'est la seule évaluation qui, par définition, est exempte de biais.
Et il y a une chose à laquelle je ne fais pas confiance : tout chiffre concernant le nombre de jetons par seconde ou tout résultat de test de performance cité sans cadre de référence, sans précision sur la quantification et sans date. Considérez cela comme des estimations d'ordre de grandeur.
Cinquième partie : Le nombre qui a réellement évolué — L'horizon temporel agentique
Si vous ne devez retenir qu'un seul indicateur de cet article, retenez celui-ci.
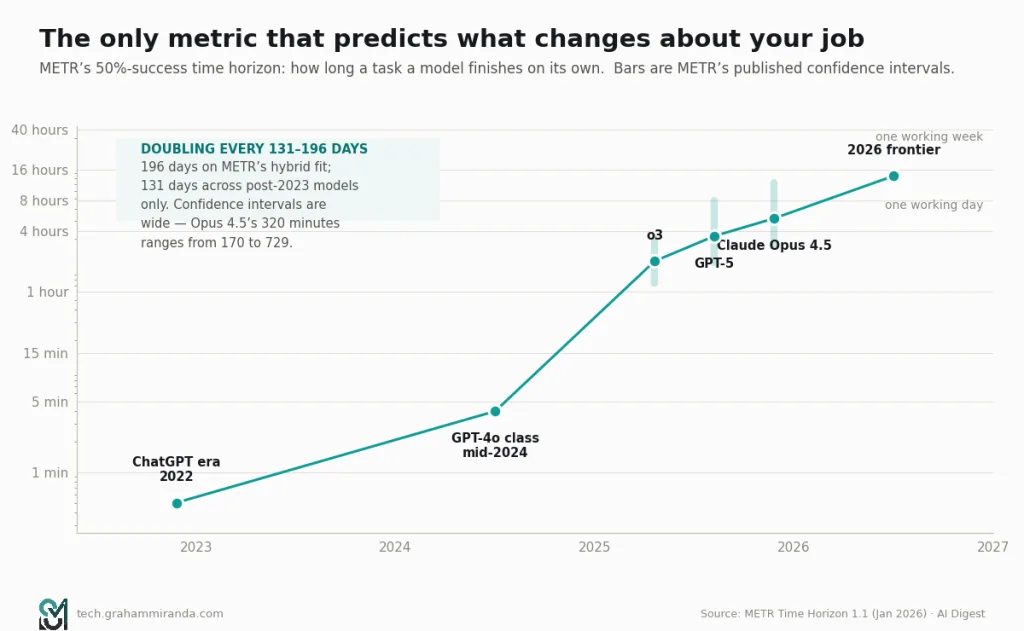
Le METR mesure la durée d’une tâche — en heures-homme — qu’un modèle est capable d’accomplir de manière autonome en réussissant le test 50%. C'est un meilleur indicateur pour déterminer si “ cette chose est capable de faire mon travail ” que n'importe quel benchmark de connaissances, car il rend compte de ce qui échoue réellement dans la pratique : non pas le fait de ne pas connaître la réponse, mais celui de rester cohérent suffisamment longtemps pour y parvenir.
L'évolution, d'après les travaux menés par METR et le suivi effectué par AI Digest :
| Période | 50% - horizon de réussite |
|---|---|
| 2022 (époque du lancement de ChatGPT) | environ 30 secondes |
| Mi-2024 (classe GPT-4o) | environ 4 minutes |
| Fin 2025 (Claude Opus 4.5) | 320 minutes (environ 5,3 heures), IC [170, 729] |
| 2026 : à l'aube d'une nouvelle ère | Plus de 14 heures |
C'est le temps de doublement qui fait débat. La version 1.1 de « Time Horizon » de METR, publiée le 29 janvier 2026 — 228 tâches, dont 31 estimées à huit heures ou plus de travail humain, ont été transférées vers le cadre « Inspect » de l'UK AI Security Institute — indique 196 jours (7 mois) sur un mélange de données anciennes et récentes, mais 131 jours si l'on se limite aux modèles postérieurs à 2023, ce qui représente une accélération d'environ 20% par rapport aux 165 jours obtenus avec la méthodologie précédente.
C'est en extrapolant une courbe exponentielle que l'on se met dans l'embarras ; je tiens donc à souligner clairement les mises en garde avant d'utiliser ce chiffre.
Les réserves sont importantes. Les intervalles de confiance propres à METR sont énormes : l’horizon de 320 minutes d’Opus 4.5 s’étend de 170 à 729 minutes. Seules 5 de leurs 31 tâches longues disposent de références humaines mesurées ; les autres sont des estimations. La composition des tâches modifie la tendance mesurée. Et ’ la réussite de 50% sur une tâche bien spécifiée dans un environnement propre “ est bien loin de ” la réussite de 50% sur votre base de code, avec votre suite de tests instable et votre processus de déploiement non documenté “.”
Cela étant dit,, la tendance ne fait aucun doute et l'ordre de grandeur est globalement correct. D'après cette extrapolation, les agents de pointe atteindront une autonomie d'environ une journée de travail en 2027 et d'environ une semaine de travail en 2028.
Pourquoi ce chiffre est-il si important ?
Parce que C'est le seul indicateur qui permet de prévoir les changements qui vont intervenir dans votre travail.
Un modèle avec un horizon de 4 minutes est doté d'une fonction d'autocomplétion. Vous restez constamment informé, et la qualité du modèle détermine la pertinence des suggestions.
Un modèle avec un horizon de 5 heures, c'est comme un collègue à qui vous faites le point le matin et avec qui vous faites le bilan à midi. Vous n'êtes pas au cœur du processus ; vous en êtes à la fin. La qualité du modèle détermine à quelle fréquence ce bilan s'avère pénible.
Nous ne disposons pas de structure de gestion adaptée à un modèle avec un horizon de 40 heures. Vous seriez amené à examiner une semaine de travail que vous n’avez pas suivie, dans une base de code qui a évolué pendant votre absence, en vous référant à un cahier des charges que vous avez rédigé avant même de connaître les problèmes.
Tous les arguments développés dans la suite de cet article — qu'il s'agisse du « vibe coding », de la vérification ou de l'identification du goulot d'étranglement — portent en réalité sur ce qui se passe lorsque ce chiffre augmente. Les modèles ont acquis une vision à long terme. Ce n'est pas le cas de nos processus d'évaluation.
Afficher l'image L'horizon temporel de réussite du modèle 50%, avec les intervalles de confiance de METR présentés en toute transparence. Ces intervalles sont suffisamment larges pour avoir une incidence — et la tendance se maintient malgré tout.
ACTE II — L'AVENIR DU « VIBE CODING »
Sixième partie : Que signifie aujourd’hui le “ Vibe Coding ” ?
Andrej Karpathy a inventé ce terme en février 2025 pour décrire un phénomène précis et quelque peu espiègle : se laisser porter par l'ambiance, oublier que le code existe, accepter les diffs sans les lire et laisser le modèle prendre les commandes. Il s'agissait d'une description d'un mode, a-t-il déclaré, à moitié pour plaisanter, pour des petits projets de fin de semaine sans grande importance.
Dix-huit mois plus tard, cette expression a parcouru tout son cycle de vie. Elle est d’abord devenue un mouvement, puis un intitulé de poste, ensuite un terme péjoratif, puis le mot de l’année selon le dictionnaire Collins, puis une catégorie de financement par capital-risque, et aujourd’hui — dans la seule évolution qui compte vraiment — un ensemble de pratiques d'ingénierie qui ne correspondent plus à ce que Karpathy avait décrit.
Je tiens à être précis quant à cette distinction, car ces deux notions sont constamment confondues alors qu'elles présentent des profils de risque opposés.
Le « vibe coding », au sens premier du terme. Demander la confirmation, accepter, exécuter, demander à nouveau la confirmation. Ne pas lire le fichier diff. L'artefact est jetable. C'est vraiment génial, et je le fais plusieurs fois par semaine — pour un script qui reformate un fichier CSV, un scraper ponctuel, une visualisation que je ne consulterai qu'une seule fois, un prototype dont le seul but est de concrétiser une conversation. Ce qui le caractérise, ce n'est pas la vitesse. C'est le fait que personne ne s'y fiera jamais.
Ingénierie agentique, détection de courant. Rédigez un cahier des charges. Fournissez à l'agent une suite de tests, un linter, un vérificateur de types et un environnement de test isolé. Laissez-le tourner pendant une heure. Examinez attentivement les modifications. Effectuez la fusion en respectant les mêmes règles de validation qu'une pull request humaine. La caractéristique principale réside dans le fait que les résultats du modèle sont considérés comme ceux d'un collègue débutant : utiles, rapides, mais peu fiables.
Ces deux produits partagent la même technologie, mais n'ont pratiquement rien d'autre en commun. Si vous souhaitez la version « pour professionnels » du second, c'est celle-là qu'il vous faut. mon précédent article sur le « vibe coding » en 2026 traite de ; cette section aborde l’orientation que prend cette pratique. Les conséquences catastrophiques décrites dans la huitième partie résultent toutes de l’application des pratiques du premier mode aux enjeux du second mode.
Les chiffres relatifs aux adoptions sont colossaux et, pour la plupart, ne font l'objet d'aucune contestation
- 90% de développeurs utilisent au moins un outil d'IA au travail, selon l'enquête ’ AI Pulse » de JetBrains (janvier 2026). L'enquête de Stack Overflow de 2025 avait recensé 84% qui utilisaient ou prévoyaient d'utiliser un tel outil.
- Près de 80% de nouveaux développeurs sur GitHub adopter Copilot dès leur première semaine (GitHub Octoverse 2025).
- 59% de développeurs utilisent au moins trois outils de codage basés sur l'IA en parallèle. Cette statistique en dit plus long que le simple chiffre d'adoption : le marché ne s'est pas consolidé, il s'est fragmenté en outils dédiés à des tâches spécifiques.
Les chiffres du marché
| Outil | Métrique | Source / date |
|---|---|---|
| GitHub Copilot | ~42% : part de marché en fonction du nombre d'utilisateurs ; plus de 20 millions d'utilisateurs | Gartner / fournisseur, 2026 |
| Curseur | $2B+ ARR ; plus d'un million d'utilisateurs actifs quotidiens ; environ 20 à 25% de part de marché en termes de chiffre d'affaires | Publié en février 2026 |
| Claude Code | ~$2,5B en rythme annuel ; 46% “ les plus appréciés ” contre 19% pour Cursor | Publié en avril 2026 |
| Marché des agents de codage d'entreprise | ~$9,8–11B en données annualisées | Gartner, avril 2026 |
Deux éléments ressortent. Copilot compte le plus grand nombre d'utilisateurs, mais affiche le taux de satisfaction le plus bas parmi les trois principaux acteurs. Claude Code dispose de la plus petite base d'utilisateurs, mais bénéficie de loin du plus haut niveau d'attachement. C'est là la marque d'un marché en pleine transition : l'acteur historique a remporté la distribution, le challenger a conquis le flux de travail, et les utilisateurs n'ont pas encore achevé leur migration.
Et le chiffre qui remet tout cela en cause
La confiance des développeurs dans les résultats générés par l'IA est passée d'environ 40% en 2024 à 29% en 2026. Une autre enquête menée par SonarSource a révélé que 96% de développeurs ne font pas entièrement confiance à la justesse fonctionnelle du code généré par l'IA.
Réfléchissez-y. L'utilisation a augmenté. La confiance a diminué. Ces deux phénomènes ne sont pas contradictoires ; ils reflètent justement le processus d'adoption d'un outil par des utilisateurs expérimentés. Personne ne “ fait confiance ” à une tronçonneuse. On l'utilise sans cesse, à deux mains, en portant des équipements de protection, et on ne lui tourne jamais le dos.
Ce sont ceux qui maîtrisent le mieux ces outils qui les utilisent avec le plus de prudence. C'est un signe encourageant, qui est pourtant totalement absent de la plupart des stratégies marketing des fournisseurs.
Septième partie : Est-ce que ça vous rend vraiment plus rapide ? Les faits, en toute honnêteté
C'est là que je risque de perdre certains lecteurs, mais je préfère les perdre à ce stade plutôt que de les induire en erreur.
L'essai randomisé apporte une réponse négative
C'est METR qui a mené l'étude que tout le monde cite, en juillet 2025 : des développeurs open source expérimentés, travaillant sur leurs propres dépôts bien établis (plus d'un million de lignes de code), ont été répartis de manière aléatoire, au niveau des tâches, entre deux groupes : l'un utilisant les outils d'IA du début de l'année 2025, l'autre n'y ayant pas recours.
Résultat : 191 TP3T plus lent avec l'IA.
Et cette conclusion qui importe davantage que le titre : Les développeurs estimaient avoir gagné environ 20% en vitesse. Ils ont surestimé l'impact de l'IA sur leur temps de travail d'environ 40 points de pourcentage.
Le suivi de 2026 n'a pas permis de résoudre le problème — il a révélé quelque chose de pire encore
METR a tenté de refaire l'expérience et, en février 2026, a publié un article d'une franchise inhabituelle expliquant pourquoi la conception avait échoué.
- Le recrutement a échoué. Les développeurs refusent de plus en plus de travailler sans avoir accès à l'IA, même à $50 de l'heure.
- La sélection des tâches a été faussée. Entre 30 et 50% de développeurs ont reconnu avoir évité les tâches qu’ils pensaient que l’IA serait capable de gérer efficacement. Un participant l’a parfaitement résumé : “ J’évite les remarques du genre : ”L’IA peut faire ça en seulement deux heures, alors que moi, je dois y passer vingt heures.” »
- Le suivi du temps ne fonctionne plus À une époque, les développeurs exécutaient plusieurs agents simultanément.
Leurs chiffres provisoires bruts pour 2026 variaient entre −18% et −4% — une évolution toujours plus lente, mais de manière moins marquée — ; toutefois, METR qualifie lui-même ces résultats de “ preuves très faibles ” compte tenu du biais de sélection.
Relisez le deuxième point, car il s'agit de la conclusion la plus intéressante de toute la littérature scientifique et elle est noyée dans une note méthodologique. Si les développeurs affectent systématiquement les tâches adaptées à l'IA loin D’après une étude visant à évaluer les avantages de l’IA, celle-ci sous-estimera ces avantages. Cela implique également que, dans la pratique, les développeurs s’occupent déjà de l’acheminement — ce qui est précisément le comportement qui confère toute leur valeur à ces outils et rend difficile la mise en œuvre d’un essai contrôlé randomisé (RCT).
Les sondages indiquent que oui, et de loin, mais leurs résultats sont exagérés
L'enquête menée par METR en mai 2026 (n = 349 : 87 ingénieurs en informatique, 71 chercheurs, 129 universitaires et doctorants, 48 fondateurs et dirigeants ; en moyenne 12 ans d'expérience en programmation, 19 mois d'utilisation d'outils d'IA) a adopté une approche astucieuse. Elle a distingué valeur de vitesse.
Le répondant médian a déclaré un Multiplicateur de vitesse × 3 mais seulement un Une augmentation de 1,4 à 2 fois la valeur de leur travail. Rétrospectivement, ils ont estimé que cette valeur serait de 1,3 fois supérieure en mars 2025 ; ils prévoient qu'elle atteindra 2,5 fois cette valeur d'ici mars 2027.
METR précise clairement que la valeur est le chiffre qui intéresse réellement les concepteurs d'enquêtes, et que les personnes interrogées raisonnent naturellement en termes de vitesse — ce qui correspond exactement au biais que l'essai contrôlé aléatoire (RCT) de 2025 a chiffré à 40 points de pourcentage.
Donc : selon les déclarations des personnes interrogées, le chiffre est de 3×. Si l'on tient compte de ce que les personnes ont réellement voulu dire, ce chiffre se situe entre 1,4 et 2×. La seule mesure contrôlée dont nous disposons indique 0,81×.
Les données organisationnelles indiquent que “ cela dépend de vous, et non de l'outil ”.”
Le rapport 2026 de DORA (Google Cloud, mai 2026) est la publication la plus utile de l'année sur ce sujet, et il est utile précisément parce qu'il cesse de se perdre en débats sur l'outil.
- Retour sur investissement (ROI) estimé pour la première année de 39% pour une structure d'ingénierie comptant 500 personnes, avec environ un Amortissement en 8 mois — Une valeur de $11,6 millions contre un investissement de $8,4 millions.
- A courbe en J: la productivité connaît une baisse avant de remonter, en raison de l'adaptation des processus de travail, des coûts liés à la vérification des revues de code et des modifications en aval apportées aux étapes de test et de validation.
- Le taux d'échec des modifications passe de 5% à 6% après l'adoption, ce qui représente un coût de $344 000 en temps d'arrêt selon leur exemple de calcul.
- Et la thèse : “ Les meilleurs retours sur investissement en matière d'IA ne proviennent pas des outils eux-mêmes, mais d'une approche stratégique axée sur le système organisationnel sous-jacent. ”
Cette dernière phrase correspond au consensus pour 2026, s'il y en a un. L'IA renforce les pratiques d'ingénierie que vous mettez déjà en œuvre. Des tests de qualité, une véritable révision du code, une annulation rapide des modifications, une responsabilité clairement définie : l'IA permet à ces organisations de gagner considérablement en rapidité. Des tests médiocres, une révision purement formelle, des déploiements manuels, une responsabilité floue : l'IA fait en sorte que ces organisations échouent plus rapidement et à plus grande échelle.
Comment concilier tout cela ?
Je ne pense pas que ces conclusions soient réellement contradictoires. Voici la synthèse à laquelle je suis parvenu, que je considère toutefois comme provisoire :
Les outils de programmation basés sur l'IA constituent un atout majeur pour les tâches peu familières et un léger inconvénient pour celles que l'on maîtrise parfaitement. Sur une base de code que vous connaissez sur le bout des doigts, dans un langage que vous maîtrisez parfaitement, face à un problème que vous avez déjà résolu, vous êtes plus rapide que le cycle « révision-correction ». Face à un framework inconnu, à un langage que vous n'utilisez que deux fois par an, à du code standard, à la mise en place de tests, à des migrations ou à une base de code que vous n'avez pas ouverte depuis huit mois, ce modèle change la donne.
METR a mené une étude auprès de développeurs expérimentés sur leurs propres dépôts de code bien établis — le seul scénario dans lequel on pourrait s'attendre à un gain minimal. Cela ne signifie pas pour autant que cette conclusion soit erronée. Cela la rend simplement spécifique, et cela devrait vous inciter à vous méfier de quiconque la cite comme un verdict général, dans un sens comme dans l'autre.
La deuxième réconciliation : les progrès sont bien réels, mais ils se manifestent ailleurs que là où on les attend. Pas “ cette fonctionnalité a pris quatre heures au lieu de six ”. Mais plutôt : la migration qui n’allait jamais être priorisée a été réalisée ; la couverture de test qui allait toujours rester à 40% est passée à 75% ; la documentation existe. Ces éléments n’apparaissent pas dans une étude sur le temps de réalisation des tâches, et pourtant, ils constituent l’essentiel de la valeur réelle.
Huitième partie : Le projet de loi sur la sécurité est arrivé, et il est détaillé
Si la septième partie était dérangeante, c'est celle-ci que les gens ont tendance à sauter. Je vous prie de ne pas la sauter.
Les mesures
Veracode a testé plus de 100 grands modèles linguistiques sur 80 tâches de programmation en Java, Python, C# et JavaScript :
- 45% d'exemples de code générés par l'IA présentent une vulnérabilité figurant dans le classement « OWASP Top 10 ». Le taux de réussite est resté pratiquement inchangé jusqu'au début de l'année 2026 : les modèles sont devenus bien plus performants, mais pas plus sûrs.
- Java a obtenu les pires résultats, avec un taux d'échec de 721 TP3T.
- 86% n'ont pas réussi à se protéger contre les attaques de type « cross-site scripting ». 88% étaient vulnérables à l'injection de journaux.
Apiiro a appliqué son moteur d'analyse approfondie du code aux référentiels d'entreprises du classement Fortune 50 entre décembre 2024 et juin 2025 :
- Les développeurs aidés par l'IA effectuent des commits à trois à quatre fois le taux de leurs pairs.
- Ils présentent leurs conclusions en matière de sécurité sur dix fois le taux.
- Les failles permettant l'escalade de privilèges ont augmenté de 3 221 TP3T. Les failles liées à la conception architecturale ont augmenté de 1 531 TP3T.
USENIX Security 2025 a analysé 576 000 exemples de code générés par l'IA :
- Environ 20% de paquets de référence qui n'existent pas.
- 43% de noms de paquets imaginaires apparaissent systématiquement dans des invites similaires — c'est précisément cet élément qui transforme un bug en surface d'attaque. Une « hallucination prévisible » correspond à un emplacement qu'un attaquant peut préenregistrer sur npm ou PyPI.
Le « Vibe Security Radar » de Georgia Tech a remonté la piste des CVE dans l'historique Git pour les attribuer à des outils d'IA :
| Mois (2026) | CVE attribués |
|---|---|
| janvier | 6 |
| février | 15 |
| mars | 35 |
74 cas confirmés au total ; les chercheurs estiment que le nombre réel dans l'ensemble des logiciels libres s'élève à cinq à dix fois plus élevé.
RedAccess indexé de manière approximative 380 000 applications accessibles au public et classées par ambiance sur Lovable, Base44, Replit et Netlify. Environ 5 000 d'entre elles exposaient des données sensibles, qu'elles soient d'entreprise ou personnelles.
Les incidents, qui ont eu lieu le
| Date | Incident |
|---|---|
| juillet 2025 | Replit AI a supprimé une base de données de production ; 1 200 fiches de cadres ont été affectées et 4 000 comptes fictifs ont été créés |
| février 2026 | Une application EdTech développée par Lovable a exposé 18 697 enregistrements d'utilisateurs, dont 4 538 comptes d'étudiants |
| avril 2026 | La charmante vulnérabilité de BOLA : tous les projets antérieurs à novembre 2025 sont accessibles en cinq appels API |
| 26 avril 2026 | Un “ effacement en 9 secondes ” par inadvertance : la base de données d’une entreprise a été supprimée, ainsi que ses sauvegardes |
| 30 avril 2026 | Vulnérabilité CVSS-10 de Gemini CLI permettant l'exécution de code à distance dans les workflows CI, corrigée |
L'affaire Amazon, que je vais traiter avec prudence
Vous avez sans doute entendu parler de l'affaire Amazon. Quatre incidents de niveau Sev-1 entre décembre 2025 et mars 2026 : une panne de 13 heures d'AWS Cost Explorer en Chine, des délais de livraison erronés affichés dans les paniers d'achat le 2 mars, qui auraient entraîné la perte d'environ 120 000 commandes, et un incident de 6 heures le 5 mars au cours duquel les commandes en Amérique du Nord auraient chuté de 99%.
Des articles publiés par le Financial Times, Fortune et The Register ont établi un lien entre des documents internes d'Amazon et ce qui a été décrit comme des “ modifications assistées par l'IA de nouvelle génération ”, en soulignant que la génération rapide de code exposait le système à des vulnérabilités. Amazon a contesté l'existence d'un lien de causalité direct, affirmant dans certaines réponses qu'aucun de ces incidents n'impliquait de code rédigé par une IA.
Je tiens à souligner trois points concernant cette histoire plutôt que de la répéter comme un fait avéré :
- Le chiffre le plus souvent cité concernant l'impact (6,3 millions de commandes perdues) provient d'un article publié sur Medium, et non d'Amazon ni d'un reportage d'un média en particulier. Il convient de le considérer comme une estimation, et non comme un chiffre avéré.
- Le déploiement du 5 mars aurait eu lieu sans documentation officielle ni autorisation. Il s'agit d'une défaillance du processus. La vitesse de l'IA a fait en sorte que possible pour que cela se fasse plus rapidement ; cela n’a pas rendu l’étape d’approbation facultative.
- C'est justement cette distinction qui est essentielle, et c'est la raison pour laquelle je mentionne cette histoire. Le mode de défaillance n'est presque jamais “ l'IA a écrit un code défectueux ”. Il s'agit plutôt de “ l'IA a écrit le code plus vite que le processus censé le vérifier ”.”
Ce que cela implique concrètement dans la pratique
Il ne s'agit pas de “ cesser d'utiliser ces outils ”. Personne de sérieux ne défend cette position, et la note de recherche de la CSA elle-même — qui rassemble la plupart des éléments cités ci-dessus — met l'accent sur la gouvernance plutôt que sur l'abstinence.
La mise en œuvre concrète, telle que je la concevrais :
- Considérez tout outil d'IA disposant d'un accès aux identifiants comme un système privilégié. C'est bien ça. Adaptez vos jetons en conséquence.
- SAST, analyse des dépendances et détection des secrets à chaque commit. Pas tous les soirs. À chaque commit. La fréquence des commits a été multipliée par trois ou quatre ; un scan nocturne correspond désormais, en pratique, à une boucle de rétroaction de trois jours.
- Analyse de la composition logicielle, en particulier pour les paquets « hallucinés ». Il s'agit du composant le moins cher et offrant le meilleur rapport qualité-prix de la liste, car la valeur 20% est très élevée et sa défaillance passe totalement inaperçue.
- Une politique écrite stipulant que l’assistance par IA ne doit pas être utilisée sans vérification préalable dans les domaines de l’authentification, de la cryptographie, de l’autorisation ou des codes de paiement. Ce sont là les quatre domaines dans lesquels une erreur, même minime, est à la fois probable et catastrophique, et où l'œil avisé d'un relecteur s'avère le plus précieux.
- Élargissez votre SBOM pour consigner la provenance des outils d'IA. Lorsque la prochaine étude d'attribution de type Georgia Tech portera sur votre base de code, vous voudrez pouvoir répondre vous-même à cette question.
- Considérez les plateformes tierces de codage d'ambiance comme des fournisseurs de services SaaS. Les chiffres de RedAccess, c'est ce qui arrive quand personne ne s'en charge.
Tout cela n'a rien d'exceptionnel. La plupart de ces pratiques correspondaient déjà à ce que faisait n'importe quel magasin compétent en 2019. La différence, c'est que le volume a augmenté d'un ordre de grandeur ; les contrôles doivent donc être automatiques plutôt que culturels.
Afficher l'image Les données relatives à la sécurité proviennent de Veracode, Apiiro, USENIX et Georgia Tech. Remarquez la courbe : la cadence des commits a été multipliée par 3 à 4, tandis que le nombre de failles de sécurité a été multiplié par 10. L'écart entre ces deux multiplicateurs résume tout le problème.
Neuvième partie : Ce qui a remplacé le « Vibe Coding »
La pratique qui fonctionne réellement en 2026 porte un nom — plusieurs noms concurrents, ce qui prouve d'ailleurs qu'elle existe bel et bien — et elle est à peu près à l'opposé de ce qu'on appelle les « vibes ».
Appelons ça développement axé sur les spécifications, ingénierie agentiqueou ingénierie contextuelle. La structure type :
1. Le cahier des charges correspond désormais au code source
Pas un ticket Jira. Un véritable document : ce que fait le système, ce qu’il ne doit pas faire, quelles sont ses interfaces, à quoi ressemble un résultat “ terminé ”, quels sont les modes de défaillance. Enregistré dans le référentiel, versionné, révisé.
On a l’impression de revenir en 1998, mais ce n’est pas le cas. La différence, c’est qu’en 1998, le cahier des charges servait de base à un être humain qui le réinterprétait, et il perdait toute valeur dès le début de la programmation. En 2026, le cahier des charges sert de base à un processus qui régénère l’implémentation à moindre coût — ce qui signifie que lorsque les exigences changent, on modifie le cahier des charges et on le redérive, plutôt que de rafistoler du code qui ne correspond plus à aucune description écrite de lui-même.
La donne économique s'est inversée. Lorsque la mise en œuvre coûtait cher et que la définition du cahier des charges ne coûtait pas cher, on définissait le cahier des charges de manière vague et on investissait dans le code. Lorsque la mise en œuvre ne coûte pas cher et que la définition du cahier des charges constitue le goulot d'étranglement, on investit dans le cahier des charges.
2. La suite de tests constitue la limite de confiance
Un outil capable d'exécuter vos tests et d'effectuer des itérations à partir de ceux-ci est fondamentalement différent d'un outil qui en est incapable. Il s'agit là du changement le plus déterminant que la plupart des équipes puissent mettre en œuvre, et cela n'a absolument rien à voir avec l'IA : c'est simplement que l'IA a enfin permis de mettre en évidence le retour sur investissement lié à la couverture de test pour des personnes que les arguments techniques n'auraient jamais pu convaincre.
Version pratique : L'agent dispose d'un environnement de test, d'une commande de test, d'une commande de vérification syntaxique et d'une vérification de type ; le processus n'est pas terminé tant que ces quatre éléments n'affichent pas tous le statut « vert ». Tout le reste est négociable.
3. La révision est passée de l'analyse ligne par ligne à la comparaison des différences, puis à l'analyse du comportement
La révision ligne par ligne n'est pas adaptée à un fichier de différences de mille lignes généré par un agent, et prétendre le contraire, c'est commencer à valider sans discernement.
Voici ce qui fonctionne, par ordre décroissant d'importance :
- Examinez le cahier des charges, et non la mise en œuvre. Si le cahier des charges est correct et que les tests sont réussis, la mise en œuvre n'est qu'un détail.
- Vérifiez la forme du différentiel — quels fichiers ont été modifiés, quelles dépendances ont été ajoutées, ce qui a été supprimé. La plupart des incidents liés aux agents sont visibles à ce niveau : un fichier inattendu, une nouvelle dépendance, une suppression non sollicitée.
- Examinez tout particulièrement les lignes sensibles sur le plan de la sécurité. Authentification, cryptographie, autorisation, paiements, tout ce qui touche aux données à caractère personnel. Cela ne représente qu'une infime partie de tout diff.
- Ne relisez pas le texte standard. De toute façon, tu ne l'as jamais vraiment évalué.
4. Le harnais est tout aussi important que le modèle
Cet aspect est sous-estimé. Un même modèle, utilisé dans deux boucles d'agents différentes, produit des résultats d'une qualité extrêmement variable — ce qui explique précisément pourquoi les comparaisons de performances entre laboratoires sont si délicates.
Les éléments essentiels : la manière dont le contexte est géré lorsque l'exécution s'éternise, la capacité de l'agent à identifier ses propres échecs de test, sa capacité à parcourir le référentiel ou à se limiter uniquement à ce que vous y collez, la distinction entre une étape de planification et une étape d'exécution, et sa capacité à savoir quand s'arrêter et demander de l'aide.
Les notes de mise à jour de la version 1.3 de Muse Spark de Meta sont particulièrement intéressantes sur ce point précis : elles indiquent que le modèle pose désormais des questions de clarification en cas de requêtes ambiguës, sollicite de l'aide lorsqu'il est bloqué et demande confirmation avant d'entreprendre des actions importantes. Ce ne sont pas des progrès en matière d'intelligence. Ce sont des questions de bonnes manières., et ce sont les bonnes manières qui permettent à un agent à long terme d'assurer sa survie.
5. Le routage par modèle est désormais une pratique courante
Personne de sérieux n'utilise un seul modèle pour tout — j'ai présenté une version à deux modèles de ce concept dans GLM-5.3-Flash vs MiniMax M3 dans OpenCode. La tendance qui s'est installée :
json
{
  "$schema" : "https://opencode.ai/config.json",
  "model" : "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
 "description": "Architecture, cause première, tout ce où se tromper coûte cher",
 "model": "anthropic/claude-fable-5-1"
    },
    "build" : {
 "description" : "L'essentiel de la mise en œuvre — horizon à long terme, sensible aux coûts",
 "model" : "anthropic/claude-opus-5"
    },
    "bulk" : {
 "description" : "Travail mécanique à haut volume où le prix est déterminant",
 "model" : "zai/glm-5-3-flash"
    },
    "private" : {
 "description" : "Tout ce qui touche aux données des clients — s'exécute sur notre propre matériel",
 "model" : "mlx/gpt-oss-120b"
    },
    "grunt" : {
 "description" : "Renommage, chaînes de documentation, corrections de lint, création de tests",
 "model" : "ollama/gemma-4-26b-a4b"
    }
  }
}
Le raisonnement, ligne par ligne :
- Optez pour le modèle le plus performant que vous pouvez vous permettre. Un mauvais plan coûte plus de jetons en aval que ce qu’il a jamais coûté.
- On mise sur le meilleur modèle à long terme, à un prix raisonnable. L'Opus 5, disponible aux références $5 et $25, est clairement conçu à cet effet et coûte la moitié du prix du Fable.
- Le travail mécanique en masse est attribué à GLM-5.3-Flash à $0.15/$0.47, car à ce prix-là, la question n'est pas de savoir s'il est aussi bon, mais s'il est suffisamment performant pour la tâche en question. C'est souvent le cas.
- Tout ce qui est privé reste local, sur un modèle adapté à votre machine.
- Le travail de base revient à une petite agence de communication locale, car renommer un symbole dans quarante fichiers ne nécessite pas de réflexion approfondie et ne vous oblige pas à vous éloigner de votre ordinateur portable.
Notez les identifiants des modèles de manière à ce que l'interversion de l'un d'entre eux ne nécessite qu'une seule ligne de modification. Étant donné que quatre laboratoires ont commercialisé un modèle figurant dans le top 10 entre juin et septembre, vous devrez effectuer cette modification à nouveau au cours du trimestre.
Dixième partie : L'avenir du « Vibe Coding » — Six prévisions, accompagnées d'un niveau de confiance
Les pronostics sans niveau de confiance ne sont que du divertissement. Voici les miens, avec le montant que je serais prêt à parier.
1. Le mot disparaît ; la pratique se divise définitivement. Confiance élevée.
“Le ” vibe coding » est déjà en passe de devenir un terme péjoratif dans les milieux professionnels et un motif de fierté uniquement dans le domaine du marketing. Ce qui le remplace, c’est une distinction claire en deux catégories : d’un côté, des artefacts jetables générés par l’IA dont personne ne lit le code (très bien, c’est correct, il faut en faire davantage) ; de l’autre, une ingénierie « agentique » validée, où la production du modèle passe par les mêmes filtres que celle d’un humain (très bien aussi, et c’est là que se trouve tout l’argent des entreprises).
C'est ce « juste milieu dangereux » — le code de production, non relu — qui constitue la liste des incidents de 2026, et il finira par disparaître dans les contextes commerciaux, sous l'effet des réglementations, des assurances ou des audits. Non pas parce que quelqu'un l'interdit, mais parce qu'un questionnaire de sécurité finira par le demander.
2. La vérification devient le goulot d'étranglement, et les investissements en outils s'y concentrent. Confiance élevée.
Nous en sommes déjà là et le marché n'a pas encore réévalué les prix. Si les agents sont capables de produire une semaine de travail, la contrainte réside dans la capacité humaine à vérifier que cette semaine de travail est bien correcte.
On peut s'attendre à ce que les produits phares de 2027 concernent vérification plutôt que générer: la génération de tests basée sur les propriétés, les outils de comparaison sémantique qui décrivent les changements de comportement plutôt que les modifications de code, la vérification automatisée de la conformité aux spécifications, la vérification à l'exécution des actions des agents, et — c'est celui-là que je développerais — des outils qui vous indiquent quels 5% d'un fichier de différences volumineux une personne doit réellement lire.
3. Les méthodes formelles ont enfin leur heure de gloire, avec vingt ans de retard. Confiance moyenne.
L'objection historique à la spécification formelle était que la rédaction de la spécification coûtait plus cher que l'écriture du code. Cette objection n'a plus lieu d'être aujourd'hui, car l'écriture du code ne coûte pratiquement rien et c'est de toute façon la rédaction des spécifications qui constitue le goulot d'étranglement.
Les systèmes de types, les contrats, les invariants, les tests de propriétés et la vérification formelle allégée trouvent soudainement un cas d’utilisation qui justifie pleinement leur existence : ce sont des déclarations d’intention vérifiables par une machine, que l’agent peut tester de manière itérative sans intervention humaine. Je m’attends à ce que Rust, les modes plus stricts de TypeScript et les bibliothèques de contrats en Python en tirent un bénéfice disproportionné.
La raison pour laquelle ma confiance n'est que modérée : depuis 1985, le milieu prévoit une renaissance des méthodes formelles à peu près tous les sept ans.
4. Les modèles locaux prennent entièrement en charge le niveau « grunt ». Confiance moyenne à élevée.
Regardez ce que fait actuellement un modèle 27B sous licence Apache 2.0, ajoutez-y une année supplémentaire, puis installez-le sur une machine dotée de 64 Go de mémoire unifiée. Renommage, chaînes de documentation, structure de tests, messages de commit, corrections de lint, premières ébauches de traduction, analyse des logs… Rien de tout cela ne nécessite un modèle de pointe ; tout cela représente un volume important, et tout cela correspond exactement au type de travail que vous préférez ne pas confier à un tiers à partir du dépôt d’un client.
La frontière reste dans le cloud pour la planification et les calculs complexes. Le volume se déplace vers le local. À partir de la onzième partie, nous expliquerons pourquoi cela est désormais physiquement possible.
5. Le poste de développeur junior évolue plutôt que de disparaître. Confiance moyenne, et c'est celle que je considère comme la moins sûre.
Le scénario pessimiste est simple : si les agents effectuent le travail que faisaient auparavant les jeunes employés, personne n'embauche de jeunes employés, et dans dix ans, il n'y aura plus de cadres.
Je pense que le scénario le plus probable est que le poste de débutant passe de “ écrire le code ” à “ vérifier le code et prendre en charge le cahier des charges ” — ce qui est un métier plus difficile à aborder au départ, et non pas plus facile, et qui va obliger le secteur à repenser la manière dont il forme ses collaborateurs. Les équipes qui comprendront cela bénéficieront d’un énorme avantage en matière de recrutement par rapport à celles qui se contenteront de cesser d’embaucher.
Une mise en garde en toute honnêteté : c'est précisément dans ce cas que mes motivations et mon analyse vont dans le même sens, et c'est justement à ce moment-là qu'il faut se méfier de soi-même.
6. Quelqu’un est victime d’une défaillance véritablement catastrophique du code d’une IA, dont la responsabilité est publiquement attribuée. Grande certitude quant à l'événement, mais peu de certitude quant à la date.
Il ne s'agit pas d'une fuite de base de données. Il s'agit d'un incident impliquant une autorité de régulation, dont l'impact financier se chiffre en centaines de millions, et dont l'analyse des causes profondes révèle qu'un agent a effectué une opération qui n'a fait l'objet d'aucun contrôle humain.
La courbe d'attribution des CVE — 6, puis 15, puis 35 au cours des mois successifs de 2026, les chercheurs estimant que le taux réel est cinq à dix fois plus élevé — n'est pas une courbe qui s'aplatit d'elle-même. La question est de savoir si le secteur va renforcer ses propres mesures de sécurité de son propre chef ou s'il va attendre qu'un incident l'y oblige.
Ce que je ferais pour les six, en un mot : il vaut mieux investir dans les tests, les spécifications et les outils de vérification plutôt que dans les techniques de prompt, car ces dernières perdent de leur valeur à chaque nouvelle version du modèle, tandis que l'infrastructure de vérification ne cesse de se renforcer.
Afficher l'image Ces deux pratiques ont pour seul point commun la technologie. La boucle de gauche est adaptée aux tâches ponctuelles, mais catastrophique pour la production ; la boucle de droite est ce qui manquait dans la liste des incidents de la huitième partie.
ACTE III — L'IA HORS LIGNE SUR LES APPAREILS GRAND PUBLIC
Onzième partie : L'IA hors ligne a cessé d'être un simple passe-temps cette année
Pendant environ deux ans, “ le gérer localement ” a constitué un compromis fondé sur des principes. C'était possible. L'argument de vente, en toute honnêteté, était le suivant : Voici un modèle de 7 milliards de paramètres qui est moins performant que l'offre gratuite de n'importe quel service, sur du matériel que vous possédez déjà, et la raison pour laquelle on le fait, c'est par principe.
La situation a changé en 2026, et ce changement s'explique par trois raisons distinctes qui se sont produites simultanément.
Les petits modèles sont devenus vraiment bons. Le modèle E4B de Gemma 4 compte environ 8 milliards de paramètres, prend en charge 128 Ko de contexte, traite le texte, les images, la vidéo et l'audio natif, et est soumis à la licence Apache 2.0. La variante dense de 31 milliards obtient un score de 39 sur l’indice Artificial Analysis — ce qui se situe dans la fourchette considérée comme de pointe il y a dix-huit mois — et a effectué l’intégralité du test sur 39 millions de tokens de sortie, soit une fraction de ce que consomment des modèles comparables. Qwen3.8-27B est un modèle multimodal dense sous licence Apache 2.0, doté d’un contexte natif de 262 000, qui, selon Alibaba, surpasse le bien plus volumineux Qwen3.7-Plus dans les tâches de codage et de bureautique.
Ce sont les systèmes d'exploitation qui l'ont fourni. C'est là le changement qui compte vraiment, et il s'est produit en toute discrétion. Microsoft a intégré Aion 1.0 à Windows 11. Apple propose sur ses iPhone un modèle dense de 3 milliards de paramètres ainsi qu'un modèle clairsemé de 20 milliards de paramètres. Google intègre Gemini Nano aux appareils Pixel et Samsung. L'IA embarquée n'est plus un élément que l'on installe, mais une fonctionnalité qui est déjà présente, ce qui fait la différence entre une technologie réservée aux passionnés et une technologie accessible à tous.
Et le matériel dispose enfin de la mémoire nécessaire. Ce n'est pas la puissance de calcul, mais la mémoire. Je reviendrai plus tard sur les raisons pour lesquelles cette distinction est essentielle.
Ce que l“” IA hors ligne » vous apporte réellement
Je vais être précis, car ce produit est mal présenté.
Latence. Un modèle 4B local répond en quelques dizaines de millisecondes. Un aller-retour vers le cloud prend, au mieux, plusieurs centaines de millisecondes. Pour tout ce qui est interactif et continu — dictée, traduction en temps réel, saisie semi-automatique, synthèse au fur et à mesure de la saisie —, la solution locale l’emporte en termes de fluidité, et non de qualité, et c’est cette fluidité que les utilisateurs remarquent.
Une protection de la vie privée qui relève davantage de l'architecture que du contrat. Avec une API, chaque requête sort de votre infrastructure et vous devez disposer d'un accord de traitement, d'une analyse d'impact sur le transfert, d'une cartographie des flux de données et d'une réponse à fournir à votre délégué à la protection des données. Avec un modèle fonctionnant sur l'appareil, La question du transfert transfrontalier ne se pose pas, puisqu'il n'y a pas de transfert. Dans le cadre des relations commerciales avec l'Allemagne et l'Union européenne, c'est souvent là tout l'argument, et c'est ce qui permet de conclure des affaires, ce que le prix seul ne permettrait jamais.
Disponibilité. Dans un avion. Sur un site sans réseau. Dans un établissement où l'accès au réseau est interdit. Lors d'une panne chez votre opérateur.
Prévisibilité des coûts. Ce n'est pas une question d'économies — je ferai le calcul dans la quinzième partie, et le résultat ne correspondra pas à ce que les gens espèrent. Mais un coût matériel fixe associé à un coût marginal nul par jeton représente une ligne budgétaire très différente d'une facturation basée sur l'utilisation, qui évolue en fonction de l'enthousiasme de l'agent.
Verrouillage de version. Dans un modèle API fermé, les mises à jour s'effectuent sous un identifiant de modèle stable, mais le comportement du modèle évolue. Un point de contrôle local reste identique au byte près au bout d'un an. Si vous avez déjà vu une instruction qui fonctionnait cesser soudainement de fonctionner, vous savez à quel point cela a de la valeur.
Et ce que cela ne vous apporte pas
Capacité d'exploration. L'écart entre un modèle 4B sur votre téléphone et Claude Fable 5.1 n'est pas négligeable et ne se comblera pas. Quiconque vous dit le contraire cherche à vous vendre quelque chose.
Vitesse sur les grands modèles. Un modèle 400B local génère des jetons plus lentement que le même modèle sur l'API d'un fournisseur, car ce dernier l'exécute sur du matériel disposant d'une bande passante mémoire quatre à six fois supérieure à la vôtre. Vous sacrifiez le débit au profit du contrôle.
Douzième partie : Le téléphone dans votre poche
La caractéristique qui fait toute la différence, c'est la mémoire vive (RAM)
Toutes les grandes plateformes ont désormais fixé une limite en matière de mémoire, et cette limite est de 12 Go.
| Plate-forme | Modèle intégré à l'appareil | Porte de mémoire |
|---|---|---|
| Pomme | AFM 3 Core (3 milliards de nœuds denses) + AFM 3 Core Advanced (20 milliards de nœuds clairsemés, 1 à 4 milliards de nœuds actifs) | 12 Go pour deux fonctionnalités d'iOS 27 |
| Gemini Nano v3 (Pixel 10 uniquement) ; Nano v2 sur le Pixel 9 et les modèles antérieurs ; Nano v4 à venir | 12 Go minimum pour Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 pour Galaxy — processeur Oryon de 3e génération, NPU Hexagon, +39% Capacité NPU | Dépendant du périphérique |
C'est la solution proposée par Apple qui présente le plus d'intérêt sur le plan technique. AFM 3 Core Advanced est un modèle clairsemé de 20 milliards de paramètres stocké sur un support Flash. Les experts partagés restent en mémoire ; les experts acheminés ne sont chargés en DRAM que lorsqu'une requête les sollicite. C'est ainsi qu'il est possible d'intégrer un modèle de 20 milliards d'éléments dans un téléphone : on sacrifie la bande passante de lecture de la mémoire NAND au profit de la capacité de la DRAM.
Mais pour stocker les experts dans la mémoire DRAM, il faut tout de même un endroit où les stocker dans, en plus du système d'exploitation, de l'application en cours d'exécution et du pipeline de la caméra. L'écart entre 9 Go et 12 Go ne correspond pas à une segmentation du marché de trois gigaoctets. Il s'agit du « working set » nécessaire à une gestion experte de la pagination en cas de forte pression sur la mémoire physique. Ming-Chi Kuo indique que deux fonctionnalités d’iOS 27 nécessitent 12 Go : l’expressivité vocale de Siri et la personnalisation du débit, ainsi qu’une amélioration significative de la précision de la reconnaissance vocale. L’iPhone 18 de base, dont la sortie a été repoussée au printemps 2027 et qui disposerait de 9 Go, ne répond pas à ces exigences.
Google est confronté aux mêmes contraintes techniques et à un problème de relations publiques encore plus grave. Gemini Intelligence nécessite Nano v3, or Nano v3 n’est actuellement disponible que sur le Pixel 10 et les appareils Pixel 9 — commercialisés sous une promesse de mise à jour tous les sept ans — utilisent Nano v2. La promesse portait sur les mises à jour. Il n’a jamais été question de fonctionnalités, et la distinction qui semblait logique à un chef de produit en 2023 n’a plus aucun sens pour un client en 2026.
Voici ce qui devrait marquer l'actualité de l'IA grand public au cours des deux prochaines années : une promesse de prise en charge à long terme qui consiste à fournir des correctifs de sécurité à un appareil incapable d'exécuter les fonctionnalités associées à ces correctifs.
Ce qu'un téléphone est réellement capable de faire, mesuré
Tests de performance indépendants réalisés sur un iPhone 17 Pro (A19 Pro) pour quatre durées d'exécution :
| Modèle | Durée d'exécution | Décodage en tok/s | Mémoire maximale |
|---|---|---|---|
| Gemma 4 E2B (4 bits) | LiteRT-LM | 55.4 | 641 Mo |
| Gemma 4 E2B (4 bits) | MLX | 47.5 | 2 900 Mo |
| Gemma 4 E2B (4 bits) | llama.cpp | 37.8 | 3 156 Mo |
| Gemma 4 E2B (4 bits) | CoreML / ANE | 33.4 | 1 187 Mo |
| Qwen 3.5 2B (4 bits) | MLX | 61.2 | 1 279 Mo |
| Qwen 3.5 2B (4 bits) | llama.cpp | 39.1 | 1 479 Mo |
| Qwen 3.5 2B (4 bits) | CoreML / ANE | 27.9 | 241 Mo |
Deux conclusions sautent aux yeux.
Le Neural Engine est la voie la plus lente, mais de loin celle qui utilise le moins de mémoire. 27,9 tok/s à 241 Mo contre 61,2 tok/s à 1 279 Mo pour le MLX : une vitesse cinq fois supérieure pour une mémoire cinq fois plus importante. C’est précisément ce compromis qui explique pourquoi Apple utilise l’ANE pour les fonctionnalités système fonctionnant en permanence et pourquoi les applications tierces ne l’utilisent pas pour les discussions interactives.
Soixante jetons par seconde sur un modèle 2B que vous avez dans votre poche, c'est plus rapide que la vitesse de lecture de la plupart des gens. Ce qui signifie que la contrainte qui pèse sur l'IA locale sur mobile n'est pas la vitesse. C'est la capacité ; la capacité dépend des paramètres, les paramètres dépendent de la mémoire — et c'est justement la mémoire que tous les fournisseurs viennent de limiter.
Treizième partie : Le PC et le pari discret de Microsoft
Lors de la conférence Build 2026, le 2 juin, Microsoft a pris une initiative qui, selon moi, prendra davantage d'importance avec le recul qu'elle ne l'a fait le jour même : il a intégré des modèles directement dans Windows.
Guide d'Aion 1.0 Il s'agit d'un petit modèle linguistique destiné à la synthèse, à la réécriture et à l'extraction. Il nécessite un processeur moderne et Windows 11 — pas besoin de NPU ni de carte graphique dédiée. Il est désormais disponible dans Edge Canary à partir de la version 150.0.4070, accessible aux développeurs web via les API Prompt, Summarizer, Writer et Rewriter, et ses poids ouverts ont été publiés sur Hugging Face en juillet 2026.
Plan Aion 1.0 C'est celui-là qui est intéressant : un Modèle de raisonnement et d'appel d'outils comportant 14 milliards de paramètres, avec une fenêtre de contexte de 32K, conçu pour les flux de travail basés sur des agents, la gestion de fichiers et l'orchestration de sous-agents. “ Dans les mois à venir ” au moment de la rédaction de cet article.
Le slogan utilisé par Microsoft était “ une intelligence illimitée pour chaque foyer et chaque bureau ”. Laissons de côté l'aspect marketing et concentrons-nous sur le choix architectural : une API JavaScript dans le navigateur qui interroge un modèle local, sans clé, sans facture et sans connexion réseau. Si cela devient la norme, une vaste catégorie de petites fonctionnalités d'IA cessera d'être un produit SaaS pour devenir une fonctionnalité de la plateforme. Cela aura un impact bien plus important sur l'économie du secteur de l'IA que n'importe quel lancement de modèle individuel cette année.
L'étage dédié au matériel informatique existe bel et bien et exclut de nombreuses machines
La solution NPU nécessite un PC équipé de Copilot+ avec un au moins 40 TOPS NPU:
| Silicium | NPU | Est-ce que ça correspond aux critères ? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 HAUTS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 HAUTS | ✅ matériel ; logiciels “ à venir ” |
| Intel Meteor Lake | ~10–11 AU MAXIMUM | ❌ |
Et voici le chiffre qui devrait remettre les attentes à zéro : Sur un NPU 45-TOPS, un modèle 8B génère environ 5 tokens par seconde. The 14B Plan model will be slower.
Five tokens per second is not a chat experience. It is fine for a background summarisation, a rewrite, a classification, an extraction — the things Aion 1.0 Instruct is actually for. It is not fine for anything you sit and watch.
Why so slow on 45 TOPS? Because token generation is bound by memory bandwidth, not by raw compute. The NPU can do the matrix multiplications; the problem is streaming the weights out of system memory for every single token. This is the same wall that governs every device in this article, and it is why “TOPS” is a nearly useless number for shopping.
The desktop boxes
If you want a machine specifically for local inference, the 128 GB class has settled into two options and one outlier:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| Mémoire | 128 GB unified | 128 GB LPDDR5X-8000 | up to 512 GB unified |
| Largeur de bande | ~273 GB/s | ~256 GB/s | 1.2 TB/s |
| Prix | ~$3,999 | $2,300–$2,500 | from $5,499 |
| Notes | CUDA ecosystem | Strong CPU (1.6 TFLOPS Linpack vs Spark’s 708 GFLOPS) | 512 GB tier late Oct, unpriced |
Those prices and the Spark and Strix Halo figures come from testing published in late December 2025, so treat them as indicative rather than current — memory pricing has moved since. The DGX Spark and Strix Halo are much closer on token generation than their compute figures suggest — because both are stuck around 256–273 GB/s of bandwidth and that is the binding constraint. The Spark wins decisively on image generation (~120 TFLOPS vs ~46 on FLUX.1 Dev BF16) and on CUDA compatibility. Strix Halo wins on price and CPU.
The Mac Studio M5 Ultra is in a different category entirely on both memory and bandwidth, and I wrote about it at length in the local AI hardware piece. The short version: 512 GB at 1.2 TB/s is the only mainstream machine that can hold a 400B-class model in memory, and the price for that privilege is somewhere around $16,000–$20,000 configured.
The models to actually run
| Modèle | Params | Licence | Runs comfortably in | Good for |
|---|---|---|---|---|
| Gemma 4 E2B | 5.1B / 2.3B active | Apache 2.0 | 4 GB | Phones, always-on, audio input |
| Gemma 4 E4B | ~8 milliards | Apache 2.0 | 8 Go | Laptop grunt work, summarisation |
| Guide d'Aion 1.0 | small SLM | Open weights (HF, Jul 2026) | CPU only | Windows-native text tasks |
| Qwen3.8-27B | 27B dense | Apache 2.0 | 24–32 GB | Best general local model under 32 GB |
| Gemma 4 26B-A4B | 26B / 4B active | Apache 2.0 | 24 GB | Fast MoE, low active cost |
| Gemma 4 31B | 31B dense | Apache 2.0 | 32 GB | Highest local quality under 32 GB |
| Ornith-1.5 35B | 35B / 3B active | MIT | 32 GB | Agentic coding, tiny active footprint |
| gpt-oss-120b | 120B / 5.1B active | Apache 2.0 | 128 GB | The 128 GB sweet spot |
| Ornith-1.5-397B | 397B Ministère de l'Éducation | MIT | 256 GB+ | Frontier-adjacent, needs a big box |
| MiniMax M3 | 428B / 23B active | Personnalisé | 512 GB | Only fits on an M5 Ultra |
| DeepSeek V4 Pro | 1.6T / 49B active | MIT | Cluster | Not a consumer device model |
| Kimi K3 | 2.8T / 104B active | Personnalisé | Cluster | Fits on no Mac Apple sells |
If you are sizing an Apple machine specifically, I went through the memory tiers in detail in the MacBook Pro M5 Pro 64GB local AI guide — the short version is that 64 GB is the point where the compromises stop being annoying.
If you want one recommendation: on a 32 GB machine, run Qwen3.8-27B ou Gemma 4 31B. Both Apache 2.0, both multimodal, both genuinely useful, both fit. That is the 2026 default and it is a much better default than 2025 had.
Afficher l'image What actually fits, by memory tier. The vertical rules are the memory sizes consumers can actually buy; the models that overflow the right-hand rule are the ceiling of local frontier AI in 2026.
Part Fourteen: The Memory Wall Is The Whole Story
Everything in Act III comes back to one equation, so here it is explicitly.
Will it fit?
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory × 0.75) − OS and app overhead − KV cache
How fast will it generate?
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenNote that the second formula uses active parameters, not total. This is why mixture-of-experts models are so disproportionately good on consumer hardware. Gemma 4’s 26B-A4B has 26 billion parameters of capability and 4 billion parameters of per-token cost. Ornith-1.5’s 35B activates 3B. MiniMax M3 has 428B total and 23B active.
Efficiency in that formula is roughly 0.5 to 0.8 in practice depending on runtime, quantisation and how much of the memory bandwidth the rest of the system is using.
Now apply it. A 45-TOPS NPU laptop with LPDDR5X at, say, 120 GB/s, running an 8B model at 4-bit (4 GB of active weights): 120 × 0.6 ÷ 4 ≈ 18 tokens/second in theory. The measured figure is about 5. The difference is scheduling, memory contention, prefill costs and the fact that NPU toolchains are immature. That gap between the arithmetic and the measurement is where most disappointment in this space lives.
The DRAM shortage is the hidden variable behind every number in this article
Memory manufacturers spent 2025 and 2026 reallocating capacity toward AI datacentre customers, who sign larger contracts at better margins than consumer device makers. The consequences show up everywhere:
- Apple raised prices across Macs and iPads in June 2026.
- The 512 GB Mac Studio tier slipped to late October on supply grounds and remains unpriced.
- Apple’s M6 caps at 32 GB of unified memory, and the M6 Pro, Max and Ultra were cancelled outright.
- Ming-Chi Kuo reported Apple cutting 2026 hardware shipments over memory supply.
Every ceiling in this article traces to the same shortage. The 12 GB phone gate. The 32 GB M6 cap. The 128 GB laptop ceiling. The delayed 512 GB tier. Not one of them is a technical limit of the silicon; all of them are allocation decisions in a market where memory is scarce and expensive.
If you have been waiting for prices to normalise before buying a machine for local inference: nobody credible is forecasting when that happens.
Part Fifteen: Setting It Up
The practical section. Everything here I have run; where I am reporting rather than running, I say so.
The easiest path: LM Studio
A GUI, MLX-native on Apple Silicon, model browser built in, OpenAI-compatible server with one toggle. If you want to be running a model in ten minutes, start here. It is also the tool Apple benchmarks against in its own press releases, which tells you something about how mainstream this has become.
The most flexible path: Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
That second command is the one people miss. Ollama’s default context is set conservatively; on a code task it will silently truncate and you will blame the model.
The fastest path on Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Point any OpenAI-compatible client at http://localhost:8080/v1.
Raise the wired memory limit before you complain about crashes
macOS will not let the GPU wire all of your unified memory by default. On a large-memory machine this is the difference between a model loading and a model failing:
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Do not set this to your full memory size. Leave the OS 12–16 GB on a large machine or you will get kernel panics rather than fast inference. And re-check it after every macOS update, because updates reset it.
On Windows, use the OS models first
Before installing anything, check what Windows already gives you. The Prompt, Summarizer, Writer and Rewriter APIs in Edge call Aion 1.0 Instruct locally with no key and no bill. For summarisation, rewriting and extraction inside a web app, that is a complete solution with zero infrastructure.
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
If you need more than that, LM Studio and Ollama both run fine on Windows, and on a machine without a qualifying NPU they will use the GPU or CPU, which for models in the 8B class is frequently faster than the NPU path anyway.
A sane hybrid setup
The architecture I would actually build, and roughly what I run:
- Tier 1 — on device. A small model for routing, classification, extraction, summarisation, dictation. Gemma 4 E4B or Aion 1.0 Instruct. Always available, zero marginal cost.
- Tier 2 — your own hardware. A 27B–120B open-weight model on a machine you own, for anything touching client data that must not leave the jurisdiction. Qwen3.8-27B on 32 GB,
gpt-oss-120bon 128 GB. - Tier 3 — frontier via API. Planning, hard reasoning, long agentic runs, anything where being wrong is expensive.
The debate is never “local or cloud.” It is where you draw the lines, and the lines moved a long way this year.
Part Sixteen: The Cost And Compliance Maths
The savings argument does not survive a calculator
Take a realistic small-business workload: a working month of moderate agentic coding, say 40 million input and 3 million output tokens.
| Option | Monthly cost |
|---|---|
| GLM-5.3-Flash API ($0.15 / $0.47) | ~$7.40 |
| Gemini 3.8 Flash API ($0.75 / $3.75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50, uncached) | ~$550 |
| A $2,400 Strix Halo box, amortised over 3 years | ~$67/month + electricity |
Note what that table actually says. Local hardware is cheaper than the top of the frontier and more expensive than the bottom of it. Against GLM-5.3-Flash, a local box never breaks even on tokens. Against Fable 5.1 running uncached, it pays for itself in five months — but you are not comparing like with like, because Fable 5.1 is a much better model than anything that fits in 128 GB.
So do not buy local hardware to save money. Buy it for one of these five reasons, all of which are real:
- Data residency that is an architecture decision rather than a legal project.
- No rate limits, no quotas, no capacity incidents. Your machine does not have a busy Tuesday.
- Version pinning forever. A local checkpoint is byte-identical in a year.
- Offline operation.
- You needed the workstation anyway. This is the most common case where buying is straightforwardly correct — if you were already going to spend €2,500 on a machine, the marginal cost of the AI capability is the memory upgrade, not the whole box.
The EU compliance picture, because it changed in 2026
For readers in Germany and the EU, the regulatory ground moved this year and the dates are now fixed rather than conditional.
- 2 August 2025 — GPAI model providers took on documentation, training-content-summary and copyright obligations.
- 2 August 2026 — enforcement powers and Article 50 transparency duties took effect. Fines are now applicable.
- 27 July 2026 — the Digital Omnibus, Regulation (EU) 2026/1744, entered into force, replacing the previous conditional mechanism for high-risk systems with fixed dates.
- 2 December 2026 — end of the grace period for machine-readable watermarking on existing systems.
- 2 August 2027 — the two-year transition window closes for GPAI models already on the market.
- 2 December 2027 — stand-alone high-risk systems under Annex III (hiring, credit scoring, education, critical infrastructure).
- 2 August 2028 — high-risk AI embedded in regulated products under Annex I (medical devices, machinery).
The Digital Omnibus also added prohibitions on AI-generated non-consensual intimate imagery and CSAM, and expanded the EU AI Office’s supervisory powers.
What this means practically for the readers of this article. If you are building on top of models rather than training them, most of the GPAI obligations sit with the provider, not with you. What lands on you is transparency — telling people when they are interacting with AI, and marking synthetic content — plus the high-risk classification question if your system touches hiring, credit, education or critical infrastructure. The December 2027 date is far enough away to plan for and close enough that “we’ll look at it later” is no longer a strategy.
And the point most relevant to Act III: an on-device model materially simplifies several of these conversations at once. No transfer, no processor, a much shorter data flow map. That is not a loophole — the transparency obligations still apply — but it removes an entire category of work.
I am not a lawyer and this is not legal advice. For anything with money attached, get a German or EU-qualified adviser to look at your specific deployment.
Part Seventeen: The Honest Case Against All Of This
If I stopped at Part Sixteen this would be an advert.
The measured productivity evidence still does not support the enthusiasm. One randomised controlled trial, 19% slower. A follow-up that could not be run cleanly. Self-reports inflated by 40 percentage points. Everyone in this industry, myself included, is operating substantially on vibes about vibes.
The security data is bad and not improving. Veracode’s 45% OWASP failure rate was essentially unchanged through early 2026 while models got dramatically smarter. That is not a transitional problem that scale fixes. Capability and security are not the same axis, and nobody is optimising hard for the second one.
Benchmarks are saturated at the top and unverifiable in the middle. SWE-bench Verified has three models within a point. The benchmarks replacing it are increasingly private, which solves contamination by making independent verification impossible.
Open weights are one licence revision from not being open. Z.ai moved GLM from MIT to a proprietary licence with a security-review gate between 5.2 and 5.3. Meta has promised open weights for Muse Spark with no date, no size and no licence text. If your architecture assumes downloadable weights next year, that assumption is a vendor’s business decision, not a law of nature.
The frontier is still not local, and increasingly not purchasable either. Mythos 5.1, the highest scorer on Terminal-Bench 4.0, is restricted to vetted cyberdefenders and life scientists, currently mostly in the US. Kimi K3 and DeepSeek V4 Pro do not fit on any consumer machine. What fits on your desk is an excellent second-tier model, which is a genuinely useful thing to be and is not the frontier.
On-device performance is worse than the marketing implies. Five tokens per second for an 8B model on a 45-TOPS NPU. A 12 GB memory gate that excludes most phones in circulation. A seven-year update promise that does not cover features. The gap between “AI PC” branding and what the machine can actually run is currently enormous.
And geopolitics is a procurement input whether or not you think it should be. Several of the best open-weight models — Kimi, GLM, DeepSeek, Qwen, MiniMax — come from Chinese labs. For public-sector, defence-adjacent and some regulated clients that is a hard blocker regardless of where the weights run or what the licence says. Meanwhile the most capable Anthropic coding model is gated to vetted US organisations. The open ecosystem is being pulled apart along national lines from both ends, and if you are in Europe you are on neither end of it.
Part Eighteen: The Decision Framework for the State of AI 2026
Afficher l'image Seven situations, seven answers. Find the row that sounds like your year.
Seven situations, mapped onto the state of AI 2026 as it actually stands today.
1. “I want the best model and cost is not the issue.”
Claude Fable 5.1 at 65.7 on the aggregate index, $10/$50, 1M context — and turn caching on, because the 75% cache read cut is worth 25–45% of your bill. Keep GPT-5.6 Sol available for browsing-heavy research at 90.4% BrowseComp. Do not agonise; the gap between them is smaller than the gap between your best and worst prompt.
2. “I run a lot of agents and the bill is getting silly.”
Claude Opus 5 at $5/$25 for the long-horizon work, GLM-5.3-Flash at $0.15/$0.47 for bulk mechanical work, and a local model for grunt. Routing is the single biggest cost lever available to you and it is a config file, not a project. Measure your token split by agent role before you optimise anything — most people discover 80% of their spend is on tasks that did not need a frontier model.
3. “GDPR and data residency are hard requirements for client work.”
Qwen3.8-27B or Gemma 4 31B on hardware you own, both Apache 2.0, both multimodal. Step up to gpt-oss-120b on a 128 GB machine if the work needs it. The point is not speed — it is that no prompt leaves the building and your legal review becomes a licence read instead of a transfer impact assessment. Pick permissively licensed models specifically so that read is short.
4. “I want to try local AI without spending much.”
Whatever you already own, plus LM Studio, plus Gemma 4 E4B. Eight gigabytes of memory is enough to be genuinely useful. Find out whether local AI is for you before you spend money on it — most people discover they want tier 1 and tier 3 and never needed tier 2 at all.
5. “I’m buying a machine specifically for local inference.”
Buy on memory bandwidth and capacity, in that order, and ignore TOPS. In the 128 GB class, Strix Halo at ~$2,400 is the value pick and DGX Spark at ~$3,999 buys you CUDA and much better image generation. Above that, the Mac Studio M5 Ultra is the only thing that holds a 400B model, at a price that only makes sense if you needed the workstation anyway.
6. “My team is adopting AI coding tools and I own the risk.”
Do the boring things, in this order: SAST and secret detection on every commit; software composition analysis for hallucinated packages; a written policy excluding unreviewed AI code from auth, crypto, authz and payments; agent credentials scoped as privileged; and an SBOM that records tool provenance. Then expect a courbe en J — DORA measured a real dip before the gain — and do not panic in month three.
7. “Which phone should I buy for AI?”
Any 12 GB model. That is the line every platform has drawn: iPhone 17 Pro and 18 Pro at 12 GB, Pixel 10 for Nano v3, Galaxy S26 Ultra on Snapdragon 8 Elite Gen 5. The base iPhone 18 at a reported 9 GB and Pixel 9 and older will run the phone fine and will not get the features. If you are on a 12 GB device already, this year’s upgrade is incremental for AI specifically.
Part Nineteen: What I Am Watching Next Quarter
Whether Meta actually ships Muse Spark’s weights, and under what licence. “Soon” from a CEO on X, with no parameter count and no licence text, is the weakest form of commitment in this article. If they ship under Apache 2.0 it materially changes the open ecosystem. If they ship under a bespoke licence with a revenue gate, that is now the industry default and open weights become a marketing category rather than a property.
Whether the Ornith-1.5 self-improvement result replicates. An independent evaluation on tasks outside the self-generated curriculum is the thing that would settle it. This is the highest-variance item on the list: it is either the most important result of 2026 or a cautionary tale about self-generated benchmarks, and I do not currently know which.
Whether Aion 1.0 Plan actually ships and what it runs at. A 14B reasoning model in Windows is a genuinely new category. If it runs at 3 tokens per second on qualifying hardware, it is a demo. If it runs at 20, it changes what a desktop application can assume.
The CVE attribution curve. 6, 15, 35 in successive months. If April through August continued that trajectory, the Georgia Tech data will be the most consequential AI security publication of the year when it lands.
Whether anyone builds the review tooling. The gap between what agents can produce and what humans can verify is the defining problem of 2027, and as of today almost all the venture money is still going into generation rather than verification. Whoever ships the tool that reliably tells you which 5% of a diff needs human eyes will be very hard to compete with.
Whether the memory shortage eases. It is the hidden variable behind the 12 GB phone gate, the 32 GB M6 cap, the delayed 512 GB Mac tier and the June Apple price rise. Nobody credible is forecasting relief.
And whether safety-gated frontier models stay an exception. Mythos 5.1 is gated for dual-use reasons that I find defensible, and Project Glasswing is actively widening access — roughly 150 organisations across more than fifteen countries by June 2026. But the precedent is set: the top scorer on a public coding benchmark is now something most organisations cannot buy at any price. If that becomes a pattern rather than a special case, “can my organisation get vetted” turns into a model selection criterion, and the argument for open weights outside the US stops being about cost entirely.
Foire aux questions
What is the best LLM in September 2026?
On the aggregate, Claude Fable 5.1 leads Artificial Analysis’s Intelligence Index v4.1.1 at 65.7, ahead of Claude Opus 5 at 63.0, Claude Fable 5 at 62.1, Grok 4.6 at 60.9 and GPT-5.6 Sol at 58.9. But the aggregate compresses the differences that matter. GPT-5.6 Sol leads browsing at 90.4% on BrowseComp; Gemini 3.8 Flash delivers 58.7 at $0.75 per million input tokens; GLM-5.3-Flash delivers 57.5 at $0.15. For most real workloads the top eight models are interchangeable and the decision should be made on price, latency, cache economics and licence rather than on ranking.
What is the best open-weight model right now?
It depends on your hardware and your licence tolerance. GLM-5.3 (753B) scores highest at 59.5 but carries a custom licence with a $10 billion revenue security-review gate. DeepSeek V4 Pro (1.6T total, 49B active) is MIT licensed and scores 87.9 on Terminal-Bench 2.1, but needs a cluster. For a machine you actually own, Qwen3.8-27B or Gemma 4 31B — both Apache 2.0 — are the best models that fit in 32 GB.
Is vibe coding dead in 2026?
The word is dying; the practice split in two. Vibe coding in the original sense — prompt, accept, do not read the diff — remains correct for disposable work: scripts, prototypes, one-off analyses. What replaced it for anything that ships is spec-driven agentic engineering: a written specification, a sandbox, a test suite the agent must pass, and a real review of the resulting diff. The dangerous middle — production code, unreviewed — is where every documented incident of 2026 came from.
Does AI coding actually make developers faster?
The only randomised controlled trial says no. METR found experienced developers were 19% slower with early-2025 AI tools on mature codebases, while believing they had been 20% faster — a 40-percentage-point overestimate. Their 2026 follow-up could not be run cleanly because developers refused to work without AI. Surveys report a 3× speed multiplier but only a 1.4–2× change in the value of work. My reading: large gains on unfamiliar work, boilerplate, tests and migrations; small or negative gains on codebases you know intimately.
How risky is AI-generated code?
Measurably risky and improving slowly. Veracode found 45% of AI-generated samples introduce an OWASP Top 10 vulnerability, with Java worst at 72%. Apiiro measured AI-assisted developers producing commits 3–4× faster and security findings 10× faster, with privilege escalation paths up 322%. Roughly 20% of AI-generated code references packages that do not exist, and 43% of those hallucinated names recur consistently — which is a supply chain attack surface. The fix is automated gates on every commit, not abstinence.
Can I run a good LLM offline on my own computer?
Yes, and 2026 is the first year that is unambiguously true. On 8 GB of memory, Gemma 4 E4B is genuinely useful. On 32 GB, Qwen3.8-27B or Gemma 4 31B are strong multimodal models under Apache 2.0. On 128 GB, gpt-oss-120b is the sweet spot. What does not fit on any consumer machine is the actual frontier: Kimi K3 at 2.8 trillion parameters and DeepSeek V4 Pro at 1.6 trillion both need a cluster.
What is Microsoft Aion 1.0?
A family of on-device models announced at Build on 2 June 2026 and shipped into Windows 11. Aion 1.0 Instruct is a small model for summarisation, rewriting and extraction that runs on a modern CPU with no NPU required, exposed through Edge’s Prompt, Summarizer, Writer and Rewriter JavaScript APIs, with open weights on Hugging Face since July 2026. Aion 1.0 Plan is a 14-billion-parameter reasoning and tool-calling model with a 32K context window for agentic workflows, requiring a Copilot+ PC with a 40-TOPS minimum NPU, and was still “coming months” at the start of September 2026.
Why do phones need 12 GB of RAM for AI features?
Because on-device models are memory-bound, not compute-bound. Apple’s AFM 3 Core Advanced is a 20-billion-parameter sparse model that lives in flash storage and swaps routed experts into DRAM on demand — which still needs somewhere to swap them into, on top of the OS, the app and the camera pipeline. Ming-Chi Kuo reports two iOS 27 features requiring 12 GB. Google’s Gemini Intelligence has the same 12 GB minimum. The gap between 9 GB and 12 GB is the working set, not market segmentation.
Is an NPU worth having for local AI?
Less than the marketing implies. On a 45-TOPS NPU, an 8B model generates roughly 5 tokens per second, because token generation is limited by memory bandwidth rather than compute. NPUs are excellent for always-on, low-power, short-burst tasks — the ones an operating system runs constantly. For interactive chat on a laptop, the GPU or even the CPU path is frequently faster. Buy on memory bandwidth and capacity; treat TOPS as close to meaningless for shopping.
Are open-weight models actually open source?
Mostly not. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) and Ornith-1.5 (MIT) carry genuinely permissive licences. GLM-5.3 requires companies above $10 billion revenue to pass Z.ai’s security review; Kimi K3 uses a revenue-tiered licence; MiniMax M3 mandates prominent “Built with MiniMax M3” attribution for any commercial use and written authorisation above $20 million revenue. None of them release training data or training code. “Open weight” is the accurate term; “open source” is doing dishonest work.
Is it cheaper to run models locally than to use an API?
Almost never on token cost alone. A moderate month of agentic work — 40M input and 3M output tokens — costs about $7 on GLM-5.3-Flash and about $41 on Gemini 3.8 Flash. A $2,400 local box amortised over three years is roughly $67 a month before electricity. Local hardware beats the top of the frontier on cost and loses to the bottom of it. Buy local for data residency, rate-limit freedom, version pinning and offline operation — or because you needed the workstation anyway.
What does the EU AI Act require in 2026?
As of 2 August 2026, enforcement powers and Article 50 transparency duties apply to general-purpose AI, and fines are now available. The Digital Omnibus, Regulation (EU) 2026/1744, entered into force on 27 July 2026 and set fixed dates: 2 December 2026 ends the watermarking grace period; 2 August 2027 closes the transition for GPAI models already on the market; 2 December 2027 applies to stand-alone high-risk systems under Annex III; 2 August 2028 covers high-risk AI embedded in regulated products. If you build on models rather than train them, most GPAI obligations sit with the provider — transparency and high-risk classification are what land on you. This is not legal advice.
How long can an AI agent work unsupervised?
METR measures the task length a model completes autonomously with 50% success. That figure went from about 30 seconds in 2022 to over 14 hours for frontier systems in 2026, with a doubling time of roughly 196 days on METR’s hybrid fit, or 131 days when restricted to post-2023 models. The confidence intervals are very wide — Claude Opus 4.5’s 320-minute horizon ranges from 170 to 729 minutes — and only 5 of METR’s 31 long tasks use measured human baselines. Extrapolated, that is about one working day of autonomous task length in 2027.
Which model should I use for coding specifically?
Route rather than choose. Planning and architecture to the most capable model you can afford (Claude Fable 5.1); the bulk of long-horizon implementation to Claude Opus 5 at half the price; high-volume mechanical work to GLM-5.3-Flash at $0.15/$0.47; anything touching client data to a local open-weight model; and renames, docstrings and lint fixes to a small local model. Write the model IDs so that swapping one is a single-line change — four labs shipped a top-ten model between June and September 2026.
En résumé
Twelve months ago, the interesting question in AI was which model was smartest. The state of AI 2026 is that this question has become close to uninteresting. The top ten models span 8.2 points on the best available aggregate, and the cheapest of them costs one sixty-seventh of the most expensive.
What replaced it is more useful and less exciting: can you verify what these things produce, fast enough to keep up with them?
That single question explains every finding in this article. It explains why SWE-bench saturated at 96% and stopped being informative. It explains why adoption of AI coding tools hit 90% while trust fell to 29%. It explains why Veracode’s security failure rate did not budge while capability soared, because capability and verifiability are different axes and only one of them is being optimised. It explains why DORA found that the returns come from the organisation rather than the tool. And it explains why the practice that actually works in 2026 — specification, sandbox, test gate, real review — looks so much less magical than the demos.
Four things I would take away.
The frontier commoditised faster than anyone expected, and the open-weight gap is now about six months. A 397B MIT-licensed model beats last generation’s closed frontier on SWE-bench. A 753B open-weight model outranks GPT-5.6 Sol on the aggregate index. Plan for a world where the model is not your differentiator, because it very nearly is not one already.
Read the licence before the benchmark. Capability is converging; terms are diverging. Z.ai moved away from MIT between releases. Meta has promised weights with no licence text. Anthropic’s best coding model is gated by nationality. For a commercial buyer, four points of benchmark is worth less than a licence your lawyer can read in ninety seconds.
Verification is the whole game now, and almost nobody is funding it. Agents can produce a day of work; we review it with tools built for reviewing an hour of work. If you are choosing where to spend engineering effort in the next twelve months, spend it on tests, specifications and review tooling rather than on prompt technique. Prompt technique depreciates with every model release. Verification infrastructure compounds.
And offline AI got real, on a memory budget that just got expensive. A 27-billion-parameter Apache-licensed multimodal model runs on a machine you can buy for €2,500. Windows ships a model in the operating system. Your phone runs a 20-billion-parameter sparse model out of flash. Every ceiling on that — the 12 GB phone gate, the 32 GB laptop cap, the 40-TOPS floor — is a memory allocation decision in a market where DRAM is scarce, not a limit of the silicon.
The setup I would actually build today: Gemma 4 E4B on the device for the always-on tier; Qwen3.8-27B on your own hardware for anything that must not leave the building; GLM-5.3-Flash at $0.15/$0.47 for the high-volume middle; and Claude Opus 5 or Fable 5.1 for planning and the genuinely hard problems, with caching switched on. Route between them in a config file, and expect to rewrite that file in three months.
Revisit this in December. Meta will either have shipped weights or not. Aion 1.0 Plan will either be real or vapour. The Ornith self-improvement result will have replicated or quietly disappeared. And the CVE attribution curve will have told us whether 2026 was the year the industry tightened its own gates or the year it waited for someone else to.
Are you running open-weight models in production in the EU, or shipping agent-written code through a review process you actually trust? I am particularly interested in two things: measured token-cost splits by agent role, and anything that works for reviewing thousand-line agent diffs. Corrections and counter-evidence welcome — this article gets updated when the picture changes.
Last updated: 3 September 2026.