 Deutsch
 English
 Español
 Italiano
 Français

Der Stand der KI im Jahr 2026 lässt sich auf drei Ereignisse in den ersten acht Monaten des Jahres zurückführen – und fast niemand hat diese in einem Atemzug genannt.
Ein Modell hat 96% auf der SWE-Bench „Verified“ durchlaufen. Nicht 96% in einem Spielzeug-Benchmark – sondern 96% bei echten GitHub-Issues aus Django, Flask und scikit-learn: der Benchmark, der eigentlich Jahre dauern sollte. Er ist nun als Diskriminator praktisch abgeschlossen, und die drei Modelle an der Spitze liegen weniger als einen Prozentpunkt auseinander.
Die besten derzeit verfügbaren Erkenntnisse darüber, ob KI-Programmierwerkzeuge erfahrenen Entwicklern helfen, schneller zu arbeiten, besagen nach wie vor: Nein. Die randomisierte kontrollierte Studie von METR ergab eine Verlangsamung um 19%. Der Versuch des Unternehmens, die Studie im Jahr 2026 zu wiederholen, scheiterte, da die Entwickler sich weigerten, ohne KI zu arbeiten – selbst bei einem Stundenlohn von $50. Die Nutzer dieser Tools glauben, dass sie dreimal schneller sind. Messungen zeigen jedoch, dass dies nicht der Fall ist.
Und Microsoft hat ein Modell mit 14 Milliarden Parametern direkt in Windows integriert., ein Satz, der im Jahr 2024 noch Science-Fiction gewesen wäre und nun eine Fußnote in einer Build-Keynote ist.
Diese drei Tatsachen sind alles Stand der KI im Jahr 2026 im Kleinen. Die Modelle wurden außergewöhnlich. Der erwartete Produktivitätsgewinn blieb jedoch aus. Und die interessante Grenze verlagerte sich still und leise vom Rechenzentrum auf das Gerät in Ihrer Hand.
Dies ist die ausführliche Fassung des Berichts „Stand der KI 2026“. Er richtet sich an Personen, die finanzielle Entscheidungen treffen müssen – welches Modell sie einsetzen sollen, ob sie Agenten Produktionscode schreiben lassen, was sie kaufen und was sie einem Kunden oder einem Datenschutzbeauftragten mitteilen sollen. Ich habe zwischen bereits veröffentlichten Funktionen, Berichten und Gerüchten unterschieden, denn der mit Abstand teuerste Fehler in diesem Bereich ist es, die Planung auf ein Modell auszurichten, das noch gar nicht existiert.
Zuletzt aktualisiert am 3. September 2026. Bis Weihnachten muss es erneut aktualisiert werden.
TL;DR – Der Stand der KI im Jahr 2026 in 90 Sekunden
Es ist ein Vierkampf, und Anthropic liegt derzeit in der Gesamtwertung vorn. Stand 2. September 2026 weist der Intelligence Index v4.1.1 von Artificial Analysis für Claude Fable 5.1 einen Wert von 65,7, für Claude Opus 5 einen Wert von 63,0, Grok 4.6 bei 60,9 und GPT-5.6 Sol bei 58,9. Doch hinter diesem Gesamtwert verbirgt sich das Interessante: GPT-5.6 Sol führt bei BrowseComp mit 90,41 TP3T, „Gemini 3.8 Flash“ liefert 58,7 bei $0,75 pro Million Eingabetoken, und die Top-Ten-Modelle liegen nur 8,2 Punkte auseinander – eine Spanne, die so eng ist, dass Unterschiede bei Harness und Prompt ein Modell um mehrere Plätze verschieben können.
Die offenen Gewichtsklassen liegen etwa eine Generation zurück, holen aber auf. GLM-5.3 (753B, offen) liegt bei 59,5 – auf Platz sechs der Gesamtwertung, vor GPT-5.6 Sol. DeepSeek V4 Pro wurde mit 1,6 Billionen Parametern unter einer echten MIT-Lizenz ausgeliefert. Ornith-1.5-397B erreichte 86 Punkte im SWE-Bench Verified und übertraf Claude Opus 4.8 im Terminal-Bench 2.1 knapp mit 86,1 zu 85,0. Die Qualifikationslücke beträgt derzeit etwa sechs Monate. Entscheidend ist jedoch die Lizenzlücke.
“Vibe-Coding” hat die Debatte über die Akzeptanz gewonnen, aber die Debatte über die Beweislage verloren. 90% der Entwickler nutzen bei der Arbeit mindestens ein KI-Codierungs-Tool. Der Markt für Coding-Agenten für Unternehmen hat ein annualisiertes Volumen von rund $10 Milliarden. Und das Vertrauen der Entwickler in KI-Ergebnisse sank innerhalb von zwei Jahren von 40% auf 29%. Die Tools sind universell einsetzbar, und die Menschen, die sie nutzen, vertrauen ihnen von Jahr zu Jahr weniger. Beides ist rational.
Die Sicherheitsrechnung ist eingetroffen und enthält eine detaillierte Aufstellung. Veracode stellte fest, dass 45% der von KI generierten Code-Beispiele eine OWASP-Top-10-Sicherheitslücke aufweisen. Apiiro ermittelte, dass KI-unterstützte Entwickler Commits drei- bis viermal schneller erstellen und Sicherheitsbefunde zehnmal schneller ermitteln. Etwa 20% des KI-generierten Codes verweisen auf Pakete, die nicht existieren. Dies ist kein Argument gegen die Tools. Es ist vielmehr eine Frage danach, wo man die Grenze zieht.
Offline-KI hat sich in diesem Jahr auf Hardware, die die Nutzer bereits besitzen, als wirklich nützlich erwiesen. Ein Modell mit 2 Milliarden Parametern läuft auf einem iPhone mit 61 Tokens pro Sekunde. Microsoft hat einen Reasoner mit 14 Milliarden Parametern in Windows integriert, für den eine NPU mit 40 TOPS erforderlich ist. Google beschränkt den Zugriff auf sein bestes On-Device-Modell auf Geräte mit mindestens 12 GB RAM, ebenso wie Apple. Entscheidend dafür, was man offline ausführen kann, ist der Arbeitsspeicher, nicht die Rechenleistung, und gerade der Arbeitsspeicher ist knapp geworden.
Der treffende Einzeiler zum Stand der KI im Jahr 2026: Dies ist das Jahr, in dem die Modelle nicht mehr den Engpass darstellten. Die Verifizierung wurde zum Engpass. Jede wichtige Entscheidung in diesem Artikel – welches Modell, welches Kabelbaum, welches Gerät, welches Tor – ergibt sich aus dieser einen Änderung.
Schnellvergleich: „The Frontier“, September 2026
Der Artificial Analysis Intelligence Index v4.1.1 fasst neun Bewertungen zusammen: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience und AA-LCR. Die folgenden Werte entsprechen dem Stand vom 2. September 2026.
| Modell | Labor | AA-Index | Gewichte | Ein-/Ausgabe pro 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | Geschlossen | $10.00 / $50.00 |
| Claude Opus 5 | Anthropic | 63.0 | Geschlossen | $5.00 / $25.00 |
| Claude Fable 5 | Anthropic | 62.1 | Geschlossen | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | Geschlossen | — |
| Kimi K3 | Moonshot | 59.7 | Offene Gewichtsklasse | — |
| GLM-5.3 | Z.ai | 59.5 | Offene Gewichtsklasse | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Geschlossen | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | Geschlossen | $0.75 / $3.75 | |
| Qwen 3.8 Max – Vorschau | Alibaba | 58.1 | Geschlossen | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Offene Gewichtsklasse | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropic | 57.3 | Geschlossen | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | Geschlossen | — |
| GPT-5.5 | OpenAI | 56.3 | Geschlossen | — |
Lies die vierte Spalte vor der dritten. Zwei der zehn besten Modelle verfügen über herunterladbare Gewichte, und einer davon kostet $0,15 pro Million eingehender Token.
Schnellvergleich: Die Grenze der offenen Gewichtsklassen
| Modell | Gesamt / Aktiv | Kontext | Lizenz | Veröffentlicht |
|---|---|---|---|---|
| Kimi K3 | 2,8 T / 104 B | 1 Mio. | Umsatzabhängig (benutzerdefiniert) | Juli 2026 |
| Qwen3.8-2.4T-A95B | 2,4 T / 95 B | 262.000 (1 Million über YaRN) | Apache 2.0 | 14. August 2026 |
| DeepSeek V4 Pro | 1,6 T / 49 B | 1 Mio. | MIT | 12. August 2026 |
| GLM-5.3 | 753B / ~40B | 1 Mio. | Kundenspezifisch ($10B-Gate) | August 2026 |
| MiniMax M3 | 428B / 23B | 1 Mio. | Benutzerdefiniert (Quellenangabe) | 1. Juni 2026 |
| Ornith-1.5-397B | 397B MoE | 262.000 (1 Million über YaRN) | MIT | August 2026 |
| Gemma 4 31B | 31B dicht | 256 KB | Apache 2.0 | 6. April 2026 |
| Qwen3.8-27B | 27B dicht | 262.000 | Apache 2.0 | 14. August 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6. April 2026 |
Drei dieser neun sind wirklich OSI-konform. Das ist die wahre Geschichte der offenen Gewichte im Jahr 2026, und darauf werde ich in Teil 3 noch einmal zurückkommen.
ERSTER AKT – DIE MODELS
Teil 1: Was 2026 tatsächlich ausgeliefert wurde
Bevor wir ins Detail gehen, zunächst einmal die Bilanz. Ich unterteile dies in drei Ebenen, da genau in den Unterschieden zwischen ihnen Geld verschwendet wird.
Bestätigt und versandfertig
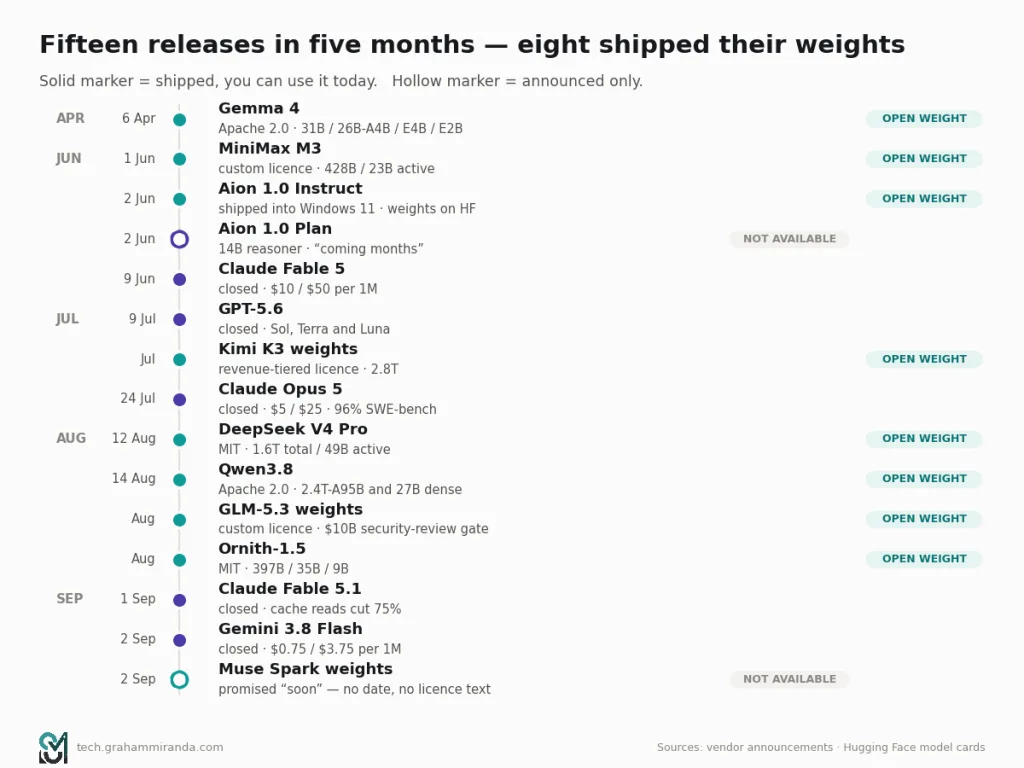
- 6. April 2026 – Google veröffentlicht Gemma 4 unter Apache 2.0, eine Änderung der Lizenzbedingungen gegenüber den maßgeschneiderten Bedingungen von Gemma 3. Vier Varianten: 31B (dicht), 26B mit 4B aktiven Elementen (MoE), E4B mit ca. 8B und E2B mit insgesamt 5,1B, davon 2,3B aktive Elemente. 256K Kontext bei den großen Modellen, 128K bei der E-Serie. Alle unterstützen Text-, Bild- und Videoeingaben; E2B und E4B bieten zusätzlich native Audiounterstützung.
- 1. Juni 2026 – MiniMax M3. Insgesamt 428B / 23B aktiv, 1M Kontext, native Multimodalität, ein neuer Sparse-Attention-Operator, Gewichte auf Hugging Face. Ausführlich behandelt in meinem früherer Beitrag über lokale KI-Hardware.
- 2. Juni 2026 – Microsoft kündigt auf der Build „Aion 1.0“ an. Eine Reihe von On-Device-Modellen, die direkt in Windows 11 integriert wurden: Aion 1.0 Instruct (CPU-fähig, in Edge Canary ab Version 150.0.4070) und Aion 1.0 Plan, ein Modell mit 14 Milliarden Parametern für Schlussfolgerungen und den Aufruf von Tools mit einem Kontextfenster von 32 KB.
- 9. Juni 2026 – Claude Fable 5. Anthropics Spitzenklasse: $10/$50 pro Million, 1 Mio. Kontext, 128K maximale Ausgabe.
- 9. Juli 2026 – OpenAI bringt GPT-5.6 auf den Markt in drei Varianten: Sol ($5/$30), Terra ($2,50/$15) und Luna ($1/$6). Die Cyber-Fähigkeiten sind bei Sol bereits integriert und werden nicht als separates Modell angeboten; der Zugriff erfolgt über das „Trusted Access for Cyber“-Programm von OpenAI.
- Juli 2026 – Moonshot gibt die Gewichte des Kimi K3 bekannt. 2,8 Billionen Parameter, 1 Mio. Kontext, natives MXFP4, im Rahmen einer umsatzabhängigen Lizenz.
- 24. Juli 2026 – Claude Opus 5. $5/$25, unverändert gegenüber Opus 4.8. Anthropic gibt an, dass es die Leistung von Opus 4.8 auf Frontier-Bench v0.1 “mehr als verdoppelt’ und auf ARC-AGI 3 dreimal so viele Punkte erzielt wie das nächstbeste Modell.
- 12. August 2026 – DeepSeek V4 Pro verlässt die Vorschauphase mit Gewichten unter MIT-Lizenz: insgesamt 1,6 T (in einigen Berichten wird dieser Wert auf 1,7 T gerundet), 49 Mrd. aktive Gewichte, 1 Mio. Kontextgewichte, 893 GB an BF16- und FP8-Tensoren sowie ein spekulatives Dekodierungsmodul von DSpark. Terminal-Bench 2.1 bei 87,9, HLE-with-tools bei 60,0, CyberGym bei 83,3. DeepSeek hat gleichzeitig die API-Preise erhöht.
- 14. August 2026 – Qwen 3.8, offene Gewichtsklassen unter Apache 2.0: ein 27B-Dense-Multimodal-Modell und ein 2,4T-A95B-Giant, beide auf Hugging Face und ModelScope, 262K nativer Kontext, mit YaRN auf 1M erweiterbar.
- August 2026 – GLM-5.3-Gewichte Etwa zwei Wochen nach dem Start der API auf Hugging Face veröffentlicht. 753B MoE, 1M Kontext, 128K Ausgabe, BF16 und FP8.
- August 2026 – Ornith-1.5. Drei Modelle (397B MoE, 35B MoE mit 3B aktiv, 9B dicht), die auf Qwen3.5 und Gemma 4 basieren und weiter vortrainiert wurden, unter MIT-Lizenz stehen und laut eigenen Angaben 86 Punkte auf dem SWE-Bench Verified erzielen.
- 1. September 2026 – Claude Fable 5.1 und Mythos 5.1. Adaptives Denken standardmäßig aktiviert, 1 Mio. Kontext, 128 KB Ausgabe. Die Grundpreise bleiben unverändert bei 1 TP 4 T 10/1 TP 4 T 50, aber die Cache-Lesevorgänge sinken um 751 TP 3 T, von 1 TP 4 T 1,00 auf 1 TP 4 T 0,25 pro Million.
- 2. September 2026 – Gemini 3.8 Flash bei $0,75/$3,75, 1 Mio. Zeichen Eingabekontext, 66.000 Zeichen Ausgabe, Wissensstand März 2026, mit Eingaben in Form von Text, Bildern, Videos, Audiodateien und PDF-Dateien.
- 2. September 2026 – Meta bringt Muse Spark 1.3 auf den Markt und die Muse Code-Befehlszeilenschnittstelle.
Gemeldet, glaubwürdig, nicht bestätigt
- Meta wird die Gewichte von Muse Spark “in Kürze” veröffentlichen.” Das ist Mark Zuckerberg auf X – ohne Datum, ohne Angabe der Parameteranzahl, ohne Details zur Architektur und ohne Lizenztext. Meta hat die Größe des Modells in keiner Version offengelegt.
- Gemini Nano v4 wird als demnächst für Android verfügbar beschrieben, wobei Nano v3 derzeit auf die Pixel-10-Serie beschränkt ist.
- Aion 1.0-Plan Die allgemeine Verfügbarkeit ist für die “kommenden Monate” geplant; derzeit befindet sich nur „Instruct“ in der Vorschauphase.
Gerücht, aus einer einzigen Quelle, entsprechend behandeln
- Alles, was Sie über das nächste Flaggschiff von Anthropic, OpenAI oder Google gelesen haben. In einem Markt, in dem vier Forschungslabore innerhalb von neun Wochen ein Top-10-Modell auf den Markt gebracht haben, haben Gerüchte über zukünftige Entwicklungen eine Halbwertszeit von etwa zwei Wochen.
Noch eine Sache, die es wert ist, erwähnt zu werden, da sie neu ist und außerhalb der Sicherheitsbranche fast niemand darüber spricht. Claude Mythos 5.1 erreicht im Terminal-Bench 4.0 60,9 Punkte – mehr als die 55,8 Punkte von Fable 5.1 – und 95,51 TP3T im SWE-Bench Verified. Es ist nicht im Handel erhältlich.
Anthropic beschreibt Mythos als sein “leistungsfähigstes Modell für Cybersicherheit und biologische Forschung”, und es steht ausschließlich geprüften Cybersicherheitsexperten und Biowissenschaftlern über zwei Programme für vertrauenswürdigen Zugang zur Verfügung: das “Cyber Verification Program” und das „Life Sciences Verification Program“. Anthropic formuliert es selbst so, dass man „es derzeit nur einer ausgewählten Gruppe von US-Organisationen zur Verfügung stellen kann, wir jedoch daran arbeiten, den Zugang auszuweiten“. Das Projekt „Glasswing“, die Initiative zur Ausweitung des Zugangs, hatte etwa 150 Organisationen in mehr als fünfzehn Ländern Stand: Juni 2026.
Die Argumentation basiert auf dem Dual-Use-Prinzip – ein Modell, das sich hervorragend zum Aufspüren von Schwachstellen eignet, ist für beide Seiten gleichermaßen nützlich –, und ich halte sie für vertretbar. Man sollte jedoch die strukturellen Konsequenzen beachten, denn sie sind wirklich neu: Das Modell mit der höchsten Punktzahl in einem öffentlichen Programmier-Benchmark ist mittlerweile eines, auf das der Großteil der Weltbevölkerung zu keinem Preis zugreifen kann. Die Einschränkung von Funktionen aus Sicherheitsgründen statt aus wirtschaftlichen Gründen wird eher zunehmen als abnehmen, und wenn Sie außerhalb der USA leben, ist dies ein Argument dafür, auf offene Gewichtsangaben zu achten – ein Argument, das nichts mit den Kosten zu tun hat.
Bild anzeigen Neun Monate, zwölf bedeutende Veröffentlichungen, davon vier im offenen Gewichtsbereich. Durchgezogene Balken stehen bereits zur Verfügung oder bieten API-Zugriff, den Sie heute erwerben können; gepunktete Umrisse sind angekündigt, aber noch nicht verfügbar.
Teil 2: Was die aktuellen Frontier-Modelle tatsächlich voneinander unterscheidet
Hier ist die unangenehme Wahrheit über die Spitze dieser Rangliste: Bei den meisten Aufgaben, die Sie tatsächlich erledigen werden, sind die acht besten Modelle untereinander austauschbar.
Ich sage das nicht, um gegen den Strom zu schwimmen. Ich sage es, weil der Gesamtindex-Spread zwischen Claude Fable 5.1 bei 65,7 und GLM-5.3-Flash bei 57,5 acht Punkte beträgt, und GLM-5.3-Flash kostet $0,15 pro Million Eingabetoken, während Fable $10,00 kostet. Das ist ein Ein 12%-Leistungsunterschied bei der Gesamtpunktzahl führt zu einem 67-fachen Preisunterschied, und zusammengesetzte Bewertungen verdichten genau die Unterschiede, die für Sie wichtig sind, während sie diejenigen überbewerten, die es nicht sind.
Die entscheidende Frage lautet also nicht: “Welches Modell ist das beste?”, sondern: “Wofür eignet sich jedes einzelne Modell am besten, und deckt sich das mit meinem Wochenablauf?”
Die vier Dinge, die sich wirklich unterscheiden
1. Agentische Zuverlässigkeit über einen langen Zeithorizont. Das ist das eigentliche Unterscheidungsmerkmal für 2026, und es wird nur unzureichend gemessen. Anthropics Opus 5 wird ausdrücklich als “sprunghafte Verbesserung für die Opus-Stufe, die lang laufende Agenten antreibt” positioniert – nicht als intelligenteres Modell, sondern als ein Modell, das nicht bereits in der sechsten Stunde zusammenbricht. Die Belege für diese Art von Verbesserung finden sich eher in agentenbasierten Benchmarks (Terminal-Bench, OSWorld, Frontier-Bench) als in Wissens-Benchmarks, und diese Benchmarks sind noch jung, ungenau und anfällig für Scaffolding-Effekte.
2. Cache-Ökonomie. Die wichtigste Neuerung in Fable 5.1 war kein sprunghafter Leistungszuwachs. Vielmehr wurden die Cache-Lesevorgänge um 751 TP3T reduziert, und zwar von 1 TP4T1,00 auf 1 TP4T0,25 pro Million Token – was laut MarkTechPost bei typischen Workflows eine Kostenersparnis von etwa 251 TP3T und bei agentenbasierten Workflows von bis zu 451 TP3T bedeutet. Für jeden Agenten, der in jeder Runde eine umfangreiche Systemanweisung oder den gesamten Quellcode erneut ausliest, hat die Cache-Preisgestaltung einen größeren Einfluss auf Ihre monatliche Rechnung als die Wahl des Modells. So etwas kommt in keine Rangliste.
3. Navigation und Nutzung der Werkzeuge. GPT-5.6 Sol erreicht bei BrowseComp 90,41 TP3T – 92,21 TP3T bei der Einstellung „Ultra Reasoning“. Das ist eine konkrete, veröffentlichte Leistungsangabe, und wenn Ihre Arbeitslast eher im Bereich „Recherche und Synthese“ als im Bereich „Codierung und Verifizierung“ liegt, ist dies mehr als zwei Punkte des Gesamtindex wert.
4. Preis pro zutreffender Antwort. Gemini 3.8 Flash mit einem Index von 58,7 für die Eingabekombination $0,75 ist im Vergleich zur geschlossenen Grenze das offensichtlich am stärksten falsch bewertete Produkt auf dem Markt. GLM-5.3-Flash mit einem Index von 57,5 für die Eingabekombination $0,15 ist ganz einfach das offensichtlich am stärksten falsch bewertete Produkt überhaupt.
Die Preistabelle, denn sie ist ausschlaggebend für die Entscheidung
| Modell | Eingabe /1M | Ausgabe /1M | Zwischengespeicherte Eingabe /1M | Kontext |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M / 128K Ausgang |
| Claude Opus 5 | $5.00 | $25.00 | — | 1M / 128K Ausgang |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonett 5 | $2.00 | $10.00 | — | 1M / 128K Ausgang |
| GLM-5.3 | $1.40 | $4.40 | — | 1M / 128K Ausgang |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1 Mio. / 66.000 ausgegeben |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1 Mio. |
| Muse Spark (Mitwirkende) | $0.10 | $0.20 | $0.002 | — |
Diese letzte Zeile verdient einen zweiten Blick. Die „Contributors“-Stufe von Meta umfasst $0.10 eingehende und $0.20 ausgehende Daten – mit möglichem Zugriff auf Ihre Daten zu Trainingszwecken. Das ist kein Preis, sondern ein Tauschgeschäft. Es ist außerdem, soweit ich das beurteilen kann, der ehrlichste Ausdruck des tatsächlichen Geschäftsmodells, das hinter vielen billigen Schlussfolgerungen steckt, und ich hätte es lieber in einer Preistabelle aufgeführt, als dass es in einer DPA versteckt ist.
Bild anzeigen Auf der einen Achse die Intelligenz, auf der anderen der Preis in logarithmischer Skalierung. Acht Indexpunkte trennen den oberen vom unteren Rand des Diagramms; die Preise liegen im Verhältnis 67:1 auseinander. Die effiziente Grenze verläuft unten rechts, und dort kauft fast niemand.
Die API-Änderung, vor der dich niemand gewarnt hat
Fable 5.1 enthält drei grundlegende Änderungen: Die erzwungene Verwendung von Werkzeugen entfällt, Denkblöcke sind nun modellspezifisch, und Änderungen an Systemmeldungen oder Werkzeugen während eines Dialogs führen nun zu Fehlern, anstatt stillschweigend akzeptiert zu werden.
Das dritte Beispiel wird Probleme verursachen. Viele Agenten-Harnesses verändern die Systemaufforderung oder die Werkzeugliste zwischen den Zügen – sie fügen ein Werkzeug hinzu, wenn eine Teilaufgabe beginnt, oder kürzen Anweisungen, um Kontext zu sparen. In Fable 5.1 wird dies nun als Fehler behandelt. Wenn Sie eine Modell-ID in einer Konfigurationsdatei aktualisieren und Ihr Agent ab Runde vier 400er-Fehler ausgibt, ist dies der Grund dafür.
Die allgemeine Erkenntnis, die mehr wert ist als die konkrete: Im Jahr 2026 ist eine Modellaktualisierung gleichbedeutend mit einer API-Migration. Vergeben Sie Ihre Modell-IDs so, dass das Austauschen einer ID nur eine Änderung von einer Zeile erfordert, und fixieren Sie sie. Diese Änderung werden Sie innerhalb eines Quartals erneut vornehmen müssen.
Teil 3: Die Grenze der offenen Gewichtsklassen und die Lizenzfalle
Das ist der Teil der Geschichte rund um das Jahr 2026, den ich wirklich spannend finde, und zugleich der Teil, bei dem das Marketing am irreführendsten ist.
Die Leistungslücke beträgt etwa sechs Monate
Sehen Sie sich an, was die offenen Gewichte zwischen Juni und August 2026 erreicht haben:
- DeepSeek V4 Pro: Insgesamt 1,6 T, 49 B aktiv, MIT-Lizenz, Terminal-Bench 2.1 bei 87,9. Das ist ein höherer Terminal-Bench-Wert als bei den meisten in diesem Jahr veröffentlichten geschlossenen Modellen.
- Ornith-1.5-397B: 86 auf SWE-Bench (verifiziert), 86,1 auf Terminal-Bench 2.1 im Vergleich zu 85,0 bei Claude Opus 4.8 und 92,8 auf GPQA Diamond. MIT-lizenziert, 262K nativer Kontext, mit YaRN auf etwa 1M erweiterbar. Basiert auf Qwen 3.5 und Gemma 4 mit fortlaufendem Vor- und Nachtraining.
- GLM-5.3: Platz sechs im „Artificial Analysis“-Index mit 59,5, noch vor GPT-5.6 Sol.
- Qwen 3.8: ein Modell mit 2,4 Billionen Parametern unter der Apache-2.0-Lizenz sowie ein 27 Milliarden Parameter umfassendes, dichtes multimodales Schwestermodell, das laut Alibaba das größere Qwen3.7-Plus bei Programmier- und Büroaufgaben übertrifft.
Vor sechs Monaten lautete die ehrliche Darstellung noch: “Offene Gewichte sind eine Generation im Rückstand und billiger.” Diese Darstellung ist mittlerweile falsch. Die richtige Darstellung lautet: Speziell bei der Kodierung und agentischen Arbeit liegen die besten Modelle mit offenen Gewichten innerhalb der Fehlerbänder der geschlossenen Grenze der letzten Generation und sind zudem 10- bis 60-mal kostengünstiger.
Ornith-1.5 ist das interessanteste Modell des Jahres, und fast niemand hat davon gehört
Darauf möchte ich näher eingehen, denn es handelt sich hierbei um eine wirklich neuartige Erkenntnis und nicht um ein Skalierungsergebnis.
Ornith beschreibt Version 1.5 als eine Erweiterung des “Selbst-Scaffoldings zu einem durchgängigen Kreislauf der Selbstverbesserung”. Im Klartext: Das System schlägt eigene neue Trainingsaufgaben vor, generiert dafür aufgabenspezifische Hilfestellungen, erstellt Lösungsentwürfe und optimiert alle drei Aspekte gemeinsam mithilfe von GRPO. Leistungsfähigere Modelle ermöglichen es ihm, schwierigere Aufgaben vorzuschlagen; bessere Hilfestellungen führen zur Entdeckung besserer Strategien; bessere Ergebnisse liefern ein klareres Lernsignal.
Es wurde auf der Grundlage von Qwen 3.5 und Gemma 4 trainiert – also auf der Basis von Open-Source-Gewichten anderer Entwickler – und übertrifft Claude Opus 4.8 auf Terminal-Bench 2.1, obwohl es nur 397B Parameter umfasst und unter der MIT-Lizenz steht.
Sollte sich diese Schleife verallgemeinern lassen, wäre dies das folgenreichste Ergebnis dieses Artikels., denn das bedeutet, dass sich das offene Ökosystem verbessern kann, ohne dass ein Labor Unsummen für einen Vortrainingslauf ausgeben muss. Wenn es nicht verallgemeinerbar ist – wenn das, was wir beobachten, ein benchmark-spezifisches Überlernen aufgrund eines selbst generierten Lehrplans ist –, dann ist es eine warnende Geschichte, die genau dasselbe Thema betrifft. Ich weiß nicht, was davon zutrifft. Soweit ich das beurteilen kann, weiß das auch niemand außerhalb von Ornith. Was ich mir wünschen würde, bevor ich darauf setze: eine unabhängige Bewertung an Aufgaben, die nicht im Umfeld des selbst generierten Lehrplans liegen, sowie eine als Referenz herangezogene menschliche Basisleistung. Beides gibt es noch nicht.
Nun zu den Lizenzen, denn “Open Source” wird für viele unlautere Praktiken missbraucht
Und das sind die Kosten, die Ihnen diese Gewichte tatsächlich in Form von Verpflichtungen verursachen:
| Modell | Lizenz | Der Haken |
|---|---|---|
| DeepSeek V4 Pro | MIT | Keine. Echte Open-Source-Software. |
| Qwen 3.8 | Apache 2.0 | Keine. Echte Open-Source-Software. |
| Gemma 4 | Apache 2.0 | Keine – und eine echte Verbesserung gegenüber den individuellen Konditionen von Gemma 3. |
| Ornith-1.5 | MIT | Keine Angabe. Bitte überprüfen Sie die Typenschildangaben vor dem Versand selbst. |
| GLM-5.3 | Benutzerdefiniert | Unternehmen über $10B Jahresumsatz müssen die Prüfung von Z.ai bestehen Sicherheitsüberprüfung vor jeglicher kommerziellen Nutzung. Z.ai ist umgezogen weg vom MIT für diese Veröffentlichung. |
| Kimi K3 | Benutzerdefiniert | Umsatzabhängig; für Anbieter mit hohem Volumen ist eine deutliche Zuordnung erforderlich. |
| MiniMax M3 | Benutzerdefiniert | Bei kommerzieller Nutzung ist ein deutlich sichtbarer Hinweis “Built with MiniMax M3” erforderlich; siehe separate schriftliche Genehmigung oben $20M Jahresumsatz. |
| Muse Spark | Unbekannt | Als “in Kürze verfügbar” angekündigt. Es liegt kein Lizenztext vor. |
Drei Anmerkungen. Auf die ersten drei davon bin ich im Kleingedruckten ausführlich eingegangen in Kimi K3 vs. Fable 5.1 vs. GLM-5.3, daher werde ich mich hier auf die Änderungen konzentrieren, die seitdem vorgenommen wurden.
Erstens richten sich die Gates an Hyperscaler, nicht an Sie. Eine Umsatzschwelle von $10 Milliarden schließt im Grunde jeden Leser dieses Artikels aus. Wenn Sie ein deutsches Mittelstandsunternehmen, eine Agentur, eine Beratungsfirma oder ein Einzelentwickler sind, lautet die praktische Antwort in Bezug auf GLM-5.3 und Kimi K3: Sie sind auf der sicheren Seite.
Zweitens ist “mit Ihnen ist alles in Ordnung” nicht dasselbe wie “Ihre rechtliche Prüfung ist in Ordnung”.” Eine maßgeschneiderte Lizenz bedeutet, dass Ihnen jemand das Lesen in Rechnung stellt. Eine MIT- oder Apache-2.0-Lizenz bedeutet, dass jemand sie in neunzig Sekunden durchliest und dann weitermacht. Für die Unternehmensbeschaffung ist dieser Unterschied mehr als vier Benchmark-Punkte wert, und er ist das stärkste Einzelargument für DeepSeek V4 Pro und Qwen3.8 gegenüber GLM-5.3 in einem kommerziellen Produkt.
Drittens: Achten Sie auf die Fahrtrichtung. Z.ai wechselte von der MIT-Lizenz für GLM-5.2 zu einer proprietären Lizenz mit Sicherheitsprüfung für GLM-5.3. DeepSeek ging den umgekehrten Weg und behielt die MIT-Lizenz bei, erhöhte jedoch die API-Preise – was eine schlüssige Strategie ist: Komfort in Rechnung stellen, die Gewichte kostenlos zur Verfügung stellen und die Anbieter von Inferenzdiensten im Wettbewerb um die Bereitstellung konkurrieren lassen. „Open Weights“ sind keine Bewegung. Es handelt sich um eine kommerzielle Taktik, und diese Taktiken ändern sich mit jeder neuen Version. Entwickeln Sie keine Produktarchitektur, die davon ausgeht, dass die Version des nächsten Jahres die Lizenz dieses Jahres übernehmen wird.
Der Begriff “Open Source” sollte im Zusammenhang mit Modellen nicht mehr verwendet werden
Keine dieser Lizenzen ist im Sinne der OSI Open Source, mit Ausnahme der MIT- und Apache-2.0-Lizenzen – und selbst diese stellen zwar Gewichtsdaten zur Verfügung, veröffentlichen jedoch weder Trainingsdaten noch Trainingscode, was sich wesentlich von Open-Source-Software unterscheidet.
Die Begriffe, die ich verwende und empfehlen würde:
- Offene Gewichtsklasse — Man kann die Parameter herunterladen und ausführen. Über die Bedingungen wird nichts gesagt.
- Unter einer offenen Lizenz — MIT, Apache 2.0 oder gleichwertig. Keine Umsatzschwelle, keine Nennungspflicht, keine Einschränkungen hinsichtlich des Verwendungszwecks.
- Open Source — Gewichte, Trainingscode und Datenzusammensetzung unter einer von der OSI genehmigten Lizenz. An der Grenze gibt es so gut wie nichts, was diese Kriterien erfüllt.
Wenn ein Anbieter von einem “Open-Source-Modell” spricht und dabei die erste Variante meint, ist das zwar nicht unbedingt eine Lüge, aber es handelt sich um eine Ungenauigkeit, die in die Ausschreibungsunterlagen einfließt und schließlich zu einem Rechtsstreit führt.
Bild anzeigen Die Leistungsfähigkeit gleicht sich an. Die Lizenzen unterscheiden sich zunehmend. Für die meisten gewerblichen Käufer ist die rechte Spalte ausschlaggebend für die Kaufentscheidung, nicht die Punktzahl.
Teil 4: Das Benchmark-Problem
SWE-bench Verified sieht nun wie folgt aus:
| Rang | Modell | Ergebnis |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptiv) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonett 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
Drei Modelle liegen an der Spitze innerhalb eines Prozentpunkts. Dieser Vergleich ist hinfällig. Er liefert keine nützlichen Erkenntnisse über den Unterschied zwischen Opus 5, Mythos 5 und Fable 5, und wer ihn im September 2026 als Kaufargument heranzieht, stützt sich auf ein gesättigtes Messinstrument.
So sieht derzeit die allgemeine Lage bei der Bewertung von KI aus, und es gibt vier nennenswerte Fehlerquellen:
Sättigung. Wenn sich die Spitzenwerte oberhalb von 90% konzentrieren, sind die verbleibenden Unterschiede eher auf Label-Rauschen und Details der Testumgebung zurückzuführen als auf die Leistungsfähigkeit. SWE-bench Verified ist dabei. GPQA Diamond liegt knapp dahinter.
Empfindlichkeit gegenüber Gerüsten. Dasselbe Modell erzielt je nach der es umgebenden Agenten-Schleife unterschiedliche Ergebnisse – je nach Wiederholungsrichtlinie, Toolset, Kontextmanagement und der Anzahl der Durchläufe. Die Ergebnisse von Terminal-Bench und OSWorld reagieren besonders empfindlich darauf. Zwei Labore, die über denselben Benchmark berichten, führen häufig nicht dasselbe Experiment durch.
Verunreinigung. Jeder öffentliche Benchmark gelangt früher oder später in die Trainingskorpora. Die Reaktion darauf war ein Wettrüsten um immer neuere, anspruchsvollere und private Benchmarks – Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science –, wodurch zwar das Problem der Kontamination gelöst wurde, aber ein neues Problem entstand: Ein privater Benchmark lässt sich nicht unabhängig überprüfen.
Auswahl. Die Forschungslabore veröffentlichen die Benchmarks, bei denen sie den ersten Platz belegen. Anthropic lag bei ’Frontier-Bench“ und „ARC-AGI-3“ für Opus 5 an der Spitze. OpenAI führte bei „Agents’ Last Exam“ und dem „Coding Agent Index“ für GPT-5.6. Z.ai lag bei „CyberGym“ an der Spitze. Keiner von ihnen lügt. Sie alle treffen eine Entscheidung.
Worauf ich im September 2026 tatsächlich vertraue
Mannschaftswettbewerbe vor Einzelspielen. Der Index von Artificial Analysis hat den Vorteil, dass er von einem unabhängigen Dritten nach einem festgelegten Schema auf der Grundlage von neun Bewertungen und 190 Modellen erstellt wird. Seine absoluten Zahlen sagen wenig aus; seine Bestellung ist das am besten zu begründende öffentliche Signal, das es gibt.
Kostenbereinigte Ergebnisse. Die Angaben von Anthropic zu Opus 5 sind ein gutes Beispiel dafür, wie man darüber berichten sollte: “innerhalb von 0,51 TP3T der Höchstpunktzahl von Fable 5 bei halb so hohen Kosten’ auf CursorBench 3.2 und Fable 5 auf OSWorld 2.0 ”bei einem Drittel der Kosten“ übertreffend. Das ist eine aussagekräftige Angabe, da sie den Kompromiss benennt.
Token-Effizienz. Artificial Analysis stellte fest, dass Gemma 4 31B lediglich 39 Millionen Output-Token benötigte, um den gesamten Intelligence Index zu vervollständigen. Bei einer agentischen Arbeitslast bedeutet ein Modell, das mit einem Drittel der Token zum gleichen Ergebnis gelangt, ein Drittel der Kosten und ein Drittel der Latenzzeit. Dies wird zu selten erwähnt, dabei ist es eine der wenigen Kennzahlen, die sich direkt in Geld ausdrücken lassen.
Ihre eigenen Bewertungen. Zwanzig Aufgaben aus Ihrem aktuellen Backlog, die mit drei Modellen abgeglichen und von Ihnen bewertet werden. Das dauert einen Nachmittag. Diese Auswertung sagt Ihnen mehr als alle Ranglisten in diesem Artikel zusammen, und sie ist die einzige Bewertung, die per Definition unverfälscht ist.
Und einer Sache traue ich nicht: jeder Angabe von „Tokens pro Sekunde“ oder jedem Benchmark-Wert, der ohne Testumgebung, Quantifizierung und Datumsangabe genannt wird. Betrachten Sie diese Angaben als Größenordnungsangaben.
Teil 5: Die Zahl, die sich tatsächlich veränderte – Der agentische Zeithorizont
Wenn Sie nur eine Kennzahl aus diesem Artikel mitnehmen, dann sollte es diese sein.
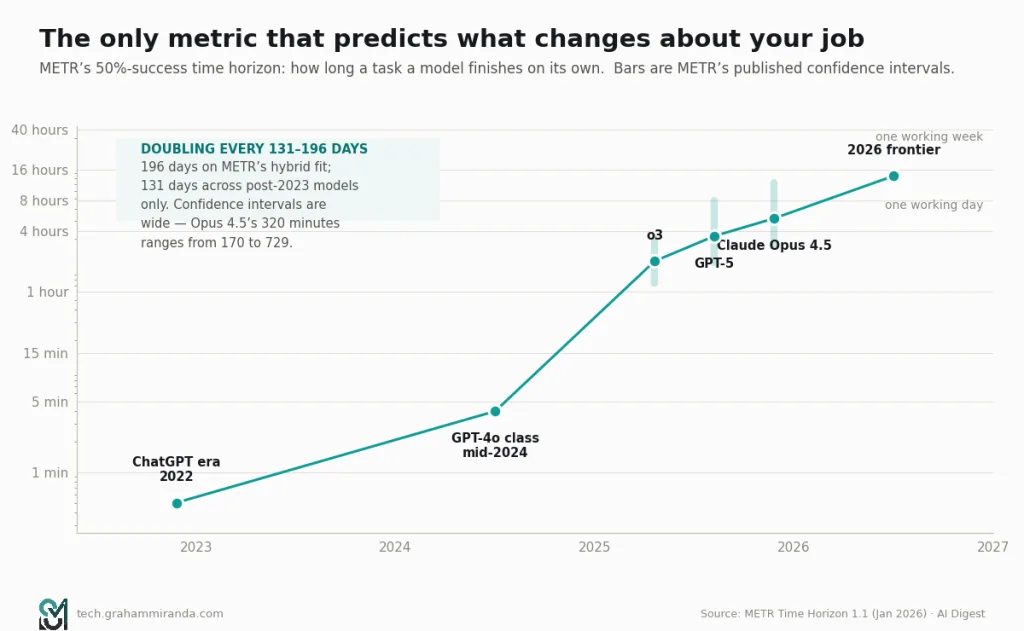
METR misst die Dauer einer Aufgabe – in Arbeitsstunden –, die ein Modell mit 50%-Erfolg selbstständig bewältigen kann. Es ist ein besserer Indikator für die Frage “Kann dieses System meine Arbeit erledigen?” als jeder Wissens-Benchmark, da es genau das erfasst, was in der Praxis tatsächlich scheitert: nicht die Antwort zu kennen, sondern lange genug kohärent zu bleiben, um dorthin zu gelangen.
Die Entwicklung, basierend auf den eigenen Untersuchungen von METR und den Beobachtungen des AI Digest:
| Zeitraum | 50% – Zeithorizont für den Erfolg |
|---|---|
| 2022 (Zeit der Einführung von ChatGPT) | ~30 Sekunden |
| Mitte 2024 (GPT-4o-Klasse) | ca. 4 Minuten |
| Ende 2025 (Claude Opus 4.5) | 320 Minuten (~5,3 Stunden), KI [170, 729] |
| 2026 – die Grenze | 14+ Stunden |
Umstritten ist die Verdopplungszeit. Die am 29. Januar 2026 veröffentlichte Version 1.1 von METR „Time Horizon“ – 228 Aufgaben, von denen 31 einen geschätzten menschlichen Arbeitsaufwand von acht oder mehr Stunden erfordern und auf das „Inspect“-Framework des britischen AI Security Institute migriert wurden – berichtet 196 Tage (7 Monate) auf der Grundlage einer Mischung aus alten und neuen Daten, aber 131 Tage Wenn man sich auf Modelle ab 2023 beschränkt, ist dies etwa 20% schneller als die 165 Tage, die sich nach der bisherigen Methodik ergaben.
Die Extrapolation einer Exponentialfunktion ist etwas, womit man sich leicht blamiert; daher möchte ich die Vorbehalte laut und deutlich hervorheben, bevor ich die Zahl verwende.
Die Vorbehalte sind groß. Die von METR selbst ermittelten Konfidenzintervalle sind enorm – der 320-Minuten-Horizont von Opus 4.5 weist eine Spanne von 170 bis 729 Minuten auf. Nur 5 ihrer 31 langwierigen Aufgaben verfügen über gemessene menschliche Referenzwerte; der Rest sind Schätzungen. Die Zusammensetzung der Aufgaben verändert den gemessenen Trend. Und ’50%-Erfolg bei einer klar definierten Aufgabe in einer sauberen Umgebung“ ist weit entfernt von ”50%-Erfolg in Ihrer Codebasis mit Ihrer unzuverlässigen Testsuite und Ihrem undokumentierten Bereitstellungsprozess“.”
Nach all dem, die Richtung steht außer Frage und die Größenordnung ist in etwa richtig. Der Extrapolation zufolge werden die „Frontier“-Agenten im Jahr 2027 eine autonome Aufgabenausführung von etwa einem Arbeitstag und im Jahr 2028 von etwa einer Arbeitswoche erreichen.
Warum diese Zahl entscheidend ist
Weil Es ist der einzige Indikator, der vorhersagt, was sich an Ihrem Job ändern wird.
Ein Modell mit einem Zeithorizont von 4 Minuten verfügt über eine Autovervollständigungsfunktion. Sie bleiben ständig auf dem Laufenden, und die Qualität des Modells bestimmt, wie gut die Vorschläge sind.
Ein Modell mit einem Zeithorizont von fünf Stunden ist wie ein Kollege, den man morgens einweist und mittags mit ihm bespricht. Man ist nicht Teil des Prozesses, sondern steht am Ende davon. Die Qualität des Modells bestimmt, wie oft diese Besprechung mühsam ist.
Für ein Modell mit einem Zeithorizont von 40 Stunden verfügen wir über keine entsprechende Verwaltungsstruktur. Sie würden eine Woche Arbeit überprüfen, die Sie nicht mitverfolgt haben – in einem Code, der sich geändert hat, während Sie nicht hingeschaut haben, und anhand einer Spezifikation, die Sie verfasst haben, bevor Sie wussten, wo die Probleme lagen.
Jedes Argument im weiteren Verlauf dieses Artikels – sei es zum Thema „Vibe-Coding“, zur Verifikation oder dazu, wo der Engpass liegt – dreht sich im Grunde genommen darum, was passiert, wenn diese Zahl steigt. Die Modelle wurden auf einen langen Zeithorizont ausgelegt. Unsere Überprüfungsprozesse hingegen nicht.
Bild anzeigen Der Zeithorizont für den Erfolg des 50%, wobei die Konfidenzintervalle von METR ehrlich dargestellt sind. Die Intervalle sind breit genug, um von Bedeutung zu sein – und der Trend bleibt dennoch bestehen.
AKT II – DIE ZUKUNFT DES VIBE-CODING
Teil 6: Was “Vibe Coding” heute bedeutet
Andrej Karpathy prägte den Begriff im Februar 2025, um etwas Bestimmtes und leicht Schelmisches zu beschreiben: sich der Stimmung hingeben, vergessen, dass es den Code überhaupt gibt, Diffs akzeptieren, ohne sie zu lesen, und das Modell das Ruder übernehmen lassen. Es war eine Beschreibung einer Modus, halb im Scherz vorgeschlagen, für kleine Wochenendprojekte.
Achtzehn Monate später hat der Begriff seinen gesamten Lebenszyklus durchlaufen. Er wurde zu einer Bewegung, dann zu einer Berufsbezeichnung, anschließend zu einem abwertenden Begriff, danach zum „Wort des Jahres“ des Collins-Wörterbuchs, dann zu einer Kategorie der Risikokapitalfinanzierung und nun – in der einzigen Entwicklung, die tatsächlich von Bedeutung ist – eine Reihe von technischen Vorgehensweisen, die nicht mehr dem entsprechen, was Karpathy beschrieben hat.
Ich möchte bei der Unterscheidung genau sein, da diese beiden Dinge ständig miteinander verwechselt werden und gegensätzliche Risikoprofile aufweisen.
Vibe-Codierung, ursprüngliche Bedeutung. Eingabeaufforderung, akzeptieren, ausführen, erneute Eingabeaufforderung. Den Diff nicht lesen. Das Ergebnis ist wegwerfbar. Das ist wirklich großartig, und ich mache das mehrmals pro Woche – für ein Skript, das eine CSV-Datei umformatiert, einen einmaligen Scraper, eine Visualisierung, die ich mir nur einmal ansehen werde, oder einen Prototyp, dessen einzige Aufgabe darin besteht, ein Gespräch zu konkretisieren. Das entscheidende Merkmal ist nicht die Geschwindigkeit. Es ist vielmehr, dass sich niemand jemals darauf verlassen wird.
Agentbasierte Technik, Strommessung. Erstellen Sie eine Spezifikation. Stellen Sie dem Agenten eine Testsuite, einen Linter, einen Typ-Checker und eine Sandbox zur Verfügung. Lassen Sie ihn eine Stunde lang laufen. Überprüfen Sie die Änderungen sorgfältig. Führen Sie den Merge unter denselben Bedingungen durch wie bei einem von einem Menschen erstellten PR. Das entscheidende Merkmal besteht darin, dass die Ergebnisse des Modells wie die Arbeit eines Nachwuchskollegen behandelt werden – nützlich, schnell und nicht vertrauenswürdig.
Diese beiden haben lediglich die Technologie gemeinsam, ansonsten fast gar nichts. Wenn Sie die Version des zweiten Produkts für Fachleute suchen, dann ist das genau das, was mein früherer Beitrag zum Thema „Vibe-Coding“ im Jahr 2026 geht es; in diesem Abschnitt geht es darum, in welche Richtung sich die Praxis entwickelt. Die katastrophalen Folgen in Teil Acht sind allesamt darauf zurückzuführen, dass die Praktiken des ersten Modus auf die Herausforderungen des zweiten Modus angewendet wurden.
Die Zahlen zu den Adoptionen sind enorm und größtenteils unumstritten
- 90% Entwickler Laut der ’AI Pulse“-Umfrage von JetBrains (Januar 2026) nutzen mindestens ein KI-Tool bei der Arbeit. In der Umfrage von Stack Overflow aus dem Jahr 2025 gaben 84% an, ein solches Tool zu nutzen oder dessen Nutzung zu planen.
- Fast 80% neue GitHub-Entwickler Copilot bereits in der ersten Woche einführen (GitHub Octoverse 2025).
- 59% der Entwickler nutzen drei oder mehr KI-Programmierwerkzeuge parallel. Diese Statistik sagt mehr aus als die Zahl der Nutzer – der Markt hat sich nicht konsolidiert, sondern in aufgabenspezifische Tools aufgesplittert.
Die Marktzahlen
| Werkzeug | Metrisch | Quelle / Datum |
|---|---|---|
| GitHub Copilot | ~42% nach Nutzerbasis; über 20 Millionen Nutzer | Gartner / Anbieter, 2026 |
| Cursor | $2B+ ARR; 1M+ aktive Nutzer pro Tag; ~20–25% Marktanteil nach Umsatz | Berichtet, Februar 2026 |
| Claude-Code | ~$2,5B Run-Rate; 46% “beliebteste” gegenüber 19% bei Cursor | Berichtet, April 2026 |
| Markt für Coding-Agenten im Unternehmensbereich | ~$9,8–11B (auf Jahresbasis) | Gartner, April 2026 |
Zwei Dinge fallen besonders auf: Copilot hat die meisten Nutzer und die geringste Zufriedenheit unter den drei Marktführern. Claude Code hat die geringste Nutzerbasis und bei weitem die höchste Beliebtheit. Das ist das Kennzeichen eines Marktes, der sich mitten im Wandel befindet – der etablierte Anbieter hat den Vertrieb für sich entschieden, der Herausforderer den Arbeitsablauf, und die Nutzer haben den Wechsel noch nicht vollständig vollzogen.
Und die Zahl, die all das in den Schatten stellt
Das Vertrauen der Entwickler in KI-Ergebnisse sank von etwa 40% im Jahr 2024 auf 29% im Jahr 2026. Eine separate Umfrage von SonarSource ergab, dass 96% der Entwickler nicht voll und ganz darauf vertrauen, dass von KI generierter Code funktional korrekt ist.
Denken Sie mal darüber nach. Die Nutzung stieg, das Vertrauen sank. Das ist kein Widerspruch, sondern genau das, wie eine ausgereifte Einführung eines Werkzeugs aussieht. Niemand “vertraut” einer Kettensäge. Man benutzt sie ständig, mit beiden Händen, trägt Schutzkleidung und wendet ihr niemals den Rücken zu.
Diejenigen, die diese Werkzeuge am besten verstehen, gehen auch am vorsichtigsten damit um. Das ist ein positives Zeichen, das in den Marketingmaßnahmen der meisten Anbieter jedoch völlig fehlt.
Teil 7: Macht es einen tatsächlich schneller? Die Fakten, ganz ehrlich
An dieser Stelle verliere ich einige Leser, und ich verliere sie lieber hier, als sie in die Irre zu führen.
Die randomisierte Studie sagt Nein
METR führte im Juli 2025 die Studie durch, auf die sich alle beziehen: Erfahrene Open-Source-Entwickler, die an ihren eigenen ausgereiften Repositories (über 1 Million Zeilen) arbeiteten, wurden auf Aufgabenebene nach dem Zufallsprinzip in zwei Gruppen eingeteilt, von denen die eine die KI-Tools von Anfang 2025 nutzte und die andere nicht.
Ergebnis: 191 TP3T langsamer mit KI.
Und die Erkenntnis, die wichtiger ist als die Schlagzeile: Die Entwickler gingen davon aus, dass sie etwa 20% schneller gewesen seien. Sie haben den Einfluss der KI auf ihren Zeitaufwand um rund 40 Prozentpunkte überschätzt.
Die Nachuntersuchung im Jahr 2026 brachte keine Klärung – sie deckte etwas Schlimmeres auf
METR versuchte, das Experiment zu wiederholen, und veröffentlichte im Februar 2026 einen ungewöhnlich offenen Beitrag darüber, warum das Versuchsdesign versagt hatte.
- Die Personalbeschaffung ist gescheitert. Entwickler weigern sich zunehmend, ohne Zugang zu KI zu arbeiten – selbst bei einem Stundenlohn von $50.
- Die Aufgabenauswahl war verzerrt. 30–50% der Entwickler gaben zu, dass sie Aufgaben vermieden, von denen sie erwarteten, dass KI diese gut bewältigen würde. Ein Teilnehmer brachte es auf den Punkt: “Ich vermeide Themen wie: ”Die KI schafft das in nur zwei Stunden, aber ich brauche dafür 20 Stunden.‘“
- Die Zeiterfassung funktioniert nicht mehr Früher ließen Entwickler mehrere Agenten gleichzeitig laufen.
Ihre vorläufigen Zahlen für 2026 lagen zwischen −18% und −4% – also immer noch langsamer, wenn auch nicht ganz so drastisch –, doch METR selbst bezeichnet dies angesichts der Verzerrung durch die Auswahl als “nur sehr schwachen Hinweis”.
Lesen Sie den zweiten Punkt noch einmal, denn es handelt sich dabei um die interessanteste Erkenntnis in der gesamten Literatur, die jedoch in einem methodischen Hinweis versteckt ist. Wenn Entwickler die KI-geeigneten Aufgaben systematisch zuweisen weg Aus einer Studie, in der der Nutzen von KI gemessen wird, geht hervor, dass der Nutzen in dieser Studie unterschätzt wird. Dies deutet zudem darauf hin, dass Entwickler in der Praxis bereits die Zuordnung vornehmen – und genau dieses Verhalten macht die Tools so wertvoll und erschwert die Durchführung der RCT.
Die Umfragen sagen „Ja“, und zwar mit großem Abstand, und die Ergebnisse sind überhöht.
Die METR-Umfrage vom Mai 2026 (n = 349: 87 Softwareentwickler, 71 Forscher, 129 Wissenschaftler und Doktoranden, 48 Gründer und Führungskräfte; durchschnittlich 12 Jahre Programmiererfahrung, 19 Monate Erfahrung im Umgang mit KI-Tools) verfolgte einen cleveren Ansatz. Sie unterteilte Wert aus Geschwindigkeit.
Der Medianwert der Befragten lag bei 3-facher Geschwindigkeitsmultiplikator aber nur ein Eine Wertsteigerung ihrer Arbeit um das 1,4- bis 2-Fache. Rückblickend schätzten sie den Wert im März 2025 auf das 1,3-Fache; bis März 2027 prognostizieren sie das 2,5-Fache.
METR stellt ausdrücklich fest, dass der Wert die Zahl ist, auf die es den Umfragegestaltern tatsächlich ankommt, und dass die Befragten ganz selbstverständlich in Geschwindigkeitsgrößen denken – und genau diese Verzerrung hat die RCT von 2025 mit 40 Prozentpunkten beziffert.
Also: Die Selbstauskunft ergibt 3×. Die um die tatsächliche Bedeutung der Befragten bereinigte Selbstauskunft ergibt 1,4–2×. Die einzige kontrollierte Messung, die uns vorliegt, ergibt 0,81×.
Die Organisationsdaten besagen: “Es kommt auf dich an, nicht auf das Tool.”
Der DORA-Bericht von 2026 (Google Cloud, Mai 2026) ist das Nützlichste, was das ganze Jahr über zu diesem Thema veröffentlicht wurde, und er ist deshalb so nützlich, weil er die Debatte über das Tool beendet.
- Modellierter ROI im ersten Jahr von 39% für eine Ingenieursorganisation mit 500 Mitarbeitern, mit etwa einem Amortisationszeit von 8 Monaten — Ein Wert von $11,6 Mio. gegenüber einer Investition von $8,4 Mio.
- A J-Kurve: Die Produktivität sinkt zunächst, bevor sie wieder steigt, was auf die Anpassung der Arbeitsabläufe, den Aufwand für die Code-Review-Prüfung sowie nachgelagerte Änderungen an den Test- und Freigabestufen zurückzuführen ist.
- Die Ausfallrate bei Änderungen steigt von 5% auf 6% nach der Einführung, was in ihrer Beispielberechnung zu Ausfallkosten in Höhe von $344.000 führte.
- Und die These: “Die größten Erträge aus Investitionen in KI ergeben sich nicht aus den Tools selbst, sondern aus einer strategischen Ausrichtung auf das zugrunde liegende Organisationssystem.”
Diese letzte Zeile ist der Konsens für das Jahr 2026, sofern es einen gibt. KI verstärkt das, was Ihre Ingenieurpraxis ohnehin schon ausmacht. Gute Tests, echte Code-Reviews, schnelle Rollbacks, klare Zuständigkeiten – KI sorgt dafür, dass diese Unternehmen deutlich schneller arbeiten. Schwache Tests, oberflächliche Reviews, manuelle Bereitstellungen, unklare Zuständigkeiten – KI führt dazu, dass diese Unternehmen schneller und in größerem Umfang scheitern.
Wie lässt sich das alles miteinander vereinbaren?
Ich glaube nicht, dass diese Erkenntnisse tatsächlich im Widerspruch zueinander stehen. Hier ist die Erklärung, zu der ich gelangt bin, und ich halte mich daran, ohne mich daran festzuklammern:
KI-Programmierwerkzeuge bieten große Vorteile bei ungewohnten Aufgaben und nur geringe Nachteile bei sehr vertrauten Aufgaben. Bei einem Code, den Sie in- und auswendig kennen, in einer Sprache, die Sie fließend beherrschen, und bei einem Problem, das Sie bereits gelöst haben, sind Sie schneller als der Kreislauf aus Überprüfung und Korrektur. Bei einem unbekannten Framework, einer Sprache, die du nur zweimal im Jahr verwendest, bei Boilerplate-Code, Test-Scaffolding, Migrationen oder einer Codebasis, die du seit acht Monaten nicht mehr geöffnet hast, wirkt sich dieses Modell grundlegend aus.
METR untersuchte erfahrene Entwickler anhand ihrer eigenen, ausgereiften Repositories – dem einzigen Szenario, in dem man den geringsten Gewinn erwarten würde. Das macht das Ergebnis nicht falsch. Es macht es vielmehr spezifisch, und man sollte jedem misstrauisch gegenüberstehen, der es als allgemeingültiges Urteil in die eine oder andere Richtung anführt.
Die zweite Versöhnung: Die Gewinne sind real, aber sie landen an einem anderen Ort als dem, an dem die Menschen nach ihnen suchen. Nicht: “Diese Funktion hat vier statt sechs Stunden gedauert.” Sondern eher: Die Migration, die eigentlich nie Priorität haben sollte, wurde erledigt; die Testabdeckung, die eigentlich immer bei 40% bleiben sollte, stieg auf 75%; die Dokumentation ist vorhanden. Diese Dinge tauchen in einer Zeitanalyse zur Aufgabenbearbeitung nicht auf, machen aber den größten Teil des tatsächlichen Nutzens aus.
Teil 8: Der Sicherheitsgesetzentwurf ist da, und er ist detailliert aufgeschlüsselt
Wenn Teil 7 schon unangenehm war, dann ist dies der Teil, den die Leute überspringen. Bitte überspringen Sie ihn nicht.
Die Messungen
Veracode hat über 100 große Sprachmodelle bei 80 Programmieraufgaben in Java, Python, C# und JavaScript getestet:
- 45% der von KI generierten Code-Beispiele weisen eine Schwachstelle aus den OWASP Top 10 auf. Die Erfolgsquote blieb bis Anfang 2026 im Wesentlichen unverändert – die Modelle wurden zwar deutlich intelligenter, aber nicht sicherer.
- Java schnitt mit einer Ausfallrate von 721 TP3T am schlechtesten ab.
- 86% wiesen Schwachstellen beim Schutz vor Cross-Site-Scripting auf. 88% waren anfällig für Log-Injection-Angriffe.
Apiiro hat von Dezember 2024 bis Juni 2025 seine Deep-Code-Analyse-Engine auf die Repositorys von Fortune-50-Unternehmen angewendet:
- KI-unterstützte Entwickler erstellen Commits bei drei- bis viermal im Vergleich zu ihren Altersgenossen.
- Sie stellen Sicherheitsbefunde vor unter zehnmal der Zinssatz.
- Die Anzahl der Wege zur Rechteausweitung stieg um 322%. Die Anzahl der architektonischen Designfehler stieg um 153%.
USENIX Security 2025 576.000 von KI generierte Code-Beispiele analysiert:
- Etwa 20% Referenzpakete, die nicht existieren.
- 43% der erfundenen Paketnamen tauchen bei ähnlichen Eingabeaufforderungen immer wieder auf — und genau das ist der Teil, der aus einem Fehler eine Angriffsfläche macht. Eine vorhersehbare Halluzination ist ein Slot, den ein Angreifer vorab bei npm oder PyPI registrieren kann.
Das „Vibe Security Radar“ der Georgia Tech haben die CVEs anhand der Git-Historie zurückverfolgt, um sie KI-Tools zuzuordnen:
| Monat (2026) | Zugeordnete CVEs |
|---|---|
| Januar | 6 |
| Februar | 15 |
| März | 35 |
Insgesamt wurden 74 Fälle bestätigt, wobei Forscher die tatsächliche Zahl im Open-Source-Bereich auf fünf- bis zehnmal höher.
RedAccess grob indexiert 380.000 öffentlich zugängliche, nach Stimmung kodierte Anwendungen auf Lovable, Base44, Replit und Netlify. Bei etwa 5.000 davon wurden sensible Unternehmens- oder personenbezogene Daten offengelegt.
Die Vorfälle vom
| Datum | Vorfall |
|---|---|
| Juli 2025 | Replit AI löscht eine Produktionsdatenbank; 1.200 Datensätze von Führungskräften sind betroffen, 4.000 fiktive Konten wurden erstellt |
| Februar 2026 | Eine von Lovable entwickelte EdTech-App hat 18.697 Nutzerdatensätze offengelegt, darunter 4.538 Schülerkonten |
| April 2026 | Die liebenswerte BOLA-Sicherheitslücke – jedes Projekt vor November 2025 ist mit fünf API-Aufrufen erreichbar |
| 26. April 2026 | Cursor “9-Sekunden-Wipe”: Eine Unternehmensdatenbank wurde zusammen mit ihren Backups gelöscht |
| 30. April 2026 | Gemini CLI: CVSS-10 – Remote-Codeausführung in CI-Workflows, behoben |
Der Amazon-Fall, den ich mit Bedacht angehen werde
Sie haben sicher von den Vorfällen bei Amazon gehört. Vier „Sev-1“-Vorfälle zwischen Dezember 2025 und März 2026 – ein 13-stündiger Ausfall des AWS Cost Explorer in China, falsche Lieferzeiten in den Warenkörben am 2. März, die Berichten zufolge rund 120.000 Bestellungen kosteten, sowie eine sechsstündige Störung am 5. März, bei der die Bestellungen aus Nordamerika Berichten zufolge um 99% zurückgingen.
Berichte der “Financial Times”, von „Fortune“ und „The Register“ brachten interne Amazon-Dokumente mit sogenannten „durch Gen-AI unterstützten Änderungen“ in Verbindung und warnten davor, dass die schnelle Codegenerierung Schwachstellen offenlege. Amazon hat einen direkten Kausalzusammenhang bestritten und in einigen Antworten erklärt, dass bei keinem der Vorfälle von KI geschriebener Code eine Rolle gespielt habe.
Ich möchte drei Punkte zu dieser Geschichte hervorheben, anstatt sie als Tatsache zu wiederholen:
- Die am häufigsten zitierte Zahl zu den Auswirkungen (6,3 Millionen entgangene Bestellungen) stammt aus einem Beitrag auf Medium und nicht von Amazon oder aus der Berichterstattung eines namentlich genannten Mediums. Betrachten Sie sie als Schätzung und nicht als konkrete Zahl.
- Der Einsatz vom 5. März soll stattgefunden haben ohne formelle Unterlagen oder Genehmigung. Das ist ein Prozessfehler. Die KI-Geschwindigkeit hat dazu geführt, dass möglich damit es schneller vorangeht; dadurch wurde die Genehmigungsstufe nicht optional.
- Genau diese Unterscheidung ist der springende Punkt, und deshalb habe ich die Geschichte überhaupt erst aufgenommen. Der Fehler liegt so gut wie nie darin, dass “die KI schlechten Code geschrieben hat”. Vielmehr liegt er darin, dass “die KI den Code schneller geschrieben hat, als der Prozess, der ihn eigentlich hätte überprüfen sollen”.”
Was dies konkret für die Praxis bedeutet
Nicht “die Tools nicht mehr nutzen”. Niemand, der es ernst meint, vertritt diese Ansicht, und auch die eigene Forschungsnotiz der CSA – in der der Großteil der oben genannten Punkte zusammengefasst ist – stellt Governance in den Vordergrund und nicht die Abstinenz.
Die praktische Umsetzung, in der Reihenfolge, in der ich sie umsetzen würde:
- Behandeln Sie jedes KI-Tool, auf das Sie mit Zugangsdaten zugreifen können, als privilegiertes System. Es ist eins. Passen Sie die Token entsprechend an.
- SAST, Abhängigkeitsprüfung und Erkennung vertraulicher Daten bei jedem Commit. Nicht jede Nacht. Bei jedem Commit. Die Commit-Rate hat sich verdreifacht bis vervierfacht; ein nächtlicher Scan entspricht nun effektiv einer dreitägigen Feedbackschleife.
- Analyse der Softwarezusammensetzung, insbesondere im Hinblick auf „halluzinierte“ Pakete. Dies ist das günstigste und preiswerteste Kontrollelement auf der Liste, da der Wert 20% so groß ist und der Ausfall so unbemerkt bleibt.
- Eine schriftliche Richtlinie, wonach KI-Unterstützung bei der Authentifizierung, Kryptografie, Autorisierung oder bei Zahlungskodes nicht ohne Überprüfung eingesetzt wird. Dies sind die vier Bereiche, in denen ein kleiner Fehler sowohl wahrscheinlich als auch katastrophal sein kann und in denen das geschulte Auge eines Lektors am wertvollsten ist.
- Erweitern Sie Ihre SBOM, um die Herkunft von KI-Tools zu erfassen. Wenn die nächste Attributionsstudie nach dem Vorbild der Georgia Tech auf Ihre Codebasis trifft, möchten Sie diese Frage selbst beantworten können.
- Behandeln Sie Vibe-Coding-Plattformen von Drittanbietern wie SaaS-Anbieter. Die RedAccess-Zahlen zeigen, was passiert, wenn niemand etwas unternimmt.
Das ist alles nichts Außergewöhnliches. Das meiste davon gehörte bereits 2019 zum Standardrepertoire eines kompetenten Betriebs. Der Unterschied besteht darin, dass das Volumen um eine Größenordnung gestiegen ist, sodass die Kontrollen nun automatisiert statt auf kultureller Ebene erfolgen müssen.
Bild anzeigen Die Sicherheitsdaten stammen von Veracode, Apiiro, USENIX und Georgia Tech. Beachten Sie den Verlauf: Die Commit-Geschwindigkeit stieg um das 3- bis 4-Fache, die Anzahl der Sicherheitsbefunde um das 10-Fache. Die Differenz zwischen diesen beiden Multiplikatoren ist das eigentliche Problem.
Teil 9: Was kam an die Stelle von „Vibe Coding“?
Die Methode, die im Jahr 2026 tatsächlich funktioniert, hat einen Namen – mehrere konkurrierende Namen, woran man erkennt, dass es sie wirklich gibt – und sie ist sozusagen das Gegenteil von „Vibes“.
Nenn es spezifikationsgesteuerte Entwicklung, Agentic Engineering, oder Kontext-Engineering. Die übliche Struktur:
1. Die Spezifikation ist nun der Quellcode.
Kein Jira-Ticket. Ein echtes Dokument: Was das Ding leistet, was es nicht leisten darf, welche Schnittstellen es gibt, wie der “fertige” Zustand aussieht, welche Fehlermöglichkeiten es gibt. In das Repository eingecheckt, versioniert, geprüft.
Das fühlt sich an wie ein Rückschritt ins Jahr 1998, ist es aber nicht. Der Unterschied besteht darin, dass die Spezifikation 1998 als Grundlage für einen Menschen diente, der sie neu interpretierte, und dass sie in dem Moment, in dem mit der Programmierung begonnen wurde, ihren Wert verlor. Im Jahr 2026 dient die Spezifikation als Eingabe für einen Prozess, der die Implementierung kostengünstig neu generiert – das bedeutet: Wenn sich die Anforderungen ändern, passt man die Spezifikation an und leitet die Implementierung neu ab, anstatt Code zu flicken, der keiner schriftlichen Beschreibung seiner selbst mehr entspricht.
Die wirtschaftliche Lage hat sich umgekehrt. Als die Umsetzung noch teuer und die Spezifikation noch günstig war, hat man die Spezifikation locker gehalten und in den Code investiert. Wenn die Umsetzung günstig ist und die Spezifikation den Engpass darstellt, investiert man in die Spezifikation.
2. Die Testsuite bildet die Vertrauensgrenze.
Ein Tool, das Ihre Tests ausführen und iterativ durchlaufen kann, unterscheidet sich grundlegend von einem Tool, das dazu nicht in der Lage ist. Dies ist die Maßnahme mit der größten Hebelwirkung, die die meisten Teams umsetzen können, und dabei geht es überhaupt nicht um KI – vielmehr hat die KI endlich den ROI der Testabdeckung für diejenigen offensichtlich gemacht, die sich durch fachliche Argumente niemals hätten überzeugen lassen.
Praktische Variante: Der Agent erhält eine Sandbox, einen Testbefehl, einen Lint-Befehl und eine Typüberprüfung, und der Vorgang ist erst abgeschlossen, wenn alle vier grün sind. Alles andere ist verhandelbar.
3. Die Überprüfung wurde von Zeilen auf Diffs und schließlich auf das Verhalten verlagert
Eine zeilenweise Überprüfung lässt sich nicht auf einen vom Agenten generierten Diff mit tausend Zeilen skalieren, und wenn man so tut, als wäre das anders, ist das der Anfang von reiner Routinearbeit.
Was stattdessen funktioniert, in grober Reihenfolge nach ihrer Bedeutung:
- Prüfen Sie die Spezifikation, nicht die Umsetzung. Wenn die Spezifikation stimmt und die Tests erfolgreich sind, ist die Umsetzung nur noch eine Nebensache.
- Überprüfen Sie die Form des Differentials — welche Dateien verändert wurden, welche Abhängigkeiten hinzugefügt wurden, was gelöscht wurde. Die meisten Agent-Pannen lassen sich auf dieser Ebene erkennen: eine unerwartete Datei, eine neue Abhängigkeit, eine Löschung, die niemand gewollt hat.
- Überprüfen Sie insbesondere die sicherheitsrelevanten Zeilen. Authentifizierung, Kryptografie, Autorisierung, Zahlungen, alles, was mit personenbezogenen Daten zu tun hat. Das ist nur ein kleiner Teil des gesamten Unterschieds.
- Bitte überprüfen Sie den Standardtext nicht. Du hast es sowieso nie wirklich rezensiert.
4. Der Gurt ist genauso wichtig wie das Modell
Dies wird oft unterschätzt. Dasselbe Modell liefert in zwei unterschiedlichen Agenten-Schleifen Ergebnisse von völlig unterschiedlicher Qualität – und genau deshalb sind Benchmark-Vergleiche zwischen verschiedenen Labors so heikel.
Die entscheidenden Aspekte: Wie wird der Kontext verwaltet, wenn der Lauf länger dauert? Kann der Agent seine eigenen Testfehler erkennen? Kann er das Repository durchsuchen oder nur das, was Sie einfügen? Verfügt er über einen vom Ausführungsschritt getrennten Planungsschritt? Und weiß er, wann er anhalten und nachfragen muss?.
Die Versionshinweise zu Meta’s Muse Spark 1.3 sind genau in diesem Punkt interessant – darin wird beschrieben, dass das Modell nun bei mehrdeutigen Eingaben klärende Fragen stellt, bei Schwierigkeiten Hilfe anfordert und vor weitreichenden Aktionen eine Bestätigung einholt. Das sind keine Verbesserungen der Intelligenz. Das sind Umgangsformen., und es sind die Umgangsformen, die einem Akteur mit langfristiger Perspektive das Überleben sichern.
5. Das Modell-Routing ist mittlerweile gängige Praxis
Niemand, der es ernst meint, verwendet ein einziges Modell für alles – ich habe eine Variante mit zwei Modellen davon in GLM-5.3-Flash vs. MiniMax M3 in OpenCode. Das Muster, das sich herausgebildet hat:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
 "description": "Architektur, Grundursache, alles, wo Fehler teuer sind",
 "model": "anthropic/claude-fable-5-1"
    },
    "build": {
 "description": "Der Großteil der Umsetzung – langfristige Perspektive, kostenbewusst",
 "model": "anthropic/claude-opus-5"
    },
    "bulk": {
 "description": "Mechanische Arbeit in großem Umfang, bei der der Preis ausschlaggebend ist",
 "model": "zai/glm-5-3-flash"
    },
    "private": {
 "description": "Alles, was mit Kundendaten zu tun hat – läuft auf unserer eigenen Hardware",
 "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
 "description": "Umbenennungen, Docstrings, Lint-Korrekturen, Test-Scaffolding",
 "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
Die Begründung, Zeile für Zeile:
- Entscheiden Sie sich für das leistungsstärkste Modell, das Sie sich leisten können. Ein schlechter Plan kostet im Nachhinein mehr Token, als der Plan jemals gekostet hat.
- Die Entscheidung fällt auf das beste Modell mit langfristigem Horizont zu einem vernünftigen Preis. Opus 5 mit den Spezifikationen $5/$25 ist genau darauf ausgelegt und kostet nur die Hälfte des Preises von Fable.
- Der Großteil der mechanischen Arbeit wird an GLM-5.3-Flash mit den Parametern $0.15/$0.47 übertragen., denn bei diesem Preis geht es nicht darum, ob es genauso gut ist, sondern ob es für die jeweilige Aufgabe gut genug ist. Oft ist es das auch.
- Alles, was privat ist, bleibt lokal, und zwar in einer Ausführung, die zu Ihrer Maschine passt.
- Die Routinearbeit übernimmt ein kleines lokales Model, denn um ein Symbol in vierzig Dateien umzubenennen, braucht man weder bahnbrechende Überlegungen noch muss man den Laptop verlassen.
Notieren Sie sich die Modell-IDs, damit das Austauschen eines Modells mit einer einzigen Zeile auskommt. Da vier Labore zwischen Juni und September ein Modell aus den Top Ten ausgeliefert haben, werden Sie diese Änderung noch im Laufe des Quartals erneut vornehmen müssen.
Teil 10: Die Zukunft des Vibe-Codings – Sechs Prognosen, mit entsprechender Zuversicht
Prognosen ohne Konfidenzintervalle sind reine Unterhaltung. Hier sind meine Prognosen – zusammen mit dem Betrag, den ich darauf setzen würde.
1. Das Wort stirbt; die Praxis spaltet sich endgültig. Hohe Zuversicht.
“Vibe-Coding” entwickelt sich in professionellen Kreisen bereits zu einem Schimpfwort und ist nur im Marketing noch ein Begriff, auf den man stolz ist. An seine Stelle tritt eine klare Zweiteilung: Wegwerfprodukte, die von KI generiert werden und bei denen niemand den Code liest (gut so, richtig so, davon sollte es mehr geben), und überprüfte, agentische Entwicklung, bei der die Modellausgabe dieselben Prüfungen durchläuft wie die eines Menschen (ebenfalls gut so, und hier fließt das gesamte Unternehmensgeld hin).
Der gefährliche Mittelweg – Produktionscode, ungelesen – ist der Stoff, aus dem die Vorfallliste von 2026 besteht, und er wird im kommerziellen Umfeld durch Vorschriften, Versicherungen oder Audits aus dem Verkehr gezogen werden. Nicht, weil ihn jemand verbietet, sondern weil er irgendwann in einem Sicherheitsfragebogen abgefragt wird.
2. Die Verifizierung wird zum Engpass, und die Ausgaben für Werkzeuge richten sich danach. Hohe Zuversicht.
Wir sind bereits an diesem Punkt angelangt, und der Markt hat sich noch nicht neu bewertet. Wenn Agenten eine Arbeitswoche erzeugen können, besteht die Einschränkung darin, dass ein Mensch feststellen muss, ob diese Arbeitswoche korrekt ist.
Man kann davon ausgehen, dass es bei den interessanten Produkten des Jahres 2027 um Folgendes gehen wird: Überprüfung anstatt Erzeugen: eigenschaftsbasierte Testgenerierung, Semantic-Diff-Tools, die Verhaltensänderungen statt Zeilenänderungen beschreiben, automatisierte Überprüfung der Spezifikationskonformität, Laufzeitüberprüfung von Agentenaktionen und – das ist das, was ich entwickeln würde – Tools, die einem zeigen, welche 5% eines umfangreichen Diff ein Mensch tatsächlich lesen muss.
3. Formale Methoden erleben ihren Durchbruch – zwanzig Jahre zu spät. Mittlere Zuverlässigkeit.
Der historische Einwand gegen formale Spezifikationen lautete, dass das Verfassen der Spezifikation mehr koste als das Schreiben des Codes. Dieser Einwand ist mittlerweile hinfällig, da das Schreiben von Code nahezu kostenlos ist und das Verfassen von Spezifikationen ohnehin den Engpass darstellt.
Typsysteme, Verträge, Invarianten, Eigenschaftsprüfungen und einfache formale Verifikation haben plötzlich einen Anwendungsfall, der sich bezahlt macht: Es handelt sich um maschinell überprüfbare Absichtserklärungen, anhand derer ein Agent iterativ vorgehen kann, ohne dass ein Mensch eingreifen muss. Ich gehe davon aus, dass Rust, die strengeren Modi von TypeScript und Vertragsbibliotheken in Python davon überproportional profitieren werden.
Der Grund, warum meine Zuversicht nur mäßig ist: Seit 1985 wird in der Fachwelt etwa alle sieben Jahre eine Renaissance der formalen Methoden vorhergesagt.
4. Lokale Modelle übernehmen die gesamte „Grunt“-Ebene. Mittlere bis hohe Zuverlässigkeit.
Schauen Sie sich an, was ein 27B-Modell unter Apache 2.0 derzeit leistet, rechnen Sie ein weiteres Jahr hinzu und setzen Sie es auf einem Rechner mit 64 GB einheitlichem Arbeitsspeicher ein. Umbenennungen, Docstrings, Testgerüste, Commit-Meldungen, Lint-Korrekturen, Übersetzungsentwürfe, Protokollanalysen – für all das braucht man kein „Frontier“-Modell, all das ist sehr umfangreich, und all das sind genau die Aufgaben, die man lieber nicht aus dem Repository eines Kunden an einen Dritten weitergeben möchte.
Die Grenze bleibt in der Cloud, was die Planung und das logische Denken betrifft. Das Volumen verlagert sich in den lokalen Bereich. Ab Teil 11 geht es darum, warum dies nun physisch möglich ist.
5. Die Rolle des Junior-Entwicklers verändert sich, verschwindet aber nicht. Mittlere Sicherheit, und diese Einschätzung ist für mich am wenigsten feststehend.
Das pessimistische Szenario ist klar: Wenn die Mitarbeiter die Aufgaben übernehmen, die früher von Nachwuchskräften erledigt wurden, stellt niemand mehr Nachwuchskräfte ein, und in zehn Jahren gibt es keine erfahrenen Mitarbeiter mehr.
Ich glaube, das wahrscheinlichere Szenario ist, dass sich die Einstiegsaufgabe von “Code schreiben” zu “Code überprüfen und für die Spezifikation verantwortlich sein” wandelt – was für den Berufseinstieg eine größere Herausforderung darstellt, nicht eine Erleichterung, und was von der Branche erfordern wird, ihre Ausbildungskonzepte neu zu gestalten. Die Teams, die dies erkennen, werden einen enormen Vorteil bei der Personalbeschaffung gegenüber den Teams haben, die einfach aufhören, neue Mitarbeiter einzustellen.
Ein ehrlicher Vorbehalt: Dies ist die Prognose, bei der meine Motive und meine Analyse in dieselbe Richtung weisen – und genau dann sollte man sich selbst gegenüber misstrauisch sein.
6. Bei jemandem kommt es zu einem wirklich katastrophalen, öffentlich bekannt gewordenen Fehler bei der KI-Programmierung. Hohe Zuversicht hinsichtlich der Veranstaltung, geringe hinsichtlich des Zeitpunkts.
Keine durchgesickerte Datenbank. Es geht um eine Aufsichtsbehörde, finanzielle Auswirkungen in neunstelliger Höhe und eine Ursachenanalyse, aus der hervorgeht, dass ein Mitarbeiter etwas getan hat, was von keinem Menschen überprüft wurde.
Die CVE-Zuschreibungskurve – 6, dann 15, dann 35 in aufeinanderfolgenden Monaten des Jahres 2026, wobei Forscher die tatsächliche Rate auf das Fünf- bis Zehnfache schätzen – ist keine Kurve, die sich von selbst abflacht. Die Frage ist, ob die Branche ihre eigenen Sicherheitsvorkehrungen zuerst verschärft oder auf den Vorfall wartet, der sie dazu zwingt.
Was ich mit allen sechs machen würde, in einem Satz: Investieren Sie lieber in Tests, Spezifikationen und Überprüfungswerkzeuge als in Prompt-Techniken, denn Prompt-Techniken verlieren bei jeder neuen Modellversion an Wert, während die Verifizierungsinfrastruktur immer umfangreicher wird.
Bild anzeigen Die beiden Vorgehensweisen haben lediglich die Technologie gemeinsam, sonst nichts. Die linke Schleife ist für Einmalarbeiten geeignet, für die Produktion jedoch katastrophal; die rechte Schleife ist das, was in der Vorfallliste in Teil Acht fehlte.
AKT III – OFFLINE-KI AUF VERBRAUCHERGERÄTEN
Teil 11: Offline-KI ist seit diesem Jahr kein Hobby mehr
Etwa zwei Jahre lang war “vor Ort betreiben” ein prinzipieller Kompromiss. Man konnte es tun. Das ehrliche Argument lautete: Hier ist ein Modell mit 7 Milliarden Parametern, das schlechter ist als die kostenlose Basisversion von allem, und zwar auf Hardware, die Sie bereits besitzen – und der Grund dafür ist eine Frage des Prinzips.
Das änderte sich im Jahr 2026, und zwar aus drei verschiedenen Gründen, die zeitgleich eintraten.
Die kleinen Modelle sind wirklich gut geworden. Das E4B-Modell von Gemma 4 verfügt über rund 8 Milliarden Parameter, unterstützt 128K Kontext, verarbeitet Text, Bilder, Videos und natives Audio und unterliegt der Apache-2.0-Lizenz. Die 31B-Dense-Variante erreicht im Artificial Analysis Index einen Wert von 39 – was noch vor achtzehn Monaten im Spitzenbereich lag – und absolvierte den gesamten Indexlauf mit 39 Millionen Ausgabetoken, was nur einen Bruchteil dessen ausmacht, was vergleichbare Modelle verbrauchen. Qwen3.8-27B ist ein dichtes multimodales Modell unter der Apache-2.0-Lizenz mit 262.000 nativem Kontext, das laut Alibaba das wesentlich größere Qwen3.7-Plus bei Programmier- und Büroaufgaben übertrifft.
Die Betriebssysteme haben es ausgeliefert. Das ist die Veränderung, auf die es wirklich ankommt, und sie erfolgte ganz im Stillen. Microsoft hat Aion 1.0 in Windows 11 integriert. Apple liefert ein dichtes Modell mit 3 Milliarden Parametern sowie ein spärliches Modell mit 20 Milliarden Parametern auf iPhones aus. Google liefert Gemini Nano auf Pixel- und Samsung-Geräten aus. Geräteinterne KI ist nicht mehr etwas, das man installiert, sondern etwas, das bereits vorhanden ist., was den Unterschied zwischen einer Technologie, die von Technikbegeisterten genutzt wird, und einer Technologie, die jeder nutzt, ausmacht.
Und die Hardware verfügt nun endlich über den Speicher. Nicht die Rechenleistung – der Arbeitsspeicher. Ich werde noch darauf zurückkommen, warum genau diese Unterscheidung den entscheidenden Unterschied ausmacht.
Was Ihnen “Offline-KI” tatsächlich bringt
Lassen Sie mich das konkretisieren, denn das wird hier schlecht vermittelt.
Latenz. Ein lokales 4B-Modell reagiert innerhalb von zehn Millisekunden. Ein Hin- und Rücklauf in die Cloud dauert bestenfalls Hunderte von Millisekunden. Bei allen interaktiven und kontinuierlichen Anwendungen – Diktat, Live-Übersetzung, Autovervollständigung, Zusammenfassung während der Eingabe – punktet die lokale Lösung in puncto Benutzererlebnis, nicht in puncto Qualität, und das Benutzererlebnis ist das, was den Nutzern auffällt.
Privatsphäre, die eher architektonischer als vertraglicher Natur ist. Bei einer API verlässt jede Anfrage Ihre Infrastruktur, und Sie benötigen eine Verarbeitungsvereinbarung, eine Folgenabschätzung zur Datenübermittlung, eine Datenflussübersicht sowie eine Antwort für Ihren Datenschutzbeauftragten. Bei einem Modell, das auf dem Gerät läuft, Die Frage der grenzüberschreitenden Übermittlung stellt sich nicht, da keine Übermittlung stattfindet. Bei Geschäften in Deutschland und der EU ist dies häufig das entscheidende Argument, und es bringt Geschäfte zustande, was der Preis allein niemals könnte.
Verfügbarkeit. Im Flugzeug. An einem Ort ohne Netzempfang. In einer Einrichtung, in der der Zugang zum Netz verboten ist. Während einer Störung bei Ihrem Anbieter.
Vorhersehbarkeit der Kosten. Das spart keine Kosten – ich werde das in Teil 15 genau durchrechnen, und das Ergebnis wird nicht das sein, was sich viele erhoffen. Aber feste Hardwarekosten bei Grenzkosten von null pro Token ergeben eine ganz andere Budgetkurve als eine nutzungsabhängige Abrechnung, deren Höhe sich nach dem Engagement eines Agenten richtet.
Versionsbindung. Ein geschlossenes API-Modell wird unter Beibehaltung einer stabilen Modell-ID aktualisiert, wodurch es zu Verhaltensabweichungen kommt. Ein lokaler Checkpoint bleibt über ein Jahr hinweg byteweise identisch. Wenn Sie schon einmal erlebt haben, dass ein funktionierender Prompt plötzlich nicht mehr funktioniert, wissen Sie, wie wertvoll das ist.
Und was man dafür nicht bekommt
Pionierleistung. Der Unterschied zwischen einem 4B-Modell auf Ihrem Smartphone und Claude Fable 5.1 ist nicht gering und wird sich auch nicht verringern. Wer Ihnen etwas anderes erzählt, will Ihnen etwas verkaufen.
Geschwindigkeit bei großen Modellen. Ein lokales 400B-Modell generiert Token langsamer als dasselbe Modell über die API eines Anbieters, da der Anbieter es auf Hardware mit einer vier- bis sechsmal höheren Speicherbandbreite als bei Ihnen ausführt. Sie tauschen Durchsatz gegen Kontrolle ein.
Teil 12: Das Handy in deiner Hosentasche
Die Spezifikation, die über alles entscheidet, ist der Arbeitsspeicher
Jede große Plattform hat inzwischen eine Speichergrenze festgelegt, und diese liegt bei 12 GB.
| Plattform | Geräteinternes Modell | Speicher-Gate |
|---|---|---|
| Apfel | AFM 3 Core (3 Mrd. dichte Knoten) + AFM 3 Core Advanced (20 Mrd. spärliche Knoten, 1–4 Mrd. aktive Knoten) | 12 GB für zwei Funktionen von iOS 27 |
| Gemini Nano v3 (nur Pixel 10); Nano v2 auf dem Pixel 9 und älteren Modellen; Nano v4 in Kürze erhältlich | 12 GB Mindestanforderung für Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 für Galaxy – Oryon-CPU der 3. Generation, Hexagon-NPU, +39% NPU-Kapazität | Geräteabhängig |
Apples Lösung ist technisch gesehen die interessanteste. AFM 3 Core Advanced ist ein spärliches Modell mit 20 Milliarden Parametern, das im Flash-Speicher abgelegt ist. Gemeinsam genutzte Experten bleiben im Speicher resident; geroutete Experten werden erst dann in den DRAM geladen, wenn sie aufgrund einer Anfrage benötigt werden. Auf diese Weise lässt sich ein 20B-Modell überhaupt erst auf ein Smartphone integrieren – man tauscht NAND-Lese-Bandbreite gegen DRAM-Kapazität ein.
Aber um Experten in den DRAM zu verschieben, braucht man immer noch einen Ort, an den man sie verschieben kann in, zusätzlich zum Betriebssystem, der laufenden App und der Kamerapipeline. Die Differenz zwischen 9 GB und 12 GB entspricht nicht einer Marktsegmentierung von drei Gigabyte. Es handelt sich vielmehr um den Arbeitsspeicherbereich für das „Expert Swapping“ unter echtem Speicherdruck. Ming-Chi Kuo berichtet, dass zwei Funktionen von iOS 27 12 GB erfordern: die Anpassung der Ausdruckskraft und des Sprechtempos von Siri sowie eine erhebliche Verbesserung der Genauigkeit bei der Sprach-zu-Text-Umwandlung. Das Basis-iPhone 18, dessen Markteinführung auf das Frühjahr 2027 verschoben wurde und das Berichten zufolge über 9 GB verfügt, erreicht diese Anforderungen nicht.
Google hat die gleichen technischen Herausforderungen und ein noch größeres PR-Problem. Gemini Intelligence benötigt Nano v3, Nano v3 ist derzeit jedoch nur auf dem Pixel 10 verfügbar, und Pixel-9-Geräte – die unter einem Versprechen einer Aktualisierung alle sieben Jahre — nutzen Nano v2. Das Versprechen bezog sich auf Updates. Es ging nie um Funktionen, und die Unterscheidung, die für einen Produktmanager im Jahr 2023 Sinn ergab, ergibt für einen Kunden im Jahr 2026 überhaupt keinen Sinn mehr.
Das dürfte in den nächsten zwei Jahren das große Thema im Bereich der Verbraucher-KI sein: Ein Versprechen auf langfristigen Support, bei dem Sicherheitspatches für ein Gerät bereitgestellt werden, auf dem die Funktionen, mit denen die Patches ausgeliefert werden, nicht ausgeführt werden können.
Was ein Smartphone tatsächlich leisten kann – gemessen
Unabhängige Benchmark-Tests auf einem iPhone 17 Pro (A19 Pro) über vier Ausführungszeiten hinweg:
| Modell | Laufzeit | Tok/s dekodieren | Spitzenspeicher |
|---|---|---|---|
| Gemma 4 E2B (4-Bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-Bit) | MLX | 47.5 | 2.900 MB |
| Gemma 4 E2B (4-Bit) | lama.cpp | 37.8 | 3.156 MB |
| Gemma 4 E2B (4-Bit) | CoreML / ANE | 33.4 | 1.187 MB |
| Qwen 3.5 2B (4 Bit) | MLX | 61.2 | 1.279 MB |
| Qwen 3.5 2B (4 Bit) | lama.cpp | 39.1 | 1.479 MB |
| Qwen 3.5 2B (4 Bit) | CoreML / ANE | 27.9 | 241 MB |
Zwei Erkenntnisse fallen besonders ins Auge.
Die Neural Engine ist der langsamste Weg und bei weitem der speichereffizienteste. 27,9 tok/s bei 241 MB gegenüber 61,2 tok/s bei 1.279 MB beim MLX – fünfmal so schnell bei fünfmal so viel Speicher. Genau dieser Kompromiss ist der Grund, warum Apple das ANE für ständig aktive Systemfunktionen nutzt und warum Apps von Drittanbietern es für interaktive Chats meiden.
Sechzig Token pro Sekunde auf einem 2B-Modell in deiner Hosentasche – das ist schneller, als die meisten Menschen lesen können. Das bedeutet, dass die Einschränkung bei der lokal auf dem Smartphone ausgeführten KI nicht in der Geschwindigkeit liegt. Es liegt in der Leistungsfähigkeit, und die Leistungsfähigkeit hängt von den Parametern ab, die wiederum vom Speicher abhängen – und genau diesen Speicher haben alle Anbieter gerade begrenzt.
Teil 13: Der PC und Microsofts stille Wette
Microsoft hat am 2. Juni auf der Build 2026 etwas getan, das meiner Meinung nach im Rückblick bedeutender erscheinen wird, als es an diesem Tag den Anschein hatte: Es hat Modelle direkt in Windows integriert.
Aion 1.0 – Anleitung ist ein kleines Sprachmodell für Zusammenfassungen, Umschreibungen und Extraktionen. Es benötigt eine moderne CPU und Windows 11 – keine NPU, keine diskrete GPU. Es ist ab sofort in Edge Canary ab Build 150.0.4070 verfügbar und steht Webentwicklern über die Prompt-, Summarizer-, Writer- und Rewriter-APIs zur Verfügung; die offenen Gewichte wurden im Juli 2026 auf Hugging Face veröffentlicht.
Aion 1.0-Plan ist der interessante: ein Modell für Schlussfolgerungen und den Aufruf von Werkzeugen mit 14 Milliarden Parametern und einem Kontextfenster von 32K, entwickelt für agentenbasierte Arbeitsabläufe, Dateiverwaltung und die Koordination von Unteragenten. Zum Zeitpunkt der Erstellung dieses Artikels “in den kommenden Monaten”.
Microsoft formulierte dies mit den Worten: “Unbegrenzte Intelligenz für jeden Haushalt und jeden Schreibtisch.” Lassen wir das Marketing einmal beiseite und betrachten wir die architektonische Entscheidung: eine JavaScript-API im Browser, die ein lokales Modell aufruft – ohne Schlüssel, ohne Rechnung und ohne Netzwerk. Wenn sich das durchsetzt, wird eine riesige Kategorie kleiner KI-Funktionen nicht mehr als SaaS-Produkt, sondern als Plattformfunktion betrachtet. Das hat weitaus größere Auswirkungen auf die Wirtschaftlichkeit der KI-Branche als jede einzelne Modellveröffentlichung in diesem Jahr.
Die Hardware-Etage gibt es wirklich, und viele Geräte sind dort nicht vertreten.
Für den NPU-Pfad ist ein Copilot+-PC mit einem mindestens 40-TOPS-NPU:
| Silizium | NPU | Erfüllt die Voraussetzungen? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 Oberteile | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ Hardware; Software “folgt später” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
Und hier ist die Zahl, die die Erwartungen neu kalibrieren sollte: Auf einer 45-TOPS-NPU erzeugt ein 8B-Modell etwa 5 Token pro Sekunde. Das Modell „14B Plan“ wird langsamer sein.
Fünf Tokens pro Sekunde sind kein Chat-Erlebnis. Das reicht für eine Zusammenfassung im Hintergrund, eine Umformulierung, eine Klassifizierung oder eine Extraktion – also genau die Aufgaben, für die Aion 1.0 Instruct eigentlich gedacht ist. Für alles, was man sich aktiv ansieht, reicht das jedoch nicht aus.
Warum läuft es bei 45 TOPS so langsam? Denn die Token-Generierung wird durch die Speicherbandbreite begrenzt, nicht durch die reine Rechenleistung. Die NPU kann zwar die Matrixmultiplikationen durchführen; das Problem besteht jedoch darin, die Gewichte für jedes einzelne Token aus dem Systemspeicher zu streamen. Das ist dieselbe Grenze, die für alle in diesem Artikel vorgestellten Geräte gilt, und deshalb ist “TOPS” als Kaufkriterium nahezu nutzlos.
Die Desktop-Boxen
Wenn Sie einen Rechner speziell für lokale Inferenz suchen, hat sich die 128-GB-Klasse auf zwei Optionen und einen Ausreißer festgelegt:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| Speicher | 128 GB einheitlich | 128 GB LPDDR5X-8000 | bis zu 512 GB vereinheitlicht |
| Bandbreite | ~273 GB/s | ~256 GB/s | 1,2 TB/s |
| Preis | ~$3,999 | $2.300–$2.500 | ab $5.499 |
| Anmerkungen | CUDA-Ökosystem | Leistungsstarke CPU (1,6 TFLOPS Linpack gegenüber 708 GFLOPS bei Spark) | 512-GB-Variante Ende Oktober, Preis noch nicht bekannt |
Diese Preise sowie die Zahlen für Spark und Strix Halo stammen aus Testberichten, die Ende Dezember 2025 veröffentlicht wurden; betrachten Sie sie daher eher als Richtwerte und nicht als aktuelle Angaben – die Speicherpreise haben sich seitdem verändert. Was die Token-Generierung angeht, liegen der DGX Spark und der Strix Halo viel näher beieinander, als ihre Rechenleistungswerte vermuten lassen – denn beide bleiben bei einer Bandbreite von etwa 256–273 GB/s hängen, und genau das ist die einschränkende Größe. Der Spark hat bei der Bildgenerierung (~120 TFLOPS gegenüber ~46 bei FLUX.1 Dev BF16) und bei der CUDA-Kompatibilität eindeutig die Nase vorn. Der Strix Halo punktet bei Preis und CPU.
Der Mac Studio M5 Ultra spielt sowohl in puncto Arbeitsspeicher als auch Bandbreite in einer ganz anderen Liga, und ich habe ausführlich darüber berichtet in die lokale KI-Hardwarekomponente. Kurz gesagt: Ein System mit 512 GB und einer Übertragungsrate von 1,2 TB/s ist der einzige Mainstream-Rechner, der ein Modell der 400B-Klasse im Arbeitsspeicher unterbringen kann, und der Preis für dieses Privileg liegt bei einer Konfiguration von etwa $16.000 bis $20.000.
Die Modelle, die tatsächlich ausgeführt werden sollen
| Modell | Parameter | Lizenz | Läuft bequem in | Geeignet für |
|---|---|---|---|---|
| Gemma 4 E2B | 5,1 Mrd. / 2,3 Mrd. aktiv | Apache 2.0 | 4 GB | Telefone, ständig eingeschaltet, Audioeingang |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | Routinearbeiten am Laptop, Zusammenfassung |
| Aion 1.0 – Anleitung | kleines SLM | Offene Gewichtsklassen (HF, Juli 2026) | Nur CPU | Windows-eigene Textaufgaben |
| Qwen3.8-27B | 27B dicht | Apache 2.0 | 24–32 GB | Bestes allgemeines lokales Modell unter 32 GB |
| Gemma 4 26B-A4B | 26B / 4B aktiv | Apache 2.0 | 24 GB | Schnelles MoE, geringe Aktivierungskosten |
| Gemma 4 31B | 31B dicht | Apache 2.0 | 32 GB | Höchste lokale Qualität unter 32 GB |
| Ornith-1.5 35B | 35B / 3B aktiv | MIT | 32 GB | Agentenbasierte Codierung, minimaler aktiver Speicherbedarf |
| gpt-oss-120b | 120B / 5,1B aktiv | Apache 2.0 | 128 GB | Der „Sweet Spot“ bei 128 GB |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB und mehr | Liegt in der Nähe der Grenze, benötigt einen großen Container |
| MiniMax M3 | 428B / 23B aktiv | Benutzerdefiniert | 512 GB | Passt nur auf einen M5 Ultra |
| DeepSeek V4 Pro | 1,6 T / 49 B aktiv | MIT | Cluster | Kein Modell für Endverbraucher |
| Kimi K3 | 2,8 T / 104 B aktiv | Benutzerdefiniert | Cluster | Passt auf keinen Mac, den Apple verkauft |
Falls Sie speziell die Speicherausstattung eines Apple-Geräts festlegen möchten: Ich habe die verschiedenen Speicherstufen ausführlich in Der Leitfaden zur lokalen KI des MacBook Pro M5 Pro mit 64 GB — Kurz gesagt: Ab 64 GB sind die Kompromisse nicht mehr störend.
Wenn du eine Empfehlung möchtest: Führen Sie auf einem Rechner mit 32 GB Speicher Folgendes aus: Qwen3.8-27B oder Gemma 4 31B. Beide unterliegen der Apache-2.0-Lizenz, beide sind multimodal, beide sind wirklich nützlich, beide passen. Das ist die Standardeinstellung für 2026, und sie ist eine viel bessere Standardeinstellung als die von 2025.
Bild anzeigen Was tatsächlich passt, nach Speicherklassen. Die vertikalen Linien stellen die Speichergrößen dar, die Verbraucher tatsächlich erwerben können; die Modelle, die über die rechte Linie hinausragen, bilden die Obergrenze der lokalen KI im Jahr 2026.
Teil 14: Die Erinnerungswand erzählt die ganze Geschichte
Im dritten Akt läuft alles auf eine einzige Gleichung hinaus, daher hier noch einmal ausdrücklich.
Wird es passen?
Gewichte (GB) ≈ Gesamtparameter (B) × Bytes pro Parameter
 4-Bit  → × 0,5
 8-Bit  → × 1,0
 BF16   → × 2,0

verfügbar ≈ (Systemspeicher × 0,75) − Overhead von Betriebssystem und Anwendung − KV-Cache
Wie schnell wird es generiert?
Token/Sek. ≈ (Speicherbandbreite × Effizienz) ÷ aktive Bytes pro TokenBeachten Sie, dass in der zweiten Formel aktiv Parameter, nicht die Gesamtzahl. Deshalb sind ’Mixture-of-Experts’-Modelle auf handelsüblicher Hardware so überproportional gut. Das Modell „26B-A4B“ von Gemma 4 verfügt über 26 Milliarden Parameter für die Leistungsfähigkeit und 4 Milliarden Parameter für die Kosten pro Token. Bei Ornith-1.5 sind von 35B 3B aktiv. MiniMax M3 hat insgesamt 428B und davon 23B aktiv.
Der Wirkungsgrad in dieser Formel liegt in der Praxis bei etwa 0,5 bis 0,8. abhängig von der Laufzeit, der Quantisierung und davon, wie viel der Speicherbandbreite der Rest des Systems beansprucht.
Wenden wir das nun an. Ein Laptop mit einer 45-TOPS-NPU und LPDDR5X mit beispielsweise 120 GB/s, auf dem ein 8B-Modell mit 4 Bit (4 GB aktive Gewichte) läuft: 120 × 0,6 ÷ 4 ≈ 18 Token pro Sekunde Theoretisch. Der gemessene Wert liegt bei etwa 5. Der Unterschied ist auf die Planung, Speicherkonflikte, Vorabfüllungskosten und die Tatsache zurückzuführen, dass die NPU-Toolchains noch nicht ausgereift sind. Genau in dieser Diskrepanz zwischen Berechnung und Messung liegt der Hauptgrund für die Enttäuschung in diesem Bereich.
Die DRAM-Knappheit ist die versteckte Variable hinter jeder Zahl in diesem Artikel
Die Speicherhersteller nutzten die Jahre 2025 und 2026 dazu, ihre Kapazitäten auf KI-Rechenzentrumskunden umzuverteilen, die größere Verträge mit besseren Margen abschließen als Hersteller von Verbrauchergeräten. Die Folgen sind überall spürbar:
- Apple hat im Juni 2026 die Preise für Macs und iPads erhöht.
- Die Auslieferung der 512-GB-Version des Mac Studio wurde aus Lieferengpässen auf Ende Oktober verschoben; der Preis steht noch nicht fest.
- Apples M6 ist auf 32 GB einheitlichen Speicher begrenzt, und die Modelle M6 Pro, Max und Ultra wurden komplett gestrichen.
- Ming-Chi Kuo berichtete, dass Apple die Hardware-Auslieferungen für 2026 aufgrund von Lieferengpässen bei Speicherchips gekürzt habe.
Jede Obergrenze in diesem Artikel lässt sich auf denselben Mangel zurückführen. Die 12-GB-Hürde bei Smartphones. Die 32-GB-Obergrenze beim M6. Die 128-GB-Obergrenze bei Laptops. Die verzögerte Einführung der 512-GB-Stufe. Keine davon ist eine technische Grenze des Siliziums; es handelt sich ausschließlich um Zuteilungsentscheidungen in einem Markt, in dem Speicherplatz knapp und teuer ist.
Falls Sie darauf gewartet haben, dass sich die Preise wieder normalisieren, bevor Sie eine Maschine für lokale Inferenz anschaffen: Niemand, der glaubwürdig ist, kann vorhersagen, wann das geschehen wird.
Teil 15: Einrichtung
Der praktische Teil. Alles hier habe ich selbst ausprobiert; wenn ich nur darüber berichte, anstatt es selbst auszuprobieren, weise ich ausdrücklich darauf hin.
Der einfachste Weg: LM Studio
Eine grafische Benutzeroberfläche, die nativ auf Apple Silicon läuft, mit integriertem Modellbrowser und einem OpenAI-kompatiblen Server, der sich mit einem einzigen Schalter aktivieren lässt. Wenn Sie ein Modell innerhalb von zehn Minuten zum Laufen bringen möchten, fangen Sie hier an. Es ist zudem das Tool, an dem Apple in seinen eigenen Pressemitteilungen Maß nimmt – was deutlich macht, wie sehr sich diese Technologie mittlerweile etabliert hat.
Der flexibelste Weg: Ollama
bash
# Installation
curl -fsSL https://ollama.com/install.sh | sh

# 2026-Standard abrufen und ausführen
ollama run qwen3.8:27b

# Der Standardkontext ist für echte Code-Arbeiten zu klein – vergrößern Sie ihn
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
Genau dieses zweite Kommando wird oft übersehen. Der Standardkontext von Ollama ist konservativ eingestellt; bei einer Code-Aufgabe wird der Text stillschweigend gekürzt, und man gibt dem Modell die Schuld dafür.
Der schnellste Weg auf Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Direkt generieren
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Erläutern Sie das Mixture-of-Experts-Routing in zwei Absätzen." \
  --max-tokens 512

# Oder einen OpenAI-kompatiblen Endpunkt bereitstellen
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Richten Sie einen beliebigen OpenAI-kompatiblen Client auf http://localhost:8080/v1.
Erhöhen Sie die festgelegte Speichergrenze, bevor Sie sich über Abstürze beschweren
macOS lässt standardmäßig nicht zu, dass die GPU den gesamten einheitlichen Speicher anspannt. Auf einem Rechner mit großem Arbeitsspeicher entscheidet dies darüber, ob ein Modell geladen wird oder nicht:
bash
# Aktuelles Limit prüfen
sysctl iogpu.wired_limit_mb

# Beispiel für einen Rechner mit 128 GB, wobei ~14 GB für das Betriebssystem verbleiben
sudo sysctl iogpu.wired_limit_mb=116736

# Als Daueränderung speichern
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Stellen Sie diesen Wert nicht auf die gesamte Speichergröße ein. Lassen Sie auf einem leistungsstarken Rechner 12–16 GB für das Betriebssystem frei, sonst kommt es zu Kernel-Panics statt zu schneller Inferenz. Überprüfen Sie dies nach jedem macOS-Update erneut, da die Updates diese Einstellung zurücksetzen.
Unter Windows sollten Sie zunächst die Betriebssystemmodelle verwenden
Bevor Sie irgendetwas installieren, prüfen Sie, was Windows Ihnen bereits bietet. Die APIs „Prompt“, „Summarizer“, „Writer“ und „Rewriter“ in Edge nutzen Aion 1.0 – lokal, ohne Schlüssel und ohne Kosten. Für die Zusammenfassung, das Umschreiben und die Extraktion innerhalb einer Web-App ist dies eine Komplettlösung, die keinerlei Infrastruktur erfordert.
JavaScript
// Edge Canary 150.0.4070+ – läuft vollständig auf dem Gerät
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
Falls Sie mehr benötigen, laufen sowohl LM Studio als auch Ollama problemlos unter Windows, und auf einem Rechner ohne geeignete NPU nutzen sie die GPU oder CPU, was bei Modellen der 8B-Klasse häufig schneller als der NPU-Pfad ohnehin.
Eine sinnvolle Hybridkonfiguration
Die Architektur, die ich tatsächlich aufbauen würde, und in etwa das, was ich derzeit betreibe:
- Stufe 1 – auf dem Gerät. Ein kleines Modell für Routing, Klassifizierung, Extraktion, Zusammenfassung und Diktat. Gemma 4 E4B oder Aion 1.0 Instruct. Immer verfügbar, ohne Grenzkosten.
- Stufe 2 – eigene Hardware. Ein Modell der Klasse „Open Weight“ (27B–120B) auf einem Rechner aus Ihrem Besitz – für alle Anwendungen, die Kundendaten verarbeiten, die den Gerichtsbezirk nicht verlassen dürfen. Qwen3.8-27B auf 32 GB,
gpt-oss-120bauf 128 GB. - Stufe 3 – Frontier über API. Planung, komplexe Schlussfolgerungen, lange Handlungsabläufe – alles, bei dem Fehler hohe Kosten verursachen.
Bei der Debatte geht es nie um “lokal oder Cloud”. Es geht darum, wo man die Grenzen zieht – und diese Grenzen haben sich in diesem Jahr deutlich verschoben.
Teil 16: Die Kosten- und Compliance-Rechnung
Das Argument der Einsparungen hält einer Berechnung nicht stand
Nehmen wir ein realistisches Arbeitsvolumen für ein Kleinunternehmen als Beispiel: einen Arbeitsmonat mit mäßigem Programmieraufwand, sagen wir 40 Millionen Eingabe- und 3 Millionen Ausgabetoken.
| Option | Monatliche Kosten |
|---|---|
| GLM-5.3-Flash-API ($0.15 / $0.47) | ~$7.40 |
| Gemini 3.8 Flash-API ($0.75 / $3.75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50, nicht zwischengespeichert) | ~$550 |
| Eine Strix Halo-Box vom Typ $2.400, abgeschrieben über 3 Jahre | ~$67/Monat + Strom |
Achten Sie darauf, was in dieser Tabelle tatsächlich steht. Lokale Hardware ist günstiger als die teuersten Modelle und teurer als die günstigsten. Im Vergleich zu GLM-5.3-Flash erreicht ein lokaler Rechner bei Tokens nie die Gewinnschwelle. Im Vergleich zu Fable 5.1, das ohne Cache läuft, amortisiert es sich in fünf Monaten – allerdings vergleicht man hier nicht Gleiches mit Gleichem, da Fable 5.1 ein weitaus besseres Modell ist als alles, was in 128 GB Platz findet.
Kaufen Sie also keine Hardware vor Ort, um Geld zu sparen. Kaufen Sie es aus einem dieser fünf Gründe – die alle echt sind:
- Datenstandort – eher eine architektonische Entscheidung als ein rechtliches Vorhaben.
- Keine Ratenbeschränkungen, keine Kontingente, keine Kapazitätsprobleme. Ihr Gerät hat am Dienstag keinen Betrieb.
- Version dauerhaft festlegen. Ein lokaler Prüfpunkt ist innerhalb eines Jahres byteweise identisch.
- Offline-Betrieb.
- Du hast die Workstation sowieso gebraucht. Dies ist der häufigste Fall, in dem der Kauf ganz einfach die richtige Entscheidung ist – wenn Sie ohnehin vorhatten, 2.500 € für einen Rechner auszugeben, bestehen die Grenzkosten für die KI-Fähigkeit lediglich in der Speichererweiterung und nicht im gesamten Gerät.
Die Situation hinsichtlich der Einhaltung der EU-Vorschriften, da sie sich im Jahr 2026 geändert hat
Für Leser in Deutschland und der EU haben sich die rechtlichen Rahmenbedingungen in diesem Jahr geändert, und die Termine stehen nun fest und sind nicht mehr an bestimmte Bedingungen geknüpft.
- 2. August 2025 — Die Anbieter von GPAI-Modellen übernahmen die Verpflichtungen hinsichtlich der Dokumentation, der Zusammenfassung der Schulungsinhalte und des Urheberrechts.
- 2. August 2026 — Die Durchsetzungsbefugnisse und die Transparenzpflichten gemäß Artikel 50 traten in Kraft. Es werden nun Bußgelder verhängt.
- 27. Juli 2026 — Der „Digital Omnibus“ (Verordnung (EU) 2026/1744) trat in Kraft und ersetzte den bisherigen bedingten Mechanismus für Systeme mit hohem Risiko durch feste Fristen.
- 2. Dezember 2026 — Ende der Übergangsfrist für maschinenlesbare Wasserzeichen in bestehenden Systemen.
- 2. August 2027 — Die zweijährige Übergangsfrist für bereits auf dem Markt befindliche GPAI-Modelle läuft ab.
- 2. Dezember 2027 — eigenständige Systeme mit hohem Risiko gemäß Anhang III (Personalbeschaffung, Bonitätsbewertung, Bildung, kritische Infrastruktur).
- 2. August 2028 — risikoreiche KI, die in regulierte Produkte gemäß Anhang I (Medizinprodukte, Maschinen) integriert ist.
Der „Digital Omnibus“ führte zudem Verbote für KI-generierte intime Darstellungen ohne Einwilligung sowie für kinderpornografisches Material (CSAM) ein und erweiterte die Aufsichtsbefugnisse des EU-KI-Büros.
Was das für die Leser dieses Artikels konkret bedeutet. Wenn Sie auf bestehenden Modellen aufbauen, anstatt diese selbst zu trainieren, liegen die meisten Verpflichtungen im Rahmen der allgemeinen KI-Verordnung (GPAI) beim Anbieter und nicht bei Ihnen. Was Ihnen obliegt, ist Transparenz – den Nutzern mitzuteilen, wann sie mit KI interagieren, und synthetische Inhalte zu kennzeichnen – sowie die Frage der Einstufung als “hohes Risiko”, falls Ihr System Bereiche wie Personalbeschaffung, Kreditvergabe, Bildung oder kritische Infrastruktur betrifft. Der Termin im Dezember 2027 ist weit genug entfernt, um planen zu können, und nah genug, dass „wir uns das später ansehen“ keine Strategie mehr ist.
Und der für den dritten Akt relevanteste Punkt: Ein geräteinternes Modell vereinfacht gleich mehrere dieser Gespräche erheblich. Keine Datenübermittlung, kein Datenverarbeiter, ein deutlich kürzerer Datenflussplan. Das ist keine Lücke – die Transparenzpflichten gelten weiterhin –, aber dadurch entfällt eine ganze Kategorie von Aufgaben.
Ich bin kein Rechtsanwalt, und dies stellt keine Rechtsberatung dar. Bei allen Angelegenheiten, bei denen es um Geld geht, sollten Sie einen in Deutschland oder der EU zugelassenen Berater hinzuziehen, der Ihre konkrete Situation prüft.
Teil 17: Die ehrliche Argumentation gegen all das
Wenn ich bei Teil 16 aufhören würde, wäre das hier eine Werbung.
Die gemessenen Produktivitätsdaten rechtfertigen diese Begeisterung nach wie vor nicht. Eine randomisierte kontrollierte Studie, 19% langsamer. Eine Nachbeobachtung, die nicht einwandfrei durchgeführt werden konnte. Selbstauskünfte, die um 40 Prozentpunkte überhöht waren. Jeder in dieser Branche, mich eingeschlossen, orientiert sich im Wesentlichen an Eindrücken über Eindrücke.
Die Sicherheitsdaten sind schlecht und zeigen keine Besserung. Die OWASP-Fehlerquote von Veracode für 45% blieb bis Anfang 2026 im Wesentlichen unverändert, während die Modelle deutlich intelligenter wurden. Das ist kein vorübergehendes Problem, das sich durch Skalierung beheben lässt. Leistungsfähigkeit und Sicherheit sind nicht dasselbe, und niemand optimiert intensiv für Letzteres.
Die Benchmark-Ergebnisse sind im oberen Bereich gesättigt und im mittleren Bereich nicht überprüfbar. SWE-bench Verified umfasst drei Modelle innerhalb eines Punktes. Die Benchmarks, die es ersetzen, sind zunehmend privat, was das Problem der Verfälschung löst, da eine unabhängige Überprüfung dadurch unmöglich wird.
Offene Gewichtsklassen sind nur eine Lizenzänderung davon entfernt, nicht mehr offen zu sein. Z.ai hat GLM vom MIT auf eine proprietäre Lizenz umgestellt, wobei zwischen den Versionen 5.2 und 5.3 eine Sicherheitsüberprüfung stattfand. Meta hat offene Gewichte für Muse Spark versprochen, ohne jedoch ein Datum, eine Größe oder einen Lizenztext anzugeben. Wenn Ihre Architektur davon ausgeht, dass die Gewichte im nächsten Jahr herunterladbar sein werden, handelt es sich bei dieser Annahme um eine geschäftliche Entscheidung des Anbieters und nicht um ein Naturgesetz.
Die Grenze ist nach wie vor nicht lokal und wird auch immer weniger käuflich. Mythos 5.1, das bei Terminal-Bench 4.0 die höchste Punktzahl erzielte, ist auf geprüfte Cybersicherheitsexperten und Biowissenschaftler beschränkt, die derzeit überwiegend in den USA ansässig sind. Kimi K3 und DeepSeek V4 Pro lassen sich auf keinem handelsüblichen Rechner installieren. Was auf Ihren Schreibtisch passt, ist ein hervorragendes Modell der zweiten Kategorie, das zwar wirklich nützlich ist, aber nicht die Spitze der Entwicklung darstellt.
Die Leistung des Geräts ist schlechter, als es die Werbung vermuten lässt. Fünf Token pro Sekunde für ein 8B-Modell auf einer NPU mit 45 TOPS. Ein Speicherbedarf von 12 GB, der die meisten im Umlauf befindlichen Smartphones ausschließt. Ein Update-Versprechen für sieben Jahre, das keine neuen Funktionen umfasst. Die Kluft zwischen dem Begriff “AI-PC” und dem, was das Gerät tatsächlich leisten kann, ist derzeit enorm.
Und Geopolitik ist ein Faktor im Beschaffungsprozess – ganz gleich, ob man das nun für richtig hält oder nicht. Einige der besten Open-Weight-Modelle – Kimi, GLM, DeepSeek, Qwen, MiniMax – stammen aus chinesischen Forschungslabors. Für Kunden aus dem öffentlichen Sektor, aus verteidigungsnahen Bereichen und aus bestimmten regulierten Branchen stellt dies ein unüberwindbares Hindernis dar, unabhängig davon, wo die Gewichte verwaltet werden oder was in der Lizenz steht. Das leistungsfähigste Modell von Anthropic ist hingegen auf geprüfte US-amerikanische Organisationen beschränkt. Das offene Ökosystem wird von beiden Seiten entlang nationaler Grenzen auseinandergerissen., und wenn Sie in Europa sind, befinden Sie sich an keinem der beiden Enden davon.
Teil 18: Der Entscheidungsrahmen für den Stand der KI im Jahr 2026
Bild anzeigen Sieben Situationen, sieben Antworten. Finde die Zeile, die zu deinem Jahr passt.
Sieben Szenarien, die auf den aktuellen Stand der KI im Jahr 2026 übertragen wurden, so wie er heute tatsächlich aussieht.
1. “Ich möchte das beste Modell, und die Kosten spielen keine Rolle.”
Claude Fable 5.1 bei einem Gesamtindex von 65,7, $10/$50, 1M-Kontext – und aktivieren Sie das Caching, denn die Cache-Lese-Reduzierung von 75% spart Ihnen 25–45% Ihrer Rechnung ein. Behalten Sie GPT-5.6 Sol Verfügbar für recherchienintensive Arbeiten unter 90.4% BrowseComp. Machen Sie sich keine Sorgen; der Unterschied zwischen beiden ist geringer als der zwischen Ihrem besten und Ihrem schlechtesten Prompt.
2. “Ich setze viele Agenten ein, und die Rechnung wird langsam lächerlich.”
Claude Opus 5 mit den Parametern $5/$25 für die Arbeit mit langem Zeithorizont, GLM-5.3-Flash mit den Parametern $0,15/$0,47 für die mechanische Arbeit im großen Maßstab sowie ein lokales Modell für „Grunt“. Das Routing ist der wichtigste Kostenhebel, der Ihnen zur Verfügung steht, und es handelt sich dabei um eine Konfigurationsdatei, nicht um ein Projekt. Ermitteln Sie zunächst die Aufteilung Ihrer Token nach Agentenrollen, bevor Sie irgendetwas optimieren – die meisten stellen fest, dass 80% ihrer Ausgaben auf Aufgaben entfallen, für die kein Frontier-Modell erforderlich war.
3. “Die DSGVO und die Datenlokalisierung sind zwingende Voraussetzungen für die Arbeit mit Kunden.”
Qwen3.8-27B oder Gemma 4 31B auf Ihrer eigenen Hardware, beide unter Apache 2.0, beide multimodal. Steigen Sie um auf gpt-oss-120b auf einem Rechner mit 128 GB, falls die Arbeit dies erfordert. Es geht nicht um Geschwindigkeit – es geht darum, dass keine Eingabeaufforderung das Gebäude verlässt und Ihre rechtliche Prüfung zu einer Lektüre der Lizenzbedingungen wird, anstatt zu einer Folgenabschätzung zur Datenübermittlung. Wählen Sie bewusst Modelle mit freizügigen Lizenzen aus, damit der Lesetext kurz bleibt.
4. “Ich möchte lokale KI ausprobieren, ohne viel Geld auszugeben.”
Alles, was Sie bereits besitzen, plus LM Studio, plus Gemma 4 E4B. Acht Gigabyte Speicher reichen aus, um wirklich nützlich zu sein. Finden Sie heraus, ob lokale KI das Richtige für Sie ist, bevor Sie Geld dafür ausgeben – die meisten Menschen stellen fest, dass sie Tier 1 und Tier 3 benötigen und Tier 2 überhaupt nie gebraucht haben.
5. “Ich kaufe eine Maschine speziell für lokale Inferenz.”
Entscheiden Sie sich in dieser Reihenfolge für Speicherbandbreite und -kapazität und ignorieren Sie TOPS. In der 128-GB-Klasse ist das Strix Halo für ca. $2.400 die preiswerteste Wahl, während man mit dem DGX Spark für ca. $3.999 CUDA-Fähigkeit und eine deutlich bessere Bildgenerierung erhält. Darüber hinaus ist der Mac Studio M5 Ultra das einzige Modell, das eine 400B-Konfiguration bietet – zu einem Preis, der nur dann Sinn macht, wenn Sie die Workstation ohnehin benötigen.
6. “Mein Team setzt KI-Programmierwerkzeuge ein, und ich trage die Verantwortung dafür.”
Erledige die langweiligen Dinge in dieser Reihenfolge: SAST und Erkennung von Geheimnissen bei jedem Commit; Analyse der Softwarezusammensetzung für „halluzinierte“ Pakete; eine schriftlich festgelegte Richtlinie, die ungeprüften KI-Code aus den Bereichen Authentifizierung, Kryptografie, Autorisierung und Zahlungsverkehr ausschließt; als privilegiert eingestufte Anmeldeinformationen für Agenten; sowie eine SBOM, die die Herkunft der Tools dokumentiert. Dann ist mit einem J-Kurve — DORA verzeichnete vor dem Anstieg einen deutlichen Rückgang — und keine Panik im dritten Monat.
7. “Welches Smartphone sollte ich mir für KI kaufen?”
Jedes Modell mit 12 GB. Das ist die Grenze, die jede Plattform gezogen hat: iPhone 17 Pro und 18 Pro mit 12 GB, Pixel 10 für Nano v3, Galaxy S26 Ultra mit Snapdragon 8 Elite Gen 5. Das Basis-iPhone 18 mit angeblich 9 GB sowie das Pixel 9 und ältere Modelle lassen sich problemlos nutzen, erhalten jedoch die neuen Funktionen nicht. Wenn Sie bereits ein Gerät mit 12 GB besitzen, ist das diesjährige Upgrade speziell im Hinblick auf KI nur eine schrittweise Verbesserung.
Teil 19: Was ich mir im nächsten Quartal ansehen werde
Ob Meta die Schriftgewichte von Muse Spark tatsächlich bereitstellt und unter welcher Lizenz. “Bald” – so formuliert von einem CEO auf X, ohne Angabe von Parametern und ohne Lizenztext – ist die schwächste Form einer Zusage in diesem Artikel. Wenn sie unter Apache 2.0 veröffentlichen, verändert dies das offene Ökosystem erheblich. Wenn sie unter einer maßgeschneiderten Lizenz mit Umsatzschwelle veröffentlichen, ist dies mittlerweile der Branchenstandard, und „Open“ wird eher zu einer Marketingkategorie als zu einer Eigenschaft.
Ob sich das Ergebnis der Selbstoptimierung von Ornith-1.5 wiederholen lässt. Eine unabhängige Bewertung der Aufgaben außerhalb des selbst erstellten Lehrplans wäre ausschlaggebend. Dies ist der Punkt auf der Liste, bei dem die Varianz am größten ist: Entweder ist es das wichtigste Ergebnis des Jahres 2026 oder eine warnende Geschichte über selbst erstellte Maßstäbe – und ich weiß derzeit noch nicht, was davon zutrifft.
Ob „Aion 1.0 Plan“ tatsächlich erscheint und mit welcher Leistung es läuft. Ein 14B-Schlussfolgerungsmodell unter Windows stellt eine völlig neue Kategorie dar. Wenn es auf geeigneter Hardware mit 3 Tokens pro Sekunde läuft, handelt es sich um eine Demo. Läuft es mit 20 Tokens pro Sekunde, verändert dies die Rahmenbedingungen für Desktop-Anwendungen.
Die CVE-Zuschreibungskurve. 6, 15, 35 in aufeinanderfolgenden Monaten. Sollten sich die Monate April bis August in dieser Richtung fortsetzen, werden die Daten der Georgia Tech bei ihrer Veröffentlichung die bedeutendste Veröffentlichung des Jahres zum Thema KI-Sicherheit sein.
Ob jemand die Tools für die Überprüfung entwickelt. Die Kluft zwischen dem, was Algorithmen erzeugen können, und dem, was Menschen überprüfen können, ist das zentrale Problem des Jahres 2027, und bis heute fließt fast das gesamte Risikokapital nach wie vor in die Erzeugung statt in die Überprüfung. Wer auch immer das Tool auf den Markt bringt, das zuverlässig anzeigt, welche 5% eines Diffs von einem Menschen überprüft werden müssen, wird nur sehr schwer zu übertreffen sein.
Ob sich die Speicherengpässe entspannen werden. Es ist die verborgene Variable hinter dem „12-GB-Handy-Skandal“, der Begrenzung des M6 auf 32 GB, der Verzögerung bei der Einführung des 512-GB-Mac-Modells und der Apple-Preiserhöhung im Juni. Niemand, der glaubwürdig ist, prognostiziert eine Entspannung der Lage.
Und ob Modelle mit Sicherheitsgitter weiterhin eine Ausnahme bleiben. Mythos 5.1 unterliegt aus Gründen der doppelten Nutzung einer Zugangsbeschränkung, die ich für vertretbar halte, und das Projekt Glasswing erweitert derzeit aktiv den Zugang – bis Juni 2026 sollen rund 150 Organisationen in mehr als fünfzehn Ländern Zugang erhalten. Doch der Präzedenzfall ist geschaffen: Der Spitzenreiter eines öffentlichen Programmier-Benchmarks ist nun etwas, das sich die meisten Organisationen um keinen Preis leisten können. Wenn dies eher zur Regel als zum Sonderfall wird, wird die Frage “Kann meine Organisation einer Sicherheitsüberprüfung unterzogen werden?” zu einem entscheidenden Auswahlkriterium, und bei der Argumentation für offene Bewertungskriterien außerhalb der USA geht es dann überhaupt nicht mehr um Kosten.
Häufig gestellte Fragen
Welcher LLM-Studiengang ist im September 2026 der beste?
Insgesamt führt Claude Fable 5.1 den Intelligence Index v4.1.1 von Artificial Analysis mit 65,7 an, gefolgt von Claude Opus 5 mit 63,0, Claude Fable 5 mit 62,1, Grok 4.6 mit 60,9 und GPT-5.6 Sol mit 58,9. Doch die Gesamtwerte verschleiern die entscheidenden Unterschiede. GPT-5.6 Sol führt beim Browsen mit 90,41 TP3T auf BrowseComp; „Gemini 3.8 Flash“ liefert 58,7 bei $0,75 pro Million Eingabetoken; „GLM-5.3-Flash“ liefert 57,5 bei $0,15. Für die meisten realen Workloads sind die acht besten Modelle austauschbar, und die Entscheidung sollte eher anhand von Preis, Latenz, Cache-Effizienz und Lizenzbedingungen getroffen werden als anhand der Rangliste.
Welches ist derzeit das beste Modell in der offenen Gewichtsklasse?
Das hängt von Ihrer Hardware und Ihrer Lizenztoleranz ab. GLM-5.3 (753B) erzielt mit 59,5 die höchste Punktzahl, unterliegt jedoch einer benutzerdefinierten Lizenz mit einer Sicherheitsüberprüfung bei einem Umsatz von $10 Milliarden. DeepSeek V4 Pro (insgesamt 1,6 T, 49 Mrd. aktiv) ist unter der MIT-Lizenz verfügbar und erreicht auf Terminal-Bench 2.1 87,9 Punkte, benötigt jedoch einen Cluster. Für einen Rechner, den Sie tatsächlich besitzen, sind Qwen 3.8-27B oder Gemma 4 31B – beide unter Apache 2.0-Lizenz – die besten Modelle, die in 32 GB passen.
Ist Vibe-Coding im Jahr 2026 passé?
Der Begriff stirbt aus; die Praxis hat sich zweigeteilt. „Vibe-Coding“ im ursprünglichen Sinne – Eingabeaufforderung, Akzeptieren, den Diff nicht lesen – ist nach wie vor richtig für Wegwerf-Arbeiten: Skripte, Prototypen, einmalige Analysen. Was sie für alles, was veröffentlicht wird, abgelöst hat, ist spezifikationsgesteuertes, agentenbasiertes Engineering: eine schriftliche Spezifikation, eine Sandbox, eine Testsuite, die der Agent bestehen muss, und eine echte Überprüfung des resultierenden Diffs. Die gefährliche Mitte – Produktionscode, ungeprüft – ist der Ursprung jedes dokumentierten Vorfalls des Jahres 2026.
Macht KI-Programmierung Entwickler tatsächlich schneller?
Die einzige randomisierte kontrollierte Studie kommt zu einem anderen Ergebnis. METR stellte fest, dass erfahrene Entwickler mit KI-Tools von Anfang 2025 bei ausgereiften Codebasen um 19% langsamer waren, während sie glaubten, um 20% schneller gewesen zu sein – eine Überschätzung um 40 Prozentpunkte. Ihre Nachuntersuchung aus dem Jahr 2026 konnte nicht ordnungsgemäß durchgeführt werden, da sich die Entwickler weigerten, ohne KI zu arbeiten. Umfragen berichten von einem 3-fachen Geschwindigkeitsmultiplikator, aber nur einer 1,4- bis 2-fachen Veränderung des Arbeitsaufwands. Meine Einschätzung: große Gewinne bei ungewohnten Aufgaben, Standardcode, Tests und Migrationen; geringe oder negative Gewinne bei Codebasen, die man in- und auswendig kennt.
Wie riskant ist von KI generierter Code?
Messbar risikobehaftet und nur langsame Verbesserung. Veracode stellte fest, dass 45% der KI-generierten Beispiele eine OWASP-Top-10-Sicherheitslücke aufweisen, wobei Java mit 72% am schlechtesten abschneidet. Apiiro hat gemessen, dass KI-unterstützte Entwickler Commits 3–4-mal schneller und Sicherheitsbefunde 10-mal schneller erstellen, wobei die Anzahl der Wege zur Rechteausweitung um 322% gestiegen ist. Etwa 20% des KI-generierten Codes verweist auf nicht existierende Pakete, und 43% dieser „halluzinierten“ Namen tauchen immer wieder auf – was eine Angriffsfläche in der Lieferkette darstellt. Die Lösung sind automatisierte Prüfmechanismen bei jedem Commit, nicht der Verzicht auf KI.
Kann ich ein gutes LLM offline auf meinem eigenen Computer ausführen?
Ja, und 2026 ist das erste Jahr, in dem dies eindeutig zutrifft. Mit 8 GB Arbeitsspeicher ist Gemma 4 E4B wirklich nützlich. Bei 32 GB sind Qwen3.8-27B oder Gemma 4 31B leistungsstarke multimodale Modelle unter der Apache-2.0-Lizenz. Bei 128 GB ist gpt-oss-120b der ideale Kompromiss. Was auf keinem Endverbraucher-Rechner Platz findet, ist die eigentliche Spitzenklasse: Kimi K3 mit 2,8 Billionen Parametern und DeepSeek V4 Pro mit 1,6 Billionen benötigen beide einen Cluster.
Was ist Microsoft Aion 1.0?
Eine Familie von On-Device-Modellen, die am 2. Juni 2026 auf der Build-Konferenz angekündigt und in Windows 11 integriert wurde. Aion 1.0 Instruct ist ein kleines Modell für Zusammenfassung, Umschreibung und Extraktion, das auf einer modernen CPU läuft, ohne dass eine NPU erforderlich ist. Es wird über die JavaScript-APIs “Prompt”, „Summarizer“, „Writer“ und „Rewriter“ von Edge bereitgestellt, wobei die Gewichte seit Juli 2026 auf Hugging Face offen zugänglich sind. Aion 1.0 Plan ist ein Modell mit 14 Milliarden Parametern für Schlussfolgerungen und den Aufruf von Tools mit einem Kontextfenster von 32K für agentische Workflows, das einen Copilot+-PC mit einer NPU von mindestens 40 TOPS erfordert, und befand sich Anfang September 2026 noch immer „in einigen Monaten“ vor der Veröffentlichung.
Warum benötigen Smartphones 12 GB RAM für KI-Funktionen?
Denn Modelle auf dem Gerät sind speichergebunden, nicht rechengebunden. Apples „AFM 3 Core Advanced“ ist ein spärliches Modell mit 20 Milliarden Parametern, das im Flash-Speicher residiert und geroutete Experten bei Bedarf in den DRAM auslagert – wofür jedoch zusätzlich zum Betriebssystem, der App und der Kamerapipeline noch Platz benötigt wird. Ming-Chi Kuo berichtet von zwei Funktionen in iOS 27, die 12 GB erfordern. Googles „Gemini Intelligence“ hat dieselbe Mindestanforderung von 12 GB. Der Unterschied zwischen 9 GB und 12 GB liegt im Arbeitsspeicherbedarf, nicht in der Marktsegmentierung.
Lohnt sich eine NPU für lokale KI?
Weniger, als die Werbung vermuten lässt. Auf einer NPU mit 45 TOPS erzeugt ein 8B-Modell etwa 5 Token pro Sekunde, da die Token-Generierung eher durch die Speicherbandbreite als durch die Rechenleistung begrenzt wird. NPUs eignen sich hervorragend für ständig laufende, stromsparende Aufgaben mit kurzen Auslastungsspitzen – also genau die Aufgaben, die ein Betriebssystem ständig ausführt. Für interaktive Chats auf einem Laptop ist der GPU- oder sogar der CPU-Weg häufig schneller. Achten Sie beim Kauf auf Speicherbandbreite und -kapazität; betrachten Sie TOPS beim Kauf als nahezu bedeutungslos.
Are open-weight models actually open source?
Mostly not. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) and Ornith-1.5 (MIT) carry genuinely permissive licences. GLM-5.3 requires companies above $10 billion revenue to pass Z.ai’s security review; Kimi K3 uses a revenue-tiered licence; MiniMax M3 mandates prominent “Built with MiniMax M3” attribution for any commercial use and written authorisation above $20 million revenue. None of them release training data or training code. “Open weight” is the accurate term; “open source” is doing dishonest work.
Is it cheaper to run models locally than to use an API?
Almost never on token cost alone. A moderate month of agentic work — 40M input and 3M output tokens — costs about $7 on GLM-5.3-Flash and about $41 on Gemini 3.8 Flash. A $2,400 local box amortised over three years is roughly $67 a month before electricity. Local hardware beats the top of the frontier on cost and loses to the bottom of it. Buy local for data residency, rate-limit freedom, version pinning and offline operation — or because you needed the workstation anyway.
What does the EU AI Act require in 2026?
As of 2 August 2026, enforcement powers and Article 50 transparency duties apply to general-purpose AI, and fines are now available. The Digital Omnibus, Regulation (EU) 2026/1744, entered into force on 27 July 2026 and set fixed dates: 2 December 2026 ends the watermarking grace period; 2 August 2027 closes the transition for GPAI models already on the market; 2 December 2027 applies to stand-alone high-risk systems under Annex III; 2 August 2028 covers high-risk AI embedded in regulated products. If you build on models rather than train them, most GPAI obligations sit with the provider — transparency and high-risk classification are what land on you. This is not legal advice.
How long can an AI agent work unsupervised?
METR measures the task length a model completes autonomously with 50% success. That figure went from about 30 seconds in 2022 to over 14 hours for frontier systems in 2026, with a doubling time of roughly 196 days on METR’s hybrid fit, or 131 days when restricted to post-2023 models. The confidence intervals are very wide — Claude Opus 4.5’s 320-minute horizon ranges from 170 to 729 minutes — and only 5 of METR’s 31 long tasks use measured human baselines. Extrapolated, that is about one working day of autonomous task length in 2027.
Which model should I use for coding specifically?
Route rather than choose. Planning and architecture to the most capable model you can afford (Claude Fable 5.1); the bulk of long-horizon implementation to Claude Opus 5 at half the price; high-volume mechanical work to GLM-5.3-Flash at $0.15/$0.47; anything touching client data to a local open-weight model; and renames, docstrings and lint fixes to a small local model. Write the model IDs so that swapping one is a single-line change — four labs shipped a top-ten model between June and September 2026.
Das Fazit
Twelve months ago, the interesting question in AI was which model was smartest. The state of AI 2026 is that this question has become close to uninteresting. The top ten models span 8.2 points on the best available aggregate, and the cheapest of them costs one sixty-seventh of the most expensive.
What replaced it is more useful and less exciting: can you verify what these things produce, fast enough to keep up with them?
That single question explains every finding in this article. It explains why SWE-bench saturated at 96% and stopped being informative. It explains why adoption of AI coding tools hit 90% while trust fell to 29%. It explains why Veracode’s security failure rate did not budge while capability soared, because capability and verifiability are different axes and only one of them is being optimised. It explains why DORA found that the returns come from the organisation rather than the tool. And it explains why the practice that actually works in 2026 — specification, sandbox, test gate, real review — looks so much less magical than the demos.
Four things I would take away.
The frontier commoditised faster than anyone expected, and the open-weight gap is now about six months. A 397B MIT-licensed model beats last generation’s closed frontier on SWE-bench. A 753B open-weight model outranks GPT-5.6 Sol on the aggregate index. Plan for a world where the model is not your differentiator, because it very nearly is not one already.
Read the licence before the benchmark. Capability is converging; terms are diverging. Z.ai moved away from MIT between releases. Meta has promised weights with no licence text. Anthropic’s best coding model is gated by nationality. For a commercial buyer, four points of benchmark is worth less than a licence your lawyer can read in ninety seconds.
Verification is the whole game now, and almost nobody is funding it. Agents can produce a day of work; we review it with tools built for reviewing an hour of work. If you are choosing where to spend engineering effort in the next twelve months, spend it on tests, specifications and review tooling rather than on prompt technique. Prompt technique depreciates with every model release. Verification infrastructure compounds.
And offline AI got real, on a memory budget that just got expensive. A 27-billion-parameter Apache-licensed multimodal model runs on a machine you can buy for €2,500. Windows ships a model in the operating system. Your phone runs a 20-billion-parameter sparse model out of flash. Every ceiling on that — the 12 GB phone gate, the 32 GB laptop cap, the 40-TOPS floor — is a memory allocation decision in a market where DRAM is scarce, not a limit of the silicon.
The setup I would actually build today: Gemma 4 E4B on the device for the always-on tier; Qwen3.8-27B on your own hardware for anything that must not leave the building; GLM-5.3-Flash at $0.15/$0.47 for the high-volume middle; and Claude Opus 5 or Fable 5.1 for planning and the genuinely hard problems, with caching switched on. Route between them in a config file, and expect to rewrite that file in three months.
Revisit this in December. Meta will either have shipped weights or not. Aion 1.0 Plan will either be real or vapour. The Ornith self-improvement result will have replicated or quietly disappeared. And the CVE attribution curve will have told us whether 2026 was the year the industry tightened its own gates or the year it waited for someone else to.
Are you running open-weight models in production in the EU, or shipping agent-written code through a review process you actually trust? I am particularly interested in two things: measured token-cost splits by agent role, and anything that works for reviewing thousand-line agent diffs. Corrections and counter-evidence welcome — this article gets updated when the picture changes.
Last updated: 3 September 2026.