
 Русский
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 العربية
 हिन्दी

Есть совершенно особый вид усталости от решений, который накрывает вас около 11 вечера, после третьей чашки кофе, когда вы смотрите на выбор модели в OpenCode.
У вас есть ключ Z.ai. У вас есть ключ MiniMax. Обе модели заявляют миллион токенов контекста. Обе имеют открытые веса. Обе стоят примерно ничего по сравнению с передовыми закрытыми моделями. У обеих есть график бенчмарков, где они побеждают. А вы просто хотите узнать, какую из них поставить по умолчанию, чтобы вернуться к работе.
Эта статья — ответ на этот вопрос, в длинной версии, потому что короткая версия (“GLM-5.3-Flash, наверное”) скрывает около шести оговорок, которые вас укусят, если их пропустить.
Я собрал детали архитектуры, бенчмарки производителей, независимые оценки, реальные цены за токен с учётом ловушки ярусной надбавки за длинный контекст, опубликованную самим OpenCode телеметрию использования и фактические конфигурационные файлы для обеих моделей. Затем я посчитал стоимость для нормального рабочего месяца, а не для сценария из пресс-релиза.
Вот что получилось.
Кратко — вердикт за 30 секунд
Запустите GLM-5.3-Flash как модель OpenCode по умолчанию. Она умнее практически во всех агентных и кодовых бенчмарках, которые имеют значение, стоит примерно вдвое меньше за токен, действительно распространяется под лицензией MIT, и именно к ней на самом деле пришло сообщество OpenCode.
Оставьте MiniMax M3 в качестве скоростной модели. Она генерирует примерно втрое быстрее и отвечает примерно вдвое быстрее по времени до первого токена. Для циклов с большим числом шагов и низкой сложностью — переименование файлов, создание каркаса тестов, генерация документации, проходы lint-and-fix, крупные механические рефакторинги — эта разница в скорости ощущается сильнее, чем разрыв в интеллекте.
Честный ответ в одну строку: GLM-5.3-Flash думает лучше, MiniMax M3 печатает быстрее. Агентное кодирование — в основном задача мышления, поэтому GLM выигрывает место по умолчанию. Но если вы не запускаете обе, вы оставляете пропускную способность неиспользованной, а OpenCode делает одновременный запуск обеих до смешного простым.
Краткая таблица сравнения
| GLM-5.3-Flash | MiniMax M3 | |
|---|---|---|
| Производитель | Z.ai (Zhipu AI) | MiniMax |
| Выпуск | 26 августа 2026 | 1 июня 2026 |
| Всего параметров | 320 млрд | ~428 млрд |
| Активных на токен | 18 млрд | ~23 млрд |
| Архитектура | Гибридное линейное внимание KDA + разреженное MLA с NoPE, MoE (8 из 288 экспертов + 1 общий) | Основа GQA + MiniMax Sparse Attention (MSA), разреженный MoE |
| Контекстное окно | 1 млн (1 048 576) | 1 млн (512 тыс. — гарантированный минимум) |
| Макс. выход | 131 072 токена | до 262 144 токенов |
| Мультимодальный ввод | Текст, изображение, видео, файл | Текст, изображение, видео |
| Лицензия | MIT | MiniMax Community License |
| Цена ввода через API | $0,15 / 1 млн ($0,03 из кэша) | $0,30 / 1 млн ($0,06 из кэша) |
| Цена вывода через API | $0,50 / 1 млн | $1,20 / 1 млн |
| Надбавка за длинный контекст | Не опубликована | 2× при вводе свыше 512 тыс. |
| Скорость вывода | ~48,6 ток/с | ~147,9 ток/с |
| Время до первого токена | ~1,51 с | ~0,99 с |
| Terminal-Bench 2.1 | 84.3 | 66.0 |
| Artificial Analysis Intelligence | 57 | 45 |
| Доля токенов OpenCode | 10.3% | 1.12% |
| Режим размышления | Всегда включён (отключить нельзя) | Настраиваемый |
| Начальная цена подписки | $18/мес (GLM Coding Plan Lite) | $20/мес (MiniMax Plus) |
Цены взяты из официальных прайс-листов каждого производителя. Маршрутизирующие шлюзы вроде OpenRouter часто показывают более низкие фактические цены, потому что балансируют нагрузку между сторонними хостами — подробнее об этом ниже, потому что это важно.
Почему это сравнение важно именно сейчас
Двенадцать месяцев назад разговор о кодинге с открытыми весами шёл о том, пригодны ли эти модели вообще. Этот вопрос закрыт. Разговор во второй половине 2026 года уже, и он интереснее: на какую модель с открытыми весами вы нацеливаете свой harness для агентов и во что вам обойдётся ошибка?
OpenCode заострил этот вопрос. Это не окно чата — это родной для терминала агент, который планирует, читает файлы, правит их, выполняет команды, читает вывод и повторяет цикл. Такая нагрузка наказывает модели так, как бенчмарк для чата никогда не покажет. Модель, которая пишет красивые изолированные функции, всё ещё может быть бесполезной в OpenCode, если теряет нить после двадцати вызовов инструментов, выдумывает путь к файлу или сжигает 90 000 токенов, решая, что делать.
GLM-5.3-Flash и MiniMax M3 — две модели с открытыми весами, которые сейчас наиболее обоснованно участвуют в этом разговоре. Они вышли с разницей в три месяца, решают одну и ту же задачу, стоят в пределах одного порядка величин и сделали почти противоположные инженерные ставки.
Последняя часть — самое интересное.
Что на самом деле представляет собой GLM-5.3-Flash
У GLM-5.3-Flash был один из лучших запусков года, и это не случайность.
Прежде чем Z.ai поставила своё имя хоть на что-то, модель появилась на OpenRouter под кодовым названием “Ox Alpha.” Никакой атрибуции лаборатории, почти бесплатный доступ, никакого маркетинга. Она тихо поднялась на вершину графиков использования OpenRouter и OpenCode и продержалась там около недели, пока сообщество спорило, кто её создал. 26 августа 2026 года Z.ai подтвердила, что модель её, и открыла веса под MIT.
Выпустить модель в дикую природу и дать ей заслужить доверие, прежде чем заявлять о ней, — по-настоящему хороший ход, и он сработал: за моделью стояли реальные данные об использовании ещё до того, как кто-либо увидел график бенчмарка.
Архитектура простыми словами
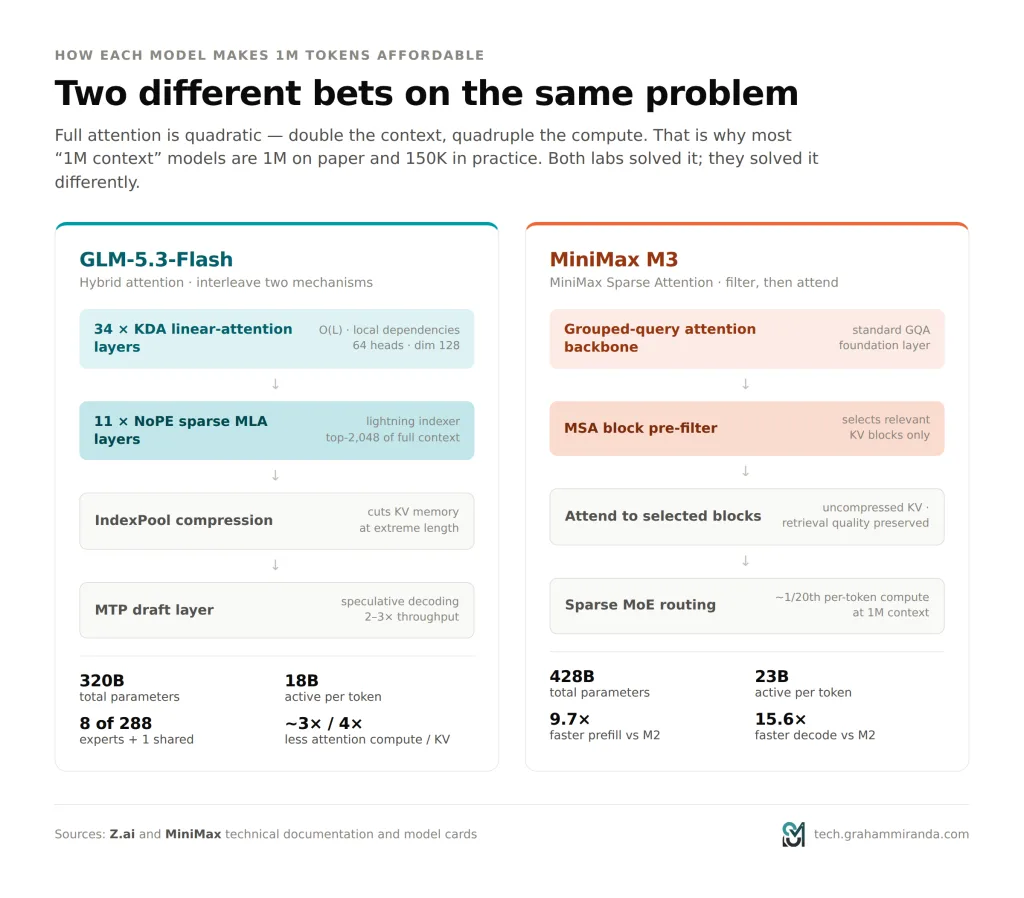
GLM-5.3-Flash — это модель смеси экспертов с 320 млрд параметров, которая активирует лишь около 18 млрд параметров на токен. Она направляет каждый токен через 8 из 288 маршрутизируемых экспертов плюс одного общего эксперта — примерно 2,8 % весов экспертов срабатывают на каждом прямом проходе. Отсюда и экономика “Flash”: знания масштаба фронтира, стоимость инференса небольшой модели.
По-настоящему новаторская часть — устройство внимания. Вместо одного однородного механизма внимания оно чередует два:
- 34 слоя линейного внимания KDA. Они работают за линейное время относительно длины последовательности, а не за квадратичное. Они дёшево обрабатывают локальные зависимости и не дают пропускной способности обваливаться по мере роста контекста.
- 11 разреженных слоёв MLA с NoPE. Многоголовое латентное внимание в стиле DeepSeek без позиционных эмбеддингов, перед которым стоит “молниевый индексатор”, выбирающий 2 048 наиболее релевантных токенов из всего контекста. Именно это сохраняет качество поиска на длинной дистанции.
Есть также IndexPool этап сжатия, который агрегирует ключевые векторы индексатора, чтобы сократить накладные расходы памяти при экстремальных длинах контекста, и голова предсказания нескольких токенов для спекулятивного декодирования — реализация в vLLM по умолчанию использует 5 спекулятивных токенов на шаг декодирования, что даёт 2–3× пропускной способности при малых размерах батча.
Итоговый эффект по сравнению с полной GLM-5.3: примерно в 3 раза меньше вычислений на внимание и KV-кэш более чем в 4 раза меньше. Именно поэтому контекст в 1 млн токенов действительно пригоден для работы, а не доступен лишь теоретически.
Почему это важно для агентов, пишущих код
Конкретно три вещи.
Она нативно мультимодальна, и здесь это не трюк. У прежних кодирующих моделей GLM была слепая зона для всего, что они не могли прочитать как текст. Если ваш агент ломает вёрстку, текстовая модель никак об этом не узнает. GLM-5.3-Flash нативно принимает изображения, видео и файлы, а значит, отладка по скриншотам, превращение дизайна в код и циклы проверки “действительно ли это выглядит правильно” становятся доступны.
Размышление обязательно. Отключить его нельзя. Можно задать reasoning_effort до низкий, высокий, или максимум (задокументированное значение по умолчанию — максимум), но модель всегда рассуждает, прежде чем действовать. Для агентной работы это правильное значение по умолчанию — режим отказа дешёвых моделей для кодинга — уверенные действия без планирования, и Z.ai убрала эту возможность.
Скачок между поколениями реален, и он получен за счёт посттренинга. GLM-5.3 использует ту же базовую модель, что и GLM-5.2. Весь прирост дал масштабированный посттренинг — по сообщениям, в десять раз больше сред с длинными задачами, причём обучающие задачи имитировали полный жизненный цикл разработки ПО: от выявления ошибок до тестирования и развёртывания, а некоторые были размером с “нагрузку старшего инженера за несколько дней”. Оценка DeepSWE v1.1 выросла с 46,2 до 63,4. Terminal-Bench 3.0 — с 4,6 до 28,3. Это не колебания от настройки.
Что на самом деле представляет собой MiniMax M3
MiniMax M3 появилась 1 июня 2026 года и сделала другую ставку: оптимизировать не пиковое качество рассуждений, а экономику длительных агентных циклов.
Это разреженная MoE примерно на 428 млрд параметров, из которых около 23 млрд активны на каждый токен; в основе — магистраль grouped-query-attention с собственной MSA (MiniMax Sparse Attention) сверху.
Ставка на MSA
Классическое внимание квадратично: вдвое больше контекста — вчетверо больше вычислений. Поэтому у большинства моделей с “контекстом 1M” он равен 1M только на бумаге, а на практике — 150K: технически окно заполнить можно, но платить за это вам не захочется.
MSA заменяет полное внимание на выбор KV-блоков. Он предварительно отфильтровывает контекст до релевантных блоков и работает только с ними, используя несжатые ключи-значения, чтобы качество поиска не страдало от фильтрации. MiniMax сообщает результат примерно как 1/20 вычислений на токен по сравнению с предыдущим поколением при контексте 1M, при этом в 9,7 раза быстрее prefill и в 15,6 раза быстрее декодирование по сравнению с M2.
Это по-настоящему умное инженерное решение, и оно видно по цифрам, которые вы ощущаете: ~148 токенов/с на выходе и меньше секунды до первого токена. Рядом с ~49 ток/с и ~1,5 с TTFT у GLM-5.3-Flash M3 ощущается инструментом другого класса. В длинном агентном цикле из десятков шагов это складывается в минуты разницы по реальному времени на каждую задачу.
MiniMax также рекламирует M3 как способную на “автономные сессии кодинга длиной 8+ часов”. Воспринимайте это как заявление, а не характеристику — независимой проверки не было.
Где M3 действительно сильна
Мультимодальная сторона M3 и её работа как десктопного агента недооценены. OSWorld-Verified — 70,06% — серьёзный результат для задач десктопных/GUI-агентов. MCP Atlas — 74,2% говорит о том, что вызов инструментов у неё надёжен. GPQA Diamond — 92,9% близка к фронтиру в сложных рассуждениях. А SWE-bench Verified — 80,5% — сильный показатель.
Если ваша работа — это “управлять браузером, смотреть видео, работать с интерфейсом, последовательно вызывать двенадцать инструментов MCP”, то M3 не компромисс. Возможно, это даже лучший инструмент.
Бенчмарки — и что они скрывают
Здесь нужно быть осторожным, потому что оба производителя публикуют собственные цифры, а две модели в основном оценивают на разных наборах бенчмарков. Это не случайно. Лаборатории выбирают те оценки, в которых побеждают.
Где они пересекаются напрямую
| Бенчмарк | GLM-5.3-Flash | MiniMax M3 | Что он измеряет |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 66.0 | Задачи агентов в оболочке/терминале |
| Индекс интеллекта Artificial Analysis | 57 | 45 | Совокупный интеллект |
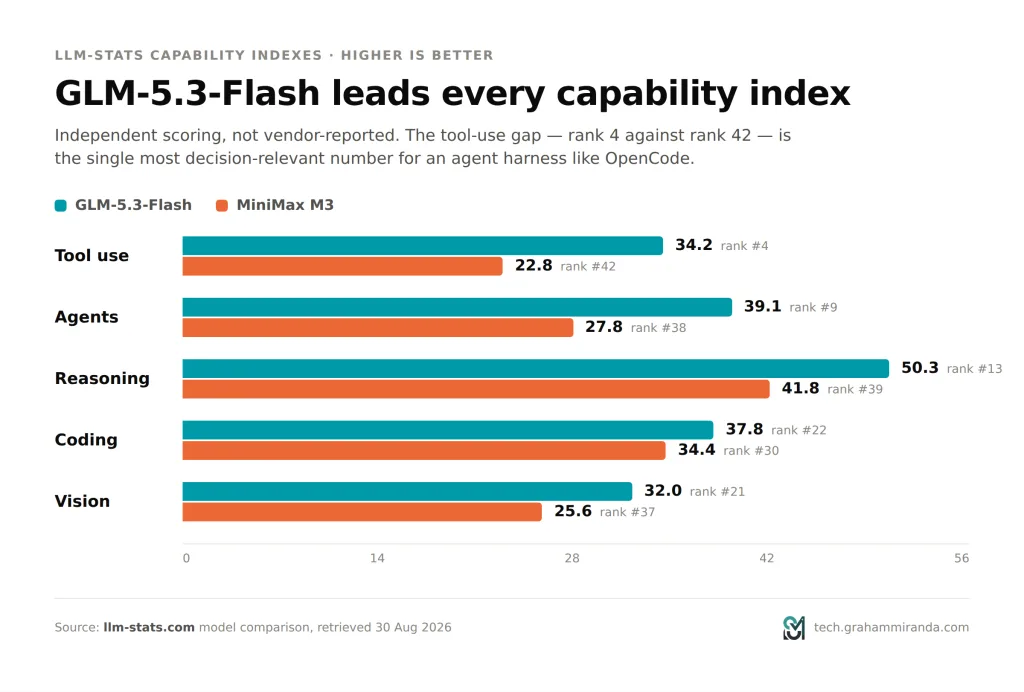
| Индекс рассуждений (llm-stats) | 50.3 (#13) | 41.8 (#39) | Многошаговые рассуждения |
| Индекс кодинга (llm-stats) | 37.8 (#22) | 34.4 (#30) | Генерация кода |
| Индекс агентов (llm-stats) | 39.1 (#9) | 27.8 (#38) | Выполнение агентных задач |
| Индекс использования инструментов (llm-stats) | 34.2 (#4) | 22.8 (#42) | Вызов функций и инструментов |
| Индекс зрения (llm-stats) | 32.0 (#21) | 25.6 (#37) | Мультимодальное понимание |
Именно Terminal-Bench 2.1 стоит учитывать в первую очередь для OpenCode, потому что это самый близкий публичный прокси к тому, что OpenCode делает на самом деле: агент в терминале, выполняет команды, читает вывод, повторяет итерации. Разрыв в 18 пунктов здесь — не погрешность округления.
Рейтинг использования инструментов — второй, который я бы не пропустил. GLM-5.3-Flash — #4 в общем зачёте против M3 на #42 — это самая важная для принятия решения строка во всей статье. Harness для агентов — это машина для вызова инструментов. Модель, которая на 42-м месте по использованию инструментов, будет выдавать больше некорректных вызовов, больше повторов, больше впустую потраченных ходов — и каждый впустую потраченный ход стоит вам токенов и и реального времени, что незаметно сводит на нет преимущество M3’ в скорости.
Показатели GLM-5.3-Flash в отдельности
- Terminal-Bench 2.1: 84.3 — против Claude Opus 4.8 с 85,0. В пределах одного пункта от фронтирной закрытой модели, при цене примерно в 1/30.
- DeepSWE v1.1: 63.4 — выше, чем 46,2 у GLM-5.2’.
- AutomationBench v1.0.6: 48.8 — против 41,0 у Opus 4.8. Это его наибольший отрыв от фронтирной модели.
- Z.ai Code Bench v1.0: 29.0 — у Opus 4.8 — 29,5.
- GDPval-AA v2: 1773 — лучший результат среди сравниваемых моделей по способности к работе со знаниями.
- Toolathlon: 78.4 · OfficeQA Pro: 62.4 · CharXiv-R: 89.4% · MMVU: 80.5 · Chartography: 78.0
Показатели MiniMax M3 в отдельности
- SWE-bench Verified: 80.5%
- SWE-bench Pro: 59.0% — более сложные репозитории, запуск с каркасом Claude Code
- MCP Atlas: 74.2% · OSWorld-Verified: 70.06% · GPQA Diamond: 92.9%
- KernelBench Hard: 28,8% · SWE-fficiency: 34,8%
Оговорка, которую действительно стоит учесть
Цифры, которые оба разработчика приводят при запуске, — это их собственные данные. В частности, набор бенчмарков MiniMax на момент выхода не появлялся на нейтральных оценочных площадках, а аналитики самого Z.ai отметили, что автоматические перенаправления со старых версий моделей на платформе Z.ai делают чистое сравнение A/B по-настоящему сложным.
Там, где нейтральные агрегаторы — Artificial Analysis и llm-stats — провели собственные оценки, GLM-5.3-Flash побеждает во всех категориях. Именно этим доказательствам я доверяю больше всего, потому что ни один из поставщиков не выбирал эти бенчмарки.
Сигнал, о котором никто не говорит: собственные данные OpenCode об использовании
Это та часть, которая убедила меня больше всего, и именно её большинство обзорных статей полностью пропускают.
OpenCode публикует телеметрию использования моделей, работающих внутри него. Не заявления поставщиков. Не наборы бенчмарков. Реальные разработчики за реальной работой выбирают, чем продолжать пользоваться.
| Метрика | GLM-5.3-Flash | MiniMax M3 |
|---|---|---|
| Уникальные пользователи | 566 тыс. | 436 тыс. |
| Доля обработанных токенов | 10.3% | 1.12% |
| Токенов за два месяца | 46 трлн (+100%) | 5 трлн (−51%) |
| Вернувшиеся на первой неделе пользователи | ожидается | 66% (32 тыс. пользователе-недель) |
Перечитайте эти две цифры доли токенов. Количество пользователей примерно сопоставимо — у GLM-5.3-Flash примерно на 30% больше тех, кто его попробовал, — но более чем в девять раз больше пропускная способность по токенам.
Этот разрыв не о том, кто что попробовал. Он о том, кто на чём остался для реальной работы. Люди открывают сессию с M3, а люди живут в сессиях с GLM-5.3-Flash.
Линия тренда говорит о том же громче: за два месяца объём токенов у GLM-5.3-Flash удвоился, а M3 потерял половину своего.
Две справедливые оговорки. Во-первых, GLM-5.3-Flash на три месяца новее, а новые модели получают прибавку за новизну; его кривая выровняется. Во-вторых, удержание 66% на первой неделе у M3 — здоровый показатель: те, кто его выбрал, не бросают его, просто их меньше и пользуются они им легче. И спад M3 отчасти объясняется каннибализацией со стороны его же преемников и общим темпом выпуска китайских моделей с открытыми весами, а не чистым отказом.
Но если вы спрашиваете, “чем опытные пользователи OpenCode на самом деле пользуются весь день,” данные отвечают на это однозначно.
Настройка MiniMax M3 в OpenCode
Отдадим должное: У MiniMax более простая настройка, потому что в OpenCode есть встроенный провайдер MiniMax. Ни файла конфигурации, ни JSON, ни base URL.
bash
# 1. Install OpenCode (skip if you already have it)
curl -fsSL https://opencode.ai/install | bash
# or: npm i -g opencode-ai

# 2. Authenticate
opencode auth login
# Select: "MiniMax Token Plan (minimax.io)"
# Paste your Subscription Key (starts sk-cp-...)

# 3. Go
opencode
Затем /models внутри сессии и выберите MiniMax-M3.
Ловушка с типом ключа
На этом попадаются почти все. Ключи MiniMax Token Plan (подписка) и API-ключи с оплатой по мере использования не взаимозаменяемы. Они маршрутизируются по-разному и по-разному тарифицируются. Если вы авторизуетесь ключом PAYG у провайдера Token Plan, вы получите ошибки аутентификации или баланса, которые выглядят как сбой, а на самом деле означают несовпадение.
Ключи подписки начинаются с sk-cp- и требуют назначенного места или кредитов. Получите свой на странице Token Plan в пользовательском центре MiniMax, а не на общей странице API-ключей.
Если вам нужен блок провайдера, заданный вручную
Если ваша сборка OpenCode старше встроенного провайдера или вы хотите явно указать ключ PAYG:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "minimax": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "MiniMax",
      "options": {
        "baseURL": "https://api.minimax.io/v1",
        "apiKey": "{env:MINIMAX_API_KEY}"
      },
      "models": {
        "MiniMax-M3": {
          "name": "MiniMax M3",
          "limit": {
            "context": 1000000,
            "output": 262144
          }
        }
      }
    }
  }
}
Обратите внимание на явный limit.context. Это не украшение — см. следующий раздел.
Ловушка контекстного окна MiniMax (прочитайте это до того, как сделаете выбор)
Если вы направляете MiniMax M3 через harness, совместимый с Anthropic, — Claude Code или конфигурацию OpenCode с @ai-sdk/anthropic против https://api.minimax.io/anthropic — есть задокументированный, всё ещё открытый баг, о котором вам нужно знать.
Этот /anthropic эндпоинт сообщает контекстное окно 200K вместо фактического 1M у M3’s.
Похоже, слой совместимости наследует метаданные Claude Sonnet’s, а не сообщает реальные характеристики M3’s. Агенты для кодинга доверяют этим метаданным и соответственно рассчитывают бюджет контекста — а значит, автосжатие срабатывает примерно на 167K токенов хотя модель спокойно вмещает в пять раз больше.
Это по-настоящему раздражающий режим отказа, потому что он невидим. Ваш агент не выдаёт ошибку. Он просто тихо начинает забывать вещи гораздо раньше, чем следовало бы, и вы тратите полдня, гадая, почему модель с окном на миллион токенов теряет нить уже на втором файле рефакторинга. Проблему зарегистрировали в день релиза M3’s, и она до сих пор открыта.
Как это обойти
В OpenCode: используйте встроенного провайдера MiniMax (маршрут, совместимый с OpenAI), а не маршрут Anthropic, и задайте limit.context явно, если определяете блок провайдера вручную.
В Claude Code, переопределите окно сжатия напрямую:
json
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.minimax.io/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "<YOUR_MINIMAX_SUBSCRIPTION_KEY>",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "MiniMax-M3[1m]"
  }
}
Две важные детали: суффикс [1m] в ID модели запрашивает вариант с полным контекстом, а переменные окружения оболочки имеют приоритет settings.json согласно документации MiniMax’s. Если у вас осталась устаревшая ANTHROPIC_BASE_URL экспортированная в вашем .zshrc, она незаметно побеждает, и вы будете гоняться за собственным хвостом.
И ещё — не задавайте учётные данные провайдеров как глобальные экспорты. ANTHROPIC_BASE_URL — это глобальная переменная; если экспортировать её навсегда, она незаметно перенаправит каждый инструмент, работающий с Anthropic, на вашей машине в MiniMax. Задавайте её для проекта или для отдельного вызова.
Настройка GLM-5.3-Flash в OpenCode
OpenCode также включает встроенного провайдера Z.AI, так что это почти так же просто — с одной развилкой на пути.
bash
# 1. Получите ключ в Z.ai — обычный API-ключ или ключ GLM Coding Plan
# 2. Пройдите аутентификацию
opencode auth login
# Выберите "Z.AI" для обычного API-ключа
# Выберите "Z.AI Coding Plan" для ключа подписки Coding Plan

# 3. Запустите OpenCode и выберите модель
opencode
/models   # выберите GLM-5.3-Flash
Сопоставьте провайдера с типом ключа. Обычные API-ключи и ключи Coding Plan используют разные маршруты и разную тарификацию. Неверный выбор даёт ошибки аутентификации или баланса, которые выглядят как сломанный аккаунт.
Эндпоинты Coding Plan
Если вы подключаете всё вручную или настраиваете другой инструмент, пакет разработчика Z.ai’s предлагает три варианта:
| Протокол | Базовый URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
Об одном ограничении стоит упомянуть: GLM Coding Plan по договору ограничен официально поддерживаемыми инструментами — Claude Code, OpenCode, Cline, Roo Code, Kilo Code, Cursor, Goose, Crush, OpenClaw и ещё несколько других. Если вы собираетесь направить ключ Coding Plan на свой собственный самодельный harness, сначала прочитайте условия. Для этого используйте стандартный API.
Ручной блок провайдера
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3-flash": {
          "name": "GLM-5.3-Flash",
          "limit": {
            "context": 1048576,
            "output": 131072
          },
          "options": {
            "reasoning_effort": "high",
            "temperature": 1,
            "top_p": 0.95
          }
        }
      }
    }
  },
  "model": "zai/glm-5.3-flash"
}
Рекомендуемые настройки сэмплирования
Документированные рекомендации Z.ai’s для GLM-5.3-Flash, от которых я бы без причины не отступал:
temperature: 1top_p: 0.95reasoning_effort: max(задокументированное значение по умолчанию)thinking.clear_thinking: falsestream: trueиtool_stream: trueдля потоковых запросов
reasoning_effort — это ваша главная ручка соотношения качества и задержки. низкий для работы, чувствительной к задержке, высокий для серьёзного кодинга, максимум для самых сложных задач. Учитывая, что GLM-5.3-Flash и так медленнее из двух моделей — около 49 ток/с, высокий — разумная повседневная настройка, а максимум — это то, к чему вы прибегаете, когда задача действительно оказывается слишком сложной высокий.
Схема, которую я действительно рекомендую: запускайте обе
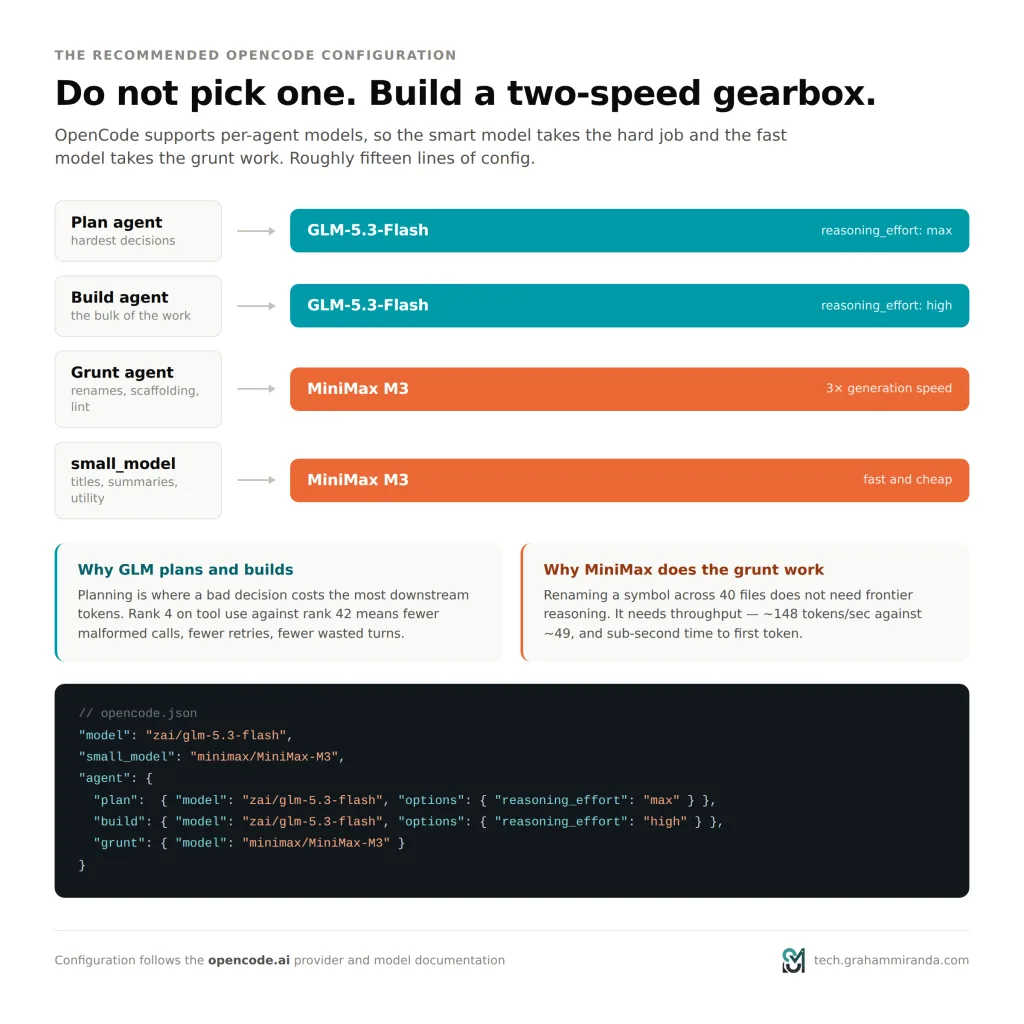
Здесь противопоставление “versus” рассыпается, потому что OpenCode не заставляет выбирать одну. Его конфигурация поддерживает модели для каждого агента, а значит, умную модель можно поставить на трудную работу, а быструю — на рутину.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3-flash",
  "small_model": "minimax/MiniMax-M3",
  "agent": {
    "build": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "high" }
    },
    "plan": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "max" }
    },
    "grunt": {
      "description": "Mechanical, high-volume edits: renames, test scaffolding, docstrings, lint fixes",
      "model": "minimax/MiniMax-M3"
    }
  }
}
Логика такая:
- Планирование получает
reasoning_effort: maxна GLM-5.3-Flash. Именно на этапе планирования плохое решение стоит вам больше всего последующих токенов. Покупайте лучшее мышление, какое можете себе позволить на этом шаге. - Реализация достаётся
высокий. Хороший баланс качества и задержки для основной части работы. - Механическая работа достаётся M3. Переименование символа в 40 файлах не требует модели с 4-м местом по работе с инструментами. Ей нужна пропускная способность, а M3 втрое быстрее.
small_modelвыполняет внутренние служебные задачи OpenCode’s — генерация заголовков, суммаризация, мелкие служебные вызовы. Направьте её на быструю и дешёвую модель.
Вы не выбираете победителя. Вы собираете двухскоростную коробку передач.
Расчёт стоимости на конкретных цифрах
Бенчмарки абстрактны. Счета — нет. Давайте смоделирую реалистичную агентную задачу и прогоню её через оба прайс-листа.
Сценарий
Одна средняя по размеру функция, выполненная агентно в OpenCode: примерно 60 шагов с вызовами инструментов, в среднем 45 тыс. входных токенов на шаг по мере накопления контекста, и 2 тыс. выходных токенов на шаг.
- Всего на входе: 2,7 млн токенов
- Всего на выходе: 120 тыс. токенов
- Предполагаемая доля попаданий в кэш промпта: 80% (2,16 млн из кэша, 540 тыс. новых)
GLM-5.3-Flash
| Компонент | Токены | Ставка | Стоимость |
|---|---|---|---|
| Новые входные | 540 тыс. | $0.15/M | $0.081 |
| Входные из кэша | 2,16 млн | $0.03/M | $0.065 |
| Вывод | 120 тыс. | $0.50/M | $0.060 |
| Итого | ≈ $0.21 |
MiniMax M3 (стандартный тариф, вход ≤512 тыс.)
| Компонент | Токены | Ставка | Стоимость |
|---|---|---|---|
| Новые входные | 540 тыс. | $0.30/M | $0.162 |
| Входные из кэша | 2,16 млн | $0.06/M | $0.130 |
| Вывод | 120 тыс. | $1.20/M | $0.144 |
| Итого | ≈ $0.44 |
GLM-5.3-Flash примерно в 2,1 раза дешевле за ту же работу. Это согласуется с независимой оценкой: примерно в 2,2 раза дешевле при смешанном соотношении вход/выход 3:1.
Масштабируем на месяц
Четыре такие задачи в день, двадцать рабочих дней — 80 агентных прогонов:
- GLM-5.3-Flash: ≈ $16.50 в месяц
- MiniMax M3: ≈ $35 в месяц
Надбавка за длинный контекст, о которой никто не упоминает
Вот в чём ловушка. Цены MiniMax M3 зависят от длины входных данных, и как только любой отдельный запрос превышает 512 тыс. входных токенов, тариф удваивается:, и как только один запрос превышает 512K входных токенов, тариф удваивается:
| Уровень | Ввод | Вывод | Чтение кэша |
|---|---|---|---|
| ≤512K на входе | $0.30/M | $1.20/M | $0.06/M |
| >512K на входе | $0.60/M | $2.40/M | $0.12/M |
| Приоритетный уровень | 1,5× от стандартного | 1,5× от стандартного | 1,5× от стандартного |
Так что громкое обещание “1M контекста” идёт со сноской: вторая половина этого окна стоит вдвое дороже. Если ваш рабочий процесс действительно включает загрузку огромных репозиториев в контекст, M3 превращается из 2× дороже GLM-5.3-Flash в примерно 4× дороже именно тогда, когда контекст нужнее всего.
Z.ai не публикует аналогичной надбавки для GLM-5.3-Flash. Его миллион токенов стоит по фиксированной цене.
Подписки против оплаты по мере использования
| GLM Coding Plan | MiniMax Token Plan | |
|---|---|---|
| Начальный | Lite $18/мес (~80 промптов/5 ч, ~400/нед, 100 вызовов MCP/мес) | Plus $20/мес (~3–4 агента) |
| Средний | Pro $72/мес (~400 промптов/5 ч, ~2 000/нед, 1 000 вызовов MCP) | Max $50/мес (~4–5 агентов, 3 генерации видео/день) |
| Топ | Max $160/мес (~1 600 промптов/5 ч, ~8 000/нед, 4 000 вызовов MCP) | Ultra $120/мес (~6–7 агентов, 5 генераций видео/день) |
| Годовая скидка | ~30 % скидки | Не публикуется |
| Включённые модели | GLM-5.3, GLM-5.3-Flash, GLM-5.2, GLM-5-Turbo | Семейство моделей MiniMax |
Две детали, которые меняют расчёт.
GLM-5.3-Flash получает 3× квоты в Coding Plan по сравнению с GLM-5.3, а использование в непиковые часы расходует 50 % стандартных баллов. Выбрав Flash вместо полного GLM-5.3, вы фактически утраиваете ценность подписки, а перенос тяжёлых прогонов за пределы пикового окна 14:00–18:00 UTC+8 растягивает её ещё больше.
Квота MiniMax не переносится. Неиспользованный лимит сгорает в конце каждого расчётного периода, и сама MiniMax рекомендует для боевых развёртываний оплату по факту использования, а не Token Plan.
При моём расчётном потреблении (~$16–35 в месяц на токены) оплата по факту и начальные подписки примерно выходят в ноль. Если ежедневной агентной работы больше примерно 6–8 часов, подписки выигрывают решительно — GLM Coding Plan Lite за $18 с ~400 промптами в неделю действительно трудно перебить.
Замечание о ценах у шлюзов
Цифры будут сильно различаться в зависимости от того, куда вы смотрите. OpenRouter указывает для GLM-5.3-Flash около $0.05/M на входе и $0.17/M на выходе; собственные данные OpenCode о моделях показывают $0.07/M и $0.25/M. Оба варианта ниже официальных $0.15/$0.50 у Z.ai.
Это не противоречие. Шлюзы с маршрутизацией балансируют нагрузку между более чем 20 сторонними хостами — Baseten, DeepInfra, Novita, Cloudflare и другими — а те конкурируют ценой. Через шлюз вполне можно получить GLM-5.3-Flash дешевле прайс-листа. Вы платите за это стабильностью: пропускная способность на OpenRouter колеблется от 8 до 111 токенов/с в зависимости от того, к какому провайдеру вы попадёте, а для длинного агентного цикла это разница между задачей на две минуты и задачей на пятнадцать.
Для агентной работы я предпочту заплатить по прайс-листу первой стороне и получить предсказуемую задержку. Шлюзы используйте для пакетных задач и экспериментов.
Лицензии и self-hosted (самостоятельный хостинг): часть, которую европейским компаниям стоит прочитать дважды
Если вы ведёте компанию в ЕС, лицензия — не сноска. Это вопрос закупки.
GLM-5.3-Flash: MIT
Веса опубликованы на Hugging Face по адресу zai-org/GLM-5.3-Flash по лицензии MIT. Это примерно максимум разрешительности в лицензировании ПО: используйте коммерчески, изменяйте, распространяйте, встраивайте в продукт — без порогов по выручке, без приложения о допустимом использовании, без ограничений по области применения. Сохраните уведомление об авторских правах — и всё.
Для немецкой или европейской компании MIT плюс self-hosted (самостоятельный хостинг) весов означает, что вы можете поместить всё в свою инфраструктуру и сделать вопрос локализации данных неактуальным — без оценки трансграничной передачи, без соглашения об обработке с китайским поставщиком, без зависимости от чужого аптайма.
MiniMax M3: MiniMax Community License
Веса M3 также открыты на Hugging Face, но по MiniMax Community License — кастомной лицензии, а не стандартной разрешительной. Сообщество в целом отреагировало положительно (она разрешительнее лицензии, под которой выходила M2.7), а несколько источников описывают коммерческое использование как фактически неограниченное.
Но “описывается как неограниченное” и “проверено вашим юристом” — разные вещи. Если MiniMax M3 идёт в коммерческий продукт, прочитайте текст лицензии напрямую до выпуска. Кастомная лицензия добавляет издержки на юридическую проверку, которых у MIT просто нет.
Трезвый взгляд на самостоятельный хостинг
Обе модели с открытыми весами. Ни одна не запустится на вашем ноутбуке.
GLM-5.3-Flash:
- Чекпойнт FP8: 331 GB на 62 шардах (~306 GiB весов до KV-кеша)
- Вариант BF16: 640 GB на 120 шардах
- FP8 при TP=4 на одном GB200: ~386 GB VRAM
- BF16 при TP=8: ~772 GB VRAM
- Требуется Поколение Hopper или новее — H100/H200/B200/B300/GB200/GB300 или AMD MI300X/MI325X/MI355X
- Стек: vLLM 0.29.0+, FlashInfer 0.6.17+; также SGLang, TokenSpeed, KTransformers, Transformers, Unsloth
MiniMax M3:
- Примерно 214 GB при 4-битном квантовании — меньше, но по-прежнему уверенно серверного класса
Собственная хостинговая инфраструктура Z.ai сообщает о ~48.7 выходных токенов/с при TTFT 1.52 с, а при TP=4 на GB200 — о пуле KV на 14.92M токенов, поддерживающем 113.81× максимальной конкурентности при контексте 128K. Вот какого масштаба оборудование нужно, чтобы нормально это обслуживать.
Практический вывод: самостоятельный хостинг любой из моделей означает аренду или покупку нескольких GPU дата-центра. Для большинства команд — включая большинство моих клиентов — правильный ответ — API, а открытые веса служат страховка. Если поставщик поднимет цены, ухудшит модель или исчезнет, у вас останется выход. Эта возможность имеет реальную ценность, даже если вы ею никогда не воспользуетесь.
Где каждая модель реально ломается
Без хайпа. Вот честные слабые места.
Слабые места GLM-5.3-Flash
Он медленный. ~48,6 токена/с на выходе и ~1,51 с до первого токена. На фоне ~148 ток/с и ~0,99 с у M3 вы ощущаете каждую долгую генерацию. В цикле агента на 40 шагов это складывается в реальные минуты, потраченные на пустое ожидание.
Размышления отключить нельзя. Обязательные рассуждения оправданы в сложной агентной работе и расточительны для тривиальных запросов. Каждый запрос вроде “добавь docstring в эту функцию” платит налог на рассуждения. Именно поэтому для черновой работы стоит подключить M3 или модель поменьше.
Токены рассуждений — это оплачиваемые токены. С reasoning_effort: max при значении по умолчанию, указанном в документации, реальная стоимость задачи оказывается выше наивных оценок, построенных только по количеству входных и выходных токенов. Установите его в высокий если задача не заслуживает максимум.
Он новый. Выпущен 26 августа 2026 года. Редкие ошибки интеграции по всей экосистеме harness ещё не все проявились, а знаний в сообществе пока мало. Если вы наткнётесь на неочевидный режим отказа, возможно, вы сообщите о нём первым.
Не путайте его с GLM-5.3. Это разные модели с разными возможностями — в частности, GLM-5.3 без приставки Flash работает только с текстом. Отправка изображений на неправильный ID модели — частая ошибка на старте.
Слабые места MiniMax M3
Настоящая проблема — рейтинг по работе с инструментами. #42 в индексе работы с инструментами на llm-stats, тогда как GLM-5.3-Flash на #4. Для harness для агентов это несущая способность. Ждите больше некорректных вызовов инструментов, больше повторов, больше потраченных шагов на восстановление — а это съедает преимущество в скорости, за которое вы заплатили.
Ошибка с отображением контекста не исправлена. Открыта с момента выпуска. Обойти можно, но это мелкая заноза, с которой вы живёте.
Независимая проверка почти отсутствует. Стартовые бенчмарки MiniMax не появлялись на нейтральных площадках, а там, где нейтральные агрегаторы проводили замеры, M3 оказывается в середине таблицы, а не у вершины. Разрыв между подачей вендора и сторонними измерениями здесь шире, чем у Z.ai.
Цена за длинный контекст удваивается после 512K. У главной функции есть доплата.
Собственная лицензия. Дополнительная юридическая проверка перед коммерческим развёртыванием.
Снижение использования. Падение объёма токенов в OpenCode на 51% за два месяца — сигнал о динамике экосистемы, какова бы ни была причина. Меньше пользователей — меньше людей, которые натыкаются на те же ошибки, что и вы, и исправляют их.
Как принять решение: пять сценариев
1. “Хочу одну модель: настроил и забыл.”
GLM-5.3-Flash. Лучше на каждом нейтральном бенчмарке, вдвое дешевле, под лицензией MIT, и именно к нему пришло сообщество. Установите reasoning_effort: high, добавьте GLM Coding Plan Lite за $18 в месяц, если кодите каждый день, и живите дальше.
2. “Я провожу огромные механические рефакторинги по гигантским кодовым базам.”
MiniMax M3 — для механических проходов, GLM-5.3-Flash — для плана. MSA делает M3 по-настоящему экономичным на длинном контексте, а трёхкратная скорость генерации сильнее всего ощущается на массовых правках низкой сложности. Только следите за ценовым обрывом на 512K и дайте GLM спланировать рефакторинг, прежде чем M3 его выполнит.
3. “Моя работа визуальная — UI, перенос дизайна в код, отладка по скриншотам.”
GLM-5.3-Flash в первую очередь, M3 — крепкий второй вариант. Нативная мультимодальность GLM создана именно для этого, и по индексу зрения она опережает M3 (32,0 против 25,6). Но результат M3 на OSWorld-Verified — 70,06% — делает её лучшим выбором именно для работы десктопного и GUI-агента — управления реальными приложениями, а не чтения скриншотов.
4. “Мне нужен self-hosted (самостоятельный хостинг) из-за требований к резидентности данных или соответствия нормам.”
GLM-5.3-Flash, без всяких сомнений. Когда в деле участвует ваш юридический отдел, выбор между MIT и особой community-лицензией не назовёшь очевидным, а self-hosted (самостоятельный хостинг) под MIT полностью снимает вопрос трансграничной передачи данных. Заложите в бюджет железо класса Hopper или европейский хостинг с GPU.
5. “У меня небольшая команда и жёсткий бюджет.”
GLM Coding Plan Lite за $18 в месяц с GLM-5.3-Flash по умолчанию. Множитель квоты 3× для Flash внутри плана делает его самым выгодным вариантом в расчёте на евро из доступных сейчас. Тяжёлые пакетные прогоны ставьте вне пикового окна 14:00–18:00 UTC+8, чтобы получить 50%-ную скидку по баллам. MiniMax добавьте позже, если пропускная способность станет узким местом.
За чем я буду следить в следующем квартале
Независимые прогоны Terminal-Bench и SWE-bench Pro для GLM-5.3-Flash. Цифры вендора отличные. Независимые агрегаторы в целом их подтверждают. Но конкретное утверждение “в пределах одного пункта от Claude Opus 4.8 на Terminal-Bench 2.1” заслуживает воспроизведения третьей стороной, прежде чем кто-то построит на нём бизнес-кейс.
Будет ли исправлен /anthropic баг с контекстом в MiniMax. Он небольшой, задокументирован и открыт с июня. То, как быстро его закроют, скажет кое-что о скорости поддержки.
Кривая удержания GLM-5.3-Flash в OpenCode. Цифра доли токенов впечатляет, но она молода. Интересный вопрос — удержится ли она выше 10%, когда новизна спадёт. Если да, это не момент, а новый стандарт.
Частота релизов от китайских лабораторий с открытыми весами. Qwen3.8-Flash-Next вышел примерно одновременно с GLM-5.3-Flash. Kimi K3 уже обходит GLM-5.3 на DeepSWE (67,5 против 66,9) и Toolathlon (76,5 против 73,0). Разрыв между “лучшей на сегодня моделью с открытыми весами для кодинга” и “второй” теперь измеряется неделями. Стройте конфигурацию так, чтобы смена строки модели была правкой в одну строку — вам придётся делать её снова.
Опубликует ли Z.ai единые цены на API для полной GLM-5.3. На момент написания строки с ценой за токен для GLM-5.3 на официальной странице цен всё ещё не было, тогда как GLM-5.3-Flash была оценена полностью. Странная асимметрия, за которой стоит следить.
Часто задаваемые вопросы
Лучше ли GLM-5.3-Flash, чем MiniMax M3, для кодинга? Судя по доступным данным, да. GLM-5.3-Flash лидирует на Terminal-Bench 2.1 (84,3 против 66,0), в Intelligence Index от Artificial Analysis (57 против 45) и во всех индексах возможностей llm-stats, включая кодинг, агентов и работу с инструментами. К тому же она примерно вдвое дешевле за токен. MiniMax M3 быстрее — примерно в 3 раза по скорости вывода, — но агентный кодинг больше вознаграждает качество рассуждений, чем сырую скорость генерации.
Что дешевле — GLM-5.3-Flash или MiniMax M3? GLM-5.3-Flash, примерно в 2 раза. Официальные цены: $0,15 за 1M входных и $0,50 за 1M выходных токенов для GLM-5.3-Flash против $0,30 и $1,20 за 1M для MiniMax M3. При запросах свыше 512K входных токенов разрыв растёт примерно до 4 раз: MiniMax удваивает тарифы, а Z.ai надбавку не публикует.
Можно ли запустить GLM-5.3-Flash локально? Только на серверном железе. FP8-чекпоинт весит 331 ГБ и требует примерно 386 ГБ видеопамяти при TP=4 на GPU поколения Hopper или новее. Это не модель для потребительского железа. Лицензия MIT делает self-hosted (самостоятельный хостинг) юридически простым; из-за железа он дорогой.
Поддерживает ли OpenCode обе модели нативно? Да. В OpenCode есть встроенные провайдеры и для Z.AI, и для MiniMax. Запустите opencode auth login, выберите провайдера, соответствующего типу вашего ключа, затем /models чтобы выбрать модель. Никакого opencode.json редактирования не требуется при стандартной настройке.
Почему MiniMax M3 показывает всего 200K контекста в Claude Code? Известный и до сих пор не закрытый баг в Anthropic-совместимом эндпоинте MiniMax: он отдаёт метаданные Claude Sonnet вместо реальных характеристик M3, из-за чего автосжатие срабатывает примерно на 167K токенов. Задайте CLAUDE_CODE_AUTO_COMPACT_WINDOW до 1000000 в настройках или используйте вместо него маршрут, совместимый с OpenAI.
В чём разница между GLM-5.3 и GLM-5.3-Flash? Это разные модели. GLM-5.3 вышла 14 августа 2026 года, работает только с текстом и делит базовую модель с GLM-5.2. GLM-5.3-Flash вышла 26 августа, нативно мультимодальна, использует гибридную MoE-архитектуру с вниманием 320B/18B, распространяется по лицензии MIT с открытыми весами и стоит примерно в десять раз меньше. Внутри GLM Coding Plan у Flash ещё и квота в 3 раза больше.
Действительно ли MiniMax M3 — открытый исходный код? Веса открыто скачиваются с Hugging Face, но по собственной MiniMax Community License, а не по стандартной разрешительной лицензии вроде MIT или Apache 2.0. Коммерческое использование повсеместно описывают как неограниченное, но прочитайте текст лицензии, прежде чем выпускать на ней коммерческий продукт.
Использовать подписки или платить по факту использования? Пока вы тратите на токены меньше примерно $20–30 в месяц, подписка и оплата по факту почти не отличаются по цене. Если вы занимаетесь агентным кодингом 6–8 часов в день, подписки явно выигрывают: GLM Coding Plan Lite за $18 в месяц, покрывающий около 400 промптов в неделю, — самое выгодное предложение начального уровня. Учтите, что квота MiniMax не переносится, и сама MiniMax рекомендует оплату по факту использования для рабочих нагрузок.
Итог
Если из всего этого запомнить только одно: GLM-5.3-Flash — лучший вариант по умолчанию для OpenCode в конце 2026 года, и по параметрам, которые определяют исход агентного кодинга — качеству рассуждений, надёжности вызова инструментов и стоимости выполненной задачи, — его преимущество бесспорно.
MiniMax M3 — не плохая модель. Просто она оптимизирована иначе, а её архитектура MSA — по-настоящему изящный ответ на проблему экономики длинного контекста. Есть реальные задачи — массовые механические правки, задачи агентов на десктопе и в графических интерфейсах, всё, где решает трёхкратная скорость генерации, — для которых это правильный инструмент.
Но агентное кодинг — это в основе своей задача принятия решений, а не задача скорости набора текста. Модель, которая лучше планирует, надёжнее вызывает инструменты и изящнее восстанавливается после сбоев, выполнит больше задач на каждый евро, даже если генерирует токены втрое медленнее.
Прагматичный подход — коробка передач на две скорости: GLM-5.3-Flash на планирование и сборку, MiniMax M3 на черновую работу, small_model переключённую на быструю. В OpenCode это правка конфигурации на пятнадцать строк, и вы получаете интеллект там, где это важно, и пропускную способность там, где она не критична.
И напишите эту конфигурацию так, чтобы идентификаторы моделей было легко заменить. На этом рынке у очевидного сегодня ответа срок годности измеряется неделями.
Вы уже используете одну из этих моделей как основную в OpenCode? Мне особенно интересно, подтверждаются ли показатели GLM-5.3-Flash в Terminal-Bench на реальных репозиториях и нашёл ли кто-нибудь более аккуратный обходной путь для бага MiniMax с отчётом о контексте. Пишите — исправления и контрпримеры приветствуются, а статья обновляется, когда картина меняется.
Последнее обновление: 30 августа 2026.


