Tiếng Việt
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 ไทย
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

Lập luận đó diễn ra như sau. Một gói đăng ký AI cao cấp nhất giá 200 USD một tháng, tức 2.400 USD một năm. Một chiếc MacBook Pro với 128 GB bộ nhớ hợp nhất có thể chạy mô hình ngôn ngữ lớn ngay trên máy, riêng tư và không giới hạn lượt dùng. Vậy nên hãy hủy gói đăng ký, mua MacBook để chạy LLM cục bộ, và trong một hai năm nó sẽ tự hoàn vốn.
Bạn sẽ gặp đủ phiên bản của lập luận này khắp năm 2026: trong các video YouTube hỏi bạn có nên hủy gói AI 200 USD và mua một chiếc Mac 9.499 USD không, trong các bài Medium lấy giá một chiếc Mac chia cho 200 USD, và trong một bài báo của Forbes đã chạy lại các con số khi Apple ra mắt Mac Studio mới vào tháng Tám. Tại buổi ra mắt MacBook Pro M5 Max, giám đốc phần cứng của Apple, John Ternus, nói rằng máy mới cho phép giới chuyên môn “chạy các LLM tiên tiến ngay trên thiết bị”.
Mua MacBook để chạy LLM cục bộ là ý tưởng hoàn toàn hợp lý với một số người. Nhưng để thay thế gói Claude hay ChatGPT 200 USD thì nó thất bại, và thất bại ở đúng một thứ mà lập luận kia không bao giờ định giá: chất lượng. Gói đăng ký cho bạn thuê những mô hình tốt nhất thế giới. Chiếc Mac chạy những mô hình tốt nhất vừa với 128 GB. Tính đến hôm qua, chúng ta có thể đo khoảng cách giữa hai thứ đó chính xác hơn bao giờ hết, và nó rộng hơn những gì cơn sốt quảng bá gợi ý.
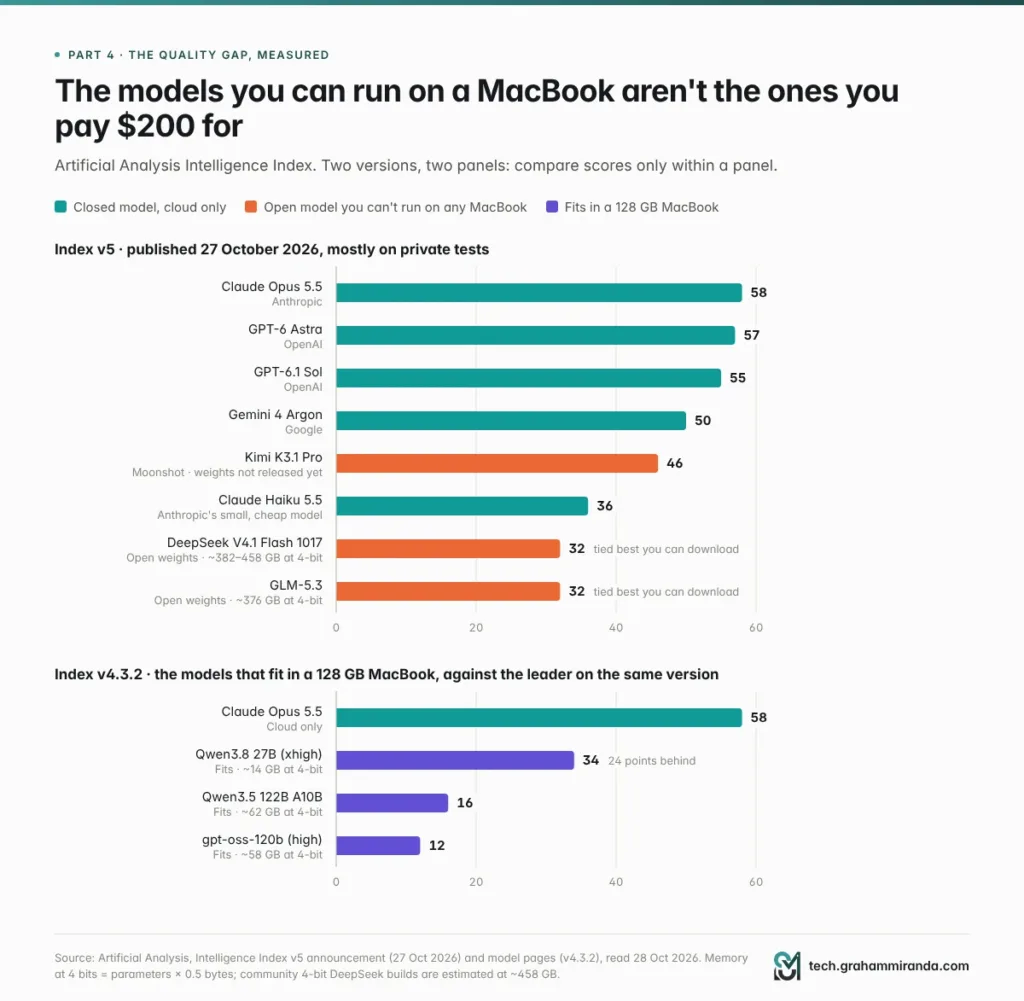
Ngày 27 tháng 10, Artificial Analysis xây dựng lại Intelligence Index của mình quanh phần lớn các bài kiểm tra riêng tư. Claude Opus 5.5 dẫn đầu với 58. Những mô hình trọng số mở tốt nhất mà bạn thực sự có thể tải về, DeepSeek V4.1 Flash 1017 và GLM-5.3, đạt 32, thấp hơn Claude Haiku 5.5, mô hình nhỏ và rẻ của Anthropic, ở mức 36. Không mô hình mở nào trong hai mô hình đó vừa với bất kỳ chiếc MacBook nào: ở 4-bit chúng cần khoảng 375 đến 460 GB. Mô hình mạnh nhất tôi tìm được mà vừa với MacBook 128 GB, Qwen3.8 27B, đạt 34 trên phiên bản trước của chỉ số, phiên bản mà Opus 5.5 cũng đạt 58.
Trong khi đó phần cứng lại đắt hơn. Tháng Sáu, Apple tăng gấp đôi giá nâng cấp bộ nhớ 128 GB trên M5 Max. Một chiếc MacBook Pro 16 inch với 128 GB giờ có giá $6,999 tại Mỹ và, theo ước tính của tôi, khoảng €8,199 tại Đức.
Vậy đây là phiên bản trung thực của bài toán: 200 USD một tháng thực sự mua được gì, 7.000 USD thực sự mua được gì, khoảng cách chất lượng lớn đến đâu và vì sao nó tồn tại, M5 Max thực sự nhanh đến mức nào, lượng tử hóa khiến bạn mất gì, khi nào mua Mac để chạy AI cục bộ mới hợp lý, và những cách rẻ hơn để cắt hóa đơn 200 USD nếu đó mới là điều bạn thực sự muốn. Mọi con số đều được đối chiếu với nguồn vào 28 tháng 10 năm 2026.
TL;DR — Bản tóm tắt 60 giây
- Những mô hình bạn trả 200 USD để dùng thì không thể tải về, còn những mô hình tốt nhất bạn tải được thì không vừa với MacBook. Trên Intelligence Index v5 mới của Artificial Analysis, Claude Opus 5.5 đạt 58 điểm. Những mô hình mở tải được hàng đầu, DeepSeek V4.1 Flash 1017 và GLM-5.3, đạt 32 điểm và cần khoảng 375–460 GB bộ nhớ ở 4-bit.
- Những gì vừa máy thì điểm thấp hơn nhiều. Mô hình mạnh nhất tôi tìm được cho MacBook 128 GB, Qwen3.8 27B, đạt 34 so với 58 của Opus 5.5 trên cùng phiên bản chỉ số (v4.3.2). Những mô hình lớp 120B thực sự cần thêm bộ nhớ còn thấp hơn: 16 với Qwen3.5 122B, 12 với gpt-oss-120b.
- MacBook 128 GB đắt lên. Tháng Sáu, Apple tăng gấp đôi giá nâng cấp 128 GB lên 2.000 USD, nên một chiếc M5 Max 16 inch với 128 GB giờ là 6.999 USD (khoảng 8.199 € tại Đức, theo ước tính của tôi). Cùng con chip và bộ nhớ đó trong một chiếc Mac Studio có giá 4.799 USD.
- Điểm hòa vốn là ba đến bốn năm, không phải một năm. Kể cả khi chiếc Mac thay thế hoàn toàn gói đăng ký, phải mất khoảng 37 tháng mới thắng được gói 200 USD, 41 tháng nếu bạn giữ một gói 20 USD cho việc khó, và hơn sáu năm nếu so với gói 100 USD.
- Viết thì nhanh; đọc thì chậm. M5 Max tạo ra 55–88 token mỗi giây trên các mô hình mixture-of-experts, không cách xa mức 98 của Opus 5.5 trên API của Anthropic. Nhưng nó cần 13–55 giây chỉ để đọc một prompt 32.000 token, mà các tác nhân AI thì đọc lại prompt dài cả ngày.
- Ép mô hình lớn vào máy phải trả giá bằng chất lượng. Lượng tử hóa 4-bit gần như không mất mát trên các tác vụ ngắn, nhưng trong một nghiên cứu EMNLP 2025, nó làm mất tới 59% trên đầu vào dài, và mất nhiều hơn ở các ngôn ngữ khác ngoài tiếng Anh. Ở 3 bit, điểm toán của một mô hình suy luận nhỏ giảm từ 85,6% xuống 47,0%.
- Các benchmark công khai có vẻ ưu ái mô hình mở. Khi Artificial Analysis chuyển sang phần lớn là bài kiểm tra riêng tư, bốn mô hình trọng số mở hàng đầu mất trung bình 13 điểm. Bốn mô hình đóng hàng đầu gần như không đổi.
- Chạy cục bộ vẫn thắng ở quyền riêng tư, dùng ngoại tuyến, không giới hạn tần suất và các việc hàng loạt, và khi dù sao bạn cũng định mua Mac. Hãy mua vì những lý do đó, không phải để hủy một gói đăng ký.
- Có những cách tiết kiệm rẻ hơn. Hạ xuống gói 100 USD và tiết kiệm 1.200 USD một năm, trả theo token cho các mô hình mở (DeepSeek V4.1 Flash giá 0,60 USD mỗi triệu token đầu ra vào giờ thấp điểm), hoặc dùng gói lập trình từ 18 USD một tháng.
Lập luận và thực tế
| Lập luận | Thực tế, tháng 10 năm 2026 |
|---|---|
| “Nó tự hoàn vốn trong một năm” | Một chiếc MacBook Pro 16 inch với 128 GB có giá 6.999 USD. Với 200 USD một tháng thì đó là 35 tháng, chưa tính tiền điện, và 41 tháng khi bạn cộng thêm gói 20 USD bạn sẽ giữ cho những việc khó |
| “Mô hình cục bộ giờ cơ bản tốt ngang rồi” | Opus 5.5 đạt 58. Mô hình tốt nhất vừa với 128 GB đạt 34 (Qwen3.8 27B, chỉ số v4.3.2). Những mô hình mở tải được tốt nhất đạt 32 trên v5 mới |
| “128 GB chạy được các mô hình mở lớn” | GLM-5.3 cần khoảng 376 GB ở 4-bit, DeepSeek V4.1 Flash khoảng 380–460 GB, Kimi K3 khoảng 1,5 TB. Không mô hình nào vừa với bất kỳ chiếc MacBook nào |
| “M5 Max nhanh” | Khi viết thì đúng: 55–88 token mỗi giây trên các mô hình mixture-of-experts. Khi đọc một prompt 32K token: 13 đến 55 giây |
| “4-bit không mất mát” | Trên benchmark ngắn thì gần như vậy. Với đầu vào trên 64K token, một nghiên cứu cho thấy kém tới 59%, và còn kém hơn nữa ngoài tiếng Anh |
| “Không giới hạn, riêng tư tuyệt đối” | Đúng. Đó mới là lý do thật để mua một chiếc |
Mục lục
- TL;DR — Bản tóm tắt 60 giây
- Lập luận và thực tế
- Phần 1 — Lập luận “Hủy gói 200 USD của bạn”, và vì sao nó nghe quá hợp lý
- Phần 2 — 200 USD một tháng thực sự mua được gì vào tháng 10 năm 2026
- Phần 3 — MacBook 128 GB giờ thực sự có giá bao nhiêu
- Phần 4 — Khoảng cách chất lượng, đo được
- Phần 5 — Vì sao những mô hình bạn thực sự muốn lại không vừa
- Phần 6 — Lượng tử hóa: mức thuế chất lượng bạn trả để vừa máy
- Phần 7 — Tốc độ: nhanh khi viết, chậm khi đọc
- Phần 8 — Vấn đề laptop
- Phần 9 — Khoảng cách phần mềm: những gì bạn sẽ phải dựng lại
- Phần 10 — Bài toán hòa vốn, tính một cách trung thực
- Phần 11 — Trường hợp chính đáng: khi nào mua Mac để chạy AI cục bộ là hợp lý
- Phần 12 — Những cách rẻ hơn để cắt hóa đơn AI 200 USD
- Phần 13 — Có nên mua MacBook để chạy LLM cục bộ? Hướng dẫn quyết định
- Phần 14 — Nếu bạn vẫn mua: làm sao tận dụng tối đa
- Câu hỏi thường gặp
- MacBook có thể thay thế gói đăng ký ChatGPT Pro hay Claude Max không?
- LLM cục bộ tốt nhất cho MacBook Pro 128 GB năm 2026 là gì?
- MacBook Pro 128 GB giờ có giá bao nhiêu?
- Mua MacBook bao lâu thì hoàn vốn so với gói đăng ký AI 200 USD?
- M5 Max có đủ nhanh cho LLM cục bộ không?
- LLM cục bộ giờ có tốt ngang ChatGPT hay Claude không?
- Lượng tử hóa có làm mô hình cục bộ kém đi không?
- Tôi có thể chạy DeepSeek V4.1 Flash hay GLM-5.3 trên MacBook không?
- 64 GB có đủ cho AI cục bộ không, hay tôi cần 128 GB?
- Tôi có nên mua Mac Studio thay vì MacBook Pro để chạy LLM cục bộ không?
- Chạy AI cục bộ có tốt hơn cho quyền riêng tư và GDPR không?
- Tôi có thể dùng Claude Code với một mô hình cục bộ không?
- MacBook Pro OLED mới có thay đổi được gì trong chuyện này không?
- Điểm mấu chốt
Phần 1 — Lập luận “Hủy gói 200 USD của bạn”, và vì sao nó nghe quá hợp lý
Hãy bắt đầu từ việc vì sao lập luận này lan đi dễ đến thế, vì phần lớn nó hợp lý.
Ba phòng thí nghiệm cùng hội tụ ở mức 200 USD. Claude Max 20× của Anthropic giá 200 USD một tháng. ChatGPT Pro của OpenAI có các phiên bản 100 USD, 200 USD và 500 USD. AI Ultra của Google có gói 100 USD và gói 200 USD. Trả chừng đó mỗi tháng thì con số cứ thế: 2.400 USD một năm, 7.200 USD trong ba năm.
Phần cứng đã trở nên nghiêm túc. MacBook Pro M5 Max, bán từ tháng Ba, nhận tối đa 128 GB bộ nhớ hợp nhất với băng thông 614 GB/s, và Apple đưa Neural Accelerator, phần cứng tính toán ma trận chuyên dụng, vào từng lõi GPU. Tháng Tám, Mac Studio xuất hiện với tùy chọn M5 Ultra lên tới 512 GB. Tiếp thị của Apple dựa vào AI cục bộ mạnh hơn bao giờ hết.
Các gói đăng ký trở nên keo kiệt hơn. Giới hạn hàng tuần của Claude Max, được thêm vào vài tháng sau khi gói ra mắt, là đối tượng của một vụ kiện tập thể nộp ngày 8 tháng 9, cho rằng các nhãn “5×” và “20×” không nói rõ mức trần hàng tuần. OpenAI được cho là đã cắt hạn mức của gói Pro 200 USD cho người đăng ký mới từ 20 lần ChatGPT Plus xuống 10 lần. Khi thứ bạn thuê cứ teo dần, sở hữu bắt đầu trở nên hấp dẫn.
Quyền riêng tư là mối lo thật sự. Bất cứ gì bạn dán vào một mô hình trên đám mây đều rời khỏi máy bạn. Với một doanh nghiệp Đức đang giữ dữ liệu khách hàng, đó không phải hoang tưởng; đó là GDPR.
Và phép tính thì dễ. Phiên bản được chia sẻ nhiều nhất: một chiếc Mac Studio 2.499 USD chia cho 200 USD một tháng là khoảng 12,5 tháng. Forbes đã đăng một phiên bản cẩn thận hơn nhiều vào tháng Tám, với cấu hình thật và ba năm tiền điện, và kết luận rằng một chiếc Mac có lẽ sẽ không cho phép bạn hủy gói Claude hay ChatGPT nếu bạn viết mã với các tác nhân. Nhưng phiên bản ngắn mới là thứ người ta nhớ.
Đây là chỗ hỏng. Lập luận đó so sánh giá với giá. Đáng ra phải so sánh sản phẩm với sản phẩm. Phần còn lại của bài viết làm đúng như vậy, bắt đầu từ việc 200 USD thực sự trả cho cái gì.
Phần 2 — 200 USD một tháng thực sự mua được gì vào tháng 10 năm 2026
| Nhà cung cấp | Gói 20 USD | Gói 100 USD | Gói 200 USD | Trên 200 USD |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: 20 USD (17 USD một tháng khi thanh toán theo năm) | Max 5×: 100 USD | Max 20×: 200 USD | Team và Enterprise |
| OpenAI (ChatGPT) | Plus: 20 USD (Go: 8 USD) | Pro 100: 100 USD | Pro 200: 200 USD | Pro 500: 500 USD |
| Google (Gemini) | AI Pro: 20 USD | AI Ultra: 100 USD | AI Ultra: 200 USD | — |
Giá tại Mỹ mỗi tháng, chưa gồm VAT. Claude theo claude.com; ChatGPT theo bảng theo dõi của AI Business Weekly, cập nhật ngày 4 tháng 10; Google theo bài của Engadget về lần ra mắt lại hồi tháng Năm. Giá và hạn mức thay đổi thường xuyên, nên hãy kiểm tra trước khi đăng ký.
Số tiền thực sự trả cho cái gì
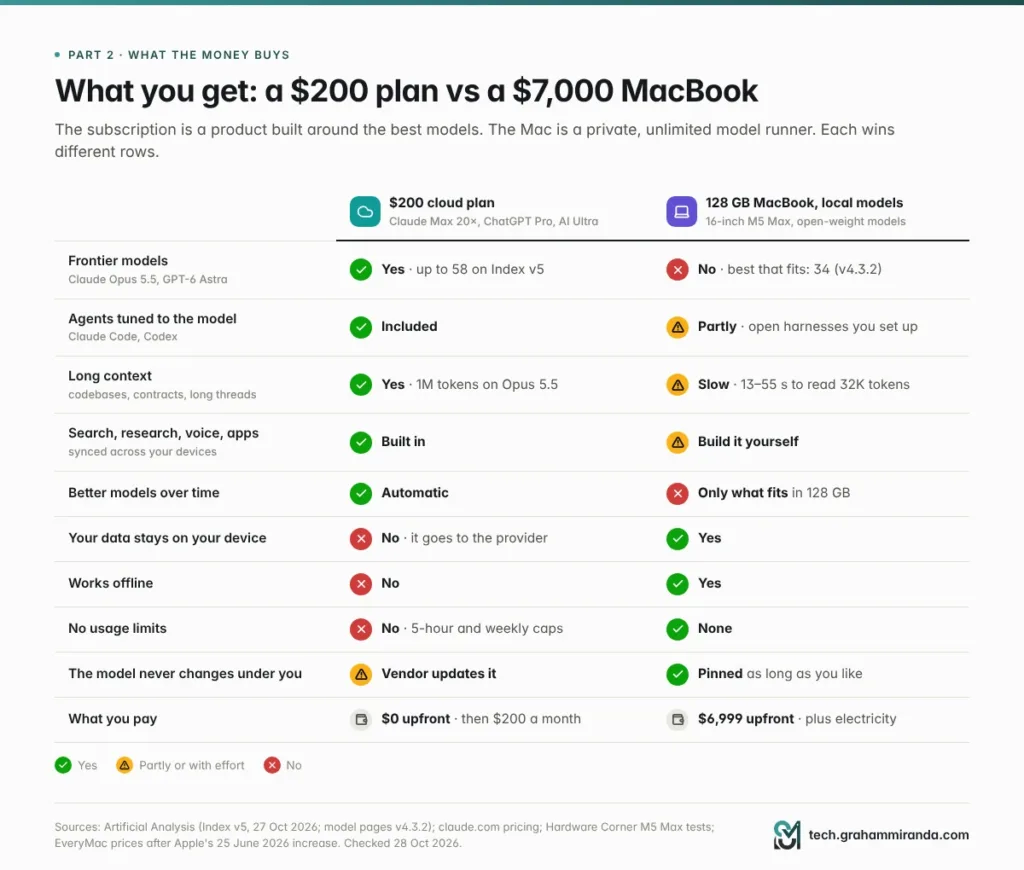
1. Những mô hình tiên phong mà bạn không thể có ở bất kỳ đâu khác. Trên chỉ số mới của Artificial Analysis, Anthropic và OpenAI giữ cả năm vị trí đầu. Không mô hình nào trong số đó tải được với bất kỳ giá nào. Gói đăng ký là cách rẻ nhất để hầu hết mọi người từng được dùng chúng.
2. Các tác nhân được xây quanh những mô hình đó. Các gói trả phí của Claude có Claude Code; của ChatGPT có Codex. Harness và mô hình được tinh chỉnh cùng nhau, điều này phần nào giải thích vì sao chúng đứng đầu các bảng xếp hạng viết mã bằng tác nhân. (Tôi đã so sánh 28 công cụ trong số này trong So sánh mọi harness coding AI.)
3. Ngữ cảnh khổng lồ. Theo Artificial Analysis, Claude Opus 5.5 nhận cửa sổ ngữ cảnh một triệu token: cả kho mã, cả hợp đồng, cả quý email.
4. Sản phẩm bao quanh mô hình. Tìm kiếm web và nghiên cứu chuyên sâu, phân tích tệp, giọng nói, bộ nhớ, tạo ảnh, kết nối tới mail và tài liệu của bạn, và các ứng dụng đồng bộ trên điện thoại, laptop và trình duyệt. Không thứ nào trong đó đi kèm một tệp mô hình.
5. Nâng cấp mà bạn không phải cài. Mô hình đứng sau gói đăng ký của bạn vào quý sau sẽ tốt hơn mô hình hôm nay. Mô hình trên chiếc Mac của bạn chỉ đổi khi bạn tải một mô hình khác về, và chỉ khi mô hình mới vừa máy.
6. Một phần tiền được trả lại. Trang giá của Anthropic giờ liệt kê tín dụng API hàng tháng kèm Max: 100 USD ở gói 5× và 200 USD ở gói 20×.
Những gì nó không mua được
Dùng không giới hạn. Các gói Claude vận hành theo cửa sổ luân chuyển năm giờ cộng thêm mức trần hàng tuần, còn OpenAI và Google phần lớn mô tả các gói cao nhất của mình bằng bội số của gói rẻ hơn, khi họ có mô tả. Kiểm soát được dữ liệu của bạn đi đâu, điều này rất quan trọng với dữ liệu cá nhân và dữ liệu khách hàng. Và khả năng dự đoán trước: hạn mức đã thay đổi hơn một lần trong năm nay.
Hãy nhớ ba điều đó. Đó là lý lẽ trung thực cho AI cục bộ, và Phần 11 sẽ xem xét chúng đầy đủ.
Hiện ảnh Gói đăng ký là một sản phẩm; chiếc Mac là một cỗ máy chạy mô hình. Mỗi bên thắng ở những dòng khác nhau, nên câu trả lời đúng với hầu hết mọi người là cả hai.
Phần 3 — MacBook 128 GB giờ thực sự có giá bao nhiêu
Chỉ một con chip đưa bạn tới 128 GB. Ở thế hệ M5, lượng bộ nhớ hợp nhất đó chỉ có trên M5 Max với GPU 40 lõi, với băng thông bộ nhớ 614 GB/s. M5 Max GPU 32 lõi cố định ở 36 GB và 460 GB/s, còn M5 Pro tối đa 64 GB và 307 GB/s.
| Cấu hình | Giá tại Mỹ | Đức |
|---|---|---|
| 16″ M5 Max (CPU 18 nhân, GPU 40 nhân), 48 GB, 2 TB | $4,999 | €5,699 |
| Nâng cấp lên 128 GB | +$2.000 (trước là +$1.000 cho đến 25 tháng 6) | khoảng +€2.500 (trước là +€1.250 khi ra mắt), ước tính |
| 16″ M5 Max, 128 GB, 2 TB | $6,999 | khoảng €8.199 (ước tính; €6.249 khi ra mắt) |
| Tối đa: 128 GB, 8 TB, màn hình nano-texture | $10,149 | — |
| Để so sánh: Mac Studio, M5 Max, 128 GB | $4,799 | — |
Giá tại Mỹ chưa gồm thuế bán hàng; giá tại Đức đã gồm VAT 19%. Mức nâng cấp 128 GB ở Đức là ước tính của tôi: Apple tính €1.250 khi ra mắt, còn giá nâng cấp tính bằng đô la đã tăng gấp đôi vào tháng 6. Hãy kiểm tra trình cấu hình của Apple trước khi mua.
Có ba điểm đáng chú ý.
Giờ bộ nhớ mới là phần đắt đỏ. Apple tăng giá toàn dòng Mac vào ngày 25 tháng 6 và đổ lỗi cho chi phí bộ nhớ, lưu trữ. Hãng nói với Reuters rằng họ “chưa từng thấy giá linh kiện tăng nhiều và nhanh đến thế”. Bản nâng cấp 64 GB và 128 GB của M5 Max đều tăng gấp đôi. Linh kiện mà AI cục bộ cần nhất lại chính là thứ đắt lên gấp đôi.
Mức phụ trội của dòng laptop là $2.200. Cùng một con M5 Max với cùng 128 GB trong một chiếc Mac Studio có giá $4.799 khi Forbes định giá vào tháng 8. Nếu bạn cần bộ nhớ cho AI, kiểu dáng laptop khiến bạn tốn thêm 46%.
Bản 14 inch là một sự thỏa hiệp. Bạn cũng có thể đặt bản 14 inch với 128 GB, nhưng trong bài đánh giá của Notebookcheck, khung máy gặp khó khi tản nhiệt cho M5 Max dưới tải kéo dài. Phần 8 nói kỹ hơn.
Mac mới trong tuần này. Ngày 27 tháng 10, Apple công bố MacBook Pro 14 inch dùng chip M6 M6: tối đa 32 GB và 170 GB/s, từ $1.999. Đây là một chiếc laptop tốt, nhưng không phải máy chạy LLM. Và tối nay (28 tháng 10, 10:00 giờ Thái Bình Dương, 18:00 tại Đức) Apple tổ chức sự kiện “Pro and Tell”, nơi MacBook Pro màn hình cảm ứng OLED được dự đoán rộng rãi sẽ ra mắt. Các báo cáo nói máy dùng lại chip M5 Pro và M5 Max, nghĩa là giới hạn 128 GB và 614 GB/s sẽ không đổi.
Phần 4 — Khoảng cách chất lượng, đo được
Làm sao so sánh một mô hình trên bàn bạn với một mô hình trong trung tâm dữ liệu? Không phải bằng cảm giác, và cũng không phải bằng bảng benchmark của chính nhà cung cấp. Artificial Analysis (AA) chạy cùng một bộ kiểm thử trên hàng trăm mô hình, qua cùng một khung kiểm thử, rồi cô đọng kết quả thành một Intelligence Index duy nhất. Không chỉ số nào là hoàn hảo, nhưng của AA độc lập, và là thứ gần nhất với một thước đo chung mà ngành này có.
Ngày 27 tháng 10, AA công bố phiên bản 5. Thay đổi lớn nhất: khoảng 60% chỉ số giờ chạy trên các bộ kiểm thử riêng hoặc đáp án giữ kín, nên mô hình không thể đã thấy câu hỏi trong lúc huấn luyện. Công việc tri thức, lập trình, khoa học và kiến thức chung mỗi phần chiếm một phần tư.
Bảng xếp hạng mới
| Mô hình | Bạn có tải được nó về không? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | Không | 58 |
| GPT-6 Astra (max) | Không | 57 |
| GPT-6.1 Sol (max) | Không | 55 |
| Gemini 4 Argon (high) | Không | 50 |
| Kimi K3.1 Pro | Chưa; chưa phát hành trọng số | 46 |
| Claude Haiku 5.5 (max) | Không | 36 |
| DeepSeek V4.1 Flash 1017 (max) | Có, giấy phép MIT | 32 |
| GLM-5.3 (max) | Có | 32 |
Nguồn: Artificial Analysis, công bố Intelligence Index v5, ngày 27 tháng 10 năm 2026.
Ba điểm trong bảng đó quan trọng nếu bạn đang tính giá một chiếc MacBook.
- Năm vị trí đầu đều thuộc về Anthropic và OpenAI, và không mô hình nào trong số đó tải về được với bất kỳ giá nào.
- Mô hình mở tốt nhất, Kimi K3.1 Pro, chưa phát hành trọng số. Trong số các mô hình bạn thực sự tải được, điểm cao nhất là 32, tức là chúng kém người dẫn đầu 26 điểm. Ở phiên bản trước, khoảng cách giữa mô hình mở tốt nhất và mô hình đóng tốt nhất là 3 điểm. Giờ là 12, hoặc 26 nếu bạn chỉ tính trọng số tải được.
- Claude Haiku 5.5 đánh bại mọi mô hình mở tải được. Đó là dòng nhỏ, nhanh và rẻ của Anthropic, không phải mẫu chủ lực.
Cụ thể là viết mã
Chỉ số mới bao gồm FrontierCode 2.0, 132 bài lập trình riêng từ Cognition. Claude Opus 5.5 giải được 46%; DeepSeek V4.1 Flash 1017, đồng hạng mạnh nhất trong các mô hình tải được, giải được 28%. Trên Terminal-Bench-Science, 70 bài khoa học dạng tác nhân, tỉ lệ là 59% so với 13%.
Công bằng với các mô hình mở: Kimi K3.1 Pro dẫn đầu Terminal-Bench 4.0 với 67%, trên mọi mô hình đóng. Các mô hình mở có thể và thực sự thắng từng benchmark riêng lẻ. Nhưng mô hình đó chưa tải được, và mô hình tiền nhiệm Kimi K3 có 2,8 nghìn tỉ tham số. Bạn sẽ không chạy nó trên laptop.
Vì sao khoảng cách vừa rộng ra
Cú nhảy từ v4.3 lên v5 không đối xử công bằng với tất cả.
| Mô hình | Loại | v4.3 | v5 | Thay đổi |
|---|---|---|---|---|
| Claude Opus 5.5 | Đóng | 58 | 58 | 0 |
| GPT-6 Astra | Đóng | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Đóng | 56 | 54 | −2 |
| Gemini 4 Argon | Đóng | 53 | 50 | −3 |
| Kimi K3.1 Pro | Mở (chưa phát hành) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Mở | 45 | 32 | −13 |
| Muse Spark Open (Meta) | Mở | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | Mở | 46 | 30 | −16 |
Số liệu v4.3 và v5 theo Trending Topics ngày 28 tháng 10, với điểm v5 khớp với công bố của AA.
Trung bình, bốn mô hình mở đó mất 13 điểm. Bốn mô hình đóng chỉ nhích một phần tư điểm.
AA chưa nói lý do. Cách hiểu rõ ràng nhất là khi câu hỏi kiểm thử được giữ kín, mô hình không thể đã thấy chúng, và các benchmark công khai thường làm đẹp cho những mô hình được huấn luyện nhiều trên dữ liệu công khai. Phản biện cũng có lý: không thể kiểm tra bộ kiểm thử riêng từ bên ngoài, và cách bạn đặt trọng số cho các hạng mục sẽ làm thay đổi thứ hạng. Đừng coi bất kỳ chỉ số nào là chân lý. Nhưng khi bốn mô hình mở giảm hai chữ số còn bốn mô hình đóng thì không, đó là tín hiệu đáng để ý: các bảng benchmark công bố, đặc biệt là của chính nhà cung cấp, phóng đại mức độ gần nhau của các mô hình mở.
Và những mô hình thực sự vừa với MacBook
Những mô hình AA chấm lại cho công bố của mình phần lớn quá lớn so với laptop. Với những mô hình vừa vặn, trang mô hình của AA vẫn hiển thị v4.3.2 điểm, và trên phiên bản đó Opus 5.5 cũng được 58. Vậy đây là so sánh trên một thang đo nhất quán:
| Mô hình | Vừa trong MacBook 128 GB? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | Không, chỉ trên cloud | 58 |
| Qwen3.8 27B (xhigh) | Có, ở 4-bit thậm chí trên Mac 32 GB | 34 |
| Qwen3.5 122B A10B (reasoning) | Có, khoảng 70 GB ở 4-bit | 16 |
| gpt-oss-120b (high) | Có, khoảng 64 GB | 12 |
Nguồn: trang mô hình của Artificial Analysis, truy cập ngày 28 tháng 10 năm 2026.
AA xếp Qwen3.8 27B đứng đầu trong 141 mô hình tương đương. Nó thực sự xuất sắc so với kích thước, và là mô hình mở phát hành theo Apache 2.0. Nó vẫn kém 24 điểm.
Hiện ảnh Hai phiên bản chỉ số, hai bảng riêng, không bao giờ chung một trục. Trên: Artificial Analysis Intelligence Index v5 (27 tháng 10 năm 2026). Dưới: các mô hình vừa với MacBook 128 GB, trên v4.3.2, phiên bản mà điểm số của chúng được công bố.
Nghịch lý 128 GB
Hãy nhìn lại bảng cuối cùng đó. Mô hình tốt nhất cho MacBook 128 GB vừa trong 32 GB. Những mô hình thực sự cần thêm bộ nhớ, các mô hình hỗn hợp chuyên gia 120 tỉ tham số, lại có điểm thấp hơn, chủ yếu vì chúng cũ hơn: gpt-oss-120b ra mắt tháng 8 năm 2025, còn Qwen3.5 122B đã được benchmark trên M5 Max từ tháng 3, nhiều tháng trước khi Qwen3.8 27B xuất hiện.
Vậy bản nâng cấp $2.000 từ 48 GB lên 128 GB hôm nay mua được gì? Chỗ trống: ngữ cảnh dài hơn, độ chính xác 8-bit thay vì 4-bit, nhiều mô hình nạp cùng lúc, và khả năng chạy một mô hình mạnh cỡ 100 tỉ khi có. Đó là những lợi ích thật. Một mô hình thông minh hơn thì không, ít nhất là trên bảng xếp hạng hôm nay. Hãy kiểm tra AA trước khi mua; đây là loại sự thật có thể thay đổi chỉ với một lần phát hành.
34 so với 58 cảm giác thế nào trên thực tế
Điểm chỉ số không phải “phần trăm thông minh hơn”, và chúng không rơi đều trên các loại việc.
Với những việc ngắn, rõ ràng, như viết lại một email, tóm tắt một tài liệu bạn dán vào hay rút trường dữ liệu từ một hoá đơn, một mô hình 27B tốt thường không khác gì mô hình hàng đầu. Khoảng cách mở ra ở những việc dài, nhiều bước: một tác nhân phải đọc cả kho mã, lập kế hoạch, sửa năm tệp, chạy kiểm thử và tự sửa sai; nghiên cứu phải đối chiếu các nguồn; suy luận mà một bước sai làm hỏng phần còn lại. Đó chính là loại việc người ta mua gói $200.
Bài báo tháng 8 của Forbes nêu một ví dụ cụ thể từ chính bài nghiên cứu của Qwen: Qwen3-Coder-Next chạy trong Claude Code đạt 30.9% trên Terminal-Bench 2.0, so với 53.9% của Claude Opus 4.5 trong cùng bài báo. Đó là các mô hình năm ngoái, nhưng hình dạng vấn đề không đổi: ở các việc dạng tác nhân, bộ thiết lập cục bộ thất bại nhiều hơn hẳn.
Phần 5 — Vì sao những mô hình bạn thực sự muốn lại không vừa
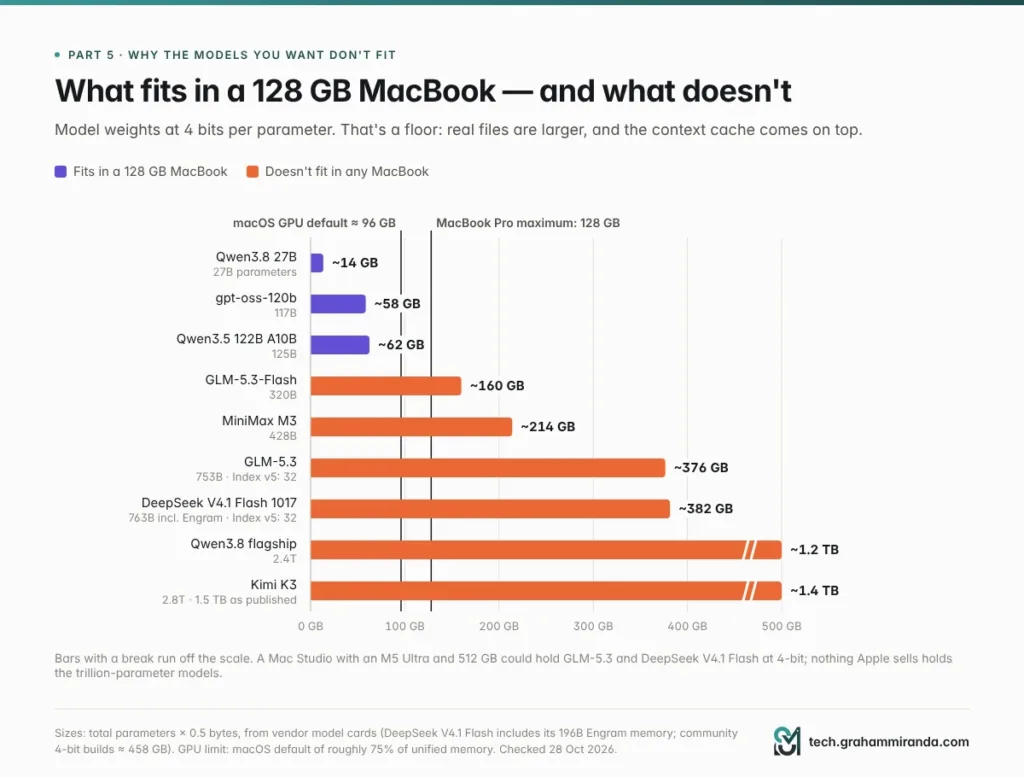
Kích thước bộ nhớ của một mô hình dễ ước tính:
text
trọng số (GB) ≈ tham số (tỉ) × byte mỗi tham số
               8-bit → × 1,0     4-bit → × 0,5     2-bit → × 0,25
Sau đó cộng thêm KV cache, bộ nhớ làm việc của mô hình cho cuộc trò chuyện, tăng theo độ dài ngữ cảnh. Và nhớ rằng macOS không giao toàn bộ bộ nhớ hợp nhất cho GPU: mặc định nó cho GPU giữ khoảng 75% trên Mac bộ nhớ lớn, khoảng 96 GB trong máy 128 GB. Bạn có thể nâng giới hạn bằng sudo sysctl iogpu.wired_limit_mb=…, tự chịu rủi ro; phần bạn cho mô hình thì trình duyệt, trình soạn thảo và hệ điều hành không có.
Đây là ý nghĩa với những mô hình người ta thực sự nói đến:
| Mô hình | Tổng số tham số | Trọng số 4-bit (mức tối thiểu) | Vừa trong MacBook 128 GB? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ Dễ dàng |
| gpt-oss-120b | 117B | ~58 GB (tệp 64 GB) | ✅ Có |
| Qwen3.5 122B A10B | 125B | ~62 GB (tệp 69,6 GB) | ✅ Có |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ Không |
| MiniMax M3 | 428B | ~214 GB | ❌ Không |
| GLM-5.3 | 753B | ~376 GB | ❌ Không |
| DeepSeek V4.1 Flash 1017 | 763B gồm bộ nhớ Engram | ~382 GB (bản dựng 4-bit của cộng đồng ước tính ~458 GB) | ❌ Không |
| Qwen3.8 chủ lực | 2.4T | ~1,2 TB | ❌ Không |
| Kimi K3 | 2.8T | ~1,5 TB theo công bố (MXFP4 gốc) | ❌ Không |
Cột 4-bit là tham số × 0,5 byte: chỉ trọng số, chưa tính KV cache và chi phí tệp, nên tệp thật lớn hơn. Kích thước tệp lấy từ các bài kiểm thử M5 Max của Hardware Corner.
Những mô hình đạt 32 trên chỉ số mới, tốt nhất bạn tải được, cần ba đến bốn lần nhiều hơn một chiếc MacBook có. Và những mô hình ở giữa cũng không chen vào được. Nếu dành 100 GB trong 128 GB cho trọng số, đây là số bit mỗi trọng số bạn có thể đủ:
| Mô hình | Số bit mỗi trọng số trong ngân sách 100 GB |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Khoảng ba bit trở xuống thì chất lượng lao dốc (phần 6 có nghiên cứu). Một bit mỗi trọng số không phải lượng tử hoá. Đó là chặt cụt.
Ngữ cảnh cũng tốn bộ nhớ. Trong các bài kiểm thử của Hardware Corner, Qwen3-Coder-Next ở 8-bit dùng 87,1 GB với ngữ cảnh 4K và 92,6 GB với 64K: thêm năm gigabyte rưỡi chỉ để giữ một cuộc trò chuyện dài hơn. Các tác nhân đọc cả kho mã cần ngữ cảnh dài, nên phần dư đó biến mất rất nhanh.
Còn Mac Studio 512 GB thì sao? Một chiếc Mac Studio M5 Ultra 512 GB có thể chứa GLM-5.3 hoặc DeepSeek V4.1 Flash ở 4-bit. Apple nói cấu hình đó sẽ có vào cuối tháng 10; MacRumors dự đoán giá cao hơn $10.000 nhiều, và khi tôi kiểm tra thì Apple chưa công bố giá. Bạn sẽ trả năm chữ số để chạy những mô hình đạt 32 trên chỉ số mới, có lẽ chậm hơn chính nhà sản xuất phục vụ. Bài Kimi K3 vs Fable 5.1 vs GLM-5.3 so sánh của tôi đi sâu hơn vào những gì thực sự cần để tự lưu trữ các mô hình mở lớn.
Hiện ảnh Chỉ tính trọng số, ở 4 bit mỗi tham số; bộ nhớ đệm ngữ cảnh tính thêm. Mọi thứ bên phải vạch 128 GB đều cần Mac Studio hoặc một máy chủ.
Phần 6 — Lượng tử hóa: mức thuế chất lượng bạn trả để vừa máy
Lượng tử hoá lưu trọng số của mô hình bằng ít bit hơn, 8 hoặc 4 thay vì 16 bit lúc huấn luyện, nên tốn ít bộ nhớ hơn và chạy nhanh hơn. Mọi mô hình cục bộ bạn chạy trên Mac đều đã lượng tử hoá. Câu hỏi là cái giá của nó, và nghiên cứu đưa ra câu trả lời rõ ràng và hơi khó chịu.
Tin tốt: 8-bit gần như miễn phí, 4-bit phần lớn là ổn
- Một trong những nghiên cứu lớn nhất đến nay, của Eldar Kurtic và cộng sự, chạy hơn 500.000 đánh giá trên các mô hình Llama 3.1 đã lượng tử hoá. FP8 gần như không mất gì ở mọi kích thước; INT8 mất khoảng 1–3% nếu tinh chỉnh cẩn thận; và lượng tử hoá chỉ trọng số 4-bit “cạnh tranh hơn dự kiến”, gần với 8-bit.
- Với các mô hình suy luận, một nghiên cứu năm 2025 của Ruikang Liu và cộng sự cho thấy trọng số và activation 8-bit, hoặc trọng số 4-bit với activation 16-bit, có thể không mất gì trên các benchmark toán, khoa học và lập trình. Độ rộng bit thấp hơn mang lại cái mà các tác giả gọi là rủi ro chính xác đáng kể, và độ khó của bài kiểm tra ảnh hưởng mạnh đến mức mất mát.
Nếu bạn chỉ hỏi những câu ngắn bằng tiếng Anh, mô hình 4-bit sẽ có cảm giác gần như bản gốc.
Tin xấu: đầu vào dài, ngôn ngữ khác và mọi thứ dưới 4 bit
- Ngữ cảnh dài. Anmol Mekala và cộng sự đã thử năm phương pháp lượng tử hoá trên 9.700 mẫu với đầu vào 64.000 token trở lên (EMNLP 2025). 8-bit mất khoảng 0.8% trung bình. 4-bit mất tới 59%, và mức tổn thất phụ thuộc nhiều vào mô hình: với một phương pháp 4-bit, Llama 3.1 70B giảm 32% ở một bài mà Qwen 2.5 72B vẫn giữ được.
- Các ngôn ngữ khác ngoài tiếng Anh. Cùng nghiên cứu đó thấy mức suy giảm thường nặng hơn khi đầu vào không phải tiếng Anh. Nếu bạn làm việc bằng tiếng Đức, hãy kiểm thử bằng tiếng Đức.
- Dưới 4 bit, suy luận sụp đổ. Các nhà nghiên cứu tại Meta FAIR công bố một nghiên cứu tháng 6 năm 2026 cho thấy mô hình suy luận đã lượng tử hoá suy nghĩ quá nhiều. Với AWQ 3-bit, điểm của một mô hình suy luận 1,5B trên benchmark MATH-500 giảm từ 85,6% xuống 47,0%, và chuỗi suy nghĩ tăng từ 5.200 lên 23.400 token, dài gấp 4,5 lần. Trên một chiếc laptop ghi 20 đến 80 token mỗi giây, một mô hình suy nghĩ lâu gấp bốn lần cũng chậm khoảng bốn lần.
Hiện ảnh Nghiên cứu cho biết mỗi bậc giảm độ chính xác tốn bao nhiêu. Cách nén để nhét một mô hình lớn hơn vào 128 GB đúng là cách gây hại nhất.
Điều đó nghĩa là gì với MacBook 128 GB
Mức lượng tử hoá bạn đủ sức cho một mô hình bạn muốn dùng lại chính là mức gây hại nhất. Một mô hình 27B chạy được ở 8-bit trên Mac mà vẫn dư chỗ, và nên chạy như vậy. Các mô hình cỡ 120B chạy ở 4-bit, ổn cho trò chuyện và mạo hiểm với tài liệu dài. Và cách duy nhất để đưa bất cứ thứ gì thuộc nhóm trên 300B lên laptop là hai hoặc ba bit mỗi trọng số, nơi các nghiên cứu trên nói rằng suy luận sụp đổ.
Nguyên tắc của tôi:
- Dùng 8-bit cho mọi thứ bạn sẽ dựa vào, nhất là tài liệu dài và việc dạng tác nhân.
- 4-bit ổn cho trò chuyện, phác thảo và việc ngắn. Hãy thử hành vi ngữ cảnh dài trên chính tài liệu của bạn.
- Đừng chạy mô hình suy luận hoặc lập trình dưới 4-bit trừ khi bạn đang thử nghiệm.
- Kiểm thử bằng ngôn ngữ bạn làm việc.
Phần 7 — Tốc độ: nhanh khi viết, chậm khi đọc
Một LLM làm hai việc khác nhau với hai tốc độ khác nhau. Prefill đọc prompt của bạn, mọi thứ bạn đã dán cộng với cuộc trò chuyện đến lúc đó, và bị giới hạn bởi sức tính toán thuần. Sinh văn bản viết câu trả lời từng token một, và bị giới hạn bởi băng thông bộ nhớ. Chính các nhà nghiên cứu học máy của Apple đã đo cả hai trên M5: các Neural Accelerator mới trên GPU giúp thời gian đến token đầu tiên nhanh hơn 3,3 đến 4,1 lần so với M4, trong khi tốc độ sinh chữ chỉ tăng 1,19 đến 1,27 lần, gần tương ứng với phần băng thông tăng thêm.
Vậy một chiếc M5 Max 128 GB thực sự làm được gì? Hardware Corner công bố các bài kiểm thử chạy bằng framework MLX của Apple trên MacBook Pro 14 inch M5 Max 128 GB:
| Mô hình | Ngữ cảnh | Đọc (prefill), tok/s | Thời gian đọc toàn bộ prompt | Viết, tok/s |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3,1 s | 87.9 |
| 32K | 2,537 | 12,9 s | 64.5 | |
| Qwen3.5 122B A10B (4-bit) | 4K | 881 | 4,6 s | 65.9 |
| 32K | 1,068 | 30,7 s | 54.9 | |
| Qwen3.5 27B (dense, 6-bit) | 4K | 811 | 5,1 s | 23.6 |
| 32K | 591 | 55,4 s | 14.9 | |
| Qwen3-Coder-Next (8-bit) | 64K | 1,432 | 45,8 s | 48.2 |
Đo bởi người dùng Reddit cryingneko và công bố trên Hardware Corner. “Thời gian đọc toàn bộ prompt” là độ dài ngữ cảnh chia cho tốc độ prefill đo được.
Tốc độ viết giờ đã ổn, ít nhất trên các mô hình MoE
Mô hình hỗn hợp chuyên gia chỉ dùng một phần trọng số cho mỗi token, nên chúng viết nhanh: 55 đến 88 token mỗi giây trên M5 Max. Để so sánh, Artificial Analysis đo Claude Opus 5.5 ở 98 token mỗi giây trên API của Anthropic. Khi trò chuyện với một mô hình cỡ 120B, M5 Max thực sự dễ chịu. Mô hình dense lại là câu chuyện khác: một mô hình 27B dùng toàn bộ trọng số cho mỗi token chỉ ghi được 15 đến 24 token mỗi giây.
Hai tác động nhỏ hơn cũng cộng dồn. Tốc độ ghi giảm khi cuộc trò chuyện dài ra: chậm hơn 17% đến 37% ở 32K so với 4K trên cả ba mô hình đó. Và các mô hình suy luận tiêu tốn hàng trăm đến hàng nghìn token để suy nghĩ trước khi trả lời.
Đọc mới là chỗ phải chờ
Hãy nhìn lại cột thời gian đọc. Một prompt 32.000 token (vài tệp mã nguồn, một hợp đồng dài, một chuỗi email lớn) mất 13 đến 55 giây để đọc xong trước khi từ đầu tiên của câu trả lời xuất hiện.
Điều đó quan trọng nhất đúng với loại công việc mà người ta mua gói $200 để làm. Các tác nhân lập trình AI gửi cho mô hình một system prompt lớn, định nghĩa của mọi công cụ, những tệp chúng đã mở và toàn bộ cuộc trò chuyện từ đầu, và chúng làm vậy ở mỗi bước. Máy chủ cục bộ có thể tái sử dụng phần prompt không thay đổi, điều này giúp ích rất nhiều. Nhưng mỗi khi có thứ gì đó ở đầu ngữ cảnh thay đổi, ví dụ khi tác nhân nén lịch sử hoặc bạn chuyển sang tác vụ mới, mọi thứ sau điểm đó đều phải đọc lại. Forbes dẫn lời một lập trình viên đã chờ khoảng 90 giây cho token đầu tiên trên một M3 Ultra 512 GB với system prompt 16.000 token, và một người khác thấy khoảng 20 giây từ trạng thái nguội trên một laptop M4 Pro 48 GB. Theo chính số đo của Apple, chip thế hệ M5 nhanh hơn nhiều so với Mac cũ ở khoản này, nhưng bản chất vấn đề vẫn y nguyên.
Để so sánh, các bài kiểm tra Hardware Corner tương tự chạy trên một card workstation Nvidia RTX Pro 6000, giá khoảng $8,800 chỉ riêng card: nó đọc prompt nhanh hơn 2 đến 2,4 lần và ghi nhanh hơn 1,7 đến 2,8 lần so với M5 Max.
Hiện ảnh Đo bằng MLX trên một M5 Max 128 GB. Tốc độ ghi đủ nhanh; đọc prompt dài, việc mà các tác nhân làm liên tục, mới là chỗ phải chờ.
Phần 8 — Vấn đề laptop
Kể cả nếu các mô hình đã đủ tốt, laptop vẫn là chỗ chạy chúng một cách gượng gạo.
Nhiệt. Chạy một mô hình lớn là tải liên tục: GPU và bộ nhớ hoạt động hết công suất trong nhiều phút hoặc nhiều giờ, chứ không phải một đợt bùng nổ mười giây. Bài đánh giá của Notebookcheck về chiếc M5 Max 14 inch kết luận rằng khung máy và hệ thống tản nhiệt của nó “đơn giản là không thể xử lý M5 Max một cách thỏa đáng”: hiệu năng trong bài kiểm tra căng thẳng CPU 30 phút giảm 24%, và quạt đạt 53,2 dB(A) ở chế độ High Power. Bài đánh giá đó đo tải CPU và đồ họa chứ không phải LLM, và chính Notebookcheck gợi ý rằng M5 Max thuộc về chiếc 16 inch. Nếu bạn thật sự mua MacBook cho AI cục bộ, hãy mua bản 16 inch. Bài Hướng dẫn MacBook Pro M5 Pro 64 GB cũng đi đến kết luận tương tự về công việc liên tục trên khung máy nhỏ hơn.
Nó cũng là chiếc máy tính hằng ngày của bạn. Nạp một mô hình 70 GB cùng ngữ cảnh của nó và bạn vẫn còn chỗ cho trình duyệt và trình soạn thảo. Đẩy tới khoảng 96 GB mà GPU được cấp mặc định, hoặc nâng giới hạn để nhồi vào thứ gì đó lớn hơn, thì phần việc còn lại của bạn bắt đầu tranh bộ nhớ với mô hình. Mỗi mô hình bạn giữ trong bộ nhớ là bộ nhớ mà các ứng dụng khác không có.
Pin thì không thích điều đó. Tải GPU liên tục rút cạn pin laptop rất nhanh, nên những phiên suy luận cục bộ dài rốt cuộc phải cắm điện, điều này làm yếu đi đáng kể lời chào mời “AI ở mọi nơi, ngoại tuyến”.
Bạn mua trần hiệu năng của mình ngay từ ngày đầu. Bộ nhớ hợp nhất không thể nâng cấp sau khi mua. Nếu mô hình mở tốt nhất năm sau cần 160 GB, một chiếc MacBook 128 GB đơn giản là không chạy được nó.
Và nó mất giá nhanh. Công ty tân trang MacFinder của Anh đã phân tích sáu năm dữ liệu mua hàng của chính mình và thấy phần lớn MacBook mất khoảng một nửa giá trị trong năm đầu, các mô hình cao cấp thường rơi mạnh hơn: một MacBook Pro M4 16 inch mất tới 60% trong một năm. Một chiếc máy $6,999 là một canh bạc $6,999 rằng trần bộ nhớ hôm nay vẫn còn hữu ích sau ba năm nữa.
Máy để bàn là một cỗ máy LLM tốt hơn. Nếu mục đích là AI cục bộ, một chiếc Mac Studio với cùng M5 Max và 128 GB rẻ hơn $2,200, không có pin để bị nung nóng và không có nắp để đóng, và có thể chạy suốt ngày đêm như một máy chủ riêng cho laptop và điện thoại của bạn. Ghép nó với bất kỳ laptop nào bạn vốn thích.
Phần 9 — Khoảng cách phần mềm: những gì bạn sẽ phải dựng lại
Một gói đăng ký là một mô hình cộng với một sản phẩm. Một thiết lập cục bộ cho bạn mô hình và để phần sản phẩm lại cho bạn.
| Gói đăng ký làm gì cho bạn | Bạn sẽ phải tự làm gì ở cục bộ |
|---|---|
| Lưu trữ và cập nhật mô hình | Tự tải, chuyển đổi và cập nhật mô hình (LM Studio, Ollama hoặc MLX) |
| Tìm kiếm web và nghiên cứu sâu | Nối một API tìm kiếm hoặc tìm kiếm tự lưu trữ, cộng thêm một tác nhân để điều khiển nó |
| Đọc PDF, bảng tính và hình ảnh | Chọn mô hình có thị giác, thêm bộ phân tích tài liệu |
| Giọng nói, bộ nhớ, tạo hình ảnh | Mô hình và ứng dụng riêng cho từng thứ (Whisper cho giọng nói, Draw Things hoặc ComfyUI cho hình ảnh) |
| Ứng dụng trên mọi thiết bị, được đồng bộ | Chạy một máy chủ và một giao diện, rồi mở nó cho điện thoại của bạn một cách an toàn |
| Claude Code hoặc Codex, được tinh chỉnh cho mô hình riêng của chúng | Trỏ một harness mở, hoặc chính Claude Code, vào một máy chủ cục bộ |
| Mẫu chat, định dạng gọi công cụ và các vấn đề an toàn đã được xử lý sẵn | Gỡ lỗi khi một mô hình mới ra mắt với mẫu mà công cụ của bạn không hiểu |
Bộ công cụ giờ thực sự tốt. LM Studio là cách khởi đầu dễ nhất trên Mac, Ollama cho bạn một API duy nhất cho cả mô hình cục bộ và đám mây, còn MLX của Apple thường là nhanh nhất. Ollama thậm chí còn cung cấp một API tương thích với Anthropic, nên bạn có thể trỏ Claude Code vào một mô hình cục bộ bằng cách đặt ANTHROPIC_BASE_URL=http://localhost:11434. Tuy nhiên tài liệu của nó thẳng thắn về các khoảng trống: các điều khiển bộ nhớ đệm prompt của Anthropic, đếm token, xử lý theo lô và đầu vào PDF đều không được hỗ trợ. Và Claude Code được tinh chỉnh cho các mô hình Claude; một mô hình cục bộ phải xoay xở với system prompt dài và định nghĩa công cụ của Claude Code, và đó chính là chỗ thời gian prefill ở Phần 7 cắn vào.
Không điều nào trong số này là bất khả thi. Bài OpenCode v2 vs Hermes Agent vs OpenClaw viết của tôi về các tác nhân mở làm việc với mô hình cục bộ. Nhưng đó là công việc thật, và giờ của bạn không miễn phí. Hãy dành một cuối tuần để thiết lập và vài giờ mỗi tháng để giữ nó luôn mới.
Phần 10 — Bài toán hòa vốn, tính một cách trung thực
Đây là phép tính mà lời chào mời thường bỏ qua.
Bước 1: phiên bản ngây thơ
$6,999 ÷ $200 một tháng = 35 tháng. Không phải mười hai. Gần ba năm, và đó là phiên bản tâng bốc nhất.
Bước 2: cộng thêm tiền điện
Forbes ước tính khoảng $10 một tháng cho một chiếc Mac chạy AI tám giờ một ngày theo mức giá trung bình của Mỹ. Ở Đức, với mức trung bình tháng Mười là 29,68 cent mỗi kWh, một laptop tiêu thụ trung bình 60–150 W trong tám giờ một ngày tốn khoảng €4–11 một tháng. Nhỏ thôi, nhưng nó đẩy điểm hòa vốn tới khoảng 37 tháng.
Bước 3: giữ một gói rẻ cho việc khó
Bạn sẽ giữ một gói thôi. Ít ai đã dùng một mô hình tiên phong cho lập trình tác nhân hoặc nghiên cứu nghiêm túc lại quay về một mô hình 34 điểm cho mọi việc. Giữ một gói $20 cho 10% khó nhằn, và chiếc Mac tiết kiệm cho bạn $170 một tháng, không phải $200: khoảng 41 tháng.
Bước 4: so với gói bạn thực sự sẽ hạ xuống
Nếu bạn đủ để ý đến chi phí để cân nhắc một chiếc laptop $7,000, thì bạn cũng đủ để ý đến chi phí để xuống gói $100. So với $100 một tháng, điểm hòa vốn là khoảng 78 tháng, hơn sáu năm rưỡi, lâu hơn thời gian nhiều người giữ một chiếc laptop.
| Kịch bản | Trả trước | Bạn vẫn trả | Tiết kiệm mỗi tháng | Hòa vốn |
|---|---|---|---|---|
| MacBook so với gói $200, không tính điện | $6,999 | — | $200 | 35 tháng |
| MacBook so với gói $200, có tính điện | $6,999 | $10 | $190 | 37 tháng |
| … và bạn giữ thêm một gói $20 | $6,999 | $30 | $170 | 41 tháng |
| MacBook so với gói $100 | $6,999 | $10 | $90 | 78 tháng |
| Mac Studio (128 GB) so với gói $200 | $4,799 | $10 | $190 | 25 tháng |
| Mac Studio so với gói $200, giữ thêm một gói $20 | $4,799 | $30 | $170 | 28 tháng |
Tất cả những con số này đều giả định chiếc Mac làm trọn công việc của gói đăng ký. Phần 4 đến Phần 9 giải thích vì sao nó không làm được.
Hiện ảnh Chi phí cộng dồn trong bốn năm, giả định chiếc Mac thay thế hoàn toàn gói đăng ký, điều mà nó không làm được. Tiền điện khoảng $10 một tháng.
Bước 5: ba năm, có tính bán lại
Phần cứng có giá trị bán lại, và đó là lập luận mạnh nhất cho việc mua. Giả sử bạn bán sau ba năm với 35% giá mua. Đó là giả định của tôi, không phải một báo giá, dựa trên dữ liệu của MacFinder cho thấy khoảng một nửa giá trị mất đi trong năm đầu và mức mất giá chậm lại sau đó.
| Tùy chọn | Chi phí 36 tháng |
|---|---|
| Gói $200 | $7,200 |
| MacBook (128 GB) + tiền điện, bán được 35% | $4,909 |
| … cộng thêm một gói $20 cho công việc tiên phong | $5,629 |
| Mac Studio (128 GB) + tiền điện + gói $20, bán được 35% | $4,199 |
| Gói $100 | $3,600 |
| Gói $20 | $720 |
Vậy là đúng: trong ba năm, một chiếc MacBook cộng một gói $20 có thể rẻ hơn khoảng $1,600 so với gói $200, nếu bạn bán được giá khá. Nhưng hãy nhìn xem số tiền đó mua được gì. Một bên là những mô hình tốt nhất thế giới với đủ mọi công cụ vây quanh. Bên kia là một mô hình 34 điểm, vài nghìn đô-la khấu hao và một gói rẻ để dùng khi bạn cần thứ thật sự. Gói $100 đánh bại mọi phương án phần cứng về chi phí, còn gói $20 đánh bại tất cả.
Bạn không tiết kiệm được nhiều tiền với một chiếc MacBook cho LLM cục bộ. Bạn đang chi một số tiền tương đương cho một sản phẩm khác: quyền riêng tư, quyền kiểm soát và sự tự do khỏi các giới hạn, kèm theo ít trí tuệ hơn.
Góc nhìn chi phí biên
Có một cách nhìn trong đó việc mua hợp lý hơn: bạn dù sao cũng cần một chiếc MacBook mới. Khi đó chi phí riêng cho AI chỉ là khoản nâng bộ nhớ từ 48 GB lên 128 GB, $2,000, tức mười tháng của gói $200. Như vậy không đến mức điên rồ. Nhưng hãy nhớ nghịch lý 128 GB ở Phần 4: trên bảng xếp hạng hôm nay, khoản nâng cấp đó mua được mô hình lớn hơn, không phải mô hình thông minh hơn. Nếu bạn kiểu gì cũng mua MacBook, thì 48–64 GB chạy được mô hình tốt nhất cỡ Mac ở 8-bit với ngữ cảnh thoải mái.
6.999 USD mua được gì thay vào đó
- 35 tháng của gói $200, 70 tháng của gói $100, hoặc 29 năm của gói $20
- Khoảng 11,7 tỷ token đầu ra từ DeepSeek V4.1 Flash ở mức giá API ngoài giờ cao điểm, một mô hình có điểm cao hơn mọi thứ chạy vừa trong MacBook
- Khoảng 350 triệu token đầu ra của Claude Opus 5.5 qua API của Anthropic, theo mức $20 mỗi triệu token mà Artificial Analysis đưa ra
Phần 11 — Trường hợp chính đáng: khi nào mua Mac để chạy AI cục bộ là hợp lý
Không điều nào trong số này có nghĩa AI cục bộ là một chiêu trò. Tôi viết về nó liên tục trên blog này vì nó hữu ích. Nó chỉ hữu ích vì những lý do khác với những gì lời chào mời tuyên bố. Đây là những lý do chính đáng.
1. Dữ liệu không được rời khỏi tầm kiểm soát của bạn
Nếu bạn xử lý tệp của khách hàng, thông tin sức khỏe, số liệu tài chính chưa công bố hay bất cứ thứ gì thuộc nghĩa vụ bảo mật, một mô hình cục bộ nghĩa là không có gì đi ra bên thứ ba. Không cần thỏa thuận xử lý dữ liệu, không chuyển dữ liệu quốc tế, không phải băn khoăn về cài đặt huấn luyện. Ở Đức, những người hành nghề bị ràng buộc bởi § 203 StGB, như luật sư, bác sĩ và cố vấn thuế, cần các biện pháp bảo vệ bằng hợp đồng trước khi dữ liệu khách hàng được gửi tới bất kỳ nhà cung cấp dịch vụ bên ngoài nào, kể cả nhà cung cấp AI. Một mô hình cục bộ né tránh hoàn toàn câu hỏi đó. Đây là lý do mạnh nhất để sở hữu phần cứng, và nó không phụ thuộc vào việc mô hình cục bộ có thông minh bằng Opus hay không. Bài Hiện trạng AI 2026 báo cáo của tôi đi sâu hơn vào khía cạnh chi phí và tuân thủ của việc chạy AI ngoại tuyến.
2. Làm việc ngoại tuyến
Trên máy bay, ở chỗ làm việc của khách hàng không có mạng, trong một cơ sở nơi mạng chính là thứ bị cấm.
3. Không giới hạn, không thay đổi chính sách, một mô hình không bao giờ đổi
Không có cửa sổ năm giờ, không có hạn mức tuần, không có kiện tụng tập thể về cách chúng được công bố. Và một checkpoint cục bộ cư xử y như nhau sau một năm, điều này quan trọng nếu bạn đã xây quy trình làm việc quanh cách một mô hình hành xử.
4. Việc hàng loạt, nhàm chán, được định nghĩa rõ
Phân loại hàng nghìn phiếu hỗ trợ, rút các trường ra khỏi hóa đơn, tóm tắt ghi chú của chính bạn, dịch bản nháp, gắn thẻ ảnh, tạo embedding để tìm kiếm trên tài liệu của bạn, phiên âm cuộc họp bằng Whisper. Các mô hình cục bộ cỡ trung làm những việc này rất tốt, và chạy một triệu lần chỉ tốn điện.
5. Học và xây dựng
Nếu bạn xây ứng dụng local-first, tinh chỉnh các mô hình nhỏ hay chỉ muốn hiểu cách những thứ này vận hành, sở hữu phần cứng là người thầy tốt nhất. (Nếu xây ứng dụng bằng AI là việc của bạn, tôi đã viết lại toàn bộ quy trình trong Cách xây dựng ứng dụng từ đầu với AI năm 2026.)
6. Dù sao bạn cũng định mua Mac
Khi đó hãy mua đủ bộ nhớ cho những mô hình bạn thực sự sẽ chạy (xem Phần 14), và coi AI cục bộ là phần thêm, không phải một bài toán kinh doanh.
Những gì chạy tốt cục bộ
| Việc | Chạy gì | Bộ nhớ thoải mái |
|---|---|---|
| Chat riêng tư, soạn thảo, viết lại | Qwen3.8 27B ở 8-bit | 48–64 GB |
| Tóm tắt và Q&A trên tài liệu của bạn | Qwen3.8 27B, cộng thêm một mô hình embedding | 48–64 GB |
| Trích xuất và phân loại hàng loạt | Mô hình nhỏ hơn (Gemma 4, gpt-oss-20b) | 16–32 GB |
| Chuyển giọng nói thành văn bản | Whisper | 8–16 GB |
| Tạo hình ảnh | Draw Things hoặc ComfyUI với các mô hình cỡ FLUX | 32 GB+ |
| Một mô hình chat lớn và nhanh | gpt-oss-120b hoặc Qwen3.5 122B | 128 GB |
Với tạo video cục bộ, Mac vẫn chậm so với phần cứng Nvidia hoặc GPU đám mây; bài hướng dẫn M5 Pro 64 GB của tôi có đầy đủ các con số.
Phần 12 — Những cách rẻ hơn để cắt hóa đơn AI 200 USD
Nếu điều bạn thực sự muốn là một hóa đơn AI nhỏ hơn, có những cách rẻ hơn một chiếc laptop $7,000.
1. Xuống một bậc. Claude Max 5× và ChatGPT Pro 100 giá $100, còn AI Ultra của Google giờ bắt đầu từ $100. Nếu bạn hiếm khi chạm giới hạn trên gói $200, cách này tiết kiệm $1,200 một năm mà không mất chút chất lượng nào.
2. Kết hợp hai gói $20. Claude Pro cộng ChatGPT Plus tốn $40 một tháng và cho bạn hai nhóm giới hạn riêng biệt cùng hai dòng mô hình tiên phong để chuyển đổi qua lại.
3. Trả tiền theo token cho các mô hình mở. Chính những mô hình trọng số mở bạn chạy trên Mac, và cả những mô hình lớn hơn không bao giờ chạy vừa, đều có sẵn theo token từ nhiều nhà cung cấp, với tốc độ trung tâm dữ liệu. DeepSeek V4.1 Flash, mô hình có điểm cao hơn mọi mô hình chạy vừa trong MacBook, tốn $0.15 mỗi triệu token đầu vào và $0.60 mỗi triệu token đầu ra ngoài giờ cao điểm trên API riêng của DeepSeek (gấp đôi vào giờ cao điểm). Qwen3.8 27B được niêm yết trên OpenRouter từ khoảng $0.035 mỗi triệu token đầu vào. Với dữ liệu cá nhân hoặc của khách hàng, hãy dùng một nhà cung cấp có máy chủ ở EU và có thỏa thuận xử lý dữ liệu thay vì API riêng của DeepSeek, vốn xử lý dữ liệu ở Trung Quốc.
4. Dùng gói lập trình giá cố định cho các mô hình mở. Gói của Z.ai GLM Coding Plan bắt đầu từ $18 một tháng và bao gồm GLM-5.3, đồng hạng nhất trong số các mô hình tải về được trên bảng xếp hạng mới, cùng GLM-5.3-Flash, và nó hoạt động trong Claude Code, Codex, OpenCode cùng các công cụ khác. Giảm 10% gói GLM Coding Plan qua liên kết tiếp thị của tôi. (Liên kết tiếp thị — xem phần tiết lộ ở đầu bài.) Nó không phải Opus 5.5, và bảng xếp hạng nói thẳng như vậy, nhưng nó tốn chưa đến một phần mười gói $200. Tôi đã so sánh nó với sản phẩm của MiniMax trong GLM-5.3-Flash vs MiniMax M3.
5. Dùng chiếc Mac bạn đã có. Nếu chiếc Mac hiện tại của bạn có 16 đến 32 GB, các mô hình cục bộ nhỏ xử lý miễn phí một khối lượng đáng ngạc nhiên trong số công việc hàng loạt ở Phần 11.
6. Định tuyến theo tác vụ. Thiết lập hợp với phần lớn mọi người: một mô hình cục bộ cho các việc riêng tư và hàng loạt, một gói rẻ hoặc mô hình mở tính theo token cho công việc hằng ngày, và quyền truy cập mô hình tiên phong cho 10% khó nhằn. Bài so sánh harness coding AI của tôi có năm thiết lập cụ thể ở các mức ngân sách khác nhau.
Hiện ảnh Chi phí hằng tháng của từng phương án tính bằng đô-la Mỹ, chưa gồm VAT. Chi phí trả theo token phụ thuộc vào mức bạn dùng; giá được kiểm tra ngày 28 tháng 10 năm 2026.
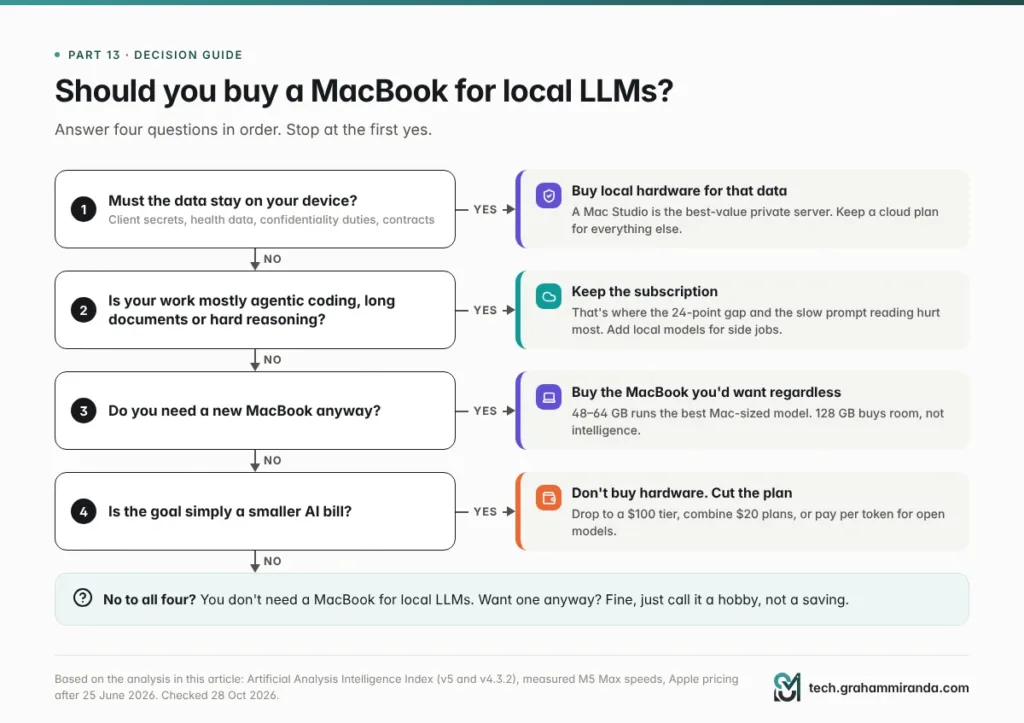
Phần 13 — Có nên mua MacBook để chạy LLM cục bộ? Hướng dẫn quyết định
Hiện ảnh Hãy bắt đầu từ trên cùng. Hầu hết các con đường đều kết thúc ở “giữ một gói đám mây”, và đó chính là điểm mấu chốt.
Hãy đi qua bốn câu hỏi theo thứ tự.
1. Dữ liệu có buộc phải ở lại trên thiết bị của bạn không? Nếu có, vì bảo mật thông tin khách hàng, dữ liệu sức khỏe hay một hợp đồng, hãy mua phần cứng cục bộ: yêu cầu đó không quan tâm đến benchmark. Cân nhắc một chiếc Mac Studio làm máy chủ riêng, và giữ một gói đám mây cho công việc không liên quan đến dữ liệu đó.
2. Công việc của bạn chủ yếu là lập trình tác nhân, tài liệu dài hay suy luận khó? Nếu đúng, hãy giữ gói đăng ký. Đó chính là chỗ khoảng cách 24 điểm và thời gian prefill gây khó chịu nhất. Một mô hình cục bộ vẫn có thể giúp cho các việc phụ.
3. Dù sao bạn có cần một chiếc MacBook mới không? Nếu có, hãy mua chiếc bạn vốn muốn. 48–64 GB chạy tốt mô hình tốt nhất cỡ Mac. Chỉ lên 128 GB nếu bạn đặc biệt muốn các mô hình cỡ 120B hoặc nhiều mô hình nạp cùng lúc, và biết rằng mình đang trả $2,000 cho chỗ trống, không phải cho trí tuệ.
4. Mục tiêu có đơn giản chỉ là một hóa đơn nhỏ hơn không? Vậy thì đừng mua phần cứng. Xuống một bậc, kết hợp các gói $20, hoặc trả theo token cho các mô hình mở (Phần 12).
Nếu bạn trả lời không cho cả bốn, bạn không cần một chiếc MacBook cho LLM cục bộ. Bạn vẫn có thể muốn một chiếc, và điều đó không sao. Chỉ cần gọi đó là sở thích, không phải một khoản tiết kiệm.
Phần 14 — Nếu bạn vẫn mua: làm sao tận dụng tối đa
Chọn đúng chiếc máy.
- Mua bản 16 inch, không phải 14 inch, nếu M5 Max dành cho công việc AI liên tục.
- Hãy cân nhắc một chiếc Mac Studio thay thế. Cùng chip và bộ nhớ với giá rẻ hơn $2,200, tản nhiệt tốt hơn, và nó có thể phục vụ laptop cùng điện thoại của bạn suốt ngày đêm.
- Đừng mua thừa bộ nhớ cho các mô hình hôm nay. 48–64 GB chạy Qwen3.8 27B ở 8-bit với ngữ cảnh dài. Mua 128 GB cho các mô hình cỡ 120B, nhiều mô hình cùng lúc hoặc dư địa cho các bản phát hành tương lai, với hiểu biết về cái giá của nó.
- Nếu bạn định mua trong tuần này, hãy chờ sau sự kiện tối nay. Bạn sẽ biết chiếc MacBook Pro OLED có gì và giá bao nhiêu trước khi quyết định.
Thiết lập cho đàng hoàng.
- Bắt đầu với LM Studio (MLX trên Apple Silicon) để có con đường dễ nhất, hoặc Ollama nếu bạn muốn một API duy nhất cho mô hình cục bộ và đám mây.
- Ưu tiên 8-bit cho bất cứ thứ gì bạn sẽ dựa vào; dùng 4-bit để chat nhanh hơn.
- Đặt độ dài ngữ cảnh một cách có chủ đích. Nhiều runtime mặc định ngữ cảnh nhỏ; các tác nhân cần nhiều hơn thế.
- Chỉ nâng giới hạn bộ nhớ GPU nếu bạn hiểu sự đánh đổi, và để chỗ cho macOS.
- Giữ một gói đám mây $20 cho 10% khó nhằn. Nó rẻ hơn thời gian của chính bạn.
Hãy thử nó trên chính công việc của bạn. Lấy 20 prompt thật từ tháng vừa qua: email, tài liệu, tác vụ lập trình, bất cứ thứ gì bạn thực sự làm. Chạy từng prompt qua mô hình cục bộ và mô hình đám mây của bạn, che đi đâu là cái nào, rồi chấm điểm. Hãy làm bằng ngôn ngữ bạn làm việc. Một giờ đó sẽ cho bạn biết nhiều hơn mọi bảng xếp hạng, kể cả những bảng trong bài này.
Câu hỏi thường gặp
MacBook có thể thay thế gói đăng ký ChatGPT Pro hay Claude Max không?
Không phải ở chất lượng. Những mô hình đứng sau gói $200, như Claude Opus 5.5 và GPT-6 Astra, không thể tải về, còn những mô hình mở tốt nhất có thể tải về cần 375–460 GB bộ nhớ ở 4-bit, vượt xa mọi MacBook. Trên bảng xếp hạng của Artificial Analysis, Opus 5.5 đạt 58; mô hình mạnh nhất tôi tìm được vừa với MacBook 128 GB là Qwen3.8 27B đạt 34 trên cùng phiên bản. MacBook có thể thay thế một gói đăng ký cho công việc riêng tư, ngoại tuyến hoặc hàng loạt, nhưng không cho các tác vụ tiên tiến nhất.
LLM cục bộ tốt nhất cho MacBook Pro 128 GB năm 2026 là gì?
Về chất lượng, Qwen3.8 27B: Artificial Analysis xếp nó đứng đầu trong 141 mô hình tương đương, với 34 điểm trên Intelligence Index v4.3.2, và nó vừa thoải mái ở 8-bit. Về tốc độ, gpt-oss-120b và Qwen3.5 122B là các mô hình mixture-of-experts, viết 55–88 token mỗi giây trên M5 Max, nhưng điểm thấp hơn (12 và 16). Hãy kiểm tra Artificial Analysis trước khi chọn, vì các mô hình mở mới thay đổi thứ hạng này vài tuần một lần.
MacBook Pro 128 GB giờ có giá bao nhiêu?
Một chiếc MacBook Pro 16 inch với M5 Max (CPU 18 nhân, GPU 40 nhân), 128 GB và 2 TB có giá $6,999 tại Mỹ, chưa gồm thuế bán hàng. Apple đã tăng giá Mac vào ngày 25 tháng 6 năm 2026 và nhân đôi giá nâng cấp 128 GB từ $1,000 lên $2,000. Ở Đức, cấu hình tương tự có giá €6,249 khi ra mắt và theo ước tính của tôi hiện khoảng €8,199. Một chiếc Mac Studio với cùng chip và bộ nhớ có giá $4,799.
Mua MacBook bao lâu thì hoàn vốn so với gói đăng ký AI 200 USD?
Khoảng 35 tháng với $6,999, nếu nó thay thế hoàn toàn gói đăng ký và không tốn gì để chạy. Với khoảng $10 tiền điện mỗi tháng thì là khoảng 37 tháng, và nếu bạn vẫn giữ một gói $20 cho các tác vụ tiên tiến thì khoảng 41 tháng. So với gói $100 thì hơn sáu năm. Một chiếc Mac Studio cùng chip hoà vốn sớm hơn, sau khoảng 25 đến 28 tháng.
M5 Max có đủ nhanh cho LLM cục bộ không?
Với việc viết câu trả lời bằng các mô hình mixture-of-experts, thì có: đo bằng MLX, một chiếc M5 Max với 128 GB tạo ra 55–88 token mỗi giây, gần với 98 của Claude Opus 5.5 trên API của Anthropic. Đọc prompt dài là điểm yếu. Một prompt 32.000 token mất 13 giây với gpt-oss-120b, 31 giây với Qwen3.5 122B và 55 giây với một mô hình dense 27B, trong khi các tác nhân lập trình AI đọc lại prompt dài liên tục.
LLM cục bộ giờ có tốt ngang ChatGPT hay Claude không?
Không phải những mô hình vừa với laptop. Trên Intelligence Index v5 mới của Artificial Analysis, công bố ngày 27 tháng 10 năm 2026, những mô hình mở tải về được tốt nhất đạt 32 so với 58 của Claude Opus 5.5, và thấp hơn Claude Haiku 5.5 với 36. Những mô hình đủ nhỏ cho MacBook đạt tối đa 34 trên phiên bản trước của chỉ số này, nơi Opus 5.5 cũng đạt 58. Với các tác vụ ngắn, đơn giản, khác biệt thường nhỏ; với lập trình dạng tác nhân, tài liệu dài và suy luận khó, khác biệt rất lớn.
Lượng tử hóa có làm mô hình cục bộ kém đi không?
Một chút ở 8-bit, nhiều hơn ở 4-bit, rất nhiều ở mức thấp hơn. Một nghiên cứu với hơn 500.000 lượt đánh giá cho thấy FP8 gần như không mất mát và lượng tử hoá chỉ trọng số 4-bit gần bằng 8-bit trên các benchmark tiêu chuẩn. Nhưng với đầu vào từ 64.000 token trở lên, một nghiên cứu EMNLP 2025 đo được mức giảm tới 59% ở 4-bit, tệ hơn với văn bản không phải tiếng Anh, và ở 3 bit điểm toán của một mô hình suy luận giảm từ 85,6% xuống 47,0%.
Tôi có thể chạy DeepSeek V4.1 Flash hay GLM-5.3 trên MacBook không?
Không. GLM-5.3 có 753 tỷ tham số và DeepSeek V4.1 Flash có 763 tỷ, tính cả bộ nhớ Engram, nên ngay cả ở 4-bit chúng cần khoảng 375–460 GB, nhiều hơn hẳn mức tối đa 128 GB của mọi MacBook. Một chiếc Mac Studio với M5 Ultra và 512 GB thì có thể chứa được. Cách thực tế để dùng chúng là qua API, lý tưởng nhất là nhà cung cấp có máy chủ tại EU và có thoả thuận xử lý dữ liệu.
64 GB có đủ cho AI cục bộ không, hay tôi cần 128 GB?
Với hầu hết mọi người, 48–64 GB là đủ. Mô hình cỡ Mac tốt nhất trên bảng xếp hạng của Artificial Analysis, Qwen3.8 27B, vừa ở 8-bit với chỗ trống cho ngữ cảnh dài. 128 GB cho phép bạn chạy các mô hình cỡ 120B như gpt-oss-120b, giữ nhiều mô hình cùng lúc và dùng ngữ cảnh dài hơn, nhưng trên bảng xếp hạng hiện nay những mô hình lớn hơn đó lại điểm thấp hơn, nên khoản nâng cấp $2,000 mua chỗ trống chứ không mua trí tuệ.
Tôi có nên mua Mac Studio thay vì MacBook Pro để chạy LLM cục bộ không?
Nếu AI cục bộ là lý do chính, thường thì nên. Một chiếc Mac Studio với cùng M5 Max và 128 GB có giá $4,799, rẻ hơn $2,200 so với MacBook Pro 16 inch, tản nhiệt bền bỉ hơn và không phải lo về pin. Nó có thể chạy suốt ngày đêm như một máy chủ mô hình riêng cho laptop và điện thoại của bạn. Hãy mua MacBook Pro nếu bạn cần tính di động vì lý do khác.
Chạy AI cục bộ có tốt hơn cho quyền riêng tư và GDPR không?
Có, đó là ưu điểm mạnh nhất của nó. Với mô hình cục bộ, prompt và tài liệu không bao giờ rời khỏi thiết bị của bạn, nên không cần ký thoả thuận xử lý dữ liệu và không có chuyển dữ liệu quốc tế. Điều đó quan trọng với dữ liệu khách hàng, thông tin sức khoẻ và những ngành nghề bị ràng buộc bởi bí mật, như các đối tượng thuộc § 203 StGB ở Đức. Lợi ích về quyền riêng tư vẫn đúng dù mô hình cục bộ có giỏi bằng mô hình đám mây hay không. Đây không phải là tư vấn pháp lý.
Tôi có thể dùng Claude Code với một mô hình cục bộ không?
Được. Ollama cung cấp API tương thích với Anthropic, nên bạn có thể trỏ Claude Code vào một mô hình cục bộ bằng cách đặt ANTHROPIC_BASE_URL thành http://localhost:11434. Hãy chuẩn bị cho những đánh đổi: Ollama không hỗ trợ các điều khiển bộ nhớ đệm prompt của Anthropic, prompt hệ thống dài và các định nghĩa công cụ của Claude Code khiến mô hình cục bộ phải đọc rất nhiều ở mỗi bước, và Claude Code được tinh chỉnh cho các mô hình Claude. Những harness mở như OpenCode thường phù hợp hơn với mô hình cục bộ.
MacBook Pro OLED mới có thay đổi được gì trong chuyện này không?
Có lẽ không nhiều cho AI cục bộ. Sự kiện “Pro and Tell” của Apple diễn ra lúc 10:00 giờ Thái Bình Dương ngày 28 tháng 10 năm 2026, và chiếc MacBook Pro màn hình cảm ứng OLED được mong đợi ở đó được cho là dùng cùng chip M5 Pro và M5 Max, tức vẫn giữ mức trần 128 GB và băng thông 614 GB/s. Chiếc MacBook Pro 14 inch với M6 công bố ngày 27 tháng 10 chỉ đạt tối đa 32 GB.
Điểm mấu chốt
Lập luận “huỷ gói $200 và mua một chiếc Mac” đúng ở hai điểm: các gói đăng ký thì đắt, và AI cục bộ thực sự hữu ích. Nó sai ở điều quan trọng nhất. Một gói $200 cho bạn thuê những mô hình tốt nhất thế giới, các tác nhân được xây quanh chúng và một sản phẩm cải thiện mỗi tháng. Một chiếc MacBook $7,000 chỉ chạy những mô hình tốt nhất vừa với 128 GB, và hiện nay chúng đạt 34 so với 58 của nhóm tiên tiến nhất, đọc prompt dài chậm và mất chất lượng đúng ở những chỗ bạn sẽ phải nén chúng mạnh nhất.
Phép tính cũng không cứu được lập luận này. Ngay cả trong trường hợp hào phóng nhất, chiếc MacBook mất ba đến bốn năm mới hoà vốn, và trong ba năm nó tốn kém chỉ cách gói đăng ký vài nghìn đô la, tuỳ vào giá bạn bán lại được. Đó là hoá đơn tương đương cho một sản phẩm kém năng lực hơn.
Vậy hãy mua MacBook để chạy LLM cục bộ nếu dữ liệu của bạn không thể ra khỏi toà nhà, nếu bạn làm việc ngoại tuyến, nếu bạn muốn không giới hạn và một mô hình không bao giờ thay đổi, hoặc nếu dù sao bạn cũng định mua một chiếc Mac. Đó là những lý do chính đáng, và nhiều người có chúng. Chỉ đừng mua nó để huỷ gói đăng ký của bạn. Hãy giữ một gói đám mây cho 10% khó nhằn, đặt 90% riêng tư và nhàm chán lên phần cứng của bạn, và để bảng xếp hạng cho bạn biết khi nào cán cân đó thay đổi.
Bạn đang chạy mô hình cục bộ cho công việc, hay thấy điều ngược lại với bài viết này? Tôi muốn biết bạn dùng mô hình nào, máy nào và cho tác vụ nào, kèm con số nếu có. Rất hoan nghênh các chỉnh sửa và bằng chứng ngược lại; bài viết này được cập nhật khi bảng xếp hạng và giá thay đổi, mà năm 2026 thì điều đó diễn ra thường xuyên.
Đã kiểm chứng: 28 tháng 10 năm 2026.