
 Tiếng Việt
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 ไทย
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

Sáu tuần trước, tôi đã viết bài này theo cách khác.
Tháng 7, Moonshot AI đưa 2,8 nghìn tỷ tham số của một mô hình đẳng cấp biên giới lên Hugging Face và để bất kỳ ai tải về. Ngày 28 tháng 8, Z.ai cuối cùng phát hành trọng số GLM-5.3 mà họ đã giữ suốt hai tuần — sau khi phát hiện mô hình của chính mình có thể nối các khai thác lỗ hổng theo những cách không ai yêu cầu. Và ngày 1 tháng 9, Anthropic tung ra Claude Fable 5.1, làm công việc tác nhân rẻ hơn tới 45% mà không động đến mức giá niêm yết.
Ba mô hình. Ba câu trả lời hoàn toàn khác nhau cho câu hỏi một phòng thí nghiệm AI nợ công chúng điều gì. Và lần đầu tiên kể từ khi mọi chuyện bắt đầu, các lựa chọn trọng số mở không còn là phương án thỏa hiệp.
Đó mới là câu chuyện thật của cuối năm 2026, và nó đáng khoảng tám nghìn chữ, vì các chi tiết là nơi chứa toàn bộ tiền bạc và toàn bộ sai lầm.
Tôi đã kéo về các bài báo kiến trúc, model card, văn bản giấy phép — đọc tử tế, từng dòng một, vì hai trong ba mô hình không đúng như cách người ta vẫn gọi — rồi benchmark của nhà cung cấp, điểm của các bên tổng hợp trung lập, mức giá thật trên mỗi token, và bảng giá mới tinh của Ollama. Sau đó tôi tính chi phí cho một tháng làm việc bình thường thay vì kịch bản ngày ra mắt.
Đây là kết quả.
Tóm tắt nhanh — Kết luận trong 60 giây
GLM-5.3 hiện là lựa chọn đáng tiền nhất trong làng AI, và khoảng cách không hề sát nút. Artificial Analysis chấm nó kém Kimi K3 nửa điểm và kém Claude Opus 5 khoảng ba điểm rưỡi, với giá $1,40 đầu vào và $4,40 đầu ra mỗi triệu token. Với cùng một tác vụ tác nhân, chi phí chỉ khoảng một phần sáu so với Fable 5.1. Trọng số thì tải được. Nếu bạn cần một mô hình để trỏ tác nhân của mình vào và bạn không điều hành một doanh nghiệp doanh thu 10 tỷ đô, thì đây chính là nó.
Kimi K3 là thứ mạnh nhất bạn có thể tải về một cách hợp pháp. 2,8 nghìn tỷ tham số, 104 tỷ tham số hoạt động, cửa sổ ngữ cảnh 1M thật sự, thị giác gốc, điểm duyệt web tác nhân tốt nhất từng được công bố (BrowseComp 91.2), và — con số đáng lẽ phải kết thúc lập luận “mô hình mở đi sau” — 88,3 trên Terminal-Bench 2.1, so với 88,0 của Claude Fable 5 và 88,8 của GPT-5.6 Sol trên cùng phiên bản. Nó cũng có giá $3/$15 — hơn gấp đôi GLM-5.3 — và 1,5 TB trọng số của nó cần cả một giá rack, không phải một máy trạm. Đây là mô hình bạn dùng khi tác vụ khó và dài, và là mô hình bạn dẫn ra khi có người nói trọng số mở đi sau một thế hệ.
Claude Fable 5.1 vẫn là mô hình bạn chọn khi sai sót phải trả giá đắt. Nó dẫn đầu ở kiểu công việc tác nhân kéo dài nhiều giờ và ở những màn gỡ lỗi lộn xộn hiếm khi hiện rõ trên bảng xếp hạng. Anthropic đã cắt giá đọc bộ đệm 75% vào ngày 1 tháng 9, khiến các phiên tác nhân dài rẻ đi rõ rệt so với trước. Nhưng giá mỗi tác vụ cũng gấp sáu lần GLM-5.3, mô hình đóng, và giờ còn mang các hạn chế chống chưng cất làm hỏng một số tích hợp hiện có.
Tóm gọn một cách thẳng thắn: các mô hình trọng số mở đã thu hẹp khoảng cách năng lực xuống còn khoảng ba đến năm tháng, và chúng đã xóa sổ khoảng cách giá. Thứ bạn thực sự mua từ Anthropic vào tháng 9 năm 2026 là độ tin cậy trên 10% công việc khó nhất — và quyền không phải nghĩ về bất kỳ điều gì trong số này.
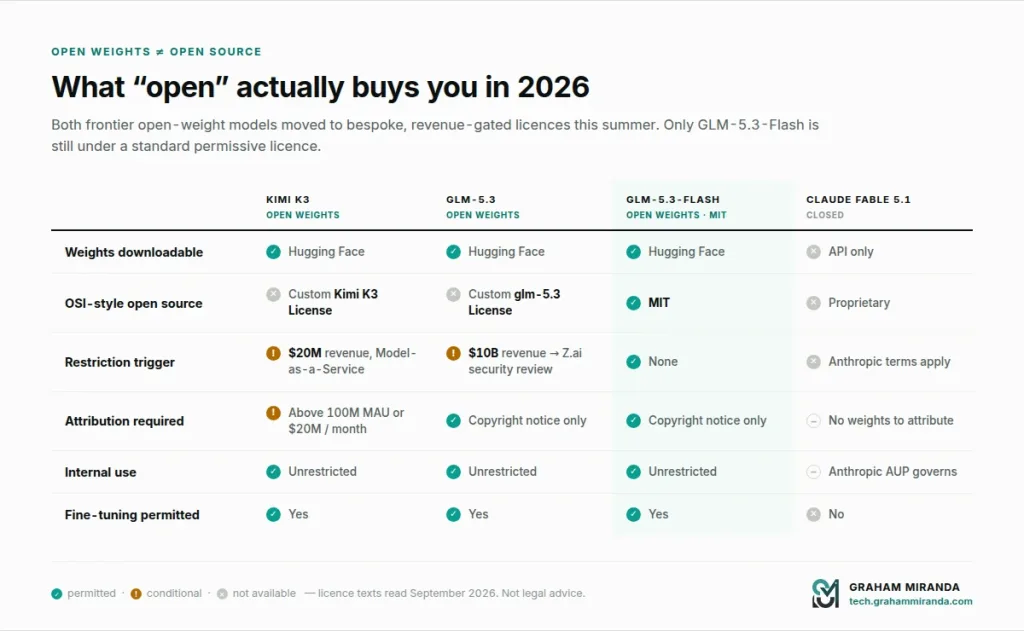
Và cú twist chẳng ai muốn nói to: cả Kimi K3 lẫn GLM-5.3 đều không còn phát hành dưới giấy phép mã nguồn mở. Cả hai đã chuyển sang điều khoản riêng, gắn với mức doanh thu trong mùa hè này. Trọng số mở thì có. Mã nguồn mở thì không. Hãy đọc phần về giấy phép trước cả đội pháp chế của bạn.
Bảng so sánh nhanh
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Nhà phát triển | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| Phát hành | 16 tháng 7 năm 2026 (API) · 27 tháng 7 (trọng số) | 14 tháng 8 năm 2026 (API) · 28 tháng 8 (trọng số) | 1 tháng 9 năm 2026 |
| Có sẵn trọng số | Có | Có | Không |
| Giấy phép | Giấy phép Kimi K3 (riêng, gắn với doanh thu) | Giấy phép glm-5.3 (riêng, gắn với doanh thu) | Độc quyền |
| Tổng số tham số | 2.8T | 753B | Không công bố |
| Tham số hoạt động mỗi token | 104B (16 trên 896 chuyên gia) | ~40B (ước tính) | Không công bố |
| Kiến trúc | KDA + Attention Residuals, Stable LatentMoE, 69 lớp KDA + 24 lớp Gated MLA | MoE, cùng nền với GLM-5.2, chỉ cải thiện nhờ huấn luyện sau | Không công bố |
| Cửa sổ ngữ cảnh | 1,048,576 | 1,000,000 | 1,000,000 |
| Đầu ra tối đa | mặc định 131.072 (tới 1.048.576) | 128,000 | 128,000 |
| Đầu vào đa phương thức | Văn bản, hình ảnh, video (MoonViT-V2) | Chỉ văn bản | Văn bản, hình ảnh |
| Suy nghĩ | Luôn bật | Luôn bật, reasoning_effort low/high/max | Luôn bật, thích ứng, mức nỗ lực theo từng tin nhắn (beta) |
| Giá đầu vào / 1M | $3.00 | $1.40 | $10.00 |
| Đầu vào đã lưu đệm / 1M | $0.30 | $0.26 | $0.25 |
| Giá đầu ra / 1M | $15.00 | $4.40 | $50.00 |
| Chỉ số trí tuệ AA | 59.7 | 59.5 | Chưa được chấm (Fable 5: 62,1) |
| Chi phí mỗi tác vụ đánh giá AA | $0.84 | $0.68 | — (Opus 5: $2,34) |
| Dấu chân tự lưu trữ | ~1,5 TB (MXFP4 gốc) | ~1,5 TB BF16 / ~750 GB FP8 | N/A |
| Trên Ollama | kimi-k3:cloud | glm-5.3:cloud | Qua Claude Code / Claude Desktop như một client |
Mọi mức giá đều là giá niêm yết của chính nhà cung cấp. Số liệu của Artificial Analysis lấy từ bản chụp chỉ số tháng 9 năm 2026; Fable 5.1 ra mắt ngày 1 tháng 9 và chưa được chấm độc lập vào thời điểm viết bài.
Vì sao phép so sánh ba bên này mới là điều quan trọng
Suốt hai năm, cuộc tranh luận mở-so-với-đóng có một hình dạng dễ chịu: mô hình đóng tốt hơn, mô hình mở rẻ hơn, và bạn chọn điểm đứng của mình trên cái đánh đổi đó. Ai cũng biết mình đang ở đâu.
Hình dạng đó vỡ tan trong mùa hè này.
Nathan Lambert, người theo dõi chuyện này kỹ hơn gần như tất cả mọi người, đặt khoảng cách năng lực hiện tại giữa mô hình trọng số mở biên giới và mô hình đóng biên giới ở mức ba đến năm tháng — giảm từ mức sáu đến chín tháng mà người ta vẫn trích dẫn một năm trước. Vào lúc ông ấy viết, Kimi K3 đứng thứ 2 trên chỉ số Vals AI và gần đỉnh bảng của Artificial Analysis, chỉ kém Claude Fable và GPT-5.6 Sol Max. Bản chụp chỉ số tháng 9 mà tôi dùng ở phần sau bài này xếp nó thứ tư, sau Grok 4.6. Dù thế nào: đó không phải là “tốt đối với một mô hình mở.” Đó là một suất trên bục.
Trong khi đó, dữ liệu sử dụng đã đi tới một nơi thực sự đáng ngạc nhiên. Các mô hình gốc Trung Quốc chiếm khoảng 61% tổng số token được định tuyến qua OpenRouter vào tháng 5 năm 2026. Tỷ trọng của Mỹ trong lưu lượng đó sụp từ khoảng 70% xuống khoảng 30% trong mười hai tháng. Llama của Meta — mô hình khởi đầu làn sóng trọng số mở — rơi xuống dưới 1% khối lượng được định tuyến. Tỷ trọng của Google đi từ khoảng 37% xuống 13%. Nghiên cứu 100 nghìn tỷ token của chính OpenRouter với a16z cho thấy mô hình trọng số mở chiếm khoảng một phần ba tổng khối lượng token trên nền tảng.
Bạn có thể tranh luận lưu lượng OpenRouter đại diện cho điều gì. Nó nghiêng quá nhiều về lập trình viên, người chơi và các tác vụ nhạy cảm về chi phí, đồng thời đếm thiếu các hợp đồng doanh nghiệp không bao giờ đi qua router. Được thôi. Nhưng đó là bộ dữ liệu công khai lớn nhất mà chúng ta có về việc người ta thực sự chọn gì khi được chọn tự do, và hướng đi thì không thể nhầm lẫn.
Vậy nên câu hỏi của tháng 9 năm 2026 không còn là “liệu mô hình mở đã đủ tốt chưa.” Nó sắc hơn nhiều:
Với ba mô hình đều vượt ngưỡng, bạn trỏ tác nhân của mình vào cái nào — và việc chọn sai thực sự khiến bạn tốn bao nhiêu?
Đó là câu hỏi về benchmark, giá, giấy phép và hạ tầng, theo đúng thứ tự mức độ người ta nghĩ về chúng và đúng thứ tự ngược lại với mức độ chúng quan trọng.
Kimi K3 thực sự là gì
Moonshot AI công bố Kimi K3 ngày 16 tháng 7 năm 2026 và phát hành toàn bộ trọng số ngày 27 tháng 7. Xét theo số tham số, đây là mô hình trọng số mở lớn nhất từng được công bố — tổng cộng 2,8 nghìn tỷ tham số, lớn hơn DeepSeek V4 Pro khoảng 75%.
Con số đó kém ấn tượng hơn nó nghe và cũng ấn tượng hơn nó nghe, theo đúng thứ tự đó.
Kiến trúc, nói theo cách dễ hiểu
Kimi K3 là mô hình hỗn hợp chuyên gia, kích hoạt 104 tỷ tham số mỗi token, chọn 16 chuyên gia từ một nhóm 896. Vậy dù tổng cộng là 2,8T, mỗi lượt lan truyền xuôi chỉ chạm dưới 4% trọng số. Đó là nguồn gốc của bài toán kinh tế: kho kiến thức khổng lồ, chi phí suy luận vừa phải.
Phần kỹ thuật đáng chú ý nằm ở chồng attention. K3 dùng 93 lớp, gồm 69 lớp KDA (Kimi Delta Attention) và 24 lớp Gated MLA — thiết kế attention lai giữa tuyến tính và đầy đủ với tỷ lệ xen kẽ khoảng 3:1. KDA là một biến thể attention tuyến tính chạy trong thời gian tuyến tính theo độ dài chuỗi thay vì bậc hai, và chính điều đó khiến cửa sổ ngữ cảnh 1M khả thi về mặt kinh tế chứ không chỉ để quảng cáo. Moonshot báo cáo mức giảm tới 75% bộ đệm KV và tăng tới 6 lần thông lượng giải mã ở ngữ cảnh 1M nhờ đó.
Bên trên còn có Attention Residuals (AttnRes), mà Moonshot mô tả là thứ thay thế trực tiếp cho các kết nối residual tiêu chuẩn, cùng một Stable LatentMoE khung định tuyến. Sự kết hợp này được cho là mang lại mức cải thiện hiệu quả mở rộng tổng thể 2,5 lần so với Kimi K2.
Phần thị giác đến từ MoonViT-V2, một bộ mã hóa 401M tham số, và nó là gốc chứ không phải gắn thêm — K3 xử lý văn bản, hình ảnh và video trong cùng một mô hình.
Một chi tiết nữa quan trọng với ai đang cân nhắc tự lưu trữ: K3 được huấn luyện với huấn luyện nhận biết lượng tử hóa MXFP4 gốc, với các chuyên gia ở MXFP4 và activations ở MXFP8. Đây không phải lượng tử hóa làm sau. Checkpoint được phát hành chính là mô hình đã lượng tử hóa, và đó là lý do 2,8 nghìn tỷ tham số chỉ chiếm khoảng 1,5 TB trên đĩa thay vì khoảng 5,6 TB mà một checkpoint BF16 cỡ đó sẽ cần.
Câu chuyện benchmark
Các con số Moonshot công bố đều mạnh trên mọi mặt, và điều bất thường là một số đã trụ vững qua đánh giá độc lập:
- Terminal-Bench 2.1: 88,3 — điểm cao nhất từng công bố trên phiên bản đó của benchmark
- FrontierSWE: 81,2
- DeepSWE: 67,5
- BrowseComp: 91,2 — mức tốt nhất hiện nay cho nghiên cứu web bằng tác nhân
- GPQA Diamond: 93,5
- MMMU-Pro: 81,6 / 83,4 (thị giác)
- SWE Marathon: 91,0
- OfficeQA Pro: 81,3
- AutomationBench: 30,8
- LMArena Frontend Code Arena: 1.679 Elo — vị trí thứ nhất, vượt qua Claude Fable 5 (1.631) và GPT-5.6 Sol (1.618), thắng sáu trong bảy lĩnh vực frontend
Điều cuối cùng đó đáng để dừng lại một chút. Một mô hình trọng số mở mà bạn có thể tải miễn phí đã giành vị trí đầu trên một đấu trường lập trình frontend do con người bình chọn, vượt qua các mô hình đóng hàng đầu của hai phòng thí nghiệm được đầu tư mạnh nhất thế giới. Dù bạn nghĩ gì về benchmark đấu trường như một phương pháp đánh giá, đó vẫn là một tiêu đề mà năm 2025 không ai dám nghĩ tới.
Trên các chỉ số tổng hợp, nó đứng thấp hơn một chút: 59,7 trên Intelligence Index của Artificial Analysis, đứng thứ ba chung cuộc, sau Claude Opus 5 (63,0) và Claude Fable 5 (62,1). Những con số tự công bố của Moonshot’ — GDPval-AA v2 đạt 1.687 và AA-Briefcase đạt 1.527 — lần lượt đưa nó lên thứ ba và thứ hai trong các đánh giá công việc tri thức đó. Trên Vals Index v2, nó đạt 57.8%, so với 67,2% của Claude Opus 5, 66,0% của Claude Fable 5 và 63,7% của GPT-5.6 Sol — khoảng cách giữa mở và đóng lớn nhất trong mọi chỉ số tôi tìm được, và đáng để ghi nhớ bên cạnh các con số về lập trình.
Các bản demo và cách đọc chúng
Moonshot công bố hai bản demo tự chủ dài hạn thu hút rất nhiều chú ý: một lần chạy tự chủ 48 giờ hoàn thành toàn bộ quy trình thiết kế chip (một thiết kế 4mm đạt timing ở 100 MHz, mô phỏng ở hơn 8.700 token/giây), và một bản tái tạo quan hệ vật lý thiên văn I-Love-Q trong khoảng hai giờ, so với một đến hai tuần mà một nhà nghiên cứu kỳ cựu thường cần.
Những bản demo này thực sự ấn tượng và tôi sẽ không dựa vào chúng để ra quyết định mua. Các bản demo do nhà cung cấp chạy, do nhà cung cấp dựng khung, do nhà cung cấp chọn lọc, cho bạn biết mô hình làm được gì vào một ngày đẹp trời với sự giám sát của chuyên gia, chứ không phải nó làm gì trong kho mã của bạn vào một ngày thứ Ba. Hãy coi chúng là bằng chứng cho thấy năng lực dài hạn tồn tại, không phải một bản đặc tả.
Hiện ảnh Hai kiến trúc được công bố và một hộp đen. Các mô hình mở cho bạn biết chính xác chúng hoạt động ra sao; mô hình đóng chỉ cho bạn biết nó đạt bao nhiêu điểm.
GLM-5.3 thực sự là gì
GLM-5.3 có câu chuyện phát hành kỳ lạ nhất trong ba mô hình, và đây là câu chuyện đáng được kể cho đàng hoàng, vì đây là lần đầu một phòng thí nghiệm lớn do dự rõ rệt trước việc công bố trọng số vì lý do không phải thương mại.
Z.ai công bố GLM-5.3 vào ngày 14 tháng 8 năm 2026 với khẩu hiệu “Built to Code. Ready for Cyber Defense.” Mô hình là một hỗn hợp chuyên gia 753 tỷ tham số, với khoảng 40 tỷ tham số hoạt động mỗi token theo ước tính của cộng đồng dựa trên cấu hình GLM-5.2. Nó có cửa sổ ngữ cảnh 1M token và đầu ra tối đa 128K, và — khác với GLM-5.3-Flash, một mô hình hoàn toàn khác — nó chỉ xử lý văn bản.
“Mở rộng hậu huấn luyện là tất cả những gì chúng tôi làm”
Sự thật kỹ thuật thú vị nhất về GLM-5.3 là không có mô hình nền mới. Nó dùng lại đúng nền tảng đã huấn luyện trước như GLM-5.2. Mọi mức tăng đều đến từ hậu huấn luyện được mở rộng mạnh mẽ, mà Z.ai tóm tắt là: “Mở rộng hậu huấn luyện là tất cả những gì chúng tôi làm cho GLM-5.3.”
Mức chênh không hề nhỏ:
| Benchmark | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Mức cải thiện gấp sáu lần trên Terminal-Bench và bước nhảy hai mươi điểm trên DeepSWE, từ cùng một bộ trọng số nền, là một kết quả thực sự quan trọng. Nó cho thấy biên giới vẫn còn nhiều dư địa trong hậu huấn luyện, phần rẻ hơn nhiều so với nửa còn lại của hóa đơn huấn luyện. Đó chính là lý do các phòng thí nghiệm Trung Quốc, những nơi hoạt động với — như Lambert nói — “ít vốn hơn nhiều bậc độ lớn” so với các phòng thí nghiệm Mỹ, vẫn bám sát được.
Hai tuần Z.ai không phát hành
Z.ai nói khi ra mắt rằng trọng số sẽ được phát hành tiếp “theo từng giai đoạn sau các đánh giá an toàn nghiêm ngặt”, với mục tiêu khoảng hai tuần. Kho Hugging Face của họ ghi ngày 28 tháng 8. Ngày đó đến, trôi qua vài giờ, rồi trọng số xuất hiện cùng một bài viết kỹ thuật giải thích sự chậm trễ.
Lý do là năng lực không gian mạng. Trong quá trình đánh giá, Z.ai báo cáo rằng GLM-5.3 đã phát hiện 2.436 lỗ hổng trong 269 dự án mã nguồn mở, trong đó 1.097 lỗ hổng được xếp mức nghiêm trọng hoặc cao. Đáng chú ý hơn, mô hình đã thể hiện suy luận chuỗi khai thác nhiều giai đoạn — tự động nối các bước khai thác lại với nhau — hành vi mà Z.ai mô tả là “không hoàn toàn nằm trong dự tính” và “tiếp tục tích lũy khi quy mô huấn luyện tăng.”
Tôi muốn thận trọng ở đây, vì điều này dễ bị đọc thành tiếp thị hoặc báo động, và có lẽ không phải cả hai. Một mô hình giỏi tìm lỗ hổng thì giỏi tìm lỗ hổng; mục đích phòng thủ và tấn công chỉ là cùng một năng lực hướng theo hai phía khác nhau. Mức chênh benchmark của Z.ai’ phản ánh điều đó một cách trung thực: CyberGym 84,5% (phát hiện lỗ hổng, nơi nó dẫn đầu) so với ExploitBench 54,4% (khai thác, nơi Claude Fable 5 đạt 78,0%). Phòng thí nghiệm đã cố ý tối ưu cho nửa phòng thủ và điều đó thể hiện rõ.
Điều thực sự đáng chú ý là một phòng thí nghiệm đã giữ một bản phát hành chủ lực lại hai tuần và công bố lý do. Dù bạn thấy lý do đó có thuyết phục hay không, tiền lệ này là mới.
GLM-5.3 thực sự đứng ở đâu
Biểu đồ so sánh do Z.ai’ công bố không tuyên bố thắng áp đảo, và điều đó thật dễ chịu:
| Benchmark | GLM-5.3 | Đối thủ so sánh tốt nhất |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3 dẫn đầu |
| CyberGym | 84.5% | GLM-5.3 dẫn đầu |
| GDPval-AA v2 | 1,769 | GLM-5.3 dẫn đầu |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34,6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72,7% |
| ExploitBench | 54.4% | Claude Fable 5: 78,0% |
| Code Bench (50K token) | 31.4% | — |
Đánh giá độc lập, Artificial Analysis xếp nó ở 59,5 trên Intelligence Index — không thể phân biệt về mặt thống kê so với 59,7 của Kimi K3, mà lại đến từ một mô hình chỉ bằng khoảng một phần tư số tham số.
Một lưu ý từ chính đánh giá đó mà không ai trong phần tiếp thị nhắc đến: GLM-5.3 đã tạo ra 170 triệu token đầu ra trong bộ đánh giá Artificial Analysis, so với mức trung vị 72 triệu của cùng phân khúc. Nó nói dài. reasoning_effort mặc định là tối đa và không thể tắt suy nghĩ, nên bạn phải trả cho rất nhiều lần cân nhắc dù tác vụ có xứng đáng hay không. Dẫu vậy, tổng chi phí chạy toàn bộ đánh giá là $0,68 mỗi tác vụ, so với $0,84 cho Kimi K3 và $2,34 cho Claude Opus 5 — nên việc nói dài không xóa bỏ lợi thế về giá. Nó chỉ thu hẹp lại.
Claude Fable 5.1 thực sự là gì
Anthropic phát hành Claude Fable 5.1 vào 1 tháng 9 năm 2026, cùng với Claude Mythos 5.1 — cùng mô hình nhưng cấu hình biện pháp bảo vệ khác, chỉ có được qua các chương trình truy cập tin cậy dành cho công việc an ninh mạng và khoa học sự sống.
Định vị rất cụ thể và, tôi nghĩ, đúng: đây là “một mô hình được xây dựng cho công việc không kết thúc trong một prompt.” Anthropic không tuyên bố một bước nhảy vọt về trí tuệ tổng quát. Họ tuyên bố rằng các phiên tác nhân kéo dài nhiều giờ sẽ chạy tốt hơn.
Những con số
| Benchmark | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (một phần) | 72.9% | 77.9% | — |
| Humanity’s Last Exam (có công cụ) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Để có bối cảnh bên ngoài trên cùng thước đo: GPT-5.6 Sol đạt 52,3% trên Terminal-Bench 4.0, nên 55,8% của Fable 5.1 dẫn đầu và 60,9% của Mythos 5.1 nới rộng khoảng cách.
Bước nhảy Terminal-Bench-Science — từ 24,7% lên 52,6%, đúng gấp đôi — là con số tôi sẽ cân nặng nhất nếu công việc của bạn liên quan đến tính toán khoa học hoặc pipeline dữ liệu. Và trên benchmark sử dụng máy tính khó nhất của Browserbase, Fable 5.1 hoàn thành 82% tác vụ, so với 74% của Claude Opus 5.
Anthropic cũng báo cáo khoảng mức giảm 60% dương tính giả về an toàn không gian mạng — việc mô hình từ chối công việc bảo mật chính đáng vì khớp mẫu với thứ gì đó nguy hiểm. Nếu bạn từng gặp trợ lý lập trình từ chối giúp viết bộ giới hạn tốc độ, bạn sẽ hiểu vì sao điều đó quan trọng.
Thay đổi về giá mới là tin thật sự
Giá niêm yết không đổi: $10 mỗi triệu token đầu vào, $50 mỗi triệu token đầu ra. Cái thay đổi là hệ số đọc bộ nhớ đệm, và nó thay đổi rất nhiều.
| Fable 5 | Fable 5.1 | |
|---|---|---|
| Đầu vào | $10.00 | $10.00 |
| Đầu ra | $50.00 | $50.00 |
| Ghi bộ nhớ đệm (5 phút) | $12.50 | $12.50 |
| Ghi bộ nhớ đệm (1 giờ) | $20.00 | $20.00 |
| Đọc bộ đệm | $1.00 | $0.25 |
Đó là mức giảm 75%, đạt được bằng cách đưa hệ số đọc bộ nhớ đệm từ mức chuẩn 0,1× giá đầu vào cơ bản xuống 0,025×. Anthropic nói khoảng rẻ hơn 25% cho khối lượng công việc điển hình và rẻ hơn tới 45% cho công việc tác nhân chuyên sâu — và con số thứ hai là thật, vì vòng lặp tác nhân chủ yếu là đọc bộ nhớ đệm. Một phiên tác nhân 60 lượt đọc lại cùng ngữ cảnh tích lũy hàng chục lần. Batch API còn giảm một nửa giá đầu vào và đầu ra, xuống còn $5/$25.
Đây là một đợt giảm giá thông minh và có chủ đích. Nó làm cho đúng thứ Fable 5.1 giỏi nhất — các phiên dài — rẻ đi đáng kể mà không làm mất giá trị mô hình nói chung.
Ba thay đổi phá vỡ tương thích, một thoái bộ
Trước khi nâng cấp một tích hợp đang chạy thật, hãy đọc kỹ những điều này.
1. Buộc dùng công cụ đã bị bỏ. Các yêu cầu dùng tool_choice: "any" hoặc tool_choice: "tool" giờ trả về lỗi 400. Suy nghĩ luôn bật và không thể bỏ qua, và việc buộc gọi công cụ sẽ bỏ qua bước đó. Bạn phải dùng tool_choice: "auto".
2. Các khối suy nghĩ chỉ đi một chiều. Fable 5.1 có thể đọc các khối suy nghĩ do những mô hình Claude trước tạo ra, nhưng các mô hình trước không đọc được khối của Fable 5.1. Chỉ Mythos 5.1 làm được. Nếu kiến trúc của bạn chuyển mô hình giữa cuộc trò chuyện để tiết kiệm chi phí, phương án dự phòng đó giờ buộc phải lập lại kế hoạch.
3. Sửa lịch sử làm mất hiệu lực các khối suy nghĩ. Với các tài khoản tạo sau ngày 31 tháng 8 năm 2026, việc sửa các lượt trước, prompt hệ thống hoặc mảng công cụ sẽ làm mất hiệu lực mọi khối suy nghĩ sau đó — lỗi hoặc bị bỏ âm thầm. Đây là biện pháp chống chưng cất rõ ràng và nó phá vỡ một mẫu phổ biến trong đó các framework tác nhân viết lại ngữ cảnh giữa các lượt.
Và một thoái bộ đáng biết: gọi công cụ song song được báo cáo là biến thiên hơn ở 5.1, đôi khi chỉ phát một lệnh mỗi lượt trong khi bản 5 gộp nhiều lệnh. Trên một vòng lặp tác nhân dài, điều đó tốn thời gian thực.
Còn một chi tiết về tokenizer khiến nhiều người sai khi so sánh chi phí: Fable 5.1 dùng cùng tokenizer với Claude Opus 4.7, vốn tạo ra khoảng nhiều token hơn 30% so với tokenizer trong các mô hình Claude cũ với cùng một đoạn văn bản. Nếu bạn đang đo chi phí so với mốc 2025, hãy điều chỉnh điều đó trước khi kết luận bất cứ điều gì.
Vấn đề benchmark: ba mô hình, ba thước đo khác nhau
Đây là phần mà hầu hết các bài so sánh làm sai, và đáng nói thẳng.
Bạn không thể so ba mô hình này trên Terminal-Bench. Hãy xem:
- Kimi K3: 88.3 trên Terminal-Bench 2.1
- GLM-5.3: 28.3 trên Terminal-Bench 3.0
- Fable 5.1: 55.8 trên Terminal-Bench 4.0
Đó là ba benchmark khác nhau chỉ chung một cái tên. Mỗi phiên bản khó hơn đáng kể so với phiên bản trước — đó chính là mục đích của việc phát hành phiên bản mới. Đọc ba con số đó như một bảng xếp hạng sẽ cho bạn biết Kimi K3 giỏi gấp ba lần GLM-5.3 trong công việc terminal, điều hoàn toàn vô lý.
Vấn đề tương tự cũng áp dụng cho AutomationBench, nơi số phiên bản được báo cáo không nhất quán, và cho họ SWE-bench, nơi các biến thể Verified, Pro và Marathon đo những thứ thực sự khác nhau. Các phòng thí nghiệm không làm vậy để lừa ai — họ chạy bản đánh giá đang có khi họ huấn luyện, và các bản đánh giá giờ thay đổi vài tháng một lần. Nhưng tác động lên một người đọc bình thường thì giống hệt sự lừa dối, nên đáng được nêu to rõ.
Những gì bạn có thể so sánh hợp lý, trong cùng một phiên bản:
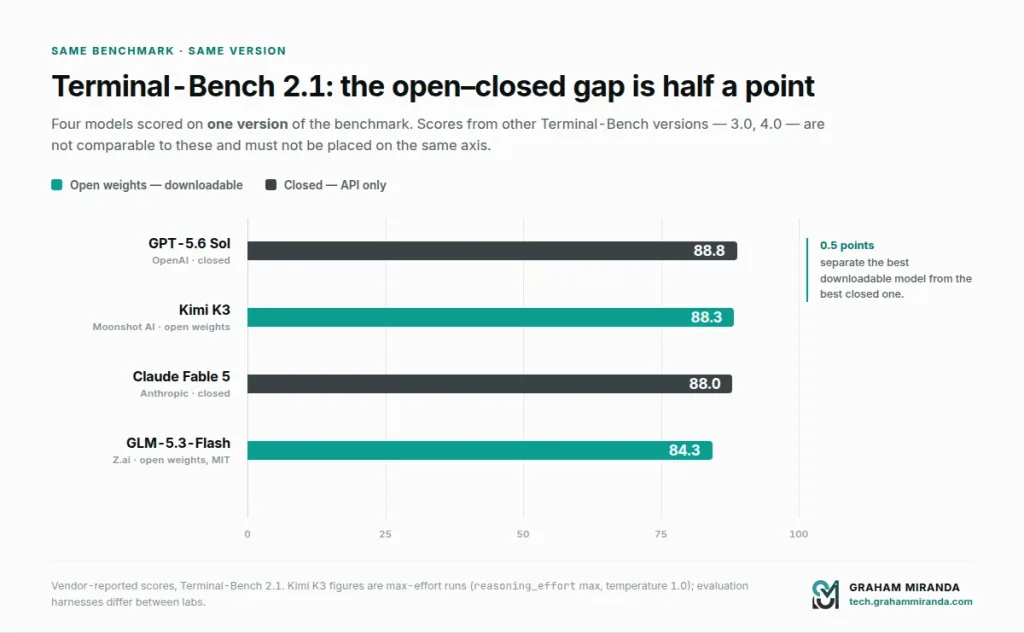
Bật Terminal-Bench 2.1: Kimi K3 (88,3), GPT-5.6 Sol (88,8), Claude Fable 5 (88,0) và GLM-5.3-Flash (84,3). Bốn mô hình, một thước đo. Đây là phép so sánh thực sự quan trọng và tôi đã dành cho nó một bảng riêng ở phần tiếp theo.
Bật Terminal-Bench 4.0: Fable 5.1 (55,8) so với GPT-5.6 Sol (52,3). Fable thắng.
Ngoài ra, hãy hoài nghi bất kỳ ai cho bạn xem một biểu đồ cột duy nhất với cả ba mô hình chủ đề của bài này trên trục Terminal-Bench. Không thể làm điều đó một cách trung thực.
Nơi chúng thực sự gặp nhau: những con số so sánh chéo được
Loại bỏ những chỗ lệch phiên bản benchmark và ba phép so sánh vẫn đứng vững.
1. Intelligence Index của Artificial Analysis (tháng 9 năm 2026)
Chạy độc lập, cùng phương pháp cho mọi mô hình, không có sự tham gia của nhà cung cấp trong việc chọn mẫu.
| Hạng | Mô hình | Điểm | Trọng số mở |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | Không |
| 2 | Claude Fable 5 | 62.1 | Không |
| 3 | Grok 4.6 | 60.9 | Không |
| 4 | Kimi K3 | 59.7 | Có |
| 5 | GLM-5.3 | 59.5 | Có |
| 6 | GPT-5.6 Sol | 58.9 | Không |
| 7 | Qwen3.8 Max Preview | 58.1 | Trọng số chưa phát hành |
| 8 | GLM-5.3-Flash | 57.5 | Có (MIT) |
| 31 | MiniMax M3 | 45.4 | Có |
Fable 5.1 chưa được chấm điểm độc lập vào thời điểm viết bài — nó ra mắt một ngày trước đó. Với mức chênh benchmark của 5.1 so với Fable 5, có thể kỳ vọng nó đạt 62,1 hoặc cao hơn khi được chấm.
Một lưu ý về độ chính xác: các bản chụp khác nhau của chỉ số này làm tròn khác nhau — một lần lấy dữ liệu tháng 9 cho Kimi K3 và GLM-5.3 cùng 60 và GPT-5.6 Sol 61. Thứ tự ở nhóm đầu thì ổn định; các khoảng cách dưới một điểm thì không. Đừng xây dựng lập luận trên nửa điểm.
Hãy đọc bảng đó cẩn thận. Mô hình trọng số mở tốt nhất kém mô hình đóng tốt nhất 3,3 điểm trên chỉ số trung lập rộng nhất hiện có. Một năm trước, khoảng cách đó là hai chữ số.
2. Terminal-Bench 2.1 — phiên bản duy nhất có ba mô hình gặp nhau
Đây là bảng hữu ích nhất trong bài, và tôi suýt bỏ qua nó. Kimi K3, Claude Fable 5 và GPT-5.6 Sol đều được chấm trên cùng một phiên bản của Terminal-Bench:
| Mô hình | Terminal-Bench 2.1 | Trọng số mở |
|---|---|---|
| GPT-5.6 Sol | 88.8 | Không |
| Kimi K3 | 88.3 | Có |
| Claude Fable 5 | 88.0 | Không |
| GLM-5.3-Flash | 84.3 | Có (MIT) |
Nửa điểm là khoảng cách giữa một mô hình bạn có thể tải về và mô hình đóng tốt nhất trên cùng benchmark, cùng phiên bản, trong công việc tác nhân thuần terminal.
Đó là con số cần nhớ. Không phải chỉ số tổng hợp, không phải biểu đồ nhà cung cấp — mà là con số này. Với đúng dạng tác vụ mà lập trình tác nhân thực sự là, khoảng cách nằm trong nhiễu.
Một lưu ý do chính nguồn nêu ra và đáng nhắc lại: tất cả số liệu công bố của Kimi K3’ đều là các lần chạy ở mức nỗ lực tối đa, với reasoning_effort maximum và temperature 1.0. Các phòng thí nghiệm khác nhau dùng harness đánh giá và thiết lập nỗ lực khác nhau, nên ngay cả so sánh cùng phiên bản cũng mang nhiều bất định hơn một bảng gọn gàng gợi ra.
3. Chi phí chạy cùng một bộ đánh giá
Nếu bảng trên là so sánh năng lực tốt nhất, thì đây là so sánh giá trị tốt nhất — vì đây là con số duy nhất gộp năng lực, độ dài, chi phí suy luận và giá vào một số duy nhất:
| Mô hình | Chi phí mỗi tác vụ Intelligence Index |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
Cùng tác vụ, cùng cách chấm, hóa đơn thật. GLM-5.3 đạt 94% điểm chỉ số của Opus 5 với 29% chi phí.
4. GDPval-AA v2 (công việc tri thức)
| Mô hình | Điểm |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
Bảng này cần lưu ý: nó được ghép từ các biểu đồ do nhà cung cấp công bố chứ không phải một lần chạy độc lập, và hậu tố “Max” chỉ các thiết lập nỗ lực khác nhau. Nhưng thứ tự nhìn chung nhất quán giữa các nguồn, và nó nói lên điều thật — trong công việc tri thức tổng quát, khác với lập trình, các mô hình đóng vẫn giữ lợi thế rõ hơn so với điều các benchmark lập trình gợi ra.
Đó là mẫu hình xuyên suốt cả ba phép so sánh. Các mô hình mở về cơ bản đã đuổi kịp ở mảng lập trình và tác vụ tác nhân. Chúng vẫn chậm một bước trong công việc tri thức rộng. Nếu khối lượng công việc của bạn thuộc loại trước, lý lẽ trả giá mô hình đóng là yếu. Nếu thuộc loại sau, nó vẫn còn hợp lý.
Hiện ảnh Ba điểm lẻ vài phần mười là khoảng cách giữa mô hình đóng tốt nhất và mô hình tải về được tốt nhất. Mười hai tháng trước, khoảng cách đó là hai chữ số.
Bài toán chi phí, với con số thật
Benchmark thì trừu tượng. Hóa đơn thì không.
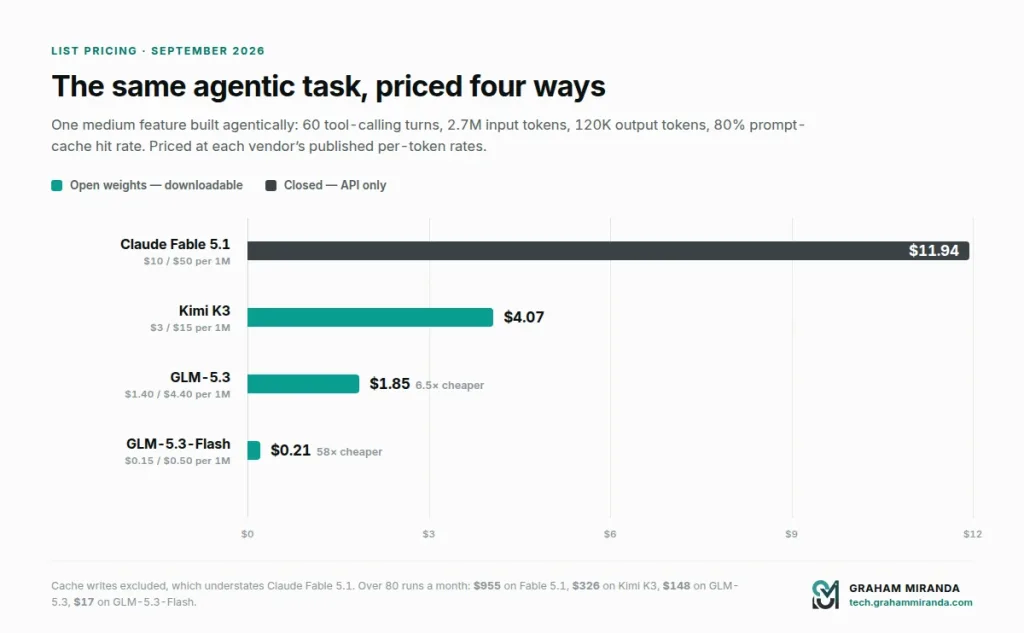
Kịch bản
Một tính năng cỡ trung, làm theo kiểu tác nhân: khoảng 60 lượt gọi công cụ, trung bình 45.000 token đầu vào mỗi lượt khi ngữ cảnh tích lũy, và 2.000 token đầu ra mỗi lượt.
- Tổng đầu vào: 2,7M token
- Tổng đầu ra: 120K token
- Tỷ lệ trúng bộ đệm prompt giả định: 80% (2,16M đã lưu đệm, 540K mới)
Claude Fable 5.1
| Thành phần | Token | Mức giá | Chi phí |
|---|---|---|---|
| Đầu vào mới | 540K | $10.00/M | $5.40 |
| Đầu vào đã lưu đệm | 2,16M | $0.25/M | $0.54 |
| Đầu ra | 120K | $50.00/M | $6.00 |
| Tổng | ≈ $11,94 |
Kimi K3
| Thành phần | Token | Mức giá | Chi phí |
|---|---|---|---|
| Đầu vào mới | 540K | $3.00/M | $1.62 |
| Đầu vào đã lưu đệm | 2,16M | $0.30/M | $0.65 |
| Đầu ra | 120K | $15.00/M | $1.80 |
| Tổng | ≈ $4,07 |
GLM-5.3
| Thành phần | Token | Mức giá | Chi phí |
|---|---|---|---|
| Đầu vào mới | 540K | $1.40/M | $0.76 |
| Đầu vào đã lưu đệm | 2,16M | $0.26/M | $0.56 |
| Đầu ra | 120K | $4.40/M | $0.53 |
| Tổng | ≈ $1,85 |
Và để tham chiếu — GLM-5.3-Flash
| Thành phần | Token | Mức giá | Chi phí |
|---|---|---|---|
| Đầu vào mới | 540K | $0.15/M | $0.08 |
| Đầu vào đã lưu đệm | 2,16M | $0.03/M | $0.06 |
| Đầu ra | 120K | $0.50/M | $0.06 |
| Tổng | ≈ $0,21 |
Các tỷ lệ
- GLM-5.3 rẻ hơn Fable 5.1 6,5 lần cho cùng một công việc
- Kimi K3 rẻ hơn Fable 5.1 2,9 lần
- GLM-5.3 rẻ hơn Kimi K3 2,2 lần
- GLM-5.3-Flash rẻ hơn Fable 5.1 58 lần, với 57,5 trên intelligence index so với 62,1 của Fable 5
Quy ra một tháng làm việc
Bốn tác vụ như vậy mỗi ngày, hai mươi ngày làm việc — 80 lượt chạy tác nhân:
| Mô hình | Chi phí token hàng tháng |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
Ba lưu ý trung thực về những con số này
Chưa tính phần ghi bộ nhớ đệm. Fable 5.1 tính $12,50/M cho mỗi lần ghi bộ nhớ đệm 5 phút, và một phiên dài sẽ ghi bộ nhớ đệm lặp đi lặp lại. Nếu tính cả phần ghi, con số thực của Fable’s sẽ tăng lên chứ không giảm. Tỷ lệ trúng 80% cũng là con số lạc quan với các phiên ngắn.
Token suy luận được tính như token đầu ra. Cả ba mô hình đều bật chế độ suy nghĩ liên tục. GLM-5.3 đặc biệt được ghi nhận là dài dòng — 170M token đầu ra so với mức trung vị 72M của cùng nhóm trên toàn bộ bộ kiểm thử AA — nên khối lượng đầu ra thực tế của nó cao hơn những gì một phép đếm lượt đơn giản gợi ra. Con số $0,68 mỗi tác vụ đã tính đến điều này, đó là lý do tôi tin nó hơn cả mô hình của chính mình ở trên.
Bộ tách token của Fable 5.1’s tạo ra nhiều hơn khoảng 30% token so với các mô hình Claude cũ hơn với cùng một đoạn văn bản. Nếu bạn đang so với hóa đơn Claude trước đây, hãy điều chỉnh.
Kể cả sau cả ba lần điều chỉnh, thứ tự vẫn không đổi và độ lớn gần như không đổi. Tính trên mỗi tác vụ hoàn thành, công việc với mô hình tiên phong đóng tốn khoảng gấp sáu lần mô hình trọng số mở tốt nhất.
Hiện ảnh Cùng một tác vụ tác nhân 60 lượt theo giá niêm yết của từng nhà cung cấp. Trục tung chính là toàn bộ lý lẽ dành cho trọng số mở.
Giấy phép: “Mở” thực sự mang lại gì cho bạn trong năm 2026
Đây là phần tôi muốn mọi người đọc nhất, vì cách dùng từ đã trôi dạt đến mức tệ hại và nó sẽ khiến ai đó mất rất nhiều tiền.
Cả Kimi K3 lẫn GLM-5.3 đều không phải mã nguồn mở. Cả hai đều công bố trọng số có thể tải xuống theo những giấy phép riêng với các điều kiện kích hoạt bởi doanh thu. Đó là một thứ khác biệt có ý nghĩa so với MIT hay Apache 2.0, và sự khác biệt đó nhắm thẳng vào kiểu doanh nghiệp được hưởng lợi nhiều nhất từ việc tự lưu trữ.
Giấy phép Kimi K3
Bạn sẽ thấy “Modified MIT” được nhắc đi nhắc lại khắp internet khi nói về K3. Điều đó sai — cụm từ đó mô tả K2. K3 được phát hành theo một văn bản tùy chỉnh với hai cửa chặn riêng biệt:
Cửa chặn Model-as-a-Service. Nếu bạn cung cấp cho bên thứ ba quyền truy cập vào suy luận hoặc tinh chỉnh mô hình — khi bên thứ ba đó kiểm soát đầu vào, tham số hoặc dữ liệu huấn luyện — và “tổng doanh thu của Bên được cấp phép cùng các bên liên kết vượt 20 triệu đô la Mỹ” trong bất kỳ 12 tháng liên tiếp nào, bạn phải đàm phán một thỏa thuận thương mại riêng với Moonshot. Lưu ý tổng doanh thu, tính trên toàn bộ các bên liên kết, không phải phần doanh thu quy cho K3. Một công ty tư vấn doanh thu €25M mà bán lại suy luận là vượt ngưỡng, kể cả khi mảng AI chỉ là một con số làm tròn.
Cửa chặn ghi nguồn. Sản phẩm vượt 100 triệu người dùng hoạt động hàng tháng hoặc 20 triệu đô la doanh thu hàng tháng phải hiển thị “Kimi K3” nổi bật trong giao diện sản phẩm.
Điều khoản miễn trừ quan trọng nhất: sử dụng thuần túy nội bộ là không bị hạn chế. Chạy K3 để hỗ trợ lập trình viên, nhà nghiên cứu, đội pháp chế hay năng suất chung của nhân viên đều không kích hoạt cửa chặn nào. Với đại đa số doanh nghiệp — gần như toàn bộ khách hàng của tôi — đó là điều khoản liên quan, và câu trả lời là bạn không sao cả.
Điều khoản mới so với K2 là cửa chặn MaaS 20 triệu đô. K2 chỉ yêu cầu ghi nguồn khi vượt ngưỡng. K3 thêm một ngưỡng doanh thu thấp hơn nhiều, nhắm cụ thể vào các bên bán lại suy luận thương mại. Moonshot không cố ngăn bạn dùng mô hình; họ cố ngăn các nhà cung cấp đám mây xây dựng doanh nghiệp trên đó miễn phí.
Giấy phép glm-5.3
Mô hình chủ lực của Z.ai’s đi theo hướng khác, và đó là sự phá lệ lớn hơn nhiều bài viết đã thừa nhận.
GLM-5.2 phát hành theo MIT. GLM-5.3-Flash phát hành theo MIT. GLM-5.3 thì không.
Giấy phép tùy chỉnh cho phép cá nhân và doanh nghiệp thông thường chạy, triển khai và tinh chỉnh mô hình mà không có thêm hạn chế nào. Cửa chặn duy nhất nhắm vào các hãng siêu quy mô: một pháp nhân có “tổng doanh thu của Bên được cấp phép và các bên liên kết vượt 10 tỷ đô la Mỹ (hoặc giá trị tương đương bằng ngoại tệ khác) trong bất kỳ 12 tháng liên tiếp nào” phải phải vượt qua đánh giá bảo mật của Z.AI’s trước khi dùng mô hình hoặc các sản phẩm phái sinh cho bất kỳ mục đích thương mại nào.
Đó là ngưỡng 10 tỷ đô la. Nó loại trừ gần như tất cả mọi người. Nhưng hai chi tiết trong phần chữ nhỏ đáng để ý:
Thứ nhất, giấy phép loại trừ rõ ràng các nhà phát triển ứng dụng nhúng mô hình vào tính năng, và các bên bán lại chỉ chuyển tiếp yêu cầu đến máy chủ khác. Mục tiêu hẹp và được dán nhãn rõ ràng: những công ty muốn máy chủ GLM-5.3 ở quy mô lớn cho mục đích thương mại.
Thứ hai — và đây là phần thực sự khó xử — giấy phép không công bố tiêu chí, mốc thời gian hay quy trình khiếu nại nào cho lần đánh giá bảo mật đó. Văn bản chỉ nói rằng “phạm vi và phương pháp… sẽ do Z.AI quyết định một cách hợp lý.” Nếu bạn là một doanh nghiệp lớn, đó là sự phụ thuộc không giới hạn vào quyền tự quyết của vendor’s nước ngoài, và đội mua sắm của bạn sẽ nói đúng như vậy.
Cũng đáng lưu ý: dù có hai tuần trì hoãn vì lo ngại năng lực tấn công mạng trước khi phát hành, giấy phép không có hạn chế về mục đích sử dụng được phép, không có ngoại lệ nào về tấn công mạng và không có tuyên bố sở hữu đầu ra. Lo ngại về an toàn đã định hình thời điểm phát hành, chứ không phải điều khoản phát hành.
Vậy thực sự còn gì vẫn theo MIT?
GLM-5.3-Flash. 320B tham số, 18B hoạt động, đa phương thức gốc, giấy phép MIT, 57,5 trên chỉ số trí tuệ, và $0,15/$0,50 mỗi triệu token — hiện chỉ bằng một nửa mức đó nhờ giảm giá khuyến mại kéo dài đến 9 tháng 9 năm 2026. Nếu yêu cầu của bạn là giấy phép thực sự mở, không hạn chế, chứ không chỉ là trọng số tải xuống được, thì đó là nơi biên giới hiện đang dừng lại, và nó cao một cách đáng kinh ngạc.
Tóm tắt thực dụng
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Trọng số có thể tải xuống | Có | Có | Có | Không |
| Mã nguồn mở kiểu OSI | Không | Không | Có (MIT) | Không |
| Điều kiện kích hoạt hạn chế | Doanh thu 20 triệu đô (MaaS) | Doanh thu 10 tỷ đô (MaaS) | Không có | N/A |
| Bắt buộc ghi nguồn | Trên 100 triệu MAU / 20 triệu đô mỗi tháng | Chỉ cần thông báo bản quyền | Chỉ cần thông báo bản quyền | N/A |
| Hạn chế sử dụng nội bộ | Không | Không | Không | N/A |
| Được phép tinh chỉnh | Có | Có | Có | Không |
| Chính sách sử dụng được phép | Tiêu chuẩn | Không có trong văn bản giấy phép | Không có | Áp dụng AUP của Anthropic |
Với một doanh nghiệp Mittelstand Đức điển hình, một agency, hay một công ty tư vấn chạy mô hình nội bộ hoặc nhúng chúng vào sản phẩm: cả ba lựa chọn mở đều dùng được mà không cần đàm phán gì. Các cửa chặn tồn tại để bắt AWS, không phải bạn. Nhưng “hãy đọc giấy phép” đã từ lời khuyên sáo rỗng thành lời khuyên thật sự, và nếu bạn có doanh thu trên khoảng €20M và bán lại suy luận dưới bất kỳ hình thức nào, hãy đưa nó cho luật sư xem trước khi triển khai.
Lý lẽ thực sự cho các mô hình mở
Tôi muốn trình bày lý lẽ này một cách đàng hoàng chứ không phải như một khẩu hiệu, vì “mô hình mở rất tuyệt” không phải là lý lẽ và những lý do thực sự thú vị hơn việc cổ vũ.
1. Giá sụt không phải là trợ cấp, đó là yếu tố cấu trúc
Phản đối bản năng với các mô hình Trung Quốc giá rẻ là giá đó bán lỗ để giành thị phần và rồi sẽ trở về bình thường. Một phần chắc chắn là vậy. Nhưng luận điểm cấu trúc vẫn đứng vững độc lập: khi trọng số được công khai, suy luận trở thành một thị trường hàng hóa phổ thông. Hai mươi nhà cung cấp lưu trữ cạnh tranh để phục vụ cùng một mô hình, và không ai có thể thu thêm phí năng lực vì không ai có hào bảo vệ năng lực. Đó là lý do GLM-5.3 chạy ở mức $1,40/$4,40 còn Fable 5.1 chạy ở mức $10/$50 dù điểm số chỉ cách nhau ba điểm.
Giá mô hình đóng bao gồm khấu hao R&D, biên lợi nhuận, và việc chỉ có đúng một người bán. Giá trọng số mở bao gồm điện, khấu hao phần cứng và biên lợi nhuận mỏng. Đó là hai kiểu kinh doanh khác nhau, và khoảng cách sẽ không thu hẹp bằng cách mô hình mở trở nên đắt hơn.
Bằng chứng cho thấy điều này là thật chứ không tạm thời: DeepSeek chiếm khoảng 17% lượng token sử dụng trên Vercel tính đến tháng 5 năm 2026 trong khi chỉ nắm khoảng 1% thị phần doanh thu. Đó không phải là bất thường về giá. Đó là hình dáng của quá trình hàng hóa hóa trên biểu đồ.
2. Quyền rút lui thay đổi vị thế đàm phán của bạn kể cả khi bạn không bao giờ dùng đến
Hầu hết các nhóm đọc bài này sẽ không tự lưu trữ. Phần phần cứng bên dưới giải thích lý do — Kimi K3 cần cả một rack. Nhưng lựa chọn đó vẫn có giá trị.
Nếu Anthropic tăng giá, ngừng hỗ trợ mô hình bạn đã xây dựng trên đó, thay đổi chính sách sử dụng được phép theo cách phá vỡ sản phẩm của bạn, hoặc có một quý tồi tệ, thì cách xử lý với mô hình đóng là một dự án di trú. Với mô hình trọng số mở, cách xử lý là tải về một tệp mà bạn có thể tải bất cứ lúc nào. Có thể bạn sẽ không bao giờ làm vậy. Nhưng việc bạn có thể làm điều đó chính là điều biến mối quan hệ với nhà cung cấp thành quan hệ thương mại chứ không phải sự phụ thuộc.
Điều này không phải lý thuyết. Fable 5.1 phát hành kèm ba thay đổi gây lỗi vào ngày 1 tháng 9, một trong số đó vô hiệu hóa các khối suy nghĩ khi bạn sửa lịch sử hội thoại với tài khoản tạo sau ngày 31 tháng 8. Nếu mô thức đó là trụ cột trong kiến trúc của bạn, bạn đang phải làm lại kỹ thuật theo lịch của Anthropic’s, không phải lịch của bạn.
3. Lưu trú dữ liệu không còn là một dự án
Với bất kỳ ai hoạt động theo GDPR, đây là lý lẽ thực sự chốt được hợp đồng.
Với API đóng, mọi prompt đều rời khỏi hạ tầng của bạn. Bạn cần một thỏa thuận bên xử lý dữ liệu, một đánh giá tác động chuyển dữ liệu nếu bên xử lý ở ngoài EEA, một bản đồ luồng dữ liệu, và một câu trả lời cho DPO của bạn về việc dữ liệu lưu trữ sẽ ra sao. Tất cả đều làm được. Nhưng cũng mất hàng tuần cho mỗi nhà cung cấp, lặp lại mỗi khi nhà cung cấp thay đổi bất cứ điều gì.
Với trọng số mở trên hạ tầng bạn kiểm soát — phần cứng của bạn, hoặc một nhà cung cấp GPU ở Đức hay EU — câu hỏi chuyển dữ liệu xuyên biên giới không nảy sinh, vì không có việc chuyển nào cả. Mô hình chạy ngay nơi dữ liệu của bạn vốn đã ở. Việc rà soát pháp lý chuyển từ đánh giá chuyển dữ liệu sang đọc giấy phép.
Với khách hàng Đức và EU, đây thường là yếu tố quyết định, và cần nói rõ một điều kiện kèm theo: dùng GLM-5.3 qua API của Z.ai’s không mang lại điều đó. Bạn có được điều đó khi tự chạy trọng số, hoặc từ một nhà cung cấp lưu trữ chúng trong phạm vi tài phán của bạn. Giấy phép làm điều đó hợp pháp; nó không khiến điều đó tự động xảy ra.
4. Khả năng kiểm tra là có thật, dù ít được dùng
Trọng số mở nghĩa là bạn có thể xem xét kiến trúc, tự chạy đánh giá trên chính mô hình thay vì trên một endpoint có thể bị cập nhật âm thầm, lượng tử hóa để vừa phần cứng của mình, tinh chỉnh nó trên lĩnh vực của bạn, và — quan trọng — ghim một phiên bản mãi mãi.
Điểm cuối thường bị đánh giá thấp. API đóng được cập nhật phía sau những ID mô hình ổn định. Hành vi trôi dạt dần. Những prompt từng hiệu quả bỗng ngừng hiệu quả, và bạn không thể diff thay đổi vì bạn không nhìn thấy nó. Một checkpoint cục bộ vẫn giống hệt từng byte sau một năm’s.
5. Áp lực cạnh tranh có lợi cho tất cả, kể cả người dùng mô hình đóng
Hãy nhìn những gì xảy ra mùa hè này. Kimi K3 ra mắt tháng Bảy với giá $3/$15 và điểm số sát ngưỡng tiên phong. GLM-5.3 ra mắt tháng Tám với giá $1,40/$4,40, chỉ kém nửa điểm. Và ngày 1 tháng 9, Anthropic giảm giá đọc bộ nhớ đệm 75%.
Tôi không khẳng định quan hệ nhân quả trực tiếp — Anthropic không công bố lý do định giá và việc giảm giá đọc bộ nhớ đệm là một tối ưu tự nhiên. Nhưng một thị trường có các lựa chọn thay thế rẻ đáng tin định giá khác với thị trường không có chúng, và năm nay các lựa chọn thay thế đã trở nên đáng tin. Nếu bạn chỉ dùng mô hình đóng, hệ sinh thái trọng số mở vẫn đang âm thầm làm hóa đơn của bạn nhỏ đi.
6. Lợi ích nằm ở hậu huấn luyện, và nó rẻ
Kết quả nổi bật của GLM-5.3’s — cải thiện Terminal-Bench gấp sáu lần từ cùng bộ trọng số gốc — là con số quan trọng nhất về chiến lược trong toàn bộ bài viết này, và nó không nói về GLM.
Nó nói rằng phần đắt đỏ khi xây một mô hình tiên phong (tiền huấn luyện) ngày càng là một đầu vào đã được giải quyết, đã hàng hóa hóa, còn phần tạo khác biệt (hậu huấn luyện, môi trường RL, thiết kế tác vụ dài hạn) thì tương đối rẻ. Đó là lý do bốn phòng thí nghiệm Trung Quốc với định giá tổng cộng khoảng 159 tỷ đô la vẫn bắt kịp các phòng thí nghiệm Mỹ được định giá gấp nhiều lần. Đánh giá của Lambert’s là các phòng thí nghiệm Trung Quốc đang chạy với “ít vốn hơn nhiều bậc độ lớn.”
Với bất kỳ ai ở phía sau, hàm ý rất rõ ràng: số nhà cung cấp mô hình đáng tin đang tăng lên, không giảm đi. Hãy lên kế hoạch kiến trúc của bạn cho phù hợp.
7. Hiệu ứng hệ sinh thái cộng dồn
Qwen đã vượt một tỷ lượt tải tích lũy trên Hugging Face, vượt qua Llama, và hiện là nền tảng cho hơn 200.000 mô hình được gắn thẻ và hơn 113.000 sản phẩm phái sinh — khoảng 40% tổng số sản phẩm phái sinh LLM mới trên nền tảng dựa trên Qwen. Đó là một hệ sinh thái công cụ, lượng tử hóa, tinh chỉnh và triển khai chỉ tồn tại vì trọng số được công khai.
Bạn hưởng lợi từ hệ sinh thái đó dù có đóng góp vào nó hay không. Chuyển đổi GGUF, kernel vLLM, adapter LoRA, công thức lượng tử hóa, harness đánh giá — tất cả tồn tại vì hàng nghìn người có thể tiếp cận chính bộ trọng số.
8. Đó là nơi các lập trình viên đã đến
Các mô hình gốc Trung Quốc chiếm ~61% lượng token trên OpenRouter. Thị phần mô hình Mỹ giảm từ ~70% xuống ~30% trong một năm. Bốn trong năm mô hình được dùng nhiều nhất trên router có gốc Trung Quốc. Riêng các mô hình MiMo của Xiaomi’s chiếm khoảng 21% lượng token được định tuyến và khoảng 22% tổng lưu lượng lập trình.
Hành vi lập trình viên là chỉ báo dẫn dắt. Nó từng là chỉ báo dẫn dắt với Docker, với Postgres, với Linux. Đặt cược chống lại nó có thành tích lịch sử kém.
…Và lý lẽ trung thực chống lại
Nếu tôi chỉ viết phần trên, bài này sẽ là một quảng cáo.
Trọng số mở không phải mã nguồn mở, và việc trôi dạt từ ngữ là một vấn đề thật. Hai trong ba mô hình ở đây phát hành theo giấy phép riêng có ngưỡng doanh thu, không có OSI phê chuẩn. Điều khoản đánh giá bảo mật của GLM-5.3’s không có tiêu chí hay quy trình khiếu nại nào được công bố. Nếu khung tuân thủ của bạn yêu cầu giấy phép được OSI phê chuẩn, câu trả lời trung thực là các lựa chọn của bạn gồm GLM-5.3-Flash, các mô hình chủ lực của DeepSeek’s theo giấy phép MIT, và một danh sách ngày càng ngắn những cái khác.
Benchmark của nhà cung cấp vẫn là benchmark của nhà cung cấp. Mọi con số nổi bật mà Moonshot và Z.ai công bố đều do họ tự báo cáo và tự chọn. Ở những nơi các bên tổng hợp trung lập đã đo, các con số nhìn chung vẫn đúng — điều đó thực sự là điểm cộng cho cả hai phòng thí nghiệm’ — nhưng “nhìn chung vẫn đúng” đang gánh cả trọng lượng trong câu đó.
Tự lưu trữ là ảo tưởng với hầu hết các nhóm. Kimi K3 nặng 1,5 TB và Moonshot khuyến nghị 64+ accelerator. GLM-5.3 cần tối thiểu 8×H200 ở FP8. Quyền rút lui là thật; chi phí thực hiện là một trung tâm dữ liệu.
Hỗ trợ là thứ bạn tự tạo ra. Khi Fable 5.1 hỏng, có một công ty với SLA. Khi bản triển khai GLM-5.3 tự lưu trữ của bạn tạo ra rác ở cửa sổ ngữ cảnh 300K vào tối thứ Sáu, thì chỉ có một issue trên GitHub và năng lực của chính bạn.
Địa chính trị là một yếu tố đầu vào thực sự trong mua sắm. Cả ba lựa chọn trọng số mở bàn ở đây đều đến từ các phòng thí nghiệm Trung Quốc. Với một số khách hàng — khu vực công, lĩnh vực gần quốc phòng, một số ngành được quản lý chặt — đó là rào cản cứng bất kể điều khoản giấy phép hay trọng số chạy ở đâu. Việc nói cho bạn biết lo ngại đó có căn cứ hay không không phải việc của tôi. Việc của tôi là nói rằng nó sẽ được nêu ra trong cuộc họp.
Các mô hình đóng vẫn dẫn đầu ở công việc tri thức tổng quát. GDPval-AA v2 cho Fable 5.1 đạt 1.853, so với 1.769 của GLM-5.3’s và 1.687 của Kimi K3’s. Ở lập trình, khoảng cách đã biến mất. Ở công việc tri thức chuyên môn rộng, thì chưa.
Hiện ảnh Trọng số tải được, nhưng ba bộ điều khoản khác nhau. Chỉ GLM-5.3-Flash còn giấy phép MIT.
Ollama năm 2026: thay đổi giá thực sự có ý nghĩa
Ollama đã âm thầm trở thành mảnh hạ tầng quan trọng nhất trong cuộc trò chuyện này, và vào ngày 31 tháng 8 năm 2026 nó đã thay đổi cách tính phí theo một cách đáng để hiểu cho đúng.
Những gì đã thay đổi
Ollama chuyển các gói Pro, Max và Team từ tính phí theo thời gian GPU sang cách tính giá theo token tiêu chuẩn ngành, với một lượng credit sử dụng có sẵn trong mỗi gói. Lý do công ty’s đưa ra cụ thể một cách sảng khoái: những mô hình như Kimi K3 khiến các chỉ số thời gian GPU không thể dự đoán. Khi một mô hình kích hoạt 104B tham số còn mô hình khác kích hoạt 3B, “một giờ GPU” chẳng còn nghĩa gì với người trả tiền.
Các gói mới
| Gói | Giá | Mức sử dụng hàng tháng bao gồm | Số yêu cầu đồng thời |
|---|---|---|---|
| Miễn phí | $0 | Credit hàng tháng nhỏ, các mô hình khởi đầu | 1 yêu cầu |
| Pro | $20/tháng (hoặc $200/năm) | $60 giá trị sử dụng | 3 yêu cầu |
| Max | $100/tháng | $300 giá trị sử dụng | 10 yêu cầu |
| Team | $500/tháng | $1.000 dùng chung, không giới hạn người dùng | 10 yêu cầu |
| Doanh nghiệp | Tùy chỉnh | Tùy chỉnh | Tùy chỉnh |
Đọc lại dòng Pro. $20 mua được $60 token. Đó là hệ số nhân 3× trên mức sử dụng bao gồm, và khi hết hạn mức bạn tiếp tục trả đúng mức giá theo token đã công bố — không có bậc phạt, không có phí dịch vụ.
Những gì đã bị bỏ
Đây là phần mà các lập trình viên thực sự để ý: không còn reset 5 giờ và không có giới hạn hàng tuần. Bất kỳ ai từng đụng phải cửa sổ sử dụng trượt giữa lúc đang refactor sẽ hiểu vì sao điều đó quan trọng hơn giá. Hạn mức hàng tháng được làm mới vào ngày đăng ký của bạn và, quan trọng là, không cộng dồn — vì vậy hãy chọn gói theo tháng bình thường của bạn, không phải tháng bận rộn nhất.
Những điều khoản quan trọng cho công việc ở EU
Ba cam kết trong thông báo có liên quan trực tiếp nếu bạn đang xử lý dữ liệu khách hàng:
- Không lưu giữ dữ liệu. Prompt và phản hồi không bao giờ bị ghi log và không bao giờ được dùng để huấn luyện.
- Lưu trữ tại Mỹ và châu Âu, cộng thêm Singapore cho một nhóm hạn chế các mô hình Qwen.
- Khả năng xem chi phí từng yêu cầu trong tài khoản của bạn — bạn có thể thấy chính xác mỗi lệnh gọi tốn bao nhiêu.
Với một công ty tư vấn Đức, đó là một câu chuyện tuân thủ tốt hơn đáng kể so với hầu hết nhà cung cấp gateway, dù “lưu trữ tại châu Âu” là một tuyên bố về định tuyến chứ không phải bảo đảm lưu trú dữ liệu mang tính hợp đồng. Nếu lưu trú dữ liệu là yêu cầu cứng chứ không chỉ là sở thích, hãy yêu cầu Ollama xác nhận bằng văn bản trước khi bạn mặc định điều đó.
Mức giá thực tế theo token
Đây là chỗ thú vị. Ollama công bố giá theo từng mô hình, và chúng bám sát giá của bên gốc:
| Mô hình trên Ollama | Đầu vào / 1M | Bộ nhớ đệm / 1M | Đầu ra / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
Hãy áp phép tính hàng tháng ở trên vào đây. Tám mươi lần chạy tác vụ tự động mỗi tháng trên GLM-5.3 tốn khoảng $148 tiền token. Một gói Max $100/tháng bao gồm $300 giá trị sử dụng — vì vậy cùng khối lượng công việc đó, nếu tốn khoảng $955/tháng trên Fable 5.1, lại nằm gọn trong một đăng ký Ollama $100 với dư địa thoải mái.
Đó là toàn bộ lập luận kinh tế của mô hình mở, nén lại thành một dòng trên hóa đơn.
Hiện ảnh Tám mươi lần chạy tác vụ tự động mỗi tháng trên GLM-5.3 nằm gọn trong gói Ollama Max $100 và còn dư. Cùng công việc đó trên Fable 5.1 là hóa đơn $955.
Những gì khác Ollama ra mắt trong năm 2026
Thay đổi giá không diễn ra đơn lẻ. Mấy tháng qua khá bận rộn:
- 25 tháng 8 — hỗ trợ Claude Desktop. Ollama giờ hoạt động như một nhà cung cấp gateway bên thứ ba cho Claude Desktop, nên bạn có thể điều khiển các mô hình mở qua chính client của Anthropic’s.
- 26 tháng 8 — v0.33.0. Tích hợp gateway Claude Desktop đã có mặt, tính năng khôi phục prefill được trả lại cho bộ nhớ đệm, và Ollama đã tắt thông báo hệ thống đếm ngược token của Claude Code’s, thứ vẫn làm mất hiệu lực bộ nhớ đệm KV sau mỗi lượt. Điểm cuối là một sửa lỗi hiệu năng âm thầm nhưng đáng kể.
- 26 tháng 8 — v0.33.1. Hỗ trợ MLX cho Qwen3.8 Flash Next, đầu ra có cấu trúc, và bản sửa lỗi timeout GPU khi tải mô hình từ lưu trữ chậm hơn.
- 28 tháng 8 — v0.33.2. Khôi phục chế độ tối, sửa handoff trên macOS, và giữ cho các yêu cầu proxy của Claude Desktop không bị ngắt trong khi danh mục mô hình cập nhật.
- 20 tháng 8 — v0.32.15. Onboarding mới trên desktop, và bộ nhớ đệm metadata giữa các yêu cầu giúp cắt thời gian đến token đầu tiên xuống còn khoảng một nửa.
- 11 tháng 8 — NVIDIA Nemotron 3.5 Lightning, một mô hình 30B được tinh chỉnh cho quy trình làm việc tác nhân với gọi công cụ trên phần cứng cá nhân.
- 10 tháng 8 — Muse Glimmer của Meta, một mô hình đa phương thức 30B theo Apache 2.0, được tăng tốc bởi engine MLX của Ollama. Đáng chú ý vì Llama đã sụp đổ về lượng sử dụng được định tuyến — Meta vẫn phát hành những trọng số thực sự cởi mở.
- 9 tháng 7 — vòng gọi vốn $88M, với việc Ollama báo cáo 8,9 triệu nhà phát triển.
- 29 tháng 6 — Gemma 4 trên MLX nhanh hơn tới 90% nhờ dự đoán đa token, thứ mang lại lợi ích lớn hơn hẳn cho các tác nhân lập trình trên Apple Silicon.
- 5 tháng 6 — v0.30 thêm khả năng tương thích GGUF thông qua llama.cpp, mở rộng hỗ trợ phần cứng vượt xa Apple Silicon.
Điểm xuyên suốt là Ollama đã không còn là “cách dễ dàng để chạy một mô hình nhỏ trên laptop” mà trở thành một cổng đa dụng, tình cờ cũng chạy mô hình cục bộ. Danh mục đám mây giờ đã có kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 với bảy kích cỡ, gpt-oss ở 20b và 120b, gemma4, dòng Nemotron 3 và mistral-large-3.
Thiết lập tất cả: cấu hình sao chép dán
Ollama + Claude Code (đường nhanh nhất)
Ollama có trình khởi chạy một lệnh tự lo phần nối môi trường cho bạn:
bash
ollama launch claudeNếu bạn thích làm thủ công hơn — nên làm vậy nếu bạn viết script — hãy cài Claude Code trước:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
Sau đó trỏ nó vào Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
Và chạy với bất kỳ mô hình nào bạn muốn:
bash
# A local model
claude --model qwen3.5

# A cloud model — note the :cloud suffix
claude --model kimi-k3:cloud
Hoặc đặt ngay trong lệnh, không export gì ra toàn cục:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Hai điều sẽ khiến bạn phải trả giá.
Thứ nhất, đừng export ANTHROPIC_BASE_URL vĩnh viễn trong profile shell của bạn. Đó là một biến toàn cục và nó sẽ âm thầm chuyển hướng mọi công cụ nói tiếng Anthropic trên máy bạn sang Ollama, kể cả công cụ mà bạn muốn nói chuyện với Anthropic. Hãy giới hạn nó theo từng dự án hoặc từng lần gọi.
Thứ hai, đặt độ dài ngữ cảnh của bạn từ 64k trở lên cho bất cứ thứ gì làm việc trên một kho mã thật. Mặc định của Ollama nhỏ hơn, và một tác nhân lập trình âm thầm hết cửa sổ ngữ cảnh sẽ bắt đầu quên dần mọi thứ thay vì báo lỗi.
Với CI, Docker hay các lần chạy bằng script, --yes bỏ qua các câu hỏi tương tác:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "how does this repository work?"GLM-5.3 trực tiếp từ Z.ai
Nếu bạn muốn định tuyến trực tiếp từ nhà cung cấp thay vì đi qua Ollama, Z.ai mở ra ba endpoint giao thức:
| Giao thức | URL gốc |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
Một khối provider OpenCode cho GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3": {
          "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
          "options": { "reasoning_effort": "high", "temperature": 1 }
        }
      }
    }
  },
  "model": "zai/glm-5.3"
}
Lưu ý quan trọng khi nâng cấp: GLM-5.3 yêu cầu bật suy luận. Nếu cấu hình hiện tại của bạn đặt thinking.type: "disabled", giờ nó sẽ lỗi. Hãy đổi thành "enabled" và đặt reasoning_effort: "low" nếu bạn muốn lấy lại độ trễ như trước.
reasoning_effort là nút điều chỉnh chất lượng so với chi phí chính của bạn: thấp cho các lệnh gọi nhạy cảm về độ trễ, cao cho công việc lớn, tối đa (mặc định) cho những vấn đề đã thực sự đánh bại cao. Với độ dài dòng chữ đã được ghi nhận, tôi sẽ chạy cao như một thiết lập hằng ngày thay vì để tối đa bật và tự hỏi token đầu ra đã đi đâu.
Thiết lập định tuyến mà tôi thực sự khuyên dùng
Không có gì trong số này là quyết định “chọn một”. Câu trả lời đúng cho hầu hết đội ngũ là một bảng định tuyến ba tầng, và mọi harness tác nhân nghiêm túc đều hỗ trợ mô hình riêng cho từng tác nhân.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
      "description": "Architecture, root-cause analysis, anything expensive to get wrong",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation work",
      "model": "zai/glm-5.3",
      "options": { "reasoning_effort": "high" }
    },
    "research": {
      "description": "Long-context reading, web research, multi-source synthesis",
      "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
      "description": "Renames, docstrings, test scaffolding, lint fixes",
      "model": "ollama/glm-5.3-flash"
    }
  }
}
Lý do đằng sau từng dòng:
- Lập kế hoạch dùng Fable 5.1. Lập kế hoạch là nơi một quyết định tồi khiến bạn tốn nhiều token nhất về sau, và khả năng mạch lạc trong thời gian dài chính là thứ 5.1 được xây dựng để làm. Đây cũng là nơi bạn tốn ít token nhất, nên phần giá cao chỉ áp lên phần nhỏ nhất trong hoá đơn của bạn.
- Xây dựng dùng GLM-5.3. Khả năng trên mỗi euro tốt nhất thị trường, và phần lớn chi phí token của bạn rơi vào đây.
- Nghiên cứu dùng Kimi K3. BrowseComp 91.2 và ngữ cảnh 1M thực sự khiến nó thành lựa chọn tốt nhất để đọc nhiều thứ và tổng hợp chúng.
- Công việc máy móc dùng GLM-5.3-Flash. Ở mức $0,15/$0,50, nó gần như miễn phí, và đổi tên một ký hiệu trong 40 tệp không cần suy luận tiên phong.
small_modeldùng một mô hình rất nhỏ cho những việc nội bộ của harness — tạo tiêu đề, tóm tắt, các lệnh gọi tiện ích nội bộ.
Bạn không đang chọn một người thắng. Bạn đang lắp một hộp số. Và hãy viết ID mô hình sao cho việc đổi một cái chỉ là sửa một dòng, vì trong thị trường này bạn sẽ lại phải đổi trong vòng một quý.
Những gì bạn thực sự chạy được cục bộ (thực tế phần cứng)
Để tôi dẹp một giả định trước khi nó khiến ai đó mất tiền.
Bạn không thể chạy Kimi K3 hay GLM-5.3 trên một máy trạm. Không phải với một 5090. Cũng không phải với hai.
Kimi K3
- ~1,5 TB trọng số ở định dạng MXFP4 gốc — và hãy nhớ, đó là là checkpoint đã lượng tử hoá, không phải điểm khởi đầu để nén thêm
- Moonshot khuyến nghị tối thiểu 64 bộ tăng tốc để phục vụ ở mức cạnh tranh
- Tự lưu trữ thực tế bắt đầu từ các cụm nhiều node; các triển khai tham chiếu dùng rack GB300 NVL72
- Không có mục thư viện Ollama chính thức cho Kimi K3 cục bộ và không có bản chuyển đổi GGUF cho người dùng phổ thông nào đáng để bạn thử
- Có những báo cáo về việc nó chạy trên các cụm RTX 5090 tiêu dùng, nhưng “một cụm 5090” không phải laptop và thông lượng không thể so sánh được
GLM-5.3
- ~1,5 TB ở BF16, khoảng 750 GB ở FP8
- Node đơn tối thiểu khả dụng: 8× H200 (1.128 GB bộ nhớ GPU) ở FP8, còn lại khoảng 375 GB cho KV cache
- BF16 cần hai node 8×H200, hoặc một node 8×B300 (2.304 GB)
- Một node 8×H200 ở BF16 là quá nhỏ cho trọng số cộng thêm cache
Hiện ảnh Các mô hình mở tiên phong cần cả một rack. Phân khúc 24 GB mới là nơi “chạy trên máy tôi” thực sự tồn tại — và nó đã trở nên rất tốt.
Vậy “AI cục bộ” thực sự nghĩa là gì vào tháng 9 năm 2026?
Nó có nghĩa là một tầng mô hình khác, và tầng đó đã thực sự tốt:
| Mô hình | VRAM | Dùng để làm gì |
|---|---|---|
| Qwen3.8-27B | 24 GB ở Q4 | Lựa chọn toàn diện nhất trên phần cứng tiêu dùng — 61,7% SWE-bench |
| gpt-oss:20b | 16 GB | Mô hình nhỏ tốt nhất, mức suy luận điều chỉnh được |
| Gemma 4 E4B | ~6 GB | Thị giác cộng gọi công cụ trên một laptop hiện đại |
| Mistral 7B | 8 GB | Lựa chọn đa dụng nhanh nhất, 40–60 tok/giây |
| DeepSeek-R1 7B | 5 GB | Suy luận chuỗi tư duy trên GPU laptop |
| Llama 4 Scout | ~55 GB ở Q4 | Ngữ cảnh 10M, đa phương thức — lãnh địa máy trạm |
Một Qwen3.8-27B đạt 61,7% trên SWE-bench, chạy hoàn toàn trên GPU tiêu dùng 24 GB không có kết nối mạng, là một điều đáng kinh ngạc mà mười tám tháng trước nghe như khoa học viễn tưởng. Nó không phải GLM-5.3 và nó không giả vờ như vậy.
Cách nói trung thực: trọng số mở ở mức tiên phong mang lại cho bạn chủ quyền và giá, không phải thực thi cục bộ. Trọng số mở trong khoảng 7B–30B mang lại cho bạn khả năng thực thi cục bộ thực sự, với một cái giá về năng lực có thật nhưng chấp nhận được, và đó là tầng mà “chạy trên máy tôi, không thấy mạng” là một yêu cầu khả thi.
Kiến trúc hiệu quả với hầu hết khách hàng của tôi đúng là cách chia đó: một mô hình cục bộ nhỏ cho bất cứ thứ gì chạm đến dữ liệu thực sự nhạy cảm, và một mô hình mở tiên phong chạy trên máy chủ cho mọi thứ còn lại — với trọng số sẵn có như một bảo hiểm chứ không phải một kế hoạch triển khai.
Mỗi mô hình thực sự gãy ở đâu
Không tô vẽ. Đây là những điểm yếu thật.
Điểm yếu của Kimi K3
Nó đắt đối với một mô hình mở. $3/$15 là 2,1 lần giá đầu vào của GLM-5.3 và 3,4 lần giá đầu ra, cho gần như cùng một điểm chỉ số thông minh. Nếu bạn chọn K3 thay vì GLM-5.3, hãy rõ ràng về việc bạn mua gì bằng khoản phụ phí đó — thường là bộ thị giác hoặc hiệu năng duyệt web.
Giấy phép có ngưỡng thấp hơn. Ngưỡng doanh thu tổng hợp $20M cho MaaS bắt được nhiều tổ chức hơn hẳn ngưỡng $10B của GLM-5.3. Nếu việc bán lại suy luận có ở bất kỳ đâu trong mô hình kinh doanh của bạn, K3 là mô hình bị ràng buộc hơn trong hai.
Tự lưu trữ nằm ngoài tầm với của gần như tất cả mọi người. 1,5 TB và 64+ bộ tăng tốc là một cam kết hạ tầng nghiêm túc. Quyền rút lui ở đây mang tính lý thuyết hơn so với bất kỳ mô hình nào khác trong so sánh này.
Công việc tri thức nói chung còn kém hơn. GDPval-AA v2 ở mức 1.687 khiến nó đứng sau GLM-5.3, cả hai bản Claude Fable và GPT-5.6 Sol Max. Nó là một chuyên gia lập trình và tác nhân, tình cờ lại rất lớn.
Điểm yếu của GLM-5.3
Chỉ văn bản. Không nhận hình ảnh, không nhận video. Nếu quy trình làm việc của bạn có gỡ lỗi bằng ảnh chụp màn hình, chuyển thiết kế thành mã hay đọc tài liệu bằng thị giác, GLM-5.3 đơn giản là không làm được và bạn cần GLM-5.3-Flash, Kimi K3 hoặc Fable 5.1 thay thế. Đây là lỗi cấu hình phổ biến nhất mà tôi dự đoán mọi người sẽ mắc, vì các ID mô hình trông có vẻ liên quan nhưng không phải.
Nó dài dòng, và sự dài dòng thì bị tính tiền. 170M token đầu ra so với mức trung vị 72M của phân khúc trên bộ AA. reasoning_effort mặc định là tối đa, và không thể tắt chế độ suy nghĩ. Hãy dự trù nhiều token đầu ra hơn số lượt của bạn gợi ý.
Giấy phép không còn là MIT nữa, và điều khoản đánh giá bảo mật là không giới hạn. Với hầu hết độc giả, ngưỡng $10B khiến điều này thành chuyện lý thuyết. Với ai ở gần ngưỡng đó, “phạm vi và phương pháp sẽ do Z.AI quyết định một cách hợp lý” không phải điều khoản mà đội pháp chế của bạn sẽ thích.
Terminal-Bench 3.0 ở mức 28,3 kém hơn 34,6 của GPT-5.6 Sol. Trên benchmark cụ thể gần nhất với lập trình tác nhân gốc terminal, nó đứng sau đối thủ đóng trên cùng một thước đo.
Nó còn mới trong làng trọng số mở. Phát hành ngày 28 tháng 8. Cộng đồng mới có vài ngày, chưa phải vài tháng. Những lỗi triển khai hiếm gặp vẫn chưa lộ ra.
Điểm yếu của Claude Fable 5.1
Giá. Khoảng 6,5 lần GLM-5.3 cho mỗi tác vụ tác nhân hoàn thành, ngay cả sau khi cắt 75% giá đọc cache. Với hầu hết công việc, khoảng cách đó không còn biện minh được bằng năng lực nữa.
Ba thay đổi gây hỏng. Buộc dùng công cụ trả về 400. Các khối suy nghĩ không truyền ngược về những mô hình cũ hơn. Sửa lịch sử hội thoại làm mất hiệu lực các khối suy nghĩ trên những tài khoản tạo sau ngày 31 tháng 8 năm 2026. Bất kỳ điều nào trong số này đều có thể làm hỏng một tích hợp đang chạy khi nâng cấp.
Gọi công cụ song song bị giảm sút. Có báo cáo về một lệnh gọi mỗi lượt trong khi Fable 5 gộp nhiều lệnh. Trong một vòng tác nhân dài, đó là thời gian thực mà bạn phải trả giá hai lần.
Không có lựa chọn rút lui. Không có trọng số, không tự lưu trữ, không ghim phiên bản ngoài những gì Anthropic cung cấp, không kiểm tra được. Khi nó thay đổi, bạn phải thích nghi.
Bộ tokenizer thổi phồng các so sánh. Nhiều hơn khoảng 30% token so với các mô hình Claude cũ với cùng một đoạn văn bản, khiến các so sánh chi phí lịch sử trở nên sai lệch theo hướng có lợi cho Anthropic nếu bạn không cẩn thận.
Khung quyết định: sáu tình huống
Hiện ảnh Sáu tình huống, sáu câu trả lời. Hãy tìm dòng giống với tuần làm việc của bạn.
1. “Tôi muốn một mô hình. Đặt rồi quên, giữ hoá đơn ở mức hợp lý.”
GLM-5.3. Trong khoảng nửa điểm so với Kimi K3 và khoảng ba điểm so với mô hình đóng tốt nhất trên chỉ số trung lập, ở mức $1,40/$4,40. Chạy nó qua Ollama với gói Pro hoặc Max, đặt reasoning_effort: high, rồi làm tiếp công việc của bạn. Điều duy nhất nên khiến bạn rời khỏi câu trả lời này là cần đầu vào hình ảnh.
2. “Công việc của tôi mang tính thị giác — UI, chuyển thiết kế thành mã, gỡ lỗi bằng ảnh chụp màn hình, tài liệu.”
Kimi K3 hoặc GLM-5.3-Flash, không phải GLM-5.3. MoonViT-V2 của K3 xử lý văn bản, hình ảnh và video một cách gốc và đạt 81,6/83,4 trên MMMU-Pro. GLM-5.3-Flash là lựa chọn tiết kiệm với khả năng đa phương thức gốc và giấy phép MIT. GLM-5.3 chỉ xử lý văn bản và sẽ đơn giản từ chối đầu vào.
3. “Những phiên tự chủ dài, nơi sai sót rất tốn kém.”
Claude Fable 5.1. Đây chính là thứ nó được xây dựng để làm và các benchmark xác nhận điều đó: Terminal-Bench-Science tăng gấp đôi, 82% trên những tác vụ dùng máy tính khó nhất của Browserbase so với 74% của Opus 5, và mức tăng lớn nhất được công bố trên công việc tác nhân kéo dài nhiều giờ. Việc cắt 75% giá đọc cache khiến đúng loại khối lượng công việc này rẻ hơn tới 45% so với trước. Hãy trả thêm ở nơi một sai sót tốn hơn token.
4. “Lưu trú dữ liệu tại EU là yêu cầu bắt buộc.”
GLM-5.3-Flash nếu bạn cần MIT, GLM-5.3 nếu bạn cần năng lực. Tự lưu trữ trên phần cứng của bạn hoặc một nhà cung cấp GPU tại EU và câu hỏi về chuyển dữ liệu xuyên biên giới không còn tồn tại. Dự trù 8×H200 cho GLM-5.3 ở FP8; Flash dễ xử lý hơn nhiều ở 320B/18B. Nếu tự lưu trữ vượt ngân sách, dịch vụ lưu trữ châu Âu của Ollama với không lưu giữ dữ liệu là giải pháp trung dung thực tế — nhưng hãy lấy cam kết về lưu trú dữ liệu bằng văn bản thay vì suy ra từ một trang quảng cáo.
5. “Đội nhỏ, ngân sách eo hẹp, lập trình cả ngày.”
GLM-5.3-Flash làm mặc định, GLM-5.3 cho bài toán khó, Ollama Pro ở mức $20. Flash có giá $0,15/$0,50 — hiện chỉ bằng nửa mức đó đến ngày 9 tháng 9 — và đạt 57,5 trên chỉ số thông minh. Hai mươi đô mua được sáu mươi đô token mà không có giới hạn theo tuần. Với một đội hai đến bốn người, gần như không gì địch lại. Gói GLM Coding Plan ở mức $18/tháng (Lite) là lựa chọn thay thế nếu bạn thích hạn mức cố định hơn là một quỹ tín dụng.
6. “Tôi cần biện minh điều này với đội mua hàng hoặc pháp chế.”
GLM-5.3-Flash. Đây là mô hình duy nhất trong so sánh này theo một giấy phép chuẩn do OSI phê chuẩn (MIT), nó đa phương thức gốc, đạt 57,5 trên chỉ số trung lập, và trọng số có trên Hugging Face không có ngưỡng doanh thu, không bắt ghi công, không có điều khoản đánh giá bảo mật. Khi câu hỏi là “chúng ta bảo vệ được gì trong một buổi rà soát hợp đồng”, giấy phép thoáng luôn thắng ba điểm benchmark.
Những gì tôi sẽ theo dõi trong quý tới
Liệu Fable 5.1 có vượt 62,1 trên chỉ số Artificial Analysis hay không. Nó ra mắt một ngày trước bài viết này và chưa được chấm điểm độc lập. Mức chênh benchmark so với Fable 5 cho thấy lẽ ra nó nên vượt, nhưng “nên” không phải “đã”, và khoảng cách tới 59,7 của Kimi K3 là con số mà toàn bộ cuộc tranh luận mở-so-với-đóng xoay quanh.
Liệu xu hướng trôi giấy phép có tiếp diễn. Trong tám tuần, chúng ta đi từ GLM-5.2 theo MIT đến GLM-5.3 theo một giấy phép riêng có đánh giá bảo mật tuỳ ý, và từ MIT sửa đổi của Kimi K2 đến các điều khoản gắn ngưỡng doanh thu của K3. Nếu GLM-6 và K4 siết thêm, “trọng số mở” sẽ thành một thuật ngữ tiếp thị hơn là một phạm trù có nghĩa. Việc GLM-5.3-Flash vẫn giữ MIT là tín hiệu ngược lại đáng theo dõi.
Liệu các phòng lab khác có áp dụng cách phát hành theo giai đoạn của Z.ai. Việc giữ lại hai tuần kèm lý do an toàn được công bố là một chuẩn mực mới. Nếu nó được duy trì, đó là chuẩn mực tốt. Nếu nó trở thành lý do để trọng số ngày càng ra mắt muộn hơn, thì đó là con đường mềm để không bao giờ phát hành chúng nữa.
Việc tái lập độc lập các tuyên bố về năng lực tấn công mạng. 2.436 lỗ hổng trên 269 dự án là một con số phi thường và hoàn toàn do họ tự báo cáo. Cần một bên trung lập kiểm tra, vì nếu chính xác thì nó định hình lại toàn bộ cuộc trò chuyện về an toàn của trọng số mở, còn nếu không thì đó là một chiến dịch tiếp thị hiệu quả.
Giá theo token của Ollama sau sáu tháng nữa. $20 cho $60 mức sử dụng là một thế chào hàng mạnh từ một công ty đã gọi được $88M vào tháng 7. Liệu những hệ số đó có sống sót khi gặp bài toán kinh tế đơn vị thực tế là biến số lớn nhất trong luận điểm “mô hình mở giá rẻ” dành cho các đội nhỏ.
Liệu các mô hình cục bộ có thu hẹp khoảng cách ở tầng 30B. Qwen3.8-27B đạt 61,7% SWE-bench trên 24 GB là kết quả ít được bàn đến nhất trong năm. Tầng tiên phong nhận tiêu đề; tầng 24 GB mới là thứ thay đổi những gì một doanh nghiệp bình thường có thể làm mà không cần API key.
Câu hỏi thường gặp
Kimi K3 có thực sự là mã nguồn mở? Không. Trọng số của Kimi K3 tải miễn phí từ Hugging Face, nhưng theo một “Kimi K3 License” riêng, không phải giấy phép mã nguồn mở do OSI phê chuẩn. Các nhà vận hành Model-as-a-Service có tổng doanh thu vượt 20 triệu USD trong bất kỳ 12 tháng liên tiếp nào phải đàm phán một thoả thuận thương mại riêng với Moonshot, và các sản phẩm vượt 100 triệu người dùng hoạt động hàng tháng hoặc 20 triệu USD doanh thu hàng tháng phải hiển thị “Kimi K3” trong giao diện. Sử dụng hoàn toàn nội bộ thì không bị hạn chế.
GLM-5.3 có tốt hơn Kimi K3 không? Chúng thực tế ngang nhau trên chỉ số tổng hợp trung lập — 59,5 so với 59,7 trên Artificial Analysis. GLM-5.3 rẻ hơn 2,2 lần cho mỗi tác vụ tác nhân và điểm cao hơn ở công việc tri thức (GDPval-AA v2: 1.769 so với 1.687). Kimi K3 đa phương thức gốc, dẫn đầu về duyệt web tác nhân (BrowseComp 91.2) và giành vị trí đầu trên đấu trường mã frontend của Arena.AI. Chọn GLM-5.3 vì chi phí và lập trình văn bản; Kimi K3 cho thị giác, duyệt web và nghiên cứu dài hạn.
Các mô hình mở rẻ hơn Claude Fable 5.1 bao nhiêu? Trong một tác vụ tác nhân mô phỏng 60 lượt, GLM-5.3 tốn khoảng $1,85 so với $11,94 của Fable 5.1 — rẻ hơn khoảng 6,5 lần. Kimi K3 tốn khoảng $4,07, rẻ hơn khoảng 2,9 lần. GLM-5.3-Flash tốn khoảng $0,21, rẻ hơn khoảng 58 lần. Với 80 lần chạy một tháng, đó là $148 so với $955.
Tôi có thể chạy Kimi K3 hoặc GLM-5.3 cục bộ không? Không phải trên phần cứng tiêu dùng. Kimi K3 nặng khoảng 1,5 TB ngay cả ở định dạng MXFP4 gốc và Moonshot khuyến nghị 64+ bộ tăng tốc. GLM-5.3 cần tối thiểu 8×H200 (1.128 GB) ở FP8. Để thực thi cục bộ thực sự, hãy xem Qwen3.8-27B (24 GB ở Q4), gpt-oss:20b (16 GB) hoặc Gemma 4 E4B (~6 GB).
Claude Fable 5.1 có gì thay đổi? Phát hành ngày 1 tháng 9 năm 2026. Giá đọc cache giảm 75% từ $1,00 xuống $0,25 mỗi triệu token, khiến khối lượng công việc thông thường rẻ hơn khoảng 25% và khối lượng tác nhân rẻ hơn tới 45%; giá đầu vào và đầu ra giữ nguyên ở $10/$50. Terminal-Bench 4.0 tăng từ 42,0% lên 55,8%, Terminal-Bench-Science từ 24,7% lên 52,6%, AutomationBench từ 17,1% lên 31,4%. Ba thay đổi gây hỏng ảnh hưởng đến việc buộc dùng công cụ, tính di động của khối suy nghĩ và việc sửa lịch sử.
Giá mới của Ollama là gì? Từ ngày 31 tháng 8 năm 2026, các gói Pro, Max và Team dùng cách tính giá theo token kèm credit có sẵn: Pro $20/tháng cho $60 mức sử dụng, Max $100 cho $300, Team $500 cho $1.000 chia sẻ cho không giới hạn người dùng. Giới hạn 5 giờ và giới hạn theo tuần đã được bỏ hoàn toàn, không có phí dịch vụ, credit không chuyển sang kỳ sau, và mọi gói đều không lưu giữ dữ liệu với máy chủ đặt tại Mỹ và châu Âu.
Mô hình nào trong số này thực sự có giấy phép MIT? Chỉ GLM-5.3-Flash — một mô hình riêng 320B/18B đa phương thức gốc phát hành ngày 26 tháng 8 năm 2026, đạt 57,5 trên chỉ số Artificial Analysis với giá $0,15/$0,50 mỗi triệu token. GLM-5.3 và Kimi K3 đều dùng giấy phép riêng gắn ngưỡng doanh thu; Claude Fable 5.1 hoàn toàn độc quyền.
Tại sao tôi không thể so sánh các mô hình này trên Terminal-Bench? Vì mỗi mô hình được đánh giá trên một phiên bản khác nhau. 88,3 của Kimi K3 là trên Terminal-Bench 2.1, 28,3 của GLM-5.3 là trên 3.0, và 55,8 của Fable 5.1 là trên 4.0. Mỗi phiên bản khó hơn hẳn phiên bản trước, nên các con số không cùng thang đo. Chỉ so sánh trong cùng một phiên bản. Ví dụ, trên Terminal-Bench 2.1, Kimi K3 đạt 88,3 so với 88,0 của Claude Fable 5, 88,8 của GPT-5.6 Sol và 84,3 của GLM-5.3-Flash — so sánh đó hợp lệ, và đó là so sánh đáng trích dẫn.
Nên dùng Ollama hay đi thẳng tới nhà cung cấp? Ollama nếu bạn muốn một mối quan hệ thanh toán duy nhất, một bề mặt API, chuyển model dễ dàng và lưu trữ tại EU/US với không lưu dữ liệu — giá theo token của nó bám sát giá nhà cung cấp gốc. Đi thẳng nếu bạn cần các tính năng gốc như Z.ai’s reasoning_effort các kiểm soát ở mức đầy đủ, SLA của nhà cung cấp, hoặc gói đăng ký như GLM Coding Plan. Nhiều đội chạy cả hai và định tuyến theo khối lượng công việc.
GLM-5.3 có hỗ trợ hình ảnh không? Không. GLM-5.3 chỉ xử lý văn bản. GLM-5.3-Flash — một model hoàn toàn khác dù tên gần giống — vốn đã đa phương thức và xử lý được văn bản, hình ảnh, video và tệp đầu vào. Gửi hình ảnh tới sai model ID là lỗi phổ biến nhất khi mới dùng dòng GLM.
Điểm mấu chốt
Mười hai tháng trước, câu hỏi về trọng số mở là liệu các model này có dùng được không. Sáu tháng trước, là liệu chúng có cạnh tranh không. Tháng 9 năm 2026, câu hỏi thực sự là: bạn còn đang trả khoản phụ phí cho model đóng để làm gì?
Câu hỏi đó có câu trả lời thật, và phạm vi đã hẹp hơn trước. Claude Fable 5.1 dẫn đầu ở những tác vụ tác nhân kéo dài khó nhất, ở công việc tri thức tổng quát, và ở kiểu gỡ lỗi mà model phải giữ một vấn đề rối rắm trong đầu hàng giờ mà không lệch hướng. Việc Anthropic cắt 75% chi phí đọc cache nhắm đúng vào loại khối lượng đó. Nếu chi phí khi sai lớn hơn chi phí token, khoản phụ phí đó là hợp lý.
Với mọi thứ còn lại, bài toán đã thay đổi. GLM-5.3 đạt 94% điểm chỉ số của Claude Opus 5 với 29% chi phí. Kimi K3 đạt 88,3 trên Terminal-Bench 2.1, so với 88,0 của Claude Fable 5 trên cùng phiên bản, và giành vị trí đầu trên Frontend Code Arena của LMArena, vượt cả hai model đóng hàng đầu. Ollama bán cho bạn 60 USD token với giá 20 USD và bỏ luôn giới hạn sử dụng. Sự kết hợp đó không tồn tại vào mùa xuân.
Nhưng đừng để sự hào hứng khiến bạn bỏ qua phần chữ nhỏ, vì có hai điều và cả hai đều quan trọng.
Thứ nhất là giấy phép. “Trọng số mở” và “mã nguồn mở” đã lặng lẽ thôi mang cùng một nghĩa. Kimi K3 và GLM-5.3 đều phát hành dưới giấy phép riêng, có cổng doanh thu. Các cổng này đủ cao để hầu hết độc giả không bị ảnh hưởng — nhưng “hầu hết độc giả không bị ảnh hưởng” không giống “không hạn chế”, và điều khoản đánh giá bảo mật không được định nghĩa của GLM-5.3 là rủi ro mua sắm thực sự với các doanh nghiệp lớn. GLM-5.3-Flash dưới MIT là lựa chọn hoàn toàn dễ dãi cuối cùng ở tầm cận biên, và chính vì thế nó xứng đáng được chú ý hơn mức hiện tại.
Thứ hai là việc tự lưu trữ phần lớn chỉ là mong muốn. 1,5 TB trọng số và 64 bộ tăng tốc không phải là phương án rút lui cho một doanh nghiệp tầm trung. Ở tầng này, trọng số mở mang lại cho bạn một thị trường suy luận cạnh tranh, minh bạch giá, ghim phiên bản, lựa chọn khu vực pháp lý và vị thế đàm phán. Những thứ đó đáng giá rất nhiều. Chúng không giống việc tự chạy model trong tầng hầm nhà bạn.
Thiết lập tôi thực sự sẽ dựng: GLM-5.3 làm mặc định, Fable 5.1 cho lập kế hoạch và những vấn đề thực sự khó, Kimi K3 cho thị giác và nghiên cứu dài hạn, GLM-5.3-Flash cho việc nặng nhọc, và một model cục bộ 27B cho bất cứ thứ gì không được rời khỏi toà nhà. Định tuyến theo khối lượng công việc, không theo lòng trung thành. Viết cấu hình sao cho model ID chỉ cần đổi một dòng.
Vì dự đoán duy nhất tôi chắc chắn là bài viết này sẽ cần cập nhật trước Giáng sinh.
Bạn có đang chạy một trong ba model này trong môi trường thực tế không? Tôi đặc biệt quan tâm liệu tính dài dòng của GLM-5.3 có thành vấn đề chi phí thực sự ở quy mô lớn, và liệu có ai đã thực sự đưa giấy phép Kimi K3 cho luật sư và có được cách hiểu rõ ràng về định nghĩa MaaS. Hãy liên hệ — hoan nghênh các đính chính và bằng chứng ngược lại, và bài viết này sẽ được cập nhật khi tình hình thay đổi.
Cập nhật lần cuối: 2 tháng 9 năm 2026.


