
 Bahasa Indonesia
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Русский
 العربية
 हिन्दी

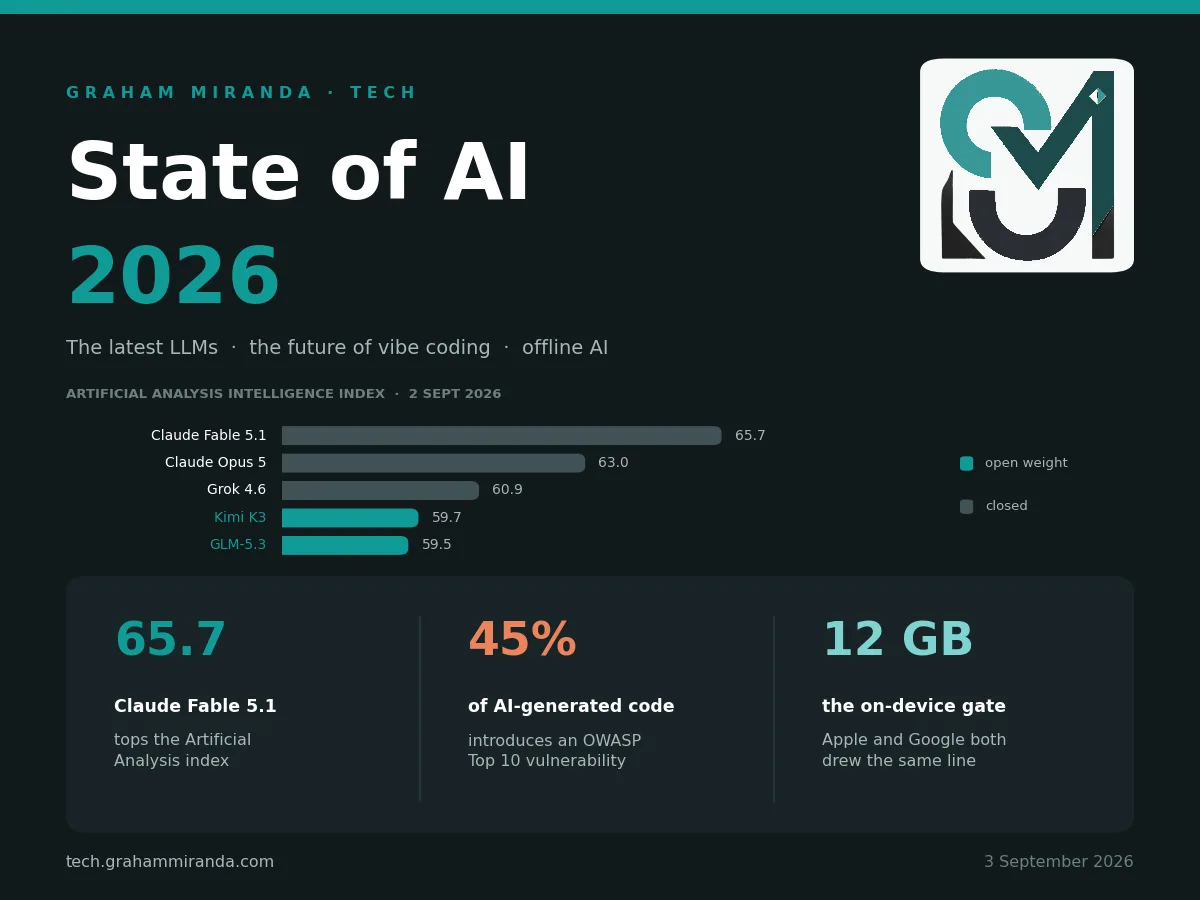
Kondisi AI 2026 bertumpu pada tiga hal yang terjadi dalam delapan bulan pertama tahun ini — dan hampir tidak ada yang menempatkannya dalam satu kalimat yang sama.
Sebuah model melewati 96% pada SWE-bench Verified. Bukan 96% pada benchmark mainan — 96% pada isu GitHub nyata dari Django, Flask, dan scikit-learn, benchmark yang seharusnya butuh bertahun-tahun. Sekarang benchmark itu praktis selesai sebagai pembeda, dan tiga model teratasnya hanya terpaut kurang dari satu poin persentase.
Bukti terbaik yang tersedia tentang apakah alat coding AI membuat pengembang berpengalaman lebih cepat masih mengatakan tidak. Uji acak terkontrol METR’s menemukan perlambatan 19%. Upaya mereka sendiri untuk mengulanginya pada 2026 gagal karena para pengembang menolak bekerja tanpa AI, bahkan dengan bayaran $50 per jam. Orang-orang yang memakai alat ini percaya mereka tiga kali lebih cepat. Saat diukur, ternyata tidak.
Dan Microsoft mengirimkan model penalaran 14 miliar parameter ke Windows sendiri, sebuah kalimat yang pada 2024 masih fiksi ilmiah dan kini hanya catatan kaki dalam keynote Build.
Tiga fakta itu adalah keseluruhan kondisi AI 2026 dalam bentuk mini. Model-modelnya menjadi luar biasa. Peningkatan produktivitas yang terukur tidak mengikuti. Dan garis terdepan yang menarik diam-diam berpindah dari pusat data ke perangkat di tanganmu.
Ini versi panjang dari kondisi AI 2026. Tulisan ini untuk orang yang harus mengambil keputusan yang menyangkut uang — model mana yang dipakai, apakah agen dibiarkan menulis kode produksi, apa yang harus dibeli, dan apa yang harus disampaikan ke klien atau petugas perlindungan data. Saya memisahkan yang sudah dirilis dari yang baru dilaporkan dari yang masih rumor, karena kesalahan termahal di bidang ini adalah merencanakan berdasarkan model yang belum ada.
Terakhir diperbarui 3 September 2026. Perlu diperbarui lagi sebelum Natal.
TL;DR — Kondisi AI 2026 dalam 90 Detik
Garis terdepan adalah pacuan empat kuda dan Anthropic saat ini memimpin secara agregat. Per 2 September 2026, Intelligence Index v4.1.1 dari Artificial Analysis menempatkan Claude Fable 5.1 di 65,7, Claude Opus 5 di 63,0, Grok 4.6 di 60,9, dan GPT-5.6 Sol di 58,9. Namun agregat menyembunyikan bagian yang menarik: GPT-5.6 Sol memimpin BrowseComp dengan 90,4%, Gemini 3.8 Flash menghasilkan 58,7 dengan $0,75 per juta token masukan, dan sepuluh model teratas hanya berselisih 8,2 poin — rentang yang cukup sempit sehingga perbedaan harness dan prompt bisa menggeser sebuah model beberapa peringkat.
Bobot terbuka kira-kira tertinggal satu generasi dan sedang mengejar. GLM-5.3 (753B, terbuka) berada di 59,5 — peringkat keenam secara keseluruhan, di atas GPT-5.6 Sol. DeepSeek V4 Pro dirilis dengan 1,6 triliun parameter di bawah lisensi MIT sungguhan. Ornith-1.5-397B mencapai 86 pada SWE-bench Verified dan sedikit melewati Claude Opus 4.8 pada Terminal-Bench 2.1, 86,1 berbanding 85,0. Kesenjangan kemampuan kini sekitar enam bulan. Kesenjangan lisensi adalah yang penting.
“Vibe coding” menang dalam argumen adopsi dan kalah dalam argumen bukti. 90% pengembang memakai setidaknya satu alat coding AI di tempat kerja. Pasar agen coding perusahaan berjalan sekitar $10 miliar per tahun. Dan kepercayaan pengembang pada keluaran AI turun dari 40% ke 29% dalam dua tahun. Alat-alatnya sudah universal, dan orang yang memakainya makin tidak percaya setiap tahun. Keduanya rasional.
Tagihan keamanan sudah datang dan sudah dirinci. Veracode menemukan 45% sampel kode hasil AI memunculkan kerentanan OWASP Top 10. Apiiro mengukur pengembang yang dibantu AI menghasilkan commit tiga sampai empat kali lebih cepat dan temuan keamanan sepuluh kali lebih cepat. Sekitar 20% kode hasil AI merujuk paket yang tidak ada. Ini bukan argumen menentang alatnya. Ini argumen tentang di mana kamu menaruh gerbangnya.
AI offline menjadi benar-benar berguna tahun ini, pada perangkat keras yang sudah dimiliki orang. Model 2 miliar parameter berjalan pada 61 token per detik di iPhone. Microsoft menaruh model penalaran 14B ke Windows dengan syarat NPU 40 TOPS. Google membatasi model on-device terbaiknya di balik 12 GB RAM, begitu juga Apple. Spesifikasi yang menentukan apa yang bisa kamu jalankan offline adalah memori, bukan komputasi, dan memori justru yang menjadi langka.
Ringkasan jujur satu kalimat tentang kondisi AI 2026: inilah tahun ketika model berhenti menjadi hambatan. Verifikasi menjadi hambatannya. Setiap keputusan penting dalam artikel ini — model mana, harness mana, perangkat mana, gerbang mana — adalah turunan dari satu perubahan itu.
Perbandingan singkat: Garis terdepan, September 2026
Intelligence Index v4.1.1 dari Artificial Analysis menggabungkan sembilan evaluasi: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience, dan AA-LCR. Skor di bawah adalah snapshot 2 September 2026.
| Model | Lab | Indeks AA | Bobot | Masukan / keluaran per 1 juta |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | Tertutup | $10.00 / $50.00 |
| Claude Opus 5 | Anthropic | 63.0 | Tertutup | $5.00 / $25.00 |
| Claude Fable 5 | Anthropic | 62.1 | Tertutup | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | Tertutup | — |
| Kimi K3 | Moonshot | 59.7 | Bobot terbuka | — |
| GLM-5.3 | Z.ai | 59.5 | Bobot terbuka | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Tertutup | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | Tertutup | $0.75 / $3.75 | |
| Qwen3.8 Max Preview | Alibaba | 58.1 | Tertutup | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Bobot terbuka | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropic | 57.3 | Tertutup | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | Tertutup | — |
| GPT-5.5 | OpenAI | 56.3 | Tertutup | — |
Baca kolom keempat sebelum kolom ketiga. Dua dari sepuluh model teratas punya bobot yang bisa diunduh, dan salah satunya berharga $0,15 per juta.token masukan.
Perbandingan singkat: Garis terdepan bobot terbuka
| Model | Total / aktif | Konteks | Lisensi | Dirilis |
|---|---|---|---|---|
| Kimi K3 | 2,8T / 104B | 1 juta | Berjenjang pendapatan (khusus) | Juli 2026 |
| Qwen3.8-2.4T-A95B | 2,4T / 95B | 262K (1 juta via YaRN) | Apache 2.0 | 14 Agu 2026 |
| DeepSeek V4 Pro | 1,6T / 49B | 1 juta | MIT | 12 Agu 2026 |
| GLM-5.3 | 753B / ~40B | 1 juta | Khusus (gerbang $10B) | Agu 2026 |
| MiniMax M3 | 428B / 23B | 1 juta | Khusus (atribusi) | 1 Juni 2026 |
| Ornith-1.5-397B | 397B MoE | 262K (1 juta via YaRN) | MIT | Agu 2026 |
| Gemma 4 31B | 31B dense | 256 ribu | Apache 2.0 | 6 Apr 2026 |
| Qwen3.8-27B | 27B dense | 262K | Apache 2.0 | 14 Agu 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 Apr 2026 |
Tiga dari sembilan itu benar-benar bersih menurut OSI. Itulah kisah sebenarnya bobot terbuka pada 2026, dan saya akan kembali ke sana di Bagian Tiga.
Babak I — Model
Bagian satu: Apa yang benar-benar dirilis pada 2026
Sebelum argumen apa pun, catatannya dulu. Saya memisahkan ini ke tiga tingkat karena perbedaan di antaranya adalah tempat uang terbuang.
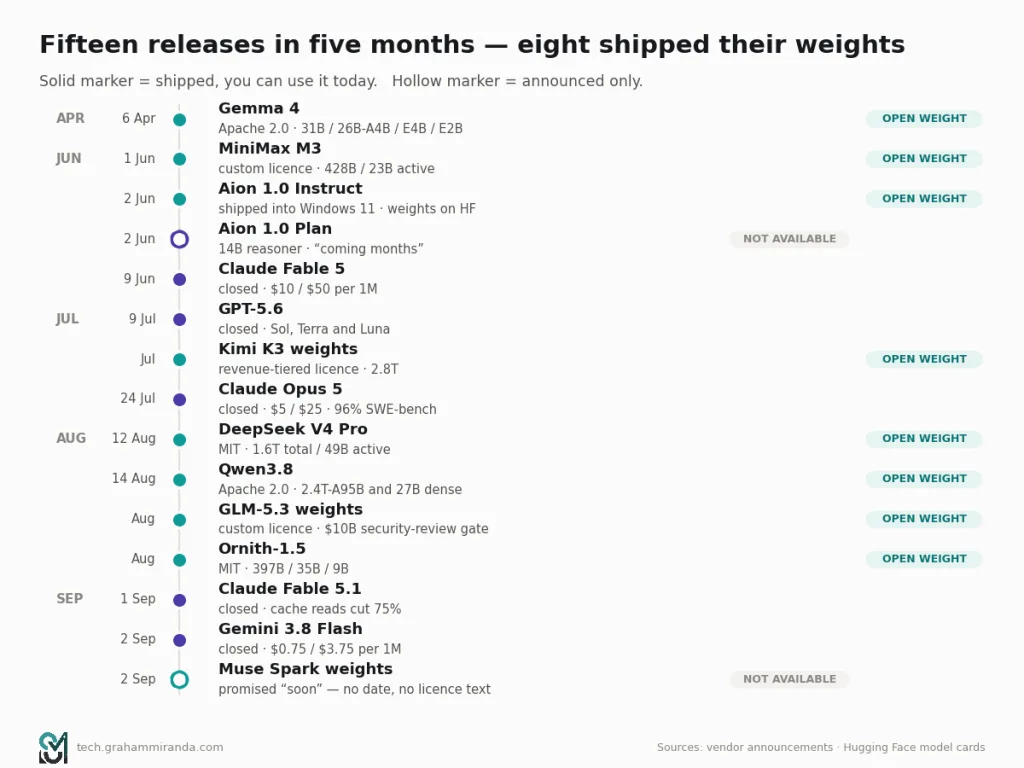
Terkonfirmasi dan sudah tersedia
- 6 April 2026 — Google merilis Gemma 4 di bawah Apache 2.0, perubahan lisensi dari ketentuan khusus Gemma 3’s. Empat varian: 31B dense, 26B dengan 4B aktif (MoE), E4B sekitar 8B, dan E2B dengan total 5,1B dan 2,3B aktif. Konteks 256K pada model besar, 128K pada seri E. Semua mendukung masukan teks, gambar, dan video; E2B dan E4B menambahkan audio native.
- 1 Juni 2026 — MiniMax M3. total 428B / 23B aktif, konteks 1 juta, multimodalitas native, operator atensi sparse baru, bobot di Hugging Face. Dibahas mendalam di artikel saya sebelumnya tentang perangkat keras AI lokal.
- 2 Juni 2026 — Microsoft mengumumkan Aion 1.0 di Build. Satu keluarga model on-device dikirim ke Windows 11 sendiri: Aion 1.0 Instruct (mampu CPU, di Edge Canary sejak 150.0.4070) dan Aion 1.0 Plan, model penalaran dan pemanggilan alat 14 miliar parameter dengan jendela konteks 32K.
- 9 Juni 2026 — Claude Fable 5. Tingkat teratas Anthropic’s, $10/$50 per juta, konteks 1 juta, keluaran maksimum 128K.
- 9 Juli 2026 — OpenAI merilis GPT-5.6 dalam tiga varian: Sol ($5/$30), Terra ($2,50/$15), dan Luna ($1/$6). Kemampuan siber dibangun ke dalam Sol, bukan dijual sebagai model terpisah, dengan akses yang ditingkatkan lewat program Trusted Access for Cyber milik OpenAI’s.
- Juli 2026 — Moonshot membuka bobot Kimi K3’s. 2,8 triliun parameter, konteks 1 juta, MXFP4 native, di bawah lisensi berjenjang pendapatan.
- 24 Juli 2026 — Claude Opus 5. $5/$25, tidak berubah dari Opus 4.8. Anthropic mengklaim model ini “lebih dari dua kali lipat performa Opus 4.8’s” pada Frontier-Bench v0.1 dan mencetak tiga kali skor model terbaik berikutnya pada ARC-AGI 3.
- 12 Agustus 2026 — DeepSeek V4 Pro keluar dari pratinjau dengan bobot berlisensi MIT: total 1,6T (sebagian liputan membulatkannya jadi 1,7T), 49B aktif, konteks 1 juta, 893 GB tensor BF16 dan FP8, plus modul decoding spekulatif DSpark. Terminal-Bench 2.1 di 87,9, HLE-with-tools di 60,0, CyberGym di 83,3. DeepSeek menaikkan harga API pada waktu yang sama.
- 14 Agustus 2026 — bobot terbuka Qwen3.8 di bawah Apache 2.0: model multimodal dense 27B dan raksasa 2,4T-A95B, keduanya ada di Hugging Face dan ModelScope, konteks native 262K yang bisa diperluas ke 1 juta dengan YaRN.
- Agustus 2026 — bobot GLM-5.3 mendarat di Hugging Face sekitar dua minggu setelah peluncuran API. 753B MoE, konteks 1 juta, keluaran 128K, BF16 dan FP8.
- Agustus 2026 — Ornith-1.5. Tiga skala (397B MoE, 35B MoE dengan 3B aktif, 9B dense), dibangun di atas Qwen3.5 dan Gemma 4 dengan pretraining lanjutan, berlisensi MIT, dan mengklaim 86 pada SWE-bench Verified.
- 1 September 2026 — Claude Fable 5.1 dan Mythos 5.1. Adaptive thinking aktif secara bawaan, konteks 1 juta, keluaran 128K. Harga dasar tidak berubah di $10/$50, tetapi pembacaan cache turun 75%, dari $1,00 ke $0,25 per juta.
- 2 September 2026 — Gemini 3.8 Flash dengan $0,75/$3,75, konteks masukan 1 juta, keluaran 66K, batas pengetahuan Maret 2026, serta masukan teks, gambar, video, audio, dan PDF.
- 2 September 2026 — Meta merilis Muse Spark 1.3 dan Muse Code CLI.
Dilaporkan, kredibel, belum dikonfirmasi
- Meta akan membuka bobot Muse Spark’s “segera.” Itu Mark Zuckerberg di X, tanpa tanggal, tanpa jumlah parameter, tanpa detail arsitektur, dan tanpa teks lisensi. Meta belum pernah mengungkap ukuran model ini pada versi mana pun.
- Gemini Nano v4 disebut akan segera hadir untuk Android, dengan Nano v3 saat ini terbatas pada seri Pixel 10.
- Aion 1.0 Plan disebut akan tersedia umum “dalam beberapa bulan ke depan”; hanya Instruct yang ada dalam pratinjau.
Rumor, satu sumber, perlakukan sebagaimana mestinya
- Semua yang sudah kamu baca tentang model unggulan Anthropic, OpenAI, atau Google berikutnya. Di pasar tempat empat lab merilis model sepuluh teratas dalam rentang sembilan minggu, rumor ke depan punya waktu paruh sekitar dua minggu.
Satu hal lagi yang perlu ditandai, karena ini baru dan hampir tidak ada orang di luar bidang keamanan yang membicarakannya. Claude Mythos 5.1 mencetak 60,9 pada Terminal-Bench 4.0 — lebih tinggi daripada 55,8 Fable 5.1’s — dan 95,5% pada SWE-bench Verified. Kamu tidak bisa membelinya.
Anthropic menyebut Mythos sebagai “model paling mumpuni untuk riset keamanan siber dan biologi” miliknya, dan model ini hanya tersedia bagi pembela siber dan ilmuwan hayati yang sudah diverifikasi melalui dua program akses tepercaya: Cyber Verification Program dan Life Sciences Verification Program. Kalimat Anthropic’s sendiri adalah bahwa mereka “hanya bisa menyediakannya untuk sejumlah organisasi di AS, meski kami sedang berupaya memperluas akses.” Project Glasswing, upaya perluasan akses itu, telah mencapai sekitar 150 organisasi di lebih dari lima belas negara per Juni 2026.
Alasannya adalah penggunaan ganda — model yang sangat baik menemukan kerentanan juga sangat baik menemukannya untuk pihak mana pun — dan menurut saya itu bisa dipertahankan. Tapi perhatikan konsekuensi strukturalnya, karena ini benar-benar baru: model dengan skor tertinggi pada benchmark coding publik kini adalah model yang sebagian besar dunia tidak bisa akses dengan harga berapa pun. Pembatasan kemampuan atas dasar keselamatan, bukan dasar komersial, akan makin umum, bukan makin jarang, dan jika kamu berada di luar AS itu adalah alasan untuk peduli pada bobot terbuka yang sama sekali tidak ada hubungannya dengan biaya.
Tampilkan gambar Sembilan bulan, dua belas rilis penting, empat di antaranya bobot terbuka. Batang solid adalah rilis dengan bobot atau akses API yang bisa kamu beli hari ini; garis putus-putus adalah yang sudah diumumkan tetapi belum tersedia.
Bagian dua: Apa yang sebenarnya membedakan model garis terdepan sekarang
Inilah kebenaran yang tidak nyaman tentang puncak papan peringkat itu: pada sebagian besar pekerjaan yang benar-benar akan kamu lakukan, delapan model teratas bisa saling menggantikan.
Saya tidak mengatakan itu untuk sekadar membantah. Saya mengatakannya karena selisih indeks agregat antara Claude Fable 5.1 di 65,7 dan GLM-5.3-Flash di 57,5 adalah delapan poin, dan GLM-5.3-Flash berharga $0,15 per juta token masukan, sementara Fable’s $10,00. Itu adalah Selisih harga 67× untuk perbedaan kemampuan 12% pada skor komposit, dan skor komposit justru memampatkan perbedaan yang penting bagimu sambil membesarkan yang tidak penting.
Jadi pertanyaan yang berguna bukanlah “model mana yang terbaik.” Melainkan “apa sebenarnya keunggulan masing-masing, dan apakah itu beririsan dengan minggu kerjaku.”
Empat hal yang benar-benar berbeda
1. Keandalan agentic jangka panjang. Inilah pembeda sesungguhnya pada 2026 dan ini diukur dengan buruk. Opus 5 dari Anthropic secara eksplisit diposisikan sebagai “lompatan peningkatan bagi tier Opus yang menggerakkan agen berjalan lama” — bukan sebagai model yang lebih pintar, melainkan model yang tidak tumbang pada jam keenam. Bukti untuk kelas peningkatan ini ada di benchmark agentic (Terminal-Bench, OSWorld, Frontier-Bench), bukan di benchmark pengetahuan, dan benchmark itu masih muda, berisik, dan sensitif terhadap scaffold.
2. Ekonomi cache. Perubahan utama Fable 5.1’s bukan lonjakan kemampuan. Perubahan itu adalah memangkas pembacaan cache 75%, dari $1,00 ke $0,25 per juta token — yang menurut perhitungan MarkTechPost sekitar 25% lebih murah untuk alur kerja biasa dan hingga 45% untuk alur kerja agentic. Bagi agen mana pun yang membaca ulang system prompt atau basis kode besar pada setiap giliran, harga cache adalah tuas yang lebih besar pada tagihan bulananmu daripada pilihan model. Tidak ada yang menaruh itu di papan peringkat.
3. Penjelajahan web dan penggunaan alat. GPT-5.6 Sol mencetak 90,4% pada BrowseComp — 92,2% pada pengaturan penalaran Ultra. Itu kekuatan spesifik yang sudah dipublikasikan, dan jika beban kerjamu adalah riset dan sintesis ketimbang kode dan verifikasi, itu bernilai lebih dari dua poin indeks agregat.
4. Harga per jawaban yang memadai. Gemini 3.8 Flash dengan indeks 58,7 untuk masukan $0,75 adalah hal paling jelas salah harga di papan dibanding garis terdepan tertutup. GLM-5.3-Flash di 57,5 dengan $0,15 adalah hal paling jelas salah harga, titik.
Tabel harga, karena inilah keputusan sebenarnya
| Model | Masukan /1 juta | Keluaran /1 juta | Masukan cache /1 juta | Konteks |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1 juta / keluaran 128K |
| Claude Opus 5 | $5.00 | $25.00 | — | 1 juta / keluaran 128K |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1 juta / keluaran 128K |
| GLM-5.3 | $1.40 | $4.40 | — | 1 juta / keluaran 128K |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1M / 66K keluaran |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1 juta |
| Muse Spark (Contributors) | $0.10 | $0.20 | $0.002 | — |
Baris terakhir itu layak dilihat lagi. Tingkat Contributors milik Meta adalah $0,10 masuk dan $0,20 keluar — dengan potensi akses ke datamu untuk pelatihan. Itu bukan harga; itu barter. Sejauh yang bisa kulihat, itu juga ungkapan paling jujur dari model bisnis sebenarnya di balik banyak inferensi murah, dan aku lebih suka itu dinyatakan di tabel harga daripada dikubur dalam DPA.
Tampilkan gambar Kecerdasan di satu sumbu, harga dalam skala log di sumbu lain. Delapan poin indeks memisahkan puncak grafik dari dasarnya; 67× memisahkan harganya. Frontier efisien ada di kanan bawah, dan hampir tidak ada yang membeli di sana.
Kerusakan API yang tidak diperingatkan siapa pun
Fable 5.1 dirilis dengan tiga perubahan yang memutus kompatibilitas: penggunaan alat secara paksa sudah hilang, blok thinking kini spesifik per model, dan perubahan di tengah percakapan pada pesan sistem atau alat kini menghasilkan galat alih-alih diterima diam-diam.
Yang ketiga akan menggigit banyak orang. Banyak harness agen mengubah prompt sistem atau daftar alat antar giliran — menambahkan alat saat subtugas dimulai, memangkas instruksi untuk menghemat konteks. Di Fable 5.1 itu kini menjadi galat. Kalau kamu meningkatkan ID model di berkas konfigurasi dan agenmu mulai melempar 400 di giliran keempat, itulah sebabnya.
Pelajaran umumnya, yang lebih bernilai daripada yang spesifik: pada 2026 peningkatan model adalah migrasi API. Tulis ID modelmu supaya menggantinya cukup satu baris perubahan, dan pin. Kamu akan melakukan perubahan itu lagi dalam seperempat tahun.
Bagian Tiga: Frontier Bobot Terbuka, dan Jebakan Lisensi
Ini bagian dari kisah 2026 yang benar-benar membuatku bersemangat, dan juga bagian di mana pemasarannya paling menyesatkan.
Jarak kemampuannya sekitar enam bulan
Lihat apa yang dicapai bobot terbuka antara Juni dan Agustus 2026:
- DeepSeek V4 Pro: total 1,6T, 49B aktif, lisensi MIT, Terminal-Bench 2.1 di 87,9. Itu angka Terminal-Bench yang lebih tinggi daripada yang dipublikasikan sebagian besar model tertutup tahun ini.
- Ornith-1.5-397B: 86 pada SWE-bench Verified, 86,1 pada Terminal-Bench 2.1 melawan 85,0 milik Claude Opus 4.8, dan 92,8 pada GPQA Diamond. Berlisensi MIT, konteks asli 262K yang bisa diperluas hingga sekitar 1M dengan YaRN. Dibangun di atas Qwen3.5 dan Gemma 4 dengan pretraining dan post-training lanjutan.
- GLM-5.3: peringkat keenam pada indeks Artificial Analysis di 59,5, di atas GPT-5.6 Sol.
- Qwen3.8: model 2,4 triliun parameter di bawah Apache 2.0, plus saudara dense multimodal 27B yang menurut Alibaba mengalahkan Qwen3.7-Plus yang lebih besar pada tugas coding dan perkantoran.
Enam bulan lalu kerangka yang jujur adalah “bobot terbuka tertinggal satu generasi dan lebih murah.” Kerangka itu kini salah. Kerangka yang benar adalah: khusus untuk coding dan pekerjaan agentic, model bobot terbuka terbaik berada di dalam batas galat frontier tertutup generasi lalu, dan harganya 10× hingga 60× lebih murah.
Ornith-1.5 adalah model paling menarik tahun ini dan hampir tidak ada yang pernah mendengarnya
Aku ingin membahas yang ini lebih lama, karena ini benar-benar hal baru, bukan sekadar hasil scaling.
Ornith menggambarkan 1.5 sebagai perluasan “self-scaffolding menjadi lingkaran peningkatan diri end-to-end.” Dalam bahasa sederhana: sistem mengusulkan tugas pelatihannya sendiri yang baru, menghasilkan scaffold khusus tugas untuk itu, memproduksi rollout solusi, dan mengoptimalkan ketiganya secara bersama dengan GRPO. Model yang lebih kuat memungkinkannya mengusulkan tugas yang lebih sulit; scaffold yang lebih baik menemukan strategi yang lebih baik; keluaran yang lebih baik memberi sinyal belajar yang lebih bersih.
Model ini dilatih di atas Qwen3.5 dan Gemma 4 — yaitu, di atas bobot terbuka milik orang lain — dan mengalahkan Claude Opus 4.8 pada Terminal-Bench 2.1 dengan ukuran 397B parameter dan lisensi MIT.
Kalau lingkaran itu bisa digeneralisasi, itu hasil paling berdampak dalam artikel ini, karena artinya ekosistem terbuka bisa berkembang tanpa ada lab yang mengeluarkan uang sekelas frontier untuk satu putaran pretraining. Kalau tidak bisa digeneralisasi — kalau yang kita lihat adalah overfitting khusus benchmark dari kurikulum yang dihasilkan sendiri — maka itu justru jadi kisah peringatan tentang hal yang sama persis. Aku tidak tahu yang mana. Sejauh yang bisa kutahu, tidak ada orang di luar Ornith yang tahu juga. Yang kuinginkan sebelum bertaruh padanya: evaluasi independen pada tugas-tugas yang tidak berada di sekitar kurikulum yang dihasilkan sendiri, dan baseline manusia yang disisihkan. Keduanya belum ada.
Sekarang lisensinya, karena “sumber terbuka” melakukan banyak kerja yang tidak jujur
Inilah biaya kewajiban yang sebenarnya dikenakan bobot tersebut padamu:
| Model | Lisensi | Jebakannya |
|---|---|---|
| DeepSeek V4 Pro | MIT | Tidak ada. Benar-benar sumber terbuka. |
| Qwen3.8 | Apache 2.0 | Tidak ada. Benar-benar sumber terbuka. |
| Gemma 4 | Apache 2.0 | Tidak ada — dan peningkatan nyata dibanding syarat khusus Gemma 3. |
| Ornith-1.5 | MIT | Tidak ada yang dinyatakan. Verifikasi sendiri kartu modelnya sebelum merilis. |
| GLM-5.3 | Khusus | Perusahaan dengan pendapatan tahunan $10B harus lulus tinjauan keamanan Z.ai sebelum penggunaan komersial apa pun. Z.ai beralih menjauh dari MIT untuk rilis ini. |
| Kimi K3 | Khusus | Berjenjang berdasarkan pendapatan; atribusi menonjol wajib bagi penyedia bervolume tinggi. |
| MiniMax M3 | Khusus | Penggunaan komersial mewajibkan atribusi “Built with MiniMax M3” yang menonjol; otorisasi tertulis terpisah di atas $20M pendapatan tahunan. |
| Muse Spark | Tidak diketahui | Diumumkan sebagai “segera hadir.” Teks lisensinya belum ada. |
Tiga pengamatan. Aku sudah membahas detail cetak kecil dari tiga yang pertama secara rinci di Kimi K3 versus Fable 5.1 versus GLM-5.3, jadi di sini aku akan fokus pada apa yang berubah sejak itu.
Pertama, gerbangnya ditujukan untuk hyperscaler, bukan untukmu. Ambang pendapatan $10 miliar pada dasarnya mengecualikan setiap pembaca artikel ini. Kalau kamu bisnis Mittelstand Jerman, agensi, konsultan, atau developer solo, jawaban praktis untuk GLM-5.3 dan Kimi K3 adalah: kamu aman.
Kedua, “kamu aman” tidak sama dengan “tinjauan hukummu aman.” Lisensi khusus berarti ada orang yang menagihmu untuk membacanya. Lisensi MIT atau Apache 2.0 berarti seseorang membacanya dalam sembilan puluh detik lalu lanjut. Bagi pengadaan perusahaan, perbedaan itu lebih bernilai daripada empat poin benchmark, dan itu argumen terkuat untuk memilih DeepSeek V4 Pro dan Qwen3.8 daripada GLM-5.3 dalam produk komersial.
Ketiga, perhatikan arah pergerakannya. Z.ai beralih dari MIT pada GLM-5.2 ke lisensi proprietary dengan gerbang tinjauan keamanan pada GLM-5.3. DeepSeek bergerak ke arah sebaliknya dan tetap memakai MIT sambil menaikkan harga API — strategi yang koheren: menagih untuk kemudahan, membagikan bobotnya gratis, dan membiarkan penyedia inferensi bersaing dalam penyajian. Bobot terbuka bukan sebuah gerakan. Itu taktik komersial, dan taktik berubah tiap rilis. Jangan bangun arsitektur produk yang mengasumsikan versi tahun depan akan membawa lisensi tahun ini.
Kata “sumber terbuka” sebaiknya dipensiunkan untuk model
Tidak satu pun dari ini adalah sumber terbuka dalam arti yang dimaksud OSI, kecuali yang berlisensi MIT dan Apache 2.0 — dan bahkan itu merilis bobot tanpa merilis data pelatihan atau kode pelatihan, yang secara makna berbeda dari perangkat lunak sumber terbuka.
Kosakata yang kupakai, dan yang kusarankan:
- Bobot terbuka — kamu bisa mengunduh dan menjalankan parameternya. Tidak mengatakan apa pun soal syarat.
- Berlisensi terbuka — MIT, Apache 2.0, atau setara. Tanpa gerbang pendapatan, tanpa kewajiban atribusi, tanpa pembatasan bidang penggunaan.
- Sumber terbuka — bobot, kode pelatihan, dan komposisi data, di bawah lisensi yang disetujui OSI. Hampir tidak ada di frontier yang memenuhi syarat.
Kalau vendor mengatakan “model sumber terbuka” dan yang dimaksud adalah yang pertama, itu tidak tepat disebut bohong, tapi itulah jenis ketidaktepatan yang berakhir di dokumen pengadaan lalu di sengketa.
Tampilkan gambar Kemampuan semakin konvergen. Lisensi semakin divergen. Bagi sebagian besar pembeli komersial, kolom kananlah yang menentukan pembelian, bukan skornya.
Bagian Empat: Masalah Benchmark
SWE-bench Verified sekarang terlihat seperti ini:
| Peringkat | Model | Skor |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
Tiga model dalam selisih satu poin persentase di puncak. Benchmark itu sudah selesai. Ia tidak bisa memberitahumu hal berguna apa pun tentang perbedaan antara Opus 5, Mythos 5, dan Fable 5, dan siapa pun yang mengutipnya sebagai masukan pembelian pada September 2026 sedang mengutip instrumen yang sudah jenuh.
Inilah kondisi umum evaluasi AI saat ini, dan ada empat mode kegagalan yang layak disebut:
Saturasi. Saat skor teratas menggerombol di atas 90%, perbedaan yang tersisa didominasi derau label dan detail harness, bukan kemampuan. SWE-bench Verified sudah di sana. GPQA Diamond mendekat.
Sensitivitas scaffold. Model yang sama mendapat skor berbeda tergantung lingkaran agen yang membungkusnya — kebijakan percobaan ulang, set alat, pengelolaan konteks, berapa banyak giliran yang didapat. Hasil Terminal-Bench dan OSWorld sangat sensitif terhadap ini. Dua lab yang melaporkan benchmark yang sama sering kali tidak menjalankan eksperimen yang sama.
Kontaminasi. Setiap benchmark publik pada akhirnya bocor ke korpus pelatihan. Jawabannya adalah perlombaan senjata benchmark privat yang lebih segar dan lebih sulit — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science — yang menyelesaikan kontaminasi dan menciptakan masalah baru: kamu tidak bisa memverifikasi benchmark privat secara independen.
Seleksi. Lab menerbitkan benchmark yang mereka menangkan. Anthropic memimpin dengan Frontier-Bench dan ARC-AGI-3 untuk Opus 5. OpenAI memimpin dengan Agents’ Last Exam dan Coding Agent Index untuk GPT-5.6. Z.ai memimpin dengan CyberGym. Tidak ada yang berbohong. Semua memilih.
Apa yang benar-benar kupercaya pada September 2026
Agregat daripada angka tunggal. Indeks Artificial Analysis punya keunggulan karena dijalankan pihak ketiga, pada harness tetap, di sembilan evaluasi, atas 190 model. Angka absolutnya sedikit berarti; urutanannya adalah sinyal publik paling dapat dipertahankan yang tersedia.
Hasil yang dinormalisasi biaya. Klaim Opus 5 milik Anthropic sendiri adalah contoh baik cara melaporkan ini: “dalam 0,5% dari skor puncak Fable 5 dengan biaya setengahnya” pada CursorBench 3.2, dan mengalahkan Fable 5 pada OSWorld 2.0 “dengan sepertiga biaya.” Itu klaim yang berguna karena menyebutkan trade-off-nya.
Efisiensi token. Artificial Analysis mencatat bahwa Gemma 4 31B hanya memakai 39 juta token keluaran untuk menyelesaikan seluruh Intelligence Index. Untuk beban kerja agentic, model yang mencapai jawaban sama dengan sepertiga token berarti sepertiga tagihan dan sepertiga latensi. Ini kurang dilaporkan dan merupakan salah satu dari sedikit metrik yang langsung berterjemah menjadi uang.
Eval milikmu sendiri. Dua puluh tugas dari backlog aktualmu, dijalankan pada tiga model, dinilai olehmu. Butuh satu sore. Hasilnya akan memberitahumu lebih banyak daripada gabungan semua papan peringkat di artikel ini, dan itu satu-satunya evaluasi yang secara definisi tidak terkontaminasi.
Dan satu hal yang tidak kupercaya: angka token per detik atau angka benchmark tunggal apa pun yang dikutip tanpa harness, kuantisasi, dan tanggal. Perlakukan itu sebagai klaim orde besaran.
Bagian Lima: Angka yang Benar-Benar Bergerak — Horizon Waktu Agentic
Kalau kamu hanya mengambil satu metrik dari artikel ini, ambil yang ini.
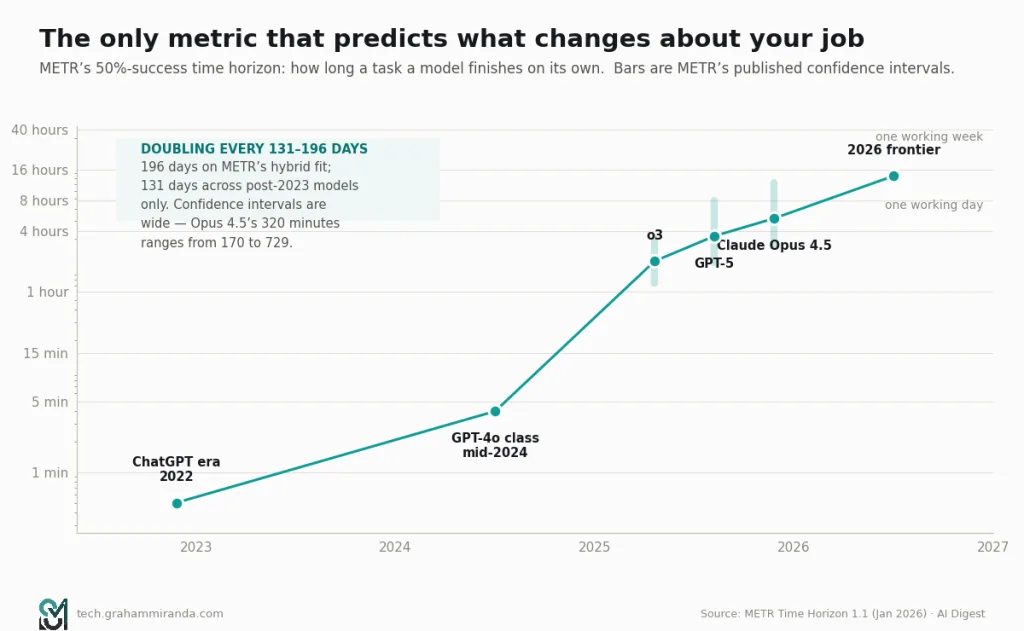
METR mengukur panjang tugas — dalam jam manusia — yang bisa diselesaikan model secara mandiri dengan keberhasilan 50%. Ini proksi yang lebih baik untuk “apakah benda ini bisa melakukan pekerjaanku” daripada benchmark pengetahuan mana pun, karena menangkap hal yang benar-benar gagal dalam praktik: bukan tidak tahu jawabannya, melainkan tidak mampu tetap koheren cukup lama untuk sampai ke sana.
Trennya, dari karya METR sendiri dan pemantauan AI Digest atasnya:
| Periode | Horizon waktu keberhasilan 50% |
|---|---|
| 2022 (era peluncuran ChatGPT) | ~30 detik |
| Pertengahan 2024 (kelas GPT-4o) | ~4 menit |
| Akhir 2025 (Claude Opus 4.5) | 320 menit (~5,3 jam), CI [170, 729] |
| Frontier 2026 | 14+ jam |
Waktu penggandaan adalah bagian yang diperdebatkan. Rilis Time Horizon 1.1 METR pada 29 Januari 2026 — 228 tugas, 31 di antaranya diperkirakan membutuhkan delapan jam atau lebih upaya manusia, dimigrasikan ke framework Inspect milik UK AI Security Institute — melaporkan 196 hari (7 bulan) pada campuran data lama dan baru, tetapi 131 hari saat dibatasi pada model pasca-2023, yang sekitar 20% lebih cepat daripada 165 hari yang diberikan metodologi sebelumnya.
Mengekstrapolasi eksponensial adalah cara orang mempermalukan diri sendiri, jadi biar kusebutkan peringatannya dengan lantang sebelum aku memakai angka itu.
Peringatannya besar. Interval kepercayaan METR sendiri sangat besar — horizon 320 menit Opus 4.5 punya rentang 170 hingga 729 menit. Hanya 5 dari 31 tugas panjang mereka yang punya baseline manusia terukur; sisanya perkiraan. Komposisi tugas mengubah tren yang terukur. Dan “keberhasilan 50% pada tugas yang terspesifikasi baik dengan lingkungan bersih” jauh berbeda dari “keberhasilan 50% pada basis kodemu dengan suite tesmu yang tidak stabil dan proses deployment-mu yang tidak terdokumentasi.”
Dengan semua itu, arahnya tidak diragukan dan besarnya kira-kira benar. Berdasarkan ekstrapolasi, agen frontier mencapai sekitar satu hari kerja panjang tugas mandiri pada 2027 dan sekitar satu minggu kerja pada 2028.
Mengapa ini angka yang penting
Karena ini satu-satunya metrik yang memprediksi apa yang berubah pada pekerjaanmu.
Model dengan horizon 4 menit adalah autocomplete. Kamu terus berada dalam lingkaran, dan kualitas model menentukan seberapa bagus saranannya.
Model dengan horizon 5 jam adalah kolega yang kamu beri arahan pagi hari dan kamu tinjau saat makan siang. Kamu bukan bagian dari lingkaran; kamu ada di ujungnya. Kualitas model menentukan seberapa sering tinjauannya menyakitkan.
Model dengan horizon 40 jam adalah sesuatu yang belum punya struktur manajemen. Kamu akan meninjau pekerjaan seminggu yang tidak kamu lihat terjadi, pada basis kode yang berubah saat kamu tidak melihat, terhadap spesifikasi yang kamu tulis sebelum kamu tahu apa masalahnya.
Setiap argumen di sisa artikel ini — tentang vibe coding, tentang verifikasi, tentang di mana bottleneck berada — sebenarnya adalah argumen tentang apa yang terjadi saat angka itu naik. Modelnya menjadi berhorizon panjang. Proses tinjauan kami tidak.
Tampilkan gambar Horizon waktu dengan keberhasilan 50%, dengan interval kepercayaan METR ditampilkan secara jujur. Intervalnya cukup lebar untuk berarti — dan trennya tetap bertahan.
BABAK II — MASA DEPAN VIBE CODING
Bagian Enam: Apa Arti “Vibe Coding” Sekarang
Andrej Karpathy menciptakan istilah itu pada Februari 2025 untuk menggambarkan sesuatu yang spesifik dan sedikit nakal: menyerah pada vibe, melupakan bahwa kodenya ada, menerima diff tanpa membacanya, dan membiarkan model yang menyetir. Itu adalah deskripsi dari sebuah mode, ditawarkan setengah bercanda, untuk proyek akhir pekan yang sekali pakai.
Delapan belas bulan kemudian, frasa itu telah melewati siklus hidup lengkapnya. Ia menjadi gerakan, lalu jabatan, lalu ejekan, lalu kata tahun ini versi Collins, lalu kategori pendanaan ventura, dan sekarang — dalam satu-satunya perkembangan yang benar-benar penting — seperangkat praktik rekayasa yang tidak lagi mirip dengan apa yang digambarkan Karpathy.
Aku ingin tepat soal pemisahannya, karena kedua hal itu terus-menerus dicampur dan profil risikonya berlawanan.
Vibe coding, arti aslinya. Prompt, terima, jalankan, prompt lagi. Jangan baca diff-nya. Artefaknya sekali pakai. Ini benar-benar hebat, dan aku melakukannya beberapa kali seminggu — untuk skrip yang mengubah bentuk CSV, scraper sekali pakai, visualisasi yang akan kulihat sekali, prototipe yang satu-satunya tugasnya adalah membuat percakapan jadi konkret. Ciri penentunya bukan kecepatan. Ciri penentunya adalah tidak ada orang yang akan pernah bergantung padanya.
Agentic engineering, arti sekarang. Tulis spesifikasi. Beri agen suite tes, linter, pemeriksa tipe, dan sandbox. Biarkan ia berjalan satu jam. Tinjau diff-nya dengan benar. Merge di balik gerbang yang sama seperti PR manusia. Ciri penentunya adalah keluaran model diperlakukan seperti keluaran kolega junior — berguna, cepat, dan tidak dipercaya.
Keduanya berbagi teknologi dan hampir tidak berbagi hal lain. Kalau kamu ingin versi praktisi dari yang kedua, itulah yang tulisan awalku tentang vibe coding pada 2026 dibahas; bagian ini tentang ke mana praktiknya menuju. Hasil katastrofik di Bagian Delapan semuanya berasal dari menerapkan praktik mode pertama pada taruhan mode kedua.
Angka adopsinya sangat besar dan sebagian besar tidak diperdebatkan
- 90% developer memakai setidaknya satu alat AI di tempat kerja, menurut survei AI Pulse JetBrains (Januari 2026). Survei Stack Overflow 2025 mencatat 84% memakai atau berencana memakai.
- Hampir 80% developer baru GitHub mengadopsi Copilot dalam minggu pertama mereka (GitHub Octoverse 2025).
- 59% developer memakai tiga atau lebih alat coding AI secara paralel. Statistik itu memberitahumu lebih banyak daripada angka adopsinya — pasarnya tidak terkonsolidasi, melainkan terpecah menjadi alat-alat khusus tugas.
Angka pasarnya
| Alat | Metrik | Sumber / tanggal |
|---|---|---|
| GitHub Copilot | ~42% pangsa berdasarkan basis pengguna; 20 juta+ pengguna | Gartner / vendor, 2026 |
| Cursor | $2B+ ARR; 1 juta+ pengguna aktif harian; ~20–25% pasar berdasarkan pendapatan | Dilaporkan, Februari 2026 |
| Claude Code | ~$2,5B run-rate; 46% “paling disukai” vs 19% milik Cursor | Dilaporkan, April 2026 |
| Pasar coding-agent perusahaan | ~$9,8–11B per tahun | Gartner, April 2026 |
Dua hal menonjol. Copilot punya penggunanya dan kepuasan terendah di antara tiga teratas. Claude Code punya basis instalasi terkecil dan kasih sayang tertinggi sejauh ini. Itu tanda pasar yang sedang di tengah transisi — pemain lama menang distribusi, penantang menang alur kerja, dan para pengguna belum selesai berpindah.
Dan angka yang meruntuhkan semua itu
Kepercayaan developer pada keluaran AI turun dari sekitar 40% pada 2024 menjadi 29% pada 2026. Survei SonarSource terpisah menemukan 96% developer tidak sepenuhnya percaya kode buatan AI benar secara fungsional.
Renungkan itu. Pemakaian naik. Kepercayaan turun. Keduanya tidak kontradiktif; begitulah bentuk adopsi alat yang matang. Tidak ada orang yang “mempercayai” gergaji mesin. Mereka memakainya terus-menerus, dengan dua tangan, memakai pelindung, dan tidak pernah membelakanginya.
Orang yang paling memahami alat-alat ini adalah yang paling hati-hati menggunakannya. Itu sinyal yang sehat, dan sama sekali tidak ada di sebagian besar pemasaran vendor.
Bagian Tujuh: Apakah Ini Benar-Benar Membuatmu Lebih Cepat? Buktinya, dengan Jujur
Di sinilah aku kehilangan sebagian pembaca, dan aku lebih suka kehilangan mereka di sini daripada menyesatkan mereka.
Uji acak mengatakan tidak
METR menjalankan studi yang semua orang kutip, pada Juli 2025: developer sumber terbuka berpengalaman, bekerja pada repositori matang mereka sendiri (1 juta+ baris), diacak pada tingkat tugas untuk memakai atau tidak memakai alat AI awal 2025.
Hasil: 19% lebih lambat dengan AI.
Dan temuan yang lebih penting daripada judul besarnya: para developer percaya mereka sekitar 20% lebih cepat. Mereka melebih-lebihkan efek AI pada waktu mereka sekitar 40 poin persentase.
Tindak lanjut 2026 tidak menyelesaikannya — ia mengungkap sesuatu yang lebih buruk
METR mencoba menjalankan ulang eksperimen itu dan, pada Februari 2026, menerbitkan tulisan yang luar biasa terbuka tentang mengapa desainnya rusak.
- Rekrutmen gagal. Developer semakin menolak bekerja tanpa akses AI, bahkan dengan $50 per jam.
- Seleksi tugas terkontaminasi. 30–50% developer mengaku menghindari tugas yang mereka perkirakan akan ditangani AI dengan baik. Seorang peserta mengungkapkannya dengan sempurna: “Aku menghindari issue seperti AI bisa menyelesaikan sesuatu dalam 2 jam, tapi aku harus menghabiskan 20 jam.”
- Pelacakan waktu berhenti bekerja begitu developer menjalankan beberapa agen sekaligus.
Angka interim mentah 2026 mereka berkisar dari −18% hingga −4% — masih lebih lambat, tidak sedramatis itu — tetapi METR sendiri menyebutnya “bukti yang sangat lemah” mengingat bias seleksi.
Baca ulang poin kedua, karena itu temuan paling menarik di seluruh literatur dan terkubur dalam catatan metodologi. Kalau developer secara sistematis mengalihkan tugas-tugas yang ramah AI menjauh dari studi yang mengukur manfaat AI, studi itu akan meremehkan manfaatnya. Ini juga menyiratkan bahwa dalam kehidupan nyata, developer sudah melakukan pengalihan itu — yang justru merupakan perilaku yang membuat alat-alat ini bernilai dan membuat RCT sulit dijalankan.
Survei mengatakan ya, cukup besar, dan angkanya digelembungkan
Survei METR Mei 2026 (n=349: 87 insinyur perangkat lunak, 71 peneliti, 129 akademisi dan mahasiswa PhD, 48 founder dan manajer; rata-rata 12 tahun pengalaman pemrograman, 19 bulan penggunaan alat AI) melakukan sesuatu yang cerdas. Survei itu memisahkan nilai dari kecepatan.
Responden median melaporkan pengali kecepatan 3× tetapi hanya perubahan 1,4–2× pada nilai pekerjaan mereka. Secara retrospektif mereka memperkirakan nilai 1,3× pada Maret 2025; mereka memperkirakan 2,5× pada Maret 2027.
METR menjelaskan dengan tegas bahwa nilai adalah angka yang benar-benar dipedulikan perancang survei, dan bahwa responden secara alami berpikir dalam ukuran kecepatan — dan itulah tepatnya bias yang diukur oleh RCT 2025 sebesar 40 poin persentase.
Jadi: laporan sendiri menyebut 3×. Laporan sendiri yang dikoreksi sesuai maksud orang menyebut 1,4–2×. Satu-satunya pengukuran terkontrol yang kita punya menyebut 0,81×.
Data organisasi mengatakan “itu tergantung kamu, bukan alatnya”
Laporan DORA’s 2026 (Google Cloud, Mei 2026) adalah hal paling berguna yang terbit soal ini sepanjang tahun, dan berguna karena berhenti memperdebatkan alatnya.
- ROI tahun pertama yang dimodelkan sebesar 39% untuk organisasi teknik berisi 500 orang, dengan sekitar pengembalian 8 bulan — $11,6 juta nilai dibanding $8,4 juta investasi.
- A Kurva J: produktivitas turun dulu sebelum naik, didorong oleh adaptasi alur kerja, biaya verifikasi tinjauan kode, dan perubahan hilir pada tahap pengujian dan persetujuan.
- Tingkat kegagalan perubahan naik dari 5% ke 6% setelah adopsi, memakan $344.000 biaya waktu henti dalam perhitungan sampel mereka.
- Dan tesisnya: “Hasil terbesar dari investasi AI bukan berasal dari alatnya sendiri, melainkan dari fokus strategis pada sistem organisasi yang mendasarinya.”
Baris terakhir itu adalah konsensus 2026, kalau memang ada konsensus. AI memperkuat apa pun yang sudah menjadi praktik teknikmu. Pengujian yang baik, tinjauan kode yang sungguhan, rollback cepat, kepemilikan yang jelas — AI membuat organisasi seperti itu jauh lebih cepat. Pengujian lemah, tinjauan sekadar cap, deploy manual, kepemilikan tidak jelas — AI membuat organisasi seperti itu gagal lebih cepat dan dalam jumlah lebih besar.
Cara menyatukan semua ini
Menurut saya temuan-temuan ini sebenarnya tidak bertentangan. Inilah sintesis yang saya dapatkan, dan saya memegangnya dengan longgar:
Alat coding AI memberi keuntungan besar pada pekerjaan yang tidak familiar dan kerugian kecil pada pekerjaan yang sangat familiar. Pada basis kode yang kamu kenal betul, dalam bahasa yang kamu kuasai, pada masalah yang pernah kamu selesaikan, kamu lebih cepat daripada siklus tinjau-dan-perbaiki. Pada framework yang tidak familiar, bahasa yang kamu pakai dua kali setahun, boilerplate, kerangka pengujian, migrasi, atau basis kode yang delapan bulan belum kamu buka, modelnya mengubah segalanya.
METR meneliti pengembang berpengalaman di repositori matang milik mereka sendiri — satu-satunya skenario yang paling kecil kemungkinan untungnya. Itu tidak membuat temuannya salah. Itu membuatnya spesifik, dan seharusnya membuatmu curiga pada siapa pun yang mengutipnya sebagai vonis umum, ke arah mana pun.
Sintesis kedua: keuntungannya nyata, tetapi mendarat di tempat lain, bukan di tempat orang mencarinya. Bukan “fitur ini selesai empat jam, bukan enam jam.” Lebih seperti: migrasi yang tidak akan pernah diprioritaskan akhirnya selesai; cakupan pengujian yang tadinya akan tetap 40% naik ke 75%; dokumentasinya ada. Hal-hal itu tidak muncul dalam studi waktu penyelesaian tugas, dan justru di situlah sebagian besar nilai sebenarnya.
Bagian delapan: tagihan keamanannya sudah datang, dan rinciannya ada
Kalau Bagian Tujuh terasa tidak nyaman, bagian inilah yang biasanya orang lewati. Tolong jangan dilewati.
Pengukurannya
Veracode menguji lebih dari 100 model bahasa besar pada 80 tugas coding dalam Java, Python, C# dan JavaScript:
- 45% sampel kode buatan AI memunculkan kerentanan OWASP Top 10. Tingkat kelulusannya praktis tidak berubah sampai awal 2026 — model jadi jauh lebih pintar dan tidak lebih aman.
- Java paling buruk dengan tingkat kegagalan 72%.
- 86% gagal dalam pertahanan terhadap cross-site scripting. 88% rentan terhadap log injection.
Apiiro menjalankan mesin Deep Code Analysis-nya pada repositori perusahaan Fortune 50 dari Desember 2024 sampai Juni 2025:
- Pengembang yang dibantu AI menghasilkan commit dengan tiga sampai empat kali laju rekan-rekan mereka.
- Mereka memunculkan temuan keamanan dengan sepuluh kali laju itu.
- Jalur eskalasi hak istimewa naik 322%. Cacat desain arsitektur naik 153%.
USENIX Security 2025 menganalisis 576.000 sampel kode buatan AI:
- Sekitar 20% merujuk ke paket yang tidak ada.
- 43% nama paket hasil halusinasi muncul konsisten pada prompt yang serupa — inilah bagian yang mengubah bug menjadi permukaan serangan. Halusinasi yang bisa diprediksi adalah celah yang bisa didaftarkan lebih dulu oleh penyerang di npm atau PyPI.
Vibe Security Radar dari Georgia Tech menelusuri CVE lewat riwayat git untuk menghubungkannya dengan perkakas AI:
| Bulan (2026) | CVE yang diatribusikan |
|---|---|
| Januari | 6 |
| Februari | 15 |
| Maret | 35 |
74 terkonfirmasi secara keseluruhan, dan para peneliti memperkirakan angka sebenarnya di seluruh sumber terbuka adalah lima sampai sepuluh kali lebih tinggi.
RedAccess mengindeks sekitar 380.000 aplikasi hasil vibe coding yang dapat diakses publik di Lovable, Base44, Replit, dan Netlify. Sekitar 5.000 di antaranya membocorkan data korporat atau pribadi yang sensitif.
Insiden beserta tanggalnya
| Tanggal | Insiden |
|---|---|
| Jul 2025 | Replit AI menghapus basis data produksi; 1.200 catatan eksekutif terdampak, 4.000 akun palsu dibuat |
| Feb 2026 | Aplikasi EdTech buatan Lovable membuka 18.697 catatan pengguna termasuk 4.538 akun siswa |
| Apr 2026 | Kerentanan BOLA Lovable — setiap proyek sebelum November 2025 bisa dijangkau dalam lima panggilan API |
| 26 Apr 2026 | Cursor “penghapusan 9 detik”: basis data sebuah perusahaan terhapus bersama cadangannya |
| 30 Apr 2026 | Eksekusi kode jarak jauh CVSS-10 di Gemini CLI dalam alur kerja CI, sudah ditambal |
Kasus Amazon, yang akan saya tangani dengan hati-hati
Kamu pasti sudah melihat kisah Amazon. Empat insiden Sev-1 antara Desember 2025 dan Maret 2026 — gangguan AWS Cost Explorer selama 13 jam di Tiongkok, estimasi waktu pengiriman yang salah di keranjang belanja pada 2 Maret yang menurut laporan memakan sekitar 120.000 pesanan, dan insiden 6 jam pada 5 Maret ketika pesanan di Amerika Utara dilaporkan turun 99%.
Laporan dari Financial Times, Fortune, dan The Register menghubungkan dokumen internal Amazon dengan apa yang disebut sebagai “perubahan dengan bantuan Gen-AI,” disertai peringatan bahwa pembuatan kode yang cepat mengekspos kerentanan. Amazon membantah hubungan sebab-akibat langsung, dan dalam beberapa tanggapan menyatakan bahwa tidak satu pun insiden melibatkan kode tulisan AI.
Saya menandai tiga hal tentang kisah ini, bukan mengulanginya sebagai fakta:
- Angka dampak yang paling sering dikutip (6,3 juta pesanan hilang) berasal dari pos Medium, bukan dari Amazon atau dari laporan resmi media yang disebut namanya sendiri. Perlakukan itu sebagai perkiraan, bukan angka pasti.
- Penerapan pada 5 Maret dilaporkan berjalan tanpa dokumentasi atau persetujuan formal. Itu kegagalan proses. Kecepatan AI membuatnya mungkin terjadi lebih cepat; itu tidak membuat gerbang persetujuan menjadi opsional.
- Perbedaan itulah intinya, dan itulah sebabnya saya tetap menyertakan kisah ini. Mode kegagalannya hampir tidak pernah “AI menulis kode buruk.” Melainkan “AI menulis kode lebih cepat daripada proses yang seharusnya memeriksanya.”
Apa implikasi sebenarnya untuk praktik
Bukan “berhenti menggunakan alatnya.” Tidak ada orang serius yang berargumen begitu, dan catatan riset CSA’s sendiri — yang merangkum sebagian besar hal di atas — mengutamakan tata kelola daripada pantang penggunaan.
Bentuk praktisnya, dalam urutan yang akan saya terapkan:
- Perlakukan alat AI apa pun yang memiliki akses kredensial sebagai sistem istimewa. Itu memang sistem istimewa. Batasi cakupan tokennya sesuai itu.
- SAST, pemindaian dependensi, dan deteksi rahasia pada setiap commit. Bukan tiap malam. Setiap commit. Laju commit naik tiga hingga empat kali; pemindaian tiap malam kini secara efektif menjadi siklus umpan balik tiga hari.
- Analisis komposisi perangkat lunak, khususnya untuk paket halusinasi. Ini adalah kontrol termurah dengan nilai tertinggi dalam daftar karena angka 20% itu sangat besar dan kegagalannya sangat senyap.
- Kebijakan tertulis bahwa bantuan AI tidak digunakan tanpa tinjauan pada kode autentikasi, kriptografi, otorisasi, atau pembayaran. Ini adalah empat area di mana kesalahan kecil kemungkinan besar terjadi dan berdampak katastrofik, serta tempat mata peninjau’ paling berharga.
- Perluas SBOM kamu untuk mencatat asal-usul alat AI. Ketika studi atribusi bergaya Georgia Tech berikutnya tiba di basis kode kamu, kamu ingin bisa menjawab pertanyaan itu sendiri.
- Perlakukan platform vibe coding pihak ketiga sebagai pemasok SaaS. Angka RedAccess adalah apa yang terjadi ketika tidak ada yang melakukannya.
Tidak ada yang eksotis dari semua itu. Sebagian besar adalah apa yang dilakukan tim kompeten pada 2019. Perubahannya adalah volumenya naik satu orde magnitudo, jadi kontrolnya harus otomatis, bukan kultural.
Tampilkan gambar Data keamanan, dari Veracode, Apiiro, USENIX, dan Georgia Tech. Perhatikan bentuknya: kecepatan commit naik 3–4×, temuan keamanan naik 10×. Selisih antara kedua pengali itu adalah seluruh masalahnya.
Bagian sembilan: apa yang menggantikan vibe coding
Praktik yang benar-benar berhasil pada 2026 punya nama — beberapa nama yang bersaing, yang justru menandakan itu nyata — dan kira-kira kebalikan dari vibe.
Sebut saja pengembangan berbasis spesifikasi, rekayasa agentic, atau rekayasa konteks. Struktur umumnya:
1. Spesifikasi sekarang adalah kode sumber
Bukan tiket Jira. Dokumen sungguhan: apa yang dilakukan hal itu, apa yang tidak boleh dilakukannya, apa antarmukanya, seperti apa “selesai” itu, apa saja mode kegagalannya. Di-commit ke repositori, diberi versi, ditinjau.
Ini terasa seperti kemunduran ke 1998, padahal bukan. Bedanya, pada 1998 spesifikasi adalah masukan bagi manusia yang akan menafsirkannya ulang, dan spesifikasi itu membusuk begitu penulisan kode dimulai. Pada 2026 spesifikasi adalah masukan bagi proses yang meregenerasi implementasi dengan murah — yang berarti ketika kebutuhan berubah, kamu mengubah spesifikasi dan menurunkan ulang implementasinya, alih-alih menambal kode yang tidak lagi cocok dengan deskripsi tertulisnya sendiri.
Logika ekonominya berbalik. Ketika implementasi mahal dan spesifikasi murah, kamu menentukan spesifikasi secara longgar dan berinvestasi pada kode. Ketika implementasi murah dan spesifikasi menjadi hambatan, kamu berinvestasi pada spesifikasi.
2. Rangkaian tes adalah batas kepercayaan
Agen yang dapat menjalankan tes kamu dan beriterasi terhadapnya adalah alat yang secara mendasar berbeda dari agen yang tidak bisa. Ini adalah perubahan dengan daya ungkit tertinggi yang bisa dilakukan sebagian besar tim, dan sama sekali bukan soal AI — melainkan bahwa AI akhirnya membuat ROI cakupan tes menjadi jelas bagi orang-orang yang tidak akan pernah terbujuk oleh argumen soal keahlian.
Versi praktisnya: agen mendapat sandbox, perintah tes, perintah lint, dan pemeriksaan tipe, dan tugasnya belum selesai sampai keempatnya hijau. Segala hal lainnya bisa dinegosiasikan.
3. Tinjauan bergeser dari baris ke diff lalu ke perilaku
Tinjauan baris demi baris tidak berskala untuk diff sepanjang seribu baris yang dihasilkan agen, dan berpura-pura sebaliknya adalah cara pengesahan asal-asalan dimulai.
Yang berhasil sebagai gantinya, dalam urutan nilai secara kasar:
- Tinjau spesifikasinya, bukan implementasinya. Kalau spesifikasinya benar dan tesnya lulus, implementasinya cuma detail.
- Periksa bentuk diff’nya — berkas apa yang disentuh, dependensi apa yang ditambahkan, apa yang terhapus. Sebagian besar bencana agen terlihat di level ini: berkas tak terduga, dependensi baru, penghapusan yang tidak diminta siapa pun.
- Periksa khususnya baris-baris yang sensitif keamanan. Auth, kripto, authz, pembayaran, apa pun yang menyentuh PII. Ini hanya sebagian kecil dari diff mana pun.
- Jangan periksa boilerplate-nya. Lagipula kamu memang tidak pernah benar-benar memeriksanya.
4. Harness sama pentingnya dengan model
Ini kurang dihargai. Model yang sama, dalam dua loop agen yang berbeda, menghasilkan pekerjaan dengan kualitas yang jauh berbeda — itulah sebabnya perbandingan benchmark antar-lab begitu licin.
Bagian yang penting: bagaimana konteks dikelola saat proses memanjang, apakah agen bisa melihat kegagalan tesnya sendiri, apakah ia bisa menjelajahi repositori atau hanya yang kamu tempel, apakah ia punya langkah perencanaan yang terpisah dari langkah eksekusi, dan apakah ia tahu kapan harus berhenti dan bertanya.
Catatan rilis Muse Spark 1.3 dari Meta menarik justru pada titik ini — mereka menggambarkan model itu kini mengajukan pertanyaan klarifikasi pada prompt yang ambigu, meminta bantuan saat macet, dan mengonfirmasi sebelum tindakan yang berdampak. Itu bukan peningkatan kecerdasan. Itu sopan santun, dan sopan santun itulah yang membuat agen berjangkauan panjang bisa bertahan.
5. Perutean model kini jadi praktik standar
Tidak ada orang serius yang memakai satu model untuk semuanya — saya membahas versi dua model dari ini di GLM-5.3-Flash vs MiniMax M3 di OpenCode. Pola yang sudah mapan:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
      "description": "Architecture, root cause, anything where being wrong is expensive",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation — long-horizon, cost-sensitive",
      "model": "anthropic/claude-opus-5"
    },
    "bulk": {
      "description": "High-volume mechanical work where price dominates",
      "model": "zai/glm-5-3-flash"
    },
    "private": {
      "description": "Anything touching client data — runs on hardware we own",
      "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
      "description": "Renames, docstrings, lint fixes, test scaffolding",
      "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
Alasannya, baris demi baris:
- Perencanaan diberikan ke model paling mumpuni yang sanggup kamu bayar. Rencana yang buruk memakan token hilir lebih banyak daripada biaya rencananya sendiri.
- Pembangunan diberikan ke model berjangkauan panjang terbaik dengan harga yang wajar. Opus 5 pada $5/$25 memang diposisikan secara eksplisit untuk ini dan harganya hanya separuh Fable’s.
- Pekerjaan mekanis massal diberikan ke GLM-5.3-Flash pada $0.15/$0.47, karena pada harga itu pertanyaannya bukan apakah ia sama bagusnya, melainkan apakah ia cukup bagus untuk tugas tertentu. Sering kali iya.
- Apa pun yang privat dijalankan secara lokal, pada model yang muat di mesinmu.
- Pekerjaan kasar diberikan ke model lokal kecil, karena mengganti nama sebuah simbol di empat puluh berkas tidak butuh penalaran terdepan dan tidak perlu keluar dari laptopmu.
Tulis ID model sedemikian rupa sehingga menukarnya cukup mengubah satu baris. Mengingat empat lab merilis model sepuluh teratas antara Juni dan September, kamu akan melakukan perubahan itu lagi dalam kuartal ini.
Bagian Sepuluh: Masa Depan Vibe Coding — Enam Prediksi, Lengkap dengan Tingkat Keyakinan
Prediksi tanpa tingkat keyakinan hanyalah hiburan. Ini prediksi saya, beserta seberapa besar saya mau bertaruh.
1. Istilahnya mati; praktiknya terbelah permanen. Keyakinan tinggi.
“Vibe coding” sudah menjadi istilah hinaan di lingkungan profesional dan istilah kebanggaan di mana pun kecuali pemasaran. Yang menggantikannya adalah pembelahan dua tingkat yang bersih: artefak sekali pakai hasil AI yang kodenya tidak dibaca siapa pun (boleh, benar, lakukan lebih banyak), dan rekayasa agen yang ditinjau, di mana keluaran model’nya melewati gerbang yang sama dengan keluaran manusia’nya (juga boleh, dan di situlah seluruh uang perusahaan berada).
Bagian tengah yang berbahaya — kode produksi, tanpa dibaca — itulah isi daftar insiden 2026, dan ia akan tergusur dari keberadaannya lewat regulasi, asuransi, atau audit di konteks komersial. Bukan karena ada yang melarangnya, tetapi karena kuesioner keamanan pada akhirnya akan menanyakannya.
2. Verifikasi menjadi penghambat, dan uang perkakas mengikutinya. Keyakinan tinggi.
Kita sudah berada di sana dan pasar belum menyesuaikan harganya. Kalau agen bisa menghasilkan pekerjaan seminggu, batasannya adalah kapasitas manusia’nya untuk memastikan bahwa pekerjaan seminggu itu benar.
Perkirakan produk menarik tahun 2027 berkisar pada pemeriksaan daripada pembuatan: pembuatan tes berbasis properti, alat diff semantik yang menjelaskan perubahan perilaku alih-alih perubahan baris, pemeriksaan kesesuaian spesifikasi otomatis, verifikasi runtime atas tindakan agen, dan — ini yang akan saya bangun — alat yang memberitahu kamu 5% mana dari diff besar yang benar-benar perlu dibaca manusia.
3. Metode formal akhirnya mendapat momennya, dua puluh tahun terlambat. Keyakinan sedang.
Keberatan historis terhadap spesifikasi formal adalah bahwa menulis spesifikasi lebih mahal daripada menulis kode. Keberatan itu kini mati, karena menulis kode hampir gratis dan menulis spesifikasi justru menjadi hambatannya.
Sistem tipe, kontrak, invarian, tes properti dan verifikasi formal ringan tiba-tiba punya kasus penggunaan yang membayar dirinya sendiri: semua itu pernyataan niat yang dapat diperiksa mesin, yang bisa dijadikan dasar iterasi agen tanpa manusia dalam lingkarannya. Saya memperkirakan Rust, mode yang lebih ketat dari TypeScript’s, dan pustaka kontrak di Python akan menjadi penerima manfaat yang tidak proporsional.
Alasan keyakinan saya hanya sedang: bidang ini telah memprediksi kebangkitan metode formal kira-kira setiap tujuh tahun sejak 1985.
4. Model lokal sepenuhnya menelan lapisan kerja kasar. Keyakinan cukup tinggi.
Lihat apa yang dilakukan model 27B berlisensi Apache 2.0 sekarang, tambahkan satu tahun lagi, dan jalankan di mesin dengan memori terpadu 64 GB. Penggantian nama, docstring, kerangka tes, pesan commit, perbaikan lint, terjemahan draf pertama, analisis log — tidak satu pun dari itu butuh model frontier, semuanya bervolume tinggi, dan semuanya persis pekerjaan yang lebih baik tidak kamu kirim ke pihak ketiga dari repositori klien’s.
Frontier tetap di cloud untuk perencanaan dan penalaran sulit. Volume berpindah ke lokal. Bagian Sebelas dan seterusnya membahas mengapa itu kini mungkin secara fisik.
5. Peran pengembang junior berubah bentuk, bukan menghilang. Keyakinan sedang, dan ini yang paling longgar saya pegang.
Skenario pesimistisnya lugas: jika agen mengerjakan pekerjaan yang dulu dilakukan junior, tidak ada yang merekrut junior, dan dalam sepuluh tahun tidak ada senior.
Saya pikir hasil yang lebih mungkin adalah pekerjaan tingkat pemula berubah dari “menulis kode” menjadi “memverifikasi kode dan memiliki spesifikasinya” — pekerjaan yang lebih sulit untuk dimulai, bukan lebih mudah, dan yang akan menuntut industri membangun ulang cara melatih orang. Tim yang memahami hal ini akan punya keunggulan perekrutan yang besar atas tim yang sekadar berhenti merekrut.
Catatan jujurnya: ini prediksi di mana insentif dan analisis saya menunjuk arah yang sama, dan justru saat itulah kamu harus curiga pada diri sendiri.
6. Seseorang mengalami kegagalan pengodean AI yang benar-benar bencana dan secara publik dikaitkan dengannya. Keyakinan tinggi pada peristiwanya, rendah pada waktunya.
Bukan basis data bocor. Sesuatu yang melibatkan regulator, dampak finansial sembilan digit, dan analisis akar masalah yang menyatakan agen melakukan sesuatu yang tidak ditinjau manusia.
Kurva atribusi CVE — 6, lalu 15, lalu 35 pada bulan-bulan berurutan di 2026, dengan peneliti memperkirakan laju sebenarnya lima sampai sepuluh kali lebih tinggi — bukan kurva yang mendatar sendiri. Pertanyaannya apakah industri memperketat gerbangnya sendiri lebih dulu atau menunggu insiden yang memaksanya.
Apa yang akan saya lakukan dengan keenamnya, dalam satu kalimat: berinvestasilah pada tes, spesifikasi dan perkakas tinjauan alih-alih pada teknik prompt, karena teknik prompt terdepresiasi setiap kali sebuah model dirilis dan infrastruktur verifikasi berbunga majemuk.
Tampilkan gambar Dua praktik itu berbagi teknologi dan tidak berbagi apa pun selain itu. Lingkar kiri tepat untuk pekerjaan sekali pakai dan fatal untuk produksi; lingkar kanan itulah yang hilang dari daftar insiden di Bagian Delapan.
BABAK III — AI OFFLINE DI PERANGKAT KONSUMEN
Bagian Sebelas: AI offline berhenti jadi hobi tahun ini
Selama sekitar dua tahun, “jalankan secara lokal” adalah kompromi berprinsip. Kamu bisa melakukannya. Tawaran jujurnya adalah: ini model 7 miliar parameter yang lebih buruk daripada tier gratis dari segala hal, di perangkat keras yang sudah kamu miliki, dan alasan melakukannya adalah prinsip.
Itu berubah pada 2026, dan berubah karena tiga alasan terpisah yang datang bersamaan.
Model kecil menjadi benar-benar bagus. Gemma 4’s E4B berukuran sekitar 8 miliar parameter, mendukung konteks 128K, menangani teks, gambar, video dan audio native, serta berlisensi Apache 2.0. Varian dense 31B mencetak 39 pada indeks Artificial Analysis — di dalam rentang yang merupakan frontier delapan belas bulan lalu — dan menjalani seluruh indeks dengan 39 juta token output, hanya sebagian kecil dari yang dibakar model sebanding. Qwen3.8-27B adalah model multimodal dense di bawah Apache 2.0 dengan konteks native 262K yang diklaim Alibaba mengalahkan Qwen3.7-Plus yang jauh lebih besar pada tugas coding dan perkantoran.
Sistem operasinya ikut membawanya. Inilah perubahan yang benar-benar penting, dan terjadi diam-diam. Microsoft menaruh Aion 1.0 ke Windows 11. Apple membawa model dense 3 miliar parameter plus model sparse 20 miliar parameter di iPhone. Google membawa Gemini Nano di perangkat Pixel dan Samsung. AI di perangkat berhenti menjadi sesuatu yang kamu pasang dan menjadi sesuatu yang sudah ada, itulah bedanya antara teknologi yang dipakai para penggemar dan teknologi yang dipakai semua orang.
Dan perangkat kerasnya akhirnya punya memorinya. Bukan komputasinya — memorinya. Saya akan kembali ke mengapa perbedaan itu adalah keseluruhan ceritanya.
Apa yang sebenarnya kamu dapat dari “AI offline”
Biar konkret, karena hal ini dijual dengan buruk.
Latensi. Model 4B lokal merespons dalam puluhan milidetik. Perjalanan pulang-pergi ke cloud paling baik ratusan milidetik. Untuk apa pun yang interaktif dan berkelanjutan — dikte, terjemahan langsung, pelengkapan otomatis, meringkas saat kamu mengetik — lokal menang pada rasa, bukan pada kualitas, dan rasa itulah yang orang sadari.
Privasi yang bersifat arsitektural, bukan kontraktual. Dengan API, setiap prompt keluar dari infrastrukturmu dan kamu perlu perjanjian pemroses, penilaian dampak transfer, peta aliran data, dan jawaban untuk petugas perlindungan datamu. Dengan model yang berjalan di perangkat, pertanyaan tentang transfer lintas batas tidak muncul, karena tidak ada transfer. Untuk pekerjaan di Jerman dan UE, ini sering kali menjadi seluruh argumennya, dan ini menutup kesepakatan yang tidak akan pernah bisa ditutup oleh harga.
Ketersediaan. Di pesawat. Di lokasi tanpa sinyal. Di fasilitas yang justru melarang akses jaringan. Saat penyedia’mu mengalami gangguan.
Prediktabilitas biaya. Bukan penghematan biaya — saya akan menghitungnya di Bagian Lima Belas dan hasilnya tidak seperti yang orang ingin dengar. Tapi biaya perangkat keras tetap dengan biaya marginal nol per token adalah pos anggaran yang sangat berbeda dari tagihan berbasis pemakaian yang membesar seiring semangat agen’nya.
Penyematan versi. Model API tertutup diperbarui di balik ID model yang stabil dan perilakunya bergeser. Checkpoint lokal tetap identik byte demi byte setahun kemudian. Kalau kamu pernah mengalami prompt yang tadinya jalan lalu diam-diam berhenti bekerja, kamu tahu nilainya.
Dan apa yang tidak kamu dapatkan
Kemampuan terdepan. Jarak antara model 4B di ponselmu dan Claude Fable 5.1 tidak kecil dan tidak akan menutup. Siapa pun yang bilang sebaliknya sedang menjual sesuatu.
Kecepatan pada model besar. Model 400B lokal menghasilkan token lebih lambat daripada model yang sama di API vendor’nya, karena vendor menjalankannya di perangkat keras dengan bandwidth memori empat sampai enam kali lipat milikmu. Kamu menukar throughput dengan kendali.
Bagian Dua Belas: Ponsel di Kantongmu
Spesifikasi yang menentukan segalanya adalah RAM
Setiap platform besar kini menetapkan garis memori, dan garisnya adalah 12 GB.
| Platform | Model di perangkat | Ambang memori |
|---|---|---|
| Apple | AFM 3 Core (3B dense) + AFM 3 Core Advanced (20B sparse, 1–4B aktif) | 12 GB untuk dua fitur iOS 27 |
| Gemini Nano v3 (hanya Pixel 10); Nano v2 di Pixel 9 dan yang lebih lama; Nano v4 akan datang | 12 GB minimum untuk Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 for Galaxy — CPU Oryon generasi ke-3, NPU Hexagon, +39% kapasitas NPU | Tergantung perangkat |
Penataan Apple’nya adalah yang paling menarik secara teknis. AFM 3 Core Advanced adalah model sparse 20 miliar parameter yang tinggal di penyimpanan flash. Expert bersama tetap tinggal di memori; expert yang dirutekan baru dipindahkan ke DRAM saat permintaan membutuhkannya. Itulah cara menjejalkan model 20B ke ponsel — kamu menukar bandwidth baca NAND dengan kapasitas DRAM.
Tapi memindahkan expert ke DRAM tetap butuh ruang untuk memindahkannya, di atas OS, aplikasi yang berjalan, dan pipeline kamera. Selisih antara 9 GB dan 12 GB bukan sekadar tiga gigabyte segmentasi pasar. Itu adalah working set untuk pertukaran expert di bawah tekanan memori nyata. Ming-Chi Kuo melaporkan bahwa dua fitur iOS 27 memerlukan 12 GB: ekspresivitas dan penyesuaian tempo suara Siri, serta peningkatan akurasi speech-to-text yang signifikan. iPhone 18 dasar, yang tertunda hingga musim semi 2027 dengan laporan 9 GB, tidak memenuhi syarat.
Google menghadapi fisika yang sama dan masalah hubungan masyarakat yang lebih buruk. Gemini Intelligence butuh Nano v3, Nano v3 saat ini hanya ada di Pixel 10, dan perangkat Pixel 9 — yang dijual dengan janji pembaruan tujuh tahun — masih memakai Nano v2. Janji itu soal pembaruan. Bukan pernah soal fitur, dan perbedaan yang masuk akal bagi manajer produk pada 2023 sama sekali tidak masuk akal bagi pelanggan pada 2026.
Perkirakan ini menjadi cerita AI konsumen dua tahun ke depan: janji dukungan panjang yang mengirim patch keamanan ke perangkat yang tidak bisa menjalankan fitur yang dikirim bersamaan dengan patch itu.
Apa yang benar-benar bisa dilakukan ponsel, secara terukur
Benchmark independen di iPhone 17 Pro (A19 Pro) pada empat runtime:
| Model | Runtime | Dekode tok/s | Memori puncak |
|---|---|---|---|
| Gemma 4 E2B (4-bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-bit) | MLX | 47.5 | 2.900 MB |
| Gemma 4 E2B (4-bit) | llama.cpp | 37.8 | 3.156 MB |
| Gemma 4 E2B (4-bit) | CoreML / ANE | 33.4 | 1.187 MB |
| Qwen 3.5 2B (4-bit) | MLX | 61.2 | 1.279 MB |
| Qwen 3.5 2B (4-bit) | llama.cpp | 39.1 | 1.479 MB |
| Qwen 3.5 2B (4-bit) | CoreML / ANE | 27.9 | 241 MB |
Dua temuan menonjol.
Neural Engine adalah jalur paling lambat dan sejauh ini paling hemat memori. 27,9 tok/s pada 241 MB dibandingkan 61,2 tok/s MLX’nya pada 1.279 MB — lima kali kecepatan untuk lima kali memori. Pertukaran itu justru alasan Apple memakai ANE untuk fitur sistem yang selalu aktif dan alasan aplikasi pihak ketiga melewatinya untuk obrolan interaktif.
Enam puluh token per detik pada model 2B di kantongmu lebih cepat daripada kecepatan baca kebanyakan orang. Artinya, kendala AI lokal di ponsel bukan kecepatan. Kendalanya adalah kemampuan, kemampuan adalah fungsi dari parameter, parameter adalah fungsi dari memori — dan memori adalah hal yang baru saja dibatasi setiap vendor.
Bagian Tiga Belas: PC, dan Taruhan Diam-Diam Microsoft’nya
Microsoft melakukan sesuatu di Build 2026 pada 2 Juni yang menurut saya akan terlihat lebih penting saat dilihat ke belakang daripada saat itu: mereka mengirim model langsung ke dalam Windows.
Aion 1.0 Instruct adalah model bahasa kecil untuk peringkasan, penulisan ulang, dan ekstraksi. Ia hanya butuh CPU modern dan Windows 11 — tanpa NPU, tanpa GPU diskret. Saat ini tersedia di Edge Canary mulai build 150.0.4070, diekspos ke pengembang web melalui API Prompt, Summarizer, Writer, dan Rewriter, dan bobot terbukanya dirilis di Hugging Face pada Juli 2026.
Aion 1.0 Plan adalah yang menarik: sebuah model penalaran dan pemanggilan alat 14 miliar parameter dengan jendela konteks 32K, dibuat untuk alur kerja agen, pengelolaan berkas, dan orkestrasi sub-agen. “Beberapa bulan ke depan” saat tulisan ini dibuat.
Framing yang dipakai Microsoft adalah “kecerdasan tanpa meteran ke setiap rumah dan setiap meja.” Sisihkan pemasaran dan lihat keputusan arsitekturnya: API JavaScript di browser yang memanggil model lokal, tanpa kunci, tanpa tagihan, dan tanpa jaringan. Kalau itu menjadi normal, kategori besar fitur AI kecil berhenti menjadi produk SaaS dan menjadi kemampuan platform. Itu jauh lebih besar dampaknya bagi ekonomi industri AI’nya daripada rilis model mana pun tahun ini.
Ambang perangkat kerasnya nyata dan mengecualikan banyak mesin
Jalur NPU membutuhkan Copilot+ PC dengan minimum 40-TOPS NPU:
| Silikon | NPU | Memenuhi? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ perangkat keras; perangkat lunak “menyusul nanti” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
Dan inilah angka yang seharusnya mengatur ulang ekspektasi: pada NPU 45 TOPS, model 8B menghasilkan sekitar 5 token per detik. Model Plan 14B akan lebih lambat.
Lima token per detik bukan pengalaman mengobrol. Itu cukup untuk peringkasan latar belakang, penulisan ulang, klasifikasi, ekstraksi — hal-hal yang memang jadi tujuan Aion 1.0 Instruct. Itu tidak cukup untuk apa pun yang kamu duduk dan tonton.
Kenapa begitu lambat pada 45 TOPS? Karena pembuatan token dibatasi bandwidth memori, bukan komputasi mentah. NPU bisa melakukan perkalian matriks; masalahnya adalah mengalirkan bobot keluar dari memori sistem untuk setiap token. Ini dinding yang sama yang mengatur setiap perangkat di artikel ini, dan inilah sebabnya “TOPS” hampir tidak berguna sebagai angka untuk belanja.
Kotak desktop
Kalau kamu ingin mesin khusus untuk inferensi lokal, kelas 128 GB sudah mengerucut ke dua pilihan dan satu pengecualian:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| Memori | 128 GB terpadu | 128 GB LPDDR5X-8000 | hingga 512 GB terpadu |
| Bandwidth | ~273 GB/s | ~256 GB/s | 1,2 TB/s |
| Harga | ~$3,999 | $2.300–$2.500 | mulai $5.499 |
| Catatan | ekosistem CUDA | CPU kuat (1,6 TFLOPS Linpack vs 708 GFLOPS Spark’nya) | tier 512 GB akhir Okt, belum berharga |
Harga-harga itu serta angka Spark dan Strix Halo berasal dari pengujian yang diterbitkan akhir Desember 2025, jadi anggap sebagai indikasi, bukan angka terkini — harga memori sudah bergerak sejak itu. DGX Spark dan Strix Halo jauh lebih berdekatan dalam pembuatan token daripada yang disiratkan angka komputasi mereka — karena keduanya tertahan di sekitar 256–273 GB/s bandwidth dan itulah kendala yang mengikat. Spark menang telak dalam pembuatan gambar (~120 TFLOPS vs ~46 pada FLUX.1 Dev BF16) dan kompatibilitas CUDA. Strix Halo menang pada harga dan CPU.
Mac Studio M5 Ultra berada di kategori yang sama sekali berbeda dalam hal memori maupun bandwidth, dan saya menulisnya panjang lebar di artikel perangkat keras AI lokal. Versi singkatnya: 512 GB pada 1,2 TB/s adalah satu-satunya mesin arus utama yang bisa menampung model kelas 400B di memori, dan harga untuk keistimewaan itu sekitar $16.000–$20.000 dalam konfigurasi lengkap.
Model yang benar-benar dijalankan
| Model | Param | Lisensi | Berjalan nyaman di | Cocok untuk |
|---|---|---|---|---|
| Gemma 4 E2B | 5,1B / 2,3B aktif | Apache 2.0 | 4 GB | Ponsel, selalu aktif, input audio |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | Kerja berat laptop, peringkasan |
| Aion 1.0 Instruct | SLM kecil | Bobot terbuka (HF, Jul 2026) | Hanya CPU | Tugas teks native Windows |
| Qwen3.8-27B | 27B dense | Apache 2.0 | 24–32 GB | Model lokal umum terbaik di bawah 32 GB |
| Gemma 4 26B-A4B | 26B / 4B aktif | Apache 2.0 | 24 GB | MoE cepat, biaya aktif rendah |
| Gemma 4 31B | 31B dense | Apache 2.0 | 32 GB | Kualitas lokal tertinggi di bawah 32 GB |
| Ornith-1.5 35B | 35B / 3B aktif | MIT | 32 GB | Coding agen, jejak aktif sangat kecil |
| gpt-oss-120b | 120B / 5,1B aktif | Apache 2.0 | 128 GB | Titik manis 128 GB |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB+ | Mendekati frontier, butuh mesin besar |
| MiniMax M3 | 428B / 23B aktif | Khusus | 512 GB | Hanya muat di M5 Ultra |
| DeepSeek V4 Pro | 1,6T / 49B aktif | MIT | Klaster | Bukan model perangkat konsumen |
| Kimi K3 | 2,8T / 104B aktif | Khusus | Klaster | Tidak muat di Mac mana pun yang dijual Apple |
Kalau kamu sedang memilih ukuran mesin Apple secara khusus, saya membahas tingkatan memori secara rinci di panduan AI lokal MacBook Pro M5 Pro 64GB — versi singkatnya, 64 GB adalah titik ketika kompromi berhenti mengganggu.
Kalau kamu ingin satu rekomendasi: di mesin 32 GB, jalankan Qwen3.8-27B atau Gemma 4 31B. Keduanya Apache 2.0, keduanya multimodal, keduanya benar-benar berguna, keduanya muat. Itulah default 2026 dan itu default yang jauh lebih baik daripada yang dimiliki 2025.
Tampilkan gambar Apa yang benar-benar muat, menurut tingkat memori. Garis vertikal adalah ukuran memori yang benar-benar bisa dibeli konsumen; model yang melewati garis kanan adalah plafon AI frontier lokal pada 2026.
Bagian Empat Belas: Dinding Memori adalah Seluruh Ceritanya
Semua di Babak III bermuara pada satu persamaan, jadi ini dia secara eksplisit.
Apakah akan muat?
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory ×
Seberapa cepat ia menghasilkan?
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenPerhatikan bahwa rumus kedua memakai aktif parameter aktif, bukan total. Inilah sebabnya model mixture-of-experts begitu tidak proporsional bagusnya di perangkat keras konsumen. Gemma 4’nya 26B-A4B punya 26 miliar parameter kemampuan dan 4 miliar parameter biaya per token. Ornith-1.5’nya 35B mengaktifkan 3B. MiniMax M3 punya total 428B dan 23B aktif.
Efisiensi dalam rumus itu kira-kira 0,5 sampai 0,8 dalam praktik tergantung runtime, kuantisasi, dan seberapa banyak bandwidth memori yang dipakai sisa sistem.
Sekarang terapkan. Laptop NPU 45 TOPS dengan LPDDR5X, katakanlah 120 GB/s, menjalankan model 8B pada 4-bit (4 GB bobot aktif): 120 × 0,6 ÷ 4 ≈ 18 token/detik secara teori. Angka terukurnya sekitar 5. Selisihnya adalah penjadwalan, rebutan memori, biaya prefill, dan fakta bahwa toolchain NPU masih belum matang. Jurang antara aritmetika dan pengukuran itulah tempat sebagian besar kekecewaan di bidang ini bersemayam.
Kelangkaan DRAM adalah variabel tersembunyi di balik setiap angka di artikel ini
Produsen memori menghabiskan 2025 dan 2026 untuk mengalihkan kapasitas ke pelanggan pusat data AI, yang menandatangani kontrak lebih besar dengan margin lebih baik daripada pembuat perangkat konsumen. Konsekuensinya muncul di mana-mana:
- Apple menaikkan harga Mac dan iPad pada Juni 2026.
- Tier Mac Studio 512 GB mundur ke akhir Oktober karena pasokan dan masih belum ada harganya.
- M6 milik Apple’nya dibatasi pada 32 GB memori terpadu, dan M6 Pro, Max, serta Ultra dibatalkan sepenuhnya.
- Ming-Chi Kuo melaporkan Apple memangkas pengiriman perangkat keras 2026 karena pasokan memori.
Setiap plafon di artikel ini berpangkal pada kelangkaan yang sama. Ambang 12 GB di ponsel. Batas 32 GB di M6. Plafon 128 GB di laptop. Tier 512 GB yang tertunda. Tidak satu pun dari itu batas teknis silikon; semuanya keputusan alokasi di pasar tempat memori langka dan mahal.
Kalau kamu menunggu harga normal sebelum membeli mesin untuk inferensi lokal: tidak ada pihak kredibel yang meramalkan kapan itu terjadi.
Bagian Lima Belas: Menyiapkannya
Bagian praktis. Semua di sini sudah saya jalankan; kalau saya hanya melaporkan dan bukan menjalankan, saya bilang.
Jalur termudah: LM Studio
GUI, MLX-native di Apple Silicon, penjelajah model bawaan, server kompatibel OpenAI dengan satu tombol. Kalau kamu ingin menjalankan model dalam sepuluh menit, mulai di sini. Ini juga alat yang dijadikan pembanding Apple di siaran persnya sendiri, yang memberi tahu sesuatu tentang seberapa arus utama hal ini sudah jadi.
Jalur paling fleksibel: Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
Perintah kedua itulah yang sering terlewat. Konteks default Ollama’nya diatur konservatif; pada tugas kode ia akan memotong diam-diam dan kamu akan menyalahkan modelnya.
Jalur tercepat di Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Arahkan klien apa pun yang kompatibel dengan OpenAI ke http://localhost:8080/v1.
Naikkan batas memori wired sebelum mengeluh soal crash
macOS tidak akan membiarkan GPU me-wire seluruh memori terpadumu secara default. Di mesin bermemori besar, ini adalah perbedaan antara model yang termuat dan model yang gagal:
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Jangan setel ini ke ukuran memori penuhmu. Sisakan 12–16 GB untuk OS di mesin besar, kalau tidak kamu akan mendapat kernel panic alih-alih inferensi cepat. Dan periksa ulang setelah setiap pembaruan macOS, karena pembaruan mengembalikannya.
Di Windows, pakai model bawaan OS dulu
Sebelum memasang apa pun, periksa apa yang sudah diberikan Windows. API Prompt, Summarizer, Writer, dan Rewriter di Edge memanggil Aion 1.0 Instruct secara lokal tanpa kunci dan tanpa tagihan. Untuk peringkasan, penulisan ulang, dan ekstraksi di dalam aplikasi web, itu solusi lengkap tanpa infrastruktur.
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
Kalau kamu butuh lebih dari itu, LM Studio dan Ollama sama-sama berjalan baik di Windows, dan di mesin tanpa NPU yang memenuhi syarat keduanya akan memakai GPU atau CPU, yang untuk model kelas 8B sering kali lebih cepat daripada jalur NPU.
Pengaturan hibrida yang masuk akal
Arsitektur yang benar-benar akan saya bangun, dan kira-kira yang saya jalankan:
- Tingkat 1 — di perangkat. Model kecil untuk routing, klasifikasi, ekstraksi, ringkasan, dan dikte. Gemma 4 E4B atau Aion 1.0 Instruct. Selalu tersedia, tanpa biaya marginal.
- Tingkat 2 — perangkat keras milikmu sendiri. Model bobot terbuka 27B–120B di mesin milikmu, untuk apa pun yang menyentuh data klien yang tidak boleh keluar dari yurisdiksi. Qwen3.8-27B di 32 GB,
gpt-oss-120bdi 128 GB. - Tingkat 3 — frontier lewat API. Perencanaan, penalaran sulit, proses agen berjangkauan panjang, apa pun yang mahal kalau salah.
Debatnya tidak pernah soal “lokal atau cloud.” Debatnya soal di mana kamu menarik garis, dan garis itu bergeser jauh tahun ini.
Bagian Enam Belas: Hitungan Biaya dan Kepatuhan
Argumen penghematan tidak bertahan di depan kalkulator
Ambil beban kerja usaha kecil yang realistis: sebulan kerja coding agen tingkat sedang, katakanlah 40 juta token input dan 3 juta token output.
| Opsi | Biaya bulanan |
|---|---|
| GLM-5.3-Flash API ($0,15 / $0,47) | ~$7.40 |
| Gemini 3.8 Flash API ($0,75 / $3,75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50, tanpa cache) | ~$550 |
| Mesin Strix Halo $2.400, diamortisasi selama 3 tahun | ~$67/bulan + listrik |
Perhatikan apa yang sebenarnya dikatakan tabel itu. Perangkat keras lokal lebih murah daripada puncak frontier dan lebih mahal daripada dasarnya. Dibanding GLM-5.3-Flash, mesin lokal tidak pernah balik modal dari sisi token. Dibanding Fable 5.1 yang berjalan tanpa cache, ia balik modal dalam lima bulan — tetapi kamu tidak membandingkan hal yang setara, karena Fable 5.1 jauh lebih baik daripada model apa pun yang muat di 128 GB.
Jadi jangan beli perangkat keras lokal untuk menghemat uang. Belilah karena salah satu dari lima alasan ini, yang semuanya nyata:
- Residensi data yang menjadi keputusan arsitektur, bukan proyek hukum.
- Tanpa batas laju, tanpa kuota, tanpa insiden kapasitas. Mesinmu tidak punya hari Selasa yang sibuk.
- Penyematan versi selamanya. Checkpoint lokal tetap identik byte demi byte setahun kemudian.
- Operasi offline.
- Lagi pula kamu memang butuh workstation itu. Ini kasus paling umum di mana membeli jelas tepat — kalau kamu memang sudah akan menghabiskan €2.500 untuk sebuah mesin, biaya marginal kemampuan AI-nya adalah peningkatan memori, bukan seluruh mesinnya.
Gambaran kepatuhan EU, karena berubah pada 2026
Bagi pembaca di Jerman dan EU, landasan regulasi bergeser tahun ini dan tanggalnya kini pasti, bukan bersyarat.
- 2 Agustus 2025 — penyedia model GPAI menanggung kewajiban dokumentasi, ringkasan konten pelatihan, dan hak cipta.
- 2 Agustus 2026 — kewenangan penegakan dan kewajiban transparansi Pasal 50 mulai berlaku. Denda kini bisa dijatuhkan.
- 27 Juli 2026 — Digital Omnibus, Regulation (EU) 2026/1744, mulai berlaku, menggantikan mekanisme bersyarat sebelumnya untuk sistem berisiko tinggi dengan tanggal pasti.
- 2 Desember 2026 — berakhirnya masa tenggang untuk watermark yang dapat dibaca mesin pada sistem yang sudah ada.
- 2 Agustus 2027 — jendela transisi dua tahun berakhir untuk model GPAI yang sudah ada di pasar.
- 2 Desember 2027 — sistem berisiko tinggi yang berdiri sendiri menurut Lampiran III (rekrutmen, penilaian kredit, pendidikan, infrastruktur kritis).
- 2 Agustus 2028 — AI berisiko tinggi yang tertanam dalam produk teregulasi menurut Lampiran I (perangkat medis, mesin).
Digital Omnibus juga menambahkan larangan atas citra intim non-konsensual dan CSAM yang dihasilkan AI, serta memperluas kewenangan pengawasan EU AI Office.
Apa artinya secara praktis bagi pembaca artikel ini. Kalau kamu membangun di atas model, bukan melatihnya, sebagian besar kewajiban GPAI ada pada penyedia, bukan padamu. Yang menjadi bebanmu adalah transparansi — memberi tahu orang saat mereka berinteraksi dengan AI, dan menandai konten sintetis — plus pertanyaan klasifikasi berisiko tinggi kalau sistemmu menyentuh rekrutmen, kredit, pendidikan, atau infrastruktur kritis. Tanggal Desember 2027 cukup jauh untuk direncanakan dan cukup dekat sehingga “kita’kan lihat nanti” bukan lagi strategi.
Dan poin yang paling relevan untuk Babak III: model di perangkat secara nyata menyederhanakan beberapa percakapan ini sekaligus. Tanpa transfer, tanpa prosesor, peta aliran data jauh lebih pendek. Itu bukan celah — kewajiban transparansi tetap berlaku — tetapi menghapus satu kategori pekerjaan sepenuhnya.
Saya bukan pengacara dan ini bukan nasihat hukum. Untuk apa pun yang melibatkan uang, mintalah penasihat berkualifikasi Jerman atau EU untuk meninjau penerapan spesifikmu.
Bagian Tujuh Belas: Argumentasi Jujur Menentang Semua Ini
Kalau saya berhenti di Bagian Enam Belas, ini akan jadi iklan.
Bukti produktivitas yang terukur masih tidak mendukung antusiasme itu. Satu uji acak terkontrol, 19% lebih lambat. Tindak lanjut yang tidak bisa dijalankan dengan bersih. Laporan diri yang membengkak 40 poin persentase. Semua orang di industri ini, termasuk saya, sebagian besar beroperasi berdasarkan perasaan tentang perasaan.
Data keamanan buruk dan tidak membaik. Tingkat kegagalan OWASP Veracode sebesar 45% praktis tidak berubah sepanjang awal 2026 sementara model menjadi jauh lebih pintar. Itu bukan masalah transisi yang bisa diperbaiki dengan skala. Kemampuan dan keamanan bukan sumbu yang sama, dan tidak ada yang berusaha keras mengoptimalkan yang kedua.
Benchmark jenuh di puncak dan tak terverifikasi di tengah. SWE-bench Verified punya tiga model dalam selisih satu poin. Benchmark yang menggantikannya makin banyak yang privat, yang menyelesaikan kontaminasi dengan membuat verifikasi independen mustahil.
Bobot terbuka hanya berjarak satu revisi lisensi dari tidak lagi terbuka. Z.ai memindahkan GLM dari MIT ke lisensi proprietary dengan gerbang tinjauan keamanan antara 5.2 dan 5.3. Meta menjanjikan bobot terbuka untuk Muse Spark tanpa tanggal, tanpa ukuran, dan tanpa teks lisensi. Kalau arsitekturmu mengasumsikan bobot yang bisa diunduh tahun depan, asumsi itu adalah keputusan bisnis vendor, bukan hukum alam.
Frontier masih belum lokal, dan makin tidak bisa dibeli juga. Mythos 5.1, skor tertinggi di Terminal-Bench 4.0, dibatasi untuk pembela siber dan ilmuwan hayati yang tersertifikasi, saat ini sebagian besar di AS. Kimi K3 dan DeepSeek V4 Pro tidak muat di mesin konsumen mana pun. Yang muat di mejamu adalah model lapis kedua yang sangat baik, yang sebenarnya berguna dan bukan frontier.
Kinerja di perangkat lebih buruk daripada yang disiratkan pemasaran. Lima token per detik untuk model 8B pada NPU 45 TOPS. Ambang memori 12 GB yang mengecualikan sebagian besar ponsel yang beredar. Janji pembaruan tujuh tahun yang tidak mencakup fitur. Jurang antara branding “AI PC” dan apa yang benar-benar bisa dijalankan mesin itu saat ini sangat besar.
Dan geopolitik adalah masukan pengadaan, suka atau tidak. Beberapa model bobot terbuka terbaik — Kimi, GLM, DeepSeek, Qwen, MiniMax — berasal dari lab Tiongkok. Bagi sektor publik, klien yang bersinggungan dengan pertahanan, dan sebagian klien teregulasi, itu penghalang mutlak terlepas dari di mana bobotnya berjalan atau apa isi lisensinya. Sementara itu, model coding Anthropic paling mumpuni dibatasi untuk organisasi AS yang tersertifikasi. Ekosistem terbuka ditarik terpisah sepanjang garis nasional dari kedua ujungnya, dan kalau kamu di Eropa, kamu tidak ada di ujung mana pun.
Bagian Delapan Belas: Kerangka Keputusan untuk Kondisi AI 2026
Tampilkan gambar Tujuh situasi, tujuh jawaban. Temukan baris yang terdengar seperti tahunmu.
Tujuh situasi, dipetakan ke kondisi AI 2026 seperti yang benar-benar terjadi hari ini.
1. “Aku ingin model terbaik dan biaya bukan masalah.”
Claude Fable 5.1 pada 65,7 di indeks agregat, $10/$50, konteks 1M — dan aktifkan caching, karena potongan 75% untuk baca cache bernilai 25–45% dari tagihanmu. Pertahankan GPT-5.6 Sol tersedia untuk riset berat browsing pada 90,4% BrowseComp. Jangan terlalu dipikirkan; selisih di antara keduanya lebih kecil daripada selisih antara prompt terbaik dan terburukmu.
2. “Aku menjalankan banyak agen dan tagihannya makin menggelikan.”
Claude Opus 5 dengan $5/$25 untuk pekerjaan berjangkauan panjang, GLM-5.3-Flash dengan $0,15/$0,47 untuk pekerjaan mekanis massal, dan model lokal untuk pekerjaan kasar. Routing adalah tuas biaya terbesar yang tersedia bagimu, dan itu hanya berkas konfigurasi, bukan proyek. Ukur pembagian tokenmu per peran agen sebelum mengoptimalkan apa pun — kebanyakan orang menemukan 80% pengeluaran mereka ada pada tugas yang tidak butuh model frontier.
3. “GDPR dan residensi data adalah syarat mutlak untuk pekerjaan klien.”
Qwen3.8-27B atau Gemma 4 31B di perangkat keras milikmu, keduanya Apache 2.0, keduanya multimodal. Naik ke gpt-oss-120b di mesin 128 GB kalau pekerjaannya menuntut. Intinya bukan kecepatan — intinya tidak ada prompt yang keluar dari gedung dan tinjauan hukummu berubah menjadi membaca lisensi, bukan penilaian dampak transfer. Pilih model berlisensi permisif justru supaya bacaan itu singkat.
4. “Aku mau coba AI lokal tanpa keluar banyak uang.”
Apa pun yang sudah kamu punya, plus LM Studio, plus Gemma 4 E4B. Delapan gigabyte memori cukup untuk benar-benar berguna. Cari tahu apakah AI lokal cocok untukmu sebelum mengeluarkan uang — kebanyakan orang menemukan bahwa mereka hanya butuh tingkat 1 dan tingkat 3 dan tidak pernah perlu tingkat 2.
5. “Aku’kan beli mesin khusus untuk inferensi lokal.”
Belilah berdasarkan bandwidth dan kapasitas memori, dalam urutan itu, dan abaikan TOPS. Di kelas 128 GB, Strix Halo sekitar $2.400 adalah pilihan paling bernilai dan DGX Spark sekitar $3.999 memberimu CUDA dan pembuatan gambar yang jauh lebih baik. Di atas itu, Mac Studio M5 Ultra satu-satunya yang bisa menampung model 400B, dengan harga yang hanya masuk akal kalau kamu memang butuh workstation itu.
6. “Timku mengadopsi alat coding AI dan risikonya ada di aku.”
Lakukan hal-hal membosankan ini, dalam urutan berikut: SAST dan deteksi secret pada setiap commit; analisis komposisi perangkat lunak untuk paket halusinasi; kebijakan tertulis yang mengecualikan kode AI tanpa tinjauan dari auth, kripto, authz, dan pembayaran; kredensial agen dibatasi sebagai privileged; dan SBOM yang mencatat asal-usul alat. Lalu perkirakan Kurva J — DORA mengukur penurunan nyata sebelum perbaikan — dan jangan panik di bulan ketiga.
7. “Ponsel mana yang harus aku beli untuk AI?”
Ponsel model apa pun dengan RAM 12 GB. Itulah garis yang ditarik setiap platform: iPhone 17 Pro dan 18 Pro pada 12 GB, Pixel 10 untuk Nano v3, Galaxy S26 Ultra dengan Snapdragon 8 Elite Gen 5. iPhone 18 dasar dengan laporan 9 GB serta Pixel 9 dan yang lebih lama akan menjalankan ponselnya dengan baik tetapi tidak mendapat fiturnya. Kalau kamu sudah di perangkat 12 GB, peningkatan tahun ini bersifat inkremental khusus untuk AI.
Bagian Sembilan Belas: Yang Saya Pantau Kuartal Depan
Apakah Meta benar-benar merilis bobot Muse Spark, dan dengan lisensi apa. “Segera” dari seorang CEO di X, tanpa jumlah parameter dan tanpa teks lisensi, adalah bentuk komitmen terlemah dalam artikel ini. Kalau mereka merilis dengan Apache 2.0, itu mengubah ekosistem terbuka secara nyata. Kalau mereka merilis dengan lisensi khusus bergerbang pendapatan, itu kini menjadi standar industri dan bobot terbuka berubah menjadi kategori pemasaran, bukan properti.
Apakah hasil peningkatan diri Ornith-1.5 dapat direplikasi. Evaluasi independen pada tugas di luar kurikulum yang dihasilkan sendiri adalah hal yang bisa memastikannya. Ini item dengan varians tertinggi dalam daftar: entah hasil terpenting 2026 atau kisah peringatan tentang benchmark yang dihasilkan sendiri, dan saya belum tahu yang mana.
Apakah Aion 1.0 Plan benar-benar dirilis dan pada kecepatan berapa ia berjalan. Model penalaran 14B di Windows adalah kategori yang benar-benar baru. Kalau ia berjalan 3 token per detik pada perangkat keras yang memenuhi syarat, itu hanya demo. Kalau 20, itu mengubah apa yang bisa diasumsikan aplikasi desktop.
Kurva atribusi CVE. 6, 15, 35 dalam bulan-bulan berurutan. Kalau April sampai Agustus melanjutkan lintasan itu, data Georgia Tech akan menjadi publikasi keamanan AI paling berdampak tahun ini saat terbit.
Apakah ada yang membangun perkakas tinjauan. Jurang antara apa yang bisa dihasilkan agen dan apa yang bisa diverifikasi manusia adalah masalah penentu 2027, dan sampai hari ini hampir semua uang ventura masih mengalir ke generasi, bukan verifikasi. Siapa pun yang merilis alat yang andal memberi tahu 5% diff mana yang butuh mata manusia akan sangat sulit disaingi.
Apakah kelangkaan memori mereda. Itu variabel tersembunyi di balik ambang 12 GB di ponsel, batas 32 GB pada M6, tertundanya varian Mac 512 GB, dan kenaikan harga Apple pada Juni. Tidak ada yang kredibel meramalkan kelegaan.
Dan apakah model frontier bergerbang keamanan tetap menjadi pengecualian. Mythos 5.1 dibatasi karena alasan penggunaan ganda yang menurut saya bisa dibela, dan Project Glasswing secara aktif memperluas akses — sekitar 150 organisasi di lebih dari lima belas negara pada Juni 2026. Tetapi presedennya sudah terbentuk: skor tertinggi pada benchmark coding publik kini adalah sesuatu yang tidak bisa dibeli organisasi mana pun dengan harga berapa pun. Kalau itu menjadi pola, bukan kasus khusus, “apakah organisasiku bisa tersertifikasi” berubah menjadi kriteria pemilihan model, dan argumen untuk bobot terbuka di luar AS sepenuhnya berhenti soal biaya.
Pertanyaan yang sering diajukan
Apa LLM terbaik pada September 2026?
Secara agregat, Claude Fable 5.1 memimpin Intelligence Index v4.1.1 dari Artificial Analysis pada 65,7, di atas Claude Opus 5 pada 63,0, Claude Fable 5 pada 62,1, Grok 4.6 pada 60,9, dan GPT-5.6 Sol pada 58,9. Tetapi agregat itu memadatkan perbedaan yang penting. GPT-5.6 Sol memimpin browsing pada 90,4% di BrowseComp; Gemini 3.8 Flash menghasilkan 58,7 dengan $0,75 per juta token input; GLM-5.3-Flash menghasilkan 57,5 dengan $0,15. Untuk sebagian besar beban kerja nyata, delapan model teratas bisa saling ditukar dan keputusannya sebaiknya diambil berdasarkan harga, latensi, ekonomi cache, dan lisensi, bukan peringkat.
Apa model bobot terbuka terbaik saat ini?
Tergantung perangkat kerasmu dan toleransimu terhadap lisensi. GLM-5.3 (753B) mendapat skor tertinggi 59,5 tetapi membawa lisensi khusus dengan gerbang tinjauan keamanan untuk pendapatan $10 miliar. DeepSeek V4 Pro (total 1,6T, aktif 49B) berlisensi MIT dan mendapat 87,9 di Terminal-Bench 2.1, tetapi butuh klaster. Untuk mesin yang benar-benar kamu miliki, Qwen3.8-27B atau Gemma 4 31B — keduanya Apache 2.0 — adalah model terbaik yang muat di 32 GB.
Apakah vibe coding sudah mati pada 2026?
Istilahnya sekarat; praktiknya terbelah dua. Vibe coding dalam arti aslinya — prompt, terima, jangan baca diff-nya — tetap tepat untuk pekerjaan sekali pakai: skrip, prototipe, analisis sekali jalan. Yang menggantikannya untuk apa pun yang benar-benar dirilis adalah rekayasa agen berbasis spesifikasi: spesifikasi tertulis, sandbox, rangkaian tes yang harus dilewati agen, dan tinjauan nyata atas diff yang dihasilkan. Bagian tengah yang berbahaya — kode produksi tanpa tinjauan — adalah asal semua insiden terdokumentasi pada 2026.
Apakah coding AI benar-benar membuat developer lebih cepat?
Satu-satunya uji acak terkontrol mengatakan tidak. METR menemukan developer berpengalaman 19% lebih lambat dengan alat AI awal 2025 pada basis kode matang, sambil percaya bahwa mereka 20% lebih cepat — kelebihan perkiraan 40 poin persentase. Tindak lanjut mereka pada 2026 tidak bisa dijalankan dengan bersih karena para developer menolak bekerja tanpa AI. Survei melaporkan pengali kecepatan 3× tetapi hanya perubahan 1,4–2× pada nilai pekerjaan. Bacaan saya: keuntungan besar pada pekerjaan yang tidak familiar, boilerplate, tes, dan migrasi; keuntungan kecil atau negatif pada basis kode yang kamu kenal betul.
Seberapa berisiko kode yang dihasilkan AI?
Terukur berisiko dan membaik perlahan. Veracode menemukan 45% sampel hasil AI memunculkan kerentanan OWASP Top 10, dengan Java terburuk pada 72%. Apiiro mengukur developer berbantuan AI menghasilkan commit 3–4× lebih cepat dan temuan keamanan 10× lebih cepat, dengan jalur eskalasi hak istimewa naik 322%. Sekitar 20% kode hasil AI merujuk paket yang tidak ada, dan 43% nama halusinasi itu muncul konsisten berulang — yang menjadi permukaan serangan rantai pasok. Solusinya adalah gerbang otomatis pada setiap commit, bukan pantangan.
Bisakah aku menjalankan LLM bagus secara offline di komputeku sendiri?
Bisa, dan 2026 adalah tahun pertama yang jelas membuktikannya. Dengan memori 8 GB, Gemma 4 E4B benar-benar berguna. Dengan 32 GB, Qwen3.8-27B atau Gemma 4 31B adalah model multimodal kuat di bawah Apache 2.0. Dengan 128 GB, gpt-oss-120b adalah titik optimalnya. Yang tidak muat di mesin konsumen mana pun adalah frontier sesungguhnya: Kimi K3 dengan 2,8 triliun parameter dan DeepSeek V4 Pro dengan 1,6 triliun keduanya butuh klaster.
Apa itu Microsoft Aion 1.0?
Keluarga model di perangkat yang diumumkan di Build pada 2 Juni 2026 dan dikirim ke Windows 11. Aion 1.0 Instruct adalah model kecil untuk ringkasan, penulisan ulang, dan ekstraksi yang berjalan di CPU modern tanpa perlu NPU, diekspos lewat API JavaScript Prompt, Summarizer, Writer, dan Rewriter di Edge, dengan bobot terbuka di Hugging Face sejak Juli 2026. Aion 1.0 Plan adalah model penalaran dan pemanggilan alat berparameter 14 miliar dengan jendela konteks 32K untuk alur kerja agen, membutuhkan PC Copilot+ dengan NPU minimal 40 TOPS, dan pada awal September 2026 masih berstatus “beberapa bulan lagi”.
Mengapa ponsel butuh RAM 12 GB untuk fitur AI?
Karena model di perangkat dibatasi memori, bukan komputasi. AFM 3 Core Advanced dari Apple adalah model sparse 20 miliar parameter yang tinggal di penyimpanan flash dan menukar expert terpilih ke DRAM sesuai kebutuhan — yang tetap butuh tempat untuk menukarnya, di atas OS, aplikasi, dan pipeline kamera. Ming-Chi Kuo melaporkan dua fitur iOS 27 yang membutuhkan 12 GB. Gemini Intelligence dari Google punya batas minimum 12 GB yang sama. Selisih antara 9 GB dan 12 GB adalah working set, bukan segmentasi pasar.
Apakah NPU layak dimiliki untuk AI lokal?
Lebih kecil daripada yang disiratkan pemasaran. Pada NPU 45 TOPS, model 8B menghasilkan sekitar 5 token per detik, karena generasi token dibatasi bandwidth memori, bukan komputasi. NPU sangat baik untuk tugas yang selalu aktif, berdaya rendah, dan berlangsung singkat — yang dijalankan sistem operasi terus-menerus. Untuk chat interaktif di laptop, jalur GPU atau bahkan CPU sering kali lebih cepat. Belilah berdasarkan bandwidth dan kapasitas memori; anggap TOPS hampir tidak berarti saat berbelanja.
Apakah model bobot terbuka benar-benar sumber terbuka?
Sebagian besar tidak. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0), dan Ornith-1.5 (MIT) memakai lisensi yang benar-benar permisif. GLM-5.3 mewajibkan perusahaan dengan pendapatan di atas $10 miliar melewati tinjauan keamanan Z.ai; Kimi K3 memakai lisensi berjenjang pendapatan; MiniMax M3 mewajibkan atribusi “Built with MiniMax M3” yang menonjol untuk penggunaan komersial apa pun dan otorisasi tertulis di atas pendapatan $20 juta. Tidak satu pun merilis data pelatihan atau kode pelatihan. “Bobot terbuka” adalah istilah yang akurat; “sumber terbuka” sedang bekerja secara tidak jujur.
Apakah lebih murah menjalankan model secara lokal daripada memakai API?
Hampir tidak pernah kalau hanya soal biaya token. Sebulan kerja agen tingkat sedang — 40 juta token input dan 3 juta token output — biayanya sekitar $7 di GLM-5.3-Flash dan sekitar $41 di Gemini 3.8 Flash. Mesin lokal $2.400 yang diamortisasi selama tiga tahun sekitar $67 per bulan sebelum listrik. Perangkat keras lokal mengalahkan puncak frontier dalam biaya dan kalah dari dasarnya. Belilah lokal untuk residensi data, bebas batas laju, penyematan versi, dan operasi offline — atau karena kamu memang butuh workstation itu.
Apa yang diwajibkan EU AI Act pada 2026?
Sejak 2 Agustus 2026, kewenangan penegakan dan kewajiban transparansi Pasal 50 berlaku untuk AI tujuan umum, dan denda kini bisa dijatuhkan. Digital Omnibus, Regulation (EU) 2026/1744, mulai berlaku pada 27 Juli 2026 dan menetapkan tanggal pasti: 2 Desember 2026 mengakhiri masa tenggang watermark; 2 Agustus 2027 menutup transisi untuk model GPAI yang sudah ada di pasar; 2 Desember 2027 berlaku untuk sistem berisiko tinggi yang berdiri sendiri menurut Lampiran III; 2 Agustus 2028 mencakup AI berisiko tinggi yang tertanam dalam produk teregulasi. Kalau kamu membangun di atas model, bukan melatihnya, sebagian besar kewajiban GPAI ada pada penyedia — transparansi dan klasifikasi berisiko tinggi adalah yang menjadi bebanmu. Ini bukan nasihat hukum.
Berapa lama agen AI bisa bekerja tanpa pengawasan?
METR mengukur panjang tugas yang diselesaikan model secara mandiri dengan tingkat keberhasilan 50%. Angka itu naik dari sekitar 30 detik pada 2022 menjadi lebih dari 14 jam untuk sistem frontier pada 2026, dengan waktu penggandaan sekitar 196 hari pada kecocokan hibrida METR, atau 131 hari bila dibatasi pada model pasca-2023. Interval kepercayaannya sangat lebar — horizon 320 menit Claude Opus 4.5 berkisar dari 170 sampai 729 menit — dan hanya 5 dari 31 tugas panjang METR yang memakai garis dasar manusia yang terukur. Kalau diekstrapolasi, itu sekitar satu hari kerja panjang tugas mandiri pada 2027.
Model mana yang sebaiknya kupakai khusus untuk coding?
Lakukan routing daripada memilih. Perencanaan dan arsitektur ke model paling mumpuni yang mampu kamu biayai (Claude Fable 5.1); sebagian besar implementasi berjangkauan panjang ke Claude Opus 5 dengan setengah harga; pekerjaan mekanis bervolume tinggi ke GLM-5.3-Flash dengan $0,15/$0,47; apa pun yang menyentuh data klien ke model bobot terbuka lokal; dan penggantian nama, docstring, serta perbaikan lint ke model lokal kecil. Tulis ID model sedemikian rupa sehingga menukarnya cukup satu baris perubahan — empat lab merilis model sepuluh teratas antara Juni dan September 2026.
Kesimpulan
Dua belas bulan lalu, pertanyaan menarik dalam AI adalah model mana yang paling pintar. Kondisi AI 2026 adalah pertanyaan itu kini nyaris tidak menarik lagi. Sepuluh model teratas hanya berselisih 8,2 poin pada agregat terbaik yang tersedia, dan yang termurah di antaranya berharga seperenam puluh tujuh dari yang termahal.
Yang menggantikannya lebih berguna dan kurang seru: bisakah kamu memverifikasi apa yang dihasilkan benda-benda ini, cukup cepat untuk mengejar mereka?
Pertanyaan tunggal itu menjelaskan setiap temuan dalam artikel ini. Itu menjelaskan mengapa SWE-bench jenuh di 96% dan berhenti informatif. Itu menjelaskan mengapa adopsi alat coding AI mencapai 90% sementara kepercayaan turun ke 29%. Itu menjelaskan mengapa tingkat kegagalan keamanan Veracode tidak bergerak sementara kemampuan melesat, karena kemampuan dan keterverifikasian adalah sumbu berbeda dan hanya satu yang dioptimalkan. Itu menjelaskan mengapa DORA menemukan bahwa imbal hasil datang dari organisasi, bukan dari alatnya. Dan itu menjelaskan mengapa praktik yang benar-benar berhasil pada 2026 — spesifikasi, sandbox, gerbang tes, tinjauan nyata — terlihat jauh kurang ajaib dibanding demo.
Empat hal yang akan saya bawa pulang.
Frontier menjadi komoditas lebih cepat dari yang diperkirakan siapa pun, dan selisih bobot terbuka kini sekitar enam bulan. Model 397B berlisensi MIT mengalahkan frontier tertutup generasi lalu di SWE-bench. Model bobot terbuka 753B berada di atas GPT-5.6 Sol pada indeks agregat. Rencanakan untuk dunia di mana model bukan pembeda utamamu, karena hampir saja itu sudah terjadi sekarang.
Baca lisensinya sebelum benchmark-nya. Kemampuan makin konvergen; persyaratannya makin divergen. Z.ai meninggalkan MIT antar rilis. Meta menjanjikan bobot tanpa teks lisensi. Model coding terbaik Anthropic dibatasi oleh kewarganegaraan. Bagi pembeli komersial, empat poin benchmark bernilai lebih kecil daripada lisensi yang bisa dibaca pengacaramu dalam sembilan puluh detik.
Verifikasi adalah seluruh permainannya sekarang, dan hampir tidak ada yang membiayainya. Agen bisa menghasilkan satu hari kerja; kita meninjaunya dengan alat yang dibuat untuk meninjau satu jam kerja. Kalau kamu memilih di mana menaruh upaya engineering dalam dua belas bulan ke depan, taruhlah pada tes, spesifikasi, dan perkakas tinjauan, bukan pada teknik prompt. Teknik prompt terdepresiasi dengan setiap rilis model. Infrastruktur verifikasi berbunga majemuk.
Dan AI offline menjadi nyata, dengan anggaran memori yang baru saja jadi mahal. Model multimodal berparameter 27 miliar berlisensi Apache berjalan di mesin yang bisa kamu beli seharga €2.500. Windows mengirimkan model di dalam sistem operasinya. Ponselmu menjalankan model sparse 20 miliar parameter langsung dari flash. Setiap batas atas untuk itu — ambang 12 GB di ponsel, batas 32 GB di laptop, lantai 40 TOPS — adalah keputusan alokasi memori di pasar yang DRAM-nya langka, bukan batas silikonnya.
Susunan yang benar-benar akan saya bangun hari ini: Gemma 4 E4B di perangkat untuk lapisan yang selalu aktif; Qwen3.8-27B di perangkat keras milikmu untuk apa pun yang tidak boleh keluar dari gedung; GLM-5.3-Flash dengan $0,15/$0,47 untuk lapisan tengah bervolume tinggi; dan Claude Opus 5 atau Fable 5.1 untuk perencanaan dan masalah yang benar-benar sulit, dengan caching diaktifkan. Lakukan routing di antara mereka dalam satu berkas konfigurasi, dan perkirakan menulis ulang berkas itu dalam tiga bulan.
Tinjau lagi ini pada Desember. Meta mungkin sudah merilis bobotnya atau belum. Aion 1.0 Plan akan nyata atau hanya wacana. Hasil peningkatan diri Ornith akan tereplikasi atau menghilang diam-diam. Dan kurva atribusi CVE akan memberi tahu kita apakah 2026 adalah tahun industri memperketat gerbangnya sendiri atau tahun mereka menunggu orang lain melakukannya.
Apakah kamu menjalankan model bobot terbuka di produksi di EU, atau merilis kode tulisan agen lewat proses tinjauan yang benar-benar kamu percaya? Saya khususnya tertarik pada dua hal: pembagian biaya token yang terukur per peran agen, dan apa pun yang berhasil untuk meninjau diff agen sepanjang seribu baris. Koreksi dan bukti tandingan diterima — artikel ini diperbarui saat gambaran berubah.
Terakhir diperbarui: 3 September 2026.


