
 Tiếng Việt
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 ไทย
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

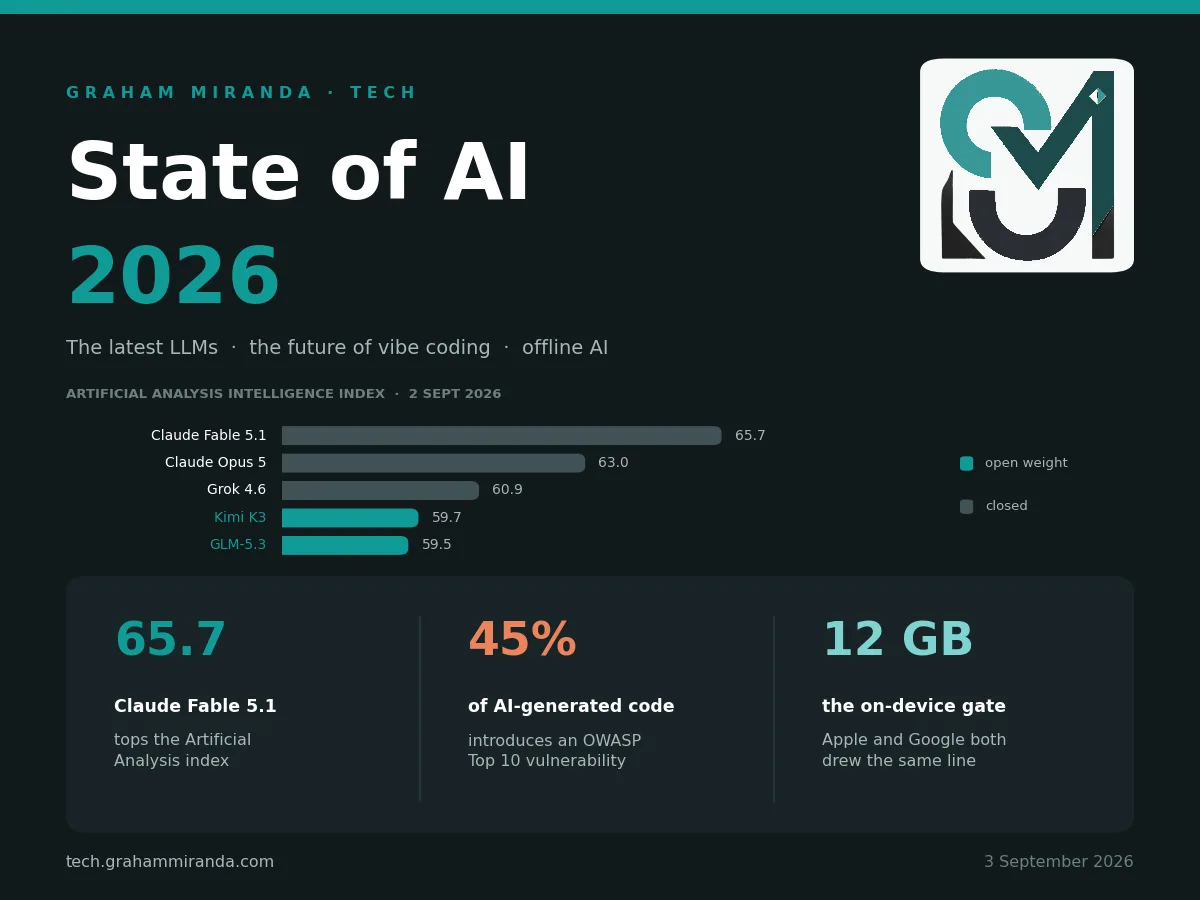
Hiện trạng AI 2026 quy về ba việc xảy ra trong tám tháng đầu năm — và gần như không ai đặt chúng vào cùng một câu.
Một mô hình đã vượt 96% trên SWE-bench Verified. Không phải 96% trên một benchmark đồ chơi — mà 96% trên các issue GitHub thật từ Django, Flask và scikit-learn, benchmark mà người ta tưởng phải mất nhiều năm. Giờ nó gần như hết khả năng phân biệt, và ba mô hình dẫn đầu chỉ cách nhau chưa tới một điểm phần trăm.
Bằng chứng tốt nhất hiện có về việc công cụ coding AI có giúp lập trình viên giàu kinh nghiệm nhanh hơn hay không vẫn nói là không. METR’s thử nghiệm ngẫu nhiên có kiểm soát cho thấy tốc độ chậm đi 19%. Nỗ lực chạy lại thử nghiệm năm 2026 của chính họ đổ vỡ vì lập trình viên từ chối làm việc không có AI, kể cả với $50 một giờ. Những người dùng các công cụ này tin mình nhanh gấp ba lần. Đo đạc thì không phải vậy.
Và Microsoft đưa một mô hình suy luận 14 tỷ tham số vào chính Windows, điều mà năm 2024 sẽ là khoa học viễn tưởng và giờ chỉ là chú thích trong một bài phát biểu Build.
Ba sự thật đó chính là toàn bộ hiện trạng AI 2026 trong một bức tranh thu nhỏ. Các mô hình đã trở nên phi thường. Mức tăng năng suất đo được không theo kịp. Và biên giới đáng chú ý lặng lẽ rời khỏi trung tâm dữ liệu, chuyển vào thiết bị trong tay bạn.
Đây là bản dài của hiện trạng AI 2026. Nó dành cho những người phải ra quyết định gắn với tiền — chọn mô hình nào để định tuyến, có để tác nhân viết mã production hay không, mua gì, và nói gì với khách hàng hay cán bộ bảo vệ dữ liệu. Tôi đã tách những gì đã phát hành khỏi những gì được báo cáo và những gì chỉ là tin đồn, vì sai lầm tốn kém nhất trong lĩnh vực này là lập kế hoạch dựa trên một mô hình chưa tồn tại.
Cập nhật lần cuối ngày 3 tháng 9 năm 2026. Sẽ phải cập nhật lại trước Giáng sinh.
TL;DR — Hiện trạng AI 2026 trong 90 giây
Tuyến biên giới là cuộc đua bốn ngựa và Anthropic hiện đang thắng trên điểm tổng hợp. Tính đến ngày 2 tháng 9 năm 2026, Artificial Analysis’s Intelligence Index v4.1.1 cho Claude Fable 5.1 65,7 điểm, Claude Opus 5 63,0, Grok 4.6 60,9 và GPT-5.6 Sol 58,9. Nhưng điểm tổng hợp che mất phần thú vị: GPT-5.6 Sol dẫn BrowseComp với 90,4%, Gemini 3.8 Flash đạt 58,7 với $0,75 mỗi triệu token đầu vào, và mười mô hình hàng đầu chỉ trải trên 8,2 điểm — khoảng cách đủ hẹp để khác biệt về harness và prompt có thể đẩy một mô hình lên vài bậc.
Trọng số mở hiện chậm khoảng một thế hệ và đang thu hẹp dần. GLM-5.3 (753B, mở) đứng ở 59,5 — thứ sáu toàn bảng, trên GPT-5.6 Sol. DeepSeek V4 Pro phát hành 1,6 nghìn tỷ tham số dưới giấy phép MIT thực sự. Ornith-1.5-397B đạt 86 trên SWE-bench Verified và vượt Claude Opus 4.8 trên Terminal-Bench 2.1, 86,1 so với 85,0. Khoảng cách năng lực giờ khoảng sáu tháng. Khoảng cách giấy phép mới là thứ quan trọng.
“Vibe coding” thắng cuộc tranh luận về mức độ phổ biến và thua cuộc tranh luận về bằng chứng. 90% lập trình viên dùng ít nhất một công cụ coding AI khi làm việc. Thị trường tác nhân coding doanh nghiệp đang chạy khoảng $10 tỷ mỗi năm. Và niềm tin của lập trình viên vào đầu ra AI giảm từ 40% xuống 29% trong hai năm. Công cụ thì phổ cập, còn người dùng chúng mỗi năm lại tin ít hơn. Cả hai điều đó đều hợp lý.
Hóa đơn bảo mật đã đến và nó được liệt kê từng khoản. Veracode phát hiện 45% mẫu mã do AI tạo ra mang lỗ hổng thuộc OWASP Top 10. Apiiro đo được lập trình viên có AI hỗ trợ tạo commit nhanh gấp ba đến bốn lần và phát hiện bảo mật nhanh gấp mười lần. Khoảng 20% mã do AI tạo ra tham chiếu tới các gói không tồn tại. Đây không phải lập luận chống lại các công cụ. Đây là lập luận về việc đặt cổng kiểm soát ở đâu.
AI ngoại tuyến năm nay trở nên thực sự hữu ích, trên chính phần cứng người ta đã có. Một mô hình 2 tỷ tham số chạy 61 token mỗi giây trên iPhone. Microsoft đưa mô hình suy luận 14B vào Windows sau yêu cầu NPU 40 TOPS. Google chặn mô hình trên thiết bị tốt nhất của mình sau mức 12 GB RAM, và Apple cũng vậy. Thông số quyết định thứ bạn chạy được ngoại tuyến là bộ nhớ, không phải sức tính toán, và bộ nhớ là thứ trở nên khan hiếm.
Một câu tóm gọn trung thực về hiện trạng AI 2026: đây là năm các mô hình thôi là nút thắt. Kiểm chứng trở thành nút thắt. Mọi quyết định quan trọng trong bài này — mô hình nào, harness nào, thiết bị nào, cổng nào — đều đi sau thay đổi đó.
So sánh nhanh: tuyến biên giới, tháng 9 năm 2026
Artificial Analysis Intelligence Index v4.1.1 tổng hợp chín bài đánh giá: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience và AA-LCR. Điểm dưới đây là ảnh chụp ngày 2 tháng 9 năm 2026.
| Mô hình | Hãng | Chỉ số AA | Trọng số | Đầu vào / đầu ra mỗi 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | Đóng | $10.00 / $50.00 |
| Claude Opus 5 | Anthropic | 63.0 | Đóng | $5.00 / $25.00 |
| Claude Fable 5 | Anthropic | 62.1 | Đóng | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | Đóng | — |
| Kimi K3 | Moonshot | 59.7 | Trọng số mở | — |
| GLM-5.3 | Z.ai | 59.5 | Trọng số mở | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Đóng | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | Đóng | $0.75 / $3.75 | |
| Qwen3.8 Max Preview | Alibaba | 58.1 | Đóng | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Trọng số mở | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropic | 57.3 | Đóng | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | Đóng | — |
| GPT-5.5 | OpenAI | 56.3 | Đóng | — |
Đọc cột thứ tư trước cột thứ ba. Hai trong mười mô hình hàng đầu có trọng số tải về được, và một trong đó có giá $0,15 mỗi triệu token đầu vào.
So sánh nhanh: tuyến biên giới trọng số mở
| Mô hình | Tổng / hoạt động | Ngữ cảnh | Giấy phép | Phát hành |
|---|---|---|---|---|
| Kimi K3 | 2,8T / 104B | 1M | Theo bậc doanh thu (tùy chỉnh) | Tháng 7 năm 2026 |
| Qwen3.8-2.4T-A95B | 2,4T / 95B | 262K (1M qua YaRN) | Apache 2.0 | 14 tháng 8 năm 2026 |
| DeepSeek V4 Pro | 1,6T / 49B | 1M | MIT | 12 tháng 8 năm 2026 |
| GLM-5.3 | 753B / ~40B | 1M | Tùy chỉnh (ngưỡng $10B) | Tháng 8 năm 2026 |
| MiniMax M3 | 428B / 23B | 1M | Tùy chỉnh (ghi nguồn) | 1 tháng 6 năm 2026 |
| Ornith-1.5-397B | 397B MoE | 262K (1M qua YaRN) | MIT | Tháng 8 năm 2026 |
| Gemma 4 31B | 31B dense | 256K | Apache 2.0 | 6 tháng 4 năm 2026 |
| Qwen3.8-27B | 27B dense | 262K | Apache 2.0 | 14 tháng 8 năm 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 tháng 4 năm 2026 |
Ba trong chín cái đó thực sự sạch theo OSI. Đó là câu chuyện thật của trọng số mở năm 2026, và tôi sẽ quay lại ở Phần ba.
HỒI I — CÁC MÔ HÌNH
Phần một: Những gì thực sự đã phát hành trong năm 2026
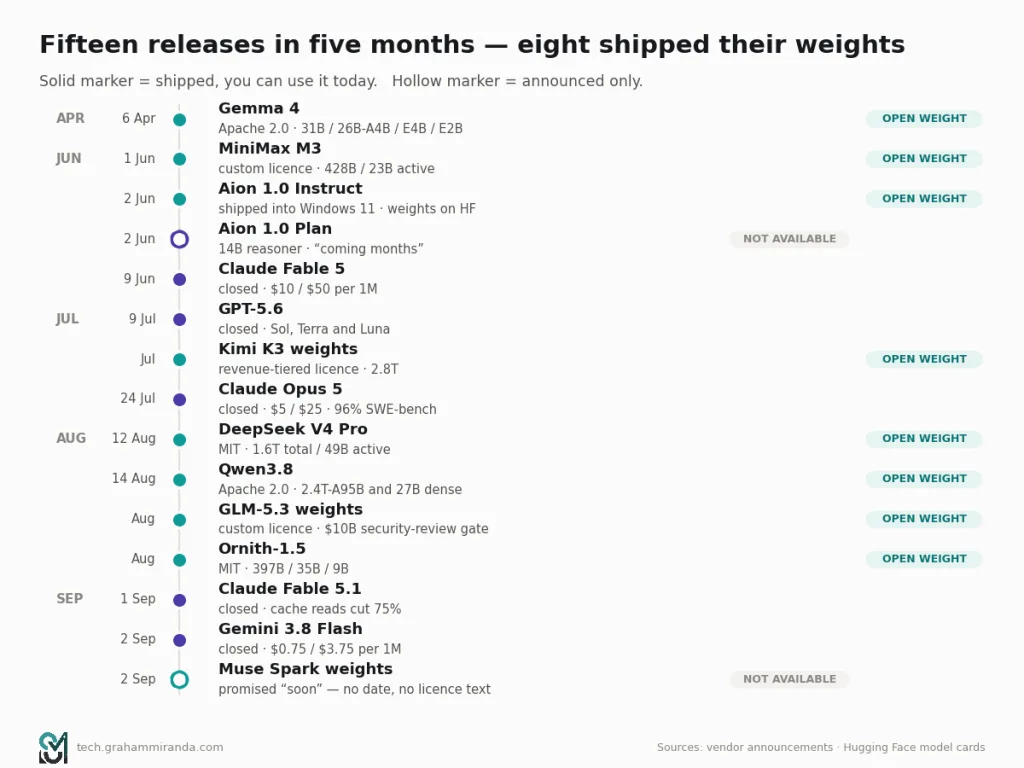
Trước mọi lập luận, là bảng kê. Tôi chia thành ba tầng vì khác biệt giữa chúng là nơi tiền bị lãng phí.
Đã xác nhận và đang phát hành
- Ngày 6 tháng 4 năm 2026 — Google phát hành Gemma 4 theo Apache 2.0, một thay đổi giấy phép so với Gemma 3’s điều khoản riêng. Bốn biến thể: 31B dense, 26B với 4B active (MoE), E4B khoảng 8B, và E2B tổng 5,1B với 2,3B active. Ngữ cảnh 256K trên các mô hình lớn, 128K trên dòng E. Tất cả đều hỗ trợ đầu vào văn bản, hình ảnh và video; E2B và E4B thêm âm thanh gốc.
- Ngày 1 tháng 6 năm 2026 — MiniMax M3. 428B tổng / 23B active, ngữ cảnh 1M, đa phương thức gốc, một toán tử attention thưa mới, trọng số trên Hugging Face. Được phân tích kỹ trong bài trước của tôi về phần cứng AI cục bộ.
- Ngày 2 tháng 6 năm 2026 — Microsoft công bố Aion 1.0 tại Build. Một họ mô hình trên thiết bị được đưa vào chính Windows 11: Aion 1.0 Instruct (chạy được trên CPU, trong Edge Canary từ 150.0.4070) và Aion 1.0 Plan, mô hình suy luận và gọi công cụ 14 tỷ tham số với cửa sổ ngữ cảnh 32K.
- Ngày 9 tháng 6 năm 2026 — Claude Fable 5. Anthropic’s tầng cao nhất, $10/$50 mỗi triệu token, ngữ cảnh 1M, đầu ra tối đa 128K.
- Ngày 9 tháng 7 năm 2026 — OpenAI phát hành GPT-5.6 với ba biến thể: Sol ($5/$30), Terra ($2,50/$15) và Luna ($1/$6). Năng lực tấn công mạng được tích hợp vào Sol thay vì bán như một mô hình riêng, với quyền truy cập mở rộng qua chương trình OpenAI’s Trusted Access for Cyber.
- Tháng 7 năm 2026 — Moonshot mở trọng số Kimi K3’s. 2,8 nghìn tỷ tham số, ngữ cảnh 1M, MXFP4 gốc, theo giấy phép phân tầng theo doanh thu.
- Ngày 24 tháng 7 năm 2026 — Claude Opus 5. $5/$25, không đổi so với Opus 4.8. Anthropic tuyên bố nó “hơn gấp đôi hiệu năng Opus 4.8’s” trên Frontier-Bench v0.1 và đạt gấp ba mô hình tốt thứ hai trên ARC-AGI 3.
- Ngày 12 tháng 8 năm 2026 — DeepSeek V4 Pro ra khỏi bản xem trước với trọng số giấy phép MIT: tổng 1,6T (một số bài viết làm tròn thành 1,7T), 49B active, ngữ cảnh 1M, 893 GB tensor BF16 và FP8, cùng mô-đun giải mã suy đoán DSpark. Terminal-Bench 2.1 đạt 87,9, HLE có công cụ 60,0, CyberGym 83,3. DeepSeek tăng giá API cùng lúc.
- Ngày 14 tháng 8 năm 2026 — trọng số mở Qwen3.8 theo Apache 2.0: một mô hình đa phương thức dense 27B và một gã khổng lồ 2,4T-A95B, cả hai trên Hugging Face và ModelScope, ngữ cảnh gốc 262K mở rộng tới 1M bằng YaRN.
- Tháng 8 năm 2026 — trọng số GLM-5.3 lên Hugging Face khoảng hai tuần sau khi ra API. 753B MoE, ngữ cảnh 1M, đầu ra 128K, BF16 và FP8.
- Tháng 8 năm 2026 — Ornith-1.5. Ba quy mô (397B MoE, 35B MoE với 3B active, 9B dense), xây trên Qwen3.5 và Gemma 4 với tiền huấn luyện tiếp, giấy phép MIT, và tuyên bố 86 trên SWE-bench Verified.
- Ngày 1 tháng 9 năm 2026 — Claude Fable 5.1 và Mythos 5.1. Suy nghĩ thích ứng bật mặc định, ngữ cảnh 1M, đầu ra 128K. Giá cơ bản không đổi ở $10/$50, nhưng đọc cache giảm 75%, từ $1,00 xuống $0,25 mỗi triệu.
- Ngày 2 tháng 9 năm 2026 — Gemini 3.8 Flash ở mức $0,75/$3,75, ngữ cảnh đầu vào 1M, đầu ra 66K, kiến thức cập nhật tới tháng 3 năm 2026, với đầu vào văn bản, hình ảnh, video, âm thanh và PDF.
- Ngày 2 tháng 9 năm 2026 — Meta phát hành Muse Spark 1.3 và Muse Code CLI.
Được báo cáo, đáng tin, chưa xác nhận
- Meta sẽ mở Muse Spark’s trọng số “sớm.” Đó là Mark Zuckerberg trên X, không ngày tháng, không số tham số, không chi tiết kiến trúc và không văn bản giấy phép. Meta chưa công bố kích thước mô hình’s ở bất kỳ phiên bản nào.
- Gemini Nano v4 được mô tả là sẽ có cho Android, với Nano v3 hiện chỉ giới hạn ở dòng Pixel 10.
- Aion 1.0 Plan sẽ “ra mắt trong vài tháng tới” để dùng chung; chỉ Instruct đang ở bản xem trước.
Tin đồn, một nguồn, hãy xử lý tương ứng
- Mọi thứ bạn đã đọc về mô hình chủ lực tiếp theo của Anthropic, OpenAI hay Google. Trong một thị trường mà bốn phòng lab phát hành mô hình top 10 trong chín tuần, tin đồn hướng tới tương lai có chu kỳ bán rã khoảng hai tuần.
Một điều nữa đáng nêu, vì nó mới và gần như không ai ngoài giới bảo mật đang bàn tới. Claude Mythos 5.1 đạt 60,9 trên Terminal-Bench 4.0 — cao hơn Fable 5.1’s 55,8 — và 95,5% trên SWE-bench Verified. Bạn không thể mua nó.
Anthropic mô tả Mythos là “mô hình có năng lực nhất cho nghiên cứu an ninh mạng và sinh học”, và nó chỉ dành cho những chuyên gia phòng thủ mạng và nhà khoa học sự sống đã được thẩm định qua hai chương trình truy cập tin cậy: Cyber Verification Program và Life Sciences Verification Program. Anthropic’s cách diễn đạt là họ “chỉ có thể cung cấp nó cho một số tổ chức ở Mỹ, dù chúng tôi đang mở rộng quyền truy cập.” Project Glasswing, nỗ lực mở rộng truy cập, đã đạt khoảng 150 tổ chức ở hơn mười lăm quốc gia tính đến tháng 6 năm 2026.
Lý do là dùng kép — một mô hình giỏi tìm lỗ hổng thì cũng giỏi tìm chúng cho cả hai phía — và tôi cho rằng điều đó có thể biện hộ được. Nhưng hãy để ý hệ quả cấu trúc, vì nó thực sự mới: mô hình điểm cao nhất trên một benchmark lập trình công khai giờ là mô hình mà phần lớn thế giới không thể truy cập với bất kỳ giá nào. Việc giới hạn năng lực vì lý do an toàn chứ không vì lý do thương mại sẽ trở nên phổ biến hơn, không phải ít hơn, và nếu bạn ở ngoài nước Mỹ thì đó là lý do để quan tâm tới trọng số mở, chẳng liên quan gì tới chi phí.
Hiện ảnh Chín tháng, mười hai bản phát hành đáng kể, bốn trong đó là trọng số mở. Thanh đặc là đã phát hành kèm trọng số hoặc API bạn có thể mua hôm nay; đường viền chấm là đã công bố nhưng chưa có.
Phần hai: Điều gì thực sự tách biệt các mô hình biên giới hiện nay
Đây là sự thật không thoải mái về đỉnh của bảng xếp hạng đó: với phần lớn công việc bạn thực sự làm, tám mô hình hàng đầu có thể hoán đổi cho nhau.
Tôi không nói thế để cãi cho khác người. Tôi nói vì chênh lệch chỉ số tổng hợp giữa Claude Fable 5.1 ở 65,7 và GLM-5.3-Flash ở 57,5 là tám điểm, còn GLM-5.3-Flash giá $0,15 mỗi triệu token đầu vào so với $10,00 của Fable’s. Đó là mức chênh lệch giá 67 lần cho chênh lệch năng lực 12% trên một điểm tổng hợp, và điểm tổng hợp nén đúng những khác biệt quan trọng với bạn trong khi phóng đại những khác biệt không quan trọng.
Nên câu hỏi hữu ích không phải “mô hình nào tốt nhất”. Mà là “mỗi mô hình thực sự giỏi nhất ở việc gì, và điều đó có trùng với tuần làm việc của tôi không”.
Bốn thứ thực sự khác biệt
1. Độ tin cậy của tác nhân trong tác vụ dài. Đây là yếu tố khác biệt thật sự của năm 2026 và nó được đo rất kém. Anthropic’s Opus 5 được định vị rõ ràng là “một bước tiến cho tầng Opus vận hành các tác nhân chạy dài” — không phải mô hình thông minh hơn, mà là mô hình không đổ vào giờ thứ sáu. Bằng chứng cho loại cải thiện này nằm ở các benchmark tác nhân (Terminal-Bench, OSWorld, Frontier-Bench) chứ không phải benchmark kiến thức, và những benchmark đó còn non, nhiễu và nhạy với scaffold.
2. Kinh tế của cache. Thay đổi chính của Fable 5.1’s không phải bước nhảy năng lực. Đó là việc cắt giá đọc cache 75%, từ $1,00 xuống $0,25 mỗi triệu token — mà MarkTechPost ước tính giúp giảm khoảng 25% chi phí cho quy trình làm việc thông thường và tới 45% cho quy trình tác nhân. Với bất kỳ tác nhân nào đọc lại một system prompt hoặc codebase lớn ở mỗi lượt, giá cache là đòn bẩy lớn hơn cho hóa đơn hàng tháng so với việc chọn mô hình. Không ai đưa thứ đó lên bảng xếp hạng.
3. Duyệt web và dùng công cụ. GPT-5.6 Sol đạt 90,4% trên BrowseComp — 92,2% ở chế độ suy luận Ultra. Đó là một điểm mạnh cụ thể, đã công bố, và nếu công việc của bạn là nghiên cứu-tổng hợp chứ không phải viết mã-kiểm chứng, nó đáng giá hơn hai điểm chỉ số tổng hợp.
4. Giá trên mỗi câu trả lời đủ tốt. Gemini 3.8 Flash với chỉ số 58,7 cho $0,75 đầu vào là thứ bị định giá sai rõ ràng nhất trên bảng so với tuyến biên giới đóng. GLM-5.3-Flash ở 57,5 với $0,15 là thứ bị định giá sai rõ ràng nhất, hết.
Bảng giá, vì đó mới là quyết định thật
| Mô hình | Đầu vào /1M | Đầu ra /1M | Đầu vào cache /1M | Ngữ cảnh |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M / 128K ra |
| Claude Opus 5 | $5.00 | $25.00 | — | 1M / 128K ra |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1M / 128K ra |
| GLM-5.3 | $1.40 | $4.40 | — | 1M / 128K ra |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1M / 66K đầu ra |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1M |
| Muse Spark (Contributors) | $0.10 | $0.20 | $0.002 | — |
Dòng cuối đó đáng để xem lại. Gói Meta’s Contributors có giá 0,10 USD đầu vào và 0,20 USD đầu ra — kèm khả năng dữ liệu của bạn bị dùng để huấn luyện. Đó không phải là giá; đó là một cuộc trao đổi. Theo tôi thấy, đây cũng là cách thể hiện trung thực nhất mô hình kinh doanh thật sự nằm dưới rất nhiều dịch vụ suy luận giá rẻ, và tôi thà thấy nó được ghi rõ trong bảng giá còn hơn bị chôn trong một thỏa thuận xử lý dữ liệu (DPA).
Hiện ảnh Trí tuệ trên một trục, giá trên thang logarit ở trục kia. Tám điểm chỉ số phân tách đỉnh và đáy của biểu đồ; 67× phân tách mức giá. Đường biên hiệu quả nằm ở góc dưới bên phải, và gần như không ai mua ở đó.
Sự cố API mà không ai cảnh báo bạn
Fable 5.1 ra mắt với ba thay đổi gây lỗi: không còn ép buộc dùng công cụ, khối suy nghĩ giờ phụ thuộc từng mô hình, và việc sửa thông điệp hệ thống hoặc công cụ giữa cuộc trò chuyện giờ báo lỗi thay vì được âm thầm chấp nhận.
Điều thứ ba sẽ khiến nhiều người gặp rắc rối. Rất nhiều harness tác nhân thay đổi prompt hệ thống hoặc danh sách công cụ giữa các lượt — thêm công cụ khi bắt đầu tác vụ con, cắt bớt hướng dẫn để tiết kiệm ngữ cảnh. Trên Fable 5.1, việc đó giờ là lỗi. Nếu bạn nâng cấp một model ID trong tệp cấu hình và tác nhân bắt đầu trả về lỗi 400 ở lượt thứ tư, thì đó là lý do.
Bài học chung, đáng giá hơn bài học cụ thể: Năm 2026, nâng cấp mô hình là một cuộc di chuyển API. Viết model ID sao cho việc đổi mô hình chỉ là thay một dòng, và ghim chúng. Bạn sẽ lại phải làm việc đó trong vòng một quý.
Phần ba: Biên giới trọng số mở và cái bẫy giấy phép
Đây là phần của câu chuyện năm 2026 mà tôi thấy thật sự hào hứng, cũng là phần mà tiếp thị gây hiểu lầm nhiều nhất.
Khoảng cách năng lực vào khoảng sáu tháng
Hãy xem trọng số mở đã đạt được gì từ tháng 6 đến tháng 8 năm 2026:
- DeepSeek V4 Pro: tổng 1,6T, 49B hoạt động, giấy phép MIT, Terminal-Bench 2.1 đạt 87,9. Đó là con số Terminal-Bench cao hơn hầu hết mô hình đóng công bố trong năm nay.
- Ornith-1.5-397B: 86 trên SWE-bench Verified, 86,1 trên Terminal-Bench 2.1 so với 85,0 của Claude Opus 4.8’s, và 92,8 trên GPQA Diamond. Giấy phép MIT, ngữ cảnh gốc 262K có thể mở rộng tới khoảng 1M bằng YaRN. Được xây dựng trên Qwen3.5 và Gemma 4 bằng tiền huấn luyện và hậu huấn luyện tiếp nối.
- GLM-5.3: đứng thứ sáu trên chỉ số Artificial Analysis với 59,5, xếp trên GPT-5.6 Sol.
- Qwen3.8: một mô hình 2,4 nghìn tỷ tham số theo Apache 2.0, cùng một mô hình anh em 27B dense đa phương thức mà Alibaba nói vượt Qwen3.7-Plus lớn hơn ở tác vụ lập trình và văn phòng.
Sáu tháng trước, cách nói trung thực là “trọng số mở chậm một thế hệ và rẻ hơn.” Cách nói đó giờ đã sai. Cách nói đúng là: cụ thể với công việc lập trình và tác nhân, các mô hình trọng số mở tốt nhất nằm trong biên sai số của biên giới đóng của 'thế hệ trước’, và chúng rẻ hơn 10× đến 60×.
Ornith-1.5 là mô hình thú vị nhất năm và gần như không ai từng nghe đến
Tôi muốn dừng lại ở mô hình này, vì nó thật sự mới lạ chứ không phải một kết quả từ việc mở rộng quy mô.
Ornith mô tả 1.5 là mở rộng “tự dựng giàn giáo thành một vòng tự cải thiện đầu-cuối”. Nói đơn giản: hệ thống tự đề xuất các tác vụ huấn luyện mới, tạo giàn giáo riêng cho từng tác vụ, sinh các lần chạy thử lời giải, rồi tối ưu đồng thời cả ba bằng GRPO. Mô hình mạnh hơn giúp nó đề xuất tác vụ khó hơn; giàn giáo tốt hơn giúp khám phá chiến lược tốt hơn; đầu ra tốt hơn cho tín hiệu học sạch hơn.
Nó được huấn luyện dựa trên Qwen3.5 và Gemma 4 — tức là trên trọng số mở của 'người khác’ — và vượt Claude Opus 4.8 trên Terminal-Bench 2.1 dù chỉ có 397B tham số và giấy phép MIT.
Nếu vòng lặp đó khái quát hóa được, đây là kết quả có hệ quả lớn nhất trong bài viết này, vì điều đó có nghĩa hệ sinh thái mở có thể tiến bộ mà không cần phòng thí nghiệm nào chi khoản tiền quy mô biên giới cho một lần tiền huấn luyện. Nếu nó không khái quát hóa được — nếu những gì ta thấy chỉ là quá khớp đặc thù theo benchmark từ một chương trình giảng dạy tự sinh — thì đó lại là một câu chuyện cảnh báo về đúng điều tương tự. Tôi không biết trường hợp nào đúng. Theo tôi biết, cũng không ai ngoài Ornith biết. Điều tôi muốn có trước khi đặt cược vào nó: một đánh giá độc lập trên các tác vụ không nằm gần 'chương trình tự sinh’, và một mốc chuẩn con người được giữ riêng. Cả hai đều chưa tồn tại.
Giờ đến giấy phép, vì “mã nguồn mở” đang được dùng để làm rất nhiều điều thiếu trung thực
Đây là những nghĩa vụ mà các trọng số đó thực sự khiến bạn phải gánh:
| Mô hình | Giấy phép | Cái bẫy |
|---|---|---|
| DeepSeek V4 Pro | MIT | Không có. Mã nguồn mở thực sự. |
| Qwen3.8 | Apache 2.0 | Không có. Mã nguồn mở thực sự. |
| Gemma 4 | Apache 2.0 | Không có — và là cải thiện thực sự so với các điều khoản riêng của Gemma 3’s. |
| Ornith-1.5 | MIT | Không có ghi chú. Hãy tự kiểm tra model card trước khi phát hành. |
| GLM-5.3 | Tùy chỉnh | Các công ty trên 10 tỷ USD doanh thu hằng năm phải vượt qua bước đánh giá Z.ai’s về bảo mật trước khi dùng cho mục đích thương mại. Z.ai đã chuyển ra khỏi MIT cho bản phát hành này. |
| Kimi K3 | Tùy chỉnh | Chia theo bậc doanh thu; nhà cung cấp khối lượng lớn phải ghi công rõ ràng. |
| MiniMax M3 | Tùy chỉnh | Dùng thương mại phải ghi công rõ ràng “Built with MiniMax M3”; cần ủy quyền bằng văn bản riêng khi vượt 20 triệu USD doanh thu hằng năm. |
| Muse Spark | Không rõ | Được công bố là “sắp ra mắt.” Chưa có văn bản giấy phép nào. |
Ba nhận xét. Tôi đã đi kỹ vào phần chữ nhỏ của ba mục đầu tiên trong Kimi K3 vs Fable 5.1 vs GLM-5.3, nên ở đây tôi chỉ nói những gì đã thay đổi kể từ đó.
Thứ nhất, các cổng kiểm soát nhắm vào những nhà cung cấp siêu quy mô, không nhắm vào bạn. Ngưỡng doanh thu 10 tỷ USD loại trừ gần như mọi độc giả của bài viết này. Nếu bạn là doanh nghiệp Mittelstand của Đức, một agency, một công ty tư vấn hay một lập trình viên độc lập, câu trả lời thực tế cho GLM-5.3 và Kimi K3 là: bạn ổn.
Thứ hai, “bạn ổn” không giống với “đánh giá pháp lý của bạn ổn.” Giấy phép riêng nghĩa là ai đó sẽ tính phí bạn để đọc nó. Giấy phép MIT hay Apache 2.0 nghĩa là ai đó đọc trong chín mươi giây rồi bỏ qua. Với bộ phận mua sắm doanh nghiệp, khác biệt đó đáng giá hơn bốn điểm benchmark, và đó là lý lẽ mạnh nhất để chọn DeepSeek V4 Pro và Qwen3.8 thay vì GLM-5.3 trong một sản phẩm thương mại.
Thứ ba, hãy để ý hướng đi. Z.ai đi từ MIT trên GLM-5.2 sang giấy phép độc quyền kèm cổng đánh giá bảo mật trên GLM-5.3. DeepSeek đi ngược lại, giữ MIT trong khi tăng giá API — một chiến lược mạch lạc: thu tiền vì sự tiện lợi, cho không trọng số, để các nhà cung cấp suy luận cạnh tranh ở khâu phục vụ. Trọng số mở không phải một phong trào. Đó là một chiến thuật thương mại, và chiến thuật thay đổi theo từng bản phát hành. Đừng xây kiến trúc sản phẩm dựa trên giả định rằng phiên bản 'năm sau’ sẽ giữ giấy phép 'năm nay’.
Nên bỏ từ “mã nguồn mở” khi nói về mô hình
Không mô hình nào trong số này là mã nguồn mở theo nghĩa OSI, trừ những mô hình MIT và Apache 2.0 — và ngay cả chúng cũng chỉ phát hành trọng số mà không phát hành dữ liệu huấn luyện hay mã huấn luyện, một điều khác biệt có ý nghĩa so với phần mềm mã nguồn mở.
Bộ từ tôi dùng, và muốn đề xuất:
- Trọng số mở — bạn có thể tải và chạy các tham số. Không nói gì về điều khoản.
- Có giấy phép mở — MIT, Apache 2.0 hoặc tương đương. Không có cổng doanh thu, không bắt buộc ghi công, không hạn chế lĩnh vực sử dụng.
- Mã nguồn mở — trọng số, mã huấn luyện và thành phần dữ liệu, theo một giấy phép được OSI chấp thuận. Gần như không có gì ở biên giới đáp ứng được.
Nếu một nhà cung cấp nói “mô hình mã nguồn mở” và ý là trường hợp đầu tiên, thì đó không hẳn là nói dối, nhưng đó là kiểu thiếu chính xác sẽ đi vào hồ sơ mua sắm rồi thành tranh chấp.
Hiện ảnh Năng lực đang hội tụ. Giấy phép đang phân kỳ. Với hầu hết người mua thương mại, cột bên phải mới là thứ quyết định việc mua, không phải điểm số.
Phần bốn: Vấn đề benchmark
SWE-bench Verified giờ trông như thế này:
| Hạng | Mô hình | Điểm |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
Ba mô hình nằm trong khoảng một điểm phần trăm ở đỉnh. Benchmark đó đã xong. Nó không thể cho bạn biết gì hữu ích về khác biệt giữa Opus 5, Mythos 5 và Fable 5, và bất kỳ ai trích dẫn nó như dữ liệu đầu vào để mua hàng vào tháng 9 năm 2026 đang trích dẫn một công cụ đã bão hòa.
Đây là tình trạng chung của việc đánh giá AI hiện nay, và nó có bốn kiểu thất bại đáng gọi tên:
Bão hòa. Khi điểm cao nhất tụ lại trên 90%, khác biệt còn lại bị chi phối bởi nhiễu nhãn và chi tiết harness chứ không phải năng lực. SWE-bench Verified đã tới đó. GPQA Diamond thì gần tới.
Độ nhạy với giàn giáo. Cùng một mô hình cho điểm khác nhau tùy vòng lặp tác nhân bao quanh nó — chính sách thử lại, bộ công cụ, quản lý ngữ cảnh, số lượt được chạy. Kết quả Terminal-Bench và OSWorld đặc biệt nhạy với điều này. Hai phòng thí nghiệm báo cáo cùng một benchmark thường không chạy cùng một thí nghiệm.
Nhiễm dữ liệu. Mọi benchmark công khai cuối cùng đều rò rỉ vào kho dữ liệu huấn luyện. Phản ứng là một cuộc chạy đua vũ trang với các benchmark riêng mới hơn, khó hơn — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science — cách này giải quyết nhiễm dữ liệu nhưng tạo ra vấn đề mới: bạn không thể kiểm chứng độc lập một benchmark riêng.
Chọn lọc. Các phòng thí nghiệm công bố những benchmark họ thắng. Anthropic dẫn đầu với Frontier-Bench và ARC-AGI-3 cho Opus 5. OpenAI dẫn đầu với Agents’ Last Exam và Coding Agent Index cho GPT-5.6. Z.ai dẫn đầu với CyberGym. Không ai nói dối. Tất cả đều đang chọn.
Điều tôi thực sự tin vào tháng 9 năm 2026
Ưu tiên tổng hợp hơn từng chỉ số riêng lẻ. Chỉ số Artificial Analysis’s có ưu điểm là do bên thứ ba vận hành, trên một harness cố định, qua chín đánh giá, trên 190 mô hình. Các con số tuyệt đối của nó không có nhiều ý nghĩa; còn thứ tự của nó là tín hiệu công khai có thể bảo vệ nhất hiện có.
Kết quả chuẩn hóa theo chi phí. Các tuyên bố về Opus 5 của chính Anthropic’s là ví dụ tốt về cách báo cáo điều này: “trong khoảng 0,5% điểm cao nhất của Fable 5’s với một nửa chi phí” trên CursorBench 3.2, và vượt Fable 5 trên OSWorld 2.0 “với một phần ba chi phí.” Đó là một tuyên bố hữu ích vì nó nêu rõ sự đánh đổi.
Hiệu quả token. Artificial Analysis lưu ý rằng Gemma 4 31B chỉ dùng 39 triệu token đầu ra để hoàn thành toàn bộ Intelligence Index. Với khối lượng công việc tác nhân, một mô hình đạt cùng câu trả lời với một phần ba số token sẽ tốn một phần ba hóa đơn và một phần ba độ trễ. Điều này ít được báo cáo và là một trong số ít chỉ số quy đổi trực tiếp thành tiền.
Đánh giá của chính bạn. Hai mươi tác vụ từ đúng backlog thực tế của bạn, chạy với ba mô hình, do bạn chấm điểm. Chỉ mất một buổi chiều. Nó sẽ cho bạn biết nhiều hơn tất cả bảng xếp hạng trong bài này cộng lại, và đó là đánh giá duy nhất theo định nghĩa là không bị nhiễm dữ liệu.
Và một điều tôi không tin: bất kỳ con số token/giây hay benchmark đơn lẻ nào được trích dẫn mà không kèm harness, cách lượng tử hóa và ngày tháng. Hãy coi đó là những tuyên bố về bậc độ lớn.
Phần năm: Con số thực sự thay đổi — chân trời thời gian tác nhân
Nếu bạn chỉ mang theo một chỉ số từ bài viết này, hãy chọn chỉ số này.
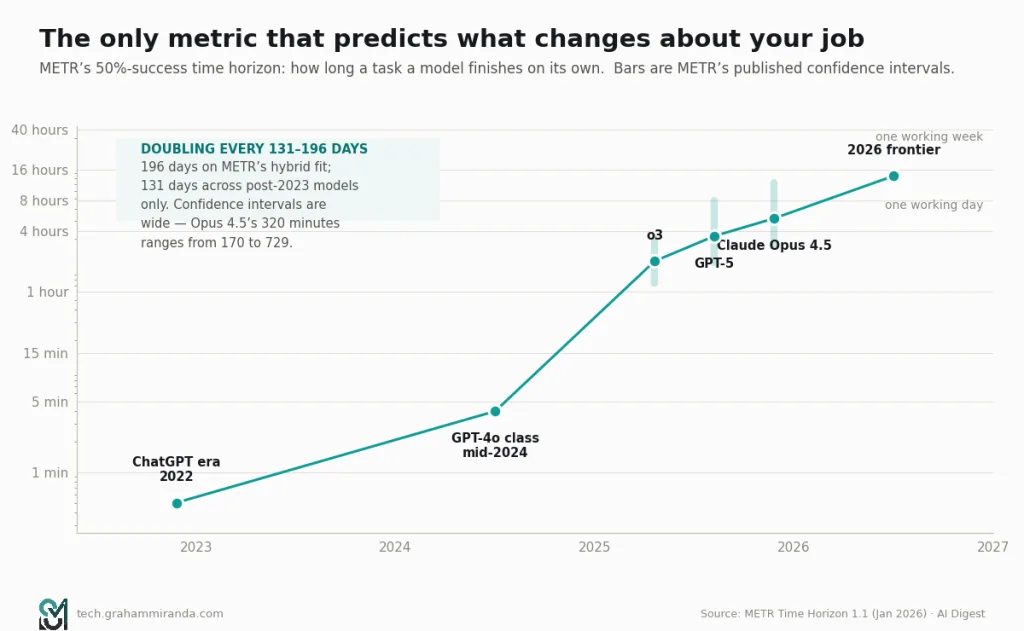
METR đo độ dài tác vụ — tính bằng giờ người — mà một mô hình có thể tự hoàn thành với xác suất thành công 50%. Đó là chỉ số đại diện tốt hơn cho câu hỏi “liệu thứ này có làm được việc của tôi không” so với bất kỳ benchmark kiến thức nào, vì nó nắm bắt thứ thực sự thất bại trong thực tế: không phải việc không biết câu trả lời, mà là giữ được mạch lạc đủ lâu để đi tới đó.
Quỹ đạo, theo công trình của chính METR’s và bản theo dõi của AI Digest’s:
| Giai đoạn | Chân trời thời gian thành công 50% |
|---|---|
| 2022 (thời ChatGPT ra mắt) | ~30 giây |
| Giữa 2024 (nhóm GPT-4o) | ~4 phút |
| Cuối 2025 (Claude Opus 4.5) | 320 phút (~5,3 giờ), CI [170, 729] |
| Biên giới 2026 | 14+ giờ |
Thời gian nhân đôi là phần gây tranh cãi. Bản phát hành Time Horizon 1.1 của METR’s ngày 29 tháng 1 năm 2026 — 228 tác vụ, 31 trong đó được ước tính cần từ tám giờ công trở lên, được chuyển sang khung Inspect của Viện An ninh AI Vương quốc Anh’s — báo cáo 196 ngày (7 tháng) trên dữ liệu hỗn hợp cũ và mới, nhưng 131 ngày khi chỉ giới hạn ở các mô hình sau 2023, nhanh hơn khoảng 20% so với 165 ngày mà phương pháp trước đưa ra.
Ngoại suy một hàm mũ là cách người ta tự làm mình bẽ mặt, nên để tôi nêu thật to các lưu ý trước khi dùng con số này.
Những lưu ý này rất lớn. Các khoảng tin cậy của chính METR’s là rất lớn — chân trời 320 phút của Opus 4.5’s có khoảng từ 170 đến 729 phút. Chỉ 5 trong 31 tác vụ dài của họ có mốc chuẩn con người được đo; phần còn lại là ước tính. Thành phần tác vụ làm thay đổi xu hướng đo được. Và “50% thành công trên một tác vụ được đặc tả tốt với môi trường sạch” còn cách xa “50% thành công trên codebase của bạn với bộ test chập chờn và quy trình triển khai không có tài liệu.”
Dù vậy, hướng đi không còn nghi ngờ và độ lớn gần đúng. Theo ngoại suy, các tác nhân biên giới đạt độ dài tác vụ tự chủ khoảng một ngày làm việc vào 2027 và khoảng một tuần làm việc vào 2028.
Vì sao đây là con số quan trọng
Bởi vì đó là chỉ số duy nhất dự đoán điều gì sẽ thay đổi trong công việc của bạn.
Một mô hình có chân trời 4 phút là tự động hoàn thành. Bạn liên tục ở trong vòng lặp, và chất lượng mô hình quyết định gợi ý tốt đến đâu.
Một mô hình có chân trời 5 giờ là đồng nghiệp bạn giao việc buổi sáng và xem lại vào bữa trưa. Bạn không ở trong vòng lặp; bạn ở cuối vòng lặp. Chất lượng mô hình quyết định việc xem lại đau đớn thường xuyên đến đâu.
Một mô hình có chân trời 40 giờ là thứ chúng ta chưa có cơ cấu quản lý để xử lý. Bạn sẽ phải xem lại một tuần công việc mà bạn không nhìn thấy nó diễn ra, trong một codebase đã thay đổi khi bạn không để ý, đối chiếu với một đặc tả bạn viết trước khi biết vấn đề là gì.
Mọi lập luận trong phần còn lại của bài viết này — về vibe coding, về kiểm chứng, về nơi đặt nút thắt — thực chất là lập luận về điều gì xảy ra khi con số đó tăng lên. Các mô hình đã có chân trời dài. Quy trình đánh giá của chúng ta thì chưa.
Hiện ảnh Chân trời thời gian thành công 50%, với các khoảng tin cậy METR’s được trình bày trung thực. Các khoảng này đủ rộng để có ý nghĩa — và xu hướng vẫn đứng vững bất chấp chúng.
HỒI HAI — TƯƠNG LAI CỦA VIBE CODING
Phần sáu: “Vibe coding” giờ có nghĩa gì
Andrej Karpathy đặt ra thuật ngữ này vào tháng 2 năm 2025 để mô tả một điều cụ thể và hơi tinh nghịch: buông theo cảm hứng, quên rằng mã đang tồn tại, chấp nhận diff mà không đọc, và để mô hình dẫn dắt. Đó là mô tả của một chế độ, được đưa ra nửa đùa nửa thật, cho những dự án cuối tuần dùng một lần rồi bỏ.
Mười tám tháng sau, cụm từ này đã đi qua toàn bộ vòng đời. Nó thành một phong trào, rồi một chức danh, rồi một từ mang nghĩa xúc phạm, rồi một từ của năm do Collins bình chọn, rồi một hạng mục đầu tư mạo hiểm, và giờ — trong thay đổi duy nhất thực sự quan trọng — một bộ thực hành kỹ thuật không còn giống điều Karpathy mô tả.
Tôi muốn nói chính xác về sự tách biệt này, vì hai thứ thường xuyên bị gộp lại và chúng có rủi ro trái ngược nhau.
Vibe coding, nghĩa ban đầu. Prompt, chấp nhận, chạy, prompt lại. Không đọc diff. Sản phẩm tạo ra là thứ dùng một lần rồi bỏ. Điều này thật sự tuyệt, và tôi làm vài lần mỗi tuần — cho một script định dạng lại CSV, một scraper dùng một lần, một biểu đồ tôi chỉ xem một lần, một nguyên mẫu mà nhiệm vụ duy nhất là làm một cuộc trò chuyện trở nên cụ thể. Đặc điểm định hình không phải tốc độ. Mà là sẽ không ai phụ thuộc vào nó.
Kỹ thuật tác nhân, nghĩa hiện nay. Viết một đặc tả. Cho tác nhân một bộ test, linter, trình kiểm tra kiểu và sandbox. Để nó chạy một giờ. Xem diff cẩn thận. Hợp nhất qua đúng các cổng như một PR của con người. Đặc điểm định hình là đầu ra của mô hình được đối xử như đầu ra của một 'đồng nghiệp cấp dưới’ — hữu ích, nhanh và 'không được tin tưởng’.
Hai thứ này chia sẻ một công nghệ và gần như không chia sẻ gì khác. Nếu bạn muốn phiên bản dành cho người thực hành của cách thứ hai, thì đó là điều bài viết trước của tôi về vibe coding năm 2026 nói về; phần này nói về nơi thực hành đang đi tới. Các kết cục thảm khốc trong Phần tám đều đến từ việc áp dụng thực hành của 'chế độ thứ nhất’ vào mức đặt cược của 'chế độ thứ hai’.
Các con số về mức độ chấp nhận là rất lớn và phần lớn không bị tranh cãi
- 90% lập trình viên dùng ít nhất một công cụ AI khi làm việc, theo khảo sát AI Pulse của JetBrains’ (tháng 1 năm 2026). Khảo sát năm 2025 của Stack Overflow’s có 84% đang dùng hoặc dự định dùng.
- Gần 80% lập trình viên mới của GitHub dùng Copilot trong tuần đầu tiên (GitHub Octoverse 2025).
- 59% lập trình viên dùng từ ba công cụ viết mã AI trở lên song song. Thống kê đó cho bạn biết nhiều hơn con số về mức độ chấp nhận — thị trường chưa hợp nhất mà đã phân mảnh thành các công cụ chuyên từng tác vụ.
Các con số thị trường
| Công cụ | Chỉ số | Nguồn / ngày |
|---|---|---|
| GitHub Copilot | ~42% thị phần theo lượng người dùng; hơn 20 triệu người dùng | Gartner / nhà cung cấp, 2026 |
| Cursor | ARR hơn 2 tỷ USD; hơn 1 triệu người dùng hoạt động hằng ngày; ~20–25% thị trường theo doanh thu | Theo báo cáo, tháng 2 năm 2026 |
| Claude Code | ~2,5 tỷ USD doanh thu quy năm; 46% “được yêu thích nhất” so với 19% của Cursor’s | Theo báo cáo, tháng 4 năm 2026 |
| Thị trường tác nhân viết mã doanh nghiệp | ~9,8–11 tỷ USD quy năm | Gartner, tháng 4 năm 2026 |
Hai điều nổi bật. Copilot có người dùng và mức hài lòng thấp nhất trong ba cái tên hàng đầu. Claude Code có lượng cài đặt nhỏ nhất và mức thiện cảm cao nhất từ xa. Đó là dấu hiệu của một thị trường đang chuyển dịch — kẻ dẫn đầu thắng về phân phối, kẻ thách thức thắng về quy trình làm việc, và người dùng vẫn chưa chuyển xong.
Và con số làm lung lay tất cả
Niềm tin của lập trình viên vào đầu ra AI giảm từ khoảng 40% năm 2024 xuống 29% năm 2026. Một khảo sát riêng của SonarSource cho thấy 96% lập trình viên không hoàn toàn tin mã do AI tạo ra là đúng về chức năng.
Hãy ngẫm điều đó. Mức sử dụng tăng. Niềm tin giảm. Hai điều đó không mâu thuẫn; chúng là dáng vẻ của việc chấp nhận công cụ ở mức trưởng thành. Không ai “tin” một cái cưa máy. Người ta dùng nó liên tục, bằng hai tay, mang đồ bảo hộ, và không bao giờ quay lưng lại với nó.
Những người hiểu các công cụ này rõ nhất là những người cẩn thận nhất với chúng. Đó là một tín hiệu lành mạnh, và nó hoàn toàn vắng mặt trong phần lớn tiếp thị của nhà cung cấp.
Phần bảy: Nó có thực sự giúp bạn nhanh hơn? Bằng chứng, một cách trung thực
Đây là chỗ tôi sẽ mất một số độc giả, và tôi thà mất họ ở đây còn hơn dẫn họ đi sai.
Thử nghiệm ngẫu nhiên nói không
METR đã chạy nghiên cứu mà ai cũng trích dẫn vào tháng 7 năm 2025: các lập trình viên mã nguồn mở có kinh nghiệm, làm việc trên kho mã trưởng thành của chính họ (hơn 1 triệu dòng), được phân nhóm ngẫu nhiên ở cấp tác vụ để dùng hoặc không dùng công cụ AI đầu năm 2025.
Kết quả: chậm hơn 19% khi dùng AI.
Và phát hiện quan trọng hơn tiêu đề: các lập trình viên tin rằng họ đã nhanh hơn khoảng 20%. Họ đánh giá quá cao tác động của AI’s lên thời gian của mình khoảng 40 điểm phần trăm.
Nghiên cứu tiếp theo năm 2026 không giải quyết được điều đó — nó phơi ra một điều tệ hơn
METR cố chạy lại thí nghiệm và vào tháng 2 năm 2026 đã công bố một bài viết thẳng thắn bất thường về lý do thiết kế bị phá vỡ.
- Việc tuyển người thất bại. Lập trình viên ngày càng từ chối làm việc không có quyền truy cập AI, ngay cả với 50 USD một giờ.
- Việc chọn tác vụ bị nhiễm. 30–50% lập trình viên thừa nhận né những tác vụ họ nghĩ AI sẽ xử lý tốt. Một người tham gia nói rất chuẩn: “Tôi né những vấn đề kiểu AI có thể xong trong 2 giờ, nhưng tôi phải mất 20 giờ.”
- Việc theo dõi thời gian ngừng hoạt động khi lập trình viên chạy nhiều tác nhân cùng lúc.
Các con số tạm thời thô năm 2026 của họ dao động từ −18% đến −4% — vẫn chậm hơn, nhưng ít kịch tính hơn — tuy nhiên chính METR mô tả đây là “chỉ là bằng chứng rất yếu” do thiên lệch chọn mẫu.
Hãy đọc lại gạch đầu dòng thứ hai, vì đó là phát hiện thú vị nhất trong toàn bộ tài liệu và nó bị chôn trong một ghi chú phương pháp. Nếu lập trình viên có hệ thống chuyển các tác vụ thân thiện với AI ra ra khỏi một nghiên cứu đo lợi ích của AI’s, nghiên cứu đó sẽ đánh giá thấp lợi ích. Điều này cũng ngụ ý rằng trong thực tế, lập trình viên đã tự định tuyến — chính hành vi khiến công cụ có giá trị và khiến RCT khó chạy.
Các khảo sát nói có, rất nhiều, và chúng bị thổi phồng
Khảo sát tháng 5 năm 2026 của METR’s (n=349: 87 kỹ sư phần mềm, 71 nhà nghiên cứu, 129 học giả và nghiên cứu sinh, 48 nhà sáng lập và quản lý; trung bình 12 năm’ kinh nghiệm lập trình, 19 tháng dùng công cụ AI) đã làm một điều khéo léo. Khảo sát tách giá trị từ tốc độ.
Người trả lời trung vị báo cáo hệ số tốc độ 3× nhưng chỉ thay đổi 1,4–2× về giá trị công việc của họ. Nhìn lại, họ ước tính giá trị 1,3× vào tháng 3 năm 2025; họ dự báo 2,5× vào tháng 3 năm 2027.
METR nói rõ rằng giá trị mới là con số mà người thiết kế khảo sát thực sự quan tâm, và rằng người trả lời tự nhiên nghĩ theo tốc độ — đúng cái thiên lệch mà RCT 2025 định lượng là 40 điểm phần trăm.
Vậy: tự báo cáo nói 3×. Tự báo cáo đã hiệu chỉnh theo ý người ta thực sự muốn nói là 1,4–2×. Phép đo có đối chứng duy nhất chúng ta có nói 0,81×.
Dữ liệu tổ chức nói “nó phụ thuộc vào bạn, không phải công cụ”
Báo cáo DORA 2026 (Google Cloud, tháng 5 năm 2026) là thứ hữu ích nhất được công bố về chủ đề này trong cả năm, và nó hữu ích vì nó ngừng tranh cãi về công cụ.
- ROI năm đầu ước tính của 39% một tổ chức kỹ thuật 500 người, với khoảng hoàn vốn 8 tháng — 11,6 triệu USD giá trị so với 8,4 triệu USD đầu tư.
- A Đường cong J: năng suất giảm trước khi tăng, do việc thích nghi quy trình làm việc, chi phí xác minh khi review mã, và những thay đổi phía sau ở khâu kiểm thử và cổng phê duyệt.
- Tỷ lệ thất bại khi thay đổi tăng từ 5% lên 6% sau khi áp dụng, gây thiệt hại 344.000 đô la do ngừng hệ thống trong phép tính mẫu của họ.
- Và luận điểm: “Lợi nhuận lớn nhất từ đầu tư AI không đến từ bản thân công cụ mà từ việc tập trung chiến lược vào hệ thống tổ chức bên dưới.”
Dòng cuối đó là đồng thuận của năm 2026, nếu có một đồng thuận như vậy. AI khuếch đại bất cứ điều gì mà thực hành kỹ thuật của bạn vốn đã là. Kiểm thử tốt, review mã thực chất, rollback nhanh, quyền sở hữu rõ ràng — AI giúp những tổ chức đó nhanh hơn đáng kể. Kiểm thử yếu, review kiểu đóng dấu, triển khai thủ công, quyền sở hữu mơ hồ — AI khiến những tổ chức đó thất bại nhanh hơn và với khối lượng lớn hơn.
Làm sao dung hoà tất cả những điều này
Tôi không nghĩ những phát hiện này thực sự mâu thuẫn. Đây là cách dung hoà mà tôi đã đi đến, và tôi giữ nó khá lỏng:
Công cụ coding AI là lợi ích lớn với công việc xa lạ và thiệt hại nhỏ với công việc quá quen thuộc. Trên một codebase bạn biết tường tận, bằng ngôn ngữ bạn thành thạo, với bài toán bạn từng giải, bạn nhanh hơn vòng lặp review-rồi-sửa. Với một framework xa lạ, một ngôn ngữ bạn dùng hai lần mỗi năm, boilerplate, giàn giáo kiểm thử, migration, hay một codebase bạn không mở trong tám tháng, mô hình mang tính đột phá.
METR nghiên cứu những lập trình viên giàu kinh nghiệm trên chính các kho mã trưởng thành của họ — kịch bản duy nhất mà bạn sẽ dự đoán mức lợi ích nhỏ nhất. Điều đó không làm phát hiện sai. Nó làm phát hiện trở nên cụ thể, và nó nên khiến bạn nghi ngờ bất cứ ai trích dẫn nó như một phán quyết chung, theo cả hai hướng.
Cách dung hoà thứ hai: lợi ích là thật nhưng chúng rơi vào chỗ khác với chỗ người ta tìm kiếm. Không phải “tính năng này mất bốn giờ thay vì sáu giờ.” Mà giống như: bản migration không bao giờ được ưu tiên đã được làm xong; độ phủ kiểm thử vốn sẽ mãi ở 40% đã lên 75%; tài liệu đã tồn tại. Những thứ đó không xuất hiện trong một nghiên cứu đo thời gian hoàn thành tác vụ, và chúng là phần lớn giá trị thực.
Phần tám: Hoá đơn bảo mật đã đến, và nó được liệt kê từng mục
Nếu Phần bảy đã khiến bạn thấy khó chịu, thì đây là phần người ta hay bỏ qua. Làm ơn đừng bỏ qua.
Các phép đo
Veracode đã thử nghiệm hơn 100 mô hình ngôn ngữ lớn trên 80 tác vụ lập trình bằng Java, Python, C# và JavaScript:
- 45% mẫu mã do AI tạo ra đưa vào một lỗ hổng thuộc OWASP Top 10. Tỷ lệ đạt gần như không đổi đến đầu năm 2026 — các mô hình thông minh hơn nhiều mà không an toàn hơn.
- Java tệ nhất với tỷ lệ thất bại 72%.
- 86% thất bại trong phòng chống cross-site scripting. 88% dễ bị tấn công log injection.
Apiiro đã chạy công cụ Deep Code Analysis của mình trên các kho mã doanh nghiệp thuộc Fortune 50 từ tháng 12 năm 2024 đến tháng 6 năm 2025:
- Lập trình viên có AI hỗ trợ tạo commit với ba đến bốn lần so với đồng nghiệp.
- Họ tạo ra các phát hiện bảo mật với tốc độ gấp mười lần của đồng nghiệp.
- Số đường leo thang đặc quyền tăng 322%. Lỗi thiết kế kiến trúc tăng 153%.
USENIX Security 2025 đã phân tích 576.000 mẫu mã do AI tạo ra:
- Khoảng 20% tham chiếu đến các gói không tồn tại.
- 43% các tên gói bị ảo giác lặp lại nhất quán qua những prompt tương tự — đây chính là phần biến một lỗi thành bề mặt tấn công. Một ảo giác có thể dự đoán là một chỗ mà kẻ tấn công có thể đăng ký trước trên npm hoặc PyPI.
Vibe Security Radar của Georgia Tech đã truy ngược các CVE qua lịch sử git để quy chúng về công cụ AI:
| Tháng (2026) | Số CVE được quy nguồn |
|---|---|
| Tháng 1 | 6 |
| Tháng 2 | 15 |
| Tháng 3 | 35 |
tổng cộng 74 trường hợp được xác nhận, với các nhà nghiên cứu ước tính con số thật trong mã nguồn mở là cao hơn năm đến mười lần.
RedAccess đã lập chỉ mục khoảng 380.000 ứng dụng vibe-coded truy cập công khai trên Lovable, Base44, Replit và Netlify. Khoảng 5.000 ứng dụng đang rò rỉ dữ liệu doanh nghiệp hoặc cá nhân nhạy cảm.
Các sự cố, theo ngày
| Ngày | Sự cố |
|---|---|
| Thg 7 2025 | AI của Replit xoá một cơ sở dữ liệu production; 1.200 bản ghi lãnh đạo bị ảnh hưởng, 4.000 tài khoản bịa đặt được tạo ra |
| Thg 2 2026 | Ứng dụng EdTech xây bằng Lovable làm lộ 18.697 bản ghi người dùng, trong đó có 4.538 tài khoản học sinh |
| Thg 4 2026 | Lỗ hổng BOLA của Lovable — mọi dự án trước tháng 11 năm 2025 đều truy cập được bằng năm lệnh gọi API |
| 26 thg 4 2026 | Cursor “xoá trong 9 giây”: cơ sở dữ liệu của một công ty bị xoá cùng với bản sao lưu |
| 30 thg 4 2026 | Lỗi thực thi mã từ xa CVSS-10 trong Gemini CLI ở quy trình làm việc CI, đã được vá |
Vụ Amazon, mà tôi sẽ xử lý cẩn thận
Bạn hẳn đã thấy câu chuyện Amazon. Bốn sự cố Sev-1 từ tháng 12 năm 2025 đến tháng 3 năm 2026 — sự cố AWS Cost Explorer kéo dài 13 giờ tại Trung Quốc, thời gian giao hàng sai trong giỏ hàng ngày 2 tháng 3 khiến khoảng 120.000 đơn hàng bị ảnh hưởng, và sự cố 6 giờ ngày 5 tháng 3 khi đơn hàng Bắc Mỹ được báo cáo giảm 99%.
Các bài báo của Financial Times, Fortune và The Register đã liên hệ tài liệu nội bộ của Amazon với những gì được mô tả là “thay đổi có Gen-AI hỗ trợ”, kèm cảnh báo rằng việc tạo mã nhanh đang làm lộ các lỗ hổng. Amazon phủ nhận quan hệ nhân quả trực tiếp, cho biết trong một số phản hồi rằng không sự cố nào liên quan đến mã do AI viết.
Tôi nêu ra ba điểm về câu chuyện này thay vì lặp lại nó như một sự thật:
- Con số tác động được trích dẫn nhiều nhất (6,3 triệu đơn hàng bị mất) bắt nguồn từ một bài đăng Medium, không phải từ Amazon hay từ bài báo của một cơ quan có tên. Hãy coi đó là ước lượng, không phải con số.
- Bản triển khai ngày 5 tháng 3 được cho là đã phát hành không có tài liệu hay phê duyệt chính thức. Đó là lỗi quy trình. Tốc độ của AI khiến nó có thể xảy ra nhanh hơn; nó không làm cổng phê duyệt thành tuỳ chọn.
- Sự phân biệt đó chính là điểm mấu chốt, và đó là lý do tôi đưa câu chuyện này vào. Kiểu thất bại hầu như không bao giờ là “AI viết mã tồi.” Mà là “AI viết mã nhanh hơn quy trình lẽ ra phải kiểm tra nó.”
Điều này thực sự hàm ý gì cho thực hành
Không phải “ngừng dùng công cụ.” Không ai nghiêm túc lập luận như vậy, và chính ghi chú nghiên cứu của CSA — tập hợp phần lớn những điều trên — mở đầu bằng quản trị chứ không phải kiêng dùng.
Hình hài thực tế, theo thứ tự tôi sẽ triển khai:
- Coi mọi công cụ AI có quyền truy cập thông tin đăng nhập là hệ thống đặc quyền. Nó đúng là như vậy. Giới hạn phạm vi token của nó cho tương xứng.
- SAST, quét phụ thuộc và phát hiện secret trên mọi commit. Không phải hằng đêm. Mọi commit. Tốc độ commit tăng ba đến bốn lần; quét hằng đêm giờ tương đương một vòng phản hồi ba ngày.
- Phân tích thành phần phần mềm, dành riêng cho các gói bị ảo giác. Đây là biện pháp kiểm soát rẻ nhất và giá trị nhất trong danh sách vì con số 20% quá lớn và thất bại quá âm thầm.
- Một chính sách bằng văn bản rằng không dùng hỗ trợ AI mà không review cho mã xác thực, mật mã, phân quyền hay thanh toán. Đây là bốn lĩnh vực mà một lỗi tinh vi vừa dễ xảy ra vừa thảm khốc, và là nơi con mắt của người review có giá trị nhất.
- Mở rộng SBOM của bạn để ghi lại nguồn gốc công cụ AI. Khi nghiên cứu quy nguồn kiểu Georgia Tech tiếp theo nhắm vào codebase của bạn, bạn muốn tự mình trả lời được câu hỏi đó.
- Coi các nền tảng vibe-coding bên thứ ba như nhà cung cấp SaaS. Những con số của RedAccess là điều xảy ra khi không ai làm vậy.
Không có gì trong đó là lạ. Phần lớn là những gì một xưởng làm ăn tử tế đã làm từ năm 2019. Điều thay đổi là khối lượng tăng lên một bậc độ lớn, nên các biện pháp kiểm soát phải tự động thay vì dựa vào văn hoá.
Hiện ảnh Dữ liệu bảo mật, từ Veracode, Apiiro, USENIX và Georgia Tech. Hãy để ý hình dạng: tốc độ commit tăng 3–4×, phát hiện bảo mật tăng 10×. Khoảng cách giữa hai hệ số đó chính là toàn bộ vấn đề.
Phần chín: Điều gì đã thay thế vibe coding
Cách làm thực sự hiệu quả trong năm 2026 có một cái tên — vài cái tên cạnh tranh nhau, đó là cách bạn biết nó là thật — và nó gần như ngược lại với cảm tính.
Gọi nó là phát triển dựa trên đặc tả, kỹ thuật tác nhân, hoặc kỹ nghệ ngữ cảnh. Cấu trúc chung:
1. Đặc tả giờ chính là mã nguồn
Không phải một ticket Jira. Một tài liệu thật sự: thứ đó làm gì, nó không được làm gì, các giao diện là gì, “xong” trông như thế nào, các kiểu thất bại là gì. Được commit vào kho mã, có phiên bản, được review.
Điều này có vẻ như một bước lùi về năm 1998, nhưng không phải. Khác biệt là năm 1998 đặc tả là đầu vào cho một con người sẽ diễn giải lại nó, và nó mục ngay khi bắt đầu viết mã. Năm 2026 đặc tả là đầu vào cho một quy trình tái tạo bản triển khai với chi phí thấp — nghĩa là khi yêu cầu thay đổi, bạn đổi đặc tả và suy ra lại, thay vì vá đoạn mã không còn khớp với bất kỳ mô tả bằng văn bản nào về chính nó.
Kinh tế học đã đảo chiều. Khi triển khai đắt và đặc tả rẻ, bạn đặc tả lỏng và đầu tư vào mã. Khi triển khai rẻ và đặc tả là nút thắt, bạn đầu tư vào đặc tả.
2. Bộ kiểm thử là ranh giới tin cậy
Một tác nhân có thể chạy kiểm thử của bạn và lặp lại dựa trên chúng là công cụ khác về bản chất so với công cụ không làm được. Đây là thay đổi có đòn bẩy lớn nhất mà hầu hết đội có thể thực hiện, và nó không liên quan gì đến AI — mà là AI cuối cùng đã khiến ROI của độ phủ kiểm thử trở nên rõ ràng với những người sẽ không bao giờ bị thuyết phục bởi các lập luận về tay nghề.
Bản thực dụng: tác nhân có sandbox, một lệnh test, một lệnh lint và một lần kiểm tra kiểu, và nó chưa xong cho đến khi cả bốn đều xanh. Mọi thứ khác đều có thể thương lượng.
3. Review chuyển từ dòng sang diff sang hành vi
Review từng dòng không mở rộng được cho một diff nghìn dòng do tác nhân tạo ra, và giả vờ ngược lại chính là cách thói đóng dấu bắt đầu.
Điều hiệu quả thay thế, theo thứ tự giá trị tương đối:
- Review đặc tả, không phải bản triển khai. Nếu đặc tả đúng và kiểm thử qua, bản triển khai chỉ là chi tiết.
- Review hình dạng của diff — những tệp nào bị chạm, phụ thuộc nào được thêm, cái gì bị xoá. Phần lớn thảm hoạ do tác nhân gây ra đều thấy được ở mức này: một tệp bất ngờ, một phụ thuộc mới, một lần xoá không ai yêu cầu.
- Review riêng những dòng nhạy cảm về bảo mật. Xác thực, mật mã, phân quyền, thanh toán, bất cứ thứ gì chạm đến PII. Đó là một phần nhỏ của bất kỳ diff nào.
- Đừng review phần boilerplate. Dù sao thì bạn cũng chưa bao giờ thực sự review nó.
4. Harness quan trọng ngang với mô hình
Điều này bị đánh giá thấp. Cùng một mô hình, trong hai vòng lặp tác nhân khác nhau, tạo ra công việc có chất lượng khác nhau rất xa — đó chính là lý do các so sánh benchmark giữa các lab trở nên trơn tuột đến vậy.
Những mảnh quan trọng: ngữ cảnh được quản lý thế nào khi phiên chạy dài ra, tác nhân có thấy được lỗi kiểm thử của chính nó không, nó có duyệt được kho mã hay chỉ những gì bạn dán vào, nó có bước lập kế hoạch tách khỏi bước thực thi không, và nó có biết khi nào nên dừng lại và hỏi không.
Ghi chú phát hành Muse Spark 1.3 của Meta thú vị đúng ở điểm này — chúng mô tả mô hình giờ biết đặt câu hỏi làm rõ với prompt mơ hồ, gọi trợ giúp khi bị kẹt, và xác nhận trước những hành động hệ trọng. Đó không phải cải thiện trí tuệ. Đó là phép lịch sự, và phép lịch sự là thứ khiến một tác nhân dài hạn sống sót được.
5. Định tuyến mô hình giờ là thực hành chuẩn
Không ai nghiêm túc chạy một mô hình cho mọi việc — tôi đã đi qua một phiên bản hai mô hình của cách này trong So sánh GLM-5.3-Flash với MiniMax M3 trong OpenCode. Mẫu hình đã ổn định:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
      "description": "Architecture, root cause, anything where being wrong is expensive",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation — long-horizon, cost-sensitive",
      "model": "anthropic/claude-opus-5"
    },
    "bulk": {
      "description": "High-volume mechanical work where price dominates",
      "model": "zai/glm-5-3-flash"
    },
    "private": {
      "description": "Anything touching client data — runs on hardware we own",
      "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
      "description": "Renames, docstrings, lint fixes, test scaffolding",
      "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
Lý do, từng dòng một:
- Lập kế hoạch giao cho mô hình mạnh nhất bạn có thể chi trả. Một kế hoạch tồi tốn nhiều token phía sau hơn chi phí của chính kế hoạch.
- Xây dựng giao cho mô hình dài hạn tốt nhất ở mức giá hợp lý. Opus 5 với giá $5/$25 được định vị rõ ràng cho việc này và chỉ bằng nửa giá Fable.
- Công việc cơ học hàng loạt giao cho GLM-5.3-Flash với giá $0.15/$0.47, vì ở mức giá đó câu hỏi không phải là nó có tốt bằng không, mà là nó có đủ tốt cho tác vụ cụ thể không. Thường thì có.
- Mọi thứ riêng tư chạy cục bộ, trên một mô hình vừa với máy của bạn.
- Việc lặt vặt giao cho một mô hình cục bộ nhỏ, vì đổi tên một biểu tượng trên bốn mươi tệp không cần suy luận ở mức biên giới và không cần rời khỏi laptop của bạn.
Viết ID mô hình sao cho đổi một cái chỉ là thay đổi một dòng. Với việc bốn lab đã phát hành một mô hình top mười từ tháng 6 đến tháng 9, bạn sẽ lại phải đổi trong quý này.
Phần mười: Tương lai của vibe coding — sáu dự đoán, kèm mức độ tin cậy
Dự đoán không có mức độ tin cậy chỉ là giải trí. Đây là của tôi, kèm mức tôi sẵn sàng đặt cược.
1. Từ đó sẽ chết; cách làm tách đôi vĩnh viễn. Tin cậy cao.
“Vibe coding” đang trở thành một từ mang tính miệt thị trong môi trường chuyên nghiệp và không là niềm tự hào ở đâu ngoài marketing. Thứ thay thế nó là một sự tách hai tầng rõ ràng: các sản phẩm do AI tạo dùng một lần, nơi không ai đọc mã (ổn, đúng, làm nhiều hơn), và kỹ nghệ tác nhân có review, nơi đầu ra của mô hình đi qua đúng những cổng như của con người (cũng ổn, và là nơi toàn bộ tiền doanh nghiệp nằm).
Khoảng giữa nguy hiểm — mã production, không ai đọc — chính là thứ tạo nên danh sách sự cố năm 2026, và nó sẽ bị quy định, bảo hiểm hoặc kiểm toán loại bỏ khỏi các bối cảnh thương mại. Không phải vì ai đó cấm nó, mà vì cuối cùng sẽ có một bảng hỏi bảo mật hỏi đến.
2. Xác minh trở thành nút thắt, và tiền đầu tư công cụ đi theo nó. Tin cậy cao.
Chúng ta đã ở đó và thị trường chưa định giá lại. Nếu tác nhân có thể tạo ra một tuần làm việc, ràng buộc là khả năng của con người trong việc xác lập rằng một tuần làm việc đó là đúng.
Hãy chờ những sản phẩm thú vị của năm 2027 nói về việc kiểm tra thay vì việc tạo ra: tạo kiểm thử dựa trên thuộc tính, công cụ diff ngữ nghĩa mô tả thay đổi hành vi thay vì thay đổi dòng, kiểm tra tuân thủ đặc tả tự động, xác minh hành động của tác nhân lúc chạy, và — đây là thứ tôi sẽ xây — công cụ cho bạn biết 5% nào của một diff lớn mà con người thực sự cần đọc.
3. Các phương pháp hình thức có thời của chúng, muộn hai mươi năm. Tin cậy trung bình.
Phản đối lịch sử với đặc tả hình thức là viết đặc tả tốn hơn viết mã. Phản đối đó giờ đã chết, vì viết mã gần như miễn phí và viết đặc tả dù sao cũng là nút thắt.
Hệ thống kiểu, contract, bất biến, kiểm thử thuộc tính và xác minh hình thức nhẹ bỗng có một trường hợp sử dụng tự hoàn vốn: chúng là những phát biểu ý định mà máy kiểm tra được, để tác nhân lặp lại dựa trên đó mà không cần con người trong vòng lặp. Tôi cho rằng Rust, các chế độ chặt hơn của TypeScript và các thư viện contract trong Python sẽ được hưởng lợi không cân xứng.
Lý do mức tin cậy của tôi chỉ ở mức trung bình: ngành này đã dự đoán một cuộc phục hưng của phương pháp hình thức khoảng bảy năm một lần kể từ năm 1985.
4. Mô hình cục bộ nuốt trọn tầng việc lặt vặt. Tin cậy trung bình cao.
Hãy xem một mô hình 27B theo Apache 2.0 làm được gì bây giờ, cộng thêm một năm nữa, và đặt nó trên một máy có 64 GB bộ nhớ hợp nhất. Đổi tên, docstring, giàn giáo kiểm thử, thông điệp commit, sửa lint, bản dịch nháp đầu tiên, phân tích log — không thứ nào cần mô hình biên giới, tất cả đều khối lượng lớn, và tất cả đều đúng là loại việc bạn không muốn gửi cho bên thứ ba từ kho mã của khách hàng.
Tầng biên giới vẫn ở trên cloud cho việc lập kế hoạch và suy luận khó. Khối lượng chuyển về cục bộ. Từ Phần mười một trở đi nói về lý do điều đó giờ khả thi về mặt vật lý.
5. Vai trò lập trình viên junior thay đổi hình dạng chứ không biến mất. Tin cậy trung bình, và tôi giữ dự đoán này lỏng nhất.
Kịch bản bi quan thì đơn giản: nếu tác nhân làm việc mà junior từng làm, không ai tuyển junior, và mười năm sau không còn senior.
Tôi nghĩ kết cục dễ xảy ra hơn là công việc đầu vào chuyển từ “viết mã” sang “xác minh mã và chịu trách nhiệm về đặc tả” — một công việc khó bắt đầu hơn, không phải dễ hơn, và sẽ buộc ngành phải xây lại cách đào tạo con người. Những đội hiểu ra điều này sẽ có lợi thế tuyển dụng khổng lồ so với những đội chỉ đơn giản là ngừng tuyển.
Lời cảnh báo trung thực: đây là dự đoán mà động cơ và phân tích của tôi chỉ về cùng một hướng, đúng lúc bạn nên nghi ngờ chính mình.
6. Ai đó sẽ có một thất bại coding AI thảm khốc thật sự, được công khai quy nguồn. Tin cậy cao về sự kiện, thấp về thời điểm.
Không phải một cơ sở dữ liệu bị rò rỉ. Mà là thứ có cơ quan quản lý, tác động tài chính chín chữ số, và một phân tích nguyên nhân gốc nói rằng một tác nhân đã làm việc mà không con người nào review.
Đường cong quy nguồn CVE — 6, rồi 15, rồi 35 trong các tháng liên tiếp của năm 2026, với các nhà nghiên cứu ước tính tỷ lệ thật cao hơn năm đến mười lần — không phải đường cong tự phẳng lại. Câu hỏi là liệu ngành có tự siết cổng của mình trước hay chờ sự cố buộc phải làm.
Tôi sẽ làm gì với cả sáu dự đoán, trong một câu: đầu tư vào kiểm thử, đặc tả và công cụ review thay vì kỹ thuật prompt, vì kỹ thuật prompt mất giá mỗi khi một mô hình ra mắt còn hạ tầng xác minh thì tích luỹ.
Hiện ảnh Hai cách làm chia sẻ một công nghệ và không gì khác. Vòng lặp bên trái đúng cho công việc dùng một lần và thảm khốc cho production; vòng lặp bên phải chính là thứ mà danh sách sự cố ở Phần tám còn thiếu.
HỒI III — AI NGOẠI TUYẾN TRÊN THIẾT BỊ TIÊU DÙNG
Phần mười một: AI ngoại tuyến ngừng là sở thích trong năm nay
Trong khoảng hai năm, “chạy nó cục bộ” là một thoả hiệp có nguyên tắc. Bạn làm được. Lời chào hàng trung thực là: đây là một mô hình 7 tỷ tham số tệ hơn gói miễn phí của mọi thứ, trên phần cứng bạn đã có, và lý do để làm là nguyên tắc.
Điều đó thay đổi vào năm 2026, và thay đổi vì ba lý do riêng biệt đến cùng một lúc.
Các mô hình nhỏ trở nên thực sự tốt. E4B của Gemma 4 có khoảng 8 tỷ tham số, hỗ trợ 128K ngữ cảnh, xử lý văn bản, hình ảnh, video và âm thanh gốc, và theo Apache 2.0. Biến thể dense 31B đạt 39 trên chỉ số Artificial Analysis — nằm trong khoảng từng là biên giới mười tám tháng trước — và chạy toàn bộ chỉ số với 39 triệu token đầu ra, chỉ là một phần nhỏ so với mức các mô hình tương đương đốt. Qwen3.8-27B là mô hình đa phương thức dense theo Apache 2.0 với 262K ngữ cảnh gốc mà Alibaba tuyên bố vượt Qwen3.7-Plus lớn hơn nhiều ở các tác vụ coding và văn phòng.
Các hệ điều hành đã phát hành nó. Đây là thay đổi thực sự quan trọng và nó diễn ra âm thầm. Microsoft đưa Aion 1.0 vào Windows 11. Apple phát hành một mô hình dense 3 tỷ tham số cộng một mô hình sparse 20 tỷ tham số trên iPhone. Google phát hành Gemini Nano trên Pixel và thiết bị Samsung. AI trên thiết bị ngừng là thứ bạn phải cài và trở thành thứ đã có sẵn, và đó là khác biệt giữa một công nghệ mà người đam mê dùng và một công nghệ mà mọi người dùng.
Và phần cứng cuối cùng đã có bộ nhớ. Không phải năng lực tính toán — mà là bộ nhớ. Tôi sẽ quay lại lý do sự phân biệt đó là toàn bộ câu chuyện.
AI “ngoại tuyến” thực sự mang lại gì cho bạn
Để tôi nói cụ thể, vì thứ này được bán rất kém.
Độ trễ. Một mô hình 4B cục bộ phản hồi trong vài chục mili giây. Một vòng round trip qua cloud tốt nhất cũng vài trăm. Với bất cứ thứ gì tương tác và liên tục — đọc chính tả, dịch trực tiếp, tự động hoàn thành, tóm tắt khi bạn gõ — cục bộ thắng về cảm giác, không phải chất lượng, và cảm giác là thứ người ta nhận ra.
Quyền riêng tư mang tính kiến trúc chứ không phải hợp đồng. Với API, mọi prompt đều rời khỏi hạ tầng của bạn và bạn cần một thoả thuận xử lý dữ liệu, một đánh giá tác động chuyển dữ liệu, một bản đồ luồng dữ liệu và một câu trả lời cho cán bộ bảo vệ dữ liệu của bạn. Với một mô hình chạy trên thiết bị, câu hỏi về chuyển dữ liệu xuyên biên giới không phát sinh, vì không có việc chuyển dữ liệu nào. Với công việc ở Đức và EU, đây thường là toàn bộ lập luận, và nó chốt được những thương vụ mà giá cả không bao giờ chốt được.
Tính sẵn sàng. Trên máy bay. Ở một công trường không có sóng. Trong một cơ sở mà truy cập mạng là thứ bị cấm. Trong lúc nhà cung cấp của bạn gặp sự cố.
Khả năng dự đoán chi phí. Không phải tiết kiệm chi phí — tôi sẽ làm phép tính đó ở Phần Mười Lăm và nó không nói ra điều mọi người muốn nghe. Nhưng một chi phí phần cứng cố định với chi phí biên bằng không cho mỗi token là một dòng ngân sách rất khác so với hóa đơn theo mức sử dụng, thứ tăng theo độ hào hứng của tác nhân.
Ghim phiên bản. Một mô hình API đóng được cập nhật phía sau một mã mô hình ổn định và hành vi trôi dần. Một checkpoint cục bộ vẫn giống hệt từng byte sau một năm. Nếu bạn từng có một prompt đang chạy tốt bỗng lặng lẽ ngừng hoạt động, bạn biết điều đó đáng giá bao nhiêu.
Và những gì nó không mang lại cho bạn
Năng lực tiên phong. Khoảng cách giữa một mô hình 4B trên điện thoại của bạn và Claude Fable 5.1 không hề nhỏ và sẽ không khép lại. Ai nói khác là đang bán cái gì đó.
Tốc độ trên các mô hình lớn. Một mô hình 400B cục bộ sinh token chậm hơn cùng mô hình đó trên API của nhà cung cấp, vì nhà cung cấp chạy nó trên phần cứng có băng thông bộ nhớ gấp bốn đến sáu lần của bạn. Bạn đánh đổi thông lượng để lấy quyền kiểm soát.
Phần Mười Hai: Chiếc điện thoại trong túi bạn
Thông số quyết định mọi thứ là RAM
Mọi nền tảng lớn giờ đều đã vạch ra một ranh giới bộ nhớ, và ranh giới đó là 12 GB.
| Nền tảng | Mô hình trên thiết bị | Ngưỡng bộ nhớ |
|---|---|---|
| Apple | AFM 3 Core (3B dense) + AFM 3 Core Advanced (20B sparse, 1–4B hoạt động) | 12 GB cho hai tính năng của iOS 27 |
| Gemini Nano v3 (chỉ trên Pixel 10); Nano v2 trên Pixel 9 và các máy cũ hơn; Nano v4 sắp ra mắt | 12 GB mức tối thiểu cho Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 for Galaxy — CPU Oryon thế hệ 3, NPU Hexagon, +39% năng lực NPU | Tùy thiết bị |
Cách bố trí của Apple là phương án thú vị về mặt kỹ thuật. AFM 3 Core Advanced là mô hình sparse 20 tỷ tham số sống trong bộ nhớ flash. Các expert dùng chung thường trú trong bộ nhớ; các expert được định tuyến chỉ được hoán đổi vào DRAM khi một yêu cầu cần đến chúng. Đó là cách bạn nhét được một mô hình 20B vào điện thoại — bạn đánh đổi băng thông đọc NAND lấy dung lượng DRAM.
Nhưng hoán đổi expert vào DRAM vẫn cần một chỗ để hoán đổi chúng vào, chồng lên hệ điều hành, ứng dụng đang chạy và pipeline camera. Khoảng cách giữa 9 GB và 12 GB không phải ba gigabyte của việc phân khúc thị trường. Đó là tập làm việc cho việc hoán đổi expert dưới áp lực bộ nhớ thật. Ming-Chi Kuo báo cáo rằng hai tính năng của iOS 27 cần 12 GB: khả năng biểu cảm giọng nói và tùy chỉnh nhịp điệu của Siri, cùng một cải thiện đáng kể về độ chính xác chuyển giọng nói thành văn bản. Chiếc iPhone 18 bản cơ bản, bị hoãn đến mùa xuân 2027 với 9 GB theo báo cáo, không vượt qua ngưỡng.
Google có cùng giới hạn vật lý và một vấn đề quan hệ công chúng tệ hơn. Gemini Intelligence cần Nano v3, Nano v3 hiện chỉ có trên Pixel 10, và các thiết bị Pixel 9 — được bán dưới một cam kết cập nhật bảy năm — đang chạy Nano v2. Cam kết đó nói về cập nhật. Nó chưa bao giờ nói về tính năng, và sự phân biệt từng hợp lý với một giám đốc sản phẩm năm 2023 chẳng có nghĩa gì với một khách hàng năm 2026.
Hãy chờ đợi đây sẽ là câu chuyện AI tiêu dùng của hai năm tới: một cam kết hỗ trợ dài hạn giao các bản vá bảo mật cho một thiết bị không chạy nổi những tính năng được phát hành cùng các bản vá đó.
Điện thoại thực sự làm được gì, đo đạc cụ thể
Đo hiệu năng độc lập trên iPhone 17 Pro (A19 Pro) với bốn runtime:
| Mô hình | Runtime | Giải mã tok/s | Bộ nhớ đỉnh |
|---|---|---|---|
| Gemma 4 E2B (4-bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-bit) | MLX | 47.5 | 2.900 MB |
| Gemma 4 E2B (4-bit) | llama.cpp | 37.8 | 3.156 MB |
| Gemma 4 E2B (4-bit) | CoreML / ANE | 33.4 | 1.187 MB |
| Qwen 3.5 2B (4-bit) | MLX | 61.2 | 1.279 MB |
| Qwen 3.5 2B (4-bit) | llama.cpp | 39.1 | 1.479 MB |
| Qwen 3.5 2B (4-bit) | CoreML / ANE | 27.9 | 241 MB |
Hai phát hiện nổi bật.
Neural Engine là con đường chậm nhất và tiết kiệm bộ nhớ nhất, cách xa phần còn lại. 27,9 tok/s ở 241 MB so với 61,2 tok/s của MLX ở 1.279 MB — gấp năm lần tốc độ cho gấp năm lần bộ nhớ. Sự đánh đổi đó chính là lý do Apple dùng ANE cho các tính năng hệ thống luôn bật và lý do các ứng dụng bên thứ ba bỏ qua nó khi trò chuyện tương tác.
Sáu mươi token mỗi giây trên một mô hình 2B trong túi bạn nhanh hơn tốc độ đọc của hầu hết mọi người. Nghĩa là ràng buộc của AI cục bộ trên điện thoại không phải tốc độ. Đó là năng lực, năng lực là hàm của số tham số, số tham số là hàm của bộ nhớ — và bộ nhớ là thứ mà mọi nhà sản xuất vừa mới đặt ngưỡng.
Phần Mười Ba: Chiếc PC, và canh bạc thầm lặng của Microsoft
Microsoft đã làm một việc tại Build 2026 ngày 2 tháng 6 mà tôi nghĩ khi nhìn lại sẽ quan trọng hơn nhiều so với chính ngày hôm đó: họ đưa các mô hình vào chính Windows.
Aion 1.0 Instruct là một mô hình ngôn ngữ nhỏ để tóm tắt, viết lại và trích xuất. Nó cần CPU hiện đại và Windows 11 — không cần NPU, không cần GPU rời. Hiện nó có trong Edge Canary từ bản 150.0.4070, được mở cho nhà phát triển web qua các API Prompt, Summarizer, Writer và Rewriter, và trọng số mở của nó đã lên Hugging Face vào tháng 7 năm 2026.
Aion 1.0 Plan mới là cái thú vị: một mô hình suy luận và gọi công cụ 14 tỷ tham số với cửa sổ ngữ cảnh 32K, được xây dựng cho quy trình làm việc tác nhân, quản lý tệp và điều phối tác nhân con. “Vài tháng tới” ở thời điểm viết bài.
Cách Microsoft đặt vấn đề là “trí tuệ không giới hạn cho mọi nhà và mọi bàn làm việc.” Gạt phần tiếp thị sang một bên và nhìn vào quyết định kiến trúc: một API JavaScript trong trình duyệt gọi mô hình cục bộ, không cần khóa, không hóa đơn và không cần mạng. Nếu điều đó trở thành bình thường, một nhóm khổng lồ các tính năng AI nhỏ sẽ không còn là sản phẩm SaaS mà thành năng lực của nền tảng. Điều đó có ý nghĩa lớn hơn nhiều với kinh tế học của ngành AI so với bất kỳ bản phát hành mô hình riêng lẻ nào trong năm nay.
Ngưỡng phần cứng là có thật và nó loại bỏ rất nhiều máy
Con đường NPU đòi hỏi một PC Copilot+ với minimum 40-TOPS NPU:
| Chip | NPU | Đạt chuẩn? |
|---|---|---|
| Chip Snapdragon X Elite của Qualcomm | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ phần cứng; phần mềm “sẽ ra sau” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
Và đây là con số nên đặt lại kỳ vọng: trên một NPU 45 TOPS, một mô hình 8B sinh ra khoảng 5 token mỗi giây. Mô hình Plan 14B sẽ chậm hơn.
Năm token mỗi giây không phải trải nghiệm trò chuyện. Nó ổn cho việc tóm tắt chạy nền, viết lại, phân loại, trích xuất — những việc Aion 1.0 Instruct thực sự để làm. Nó không ổn cho bất cứ thứ gì bạn ngồi nhìn.
Vì sao chậm thế trên 45 TOPS? Vì việc sinh token bị giới hạn bởi băng thông bộ nhớ, không phải sức tính toán thô. NPU làm được các phép nhân ma trận; vấn đề là phải truyền trọng số ra khỏi bộ nhớ hệ thống cho từng token một. Đây là cùng một bức tường chi phối mọi thiết bị trong bài viết này, và đó là lý do “TOPS” là một con số gần như vô dụng khi mua sắm.
Những chiếc máy để bàn
Nếu bạn muốn một cỗ máy dành riêng cho suy luận cục bộ, phân khúc 128 GB đã ổn định thành hai lựa chọn và một kẻ ngoại lệ:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Máy Mac Studio M5 Ultra | |
|---|---|---|---|
| Bộ nhớ | 128 GB hợp nhất | 128 GB LPDDR5X-8000 | lên đến 512 GB hợp nhất |
| Băng thông | ~273 GB/s | ~256 GB/s | 1,2 TB/s |
| Giá | ~$3,999 | $2.300–$2.500 | từ $5.499 |
| Ghi chú | Hệ sinh thái CUDA | CPU mạnh (1,6 TFLOPS Linpack so với 708 GFLOPS của Spark) | Bản 512 GB cuối tháng 10, chưa có giá |
Những mức giá đó cùng các con số của Spark và Strix Halo đến từ thử nghiệm công bố cuối tháng 12 năm 2025, nên hãy coi chúng là tham khảo chứ không phải hiện tại — giá bộ nhớ đã thay đổi từ đó. DGX Spark và Strix Halo gần nhau hơn nhiều về tốc độ sinh token so với những gì các con số tính toán gợi ý — vì cả hai đều bị kẹt quanh 256–273 GB/s băng thông và đó là ràng buộc quyết định. Spark thắng rõ rệt về tạo ảnh (~120 TFLOPS so với ~46 trên FLUX.1 Dev BF16) và về tương thích CUDA. Strix Halo thắng về giá và CPU.
Mac Studio M5 Ultra nằm ở một đẳng cấp hoàn toàn khác về cả bộ nhớ lẫn băng thông, và tôi đã viết dài về nó trong bài về phần cứng AI cục bộ. Bản ngắn: 512 GB ở 1,2 TB/s là cỗ máy phổ thông duy nhất chứa được một mô hình cỡ 400B trong bộ nhớ, và cái giá cho đặc quyền đó vào khoảng $16.000–$20.000 khi cấu hình đầy đủ.
Những mô hình thực sự nên chạy
| Mô hình | Tham số | Giấy phép | Chạy thoải mái trong | Phù hợp cho |
|---|---|---|---|---|
| Gemma 4 E2B | 5,1B / 2,3B hoạt động | Apache 2.0 | 4 GB | Điện thoại, luôn bật, đầu vào âm thanh |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | Việc nặng trên laptop, tóm tắt |
| Aion 1.0 Instruct | SLM nhỏ | Trọng số mở (HF, tháng 7 năm 2026) | Chỉ CPU | Tác vụ văn bản gốc Windows |
| Qwen3.8-27B | 27B dense | Apache 2.0 | 24–32 GB | Mô hình cục bộ đa dụng tốt nhất dưới 32 GB |
| Mô hình Gemma 4 26B-A4B | 26B / 4B hoạt động | Apache 2.0 | 24 GB | MoE nhanh, chi phí hoạt động thấp |
| Gemma 4 31B | 31B dense | Apache 2.0 | 32 GB | Chất lượng cục bộ cao nhất dưới 32 GB |
| Ornith-1.5 35B | 35B / 3B hoạt động | MIT | 32 GB | Lập trình tác nhân, dấu chân hoạt động rất nhỏ |
| gpt-oss-120b | 120B / 5,1B hoạt động | Apache 2.0 | 128 GB | Điểm ngọt 128 GB |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB+ | Gần mức tiên phong, cần một cỗ máy lớn |
| MiniMax M3 | 428B / 23B hoạt động | Tùy chỉnh | 512 GB | Chỉ vừa trên M5 Ultra |
| DeepSeek V4 Pro | 1,6T / 49B hoạt động | MIT | Cụm | Không phải mô hình cho thiết bị tiêu dùng |
| Kimi K3 | 2,8T / 104B hoạt động | Tùy chỉnh | Cụm | Không vừa trên chiếc Mac nào Apple bán |
Nếu bạn đang cân nhắc cấu hình cho riêng một cỗ máy Apple, tôi đã đi qua các mức bộ nhớ chi tiết trong hướng dẫn AI cục bộ trên MacBook Pro M5 Pro 64GB — bản ngắn là 64 GB là mốc mà những đánh đổi thôi gây khó chịu.
Nếu bạn muốn một gợi ý duy nhất: trên một máy 32 GB, hãy chạy Qwen3.8-27B hoặc Gemma 4 31B. Cả hai đều Apache 2.0, cả hai đều đa phương thức, cả hai đều thực sự hữu ích, cả hai đều vừa. Đó là mặc định của năm 2026 và nó tốt hơn nhiều so với mặc định mà năm 2025 có.
Hiện ảnh Cái gì thực sự vừa, theo mức bộ nhớ. Các vạch dọc là những dung lượng bộ nhớ mà người tiêu dùng thực sự mua được; những mô hình vượt qua vạch bên phải là giới hạn trên của AI tiên phong cục bộ năm 2026.
Phần Mười Bốn: Bức tường bộ nhớ là toàn bộ câu chuyện
Mọi thứ trong Hồi III đều quy về một phương trình, nên đây là nó, viết rõ ra.
Nó có vừa không?
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory × 0.75) − OS and app overhead − KV cache
Nó sẽ sinh nhanh đến mức nào?
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenLưu ý rằng công thức thứ hai dùng hoạt động các tham số hoạt động, chứ không phải tổng số. Đây là lý do các mô hình hỗn hợp chuyên gia lại tốt một cách không cân xứng trên phần cứng tiêu dùng. Gemma 4’s 26B-A4B có 26 tỷ tham số năng lực và 4 tỷ tham số chi phí mỗi token. Ornith-1.5’s 35B kích hoạt 3B. MiniMax M3 có tổng 428B và 23B hoạt động.
Hiệu suất trong công thức đó trên thực tế vào khoảng 0,5 đến 0,8 tùy thuộc vào runtime, lượng tử hóa và phần băng thông bộ nhớ mà phần còn lại của hệ thống đang dùng.
Giờ áp dụng. Một laptop NPU 45 TOPS với LPDDR5X ở, giả sử, 120 GB/s, chạy mô hình 8B ở 4-bit (4 GB trọng số hoạt động): 120 × 0,6 ÷ 4 ≈ 18 token/giây trên lý thuyết. Con số đo được là khoảng 5. Khác biệt nằm ở lập lịch, tranh chấp bộ nhớ, chi phí prefill và việc các bộ công cụ NPU còn non. Khoảng cách giữa phép tính và phép đo là nơi chứa phần lớn sự thất vọng trong lĩnh vực này.
Sự thiếu hụt DRAM là biến ẩn phía sau mọi con số trong bài viết này
Các nhà sản xuất bộ nhớ đã dành 2025 và 2026 để phân bổ lại công suất cho khách hàng trung tâm dữ liệu AI, những người ký hợp đồng lớn hơn với biên lợi nhuận tốt hơn các nhà sản xuất thiết bị tiêu dùng. Hậu quả xuất hiện ở khắp nơi:
- Apple tăng giá toàn bộ Mac và iPad vào tháng 6 năm 2026.
- Bản 512 GB của Mac Studio bị đẩy sang cuối tháng 10 vì lý do nguồn cung và vẫn chưa có giá.
- M6 của Apple dừng ở 32 GB bộ nhớ hợp nhất, còn M6 Pro, Max và Ultra bị hủy hoàn toàn.
- Ming-Chi Kuo đưa tin Apple cắt giảm lượng giao phần cứng năm 2026 vì nguồn cung bộ nhớ.
Mọi giới hạn trên trong bài viết này đều bắt nguồn từ cùng một sự thiếu hụt. Ngưỡng 12 GB trên điện thoại. Giới hạn 32 GB của M6. Mức trần 128 GB trên laptop. Bản 512 GB bị trì hoãn. Không cái nào là giới hạn kỹ thuật của chip; tất cả đều là quyết định phân bổ trong một thị trường mà bộ nhớ khan hiếm và đắt đỏ.
Nếu bạn đang chờ giá trở lại bình thường trước khi mua máy cho suy luận cục bộ: không ai đáng tin đưa ra dự đoán về thời điểm đó.
Phần Mười Lăm: Cài đặt
Phần thực hành. Mọi thứ ở đây tôi đều đã chạy; chỗ nào tôi chỉ tường thuật chứ không tự chạy, tôi nói rõ.
Con đường dễ nhất: LM Studio
Một GUI, gốc MLX trên Apple Silicon, trình duyệt mô hình tích hợp sẵn, máy chủ tương thích OpenAI chỉ với một công tắc. Nếu bạn muốn chạy được một mô hình trong mười phút, hãy bắt đầu ở đây. Đây cũng là công cụ mà Apple dùng để benchmark trong các thông cáo của chính mình, điều đó cho bạn biết nó đã phổ biến đến mức nào.
Con đường linh hoạt nhất: Ollama
bash
# Cài đặt
curl -fsSL https://ollama.com/install.sh | sh

# Tải và chạy mặc định của 2026
ollama run qwen3.8:27b

# Ngữ cảnh mặc định quá nhỏ cho công việc code thật — hãy tăng lên
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
Lệnh thứ hai là lệnh mọi người hay bỏ sót. Ngữ cảnh mặc định của Ollama được đặt thận trọng; trong một tác vụ code, nó sẽ lặng lẽ cắt bớt và bạn sẽ đổ lỗi cho mô hình.
Con đường nhanh nhất trên Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Trỏ bất kỳ ứng dụng khách tương thích OpenAI nào vào http://localhost:8080/v1.
Hãy nâng giới hạn bộ nhớ wired trước khi phàn nàn về việc crash
macOS mặc định không cho GPU giữ cố định toàn bộ bộ nhớ hợp nhất của bạn. Trên một máy nhiều bộ nhớ, đây là khác biệt giữa việc mô hình tải được và việc mô hình thất bại:
bash
# Kiểm tra giới hạn hiện tại
sysctl iogpu.wired_limit_mb

# Ví dụ cho máy 128 GB, chừa ~14 GB cho hệ điều hành
sudo sysctl iogpu.wired_limit_mb=116736

# Duy trì sau khi khởi động lại
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Đừng đặt nó bằng toàn bộ dung lượng bộ nhớ của bạn. Hãy chừa cho hệ điều hành 12–16 GB trên một máy lớn, nếu không bạn sẽ gặp kernel panic thay vì suy luận nhanh. Và kiểm tra lại sau mỗi bản cập nhật macOS, vì các bản cập nhật đặt lại giá trị này.
Trên Windows, hãy dùng các mô hình của hệ điều hành trước
Trước khi cài bất cứ thứ gì, hãy xem Windows đã cho bạn những gì. Các API Prompt, Summarizer, Writer và Rewriter trong Edge gọi Aion 1.0 Instruct ngay trên máy, không cần khóa và không tốn phí. Với việc tóm tắt, viết lại và trích xuất bên trong một ứng dụng web, đó là giải pháp hoàn chỉnh với hạ tầng bằng không.
javascript
// Edge Canary 150.0.4070+ — chạy hoàn toàn trên thiết bị
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
Nếu bạn cần nhiều hơn thế, LM Studio và Ollama đều chạy tốt trên Windows, và trên một máy không có NPU đạt chuẩn, chúng sẽ dùng GPU hoặc CPU, mà với các mô hình cỡ 8B thì thường nhanh hơn so với con đường NPU dù sao đi nữa.
Một thiết lập kết hợp hợp lý
Kiến trúc tôi thực sự sẽ dựng, và đại khái là những gì tôi đang chạy:
- Tầng 1 — trên thiết bị. Một mô hình nhỏ để định tuyến, phân loại, trích xuất, tóm tắt, đọc chính tả. Gemma 4 E4B hoặc Aion 1.0 Instruct. Luôn sẵn có, chi phí biên bằng không.
- Tầng 2 — phần cứng của bạn. Một mô hình trọng số mở 27B–120B trên máy bạn sở hữu, cho mọi việc chạm đến dữ liệu khách hàng không được rời khỏi phạm vi pháp lý. Qwen3.8-27B trên 32 GB,
gpt-oss-120btrên 128 GB. - Tầng 3 — mô hình tiên phong qua API. Lập kế hoạch, suy luận khó, các phiên tác nhân dài, bất cứ việc gì mà sai thì tốn kém.
Cuộc tranh luận không bao giờ là “cục bộ hay đám mây.” Mà là bạn vạch ranh giới ở đâu, và năm nay ranh giới đã dịch rất xa.
Phần mười sáu: Bài toán chi phí và tuân thủ
Lập luận về tiết kiệm không trụ nổi khi bấm máy tính.
Lấy một khối lượng việc thực tế của doanh nghiệp nhỏ: một tháng làm việc với mức lập trình tác nhân vừa phải, giả sử 40 triệu token đầu vào và 3 triệu token đầu ra.
| Tùy chọn | Chi phí hàng tháng |
|---|---|
| GLM-5.3-Flash API ($0,15 / $0,47) | ~$7.40 |
| Gemini 3.8 Flash API ($0,75 / $3,75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50, không dùng bộ nhớ đệm) | ~$550 |
| Một bộ Strix Halo $2.400, khấu hao trong 3 năm | ~$67/tháng + tiền điện |
Hãy để ý bảng đó thực sự nói gì. Phần cứng cục bộ rẻ hơn đỉnh của giới tiên phong và đắt hơn đáy của nó. So với GLM-5.3-Flash, một bộ máy cục bộ không bao giờ hòa vốn theo token. So với Fable 5.1 chạy không dùng bộ nhớ đệm, nó tự trả vốn trong năm tháng — nhưng bạn không so sánh cùng loại, vì Fable 5.1 là một mô hình tốt hơn nhiều so với bất cứ thứ gì vừa trong 128 GB.
Vậy đừng mua phần cứng cục bộ để tiết kiệm tiền. Mua vì một trong năm lý do sau, và cả năm đều có thật:
- Dữ liệu lưu trú là quyết định kiến trúc chứ không phải một dự án pháp lý.
- Không giới hạn tốc độ, không hạn mức, không sự cố năng lực. Máy của bạn không có thứ Ba bận rộn.
- Ghim phiên bản mãi mãi. Một bản checkpoint cục bộ vẫn giống hệt từng byte sau một năm.
- Vận hành ngoại tuyến.
- Bạn dù sao cũng cần máy trạm đó. Đây là trường hợp phổ biến nhất mà việc mua là hoàn toàn đúng — nếu bạn vốn định chi €2.500 cho một chiếc máy, chi phí biên của năng lực AI chỉ là nâng cấp bộ nhớ, không phải cả bộ máy.
Bức tranh tuân thủ EU, vì nó đã thay đổi trong năm 2026
Với độc giả ở Đức và EU, nền tảng quy định đã dịch chuyển trong năm nay và các mốc thời gian giờ là cố định thay vì có điều kiện.
- 2 tháng 8 năm 2025 — các nhà cung cấp mô hình GPAI nhận nghĩa vụ về tài liệu, tóm tắt nội dung huấn luyện và bản quyền.
- 2 tháng 8 năm 2026 — quyền cưỡng chế và nghĩa vụ minh bạch theo Điều 50 có hiệu lực. Các khoản phạt giờ đã có thể áp dụng.
- 27 tháng 7 năm 2026 — Digital Omnibus, Quy định (EU) 2026/1744, có hiệu lực, thay thế cơ chế có điều kiện trước đó cho các hệ thống rủi ro cao bằng các mốc thời gian cố định.
- 2 tháng 12 năm 2026 — kết thúc thời gian ân hạn cho việc gắn watermark máy đọc được trên các hệ thống hiện có.
- 2 tháng 8 năm 2027 — cửa sổ chuyển đổi hai năm đóng lại đối với các mô hình GPAI đã có trên thị trường.
- 2 December 2027 — các hệ thống rủi ro cao độc lập theo Phụ lục III (tuyển dụng, chấm điểm tín dụng, giáo dục, hạ tầng trọng yếu).
- 2 tháng 8 năm 2028 — AI rủi ro cao nhúng trong các sản phẩm được quản lý theo Phụ lục I (thiết bị y tế, máy móc).
Digital Omnibus cũng bổ sung lệnh cấm đối với hình ảnh thân mật không có sự đồng thuận do AI tạo ra và CSAM, đồng thời mở rộng quyền giám sát của EU AI Office.
Điều này thực tế có nghĩa gì với độc giả bài viết này. Nếu bạn xây dựng trên nền các mô hình thay vì huấn luyện chúng, phần lớn nghĩa vụ GPAI thuộc về nhà cung cấp, không phải bạn. Điều rơi vào bạn là tính minh bạch — cho người ta biết khi họ đang tương tác với AI, và đánh dấu nội dung tổng hợp — cộng với câu hỏi phân loại rủi ro cao nếu hệ thống của bạn chạm đến tuyển dụng, tín dụng, giáo dục hoặc hạ tầng trọng yếu. Mốc tháng 12 năm 2027 đủ xa để lập kế hoạch và đủ gần để “để sau xem” không còn là chiến lược.
Và điểm liên quan nhất đến Hồi III: một mô hình trên thiết bị đơn giản hóa đáng kể nhiều cuộc trao đổi như vậy cùng lúc. Không chuyển dữ liệu, không bên xử lý, bản đồ luồng dữ liệu ngắn hơn nhiều. Đó không phải lỗ hổng — nghĩa vụ minh bạch vẫn áp dụng — nhưng nó loại bỏ cả một nhóm việc.
Tôi không phải luật sư và đây không phải tư vấn pháp lý. Với bất cứ việc gì liên quan đến tiền, hãy nhờ cố vấn đủ trình độ ở Đức hoặc EU xem xét triển khai cụ thể của bạn.
Phần mười bảy: Trường hợp trung thực chống lại tất cả những điều này
Nếu tôi dừng ở Phần mười sáu thì đây sẽ là một bài quảng cáo.
Bằng chứng đo lường về năng suất vẫn không ủng hộ sự hào hứng. Một thử nghiệm đối chứng ngẫu nhiên, chậm hơn 19%. Một nghiên cứu tiếp theo không thể chạy sạch. Tự báo cáo bị thổi phồng 40 điểm phần trăm. Mọi người trong ngành này, kể cả tôi, phần lớn đang vận hành dựa trên cảm giác về cảm giác.
Dữ liệu bảo mật thì tệ và không cải thiện. Tỷ lệ thất bại OWASP 45% của Veracode hầu như không đổi suốt đầu năm 2026 trong khi các mô hình thông minh lên trông thấy. Đó không phải vấn đề chuyển tiếp mà quy mô sẽ khắc phục. Năng lực và bảo mật không cùng một trục, và không ai đang tối ưu mạnh cho trục thứ hai.
Các benchmark đã bão hòa ở đỉnh và không thể kiểm chứng ở giữa. SWE-bench Verified có ba mô hình cách nhau dưới một điểm. Các benchmark thay thế nó ngày càng riêng tư, điều này giải quyết nhiễm bẩn bằng cách khiến việc xác minh độc lập trở nên bất khả thi.
Trọng số mở chỉ cách một lần sửa giấy phép là không còn mở. Z.ai đã chuyển GLM từ MIT sang giấy phép độc quyền có cổng đánh giá bảo mật giữa 5.2 và 5.3. Meta đã hứa trọng số mở cho Muse Spark mà không có ngày, không có kích thước và không có nội dung giấy phép. Nếu kiến trúc của bạn giả định có trọng số tải xuống vào năm sau, giả định đó là quyết định kinh doanh của nhà cung cấp, không phải quy luật tự nhiên.
Giới tiên phong vẫn không ở cục bộ, và ngày càng cũng không mua được. Mythos 5.1, mô hình điểm cao nhất trên Terminal-Bench 4.0, bị giới hạn cho các chuyên gia phòng thủ mạng và nhà khoa học sự sống đã qua thẩm định, hiện chủ yếu ở Mỹ. Kimi K3 và DeepSeek V4 Pro không vừa trên bất kỳ máy tiêu dùng nào. Thứ vừa trên bàn bạn là một mô hình hạng hai xuất sắc, một thứ thực sự hữu ích nhưng không phải giới tiên phong.
Hiệu năng trên thiết bị kém hơn lời quảng cáo. Năm token mỗi giây cho một mô hình 8B trên NPU 45 TOPS. Một cổng bộ nhớ 12 GB loại bỏ phần lớn điện thoại đang lưu hành. Một lời hứa cập nhật bảy năm không bao gồm tính năng. Khoảng cách giữa nhãn hiệu “AI PC” và những gì máy thực sự chạy được hiện nay là rất lớn.
Và địa chính trị là một yếu tố đầu vào của việc mua sắm, dù bạn có nghĩ nó nên như vậy hay không. Một số mô hình trọng số mở tốt nhất — Kimi, GLM, DeepSeek, Qwen, MiniMax — đến từ các phòng thí nghiệm Trung Quốc. Với khu vực công, các bên gần quốc phòng và một số khách hàng chịu quản lý, đó là rào cản cứng bất kể trọng số chạy ở đâu hay giấy phép nói gì. Trong khi đó, mô hình lập trình mạnh nhất của Anthropic bị giới hạn cho các tổ chức Mỹ đã qua thẩm định. Hệ sinh thái mở đang bị xé theo ranh giới quốc gia từ cả hai đầu, và nếu bạn ở châu Âu thì bạn không ở đầu nào của nó.
Phần mười tám: Khung quyết định cho hiện trạng AI 2026
Hiện ảnh Bảy tình huống, bảy câu trả lời. Tìm hàng nghe giống năm của bạn.
Bảy tình huống, ánh xạ vào hiện trạng AI 2026 đúng như nó đang diễn ra hôm nay.
1. “Tôi muốn mô hình tốt nhất và chi phí không phải vấn đề.”
Claude Fable 5.1 ở 65,7 trên chỉ số tổng hợp, $10/$50, ngữ cảnh 1M — và bật bộ nhớ đệm, vì mức giảm 75% khi đọc từ bộ nhớ đệm đáng giá 25–45% hóa đơn của bạn. Giữ GPT-5.6 Sol sẵn có cho nghiên cứu nặng về duyệt web ở 90,4% BrowseComp. Đừng day dứt; khoảng cách giữa chúng nhỏ hơn khoảng cách giữa prompt tốt nhất và tệ nhất của bạn.
2. “Tôi chạy nhiều tác nhân và hóa đơn đang trở nên vô lý.”
Claude Opus 5 ở $5/$25 cho công việc dài hạn, GLM-5.3-Flash ở $0,15/$0,47 cho khối lượng công việc cơ học, và một mô hình cục bộ cho việc lặt vặt. Định tuyến là đòn tiết kiệm chi phí lớn nhất bạn có, và nó là một tệp cấu hình, không phải một dự án. Đo tỷ lệ token theo vai trò tác nhân trước khi tối ưu bất cứ thứ gì — hầu hết mọi người phát hiện 80% chi tiêu của họ dành cho các tác vụ không cần mô hình tiên phong.
3. “GDPR và lưu trú dữ liệu là yêu cầu cứng cho công việc khách hàng.”
Qwen3.8-27B hoặc Gemma 4 31B trên phần cứng bạn sở hữu, cả hai đều theo Apache 2.0, cả hai đều đa phương thức. Nâng lên gpt-oss-120b trên máy 128 GB nếu công việc cần. Điểm mấu chốt không phải tốc độ — mà là không prompt nào rời khỏi tòa nhà và việc rà soát pháp lý của bạn trở thành đọc giấy phép thay vì đánh giá tác động chuyển dữ liệu. Chọn mô hình có giấy phép dễ dãi chính là để lần đọc đó ngắn gọn.
4. “Tôi muốn thử AI cục bộ mà không tốn nhiều tiền.”
Bất cứ thứ gì bạn đã có, cộng thêm LM Studio, cộng thêm Gemma 4 E4B. Tám gigabyte bộ nhớ là đủ để thực sự hữu ích. Tìm hiểu xem AI cục bộ có hợp với bạn không trước khi chi tiền — hầu hết mọi người phát hiện họ muốn tầng 1 và tầng 3 và chưa bao giờ cần tầng 2.
5. “Tôi đang mua một chiếc máy riêng cho suy luận cục bộ.”
Mua dựa trên băng thông bộ nhớ và dung lượng, theo thứ tự đó, và bỏ qua TOPS. Trong nhóm 128 GB, Strix Halo ở ~$2.400 là lựa chọn đáng tiền và DGX Spark ở ~$3.999 mua cho bạn CUDA và khả năng tạo ảnh tốt hơn nhiều. Trên mức đó, Mac Studio M5 Ultra là thứ duy nhất chứa được mô hình 400B, với mức giá chỉ hợp lý nếu bạn vốn cần máy trạm đó.
6. “Nhóm của tôi đang áp dụng công cụ lập trình AI và tôi gánh rủi ro.”
Làm những việc nhàm chán, theo thứ tự này: SAST và phát hiện bí mật trên mỗi commit; phân tích thành phần phần mềm cho các gói bị ảo giác; một chính sách bằng văn bản loại trừ mã AI chưa được rà soát khỏi auth, crypto, authz và thanh toán; thông tin đăng nhập của tác nhân được giới hạn phạm vi và coi là đặc quyền; và một SBOM ghi lại nguồn gốc công cụ. Rồi hãy mong đợi một Đường cong J — DORA đo được một sụt giảm thật trước khi có lợi ích — và đừng hoảng loạn vào tháng thứ ba.
7. “Tôi nên mua điện thoại nào cho AI?”
Bất kỳ mẫu 12 GB nào. Đó là ranh giới mọi nền tảng đã vạch ra: iPhone 17 Pro và 18 Pro ở 12 GB, Pixel 10 cho Nano v3, Galaxy S26 Ultra trên Snapdragon 8 Elite Gen 5. iPhone 18 bản cơ sở được báo cáo 9 GB và Pixel 9 trở về trước sẽ chạy điện thoại ổn và sẽ không nhận được các tính năng. Nếu bạn đang dùng thiết bị 12 GB, bản nâng cấp năm nay là gia tăng dần đối với AI cụ thể.
Phần mười chín: Những gì tôi đang theo dõi quý tới
Liệu Meta có thực sự phát hành trọng số của Muse Spark không, và theo giấy phép nào. “Sớm” từ một CEO trên X, không có số tham số và không có nội dung giấy phép, là hình thức cam kết yếu nhất trong bài viết này. Nếu họ phát hành theo Apache 2.0 thì nó thay đổi đáng kể hệ sinh thái mở. Nếu họ phát hành theo giấy phép riêng có cổng doanh thu, đó giờ là mặc định của ngành và trọng số mở trở thành một hạng mục tiếp thị chứ không phải một thuộc tính.
Liệu kết quả tự cải thiện của Ornith-1.5 có tái lập được không. Một đánh giá độc lập trên các tác vụ nằm ngoài chương trình tự tạo là thứ sẽ giải quyết điều đó. Đây là mục có phương sai cao nhất trong danh sách: nó hoặc là kết quả quan trọng nhất của năm 2026, hoặc là một câu chuyện cảnh báo về benchmark tự tạo, và hiện tôi chưa biết là cái nào.
Liệu Aion 1.0 Plan có thực sự phát hành và chạy ở tốc độ nào. Một mô hình suy luận 14B trong Windows là một hạng mục thực sự mới. Nếu nó chạy 3 token mỗi giây trên phần cứng đủ điều kiện, đó là bản demo. Nếu chạy 20, nó thay đổi những gì một ứng dụng máy tính để bàn có thể giả định.
Đường cong quy kết CVE. 6, 15, 35 trong các tháng liên tiếp. Nếu từ tháng 4 đến tháng 8 tiếp tục quỹ đạo đó, dữ liệu của Georgia Tech sẽ là công bố bảo mật AI hệ trọng nhất trong năm khi nó ra mắt.
Liệu có ai xây công cụ rà soát. Khoảng cách giữa những gì tác nhân có thể tạo ra và những gì con người có thể xác minh là vấn đề định hình của năm 2027, và tính đến hôm nay gần như toàn bộ tiền đầu tư mạo hiểm vẫn đổ vào tạo sinh thay vì xác minh. Ai phát hành được công cụ chỉ ra đáng tin cậy 5% nào của một diff cần mắt người sẽ rất khó bị cạnh tranh.
Liệu tình trạng thiếu bộ nhớ có dịu đi. Nó là biến ẩn đằng sau cổng 12 GB trên điện thoại, giới hạn 32 GB của M6, bậc Mac 512 GB bị trì hoãn và đợt tăng giá Apple tháng Sáu. Không ai đáng tin đang dự báo tình hình dịu đi.
Và liệu các mô hình tiên phong bị rào bởi an toàn có còn là ngoại lệ. Mythos 5.1 bị giới hạn vì lý do lưỡng dụng mà tôi thấy có thể biện hộ được, và Project Glasswing đang chủ động mở rộng quyền truy cập — khoảng 150 tổ chức tại hơn mười lăm quốc gia vào tháng 6 năm 2026. Nhưng tiền lệ đã được đặt: mô hình điểm cao nhất trên một benchmark lập trình công khai giờ là thứ mà hầu hết tổ chức không thể mua bằng bất kỳ giá nào. Nếu điều đó trở thành khuôn mẫu chứ không phải ngoại lệ đặc biệt, “tổ chức của tôi có được thẩm định không” trở thành một tiêu chí chọn mô hình, và lập luận cho trọng số mở bên ngoài Mỹ không còn hoàn toàn về chi phí.
Câu hỏi thường gặp
Mô hình LLM tốt nhất vào tháng 9 năm 2026 là gì?
Trên chỉ số tổng hợp, Claude Fable 5.1 dẫn đầu Intelligence Index v4.1.1 của Artificial Analysis với 65,7, trên Claude Opus 5 ở 63,0, Claude Fable 5 ở 62,1, Grok 4.6 ở 60,9 và GPT-5.6 Sol ở 58,9. Nhưng chỉ số tổng hợp nén mất những khác biệt quan trọng. GPT-5.6 Sol dẫn đầu duyệt web với 90,4% trên BrowseComp; Gemini 3.8 Flash đạt 58,7 với $0,75 mỗi triệu token đầu vào; GLM-5.3-Flash đạt 57,5 với $0,15. Với hầu hết khối lượng công việc thực tế, tám mô hình hàng đầu có thể hoán đổi cho nhau và quyết định nên dựa trên giá, độ trễ, kinh tế bộ nhớ đệm và giấy phép thay vì xếp hạng.
Mô hình trọng số mở tốt nhất hiện nay là gì?
Còn tùy phần cứng và mức độ chấp nhận giấy phép của bạn. GLM-5.3 (753B) đạt điểm cao nhất 59,5 nhưng mang giấy phép tùy chỉnh với cổng đánh giá bảo mật cho doanh thu $10 tỷ. DeepSeek V4 Pro (1,6T tổng, 49B hoạt động) có giấy phép MIT và đạt 87,9 trên Terminal-Bench 2.1, nhưng cần một cụm máy. Với một chiếc máy bạn thực sự sở hữu, Qwen3.8-27B hoặc Gemma 4 31B — cả hai Apache 2.0 — là những mô hình tốt nhất vừa trong 32 GB.
Liệu vibe coding có chết vào năm 2026?
Từ này đang chết dần; thực hành thì tách làm hai. Vibe coding theo nghĩa gốc — prompt, chấp nhận, không đọc diff — vẫn đúng cho công việc dùng một lần: script, nguyên mẫu, phân tích một lần. Thứ thay thế nó cho bất cứ thứ gì được phát hành là kỹ thuật tác nhân dựa trên đặc tả: một đặc tả bằng văn bản, một sandbox, một bộ kiểm thử mà tác nhân phải vượt qua, và một lần rà soát thực sự diff kết quả. Phần giữa nguy hiểm — mã sản xuất, chưa rà soát — là nơi mọi sự cố được ghi nhận của năm 2026 bắt nguồn.
Liệu lập trình AI có thực sự giúp lập trình viên nhanh hơn?
Thử nghiệm đối chứng ngẫu nhiên duy nhất nói không. METR phát hiện các lập trình viên giàu kinh nghiệm chậm hơn 19% với công cụ AI đầu năm 2025 trên các cơ sở mã trưởng thành, trong khi tin rằng họ nhanh hơn 20% — ước lượng quá cao 40 điểm phần trăm. Nghiên cứu tiếp theo năm 2026 của họ không thể chạy sạch vì lập trình viên từ chối làm việc không có AI. Các khảo sát báo cáo tốc độ nhân 3 nhưng chỉ thay đổi 1,4–2 lần giá trị công việc. Cách tôi đọc: lợi ích lớn với công việc lạ, mã khuôn mẫu, kiểm thử và di chuyển; lợi ích nhỏ hoặc âm với cơ sở mã bạn biết rõ.
Mã do AI tạo ra rủi ro đến mức nào?
Rủi ro đo được và đang cải thiện chậm. Veracode phát hiện 45% mẫu do AI tạo ra đưa vào lỗ hổng OWASP Top 10, với Java tệ nhất ở 72%. Apiiro đo được các lập trình viên có AI hỗ trợ tạo commit nhanh gấp 3–4 lần và phát hiện bảo mật nhanh gấp 10 lần, với đường leo thang đặc quyền tăng 322%. Khoảng 20% mã do AI tạo tham chiếu các gói không tồn tại, và 43% trong số tên bị ảo giác đó lặp lại nhất quán — đây là bề mặt tấn công chuỗi cung ứng. Cách khắc phục là cổng tự động trên mỗi commit, không phải kiêng tuyệt đối.
Tôi có thể chạy một LLM tốt ngoại tuyến trên máy tính của mình không?
Có, và 2026 là năm đầu tiên điều đó đúng một cách rõ ràng. Với 8 GB bộ nhớ, Gemma 4 E4B thực sự hữu ích. Với 32 GB, Qwen3.8-27B hoặc Gemma 4 31B là những mô hình đa phương thức mạnh theo Apache 2.0. Với 128 GB, gpt-oss-120b là điểm ngọt. Thứ không vừa trên bất kỳ máy tiêu dùng nào là biên giới tiên phong thực sự: Kimi K3 với 2,8 nghìn tỷ tham số và DeepSeek V4 Pro với 1,6 nghìn tỷ đều cần một cụm máy.
Microsoft Aion 1.0 là gì?
Một họ mô hình trên thiết bị được công bố tại Build ngày 2 tháng 6 năm 2026 và phát hành vào Windows 11. Aion 1.0 Instruct là một mô hình nhỏ để tóm tắt, viết lại và trích xuất, chạy trên CPU hiện đại không cần NPU, được cung cấp qua các API JavaScript Prompt, Summarizer, Writer và Rewriter của Edge, với trọng số mở trên Hugging Face từ tháng 7 năm 2026. Aion 1.0 Plan là mô hình suy luận và gọi công cụ 14 tỷ tham số với cửa sổ ngữ cảnh 32K cho quy trình làm việc tác nhân, yêu cầu PC Copilot+ với NPU tối thiểu 40 TOPS, và vẫn ở trạng thái “sắp ra mắt trong vài tháng” vào đầu tháng 9 năm 2026.
Tại sao điện thoại cần 12 GB RAM cho tính năng AI?
Vì mô hình trên thiết bị bị giới hạn bởi bộ nhớ, không phải năng lực tính toán. AFM 3 Core Advanced của Apple là mô hình thưa 20 tỷ tham số sống trong bộ nhớ flash và hoán đổi các chuyên gia được định tuyến vào DRAM khi cần — mà vẫn cần chỗ để hoán đổi, chồng lên hệ điều hành, ứng dụng và pipeline camera. Ming-Chi Kuo báo cáo hai tính năng iOS 27 cần 12 GB. Gemini Intelligence của Google cũng có mức tối thiểu 12 GB. Khoảng cách giữa 9 GB và 12 GB là tập làm việc, không phải phân khúc thị trường.
NPU có đáng có cho AI cục bộ không?
Ít hơn lời quảng cáo. Trên NPU 45 TOPS, một mô hình 8B tạo khoảng 5 token mỗi giây, vì việc tạo token bị giới hạn bởi băng thông bộ nhớ chứ không phải tính toán. NPU rất tốt cho các tác vụ luôn bật, công suất thấp, ngắn — những thứ hệ điều hành chạy liên tục. Với trò chuyện tương tác trên laptop, đường GPU hoặc thậm chí CPU thường nhanh hơn. Mua dựa trên băng thông và dung lượng bộ nhớ; coi TOPS gần như vô nghĩa khi mua sắm.
Mô hình trọng số mở có thực sự là mã nguồn mở không?
Phần lớn là không. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) và Ornith-1.5 (MIT) có giấy phép thực sự dễ dãi. GLM-5.3 yêu cầu các công ty doanh thu trên $10 tỷ phải qua đánh giá bảo mật của Z.ai; Kimi K3 dùng giấy phép theo bậc doanh thu; MiniMax M3 bắt buộc ghi công rõ ràng “Built with MiniMax M3” cho mọi mục đích thương mại và có sự cho phép bằng văn bản khi doanh thu trên $20 triệu. Không mô hình nào trong số đó phát hành dữ liệu huấn luyện hay mã huấn luyện. “Trọng số mở” là thuật ngữ chính xác; “mã nguồn mở” đang bị dùng không trung thực.
Chạy mô hình cục bộ có rẻ hơn dùng API không?
Hầu như không bao giờ nếu chỉ xét chi phí token. Một tháng làm việc tác nhân vừa phải — 40 triệu token đầu vào và 3 triệu token đầu ra — tốn khoảng $7 trên GLM-5.3-Flash và khoảng $41 trên Gemini 3.8 Flash. Một bộ máy cục bộ $2.400 khấu hao trong ba năm là khoảng $67 một tháng trước khi tính điện. Phần cứng cục bộ thắng đỉnh của giới tiên phong về chi phí và thua đáy của nó. Mua cục bộ vì lưu trú dữ liệu, tự do giới hạn tốc độ, ghim phiên bản và vận hành ngoại tuyến — hoặc vì bạn vốn cần máy trạm đó.
Đạo luật AI của EU yêu cầu gì trong năm 2026?
Kể từ ngày 2 tháng 8 năm 2026, quyền cưỡng chế và nghĩa vụ minh bạch theo Điều 50 áp dụng cho AI đa dụng, và các khoản phạt giờ đã có thể áp dụng. Digital Omnibus, Quy định (EU) 2026/1744, có hiệu lực ngày 27 tháng 7 năm 2026 và đặt các mốc cố định: ngày 2 tháng 12 năm 2026 kết thúc thời gian ân hạn gắn watermark; ngày 2 tháng 8 năm 2027 đóng chuyển đổi cho các mô hình GPAI đã có trên thị trường; ngày 2 tháng 12 năm 2027 áp dụng cho các hệ thống rủi ro cao độc lập theo Phụ lục III; ngày 2 tháng 8 năm 2028 bao gồm AI rủi ro cao nhúng trong sản phẩm được quản lý. Nếu bạn xây dựng trên mô hình thay vì huấn luyện chúng, phần lớn nghĩa vụ GPAI thuộc về nhà cung cấp — tính minh bạch và phân loại rủi ro cao là thứ rơi vào bạn. Đây không phải tư vấn pháp lý.
Một tác nhân AI có thể làm việc không giám sát trong bao lâu?
METR đo độ dài tác vụ mà một mô hình hoàn thành tự động với 50% thành công. Con số đó đi từ khoảng 30 giây năm 2022 lên hơn 14 giờ với các hệ thống tiên phong năm 2026, với thời gian nhân đôi khoảng 196 ngày theo mô hình lai của METR, hoặc 131 ngày khi giới hạn ở các mô hình sau 2023. Khoảng tin cậy rất rộng — chân trời 320 phút của Claude Opus 4.5 dao động từ 170 đến 729 phút — và chỉ 5 trong 31 tác vụ dài của METR dùng đường cơ sở đo được của con người. Ngoại suy ra, đó là khoảng một ngày làm việc độ dài tác vụ tự động vào năm 2027.
Tôi nên dùng mô hình nào riêng cho lập trình?
Định tuyến thay vì chọn. Lập kế hoạch và kiến trúc cho mô hình mạnh nhất bạn đủ khả năng (Claude Fable 5.1); phần lớn triển khai dài hạn cho Claude Opus 5 với nửa giá; công việc cơ học khối lượng lớn cho GLM-5.3-Flash ở $0,15/$0,47; bất cứ thứ gì chạm đến dữ liệu khách hàng cho một mô hình trọng số mở cục bộ; và đổi tên, docstring cùng sửa lint cho một mô hình cục bộ nhỏ. Viết ID mô hình sao cho đổi một cái chỉ là thay đổi một dòng — bốn phòng thí nghiệm đã phát hành một mô hình top 10 từ tháng 6 đến tháng 9 năm 2026.
Điểm mấu chốt
Mười hai tháng trước, câu hỏi thú vị trong AI là mô hình nào thông minh nhất. Hiện trạng AI 2026 là câu hỏi đó đã gần như không còn thú vị. Mười mô hình hàng đầu trải trên 8,2 điểm theo chỉ số tổng hợp tốt nhất hiện có, và mô hình rẻ nhất trong số đó có giá bằng một phần sáu mươi bảy mô hình đắt nhất.
Thứ thay thế nó hữu ích hơn và ít hào hứng hơn: bạn có thể xác minh những gì mấy thứ này tạo ra, đủ nhanh để theo kịp chúng không?
Một câu hỏi đó giải thích mọi phát hiện trong bài này. Nó giải thích tại sao SWE-bench bão hòa ở 96% và không còn nhiều thông tin. Nó giải thích tại sao việc áp dụng công cụ lập trình AI đạt 90% trong khi niềm tin giảm còn 29%. Nó giải thích tại sao tỷ lệ thất bại bảo mật của Veracode không nhúc nhích trong khi năng lực tăng vọt, vì năng lực và khả năng xác minh là hai trục khác nhau và chỉ một trục được tối ưu. Nó giải thích tại sao DORA phát hiện lợi ích đến từ tổ chức chứ không phải công cụ. Và nó giải thích tại sao cách thực hành thực sự hiệu quả năm 2026 — đặc tả, sandbox, cổng kiểm thử, rà soát thực sự — trông kém huyền diệu hơn nhiều so với các bản demo.
Bốn điều tôi sẽ rút ra.
Giới tiên phong bị hàng hóa hóa nhanh hơn bất kỳ ai dự đoán, và khoảng cách trọng số mở giờ khoảng sáu tháng. Một mô hình 397B giấy phép MIT vượt biên giới đóng của thế hệ trước trên SWE-bench. Một mô hình trọng số mở 753B xếp trên GPT-5.6 Sol trên chỉ số tổng hợp. Hãy lập kế hoạch cho một thế giới nơi mô hình không phải yếu tố khác biệt của bạn, vì nó gần như đã không còn là một yếu tố như vậy.
Đọc giấy phép trước benchmark. Năng lực đang hội tụ; điều khoản đang phân kỳ. Z.ai đã rời MIT giữa các bản phát hành. Meta đã hứa trọng số mà không có nội dung giấy phép. Mô hình lập trình tốt nhất của Anthropic bị giới hạn theo quốc tịch. Với người mua thương mại, bốn điểm benchmark đáng giá ít hơn một giấy phép mà luật sư của bạn đọc xong trong chín mươi giây.
Xác minh giờ là toàn bộ cuộc chơi, và gần như không ai đang tài trợ cho nó. Tác nhân có thể tạo ra một ngày làm việc; chúng ta rà soát nó bằng công cụ xây để rà soát một giờ làm việc. Nếu bạn đang chọn nơi dồn nỗ lực kỹ thuật trong mười hai tháng tới, hãy dồn vào kiểm thử, đặc tả và công cụ rà soát thay vì kỹ thuật prompt. Kỹ thuật prompt mất giá với mỗi bản phát hành mô hình. Hạ tầng xác minh thì tích lũy.
Và AI ngoại tuyến đã trở nên thực sự hữu ích, trên một ngân sách bộ nhớ vừa trở nên đắt đỏ. Một mô hình đa phương thức 27 tỷ tham số giấy phép Apache chạy trên chiếc máy bạn có thể mua với €2.500. Windows phát hành một mô hình trong hệ điều hành. Điện thoại của bạn chạy một mô hình thưa 20 tỷ tham số từ bộ nhớ flash. Mọi giới hạn trên đó — cổng 12 GB trên điện thoại, giới hạn 32 GB trên laptop, mức sàn 40 TOPS — là quyết định phân bổ bộ nhớ trong một thị trường DRAM khan hiếm, không phải giới hạn của silicon.
Bộ thiết lập tôi sẽ thực sự dựng hôm nay: Gemma 4 E4B trên thiết bị cho tầng luôn bật; Qwen3.8-27B trên phần cứng của bạn cho bất cứ thứ gì không được rời khỏi tòa nhà; GLM-5.3-Flash ở $0,15/$0,47 cho phần giữa khối lượng lớn; và Claude Opus 5 hoặc Fable 5.1 cho lập kế hoạch và những vấn đề thực sự khó, với bộ nhớ đệm bật. Định tuyến giữa chúng trong một tệp cấu hình, và dự kiến viết lại tệp đó sau ba tháng.
Xem lại vào tháng 12. Meta hoặc đã phát hành trọng số hoặc chưa. Aion 1.0 Plan hoặc là thật hoặc là hơi nước. Kết quả tự cải thiện của Ornith sẽ được tái lập hoặc lặng lẽ biến mất. Và đường cong quy kết CVE sẽ cho chúng ta biết 2026 là năm ngành tự siết cổng của mình hay là năm chờ người khác làm.
Bạn có đang chạy mô hình trọng số mở trong sản xuất ở EU, hay đưa mã do tác nhân viết qua một quy trình rà soát mà bạn thực sự tin không? Tôi đặc biệt quan tâm hai điều: phân tách chi phí token đo được theo vai trò tác nhân, và bất cứ thứ gì hiệu quả để rà soát diff tác nhân hàng nghìn dòng. Hoan nghênh đính chính và bằng chứng phản bác — bài này được cập nhật khi bức tranh thay đổi.
Cập nhật lần cuối: 3 tháng 9 năm 2026.


