
 Русский
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 العربية
 हिन्दी

Положение дел в ИИ в 2026 году сводится к трём вещам, которые произошли за первые восемь месяцев года, — и почти никто не поставил их в одно предложение.
Одна модель преодолела 96% на SWE-bench Verified. Не 96% на игрушечном бенчмарке, а 96% на реальных issue из GitHub в Django, Flask и scikit-learn — бенчмарке, который, по ожиданиям, должен был продержаться годы. Сейчас он фактически исчерпан как критерий различения, и три модели на его вершине разделяет меньше процентного пункта.
Лучшие доступные данные о том, ускоряют ли инструменты ИИ-кодинга опытных разработчиков, по-прежнему говорят: нет. Рандомизированное контролируемое исследование METR показало замедление на 19%. Их собственная попытка повторить его в 2026 году сорвалась, потому что разработчики отказались работать без ИИ даже за $50 в час. Те, кто пользуется этими инструментами, считают, что стали втрое быстрее. По измерениям — нет.
А Microsoft встроила рассуждающую модель с 14 миллиардами параметров в сам Windows, и это фраза, которая в 2024 году была бы научной фантастикой, а сегодня — сноска в докладе на Build.
Эти три факта — и есть всё состояние ИИ 2026 года в миниатюре. Модели стали выдающимися. Измеримый прирост производительности за этим не последовал. А интересный фронтир тихо сместился из дата-центра в устройство в вашей руке.
Это длинная версия рассказа о состоянии ИИ в 2026 году. Она написана для людей, которым нужно принимать решения, связанные с деньгами: на какую модель направлять запросы, позволять ли агентам писать код для продакшена, что покупать и что говорить клиенту или сотруднику по защите данных. Я отделил то, что уже вышло, от того, что только сообщается, и от слухов, потому что самая дорогая ошибка в этой области — планировать вокруг модели, которой ещё не существует.
Последнее обновление — 3 сентября 2026 года. К Рождеству понадобится обновить снова.
Кратко — состояние ИИ в 2026 году за 90 секунд
На фронтире гонка четырёх, и по совокупному показателю сейчас в ней побеждает Anthropic. По состоянию на 2 сентября 2026 года Intelligence Index v4.1.1 от Artificial Analysis показывает Claude Fable 5.1 на 65.7, Claude Opus 5 на 63.0, Grok 4.6 на 60.9 и GPT-5.6 Sol на 58.9. Но совокупный балл скрывает самое интересное: GPT-5.6 Sol лидирует в BrowseComp с 90.4%, Gemini 3.8 Flash выдаёт 58.7 при $0.75 за миллион входных токенов, а топ-10 моделей разделяют всего 8.2 балла — диапазон настолько узкий, что различия в harness и промптах могут сдвинуть модель на несколько мест.
Открытые веса отстают примерно на одно поколение и сокращают разрыв. GLM-5.3 (753B, открытая) находится на 59.5 — шестое место в общем зачёте, выше GPT-5.6 Sol. DeepSeek V4 Pro вышла с 1.6 триллиона параметров под настоящей лицензией MIT. Ornith-1.5-397B получила 86 на SWE-bench Verified и обошла Claude Opus 4.8 на Terminal-Bench 2.1 — 86.1 против 85.0. Разрыв в возможностях сейчас около шести месяцев. Разрыв в лицензиях — тот, что действительно важен.
“Вайб-кодинг” выиграл спор о внедрении и проиграл спор о доказательствах. 90% разработчиков используют на работе хотя бы один инструмент ИИ-кодинга. Рынок корпоративных кодинг-агентов оценивается примерно в $10 миллиардов в год. А доверие разработчиков к результатам ИИ за два года упало с 40% до 29%. Инструменты универсальны, и люди, которые ими пользуются, доверяют им всё меньше с каждым годом. И то и другое рационально.
Счёт за безопасность пришёл, и он детализирован. Veracode обнаружила, что 45% образцов кода, сгенерированного ИИ, вносят уязвимость из OWASP Top 10. Apiiro измерила, что разработчики с ИИ создают коммиты в три-четыре раза быстрее, а находки по безопасности — в десять раз быстрее. Примерно 20% кода, сгенерированного ИИ, ссылается на пакеты, которых не существует. Это не аргумент против инструментов. Это аргумент о том, где ставить контроль.
Офлайн-ИИ в этом году стал по-настоящему полезным — на железе, которое у людей уже есть. Модель с 2 миллиардами параметров выдаёт 61 токен в секунду на iPhone. Microsoft встроила в Windows рассуждающую модель на 14B с требованием NPU на 40 TOPS. Google открывает доступ к своей лучшей локальной модели только при 12 ГБ RAM, и Apple тоже. То, что решает, что вы можете запускать офлайн, — это память, а не вычисления, и именно память стала дефицитом.
Честная формулировка о состоянии ИИ в 2026 году в одну строку: это год, когда модели перестали быть узким местом. Узким местом стала проверка. Каждое важное решение в этой статье — какая модель, какой harness, какое устройство, какой контроль — следствие этого одного изменения.
Быстрое сравнение: фронтир, сентябрь 2026
Intelligence Index v4.1.1 от Artificial Analysis агрегирует девять оценок: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience и AA-LCR. Оценки ниже — срез на 2 сентября 2026 года.
| Модель | Лаборатория | Индекс AA | Веса | Вход / выход за 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | Закрытые | $10.00 / $50.00 |
| Claude Opus 5 | Anthropic | 63.0 | Закрытые | $5.00 / $25.00 |
| Claude Fable 5 | Anthropic | 62.1 | Закрытые | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | Закрытые | — |
| Kimi K3 | Moonshot | 59.7 | Открытые веса | — |
| GLM-5.3 | Z.ai | 59.5 | Открытые веса | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Закрытые | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | Закрытые | $0.75 / $3.75 | |
| Qwen3.8 Max Preview | Alibaba | 58.1 | Закрытые | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Открытые веса | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropic | 57.3 | Закрытые | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | Закрытые | — |
| GPT-5.5 | OpenAI | 56.3 | Закрытые | — |
Смотрите четвёртый столбец раньше третьего. У двух моделей из топ-10 веса можно скачать, и одна из них стоит $0.15 за миллион входных токенов.
Быстрое сравнение: фронтир открытых весов
| Модель | Всего / активных | Контекст | Лицензия | Выпуск |
|---|---|---|---|---|
| Kimi K3 | 2.8T / 104B | 1M | По уровням выручки (собственная) | июль 2026 |
| Qwen3.8-2.4T-A95B | 2.4T / 95B | 262K (1M с YaRN) | Apache 2.0 | 14 авг. 2026 |
| DeepSeek V4 Pro | 1.6T / 49B | 1M | MIT | 12 авг. 2026 |
| GLM-5.3 | 753B / ~40B | 1M | Собственная (порог $10B) | авг. 2026 |
| MiniMax M3 | 428B / 23B | 1M | Собственная (с указанием авторства) | 1 июня 2026 |
| Ornith-1.5-397B | 397B MoE | 262K (1M с YaRN) | MIT | авг. 2026 |
| Gemma 4 31B | 31B dense | 256K | Apache 2.0 | 6 апр. 2026 |
| Qwen3.8-27B | 27B dense | 262K | Apache 2.0 | 14 авг. 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 апр. 2026 |
Три из этих девяти действительно OSI-clean. Это и есть настоящая история открытых весов в 2026 году, и я вернусь к ней в третьей части.
АКТ I — МОДЕЛИ
Часть первая: что действительно вышло в 2026 году
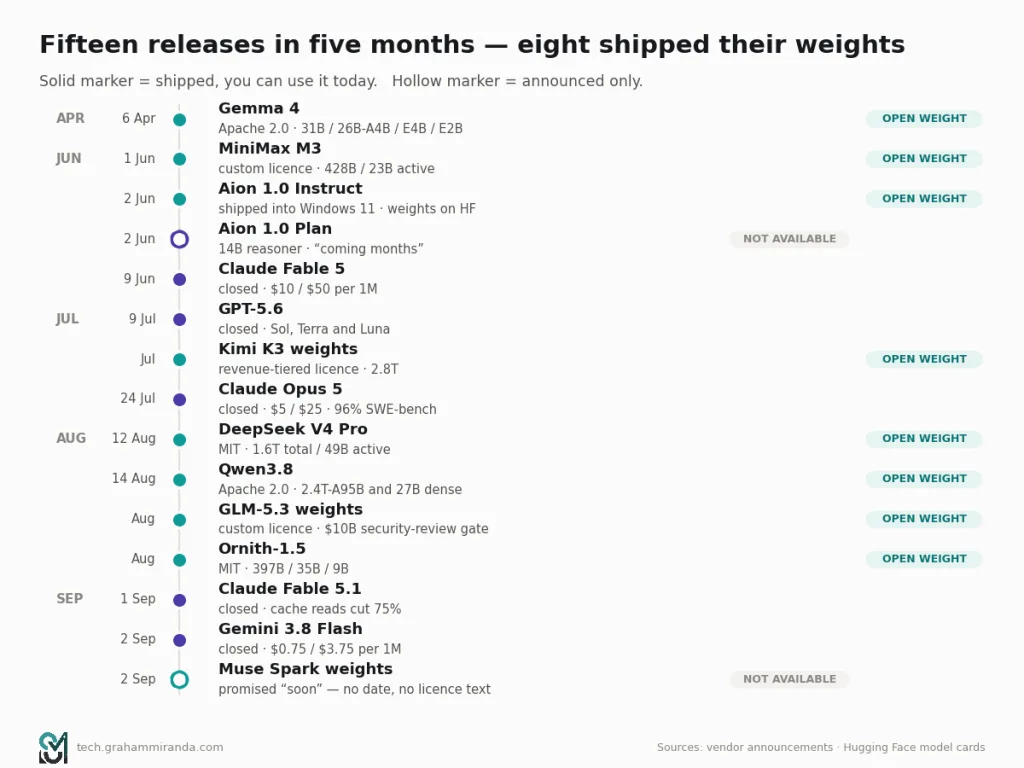
Прежде чем спорить — реестр. Я делю его на три уровня, потому что разница между ними — это место, где теряются деньги.
Подтверждено и уже поставляется
- 6 апреля 2026 — Google выпускает Gemma 4 под Apache 2.0 — смена лицензии с индивидуальных условий Gemma 3. Четыре варианта: 31B dense, 26B с 4B активных (MoE), E4B около 8B и E2B с 5.1B всего при 2.3B активных. Контекст 256K у больших моделей, 128K у серии E. Все поддерживают ввод текста, изображений и видео; E2B и E4B добавляют нативный звук.
- 1 июня 2026 — MiniMax M3. 428B всего / 23B активных, контекст 1M, нативная мультимодальность, новый оператор разреженного внимания, веса на Hugging Face. Подробно разобрано в моей более ранней статье о локальном ИИ-железе.
- 2 июня 2026 — Microsoft анонсирует Aion 1.0 на Build. Семейство локальных моделей, встроенных в сам Windows 11: Aion 1.0 Instruct (работает на CPU, в Edge Canary начиная с 150.0.4070) и Aion 1.0 Plan — модель рассуждений и вызова инструментов с 14 миллиардами параметров и контекстным окном 32K.
- 9 июня 2026 — Claude Fable 5. Топовый уровень Anthropic: $10/$50 за миллион, контекст 1M, до 128K вывода.
- 9 июля 2026 — OpenAI выпускает GPT-5.6 в трёх вариантах: Sol ($5/$30), Terra ($2.50/$15) и Luna ($1/$6). Кибербезопасность встроена в Sol, а не продаётся отдельной моделью, с расширенным доступом по программе Trusted Access for Cyber от OpenAI.
- Июль 2026 — Moonshot открывает веса Kimi K3. 2.8 триллиона параметров, контекст 1M, нативный MXFP4, по лицензии с уровнями по выручке.
- 24 июля 2026 — Claude Opus 5. $5/$25, без изменений относительно Opus 4.8. Anthropic утверждает, что модель “более чем вдвое превосходит Opus 4.8 по производительности” на Frontier-Bench v0.1 и набирает втрое больше следующей лучшей модели на ARC-AGI 3.
- 12 августа 2026 — DeepSeek V4 Pro выходит из превью с весами под лицензией MIT: 1.6T всего (в части обзоров округляют до 1.7T), 49B активных, контекст 1M, 893 ГБ тензоров BF16 и FP8 плюс модуль спекулятивного декодирования DSpark. Terminal-Bench 2.1 — 87.9, HLE с инструментами — 60.0, CyberGym — 83.3. Одновременно DeepSeek подняла цены на API.
- 14 августа 2026 — открытые веса Qwen3.8 под Apache 2.0: плотная мультимодальная модель на 27B и гигант 2.4T-A95B, обе на Hugging Face и ModelScope, нативный контекст 262K с расширением до 1M через YaRN.
- Август 2026 — веса GLM-5.3 появляются на Hugging Face примерно через две недели после запуска API. 753B MoE, контекст 1M, вывод 128K, BF16 и FP8.
- Август 2026 — Ornith-1.5. Три масштаба (397B MoE, 35B MoE с 3B активных, 9B dense), построены на Qwen3.5 и Gemma 4 с продолженным предобучением, лицензия MIT, заявлено 86 на SWE-bench Verified.
- 1 сентября 2026 — Claude Fable 5.1 и Mythos 5.1. Адаптивное мышление включено по умолчанию, контекст 1M, вывод 128K. Базовая цена не изменилась — $10/$50, но чтение из кэша подешевело на 75%, с $1.00 до $0.25 за миллион.
- 2 сентября 2026 — Gemini 3.8 Flash по $0.75/$3.75, входной контекст 1M, вывод 66K, отсечка знаний — март 2026 года, на входе текст, изображения, видео, звук и PDF.
- 2 сентября 2026 — Meta выпускает Muse Spark 1.3 и Muse Code CLI.
Сообщается, источник достоверный, не подтверждено
- Meta откроет веса Muse Spark “скоро”. Это Марк Цукерберг в X — без даты, без числа параметров, без деталей архитектуры и без текста лицензии. Meta не раскрывала размер модели ни в одной версии.
- Gemini Nano v4 описывается как предстоящая для Android, тогда как Nano v3 сейчас ограничена серией Pixel 10.
- Aion 1.0 Plan ожидается через “ближайшие месяцы” в общем доступе; в превью только Instruct.
Слух, один источник — относитесь соответственно
- Всё, что вы читали о следующем флагмане Anthropic, OpenAI или Google. На рынке, где четыре лаборатории выпустили модель из топ-10 за девять недель, слухи о будущем живут около двух недель.
Ещё одна вещь, которую стоит отметить, потому что она нова и почти никто за пределами сферы ИБ её не обсуждает. Claude Mythos 5.1 набирает 60.9 на Terminal-Bench 4.0 — больше, чем 55.8 у Fable 5.1, — и 95.5% на SWE-bench Verified. Купить её нельзя.
Anthropic описывает Mythos как свою “самую способную модель для исследований в кибербезопасности и биологии”, и она доступна только проверенным киберзащитникам и специалистам по наукам о жизни через две программы доверенного доступа: Cyber Verification Program и Life Sciences Verification Program. Формулировка самой Anthropic: они “могут предоставить её только ряду организаций в США, хотя работают над расширением доступа”. Проект Glasswing, усилие по расширению доступа, к тому моменту охватил примерно 150 организаций более чем в пятнадцати странах по состоянию на июнь 2026 года.
Причина в двойном назначении: модель, которая отлично находит уязвимости, отлично находит их для любой из сторон, — и, на мой взгляд, это оправданно. Но обратите внимание на структурное следствие, потому что оно действительно ново: модель с самым высоким результатом на публичном бенчмарке по кодингу — теперь та, к которой большая часть мира не может получить доступ ни за какие деньги. Ограничение возможностей по соображениям безопасности, а не коммерции, будет встречаться чаще, а не реже, и если вы за пределами США, это аргумент заботиться об открытых весах по причинам, никак не связанным с ценой.
Показать изображение Девять месяцев, двенадцать значимых релизов, четыре из них с открытыми весами. Сплошные полосы — выпущено с весами или с доступом к API, которые можно купить сегодня; пунктирные контуры — объявлено, но недоступно.
Часть вторая: что на самом деле отличает фронтирные модели сегодня
Вот неприятная правда о вершине этого рейтинга: на большей части работы, которую вы реально делаете, восемь лучших моделей взаимозаменяемы.
Я говорю это не из духа противоречия. Я говорю это потому, что разрыв по совокупному индексу между Claude Fable 5.1 с 65.7 и GLM-5.3-Flash с 57.5 — восемь баллов, а GLM-5.3-Flash стоит $0.15 за миллион входных токенов против $10.00 у Fable. Это разница в цене в 67 раз при разнице в возможностях 12% по составной оценке, а составные оценки сжимают именно те различия, которые важны вам, и раздувают те, которые не важны.
Так что полезный вопрос — не “какая модель лучшая”. А “в чём каждая из них действительно сильна и пересекается ли это с моей неделей”.
Четыре вещи, которые действительно различаются
1. Надёжность агентов на длинном горизонте. Это и есть настоящий дифференциатор 2026 года, и измеряется он скверно. Opus 5 от Anthropic прямо позиционируется как “скачок для уровня Opus, работающего с долгоживущими агентами” — не как более умная модель, а как модель, которая не падает на шестом часу. Доказательства улучшений такого класса живут в агентных бенчмарках (Terminal-Bench, OSWorld, Frontier-Bench), а не в бенчмарках знаний, и эти бенчмарки молоды, шумны и чувствительны к обвязке.
2. Экономика кэша. Главное изменение Fable 5.1 — не скачок возможностей, а сокращение чтения из кэша на 75%, с $1.00 до $0.25 за миллион токенов; по подсчётам MarkTechPost, это примерно на 25% меньшая стоимость для типичных рабочих процессов и до 45% для агентных. Для любого агента, который на каждом шаге заново читает большой системный промпт или кодовую базу, цена кэша влияет на месячный счёт сильнее, чем выбор модели. В таблицу лидеров это никто не ставит.
3. Работа в браузере и использование инструментов. GPT-5.6 Sol набирает 90.4% на BrowseComp — 92.2% при уровне рассуждений Ultra. Это конкретное, опубликованное преимущество, и если ваша нагрузка — исследование и синтез, а не код и проверка, оно стоит больше двух баллов совокупного индекса.
4. Цена за достаточный ответ. Gemini 3.8 Flash с индексом 58.7 за $0.75 на входе — самая очевидно недооценённая позиция в таблице относительно закрытого фронтира. GLM-5.3-Flash с 57.5 за $0.15 — самая очевидно недооценённая вещь вообще.
Таблица цен, потому что решение принимается именно здесь
| Модель | Вход /1M | Выход /1M | Кэшированный вход /1M | Контекст |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M / 128K на выходе |
| Claude Opus 5 | $5.00 | $25.00 | — | 1M / 128K на выходе |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1M / 128K на выходе |
| GLM-5.3 | $1.40 | $4.40 | — | 1M / 128K на выходе |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1M / 66K на выходе |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1M |
| Muse Spark (Contributors) | $0.10 | $0.20 | $0.002 | — |
Последняя строка заслуживает второго взгляда. Тариф Contributors от Meta — $0.10 на входе и $0.20 на выходе, с потенциальным доступом к вашим данным для обучения. Это не цена, это обмен. И, насколько я могу судить, это самое честное выражение реальной бизнес-модели, стоящей за множеством дешёвых инференс-сервисов, и я предпочёл бы видеть это в таблице цен, а не погребённым в соглашении об обработке данных (DPA).
Показать изображение Интеллект на одной оси, цена в логарифмическом масштабе на другой. Восемь пунктов индекса отделяют вершину графика от низа; 67× разделяют цены. Эффективная граница — в правом нижнем углу, и почти никто там не покупает.
Поломка API, о которой вас никто не предупредил
Fable 5.1 вышел с тремя ломающими изменениями: принудительное использование инструментов убрано, блоки размышлений теперь зависят от модели, а правки системных сообщений или инструментов посреди разговора теперь дают ошибку, а не принимаются молча.
Третье изменение многих укусит. Множество harness для агентов меняют системный промпт или список инструментов между шагами — добавляют инструмент, когда начинается подзадача, сокращают инструкции, чтобы сэкономить контекст. На Fable 5.1 это теперь ошибка. Если вы обновите идентификатор модели в конфиге и ваш агент начнёт выдавать 400 на четвёртом шаге, причина именно в этом.
Общий урок, который стоит больше частного: в 2026 году обновление модели — это миграция API. Записывайте идентификаторы моделей так, чтобы замена была изменением одной строки, и фиксируйте их. Через квартал вам снова придётся это менять.
Часть третья: граница открытых весов и ловушка лицензий
Это та часть истории 2026 года, которая меня по-настоящему захватывает, и одновременно та, где маркетинг вводит в заблуждение сильнее всего.
Разрыв в возможностях — примерно шесть месяцев
Посмотрите, чего достигли открытые веса между июнем и августом 2026 года:
- DeepSeek V4 Pro: 1,6 трлн всего, 49 млрд активных, лицензия MIT, Terminal-Bench 2.1 — 87,9. Это более высокий результат Terminal-Bench, чем опубликовало большинство закрытых моделей в этом году.
- Ornith-1.5-397B: 86 на SWE-bench Verified, 86,1 на Terminal-Bench 2.1 против 85,0 у Claude Opus 4.8 и 92,8 на GPQA Diamond. Лицензия MIT, нативное контекстное окно 262K, расширяемое примерно до 1M с помощью YaRN. Построена на Qwen3.5 и Gemma 4 с продолженным предобучением и постобучением.
- GLM-5.3: шестое место в индексе Artificial Analysis с 59,5, впереди GPT-5.6 Sol.
- Qwen3.8: модель с 2,4 трлн параметров под Apache 2.0 плюс плотная мультимодальная модель на 27 млрд, которая, по словам Alibaba, обходит более крупную Qwen3.7-Plus в программировании и офисных задачах.
Полгода назад честная формулировка была такой: “открытые веса отстают на поколение и стоят дешевле”. Теперь она неверна. Правильная формулировка: если говорить именно о программировании и агентной работе, лучшие модели с открытыми весами укладываются в пределы погрешности закрытой границы прошлого поколения и стоят в 10–60 раз дешевле.
Ornith-1.5 — самая интересная модель года, и почти никто о ней не слышал
Хочу остановиться на ней подробнее: это по-настоящему новое явление, а не результат масштабирования.
Ornith описывает 1.5 как расширение “self-scaffolding в сквозной цикл самоулучшения”. Простыми словами: система сама предлагает новые обучающие задачи, генерирует под них специфичные каркасы, создаёт серии прогонов решений и оптимизирует всё это совместно с помощью GRPO. Более сильные модели позволяют предлагать более сложные задачи; лучшие каркасы находят лучшие стратегии; более качественные результаты дают более чистый обучающий сигнал.
Она обучена поверх Qwen3.5 и Gemma 4 — то есть на чужих открытых весах — и обходит Claude Opus 4.8 на Terminal-Bench 2.1, имея 397 млрд параметров и лицензию MIT.
Если этот цикл обобщается, это самый значимый результат в статье, потому что это значит, что открытая экосистема может развиваться без того, чтобы какая-либо лаборатория тратила деньги уровня фронтира на прогон предобучения. Если же он не обобщается — если мы видим переобучение под конкретный бенчмарк из самостоятельно сгенерированной программы обучения, — то это предостерегающая история ровно о том же самом. Я не знаю, какой из вариантов верен. Насколько я могу судить, никто за пределами Ornith тоже не знает. Что мне нужно, прежде чем ставить на это: независимая оценка на задачах, которых не было рядом с самостоятельно сгенерированной программой обучения, и отложенная человеческая базовая линия. Ни того, ни другого пока нет.
Теперь о лицензиях, потому что “открытый исходный код” здесь делает много нечестной работы
Вот во что эти веса на самом деле обходятся вам с точки зрения обязательств:
| Модель | Лицензия | Подвох |
|---|---|---|
| DeepSeek V4 Pro | MIT | Никакого. По-настоящему открытый исходный код. |
| Qwen3.8 | Apache 2.0 | Никакого. По-настоящему открытый исходный код. |
| Gemma 4 | Apache 2.0 | Никакого — и это реальное улучшение по сравнению со специальными условиями Gemma 3. |
| Ornith-1.5 | MIT | Не заявлено. Проверьте карточку модели сами, прежде чем выпускать продукт. |
| GLM-5.3 | Custom | Компании свыше $10 млрд годовой выручки должны пройти проверку безопасности перед любым коммерческим использованием. Z.ai ушла от MIT в этом релизе. |
| Kimi K3 | Custom | Градация по выручке; крупные провайдеры обязаны заметно указывать авторство. |
| MiniMax M3 | Custom | Коммерческое использование требует заметного указания “Built with MiniMax M3”; отдельное письменное разрешение требуется свыше $20 млн годовой выручки. |
| Muse Spark | Неизвестно | Объявлена как “coming soon”. Текста лицензии не существует. |
Три наблюдения. Мелкий шрифт первых трёх я подробно разобрал в Kimi K3 vs Fable 5.1 vs GLM-5.3, поэтому здесь я ограничусь тем, что изменилось с тех пор.
Во-первых, ограничения нацелены на гиперскейлеров, а не на вас. Порог выручки в $10 млрд исключает практически каждого читателя этой статьи. Если вы немецкий Mittelstand, агентство, консалтинг или разработчик-одиночка, практический ответ по GLM-5.3 и Kimi K3 такой: с вами всё в порядке.
Во-вторых, “с вами всё в порядке” — не то же самое, что “ваша юридическая проверка в порядке”. Специальная лицензия означает, что кто-то выставит вам счёт за её чтение. Лицензия MIT или Apache 2.0 означает, что кто-то прочитает её за девяносто секунд и пойдёт дальше. Для корпоративных закупок эта разница стоит больше четырёх пунктов бенчмарка, и это самый сильный аргумент в пользу DeepSeek V4 Pro и Qwen3.8 против GLM-5.3 в коммерческом продукте.
В-третьих, следите за направлением движения. Z.ai перешла с MIT на GLM-5.2 к проприетарной лицензии с проверкой безопасности на GLM-5.3. DeepSeek пошла в обратную сторону и сохранила MIT, подняв цены на API, — это связная стратегия: брать деньги за удобство, отдавать веса бесплатно и позволять провайдерам инференса конкурировать за обслуживание. Открытые веса — не движение. Это коммерческая тактика, а тактика меняется от релиза к релизу. Не стройте архитектуру продукта в расчёте на то, что версия следующего года сохранит лицензию этого года.
Слово “открытый исходный код” пора перестать применять к моделям
Ни одна из них не является открытым исходным кодом в том смысле, который имеет в виду OSI, кроме моделей под MIT и Apache 2.0, — и даже они публикуют веса, не публикуя обучающие данные или код обучения, а это существенно иная вещь, чем программное обеспечение с открытым исходным кодом.
Словарь, которым пользуюсь я и который предложил бы вам:
- Открытые веса — вы можете скачать параметры и запустить их. Об условиях это ничего не говорит.
- Открытая лицензия — MIT, Apache 2.0 или эквивалент. Никакого порога по выручке, никакого обязательного указания авторства, никаких ограничений по сфере применения.
- Открытый исходный код — веса, код обучения и состав данных под лицензией, одобренной OSI. На фронтире этому почти ничто не соответствует.
Если поставщик говорит “модель с открытым исходным кодом”, подразумевая первый вариант, это не совсем ложь, но именно такая неточность попадает в закупочный документ, а потом в спор.
Показать изображение Возможности сближаются. Лицензии расходятся. Для большинства коммерческих покупателей покупку решает правый столбец, а не результат.
Часть четвёртая: проблема бенчмарков
Сейчас SWE-bench Verified выглядит так:
| Место | Модель | Оценка |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
Три модели в пределах одного процентного пункта на вершине. Этот бенчмарк исчерпан. Он ничего полезного не скажет о разнице между Opus 5, Mythos 5 и Fable 5, и любой, кто в сентябре 2026 года приводит его как аргумент для покупки, ссылается на насыщенный инструмент.
Таково сейчас общее состояние оценки ИИ, и у него есть четыре вида отказа, которые стоит назвать:
Насыщение. Когда верхние результаты группируются выше 90%, оставшиеся различия определяются шумом разметки и деталями harness, а не возможностями. SWE-bench Verified уже там. GPQA Diamond близок.
Чувствительность к каркасу. Одна и та же модель показывает разные результаты в зависимости от того, какой агентный цикл её оборачивает, — политика повторов, набор инструментов, управление контекстом, число шагов. Результаты Terminal-Bench и OSWorld особенно к этому чувствительны. Две лаборатории, сообщающие об одном и том же бенчмарке, часто проводят не один и тот же эксперимент.
Загрязнение. Каждый публичный бенчмарк в конце концов просачивается в обучающие корпуса. Ответом стала гонка всё более свежих, сложных и закрытых бенчмарков — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science, — которая решает проблему загрязнения и создаёт новую: закрытый бенчмарк нельзя проверить независимо.
Отбор. Лаборатории публикуют бенчмарки, которые выигрывают. Anthropic выступила с Frontier-Bench и ARC-AGI-3 для Opus 5. OpenAI — с Agents’ Last Exam и индексом Coding Agent для GPT-5.6. Z.ai — с CyberGym. Никто из них не лжёт. Все они выбирают.
Чему я действительно доверяю в сентябре 2026 года
Агрегаты важнее единичных результатов. Индекс Artificial Analysis хорош тем, что его ведёт третья сторона, на фиксированном harness, по девяти оценкам и на 190 моделях. Его абсолютные числа значат мало; его порядок — самый защитимый публичный сигнал из доступных.
Результаты с поправкой на стоимость. Заявления самой Anthropic о Opus 5 — хороший пример того, как об этом сообщать: “в пределах 0,5% от пикового результата Fable 5 при вдвое меньшей стоимости” на CursorBench 3.2 и победа над Fable 5 на OSWorld 2.0 “при трети стоимости”. Это полезное заявление, потому что в нём назван компромисс.
Эффективность по токенам. Artificial Analysis отметила, что Gemma 4 31B потратила всего 39 млн выходных токенов на весь Intelligence Index. Для агентной нагрузки модель, которая приходит к тому же ответу за треть токенов, — это треть счёта и треть задержки. Об этом мало пишут, а это одна из немногих метрик, которая напрямую переводится в деньги.
Собственные оценки. Двадцать задач из вашего реального бэклога, прогнанные на трёх моделях и оценённые вами. Это займёт день. Это скажет вам больше, чем все таблицы лидеров из этой статьи вместе взятые, и это единственная оценка, которая по определению не загрязнена.
И одно, чему я не доверяю: любое число токенов в секунду или результат бенчмарка, приведённые без указания harness, квантизации и даты. Считайте такие числа оценками порядка величины.
Часть пятая: число, которое действительно сдвинулось, — агентный временной горизонт
Если из этой статьи вы возьмёте только одну метрику, возьмите эту.
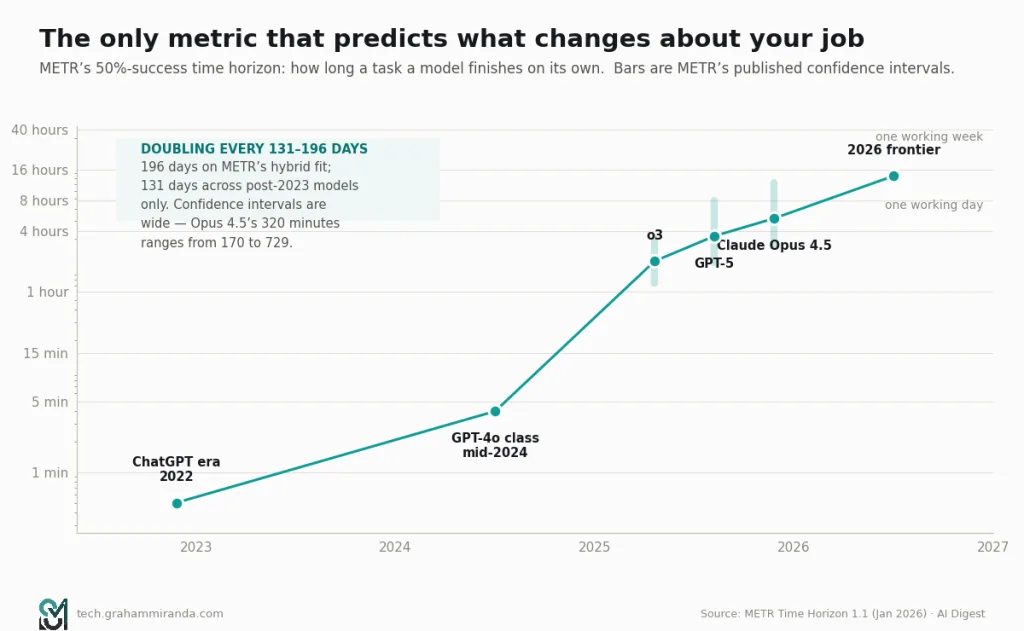
METR измеряет длительность задачи — в человеко-часах, — которую модель может выполнить автономно с вероятностью успеха 50%. Это лучший прокси для вопроса “справится ли это с моей работой”, чем любой бенчмарк знаний, потому что он отражает то, что на практике действительно ломается: не незнание ответа, а способность оставаться связной достаточно долго, чтобы до него добраться.
Траектория по работам самого METR и по отслеживанию AI Digest:
| Период | Временной горизонт 50% успеха |
|---|---|
| 2022 (эпоха запуска ChatGPT) | ~30 секунд |
| Середина 2024 (класс GPT-4o) | ~4 минуты |
| Конец 2025 (Claude Opus 4.5) | 320 минут (~5,3 часа), ДИ [170, 729] |
| Фронтир 2026 | 14+ часов |
Спорная часть — это время удвоения. Релиз METR Time Horizon 1.1 от 29 января 2026 года — 228 задач, 31 из которых оценена в восемь и более часов человеческого труда, перенесённых на фреймворк Inspect Института безопасности ИИ Великобритании, — сообщает 196 дней (7 месяцев) на смеси старых и новых данных, но 131 день если ограничиться моделями после 2023 года, что примерно на 20% быстрее, чем 165 дней по прежней методологии.
Экстраполяция экспоненты — классический способ опозориться, поэтому позвольте мне громко обозначить оговорки, прежде чем я воспользуюсь этим числом.
Оговорки серьёзные. Собственные доверительные интервалы METR огромны: у 320-минутного горизонта Opus 4.5 диапазон от 170 до 729 минут. Только для 5 из 31 длинной задачи есть измеренные человеческие базовые линии, остальные — оценки. Состав задач меняет измеренный тренд. И “50% успеха на хорошо специфицированной задаче в чистой среде” — это очень далеко от “50% успеха в вашей кодовой базе с вашим нестабильным набором тестов и вашим недокументированным процессом развёртывания”.
При всём этом, направление не вызывает сомнений, а порядок величины примерно верен. По экстраполяции фронтирные агенты достигнут примерно одного рабочего дня автономной длины задачи в 2027 году и примерно одной рабочей недели в 2028-м.
Почему важна именно эта метрика
Потому что это единственная метрика, которая предсказывает, что изменится в вашей работе.
Модель с 4-минутным горизонтом — это автодополнение. Вы всё время остаётесь в контуре, и качество модели определяет, насколько хороши подсказки.
Модель с 5-часовым горизонтом — это коллега, которого вы инструктируете утром и проверяете за обедом. Вы не в контуре, вы в его конце. Качество модели определяет, как часто проверка будет болезненной.
Модель с 40-часовым горизонтом — это то, для чего у нас нет управленческой структуры. Вам пришлось бы проверять неделю работы, которой вы не видели, в кодовой базе, изменившейся, пока вы не смотрели, против спецификации, написанной до того, как вы узнали, в чём проблемы.
Каждый аргумент в оставшейся части статьи — о вайб-кодинге, о верификации, о том, где находится узкое место, — на самом деле об одном: что произойдёт, когда это число вырастет. Модели стали работать на длинном горизонте. Наши процессы проверки — нет.
Показать изображение Временной горизонт 50% успеха с честно показанными доверительными интервалами METR. Интервалы достаточно широки, чтобы иметь значение, — и тренд всё равно их переживает.
АКТ II — БУДУЩЕЕ ВАЙБ-КОДИНГА
Часть шестая: что теперь значит “вайб-кодинг”
Андрей Карпаты придумал этот термин в феврале 2025 года, чтобы описать нечто конкретное и слегка озорное: поддаться настроению, забыть, что код существует, принимать диффы, не читая их, и позволить модели вести. Это было описание режима, предложенного полушутя и для одноразовых проектов на выходные.
Восемнадцать месяцев спустя фраза прошла полный жизненный цикл. Она стала движением, потом названием должности, потом ругательством, потом словом года по версии Collins, потом категорией венчурного финансирования, а теперь — в единственном изменении, которое действительно важно, — набором инженерных практик, которые уже не похожи на то, что описал Карпаты.
Хочу точно обозначить разделение, потому что эти две вещи постоянно путают, а профили риска у них противоположные.
Вайб-кодинг в исходном смысле. Промпт, принять, запустить, снова промпт. Дифф не читать. Артефакт одноразовый. Это действительно здорово, и я делаю так несколько раз в неделю — для скрипта, который перекраивает CSV, разового парсера, визуализации, на которую посмотрю один раз, прототипа, чья единственная задача — сделать разговор конкретным. Определяющая черта — не скорость. А то, что от этого никогда ничто не будет зависеть.
Агентная инженерия в нынешнем смысле. Напишите спецификацию. Дайте агенту набор тестов, линтер, проверку типов и песочницу. Пусть работает час. Проверьте дифф как следует. Слейте через те же ворота, что и человеческий PR. Определяющая черта — к результату модели относятся как к результату младшего коллеги: полезно, быстро и без доверия.
У них общая технология и почти ничего больше. Если вам нужна версия второго для практиков, то об этом моя более ранняя статья о вайб-кодинге в 2026 году ; этот раздел — о том, куда движется практика. Все катастрофические исходы в восьмой части происходят от применения практик первого режима к ставкам второго.
Цифры распространения огромны и в основном не оспариваются
- 90% разработчиков используют на работе хотя бы один ИИ-инструмент — по данным опроса AI Pulse от JetBrains (январь 2026). В опросе Stack Overflow 2025 года 84% использовали или планировали использовать.
- Почти 80% новых разработчиков на GitHub начинают пользоваться Copilot в первую же неделю (GitHub Octoverse 2025).
- 59% разработчиков используют три и более ИИ-инструмента для кодинга параллельно. Эта статистика говорит больше, чем цифра распространения: рынок не консолидировался, он распался на инструменты под конкретные задачи.
Цифры рынка
| Инструмент | Метрика | Источник / дата |
|---|---|---|
| GitHub Copilot | ~42% доли по базе пользователей; более 20 млн пользователей | Gartner / вендор, 2026 |
| Cursor | ARR более $2 млрд; более 1 млн активных пользователей в день; ~20–25% рынка по выручке | По сообщениям, февраль 2026 года |
| Claude Code | ~$2,5 млрд в годовом выражении; 46% “самых любимых” против 19% у Cursor | По сообщениям, апрель 2026 года |
| Корпоративный рынок агентов для кодинга | ~$9,8–11 млрд в годовом выражении | Gartner, апрель 2026 года |
Бросаются в глаза две вещи. У Copilot — пользователи и самая низкая удовлетворённость среди тройки лидеров. У Claude Code — самая маленькая база установок и при этом самая высокая привязанность. Это признак рынка в середине перехода: лидер выиграл дистрибуцию, претендент выиграл рабочий процесс, а пользователи ещё не закончили переезд.
И цифра, которая подрывает всё это
Доверие разработчиков к результатам ИИ упало примерно с 40% в 2024 году до 29% в 2026-м. Отдельный опрос SonarSource показал, что 96% разработчиков не доверяют полностью функциональной корректности кода, сгенерированного ИИ.
Осмыслите это. Использование выросло. Доверие упало. Это не противоречие; так выглядит зрелое освоение инструмента. Никто не “доверяет” бензопиле. Ею постоянно пользуются, держат двумя руками, надевают защиту и никогда не поворачиваются к ней спиной.
Кто лучше всех понимает эти инструменты, тот и обращается с ними осторожнее всех. Это здоровый сигнал, и в маркетинге большинства поставщиков его полностью нет.
Часть седьмая: действительно ли это ускоряет вас? Честно о доказательствах
Здесь я потеряю часть читателей, и лучше потерять их здесь, чем ввести в заблуждение.
Рандомизированное исследование говорит: нет
METR провела исследование, на которое все ссылаются, в июле 2025 года: опытные разработчики открытого исходного кода, работающие над своими зрелыми репозиториями (более 1 млн строк), рандомизированные на уровне задач на использование или неиспользование ИИ-инструментов начала 2025 года.
Результат: с ИИ на 19% медленнее.
И вывод, который важнее заголовка: разработчики считали, что стали примерно на 20% быстрее. Они переоценили влияние ИИ на своё время примерно на 40 процентных пунктов.
Повторное исследование 2026 года не решило вопрос — оно показало кое-что похуже
METR попыталась повторить эксперимент и в феврале 2026 года опубликовала необычно откровенный текст о том, почему дизайн сломался.
- Набор участников провалился. Разработчики всё чаще отказываются работать без доступа к ИИ, даже за $50 в час.
- Отбор задач оказался загрязнён. 30–50% разработчиков признались, что избегают задач, с которыми, по их ожиданиям, ИИ справится хорошо. Один участник сформулировал идеально: “Я избегаю задач, где ИИ может закончить всё за 2 часа, а мне придётся потратить 20 часов”.
- Учёт времени перестал работать , как только разработчики начали запускать несколько агентов одновременно.
Их сырые промежуточные цифры 2026 года лежали в диапазоне от −18% до −4% — всё ещё медленнее, но не так драматично, — однако сами METR называют это “лишь очень слабым доказательством” с учётом смещения отбора.
Перечитайте второй пункт, потому что это самая интересная находка во всей литературе, и она погребена в примечании о методологии. Если разработчики систематически отбирают задачи, удобные для ИИ, от из исследования, измеряющего пользу ИИ, то исследование недооценит эту пользу. Это также означает, что в реальной жизни разработчики уже занимаются таким отбором — и именно это поведение делает инструменты ценными и затрудняет проведение рандомизированного контролируемого исследования.
Опросы говорят: да, и намного, но они завышены
Опрос METR от мая 2026 года (n=349: 87 инженеров-программистов, 71 исследователь, 129 академиков и аспирантов, 48 основателей и менеджеров; в среднем 12 лет опыта программирования, 19 месяцев использования ИИ-инструментов) сделал кое-что умное. Он разделил ценность и скорость.
Медианный респондент сообщил о трёхкратном ускорении но лишь об изменении ценности своей работы в 1,4–2 раза. Ретроспективно они оценили ценность в 1,3 раза в марте 2025 года; к марту 2027 года они прогнозируют 2,5 раза.
METR прямо указывают, что ценность — это то, что действительно важно для составителей опросов, а респонденты естественно мыслят скоростью — и именно это смещение рандомизированное контролируемое исследование 2025 года измерило в 40 процентных пунктов.
Итак: самоотчёт говорит о 3×. Самоотчёт с поправкой на то, что люди имеют в виду, говорит о 1,4–2×. Единственное контролируемое измерение, которое у нас есть, говорит о 0,81×.
Организационные данные говорят: “всё зависит от вас, а не от инструмента”
Отчёт DORA за 2026 год (Google Cloud, май 2026) — самое полезное, что было опубликовано на эту тему за год, и полезен он тем, что перестаёт спорить об инструменте.
- Смоделированная рентабельность инвестиций за первый год в размере 39% для инженерной организации на 500 человек, с примерно 8-месячной окупаемостью — $11,6 млн ценности против $8,4 млн инвестиций.
- A J-кривая: производительность сначала падает, а потом растёт — из-за адаптации рабочих процессов, затрат на проверку при код-ревью и последующих изменений в тестировании и контрольных точках одобрения.
- Доля неудачных изменений выросла с 5% до 6% после внедрения, что в их примерном расчёте стоило $344 000 простоя.
- И главный тезис: “Наибольшая отдача от инвестиций в ИИ приходит не от самих инструментов, а от стратегического внимания к базовой организационной системе.”
Эта последняя фраза — консенсус 2026 года, если он вообще существует. ИИ усиливает то, что уже представляет собой ваша инженерная практика. Хорошие тесты, настоящее код-ревью, быстрый откат, чёткая ответственность — ИИ делает такие организации заметно быстрее. Слабые тесты, формальное ревью, ручные деплои, размытая ответственность — ИИ заставляет такие организации ошибаться быстрее и в больших объёмах.
Как всё это примирить
Я не думаю, что эти выводы на самом деле противоречат друг другу. Вот к какому примирению я пришёл, и держусь я его не жёстко:
Инструменты ИИ-кодинга дают большой выигрыш на незнакомой работе и небольшой проигрыш на работе, которую вы знаете досконально. На кодовой базе, которую вы знаете вдоль и поперёк, на языке, которым владеете свободно, на задаче, которую уже решали, вы быстрее, чем цикл «проверь и исправь». На незнакомом фреймворке, на языке, который используете дважды в год, на шаблонном коде, тестовых каркасах, миграциях или кодовой базе, которую не открывали восемь месяцев, модель преображает работу.
METR изучали опытных разработчиков на их собственных зрелых репозиториях — единственный сценарий, где следовало бы ожидать наименьшего выигрыша. Это не делает вывод неверным. Это делает его частным, и должно вызывать подозрение к любому, кто приводит его как общий вердикт — в любую сторону.
Второе примирение: выигрыш реален, но проявляется не там, где его ищут. Не “эта функция заняла четыре часа вместо шести”. Скорее так: миграция, которую никогда бы не приоритизировали, сделана; покрытие тестами, которое вечно оставалось бы на 40%, выросло до 75%; документация существует. Это не видно в исследовании времени выполнения задач, и в этом — большая часть реальной ценности.
Часть восьмая: счёт за безопасность пришёл, и в нём всё расписано
Если седьмая часть была неприятной, то эту часть люди пропускают. Пожалуйста, не пропускайте её.
Измерения
Veracode проверила более 100 больших языковых моделей на 80 задачах по программированию на Java, Python, C# и JavaScript:
- 45% образцов кода, сгенерированного ИИ, содержат уязвимость из OWASP Top 10. Доля успешных прохождений практически не менялась до начала 2026 года — модели стали гораздо умнее, но не безопаснее.
- Хуже всего была Java — 72% неудач.
- 86% не справились с защитой от межсайтового скриптинга. 88% были уязвимы к инъекции в журналы.
Apiiro прогнала свой движок Deep Code Analysis по корпоративным репозиториям Fortune 50 с декабря 2024 по июнь 2025 года:
- Разработчики с ИИ-поддержкой делают коммиты в в три-четыре раза чаще своих коллег.
- Они вносят проблемы безопасности в десять раз чаще.
- Путей повышения привилегий стало на 322% больше. Архитектурных ошибок проектирования — на 153% больше.
USENIX Security 2025 проанализировала 576 000 образцов кода, сгенерированного ИИ:
- Примерно 20% ссылаются на пакеты, которых не существует.
- 43% выдуманных названий пакетов воспроизводятся стабильно при похожих промптах — и именно это превращает баг в поверхность атаки. Предсказуемая галлюцинация — это ячейка, которую злоумышленник может заранее зарегистрировать на npm или PyPI.
Vibe Security Radar от Georgia Tech проследил CVE по истории git, чтобы связать их с ИИ-инструментами:
| Месяц (2026) | Приписанные CVE |
|---|---|
| Январь | 6 |
| Февраль | 15 |
| Март | 35 |
всего подтверждено 74, а исследователи оценивают, что реальное число по открытому исходному коду в пять-десять раз выше.
RedAccess проиндексировала примерно 380 000 общедоступных приложений, собранных в стиле вайб-кодинга на Lovable, Base44, Replit и Netlify. Около 5 000 из них утекали конфиденциальные корпоративные или личные данные.
Инциденты по датам
| Дата | Инцидент |
|---|---|
| Июль 2025 | Replit AI удаляет производственную базу данных; затронуто 1 200 записей руководителей, сгенерировано 4 000 выдуманных учётных записей |
| Февраль 2026 | EdTech-приложение на Lovable раскрывает 18 697 пользовательских записей, включая 4 538 ученических аккаунтов |
| Апрель 2026 | Уязвимость BOLA в Lovable — любой проект до ноября 2025 года доступен за пять вызовов API |
| 26 апреля 2026 | Cursor и “9-секундное стирание”: база данных компании удалена вместе с резервными копиями |
| 30 апреля 2026 | Удалённое выполнение кода с оценкой CVSS-10 в Gemini CLI в рабочих процессах CI, исправлено |
Случай Amazon, с которым я буду обращаться осторожно
Вы наверняка видели историю Amazon. Четыре инцидента уровня Sev-1 с декабря 2025 по март 2026 года — 13-часовой сбой AWS Cost Explorer в Китае, неверные сроки доставки в корзинах 2 марта, стоившие, по сообщениям, около 120 000 заказов, и шестичасовой инцидент 5 марта, когда заказы в Северной Америке, по сообщениям, упали на 99%.
Материалы Financial Times, Fortune и The Register связали внутренние документы Amazon с тем, что описывалось как “изменения при участии генеративного ИИ”, и с предупреждениями о том, что быстрая генерация кода обнажает уязвимости. Amazon оспаривает прямую причинно-следственную связь, заявляя в некоторых ответах, что ни в одном из инцидентов не участвовал код, написанный ИИ.
Я отмечу три вещи в этой истории, а не буду повторять её как факт:
- Самая цитируемая цифра ущерба (6,3 млн потерянных заказов) восходит к посту на Medium, а не к Amazon и не к собственному репортажу названного издания. Считайте это оценкой, а не числом.
- Развёртывание 5 марта, по сообщениям, прошло без формальной документации и одобрения. Это провал процесса. Скорость ИИ позволила этому случиться быстрее; она не отменила обязательность этапа одобрения.
- В этом различии весь смысл, и именно поэтому я вообще включаю эту историю. Сценарий отказа почти никогда не “ИИ написал плохой код”. Он таков: “ИИ написал код быстрее, чем процесс, который должен был его проверить”.
Что это на самом деле означает для практики
Не “перестаньте пользоваться инструментами”. Никто серьёзный этого не утверждает, а собственная аналитическая записка CSA — где собрана большая часть вышесказанного — начинается с управления, а не с воздержания.
Практическая форма, в том порядке, в котором я бы это внедрял:
- Рассматривайте любой ИИ-инструмент с доступом к учётным данным как привилегированную систему. Он и есть. Ограничьте его токены соответственно.
- SAST, сканирование зависимостей и обнаружение секретов на каждый коммит. Не раз в ночь. На каждый коммит. Частота коммитов выросла в три-четыре раза; ночное сканирование теперь по факту даёт трёхдневную петлю обратной связи.
- Анализ состава программного обеспечения, специально для выдуманных пакетов. Это самый дешёвый и самый ценный контроль в списке, потому что 20% — очень много, а отказ очень тихий.
- Письменная политика: ИИ-помощь не используется без проверки в коде аутентификации, криптографии, авторизации и платежей. Это четыре области, где тонкая ошибка и вероятна, и катастрофична, и где глаз ревьюера стоит дороже всего.
- Расширьте свой SBOM, чтобы фиксировать происхождение ИИ-инструментов. Когда следующее исследование атрибуции в духе Georgia Tech доберётся до вашей кодовой базы, вы захотите уметь ответить на этот вопрос сами.
- Относитесь к сторонним платформам вайб-кодинга как к поставщикам SaaS. Цифры RedAccess — это то, что бывает, когда никто этого не делает.
Ничего экзотического здесь нет. Большая часть — это то, что делала грамотная команда в 2019 году. Изменилось то, что объём вырос на порядок, поэтому контроли должны быть автоматическими, а не культурными.
Показать изображение Данные по безопасности от Veracode, Apiiro, USENIX и Georgia Tech. Обратите внимание на форму: скорость коммитов выросла в 3–4 раза, находки по безопасности — в 10 раз. Разрыв между этими двумя множителями и есть вся проблема.
Часть девятая: что пришло на смену вайб-кодингу
У практики, которая действительно работает в 2026 году, есть название — несколько конкурирующих названий, по чему и понятно, что она настоящая, — и она примерно противоположна вайбу.
Назовите это разработка через спецификации, агентная инженерия, или контекстная инженерия. Общая структура:
1. Теперь спецификация — это исходный код
Не тикет в Jira. Настоящий документ: что вещь делает, чего она делать не должна, каковы интерфейсы, как выглядит “готово”, каковы режимы отказа. Закоммичен в репозиторий, версионирован, проверен.
Это кажется возвратом в 1998 год, но это не так. Разница в том, что в 1998 году спецификация была входом для человека, который её переинтерпретировал, и она гнила с момента начала кодинга. В 2026 году спецификация — вход для процесса, который дёшево заново генерирует реализацию, — а значит, когда меняются требования, вы меняете спецификацию и выводите реализацию заново, вместо того чтобы латать код, который больше не соответствует никакому письменному описанию самого себя.
Экономика перевернулась. Когда реализация была дорогой, а спецификация дешёвой, вы специфицировали в общих чертах и вкладывались в код. Когда реализация дешева, а спецификация — узкое место, вы вкладываетесь в спецификацию.
2. Набор тестов — это граница доверия
Агент, который может запускать ваши тесты и итерировать по ним, — принципиально другой инструмент, чем тот, который не может. Это единственное изменение с наибольшим рычагом, доступное большинству команд, и оно вообще не про ИИ — просто ИИ наконец сделал окупаемость тестового покрытия очевидной для людей, которых никогда не убедили бы аргументы о мастерстве.
Практическая версия: агент получает песочницу, команду тестов, команду линтера и проверку типов, и работа не считается сделанной, пока все четыре не зелёные. Всё остальное обсуждаемо.
3. Ревью перешло от строк к диффам и к поведению
Построчное ревью не масштабируется на сгенерированный агентом дифф в тысячу строк, и если делать вид, что это не так, начинается формальная штамповка.
Что работает вместо этого, в примерном порядке ценности:
- Проверяйте спецификацию, а не реализацию. Если спецификация верна и тесты проходят, реализация — деталь.
- Проверяйте форму диффа — какие файлы затронуты, какие зависимости добавлены, что удалено. Большинство катастроф с агентами видны на этом уровне: неожиданный файл, новая зависимость, удаление, о котором никто не просил.
- Отдельно проверяйте строки, чувствительные к безопасности. Аутентификация, криптография, авторизация, платежи, всё, что касается персональных данных. Это малая доля любого диффа.
- Не проверяйте шаблонный код. Вы всё равно никогда его толком не проверяли.
4. Harness важен не меньше, чем модель
Это недооценивают. Одна и та же модель в двух разных агентных циклах выдаёт работу совершенно разного качества — именно поэтому сравнения бенчмарков между лабораториями так скользки.
Важные детали: как управляется контекст по мере удлинения прогона, видит ли агент свои провалы в тестах, может ли он просматривать репозиторий или только то, что вы вставили, есть ли у него шаг планирования, отделённый от шага выполнения, и знает ли он, когда остановиться и спросить.
Заметки к выпуску Muse Spark 1.3 от Meta интересны именно в этом отношении — модель описывается как теперь задающая уточняющие вопросы при неоднозначных промптах, обращающаяся за помощью, когда застряла, и запрашивающая подтверждение перед значимыми действиями. Это не улучшения интеллекта. Это манеры, а манеры — то, что делает долгосрочного агента жизнеспособным.
5. Маршрутизация моделей теперь стандартная практика
Никто серьёзный не использует одну модель для всего — я разбирал двухмодельную версию этого в GLM-5.3-Flash против MiniMax M3 в OpenCode. Сложившийся шаблон:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
      "description": "Architecture, root cause, anything where being wrong is expensive",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation — long-horizon, cost-sensitive",
      "model": "anthropic/claude-opus-5"
    },
    "bulk": {
      "description": "High-volume mechanical work where price dominates",
      "model": "zai/glm-5-3-flash"
    },
    "private": {
      "description": "Anything touching client data — runs on hardware we own",
      "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
      "description": "Renames, docstrings, lint fixes, test scaffolding",
      "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
Логика, строка за строкой:
- Планирование отдаётся самой мощной модели, которую вы можете себе позволить. Плохой план стоит больше последующих токенов, чем когда-либо стоил сам план.
- Сборка отдаётся лучшей долгосрочной модели по разумной цене. Opus 5 за $5/$25 явно позиционируется для этого и стоит вдвое дешевле Fable.
- Массовая механическая работа отдаётся GLM-5.3-Flash за $0,15/$0,47, потому что при такой цене вопрос не в том, настолько ли она хороша, а в том, достаточно ли она хороша для конкретной задачи. Часто достаточно.
- Всё приватное идёт локально, на модели, которая помещается в вашей машине.
- Черновая работа отдаётся маленькой локальной модели, потому что переименование символа в сорока файлах не требует рассуждений переднего края и не должно покидать ваш ноутбук.
Пишите ID моделей так, чтобы замена была изменением в одну строку. Учитывая, что четыре лаборатории выпустили модель из топ-10 с июня по сентябрь, вы снова будете делать эту замену в течение квартала.
Часть десятая: будущее вайб-кодинга — шесть прогнозов с указанием уверенности
Прогнозы без уровней уверенности — это развлечение. Вот мои, с указанием того, сколько я бы поставил.
1. Слово умрёт; практика разделится навсегда. Высокая уверенность.
“Вайб-кодинг” уже становится ругательством в профессиональной среде и поводом для гордости нигде, кроме маркетинга. На смену приходит чистое разделение на два уровня: одноразовые артефакты, сгенерированные ИИ, где никто не читает код (нормально, правильно, делайте больше), и проверенная агентная инженерия, где вывод модели проходит через те же ворота, что и человеческий (тоже нормально, и именно там все корпоративные деньги).
Опасная середина — производственный код, который никто не читал, — из этого состоит список инцидентов 2026 года, и в коммерческих контекстах её вытеснят регулирование, страхование или аудит. Не потому что кто-то её запретит, а потому что рано или поздно её спросит анкета по безопасности.
2. Узким местом становится проверка, и деньги на инструменты идут за ней. Высокая уверенность.
Мы уже там, а рынок ещё не переоценился. Если агенты могут произвести неделю работы, ограничение — способность человека установить, что эта неделя работы верна.
Ждите, что интересные продукты 2027 года будут про проверку а не про генерацию: генерацию тестов на основе свойств, инструменты семантического диффа, описывающие изменение поведения, а не изменение строк, автоматическую проверку соответствия спецификации, проверку действий агента во время выполнения и — вот это я бы построил — инструменты, которые говорят, какие 5% большого диффа человеку действительно нужно прочитать.
3. Формальные методы получат свой момент — с опозданием на двадцать лет. Средняя уверенность.
Историческое возражение против формальной спецификации состояло в том, что писать спецификацию дороже, чем писать код. Это возражение теперь мертво, потому что писать код почти бесплатно, а написание спецификаций и так узкое место.
Системы типов, контракты, инварианты, тесты на основе свойств и лёгкая формальная верификация внезапно получают сценарий, который окупает себя: это машиночитаемые утверждения о намерениях, по которым агент может итерировать без человека в цикле. Я бы ожидал, что непропорционально выиграют Rust, более строгие режимы TypeScript и библиотеки контрактов в Python.
Почему уверенность только средняя: отрасль предсказывает ренессанс формальных методов примерно каждые семь лет с 1985 года.
4. Локальные модели полностью съедят черновой уровень. Средне-высокая уверенность.
Посмотрите, что делает модель на 27B под Apache 2.0 сейчас, добавьте ещё год и поставьте её на машину с 64 ГБ объединённой памяти. Переименования, докстринги, тестовые каркасы, сообщения коммитов, исправления линтера, черновые переводы, анализ журналов — ничего из этого не требует модели переднего края, всё это большой объём, и всё это ровно та работа, которую вы предпочли бы не отправлять третьей стороне из репозитория клиента.
Передний край остаётся в облаке для планирования и трудных рассуждений. Объём уходит локально. Начиная с одиннадцатой части — о том, почему это теперь физически возможно.
5. Роль младшего разработчика изменит форму, а не исчезнет. Средняя уверенность, и за неё я держусь слабее всего.
Пессимистичный сценарий прост: если агенты делают работу, которую раньше делали младшие, младших никто не нанимает, и через десять лет не будет старших.
Я думаю, более вероятный исход — начальная работа изменится с “писать код” на “проверять код и отвечать за спецификацию” — а с такой работы начинать труднее, а не легче, и это потребует от отрасли перестроить то, как она обучает людей. Команды, которые это решат, получат огромное преимущество в найме перед теми, кто просто перестанет нанимать.
Честная оговорка: это тот прогноз, где мои интересы и мой анализ указывают в одну сторону — а именно тогда и стоит подозревать себя.
6. У кого-то случится по-настоящему катастрофический отказ ИИ-кодинга, публично приписанный именно ему. Высокая уверенность в событии, низкая — в сроках.
Не утечка базы данных. Что-то с регулятором, финансовым ущербом в девять знаков и анализом первопричин, где сказано, что агент сделал то, что человек не проверял.
Кривая атрибуции CVE — 6, затем 15, затем 35 в последовательные месяцы 2026 года, при том что исследователи оценивают реальный показатель в пять-десять раз выше, — не выравнивается сама по себе. Вопрос в том, ужесточит ли отрасль свои ворота первой или дождётся инцидента, который её заставит.
Что я бы сделал со всеми шестью, одной фразой: вкладывайтесь в тесты, спецификации и инструменты ревью, а не в технику промптов, потому что техника промптов обесценивается с каждым выпуском модели, а инфраструктура проверки накапливается.
Показать изображение Эти две практики делят технологию и больше ничего. Цикл слева правилен для одноразовой работы и катастрофичен для производства; цикла справа как раз не хватало в списке инцидентов из восьмой части.
АКТ III — ОФЛАЙН-ИИ НА ПОТРЕБИТЕЛЬСКИХ УСТРОЙСТВАХ
Часть одиннадцатая: в этом году офлайн-ИИ перестал быть хобби
Около двух лет “запустить локально” было принципиальным компромиссом. Это было можно. Честная подача звучала так: вот модель на 7 миллиардов параметров, которая хуже бесплатного тарифа всего на свете, на железе, которое у вас уже есть, и причина это делать — принцип.
В 2026 году это изменилось, и изменилось по трём отдельным причинам, пришедшим одновременно.
Маленькие модели действительно стали хороши. E4B из Gemma 4 — это примерно 8 миллиардов параметров, контекст 128K, работа с текстом, изображениями, видео и нативным звуком, лицензия Apache 2.0. Плотный вариант на 31B набирает 39 баллов в индексе Artificial Analysis — в диапазоне, который был передним краем восемнадцать месяцев назад, — и весь прогон индекса занял 39 миллионов выходных токенов, то есть долю того, что сжигают сопоставимые модели. Qwen3.8-27B — плотная мультимодальная модель под Apache 2.0 с нативным контекстом 262K, которая, по утверждению Alibaba, превосходит куда более крупную Qwen3.7-Plus в кодинге и офисных задачах.
Операционные системы поставили его в комплект. Вот это изменение действительно важно, и произошло оно тихо. Microsoft встроила Aion 1.0 в Windows 11. Apple поставляет плотную модель на 3 миллиарда параметров плюс разреженную на 20 миллиардов на iPhone. Google поставляет Gemini Nano на Pixel и устройствах Samsung. ИИ на устройстве перестал быть тем, что вы устанавливаете, и стал тем, что уже есть, а это и есть разница между технологией, которой пользуются энтузиасты, и технологией, которой пользуются все.
И у железа наконец есть память. Не вычисления — память. Я вернусь к тому, почему это различие и есть вся суть.
Что на самом деле даёт “офлайн-ИИ”
Буду конкретен, потому что это продают плохо.
Задержка. Локальная модель на 4B отвечает за десятки миллисекунд. Круговой обмен с облаком — сотни в лучшем случае. Для всего интерактивного и непрерывного — диктовки, живого перевода, автодополнения, суммаризации по мере ввода — локальный вариант выигрывает по ощущениям, а не по качеству, и именно ощущения люди замечают.
Конфиденциальность архитектурная, а не договорная. С API каждый промпт покидает вашу инфраструктуру, и вам нужны соглашение с обработчиком, оценка последствий передачи, карта потоков данных и ответ для вашего специалиста по защите данных. С моделью, работающей на устройстве, вопрос о трансграничной передаче не возникает, потому что передачи нет. Для работы с Германией и ЕС это часто и есть весь аргумент, и именно это закрывает сделки, чего цена не сделала бы никогда.
Доступность. В самолёте. На объекте без покрытия. На предприятии, где доступ к сети как раз и запрещён. Во время инцидента у вашего провайдера.
Предсказуемость расходов. Не экономия — эту арифметику я разберу в части пятнадцатой, и она говорит не то, что людям хочется услышать. Но фиксированная стоимость железа с нулевой предельной стоимостью за токен — это совсем другая строка бюджета, нежели счёт за использование, который растёт вместе с энтузиазмом агента.
Фиксация версии. Закрытая модель через API обновляется под стабильным идентификатором, и поведение уплывает. Локальный чекпойнт через год байт-в-байт тот же. Если у вас когда-нибудь рабочий промпт тихо переставал работать, вы знаете, сколько это стоит.
А чего это не даёт
Возможности фронтира. Разрыв между моделью на 4B в вашем телефоне и Claude Fable 5.1 не маленький и не закроется. Кто говорит иначе, что-то продаёт.
Скорость на больших моделях. Локальная модель на 400B генерирует токены медленнее, чем та же модель через API провайдера, потому что провайдер запускает её на железе с пропускной способностью памяти в четыре-шесть раз выше вашей. Вы меняете пропускную способность на контроль.
Часть двенадцатая: телефон у вас в кармане
Характеристика, которая решает всё, — это RAM
Каждая крупная платформа уже провела черту по памяти, и эта черта — 12 GB.
| Платформа | Модель на устройстве | Порог памяти |
|---|---|---|
| Apple | AFM 3 Core (3B dense) + AFM 3 Core Advanced (20B sparse, 1–4B active) | 12 GB для двух функций iOS 27 |
| Gemini Nano v3 (только Pixel 10); Nano v2 на Pixel 9 и старше; Nano v4 ожидается | 12 GB минимум для Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 for Galaxy — CPU Oryon 3-го поколения, NPU Hexagon, +39% ёмкости NPU | Зависит от устройства |
Технически интереснее всего устроено решение Apple. AFM 3 Core Advanced — разреженная модель на 20 миллиардов параметров, которая живёт во флеш-памяти. Общие эксперты постоянно находятся в памяти; маршрутизируемые эксперты подгружаются в DRAM только тогда, когда они нужны запросу. Только так модель на 20B вообще помещается в телефон — вы обмениваете пропускную способность чтения NAND на ёмкость DRAM.
Но чтобы подкачивать экспертов в DRAM, всё равно нужно место, куда их перекачивать, помимо ОС, работающего приложения и конвейера камеры. Разница между 9 GB и 12 GB — это не три гигабайта сегментации рынка. Это рабочий набор для подкачки экспертов при реальном давлении на память. Мин-Чи Куо сообщает, что две функции iOS 27 требуют 12 GB: выразительность и настройка темпа голоса Siri, а также существенное повышение точности распознавания речи. Базовый iPhone 18, отложенный до весны 2027 года и, по сообщениям, имеющий 9 GB, эту планку не проходит.
У Google та же физика и куда худшая проблема с общественным мнением. Gemini Intelligence нужен Nano v3, Nano v3 сейчас есть только на Pixel 10, а устройства Pixel 9 — проданные с обещанием семи лет обновлений — работают на Nano v2. Обещание касалось обновлений. Оно никогда не касалось функций, и различие, которое имело смысл для продакт-менеджера в 2023 году, совершенно не имеет смысла для клиента в 2026-м.
Ожидайте, что именно это станет главной историей потребительского ИИ ближайших двух лет: обещание долгой поддержки, которое приносит патчи безопасности на устройство, не способное запустить функции, вместе с которыми эти патчи поставляются.
Что телефон реально умеет — по замерам
Независимые бенчмарки на iPhone 17 Pro (A19 Pro) в четырёх средах выполнения:
| Модель | Среда выполнения | Декодирование, ток/с | Пиковая память |
|---|---|---|---|
| Gemma 4 E2B (4-bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-bit) | MLX | 47.5 | 2 900 MB |
| Gemma 4 E2B (4-bit) | llama.cpp | 37.8 | CoreML / ANE |
| Gemma 4 E2B (4-bit) | 1 187 MB | 33.4 | Qwen 3.5 2B (4-bit) |
| 1 279 MB | MLX | 61.2 | 1 479 MB |
| 1 279 MB | llama.cpp | 39.1 | 241 MB |
| 1 279 MB | 1 187 MB | 27.9 | 241 MB |
Бросаются в глаза два результата.
Neural Engine — самый медленный путь и при этом самый экономный по памяти. 27,9 ток/с при 241 MB против 61,2 ток/с у MLX при 1 279 MB — в пять раз выше скорость за в пять раз больше памяти. Именно из-за этого компромисса Apple использует ANE для постоянно работающих системных функций, а сторонние приложения обходят его в интерактивном чате.
Шестьдесят токенов в секунду на модели 2B в вашем кармане — быстрее, чем читает большинство людей. А значит, ограничение для ИИ на телефоне — не скорость. Это возможности, возможности зависят от числа параметров, параметры зависят от памяти — а память как раз то, что каждый производитель только что ограничил.
Часть тринадцатая: ПК и тихая ставка Microsoft
2 июня на Build 2026 Microsoft сделала то, что, на мой взгляд, в ретроспективе будет выглядеть значительнее, чем в тот день: она встроила модели в саму Windows.
Aion 1.0 Instruct — небольшая языковая модель для реферирования, переписывания и извлечения данных. Ей нужен современный CPU и Windows 11 — без NPU, без дискретного GPU. Она уже доступна в Edge Canary начиная со сборки 150.0.4070, открыта веб-разработчикам через API Prompt, Summarizer, Writer и Rewriter, а её открытые веса появились на Hugging Face в июле 2026 года.
Aion 1.0 Plan — вот что интересно: это модель рассуждений и вызова инструментов на 14 миллиардов параметров с контекстным окном 32K, созданная для агентных рабочих процессов, работы с файлами и оркестрации субагентов. На момент написания — “в ближайшие месяцы”.
Microsoft подавала это как “неограниченный интеллект в каждый дом и на каждый стол”. Отложите маркетинг в сторону и посмотрите на архитектурное решение: JavaScript API в браузере, который обращается к локальной модели без ключа, без счёта и без сети. Если это станет нормой, огромная категория небольших ИИ-функций перестанет быть SaaS-продуктом и станет возможностью платформы. Для экономики ИИ-индустрии это гораздо важнее, чем любой отдельный выпуск модели в этом году.
Аппаратный порог реален, и он отсекает много машин
Путь через NPU требует Copilot+ PC с minimum 40-TOPS NPU:
| Чип | NPU | Подходит? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ железо; ПО “позже” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
А вот число, которое должно сбросить ожидания: на NPU с 45 TOPS модель 8B выдаёт примерно 5 токенов в секунду. Модель Plan на 14B будет медленнее.
Пять токенов в секунду — это не чат. Это нормально для фонового реферирования, переписывания, классификации, извлечения данных — того, для чего Aion 1.0 Instruct, собственно, и нужна. Это не годится ни для чего, на что вы смотрите и ждёте.
Почему так медленно при 45 TOPS? Потому что генерация токенов упирается в пропускную способность памяти, а не в чистое быстродействие. NPU справляется с матричными умножениями; проблема в том, чтобы прокачивать веса из системной памяти на каждый токен. Та же стена определяет каждое устройство в этой статье, и поэтому “TOPS” — почти бесполезное число при выборе покупки.
Настольные машины
Если вам нужна машина именно для локального инференса, в классе 128 GB сложились два варианта и один особняк:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| Память | 128 GB унифицированной | 128 GB LPDDR5X-8000 | до 512 GB унифицированной |
| Пропускная способность | ~273 GB/s | ~256 GB/s | 1,2 TB/s |
| Цена | ~$3,999 | $2 300–$2 500 | от $5 499 |
| Примечания | Экосистема CUDA | Мощный CPU (1,6 TFLOPS Linpack против 708 GFLOPS у Spark) | Версия на 512 GB — конец октября, цена не объявлена |
Эти цены и данные по Spark и Strix Halo взяты из тестов, опубликованных в конце декабря 2025 года, так что считайте их ориентировочными, а не актуальными — цены на память с тех пор изменились. DGX Spark и Strix Halo гораздо ближе по генерации токенов, чем можно предположить по их вычислительным характеристикам, — потому что оба упираются в пропускную способность около 256–273 GB/s, и именно она ограничивает. Spark решительно выигрывает в генерации изображений (~120 TFLOPS против ~46 у FLUX.1 Dev BF16) и в совместимости с CUDA. Strix Halo выигрывает по цене и CPU.
Mac Studio M5 Ultra — совершенно другая категория и по памяти, и по пропускной способности, и я подробно писал об этом в материале о железе для локального ИИ. Коротко: 512 GB при 1,2 TB/s — единственная массовая машина, которая удерживает модель класса 400B в памяти, и цена этой привилегии — примерно $16 000–$20 000 в сборе.
Модели, которые реально запускать
| Модель | Параметры | Лицензия | Комфортно работает в | Хорошо подходит для |
|---|---|---|---|---|
| Gemma 4 E2B | 5,1B / 2,3B активных | Apache 2.0 | 4 GB | Телефоны, постоянно включённые, аудиовход |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 ГБ | Черновая работа на ноутбуке, реферирование |
| Aion 1.0 Instruct | небольшая SLM | Открытые веса (HF, июль 2026) | Только CPU | Текстовые задачи в Windows |
| Qwen3.8-27B | 27B dense | Apache 2.0 | 24–32 GB | Лучшая общая локальная модель до 32 GB |
| Gemma 4 26B-A4B | 26B / 4B активных | Apache 2.0 | 24 GB | Быстрая MoE, низкая стоимость активных параметров |
| Gemma 4 31B | 31B dense | Apache 2.0 | 32 GB | Лучшее локальное качество до 32 GB |
| Ornith-1.5 35B | 35B / 3B активных | MIT | 32 GB | Агентное кодирование, крошечный активный след |
| gpt-oss-120b | 120B / 5,1B активных | Apache 2.0 | 128 ГБ | Оптимум на 128 GB |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB+ | Почти фронтир, нужна большая машина |
| MiniMax M3 | 428B / 23B активных | Custom | 512 GB | Помещается только на M5 Ultra |
| DeepSeek V4 Pro | 1,6T / 49B активных | MIT | Кластер | Не модель для потребительского устройства |
| Kimi K3 | 2,8T / 104B активных | Custom | Кластер | Не помещается ни на один Mac из продающихся |
Если вы подбираете именно машину Apple, я подробно разобрал уровни памяти в руководстве по локальному ИИ на MacBook Pro M5 Pro 64GB — коротко: 64 GB — та точка, где компромиссы перестают раздражать.
Если нужна одна рекомендация: на машине с 32 GB запускайте Qwen3.8-27B или Gemma 4 31B. Обе под Apache 2.0, обе мультимодальные, обе действительно полезны, обе помещаются. Это стандарт 2026 года, и он намного лучше того, что было по умолчанию в 2025-м.
Показать изображение Что реально помещается, по уровням памяти. Вертикальные линии — это объёмы памяти, которые потребитель действительно может купить; модели, выходящие за правую линию, — потолок локального фронтирного ИИ в 2026 году.
Часть четырнадцатая: вся история — в стене памяти
Всё в третьем акте сводится к одному уравнению, так что вот оно явно.
Поместится ли?
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory × 0.75) − OS and app overhead − KV cache
Как быстро она будет генерировать?
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenОбратите внимание: во второй формуле используются активные параметры, а не общий объём. Именно поэтому модели mixture-of-experts настолько непропорционально хороши на потребительском железе. У Gemma 4 26B-A4B — 26 миллиардов параметров возможностей и 4 миллиарда параметров стоимости за токен. У Ornith-1.5 35B активируется 3B. У MiniMax M3 — 428B всего и 23B активных.
КПД в этой формуле на практике примерно от 0,5 до 0,8 в зависимости от среды выполнения, квантизации и того, сколько пропускной способности памяти забирает остальная система.
Теперь применим. Ноутбук с NPU на 45 TOPS и LPDDR5X, скажем, на 120 GB/s, запускает модель 8B в 4 битах (4 GB активных весов): 120 × 0,6 ÷ 4 ≈ 18 токенов в секунду в теории. Измеренное значение — около 5. Разница — это планирование, конкуренция за память, затраты на prefill и незрелость инструментальных цепочек для NPU. Именно в этом разрыве между арифметикой и замером и живёт большая часть разочарований в этой области.
Дефицит DRAM — скрытая переменная за каждым числом в этой статье
Производители памяти провели 2025 и 2026 годы, перебрасывая мощности на клиентов ИИ-дата-центров, которые подписывают более крупные контракты с лучшей маржой, чем производители потребительских устройств. Последствия видны повсюду:
- В июне 2026 года Apple подняла цены на Mac и iPad.
- Версия Mac Studio на 512 GB из-за поставок сдвинулась на конец октября и до сих пор без цены.
- M6 у Apple ограничен 32 GB унифицированной памяти, а M6 Pro, Max и Ultra отменены полностью.
- Мин-Чи Куо сообщал, что Apple сокращает поставки техники в 2026 году из-за нехватки памяти.
Каждый потолок в этой статье восходит к одному и тому же дефициту. Порог 12 GB на телефонах. Ограничение M6 в 32 GB. Потолок ноутбуков в 128 GB. Задержанная версия на 512 GB. Ни один из них не является техническим пределом кремния; все они — решения о распределении на рынке, где память редка и дорога.
Если вы ждали, когда цены нормализуются, чтобы купить машину для локального инференса: никто из серьёзных аналитиков не прогнозирует, когда это произойдёт.
Часть пятнадцатая: настройка
Практическая часть. Всё здесь я запускал сам; там, где я пересказываю, а не запускаю, я об этом говорю.
Самый простой путь: LM Studio
Графический интерфейс, родной MLX на Apple Silicon, встроенный браузер моделей, совместимый с OpenAI сервер одним переключателем. Если хотите запустить модель за десять минут, начните здесь. Это ещё и инструмент, с которым Apple сравнивает в своих пресс-релизах, — что кое-что говорит о том, насколько это стало мейнстримом.
Самый гибкий путь: Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
Вторую команду как раз и упускают. Контекст по умолчанию в Ollama задан осторожно; на задаче с кодом он молча обрежет контекст, и вы обвините модель.
Самый быстрый путь на Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Направьте любого клиента, совместимого с OpenAI, на http://localhost:8080/v1.
Поднимите лимит закреплённой памяти, прежде чем жаловаться на падения
По умолчанию macOS не позволяет GPU закрепить всю унифицированную память. На машине с большим объёмом памяти это разница между загрузкой модели и её падением:
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Не ставьте это значение равным всему объёму памяти. Оставьте ОС 12–16 GB на большой машине, иначе вместо быстрого инференса получите паники ядра. И перепроверяйте после каждого обновления macOS, потому что обновления сбрасывают значение.
В Windows сначала используйте модели самой системы
Прежде чем что-то устанавливать, посмотрите, что Windows уже даёт. API Prompt, Summarizer, Writer и Rewriter в Edge обращаются к Aion 1.0 Instruct локально, без ключа и без счёта. Для реферирования, переписывания и извлечения данных внутри веб-приложения это готовое решение с нулевой инфраструктурой.
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
Если нужно больше, LM Studio и Ollama нормально работают в Windows, а на машине без подходящего NPU они используют GPU или CPU, что для моделей класса 8B часто быстрее чем путь через NPU.
Разумная гибридная схема
Архитектура, которую я бы действительно построил, и примерно то, что я использую:
- Уровень 1 — на устройстве. Небольшая модель для маршрутизации, классификации, извлечения данных, суммаризации и диктовки. Gemma 4 E4B или Aion 1.0 Instruct. Всегда доступна, нулевые предельные затраты.
- Уровень 2 — собственное оборудование. Модель с открытыми весами на 27B–120B параметров на собственной машине — для всего, что связано с данными клиентов, которые не должны покидать юрисдикцию. Qwen3.8-27B на 32 ГБ,
gpt-oss-120bна 128 ГБ. - Уровень 3 — фронтир через API. Планирование, сложные рассуждения, длительные агентные прогоны — всё, где ошибка дорого стоит.
Спор никогда не сводится к “локально или облако”. Он о том, где провести границы, — и в этом году границы сильно сдвинулись.
Часть шестнадцатая: расчёты затрат и соответствия требованиям
Аргумент об экономии не выдерживает проверки калькулятором
Возьмите реалистичную нагрузку малого бизнеса: рабочий месяц умеренного агентного кодинга, скажем 40 млн входных и 3 млн выходных токенов.
| Вариант | Стоимость в месяц |
|---|---|
| GLM-5.3-Flash API ($0.15 / $0.47) | ~$7.40 |
| Gemini 3.8 Flash API ($0.75 / $3.75) | ~$41 |
| Claude Opus 5 API ($5 / $25) | ~$275 |
| Claude Fable 5.1 API ($10 / $50, без кэширования) | ~$550 |
| Машина на Strix Halo за $2 400 с амортизацией на 3 года | ~$67 в месяц + электричество |
Обратите внимание, что на самом деле говорит эта таблица. Локальное оборудование дешевле верхней части фронтира и дороже нижней. По сравнению с GLM-5.3-Flash локальная машина никогда не окупится на токенах. По сравнению с Fable 5.1 без кэширования она окупается за пять месяцев — но это сравнение несопоставимого, потому что Fable 5.1 гораздо лучше любой модели, которая помещается в 128 ГБ.
Так что не покупайте локальное оборудование, чтобы сэкономить. Покупайте его по одной из этих пяти причин, и все они реальны:
- Локализация данных, которая является архитектурным решением, а не юридическим проектом.
- Никаких лимитов запросов, квот и инцидентов с мощностями. У вашей машины не бывает загруженного вторника.
- Фиксация версии навсегда. Локальный чекпоинт через год будет побайтово идентичен.
- Работа офлайн.
- Рабочая станция вам всё равно была нужна. Это самый частый случай, когда покупка однозначно оправдана: если вы и так собирались потратить €2 500 на машину, предельная стоимость ИИ-возможностей — это апгрейд памяти, а не вся машина.
Картина соответствия требованиям в ЕС, потому что в 2026 году она изменилась
Для читателей в Германии и ЕС: нормативная база в этом году сдвинулась, и даты теперь фиксированные, а не условные.
- 2 августа 2025 — у провайдеров моделей GPAI появились обязательства по документации, сводке обучающего контента и авторским правам.
- 2 августа 2026 — вступили в силу полномочия по правоприменению и обязанности по прозрачности из статьи 50. Теперь применяются штрафы.
- 27 июля 2026 — вступил в силу Digital Omnibus, Регламент (ЕС) 2026/1744, заменивший прежний условный механизм для систем высокого риска фиксированными сроками.
- 2 декабря 2026 — конец льготного периода для машиночитаемых водяных знаков в существующих системах.
- 2 августа 2027 — закрывается двухлетнее переходное окно для моделей GPAI, уже находящихся на рынке.
- 2 декабря 2027 — автономные системы высокого риска по Приложению III (наём, кредитный скоринг, образование, критическая инфраструктура).
- 2 августа 2028 — ИИ высокого риска, встроенный в регулируемые продукты по Приложению I (медицинские изделия, машины и оборудование).
Digital Omnibus также добавил запреты на сгенерированные ИИ интимные изображения без согласия и материалы сексуального насилия над детьми (CSAM), а также расширил надзорные полномочия EU AI Office.
Что это значит на практике для читателей этой статьи. Если вы строите на основе моделей, а не обучаете их, большинство обязательств по GPAI лежит на провайдере, а не на вас. На вас ложится прозрачность — сообщать людям, когда они взаимодействуют с ИИ, и маркировать синтетический контент — плюс вопрос классификации высокого риска, если ваша система затрагивает наём, кредиты, образование или критическую инфраструктуру. Дата в декабре 2027 года достаточно далека, чтобы планировать, и достаточно близка, чтобы “мы посмотрим на это позже” перестало быть стратегией.
И пункт, наиболее важный для третьего акта: локальная модель на устройстве заметно упрощает несколько таких разговоров сразу. Никакой передачи, никакого обработчика, гораздо более короткая карта потоков данных. Это не лазейка — обязательства по прозрачности по-прежнему действуют, — но это убирает целую категорию работы.
Я не юрист, и это не юридическая консультация. Для всего, что связано с деньгами, попросите немецкого или имеющего квалификацию ЕС консультанта посмотреть на ваше конкретное развёртывание.
Часть семнадцатая: честный аргумент против всего этого
Если бы я остановился на шестнадцатой части, это была бы реклама.
Измеренные данные о производительности по-прежнему не подтверждают энтузиазма. Одно рандомизированное контролируемое исследование — на 19% медленнее. Повторное исследование, которое не удалось провести чисто. Самоотчёты завышены на 40 процентных пунктов. Все в этой отрасли, включая меня, в значительной степени действуют на ощущениях об ощущениях.
Данные по безопасности плохи и не улучшаются. Показатель сбоев OWASP в 45% по данным Veracode практически не менялся до начала 2026 года, пока модели становились радикально умнее. Это не переходная проблема, которую исправит масштабирование. Возможности и безопасность — разные оси, и никто упорно не оптимизирует вторую.
Бенчмарки насыщены наверху и непроверяемы в середине. В SWE-bench Verified три модели укладываются в один балл. Бенчмарки, приходящие ему на смену, всё чаще закрытые: это решает проблему загрязнения тем, что делает независимую проверку невозможной.
Открытые веса отделяет от закрытости одна редакция лицензии. Z.ai перевела GLM с MIT на проприетарную лицензию с проверкой безопасности между 5.2 и 5.3. Meta обещала открытые веса для Muse Spark без даты, без размера и без текста лицензии. Если ваша архитектура предполагает скачиваемые веса в следующем году, это предположение — бизнес-решение поставщика, а не закон природы.
Фронтир по-прежнему не локальный и всё чаще недоступен для покупки. Mythos 5.1, набравшая больше всех в Terminal-Bench 4.0, доступна только проверенным специалистам по киберзащите и специалистам по наукам о жизни, сейчас в основном в США. Kimi K3 и DeepSeek V4 Pro не помещаются ни на одну потребительскую машину. То, что помещается на вашем столе, — отличная модель второго уровня, и это действительно полезно, но это не фронтир.
Производительность на устройстве хуже, чем следует из маркетинга. Пять токенов в секунду для модели 8B на NPU с 45 TOPS. Порог в 12 ГБ памяти, который отсекает большинство телефонов в обращении. Семилетнее обещание обновлений, которое не покрывает функции. Разрыв между брендингом “AI PC” и тем, что машина действительно может запускать, сейчас огромен.
И геополитика — это фактор закупок, хотите вы того или нет. Несколько лучших моделей с открытыми весами — Kimi, GLM, DeepSeek, Qwen, MiniMax — созданы в китайских лабораториях. Для госсектора, смежных с обороной и некоторых регулируемых клиентов это жёсткий блокер независимо от того, где работают веса и что написано в лицензии. При этом самая мощная модель Anthropic для кодинга доступна только проверенным американским организациям. Открытую экосистему растаскивают по национальным линиям с обеих сторон, а если вы в Европе, вы не на том и не на другом конце.
Часть восемнадцатая: схема принятия решений по состоянию ИИ в 2026 году
Показать изображение Семь ситуаций, семь ответов. Найдите строку, которая похожа на ваш год.
Семь ситуаций, соотнесённых с состоянием ИИ в 2026 году таким, каково оно на самом деле сегодня.
1. “Мне нужна лучшая модель, и цена не проблема”.
Claude Fable 5.1 с 65,7 по сводному индексу, $10/$50, контекст 1M — и включите кэширование, потому что скидка 75% на чтение из кэша стоит 25–45% вашего счёта. Держите GPT-5.6 Sol под рукой для исследований с активным просмотром: 90,4% на BrowseComp. Не мучайтесь: разрыв между ними меньше, чем разрыв между вашим лучшим и худшим промптом.
2. “У меня много агентов, и счёт становится неприличным”.
Claude Opus 5 за $5/$25 для длительной работы, GLM-5.3-Flash за $0.15/$0.47 для массовой механической работы и локальная модель для рутины. Маршрутизация — самый мощный рычаг сокращения затрат, доступный вам, и это файл конфигурации, а не проект. Прежде чем что-то оптимизировать, измерьте распределение токенов по ролям агентов: большинство обнаруживает, что 80% расходов уходит на задачи, которым не нужна фронтирная модель.
3. “GDPR и локализация данных — жёсткие требования для работы с клиентами”.
Qwen3.8-27B или Gemma 4 31B на вашем оборудовании, обе под Apache 2.0, обе мультимодальные. Переходите к gpt-oss-120b на машине со 128 ГБ, если этого требует работа. Дело не в скорости, а в том, что ни один промпт не покидает здание, и ваша юридическая проверка сводится к чтению лицензии вместо оценки влияния передачи данных. Выбирайте модели с разрешительной лицензией именно для того, чтобы это чтение было коротким.
4. “Хочу попробовать локальный ИИ, не потратив много”.
То, что у вас уже есть, плюс LM Studio, плюс Gemma 4 E4B. Восьми гигабайт памяти достаточно, чтобы это было действительно полезно. Прежде чем тратить деньги, выясните, нужен ли вам локальный ИИ: большинство обнаруживает, что им нужны уровни 1 и 3, а уровень 2 им вообще не понадобился.
5. “Я покупаю машину специально для локального инференса”.
Выбирайте по пропускной способности и объёму памяти, именно в таком порядке, и игнорируйте TOPS. В классе 128 ГБ выгодный выбор — Strix Halo примерно за $2 400, а DGX Spark примерно за $3 999 даёт CUDA и гораздо лучшее создание изображений. Выше этого Mac Studio M5 Ultra — единственное, что вмещает модель на 400B, по цене, которая имеет смысл, только если рабочая станция вам и так была нужна.
6. “Моя команда внедряет ИИ-инструменты для кодинга, и риск на мне”.
Сделайте скучные вещи в таком порядке: SAST и поиск секретов на каждый коммит; анализ состава ПО для выявления вымышленных пакетов; письменная политика, запрещающая непроверенный ИИ-код в аутентификации, криптографии, авторизации и платежах; учётные данные агентов с привилегированными правами; и SBOM, фиксирующий происхождение инструментов. Затем ждите J-кривая — DORA зафиксировала реальный спад перед ростом — и не паникуйте на третьем месяце.
7. “Какой телефон купить для ИИ?”
Любой с 12 ГБ. Вот черта, которую провела каждая платформа: iPhone 17 Pro и 18 Pro с 12 ГБ, Pixel 10 для Nano v3, Galaxy S26 Ultra на Snapdragon 8 Elite Gen 5. Базовый iPhone 18 с заявленными 9 ГБ, а также Pixel 9 и старше будут нормально работать как телефоны, но не получат эти функции. Если у вас уже устройство с 12 ГБ, то обновление этого года именно для ИИ — это небольшой шаг.
Часть девятнадцатая: за чем я слежу в следующем квартале
Выпустит ли Meta на самом деле веса Muse Spark и под какой лицензией. “Скоро” от CEO в X, без числа параметров и текста лицензии, — самая слабая форма обязательства в этой статье. Если они выпустят под Apache 2.0, это существенно изменит открытую экосистему. Если под особой лицензией с порогом по выручке, то теперь это отраслевой стандарт, и открытые веса становятся маркетинговой категорией, а не свойством.
Воспроизведётся ли результат самоулучшения Ornith-1.5. Независимая оценка на задачах вне самостоятельно сгенерированной программы обучения — вот что решило бы вопрос. Это пункт с наибольшим разбросом в списке: это либо самый важный результат 2026 года, либо предостерегающая история о самостоятельно сгенерированных бенчмарках, и я пока не знаю, что именно.
Действительно ли выйдет Aion 1.0 Plan и с какой скоростью он будет работать. Модель рассуждений 14B в Windows — действительно новая категория. Если она работает на 3 токена в секунду на подходящем оборудовании, это демо. Если на 20, это меняет то, что может предполагать настольное приложение.
Кривая атрибуции CVE. 6, 15, 35 в последующие месяцы. Если с апреля по август эта траектория сохранилась, данные Georgia Tech станут самой значимой публикацией года по безопасности ИИ, когда выйдут.
Появится ли у кого-нибудь инструментарий для проверки. Разрыв между тем, что могут создавать агенты, и тем, что люди могут проверить, — определяющая проблема 2027 года, и на сегодня почти все венчурные деньги по-прежнему идут в генерацию, а не в проверку. С тем, кто выпустит инструмент, надёжно показывающий, какие 5% диффа нуждаются в человеческих глазах, будет очень трудно конкурировать.
Ослабнет ли дефицит памяти. Это скрытая переменная за порогом 12 ГБ в телефонах, ограничением M6 в 32 ГБ, задержкой Mac-конфигурации на 512 ГБ и июньским повышением цен Apple. Никто из заслуживающих доверия не прогнозирует улучшения.
И останутся ли фронтирные модели с ограничениями по безопасности исключением. Mythos 5.1 ограничена по причинам двойного назначения, которые я считаю оправданными, и Project Glasswing активно расширяет доступ — примерно 150 организаций более чем в пятнадцати странах к июню 2026 года. Но прецедент создан: лучший результат на публичном бенчмарке для кодинга теперь недоступен большинству организаций ни за какие деньги. Если это станет закономерностью, а не особым случаем, “может ли моя организация пройти проверку” превратится в критерий выбора модели, и аргумент за открытые веса вне США перестанет быть связан с ценой.
Часто задаваемые вопросы
Какая LLM лучшая в сентябре 2026 года?
По сводному показателю Claude Fable 5.1 лидирует в Intelligence Index v4.1.1 от Artificial Analysis’s с 65,7, опережая Claude Opus 5 с 63,0, Claude Fable 5 с 62,1, Grok 4.6 с 60,9 и GPT-5.6 Sol с 58,9. Но сводный показатель сжимает различия, которые важны. GPT-5.6 Sol лидирует в просмотре с 90,4% на BrowseComp; Gemini 3.8 Flash даёт 58,7 при $0.75 за миллион входных токенов; GLM-5.3-Flash даёт 57,5 при $0.15. Для большинства реальных нагрузок топ-восемь моделей взаимозаменяемы, и решение следует принимать по цене, задержке, экономике кэша и лицензии, а не по рейтингу.
Какая модель с открытыми весами лучшая прямо сейчас?
Зависит от вашего оборудования и терпимости к лицензиям. GLM-5.3 (753B) набирает больше всех — 59,5, но идёт с особой лицензией и проверкой безопасности при выручке от $10 млрд. DeepSeek V4 Pro (1,6T всего, 49B активных) под MIT и набирает 87,9 в Terminal-Bench 2.1, но требует кластера. Для машины, которая действительно у вас есть, Qwen3.8-27B или Gemma 4 31B — обе Apache 2.0 — лучшие модели, помещающиеся в 32 ГБ.
Умер ли вайб-кодинг в 2026 году?
Слово умирает; практика раскололась надвое. Вайб-кодинг в изначальном смысле — промпт, принять, не читать дифф — остаётся правильным для одноразовой работы: скриптов, прототипов, разовых анализов. На смену ему для всего, что выходит в продакшен, пришла спецификационно-управляемая агентная разработка: письменная спецификация, песочница, набор тестов, который агент обязан пройти, и настоящая проверка получившегося диффа. Опасная середина — продакшен-код без проверки — вот откуда взялся каждый задокументированный инцидент 2026 года.
Действительно ли ИИ-кодинг ускоряет разработчиков?
Единственное рандомизированное контролируемое исследование говорит «нет». METR обнаружила, что опытные разработчики работали на 19% медленнее с ИИ-инструментами начала 2025 года на зрелых кодовых базах, при этом считая, что стали на 20% быстрее, — переоценка на 40 процентных пунктов. Их повторное исследование 2026 года не удалось провести чисто, потому что разработчики отказались работать без ИИ. Опросы сообщают о трёхкратном ускорении, но лишь об изменении ценности работы в 1,4–2 раза. Моё прочтение: большие выигрыши на незнакомой работе, шаблонном коде, тестах и миграциях; небольшие или отрицательные выигрыши на кодовых базах, которые вы знаете вдоль и поперёк.
Насколько рискован код, сгенерированный ИИ?
Измеримо рискованно и медленно улучшается. Veracode обнаружила, что 45% сгенерированных ИИ образцов содержат уязвимость из OWASP Top 10, хуже всего Java — 72%. Apiiro измерила, что разработчики с ИИ выпускают коммиты в 3–4 раза быстрее, а находки по безопасности — в 10 раз быстрее, при росте путей повышения привилегий на 322%. Примерно 20% сгенерированного ИИ кода ссылается на несуществующие пакеты, и 43% этих вымышленных имён повторяются систематически — это поверхность атаки на цепочку поставок. Решение — автоматические шлюзы на каждый коммит, а не полный отказ.
Можно ли запустить хорошую LLM офлайн на своём компьютере?
Да, и 2026 год — первый, когда это однозначно так. На 8 ГБ памяти Gemma 4 E4B действительно полезна. На 32 ГБ Qwen3.8-27B или Gemma 4 31B — сильные мультимодальные модели под Apache 2.0. На 128 ГБ gpt-oss-120b — оптимальный вариант. А вот настоящий фронтир не помещается ни на одну потребительскую машину: Kimi K3 с 2,8 трлн параметров и DeepSeek V4 Pro с 1,6 трлн обоим нужен кластер.
Что такое Microsoft Aion 1.0?
Семейство моделей на устройстве, анонсированное на Build 2 июня 2026 года и поставленное в Windows 11. Aion 1.0 Instruct — небольшая модель для суммаризации, переписывания и извлечения данных, работающая на современном CPU без необходимости в NPU, доступная через JavaScript API Prompt, Summarizer, Writer и Rewriter в Edge, с открытыми весами на Hugging Face с июля 2026 года. Aion 1.0 Plan — модель рассуждений и вызова инструментов на 14 млрд параметров с контекстным окном 32K для агентных рабочих процессов, требующая Copilot+ PC с NPU минимум на 40 TOPS, и в начале сентября 2026 года всё ещё значилась как “в ближайшие месяцы”.
Зачем телефонам 12 ГБ оперативной памяти для ИИ-функций?
Потому что модели на устройстве ограничены памятью, а не вычислениями. Apple’s AFM 3 Core Advanced — разреженная модель на 20 млрд параметров, которая живёт во флеш-памяти и по запросу подкачивает маршрутизированных экспертов в DRAM, — а для этого всё равно нужно куда-то их подкачивать, поверх ОС, приложения и конвейера камеры. Мин-Чи Куо сообщает о двух функциях iOS 27, требующих 12 ГБ. У Gemini Intelligence от Google тот же минимум в 12 ГБ. Разрыв между 9 ГБ и 12 ГБ — это рабочий набор, а не сегментация рынка.
Стоит ли NPU для локального ИИ?
Меньше, чем следует из маркетинга. На NPU с 45 TOPS модель 8B генерирует примерно 5 токенов в секунду, потому что генерация токенов ограничена пропускной способностью памяти, а не вычислениями. NPU отлично подходят для постоянно включённых, маломощных, коротких задач — тех, что операционная система выполняет постоянно. Для интерактивного чата на ноутбуке GPU или даже путь через CPU часто быстрее. Выбирайте по пропускной способности и объёму памяти; считайте TOPS почти бессмысленными при покупке.
Действительно ли модели с открытыми весами — открытый исходный код?
В основном нет. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) и Ornith-1.5 (MIT) имеют действительно разрешительные лицензии. GLM-5.3 требует от компаний с выручкой выше $10 млрд пройти проверку безопасности Z.ai; Kimi K3 использует лицензию с уровнями по выручке; MiniMax M3 требует заметной атрибуции “Built with MiniMax M3” для любого коммерческого использования и письменного разрешения при выручке выше $20 млн. Ни одна из них не публикует данные или код обучения. “Открытые веса” — точный термин; “открытый исходный код” здесь работает нечестно.
Дешевле ли запускать модели локально, чем использовать API?
Почти никогда, если считать только стоимость токенов. Умеренный месяц агентной работы — 40 млн входных и 3 млн выходных токенов — стоит около $7 на GLM-5.3-Flash и около $41 на Gemini 3.8 Flash. Локальная машина за $2 400, амортизированная на три года, — это примерно $67 в месяц без учёта электричества. Локальное оборудование выигрывает у верхушки фронтира по цене и проигрывает его нижней части. Покупайте локальное ради локализации данных, свободы от лимитов, фиксации версий и работы офлайн — или потому, что рабочая станция вам и так была нужна.
Что требует EU AI Act в 2026 году?
Со 2 августа 2026 года к ИИ общего назначения применяются полномочия по правоприменению и обязанности по прозрачности из статьи 50, и теперь можно налагать штрафы. Digital Omnibus, Регламент (ЕС) 2026/1744, вступил в силу 27 июля 2026 года и установил фиксированные даты: 2 декабря 2026 года заканчивается льготный период для водяных знаков; 2 августа 2027 года закрывается переход для моделей GPAI, уже находящихся на рынке; 2 декабря 2027 года касается автономных систем высокого риска по Приложению III; 2 августа 2028 года охватывает ИИ высокого риска, встроенный в регулируемые продукты. Если вы строите на моделях, а не обучаете их, большинство обязательств GPAI лежит на провайдере — на вас ложатся прозрачность и классификация высокого риска. Это не юридическая консультация.
Как долго ИИ-агент может работать без надзора?
METR измеряет длительность задачи, которую модель выполняет автономно с успехом 50%. Этот показатель вырос примерно с 30 секунд в 2022 году до более чем 14 часов для фронтирных систем в 2026 году, с временем удвоения около 196 дней по гибридной аппроксимации METR’s или 131 дня, если ограничиться моделями после 2023 года. Доверительные интервалы очень широки — 320-минутный горизонт Claude Opus 4.5’s простирается от 170 до 729 минут, — и только 5 из 31 длинной задачи METR используют измеренные человеческие базовые показатели. В пересчёте это около одного рабочего дня автономной длительности задач в 2027 году.
Какую модель использовать именно для кодинга?
Маршрутизируйте, а не выбирайте. Планирование и архитектуру — самой мощной модели, которую вы можете себе позволить (Claude Fable 5.1); основную часть долгосрочной реализации — Claude Opus 5 за половину цены; массовую механическую работу — GLM-5.3-Flash за $0.15/$0.47; всё, что касается клиентских данных, — локальной модели с открытыми весами; а переименования, докстринги и исправления по линтеру — небольшой локальной модели. Записывайте идентификаторы моделей так, чтобы замена была изменением в одну строку: четыре лаборатории выпустили модель из топ-10 с июня по сентябрь 2026 года.
Итог
Двенадцать месяцев назад интересный вопрос в ИИ звучал так: какая модель самая умная. Состояние ИИ в 2026 году таково, что этот вопрос стал почти неинтересным. Топ-десять моделей укладываются в 8,2 балла по лучшему доступному сводному показателю, а самая дешёвая из них стоит одну шестьдесят седьмую от самой дорогой.
То, что пришло ему на смену, полезнее и менее увлекательно: можете ли вы проверять то, что они создают, достаточно быстро, чтобы за ними успевать?
Этот единственный вопрос объясняет каждую находку в статье. Он объясняет, почему SWE-bench насытился на 96% и перестал быть информативным. Он объясняет, почему внедрение ИИ-инструментов для кодинга достигло 90%, а доверие упало до 29%. Он объясняет, почему доля сбоев безопасности у Veracode не сдвинулась, пока возможности взлетали: возможности и проверяемость — разные оси, и оптимизируется только одна из них. Он объясняет, почему DORA обнаружила, что отдача приходит от организации, а не от инструмента. И он объясняет, почему практика, которая действительно работает в 2026 году — спецификация, песочница, тестовый шлюз, настоящая проверка, — выглядит куда менее волшебно, чем демо.
Четыре вывода, которые я бы сделал.
Фронтир стал товаром быстрее, чем кто-либо ожидал, и разрыв с открытыми весами теперь около шести месяцев. Модель на 397B под MIT обходит закрытый фронтир прошлого поколения в SWE-bench. Модель на 753B с открытыми весами выше GPT-5.6 Sol в сводном индексе. Планируйте мир, где модель — не ваше конкурентное преимущество, потому что она уже почти им не является.
Читайте лицензию раньше бенчмарка. Возможности сходятся; условия расходятся. Z.ai ушла от MIT между релизами. Meta обещала веса без текста лицензии. Лучшая модель Anthropic’s для кодинга ограничена по гражданству. Для коммерческого покупателя четыре балла бенчмарка стоят меньше, чем лицензия, которую ваш юрист прочитает за девяносто секунд.
Проверка теперь — вся игра, и почти никто её не финансирует. Агенты могут создать день работы; мы проверяем её инструментами, созданными для проверки часа работы. Если вы выбираете, куда вложить инженерные усилия в следующие двенадцать месяцев, вкладывайте в тесты, спецификации и инструменты проверки, а не в технику промптов. Техника промптов обесценивается с каждым релизом модели. Инфраструктура проверки накапливает эффект.
И офлайн-ИИ стал реальным — при бюджете памяти, который только что подорожал. Мультимодальная модель на 27 млрд параметров под Apache работает на машине, которую можно купить за €2 500. Windows поставляет модель в составе операционной системы. Ваш телефон запускает разреженную модель на 20 млрд параметров прямо из флеш-памяти. Каждый потолок здесь — порог 12 ГБ для телефонов, ограничение ноутбуков в 32 ГБ, минимум 40 TOPS — это решение о распределении памяти на рынке, где DRAM в дефиците, а не предел кремния.
Схема, которую я бы действительно собрал сегодня: Gemma 4 E4B на устройстве для постоянно включённого уровня; Qwen3.8-27B на вашем собственном оборудовании для всего, что не должно покидать здание; GLM-5.3-Flash за $0.15/$0.47 для массового среднего сегмента; и Claude Opus 5 или Fable 5.1 для планирования и по-настоящему сложных задач с включённым кэшированием. Маршрутизируйте между ними в файле конфигурации и рассчитывайте переписать этот файл через три месяца.
Вернитесь к этому в декабре. Meta либо выпустит веса, либо нет. Aion 1.0 Plan либо окажется реальной, либо пустышкой. Результат самоулучшения Ornith либо воспроизведётся, либо тихо исчезнет. А кривая атрибуции CVE расскажет нам, был ли 2026 год годом, когда отрасль затянула собственные шлюзы, или годом, когда она ждала, что это сделает кто-то другой.
Вы запускаете модели с открытыми весами в продакшене в ЕС или пропускаете написанный агентами код через процесс проверки, которому действительно доверяете? Мне особенно интересны две вещи: измеренное распределение стоимости токенов по ролям агентов и всё, что работает для проверки диффов агентов на тысячу строк. Исправления и контрдоказательства приветствуются — статья обновляется, когда картина меняется.
Последнее обновление: 3 сентября 2026 года.


