Português do Brasil
 English
 Deutsch
 Español
 Italiano
 Français

O argumento é assim. Uma assinatura de IA de topo custa US$ 200 por mês, o que dá US$ 2.400 por ano. Um MacBook Pro com 128 GB de memória unificada consegue rodar grandes modelos de linguagem localmente, com privacidade e sem limites de uso. Então cancele a assinatura, compre um MacBook para LLMs locais e, em um ou dois anos, ele se paga.
Você encontra versões disso por todo 2026: em vídeos no YouTube perguntando se você deveria cancelar seu plano de IA de US$ 200 e comprar um Mac de US$ 9.499, em posts no Medium que dividem o preço de um Mac por US$ 200 e em uma coluna da Forbes que fez as contas quando a Apple lançou seu novo Mac Studio em agosto. No lançamento do MacBook Pro M5 Max, o chefe de hardware da Apple, John Ternus, disse que as novas máquinas permitem aos profissionais “rodar LLMs avançados no dispositivo”.
Comprar um MacBook para LLMs locais é uma ideia perfeitamente boa para algumas pessoas. Como substituto de um plano de US$ 200 do Claude ou do ChatGPT, falha, e falha naquilo que o argumento nunca coloca no preço: qualidade. A assinatura aluga para você os melhores modelos do mundo. O Mac roda os melhores modelos que cabem em 128 GB. Desde ontem, dá para medir a distância entre essas duas coisas com mais precisão do que nunca, e ela é maior do que o hype sugere.
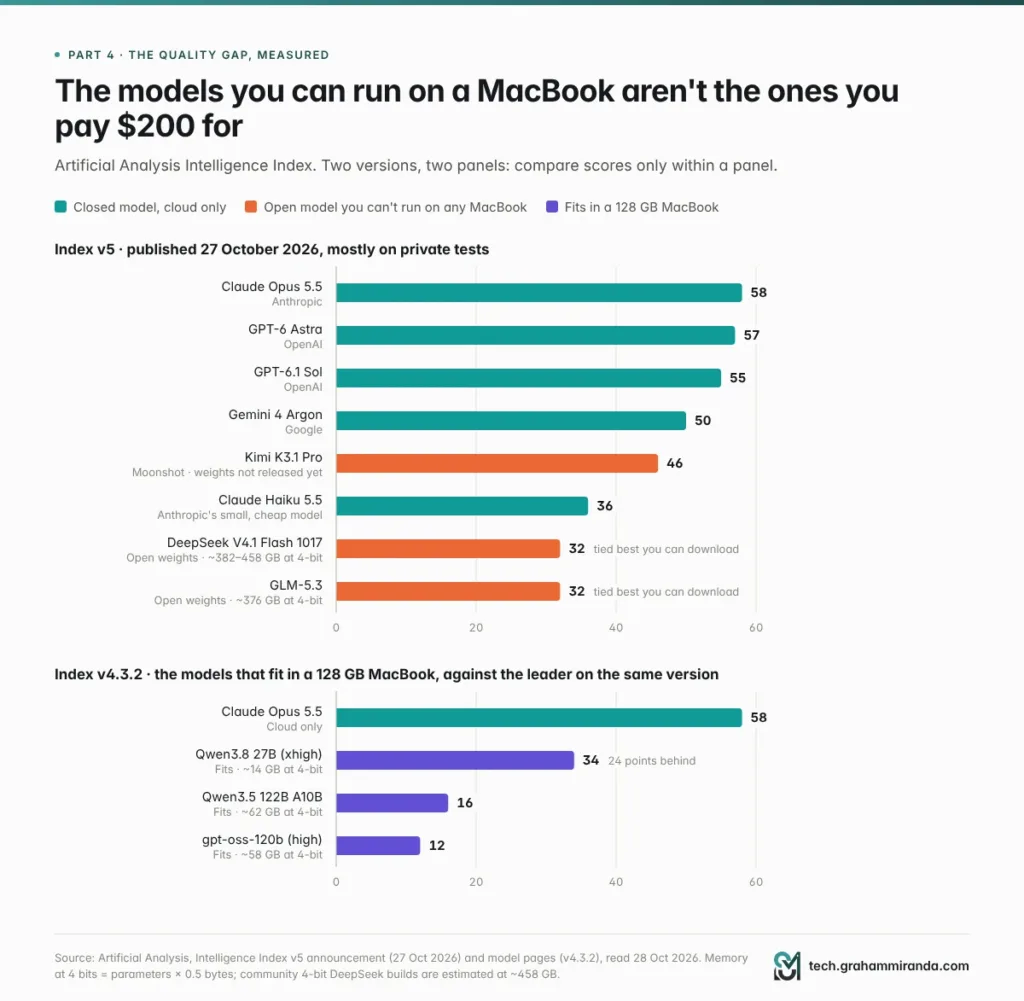
Em 27 de outubro, a Artificial Analysis reconstruiu seu Intelligence Index em torno de testes majoritariamente privados. Claude Opus 5.5 lidera com 58. Os melhores modelos de pesos abertos que você realmente consegue baixar, DeepSeek V4.1 Flash 1017 e GLM-5.3, marcam 32, abaixo do Claude Haiku 5.5, o modelo pequeno e barato da Anthropic, com 36. Nenhum desses modelos abertos cabe em qualquer MacBook: em 4 bits, eles precisam de algo entre 375 e 460 GB. O modelo mais forte que encontrei que cabe em um MacBook de 128 GB, o Qwen3.8 27B, marca 34 na versão anterior do índice, aquela em que o Opus 5.5 também marca 58.
Enquanto isso, o hardware ficou mais caro. Em junho, a Apple dobrou o preço do upgrade de memória de 128 GB no M5 Max. Um MacBook Pro de 16 polegadas com 128 GB agora custa US$ 6.999 nos Estados Unidos e, pela minha estimativa, cerca de € 8.199 na Alemanha.
Então esta é a versão honesta das contas: o que US$ 200 por mês realmente compram, o que US$ 7.000 realmente compram, qual é o tamanho da diferença de qualidade e por que ela existe, quão rápido um M5 Max é de verdade, quanto a quantização custa a você, quando comprar um Mac para IA local faz sentido e formas mais baratas de cortar uma conta de US$ 200, se é isso que você realmente quer. Cada número foi conferido na fonte em 28 de outubro de 2026.
TL;DR — A versão em 60 segundos
- Os modelos pelos quais você paga US$ 200 não podem ser baixados, e os melhores que podem ser baixados não cabem em um MacBook. No novo Intelligence Index v5 da Artificial Analysis, Claude Opus 5.5 marca 58. Os principais modelos abertos baixáveis, DeepSeek V4.1 Flash 1017 e GLM-5.3, marcam 32 e precisam de cerca de 375–460 GB de memória em 4 bits.
- O que cabe marca muito menos. O modelo mais forte que encontrei para um MacBook de 128 GB, o Qwen3.8 27B, marca 34 contra os 58 do Opus 5.5 na mesma versão do índice (v4.3.2). Os modelos da classe de 120B que realmente precisam da memória extra marcam ainda menos: 16 para o Qwen3.5 122B, 12 para o gpt-oss-120b.
- O MacBook de 128 GB ficou mais caro. A Apple dobrou o upgrade de 128 GB para US$ 2.000 em junho, então um M5 Max de 16 polegadas com 128 GB agora custa US$ 6.999 (cerca de € 8.199 na Alemanha, minha estimativa). O mesmo chip e a mesma memória em um Mac Studio custam US$ 4.799.
- O ponto de equilíbrio é de três a quatro anos, não um. Mesmo que o Mac substituísse a assinatura por completo, seriam necessários cerca de 37 meses para superar um plano de US$ 200, 41 se você mantiver um plano de US$ 20 para o trabalho pesado, e mais de seis anos contra um plano de US$ 100.
- Escrever é rápido; ler é lento. Um M5 Max gera 55–88 tokens por segundo em modelos mixture-of-experts, não muito longe dos 98 do Opus 5.5 na API da Anthropic. Mas ele precisa de 13–55 segundos só para ler um prompt de 32.000 tokens, e agentes de IA releem prompts longos o dia todo.
- Apertar modelos grandes para caber custa qualidade. A quantização em 4 bits é quase sem perdas em tarefas curtas, mas em um estudo da EMNLP 2025 custou até 59% em entradas longas, e mais ainda em idiomas diferentes do inglês. Em 3 bits, a nota de matemática de um pequeno modelo de raciocínio caiu de 85,6% para 47,0%.
- Benchmarks públicos parecem favorecer os modelos abertos. Quando a Artificial Analysis passou para testes majoritariamente privados, quatro modelos líderes de pesos abertos perderam 13 pontos em média. Quatro modelos fechados líderes quase não se moveram.
- O local ainda ganha em privacidade, uso offline, ausência de limites de taxa e tarefas em volume, e quando você já ia comprar um Mac de qualquer jeito. Compre por esses motivos, não para cancelar uma assinatura.
- Existem formas mais baratas de economizar. Desça para a faixa de US$ 100 e economize US$ 1.200 por ano, pague por token pelos modelos abertos (o DeepSeek V4.1 Flash custa US$ 0,60 por milhão de tokens de saída fora de pico) ou use um plano de programação a partir de US$ 18 por mês.
O argumento vs. a realidade
| O argumento | A realidade, outubro de 2026 |
|---|---|
| “Ele se paga em um ano” | Um MacBook Pro de 16 polegadas com 128 GB custa US$ 6.999. A US$ 200 por mês, isso dá 35 meses antes da eletricidade, e 41 meses quando você soma o plano de US$ 20 que vai manter para tarefas difíceis |
| “Os modelos locais agora são basicamente tão bons” | O Opus 5.5 marca 58. O melhor modelo que cabe em 128 GB marca 34 (Qwen3.8 27B, índice v4.3.2). Os melhores modelos abertos baixáveis marcam 32 no novo v5 |
| “128 GB rodam os grandes modelos abertos” | GLM-5.3 precisa de cerca de 376 GB em 4 bits, DeepSeek V4.1 Flash de cerca de 380–460 GB, Kimi K3 de cerca de 1,5 TB. Nenhum cabe em qualquer MacBook |
| “O M5 Max é rápido” | Ao escrever, sim: 55–88 tokens por segundo em modelos mixture-of-experts. Ao ler um prompt de 32K tokens: 13 a 55 segundos |
| “4 bits é sem perdas” | Em benchmarks curtos, quase. Em entradas acima de 64K tokens, até 59% pior em um estudo, e pior ainda fora do inglês |
| “Sem limites, privacidade total” | Verdade. É o motivo real para comprar um |
Índice
- TL;DR — A versão em 60 segundos
- O argumento vs. a realidade
- Parte 1 — O argumento de “cancele seu plano de US$ 200”, e por que ele parece tão certo
- Parte 2 — O que US$ 200 por mês realmente compram em outubro de 2026
- Parte 3 — Quanto custa hoje um MacBook de 128 GB
- Parte 4 — A diferença de qualidade, medida
- Parte 5 — Por que os modelos que você realmente quer não cabem
- Parte 6 — Quantização: o imposto de qualidade que você paga para caber
- Parte 7 — Velocidade: rápido para escrever, lento para ler
- Parte 8 — O problema do laptop
- Parte 9 — A lacuna de software: o que você teria que reconstruir
- Parte 10 — As contas do ponto de equilíbrio, feitas com honestidade
- Parte 11 — O caso justo: quando comprar um Mac para IA local faz sentido
- Parte 12 — Formas mais baratas de cortar uma conta de IA de US$ 200
- Parte 13 — Você deve comprar um MacBook para LLMs locais? Um guia de decisão
- Parte 14 — Se você comprar um mesmo assim: como aproveitar ao máximo
- Perguntas frequentes
- Um MacBook pode substituir uma assinatura ChatGPT Pro ou Claude Max?
- Qual é o melhor LLM local para um MacBook Pro de 128 GB em 2026?
- Quanto custa hoje um MacBook Pro com 128 GB?
- Quanto tempo um MacBook leva para se pagar em comparação com uma assinatura de IA de US$ 200?
- O M5 Max é rápido o suficiente para LLMs locais?
- Os LLMs locais são tão bons quanto o ChatGPT ou o Claude hoje?
- A quantização deixa os modelos locais piores?
- Consigo rodar DeepSeek V4.1 Flash ou GLM-5.3 em um MacBook?
- 64 GB bastam para IA local, ou preciso de 128 GB?
- Devo comprar um Mac Studio em vez de um MacBook Pro para LLMs locais?
- Rodar IA localmente é melhor para privacidade e GDPR?
- Posso usar o Claude Code com um modelo local?
- O novo MacBook Pro OLED vai mudar algo disso?
- A conclusão
Parte 1 — O argumento de “cancele seu plano de US$ 200”, e por que ele parece tão certo
Comece por entender por que esse argumento se espalha tão bem, porque a maior parte dele é razoável.
Três laboratórios convergiram para US$ 200. O Claude Max 20× da Anthropic custa US$ 200 por mês. O ChatGPT Pro da OpenAI vem em versões de US$ 100, US$ 200 e US$ 500. O AI Ultra do Google tem uma faixa de US$ 100 e uma de US$ 200. Pague isso todo mês e o número fixa: US$ 2.400 por ano, US$ 7.200 em três.
O hardware ficou sério. O MacBook Pro com M5 Max, à venda desde março, aceita até 128 GB de memória unificada com 614 GB/s de largura de banda, e a Apple colocou um Neural Accelerator, hardware dedicado a cálculos de matriz, em cada núcleo da GPU. Em agosto, chegou o Mac Studio com uma opção M5 Ultra avaliada em até 512 GB. O marketing da Apple aposta na IA local com mais força do que nunca.
As assinaturas ficaram mais mesquinhas. Os limites semanais do Claude Max, adicionados meses depois do lançamento do plano, são objeto de uma ação coletiva protocolada em 8 de setembro, que argumenta que os rótulos “5×” e “20×” não deixam os tetos semanais claros o suficiente. A OpenAI teria cortado a cota do seu plano Pro de US$ 200 para novos assinantes de 20 vezes o ChatGPT Plus para 10 vezes. Quando a coisa que você aluga continua encolhendo, possuir começa a parecer atraente.
Privacidade é uma preocupação real. Tudo o que você cola em um modelo na nuvem sai da sua máquina. Para uma empresa alemã que guarda dados de clientes, isso não é paranoia; é o GDPR.
E a aritmética é fácil. A versão mais compartilhada: um Mac Studio de US$ 2.499 dividido por US$ 200 por mês dá cerca de 12,5 meses. A Forbes publicou uma versão muito mais cuidadosa em agosto, com configurações reais e três anos de eletricidade, e concluiu que um Mac provavelmente não vai permitir cancelar seu plano do Claude ou do ChatGPT se você programa com agentes. Mas a versão curta é a que as pessoas lembram.
Aqui está a falha. O argumento compara um preço com um preço. Deveria comparar um produto com um produto. É o que o resto deste artigo faz, começando pelo que os US$ 200 realmente pagam.
Parte 2 — O que US$ 200 por mês realmente compram em outubro de 2026
| Provedor | Faixa de US$ 20 | Faixa de US$ 100 | Faixa de US$ 200 | Acima de US$ 200 |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: US$ 20 (US$ 17 por mês na cobrança anual) | Max 5×: US$ 100 | Max 20×: US$ 200 | Team e Enterprise |
| OpenAI (ChatGPT) | Plus: US$ 20 (Go: US$ 8) | Pro 100: US$ 100 | Pro 200: US$ 200 | Pro 500: US$ 500 |
| Google (Gemini) | AI Pro: US$ 20 | AI Ultra: US$ 100 | AI Ultra: US$ 200 | — |
Preços em dólares por mês, sem impostos. Claude de claude.com; ChatGPT do rastreador do AI Business Weekly, atualizado em 4 de outubro; Google do relatório do Engadget sobre o relançamento de maio. Preços e cotas mudam com frequência, então confira antes de assinar.
O que o dinheiro realmente paga
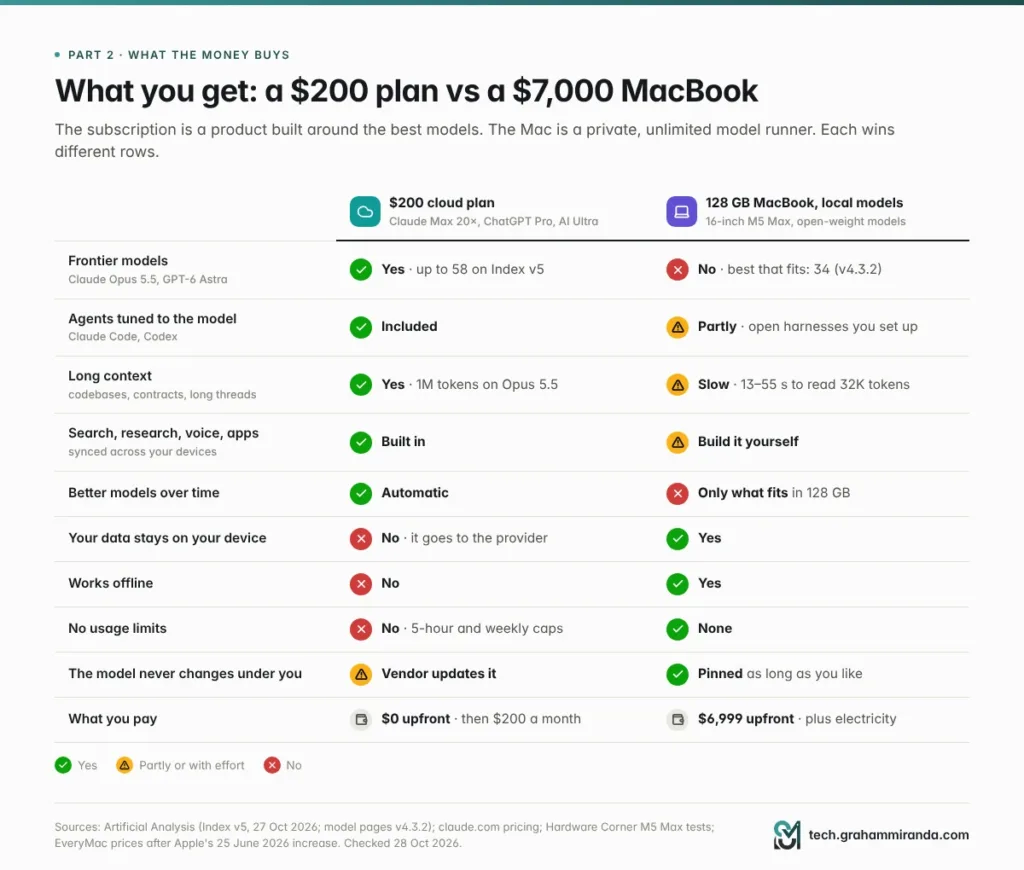
1. Os modelos de fronteira, que você não consegue em nenhum outro lugar. No novo índice da Artificial Analysis, a Anthropic e a OpenAI ocupam todas as cinco primeiras posições. Nenhum desses modelos pode ser baixado por preço nenhum. A assinatura é a forma mais barata de a maioria das pessoas chegar a usá-los.
2. Agentes construídos em torno desses modelos. Os planos pagos do Claude incluem o Claude Code; os do ChatGPT incluem o Codex. O harness e o modelo são ajustados juntos, o que ajuda a explicar por que eles ficam no topo dos rankings de programação agêntica. (Comparei 28 dessas ferramentas em Todos os harnesses de codificação com IA comparados.)
3. Contexto enorme. O Claude Opus 5.5 tem uma janela de contexto de um milhão de tokens, segundo a Artificial Analysis: bases de código inteiras, contratos inteiros, trimestres inteiros de e-mail.
4. O produto em torno do modelo. Pesquisa na web e pesquisa profunda, análise de arquivos, voz, memória, geração de imagens, conectores para seu e-mail e seus documentos, e aplicativos que sincronizam entre seu celular, laptop e navegador. Nada disso vem com um arquivo de modelo.
5. Atualizações que você não precisa instalar. O modelo por trás da sua assinatura no próximo trimestre será melhor que o de hoje. O modelo no seu Mac só muda quando você baixa outro, e só se o novo couber.
6. Parte do dinheiro de volta. A página de preços da Anthropic agora lista créditos mensais de API com o Max: US$ 100 no plano 5× e US$ 200 no 20×.
O que ele não compra
Uso ilimitado. Os planos do Claude funcionam com janelas móveis de cinco horas mais tetos semanais, e a OpenAI e o Google descrevem seus planos mais caros principalmente como múltiplos dos mais baratos, quando os descrevem. Controle sobre para onde vão seus dados, o que importa muito para dados pessoais e de clientes. E previsibilidade: as cotas mudaram mais de uma vez neste ano.
Tenha esses três em mente. Eles são o argumento honesto a favor da IA local, e a Parte 11 os examina por completo.
Mostrar imagem A assinatura é um produto; o Mac é um executor de modelos. Cada um vence linhas diferentes, e é por isso que a resposta certa para a maioria das pessoas é os dois.
Parte 3 — Quanto custa hoje um MacBook de 128 GB
Só um chip chega a 128 GB. Na geração M5, essa quantidade de memória unificada só vem com o M5 Max com GPU de 40 núcleos, que tem 614 GB/s de largura de banda de memória. O M5 Max com GPU de 32 núcleos é fixo em 36 GB e 460 GB/s, e o M5 Pro vai no máximo a 64 GB e 307 GB/s.
| Configuração | Preço nos EUA | Alemanha |
|---|---|---|
| 16″ M5 Max (CPU de 18 núcleos, GPU de 40 núcleos), 48 GB, 2 TB | US$ 4.999 | € 5.699 |
| Upgrade para 128 GB | +US$ 2.000 (era +US$ 1.000 até 25 de junho) | cerca de +€ 2.500 (era +€ 1.250 no lançamento), estimado |
| 16″ M5 Max, 128 GB, 2 TB | US$ 6.999 | cerca de € 8.199 (estimado; € 6.249 no lançamento) |
| Configuração máxima: 128 GB, 8 TB, tela nano-texture | US$ 10.149 | — |
| Para comparação: Mac Studio, M5 Max, 128 GB | US$ 4.799 | — |
Os preços nos EUA não incluem imposto sobre vendas; os preços alemães incluem 19% de IVA. O upgrade de 128 GB na Alemanha é minha estimativa: a Apple cobrava € 1.250 por ele no lançamento, e o upgrade em dólar dobrou em junho. Confira o configurador da Apple antes de comprar.
Três coisas se destacam.
A memória agora é a parte cara. A Apple aumentou os preços de toda a linha Mac em 25 de junho e culpou os custos de memória e armazenamento. Disse à Reuters que “nunca tinha visto um aumento no preço de um componente tão grande e tão rápido”. Os upgrades de 64 GB e 128 GB do M5 Max dobraram. O componente de que a IA local mais precisa é justamente o que ficou duas vezes mais caro.
O prêmio do notebook é de US$ 2.200. O mesmo M5 Max com os mesmos 128 GB em um Mac Studio custava US$ 4.799 quando a Forbes orçou em agosto. Se você quer a memória para IA, o formato notebook custa 46% a mais.
O modelo de 14 polegadas é um meio-termo. Você também pode encomendar o de 14 polegadas com 128 GB, mas, na análise da Notebookcheck, o chassi teve dificuldade para resfriar o M5 Max sob carga sustentada. Mais sobre isso na Parte 8.
Novos Macs esta semana. Em 27 de outubro, a Apple anunciou um MacBook Pro de 14 polegadas com o chip M6 com o chip: até 32 GB e 170 GB/s, a partir de US$ 1.999. É um bom notebook, não uma máquina de LLM. E hoje à noite (28 de outubro, 10:00 no Pacífico, 18:00 na Alemanha) a Apple realiza seu evento “Pro and Tell”, onde um MacBook Pro OLED com tela sensível ao toque é amplamente esperado. Relatos dizem que ele usa os mesmos chips M5 Pro e M5 Max, o que deixaria o teto de 128 GB e os 614 GB/s inalterados.
Parte 4 — A diferença de qualidade, medida
Como você compara um modelo na sua mesa com um em um data center? Não com achismo, e não com a tabela de benchmark do próprio fornecedor. Artificial Analysis (AA) executa a mesma bateria de testes em centenas de modelos, pelo mesmo harness, e resume os resultados em um único Intelligence Index. Nenhum índice é perfeito, mas o da AA é independente, e é a coisa mais próxima de uma régua comum que a indústria tem.
Em 27 de outubro, a AA publicou a versão 5. A principal mudança: cerca de 60% do índice agora roda em conjuntos de testes privados ou respostas reservadas, para que um modelo não possa ter visto as perguntas durante o treinamento. Trabalho de conhecimento, programação, ciência e conhecimento geral contam um quarto cada.
O novo ranking
| Modelo | Você pode baixá-lo? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | Não | 58 |
| GPT-6 Astra (max) | Não | 57 |
| GPT-6.1 Sol (max) | Não | 55 |
| Gemini 4 Argon (high) | Não | 50 |
| Kimi K3.1 Pro | Ainda não; pesos não divulgados | 46 |
| Claude Haiku 5.5 (max) | Não | 36 |
| DeepSeek V4.1 Flash 1017 (max) | Sim, licença MIT | 32 |
| GLM-5.3 (max) | Sim | 32 |
Fonte: Artificial Analysis, anúncio do Intelligence Index v5, 27 de outubro de 2026.
Três coisas nessa tabela são importantes se você está calculando o custo de um MacBook.
- As cinco primeiras posições pertencem à Anthropic e à OpenAI, e nenhum desses modelos pode ser baixado por preço algum.
- O melhor modelo aberto, Kimi K3.1 Pro, ainda não divulgou seus pesos. Entre os modelos que você pode realmente baixar, a melhor pontuação é 32, o que os deixa 26 pontos atrás do líder. Na versão anterior, a diferença entre o melhor modelo aberto e o melhor fechado era de 3 pontos. Agora é 12, ou 26 se você contar apenas os pesos que pode baixar.
- O Claude Haiku 5.5 supera todos os modelos abertos que podem ser baixados. Essa é a camada pequena, rápida e barata da Anthropic, não seu carro-chefe.
Programação, especificamente
O novo índice inclui FrontierCode 2.0, 132 tarefas privadas de programação da Cognition. O Claude Opus 5.5 resolveu 46%; o DeepSeek V4.1 Flash 1017, empatado como o mais forte entre os modelos que podem ser baixados, resolveu 28%. No Terminal-Bench-Science, 70 tarefas de ciência agêntica, é 59% contra 13%.
Para ser justo com os modelos abertos: o Kimi K3.1 Pro lidera Terminal-Bench 4.0 com 67%, à frente de todos os modelos fechados. Modelos abertos podem vencer benchmarks individuais, e vencem. Mas esse ainda não pode ser baixado, e seu antecessor, o Kimi K3, tem 2,8 trilhões de parâmetros. Você não vai executá-lo em um notebook.
Por que a diferença acabou de aumentar
O salto da v4.3 para a v5 não tratou todos igualmente.
| Modelo | Tipo | v4.3 | v5 | Mudança |
|---|---|---|---|---|
| Claude Opus 5.5 | Fechado | 58 | 58 | 0 |
| GPT-6 Astra | Fechado | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Fechado | 56 | 54 | −2 |
| Gemini 4 Argon | Fechado | 53 | 50 | −3 |
| Kimi K3.1 Pro | Aberto (não divulgado) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Abrir | 45 | 32 | −13 |
| Muse Spark Open (Meta) | Abrir | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | Abrir | 46 | 30 | −16 |
números da v4.3 e da v5 conforme relatado pelo Trending Topics em 28 de outubro, com as pontuações da v5 correspondendo ao anúncio da AA.
Em média, esses quatro modelos abertos perderam 13 pontos. Os quatro fechados variaram um quarto de ponto.
A AA não disse por quê. A leitura óbvia é que, quando as perguntas do teste são secretas, um modelo não pode tê-las visto, e que benchmarks públicos favorecem modelos treinados intensamente com dados públicos. O contraponto também é justo: testes privados não podem ser verificados de fora, e a forma como você pondera as categorias altera o ranking. Não trate nenhum índice isolado como verdade absoluta. Mas quando quatro modelos abertos caem por dois dígitos e quatro fechados não, esse é um sinal que vale a pena levar a sério: as tabelas de benchmark publicadas, e especialmente as dos próprios fornecedores, superestimam a proximidade dos modelos abertos.
E os modelos que realmente cabem em um MacBook
Os modelos que a AA reavaliou para seu anúncio são, em sua maioria, grandes demais para um notebook. Para os que cabem, as páginas de modelos da AA ainda mostram pontuações da v4.3.2 , e nessa versão o Opus 5.5 também pontua 58. Então aqui está a comparação em uma escala consistente:
| Modelo | Cabe em um MacBook de 128 GB? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | Não, somente na nuvem | 58 |
| Qwen3.8 27B (xhigh) | Sim, em 4 bits, até em um Mac de 32 GB | 34 |
| Qwen3.5 122B A10B (raciocínio) | Sim, cerca de 70 GB em 4 bits | 16 |
| gpt-oss-120b (high) | Sim, cerca de 64 GB | 12 |
Fonte: páginas de modelos da Artificial Analysis, consultadas em 28 de outubro de 2026.
A AA classifica o Qwen3.8 27B em primeiro entre 141 modelos comparáveis. Ele é genuinamente excelente para seu tamanho, e é um modelo aberto lançado sob a licença Apache 2.0. Ainda está 24 pontos atrás.
Mostrar imagem Duas versões do índice, dois painéis separados, nunca um único eixo. Em cima: Intelligence Index v5 da Artificial Analysis (27 de outubro de 2026). Embaixo: modelos que cabem em um MacBook de 128 GB, na v4.3.2, a versão em que as notas deles são publicadas.
O paradoxo dos 128 GB
Olhe para aquela última tabela novamente. O melhor modelo para um MacBook de 128 GB cabe em 32 GB. Os modelos que realmente precisam da memória extra, misturas de especialistas de 120 bilhões de parâmetros, pontuam menos, principalmente porque são mais antigos: o gpt-oss-120b saiu em agosto de 2025, e o Qwen3.5 122B já estava sendo testado no M5 Max em março, meses antes de o Qwen3.8 27B chegar.
Então o que o upgrade de US$ 2.000 de 48 GB para 128 GB compra hoje? Espaço: contextos mais longos, precisão de 8 bits em vez de 4 bits, vários modelos carregados ao mesmo tempo e a opção de rodar um modelo forte da classe de 100 bilhões, se algum aparecer. Esses são benefícios reais. Um modelo mais inteligente não é um deles, pelo menos não no ranking de hoje. Confira o AA antes de comprar; esse é o tipo de fato que muda com um lançamento.
Como 34 contra 58 se sente na prática
Pontos de índice não equivalem a “por cento mais inteligente”, e não se distribuem igualmente entre as tarefas.
Para tarefas curtas e bem definidas, como reescrever um e-mail, resumir um documento que você cola ou extrair campos de uma fatura, um bom modelo de 27B costuma ser indistinguível de um de fronteira. A diferença aparece em trabalho longo e de várias etapas: um agente que precisa ler uma base de código, planejar, editar cinco arquivos, rodar os testes e se recuperar dos próprios erros; pesquisa que precisa conciliar fontes; raciocínio em que um passo errado contamina o resto. É exatamente o trabalho pelo qual as pessoas pagam planos de US$ 200.
A coluna da Forbes de agosto deu um exemplo concreto do próprio artigo de pesquisa do Qwen: o Qwen3-Coder-Next rodando no Claude Code pontuou 30.9% no Terminal-Bench 2.0, contra 53.9% para o Claude Opus 4.5 no mesmo artigo. Esses são modelos do ano passado, mas o padrão não mudou: em tarefas agênticas, a configuração local falhava com muito mais frequência.
Parte 5 — Por que os modelos que você realmente quer não cabem
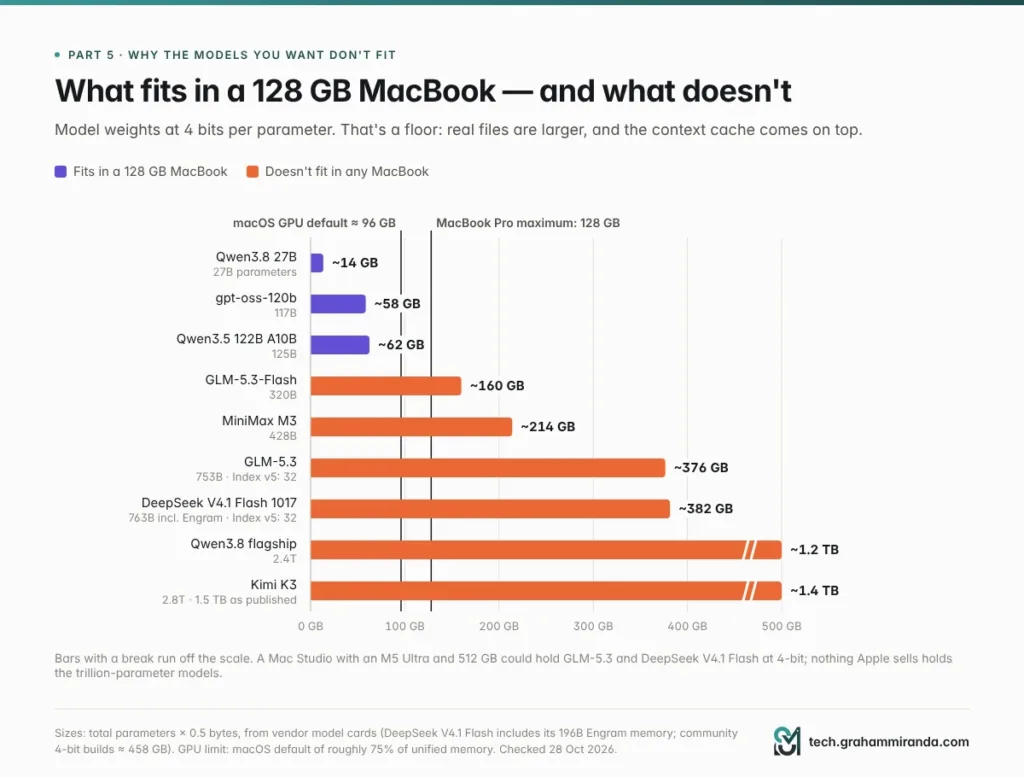
O tamanho de um modelo na memória é simples de estimar:
texto
pesos (GB) ≈ parâmetros (bilhões) × bytes por parâmetro
               8 bits → × 1,0     4 bits → × 0,5     2 bits → × 0,25
Depois some o cache KV, a memória de trabalho do modelo para sua conversa, que cresce com o tamanho do contexto. E lembre-se de que o macOS não entrega toda a sua memória unificada à GPU: por padrão, ele permite que a GPU reserve aproximadamente 75% em Macs com muita memória, cerca de 96 GB de uma máquina de 128 GB. Você pode aumentar o limite com sudo sysctl iogpu.wired_limit_mb=…, por sua conta e risco; tudo o que você der ao modelo, seu navegador, editor e sistema operacional não terão.
Veja o que isso significa para os modelos que as pessoas realmente comentam:
| Modelo | Parâmetros totais | Pesos em 4 bits (mínimo) | Cabe em um MacBook de 128 GB? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ Facilmente |
| gpt-oss-120b | 117B | ~58 GB (arquivo de 64 GB) | ✅ Sim |
| Qwen3.5 122B A10B | 125B | ~62 GB (arquivo de 69,6 GB) | ✅ Sim |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ Não |
| MiniMax M3 | 428B | ~214 GB | ❌ Não |
| GLM-5.3 | 753B | ~376 GB | ❌ Não |
| DeepSeek V4.1 Flash 1017 | 763B incluindo memória Engram | ~382 GB (versões comunitárias em 4 bits estimadas em ~458 GB) | ❌ Não |
| Qwen3.8 topo de linha | 2.4T | ~1,2 TB | ❌ Não |
| Kimi K3 | 2.8T | ~1,5 TB conforme publicado (MXFP4 nativo) | ❌ Não |
A coluna de 4 bits é parâmetros × 0,5 bytes: somente pesos, antes do cache KV e da sobrecarga do arquivo, então os arquivos reais são maiores. Os tamanhos de arquivo vêm dos testes do M5 Max da Hardware Corner.
Os modelos que pontuam 32 no novo índice, os melhores que você pode baixar, precisam de três a quatro vezes o que um MacBook tem. E os intermediários também não cabem. Se você desse 100 GB dos seus 128 GB aos pesos do modelo, veja quantos bits por peso você poderia pagar:
| Modelo | Bits por peso em um orçamento de 100 GB |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Em torno de três bits e abaixo, a qualidade despenca (a Parte 6 traz a pesquisa). Um bit por peso não é quantização. É amputação.
O contexto também custa memória. Nos testes da Hardware Corner, o Qwen3-Coder-Next em 8 bits usou 87,1 GB com contexto de 4K e 92,6 GB com 64K: cinco gigabytes e meio extras só para manter uma conversa mais longa. Agentes que leem repositórios inteiros precisam de contextos longos, então essa folga desaparece rápido.
E um Mac Studio de 512 GB? Um Mac Studio M5 Ultra com 512 GB poderia acomodar o GLM-5.3 ou o DeepSeek V4.1 Flash em 4 bits. A Apple disse que essa configuração chegaria no fim de outubro; o MacRumors espera que custe bem acima de US$ 10.000, e a Apple não tinha publicado um preço quando verifiquei. Você estaria pagando cinco dígitos para rodar modelos que marcam 32 no novo índice, provavelmente mais devagar do que seus criadores os servem. Meu Kimi K3 vs Fable 5.1 vs GLM-5.3 se aprofunda no que realmente é preciso para auto-hospedar os grandes modelos abertos.
Mostrar imagem Apenas os pesos, a 4 bits por parâmetro; o cache de contexto vem por cima. Tudo à direita da linha de 128 GB precisa de um Mac Studio ou de um servidor.
Parte 6 — Quantização: o imposto de qualidade que você paga para caber
A quantização armazena os pesos de um modelo em menos bits, 8 ou 4 em vez dos 16 usados no treinamento, para ocupar menos memória e rodar mais rápido. Todo modelo local que você rodar em um Mac é quantizado. A questão é quanto isso custa, e a pesquisa dá uma resposta clara e um pouco incômoda.
A boa notícia: 8 bits é quase de graça, 4 bits é basicamente aceitável
- Um dos maiores estudos até agora, de Eldar Kurtic e colegas, realizou mais de 500.000 avaliações em modelos Llama 3.1 quantizados. O FP8 foi efetivamente sem perdas em todos os tamanhos; o INT8 custou cerca de 1–3% com ajuste cuidadoso; e a quantização somente de pesos em 4 bits foi “mais competitiva do que o esperado”, próxima de 8 bits.
- Para modelos de raciocínio, um estudo de 2025 de Ruikang Liu e colegas descobriu que pesos e ativações em 8 bits, ou pesos em 4 bits com ativações em 16 bits, podem ser sem perdas em benchmarks de matemática, ciência e programação. Larguras de bits menores trouxeram o que os autores chamam de riscos significativos de precisão, e a dificuldade da tarefa afetou fortemente o quanto se perdia.
Se você só fizer perguntas curtas em inglês, um modelo em 4 bits parecerá próximo do original.
A má notícia: entradas longas, outros idiomas e qualquer coisa abaixo de 4 bits
- Contexto longo. Anmol Mekala e colegas testaram cinco métodos de quantização em 9.700 exemplos com entradas de 64.000 tokens ou mais (EMNLP 2025). 8 bits custaram cerca de 0.8% em média. 4 bits custaram até 59%, e o dano dependeu muito do modelo: em um método de 4 bits, o Llama 3.1 70B caiu 32% em uma tarefa em que o Qwen 2.5 72B resistiu.
- Idiomas diferentes do inglês. O mesmo estudo descobriu que a degradação tendia a ser pior quando a entrada não estava em inglês. Se você trabalha em alemão, teste em alemão.
- Abaixo de 4 bits, o raciocínio entra em colapso. Pesquisadores da Meta FAIR publicaram um estudo em junho de 2026 mostrando que modelos de raciocínio quantizados pensam demais. Com AWQ de 3 bits, a pontuação de um modelo de raciocínio de 1,5B no benchmark MATH-500 caiu de 85,6% para 47,0%, e sua cadeia de pensamento cresceu de 5.200 para 23.400 tokens, 4,5 vezes mais longa. Em um notebook que escreve de 20 a 80 tokens por segundo, um modelo que pensa quatro vezes mais também é cerca de quatro vezes mais lento.
Mostrar imagem O que a pesquisa diz sobre o custo de cada redução de precisão. A compressão que encaixaria um modelo maior em 128 GB é exatamente a que mais machuca.
O que isso significa para um MacBook de 128 GB
A quantização que você pode pagar por um modelo que gostaria de usar é justamente a que mais machuca. Um modelo de 27B pode rodar em 8 bits em um Mac com folga, e deveria. Os modelos da classe de 120B rodam em 4 bits, o que é bom para chat e arriscado em documentos longos. E a única forma de colocar algo da classe de 300B ou mais em um notebook é com dois ou três bits por peso, onde os estudos acima dizem que o raciocínio desmorona.
Minhas regras práticas:
- Use 8 bits para tudo em que você vai confiar, especialmente documentos longos e trabalho com agentes.
- 4 bits é suficiente para chat, rascunhos e tarefas curtas. Verifique o comportamento em contextos longos com seus próprios documentos.
- Não rode modelos de raciocínio ou programação abaixo de 4 bits a menos que você esteja experimentando.
- Teste no idioma em que você trabalha.
Parte 7 — Velocidade: rápido para escrever, lento para ler
Um LLM faz dois trabalhos diferentes em duas velocidades diferentes. Prefill lê seu prompt, tudo o que você colou mais a conversa até agora, e é limitado pela computação bruta. Geração escreve a resposta um token por vez, e é limitada pela largura de banda da memória. Os próprios pesquisadores de aprendizado de máquina da Apple mediram ambos no M5: seus novos Neural Accelerators de GPU tornaram o tempo até o primeiro token 3,3 a 4,1 vezes mais rápido do que no M4, enquanto a geração melhorou apenas 1,19 a 1,27 vezes, mais ou menos em linha com a largura de banda extra.
Então o que um M5 Max com 128 GB realmente faz? A Hardware Corner publicou testes executados com o framework MLX da Apple em um M5 Max de 14 polegadas com 128 GB:
| Modelo | Contexto | Leitura (prefill), tok/s | Tempo para ler o prompt inteiro | Escrita, tok/s |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3,1 s | 87.9 |
| 32K | 2,537 | 12,9 s | 64.5 | |
| Qwen3.5 122B A10B (4 bits) | 4K | 881 | 4,6 s | 65.9 |
| 32K | 1,068 | 30,7 s | 54.9 | |
| Qwen3.5 27B (denso, 6 bits) | 4K | 811 | 5,1 s | 23.6 |
| 32K | 591 | 55,4 s | 14.9 | |
| Qwen3-Coder-Next (8 bits) | 64K | 1,432 | 45,8 s | 48.2 |
Medido pelo usuário do Reddit cryingneko e publicado pela Hardware Corner. “Tempo para ler o prompt inteiro” é o tamanho do contexto dividido pela velocidade de prefill medida.
A velocidade de escrita está boa agora, pelo menos em modelos MoE
Modelos de mistura de especialistas usam apenas uma fração de seus pesos para cada token, então escrevem rápido: 55 a 88 tokens por segundo no M5 Max. Para comparação, a Artificial Analysis mede o Claude Opus 5.5 em 98 tokens por segundo na API da Anthropic. Para conversar com um modelo da classe 120B, o M5 Max é genuinamente agradável. Modelos densos são outra história: um modelo de 27B que usa cada peso para cada token escreve de 15 a 24 tokens por segundo.
Dois efeitos menores também se acumulam. A escrita desacelera conforme a conversa cresce: de 17% a 37% mais lenta em 32K do que em 4K nesses três modelos. E modelos de raciocínio gastam centenas ou milhares de tokens pensando antes de responder.
A espera está na leitura
Olhe de novo para a coluna de tempo de leitura. Um prompt de 32.000 tokens (alguns arquivos de código, um contrato longo, uma thread de e-mail enorme) leva 13 a 55 segundos para ser lido antes que a primeira palavra da resposta apareça.
Isso importa sobretudo exatamente para o trabalho pelo qual se compra um plano de US$ 200. Agentes de programação com IA enviam ao modelo um system prompt grande, as definições de cada ferramenta, os arquivos que abriram e a conversa até o momento, e fazem isso a cada passo. Servidores locais conseguem reaproveitar a parte do prompt que não mudou, o que ajuda muito. Mas, sempre que algo no início do contexto muda, por exemplo quando o agente compacta seu histórico ou você troca para uma nova tarefa, tudo depois desse ponto precisa ser lido de novo. A Forbes citou um desenvolvedor que esperou cerca de 90 segundos pelo primeiro token em um M3 Ultra de 512 GB com um system prompt de 16.000 tokens, e outro que viu cerca de 20 segundos a frio em um notebook M4 Pro de 48 GB. Os chips da geração M5 são muito mais rápidos nisso do que Macs mais antigos, pelas próprias medições da Apple, mas a forma do problema é a mesma.
Para efeito de comparação, os mesmos testes do Hardware Corner rodaram em uma placa de workstation Nvidia RTX Pro 6000, que custa cerca de US$ 8.800 sozinha: ela leu prompts 2 a 2,4 vezes mais rápido e escreveu 1,7 a 2,8 vezes mais rápido do que o M5 Max.
Mostrar imagem Medido com MLX em um M5 Max de 128 GB. A escrita é rápida o suficiente; ler prompts longos, algo que os agentes fazem o tempo todo, é onde a espera acontece.
Parte 8 — O problema do laptop
Mesmo que os modelos fossem bons o bastante, um notebook é um lugar desconfortável para rodá-los.
Calor. Rodar um modelo grande é carga sustentada: minutos ou horas de GPU e memória trabalhando a pleno vapor, não um pico de dez segundos. A análise do Notebookcheck do M5 Max de 14 polegadas concluiu que seu chassi e sua refrigeração “simplesmente não dão conta do M5 Max”: o desempenho em um teste de estresse de CPU de 30 minutos caiu 24%, e as ventoinhas chegaram a 53,2 dB(A) no modo High Power. Essa análise mediu cargas de CPU e gráficos, não LLMs, e o próprio Notebookcheck sugere que o M5 Max pertence ao modelo de 16 polegadas. Se você for comprar um MacBook para IA local, compre o de 16 polegadas. Meu Guia do MacBook Pro M5 Pro 64 GB chegou à mesma conclusão sobre trabalho sustentado no chassi menor.
Ele também é seu computador do dia a dia. Carregue um modelo de 70 GB mais o contexto dele e você ainda tem espaço para um navegador e um editor. Aproxime-se dos cerca de 96 GB que a GPU usa por padrão, ou aumente o limite para encaixar algo maior, e o resto do seu trabalho passa a competir com o modelo por memória. Cada modelo que você mantém carregado é memória que seus outros apps não recebem.
As baterias não gostam. Carga sustentada na GPU drena rápido a bateria de um notebook, então sessões longas de inferência local acabam acontecendo na tomada, o que enfraquece bastante o argumento de “IA em qualquer lugar, offline”.
Você compra seu teto no primeiro dia. A memória unificada não pode ser atualizada depois da compra. Se o melhor modelo aberto do ano que vem precisar de 160 GB, um MacBook de 128 GB simplesmente não roda.
E ele desvaloriza rápido. A revendedora britânica de recondicionados MacFinder analisou seis anos dos próprios dados de compra e descobriu que a maioria dos MacBooks perde cerca de metade do valor no primeiro ano, com os modelos de topo caindo ainda mais: um MacBook Pro M4 de 16 polegadas perdeu até 60% em um ano. Uma máquina de US$ 6.999 é uma aposta de US$ 6.999 de que o teto de memória de hoje ainda será útil em três anos.
Um desktop é uma máquina melhor para LLMs. Se o ponto é IA local, um Mac Studio com o mesmo M5 Max e 128 GB custa US$ 2.200 a menos, não tem bateria para assar nem tampa para fechar, e pode ficar ligado 24 horas como servidor privado para o seu notebook e seu celular. Combine com o notebook que você já gosta.
Parte 9 — A lacuna de software: o que você teria que reconstruir
Uma assinatura é um modelo mais um produto. Uma configuração local entrega o modelo e deixa o produto por sua conta.
| O que a assinatura faz por você | O que você faria localmente |
|---|---|
| Hospeda e atualiza o modelo | Baixar, converter e atualizar modelos por conta própria (LM Studio, Ollama ou MLX) |
| Busca na web e pesquisa profunda | Conectar uma API de busca ou uma busca auto-hospedada, além de um agente para conduzi-la |
| Lê PDFs, planilhas e imagens | Escolher modelos com visão, adicionar análise de documentos |
| Voz, memória, geração de imagens | Modelos e apps separados para cada um (Whisper para fala, Draw Things ou ComfyUI para imagens) |
| Apps em todos os dispositivos, sincronizados | Rodar um servidor e um front-end, e expô-lo ao celular com segurança |
| Claude Code ou Codex, ajustados aos próprios modelos | Apontar um harness aberto, ou o próprio Claude Code, para um servidor local |
| Templates de chat, formatos de chamada de ferramentas e segurança resolvidos | Depurá-los quando um novo modelo chega com um template que suas ferramentas não entendem |
As ferramentas estão genuinamente boas agora. O LM Studio é o começo mais fácil em um Mac, o Ollama dá uma API única para modelos locais e na nuvem, e o MLX da Apple costuma ser o mais rápido. O Ollama até expõe uma API compatível com a Anthropic, então você pode apontar o Claude Code para um modelo local definindo ANTHROPIC_BASE_URL=http://localhost:11434. A documentação dela é sincera sobre as lacunas, porém: os controles de cache de prompt da Anthropic, a contagem de tokens, os lotes e a entrada de PDF não são suportados. E o Claude Code é ajustado para modelos Claude; um modelo local precisa lidar com o prompt de sistema longo e as definições de ferramentas do Claude Code, que é onde os tempos de prefill da Parte 7 pesam.
Nada disso é impossível. Meu artigo OpenCode v2 vs Hermes Agent vs OpenClaw cobre agentes abertos que funcionam com modelos locais. Mas é trabalho de verdade, e suas horas não são grátis. Reserve um fim de semana para configurar e algumas horas por mês para manter tudo atualizado.
Parte 10 — As contas do ponto de equilíbrio, feitas com honestidade
Aqui está o cálculo que o discurso costuma pular.
Passo 1: a versão ingênua
US$ 6.999 ÷ US$ 200 por mês = 35 meses. Não doze. Quase três anos, e essa é a versão mais generosa.
Passo 2: acrescente a eletricidade
A Forbes estimou cerca de US$ 10 por mês para um Mac rodando IA oito horas por dia às tarifas médias dos EUA. Na Alemanha, com a média de outubro de 29,68 centavos por kWh, um notebook consumindo em média 60–150 W por oito horas por dia custa cerca de € 4–11 por mês. Pouco, mas empurra o ponto de equilíbrio para cerca de 37 meses.
Passo 3: mantenha um plano barato para o que é difícil
Você vai. Poucas pessoas que usaram um modelo de fronteira para programação agêntica ou pesquisa séria voltam a um modelo de 34 pontos para tudo. Mantenha um plano de US$ 20 para os 10% difíceis e o Mac economiza US$ 170 por mês, não US$ 200: cerca de 41 meses.
Passo 4: compare com aquilo para o que você realmente faria downgrade
Se você é tão atento a custos a ponto de considerar um notebook de US$ 7.000, é atento o suficiente para descer para a faixa de US$ 100. Contra US$ 100 por mês, o ponto de equilíbrio é cerca de 78 meses, mais de seis anos e meio, mais tempo do que muita gente mantém um notebook.
| Cenário | Valor inicial | Você ainda paga | Economia mensal | Ponto de equilíbrio |
|---|---|---|---|---|
| MacBook vs. plano de US$ 200, sem energia | US$ 6.999 | — | US$ 200 | 35 meses |
| MacBook vs. plano de US$ 200, com energia | US$ 6.999 | US$ 10 | US$ 190 | 37 meses |
| … e você mantém um plano de US$ 20 | US$ 6.999 | US$ 30 | US$ 170 | 41 meses |
| MacBook vs. plano de US$ 100 | US$ 6.999 | US$ 10 | US$ 90 | 78 meses |
| Mac Studio (128 GB) vs. plano de US$ 200 | US$ 4.799 | US$ 10 | US$ 190 | 25 meses |
| Mac Studio vs. plano de US$ 200, mantendo um plano de US$ 20 | US$ 4.799 | US$ 30 | US$ 170 | 28 meses |
Todos esses números assumem que o Mac faz o trabalho da assinatura por completo. As Partes 4 a 9 explicam por que não faz.
Mostrar imagem Custo acumulado em quatro anos, assumindo que o Mac substitui a assinatura por completo, o que não acontece. Eletricidade a cerca de US$ 10 por mês.
Passo 5: três anos, com revenda
Hardware tem valor de revenda, e esse é o argumento mais forte a favor de comprar. Suponha que você venda depois de três anos por 35% do preço de compra. Essa é a minha premissa, não uma cotação, baseada nos dados da MacFinder que mostram cerca de metade do valor perdido no primeiro ano e perdas mais lentas depois.
| Opção | Custo em 36 meses |
|---|---|
| Plano de US$ 200 | US$ 7.200 |
| MacBook (128 GB) + eletricidade, vendido por 35% | US$ 4.909 |
| … mais um plano de US$ 20 para trabalho de fronteira | US$ 5.629 |
| Mac Studio (128 GB) + energia + plano de US$ 20, vendido por 35% | US$ 4.199 |
| Plano de US$ 100 | US$ 3.600 |
| Plano de US$ 20 | US$ 720 |
Então sim: em três anos, um MacBook mais um plano de US$ 20 pode sair cerca de US$ 1.600 mais barato que um plano de US$ 200, se você o vender por um preço decente. Mas veja o que esse dinheiro compra. De um lado, os melhores modelos do mundo com todas as ferramentas em volta. Do outro, um modelo de 34 pontos, alguns milhares de dólares de depreciação e um plano barato para quando você precisa do negócio de verdade. O plano de US$ 100 vence todas as opções de hardware em custo, e o plano de US$ 20 vence tudo.
Você não economiza muito dinheiro com um MacBook para LLMs locais. Você gasta um valor parecido em um produto diferente: privacidade, controle e liberdade de limites, com menos inteligência acoplada.
A visão do custo marginal
Há um enquadramento em que comprar faz mais sentido: você precisa de um MacBook novo de qualquer forma. Então o custo específico de IA é só o upgrade de memória de 48 GB para 128 GB, US$ 2.000, ou dez meses de um plano de US$ 200. Não é uma loucura. Mas lembre do paradoxo dos 128 GB da Parte 4: no ranking de hoje, esse upgrade compra modelos maiores, não mais inteligentes. Se você vai comprar um MacBook de qualquer forma, 48–64 GB rodam o melhor modelo do tamanho de um Mac em 8 bits com bastante contexto.
O que US$ 6.999 compram em vez disso
- 35 meses de um plano de US$ 200, 70 meses de um plano de US$ 100, ou 29 anos de um plano de US$ 20
- Cerca de 11,7 bilhões de tokens de saída do DeepSeek V4.1 Flash no preço fora de pico da API, um modelo que supera tudo o que cabe em um MacBook
- Cerca de 350 milhões de tokens de saída de Claude Opus 5.5 pela API da Anthropic, aos US$ 20 por milhão que a Artificial Analysis lista
Parte 11 — O caso justo: quando comprar um Mac para IA local faz sentido
Nada disso significa que a IA local é um truque. Escrevo sobre ela o tempo todo neste blog porque é útil. Só que é útil por motivos diferentes dos que o discurso alega. Estes são os bons.
1. Dados que não podem sair do seu controle
Se você lida com arquivos de clientes, informações de saúde, números financeiros não publicados ou qualquer coisa coberta por um dever de confidencialidade, um modelo local significa que nada vai para terceiros. Sem contrato de processamento, sem transferência internacional, sem dúvidas sobre configurações de treinamento. Na Alemanha, profissionais sujeitos ao § 203 StGB, como advogados, médicos e consultores fiscais, precisam de garantias contratuais antes que dados de clientes cheguem a qualquer fornecedor externo, incluindo provedores de IA. Um modelo local contorna essa questão por completo. Esse é o motivo mais forte para ter o hardware, e não depende de o modelo local ser tão inteligente quanto o Opus. Meu relatório Estado da IA em 2026 detalha melhor o lado de custo e conformidade de rodar IA offline.
2. Trabalho offline
Em um avião, no site de um cliente sem rede, em uma instalação onde a rede é justamente o que é proibido.
3. Sem limites, sem mudança de política, um modelo que nunca muda
Sem janelas de cinco horas, sem limites semanais, sem ações coletivas sobre como eles são divulgados. E um checkpoint local se comporta da mesma forma em um ano como hoje, o que importa se você construiu um fluxo de trabalho em torno de como um modelo se comporta.
4. Trabalho em volume, chato e bem definido
Classificar milhares de tickets de suporte, extrair campos de faturas, resumir suas próprias anotações, traduzir rascunhos, marcar fotos, gerar embeddings para busca nos seus próprios documentos, transcrever reuniões com o Whisper. Modelos locais de porte médio são excelentes nisso, e rodar um milhão deles custa apenas eletricidade.
5. Aprender e construir
Se você constrói apps local-first, faz ajuste fino de modelos pequenos ou só quer entender como essas coisas funcionam, ter o hardware é o melhor professor que existe. (Se construir apps com IA é a sua praia, escrevi o processo inteiro em Como criar um app do zero com IA em 2026.)
6. Você já ia comprar um Mac de qualquer jeito
Então compre memória suficiente para os modelos que você realmente vai rodar (veja a Parte 14), e trate a IA local como bônus, não como justificativa de negócio.
O que roda bem localmente
| Tarefa | O que rodar | Memória confortável |
|---|---|---|
| Chat privado, rascunhos, reescrita | Qwen3.8 27B em 8 bits | 48–64 GB |
| Resumos e Q&A sobre seus documentos | Qwen3.8 27B, mais um modelo de embedding | 48–64 GB |
| Extração e classificação em massa | Modelos menores (Gemma 4, gpt-oss-20b) | 16–32 GB |
| Fala para texto | Whisper | 8–16 GB |
| Geração de imagens | Draw Things ou ComfyUI com modelos da classe FLUX | 32 GB+ |
| Um modelo de chat grande e rápido | gpt-oss-120b ou Qwen3.5 122B | 128 GB |
Para geração de vídeo local, os Macs continuam lentos em comparação com hardware Nvidia ou GPUs na nuvem; meu guia do M5 Pro de 64 GB tem os números.
Parte 12 — Formas mais baratas de cortar uma conta de IA de US$ 200
Se o que você realmente quer é uma conta de IA menor, existem caminhos mais baratos que um notebook de US$ 7.000.
1. Desça um nível. O Claude Max 5× e o ChatGPT Pro 100 custam US$ 100, e o AI Ultra do Google agora começa em US$ 100. Se você raramente atinge seus limites em um plano de US$ 200, isso economiza US$ 1.200 por ano sem nenhuma perda de qualidade.
2. Combine dois planos de US$ 20. O Claude Pro mais o ChatGPT Plus custam US$ 40 por mês e dão dois conjuntos separados de limites e duas famílias de modelos de fronteira para alternar.
3. Pague por token pelos modelos abertos. Os mesmos modelos de pesos abertos que você rodaria em um Mac, e outros maiores que nunca vão caber, estão disponíveis por token em muitos provedores, na velocidade de data center. DeepSeek V4.1 Flash, que supera todos os modelos que cabem em um MacBook, custa US$ 0,15 por milhão de tokens de entrada e US$ 0,60 por milhão de tokens de saída fora de pico na própria API da DeepSeek (o dobro em horários de pico). Qwen3.8 27B está listado no OpenRouter a partir de cerca de US$ 0.035 por milhão de tokens de entrada. Para dados pessoais ou de clientes, use um provedor com hospedagem na UE e um contrato de processamento de dados em vez da API do próprio DeepSeek, que processa dados na China.
4. Use um plano de codificação de tarifa fixa para modelos abertos. O plano da Z.ai GLM Coding Plan começa em US$ 18 por mês e inclui o GLM-5.3, empatado como melhor entre os modelos baixáveis no novo índice, além do GLM-5.3-Flash, e funciona no Claude Code, Codex, OpenCode e outras ferramentas. Ganhe 10% de desconto no GLM Coding Plan pelo meu link de afiliado. (Link de afiliado — veja a divulgação no topo.) Não é o Opus 5.5, e o índice diz isso claramente, mas custa menos de um décimo de um plano de US$ 200. Eu o comparei com a oferta da MiniMax em GLM-5.3-Flash vs MiniMax M3.
5. Use o Mac que você já tem. Se o seu Mac atual tem de 16 a 32 GB, modelos locais pequenos dão conta de uma parte surpreendente do trabalho em massa da Parte 11 de graça.
6. Direcione por tarefa. A configuração que funciona para a maioria das pessoas: um modelo local para tarefas privadas e em massa, um plano barato ou modelo aberto por token para o dia a dia, e acesso de fronteira para os 10% difíceis. Meu comparativo de harness de codificação com IA tem cinco configurações montadas em orçamentos diferentes.
Mostrar imagem Custo mensal de cada opção em dólares americanos, antes de impostos. Custos por token dependem do quanto você usa; preços verificados em 28 de outubro de 2026.
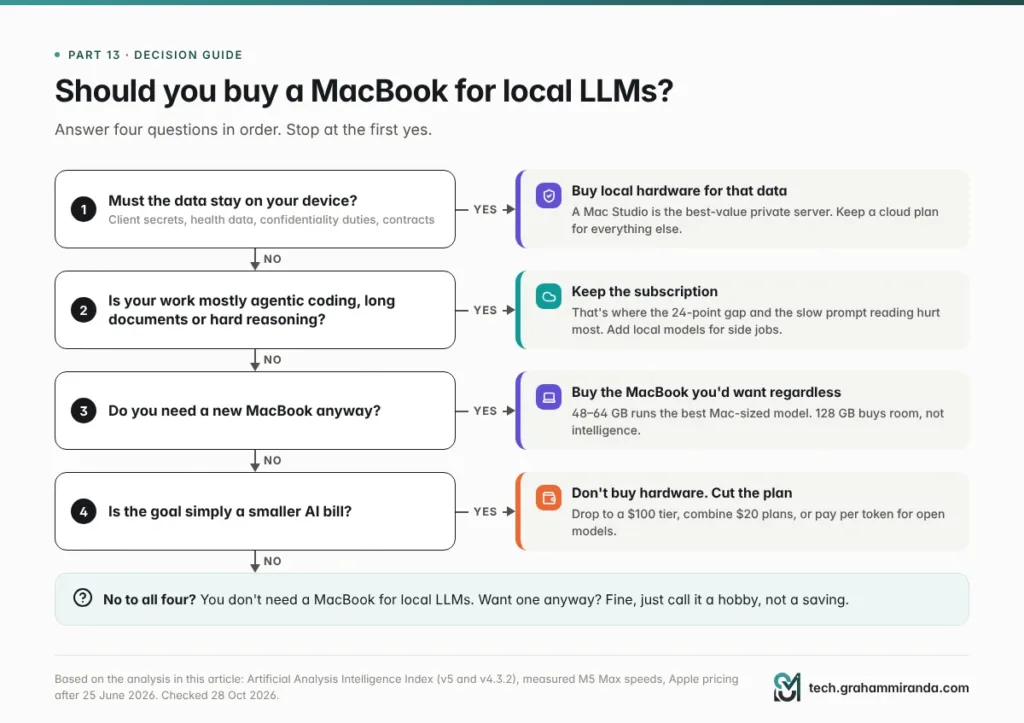
Parte 13 — Você deve comprar um MacBook para LLMs locais? Um guia de decisão
Mostrar imagem Comece pelo topo. A maioria dos caminhos termina em “mantenha um plano na nuvem”, e esse é o ponto.
Passe por quatro perguntas em ordem.
1. Os dados precisam ficar no seu dispositivo? Se sim, por confidencialidade de cliente, dados de saúde ou contrato, compre hardware local: esse requisito não liga para benchmarks. Considere um Mac Studio como servidor privado e mantenha um plano na nuvem para o trabalho que não envolve esses dados.
2. Seu trabalho é principalmente codificação agêntica, documentos longos ou raciocínio difícil? Se sim, mantenha a assinatura. É exatamente aí que a diferença de 24 pontos e os tempos de prefill machucam mais. Um modelo local ainda pode ajudar em tarefas paralelas.
3. Você precisa de um MacBook novo de qualquer forma? Se sim, compre o que você ia querer de qualquer forma. 48–64 GB rodam bem o melhor modelo do tamanho de um Mac. Vá para 128 GB só se você quer especificamente modelos da classe de 120B ou vários modelos carregados ao mesmo tempo, e saiba que está pagando US$ 2.000 por espaço, não por inteligência.
4. O objetivo é simplesmente uma conta menor? Então não compre hardware. Desça uma faixa, combine planos de US$ 20 ou pague por token pelos modelos abertos (Parte 12).
Se você respondeu não a todas as quatro, não precisa de um MacBook para LLMs locais. Talvez ainda queira um, e não há problema. Só chame de hobby, não de economia.
Parte 14 — Se você comprar um mesmo assim: como aproveitar ao máximo
Escolha a máquina certa.
- Compre o de 16 polegadas, não o de 14 polegadas, se o M5 Max é para trabalho de IA sustentado.
- Considere um Mac Studio em vez disso. Mesmo chip e mesma memória por US$ 2.200 a menos, melhor refrigeração, e pode servir seu notebook e seu celular 24 horas por dia.
- Não compre memória demais para os modelos de hoje. 48–64 GB rodam o Qwen3.8 27B em 8 bits com contextos longos. Compre 128 GB para modelos da classe 120B, vários modelos ao mesmo tempo ou folga para lançamentos futuros, sabendo quanto isso custa.
- Se você vai comprar esta semana, espere o evento desta noite. Você vai saber o que o MacBook Pro OLED oferece e quanto custa antes de decidir.
Configure direito.
- Comece com o LM Studio (MLX em Apple Silicon) para o caminho mais fácil, ou Ollama se você quer uma API única para modelos locais e na nuvem.
- Prefira 8 bits para qualquer coisa com que você vá contar; use 4 bits para velocidade no chat.
- Defina o comprimento de contexto de propósito. Muitos runtimes usam contextos pequenos por padrão; agentes precisam de muito mais.
- Aumente o limite de memória da GPU só se você entender a troca, e deixe espaço para o macOS.
- Mantenha um plano de nuvem de US$ 20 para os 10% difíceis. Sai mais barato que o seu próprio tempo.
Teste no seu próprio trabalho. Pegue 20 prompts reais do mês passado: e-mails, documentos, tarefas de código, o que você realmente faz. Rode cada um no seu modelo local e no modelo na nuvem, esconda qual é qual e dê notas. Faça isso no idioma em que você trabalha. Essa uma hora vai te dizer mais do que qualquer ranking, incluindo os deste artigo.
Perguntas frequentes
Um MacBook pode substituir uma assinatura ChatGPT Pro ou Claude Max?
Não em qualidade. Os modelos por trás de um plano de US$ 200, como o Claude Opus 5.5 e o GPT-6 Astra, não podem ser baixados, e os melhores modelos abertos que podem ser baixados precisam de 375–460 GB de memória em 4 bits, muito além de qualquer MacBook. No índice da Artificial Analysis, o Opus 5.5 marca 58; o modelo mais forte que encontrei que cabe em um MacBook de 128 GB, o Qwen3.8 27B, marca 34 na mesma versão. Um MacBook pode substituir uma assinatura para trabalho privado, offline ou em volume, não para tarefas de fronteira.
Qual é o melhor LLM local para um MacBook Pro de 128 GB em 2026?
Para qualidade, o Qwen3.8 27B: a Artificial Analysis o coloca em primeiro entre 141 modelos comparáveis, com 34 no Intelligence Index v4.3.2, e ele cabe com folga em 8 bits. Para velocidade, o gpt-oss-120b e o Qwen3.5 122B são modelos de mistura de especialistas que escrevem 55–88 tokens por segundo em um M5 Max, mas marcam menos (12 e 16). Consulte a Artificial Analysis antes de escolher, porque novos modelos abertos mudam esse ranking a cada poucas semanas.
Quanto custa hoje um MacBook Pro com 128 GB?
Um MacBook Pro de 16 polegadas com M5 Max (CPU de 18 núcleos, GPU de 40 núcleos), 128 GB e 2 TB custa US$ 6.999 nos EUA, antes do imposto sobre vendas. A Apple aumentou os preços dos Macs em 25 de junho de 2026 e dobrou o upgrade de 128 GB de US$ 1.000 para US$ 2.000. Na Alemanha, a mesma configuração custava € 6.249 no lançamento e, pela minha estimativa, custa cerca de € 8.199 agora. Um Mac Studio com o mesmo chip e memória custava US$ 4.799.
Quanto tempo um MacBook leva para se pagar em comparação com uma assinatura de IA de US$ 200?
Cerca de 35 meses a US$ 6.999, se ele substituísse a assinatura por completo e não custasse nada para funcionar. Com mais ou menos US$ 10 por mês de energia, são uns 37 meses, e se você mantiver um plano de US$ 20 para tarefas de fronteira, são uns 41 meses. Contra um plano de US$ 100, são mais de seis anos. Um Mac Studio com o mesmo chip se paga antes, depois de cerca de 25 a 28 meses.
O M5 Max é rápido o suficiente para LLMs locais?
Para escrever respostas com modelos de mistura de especialistas, sim: medido com MLX, um M5 Max com 128 GB gerou 55–88 tokens por segundo, perto dos 98 do Claude Opus 5.5 na API da Anthropic. Ler prompts longos é o ponto fraco. Um prompt de 32.000 tokens levou 13 segundos com o gpt-oss-120b, 31 segundos com o Qwen3.5 122B e 55 segundos com um modelo denso de 27B, e agentes de codificação com IA releem prompts longos o tempo todo.
Os LLMs locais são tão bons quanto o ChatGPT ou o Claude hoje?
Não os que cabem em um notebook. No novo Intelligence Index v5 da Artificial Analysis, publicado em 27 de outubro de 2026, os melhores modelos abertos que dá para baixar marcaram 32 contra 58 do Claude Opus 5.5, e ficaram abaixo do Claude Haiku 5.5, com 36. Modelos pequenos o bastante para um MacBook marcaram no máximo 34 na versão anterior do índice, em que o Opus 5.5 também marcava 58. Para tarefas curtas e simples, a diferença costuma ser pequena; para codificação agêntica, documentos longos e raciocínio difícil, ela é grande.
A quantização deixa os modelos locais piores?
Um pouco em 8 bits, mais em 4 bits, muito abaixo disso. Um estudo com mais de 500.000 avaliações concluiu que o FP8 é praticamente sem perdas e que a quantização apenas de pesos em 4 bits fica perto de 8 bits nos benchmarks padrão. Mas em entradas de 64.000 tokens ou mais, um estudo da EMNLP 2025 mediu quedas de até 59% em 4 bits, piores em textos que não são em inglês, e em 3 bits a nota de matemática de um modelo de raciocínio caiu de 85,6% para 47,0%.
Consigo rodar DeepSeek V4.1 Flash ou GLM-5.3 em um MacBook?
Não. O GLM-5.3 tem 753 bilhões de parâmetros, e o DeepSeek V4.1 Flash, 763 bilhões, incluindo sua memória Engram, então mesmo em 4 bits eles precisam de cerca de 375–460 GB, muito mais que os 128 GB máximos de qualquer MacBook. Um Mac Studio com M5 Ultra e 512 GB conseguiria rodá-los. A forma prática de usá-los é por uma API, de preferência de um provedor com hospedagem na UE e um contrato de processamento de dados.
64 GB bastam para IA local, ou preciso de 128 GB?
Para a maioria das pessoas, 48–64 GB é suficiente. O melhor modelo do tamanho de um Mac no índice da Artificial Analysis, o Qwen3.8 27B, cabe em 8 bits com espaço para contextos longos. Com 128 GB você roda modelos da classe 120B, como o gpt-oss-120b, mantém vários modelos carregados e usa contextos mais longos, mas no ranking atual esses modelos maiores pontuam menos, então o upgrade de US$ 2.000 compra espaço, não inteligência.
Devo comprar um Mac Studio em vez de um MacBook Pro para LLMs locais?
Se a IA local é o motivo principal, normalmente sim. Um Mac Studio com o mesmo M5 Max e 128 GB custava US$ 4.799, US$ 2.200 menos que o MacBook Pro de 16 polegadas, com refrigeração sustentada melhor e sem bateria com que se preocupar. Ele pode rodar 24 horas por dia como servidor de modelos privado para seu notebook e seu celular. Compre um MacBook Pro se você precisa da portabilidade por outros motivos.
Rodar IA localmente é melhor para privacidade e GDPR?
Sim, essa é a vantagem mais forte. Com um modelo local, prompts e documentos nunca saem do seu dispositivo, então não há contrato de processamento para assinar nem transferência internacional de dados. Isso importa para dados de clientes, informações de saúde e profissões sujeitas a sigilo, como as abrangidas pelo § 203 StGB na Alemanha. O ganho de privacidade vale mesmo que o modelo local não seja tão capaz quanto um na nuvem. Isto não é orientação jurídica.
Posso usar o Claude Code com um modelo local?
Sim. O Ollama oferece uma API compatível com a Anthropic, então você pode apontar o Claude Code para um modelo local definindo ANTHROPIC_BASE_URL como http://localhost:11434. Espere trade-offs: o Ollama não oferece suporte aos controles de cache de prompt da Anthropic, o prompt de sistema longo e as definições de ferramentas do Claude Code fazem o modelo local ler muito a cada passo, e o Claude Code é ajustado para modelos Claude. Harnesses abertos como o OpenCode costumam se encaixar melhor em modelos locais.
O novo MacBook Pro OLED vai mudar algo disso?
Provavelmente não muito para IA local. O evento “Pro and Tell” da Apple acontece em 28 de outubro de 2026 às 10:00 no horário do Pacífico, e o MacBook Pro OLED com tela sensível ao toque esperado para lá deve usar os mesmos chips M5 Pro e M5 Max, o que manteria o teto de 128 GB e os 614 GB/s de banda. O MacBook Pro de 14 polegadas com M6 anunciado em 27 de outubro chega no máximo a 32 GB.
A conclusão
O discurso de “cancele seu plano de US$ 200 e compre um Mac” acerta em duas coisas: as assinaturas são caras e a IA local é realmente útil. Erra no ponto importante. Um plano de US$ 200 aluga para você os melhores modelos do mundo, os agentes construídos em torno deles e um produto que melhora todo mês. Um MacBook de US$ 7.000 roda os melhores modelos que cabem em 128 GB, e hoje eles pontuam 34 contra 58 da fronteira, leem prompts longos devagar e perdem qualidade exatamente onde você mais os apertaria.
A matemática também não salva. Mesmo no cenário mais generoso, o MacBook leva de três a quatro anos para se pagar, e em três anos ele custa algo dentro de alguns milhares de dólares da assinatura, dependendo de por quanto você consegue vendê-lo. É uma conta parecida por um produto menos capaz.
Então compre um MacBook para LLMs locais se seus dados não podem sair do prédio, se você trabalha offline, se não quer limites e quer um modelo que nunca muda, ou se você já ia comprar um Mac de qualquer jeito. Esses são bons motivos, e muita gente tem. Só não compre para cancelar sua assinatura. Mantenha um plano na nuvem para os 10% difíceis, coloque os 90% privados e entediantes no seu próprio hardware, e deixe os rankings avisarem quando esse equilíbrio mudar.
Roda modelos locais no trabalho, ou encontrou o oposto do que este artigo diz? Gostaria de saber qual modelo, qual máquina e quais tarefas, com números se você tiver. Correções e contraevidências são bem-vindas; este artigo é atualizado quando os rankings e os preços mudam, o que em 2026 significa com frequência.
Fatos verificados: 28 de outubro de 2026.