
 Português do Brasil
 English
 Deutsch
 Español
 Italiano
 Français

Existe um tipo muito específico de cansaço na hora de decidir que bate por volta das 23h, depois de três cafés, enquanto você encara o seletor de modelos do OpenCode.
Você tem uma chave da Z.ai. Você tem uma chave da MiniMax. Os dois modelos prometem um milhão de tokens de contexto. Os dois são de pesos abertos. Os dois custam praticamente nada comparados aos modelos fechados de fronteira. Os dois têm um gráfico de benchmark em que estão vencendo. E você só quer saber qual definir como padrão para voltar ao trabalho.
Este artigo é a resposta para essa pergunta — a versão longa, porque a versão curta (“GLM-5.3-Flash, provavelmente”) esconde umas seis ressalvas que vão te pegar se você ignorá-las.
Eu levantei os detalhes da arquitetura, os benchmarks dos fornecedores, as avaliações neutras, o preço real por token — incluindo a armadilha das faixas de contexto longo —, a telemetria de uso publicada pelo próprio OpenCode e os arquivos de configuração reais de ambos. Depois fiz as contas de custo para um mês normal de trabalho, em vez de um cenário de release de imprensa.
Eis o que saiu.
TL;DR — O veredito em 30 segundos
Rode o GLM-5.3-Flash como seu modelo padrão no OpenCode. Ele é mais inteligente em quase todos os benchmarks agênticos e de programação que importam, custa cerca de metade por token, tem licença MIT de verdade e é para onde a comunidade do OpenCode realmente foi.
Mantenha o MiniMax M3 como sua opção rápida. Ele gera cerca de três vezes mais rápido e responde cerca de duas vezes mais rápido no primeiro token. Para ciclos de muitos turnos e baixa dificuldade — renomear arquivos, montar esqueleto de testes, gerar documentação, passes de lint e correção, grandes refatorações mecânicas —, essa diferença de velocidade é sentida mais do que a lacuna de inteligência.
Resumindo com honestidade: O GLM-5.3-Flash pensa melhor, o MiniMax M3 digita mais rápido. Codificação agêntica é sobretudo um problema de pensamento, então o GLM fica com a vaga padrão. Mas se você não roda os dois, está abrindo mão de vazão, e o OpenCode torna rodar os dois algo trivialmente fácil.
Tabela comparativa rápida
| GLM-5.3-Flash | MiniMax M3 | |
|---|---|---|
| Fabricante | Z.ai (Zhipu AI) | MiniMax |
| Lançamento | 26 de agosto de 2026 | 1 de junho de 2026 |
| Parâmetros totais | 320B | ~428B |
| Ativos por token | 18B | ~23B |
| Arquitetura | Atenção linear KDA híbrida + MLA esparsa NoPE, MoE (8 de 288 especialistas + 1 compartilhado) | Backbone GQA + MiniMax Sparse Attention (MSA), MoE esparsa |
| Janela de contexto | 1M (1,048,576) | 1M (piso garantido de 512K) |
| Saída máxima | 131,072 tokens | até 262,144 tokens |
| Entrada multimodal | Texto, imagem, vídeo, arquivo | Texto, imagem, vídeo |
| Licença | MIT | MiniMax Community License |
| Preço de entrada da API | US$ 0,15 / 1M (US$ 0,03 em cache) | US$ 0,30 / 1M (US$ 0,06 em cache) |
| Preço de saída da API | US$ 0,50 / 1M | US$ 1,20 / 1M |
| Sobretaxa de contexto longo | Nenhuma publicada | 2× acima de 512K de entrada |
| Velocidade de saída | ~48,6 tok/seg | ~147,9 tok/seg |
| Tempo até o primeiro token | ~1,51 s | ~0,99 s |
| Terminal-Bench 2.1 | 84.3 | 66.0 |
| Artificial Analysis Intelligence | 57 | 45 |
| Participação de tokens no OpenCode | 10.3% | 1.12% |
| Modo de pensamento | Sempre ativo (não pode ser desativado) | Configurável |
| Preço de entrada da assinatura | US$ 18/mês (GLM Coding Plan Lite) | US$ 20/mês (MiniMax Plus) |
Os preços são os de tabela oficiais de cada fornecedor. Gateways roteados como o OpenRouter costumam mostrar preços efetivos menores porque fazem balanceamento de carga entre hosts de terceiros — mais sobre isso abaixo, porque importa.
Por que esta comparação é a que importa agora
Doze meses atrás, a conversa sobre codificação com pesos abertos era se esses modelos eram minimamente utilizáveis. Essa questão está resolvida. A conversa no segundo semestre de 2026 é mais estreita e mais interessante: para qual modelo de pesos abertos você aponta seu harness de agentes, e quanto custa errar a escolha?
O OpenCode afiou essa pergunta. Ele não é uma janela de chat — é um agente nativo de terminal que planeja, lê arquivos, edita, executa comandos, lê a saída e itera. Essa carga de trabalho pune os modelos de formas que um benchmark de chat nunca revela. Um modelo que escreve funções isoladas lindas ainda pode ser inútil no OpenCode se perder o fio da meada depois de vinte chamadas de ferramenta, alucinar um caminho de arquivo ou queimar 90.000 tokens decidindo o que fazer.
GLM-5.3-Flash e MiniMax M3 são os dois modelos de pesos abertos com mais credibilidade nessa conversa hoje. Chegaram com três meses de diferença, miram o mesmo trabalho, têm preços na mesma ordem de grandeza e fizeram apostas de engenharia quase opostas.
Essa última parte é o que interessa.
O que o GLM-5.3-Flash realmente é
O GLM-5.3-Flash teve um dos melhores lançamentos do ano, e não foi por acaso.
Antes de a Z.ai colocar seu nome em qualquer coisa, o modelo apareceu no OpenRouter com o codinome “Ox Alpha.” Sem atribuição de laboratório, acesso quase gratuito, sem marketing. Ele subiu discretamente ao topo dos rankings de uso do OpenRouter e do OpenCode e ficou lá por cerca de uma semana enquanto a comunidade discutia quem o tinha construído. Em 26 de agosto de 2026, a Z.ai confirmou que era dela e abriu os pesos sob MIT.
Lançar um modelo no mundo e deixar que ele conquiste credibilidade antes de reivindicá-lo é uma jogada genuinamente boa, e funcionou — o modelo tinha dados reais de uso por trás antes de qualquer pessoa ter visto um gráfico de benchmark.
A arquitetura, em linguagem simples
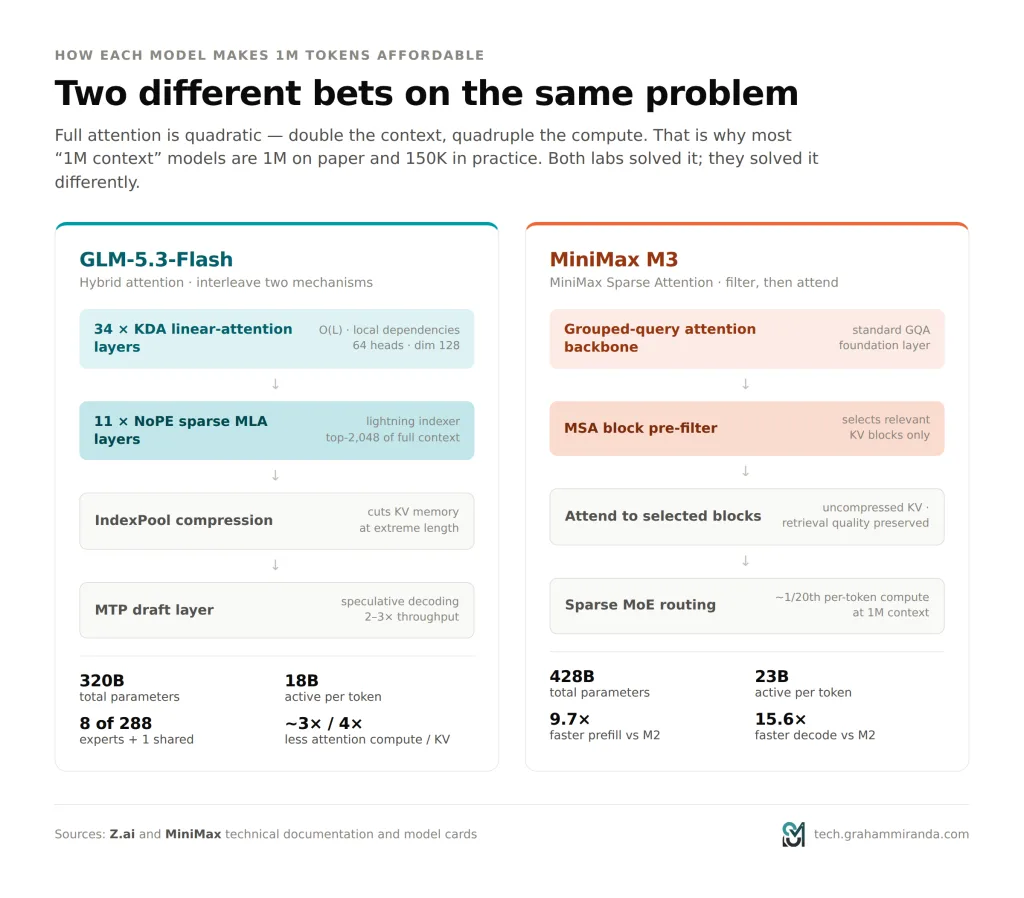
O GLM-5.3-Flash é um modelo de mistura de especialistas de 320 bilhões de parâmetros que ativa apenas cerca de 18 bilhões de parâmetros por token. Ele encaminha cada token por 8 de 288 especialistas roteados mais um especialista compartilhado — cerca de 2,8% dos pesos dos especialistas são acionados em cada passagem direta. É daí que vem a economia “Flash”: conhecimento em escala de fronteira com custo de inferência de modelo pequeno.
O design de atenção é a parte realmente nova. Em vez de um único mecanismo de atenção uniforme, ele intercala dois:
- 34 camadas de atenção linear KDA. Elas rodam em tempo linear em relação ao comprimento da sequência, em vez de quadrático. Lidam com dependências locais a baixo custo e evitam que a vazão desabe conforme seu contexto cresce.
- 11 camadas MLA esparsas NoPE. Atenção latente multi-head no estilo DeepSeek sem embeddings posicionais, precedida por um “indexador relâmpago” que seleciona os 2.048 tokens mais relevantes de todo o contexto. É isso que preserva a qualidade de recuperação de longo alcance.
Há também uma IndexPool etapa de compressão que agrega vetores de chave do indexador para reduzir o consumo de memória em comprimentos de contexto extremos, e uma cabeça de predição multi-token para decodificação especulativa — a implementação do vLLM usa por padrão 5 tokens especulativos por passo de decodificação, o que vale de 2 a 3× de vazão em lotes pequenos.
Efeito líquido em relação ao GLM-5.3 completo: cerca de 3× menos custo computacional de atenção e um cache KV mais de 4× menor. É por isso que um contexto de 1M de tokens é realmente utilizável, e não apenas disponível na teoria.
Por que isso importa para agentes de código
Três coisas, especificamente.
Ele é nativamente multimodal, e isso aqui não é truque de marketing. Os modelos GLM de código anteriores tinham um ponto cego para tudo o que não conseguiam ler como texto. Se seu agente quebra um layout, um modelo só de texto não tem como saber. O GLM-5.3-Flash aceita imagens, vídeo e arquivos nativamente, o que significa que depuração por captura de tela, design-to-code e ciclos de verificação do tipo “isso está realmente certo” entram no cardápio.
O raciocínio é obrigatório. Você não pode desativá-lo. Você pode definir reasoning_effort a low, high, ou max (o padrão documentado é max), mas o modelo sempre raciocina antes de agir. Para trabalho agêntico, esse é o padrão correto — o modo de falha dos modelos de código baratos é agir com confiança sem planejar, e a Z.ai removeu essa opção.
O salto geracional é real, e veio do pós-treinamento. O GLM-5.3 reutiliza o mesmo modelo base do GLM-5.2. Todo o ganho veio de escalar o pós-treinamento — supostamente dez vezes mais ambientes de tarefas de longo horizonte, com tarefas de treino que simulavam ciclos completos de vida de software, da identificação de bugs aos testes e ao deploy, algumas dimensionadas para “a carga de trabalho de um engenheiro sênior ao longo de vários dias.” A pontuação no DeepSWE v1.1 passou de 46,2 para 63,4. O Terminal-Bench 3.0 passou de 4,6 para 28,3. Esses não são deltas de ruído de ajuste.
O que o MiniMax M3 realmente é
O MiniMax M3 chegou em 1º de junho de 2026 e fez uma aposta diferente: em vez de otimizar para raciocínio de pico, otimizar para a economia de loops de agente sustentados.
É um MoE esparso de ~428B parâmetros com cerca de 23B parâmetros ativos por token, construído sobre uma base de grouped-query attention com a própria MSA (MiniMax Sparse Attention) por cima.
A aposta no MSA
A atenção tradicional é quadrática: dobre o contexto, quadruplique o compute. É por isso que a maioria dos modelos de “1M de contexto” tem 1M de contexto no papel e 150K na prática — tecnicamente você pode encher a janela, mas não vai querer pagar por isso.
O MSA substitui a atenção completa por seleção de blocos de KV. Ele pré-filtra o contexto para os blocos relevantes e considera apenas esses, usando key-values não comprimidos para que a qualidade de recuperação sobreviva à filtragem. A MiniMax relata o resultado como cerca de 1/20 do compute por token da geração anterior em 1M de contexto, com prefill 9,7× mais rápido e decodificação 15,6× mais rápida em comparação com o M2.
É uma peça de engenharia legitimamente inteligente, e isso aparece nos números que você sente: ~148 tokens/s de saída e tempo até o primeiro token abaixo de um segundo. Ao lado dos ~49 tok/s e ~1,5s de TTFT do GLM-5.3-Flash, o M3 parece uma categoria diferente de ferramenta. Em um loop de agente longo, com dezenas de turnos, isso se acumula em minutos de diferença de tempo real por tarefa.
A MiniMax também vende o M3 como capaz de “sessões autônomas de código de mais de 8 horas”. Trate isso como afirmação, não como especificação — não foi validado de forma independente.
Onde o M3 é realmente forte
O lado multimodal e de agente de desktop do M3 é subestimado. OSWorld-Verified com 70,06% é uma pontuação séria para tarefas de agente em desktop/GUI. MCP Atlas com 74,2% mostra que o comportamento de invocação de ferramentas é sólido. GPQA Diamond com 92,9% fica próximo da fronteira em raciocínio difícil. E SWE-bench Verified com 80,5% é um número de manchete forte.
Se sua carga de trabalho é “conduzir um navegador, ler um vídeo, operar uma interface, chamar doze ferramentas MCP em sequência”, o M3 não é um compromisso. Ele é, possivelmente, a melhor ferramenta.
Os benchmarks — e o que eles escondem
Aqui eu preciso ter cuidado, porque os dois fabricantes publicam seus próprios números e os dois modelos são avaliados em grande parte em conjuntos de benchmarks diferentes. Isso não é acidente. Os laboratórios escolhem as avaliações em que vencem.
Onde eles se sobrepõem diretamente
| Benchmark | GLM-5.3-Flash | MiniMax M3 | O que mede |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 66.0 | Tarefas de agente em shell/terminal |
| Artificial Analysis Intelligence Index | 57 | 45 | Inteligência agregada |
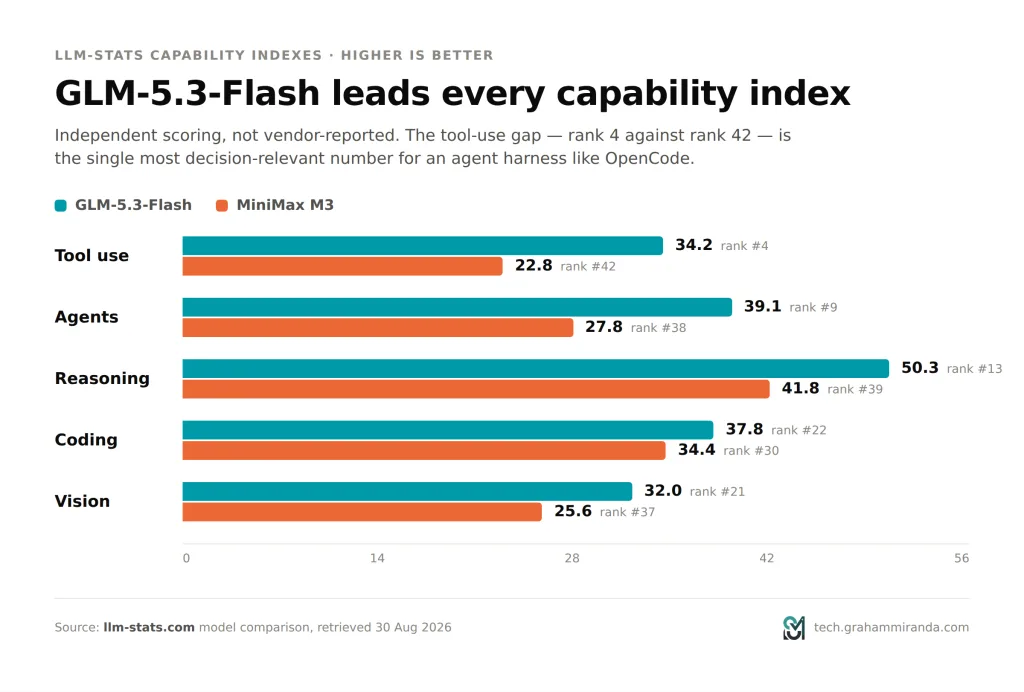
| Índice de raciocínio (llm-stats) | 50.3 (#13) | 41.8 (#39) | Raciocínio em várias etapas |
| Índice de código (llm-stats) | 37.8 (#22) | 34.4 (#30) | Geração de código |
| Índice de agentes (llm-stats) | 39.1 (#9) | 27.8 (#38) | Conclusão de tarefas agênticas |
| Índice de uso de ferramentas (llm-stats) | 34.2 (#4) | 22.8 (#42) | Chamada de funções/ferramentas |
| Índice de visão (llm-stats) | 32.0 (#21) | 25.6 (#37) | Compreensão multimodal |
O Terminal-Bench 2.1 é o que deve pesar mais para o OpenCode, porque é o proxy público mais próximo do que o OpenCode realmente faz: um agente em um terminal, executando comandos, lendo a saída, iterando. Uma diferença de 18 pontos ali não é erro de arredondamento.
O ranking de uso de ferramentas é o outro que eu não pularia. O GLM-5.3-Flash em #4 no geral contra o M3 em #42 é a linha mais relevante para a decisão em todo este artigo. Um harness de agentes é uma máquina de chamar ferramentas. Um modelo que está em #42 em uso de ferramentas vai produzir mais chamadas malformadas, mais novas tentativas, mais turnos desperdiçados — e cada turno desperdiçado custa tokens e tempo real, o que apaga silenciosamente a vantagem de velocidade do M3.
Onde o GLM-5.3-Flash fica por conta própria
- Terminal-Bench 2.1: 84,3 — contra o Claude Opus 4.8 com 85,0. A um ponto de um modelo fechado de fronteira, por cerca de 1/30 do preço.
- DeepSWE v1.1: 63,4 — acima dos 46,2 do GLM-5.2.
- AutomationBench v1.0.6: 48,8 — contra o Opus 4.8 com 41,0. Esta é a maior vantagem dele sobre um modelo de fronteira.
- Z.ai Code Bench v1.0: 29,0 — o Opus 4.8 marca 29,5.
- GDPval-AA v2: 1773 — maior pontuação entre os modelos comparados em capacidade de trabalho de conhecimento.
- Toolathlon: 78,4 · OfficeQA Pro: 62,4 · CharXiv-R: 89,4% · MMVU: 80,5 · Chartography: 78,0
Onde o MiniMax M3 fica por conta própria
- SWE-bench Verified: 80,5%
- SWE-bench Pro: 59,0% — repositórios mais difíceis, executados com o scaffolding do Claude Code
- MCP Atlas: 74,2% · OSWorld-Verified: 70,06% · GPQA Diamond: 92,9%
- KernelBench Hard: 28,8% · SWE-fficiency: 34.8%
A ressalva que você realmente deve considerar
Os números de lançamento dos dois laboratórios são auto-relatados. A suíte de benchmarks do MiniMax, em particular, ainda não havia aparecido em placas de avaliação neutras na época do seu lançamento, e os próprios analistas da Z.ai observaram que os redirecionamentos automáticos de versões mais antigas dos modelos na plataforma da Z.ai tornam comparações A/B limpas genuinamente difíceis.
Onde os agregadores neutros — Artificial Analysis e llm-stats — fizeram suas próprias avaliações, O GLM-5.3-Flash vence em todas as categorias. Essa é a evidência que eu mais considero, porque nenhum dos fornecedores escolheu esses benchmarks.
O sinal de que ninguém fala: os dados de uso do próprio OpenCode
Esta é a parte que achei mais persuasiva, e é justamente a parte que a maioria dos artigos de comparação ignora por completo.
O OpenCode publica telemetria de uso dos modelos que rodam dentro dele. Não são alegações de fornecedores. Não são suítes de benchmark. São desenvolvedores reais, fazendo trabalho real, escolhendo o que continuar usando.
| Métrica | GLM-5.3-Flash | MiniMax M3 |
|---|---|---|
| Usuários únicos | 566K | 436K |
| Parcela de tokens processados | 10.3% | 1.12% |
| Tokens em dois meses | 46T (+100%) | 5T (−51%) |
| Usuários que voltaram na primeira semana | pendente | 66% (32K semanas-usuário) |
Leia de novo aqueles dois números de participação em tokens. Contagens de usuários aproximadamente comparáveis — o GLM-5.3-Flash tem cerca de 30% mais pessoas que o experimentaram — mas mais de nove vezes a vazão de tokens.
Essa diferença não é sobre quem experimentou o quê. É sobre quem permaneceu com o quê para trabalho de verdade. As pessoas abrem uma sessão com o M3, e as pessoas vivem em sessões com o GLM-5.3-Flash.
A linha de tendência diz a mesma coisa em voz mais alta: o GLM-5.3-Flash dobrou seu volume de tokens em dois meses, enquanto o M3 perdeu metade do seu.
Duas ressalvas justas. Primeira: o GLM-5.3-Flash é três meses mais novo, e modelos novos ganham um impulso de novidade; a curva dele vai achatar. Segunda: a retenção de 66% na primeira semana do M3 é um número saudável — as pessoas que o escolheram não o estão abandonando, só há menos delas e elas o usam com menos intensidade. E a queda do M3 é em parte canibalização pelos seus próprios sucessores e pelo ritmo mais amplo de lançamentos chineses de pesos abertos, não pura rejeição.
Mas se a sua pergunta é “o que usuários experientes do OpenCode realmente rodam o dia todo”, os dados respondem sem ambiguidade.
Configurando o MiniMax M3 no OpenCode
Crédito a quem merece: O MiniMax tem a configuração mais fácil, porque o OpenCode já vem com um provedor MiniMax embutido. Sem arquivo de configuração, sem JSON, sem base URL.
bash
# 1. Instale o OpenCode (pule se já tiver)
curl -fsSL https://opencode.ai/install | bash
# ou: npm i -g opencode-ai

# 2. Autentique-se
opencode auth login
# Selecione: "MiniMax Token Plan (minimax.io)"
# Cole sua Subscription Key (começa com sk-cp-...)

# 3. Pronto
opencode
Depois /models dentro da sessão e escolha MiniMax-M3.
A armadilha do tipo de chave
Esta pega quase todo mundo. As chaves do MiniMax Token Plan (assinatura) e as chaves de API de pagamento conforme o uso não são intercambiáveis. Elas usam rotas diferentes e cobram de forma diferente. Se você autenticar com uma chave PAYG no provedor Token Plan, vai receber erros de autenticação ou de saldo que parecem uma indisponibilidade e na verdade são um descasamento.
As chaves de assinatura começam com sk-cp- e exigem um assento atribuído ou créditos. Pegue a sua na página do Token Plan no centro do usuário da MiniMax, não na página geral de chaves de API.
Se você precisar de um bloco de provedor manual
Se a sua versão do OpenCode for anterior ao provedor embutido, ou se quiser apontar explicitamente para uma chave PAYG:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "minimax": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "MiniMax",
      "options": {
        "baseURL": "https://api.minimax.io/v1",
        "apiKey": "{env:MINIMAX_API_KEY}"
      },
      "models": {
        "MiniMax-M3": {
          "name": "MiniMax M3",
          "limit": {
            "context": 1000000,
            "output": 262144
          }
        }
      }
    }
  }
}
Observe o limit.context. Isso não é decoração — veja a próxima seção.
A armadilha da janela de contexto do MiniMax (leia antes de se comprometer)
Se você encaminhar o MiniMax M3 por um harness compatível com Anthropic — Claude Code, ou uma configuração do OpenCode usando @ai-sdk/anthropic contra https://api.minimax.io/anthropic — existe um bug documentado e ainda aberto que você precisa conhecer.
O /anthropic endpoint informa uma janela de contexto de 200K em vez do 1M real do M3.
A camada de compatibilidade parece herdar os metadados do Claude Sonnet em vez de informar a especificação real do M3. Os agentes de codificação confiam nesses metadados e dimensionam seu orçamento de contexto de acordo — o que significa que a compactação automática dispara por volta de 167K tokens embora o modelo consiga comportar tranquilamente cinco vezes isso.
Este é um modo de falha bem irritante, porque é invisível. Seu agente não dá erro. Ele simplesmente começa a esquecer coisas muito antes do que deveria, e você passa uma tarde se perguntando por que um modelo com uma janela de um milhão de tokens perde o fio da meada dois arquivos depois de começar uma refatoração. A issue foi aberta no dia do lançamento do M3 e continua aberta.
Contornando o problema
No OpenCode: use o provedor MiniMax embutido (rota compatível com OpenAI) em vez da rota Anthropic, e defina limit.context explicitamente se você definir um bloco de provedor manual.
No Claude Code, substitua a janela de compactação diretamente:
json
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.minimax.io/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "<YOUR_MINIMAX_SUBSCRIPTION_KEY>",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "MiniMax-M3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "MiniMax-M3[1m]"
  }
}
Dois detalhes que importam: o sufixo [1m] no ID do modelo solicita a variante de contexto completo, e variáveis de ambiente do shell substituem settings.json no comportamento documentado da MiniMax. Se você tiver uma ANTHROPIC_BASE_URL desatualizada exportada no seu .zshrc, ela vence em silêncio e você vai ficar rodando em círculos.
Além disso — não defina credenciais de provedor como exportações globais. ANTHROPIC_BASE_URL é uma variável global; exportá-la permanentemente vai redirecionar em silêncio toda ferramenta que fala Anthropic na sua máquina para a MiniMax. Restrinja por projeto ou por invocação.
Configurando o GLM-5.3-Flash no OpenCode
O OpenCode também traz um provedor Z.AI embutido, então isso é quase tão fácil — com uma bifurcação no caminho.
bash
# 1. Obtenha uma chave na Z.ai — uma chave de API padrão ou uma chave do GLM Coding Plan
# 2. Autentique-se
opencode auth login
# Selecione "Z.AI" para uma chave de API padrão
# Selecione "Z.AI Coding Plan" para uma chave de assinatura do Coding Plan

# 3. Abra o OpenCode e escolha seu modelo
opencode
/models   # selecione GLM-5.3-Flash
Combine o provedor com o tipo de chave. Chaves de API padrão e chaves do Coding Plan usam rotas e cobranças diferentes. Escolher a errada produz erros de autenticação ou de saldo que parecem uma conta quebrada.
Os endpoints do Coding Plan
Se você estiver configurando tudo manualmente ou configurando outra ferramenta, o pacote para desenvolvedores da Z.ai expõe três:
| Protocolo | Base URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
Uma restrição que vale destacar: o GLM Coding Plan é contratualmente limitado a ferramentas oficialmente suportadas — Claude Code, OpenCode, Cline, Roo Code, Kilo Code, Cursor, Goose, Crush, OpenClaw e algumas outras. Se você pretende apontar uma chave do Coding Plan para um harness caseiro seu, leia os termos primeiro. Para isso, use a API padrão.
Bloco de provedor manual
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3-flash": {
          "name": "GLM-5.3-Flash",
          "limit": {
            "context": 1048576,
            "output": 131072
          },
          "options": {
            "reasoning_effort": "high",
            "temperature": 1,
            "top_p": 0.95
          }
        }
      }
    }
  },
  "model": "zai/glm-5.3-flash"
}
Configurações de amostragem recomendadas
As recomendações documentadas da Z.ai para o GLM-5.3-Flash, das quais eu não me afastaria sem um motivo:
temperature: 1top_p: 0.95reasoning_effort: max(padrão documentado)thinking.clear_thinking: falsestream: trueetool_stream: truepara requisições de streaming
reasoning_effort é o seu principal ajuste de qualidade versus latência. low para trabalhos sensíveis à latência, high para codificação pesada, max para os problemas mais difíceis. Como o GLM-5.3-Flash já é o mais lento dos dois modelos, com ~49 tok/s, high é uma configuração sensata para o dia a dia e max é o que você aciona quando uma tarefa realmente derrotou high.
A configuração que eu realmente recomendaria: rode os dois
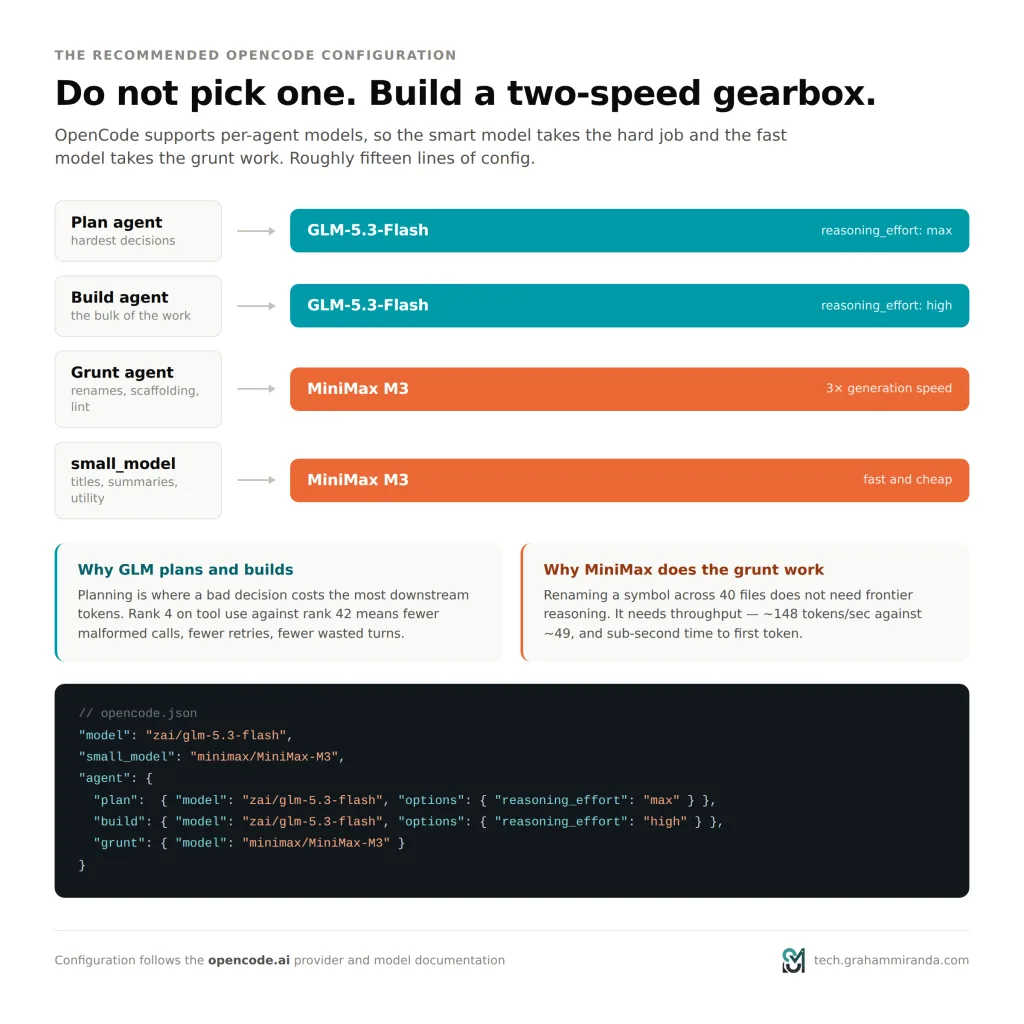
É aqui que o enquadramento “versus” desmorona, porque o OpenCode não te obriga a escolher um. A configuração dele suporta modelos por agente, o que significa que você pode colocar o modelo inteligente no trabalho difícil e o modelo rápido no trabalho braçal.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3-flash",
  "small_model": "minimax/MiniMax-M3",
  "agent": {
    "build": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "high" }
    },
    "plan": {
      "model": "zai/glm-5.3-flash",
      "options": { "reasoning_effort": "max" }
    },
    "grunt": {
      "description": "Mechanical, high-volume edits: renames, test scaffolding, docstrings, lint fixes",
      "model": "minimax/MiniMax-M3"
    }
  }
}
A lógica:
- O planejamento fica com
reasoning_effort: maxno GLM-5.3-Flash. O planejamento é onde uma decisão ruim custa mais tokens nas etapas seguintes. Compre o melhor raciocínio que você puder pagar nesta etapa. - A construção fica com
high. Bom equilíbrio entre qualidade e latência para a maior parte do trabalho. - O trabalho mecânico vai para o M3. Renomear um símbolo em 40 arquivos não precisa de um modelo de uso de ferramentas em 4º lugar. Precisa de vazão, e o M3 é três vezes mais rápido.
small_modelcuida da manutenção interna do OpenCode — geração de títulos, resumos, pequenas chamadas utilitárias. Aponte para o modelo rápido e barato.
Você não está escolhendo um vencedor. Está construindo um câmbio de duas velocidades.
A conta de custo, com números reais
Benchmarks são abstratos. Faturas não são. Vou modelar uma tarefa agêntica realista e passá-la pelas duas tabelas de preços.
O cenário
Um recurso de porte médio, feito de forma agêntica no OpenCode: cerca de 60 turnos de chamada de ferramentas, com média de 45 mil tokens de entrada por turno conforme o contexto se acumula, e 2 mil tokens de saída por turno.
- Entrada total: 2,7 milhões de tokens
- Saída total: 120 mil tokens
- Taxa de acerto de cache de prompt assumida: 80% (2,16 milhões em cache, 540 mil novos)
GLM-5.3-Flash
| Componente | Tokens | Tarifa | Custo |
|---|---|---|---|
| Entrada nova | 540 mil | US$ 0,15/M | US$ 0.081 |
| Entrada em cache | 2,16 milhões | US$ 0,03/M | US$ 0.065 |
| Saída | 120 mil | US$ 0,50/M | US$ 0.060 |
| Total | ≈ US$ 0,21 |
MiniMax M3 (nível padrão, ≤512K de entrada)
| Componente | Tokens | Tarifa | Custo |
|---|---|---|---|
| Entrada nova | 540 mil | US$ 0,30/M | US$ 0.162 |
| Entrada em cache | 2,16 milhões | US$ 0,06/M | US$ 0.130 |
| Saída | 120 mil | US$ 1,20/M | US$ 0.144 |
| Total | ≈ US$ 0,44 |
O GLM-5.3-Flash é cerca de 2,1× mais barato para o mesmo trabalho. Isso bate com a estimativa independente de ~2,2× mais barato em uma base combinada de 3:1 entre entrada e saída.
Escalando para um mês
Quatro tarefas assim por dia, vinte dias úteis — 80 execuções agênticas:
- GLM-5.3-Flash: ≈ US$ 16,50/mês
- MiniMax M3: ≈ US$ 35/mês
A sobretaxa de contexto longo que ninguém menciona
Aqui está a armadilha. O preço do MiniMax M3 é escalonado pelo tamanho da entrada, e quando qualquer requisição única passa de 512 mil tokens de entrada, a tarifa dobra:
| Nível | Entrada | Saída | Leitura de cache |
|---|---|---|---|
| ≤512K de entrada | US$ 0,30/M | US$ 1,20/M | US$ 0,06/M |
| >512K de entrada | US$ 0,60/M | US$ 2,40/M | US$ 0,12/M |
| Nível prioritário | 1,5× o padrão | 1,5× o padrão | 1,5× o padrão |
Então o “contexto de 1M” da manchete vem com uma nota de rodapé: a segunda metade dessa janela custa o dobro. Se o seu fluxo de trabalho realmente envolve carregar repositórios enormes no contexto, o M3 passa de 2× mais caro que o GLM-5.3-Flash para cerca de 4× mais caro exatamente quando você mais precisa do contexto.
A Z.ai não publica sobretaxa equivalente para o GLM-5.3-Flash. O milhão de tokens dele tem preço fixo.
Assinaturas versus pagamento conforme o uso
| GLM Coding Plan | MiniMax Token Plan | |
|---|---|---|
| Inicial | Lite US$ 18/mês (~80 prompts/5h, ~400/semana, 100 chamadas MCP/mês) | Plus US$ 20/mês (~3–4 agentes) |
| Intermediário | Pro US$ 72/mês (~400 prompts/5h, ~2.000/semana, 1.000 chamadas MCP) | Max US$ 50/mês (~4–5 agentes, 3 gerações de vídeo/dia) |
| Topo | Max US$ 160/mês (~1.600 prompts/5h, ~8.000/semana, 4.000 chamadas MCP) | Ultra US$ 120/mês (~6–7 agentes, 5 gerações de vídeo/dia) |
| Desconto anual | ~30% de desconto | Não publicado |
| Modelos incluídos | GLM-5.3, GLM-5.3-Flash, GLM-5.2, GLM-5-Turbo | Família de modelos MiniMax |
Dois detalhes que mudam as contas.
O GLM-5.3-Flash tem cota de 3× dentro do Coding Plan em comparação com o GLM-5.3, e o uso fora do horário de pico consome 50% dos pontos padrão. Escolher o Flash em vez do GLM-5.3 completo praticamente triplica o valor da sua assinatura, e deslocar as execuções pesadas para fora da janela de pico das 14:00–18:00 UTC+8 estica esse ganho ainda mais.
A cota do MiniMax não acumula. A franquia não utilizada expira no fim de cada ciclo de cobrança, e a própria MiniMax recomenda o modelo pay-as-you-go para implantações em produção, em vez do Token Plan.
No uso que modelei (~US$ 16–35/mês em tokens), o pagamento por uso e as assinaturas de entrada ficam praticamente empatados. Acima de cerca de 6–8 horas de trabalho agêntico diário, as assinaturas ganham com folga — o GLM Coding Plan Lite a US$ 18, cobrindo ~400 prompts por semana, é realmente difícil de bater.
Uma nota sobre os preços dos gateways
Você vai ver números bem diferentes dependendo de onde olha. O OpenRouter lista o GLM-5.3-Flash por cerca de US$ 0,05/M de entrada e US$ 0,17/M de saída; os dados de modelos do próprio OpenCode mostram US$ 0,07/M e US$ 0,25/M. Ambos ficam abaixo dos US$ 0,15/US$ 0,50 oficiais da Z.ai.
Isso não é uma contradição. Gateways roteados fazem balanceamento entre mais de 20 hosts de terceiros — Baseten, DeepInfra, Novita, Cloudflare e outros — e esses hosts competem por preço. Você consegue perfeitamente pagar menos que o preço de lista pelo GLM-5.3-Flash usando um gateway. O que você abre mão é da consistência: a vazão no OpenRouter varia de 8 a 111 tokens/s dependendo do provedor em que você cai, e, num loop de agente longo, isso é a diferença entre uma tarefa de dois minutos e uma de quinze.
Para trabalho com agentes, prefiro pagar o preço de lista ao fornecedor original e ter latência previsível. Use gateways para lote e experimentação.
Licenciamento e auto-hospedagem: a parte que empresas europeias deveriam ler duas vezes
Se você comanda uma empresa dentro da UE, a licença não é nota de rodapé. É uma questão de compras.
GLM-5.3-Flash: MIT
Os pesos estão no Hugging Face em zai-org/GLM-5.3-Flash sob a licença MIT. É mais ou menos o máximo de permissividade que um licenciamento de software oferece: use comercialmente, modifique, redistribua, incorpore em um produto, sem limite de faturamento, sem anexo de uso aceitável, sem restrições de área de uso. Basta manter o aviso de copyright e pronto.
Para uma empresa alemã ou da UE, MIT mais pesos auto-hospedáveis significa que você pode colocar tudo dentro da sua própria infraestrutura e tornar a residência de dados um não-problema — sem avaliação de transferência internacional, sem contrato de processador com um fornecedor chinês, sem dependência do uptime de outra pessoa.
MiniMax M3: MiniMax Community License
Os pesos do M3 também estão abertos no Hugging Face, mas sob a MiniMax Community License — uma licença personalizada, não uma licença permissiva padrão. A recepção da comunidade foi amplamente positiva (é mais permissiva que a licença sob a qual o M2.7 foi lançado), e várias fontes descrevem o uso comercial como irrestrito na prática.
Mas “descrito como irrestrito” e “auditado pelo seu jurídico” são coisas diferentes. Se o MiniMax M3 vai entrar em um produto comercial, leia o texto da licença diretamente antes de lançar. Uma licença personalizada traz uma sobrecarga de revisão que a MIT simplesmente não tem.
O teste de realidade da auto-hospedagem
Os dois modelos são de pesos abertos. Nenhum deles roda no seu notebook.
GLM-5.3-Flash:
- Checkpoint FP8: 331 GB em 62 shards (~306 GiB de pesos antes do cache KV)
- Variante BF16: 640 GB em 120 shards
- FP8 com TP=4 em um único GB200: ~386 GB de VRAM
- BF16 com TP=8: ~772 GB de VRAM
- Exige Geração Hopper ou mais nova — H100/H200/B200/B300/GB200/GB300, ou AMD MI300X/MI325X/MI355X
- Stack: vLLM 0.29.0+, FlashInfer 0.6.17+; também SGLang, TokenSpeed, KTransformers, Transformers, Unsloth
MiniMax M3:
- Cerca de 214 GB em quantização de 4 bits — menor, mas ainda firmemente da categoria servidor
A própria infraestrutura hospedada da Z.ai relata ~48,7 tokens de saída/s com TTFT de 1,52 s e, com TP=4 em GB200, um pool de KV de 14,92 M tokens que sustenta 113,81× a concorrência máxima em contexto de 128K. Esse é o porte de hardware necessário para servir isso direito.
Tradução prática: auto-hospedar qualquer um dos modelos significa alugar ou comprar várias GPUs de data center. Para a maioria das equipes — incluindo a maioria dos meus clientes — a resposta certa é a API, com os pesos abertos funcionando como seguro. Se o fornecedor aumentar os preços, piorar o modelo ou desaparecer, você tem uma saída. Essa opcionalidade tem valor real mesmo que você nunca a use.
Onde cada modelo realmente quebra
Sem seção de hype. Aqui estão as fraquezas honestas.
Fraquezas do GLM-5.3-Flash
Ele é lento. ~48,6 tokens/s de saída e ~1,51 s até o primeiro token. Contra os ~148 tokens/s e os ~0,99 s do M3, você sente cada geração longa. Num loop de agente de 40 turnos, isso soma minutos reais de espera ociosa.
Você não consegue desligar o raciocínio. Raciocínio obrigatório é o certo para trabalho agêntico difícil e desperdício em chamadas triviais. Todo pedido de “adicione uma docstring a esta função” paga um imposto de raciocínio. É exatamente por isso que você quer o M3 ou um modelo menor ligado para o trabalho braçal.
Tokens de raciocínio são tokens cobrados. Com reasoning_effort: max como padrão documentado, o custo real por tarefa fica acima das estimativas ingênuas baseadas só na contagem de entrada/saída. Defina como high a menos que a tarefa justifique max.
Ele é novo. Lançado em 26 de agosto de 2026. Bugs de integração de cauda longa em todo o ecossistema de harness ainda não apareceram todos, e o conhecimento da comunidade ainda é escasso. Se você encontrar um modo de falha obscuro, pode ser o primeiro a reportá-lo.
Não confunda com o GLM-5.3. São modelos diferentes, com capacidades diferentes — em especial, o GLM-5.3 sem o Flash é só texto. Enviar imagens para o ID de modelo errado é um erro comum no começo.
Fraquezas do MiniMax M3
O ranking de uso de ferramentas é o problema de verdade. #42 no índice de uso de ferramentas do llm-stats, contra #4 do GLM-5.3-Flash. Para um harness de agentes, essa é a capacidade que sustenta tudo. Espere mais chamadas de ferramenta malformadas, mais novas tentativas, mais turnos gastos para se recuperar — o que come a vantagem de velocidade que você pagou.
O bug de relato de contexto segue sem solução. Aberto desde o lançamento. Dá para contornar, mas é um arranhão que você carrega.
A verificação independente é escassa. Os benchmarks de lançamento da MiniMax não apareceram em painéis neutros e, onde os agregadores neutros mediram, o M3 fica no meio da tabela, não perto do topo. A distância entre o discurso do fornecedor e a medição de terceiros é maior aqui do que no caso da Z.ai.
O preço de contexto longo dobra acima de 512K. O recurso de destaque vem com uma taxa extra.
Licença personalizada. Revisão jurídica extra antes da implantação comercial.
Uso em queda. Uma queda de 51% no volume de tokens do OpenCode em dois meses é um sinal sobre o momento do ecossistema, qualquer que seja a causa. Menos usuários significa menos gente encontrando e corrigindo os mesmos bugs que você vai encontrar.
O quadro de decisão: cinco cenários
1. “Quero um modelo, configuro e esqueço.”
GLM-5.3-Flash. Melhor em todos os benchmarks neutros, metade do preço, licença MIT e onde a comunidade já está. Defina reasoning_effort: high, adicione o GLM Coding Plan Lite a US$ 18/mês se você programa todo dia e siga com a sua vida.
2. “Faço refatorações mecânicas enormes em bases de código gigantes.”
MiniMax M3 para as passadas mecânicas, GLM-5.3-Flash para o plano. O MSA torna o M3 realmente econômico em contexto longo, e o triplo da velocidade de geração se sente mais em edições de alto volume e baixa dificuldade. Só fique de olho no penhasco de preço dos 512K, e deixe o GLM planejar a refatoração antes de o M3 executá-la.
3. “Meu trabalho é visual — UI, design-to-code, depuração por captura de tela.”
GLM-5.3-Flash em primeiro, M3 como um forte segundo. A multimodalidade nativa do GLM foi feita exatamente para isso e ele supera o M3 no índice de visão (32,0 contra 25,6). Mas a pontuação de 70,06% do M3 no OSWorld-Verified o torna a escolha melhor especificamente para trabalho de agente de desktop e GUI — conduzindo aplicativos de verdade em vez de ler capturas de tela.
4. “Preciso auto-hospedar por residência de dados ou conformidade.”
GLM-5.3-Flash, sem dúvida. MIT contra uma licença comunitária personalizada não é uma decisão apertada quando o seu jurídico está envolvido, e a auto-hospedagem sob MIT tira toda a questão de transferência internacional de dados da mesa. Reserve orçamento para hardware da classe Hopper ou para um host de GPU europeu.
5. “Comando uma equipe pequena com orçamento apertado.”
GLM Coding Plan Lite a US$ 18/mês, com GLM-5.3-Flash como padrão. O multiplicador de cota de 3× para o Flash dentro do plano faz dele a opção de maior valor por euro disponível hoje. Agende as execuções pesadas em lote fora da janela de pico das 14:00–18:00 UTC+8 para ganhar o desconto de 50% nos pontos. Adicione o MiniMax depois, se a vazão virar o gargalo.
O que eu ficaria de olho no próximo trimestre
Execuções independentes de Terminal-Bench e SWE-bench Pro para o GLM-5.3-Flash. Os números do fornecedor são excelentes. Agregadores neutros em geral os corroboram. Mas a alegação específica de “a um ponto do Claude Opus 4.8 no Terminal-Bench 2.1” merece replicação por terceiros antes de alguém montar um caso de negócio em cima dela.
Se o bug de contexto do endpoint /anthropic da MiniMax for corrigido. É pequeno, está documentado e está aberto desde junho. A rapidez com que for fechado diz algo sobre a velocidade de manutenção.
A curva de retenção do GLM-5.3-Flash no OpenCode. O número de participação em tokens é espetacular, mas é jovem. O dado interessante é se ele se mantém acima de 10% quando a novidade passar. Se mantiver, isso não é um momento — é um novo padrão.
Cadência de lançamentos dos laboratórios chineses de pesos abertos. O Qwen3.8-Flash-Next foi lançado mais ou menos junto com o GLM-5.3-Flash. O Kimi K3 já supera o GLM-5.3 no DeepSWE (67,5 vs 66,9) e no Toolathlon (76,5 vs 73,0). O intervalo entre “melhor modelo de codificação de pesos abertos atual” e “segundo melhor” agora é medido em semanas. Monte sua configuração de forma que trocar a string do modelo seja uma mudança de uma linha, porque você vai fazer essa troca de novo.
Se a Z.ai vai publicar um preço fixo e avulso de API para o GLM-5.3 completo. No momento em que escrevo, a linha de preço por token do GLM-5.3 ainda faltava na página oficial de preços, enquanto o GLM-5.3-Flash estava totalmente precificado. É uma assimetria estranha e vale acompanhar.
Perguntas frequentes
O GLM-5.3-Flash é melhor que o MiniMax M3 para programar? Pelas evidências disponíveis, sim. O GLM-5.3-Flash lidera no Terminal-Bench 2.1 (84,3 vs 66,0), no Intelligence Index da Artificial Analysis (57 vs 45) e em todos os índices de capacidade do llm-stats, incluindo programação, agentes e uso de ferramentas. Também custa cerca de metade do preço por token. O MiniMax M3 é mais rápido — cerca de 3× a velocidade de saída —, mas a codificação agêntica recompensa a qualidade de raciocínio mais do que a velocidade bruta de geração.
Qual é mais barato, GLM-5.3-Flash ou MiniMax M3? GLM-5.3-Flash, por cerca de 2× menos. O preço oficial é US$ 0,15/M de entrada e US$ 0,50/M de saída para o GLM-5.3-Flash, contra US$ 0,30/M e US$ 1,20/M do MiniMax M3. A diferença sobe para cerca de 4× em requisições acima de 512K tokens de entrada, quando a MiniMax dobra as tarifas e a Z.ai não publica sobretaxa.
Posso rodar o GLM-5.3-Flash localmente? Só em hardware de classe servidor. O checkpoint FP8 tem 331 GB e precisa de cerca de 386 GB de VRAM com TP=4, em GPUs da geração Hopper ou mais novas. Não é um modelo para hardware de consumidor. A licença MIT torna a auto-hospedagem legalmente simples; o hardware é o que a torna cara.
O OpenCode suporta os dois modelos nativamente? Sim. O OpenCode já traz provedores embutidos para Z.AI e MiniMax. Execute opencode auth login, selecione o provedor correspondente ao tipo da sua chave e depois /models para escolher seu modelo. Nenhuma edição do opencode.json é necessária numa configuração padrão.
Por que o MiniMax M3 mostra só 200K de contexto no Claude Code? Um bug conhecido e ainda aberto no endpoint compatível com Anthropic do MiniMax: ele informa os metadados do Claude Sonnet em vez da especificação real do M3, disparando a compactação automática por volta de 167K tokens. Defina CLAUDE_CODE_AUTO_COMPACT_WINDOW a 1000000 nas suas configurações, ou use a rota compatível com OpenAI.
Qual é a diferença entre GLM-5.3 e GLM-5.3-Flash? São modelos diferentes. O GLM-5.3 foi lançado em 14 de agosto de 2026 e é só texto, compartilhando o modelo-base com o GLM-5.2. O GLM-5.3-Flash foi lançado em 26 de agosto, é nativamente multimodal, usa uma arquitetura MoE de atenção híbrida 320B/18B, tem licença MIT com pesos abertos e custa cerca de um décimo. Dentro do GLM Coding Plan, o Flash também recebe 3× a cota.
O MiniMax M3 é realmente de código aberto? Os pesos podem ser baixados abertamente no Hugging Face, mas sob a licença personalizada MiniMax Community License, e não uma licença permissiva padrão como MIT ou Apache 2.0. O uso comercial é amplamente descrito como irrestrito, mas leia o texto da licença antes de lançar um produto comercial com ele.
Devo usar os planos de assinatura ou o pagamento por uso? Abaixo de cerca de US$ 20–30/mês de gasto em tokens, elas ficam perto do empate. Acima de 6–8 horas de programação agêntica diária, as assinaturas ganham claramente — o GLM Coding Plan Lite a US$ 18/mês, cobrindo cerca de 400 prompts por semana, é o melhor custo-benefício de entrada disponível. Observe que a cota do MiniMax não acumula, e a própria MiniMax recomenda o pagamento por uso para cargas de produção.
A conclusão
Se você levar uma coisa só daqui: o GLM-5.3-Flash é o melhor padrão para o OpenCode no fim de 2026, e a vantagem não é pequena nas dimensões que decidem os resultados da codificação agêntica — qualidade de raciocínio, confiabilidade no uso de ferramentas e custo por tarefa concluída.
O MiniMax M3 não é um modelo ruim. É um modelo otimizado de outra forma, e sua arquitetura MSA é uma resposta genuinamente elegante para o problema econômico do contexto longo. Existem cargas de trabalho reais — edições mecânicas em volume, tarefas de agentes em desktop e GUI, qualquer coisa em que a velocidade de geração 3× domine — em que ele é a ferramenta correta.
Mas a codificação agêntica é fundamentalmente um problema de tomada de decisão, não de velocidade de digitação. O modelo que planeja melhor, chama ferramentas com mais confiabilidade e se recupera de falhas com mais elegância conclui mais tarefas por euro, mesmo gerando tokens três vezes mais devagar.
A jogada pragmática é o câmbio de duas velocidades: GLM-5.3-Flash no planejamento e na construção, MiniMax M3 no trabalho braçal, small_model apontado para o modelo rápido. O OpenCode transforma isso numa mudança de quinze linhas de configuração, e você ganha inteligência onde ela importa e vazão onde não importa.
E escreva essa configuração de modo que os IDs dos modelos sejam fáceis de trocar. Neste mercado, a resposta óbvia de hoje tem prazo de validade medido em semanas.
Você já usou algum desses como seu modelo principal no OpenCode? Tenho interesse especial em saber se os números do GLM-5.3-Flash no Terminal-Bench se sustentam em repositórios reais, e se alguém encontrou uma solução mais limpa para o bug de relato de contexto do MiniMax. Entre em contato — correções e contraprovas são bem-vindas, e este artigo é atualizado quando o cenário muda.
Última atualização: 30 de agosto de 2026.


