Italiano
 English
 Deutsch
 Español
 Français

La situazione dell’IA nel 2026 si riassume in tre eventi verificatisi nei primi otto mesi dell’anno — e quasi nessuno li ha mai menzionati tutti insieme nella stessa frase.
Un modello ha superato il test 96% su SWE-bench Verified. Non il 96% su un benchmark fittizio, ma il 96% su vere issue di GitHub relative a Django, Flask e scikit-learn: il benchmark che avrebbe dovuto richiedere anni. Ora è di fatto completato come discriminatore, e i tre modelli in cima alla classifica sono separati da meno di un punto percentuale.
Le prove più attendibili disponibili sul fatto che gli strumenti di programmazione basati sull'intelligenza artificiale consentano agli sviluppatori esperti di lavorare più velocemente continuano a indicare che non è così. Lo studio clinico randomizzato e controllato condotto da METR ha rilevato un rallentamento pari a 19%. Il loro tentativo di ripeterlo nel 2026 è fallito perché gli sviluppatori si sono rifiutati di lavorare senza l’intelligenza artificiale, anche a una velocità di $50 all’ora. Chi utilizza questi strumenti ritiene che siano tre volte più veloci. In realtà, secondo le misurazioni, non lo sono.
E Microsoft ha integrato direttamente in Windows un modello di ragionamento con 14 miliardi di parametri, una frase che nel 2024 sarebbe stata pura fantascienza e che ora è solo una nota a piè di pagina in un discorso di apertura del Build.
Questi tre fatti costituiscono l'insieme Lo stato dell'IA nel 2026 in miniatura. I modelli erano straordinari. Il previsto aumento di produttività, però, non si è verificato. E la frontiera dell’innovazione si è silenziosamente spostata dal data center al dispositivo che hai in mano.
Questa è la versione estesa del rapporto “Lo stato dell’IA nel 2026”. È pensata per chi deve prendere decisioni che comportano un investimento economico: quale modello scegliere, se consentire agli agenti di scrivere codice di produzione, cosa acquistare e cosa comunicare a un cliente o a un responsabile della protezione dei dati. Ho distinto ciò che è stato effettivamente rilasciato da ciò che viene riportato e dalle semplici voci, poiché l’errore più costoso in assoluto in questo campo è pianificare sulla base di un modello che non esiste ancora.
Ultimo aggiornamento: 3 settembre 2026. Sarà necessario aggiornarlo nuovamente entro Natale.
TL;DR — Lo stato dell'IA nel 2026 in 90 secondi
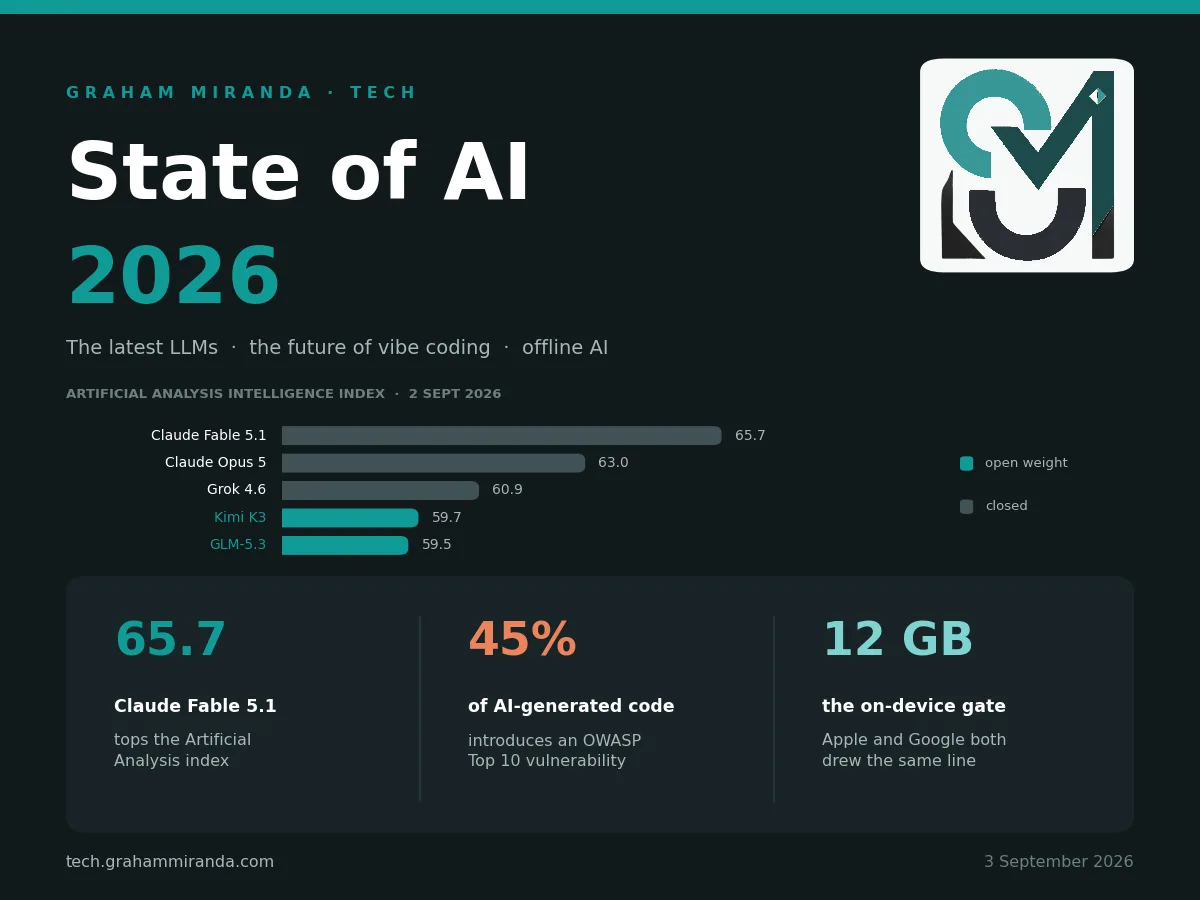
La corsa è molto serrata e, nel complesso, Anthropic è attualmente in testa. Al 2 settembre 2026, l’Intelligence Index v4.1.1 di Artificial Analysis attribuisce a Claude Fable 5.1 un punteggio di 65,7, a Claude Opus 5 un punteggio di 63,0, Grok 4.6 a 60,9 e GPT-5.6 Sol a 58,9. Ma il dato aggregato nasconde la parte interessante: GPT-5.6 Sol è in testa a BrowseComp con 90,41 TP3T, Gemini 3.8 Flash raggiunge 58,7 a $0,75 per milione di token in ingresso, e i primi dieci modelli coprono un intervallo di soli 8,2 punti — un intervallo talmente ristretto che le differenze relative all’harness e ai prompt possono far scalare un modello di diverse posizioni.
I pesi aperti sono all'incirca una generazione indietro, ma stanno recuperando terreno. GLM-5.3 (753B, versione aperta) si attesta a 59,5 — sesto posto in classifica generale, davanti a GPT-5.6 Sol. DeepSeek V4 Pro è stato distribuito con 1,6 trilioni di parametri sotto una licenza MIT effettiva. Ornith-1.5-397B ha raggiunto 86 su SWE-bench Verified e ha superato di poco Claude Opus 4.8 su Terminal-Bench 2.1, con un punteggio di 86,1 contro 85,0. Il divario in termini di capacità è ora di circa sei mesi. È il divario relativo alle licenze quello che conta.
“Il ”vibe coding” ha avuto la meglio nella discussione sull’adozione, ma ha perso quella sulle prove. Il 90% degli sviluppatori utilizza almeno uno strumento di programmazione basato sull’intelligenza artificiale (IA) sul lavoro. Il mercato degli agenti di programmazione aziendali registra un fatturato annualizzato di circa $10 miliardi. Inoltre, la fiducia degli sviluppatori nei risultati prodotti dall’IA è scesa da 40% a 29% in due anni. Gli strumenti sono universali, ma chi li utilizza si fida sempre meno di anno in anno. Entrambe queste osservazioni sono razionali.
La fattura relativa alla sicurezza è arrivata ed è dettagliata. Veracode ha rilevato che 45% di esempi di codice generati dall’IA presentano una vulnerabilità inclusa nella Top 10 dell’OWASP. Apiiro ha misurato che gli sviluppatori assistiti dall’IA producono commit da tre a quattro volte più velocemente e individuano problemi di sicurezza dieci volte più rapidamente. Circa 20% di codice generato dall’IA fa riferimento a pacchetti inesistenti. Questo non è un argomento contro gli strumenti, ma riguarda piuttosto dove si decide di porre il limite.
Quest'anno l'intelligenza artificiale offline è diventata davvero utile, su dispositivi che le persone possiedono già. Un modello da 2 miliardi di parametri funziona a una velocità di 61 token al secondo su un iPhone. Microsoft ha integrato in Windows un motore di inferenza da 14 miliardi di parametri, con un requisito di 40 TOPS per l’NPU. Google limita l’accesso al suo miglior modello on-device a dispositivi con almeno 12 GB di RAM, e lo stesso vale per Apple. Il fattore che determina cosa è possibile eseguire in modalità offline è la memoria, non la potenza di calcolo, ed è proprio la memoria ad essere diventata una risorsa scarsa.
Una breve e sincera riflessione sullo stato dell’arte dell’IA nel 2026: Quest'anno i modelli hanno smesso di rappresentare il collo di bottiglia. Il collo di bottiglia è diventato ora il processo di verifica. Ogni decisione importante citata in questo articolo — quale modello, quale sistema di test, quale dispositivo, quale gate — deriva da quell'unico cambiamento.
Confronto rapido: The Frontier, settembre 2026
L'Artificial Analysis Intelligence Index v4.1.1 aggrega nove valutazioni: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience e AA-LCR. I punteggi riportati di seguito si riferiscono alla situazione al 2 settembre 2026.
| Modello | Laboratorio | Indice AA | Pesi | Input / Output per 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Antropico | 65.7 | Chiuso | $10.00 / $50.00 |
| Claude Opus 5 | Antropico | 63.0 | Chiuso | $5.00 / $25.00 |
| Claude Fable 5 | Antropico | 62.1 | Chiuso | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | Chiuso | — |
| Kimi K3 | Moonshot | 59.7 | Categoria "Open" | — |
| GLM-5.3 | Z.ai | 59.5 | Categoria "Open" | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Chiuso | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | Chiuso | $0.75 / $3.75 | |
| Anteprima di Qwen 3.8 Max | Alibaba | 58.1 | Chiuso | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Categoria "Open" | $0.15 / $0.47 |
| Claude Opus 4.8 | Antropico | 57.3 | Chiuso | $5.00 / $25.00 |
| Muse Spark 1.2 | Meta | 56.8 | Chiuso | — |
| GPT-5.5 | OpenAI | 56.3 | Chiuso | — |
Leggi la quarta colonna prima della terza. Due dei dieci modelli principali dispongono di pesi scaricabili, e uno di questi costa $0,15 per milione di token immessi.
Confronto rapido: la frontiera delle categorie senza limiti di peso
| Modello | Totale / Attivi | Contesto | Licenza | Pubblicato |
|---|---|---|---|---|
| Kimi K3 | 2,8 T / 104 B | 1 milione | In base al fatturato (personalizzato) | Luglio 2026 |
| Qwen3.8-2.4T-A95B | 2,4 T / 95 B | 262.000 (1 milione tramite YaRN) | Apache 2.0 | 14 agosto 2026 |
| DeepSeek V4 Pro | 1,6 T / 49 B | 1 milione | MIT | 12 agosto 2026 |
| GLM-5.3 | 753B / ~40B | 1 milione | Personalizzato (gate $10B) | Agosto 2026 |
| MiniMax M3 | 428B / 23B | 1 milione | Personalizzato (attribuzione) | 1° giugno 2026 |
| Ornith-1.5-397B | 397B MoE | 262.000 (1 milione tramite YaRN) | MIT | Agosto 2026 |
| Gemma 4 31B | 31B denso | 256K | Apache 2.0 | 6 aprile 2026 |
| Qwen3.8-27B | 27B denso | 262.000 | Apache 2.0 | 14 agosto 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 aprile 2026 |
Tre di quei nove sono davvero “OSI-clean”. Questa è la vera storia delle categorie di peso aperte nel 2026, e tornerò sull’argomento nella terza parte.
ATTO I — LE MODELLE
Prima parte: Cosa è stato effettivamente commercializzato nel 2026
Prima di qualsiasi discussione, il bilancio. Lo suddivido in tre livelli perché è proprio nella differenza tra loro che si verificano gli sprechi di denaro.
Confermato e in spedizione
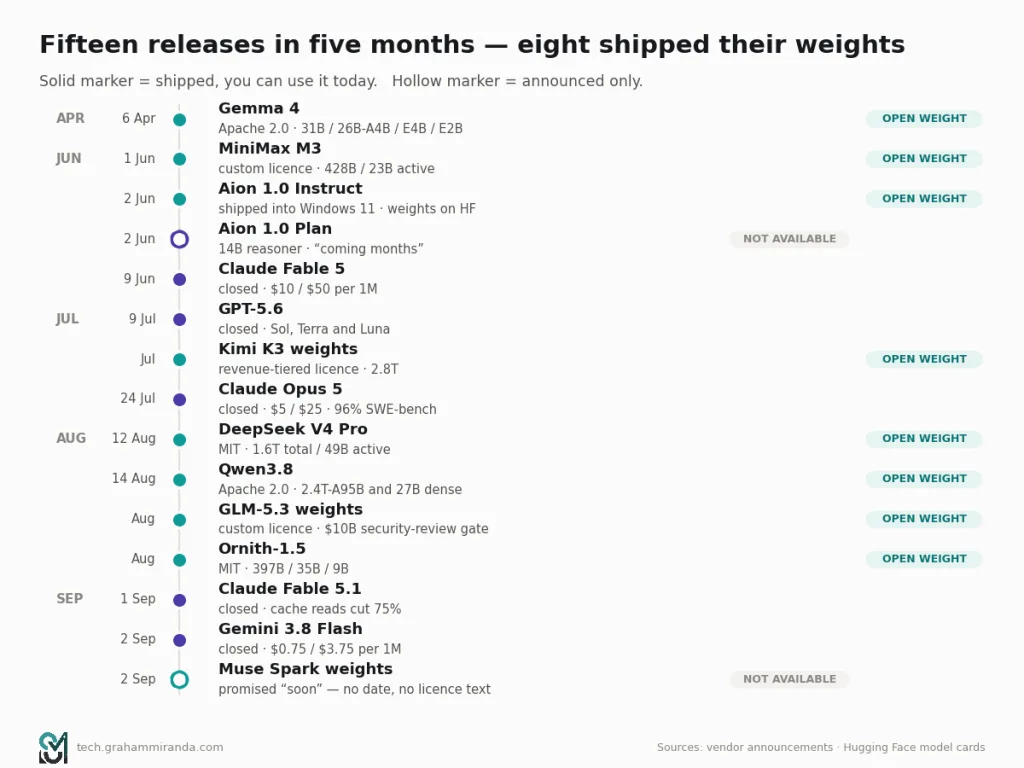
- 6 aprile 2026 — Google lancia Gemma 4 sotto licenza Apache 2.0, che rappresenta un cambiamento rispetto ai termini personalizzati di Gemma 3. Quattro varianti: 31B densa, 26B con 4B attivi (MoE), E4B a circa 8B ed E2B a 5,1B in totale con 2,3B attivi. 256K di contesto sui modelli di grandi dimensioni, 128K sulla serie E. Tutti supportano l’input di testo, immagini e video; E2B ed E4B aggiungono l’audio nativo.
- 1° giugno 2026 — MiniMax M3. 428 miliardi in totale / 23 miliardi attivi, 1 milione di contesti, multimodalità nativa, un nuovo operatore di attenzione sparsa, pesi su Hugging Face. Argomento trattato in modo approfondito nel mio precedente articolo sull'hardware locale per l'intelligenza artificiale.
- 2 giugno 2026 — Microsoft annuncia Aion 1.0 alla conferenza Build. Una famiglia di modelli integrati direttamente in Windows 11: Aion 1.0 Instruct (compatibile con la CPU, disponibile in Edge Canary a partire dalla versione 150.0.4070) e Aion 1.0 Plan, un modello di ragionamento e richiamo di strumenti con 14 miliardi di parametri e una finestra di contesto di 32K.
- 9 giugno 2026 — Claude Fable 5. Livello massimo di Anthropic: $10/$50 per milione, contesto da 1 milione, output massimo di 128K.
- 9 luglio 2026 — OpenAI lancia GPT-5.6 in tre varianti: Sol ($5/$30), Terra ($2,50/$15) e Luna ($1/$6). La funzionalità informatica è integrata nel modello Sol anziché essere venduta come modello separato, con un accesso potenziato tramite il programma Trusted Access for Cyber di OpenAI.
- Luglio 2026 — Moonshot svela i pesi della Kimi K3. 2,8 trilioni di parametri, 1 milione di contesti, MXFP4 nativo, con licenza a livelli in base al fatturato.
- 24 luglio 2026 — Claude Opus 5. $5/$25, invariato rispetto a Opus 4.8. Anthropic sostiene che “raddoppi di gran lunga le prestazioni di Opus 4.8’ su Frontier-Bench v0.1 e ottenga un punteggio tre volte superiore a quello del modello che lo segue nella classifica su ARC-AGI 3.
- 12 agosto 2026 — DeepSeek V4 Pro esce dalla fase di anteprima con pesi con licenza MIT: 1,6 T in totale (alcune fonti arrotondano questa cifra a 1,7 T), 49 miliardi attivi, 1 milione di contesto, 893 GB di tensori BF16 e FP8, oltre a un modulo di decodifica speculativa DSpark. Terminal-Bench 2.1 a 87,9, HLE-with-tools a 60,0, CyberGym a 83,3. DeepSeek ha aumentato i prezzi delle API contemporaneamente.
- 14 agosto 2026 — Qwen 3.8, categoria pesi liberi sotto licenza Apache 2.0: un modello multimodale denso da 27 miliardi di parametri e un modello gigante da 2,4 terabyte-A95B, entrambi disponibili su Hugging Face e ModelScope, con un contesto nativo da 262.000 estendibile a 1 milione grazie a YaRN.
- Agosto 2026 — Pesi GLM-5.3 pubblicato su Hugging Face circa due settimane dopo il lancio dell'API. 753 miliardi di MoE, 1 milione di parole di contesto, 128K di output, BF16 e FP8.
- Agosto 2026 — Ornith-1.5. Tre modelli (397B MoE, 35B MoE con 3B attivi, 9B densi), basati su Qwen3.5 e Gemma 4 con pre-addestramento continuativo, con licenza MIT, che dichiarano un punteggio di 86 su SWE-bench Verified.
- 1° settembre 2026 — Claude Fable 5.1 e Mythos 5.1. Pensiero adattivo attivato di default, contesto da 1M, output da 128K. Il prezzo base rimane invariato a $10/$50, ma le letture dalla cache scendono a 75%, passando da $1,00 a $0,25 per milione.
- 2 settembre 2026 — Gemini 3.8 Flash a $0,75/$3,75, contesto di input da 1M, output da 66K, data di aggiornamento delle conoscenze a marzo 2026, con input di testo, immagini, video, audio e PDF.
- 2 settembre 2026 — Meta lancia Muse Spark 1.3 e la CLI di Muse Code.
Segnalato, attendibile, non confermato
- Meta renderà pubblici i pesi di Muse Spark “a breve”.” Quello è Mark Zuckerberg su X, senza data, senza numero di parametri, senza dettagli sull’architettura e senza testo della licenza. Meta non ha reso nota la dimensione del modello in nessuna delle sue versioni.
- Gemini Nano v4 è previsto per Android, mentre Nano v3 è attualmente limitato alla serie Pixel 10.
- Piano Aion 1.0 sarà disponibile al pubblico nei “prossimi mesi”; al momento solo Instruct è in versione di anteprima.
Voce di corridoio, proveniente da un'unica fonte; da considerare con cautela
- Tutto quello che avete letto sul prossimo prodotto di punta di Anthropic, OpenAI o Google. In un mercato in cui quattro laboratori hanno lanciato un modello tra i primi dieci in sole nove settimane, le voci sulle novità future hanno un’emivita di circa due settimane.
Un'altra cosa che vale la pena sottolineare, perché è una novità e quasi nessuno al di fuori del settore della sicurezza ne sta parlando. Claude Mythos 5.1 ottiene un punteggio di 60,9 su Terminal-Bench 4.0 — superiore al 55,8 di Fable 5.1 — e 95,51 TP3T su SWE-bench Verified. Non è in vendita.
Anthropic descrive Mythos come il suo “modello più avanzato per la ricerca nel campo della sicurezza informatica e delle scienze della vita”, ed è disponibile esclusivamente per esperti di sicurezza informatica e ricercatori nel campo delle scienze della vita sottoposti a verifica, attraverso due programmi di accesso riservato: il Cyber Verification Program e il Life Sciences Verification Program. Secondo le stesse parole di Anthropic, l’azienda è “in grado di renderlo disponibile solo a una serie di organizzazioni statunitensi, sebbene stiamo lavorando per ampliarne l’accesso”. Il Progetto Glasswing, l’iniziativa volta all’espansione dell’accesso, aveva raggiunto circa 150 organizzazioni in più di quindici paesi a partire da giugno 2026.
Il ragionamento si basa sul concetto di "doppio uso" — un modello eccellente nell'individuare le vulnerabilità lo è per entrambe le parti — e ritengo che sia difendibile. Ma occorre prestare attenzione alla conseguenza strutturale, poiché si tratta di un aspetto davvero nuovo: il modello che ha ottenuto il punteggio più alto in un benchmark pubblico di codifica è ora uno a cui la maggior parte del mondo non può accedere a nessun prezzo. La limitazione delle funzionalità per motivi di sicurezza, piuttosto che per ragioni commerciali, è destinata a diventare sempre più comune, non meno, e se ci si trova al di fuori degli Stati Uniti, questo è un motivo in più per prestare attenzione alla trasparenza dei pesi, che non ha nulla a che vedere con i costi.
Mostra immagine Nove mesi, dodici versioni significative, quattro delle quali senza limiti di peso. Le barre piene indicano versioni già disponibili o l'accesso all'API che è possibile acquistare oggi; i contorni tratteggiati indicano versioni annunciate ma non ancora disponibili.
Parte seconda: Cosa distingue effettivamente i modelli Frontier al momento
Ecco la scomoda verità riguardo alla vetta di quella classifica: Per la maggior parte del lavoro che dovrai effettivamente svolgere, gli otto modelli principali sono intercambiabili.
Non lo dico per fare il contrarian. Lo dico perché il differenziale dell’indice aggregato tra Claude Fable 5.1 a 65,7 e GLM-5.3-Flash a 57,5 è di otto punti, e GLM-5.3-Flash costa $0,15 per milione di token immessi, contro i $10,00 di Fable. Si tratta di un Differenza di prezzo pari a 67 volte per una differenza di prestazioni pari a 12% nel punteggio composito, e i punteggi compositi riducono proprio le differenze che contano per te, mentre amplificano quelle che non contano.
Quindi la domanda utile non è “quale modello sia il migliore”, bensì “in cosa eccelle effettivamente ciascuno di essi e se ciò coincide con la mia settimana”.”
Le quattro cose che differiscono davvero
1. Affidabilità agenziale a lungo termine. Questo è il vero fattore di differenziazione per il 2026 ed è misurato in modo inadeguato. Opus 5 di Anthropic è esplicitamente posizionato come “un miglioramento radicale per la classe Opus che alimenta agenti a lungo termine” — non come un modello più intelligente, ma come un modello che non si blocca alla sesta ora. Le prove a sostegno di questa classe di miglioramenti risiedono nei benchmark agenti (Terminal-Bench, OSWorld, Frontier-Bench) piuttosto che nei benchmark basati sulla conoscenza, e tali benchmark sono recenti, soggetti a rumore e sensibili alle strutture di supporto.
2. L'economia della cache. La novità principale di Fable 5.1 non è stata un salto di qualità in termini di prestazioni. Si è trattato invece di una riduzione delle letture dalla cache pari a 75%, da $1,00 a $0,25 per milione di token — che, secondo MarkTechPost, comporta un costo inferiore di circa 25% per i flussi di lavoro tipici e fino a 45% per quelli basati su agenti. Per qualsiasi agente che rilegga ad ogni turno un prompt di sistema di grandi dimensioni o un codice sorgente, il costo della cache incide maggiormente sulla fattura mensile rispetto alla scelta del modello. Nessuno lo inserisce in una classifica.
3. Navigazione e utilizzo degli strumenti. GPT-5.6 Sol ottiene un punteggio di 90,41 TP3T su BrowseComp — 92,21 TP3T con l’impostazione “Ultra reasoning”. Si tratta di un punto di forza specifico e documentato e, se il tuo carico di lavoro riguarda la ricerca e la sintesi piuttosto che la scrittura e la verifica del codice, vale più di due punti dell’indice aggregato.
4. Prezzo per risposta adeguata. Gemini 3.8 Flash a un indice di 58,7 per un input $0,75 è l'elemento con il prezzo più palesemente errato sulla piattaforma rispetto alla frontiera chiusa. GLM-5.3-Flash a 57,5 per un input $0,15 è l'elemento con il prezzo più palesemente errato in assoluto.
La tabella dei prezzi, poiché rappresenta la decisione effettiva
| Modello | Input /1M | Uscita /1M | Dati in cache /1M | Contesto |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M / 128K in uscita |
| Claude Opus 5 | $5.00 | $25.00 | — | 1M / 128K in uscita |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonetto 5 | $2.00 | $10.00 | — | 1M / 128K in uscita |
| GLM-5.3 | $1.40 | $4.40 | — | 1M / 128K in uscita |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1 milione / 66.000 in uscita |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1 milione |
| Muse Spark (Collaboratori) | $0.10 | $0.20 | $0.002 | — |
Vale la pena dare un’altra occhiata a quell’ultima riga. Il livello “Contributors” di Meta prevede un input di $0.10 e un output di $0.20, con la possibilità che i tuoi dati vengano utilizzati per l’addestramento. Quello non è un prezzo; è uno scambio. È anche, per quanto mi risulta, l’espressione più onesta del vero modello di business che si cela dietro molte deduzioni superficiali, e preferirei che fosse indicato in una tabella dei prezzi piuttosto che nascosto in un accordo sui dati (DPA).
Mostra immagine Da un lato l'intelligenza, dall'altro il prezzo su una scala logaritmica. Otto punti dell'indice separano la parte superiore del grafico da quella inferiore; i prezzi sono distanziati di 67×. La frontiera efficiente si trova in basso a destra, e quasi nessuno acquista in quel punto.
Il cambiamento nell'API di cui nessuno ti ha avvertito
La versione 5.1 di Fable presenta tre modifiche che comportano incompatibilità: l'uso forzato degli strumenti è stato eliminato, i blocchi di riflessione sono ora specifici per ciascun modello e le modifiche apportate ai messaggi di sistema o agli strumenti nel corso di una conversazione generano ora errori anziché essere accettate silenziosamente.
Quel terzo agente causerà problemi. Molti set di agenti modificano il prompt di sistema o l’elenco degli strumenti tra un turno e l’altro — aggiungendo uno strumento all’avvio di un’attività secondaria, o riducendo le istruzioni per risparmiare contesto. Su Fable 5.1 questo ora genera un errore. Se aggiorni l’ID di un modello in un file di configurazione e il tuo agente inizia a restituire errori 400 al quarto turno, ecco il motivo.
La lezione generale, che vale più di quella specifica: Nel 2026, l'aggiornamento di un modello consisterà in una migrazione dell'API. Scrivi gli ID dei tuoi modelli in modo che sostituirne uno richieda solo una modifica di una riga, e fissali. Dovrai apportare nuovamente quella modifica entro un trimestre.
Terza parte: La frontiera del peso libero e la trappola della licenza
Questa è la parte della storia del 2026 che trovo davvero entusiasmante, ma è anche quella in cui il marketing è più fuorviante.
Il divario in termini di capacità è di circa sei mesi
Guardate quali risultati hanno ottenuto le categorie di peso aperte tra giugno e agosto 2026:
- DeepSeek V4 Pro: 1,6 T in totale, 49 B attivi, licenza MIT, Terminal-Bench 2.1 a 87,9. Si tratta di un valore Terminal-Bench superiore a quello della maggior parte dei modelli chiusi pubblicati quest'anno.
- Ornith-1.5-397B: 86 su SWE-bench (verificato), 86,1 su Terminal-Bench 2.1 rispetto all’85,0 di Claude Opus 4.8 e 92,8 su GPQA Diamond. Licenza MIT, 262K di contesto nativo estendibile a circa 1M con YaRN. Realizzato sulla base di Qwen 3.5 e Gemma 4 con pre-addestramento e post-addestramento continui.
- GLM-5.3: sesto posto nell’indice di Artificial Analysis con 59,5, davanti a GPT-5.6 Sol.
- Qwen 3.8: un modello da 2,4 trilioni di parametri distribuito sotto licenza Apache 2.0, oltre a una versione multimodale densa da 27 miliardi di parametri che, secondo Alibaba, supera il più grande Qwen3.7-Plus nelle attività di programmazione e d’ufficio.
Sei mesi fa, la visione onesta era che “i pesi aperti sono in ritardo di una generazione e più economici”. Ora quella visione è errata. La visione corretta è: Per quanto riguarda in particolare la codifica e il lavoro agenziale, i migliori modelli a peso aperto rientrano nei margini di errore della frontiera chiusa della generazione precedente e sono da 10 a 60 volte più economici.
Ornith-1.5 è il modello più interessante dell'anno e quasi nessuno ne ha sentito parlare
Vorrei soffermarmi su questo punto, perché si tratta di una novità autentica e non di un semplice risultato di estensione.
Ornith descrive la versione 1.5 come un’estensione dello “scaffolding autonomo in un ciclo di auto-miglioramento end-to-end”. In parole povere: il sistema propone autonomamente nuovi compiti di addestramento, genera per essi supporti specifici, produce soluzioni e ottimizza tutti e tre questi aspetti congiuntamente tramite il GRPO. Modelli più potenti consentono di proporre compiti più difficili; supporti migliori consentono di scoprire strategie migliori; risultati migliori forniscono un segnale di apprendimento più chiaro.
È stato addestrato sulla base di Qwen3.5 e Gemma 4 — ovvero utilizzando i modelli open source di altri — e supera Claude Opus 4.8 su Terminal-Bench 2.1, pur avendo 397 miliardi di parametri ed essendo distribuito sotto licenza MIT.
Se tale ciclo è generalizzabile, si tratta del risultato più significativo di questo articolo, perché significa che l’ecosistema aperto può migliorare senza che alcun laboratorio debba spendere somme astronomiche per un ciclo di pre-addestramento. Se non si generalizza — se ciò che stiamo osservando è un overfitting specifico per il benchmark derivante da un curriculum autogenerato — allora si tratta di un monito proprio su questo stesso argomento. Non so quale delle due ipotesi sia vera. E, per quanto ne so, nessuno al di fuori di Ornith lo sa. Ciò che vorrei vedere prima di scommetterci: una valutazione indipendente su compiti che non rientrassero nell’ambito del curriculum autogenerato e una linea di riferimento umana tenuta fuori dal test. Nessuna delle due cose esiste ancora.
E ora parliamo delle licenze, perché il mondo “open source” sta compiendo molte azioni disoneste
Ecco quanto ti costano effettivamente questi pesi in termini di obblighi:
| Modello | Licenza | Il problema |
|---|---|---|
| DeepSeek V4 Pro | MIT | Nessuno. Veramente open source. |
| Qwen 3.8 | Apache 2.0 | Nessuno. Veramente open source. |
| Gemma 4 | Apache 2.0 | Nessuna — e un vero miglioramento rispetto alle condizioni personalizzate di Gemma 3. |
| Ornith-1.5 | MIT | Non specificato. Verificare personalmente la scheda tecnica del modello prima della spedizione. |
| GLM-5.3 | Personalizzato | Aziende oltre Fatturato annuo $10B devono superare l'esame di Z.ai revisione della sicurezza prima di qualsiasi utilizzo commerciale. Z.ai si è trasferita lontano dal MIT per questa versione. |
| Kimi K3 | Personalizzato | A scaglioni in base al fatturato; per i fornitori con volumi elevati è richiesta un’attribuzione ben evidente. |
| MiniMax M3 | Personalizzato | L'uso commerciale richiede l'indicazione ben visibile “Realizzato con MiniMax M3”; è necessaria un'autorizzazione scritta separata come indicato sopra $20M fatturato annuo. |
| Muse Spark | Sconosciuto | Annunciato come “in arrivo”. Non è presente alcun testo relativo alla licenza. |
Tre osservazioni. Ho esaminato in dettaglio le clausole scritte in piccolo relative alle prime tre di queste in Kimi K3 vs Fable 5.1 vs GLM-5.3, quindi qui mi limiterò a illustrare cosa è cambiato da allora.
Innanzitutto, i gate sono destinati agli hyperscaler, non a te. Una soglia di fatturato di $10 miliardi esclude praticamente tutti i lettori di questo articolo. Se sei un’azienda tedesca di medie dimensioni (Mittelstand), un’agenzia, una società di consulenza o uno sviluppatore indipendente, la risposta concreta per GLM-5.3 e Kimi K3 è: non hai nulla da temere.
In secondo luogo, “va bene” non equivale a “la tua revisione legale va bene”.” Una licenza personalizzata significa che qualcuno ti fa pagare per leggerla. Una licenza MIT o Apache 2.0 significa che qualcuno la legge in novanta secondi e passa oltre. Per gli acquisti aziendali, questa differenza vale più di quattro punti di benchmark ed è l’argomento più forte a favore di DeepSeek V4 Pro e Qwen3.8 rispetto a GLM-5.3 in un prodotto commerciale.
In terzo luogo, prestate attenzione alla direzione di marcia. Z.ai è passata dalla licenza MIT su GLM-5.2 a una licenza proprietaria con un controllo di sicurezza su GLM-5.3. DeepSeek ha seguito il percorso opposto, mantenendo la licenza MIT e aumentando al contempo i prezzi delle API — il che rappresenta una strategia coerente: far pagare per la comodità, fornire gratuitamente i pesi e lasciare che i fornitori di servizi di inferenza competano sul servizio offerto. I pesi liberi non sono un movimento. Sono una strategia commerciale, e le strategie cambiano a ogni nuova versione. Non progettare un’architettura di prodotto che presupponga che la versione dell’anno prossimo utilizzi la licenza di quest’anno.
Il termine “open source” dovrebbe essere abbandonato quando si parla di modelli
Nessuna di queste è open source nel senso inteso dall’OSI, ad eccezione di quelle con licenza MIT e Apache 2.0 — e anche queste rilasciano i modelli senza rendere pubblici i dati di addestramento o il codice di addestramento, il che rappresenta una differenza sostanziale rispetto al software open source.
Il vocabolario che utilizzo e che consiglio:
- Categoria "Open" — È possibile scaricare ed eseguire i parametri. Non dice nulla riguardo alle condizioni.
- Con licenza aperta — MIT, Apache 2.0 o equivalente. Nessuna limitazione relativa ai ricavi, nessun obbligo di attribuzione, nessuna restrizione relativa al campo di utilizzo.
- Open source — pesi, codice di allenamento e composizione dei dati, con una licenza approvata dall’OSI. Quasi nulla in questo campo soddisfa tali requisiti.
Se un fornitore parla di “modello open source” e intende il primo, non si tratta propriamente di una bugia, ma è quel tipo di imprecisione che finisce in un documento di appalto e poi dà luogo a una controversia.
Mostra immagine Le funzionalità si stanno uniformando. Le licenze, invece, presentano differenze sempre maggiori. Per la maggior parte degli acquirenti commerciali, è la colonna di destra a determinare la scelta di acquisto, non il punteggio.
Parte quarta: Il problema del benchmark
SWE-bench Verified ora si presenta così:
| Classifica | Modello | Punteggio |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonetto 5 | 85.2% |
| 8 | Codice GPT-5.3 | 85% |
Tre modelli con una differenza di appena un punto percentuale ai vertici della classifica. Quel benchmark è ormai superato. Non è in grado di fornire alcuna informazione utile sulla differenza tra Opus 5, Mythos 5 e Fable 5, e chiunque lo citi come criterio di acquisto nel settembre 2026 sta facendo riferimento a uno strumento ormai superato.
Questa è la situazione generale in cui versa attualmente la valutazione dell’IA, e presenta quattro modalità di fallimento che vale la pena menzionare:
Saturazione. Quando i punteggi più alti si concentrano al di sopra di 90%, le differenze residue sono determinate principalmente dal rumore delle etichette e dai dettagli del cablaggio, piuttosto che dalle capacità del sistema. SWE-bench Verified si trova in quella fascia. GPQA Diamond è vicino.
Sensibilità dello scaffold. Lo stesso modello ottiene punteggi diversi a seconda del ciclo dell’agente che lo circonda: la politica di riprova, il set di strumenti, la gestione del contesto, il numero di turni a sua disposizione. I risultati di Terminal-Bench e OSWorld sono particolarmente sensibili a questo aspetto. Spesso, due laboratori che riportano lo stesso benchmark non stanno eseguendo lo stesso esperimento.
Contaminazione. Ogni benchmark pubblico finisce prima o poi per infiltrarsi nei corpora di addestramento. La risposta è stata una corsa agli armamenti fatta di benchmark privati sempre più recenti, complessi e difficili — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science — che risolve il problema della contaminazione ma ne crea uno nuovo: non è possibile verificare in modo indipendente un benchmark privato.
Selezione. I laboratori pubblicano i benchmark in cui si sono classificati al primo posto. Anthropic si è distinta con Frontier-Bench e ARC-AGI-3 per Opus 5. OpenAI si è distinta con Agents’ Last Exam e un Coding Agent Index per GPT-5.6. Z.ai si è distinta con CyberGym. Nessuno di loro sta mentendo. Tutti stanno facendo una scelta.
Ciò in cui ripongo davvero fiducia nel settembre 2026
I tornei a coppie rispetto a quelli individuali. L’indice di Artificial Analysis ha il pregio di essere gestito da una terza parte, secondo un metodo prestabilito, sulla base di nove valutazioni condotte su 190 modelli. I suoi dati assoluti hanno scarso significato; il suo ordinazione è il segnale pubblico più giustificabile a disposizione.
Risultati normalizzati in termini di costo. Le affermazioni di Opus 5 di Anthropic sono un ottimo esempio di come riportare questi dati: “a meno di 0,51 TP3T dal punteggio massimo di Fable 5 a metà del costo’ su CursorBench 3.2, e superando Fable 5 su OSWorld 2.0 ”a un terzo del costo“. Si tratta di un’affermazione utile perché specifica il compromesso.
Efficienza dei token. Artificial Analysis ha osservato che Gemma 4 31B ha utilizzato solo 39 milioni di token di output per completare l’intero Intelligence Index. Per un carico di lavoro di tipo agentico, un modello che raggiunge la stessa risposta utilizzando un terzo dei token comporta un terzo dei costi e un terzo della latenza. Questo aspetto è sottovalutato ed è una delle poche metriche che si traduce direttamente in denaro.
Le tue valutazioni. Venti attività tratte dal tuo backlog effettivo, elaborate con tre modelli diversi e valutate da te. Ci vorrà un pomeriggio. Ti dirà più di tutte le classifiche citate in questo articolo messe insieme, ed è l’unica valutazione che, per definizione, non è viziata da alcun fattore esterno.
E c'è una cosa di cui diffido: qualsiasi dato relativo ai token al secondo o a un benchmark riportato senza un framework di test, una quantificazione e una data. Considerale come affermazioni relative all’ordine di grandezza.
Parte quinta: Il numero che si è effettivamente mosso — L’orizzonte temporale agenziale
Se dovessi trarre un solo dato da questo articolo, scegli proprio questo.
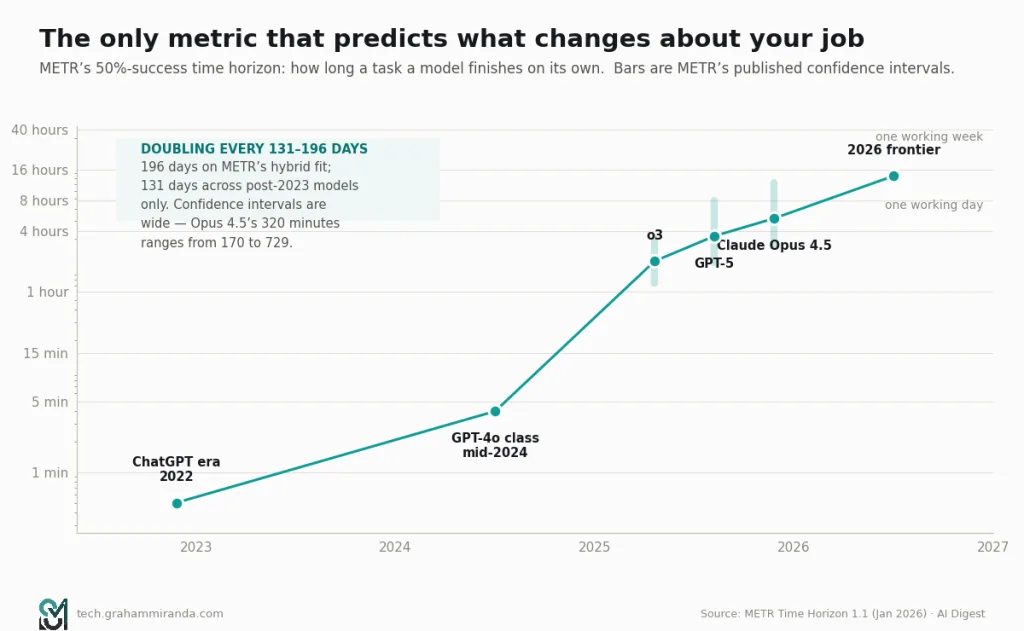
Il METR misura la durata dell’attività — espressa in ore-uomo — che un modello è in grado di portare a termine in modo autonomo con successo secondo il 50%. Si tratta di un indicatore più attendibile per rispondere alla domanda “questo sistema è in grado di svolgere il mio lavoro?” rispetto a qualsiasi benchmark basato sulla conoscenza, poiché coglie ciò che nella pratica risulta effettivamente un punto debole: non è il fatto di non conoscere la risposta, ma quello di riuscire a mantenere la coerenza abbastanza a lungo da arrivarci.
L'andamento, sulla base del lavoro svolto da METR e del monitoraggio effettuato da AI Digest:
| Periodo | 50% - orizzonte temporale di successo |
|---|---|
| 2022 (l'era del lancio di ChatGPT) | circa 30 secondi |
| Metà del 2024 (classe GPT-4o) | circa 4 minuti |
| Fine del 2025 (Claude Opus 4.5) | 320 minuti (~5,3 ore), IC [170, 729] |
| Frontiera 2026 | 14+ ore |
Il tempo di raddoppio è il punto controverso. La versione 1.1 di Time Horizon di METR, rilasciata il 29 gennaio 2026 — 228 attività, 31 delle quali con un impegno umano stimato di otto o più ore, migrate sul framework Inspect dell’UK AI Security Institute — riporta 196 giorni (7 mesi) su una combinazione di dati vecchi e nuovi, ma 131 giorni se si considerano solo i modelli successivi al 2023, il che è circa 20% più veloce rispetto ai 165 giorni indicati dalla metodologia precedente.
L'estrapolazione di una funzione esponenziale è il modo in cui le persone finiscono per mettersi in imbarazzo, quindi vorrei sottolineare con forza alcune avvertenze prima di utilizzare il dato.
Le riserve sono notevoli. Gli intervalli di confidenza di METR sono enormi: l’orizzonte temporale di 320 minuti di Opus 4.5 ha un intervallo compreso tra 170 e 729 minuti. Solo 5 delle loro 31 attività lunghe hanno valori di riferimento umani misurati; il resto sono stime. La composizione delle attività modifica la tendenza misurata. E ’il successo di 50% su un’attività ben specificata in un ambiente pulito“ è ben lontano dal ”successo di 50% sul proprio codice sorgente con una suite di test instabile e un processo di distribuzione non documentato“.”
Detto questo, la direzione non è in dubbio e l'ordine di grandezza è più o meno corretto. Secondo l'estrapolazione, gli agenti di frontiera raggiungeranno una durata delle attività autonome pari a circa un giorno lavorativo nel 2027 e a circa una settimana lavorativa nel 2028.
Perché è proprio questo il numero che conta
Poiché È l'unico indicatore in grado di prevedere quali cambiamenti interverranno nel tuo lavoro.
Un modello con un orizzonte temporale di 4 minuti è di tipo "autocomplete". Si rimane costantemente aggiornati e la qualità del modello determina la qualità dei suggerimenti.
Un modello con un orizzonte temporale di 5 ore è come un collega a cui dai istruzioni al mattino e con cui fai il punto a pranzo. Non sei nel giro; sei alla fine della catena. La qualità del modello determina quanto spesso il punto della situazione risulti doloroso.
Non disponiamo di una struttura gestionale per un modello con un orizzonte temporale di 40 ore. Ti ritroveresti a revisionare una settimana di lavoro a cui non hai assistito, in un codice che è cambiato mentre non guardavi, sulla base di specifiche che hai redatto prima ancora di sapere quali fossero i problemi.
Ogni argomentazione contenuta nel resto di questo articolo — sul "vibe coding", sulla verifica, su dove si trovi il collo di bottiglia — è in realtà un'argomentazione su ciò che accade man mano che quel numero aumenta. I modelli hanno un orizzonte temporale lungo. I nostri processi di revisione, invece, no.
Mostra immagine L'orizzonte temporale di successo del modello 50%, con gli intervalli di confidenza del METR riportati in modo trasparente. Gli intervalli sono sufficientemente ampi da essere rilevanti — e la tendenza rimane comunque valida al loro interno.
ATTO II — IL FUTURO DELLA PROGRAMMAZIONE VIBE
Parte sesta: Cosa significa oggi il “Vibe Coding”
Andrej Karpathy ha coniato il termine nel febbraio 2025 per descrivere qualcosa di specifico e un po’ malizioso: lasciarsi trasportare dall’atmosfera, dimenticare l’esistenza del codice, accettare le modifiche senza leggerle e lasciare che sia il modello a guidare. Era la descrizione di un modalità, ha detto, un po’ per scherzo, per quei progetti del fine settimana che si fanno tanto per divertirsi.
Diciotto mesi dopo, quella frase ha completato il suo intero ciclo di vita. È diventata un movimento, poi una qualifica professionale, poi un termine dispregiativo, poi la parola dell’anno secondo il Collins, poi una categoria di finanziamento per le start-up e ora — nell’unico sviluppo che conta davvero — una serie di pratiche ingegneristiche che non hanno più nulla a che vedere con quelle descritte da Karpathy.
Vorrei essere preciso riguardo a questa distinzione, perché le due cose vengono costantemente confuse e presentano profili di rischio opposti.
Codifica Vibe, nel senso originario del termine. Richiedi, accetta, esegui, richiedi di nuovo. Non leggere il diff. L'artefatto è usa e getta. È davvero fantastico, e lo faccio diverse volte alla settimana — per uno script che riorganizza un CSV, uno scraper usa e getta, una visualizzazione che guarderò una sola volta, un prototipo il cui unico scopo è concretizzare una conversazione. La caratteristica distintiva non è la velocità. È il fatto che nessuno ne dipenderà mai.
Ingegneria agentica, rilevamento della corrente. Scrivi una specifica. Fornisci all’agente una suite di test, un linter, un type checker e una sandbox. Lascialo in esecuzione per un’ora. Esamina attentamente le differenze. Esegui il merge seguendo le stesse procedure previste per una pull request creata da un utente. La caratteristica distintiva è che il risultato del modello viene considerato alla stregua del lavoro di un collega alle prime armi: utile, veloce, ma di cui non ci si fida.
Questi due prodotti condividono la stessa tecnologia, ma per il resto non hanno quasi nulla in comune. Se vuoi la versione professionale del secondo, ecco cosa il mio precedente articolo sul "vibe coding" nel 2026 tratta; questa sezione riguarda la direzione che sta prendendo questa pratica. Gli esiti catastrofici descritti nella Parte Ottava derivano tutti dall’applicazione delle pratiche della prima modalità alle poste in gioco della seconda modalità.
I dati relativi alle adozioni sono enormi e, per la maggior parte, non sono oggetto di contestazione
- 90% di sviluppatori utilizzano almeno uno strumento di intelligenza artificiale sul lavoro, secondo il sondaggio ’AI Pulse” di JetBrains (gennaio 2026). Il sondaggio di Stack Overflow del 2025 ha rilevato che 84% utilizzavano o intendevano utilizzare tali strumenti.
- Quasi 80% di nuovi sviluppatori su GitHub adottare Copilot entro la prima settimana (GitHub Octoverse 2025).
- Il 59% degli sviluppatori utilizza tre o più strumenti di programmazione basati sull'intelligenza artificiale in parallelo. Quella statistica è più eloquente del semplice dato relativo alle adozioni: il mercato non si è consolidato, ma si è frammentato in strumenti dedicati a compiti specifici.
I dati di mercato
| Strumento | Metrico | Fonte / data |
|---|---|---|
| GitHub Copilot | ~42%: quota in base al numero di utenti; oltre 20 milioni di utenti | Gartner / fornitore, 2026 |
| Cursore | $2B+ ARR; oltre 1 milione di utenti attivi al giorno; circa il 20–25% del mercato in termini di fatturato | Pubblicato nel febbraio 2026 |
| Claude Code | ~$2,5B di run-rate; 46% “i più amati” contro i 19% di Cursor | Pubblicato nell'aprile 2026 |
| Mercato degli agenti di codifica aziendali | ~$9,8–11B su base annua | Gartner, aprile 2026 |
Due aspetti saltano all’occhio. Copilot ha il maggior numero di utenti e il livello di soddisfazione più basso tra i primi tre. Claude Code ha la base installata più ridotta e, di gran lunga, il grado di affezionamento più elevato. Questo è il segno distintivo di un mercato in fase di transizione: l’operatore storico ha conquistato la distribuzione, lo sfidante ha conquistato il flusso di lavoro e gli utenti non hanno ancora completato il passaggio.
E il numero che mette tutto in discussione
La fiducia degli sviluppatori nei risultati forniti dall'intelligenza artificiale è scesa da circa 40% nel 2024 a 29% nel 2026. Da un altro sondaggio condotto da SonarSource è emerso che il 96% degli sviluppatori non si fida completamente della correttezza funzionale del codice generato dall'intelligenza artificiale.
Rifletteteci un attimo. L’utilizzo è aumentato. La fiducia è diminuita. Non si tratta di un paradosso; è proprio così che si presenta l’adozione matura di uno strumento. Nessuno “si fida” di una motosega. La si usa costantemente, con entrambe le mani, indossando dispositivi di protezione, e non le si volta mai le spalle.
Le persone che conoscono meglio questi strumenti sono quelle che li utilizzano con maggiore cautela. Si tratta di un segnale positivo, che però è del tutto assente nella maggior parte delle campagne di marketing dei fornitori.
Parte settima: Ti rende davvero più veloce? Le prove, in tutta onestà
È proprio qui che perdo alcuni lettori, ma preferisco perderli qui piuttosto che fuorviarli.
Lo studio randomizzato dice di no
METR ha condotto lo studio che tutti citano, nel luglio 2025: sviluppatori open source esperti, che lavoravano sui propri repository consolidati (oltre 1 milione di righe), assegnati in modo casuale, a livello di attività, all’utilizzo o meno degli strumenti di IA disponibili all’inizio del 2025.
Risultato: 19% più lento con l'IA.
E la conclusione che conta più del titolo: gli sviluppatori ritenevano di essere stati circa 20% più veloci. Hanno sovrastimato l'impatto dell'intelligenza artificiale sul loro tempo di circa 40 punti percentuali.
Il follow-up del 2026 non ha risolto la questione, ma ha rivelato qualcosa di peggio
METR ha cercato di ripetere l'esperimento e, nel febbraio 2026, ha pubblicato un post insolitamente sincero sui motivi per cui il progetto non ha funzionato.
- La selezione non è andata a buon fine. Gli sviluppatori si rifiutano sempre più spesso di lavorare senza poter accedere all'intelligenza artificiale, anche a $50 all'ora.
- La selezione dei compiti è stata viziata. Il 30–50% degli sviluppatori ha ammesso di aver evitato i compiti che si aspettavano venissero gestiti bene dall’IA. Un partecipante lo ha espresso perfettamente: “Evito argomenti del tipo: ”L’intelligenza artificiale riesce a portare a termine un lavoro in sole 2 ore, mentre io ci metto 20 ore”».”
- Il monitoraggio del tempo ha smesso di funzionare Un tempo gli sviluppatori eseguivano più agenti contemporaneamente.
I loro dati provvisori grezzi relativi al 2026 variavano da −18% a −4% — un rallentamento comunque presente, anche se meno marcato — ma gli stessi autori del METR lo descrivono come “una prova solo molto debole”, dato il bias di selezione.
Rileggi il secondo punto, perché rappresenta la scoperta più interessante di tutta la letteratura sull'argomento ed è nascosta in una nota metodologica. Se gli sviluppatori assegnassero sistematicamente i compiti adatti all'IA lontano Da uno studio volto a misurare i benefici dell’IA, emerge che lo studio tenderà a sottostimare tali benefici. Ciò implica inoltre che, nella pratica, gli sviluppatori stiano già effettuando il routing — il che è proprio il comportamento che rende preziosi questi strumenti e rende difficile condurre un RCT.
I sondaggi dicono di sì, e di gran lunga, ma i risultati sono gonfiati
L'indagine condotta da METR nel maggio 2026 (n=349: 87 ingegneri del software, 71 ricercatori, 129 docenti universitari e dottorandi, 48 fondatori e dirigenti; in media 12 anni di esperienza nella programmazione, 19 mesi di utilizzo di strumenti di IA) ha adottato un approccio ingegnoso. Ha distinto valore da velocità.
Il rispondente mediano ha dichiarato un Moltiplicatore di velocità 3× ma solo un Un aumento compreso tra 1,4 e 2 volte del valore del loro lavoro. A posteriori, hanno stimato un valore pari a 1,3 volte nel marzo 2025; prevedono invece un valore pari a 2,5 volte entro marzo 2027.
METR afferma chiaramente che il valore è l'elemento a cui i progettisti dei sondaggi attribuiscono effettivamente importanza, e che gli intervistati ragionano naturalmente in termini di velocità — il che corrisponde esattamente al bias che l'RCT del 2025 ha quantificato in 40 punti percentuali.
Quindi: secondo i dati auto-dichiarati il valore è 3×. Secondo i dati auto-dichiarati corretti in base a ciò che le persone intendono, il valore è compreso tra 1,4× e 2×. L'unica misurazione controllata di cui disponiamo indica un valore di 0,81×.
I dati organizzativi indicano che “dipende da te, non dallo strumento”
Il rapporto DORA del 2026 (Google Cloud, maggio 2026) è il documento più utile pubblicato quest’anno su questo argomento, ed è utile proprio perché smette di discutere sullo strumento.
- ROI stimato per il primo anno pari a 39% per un’organizzazione di ingegneria composta da 500 persone, con circa un Ritorno sull'investimento in 8 mesi — $11,6 milioni di valore a fronte di $8,4 milioni di investimento.
- A Curva a J: la produttività subisce un calo prima di registrare un aumento, a causa dell’adattamento del flusso di lavoro, dei costi legati alla verifica del codice e delle modifiche a valle relative alle fasi di test e approvazione.
- Il tasso di insuccesso delle modifiche è aumentato da 5% a 6% post-adozione, con un costo pari a $344.000 in termini di tempi di inattività nel loro calcolo di esempio.
- E la tesi: “I maggiori benefici derivanti dagli investimenti nell’intelligenza artificiale non derivano dagli strumenti in sé, ma da un approccio strategico incentrato sul sistema organizzativo sottostante”.”
Quell'ultima frase rappresenta il consenso per il 2026, ammesso che ce ne sia uno. L'intelligenza artificiale potenzia qualsiasi sia la tua attuale pratica ingegneristica. Test efficaci, revisione del codice concreta, rollback rapidi, responsabilità ben definite: l’IA rende queste organizzazioni significativamente più veloci. Test inadeguati, revisioni di facciata, distribuzioni manuali, responsabilità poco chiare: l’IA fa sì che queste organizzazioni falliscano più rapidamente e in misura maggiore.
Come conciliare tutto questo
Non credo che questi risultati siano effettivamente in contraddizione tra loro. Ecco la sintesi a cui sono giunto, che considero comunque provvisoria:
Gli strumenti di programmazione basati sull'intelligenza artificiale rappresentano un grande vantaggio quando si tratta di attività poco familiari e un piccolo svantaggio quando si tratta di attività che si conoscono molto bene. Su un codice che conosci alla perfezione, in un linguaggio che padroneggi, su un problema che hai già risolto in passato, sei più veloce del ciclo “revisione e correzione”. Su un framework che non conosci, un linguaggio che usi due volte all’anno, codice boilerplate, strutture di test, migrazioni o un codice che non apri da otto mesi, il modello è rivoluzionario.
METR ha condotto uno studio su sviluppatori esperti, analizzando i loro repository già consolidati — l’unico scenario in cui ci si aspetterebbe di ottenere il guadagno minore. Ciò non rende il risultato errato. Lo rende specifico e dovrebbe indurre a diffidare di chiunque lo citi come verdetto generale, in un senso o nell’altro.
La seconda riconciliazione: i benefici sono reali, ma si manifestano in un ambito diverso da quello in cui la gente se li aspetta. Non “questa funzionalità ha richiesto quattro ore invece di sei”. Piuttosto: la migrazione a cui non sarebbe mai stata data priorità è stata portata a termine; la copertura dei test, che sarebbe rimasta per sempre a 40%, è salita a 75%; la documentazione esiste. Questi aspetti non emergono da uno studio sui tempi di completamento delle attività, eppure costituiscono la maggior parte del valore effettivo.
Parte ottava: Il disegno di legge sulla sicurezza è arrivato, ed è dettagliato
Se la settima parte era sgradevole, questa è quella che la gente tende a saltare. Vi prego di non saltarla.
Le misurazioni
Veracode ha testato oltre 100 modelli linguistici di grandi dimensioni su 80 attività di programmazione in Java, Python, C# e JavaScript:
- 45% di esempi di codice generati dall'intelligenza artificiale presentano una vulnerabilità inclusa nella Top 10 dell'OWASP. Il tasso di superamento è rimasto sostanzialmente invariato fino all’inizio del 2026: i modelli sono diventati molto più intelligenti, ma non più sicuri.
- Java ha registrato il risultato peggiore, con un tasso di errore pari a 72%.
- 86% non ha superato il test di difesa contro gli attacchi cross-site scripting. 88% erano vulnerabili all'iniezione di log.
Apiiro ha applicato il proprio motore di analisi approfondita del codice ai repository aziendali delle società incluse nella classifica Fortune 50 da dicembre 2024 a giugno 2025:
- Gli sviluppatori assistiti dall'intelligenza artificiale generano commit a da tre a quattro volte rispetto alla media dei loro coetanei.
- Presentano i risultati delle verifiche di sicurezza su dieci volte il tasso.
- I percorsi di escalation dei privilegi sono aumentati del 322%. I difetti di progettazione architettonica sono aumentati del 153%.
USENIX Security 2025 ha analizzato 576.000 esempi di codice generati dall'intelligenza artificiale:
- Circa 20% pacchetti di riferimento che non esistono.
- I nomi di pacchetti allucinati del tipo 43% si ripetono in modo coerente in prompt simili — che è proprio l’elemento che trasforma un bug in una superficie di attacco. Un’allucinazione prevedibile è uno slot che un aggressore può pre-registrare su npm o PyPI.
Il radar di sicurezza “Vibe” del Georgia Tech ha risalito i CVE attraverso la cronologia di Git per attribuirli agli strumenti di intelligenza artificiale:
| Mese (2026) | CVE attribuiti |
|---|---|
| Gennaio | 6 |
| febbraio | 15 |
| marzo | 35 |
74 casi confermati in totale; secondo le stime dei ricercatori, il numero effettivo nell’ambito dell’open source è da cinque a dieci volte superiore.
RedAccess indicizzato in modo approssimativo 380.000 applicazioni con codifica "vibe" accessibili al pubblico su Lovable, Base44, Replit e Netlify. Circa 5.000 di questi presentavano fughe di dati sensibili aziendali o personali.
Gli episodi, avvenuti in data
| Data | Incidente |
|---|---|
| Luglio 2025 | Replit AI cancella un database di produzione; 1.200 record relativi ai dirigenti sono stati interessati dall'incidente, mentre sono stati generati 4.000 account fittizi |
| febbraio 2026 | Un'app EdTech sviluppata da Lovable ha reso pubblici 18.697 record di utenti, tra cui 4.538 account di studenti |
| Aprile 2026 | L'adorabile vulnerabilità di BOLA: ogni progetto precedente al novembre 2025 è accessibile con cinque chiamate API |
| 26 aprile 2026 | Cursore “9-second wipe”: il database di un’azienda cancellato insieme ai relativi backup |
| 30 aprile 2026 | Gemini CLI: vulnerabilità CVSS-10 relativa all'esecuzione remota di codice nei flussi di lavoro CI, risolta |
Il caso Amazon, che intendo gestire con cautela
Avrete sicuramente sentito parlare della vicenda di Amazon. Quattro incidenti di livello Sev-1 tra dicembre 2025 e marzo 2026: un’interruzione di 13 ore del servizio AWS Cost Explorer in Cina, tempi di consegna errati nei carrelli degli acquisti il 2 marzo che, secondo quanto riportato, sono costati circa 120.000 ordini, e un incidente di 6 ore il 5 marzo, durante il quale gli ordini provenienti dal Nord America sarebbero crollati del 99%.
Secondo quanto riportato dal Financial Times, da Fortune e da The Register, alcuni documenti interni di Amazon sono stati collegati a quelle che sono state definite “modifiche assistite dall’IA di nuova generazione”, con avvertimenti sul fatto che la rapida generazione di codice stesse mettendo a rischio la sicurezza del sistema. Amazon ha contestato l'esistenza di un nesso causale diretto, affermando in alcune risposte che nessuno degli incidenti ha coinvolto codice scritto dall'intelligenza artificiale.
Vorrei sottolineare tre aspetti di questa storia, piuttosto che ripeterla come se fosse un fatto:
- La cifra relativa all'impatto più citata (6,3 milioni di ordini persi) proviene da un post pubblicato su Medium, non da Amazon né da un articolo di un testata giornalistica specifica. Consideratela una stima, non un dato certo.
- Secondo quanto riferito, la spedizione del 5 marzo è partita senza documentazione formale o approvazione. Si tratta di un errore di processo. La velocità dell'IA ha fatto sì che possibile affinché avvenisse più rapidamente; ciò non ha reso facoltativo il passaggio di approvazione.
- È proprio questa distinzione il punto centrale, ed è per questo che ho deciso di inserire questa storia. La causa del malfunzionamento non è quasi mai “l’IA ha scritto codice errato”, bensì “l’IA ha scritto il codice più velocemente di quanto ci mettesse il processo che avrebbe dovuto controllarlo”.”
Cosa comporta questo, in pratica
Non significa “smettere di usare questi strumenti”. Nessuno che sia serio sostiene una cosa del genere, e la stessa nota di ricerca della CSA — che raccoglie gran parte di quanto detto sopra — pone l’accento sulla governance piuttosto che sull’astinenza.
La struttura pratica, nell'ordine in cui la implementerei:
- Considerare qualsiasi strumento di intelligenza artificiale con accesso alle credenziali come un sistema privilegiato. È uno. Analizza i suoi token di conseguenza.
- SAST, analisi delle dipendenze e rilevamento delle informazioni riservate ad ogni commit. Non ogni notte. Ad ogni commit. La frequenza dei commit è aumentata di tre o quattro volte; una scansione notturna equivale ora, in termini effettivi, a un ciclo di feedback di tre giorni.
- Analisi della composizione del software, in particolare per i pacchetti “allucinati”. Questo è il controllo più economico e con il miglior rapporto qualità-prezzo della lista, poiché il valore 20% è molto elevato e il guasto è del tutto impercettibile.
- Una politica scritta che stabilisca che l’assistenza fornita dall’intelligenza artificiale non venga utilizzata senza previa verifica in materia di autenticazione, crittografia, autorizzazione o codice di pagamento. Queste sono le quattro aree in cui un errore impercettibile è sia probabile che catastrofico, e in cui l’occhio del revisore è fondamentale.
- Estendi la tua SBOM per registrare la provenienza degli strumenti di intelligenza artificiale. Quando il prossimo studio sull’attribuzione in stile Georgia Tech arriverà sul tuo codice, vorrai essere in grado di rispondere alla domanda da solo.
- Considerare le piattaforme di codifica delle vibrazioni di terze parti come fornitori SaaS. I numeri di RedAccess sono ciò che accade quando nessuno interviene.
Niente di tutto ciò è straordinario. Per la maggior parte si tratta di ciò che un’azienda competente faceva già nel 2019. La novità è che i volumi sono aumentati di un ordine di grandezza, quindi i controlli devono essere automatici anziché basati sulla cultura aziendale.
Mostra immagine I dati sulla sicurezza provengono da Veracode, Apiiro, USENIX e Georgia Tech. Si noti l’andamento: la velocità dei commit è aumentata di 3–4 volte, mentre i problemi di sicurezza rilevati sono aumentati di 10 volte. Il divario tra questi due moltiplicatori è il vero problema.
Parte nona: Cosa ha sostituito il “Vibe Coding”
La pratica che funziona davvero nel 2026 ha un nome — anzi, diversi nomi in competizione tra loro, ed è proprio questo che dimostra che è reale — ed è più o meno l’opposto delle “vibrazioni”.
Chiamalo sviluppo basato sulle specifiche, ingegneria agentica, o ingegneria del contesto. La struttura comune:
1. La specifica è ora il codice sorgente
Non un ticket di Jira. Un vero e proprio documento: cosa fa il sistema, cosa non deve fare, quali sono le interfacce, come si presenta una versione “completata”, quali sono le modalità di errore. Inserito nel repository, con versione, revisionato.
Sembra quasi un ritorno al 1998, ma non lo è. La differenza è che nel 1998 le specifiche erano un input per una persona che le reinterpretava, e perdevano di validità nel momento stesso in cui iniziava la scrittura del codice. Nel 2026 le specifiche costituiscono l’input per un processo che rigenera l’implementazione a basso costo — il che significa che quando i requisiti cambiano, si modificano le specifiche e si ricava nuovamente l’implementazione, anziché applicare patch a un codice che non corrisponde più a nessuna descrizione scritta di sé stesso.
La situazione economica si è ribaltata. Quando l'implementazione era costosa e la definizione delle specifiche era poco onerosa, si definivano le specifiche in modo approssimativo e si investiva nel codice. Quando l'implementazione è poco onerosa e la definizione delle specifiche rappresenta il collo di bottiglia, si investe nelle specifiche.
2. La suite di test costituisce il confine di fiducia
Un agente in grado di eseguire i test e di iterare su di essi è uno strumento fondamentalmente diverso da uno che non ne è in grado. Questo è il cambiamento con il maggiore impatto che la maggior parte dei team possa apportare, e non ha nulla a che vedere con l’intelligenza artificiale: è semplicemente che l’intelligenza artificiale ha finalmente reso evidente il ritorno sull’investimento (ROI) della copertura dei test a persone che non si sarebbero mai lasciate convincere da argomentazioni tecniche.
Versione pratica: L'agente riceve una sandbox, un comando di test, un comando lint e un controllo dei tipi, e l'operazione non viene completata finché tutti e quattro non risultano verdi. Tutto il resto è negoziabile.
3. La revisione è passata dalle righe ai diff, per arrivare al comportamento
La revisione riga per riga non è scalabile per un diff di mille righe generato da un agente, e fingere il contrario è il primo passo verso l’approvazione automatica.
Ecco invece cosa funziona, in ordine approssimativo di importanza:
- Esamina le specifiche, non l'implementazione. Se le specifiche sono corrette e i test vengono superati, l'implementazione è solo un dettaglio.
- Esamina la forma del differenziale — quali file sono stati modificati, quali dipendenze sono state aggiunte, cosa è stato eliminato. La maggior parte dei problemi legati agli agenti è visibile a questo livello: un file inaspettato, una nuova dipendenza, un’eliminazione non richiesta.
- Esaminare in modo specifico le righe relative alla sicurezza. Autenticazione, criptografia, autorizzazione, pagamenti, qualsiasi cosa che riguardi i dati personali. Questa è solo una piccola parte di qualsiasi diff.
- Non rivedere il testo standard. Del resto, non lo stavi mai recensendo davvero.
4. L'imbracatura è importante quanto il modello
Questo aspetto viene sottovalutato. Lo stesso modello, in due diversi cicli di agenti, produce risultati di qualità estremamente diversa — ed è proprio questo il motivo per cui i confronti tra laboratori sulla base dei benchmark sono così insidiosi.
Gli aspetti fondamentali: come viene gestito il contesto man mano che l'esecuzione si protrae, se l'agente è in grado di individuare i propri errori di test, se può esplorare il repository o solo ciò che gli viene fornito, se dispone di una fase di pianificazione separata da quella di esecuzione e se sa quando fermarsi e chiedere conferma.
Le note di rilascio della versione 1.3 di Muse Spark di Meta sono interessanti proprio su questo punto: descrivono come il modello ora ponga domande chiarificatrici in caso di prompt ambigui, chieda aiuto quando si trova in difficoltà e richieda conferma prima di compiere azioni con conseguenze significative. Non si tratta di miglioramenti a livello di intelligenza. Si tratta di buone maniere., e sono proprio le buone maniere a garantire la sopravvivenza di un agente con una visione a lungo termine.
5. Il routing dei modelli è ormai una prassi standard
Nessuno che si intenda davvero usa un unico modello per tutto — ho illustrato una versione con due modelli di questo argomento in GLM-5.3-Flash contro MiniMax M3 in OpenCode. Il modello che si è ormai consolidato:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
 "description": "Architettura, causa principale, qualsiasi cosa in cui sbagliare comporti un costo elevato",
 "model": "anthropic/claude-fable-5-1"
    },
    "build": {
 "description": "La parte principale dell’implementazione — orizzonte temporale lungo, sensibile ai costi",
 "model": "anthropic/claude-opus-5"
    },
    "bulk": {
 "description": "Lavoro meccanico ad alto volume in cui il prezzo è il fattore dominante",
 "model": "zai/glm-5-3-flash"
    },
    "private": {
 "description": "Tutto ciò che riguarda i dati dei clienti — viene eseguito su hardware di nostra proprietà",
 "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
 "description": "Rinominazioni, stringhe di documentazione, correzioni lint, struttura di test",
 "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
Il ragionamento, riga per riga:
- La scelta ricade sul modello più performante che ci si può permettere. Un piano sbagliato costa, a lungo termine, più token di quanto il piano stesso sia mai costato.
- L'investimento va al miglior modello con orizzonte temporale lungo a un prezzo ragionevole. Opus 5, con specifiche $5/$25, è progettato appositamente per questo scopo e costa la metà rispetto a Fable.
- Il lavoro meccanico di massa viene assegnato a GLM-5.3-Flash con $0.15/$0.47, perché a quel prezzo la questione non è se sia altrettanto valido, ma se sia abbastanza valido per lo scopo specifico. Spesso lo è.
- Tutto ciò che è privato rimane a livello locale, su un modello adatto alla tua macchina.
- Il lavoro di base viene affidato a una piccola agenzia di modelle locale, perché rinominare un simbolo in quaranta file non richiede un ragionamento complesso e non comporta la necessità di allontanarsi dal proprio portatile.
Scrivi gli ID dei modelli in modo che sostituirne uno richieda solo una modifica di una riga. Considerando che quattro laboratori hanno lanciato un modello tra i primi dieci tra giugno e settembre, dovrai apportare nuovamente tale modifica entro la fine del trimestre.
Parte decima: Il futuro del Vibe Coding — Sei previsioni, accompagnate da una valutazione di affidabilità
Le previsioni senza livelli di confidenza sono solo intrattenimento. Ecco le mie, con l’importo che sarei disposto a scommettere.
1. La parola muore; la pratica si divide definitivamente. Elevato livello di affidabilità.
“Il ”vibe coding” sta già diventando un termine dispregiativo negli ambienti professionali e un motivo di orgoglio solo nel mondo del marketing. A sostituirlo c’è una netta divisione in due livelli: artefatti usa e getta generati dall’IA, il cui codice nessuno legge (va bene, è corretto, continuate così), e un’ingegneria agenziale sottoposta a revisione, in cui l’output del modello passa attraverso gli stessi filtri di quello umano (va bene anche questo, ed è qui che si concentrano tutti gli investimenti aziendali).
Quella zona grigia pericolosa — codice di produzione, non letto — è proprio ciò di cui è composta la lista degli incidenti del 2026, e nei contesti commerciali finirà per essere eliminata da normative, assicurazioni o verifiche. Non perché qualcuno la vieti, ma perché prima o poi un questionario sulla sicurezza lo richiederà.
2. La verifica diventa il collo di bottiglia, e gli investimenti in strumenti seguono questa tendenza. Elevato livello di affidabilità.
Ci siamo già arrivati e il mercato non ha ancora adeguato i prezzi. Se gli agenti riescono a produrre una settimana di lavoro, il limite è la capacità umana di stabilire che quella settimana di lavoro sia corretta.
Ci si aspetta che i prodotti più interessanti del 2027 riguardino verifica piuttosto che generazione: generazione di test basata sulle proprietà, strumenti di confronto semantico che descrivono i cambiamenti di comportamento anziché quelli a livello di codice, verifica automatizzata della conformità alle specifiche, verifica in fase di esecuzione delle azioni degli agenti e — questo è quello che realizzerei io — strumenti che indicano quali parti di un diff di grandi dimensioni una persona debba effettivamente leggere.
3. I metodi formali hanno il loro momento di gloria, con vent’anni di ritardo. Fiducia media.
L'obiezione storicamente avanzata nei confronti delle specifiche formali era che redigere le specifiche costasse più che scrivere il codice. Tale obiezione è ormai superata, poiché scrivere codice è praticamente gratuito e la redazione delle specifiche rappresenta comunque il collo di bottiglia.
I sistemi di tipi, i contratti, gli invarianti, i test di proprietà e la verifica formale leggera hanno improvvisamente trovato un caso d’uso che ne giustifica il costo: sono dichiarazioni di intenti verificabili automaticamente, che un agente può eseguire in modo iterativo senza l’intervento umano. Mi aspetto che Rust, le modalità più rigorose di TypeScript e le librerie di contratti in Python ne traggano benefici sproporzionati.
Il motivo per cui la mia fiducia è solo moderata è che, dal 1985, il settore ha previsto una rinascita dei metodi formali all’incirca ogni sette anni.
4. I modelli locali coprono interamente il livello di base. Livello di affidabilità medio-alto.
Guarda cosa fa ora un modello 27B con licenza Apache 2.0, aggiungi un altro anno e installalo su una macchina con 64 GB di memoria unificata. Rinominazioni, stringhe di documentazione, struttura dei test, messaggi di commit, correzioni di lint, prime bozze di traduzioni, analisi dei log: nessuna di queste attività richiede un modello all’avanguardia, tutte comportano un volume elevato di lavoro e rappresentano esattamente il tipo di attività che preferiresti non affidare a terzi dal repository di un cliente.
La frontiera rimane nel cloud per la pianificazione e le analisi complesse. Il volume si sposta a livello locale. Dalla parte undicesima in poi si spiega perché ciò sia ora fisicamente possibile.
5. Il ruolo dello sviluppatore junior cambia forma, ma non scompare. Fiducia media, e su questo punto sono il più flessibile.
Lo scenario pessimistico è chiaro: se gli agenti svolgono il lavoro che prima facevano i giovani, nessuno assume i giovani e, tra dieci anni, non ci saranno più i più esperti.
Penso che lo scenario più probabile sia che il lavoro di livello base passi dal “scrivere il codice” al “verificare il codice e occuparsi delle specifiche” — il che rappresenta un lavoro più difficile da affrontare all’inizio, non più facile, e che richiederà al settore di riorganizzare il modo in cui forma il personale. I team che riusciranno a comprendere questo cambiamento avranno un enorme vantaggio in termini di assunzioni rispetto a quelli che si limiteranno a smettere di assumere.
Un avvertimento in tutta onestà: questa è la previsione in cui i miei interessi e la mia analisi vanno nella stessa direzione, ed è proprio in questi casi che bisogna diffidare di se stessi.
6. Qualcuno subisce un vero e proprio disastro, attribuito pubblicamente a un errore di programmazione dell’IA. Grande fiducia nell'evento, poca invece riguardo alla tempistica.
Non si tratta di una fuga di dati da un database. Si tratta di un caso che coinvolge un’autorità di regolamentazione, con un impatto finanziario a nove cifre e un’analisi delle cause alla radice che indica che un agente ha compiuto un’azione che non è stata verificata da nessun essere umano.
La curva di attribuzione dei CVE — 6, poi 15, poi 35 nei mesi successivi del 2026, con i ricercatori che stimano che il tasso reale sia da cinque a dieci volte superiore — non è una curva destinata ad appiattirsi da sola. La domanda è se il settore rafforzerà per primo le proprie misure di sicurezza o se aspetterà che si verifichi un incidente che lo costringa a farlo.
Cosa farei riguardo a tutti e sei, in una frase: è meglio investire in test, specifiche e strumenti di revisione piuttosto che nella tecnica dei prompt, perché quest’ultima perde valore ogni volta che viene rilasciato un modello, mentre l’infrastruttura di verifica si rafforza.
Mostra immagine Le due procedure hanno in comune solo la tecnologia e nient’altro. Il ciclo a sinistra è corretto per i lavori occasionali ma disastroso per la produzione; il ciclo a destra è proprio ciò che mancava nell’elenco degli incidenti riportato nella Parte Ottava.
ATTO III — IA OFFLINE SU DISPOSITIVI DI CONSUMO
Parte undicesima: quest’anno l’IA offline ha smesso di essere un hobby
Per circa due anni, “eseguirlo localmente” è stato un compromesso basato su principi. Era possibile farlo. L’argomentazione sincera era: Ecco un modello da 7 miliardi di parametri che offre prestazioni inferiori persino al piano gratuito di qualsiasi servizio, su hardware che già possiedi, e il motivo per cui lo si fa è una questione di principio.
La situazione è cambiata nel 2026, e ciò è avvenuto per tre ragioni distinte che si sono verificate contemporaneamente.
I modelli di piccole dimensioni sono diventati davvero validi. L'E4B di Gemma 4 conta circa 8 miliardi di parametri, supporta 128K di contesto, gestisce testo, immagini, video e audio nativo ed è distribuito sotto licenza Apache 2.0. La variante densa da 31 miliardi ottiene un punteggio di 39 nell’indice Artificial Analysis — rientrando nell’intervallo che diciotto mesi fa era all’avanguardia — e ha completato l’intero test dell’indice su 39 milioni di token di output, una frazione di quanto consumano modelli comparabili. Qwen3.8-27B è un modello multimodale denso con licenza Apache 2.0 e 262K di contesto nativo che, secondo Alibaba, supera il ben più grande Qwen3.7-Plus nelle attività di programmazione e d'ufficio.
Sono stati i sistemi operativi a fornirlo. Questo è il cambiamento che conta davvero, ed è avvenuto in sordina. Microsoft ha integrato Aion 1.0 in Windows 11. Apple fornisce un modello denso da 3 miliardi di parametri e un modello sparso da 20 miliardi di parametri sugli iPhone. Google fornisce Gemini Nano sui dispositivi Pixel e Samsung. L'intelligenza artificiale integrata nei dispositivi ha smesso di essere qualcosa che si installa ed è diventata qualcosa che è già presente, ovvero la differenza tra una tecnologia utilizzata dagli appassionati e una tecnologia utilizzata da tutti.
E finalmente l'hardware dispone della memoria necessaria. Non è una questione di potenza di calcolo, ma di memoria. Tornerò più avanti sul motivo per cui questa distinzione è fondamentale.
Cosa offre realmente l“”IA offline"
Cercherò di essere concreto, perché questo prodotto viene venduto male.
Latenza. Un modello 4B locale risponde in poche decine di millisecondi. Un round trip nel cloud richiede, nella migliore delle ipotesi, centinaia di millisecondi. Per qualsiasi attività interattiva e continua — dettatura, traduzione in tempo reale, completamento automatico, sintesi durante la digitazione — il modello locale vince in termini di fluidità, non di qualità, ed è proprio la fluidità che le persone notano.
Una privacy di natura architettonica piuttosto che contrattuale. Con un'API, ogni richiesta esce dalla tua infrastruttura e devi stipulare un accordo sul trattamento dei dati, effettuare una valutazione dell'impatto del trasferimento, redigere una mappa dei flussi di dati e fornire una risposta al tuo responsabile della protezione dei dati. Con un modello in esecuzione sul dispositivo, La questione del trasferimento transfrontaliero non si pone, poiché non vi è alcun trasferimento. Nel contesto tedesco e dell’Unione Europea, questo è spesso l’unico argomento valido, e permette di concludere accordi che il prezzo da solo non riuscirebbe mai a garantire.
Disponibilità. In aereo. In un luogo senza copertura di rete. In una struttura in cui l’accesso alla rete è vietato. Durante un’interruzione del servizio del tuo operatore.
Prevedibilità dei costi. Non si tratta di un risparmio sui costi — farò i conti nella Parte Quindici e il risultato non sarà quello che la gente vorrebbe. Ma un costo fisso per l’hardware con un costo marginale pari a zero per ogni token rappresenta una linea di bilancio molto diversa da una fatturazione basata sull’utilizzo, che varia in base all’entusiasmo dell’agente.
Fissaggio della versione. Un modello API chiuso viene aggiornato con un ID modello stabile, ma il suo comportamento subisce delle variazioni. Un checkpoint locale rimane identico a livello di byte anche dopo un anno. Se ti è mai capitato che un prompt funzionante smettesse improvvisamente di funzionare, sai bene quanto questo sia importante.
E ciò che non ti garantisce
Capacità di frontiera. Il divario tra un modello 4B sul tuo telefono e Claude Fable 5.1 non è affatto piccolo e non si colmerà mai. Chiunque ti dica il contrario sta cercando di venderti qualcosa.
Velocità sui modelli di grandi dimensioni. Un modello 400B locale genera token più lentamente rispetto allo stesso modello sull'API di un fornitore, poiché quest'ultimo lo esegue su hardware con una larghezza di banda di memoria da quattro a sei volte superiore alla tua. Si sacrifica la velocità di elaborazione a favore del controllo.
Parte dodicesima: Il telefono che hai in tasca
La caratteristica che fa la differenza è la RAM
Ormai tutte le principali piattaforme hanno fissato un limite massimo di memoria, che è pari a 12 GB.
| Piattaforma | Modello integrato nel dispositivo | Porta di memoria |
|---|---|---|
| Mela | AFM 3 Core (3 miliardi di nodi densi) + AFM 3 Core Advanced (20 miliardi di nodi sparsi, 1–4 miliardi attivi) | 12 GB per due funzionalità di iOS 27 |
| Gemini Nano v3 (solo Pixel 10); Nano v2 su Pixel 9 e modelli precedenti; Nano v4 in arrivo | 12 GB minimo per Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 per Galaxy — CPU Oryon di terza generazione, NPU Hexagon, +39% Capacità NPU | Dipendente dal dispositivo |
La soluzione proposta da Apple è quella più interessante dal punto di vista tecnico. AFM 3 Core Advanced è un modello sparsa da 20 miliardi di parametri che risiede in una memoria flash. Gli esperti condivisi rimangono residenti in memoria; quelli instradati vengono caricati nella DRAM solo quando una richiesta li richiede. È proprio così che si riesce a far stare un modello da 20 miliardi su un telefono: si scambia la larghezza di banda di lettura della NAND con la capacità della DRAM.
Ma per trasferire gli esperti nella DRAM occorre comunque un posto dove trasferirli in, oltre al sistema operativo, all'app in esecuzione e alla pipeline della fotocamera. La differenza tra 9 GB e 12 GB non corrisponde a tre gigabyte di segmentazione di mercato. Si tratta del working set necessario per uno swapping avanzato in condizioni di reale pressione sulla memoria. Ming-Chi Kuo riferisce che due funzionalità di iOS 27 richiedono 12 GB: l’espressività vocale di Siri e la personalizzazione del ritmo, oltre a un notevole miglioramento della precisione della trascrizione vocale. L’iPhone 18 base, il cui lancio è stato posticipato alla primavera del 2027 e che secondo quanto riportato dovrebbe avere 9 GB, non soddisfa i requisiti.
Google si trova nella stessa situazione, ma con un problema di pubbliche relazioni ancora più grave. Gemini Intelligence richiede Nano v3, che al momento è disponibile solo su Pixel 10, mentre i dispositivi Pixel 9 — venduti con il marchio promessa di aggiornamento per sette anni — utilizzano Nano v2. La promessa riguardava gli aggiornamenti. Non ha mai riguardato le funzionalità, e la distinzione che aveva senso per un product manager nel 2023 non ha alcun senso per un cliente nel 2026.
Ecco quale sarà, secondo le previsioni, la tendenza nel campo dell’IA per i consumatori nei prossimi due anni: una promessa di supporto a lungo termine che prevede la fornitura di patch di sicurezza a un dispositivo che non è in grado di utilizzare le funzionalità incluse nelle patch stesse.
Cosa è effettivamente in grado di fare un telefono, misurato
Test comparativi indipendenti su un iPhone 17 Pro (A19 Pro) in quattro scenari di utilizzo:
| Modello | Tempo di esecuzione | Decodifica tok/s | Memoria di picco |
|---|---|---|---|
| Gemma 4 E2B (4 bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4 bit) | MLX | 47.5 | 2.900 MB |
| Gemma 4 E2B (4 bit) | lama.cpp | 37.8 | 3.156 MB |
| Gemma 4 E2B (4 bit) | CoreML / ANE | 33.4 | 1.187 MB |
| Qwen 3.5 2B (4 bit) | MLX | 61.2 | 1.279 MB |
| Qwen 3.5 2B (4 bit) | lama.cpp | 39.1 | 1.479 MB |
| Qwen 3.5 2B (4 bit) | CoreML / ANE | 27.9 | 241 MB |
Due risultati saltano subito all’occhio.
Il Neural Engine rappresenta il percorso più lento, ma è di gran lunga quello che consuma meno memoria. 27,9 tok/s a 241 MB contro i 61,2 tok/s di MLX a 1.279 MB: una velocità cinque volte superiore a fronte di una quantità di memoria cinque volte maggiore. Questo compromesso spiega esattamente perché Apple utilizzi l’ANE per le funzionalità di sistema sempre attive e perché le app di terze parti lo evitino per le chat interattive.
Sessanta token al secondo su un modello 2B che hai in tasca: è più veloce di quanto la maggior parte delle persone riesca a leggere. Il che significa che il limite dell’IA locale sui telefoni non è la velocità. È la capacità; la capacità dipende dai parametri, i parametri dipendono dalla memoria — e la memoria è proprio ciò che ogni produttore ha appena limitato.
Parte tredicesima: Il PC e la scommessa silenziosa di Microsoft
Il 2 giugno, in occasione del Build 2026, Microsoft ha fatto qualcosa che, a mio avviso, apparirà più significativo col senno di poi di quanto non lo sia sembrato in quel momento: ha integrato i modelli direttamente in Windows.
Guida ad Aion 1.0 È un modello linguistico di piccole dimensioni per la sintesi, la riscrittura e l'estrazione. Richiede una CPU moderna e Windows 11 — non supporta NPU né GPU discrete. È ora disponibile in Edge Canary a partire dalla build 150.0.4070, accessibile agli sviluppatori web tramite le API Prompt, Summarizer, Writer e Rewriter, mentre i suoi pesi aperti sono stati pubblicati su Hugging Face nel luglio 2026.
Piano Aion 1.0 è quello interessante: un Modello di ragionamento e richiamo di strumenti con 14 miliardi di parametri e una finestra di contesto di 32K, progettato per flussi di lavoro basati su agenti, la gestione dei file e l’orchestrazione dei sotto-agenti. “Nei prossimi mesi”, al momento della stesura di questo articolo.
Lo slogan utilizzato da Microsoft era “intelligenza illimitata in ogni casa e su ogni scrivania”. Lasciando da parte gli aspetti di marketing, concentriamoci sulla scelta architettonica: un'API JavaScript nel browser che richiama un modello locale, senza chiave, senza fattura e senza connessione di rete. Se questa situazione dovesse diventare la norma, un’enorme categoria di piccole funzionalità di IA smetterebbe di essere un prodotto SaaS per diventare una funzionalità della piattaforma. Si tratta di un evento di gran lunga più rilevante per l’economia del settore dell’IA rispetto al lancio di qualsiasi singolo modello quest’anno.
Il reparto hardware esiste davvero ed esclude molte macchine
Il percorso NPU richiede un PC Copilot+ dotato di un NPU da almeno 40 TOPS:
| Silicio | NPU | È idoneo? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 MAGLIETTE | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 MAGLIETTE | ✅ hardware; software “in arrivo” |
| Intel Meteor Lake | ~10–11 AL MASSIMO | ❌ |
Ed ecco il dato che dovrebbe ridefinire le aspettative: Su una NPU da 45 TOPS, un modello da 8 miliardi di parametri genera circa 5 token al secondo. Il modello del Piano 14B sarà più lento.
Cinque token al secondo non sono sufficienti per un'esperienza di chat. Vanno bene per una sintesi in background, una riscrittura, una classificazione, un'estrazione — ovvero le attività per cui Aion 1.0 Instruct è effettivamente progettato. Non vanno bene per nulla che si guardi attivamente.
Perché è così lento su 45 TOPS? Questo perché la generazione dei token è limitata dalla larghezza di banda della memoria, non dalla potenza di calcolo pura. L’NPU è in grado di eseguire le moltiplicazioni matriciali; il problema è trasferire i pesi dalla memoria di sistema per ogni singolo token. Si tratta dello stesso ostacolo che caratterizza tutti i dispositivi citati in questo articolo, ed è per questo che il valore “TOPS” è un dato praticamente inutile ai fini dell’acquisto.
I computer da tavolo
Se si desidera un dispositivo specifico per l'inferenza locale, la categoria da 128 GB si è stabilizzata su due opzioni e un caso a sé stante:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| Memoria | 128 GB unificati | 128 GB LPDDR5X-8000 | fino a 512 GB unificato |
| Larghezza di banda | ~273 GB/s | ~256 GB/s | 1,2 TB/s |
| Prezzo | ~$3,999 | da $2.300 a $2.500 | a partire da $5.499 |
| Note | Ecosistema CUDA | CPU potente (1,6 TFLOPS Linpack contro i 708 GFLOPS di Spark) | Versione da 512 GB a fine ottobre, prezzo da definire |
Tali prezzi e i dati relativi a Spark e Strix Halo provengono da test pubblicati alla fine di dicembre 2025, quindi è bene considerarli indicativi piuttosto che aggiornati: da allora i prezzi della memoria hanno subito variazioni. Il DGX Spark e lo Strix Halo sono molto più vicini in termini di generazione di token di quanto suggeriscano i loro dati di calcolo — poiché entrambi si attestano intorno ai 256–273 GB/s di larghezza di banda e questo rappresenta il vincolo limitante. Lo Spark vince nettamente nella generazione di immagini (~120 TFLOPS contro ~46 su FLUX.1 Dev BF16) e nella compatibilità CUDA. Lo Strix Halo vince in termini di prezzo e CPU.
Il Mac Studio M5 Ultra appartiene a una categoria completamente diversa sia in termini di memoria che di larghezza di banda, e ne ho parlato ampiamente in il componente hardware locale dedicato all'intelligenza artificiale. In breve: un sistema da 512 GB a 1,2 TB/s è l’unico dispositivo di fascia mainstream in grado di contenere in memoria un modello di classe 400B, e il prezzo da pagare per questo privilegio si aggira intorno a $16.000–$20.000, configurato.
I modelli da eseguire effettivamente
| Modello | Parametri | Licenza | Funziona perfettamente in | Adatto a |
|---|---|---|---|---|
| Gemma 4 E2B | 5,1 miliardi / 2,3 miliardi attivi | Apache 2.0 | 4 GB | Telefoni, sempre attivi, ingresso audio |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | Lavoro di routine al computer portatile, sintesi |
| Guida ad Aion 1.0 | piccolo SLM | Categorie di peso aperte (HF, luglio 2026) | Solo CPU | Operazioni di testo native di Windows |
| Qwen3.8-27B | 27B denso | Apache 2.0 | 24–32 GB | Miglior modello locale generico con meno di 32 GB |
| Gemma 4 26B-A4B | 26B / 4B attivo | Apache 2.0 | 24 GB | MoE veloce, basso costo di attivazione |
| Gemma 4 31B | 31B denso | Apache 2.0 | 32 GB | La massima qualità locale con meno di 32 GB |
| Ornith-1.5 35B | 35B / 3B attivo | MIT | 32 GB | Codifica agenziale, ingombro attivo minimo |
| gpt-oss-120b | 120B / 5,1B attivi | Apache 2.0 | 128 GB | I 128 GB: il punto di equilibrio ideale |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB e oltre | Vicino alla frontiera, serve un container capiente |
| MiniMax M3 | 428B / 23B attivo | Personalizzato | 512 GB | Compatibile esclusivamente con l'M5 Ultra |
| DeepSeek V4 Pro | 1,6 T / 49 B attivi | MIT | Cluster | Non è un modello di dispositivo destinato al consumatore |
| Kimi K3 | 2,8 T / 104 miliardi attivi | Personalizzato | Cluster | Non è compatibile con nessun Mac venduto da Apple |
Se stai valutando le specifiche di un computer Apple in particolare, ho analizzato in dettaglio i livelli di memoria in Guida all'IA locale del MacBook Pro M5 Pro da 64 GB — In breve, 64 GB è la soglia oltre la quale i compromessi smettono di essere fastidiosi.
Se vuoi un consiglio: su un computer da 32 GB, eseguire Qwen3.8-27B fido Gemma 4 31B. Entrambi Apache 2.0, entrambi multimodali, entrambi davvero utili, entrambi adatti. Questa è l'impostazione predefinita del 2026 ed è un'impostazione predefinita di gran lunga migliore rispetto a quella del 2025.
Mostra immagine Cosa è effettivamente realizzabile, per livello di memoria. Le linee verticali indicano le dimensioni di memoria che gli utenti possono effettivamente acquistare; i modelli che superano il limite indicato dalla linea di destra rappresentano il limite massimo dell’IA di frontiera locale nel 2026.
Parte quattordicesima: Il muro dei ricordi è tutta la storia
Tutto ciò che accade nel terzo atto si riduce a un'unica equazione, quindi eccola qui, espressa in modo esplicito.
Ci starà?
pesi (GB) ≈ totale_parametri (B) × byte_per_parametro
 4 bit  → × 0,5
 8 bit  → × 1,0
 BF16   → × 2,0

disponibile ≈ (memoria di sistema × 0,75) − overhead del sistema operativo e delle app − cache KV
Con quale velocità verrà generato?
token/sec ≈ (larghezza di banda della memoria × efficienza) ÷ byte attivi per tokenSi noti che la seconda formula utilizza attivo parametri, non in termini assoluti. Ecco perché i modelli ’mixture-of-experts’ offrono prestazioni così sproporzionatamente elevate su hardware di consumo. Il modello 26B-A4B di Gemma 4 presenta 26 miliardi di parametri di capacità e 4 miliardi di parametri di costo per token. Il modello 35B di Ornith-1.5 ne attiva 3 miliardi. MiniMax M3 ne ha 428 miliardi in totale e 23 miliardi attivi.
In pratica, l'efficienza indicata in quella formula è compresa approssimativamente tra 0,5 e 0,8 a seconda del tempo di esecuzione, della quantizzazione e della quantità di larghezza di banda di memoria utilizzata dal resto del sistema.
Ora applichiamolo. Un laptop con NPU da 45 TOPS e LPDDR5X a, diciamo, 120 GB/s, che esegue un modello a 8 bit a 4 bit (4 GB di pesi attivi): 120 × 0,6 ÷ 4 ≈ 18 gettoni al secondo in teoria. Il valore misurato è circa 5. La differenza è dovuta alla pianificazione, al contenzioso di memoria, ai costi di prefill e al fatto che le toolchain delle NPU sono ancora immature. È proprio in quel divario tra i calcoli e i risultati misurati che risiede gran parte della delusione in questo ambito.
La carenza di DRAM è la variabile nascosta dietro ogni dato riportato in questo articolo
Nel 2025 e nel 2026 i produttori di memorie hanno riorientato la propria capacità produttiva verso i clienti dei data center dedicati all’intelligenza artificiale, che stipulano contratti più consistenti con margini più elevati rispetto ai produttori di dispositivi di consumo. Le conseguenze sono evidenti ovunque:
- Nel giugno 2026 Apple ha aumentato i prezzi di tutti i modelli di Mac e iPad.
- La versione da 512 GB del Mac Studio è stata posticipata alla fine di ottobre per motivi legati alla disponibilità e non ha ancora un prezzo.
- L'M6 di Apple ha un limite massimo di 32 GB di memoria unificata, mentre i modelli M6 Pro, Max e Ultra sono stati cancellati del tutto.
- Ming-Chi Kuo ha riferito che Apple ridurrà le spedizioni di hardware nel 2026 a causa di problemi di approvvigionamento della memoria.
Ogni limite di cui si parla in questo articolo deriva dalla stessa carenza. Il “gate” dei telefoni da 12 GB. Il limite massimo di 32 GB per l’M6. Il tetto massimo di 128 GB per i portatili. Il ritardo nell’introduzione della fascia da 512 GB. Nessuna di queste è un limite tecnico del silicio; si tratta esclusivamente di decisioni di allocazione in un mercato in cui la memoria è scarsa e costosa.
Se state aspettando che i prezzi tornino alla normalità prima di acquistare un dispositivo per l'inferenza locale: nessuno di cui ci si possa fidare è in grado di prevedere quando ciò avverrà.
Parte quindicesima: Configurazione
La parte pratica. Tutto ciò che è riportato qui l’ho provato personalmente; nei casi in cui mi limito a descrivere qualcosa anziché averlo provato, lo specifico chiaramente.
La strada più semplice: LM Studio
Un'interfaccia grafica (GUI), nativa per MLX su Apple Silicon, con browser dei modelli integrato e server compatibile con OpenAI attivabile con un solo clic. Se vuoi eseguire un modello in dieci minuti, inizia da qui. È anche lo strumento con cui Apple effettua i benchmark nei propri comunicati stampa, il che la dice lunga su quanto questa tecnologia sia ormai diventata di uso comune.
Il percorso più flessibile: Ollama
bash
Installazione di #
curl -fsSL https://ollama.com/install.sh | sh

# Scarica ed esegui l'impostazione predefinita per il 2026
ollama run qwen3.8:27b

# Il contesto predefinito è troppo piccolo per lavorare con codice reale — aumentiamolo
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
È proprio quel secondo comando che spesso sfugge. Il contesto predefinito di Ollama è impostato in modo prudente; in un’attività di codice, il testo verrà troncato in modo silenzioso e tu darai la colpa al modello.
Il percorso più veloce su Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Genera direttamente
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Spiega il routing "mixture-of-experts' in due paragrafi." \
  --max-tokens 512

# Oppure mettere in servizio un endpoint compatibile con OpenAI
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Punta qualsiasi client compatibile con OpenAI verso http://localhost:8080/v1.
Aumenta il limite di memoria fisica prima di lamentarti dei crash
Per impostazione predefinita, macOS non consente alla GPU di utilizzare tutta la memoria unificata. Su un computer dotato di molta memoria, questa è la differenza tra il caricamento corretto di un modello e il suo malfunzionamento:
bash
# Verifica il limite corrente
sysctl iogpu.wired_limit_mb

# Esempio per una macchina da 128 GB, lasciando circa 14 GB per il sistema operativo
sudo sysctl iogpu.wired_limit_mb=116736

# Rendere permanente l'impostazione
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Non impostare questo valore pari alla capacità totale della memoria. Su un computer potente, lascia al sistema operativo 12–16 GB di spazio libero, altrimenti si verificheranno errori di kernel invece di ottenere un’inferenza veloce. Ricontrolla dopo ogni aggiornamento di macOS, poiché gli aggiornamenti azzerano questa impostazione.
Su Windows, utilizzare innanzitutto i modelli del sistema operativo
Prima di installare qualsiasi cosa, verifica cosa ti offre già Windows. Le API Prompt, Summarizer, Writer e Rewriter di Edge utilizzano Aion 1.0 in modalità locale, senza chiavi né costi. Per la sintesi, la riscrittura e l'estrazione all'interno di un'applicazione web, si tratta di una soluzione completa che non richiede alcuna infrastruttura.
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
Se ti serve qualcosa in più, sia LM Studio che Ollama funzionano bene su Windows e, su un computer privo di un’NPU compatibile, utilizzeranno la GPU o la CPU, il che, per i modelli della classe 8B, è spesso più veloce comunque più veloce del percorso NPU.
Una configurazione ibrida ragionevole
L'architettura che realizzerei effettivamente e, a grandi linee, quella che utilizzo:
- Livello 1 — sul dispositivo. Un piccolo modello per l'instradamento, la classificazione, l'estrazione, la sintesi e la dettatura. Gemma 4 E4B o Aion 1.0 Instruct. Sempre disponibile, a costo marginale zero.
- Livello 2 — hardware proprio. Un modello open-weight 27B–120B su un computer di tua proprietà, per qualsiasi operazione che coinvolga dati dei clienti che non devono uscire dalla giurisdizione. Qwen3.8-27B su 32 GB,
gpt-oss-120bsu 128 GB. - Livello 3 — frontiera tramite API. Pianificazione, ragionamenti complessi, sequenze di azioni prolungate, qualsiasi situazione in cui sbagliare comporti un costo elevato.
Il dibattito non verte mai sulla scelta tra “locale o cloud”. Si tratta piuttosto di stabilire dove tracciare i confini, e quest’anno tali confini si sono spostati notevolmente.
Parte sedicesima: I calcoli relativi ai costi e alla conformità
L'argomento del risparmio non regge al confronto con la calcolatrice
Prendiamo in considerazione un carico di lavoro realistico per una piccola impresa: un mese lavorativo di codifica agentica moderata, diciamo 40 milioni di token in ingresso e 3 milioni di token in uscita.
| Opzione | Costo mensile |
|---|---|
| GLM-5.3-API Flash ($0.15 / $0.47) | ~$7.40 |
| API Flash Gemini 3.8 ($0.75 / $3.75) | ~$41 |
| API Claude Opus 5 ($5 / $25) | ~$275 |
| API Claude Fable 5.1 ($10 / $50, senza cache) | ~$550 |
| Un box Strix Halo $2.400, ammortizzato in 3 anni | ~$67 al mese + elettricità |
Si noti cosa dice effettivamente quella tabella. L'hardware locale è più economico rispetto alla fascia alta del mercato e più costoso rispetto alla fascia bassa. Rispetto al GLM-5.3-Flash, un dispositivo locale non raggiunge mai il punto di pareggio in termini di token. Rispetto a Fable 5.1 in modalità senza cache, si ripaga in cinque mesi — ma non si tratta di un confronto omogeneo, poiché Fable 5.1 è un modello di gran lunga superiore a qualsiasi altro che rientri nei 128 GB.
Quindi non comprate ferramenta locale per risparmiare. Acquistalo per uno di questi cinque motivi, tutti validi:
- La residenza dei dati è una scelta architettonica piuttosto che un progetto di natura giuridica.
- Nessun limite di velocità, nessuna quota, nessun problema di capacità. Martedì non ci sono lavori in programma per la tua macchina.
- Blocco delle versioni a tempo indeterminato. Un checkpoint locale rimane identico, byte per byte, nel corso di un anno.
- Funzionamento offline.
- Ti serviva comunque quella postazione di lavoro. Questo è il caso più comune in cui l'acquisto è semplicemente la scelta giusta: se avevi già intenzione di spendere 2.500 € per un computer, il costo marginale della funzionalità di intelligenza artificiale è rappresentato dall'aggiornamento della memoria, non dall'intero dispositivo.
Il quadro normativo dell'UE, poiché è cambiato nel 2026
Per i lettori in Germania e nell'UE, quest'anno il quadro normativo è cambiato e le date sono ora definitive anziché subordinate a determinate condizioni.
- 2 agosto 2025 — I fornitori del modello GPAI si sono assunti gli obblighi relativi alla documentazione, alla sintesi dei contenuti formativi e al diritto d’autore.
- 2 agosto 2026 — sono entrati in vigore i poteri di applicazione e gli obblighi di trasparenza previsti dall’articolo 50. Sono ora previste delle multe.
- 27 luglio 2026 — È entrato in vigore il “Digital Omnibus”, il regolamento (UE) n. 2026/1744, che sostituisce il precedente meccanismo condizionale per i sistemi ad alto rischio con scadenze fisse.
- 2 dicembre 2026 — fine del periodo di transizione per l’introduzione della filigranatura leggibile da dispositivi automatici sui sistemi esistenti.
- 2 agosto 2027 — Si conclude il periodo di transizione di due anni per i modelli GPAI già presenti sul mercato.
- 2 dicembre 2027 — sistemi autonomi ad alto rischio di cui all’allegato III (assunzioni, valutazione del merito creditizio, istruzione, infrastrutture critiche).
- 2 agosto 2028 — IA ad alto rischio integrata in prodotti soggetti a regolamentazione ai sensi dell’allegato I (dispositivi medici, macchinari).
Il pacchetto "Digital Omnibus" ha inoltre introdotto divieti relativi alle immagini intime generate dall'intelligenza artificiale senza consenso e al materiale pedopornografico (CSAM), ampliando i poteri di vigilanza dell'Ufficio dell'UE per l'intelligenza artificiale.
Cosa significa questo, in pratica, per i lettori di questo articolo. Se sviluppi sistemi basati su modelli già esistenti anziché addestrarli, la maggior parte degli obblighi relativi alla GPAI ricade sul fornitore, non su di te. Ciò che spetta a te è la trasparenza — comunicare alle persone quando stanno interagendo con l’IA e contrassegnare i contenuti sintetici — oltre alla questione della classificazione ad alto rischio, qualora il tuo sistema riguardi l’assunzione, il credito, l’istruzione o le infrastrutture critiche. La data del dicembre 2027 è abbastanza lontana da consentire una pianificazione adeguata, ma anche abbastanza vicina da rendere il “ne parleremo più avanti” una strategia ormai superata.
E il punto più rilevante per il terzo atto: Un modello integrato nel dispositivo semplifica notevolmente diverse di queste interazioni contemporaneamente. Nessun trasferimento, nessun responsabile del trattamento, una mappa del flusso dei dati molto più breve. Non si tratta di una scappatoia — gli obblighi di trasparenza rimangono validi — ma elimina un’intera categoria di attività.
Non sono un avvocato e quanto segue non costituisce una consulenza legale. Per qualsiasi questione di natura finanziaria, rivolgiti a un consulente abilitato in Germania o nell’Unione Europea affinché esamini la tua situazione specifica.
Parte diciassettesima: Le argomentazioni sincere contro tutto questo
Se mi fermassi alla Parte Sedici, questo sarebbe un annuncio pubblicitario.
I dati misurati sulla produttività continuano a non confermare tale entusiasmo. Uno studio clinico randomizzato controllato, il 19%, più lento. Un follow-up che non è stato possibile condurre in modo corretto. Dati auto-dichiarati gonfiati di 40 punti percentuali. Tutti in questo settore, me compreso, agiscono in gran parte basandosi su sensazioni e intuizioni.
I dati sulla sicurezza sono negativi e non mostrano segni di miglioramento. Il tasso di errore OWASP 45% di Veracode è rimasto sostanzialmente invariato fino all’inizio del 2026, mentre i modelli sono diventati notevolmente più intelligenti. Non si tratta di un problema transitorio risolvibile con l’aumento di scala. Le capacità e la sicurezza non sono lo stesso asse, e nessuno sta ottimizzando in modo mirato il secondo.
I benchmark sono saturi ai livelli più alti e non verificabili a livelli intermedi. SWE-bench Verified comprende tre modelli all’interno di un punto. I benchmark che lo sostituiscono sono sempre più riservati, il che risolve il problema della contaminazione rendendo impossibile una verifica indipendente.
Ai pesi liberi basta una sola revisione della licenza per non essere più considerati “aperti”. Z.ai ha trasferito GLM dal MIT a una licenza proprietaria con una fase di revisione della sicurezza tra le versioni 5.2 e 5.3. Meta ha promesso di rendere pubblici i pesi di Muse Spark senza specificarne la data, la dimensione né il testo della licenza. Se la tua architettura presuppone che i pesi saranno scaricabili l’anno prossimo, tale presupposto è una decisione aziendale del fornitore, non una legge di natura.
La frontiera non è ancora locale e, sempre più, non è nemmeno acquistabile. Mythos 5.1, il programma che ha ottenuto il punteggio più alto su Terminal-Bench 4.0, è riservato a esperti di sicurezza informatica e ricercatori nel campo delle scienze della vita sottoposti a controlli di sicurezza, attualmente per lo più negli Stati Uniti. Kimi K3 e DeepSeek V4 Pro non sono compatibili con nessun computer di uso comune. Quello che trova posto sulla tua scrivania è un eccellente modello di seconda fascia, che è davvero utile ma non rappresenta certo la frontiera della tecnologia.
Le prestazioni del dispositivo sono inferiori a quanto suggerito dalla campagna pubblicitaria. Cinque token al secondo per un modello 8B su una NPU da 45 TOPS. Una memoria da 12 GB che esclude la maggior parte degli smartphone in circolazione. Una promessa di aggiornamenti per sette anni che non riguarda le funzionalità. Il divario tra il marchio “AI PC” e ciò che il dispositivo è effettivamente in grado di eseguire è attualmente enorme.
E la geopolitica è un fattore che incide sugli appalti, che lo si ritenga giusto o meno. Molti dei migliori modelli a peso aperto — Kimi, GLM, DeepSeek, Qwen, MiniMax — provengono da laboratori cinesi. Per i clienti del settore pubblico, quelli legati alla difesa e alcuni soggetti a regolamentazione, questo rappresenta un ostacolo insormontabile, indipendentemente da dove vengano gestiti i pesi o da cosa preveda la licenza. Nel frattempo, il modello di codifica più avanzato di Anthropic è riservato esclusivamente a organizzazioni statunitensi sottoposte a verifica. L'ecosistema aperto viene lacerato lungo i confini nazionali da entrambe le parti, e se ti trovi in Europa non sei in nessuna delle due estremità.
Parte XVIII: Il quadro decisionale per lo “Stato dell’IA 2026”
Mostra immagine Sette situazioni, sette risposte. Trova la riga che rispecchia il tuo anno.
Sette scenari, rapportati allo stato attuale dell’IA nel 2026, così come si presenta oggi.
1. “Voglio il modello migliore e il costo non è un problema.”
Claude Fable 5.1 a 65,7 sull'indice aggregato, $10/$50, contesto 1M — e attiva la cache, perché la riduzione della lettura dalla cache di 75% ti fa risparmiare 25–45% sulla fattura. Mantieni GPT-5.6 Sol disponibile per ricerche che richiedono un'intensa navigazione su 90.4% BrowseComp. Non preoccuparti: la differenza tra i due è minore di quella tra il tuo prompt migliore e quello peggiore.
2. “Ho un sacco di agenti e la bolletta sta diventando assurda.”
Claude Opus 5 con parametri $5/$25 per il lavoro a lungo termine, GLM-5.3-Flash con parametri $0.15/$0.47 per il lavoro meccanico di massa e un modello locale per il lavoro di base. Il routing è la leva di costo più importante a tua disposizione ed è un file di configurazione, non un progetto. Valuta la ripartizione dei token in base al ruolo degli agenti prima di ottimizzare qualsiasi cosa: la maggior parte delle persone scopre che l’80% della propria spesa è destinata ad attività che non richiedevano un modello Frontier.
3. “Il GDPR e la residenza dei dati sono requisiti imprescindibili per il lavoro con i clienti.”
Qwen3.8-27B o Gemma 4 31B sull'hardware di cui disponi, entrambi Apache 2.0, entrambi multimodali. Il salto successivo è gpt-oss-120b una macchina da 128 GB se il lavoro lo richiede. Il punto non è la velocità — è che nessun prompt esce dall’edificio e la tua revisione legale diventa leggere una licenza invece di una valutazione d’impatto sul trasferimento. Scegli apposta modelli con licenze permissive, così quella lettura è breve.
4. “Voglio provare l’AI locale senza spendere molto.”
Quello che hai già, più LM Studio, più Gemma 4 E4B. Otto gigabyte di memoria bastano per essere davvero utili. Scopri se l’AI locale fa per te prima di spenderci soldi — la maggior parte delle persone scopre di volere il livello 1 e il livello 3 e di non aver mai avuto bisogno del livello 2.
5. “Sto comprando una macchina apposta per l’inferenza locale.”
Compra in base alla larghezza di banda e alla capacità della memoria, in quest’ordine, e ignora i TOPS. Nella classe dei 128 GB, Strix Halo a ~$2.400 è la scelta col miglior rapporto qualità-prezzo e DGX Spark a ~$3.999 ti dà CUDA e una generazione di immagini molto migliore. Sopra, il Mac Studio M5 Ultra è l’unica cosa che regge un modello da 400B, a un prezzo che ha senso solo se la workstation ti serviva comunque.
6. “Il mio team sta adottando strumenti di coding con l’AI e il rischio è mio.”
Fai le cose noiose, in quest’ordine: SAST e rilevamento dei segreti su ogni commit; analisi della composizione software per i pacchetti inventati; una policy scritta che esclude il codice AI non revisionato da auth, crypto, authz e pagamenti; credenziali degli agenti trattate come privilegiate; e un SBOM che registra la provenienza degli strumenti. Poi metti in conto Curva a J un calo reale prima del miglioramento — DORA l’ha misurato — e non farti prendere dal panico al terzo mese.
7. “Quale telefono devo comprare per l’AI?”
Qualsiasi modello con 12 GB. È la linea che ogni piattaforma ha tracciato: iPhone 17 Pro e 18 Pro a 12 GB, Pixel 10 per Nano v3, Galaxy S26 Ultra su Snapdragon 8 Elite Gen 5. L’iPhone 18 base, con 9 GB secondo le indiscrezioni, e Pixel 9 e precedenti faranno girare bene il telefono e non avranno le funzioni. Se sei già su un dispositivo da 12 GB, l’aggiornamento di quest’anno è incrementale proprio sul fronte AI.
Parte diciannovesima: cosa guardo nel prossimo trimestre
Se Meta pubblicherà davvero i pesi di Muse Spark, e con quale licenza d’uso. “Presto” detto da un CEO su X, senza numero di parametri e senza testo di licenza, è la forma di impegno più debole di questo articolo. Se pubblicano con Apache 2.0, l’ecosistema aperto cambia in modo sostanziale. Se pubblicano con una licenza su misura e una soglia di fatturato, quello è ormai lo standard del settore e i pesi aperti diventano una categoria di marketing più che una proprietà.
Se il risultato di auto-miglioramento di Ornith-1.5 è replicabile. Una valutazione indipendente su compiti fuori dal curriculum auto-generato è ciò che lo chiarirebbe. È la voce con la varianza più alta della lista: o è il risultato più importante del 2026 o è una storia ammonitrice sui benchmark auto-generati, e al momento non so quale delle due.
Se Aion 1.0 Plan uscirà davvero e a che velocità gira. Un modello di ragionamento da 14B dentro Windows è una categoria davvero nuova. Se gira a 3 token al secondo sull’hardware che lo supporta, è una demo. Se gira a 20, cambia ciò che un’applicazione desktop può dare per scontato.
La curva di attribuzione delle CVE. 6, 15, 35 in mesi consecutivi. Se da aprile ad agosto la traiettoria è proseguita, i dati della Georgia Tech saranno, quando usciranno, la pubblicazione sulla sicurezza AI più rilevante dell’anno.
Se qualcuno costruirà gli strumenti di revisione. Il divario tra ciò che gli agenti possono produrre e ciò che gli umani possono verificare è il problema decisivo del 2027, e a oggi quasi tutti i capitali di venture vanno ancora nella generazione e non nella verifica. Chi rilascerà lo strumento che ti dice in modo affidabile quale 5% di un diff ha bisogno di occhi umani sarà difficilissimo da contrastare.
Se la carenza di memoria si allenterà. È la variabile nascosta dietro la soglia dei 12 GB sui telefoni, il tetto dei 32 GB sull’M6, il ritardo del livello Mac da 512 GB e l’aumento dei prezzi Apple di giugno. Nessuno credibile prevede un miglioramento.
E se i modelli frontier con accesso limitato per sicurezza resteranno un’eccezione. Mythos 5.1 è ad accesso limitato per ragioni di duplice uso che trovo difendibili, e Project Glasswing sta attivamente ampliando l’accesso — circa 150 organizzazioni in più di quindici paesi entro giugno 2026. Ma il precedente è creato: il miglior punteggio su un benchmark pubblico di coding è ormai qualcosa che la maggior parte delle organizzazioni non può comprare a nessun prezzo. Se diventa un pattern e non un caso speciale, “la mia organizzazione può superare la verifica” diventa un criterio di scelta del modello, e l’argomento a favore dei pesi aperti fuori dagli Stati Uniti smette del tutto di riguardare i costi.
Domande frequenti
Qual è il miglior LLM a settembre 2026?
Nell’aggregato, Claude Fable 5.1 guida l’Intelligence Index v4.1.1 di Artificial Analysis con 65,7, davanti a Claude Opus 5 a 63,0, Claude Fable 5 a 62,1, Grok 4.6 a 60,9 e GPT-5.6 Sol a 58,9. Ma l’aggregato comprime le differenze che contano. GPT-5.6 Sol guida il browsing con il 90,4% su BrowseComp; Gemini 3.8 Flash arriva a 58,7 a $0,75 per milione di token in input; GLM-5.3-Flash arriva a 57,5 a $0,15. Per la maggior parte dei carichi reali gli otto modelli migliori sono intercambiabili e la decisione va presa su prezzo, latenza, economia della cache e licenza, non sulla classifica.
Qual è il miglior modello a pesi aperti in questo momento?
Dipende dal tuo hardware e da quanto tolleri le licenze. GLM-5.3 (753B) ha il punteggio più alto, 59,5, ma ha una licenza su misura con una soglia di revisione di sicurezza a 10 miliardi di dollari di fatturato. DeepSeek V4 Pro (1,6T totali, 49B attivi) è con licenza MIT e segna 87,9 su Terminal-Bench 2.1, ma serve un cluster. Per una macchina che possiedi davvero, Qwen3.8-27B o Gemma 4 31B — entrambi Apache 2.0 — sono i modelli migliori che stanno in 32 GB.
Il vibe coding è morto nel 2026?
La parola sta morendo; la pratica si è divisa in due. Il vibe coding nel senso originale — prompt, accetta, non leggere il diff — resta giusto per il lavoro usa e getta: script, prototipi, analisi una tantum. Ciò che l’ha sostituito per tutto quello che va in produzione è l’ingegneria agentica guidata da specifiche: una specifica scritta, una sandbox, una suite di test che l’agente deve superare e una revisione vera del diff risultante. La via di mezzo pericolosa — codice di produzione, non revisionato — è da dove sono venuti tutti gli incidenti documentati del 2026.
Il coding con l’AI rende davvero più veloci gli sviluppatori?
L’unico studio controllato randomizzato dice di no. METR ha rilevato che gli sviluppatori esperti erano il 19% più lenti con gli strumenti AI di inizio 2025 su codebase mature, pur credendo di essere stati il 20% più veloci — una sovrastima di 40 punti percentuali. Il loro follow-up del 2026 non è stato eseguibile in modo pulito perché gli sviluppatori si sono rifiutati di lavorare senza AI. I sondaggi riportano un moltiplicatore di velocità di 3× ma solo un cambiamento di 1,4–2× nel valore del lavoro. La mia lettura: guadagni grandi sul lavoro che non conosci, sul boilerplate, sui test e sulle migrazioni; guadagni piccoli o negativi sulle codebase che conosci a fondo.
Quanto è rischioso il codice generato dall’AI?
Rischioso in modo misurabile e in lento miglioramento. Veracode ha trovato che il 45% dei campioni generati dall’AI introduce una vulnerabilità dell’OWASP Top 10, con Java il peggiore al 72%. Apiiro ha misurato sviluppatori assistiti dall’AI che producono commit da 3 a 4 volte più velocemente e risultati di sicurezza 10 volte più velocemente, con percorsi di escalation di privilegi in crescita del 322%. Circa il 20% del codice generato dall’AI fa riferimento a pacchetti che non esistono, e il 43% di quei nomi allucinati ricorre in modo coerente — che è una superficie d’attacco nella supply chain. La soluzione sono i controlli automatici su ogni commit, non l’astinenza.
Posso far girare un buon LLM offline sul mio computer?
Sì, e il 2026 è il primo anno in cui è indiscutibilmente vero. Con 8 GB di memoria, Gemma 4 E4B è davvero utile. Con 32 GB, Qwen3.8-27B o Gemma 4 31B sono solidi modelli multimodali sotto Apache 2.0. Con 128 GB, gpt-oss-120b è il punto giusto. Ciò che non entra in nessuna macchina consumer è la vera frontier: Kimi K3 con 2,8 trilioni di parametri e DeepSeek V4 Pro con 1,6 trilioni hanno entrambi bisogno di un cluster.
Cos’è Microsoft Aion 1.0?
Una famiglia di modelli on-device annunciata al Build il 2 giugno 2026 e distribuita dentro Windows 11. Aion 1.0 Instruct è un modello piccolo per la sintesi, la riscrittura e l’estrazione, che gira su una CPU moderna senza bisogno di NPU, esposto tramite le API JavaScript Prompt, Summarizer, Writer e Rewriter di Edge, con i pesi aperti su Hugging Face da luglio 2026. Aion 1.0 Plan è un modello di ragionamento e tool-calling da 14 miliardi di parametri con una finestra di contesto da 32K per i flussi agentici, richiede un Copilot+ PC con NPU minima da 40 TOPS ed era ancora “in arrivo nei prossimi mesi” all’inizio di settembre 2026.
Perché i telefoni hanno bisogno di 12 GB di RAM per le funzioni AI?
Perché i modelli on-device sono limitati dalla memoria, non dal calcolo. L’AFM 3 Core Advanced di Apple è un modello sparso da 20 miliardi di parametri che vive nella memoria flash e porta gli esperti instradati nella DRAM su richiesta — il che richiede comunque uno spazio in cui metterli, oltre al sistema operativo, all’app e alla pipeline della fotocamera. Ming-Chi Kuo riporta due funzioni di iOS 27 che richiedono 12 GB. Gemini Intelligence di Google ha la stessa soglia minima di 12 GB. Il divario tra 9 GB e 12 GB è il working set, non una segmentazione di mercato.
Vale la pena avere una NPU per l’AI locale?
Meno di quanto lasci intendere il marketing. Su una NPU da 45 TOPS, un modello da 8B genera circa 5 token al secondo, perché la generazione di token è limitata dalla larghezza di banda della memoria e non dal calcolo. Le NPU sono ottime per i compiti sempre attivi, a basso consumo e a brevi raffiche — quelli che un sistema operativo esegue di continuo. Per una chat interattiva su un portatile, la GPU o persino il percorso CPU è spesso più veloce. Compra in base alla larghezza di banda e alla capacità della memoria; considera i TOPS quasi privi di significato quando devi scegliere.
I modelli a pesi aperti sono davvero open source?
Per lo più no. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) e Ornith-1.5 (MIT) hanno licenze davvero permissive. GLM-5.3 richiede alle aziende sopra i 10 miliardi di dollari di fatturato di superare la revisione di sicurezza di Z.ai; Kimi K3 usa una licenza a fasce di fatturato; MiniMax M3 impone l’attribuzione ben visibile “Built with MiniMax M3” per qualsiasi uso commerciale e un’autorizzazione scritta sopra i 20 milioni di dollari di fatturato. Nessuno di loro rilascia i dati di addestramento o il codice di addestramento. “Pesi aperti” è il termine corretto; “open source” sta facendo un lavoro disonesto.
Costa meno far girare i modelli in locale che usare un’API?
Quasi mai sul solo costo dei token. Un mese moderato di lavoro agentico — 40M token in input e 3M in output — costa circa $7 su GLM-5.3-Flash e circa $41 su Gemini 3.8 Flash. Una macchina locale da $2.400 ammortizzata su tre anni è circa $67 al mese, prima dell’elettricità. L’hardware locale batte la parte alta della frontier sul costo e perde contro quella bassa. Compra in locale per la residenza dei dati, la libertà dai rate limit, il blocco delle versioni e il funzionamento offline — o perché la workstation ti serviva comunque.
Cosa richiede l’AI Act europeo nel 2026?
Dal 2 agosto 2026 i poteri di esecuzione e gli obblighi di trasparenza dell’articolo 50 si applicano all’AI per uso generale, e le sanzioni sono ora disponibili. Il Digital Omnibus, regolamento (UE) 2026/1744, è entrato in vigore il 27 luglio 2026 e ha fissato date precise: il 2 dicembre 2026 termina il periodo di tolleranza sul watermarking; il 2 agosto 2027 chiude la transizione per i modelli GPAI già sul mercato; il 2 dicembre 2027 vale per i sistemi autonomi ad alto rischio dell’allegato III; il 2 agosto 2028 copre l’AI ad alto rischio incorporata in prodotti regolamentati. Se costruisci sopra i modelli invece di addestrarli, la maggior parte degli obblighi GPAI resta in capo al fornitore — trasparenza e classificazione ad alto rischio sono ciò che ricade su di te. Questo non è un parere legale.
Quanto a lungo può lavorare un agente AI senza supervisione?
METR misura la durata del compito che un modello completa in autonomia con il 50% di successo. Quel valore è passato da circa 30 secondi nel 2022 a oltre 14 ore per i sistemi frontier nel 2026, con un tempo di raddoppio di circa 196 giorni sull’adattamento ibrido di METR, o 131 giorni se si guardano solo i modelli successivi al 2023. Gli intervalli di confidenza sono molto ampi — l’orizzonte di 320 minuti di Claude Opus 4.5 va da 170 a 729 minuti — e solo 5 dei 31 compiti lunghi di METR usano baseline umane misurate. Estrapolando, nel 2027 si arriva a circa un’intera giornata di lavoro autonomo.
Quale modello devo usare per il coding in particolare?
Instrada invece di scegliere. Pianificazione e architettura al modello più capace che puoi permetterti (Claude Fable 5.1); il grosso dell’implementazione a lungo orizzonte a Claude Opus 5 a metà prezzo; il lavoro meccanico ad alto volume a GLM-5.3-Flash a $0,15/$0,47; tutto ciò che tocca dati dei clienti a un modello locale a pesi aperti; e rinomine, docstring e correzioni di lint a un modello locale piccolo. Scrivi gli ID dei modelli in modo che sostituirne uno sia una modifica di una riga — quattro laboratori hanno pubblicato un modello da top ten tra giugno e settembre 2026.
In sintesi
Dodici mesi fa la domanda interessante nell’AI era quale modello fosse il più intelligente. Lo stato dell’AI nel 2026 è che questa domanda è diventata quasi priva di interesse. I dieci modelli migliori coprono 8,2 punti sul miglior aggregato disponibile, e il più economico costa un sessantasettesimo del più caro.
Ciò che l’ha sostituita è più utile e meno eccitante: riesci a verificare ciò che queste cose producono, abbastanza in fretta da stargli dietro?
Quella singola domanda spiega ogni risultato di questo articolo. Spiega perché SWE-bench si è saturato al 96% e ha smesso di essere informativo. Spiega perché l’adozione degli strumenti di coding AI ha raggiunto il 90% mentre la fiducia è scesa al 29%. Spiega perché il tasso di fallimenti di sicurezza di Veracode non si è mosso mentre le capacità salivano, perché capacità e verificabilità sono assi diversi e solo uno dei due viene ottimizzato. Spiega perché DORA ha scoperto che i ritorni vengono dall’organizzazione e non dallo strumento. E spiega perché la pratica che nel 2026 funziona davvero — specifica, sandbox, test obbligatori, revisione vera — sembra tanto meno magica delle demo.
Quattro cose che porterei a casa.
La frontier si è commoditizzata più in fretta di quanto chiunque si aspettasse, e il divario dei pesi aperti è ora di circa sei mesi. Un modello da 397B con licenza MIT batte la frontier chiusa della generazione precedente su SWE-bench. Un modello a pesi aperti da 753B supera GPT-5.6 Sol nell’indice aggregato. Pianifica per un mondo in cui il modello non è il tuo elemento distintivo, perché quasi non lo è già.
Leggi la licenza prima del benchmark. Le capacità convergono; i termini divergono. Z.ai si è allontanata dalla MIT tra una release e l’altra. Meta ha promesso pesi senza testo di licenza. Il miglior modello di coding di Anthropic è limitato per nazionalità. Per un acquirente commerciale, quattro punti di benchmark valgono meno di una licenza che il tuo avvocato legge in novanta secondi.
Ora la verifica è tutto il gioco, e quasi nessuno la finanzia. Gli agenti possono produrre una giornata di lavoro; noi la revisioniamo con strumenti pensati per revisionare un’ora di lavoro. Se devi scegliere dove spendere sforzo ingegneristico nei prossimi dodici mesi, spendilo in test, specifiche e strumenti di revisione invece che in tecnica di prompt. La tecnica di prompt si svaluta a ogni release di modello. L’infrastruttura di verifica si accumula nel tempo.
E l’AI offline è diventata reale, su un budget di memoria che è appena diventato caro. Un modello multimodale da 27 miliardi di parametri con licenza Apache gira su una macchina che puoi comprare per 2.500 €. Windows porta un modello dentro il sistema operativo. Il tuo telefono fa girare un modello sparso da 20 miliardi di parametri dalla flash. Ogni tetto su questo — la soglia dei 12 GB sui telefoni, il limite dei 32 GB sui portatili, il minimo di 40 TOPS — è una decisione di allocazione di memoria in un mercato dove la DRAM è scarsa, non un limite del silicio.
La configurazione che costruirei davvero oggi: Gemma 4 E4B sul dispositivo per il livello sempre attivo; Qwen3.8-27B sul tuo hardware per tutto ciò che non deve uscire dall’edificio; GLM-5.3-Flash a $0,15/$0,47 per la fascia intermedia ad alto volume; e Claude Opus 5 o Fable 5.1 per la pianificazione e i problemi davvero difficili, con la cache attiva. Instrada tra loro in un file di configurazione, e aspettati di riscriverlo tra tre mesi.
Rileggi tutto a dicembre. Meta avrà pubblicato i pesi o no. Aion 1.0 Plan sarà reale o fumo. Il risultato di auto-miglioramento di Ornith si sarà replicato o sarà sparito in silenzio. E la curva di attribuzione delle CVE ci avrà detto se il 2026 è stato l’anno in cui il settore ha stretto i propri controlli o l’anno in cui ha aspettato che lo facesse qualcun altro.
Fai girare modelli a pesi aperti in produzione nell’UE, o mandi in produzione codice scritto dagli agenti attraverso un processo di revisione di cui ti fidi davvero? Mi interessano in particolare due cose: ripartizioni misurate del costo per token per ruolo dell’agente, e qualsiasi cosa che funzioni per revisionare diff di agenti da mille righe. Correzioni e controevidenze sono benvenute — questo articolo si aggiorna quando il quadro cambia.
Ultimo aggiornamento: 3 settembre 2026.