Italiano
 English
 Deutsch
 Español
 Français

Il ragionamento è questo. Un abbonamento AI di fascia alta costa 200 $ al mese, cioè 2.400 $ all’anno. Un MacBook Pro con 128 GB di memoria unificata può far girare grandi modelli linguistici in locale, in privato e senza limiti di utilizzo. Quindi disdici l’abbonamento, compra invece un MacBook per gli LLM locali e in un anno o due si è ripagato.
Ne trovi versioni in tutto il 2026: in video su YouTube che si chiedono se conviene disdire l’abbonamento AI da 200 $ e comprare un Mac da 9.499 $, in post su Medium che dividono il prezzo di un Mac per 200 $, e in una colonna di Forbes che ha fatto i conti quando Apple ha lanciato il suo nuovo Mac Studio d’agosto. Al lancio del MacBook Pro M5 Max, il capo dell’hardware di Apple, John Ternus, ha detto che le nuove macchine permettono ai professionisti di “far girare LLM avanzati sul dispositivo”.
Comprare un MacBook per gli LLM locali è un’idea del tutto sensata per alcune persone. Come sostituto di un piano Claude o ChatGPT da 200 $, però, fallisce, e fallisce su una cosa che il ragionamento non mette mai nel conto: la qualità. Il piano ti noleggia i modelli migliori del mondo. Il Mac fa girare i modelli migliori che entrano in 128 GB. Da ieri possiamo misurare la distanza tra queste due cose con più precisione che mai, ed è più ampia di quanto suggerisca l’entusiasmo.
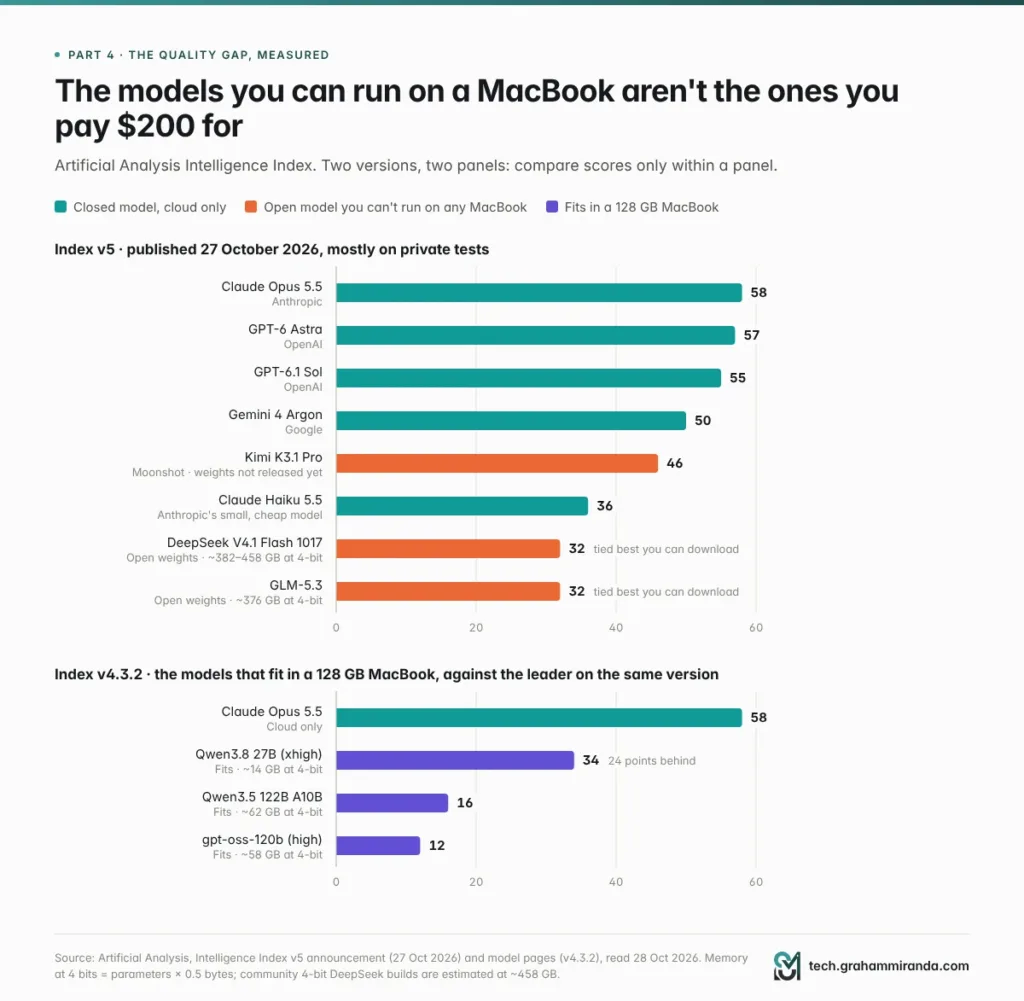
Il 27 ottobre Artificial Analysis ha ricostruito il suo Intelligence Index attorno a test in gran parte privati. Claude Opus 5.5 è in testa con 58. I migliori modelli a pesi aperti che puoi davvero scaricare, DeepSeek V4.1 Flash 1017 e GLM-5.3, segnano 32, sotto Claude Haiku 5.5, il modello piccolo ed economico dell’azienda, fermo a 36. Nessuno di quei modelli aperti entra in un MacBook: a 4 bit servono tra 375 e 460 GB. Il modello più forte che sono riuscito a trovare che entri davvero in un MacBook da 128 GB, Qwen3.8 27B, segna 34 nella versione precedente dell’indice, quella in cui anche Opus 5.5 segna 58.
Intanto l’hardware è diventato più caro. A giugno Apple ha raddoppiato il prezzo dell’aggiornamento a 128 GB di memoria sull’M5 Max. Un MacBook Pro da 16 pollici con 128 GB ora costa $6,999 negli Stati Uniti e, secondo le mie stime, circa €8,199 in Germania.
Questa è quindi la versione onesta dei conti: cosa comprano davvero 200 $ al mese, cosa comprano davvero 7.000 $, quanto è grande il divario di qualità e perché c’è, quanto è veloce davvero un M5 Max, quanto ti costa la quantizzazione, quando comprare un Mac per l’AI locale ha senso e i modi più economici per tagliare una bolletta da 200 $ se è proprio quello che cerchi. Ogni cifra è stata verificata alla fonte il 28 ottobre 2026.
TL;DR — La versione in 60 secondi
- Non c’è modo di scaricare i modelli che paghi 200 $, e i migliori che puoi scaricare non c’entrano in un MacBook. Nel nuovo Intelligence Index v5 di Artificial Analysis, Claude Opus 5.5 segna 58. I migliori modelli aperti scaricabili, DeepSeek V4.1 Flash 1017 e GLM-5.3, segnano 32 e a 4 bit richiedono all’incirca 375–460 GB di memoria.
- Quello che entra segna molto meno. Il modello più forte che ho trovato per un MacBook da 128 GB, Qwen3.8 27B, segna 34 contro i 58 di Opus 5.5 sulla stessa versione dell’indice (v4.3.2). I modelli della classe 120B che hanno davvero bisogno della memoria extra segnano ancora meno: 16 per Qwen3.5 122B, 12 per gpt-oss-120b.
- Il MacBook da 128 GB è diventato più caro. Apple ha raddoppiato l’aggiornamento a 128 GB portandolo a 2.000 $ a giugno, quindi un 16 pollici M5 Max con 128 GB ora costa 6.999 $ (circa 8.199 € in Germania, secondo le mie stime). Lo stesso chip e la stessa memoria in un Mac Studio costavano 4.799 $.
- Il punto di pareggio è a tre o quattro anni, non a uno. Anche se il Mac sostituisse del tutto l’abbonamento, servirebbero circa 37 mesi per battere un piano da 200 $, 41 se tieni un piano da 20 $ per il lavoro duro, e più di sei anni contro un piano da 100 $.
- La scrittura è veloce; la lettura è lenta. Un M5 Max genera 55–88 token al secondo sui modelli mixture-of-experts, non lontano dai 98 di Opus 5.5 sull’API di Anthropic. Ma per leggere un prompt da 32.000 token servono 13–55 secondi, e gli agenti AI rileggono l’intero prompt tutto il giorno.
- Comprimere i modelli grandi costa qualità. La quantizzazione a 4 bit è quasi senza perdite sui compiti brevi, ma in uno studio EMNLP 2025 è costata fino al 59% sugli input lunghi, e di più nelle lingue diverse dall’inglese. A 3 bit, il punteggio di matematica di un piccolo modello di reasoning è sceso da 85,6% a 47,0%.
- I benchmark pubblici sembrano lusingare i modelli aperti. Quando Artificial Analysis è passata a test in gran parte privati, quattro modelli aperti di punta hanno perso in media 13 punti. Quattro modelli chiusi di punta si sono mossi appena.
- Il locale vince ancora su privacy, uso offline, nessun limite di richieste e lavori in blocco, e su quando stavi comunque comprando un Mac. Compra un Mac per questi motivi, non per disdire un abbonamento.
- Ci sono modi più economici per risparmiare. Scendi a un livello da 100 $ e risparmi 1.200 $ all’anno, paga al token i modelli aperti (DeepSeek V4.1 Flash costa 0,60 $ per milione di token di output fuori punta), oppure usa un piano di coding da 18 $ al mese.
La promessa e la realtà
| La promessa | La realtà, ottobre 2026 |
|---|---|
| “Si ripaga in un anno” | Un MacBook Pro da 16 pollici con 128 GB costa 6.999 $. A 200 $ al mese sono 35 mesi prima dell’elettricità, e 41 mesi una volta aggiunto il piano da 20 $ che terrai per l’attività più impegnativa |
| “I modelli locali ormai sono praticamente uguali” | Opus 5.5 segna 58. Il miglior modello che entra in 128 GB segna 34 (Qwen3.8 27B, indice v4.3.2). I migliori modelli aperti scaricabili segnano 32 sul nuovo v5 |
| “128 GB fanno girare i grandi modelli aperti” | GLM-5.3 richiede circa 376 GB a 4 bit, DeepSeek V4.1 Flash circa 380–460 GB, Kimi K3 circa 1,5 TB. Nessuno entra in un MacBook |
| “L’M5 Max è veloce” | In scrittura sì: 55–88 token al secondo sui modelli mixture-of-experts. In lettura di un prompt da 32K: da 13 a 55 secondi |
| “Il 4 bit è senza perdite” | Sui benchmark brevi, quasi. Su input oltre 64K token, fino al 59% peggio in uno studio, e peggio ancora fuori dall’inglese |
| “Nessun limite, privacy totale” | Vero. È proprio questa la ragione d’acquisto. |
Indice dei contenuti
- TL;DR — La versione in 60 secondi
- La promessa e la realtà
- Parte 1 — La promessa “disdici il tuo piano da 200 $” e perché suona così convincente
- Parte 2 — Cosa comprano davvero 200 $ al mese nell’ottobre 2026
- Parte 3 — Quanto costa davvero oggi un MacBook da 128 GB
- Parte 4 — Il divario di qualità, misurato
- Parte 5 — Perché i modelli che vuoi davvero non c’entrano
- Parte 6 — La quantizzazione: la tassa sulla qualità che paghi per farli entrare
- Parte 7 — Velocità: veloce in scrittura, lenta in lettura
- Parte 8 — Il problema del portatile
- Parte 9 — Il divario software: quello che dovresti ricostruire
- Parte 10 — I conti del punto di pareggio, fatti per bene
- Parte 11 — Il caso giusto: quando comprare un Mac per l’AI locale ha senso
- Parte 12 — Modi più economici per tagliare una bolletta AI da 200 $
- Parte 13 — Dovresti comprare un MacBook per gli LLM locali? Una guida alle decisioni
- Parte 14 — Se lo compri comunque: come ricavarne il massimo
- Domande frequenti
- Un MacBook può sostituire un abbonamento ChatGPT Pro o Claude Max?
- Qual è il miglior LLM locale per un MacBook Pro da 128 GB nel 2026?
- Quanto costa oggi un MacBook Pro con 128 GB?
- Quanto tempo serve a un MacBook per ripagarsi rispetto a un abbonamento AI da 200 $?
- L’M5 Max è abbastanza veloce per gli LLM locali?
- Gli LLM locali sono ormai buoni quanto ChatGPT o Claude?
- La quantizzazione peggiora i modelli locali?
- Posso far girare DeepSeek V4.1 Flash o GLM-5.3 su un MacBook?
- 64 GB bastano per l’AI locale o mi servono 128 GB?
- Conviene comprare un Mac Studio invece di un MacBook Pro per gli LLM locali?
- Far girare l’AI in locale è meglio per privacy e GDPR?
- Posso usare Claude Code con un modello locale?
- Il nuovo MacBook Pro OLED cambierà qualcosa?
- In sintesi
Parte 1 — La promessa “disdici il tuo piano da 200 $” e perché suona così convincente
Cominciamo dal perché questo argomento circola così bene: gran parte è ragionevole.
Tre laboratori si sono allineati sui 200 $. L’offerta Claude Max 20× di Anthropic costa 200 $ al mese. Il ChatGPT Pro di OpenAI esiste in versioni da 100, 200 e 500 $. L’AI Ultra di Google ha un livello da 100 $ e uno da 200 $. Se lo paghi ogni mese, il numero si accumula: 2.400 $ all’anno, 7.200 $ in tre anni.
L’hardware è diventato serio. Il MacBook Pro M5 Max, in vendita da marzo, arriva a 128 GB di memoria unificata con 614 GB/s di banda, e Apple ha messo un Neural Accelerator, hardware dedicato alla matematica matriciale, in ogni core GPU. Ad agosto è arrivato il Mac Studio con la variante M5 Ultra dichiarata fino a 512 GB. Il marketing di Apple spinge sull’AI locale più che mai.
Gli abbonamenti sono diventati più tirchi. I limiti settimanali di Claude Max, aggiunti mesi dopo il lancio dell’abbonamento, sono oggetto di una class action depositata l’8 settembre, che sostiene che le etichette “5×” e “20×” non rendano abbastanza chiari i tetti settimanali. Secondo quanto riportato, OpenAI ha ridotto la quota del suo piano Pro da 200 $ per i nuovi abbonati da 20 volte ChatGPT Plus a 10 volte. Quando la cosa che affitti continua a restringersi, possedere inizia a sembrare attraente.
La privacy è un problema reale. Qualsiasi cosa incolli in un modello cloud lascia la tua macchina. Per un’azienda tedesca che detiene dati dei clienti non è paranoia: è l’obbligo del GDPR.
E l’aritmetica è facile. La versione che circola di più: un Mac Studio da 2.499 $ diviso per 200 $ al mese fa circa 12,5 mesi. Forbes ad agosto ne ha pubblicata una molto più attenta, con configurazioni reali e tre anni d’elettricità, e ha concluso che un Mac probabilmente non ti permetterà di disdire il piano Claude o ChatGPT se scrivi codice con gli agenti. Ma la versione breve è quella che la gente ricorda.
Ecco dov’è il difetto. La promessa confronta un prezzo con un prezzo. Dovrebbe confrontare un prodotto con un prodotto. È quello che fa il resto dell’articolo, partendo da cosa comprano davvero i 200 $.
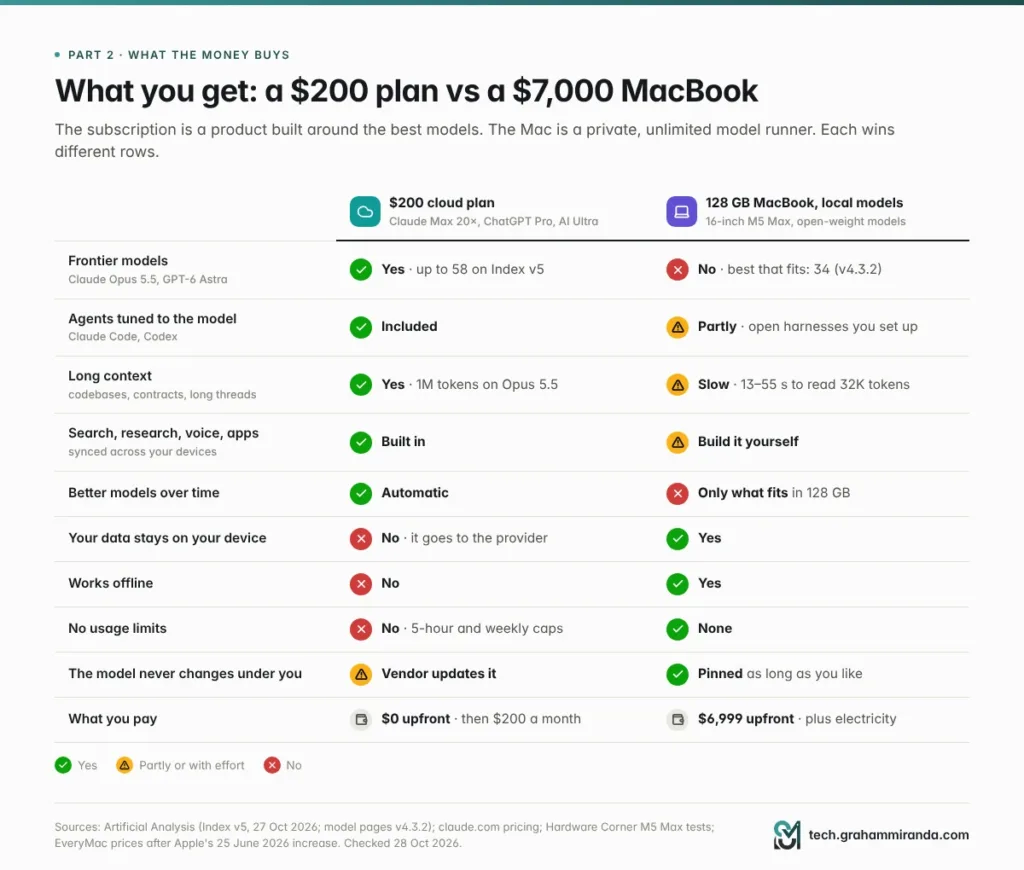
Parte 2 — Cosa comprano davvero 200 $ al mese nell’ottobre 2026
| Fornitore | Livello da 20 $ | Livello da 100 $ | Livello da 200 $ | Oltre 200 $ |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: 20 $ (17 $ al mese con fatturazione annuale) | Max 5×: 100 $ | Max 20×: 200 $ | Team ed Enterprise |
| OpenAI (ChatGPT) | Plus: 20 $ (Go: 8 $) | Pro 100: 100 $ | Pro 200: 200 $ | Pro 500: 500 $ |
| Google (Gemini) | AI Pro: 20 $ | AI Ultra: 100 $ | AI Ultra: 200 $ | — |
Prezzi statunitensi al mese, IVA esclusa. Claude da claude.com; ChatGPT dal tracker di AI Business Weekly, aggiornato il 4 ottobre; Google dal report d’Engadget sul rilancio di maggio. Prezzi e quote cambiano spesso, quindi controlla prima d’abbonarti.
Per cosa paghi davvero
1. I modelli di frontiera, che non trovi da nessun’altra parte. Sul nuovo indice di Artificial Analysis, Anthropic e OpenAI occupano tutti e cinque i primi posti. Nessuno di quei modelli si può scaricare a nessun prezzo. L’abbonamento è il modo più economico che la maggior parte delle persone avrà mai di usarli.
2. Agenti costruiti attorno a quei modelli. I piani a pagamento di Claude includono Claude Code; quelli di ChatGPT includono Codex. L’harness e il modello sono messi a punto insieme, il che aiuta a spiegare perché stanno in cima alle classifiche dell’agentic coding. (Ho confrontato 28 di questi strumenti in Tutti gli harness di coding IA a confronto.)
3. Contesto enorme. Claude Opus 5.5 ha una finestra di contesto da un milione di token, secondo Artificial Analysis: interi codebase, interi contratti, interi trimestri di email.
4. Il prodotto attorno al modello. Ricerca web e deep research, analisi di file, voce, memoria, generazione di immagini, connettori alla tua posta e ai tuoi documenti, e app che si sincronizzano su telefono, portatile e browser. Niente di tutto questo arriva con un file di modello.
5. Aggiornamenti che non richiedono l’installazione. Il modello dietro il tuo abbonamento il trimestre prossimo sarà migliore di quello d’oggi. Il modello sul tuo Mac cambia solo quando ne scarichi un altro, e solo se quello nuovo ci sta.
6. Parte dei soldi indietro. La pagina dei prezzi d’Anthropic ora elenca crediti API mensili con Max: 100 $ sul piano 5× e 200 $ sul 20×.
Cosa non c’è nel prezzo
Uso illimitato. I piani di Claude funzionano su finestre mobili di cinque ore d’uso più tetti settimanali, e OpenAI e Google descrivono per lo più i loro livelli top come multipli di quelli più economici, quando li descrivono. Controllo su dove finiscono i tuoi dati, che conta molto per i dati personali e dei clienti. E prevedibilità: le quote si sono mosse più di una volta quest’anno.
Tieni a mente queste tre cose. Sono il caso onesto per l’AI locale, e la Parte 11 le esamina a fondo.
Mostra immagine L’abbonamento è un prodotto; il Mac è un esecutore di modelli. Ognuno vince righe diverse, ed è per questo che la risposta giusta per la maggior parte delle persone è entrambi.
Parte 3 — Quanto costa davvero oggi un MacBook da 128 GB
Solo un chip ti porta a 128 GB. Nella generazione M5, quella quantità di memoria unificata arriva solo con l’ M5 Max con GPU da 40 core, che ha 614 GB/s di banda di memoria. L’M5 Max con GPU da 32 core è fermo a 36 GB e 460 GB/s, e l’M5 Pro arriva al massimo a 64 GB e 307 GB/s.
| Configurazione | Prezzo USA | Germania |
|---|---|---|
| 16″ M5 Max (CPU 18 core, GPU 40 core), 48 GB, 2 TB | $4,999 | €5,699 |
| Aggiornamento a 128 GB | +2.000 $ (era +1.000 $ fino al 25 giugno) | circa +2.500 € (era +1.250 € al lancio), stima |
| 16″ M5 Max, 128 GB, 2 TB | $6,999 | circa 8.199 € (stima; 6.249 € al lancio) |
| Al massimo: 128 GB, 8 TB, display nano-texture | $10,149 | — |
| Per confronto: Mac Studio, M5 Max, 128 GB | $4,799 | — |
I prezzi USA escludono l’imposta sulle vendite; quelli tedeschi includono il 19% di IVA. L’aggiornamento tedesco a 128 GB è una mia stima: Apple lo faceva pagare 1.250 € al lancio, e l’aggiornamento in dollari è raddoppiato a giugno. Controlla il configuratore di Apple prima di comprare.
Tre cose saltano all’occhio.
La memoria ora è la parte costosa. Apple ha alzato i prezzi su tutta la linea Mac il 25 giugno, dando la colpa ai costi di memoria e archiviazione. Ha detto a Reuters di non aver “mai visto un componente rincarare così tanto, così in fretta”. Gli aggiornamenti da 64 GB e 128 GB dell’M5 Max sono entrambi raddoppiati. L’unico componente di cui l’AI locale ha più bisogno è quello che è diventato due volte più caro.
Il sovrapprezzo del portatile è di 2.200 $. Lo stesso M5 Max con gli stessi 128 GB in un Mac Studio costava 4.799 $ quando Forbes l’ha prezzato ad agosto. Se vuoi la memoria per l’AI, il formato portatile costa il 46% in più.
Il 14 pollici è un compromesso. Puoi ordinare anche il 14 pollici con 128 GB, ma nella recensione di Notebookcheck il telaio faceva fatica a raffreddare l’M5 Max sotto carico prolungato. Ne parlo meglio nella Parte 8.
Nuovi Mac questa settimana. Il 27 ottobre Apple ha annunciato un MacBook Pro da 14 pollici con il chip M6 di base: fino a 32 GB e 170 GB/s, da 1.999 $. È un buon portatile, non una macchina per LLM. E stasera (28 ottobre, 10:00 del Pacifico, 18:00 in Germania) Apple tiene l’evento “Pro and Tell”, dove un MacBook Pro OLED con touchscreen è ampiamente atteso. I resoconti dicono che usa gli stessi chip M5 Pro e M5 Max, il che lascerebbe invariati il tetto dei 128 GB e i 614 GB/s.
Parte 4 — Il divario di qualità, misurato
Come confronti un modello sulla tua scrivania con uno in un data center? Non con le sensazioni, e non con la tabella di benchmark dell’azienda che lo vende. Artificial Analysis (AA) esegue la stessa batteria di test su centinaia di modelli, attraverso lo stesso harness, e condensa i risultati in un unico Intelligence Index. Nessun indice è perfetto, ma quello dell’AA è indipendente, ed è la cosa più vicina a un metro comune che l’industria abbia.
Il 27 ottobre AA ha pubblicato la versione 5. Il cambiamento principale: circa il 60% dell’indice ora gira su set di test privati o risposte tenute da parte, così che un modello non possa aver visto le domande durante l’addestramento. Lavoro di conoscenza, coding, scienza e conoscenza generale contano un quarto ciascuno.
La nuova classifica
| Modello | Puoi scaricarlo? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | No | 58 |
| GPT-6 Astra (max) | No | 57 |
| GPT-6.1 Sol (max) | No | 55 |
| Gemini 4 Argon (high) | No | 50 |
| Kimi K3.1 Pro | Non ancora; pesi non rilasciati | 46 |
| Claude Haiku 5.5 (max) | No | 36 |
| DeepSeek V4.1 Flash 1017 (max) | Sì, licenza MIT | 32 |
| GLM-5.3 (max) | Sì | 32 |
Fonte: Artificial Analysis, annuncio dell’Intelligence Index v5, 27 ottobre 2026.
Tre cose in quella tabella contano se stai valutando l’acquisto di un MacBook.
- Tutti e cinque i primi posti sono di Anthropic e OpenAI, e nessuno di quei modelli si può scaricare a nessun prezzo.
- Il miglior modello aperto, Kimi K3.1 Pro, non ha ancora rilasciato i pesi. Tra i modelli che puoi davvero scaricare, il punteggio migliore è 32, il che li lascia 26 punti dietro il leader. Nella versione precedente c’erano 3 punti tra il miglior modello aperto e il migliore chiuso. Ora sono 12, o 26 se conti solo i pesi che puoi scaricare.
- Claude Haiku 5.5 batte ogni modello aperto scaricabile. È il livello piccolo, veloce ed economico d’Anthropic, non l’ammiraglia.
Il coding, in particolare
Il nuovo indice include FrontierCode 2.0, 132 compiti di coding privati di Cognition. Claude Opus 5.5 ne ha risolti il 46%; DeepSeek V4.1 Flash 1017, il più forte a pari merito tra i modelli scaricabili, il 28%. Su Terminal-Bench-Science, 70 compiti di scienza agentica, è il 59% contro il 13%.
Per essere giusti con i modelli aperti: Kimi K3.1 Pro guida Terminal-Bench 4.0 con il 67%, davanti a ogni modello chiuso. I modelli aperti possono vincere, e vincono, singoli benchmark. Ma quello non è ancora scaricabile, e il suo predecessore, Kimi K3, ha 2.800 miliardi di parametri. Non lo farai girare su un portatile.
Perché il divario si è appena allargato
Il salto dalla v4.3 alla v5 non ha trattato tutti allo stesso modo.
| Modello | Tipo | v4.3 | v5 | Variazione |
|---|---|---|---|---|
| Claude Opus 5.5 | Chiuso | 58 | 58 | 0 |
| GPT-6 Astra | Chiuso | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Chiuso | 56 | 54 | −2 |
| Gemini 4 Argon | Chiuso | 53 | 50 | −3 |
| Kimi K3.1 Pro | Aperto (non rilasciato) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Ricarica | 45 | 32 | −13 |
| Muse Spark Open (Meta) | Ricarica | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | Ricarica | 46 | 30 | −16 |
Dati v4.3 e v5 come riportati da Trending Topics il 28 ottobre, con i punteggi v5 coerenti con l’annuncio di AA.
In media, quei quattro modelli aperti hanno perso 13 punti. I quattro chiusi si sono mossi di un quarto di punto.
AA non ha spiegato perché. L’ovvia lettura è che, quando le domande dei test sono segrete, un modello non può averle viste, e che i benchmark pubblici lusingano i modelli addestrati molto su dati pubblici. Anche la controobiezione è giusta: i test privati non si possono verificare dall’esterno, e il peso che dai alle categorie sposta la classifica. Non prendere nessun indice come Vangelo. Ma quando quattro modelli aperti scendono a doppia cifra e quattro chiusi no, è un segnale da prendere sul serio: le tabelle di benchmark pubblicate, e soprattutto quelle dei fornitori, sovrastimano quanto i modelli aperti siano vicini.
E i modelli che entrano davvero in un MacBook
I modelli che AA ha ripunteggiato per il suo annuncio sono in gran parte troppo grandi per un portatile. Per quelli che ci stanno, le pagine dell’AA mostrano ancora i punteggi v4.3.2 e su quella versione anche Opus 5.5 segna 58. Quindi ecco il confronto su un’unica scala coerente:
| Modello | Entra in un MacBook da 128 GB? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | No, solo cloud | 58 |
| Qwen3.8 27B (xhigh) | Sì, a 4 bit persino su un Mac da 32 GB | 34 |
| Qwen3.5 122B A10B (reasoning) | Sì, circa 70 GB a 4 bit | 16 |
| gpt-oss-120b (high) | Sì, circa 64 GB | 12 |
Fonte: pagine dei modelli di Artificial Analysis, consultate il 28 ottobre 2026.
AA classifica Qwen3.8 27B al primo posto su 141 modelli comparabili. È davvero eccellente per la sua dimensione, ed è un modello aperto rilasciato con licenza Apache 2.0. Resta comunque 24 punti dietro.
Mostra immagine Due versioni dell’indice, due pannelli separati, mai un solo asse. In alto: Intelligence Index v5 di Artificial Analysis (27 ottobre 2026). In basso: i modelli che entrano in un MacBook da 128 GB, sulla v4.3.2, la versione su cui sono pubblicati i loro punteggi.
Il paradosso dei 128 GB
Guarda di nuovo quell’ultima tabella. Il miglior modello per un MacBook da 128 GB entra in 32 GB. I modelli che hanno davvero bisogno della memoria in più, mixture-of-experts da 120 miliardi di parametri, segnano meno, soprattutto perché sono più vecchi: gpt-oss-120b è uscito ad agosto 2025, e Qwen3.5 122B era già in benchmark sull’M5 Max a marzo, mesi prima che arrivasse Qwen3.8 27B.
Quindi cosa ti compra oggi l’aggiornamento da 2.000 $ da 48 GB a 128 GB? Spazio: contesti più lunghi, precisione a 8 bit invece che a 4, diversi modelli caricati insieme e la possibilità di far girare un forte modello da 100 miliardi se ne esce uno. Sono vantaggi reali. Un modello più intelligente non è tra questi, almeno non nella classifica di oggi. Controlla AA prima di comprare: è il tipo di fatto che cambia con un solo rilascio.
Che cosa significa 34 contro 58, in pratica
I punti dell’indice non sono “percento più intelligente”, e non si distribuiscono in modo uniforme tra un compito e l’altro.
Per i compiti brevi e ben definiti, come riscrivere un’email, riassumere un documento che incolli o estrarre campi da una fattura, un buon modello da 27B è spesso indistinguibile da uno di frontiera. Il divario si apre sul lavoro lungo e a più passaggi: un agente che deve leggere un codebase, pianificare, modificare cinque file, eseguire i test e rimettersi in piedi dai propri errori; una ricerca che deve riconciliare fonti; un ragionamento in cui un passo sbagliato avvelena il resto. È esattamente il lavoro per cui la gente compra piani da 200 $.
La colonna d’agosto di Forbes dava un esempio concreto dal paper di ricerca dell’azienda Qwen: Qwen3-Coder-Next dentro Claude Code segnava 30.9% su Terminal-Bench 2.0, contro 53.9% di Claude Opus 4.5 nello stesso paper. Sono modelli dell’anno scorso, ma la forma non è cambiata: sui compiti agentici, la configurazione locale falliva molto più spesso.
Parte 5 — Perché i modelli che vuoi davvero non c’entrano
L’ingombro di un modello in memoria è facile da stimare:
testo
pesi (GB) ≈ parametri (miliardi) × byte per parametro
               8 bit → × 1,0     4 bit → × 0,5     2 bit → × 0,25
Poi aggiungi la KV cache, la memoria di lavoro del modello per la tua conversazione, che cresce con la lunghezza del contesto. E ricorda che macOS non dà l’intera memoria unificata alla GPU: per impostazione predefinita lascia che la GPU ne riservi all’incirca 75% sui Mac con molta memoria, circa 96 GB di una macchina da 128 GB. Puoi alzare il limite con sudo sysctl iogpu.wired_limit_mb=…, a tuo rischio; qualunque cosa tu dia al modello, il browser, l’editor e il sistema operativo non ce l’hanno.
Ecco l’effetto sui modelli di cui si parla davvero:
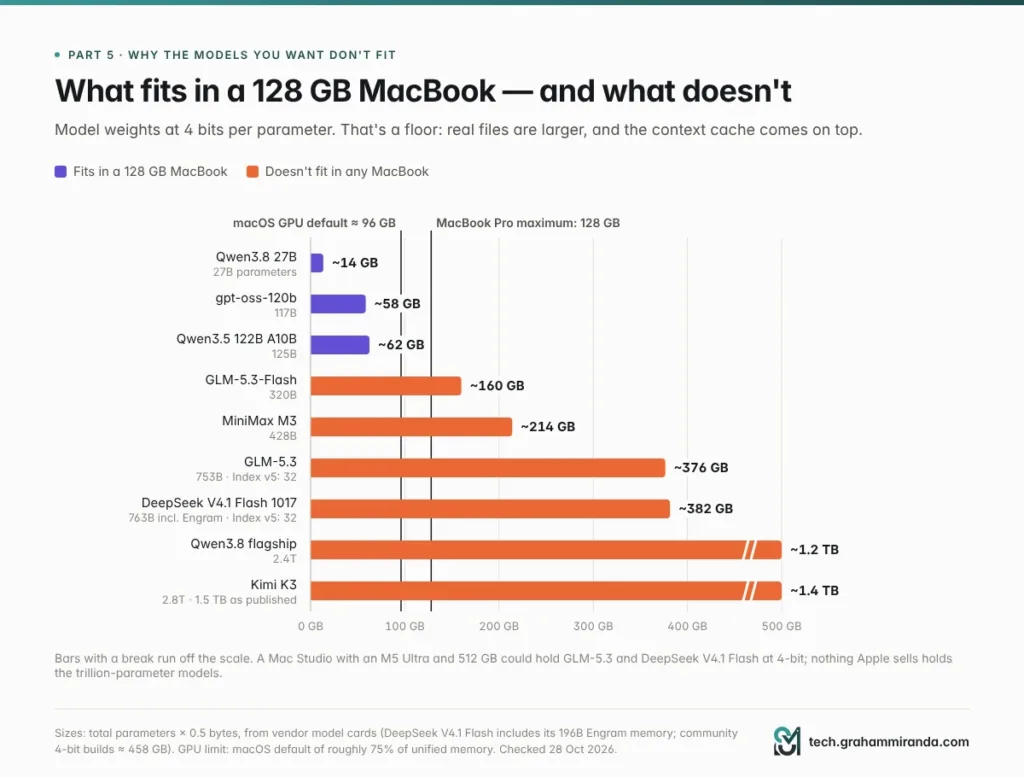
| Modello | Parametri totali | Pesi a 4 bit (minimo) | Entra in un MacBook da 128 GB? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ Senza problemi |
| gpt-oss-120b | 117B | ~58 GB (file da 64 GB) | ✅ Sì |
| Qwen3.5 122B A10B | 125B | ~62 GB (file da 69,6 GB) | ✅ Sì |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ No |
| MiniMax M3 | 428B | ~214 GB | ❌ No |
| GLM-5.3 | 753B | ~376 GB | ❌ No |
| DeepSeek V4.1 Flash 1017 | 763B incl. memoria Engram | ~382 GB (build community a 4 bit stimate a ~458 GB) | ❌ No |
| Qwen3.8 flagship | 2,4 T | ~1,2 TB | ❌ No |
| Kimi K3 | 2,8 T | ~1,5 TB come pubblicato (MXFP4 nativo) | ❌ No |
La colonna a 4 bit è parametri × 0,5 byte: solo pesi, prima della KV cache e dell’overhead dei file, quindi i file reali sono più grandi. Le dimensioni dei file vengono dai test di Hardware Corner sull’M5 Max.
I modelli che segnano 32 sul nuovo indice, i migliori che puoi scaricare, hanno bisogno di da tre a quattro volte quello che ha un MacBook. E quelli nel mezzo non ci entrano nemmeno loro. Se dai ai pesi del modello 100 GB dei tuoi 128 GB, ecco quanti bit per peso ti puoi permettere:
| Modello | Bit per peso in un budget da 100 GB |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Attorno ai tre bit e sotto, la qualità crolla (nella Parte 6 c’è la ricerca). Un bit per peso non è quantizzazione, è un’amputazione.
Anche il contesto costa memoria. Nei test di Hardware Corner, Qwen3-Coder-Next a 8 bit usava 87,1 GB con un contesto da 4K e 92,6 GB a 64K: cinque gigabyte e mezzo in più solo per tenere una conversazione più lunga. Gli agenti che leggono interi repository hanno bisogno di contesti lunghi, quindi quel margine sparisce in fretta.
E un Mac Studio da 512 GB? Un Mac Studio M5 Ultra con 512 GB potrebbe tenere GLM-5.3 o DeepSeek V4.1 Flash a 4 bit. Apple ha detto che quella configurazione sarebbe arrivata entro la fine d’ottobre; MacRumors si aspetta che costi ben oltre 10.000 $, e Apple non aveva pubblicato un prezzo l’ultima volta che ho controllato. Pagheresti cinque cifre per far girare modelli che segnano 32 sul nuovo indice, probabilmente più lentamente di come li servono i loro produttori. Il mio Kimi K3 vs Fable 5.1 vs GLM-5.3 confronto approfondisce cosa serve davvero per autoospitare i grandi modelli aperti.
Mostra immagine Solo pesi, a 4 bit per parametro; la cache del contesto si aggiunge. Tutto ciò che sta a destra della linea dei 128 GB richiede un Mac Studio o un server.
Parte 6 — La quantizzazione: la tassa sulla qualità che paghi per farli entrare
La quantizzazione salva i pesi di un modello in meno bit, 8 o 4 invece dei 16 usati per l’addestramento, così occupa meno memoria e gira più veloce. Ogni modello locale che farai girare su un Mac è quantizzato. La domanda è quanto costa, e la ricerca dà una risposta chiara e un po’ scomoda.
La buona notizia: l’8 bit è quasi gratis, il 4 bit va per lo più bene
- Uno degli studi più ampi finora, di Eldar Kurtic e colleghi, ha eseguito più di 500.000 valutazioni su modelli Llama 3.1 quantizzati. FP8 era di fatto senza perdite a ogni dimensione; INT8 costava circa l’1–3% con una messa a punto accurata; e la quantizzazione a 4 bit dei soli pesi era “più competitiva del previsto”, vicina all’8 bit.
- Per i modelli di reasoning, uno studio del 2025 di Ruikang Liu e colleghi ha scoperto che pesi e attivazioni a 8 bit, o pesi a 4 bit con attivazioni a 16 bit, possono essere senza perdite su benchmark di matematica, scienza e coding. Larghezze di bit inferiori portavano a quelli che gli autori chiamano rischi significativi di accuratezza, e la difficoltà del compito influenzava molto quanto si perdeva.
Se fai solo domande brevi in inglese, un modello a 4 bit ti sembrerà vicino all’originale.
La cattiva notizia: input lunghi, altre lingue e qualsiasi cosa sotto i 4 bit
- Contesto lungo. Anmol Mekala e colleghi hanno testato cinque metodi di quantizzazione su 9.700 esempi con input di 64.000 token o più (EMNLP 2025). L’8 bit costava circa 0.8% in media. Il 4 bit costava fino al 59%, e il danno dipendeva molto dal modello: con un metodo a 4 bit, Llama 3.1 70B perdeva il 32% su un compito in cui Qwen 2.5 72B teneva.
- Lingue diverse dall’inglese. Lo stesso studio ha trovato che il degrado tendeva a essere peggiore quando l’input non era in inglese. Se lavori in tedesco, prova in tedesco.
- Sotto i 4 bit, il reasoning crolla. Ricercatori di Meta FAIR hanno pubblicato a giugno 2026 uno studio che mostra che i modelli di reasoning quantizzati pensano troppo. Con l’AWQ a 3 bit, il punteggio di un modello di reasoning da 1,5 miliardi sul benchmark MATH-500 è sceso da 85,6% a 47,0%, e la sua catena di pensiero è cresciuta da 5.200 a 23.400 token, 4,5 volte più lunga. Su un portatile che scrive a 20–80 token al secondo, un modello che pensa quattro volte più a lungo è anche circa quattro volte più lento.
Mostra immagine Quanto costa, secondo la ricerca, ogni gradino in meno di precisione. La compressione che farebbe entrare un modello più grande in 128 GB è esattamente quella che fa più male.
Cosa significa per un MacBook da 128 GB
La quantizzazione che puoi permetterti per un modello che vorresti è la quantizzazione che fa più male. Un modello da 27B può girare a 8 bit su un Mac con spazio in abbondanza, e dovrebbe. I modelli della classe 120B girano a 4 bit, che va bene per la chat ed è rischioso sui documenti lunghi. E l’unico modo per portare qualcosa della classe 300B+ su un portatile sono due o tre bit per peso, dove gli studi sopra dicono che il reasoning si sfascia.
Le mie regole pratiche:
- Usa l’8 bit per qualsiasi cosa su cui farai affidamento, soprattutto documenti lunghi e lavoro con agenti.
- Il 4 bit va bene per chat, bozze e compiti brevi. Controlla come si comporta sui contesti lunghi con i tuoi documenti.
- Non far girare modelli di reasoning o coding sotto i 4 bit a meno che tu non stia sperimentando.
- Prova nella lingua in cui lavori.
Parte 7 — Velocità: veloce in scrittura, lenta in lettura
Un LLM fa due lavori diversi a due velocità diverse. Prefill legge il tuo prompt, tutto quello che hai incollato più l’intera conversazione fino a quel punto, ed è limitato dalla potenza di calcolo grezza. Generazione scrive l’intera risposta un token alla volta, ed è limitata dalla banda di memoria. I ricercatori di machine learning di Apple hanno misurato entrambe sull’M5: i nuovi Neural Accelerator della GPU hanno reso il tempo al primo token da 3,3 a 4,1 volte più veloce rispetto all’M4, mentre la generazione è migliorata solo di da 1,19 a 1,27 volte, più o meno in linea con la banda in più.
Quindi cosa fa davvero un M5 Max con 128 GB? Hardware Corner ha pubblicato test eseguiti con il framework MLX di Apple su un 14 pollici M5 Max con 128 GB:
| Modello | Contesto | Lettura (prefill), tok/s | Tempo per leggere tutto il prompt | Scrittura, tok/s |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3,1 s | 87.9 |
| 32K | 2,537 | 12,9 s | 64.5 | |
| Qwen3.5 122B A10B (4 bit) | 4K | 881 | 4,6 s | 65.9 |
| 32K | 1,068 | 30,7 s | 54.9 | |
| Qwen3.5 27B (dense, 6 bit) | 4K | 811 | 5,1 s | 23.6 |
| 32K | 591 | 55,4 s | 14.9 | |
| Qwen3-Coder-Next (8 bit) | 64K | 1,432 | 45,8 s | 48.2 |
Misurato dall’utente Reddit cryingneko e pubblicato da Hardware Corner. “Tempo per leggere tutto il prompt” è la lunghezza del contesto divisa per la velocità di prefill misurata.
La velocità di scrittura oggi va bene, almeno sui modelli MoE
I modelli mixture-of-experts usano solo una frazione dei loro pesi per ogni token, quindi scrivono in fretta: da 55 a 88 token al secondo sull’M5 Max. Per confronto, Artificial Analysis misura Claude Opus 5.5 a 98 token al secondo sull’API di Anthropic. Per chattare con un modello della classe 120B, l’M5 Max è davvero piacevole. I modelli dense sono un’altra storia: un modello da 27B che usa ogni peso per ogni token scrive a 15–24 token al secondo.
Si sommano anche due effetti più piccoli. La scrittura rallenta man mano che la conversazione cresce: dal 17% al 37% più lenta a 32K rispetto a 4K su quei tre modelli. E i modelli di reasoning passano centinaia o migliaia di token a pensare prima di rispondere.
La lettura è dove sta l’attesa
Guarda di nuovo la colonna del tempo di lettura. Un prompt da 32.000 token (qualche file sorgente, un contratto lungo, una lunga catena di email) impiega da 13 a 55 secondi a essere letto prima che compaia la prima parola della risposta.
Questo conta soprattutto per il lavoro per cui si compra un piano da 200 $. Gli agenti di coding AI mandano al modello un grande prompt di sistema, le definizioni di ogni strumento, i file che hanno aperto e la conversazione fino a quel punto, e lo fanno a ogni passo. I server locali possono riusare la parte del prompt che non è cambiata, il che aiuta molto. Ma ogni volta che cambia qualcosa all’inizio del contesto, per esempio quando l’agente compatta la sua cronologia o tu passi a un nuovo compito, tutto quello che viene dopo va riletto. Forbes ha citato uno sviluppatore che ha aspettato circa 90 secondi per il primo token su un M5 Ultra da 512 GB con un prompt di sistema da 16.000 token, e un altro che ha visto circa 20 secondi a freddo su un portatile M4 Pro da 48 GB. I chip della generazione M5 sono molto più veloci in questo dei Mac più vecchi, secondo le misurazioni di Apple, ma la forma del problema è la stessa.
Per dare un’idea, gli stessi test di Hardware Corner eseguiti su una scheda workstation Nvidia RTX Pro 6000, che da sola costa circa 8.800 $: leggeva i prompt da 2 a 2,4 volte più veloce e scriveva da 1,7 a 2,8 volte più veloce dell’M5 Max.
Mostra immagine Misurato con MLX su un M5 Max con 128 GB. La scrittura è abbastanza veloce; la lettura di prompt lunghi, che gli agenti fanno di continuo, è dove si aspetta.
Parte 8 — Il problema del portatile
Anche se i modelli fossero abbastanza buoni, un portatile è un posto scomodo per farli girare.
Calore. Far girare un modello grande è carico prolungato: minuti o ore in cui GPU e memoria lavorano a pieno regime, non una raffica da dieci secondi. La recensione di Notebookcheck del 14 pollici M5 Max conclude che telaio e raffreddamento “semplicemente non riescono a gestire l’M5 Max in modo adeguato”: le prestazioni in uno stress test CPU da 30 minuti sono calate del 24%, e le ventole hanno raggiunto 53,2 dB(A) in modalità High Power. Quella recensione misurava carichi di CPU e grafica, non LLM, e Notebookcheck stessa suggerisce che l’M5 Max stia nel 16 pollici. Se compri un MacBook per l’AI locale, compra il 16 pollici. La mia guida al MacBook Pro M5 Pro da 64 GB è arrivata alla stessa conclusione sul lavoro prolungato sul telaio più piccolo.
È anche il computer d’ogni giorno. Carica un modello da 70 GB più il suo contesto e hai ancora spazio per il browser e l’editor. Spingi verso i circa 96 GB che la GPU ha per impostazione predefinita, o alza il limite per far entrare qualcosa di più grande, e il resto del tuo lavoro inizia a competere con il modello per la memoria. Ogni modello che tieni caricato è memoria che le tue altre app non hanno.
Le batterie non l’apprezzano. Un carico GPU prolungato scarica in fretta la batteria di un portatile, quindi le sessioni lunghe di inferenza locale finiscono per avvenire con la spina attaccata, il che indebolisce non poco la promessa di “AI ovunque, offline”.
Il tuo tetto lo compri il primo giorno. La memoria unificata non si può aggiornare dopo l’acquisto. Se il miglior modello aperto dell’anno prossimo richiede 160 GB, un MacBook da 128 GB semplicemente non può farlo girare.
E si svaluta in fretta. Il rivenditore britannico di Mac ricondizionati MacFinder ha analizzato sei anni dei propri dati di acquisto e ha scoperto che la maggior parte dei MacBook perde circa metà del suo valore nel primo anno, con i modelli di fascia alta che spesso scendono ancora di più: un MacBook Pro M4 da 16 pollici ha perso fino al 60% in un anno. Una macchina da 6.999 $ è una scommessa da 6.999 $ che il tetto di memoria d’oggi sarà ancora utile tra tre anni.
Un desktop è una macchina migliore per gli LLM. Se l’AI locale è il punto, un Mac Studio con lo stesso M5 Max e 128 GB costa 2.200 $ in meno, non ha una batteria da far cuocere né un coperchio da chiudere, e può girare 24 ore su 24 come server privato per il tuo portatile e il tuo telefono. Abbinalo al portatile che ti piace già.
Parte 9 — Il divario software: quello che dovresti ricostruire
Un abbonamento è un modello più un prodotto. Una configurazione locale ti dà il modello e lascia il prodotto a te.
| Cosa fa l’abbonamento per te | Cosa faresti in locale |
|---|---|
| Ospita e aggiorna il modello | Scarichi, converti e aggiorni i modelli da solo (LM Studio, Ollama o MLX) |
| Ricerca web e deep research | Colleghi un’API di ricerca o una ricerca autoospitata, più un agente che la guidi |
| Legge PDF, fogli di calcolo e immagini | Scegli modelli con visione, aggiungi il parsing dei documenti |
| Voce, memoria, generazione di immagini | Modelli e app separati per ciascuna (Whisper per la voce, Draw Things o ComfyUI per le immagini) |
| App su ogni dispositivo, sincronizzate | Fai girare un server e un front-end, ed esponilo al tuo telefono in sicurezza |
| Claude Code o Codex, tarati sui loro modelli | Punti un harness aperto, o Claude Code stesso, su un server locale |
| Template di chat, formati di tool call e sicurezza gestiti | Li metti a punto quand’esce un nuovo modello con un template che i tuoi strumenti non capiscono |
Gli strumenti oggi sono davvero buoni. LM Studio è il modo più semplice per iniziare su un Mac, Ollama ti dà un’unica API per modelli locali e cloud, e MLX di Apple è di solito il più veloce. Ollama espone persino un’ API compatibile con Anthropic, così puoi puntare Claude Code su un modello locale impostando ANTHROPIC_BASE_URL=http://localhost:11434. La sua documentazione è però sincera sulle lacune: i controlli di prompt caching d’Anthropic, il conteggio dei token, i batch e l’input PDF non sono supportati. E Claude Code è tarato sui modelli Claude; un modello locale deve fare i conti con il lungo prompt di sistema e le definizioni degli strumenti di Claude Code, ed è lì che mordono i tempi di prefill della Parte 7.
Niente di tutto questo è impossibile. Il mio OpenCode v2 vs Hermes Agent vs OpenClaw pezzo copre gli agenti aperti che funzionano con i modelli locali. Ma è lavoro vero, e le tue ore non sono gratis. Metti in conto un weekend per configurarlo e qualche ora al mese per tenerlo aggiornato.
Parte 10 — I conti del punto di pareggio, fatti per bene
Ecco il calcolo che la promessa di solito salta.
Passo 1: la versione ingenua
6.999 $ ÷ 200 $ al mese = 35 mesi. Non dodici. Quasi tre anni, e questa è l’ipotesi più generosa.
Passo 2: aggiungi l’elettricità
Forbes stimava circa 10 $ al mese per un Mac che fa girare AI otto ore al giorno ai prezzi medi statunitensi. In Germania, con la media di ottobre di 29,68 centesimi per kWh, un portatile che consuma in media 60–150 W per otto ore al giorno costa circa 4–11 € al mese. Poco, ma spinge il punto di pareggio a circa 37 mesi.
Passo 3: tieni un piano economico per le cose difficili
Lo farai. Poche persone che hanno usato un modello di frontiera per il coding agentico o per una ricerca seria tornano a un modello da 34 punti per tutto. Tieni un piano da 20 $ per il 10% difficile e il Mac ti fa risparmiare 170 $ al mese, non 200 $: circa 41 mesi.
Passo 4: confronta con l’alternativa a cui ripiegheresti davvero
Se sei abbastanza attento ai costi da considerare un portatile da 7.000 $, sei abbastanza attento ai costi da scendere a un livello da 100 $. Contro 100 $ al mese il punto di pareggio è circa 78 mesi, più di sei anni e mezzo, più a lungo di quanto molte persone tengano un portatile.
| Scenario | Anticipo | Paghi comunque | Risparmio mensile | Pareggio |
|---|---|---|---|---|
| MacBook contro piano da 200 $, senza elettricità | $6,999 | — | $200 | 35 mesi |
| MacBook contro piano da 200 $, con elettricità | $6,999 | $10 | $190 | 37 mesi |
| … e tieni un piano da 20 $ | $6,999 | $30 | $170 | 41 mesi |
| MacBook contro piano da 100 $ | $6,999 | $10 | $90 | 78 mesi |
| Mac Studio (128 GB) contro piano da 200 $ | $4,799 | $10 | $190 | 25 mesi |
| Mac Studio contro piano da 200 $, tenendo un piano da 20 $ | $4,799 | $30 | $170 | 28 mesi |
Tutti questi assumono che il Mac faccia del tutto il lavoro dell’abbonamento. Le Parti dalla 4 alla 9 spiegano perché non lo fa.
Mostra immagine Costo cumulato su quattro anni, assumendo che il Mac sostituisca del tutto l’abbonamento, cosa che non fa. Elettricità a circa 10 $ al mese.
Passo 5: tre anni, con la rivendita
L’hardware ha valore di rivendita, e questo è l’argomento più forte a favore dell’acquisto. Ipotizza di venderlo dopo tre anni al 35% del prezzo d’acquisto. È un’ipotesi mia, non un preventivo, basata sui dati di MacFinder che mostrano circa metà del valore perso nell’arco del primo anno e perdite più lente dopo.
| Opzione | Costo a 36 mesi |
|---|---|
| Piano da 200 $ | $7,200 |
| MacBook (128 GB) + elettricità, venduto al 35% | $4,909 |
| … più un piano da 20 $ per il lavoro di frontiera | $5,629 |
| Mac Studio (128 GB) + elettricità + piano da 20 $, venduto al 35% | $4,199 |
| Piano da 100 $ | $3,600 |
| Piano da 20 $ | $720 |
Quindi sì: su tre anni, un MacBook più un piano da 20 $ può arrivare a costare circa 1.600 $ in meno di un piano da 200 $, se lo vendi a un prezzo decente. Ma guarda cosa ci compri con quei soldi. Da una parte, i modelli migliori del mondo con tutti gli strumenti attorno. Dall’altra, un modello da 34 punti, qualche migliaio di dollari di svalutazione e un piano economico per quando ti serve la cosa vera. Il piano da 100 $ batte ogni opzione hardware sul costo, e il piano da 20 $ batte tutto.
Non c’è un gran risparmio con un MacBook per gli LLM locali. Stai spendendo all’incirca la stessa cifra per un prodotto diverso: privacy, controllo e libertà dai limiti, con meno intelligenza al seguito.
La lettura del costo marginale
C’è una lettura in cui comprare ha più senso: devi comunque comprare un MacBook nuovo. Allora il costo specifico per l’AI è solo l’aggiornamento di memoria da 48 GB a 128 GB, 2.000 $, ovvero dieci mesi di un piano da 200 $. Non è follia. Ma ricorda il paradosso dei 128 GB della Parte 4: nella classifica di oggi, quell’aggiornamento compra modelli più grandi, non più intelligenti. Se stai comprando un MacBook comunque, 48–64 GB fanno girare il miglior modello da Mac a 8 bit con abbondanza di contesto.
Cosa compri invece con 6.999 $
- 35 mesi di un piano da 200 $, 70 mesi di un piano da 100 $, o 29 anni di un piano da 20 $
- Circa 11,7 miliardi di token di output da DeepSeek V4.1 Flash al suo prezzo API fuori punta, un modello che supera tutto ciò che entra in un MacBook
- Circa 350 milioni di token di output di Claude Opus 5.5 tramite l’API di Anthropic, ai 20 $ per milione che elenca Artificial Analysis
Parte 11 — Il caso giusto: quando comprare un Mac per l’AI locale ha senso
Niente di tutto questo significa che l’AI locale sia un gadget. Ne scrivo di continuo su questo blog perché è utile. È solo utile per ragioni diverse da quelle che la promessa dichiara. Queste sono quelle buone.
1. Dati che non devono uscire dall’ambito del tuo controllo
Se gestisci file di clienti, informazioni sanitarie, dati finanziari non pubblicati o qualsiasi cosa coperta da un obbligo di riservatezza, un modello locale significa che niente va a terze parti. Nessun accordo con un responsabile del trattamento, nessun trasferimento internazionale, nessun dubbio sulle impostazioni di addestramento. In Germania, i professionisti vincolati al § 203 StGB, come avvocati, medici e consulenti fiscali, hanno bisogno di garanzie contrattuali prima che i dati dei clienti vadano a qualsiasi fornitore esterno, compresi i fornitori di AI. Un modello locale aggira del tutto la questione. Questa è la ragione più forte per possedere l’hardware, e non dipende dal fatto che il modello locale sia intelligente quanto Opus. Il mio State of AI 2026 report passa in modo più dettagliato sul lato costi e conformità del far girare l’AI offline.
2. Lavoro offline
Su un aereo, presso un cliente senza rete, in una struttura dove la rete è la cosa proibita.
3. Nessun limite, nessuna deriva delle policy, un modello che non cambia mai
Nessuna finestra di cinque ore, nessun tetto settimanale, nessuna class action su come vengono comunicati. E un checkpoint locale si comporta tra un anno come oggi, il che conta se hai costruito un flusso di lavoro attorno al comportamento di un modello.
4. Lavoro in blocco, noioso, ben definito
Classificare migliaia di ticket di supporto, estrarre campi dalle fatture, riassumere i tuoi appunti, tradurre bozze, taggare le foto, generare embedding per la ricerca sui tuoi documenti, trascrivere riunioni con Whisper. I modelli locali di taglia media sono eccellenti in queste cose, e farne girare un milione non costa altro che elettricità.
5. Imparare e costruire
Se costruisci app local-first, fai fine-tuning di modelli piccoli o vuoi solo capire come funzionano queste cose, possedere l’hardware è il miglior insegnante che ci sia. (Se costruire app con l’AI è la tua passione, ho raccontato tutto il processo in Come costruire un’app da zero con l’AI nel 2026.)
6. Stavi comunque comprando un Mac
Allora compra memoria sufficiente per i modelli che farai girare davvero (vedi la Parte 14), e tratta l’AI locale come un bonus, non come un business case.
Cosa gira bene in locale
| Compito | Cosa far girare | Memoria comoda |
|---|---|---|
| Chat privata, bozze, riscrittura | Qwen3.8 27B a 8 bit | 48–64 GB |
| Riassunti e domande & risposte sui tuoi documenti | Qwen3.8 27B, più un modello di embedding | 48–64 GB |
| Estrazione e classificazione in blocco | Modelli più piccoli (Gemma 4, gpt-oss-20b) | 16–32 GB |
| Voce in testo | Whisper | 8–16 GB |
| Generazione di immagini | Draw Things o ComfyUI con modelli di classe FLUX | 32 GB+ |
| Un modello di chat grande e veloce | gpt-oss-120b o Qwen3.5 122B | 128 GB |
Per la generazione video locale, i Mac restano lenti rispetto all’hardware Nvidia o alle GPU cloud; la mia guida all’M5 Pro da 64 GB ha i numeri.
Parte 12 — Modi più economici per tagliare una bolletta AI da 200 $
Se quello che vuoi davvero è una bolletta AI più piccola, ci sono strade più economiche di un portatile da 7.000 $.
1. Scendi di un livello. Claude Max 5× e ChatGPT Pro 100 costano 100 $, e l’AI Ultra di Google ora parte da 100 $. Se raramente tocchi i limiti su un piano da 200 $, questo fa risparmiare 1.200 $ all’anno senza alcuna perdita di qualità.
2. Combina due piani da 20 $. Claude Pro più ChatGPT Plus costa 40 $ al mese e ti dà due pool separati di limiti e due famiglie di modelli di frontiera tra cui alternare.
3. Paga al token per i modelli aperti. Gli stessi modelli a pesi aperti che faresti girare su un Mac, e altri più grandi che non entreranno mai, sono disponibili al token da molti fornitori, alla velocità d’un data center. DeepSeek V4.1 Flash, che supera ogni modello che entra in un MacBook, costa 0,15 $ per milione di token di input e 0,60 $ per milione di token di output fuori punta sull’API di DeepSeek (il doppio nelle ore di punta). Qwen3.8 27B è listato su OpenRouter da circa 0,035 $ per milione di token di input. Per dati personali o dei clienti, usa un fornitore con hosting UE e un accordo sul trattamento dei dati invece dell’API di DeepSeek, che tratta i dati in Cina.
4. Usa un piano di coding a tariffa flat per i modelli aperti. Il piano d’abbonamento di Z.ai Piano di codifica GLM parte da 18 $ al mese e include GLM-5.3, il migliore a pari merito tra i modelli scaricabili sul nuovo indice, più GLM-5.3-Flash, e funziona in Claude Code, Codex, OpenCode e altri strumenti. Ottieni il 10% di sconto sul GLM Coding Plan tramite il mio link affiliato. (Link affiliato — vedi l'informativa in cima.) Non è Opus 5.5, e l’indice lo dice chiaramente, ma costa meno di un decimo di un piano da 200 $. L’ho confrontato con l’offerta di MiniMax in GLM-5.3-Flash vs MiniMax M3.
5. Usa il Mac che hai già. Se il tuo Mac attuale ha da 16 a 32 GB, piccoli modelli locali gestiscono una quantità sorprendente del lavoro in blocco della Parte 11 gratis.
6. Instrada in base al compito. La configurazione che funziona per la maggior parte delle persone: un modello locale per i lavori privati e in blocco, un piano economico o un modello aperto al token per il lavoro quotidiano, e accesso alla frontiera per il 10% difficile. Il mio confronto tra harness di coding IA ha cinque configurazioni pronte a budget diversi.
Mostra immagine Costo mensile di ogni opzione in dollari statunitensi, IVA esclusa. I costi al token dipendono da quanto usi il servizio; prezzi verificati il 28 ottobre 2026.
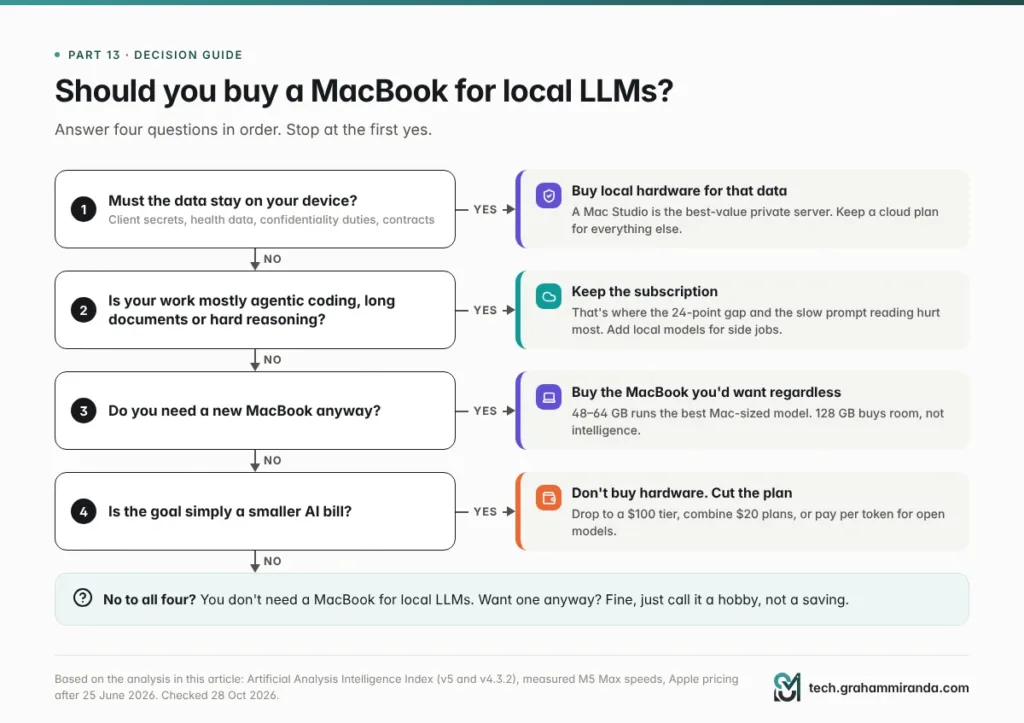
Parte 13 — Dovresti comprare un MacBook per gli LLM locali? Una guida alle decisioni
Mostra immagine Parti dall’alto. La maggior parte dei percorsi finisce con “tieni un piano cloud”, e il punto è proprio questo.
Rispondi a quattro domande, in ordine.
1. I dati devono restare sul tuo dispositivo? Se sì, per riservatezza verso il cliente, dati sanitari o un contratto, compra hardware locale: quel requisito non guarda i benchmark. Considera un Mac Studio come server privato, e tieni un piano cloud per il lavoro che non coinvolge quei dati.
2. Il tuo lavoro è soprattutto coding agentico, documenti lunghi o ragionamento difficile? Se sì, tieni l’abbonamento. È esattamente lì che il divario di 24 punti e i tempi di prefill fanno più male. Un modello locale può comunque aiutare con i lavori laterali.
3. Devi comunque comprare un MacBook nuovo? Se sì, compra quello che vorresti comunque. 48–64 GB fanno girare bene il miglior modello da Mac. Passa a 128 GB solo se vuoi specificamente modelli della classe 120B o più modelli caricati insieme, e sapendo che stai pagando 2.000 $ per lo spazio, non per l’intelligenza.
4. L’obiettivo è semplicemente una bolletta più bassa? Allora non comprare hardware. Scendi di un livello, combina piani da 20 $, o paga al token i modelli aperti (Parte 12).
Se hai risposto no a tutte e quattro, non ti serve un MacBook per gli LLM locali. Potresti volerne comunque uno, e va bene. Chiamalo hobby, però, non risparmio.
Parte 14 — Se lo compri comunque: come ricavarne il massimo
Scegli la macchina giusta.
- Compra il 16 pollici, non il 14 pollici, se l’M5 Max è per un lavoro AI prolungato.
- Considera invece un Mac Studio. Stesso chip e stessa memoria per 2.200 $ in meno, raffreddamento migliore, e può servire il tuo portatile e il tuo telefono 24 ore su 24.
- Non comprare più memoria di quanta ne serve per i modelli d’oggi. 48–64 GB fanno girare Qwen3.8 27B a 8 bit con contesti lunghi. Compra 128 GB per modelli della classe 120B, per più modelli insieme o per avere margine per uscite future, sapendo quanto costa.
- Se stai comprando questa settimana, aspetta dopo l’evento di stasera. Saprai cosa offre e quanto costa il MacBook Pro OLED prima d’impegnarti.
Configuralo come si deve.
- Inizia con LM Studio (MLX su Apple Silicon) per la strada più semplice, oppure Ollama se vuoi un’unica API per modelli locali e cloud.
- Preferisci l’8 bit per qualsiasi cosa su cui farai affidamento; usa il 4 bit per la velocità in chat.
- Imposta la lunghezza del contesto di proposito. Molti runtime usano per impostazione predefinita contesti piccoli; gli agenti ne hanno bisogno di molto più grandi.
- Alza il limite di memoria della GPU solo se capisci il compromesso, e lascia spazio a macOS.
- Tieni un piano cloud da 20 $ per il 10% difficile. Costa meno del tuo tempo.
Provaci sul tuo lavoro. Prendi 20 prompt reali dall’ultimo mese: email, documenti, compiti di coding, qualunque cosa tu faccia davvero. Falli passare dal tuo modello locale e da quello cloud, nascondi quale sia quale, e dai un voto. Fallo nella lingua in cui lavori. Quell’ora ti dirà più di qualsiasi classifica, comprese quelle di questo articolo.
Domande frequenti
Un MacBook può sostituire un abbonamento ChatGPT Pro o Claude Max?
Non sulla qualità. I modelli dietro un piano da 200 $, come Claude Opus 5.5 e GPT-6 Astra, non si possono scaricare, e i migliori modelli aperti scaricabili richiedono 375–460 GB di memoria a 4 bit, ben oltre qualsiasi MacBook. Sull’indice di Artificial Analysis, Opus 5.5 segna 58; il modello più forte che ho trovato che entra in un MacBook da 128 GB, Qwen3.8 27B, segna 34 sulla stessa versione. Un MacBook può sostituire un abbonamento per lavoro privato, offline o in blocco, non per compiti di frontiera.
Qual è il miglior LLM locale per un MacBook Pro da 128 GB nel 2026?
Per la qualità, Qwen3.8 27B: Artificial Analysis lo mette al primo posto su 141 modelli comparabili, con 34 sull’Intelligence Index v4.3.2, ed entra comodamente a 8 bit. Per la velocità, gpt-oss-120b e Qwen3.5 122B sono modelli mixture-of-experts che scrivono 55–88 token al secondo su un M5 Max, ma segnano meno (12 e 16). Controlla Artificial Analysis prima di scegliere, perché nuovi modelli aperti cambiano questa classifica ogni poche settimane.
Quanto costa oggi un MacBook Pro con 128 GB?
Un MacBook Pro da 16 pollici con un M5 Max (CPU 18 core, GPU 40 core), 128 GB e 2 TB costa 6.999 $ negli Stati Uniti, prima delle imposte sulle vendite. Apple ha alzato i prezzi dei Mac il 25 giugno 2026 e raddoppiato l’aggiornamento a 128 GB da 1.000 $ a 2.000 $. In Germania la stessa configurazione costava 6.249 € al lancio e, secondo le mie stime, ora costa circa 8.199 €. Un Mac Studio con lo stesso chip e la stessa memoria costava 4.799 $.
Quanto tempo serve a un MacBook per ripagarsi rispetto a un abbonamento AI da 200 $?
Circa 35 mesi a 6.999 $, se sostituisse del tutto l’abbonamento e non costasse nulla farlo girare. Con circa 10 $ al mese d’elettricità sono circa 37 mesi, e se tieni un piano da 20 $ per i compiti di frontiera sono circa 41 mesi. Contro un piano da 100 $ sono più di sei anni. Un Mac Studio con lo stesso chip va in pareggio prima, dopo circa 25-28 mesi.
L’M5 Max è abbastanza veloce per gli LLM locali?
Per scrivere risposte con modelli mixture-of-experts, sì: misurato con MLX, un M5 Max con 128 GB ha generato 55–88 token al secondo, vicino ai 98 di Claude Opus 5.5 sull’API di Anthropic. La lettura dei prompt lunghi è il punto debole. Un prompt da 32.000 token ha richiesto 13 secondi con gpt-oss-120b, 31 secondi con Qwen3.5 122B e 55 secondi con un modello dense da 27B, e gli agenti di coding AI rileggono di continuo prompt lunghi.
Gli LLM locali sono ormai buoni quanto ChatGPT o Claude?
Non quelli che entrano in un portatile. Nel nuovo Intelligence Index v5 di Artificial Analysis, pubblicato il 27 ottobre 2026, i migliori modelli aperti scaricabili hanno segnato 32 contro i 58 di Claude Opus 5.5, e sotto Claude Haiku 5.5 a 36. I modelli abbastanza piccoli per un MacBook hanno segnato al massimo 34 sulla versione precedente dell’indice, dove anche Opus 5.5 segnava 58. Per i compiti brevi e semplici la differenza è spesso piccola; per il coding agentico, i documenti lunghi e il ragionamento difficile è grande.
La quantizzazione peggiora i modelli locali?
Un po’ a 8 bit, di più a 4 bit, molto sotto. Uno studio su più di 500.000 valutazioni ha trovato FP8 di fatto senza perdite e la quantizzazione a 4 bit dei soli pesi vicina all’8 bit sui benchmark standard. Ma su input da 64.000 token o più, uno studio EMNLP 2025 ha misurato cali fino al 59% a 4 bit, peggiori per il testo non inglese, e a 3 bit il punteggio di matematica di un modello di reasoning è sceso dall’85,6% al 47,0%.
Posso far girare DeepSeek V4.1 Flash o GLM-5.3 su un MacBook?
No. GLM-5.3 ha 753 miliardi di parametri e DeepSeek V4.1 Flash 763 miliardi inclusa la sua memoria Engram, quindi anche a 4 bit richiedono più o meno 375–460 GB, molto più dei 128 GB massimi di qualsiasi MacBook. Un Mac Studio con un M5 Ultra e 512 GB potrebbe tenerli. Il modo pratico per usarli è tramite un’API, meglio se di un fornitore con hosting UE e un accordo sul trattamento dei dati.
64 GB bastano per l’AI locale o mi servono 128 GB?
Per la maggior parte delle persone, 48–64 GB bastano. Il miglior modello da Mac nell’indice di Artificial Analysis, Qwen3.8 27B, entra a 8 bit con spazio per contesti lunghi. I 128 GB ti permettono di far girare modelli della classe 120B come gpt-oss-120b, tenere caricati diversi modelli e usare contesti più lunghi, ma nella classifica di oggi quei modelli più grandi segnano meno, quindi l’aggiornamento da 2.000 $ compra spazio più che intelligenza.
Conviene comprare un Mac Studio invece di un MacBook Pro per gli LLM locali?
Se l’AI locale è il motivo principale, di solito sì. Un Mac Studio con lo stesso M5 Max e 128 GB costava 4.799 $, 2.200 $ in meno del MacBook Pro da 16 pollici, con un raffreddamento prolungato migliore e nessuna batteria di cui preoccuparsi. Può girare 24 ore su 24 come server di modelli privato per il tuo portatile e il tuo telefono. Compra un MacBook Pro se ti serve la portabilità per altri motivi.
Far girare l’AI in locale è meglio per privacy e GDPR?
Sì, è il suo vantaggio più forte. Con un modello locale, prompt e documenti non lasciano mai il tuo dispositivo, quindi non c’è nessun accordo con un responsabile del trattamento da firmare e nessun trasferimento internazionale di dati. Questo conta per i dati dei clienti, le informazioni sanitarie e le professioni vincolate alla riservatezza, come quelle coperte dal § 203 StGB in Germania. Il vantaggio per la privacy vale che il modello locale sia capace quanto uno cloud o no. Questo non è un parere legale.
Posso usare Claude Code con un modello locale?
Sì. Ollama fornisce un’API compatibile con Anthropic, così puoi puntare Claude Code su un modello locale impostando ANTHROPIC_BASE_URL a http://localhost:11434. Aspettati dei compromessi: Ollama non supporta i controlli di prompt caching d’Anthropic, il lungo prompt di sistema e le definizioni degli strumenti di Claude Code fanno leggere molto al modello locale a ogni passo, e Claude Code è tarato sui modelli Claude. Gli harness aperti come OpenCode spesso si adattano meglio ai modelli locali.
Il nuovo MacBook Pro OLED cambierà qualcosa?
Probabilmente non molto per l’AI locale. L’evento “Pro and Tell” di Apple si tiene il 28 ottobre 2026 alle 10:00 del Pacifico, e il MacBook Pro OLED con touchscreen atteso in quell’occasione dovrebbe usare gli stessi chip M5 Pro e M5 Max, il che manterrebbe il tetto dei 128 GB e i 614 GB/s di banda. Il MacBook Pro da 14 pollici con M6 annunciato il 27 ottobre arriva al massimo a 32 GB.
In sintesi
La promessa “disdici il piano da 200 $ e compra un Mac” azzecca due cose: gli abbonamenti costano cari, e l’AI locale è davvero utile. Sbaglia la cosa importante. Un piano da 200 $ ti noleggia i modelli migliori del mondo, gli agenti costruiti attorno a loro e un prodotto che migliora ogni mese. Un MacBook da 7.000 $ fa girare i modelli migliori che entrano in 128 GB, e oggi quelli segnano 34 contro i 58 della frontiera, leggono lentamente i prompt lunghi e perdono qualità esattamente dove li comprimeresti di più.
Nemmeno i conti lo salvano. Anche nel caso più generoso, il MacBook impiega tre o quattro anni per andare in pareggio, e su tre anni costa entro un paio di migliaia di dollari dall’abbonamento, a seconda di quanto riesci a venderlo. È una bolletta simile per un prodotto meno capace.
Quindi compra un MacBook per gli LLM locali se i tuoi dati non possono uscire dall’edificio, se lavori offline, se vuoi nessun limite e un modello che non cambia mai, o se stavi comunque comprando un Mac. Sono buone ragioni, e molte persone le hanno. Solo non comprarlo per disdire l’abbonamento. Tieni un piano cloud per il 10% difficile, metti il 90% privato e noioso sul tuo hardware, e lascia che le classifiche ti dicano quando quell’equilibrio cambia.
Fai girare modelli locali per lavoro, o hai trovato l’opposto di quello che dice questo articolo? Mi piacerebbe sapere quale modello, quale macchina e quali compiti, con i numeri se li hai. Correzioni e controprove sono benvenute; questo articolo viene aggiornato quando si muovono le classifiche e i prezzi, il che nel 2026 significa spesso.
Fatti verificati: 28 ottobre 2026.