
 हिन्दी
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 العربية

छह हफ़्ते पहले मैं यह लेख अलग तरह से लिखता।
जुलाई में Moonshot AI ने 2.8 ट्रिलियन पैरामीटर का फ़्रंटियर-क्लास मॉडल Hugging Face पर डाल दिया और किसी को भी उसे डाउनलोड करने दिया। 28 अगस्त को Z.ai ने आख़िरकार GLM-5.3 के वेट्स रिलीज़ किए, जिन्हें वह दो हफ़्ते से रोके हुए था — यह पता चलने के बाद कि उसका अपना मॉडल खुद के एक्सप्लॉइट्स को ऐसे तरीक़ों से जोड़ सकता है जैसा किसी ने उससे कहा ही नहीं था। और 1 सितंबर को Anthropic ने Claude Fable 5.1 जारी किया और मुख्य प्राइस को छुए बिना एजेंटिक काम को 45% तक सस्ता कर दिया।
तीन मॉडल। इस सवाल के तीन बिल्कुल अलग जवाब कि एक AI लैब का जनता के प्रति क्या दायित्व है। और यह सब शुरू होने के बाद पहली बार, ओपन-वेट विकल्प कोई समझौते वाला चुनाव नहीं हैं।
यही 2026 के आख़िर की असली कहानी है, और यह क़रीब आठ हज़ार शब्दों की हक़दार है, क्योंकि सारा पैसा और सारी ग़लतियाँ ब्यौरों में ही रहती हैं।
मैंने आर्किटेक्चर पेपर, मॉडल कार्ड, लाइसेंस के टेक्स्ट — ठीक से, लाइन दर लाइन, क्योंकि इनमें से दो वह नहीं हैं जो लोग उन्हें सहज में कह रहे हैं — वेंडर बेंचमार्क, न्यूट्रल एग्रीगेटर स्कोर, असली प्रति-टोकन दरें और Ollama’s बिल्कुल नई प्राइसिंग शीट निकाला। फिर मैंने लॉन्च-डे के बजाय एक सामान्य कामकाजी महीने पर लागत का हिसाब किया।
नतीजा यह रहा।
TL;DR — 60 सेकंड में फ़ैसला
GLM-5.3 इस समय AI में सबसे बेहतर वैल्यू है, और कोई इसके क़रीब भी नहीं है। Artificial Analysis इसे Kimi K3 से आधे पॉइंट के भीतर और Claude Opus 5 से क़रीब साढ़े तीन पॉइंट पीछे रखता है, प्रति मिलियन टोकन $1.40 इन और $4.40 आउट पर। उसी एजेंटिक टास्क पर इसकी लागत Fable 5.1 की लागत का क़रीब छठा हिस्सा है। वेट्स डाउनलोड हो सकते हैं। अगर आपको एक ऐसा मॉडल चाहिए जिस पर अपना एजेंट चलाएँ और आप $10 अरब रेवेन्यू का बिज़नेस नहीं चला रहे, तो यही है।
Kimi K3 वह सबसे काबिल चीज़ है जिसे आप क़ानूनी तौर पर डाउनलोड कर सकते हैं। 2.8 ट्रिलियन पैरामीटर, 104 अरब सक्रिय, सचमुच 1M कॉन्टेक्स्ट, नेटिव विज़न, अब तक का सबसे बेहतर एजेंटिक ब्राउज़िंग स्कोर (BrowseComp 91.2), और — वह आँकड़ा जो “ओपन मॉडल पीछे हैं” वाली बहस ख़त्म कर देना चाहिए — Terminal-Bench 2.1 पर 88.3, जबकि उसी वर्ज़न पर Claude Fable 5’s 88.0 और GPT-5.6 Sol’s 88.8 रहा। इसकी क़ीमत भी $3/$15 है — GLM-5.3 से दोगुनी से ज़्यादा — और इसके 1.5 TB वेट्स के लिए वर्कस्टेशन नहीं, रैक चाहिए। यह वह मॉडल है जो आप तब इस्तेमाल करते हैं जब टास्क मुश्किल और लंबा हो, और वह मॉडल जिसका हवाला आप तब देते हैं जब कोई कहे कि ओपन वेट्स एक जनरेशन पीछे हैं।
Claude Fable 5.1 अब भी वह मॉडल है जिसकी ओर आप तब जाते हैं जब ग़लत होना महँगा पड़ता है। लंबे समय तक चलने वाले, कई घंटों के एजेंटिक काम में और उस उलझे डीबगिंग में यह सबसे आगे है जो लीडरबोर्ड पर कभी साफ़ नज़र नहीं आती। Anthropic ने 1 सितंबर को कैश रीड्स 75% घटा दिए, जिससे लंबे एजेंट सेशन पहले के मुक़ाबले बहुत सस्ते हो गए। साथ ही यह प्रति टास्क GLM-5.3 से छह गुना महँगा है, क्लोज़्ड है, और अब इस पर एंटी-डिस्टिलेशन पाबंदियाँ भी हैं जो कुछ मौजूदा इंटीग्रेशन तोड़ देती हैं।
ईमानदार बात, एक लाइन में: ओपन-वेट मॉडलों ने क्षमता का अंतर क़रीब तीन से पाँच महीने तक ला दिया है, और प्राइस का अंतर उन्होंने मिटा दिया है। सितंबर 2026 में आप Anthropic से असल में जो ख़रीद रहे हैं वह है सबसे मुश्किल 10% काम पर भरोसा — और यह अधिकार कि आपको इनमें से कुछ भी सोचना न पड़े।
और वह मोड़ जिसे कोई ज़ोर से कहना नहीं चाहता: अब न Kimi K3 और न ही GLM-5.3 ओपन सोर्स लाइसेंस के तहत आते हैं। दोनों इस गर्मी में अपने-अपने बने हुए, रेवेन्यू पर शर्त लगाने वाले नियमों पर चले गए। ओपन वेट्स, हाँ। ओपन सोर्स, नहीं। लाइसेंस वाला हिस्सा अपनी लीगल टीम से पहले पढ़ लें।
त्वरित तुलना तालिका
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| निर्माता | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| रिलीज़ | 16 जुलाई 2026 (API) · 27 जुलाई (वेट्स) | 14 अगस्त 2026 (API) · 28 अगस्त (वेट्स) | 1 सितंबर 2026 |
| वेट्स उपलब्ध | हाँ | हाँ | नहीं |
| लाइसेंस | Kimi K3 License (कस्टम, रेवेन्यू-गेटेड) | glm-5.3 License (कस्टम, रेवेन्यू-गेटेड) | प्रोप्राइटरी |
| कुल पैरामीटर | 2.8T | 753B | खुलासा नहीं |
| प्रति टोकन सक्रिय | 104B (896 में से 16 एक्सपर्ट) | ~40B (अनुमानित) | खुलासा नहीं |
| आर्किटेक्चर | KDA + Attention Residuals, Stable LatentMoE, 69 KDA + 24 Gated MLA लेयर्स | MoE, GLM-5.2 जैसा ही बेस, सुधार सिर्फ़ पोस्ट-ट्रेनिंग से | खुलासा नहीं |
| कॉन्टेक्स्ट विंडो | 1,048,576 | 1,000,000 | 1,000,000 |
| अधिकतम आउटपुट | 131,072 डिफ़ॉल्ट (1,048,576 तक) | 128,000 | 128,000 |
| मल्टीमॉडल इनपुट | टेक्स्ट, इमेज, वीडियो (MoonViT-V2) | सिर्फ़ टेक्स्ट | टेक्स्ट, इमेज |
| थिंकिंग | हमेशा चालू | हमेशा चालू, reasoning_effort low/high/max | हमेशा चालू, अडैप्टिव, हर मैसेज पर एफ़र्ट (बीटा) |
| इनपुट कीमत / 1M | $3.00 | $1.40 | $10.00 |
| कैश्ड इनपुट / 1M | $0.30 | $0.26 | $0.25 |
| आउटपुट कीमत / 1M | $15.00 | $4.40 | $50.00 |
| AA इंटेलिजेंस इंडेक्स | 59.7 | 59.5 | अभी स्कोर नहीं हुआ (Fable 5: 62.1) |
| प्रति AA इवैल टास्क लागत | $0.84 | $0.68 | — (Opus 5: $2.34) |
| सेल्फ-होस्ट फ़ुटप्रिंट | ~1.5 TB (नेटिव MXFP4) | ~1.5 TB BF16 / ~750 GB FP8 | N/A |
| Ollama पर | kimi-k3:cloud | glm-5.3:cloud | Claude Code / Claude Desktop को क्लाइंट के तौर पर |
सारी प्राइसिंग फ़र्स्ट-पार्टी लिस्ट प्राइसिंग है। Artificial Analysis के आँकड़े सितंबर 2026 इंडेक्स स्नैपशॉट के हैं; Fable 5.1 1 सितंबर को आया और लिखने के समय तक इसका स्वतंत्र स्कोर नहीं हुआ था।
यह तीन-तरफ़ा तुलना ही क्यों मायने रखती है
दो साल तक ओपन बनाम क्लोज़्ड की बहस एक आरामदेह ढाँचे में चलती रही: क्लोज़्ड मॉडल बेहतर थे, ओपन मॉडल सस्ते थे, और आप इसी सौदे में अपनी जगह चुन लेते थे। सबको पता था कि वे कहाँ खड़े हैं।
यह ढाँचा इस गर्मी में टूट गया।
Nathan Lambert, जो इसे लगभग सबसे ज़्यादा बारीकी से ट्रैक करते हैं, फ़्रंटियर ओपन-वेट और फ़्रंटियर क्लोज़्ड मॉडलों के बीच मौजूदा क्षमता का अंतर तीन से पाँच महीने — जो एक साल पहले लोगों के बताए छह से नौ महीनों से कम है। जब उन्होंने लिखा, तब Kimi K3 Vals AI इंडेक्स पर #2 पर था और Artificial Analysis’s में भी टॉप के क़रीब, सिर्फ़ Claude Fable और GPT-5.6 Sol Max से पीछे। इस लेख में आगे जो सितंबर इंडेक्स स्नैपशॉट मैंने इस्तेमाल किया है, उसमें यह चौथे स्थान पर है, Grok 4.6 के बाद। किसी भी तरह: यह “ओपन मॉडल के लिए अच्छा” नहीं है। यह पोडियम फ़िनिश है।
इस बीच इस्तेमाल का डेटा सचमुच हैरान करने वाली जगह पहुँच गया है। चीनी मूल के मॉडलों ने क़रीब OpenRouter के ज़रिए जाने वाले सभी टोकन का 61% मई 2026 तक हासिल कर लिया। उस ट्रैफ़िक में अमेरिका का हिस्सा बारह महीनों में लगभग 70% से गिरकर क़रीब 30% रह गया। Meta’s Llama — वही मॉडल जिसने ओपन-वेट लहर शुरू की थी — रूट होने वाले वॉल्यूम के 1% से नीचे चला गया। Google का हिस्सा क़रीब 37% से 13% हो गया। OpenRouter के a16z के साथ अपने 100-ट्रिलियन-टोकन अध्ययन में पाया गया कि ओपन-वेट मॉडल प्लेटफ़ॉर्म पर सारे टोकन वॉल्यूम का क़रीब एक-तिहाई हैं।
आप बहस कर सकते हैं कि OpenRouter का ट्रैफ़िक क्या दर्शाता है। इसमें डेवलपर्स, हॉबीस्ट और लागत के प्रति संवेदनशील कामों का हिस्सा ज़्यादा दिखता है, और उन एंटरप्राइज़ कॉन्ट्रैक्ट्स की गिनती कम होती है जो कभी किसी राउटर तक पहुँचते ही नहीं। ठीक है। लेकिन जब लोग आज़ादी से चुन सकते हैं तो असल में क्या चुनते हैं, इस पर हमारे पास यही सबसे बड़ा सार्वजनिक डेटासेट है, और दिशा साफ़ है।
तो सितंबर 2026 में सवाल अब “क्या ओपन मॉडल अभी काफ़ी अच्छे हो गए हैं” नहीं है। सवाल कहीं तेज़ है:
जब तीनों मॉडल बार पार कर लेते हैं, तो आप अपना एजेंट किस पर लगाते हैं — और ग़लत होने पर असल में आपको कितना चुकाना पड़ता है?
यह सवाल बेंचमार्क, प्राइस, लाइसेंस और इन्फ्रास्ट्रक्चर के बारे में है — लगभग उसी क्रम में जितना लोग इनके बारे में सोचते हैं, और ठीक उल्टे क्रम में जितना ये मायने रखते हैं।
Kimi K3 असल में क्या है
Moonshot AI ने Kimi K3 की घोषणा 16 जुलाई 2026 को की और 27 जुलाई को पूरे वेट्स रिलीज़ किए। पैरामीटर संख्या के हिसाब से यह अब तक का सबसे बड़ा ओपन-वेट मॉडल है — कुल 2.8 ट्रिलियन पैरामीटर, DeepSeek V4 Pro से क़रीब 75% बड़ा।
वह आँकड़ा सुनने में जितना शानदार लगता है उससे कम शानदार है, और सुनने में जितना लगता है उससे ज़्यादा शानदार भी है — इसी क्रम में।
आर्किटेक्चर, आसान भाषा में
Kimi K3 एक मिक्सचर-ऑफ़-एक्सपर्ट्स मॉडल है जो सक्रिय करता है प्रति टोकन 104 अरब पैरामीटर, 896 के पूल में से 16 एक्सपर्ट चुनकर। तो कुल 2.8T होने के बावजूद, किसी भी फ़ॉरवर्ड पास में वेट्स का 4% से भी कम छूता है। यहीं से इकोनॉमिक्स आती है: ज़बरदस्त जमा ज्ञान, मध्यम इन्फ़रेंस लागत।
दिलचस्प इंजीनियरिंग अटेंशन स्टैक में है। K3 इस्तेमाल करता है 69 KDA (Kimi Delta Attention) लेयर्स और 24 Gated MLA लेयर्स से बने 93 लेयर्स — क़रीब 3:1 इंटरलीव अनुपात वाला एक हाइब्रिड लीनियर-टू-फ़ुल अटेंशन डिज़ाइन। KDA लीनियर-अटेंशन का एक वेरिएंट है जो सीक्वेंस की लंबाई के हिसाब से क्वाड्रैटिक की जगह लीनियर समय में चलता है, और यही 1M कॉन्टेक्स्ट को सिर्फ़ दावा नहीं, आर्थिक रूप से व्यवहार्य बनाता है। Moonshot के मुताबिक़ 75% KV-कैश कमी और 1M कॉन्टेक्स्ट पर 6× डिकोड थ्रूपुट तक की बढ़त दर्ज की गई है।
इसके ऊपर है Attention Residuals (AttnRes), जिसे Moonshot मानक रेज़िडुअल कनेक्शन का ड्रॉप-इन रिप्लेसमेंट बताता है, और एक Stable LatentMoE राउटिंग के लिए फ़्रेमवर्क। दावा है कि इनके मेल से क़रीब कुल स्केलिंग एफ़िशिएंसी में 2.5× सुधार Kimi K2 के मुक़ाबले मिलता है।
विज़न आता है MoonViT-V2, एक 401M-पैरामीटर एनकोडर से, और यह बाद में जोड़ा गया नहीं बल्कि नेटिव है — K3 एक ही मॉडल में टेक्स्ट, इमेज और वीडियो संभालता है।
एक और ब्यौरा जो सेल्फ-होस्टिंग के बारे में सोचने वाले किसी भी व्यक्ति के लिए मायने रखता है: K3 को ट्रेन किया गया नेटिव MXFP4 क्वांटाइज़ेशन-अवेयर ट्रेनिंग से, एक्सपर्ट MXFP4 में और एक्टिवेशन MXFP8 में रखकर। यह बाद में किया गया क्वांटाइज़ेशन नहीं है। प्रकाशित चेकपॉइंट क्वांटाइज़्ड मॉडल ही है, इसीलिए 2.8 ट्रिलियन पैरामीटर क़रीब 1.5 TB डिस्क पर पर आ जाते हैं, उस ~5.6 TB की जगह जो उस आकार के BF16 चेकपॉइंट को चाहिए होता।
बेंचमार्क की कहानी
Moonshot’s के प्रकाशित आँकड़े हर मोर्चे पर मज़बूत हैं, और असामान्य रूप से, कई स्वतंत्र मूल्यांकन में भी टिके हैं:
- Terminal-Bench 2.1: 88.3 — बेंचमार्क के उस वर्ज़न पर अब तक का सबसे ऊँचा प्रकाशित स्कोर
- FrontierSWE: 81.2
- DeepSWE: 67.5
- BrowseComp: 91.2 — एजेंटिक वेब रिसर्च में स्टेट ऑफ़ द आर्ट
- GPQA Diamond: 93.5
- MMMU-Pro: 81.6 / 83.4 (विज़न)
- SWE Marathon: 91.0
- OfficeQA Pro: 81.3
- AutomationBench: 30.8
- LMArena Frontend Code Arena: 1,679 Elo — पहला स्थान, Claude Fable 5 (1,631) और GPT-5.6 Sol (1,618) से आगे, सात में से छह फ़्रंटएंड डोमेन जीतते हुए
पिछली बात पर एक पल रुकना बनता है। मुफ़्त डाउनलोड होने वाले एक ओपन-वेट मॉडल ने इंसानी पसंद वाले फ़्रंटएंड कोडिंग एरीना में पहला स्थान लिया — दुनिया की दो सबसे ज़्यादा फ़ंडिंग वाली लैब्स के फ़्लैगशिप क्लोज़्ड मॉडल्स से आगे। एरीना बेंचमार्क को आप मेथडोलॉजी के तौर पर चाहे जो मानें, यह ऐसी हेडलाइन है जो 2025 में सोची भी नहीं जा सकती थी।
एग्रीगेट इंडेक्स पर यह थोड़ा नीचे रहता है: Artificial Analysis Intelligence Index पर 59.7, कुल मिलाकर तीसरा स्थान, Claude Opus 5 (63.0) और Claude Fable 5 (62.1) के बाद। Moonshot’s अपने शोकेस आँकड़े — GDPval-AA v2 पर 1,687 और AA-Briefcase पर 1,527 — उन नॉलेज-वर्क मूल्यांकनों में इसे क्रमशः तीसरा और दूसरा स्थान दिलाते हैं। Vals Index v2 पर यह पहुँचता है 57.8%, Claude Opus 5’s 67.2%, Claude Fable 5’s 66.0% और GPT-5.6 Sol’s 63.7% के मुक़ाबले — जो मुझे मिले किसी भी इंडेक्स में ओपन बनाम क्लोज़्ड का सबसे बड़ा अंतर है, और कोडिंग के आँकड़ों के सामने इसे याद रखना बनता है।
डेमो, और उन्हें कैसे पढ़ें
Moonshot ने लंबी अवधि की स्वायत्तता के दो प्रदर्शन प्रकाशित किए जिन पर खूब ध्यान गया: एक 48 घंटे की स्वायत्त रन, जिसमें पूरी चिप डिज़ाइन पाइपलाइन पूरी हुई (4mm डिज़ाइन, जिसने 100 MHz पर टाइमिंग क्लोज़ की, 8,700+ tokens/second पर सिम्युलेशन करते हुए), और एस्ट्रोफ़िज़िक्स के I-Love-Q संबंध का लगभग दो घंटे में पुनरुत्पादन, जबकि एक वरिष्ठ शोधकर्ता को आम तौर पर एक से दो हफ़्ते लगते।
ये सचमुच प्रभावशाली हैं और मैं इनके आधार पर खरीदारी का फ़ैसला नहीं बनाऊँगा। वेंडर द्वारा चलाए गए, वेंडर द्वारा तैयार किए गए और वेंडर द्वारा चुने गए डेमो बताते हैं कि कोई मॉडल अच्छे दिन में विशेषज्ञ निगरानी के साथ क्या कर सकता है — यह नहीं कि मंगलवार को आपके रिपॉज़िटरी में वह क्या करता है। इन्हें लंबी अवधि की क्षमता का अस्तित्व-प्रमाण मानिए, स्पेसिफ़िकेशन नहीं।
छवि दिखाएँ दो प्रकाशित आर्किटेक्चर और एक ब्लैक बॉक्स। ओपन मॉडल ठीक-ठीक बताते हैं कि वे कैसे काम करते हैं; क्लोज़्ड मॉडल बताता है कि उसका स्कोर क्या है।
GLM-5.3 असल में क्या है
तीनों में सबसे अजीब रिलीज़ कहानी GLM-5.3 की है, और यही कहानी ठीक से बताने लायक है, क्योंकि पहली बार किसी बड़ी लैब ने व्यावसायिक कारणों से अलग, किसी और वजह से वेट्स प्रकाशित करने में साफ़ झिझक दिखाई है।
Z.ai ने GLM-5.3 की घोषणा 14 August 2026 को “Built to Code. Ready for Cyber Defense.” टैगलाइन के साथ की। यह मॉडल एक 753 अरब पैरामीटर वाला मिक्सचर-ऑफ़-एक्सपर्ट्स, जिसमें GLM-5.2 कॉन्फ़िगरेशन से निकाले गए कम्युनिटी अनुमानों के मुताबिक़ प्रति टोकन लगभग 40 अरब पैरामीटर सक्रिय रहते हैं। इसमें 1M-टोकन कॉन्टेक्स्ट विंडो और 128K का अधिकतम आउटपुट है, और — GLM-5.3-Flash के उलट, जो बिल्कुल अलग मॉडल है — यह सिर्फ़ टेक्स्ट.
“हमने बस पोस्ट-ट्रेनिंग को स्केल किया”
GLM-5.3 की सबसे दिलचस्प तकनीकी बात यह है कि इसमें कोई नया बेस मॉडल नहीं है। यह GLM-5.2 वाली वही प्रीट्रेंड बुनियाद दोबारा इस्तेमाल करता है। हर बढ़त बेहद लंबी पोस्ट-ट्रेनिंग से आई, जिसे Z.ai ने इस तरह समेटा: “GLM-5.3 के लिए हमने बस पोस्ट-ट्रेनिंग को स्केल किया।”
अंतर छोटे नहीं हैं:
| बेंचमार्क | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
एक ही बेस वेट्स से Terminal-Bench पर छह गुना सुधार और DeepSWE पर बीस अंकों की छलांग सचमुच अहम नतीजा है। यह बताता है कि फ़्रंटियर के पास पोस्ट-ट्रेनिंग में अब भी बहुत गुंजाइश है, जो ट्रेनिंग के बिल का कहीं ज़्यादा सस्ता आधा हिस्सा है। ठीक इसी वजह से चीनी लैब्स, जो Lambert के शब्दों में अमेरिकी लैब्स से “कई गुना कम पूँजी” के साथ काम कर रही हैं, क़दम से क़दम मिला रही हैं।
वे दो हफ़्ते जो Z.ai ने रिलीज़ न करते हुए बिताए
Z.ai ने लॉन्च के समय कहा था कि वेट्स “कड़े सेफ़्टी मूल्यांकनों के बाद चरणों में” आएँगे, और लक्ष्य लगभग दो हफ़्ते का था। इसके Hugging Face रिपॉज़िटरी पर 28 August लिखा था। वह तारीख़ आई, कुछ ही घंटों में बीत गई, और फिर वेट्स सामने आए — साथ में देरी की वजह समझाता एक तकनीकी लेख।
वजह साइबर क्षमता थी। मूल्यांकन के दौरान Z.ai ने बताया कि GLM-5.3 ने 269 ओपन सोर्स प्रोजेक्ट्स में 2,436 कमज़ोरियाँ, जिनमें से 1,097 को क्रिटिकल या हाई सीवियरिटी बताया गया। इससे भी बड़ी बात, मॉडल ने मल्टी-स्टेज एक्सप्लॉइट-चेन रीज़निंग दिखाई — यानी खुद-ब-खुद एक्सप्लॉइटेशन के चरणों को एक साथ जोड़ना — जिसे Z.ai ने ऐसा व्यवहार बताया जो “पूरी तरह इरादे में नहीं था” और जो “ट्रेनिंग स्केल होने के साथ लगातार बढ़ता गया।”
यहाँ मैं सतर्क रहना चाहूँगा, क्योंकि इसे मार्केटिंग या डर फैलाना, दोनों तरह से पढ़ा जा सकता है — और शायद यह न तो है न वो। जो मॉडल कमज़ोरियाँ खोजने में अच्छा है, वह कमज़ोरियाँ खोजने में अच्छा है; रक्षात्मक और आक्रामक इस्तेमाल एक ही क्षमता की दो अलग दिशाएँ हैं। Z.ai का बेंचमार्क फैलाव इसे ईमानदारी से दिखाता है: CyberGym 84.5% (कमज़ोरी खोजना, जहाँ यह अव्वल है) बनाम ExploitBench 54.4% (एक्सप्लॉइटेशन, जहाँ Claude Fable 5 को 78.0% मिलता है)। लैब ने जान-बूझकर रक्षात्मक आधे हिस्से के लिए ऑप्टिमाइज़ किया और यह दिखता है।
असल में उल्लेखनीय यह है कि एक लैब ने अपनी फ़्लैगशिप रिलीज़ दो हफ़्ते रोकी और अपनी वजहें सार्वजनिक कीं। आपको वे वजहें चाहे विश्वसनीय लगें या न लगें, ऐसी मिसाल नई है।
GLM-5.3 असल में कहाँ टिकता है
Z.ai का प्रकाशित तुलना चार्ट पूरी जीत का दावा नहीं करता, जो ताज़गी भरी बात है:
| बेंचमार्क | GLM-5.3 | सबसे अच्छा तुलना-मॉडल |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3 आगे |
| CyberGym | 84.5% | GLM-5.3 आगे |
| GDPval-AA v2 | 1,769 | GLM-5.3 आगे |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34.6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72.7% |
| ExploitBench | 54.4% | Claude Fable 5: 78.0% |
| Code Bench (50K tokens) | 31.4% | — |
स्वतंत्र रूप से, Artificial Analysis इसे Intelligence Index पर 59.5 अंक पर रखता है — जो सांख्यिकीय रूप से Kimi K3’s 59.7 से अलग नहीं है, और वह भी लगभग एक-चौथाई पैरामीटर वाले मॉडल से।
उसी मूल्यांकन की एक बात, जिसका ज़िक्र मार्केटिंग में कोई नहीं करता: GLM-5.3 ने पूरे Artificial Analysis सूट में 170 मिलियन आउटपुट टोकन बनाए, जबकि इस श्रेणी का मीडियन 72 मिलियन है। यह बहुत लंबा लिखता है। reasoning_effort डिफ़ॉल्ट रूप से अधिकतम पर सेट रहता है, और सोच बंद नहीं की जा सकती, इसलिए काम उसके लायक हो या न हो, आप बहुत सारी सोच का दाम चुकाते हैं। फिर भी, पूरा मूल्यांकन चलाने की कुल लागत आई प्रति टास्क $0.68, जबकि Kimi K3 के लिए $0.84 और Claude Opus 5 के लिए $2.34 — यानी ज़्यादा लिखना कीमत का फ़ायदा मिटाता नहीं। वह बस उसे कम कर देता है।
Claude Fable 5.1 असल में क्या है
Anthropic ने Claude Fable 5.1 को 1 सितंबर 2026को जारी किया, साथ ही Claude Mythos 5.1 — वही मॉडल, अलग सेफ़गार्ड कॉन्फ़िगरेशन के साथ, जो सिर्फ़ भरोसेमंद-पहुँच कार्यक्रमों के ज़रिए साइबर सुरक्षा और जीव-विज्ञान के काम के लिए उपलब्ध है।
इसकी पोज़िशनिंग स्पष्ट है और, मेरे ख़याल से, सही भी: यह है “ऐसे काम के लिए बना मॉडल जो एक ही प्रॉम्प्ट में पूरा नहीं होता।” Anthropic सामान्य बुद्धिमत्ता में छलांग का दावा नहीं कर रहा। वह यह दावा कर रहा है कि घंटों लगातार चलने वाले एजेंटिक सेशन बेहतर चलते हैं।
आँकड़े
| बेंचमार्क | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (आंशिक) | 72.9% | 77.9% | — |
| Humanity’s Last Exam (टूल्स के साथ) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
उसी पैमाने पर बाहरी संदर्भ के लिए: GPT-5.6 Sol को Terminal-Bench 4.0 पर 52.3% मिलता है, इसलिए Fable 5.1’s 55.8% बढ़त ले लेता है और Mythos 5.1’s 60.9% उसे और आगे बढ़ा देता है।
Terminal-Bench-Science की छलांग — 24.7% से 52.6%, साफ़ दोगुना — वह है जिसे मैं सबसे ज़्यादा तवज्जो दूँगा, अगर आपके काम में साइंटिफ़िक कंप्यूटिंग या डेटा पाइपलाइन शामिल हैं। और Browserbase के सबसे कठिन कंप्यूटर-यूज़ बेंचमार्क पर Fable 5.1 ने पूरे किए 82% टास्क, जबकि Claude Opus 5’s 74%.
Anthropic के मुताबिक़ लगभग साइबर-सेफ़्टी फ़ॉल्स पॉज़िटिव्स में 60% की कमी — यानी मॉडल का जायज़ सुरक्षा-कार्य से इनकार कर देना, क्योंकि उसने पैटर्न मैच करके उसे कुछ ख़तरनाक समझ लिया। अगर आपके साथ कभी ऐसा हुआ हो कि कोई कोडिंग असिस्टेंट rate limiter लिखने में मदद करने से मना कर दे, तो आप समझेंगे कि यह क्यों मायने रखता है।
असली ख़बर प्राइसिंग में बदलाव है
हेडलाइन रेट नहीं बदले: प्रति मिलियन इनपुट टोकन $10, प्रति मिलियन आउटपुट $50। जो बदला वह कैश रीड मल्टीप्लायर है, और वह काफ़ी बदला।
| Fable 5 | Fable 5.1 | |
|---|---|---|
| इनपुट | $10.00 | $10.00 |
| आउटपुट | $50.00 | $50.00 |
| कैश राइट (5 मिनट) | $12.50 | $12.50 |
| कैश राइट (1 घंटा) | $20.00 | $20.00 |
| कैश रीड | $1.00 | $0.25 |
यह 75% की कटौती है, जो कैश-रीड मल्टीप्लायर को बेस इनपुट के मानक 0.1× से 0.025× पर लाकर हुई। Anthropic लगभग आम वर्कलोड के लिए 25% सस्ता और बहुत ज़्यादा एजेंटिक काम के लिए 45% तक सस्ता — और वह दूसरा आँकड़ा सच है, क्योंकि एजेंटिक लूप्स में ज़्यादातर कैश रीड्स ही होती हैं। 60-टर्न का एजेंट सेशन वही जमा हुआ कॉन्टेक्स्ट दर्जनों बार दोबारा पढ़ता है। इसके ऊपर Batch API इनपुट और आउटपुट दोनों आधे कर देता है, यानी $5/$25।
यह समझदारी से निशाना लगाकर की गई कीमत-कटौती है। यह उसी चीज़ को, जिसमें Fable 5.1 सबसे अच्छा है — लंबे सेशन — काफ़ी सस्ता कर देती है, बिना पूरे मॉडल की कीमत घटाए।
तीन ब्रेकिंग बदलाव, एक रिग्रेशन
प्रोडक्शन इंटीग्रेशन अपग्रेड करने से पहले इन्हें ठीक से पढ़ लें।
1. ज़बरदस्ती टूल इस्तेमाल कराना अब नहीं रहा। जो रिक्वेस्ट tool_choice: "any" या tool_choice: "tool" का इस्तेमाल करती हैं, उन्हें अब 400 errorमिलता है। सोच हमेशा चालू रहती है और उसे बायपास नहीं किया जा सकता, और टूल कॉल ज़बरदस्ती कराने से वह छूट जाएगी। आपको इस्तेमाल करना होगा tool_choice: "auto".
2. थिंकिंग ब्लॉक एक-तरफ़ा हैं। Fable 5.1 पुराने Claude मॉडल्स के बनाए थिंकिंग ब्लॉक पढ़ सकता है, पर पुराने मॉडल Fable 5.1’s वाले नहीं पढ़ सकते। सिर्फ़ Mythos 5.1 पढ़ सकता है। अगर आपका आर्किटेक्चर पैसे बचाने के लिए बातचीत के बीच में मॉडल बदलता है, तो वह फ़ॉलबैक अब दोबारा प्लान बनाने पर मजबूर करता है।
3. इतिहास में बदलाव करने से थिंकिंग ब्लॉक अमान्य हो जाते हैं। 31 August 2026 के बाद बने अकाउंट्स के लिए, पिछले टर्न, सिस्टम प्रॉम्प्ट या टूल ऐरे में बदलाव करने से आगे के सारे थिंकिंग ब्लॉक अमान्य हो जाते हैं — चाहे एरर आए या चुपचाप ड्रॉप हो जाएँ। यह जान-बूझकर उठाया गया एंटी-डिस्टिलेशन क़दम है और यह उस आम पैटर्न को तोड़ता है जहाँ एजेंट फ़्रेमवर्क टर्न के बीच कॉन्टेक्स्ट दोबारा लिखते हैं।
और एक रिग्रेशन जो जानने लायक है: पैरेलल टूल कॉलिंग 5.1 में कथित तौर पर ज़्यादा अनिश्चित है, कभी-कभी एक टर्न में एक ही कॉल जाती है, जबकि 5 कई कॉल एक साथ कर देता था। लंबे एजेंट लूप में इससे वॉल-क्लॉक समय जाता है।
एक टोकनाइज़र की बात भी है जो लोगों को लागत की तुलना में चौंका देती है: Fable 5.1 वही टोकनाइज़र इस्तेमाल करता है जो Claude Opus 4.7 करता है, जो लगभग 30% ज़्यादा टोकन उसी टेक्स्ट के लिए पुराने Claude मॉडल्स के टोकनाइज़र से बनाता है। अगर आप 2025 के बेसलाइन के सामने लागत का बेंचमार्क कर रहे हैं, तो कोई नतीजा निकालने से पहले इसका हिसाब लगा लें।
बेंचमार्क की समस्या: तीन मॉडल, तीन अलग पैमाने
यहाँ वह हिस्सा है जहाँ ज़्यादातर तुलनात्मक लेख गलती करते हैं, और इस पर सीधी बात करनी चाहिए।
आप इन तीनों मॉडल्स को Terminal-Bench पर एक ही कतार में नहीं रख सकते। देखिए:
- Kimi K3: 88.3 Terminal-Bench पर 2.1
- GLM-5.3: 28.3 Terminal-Bench पर 3.0
- Fable 5.1: 55.8 Terminal-Bench पर 4.0
ये तीन अलग बेंचमार्क हैं जिनका नाम एक ही है। हर वर्ज़न पिछले से काफ़ी कठिन हुआ है — नया वर्ज़न जारी करने का पूरा मक़सद यही है। इन तीन आँकड़ों को रैंकिंग की तरह पढ़ें तो लगेगा कि टर्मिनल के काम में Kimi K3, GLM-5.3 से तीन गुना बेहतर है, जो बेतुका है।
यही समस्या AutomationBench पर भी लागू होती है, जहाँ वर्ज़न नंबर असंगत तरीक़े से बताए जाते हैं, और SWE-bench परिवार पर भी, जहाँ Verified, Pro और Marathon वेरिएंट सचमुच अलग-अलग चीज़ें मापते हैं। लैब्स ऐसा किसी को धोखा देने के लिए नहीं कर रही हैं — वे वही मूल्यांकन चलाती हैं जो उनके ट्रेनिंग के समय चालू था, और अब हर कुछ महीनों में मूल्यांकन बदल जाते हैं। पर एक सामान्य पाठक पर असर धोखे जैसा ही होता है, इसलिए इसे ज़ोर से बताना ज़रूरी है।
एक ही वर्ज़न के भीतर आप जायज़ तौर पर किसकी तुलना कर सकते हैं:
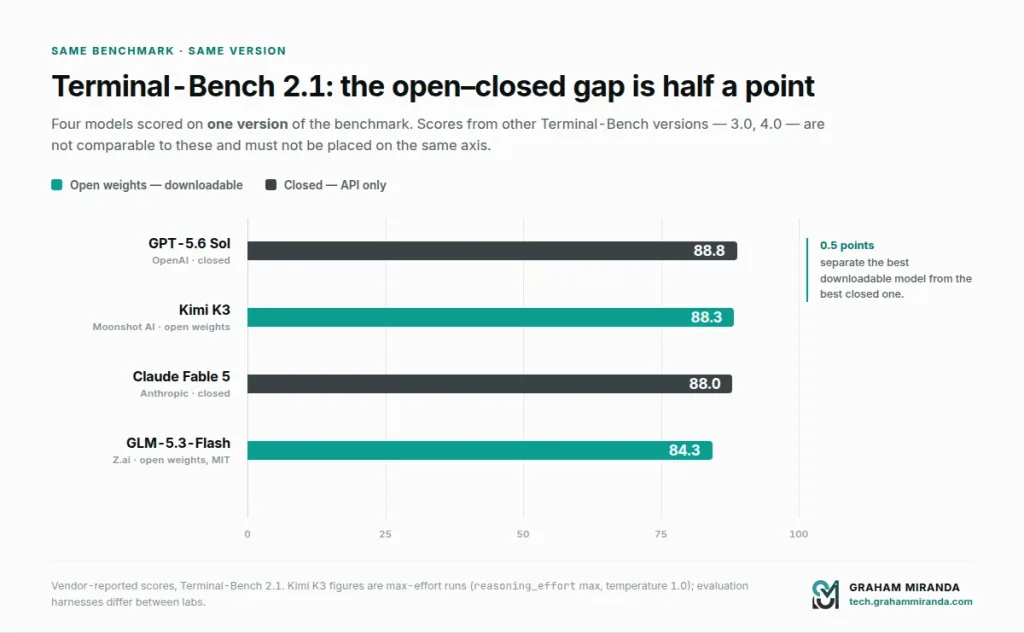
चालू Terminal-Bench 2.1: Kimi K3 (88.3), GPT-5.6 Sol (88.8), Claude Fable 5 (88.0) और GLM-5.3-Flash (84.3)। चार मॉडल, एक पैमाना। असल में मायने यही तुलना रखती है और मैंने अगले हिस्से में इसके लिए अलग तालिका दी है।
चालू Terminal-Bench 4.0: Fable 5.1 (55.8) बनाम GPT-5.6 Sol (52.3)। Fable जीतता है।
इसके अलावा, जो कोई आपको एक अकेला बार चार्ट दिखाए, जिसमें इस लेख के तीनों मुख्य मॉडल एक ही Terminal-Bench अक्ष पर हों, उस पर शक करें। ईमानदारी से ऐसा किया ही नहीं जा सकता।
जहाँ वे सचमुच मिलते हैं: आपस में तुलनीय आँकड़े
बेंचमार्क वर्ज़न की ये गड़बड़ियाँ हटा दें तो तीन तुलनाएँ बचती हैं।
1. Artificial Analysis Intelligence Index (सितंबर 2026)
स्वतंत्र रूप से चलाया गया, हर मॉडल पर वही मेथडोलॉजी, चयन में किसी वेंडर की भागीदारी नहीं।
| रैंक | मॉडल | स्कोर | ओपन-वेट |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | नहीं |
| 2 | Claude Fable 5 | 62.1 | नहीं |
| 3 | Grok 4.6 | 60.9 | नहीं |
| 4 | Kimi K3 | 59.7 | हाँ |
| 5 | GLM-5.3 | 59.5 | हाँ |
| 6 | GPT-5.6 Sol | 58.9 | नहीं |
| 7 | Qwen3.8 Max Preview | 58.1 | वेट्स अभी बाक़ी |
| 8 | GLM-5.3-Flash | 57.5 | हाँ (MIT) |
| 31 | MiniMax M3 | 45.4 | हाँ |
लेख लिखते समय Fable 5.1 का स्वतंत्र स्कोर नहीं आया था — वह ठीक एक दिन पहले लॉन्च हुआ था। Fable 5 के मुक़ाबले 5.1 के बेंचमार्क अंतर देखते हुए उम्मीद है कि जब स्कोर आएगा तब यह 62.1 या उससे ऊपर ही होगा।
सटीकता पर एक बात: इस इंडेक्स के अलग-अलग स्नैपशॉट अलग तरह से राउंड करते हैं — सितंबर के एक पुल में Kimi K3 और GLM-5.3 दोनों 60 पर थे और GPT-5.6 Sol 61 पर। ऊपर का क्रम स्थिर है; दशमलव से नीचे के अंतर नहीं। आधे अंक पर कोई तर्क मत बनाइए।
उस तालिका को ध्यान से पढ़िए। उपलब्ध सबसे व्यापक न्यूट्रल इंडेक्स पर सबसे अच्छा ओपन-वेट मॉडल सबसे अच्छे क्लोज़्ड मॉडल से 3.3 अंक पीछे है। एक साल पहले यह अंतर दोहरे अंकों में था।
2. Terminal-Bench 2.1 — वह अकेला वर्ज़न जहाँ तीनों मिलते हैं
यह लेख की सबसे काम की तालिका है, और मैं इसे लगभग छोड़ ही चुका था। Kimi K3, Claude Fable 5 और GPT-5.6 Sol — तीनों को Terminal-Bench के एक ही वर्ज़न पर स्कोर किया गया:
| मॉडल | Terminal-Bench 2.1 | ओपन-वेट |
|---|---|---|
| GPT-5.6 Sol | 88.8 | नहीं |
| Kimi K3 | 88.3 | हाँ |
| Claude Fable 5 | 88.0 | नहीं |
| GLM-5.3-Flash | 84.3 | हाँ (MIT) |
एक ही बेंचमार्क, एक ही वर्ज़न, टर्मिनल-नेटिव एजेंटिक काम पर आप जिस मॉडल को डाउनलोड कर सकते हैं और सबसे अच्छा क्लोज़्ड मॉडल — इनके बीच आधा अंक का फ़ासला है।
यही वह आँकड़ा है जो याद रखना है। इंडेक्स का औसत नहीं, वेंडर का चार्ट नहीं — यही। एजेंटिक कोडिंग असल में जिस तरह के टास्क हैं, उनमें यह अंतर शोर के भीतर ही है।
एक चेतावनी, जो स्रोत ने खुद कही है और दोहराने लायक है: Kimi K3’s सारे प्रकाशित आँकड़े मैक्स-एफ़र्ट रन के हैं, यानी reasoning_effort maximum और temperature 1.0 पर। अलग-अलग लैब अलग-अलग मूल्यांकन हार्नेस और अलग एफ़र्ट सेटिंग्स इस्तेमाल करती हैं, इसलिए एक ही वर्ज़न की तुलना में भी साफ़-सुथरी तालिका से ज़्यादा अनिश्चितता रहती है।
3. वही मूल्यांकन सूट चलाने की लागत
अगर ऊपर की तालिका सबसे अच्छी क्षमता-तुलना है, तो यह सबसे अच्छी वैल्यू-तुलना है — क्योंकि यही अकेला आँकड़ा है जो क्षमता, ज़्यादा लिखने की प्रवृत्ति, रीज़निंग का ओवरहेड और कीमत, सब एक ही संख्या में समेटता है:
| मॉडल | प्रति Intelligence Index टास्क लागत |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
वही टास्क, वही स्कोरिंग, असली बिल। GLM-5.3, Opus 5’s इंडेक्स स्कोर का 94% सिर्फ़ 29% लागत में देता है।
4. GDPval-AA v2 (नॉलेज वर्क)
| मॉडल | स्कोर |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
इस पर एक चेतावनी ज़रूरी है: यह किसी एक स्वतंत्र रन के बजाय वेंडरों के प्रकाशित चार्ट्स से जोड़ा गया है, और “Max” प्रत्यय अलग-अलग एफ़र्ट सेटिंग्स दिखाते हैं। पर स्रोतों में क्रम मोटे तौर पर एक जैसा है, और यह कुछ असली कहता है — कोडिंग के बजाय सामान्य नॉलेज वर्क में क्लोज़्ड मॉडल्स की बढ़त अब भी उससे ज़्यादा साफ़ है जितनी कोडिंग बेंचमार्क दिखाते हैं।
तीनों तुलनाओं में यही पैटर्न है। कोडिंग और एजेंटिक कामों में ओपन मॉडल्स असल में बराबरी पर आ गए हैं। व्यापक नॉलेज वर्क में वे अब भी एक क़दम पीछे हैं। अगर आपका काम पहले वाला है, तो क्लोज़्ड-मॉडल कीमतें चुकाने का तर्क कमज़ोर है। अगर दूसरा है, तो वह अब भी बनता है।
छवि दिखाएँ सबसे अच्छे क्लोज़्ड मॉडल और सबसे अच्छे डाउनलोड करने योग्य मॉडल में साढ़े तीन अंक का फ़ासला है। बारह महीने पहले यह अंतर दोहरे अंकों में था।
लागत का गणित, असली आँकड़ों के साथ
बेंचमार्क अमूर्त होते हैं। बिल नहीं।
परिदृश्य
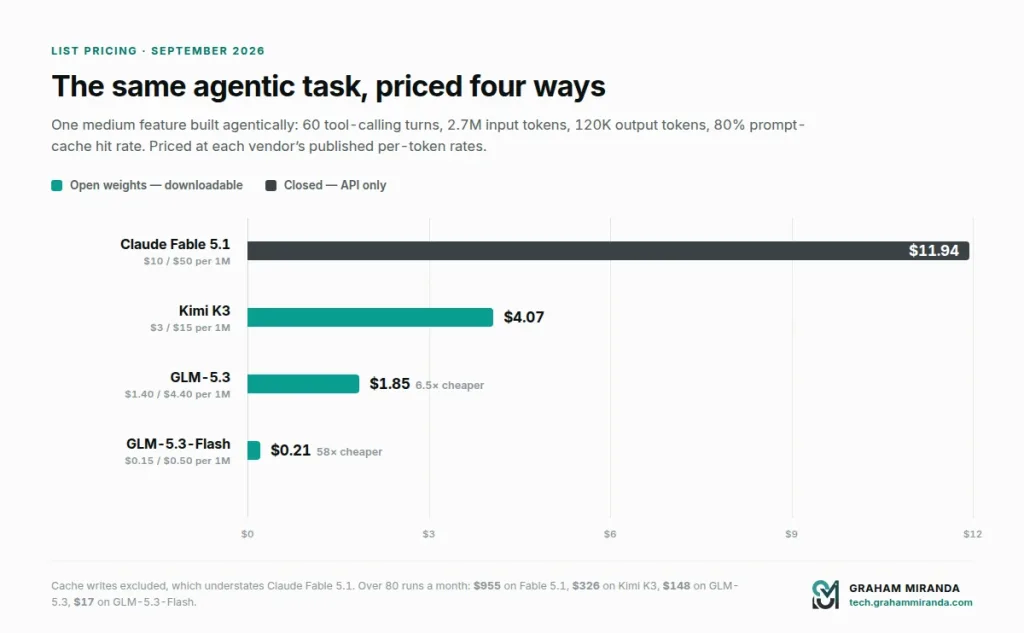
एक मध्यम फ़ीचर, एजेंटिक तरीक़े से: लगभग 60 टूल-कॉलिंग टर्न, औसतन प्रति टर्न 45,000 इनपुट टोकन क्योंकि कॉन्टेक्स्ट बढ़ता जाता है, और प्रति टर्न 2,000 आउटपुट टोकन.
- कुल इनपुट: 2.7M टोकन
- कुल आउटपुट: 120K टोकन
- माना गया प्रॉम्प्ट कैश हिट रेट: 80% (2.16M कैश्ड, 540K फ़्रेश)
Claude Fable 5.1
| घटक | टोकन | दर | लागत |
|---|---|---|---|
| फ़्रेश इनपुट | 540K | $10.00/M | $5.40 |
| कैश्ड इनपुट | 2.16M | $0.25/M | $0.54 |
| आउटपुट | 120K | $50.00/M | $6.00 |
| कुल | ≈ $11.94 |
Kimi K3
| घटक | टोकन | दर | लागत |
|---|---|---|---|
| फ़्रेश इनपुट | 540K | $3.00/M | $1.62 |
| कैश्ड इनपुट | 2.16M | $0.30/M | $0.65 |
| आउटपुट | 120K | $15.00/M | $1.80 |
| कुल | ≈ $4.07 |
GLM-5.3
| घटक | टोकन | दर | लागत |
|---|---|---|---|
| फ़्रेश इनपुट | 540K | $1.40/M | $0.76 |
| कैश्ड इनपुट | 2.16M | $0.26/M | $0.56 |
| आउटपुट | 120K | $4.40/M | $0.53 |
| कुल | ≈ $1.85 |
और संदर्भ के लिए — GLM-5.3-Flash
| घटक | टोकन | दर | लागत |
|---|---|---|---|
| फ़्रेश इनपुट | 540K | $0.15/M | $0.08 |
| कैश्ड इनपुट | 2.16M | $0.03/M | $0.06 |
| आउटपुट | 120K | $0.50/M | $0.06 |
| कुल | ≈ $0.21 |
अनुपात
- GLM-5.3, Fable 5.1 से 6.5× सस्ता है एक जैसे काम के लिए
- Kimi K3, Fable 5.1 से 2.9× सस्ता है
- GLM-5.3, Kimi K3 से 2.2× सस्ता है
- GLM-5.3-Flash, Fable 5.1 से 58× सस्ता है, इंटेलिजेंस इंडेक्स पर 57.5, जबकि Fable 5’s 62.1
पूरे कामकाजी महीने का हिसाब
रोज़ चार ऐसे टास्क, बीस कार्यदिवस — 80 एजेंटिक रन:
| मॉडल | महीने की टोकन लागत |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
इन आँकड़ों को लेकर तीन ईमानदार सावधानियाँ
कैश लिखावटें शामिल नहीं हैं। Fable 5.1 5-मिनट की कैश लिखावटों के लिए $12.50/M लेता है, और लंबा सेशन बार-बार कैश लिखता है। लिखावटें शामिल करने पर Fable’s असली आँकड़ा नीचे नहीं, ऊपर जाता है। छोटे सेशन के लिए 80% हिट रेट भी बहुत अच्छा अनुमान है।
रीज़निंग टोकन बिल किए जाने वाले आउटपुट टोकन हैं। तीनों मॉडलों में थिंकिंग हमेशा चालू रहती है। ख़ासकर GLM-5.3 को वर्बोज़ बताया गया है — AA सूट में 72M क्लास मीडियन के मुक़ाबले 170M आउटपुट टोकन — इसलिए इसका असली आउटपुट वॉल्यूम साधारण टर्न-गिनती के अनुमान से ज़्यादा रहता है। $0.68 प्रति कार्य वाला आँकड़ा इसे पहले ही ध्यान में रखता है, इसलिए मैं ऊपर अपने खुद के मॉडल से ज़्यादा उस पर भरोसा करता हूँ।
Fable 5.1’s टोकनाइज़र ~30% ज़्यादा टोकन बनाता है उसी टेक्स्ट के लिए पुराने Claude मॉडलों की तुलना में। अगर आप पुराने Claude बिल से तुलना कर रहे हैं, तो समायोजन कर लें।
तीनों सुधारों के बाद भी क्रम नहीं बदलता और परिमाण मुश्किल से बदलता है। बंद-फ्रंटियर का काम हर पूरे किए गए कार्य पर सबसे अच्छे ओपन-वेट मॉडल की लागत से लगभग छह गुना महंगा पड़ता है।
छवि दिखाएँ हर वेंडर की लिस्ट प्राइसिंग पर वही 60-टर्न एजेंटिक टास्क। खड़ी धुरी ही ओपन वेट्स के पूरे तर्क का सार है।
लाइसेंस: 2026 में “ओपन” असल में आपको क्या देता है
यह वह हिस्सा है जिसे मैं सबसे ज़्यादा लोगों से पढ़वाना चाहूँगा, क्योंकि शब्दावली बुरी तरह बदल चुकी है और इससे किसी को बहुत पैसा गँवाना पड़ेगा।
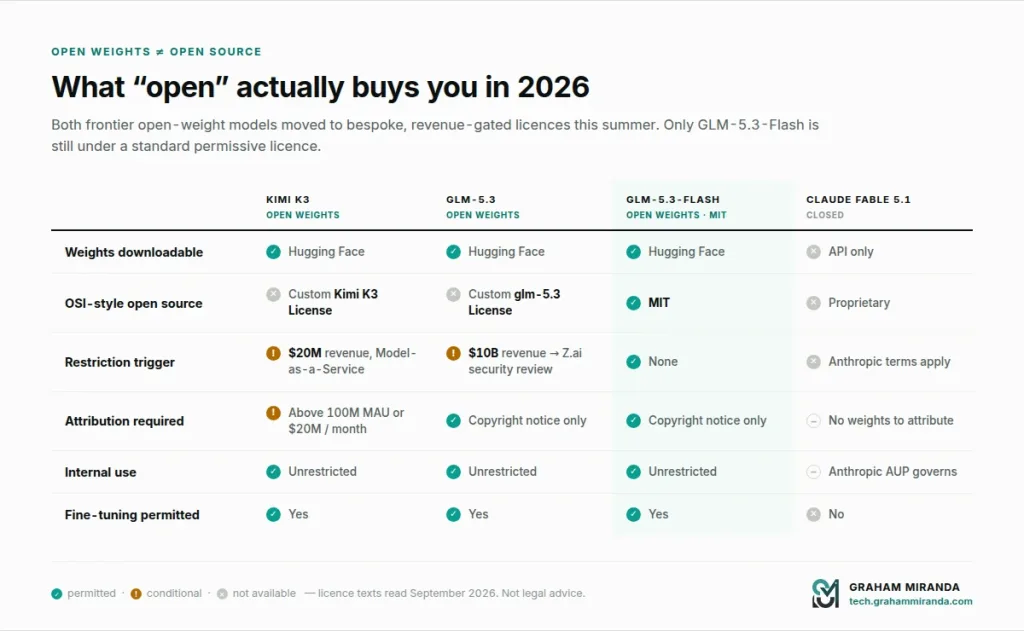
न Kimi K3 ओपन सोर्स है और न GLM-5.3। दोनों डाउनलोड करने योग्य वेट्स ऐसे कस्टम लाइसेंस के तहत जारी करते हैं जिनमें राजस्व आधारित शर्तें हैं। यह MIT या Apache 2.0 से साफ़ तौर पर अलग बात है, और इसका असर ठीक उसी तरह के कारोबार पर पड़ता है जिसे सेल्फ-होस्टिंग से सबसे ज़्यादा फ़ायदा होता।
Kimi K3 लाइसेंस
आपको इंटरनेट पर हर जगह K3 के लिए “Modified MIT” दोहराया हुआ मिलेगा। यह ग़लत है — वह K2 के लिए था। K3 दो अलग गेट वाले कस्टम दस्तावेज़ के तहत आता है:
मॉडल-एज़-ए-सर्विस गेट। अगर आप तीसरे पक्षों को मॉडल इन्फ़रेंस या फाइन-ट्यूनिंग की सुविधा देते हैं — जहाँ वे तीसरे पक्ष इनपुट, पैरामीटर या ट्रेनिंग डेटा नियंत्रित करते हैं — और “लाइसेंसी और उसके सहयोगियों का कुल राजस्व 20 मिलियन अमेरिकी डॉलर से अधिक हो जाता है” किसी भी लगातार 12 महीनों में, तो आपको Moonshot के साथ अलग व्यावसायिक समझौता करना होगा। ध्यान दें कुल राजस्व, सभी सहयोगियों का, न कि K3 से जुड़ा राजस्व। €25M टर्नओवर वाली कंसल्टेंसी जो इन्फ़रेंस दोबारा बेचती है, सीमा पार कर जाती है, भले ही AI कारोबार महज़ एक मामूली हिस्सा हो।
एट्रिब्यूशन गेट। ऐसे उत्पाद जिनके मासिक सक्रिय उपयोगकर्ता 100 मिलियन या मासिक राजस्व $20 मिलियन से अधिक हैं उन्हें उत्पाद इंटरफ़ेस में “Kimi K3” प्रमुखता से दिखाना होगा।
सबसे महत्वपूर्ण छूट: पूरी तरह आंतरिक उपयोग पर कोई रोक नहीं है। अपने डेवलपर्स, शोधकर्ताओं, लीगल टीम या आम कर्मचारी उत्पादकता के लिए K3 चलाने से कोई भी गेट सक्रिय नहीं होता। अधिकांश कारोबारों के लिए — मोटे तौर पर मेरे सभी कामों सहित — यही प्रासंगिक शर्त है, और जवाब यह है कि आप ठीक हैं।
K2 के मुक़ाबले नई शर्त $20M MaaS गेट है। K2 में केवल अपनी सीमाओं से ऊपर एट्रिब्यूशन ज़रूरी था। K3 एक बहुत कम राजस्व सीमा वाला गेट जोड़ता है जो ख़ास तौर पर व्यावसायिक इन्फ़रेंस रीसेलरों के लिए है। Moonshot आपको मॉडल इस्तेमाल करने से रोकना नहीं चाहता; वह क्लाउड प्रदाताओं को इस पर मुफ़्त में कारोबार बनाने से रोकना चाहता है।
glm-5.3 लाइसेंस
Z.ai’s फ़्लैगशिप ने अलग दिशा ली, और यह पूर्व-उदाहरण से जितना बड़ा अलगाव है, उसे ज़्यादातर कवरेज ने स्वीकार नहीं किया।
GLM-5.2 MIT के तहत आया। GLM-5.3-Flash MIT के तहत आया। GLM-5.3 नहीं।
कस्टम लाइसेंस व्यक्तियों और आम कारोबारों को बिना किसी अतिरिक्त प्रतिबंध के मॉडल चलाने, डिप्लॉय करने और फाइन-ट्यून करने की अनुमति देता है। एकमात्र गेट हाइपरस्केलर्स पर लक्षित है: ऐसी इकाई जिसका “लाइसेंसी और उसके सहयोगियों का कुल राजस्व किसी भी लगातार 12 महीनों में 10 बिलियन अमेरिकी डॉलर (या अन्य मुद्राओं में उसके बराबर) से अधिक हो जाता है” चाहिए Z.AI’s सुरक्षा समीक्षा पास करें मॉडल या उसके डेरिवेटिव का किसी भी व्यावसायिक उद्देश्य के लिए उपयोग करने से पहले।
यह $10 बिलियन की सीमा है। यह लगभग सभी को बाहर रखती है। लेकिन बारीक शर्तों में दो बातें ध्यान देने योग्य हैं:
पहला, लाइसेंस ऐप डेवलपर्स को साफ़ तौर पर छूट देता है जो मॉडल को फ़ीचर्स में शामिल करते हैं, और ऐसे रीसेलरों को जो केवल अनुरोध दूसरे होस्टों तक भेजते हैं। लक्ष्य सीमित और स्पष्ट है: ऐसी कंपनियाँ जो चाहती हैं होस्ट GLM-5.3 को व्यावसायिक रूप से बड़े पैमाने पर।
दूसरा — और यह वाक़ई अटपटा हिस्सा है — लाइसेंस उस सुरक्षा समीक्षा के लिए कोई मानदंड, समयसीमा या अपील प्रक्रिया नहीं बताता। यह केवल इतना कहता है कि उसका “दायरा और तरीका… Z.AI द्वारा उचित रूप से तय किया जाएगा।” अगर आप बड़ा उद्यम हैं, तो यह किसी विदेशी विक्रेता के विवेक पर असीमित निर्भरता है, और आपकी खरीद टीम यह कहेगी भी।
यह भी ध्यान देने योग्य है: रिलीज़ से पहले दो हफ़्ते की साइबर-क्षमता रोक के बावजूद, लाइसेंस में कोई स्वीकार्य-उपयोग प्रतिबंध, कोई साइबर छूट और आउटपुट-स्वामित्व का कोई दावा नहीं है। सुरक्षा चिंता ने रिलीज़ के समय, न कि रिलीज़ की शर्तें.
तो असल में अभी भी MIT क्या है?
GLM-5.3-Flash. 320B पैरामीटर, 18B सक्रिय, मूल रूप से मल्टीमॉडल, MIT-लाइसेंस प्राप्त, इंटेलिजेंस इंडेक्स पर 57.5, और प्रति मिलियन टोकन $0.15/$0.50 — 9 सितंबर 2026 तक चलने वाली प्रचार छूट के तहत अभी उससे आधा। अगर आपकी ज़रूरत सिर्फ़ डाउनलोड करने योग्य वेट्स नहीं, बल्कि वाक़ई बिना प्रतिबंध वाला अनुमत लाइसेंस है, तो फ्रंटियर अभी वहीं है, और वह उल्लेखनीय रूप से ऊँचा है।
व्यावहारिक सार
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| वेट्स डाउनलोड करने योग्य | हाँ | हाँ | हाँ | नहीं |
| OSI-शैली ओपन सोर्स | नहीं | नहीं | हाँ (MIT) | नहीं |
| प्रतिबंध ट्रिगर | $20M राजस्व (MaaS) | $10B राजस्व (MaaS) | कोई नहीं | N/A |
| एट्रिब्यूशन ज़रूरी | 100M MAU / $20M-माह से ऊपर | केवल कॉपीराइट सूचना | केवल कॉपीराइट सूचना | N/A |
| आंतरिक उपयोग प्रतिबंधित | नहीं | नहीं | नहीं | N/A |
| फाइन-ट्यूनिंग की अनुमति | हाँ | हाँ | हाँ | नहीं |
| स्वीकार्य-उपयोग नीति | स्टैंडर्ड | लाइसेंस टेक्स्ट में कोई नहीं | कोई नहीं | Anthropic AUP लागू |
एक आम जर्मन मिटेलस्टैंड कारोबार, एजेंसी, या ऐसी कंसल्टेंसी के लिए जो मॉडल आंतरिक रूप से चलाती है या उन्हें किसी उत्पाद में शामिल करती है: तीनों ओपन विकल्प बिना कुछ भी बातचीत किए इस्तेमाल किए जा सकते हैं। ये गेट AWS को पकड़ने के लिए हैं, आपको नहीं। लेकिन “लाइसेंस पढ़ें” अब बेकार की सलाह से असली सलाह बन गई है, और अगर आपका टर्नओवर लगभग €20M से ऊपर है और आप किसी भी रूप में इन्फ़रेंस दोबारा बेचते हैं, तो डिप्लॉय करने से पहले इसे अपने वकील के सामने रखें।
ओपन मॉडलों के पक्ष में असली दलील
मैं यह दलील नारे की तरह नहीं, ठीक से रखना चाहता हूँ, क्योंकि “ओपन मॉडल शानदार हैं” कोई दलील नहीं है और असली कारण जयकारे से ज़्यादा दिलचस्प हैं।
1. कीमतों का गिरना सब्सिडी नहीं, संरचनात्मक है
सस्ते चीनी मॉडलों पर सहज आपत्ति यह होती है कि यह प्राइसिंग घाटे में बेचने वाली है और ऊपर की ओर सामान्य हो जाएगी। इसका कुछ हिस्सा निश्चित रूप से ऐसा है। लेकिन संरचनात्मक बात अलग से कायम है: जब वेट्स सार्वजनिक होते हैं, तो इन्फ़रेंस कमोडिटी बाज़ार बन जाता है। बीस होस्टिंग प्रदाता एक ही मॉडल परोसने के लिए प्रतिस्पर्धा करते हैं, और उनमें से कोई क्षमता का प्रीमियम नहीं ले सकता क्योंकि किसी के पास क्षमता की खाई नहीं है। इसीलिए GLM-5.3 $1.40/$4.40 पर चलता है और Fable 5.1 तीन अंकों के अंतर पर $10/$50 पर चलता है।
बंद-मॉडल प्राइसिंग में R&D का परिशोधन, मार्जिन, और यह तथ्य शामिल है कि विक्रेता बिल्कुल एक ही है। ओपन-वेट प्राइसिंग में बिजली, हार्डवेयर का परिशोधन और पतला मार्जिन शामिल है। ये अलग कारोबार हैं, और ओपन मॉडलों के महँगे होने से यह अंतर ख़त्म नहीं होगा।
इस बात का सबूत कि यह अस्थायी नहीं, असली है: DeepSeek ने लगभग मई 2026 तक Vercel पर टोकन उपयोग का 17% हिस्सा लिया, जबकि राजस्व हिस्सा लगभग 1% था। यह प्राइसिंग की कोई विसंगति नहीं है। चार्ट पर कमोडिटाइज़ेशन ऐसा ही दिखता है।
2. एग्ज़िट अधिकार आपकी बातचीत की स्थिति बदल देते हैं, भले ही आप कभी उनका इस्तेमाल न करें
यह पढ़ने वाली ज़्यादातर टीमें सेल्फ-होस्ट नहीं करेंगी। नीचे हार्डवेयर वाला हिस्सा बताता है क्यों — Kimi K3 को एक रैक चाहिए। लेकिन विकल्प का महत्व फिर भी है।
अगर Anthropic दाम बढ़ाता है, जिस मॉडल पर आपने काम बनाया उसे बंद करता है, अपनी स्वीकार्य-उपयोग नीति ऐसे बदलता है जिससे आपका उत्पाद टूट जाए, या उसकी तिमाही ख़राब जाती है, तो बंद मॉडल के साथ आपका उपाय माइग्रेशन प्रोजेक्ट है। ओपन-वेट मॉडल के साथ आपका उपाय ऐसी फ़ाइल डाउनलोड करना है जिसे आप कभी भी डाउनलोड कर सकते थे। आप शायद कभी ऐसा न करें। यह तथ्य कि आप कर सकते थे यही विक्रेता संबंध को निर्भरता के बजाय व्यावसायिक संबंध बनाता है।
यह सैद्धांतिक बात नहीं है। Fable 5.1 1 सितंबर को तीन ब्रेकिंग बदलावों के साथ आया, जिनमें से एक 31 अगस्त के बाद बने खातों के लिए बातचीत का इतिहास संपादित करने पर थिंकिंग ब्लॉक्स को अमान्य कर देता है। अगर आपकी आर्किटेक्चर में यह पैटर्न भार वहन करता है, तो आप अपने नहीं, Anthropic’s शेड्यूल पर दोबारा इंजीनियरिंग कर रहे हैं।
3. डेटा रेज़िडेंसी एक प्रोजेक्ट रहना बंद हो जाती है
GDPR के तहत काम करने वाले किसी भी व्यक्ति के लिए, यही वह दलील है जो वाक़ई सौदे पूरे कराती है।
बंद API के साथ, हर प्रॉम्प्ट आपकी इन्फ्रास्ट्रक्चर से बाहर जाता है। आपको प्रोसेसर समझौता चाहिए, अगर प्रोसेसर EEA के बाहर है तो ट्रांसफ़र इम्पैक्ट असेसमेंट, डेटा-फ़्लो मैप, और अपने DPO के लिए जवाब कि डेटा आराम की स्थिति में क्या होता है। यह सब किया जा सकता है। यह हर विक्रेता पर हफ़्तों का काम भी है, और जब भी विक्रेता कुछ बदले, दोहराना पड़ता है।
अगर ओपन वेट्स आपके नियंत्रण वाली इन्फ्रास्ट्रक्चर पर हैं — आपका अपना हार्डवेयर, या जर्मन या EU GPU होस्ट — तो सीमा-पार ट्रांसफ़र का सवाल ही नहीं उठता, क्योंकि कोई ट्रांसफ़र नहीं है। मॉडल वहीं चलता है जहाँ आपका डेटा पहले से है। कानूनी समीक्षा ट्रांसफ़र असेसमेंट से लाइसेंस पढ़ने तक सिमट जाती है।
जर्मन और EU ग्राहकों के लिए यह अक्सर निर्णायक कारक होता है, और इस अपवाद के बारे में स्पष्ट रहना ज़रूरी है: Z.ai’s API के ज़रिए GLM-5.3 इस्तेमाल करने से आपको यह नहीं मिलता। यह आपको वेट्स खुद चलाने से मिलता है, या ऐसे प्रदाता से जो उन्हें आपके क्षेत्राधिकार में होस्ट करता है। लाइसेंस इसे कानूनी बनाता है; यह इसे अपने आप होने वाला नहीं बनाता।
4. निरीक्षण-क्षमता असली है, भले ही कम इस्तेमाल हो
ओपन वेट्स का मतलब है कि आप आर्किटेक्चर जाँच सकते हैं, ऐसे एंडपॉइंट के बजाय असली मॉडल पर अपने मूल्यांकन चला सकते हैं जो चुपचाप अपडेट हो सकता है, अपने हार्डवेयर में फ़िट करने के लिए उसे क्वांटाइज़ कर सकते हैं, अपने डोमेन पर फाइन-ट्यून कर सकते हैं, और — ज़रूरी बात — किसी वर्ज़न को हमेशा के लिए पिन कर सकते हैं।
यह आख़िरी बात कम आँकी जाती है। बंद API स्थिर मॉडल ID के पीछे अपडेट होते रहते हैं। व्यवहार बदलता रहता है। जो प्रॉम्प्ट चलते थे, वे चलना बंद कर देते हैं, और आप बदलाव का फ़र्क़ नहीं देख सकते क्योंकि आप उसे देख ही नहीं सकते। एक लोकल चेकपॉइंट एक साल बाद भी बाइट-दर-बाइट वही रहता है।
5. प्रतिस्पर्धी दबाव सबको फ़ायदा देता है, बंद-मॉडल उपयोगकर्ताओं सहित
देखिए इस गर्मी में क्या हुआ। Kimi K3 जुलाई में $3/$15 पर आया, फ्रंटियर के क़रीब स्कोर के साथ। GLM-5.3 अगस्त में $1.40/$4.40 पर आया, उससे आधे अंक के भीतर। और 1 सितंबर को Anthropic ने कैश रीड्स 75% कम कर दीं।
मैं सीधा कारण-संबंध नहीं कह रहा — Anthropic अपनी प्राइसिंग की वजह नहीं बताता और कैश-रीड में कटौती एक स्वाभाविक ऑप्टिमाइज़ेशन है। लेकिन भरोसेमंद सस्ते विकल्पों वाला बाज़ार उनके बिना वाले बाज़ार से अलग क़ीमत तय करता है, और इस साल विकल्प भरोसेमंद हुए हैं। अगर आप सिर्फ़ बंद मॉडल इस्तेमाल करते हैं, तब भी ओपन-वेट इकोसिस्टम चुपचाप आपके बिल छोटे कर रहा है।
6. फ़ायदे पोस्ट-ट्रेनिंग में हैं, और वह सस्ती है
GLM-5.3’s मुख्य नतीजा — उन्हीं बेस वेट्स से Terminal-Bench में छह गुना सुधार — इस पूरे लेख का सबसे रणनीतिक महत्व वाला आँकड़ा है, और यह GLM के बारे में नहीं है।
यह बताता है कि फ्रंटियर मॉडल बनाने का महँगा हिस्सा (प्रीट्रेनिंग) तेज़ी से हल हो चुका, कमोडिटी बन चुका इनपुट है, और फ़र्क़ पैदा करने वाला हिस्सा (पोस्ट-ट्रेनिंग, RL वातावरण, लंबी अवधि के कार्य डिज़ाइन) तुलनात्मक रूप से किफ़ायती है। इसीलिए लगभग $159 बिलियन के संयुक्त मूल्यांकन वाली चार चीनी लैब्स उससे कई गुना मूल्यांकन वाली अमेरिकी लैब्स के साथ क़दम मिला रही हैं। Lambert’s आकलन है कि चीनी लैब्स “परिमाण में कई गुना कम पूँजी” के साथ चल रही हैं।
आगे काम करने वाले किसी भी व्यक्ति के लिए, निहितार्थ सीधा है: भरोसेमंद मॉडल विक्रेताओं की संख्या बढ़ रही है, घट नहीं रही। अपनी आर्किटेक्चर उसी हिसाब से बनाएँ।
7. इकोसिस्टम के प्रभाव एक-दूसरे को बढ़ाते हैं
Qwen ने Hugging Face पर एक बिलियन संचयी डाउनलोड पार किए, Llama को पीछे छोड़ते हुए, और अब 200,000 से अधिक टैग किए गए मॉडल और 113,000+ डेरिवेटिव का आधार है — लगभग सभी नए LLM डेरिवेटिव का 40% प्लेटफ़ॉर्म पर Qwen-आधारित हैं। यह टूलिंग, क्वांटाइज़ेशन, फाइन-ट्यूनिंग और डिप्लॉयमेंट का ऐसा इकोसिस्टम है जो केवल इसलिए मौजूद है क्योंकि वेट्स सार्वजनिक हैं।
आप उस इकोसिस्टम से फ़ायदा उठाते हैं, चाहे आप उसमें योगदान दें या न दें। GGUF कन्वर्ज़न, vLLM कर्नेल, LoRA एडाप्टर, क्वांटाइज़ेशन रेसिपी, मूल्यांकन हार्नेस — यह सब इसलिए मौजूद है क्योंकि हज़ारों लोगों को असली वेट्स मिल सके।
8. डेवलपर्स पहले ही यहाँ जा चुके हैं
चीनी मूल के मॉडल OpenRouter टोकन का ~61%. अमेरिकी मॉडलों का हिस्सा एक साल में ~70% से ~30% पर आ गया। राउटर पर सबसे ज़्यादा इस्तेमाल होने वाले पाँच में से चार मॉडल चीनी मूल के हैं। अकेले Xiaomi’s MiMo मॉडल राउट किए गए टोकन का लगभग 21% और सभी कोडिंग ट्रैफ़िक का लगभग 22% हैं।
डेवलपर व्यवहार एक अग्रणी संकेतक है। यह Docker, Postgres और Linux के लिए अग्रणी संकेतक रहा है। इसके ख़िलाफ़ दाँव लगाने का ऐतिहासिक रिकॉर्ड ख़राब है।
…और ईमानदारी से इसके ख़िलाफ़ दलील
अगर मैं केवल ऊपर वाला हिस्सा लिखता, तो यह एक विज्ञापन होता।
ओपन वेट्स ओपन सोर्स नहीं हैं, और शब्दावली का बदलाव असली समस्या है। यहाँ के तीन में से दो मॉडल बिना OSI स्वीकृति वाले कस्टम, राजस्व-सीमा वाले लाइसेंस के तहत आते हैं। GLM-5.3’s सुरक्षा-समीक्षा शर्त में कोई प्रकाशित मानदंड या अपील प्रक्रिया नहीं है। अगर आपके अनुपालन ढाँचे को OSI-स्वीकृत लाइसेंस चाहिए, तो सच्चा जवाब यह है कि आपके विकल्प GLM-5.3-Flash, DeepSeek’s MIT-लाइसेंस वाले फ़्लैगशिप, और सिकुड़ती अन्य सूची हैं।
विक्रेता के बेंचमार्क विक्रेता के बेंचमार्क ही रहते हैं। Moonshot और Z.ai ने जो भी मुख्य आँकड़े प्रकाशित किए, वे स्व-रिपोर्टेड और स्व-चयनित हैं। जहाँ तटस्थ एग्रीगेटरों ने मापा, वहाँ आँकड़े मोटे तौर पर टिकते हैं — जो सचमुच दोनों लैब्स’ श्रेय की बात है — लेकिन “मोटे तौर पर टिकते हैं” उस वाक्य में बहुत काम कर रहा है।
सेल्फ-होस्टिंग ज़्यादातर टीमों के लिए एक कल्पना है। Kimi K3 1.5 TB है और Moonshot 64+ एक्सेलेरेटर की सिफ़ारिश करता है। GLM-5.3 को कम से कम FP8 पर 8×H200 चाहिए। एग्ज़िट अधिकार असली है; उसे लागू करने की क़ीमत एक डेटा सेंटर है।
सपोर्ट वही होता है जो आप उससे बनाते हैं। जब Fable 5.1 ख़राब होता है, तो SLA वाली एक कंपनी होती है। जब शुक्रवार रात आपका सेल्फ-होस्टेड GLM-5.3 डिप्लॉयमेंट 300K कॉन्टेक्स्ट पर कचरा पैदा करता है, तो एक GitHub इश्यू और आपकी अपनी क्षमता होती है।
भू-राजनीति खरीद में एक असली कारक है। यहाँ चर्चा किए गए तीनों ओपन-वेट विकल्प चीनी लैब्स से हैं। कुछ ग्राहकों के लिए — सार्वजनिक क्षेत्र, रक्षा से जुड़े, कुछ नियामक उद्योग — यह लाइसेंस की शर्तों या वेट्स कहाँ चलते हैं, इससे परे एक सख़्त बाधा है। यह बताना मेरा काम नहीं है कि वह चिंता तर्कसंगत है या नहीं। मेरा काम यह बताना है कि यह बैठक में ज़रूर उठेगी।
सामान्य ज्ञान-आधारित काम में बंद मॉडल अभी भी आगे हैं। GDPval-AA v2 में Fable 5.1 1,853 पर है, जबकि GLM-5.3’s 1,769 और Kimi K3’s 1,687 पर। कोडिंग में अंतर ख़त्म है। व्यापक पेशेवर ज्ञान-आधारित काम में नहीं।
छवि दिखाएँ डाउनलोड होने लायक वेट्स, लेकिन शर्तों के तीन अलग-अलग सेट। सिर्फ़ GLM-5.3-Flash ही अब भी MIT है।
2026 में Ollama: वह प्राइसिंग बदलाव जो वाक़ई मायने रखता है
Ollama चुपचाप इस बातचीत का सबसे महत्वपूर्ण इन्फ्रास्ट्रक्चर बन गया है, और 31 अगस्त 2026 इसने अपनी चार्जिंग का तरीका ऐसे बदला जिसे ठीक से समझना ज़रूरी है।
क्या बदला
Ollama ने अपने Pro, Max और Team प्लान GPU-टाइम बिलिंग से उद्योग-मानक प्रति-टोकन प्राइसिंग पर ले जाए, जिसमें हर प्लान के साथ उपयोग क्रेडिट का पूल शामिल है। कंपनी की बताई वजह सुखद रूप से ठोस है: Kimi K3 जैसे मॉडलों ने GPU-टाइम के आँकड़ों का अनुमान लगाना असंभव बना दिया। जब एक मॉडल 104B पैरामीटर सक्रिय करता है और दूसरा 3B, तो भुगतान करने वाले व्यक्ति के लिए “एक घंटा GPU” का कोई मतलब नहीं रह जाता।
नए प्लान
| Plan | क़ीमत | शामिल मासिक उपयोग | कंकरेंसी |
|---|---|---|---|
| मुफ़्त | $0 | छोटा मासिक क्रेडिट, स्टार्टर मॉडल | 1 अनुरोध |
| Pro | $20/माह (या $200/वर्ष) | $60 का उपयोग | 3 अनुरोध |
| Max | $100/माह | $300 का उपयोग | 10 अनुरोध |
| Team | $500/माह | $1,000 साझा, असीमित उपयोगकर्ता | 10 अनुरोध |
| एंटरप्राइज़ | Custom | Custom | Custom |
Pro वाली पंक्ति फिर पढ़ें। $20 में $60 के टोकन मिलते हैं। यह शामिल उपयोग पर 3× गुणक है, और जब पूल ख़त्म हो जाए तो आप ठीक उसी प्रकाशित प्रति-टोकन दर पर जारी रखते हैं — कोई पेनल्टी टियर नहीं, कोई सेवा शुल्क नहीं।
क्या हटाया गया
यही वह हिस्सा है जो डेवलपर्स ने वाक़ई नोटिस किया: कोई 5-घंटे का रीसेट नहीं और कोई साप्ताहिक कैप नहीं। जिसने भी रिफ़ैक्टर के बीच में रोलिंग उपयोग विंडो से टकराया है, वह समझेगा कि यह क़ीमत से ज़्यादा क्यों मायने रखता था। मासिक पूल आपकी सब्सक्रिप्शन तारीख़ पर रीफ़्रेश होता है और, ज़रूरी बात, आगे नहीं बढ़ता — इसलिए अपना प्लान अपने सामान्य महीने के हिसाब से तय करें, सबसे व्यस्त महीने के हिसाब से नहीं।
EU के काम के लिए मायने रखने वाली शर्तें
अगर आप ग्राहक डेटा संभालते हैं, तो घोषणा में तीन वादे सीधे प्रासंगिक हैं:
- शून्य डेटा रिटेंशन। प्रॉम्प्ट और जवाब कभी लॉग नहीं होते और उन पर कभी ट्रेनिंग नहीं होती।
- US और Europe में होस्टिंग, साथ में सीमित Qwen मॉडलों के लिए Singapore।
- प्रति-अनुरोध लागत की दृश्यता आपके खाते में — आप ठीक-ठीक देख सकते हैं कि हर कॉल की क्या क़ीमत थी।
जर्मन कंसल्टेंसी के लिए यह ज़्यादातर गेटवे प्रदाताओं की तुलना में काफ़ी बेहतर अनुपालन कहानी है, हालाँकि “Europe में होस्टेड” एक रूटिंग बयान है, संविदात्मक डेटा-रेज़िडेंसी गारंटी नहीं। अगर रेज़िडेंसी पसंद के बजाय सख़्त ज़रूरत है, तो मान लेने से पहले Ollama से लिखित में माँगें।
असली प्रति-टोकन दरें
यहाँ बात दिलचस्प होती है। Ollama हर मॉडल के लिए दरें प्रकाशित करता है, और वे फ़र्स्ट-पार्टी प्राइसिंग के काफ़ी क़रीब हैं:
| Ollama पर मॉडल | इनपुट / 1M | Cached / 1M | आउटपुट / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
पहले वाला मासिक गणित इस पर लगाइए। GLM-5.3 पर महीने में अस्सी एजेंटिक रन पर टोकन में लगभग $148 ख़र्च होते हैं। एक $100/माह वाला Max प्लान $300 का उपयोग कवर करता है — इसलिए वही काम जो Fable 5.1 पर लगभग $955/माह पड़ेगा, $100 की Ollama सब्सक्रिप्शन में आराम से, बची हुई गुंजाइश के साथ आ जाता है।
यही पूरी ओपन-मॉडल आर्थिक दलील एक इनवॉइस की एक पंक्ति में सिमटी हुई है।
छवि दिखाएँ GLM-5.3 पर महीने के अस्सी एजेंटिक रन $100 के Ollama Max प्लान में बचे-खुचे के साथ आ जाते हैं। Fable 5.1 पर वही काम $955 का इनवॉइस है।
2026 में Ollama और क्या लाया
प्राइसिंग बदलाव अलग-थलग नहीं हुआ। पिछले कुछ महीने व्यस्त रहे:
- 25 अगस्त — Claude Desktop सपोर्ट। Ollama अब Claude Desktop के लिए थर्ड-पार्टी गेटवे प्रदाता के रूप में काम करता है, इसलिए आप Anthropic’s अपने क्लाइंट से ओपन मॉडल चला सकते हैं।
- 26 अगस्त — v0.33.0। Claude Desktop गेटवे इंटीग्रेशन आया, कैश में प्रीफ़िल रिकवरी बहाल हुई, और Ollama ने Claude Code’s टोकन-काउंटडाउन सिस्टम संदेश बंद किया, जो हर टर्न पर KV कैश को अमान्य कर रहा था। यह आख़िरी बदलाव चुपचाप किया गया, लेकिन अहम परफ़ॉर्मेंस सुधार है।
- 26 अगस्त — v0.33.1। Qwen3.8 Flash Next के लिए MLX सपोर्ट, स्ट्रक्चर्ड आउटपुट, और धीमे स्टोरेज से मॉडल लोड करते समय GPU टाइमआउट का फ़िक्स।
- 28 अगस्त — v0.33.2। डार्क मोड बहाल, macOS हैंडऑफ़ ठीक, और मॉडल कैटलॉग अपडेट के दौरान Claude Desktop प्रॉक्सी अनुरोध जीवित रखे गए।
- 20 अगस्त — v0.32.15। नया डेस्कटॉप ऑनबोर्डिंग, और अनुरोधों के बीच मेटाडेटा कैशिंग जिसने टाइम-टू-फ़र्स्ट-टोकन लगभग आधा कर दिया।
- 11 अगस्त — NVIDIA Nemotron 3.5 Lightning, 30B मॉडल जो व्यक्तिगत हार्डवेयर पर टूल कॉलिंग के साथ एजेंटिक वर्कफ़्लो के लिए ट्यून किया गया है।
- 10 अगस्त — Meta’s Muse Glimmer, 30B का एक मल्टीमोडल मॉडल Apache 2.0, जो Ollama’s MLX इंजन से तेज़ होता है। Llama’s routed उपयोग में गिरावट को देखते हुए यह ध्यान देने योग्य है — Meta अब भी सचमुच उदार लाइसेंस वाले वेट्स जारी कर रहा है।
- 9 जुलाई — $88M का फंडिंग राउंड, जहाँ Ollama के मुताबिक 89 लाख डेवलपर्स.
- 29 जून — MLX पर Gemma 4 अब 90% तक तेज़ मल्टी-टोकन प्रेडिक्शन के ज़रिए, जिसका सबसे ज़्यादा फ़ायदा Apple Silicon पर चलने वाले कोडिंग एजेंट्स को मिलता है।
- 5 जून — v0.30 में GGUF कम्पैटिबिलिटी जोड़ी गई llama.cpp के ज़रिए, जिससे हार्डवेयर सपोर्ट Apple Silicon से कहीं आगे तक बढ़ गया।
मूल बात यह है कि Ollama अब “अपने लैपटॉप पर छोटा मॉडल चलाने का आसान तरीका” भर नहीं रहा — वह एक जनरल-पर्पज़ गेटवे बन गया है जो संयोग से मॉडल लोकल भी चलाता है। क्लाउड कैटलॉग में अब शामिल हैं kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 सात साइज़ में, gpt-oss 20b और 120b पर, gemma4, Nemotron 3 फ़ैमिली और mistral-large-3.
सब कुछ सेट करना: कॉपी-पेस्ट कॉन्फ़िग्स
Ollama + Claude Code (सबसे तेज़ रास्ता)
Ollama एक ऐसा लॉन्चर देता है जो एक ही कमांड में आपके लिए एनवायरनमेंट की वायरिंग संभाल लेता है:
bash
ollama launch claudeअगर आप इसे खुद करना चाहें — और स्क्रिप्ट लिख रहे हों तो करना चाहिए — तो पहले Claude Code इंस्टॉल करें:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
फिर इसे Ollama की ओर इंगित करें:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
और जिस मॉडल पर चाहें, उस पर चलाएँ:
bash
# A local model
claude --model qwen3.5

# A cloud model — note the :cloud suffix
claude --model kimi-k3:cloud
या इनलाइन, बिना कुछ भी ग्लोबली एक्सपोर्ट किए:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
दो बातें जो आपको परेशान करेंगी।
पहला, एक्सपोर्ट न करें ANTHROPIC_BASE_URL अपने shell profile में परमानेंट रूप से। यह एक ग्लोबल वेरिएबल है और आपकी मशीन पर Anthropic से बात करने वाले हर टूल को चुपचाप Ollama की ओर मोड़ देगा — उस टूल को भी जिसे आप Anthropic से बात कराना चाहते थे। इसे हर प्रोजेक्ट या हर इनवोकेशन के लिए सीमित रखें।
दूसरा, अपनी कॉन्टेक्स्ट लंबाई 64k या उससे ज़्यादा रखें असली रिपॉज़िटरी पर काम करने वाली हर चीज़ के लिए। Ollama’s डिफ़ॉल्ट इससे छोटा है, और कॉन्टेक्स्ट विंडो चुपचाप खत्म हो जाने पर कोडिंग एजेंट एरर देने के बजाय बस चीज़ें भूलने लगता है।
CI, Docker या स्क्रिप्टेड रन के लिए, --yes इंटरैक्टिव प्रॉम्प्ट छोड़ देता है:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "how does this repository work?"GLM-5.3 सीधे Z.ai से
अगर आप Ollama के रास्ते जाने के बजाय फ़र्स्ट-पार्टी राउटिंग चाहते हैं, तो Z.ai तीन प्रोटोकॉल एंडपॉइंट देता है:
| प्रोटोकॉल | बेस URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
GLM-5.3 के लिए एक OpenCode प्रोवाइडर ब्लॉक:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3": {
          "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
          "options": { "reasoning_effort": "high", "temperature": 1 }
        }
      }
    }
  },
  "model": "zai/glm-5.3"
}
अपग्रेड से जुड़ी ज़रूरी बात: GLM-5.3 में रीज़निंग चालू होना ज़रूरी है। अगर आपकी मौजूदा कॉन्फ़िगरेशन में सेट है thinking.type: "disabled", तो अब वह फ़ेल होगा। इसे बदलकर करें "enabled" और सेट करें reasoning_effort: "low" अगर आपको पुराना लेटेंसी प्रोफ़ाइल वापस चाहिए।
reasoning_effort आपका मुख्य क्वालिटी-बनाम-लागत डायल है: कम लेटेंसी के प्रति संवेदनशील कॉल्स के लिए, उच्च बड़े काम के लिए, अधिकतम (डिफ़ॉल्ट) उन समस्याओं के लिए जो सचमुच हरा चुकी हों उच्च. दर्ज की गई वर्बोसिटी को देखते हुए, मैं चलाऊँगा उच्च को रोज़मर्रा की सेटिंग के तौर पर, बजाय छोड़ने के अधिकतम चालू और यह सोचते रहने के कि आउटपुट टोकन कहाँ गए।
राउटिंग सेटअप जो मैं वास्तव में सुझाऊँगा
इनमें से कोई भी “एक चुनो” वाला फ़ैसला नहीं है। ज़्यादातर टीमों के लिए सही जवाब तीन-स्तरीय राउटिंग टेबल है, और हर गंभीर एजेंट हार्नेस हर एजेंट के लिए अलग मॉडल सपोर्ट करता है।
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
      "description": "Architecture, root-cause analysis, anything expensive to get wrong",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation work",
      "model": "zai/glm-5.3",
      "options": { "reasoning_effort": "high" }
    },
    "research": {
      "description": "Long-context reading, web research, multi-source synthesis",
      "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
      "description": "Renames, docstrings, test scaffolding, lint fixes",
      "model": "ollama/glm-5.3-flash"
    }
  }
}
हर लाइन के पीछे का तर्क:
- प्लानिंग के लिए Fable 5.1। प्लानिंग में ही एक ग़लत फ़ैसला आगे सबसे ज़्यादा टोकन खर्च कराता है, और लंबी अवधि की संगति ठीक वही चीज़ है जिसके लिए 5.1 बनाया गया है। यहीं आप सबसे कम टोकन खर्च करते हैं, इसलिए प्राइस प्रीमियम आपके बिल के सबसे छोटे हिस्से पर लगता है।
- बिल्डिंग के लिए GLM-5.3। बाज़ार में प्रति यूरो सबसे बेहतर क्षमता, और आपके टोकन खर्च का बड़ा हिस्सा यहीं जाता है।
- रिसर्च के लिए Kimi K3। BrowseComp 91.2 और असली 1M कॉन्टेक्स्ट इसे बहुत कुछ पढ़ने और उसे संश्लेषित करने के लिए सबसे अच्छा उपलब्ध विकल्प बनाते हैं।
- मशीनी काम के लिए GLM-5.3-Flash। $0.15/$0.50 पर यह लगभग मुफ़्त है, और 40 फ़ाइलों में किसी सिंबल का नाम बदलने के लिए फ़्रंटियर रीज़निंग की ज़रूरत नहीं।
small_modelको कुछ बहुत छोटा मिलता है हार्नेस’s अपने हाउसकीपिंग कामों के लिए — टाइटल जनरेशन, सारांश बनाना, अंदरूनी यूटिलिटी कॉल्स।
आप कोई विजेता नहीं चुन रहे। आप एक गियरबॉक्स बना रहे हैं। और मॉडल IDs ऐसे लिखें कि एक को बदलना एक लाइन का बदलाव हो, क्योंकि इस बाज़ार में आपको वह बदलाव तिमाही के भीतर फिर करना पड़ेगा।
आप असल में लोकल क्या चला सकते हैं (हार्डवेयर की सच्चाई)
एक धारणा को अभी खत्म कर देता हूँ, इससे पहले कि वह किसी के पैसे ले डूबे।
आप Kimi K3 या GLM-5.3 किसी वर्कस्टेशन पर नहीं चला सकते। एक 5090 से नहीं। दो से भी नहीं।
Kimi K3
- ~1.5 TB वेट्स, नेटिव MXFP4 में — और याद रखें, वह सक्षम है क्वांटाइज़्ड चेकपॉइंट है, आगे कम्प्रेशन की शुरुआत नहीं
- Moonshot सुझाव देता है कम से कम 64 एक्सेलेरेटर प्रतिस्पर्धी सर्विंग के लिए
- वास्तविक सेल्फ-होस्टिंग मल्टी-नोड क्लस्टर से शुरू होती है; रेफ़रेंस डिप्लॉयमेंट्स GB300 NVL72 रैक्स इस्तेमाल करते हैं
- यहाँ कोई आधिकारिक Ollama लाइब्रेरी एंट्री नहीं है लोकल Kimi K3 के लिए, और ऐसा कोई कंज़्यूमर GGUF कन्वर्ज़न भी नहीं है जिसकी ओर आपको भेजना समझ में आए
- इसे कंज़्यूमर RTX 5090 के क्लस्टर पर चलाने की रिपोर्टें मौजूद हैं, लेकिन “5090 का क्लस्टर” लैपटॉप नहीं होता और थ्रूपुट की तुलना नहीं की जा सकती
GLM-5.3
- ~1.5 TB in BF16, लगभग 750 GB at FP8
- न्यूनतम व्यवहार्य सिंगल नोड: 8× H200 (1,128 GB GPU मेमोरी) FP8 पर, जिसमें लगभग 375 GB KV कैश के लिए बचता है
- BF16 के लिए दो 8×H200 नोड चाहिए, या एक 8×B300 नोड (2,304 GB)
- BF16 में एक 8×H200 नोड वेट्स और कैश के लिए बहुत छोटा है
छवि दिखाएँ फ़्रंटियर ओपन मॉडलों के लिए रैक चाहिए। “मेरी मशीन पर चलता है” असल में 24 GB वर्ग में बसता है — और वह अब बहुत अच्छा हो गया है।
तो सितंबर 2026 में “लोकल AI” का असल मतलब क्या है?
इसका मतलब है मॉडलों का दूसरा वर्ग, और वह वर्ग सचमुच अच्छा हो गया है:
| मॉडल | VRAM | किस काम का है |
|---|---|---|
| Qwen3.8-27B | 24 GB at Q4 | कंज़्यूमर हार्डवेयर पर सबसे बेहतर ऑल-राउंडर — 61.7% SWE-bench |
| gpt-oss:20b | 16 GB | सबसे अच्छा छोटा मॉडल, समायोज्य रीज़निंग एफ़र्ट |
| Gemma 4 E4B | ~6 GB | आधुनिक लैपटॉप पर विज़न और टूल कॉलिंग |
| Mistral 7B | 8 GB | सबसे तेज़ जनरल-पर्पज़ विकल्प, 40–60 tok/sec |
| DeepSeek-R1 7B | 5 GB | लैपटॉप GPU पर चेन-ऑफ़-थॉट रीज़निंग |
| Llama 4 Scout | ~55 GB at Q4 | 10M कॉन्टेक्स्ट, मल्टीमोडल — वर्कस्टेशन का इलाका |
24 GB के कंज़्यूमर GPU पर, बिना किसी नेटवर्क कनेक्शन के, पूरी तरह चलता हुआ और SWE-bench पर 61.7% हासिल करता Qwen3.8-27B एक कमाल की चीज़ है, जो अठारह महीने पहले विज्ञान-कथा जैसी लगती। यह GLM-5.3 नहीं है और इसका दावा भी नहीं करता।
सीधी बात: फ़्रंटियर पर ओपन वेट्स आपको देते हैं संप्रभुता और कीमत, न कि लोकल एग्ज़िक्यूशन. 7B–30B की रेंज के ओपन वेट्स आपको सचमुच लोकल एग्ज़िक्यूशन देते हैं, एक वास्तविक लेकिन स्वीकार्य क्षमता-लागत पर, और यही वह वर्ग है जहाँ “मेरी मशीन पर चलता है, नेटवर्क नहीं देखता” एक हासिल करने योग्य शर्त है।
मेरे ज़्यादातर क्लाइंट्स के लिए जो आर्किटेक्चर काम करता है वह ठीक यही बँटवारा है: सचमुच संवेदनशील डेटा को छूने वाली हर चीज़ के लिए एक छोटा लोकल मॉडल, और बाकी सब के लिए एक होस्टेड ओपन-वेट फ़्रंटियर मॉडल — जिसमें वेट्स डिप्लॉयमेंट प्लान के बजाय बीमा के तौर पर उपलब्ध रहते हैं।
हर मॉडल असल में कहाँ फेल होता है
कोई हाइप नहीं। ये हैं सच्ची कमज़ोरियाँ।
Kimi K3 की कमज़ोरियाँ
ओपन मॉडल के हिसाब से यह महँगा है। $3/$15 लगभग उसी इंटेलिजेंस इंडेक्स स्कोर पर GLM-5.3’s इनपुट दर का 2.1× और आउटपुट दर का 3.4× है। अगर आप GLM-5.3 के बजाय K3 चुन रहे हैं, तो साफ़ रहें कि उस प्रीमियम से आप क्या खरीद रहे हैं — आम तौर पर वह विज़न स्टैक या ब्राउज़िंग परफ़ॉर्मेंस होता है।
लाइसेंस की सीमा कहीं नीचे है। $20M कुल-राजस्व वाली MaaS सीमा GLM-5.3’s $10B सीमा से कहीं ज़्यादा संगठनों को दायरे में लेती है। अगर आपके बिज़नेस मॉडल में कहीं भी इन्फ़रेंस की रीसेल है, तो K3 दोनों में ज़्यादा प्रतिबंधित है।
सेल्फ-होस्टिंग लगभग सबके बस के बाहर है। 1.5 TB और 64+ एक्सेलेरेटर एक गंभीर इन्फ्रास्ट्रक्चर प्रतिबद्धता है। इस तुलना के किसी भी अन्य मॉडल की तुलना में बाहर निकलने का अधिकार यहाँ ज़्यादा सैद्धांतिक है।
व्यापक ज्ञान-कार्य में यह पीछे है। GDPval-AA v2 पर 1,687 का स्कोर इसे GLM-5.3, दोनों Claude Fable और GPT-5.6 Sol Max से पीछे रखता है। यह कोडिंग और एजेंटिक कामों का विशेषज्ञ है जो संयोग से बहुत बड़ा है।
GLM-5.3 की कमज़ोरियाँ
सिर्फ़ टेक्स्ट। कोई इमेज इनपुट नहीं, कोई वीडियो नहीं। अगर आपके वर्कफ़्लो में स्क्रीनशॉट डीबगिंग, डिज़ाइन-टू-कोड या दस्तावेज़ विज़न शामिल है, तो GLM-5.3 यह कर ही नहीं सकता और आपको इसके बजाय GLM-5.3-Flash, Kimi K3 या Fable 5.1 चाहिए। यह सबसे आम कॉन्फ़िगरेशन ग़लती है जो लोगों से होने की मुझे उम्मीद है, क्योंकि मॉडल IDs एक जैसे लगते हैं और हैं नहीं।
यह वर्बोस है, और वर्बोसिटी का बिल लगता है। AA सूट में इस वर्ग का मीडियन 72M है, जबकि इसका आउटपुट 170M टोकन। reasoning_effort डिफ़ॉल्ट रूप से अधिकतम, और सोच बंद नहीं की जा सकती। अपने टर्न की संख्या से ज़्यादा आउटपुट टोकन का बजट रखें।
लाइसेंस अब MIT नहीं है, और सिक्योरिटी-रिव्यू क्लॉज़ की कोई सीमा नहीं है। ज़्यादातर पाठकों के लिए $10B की सीमा इसे सैद्धांतिक बना देती है। जो भी उसके क़रीब है, उसके लिए “scope and method shall be reasonably determined by Z.AI” ऐसा क्लॉज़ नहीं है जो आपकी लीगल टीम को पसंद आएगा।
Terminal-Bench 3.0 पर 28.3 का स्कोर GPT-5.6 Sol’s 34.6 से पीछे है। टर्मिनल-नेटिव एजेंटिक कोडिंग के सबसे क़रीब के बेंचमार्क पर यह उसी पैमाने पर बंद मॉडलों की प्रतिस्पर्धा से पीछे है।
ओपन वेट्स में यह नया है। 28 अगस्त को रिलीज़। कम्युनिटी को महीने नहीं, कुछ दिन ही मिले हैं। लॉन्ग-टेल डिप्लॉयमेंट बग्स अभी सामने नहीं आए हैं।
Claude Fable 5.1 की कमज़ोरियाँ
कीमत। पूरे किए गए हर एजेंटिक टास्क पर GLM-5.3 से लगभग 6.5×, 75% कैश-रीड कटौती के बाद भी। ज़्यादातर काम के लिए यह अंतर अब क्षमता के आधार पर सही नहीं ठहराया जा सकता।
तीन ब्रेकिंग बदलाव। फ़ोर्स्ड टूल यूज़ 400 लौटाता है। थिंकिंग ब्लॉक्स पुराने मॉडलों की ओर पीछे नहीं जाते। बातचीत का इतिहास संपादित करने से 31 अगस्त 2026 के बाद बने अकाउंट्स पर थिंकिंग ब्लॉक्स अमान्य हो जाते हैं। इनमें से कोई भी अपग्रेड पर चल रहा इंटीग्रेशन तोड़ सकता है।
पैरेलल टूल कॉलिंग में गिरावट आई है। ऐसी रिपोर्टें हैं कि जहाँ Fable 5 कई कॉल्स एक साथ करता था, वहाँ अब प्रति टर्न एक ही कॉल होती है। लंबे एजेंट लूप में यह वॉल-क्लॉक समय है जिसका आप दोगुना दाम देते हैं।
बाहर निकलने का कोई विकल्प नहीं। न वेट्स, न सेल्फ-होस्टिंग, Anthropic जो देता है उससे आगे कोई वर्ज़न पिनिंग नहीं, कोई निरीक्षण नहीं। जब यह बदलता है, आप ढल जाते हैं।
टोकनाइज़र तुलनाओं को बढ़ा-चढ़ा दिखाता है। उसी टेक्स्ट पर पुराने Claude मॉडलों से ~30% ज़्यादा टोकन, जिससे ऐतिहासिक लागत तुलनाएँ — अगर आप सावधान न हों — Anthropic’s पक्ष में भ्रामक हो जाती हैं।
फ़ैसले का ढाँचा: छह परिदृश्य
छवि दिखाएँ छह परिदृश्य, छह जवाब। वह पंक्ति ढूँढ़ें जो आपके हफ़्ते जैसी लगे।
1. “मुझे एक ही मॉडल चाहिए। सेट कर दीजिए, भूल जाइए, बिल काबू में रखिए।”
GLM-5.3। न्यूट्रल इंडेक्स पर Kimi K3 से आधे अंक के भीतर और सबसे अच्छे बंद मॉडल से लगभग तीन अंक पीछे, $1.40/$4.40 पर। इसे Pro या Max प्लान पर Ollama के ज़रिए चलाएँ, reasoning_effort: high, और अपने काम पर लग जाएँ। इस जवाब से आपको हटाने वाली एकमात्र चीज़ इमेज इनपुट की ज़रूरत हो सकती है।
2. “मेरा काम विज़ुअल है — UI, डिज़ाइन-टू-कोड, स्क्रीनशॉट डीबगिंग, दस्तावेज़।”
Kimi K3 या GLM-5.3-Flash, GLM-5.3 नहीं। K3’s MoonViT-V2 टेक्स्ट, इमेज और वीडियो को नेटिव रूप से संभालता है और MMMU-Pro पर 81.6/83.4 स्कोर करता है। GLM-5.3-Flash बजट विकल्प है, नेटिव मल्टीमोडैलिटी और MIT लाइसेंस के साथ। GLM-5.3 सिर्फ़ टेक्स्ट है और इनपुट को सीधे मना कर देगा।
3. “लंबे ऑटोनॉमस सेशन जहाँ ग़लत होना महँगा पड़ता है।”
Claude Fable 5.1। इसे इसी के लिए बनाया गया है और बेंचमार्क इसकी पुष्टि करते हैं: Terminal-Bench-Science दोगुना, Browserbase’s सबसे कठिन कंप्यूटर-यूज़ टास्क पर 82% बनाम Opus 5’s 74%, और मल्टी-आवर एजेंटिक काम में अब तक का सबसे बड़ा प्रकाशित सुधार। 75% कैश-रीड कटौती ठीक इसी तरह के वर्कलोड को पहले से 45% तक सस्ता बनाती है। प्रीमियम वहाँ चुकाएँ जहाँ ग़लती टोकन से ज़्यादा महँगी पड़े।
4. “EU डेटा रेज़िडेंसी एक सख़्त शर्त है।”
MIT चाहिए तो GLM-5.3-Flash, क्षमता चाहिए तो GLM-5.3। अपने हार्डवेयर या किसी EU GPU प्रोवाइडर पर सेल्फ-होस्ट करें और सीमा-पार ट्रांसफ़र का सवाल ही खत्म हो जाता है। FP8 पर GLM-5.3 के लिए 8×H200 का बजट रखें; Flash 320B/18B पर कहीं ज़्यादा व्यवहार्य है। अगर सेल्फ-होस्टिंग बजट से बाहर है, तो ज़ीरो डेटा रिटेंशन वाली Ollama’s यूरोप होस्टिंग व्यावहारिक बीच का रास्ता है — लेकिन रेज़िडेंसी की प्रतिबद्धता लिखित में लें, किसी मार्केटिंग पेज से अनुमान न लगाएँ।
5. “छोटी टीम, तंग बजट, दिन भर कोडिंग।”
डिफ़ॉल्ट में GLM-5.3-Flash, कठिन समस्याओं के लिए GLM-5.3, $20 में Ollama Pro। Flash की कीमत $0.15/$0.50 है — 9 सितंबर तक फ़िलहाल उससे आधी — और इंटेलिजेंस इंडेक्स पर 57.5 स्कोर करता है। बीस डॉलर में साठ डॉलर के टोकन मिलते हैं, बिना किसी साप्ताहिक सीमा के। दो से चार लोगों की टीम के लिए यह लगभग अजेय है। अगर आप क्रेडिट पूल के बजाय तय कोटा पसंद करते हैं, तो $18/महीने (Lite) वाला GLM Coding Plan विकल्प है।
6. “मुझे यह प्रोक्योरमेंट या लीगल टीम के सामने सही ठहराना है।”
GLM-5.3-Flash. इस तुलना में यह अकेला मॉडल है जो OSI-स्वीकृत मानक लाइसेंस (MIT) के तहत है, यह नेटिव रूप से मल्टीमोडल है, न्यूट्रल इंडेक्स पर 57.5 स्कोर करता है, और इसके वेट्स Hugging Face पर हैं — बिना किसी राजस्व-सीमा, बिना एट्रिब्यूशन अनिवार्यता और बिना सिक्योरिटी-रिव्यू क्लॉज़ के। जब सवाल “कॉन्ट्रैक्ट रिव्यू में हम किसका बचाव कर सकते हैं,” हो, तो उदार लाइसेंसिंग हर बार बेंचमार्क के तीन अंकों को हरा देती है।
अगली तिमाही में मैं किन बातों पर नज़र रखूँगा
क्या Fable 5.1 Artificial Analysis इंडेक्स पर 62.1 से ऊपर पहुँचता है। इसने इस लेख से एक दिन पहले लॉन्च किया और इसका स्वतंत्र स्कोरिंग नहीं हुई है। Fable 5 पर इसके बेंचमार्क अंतर बताते हैं कि ऐसा होना चाहिए, लेकिन “चाहिए” का मतलब “हुआ” नहीं होता, और Kimi K3’s 59.7 से इसका अंतर वही आँकड़ा है जिस पर पूरा ओपन-बनाम-बंद बहस टिकी है।
क्या लाइसेंस का खिसकाव जारी रहता है। आठ हफ़्तों में हम MIT वाले GLM-5.2 से ऐसे GLM-5.3 तक पहुँचे जो एक अलग-थलग लाइसेंस और विवेकाधीन सिक्योरिटी रिव्यू के तहत है, और Kimi K2’s संशोधित-MIT से K3 की राजस्व-सीमा वाली शर्तों तक। अगर GLM-6 और K4 और सख़्त होते हैं, तो “ओपन वेट्स” एक सार्थक श्रेणी के बजाय मार्केटिंग शब्द बन जाता है। GLM-5.3-Flash का MIT बना रहना वह उलटा संकेत है जिस पर नज़र रखनी चाहिए।
क्या दूसरी लैब्स Z.ai’s चरणबद्ध रिलीज़ पैटर्न अपनाती हैं। प्रकाशित सेफ़्टी तर्क के साथ दो हफ़्ते रोकना एक नया मानक है। अगर यह टिकता है, तो यह अच्छा मानक है। अगर यह वेट्स को और देर से भेजने का बहाना बनता है, तो यह उन्हें बिल्कुल न भेजने का एक नरम रास्ता है।
साइबर क्षमता के दावों की स्वतंत्र पुष्टि। 269 प्रोजेक्ट्स में 2,436 कमज़ोरियाँ असाधारण आँकड़ा है और यह पूरी तरह स्व-रिपोर्टेड है। किसी निष्पक्ष व्यक्ति को इसे जाँचना चाहिए, क्योंकि अगर यह सही है तो यह पूरी ओपन-वेट्स सेफ़्टी बहस को नए सिरे से परिभाषित करता है, और अगर नहीं है, तो यह कारगर मार्केटिंग थी।
छह महीने बाद Ollama’s प्रति-टोकन दरें। $60 के उपयोग पर $20 एक आक्रामक शुरुआती रुख है, उस कंपनी की ओर से जिसने जुलाई में $88M जुटाए। छोटी टीमों के लिए “सस्ते ओपन मॉडल” वाली थीसिस में सबसे बड़ा एकल चर यही है कि ये गुणक असली यूनिट इकोनॉमिक्स के संपर्क में टिकते हैं या नहीं।
क्या लोकल मॉडल 30B वर्ग में बराबरी कर पाते हैं। 24 GB पर 61.7% SWE-bench हासिल करता Qwen3.8-27B इस साल का सबसे कम चर्चित नतीजा है। सुर्खियाँ फ़्रंटियर को मिलती हैं; बिना API key के एक आम बिज़नेस क्या कर सकता है, यह 24 GB वर्ग बदलता है।
अक्सर पूछे जाने वाले प्रश्न
क्या Kimi K3 सचमुच ओपन सोर्स है? नहीं। Kimi K3’s वेट्स Hugging Face से मुफ़्त डाउनलोड किए जा सकते हैं, लेकिन एक कस्टम “Kimi K3 License” के तहत, OSI-स्वीकृत ओपन-सोर्स लाइसेंस के तहत नहीं। जिन Model-as-a-Service ऑपरेटरों का कुल राजस्व किसी भी लगातार 12 महीनों में $20 मिलियन से ज़्यादा है, उन्हें Moonshot के साथ अलग व्यावसायिक समझौता करना होगा, और 10 करोड़ मासिक सक्रिय यूज़र्स या $20 मिलियन मासिक राजस्व से ऊपर के प्रोडक्ट्स को अपने इंटरफ़ेस में “Kimi K3” दिखाना होगा। पूरी तरह अंदरूनी उपयोग पर कोई रोक नहीं।
क्या GLM-5.3 Kimi K3 से बेहतर है? न्यूट्रल एग्रीगेट इंडेक्स पर वे असल में बराबर हैं — Artificial Analysis पर 59.5 बनाम 59.7। GLM-5.3 प्रति एजेंटिक टास्क 2.2× सस्ता है और ज्ञान-कार्य में ज़्यादा स्कोर करता है (GDPval-AA v2: 1,769 बनाम 1,687)। Kimi K3 नेटिव रूप से मल्टीमोडल है, एजेंटिक ब्राउज़िंग में आगे है (BrowseComp 91.2) और Arena.AI’s फ़्रंटएंड कोड एरीना में पहले स्थान पर रहा। लागत और टेक्स्ट-आधारित कोडिंग के लिए GLM-5.3 चुनें; विज़न, ब्राउज़िंग और लंबी अवधि की रिसर्च के लिए Kimi K3।
ओपन मॉडल Claude Fable 5.1 से कितने सस्ते हैं? एक मॉडल किए गए 60-टर्न एजेंटिक टास्क पर GLM-5.3 की लागत लगभग $1.85 है, जबकि Fable 5.1’s $11.94 — लगभग 6.5× सस्ता। Kimi K3 की लागत लगभग $4.07 है, यानी लगभग 2.9× सस्ता। GLM-5.3-Flash की लागत लगभग $0.21 है, यानी लगभग 58× सस्ता। महीने में 80 रन पर यह $148 बनाम $955 होता है।
क्या मैं Kimi K3 या GLM-5.3 लोकल चला सकता हूँ? कंज़्यूमर हार्डवेयर पर नहीं। Kimi K3 अपने नेटिव MXFP4 फ़ॉर्मैट में भी लगभग 1.5 TB है और Moonshot 64+ एक्सेलेरेटर सुझाता है। GLM-5.3 को FP8 पर कम से कम 8×H200 (1,128 GB) चाहिए। सचमुच लोकल एग्ज़िक्यूशन के लिए Qwen3.8-27B (24 GB, Q4 पर), gpt-oss:20b (16 GB) या Gemma 4 E4B (~6 GB) देखें।
Claude Fable 5.1 में क्या बदला? 1 सितंबर 2026 को रिलीज़। कैश रीड 75% गिरकर प्रति मिलियन टोकन $1.00 से $0.25 हो गई, जिससे आम वर्कलोड लगभग 25% और एजेंटिक वर्कलोड 45% तक सस्ते हो गए; इनपुट और आउटपुट $10/$50 पर ही रहे। Terminal-Bench 4.0 42.0% से 55.8% हुआ, Terminal-Bench-Science 24.7% से 52.6%, AutomationBench 17.1% से 31.4%। तीन ब्रेकिंग बदलाव फ़ोर्स्ड टूल यूज़, थिंकिंग-ब्लॉक पोर्टेबिलिटी और हिस्ट्री एडिटिंग को प्रभावित करते हैं।
Ollama’s नई प्राइसिंग क्या है? 31 अगस्त 2026 से Pro, Max और Team प्लान प्रति-टोकन प्राइसिंग का इस्तेमाल करते हैं, जिसमें क्रेडिट शामिल हैं: Pro $20/माह में $60 का उपयोग, Max $100 में $300, Team $500 में $1,000 जो असीमित उपयोगकर्ताओं में साझा होते हैं। 5-घंटे और साप्ताहिक सीमाएँ पूरी तरह हटा दी गई हैं, कोई सर्विस फ़ीस नहीं है, क्रेडिट आगे नहीं बढ़ते, और सभी प्लान में US और Europe में होस्टिंग के साथ शून्य डेटा रिटेंशन है।
इनमें से कौन-सा मॉडल सचमुच MIT लाइसेंस वाला है? सिर्फ़ GLM-5.3-Flash — 26 अगस्त 2026 को रिलीज़ हुआ एक अलग 320B/18B नेटिव मल्टीमोडल मॉडल, जो प्रति मिलियन टोकन $0.15/$0.50 पर Artificial Analysis इंडेक्स में 57.5 स्कोर करता है। GLM-5.3 और Kimi K3 दोनों अलग-अलग राजस्व-सीमा वाले लाइसेंस इस्तेमाल करते हैं; Claude Fable 5.1 पूरी तरह प्रोप्राइटरी है।
मैं इन मॉडलों की तुलना Terminal-Bench पर क्यों नहीं कर सकता? क्योंकि हर मॉडल का मूल्यांकन अलग वर्ज़न पर हुआ है। Kimi K3’s 88.3 Terminal-Bench 2.1 पर है, GLM-5.3’s 28.3 पर 3.0 पर, और Fable 5.1’s 55.8 पर 4.0 पर। हर वर्ज़न पिछले से काफ़ी कठिन है, इसलिए आँकड़े एक ही पैमाने पर नहीं हैं। तुलना सिर्फ़ एक ही वर्ज़न के भीतर करें। उदाहरण के लिए Terminal-Bench 2.1 पर Kimi K3 88.3 स्कोर करता है, जबकि Claude Fable 5’s 88.0, GPT-5.6 Sol’s 88.8 और GLM-5.3-Flash’s 84.3 है — वह तुलना मान्य है, और उसी को उद्धृत करना चाहिए।
क्या मुझे Ollama इस्तेमाल करना चाहिए या सीधे वेंडर के पास जाना चाहिए? Ollama तब चुनें जब आप एक ही बिलिंग संबंध, एक ही API सरफ़ेस, आसान मॉडल स्विचिंग और शून्य डेटा रिटेंशन वाली EU/US होस्टिंग चाहते हैं — इसकी प्रति-टोकन दरें first-party प्राइसिंग के काफ़ी करीब रहती हैं। सीधे वेंडर के पास तब जाएँ जब आपको first-party सुविधाएँ चाहिए, जैसे Z.ai’ के reasoning_effort पूर्ण फ़िडेलिटी वाले कंट्रोल, वेंडर SLA, या GLM Coding Plan जैसी सब्सक्रिप्शन योजनाएँ। कई टीमें दोनों चलाती हैं और वर्कलोड के हिसाब से रूट करती हैं।
क्या GLM-5.3 इमेज सपोर्ट करता है? नहीं। GLM-5.3 सिर्फ़ टेक्स्ट के लिए है। GLM-5.3-Flash — नाम की समानता के बावजूद पूरी तरह अलग मॉडल — मूल रूप से मल्टीमॉडल है और टेक्स्ट, इमेज, वीडियो और फ़ाइल इनपुट संभालता है। गलत मॉडल ID पर इमेज भेजना GLM परिवार में सबसे आम शुरुआती गलती है।
मुख्य बात
बारह महीने पहले ओपन-वेट सवाल यह था कि ये मॉडल इस्तेमाल करने लायक हैं या नहीं। छह महीने पहले यह सवाल था कि क्या ये प्रतिस्पर्धी हैं। सितंबर 2026 में यह सचमुच यह है: आप अब भी क्लोज़्ड मॉडल का प्रीमियम किस चीज़ के लिए दे रहे हैं?
उस सवाल का असली जवाब मौजूद है, और वह पहले की तुलना में संकरा हो गया है। Claude Fable 5.1 सबसे कठिन लगातार एजेंटिक काम, सामान्य नॉलेज वर्क, और उस तरह की डीबगिंग में आगे है जहाँ मॉडल को घंटों तक एक उलझी हुई समस्या बिना भटके दिमाग में बनाए रखनी होती है। Anthropic’ की 75% कैश-रीड कटौती ठीक उसी वर्कलोड को निशाना बनाती है। अगर आपकी विफलता की लागत आपकी टोकन लागत से ज़्यादा है, तो वह प्रीमियम तर्कसंगत है।
बाक़ी सब के लिए हिसाब बदल चुका है। GLM-5.3, Claude Opus 5’ के इंडेक्स स्कोर का 94%, 29% लागत पर देता है। Kimi K3 ने Terminal-Bench 2.1 पर 88.3 स्कोर किया, जबकि उसी वर्ज़न पर Claude Fable 5’ का 88.0 है, और LMArena’ के Frontend Code Arena में दोनों फ़्लैगशिप क्लोज़्ड मॉडलों को पीछे छोड़कर पहला स्थान हासिल किया। Ollama आपको $20 में $60 के टोकन बेचेगा और ऐसा करते हुए उपयोग सीमाएँ भी हटा देगा। ऐसा संयोजन वसंत में मौजूद नहीं था।
लेकिन उत्साह में बारीक़ शर्तें न छोड़ें, क्योंकि ऐसी दो बातें हैं और दोनों मायने रखती हैं।
पहली बात लाइसेंसिंग है। “ओपन वेट्स” और “ओपन सोर्स” का मतलब चुपचाप एक जैसा होना बंद हो गया है। Kimi K3 और GLM-5.3 दोनों अपने-अपने कस्टम, राजस्व-सीमा वाले लाइसेंस के तहत आते हैं। सीमाएँ इतनी ऊँची हैं कि ज़्यादातर पाठक प्रभावित नहीं होते — लेकिन “ज़्यादातर पाठक प्रभावित नहीं होते” का मतलब “बिना किसी प्रतिबंध के” नहीं है, और GLM-5.3’ का अपरिभाषित सुरक्षा-समीक्षा खंड बड़े उद्यमों के लिए असली प्रोक्योरमेंट जोखिम है। MIT के तहत GLM-5.3-Flash आख़िरी पूरी तरह अनुमतिप्रद, फ्रंटियर के करीब का विकल्प है, और ठीक इसीलिए वह जितना ध्यान पाता है उससे ज़्यादा का हक़दार है।
दूसरी बात यह है कि सेल्फ-होस्टिंग ज़्यादातर लोगों के लिए एक इच्छा भर है। 1.5 TB वेट्स और 64 एक्सेलेरेटर किसी मध्यम आकार के व्यवसाय के लिए एग्ज़िट प्लान नहीं है। इस स्तर पर ओपन वेट्स से आपको जो मिलता है वह है प्रतिस्पर्धी इन्फ़रेंस बाज़ार, क़ीमत में पारदर्शिता, वर्ज़न पिनिंग, क्षेत्राधिकार का चुनाव और सौदेबाज़ी की स्थिति। इन सबकी क़ीमत बहुत बड़ी है। ये अपने बेसमेंट में उस चीज़ को चलाने के बराबर नहीं हैं।
मैं वास्तव में जो सेटअप बनाऊँगा: डिफ़ॉल्ट के तौर पर GLM-5.3, प्लानिंग और सचमुच कठिन समस्याओं के लिए Fable 5.1, विज़न और लंबी अवधि की रिसर्च के लिए Kimi K3, साधारण, उबाऊ काम के लिए GLM-5.3-Flash, और ऐसी हर चीज़ के लिए 27B का लोकल मॉडल जो कभी भी इमारत से बाहर नहीं जाना चाहिए। वर्कलोड के हिसाब से रूट करें, वफ़ादारी के हिसाब से नहीं। अपना कॉन्फ़िगरेशन ऐसे लिखें कि मॉडल ID बदलने के लिए सिर्फ़ एक लाइन बदलनी पड़े।
क्योंकि जिस एक भविष्यवाणी पर मुझे भरोसा है वह यह है कि इस लेख को क्रिसमस से पहले अपडेट करना पड़ेगा।
क्या आप इन तीनों में से कोई भी प्रोडक्शन में चला रहे हैं? मुझे ख़ास तौर पर यह जानने में दिलचस्पी है कि GLM-5.3’ की बहुशब्दता बड़े पैमाने पर असली लागत समस्या के रूप में सामने आती है या नहीं, और क्या किसी ने वाक़ई Kimi K3 लाइसेंस को कानूनी सलाहकार के सामने रखा है और MaaS की परिभाषा पर साफ़ समझ हासिल की है। संपर्क करें — सुधार और विरोधी सबूत दोनों का स्वागत है, और तस्वीर बदलने पर यह लेख अपडेट किया जाएगा।
अंतिम अपडेट: 2 सितंबर 2026।


