Français
 English
 Deutsch
 Español
 Italiano

L’argumentaire tourne comme ça. Un abonnement IA haut de gamme coûte 200 $ par mois, soit 2 400 $ par an. Un MacBook Pro avec 128 Go de mémoire unifiée peut faire tourner de grands modèles de langage en local, en privé et sans limite d’usage. Alors résilie l’abonnement, achète plutôt un MacBook pour des LLM locaux, et dans un an ou deux il s’est remboursé.
Tu en trouveras des versions partout en 2026 : dans des vidéos YouTube qui te demandent si tu dois résilier ton forfait IA à 200 $ et acheter un Mac à 9 499 $, dans des posts Medium qui divisent le prix d’un Mac par 200, et dans une chronique Forbes qui a fait les calculs quand Apple a lancé son nouveau Mac Studio en août. Au lancement du MacBook Pro M5 Max, le patron du matériel d’Apple, John Ternus, a déclaré que les nouvelles machines permettaient aux professionnels de “faire tourner des LLM avancés sur l’appareil”.
Acheter un MacBook pour des LLM locaux est une très bonne idée pour certaines personnes. Comme remplacement d’un forfait Claude ou ChatGPT à 200 $, ça échoue, et ça échoue sur la seule chose que l’argumentaire ne chiffre jamais : la qualité. L’abonnement te loue les meilleurs modèles du monde. Le Mac fait tourner les meilleurs modèles qui tiennent dans 128 Go. Depuis hier, on peut mesurer la distance entre ces deux choses plus précisément que jamais, et elle est plus large que le battage le suggère.
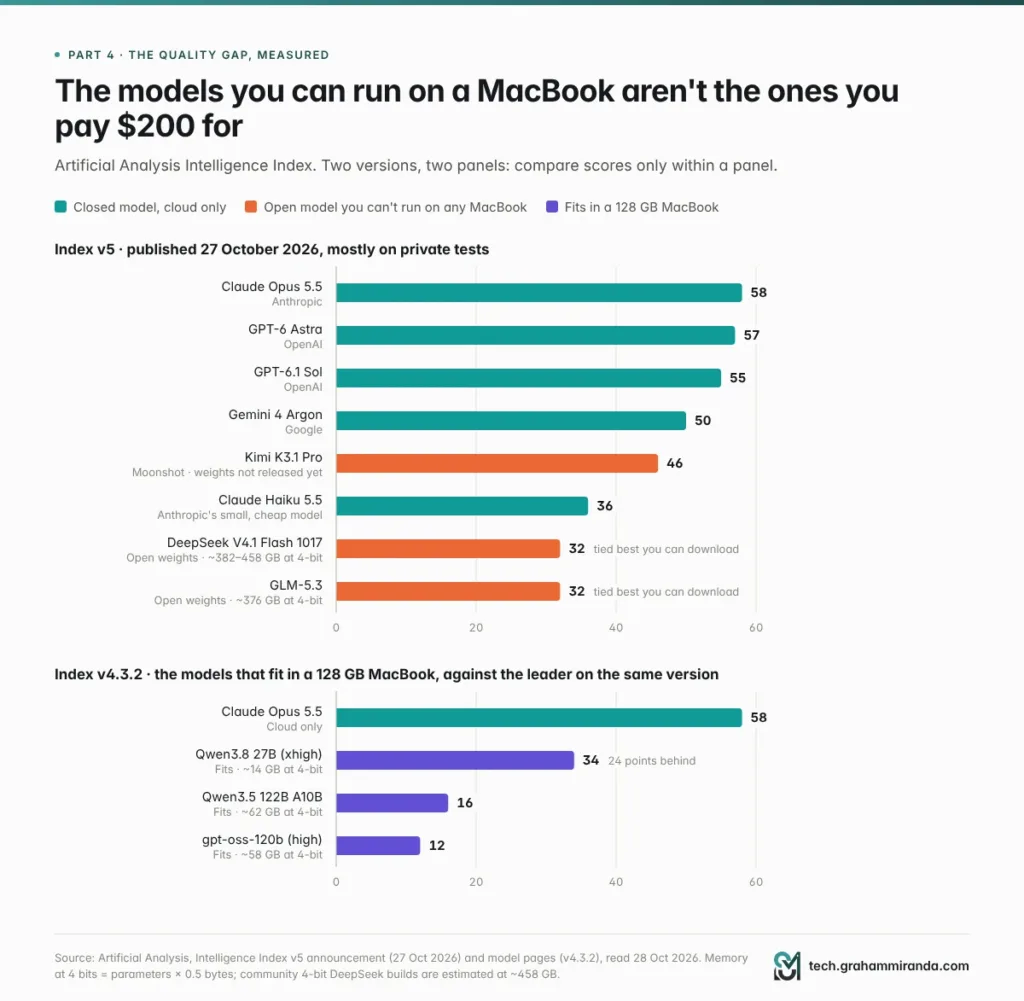
Le 27 octobre, Artificial Analysis a reconstruit son Intelligence Index autour de tests majoritairement privés. Claude Opus 5.5 mène avec 58. Les meilleurs modèles à poids ouverts que tu peux réellement télécharger, DeepSeek V4.1 Flash 1017 et GLM-5.3, obtiennent 32, en dessous de Claude Haiku 5.5, le petit modèle bon marché d’Anthropic, à 36. Aucun de ces modèles ouverts ne tient dans un MacBook : en 4 bits, il leur faut entre 375 et 460 Go. Le modèle le plus fort que j’ai trouvé qui tient dans un MacBook de 128 Go, Qwen3.8 27B, obtient 34 sur la version précédente de l’index, celle sur laquelle Opus 5.5 obtient aussi 58.
Pendant ce temps, le matériel est devenu plus cher. En juin, Apple a doublé le prix de l’option 128 Go de mémoire sur le M5 Max. Un MacBook Pro 16 pouces avec 128 Go coûte désormais $6,999 aux États-Unis et, d’après mon estimation, environ €8,199 en Allemagne.
Voilà donc la version honnête du calcul : ce que 200 $ par mois achètent vraiment, ce que 7 000 $ achètent vraiment, l’ampleur de l’écart de qualité et pourquoi il existe, la vitesse réelle d’un M5 Max, ce que la quantification te coûte, quand acheter un Mac pour de l’IA locale a du sens, et des façons moins chères de réduire une facture de 200 $ si c’est vraiment ce que tu cherches. Chaque chiffre a été vérifié à sa source le 28 octobre 2026.
TL;DR — La version en 60 secondes
- Les modèles que tu paies 200 $ ne peuvent pas être téléchargés, et les meilleurs de ceux que tu peux télécharger ne tiennent pas dans un MacBook. Sur le nouvel Intelligence Index v5 d’Artificial Analysis, Claude Opus 5.5 obtient 58. Les meilleurs modèles ouverts téléchargeables, DeepSeek V4.1 Flash 1017 et GLM-5.3, obtiennent 32 et ont besoin d’environ 375 à 460 Go de mémoire en 4 bits.
- Les modèles qui tiennent obtiennent bien moins. Le modèle le plus fort que j’ai trouvé pour un MacBook de 128 Go, Qwen3.8 27B, obtient 34 contre 58 pour Opus 5.5 sur la même version de l’index (v4.3.2). Les modèles de la classe 120B qui ont réellement besoin de la mémoire en plus obtiennent encore moins : 16 pour Qwen3.5 122B, 12 pour gpt-oss-120b.
- Le MacBook de 128 Go est devenu plus cher. Apple a doublé l’option 128 Go à 2 000 $ en juin, donc un M5 Max 16 pouces avec 128 Go coûte maintenant 6 999 $ (environ 8 199 € en Allemagne, mon estimation). La même puce et la même mémoire dans un Mac Studio coûtent 4 799 $.
- Le seuil de rentabilité est de trois à quatre ans, pas d’un an. Même si le Mac remplaçait complètement l’abonnement, il faudrait environ 37 mois pour battre un forfait à 200 $, 41 si tu gardes un forfait à 20 $ pour le travail difficile, et plus de six ans face à un forfait à 100 $.
- L’écriture est rapide ; la lecture est lente. Un M5 Max génère 55 à 88 tokens par seconde sur des modèles à mélange d’experts, pas très loin des 98 d’Opus 5.5 sur l’API d’Anthropic. Mais il lui faut 13 à 55 secondes rien que pour lire un prompt de 32 000 tokens, et les agents IA relisent de grands prompts toute la journée.
- Faire tenir de grands modèles coûte de la qualité. La quantification en 4 bits est presque sans perte sur des tâches courtes, mais dans une étude EMNLP 2025 elle coûtait jusqu’à 59 % sur de longues entrées, et davantage dans d’autres langues que l’anglais. En 3 bits, le score en maths d’un petit modèle de raisonnement est tombé de 85,6 % à 47,0 %.
- Les benchmarks publics semblent flatter les modèles ouverts. Quand Artificial Analysis est passé à des tests majoritairement privés, quatre grands modèles à poids ouverts ont perdu 13 points en moyenne. Quatre grands modèles fermés n’ont presque pas bougé.
- Le local gagne toujours sur la confidentialité, l’usage hors ligne, l’absence de limites et les tâches en volume, et quand tu allais acheter un Mac de toute façon. Achète-le pour ces raisons, pas pour résilier un abonnement.
- Il y a des façons moins chères d’économiser. Descends à un palier à 100 $ et économise 1 200 $ par an, paie au token pour les modèles ouverts (DeepSeek V4.1 Flash coûte 0,60 $ par million de tokens de sortie aux heures creuses), ou utilise un forfait de codage à partir de 18 $ par mois.
L’argumentaire face à la réalité
| L’argumentaire | La réalité, octobre 2026 |
|---|---|
| “Il se rembourse en un an” | Un MacBook Pro 16 pouces avec 128 Go coûte 6 999 $. À 200 $ par mois, ça fait 35 mois avant de compter l’électricité, et 41 mois une fois ajouté le forfait à 20 $ que tu garderas pour les tâches difficiles |
| “Les modèles locaux sont aujourd’hui à peu près aussi bons” | Opus 5.5 obtient 58. Le meilleur modèle qui tient dans 128 Go obtient 34 (Qwen3.8 27B, index v4.3.2). Les meilleurs modèles ouverts téléchargeables obtiennent 32 sur le nouveau v5 |
| “128 Go font tourner les grands modèles ouverts” | GLM-5.3 a besoin d’environ 376 Go en 4 bits, DeepSeek V4.1 Flash d’environ 380 à 460 Go, Kimi K3 d’environ 1,5 To. Aucun ne tient dans un MacBook |
| “Le M5 Max est rapide” | En écriture, oui : 55 à 88 tokens par seconde sur des modèles à mélange d’experts. En lecture d’un prompt de 32K tokens : 13 à 55 secondes |
| “Le 4 bits est sans perte” | Sur des benchmarks courts, presque. Sur des entrées de plus de 64K tokens, jusqu’à 59 % de moins dans une étude, et pire encore hors de l’anglais |
| “Aucune limite, confidentialité totale” | Vrai. C’est la vraie raison d’en acheter un |
Table des matières
- TL;DR — La version en 60 secondes
- L’argumentaire face à la réalité
- Partie 1 — L’argumentaire “résilie ton forfait à 200 $”, et pourquoi il sonne si juste
- Partie 2 — Ce que 200 $ par mois achètent vraiment en octobre 2026
- Partie 3 — Ce que coûte vraiment un MacBook de 128 Go aujourd’hui
- Partie 4 — L’écart de qualité, mesuré
- Partie 5 — Pourquoi les modèles que tu veux vraiment ne tiennent pas
- Partie 6 — La quantification : l’impôt sur la qualité que tu paies pour faire tenir
- Partie 7 — Vitesse : rapide en écriture, lente en lecture
- Partie 8 — Le problème du portable
- Partie 9 — Le déficit logiciel : ce que tu devrais reconstruire
- Partie 10 — Le calcul du seuil de rentabilité, fait honnêtement
- Partie 11 — Le bon argument : quand acheter un Mac pour de l’IA locale a du sens
- Partie 12 — Des façons moins chères de réduire une facture IA de 200 $
- Partie 13 — Faut-il acheter un MacBook pour des LLM locaux ? Un guide de décision
- Partie 14 — Si tu en achètes un quand même : comment en tirer le maximum
- Foire aux questions
- Un MacBook peut-il remplacer un abonnement ChatGPT Pro ou Claude Max ?
- Quel est le meilleur LLM local pour un MacBook Pro de 128 Go en 2026 ?
- Combien coûte aujourd’hui un MacBook Pro avec 128 Go ?
- Combien de temps faut-il à un MacBook pour se rembourser face à un abonnement IA à 200 $ ?
- Le M5 Max est-il assez rapide pour des LLM locaux ?
- Les LLM locaux sont-ils aussi bons que ChatGPT ou Claude aujourd’hui ?
- La quantification rend-elle les modèles locaux moins bons ?
- Peux-tu faire tourner DeepSeek V4.1 Flash ou GLM-5.3 sur un MacBook ?
- 64 Go suffisent-ils pour de l’IA locale, ou te faut-il 128 Go ?
- Faut-il acheter un Mac Studio plutôt qu’un MacBook Pro pour des LLM locaux ?
- Faire tourner l’IA en local est-il meilleur pour la confidentialité et le GDPR ?
- Peux-tu utiliser Claude Code avec un modèle local ?
- Le nouveau MacBook Pro OLED changera-t-il quoi que ce soit à cela ?
- En résumé
Partie 1 — L’argumentaire “résilie ton forfait à 200 $”, et pourquoi il sonne si juste
Commence par pourquoi cet argument circule si bien, parce que l’essentiel est raisonnable.
Trois labos se sont retrouvés sur 200 $. Claude Max 20× d’Anthropic coûte 200 $ par mois. ChatGPT Pro d’OpenAI existe en versions à 100, 200 et 500 $. L’AI Ultra de Google a un palier à 100 $ et un à 200 $. Paie ça chaque mois et le chiffre s’impose : 2 400 $ par an, 7 200 $ sur trois ans.
Le matériel est devenu sérieux. Le MacBook Pro M5 Max, en vente depuis mars, accepte jusqu’à 128 Go de mémoire unifiée avec 614 Go/s de bande passante, et Apple a mis un Neural Accelerator, un matériel dédié aux calculs matriciels, dans chaque cœur GPU. En août, le Mac Studio est arrivé avec une option M5 Ultra annoncée jusqu’à 512 Go. Le marketing d’Apple s’appuie sur l’IA locale plus fort que jamais.
Les abonnements sont devenus plus radins. Les limites hebdomadaires de Claude Max, ajoutées des mois après le lancement du forfait, font l’objet d’un recours collectif déposé le 8 septembre, qui soutient que les libellés “5×” et “20×” ne rendent pas les plafonds hebdomadaires assez clairs. OpenAI aurait réduit l’allocation de son forfait Pro à 200 $ pour les nouveaux abonnés, de 20 fois ChatGPT Plus à 10 fois. Quand la chose que tu loues ne cesse de rétrécir, posséder commence à devenir attrayant.
La confidentialité est une vraie préoccupation. Tout ce que tu colles dans un modèle cloud quitte ta machine. Pour une entreprise allemande qui détient des données clients, ce n’est pas de la paranoïa ; c’est le GDPR.
Et l’arithmétique est simple. La version qui circule le plus : un Mac Studio à 2 499 $ divisé par 200 $ par mois, ça fait environ 12,5 mois. Forbes a publié en août une version bien plus prudente, avec de vraies configurations et trois ans d’électricité, et a conclu qu’un Mac ne te permettra probablement pas de résilier ton forfait Claude ou ChatGPT si tu codes avec des agents. Mais c’est la version courte dont les gens se souviennent.
Voilà le défaut. L’argumentaire compare un prix avec un prix. Il devrait comparer un produit avec un produit. C’est ce que fait la suite de cet article, en commençant par ce que les 200 $ paient vraiment.
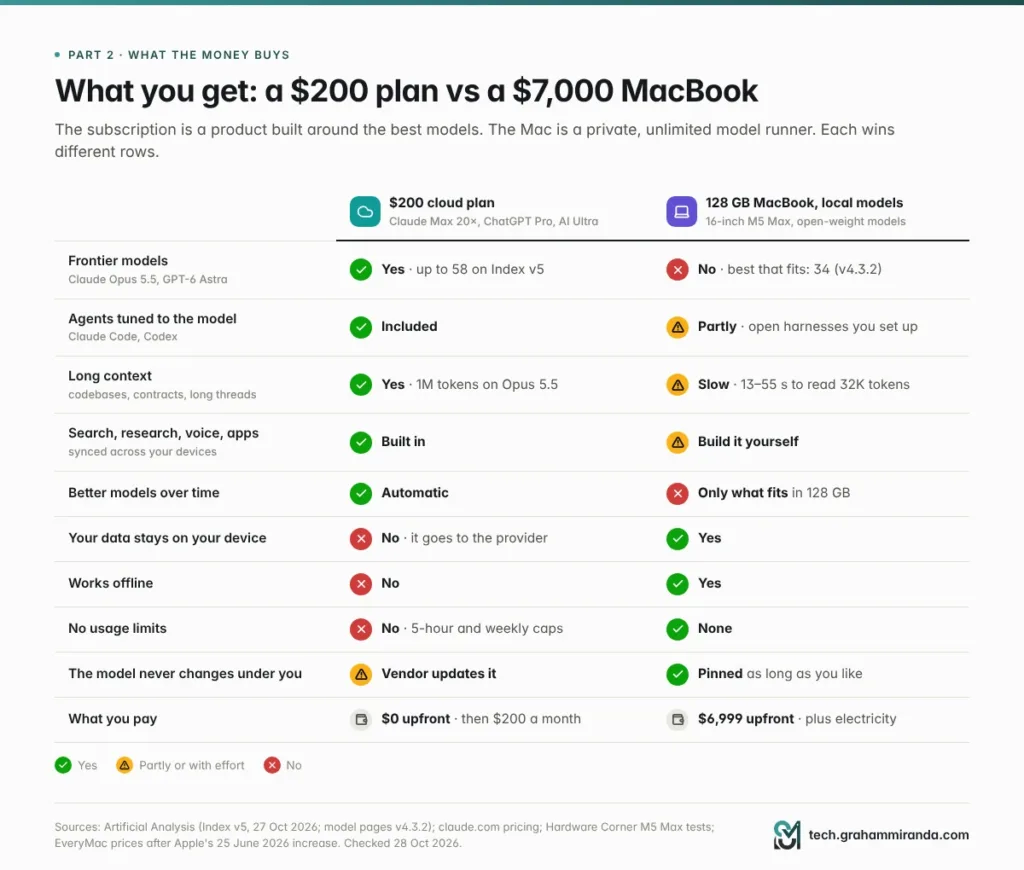
Partie 2 — Ce que 200 $ par mois achètent vraiment en octobre 2026
| Fournisseur | Palier à 20 $ | Palier à 100 $ | Palier à 200 $ | Au-dessus de 200 $ |
|---|---|---|---|---|
| Anthropic (Claude) | Pro : 20 $ (17 $ par mois en facturation annuelle) | Max 5× : 100 $ | Max 20× : 200 $ | Team et Enterprise |
| OpenAI (ChatGPT) | Plus : 20 $ (Go : 8 $) | Pro 100 : 100 $ | Pro 200 : 200 $ | Pro 500 : 500 $ |
| Google (Gemini) | AI Pro : 20 $ | AI Ultra : 100 $ | AI Ultra : 200 $ | — |
Prix américains par mois, hors TVA. Claude d’après claude.com ; ChatGPT d’après le tracker d’AI Business Weekly, mis à jour le 4 octobre ; Google d’après le rapport d’Engadget sur la relance de mai. Les prix et les allocations changent souvent, alors vérifie avant de t’abonner.
Ce que l’argent paie vraiment
1. Les modèles de pointe, que tu ne peux trouver nulle part ailleurs. Sur le nouvel index d’Artificial Analysis, Anthropic et OpenAI occupent les cinq premières places. Aucun de ces modèles ne peut être téléchargé à aucun prix. L’abonnement est le moyen le moins cher pour la plupart des gens d’y accéder un jour.
2. Des agents construits autour de ces modèles. Les forfaits payants de Claude incluent Claude Code ; ceux de ChatGPT incluent Codex. Le harnais et le modèle sont réglés ensemble, ce qui aide à expliquer pourquoi ils trônent en haut des classements de codage agentique. (J’ai comparé 28 de ces outils dans Tous les harnais de codage IA comparés.)
3. Un contexte énorme. Claude Opus 5.5 dispose d’une fenêtre de contexte d’un million de tokens, selon Artificial Analysis : des bases de code entières, des contrats entiers, des trimestres entiers d’e-mails.
4. Le produit autour du modèle. Recherche web et recherche approfondie, analyse de fichiers, voix, mémoire, génération d’images, connecteurs vers ton courrier et tes documents, et des applis qui se synchronisent entre ton téléphone, ton portable et ton navigateur. Rien de tout cela ne vient avec un fichier de modèle.
5. Des mises à niveau que tu n’as pas à installer. Le modèle derrière ton abonnement au prochain trimestre sera meilleur que celui d’aujourd’hui. Le modèle sur ton Mac ne change que si tu en télécharges un autre, et seulement si le nouveau tient.
6. Une partie de l’argent en retour. La page tarifs d’Anthropic liste désormais des crédits API mensuels avec Max : 100 $ sur le forfait 5× et 200 $ sur le 20×.
Ce qu’il n’achète pas
Usage illimité. Les forfaits de Claude fonctionnent par fenêtres glissantes de cinq heures plus des plafonds hebdomadaires, et OpenAI et Google décrivent surtout leurs paliers supérieurs comme des multiples des moins chers, quand ils les décrivent. Le contrôle de l’endroit où vont tes données, ce qui compte beaucoup pour les données personnelles et clients. Et la prévisibilité: les allocations ont bougé plus d’une fois cette année.
Garde ces trois points en tête. C’est l’argument honnête pour l’IA locale, et la partie 11 le traite à fond.
Afficher l'image L’abonnement est un produit ; le Mac est un exécuteur de modèles. Chacun l’emporte sur des lignes différentes, et c’est pourquoi, pour la plupart des gens, la bonne réponse est les deux.
Partie 3 — Ce que coûte vraiment un MacBook de 128 Go aujourd’hui
Une seule puce t’emmène à 128 Go. Dans la génération M5, autant de mémoire unifiée n’existe qu’avec le M5 Max avec GPU 40 cœurs, qui a 614 Go/s de bande passante mémoire. Le M5 Max à GPU 32 cœurs est bloqué à 36 Go et 460 Go/s, et le M5 Pro plafonne à 64 Go et 307 Go/s.
| Configuration | Prix aux États-Unis | Allemagne |
|---|---|---|
| M5 Max 16″ (CPU 18 cœurs, GPU 40 cœurs), 48 Go, 2 To | $4,999 | €5,699 |
| Passer à 128 Go | +2 000 $ (+1 000 $ jusqu’au 25 juin) | environ +2 500 € (+1 250 € au lancement), estimé |
| M5 Max 16″, 128 Go, 2 To | $6,999 | environ 8 199 € (estimé ; 6 249 € au lancement) |
| Au maximum : 128 Go, 8 To, écran nano-texturé | $10,149 | — |
| Pour comparer : Mac Studio, M5 Max, 128 Go | $4,799 | — |
Les prix américains excluent la taxe de vente ; les prix allemands incluent 19 % de TVA. L’option 128 Go allemande est mon estimation : Apple la facturait 1 250 € au lancement, et l’option en dollars a doublé en juin. Vérifie le configurateur d’Apple avant d’acheter.
Trois choses ressortent.
La mémoire est désormais la partie chère. Apple a augmenté ses prix sur toute la gamme Mac le 25 juin, en invoquant le coût de la mémoire et du stockage. Elle a déclaré à Reuters n’avoir “jamais vu le prix d’un composant augmenter autant, aussi vite”. Les options 64 Go et 128 Go du M5 Max ont toutes deux doublé. Le composant dont l’IA locale a le plus besoin est celui qui est devenu deux fois plus cher.
La surprime du portable est de 2 200 $. Le même M5 Max avec les mêmes 128 Go dans un Mac Studio coûtait 4 799 $ quand Forbes en a établi le prix en août. Si tu veux la mémoire pour l’IA, le format portable coûte 46 % de plus.
Le 14 pouces est un compromis. Tu peux aussi commander le 14 pouces avec 128 Go, mais dans le test de Notebookcheck, son châssis avait du mal à refroidir le M5 Max en charge soutenue. On en reparle à la partie 8.
Nouveaux Macs cette semaine. Le 27 octobre, Apple a annoncé un MacBook Pro 14 pouces avec la puce M6 de base : jusqu’à 32 Go et 170 Go/s, à partir de 1 999 $. C’est un bon portable, pas une machine à LLM. Et ce soir (28 octobre, 10 h heure du Pacifique, 18 h en Allemagne), Apple tient son événement “Pro and Tell”, où un MacBook Pro OLED à écran tactile est largement attendu. Les rumeurs disent qu’il utilise les mêmes puces M5 Pro et M5 Max, ce qui laisserait le plafond de 128 Go et les 614 Go/s inchangés.
Partie 4 — L’écart de qualité, mesuré
Comment comparer un modèle sur ton bureau avec un dans un centre de données ? Pas avec des impressions, et pas avec le tableau de benchmarks d’un fournisseur. Artificial Analysis (AA) fait passer la même batterie de tests à des centaines de modèles, via le même harnais, et condense les résultats en un seul Intelligence Index. Aucun index n’est parfait, mais celui d’AA est indépendant, et c’est ce que l’industrie a de plus proche d’un étalon commun.
Le 27 octobre, AA a publié la version 5. Le changement principal : environ 60 % de l’index tourne désormais sur des jeux de tests privés ou des réponses gardées de côté, donc un modèle n’a pas pu voir les questions pendant son entraînement. Le travail de connaissance, le codage, la science et la culture générale comptent chacun pour un quart.
Le nouveau classement
| Modèle | Peux-tu le télécharger ? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | Non | 58 |
| GPT-6 Astra (max) | Non | 57 |
| GPT-6.1 Sol (max) | Non | 55 |
| Gemini 4 Argon (high) | Non | 50 |
| Kimi K3.1 Pro | Pas encore ; poids non publiés | 46 |
| Claude Haiku 5.5 (max) | Non | 36 |
| DeepSeek V4.1 Flash 1017 (max) | Oui, licence MIT | 32 |
| GLM-5.3 (max) | Oui | 32 |
Source : Artificial Analysis, annonce de l’Intelligence Index v5, 27 octobre 2026.
Trois choses dans ce tableau comptent si tu calcules le prix d’un MacBook.
- Les cinq premières places appartiennent toutes à Anthropic et OpenAI, et aucun de ces modèles ne peut être téléchargé à aucun prix.
- Le meilleur modèle ouvert, Kimi K3.1 Pro, n’a pas publié ses poids. Parmi les modèles que tu peux vraiment télécharger, le meilleur score est de 32, ce qui les laisse 26 points derrière le leader. Sur la version précédente, l’écart entre le meilleur modèle ouvert et le meilleur modèle fermé était de 3 points. Aujourd’hui il est de 12, ou de 26 si tu ne comptes que les poids téléchargeables.
- Claude Haiku 5.5 bat tous les modèles ouverts téléchargeables. C’est le palier petit, rapide et bon marché d’Anthropic, pas son modèle phare.
Le codage, précisément
Le nouvel index inclut FrontierCode 2.0, 132 tâches de codage privées de Cognition. Claude Opus 5.5 en a résolu 46 % ; DeepSeek V4.1 Flash 1017, à égalité en tête des modèles téléchargeables, en a résolu 28 %. Sur Terminal-Bench-Science, 70 tâches scientifiques agentiques, c’est 59 % contre 13 %.
Pour être juste avec les modèles ouverts : Kimi K3.1 Pro mène Terminal-Bench 4.0 avec 67 %, devant tous les modèles fermés. Les modèles ouverts peuvent gagner des benchmarks isolés, et ils le font. Mais celui-là n’est pas encore téléchargeable, et son prédécesseur, Kimi K3, a 2 800 milliards de paramètres. Tu ne vas pas le faire tourner sur un portable.
Pourquoi l’écart vient de s’élargir
Le saut de la v4.3 à la v5 n’a pas traité tout le monde de la même façon.
| Modèle | Type | v4.3 | v5 | Écart |
|---|---|---|---|---|
| Claude Opus 5.5 | Fermé | 58 | 58 | 0 |
| GPT-6 Astra | Fermé | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Fermé | 56 | 54 | −2 |
| Gemini 4 Argon | Fermé | 53 | 50 | −3 |
| Kimi K3.1 Pro | Ouvert (non publié) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Recharger | 45 | 32 | −13 |
| Muse Spark Open (Meta) | Recharger | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | Recharger | 46 | 30 | −16 |
Chiffres v4.3 et v5 tels que rapportés par Trending Topics le 28 octobre, les scores v5 correspondant à l’annonce d’AA.
En moyenne, ces quatre modèles ouverts ont perdu 13 points. Les quatre modèles fermés ont bougé d’un quart de point.
AA n’a pas dit pourquoi. L’explication évidente, c’est que quand les questions de test sont secrètes, un modèle n’a pas pu les voir, et que les benchmarks publics flattent les modèles lourdement entraînés sur des données publiques. L’objection est juste aussi : les tests privés ne peuvent pas être vérifiés de l’extérieur, et la pondération des catégories déplace les classements. Ne prends aucun index pour parole d’évangile. Mais quand quatre modèles ouverts perdent plus de dix points et que quatre modèles fermés ne bougent pas, c’est un signal à prendre au sérieux : les tableaux de benchmarks publiés, et surtout ceux des fournisseurs, exagèrent la proximité des modèles ouverts.
Et les modèles qui tiennent vraiment dans un MacBook
Les modèles qu’AA a réévalués pour son annonce sont pour la plupart bien trop gros pour un portable. Pour ceux qui tiennent, les pages modèles d’AA affichent encore des scores v4.3.2 de la v4.3.2, et sur cette version Opus 5.5 obtient aussi 58. Voici donc la comparaison sur une échelle cohérente :
| Modèle | Tient dans un MacBook de 128 Go ? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | Non, cloud uniquement | 58 |
| Qwen3.8 27B (xhigh) | Oui, en 4 bits même sur un Mac de 32 Go | 34 |
| Qwen3.5 122B A10B (raisonnement) | Oui, environ 70 Go en 4 bits | 16 |
| gpt-oss-120b (high) | Oui, environ 64 Go | 12 |
Source : pages modèles d’Artificial Analysis, consultées le 28 octobre 2026.
AA classe Qwen3.8 27B premier de 141 modèles comparables. Il est vraiment excellent pour sa taille, et c’est un modèle ouvert publié sous Apache 2.0. Il reste quand même 24 points derrière.
Afficher l'image Deux versions de l’index, deux panneaux séparés, jamais un seul axe. En haut : Artificial Analysis Intelligence Index v5 (27 octobre 2026). En bas : les modèles qui tiennent dans un MacBook de 128 Go, sur la v4.3.2, la version sur laquelle leurs scores sont publiés.
Le paradoxe des 128 Go
Regarde encore ce dernier tableau. Le meilleur modèle pour un MacBook de 128 Go tient dans 32 Go. Les modèles qui ont réellement besoin de la mémoire en plus, des mélanges d’experts de 120 milliards de paramètres, obtiennent moins, surtout parce qu’ils sont plus anciens : gpt-oss-120b est sorti en août 2025, et Qwen3.5 122B était déjà évalué sur le M5 Max en mars, des mois avant l’arrivée de Qwen3.8 27B.
Alors qu’est-ce que l’option à 2 000 $ qui fait passer de 48 à 128 Go t’achète aujourd’hui ? De la place : des contextes plus longs, de la précision 8 bits au lieu de 4 bits, plusieurs modèles chargés en même temps, et la possibilité de faire tourner un bon modèle de la classe 100 milliards s’il en sort un. Ce sont de vrais avantages. Un modèle plus intelligent n’en fait pas partie, du moins pas sur le classement d’aujourd’hui. Vérifie AA avant d’acheter ; c’est le genre de fait qui change avec une seule sortie.
Ce que 34 contre 58 donne en pratique
Les points d’index ne sont pas des “pour cent plus intelligent”, et ils ne tombent pas uniformément selon les tâches.
Pour des tâches courtes et bien définies, comme réécrire un e-mail, résumer un document que tu colles ou extraire des champs d’une facture, un bon modèle 27B est souvent indiscernable d’un modèle de pointe. L’écart s’ouvre sur le travail long et en plusieurs étapes : un agent qui doit lire une base de code, planifier, modifier cinq fichiers, lancer les tests et se remettre de ses propres erreurs ; une recherche qui doit réconcilier des sources ; un raisonnement où une seule mauvaise étape empoisonne le reste. C’est exactement le travail pour lequel les gens achètent des forfaits à 200 $.
La chronique de Forbes d’août donnait un exemple concret tiré du propre article de recherche de Qwen : Qwen3-Coder-Next, lancé dans Claude Code, a obtenu 30.9% sur Terminal-Bench 2.0, contre 53.9% pour Claude Opus 4.5 dans le même article. Ce sont les modèles de l’an dernier, mais la forme n’a pas changé : sur les tâches agentiques, la configuration locale échouait bien plus souvent.
Partie 5 — Pourquoi les modèles que tu veux vraiment ne tiennent pas
La taille d’un modèle en mémoire est simple à estimer :
texte
poids (Go) ≈ paramètres (milliards) × octets par paramètre
               8 bits → × 1,0     4 bits → × 0,5     2 bits → × 0,25
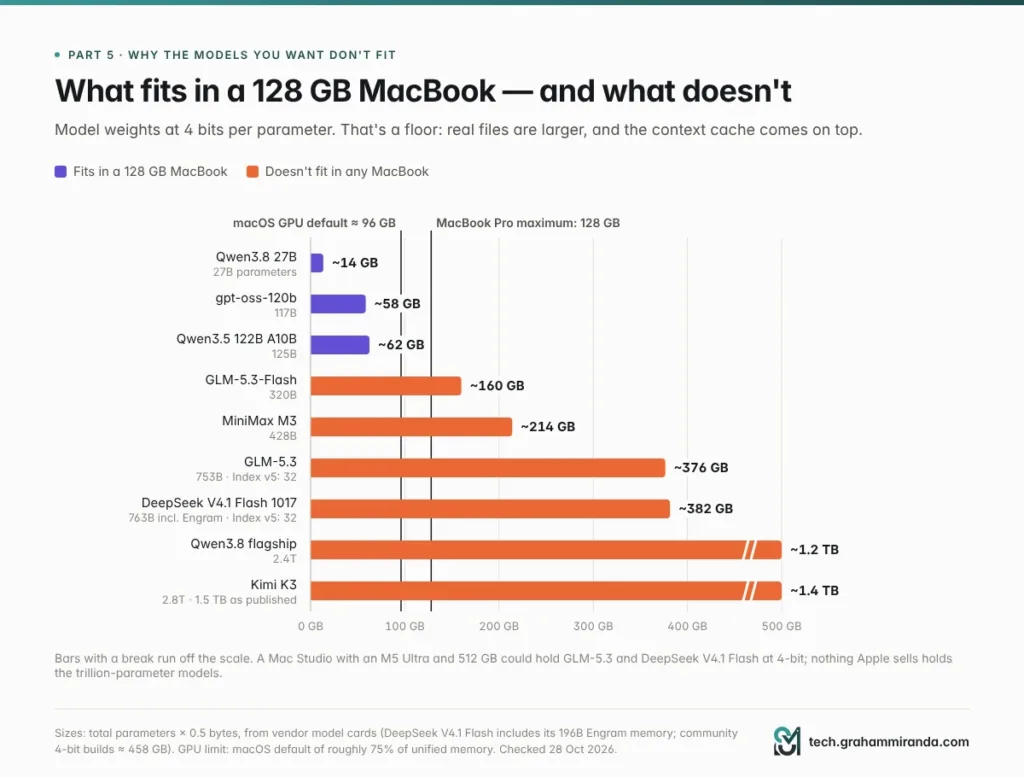
Ajoute ensuite le cache KV, la mémoire de travail du modèle pour ta conversation, qui grandit avec la longueur du contexte. Et rappelle-toi que macOS ne donne pas toute ta mémoire unifiée au GPU : par défaut, il laisse le GPU réserver 75% sur les Macs à grande mémoire, environ 96 Go d’une machine de 128 Go. Tu peux relever la limite avec sudo sysctl iogpu.wired_limit_mb=…, à tes risques ; tout ce que tu donnes au modèle, ton navigateur, ton éditeur et ton système d’exploitation ne l’ont pas.
Voici ce que ça signifie pour les modèles dont on parle vraiment :
| Modèle | Nombre total de paramètres | Poids en 4 bits (plancher) | Tient dans un MacBook de 128 Go ? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 Go | ✅ Facilement |
| gpt-oss-120b | 117B | ~58 Go (fichier de 64 Go) | ✅ Oui |
| Qwen3.5 122B A10B | 125B | ~62 Go (fichier de 69,6 Go) | ✅ Oui |
| GLM-5.3-Flash | 320B | ~160 Go | ❌ Non |
| MiniMax M3 | 428B | ~214 Go | ❌ Non |
| GLM-5.3 | 753B | ~376 Go | ❌ Non |
| DeepSeek V4.1 Flash 1017 | 763B avec mémoire Engram | ~382 Go (builds 4 bits de la communauté estimés à ~458 Go) | ❌ Non |
| Qwen3.8 (modèle phare) | 2,4 T | ~1,2 To | ❌ Non |
| Kimi K3 | 2,8 T | ~1,5 To tel que publié (MXFP4 natif) | ❌ Non |
La colonne 4 bits, c’est paramètres × 0,5 octet : poids seulement, avant le cache KV et la surcharge des fichiers, donc les fichiers réels sont plus gros. Les tailles de fichiers viennent des tests du M5 Max de Hardware Corner.
Les modèles qui obtiennent 32 sur le nouvel index, les meilleurs que tu peux télécharger, ont besoin de trois à quatre fois ce qu’un MacBook possède. Et ceux entre les deux ne rentrent pas non plus. Si tu donnais 100 Go de tes 128 Go aux poids du modèle, voici combien de bits par poids tu pourrais te permettre :
| Modèle | Bits par poids dans un budget de 100 Go |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Autour de trois bits et en dessous, la qualité s’effondre (la partie 6 contient la recherche). Un bit par poids, ce n’est pas de la quantification. C’est de l’amputation.
Le contexte coûte aussi de la mémoire. Dans les tests de Hardware Corner, Qwen3-Coder-Next en 8 bits utilisait 87,1 Go avec un contexte de 4K et 92,6 Go à 64K : cinq gigaoctets et demi de plus juste pour tenir une conversation plus longue. Les agents qui lisent des dépôts entiers ont besoin de longs contextes, donc cette marge disparaît vite.
Et un Mac Studio de 512 Go ? Un Mac Studio M5 Ultra avec 512 Go pourrait contenir GLM-5.3 ou DeepSeek V4.1 Flash en 4 bits. Apple a dit que cette configuration arriverait fin octobre ; MacRumors s’attend à un prix bien au-dessus de 10 000 $, et Apple n’avait pas publié de prix quand j’ai vérifié. Tu paierais cinq chiffres pour faire tourner des modèles qui obtiennent 32 sur le nouvel index, probablement plus lentement que leurs créateurs ne te les servent. Mon Kimi K3 vs Fable 5.1 vs GLM-5.3 comparatif creuse ce qu’il faut vraiment pour auto-héberger les grands modèles ouverts.
Afficher l'image Poids seulement, à 4 bits par paramètre ; le cache de contexte vient en plus. Tout ce qui est à droite de la ligne des 128 Go demande un Mac Studio ou un serveur.
Partie 6 — La quantification : l’impôt sur la qualité que tu paies pour faire tenir
La quantification stocke les poids d’un modèle sur moins de bits, 8 ou 4 au lieu des 16 de l’entraînement, donc il prend moins de mémoire et tourne plus vite. Tous les modèles locaux que tu feras tourner sur un Mac sont quantifiés. La question, c’est ce que ça coûte, et la recherche donne une réponse claire et un peu gênante.
La bonne nouvelle : le 8 bits est presque gratuit, le 4 bits est globalement correct
- L’une des plus grandes études à ce jour, menée par Eldar Kurtic et ses collègues, a fait plus de 500 000 évaluations sur des modèles Llama 3.1 quantifiés. Le FP8 était effectivement sans perte à toutes les tailles ; l’INT8 coûtait environ 1 à 3 % avec un réglage soigné ; et la quantification 4 bits sur les poids seulement était “plus compétitive que prévu”, proche du 8 bits.
- Pour les modèles de raisonnement, une étude de 2025 de Ruikang Liu et ses collègues a trouvé que des poids et activations en 8 bits, ou des poids en 4 bits avec des activations en 16 bits, peuvent être sans perte sur des benchmarks de maths, de science et de codage. Les largeurs de bits plus faibles apportaient ce que les auteurs appellent des risques de précision significatifs, et la difficulté de la tâche influait fortement sur ce qui était perdu.
Si tu ne poses que des questions courtes en anglais, un modèle 4 bits te semblera proche de l’original.
La mauvaise nouvelle : les longues entrées, les autres langues et tout ce qui est sous 4 bits
- Le contexte long. Anmol Mekala et ses collègues ont testé cinq méthodes de quantification sur 9 700 exemples avec des entrées de 64 000 tokens ou plus (EMNLP 2025). Le 8 bits coûtait environ 0.8% en moyenne. Le 4 bits coûtait jusqu’à 59 %, et les dégâts dépendaient beaucoup du modèle : avec une méthode 4 bits, Llama 3.1 70B perdait 32 % sur une tâche où Qwen 2.5 72B tenait bon.
- Les langues autres que l’anglais. La même étude a trouvé que la dégradation avait tendance à être pire quand l’entrée n’était pas en anglais. Si tu travailles en allemand, teste en allemand.
- Sous 4 bits, le raisonnement s’effondre. Des chercheurs de Meta FAIR ont publié en juin 2026 une étude montrant que les modèles de raisonnement quantifiés réfléchissent trop. Avec AWQ en 3 bits, le score d’un modèle de raisonnement 1,5B sur le benchmark MATH-500 est tombé de 85,6 % à 47,0 %, et sa chaîne de pensée est passée de 5 200 à 23 400 tokens, 4,5 fois plus longue. Sur un portable qui écrit à 20 à 80 tokens par seconde, un modèle qui réfléchit quatre fois plus longtemps est aussi à peu près quatre fois plus lent.
Afficher l'image Ce que la recherche dit de chaque palier de précision perdu. La compression qui ferait tenir un plus gros modèle dans 128 Go est exactement celle qui fait le plus mal.
Ce que ça signifie pour un MacBook de 128 Go
La quantification que tu peux te permettre pour un modèle que tu voudrais est celle qui fait le plus mal. Un modèle 27B peut tourner en 8 bits sur un Mac avec de la place à revendre, et il devrait. Les modèles de la classe 120B tournent en 4 bits, ce qui va pour le chat et reste risqué sur de longs documents. Et la seule façon de faire tenir quoi que ce soit de la classe 300B+ sur un portable, c’est deux ou trois bits par poids, là où les études ci-dessus disent que le raisonnement s’effondre.
Mes règles empiriques :
- Utilise le 8 bits pour tout ce sur quoi tu vas compter, surtout les longs documents et le travail d’agent.
- Le 4 bits va bien pour le chat, la rédaction et les tâches courtes. Vérifie son comportement sur contexte long avec tes propres documents.
- Ne fais pas tourner de modèles de raisonnement ou de codage sous 4 bits sauf si tu expérimentes.
- Teste dans la langue dans laquelle tu travailles.
Partie 7 — Vitesse : rapide en écriture, lente en lecture
Un LLM fait deux métiers différents à deux vitesses différentes. Le prefill lit ton prompt, tout ce que tu as collé plus la conversation jusqu’ici, et il est limité par la puissance de calcul brute. La génération écrit la réponse token par token, et elle est limitée par la bande passante mémoire. Les propres chercheurs en machine learning d’Apple ont mesuré les deux sur le M5 : ses nouveaux Neural Accelerators dans le GPU ont rendu le temps jusqu’au premier token 3,3 à 4,1 fois plus rapide que sur le M4, tandis que la génération ne s’améliorait que de 1,19 à 1,27 fois, à peu près en ligne avec la bande passante supplémentaire.
Alors que fait vraiment un M5 Max avec 128 Go ? Hardware Corner a publié des tests réalisés avec le framework MLX d’Apple sur un M5 Max 14 pouces avec 128 Go :
| Modèle | Contexte | Lecture (prefill), tok/s | Temps pour lire tout le prompt | Écriture, tok/s |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 Go) | 4K | 1,325 | 3,1 s | 87.9 |
| 32K | 2,537 | 12,9 s | 64.5 | |
| Qwen3.5 122B A10B (4 bits) | 4K | 881 | 4,6 s | 65.9 |
| 32K | 1,068 | 30,7 s | 54.9 | |
| Qwen3.5 27B (dense, 6 bits) | 4K | 811 | 5,1 s | 23.6 |
| 32K | 591 | 55,4 s | 14.9 | |
| Qwen3-Coder-Next (8 bits) | 64K | 1,432 | 45,8 s | 48.2 |
Mesuré par l’utilisateur Reddit cryingneko et publié par Hardware Corner. “Temps pour lire tout le prompt”, c’est la longueur du contexte divisée par la vitesse de prefill mesurée.
La vitesse d’écriture est correcte maintenant, au moins sur les modèles MoE
Les modèles à mélange d’experts n’utilisent qu’une fraction de leurs poids pour chaque token, donc ils écrivent vite : 55 à 88 tokens par seconde sur le M5 Max. Pour comparer, Artificial Analysis mesure Claude Opus 5.5 à 98 tokens par seconde sur l’API d’Anthropic. Pour discuter avec un modèle de la classe 120B, le M5 Max est vraiment agréable. Les modèles denses sont une autre histoire : un modèle 27B qui utilise tous ses poids pour chaque token écrit à 15 à 24 tokens par seconde.
Deux effets plus petits s’ajoutent aussi. L’écriture ralentit à mesure que la conversation grandit : 17 % à 37 % plus lent à 32K qu’à 4K sur ces trois modèles. Et les modèles de raisonnement passent des centaines ou des milliers de tokens à réfléchir avant de répondre.
C’est la lecture qui fait attendre
Regarde encore la colonne du temps de lecture. Un prompt de 32 000 tokens (quelques fichiers source, un long contrat, un gros fil d’e-mails) prend 13 à 55 secondes à lire avant que le premier mot de la réponse apparaisse.
Ça compte surtout pour exactement le travail pour lequel on achète un forfait à 200 $. Les agents de codage IA envoient au modèle un gros prompt système, les définitions de chaque outil, les fichiers qu’ils ont ouverts et la conversation jusqu’ici, et ils le font à chaque étape. Les serveurs locaux peuvent réutiliser la partie du prompt qui n’a pas changé, ce qui aide beaucoup. Mais dès que quelque chose change tôt dans le contexte, par exemple quand l’agent compacte son historique ou que tu passes à une nouvelle tâche, tout ce qui suit doit être relu. Forbes citait un développeur qui a attendu le premier token pendant environ 90 secondes sur un M3 Ultra de 512 Go avec un prompt système de 16 000 tokens, et un autre qui a vu environ 20 secondes à froid sur un portable M4 Pro de 48 Go. Les puces de génération M5 sont bien plus rapides que les anciens Mac à ce jeu, d’après les mesures d’Apple, mais la forme du problème est la même.
Pour situer, les mêmes tests de Hardware Corner ont tourné sur une carte de station de travail Nvidia RTX Pro 6000, qui coûte à elle seule environ 8 800 $ : elle lisait les prompts 2 à 2,4 fois plus vite et écrivait 1,7 à 2,8 fois plus vite que le M5 Max.
Afficher l'image Mesuré avec MLX sur un M5 Max de 128 Go. L’écriture est assez rapide ; c’est la lecture de longs prompts, ce que les agents font sans arrêt, qui fait attendre.
Partie 8 — Le problème du portable
Même si les modèles étaient assez bons, un portable est un endroit peu pratique pour les faire tourner.
La chaleur. Faire tourner un gros modèle, c’est une charge soutenue : des minutes ou des heures de GPU et de mémoire à fond, pas une rafale de dix secondes. Le test du M5 Max 14 pouces par Notebookcheck concluait que son châssis et son refroidissement “ne peuvent tout simplement pas gérer le M5 Max correctement” : les performances dans un stress test CPU de 30 minutes chutaient de 24 %, et les ventilateurs atteignaient 53,2 dB(A) en mode High Power. Ce test mesurait des charges CPU et graphiques, pas des LLM, et Notebookcheck lui-même suggère que le M5 Max a sa place dans le 16 pouces. Si tu achètes vraiment un MacBook pour de l’IA locale, prends le 16 pouces. Mon guide du MacBook Pro M5 Pro 64 Go arrivait à la même conclusion sur le travail soutenu dans le châssis plus petit.
C’est aussi ton ordinateur de tous les jours. Charge un modèle de 70 Go plus son contexte et il te reste de la place pour un navigateur et un éditeur. Pousse vers les quelque 96 Go que le GPU obtient par défaut, ou relève la limite pour faire tenir quelque chose de plus gros, et le reste de ton travail commence à se disputer la mémoire avec le modèle. Chaque modèle que tu gardes chargé, c’est de la mémoire que tes autres applis n’ont pas.
Les batteries n’aiment pas ça. Une charge GPU soutenue vide vite la batterie d’un portable, donc les longues sessions d’inférence locale finissent branchées, ce qui sape un peu l’argumentaire “IA partout, hors ligne”.
Tu achètes ton plafond le premier jour. La mémoire unifiée ne se met pas à niveau après l’achat. Si le meilleur modèle ouvert de l’an prochain a besoin de 160 Go, un MacBook de 128 Go ne peut tout simplement pas le faire tourner.
Et il perd vite de la valeur. Le reconditionneur britannique MacFinder a analysé six ans de ses propres données d’achat et constaté que la plupart des MacBook perdent environ la moitié de leur valeur la première année, les modèles haut de gamme chutant souvent plus fort : un MacBook Pro M4 16 pouces perdait jusqu’à 60 % en un an. Une machine à 6 999 $, c’est un pari à 6 999 $ que le plafond de mémoire d’aujourd’hui sera encore utile dans trois ans.
Un ordinateur de bureau est une meilleure machine pour les LLM. Si l’IA locale est le but, un Mac Studio avec le même M5 Max et 128 Go coûte 2 200 $ de moins, n’a pas de batterie à cuire ni de capot à fermer, et peut tourner 24 heures sur 24 comme serveur privé pour ton portable et ton téléphone. Associe-le au portable que tu aimes déjà.
Partie 9 — Le déficit logiciel : ce que tu devrais reconstruire
Un abonnement, c’est un modèle plus un produit. Une installation locale te donne le modèle et te laisse le produit.
| Ce que l’abonnement fait pour toi | Ce que tu ferais en local |
|---|---|
| Héberge et met à jour le modèle | Télécharge, convertis et mets à jour les modèles toi-même (LM Studio, Ollama ou MLX) |
| Recherche web et recherche approfondie | Branche une API de recherche ou une recherche auto-hébergée, plus un agent pour la piloter |
| Lit les PDF, les tableurs et les images | Choisis des modèles avec vision, ajoute l’analyse de documents |
| Voix, mémoire, génération d’images | Des modèles et applis séparés pour chaque (Whisper pour la parole, Draw Things ou ComfyUI pour les images) |
| Des applis sur chaque appareil, synchronisées | Fais tourner un serveur et un front-end, et expose-le à ton téléphone en toute sécurité |
| Claude Code ou Codex, réglés pour leurs propres modèles | Pointe un harnais ouvert, ou Claude Code lui-même, vers un serveur local |
| Les templates de chat, les formats d’appel d’outils et la sécurité sont gérés | Débogue-les quand un nouveau modèle arrive avec un template que tes outils ne comprennent pas |
L’outillage est vraiment bon maintenant. LM Studio est le départ le plus simple sur un Mac, Ollama te donne une API pour les modèles locaux et cloud, et MLX d’Apple est généralement le plus rapide. Ollama expose même une API compatible Anthropic, donc tu peux pointer Claude Code vers un modèle local en définissant ANTHROPIC_BASE_URL=http://localhost:11434. Sa documentation est franche sur les manques, cela dit : les contrôles de cache de prompt d’Anthropic, le comptage de tokens, les batchs et l’entrée PDF ne sont pas pris en charge. Et Claude Code est réglé pour les modèles Claude ; un modèle local doit encaisser le long prompt système et les définitions d’outils de Claude Code, et c’est là que les temps de prefill de la partie 7 font mal.
Rien de tout cela n’est impossible. Mon OpenCode v2 vs Hermes Agent vs OpenClaw article couvre les agents ouverts qui fonctionnent avec des modèles locaux. Mais c’est du vrai travail, et tes heures ne sont pas gratuites. Prévois un week-end pour l’installer et quelques heures par mois pour le garder à jour.
Partie 10 — Le calcul du seuil de rentabilité, fait honnêtement
Voici le calcul que l’argumentaire saute généralement.
Étape 1 : la version naïve
6 999 $ ÷ 200 $ par mois = 35 mois. Pas douze. Presque trois ans, et c’est la version la plus flatteuse.
Étape 2 : ajouter l’électricité
Forbes estimait environ 10 $ par mois pour un Mac faisant tourner de l’IA huit heures par jour aux tarifs moyens américains. En Allemagne, au tarif moyen d’octobre de 29,68 centimes par kWh, un portable consommant en moyenne 60 à 150 W huit heures par jour coûte environ 4 à 11 € par mois. C’est peu, mais ça repousse le seuil de rentabilité à environ 37 mois.
Étape 3 : garder un forfait bon marché pour les cas difficiles
Tu vas le garder. Peu de gens qui ont utilisé un modèle de pointe pour du codage agentique ou de la recherche sérieuse reviennent à un modèle à 34 points pour tout. Garde un forfait à 20 $ pour les 10 % difficiles et le Mac t’économise 170 $ par mois, pas 200 $ : environ 41 mois.
Étape 4 : comparer avec l’offre vers laquelle tu descendrais vraiment
Si tu fais assez attention aux coûts pour envisager un portable à 7 000 $, tu fais assez attention aux coûts pour descendre à un palier à 100 $. Face à 100 $ par mois, le seuil de rentabilité est d’environ 78 mois, plus de six ans et demi, plus longtemps que beaucoup de gens gardent un portable.
| Scénario | Achat initial | Tu paies encore | Économie mensuelle | Seuil de rentabilité |
|---|---|---|---|---|
| MacBook contre forfait à 200 $, sans électricité | $6,999 | — | $200 | 35 mois |
| MacBook contre forfait à 200 $, avec électricité | $6,999 | $10 | $190 | 37 mois |
| … et tu gardes un forfait à 20 $ | $6,999 | $30 | $170 | 41 mois |
| MacBook contre forfait à 100 $ | $6,999 | $10 | $90 | 78 mois |
| Mac Studio (128 Go) contre forfait à 200 $ | $4,799 | $10 | $190 | 25 mois |
| Mac Studio contre forfait à 200 $, avec forfait à 20 $ | $4,799 | $30 | $170 | 28 mois |
Tous ces calculs supposent que le Mac fait complètement le travail de l’abonnement. Les parties 4 à 9 expliquent pourquoi ce n’est pas le cas.
Afficher l'image Coût cumulé sur quatre ans, en supposant que le Mac remplace complètement l’abonnement, ce qui n’est pas le cas. Électricité à environ 10 $ par mois.
Étape 5 : trois ans, avec revente
Le matériel a une valeur de revente, et c’est le meilleur argument pour acheter. Suppose que tu revends au bout de trois ans pour 35 % du prix d’achat. C’est mon hypothèse, pas un devis, éclairée par les données de MacFinder qui montrent environ la moitié de la valeur perdue la première année et des pertes plus lentes ensuite.
| Option | Coût sur 36 mois |
|---|---|
| Forfait à 200 $ | $7,200 |
| MacBook (128 Go) + électricité, revendu à 35 % | $4,909 |
| … plus un forfait à 20 $ pour le travail de pointe | $5,629 |
| Mac Studio (128 Go) + électricité + forfait à 20 $, revendu à 35 % | $4,199 |
| Forfait à 100 $ | $3,600 |
| Forfait à 20 $ | $720 |
Donc oui : sur trois ans, un MacBook plus un forfait à 20 $ peut revenir environ 1 600 $ moins cher qu’un forfait à 200 $, si tu le revends à un prix correct. Mais regarde ce que cet argent achète. D’un côté, les meilleurs modèles du monde avec tous les outils autour. De l’autre, un modèle à 34 points, quelques milliers de dollars de dépréciation et un forfait bon marché pour quand tu as besoin du vrai truc. Le forfait à 100 $ bat toutes les options matérielles en coût, et le forfait à 20 $ bat tout.
Tu n’économises pas beaucoup d’argent avec un MacBook pour des LLM locaux. Tu dépenses une somme similaire pour un produit différent: confidentialité, contrôle et liberté face aux limites, avec moins d’intelligence attachée.
Le point de vue du coût marginal
Il y a un cadrage où acheter a plus de sens : tu as de toute façon besoin d’un nouveau MacBook. Alors le coût spécifique à l’IA, c’est juste l’option mémoire de 48 à 128 Go, 2 000 $, soit dix mois d’un forfait à 200 $. Ce n’est pas insensé. Mais souviens-toi du paradoxe des 128 Go de la partie 4 : sur le classement d’aujourd’hui, cette option achète des modèles plus gros, pas plus intelligents. Si tu achètes un MacBook de toute façon, 48 à 64 Go font bien tourner le meilleur modèle de taille Mac en 8 bits avec beaucoup de contexte.
Ce que 6 999 $ achètent à la place
- 35 mois d’un forfait à 200 $, 70 mois d’un forfait à 100 $, ou 29 ans d’un forfait à 20 $
- Environ 11,7 milliards de tokens de sortie avec DeepSeek V4.1 Flash au tarif API hors heures pleines, un modèle qui dépasse tout ce qui tient dans un MacBook
- Environ 350 millions de tokens de sortie de Claude Opus 5.5 via l’API d’Anthropic, au tarif de 20 $ par million indiqué par Artificial Analysis
Partie 11 — Le bon argument : quand acheter un Mac pour de l’IA locale a du sens
Rien de tout cela ne veut dire que l’IA locale est un gadget. J’en parle constamment sur ce blog parce que c’est utile. C’est juste utile pour d’autres raisons que celles que l’argumentaire avance. Voici les bonnes raisons.
1. Des données qui ne doivent pas quitter ton contrôle
Si tu manipules des fichiers clients, des informations de santé, des états financiers non publiés ou quoi que ce soit couvert par un devoir de confidentialité, un modèle local signifie que rien ne part chez un tiers. Pas d’accord de sous-traitance, pas de transfert international, pas de questions sur les réglages d’entraînement. En Allemagne, les professionnels liés par § 203 StGB, comme les avocats, les médecins et les conseillers fiscaux, ont besoin de garanties contractuelles avant que des données clients partent chez un prestataire externe, fournisseurs d’IA inclus. Un modèle local contourne entièrement cette question. C’est la raison la plus forte de posséder le matériel, et elle ne dépend pas de la question de savoir si le modèle local est aussi intelligent qu’Opus. Mon État des lieux de l'IA en 2026 rapport détaille le côté coûts et conformité de l’IA hors ligne.
2. Le travail hors ligne
Dans un avion, chez un client sans réseau, dans un site où le réseau est précisément ce qui est interdit.
3. Aucune limite, aucune dérive de politique, un modèle qui ne change jamais
Pas de fenêtres de cinq heures, pas de plafonds hebdomadaires, pas de recours collectifs sur la façon dont ils sont annoncés. Et un checkpoint local se comporte dans un an comme aujourd’hui, ce qui compte si tu as construit un flux de travail autour du comportement d’un modèle.
4. Le travail en volume, ennuyeux et bien défini
Classer des milliers de tickets de support, extraire des champs de factures, résumer tes propres notes, traduire des brouillons, étiqueter des photos, générer des embeddings pour la recherche dans tes documents, transcrire des réunions avec Whisper. Les modèles locaux de taille moyenne sont excellents pour ça, et en faire tourner un million ne coûte que de l’électricité.
5. Apprendre et construire
Si tu construis des applis local-first, affines de petits modèles ou veux juste comprendre comment ça marche, posséder le matériel est le meilleur professeur qui soit. (Si construire des applis avec l’IA est ton truc, j’ai raconté tout le processus dans Comment construire une appli de zéro avec l’IA en 2026.)
6. Tu allais acheter un Mac de toute façon
Alors achète assez de mémoire pour les modèles que tu feras vraiment tourner (voir partie 14), et traite l’IA locale comme un bonus, pas comme un investissement rentable.
Ce qui tourne bien en local
| Tâche | Quoi faire tourner | Mémoire confortable |
|---|---|---|
| Chat privé, rédaction, réécriture | Qwen3.8 27B en 8 bits | 48–64 Go |
| Résumés et Q&A sur tes documents | Qwen3.8 27B, plus un modèle d’embedding | 48–64 Go |
| Extraction et classification en volume | Des modèles plus petits (Gemma 4, gpt-oss-20b) | 16–32 Go |
| Transcription audio | Whisper | 8–16 Go |
| Génération d’images | Draw Things ou ComfyUI avec des modèles de classe FLUX | 32 Go+ |
| Un gros modèle de chat rapide | gpt-oss-120b ou Qwen3.5 122B | 128 Go |
Pour la génération vidéo locale, les Mac restent lents comparés au matériel Nvidia ou aux GPU cloud ; mon guide du M5 Pro 64 Go a les chiffres.
Partie 12 — Des façons moins chères de réduire une facture IA de 200 $
Si ce que tu veux vraiment, c’est une facture IA plus petite, il y a des routes moins chères qu’un portable à 7 000 $.
1. Descends d’un palier. Claude Max 5× et ChatGPT Pro 100 coûtent 100 $, et l’AI Ultra de Google commence désormais à 100 $. Si tu atteins rarement tes limites sur un forfait à 200 $, ça économise 1 200 $ par an sans aucune perte de qualité.
2. Combine deux forfaits à 20 $. Claude Pro et ChatGPT Plus coûtent 40 $ par mois et te donnent deux réserves de quotas distinctes et deux familles de modèles de pointe entre lesquelles basculer.
3. Paie au token pour les modèles ouverts. Les mêmes modèles à poids ouverts que tu ferais tourner sur un Mac, et de plus gros qui ne tiendront jamais, sont disponibles au token chez beaucoup de fournisseurs, à la vitesse d’un centre de données. DeepSeek V4.1 Flash, qui dépasse tous les modèles qui tiennent dans un MacBook, coûte 0,15 $ par million de tokens d’entrée et 0,60 $ par million de tokens de sortie hors heures pleines sur l’API de DeepSeek elle-même (le double aux heures pleines). Qwen3.8 27B est listé sur OpenRouter à partir d’environ 0,035 $ par million de tokens d’entrée. Pour des données personnelles ou clients, utilise un fournisseur hébergé dans l’UE avec un accord de traitement des données plutôt que l’API de DeepSeek elle-même, qui traite les données en Chine.
4. Utilise un forfait de codage à prix fixe pour les modèles ouverts. Le forfait GLM Coding Plan de Z.ai Plan de codage GLM commence à 18 $ par mois et inclut GLM-5.3, à égalité en tête des modèles téléchargeables sur le nouvel index, plus GLM-5.3-Flash, et il fonctionne dans Claude Code, Codex, OpenCode et d’autres outils. 10 % de réduction sur le GLM Coding Plan via mon lien d’affiliation. (Lien d’affiliation — voir la mention en haut.) Ce n’est pas Opus 5.5, et l’index le dit clairement, mais ça coûte moins d’un dixième d’un forfait à 200 $. Je l’ai comparé à l’offre de MiniMax dans GLM-5.3-Flash vs MiniMax M3.
5. Utilise le Mac que tu as déjà. Si ton Mac actuel a 16 à 32 Go, de petits modèles locaux gèrent une quantité surprenante du travail en volume de la partie 11 gratuitement.
6. Route selon la tâche. La configuration qui marche pour la plupart des gens : un modèle local pour les tâches privées et en volume, un forfait bon marché ou un modèle ouvert au token pour le travail quotidien, et un accès aux modèles de pointe pour les 10 % difficiles. Mon comparatif des harnais de codage IA a cinq configurations détaillées à différents budgets.
Afficher l'image Coût mensuel de chaque option en dollars américains, hors TVA. Les coûts au token dépendent de ton usage ; prix vérifiés le 28 octobre 2026.
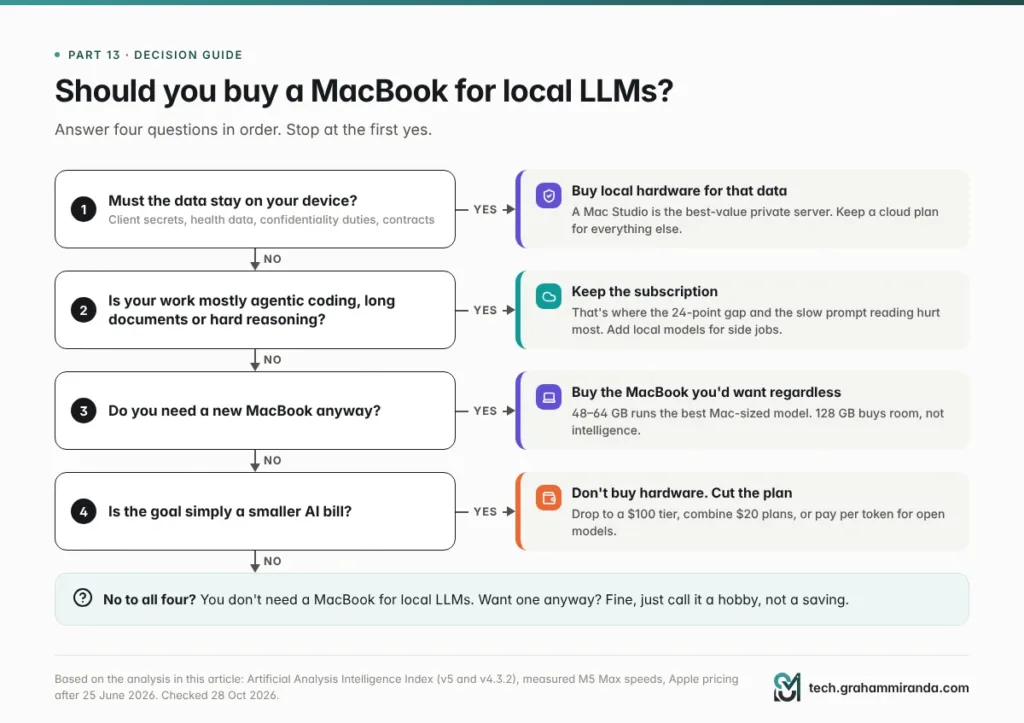
Partie 13 — Faut-il acheter un MacBook pour des LLM locaux ? Un guide de décision
Afficher l'image Commence par le haut. La plupart des chemins se terminent par “garde un forfait cloud”, et c’est tout l’intérêt.
Réponds à quatre questions dans l’ordre.
1. Les données doivent-elles rester sur ton appareil ? Si oui, à cause de la confidentialité client, de données de santé ou d’un contrat, achète du matériel local : cette exigence se fiche des benchmarks. Envisage un Mac Studio comme serveur privé, et garde un forfait cloud pour le travail qui ne concerne pas ces données.
2. Ton travail est-il surtout du codage agentique, de longs documents ou du raisonnement difficile ? Si oui, garde l’abonnement. C’est précisément là que l’écart de 24 points et les temps de prefill font le plus mal. Un modèle local peut quand même aider sur des tâches annexes.
3. As-tu de toute façon besoin d’un nouveau MacBook ? Si oui, achète celui que tu voudrais de toute façon. 48 à 64 Go font bien tourner le meilleur modèle de taille Mac. Passe à 128 Go seulement si tu veux spécifiquement des modèles de la classe 120B ou plusieurs modèles chargés en même temps, et sache que tu paies 2 000 $ pour de la place, pas pour de l’intelligence.
4. Le but est-il simplement une facture plus petite ? Alors n’achète pas de matériel. Descends d’un palier, combine des forfaits à 20 $, ou paie au token pour des modèles ouverts (partie 12).
Si tu as répondu non aux quatre, tu n’as pas besoin d’un MacBook pour des LLM locaux. Tu peux quand même en vouloir un, et ce n’est pas grave. Appelle ça un hobby, pas une économie.
Partie 14 — Si tu en achètes un quand même : comment en tirer le maximum
Choisis la bonne machine.
- Achète le 16 pouces, pas le 14 pouces, si le M5 Max est pour du travail IA soutenu.
- Envisage plutôt un Mac Studio. La même puce et la même mémoire pour 2 200 $ de moins, un meilleur refroidissement, et il peut servir ton portable et ton téléphone 24 heures sur 24.
- N’achète pas trop de mémoire pour les modèles d’aujourd’hui. 48 à 64 Go font tourner Qwen3.8 27B en 8 bits avec de longs contextes. Achète 128 Go pour des modèles de la classe 120B, plusieurs modèles à la fois ou de la marge pour les sorties futures, en sachant ce que ça coûte.
- Si tu achètes cette semaine, attends la fin de l’événement de ce soir. Tu sauras ce que le MacBook Pro OLED offre et coûte avant de t’engager.
Installe-le correctement.
- Commence avec LM Studio (MLX sur Apple Silicon) pour le chemin le plus simple, ou Ollama si tu veux une seule API pour les modèles locaux et cloud.
- Préfère le 8 bits pour tout ce sur quoi tu vas compter ; utilise le 4 bits pour la vitesse en chat.
- Règle la longueur de contexte volontairement. Beaucoup de runtimes choisissent par défaut de petits contextes ; les agents ont besoin de bien plus.
- Ne relève la limite de mémoire GPU que si tu comprends le compromis, et laisse de la place à macOS.
- Garde un forfait cloud à 20 $ pour les 10 % difficiles. C’est moins cher que ton propre temps.
Teste-le sur ton propre travail. Prends 20 vrais prompts du mois passé : e-mails, documents, tâches de codage, ce que tu fais vraiment. Passe chacun dans ton modèle local et ton modèle cloud, cache lequel est lequel, et note-les. Fais-le dans la langue dans laquelle tu travailles. Cette heure-là t’en dira plus que n’importe quel classement, y compris ceux de cet article.
Foire aux questions
Un MacBook peut-il remplacer un abonnement ChatGPT Pro ou Claude Max ?
Pas sur la qualité. Les modèles derrière un forfait à 200 $, comme Claude Opus 5.5 et GPT-6 Astra, ne peuvent pas être téléchargés, et les meilleurs modèles ouverts téléchargeables ont besoin de 375 à 460 Go de mémoire en 4 bits, bien au-delà de tout MacBook. Sur l’index d’Artificial Analysis, Opus 5.5 obtient 58 ; le modèle le plus fort que j’ai trouvé qui tient dans un MacBook de 128 Go, Qwen3.8 27B, obtient 34 sur la même version. Un MacBook peut remplacer un abonnement pour le travail privé, hors ligne ou en volume, pas pour les tâches de pointe.
Quel est le meilleur LLM local pour un MacBook Pro de 128 Go en 2026 ?
Pour la qualité, Qwen3.8 27B : Artificial Analysis le classe premier de 141 modèles comparables, avec 34 sur l’Intelligence Index v4.3.2, et il tient confortablement en 8 bits. Pour la vitesse, gpt-oss-120b et Qwen3.5 122B sont des modèles à mélange d’experts qui écrivent 55 à 88 tokens par seconde sur un M5 Max, mais ils obtiennent moins (12 et 16). Vérifie Artificial Analysis avant de choisir, parce que de nouveaux modèles ouverts changent ce classement toutes les quelques semaines.
Combien coûte aujourd’hui un MacBook Pro avec 128 Go ?
Un MacBook Pro 16 pouces avec un M5 Max (CPU 18 cœurs, GPU 40 cœurs), 128 Go et 2 To coûte 6 999 $ aux États-Unis, hors taxe de vente. Apple a augmenté les prix des Mac le 25 juin 2026 et doublé l’option 128 Go, de 1 000 $ à 2 000 $. En Allemagne, la même configuration coûtait 6 249 € au lancement et, d’après mon estimation, environ 8 199 € aujourd’hui. Un Mac Studio avec la même puce et la même mémoire coûtait 4 799 $.
Combien de temps faut-il à un MacBook pour se rembourser face à un abonnement IA à 200 $ ?
Environ 35 mois pour 6 999 $, s’il remplaçait complètement l’abonnement et ne coûtait rien à faire tourner. Avec environ 10 $ d’électricité par mois, c’est environ 37 mois, et si tu gardes un forfait à 20 $ pour les tâches de pointe, environ 41 mois. Face à un forfait à 100 $, c’est plus de six ans. Un Mac Studio avec la même puce est rentabilisé plus tôt, au bout d’environ 25 à 28 mois.
Le M5 Max est-il assez rapide pour des LLM locaux ?
Pour écrire des réponses avec des modèles à mélange d’experts, oui : mesuré avec MLX, un M5 Max de 128 Go générait 55 à 88 tokens par seconde, proche des 98 de Claude Opus 5.5 sur l’API d’Anthropic. La lecture de longs prompts est le point faible. Un prompt de 32 000 tokens prenait 13 secondes avec gpt-oss-120b, 31 secondes avec Qwen3.5 122B et 55 secondes avec un modèle dense de 27B, et les agents de codage IA relisent constamment de longs prompts.
Les LLM locaux sont-ils aussi bons que ChatGPT ou Claude aujourd’hui ?
Pas ceux qui tiennent sur un portable. Sur le nouvel Intelligence Index v5 d’Artificial Analysis, publié le 27 octobre 2026, les meilleurs modèles ouverts téléchargeables ont obtenu 32 contre 58 pour Claude Opus 5.5, et en dessous de Claude Haiku 5.5 à 36. Les modèles assez petits pour un MacBook obtenaient 34 au mieux sur la version précédente de l’index, où Opus 5.5 obtenait aussi 58. Pour des tâches courtes et simples, la différence est souvent faible ; pour le codage agentique, les longs documents et le raisonnement difficile, elle est grande.
La quantification rend-elle les modèles locaux moins bons ?
Un peu en 8 bits, plus en 4 bits, beaucoup en dessous. Une étude de plus de 500 000 évaluations a trouvé le FP8 effectivement sans perte et la quantification 4 bits sur les poids seulement proche du 8 bits sur les benchmarks standard. Mais sur des entrées de 64 000 tokens ou plus, une étude EMNLP 2025 a mesuré des chutes allant jusqu’à 59 % en 4 bits, pire pour le texte non anglais, et en 3 bits le score en maths d’un modèle de raisonnement est tombé de 85,6 % à 47,0 %.
Peux-tu faire tourner DeepSeek V4.1 Flash ou GLM-5.3 sur un MacBook ?
Non. GLM-5.3 a 753 milliards de paramètres et DeepSeek V4.1 Flash 763 milliards, mémoire Engram incluse, donc même en 4 bits ils ont besoin d’environ 375 à 460 Go, bien plus que les 128 Go maximum de n’importe quel MacBook. Un Mac Studio avec un M5 Ultra et 512 Go pourrait les contenir. La façon pratique de les utiliser, c’est via une API, idéalement un fournisseur hébergé dans l’UE avec un accord de traitement des données.
64 Go suffisent-ils pour de l’IA locale, ou te faut-il 128 Go ?
Pour la plupart des gens, 48 à 64 Go suffisent. Le meilleur modèle de taille Mac de l’index d’Artificial Analysis, Qwen3.8 27B, tient en 8 bits avec de la place pour de longs contextes. 128 Go te permettent de faire tourner des modèles de la classe 120B comme gpt-oss-120b, de garder plusieurs modèles chargés et d’utiliser des contextes plus longs, mais sur le classement d’aujourd’hui ces plus gros modèles obtiennent moins, donc l’option à 2 000 $ achète de la place plutôt que de l’intelligence.
Faut-il acheter un Mac Studio plutôt qu’un MacBook Pro pour des LLM locaux ?
Si l’IA locale est la raison principale, oui en général. Un Mac Studio avec le même M5 Max et 128 Go coûtait 4 799 $, 2 200 $ de moins que le MacBook Pro 16 pouces, avec un meilleur refroidissement soutenu et pas de batterie à surveiller. Il peut tourner 24 heures sur 24 comme serveur de modèles privé pour ton portable et ton téléphone. Achète un MacBook Pro si tu as besoin de la portabilité pour d’autres raisons.
Faire tourner l’IA en local est-il meilleur pour la confidentialité et le GDPR ?
Oui, c’est son plus grand avantage. Avec un modèle local, les prompts et les documents ne quittent jamais ton appareil, donc il n’y a pas d’accord de sous-traitance à signer ni de transfert international de données. Ça compte pour les données clients, les informations de santé et les professions tenues au secret, comme celles couvertes par le § 203 StGB en Allemagne. Le bénéfice pour la confidentialité reste vrai, que le modèle local soit aussi capable qu’un modèle cloud ou non. Ce n’est pas un conseil juridique.
Peux-tu utiliser Claude Code avec un modèle local ?
Oui. Ollama fournit une API compatible Anthropic, donc tu peux pointer Claude Code vers un modèle local en définissant ANTHROPIC_BASE_URL sur http://localhost:11434. Attends-toi à des compromis : Ollama ne prend pas en charge les contrôles de cache de prompt d’Anthropic, le long prompt système et les définitions d’outils de Claude Code obligent le modèle local à beaucoup lire à chaque étape, et Claude Code est réglé pour les modèles Claude. Les harnais ouverts comme OpenCode conviennent souvent mieux aux modèles locaux.
Le nouveau MacBook Pro OLED changera-t-il quoi que ce soit à cela ?
Probablement pas grand-chose pour l’IA locale. L’événement “Pro and Tell” d’Apple a lieu le 28 octobre 2026 à 10 h heure du Pacifique, et le MacBook Pro OLED à écran tactile attendu utiliserait, selon les informations, les mêmes puces M5 Pro et M5 Max, ce qui garderait le plafond de 128 Go et 614 Go/s de bande passante. Le MacBook Pro 14 pouces avec M6 annoncé le 27 octobre plafonne à 32 Go.
En résumé
L’argumentaire “résilie ton forfait à 200 $ et achète un Mac” voit juste sur deux choses : les abonnements sont chers, et l’IA locale est vraiment utile. Il se trompe sur l’essentiel. Un forfait à 200 $ te loue les meilleurs modèles du monde, les agents construits autour et un produit qui s’améliore chaque mois. Un MacBook à 7 000 $ fait tourner les meilleurs modèles qui tiennent dans 128 Go, et aujourd’hui ceux-ci obtiennent 34 contre 58 pour les modèles de pointe, lisent lentement les longs prompts et perdent en qualité exactement là où tu les comprimerais le plus.
Les calculs ne le sauvent pas non plus. Même dans le cas le plus généreux, le MacBook met trois à quatre ans à être rentabilisé, et sur trois ans il coûte à quelques milliers de dollars près la même chose que l’abonnement, selon le prix auquel tu peux le revendre. C’est une facture similaire pour un produit moins capable.
Alors achète un MacBook pour des LLM locaux si tes données ne peuvent pas sortir du bâtiment, si tu travailles hors ligne, si tu ne veux aucune limite et un modèle qui ne change jamais, ou si tu allais acheter un Mac de toute façon. Ce sont de bonnes raisons, et beaucoup de gens les ont. N’achète pas ça juste pour résilier ton abonnement. Garde un forfait cloud pour les 10 % difficiles, mets les 90 % privés et ennuyeux sur ton propre matériel, et laisse les classements te dire quand cet équilibre bouge.
Tu fais tourner des modèles locaux pour le boulot, ou tu as constaté le contraire de ce que dit cet article ? J’aimerais savoir quel modèle, quelle machine et quelles tâches, avec des chiffres si tu en as. Les corrections et les contre-preuves sont bienvenues ; cet article est mis à jour quand les classements et les prix bougent, ce qui en 2026 veut dire souvent.
Faits vérifiés : 28 octobre 2026.