Deutsch
 English
 Español
 Italiano
 Français

Inhaltsübersicht
- TL;DR – Das Fazit
- Erstens: Ja, dieser Chip ist echt
- Das Preisproblem (Ausgabe 2026)
- Warum gerade 64 GB? Das „Sweet-Spot“-Argument
- Schritt 1: Entfessle dein Gedächtnis (das solltest du als Erstes tun)
- Schritt 2: Stell deinen Stack zusammen
- Teil 1: LLMs ausführen
- Das eine Konzept, das alles erklärt: Bandbreite vs. Rechenleistung
- Die MoE-Revolution (warum Macs plötzlich gut wurden)
- Welche Modelle passen tatsächlich – die Tabelle
- Eine Realitätsprüfung der 70B-Modelle
- Quantisierung: Was soll man eigentlich wählen?
- MLX vs. llama.cpp – welche Laufzeitumgebung?
- Einen lokalen API-Server betreiben
- Teil 2: Bildgenerierung
- Teil 3: Videoproduktion – Der ehrliche Teil
- Teil 4: Echte Workflows, deren Einrichtung sich lohnt
- Der Alltag damit: Wärmeentwicklung, Akku und Geräuschentwicklung
- Die ehrlichen Gegenargumente
- 1. Das M5 Max ist tatsächlich schneller, und das ist nicht gerade subtil.
- 2. Ein M4 Max zum Sonderpreis könnte einen neuen M5 Pro übertrumpfen
- 3. NVIDIA hat bei der Rechenleistung weiterhin die Nase vorn
- 4. Bei den Mitbewerbern mit 128 GB Unified Memory geht es um die Speicherkapazität, nicht um die Geschwindigkeit.
- 5. Ein Mac-Desktop ist ein besseres stationäres Gerät
- 6. Der Arbeitsspeicher lässt sich nicht aufrüsten. Niemals.
- Die Kostenrechnung: Lokal vs. Cloud
- Der Einkaufsratgeber
- Häufig gestellte Fragen
- Wie geht es weiter?
- Das Fazit
Es gibt eine bestimmte Mac-Konfiguration, die sich still und leise zur Standardantwort auf die Frage “Welchen Laptop sollte ich kaufen, wenn ich selbst KI-Modelle ausführen möchte?” entwickelt hat. Es handelt sich um das MacBook Pro aus dem Jahr 2026 mit dem M5 Pro-Chip und 64 GB Unified Memory.
Nicht das günstigste. Nicht das schnellste. Aber das, bei dem die Kompromisse für die meisten Leute, die das tatsächlich wollen, genau richtig liegen. Verwendung lokale Modelle zu entwickeln, anstatt sie lediglich einem Benchmark zu unterziehen.
Dieser Leitfaden behandelt die tatsächlichen Leistungsmöglichkeiten dieses Geräts bei drei Anwendungsbereichen – große Sprachmodelle, Bildgenerierung und Videogenerierung – und liefert dabei konkrete Zahlen, sofern diese vorliegen, sowie realistische Schätzungen, wo dies nicht der Fall ist, sowie eine Schritt-für-Schritt-Anleitung zur Einrichtung, die du bereits am Tag der Lieferung deines Geräts befolgen kannst.
Außerdem wird erläutert, wo das „Sweet-Spot“-Argument nicht mehr zutrifft – denn das tut es tatsächlich nicht –, und du solltest genau wissen, wo das der Fall ist, bevor du dreitausend Dollar für Arbeitsspeicher ausgibst, den du später nicht mehr aufrüsten kannst.
TL;DR – Das Fazit
Kauf den M5 Pro 64 GB, wenn: Du möchtest einen tragbaren Rechner, der 8B–70B-Modelle und Mixture-of-Experts-Modelle schnell genug für den praktischen Einsatz ausführt, Bilder in Sekundenschnelle statt in Minuten generiert und dennoch genügend Leistung bietet, um deinen Browser, deine IDE und Docker-Container gleichzeitig ausführen zu können. Dies ist die ausgewogenste Lösung Laptop für lokale KI im Jahr 2026.
Entscheide dich für das M5 Max mit 128 GB, wenn: Du benötigst insbesondere lokale Modelle der Frontier-Klasse wie
gpt-oss-120b(was nicht (passt auf 64 GB) oder wenn du bei großen Modellen eine etwa doppelt so hohe Token-Generierungsgeschwindigkeit wünschst. Der M5 Max mit 40 Kernen verfügt über eine Speicherbandbreite von 614 GB/s gegenüber 307 GB/s beim M5 Pro, und bei der LLM-Dekodierung ist die Bandbreite entscheidend.Such lieber woanders, wenn: Die lokale Videoproduktion ist dein Hauptanwendungsbereich. Jeder Mac ist hier immer noch um ein Vielfaches langsamer als eine RTX 5090, und die Nutzung von Cloud-Ressourcen ist pro Clip deutlich günstiger.
Die drei Zahlen, die diese Maschine ausmachen:
| Metrisch | M5 Pro (20-Kern-GPU) | Warum das wichtig ist |
|---|---|---|
| 307 GB/s Speicherbandbreite | ~2× Basis M5, ~½ M5, maximal 40 Kerne | Legt die Obergrenze für Tokens pro Sekunde für LLMs fest |
| 64 GB Maximale Größe des einheitlichen Speichers | Standardmäßig stehen ca. 48–52 GB zur Verfügung | Stellt fest, welche Modelle überhaupt passen |
| 20 GPU-Kerne mit neuronalen Beschleunigern | 4×+ KI-Rechenleistung im Vergleich zum M4 Pro | Fördert die schnelle Bearbeitung und Verbreitung |
Erstens: Ja, dieser Chip ist echt
Viele der Ende 2025 und Anfang 2026 veröffentlichten Berichte über das M5 Pro waren reine Spekulation. Das ist nun nicht mehr der Fall.
Apple hat den M5 Pro und den M5 Max am 3. März 2026, und beide wurden im 14-Zoll- und 16-Zoll-MacBook Pro am 11. März 2026. Der Basis-M5 war bereits früher auf den Markt gekommen, nämlich am 22. Oktober 2025 im 14-Zoll-MacBook Pro, doch dieser Chip ist eine ganz andere Sache – er erreicht maximal 32 GB und 153 GB/s, was für die in diesem Leitfaden beschriebenen Arbeitslasten nicht ausreicht.
Folgendes hat Apple auf den Seiten „Newsroom“ und „Technische Daten“ bestätigt:
M5 Pro – bestätigte technische Daten
| Komponente | Spezifikation |
|---|---|
| CPU | 18 Kerne (6 “Super-Kerne” mit bis zu ca. 4,6 GHz + 12 Leistungskerne mit bis zu ca. 4,4 GHz). Basis-Bin: 15 Kerne. Bis zu 30% schneller im Multithread-Betrieb als der M4 Pro. |
| GPU | Bis zu 20 Kerne, jeder mit einem eigenen Neural Accelerator. Hardware-Raytracing der dritten Generation. Über viermal so hohe Spitzen-GPU-Rechenleistung für KI im Vergleich zum M4 Pro. |
| Neural Engine | 16-Kern |
| Einheitlicher Speicher | 24 GB / 48 GB / 64 GB – 64 GB sind die Obergrenze |
| Speicherbandbreite | Bis zu 307 GB/s (LPDDR5X) |
| Prozess | TSMC 3 nm (N3P), “Fusion Architecture” – zwei Chips, die über eine SoIC-mH-Verpackung miteinander verbunden sind |
| E/A und Medien | Thunderbolt 5, H.264/HEVC/ProRes/ProRes RAW-Kodierung und -Dekodierung, AV1-Dekodierung |
M5 Max – für mehr Kontrast
Der M5 Max verfügt über dieselbe 18-Kern-CPU, jedoch über eine GPU mit bis zu 40 Kernen und – was entscheidend ist – eine andere Speicherkonfiguration: Die 32-Kern-Variante erreicht eine Bandbreite von 460 GB/s, die 40-Kern-Variante 614 GB/s; die Speicherkapazität ist auf bis zu 128 GB konfigurierbar.
Diese Bandbreitenlücke ist kein unbedeutendes Detail im Datenblatt. Sie ist der mit Abstand wichtigste Faktor bei der Entscheidung zwischen dem M5 Pro und dem M5 Max, und wir werden immer wieder darauf zurückkommen.
Unabhängige Vergleichstests
Das Testgerät von Notebookcheck – ein 16-Zoll-M5 Pro mit 64 GB – erzielte im Geekbench 6.7-Test 4.295 Punkte im Single-Core-Test und 28.436 Punkte im Multi-Core-Test, im Cinebench 2024 Multi-Core 2.347 und im Cinebench 2026 Multi-Core 9.481.
Ihre GPU-Analyse ergab, dass der M5 Max in etwa mit einer Desktop-RTX 5070 mithalten kann und deutlich vor der Strix Halo von AMD liegt. Die 20-Kern-GPU des M5 Pro liegt darunter, was man sich vor Augen halten sollte: Es handelt sich um eine leistungsfähige GPU für einen Laptop, nicht um einen Ersatz für eine dedizierte Grafikkarte.
Sie wiesen zudem auf einen weniger schmeichelhaften Aspekt hin, den man ernst nehmen sollte: Das MacBook Pro von 2026 drosselt seine Leistung bei anhaltender Auslastung spürbar, wobei die CPU-Leistung selbst im „High Power“-Modus schwankt. Mehr dazu im Abschnitt zur Wärmeentwicklung.
Das Preisproblem (Ausgabe 2026)
Die M5 Pro-Reihe wurde auf der $2,199 für das 14-Zoll-Modell und $2,699 für das 16-Zoll-Modell. Dann kam es zu einer weltweiten Speicherverknappung.
Unter Im Juni 2026 erhöhte Apple die Preise für das MacBook Pro pauschal um etwa $300.. Nach der Preiserhöhung liegt das Einstiegsmodell des 14-Zoll-M5 Pro bei etwa $2.499, und ein 14-Zoll-M5 Pro mit 64 GB und einer 1-TB-SSD kostet je nach Tag und Händler zwischen $2,799–$2.999, je nach Tag und Händler. B&H und andere Wiederverkäufer gewähren auf M5 Pro-Konfigurationen mit 48 GB und 64 GB Rabatte von $300–$400; es lohnt sich, dies vor einem Direktkauf zu prüfen.
In Deutschland beginnt die M5 Pro-Reihe bei 2.199 €, wobei bei Händlern wie Edustore Sonderpreise für Bildungseinrichtungen von bis zu 1.979 € angeboten werden. Die Preise für Modelle mit 64 GB liegen deutlich höher, sobald die Mehrwertsteuer (19%) hinzugerechnet wird.
Für deine Entscheidung sind zwei Deltas von Bedeutung:
- 48 GB → 64 GB beim M5 Pro: Ursprünglich handelte es sich um ein Upgrade von $200 auf $400, doch nach der Preiserhöhung im Juni stiegen die Preise für RAM-Upgrades in vielen Konfigurationen um 50 bis 67% an.
- M5 Pro 64 GB → M5 Max 128 GB: ein deutlicher Preisanstieg. Vor der Preiserhöhung lag der Startpreis des M5 Max bei $3.599 (14 Zoll) bzw. $3.899 (16 Zoll), und die Preise für Speichererweiterungen auf 64 GB bzw. 128 GB beim M5 Max haben sich im Juni etwa verdoppelt. Ein 16-Zoll-Modell mit maximaler Ausstattung kostet nun $10,000.
Überprüfe vor dem Kauf jeden Preis in diesem Abschnitt stichprobenartig. Der Speichermarkt im Jahr 2026 verändert sich von Monat zu Monat, und alles, was hier geschrieben steht, ist nur von kurzer Dauer.
Warum gerade 64 GB? Das „Sweet-Spot“-Argument
Bei der Behauptung bezüglich des “Sweet Spots” geht es nicht darum, dass 64 GB eine magische Zahl wären. Es geht vielmehr darum, was jede Speicherstufe tatsächlich ausschließt.
Was du auf den einzelnen Stufen nicht tun darfst
16 GB / 24 GB — Modelle der Größenordnung 7B–8B lassen sich problemlos ausführen, Modelle der Größenordnung 14B bei aggressiver Quantisierung. Modelle der Klasse 30B+ lassen sich ohne aussagekräftigen Kontext nicht ausführen. Du wirst deine Zeit damit verbringen, den Speicher zu verwalten, anstatt die Modelle zu nutzen.
32 GB — Das funktioniert bei dichten 14B-Modellen und einigen kleineren MoE-Modellen. Sobald man jedoch einen KV-Cache für 32K+ Kontext, dazu Chrome, die eigene IDE und einen Docker-Daemon hinzufügt, gerät man in den Bereich, in dem der Arbeitsspeicher unter Druck gerät. Das ist die Ebene, auf der sich viele davon überzeugen, dass lokale KI nicht funktioniert.
48 GB — Wirklich gut. Lässt sich problemlos mit komplexen Modellen der 32B-Klasse arbeiten. Das Problem ist der Speicherplatz: Ein 70B-Modell bei Q4 benötigt etwa 40 GB, was zwar technisch gesehen gerade noch passt, aber für den Rest des Computers nichts mehr übrig lässt. Am Ende muss man Anwendungen beenden, um ein Modell auszuführen – und genau diese Reibungsverluste machen lokale Arbeitsabläufe unmöglich.
64 GB — An dieser Stelle kannst du ein Modell 70B Q4 festhalten fido ein MoE-Modell mit 106B Parametern im Arbeitsspeicher und Halte deine gesamte Arbeitsumgebung ständig im Hintergrund laufen. Kein Beenden von Slack. Kein Herunterfahren von Containern. Du öffnest ein Modell und arbeitest einfach weiter.
128 GB (M5 Max-Bereich) — Freischaltungen gpt-oss-120b und die 120B+-Klasse. Wirklich nützlich, wenn man das braucht, und wirklich teuer, wenn nicht.
Das “Sweet-Spot”-Argument läuft im Grunde darauf hinaus, dass man „ein ernstzunehmendes Modell UND alles andere“ einsetzen sollte. Das ist der Unterschied zwischen lokaler KI, die man nur vorführt, und lokaler KI, die man tatsächlich nutzt.
Allerdings gibt es bei 64 GB eine feste Obergrenze, und das solltest du schon jetzt wissen.
Das Problem mit dem gpt-oss-120b
gpt-oss-120b Bei der MXFP4-Quantisierung werden allein für die Gewichte etwa 63 GB benötigt. Unabhängige Messungen auf einem M5 Max mit 128 GB unter Verwendung von MLX ergaben einen Spitzen-Speicherbedarf von etwa 64,4 GB bei einem Kontext von 4.096 Token und 64,9 GB bei einem Kontext von 16K.
Auf einem Rechner mit 64 GB, bei dem das realistisch nutzbare Speicherplatzbudget bei 52–60 GB liegt, passt das nicht. Nicht “passt knapp” – es passt überhaupt nicht.
Wenn du eine Behauptung siehst, dass gpt-oss-120b Wenn es mit 64 GB läuft, sei vorsichtig. Es handelt sich um ein 128-GB-Modell. Das ist das eindeutigste Argument dafür, auf das M5 Max umzusteigen, und wenn dir dieses Modell wichtig ist, ändern auch noch so viele „Sweet-Spot“-Argumente nichts an der Rechnung.
Schritt 1: Entfessle dein Gedächtnis (das solltest du als Erstes tun)
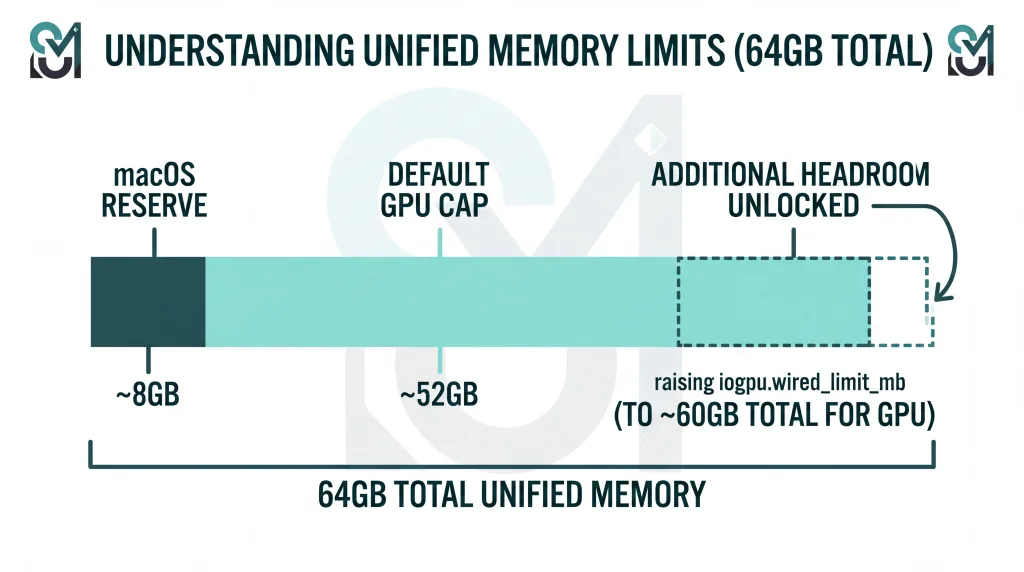
Hier ist etwas, was die meisten Käufer nicht wissen: macOS lässt nicht zu, dass die GPU den gesamten Arbeitsspeicher nutzt.
Standardmäßig begrenzt macOS den direkt an die GPU angeschlossenen Speicher auf insgesamt etwa 75%. Auf einem Rechner mit 64 GB entspricht dies etwa 51,84 GB für Modellgewichte nutzbar, der Rest ist für das System reserviert.
Du kannst dies mit einem einzigen Befehl aktivieren. Kein Neustart, keine Änderungen am Systemintegritätsschutz.
Anmerkung: Der moderne Schlüssel ist
iogpu.wired_limit_mb. Ältere Anleitungen verweisen aufdebug.iogpu.wired_limit, der inzwischen ersetzt wurde. Falls du eine Anleitung findest, in der der alte Schlüssel verwendet wird, ist diese veraltet.
Das Limit erhöhen
bash
# Stelle das Limit für den fest zugewiesenen Speicher der GPU auf 60 GB ein (60 × 1024 = 61440 MB)
sudo sysctl iogpu.wired_limit_mb=61440

# Überprüfe, ob die Änderung wirksam wurde
sysctl iogpu.wired_limit_mb

# Du kannst die Einstellung jederzeit auf den macOS-Standard zurücksetzen
sudo sysctl iogpu.wired_limit_mb=0
Speichere es dauerhaft ab
Die Einstellung wird beim Neustart zurückgesetzt. Damit sie dauerhaft gespeichert wird, füge sie zu /etc/sysctl.conf:
bash
echo "iogpu.wired_limit_mb=61440" | sudo tee -a /etc/sysctl.confAlternativ kannst du einen LaunchDaemon erstellen oder die sysctl Aufruf eines Anmeldeskripts, falls du das Skript lieber nicht bearbeiten möchtest /etc/sysctl.conf.
Wie weit sollte man es treiben?
Reserviere 4–8 GB für macOS. Auf einem Rechner mit 64 GB sind 60 GB (61.440 MB) zwar recht knapp bemessen, aber noch machbar, wenn du nicht allzu viele andere Programme laufen lässt. 56 GB (57.344 MB) sind die sicherere Einstellung für den Alltag.
Weise 100% nicht zu. Es kommt zu „Beachballs“, Anwendungsabstürzen oder einem Hard-Reset – und auf einem Rechner, der sich mitten in einer Inferenz befindet, bedeutet das den Verlust aller laufenden Prozesse.
Praktisches Budget für einen 64 GB M5 Pro:
- Standard: ~48–52 GB nutzbarer Speicherplatz
- Auf 56 GB erhöht: ausreichend für ein 70B-Q4-Modell plus Kontext
- Auf 60 GB erhöht: maximal, mit minimalem Speicherplatz für andere Anwendungen
Dieser Unterschied – 48 GB gegenüber 58 GB – entscheidet oft darüber, ob ein Modell auf der GPU läuft oder auf die CPU ausweicht, was den Durchsatz völlig zunichte macht. Das sind die fünf Minuten, die du in die Einrichtung investierst und die sich am meisten lohnen.
Eine weitere Voraussetzung
MLX erfordert macOS 26.2 oder höher, um die Neural Accelerators des M5 tatsächlich nutzen zu können. Wenn du eine ältere Version verwendest, lässt du dir die mit Abstand größte Verbesserung dieser Generation entgehen. Überprüfe die Software-Aktualisierung, bevor du irgendwelche Benchmark-Tests durchführst.
Schritt 2: Stell deinen Stack zusammen
Hier ist die vollständige Anleitung in der richtigen Reihenfolge. Plan etwa 30 Minuten plus die Downloadzeit ein.
2.1 – Grundlagen
bash
# Installiere Homebrew, falls du es noch nicht hast
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"

# Installiere „uv“ – einen schnellen Python-Paketmanager, der für diesen Zweck weitaus besser geeignet ist als „pip“
brew install uv

# Optional, aber empfohlen: ein Python-Versionsmanager
brew install [email protected]
2.2 — MLX (Apples natives ML-Framework)
MLX ist Apples eigenes Array-Framework, das speziell für die einheitliche Speicherarchitektur von Apple Silicon entwickelt wurde. Es ist der schnellste Weg für die LLM-Inferenz auf einem Mac und sollte deine Standardwahl sein.
bash
# Eine dedizierte Umgebung erstellen
uv venv ~/mlx-env
source ~/mlx-env/bin/activate

# mlx-lm installieren
uv pip install mlx-lm

# Testen – hiermit wird ein Modell heruntergeladen und ausgeführt
mlx_lm.generate \
  --model mlx-community/Qwen3.6-27B-4bit \
  --prompt "Erkläre die Unified-Memory-Architektur in drei Sätzen."
Wenn dabei Text entsteht, funktioniert dein Stack.
2.3 – LM Studio (die Benutzeroberfläche)
Herunterladen von lmstudio.ai. Dies ist die benutzerfreundlichste Art, Modelle zu durchsuchen, herunterzuladen und auszuführen, und Apple hat dies bei der Vorstellung des M5 Pro demonstriert – was deutlich macht, wie sehr sich die lokale Inferenz mittlerweile etabliert hat.
Die für Entwickler nützlichste Funktion von LM Studio ist der integrierte OpenAI-kompatible Server. Aktiviere ihn unter dem Entwickler Registerkarte und stellt einen Endpunkt unter http://localhost:1234/v1 mit dem jeder OpenAI-kompatible Client kommunizieren kann.
2.4 – Ollama (die Befehlszeilenschnittstelle und der Server)
bash
brew install ollama

# Server starten
ollama serve

# In einem anderen Terminal ein Modell abrufen und ausführen
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Wichtige Aktualisierung für 2026: auf Am 30. März 2026 stellte Ollama 0.19 sein Apple-Silicon-Backend von llama.cpp auf MLX um. Dadurch verdoppelte sich die Dekodierungsgeschwindigkeit in etwa. Bei Ollamas eigenen M5-Max-Messungen mit Qwen3.5-35B-A3B stieg die Prefill-Rate von 1.154 auf 1.810 Token/Sek. und die Dekodierungsrate von 58 auf 112 Token/Sek. – wobei die „int4“-Version die Prefill-Rate auf 1.851 und die Dekodierungsrate auf 134 steigerte.
Wenn du Ollama zuletzt vor dieser Version auf einem Mac ausprobiert hast, ist deine Vorstellung von der Leistung des Programms nicht mehr aktuell.
2.5 — Dinge zeichnen (Bilder und Videos)
Installiere die App aus dem Mac App Store. Sie ist kostenlos, nativ, für Metal optimiert und derzeit das beste Tool zur Bildgenerierung auf Apple Silicon. Die darin enthaltene Metal-Implementierung von FlashAttention v2.5 läuft auf dem M5 bis zu 4,6-mal schneller als auf dem M4 und unterstützt das LoRA-Training direkt auf dem Gerät.
2.6 – ComfyUI (wenn du Pipelines brauchst)
bash
brew install comfyuiComfyUI bietet dir eine knotenbasierte Workflow-Steuerung, mit der Draw Things nicht mithalten kann. Es läuft auf dem MPS-Backend und ist bei gleicher Arbeitsleistung auf Apple Silicon etwa 20% langsamer als Draw Things; außerdem gibt es echte Probleme mit FP8-Checkpoints auf Metal. Verwende es, wenn du komplexe Pipelines brauchst; nutze Draw Things, wenn es auf Geschwindigkeit ankommt.
2.7 – Alles überprüfen
bash
# Überprüfe, ob dein Speicherlimit feststeckt
sysctl iogpu.wired_limit_mb

# Vergewissere dich, dass MLX deine GPU erkennt
python -c "import mlx.core as mx; print(mx.default_device())"

# Überprüfe, ob Ollama erreichbar ist
curl http://localhost:11434/api/tags
Teil 1: LLMs ausführen
Das ist die größte Stärke des M5 Pro 64 GB, und es lohnt sich, dies zu verstehen warum bevor du dir die Modellliste ansiehst.
Das eine Konzept, das alles erklärt: Bandbreite vs. Rechenleistung
Die LLM-Inferenz erfolgt in zwei Phasen, die jeweils völlig unterschiedliche Teile deines Computers beanspruchen.
Vorausfüllung (schnelle Bearbeitung) ist der Durchlauf durch deine Eingabe, bevor das erste Token erscheint. Es ist rechenintensiv. Aus diesem Grund führte das Einfügen einer Datei mit 40.000 Token in einen lokalen Programmier-Agenten früher auf einem Mac zu minutenlangem Stillstand, während eine NVIDIA-Grafikkarte diese Datei in Sekundenschnelle verarbeitete.
Dekodieren (Token-Generierung) erzeugt jedes nachfolgende Token. Es ist speicherbandbreitengebunden. Für jedes generierte Token müssen die Gewichte des Modells aus dem Speicher gelesen werden. Je schneller der Speicher, desto schneller die Token. So einfach ist das fast.
Diese Aufteilung verdeutlicht das gesamte Konzept des M5 Pro:
- Sein 307 GB/s Die Bandbreite legt eine feste Obergrenze für die Dekodierungsgeschwindigkeit fest. Das entspricht etwa dem Doppelten der 153 GB/s des Basis-M5 und etwa der Hälfte der 614 GB/s des M5 Max mit 40 Kernen.
- Sein Neuronale Beschleuniger — jeweils einer pro GPU-Kern, eine Neuerung der M5-Generation — verbessern das Prefill erheblich.
Apples eigenes MLX-Forschungsteam veröffentlichte im November 2025 Messergebnisse, in denen die Basisversion des M5 mit der Basisversion des M4 auf Qwen3-14B-4bit verglichen wurden: Die Zeit bis zum ersten Token war 4,06-mal schneller, während sich die Token-Generierung lediglich um das 1,19-Fache verbesserte. Dieser bescheidene Dekodierungsgewinn entspricht genau der Bandbreitensteigerung (120 GB/s → 153 GB/s). Der enorme Gewinn beim Prefill ist ausschließlich auf die Neural Accelerators zurückzuführen.
Apple wirbt damit, dass die Pro- und Max-Varianten die Verarbeitung von LLM-Prompts bis zu viermal schneller bewältigen als der M4 Pro und der M4 Max. Der Mechanismus ist identisch, allerdings gibt es bislang noch kaum unabhängige Bestätigungen speziell für den M5 Pro.
Was das in der Praxis bedeutet: Der M5 Pro stellt gegenüber den Macs der Vor-M5-Generation ein bahnbrechendes Upgrade für Arbeiten mit langen Kontexten und agentisches Programmieren dar, bei denen die Vorabausfüllung im Vordergrund steht. Beim reinen Chat-Durchsatz, bei dem die Dekodierung im Vordergrund steht, handelt es sich hingegen um ein eher bescheidenes Upgrade.
Die MoE-Revolution (warum Macs plötzlich gut wurden)
„Mixture-of-Experts“-Architekturen haben die Berechnungsgrundlagen für Unified-Memory-Maschinen verändert – und wenn du aus diesem Leitfaden sonst nichts mitnimmst, solltest du zumindest dies verstehen.
Ein MoE-Modell verfügt über eine enorme Gesamtzahl an Parametern, aktiviert jedoch pro Token nur einen kleinen Teil davon. gpt-oss-120b hat insgesamt 117 Milliarden Parameter, aktiviert aber ungefähr 5,1 Milliarden pro Token.
- Gesamtparameter Bestimme deine Speicher Anforderung – die Macs in Hülle und Fülle erfüllen.
- Aktive Parameter Bestimme deine Dekodiergeschwindigkeit — was durch die Bandbreite begrenzt ist.
Ein MoE-Modell benötigt also die Ressource, über die Macs reichlich verfügen, und verbraucht nur wenig von der Ressource, an der es bei Macs mangelt. Ein gut ausgewähltes MoE-Modell auf einem Mac mit 64 GB liefert eine Qualität nahe dem Stand der Technik bei der Dekodiergeschwindigkeit eines wesentlich kleineren Modells.
Aus diesem Grund kann ein Laptop mit 307 GB/s bei bestimmten Arbeitslasten durchaus mit Grafikkarten mithalten, die mit 1.700 GB/s arbeiten. Entscheide dich nach Möglichkeit für MoE-Modelle.
Welche Modelle passen tatsächlich – die Tabelle
Die unten aufgeführten Messwerte stammen aus der oMLX-Community-Benchmark-Datenbank für den M5 Pro mit 20 Kernen und 64 GB. Schätzwerte sind deutlich gekennzeichnet. Vertraue keinen nicht gekennzeichneten Token- oder Sek-Nummern, die du anderswo für diesen Chip findest — Nur sehr wenige haben echte Messwerte zum M5 Pro veröffentlicht.
| Modell | Typ | Fußabdruck | Dekodierung (Token/s) | Vorabfüllung (tok/s) | Fazit |
|---|---|---|---|---|---|
| gpt-oss-20b (MXFP4) | MoE | ~12 GB | 66–80 ✅ gemessen | 1.500–2.200 ✅ | Das Alltagsauto. Schnell, leistungsstark, winzig. |
| Qwen3.5-35B-A3B / Qwen3-30B-A3B (Q4) | MoE | ~20 GB | ~55–70 (geschätzt) | Hoch | Das beste Preis-Leistungs-Verhältnis pro GB. Die effizienteste Wahl. |
| Qwen3.6-27B (4 Bit) | Dicht | ~16 GB | 17.8 ✅ gemessen | 470 ✅ | Ein typisches Modell der Klasse „27–35B“ mit fester Passform. |
| GLM-4.5 / 4.6 Air (106B-A12B) | MoE | ~40 GB+ | ~30 | Hoch | Eine Argumentation nahe am Grenzbereich, die tatsächlich zutrifft. |
| Llama 3.3 70B (Q4_K_M) | Dicht | ~40 GB | ~7–12 (geschätzt) | Mäßig | Geeignet für die Stapelverarbeitung; interaktiv nur bedingt einsetzbar. |
| Llama 3.3 70B (Q5_K_M) | Dicht | ~49 GB | ~6–10 (geschätzt) | Mäßig | Passt, ist aber knapp. Erhöhe zuerst dein Speicherlimit. |
| Qwen3 14B / 32B, Gemma 3, Mistral Small, Devstral, Command-A | Dicht | 8–24 GB | 20–60+ | Gut | Alles bequem. Nach Aufgabe auswählen. |
| gpt-oss-120b (MXFP4) | MoE | ~63 GB | — | — | ❌ Passt nicht. Ein Gerät mit 128 GB ist erforderlich. |
| Qwen3-235B-A22B (1,58-Bit, ternär) | MoE | ~53 GB | ~5.6 | Niedrig | Technisch gesehen funktioniert es. Ein Partytrick, kein Arbeitsablauf. |
Der Mengenrabatt: gpt-oss-20b auf der M5 Pro-Skala entspricht das in etwa 142 Tok/s bei einer Batch-Größe von 8. Wenn du Agenten, Auswertungsschleifen oder sonstige Workloads mit parallelen Anfragen ausführst, verbessert sich der Durchsatz gegenüber dem Wert bei einem einzelnen Datenstrom erheblich.
Eine Realitätsprüfung der 70B-Modelle
Es gibt keine veröffentlichte, unabhängig gemessene Dekodierungsrate des M5 Pro für Llama 3.3 70B. Die Schätzung von 7–12 Tok/s wurde anhand der Bandbreite extrapoliert.
Zur Einordnung: Ein M4 Max mit 128 GB und einer Übertragungsrate von 546 GB/s erreicht bei demselben Modell etwa 18–20 tok/s. Der M5 Pro kommt auf 307 GB/s. Die Rechnung fällt nicht gerade ermutigend aus.
Bei 7–12 Token pro Sekunde erhält man etwa 5–9 Wörter pro Sekunde – das ist langsamer als eine angenehme Lesegeschwindigkeit. Für Hintergrundaufgaben, die Dokumentenverarbeitung und nächtliche Batch-Verarbeitungen ist das in Ordnung. Für interaktive Chats ist es jedoch frustrierend.
Die ehrliche Empfehlung: Auf einem 64 GB M5 Pro solltest du Modelle mit 70 Milliarden Knoten als Werkzeuge für Batch-Workloads betrachten und MoE-Modelle für alle interaktiven Anwendungen nutzen.
Quantisierung: Was soll man eigentlich wählen?
| Format | Qualitätsverlust | Wann ist die Verwendung angebracht? |
|---|---|---|
| Q4_K_M (GGUF) | ~1–2% | Standard. Bestes Verhältnis von Geschwindigkeit und Qualität. |
| MLX 4-Bit | ~1–2% | Standard auf dem Mac. ~10% weniger Arbeitsspeicher und 15–30% schneller als ein vergleichbares GGUF. |
| Q5_K_M / MLX 6-Bit | <1% | Wenn du über genügend Headroom verfügst und eine nahezu verlustfreie Wiedergabe wünschst. |
| Q6_K | Vernachlässigbar | Qualitätskritische Arbeit mit reichlich Speicherplatz. |
| Q8 / FP16 | Keine | Auf einem Laptop lohnt sich das selten. Das Budget für die Modellgröße halbiert oder viertelt sich. |
| MXFP4 | Einheimische | Keine Wahl – so ist es nun einmal gpt-oss Schiffe. |
| 1,58-Bit-ternär | Schwerwiegend | Nur um ein Modell hineinzuzwängen, das sonst nicht hineinpasst. |
Faustregel: 4-Bit für Geschwindigkeit und Kompatibilität, 6-Bit, wenn es auf Qualität ankommt und du genügend Platz hast, und 8-Bit solltest du auf einem Laptop vermeiden.
MLX vs. llama.cpp – welche Laufzeitumgebung?
Die kurze Antwort lautet: MLX – allerdings mit einer Einschränkung.
- Bei ~14 Mrd. Parametern: MLX liegt mit 20–87% vor llama.cpp. Das ist kein knappes Ergebnis.
- Über ~27 Mrd.: Beides läuft zusammen, da die Speicherbandbreite zum Engpass wird und die Laufzeit keine Rolle mehr spielt.
- Speicher: MLX verbraucht bei gleicher Quantisierung etwa 10% weniger als GGUF.
- Der Vorbehalt: Bei mehr als 30.000 Token-Kontexten kann MLX bis zu 50% langsamer als „lama.cpp“ bei aktivierter „Flash Attention“-Funktion. Dies ist modell- und kontextabhängig.
Wenn du regelmäßig mit sehr langen Kontexten arbeitest, führe beide Tests anhand deiner tatsächlichen Arbeitslast durch. Andernfalls wähle MLX.
Einen lokalen API-Server betreiben
mlx-lm Ab Version 0.18 wird ein OpenAI-kompatibler Server mit kontinuierlicher Stapelverarbeitung ausgeliefert:
bash
mlx_lm.server \
  --model mlx-community/gpt-oss-20b-MXFP4 \
  --port 8080
Nun kann alles, was die OpenAI-API nutzt, dein lokales Modell verwenden:
bash
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local",
    "messages": [{"role": "user", "content": "Schreibe einen Bash-Einzeiler, um große Dateien zu finden."}]
  }'
Dieser Endpunkt bildet die Grundlage für alle Inhalte im folgenden Abschnitt „Workflows“.
Teil 2: Bildgenerierung
Bei der Bildgenerierung schneidet das M5 Pro besser ab, als es seine Bandbreite vermuten lässt, und das aus einem ganz einfachen Grund: Die Diffusion ist rechenintensiv, nicht bandbreitengebunden, und die Modelle sind so klein, dass der Arbeitsspeicher auf einem Rechner mit 64 GB niemals eine Einschränkung darstellt.
Leistung nach Modell
| Modell | Größe | Speicher | Zeit pro Bild mit einer Auflösung von 1024×1024 | Anmerkungen |
|---|---|---|---|---|
| SDXL | 3,5 Mrd. | ~7 GB | ca. 7 s bei 30 Schritten (M5 Max) | Die schnellste Option mit hoher Qualität. Ein riesiges LoRA-Ökosystem. |
| FLUX.1 [schnell] | 12B | ~7 GB (4. Quartal) | ~20–25 s in 4 Schritten | Auf Geschwindigkeit optimiert. Apache-2.0. |
| FLUX.1 [Entwicklung] | 12B | ~10 GB (Frage 6) | ~50er bei 20 Schritten (M4-Klasse) | Der Qualitätsmaßstab. |
| FLUX.2 [Klein] | 4B destilliert | ~8 GB | ~40er Jahre | Neuer, kleiner, schneller. |
| FLUX.2 [Entwicklung] | Groß | 24 GB+ | Einige Minuten | Beste Qualität – hier ist echte Geduld gefragt. |
| SD 3,5 | Unterschiedlich | 10–20 GB | Ein paar Sekunden | Ein solider Mittelweg. |
| Qwen-Image / Qwen-Image-Edit | Unterschiedlich | 15–25 GB | Ein paar Sekunden | Hervorragend geeignet für die Darstellung und Bearbeitung von Text. |
| HiDream, Chroma | Unterschiedlich | 10–20 GB | Unterschiedlich | Aufgrund der großen Stilvielfalt einen Blick wert. |
Das ML-Forschungsteam von Apple hat FLUX-dev-4bit bei der Erzeugung eines Bildes mit einer Auflösung von 1024×1024 gemessen. auf dem M5 mehr als 3,8-mal schneller als auf dem M4 mit MLX. Diese Leistungssteigerung ist auf die Neural Accelerators zurückzuführen und gilt für die gesamte M5-Familie.
Bislang wurden noch keine spezifischen Benchmark-Werte für die M5 Pro in Sekunden pro Bild veröffentlicht. Betrachte die obige Tabelle daher als Werte für die M4-Klasse, wobei mit einer deutlichen Leistungssteigerung bei der M5 zu rechnen ist. In der Praxis solltest du davon ausgehen, dass FLUX.1 [schnell] deutlich unter 20 Sekunden und SDXL in einstelligen Sekunden liegt.
Mit 64 GB kannst du diese Modelle ausführen bei FP16 ohne Quantisierung, was einen echten Qualitätsvorteil gegenüber den 16-GB- und 24-GB-Geräten darstellt, die auf Q4 beschränkt sind.
Werkzeuge: Was sollte man verwenden?
Dinge zeichnen — die Standardwahl. Native Metal-Unterstützung, keine Python-Umgebung, die Probleme verursachen könnte, Metal FlashAttention v2.5, das auf dem M5 bis zu 4,6-mal schneller läuft als auf dem M4, sowie LoRA-Training direkt auf dem Gerät. Kostenlos im App Store erhältlich.
ComfyUI — für knotenbasierte Pipelines, ControlNet-Ketten und mehrstufige Workflows. Etwa 20% langsamer als „Draw Things“ auf Apple Silicon. Achte auf FP8-Checkpoints, die unter Metal häufig fehlschlagen.
DiffusionKit — Apples eigenes Diffusions-Toolkit, unterstützt von MLX. Das sollte man im Auge behalten.
Mochi Diffusion, InvokeAI — beides ist möglich, beides ist in Ordnung.
Zu vermeiden: DiffusionBee wird praktisch nicht mehr weiterentwickelt. Automatic1111 und Forge funktionieren zwar technisch gesehen über MPS, sind jedoch langsam und werden auf dem Mac nur unzureichend gepflegt.
Schritt für Schritt: dein erstes lokales Image
- Installieren Dinge zeichnen aus dem Mac App Store.
- Öffne es und wechsle zum Modell-Manager (das Symbol oben im linken Bereich).
- Herunterladen FLUX.1 [schnell] — etwa 7 GB im vierten Quartal, oder nimm die FP16-Version, da du ja über genügend Arbeitsspeicher verfügst.
- Set Schritte bis 4 („schnell“ wird genau zu diesem Zweck destilliert) und Größe auf 1024×1024.
- Gib einen Befehl ein und drücke Erstellen.
- Beim ersten Durchlauf wird das Modell geladen. Die nachfolgenden Generationen laufen deutlich schneller.
LoRA-Training auf dem Gerät
Ein Gerät mit 64 GB Speicher kann Bildmodelle lokal feinabstimmen – eine Funktion, deren Bedeutung oft unterschätzt wird. Draw Things unterstützt das LoRA-Training direkt, und MLX unterstützt sowohl LoRA als auch QLoRA für Bild- und Sprachmodelle.
Ein kleines LoRA-Modell auf Basis von 20 bis 50 Bildern lässt sich auf einem M5 Pro über Nacht trainieren und verlässt dabei nie deinen Rechner. Für alle, die mit Kundenmaterial oder firmeneigenen Assets arbeiten, ist das wichtiger als die Geschwindigkeit.
Teil 3: Videoproduktion – Der ehrliche Teil
An dieser Stelle muss ich ganz offen zu dir sein, denn viele Informationen zu diesem Thema sind es nicht.
Die lokale Videoerstellung auf jedem Mac läuft im Jahr 2026 nur langsam. Nicht “langsamer als eine 4090” langsam. Langsam genug, um deine Arbeitsweise zu verändern.
Warum Macs gerade in diesem Bereich Schwierigkeiten haben
Die Verbreitung von Videos ist stark rechenintensiv. Im Gegensatz zur LLM-Dekodierung, bei der die reichlich vorhandene Speicherbandbreite des Macs die entscheidende Ressource ist, beansprucht die Videogenerierung vor allem die reine Rechenleistung der GPU – genau der Bereich, in dem eine 20-Kern-Laptop-GPU gegenüber einer dedizierten Grafikkarte den Kürzeren zieht.
Die Neural Accelerators des M5 helfen dabei. Sie schließen jedoch eine so große Lücke nicht.
Die Zahlen, ungeschönt
Wan 2.2 (Alibaba, Apache-2.0, verfügbar als 14B-MoE- und als kompakte 5B-Variante für die Umwandlung von Text und Bildern in Videos): Auf einem M1 Max mit 64 GB, auf dem ein GGUF-Build läuft, ein Ein 2-Sekunden-Clip mit einer Auflösung von 832×480 dauerte 82 Minuten. Ein 5-Sekunden-Clip würde drei Stunden überschreiten.
Zum Vergleich: Das gleiche Modell TI2V-5B auf einer RTX 4090 mit 24 GB benötigt für 5 Sekunden bei 720p etwa 9 Minuten.
Ein M5 Pro ist deutlich schneller als ein M1 Max, aber es geht hier um die Größenordnung.
Eine entscheidende Einschränkung bei Metallen: FP8-Checkpoints funktionieren auf Metal nicht — die Float8_e4m3fn Der Datentyp wird nicht unterstützt. Du musst GGUF-Builds verwenden. Das stellt viele Nutzer vor Probleme, die NVIDIA-orientierte Anleitungen befolgen, und es bedeutet außerdem, dass Die FP8-Vorlagen von LTX-2 funktionieren auf dem Mac überhaupt nicht..
Die gute Nachricht: Neuere, „destillierte“ Modelle ändern dies. Ivan Fioravanti hat die „destillierten“ LTX 2.3 22B in Draw Things erstellt auf einem M5 Max mit 40 Kernen in etwa 121 Sekunden ein 5-Sekunden-Video — und schlug damit sogar einen M3 Ultra mit 80 Kernen, der 206 Sekunden benötigte.
Das ist ein echtes Ergebnis und eine echte Veränderung. Aber beachte den Chip: Ein M5 Pro mit 20 Kernen wird bei solchen rechenintensiven Aufgaben deutlich langsamer sein als ein M5 Max mit 40 Kernen. Rechne eher mit mehreren Minuten als mit zwei.
Andere Modelle — HunyuanVideo, Mochi 1, CogVideoX, FramePack, Stable Video Diffusion — laufen auf dem Mac entweder sehr langsam oder sind praktisch unbrauchbar. Einige sind CUDA-orientiert und erfordern Workarounds.
Das Urteil im Video
Das Abspielen lokaler Videos auf einem M5 Pro mit 64 GB ist für gelegentliche, geduldige Experimente geeignet. — kurze Clips, niedrigere Auflösungen, vereinfachte Modelle, über Draw Things. Es funktioniert. Du wirst Dinge erschaffen.
Wenn du wirklich Durchsatz brauchst, miete dir eine GPU. RunPod, Vast.ai und Lambda betreiben einen 5090 oder einen H100 für wenige Dollar pro Stunde und liefern in wenigen Minuten das Ergebnis, für das dein Laptop eine Stunde benötigt. Insbesondere bei Videos ist der Preisunterschied enorm.
Wenn die Erstellung von Videos dein primär Je nach Arbeitsaufwand solltest du dir einen NVIDIA-Rechner zulegen oder Mittel für die Cloud einplanen. Kauf keinen Mac und verlass dich nicht auf das Glück.
Falls du es trotzdem versuchen möchtest: Schritt für Schritt
- Neu laden Dinge zeichnen und wechsle zum Video-Modell-Manager.
- Lade eine destilliert Modell – LTX 2.3 oder ein Wan 2.2 GGUF-Build. Bei optimierten Modellen geht es um den Unterschied zwischen Minuten und Stunden.
- Fang klein an: 480p, 2 Sekunden, geringe Schrittzahl. Lege vor der Skalierung deine Basiszeitvorgaben fest.
- Schließ das Gerät an und aktiviere den Hochleistungsmodus. Dadurch werden deine Lüfter in Betrieb genommen.
- Lege den Umfang und die Dauer erst fest, wenn du weißt, wie viel Zeit ein kurzer Clip in Echtzeit in Anspruch nimmt.
Verwende auf einem Mac niemals FP8-Checkpoints. GGUF oder gar nichts.
Teil 4: Echte Workflows, deren Einrichtung sich lohnt
Bei den Benchmark-Ergebnissen geht es nicht um die Leistung. Hier siehst du, wofür die Leute diesen Rechner tatsächlich nutzen.
Ablauf 1: Ein lokaler Kodierungsbeauftragter
Dies ist die teuerste Variante auf der Liste, und die Einrichtung dauert etwa zehn Minuten.
Schritt 1 – Starte einen Modellserver. Entweder die Registerkarte „Entwickler“ in LM Studio (Endpunkt unter http://localhost:1234/v1) oder:
bash
mlx_lm.server --model mlx-community/gpt-oss-20b-MXFP4 --port 1234Schritt 2 – Öffne die Datei in deinem Editor.
VS Code mit „Cline“ oder „Continue“: Einen OpenAI-kompatiblen Anbieter mit Basis-URL hinzufügen http://localhost:1234/v1, einen beliebigen nicht leeren API-Schlüssel und den Namen deines Modells.
Zed: Konfiguriere in den Einstellungen einen benutzerdefinierten OpenAI-kompatiblen Anbieter.
Aider (Terminal):
bash
export OPENAI_API_BASE=http://localhost:1234/v1
export OPENAI_API_KEY=local
aider --model openai/gpt-oss-20b
Schritt 3 – Wähle das richtige Modell aus. gpt-oss-20b Und sowohl Qwen3-Coder-30B-A3B als auch M5 sind leistungsstarke lokale Codierer. Beide sind MoE-Codierer, was genau deinen Anforderungen entspricht: schnelle Dekodierung, und dank der Verbesserungen beim Prefill des M5 kommt es bei großen Dateikontexten nicht mehr zu minutenlangen Verzögerungen.
Das bringt es dir: Unbegrenzte Iterationen ohne Kosten pro Token, ohne Ratenbeschränkungen und mit Code, der deinen Rechner niemals verlässt. Bei proprietären oder kundenspezifischen Codebasen ist gerade dieser letzte Punkt oft schon die einzige Rechtfertigung.
Workflow 2: Private RAG für deine Dokumente
Dank lokaler Einbettungen und eines 27B–70B-Modells lassen sich vertrauliche Dokumente – Verträge, Krankenakten, interne Forschungsergebnisse, Finanzdaten – durchsuchen und zusammenfassen, ohne dass auch nur ein einziges Byte deinen Laptop verlässt.
Die 64-GB-Stufe ist hier gerade deshalb von Bedeutung, weil RAG-Pipelines ein Einbettungsmodell, einen Vektorspeicher und ein Generierungsmodell gleichzeitig im Arbeitsspeicher halten. Bei 32 GB findet ständig ein Swap-Vorgang statt. Bei 64 GB ist dies nicht der Fall.
Workflow 3: Batch-Erstellung über Nacht
Stell in „Draw Things“ einige hundert Bildgenerierungen in die Warteschlange oder führe einen umfangreichen Dokumentenverarbeitungsauftrag über mlx_lm.server, und lass den Rechner arbeiten, während du schläfst. An das Stromnetz angeschlossen lassen sich mit den 70B-Modellen und Bildstapeln, die im interaktiven Betrieb zu langsam erscheinen, über Nacht problemlos verarbeiten.
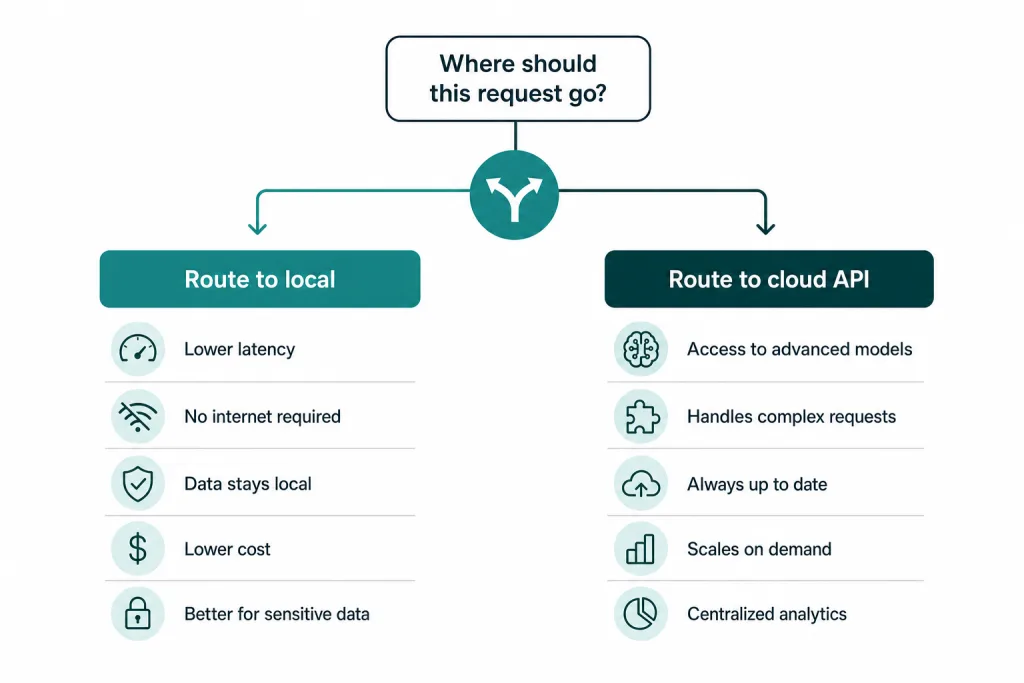
Workflow 4: Hybrides Routing (die Strategie, die die meisten Menschen anwenden sollten)
Betrachte „lokal“ und „Cloud“ nicht als Entweder-oder-Entscheidung. Entscheide je nach Aufgabe:
| An lokale Adresse senden | An die Cloud senden (API) |
|---|---|
| Alles, was den Datenschutz betrifft | Die schwierigsten Denkaufgaben |
| Massen- und Stapelverarbeitung | Fälle, die echte Pionierqualität erfordern |
| Agentenschleifen mit vielen kostengünstigen Anrufen | Einmalige Ergebnisse mit hohem Einsatz |
| Iteration und Experimentieren | Arbeiten, für die das allerneueste Modell benötigt wird |
| Offline-Arbeit | Sehr lange Kontextfenster |
Hier liegt der größte Teil des Nutzens. Die lokale Ebene kümmert sich um Volumen, Iterationen und Datenschutz. Die Cloud übernimmt die komplexe 5%-Aufgabe.
Apples eigener KI-Stack (wert, darüber Bescheid zu wissen)
Die Framework für Foundation-Modelle bietet Entwicklern direkten Swift-Zugriff auf Apples geräteinternes Modell – rund 3 Milliarden Parameter, kostenlos, privat, offline, mit integrierter geführter Generierung und Tool-Aufruf.
Die Updates für 2026 sind wichtiger als die ursprüngliche Version: Vision-Eingabe, serverseitige Ausführung und eine Sprachmodell Protokoll, mit dem du eine Sitzung auf der Grundlage des Apple-Modells oder eines Cloud-Modells unterstützen kannst, oder ein lokales MLX-Modell über MLXLanguageModel. Wenn du Mac- oder iOS-Apps entwickelst, ist dies ein einfacher Weg zu hybriden KI-Funktionen auf dem Gerät.
Xcode 26 Außerdem enthält es integrierte LLM-Programmierwerkzeuge, die ChatGPT, andere Anbieter über einen API-Schlüssel oder ein lokales Modell nutzen können, das auf deinem Mac läuft.
Der Alltag damit: Wärmeentwicklung, Akku und Geräuschentwicklung
Technische Daten sagen nichts darüber aus, wie sich ein Gerät im Alltag anfühlt. Hier ein paar ehrliche Eindrücke.
Die 14-Zoll-Modelle beschleunigen stärker als die 16-Zoll-Modelle. Notebookcheck stellte beim MacBook Pro 2026 unter Dauerbelastung starke thermische Drosselung fest, wobei das CPU-Verhalten selbst im „High Power“-Modus unregelmäßig war. Das 16-Zoll-Modell verfügt über mehr Kühlreserven und einen größeren Akku. Wenn du längere Inferenz-Sitzungen planst, ist das 16-Zoll-Modell das bessere Gerät. — Das ist ein echter funktionaler Unterschied, keine Frage der persönlichen Vorliebe.
Nicht alle KI-Workloads stellen hinsichtlich der Wärmeentwicklung die gleichen Anforderungen. Die LLM-Dekodierung ist relativ ressourcenschonend – sie ist speicherintensiv, sodass die GPU nicht voll ausgelastet ist und die Lüfter oft leise bleiben. Bild- und Videodiffusion sind rechenintensiv und beanspruchen deine GPU voll aus, lassen die Lüfter hörbar laufen und entladen den Akku schnell.
Die Realität bei Akkus: Kurze LLM-Sitzungen lassen sich problemlos ohne Netzanschluss durchführen. Bei längerer Diffusionsarbeit ist der Akku jedoch innerhalb weniger Stunden leer, und schon vorher kommt es zu einer thermischen Drosselung. Für anspruchsvollere Aufgaben solltest du das Gerät am Stromanschluss lassen.
Betriebsmodi: Das 16-Zoll-Modell verfügt über einen Hochleistungsmodus, den du bei lang andauernden Aufgaben aktivieren solltest. Der Energiesparmodus verringert die Inferenzgeschwindigkeit erheblich – vermeide dessen Verwendung, während Modelle ausgeführt werden.
Praktische Gewohnheit: Ohne Netzanschluss für Chats und Hilfe beim Programmieren. Mit Netzanschluss im Hochleistungsmodus für Bildstapel und Videos.
Die ehrlichen Gegenargumente
Ein Ratgeber, der nur eine Seite beleuchtet, ist reines Marketing. Hier sind die Argumente dagegen.
1. Das M5 Max ist tatsächlich schneller, und das ist nicht gerade subtil.
307 GB/s gegenüber 614 GB/s. Da die Dekodierung bandbreitenabhängig ist, Ein M5 Max mit 40 Kernen generiert Token etwa doppelt so schnell auf dasselbe Modell. Es passt außerdem gpt-oss-120b, was der M5 Pro nicht kann.
Wenn die Dekodiergeschwindigkeit großer Modelle dein Hauptanwendungsfall ist, ist der M5 Max die richtige Wahl, während der M5 Pro einen Kompromiss darstellt. Der Haken ist der Preis: Ab Juni 2026 wird dieses Upgrade extrem teuer.
2. Ein M4 Max zum Sonderpreis könnte einen neuen M5 Pro übertrumpfen
Das ist das Argument, das die meisten Käufer übersehen. Der M4 Max verfügt über eine Speicherbandbreite von rund 546 GB/s – deutlich mehr als die 307 GB/s des M5 Pro. Bei der reinen LLM-Dekodierung ist ein M4 Max mit 64 GB in der Regel schneller als ein M5 Pro mit 64 GB.
Was du dafür opferst: die Neural Accelerators des M5, was ein deutlich langsameres Vorladen und eine langsamere Bildgenerierung zur Folge hat.
Die Entscheidungsregel: Wenn du hauptsächlich mit großen Modellen arbeitest, ist ein M4 Max mit 64 GB zum Sonderpreis wohl die bessere Wahl. Wenn du agentische Programmierung mit langen Kontexten betreibst oder Bilder generierst, überwiegen die Vorteile des M5 Pro in Bezug auf Prefill und Diffusion.
3. NVIDIA hat bei der Rechenleistung weiterhin die Nase vorn
Eine RTX 5090 verfügt über 32 GB VRAM bei etwa 1.792 GB/s — fast das Sechsfache der Bandbreite des M5 Pro — und dazu noch deutlich mehr Rechenleistung. Bei jedem Modell, das in 32 GB Platz findet, und bei allen rechenintensiven Aufgaben (Video, Bild, Vorabfüllung) ist das kein Vergleich.
Der Vorteil des Macs beginnt genau dort, wo 32 GB VRAM an ihre Grenzen stoßen, und umfasst Mobilität, Geräuscharmut, geringen Stromverbrauch und die Möglichkeit, dies im Zug zu tun.
4. Bei den Mitbewerbern mit 128 GB Unified Memory geht es um die Speicherkapazität, nicht um die Geschwindigkeit.
NVIDIA DGX Spark / GB10: 128 GB bei etwa 273 GB/s, mit CUDA. Auf gpt-oss-120b MXFP4: Unabhängige Tests ergaben einen Wert von 34–39 tok/s.
AMD Strix Halo / Ryzen AI Max+ 395: 128 GB bei etwa 256 GB/s. AMDs eigene Angaben nennen für dasselbe Modell über „llama.cpp“ bis zu 30 tok/s. Die darauf basierenden Mini-PCs sind deutlich günstiger als jeder Mac.
Beachte, dass beide haben niedriger Bandbreite als der M5 Pro. Sie bieten dir Rechenkapazität, aber keine Geschwindigkeit. Wenn dein Ziel darin besteht, sehr große Modelle mit akzeptabler – statt mit hoher – Geschwindigkeit auszuführen, sind sie günstiger. Wenn du Geschwindigkeit willst, sind sie nicht die richtige Wahl.
5. Ein Mac-Desktop ist ein besseres stationäres Gerät
A Mac Studio M3 Ultra erreicht 512 GB bei 800 GB/s. Wenn dein Gerät auf einem Schreibtisch steht, ist es ein weitaus besseres Gerät für lokale KI als jedes MacBook Pro. Die Vorteile des Laptops liegen in der Mobilität, der Akkulaufzeit und der Geräuscharmut – wenn du diese nicht benötigst, solltest du auch nicht dafür bezahlen.
6. Der Arbeitsspeicher lässt sich nicht aufrüsten. Niemals.
Der Speicher von Apple Silicon ist auf dem Chip integriert. Was auch immer du kaufst, das steht dir für die gesamte Lebensdauer des Geräts zur Verfügung.
Da die 2026er-Modelle weiterhin den Trend zu größeren MoE-Fußabdrücken zeigen, Zu wenig RAM zu kaufen, ist der klassische Fehler, den man immer wieder bereut. Wenn du zwischen 48 GB und 64 GB wählen musst, entscheide dich für die 64-GB-Version.
Die Kostenrechnung: Lokal vs. Cloud
Lass uns einmal ehrlich nachrechnen, denn die Behauptung “lokal ist billiger” wird oft aufgestellt, aber selten konkret durchgerechnet.
Maschine: etwa $2.800 für einen M5 Pro mit 64 GB, verteilt auf drei bis vier Jahre.
API-Preise Stand August 2026 (pro Million Token, Ein-/Ausgabe):
| Dienst | Eingabe | Ausgabe |
|---|---|---|
| Klasse „Claude Sonnet“ | ~$3 | ~$15 |
| GPT-5-Klasse | ~$1,75–$5 | ~$14–$30 |
| DeepSeek V4 Flash | ~$0.14 | ~$0.28 |
| Gehostete Open-Source-Modelle (gpt-oss, Llama) | Noch tiefer | Noch tiefer |
GPU-Vermietung in der Cloud: H100 etwa $3/Stunde, H200 etwa $5/Stunde nach Bedarf.
Die Gewinnschwelle: Veröffentlichten Analysen zufolge liegt die Schwelle für ein Endverbrauchergerät bei etwa 2–3 Millionen Token pro Tag über einen Zeitraum von etwa zwölf Monaten im Vergleich zu proprietären APIs der Mittelklasse.
Das sind eine Menge Tokens. Unterhalb dieser Schwelle sind kostengünstige APIs – insbesondere solche der DeepSeek-Klasse – hinsichtlich der reinen Token-Kosten tatsächlich günstiger als lokale Lösungen.
Warum also sollte man das Gerät kaufen?
Denn die Token-Kosten sind nicht die einzigen Kosten:
- Datenschutz. Deine Daten verlassen das Gerät zu keinem Zeitpunkt. Bei rechtlichen, medizinischen, finanziellen oder urheberrechtlich geschützten Programmierarbeiten ist dies häufig eine unverzichtbare Voraussetzung, unabhängig vom Preis.
- Keine Ratenbegrenzung. Keine Drosselung, keine Warteschlangen, keine Kapazitätsfehler um 2 Uhr morgens.
- Offline. Flugzeuge, Züge, schlechtes WLAN im Hotel, Netzwerkausfälle.
- Grenzkosten gleich Null. Das verändert das Verhalten stärker, als man erwartet. Wenn jedes Experiment kostenlos ist, führt man zehnmal so viele durch. Die Tatsache, dass man beim Iterieren keine Angst vor den Kosten pro Token haben muss, zahlt sich in Form von echtem Geld bei der Leistung aus.
- Du hast sowieso einen Laptop gebraucht. Die korrekte Formulierung lautet nicht “$2.800 für KI” – es handelt sich vielmehr um die Differenz zwischen dem Gerät, das du gekauft hättest, und diesem hier.
Die richtige Schlussfolgerung lautet: „Hybrid“. Lokal für Volumen, Datenschutz, Iterationen und Agenten-Schleifen. Die Cloud für die schwierigen Probleme. Wer behauptet, dass lokale Lösungen die Frontier-APIs im Jahr 2026 vollständig ersetzen werden, übertreibt; wer behauptet, dass lokale Lösungen sinnlos sind, hat noch keine Agenten-Schleife in großem Maßstab durchgeführt.
Der Einkaufsratgeber
| Wenn du… | Kauf dieses Produkt | Warum |
|---|---|---|
| Ich möchte den Laptop mit der ausgewogensten lokalen KI | M5 Pro 64 GB, 16 Zoll | Läuft mit den Modellen 8B–70B und MoE, schnelle Bildgenerierung, Platz für alles andere. Bessere Kühlung als bei 14-Zoll-Modellen. |
Bedarf gpt-oss-120b oder Modelle der Serie 120B+ | M5 Max 128 GB | Der einzige Mac-Laptop, der diese Anforderungen erfüllt. Außerdem ~2× höhere Dekodierungsgeschwindigkeit. |
| Ich unterhalte mich hauptsächlich mit großen Models und lege Wert auf ein gutes Preis-Leistungs-Verhältnis | M4 Max 64 GB im Sonderangebot | Die höhere Bandbreite (546 GB/s) übertrifft den M5 Pro bei der Dekodierung. |
| Nimm die Videoerstellung ernst | NVIDIA (RTX 5090) oder Cloud | Rechenintensive Aufgaben; Macs sind um ein Vielfaches langsamer. |
| Du möchtest maximale Kapazität bei begrenztem Budget? | Strix Halo 128 GB Mini-PC | 128 GB zum günstigen Preis, jedoch mit geringerer Bandbreite als beim M5 Pro. |
| Am Schreibtisch arbeiten | Mac Studio M3 Ultra | Bis zu 512 GB bei 800 GB/s. |
| haben ein knappes Budget | M5 Pro 48 GB | Läuft einwandfrei in der Klasse 32B. Akzeptiere die Obergrenze von 70B/MoE. |
Was ich nicht tun würde: Kauf ein Gerät mit 24 GB oder 32 GB für anspruchsvolle lokale KI-Anwendungen. Du wirst innerhalb weniger Wochen an die Grenzen stoßen und kannst das Gerät nicht weiter aufrüsten.
Häufig gestellte Fragen
Reichen 64 GB im Jahr 2026 für lokale KI aus? Ja, für die meisten Anwendungsfälle. Mit 64 GB lassen sich Modelle mit bis zu etwa 70 Milliarden Parametern bei einer 4-Bit-Quantisierung sowie Mixture-of-Experts-Modelle wie GLM-4.6 Air problemlos ausführen, wobei noch ausreichend Speicherplatz für dein Betriebssystem und deine Anwendungen verbleibt. Die wichtigste Ausnahme ist gpt-oss-120b, das allein für die Gewichte etwa 63 GB benötigt und ein Gerät mit 128 GB erfordert.
Kann der M5 Pro den gpt-oss-120b ausführen? Nein. Die MXFP4-Version benötigt etwa 63 GB für die Gewichte, und der gemessene Spitzen-Speicherbedarf auf einem M5 Max liegt je nach Kontextlänge bei 64,4–64,9 GB. Auf einem Gerät mit 64 GB, bei dem realistisch gesehen 52–60 GB nutzbarer Speicher zur Verfügung stehen, passt das nicht. Hier handelt es sich um ein 128-GB-Modell.
Wie viele Token pro Sekunde erzeugt der M5 Pro? Das hängt stark vom Modell ab. Messwerte für den M5 Pro mit 20 Kernen und 64 GB: gpt-oss-20b bei 66–80 tok/s Dekodierung mit 1.500–2.200 tok/s Vorabfüllung und Qwen3.6-27B bei 17,8 tok/s Dekodierung mit 470 tok/s Vorabfüllung. Größere, dichte Modelle wie Llama 3.3 70B werden auf 7–12 Tok/s geschätzt.
M5 Pro oder M5 Max für lokale LLMs? M5 Max, wenn dir die Geschwindigkeit bei der Token-Generierung bei großen Modellen besonders wichtig ist – es verfügt über eine Speicherbandbreite von 614 GB/s gegenüber 307 GB/s beim M5 Pro, was die Dekodierungsgeschwindigkeit in etwa verdoppelt, und unterstützt 128 GB. M5 Pro, wenn du das beste Verhältnis zwischen Preis, Mobilität und Leistung für Modelle bis zu 70 Milliarden Parametern suchst.
Ist die Erstellung von Videos auf einem Mac praktikabel? Nicht wirklich, im Jahr 2026. Die Videoverarbeitung ist rechenintensiv, und Macs sind um ein Vielfaches langsamer als eine RTX 5090. Distilled-Modelle helfen zwar – LTX 2.3 erzeugt einen 5-Sekunden-Clip auf einem M5 Max in etwa 121 Sekunden –, doch für einen echten Durchsatz ist das Mieten von Cloud-GPUs pro Clip deutlich schneller und kostengünstiger.
Wie kann ich die GPU-Speichergrenze unter macOS erhöhen? Laufen sudo sysctl iogpu.wired_limit_mb=61440 60 GB zuweisen. Überprüfe dies mit sysctl iogpu.wired_limit_mb und auf den Wert 0. Füge es hinzu zu /etc/sysctl.conf damit die Einstellungen auch nach einem Neustart erhalten bleiben. Reserviere immer 4–8 GB für macOS.
MLX oder llama.cpp auf Apple Silicon? MLX ist in den meisten Fällen die beste Wahl. Bei Modellen unter 14B liegt es 20–87% vor llama.cpp, benötigt etwa 10% weniger Speicher und ist die Lösung, auf die Ollama 0.19 im März 2026 umgestellt hat. Die Ausnahme bilden sehr lange Kontexte – bei mehr als 30.000 Tokens kann „llama.cpp“ mit „Flash Attention“ bis zu 501 TP3T schneller sein.
Soll ich mir das 14-Zoll- oder das 16-Zoll-Modell kaufen? Das 16-Zoll-Modell eignet sich für dauerhafte KI-Anwendungen. Es verfügt über eine bessere Kühlleistung, einen größeren Akku und einen High-Power-Modus. Das 14-Zoll-Modell weist unter Dauerbelastung eine spürbare Leistungsminderung auf.
Ist ein M4 Max im Sonderangebot besser als ein neuer M5 Pro? Was die reine LLM-Dekodierung angeht, oft ja – das M4 Max erreicht etwa 546 GB/s gegenüber 307 GB/s beim M5 Pro. Dank seiner Neural Accelerators schneidet der M5 Pro bei der Prompt-Verarbeitung (bis zu 4× schneller) und der Bildgenerierung (über 3,8× schneller) besser ab. Entscheide dich je nachdem, welche Arbeitslast bei deiner Nutzung überwiegt.
Wie geht es weiter?
Ein paar Punkte, die man im Auge behalten sollte, da sie die obige Empfehlung beeinflussen könnten.
Unabhängige M5 Pro-Benchmarks auf 70B-Modellen. Bislang hat noch niemand einen ordnungsgemäß gemessenen Wert für die Dekodiergeschwindigkeit veröffentlicht. Sollten die Ergebnisse in der Praxis über 15 Tok/s liegen, verliert das Argument “Kauf dir den Max für die Dekodierung” erheblich an Gewicht.
Kleiner gpt-oss-120b Quantisierung. Wenn ein Build weniger als 52 GB groß ist, verliert das Argument der 64-GB-Obergrenze über Nacht an Gewicht.
Standardwerte für den Arbeitsspeicher unter macOS. Wenn Apple die Standard-GPU-Zuweisung über 75% erhöht, erhält jeder Besitzer eines 64-GB-Geräts kostenlosen Spielraum.
MoE gewinnt weiter. Der Trend zu Modellen mit hoher Gesamtkapazität und wenigen aktiven Parametern ist das Beste, was den Unified-Memory-Rechnern passieren konnte. Mit jeder neuen MoE-Version werden Macs im Vergleich noch wettbewerbsfähiger.
Sinkende API-Preise. Führe alle sechs Monate erneut eine Break-even-Analyse zwischen lokaler und Cloud-Lösung durch. Die Ergebnisse ändern sich.
Das Fazit
Das MacBook Pro M5 Pro mit 64 GB ist nicht das schnellste Gerät für lokale KI, das man kaufen kann. Es ist nicht einmal der schnellste Mac. Es ist jedoch die Konfiguration, bei der sich die Kompromisse nicht mehr gegenseitig ins Gehege kommen.
Es führt Modelle aus, die gut genug sind, um wirklich nützlich zu sein — gpt-oss-20b mit 66–80 Token pro Sekunde, GLM-4.6 Air bei etwa 30, Bildgenerierung in Sekundenschnelle – und dabei bleibt es ein Laptop, den man mitnehmen, im Akkubetrieb nutzen und als eigenen Computer verwenden kann. Die Neural Accelerators der M5-Generation haben die spezifische Schwäche (langsame Prompt-Verarbeitung) behoben, die frühere Macs für agentische Aufgaben und Arbeiten mit langem Kontext frustrierend machte.
Die Obergrenzen sind real und sollten beachtet werden: gpt-oss-120b Das passt nicht: 70B-Dense-Modelle sind eher Batch-Tools als Chat-Partner, und die Videogenerierung gehört in die Cloud.
Wenn diese Einschränkungen zu deiner Arbeit passen, ist dies das richtige Gerät. Wenn nicht, erfährst du in den obigen Abschnitten genau, welches Modell du stattdessen kaufen solltest – und das ist hilfreicher als ein weiterer Artikel, in dem dir versichert wird, dass alles in Ordnung ist.
Die in diesem Artikel genannten Preise, Modellvarianten und Vergleichszahlen basieren auf den im August 2026 verfügbaren Daten und können sich rasch ändern – insbesondere die Mac-Preise angesichts der anhaltenden Speicherengpässe. Bitte überprüfe vor dem Kauf die aktuellen Spezifikationen.