Deutsch
 English
 Español
 Italiano
 Français

Das Argument geht so: Ein KI-Abo der Oberklasse kostet $200 im Monat, also $2.400 im Jahr. Ein MacBook Pro mit 128 GB Unified Memory kann große Sprachmodelle lokal laufen lassen, privat und ohne Nutzungslimits. Also kündige das Abo, kauf dir stattdessen ein MacBook für lokale LLMs, und nach ein, zwei Jahren hat es sich bezahlt.
Du findest Varianten davon überall im Jahr 2026: in YouTube-Videos, die fragen, ob du deinen $200-KI-Plan kündigen und einen Mac für $9,499 kaufen solltest, in Medium-Posts, die den Preis eines Mac durch $200 teilen, und in einer Forbes-Kolumne, die die Zahlen durchrechnete, als Apple im August sein neues Mac Studio vorstellte. Beim Launch des M5 Max MacBook Pro sagte Apples Hardware-Chef John Ternus, die neuen Maschinen ließen Fachleute “fortschrittliche LLMs auf dem Gerät ausführen”.
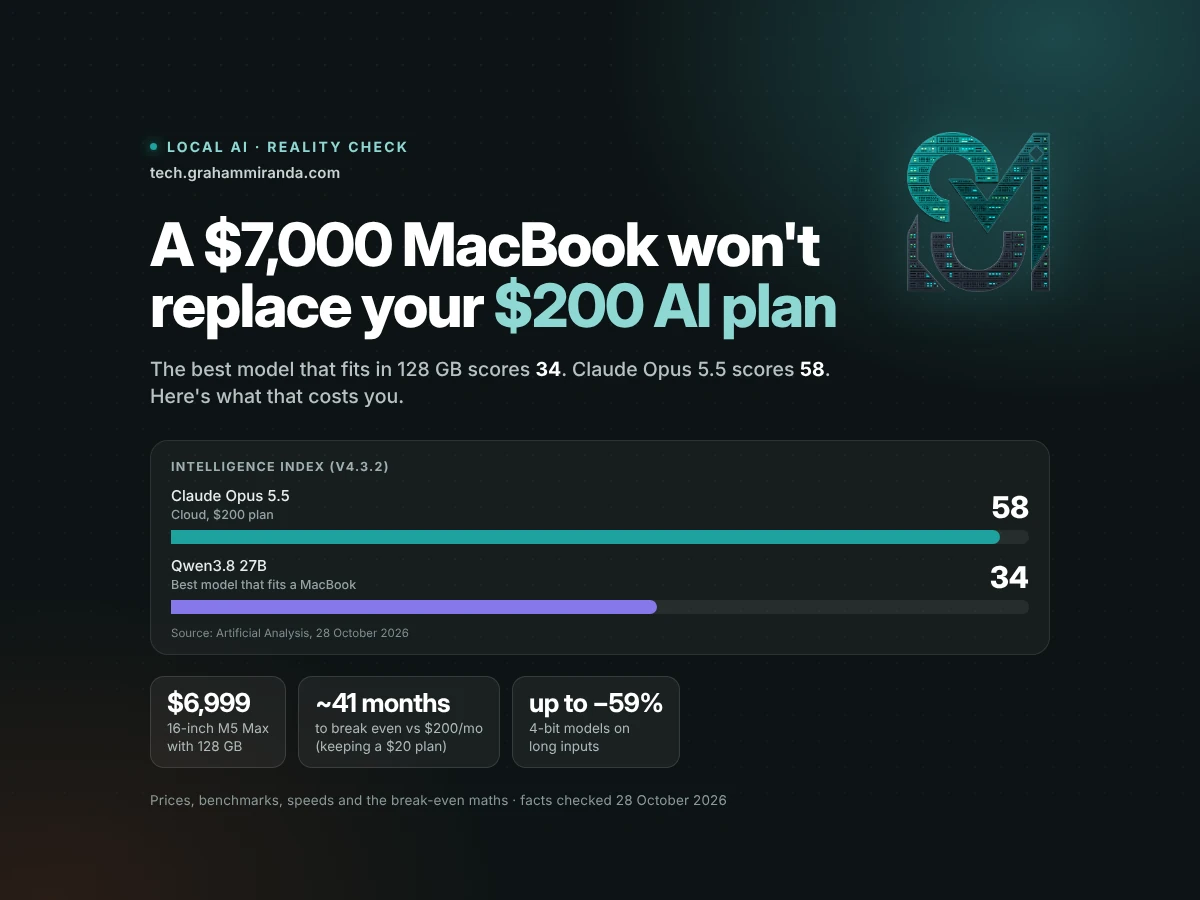
Ein MacBook für lokale LLMs zu kaufen ist für manche Menschen eine völlig gute Idee. Als Ersatz für einen $200-Plan von Claude oder ChatGPT scheitert es, und es scheitert an dem einen Punkt, den das Argument nie einpreist: Qualität. Beim Abo mietest du die besten Modelle der Welt. Der Mac lässt die besten Modelle laufen, die in 128 GB passen. Seit gestern lässt sich der Abstand zwischen diesen beiden Dingen genauer messen als je zuvor, und er ist größer, als der Hype suggeriert.
Am 27. Oktober hat Artificial Analysis seinen Intelligence Index auf überwiegend private Tests umgestellt. Claude Opus 5.5 führt mit 58. Die besten offenen Modelle, die du tatsächlich herunterladen kannst, DeepSeek V4.1 Flash 1017 und GLM-5.3, erreichen 32, unter Claude Haiku 5.5, Anthropics kleinem und günstigem Modell, mit 36. Keines dieser offenen Modelle passt in ein MacBook: Bei 4 Bit brauchen sie irgendwo zwischen 375 und 460 GB. Das stärkste Modell, das ich gefunden habe und das in ein MacBook mit 128 GB passt, Qwen3.8 27B, erreicht 34 auf der vorherigen Version des Index, auf der auch Opus 5.5 auf 58 kommt.
Unterdessen ist die Hardware teurer geworden. Im Juni hat Apple den Preis für das 128-GB-Speicher-Upgrade beim M5 Max verdoppelt. Ein 16-Zoll-MacBook Pro mit 128 GB kostet jetzt $6,999 in den USA und, nach meiner Schätzung, etwa €8,199 in Deutschland.
Das hier ist also die ehrliche Version der Rechnung: was $200 im Monat tatsächlich kaufen, was $7.000 tatsächlich kaufen, wie groß die Qualitätslücke ist und warum sie existiert, wie schnell ein M5 Max wirklich ist, was Quantisierung dich kostet, wann der Kauf eines Macs für lokale KI tatsächlich Sinn ergibt und günstigere Wege, eine $200-Rechnung zu senken, wenn du wirklich darauf aus bist. Jede Zahl wurde an ihrer Quelle geprüft am 28. Oktober 2026.
TL;DR – Die 60-Sekunden-Zusammenfassung
- Die Modelle, für die du $200 zahlst, kannst du nicht herunterladen, und die besten, die du herunterladen kannst, passen nicht in ein MacBook. Auf Artificial Analysis’ neuem Intelligence Index v5 erreicht Claude Opus 5.5 den Wert 58. Die besten herunterladbaren offenen Modelle, DeepSeek V4.1 Flash 1017 und GLM-5.3, erreichen 32 und brauchen bei 4 Bit rund 375–460 GB Speicher.
- Was passt, punktet weit niedriger. Das stärkste Modell, das ich für ein MacBook mit 128 GB gefunden habe, Qwen3.8 27B, erreicht 34 gegenüber den 58 von Opus 5.5 auf derselben Index-Version (v4.3.2). Die Modelle der 120B-Klasse, die den zusätzlichen Speicher wirklich brauchen, liegen noch niedriger: 16 für Qwen3.5 122B, 12 für gpt-oss-120b.
- Das MacBook mit 128 GB ist teurer geworden. Apple hat das 128-GB-Upgrade im Juni auf $2.000 verdoppelt, ein 16-Zoll-M5 Max mit 128 GB kostet jetzt also $6.999 (etwa €8.199 in Deutschland, meine Schätzung). Dieselben Chips und derselbe Speicher kosten im Mac Studio $4.799.
- Die Gewinnschwelle liegt bei drei bis vier Jahren, nicht bei einem. Selbst wenn der Mac das Abo vollständig ersetzte, bräuchte es etwa 37 Monate, um einen $200-Plan zu schlagen, 41, wenn du für harte Arbeit einen $20-Plan behältst, und mehr als sechs Jahre gegen einen $100-Plan.
- Schreiben ist schnell; Lesen ist langsam. Ein M5 Max erzeugt 55–88 Token pro Sekunde bei Mixture-of-Experts-Modellen, nicht weit entfernt von den 98 von Opus 5.5 über Anthropics API. Aber er braucht 13–55 Sekunden, nur um einen Prompt mit 32.000 Token zu lesen, und KI-Agenten lesen den ganzen Tag lang lange Prompts neu.
- Große Modelle hineinzupressen kostet Qualität. 4-Bit-Quantisierung ist bei kurzen Aufgaben nahezu verlustfrei, aber in einer EMNLP-2025-Studie kostete sie bei langen Eingaben bis zu 59 %, und mehr in anderen Sprachen als Englisch. Bei 3 Bit fiel die Mathe-Punktzahl eines kleinen Reasoning-Modells von 85,6 % auf 47,0 %.
- Öffentliche Benchmarks scheinen offene Modelle zu schmeicheln. Als Artificial Analysis auf überwiegend private Tests umstellte, verloren vier führende offene Modelle im Durchschnitt 13 Punkte. Vier führende geschlossene Modelle bewegten sich kaum.
- Lokal gewinnt weiter bei Datenschutz, Offline-Nutzung, fehlenden Rate-Limits und Massenjobs, und wenn du sowieso einen Mac kaufen wolltest. Kauf einen aus diesen Gründen, nicht um ein Abo zu kündigen.
- Es gibt billigere Wege zu sparen. Steig auf einen $100-Tarif um und spare $1.200 im Jahr, zahle pro Token für offene Modelle (DeepSeek V4.1 Flash kostet außerhalb der Stoßzeiten $0,60 pro Million Output-Token) oder nutze einen Coding-Plan ab $18 im Monat.
Das Argument gegen die Realität
| Das Argument | Die Realität, Oktober 2026 |
|---|---|
| “Es bezahlt sich in einem Jahr” | Ein 16-Zoll-MacBook Pro mit 128 GB kostet $6.999. Bei $200 im Monat sind das 35 Monate, bevor Strom dazukommt, und 41 Monate, sobald du den $20-Plan dazunimmst, den du für harte Aufgaben behältst |
| “Lokale Modelle sind heute im Grunde genauso gut” | Opus 5.5 erreicht 58. Das beste Modell, das in 128 GB passt, erreicht 34 (Qwen3.8 27B, Index v4.3.2). Die besten herunterladbaren offenen Modelle erreichen 32 auf dem neuen v5 |
| “128 GB laufen die großen offenen Modelle” | GLM-5.3 braucht bei 4 Bit etwa 376 GB, DeepSeek V4.1 Flash etwa 380–460 GB, Kimi K3 etwa 1,5 TB. Nichts davon passt in irgendein MacBook |
| “Der M5 Max ist schnell” | Beim Schreiben ja: 55–88 Token pro Sekunde bei Mixture-of-Experts-Modellen. Beim Lesen eines 32K-Prompts: 13 bis 55 Sekunden |
| “4-Bit ist verlustfrei” | Bei kurzen Benchmarks fast. Bei Eingaben über 64K Token in einer Studie bis zu 59 % schlechter, und außerhalb des Englischen noch schlechter |
| “Keine Limits, totale Privatsphäre” | Stimmt. Das ist der wahre Grund, einen zu kaufen |
Inhaltsübersicht
- TL;DR – Die 60-Sekunden-Zusammenfassung
- Das Argument gegen die Realität
- Teil 1 — Das Argument “Kündige deinen $200-Plan” und warum es so überzeugend klingt
- Teil 2 — Was $200 im Monat im Oktober 2026 tatsächlich kaufen
- Teil 3 — Was ein MacBook mit 128 GB heute tatsächlich kostet
- Teil 4 — Die Qualitätslücke, gemessen
- Teil 5 — Warum die Modelle, die du wirklich willst, nicht passen
- Teil 6 — Quantisierung: die Qualitätssteuer, die du fürs Passen zahlst
- Teil 7 — Tempo: schnell beim Schreiben, langsam beim Lesen
- Teil 8 — Das Laptop-Problem
- Teil 9 — Die Softwarelücke: was du selbst nachbauen müsstest
- Teil 10 — Die Break-even-Rechnung, ehrlich gemacht
- Teil 11 — Der faire Fall: Wann ein Mac für lokale KI Sinn ergibt
- Teil 12 — Günstigere Wege, eine $200-KI-Rechnung zu senken
- Teil 13 — Solltest du ein MacBook für lokale LLMs kaufen? Ein Entscheidungsleitfaden
- Teil 14 — Wenn du trotzdem eins kaufst: wie du das Meiste herausholst
- Häufig gestellte Fragen
- Kann ein MacBook ein ChatGPT-Pro- oder Claude-Max-Abo ersetzen?
- Was ist 2026 das beste lokale LLM für ein MacBook Pro mit 128 GB?
- Was kostet ein MacBook Pro mit 128 GB heute?
- Wie lange braucht ein MacBook, bis es sich gegenüber einem $200-KI-Abo bezahlt macht?
- Ist der M5 Max schnell genug für lokale LLMs?
- Sind lokale LLMs heute so gut wie ChatGPT oder Claude?
- Macht Quantisierung lokale Modelle schlechter?
- Kann ich DeepSeek V4.1 Flash oder GLM-5.3 auf einem MacBook laufen lassen?
- Reichen 64 GB für lokale KI, oder brauche ich 128 GB?
- Sollte ich für lokale LLMs ein Mac Studio statt eines MacBook Pro kaufen?
- Ist KI lokal besser für Datenschutz und DSGVO?
- Kann ich Claude Code mit einem lokalen Modell nutzen?
- Ändert das neue OLED-MacBook-Pro etwas daran?
- Das Fazit
Teil 1 — Das Argument “Kündige deinen $200-Plan” und warum es so überzeugend klingt
Fang damit an, warum dieses Argument so gut ankommt, denn das meiste daran ist vernünftig.
Drei Labore landeten bei $200. Anthropics Claude Max 20× kostet $200 im Monat. OpenAIs ChatGPT Pro gibt es in Versionen für $100, $200 und $500. Googles AI Ultra hat einen $100-Tarif und einen für $200. Zahlst du das jeden Monat, bleibt die Zahl hängen: $2.400 im Jahr, $7.200 über drei.
Die Hardware wurde ernst. Das M5 Max MacBook Pro, seit März im Verkauf, nimmt bis zu 128 GB Unified Memory mit 614 GB/s Bandbreite auf, und Apple hat einen Neural Accelerator, dedizierte Matrix-Mathe-Hardware, in jeden GPU-Kern gepackt. Im August kam das Mac Studio mit einer M5-Ultra-Option für bis zu 512 GB. Apples Marketing setzt stärker denn je auf lokale KI.
Die Abos wurden knausriger. Die Wochenlimits von Claude Max, Monate nach dem Start des Plans eingeführt, sind Gegenstand einer am 8. September eingereichten Sammelklage, die argumentiert, die Bezeichnungen “5×” und “20×” machten die wöchentlichen Obergrenzen nicht klar genug. OpenAI soll das Kontingent im $200-Pro-Plan für neue Abonnenten von 20-mal ChatGPT Plus auf 10-mal gekürzt haben. Wenn das, was du mietest, immer weiter schrumpft, beginnt Besitz attraktiv auszusehen.
Privatsphäre ist ein echtes Anliegen. Alles, was du in ein Cloud-Modell einfügst, verlässt deinen Rechner. Für ein deutsches Unternehmen mit Kundendaten ist das keine Paranoia; es ist die DSGVO.
Und die Rechnung ist einfach. Die Version, die am häufigsten geteilt wird: ein Mac Studio für $2.499 geteilt durch $200 im Monat sind etwa 12,5 Monate. Forbes rechnete im August eine viel sorgfältigere Version nach, mit echten Konfigurationen und drei Jahren Strom, und kam zu dem Schluss, dass ein Mac dir wahrscheinlich nicht erlaubt, deinen Claude- oder ChatGPT-Plan zu kündigen, wenn du mit Agenten codest. Aber die kurze Version ist die, an die sich die Leute erinnern.
Hier ist der Fehler. Das Argument vergleicht einen Preis mit einem Preis. Es sollte ein Produkt mit einem Produkt vergleichen. Genau das tut der Rest dieses Artikels, beginnend damit, wofür die $200 tatsächlich bezahlen.
Teil 2 — Was $200 im Monat im Oktober 2026 tatsächlich kaufen
| Anbieter | $20-Tarif | $100-Tarif | $200-Tarif | Über $200 |
|---|---|---|---|---|
| Anthropic (Claude) | Pro: $20 ($17 im Monat bei jährlicher Zahlung) | Max 5×: $100 | Max 20×: $200 | Team und Enterprise |
| OpenAI (ChatGPT) | Plus: $20 (Go: $8) | Pro 100: $100 | Pro 200: $200 | Pro 500: $500 |
| Google (Gemini) | AI Pro: $20 | AI Ultra: $100 | AI Ultra: $200 | — |
US-Preise pro Monat, ohne Mehrwertsteuer. Claude von claude.com; ChatGPT aus dem Tracker von AI Business Weekly, aktualisiert am 4. Oktober; Google aus Engadgets Bericht zum Relaunch im Mai. Preise und Kontingente ändern sich oft, prüfe sie also, bevor du abonnierst.
Wofür das Geld tatsächlich bezahlt
1. Die Frontier-Modelle, die du nirgendwo sonst bekommst. Auf Artificial Analysis’ neuem Index belegen Anthropic und OpenAI alle Top-5-Plätze. Keines dieser Modelle lässt sich zu irgendeinem Preis herunterladen. Das Abo ist für die meisten Menschen der günstigste Weg, sie jemals zu nutzen.
2. Agenten, die um diese Modelle herum gebaut sind. Claudes bezahlte Pläne enthalten Claude Code; ChatGPTs enthalten Codex. Harness und Modell sind aufeinander abgestimmt, was erklärt, warum sie oben in den Agentic-Coding-Leaderboards stehen. (Ich habe 28 dieser Tools verglichen in Alle KI-Coding-Harnesses im Vergleich.)
3. Enormer Kontext. Claude Opus 5.5 hat laut Artificial Analysis ein Kontextfenster von einer Million Token: ganze Codebasen, ganze Verträge, ganze Quartale voller E-Mail.
4. Das Produkt um das Modell herum. Websuche und Deep Research, Dateianalyse, Stimme, Gedächtnis, Bildgenerierung, Konnektoren zu deiner Mail und deinen Dokumenten und Apps, die sich über Handy, Laptop und Browser synchronisieren. Nichts davon kommt mit einer Modelldatei.
5. Upgrades, die du nicht installieren musst. Das Modell hinter deinem Abo wird im nächsten Quartal besser sein als das heutige. Das Modell auf deinem Mac ändert sich nur, wenn du ein anderes herunterlädst, und nur, wenn das neue passt.
6. Ein Teil des Geldes zurück. Anthropics Preisseite listet inzwischen monatliche API-Guthaben bei Max: $100 im 5×-Plan und $200 bei 20×.
Was es nicht kauft
Unbegrenzte Nutzung. Claudes Pläne laufen auf rollierenden Fünf-Stunden-Fenstern plus Wochenlimits, und OpenAI und Google beschreiben ihre Top-Tarife meist als Vielfache der günstigeren, wenn sie sie überhaupt beschreiben. Kontrolle darüber, wohin deine Daten gehen, was für persönliche Daten und Kundendaten sehr viel ausmacht. Und Planbarkeit: die Kontingente haben sich in diesem Jahr mehr als einmal verschoben.
Behalte diese drei im Kopf. Das ist das ehrliche Argument für lokale KI, und Teil 11 hört es sich vollständig an.
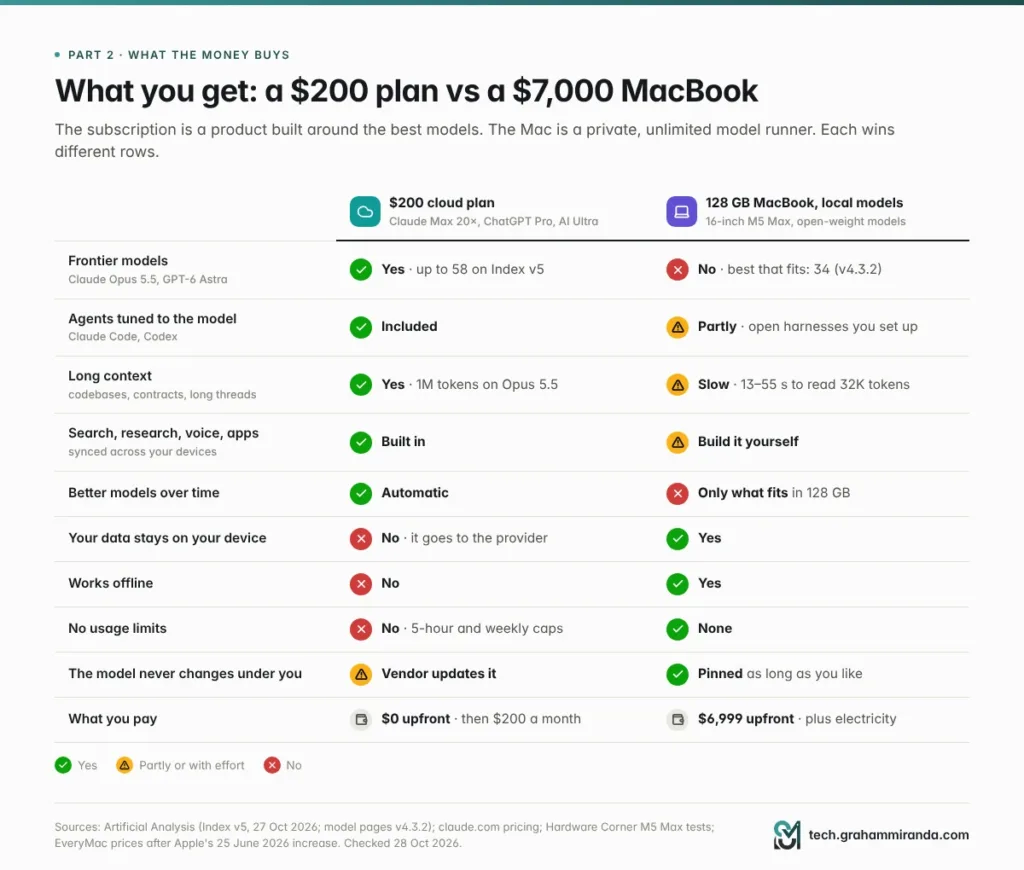
Bild anzeigen Das Abo ist ein Produkt; der Mac ist ein Modell-Runner. Jedes gewinnt andere Zeilen der Vergleichstabelle, weshalb die richtige Antwort für die meisten Menschen beides ist.
Teil 3 — Was ein MacBook mit 128 GB heute tatsächlich kostet
Nur ein Chip bringt dich auf 128 GB. In der M5-Generation gibt es so viel Unified Memory nur mit dem M5 Max mit der 40-Kern-GPU, der 614 GB/s Speicherbandbreite hat. Der M5 Max mit 32-Kern-GPU ist auf 36 GB und 460 GB/s festgelegt, und der M5 Pro endet bei 64 GB und 307 GB/s.
| Konfiguration | US-Preis | Deutschland |
|---|---|---|
| 16″ M5 Max (18-Kern-CPU, 40-Kern-GPU), 48 GB, 2 TB | $4,999 | €5,699 |
| Upgrade auf 128 GB | +$2.000 (bis 25. Juni waren es +$1.000) | etwa +€2.500 (beim Start +€1.250), geschätzt |
| 16″-M5 Max, 128 GB, 2 TB | $6,999 | etwa €8.199 (geschätzt; beim Start €6.249) |
| Voll ausgestattet: 128 GB, 8 TB, Nano-Textur-Display | $10,149 | — |
| Zum Vergleich: Mac Studio, M5 Max, 128 GB | $4,799 | — |
US-Preise ohne Umsatzsteuer; deutsche Preise inklusive 19 % Mehrwertsteuer. Das deutsche 128-GB-Upgrade ist meine Schätzung: Apple verlangte beim Start €1.250 dafür, und das Dollar-Upgrade hat sich im Juni verdoppelt. Prüfe Apples Konfigurator, bevor du kaufst.
Drei Dinge fallen auf.
Speicher ist jetzt der teure Teil. Apple erhöhte am 25. Juni die Preise über die ganze Mac-Reihe und machte Speicher- und Storage-Kosten dafür verantwortlich. Gegenüber Reuters sagte das Unternehmen, es habe “noch nie einen derart schnellen und starken Anstieg eines Komponentenpreises gesehen”. Die 64-GB- und 128-GB-Upgrades des M5 Max verdoppelten sich beide. Die eine Komponente, die lokale KI am meisten braucht, ist die, die doppelt so teuer wurde.
Der Laptop-Aufpreis beträgt $2.200. Derselbe M5 Max mit denselben 128 GB kostete in einem Mac Studio $4.799, als Forbes ihn im August bepreiste. Wenn du den Speicher für KI willst, kostet die Laptop-Bauform 46 % mehr.
Das 14-Zoll-Modell ist ein Kompromiss. Du kannst auch das 14-Zoll-Modell mit 128 GB bestellen, aber in Notebookchecks Test mühte sich sein Gehäuse, den M5 Max unter Dauerlast zu kühlen. Mehr dazu in Teil 8.
Neue Macs diese Woche. Am 27. Oktober kündigte Apple ein 14-Zoll-MacBook-Pro mit dem Basis- M6 Chip an: bis zu 32 GB und 170 GB/s, ab $1.999. Ein feiner Laptop, keine LLM-Maschine. Und heute Abend (28. Oktober, 10:00 Uhr pazifischer Zeit, 18:00 in Deutschland) hält Apple sein Event “Pro and Tell” ab, bei dem ein OLED-Touchscreen-MacBook-Pro allgemein erwartet wird. Berichte sagen, es nutze dieselben M5 Pro und M5 Max Chips, was die 128-GB-Obergrenze und 614 GB/s unverändert ließe.
Teil 4 — Die Qualitätslücke, gemessen
Wie vergleichst du ein Modell auf deinem Schreibtisch mit einem im Rechenzentrum? Nicht mit Bauchgefühl und nicht mit der Benchmark-Tabelle eines Anbieters. Artificial Analysis (AA) lässt dieselbe Testbatterie auf Hunderte Modelle durch denselben Harness laufen und verdichtet die Ergebnisse zu einem einzigen Intelligence Index. Kein Index ist perfekt, aber der von AA ist unabhängig, und er ist das, was in der Branche einem gemeinsamen Maßstab am nächsten kommt.
Am 27. Oktober veröffentlichte AA Version 5. Die wichtigste Änderung: Etwa 60 % des Index laufen jetzt auf privaten Testsets oder zurückgehaltenen Antworten, sodass ein Modell die Fragen nicht schon beim Training gesehen haben kann. Wissensarbeit, Coding, Wissenschaft und Allgemeinwissen zählen je ein Viertel.
Das neue Leaderboard
| Modell | Kannst du es herunterladen? | Intelligence Index v5 |
|---|---|---|
| Claude Opus 5.5 (max) | Nein | 58 |
| GPT-6 Astra (max) | Nein | 57 |
| GPT-6.1 Sol (max) | Nein | 55 |
| Gemini 4 Argon (high) | Nein | 50 |
| Kimi K3.1 Pro | Noch nicht; Gewichte unveröffentlicht | 46 |
| Claude Haiku 5.5 (max) | Nein | 36 |
| DeepSeek V4.1 Flash 1017 (max) | Ja, MIT-Lizenz | 32 |
| GLM-5.3 (max) | Ja | 32 |
Quelle: Artificial Analysis, Ankündigung des Intelligence Index v5, 27. Oktober 2026.
Drei Dinge in dieser Tabelle zählen, wenn du ein MacBook bepreist.
- Die fünf besten Plätze gehören alle Anthropic und OpenAI, und keines dieser Modelle lässt sich zu irgendeinem Preis herunterladen.
- Das beste offene Modell, Kimi K3.1 Pro, hat seine Gewichte nicht veröffentlicht. Unter den Modellen, die du tatsächlich herunterladen kannst, ist der beste Wert 32, was sie 26 Punkte hinter dem Spitzenreiter. In der vorherigen Version betrug der Abstand zwischen dem besten offenen und dem besten geschlossenen Modell 3 Punkte. Jetzt sind es 12, oder 26, wenn du nur Gewichte zählst, die du herunterladen kannst.
- Claude Haiku 5.5 schlägt jedes herunterladbare offene Modell. Das ist Anthropics kleine, schnelle, günstige Klasse, nicht sein Flaggschiff.
Konkret beim Coding
Der neue Index enthält FrontierCode 2.0, 132 private Coding-Aufgaben von Cognition. Claude Opus 5.5 löste 46 %; DeepSeek V4.1 Flash 1017, gemeinsam stärkstes unter den herunterladbaren Modellen, löste 28 %. Bei Terminal-Bench-Science, 70 agentischen Wissenschaftsaufgaben, sind es 59 % gegen 13 %.
Um fair zu offenen Modellen zu sein: Kimi K3.1 Pro führt Terminal-Bench 4.0 mit 67 %, vor jedem geschlossenen Modell. Offene Modelle können einzelne Benchmarks gewinnen, und sie tun es. Aber dieses ist noch nicht herunterladbar, und sein Vorgänger, Kimi K3, hat 2,8 Billionen Parameter. Das wirst du nicht auf einem Laptop laufen lassen.
Warum die Lücke gerade größer geworden ist
Der Sprung von v4.3 auf v5 hat nicht alle gleich behandelt.
| Modell | Typ | v4.3 | v5 | Änderung |
|---|---|---|---|---|
| Claude Opus 5.5 | Geschlossen | 58 | 58 | 0 |
| GPT-6 Astra | Geschlossen | 53 | 57 | +4 |
| Claude Sonnet 5.5 | Geschlossen | 56 | 54 | −2 |
| Gemini 4 Argon | Geschlossen | 53 | 50 | −3 |
| Kimi K3.1 Pro | Offen (unveröffentlicht) | 55 | 46 | −9 |
| DeepSeek V4.1 Flash 1017 | Neu laden | 45 | 32 | −13 |
| Muse Spark Open (Meta) | Neu laden | 39 | 25 | −14 |
| MiMo-V2.6-Pro (Xiaomi) | Neu laden | 46 | 30 | −16 |
v4.3- und v5-Werte nach Angaben von Trending Topics vom 28. Oktober, wobei die v5-Werte mit der Ankündigung von AA übereinstimmen.
Im Durchschnitt verloren diese vier offenen Modelle 13 Punkte. Die vier geschlossenen bewegten sich um einen Viertelpunkt.
AA hat nicht gesagt, warum. Die naheliegende Lesart: Wenn die Testfragen geheim sind, kann ein Modell sie nicht gesehen haben, und öffentliche Benchmarks schmeicheln Modellen, die stark auf öffentlichen Daten trainiert wurden. Der Gegenpunkt ist auch fair: Private Tests lassen sich von außen nicht prüfen, und wie du die Kategorien gewichtest, verschiebt die Rankings. Behandle keinen einzelnen Index als Evangelium. Aber wenn vier offene Modelle zweistellig fallen und vier geschlossene nicht, ist das ein Signal, das man ernst nehmen sollte: Die veröffentlichten Benchmark-Tabellen, und besonders die der Anbieter selbst, übertreiben, wie nah offene Modelle dran sind.
Und die Modelle, die tatsächlich in ein MacBook passen
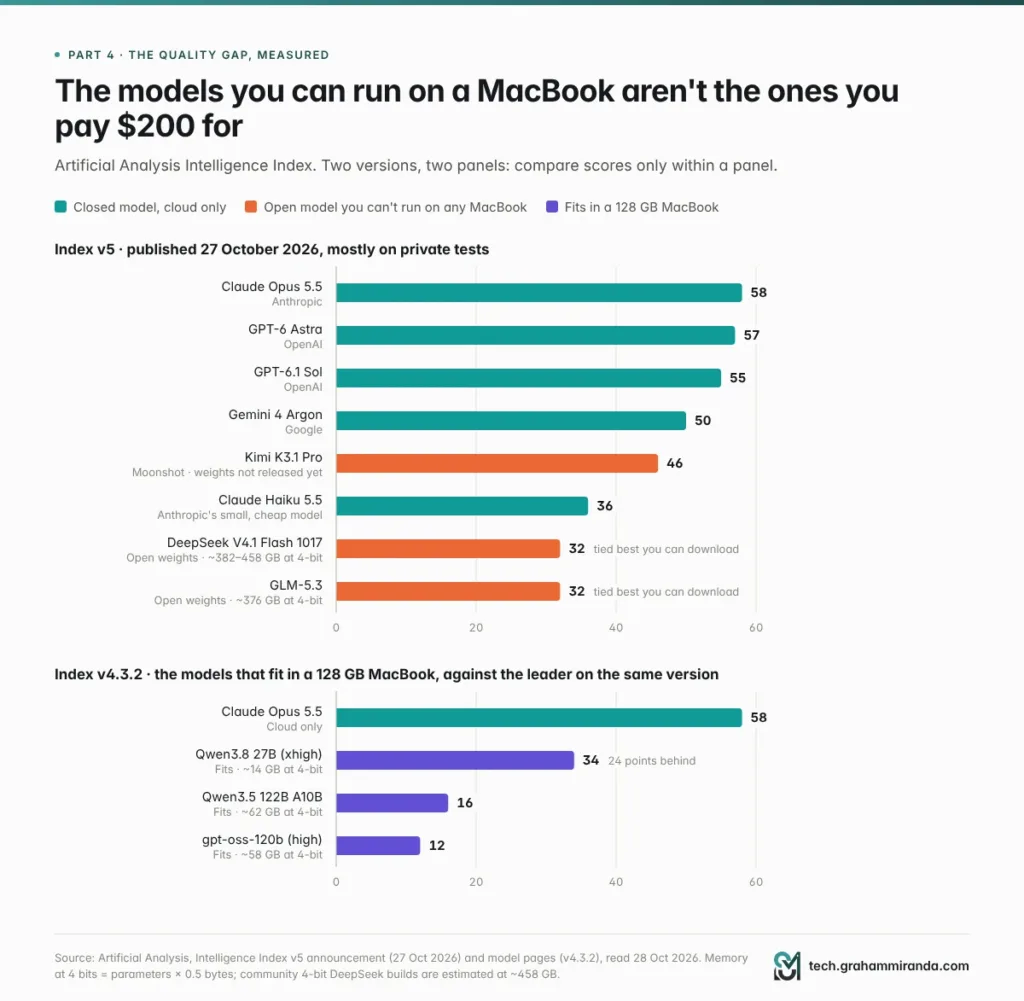
Die Modelle, die AA für seine Ankündigung neu bewertet hat, sind meist viel zu groß für einen Laptop. Für die, die passen, zeigen die Modellseiten von AA weiterhin v4.3.2 -Werte, und auf dieser Version erreicht auch Opus 5.5 den Wert 58. Hier ist also der Vergleich auf einer einheitlichen Skala:
| Modell | Passt in ein MacBook mit 128 GB? | Intelligence Index v4.3.2 |
|---|---|---|
| Claude Opus 5.5 (max) | Nein, nur Cloud | 58 |
| Qwen3.8 27B (xhigh) | Ja, bei 4 Bit sogar auf einem Mac mit 32 GB | 34 |
| Qwen3.5 122B A10B (reasoning) | Ja, etwa 70 GB bei 4 Bit | 16 |
| gpt-oss-120b (high) | Ja, etwa 64 GB | 12 |
Quelle: Modellseiten von Artificial Analysis, gelesen am 28. Oktober 2026.
AA führt Qwen3.8 27B als Erstes von 141 vergleichbaren Modellen. Es ist für seine Größe wirklich ausgezeichnet und ein offenes Modell unter Apache 2.0. Es liegt trotzdem 24 Punkte zurück.
Bild anzeigen Zwei Index-Versionen, zwei getrennte Panels, nie eine Achse. Oben: Artificial Analysis Intelligence Index v5 (27. Oktober 2026). Unten: Modelle, die in ein MacBook mit 128 GB passen, auf v4.3.2, der Version, auf der ihre Scores veröffentlicht sind.
Das 128-GB-Paradox
Schau dir die letzte Tabelle noch einmal an. Das beste Modell für ein MacBook mit 128 GB passt in 32 GB. Die Modelle, die den zusätzlichen Speicher wirklich brauchen, also Mixture-of-Experts mit 120 Milliarden Parametern, punkten niedriger, vor allem, weil sie älter sind: gpt-oss-120b kam im August 2025 heraus, und Qwen3.5 122B wurde schon im März auf dem M5 Max gebenchmarkt, Monate bevor Qwen3.8 27B erschien.
Was bringt dir das $2.000-Upgrade von 48 GB auf 128 GB heute also? Platz: längere Kontexte, 8-Bit-Präzision statt 4 Bit, mehrere Modelle gleichzeitig geladen und die Option, ein starkes Modell der 100-Milliarden-Klasse laufen zu lassen, falls eins erscheint. Das sind echte Vorteile. Ein klügeres Modell gehört nicht dazu, zumindest nicht auf dem heutigen Leaderboard. Prüfe AA, bevor du kaufst; das ist die Art Fakt, die sich mit einem einzigen Release ändert.
Wie sich 34 gegen 58 in der Praxis anfühlt
Index-Punkte sind keine “Prozent klüger”, und sie verteilen sich nicht gleichmäßig über die Aufgaben.
Für kurze, klar definierte Aufgaben wie eine E-Mail umschreiben, ein eingefügtes Dokument zusammenfassen oder Felder aus einer Rechnung ziehen ist ein gutes 27B-Modell oft nicht von einem Frontier-Modell zu unterscheiden. Die Lücke öffnet sich bei langer, mehrstufiger Arbeit: ein Agent, der eine Codebasis lesen, planen, fünf Dateien ändern, die Tests laufen lassen und sich von eigenen Fehlern erholen muss; Recherche, die Quellen abgleichen muss; Reasoning, bei dem ein falscher Schritt den Rest vergiftet. Genau diese Arbeit kaufen die Leute mit $200-Plänen.
Die August-Kolumne von Forbes brachte ein konkretes Beispiel aus Qwens eigener Forschungsarbeit: Qwen3-Coder-Next erreichte in Claude Code 30.9% auf Terminal-Bench 2.0, gegenüber 53.9% für Claude Opus 4.5 in derselben Arbeit. Das sind die Modelle des letzten Jahres, aber die Form hat sich nicht geändert: Bei agentischen Aufgaben scheiterte das lokale Setup viel häufiger.
Teil 5 — Warum die Modelle, die du wirklich willst, nicht passen
Die Größe eines Modells im Speicher lässt sich einfach schätzen:
Text
Gewichte (GB) ≈ Parameter (Milliarden) × Bytes pro Parameter
               8 Bit → × 1,0     4 Bit → × 0,5     2 Bit → × 0,25
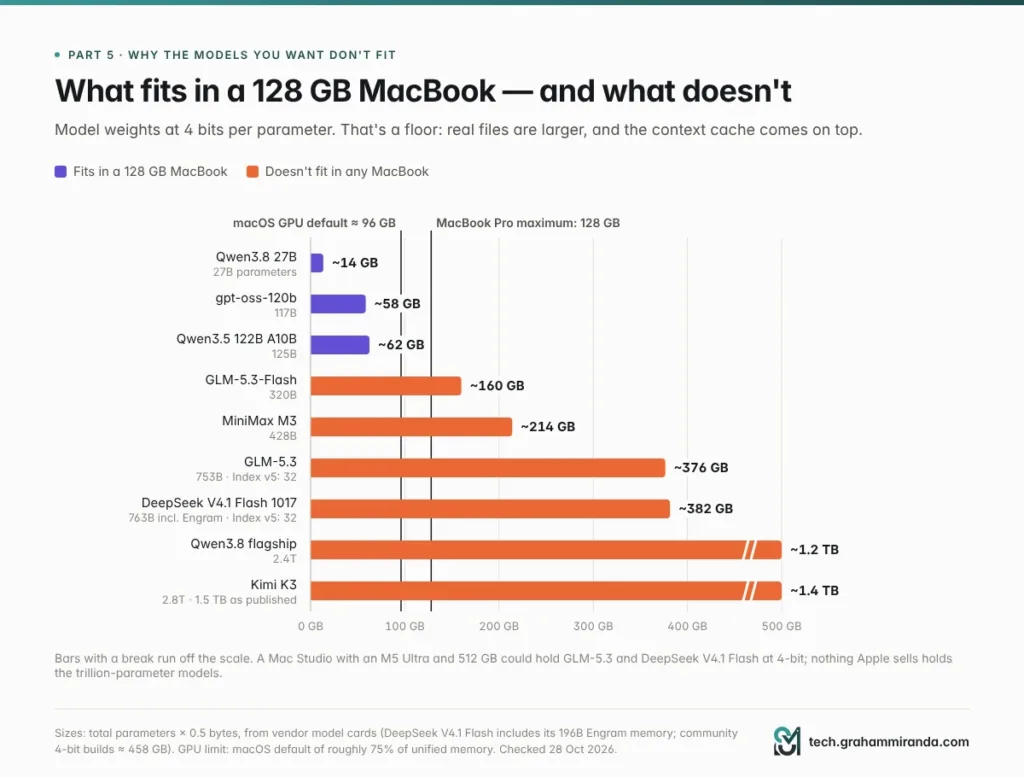
Dann kommt der KV-Cachedazu, das Arbeitsgedächtnis des Modells für deine Unterhaltung, das mit der Kontextlänge wächst. Und denk daran, dass macOS nicht deinen gesamten Unified Memory an die GPU gibt: Standardmäßig lässt es die GPU etwa 75% auf Macs mit großem Speicher, etwa 96 GB von 128 GB reservieren. Du kannst das Limit mit sudo sysctl iogpu.wired_limit_mb=…anheben, auf eigenes Risiko; was immer du dem Modell gibst, bekommen dein Browser, dein Editor und dein Betriebssystem nicht.
Hier ist, was das für die Modelle bedeutet, über die die Leute tatsächlich reden:
| Modell | Gesamtparameter | 4-Bit-Gewichte (Untergrenze) | Passt in ein MacBook mit 128 GB? |
|---|---|---|---|
| Qwen3.8 27B | 27B | ~14 GB | ✅ Mühelos |
| gpt-oss-120b | 117B | ~58 GB (64-GB-Datei) | ✅ Ja |
| Qwen3.5 122B A10B | 125B | ~62 GB (69,6-GB-Datei) | ✅ Ja |
| GLM-5.3-Flash | 320B | ~160 GB | ❌ Nein |
| MiniMax M3 | 428B | ~214 GB | ❌ Nein |
| GLM-5.3 | 753B | ~376 GB | ❌ Nein |
| DeepSeek V4.1 Flash 1017 | 763B inkl. Engram-Speicher | ~382 GB (Community-4-Bit-Builds auf ~458 GB geschätzt) | ❌ Nein |
| Qwen3.8-Flaggschiff | 2,4 T | ~1,2 TB | ❌ Nein |
| Kimi K3 | 2,8 T | ~1,5 TB wie veröffentlicht (natives MXFP4) | ❌ Nein |
Die 4-Bit-Spalte ist Parameter × 0,5 Byte: nur Gewichte, vor dem KV-Cache und Datei-Overhead, echte Dateien sind also größer. Die Dateigrößen stammen aus Hardware Corners M5-Max-Tests.
Die Modelle, die auf dem neuen Index 32 erreichen, die besten, die du herunterladen kannst, brauchen drei- bis viermal was ein MacBook hat. Und die dazwischen passen auch nicht hinein. Wenn du den Modellgewichten 100 GB deiner 128 GB gibst, könntest du dir so viele Bits pro Gewicht leisten:
| Modell | Bits pro Gewicht in einem 100-GB-Budget |
|---|---|
| GLM-5.3-Flash | 2.5 |
| MiniMax M3 | 1.9 |
| GLM-5.3 | 1.1 |
| DeepSeek V4.1 Flash | 1.0 |
| Kimi K3 | 0.3 |
Bei etwa drei Bit und darunter fällt die Qualität steil ab (die Forschung dazu steht in Teil 6). Ein Bit pro Gewicht ist keine Quantisierung. Es ist Amputation.
Auch der Kontext kostet Speicher. In Hardware Corners Tests brauchte Qwen3-Coder-Next bei 8 Bit bei einem 4K-Kontext 87,1 GB und bei 64K 92,6 GB: fünfeinhalb zusätzliche Gigabyte, nur um eine längere Unterhaltung zu halten. Agenten, die ganze Repositories lesen, brauchen lange Kontexte, dieser Spielraum verschwindet also schnell.
Was ist mit einem Mac Studio mit 512 GB? Ein M5 Ultra Mac Studio mit 512 GB könnte GLM-5.3 oder DeepSeek V4.1 Flash bei 4 Bit halten. Apple sagte, diese Konfiguration komme Ende Oktober; MacRumors erwartet einen Preis deutlich über $10.000, und Apple hatte noch keinen veröffentlicht, als ich nachsah. Du würdest fünfstellig zahlen, um Modelle laufen zu lassen, die auf dem neuen Index 32 erreichen, wahrscheinlich langsamer, als ihre Hersteller sie ausliefern. Mein Kimi K3 vs. Fable 5.1 vs. GLM-5.3 Vergleich geht tiefer darauf ein, was das Selbsthosting der großen offenen Modelle wirklich verlangt.
Bild anzeigen Nur Gewichte, bei 4 Bit pro Parameter; der Kontext-Cache kommt obendrauf. Alles rechts der 128-GB-Linie braucht ein Mac Studio oder einen Server.
Teil 6 — Quantisierung: die Qualitätssteuer, die du fürs Passen zahlst
Quantisierung speichert die Gewichte eines Modells in weniger Bits, 8 oder 4 statt der 16, mit denen es trainiert wurde, sodass es weniger Speicher braucht und schneller läuft. Jedes lokale Modell, das du auf einem Mac laufen lässt, ist quantisiert. Die Frage ist, was das kostet, und die Forschung gibt eine klare und leicht unbequeme Antwort.
Die gute Nachricht: 8 Bit sind fast gratis, 4 Bit meist in Ordnung
- Eine der größten Studien bisher, von Eldar Kurtic und Kollegen, führte mehr als 500.000 Bewertungen an quantisierten Llama-3.1-Modellen durch. FP8 war in jeder Größe praktisch verlustfrei; INT8 kostete mit sorgfältigem Tuning etwa 1–3 %; und 4-Bit-Quantisierung nur der Gewichte war “wettbewerbsfähiger als erwartet”, nahe an 8 Bit.
- Bei Reasoning-Modellen fand eine Studie aus dem Jahr 2025 von Ruikang Liu und Kollegen, dass 8-Bit-Gewichte und -Aktivierungen oder 4-Bit-Gewichte mit 16-Bit-Aktivierungen bei Mathe-, Wissenschafts- und Coding-Benchmarks verlustfrei sein können. Niedrigere Bitbreiten brachten, wie die Autoren es nennen, erhebliche Genauigkeitsrisiken, und die Aufgabenschwierigkeit beeinflusste stark, wie viel verloren ging.
Wenn du immer nur kurze Fragen auf Englisch stellst, wird sich ein 4-Bit-Modell nahe am Original anfühlen.
Die schlechte Nachricht: lange Eingaben, andere Sprachen und alles unter 4 Bit
- Langer Kontext. Anmol Mekala und Kollegen testeten fünf Quantisierungsmethoden an 9.700 Beispielen mit Eingaben von 64.000 Token oder mehr (EMNLP 2025). 8 Bit kostete etwa 0.8% im Durchschnitt. 4 Bit kostete bis zu 59 %, und der Schaden hing stark vom Modell ab: Bei einer 4-Bit-Methode fiel Llama 3.1 70B um 32 % bei einer Aufgabe, bei der Qwen 2.5 72B standhielt.
- Andere Sprachen als Englisch. Dieselbe Studie fand, dass die Verschlechterung tendenziell schlimmer war, wenn die Eingabe nicht auf Englisch war. Wenn du auf Deutsch arbeitest, teste auf Deutsch.
- Unter 4 Bit bricht das Reasoning zusammen. Forscher von Meta FAIR veröffentlichten im Juni 2026 eine Studie, die zeigt, dass quantisierte Reasoning-Modelle zu viel nachdenken. Unter 3-Bit-AWQ fiel die Punktzahl eines 1,5B-Reasoning-Modells bei MATH-500 von 85,6 % auf 47,0 %, und seine Gedankenkette wuchs von 5.200 auf 23.400 Token, 4,5-mal länger. Auf einem Laptop, der 20 bis 80 Token pro Sekunde schreibt, ist ein Modell, das viermal länger denkt, auch etwa viermal langsamer.
Bild anzeigen Die Forschung zeigt, was jeder Schritt nach unten bei der Präzision kostet. Die Quetschung, die ein größeres Modell in 128 GB unterbringen würde, ist genau die, die am meisten wehtut.
Was das für ein MacBook mit 128 GB bedeutet
Die Quantisierung, die du dir für ein Modell leisten kannst, das du wirklich willst, ist die Quantisierung, die am meisten wehtut. Ein 27B-Modell läuft auf einem Mac mit 8 Bit und reichlich Luft, und das sollte es auch. Die Modelle der 120B-Klasse laufen bei 4 Bit, was für Chat in Ordnung und bei langen Dokumenten riskant ist. Und der einzige Weg, irgendetwas aus der 300B-plus-Klasse auf einen Laptop zu bringen, sind zwei oder drei Bit pro Gewicht, wo laut den Studien oben das Reasoning auseinanderfällt.
Meine Faustregeln:
- Nutze 8 Bit für alles, worauf du dich verlässt, besonders lange Dokumente und Agentenarbeit.
- 4 Bit sind für Chat, Entwürfe und kurze Aufgaben in Ordnung. Prüfe das Langkontextverhalten an deinen eigenen Dokumenten.
- Lass Reasoning- oder Coding-Modelle nicht unter 4 Bit laufen außer du experimentierst.
- Teste in der Sprache, in der du arbeitest.
Teil 7 — Tempo: schnell beim Schreiben, langsam beim Lesen
Ein LLM erledigt zwei verschiedene Aufgaben mit zwei verschiedenen Geschwindigkeiten. Prefill liest deinen Prompt, alles Eingefügte plus die bisherige Unterhaltung, und ist durch reine Rechenleistung begrenzt. Generierung schreibt die Antwort Token für Token und ist durch die Speicherbandbreite begrenzt. Apples eigene Machine-Learning-Forscher haben beides auf dem M5 gemessen: Die neuen GPU Neural Accelerators machten die Zeit bis zum ersten Token 3,3- bis 4,1-mal schneller als auf dem M4, während die Generierung nur um das 1,19- bis 1,27-Fachezunahm, etwa im Einklang mit der zusätzlichen Bandbreite.
Was macht ein M5 Max mit 128 GB also tatsächlich? Hardware Corner veröffentlichte Tests, die mit Apples MLX-Framework auf einem 14-Zoll-M5-Max mit 128 GB liefen:
| Modell | Kontext | Lesen (Prefill), Token/s | Zeit, den ganzen Prompt zu lesen | Schreiben, Token/s |
|---|---|---|---|---|
| gpt-oss-120b (MXFP4, 64 GB) | 4K | 1,325 | 3,1 s | 87.9 |
| 32K | 2,537 | 12,9 s | 64.5 | |
| Qwen3.5 122B A10B (4 Bit) | 4K | 881 | 4,6 s | 65.9 |
| 32K | 1,068 | 30,7 s | 54.9 | |
| Qwen3.5 27B (dense, 6 Bit) | 4K | 811 | 5,1 s | 23.6 |
| 32K | 591 | 55,4 s | 14.9 | |
| Qwen3-Coder-Next (8 Bit) | 64K | 1,432 | 45,8 s | 48.2 |
Gemessen von Reddit-Nutzer cryingneko und veröffentlicht von Hardware Corner. “Zeit, den ganzen Prompt zu lesen” ist die Kontextlänge geteilt durch die gemessene Prefill-Geschwindigkeit.
Die Schreibgeschwindigkeit ist inzwischen in Ordnung, zumindest bei MoE-Modellen
Mixture-of-Experts-Modelle nutzen pro Token nur einen Bruchteil ihrer Gewichte, deshalb schreiben sie schnell: 55 bis 88 Token pro Sekunde auf dem M5 Max. Zum Vergleich: Artificial Analysis misst Claude Opus 5.5 mit 98 Token pro Sekunde über Anthropics API. Fürs Chatten mit einem Modell der 120B-Klasse ist der M5 Max wirklich angenehm. Dense Modelle sind eine andere Geschichte: Ein 27B-Modell, das jedes Gewicht für jeden Token nutzt, schreibt 15 bis 24 Token pro Sekunde.
Zwei kleinere Effekte summieren sich ebenfalls. Das Schreiben wird langsamer, je länger die Unterhaltung wird: 17 % bis 37 % langsamer bei 32K als bei 4K über diese drei Modelle hinweg. Und Reasoning-Modelle verbringen Hunderte oder Tausende Token mit Nachdenken, bevor sie antworten.
Beim Lesen entsteht die Wartezeit
Schau dir die Spalte mit der Lesezeit noch einmal an. Ein Prompt mit 32.000 Token (ein paar Quelldateien, ein langer Vertrag, ein großer E-Mail-Thread) braucht 13 bis 55 Sekunden zum Lesen, bevor das erste Wort der Antwort erscheint.
Das zählt am meisten für genau die Arbeit, für die ein $200-Plan gekauft wird. KI-Coding-Agenten schicken dem Modell einen großen System-Prompt, die Definitionen aller Tools, die Dateien, die sie geöffnet haben, und die bisherige Unterhaltung, und das bei jedem Schritt. Lokale Server können den Teil des Prompts wiederverwenden, der sich nicht geändert hat, was viel hilft. Aber wann immer sich etwas früh im Kontext ändert, etwa wenn der Agent seine Historie komprimiert oder du zu einer neuen Aufgabe wechselst, muss alles danach neu gelesen werden. Forbes zitierte einen Entwickler, der bei einem 512-GB-M3-Ultra mit einem 16.000-Token-System-Prompt etwa 90 Sekunden auf das erste Token wartete, und einen anderen, der auf einem 48-GB-M4-Pro-Laptop kalt etwa 20 Sekunden sah. Chips der M5-Generation sind dabei laut Apples eigenen Messungen viel schneller als ältere Macs, aber die Form des Problems ist dieselbe.
Zum Vergleich: Dieselben Hardware-Corner-Tests liefen auf einer Nvidia RTX Pro 6000 Workstation-Karte, die allein etwa $8.800 kostet: sie las Prompts 2- bis 2,4-mal schneller und schrieb 1,7- bis 2,8-mal schneller als der M5 Max.
Bild anzeigen Gemessen mit MLX auf einem M5 Max mit 128 GB. Das Schreiben ist schnell genug; beim Lesen langer Prompts, was Agenten ständig tun, entsteht die Wartezeit.
Teil 8 — Das Laptop-Problem
Selbst wenn die Modelle gut genug wären, ist ein Laptop ein unbequemer Ort, um sie laufen zu lassen.
Wärme. Ein großes Modell laufen zu lassen ist Dauerlast: Minuten oder Stunden, in denen GPU und Speicher auf Hochtouren arbeiten, kein Zehn-Sekunden-Sprint. Notebookchecks Test des 14-Zoll-M5-Max kam zu dem Schluss, dass sein Gehäuse und seine Kühlung “den M5 Max einfach nicht angemessen bewältigen können”: Die Leistung in einem 30-minütigen CPU-Stresstest fiel um 24 %, und die Lüfter erreichten im High-Power-Modus 53,2 dB(A). Dieser Test maß CPU- und Grafiklast, nicht LLMs, und Notebookcheck selbst legt nahe, dass der M5 Max ins 16-Zoll-Modell gehört. Wenn du wirklich ein MacBook für lokale KI kaufst, kauf das 16-Zoll. Mein Leitfaden zum MacBook Pro M5 Pro mit 64 GB kam zum selben Schluss über Dauerlast im kleineren Gehäuse.
Es ist außerdem dein Alltagsrechner. Lade ein 70-GB-Modell plus seinen Kontext, und du hast noch Platz für einen Browser und einen Editor. Geh in Richtung der rund 96 GB, die die GPU standardmäßig bekommt, oder erhöhe das Limit, um etwas Größeres hineinzuzwängen, und der Rest deiner Arbeit konkurriert mit dem Modell um Speicher. Jedes Modell, das du geladen hältst, ist Speicher, den deine anderen Apps nicht bekommen.
Akkus mögen das nicht. Dauerhafte GPU-Last saugt einen Laptop-Akku schnell leer, also laufen lange lokale Inferenz-Sessions am Ende am Netzteil, was das Argument “KI überall, offline” ziemlich untergräbt.
Deine Obergrenze kaufst du am ersten Tag. Unified Memory lässt sich nach dem Kauf nicht aufrüsten. Wenn das beste offene Modell des nächsten Jahres 160 GB braucht, kann ein MacBook mit 128 GB es schlicht nicht laufen lassen.
Und es verliert schnell an Wert. Der britische Aufbereiter MacFinder analysierte sechs Jahre eigener Einkaufsdaten und fand, dass die meisten MacBooks im ersten Jahr etwa die Hälfte ihres Werts verlieren, wobei High-End-Modelle oft stärker fallen: Ein 16-Zoll-M4-MacBook-Pro verlor in einem Jahr bis zu 60 %. Eine Maschine für $6.999 ist eine $6.999-Wette darauf, dass die Speicherobergrenze von heute in drei Jahren noch nützlich ist.
Ein Desktop ist die bessere LLM-Box. Wenn lokale KI der Punkt ist, kostet ein Mac Studio mit demselben M5 Max und 128 GB $2.200 weniger, hat keinen Akku, der durchkocht, und keinen Deckel, der zuklappt, und kann rund um die Uhr als privater Server für deinen Laptop und dein Handy laufen. Kombinier es mit dem Laptop, den du sowieso magst.
Teil 9 — Die Softwarelücke: was du selbst nachbauen müsstest
Ein Abo ist ein Modell plus ein Produkt. Ein lokales Setup gibt dir das Modell und überlässt dir das Produkt.
| Was das Abo für dich erledigt | Was du lokal selbst machen würdest |
|---|---|
| Hostet das Modell und aktualisiert es | Modelle selbst herunterladen, konvertieren und aktualisieren (LM Studio, Ollama oder MLX) |
| Websuche und Deep Research | Eine Such-API oder selbst gehostete Suche anbinden, plus einen Agenten, der sie steuert |
| Liest PDFs, Tabellen und Bilder | Modelle mit Vision wählen, Dokumenten-Parsing ergänzen |
| Stimme, Gedächtnis, Bildgenerierung | Separate Modelle und Apps für jedes davon (Whisper für Sprache, Draw Things oder ComfyUI für Bilder) |
| Apps auf jedem Gerät, synchronisiert | Einen Server und ein Frontend betreiben und es sicher für dein Handy öffnen |
| Claude Code oder Codex, auf ihre eigenen Modelle abgestimmt | Ein offenes Harness, oder Claude Code selbst, auf einen lokalen Server zeigen lassen |
| Chat-Templates, Tool-Call-Formate und Sicherheit erledigt | Debugge sie, wenn ein neues Modell mit einem Template kommt, das deine Tools nicht verstehen |
Die Werkzeuge sind inzwischen wirklich gut. LM Studio ist der einfachste Einstieg auf einem Mac, Ollama gibt dir eine API für lokale und Cloud-Modelle, und Apples MLX ist meist am schnellsten. Ollama bietet sogar eine Anthropic-kompatible API, du kannst Claude Code also mit ANTHROPIC_BASE_URL=http://localhost:11434auf ein lokales Modell zeigen lassen. Die Dokumentation ist allerdings ehrlich über die Lücken: Anthropics Prompt-Caching-Steuerung, Token-Zählung, Batches und PDF-Eingabe werden nicht unterstützt. Und Claude Code ist auf Claude-Modelle abgestimmt; ein lokales Modell muss mit Claude Codes langem System-Prompt und den Tool-Definitionen zurechtkommen, und dort beißen sich die Prefill-Zeiten aus Teil 7.
Nichts davon ist unmöglich. Mein OpenCode v2, Hermes Agent und OpenClaw im Vergleich Beitrag deckt offene Agenten ab, die mit lokalen Modellen arbeiten. Aber es ist echte Arbeit, und deine Stunden sind nicht gratis. Plane ein Wochenende für die Einrichtung ein und ein paar Stunden im Monat, um es aktuell zu halten.
Teil 10 — Die Break-even-Rechnung, ehrlich gemacht
Hier ist die Rechnung, die das Argument meist überspringt.
Schritt 1: die naive Version
$6.999 ÷ $200 im Monat = 35 Monate. Nicht zwölf. Fast drei Jahre, und das ist die schmeichelhafteste Version.
Schritt 2: Strom dazurechnen
Forbes schätzte etwa $10 im Monat für einen Mac, der acht Stunden am Tag KI bei durchschnittlichen US-Strompreisen läuft. In Deutschland kostet bei einem Oktober-Durchschnitt von 29,68 Cent pro kWh ein Laptop mit durchschnittlich 60–150 W acht Stunden am Tag etwa €4–11 im Monat. Klein, aber es schiebt die Gewinnschwelle auf etwa 37 Monate.
Schritt 3: einen günstigen Plan für die harten Fälle behalten
Das wirst du. Wenige Leute, die ein Frontier-Modell für agentisches Coding oder ernsthafte Recherche genutzt haben, gehen für alles zu einem Modell mit 34 Punkten zurück. Behalte einen $20-Plan für die harten 10 %, und der Mac spart dir $170 im Monat, nicht $200: etwa 41 Monate.
Schritt 4: vergleichen mit dem, worauf du wirklich downgraden würdest
Wenn du kostenbewusst genug bist, über einen Laptop für $7.000 nachzudenken, bist du kostenbewusst genug, auf einen $100-Tarif zu wechseln. Gegen $100 im Monat liegt die Gewinnschwelle bei etwa 78 Monaten, über sechseinhalb Jahre, länger, als viele Leute einen Laptop behalten.
| Szenario | Vorabkosten | Du zahlst weiter | Monatliche Ersparnis | Gewinnschwelle |
|---|---|---|---|---|
| MacBook gegen $200-Plan, ohne Strom | $6,999 | — | $200 | 35 Monate |
| MacBook gegen $200-Plan, mit Strom | $6,999 | $10 | $190 | 37 Monate |
| … und du behältst einen $20-Plan | $6,999 | $30 | $170 | 41 Monate |
| MacBook gegen $100-Plan | $6,999 | $10 | $90 | 78 Monate |
| Mac Studio (128 GB) gegen $200-Plan | $4,799 | $10 | $190 | 25 Monate |
| Mac Studio gegen $200-Plan, mit $20-Plan | $4,799 | $30 | $170 | 28 Monate |
All diese Zahlen gehen davon aus, dass der Mac die Aufgabe des Abos vollständig übernimmt. Teile 4 bis 9 erklären, warum er das nicht tut.
Bild anzeigen Kumulierte Kosten über vier Jahre, unter der Annahme, dass der Mac das Abo vollständig ersetzt, was er nicht tut. Strom bei etwa $10 im Monat.
Schritt 5: drei Jahre, mit Wiederverkauf
Hardware hat einen Wiederverkaufswert, und das ist das stärkste Argument fürs Kaufen. Angenommen, du verkaufst nach drei Jahren für 35 % des Kaufpreises. Das ist meine Annahme, kein Zitat, gestützt auf MacFinders Daten, die zeigen, dass im ersten Jahr etwa die Hälfte des Werts verloren geht und die Verluste danach langsamer werden.
| Option | 36-Monats-Kosten |
|---|---|
| $200-Plan | $7,200 |
| MacBook (128 GB) + Strom, für 35 % verkauft | $4,909 |
| … plus ein $20-Plan für Frontier-Arbeit | $5,629 |
| Mac Studio (128 GB) + Strom + $20-Plan, für 35 % verkauft | $4,199 |
| $100-Plan | $3,600 |
| $20-Plan | $720 |
Also ja: Über drei Jahre kann ein MacBook plus $20-Plan etwa $1.600 billiger kommen als ein $200-Plan, wenn du es zu einem anständigen Preis verkaufst. Aber schau, was dieses Geld kauft. Auf der einen Seite die besten Modelle der Welt mit allen Werkzeugen drumherum. Auf der anderen ein Modell mit 34 Punkten, ein paar Tausend Dollar Wertverlust und ein billiger Plan für den Fall, dass du das echte Ding brauchst. Der $100-Plan schlägt jede Hardware-Option bei den Kosten, und der $20-Plan schlägt alles.
Du sparst mit einem MacBook für lokale LLMs nicht viel Geld. Du gibst einen ähnlichen Betrag für ein anderes Produkt aus: Privatsphäre, Kontrolle und Freiheit von Limits, mit weniger Intelligenz dran.
Die Grenzkosten-Betrachtung
Es gibt eine Sichtweise, in der Kaufen mehr Sinn ergibt: du brauchst sowieso ein neues MacBook. Dann sind die KI-spezifischen Kosten nur das Speicher-Upgrade von 48 GB auf 128 GB, $2.000, oder zehn Monate eines $200-Plans. Das ist nicht verrückt. Aber denk an das 128-GB-Paradox aus Teil 4: Auf dem heutigen Leaderboard kauft dieses Upgrade größere Modelle, nicht klügere. Wenn du sowieso ein MacBook kaufst, läuft mit 48–64 GB das beste Mac-große Modell bei 8 Bit mit reichlich Kontext.
Was $6.999 stattdessen kaufen
- 35 Monate eines $200-Plans, 70 Monate eines $100-Plans, oder 29 Jahre eines $20-Plans
- Etwa 11,7 Milliarden Output-Token von DeepSeek V4.1 Flash zu seinem Off-Peak-API-Preis, einem Modell, das alles übertrifft, was in ein MacBook passt
- Etwa 350 Millionen Output-Token von Claude Opus 5.5 über Anthropics API, zu den $20 pro Million, die Artificial Analysis listet
Teil 11 — Der faire Fall: Wann ein Mac für lokale KI Sinn ergibt
Nichts davon bedeutet, dass lokale KI eine Spielerei ist. Ich schreibe ständig darüber in diesem Blog, weil sie nützlich ist. Nützlich ist sie nur aus anderen Gründen, als das Argument behauptet. Das sind die guten.
1. Daten, die deine Kontrolle nicht verlassen dürfen
Wenn du mit Kundendateien, Gesundheitsdaten, unveröffentlichten Finanzzahlen oder irgendetwas unter einer Vertraulichkeitspflicht zu tun hast, bedeutet ein lokales Modell, dass nichts an Dritte geht. Keine Auftragsverarbeitungsvereinbarung, kein internationaler Transfer, kein Grübeln über Trainingseinstellungen. In Deutschland brauchen Berufsgeheimnisträger nach § 203 StGB, etwa Anwälte, Ärzte und Steuerberater, vertragliche Absicherungen, bevor Kundendaten an einen externen Dienstleister gehen, KI-Anbieter eingeschlossen. Ein lokales Modell umgeht diese Frage vollständig. Das ist der stärkste Grund, die Hardware zu besitzen, und er hängt nicht davon ab, ob das lokale Modell so klug ist wie Opus. Mein Stand der KI im Jahr 2026 Bericht geht detaillierter auf die Kosten- und Compliance-Seite des Offline-Betriebs von KI ein.
2. Arbeit offline
Im Flugzeug, beim Kunden ohne Netz, in einer Einrichtung, in der das Netz das Verbotene ist.
3. Keine Limits, keine Policy-Drift, ein Modell, das sich nie ändert
Keine Fünf-Stunden-Fenster, keine Wochenlimits, keine Sammelklagen darüber, wie sie offengelegt werden. Und ein lokaler Checkpoint verhält sich in einem Jahr genauso wie heute, was zählt, wenn du einen Workflow um das Verhalten eines Modells herum gebaut hast.
4. Massenhafte, langweilige, klar definierte Arbeit
Tausende Support-Tickets klassifizieren, Felder aus Rechnungen ziehen, deine eigenen Notizen zusammenfassen, Entwürfe übersetzen, Fotos taggen, Embeddings für die Suche über deine eigenen Dokumente erzeugen, Meetings mit Whisper transkribieren. Mittlere lokale Modelle sind darin exzellent, und eine Million davon laufen zu lassen kostet nichts außer Strom.
5. Lernen und bauen
Wenn du Local-First-Apps baust, kleine Modelle fine-tunest oder einfach verstehen willst, wie das Zeug funktioniert, ist eigene Hardware der beste Lehrer. (Wenn das Bauen von Apps mit KI dein Ding ist, habe ich den ganzen Prozess beschrieben in Wie du 2026 mit KI eine App von Grund auf baust.)
6. Du wolltest sowieso einen Mac kaufen
Dann kauf genug Speicher für die Modelle, die du tatsächlich laufen lässt (siehe Teil 14), und behandle lokale KI als Bonus, nicht als Geschäftsfall.
Was lokal gut läuft
| Aufgabe | Was laufen soll | Speicher, der bequem ist |
|---|---|---|
| Privater Chat, Entwürfe, Umschreiben | Qwen3.8 27B bei 8 Bit | 48–64 GB |
| Zusammenfassungen und Q&A über deine Dokumente | Qwen3.8 27B, plus ein Embedding-Modell | 48–64 GB |
| Massenextraktion und -klassifizierung | Kleinere Modelle (Gemma 4, gpt-oss-20b) | 16–32 GB |
| Sprache-zu-Text | Whisper | 8–16 GB |
| Bildgenerierung | Draw Things oder ComfyUI mit FLUX-Klasse-Modellen | 32 GB+ |
| Ein großes, schnelles Chat-Modell | gpt-oss-120b oder Qwen3.5 122B | 128 GB |
Für lokale Videogenerierung bleiben Macs langsam im Vergleich zu Nvidia-Hardware oder Cloud-GPUs; mein Leitfaden zum M5 Pro mit 64 GB hat die Zahlen.
Teil 12 — Günstigere Wege, eine $200-KI-Rechnung zu senken
Wenn du wirklich nur eine kleinere KI-Rechnung willst, gibt es billigere Wege als einen Laptop für $7.000.
1. Eine Stufe runter. Claude Max 5× und ChatGPT Pro 100 kosten $100, und Googles AI Ultra beginnt jetzt bei $100. Wenn du deine Limits in einem $200-Plan selten erreichst, spart das $1.200 im Jahr ganz ohne Qualitätsverlust.
2. Zwei $20-Pläne kombinieren. Claude Pro plus ChatGPT Plus kostet $40 im Monat und gibt dir zwei getrennte Kontingent-Pools und zwei Frontier-Modellfamilien zum Wechseln.
3. Pro Token für offene Modelle zahlen. Dieselben offenen Modelle, die du auf einem Mac laufen würdest, und größere, die nie passen werden, gibt es bei vielen Anbietern pro Token, mit Rechenzentrumsgeschwindigkeit. DeepSeek V4.1 Flash, das jedes Modell übertrifft, das in ein MacBook passt, kostet $0,15 pro Million Input-Token und $0,60 pro Million Output-Token off-peak bei DeepSeeks eigener API (das Doppelte zu Stoßzeiten). Qwen3.8 27B wird auf OpenRouter ab etwa $0,035 pro Million Input-Token gelistet. Für persönliche Daten oder Kundendaten nutze einen Anbieter mit EU-Hosting und Auftragsverarbeitungsvertrag statt DeepSeeks eigener API, die Daten in China verarbeitet.
4. Einen Flatrate-Coding-Plan für offene Modelle nutzen. Z.ais GLM-Kodierungsplan beginnt bei $18 im Monat und enthält GLM-5.3, gemeinsam bestes unter den herunterladbaren Modellen auf dem neuen Index, plus GLM-5.3-Flash, und es funktioniert in Claude Code, Codex, OpenCode und anderen Tools. Sichere dir 10 % Rabatt auf den GLM Coding Plan über meinen Affiliate-Link. (Affiliate-Link — siehe den Hinweis oben.) Es ist nicht Opus 5.5, und der Index sagt das deutlich, aber es kostet weniger als ein Zehntel eines $200-Plans. Ich habe es mit MiniMax’ Angebot verglichen in GLM-5.3-Flash im Vergleich zu MiniMax M3.
5. Den Mac nutzen, den du schon hast. Wenn dein aktueller Mac 16 bis 32 GB hat, erledigen kleine lokale Modelle einen überraschend großen Teil der Massenarbeit aus Teil 11 kostenlos.
6. Nach Aufgabe routen. Das Setup, das für die meisten funktioniert: ein lokales Modell für private und Massenaufgaben, ein günstiger Plan oder ein offenes Modell pro Token für den Alltag und Frontier-Zugang für die harten 10 %. Mein KI-Coding-Harness-Vergleich hat fünf durchgerechnete Setups für verschiedene Budgets.
Bild anzeigen Monatliche Kosten jeder Option in US-Dollar, ohne Mehrwertsteuer. Pay-per-Token-Kosten hängen davon ab, wie viel du nutzt; Preise geprüft am 28. Oktober 2026.
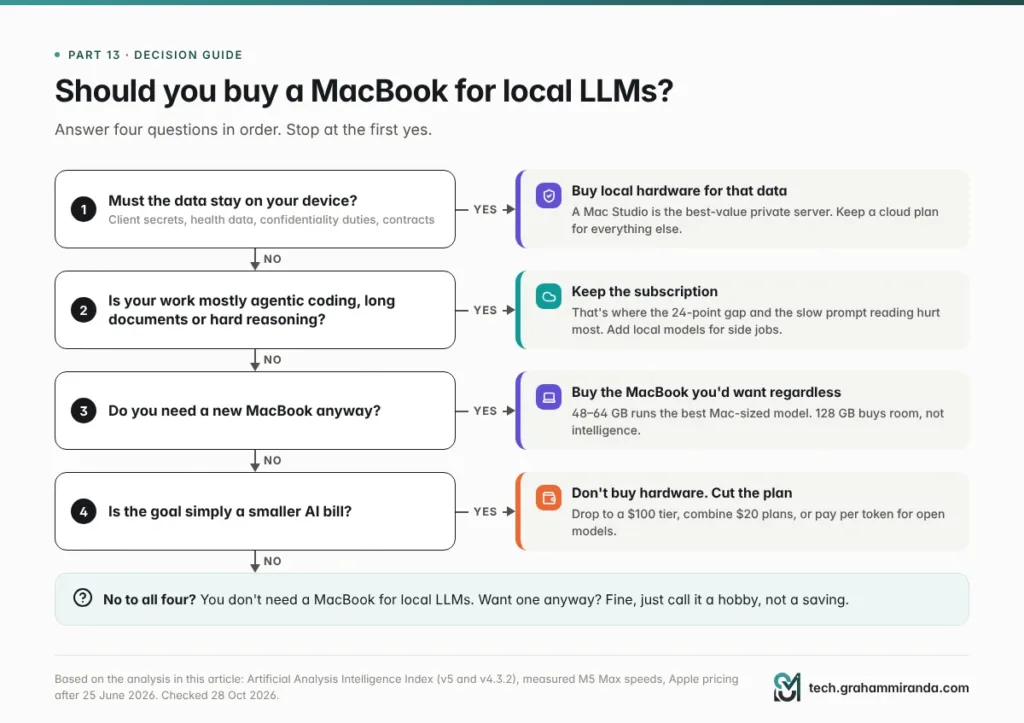
Teil 13 — Solltest du ein MacBook für lokale LLMs kaufen? Ein Entscheidungsleitfaden
Bild anzeigen Fang oben an. Die meisten Pfade enden mit “behalte einen Cloud-Plan”, und das ist der Punkt.
Geh vier Fragen der Reihe nach durch.
1. Müssen die Daten auf deinem Gerät bleiben? Wenn ja, wegen Kundenvertraulichkeit, Gesundheitsdaten oder eines Vertrags, kauf lokale Hardware: Diese Anforderung interessiert sich nicht für Benchmarks. Erwäge ein Mac Studio als privaten Server und behalte einen Cloud-Plan für Arbeit, die diese Daten nicht betrifft.
2. Besteht deine Arbeit überwiegend aus agentischem Coding, langen Dokumenten oder hartem Reasoning? Wenn ja, behalte das Abo. Genau dort tun die 24-Punkte-Lücke und die Prefill-Zeiten am meisten weh. Ein lokales Modell kann trotzdem bei Nebenaufgaben helfen.
3. Brauchst du sowieso ein neues MacBook? Wenn ja, kauf das, was du sowieso willst. Mit 48–64 GB läuft das beste Mac-große Modell gut. Geh nur dann auf 128 GB, wenn du gezielt Modelle der 120B-Klasse oder mehrere gleichzeitig geladene Modelle willst, und wisse, dass du $2.000 für Platz zahlst, nicht für Intelligenz.
4. Ist das Ziel einfach eine kleinere Rechnung? Dann kauf keine Hardware. Geh eine Stufe runter, kombiniere $20-Pläne oder zahle pro Token für offene Modelle (Teil 12).
Wenn du alle vier mit Nein beantwortet hast, brauchst du kein MacBook für lokale LLMs. Vielleicht willst du trotzdem eins, und das ist in Ordnung. Nenn es einfach ein Hobby, keine Ersparnis.
Teil 14 — Wenn du trotzdem eins kaufst: wie du das Meiste herausholst
Wähle die richtige Maschine.
- Kauf das 16-Zoll, nicht das 14-Zoll, wenn der M5 Max für dauerhafte KI-Arbeit gedacht ist.
- Erwäge stattdessen ein Mac Studio. Derselbe Chip und derselbe Speicher für $2.200 weniger, bessere Kühlung, und es kann deinen Laptop und dein Handy rund um die Uhr bedienen.
- Kauf nicht zu viel Speicher für die Modelle von heute. Mit 48–64 GB läuft Qwen3.8 27B bei 8 Bit mit langen Kontexten. Kauf 128 GB für Modelle der 120B-Klasse, mehrere Modelle gleichzeitig oder Luft für künftige Releases, im Wissen, was es kostet.
- Wenn du diese Woche kaufst, warte das Event heute Abend ab. Dann weißt du, was das OLED-MacBook-Pro bietet und kostet, bevor du dich festlegst.
Richte es richtig ein.
- Fang mit LM Studio an (MLX auf Apple Silicon) für den einfachsten Weg, oder Ollama wenn du eine API für lokale und Cloud-Modelle willst.
- Bevorzuge 8 Bit für alles, worauf du dich verlässt; nutze 4 Bit für Tempo im Chat.
- Setze die Kontextlänge bewusst. Viele Runtimes stehen standardmäßig auf kleinen Kontexten; Agenten brauchen viel mehr.
- Erhöhe das GPU-Speicherlimit nur, wenn du den Kompromiss verstehst, und lass Platz für macOS.
- Behalte einen $20-Cloud-Plan für die harten 10 %. Er ist billiger als deine eigene Zeit.
Teste es an deiner eigenen Arbeit. Nimm 20 echte Prompts aus dem letzten Monat: E-Mails, Dokumente, Coding-Aufgaben, was du halt wirklich machst. Lass jeden durch dein lokales Modell und dein Cloud-Modell laufen, verberge, welcher welcher ist, und benote sie. Mach es in der Sprache, in der du arbeitest. Diese eine Stunde sagt dir mehr als jedes Leaderboard, auch die in diesem Artikel.
Häufig gestellte Fragen
Kann ein MacBook ein ChatGPT-Pro- oder Claude-Max-Abo ersetzen?
Nicht bei der Qualität. Die Modelle hinter einem $200-Plan, etwa Claude Opus 5.5 und GPT-6 Astra, lassen sich nicht herunterladen, und die besten offenen Modelle, die man herunterladen kann, brauchen bei 4 Bit 375–460 GB Speicher, weit jenseits jedes MacBook. Auf Artificial Analysis’ Index erreicht Opus 5.5 den Wert 58; das stärkste Modell, das ich gefunden habe und das in ein MacBook mit 128 GB passt, Qwen3.8 27B, erreicht 34 auf derselben Version. Ein MacBook kann ein Abo für private, Offline- oder Massenarbeit ersetzen, nicht für Frontier-Aufgaben.
Was ist 2026 das beste lokale LLM für ein MacBook Pro mit 128 GB?
Für Qualität: Qwen3.8 27B. Artificial Analysis führt es als Erstes von 141 vergleichbaren Modellen, mit 34 auf dem Intelligence Index v4.3.2, und es passt bei 8 Bit bequem. Für Tempo sind gpt-oss-120b und Qwen3.5 122B Mixture-of-Experts-Modelle, die auf einem M5 Max 55–88 Token pro Sekunde schreiben, aber sie punkten niedriger (12 und 16). Prüfe Artificial Analysis, bevor du wählst, denn neue offene Modelle ändern dieses Ranking alle paar Wochen.
Was kostet ein MacBook Pro mit 128 GB heute?
Ein 16-Zoll-MacBook-Pro mit einem M5 Max (18-Kern-CPU, 40-Kern-GPU), 128 GB und 2 TB kostet in den USA $6.999, vor Umsatzsteuer. Apple erhöhte die Mac-Preise am 25. Juni 2026 und verdoppelte das 128-GB-Upgrade von $1.000 auf $2.000. In Deutschland kostete dieselbe Konfiguration beim Start €6.249 und kostet nach meiner Schätzung jetzt etwa €8.199. Ein Mac Studio mit demselben Chip und Speicher kostete $4.799.
Wie lange braucht ein MacBook, bis es sich gegenüber einem $200-KI-Abo bezahlt macht?
Etwa 35 Monate bei $6.999, wenn es das Abo vollständig ersetzte und nichts für den Betrieb kostete. Mit rund $10 im Monat Strom sind es etwa 37 Monate, und wenn du für Frontier-Aufgaben einen $20-Plan behältst, etwa 41 Monate. Gegen einen $100-Plan sind es mehr als sechs Jahre. Ein Mac Studio mit demselben Chip ist früher break-even, nach etwa 25 bis 28 Monaten.
Ist der M5 Max schnell genug für lokale LLMs?
Für das Schreiben von Antworten mit Mixture-of-Experts-Modellen ja: Gemessen mit MLX erzeugte ein M5 Max mit 128 GB 55–88 Token pro Sekunde, nahe an den 98 von Claude Opus 5.5 über Anthropics API. Das Lesen langer Prompts ist die Schwachstelle. Ein Prompt mit 32.000 Token brauchte mit gpt-oss-120b 13 Sekunden, mit Qwen3.5 122B 31 Sekunden und mit einem dichten 27B-Modell 55 Sekunden, und KI-Coding-Agenten lesen ständig lange Prompts neu.
Sind lokale LLMs heute so gut wie ChatGPT oder Claude?
Nicht die, die auf einen Laptop passen. Auf Artificial Analysis’ neuem Intelligence Index v5, veröffentlicht am 27. Oktober 2026, erreichten die besten herunterladbaren offenen Modelle 32 gegen 58 für Claude Opus 5.5 und lagen unter Claude Haiku 5.5 mit 36. Modelle, die klein genug für ein MacBook sind, erreichten auf der vorherigen Version des Index höchstens 34, wo Opus 5.5 ebenfalls 58 erreichte. Bei kurzen, einfachen Aufgaben ist der Unterschied oft klein; bei agentischem Coding, langen Dokumenten und hartem Reasoning ist er groß.
Macht Quantisierung lokale Modelle schlechter?
Ein wenig bei 8 Bit, mehr bei 4 Bit, viel darunter. Eine Studie mit mehr als 500.000 Bewertungen fand FP8 praktisch verlustfrei und 4-Bit-Quantisierung nur der Gewichte nahe an 8 Bit auf Standard-Benchmarks. Bei Eingaben von 64.000 Token oder mehr maß eine EMNLP-2025-Studie dagegen Einbußen von bis zu 59 % bei 4 Bit, schlimmer für nicht-englischen Text, und bei 3 Bit fiel die Mathe-Punktzahl eines Reasoning-Modells von 85,6 % auf 47,0 %.
Kann ich DeepSeek V4.1 Flash oder GLM-5.3 auf einem MacBook laufen lassen?
Nein. GLM-5.3 hat 753 Milliarden Parameter und DeepSeek V4.1 Flash 763 Milliarden inklusive seines Engram-Speichers, also brauchen sie selbst bei 4 Bit rund 375–460 GB, viel mehr als die 128 GB, die jedes MacBook maximal hat. Ein Mac Studio mit M5 Ultra und 512 GB könnte sie halten. Der praktische Weg, sie zu nutzen, ist über eine API, idealerweise einen Anbieter mit EU-Hosting und Auftragsverarbeitungsvertrag.
Reichen 64 GB für lokale KI, oder brauche ich 128 GB?
Für die meisten reichen 48–64 GB. Das beste Mac-große Modell auf Artificial Analysis’ Index, Qwen3.8 27B, passt bei 8 Bit mit Platz für lange Kontexte. 128 GB lassen dich Modelle der 120B-Klasse wie gpt-oss-120b laufen lassen, mehrere Modelle geladen halten und längere Kontexte nutzen, aber auf dem heutigen Leaderboard punkten diese größeren Modelle niedriger, das $2.000-Upgrade kauft also Platz statt Intelligenz.
Sollte ich für lokale LLMs ein Mac Studio statt eines MacBook Pro kaufen?
Wenn lokale KI der Hauptgrund ist, meistens ja. Ein Mac Studio mit demselben M5 Max und 128 GB kostete $4.799, $2.200 weniger als das 16-Zoll-MacBook-Pro, mit besserer Dauerlastkühlung und ohne Akku, um den man sich sorgen muss. Es kann rund um die Uhr als privater Modellserver für deinen Laptop und dein Handy laufen. Kauf ein MacBook Pro, wenn du die Portabilität aus anderen Gründen brauchst.
Ist KI lokal besser für Datenschutz und DSGVO?
Ja, das ist sein stärkster Vorteil. Mit einem lokalen Modell verlassen Prompts und Dokumente nie dein Gerät, es gibt also keine Auftragsverarbeitungsvereinbarung zu unterschreiben und keinen internationalen Datentransfer. Das zählt bei Kundendaten, Gesundheitsdaten und Berufen unter Vertraulichkeitspflicht, etwa denen, die in Deutschland unter § 203 StGB fallen. Der Datenschutzvorteil bleibt, ob das lokale Modell nun so leistungsfähig ist wie ein Cloud-Modell oder nicht. Das ist keine Rechtsberatung.
Kann ich Claude Code mit einem lokalen Modell nutzen?
Ja. Ollama bietet eine Anthropic-kompatible API, du kannst Claude Code also auf ein lokales Modell zeigen lassen, indem du ANTHROPIC_BASE_URL auf http://localhost:11434setzt. Erwarte Kompromisse: Ollama unterstützt Anthropics Prompt-Caching-Steuerung nicht, Claude Codes langer System-Prompt und die Tool-Definitionen lassen das lokale Modell bei jedem Schritt viel lesen, und Claude Code ist auf Claude-Modelle abgestimmt. Offene Harnesses wie OpenCode passen oft besser zu lokalen Modellen.
Ändert das neue OLED-MacBook-Pro etwas daran?
Wahrscheinlich nicht viel für lokale KI. Apples Event “Pro and Tell” findet am 28. Oktober 2026 um 10:00 pazifischer Zeit statt, und das dort erwartete OLED-Touchscreen-MacBook-Pro soll dieselben M5 Pro und M5 Max Chips nutzen, was die 128-GB-Obergrenze und 614 GB/s Bandbreite erhalten würde. Das am 27. Oktober angekündigte 14-Zoll-MacBook-Pro mit M6 endet bei 32 GB.
Das Fazit
Das Argument “kündige deinen $200-Plan und kauf einen Mac” hat zwei Dinge richtig: Die Abos sind teuer, und lokale KI ist wirklich nützlich. Das Wichtige hat es falsch. Ein $200-Plan vermietet dir die besten Modelle der Welt, die darum herum gebauten Agenten und ein Produkt, das jeden Monat besser wird. Ein MacBook für $7.000 läuft die besten Modelle, die in 128 GB passen, und die erreichen heute 34 gegenüber 58 an der Frontier, lesen lange Prompts langsam und verlieren Qualität genau dort, wo du sie am härtesten quetschen würdest.
Die Rechnung rettet es auch nicht. Selbst im großzügigsten Fall braucht das MacBook drei bis vier Jahre bis zum Break-even, und über drei Jahre kostet es innerhalb von ein paar Tausend Dollar dasselbe wie das Abo, je nachdem, für wie viel du es verkaufen kannst. Das ist eine ähnliche Rechnung für ein weniger leistungsfähiges Produkt.
Kauf also ein MacBook für lokale LLMs, wenn deine Daten das Gebäude nicht verlassen dürfen, wenn du offline arbeitest, wenn du keine Limits und ein Modell willst, das sich nie ändert, oder wenn du sowieso einen Mac kaufen wolltest. Das sind gute Gründe, und viele Leute haben sie. Kauf es nur nicht, um dein Abo zu kündigen. Behalte einen Cloud-Plan für die harten 10 %, verlege die privaten und langweiligen 90 % auf deine eigene Hardware und lass die Leaderboards dir sagen, wann sich diese Balance verschiebt.
Du setzt lokal Modelle für die Arbeit ein oder hast das Gegenteil dessen gefunden, was dieser Artikel sagt? Ich würde gern hören, welches Modell, welche Maschine und welche Aufgaben, mit Zahlen, wenn du sie hast. Korrekturen und Gegenbelege sind willkommen; dieser Artikel wird aktualisiert, wenn sich die Leaderboards und die Preise bewegen, was 2026 oft heißt.
Fakten geprüft: 28. Oktober 2026.