
 Português do Brasil
 English
 Deutsch
 Español
 Italiano
 Français

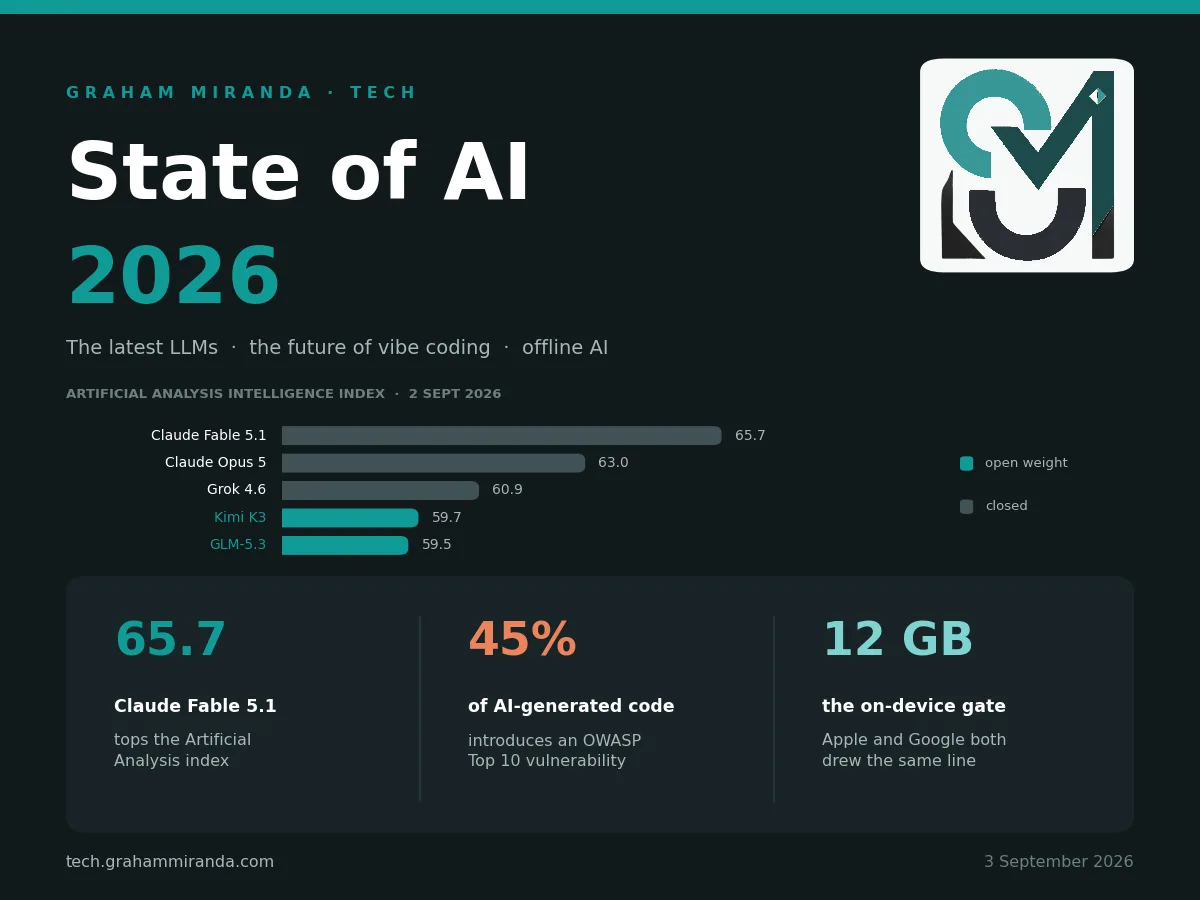
O estado da IA em 2026 se resume a três coisas que aconteceram nos primeiros oito meses do ano — e quase ninguém as colocou na mesma frase.
Um modelo ultrapassou os 96% no SWE-bench Verified. Não 96% em um benchmark de brinquedo — 96% em issues reais do GitHub de Django, Flask e scikit-learn, o benchmark que deveria levar anos. Ele agora está efetivamente esgotado como critério de diferenciação, e os três modelos no topo estão separados por menos de um ponto percentual.
A melhor evidência disponível sobre se ferramentas de codificação com IA deixam desenvolvedores experientes mais rápidos continua dizendo que não. O ensaio controlado aleatorizado da METR encontrou uma desaceleração de 19%. A própria tentativa deles de repeti-lo em 2026 fracassou porque os desenvolvedores se recusaram a trabalhar sem IA, mesmo a US$ 50 a hora. As pessoas que usam essas ferramentas acreditam ser três vezes mais rápidas. Medido, não são.
E a Microsoft colocou um modelo de raciocínio de 14 bilhões de parâmetros dentro do próprio Windows, o que é uma frase que seria ficção científica em 2024 e hoje é uma nota de rodapé em uma keynote do Build.
Esses três fatos são todo o estado da IA em 2026 em miniatura. Os modelos ficaram extraordinários. O ganho de produtividade medido não veio junto. E a fronteira interessante se deslocou discretamente do data center para o dispositivo na sua mão.
Esta é a versão longa do estado da IA em 2026. Foi escrita para quem precisa tomar decisões com dinheiro em jogo — para qual modelo direcionar cada tarefa, se deve deixar agentes escreverem código de produção, o que comprar e o que dizer a um cliente ou a um encarregado de proteção de dados. Separei o que foi lançado do que é reportado e do que é boato, porque o erro mais caro deste campo é planejar em torno de um modelo que ainda não existe.
Última atualização em 3 de setembro de 2026. Vai precisar de outra atualização antes do Natal.
TL;DR — O estado da IA em 2026 em 90 segundos
A fronteira é uma corrida de quatro cavalos e a Anthropic está vencendo no agregado neste momento. Em 2 de setembro de 2026, o Intelligence Index v4.1.1 do Artificial Analysis tem Claude Fable 5.1 com 65,7, Claude Opus 5 com 63,0, Grok 4.6 com 60,9 e GPT-5.6 Sol com 58,9. Mas o agregado esconde a parte interessante: o GPT-5.6 Sol lidera o BrowseComp com 90,4%, o Gemini 3.8 Flash entrega 58,7 a US$ 0,75 por milhão de tokens de entrada, e os dez melhores modelos abrangem apenas 8,2 pontos — uma faixa estreita o suficiente para que diferenças de harness e prompt movam um modelo várias posições.
Os pesos abertos estão cerca de uma geração atrás e se aproximando. GLM-5.3 (753B, aberto) está em 59,5 — sexto no geral, à frente de GPT-5.6 Sol. DeepSeek V4 Pro chegou com 1,6 trilhão de parâmetros sob uma licença MIT de verdade. Ornith-1.5-397B alcançou 86 no SWE-bench Verified e passou à frente de Claude Opus 4.8 no Terminal-Bench 2.1, 86,1 a 85,0. A diferença de capacidade agora é de cerca de seis meses. A diferença de licença é a que importa.
“Vibe coding” ganhou a discussão sobre adoção e perdeu a discussão sobre evidências. 90% dos desenvolvedores usam pelo menos uma ferramenta de codificação com IA no trabalho. O mercado corporativo de agentes de codificação gira em torno de US$ 10 bilhões anualizados. E a confiança dos desenvolvedores na saída da IA caiu de 40% para 29% em dois anos. As ferramentas são universais, e as pessoas que as usam confiam nelas cada vez menos a cada ano. As duas coisas são racionais.
A conta de segurança chegou e vem itemizada. A Veracode descobriu que 45% das amostras de código gerado por IA introduzem uma vulnerabilidade do OWASP Top 10. A Apiiro mediu desenvolvedores assistidos por IA produzindo commits de três a quatro vezes mais rápido e achados de segurança dez vezes mais rápido. Cerca de 20% do código gerado por IA referencia pacotes que não existem. Isso não é um argumento contra as ferramentas. É um argumento sobre onde você coloca o portão.
A IA offline se tornou genuinamente útil este ano, em hardware que as pessoas já têm. Um modelo de 2 bilhões de parâmetros roda a 61 tokens por segundo em um iPhone. A Microsoft colocou um raciocinador de 14B no Windows atrás de um requisito de NPU de 40 TOPS. O Google tranca seu melhor modelo no dispositivo atrás de 12 GB de RAM, e a Apple também. A especificação que decide o que você consegue rodar offline é memória, não capacidade de processamento, e memória é justamente o que ficou escasso.
A frase honesta sobre o estado da IA em 2026: este é o ano em que os modelos deixaram de ser o gargalo. A verificação virou o gargalo. Toda decisão importante neste artigo — qual modelo, qual harness, qual dispositivo, qual portão — decorre dessa única mudança.
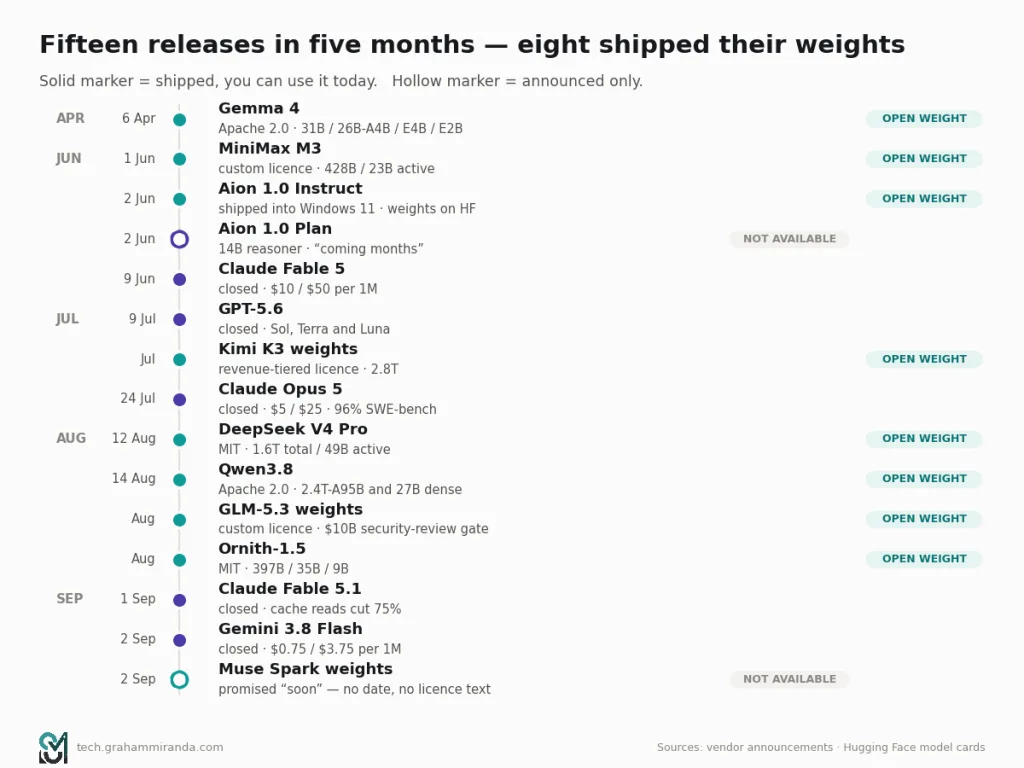
Comparação rápida: a fronteira, setembro de 2026
O Artificial Analysis Intelligence Index v4.1.1 agrega nove avaliações: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience e AA-LCR. As pontuações abaixo são o retrato de 2 de setembro de 2026.
| Modelo | Laboratório | Índice AA | Pesos | Entrada / saída por 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 65.7 | Fechado | US$ 10,00 / US$ 50,00 |
| Claude Opus 5 | Anthropic | 63.0 | Fechado | US$ 5,00 / US$ 25,00 |
| Claude Fable 5 | Anthropic | 62.1 | Fechado | US$ 10,00 / US$ 50,00 |
| Grok 4.6 | xAI | 60.9 | Fechado | — |
| Kimi K3 | Moonshot | 59.7 | Peso aberto | — |
| GLM-5.3 | Z.ai | 59.5 | Peso aberto | US$ 1,40 / US$ 4,40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Fechado | US$ 5,00 / US$ 30,00 |
| Gemini 3.8 Flash | 58.7 | Fechado | US$ 0,75 / US$ 3,75 | |
| Qwen3.8 Max Preview | Alibaba | 58.1 | Fechado | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Peso aberto | US$ 0,15 / US$ 0,47 |
| Claude Opus 4.8 | Anthropic | 57.3 | Fechado | US$ 5,00 / US$ 25,00 |
| Muse Spark 1.2 | Meta | 56.8 | Fechado | — |
| GPT-5.5 | OpenAI | 56.3 | Fechado | — |
Leia a quarta coluna antes da terceira. Dois dos dez melhores modelos têm pesos para baixar, e um deles custa US$ 0,15 por milhão de tokens de entrada.
Comparação rápida: a fronteira dos pesos abertos
| Modelo | Total / ativos | Contexto | Licença | Lançamento |
|---|---|---|---|---|
| Kimi K3 | 2,8T / 104B | 1M | Por faixa de receita (personalizada) | Julho de 2026 |
| Qwen3.8-2.4T-A95B | 2,4T / 95B | 262K (1M via YaRN) | Apache 2.0 | 14 de ago. de 2026 |
| DeepSeek V4 Pro | 1,6T / 49B | 1M | MIT | 12 de ago. de 2026 |
| GLM-5.3 | 753B / ~40B | 1M | Personalizada (limite de US$ 10 bi) | Ago. de 2026 |
| MiniMax M3 | 428B / 23B | 1M | Personalizada (atribuição) | 1 de junho de 2026 |
| Ornith-1.5-397B | 397B MoE | 262K (1M via YaRN) | MIT | Ago. de 2026 |
| Gemma 4 31B | 31B denso | 256K | Apache 2.0 | 6 de abr. de 2026 |
| Qwen3.8-27B | 27B denso | 262K | Apache 2.0 | 14 de ago. de 2026 |
| Gemma 4 E4B | ~8B | 128K | Apache 2.0 | 6 de abr. de 2026 |
Três desses nove são genuinamente limpos segundo a OSI. Essa é a verdadeira história dos pesos abertos em 2026, e volto a ela na Parte Três.
ATO I — OS MODELOS
Parte um: o que realmente foi lançado em 2026
Antes de qualquer argumento, o balanço. Separei em três níveis porque é na diferença entre eles que o dinheiro se perde.
Confirmado e disponível
- 6 de abril de 2026 — o Google lança o Gemma 4 sob a licença Apache 2.0, uma mudança de licença em relação aos termos próprios do Gemma 3’s. Quatro variantes: 31B denso, 26B com 4B ativos (MoE), E4B em ~8B e E2B com 5,1B no total e 2,3B ativos. Contexto de 256K nos modelos grandes, 128K na série E. Todos aceitam texto, imagem e vídeo como entrada; E2B e E4B acrescentam áudio nativo.
- 1 de junho de 2026 — MiniMax M3. 428B no total / 23B ativos, contexto de 1M, multimodalidade nativa, um novo operador de atenção esparsa, pesos no Hugging Face. Coberto em profundidade no meu artigo anterior sobre hardware para IA local.
- 2 de junho de 2026 — a Microsoft anuncia o Aion 1.0 no Build. Uma família de modelos no dispositivo que chegou dentro do próprio Windows 11: Aion 1.0 Instruct (com suporte a CPU, no Edge Canary a partir da 150.0.4070) e Aion 1.0 Plan, um modelo de raciocínio e chamada de ferramentas com 14 bilhões de parâmetros e janela de contexto de 32K.
- 9 de junho de 2026 — Claude Fable 5. O nível mais alto da Anthropic, US$ 10/US$ 50 por milhão, contexto de 1M, saída máxima de 128K.
- 9 de julho de 2026 — a OpenAI lança o GPT-5.6 em três variantes: Sol (US$ 5/US$ 30), Terra (US$ 2,50/US$ 15) e Luna (US$ 1/US$ 6). A capacidade cibernética vem embutida no Sol em vez de ser vendida como modelo separado, com acesso ampliado pelo programa Trusted Access for Cyber da OpenAI.
- Julho de 2026 — a Moonshot abre os pesos do Kimi K3’s. 2,8 trilhões de parâmetros, contexto de 1M, MXFP4 nativo, sob uma licença por faixa de receita.
- 24 de julho de 2026 — Claude Opus 5. US$ 5/US$ 25, inalterado em relação ao Opus 4.8. A Anthropic afirma que ele “mais que dobra o desempenho do Opus 4.8” no Frontier-Bench v0.1 e pontua três vezes o próximo melhor modelo no ARC-AGI 3.
- 12 de agosto de 2026 — o DeepSeek V4 Pro sai do preview com pesos licenciados sob MIT: 1,6T no total (parte da cobertura arredonda para 1,7T), 49B ativos, contexto de 1M, 893 GB de tensores BF16 e FP8, além de um módulo de decodificação especulativa DSpark. Terminal-Bench 2.1 em 87,9, HLE-with-tools em 60,0, CyberGym em 83,3. A DeepSeek subiu os preços da API ao mesmo tempo.
- 14 de agosto de 2026 — pesos abertos do Qwen3.8 sob Apache 2.0: um modelo multimodal denso de 27B e um gigante 2.4T-A95B, ambos no Hugging Face e no ModelScope, com contexto nativo de 262K extensível a 1M com YaRN.
- Agosto de 2026 — os pesos do GLM-5.3 chegam ao Hugging Face cerca de duas semanas depois do lançamento da API. 753B MoE, contexto de 1M, saída de 128K, BF16 e FP8.
- Agosto de 2026 — Ornith-1.5. Três escalas (397B MoE, 35B MoE com 3B ativos, 9B denso), construídas sobre Qwen3.5 e Gemma 4 com pré-treinamento continuado, licença MIT, e alegando 86 no SWE-bench Verified.
- 1 de setembro de 2026 — Claude Fable 5.1 e Mythos 5.1. Raciocínio adaptativo ativado por padrão, contexto de 1M, saída de 128K. Preço base inalterado em US$ 10/US$ 50, mas as leituras de cache caem 75%, de US$ 1,00 para US$ 0,25 por milhão.
- 2 de setembro de 2026 — Gemini 3.8 Flash a US$ 0,75/US$ 3,75, contexto de entrada de 1M, saída de 66K, corte de conhecimento de março de 2026, com entrada de texto, imagem, vídeo, áudio e PDF.
- 2 de setembro de 2026 — a Meta lança o Muse Spark 1.3 e o Muse Code CLI.
Reportado, crível, não confirmado
- A Meta vai abrir os pesos do Muse Spark’s “em breve.” Isso é Mark Zuckerberg no X, sem data, sem contagem de parâmetros, sem detalhes de arquitetura e sem texto de licença. A Meta não divulgou o tamanho do modelo’s em nenhuma versão.
- Gemini Nano v4 é descrito como algo que virá para o Android, com o Nano v3 atualmente restrito à linha Pixel 10.
- Aion 1.0 Plan chega em “alguns meses” para disponibilidade geral; só o Instruct está em preview.
Boato, fonte única, trate como tal
- Tudo o que você leu sobre o próximo carro-chefe da Anthropic, da OpenAI ou do Google. Em um mercado onde quatro laboratórios lançaram um modelo entre os dez melhores em uma janela de nove semanas, boatos futuros têm meia-vida de cerca de duas semanas.
Mais uma coisa que vale sinalizar, porque é nova e quase ninguém fora da área de segurança está falando dela. Claude Mythos 5.1 marca 60,9 no Terminal-Bench 4.0 — mais que os 55,8 do Fable 5.1’s — e 95,5% no SWE-bench Verified. Você não pode comprá-lo.
A Anthropic descreve o Mythos como seu “modelo mais capaz para pesquisa em cibersegurança e biologia”, e ele está disponível apenas para ciberdefensores e cientistas da vida verificados, por meio de dois programas de acesso confiável: o Cyber Verification Program e o Life Sciences Verification Program. Nas palavras da própria Anthropic’s, eles “só conseguem disponibilizá-lo para um conjunto de organizações dos EUA, embora estejam trabalhando para ampliar o acesso.” O Project Glasswing, o esforço de ampliação de acesso, havia chegado a cerca de 150 organizações em mais de quinze países até junho de 2026.
O raciocínio é de uso duplo — um modelo excelente em encontrar vulnerabilidades é excelente em encontrá-las para qualquer um dos lados — e acho isso defensável. Mas note a consequência estrutural, porque ela é genuinamente nova: o modelo com maior pontuação em um benchmark público de codificação agora é um que a maior parte do mundo não consegue acessar a preço nenhum. Restringir capacidade por motivos de segurança em vez de motivos comerciais vai se tornar mais comum, não menos, e se você está fora dos EUA isso é um argumento para se importar com pesos abertos que não tem nada a ver com custo.
Mostrar imagem Nove meses, doze lançamentos significativos, quatro deles com pesos abertos. Barras sólidas são lançamentos com pesos ou acesso via API que você pode comprar hoje; contornos pontilhados são anunciados mas não disponíveis.
Parte dois: o que realmente separa os modelos de fronteira agora
Aqui está a verdade incômoda sobre o topo daquele ranking: na maior parte do trabalho que você realmente fará, os oito melhores modelos são intercambiáveis.
Não digo isso para ser do contra. Digo porque a diferença no índice agregado entre o Claude Fable 5.1 com 65,7 e o GLM-5.3-Flash com 57,5 é de oito pontos, e o GLM-5.3-Flash custa US$ 0,15 por milhão de tokens de entrada contra US$ 10,00 do Fable. Isso é uma diferença de preço de 67× para uma diferença de capacidade de 12% em uma pontuação composta, e pontuações compostas comprimem exatamente as diferenças que importam para você enquanto inflam as que não importam.
Então a pergunta útil não é “qual modelo é o melhor.” É “no que cada um deles é realmente melhor, e isso se sobrepõe à minha semana.”
As quatro coisas que realmente diferem
1. Confiabilidade agêntica em horizonte longo. Este é o verdadeiro diferencial de 2026 e ele é mal medido. O Opus 5 da Anthropic’s é posicionado explicitamente como “uma mudança de patamar para a camada Opus que alimenta agentes de longa duração” — não como um modelo mais inteligente, mas como um modelo que não desaba na sexta hora. A evidência para esse tipo de melhoria está em benchmarks agênticos (Terminal-Bench, OSWorld, Frontier-Bench) e não em benchmarks de conhecimento, e esses benchmarks são jovens, ruidosos e sensíveis ao scaffold.
2. Economia de cache. A mudança principal do Fable 5.1 não foi um salto de capacidade. Foi cortar as leituras de cache em 75%, de US$ 1,00 para US$ 0,25 por milhão de tokens — o que, segundo o MarkTechPost, representa cerca de 25% menos custo para fluxos de trabalho típicos e até 45% para os agênticos. Para qualquer agente que relê um prompt de sistema grande ou uma base de código a cada turno, o preço do cache é uma alavanca maior na sua conta mensal do que a escolha do modelo. Ninguém coloca isso em um ranking.
3. Navegação e uso de ferramentas. GPT-5.6 Sol marca 90,4% no BrowseComp — 92,2% no ajuste de raciocínio Ultra. É um ponto forte específico e publicado, e se sua carga de trabalho é pesquisa e síntese em vez de código e verificação, ele vale mais que dois pontos de índice agregado.
4. Preço por resposta adequada. O Gemini 3.8 Flash com índice 58,7 por US$ 0,75 de entrada é a coisa mais obviamente mal precificada do quadro em relação à fronteira fechada. O GLM-5.3-Flash com 57,5 por US$ 0,15 é a coisa mais obviamente mal precificada, ponto.
A tabela de preços, porque é a decisão de verdade
| Modelo | Entrada /1M | Saída /1M | Entrada em cache /1M | Contexto |
|---|---|---|---|---|
| Claude Fable 5.1 | US$ 10,00 | US$ 50,00 | US$ 0,25 | 1M / 128K de saída |
| Claude Opus 5 | US$ 5,00 | US$ 25,00 | — | 1M / 128K de saída |
| GPT-5.6 Sol | US$ 5,00 | US$ 30,00 | — | — |
| GPT-5.6 Terra | US$ 2,50 | US$ 15,00 | — | — |
| Claude Sonnet 5 | US$ 2,00 | US$ 10,00 | — | 1M / 128K de saída |
| GLM-5.3 | US$ 1,40 | US$ 4,40 | — | 1M / 128K de saída |
| GPT-5.6 Luna | US$ 1,00 | US$ 6,00 | — | — |
| Gemini 3.8 Flash | US$ 0,75 | US$ 3,75 | — | 1M / 66K de saída |
| GLM-5.3-Flash | US$ 0,15 | US$ 0,47 | — | — |
| MiniMax M3 | US$ 0,30 | US$ 1,20 | — | 1M |
| Muse Spark (Contributors) | US$ 0,10 | US$ 0,20 | US$ 0.002 | — |
A última linha merece uma segunda olhada. O nível Contributors da Meta é US$ 0,10 de entrada e US$ 0,20 de saída — com potencial acesso aos seus dados para treinamento. Isso não é um preço; é uma troca. É também, pelo que consigo perceber, a expressão mais honesta do modelo de negócios real por trás de muita inferência barata, e eu prefiro que isso esteja declarado numa tabela de preços do que enterrado num DPA.
Mostrar imagem Inteligência num eixo, preço em escala logarítmica no outro. Oito pontos de índice separam o topo do gráfico da base; 67× separam os preços. A fronteira eficiente fica no canto inferior direito, e quase ninguém compra ali.
A quebra de API sobre a qual ninguém te avisou
O Fable 5.1 chegou com três mudanças que rompem compatibilidade: o uso forçado de ferramentas acabou, os blocos de pensamento agora são específicos de cada modelo, e edições no meio da conversa em mensagens de sistema ou ferramentas agora geram erros em vez de serem aceitas silenciosamente.
A terceira vai pegar muita gente. Muitos harness de agentes alteram o prompt de sistema ou a lista de ferramentas entre turnos — adicionando uma ferramenta quando uma subtarefa começa, cortando instruções para economizar contexto. No Fable 5.1 isso agora é um erro. Se você atualizar um ID de modelo num arquivo de configuração e seu agente começar a devolver 400 no quarto turno, é por isso.
A lição geral, que vale mais que a específica: em 2026, atualizar um modelo é uma migração de API. Escreva seus IDs de modelo de forma que trocar um seja uma mudança de uma linha, e fixe as versões. Você vai fazer essa mudança de novo dentro de um trimestre.
Parte Três: A fronteira dos pesos abertos e a armadilha das licenças
Esta é a parte da história de 2026 que considero genuinamente empolgante, e também a parte em que o marketing mais engana.
A diferença de capacidade é de cerca de seis meses
Veja o que os pesos abertos alcançaram entre junho e agosto de 2026:
- DeepSeek V4 Pro: 1,6T no total, 49B ativos, licença MIT, Terminal-Bench 2.1 em 87,9. Esse número de Terminal-Bench é mais alto do que o da maioria dos modelos fechados publicados este ano.
- Ornith-1.5-397B: 86 no SWE-bench Verified, 86,1 no Terminal-Bench 2.1 contra 85,0 do Claude Opus 4.8, e 92,8 no GPQA Diamond. Licenciado sob MIT, contexto nativo de 262K extensível a cerca de 1M com YaRN. Construído sobre Qwen3.5 e Gemma 4 com pré-treinamento e pós-treinamento continuados.
- GLM-5.3: sexto no índice da Artificial Analysis com 59,5, à frente do GPT-5.6 Sol.
- Qwen3.8: um modelo de 2,4 trilhões de parâmetros sob Apache 2.0, além de um irmão denso multimodal de 27B que a Alibaba diz superar o Qwen3.7-Plus, maior, em tarefas de código e de escritório.
Seis meses atrás, o enquadramento honesto era “pesos abertos estão uma geração atrás e são mais baratos”. Esse enquadramento agora está errado. O correto é: especificamente para código e trabalho agêntico, os melhores modelos de pesos abertos estão dentro das barras de erro da fronteira fechada da geração anterior, e são de 10× a 60× mais baratos.
O Ornith-1.5 é o modelo mais interessante do ano e quase ninguém ouviu falar dele
Quero me deter neste, porque é algo genuinamente novo e não um resultado de escala.
A Ornith descreve o 1.5 como uma extensão do “self-scaffolding para um ciclo de autoaperfeiçoamento de ponta a ponta”. Em linguagem simples: o sistema propõe suas próprias novas tarefas de treinamento, gera scaffolds específicos para elas, produz rollouts de solução e otimiza os três em conjunto com GRPO. Modelos mais fortes permitem propor tarefas mais difíceis; scaffolds melhores descobrem estratégias melhores; saídas melhores dão um sinal de aprendizado mais limpo.
É treinado sobre o Qwen3.5 e o Gemma 4 — ou seja, sobre os pesos abertos de outras pessoas — e supera o Claude Opus 4.8 no Terminal-Bench 2.1 com 397B parâmetros e licença MIT.
Se esse ciclo se generalizar, é o resultado mais consequente deste artigo, porque significa que o ecossistema aberto pode evoluir sem que nenhum laboratório gaste dinheiro em escala de fronteira num pré-treinamento. Se não se generalizar — se o que estamos vendo é overfitting específico de benchmark a partir de um currículo autogerado — então é uma história de alerta sobre exatamente a mesma coisa. Não sei qual dos dois. Pelo que consigo perceber, também não sabe ninguém fora da Ornith. O que eu gostaria antes de apostar nisso: uma avaliação independente em tarefas que não estejam na vizinhança do currículo autogerado, e uma linha de base humana reservada. Nenhuma das duas existe ainda.
Agora as licenças, porque “código aberto” está fazendo um trabalho bem desonesto
Aqui está o que esses pesos realmente custam a você em obrigações:
| Modelo | Licença | A pegadinha |
|---|---|---|
| DeepSeek V4 Pro | MIT | Nenhuma. Código aberto de verdade. |
| Qwen3.8 | Apache 2.0 | Nenhuma. Código aberto de verdade. |
| Gemma 4 | Apache 2.0 | Nenhuma — e uma melhoria real em relação aos termos sob medida do Gemma 3. |
| Ornith-1.5 | MIT | Nenhuma declarada. Verifique o model card você mesmo antes de colocar em produção. |
| GLM-5.3 | Custom | Empresas com mais de US$ 10 bi de receita anual precisam passar pela revisão de segurança da Z.ai antes de qualquer uso comercial. A Z.ai recuou do MIT nesta versão. |
| Kimi K3 | Custom | Faixas por receita; atribuição em destaque exigida para provedores de alto volume. |
| MiniMax M3 | Custom | O uso comercial exige atribuição em destaque “Built with MiniMax M3”; autorização escrita separada acima de US$ 20 mi de receita anual. |
| Muse Spark | Desconhecida | Anunciado como “em breve”. Não existe texto de licença. |
Três observações. Analisei as letras miúdas das três primeiras em detalhe em Kimi K3 vs Fable 5.1 vs GLM-5.3, então aqui vou me ater ao que mudou desde então.
Primeiro, as barreiras são voltadas para as hyperscalers, não para você. Um limite de receita de US$ 10 bilhões exclui essencialmente todo leitor deste artigo. Se você é uma Mittelstand alemã, uma agência, uma consultoria ou um desenvolvedor solo, a resposta prática para GLM-5.3 e Kimi K3 é: você está tranquilo.
Segundo, “você está tranquilo” não é o mesmo que “sua análise jurídica está tranquila”. Uma licença sob medida significa que alguém cobra de você para lê-la. Uma licença MIT ou Apache 2.0 significa que alguém a lê em noventa segundos e segue em frente. Para o departamento de compras de uma empresa, essa diferença vale mais do que quatro pontos de benchmark, e é o argumento mais forte a favor do DeepSeek V4 Pro e do Qwen3.8 em relação ao GLM-5.3 num produto comercial.
Terceiro, observe a direção do movimento. A Z.ai foi de MIT no GLM-5.2 para uma licença proprietária com uma barreira de revisão de segurança no GLM-5.3. A DeepSeek fez o caminho oposto e manteve a MIT enquanto aumentava os preços da API — o que é uma estratégia coerente: cobrar pela conveniência, liberar os pesos, deixar os provedores de inferência competirem pelo serviço. Pesos abertos não são um movimento. São uma tática comercial, e táticas mudam a cada lançamento. Não construa uma arquitetura de produto que presuma que a versão do ano que vem terá a licença deste ano.
A expressão “código aberto” deveria ser aposentada para modelos
Nenhum deles é código aberto no sentido que a OSI dá à expressão, exceto os de licença MIT e Apache 2.0 — e mesmo esses liberam pesos sem liberar os dados de treinamento nem o código de treinamento, o que é algo significativamente diferente de software de código aberto.
O vocabulário que eu uso, e que sugiro:
- Peso aberto — você pode baixar e executar os parâmetros. Não diz nada sobre os termos.
- Licença aberta — MIT, Apache 2.0 ou equivalente. Sem barreira de receita, sem exigência de atribuição, sem restrição de campo de uso.
- Código aberto — pesos, código de treinamento e composição dos dados, sob uma licença aprovada pela OSI. Quase nada na fronteira se qualifica.
Se um fornecedor diz “modelo de código aberto” e quer dizer o primeiro caso, não é exatamente mentira, mas é o tipo de imprecisão que acaba num documento de compras e depois numa disputa.
Mostrar imagem A capacidade está convergindo. As licenças estão divergindo. Para a maioria dos compradores comerciais, é a coluna da direita que decide a compra, não a pontuação.
Parte Quatro: O problema dos benchmarks
O SWE-bench Verified agora se parece com isto:
| Posição | Modelo | Pontuação |
|---|---|---|
| 1 | Claude Opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptive) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
Três modelos com menos de um ponto percentual de diferença no topo. Esse benchmark acabou. Ele não consegue dizer nada de útil sobre a diferença entre Opus 5, Mythos 5 e Fable 5, e quem o cita como dado de compra em setembro de 2026 está citando um instrumento saturado.
Esta é a condição geral da avaliação de IA agora, e ela tem quatro modos de falha que vale a pena nomear:
Saturação. Quando as pontuações do topo se agrupam acima de 90%, as diferenças restantes são dominadas por ruído de rótulo e detalhes do harness, e não pela capacidade. O SWE-bench Verified chegou lá. O GPQA Diamond está perto.
Sensibilidade ao scaffold. O mesmo modelo pontua de forma diferente dependendo do loop de agente que o envolve — política de nova tentativa, conjunto de ferramentas, gestão de contexto, quantos turnos ele recebe. Os resultados do Terminal-Bench e do OSWorld são especialmente sensíveis a isso. Dois laboratórios que relatam o mesmo benchmark frequentemente não estão rodando o mesmo experimento.
Contaminação. Todo benchmark público acaba vazando para os corpora de treinamento. A resposta tem sido uma corrida por benchmarks mais novos, mais difíceis e privados — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science — o que resolve a contaminação e cria um novo problema: você não pode verificar um benchmark privado de forma independente.
Seleção. Os laboratórios publicam os benchmarks que vencem. A Anthropic liderou com o Frontier-Bench e o ARC-AGI-3 para o Opus 5. A OpenAI liderou com o Agents’ Last Exam e um Coding Agent Index para o GPT-5.6. A Z.ai liderou com o CyberGym. Nenhum deles está mentindo. Todos estão escolhendo.
No que eu realmente confio em setembro de 2026
Agregados em vez de resultados isolados. O índice da Artificial Analysis tem a virtude de ser executado por um terceiro, num harness fixo, em nove avaliações, com 190 modelos. Seus números absolutos significam pouco; sua ordenação é o sinal público mais defensável disponível.
Resultados normalizados por custo. As próprias alegações da Anthropic sobre o Opus 5 são o bom exemplo de como relatar isso: “dentro de 0,5% da pontuação máxima do Fable 5 pela metade do custo” no CursorBench 3.2, e superando o Fable 5 no OSWorld 2.0 “por um terço do custo”. É uma alegação útil porque nomeia a troca.
Eficiência de tokens. A Artificial Analysis observou que o Gemma 4 31B usou apenas 39 milhões de tokens de saída para completar todo o Intelligence Index. Para uma carga de trabalho agêntica, um modelo que chega à mesma resposta com um terço dos tokens é um terço da conta e um terço da latência. Isso é pouco relatado e é uma das poucas métricas que se traduz diretamente em dinheiro.
Suas próprias avaliações. Vinte tarefas do seu backlog real, rodadas em três modelos, pontuadas por você. Leva uma tarde. Vai te dizer mais do que todos os leaderboards deste artigo juntos, e é a única avaliação que é, por definição, não contaminada.
E uma coisa em que não confio: qualquer número de tokens por segundo ou de benchmark citado sem um harness, uma quantização e uma data. Trate esses números como estimativas de ordem de grandeza.
Parte Cinco: O número que realmente mudou — horizonte de tempo agêntico
Se você levar só uma métrica deste artigo, leve esta.
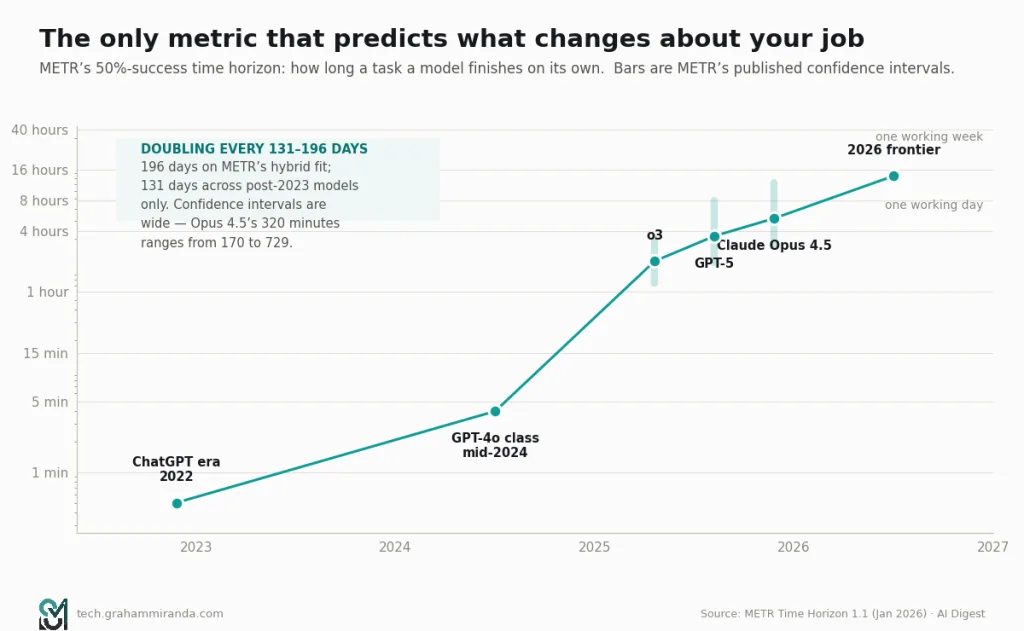
O METR mede a duração da tarefa — em horas humanas — que um modelo consegue concluir de forma autônoma com 50% de sucesso. É um proxy melhor para “essa coisa consegue fazer o meu trabalho” do que qualquer benchmark de conhecimento, porque captura o que de fato falha na prática: não é não saber a resposta, é manter a coerência por tempo suficiente para chegar a ela.
A trajetória, a partir do trabalho do próprio METR e do acompanhamento da AI Digest:
| Período | Horizonte de tempo com 50% de sucesso |
|---|---|
| 2022 (era do lançamento do ChatGPT) | ~30 segundos |
| Meados de 2024 (classe GPT-4o) | ~4 minutos |
| Final de 2025 (Claude Opus 4.5) | 320 minutos (~5,3 horas), IC [170, 729] |
| Fronteira de 2026 | 14+ horas |
O tempo de duplicação é a parte contestada. O lançamento Time Horizon 1.1 do METR, em 29 de janeiro de 2026 — 228 tarefas, 31 delas estimadas em oito ou mais horas de esforço humano, migradas para o framework Inspect do UK AI Security Institute — relata 196 dias (7 meses) com base numa combinação de dados antigos e novos, mas 131 dias quando restrito a modelos posteriores a 2023, o que é cerca de 20% mais rápido do que os 165 dias que a metodologia anterior dava.
Extrapolar uma exponencial é como as pessoas se cobrem de vergonha, então deixe-me sinalizar as ressalvas em voz alta antes de usar o número.
As ressalvas são grandes. Os intervalos de confiança do próprio METR são enormes — o horizonte de 320 minutos do Opus 4.5 tem uma faixa de 170 a 729 minutos. Apenas 5 das suas 31 tarefas longas têm linhas de base humanas medidas; o resto são estimativas. A composição das tarefas altera a tendência medida. E “50% de sucesso numa tarefa bem especificada com um ambiente limpo” está muito longe de “50% de sucesso no seu código com a sua suíte de testes instável e o seu processo de deploy não documentado”.
Dito tudo isso, a direção não está em dúvida e a magnitude está mais ou menos certa. Na extrapolação, os agentes de fronteira alcançam cerca de um dia útil de duração autônoma de tarefa em 2027 e cerca de uma semana de trabalho em 2028.
Por que este é o número que importa
Porque é a única métrica que prevê o que muda no seu trabalho.
Um modelo com horizonte de 4 minutos é autocomplete. Você fica no loop o tempo todo, e a qualidade do modelo determina quão boas são as sugestões.
Um modelo com horizonte de 5 horas é um colega a quem você passa o briefing de manhã e revisa na hora do almoço. Você não está no loop; você está no fim dele. A qualidade do modelo determina com que frequência a revisão é dolorosa.
Um modelo com horizonte de 40 horas é algo para o qual não temos estrutura de gestão. Você estaria revisando uma semana de trabalho que não viu acontecer, num código que mudou enquanto você não olhava, contra uma especificação que você escreveu antes de saber quais eram os problemas.
Todo argumento no resto deste artigo — sobre vibe coding, sobre verificação, sobre onde está o gargalo — é na verdade um argumento sobre o que acontece à medida que esse número sobe. Os modelos passaram a ter horizonte longo. Nossos processos de revisão, não.
Mostrar imagem O horizonte de tempo com 50% de sucesso, com os intervalos de confiança do METR mostrados honestamente. Os intervalos são largos o bastante para importar — e a tendência sobrevive a eles de qualquer forma.
ATO II — O FUTURO DO VIBE CODING
Parte Seis: O que “vibe coding” significa agora
Andrej Karpathy cunhou o termo em fevereiro de 2025 para descrever algo específico e um pouco travesso: ceder às vibes, esquecer que o código existe, aceitar diffs sem lê-los e deixar o modelo conduzir. Era a descrição de um modo, oferecido meio de brincadeira, para projetos descartáveis de fim de semana.
Dezoito meses depois, a expressão passou por todo o ciclo de vida. Virou um movimento, depois um cargo, depois um termo pejorativo, depois palavra do ano do Collins, depois uma categoria de investimento de risco, e agora — na única evolução que realmente importa — um conjunto de práticas de engenharia que já não se parecem com o que Karpathy descreveu.
Quero ser preciso sobre essa divisão, porque as duas coisas são confundidas o tempo todo e têm perfis de risco opostos.
Vibe coding, sentido original. Faça o prompt, aceite, execute, faça o prompt de novo. Não leia o diff. O artefato é descartável. Isso é genuinamente ótimo, e eu faço várias vezes por semana — para um script que reordena um CSV, um scraper de uso único, uma visualização que vou olhar uma vez, um protótipo cujo único trabalho é tornar uma conversa concreta. A característica definidora não é a velocidade. É que ninguém nunca vai depender disso.
Engenharia agêntica, sentido atual. Escreva uma especificação. Dê ao agente uma suíte de testes, um linter, um verificador de tipos e um sandbox. Deixe rodar por uma hora. Revise o diff direito. Faça o merge atrás das mesmas barreiras de um PR humano. A característica definidora é que a saída do modelo é tratada como a saída de um colega júnior — útil, rápida e não confiável.
Esses dois compartilham uma tecnologia e quase nada mais. Se você quer a versão para praticantes do segundo, é sobre isso que meu artigo anterior sobre vibe coding em 2026 trata; esta seção trata de para onde a prática está indo. Os resultados catastróficos da Parte Oito vêm todos de aplicar as práticas do primeiro modo às apostas do segundo modo.
Os números de adoção são enormes e em grande parte não são contestados
- 90% dos desenvolvedores usam pelo menos uma ferramenta de IA no trabalho, segundo a pesquisa AI Pulse da JetBrains (janeiro de 2026). A pesquisa de 2025 do Stack Overflow apontou 84% usando ou planejando usar.
- Quase 80% dos novos desenvolvedores do GitHub adotam o Copilot na primeira semana (GitHub Octoverse 2025).
- 59% dos desenvolvedores usam três ou mais ferramentas de codificação com IA em paralelo. Essa estatística diz mais do que o número de adoção — o mercado não se consolidou, fragmentou-se em ferramentas específicas para cada tarefa.
Os números do mercado
| Ferramenta | Métrica | Fonte / data |
|---|---|---|
| GitHub Copilot | ~42% de participação em base de usuários; mais de 20 milhões de usuários | Gartner / fornecedor, 2026 |
| Cursor | US$ 2 bi+ de ARR; mais de 1M de usuários ativos diários; ~20–25% do mercado por receita | Reportado, fevereiro de 2026 |
| Claude Code | ~US$ 2,5 bi de run-rate; 46% “mais amado” contra 19% do Cursor | Reportado, abril de 2026 |
| Mercado corporativo de agentes de codificação | ~US$ 9,8–11 bi anualizados | Gartner, abril de 2026 |
Duas coisas se destacam. O Copilot tem os usuários e a menor satisfação entre os três primeiros. O Claude Code tem a menor base instalada e, de longe, o maior carinho. Essa é a assinatura de um mercado no meio de uma transição — o incumbente venceu na distribuição, o desafiante venceu no fluxo de trabalho, e os usuários ainda não terminaram de migrar.
E o número que enfraquece tudo isso
A confiança dos desenvolvedores na saída de IA caiu de cerca de 40% em 2024 para 29% em 2026. Uma pesquisa separada da SonarSource constatou que 96% dos desenvolvedores não confiam plenamente que o código gerado por IA esteja funcionalmente correto.
Pare para pensar nisso. O uso subiu. A confiança caiu. Isso não é contraditório; é como se parece a adoção madura de uma ferramenta. Ninguém “confia” numa motosserra. As pessoas a usam o tempo todo, com as duas mãos, protegidas, e nunca lhe dão as costas.
As pessoas que mais entendem essas ferramentas são as mais cuidadosas com elas. Isso é um sinal saudável, e está completamente ausente da maior parte do marketing dos fornecedores.
Parte Sete: Isso realmente te deixa mais rápido? A evidência, honestamente
É aqui que perco alguns leitores, e prefiro perdê-los aqui do que enganá-los.
O ensaio randomizado diz que não
O METR fez o estudo que todo mundo cita, em julho de 2025: desenvolvedores experientes de código aberto, trabalhando nos próprios repositórios maduros (mais de 1 milhão de linhas), randomizados no nível da tarefa para usar ou não ferramentas de IA do início de 2025.
Resultado: 19% mais lentos com IA.
E o achado que importa mais do que a manchete: os desenvolvedores acreditavam ter sido cerca de 20% mais rápidos. Eles superestimaram o efeito da IA no seu tempo em cerca de 40 pontos percentuais.
A repetição de 2026 não resolveu a questão — revelou algo pior
O METR tentou repetir o experimento e, em fevereiro de 2026, publicou um texto incomumente franco sobre por que o desenho quebrou.
- O recrutamento falhou. Desenvolvedores recusam cada vez mais trabalhar sem acesso a IA, mesmo a US$ 50 a hora.
- A seleção de tarefas foi contaminada. 30–50% dos desenvolvedores admitiram evitar as tarefas que esperavam que a IA tratasse bem. Um participante resumiu perfeitamente: “Eu evito issues em que a IA consegue terminar as coisas em só 2 horas, mas eu tenho que gastar 20 horas.”
- O registro de tempo parou de funcionar quando os desenvolvedores passaram a rodar vários agentes ao mesmo tempo.
Seus números interinos brutos de 2026 variaram de −18% a −4% — ainda mais lentos, com menos dramaticidade —, mas o próprio METR descreve isso como “evidência muito fraca”, dado o viés de seleção.
Leia o segundo item de novo, porque é o achado mais interessante de toda a literatura e está enterrado numa nota de metodologia. Se os desenvolvedores direcionam sistematicamente as tarefas amigáveis à IA do para fora de um estudo que mede o benefício da IA, o estudo vai subestimar o benefício. Isso também implica que, na vida real, os desenvolvedores já estão fazendo esse direcionamento — que é exatamente o comportamento que torna as ferramentas valiosas e o ensaio controlado difícil de executar.
As pesquisas dizem que sim, por muito, e estão infladas
A pesquisa do METR de maio de 2026 (n=349: 87 engenheiros de software, 71 pesquisadores, 129 acadêmicos e doutorandos, 48 fundadores e gestores; média de 12 anos de experiência em programação, 19 meses de uso de ferramentas de IA) fez algo inteligente. Ela separou valor de velocidade.
O respondente mediano relatou um multiplicador de velocidade de 3× mas apenas uma mudança de 1,4–2× no valor do seu trabalho. Em retrospecto, eles estimaram um valor de 1,3× em março de 2025; preveem 2,5× até março de 2027.
O METR deixa claro que valor é o número com que os criadores de pesquisas realmente se importam, e que os entrevistados naturalmente pensam em velocidade — que é exatamente o viés que o ensaio controlado randomizado de 2025 quantificou em 40 pontos percentuais.
Então: o autorrelato diz 3×. O autorrelato corrigido pelo que as pessoas querem dizer diz 1,4–2×. A única medição controlada que temos diz 0,81×.
Os dados organizacionais dizem “depende de você, não da ferramenta”
O relatório DORA’s 2026 (Google Cloud, maio de 2026) é o material mais útil publicado sobre isso este ano, e é útil porque para de discutir a ferramenta.
- ROI modelado no primeiro ano de 39% para uma organização de engenharia de 500 pessoas, com cerca de retorno em 8 meses — US$ 11,6 mi de valor contra US$ 8,4 mi de investimento.
- A curva em J: a produtividade cai antes de subir, impulsionada pela adaptação dos fluxos de trabalho, pelo custo de verificação na revisão de código e por mudanças posteriores nos testes e nos portões de aprovação.
- Taxa de falha em mudanças subindo de 5% para 6% após a adoção, custando US$ 344.000 em tempo de inatividade no cálculo de amostra deles.
- E a tese: “Os maiores retornos do investimento em IA não vêm das ferramentas em si, mas de um foco estratégico no sistema organizacional subjacente.”
Essa última linha é o consenso de 2026, se é que existe um. A IA amplifica o que sua prática de engenharia já é. Testes bons, revisão de código de verdade, rollback rápido, responsabilidade clara — a IA torna essas organizações significativamente mais rápidas. Testes fracos, revisão de carimbo, deploys manuais, responsabilidade difusa — a IA faz essas organizações falharem mais rápido e em maior volume.
Como conciliar tudo isso
Não acho que esses achados realmente entrem em conflito. Aqui está a conciliação a que cheguei, e eu a sustento com flexibilidade:
Ferramentas de codificação com IA são um grande ganho em trabalho desconhecido e uma pequena perda em trabalho profundamente familiar. Em uma base de código que você conhece intimamente, em uma linguagem em que você é fluente, em um problema que já resolveu antes, você é mais rápido do que o ciclo de revisar e corrigir. Em um framework desconhecido, uma linguagem que você usa duas vezes por ano, boilerplate, estrutura de testes, migrações ou uma base de código que não abre há oito meses, o modelo é transformador.
O METR estudou desenvolvedores experientes em seus próprios repositórios maduros — o único cenário em que você preveria o menor ganho. Isso não torna o achado errado. Torna-o específico, e deve deixar você desconfiado de qualquer pessoa que o cite como veredito geral, em qualquer direção.
A segunda conciliação: os ganhos são reais, mas chegam a um lugar diferente de onde as pessoas os procuram. Não “este recurso levou quatro horas em vez de seis”. Mais como: a migração que nunca seria priorizada foi feita; a cobertura de testes que sempre ficaria em 40% foi para 75%; a documentação existe. Isso não aparece em um estudo de tempo de conclusão de tarefas, e é a maior parte do valor real.
Parte Oito: a conta da segurança chegou, e vem detalhada
Se a Parte Sete foi desconfortável, esta é a parte que as pessoas pulam. Por favor, não pule.
As medições
Veracode testou mais de 100 grandes modelos de linguagem em 80 tarefas de codificação em Java, Python, C# e JavaScript:
- 45% das amostras de código geradas por IA introduzem uma vulnerabilidade do OWASP Top 10. A taxa de aprovação ficou essencialmente inalterada até o início de 2026 — os modelos ficaram muito mais inteligentes e nem um pouco mais seguros.
- Java foi o pior, com uma taxa de falha de 72%.
- 86% falharam na defesa contra cross-site scripting. 88% eram vulneráveis a injeção de log.
Apiiro rodou seu mecanismo Deep Code Analysis em repositórios corporativos da Fortune 50 de dezembro de 2024 a junho de 2025:
- Desenvolvedores assistidos por IA produzem commits a três a quatro vezes a taxa de seus pares.
- Eles introduzem achados de segurança a dez vezes a taxa.
- Caminhos de escalonamento de privilégios aumentaram 322%. Falhas de design arquitetural aumentaram 153%.
USENIX Security 2025 analisou 576.000 amostras de código geradas por IA:
- Cerca de 20% referenciam pacotes que não existem.
- 43% dos nomes de pacotes alucinados se reproduzem de forma consistente em prompts semelhantes — que é a parte que transforma um bug em superfície de ataque. Uma alucinação previsível é um espaço que um atacante pode registrar antecipadamente no npm ou no PyPI.
Georgia Tech’s Vibe Security Radar rastreou CVEs pelo histórico do git para atribuí-los a ferramentas de IA:
| Mês (2026) | CVEs atribuídos |
|---|---|
| Janeiro | 6 |
| Fevereiro | 15 |
| Março | 35 |
74 confirmados no total, com pesquisadores estimando que o número real em todo o código aberto é cinco a dez vezes maior.
RedAccess indexou aproximadamente 380.000 aplicações com vibe coding acessíveis publicamente no Lovable, Base44, Replit e Netlify. Cerca de 5.000 estavam vazando dados corporativos ou pessoais sensíveis.
Os incidentes, por data
| Data | Incidente |
|---|---|
| Jul 2025 | IA do Replit apaga um banco de dados de produção; 1.200 registros de executivos afetados, 4.000 contas fabricadas geradas |
| Fev 2026 | Aplicativo EdTech feito no Lovable expõe 18.697 registros de usuários, incluindo 4.538 contas de estudantes |
| Abr 2026 | Vulnerabilidade BOLA do Lovable — todo projeto anterior a novembro de 2025 acessível em cinco chamadas de API |
| 26 abr 2026 | O “apagamento em 9 segundos” do Cursor: um banco de dados da empresa apagado junto com os backups |
| 30 abr 2026 | Execução remota de código CVSS-10 no Gemini CLI em fluxos de trabalho de CI, corrigida |
O caso da Amazon, que vou tratar com cuidado
Você provavelmente viu a história da Amazon. Quatro incidentes Sev-1 entre dezembro de 2025 e março de 2026 — uma indisponibilidade de 13 horas do AWS Cost Explorer na China, horários de entrega incorretos nos carrinhos de compras em 2 de março, custando cerca de 120.000 pedidos segundo relatos, e um incidente de 6 horas em 5 de março, quando os pedidos na América do Norte teriam caído 99%.
Reportagens do Financial Times, da Fortune e do The Register ligaram documentos internos da Amazon ao que foi descrito como “mudanças assistidas por IA generativa,” com alertas de que a geração rápida de código estava expondo vulnerabilidades. A Amazon contestou a causalidade direta, afirmando em algumas respostas que nenhum dos incidentes envolveu código escrito por IA.
Estou destacando três coisas sobre essa história em vez de repeti-la como fato:
- O número de impacto mais citado (6,3 milhões de pedidos perdidos) remonta a um post no Medium, não à Amazon nem à reportagem do próprio veículo nomeado. Trate-o como estimativa, não como número.
- O deploy de 5 de março teria saído sem documentação formal ou aprovação. Isso é uma falha de processo. A velocidade da IA tornou possível acontecer mais rápido; não tornou o portão de aprovação opcional.
- Essa distinção é o ponto central, e é por isso que incluí a história. O modo de falha quase nunca é “a IA escreveu código ruim”. É “a IA escreveu código mais rápido do que o processo que deveria verificá-lo”.
O que isso realmente implica na prática
Não “pare de usar as ferramentas”. Ninguém sério está defendendo isso, e a própria nota de pesquisa da CSA — que reúne a maior parte do que está acima — começa pela governança, não pela abstinência.
O formato prático, na ordem em que eu implementaria:
- Trate qualquer ferramenta de IA com acesso a credenciais como um sistema privilegiado. Ela é. Limite os tokens dela de acordo.
- SAST, verificação de dependências e detecção de segredos em todo commit. Não à noite. Em todo commit. A taxa de commits subiu três a quatro vezes; uma verificação noturna agora é um ciclo de feedback de três dias em termos efetivos.
- Análise de composição de software, especificamente para pacotes alucinados. Este é o controle mais barato e de maior valor da lista, porque o número de 20% é muito grande e a falha é muito silenciosa.
- Uma política escrita de que a assistência de IA não é usada sem revisão em código de autenticação, criptografia, autorização ou pagamento. Essas são as quatro áreas em que um erro sutil é provável e catastrófico, e onde o olho do revisor vale mais.
- Amplie seu SBOM para registrar a proveniência das ferramentas de IA. Quando o próximo estudo de atribuição no estilo Georgia Tech chegar à sua base de código, você vai querer conseguir responder à pergunta sozinho.
- Trate plataformas de vibe coding de terceiros como fornecedores de SaaS. Os números da RedAccess são o que acontece quando ninguém faz isso.
Nada disso é exótico. A maior parte é o que uma equipe competente já fazia em 2019. A mudança é que o volume aumentou uma ordem de magnitude, então os controles precisam ser automáticos, não culturais.
Mostrar imagem Os dados de segurança, da Veracode, Apiiro, USENIX e Georgia Tech. Note o formato: a velocidade dos commits subiu 3–4×, os achados de segurança subiram 10×. A diferença entre esses dois multiplicadores é todo o problema.
Parte Nove: o que substituiu o vibe coding
A prática que realmente funciona em 2026 tem um nome — vários nomes concorrentes, o que é sinal de que é real — e é mais ou menos o oposto de vibes.
Chame de desenvolvimento guiado por especificação ou, engenharia agêntica, ou engenharia de contexto. A estrutura comum:
1. A especificação agora é o código-fonte
Não um chamado no Jira. Um documento de verdade: o que a coisa faz, o que não pode fazer, quais são as interfaces, como é “pronto”, quais são os modos de falha. Commitado no repositório, versionado, revisado.
Isso parece um retrocesso a 1998, e não é. A diferença é que, em 1998, a especificação era uma entrada para um humano que a reinterpretaria, e apodrecia no momento em que a codificação começava. Em 2026, a especificação é uma entrada para um processo que regenera a implementação de forma barata — o que significa que, quando os requisitos mudam, você muda a especificação e deriva de novo, em vez de remendar código que não corresponde mais a nenhuma descrição escrita de si mesmo.
A lógica econômica se inverteu. Quando a implementação era cara e a especificação era barata, você especificava de forma frouxa e investia no código. Quando a implementação é barata e a especificação é o gargalo, você investe na especificação.
2. A suíte de testes é a fronteira de confiança
Um agente que consegue rodar seus testes e iterar com base neles é uma ferramenta fundamentalmente diferente de um que não consegue. Esta é a mudança de maior alavancagem que a maioria das equipes pode fazer, e não tem nada a ver com IA — é que a IA finalmente tornou o ROI da cobertura de testes óbvio para pessoas que nunca seriam convencidas por argumentos de ofício.
Versão prática: o agente recebe um sandbox, um comando de teste, um comando de lint e uma verificação de tipos, e não termina até os quatro estarem verdes. Todo o resto é negociável.
3. A revisão passou de linhas para diffs e para comportamento
A revisão linha por linha não escala para um diff de mil linhas gerado por agente, e fingir o contrário é como começa a revisão de carimbo.
O que funciona em vez disso, em ordem aproximada de valor:
- Revise a especificação, não a implementação. Se a especificação está certa e os testes passam, a implementação é um detalhe.
- Revise o formato do diff — quais arquivos foram tocados, quais dependências foram adicionadas, o que foi excluído. A maioria dos desastres com agentes é visível nesse nível: um arquivo inesperado, uma dependência nova, uma exclusão que ninguém pediu.
- Revise especificamente as linhas sensíveis à segurança. Autenticação, criptografia, autorização, pagamentos, qualquer coisa que toque em PII. Isso é uma fração pequena de qualquer diff.
- Não revise o boilerplate. Você nunca estava realmente revisando isso de qualquer forma.
4. O harness importa tanto quanto o modelo
Isso é subestimado. O mesmo modelo, em dois loops de agente diferentes, produz trabalho de qualidade radicalmente diferente — e é exatamente por isso que comparações de benchmark entre laboratórios são tão escorregadias.
As peças que importam: como o contexto é gerenciado à medida que a execução fica longa, se o agente consegue ver suas próprias falhas de teste, se consegue navegar pelo repositório ou apenas pelo que você cola, se tem uma etapa de planejamento separada de uma etapa de execução e se sabe quando parar e perguntar.
As notas de lançamento do Muse Spark 1.3 da Meta são interessantes exatamente nesse ponto — descrevem o modelo como agora fazendo perguntas de esclarecimento em prompts ambíguos, pedindo ajuda quando travado e confirmando antes de ações consequentes. Não são melhorias de inteligência. São boas maneiras, e boas maneiras são o que torna um agente de horizonte longo sustentável.
5. O roteamento de modelos agora é prática padrão
Ninguém sério usa um único modelo para tudo — eu detalhei uma versão com dois modelos disso em GLM-5.3-Flash vs MiniMax M3 no OpenCode. O padrão que se consolidou:
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
      "description": "Architecture, root cause, anything where being wrong is expensive",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation — long-horizon, cost-sensitive",
      "model": "anthropic/claude-opus-5"
    },
    "bulk": {
      "description": "High-volume mechanical work where price dominates",
      "model": "zai/glm-5-3-flash"
    },
    "private": {
      "description": "Anything touching client data — runs on hardware we own",
      "model": "mlx/gpt-oss-120b"
    },
    "grunt": {
      "description": "Renames, docstrings, lint fixes, test scaffolding",
      "model": "ollama/gemma-4-26b-a4b"
    }
  }
}
O raciocínio, linha por linha:
- O planejamento vai para o modelo mais capaz que você pode pagar. Um plano ruim custa mais tokens a jusante do que o plano jamais custou.
- A construção vai para o melhor modelo de horizonte longo a um preço sensato. O Opus 5 a US$ 5/US$ 25 é explicitamente posicionado para isso e custa metade do preço do Fable.
- Trabalho mecânico em volume vai para o GLM-5.3-Flash a US$ 0,15/US$ 0,47, porque a esse preço a pergunta não é se ele é tão bom, e sim se é bom o suficiente para a tarefa específica. Muitas vezes é.
- Qualquer coisa privada vai para o local, em um modelo que caiba na sua máquina.
- O trabalho braçal vai para um modelo local pequeno, porque renomear um símbolo em quarenta arquivos não precisa de raciocínio de fronteira e não precisa sair do seu notebook.
Escreva os IDs dos modelos de forma que trocar um seja uma mudança de uma linha. Considerando que quatro laboratórios lançaram um modelo do top ten entre junho e setembro, você vai fazer essa troca de novo dentro do trimestre.
Parte Dez: o futuro do vibe coding — seis previsões, com nível de confiança
Previsões sem níveis de confiança são entretenimento. Aqui estão as minhas, com quanto eu apostaria.
1. A palavra morre; a prática se divide permanentemente. Confiança alta.
O “vibe coding” já está virando um termo pejorativo em ambientes profissionais e um termo de orgulho em lugar nenhum, exceto no marketing. O que o substitui é uma divisão limpa em dois níveis: artefatos descartáveis gerados por IA em que ninguém lê o código (tudo bem, correto, faça mais disso) e engenharia agêntica revisada, em que a saída do modelo passa pelos mesmos portões que a de um humano (também tudo bem, e é onde está todo o dinheiro corporativo).
O meio perigoso — código de produção, não lido — é do que a lista de incidentes de 2026 é feita, e ele será regulado, segurado ou auditado até deixar de existir em contextos comerciais. Não porque alguém o proíba, mas porque um questionário de segurança acaba perguntando.
2. A verificação se torna o gargalo, e o dinheiro das ferramentas a segue. Confiança alta.
Já estamos lá e o mercado ainda não reajustou os preços. Se agentes conseguem produzir uma semana de trabalho, a restrição é a capacidade de um humano de estabelecer que uma semana de trabalho está correta.
Espere que os produtos interessantes de 2027 sejam sobre verificar em vez de gerar: geração de testes baseados em propriedades, ferramentas de diff semântico que descrevem mudanças de comportamento em vez de mudanças de linha, verificação automatizada de conformidade com a especificação, verificação em tempo de execução das ações de agentes e — esta é a que eu construiria — ferramentas que dizem qual 5% de um diff grande uma pessoa realmente precisa ler.
3. Os métodos formais têm seu momento, vinte anos atrasados. Confiança média.
A objeção histórica à especificação formal era que escrever a especificação custava mais do que escrever o código. Essa objeção está morta agora, porque escrever código é quase de graça e escrever especificações é o gargalo de qualquer forma.
Sistemas de tipos, contratos, invariantes, testes baseados em propriedades e verificação formal leve de repente têm um caso de uso que se paga: são declarações de intenção verificáveis por máquina contra as quais um agente pode iterar sem um humano no loop. Eu esperaria que Rust, os modos mais estritos do TypeScript e bibliotecas de contratos em Python fossem beneficiários desproporcionais.
O motivo de minha confiança ser apenas média: a área prevê um renascimento dos métodos formais mais ou menos a cada sete anos desde 1985.
4. Os modelos locais engolem totalmente a camada braçal. Confiança média-alta.
Veja o que um modelo de 27B sob Apache 2.0 faz agora, adicione mais um ano e coloque-o em uma máquina com 64 GB de memória unificada. Renomeações, docstrings, estrutura de testes, mensagens de commit, correções de lint, traduções de primeiro rascunho, análise de logs — nada disso precisa de um modelo de fronteira, tudo isso é alto volume, e tudo isso é exatamente o trabalho que você preferiria não enviar a terceiros a partir do repositório de um cliente.
A fronteira fica na nuvem para planejamento e raciocínio difícil. O volume vai para o local. A partir da Parte Onze, o assunto é por que isso agora é fisicamente possível.
5. O papel do desenvolvedor júnior muda de forma em vez de desaparecer. Confiança média, e é esta que eu sustento com menos firmeza.
O cenário pessimista é direto: se os agentes fazem o trabalho que os juniores costumavam fazer, ninguém contrata juniores e, em dez anos, não há seniores.
Acho que o resultado mais provável é que o trabalho de entrada mude de “escrever o código” para “verificar o código e assumir a especificação” — o que é um trabalho mais difícil para começar, não mais fácil, e que vai exigir que a indústria reconstrua a forma como treina pessoas. As equipes que descobrirem isso terão uma vantagem de contratação enorme sobre as que simplesmente pararem de contratar.
A ressalva honesta: esta é a previsão em que meus incentivos e minha análise apontam na mesma direção, que é exatamente quando você deve desconfiar de si mesmo.
6. Alguém vai ter uma falha de codificação com IA genuinamente catastrófica e atribuída publicamente. Confiança alta no evento, baixa no momento.
Não um banco de dados vazado. Algo com um regulador, um impacto financeiro de nove dígitos e uma análise de causa raiz que diga que um agente fez algo que nenhum humano revisou.
A curva de atribuição de CVEs — 6, depois 15, depois 35 em meses sucessivos de 2026, com pesquisadores estimando a taxa real de cinco a dez vezes mais — não é uma curva que se achata sozinha. A questão é se a indústria aperta os próprios portões primeiro ou espera pelo incidente que a obrigue.
O que eu faria sobre todas as seis, em uma frase: invista em testes, especificações e ferramentas de revisão, não em técnica de prompt, porque a técnica de prompt se desvaloriza a cada modelo lançado e a infraestrutura de verificação se acumula.
Mostrar imagem As duas práticas compartilham uma tecnologia e nada mais. O ciclo da esquerda é correto para trabalho descartável e catastrófico para produção; o ciclo da direita é o que faltava na lista de incidentes da Parte Oito.
Ato III — IA offline em dispositivos de consumo
Parte Onze: a IA offline deixou de ser hobby este ano
Por cerca de dois anos, “rodar localmente” foi um compromisso de princípio. Você conseguia fazer. O discurso honesto era: aqui está um modelo de 7 bilhões de parâmetros que é pior do que o nível gratuito de tudo, em hardware que você já tem, e o motivo para fazer isso é princípio.
Isso mudou em 2026, e mudou por três razões separadas que chegaram ao mesmo tempo.
Os modelos pequenos ficaram genuinamente bons. O E4B do Gemma 4 tem cerca de 8 bilhões de parâmetros, suporta 128K de contexto, lida com texto, imagens, vídeo e áudio nativo, e é Apache 2.0. A variante densa de 31B pontua 39 no índice Artificial Analysis — dentro da faixa que era fronteira dezoito meses atrás — e fez toda a execução do índice com 39 milhões de tokens de saída, o que é uma fração do que modelos comparáveis queimam. O Qwen3.8-27B é um modelo multimodal denso sob Apache 2.0 com 262K de contexto nativo que a Alibaba afirma superar o muito maior Qwen3.7-Plus em tarefas de codificação e escritório.
Os sistemas operacionais o incluíram. Esta é a mudança que realmente importa, e ela aconteceu em silêncio. A Microsoft colocou o Aion 1.0 no Windows 11. A Apple traz um modelo denso de 3 bilhões de parâmetros mais um modelo esparso de 20 bilhões de parâmetros nos iPhones. O Google traz o Gemini Nano em dispositivos Pixel e Samsung. A IA no dispositivo deixou de ser algo que você instala e passou a ser algo que já está lá, que é a diferença entre uma tecnologia que entusiastas usam e uma tecnologia que todo mundo usa.
E o hardware finalmente tem a memória. Não o poder de processamento — a memória. Vou voltar ao motivo de essa distinção ser a história inteira.
O que a “IA offline” realmente traz para você
Vou ser concreto, porque isso é vendido mal.
Latência. Um modelo local de 4B responde em dezenas de milissegundos. Uma ida e volta à nuvem leva centenas, na melhor das hipóteses. Para qualquer coisa interativa e contínua — ditado, tradução ao vivo, autocompletar, resumo enquanto você digita — o local ganha na sensação, não na qualidade, e a sensação é o que as pessoas percebem.
Privacidade arquitetural, não contratual. Com uma API, todo prompt sai da sua infraestrutura, e você precisa de um contrato de processamento de dados, uma avaliação de impacto de transferência, um mapa de fluxo de dados e uma resposta para o seu encarregado de proteção de dados. Com um modelo rodando no dispositivo, a questão da transferência internacional de dados não surge, porque não há transferência. Para trabalho na Alemanha e na UE isso muitas vezes é o argumento inteiro, e fecha negócios que o preço nunca fecharia.
Disponibilidade. Num avião. Num local sem cobertura. Numa instalação onde o acesso à rede é justamente o que é proibido. Durante o incidente do seu provedor.
Previsibilidade de custos. Não economia de custos — eu faço essa conta na Parte Quinze e ela não diz o que as pessoas querem que diga. Mas um custo fixo de hardware com custo marginal zero por token é uma linha de orçamento muito diferente de uma fatura por uso que cresce com o entusiasmo de um agente.
Fixação de versão. Um modelo fechado de API é atualizado por trás de um ID de modelo estável, e o comportamento muda. Um checkpoint local é idêntico byte a byte um ano depois. Se você já teve um prompt que funcionava parar de funcionar sem aviso, sabe quanto isso vale.
E o que você não ganha com isso
Capacidade de fronteira. A diferença entre um modelo 4B no seu celular e o Claude Fable 5.1 não é pequena e não vai fechar. Quem disser o contrário está vendendo alguma coisa.
Velocidade em modelos grandes. Um modelo local de 400B gera tokens mais devagar do que o mesmo modelo na API de um fornecedor, porque o fornecedor o executa em hardware com quatro a seis vezes a sua largura de banda de memória. Você troca vazão por controle.
Parte Doze: o celular no seu bolso
A especificação que decide tudo é a RAM
Toda grande plataforma agora traçou uma linha de memória, e a linha é 12 GB.
| Plataforma | Modelo no dispositivo | Mínimo de memória |
|---|---|---|
| Apple | AFM 3 Core (3B denso) + AFM 3 Core Advanced (20B esparso, 1–4B ativos) | 12 GB para dois recursos do iOS 27 |
| Gemini Nano v3 (somente Pixel 10); Nano v2 no Pixel 9 e anteriores; Nano v4 em breve | 12 GB mínimo para o Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 for Galaxy — CPU Oryon de 3ª geração, NPU Hexagon, +39% de capacidade da NPU | Depende do dispositivo |
A solução da Apple é a tecnicamente interessante. O AFM 3 Core Advanced é um modelo esparso de 20 bilhões de parâmetros que fica no armazenamento flash. Os especialistas compartilhados ficam residentes na memória; os especialistas roteados só são movidos para a DRAM quando uma requisição precisa deles. É assim que você consegue colocar um modelo de 20B num celular — você troca largura de banda de leitura da NAND por capacidade de DRAM.
Mas mover especialistas para a DRAM ainda exige um lugar para colocá-los, além do SO, do app em execução e do pipeline da câmera. A diferença entre 9 GB e 12 GB não é três gigabytes de segmentação de mercado. É o conjunto de trabalho para a troca de especialistas sob pressão real de memória. Ming-Chi Kuo relata que dois recursos do iOS 27 exigem 12 GB: expressividade e personalização do ritmo da voz da Siri, e uma melhora substancial na precisão de transcrição de fala. O iPhone 18 base, adiado para a primavera de 2027 com supostos 9 GB, não passa do corte.
O Google tem a mesma física e um problema de relações públicas pior. O Gemini Intelligence precisa do Nano v3, o Nano v3 hoje é exclusivo do Pixel 10, e os aparelhos Pixel 9 — vendidos sob uma promessa de sete anos de atualizações — ficam no Nano v2. A promessa era sobre atualizações. Nunca foi sobre recursos, e a distinção que fazia sentido para um gerente de produto em 2023 não faz nenhum sentido para um cliente em 2026.
Espere que esta seja a história da IA de consumo dos próximos dois anos: uma promessa de suporte longo que entrega patches de segurança a um aparelho que não consegue rodar os recursos lançados junto com esses patches.
O que um celular realmente faz, medido
Benchmark independente num iPhone 17 Pro (A19 Pro) em quatro runtimes:
| Modelo | Runtime | Decodificação tok/s | Memória de pico |
|---|---|---|---|
| Gemma 4 E2B (4-bit) | LiteRT-LM | 55.4 | 641 MB |
| Gemma 4 E2B (4-bit) | MLX | 47.5 | 2.900 MB |
| Gemma 4 E2B (4-bit) | llama.cpp | 37.8 | 3.156 MB |
| Gemma 4 E2B (4-bit) | CoreML / ANE | 33.4 | 1.187 MB |
| Qwen 3.5 2B (4-bit) | MLX | 61.2 | 1.279 MB |
| Qwen 3.5 2B (4-bit) | llama.cpp | 39.1 | 1.479 MB |
| Qwen 3.5 2B (4-bit) | CoreML / ANE | 27.9 | 241 MB |
Dois achados saltam aos olhos.
O Neural Engine é o caminho mais lento e, de longe, o mais eficiente em memória. 27,9 tok/s com 241 MB contra 61,2 tok/s do MLX com 1.279 MB — cinco vezes a velocidade por cinco vezes a memória. Essa troca é exatamente o motivo de a Apple usar a ANE para recursos de sistema sempre ativos e de apps de terceiros a evitarem no chat interativo.
Sessenta tokens por segundo num modelo 2B no seu bolso é mais rápido do que a maioria das pessoas lê. O que significa que a restrição da IA local no celular não é velocidade. É capacidade, capacidade é função de parâmetros, parâmetros são função de memória — e memória é justamente o que todo fabricante acabou de limitar.
Parte Treze: o PC e a aposta silenciosa da Microsoft
A Microsoft fez algo no Build 2026, em 2 de junho, que eu acho que vai parecer mais significativo em retrospecto do que pareceu no dia: ela colocou modelos dentro do próprio Windows.
Aion 1.0 Instruct é um modelo de linguagem pequeno para sumarização, reescrita e extração. Precisa de uma CPU moderna e do Windows 11 — sem NPU, sem GPU dedicada. Já está disponível no Edge Canary a partir do build 150.0.4070, exposto a desenvolvedores web pelas APIs Prompt, Summarizer, Writer e Rewriter, e seus pesos abertos chegaram ao Hugging Face em julho de 2026.
Aion 1.0 Plan é o interessante: um modelo de raciocínio e chamada de ferramentas de 14 bilhões de parâmetros com janela de contexto de 32K, feito para fluxos de trabalho agênticos, gerenciamento de arquivos e orquestração de subagentes. “Próximos meses” na época em que escrevo.
O enquadramento que a Microsoft usou foi “inteligência sem medição para cada casa e cada mesa.” Deixe o marketing de lado e olhe para a decisão de arquitetura: uma API JavaScript no navegador que chama um modelo local, sem chave, sem fatura e sem rede. Se isso virar normal, uma categoria enorme de pequenos recursos de IA deixa de ser um produto SaaS e passa a ser uma capacidade da plataforma. Isso é muito mais relevante para a economia da indústria de IA do que qualquer lançamento individual de modelo neste ano.
O piso de hardware é real e exclui muitas máquinas
O caminho da NPU exige um Copilot+ PC com uma minimum 40-TOPS NPU:
| Chip | NPU | Qualifica? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 TOPS | ✅ hardware; software “em breve” |
| Intel Meteor Lake | ~10–11 TOPS | ❌ |
E aqui está o número que deveria reajustar as expectativas: numa NPU de 45 TOPS, um modelo 8B gera mais ou menos 5 tokens por segundo. O modelo Plan de 14B vai ser mais lento.
Cinco tokens por segundo não é uma experiência de chat. Serve para uma sumarização em segundo plano, uma reescrita, uma classificação, uma extração — que é para o que o Aion 1.0 Instruct realmente serve. Não serve para nada que você sente e fique olhando.
Por que tão lento com 45 TOPS? Porque a geração de tokens é limitada pela largura de banda de memória, não pelo poder bruto de cálculo. A NPU consegue fazer as multiplicações de matrizes; o problema é transmitir os pesos da memória do sistema para cada token. É a mesma parede que governa todos os aparelhos deste artigo, e é por isso que “TOPS” é um número quase inútil na hora de comprar.
As máquinas de mesa
Se você quer uma máquina especificamente para inferência local, a categoria de 128 GB se estabilizou em duas opções e uma exceção:
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| Memória | 128 GB unificados | 128 GB LPDDR5X-8000 | até 512 GB unificados |
| Largura de banda | ~273 GB/s | ~256 GB/s | 1,2 TB/s |
| Preço | ~US$ 3.999 | US$ 2.300–US$ 2.500 | a partir de US$ 5.499 |
| Notas | Ecossistema CUDA | CPU forte (1,6 TFLOPS no Linpack contra 708 GFLOPS do Spark) | Versão de 512 GB no fim de outubro, sem preço |
Esses preços e os números do Spark e do Strix Halo vêm de testes publicados no fim de dezembro de 2025, então trate-os como indicativos e não como atuais — o preço da memória mudou desde então. O DGX Spark e o Strix Halo estão muito mais próximos na geração de tokens do que seus números de cálculo sugerem — porque os dois ficam presos em torno de 256–273 GB/s de largura de banda, e essa é a restrição decisiva. O Spark ganha de forma decisiva na geração de imagens (~120 TFLOPS contra ~46 no FLUX.1 Dev BF16) e na compatibilidade com CUDA. O Strix Halo ganha no preço e na CPU.
O Mac Studio M5 Ultra está numa categoria totalmente diferente, tanto em memória quanto em largura de banda, e eu escrevi sobre isso em detalhe em o artigo sobre hardware para IA local. A versão curta: 512 GB a 1,2 TB/s é a única máquina de mercado de massa que consegue manter um modelo da classe 400B na memória, e o preço por esse privilégio fica em torno de US$ 16.000–US$ 20.000 configurada.
Os modelos para rodar de verdade
| Modelo | Parâmetros | Licença | Roda bem com | Bom para |
|---|---|---|---|---|
| Gemma 4 E2B | 5,1B / 2,3B ativos | Apache 2.0 | 4 GB | Celulares, sempre ativo, entrada de áudio |
| Gemma 4 E4B | ~8B | Apache 2.0 | 8 GB | Trabalho pesado no notebook, sumarização |
| Aion 1.0 Instruct | SLM pequeno | Pesos abertos (HF, jul 2026) | Somente CPU | Tarefas de texto nativas do Windows |
| Qwen3.8-27B | 27B denso | Apache 2.0 | 24–32 GB | Melhor modelo local geral abaixo de 32 GB |
| Gemma 4 26B-A4B | 26B / 4B ativos | Apache 2.0 | 24 GB | MoE rápido, baixo custo ativo |
| Gemma 4 31B | 31B denso | Apache 2.0 | 32 GB | Maior qualidade local abaixo de 32 GB |
| Ornith-1.5 35B | 35B / 3B ativos | MIT | 32 GB | Codificação agêntica, pegada ativa minúscula |
| gpt-oss-120b | 120B / 5,1B ativos | Apache 2.0 | 128 GB | O ponto ideal de 128 GB |
| Ornith-1.5-397B | 397B MoE | MIT | 256 GB+ | Perto da fronteira, exige uma máquina grande |
| MiniMax M3 | 428B / 23B ativos | Custom | 512 GB | Só cabe num M5 Ultra |
| DeepSeek V4 Pro | 1,6T / 49B ativos | MIT | Cluster | Não é um modelo para aparelho de consumo |
| Kimi K3 | 2,8T / 104B ativos | Custom | Cluster | Não cabe em nenhum Mac que a Apple vende |
Se você está dimensionando uma máquina Apple especificamente, eu detalhei as faixas de memória em o guia de IA local do MacBook Pro M5 Pro de 64 GB — a versão curta é que 64 GB é o ponto em que os compromissos deixam de incomodar.
Se você quer uma recomendação: numa máquina de 32 GB, rode Qwen3.8-27B ou Gemma 4 31B. Os dois são Apache 2.0, os dois são multimodais, os dois são realmente úteis, os dois cabem. Esse é o padrão de 2026, e é um padrão muito melhor do que o de 2025.
Mostrar imagem O que realmente cabe, por faixa de memória. As linhas verticais são os tamanhos de memória que os consumidores realmente podem comprar; os modelos que passam da linha da direita são o teto da IA de fronteira local em 2026.
Parte Catorze: a parede da memória é a história inteira
Tudo no Ato III volta a uma equação, então aqui está ela de forma explícita.
Vai caber?
weights (GB) ≈ total_params (B) × bytes_per_param
             4-bit  → × 0.5
             8-bit  → × 1.0
             BF16   → × 2.0

usable ≈ (system memory × 0.75) − OS and app overhead − KV cache
Quão rápido ele vai gerar?
tokens/sec ≈ (memory_bandwidth × efficiency) ÷ active_bytes_per_tokenNote que a segunda fórmula usa os parâmetros ativos , não o total. É por isso que modelos de mistura de especialistas são tão desproporcionalmente bons em hardware de consumo. O 26B-A4B do Gemma 4 tem 26 bilhões de parâmetros de capacidade e 4 bilhões de parâmetros de custo por token. O 35B do Ornith-1.5 ativa 3B. O MiniMax M3 tem 428B no total e 23B ativos.
A eficiência nessa fórmula fica entre 0,5 e 0,8 na prática dependendo do runtime, da quantização e de quanta da largura de banda de memória o resto do sistema está usando.
Agora aplique. Um notebook com NPU de 45 TOPS e LPDDR5X a, digamos, 120 GB/s, rodando um modelo 8B em 4 bits (4 GB de pesos ativos): 120 × 0,6 ÷ 4 ≈ 18 tokens/segundo em teoria. O número medido é cerca de 5. A diferença é escalonamento, contenção de memória, custos de prefill e o fato de as toolchains de NPU ainda serem imaturas. É nessa lacuna entre a aritmética e a medição que mora a maior parte da decepção nessa área.
A escassez de DRAM é a variável oculta por trás de cada número deste artigo
Os fabricantes de memória passaram 2025 e 2026 realocando capacidade para clientes de data centers de IA, que assinam contratos maiores com margens melhores do que os fabricantes de aparelhos de consumo. As consequências aparecem em toda parte:
- A Apple subiu os preços de Macs e iPads em junho de 2026.
- A versão de 512 GB do Mac Studio escorregou para o fim de outubro por questões de oferta e continua sem preço definido.
- O M6 da Apple para em 32 GB de memória unificada, e o M6 Pro, Max e Ultra foram cancelados de vez.
- Ming-Chi Kuo relatou que a Apple cortou embarques de hardware em 2026 por causa do fornecimento de memória.
Todo teto neste artigo remete à mesma escassez. O limite de 12 GB nos celulares. O teto de 32 GB do M6. O teto de 128 GB nos notebooks. A versão de 512 GB atrasada. Nenhum deles é um limite técnico do silício; todos são decisões de alocação num mercado em que memória é escassa e cara.
Se você tem esperado os preços normalizarem antes de comprar uma máquina para inferência local: ninguém com credibilidade está prevendo quando isso vai acontecer.
Parte Quinze: colocando para funcionar
A seção prática. Tudo aqui eu rodei; onde estou apenas relatando e não rodando, eu aviso.
O caminho mais fácil: LM Studio
Uma GUI, nativa em MLX no Apple Silicon, com navegador de modelos embutido e servidor compatível com OpenAI num único toggle. Se você quer estar rodando um modelo em dez minutos, comece aqui. É também a ferramenta contra a qual a Apple faz benchmarks nos próprios comunicados, o que diz algo sobre o quanto isso virou mainstream.
O caminho mais flexível: Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
Esse segundo comando é o que as pessoas esquecem. O contexto padrão do Ollama é definido de forma conservadora; numa tarefa de código ele vai truncar sem avisar e você vai culpar o modelo.
O caminho mais rápido no Apple Silicon: MLX
bash
pip install --upgrade mlx-lm

# Generate directly
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain mixture-of-experts routing in two paragraphs." \
  --max-tokens 512

# Or serve an OpenAI-compatible endpoint
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Aponte qualquer cliente compatível com OpenAI para http://localhost:8080/v1.
Aumente o limite de memória wired antes de reclamar de travamentos
O macOS não deixa a GPU fixar toda a sua memória unificada por padrão. Numa máquina com muita memória, essa é a diferença entre um modelo carregar e um modelo falhar:
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Não defina isso como o tamanho total da sua memória. Deixe de 12 a 16 GB para o sistema numa máquina grande, ou você vai ter kernel panic em vez de inferência rápida. E confira de novo depois de cada atualização do macOS, porque as atualizações redefinem esse valor.
No Windows, use primeiro os modelos do sistema
Antes de instalar qualquer coisa, veja o que o Windows já oferece. As APIs Prompt, Summarizer, Writer e Rewriter no Edge chamam o Aion 1.0 Instruct localmente, sem chave e sem fatura. Para sumarização, reescrita e extração dentro de uma aplicação web, essa é uma solução completa com zero de infraestrutura.
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
Se você precisa de mais que isso, o LM Studio e o Ollama rodam bem no Windows, e numa máquina sem NPU qualificada eles vão usar a GPU ou a CPU, o que para modelos da classe 8B costuma ser mais rápido do que o caminho da NPU de qualquer forma.
Uma configuração híbrida sensata
A arquitetura que eu realmente montaria, e mais ou menos o que eu uso:
- Nível 1 — no dispositivo. Um modelo pequeno para roteamento, classificação, extração, resumo e ditado. Gemma 4 E4B ou Aion 1.0 Instruct. Sempre disponível, custo marginal zero.
- Nível 2 — seu próprio hardware. Um modelo de pesos abertos de 27B–120B em uma máquina sua, para qualquer coisa que envolva dados de clientes que não podem sair da jurisdição. Qwen3.8-27B em 32 GB,
gpt-oss-120bem 128 GB. - Nível 3 — fronteira via API. Planejamento, raciocínio difícil, execuções agênticas longas, qualquer coisa em que errar sai caro.
O debate nunca é “local ou nuvem”. É onde você traça as linhas, e as linhas se moveram muito este ano.
Parte dezesseis: as contas de custo e conformidade
O argumento da economia não sobrevive a uma calculadora
Pegue uma carga realista de pequena empresa: um mês de trabalho de codificação agêntica moderada, digamos 40 milhões de tokens de entrada e 3 milhões de saída.
| Opção | Custo mensal |
|---|---|
| GLM-5.3-Flash API (US$ 0,15 / US$ 0,47) | ~US$ 7,40 |
| Gemini 3.8 Flash API (US$ 0,75 / US$ 3,75) | ~US$ 41 |
| Claude Opus 5 API (US$ 5 / US$ 25) | ~US$ 275 |
| Claude Fable 5.1 API (US$ 10 / US$ 50, sem cache) | ~US$ 550 |
| Uma máquina Strix Halo de US$ 2.400, amortizada em 3 anos | ~US$ 67/mês + eletricidade |
Repare no que essa tabela realmente diz. Hardware local é mais barato que o topo da fronteira e mais caro que a base dela. Contra o GLM-5.3-Flash, uma máquina local nunca se paga em tokens. Contra o Fable 5.1 rodando sem cache, ela se paga em cinco meses — mas você não está comparando coisas equivalentes, porque o Fable 5.1 é um modelo muito melhor do que qualquer coisa que caiba em 128 GB.
Então não compre hardware local para economizar dinheiro. Compre por um destes cinco motivos, todos reais:
- Residência de dados que é uma decisão de arquitetura, não um projeto jurídico.
- Sem limites de taxa, sem cotas, sem incidentes de capacidade. Sua máquina não tem uma terça-feira cheia.
- Fixação de versão para sempre. Um checkpoint local é idêntico byte a byte daqui a um ano.
- Operação offline.
- Você precisava da estação de trabalho de qualquer jeito. Este é o caso mais comum em que comprar é simplesmente correto — se você já ia gastar € 2.500 numa máquina, o custo marginal da capacidade de IA é o upgrade de memória, não a máquina inteira.
O cenário de conformidade na UE, porque ele mudou em 2026
Para leitores na Alemanha e na UE, o terreno regulatório mudou este ano e as datas agora são fixas, não condicionais.
- 2 de agosto de 2025 — os provedores de modelos GPAI assumiram obrigações de documentação, resumo do conteúdo de treinamento e direitos autorais.
- 2 de agosto de 2026 — entraram em vigor os poderes de fiscalização e as obrigações de transparência do Artigo 50. As multas agora são aplicáveis.
- 27 de julho de 2026 — o Digital Omnibus, Regulamento (UE) 2026/1744, entrou em vigor, substituindo o mecanismo condicional anterior para sistemas de alto risco por datas fixas.
- 2 de dezembro de 2026 — fim do período de carência para marca d'água legível por máquina em sistemas existentes.
- 2 de agosto de 2027 — fecha-se a janela de transição de dois anos para modelos GPAI já no mercado.
- 2 de dezembro de 2027 — sistemas de alto risco autônomos sob o Anexo III (contratação, pontuação de crédito, educação, infraestrutura crítica).
- 2 de agosto de 2028 — IA de alto risco embarcada em produtos regulamentados sob o Anexo I (dispositivos médicos, máquinas).
O Digital Omnibus também acrescentou proibições a imagens íntimas não consensuais geradas por IA e a CSAM, e ampliou os poderes de supervisão do Gabinete de IA da UE.
O que isso significa na prática para os leitores deste artigo. Se você constrói sobre modelos em vez de treiná-los, a maior parte das obrigações de GPAI fica com o provedor, não com você. O que cai sobre você é a transparência — avisar as pessoas quando estão interagindo com IA e marcar conteúdo sintético — além da questão da classificação de alto risco se o seu sistema toca contratação, crédito, educação ou infraestrutura crítica. A data de dezembro de 2027 está longe o suficiente para planejar e perto o suficiente para que “vamos ver isso depois” não seja mais uma estratégia.
E o ponto mais relevante para o Ato III: um modelo no dispositivo simplifica materialmente várias dessas conversas de uma vez. Sem transferência, sem operador, um mapa de fluxo de dados muito mais curto. Isso não é uma brecha — as obrigações de transparência continuam valendo —, mas elimina uma categoria inteira de trabalho.
Não sou advogado e isto não é aconselhamento jurídico. Para qualquer coisa que envolva dinheiro, contrate um consultor qualificado na Alemanha ou na UE para analisar a sua implantação específica.
Parte dezessete: o caso honesto contra tudo isso
Se eu parasse na parte dezesseis, isto seria um anúncio.
As evidências medidas de produtividade ainda não sustentam o entusiasmo. Um ensaio controlado randomizado, 19% mais lento. Um acompanhamento que não pôde ser conduzido de forma limpa. Autorrelatos inflados em 40 pontos percentuais. Todo mundo neste setor, inclusive eu, está operando substancialmente com base em vibes sobre vibes.
Os dados de segurança são ruins e não estão melhorando. A taxa de falha de 45% no OWASP da Veracode ficou essencialmente inalterada até o início de 2026, enquanto os modelos ficaram dramaticamente mais inteligentes. Não é um problema de transição que escala resolve. Capacidade e segurança não são o mesmo eixo, e ninguém está otimizando com força o segundo.
Os benchmarks estão saturados no topo e não verificáveis no meio. O SWE-bench Verified tem três modelos dentro de um ponto. Os benchmarks que o substituem são cada vez mais privados, o que resolve a contaminação tornando a verificação independente impossível.
Pesos abertos estão a uma revisão de licença de deixar de ser abertos. A Z.ai tirou o GLM da licença MIT e passou para uma licença proprietária com uma barreira de revisão de segurança entre o 5.2 e o 5.3. A Meta prometeu pesos abertos para o Muse Spark sem data, sem tamanho e sem texto de licença. Se a sua arquitetura assume pesos baixáveis no ano que vem, essa suposição é uma decisão de negócio do fornecedor, não uma lei da natureza.
A fronteira ainda não é local, e cada vez menos comprável também. O Mythos 5.1, maior pontuador no Terminal-Bench 4.0, está restrito a defensores cibernéticos e cientistas da vida verificados, hoje em sua maioria nos EUA. Kimi K3 e DeepSeek V4 Pro não cabem em nenhuma máquina de consumidor. O que cabe na sua mesa é um excelente modelo de segundo nível, o que é uma coisa genuinamente útil de ser e não é a fronteira.
O desempenho no dispositivo é pior do que o marketing sugere. Cinco tokens por segundo para um modelo de 8B em uma NPU de 45 TOPS. Uma exigência de 12 GB de memória que exclui a maioria dos celulares em circulação. Uma promessa de sete anos de atualizações que não cobre recursos. A distância entre a marca “AI PC” e o que a máquina realmente consegue rodar hoje é enorme.
E a geopolítica é um fator de compra, quer você ache que deveria ser, quer não. Vários dos melhores modelos de pesos abertos — Kimi, GLM, DeepSeek, Qwen, MiniMax — vêm de laboratórios chineses. Para o setor público, para áreas próximas da defesa e para alguns clientes regulados, isso é um bloqueio duro, independentemente de onde os pesos rodam ou do que diz a licença. Enquanto isso, o modelo de codificação mais capaz da Anthropic está restrito a organizações norte-americanas verificadas. O ecossistema aberto está sendo rasgado por linhas nacionais de ambas as pontas, e se você está na Europa, não está em nenhuma das duas pontas.
Parte dezoito: o quadro de decisão para o estado da IA em 2026
Mostrar imagem Sete situações, sete respostas. Encontre a linha que parece com o seu ano.
Sete situações, mapeadas sobre o estado da IA em 2026 como ele realmente está hoje.
1. “Quero o melhor modelo e o custo não é problema.”
Claude Fable 5.1 com 65,7 no índice agregado, US$ 10/US$ 50, contexto de 1M — e ligue o cache, porque o corte de 75% nas leituras de cache vale de 25% a 45% da sua conta. Mantenha GPT-5.6 Sol disponível para pesquisa com muita navegação a 90,4% no BrowseComp. Não sofra; a diferença entre eles é menor que a diferença entre o seu melhor e o seu pior prompt.
2. “Rodo muitos agentes e a conta está ficando ridícula.”
Claude Opus 5 a US$ 5/US$ 25 para o trabalho de longo horizonte, GLM-5.3-Flash a US$ 0,15/US$ 0,47 para trabalho mecânico em volume, e um modelo local para o trabalho braçal. O roteamento é a maior alavanca de custo disponível para você, e é um arquivo de configuração, não um projeto. Meça a divisão de tokens por papel de agente antes de otimizar qualquer coisa — a maioria das pessoas descobre que 80% do gasto está em tarefas que não precisavam de um modelo de fronteira.
3. “GDPR e residência de dados são requisitos rígidos para trabalho com clientes.”
Qwen3.8-27B ou Gemma 4 31B em hardware que você possui, ambos Apache 2.0, ambos multimodais. Suba para gpt-oss-120b em uma máquina de 128 GB se o trabalho exigir. O ponto não é a velocidade — é que nenhum prompt sai do prédio e sua revisão jurídica vira uma leitura de licença em vez de uma avaliação de impacto de transferência. Escolha modelos com licenças permissivas justamente para que essa leitura seja curta.
4. “Quero experimentar IA local sem gastar muito.”
O que você já tem, mais o LM Studio, mais o Gemma 4 E4B. Oito gigabytes de memória bastam para ser genuinamente útil. Descubra se IA local é para você antes de gastar dinheiro com isso — a maioria das pessoas descobre que quer o nível 1 e o nível 3 e nunca precisou do nível 2.
5. “Vou comprar uma máquina especificamente para inferência local.”
Compre pela largura de banda e pela capacidade de memória, nessa ordem, e ignore os TOPS. Na classe de 128 GB, o Strix Halo a ~US$ 2.400 é a melhor relação custo-benefício e o DGX Spark a ~US$ 3.999 compra CUDA e geração de imagens muito melhor. Acima disso, o Mac Studio M5 Ultra é a única coisa que segura um modelo 400B, a um preço que só faz sentido se você já precisava da estação de trabalho.
6. “Minha equipe está adotando ferramentas de codificação com IA e o risco é meu.”
Faça as coisas chatas, nesta ordem: SAST e detecção de segredos em cada commit; análise de composição de software para pacotes alucinados; uma política escrita que exclua código de IA não revisado de autenticação, criptografia, autorização e pagamentos; credenciais de agentes com escopo privilegiado; e um SBOM que registre a proveniência das ferramentas. Depois espere uma curva em J — a DORA mediu uma queda real antes do ganho — e não entre em pânico no terceiro mês.
7. “Qual celular devo comprar para IA?”
Qualquer modelo com 12 GB. Essa é a linha que todas as plataformas traçaram: iPhone 17 Pro e 18 Pro com 12 GB, Pixel 10 para o Nano v3, Galaxy S26 Ultra com Snapdragon 8 Elite Gen 5. O iPhone 18 básico, com 9 GB segundo relatos, e o Pixel 9 e anteriores rodam o celular muito bem e não vão receber os recursos. Se você já está em um aparelho de 12 GB, o upgrade deste ano é incremental especificamente para IA.
Parte dezenove: o que estou observando no próximo trimestre
Se a Meta realmente vai liberar os pesos do Muse Spark, e sob qual licença. “Em breve” de um CEO no X, sem contagem de parâmetros e sem texto de licença, é a forma mais fraca de compromisso neste artigo. Se lançarem sob Apache 2.0, isso muda materialmente o ecossistema aberto. Se lançarem sob uma licença sob medida com barreira de receita, esse já é o padrão da indústria e pesos abertos viram uma categoria de marketing, não uma propriedade.
Se o resultado de autoaperfeiçoamento do Ornith-1.5 se replica. Uma avaliação independente em tarefas fora do currículo autogerado é o que resolveria a questão. Este é o item de maior variância da lista: ou é o resultado mais importante de 2026 ou um conto de advertência sobre benchmarks autogerados, e no momento não sei qual.
Se o Aion 1.0 Plan realmente será lançado e a que velocidade roda. Um modelo de raciocínio de 14B no Windows é uma categoria genuinamente nova. Se roda a 3 tokens por segundo no hardware qualificado, é uma demo. Se roda a 20, muda o que um aplicativo de desktop pode assumir.
A curva de atribuição de CVEs. 6, 15, 35 em meses sucessivos. Se abril a agosto continuou nessa trajetória, os dados do Georgia Tech serão a publicação de segurança de IA mais consequente do ano quando saírem.
Se alguém vai construir as ferramentas de revisão. A distância entre o que os agentes conseguem produzir e o que os humanos conseguem verificar é o problema definidor de 2027, e hoje quase todo o capital de risco ainda vai para geração, não para verificação. Quem lançar a ferramenta que diz com confiança qual 5% de um diff precisa de olhos humanos será muito difícil de enfrentar.
Se a escassez de memória vai diminuir. É a variável oculta por trás do requisito de 12 GB nos celulares, do teto de 32 GB no M6, do nível de 512 GB dos Macs que atrasou e do aumento de preço da Apple em junho. Ninguém com credibilidade prevê alívio.
E se os modelos de fronteira com barreiras de segurança continuam sendo exceção. O Mythos 5.1 tem acesso restrito por motivos de uso dual que considero defensáveis, e o Projeto Glasswing está ampliando ativamente o acesso — cerca de 150 organizações em mais de quinze países até junho de 2026. Mas o precedente está aberto: o maior pontuador em um benchmark público de codificação agora é algo que a maioria das organizações não consegue comprar a preço nenhum. Se isso virar padrão em vez de caso especial, “minha organização consegue ser verificada” passa a ser um critério de escolha de modelo, e o argumento a favor de pesos abertos fora dos EUA deixa de ser totalmente sobre custo.
Perguntas frequentes
Qual é o melhor LLM em setembro de 2026?
No agregado, o Claude Fable 5.1 lidera o Intelligence Index v4.1.1 do Artificial Analysis com 65,7, à frente do Claude Opus 5 com 63,0, do Claude Fable 5 com 62,1, do Grok 4.6 com 60,9 e do GPT-5.6 Sol com 58,9. Mas o agregado comprime as diferenças que importam. O GPT-5.6 Sol lidera a navegação com 90,4% no BrowseComp; o Gemini 3.8 Flash entrega 58,7 a US$ 0,75 por milhão de tokens de entrada; o GLM-5.3-Flash entrega 57,5 a US$ 0,15. Para a maioria das cargas reais, os oito melhores modelos são intercambiáveis e a decisão deve ser tomada com base em preço, latência, economia de cache e licença, não em ranking.
Qual é o melhor modelo de pesos abertos agora?
Depende do seu hardware e da sua tolerância a licenças. O GLM-5.3 (753B) tem a pontuação mais alta, 59,5, mas carrega uma licença personalizada com um limite de análise de segurança para empresas com US$ 10 bilhões de receita. O DeepSeek V4 Pro (1,6T no total, 49B ativos) tem licença MIT e pontua 87,9 no Terminal-Bench 2.1, mas precisa de um cluster. Para uma máquina que você realmente possui, o Qwen3.8-27B ou o Gemma 4 31B — ambos Apache 2.0 — são os melhores modelos que cabem em 32 GB.
O vibe coding morreu em 2026?
A palavra está morrendo; a prática se dividiu em duas. Vibe coding no sentido original — prompt, aceitar, não ler o diff — continua correto para trabalho descartável: scripts, protótipos, análises pontuais. O que o substituiu para qualquer coisa que vai para produção é engenharia agêntica guiada por especificação: uma especificação escrita, um sandbox, uma suíte de testes que o agente precisa passar e uma revisão de verdade do diff resultante. O meio perigoso — código de produção sem revisão — é de onde veio todo incidente documentado de 2026.
A codificação com IA realmente deixa os desenvolvedores mais rápidos?
O único ensaio controlado randomizado diz que não. O METR descobriu que desenvolvedores experientes foram 19% mais lentos com ferramentas de IA do início de 2025 em bases de código maduras, enquanto acreditavam ter sido 20% mais rápidos — uma superestimativa de 40 pontos percentuais. O acompanhamento de 2026 não pôde ser conduzido de forma limpa porque os desenvolvedores se recusaram a trabalhar sem IA. Pesquisas relatam um multiplicador de velocidade de 3×, mas apenas uma mudança de 1,4–2× no valor do trabalho. Minha leitura: ganhos grandes em trabalho desconhecido, boilerplate, testes e migrações; ganhos pequenos ou negativos em bases de código que você conhece intimamente.
Quão arriscado é o código gerado por IA?
Mensuravelmente arriscado e melhorando devagar. A Veracode descobriu que 45% das amostras geradas por IA introduzem uma vulnerabilidade do OWASP Top 10, com Java no pior caso, 72%. A Apiiro mediu desenvolvedores assistidos por IA produzindo commits 3–4× mais rápido e achados de segurança 10× mais rápido, com caminhos de escalonamento de privilégios 322% maiores. Cerca de 20% do código gerado por IA referencia pacotes que não existem, e 43% desses nomes alucinados se repetem de forma consistente — o que é uma superfície de ataque de cadeia de suprimentos. A correção são portões automatizados em cada commit, não abstinência.
Consigo rodar um bom LLM offline no meu próprio computador?
Sim, e 2026 é o primeiro ano em que isso é inequivocamente verdade. Com 8 GB de memória, o Gemma 4 E4B é genuinamente útil. Com 32 GB, Qwen3.8-27B ou Gemma 4 31B são modelos multimodais fortes sob Apache 2.0. Com 128 GB, o gpt-oss-120b é o ponto ideal. O que não cabe em nenhuma máquina de consumidor é a fronteira de verdade: Kimi K3 com 2,8 trilhões de parâmetros e DeepSeek V4 Pro com 1,6 trilhão precisam de um cluster.
O que é o Microsoft Aion 1.0?
Uma família de modelos no dispositivo anunciada no Build em 2 de junho de 2026 e entregue no Windows 11. O Aion 1.0 Instruct é um modelo pequeno para resumo, reescrita e extração que roda em uma CPU moderna sem precisar de NPU, exposto pelas APIs JavaScript Prompt, Summarizer, Writer e Rewriter do Edge, com pesos abertos no Hugging Face desde julho de 2026. O Aion 1.0 Plan é um modelo de raciocínio e chamada de ferramentas de 14 bilhões de parâmetros com janela de contexto de 32K para fluxos de trabalho agênticos, exigindo um Copilot+ PC com NPU mínima de 40 TOPS, e ainda estava “em alguns meses” no início de setembro de 2026.
Por que os celulares precisam de 12 GB de RAM para recursos de IA?
Porque modelos no dispositivo são limitados por memória, não por computação. O AFM 3 Core Advanced da Apple é um modelo esparso de 20 bilhões de parâmetros que vive no armazenamento flash e traz especialistas roteados para a DRAM sob demanda — o que ainda exige espaço para onde trazê-los, além do sistema operacional, do aplicativo e do pipeline da câmera. Ming-Chi Kuo relata dois recursos do iOS 27 que exigem 12 GB. O Gemini Intelligence do Google tem o mesmo mínimo de 12 GB. A diferença entre 9 GB e 12 GB é o conjunto de trabalho, não segmentação de mercado.
Vale a pena ter uma NPU para IA local?
Menos do que o marketing sugere. Em uma NPU de 45 TOPS, um modelo de 8B gera cerca de 5 tokens por segundo, porque a geração de tokens é limitada pela largura de banda de memória, não pela computação. As NPUs são excelentes para tarefas de curta duração, baixo consumo e sempre ativas — as que um sistema operacional executa o tempo todo. Para chat interativo em um notebook, a GPU ou até o caminho da CPU costuma ser mais rápido. Compre pela largura de banda e pela capacidade de memória; trate os TOPS como quase irrelevantes na hora de comprar.
Modelos de pesos abertos são realmente de código aberto?
Em grande parte, não. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) e Ornith-1.5 (MIT) têm licenças genuinamente permissivas. O GLM-5.3 exige que empresas com receita acima de US$ 10 bilhões passem pela revisão de segurança da Z.ai; o Kimi K3 usa uma licença por faixas de receita; o MiniMax M3 obriga a atribuição destacada “Built with MiniMax M3” para qualquer uso comercial e autorização por escrito acima de US$ 20 milhões de receita. Nenhum deles libera dados de treinamento ou código de treinamento. “Peso aberto” é o termo correto; “código aberto” está fazendo um trabalho desonesto.
É mais barato rodar modelos localmente do que usar uma API?
Quase nunca só pelo custo de tokens. Um mês moderado de trabalho agêntico — 40M de entrada e 3M de tokens de saída — custa cerca de US$ 7 no GLM-5.3-Flash e cerca de US$ 41 no Gemini 3.8 Flash. Uma máquina local de US$ 2.400 amortizada em três anos fica em torno de US$ 67 por mês antes da eletricidade. O hardware local vence o topo da fronteira em custo e perde para a base dela. Compre local por residência de dados, liberdade de limites de taxa, fixação de versão e operação offline — ou porque você já precisava da estação de trabalho.
O que o AI Act da UE exige em 2026?
Desde 2 de agosto de 2026, os poderes de fiscalização e as obrigações de transparência do Artigo 50 se aplicam à IA de uso geral, e as multas agora existem. O Digital Omnibus, Regulamento (UE) 2026/1744, entrou em vigor em 27 de julho de 2026 e fixou datas: 2 de dezembro de 2026 encerra o período de carência para marca d'água; 2 de agosto de 2027 fecha a transição para modelos GPAI já no mercado; 2 de dezembro de 2027 se aplica a sistemas de alto risco autônomos sob o Anexo III; 2 de agosto de 2028 cobre IA de alto risco embarcada em produtos regulamentados. Se você constrói sobre modelos em vez de treiná-los, a maior parte das obrigações de GPAI fica com o provedor — transparência e classificação de alto risco são o que cai sobre você. Isto não é aconselhamento jurídico.
Por quanto tempo um agente de IA consegue trabalhar sem supervisão?
O METR mede a duração de tarefa que um modelo completa de forma autônoma com 50% de sucesso. Esse número passou de cerca de 30 segundos em 2022 para mais de 14 horas em sistemas de fronteira em 2026, com tempo de duplicação de aproximadamente 196 dias no ajuste híbrido do METR, ou 131 dias quando restrito a modelos pós-2023. Os intervalos de confiança são muito amplos — o horizonte de 320 minutos do Claude Opus 4.5 vai de 170 a 729 minutos — e apenas 5 das 31 tarefas longas do METR usam linhas de base humanas medidas. Extrapolando, isso dá cerca de um dia de trabalho de duração autônoma de tarefas em 2027.
Qual modelo devo usar especificamente para codificação?
Roteie em vez de escolher. Planejamento e arquitetura para o modelo mais capaz que você puder pagar (Claude Fable 5.1); o grosso da implementação de longo horizonte para o Claude Opus 5 pela metade do preço; trabalho mecânico em volume para o GLM-5.3-Flash a US$ 0,15/US$ 0,47; qualquer coisa que toque dados de clientes para um modelo local de pesos abertos; e renomeações, docstrings e correções de lint para um modelo local pequeno. Escreva os IDs dos modelos de forma que trocar um seja uma mudança de uma linha — quatro laboratórios lançaram um modelo do top ten entre junho e setembro de 2026.
A conclusão
Doze meses atrás, a pergunta interessante em IA era qual modelo era o mais inteligente. O estado da IA em 2026 é que essa pergunta se tornou quase desinteressante. Os dez primeiros modelos abrangem 8,2 pontos no melhor agregado disponível, e o mais barato deles custa um sessenta e sete avos do mais caro.
O que a substituiu é mais útil e menos empolgante: você consegue verificar o que essas coisas produzem, rápido o suficiente para acompanhá-las?
Essa única pergunta explica todas as conclusões deste artigo. Explica por que o SWE-bench saturou em 96% e deixou de ser informativo. Explica por que a adoção de ferramentas de codificação com IA chegou a 90% enquanto a confiança caiu para 29%. Explica por que a taxa de falha de segurança da Veracode não se moveu enquanto a capacidade disparou, porque capacidade e verificabilidade são eixos diferentes e só um deles está sendo otimizado. Explica por que a DORA descobriu que os retornos vêm da organização, não da ferramenta. E explica por que a prática que realmente funciona em 2026 — especificação, sandbox, portão de testes, revisão de verdade — parece tão menos mágica que as demos.
Quatro coisas que eu levaria.
A fronteira se tornou commodity mais rápido do que qualquer um esperava, e a diferença dos pesos abertos agora é de cerca de seis meses. Um modelo de 397B licenciado sob MIT supera a fronteira fechada da geração anterior no SWE-bench. Um modelo de pesos abertos de 753B fica à frente do GPT-5.6 Sol no índice agregado. Planeje para um mundo em que o modelo não é o seu diferencial, porque ele muito quase já não é um.
Leia a licença antes do benchmark. A capacidade está convergindo; os termos estão divergindo. A Z.ai saiu do MIT entre lançamentos. A Meta prometeu pesos sem texto de licença. O melhor modelo de codificação da Anthropic é barrado por nacionalidade. Para um comprador comercial, quatro pontos de benchmark valem menos que uma licença que seu advogado lê em noventa segundos.
A verificação é o jogo inteiro agora, e quase ninguém está financiando isso. Agentes conseguem produzir um dia de trabalho; nós revisamos com ferramentas feitas para revisar uma hora de trabalho. Se você está escolhendo onde gastar esforço de engenharia nos próximos doze meses, gaste em testes, especificações e ferramentas de revisão, não em técnica de prompt. Técnica de prompt se desvaloriza a cada lançamento de modelo. Infraestrutura de verificação se acumula.
E a IA offline ficou de verdade, com um orçamento de memória que acabou de ficar caro. Um modelo multimodal de 27 bilhões de parâmetros com licença Apache roda numa máquina que você compra por € 2.500. O Windows traz um modelo no sistema operacional. Seu celular roda um modelo esparso de 20 bilhões de parâmetros direto do flash. Todo teto nisso — o limite de 12 GB nos celulares, o teto de 32 GB nos notebooks, o piso de 40 TOPS — é uma decisão de alocação de memória num mercado onde a DRAM é escassa, não um limite do silício.
A configuração que eu realmente montaria hoje: Gemma 4 E4B no dispositivo para a camada sempre ativa; Qwen3.8-27B no seu próprio hardware para qualquer coisa que não pode sair do prédio; GLM-5.3-Flash a US$ 0,15/US$ 0,47 para o meio de alto volume; e Claude Opus 5 ou Fable 5.1 para planejamento e os problemas genuinamente difíceis, com o cache ativado. Roteie entre eles em um arquivo de configuração, e espere reescrever esse arquivo em três meses.
Reveja isto em dezembro. A Meta terá liberado os pesos ou não. O Aion 1.0 Plan será real ou fumaça. O resultado de autoaperfeiçoamento do Ornith terá se replicado ou desaparecido discretamente. E a curva de atribuição de CVEs terá nos dito se 2026 foi o ano em que a indústria apertou os próprios portões ou o ano em que esperou que outra pessoa fizesse isso.
Você está rodando modelos de pesos abertos em produção na UE, ou entregando código escrito por agentes por um processo de revisão em que você realmente confia? Tenho interesse especial em duas coisas: divisões medidas de custo de tokens por papel de agente, e qualquer coisa que funcione para revisar diffs de agentes com milhares de linhas. Correções e contraevidências são bem-vindas — este artigo é atualizado quando o quadro muda.
Última atualização: 3 de setembro de 2026.


