العربية
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 हिन्दी

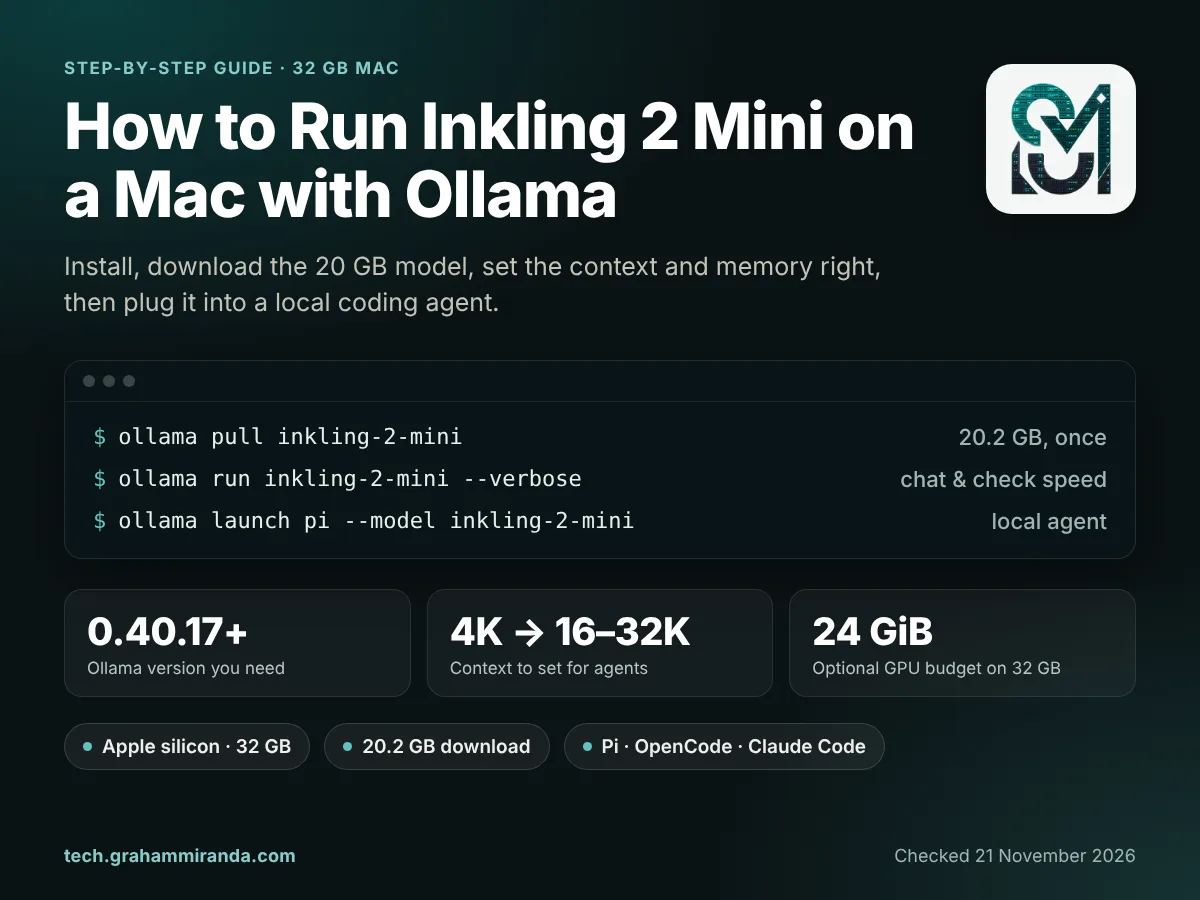
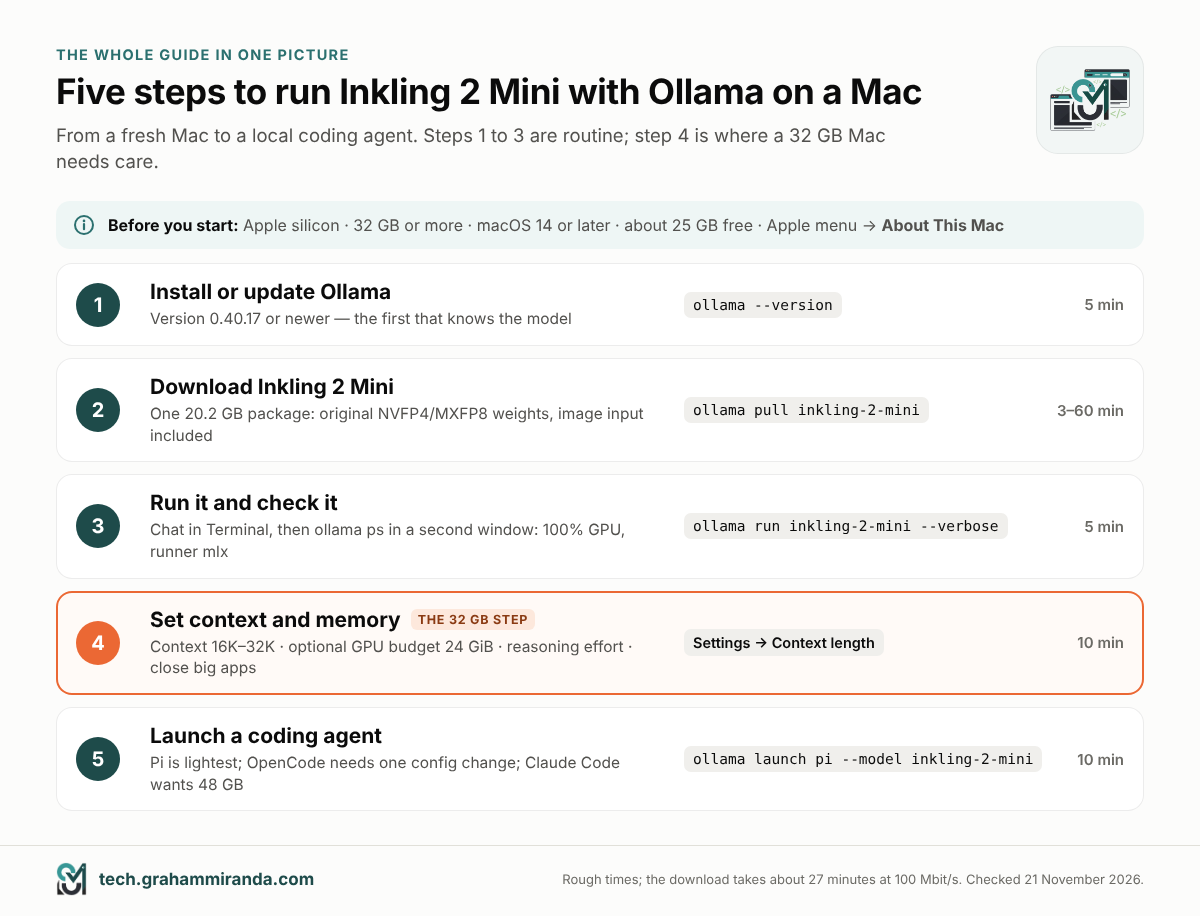
أصدرت Thinking Machines Lab نموذج Inkling 2 Mini في 20 نوفمبر بوعد غير معتاد لنموذج مفتوح بهذه القدرة: أنه يعمل على حاسوب محمول. وتدعمه الشركة على أي جهاز Mac بذاكرة 32 GB أو أكثر، عبر Ollama. بل إن باحثيها شغّلوه دون اتصال على MacBook Pro أثناء رحلة جوية، حيث بنى محاكي طيران قابلًا للعب. يوضح لك هذا الدليل، خطوة بخطوة، كيفية تشغيل Inkling 2 Mini مع Ollama على جهاز Mac بذاكرة 32 GB. يبدأ بتثبيت جديد وينتهي بوكيل برمجة محلي يعمل.
النسخة القصيرة ثلاثة أوامر. أما النسخة الطويلة فهي سبب وجود هذا الدليل. على جهاز Mac بذاكرة 32 GB يستهلك النموذج نحو 20 GB. وافتراضيًا، يحتفظ macOS أيضًا بنحو ثلث ذاكرتك بعيدًا عن وحدة معالجة الرسوميات. فيستجيب Ollama بمنح النموذج سياقًا من 4,000 رمز: وهو مناسب لمحادثة، وصغير جدًا لوكيل برمجة. وعلى معظم أجهزة Mac بذاكرة 32 GB، قد تنفد الذاكرة اليوم مع الموجّهات الطويلة جدًا. لا شيء من ذلك سبب لتخطيه. بل هو سبب لإعداده على النحو الصحيح.
لا تحتاج إلى معرفة البرمجة. ستنسخ بضعة أوامر إلى Terminal، تطبيق سطر الأوامر في الـ Mac (اضغط Cmd-Space واكتب Terminal ثم اضغط Return). كل أمر منها مشروح. دعم Ollama لـ Inkling 2 Mini عمره أيام ويتطور بسرعة، لذا تحققت من كل حقيقة أدناه في 21 نوفمبر 2026.
إفصاح عن الاستقلالية والروابط التابعة: لم ترعَ أي شركة مذكورة هنا هذا الدليل أو تراجعه أو توافق عليه. يتضمن رابط تسويق بالعمولة واحد، إلى خطة GLM Coding Plan من Z.ai (في الجزء 10). الاشتراك عبرها يمنحك خصمًا بنسبة 10% وقد يحقق لي عمولة دون أي تكلفة إضافية عليك.
باختصار — النسخة في 60 ثانية
- تحتاج إلى: جهاز Mac بشريحة Apple silicon بذاكرة 32 GB من الذاكرة أو أكثر، وmacOS 14 أو أحدث، ونحو 25 GB من مساحة القرص الحرة و Ollama 0.40.17 أو أحدث.
- ثلاثة أوامر:
ollama --version(0.40.17 أو أحدث)،ollama pull inkling-2-mini(تنزيل بحجم 20.2 GB)،ollama run inkling-2-mini. - العقبة الخفية في 32 GB: تشغل الأوزان 18.8 GiB، وافتراضيًا لا يتيح macOS لوحدة GPU سوى نحو 21.3 GiB. لذلك يضبط Ollama سياق 4K، وهو صغير جدًا بحيث لا يكفي الوكلاء.
- الإعدادات التي تهم: اضبط السياق على 16K–32K في إعدادات Ollama للوكلاء. واختياريًا، ارفع ميزانية GPU إلى 24 GiB باستخدام
sudo sysctl iogpu.wired_limit_mb=24576(تُعاد إلى قيمتها عند إعادة التشغيل). أبقِ جهد الاستدلال على مرتفع للبرمجة، منخفض للأسئلة السريعة. أغلق التطبيقات المستهلكة للذاكرة أولًا. - شريحتك مهمة اليوم: لا يفعّل Ollama 0.40.17 قراءة الموجّهات الموفرة للذاكرة إلا على M2 Pro وM2 Ultra وM3 Ultra وM4 Pro وM5 Pro وMax وUltra. وفي اختبار 32 GB المنشور الوحيد، انهار M2 Max برسالة "Insufficient Memory" بعد نحو 12,000 رمز.
- الوكلاء: يناسب Pi ذاكرة 32 GB أكثر من غيره، لأن تعليماته وأدواته تقل عن 1,000 رمز (
ollama launch pi --model inkling-2-mini). ينفّذ الأوامر دون سؤال، لذا أبقِه في مجلد مؤقت. ويبدأ OpenCode بنحو 6,900 رمز ويسأل أولًا بعد تغيير واحد في الإعدادات. أما Claude Code فيسأل افتراضيًا، لكن طلبه الأول قاس نحو 32,800 رمز: أفضل من 48 GB. - السرعة: نحو 24 رمزًا في الثانية على M2 Max بذاكرة 32 GB، ونحو 32 على M4 Pro بذاكرة 48 GB.
- السلامة: تحذّر Thinking Machines من أن النموذج قد يدخل في حلقة، أو يحذف الملفات أو يستبدلها دون سؤال، وقد يقدّم تقارير خاطئة عن نتائجه. اعمل داخل Git أو على نسخة، وأبقِ موجّهات الأذونات مفعّلة، وحدّد سقفًا لخطوات الوكيل.
نظرة سريعة
| الطراز | Inkling 2 Mini من Thinking Machines Lab، صدر في 20 نوفمبر 2026، برخصة Apache 2.0 |
| الحجم | 26.4B معامل، 3.4B نشطة لكل رمز؛ 5.4B تنشيطات أوزان عند احتساب طبقاته المتكررة |
| وسم Ollama | inkling-2-mini (أيضًا 26b-a5b و 26b-a5b-nvfp4: الحزمة نفسها بحجم 20 GB) |
| التنزيل | 20,188,097,271 بايت (20.2 GB، أو 18.8 GiB) |
| الوقت اللازم | نحو نصف ساعة، إضافة إلى 3 إلى 60 دقيقة للتنزيل |
| إصدار Ollama | 0.40.17 أو أحدث؛ Apple silicon فقط في ذلك الإصدار |
| المحرك | مشغّل MLX في Ollama، المبني على إطار تعلّم الآلة من Apple |
| ما يمكنه فعله | إدخال نص وصور، استدعاء الأدوات، التفكير |
| السياق | حتى 1M رمز في النموذج؛ والافتراضي في Ollama على معظم أجهزة Mac بذاكرة 32 GB: 4K |
| الحد الأدنى المدعوم | جهاز Mac بشريحة Apple silicon بذاكرة 32 GB (Thinking Machines وOllama) |
| macOS | 14 Sonoma أو أحدث (متطلب Ollama) |
| جهد الاستدلال | none, minimal, منخفض, medium, مرتفع (افتراضي)، xhigh, أقصى |
| وكلاء بأمر واحد | Pi وOpenCode وClaude Code وHermes Agent وOpenClaw، عبر ollama launch |
| السرعة المقاسة | M2 Max بذاكرة 32 GB: نحو 24 tok/s؛ M4 Pro بذاكرة 48 GB: نحو 32 tok/s للكتابة، و279 tok/s للقراءة |
Measured speeds are third-party results.
جدول المحتويات
- الجزء 1 — قبل أن تبدأ: هل جهاز Mac لديك جاهز؟
- الجزء 2 — الخطوة 1: تثبيت Ollama أو تحديثه
- الجزء 3 — الخطوة 2: تنزيل Inkling 2 Mini
- الجزء 4 — الخطوة 3: تشغيل Inkling 2 Mini في Ollama للمرة الأولى
- الجزء 5 — الخطوة 4: الإعدادات الموصى بها لجهاز Mac بسعة 32 GB
- الجزء 6 — مواجهة واقع 32 GB: شريحتك هي الفارق
- الجزء 7 — الخطوة 5: استخدام Inkling 2 Mini خلفيةً محلية لوكيل برمجة
- الجزء 8 — ما مدى سرعة Inkling 2 Mini على جهاز Mac بسعة 32 GB؟
- الجزء 9 — استكشاف أخطاء Inkling 2 Mini وإصلاحها في Ollama
- الجزء 10 — عندما لا تكفي 32 GB
- الأسئلة الشائعة
- الخلاصة
الجزء 1 — قبل أن تبدأ: هل جهاز Mac لديك جاهز؟
أربعة أمور تحدد ما إذا كان بإمكانك تشغيل Inkling 2 Mini باستخدام Ollama: الشريحة، والذاكرة، وإصدار macOS، ومساحة القرص الحرة. الثلاثة الأولى في شاشة واحدة: افتح قائمة Apple واختر حول هذا الـ Mac. ولمساحة القرص، افتح إعدادات النظام → عام → التخزين.
| المتطلب | الحد الأدنى | لماذا |
|---|---|---|
| الشريحة | شريحة Apple silicon (أي شريحة من سلسلة M) | يشغّل Ollama 0.40.17 نموذج Inkling 2 Mini على شرائح Apple silicon فقط. أما على أجهزة Mac المزودة بمعالجات Intel، فلا يستطيع Ollama استخدام سوى المعالج، وليس وحدة معالجة الرسومات (GPU) |
| الذاكرة | 32 GB | الحد الأدنى المدعوم من Thinking Machines’ وOllama’; النموذج وحده يشغل نحو 20 GB |
| macOS | 14 Sonoma أو أحدث | متطلب Ollama نفسه |
| مساحة القرص الحرة | نحو 25 GB | 20.2 GB للنموذج، إضافة إلى مساحة إضافية ليتنفس نظام macOS |
| Ollama | 0.40.17 أو أحدث | أول إصدار يعرف النموذج (الجزء 2) |
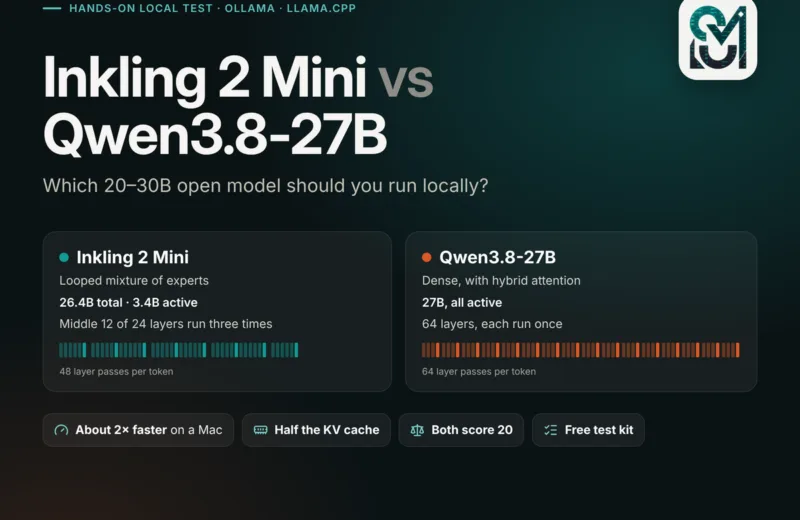
وماذا عن أجهزة Mac بسعة 16 GB و24 GB؟ ليس مع حزمة Ollama’، فهي ملف واحد بحجم 20 GB ولا يوجد منها نسخة أصغر. لكن توجد نسخ مضغوطة: تنشر Unsloth ملفات 2-bit و3-bit بحجم يقارب 9 إلى 14 GB تعمل باستخدام نسختها الخاصة من llama.cpp. وهذا مسار مختلف وأكثر تقنية، وقد تناولته في Inkling 2 Mini مقابل Qwen3.8-27B، إلى جانب ما تخسره في الجودة.
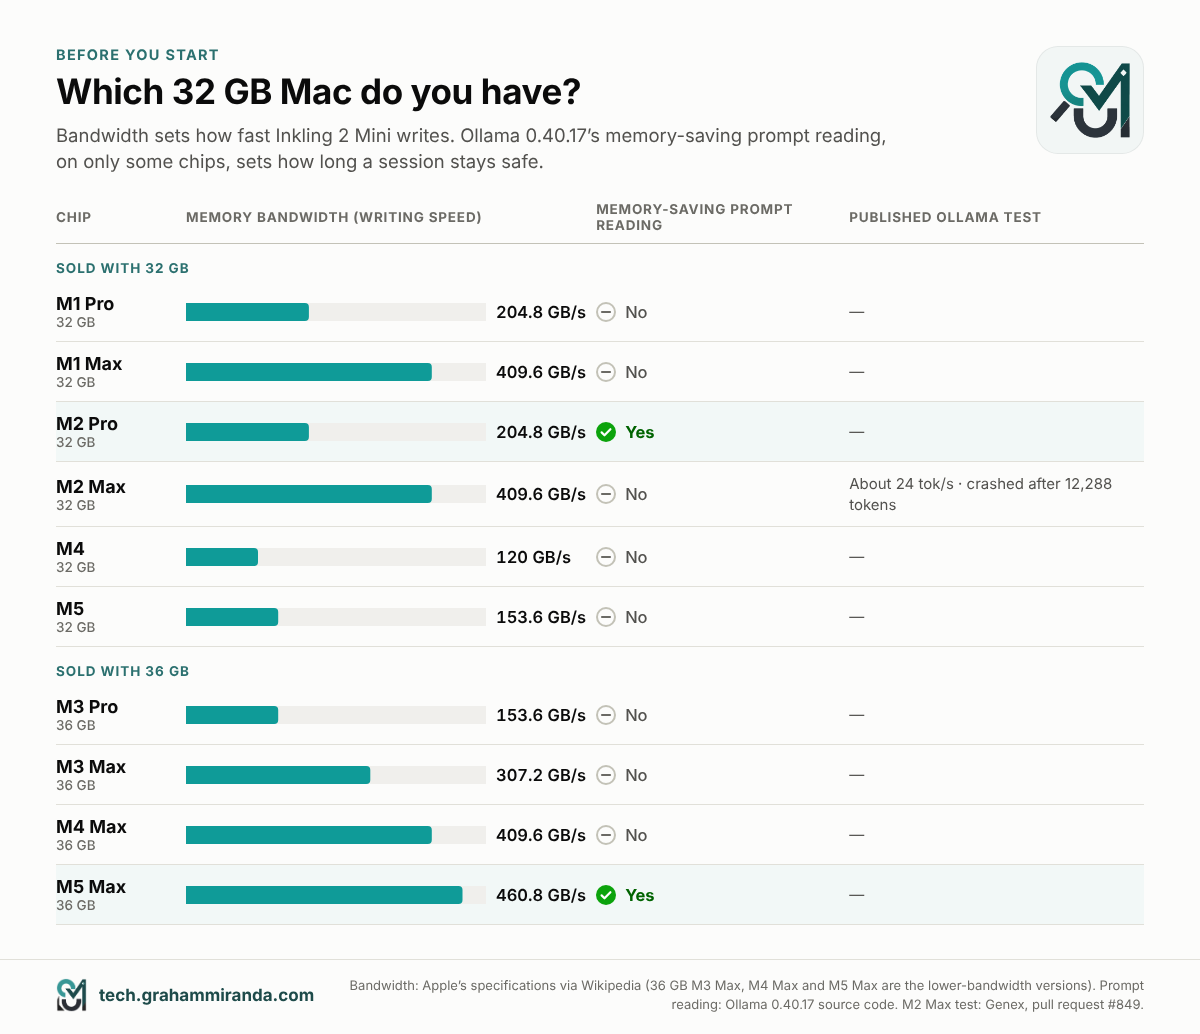
ما جهاز Mac بسعة 32 GB الذي لديك؟
لشريحتك أهمية لسببين. الأول هو السرعة. فنموذج كهذا يكتب كل كلمة بقراءة أوزانه النشطة من الذاكرة. لذا تعتمد سرعة الكتابة اعتمادًا كبيرًا على النطاق الترددي للذاكرة: مدى سرعة الشريحة في قراءة الذاكرة. فشريحتا M1 Max وM2 Max تتمتعان بضعف عرض النطاق لدى M1 Pro وM2 Pro، ونحو ثلاثة أضعافه لدى M4 وM5 الأساسيتين.
أما السبب الثاني فجديد ويخص Ollama 0.40.17 (يشرحه الجزء 6). فلـ Ollama طريقة موفّرة للذاكرة لقراءة الموجّهات الطويلة لهذا النموذج، لكنها مفعّلة لبعض الشرائح فقط. وبين أجهزة Mac التي تأتي بسعة 32 GB بالضبط، لا يملكها اليوم سوى M2 Pro.
| الشريحة | هل يأتي بسعة 32 GB؟ | النطاق الترددي للذاكرة | القراءة الموفّرة للذاكرة للموجّهات في Ollama 0.40.17 |
|---|---|---|---|
| M1 Pro | نعم | 204.8 GB/s | لا |
| M1 Max | نعم | 409.6 GB/s | لا |
| M2 Pro | نعم | 204.8 GB/s | نعم |
| M2 Max | نعم | 409.6 GB/s | لا |
| M4 | نعم | 120 GB/s | لا |
| M5 | نعم | 153.6 GB/s | لا |
| M3 Pro, M3 Max, M4 Max | إصدارات 36 GB | 153.6 / 307.2 / 409.6 GB/s | لا |
| M5 Max | إصدار 36 GB | 460.8 GB/s | نعم |
خيارات عرض النطاق والذاكرة مأخوذة من مواصفات Apple كما جمعتها Wikipedia. دعم قراءة الموجّهات مأخوذ من الشيفرة المصدرية لـ Ollama 0.40.17، الذي يفعّله على M2 Pro وM2 Ultra وM3 Ultra وM4 Pro وM5 Pro وMax وUltra. ولا تُباع M4 Pro وM5 Pro بذاكرة 32 GB.
الأجهزة المزوّدة بـ 36 GB تحصل على نحو 4 GB مساحة إضافية عمّا يفترضه كل شيء في هذا الدليل، لذا تعمل الخطوات نفسها بفارق أريح قليلًا.
الجزء 2 — الخطوة 1: تثبيت Ollama أو تحديثه
Ollama تطبيق مجاني ينزّل النماذج مفتوحة الأوزان ويشغّلها على جهاز Mac الخاص بك. وهو يشغّل أيضًا خادمًا صغيرًا في الخلفية، تتواصل معه وكلاء البرمجة لاحقًا.
إذا لم يكن Ollama لديك بعد
- اذهب إلى ollama.com/download ونزّل نسخة Mac،
Ollama.dmg. - افتح الملف واسحب Ollama إلى Applications .
- افتح Ollama من Applications. عند أول تشغيل، يتحقق مما إذا كان
ollamaأمره متاحًا في Terminal. وإن لم يكن، يطلب الإذن لإضافته إلى/usr/local/bin. وافق وأدخل كلمة مرور Mac إذا طُلب منك ذلك. تظهر أيقونة لاما صغيرة في شريط القوائم ما دام Ollama يعمل. - افتح Terminal واكتب:
ollama --version
أنت تريد 0.40.17 أو أحدث.
إذا كان Ollama لديك بالفعل
التشغيل ollama --version. إذا كانت نسخته أقدم من 0.40.17، فحدّثه:
- التطبيق: ينزّل Ollama التحديثات بنفسه. انقر أيقونة اللاما في شريط القوائم واختر إعادة التشغيل للتحديث إن ظهر لك. وإن لم يظهر، نزّل Ollama مجددًا من ollama.com/download واستبدل التطبيق. وتبقى النماذج التي نزّلتها في مكانها.
- Homebrew: شغّل
brew upgrade ollama. كانت حزمة Ollama في Homebrew عند 0.40.17 بالفعل في 21 نوفمبر.
فحص الإصدار، 21 نوفمبر 2026: أعلن Ollama دعم Inkling 2 Mini في 0.40.17 في 20 نوفمبر، كإصدار تجريبي. ووُسم الإصدار النهائي 0.40.17 على GitHub خلال يوم واحد، وHomebrew يوفّره بالفعل. وإذا كانت صفحة التنزيل لا تزال تعطيك 0.40.16، فاحصل على 0.40.17 أو أحدث من صفحة إصدارات GitHub. يرفض Ollama الأقدم التنزيل بالرسالة
pull model manifest: 412: The model you are attempting to pull requires a newer version of Ollama.
إعدادان يستحقان النظر (اختياري)
افتح الإعدادات من أيقونة اللاما أو نافذة التطبيق.
- السحابة. يفعّل هذا المفتاح نماذج Ollama السحابية والبحث على الويب. يعمل Inkling 2 Mini بالكامل على جهاز Mac لديك في الحالتين؛ ويقول قسم الأسئلة الشائعة في Ollama إنه عند التشغيل محليًا لا يرى الموجّهات التي تكتبها ولا بياناتك. أوقف مفتاح السحابة إذا أردت أن تتأكد من أن شيئًا لا يمكن أن يعود إلى نموذج سحابي. لكن انتبه إلى أن أدوات البحث على الويب في بعض الوكلاء تستخدم سحابة Ollama.
- موقع النموذج. إذا كانت مساحة قرصك الداخلي ضيقة، فوجّه هذا إلى SSD خارجي قبل قبل أن تنزّل 20 GB.
الجزء 3 — الخطوة 2: تنزيل Inkling 2 Mini
أمر واحد:
ollama pull inkling-2-mini
حجم التنزيل هو 20,188,097,271 بايت، أي ما يزيد قليلًا على 20 GB. وهذه تقديرات تقريبية للمدة عند السرعة الكاملة؛ أما التنزيلات الفعلية فعادةً أبطأ:
| اتصالك | مدة التنزيل |
|---|---|
| 50 Mbit/s | نحو 54 دقيقة |
| 100 Mbit/s | نحو 27 دقيقة |
| 250 Mbit/s | نحو 11 دقيقة |
| 500 Mbit/s | نحو 5½ دقيقة |
| 1 Gbit/s | نحو 3 دقائق |
إذا توقف التنزيل، شغّل الأمر نفسه مرة أخرى وسيكمل من حيث توقف.
ثمة أمور قليلة يجدر بك معرفتها عن الذي نزّلته للتو:
- لا يوجد سوى إصدار واحد. الوسوم الثلاثة في صفحة مكتبة Ollama،
latest,26b-a5bو26b-a5b-nvfp4، هي الحزمة نفسها بحجم 20 GB. لا يوجد إصدار أصغر من Ollama يمكنك اختياره. - إنها النسخة الأصلية، وليست نسخة مضغوطة. درّبت Thinking Machines معظم أوزان النموذج بصيغة 4 بتات تُسمى NVFP4، وطبقاته الأربع الأخيرة بصيغة 8 بتات تُسمى MXFP8. وتشحنها بهذه الصيغة. تحتوي حزمة Ollama على تلك الأوزان نفسها، فلم يُفقد شيء في أثناء التحويل.
- إنه يرى. تتعامل الحزمة مع الصور كما مع النص، ويمكنها استدعاء الأدوات، وهذا ما يتيح لوكلاء البرمجة استخدامها.
تحقق من وصوله:
ollama ls
ينبغي أن ترى inkling-2-mini:latest بحجم 20 GB.
الجزء 4 — الخطوة 3: تشغيل Inkling 2 Mini في Ollama للمرة الأولى
ابدأ محادثة في Terminal:
ollama run inkling-2-mini --verbose
يستغرق التشغيل الأول بعض الوقت، لأن Ollama يحمّل 20 GB من القرص إلى الذاكرة. ثم تحصل على >>> موجّه. جرّب شيئًا مثل:
اشرح في ثلاث جمل ما هو المحوّل ذو الحلقات.
Inkling 2 Mini يفكّر قبل أن يجيب، لذا سترى تفكيره يظهر أولًا ثم الإجابة بعده. وإذا كنت تفضّل ألا ترى تفكيره، فشغّله بـ --hidethinking بدلًا من ذلك.
اقرأ الأرقام
لأنك أضفت --verbose، يطبع Ollama إحصاءات بعد كل إجابة. سطران يهمّان:
| الخط | ما يعنيه |
|---|---|
| معدل تقييم الموجّه | مدى سرعة النموذج قراءة في قراءة رسالتك، بالتوكنات في الثانية |
| eval rate | مدى سرعة كتابته للإجابة، بالتوكنات في الثانية. التوكن يعادل نحو ثلاثة أرباع كلمة إنجليزية |
للمرجع، الاختبار المنشور الوحيد لـ Ollama على Mac بسعة 32 GB، وهو M2 Max، قاس نحو 24 توكنًا في الثانية. الجزء 8 فيه القياسات الأخرى.
أشياء قليلة يمكنك فعلها بعد ذلك
- اخرج من المحادثة: type
/byeأو اضغط Ctrl-D. يبقى النموذج في الذاكرة خمس دقائق في حال عودتك. - حرّر الذاكرة الآن:
ollama stop inkling-2-mini. - اسأل عن صورة: اكتب سؤالك، ثم اسحب ملف صورة من Finder إلى نافذة Terminal، فيُلصق مساره الكامل. اضغط Return.
- استخدم التطبيق بدلًا من ذلك: افتح تطبيق Ollama، واختر
inkling-2-miniمن قائمة النماذج وتحدّث هناك. يمكنك إفلات الصور في النافذة أيضًا.
تأكد من أن Inkling 2 Mini يعمل بشكل صحيح
بينما النموذج محمّل، افتح نافذة Terminal ثانية ونفّذ:
ollama ps
| العمود | ما تريد رؤيته |
|---|---|
| NAME | inkling-2-mini:latest |
| SIZE | مقدار الذاكرة التي يستهلكها النموذج |
| PROCESSOR | 100% GPU. على Apple silicon، هذا يعني أنه يعمل على معالج الرسوميات في الذاكرة الموحّدة |
| السياق | عدد الرموز التي يمكنه الاحتفاظ بها من المحادثة. على معظم حواسيب Mac بسعة 32 GB يعرض هذا 4096 إلى أن تغيّره في الجزء 5 |
| المشغّل | mlx، محرّك Ollama لشرائح Apple silicon |
| مدة الاحتفاظ | متى يُفرّغ Ollama النموذج من الذاكرة إذا لم تستخدمه |
يمكنك أيضًا أن تطلب من Ollama أن يخبرك بما اكتشفه عند بدء التشغيل:
grep "vram-based default context" ~/.ollama/logs/server.log | tail -1
على حاسوب Mac بسعة 32 GB يجب أن ترى total_vram بنحو 21 GiB و default_num_ctx=4096. هذا السطر وحده يشرح معظم ما في الجزء 5.
الجزء 5 — الخطوة 4: الإعدادات الموصى بها لجهاز Mac بسعة 32 GB
الدردشة تعمل دون أي تغيير على الإطلاق. أما وكلاء البرمجة والمستندات الطويلة فلا، بسبب الطريقة التي يقسّم بها حاسوب Mac بسعة 32 GB ذاكرته. كل أرقام الذاكرة في هذا الجزء بوحدة GiB، أي الجيجابايت الثنائية التي يعرضها macOS وOllama؛ حاسوب "32 GB" يملك 32 GiB.
هذه هي الميزانية. أوزان Inkling 2 Mini تستهلك 18.8 GiB. على حاسوب Mac بسعة 32 GB، يسمح macOS لمعالج الرسوميات باستخدام نحو ثلثي الذاكرة، نحو 21.3 GiB، إلا إذا غيّرتها. قاس VisualInference هذه الأوزان الأصلية نفسها في تطبيق MLX آخر هو mlx-vlm، على حاسوب M4 Pro بسعة 48 GB. بلغت الذاكرة ذروتها عند 20.3 GiB بموجّه قصير، 21.4 GiB عند 4,000 رمز و 22.1 GiB عند 16,000 رمز. بعبارة أخرى، بمجرد أن يطول الموجّه، يبلغ النموذج وحده حافة ميزانية GPU الافتراضية. وذلك قبل أن يأخذ macOS وتطبيقاتك الأخرى نصيبها.
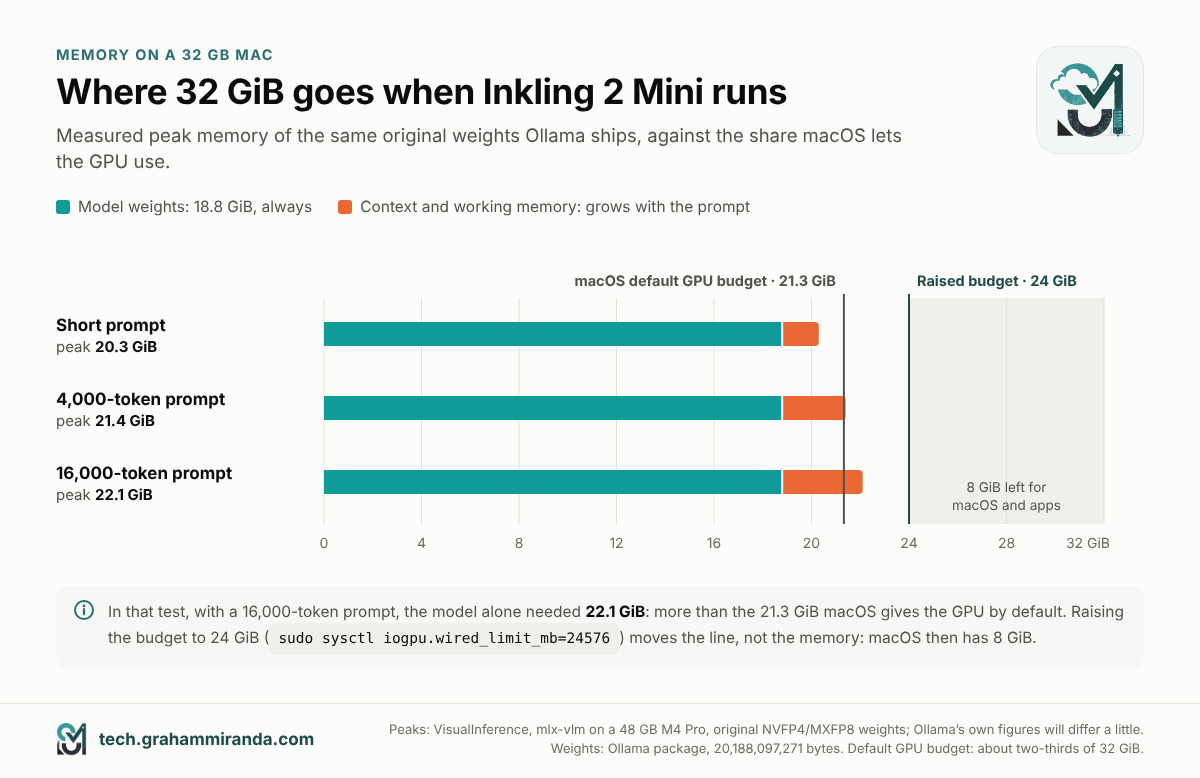
أربعة إعدادات تصنع الفرق.
الإعداد 1: طول السياق (الأكثر أهمية)
الـ طول السياق هو مقدار النص الذي يستطيع النموذج أن يحمله في وقت واحد. ويشمل ذلك رسائلك وردوده، ويشمل في حالة الوكيل موجّه النظام وتعريفات الأدوات وكل ملف قرأه. إن كان صغيرًا جدًا، يفقد الوكيل تعليماته بصمت ويبدأ في ارتكاب أخطاء غريبة. وإن كان كبيرًا جدًا، تحجز ذاكرة لن تستخدمها أبدًا.
يختار Ollama قيمة افتراضية بحسب ذاكرة GPU التي يكتشفها:
| ذاكرة GPU التي يكتشفها Ollama | السياق الافتراضي |
|---|---|
| أقل من 23 GiB (معظم حواسيب 32 GB: نحو 21.3 GiB) | 4K رمز |
| 23 إلى 47 GiB | 32K رمز |
| 47 GiB أو أكثر | 256K رمز |
تذكر وثائق Ollama أن الفئات هي أقل من 24، ومن 24 إلى 48، و48 GiB أو أكثر. أما الشيفرة في 0.40.17 فتستخدم 23 و47 GiB، لمراعاة الفروق الصغيرة فيما يعرضه كل حاسوب Mac.
ما يكلّف به سياق أكبر نموذج Inkling 2 Mini من ذاكرة، محسوبًا من إعداداته:
| السياق | ذاكرة إضافية للسياق |
|---|---|
| 4K | 0.28 GiB |
| 8K | 0.41 GiB |
| 16K | 0.66 GiB |
| 32K | 1.16 GiB |
| 64K | 2.16 GiB |
| 128K | 4.16 GiB |
يحتاج Inkling 2 Mini إلى ذاكرة أقل لكل رمز من السياق مقارنة بمعظم النماذج من حجمه. أربع طبقات فقط من طبقاته الـ24 تنظر إلى المحادثة كلها. وتُضاف إلى ذلك الذاكرة العاملة المستخدمة أثناء قراءة الموجّه؛ والقمم المقيسة أعلاه تشملها.
ما الذي تضبطه
| ما الذي تفعله | السياق | لماذا |
|---|---|---|
| الدردشة والأسئلة القصيرة | 4K–8K (القيمة الافتراضية مناسبة) | يستخدم أقل قدر من الذاكرة |
| لصق مستندات طويلة أو ملفات برمجية | 16K | نحو 12,000 كلمة إنجليزية |
| وكيل Pi | 16K (و8K على الشرائح التي تفتقر إلى قراءة الموجّه الموفّرة للذاكرة في الجزء 6) | تعليمات Pi نفسها صغيرة جدًا (الجزء 7) |
| OpenCode | 32K، على M2 Pro | أقصى ما يمكنك منحه له بارتياح على 32 GB. يوصي Ollama بـ64K أو أكثر للوكلاء، وهذا ما لا يستطيع هذا الـMac تحمّله فعلًا إلى جانب نموذج بحجم 20 GB. على شرائح أخرى، اقرأ الجزء 6 أولًا |
| Claude Code | 64K أو أكثر، وفق Ollama | غير واقعي على 32 GB؛ انظر الجزء 7 |
كيف تضبطه
أسهل طريقة لتغيير طول سياق Ollama هي التطبيق: افتح الإعدادات → طول السياق وحرّك شريط التمرير، الذي يتوقف عند 4k و8k و16k و32k و64k و128k و256k. يعيد Ollama تشغيل خادمه لتطبيقه، ويبقى الإعداد بعد إعادة تشغيل الـMac.
هناك ثلاث طرق أخرى، مفيدة لاحقًا:
# لجلسة دردشة واحدة فقط، داخل `ollama run`:
/set parameter num_ctx 16384

# لتطبيق Ollama، حتى تعيد تشغيل الـMac (ثم أغلق Ollama وأعد فتحه):
launchctl setenv OLLAMA_CONTEXT_LENGTH 32768
إذا كنت قد حرّكت شريط التمرير في التطبيق بالفعل، فإن الشريط يتغلّب على إعداد launchctl .
أو أنشئ نسخة من النموذج يتضمّن سياقه الخاص، وهو أمر مفيد عندما تريد 8K للدردشة و32K للوكيل. الصق هذا في Terminal؛ سيُنشئ ملفًا نصيًا صغيرًا باسم Modelfile ثم النموذج الجديد:
cat > Modelfile <<'EOF'
FROM inkling-2-mini
PARAMETER num_ctx 32768
EOF
ollama create inkling-2-mini-32k -f Modelfile
لا تنزّل النسخة الـ20 GB من الأوزان ولا تكرّرها. ثم تستخدم inkling-2-mini-32k أينما كنت تستخدم inkling-2-mini. أيًّا كانت الطريقة التي تختارها، تحقّق منها في السياق عمود ollama ps.
الإعداد 2: امنح GPU مساحة أكبر (اختياري)
يحدّ macOS من كمية الذاكرة التي يجوز لـ GPU أن يحتفظ بها لنفسه، ويتعامل Ollama مع هذا الحد على أنه "VRAM" الخاص بك. على Mac بذاكرة 32 GB يبلغ نحو 21.3 GiB. وتترتب على ذلك ثلاثة أمور. يضبط Ollama سياقه الافتراضي انطلاقًا منه (الإعداد 1). ويُبقي محرك MLX في Ollama النموذج المحمّل مقيمًا في الذاكرة حتى هذا الحد. وإذا كان النموذج أكبر، يسجّل تحذيرًا بأن الأداء قد يتدهور. وعندما تحتاج خطوة عمل واحدة إلى ذاكرة GPU أكبر مما هو متاح، يوقفها macOS. وهذا هو انهيار «ذاكرة غير كافية» من الجزء 6. توضّح وثائق Apple أنه يعني أن GPU لم يملك ذاكرة كافية لتنفيذ مخزن أوامر.
يمكنك رفع الحد حتى إعادة التشغيل التالية؛ وثائق MLX من Apple تعطي الأمر المخصص لهذا بالضبط. تحقّق من القيمة الحالية أولًا؛ 0 يعني القيمة الافتراضية في macOS:
sysctl iogpu.wired_limit_mb
ارفعه إلى 24 GiB، فيترك 8 GiB لـ macOS وتطبيقاتك:
sudo sysctl iogpu.wired_limit_mb=24576
ثم أغلق Ollama من شريط القوائم وافتحه من جديد، لأن Ollama لا يقرأ الحد إلا عند بدء التشغيل. شغّل grep الأمر grep من الجزء 4 مرة أخرى، وستجد total_vram الآن نحو 24 GiB.
أربعة أمور تستحق المعرفة
- وهو يغيّر سياقك الافتراضي أيضًا. مع اكتشاف 24 GiB، تقفز القيمة الافتراضية في Ollama من 4K إلى 32K (الجدول أعلاه)، لذا قد لا تحتاج إلى الإعداد 1 إطلاقًا.
- يمنح GPU مساحة أكبر، لا ذاكرة إضافية. إنه ينقل الحد الفاصل بين GPU وmacOS؛ ولا يضيف أي ذاكرة. وإذا ضاقت الذاكرة على تطبيقاتك الأخرى بعد ذلك، يستخدم macOS التبديل بدلًا من ذلك.
- يُعاد ضبطه عند إعادة تشغيل Mac. هذه شبكة أمان لا خللًا. للتراجع عنه قبل ذلك:
sudo sysctl iogpu.wired_limit_mb=0. - إنه ليس إعدادًا رسميًا في macOS. يُستخدم على نطاق واسع مع الذكاء الاصطناعي المحلي، لكن إذا كان Mac يبدّل بكثافة، أو يتجمد، أو يعيد التشغيل بغير المتوقع أثناء جلسة، فأعده إلى 0. لا تتجاوز 24 GiB بكثير على Mac بذاكرة 32 GB.
الإعداد 3: جهد الاستدلال
يقرّر Inkling 2 Mini مقدار التفكير الذي يبذله وفق جهد الاستدلال المحدَّد في الإعداد. القيمة الافتراضية في Ollama هي مرتفع. وإليك كيف يحوّل Ollama 0.40.17 الأسماء إلى القيمة التي يتلقاها النموذج فعليًا:
| إعداد Ollama | الجهد الذي يتلقاه النموذج | مناسب لـ |
|---|---|---|
none أو false |
0 (التفكير مخفي) | عمليات بحث بسيطة |
minimal |
0.1 | حقائق سريعة |
منخفض |
0.2 | إجابات قصيرة وملخصات وإعادة صياغة |
medium |
0.7 | أسئلة يومية |
مرتفع أو true (الشبكة الافتراضية) |
0.9 | البرمجة وأعمال الوكلاء |
xhigh أو أقصى |
0.99 | مسائل صعبة، حين يمكنك الانتظار |
من مُصيِّر Inkling 2 Mini في Ollama 0.40.17. وتنبّه Thinking Machines إلى أن الحد الأدنى لا يوقف الاستدلال تمامًا.
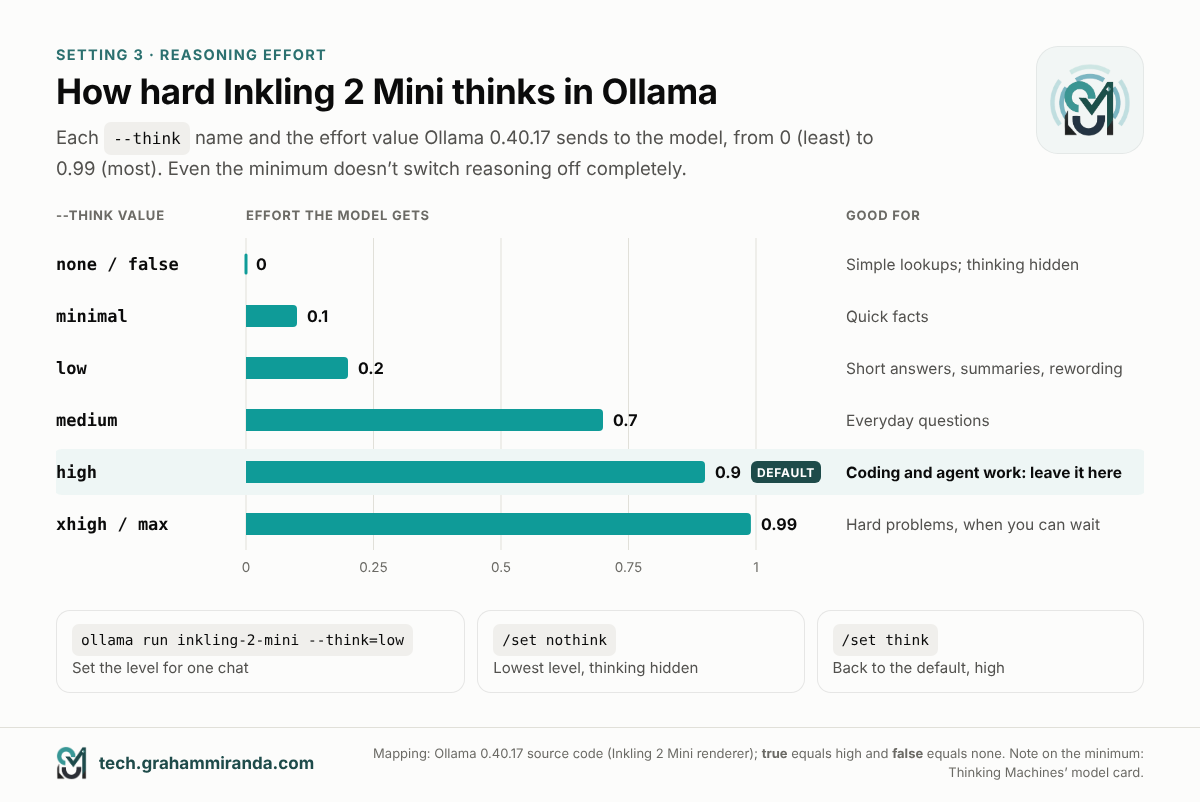
xhigh و أقصى أرسل القيمة نفسها. الإعداد الافتراضي، high، هو الإعداد المناسب للبرمجة.لضبطه للمحادثة:
ollama run inkling-2-mini --think=low
داخل المحادثة، /set nothink يخفضه إلى أدنى مستوى ويخفي التفكير، و /set think يعيد تشغيله. في واجهة API الخاصة بـ Ollama’s توضع الأسماء نفسها في think الحقل.
توصيتي: اتركه عند مرتفع للبرمجة والوكلاء، حيث يغطي التفكير تكلفته. استخدم منخفض أو medium للأسئلة السريعة، حتى لا تنتظر’ استدلالًا طويلًا من أجل إجابة من سطر واحد.
الإعداد 4: أبقِه محمّلًا، وأفرغه عندما تنتهي’
يفرّغ Ollama النموذج بعد خمس دقائق من دون استخدام، وإعادة تحميل 20 GB تستغرق وقتًا. في جلسة وكيل بها فترات توقف، يصبح هذا مزعجًا. لإبقائه محمّلًا 30 دقيقة بعد كل استخدام:
launchctl setenv OLLAMA_KEEP_ALIVE 30m
ثم أغلق Ollama وأعد فتحه. لمحادثة واحدة، ollama run inkling-2-mini --keepalive 30m يفعل الشيء نفسه. الوجه الآخر: عندما تنتهي’، أعد الذاكرة بـ ollama stop inkling-2-mini.
مقبضان إضافيان، لمن يحب التفاصيل
- نموذج المسودة المدمج. تأتي Thinking Machines بنموذج Inkling 2 Mini مع شبكة مساعدة صغيرة، DSpark، تتوقع بضع كلمات مسبقًا. ثم يتحقق النموذج الرئيسي منها دفعة واحدة. يدعمها Ollama ويشغّل المسودة افتراضيًا لأي نموذج يتضمن نموذج مسودة. في اختبارات MLX المنشورة خارج Ollama، رفع DSpark سرعة كتابة Inkling’s من 43.6 إلى 70.9 رمزًا في الثانية على M5 Max. وعلى M4 Pro خفّض السرعة من 31.1 إلى 18.7. لذا اختبره على جهاز Mac لديك: في محادثة،
/set parameter draft_num_predict 0يوقفه؛ قارن eval rate مع وبدون. - الطلبات المتوازية. منذ 0.40.17، يستطيع Ollama على Apple silicon الرد على عدة طلبات في وقت واحد، وكل طلب يحتاج ذاكرة سياق خاصة به. يختار Ollama قيمة افتراضية حذرة من ذاكرتك الحرة. إذا كان وكيل يشغّل مساعدين على التوازي لا يزال يدفع جهاز Mac لديك إلى استخدام swap، فحدّه إلى واحد بـ
launchctl setenv OLLAMA_NUM_PARALLEL 1. ثم أغلق Ollama وأعد فتحه.
إعدادات لن تُفيد’ هنا
غالبًا ما تقترح أدلة النماذج الأخرى OLLAMA_KV_CACHE_TYPE=q8_0 خفض ذاكرة السياق إلى النصف، إلى جانب flash attention. في Ollama 0.40.17 تنتمي تلك الإعدادات إلى llama.cpp محركها؛ يعمل Inkling 2 Mini على MLX المحرك، ولا شيء في شيفرة ذلك المحرك’ يقرأها. وينطبق الأمر نفسه على إعدادات طبقات GPU مثل num_gpu. واترك temperature وحده: تستخدم حزمة Ollama القيمة الافتراضية 1.0 من Thinking Machines، وهي أيضًا ما توصي به Unsloth.
قبل جلسة طويلة: حرّر الذاكرة
فتح مراقبة النشاط (في التطبيقات ← الأدوات المساعدة) ثم انقر على الذاكرة التبويب. في الأسفل سترى ضغط الذاكرة الرسم البياني و المبادلة المستخدمة. الأخضر جيد، والأصفر يعني أن macOS يضغط الذاكرة، والأحمر يعني أنه يبادل إلى قرصك، ما يجعل كل شيء بطيئًا. قبل جلسة وكيل، أغلق المستهلكين الكبار: المتصفحات ذات التبويبات الكثيرة، وDocker Desktop، ومحاكيات iPhone، ومحرري الفيديو والصور. على الحاسوب المحمول، وصّل الشاحن في الجلسات الطويلة.
الجزء 6 — مواجهة واقع 32 GB: شريحتك هي الفارق
هذا الجزء يهمك إذا كان Mac لديك بشريحة غير M2 Pro (أو M5 Max بسعة 36 GB)، وهو حال معظم حواسيب 32 GB. وهو أيضًا الجزء الذي لا تذكره ملاحظات إصدار Ollama.
ما يحدث عندما يقرأ Inkling 2 Mini موجّهًا طويلًا
قبل أن يكتب النموذج أي شيء، يقرأ موجّهك كاملًا. محرك MLX في Ollama يفعل ذلك 2,048 رمزًا في المرة. لكل مقطع، يحسب Inkling 2 Mini كيف يرتبط كل رمز جديد بكل رمز قبله، باستخدام مقياس مسافة متعلَّم بينها. تحتاج تلك الخطوة إلى جدول مؤقت ينمو مع كل ما قرأه النموذج حتى الآن في المحادثة.
يحتوي Ollama 0.40.17 على طريقة موفّرة للذاكرة لفعل ذلك، وهي تعالج الموجّه في بلاطات صغيرة بحيث لا يكبر الجدول أبدًا. ولا يفعّلها كودها المصدري إلا لهذه الشرائح: M2 Pro، وM2 Ultra، وM3 Ultra، وM4 Pro، وM5 Pro وMax وUltra. كل شريحة أخرى ترتد إلى طريقة عامة ينمو استخدامها للذاكرة مع الموجّه. ويشمل ذلك M1 Pro وMax، وM2 Max، وM4 الأساسية وM5 الأساسية.
كيف بدا ذلك على M2 Max بسعة 32 GB
الاختبار المنشور الوحيد لـ Ollama 0.40.17 على Mac بسعة 32 GB يأتي من مطوري Genex. جرّبوا Inkling 2 Mini على M2 Max بسعة 32 GB:
- نجح التنزيل، وأعاد طلب قصير لاستدعاء الأدوات إجابة صحيحة بسرعة نحو 24 رمزًا في الثانية.
- طلب من 18,003 رمز انهار بعد 12,288 رمزًا بالخطأ
mlx: [METAL] Command buffer execution failed: Insufficient Memory. ولم يساعد ضبط السياق على 32,768 وحجم الدفعة على 512. - وانهار موجّههم الحقيقي المكوّن من 15,089 رمزًا بالطريقة نفسها.
- نجحت حلقة استخدام حاسوب مدفوعة بلقطات شاشة حقيقية.
وخلصوا إلى أن النموذج يناسب Mac بسعة 32 GB مع الموجّهات القصيرة لكن ليس مع الموجّهات الطويلة لتطبيقهم. لذا غيّروا تطبيقهم ليوصي بـ Inkling 2 Mini فقط من 48 GB.
ما العمل حيال ذلك
| شريحتك | ما تتوقعه اليوم | ما يجب فعله |
|---|---|---|
| M2 Pro (32 GB) أو M5 Max (36 GB) | الموجّهات الطويلة تستخدم ذاكرة محدودة | الوكلاء بسياق 16K–32K، مع رفع ميزانية GPU (الجزء 5) |
| M1 Pro، وM1 Max، وM2 Max، وM4، وM5 (32 GB) | الجلسة التي تنمو كثيرًا بعد نحو 10,000 رمز تخاطر بانهيار "Insufficient Memory" | استخدمه للدردشة والمستندات الأقصر؛ وللوكلاء استخدم Pi بسياق 8K وابدأ جلسة جديدة لكل مهمة؛ وارفع ميزانية GPU؛ وحدّث Ollama كلما صدر إصدار جديد |
| M3 Pro، وM3 Max، وM4 Max (36 GB) | التراجع نفسه، مع مساحة أكبر بنحو 4 GB | كما سبق، مع فسحة أكبر قليلًا |
هناك أمران يجب وضعهما في الاعتبار. أولًا، هذا حد برمجي، وليس حدًا في العتاد. كود توفير الذاكرة موجود؛ لكنه ليس مفعّلًا بعد لكل شريحة، وOllama يصدر إصدارات جديدة في معظم الأسابيع. راجع ملاحظات الإصدار عند التحديث. ثانيًا، المهم هو كمية النص التي على النموذج معالجتها في جلسة واحدة، لا الرقم الظاهر على شريط تمرير السياق. تُقارن كل قطعة جديدة بكل ما سبقها، لذا تضر المحادثة الطويلة بقدر ما يضر الموجّه الطويل الواحد، ووكلاء البرمجة يبنون محادثات طويلة بسرعة. السياق الصغير يُبقي الجلسات قصيرة؛ وبدء جلسات جديدة يُبقيها أقصر من ذلك.
الجزء 7 — الخطوة 5: استخدام Inkling 2 Mini خلفيةً محلية لوكيل برمجة
وكيل البرمجة برنامج يمنح النموذج أدوات، مثل قراءة الملفات وتعديلها وتشغيل الأوامر. وهو يتيح للنموذج معالجة مهمة خطوة بخطوة. عادةً يكون النموذج داخل مركز بيانات. وهنا، يصبح Inkling 2 Mini على جهاز Mac لديك الواجهة الخلفية المحلية: إذ يرسل الوكيل طلباته إلى Ollama بدلًا من ذلك.
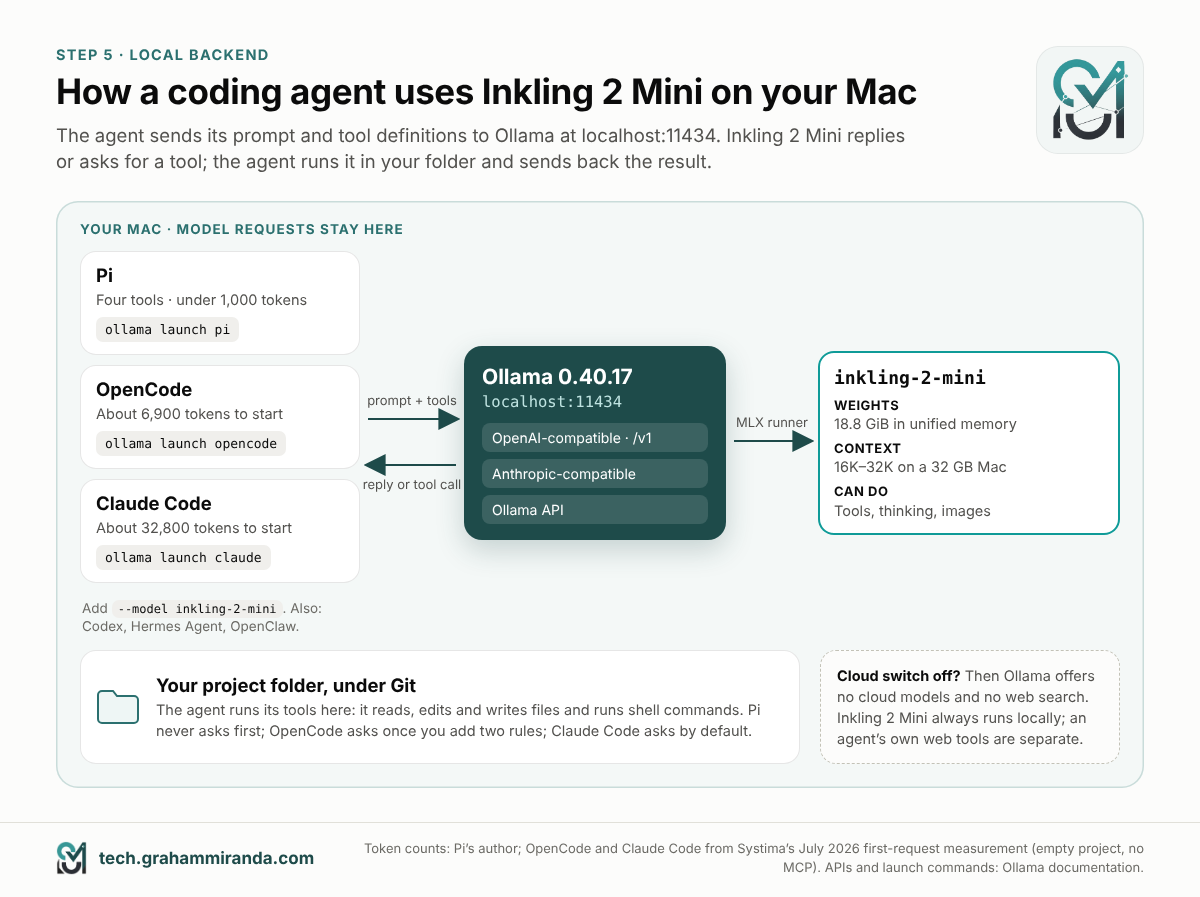
كيف يعمل
عندما يعمل Ollama، فإنه يستمع على http://localhost:11434، وهو عنوان لا تصل إليه إلا البرامج على جهاز Mac لديك. ويتحدث صيغ API التي تعرفها الوكلاء بالفعل: صيغةً متوافقة مع OpenAI على http://localhost:11434/v1، وصيغةً متوافقة مع Anthropic لـ Claude Code، وصيغته الخاصة. يرسل الوكيل موجّهه وتعريفات الأدوات، ويقرر Inkling 2 Mini أي أداة يستدعي. يشغّل الوكيل تلك الأداة على جهاز Mac لديك ويعيد النتيجة. وتتكرر الحلقة حتى تنتهي المهمة.
لست مضطرًا إلى إعداد أي من ذلك يدويًا. أمر ollama launch يثبّت الوكلاء المدعومين إن لم يكونوا موجودين، ويوجّههم إلى Ollama ويشغّلهم.
قبل تشغيل أي وكيل
- اضبط السياق أولًا (الجزء 5). هذا أهم مما يبدو: عندما تشغّل OpenCode عبر
ollama launch، يقرأ Ollama السياق الذي حُمّل به النموذج فعليًا ويخبر OpenCode بذلك الرقم. وإذا كان Ollama لا يزال على 4K، فسيصدّقه OpenCode. - اعمل في مجلد اختبار تحت Git، حتى ترى كل تغيير وتتراجع عنه:
mkdir -p ~/Projects/inkling-test
cd ~/Projects/inkling-test
git init
في أول مرة تستخدم فيها git، قد يعرض macOS تثبيت أدوات سطر الأوامر للمطورين من Apple. اقبل؛ فلن يستغرق سوى بضع دقائق.
- أغلق التطبيقات المستهلكة للذاكرة (الجزء 5).
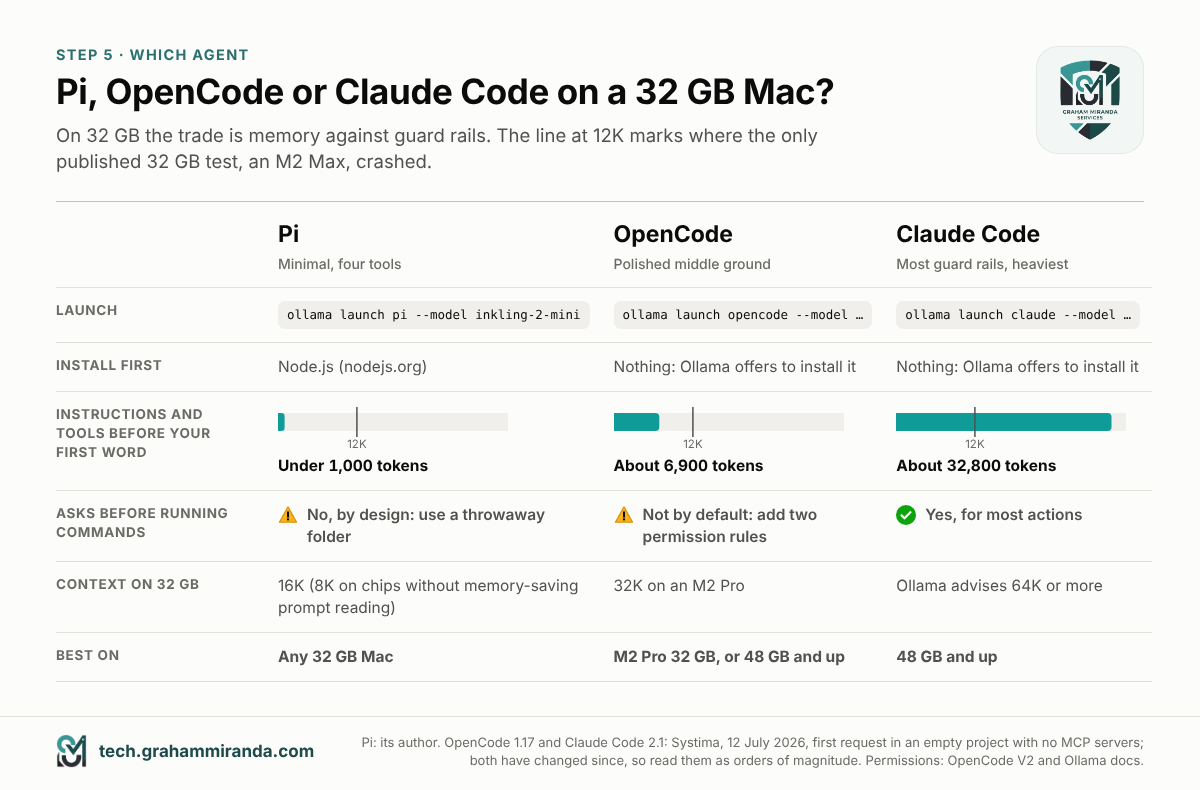
أي وكيل تستخدم على 32 GB؟
| Pi | OpenCode | Claude Code | |
|---|---|---|---|
| إعداد بأمر واحد | ollama launch pi --model inkling-2-mini |
ollama launch opencode --model inkling-2-mini |
ollama launch claude --model inkling-2-mini |
| تثبّته أنت أولًا | Node.js | لا شيء؛ يعرض Ollama تثبيته | لا شيء؛ يعرض Ollama تثبيته |
| التعليمات والأدوات المُرسلة قبل كلمتك الأولى | أقل من 1,000 رمز | نحو 6,900 رمز | نحو 32,800 رمز |
| ، بحكم التصميم | لا، بحكم التصميم | ليس افتراضيًا؛ ويكفي تغيير واحد في الإعدادات لتفعيله | نعم، لمعظم الإجراءات |
| السياق الذي يجب ضبطه على 32 GB | 16K (8K على الشرائح التي لا تتوفر على قراءة الموجّه الموفّرة للذاكرة) | 32K على M2 Pro | يوصي Ollama بـ64K أو أكثر |
| الأفضل على | أي Mac بذاكرة 32 GB، داخل مجلد مؤقت | M2 Pro بذاكرة 32 GB، أو 48 GB فأكثر | 48 GB فأكثر |
رقم Pi مأخوذ من مؤلفه. أما أرقام OpenCode وClaude Code فهي من قياس Systima في يوليو 2026 لأول طلب يرسله كل وكيل. استخدمت Systima مشروعًا فارغًا بلا خوادم MCP، مع OpenCode 1.17 وClaude Code 2.1 ونموذج Claude. وقد حُدّث الوكيلان منذ ذلك الحين، فاقرأ هذه الأرقام كتقديرات تقريبية تدل على الحجم فقط. والنصيحة العامة التي يقدّمها Ollama للوكلاء هي سياق لا يقل عن 64K.
الخيار أ: Pi، الأخفّ
Pi وكيل برمجة متواضع التصميم عن قصد، بأربع أدوات فقط: read وwrite وedit وbash. يقول مؤلفه إن موجّهه النظامي وتعريفات أدواته تصل معًا إلى أقل من 1,000 رمز. وهذا يجعله الأنسب لـMac بذاكرة 32 GB، وهو الوكيل الذي اقترحه Ollama في إعلانه الخاص عن Inkling 2 Mini.
- ثبّت Node.js: نزّل مثبّت LTS من nodejs.org ثم شغّله.
ollama launch piيحتاج إلىnpmالتابع لـNode لتثبيت Pi. - انتقل إلى مجلد الاختبار ثم شغّل:
cd ~/Projects/inkling-test
ollama launch pi --model inkling-2-mini
يثبّت Ollama أداة Pi، ويهيّئها لاستخدام نموذجك المحلي، ويفتح جلسة.
⚠️ Pi لا يطلب أي شيء. يصفه مؤلفه بأنه يعمل في "وضع YOLO الكامل": لا طلبات إذن لعمليات الملفات أو الأوامر، ووصول غير مقيّد إلى ملفاتك. كما تحذّر Thinking Machines من أن Inkling 2 Mini قد يحذف الملفات أو يستبدلها دون تأكيد. ومجموع ذلك يعني: لا تشغّل Pi إلا في مجلد مؤقت، ولا تشغّله أبدًا في مجلدك الرئيسي أو في مشروع بلا نسخة احتياطية. ويقترح مؤلفه تشغيله داخل حاوية إن أردت حدًا حقيقيًا؛ أما دليلي دليل حاويات Apple فيوضّح كيفية إعداد واحدة على Mac.
تفصيل آخر: عندما تُشغّل Pi عبر Ollama، فإن أداة البحث على الويب فيه تستخدم البحث السحابي من Ollama. ويتطلب ذلك حساب Ollama وتفعيل إعداد Cloud. وكل ما عدا ذلك يبقى على Mac.
الخيار ب: OpenCode، الحل الوسط المصقول
OpenCode وكيل برمجة مفتوح المصدر وشائع، بواجهة طرفية تملأ الشاشة، ولقطات لكل خطوة، ونظام أذونات يمكنك تشديده.
cd ~/Projects/inkling-test
ollama launch opencode --model inkling-2-mini
إن لم يكن OpenCode مثبتًا، يسألك Ollama إن كنت تريد تثبيته؛ فاختر نعم. ثم يمرّر Ollama إلى OpenCode إعداداته لهذه الجلسة، دون الكتابة فوق إعداداتك الخاصة ~/.config/opencode/opencode.json. وهو يضبط حدود OpenCode على السياق الذي حُمّل به النموذج، ويحتفظ بربع ذلك، حتى 8K رمز، للرد. ومنذ 0.40.17 يمرّر أيضًا خيارات التفكير في Inkling 2 Mini.
طلب البدء في OpenCode معتدل، نحو 6,900 رمز في قياس Systima لشهر يوليو. لكن كل ملف يقرأه وكل مخرجات أمر يستقبلها تنضم إلى المحادثة. على Mac بسعة 32 GB ودون قراءة الموجّه الموفّرة للذاكرة من الجزء 6، هذا هو الرقم الذي يجب مراقبته. لا يلزمه سوى ملفات قليلة لتجاوز 12,000 رمز حيث انهار M2 Max.
يكتشف OpenCode v2 نماذج Ollama بنفسه عند بدء التشغيل، لذا يمكنك ببساطة تشغيل opencode ثم اختيار النموذج عبر /models. يبقى التشغيل عبر Ollama المسار الأفضل على 32 GB، لأنه يخبر OpenCode بنافذة السياق المتاحة لديك فعلًا.
اجعله يسأل أولًا وحدّد خطواته
بشكل افتراضي، يسمح OpenCode v2 للنموذج بتشغيل أوامر shell وتعديل الملفات دون سؤال؛ وقواعده الافتراضية لا تسأل إلا قبل قراءة .env الملفات. مع نموذج يحذّر صانعه من الإجراءات المدمِّرة، غيّر ذلك. وتوصي Thinking Machines أيضًا بتحديد عدد أدوار الوكيل، لأن النموذج يعلق أحيانًا في حلقات استدلال طويلة، خصوصًا أثناء تنقيح الأخطاء، وخيار OpenCode steps يفعل ذلك. ضع كليهما في ~/.config/opencode/opencode.json (أنشئ الملف إن لم يكن موجودًا):
{
  "$schema": "https://opencode.ai/config.json",
  "permissions": [
    { "action": "shell", "resource": "*", "effect": "ask" },
    { "action": "edit", "resource": "*", "effect": "ask" }
  ],
  "agents": {
    "build": { "steps": 40 }
  }
}
الـ permissions تجعل OpenCode يسأل قبل كل أمر shell وكل تعديل. الوكيل build هو الافتراضي في OpenCode؛ في آخر خطوة مسموحة له، يزيل OpenCode الأدوات ويطلب من النموذج أن يلخّص. تحقق من سريانه بأن تطلب من OpenCode إنشاء ملف: يجب أن يسألك أولًا الآن. وإن لم يفعل، توضح وثائق الأذونات في OpenCode كيف يمكن للوكلاء إضافة قواعد خاصة بهم. ولكل ما يخص OpenCode، من الخطط إلى خوادم MCP، راجع دليل OpenCode الخاص بي.
الخيار C: Claude Code، الأثقل
يعمل Claude Code مع Ollama عبر واجهة API المتوافقة مع Anthropic في Ollama، لذا تذهب طلباته إلى جهاز Mac لديك بدلًا من خوادم Anthropic. وهو يطلب الإذن قبل معظم الإجراءات افتراضيًا، ما يجعله الأكثر حذرًا من الثلاثة.
cd ~/Projects/inkling-test
ollama launch claude --model inkling-2-mini
يعرض Ollama تثبيت Claude Code إن لم يكن موجودًا. وإن فضّلت تشغيله بنفسك لاحقًا، فهذه هي الإعدادات ollama launch التي يتولاها:
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
claude --model inkling-2-mini
يتيح Ollama 0.40.17 أيضًا لـ Claude Code تحميل أدوات MCP عند الحاجة فقط بدلًا من تحميلها كلها دفعة واحدة، ما يبقي الموجّهات أقصر. لكنه لا يمس الأدوات المدمجة في Claude Code، وهي ما يجعله ثقيلًا. في قياس Systima لشهر يوليو دون أي خوادم MCP، كان أول طلب في Claude Code نحو 32,800 رمز، معظمها تعريفات أدوات. وهذا أكثر مما تحمله نافذة سياق 32K، ويتجاوز بكثير 12,000 رمز حيث انهار M2 Max. وتوصي Ollama بنافذة سياق 64K أو أكثر له. على Mac بسعة 32 GB، جرّبه إن كنت فضوليًا؛ واعتمد عليه من 48 GB.
وكلاء وتطبيقات أخرى
تسرد صفحة مكتبة Ollama تشغيلًا بأمر واحد لوكيلين آخرين، والنمط نفسه ينطبق على Codex:
ollama launch hermes --model inkling-2-mini     # Hermes Agent
ollama launch openclaw --model inkling-2-mini   # OpenClaw
ollama launch codex --model inkling-2-mini      # OpenAI's Codex CLI
يمكن لأي أداة أخرى تتحدث OpenAI API أن تستخدم Inkling 2 Mini أيضًا. أعطها عنوان URL الأساسي http://localhost:11434/v1، واسم النموذج inkling-2-mini وأي نص كمفتاح API. لا يتحقق Ollama من المفتاح، لكن أدوات كثيرة ترفض مفتاحًا فارغًا.
مهمتك الأولى مع الوكيل
ابدأ بشيء صغير ومرئي، في مجلد الاختبار:
أنشئ صفحة ويب لقائمة مهام من ملف واحد باسم index.html تحفظ المهام
في المتصفح. اجعلها بسيطة واشرح كيفية فتحها عند الانتهاء.
راقب ما يفعله: أي ملفات يقرأ، وماذا يكتب، وأي أوامر يشغّل. وعندما ينتهي، افتح الصفحة بـ open index.html، وتحقق من التغيير بـ Git:
git status      # الملفات التي تغيّرت أو ظهرت
git diff        # ما تغيّر في الملفات التي كان Git يعرفها مسبقًا
إن لم يعجبك الناتج، احذف المجلد وابدأ من جديد. فهذا هو الغرض من مجلد الاختبار.
خمس قواعد لتشغيل وكيل محلي بأمان
بطاقة نموذج Thinking Machines صريحة بشكل غير معتاد بشأن أنماط فشل Inkling 2 Mini. فقد يعلق في حلقات استدلال طويلة. وقد يحذف ملفات أو يكتب فوقها دون تأكيد، وقد لا يبلّغ عن نتيجة عمله بدقة. وهو أيضًا أكثر ميلًا من النماذج الأكبر إلى ذكر معلومات خاطئة بثقة. ولا شيء من ذلك غريب لنموذج بهذا الحجم. يعني فقط:
- Git أو نسخة، دائمًا. لا تطلق وكيلًا أبدًا على ملفات لا تستطيع استعادتها.
- شغّل مطالبات الإذن حيث تكون لدى الوكيل (يحتاج OpenCode إلى تغيير الإعداد أعلاه)، واقرأ ما توافق عليه.
- حدّد سقفًا للخطوات والإخراج. استخدم إعدادات OpenCode’s
steps؛ في محادثة Ollama،/set parameter num_predict 4096يحدّ من ردٍّ واحد. - تحقّق من ادعاءاته. شغّل الاختبارات بنفسك قبل أن تصدّق "كل الاختبارات ناجحة".
- لا توجّه الوكيل أبدًا إلى مجلدك الرئيسي. وبالنسبة إلى Pi، استخدم مجلدًا مؤقتًا أو حاوية.
إن أردت المضي أبعد، فإن إلى مهارات الوكلاء وخوادم MCP يشرح كيفية تحديد ما يمكن لأدوات الوكيل الوصول إليه. مقارنة بين جميع هارنسات البرمجة بالذكاء الاصطناعي يتناول الوكلاء أنفسهم بالتفصيل.
الجزء 8 — ما مدى سرعة Inkling 2 Mini على جهاز Mac بسعة 32 GB؟
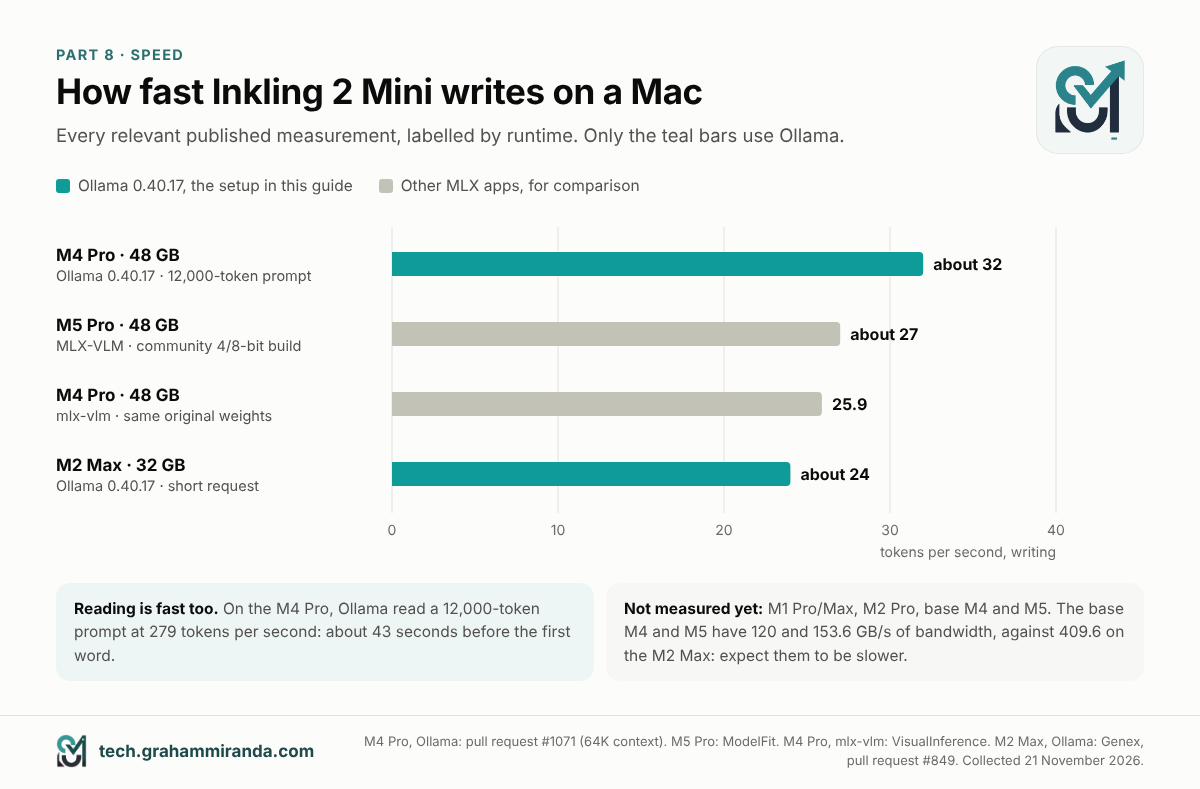
للسرعة جزءان: مدى سرعة النموذج في قراءة موجّهك ومدى سرعة كتابة رده. إليك القياسات ذات الصلة المنشورة حتى 21 نوفمبر، مع بيئة التشغيل التي استخدمها كل منها:
| Mac | بيئة التشغيل | سرعة الكتابة | سرعة القراءة | ملاحظات |
|---|---|---|---|---|
| M2 Max, 32 GB | Ollama 0.40.17 | نحو 24 tok/s | غير منشور | طلب قصير لاستدعاء الأدوات |
| M4 Pro, 48 GB | Ollama 0.40.17 | نحو 32 tok/s | 279 tok/s | موجّه من 12,000 رمز، ونافذة سياق 64K؛ 65 ثانية في الإجمال |
| M4 Pro, 48 GB | mlx-vlm، بالأوزان الأصلية نفسها | 25.9 tok/s | غير منشور | VisualInference |
| M5 Pro, 48 GB | MLX-VLM، نسخة مجتمعية بدقة 4/8 بت | نحو 27 tok/s | نحو 123–144 tok/s مع موجّهات قصيرة جدًا | ModelFit؛ الموجّهات القصيرة جدًا تُقرأ ببطء، لذا هذا غير قابل للمقارنة مع 279 أعلاه |
Third-party measurements, collected on 21 November 2026. No published Ollama runs yet for the M1 Pro, M1 Max, M2 Pro, base M4 or base M5.
ماذا تعني هذه الأرقام عمليًا
- للمحادثة، فإن نحو 24 رمزًا في الثانية أسرع من قراءتك. وجواب من 300 كلمة بعد ألف رمز من التفكير، أي نحو 1,400 رمز في الإجمال، يستغرق نحو دقيقة بهذه السرعة. اخفض جهد الاستدلال في الأسئلة السريعة وسيصبح أقصر بكثير.
- للوكلاء، فسرعة القراءة لا تقل أهمية عن سرعة الكتابة، لأن الوكيل يرسل موجّهًا طويلًا في كل دور. على M4 Pro بذاكرة 48 GB، استغرق قراءة موجّه من 12,000 رمز نحو 43 ثانية. ويعيد Ollama استخدام ذاكرته المؤقتة للجزء المشترك من بداية المحادثة بين الأدوار، لذا تقرأ الأدوار اللاحقة الجديد فقط في الغالب.
- للمقارنة، على M4 Pro نفسه، احتاج Qwen3.8-27B إلى 122 ثانية للمهمة ذات 12,000 رمز التي أنهاها Inkling 2 Mini في 65. قرأ Qwen بسرعة 107 وكتب بسرعة 27 رمزًا في الثانية. ومقارنتي بين النموذجين تتناول السبب، وتتناول الاستثناء الوحيد: تميل Inkling 2 Mini إلى كتابة رموز أكثر في كل مهمة.
ما تتوقعه على أجهزة Mac أخرى بذاكرة 32 GB
لم ينشر أحد أرقام Ollama لأجهزة M4 وM5 الأساسية بعد. عرض نطاق الذاكرة لديها 120 و153.6 GB/s، مقابل 409.6 GB/s لجهاز M2 Max الذي حقق نحو 24 رمزًا في الثانية. توقّع أن تكون أبطأ بشكل ملحوظ. ويصعب القول مسبقًا كم ستكون أبطأ، لأن Inkling 2 Mini على البرمجيات الحالية لا تتسارع بما يتناسب مع عرض النطاق. إذا كان لديك واحد منها، فشغّل --verbose الاختبار من الجزء 4 وستعرف خلال دقيقة.
الجزء 9 — استكشاف أخطاء Inkling 2 Mini وإصلاحها في Ollama
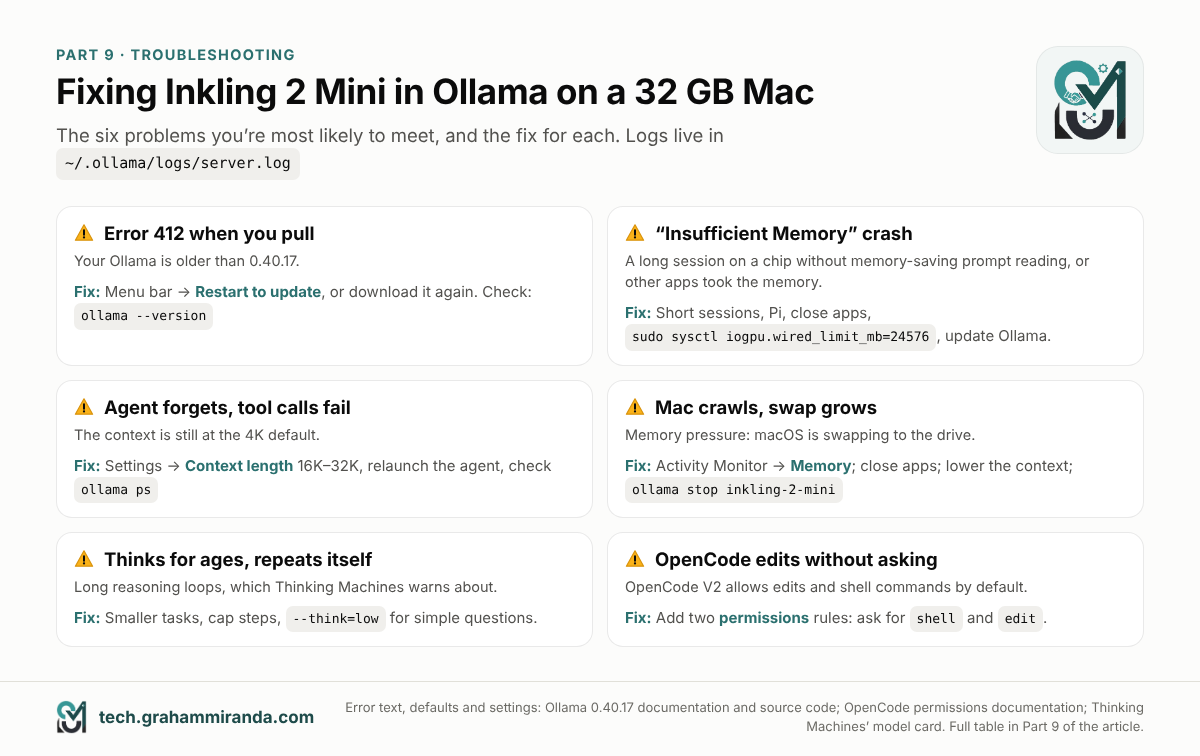
ابحث عن عَرَضك أدناه. إذا لم يكن في القائمة، فسجل Ollama يذكر عادةً ما الذي حدث من خطأ؛ ويوضح القسم الأخير من هذا الجزء كيفية قراءته.
إذا لم تُنزَّل Inkling 2 Mini أو لم تبدأ
| العرض | السبب المحتمل | الحل |
|---|---|---|
ollama pull inkling-2-mini يفشل مع 412 و"يتطلب إصدارًا أحدث" |
Ollama أقدم من 0.40.17 | حدّث (الجزء 2)، ثم نفّذ pull مرة أخرى |
ollama: command not found |
لم يُنشأ رابط سطر الأوامر | افتح تطبيق Ollama واقبل عرضه بتثبيت الأمر، أو أعد تثبيت التطبيق |
PROCESSOR في ollama ps لا يذكر 100% GPU |
هناك خلل في إعداد GPU | أغلق Ollama وأعد فتحه؛ وتأكد من أنك على Apple silicon وmacOS 14 أو أحدث |
| أنت على Windows أو Linux | يدعم Ollama 0.40.17 نموذج Inkling 2 Mini على Apple silicon فقط؛ وقد رفضت نماذج Ollama الخاصة بـ Mac فقط التنزيل في أماكن أخرى مع 412: this model requires macOS |
انتظر إصدارًا لاحقًا، أو استخدم llama.cpp أو vLLM |
إذا تعطّل Inkling 2 Mini أو نسي أو أبطأ جهاز Mac لديك
| العرض | السبب المحتمل | الحل |
|---|---|---|
يتوقف النموذج في منتصف الإجابة، مع «ذاكرة غير كافية» أو Command buffer execution failed في السجل |
كان الموجّه أطول من طاقة ذاكرة شريحتك اليوم (الجزء 6)، أو أن تطبيقات أخرى أخذت الذاكرة | أغلق التطبيقات، وقصّر الموجّه أو المستندات التي تلصقها، واستخدم Pi بدلًا من وكيل أثقل، وارفع ميزانية GPU (الجزء 5)، وحدّث Ollama |
| ينسى الوكيل التعليمات، أو تفشل نداءات الأدوات، أو تتوقف التعديلات في منتصفها | السياق صغير جدًا: على الأرجح القيمة الافتراضية 4K | اضبط 16K–32K (الجزء 5) وتحقق من عمود CONTEXT في ollama ps. ثم أعد تشغيل الوكيل |
| يتباطأ جهاز Mac لديك حتى يكاد يتوقف، وتدور المراوح، وتزداد ذاكرة المبادلة | ضغط الذاكرة | تحقق من Activity Monitor؛ وأغلق التطبيقات؛ واخفض السياق؛ ollama stop أي نموذج آخر محمّل |
| الإجابة الأولى بعد فترة توقف تكون بطيئة | ألغى Ollama تحميل النموذج بعد خمس دقائق من الخمول | اضبط OLLAMA_KEEP_ALIVE (الجزء 5) |
إذا أساء وكيل البرمجة التصرف
| العرض | السبب المحتمل | الحل |
|---|---|---|
| النموذج يفكر طويلًا جدًا أو يكرر نفسه | حلقات استدلال طويلة، وهي ما تحذر منها Thinking Machines | أعطِ مهامًا أصغر، وحدّد سقفًا للخطوات ورموز الإخراج، واستخدم جهدًا أقل للأسئلة البسيطة |
| يقول الوكيل إن النموذج لا’يوجد | خطأ مطبعي في اسم النموذج | استخدم بالضبط inkling-2-mini; ollama ls يسرد ما لديك |
| البحث على الويب في Pi’s لا’يعمل | يستخدم البحث على الويب السحابي من Ollama | سجّل الدخول إلى Ollama وفعّل Cloud، أو اعمل دون بحث على الويب |
| يعدّل OpenCode الملفات دون أن يسأل | يسمح OpenCode v2 بالتعديلات وأوامر الصدفة افتراضيًا | أضف permissions القواعد من الجزء 7 |
تحقق من سجل Ollama
سجلات Ollama موجودة في ~/.ollama/logs/server.log. لرؤية الأسطر الأخيرة بعد حدوث خطأ:
tail -n 40 ~/.ollama/logs/server.log
الجزء 10 — عندما لا تكفي 32 GB
ستعرف أنك وصلت إلى السقف عندما تتعطل الموجّهات الطويلة، أو عندما يستمر الوكلاء في ضغط محادثاتهم، أو عندما يبدأ Mac في التبديل من القرص والذاكرة في كل مرة يُحمَّل فيها النموذج. الخيارات الثلاثة الأولى لا تكلف شيئًا؛ والثلاثة الأخيرة تكلف مالًا أو خصوصية أو كليهما.
على الـ Mac الذي لديك
- أبقِه، واستخدمه فيما يناسب. الدردشة والمستندات القصيرة وأسئلة الصور وPi في المهام الصغيرة تعمل جيدًا على كل Mac بسعة 32 GB. راقب ملاحظات إصدار Ollama: وصول قراءة الموجّهات الموفرة للذاكرة من الجزء 6 إلى شرائح أكثر سيغيّر الصورة بين ليلة وضحاها.
- ملف أصغر في بيئة تشغيل مختلفة. نسخة Unsloth بدقة 4 بتات بحجم 17.6 GB، أصغر بنحو 2.6 GB من حزمة Ollama، وتعمل ببناء Unsloth الخاص من llama.cpp. إنها أكثر تقنية، وكان الدعم في يوم الإطلاق أخشن؛ مقال المقارنة يغطيه.
- نموذج محلي مختلف. يحقق Qwen3.8-27B النتيجة نفسها التي يحققها Inkling 2 Mini في مؤشر Artificial Analysis’s، ويعمل في كل مكان وهو أفضل في أسئلة المعرفة، لكنه أبطأ على الـ Mac نفسه. المقال نفسه.
أبعد من الـ Mac الخاص بك
- ذاكرة أكثر. بدءًا من 48 GB، يشغّل Inkling 2 Mini الوكلاء بارتياح، ومن 64 GB يمكنك إبقاؤه محمّلًا إلى جانب نموذج آخر. وإذا كنت’ تقرر ما تشتريه، فأدلّتي عن هل يستحق MacBook لتشغيل LLM محليًا و MacBook Pro M5 Pro بسعة 64 GB استعرض المقايضات.
- الأخ الأكبر، في السحابة. Inkling 2 Small، نموذج Thinking Machines’ البالغ 594 مليار معامل، متاح على سحابة Ollama باسم
inkling-2-small:cloud. وهي تعمل مع أوامر التشغيل نفسها، مثلollama launch opencode --model inkling-2-small:cloud. تحتاج إلى حساب Ollama، وحينها تغادر موجّهاتك جهاز Mac. - خطة برمجة للنسبة الصعبة 10%. كثير من الناس يشغّلون نموذجًا محليًا للأعمال الخاصة واليومية، ويوجّهون أصعب مهام التخطيط وتصحيح الأخطاء إلى نموذج سحابي كبير. أحد الخيارات المعقولة هو Z.ai’s GLM Coding Plan، الذي يعمل في OpenCode وClaude Code ووكلاء آخرين. يمكنك احصل على خصم 10% على GLM Coding Plan عبر رابط الإحالة الخاص بي. (رابط تابع — راجع الإفصاح في أعلى الصفحة.)
الأسئلة الشائعة
نعم. تدعم Thinking Machines وOllama كلتاهما Inkling 2 Mini على أجهزة Mac بشرائح Apple silicon بذاكرة 32 GB أو أكثر، عبر Ollama 0.40.17 أو أحدث. يشغل النموذج نحو 20 GB، لذا تعمل المحادثات والمستندات القصيرة جيدًا. الحد هو الموجّهات الطويلة. على معظم شرائح 32 GB، لا يستخدم Ollama 0.40.17 بعد قراءة الموجّهات الموفرة للذاكرة. اختبار واحد على M2 Max انهار بعد نحو 12,000 توكن.
Ollama 0.40.17 أو أحدث. أعلنت Ollama عن دعم Inkling 2 Mini في 0.40.17 في 20 نوفمبر 2026 كإصدار تجريبي، وتبعت النسخة النهائية 0.40.17 خلال يوم. تحقق باستخدام ollama --version. ترفض الإصدارات الأقدم التنزيل بخطأ 412. وفي 0.40.17، يُدعم Inkling 2 Mini على Apple silicon فقط.
20,188,097,271 بايت، أي نحو 20.2 GB أو 18.8 GiB. الوسوم الثلاثة كلها، latest, 26b-a5b و 26b-a5b-nvfp4، هي الحزمة نفسها: أوزان Thinking Machines’ الأصلية NVFP4 وMXFP8، مع دعم الصور. لا يوجد إصدار أصغر من Ollama. وعند سرعة 100 Mbit/s يستغرق التنزيل نحو 27 دقيقة.
يضبط Ollama سياقه الافتراضي انطلاقًا من ذاكرة GPU التي يكتشفها: 4K تحت نحو 23 GiB، و32K حتى نحو 47 GiB، و256K فوق ذلك. على Mac، هذا الرقم هو ميزانية GPU التي يسمح بها macOS، وهي على جهاز Mac بذاكرة 32 GB نحو 21.3 GiB، لذا تحصل على 4K. غيّره بشريط طول السياق في إعدادات Ollama، أو برفع ميزانية GPU إلى 24 GiB.
16K لـ Pi، و32K لـ OpenCode على M2 Pro، وهو أقصى ما يستطيع جهاز Mac بذاكرة 32 GB منحه بارتياح إلى جانب نموذج بحجم 20 GB. على الشرائح التي تفتقر إلى قراءة الموجّهات الموفرة للذاكرة في Ollama، استخدم 8K وجلسات قصيرة. توصي Ollama بـ 64K أو أكثر لوكلاء البرمجة، وهو ما يعمل ابتداءً من 48 GB. اضبطه قبل تشغيل الوكيل، لأن ollama launch opencode يمرّر السياق المحمّل إلى OpenCode.
على جهاز Mac بذاكرة 32 GB يساعد ذلك. تشغيل sudo sysctl iogpu.wired_limit_mb=24576 يرفع ميزانية GPU من نحو 21.3 GiB إلى 24 GiB ويترك 8 GiB لـ macOS. عندئذٍ يعتمد Ollama سياقًا افتراضيًا بحجم 32K. أغلق Ollama وأعد فتحه بعد ذلك. يُعاد الإعداد إلى حالته الأصلية عند إعادة تشغيل جهاز Mac؛ sudo sysctl iogpu.wired_limit_mb=0 يعيد الافتراضي بشكل أسرع. وهو ليس إعدادًا رسميًا في macOS، لذا ألغِه إذا كثر تبديل الذاكرة على جهازك أو صار غير مستقر.
استخدم --think الخيار: ollama run inkling-2-mini --think=low. ويقبل Ollama none, minimal, منخفض, medium, مرتفع (الافتراضي)، xhigh و أقصى، ويرسلها إلى النموذج كقيم جهد من 0 إلى 0.99. داخل المحادثة، /set nothink يضبط أدنى مستوى ويخفي التفكير. حتى الحد الأدنى لا يوقف الاستدلال تمامًا.
Pi، لأن موجّه النظام وأدواته لا تتجاوز 1,000 توكن، ما يبقي الموجّهات قصيرة: ollama launch pi --model inkling-2-mini. لكن Pi ينفّذ الأوامر دون سؤال، لذا استخدمه في مجلد مؤقت فقط. يبدأ OpenCode بنحو 6,900 توكن ويعمل بسياق 32K، وهو الأفضل على M2 Pro. يسأل قبل التنفيذ بعد إضافة قاعدتي أذونات إلى إعداداته. أما Claude Code فيسأل افتراضيًا، لكن طلبه الأول قاس نحو 32,800 توكن، أكثر مما يتسع له سياق 32K، لذا هو أفضل ابتداءً من 48 GB.
الأرجح أن الموجّه أو المحادثة كانت أطول من ذاكرة GPU في جهازك. لا يقرأ Ollama 0.40.17 الموجّهات الطويلة بطريقة موفرة للذاكرة إلا على M2 Pro وM2 Ultra وM3 Ultra وM4 Pro وM5 Pro وMax وUltra. على الشرائح الأخرى، ينمو استهلاك الذاكرة مع كل ما قرأه النموذج، وقد انهار M2 Max بذاكرة 32 GB بعد 12,288 توكن. أغلق التطبيقات الأخرى، وأبقِ الجلسات قصيرة، واستخدم Pi، وارفع ميزانية GPU، وأبقِ Ollama محدثًا.
في اختبار Ollama المنشور الوحيد على جهاز Mac بذاكرة 32 GB، وهو جهاز M2 Max، بلغ طلب قصير نحو 24 رمزًا في الثانية. وعلى جهاز M4 Pro بذاكرة 48 GB مع Ollama 0.40.17، كتب بنحو 32 رمزًا في الثانية وقرأ موجّهًا من 12,000 رمز بسرعة 279 رمزًا في الثانية. أجهزة M4 وM5 الأساسية لديها عرض نطاق ذاكرة أقل بكثير، ومن المتوقع أن تكون أبطأ؛ ولم يُنشر أي تشغيل بعد.
ليس مع حزمة Ollama، فهي إصدار واحد بحجم 20 GB، وتدعم Thinking Machines 32 GB كحد أدنى. تنشر Unsloth ملفات 2-bit و3-bit بحجم يقارب 9 إلى 14 GB تعمل بنسختها من llama.cpp على أجهزة Mac أصغر. وهي تخسر بعض الجودة وتتطلب إعدادًا أكبر.
لا، عندما يعمل محليًا. يشغّل Ollama النموذج على جهاز Mac، ويقول قسم الأسئلة الشائعة إنه لا يرى موجّهاتك أو بياناتك عند التشغيل المحلي. وكلاء البرمجة الذين تشغّلهم بـ ollama launch يتصلون بـ Ollama على localhost:11434، على جهازك أنت. أما النماذج السحابية والبحث في الويب فمختلفة: فهي ترسل البيانات إلى خوادم Ollama، ويمكنك إيقافها بإعداد Cloud. والوكلاء برامج منفصلة لها أدوات شبكة خاصة بها، مثل جلب الويب في OpenCode، لذا تحقق من إعداداتها إن كنت تحتاج إلى العمل دون اتصال بالكامل.
ليس في Ollama 0.40.17، فملاحظات إصداره تقول إن Inkling 2 Mini مدعوم على Apple silicon فقط في ذلك الإصدار. على عتاد NVIDIA، تدعم Thinking Machines كلا من vLLM وSGLang، وتشغّل نسخة Unsloth’s من llama.cpp ملفات GGUF الخاصة بها. وقد يضيف إصدار لاحق من Ollama منصات أخرى.
التشغيل ollama rm inkling-2-mini. احذف أي نسخ أنشأتها بـ ollama create، مثل inkling-2-mini-32k، بالطريقة نفسها: تُحرَّر أوزان الـ 20 GB بمجرد ألا يستخدمها أي نموذج. لإزالة Ollama نفسه، أغلق واخرج منه، واحذفه من Applications، واحذف مجلد .ollama في مجلدك الرئيسي؛ وتوثيق Ollama لنظام macOS يسرد كل ملف.
الخلاصة
Inkling 2 Mini نموذج مفتوح قادر، تدعمه الشركة المصنّعة على جهاز Mac بذاكرة 32 GB، ويجعل Ollama الأساسيات سهلة حقًا: ثبّت، واسحب، وشغّل. للمحادثات والمستندات والأسئلة عن الصور، لا تحتاج أكثر من جهاز Mac بذاكرة 32 GB.
الوكلاء هم الموضع الذي يصبح فيه 32 GB ضيقًا، لسببين. يشغّل Ollama معظم حواسيب Mac بسعة 32 GB بنافذة سياق 4K، وهو ما يعطّل الوكلاء بهدوء إلى أن تغيّرها. وعلى معظم شرائح 32 GB، قد تنفد الذاكرة مع الموجّهات الطويلة، لأن قراءة الموجّهات الموفّرة للذاكرة عند Ollama’s لا تشمل إلا بعض الشرائح. لذا اضبط السياق، وارفع ميزانية GPU، وأغلق متصفحك. ابدأ بـ Pi في مجلد مؤقت، وحدّث Ollama باستمرار.
إذا كان لديك M2 Pro، فأنت في أفضل وضع يمكن أن يكون عليه حاسوب Mac بسعة 32 GB اليوم. وإذا كانت لديك 48 GB أو أكثر، فإن معظم التحفظات الواردة هنا تزول. وأيًا كان حاسوب Mac لديك، ollama run inkling-2-mini --verbose فإنه سيخبرك عن جهازك الخاص في خمس دقائق أكثر مما تخبرك أي جدول في هذا الدليل.
هل تشغّل Inkling 2 Mini على حاسوب Mac بسعة 32 GB؟ شارك شريحتك، وإصدار Ollama، وإعداد السياق، و --verbose الأرقام في التعليقات، لا سيما من M1 أو M4 أو M5. سأضيف النتائج الأكثر فائدة إلى الجزء 8 مع الإشارة إلى أصحابها. والتصحيحات مرحّب بها أيضًا: فمع دعم بهذا الحداثة، ستتغير بعض تفاصيل اليوم بسرعة.
الإفصاح: يحتوي هذا الدليل على رابط تسويق بالعمولة واحد، إلى خطة GLM Coding Plan من Z.ai (في الجزء 10). الاشتراك عبرها يمنحك خصمًا بنسبة 10% وقد يحقق لي عمولة دون أي تكلفة إضافية عليك. لا يوجد أي منتج أو شركة أخرى في هذا الدليل تحت الرعاية، ولم تراجعه أي منها قبل النشر.
تم التحقق من الحقائق: 21 نوفمبر 2026.