Tiếng Việt
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 ไทย
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

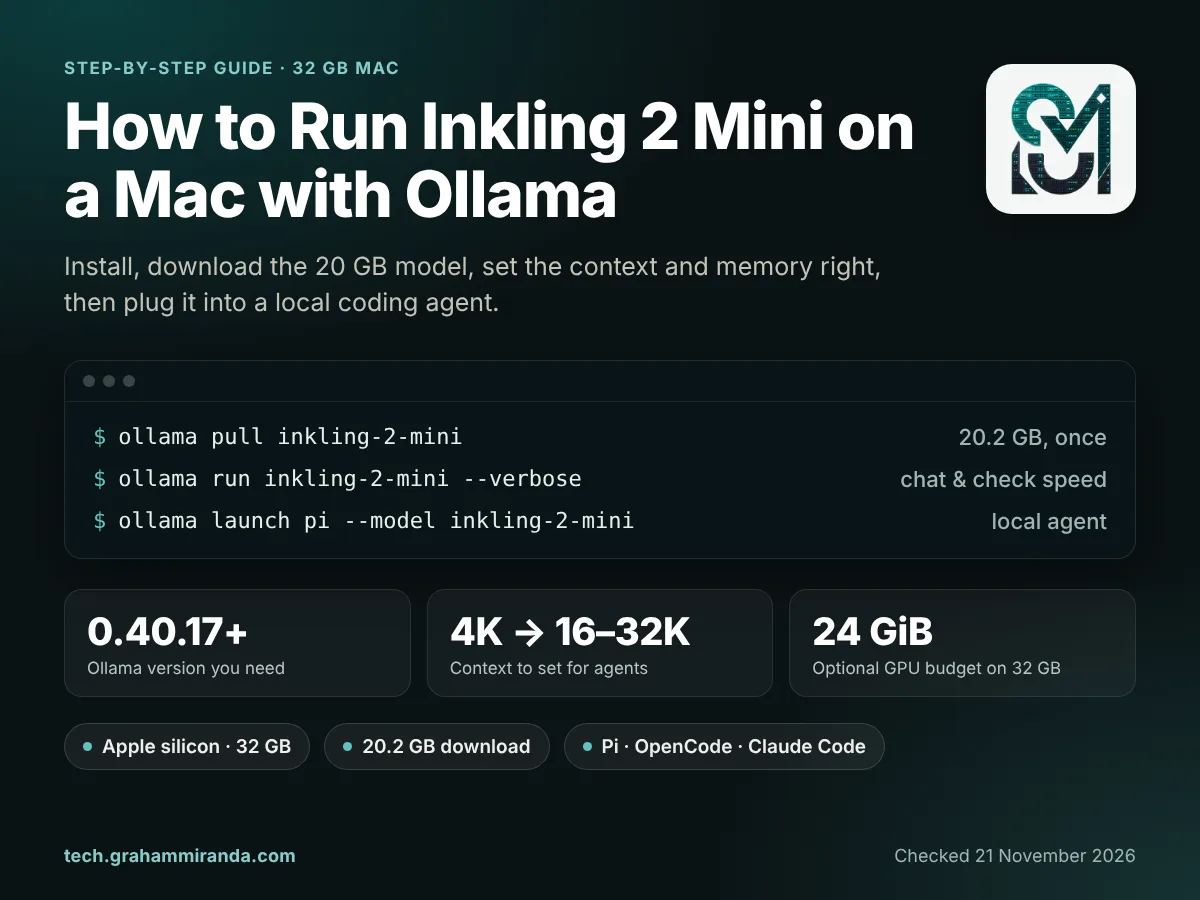
Thinking Machines Lab phát hành Inkling 2 Mini vào ngày 20 tháng 11 với một lời hứa bất thường cho một mô hình mở mạnh đến vậy: nó chạy trên một chiếc laptop. Công ty hỗ trợ nó trên mọi máy Mac có 32 GB bộ nhớ trở lên, thông qua Ollama. Các nhà nghiên cứu của hãng thậm chí đã chạy nó ngoại tuyến trên một chiếc MacBook Pro trong một chuyến bay, nơi nó dựng nên một trình mô phỏng bay chơi được. Hướng dẫn này chỉ cho bạn, từng bước, cách chạy Inkling 2 Mini với Ollama trên một máy Mac 32 GB. Nó bắt đầu bằng một bản cài đặt mới và kết thúc bằng một tác nhân lập trình cục bộ hoạt động được.
Bản ngắn gọn là ba lệnh. Bản dài hơn là lý do hướng dẫn này tồn tại. Trên một máy Mac 32 GB, mô hình chiếm khoảng 20 GB. Theo mặc định, macOS cũng giữ lại khoảng một phần ba bộ nhớ của bạn, không cho bộ xử lý đồ họa dùng. Ollama phản ứng bằng cách cấp cho mô hình cửa sổ ngữ cảnh 4.000 token: ổn cho một cuộc trò chuyện, nhưng quá nhỏ cho một tác nhân lập trình. Và trên hầu hết máy Mac 32 GB, những prompt rất dài vẫn có thể hết bộ nhớ ngay hôm nay. Không điều nào trong đó là lý do để bỏ qua. Đó là lý do để thiết lập cho đúng.
Bạn không cần biết lập trình. Bạn sẽ dán vài lệnh vào Terminal, ứng dụng dòng lệnh của Mac (nhấn Cmd-Space, gõ Terminal rồi nhấn Return). Mỗi lệnh đều được giải thích. Hỗ trợ của Ollama cho Inkling 2 Mini mới chỉ vài ngày và đang thay đổi nhanh, nên mọi thông tin dưới đây đã được kiểm tra vào ngày ngày 21 tháng 11 năm 2026.
Công bố về tính độc lập và liên kết tiếp thị: Không công ty nào được nhắc ở đây tài trợ, xem xét hay phê duyệt hướng dẫn này. Nó chứa một liên kết tiếp thị, cho GLM Coding Plan của Z.ai (ở Phần 10). Đăng ký qua đó bạn được giảm 10% và tôi có thể nhận được hoa hồng mà bạn không phải trả thêm chi phí nào.
TL;DR — Bản tóm tắt 60 giây
- Bạn cần: một máy Mac Apple silicon có 32 GB bộ nhớ trở lên, macOS 14 trở lên, khoảng 25 GB dung lượng đĩa trống và Ollama 0.40.17 trở lên.
- Ba lệnh:
ollama --version(0.40.17 trở lên),ollama pull inkling-2-mini(tải xuống 20,2 GB),ollama run inkling-2-mini. - Cái khó ở 32 GB: các trọng số chiếm 18,8 GiB, và theo mặc định macOS chỉ cho GPU dùng khoảng 21,3 GiB. Vì vậy Ollama đặt cửa sổ ngữ cảnh 4K, quá nhỏ cho tác nhân.
- Những cài đặt quan trọng: đặt ngữ cảnh thành 16K–32K trong Settings cho tác nhân của Ollama. Nếu muốn, nâng hạn mức GPU lên 24 GiB bằng
sudo sysctl iogpu.wired_limit_mb=24576(thiết lập này trở về mặc định khi khởi động lại). Giữ mức nỗ lực suy luận ở cao khi viết mã, thấp cho câu hỏi nhanh. Hãy đóng các ứng dụng ngốn bộ nhớ trước. - Chip của bạn quan trọng ngay lúc này: Ollama 0.40.17 chỉ bật cơ chế đọc prompt tiết kiệm bộ nhớ cho M2 Pro, M2 Ultra, M3 Ultra, M4 Pro và M5 Pro, Max và Ultra. Trong thử nghiệm 32 GB duy nhất được công bố, một chiếc M2 Max bị treo với "Insufficient Memory" sau khoảng 12.000 token.
- Tác nhân: Pi phù hợp nhất với 32 GB, vì hướng dẫn và công cụ của nó chỉ tốn dưới 1.000 token (
ollama launch pi --model inkling-2-mini). Nó chạy lệnh mà không hỏi, nên hãy đặt nó trong một thư mục tạm. OpenCode khởi động với khoảng 6.900 token và hỏi trước sau một lần đổi cấu hình. Claude Code hỏi theo mặc định, nhưng yêu cầu đầu tiên của nó đo được khoảng 32.800 token: tốt hơn từ 48 GB. - Tốc độ: về 24 token mỗi giây trên M2 Max 32 GB, và khoảng 32 trên M4 Pro 48 GB.
- An toàn: Thinking Machines cảnh báo rằng mô hình có thể lặp, xóa hoặc ghi đè tệp mà không hỏi, và báo cáo sai kết quả. Hãy làm việc trong Git hoặc trên một bản sao, giữ bật các lời nhắc cấp quyền và giới hạn số bước của tác nhân.
Tổng quan nhanh
| Mô hình | Inkling 2 Mini của Thinking Machines Lab, phát hành ngày 20 tháng 11 năm 2026, giấy phép Apache 2.0 |
| Kích thước | 26,4 tỷ tham số, 3,4 tỷ hoạt động mỗi token; 5,4 tỷ kích hoạt trọng số khi tính cả các lớp lặp |
| Thẻ Ollama | inkling-2-mini (cũng 26b-a5b và 26b-a5b-nvfp4: cùng gói 20 GB) |
| Tải xuống | 20.188.097.271 byte (20,2 GB, hay 18,8 GiB) |
| Thời gian cần | Khoảng nửa giờ, cộng thêm 3 đến 60 phút để tải về |
| Phiên bản Ollama | 0.40.17 trở lên; bản phát hành đó chỉ chạy trên Apple silicon |
| Bộ máy | Bộ chạy MLX của Ollama, xây trên framework học máy của Apple |
| Có thể làm | Đầu vào văn bản và hình ảnh, gọi công cụ, suy nghĩ |
| Ngữ cảnh | Tối đa 1M token trong mô hình; mặc định của Ollama trên hầu hết Mac 32 GB: 4K |
| Mức tối thiểu được hỗ trợ | Mac Apple silicon với 32 GB (Thinking Machines và Ollama) |
| macOS | 14 Sonoma trở lên (yêu cầu của Ollama) |
| Mức nỗ lực suy luận | none, minimal, thấp, medium, cao (mặc định), xhigh, tối đa |
| Tác nhân một lệnh | Pi, OpenCode, Claude Code, Hermes Agent và OpenClaw, thông qua ollama launch |
| Tốc độ đo được | M2 Max 32 GB: khoảng 24 tok/s; M4 Pro 48 GB: khoảng 32 tok/s khi ghi, 279 tok/s khi đọc |
Measured speeds are third-party results.
Mục lục
- Phần 1 — Trước khi bắt đầu: Máy Mac của bạn đã sẵn sàng?
- Phần 2 — Bước 1: Cài đặt hoặc cập nhật Ollama
- Phần 3 — Bước 2: Tải Inkling 2 Mini
- Phần 4 — Bước 3: Chạy Inkling 2 Mini trong Ollama lần đầu tiên
- Phần 5 — Bước 4: Cài đặt đề xuất cho máy Mac 32 GB
- Phần 6 — Thực tế 32 GB: chip của bạn quyết định
- Phần 7 — Bước 5: Dùng Inkling 2 Mini làm backend cục bộ cho tác nhân lập trình
- Phần 8 — Inkling 2 Mini chạy nhanh thế nào trên máy Mac 32 GB?
- Phần 9 — Xử lý sự cố Inkling 2 Mini trong Ollama
- Phần 10 — Khi 32 GB không đủ
- Câu hỏi thường gặp
- Điểm mấu chốt
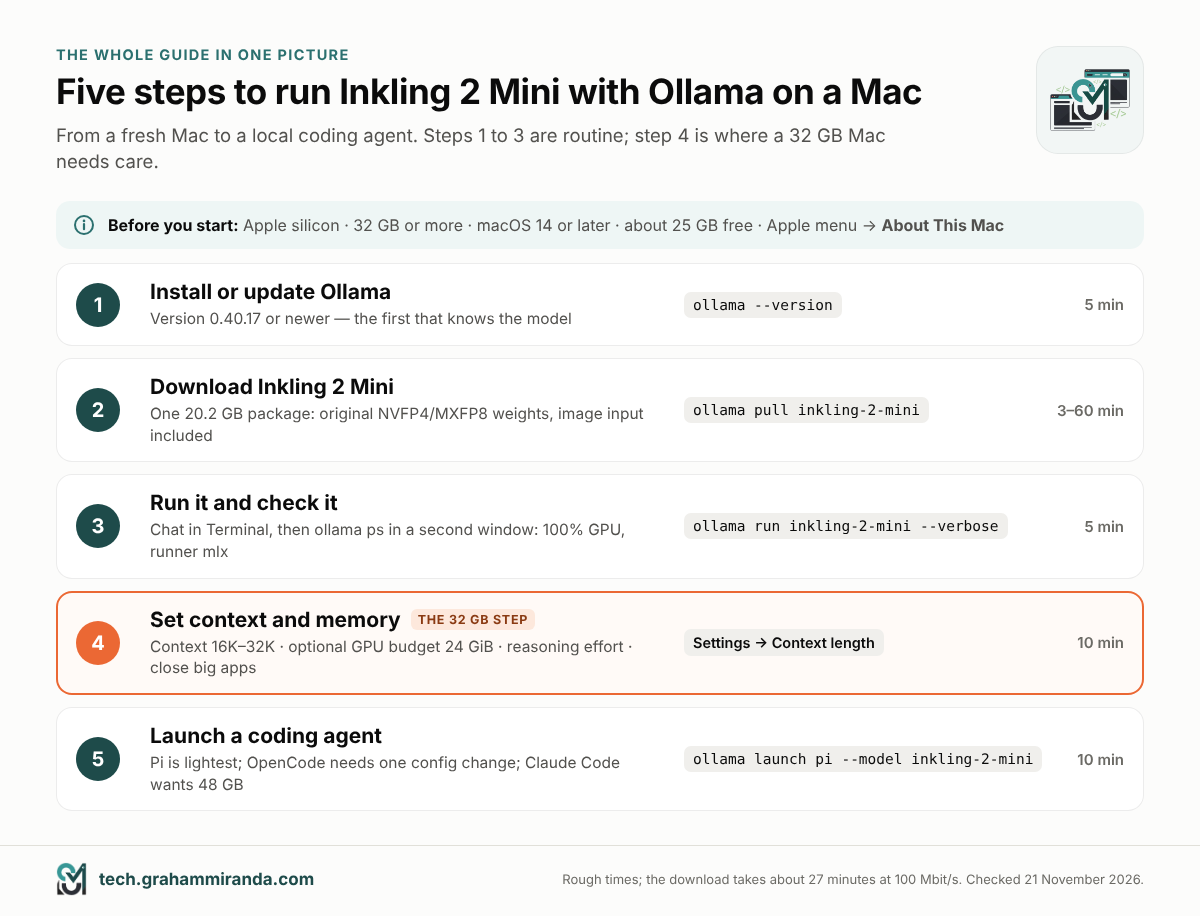
Phần 1 — Trước khi bắt đầu: Máy Mac của bạn đã sẵn sàng?
Bốn yếu tố quyết định bạn có chạy được Inkling 2 Mini với Ollama hay không: chip, bộ nhớ, phiên bản macOS và dung lượng đĩa trống. Ba yếu tố đầu nằm trên cùng một màn hình: mở menu Apple và chọn Giới thiệu về máy Mac này. Về dung lượng đĩa, mở Cài đặt hệ thống → Cài đặt chung → Lưu trữ.
| Yêu cầu | Tối thiểu | Tại sao |
|---|---|---|
| Chip | Apple silicon (bất kỳ chip dòng M nào) | Ollama 0.40.17 chỉ chạy Inkling 2 Mini trên Apple silicon. Trên máy Mac Intel, Ollama chỉ dùng được CPU chứ không dùng GPU |
| Bộ nhớ | 32 GB | Mức tối thiểu được Thinking Machines và Ollama hỗ trợ; riêng mô hình đã chiếm khoảng 20 GB |
| macOS | 14 Sonoma trở lên | Yêu cầu của chính Ollama |
| Dung lượng đĩa trống | Khoảng 25 GB | 20,2 GB cho mô hình, cộng thêm chỗ để macOS thở |
| Ollama | 0.40.17 trở lên | Bản phát hành đầu tiên biết đến mô hình này (Phần 2) |
Còn máy Mac 16 GB và 24 GB thì sao? Không, với gói của Ollama thì không — đó là một tệp 20 GB duy nhất, không có bản nhỏ hơn. Bản nén thì có: Unsloth phát hành các tệp 2-bit và 3-bit khoảng 9 đến 14 GB, chạy bằng bản build llama.cpp riêng của họ. Đó là một hướng khác, thiên về kỹ thuật hơn, mà tôi đã trình bày trong Inkling 2 Mini so với Qwen3.8-27B, cùng với những gì bạn phải đánh đổi về chất lượng.
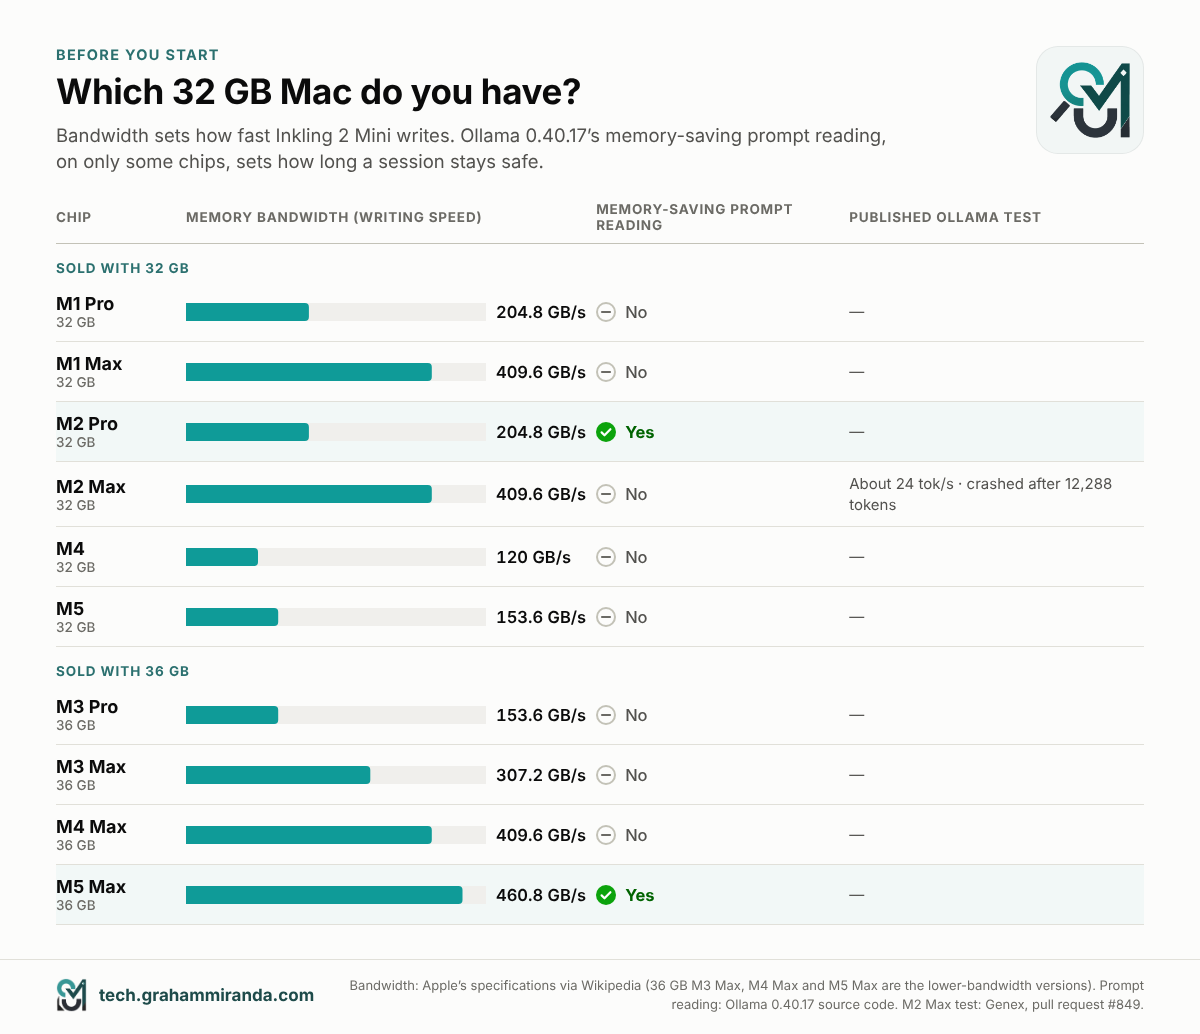
Bạn dùng máy Mac 32 GB nào?
Chip của bạn quan trọng vì hai lý do. Thứ nhất là tốc độ. Một mô hình như thế này viết từng từ bằng cách đọc các trọng số hoạt động từ bộ nhớ. Vì vậy tốc độ viết phụ thuộc rất nhiều vào băng thông bộ nhớ: tốc độ chip đọc bộ nhớ. M1 Max và M2 Max có băng thông gấp đôi M1 Pro và M2 Pro, và gấp khoảng ba lần M4 và M5 bản cơ bản.
Lý do thứ hai thì mới và chỉ riêng Ollama 0.40.17 (Phần 6 giải thích). Ollama có một cách đọc prompt dài tiết kiệm bộ nhớ cho mô hình này, nhưng nó chỉ được bật trên một số chip. Trong các máy Mac có đúng 32 GB, hôm nay chỉ M2 Pro có tính năng này.
| Chip | Có sẵn 32 GB không? | Băng thông bộ nhớ | Đọc prompt tiết kiệm bộ nhớ trong Ollama 0.40.17 |
|---|---|---|---|
| M1 Pro | Có | 204,8 GB/s | Không |
| M1 Max | Có | 409,6 GB/s | Không |
| M2 Pro | Có | 204,8 GB/s | Có |
| M2 Max | Có | 409,6 GB/s | Không |
| M4 | Có | 120 GB/s | Không |
| M5 | Có | 153.6 GB/s | Không |
| M3 Pro, M3 Max, M4 Max | phiên bản 36 GB | 153.6 / 307.2 / 409.6 GB/s | Không |
| M5 Max | phiên bản 36 GB | 460.8 GB/s | Có |
Thông số băng thông và bộ nhớ lấy từ thông số kỹ thuật của Apple do Wikipedia tổng hợp. Khả năng hỗ trợ đọc prompt lấy từ mã nguồn Ollama 0.40.17, bản này bật tính năng đó cho M2 Pro, M2 Ultra, M3 Ultra, M4 Pro và M5 Pro, Max và Ultra. M4 Pro và M5 Pro không được bán với 32 GB.
Máy 36 GB có thêm khoảng 4 GB dung lượng so với mọi giả định trong hướng dẫn này, nên các bước tương tự vẫn chạy được với chút dư địa.
Phần 2 — Bước 1: Cài đặt hoặc cập nhật Ollama
Ollama là ứng dụng miễn phí tải các mô hình mở và chạy chúng trên chính Mac của bạn. Nó cũng chạy một máy chủ nhỏ ở chế độ nền, và đó chính là thứ mà các tác nhân lập trình kết nối tới sau này.
Nếu bạn chưa có Ollama
- Đi tới ollama.com/download và tải phiên bản Mac,
Ollama.dmg. - Mở tệp và kéo Ollama vào Applications .
- Mở Ollama từ Applications. Lần khởi chạy đầu tiên, nó kiểm tra xem lệnh
ollamacó sẵn trong Terminal hay không. Nếu chưa, nó xin quyền thêm lệnh đó vào/usr/local/bin. Hãy đồng ý và nhập mật khẩu Mac nếu được hỏi. Một biểu tượng llama nhỏ xuất hiện trên thanh menu khi Ollama đang chạy. - Mở Terminal và nhập:
ollama --version
Bạn muốn 0.40.17 trở lên.
Nếu bạn đã có Ollama
Chạy ollama --version. Nếu cũ hơn 0.40.17, hãy cập nhật:
- Ứng dụng: Ollama tự tải bản cập nhật. Nhấp vào biểu tượng llama trên thanh menu và chọn Khởi động lại để cập nhật nếu có lựa chọn đó. Nếu không, hãy tải lại Ollama từ ollama.com/download và thay thế ứng dụng. Các mô hình bạn đã tải vẫn ở nguyên chỗ cũ.
- Homebrew: chạy
brew upgrade ollama. Gói Ollama của Homebrew đã ở 0.40.17 từ ngày 21 tháng 11.
Kiểm tra phiên bản, 21 tháng 11 năm 2026: Ollama công bố hỗ trợ Inkling 2 Mini trong 0.40.17 vào ngày 20 tháng 11, dưới dạng bản phát hành trước. Bản 0.40.17 chính thức được gắn thẻ trên GitHub trong vòng một ngày, và Homebrew đã cung cấp bản này. Nếu trang tải vẫn đưa bạn 0.40.16, hãy lấy 0.40.17 trở lên từ trang phát hành GitHub. Ollama cũ hơn sẽ từ chối bản tải xuống với
pull model manifest: 412: The model you are attempting to pull requires a newer version of Ollama.
Hai cài đặt đáng xem qua (tùy chọn)
Mở Cài đặt của Ollama từ biểu tượng llama hoặc cửa sổ ứng dụng.
- Đám mây. Công tắc này bật các mô hình đám mây và tìm kiếm web của Ollama. Dù bật hay tắt, Inkling 2 Mini vẫn chạy hoàn toàn trên máy Mac của bạn; FAQ của chính Ollama nói rằng khi bạn chạy cục bộ, nó không thấy prompt hay dữ liệu của bạn. Hãy tắt Đám mây nếu bạn muốn chắc chắn rằng không gì có thể rơi về một mô hình đám mây. Tuy nhiên, lưu ý rằng công cụ tìm kiếm web trong một số tác nhân dùng đám mây của Ollama.
- Vị trí mô hình. Nếu ổ trong của bạn thiếu dung lượng, hãy trỏ mục này đến một SSD gắn ngoài trước khi bạn tải 20 GB.
Phần 3 — Bước 2: Tải Inkling 2 Mini
Một lệnh:
ollama pull inkling-2-mini
Bản tải xuống nặng 20.188.097.271 byte, tức hơn 20 GB một chút. Đây là khoảng thời gian cần thiết ở tốc độ tối đa; tải thực tế thường chậm hơn:
| Kết nối của bạn | Thời gian tải |
|---|---|
| 50 Mbit/s | khoảng 54 phút |
| 100 Mbit/s | khoảng 27 phút |
| 250 Mbit/s | khoảng 11 phút |
| 500 Mbit/s | khoảng 5½ phút |
| 1 Gbit/s | khoảng 3 phút |
Nếu quá trình tải dừng lại, hãy chạy lại đúng lệnh đó và nó sẽ tiếp tục từ chỗ đã dừng.
Vài điều đáng biết về thứ bạn vừa tải xuống:
- Chỉ có một phiên bản. Ba thẻ trên trang thư viện của Ollama,
latest,26b-a5bvà26b-a5b-nvfp4, đều là cùng một gói 20 GB. Không có phiên bản Ollama nhỏ hơn để chọn. - Đây là bản gốc, không phải bản sao đã nén. Thinking Machines đã huấn luyện phần lớn trọng số của mô hình ở định dạng 4-bit có tên NVFP4, và bốn lớp cuối ở định dạng 8-bit, MXFP8. Mô hình được phát hành nguyên như vậy. Gói của Ollama chứa chính các trọng số đó, nên không mất gì trong quá trình chuyển đổi.
- Nó có thể nhìn. Gói này xử lý được cả hình ảnh lẫn văn bản, và nó có thể gọi công cụ, nhờ đó các tác nhân coding có thể dùng nó.
Kiểm tra xem nó đã về chưa:
ollama ls
Bạn sẽ thấy inkling-2-mini:latest với kích thước 20 GB.
Phần 4 — Bước 3: Chạy Inkling 2 Mini trong Ollama lần đầu tiên
Bắt đầu một cuộc trò chuyện trong Terminal:
ollama run inkling-2-mini --verbose
Lần khởi động đầu tiên mất một chút thời gian, vì Ollama nạp 20 GB từ ổ đĩa vào bộ nhớ. Sau đó bạn sẽ thấy một >>> dấu nhắc. Hãy thử một câu như:
Giải thích trong ba câu transformer vòng lặp là gì.
Inkling 2 Mini suy nghĩ trước khi trả lời, nên bạn sẽ thấy lập luận của nó hiện ra trước, rồi đến câu trả lời. Nếu bạn không muốn xem nó suy nghĩ, hãy khởi động nó với --hidethinking thay vào đó.
Đọc các con số
Vì bạn đã thêm --verbose, Ollama in thống kê sau mỗi câu trả lời. Có hai dòng quan trọng:
| Line | Ý nghĩa |
|---|---|
| prompt eval rate | Tốc độ mô hình đọc đọc tin nhắn của bạn, tính bằng token mỗi giây |
| eval rate | Tốc độ nó viết câu trả lời, tính bằng token mỗi giây. Một token xấp xỉ ba phần tư một từ tiếng Anh |
Để tham khảo, thử nghiệm Ollama công bố duy nhất trên một chiếc Mac 32 GB, một M2 Max, đo được khoảng 24 token mỗi giây. Phần 8 có các phép đo khác.
Vài việc bạn có thể làm tiếp theo
- Thoát cuộc trò chuyện: type
/byehoặc nhấn Ctrl-D. Mô hình vẫn nằm trong bộ nhớ năm phút phòng khi bạn quay lại. - Giải phóng bộ nhớ ngay:
ollama stop inkling-2-mini. - Hỏi về một hình ảnh: gõ câu hỏi của bạn, rồi kéo một tệp hình ảnh từ Finder vào cửa sổ Terminal, thao tác này dán đường dẫn đầy đủ của tệp. Nhấn Return.
- Dùng ứng dụng thay thế: mở ứng dụng Ollama, chọn
inkling-2-minitừ menu mô hình và trò chuyện ở đó. Bạn cũng có thể thả hình ảnh vào cửa sổ.
Kiểm tra xem Inkling 2 Mini có chạy đúng không
Trong khi mô hình đã được nạp, mở cửa sổ Terminal thứ hai và chạy:
ollama ps
| Cột | Điều bạn muốn thấy |
|---|---|
| NAME | inkling-2-mini:latest |
| SIZE | Mô hình chiếm bao nhiêu bộ nhớ |
| PROCESSOR | 100% GPU. Trên Apple silicon, điều đó nghĩa là nó đang chạy trên bộ xử lý đồ họa trong bộ nhớ hợp nhất |
| NGỮ CẢNH | Một cuộc trò chuyện chứa được bao nhiêu token. Trên hầu hết máy Mac 32 GB, thông số này ghi 4096 cho đến khi bạn đổi ở Phần 5 |
| TRÌNH CHẠY | mlx, bộ máy chạy của Ollama cho Apple silicon |
| ĐẾN KHI | Khi nào Ollama sẽ gỡ nó khỏi bộ nhớ nếu bạn không dùng |
Bạn cũng có thể hỏi Ollama xem lúc khởi động nó đã phát hiện được gì:
grep "vram-based default context" ~/.ollama/logs/server.log | tail -1
Trên máy Mac 32 GB, bạn sẽ thấy total_vram khoảng 21 GiB và default_num_ctx=4096. Chỉ một dòng đó đã giải thích phần lớn nội dung Phần 5.
Phần 5 — Bước 4: Cài đặt đề xuất cho máy Mac 32 GB
Trò chuyện thì chạy được mà không cần đổi gì. Còn tác nhân lập trình và tài liệu dài thì không, vì cách máy Mac 32 GB chia bộ nhớ. Mọi con số bộ nhớ trong phần này tính theo GiB, tức gigabyte nhị phân mà macOS và Ollama báo cáo; một máy Mac "32 GB" có 32 GiB.
Đây là phần ngân sách. Trọng số của Inkling 2 Mini chiếm 18,8 GiB. Trên máy Mac 32 GB, macOS chỉ cho bộ xử lý đồ họa dùng khoảng hai phần ba bộ nhớ, khoảng 21.3 GiB, trừ khi bạn đổi. VisualInference đã đo chính bộ trọng số gốc này trong một ứng dụng MLX khác, mlx-vlm, trên máy M4 Pro 48 GB. Bộ nhớ đạt đỉnh ở 20.3 GiB với một prompt ngắn, 21.4 GiB ở 4,000 token và 22.1 GiB ở 16,000 token. Nói cách khác, khi prompt dài ra, chỉ riêng mô hình đã chạm mép ngân sách GPU mặc định. Và đó là chưa tính phần mà macOS cùng các ứng dụng khác của bạn lấy đi.
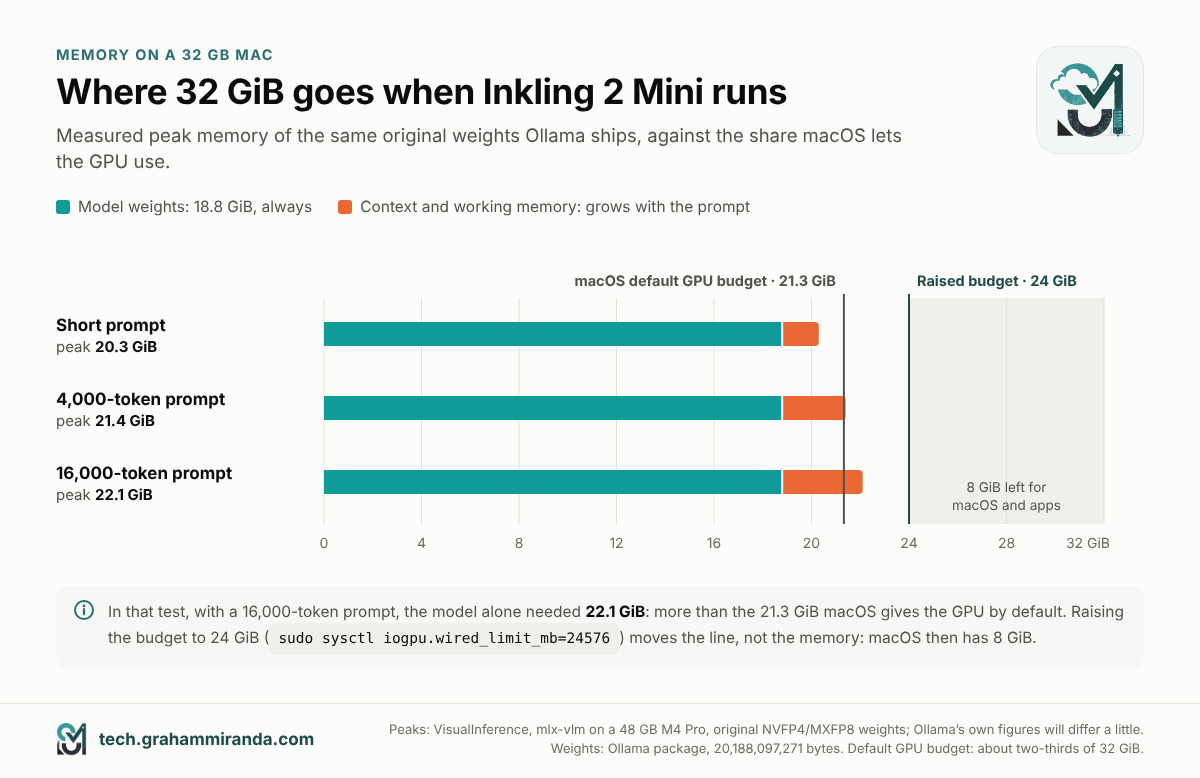
Bốn cài đặt tạo ra khác biệt.
Cài đặt 1: Độ dài ngữ cảnh (mục quan trọng nhất)
Việc độ dài ngữ cảnh là lượng văn bản mô hình giữ được cùng lúc. Con số đó gồm tin nhắn của bạn và câu trả lời của mô hình, và với một tác nhân thì còn có system prompt, định nghĩa công cụ cùng mọi tệp nó đã đọc. Quá nhỏ thì tác nhân lặng lẽ đánh mất chỉ dẫn và bắt đầu mắc những lỗi lạ. Quá lớn thì bạn giữ lại phần bộ nhớ không bao giờ dùng.
Ollama chọn mức mặc định dựa trên bộ nhớ GPU mà nó phát hiện:
| Bộ nhớ GPU mà Ollama phát hiện | Ngữ cảnh mặc định |
|---|---|
| Dưới 23 GiB (hầu hết máy Mac 32 GB: khoảng 21.3 GiB) | 4K token |
| 23 đến 47 GiB | 32K token |
| 47 GiB trở lên | 256K token |
Tài liệu của Ollama nêu các mức là dưới 24, 24–48 và từ 48 GiB trở lên. Mã trong 0.40.17 dùng 23 và 47 GiB, để tính tới khác biệt nhỏ trong con số mà mỗi máy Mac báo cáo.
Cái giá về bộ nhớ mà ngữ cảnh lớn hơn khiến Inkling 2 Mini phải trả, tính từ cấu hình của nó:
| Ngữ cảnh | Bộ nhớ bổ sung cho ngữ cảnh |
|---|---|
| 4K | 0.28 GiB |
| 8K | 0.41 GiB |
| 16K | 0.66 GiB |
| 32K | 1.16 GiB |
| 64K | 2.16 GiB |
| 128K | 4.16 GiB |
Inkling 2 Mini cần ít bộ nhớ hơn trên mỗi token ngữ cảnh so với hầu hết các mô hình cùng cỡ. Chỉ bốn trong 24 lớp của nó nhìn lại toàn bộ cuộc hội thoại. Bộ nhớ làm việc dùng khi đọc một prompt được cộng thêm vào; các đỉnh đo được ở trên đã bao gồm phần đó.
Nên đặt gì
| Bạn đang làm gì | Ngữ cảnh | Tại sao |
|---|---|---|
| Trò chuyện và câu hỏi ngắn | 4K–8K (mặc định là ổn) | Dùng ít bộ nhớ nhất |
| Dán tài liệu dài hoặc tệp mã | 16K | Khoảng 12.000 từ tiếng Anh |
| Tác nhân Pi | 16K (8K trên các chip không có tính năng đọc prompt tiết kiệm bộ nhớ ở Phần 6) | Hướng dẫn riêng của Pi rất gọn (Phần 7) |
| OpenCode | 32K, trên M2 Pro | Mức cao nhất bạn có thể thoải mái cấp cho nó trên 32 GB. Ollama khuyến nghị 64K trở lên cho tác nhân, điều mà chiếc Mac này thực sự không kham nổi bên cạnh một mô hình 20 GB. Trên các chip khác, hãy đọc Phần 6 trước |
| Claude Code | 64K trở lên, theo Ollama | Không thực tế trên 32 GB; xem Phần 7 |
Cách đặt
Cách dễ nhất để thay đổi độ dài ngữ cảnh của Ollama là dùng ứng dụng: mở Cài đặt → Độ dài ngữ cảnh và kéo thanh trượt, thanh này có các mốc 4k, 8k, 16k, 32k, 64k, 128k và 256k. Ollama khởi động lại máy chủ của nó để áp dụng, và cài đặt này vẫn còn sau khi bạn khởi động lại Mac.
Có ba cách khác, hữu ích về sau:
# Chỉ cho một phiên trò chuyện, bên trong `ollama run`:
/set parameter num_ctx 16384

# Cho ứng dụng Ollama, cho đến khi bạn khởi động lại Mac (sau đó thoát và mở lại Ollama):
launchctl setenv OLLAMA_CONTEXT_LENGTH 32768
Nếu bạn đã kéo thanh trượt của ứng dụng thì thanh trượt được ưu tiên hơn launchctl cài đặt.
Hoặc tạo một bản sao của mô hình với ngữ cảnh riêng được tích hợp sẵn, rất tiện khi bạn muốn 8K để trò chuyện nhưng 32K cho một tác nhân. Dán đoạn này vào Terminal; nó tạo ra một tệp văn bản nhỏ tên là Modelfile và sau đó là mô hình mới:
cat > Modelfile <<'EOF'
FROM inkling-2-mini
PARAMETER num_ctx 32768
EOF
ollama create inkling-2-mini-32k -f Modelfile
Bản sao không tải xuống hay nhân đôi 20 GB trọng số. Sau đó bạn dùng inkling-2-mini-32k ở bất cứ đâu bạn dùng inkling-2-mini. Dù chọn cách nào, hãy xác nhận trong NGỮ CẢNH cột của ollama ps.
Cài đặt 2: Cho GPU thêm chỗ (tùy chọn)
macOS giới hạn lượng bộ nhớ mà GPU được giữ cho riêng mình, và Ollama coi giới hạn đó là "VRAM" của bạn. Trên Mac 32 GB, con số này khoảng 21,3 GiB. Ba điều suy ra từ đó. Ollama đặt cửa sổ ngữ cảnh mặc định dựa trên nó (Cài đặt 1). Engine MLX của Ollama giữ mô hình đã nạp thường trú trong bộ nhớ tới giới hạn đó. Nếu mô hình lớn hơn, nó ghi cảnh báo rằng hiệu năng có thể bị giảm. Và khi một bước công việc cần nhiều bộ nhớ GPU hơn mức có sẵn, macOS sẽ dừng nó. Đó là lỗi Bộ nhớ không đủ ở Phần 6. Tài liệu của Apple nói rằng lỗi này nghĩa là GPU không có đủ bộ nhớ để thực thi một bộ đệm lệnh.
Bạn có thể nâng giới hạn này cho đến lần khởi động lại tiếp theo; tài liệu MLX của Apple đưa ra đúng câu lệnh cho việc này. Hãy kiểm tra giá trị hiện tại trước; 0 nghĩa là giá trị mặc định của macOS:
sysctl iogpu.wired_limit_mb
Nâng lên 24 GiB, chừa lại 8 GiB cho macOS và các ứng dụng của bạn:
sudo sysctl iogpu.wired_limit_mb=24576
Sau đó thoát Ollama từ thanh menu và mở lại, vì Ollama chỉ đọc giới hạn này khi khởi động. Hãy chạy lại lệnh grep ở Phần 4 và total_vram giờ sẽ hiện khoảng 24 GiB.
Bốn điều cần biết
- Nó cũng thay đổi cửa sổ ngữ cảnh mặc định của bạn. Khi phát hiện 24 GiB, mặc định của Ollama nhảy từ 4K lên 32K (bảng phía trên), nên bạn có thể không cần Cài đặt 1 nữa.
- Nó cho GPU thêm chỗ, không phải thêm bộ nhớ. Nó dịch chuyển ranh giới giữa GPU và macOS; nó không thêm chút bộ nhớ nào. Nếu các ứng dụng khác của bạn sau đó thiếu bộ nhớ, macOS sẽ hoán đổi thay thế.
- Nó được đặt lại khi bạn khởi động lại Mac. Đó là lưới an toàn, không phải lỗi. Để hoàn tác sớm hơn:
sudo sysctl iogpu.wired_limit_mb=0. - Đây không phải một cài đặt chính thức của macOS. Nó được dùng rộng rãi cho AI cục bộ, nhưng nếu Mac của bạn hoán đổi nhiều, bị treo hoặc khởi động lại bất ngờ trong một phiên, hãy đặt lại về 0. Đừng nâng cao hơn nhiều so với 24 GiB trên Mac 32 GB.
Cài đặt 3: Mức suy luận
Inkling 2 Mini quyết định suy nghĩ chăm đến đâu dựa trên mức suy luận cài đặt. Mặc định của Ollama là cao. Đây là cách Ollama 0.40.17 chuyển các tên gọi thành giá trị mà mô hình thực sự nhận:
| Cài đặt Ollama | Mức mô hình nhận được | Phù hợp cho |
|---|---|---|
none hoặc false |
0 (ẩn phần suy nghĩ) | Tra cứu đơn giản |
minimal |
0.1 | Thông tin nhanh |
thấp |
0.2 | Câu trả lời ngắn, tóm tắt, viết lại |
medium |
0.7 | Câu hỏi hằng ngày |
cao hoặc true (mạng mặc định) |
0.9 | Công việc lập trình và tác nhân |
xhigh hoặc tối đa |
0.99 | Vấn đề khó, khi bạn có thể chờ |
Từ bộ dựng Inkling 2 Mini của Ollama 0.40.17. Thinking Machines lưu ý rằng ngay cả mức tối thiểu cũng không tắt hoàn toàn suy luận.
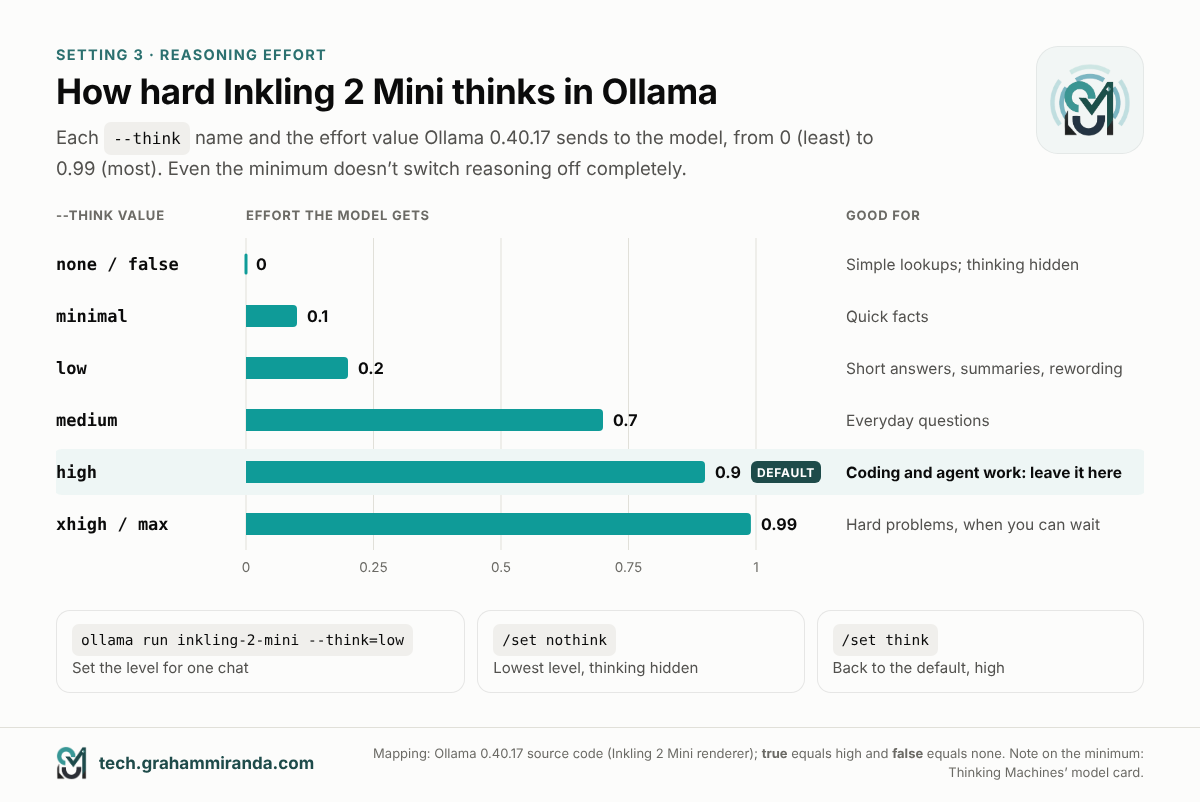
xhigh và tối đa gửi cùng một giá trị. Mức mặc định, high, là lựa chọn đúng cho việc lập trình.Để đặt mức này cho một cuộc trò chuyện:
ollama run inkling-2-mini --think=low
Bên trong cuộc trò chuyện, /set nothink hạ nó xuống mức thấp nhất và ẩn phần suy nghĩ, còn /set think bật lại. Trong API của Ollama, các tên tương tự đi vào think trường.
Khuyến nghị của tôi: hãy để ở mức cao cho việc lập trình và tác nhân, nơi suy nghĩ tự đền đáp công sức. Dùng thấp hoặc medium cho những câu hỏi nhanh, để bạn không phải chờ lý luận dài dòng cho một câu trả lời một dòng.
Cài đặt 4: Giữ mô hình trong bộ nhớ và gỡ nó khi xong
Ollama gỡ mô hình sau năm phút không dùng, và nạp lại 20 GB thì mất thời gian. Trong một phiên tác nhân có những lúc tạm dừng, điều đó thật khó chịu. Để giữ mô hình trong bộ nhớ 30 phút sau mỗi lần dùng:
launchctl setenv OLLAMA_KEEP_ALIVE 30m
Sau đó thoát và mở lại Ollama. Với một cuộc trò chuyện duy nhất, ollama run inkling-2-mini --keepalive 30m cũng làm điều tương tự. Mặt trái: khi xong, hãy trả lại bộ nhớ bằng ollama stop inkling-2-mini.
Hai núm vặn nữa, cho những ai tò mò
- Mô hình nháp tích hợp. Thinking Machines phát hành Inkling 2 Mini kèm một mạng phụ nhỏ tên DSpark, đoán trước vài từ. Sau đó mô hình chính kiểm tra chúng trong một lượt. Ollama hỗ trợ tính năng này và bật chế độ nháp theo mặc định cho mọi mô hình có kèm mô hình nháp. Trong các bài kiểm tra MLX đã công bố bên ngoài Ollama, DSpark nâng tốc độ viết của Inkling từ 43,6 lên 70,9 token mỗi giây trên M5 Max. Trên M4 Pro, nó giảm tốc độ từ 31,1 xuống 18,7. Vậy hãy thử trên máy Mac của bạn: trong một cuộc trò chuyện,
/set parameter draft_num_predict 0tắt nó; hãy so sánh eval rate khi bật và khi tắt. - Yêu cầu song song. Kể từ 0.40.17, Ollama trên Apple silicon có thể trả lời nhiều yêu cầu cùng lúc, và mỗi yêu cầu cần bộ nhớ ngữ cảnh riêng. Ollama chọn một mức mặc định thận trọng dựa trên bộ nhớ trống của bạn. Nếu một tác nhân chạy các trình phụ song song vẫn đẩy máy Mac của bạn vào swap, hãy giới hạn còn một bằng
launchctl setenv OLLAMA_NUM_PARALLEL 1. Sau đó thoát và mở lại Ollama.
Những cài đặt không giúp ích ở đây
Các hướng dẫn cho mô hình khác thường gợi ý OLLAMA_KV_CACHE_TYPE=q8_0 để giảm một nửa bộ nhớ mà ngữ cảnh sử dụng, cùng với flash attention. Trong Ollama 0.40.17, những cài đặt đó thuộc về llama.cpp engine của nó; Inkling 2 Mini chạy trên MLX engine, và không có gì trong mã của engine đó đọc chúng. Điều tương tự cũng đúng với các cài đặt lớp GPU như num_gpu. Và hãy để temperature riêng: gói của Ollama dùng giá trị mặc định 1.0 của Thinking Machines, cũng là giá trị mà Unsloth khuyến nghị.
Trước một phiên dài: giải phóng bộ nhớ
Mở Activity Monitor (trong Applications → Utilities) và nhấp vào thẻ Bộ nhớ . Ở cuối bạn sẽ thấy Áp lực bộ nhớ và biểu đồ Swap đã dùng. Màu xanh là tốt, màu vàng nghĩa là macOS đang nén bộ nhớ, còn màu đỏ nghĩa là hệ thống đang swap ra ổ đĩa, khiến mọi thứ chậm đi. Trước một phiên tác nhân, hãy đóng những ứng dụng ngốn nhiều bộ nhớ: trình duyệt mở nhiều thẻ, Docker Desktop, trình giả lập iPhone, trình chỉnh sửa video và ảnh. Trên laptop, hãy cắm sạc cho những lần chạy dài.
Phần 6 — Thực tế 32 GB: chip của bạn quyết định
Phần này quan trọng nếu máy Mac của bạn dùng chip khác M2 Pro (hoặc M5 Max 36 GB), tức là phần lớn máy Mac 32 GB. Đây cũng là phần mà ghi chú phát hành của Ollama không nhắc tới.
Điều gì xảy ra khi Inkling 2 Mini đọc một prompt dài
Trước khi mô hình viết bất cứ thứ gì, nó đọc toàn bộ prompt của bạn. Engine MLX của Ollama làm việc đó 2.048 token mỗi lần. Với mỗi khối, Inkling 2 Mini tính xem mỗi token mới liên quan thế nào đến mọi token đứng trước nó, dùng một thước đo khoảng cách đã học giữa chúng. Bước đó cần một bảng tạm lớn dần theo toàn bộ những gì mô hình đã đọc trong cuộc hội thoại.
Ollama 0.40.17 có một cách tiết kiệm bộ nhớ để làm việc này, xử lý prompt theo từng ô nhỏ để bảng không bao giờ phình to. Mã nguồn của nó chỉ bật cách này cho những chip sau: M2 Pro, M2 Ultra, M3 Ultra, M4 Pro, và M5 Pro, Max cùng Ultra. Mọi chip khác quay về một phương pháp chung có mức dùng bộ nhớ tăng theo độ dài prompt. Đó là M1 Pro và Max, M2 Max, M4 bản cơ bản và M5 bản cơ bản.
Điều đó trông thế nào trên một chiếc M2 Max 32 GB
Bài kiểm tra công khai duy nhất về Ollama 0.40.17 trên máy Mac 32 GB đến từ các nhà phát triển của Genex. Họ đã thử Inkling 2 Mini trên một chiếc M2 Max 32 GB:
- Bản tải về chạy được, và một yêu cầu gọi công cụ ngắn trả về câu trả lời đúng với tốc độ khoảng 24 token mỗi giây.
- Một yêu cầu 18.003 token bị treo sau 12.288 token với lỗi
mlx: [METAL] Command buffer execution failed: Insufficient Memory. Đặt cửa sổ ngữ cảnh thành 32.768 và kích thước lô thành 512 cũng không giúp được gì. - Prompt thật dài 15.089 token của họ cũng treo theo cách tương tự.
- Một vòng lặp điều khiển máy tính dùng ảnh chụp màn hình thật thì chạy được.
Họ kết luận rằng mô hình phù hợp với máy Mac 32 GB khi prompt ngắn, nhưng không phù hợp với những prompt dài của ứng dụng họ. Vì vậy họ sửa ứng dụng để chỉ đề xuất Inkling 2 Mini từ 48 GB trở lên.
Cách xử lý việc này
| Chip của bạn | Điều nên kỳ vọng hiện nay | Việc cần làm |
|---|---|---|
| M2 Pro (32 GB) hoặc M5 Max (36 GB) | Prompt dài dùng bộ nhớ có giới hạn | Tác nhân ở cửa sổ ngữ cảnh 16K–32K, với hạn mức GPU được nâng lên (Phần 5) |
| M1 Pro, M1 Max, M2 Max, M4, M5 (32 GB) | Một phiên vượt xa khoảng 10.000 token có nguy cơ gặp lỗi "Insufficient Memory" | Dùng nó để trò chuyện và cho các tài liệu ngắn hơn; với tác nhân, hãy dùng Pi với cửa sổ ngữ cảnh 8K và mở phiên mới cho mỗi tác vụ; nâng hạn mức GPU; cập nhật Ollama mỗi khi có phiên bản mới |
| M3 Pro, M3 Max, M4 Max (36 GB) | Cùng phương án dự phòng, nhưng dư thêm khoảng 4 GB | Như trên, nhưng có thêm chút dư địa |
Hai điều cần nhìn cho đúng. Thứ nhất, đây là một giới hạn phần mềm, chứ không phải giới hạn phần cứng. Đoạn mã tiết kiệm bộ nhớ đã có; chỉ là nó chưa được bật cho mọi con chip, và Ollama phát hành phiên bản mới gần như mỗi tuần. Hãy xem ghi chú phát hành khi bạn cập nhật. Thứ hai, điều quan trọng là lượng văn bản mà mô hình phải xử lý trong một phiên, chứ không phải con số trên thanh trượt ngữ cảnh. Mỗi đoạn mới đều được so sánh với mọi thứ trước đó, nên một cuộc trò chuyện dài gây hại chẳng kém một prompt dài, và các tác nhân lập trình nhanh chóng tạo ra những cuộc trò chuyện dài. Ngữ cảnh nhỏ giúp phiên ngắn lại; bắt đầu phiên mới còn giúp chúng ngắn hơn nữa.
Phần 7 — Bước 5: Dùng Inkling 2 Mini làm backend cục bộ cho tác nhân lập trình
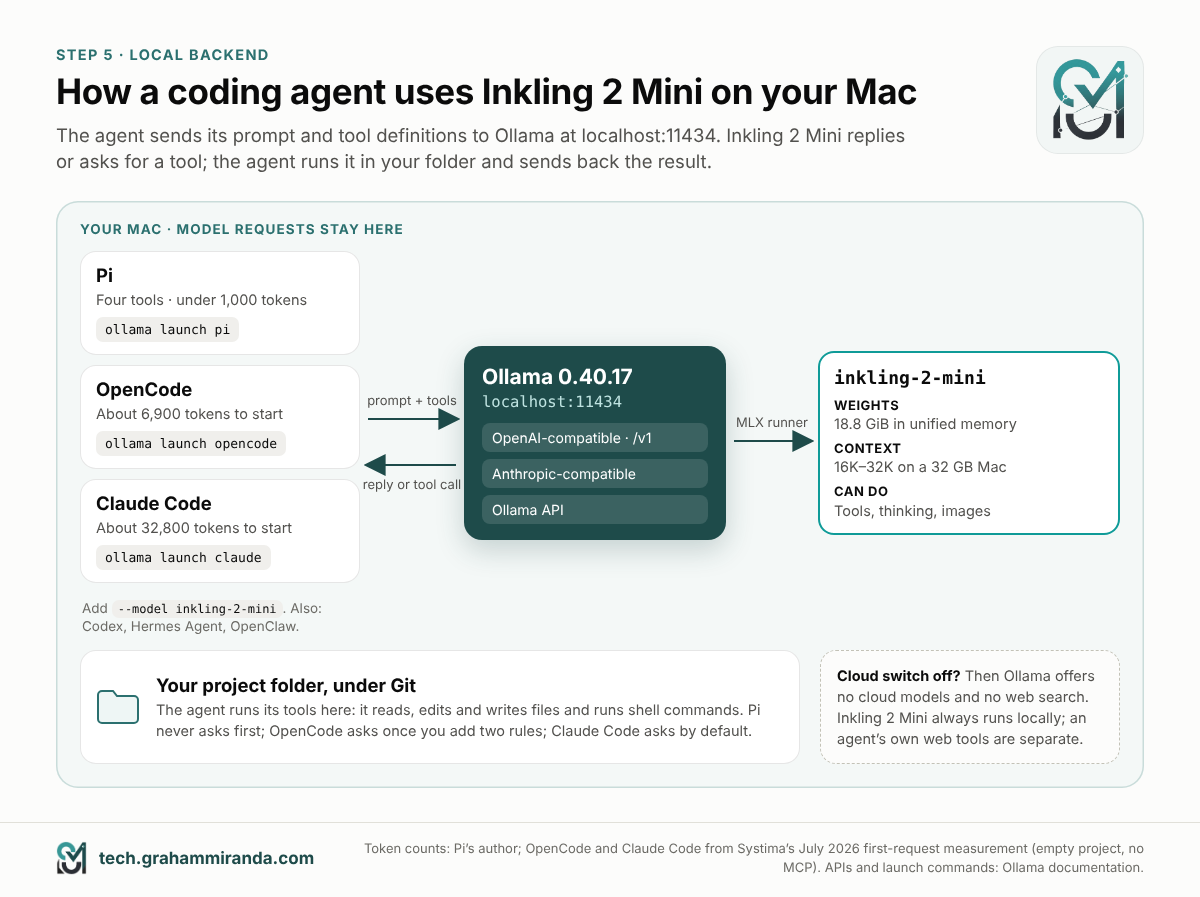
Tác nhân lập trình là một chương trình cung cấp công cụ cho mô hình, như đọc tệp, sửa tệp và chạy lệnh. Nó cho phép mô hình giải quyết một tác vụ từng bước. Thông thường mô hình nằm trong trung tâm dữ liệu. Ở đây, Inkling 2 Mini trên máy Mac của bạn trở thành backend cục bộ: tác nhân sẽ gửi yêu cầu đến Ollama thay vì gửi ra ngoài.
Cách hoạt động
Khi Ollama đang chạy, nó lắng nghe tại http://localhost:11434, một địa chỉ mà chỉ các chương trình trên máy Mac của bạn mới truy cập được. Nó nói các định dạng API mà tác nhân đã biết: một tương thích OpenAI cái tại http://localhost:11434/v1, một tương thích Anthropic một dành cho Claude Code, và một định dạng riêng của nó. Tác nhân gửi prompt và định nghĩa công cụ, rồi Inkling 2 Mini quyết định gọi công cụ nào. Tác nhân chạy công cụ đó trên máy Mac của bạn và gửi kết quả trở lại. Vòng lặp tiếp diễn cho đến khi xong tác vụ.
Bạn không phải tự cấu hình bất kỳ điều nào trong số đó. Lệnh ollama launch sẽ cài đặt các tác nhân được hỗ trợ nếu chúng chưa có, trỏ chúng vào Ollama và khởi chạy chúng.
Trước khi khởi chạy bất kỳ tác nhân nào
- Đặt ngữ cảnh trước (Phần 5). Điều này quan trọng hơn vẻ ngoài của nó: khi bạn khởi chạy OpenCode thông qua
ollama launch, Ollama đọc ngữ cảnh mà mô hình thực sự đã nạp và báo con số đó cho OpenCode. Nếu Ollama vẫn ở mức 4K, OpenCode sẽ tin như vậy. - Làm việc trong một thư mục thử nghiệm có Git, để bạn có thể xem và hoàn tác mọi thay đổi:
mkdir -p ~/Projects/inkling-test
cd ~/Projects/inkling-test
git init
Lần đầu bạn dùng git, macOS có thể gợi ý cài công cụ dòng lệnh dành cho nhà phát triển của Apple. Hãy đồng ý; việc này mất vài phút.
- Đóng các ứng dụng ngốn bộ nhớ (Phần 5).
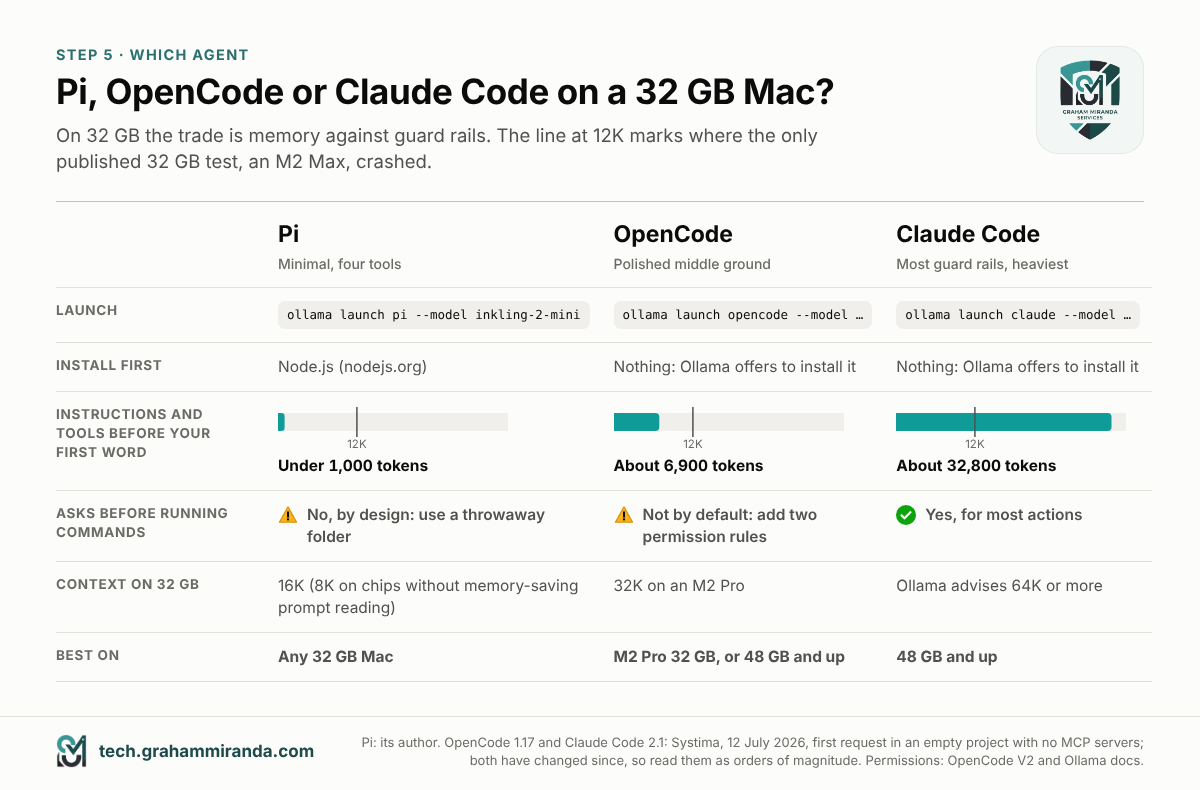
Nên dùng tác nhân nào trên 32 GB?
| Pi | OpenCode | Claude Code | |
|---|---|---|---|
| Thiết lập bằng một lệnh | ollama launch pi --model inkling-2-mini |
ollama launch opencode --model inkling-2-mini |
ollama launch claude --model inkling-2-mini |
| Bạn cài đặt trước | Node.js | Không cần gì; Ollama sẽ đề nghị cài đặt | Không cần gì; Ollama sẽ đề nghị cài đặt |
| Hướng dẫn và công cụ được gửi trước từ đầu tiên của bạn | Dưới 1.000 token | Khoảng 6.900 token | Khoảng 32.800 token |
| Hỏi trước khi chạy lệnh | Không, cố ý như vậy | Không mặc định; chỉ một thay đổi cấu hình là bật được | Có, với hầu hết thao tác |
| Ngữ cảnh cần đặt trên máy 32 GB | 16K (8K trên chip không có tính năng đọc prompt tiết kiệm bộ nhớ) | 32K trên M2 Pro | Ollama khuyến nghị 64K trở lên |
| Tốt nhất trên | Mọi máy Mac 32 GB, trong một thư mục tạm | M2 Pro với 32 GB, hoặc từ 48 GB trở lên | Từ 48 GB trở lên |
Con số của Pi do chính tác giả của nó cung cấp. Con số của OpenCode và Claude Code đến từ phép đo của Systima hồi tháng 7 năm 2026 về yêu cầu đầu tiên của mỗi tác nhân. Systima dùng một dự án trống không có máy chủ MCP, OpenCode 1.17 và Claude Code 2.1 với một model Claude. Cả hai tác nhân đều đã được cập nhật từ đó, nên hãy đọc các con số này theo bậc độ lớn. Lời khuyên chung của Ollama cho tác nhân là ngữ cảnh ít nhất 64K.
Lựa chọn A: Pi, nhẹ nhất
Pi là một tác nhân lập trình tối giản có chủ đích với bốn công cụ: read, write, edit và bash. Tác giả của nó nói rằng prompt hệ thống và các định nghĩa công cụ cộng lại chưa tới 1.000 token. Điều đó khiến nó phù hợp nhất với một chiếc Mac 32 GB, và đây cũng là tác nhân mà Ollama gợi ý trong thông báo Inkling 2 Mini của chính hãng.
- Cài đặt Node.js: tải trình cài đặt LTS từ nodejs.org và chạy nó.
ollama launch picầnnpmcủa Node để cài Pi. - Vào thư mục thử nghiệm của bạn và khởi chạy:
cd ~/Projects/inkling-test
ollama launch pi --model inkling-2-mini
Ollama cài Pi, cấu hình để nó dùng model cục bộ của bạn rồi mở một phiên.
⚠️ Pi không hỏi gì cả. Tác giả của nó mô tả nó chạy trong "chế độ YOLO hoàn toàn": không có lời nhắc cấp quyền cho thao tác tệp hay lệnh, và truy cập không giới hạn vào tệp của bạn. Thinking Machines cũng cảnh báo rằng Inkling 2 Mini có thể xóa hoặc ghi đè tệp mà không xác nhận. Gộp lại, điều đó có nghĩa là: chỉ chạy Pi trong một thư mục tạm, tuyệt đối không chạy trong thư mục home hay một dự án chưa sao lưu. Tác giả của nó gợi ý chạy nó trong một vùng chứa nếu bạn muốn một ranh giới thật sự; còn hướng dẫn về vùng chứa trên Apple của tôi chỉ cách thiết lập một cái trên Mac.
Một chi tiết nữa: khi Pi được khởi chạy qua Ollama, công cụ tìm kiếm web của nó dùng tính năng tìm kiếm web trên đám mây của Ollama. Việc đó cần một tài khoản Ollama và bật cài đặt Cloud. Mọi thứ còn lại vẫn nằm trên Mac của bạn.
Lựa chọn B: OpenCode, điểm cân bằng được trau chuốt
OpenCode là một tác nhân lập trình mã nguồn mở phổ biến với giao diện terminal toàn màn hình, ảnh chụp nhanh sau từng bước và một hệ thống cấp quyền mà bạn có thể siết chặt.
cd ~/Projects/inkling-test
ollama launch opencode --model inkling-2-mini
Nếu OpenCode chưa được cài, Ollama sẽ hỏi có cài không; hãy đồng ý. Sau đó Ollama truyền cho OpenCode các cài đặt của phiên này mà không ghi đè lên cài đặt của riêng bạn ~/.config/opencode/opencode.json. Nó đặt giới hạn của OpenCode theo ngữ cảnh mà model đã tải, và giữ lại một phần tư, tối đa 8K token, cho câu trả lời. Từ 0.40.17, nó cũng truyền các tùy chọn suy nghĩ của Inkling 2 Mini.
Yêu cầu mở đầu của OpenCode ở mức vừa phải, khoảng 6.900 token theo đo đạc tháng Bảy của Systima. Nhưng mỗi tệp nó đọc và mỗi kết quả lệnh nó nhận về đều cộng dồn vào cuộc hội thoại. Trên một chiếc Mac 32 GB không có tính năng đọc prompt tiết kiệm bộ nhớ ở Phần 6, đó là con số bạn phải để mắt. Chỉ vài tệp là đủ vượt 12.000 token, mức mà M2 Max bị treo.
OpenCode v2 cũng tự tìm ra các mô hình của Ollama khi khởi động, nên bạn chỉ cần chạy opencode và chọn mô hình bằng /models. Khởi chạy qua Ollama vẫn là cách tốt hơn trên máy 32 GB, vì nó cho OpenCode biết ngữ cảnh bạn thực sự có.
Bắt nó hỏi trước và giới hạn số bước
Mặc định, OpenCode v2 để mô hình chạy lệnh shell và sửa tệp mà không hỏi; các quy tắc mặc định của nó chỉ hỏi trước khi đọc .env tệp. Với một mô hình mà nhà sản xuất cảnh báo về những hành động phá hoại, hãy đổi điều đó. Thinking Machines cũng khuyến nghị giới hạn số lượt của tác nhân, vì đôi khi mô hình bị kẹt trong những vòng suy luận dài, đặc biệt khi gỡ lỗi, và tùy chọn steps của OpenCode làm điều đó. Đặt cả hai vào ~/.config/opencode/opencode.json (tạo tệp nếu nó chưa tồn tại):
{
  "$schema": "https://opencode.ai/config.json",
  "permissions": [
    { "action": "shell", "resource": "*", "effect": "ask" },
    { "action": "edit", "resource": "*", "effect": "ask" }
  ],
  "agents": {
    "build": { "steps": 40 }
  }
}
Việc Các quy tắc permissions khiến OpenCode hỏi trước mỗi lệnh shell và mỗi lần sửa. Tác nhân build là tác nhân mặc định của OpenCode; ở bước được phép cuối cùng, OpenCode gỡ các công cụ đi và yêu cầu mô hình tóm tắt. Hãy kiểm tra xem nó đã có hiệu lực bằng cách yêu cầu OpenCode tạo một tệp: giờ nó phải hỏi bạn trước. Nếu không, tài liệu về permissions của OpenCode giải thích cách các tác nhân tự thêm quy tắc riêng. Về mọi thứ khác của OpenCode, từ plan đến máy chủ MCP, xem Hướng dẫn OpenCode.
Lựa chọn C: Claude Code, nặng nhất
Claude Code làm việc với Ollama qua API tương thích Anthropic của Ollama, nên các yêu cầu đi tới máy Mac của bạn thay vì máy chủ của Anthropic. Mặc định nó xin phép trước hầu hết hành động, khiến nó là công cụ thận trọng nhất trong ba.
cd ~/Projects/inkling-test
ollama launch claude --model inkling-2-mini
Ollama đề nghị cài Claude Code nếu chưa có. Nếu bạn muốn tự khởi chạy sau, đây là những cài đặt ollama launch mà nó lo sẵn:
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
claude --model inkling-2-mini
Ollama 0.40.17 cũng cho phép Claude Code chỉ nạp các công cụ MCP khi cần, thay vì nạp tất cả cùng lúc, nhờ đó prompt ngắn hơn. Tuy vậy, nó không đụng tới các công cụ tích hợp của Claude Code, và chính những công cụ đó khiến nó nặng. Trong đo đạc tháng Bảy của Systima khi không có máy chủ MCP nào, yêu cầu đầu tiên của Claude Code vào khoảng 32.800 token, phần lớn là định nghĩa công cụ. Con số đó nhiều hơn sức chứa của ngữ cảnh 32K, và vượt xa 12.000 token nơi M2 Max bị treo. Ollama khuyến nghị ngữ cảnh 64K trở lên cho nó. Trên máy Mac 32 GB, cứ thử nếu bạn tò mò; còn dùng thật thì tính từ 48 GB.
Các tác nhân và ứng dụng khác
Trang thư viện của Ollama liệt kê lệnh khởi chạy một dòng cho thêm hai tác nhân nữa, và kiểu tương tự cũng dùng được cho Codex:
ollama launch hermes --model inkling-2-mini     # Hermes Agent
ollama launch openclaw --model inkling-2-mini   # OpenClaw
ollama launch codex --model inkling-2-mini      # OpenAI's Codex CLI
Bất kỳ công cụ nào khác dùng được API OpenAI cũng có thể dùng Inkling 2 Mini. Hãy đưa cho nó URL gốc http://localhost:11434/v1, tên mô hình inkling-2-mini và một chuỗi bất kỳ làm khóa API. Ollama không kiểm tra khóa, nhưng nhiều công cụ từ chối khóa rỗng.
Tác vụ tác nhân đầu tiên của bạn
Hãy bắt đầu bằng một việc nhỏ và dễ thấy, trong thư mục thử nghiệm của bạn:
Tạo một trang web danh sách việc cần làm chỉ gồm một tệp tên là index.html, lưu các tác vụ
ngay trong trình duyệt. Giữ nó đơn giản và giải thích cách mở nó khi làm xong.
Hãy xem nó làm gì: đọc những tệp nào, ghi ra gì, chạy những lệnh nào. Khi nó xong, mở trang bằng open index.html, và kiểm tra thay đổi bằng Git:
git status      # tệp nào đã thay đổi hoặc mới xuất hiện
git diff        # nội dung thay đổi trong những tệp Git đã biết
Nếu không thích kết quả, hãy xóa thư mục và làm lại. Đó chính là mục đích của một thư mục thử nghiệm.
Năm quy tắc để chạy một tác nhân cục bộ an toàn
Thẻ mô hình của Thinking Machines thẳng thắn một cách bất thường về các kiểu hỏng của Inkling 2 Mini. Nó có thể bị kẹt trong những vòng suy luận dài. Nó có thể xóa hoặc ghi đè tệp mà không hỏi trước, và có thể báo cáo kết quả công việc không chính xác. Nó cũng dễ khẳng định những điều sai với vẻ chắc chắn hơn các mô hình lớn hơn. Không điều nào trong số đó là lạ với một mô hình cỡ này. Điều đó chỉ có nghĩa là:
- Git hoặc một bản sao, luôn luôn. Đừng bao giờ để tác nhân tự do làm việc trên những tệp bạn không thể khôi phục.
- Bật lời nhắc cấp quyền nơi tác nhân có chúng (OpenCode cần thay đổi cấu hình ở trên), và đọc những gì bạn phê duyệt.
- Giới hạn số bước và đầu ra. Dùng OpenCode’s
steps; trong chat Ollama,/set parameter num_predict 4096giới hạn một câu trả lời. - Kiểm tra những gì nó khẳng định. Tự chạy kiểm thử trước khi bạn tin vào "mọi kiểm thử đều đạt".
- Đừng bao giờ trỏ tác nhân vào thư mục home của bạn. Còn với Pi, hãy dùng một thư mục tạm hoặc một vùng chứa.
Nếu bạn muốn đi xa hơn, hướng dẫn của tôi hướng dẫn về kỹ năng tác nhân và máy chủ MCP nói về cách giới hạn phạm vi mà công cụ của tác nhân có thể chạm tới. So sánh mọi harness coding AI đi sâu vào chính các tác nhân.
Phần 8 — Inkling 2 Mini chạy nhanh thế nào trên máy Mac 32 GB?
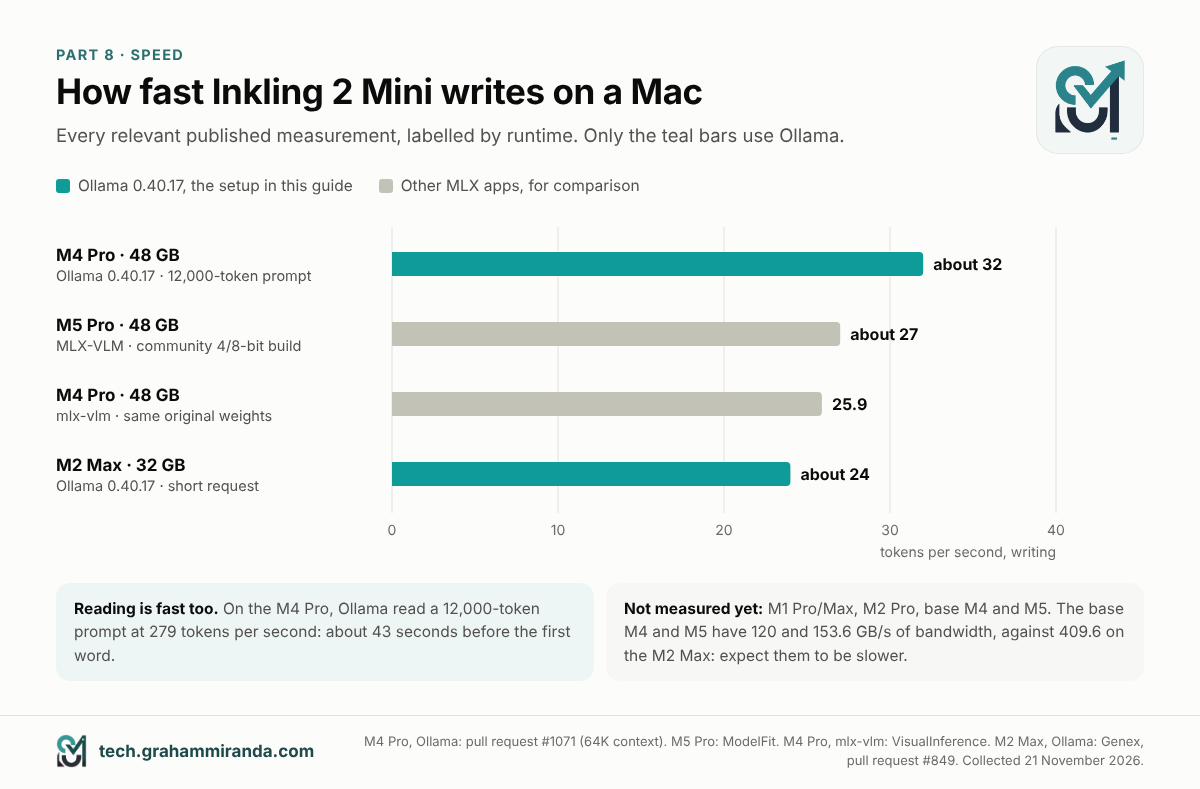
Tốc độ có hai phần: mô hình đọc prompt của bạn nhanh đến đâu và nó viết câu trả lời nhanh đến đâu. Dưới đây là những phép đo liên quan được công bố tính đến ngày 21 tháng 11, kèm runtime mà mỗi phép đo sử dụng:
| Mac | Runtime | Tốc độ ghi | Tốc độ đọc | Ghi chú |
|---|---|---|---|---|
| M2 Max, 32 GB | Ollama 0.40.17 | Khoảng 24 tok/s | Không công bố | Yêu cầu gọi công cụ ngắn |
| M4 Pro, 48 GB | Ollama 0.40.17 | Khoảng 32 tok/s | 279 tok/s | Prompt 12.000 token, ngữ cảnh 64K; tổng cộng 65 giây |
| M4 Pro, 48 GB | mlx-vlm, cùng trọng số gốc | 25,9 tok/s | Không công bố | VisualInference |
| M5 Pro, 48 GB | MLX-VLM, bản dựng 4/8-bit của cộng đồng | Khoảng 27 tok/s | Khoảng 123–144 tok/s với prompt rất ngắn | ModelFit; prompt rất ngắn được đọc chậm, nên con số này không so sánh được với 279 ở trên |
Third-party measurements, collected on 21 November 2026. No published Ollama runs yet for the M1 Pro, M1 Max, M2 Pro, base M4 or base M5.
Những con số đó có ý nghĩa gì trong thực tế
- Với chat, khoảng 24 token mỗi giây là nhanh hơn tốc độ đọc của bạn. Một câu trả lời 300 từ sau một nghìn token suy nghĩ, tổng cộng khoảng 1.400 token, mất khoảng một phút ở tốc độ đó. Hạ mức nỗ lực suy luận cho các câu hỏi nhanh và nó sẽ ngắn đi nhiều.
- Dành cho tác nhân, tốc độ đọc quan trọng ngang tốc độ viết, vì một tác nhân gửi prompt dài ở mỗi lượt. Trên chiếc M4 Pro 48 GB, một prompt 12.000 token mất khoảng 43 giây để đọc. Ollama dùng lại bộ nhớ đệm của phần mở đầu chung của cuộc hội thoại giữa các lượt, nên các lượt sau chủ yếu chỉ đọc phần mới.
- Để so sánh, trên cùng chiếc M4 Pro đó, Qwen3.8-27B mất 122 giây cho tác vụ 12.000 token mà Inkling 2 Mini hoàn thành trong 65 giây. Qwen đọc 107 và viết 27 token mỗi giây. Phần so sánh hai mô hình của tôi đi sâu vào lý do, và vào một điểm cần lưu ý: Inkling 2 Mini có xu hướng viết nhiều token hơn cho mỗi tác vụ.
Kỳ vọng gì trên những máy Mac 32 GB khác
Chưa ai công bố số liệu Ollama cho M4 và M5 bản cơ bản. Băng thông bộ nhớ của chúng là 120 và 153,6 GB/s, so với 409,6 GB/s của M2 Max, chiếc máy đạt khoảng 24 token mỗi giây. Hãy kỳ vọng chúng chậm hơn rõ rệt. Chậm hơn bao nhiêu thì khó nói trước, vì trên phần mềm hiện tại Inkling 2 Mini không tăng tốc tương ứng với băng thông. Nếu bạn có một chiếc, hãy chạy --verbose bài kiểm tra ở Phần 4 và bạn sẽ biết ngay trong một phút.
Phần 9 — Xử lý sự cố Inkling 2 Mini trong Ollama
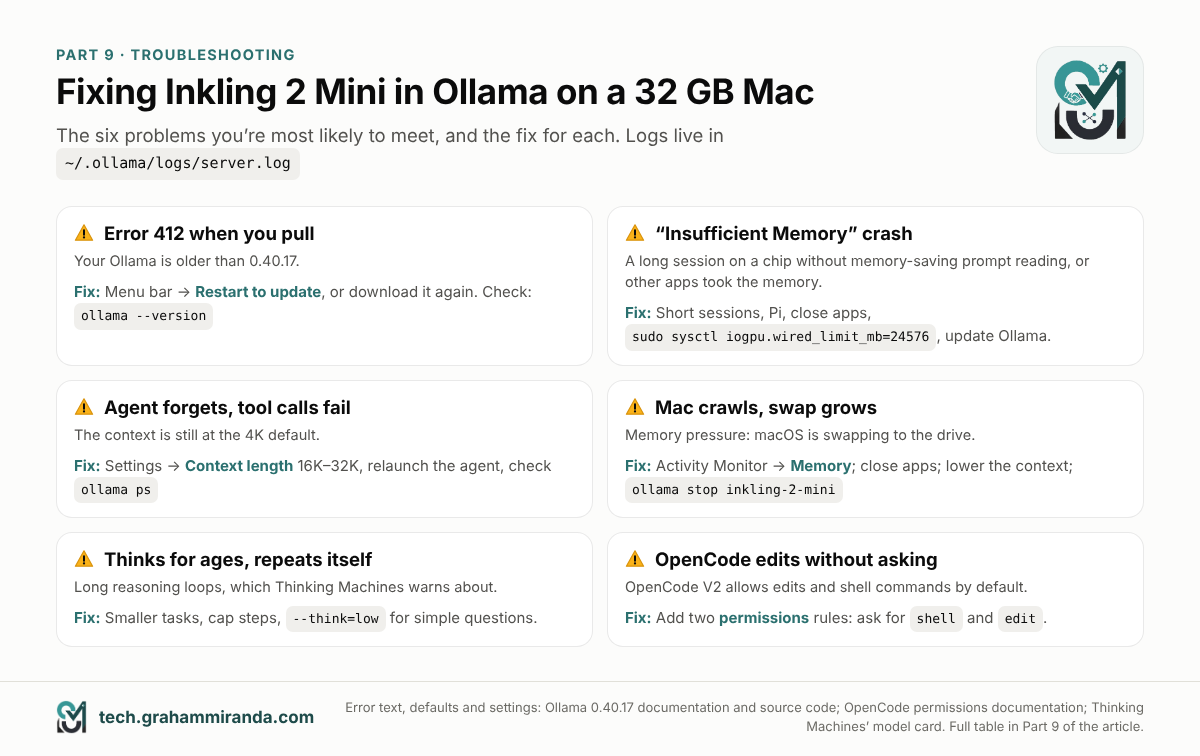
Tìm triệu chứng của bạn bên dưới. Nếu không có trong danh sách, log của Ollama thường cho biết chuyện gì đã xảy ra; phần cuối của mục này chỉ cách đọc log.
Nếu Inkling 2 Mini không tải xuống hoặc không khởi động được
| Triệu chứng | Nguyên nhân khả dĩ | Cách khắc phục |
|---|---|---|
ollama pull inkling-2-mini báo lỗi 412 và "requires a newer version" |
Ollama cũ hơn 0.40.17 | Cập nhật (Phần 2), rồi pull lại |
ollama: command not found |
Liên kết dòng lệnh chưa được tạo | Mở ứng dụng Ollama và chấp nhận lời mời cài lệnh, hoặc cài lại ứng dụng |
PROCESSOR trong ollama ps không ghi 100% GPU |
Có gì đó sai trong thiết lập GPU | Thoát và mở lại Ollama; kiểm tra xem bạn có đang dùng Apple silicon và macOS 14 trở lên không |
| Bạn đang dùng Windows hoặc Linux | Ollama 0.40.17 chỉ hỗ trợ Inkling 2 Mini trên Apple silicon; các mô hình chỉ dành cho Mac của Ollama đã từ chối tải xuống ở nơi khác với 412: this model requires macOS |
Chờ một bản phát hành sau, hoặc dùng llama.cpp hay vLLM |
Nếu Inkling 2 Mini gặp sự cố, quên mất hoặc làm chậm máy Mac của bạn
| Triệu chứng | Nguyên nhân khả dĩ | Cách khắc phục |
|---|---|---|
Mô hình dừng giữa câu trả lời, với Bộ nhớ không đủ hoặc Command buffer execution failed trong log |
Prompt quá dài so với bộ nhớ của chip bạn ở thời điểm hiện tại (Phần 6), hoặc các ứng dụng khác đã chiếm bộ nhớ | Đóng bớt ứng dụng, rút ngắn prompt hoặc các tài liệu bạn dán vào, dùng Pi thay vì một tác nhân nặng hơn, nâng hạn mức GPU (Phần 5), và cập nhật Ollama |
| Tác nhân quên chỉ dẫn, gọi công cụ thất bại, chỉnh sửa dừng giữa chừng | Ngữ cảnh quá nhỏ: có lẽ là mức mặc định 4K | Đặt 16K–32K (Phần 5) và kiểm tra cột CONTEXT trong ollama ps. Rồi khởi chạy lại tác nhân |
| Máy Mac chậm như rùa, quạt quay, swap tăng | Áp lực bộ nhớ | Kiểm tra Activity Monitor; đóng bớt ứng dụng; giảm ngữ cảnh; ollama stop mọi mô hình khác đang được nạp |
| Câu trả lời đầu tiên sau khi nghỉ thì chậm | Ollama đã gỡ mô hình sau năm phút nhàn rỗi | Đặt OLLAMA_KEEP_ALIVE (Phần 5) |
Nếu tác nhân lập trình hoạt động sai
| Triệu chứng | Nguyên nhân khả dĩ | Cách khắc phục |
|---|---|---|
| Mô hình suy nghĩ quá lâu hoặc lặp lại chính nó | Vòng lặp suy luận dài, điều mà Thinking Machines cảnh báo | Giao việc nhỏ hơn, giới hạn số bước và token đầu ra, dùng mức nỗ lực thấp hơn cho câu hỏi đơn giản |
| Tác nhân báo rằng mô hình không tồn tại | Gõ sai tên mô hình | Dùng chính xác inkling-2-mini; ollama ls liệt kê những gì bạn có |
| Tìm kiếm web của Pi không hoạt động | Nó dùng tính năng tìm kiếm web trên đám mây của Ollama | Đăng nhập vào Ollama và bật Cloud, hoặc làm việc mà không có tìm kiếm web |
| OpenCode sửa tệp mà không hỏi | OpenCode v2 cho phép sửa tệp và chạy lệnh shell theo mặc định | Thêm Các quy tắc permissions các quy tắc từ Phần 7 |
Kiểm tra nhật ký của Ollama
Nhật ký của Ollama nằm trong ~/.ollama/logs/server.log. Để xem những dòng cuối sau khi có sự cố:
tail -n 40 ~/.ollama/logs/server.log
Phần 10 — Khi 32 GB không đủ
Bạn sẽ biết mình đã chạm trần khi các prompt dài bị sập, khi các tác nhân liên tục nén cuộc hội thoại, hoặc khi Mac của bạn hoán đổi bộ nhớ mỗi lần mô hình được nạp. Ba lựa chọn đầu không tốn gì; ba lựa chọn cuối tốn tiền, quyền riêng tư hoặc cả hai.
Trên chiếc Mac bạn đang có
- Hãy giữ nó và dùng nó cho những việc phù hợp. Trò chuyện, tài liệu ngắn, câu hỏi về hình ảnh và Pi với các tác vụ nhỏ đều chạy tốt trên mọi chiếc Mac 32 GB. Hãy theo dõi ghi chú phát hành của Ollama: nếu cách đọc prompt tiết kiệm bộ nhớ ở Phần 6 đến được nhiều chip hơn, cục diện sẽ thay đổi chỉ trong một đêm.
- Một tệp nhỏ hơn trong một môi trường chạy khác. Bản 4-bit của Unsloth là 17.6 GB, nhỏ hơn khoảng 2.6 GB so với gói của Ollama, và chạy bằng bản dựng llama.cpp riêng của Unsloth. Nó thiên về kỹ thuật hơn, và hỗ trợ ngay ngày đầu ở đó còn thô hơn; bài so sánh của tôi có đề cập đến nó.
- Một mô hình cục bộ khác. Qwen3.8-27B đạt điểm ngang Inkling 2 Mini trên chỉ số của Artificial Analysis, chạy được ở mọi nơi và giỏi hơn ở các câu hỏi kiến thức, nhưng chậm hơn trên cùng một chiếc Mac. Cùng bài viết đó.
Vượt ra ngoài chiếc Mac của bạn
- Nhiều bộ nhớ hơn. Từ 48 GB, Inkling 2 Mini chạy tác nhân thoải mái, và từ 64 GB bạn có thể giữ nó trong bộ nhớ bên cạnh một mô hình khác. Nếu bạn đang cân nhắc mua gì, các hướng dẫn của tôi về liệu một chiếc MacBook cho LLM cục bộ có đáng không và MacBook Pro M5 Pro với 64 GB xem xét các đánh đổi.
- Người anh lớn, trên đám mây. Inkling 2 Small, mô hình 594 tỷ tham số của Thinking Machines, có trên đám mây của Ollama với tên
inkling-2-small:cloud. Nó hoạt động với cùng các lệnh khởi chạy, ví dụollama launch opencode --model inkling-2-small:cloud. Nó cần một tài khoản Ollama, và khi đó prompt của bạn sẽ rời khỏi máy Mac. - Một gói lập trình cho 10% khó nhất. Nhiều người chạy một mô hình cục bộ cho công việc riêng tư và hằng ngày, rồi đưa những phần lập kế hoạch và gỡ lỗi khó nhất sang một mô hình đám mây lớn. Một lựa chọn phải chăng là Z.ai’s GLM Coding Plan, hoạt động trong OpenCode, Claude Code và các tác nhân khác. Bạn có thể được giảm 10% gói GLM Coding Plan qua liên kết tiếp thị của tôi. (Liên kết tiếp thị — xem phần tiết lộ ở đầu bài.)
Câu hỏi thường gặp
Có. Cả Thinking Machines và Ollama đều hỗ trợ Inkling 2 Mini trên máy Mac Apple silicon có từ 32 GB trở lên, qua Ollama 0.40.17 hoặc mới hơn. Mô hình chiếm khoảng 20 GB, nên trò chuyện và tài liệu ngắn chạy tốt. Prompt dài là giới hạn. Trên hầu hết chip 32 GB, Ollama 0.40.17 vẫn chưa dùng cách đọc prompt tiết kiệm bộ nhớ. Một thử nghiệm trên M2 Max đã sập sau khoảng 12.000 token.
Ollama 0.40.17 hoặc mới hơn. Ollama công bố hỗ trợ Inkling 2 Mini trong 0.40.17 vào ngày 20 tháng 11 năm 2026 dưới dạng bản phát hành trước, và bản 0.40.17 chính thức ra sau đó trong vòng một ngày. Kiểm tra bằng ollama --version. Các phiên bản cũ từ chối tải xuống với lỗi 412. Trong 0.40.17, Inkling 2 Mini chỉ được hỗ trợ trên Apple silicon.
20.188.097.271 byte, khoảng 20,2 GB hay 18,8 GiB. Cả ba tag, latest, 26b-a5b và 26b-a5b-nvfp4, đều là cùng một gói: trọng số NVFP4 và MXFP8 gốc của Thinking Machines’, kèm hỗ trợ hình ảnh. Không có phiên bản Ollama nhỏ hơn. Ở tốc độ 100 Mbit/s, quá trình tải mất khoảng 27 phút.
Ollama đặt ngữ cảnh mặc định theo bộ nhớ GPU mà nó phát hiện: 4K khi dưới khoảng 23 GiB, 32K tới khoảng 47 GiB và 256K khi cao hơn. Trên máy Mac, con số đó là hạn mức GPU mà macOS cho phép, và trên máy Mac 32 GB là khoảng 21,3 GiB, nên bạn nhận được 4K. Thay đổi bằng thanh trượt Context length trong Ollama’s Settings, hoặc nâng hạn mức GPU lên 24 GiB.
16K cho Pi, và 32K cho OpenCode trên M2 Pro, mức cao nhất mà một máy Mac 32 GB có thể thoải mái dành ra cùng một mô hình 20 GB. Trên các chip không có cách đọc prompt tiết kiệm bộ nhớ của Ollama, hãy dùng 8K và phiên ngắn. Ollama khuyến nghị 64K trở lên cho tác nhân lập trình, mức này chạy được từ 48 GB. Hãy đặt trước khi khởi chạy tác nhân, vì ollama launch opencode sẽ chuyển ngữ cảnh đã nạp sang OpenCode.
Trên máy Mac 32 GB, nó có ích. Chạy sudo sysctl iogpu.wired_limit_mb=24576 sẽ nâng hạn mức GPU từ khoảng 21,3 GiB lên 24 GiB và để lại 8 GiB cho macOS. Khi đó Ollama mặc định dùng ngữ cảnh 32K. Thoát rồi mở lại Ollama sau đó. Cài đặt này được đặt lại khi bạn khởi động lại máy Mac; sudo sysctl iogpu.wired_limit_mb=0 khôi phục mặc định sớm hơn. Đây không phải cài đặt chính thức của macOS, nên hãy hoàn tác nếu máy Mac của bạn swap nhiều hoặc trở nên không ổn định.
Dùng --think cờ: ollama run inkling-2-mini --think=low. Ollama chấp nhận none, minimal, thấp, medium, cao (mặc định), xhigh và tối đa, giá trị mà nó gửi cho mô hình dưới dạng mức nỗ lực từ 0 đến 0,99. Trong cuộc trò chuyện, /set nothink sẽ đặt mức thấp nhất và ẩn phần suy nghĩ. Ngay cả mức tối thiểu cũng không tắt hoàn toàn suy luận.
Pi, vì system prompt và các công cụ của nó chỉ dưới 1.000 token, giúp prompt ngắn gọn: ollama launch pi --model inkling-2-mini. Nhưng Pi chạy lệnh mà không hỏi, nên chỉ dùng nó trong một thư mục tạm. OpenCode khởi đầu với khoảng 6.900 token và hoạt động ở ngữ cảnh 32K, tốt nhất trên M2 Pro. Nó hỏi trước khi hành động sau khi bạn thêm hai quy tắc cấp quyền vào cấu hình. Claude Code mặc định hỏi trước, nhưng yêu cầu đầu tiên của nó đo được khoảng 32.800 token, nhiều hơn sức chứa của ngữ cảnh 32K, nên nó phù hợp hơn từ 48 GB.
Nhiều khả năng prompt hoặc cuộc trò chuyện quá dài so với bộ nhớ GPU của máy Mac. Ollama 0.40.17 chỉ đọc prompt dài bằng một phương pháp tiết kiệm bộ nhớ trên M2 Pro, M2 Ultra, M3 Ultra, M4 Pro và M5 Pro, Max và Ultra. Trên các chip khác, mức dùng bộ nhớ tăng theo mọi thứ mô hình đã đọc, và một chiếc M2 Max 32 GB đã sập sau 12.288 token. Hãy đóng các ứng dụng khác, giữ phiên ngắn, dùng Pi, nâng hạn mức GPU và cập nhật Ollama.
Trong bài thử Ollama công bố duy nhất trên một máy Mac 32 GB, một chiếc M2 Max, một yêu cầu ngắn chạy ở khoảng 24 token mỗi giây. Trên một máy M4 Pro 48 GB với Ollama 0.40.17, nó ghi ở khoảng 32 token mỗi giây và đọc một prompt 12.000 token ở 279 token mỗi giây. Các máy Mac M4 và M5 bản cơ bản có băng thông bộ nhớ ít hơn nhiều và sẽ chậm hơn; chưa có bài chạy thử nào được công bố.
Không, không thể với gói của Ollama, gói này chỉ có một phiên bản 20 GB, và Thinking Machines hỗ trợ 32 GB là mức tối thiểu. Unsloth phát hành các tệp 2-bit và 3-bit khoảng 9 đến 14 GB, chạy được bằng bản llama.cpp riêng của họ trên những máy Mac nhỏ hơn. Chúng mất một phần chất lượng và cần thiết lập nhiều hơn.
Không, khi chạy cục bộ thì không. Ollama chạy mô hình trên máy Mac của bạn, và FAQ của nó nói rằng nó không thấy prompt hay dữ liệu của bạn khi bạn chạy cục bộ. Các tác nhân lập trình được khởi chạy bằng ollama launch nói chuyện với Ollama tại localhost:11434, ngay trên máy của bạn. Mô hình đám mây và tìm kiếm web thì khác: chúng gửi dữ liệu đến máy chủ của Ollama, và bạn có thể tắt chúng bằng cài đặt Cloud. Các tác nhân là những chương trình riêng có công cụ mạng riêng, ví dụ tính năng tải web của OpenCode, nên hãy kiểm tra cài đặt của chúng nếu bạn cần làm việc hoàn toàn ngoại tuyến.
Không có trong Ollama 0.40.17, bản có ghi chú phát hành nói rằng Inkling 2 Mini chỉ được hỗ trợ trên Apple silicon. Trên phần cứng NVIDIA, Thinking Machines hỗ trợ vLLM và SGLang, và bản llama.cpp của Unsloth chạy các tệp GGUF của nó. Một bản Ollama sau này có thể bổ sung nền tảng khác.
Chạy ollama rm inkling-2-mini. Xóa mọi bản sao bạn đã tạo bằng ollama create, chẳng hạn inkling-2-mini-32k, theo cùng cách: 20 GB trọng số được giải phóng khi không còn mô hình nào dùng chúng. Để gỡ chính Ollama, hãy thoát nó, xóa nó khỏi Applications và xóa thư mục .ollama trong thư mục home của bạn; tài liệu macOS của Ollama liệt kê từng tệp.
Điểm mấu chốt
Inkling 2 Mini là một mô hình mở có năng lực mà nhà sản xuất hỗ trợ trên máy Mac 32 GB, và Ollama làm cho những bước cơ bản thực sự dễ dàng: cài đặt, tải về, chạy. Với trò chuyện, tài liệu và câu hỏi về hình ảnh, một máy Mac 32 GB là đủ.
Tác nhân là chỗ 32 GB trở nên chật vật, vì hai lý do. Ollama khởi động hầu hết máy Mac 32 GB ở cửa sổ ngữ cảnh 4K, điều này âm thầm làm hỏng tác nhân cho đến khi bạn thay đổi. Và trên hầu hết chip 32 GB, prompt dài vẫn có thể hết bộ nhớ, vì cách đọc prompt tiết kiệm bộ nhớ của Ollama chỉ bao phủ một số chip. Vậy hãy đặt ngữ cảnh, nâng ngân sách GPU và đóng trình duyệt. Bắt đầu với Pi trong một thư mục tạm, và cập nhật Ollama thường xuyên.
Nếu bạn có M2 Pro, bạn đang ở vị trí tốt nhất mà một máy Mac 32 GB có thể có hôm nay. Nếu bạn có 48 GB trở lên, hầu hết các lưu ý ở đây không còn áp dụng. Và dù bạn có máy Mac nào, ollama run inkling-2-mini --verbose nó cho bạn biết nhiều hơn về cỗ máy của chính bạn trong năm phút so với bất kỳ bảng nào trong hướng dẫn này.
Đang chạy Inkling 2 Mini trên máy Mac 32 GB? Hãy chia sẻ chip, phiên bản Ollama, thiết lập ngữ cảnh và --verbose các con số trong phần bình luận, đặc biệt là từ M1, M4 hoặc M5. Tôi sẽ thêm những kết quả hữu ích nhất vào Phần 8, có ghi nguồn. Cũng hoan nghênh các chỉnh sửa: với hỗ trợ còn mới như thế này, một số chi tiết hôm nay sẽ thay đổi nhanh.
Tiết lộ: Hướng dẫn này có một liên kết tiếp thị liên kết, đến GLM Coding Plan của Z.ai’s (ở Phần 10). Đăng ký qua đó bạn được giảm 10% và tôi có thể nhận được hoa hồng mà bạn không phải trả thêm chi phí nào. Không có sản phẩm hay công ty nào khác trong hướng dẫn này được tài trợ, và không bên nào trong số đó xem xét nội dung này trước khi xuất bản.
Đã kiểm chứng thông tin: 21 tháng 11 năm 2026.