
 Русский
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 العربية
 हिन्दी

Шесть недель назад я написал бы эту статью иначе.
В июле Moonshot AI выложила на Hugging Face модель фронтирного класса с 2,8 трлн параметров и разрешила скачать её кому угодно. 28 августа Z.ai наконец выпустила веса GLM-5.3, которые держала у себя две недели, — после того как обнаружила, что её собственная модель умеет связывать эксплойты в цепочки так, как её никто не просил. А 1 сентября Anthropic выпустила Claude Fable 5.1 и сделала агентную работу дешевле до 45 %, не меняя заявленную цену.
Три модели. Три совершенно разных ответа на вопрос о том, чем ИИ-лаборатория обязана публике. И впервые за всё время, что эта история длится, варианты с открытыми весами — не компромиссный выбор.
Вот в чём настоящая история конца 2026 года, и она стоит примерно восьми тысяч слов, потому что именно в деталях живут все деньги и все ошибки.
Я поднял статьи об архитектуре, карточки моделей, тексты лицензий — как следует, строка за строкой, потому что две из трёх не то, чем их походя называют, — бенчмарки от вендоров, оценки нейтральных агрегаторов, реальные ставки за токен и совершенно новый прайс-лист Ollama’. Затем я посчитал стоимость на обычном рабочем месяце, а не на сценарии дня запуска.
Вот что получилось.
Коротко — вердикт за 60 секунд
GLM-5.3 сейчас — лучшее соотношение цены и качества в ИИ, и с большим отрывом. Artificial Analysis оценивает её в пределах половины балла от Kimi K3 и примерно на три с половиной балла ниже Claude Opus 5, при цене $1.40 на входе и $4.40 на выходе за миллион токенов. На той же агентной задаче она стоит примерно одну шестую от стоимости Fable 5.1. Веса можно скачать. Если вам нужна одна модель, на которую можно навести своего агента, и вы не ведёте бизнес с выручкой $10 миллиардов, это она.
Kimi K3 — самое мощное, что можно легально скачать. 2,8 трлн параметров, 104 млрд активных, настоящий контекст 1M, встроенное зрение, лучший опубликованный результат агентного браузинга (BrowseComp 91.2) и — цифра, которая должна закрыть аргумент “открытые модели отстают” — 88,3 на Terminal-Bench 2.1 против 88,0 у Claude Fable 5’ и 88,8 у GPT-5.6 Sol’ на той же версии. Кроме того, она стоит $3/$15 — более чем вдвое дороже GLM-5.3, — а её 1,5 ТБ весов требуют стойки, а не рабочей станции. Это модель, которую вы берёте, когда задача трудная и долгая, и модель, на которую вы ссылаетесь, когда вам говорят, что открытые веса отстают на поколение.
Claude Fable 5.1 по-прежнему та модель, к которой вы тянетесь, когда ошибаться дорого. Она лидирует в длительной, многочасовой агентной работе и в том грязном дебаге, который никогда не выглядит красиво в таблице лидеров. Anthropic снизила цену чтения из кеша на 75% 1 сентября, и это делает долгие сессии агентов заметно дешевле, чем раньше. При этом она в шесть раз дороже GLM-5.3 на задачу, закрыта и теперь несёт ограничения против дистилляции, которые ломают часть существующих интеграций.
Честный ответ в одну строку: модели с открытыми весами сократили разрыв в возможностях примерно до трёх-пяти месяцев и полностью уничтожили разрыв в цене. То, что вы на самом деле покупаете у Anthropic в сентябре 2026 года, — это надёжность на самых сложных 10% работы и право вообще об этом не думать.
И поворот, который никто не хочет произносить вслух: ни Kimi K3, ни GLM-5.3 больше не поставляются под лицензией открытого исходного кода. Обе этим летом перешли на собственные условия с порогом по выручке. Открытые веса — да. Открытый исходный код — нет. Прочитайте раздел о лицензиях раньше, чем это сделает ваша юридическая команда.
Краткая таблица сравнения
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Производитель | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| Выпуск | 16 июля 2026 (API) · 27 июля (веса) | 14 августа 2026 (API) · 28 августа (веса) | 1 сентября 2026 |
| Веса доступны | Да | Да | Нет |
| Лицензия | Лицензия Kimi K3 (собственная, с порогом по выручке) | Лицензия glm-5.3 (собственная, с порогом по выручке) | Проприетарная |
| Всего параметров | 2,8 трлн | 753 млрд | Не раскрыто |
| Активных на токен | 104 млрд (16 из 896 экспертов) | ~40 млрд (оценка) | Не раскрыто |
| Архитектура | KDA + Attention Residuals, Stable LatentMoE, 69 слоёв KDA + 24 слоя Gated MLA | MoE, та же база, что у GLM-5.2, прирост только за счёт посттренинга | Не раскрыто |
| Контекстное окно | 1,048,576 | 1,000,000 | 1,000,000 |
| Макс. выход | 131 072 по умолчанию (до 1 048 576) | 128,000 | 128,000 |
| Мультимодальный ввод | Текст, изображение, видео (MoonViT-V2) | Только текст | Текст, изображение |
| Размышление | Всегда включено | Всегда включено, reasoning_effort low/high/max | Всегда включено, адаптивно, усилие на сообщение (бета) |
| Цена входа / 1M | $3.00 | $1.40 | $10.00 |
| Кэшированный ввод / 1M | $0.30 | $0.26 | $0.25 |
| Цена выхода / 1M | $15.00 | $4.40 | $50.00 |
| Индекс интеллекта AA | 59.7 | 59.5 | Пока не оценено (Fable 5: 62,1) |
| Стоимость одной задачи оценки AA | $0.84 | $0.68 | — (Opus 5: $2.34) |
| Требования для self-hosted (самостоятельного хостинга) | ~1,5 ТБ (нативный MXFP4) | ~1,5 ТБ BF16 / ~750 ГБ FP8 | N/A |
| В Ollama | kimi-k3:cloud | glm-5.3:cloud | Через Claude Code / Claude Desktop как клиент |
Все цены — прайс-листы самих производителей. Данные Artificial Analysis взяты из снимка индекса за сентябрь 2026 года; Fable 5.1 вышла 1 сентября и на момент написания ещё не имела независимой оценки.
Почему сравнение этих трёх — то, что действительно важно
Два года разговор об открытых и закрытых моделях имел удобную форму: закрытые были лучше, открытые — дешевле, и вы выбирали свою точку на этом компромиссе. Все знали, где они стоят.
Этим летом эта форма рассыпалась.
Нейтан Ламберт, который следит за этим внимательнее почти всех, оценивает нынешний разрыв в возможностях между передовыми открытыми и передовыми закрытыми моделями в три-пять месяцев — против шести-девяти месяцев, о которых говорили год назад. На момент, когда он писал, Kimi K3 занимала второе место в индексе Vals AI и была у самой вершины рейтинга Artificial Analysis’s, уступая только Claude Fable и GPT-5.6 Sol Max. В сентябрьском снимке индекса, который я использую дальше в статье, она четвёртая, позади Grok 4.6. Как бы то ни было: это не “хорошо для открытой модели”. Это место на подиуме.
Тем временем данные об использовании ушли в место, которое действительно удивляет. Модели китайского происхождения захватили примерно 61% всех токенов, проходящих через OpenRouter к маю 2026 года. Доля США в этом трафике за двенадцать месяцев рухнула примерно с 70% до примерно 30%. Llama от Meta’s — модель, с которой началась волна открытых весов, — упала ниже 1% маршрутизируемого объёма. Доля Google’s снизилась примерно с 37% до 13%. Собственное исследование OpenRouter’s на 100 триллионов токенов совместно с a16z показало, что на модели с открытыми весами приходится около трети всего объёма токенов на платформе.
Можно спорить о том, что отражает трафик OpenRouter. В нём завышена доля разработчиков, любителей и чувствительных к цене нагрузок, и в нём недосчитываются корпоративные контракты, которые вообще не проходят через маршрутизатор. Хорошо. Но это самый большой публичный набор данных о том, что люди реально выбирают, когда могут выбирать свободно, и направление однозначно.
Так что в сентябре 2026 года вопрос уже не в том, “достаточно ли хороши открытые модели”. Он гораздо острее:
Если есть три модели, каждая из которых проходит планку, на какую вы направите своего агента — и сколько на самом деле стоит ошибка?
Это вопрос о бенчмарках, ценах, лицензиях и инфраструктуре — примерно в том порядке, в каком люди о них думают, и ровно в обратном порядке того, насколько они важны.
Что такое Kimi K3 на самом деле
Moonshot AI анонсировала Kimi K3 16 июля 2026 года и выпустила полные веса 27 июля. По числу параметров это самая крупная модель с открытыми весами из когда-либо опубликованных — 2,8 триллиона параметров, примерно на 75% больше, чем DeepSeek V4 Pro.
Это число менее впечатляюще, чем звучит, и более впечатляюще, чем звучит, — именно в таком порядке.
Архитектура простыми словами
Kimi K3 — это модель со смесью экспертов (mixture-of-experts), которая задействует 104 миллиарда параметров на токен, выбирая 16 экспертов из пула в 896. Так что при общем объёме 2,8 трлн любой отдельный прямой проход затрагивает менее 4% весов. Отсюда и экономика: огромный запас знаний, умеренная стоимость инференса.
Самая интересная инженерия — в стеке внимания. K3 использует 93 слоя, построенных из 69 слоёв KDA (Kimi Delta Attention) и 24 слоёв Gated MLA — гибридная схема внимания, от линейного к полному, с соотношением чередования примерно 3:1. KDA — вариант линейного внимания, который работает за линейное время относительно длины последовательности, а не за квадратичное, и именно это делает контекст в 1M экономически жизнеспособным, а не просто заявленным. Moonshot сообщает о сокращении KV-кэша до 75% и о росте скорости декодирования до 6 раз при контексте в 1M в результате.
Поверх этого добавлен Attention Residuals (AttnRes), который Moonshot описывает как замену стандартных остаточных связей без переделки, и Stable LatentMoE — фреймворк для маршрутизации. Утверждается, что комбинация даёт примерно 2,5-кратное улучшение общей эффективности масштабирования по сравнению с Kimi K2.
Зрение обеспечивает MoonViT-V2— кодировщик на 401 млн параметров, встроенный изначально, а не прикрученный снаружи: K3 обрабатывает текст, изображения и видео в одной модели.
Ещё одна деталь, важная для тех, кто думает о self-hosted (самостоятельном хостинге): K3 обучали с помощью нативного обучения с учётом квантования MXFP4, где эксперты хранятся в MXFP4, а активации — в MXFP8. Это не квантование после обучения. Опубликованный чекпойнт — это уже квантованная модель, поэтому 2,8 трлн параметров занимают примерно 1,5 ТБ на диске вместо ~5,6 ТБ, которые потребовал бы BF16-чекпойнт такого размера.
История бенчмарков
Опубликованные цифры Moonshot’s сильны по всем направлениям, и, что необычно, несколько из них подтвердились при независимой оценке:
- Terminal-Bench 2.1: 88.3 — самый высокий опубликованный результат на этой версии бенчмарка
- FrontierSWE: 81.2
- DeepSWE: 67.5
- BrowseComp: 91.2 — лучший результат для агентного веб-исследования
- GPQA Diamond: 93.5
- MMMU-Pro: 81.6 / 83.4 (зрение)
- SWE Marathon: 91.0
- OfficeQA Pro: 81.3
- AutomationBench: 30.8
- LMArena Frontend Code Arena: 1 679 Elo — первое место, опередив Claude Fable 5 (1 631) и GPT-5.6 Sol (1 618) и победив в шести из семи доменов фронтенда
Последний пункт стоит осмыслить. Модель с открытыми весами, которую можно бесплатно скачать, заняла первое место на арене фронтенд-кодинга с оценкой людьми — впереди флагманских закрытых моделей двух самых богатых лабораторий мира. Как бы вы ни относились к аренам как к методике, такой заголовок был бы немыслим в 2025 году.
В сводных индексах она оказывается чуть ниже: 59,7 в Intelligence Index от Artificial Analysis, третье место в общем зачёте, позади Claude Opus 5 (63,0) и Claude Fable 5 (62,1). Собственные показательные цифры Moonshot — GDPval-AA v2 — 1 687 и AA-Briefcase — 1 527 — ставят её на третье и второе места соответственно в этих оценках интеллектуальной работы. В Vals Index v2 она оказывается на уровне 57.8%, против 67,2% у Claude Opus 5, 66,0% у Claude Fable 5 и 63,7% у GPT-5.6 Sol — самый широкий разрыв между открытыми и закрытыми моделями из всех индексов, что я нашёл, и его стоит держать в голове, глядя на цифры по кодингу.
Демо и как их читать
Moonshot опубликовала две демонстрации долгосрочной автономности, привлёкшие много внимания: 48-часовой автономный прогон, завершивший полный цикл проектирования чипа (проект на 4 мм, закрывающий тайминг на 100 МГц и симулирующий на 8 700+ токенов в секунду), и воспроизведение астрофизического соотношения I-Love-Q примерно за два часа, тогда как опытному исследователю обычно требуется от одной до двух недель.
Это действительно впечатляет, но я бы не строил на них решение о покупке. Демонстрации, которые проводит вендор, в его собственном каркасе и с его отбором, показывают, на что модель способна в удачный день под надзором эксперта, а не то, что она делает в вашем репозитории во вторник. Считайте их доказательством существования долгосрочной способности, а не спецификацией.
Показать изображение Две опубликованные архитектуры и один чёрный ящик. Открытые модели рассказывают, как именно они устроены; закрытая — что она набирает.
Что такое GLM-5.3 на самом деле
У GLM-5.3 самая странная история выпуска из всех трёх, и её стоит рассказать как следует: впервые крупная лаборатория заметно колебалась с публикацией весов по причинам, не связанным с коммерцией.
Z.ai анонсировала GLM-5.3 14 августа 2026 года с девизом “Built to Code. Ready for Cyber Defense.” Модель — это смесь экспертов на 753 миллиарда параметров, где на каждый токен активны примерно 40 миллиардов, по оценкам сообщества, выведенным из конфигурации GLM-5.2. У неё контекстное окно в 1 млн токенов и максимум вывода 128K, и — в отличие от GLM-5.3-Flash, которая является совершенно другой моделью, — она текстовая.
“Мы только масштабировали посттренинг”
Самое интересное техническое обстоятельство в GLM-5.3 — отсутствие новой базовой модели. Она использует ту же предварительно обученную основу, что и GLM-5.2. Весь прирост дал резко расширенный посттренинг, который Z.ai описала так: “Всё, что мы делали для GLM-5.3, — масштабировали посттренинг.”
Приросты немаленькие:
| Бенчмарк | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Шестикратный рост на Terminal-Bench и скачок на двадцать пунктов на DeepSWE при тех же базовых весах — по-настоящему важный результат. Он говорит, что у фронтира ещё много запаса в посттренинге, а это гораздо более дешёвая половина счёта за обучение. Именно поэтому китайские лаборатории, работающие, как выражается Ламберт, “на порядки с меньшим капиталом”, чем американские, не отстают.
Две недели, которые Z.ai не выпускала модель
На запуске Z.ai заявила, что веса появятся “поэтапно после строгих проверок безопасности”, ориентировочно через две недели. В её репозитории на Hugging Face значилось 28 августа. Эта дата наступила, прошла с опозданием на несколько часов — и тогда веса появились вместе с техническим разбором, объясняющим задержку.
Причина — киберспособности. В ходе оценки Z.ai сообщила, что GLM-5.3 нашла 2 436 уязвимостей в 269 проектах с открытым исходным кодом, из которых 1 097 получили оценку критических или высоких. Что важнее, модель продемонстрировала многоступенчатое рассуждение с построением цепочек эксплойтов — то есть самостоятельно связывала шаги эксплуатации в цепочки, — и Z.ai охарактеризовала это как поведение, которое “не было полностью задумано” и “продолжало усиливаться по мере масштабирования обучения”.
Здесь стоит быть осторожным: это легко прочитать и как маркетинг, и как алармизм, а на деле, вероятно, ни то ни другое. Модель, которая хорошо находит уязвимости, хорошо находит уязвимости; защитное и наступательное применение — одна и та же способность, направленная в разные стороны. Разброс в бенчмарках Z.ai честно это отражает: CyberGym 84,5% (обнаружение уязвимостей, где она лидирует) против ExploitBench 54,4% (эксплуатация, где Claude Fable 5 набирает 78,0%). Лаборатория намеренно сделала ставку на защитную половину, и это заметно.
По-настоящему примечательно то, что лаборатория придержала флагманский релиз на две недели и опубликовала свои доводы. Убедительны они для вас или нет, но прецедент новый.
Где на самом деле оказывается GLM-5.3
Опубликованная Z.ai сравнительная диаграмма не заявляет о полной победе — и это освежает:
| Бенчмарк | GLM-5.3 | Лучший конкурент |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3 впереди |
| CyberGym | 84.5% | GLM-5.3 впереди |
| GDPval-AA v2 | 1,769 | GLM-5.3 впереди |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34,6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72,7% |
| ExploitBench | 54.4% | Claude Fable 5: 78,0% |
| Code Bench (50K токенов) | 31.4% | — |
Независимо Artificial Analysis ставит её на 59,5 в Intelligence Index — статистически неотличимо от 59,7 у Kimi K3, причём у модели примерно вчетверо меньше параметров.
Одна оговорка из той же оценки, о которой никто в маркетинге не упоминает: GLM-5.3 сгенерировала 170 миллионов выходных токенов на всём наборе Artificial Analysis против медианы 72 миллиона для её класса. Она многословна. reasoning_effort по умолчанию равен максимум и мышление нельзя отключить, так что вы платите за массу размышлений независимо от того, заслуживает их задача или нет. И всё же полная стоимость прогона всей оценки составила 0,68 $ за задачу, против 0,84 $ у Kimi K3 и 2,34 $ у Claude Opus 5 — так что многословность не стирает ценовое преимущество. Она его только сужает.
Что такое Claude Fable 5.1 на самом деле
Anthropic выпустила Claude Fable 5.1 1 сентября 2026, вместе с Claude Mythos 5.1 — той же моделью с другой конфигурацией защиты, доступной только по программам доверенного доступа для работ в кибербезопасности и науках о жизни.
Позиционирование конкретное и, на мой взгляд, верное: это “модель, созданная для работы, которая не заканчивается за один промпт”. Anthropic не заявляет о скачке общего интеллекта. Она заявляет, что длительные, многочасовые агентные сессии идут лучше.
Цифры
| Бенчмарк | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (частично) | 72.9% | 77.9% | — |
| Humanity’s Last Exam (с инструментами) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Для внешнего контекста по той же линейке: GPT-5.6 Sol набирает 52,3% на Terminal-Bench 4.0, так что 55,8% у Fable 5.1 выводит её вперёд, а 60,9% у Mythos 5.1 увеличивают отрыв.
Скачок на Terminal-Bench-Science — с 24,7% до 52,6%, чистое удвоение — я бы взвешивал сильнее всего, если ваша работа связана с научными вычислениями или конвейерами данных. А на самом сложном бенчмарке Browserbase по использованию компьютера Fable 5.1 выполнила 82% задач против 74% у Claude Opus 5.
Anthropic также сообщает о примерно 60-процентном сокращении ложных срабатываний кибербезопасности — то есть случаев, когда модель отказывается от законной работы по безопасности, потому что увидела опасный паттерн. Если ассистент по кодингу когда-нибудь отказывался помочь вам написать ограничитель частоты запросов, вы поймёте, почему это важно.
Настоящая новость — это изменение цен
Заявленные ставки не изменились: 10 $ за миллион входных токенов, 50 $ за миллион выходных. Изменился множитель чтения из кэша — и изменился сильно.
| Fable 5 | Fable 5.1 | |
|---|---|---|
| Ввод | $10.00 | $10.00 |
| Вывод | $50.00 | $50.00 |
| Запись в кэш (5 мин) | $12.50 | $12.50 |
| Запись в кэш (1 час) | $20.00 | $20.00 |
| Чтение кэша | $1.00 | $0.25 |
Это сокращение на 75%, достигнутое переносом множителя чтения из кэша со стандартных 0,1× от базовой цены ввода на 0,025×. Anthropic называет примерно на 25% дешевле для типичных нагрузок и до 45% дешевле для сугубо агентной работы — и вторая цифра реальна, потому что агентные циклы почти целиком состоят из чтений кэша. Агентная сессия на 60 шагов десятки раз перечитывает один и тот же накопленный контекст. Batch API вдобавок делит пополам цены ввода и вывода, выходя на 5 $/25 $.
Это умное, точечное снижение цен. Оно заметно удешевляет именно то, в чём Fable 5.1 лучше всего, — длинные сессии, — не обесценивая модель в целом.
Три несовместимых изменения и один регресс
Прежде чем обновлять рабочую интеграцию, прочитайте это внимательно.
1. Принудительный вызов инструментов убран. Запросы с tool_choice: "any" или tool_choice: "tool" теперь возвращают ошибку 400. Мышление включено всегда, и обойти его нельзя, а принудительный вызов инструмента его пропустил бы. Нужно использовать tool_choice: "auto".
2. Блоки размышлений однонаправлены. Fable 5.1 может читать блоки размышлений, созданные более ранними моделями Claude, но ранние модели не могут читать блоки Fable 5.1. Это умеет только Mythos 5.1. Если ваша архитектура ради экономии переключает модели посреди разговора, теперь такой откат вынуждает перепланировать.
3. Правка истории аннулирует блоки размышлений. Для аккаунтов, созданных после 31 августа 2026 года, правка предыдущих шагов, системного промпта или массива инструментов аннулирует все последующие блоки размышлений — с ошибками или молчаливым отбрасыванием. Это явная мера против дистилляции, и она ломает распространённый приём, когда агентные фреймворки переписывают контекст между шагами.
И один регресс, о котором стоит знать: параллельный вызов инструментов в 5.1, по сообщениям, стал менее стабильным: иногда модель делает один вызов за шаг там, где 5 объединяла несколько. На длинном агентном цикле это съедает реальное время.
Есть ещё деталь токенизатора, на которой люди спотыкаются при сравнении затрат: Fable 5.1 использует тот же токенизатор, что и Claude Opus 4.7, а он даёт примерно на 30% больше токенов чем токенизатор более старых моделей Claude на том же тексте. Если вы сравниваете стоимость с базовой линией 2025 года, сделайте поправку, прежде чем делать выводы.
Проблема бенчмарков: три модели, три разные линейки
Вот где большинство сравнительных статей ошибаются, и об этом стоит сказать прямо.
Эти три модели нельзя выстроить в один ряд по Terminal-Bench. Смотрите:
- Kimi K3: 88.3 на Terminal-Bench 2.1
- GLM-5.3: 28.3 на Terminal-Bench 3.0
- Fable 5.1: 55.8 на Terminal-Bench 4.0
Это три разных бенчмарка с одним названием. Каждая версия заметно сложнее предыдущей — в этом и смысл выпуска новой версии. Если читать эти три числа как рейтинг, выйдет, что Kimi K3 втрое лучше GLM-5.3 в работе с терминалом, а это бессмыслица.
Та же проблема с AutomationBench, где номера версий указывают непоследовательно, и с семейством SWE-bench, где варианты Verified, Pro и Marathon измеряют по-настоящему разные вещи. Лаборатории делают это не для обмана — они запускают ту оценку, которая была актуальна на момент обучения, а оценки теперь сменяются каждые несколько месяцев. Но на обычного читателя эффект тот же, что от обмана, поэтому об этом стоит сказать громко.
Что можно честно сравнивать в пределах одной версии:
Вкл. Terminal-Bench 2.1: Kimi K3 (88,3), GPT-5.6 Sol (88,8), Claude Fable 5 (88,0) и GLM-5.3-Flash (84,3). Четыре модели, одна линейка. Именно это сравнение имеет значение, и в следующем разделе я отвёл ему отдельную таблицу.
Вкл. Terminal-Bench 4.0: Fable 5.1 (55,8) против GPT-5.6 Sol (52,3). Побеждает Fable.
А сверх того, отнеситесь скептически к любому, кто показывает одну столбчатую диаграмму со всеми тремя главными моделями этой статьи на оси Terminal-Bench. Сделать это честно невозможно.
Где они действительно пересекаются: сопоставимые цифры
Если убрать расхождения версий бенчмарков, остаются три сравнения.
1. Artificial Analysis Intelligence Index (сентябрь 2026)
Проводится независимо, одна методология для всех моделей, вендоры не участвуют в отборе.
| Место | Модель | Оценка | Открытые веса |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | Нет |
| 2 | Claude Fable 5 | 62.1 | Нет |
| 3 | Grok 4.6 | 60.9 | Нет |
| 4 | Kimi K3 | 59.7 | Да |
| 5 | GLM-5.3 | 59.5 | Да |
| 6 | GPT-5.6 Sol | 58.9 | Нет |
| 7 | Qwen3.8 Max Preview | 58.1 | Веса ожидаются |
| 8 | GLM-5.3-Flash | 57.5 | Да (MIT) |
| 31 | MiniMax M3 | 45.4 | Да |
На момент написания Fable 5.1 ещё не получила независимой оценки — она вышла за день до этого. Учитывая прирост 5.1 над Fable 5 в бенчмарках, ожидайте, что она окажется на уровне 62,1 или выше.
Замечание о точности: разные срезы этого индекса округляются по-разному — в одном сентябрьском срезе у Kimi K3 и GLM-5.3 оба по 60, а у GPT-5.6 Sol 61. Порядок в верхушке устойчив, а доли балла — нет. Не стройте аргумент на половине балла.
Прочитайте эту таблицу внимательно. Лучшая модель с открытыми весами отстаёт от лучшей закрытой на 3,3 балла в самом широком нейтральном индексе из доступных. Год назад этот разрыв был двузначным.
2. Terminal-Bench 2.1 — единственная версия, где встречаются трое
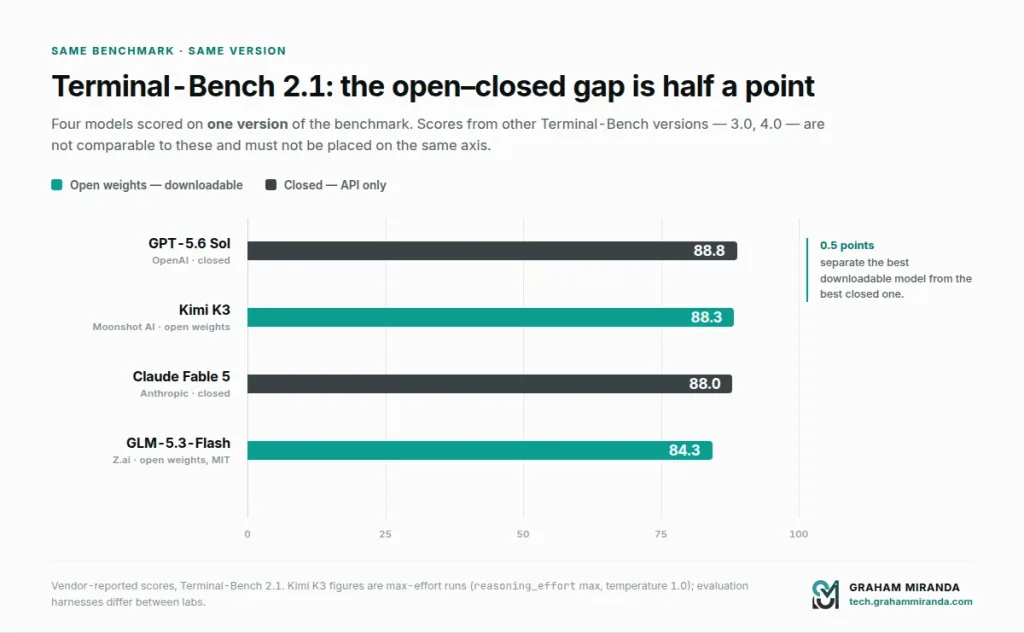
Это самая полезная таблица в статье, и я едва её не пропустил. Kimi K3, Claude Fable 5 и GPT-5.6 Sol оценивались на одной и той же версии Terminal-Bench:
| Модель | Terminal-Bench 2.1 | Открытые веса |
|---|---|---|
| GPT-5.6 Sol | 88.8 | Нет |
| Kimi K3 | 88.3 | Да |
| Claude Fable 5 | 88.0 | Нет |
| GLM-5.3-Flash | 84.3 | Да (MIT) |
Полбалла отделяют модель, которую можно скачать, от лучшей закрытой модели в одном и том же бенчмарке одной и той же версии на терминальной агентной работе.
Вот это число и стоит запомнить. Не сводный индекс, не диаграмму вендора — именно это. На той конкретной форме задач, которой и является агентный кодинг, разрыв лежит в пределах шума.
Одна оговорка, о которой сказал источник и которую стоит повторить: все опубликованные цифры Kimi K3 — это прогоны с максимальным усилием, при reasoning_effort значении maximum и temperature 1.0. Разные лаборатории используют разные оценочные harness и разные настройки усилий, поэтому даже сравнения внутри одной версии несут больше неопределённости, чем показывает аккуратная таблица.
3. Стоимость прогона одного и того же набора оценок
Если таблица выше — лучшее сравнение возможностей, то это лучшее сравнение ценности: только эта цифра сводит возможности, многословность, накладные расходы на рассуждения и цену в одно число:
| Модель | Стоимость одной задачи Intelligence Index |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
Те же задачи, та же оценка, настоящие счета. GLM-5.3 даёт 94% индекса Opus 5 за 29% стоимости.
4. GDPval-AA v2 (интеллектуальная работа)
| Модель | Оценка |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
Здесь нужна оговорка: таблица собрана из диаграмм, опубликованных вендорами, а не из одного независимого прогона, а суффиксы “Max” означают разные настройки усилий. Но порядок в целом совпадает по всем источникам и говорит о реальном: в общей интеллектуальной работе, в отличие от кодинга, закрытые модели сохраняют более явное лидерство, чем можно предположить по бенчмаркам кодинга.
Эта закономерность повторяется во всех трёх сравнениях. В кодинге и агентных задачах открытые модели по сути догнали. В широкой интеллектуальной работе они всё ещё на шаг позади. Если ваша нагрузка — первое, платить цены закрытых моделей почти нет смысла. Если второе — это всё ещё оправданно.
Показать изображение Чуть больше трёх баллов отделяют лучшую закрытую модель от лучшей скачиваемой. Двенадцать месяцев назад разрыв был двузначным.
Расчёт затрат на реальных цифрах
Бенчмарки абстрактны. Счета — нет.
Сценарий
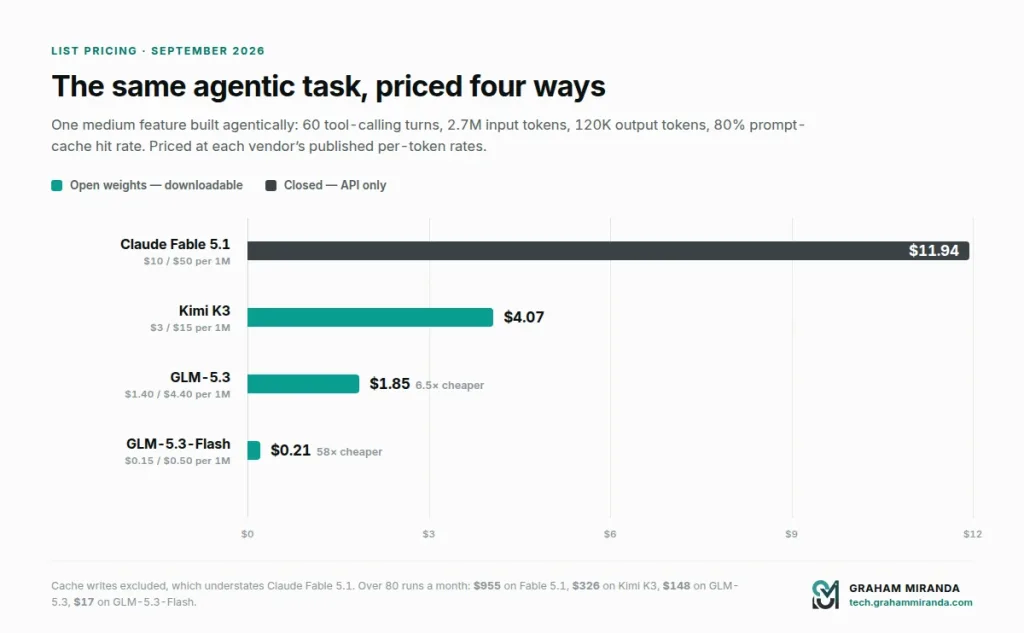
Одна средняя функция, сделанная агентно: примерно 60 шагов с вызовами инструментов, в среднем 45 000 входных токенов за шаг по мере накопления контекста, и 2 000 выходных токенов за шаг.
- Всего на входе: 2,7 млн токенов
- Всего на выходе: 120 тыс. токенов
- Предполагаемая доля попаданий в кэш промпта: 80% (2,16 млн из кэша, 540 тыс. новых)
Claude Fable 5.1
| Компонент | Токены | Ставка | Стоимость |
|---|---|---|---|
| Новые входные | 540 тыс. | 10,00 $/млн | $5.40 |
| Входные из кэша | 2,16 млн | 0,25 $/млн | $0.54 |
| Вывод | 120 тыс. | 50,00 $/млн | $6.00 |
| Итого | ≈ 11,94 $ |
Kimi K3
| Компонент | Токены | Ставка | Стоимость |
|---|---|---|---|
| Новые входные | 540 тыс. | 3,00 $/млн | $1.62 |
| Входные из кэша | 2,16 млн | $0.30/M | $0.65 |
| Вывод | 120 тыс. | 15,00 $/млн | $1.80 |
| Итого | ≈ 4,07 $ |
GLM-5.3
| Компонент | Токены | Ставка | Стоимость |
|---|---|---|---|
| Новые входные | 540 тыс. | 1,40 $/млн | $0.76 |
| Входные из кэша | 2,16 млн | 0,26 $/млн | $0.56 |
| Вывод | 120 тыс. | 4,40 $/млн | $0.53 |
| Итого | ≈ 1,85 $ |
А для справки — GLM-5.3-Flash
| Компонент | Токены | Ставка | Стоимость |
|---|---|---|---|
| Новые входные | 540 тыс. | $0.15/M | $0.08 |
| Входные из кэша | 2,16 млн | $0.03/M | $0.06 |
| Вывод | 120 тыс. | $0.50/M | $0.06 |
| Итого | ≈ $0.21 |
Соотношения
- GLM-5.3 в 6,5 раза дешевле Fable 5.1 за ту же работу
- Kimi K3 в 2,9 раза дешевле Fable 5.1
- GLM-5.3 в 2,2 раза дешевле Kimi K3
- GLM-5.3-Flash в 58 раз дешевле Fable 5.1, при 57,5 в индексе интеллекта против 62,1 у Fable 5
В пересчёте на рабочий месяц
Четыре такие задачи в день, двадцать рабочих дней — 80 агентных прогонов:
| Модель | Месячная стоимость токенов |
|---|---|
| Claude Fable 5.1 | ≈ 955 $ |
| Kimi K3 | ≈ 326 $ |
| GLM-5.3 | ≈ 148 $ |
| GLM-5.3-Flash | ≈ 17 $ |
Три честные оговорки к этим цифрам
Запись в кэш не учитывается. Fable 5.1 берёт $12,50 за миллион токенов при записи в кэш на 5 минут, а длинная сессия пишет в кэш многократно. Учёт записи сдвигает реальную цифру Fable вверх, а не вниз. Ставка попадания 80% тоже оптимистична для коротких сессий.
Токены рассуждений тарифицируются как выходные. У всех трёх моделей мышление включено постоянно. GLM-5.3 в частности документирована как многословная — 170 млн выходных токенов против медианы 72 млн по классу во всём наборе AA, — поэтому её реальный объём вывода выше, чем предполагает простой подсчёт ходов. Цифра $0,68 за задачу уже учитывает это, поэтому я доверяю ей больше, чем собственной модели выше.
Токенизатор Fable 5.1 выдаёт примерно на 30% больше токенов чем старые модели Claude для того же текста. Если вы сравниваете с историческим счётом Claude, сделайте поправку.
Даже после всех трёх поправок порядок не меняется, и величина едва меняется. Работа на закрытой передовой модели стоит примерно в шесть раз дороже, чем на лучшей модели с открытыми весами, в расчёте на выполненную задачу.
Показать изображение Одна и та же агентная задача на 60 шагов по прайс-листу каждого вендора. Вертикальная ось — это и есть весь аргумент в пользу открытых весов.
Лицензии: что “открытость” на самом деле даёт вам в 2026 году
Это раздел, который я больше всего хотел бы, чтобы люди прочитали, потому что терминология сильно поплыла, и кому-то это будет стоить больших денег.
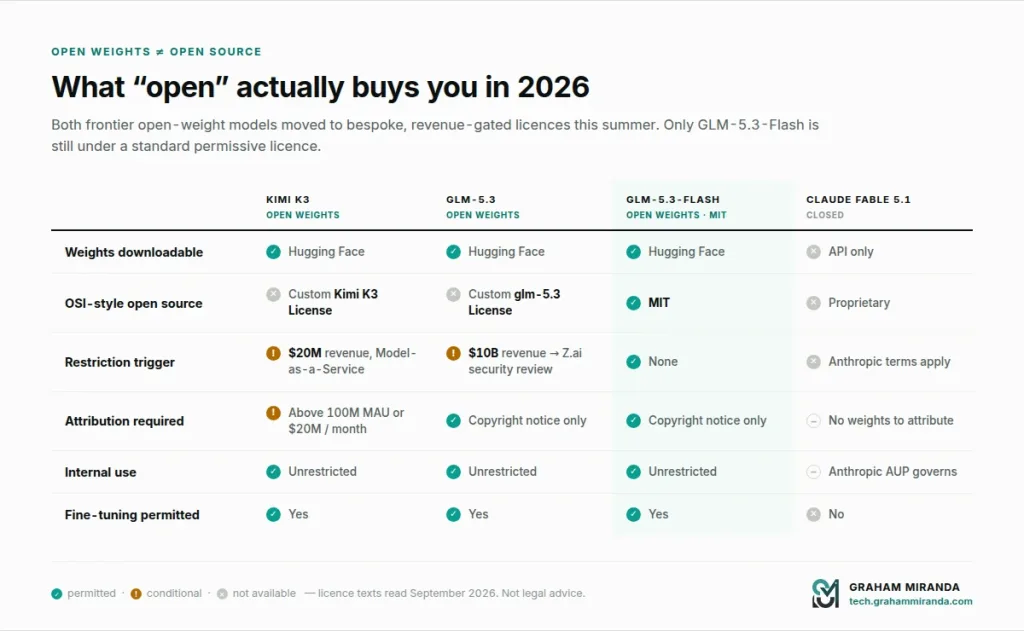
Ни Kimi K3, ни GLM-5.3 не являются открытым исходным кодом. Обе публикуют доступные для скачивания веса по индивидуальным лицензиям с условиями, срабатывающими при достижении определённой выручки. Это существенно иное, чем MIT или Apache 2.0, и разница ложится ровно на тот тип бизнеса, которому self-hosted (самостоятельный хостинг) был бы полезнее всего.
Лицензия Kimi K3
Вы увидите “Modified MIT” повторённым по всему интернету применительно к K3. Это неверно — так было с K2. K3 поставляется по собственному документу с двумя отдельными условиями:
Условие Model-as-a-Service. Если вы предоставляете третьим сторонам доступ к инференсу модели или тонкой настройке — когда эти третьи стороны контролируют входные данные, параметры или обучающие данные — и “совокупная выручка Лицензиата и его аффилированных лиц превышает 20 миллионов долларов США” за любые последовательные 12 месяцев, вы должны согласовать отдельное коммерческое соглашение с Moonshot. Учтите совокупная выручка по всем аффилированным лицам, а не выручка, относимая к K3. Консалтинговая компания с оборотом €25 млн, перепродающая инференс, переходит границу, даже если ИИ-бизнес — статистическая погрешность.
Условие указания авторства. Продукты, превышающие 100 миллионов ежемесячно активных пользователей или $20 млн месячной выручки должны заметно отображать “Kimi K3” в интерфейсе продукта.
Самое важное исключение: чисто внутреннее использование не ограничено. Запуск K3 для поддержки собственных разработчиков, исследователей, юридической команды или общей продуктивности сотрудников не активирует ни одно из условий. Для подавляющего большинства компаний — включая практически все мои — это и есть релевантный пункт, и ответ такой: у вас всё в порядке.
Новый по сравнению с K2 пункт — это условие MaaS на $20 млн. K2 требовала указания авторства только выше своих порогов. K3 добавляет гораздо более низкий порог по выручке, нацеленный именно на коммерческих перепродавцов инференса. Moonshot не пытается помешать вам использовать модель; она пытается помешать облачным провайдерам строить на ней бизнес бесплатно.
Лицензия glm-5.3
Флагман Z.ai пошёл другим путём, и это более серьёзный разрыв с прецедентом, чем признавало большинство публикаций.
GLM-5.2 вышла под MIT. GLM-5.3-Flash вышла под MIT. GLM-5.3 — нет.
Индивидуальная лицензия разрешает частным лицам и обычным компаниям запускать, развёртывать и дообучать модель без дополнительных ограничений. Единственное условие нацелено на гиперскейлеров: организацию, чья “совокупная выручка Лицензиата и его аффилированных лиц превышает 10 миллиардов долларов США (или эквивалент в других валютах) в сумме за любые последовательные 12 месяцев” должны пройти проверку безопасности Z.AI прежде чем использовать модель или её производные в каких-либо коммерческих целях.
Это порог в $10 млрд. Он исключает почти всех. Но два момента в мелком шрифте заслуживают внимания:
Во-первых, лицензия прямо исключает разработчиков приложений, встраивающих модель в функции, и реселлеров, которые лишь маршрутизируют запросы к другим хостам. Цель узкая и ясно обозначена: компании, которые хотят хост GLM-5.3 коммерчески в больших масштабах.
Во-вторых — и это по-настоящему неловкая часть — лицензия не публикует ни критериев, ни сроков, ни процедуры обжалования для этой проверки безопасности. Она лишь указывает, что её “объём и метод… разумно определяются Z.AI.” Если вы крупное предприятие, это неограниченная зависимость от усмотрения иностранного поставщика, и ваша служба закупок так и скажет.
Стоит также отметить: несмотря на двухнедельную задержку выпуска из-за киберспособностей, лицензия не содержит ограничений допустимого использования, никаких киберисключений и никаких претензий на владение результатами. Опасения по безопасности определили сроки выпуска, а не условия выпуска.
Так что же на самом деле всё ещё под MIT?
GLM-5.3-Flash. 320 млрд параметров, 18 млрд активных, нативно мультимодальная, под лицензией MIT, 57,5 в индексе интеллекта и $0,15/$0,50 за миллион токенов — сейчас вдвое меньше по промо-скидке, действующей до 9 сентября 2026 года. Если вам нужна настоящая неограниченная разрешительная лицензия, а не просто скачиваемые веса, то передний край сейчас именно здесь, и он на удивление высок.
Практическое резюме
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Веса доступны для скачивания | Да | Да | Да | Нет |
| Открытый исходный код в стиле OSI | Нет | Нет | Да (MIT) | Нет |
| Триггер ограничений | Выручка $20 млн (MaaS) | Выручка $10 млрд (MaaS) | Нет | N/A |
| Требуется указание авторства | Свыше 100 млн MAU / $20 млн в месяц | Только уведомление об авторских правах | Только уведомление об авторских правах | N/A |
| Внутреннее использование ограничено | Нет | Нет | Нет | N/A |
| Тонкая настройка разрешена | Да | Да | Да | Нет |
| Политика допустимого использования | Стандарт | Нет в тексте лицензии | Нет | Действует AUP Anthropic |
Для типичной немецкой компании среднего бизнеса, агентства или консалтинга, запускающего модели внутри или встраивающего их в продукт: все три открытых варианта можно использовать, ничего не согласовывая. Эти условия существуют, чтобы поймать AWS, а не вас. Но “прочитайте лицензию” превратилось из педантичного совета в настоящий совет, и если ваш оборот выше примерно €20 млн и вы перепродаёте инференс в любой форме, покажите её юристам до развёртывания.
Настоящий аргумент в пользу открытых моделей
Я хочу изложить этот аргумент как следует, а не как лозунг, потому что “открытые модели — это здорово” не аргумент, и настоящие причины интереснее, чем подбадривание.
1. Обвал цен — не субсидия, а структурное явление
Инстинктивное возражение против дешёвых китайских моделей состоит в том, что цены убыточны для привлечения клиентов и со временем выровняются вверх. Частично так и есть. Но структурный аргумент верен сам по себе: когда веса публичны, инференс становится сырьевым рынком. Двадцать хостинг-провайдеров конкурируют за обслуживание одной и той же модели, и ни один не может брать наценку за возможности, потому что ни у кого нет рва вокруг возможностей. Вот почему GLM-5.3 стоит $1,40/$4,40, а Fable 5.1 — $10/$50 при разнице в три балла.
Цена закрытой модели включает амортизацию R&D, маржу и тот факт, что продавец ровно один. Цена модели с открытыми весами включает электричество, амортизацию оборудования и тонкую маржу. Это разные бизнесы, и разрыв не закроется за счёт подорожания открытых моделей.
Доказательство того, что это не временно: DeepSeek заняла примерно 17% использования токенов на Vercel к маю 2026 года, имея около 1% доли выручки. Это не ценовая аномалия. Вот так выглядит превращение в товар на графике.
2. Права на выход меняют вашу переговорную позицию, даже если вы никогда ими не воспользуетесь
Большинство команд, читающих это, не станут разворачивать модель у себя. Раздел об оборудовании ниже объясняет почему — Kimi K3 требует стойки. Но сама возможность ценна независимо от этого.
Если Anthropic поднимет цены, снимет модель, на которой вы построили продукт, изменит политику допустимого использования так, что это сломает ваш продукт, или покажет плохой квартал, вашим средством защиты с закрытой моделью будет проект миграции. С моделью с открытыми весами ваше средство защиты — скачать файл, который вы могли скачать в любой момент. Возможно, вы никогда этого не сделаете. То, что вы могли — вот что делает отношения с поставщиком коммерческими, а не зависимостью.
Это не теория. Fable 5.1 вышла 1 сентября с тремя ломающими изменениями, одно из которых делает недействительными блоки мышления при редактировании истории диалога для аккаунтов, созданных после 31 августа. Если эта схема несущая в вашей архитектуре, вы переделываете всё по графику Anthropic, а не по своему.
3. Резидентность данных перестаёт быть проектом
Для всех, кто работает по GDPR, это аргумент, который реально закрывает сделки.
С закрытым API каждый промпт покидает вашу инфраструктуру. Нужен договор с обработчиком, оценка последствий передачи, если обработчик за пределами ЕЭЗ, карта потоков данных и ответ вашему DPO о том, что происходит с данными в состоянии покоя. Всё это выполнимо. Это ещё и недели работы на каждого поставщика, повторяемые каждый раз, когда поставщик что-то меняет.
С открытыми весами на инфраструктуре, которую вы контролируете, — своё оборудование или немецкий либо европейский GPU-хостинг — вопрос трансграничной передачи не возникает, потому что передачи нет. Модель работает там, где уже живут ваши данные. Юридическая проверка сводится от оценки передачи к чтению лицензии.
Для немецких и европейских клиентов это часто решающий фактор, и стоит точно обозначить оговорку: использование GLM-5.3 через API Z.ai этого вам не даёт. Вы получаете это, запуская веса сами или через провайдера, размещающего их в вашей юрисдикции. Лицензия делает это законным; она не делает это автоматическим.
4. Возможность инспекции реальна, пусть и недоиспользована
Открытые веса означают, что вы можете изучить архитектуру, провести собственные оценки на настоящей модели, а не на эндпоинте, который могут молча обновить, квантовать её под своё оборудование, дообучить на своей предметной области и — что важно — закрепить версию навсегда.
Последнее недооценивают. Закрытые API обновляются за стабильными идентификаторами моделей. Поведение дрейфует. Промпты, которые работали, перестают работать, и вы не можете сравнить изменения, потому что не видите их. Локальный чекпоинт через год байт в байт тот же.
5. Конкурентное давление выгодно всем, включая пользователей закрытых моделей
Посмотрите, что случилось этим летом. Kimi K3 выходит в июле по $3/$15 с оценками рядом с передовыми. GLM-5.3 выходит в августе по $1,40/$4,40 в пределах половины балла от неё. А 1 сентября Anthropic снизила цену чтения кэша на 75%.
Я не утверждаю прямую причинность — Anthropic не публикует обоснование своих цен, а снижение цены чтения кэша — естественная оптимизация. Но рынок с достойными дешёвыми заменителями формирует цены иначе, чем рынок без них, и заменители стали достойными в этом году. Если вы используете только закрытые модели, экосистема открытых весов всё равно тихо уменьшает ваши счета.
6. Прирост даёт постобучение, и оно дешёвое
Главный результат GLM-5.3 — шестикратное улучшение Terminal-Bench на тех же базовых весах — самая стратегически важная цифра во всей этой статье, и она не про GLM.
Она говорит, что дорогая часть создания передовой модели (предобучение) всё больше становится решённой, превращённой в товар компонентой, а отличающая часть (постобучение, RL-среды, проектирование длинных задач) сравнительно доступна. Вот почему четыре китайские лаборатории с совокупной стоимостью около $159 млрд не отстают от американских лабораторий, оценённых в разы дороже. Оценка Ламберта: китайские лаборатории работают с “на порядки меньшим капиталом”.
Для всех, кто находится дальше по цепочке, вывод прост: число достойных поставщиков моделей растёт, а не падает. Планируйте архитектуру соответственно.
7. Эффекты экосистемы накапливаются
Qwen преодолела один миллиард суммарных загрузок на Hugging Face, обогнав Llama, и теперь служит основой для более чем 200 000 размеченных моделей и 113 000+ производных — примерно 40% всех новых производных LLM на платформе созданы на базе Qwen. Это экосистема инструментов, квантования, тонкой настройки и развёртывания, которая существует только потому, что веса публичны.
Вы пользуетесь этой экосистемой независимо от того, вносите ли вы в неё вклад. Конвертации в GGUF, ядра vLLM, адаптеры LoRA, рецепты квантования, harness'ы для оценки — всё это существует потому, что тысячи людей могли получить доступ к самим весам.
8. Туда, куда разработчики уже ушли
Доля моделей китайского происхождения — ~61% токенов OpenRouter. Доля американских моделей упала с ~70% до ~30% за год. Четыре из пяти самых используемых моделей на роутере — китайского происхождения. Только модели MiMo от Xiaomi дают примерно 21% маршрутизированных токенов и около 22% всего трафика кодинга.
Поведение разработчиков — опережающий индикатор. Оно было опережающим индикатором для Docker, для Postgres, для Linux. Ставки против него имеют плохую историю.
…И честный аргумент против
Если бы я написал только раздел выше, это была бы реклама.
Открытые веса — не открытый исходный код, и смещение терминологии — реальная проблема. Две из трёх моделей здесь поставляются по индивидуальным лицензиям с порогом по выручке, без одобрения OSI. Пункт о проверке безопасности GLM-5.3 не имеет опубликованных критериев или процедуры обжалования. Если ваша система комплаенса требует лицензий, одобренных OSI, честный ответ такой: ваши варианты — GLM-5.3-Flash, флагманы DeepSeek под MIT и сокращающийся список остальных.
Бенчмарки вендоров остаются бенчмарками вендоров. Каждая громкая цифра, опубликованная Moonshot и Z.ai, — самоотчёт и самоотбор. Там, где измеряли нейтральные агрегаторы, цифры в целом подтверждаются — и это действительно заслуга обеих лабораторий, — но “в целом подтверждаются” в этом предложении несёт нагрузку.
Self-hosted (самостоятельный хостинг) — фантазия для большинства команд. Kimi K3 занимает 1,5 ТБ, и Moonshot рекомендует 64+ ускорителя. GLM-5.3 требует как минимум 8×H200 в FP8. Право на выход реально; цена его реализации — дата-центр.
Поддержка — как вы её себе сделаете. Когда Fable 5.1 ломается, есть компания с SLA. Когда ваш self-hosted (самостоятельный хостинг) экземпляр GLM-5.3 выдаёт мусор на контексте 300K в пятницу вечером, есть issue на GitHub и ваша собственная компетентность.
Геополитика — реальный фактор закупок. Все три варианта с открытыми весами, обсуждаемые здесь, происходят из китайских лабораторий. Для некоторых клиентов — госсектор, смежные с обороной организации, отдельные регулируемые отрасли — это жёсткий блокер независимо от условий лицензии или того, где запускаются веса. Не моё дело говорить вам, обоснованно ли это опасение. Моё дело — сказать, что оно всплывёт на встрече.
Закрытые модели всё ещё лидируют в общей интеллектуальной работе. В GDPval-AA v2 у Fable 5.1 — 1 853 против 1 769 у GLM-5.3 и 1 687 у Kimi K3. В кодинге разрыв исчез. В широкой профессиональной интеллектуальной работе — нет.
Показать изображение Скачиваемые веса, три разных набора условий. Только GLM-5.3-Flash всё ещё под MIT.
Ollama в 2026: изменение цен, которое действительно важно
Ollama тихо стала важнейшим элементом инфраструктуры в этом разговоре, и 31 августа 2026 года она изменила принцип тарификации так, что это стоит понять как следует.
Что изменилось
Ollama перевела планы Pro, Max и Team с оплаты по времени GPU на отраслевую оплату за токены, с пулом кредитов на использование, включённым в каждый план. Названная компанией причина освежающе конкретна: модели вроде Kimi K3 сделали метрики времени GPU непредсказуемыми. Когда одна модель активирует 104 млрд параметров, а другая — 3 млрд, “час GPU” перестаёт что-либо значить для того, кто платит.
Новые планы
| Plan | Цена | Включённое месячное использование | Одновременные запросы |
|---|---|---|---|
| Бесплатно | $0 | Небольшой месячный кредит, стартовые модели | 1 запрос |
| Pro | $20/мес (или $200/год) | Использование на $60 | 3 запроса |
| Max | $100/мес | Использование на $300 | 10 запросов |
| Team | $500/мес | $1 000 общих, неограниченное число пользователей | 10 запросов |
| Enterprise | Custom | Custom | Custom |
Перечитайте строку Pro. $20 покупают токенов на $60. Это трёхкратный множитель на включённое использование, и когда пул исчерпан, вы продолжаете по той же самой опубликованной ставке за токен — без штрафного тарифа, без сервисного сбора.
Что убрали
Вот что разработчики действительно заметили: никаких сбросов каждые 5 часов и никаких недельных лимитов. Любой, кто упирался в скользящее окно использования посреди рефакторинга, поймёт, почему это значило больше, чем цена. Месячный пул обновляется в дату вашей подписки и, что важно, не переносится — так что выбирайте план под обычный месяц, а не под самый загруженный.
Условия, важные для работы в ЕС
Три обещания в анонсе напрямую касаются вас, если вы обрабатываете данные клиентов:
- Нулевое хранение данных. Промпты и ответы никогда не журналируются и не используются для обучения.
- Размещение в США и Европе, плюс Сингапур для ограниченного набора моделей Qwen.
- Видимость стоимости каждого запроса в вашем аккаунте — вы видите, сколько стоил каждый вызов.
Для немецкого консалтинга это существенно лучшая история комплаенса, чем предлагает большинство провайдеров шлюзов, хотя “размещено в Европе” — это утверждение о маршрутизации, а не договорная гарантия резидентности данных. Если резидентность — жёсткое требование, а не предпочтение, попросите Ollama подтвердить это письменно, прежде чем исходить из этого.
Фактические ставки за токен
Вот здесь становится интересно. Ollama публикует ставки по каждой модели, и они тесно следуют ценам самих разработчиков моделей:
| Модель в Ollama | Ввод / 1 млн | Кэш / 1M | Вывод / 1 млн |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
Прогоните через это прежний расчёт за месяц. Восемьдесят агентных прогонов в месяц на GLM-5.3 стоят около $148 в токенах. А План Max за $100/месяц покрывает $300 использования — так что та же нагрузка, которая стоила бы примерно $955/месяц на Fable 5.1, спокойно укладывается в подписку Ollama за $100 с большим запасом.
Это весь экономический аргумент открытых моделей, сжатый в одну строку в счёте.
Показать изображение Восемьдесят агентных прогонов в месяц на GLM-5.3 укладываются в план Ollama Max за $100 со сдачей. Та же работа на Fable 5.1 — счёт на $955.
Что ещё Ollama выпустила в 2026 году
Изменение цен произошло не само по себе. Последние месяцы были насыщенными:
- 25 августа — поддержка Claude Desktop. Ollama теперь работает как сторонний провайдер шлюза для Claude Desktop, так что вы можете запускать открытые модели через собственный клиент Anthropic.
- 26 августа — v0.33.0. Интеграция шлюза Claude Desktop вышла, восстановление prefill вернули в кэш, а Ollama отключила системное сообщение Claude Code с обратным отсчётом токенов, которое обнуляло KV-кэш на каждом ходе. Последнее — тихое, но важное исправление производительности.
- 26 августа — v0.33.1. Поддержка MLX для Qwen3.8 Flash Next, структурированный вывод и исправление тайм-аутов GPU при загрузке моделей с более медленного хранилища.
- 28 августа — v0.33.2. Тёмная тема восстановлена, исправлена передача на macOS, а прокси-запросы Claude Desktop сохраняются живыми во время обновлений каталога моделей.
- 20 августа — v0.32.15. Новый onboarding в десктопе и кэширование метаданных между запросами, которое сократило время до первого токена примерно вдвое.
- 11 августа — NVIDIA Nemotron 3.5 Lightning, модель на 30 млрд параметров, настроенная для агентных рабочих процессов с вызовом инструментов на персональном оборудовании.
- 10 августа — Muse Glimmer от Meta, мультимодальная модель на 30B под лицензией Apache 2.0, ускоренная движком MLX от Ollama. Стоит отметить на фоне обвала Llama в маршрутизированном использовании — Meta по-прежнему выпускает по-настоящему разрешительные веса.
- 9 июля — раунд финансирования на $88 млн, и Ollama сообщает о 8,9 млн разработчиков.
- 29 июня — Gemma 4 на MLX до 90% быстрее за счёт предсказания нескольких токенов, что особенно помогает агентам для кодинга на Apple Silicon.
- 5 июня — в v0.30 появилась совместимость с GGUF через llama.cpp, что значительно расширило поддержку оборудования за пределами Apple Silicon.
Суть в том, что Ollama больше не “простой способ запустить небольшую модель на ноутбуке”, а универсальный шлюз, который попутно запускает модели локально. Облачный каталог теперь включает kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 в семи размерах, gpt-oss на 20b и 120b, gemma4, семейство Nemotron 3 и mistral-large-3.
Настройка: конфиги для копирования
Ollama + Claude Code (самый быстрый путь)
Ollama поставляет лаунчер, который запускается одной командой и сам настраивает окружение:
bash
ollama launch claudeЕсли предпочитаете вручную — а при написании скриптов так и стоит делать — сначала установите Claude Code:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
Затем направьте его на Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
И запускайте с любой нужной моделью:
bash
# A local model
claude --model qwen3.5

# A cloud model — note the :cloud suffix
claude --model kimi-k3:cloud
Или прямо в командной строке, ничего не экспортируя глобально:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Два момента, которые могут выйти боком.
Во-первых, не экспортируйте ANTHROPIC_BASE_URL навсегда в профиль оболочки. Это глобальная переменная, и она молча перенаправит в Ollama все инструменты на вашей машине, говорящие на языке Anthropic, включая тот, который вы хотели направить в Anthropic. Задавайте её для проекта или для отдельного вызова.
Во-вторых, задайте длину контекстного окна 64k или больше для всего, что работает с настоящим репозиторием. По умолчанию у Ollama она меньше, и агент для кодинга, у которого тихо закончилось окно, просто начнёт забывать вещи вместо того, чтобы выдать ошибку.
Для CI, Docker или запусков из скриптов, --yes пропускает интерактивные запросы:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "how does this repository work?"GLM-5.3 напрямую от Z.ai
Если хотите маршрутизацию напрямую, а не через Ollama, Z.ai предоставляет три протокольных эндпоинта:
| Протокол | Базовый URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
Блок провайдера OpenCode для GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3": {
          "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
          "options": { "reasoning_effort": "high", "temperature": 1 }
        }
      }
    }
  },
  "model": "zai/glm-5.3"
}
Важное замечание об обновлении: GLM-5.3 требует включённого рассуждения. Если в вашей текущей конфигурации задано thinking.type: "disabled", теперь это не сработает. Измените на "enabled" и задайте reasoning_effort: "low" если хотите вернуть прежний профиль задержки.
reasoning_effort — это ваш главный регулятор соотношения качества и цены: низкий для вызовов, чувствительных к задержке, высокий для серьёзной работы, максимум (по умолчанию) для задач, которые действительно поставили в тупик высокий. Учитывая документированную многословность, я бы использовал высокий как повседневную настройку, а не оставлял максимум включённым и не гадал, куда делись выходные токены.
Схема маршрутизации, которую я действительно рекомендую
Ничто из этого не решается выбором “одного”. Правильный ответ для большинства команд — таблица маршрутизации из трёх уровней, и каждый серьёзный harness для агентов поддерживает модели для отдельных агентов.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
      "description": "Architecture, root-cause analysis, anything expensive to get wrong",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation work",
      "model": "zai/glm-5.3",
      "options": { "reasoning_effort": "high" }
    },
    "research": {
      "description": "Long-context reading, web research, multi-source synthesis",
      "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
      "description": "Renames, docstrings, test scaffolding, lint fixes",
      "model": "ollama/glm-5.3-flash"
    }
  }
}
Логика каждой строки:
- Планирование отдаётся Fable 5.1. Планирование — это место, где плохое решение стоит больше всего последующих токенов, и долгосрочная связность — именно то, для чего создавали 5.1. Здесь же вы тратите меньше всего токенов, поэтому наценка ложится на самую маленькую часть счёта.
- Сборка отдаётся GLM-5.3. Лучшее соотношение возможностей и цены на рынке, и основная часть расходов на токены приходится сюда.
- Исследование отдаётся Kimi K3. BrowseComp 91.2 и настоящее контекстное окно на 1M делают её лучшим доступным вариантом, чтобы прочитать много всего и синтезировать это.
- Механическая работа отдаётся GLM-5.3-Flash. При $0,15/$0,50 это фактически бесплатно, а переименование символа в 40 файлах не требует рассуждений передового уровня.
small_modelполучает что-то крошечное для собственных служебных задач harness — генерации заголовков, суммаризации, внутренних служебных вызовов.
Вы не выбираете победителя. Вы собираете коробку передач. И записывайте ID моделей так, чтобы замена была изменением в одной строке, потому что на этом рынке вы сделаете такую замену снова в течение квартала.
Что действительно можно запустить локально (реальность железа)
Позвольте развеять одно предположение, пока оно кому-то не стоило денег.
Вы не запустите Kimi K3 или GLM-5.3 на рабочей станции. Ни с одной 5090. Ни с двумя.
Kimi K3
- ~1,5 ТБ весов в нативном MXFP4 — и помните, что это — это квантованный чекпойнт, а не отправная точка для дальнейшего сжатия
- Moonshot рекомендует минимум 64 ускорителя для конкурентного обслуживания
- Реалистичный самостоятельный хостинг начинается с многоузловых кластеров; в эталонных развёртываниях используют стойки GB300 NVL72
- Не существует официальной записи в библиотеке Ollama для локального Kimi K3 и нет ни одной потребительской конвертации GGUF, на которую стоит указывать
- Есть сообщения о запуске на кластерах потребительских RTX 5090, но “кластер из 5090” — это не ноутбук, и пропускная способность несопоставима
GLM-5.3
- ~1,5 ТБ в BF16, примерно 750 ГБ в FP8
- Минимально жизнеспособный одиночный узел: 8× H200 (1 128 ГБ видеопамяти) в FP8, что оставляет около 375 ГБ для KV-кэша
- BF16 требует двух узлов 8×H200 или одного узла 8×B300 (2 304 ГБ)
- Одного узла 8×H200 в BF16 слишком мало для весов и кэша
Показать изображение Передовым открытым моделям нужна стойка. Уровень 24 ГБ — это то, где на самом деле живёт “работает на моей машине”, и он стал очень хорош.
Так что же на самом деле означает “локальный ИИ” в сентябре 2026 года?
Это означает другой уровень моделей, и этот уровень действительно стал хорош:
| Модель | Видеопамять | Для чего |
|---|---|---|
| Qwen3.8-27B | 24 ГБ в Q4 | Лучший универсал на потребительском железе — 61,7% SWE-bench |
| gpt-oss:20b | 16 ГБ | Лучшая небольшая модель с настраиваемой глубиной рассуждений |
| Gemma 4 E4B | ~6 ГБ | Зрение и вызов инструментов на современном ноутбуке |
| Mistral 7B | 8 ГБ | Самый быстрый универсальный вариант, 40–60 ток/с |
| DeepSeek-R1 7B | 5 ГБ | Рассуждения по цепочке мыслей на GPU ноутбука |
| Llama 4 Scout | ~55 ГБ в Q4 | контекст 10M, мультимодальность — территория рабочих станций |
Qwen3.8-27B с результатом 61,7% на SWE-bench, полностью работающая на потребительской GPU с 24 ГБ без сетевого подключения, — удивительная вещь, которая восемнадцать месяцев назад звучала бы как научная фантастика. Это не GLM-5.3, и она не притворяется ею.
Честная формулировка: открытые веса передового уровня дают вам суверенитет и цену, а не локальное исполнение. Открытые веса в диапазоне 7B–30B дают настоящее локальное исполнение ценой реального, но приемлемого снижения возможностей, и именно на этом уровне требование “работает на моей машине и не видит сети” становится выполнимым.
Архитектура, которая работает у большинства моих клиентов, — ровно такое разделение: небольшая локальная модель для всего, что касается по-настоящему чувствительных данных, и размещённая у провайдера открытая модель передового уровня для всего остального — причём веса доступны как страховка, а не как план развёртывания.
Где каждая модель реально ломается
Без хайпа. Вот честные слабые места.
Слабые места Kimi K3
Она дорога для открытой модели. $3/$15 — это в 2,1 раза больше входной ставки GLM-5.3 и в 3,4 раза больше выходной при практически одинаковом балле индекса интеллекта. Если выбираете K3 вместо GLM-5.3, понимайте, за что платите наценку — обычно это стек зрения или производительность в браузинге.
У лицензии более низкий порог. Порог совокупной выручки $20 млн для MaaS охватывает гораздо больше организаций, чем порог GLM-5.3 в $10 млрд. Если перепродажа инференса вообще присутствует в вашей бизнес-модели, K3 — более ограниченный вариант из двух.
Самостоятельный хостинг недоступен почти всем. 1,5 ТБ и 64+ ускорителя — серьёзные обязательства по инфраструктуре. Право на выход здесь более теоретическое, чем у любой другой модели в этом сравнении.
Широкие знания отстают. GDPval-AA v2 на уровне 1 687 ставит её позади GLM-5.3, обеих Claude Fable и GPT-5.6 Sol Max. Это специалист по кодингу и агентным задачам, который просто оказался огромным.
Слабые места GLM-5.3
Только текст. Нет ввода изображений, нет видео. Если в вашем рабочем процессе есть отладка по скриншотам, преобразование дизайна в код или зрение для документов, GLM-5.3 просто не справится, и вам нужны GLM-5.3-Flash, Kimi K3 или Fable 5.1. Это самая распространённая ошибка в конфигурации, которую я ожидаю от людей, потому что ID моделей выглядят связанными, но таковыми не являются.
Она многословна, а многословие оплачивается. 170M выходных токенов против медианы 72M по классу в наборе AA. reasoning_effort по умолчанию равен максимум, а мышление нельзя отключить. Закладывайте больше выходных токенов, чем следует из числа ходов.
Лицензия больше не MIT, а пункт о проверке безопасности не ограничен. Для большинства читателей порог в $10 млрд делает это чисто теоретическим. Для тех, кто к нему близок, “объём и метод определяются по разумному усмотрению Z.AI” — не тот пункт, который понравится вашей юридической команде.
Terminal-Bench 3.0 с результатом 28,3 уступает 34,6 у GPT-5.6 Sol. На конкретном бенчмарке, ближайшем к агентному кодингу в терминале, она отстаёт от закрытых конкурентов по той же шкале.
Она новичок среди открытых весов. Выпущена 28 августа. У сообщества были дни, а не месяцы. Долгохвостые ошибки развёртывания ещё не проявились.
Слабые места Claude Fable 5.1
Цена. Примерно в 6,5 раза дороже GLM-5.3 за завершённую агентную задачу, даже после снижения цены чтения кэша на 75%. Для большинства работ этот разрыв больше не оправдать соображениями возможностей.
Три ломающих изменения. Принудительное использование инструментов возвращает 400. Блоки мышления не передаются назад старым моделям. Редактирование истории разговора делает блоки мышления недействительными в аккаунтах, созданных после 31 августа 2026 года. Любое из этого может сломать рабочую интеграцию при обновлении.
Параллельный вызов инструментов ухудшился. Есть сообщения об одном вызове за ход там, где Fable 5 объединяла несколько. В длинном агентном цикле это реальное время, за которое вы платите дважды.
Ноль вариантов выхода. Ни весов, ни самостоятельного хостинга, ни фиксации версии сверх того, что предлагает Anthropic, ни инспекции. Когда что-то меняется, вы подстраиваетесь.
Токенизатор завышает сравнения. Примерно на 30% больше токенов, чем у старых моделей Claude, для одного и того же текста, из-за чего исторические сравнения стоимости смещаются в пользу Anthropic, если не быть внимательным.
Как принимать решение: шесть сценариев
Показать изображение Шесть сценариев, шесть ответов. Найдите строку, которая похожа на вашу неделю.
1. “Хочу одну модель. Настроил, забыл, счёт остаётся разумным.”
GLM-5.3. В пределах половины балла от Kimi K3 и примерно трёх баллов от лучшей закрытой модели в нейтральном индексе, при $1,40/$4,40. Запускайте через Ollama на плане Pro или Max, задайте reasoning_effort: high, и занимайтесь работой. Единственное, что должно заставить вас отказаться от этого ответа, — необходимость ввода изображений.
2. “Моя работа визуальная — интерфейсы, преобразование дизайна в код, отладка по скриншотам, документы.”
Kimi K3 или GLM-5.3-Flash, но не GLM-5.3. MoonViT-V2 в K3 нативно обрабатывает текст, изображения и видео и набирает 81,6/83,4 на MMMU-Pro. GLM-5.3-Flash — бюджетный вариант с нативной мультимодальностью и лицензией MIT. GLM-5.3 работает только с текстом и просто откажется принимать такой ввод.
3. “Долгие автономные сессии, где ошибка дорого стоит.”
Claude Fable 5.1. Именно для этого её создавали, и бенчмарки это подтверждают: Terminal-Bench-Science вырос вдвое, 82% на самых сложных задачах компьютерного использования Browserbase против 74% у Opus 5, и наибольший опубликованный прирост на многочасовой агентной работе. Снижение цены чтения кэша на 75% делает именно эту нагрузку до 45% дешевле, чем раньше. Платите наценку там, где ошибка стоит дороже токенов.
4. “Хранение данных в ЕС — жёсткое требование.”
GLM-5.3-Flash, если нужна лицензия MIT, GLM-5.3, если нужны возможности. Разместите модель на собственном железе или у поставщика GPU в ЕС — и вопрос трансграничной передачи исчезнет. Для GLM-5.3 в FP8 закладывайте 8×H200; Flash гораздо доступнее при 320B/18B. Если самостоятельный хостинг не по бюджету, европейский хостинг Ollama с нулевым хранением данных — прагматичный компромисс, но получите обязательство о резидентности в письменном виде, а не выводите его из маркетинговой страницы.
5. “Небольшая команда, жёсткий бюджет, код весь день.”
GLM-5.3-Flash по умолчанию, GLM-5.3 для сложных задач, Ollama Pro за $20. Flash стоит $0,15/$0,50 — сейчас, до 9 сентября, вдвое меньше — и набирает 57,5 в индексе интеллекта. Двадцать долларов дают шестьдесят долларов токенов без недельных лимитов. Для команды из двух-четырёх человек это почти непобедимо. GLM Coding Plan за $18 в месяц (Lite) — альтернатива, если вы предпочитаете фиксированную квоту пулу кредитов.
6. “Мне нужно обосновать это для отдела закупок или юристов.”
GLM-5.3-Flash. Это единственная модель в сравнении под стандартной лицензией, одобренной OSI (MIT): она нативно мультимодальна, набирает 57,5 в нейтральном индексе, а веса лежат на Hugging Face без порогов по выручке, требований об указании авторства и пункта о проверке безопасности. Когда вопрос звучит как “что мы сможем защитить на проверке договора”, разрешительная лицензия каждый раз побеждает три балла бенчмарка.
За чем я буду следить в следующем квартале
Окажется ли Fable 5.1 выше 62,1 в индексе Artificial Analysis. Она вышла за день до этой статьи и ещё не получила независимой оценки. Приросты в бенчмарках относительно Fable 5 позволяют предположить, что она должна оказаться выше, но “должна” — не то же самое, что “оказалась”, и разрыв с 59,7 у Kimi K3 — это число, вокруг которого вращается весь спор открытых и закрытых моделей.
Продолжится ли дрейф лицензий. За восемь недель мы прошли путь от GLM-5.2 под MIT к GLM-5.3 под отдельной лицензией с проверкой безопасности по усмотрению Z.AI и от модифицированного MIT у Kimi K2 к условиям K3 с порогом по выручке. Если GLM-6 и K4 ужесточат ещё сильнее, “открытые веса” станут маркетинговым термином, а не содержательной категорией. То, что GLM-5.3-Flash остаётся под MIT, — встречный сигнал, за которым стоит следить.
Подхватят ли другие лаборатории схему поэтапного выпуска Z.ai. Двухнедельная задержка с опубликованным обоснованием безопасности — новая норма. Если она приживётся, это хорошая норма. Если она станет поводом выпускать веса всё позже и позже, это мягкий путь к тому, чтобы не выпускать их вообще.
Независимое воспроизведение заявлений о кибервозможностях. 2 436 уязвимостей в 269 проектах — необычайно большое число, и оно целиком основано на самоотчёте. Кто-то нейтральный должен это проверить, потому что если цифра точна, она перестраивает весь разговор о безопасности открытых весов, а если нет — это был эффективный маркетинг.
Ставки Ollama за токен через шесть месяцев. $20 за $60 использования — агрессивная вступительная позиция компании, которая привлекла $88 млн в июле. Переживут ли эти множители столкновение с реальной юнит-экономикой — главная переменная в тезисе о “дешёвых открытых моделях” для небольших команд.
Закроют ли локальные модели разрыв на уровне 30B. Qwen3.8-27B с 61,7% SWE-bench на 24 ГБ — самый недооценённый результат года. Передовой уровень получает заголовки, но именно уровень 24 ГБ меняет то, что обычный бизнес может делать без API-ключа.
Часто задаваемые вопросы
Kimi K3 действительно открытая? Нет. Веса Kimi K3 свободно скачиваются с Hugging Face, но под отдельной “Kimi K3 License”, а не под одобренной OSI лицензией открытого исходного кода. Операторы Model-as-a-Service, чья совокупная выручка превышает $20 млн за любые последовательные 12 месяцев, должны заключить отдельное коммерческое соглашение с Moonshot, а продукты с более чем 100 млн месячных активных пользователей или $20 млн месячной выручки должны показывать “Kimi K3” в интерфейсе. Чисто внутреннее использование не ограничено.
GLM-5.3 лучше Kimi K3? По нейтральному агрегатному индексу они фактически равны — 59,5 против 59,7 в Artificial Analysis. GLM-5.3 в 2,2 раза дешевле за агентную задачу и выше оценивается в работе со знаниями (GDPval-AA v2: 1 769 против 1 687). Kimi K3 нативно мультимодальна, лидирует в агентном браузинге (BrowseComp 91,2) и заняла первое место в арене фронтенд-кода Arena.AI. Выбирайте GLM-5.3 ради цены и текстового кодинга; Kimi K3 — ради зрения, браузинга и долгосрочных исследований.
Насколько открытые модели дешевле Claude Fable 5.1? На смоделированной агентной задаче из 60 ходов GLM-5.3 стоит около $1,85 против $11,94 у Fable 5.1 — примерно в 6,5 раза дешевле. Kimi K3 стоит около $4,07, примерно в 2,9 раза дешевле. GLM-5.3-Flash стоит около $0,21, примерно в 58 раз дешевле. За 80 запусков в месяц это $148 против $955.
Можно ли запустить Kimi K3 или GLM-5.3 локально? Не на потребительском железе. Kimi K3 занимает примерно 1,5 ТБ даже в нативном формате MXFP4, и Moonshot рекомендует 64+ ускорителя. GLM-5.3 требует минимум 8×H200 (1 128 ГБ) в FP8. Для настоящего локального исполнения смотрите на Qwen3.8-27B (24 ГБ в Q4), gpt-oss:20b (16 ГБ) или Gemma 4 E4B (~6 ГБ).
Что изменилось в Claude Fable 5.1? Выпущена 1 сентября 2026 года. Чтение кэша подешевело на 75% — с $1,00 до $0,25 за миллион токенов, что делает типичные нагрузки примерно на 25% дешевле, а агентные — до 45% дешевле; ввод и вывод остались на уровне $10/$50. Terminal-Bench 4.0 вырос с 42,0% до 55,8%, Terminal-Bench-Science — с 24,7% до 52,6%, AutomationBench — с 17,1% до 31,4%. Три ломающих изменения затрагивают принудительное использование инструментов, переносимость блоков мышления и редактирование истории.
Какие новые цены у Ollama? С 31 августа 2026 года в планах Pro, Max и Team действует оплата по токенам с включёнными кредитами: Pro — $20 в месяц за $60 использования, Max — $100 за $300, Team — $500 за $1 000, распределяемых между неограниченным числом пользователей. Пятичасовые и недельные лимиты полностью убраны, сервисных сборов нет, кредиты не переносятся, а все планы предполагают нулевое хранение данных с размещением в США и Европе.
Какая из этих моделей действительно под лицензией MIT? Только GLM-5.3-Flash — отдельная нативно мультимодальная модель 320B/18B, выпущенная 26 августа 2026 года, с результатом 57,5 в индексе Artificial Analysis при $0,15/$0,50 за миллион токенов. GLM-5.3 и Kimi K3 обе используют отдельные лицензии с порогом по выручке; Claude Fable 5.1 полностью проприетарна.
Почему нельзя сравнивать эти модели по Terminal-Bench? Потому что каждую оценивали на разных версиях. 88,3 у Kimi K3 — это Terminal-Bench 2.1, 28,3 у GLM-5.3 — это 3.0, а 55,8 у Fable 5.1 — это 4.0. Каждая версия существенно сложнее предыдущей, поэтому числа находятся не в одной шкале. Сравнивайте только внутри одной версии. Например, на Terminal-Bench 2.1 Kimi K3 набирает 88,3 против 88,0 у Claude Fable 5, 88,8 у GPT-5.6 Sol и 84,3 у GLM-5.3-Flash — это сравнение корректно, и именно его стоит цитировать.
Использовать Ollama или обращаться напрямую к поставщику? Ollama — если вам нужны единые отношения по оплате, один API-интерфейс, простое переключение моделей и хостинг в ЕС/США с нулевым хранением данных: его ставки за токен близки к ценам самих поставщиков. Напрямую — если нужны фирменные функции, такие как Z.ai’s reasoning_effort элементы управления в полном объёме, SLA поставщика или планы подписки, например GLM Coding Plan. Многие команды используют оба варианта и распределяют задачи по нагрузке.
GLM-5.3 поддерживает изображения? Нет. GLM-5.3 работает только с текстом. GLM-5.3-Flash — совершенно другая модель, несмотря на похожее название — нативно мультимодальна и обрабатывает текст, изображения, видео и файлы. Отправка изображений на неправильный ID модели — самая частая ранняя ошибка в семействе GLM.
Итог
Двенадцать месяцев назад вопрос об открытых весах был в том, пригодны ли эти модели. Шесть месяцев назад — конкурентоспособны ли они. В сентябре 2026 года он действительно звучит так: за что вы до сих пор платите наценку за закрытую модель?
У этого вопроса есть реальный ответ, и он уже, чем раньше. Claude Fable 5.1 лидирует в самой сложной длительной агентной работе, в работе с общими знаниями и в том классе отладки, где модель должна часами удерживать запутанную проблему в голове, не сбиваясь. Снижение Anthropic’s стоимости чтения из кэша на 75% нацелено именно на такую нагрузку. Если цена ошибки превышает стоимость токенов, эта наценка рациональна.
Для всего остального математика изменилась. GLM-5.3 даёт 94% показателя индекса Claude Opus 5’s при 29% затрат. Kimi K3 набирает 88,3 в Terminal-Bench 2.1 против 88,0 у Claude Fable 5’s в той же версии и занимает первое место в LMArena’s Frontend Code Arena, обойдя обе флагманские закрытые модели. Ollama продаст вам токенов на $60 за $20 и вдобавок снимет ограничения на использование. Такого сочетания весной не было.
Но пусть энтузиазм не заставит вас пропустить мелкий шрифт: таких пунктов два, и оба важны.
Первый — лицензирование. “Открытые веса” и “открытый исходный код” тихо перестали означать одно и то же. Kimi K3 и GLM-5.3 поставляются по индивидуальным лицензиям с порогом по выручке. Пороги достаточно высоки, чтобы большинства читателей это не касалось, — но “большинства читателей это не касается” не то же самое, что “без ограничений”, а неопределённое условие GLM-5.3’s о проверке безопасности — реальный риск для закупок в крупных компаниях. GLM-5.3-Flash под MIT — последний полностью разрешительный вариант, близкий к фронтиру, и именно поэтому он заслуживает большего внимания, чем получает.
Второй — самостоятельный хостинг в основном остаётся мечтой. 1,5 ТБ весов и 64 ускорителя — не план выхода для среднего бизнеса. Что открытые веса дают на этом уровне — конкурентный рынок инференса, прозрачность цен, фиксацию версии, выбор юрисдикции и переговорную позицию. Всё это очень много стоит. Но это не то же самое, что запускать модель у себя в подвале.
Схема, которую я бы действительно собрал: GLM-5.3 по умолчанию, Fable 5.1 для планирования и по-настоящему сложных задач, Kimi K3 для работы с изображениями и долгосрочных исследований, GLM-5.3-Flash для рутинной работы и локальная модель на 27B для всего, что никогда не должно покидать здание. Выбирайте модель под нагрузку, а не по привычке. Пишите конфигурацию так, чтобы ID моделей менялись одной строкой.
Потому что единственный прогноз, в котором я уверен: эту статью придётся обновить до Рождества.
Вы используете какую-либо из этих трёх моделей в продакшене? Мне особенно интересно, превращается ли многословность GLM-5.3’s в реальную проблему с затратами при масштабировании и показывал ли кто-нибудь лицензию Kimi K3 юристам, получив внятное толкование определения MaaS. Свяжитесь со мной — исправления и контрпримеры приветствуются, а статья обновляется, когда картина меняется.
Последнее обновление: 2 сентября 2026 г.


