
 Português do Brasil
 English
 Deutsch
 Español
 Italiano
 Français

Seis semanas atrás, eu teria escrito este artigo de outra forma.
Em julho, a Moonshot AI colocou 2,8 trilhões de parâmetros de um modelo de classe de fronteira no Hugging Face e deixou qualquer pessoa baixar. Em 28 de agosto, a Z.ai finalmente liberou os pesos do GLM-5.3 que vinha segurando por duas semanas — depois de descobrir que o próprio modelo conseguia encadear exploits de formas que ninguém tinha pedido. E em 1 de setembro, a Anthropic lançou o Claude Fable 5.1 e deixou o trabalho agêntico até 45% mais barato sem mexer no preço de tabela.
Três modelos. Três respostas completamente diferentes para a pergunta sobre o que um laboratório de IA deve ao público. E, pela primeira vez desde que tudo isso começou, as opções de pesos abertos não são a escolha de compromisso.
Essa é a história real do fim de 2026, e vale umas oito mil palavras, porque é nos detalhes que estão todo o dinheiro e todos os erros.
Eu levantei os papers de arquitetura, os model cards, os textos das licenças — de verdade, linha por linha, porque dois dos três não são o que as pessoas costumam chamá-los —, os benchmarks dos fabricantes, as notas dos agregadores neutros, as taxas reais por token e a tabela de preços novinha da Ollama’s. Depois rodei as contas de custo num mês normal de trabalho, em vez de num cenário de dia de lançamento.
Eis o que saiu.
TL;DR — o veredito em 60 segundos
GLM-5.3 é o melhor custo-benefício em IA hoje, e não é por pouco. O Artificial Analysis o pontua a meio ponto do Kimi K3 e cerca de três pontos e meio atrás do Claude Opus 5, a US$ 1,40 de entrada e US$ 4,40 de saída por milhão de tokens. Na mesma tarefa agêntica, custa cerca de um sexto do que custa o Fable 5.1. Os pesos podem ser baixados. Se você quer um modelo para apontar seu agente e não opera um negócio de US$ 10 bilhões de receita, é este.
Kimi K3 é a coisa mais capaz que você pode baixar legalmente. 2,8 trilhões de parâmetros, 104 bilhões ativos, um contexto de 1M de verdade, visão nativa, a melhor pontuação de navegação agêntica já publicada (BrowseComp 91,2), e — o número que deveria encerrar o argumento de “modelos abertos estão atrasados” — 88,3 no Terminal-Bench 2.1, contra Claude Fable 5’s 88,0 e GPT-5.6 Sol’s 88,8 na mesma versão. Ele também custa US$ 3/US$ 15 — mais que o dobro do GLM-5.3 — e seus 1,5 TB de pesos exigem um rack, não uma estação de trabalho. É o modelo que você usa quando a tarefa é difícil e longa, e o modelo que você cita quando alguém diz que pesos abertos estão uma geração atrás.
Claude Fable 5.1 continua sendo o modelo que você busca quando errar sai caro. Ele lidera o campo em trabalho agêntico sustentado de várias horas e na depuração bagunçada que nunca aparece limpa num leaderboard. A Anthropic cortou as leituras de cache em 75% em 1 de setembro, o que deixa as sessões longas de agente dramaticamente mais baratas do que eram. Também custa seis vezes o preço do GLM-5.3 por tarefa, é fechado e agora traz restrições anti-destilação que quebram algumas integrações existentes.
Resumindo com honestidade: os modelos de pesos abertos fecharam a diferença de capacidade para algo como três a cinco meses, e aniquilaram a diferença de preço. O que você está comprando de fato da Anthropic em setembro de 2026 é confiabilidade nos 10% mais difíceis do trabalho — e o direito de não pensar em nada disso.
E a reviravolta que ninguém quer dizer em voz alta: nem o Kimi K3 nem o GLM-5.3 são distribuídos sob uma licença de código aberto. Os dois migraram para termos personalizados e limitados por receita neste verão. Pesos abertos, sim. Código aberto, não. Leia a seção sobre licenças antes que seu time jurídico leia.
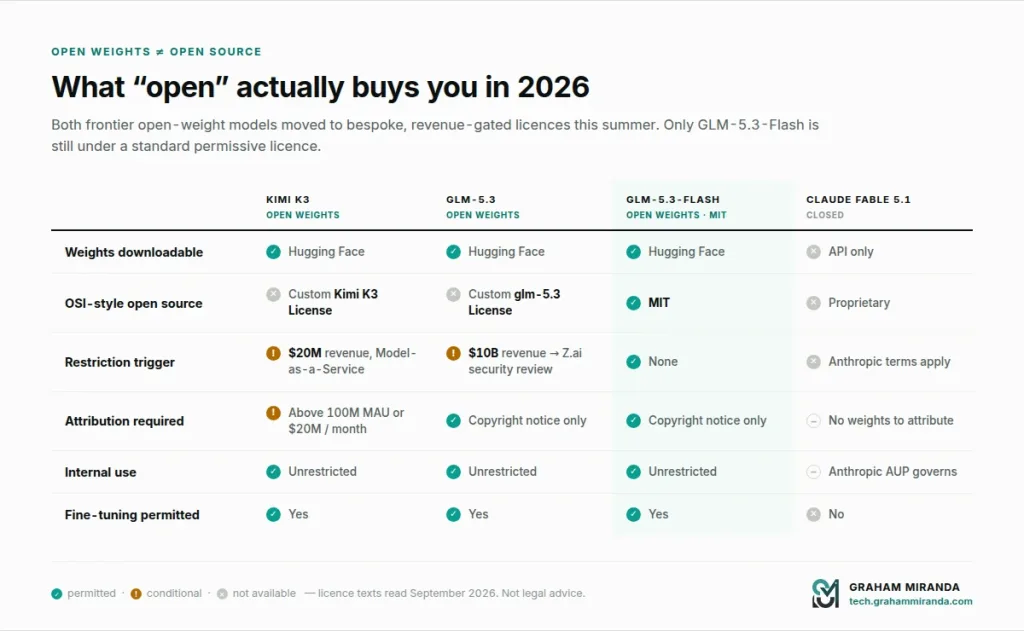
Tabela comparativa rápida
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Fabricante | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| Lançamento | 16 de julho de 2026 (API) · 27 de julho (pesos) | 14 de agosto de 2026 (API) · 28 de agosto (pesos) | 1 de setembro de 2026 |
| Pesos disponíveis | Sim | Sim | Não |
| Licença | Licença Kimi K3 (personalizada, limitada por receita) | Licença glm-5.3 (personalizada, limitada por receita) | Proprietário |
| Parâmetros totais | 2.8T | 753B | Não divulgado |
| Ativos por token | 104B (16 de 896 especialistas) | ~40B (estimado) | Não divulgado |
| Arquitetura | KDA + Attention Residuals, Stable LatentMoE, 69 camadas KDA + 24 camadas Gated MLA | MoE, mesma base do GLM-5.2, ganhos apenas do pós-treinamento | Não divulgado |
| Janela de contexto | 1,048,576 | 1,000,000 | 1,000,000 |
| Saída máxima | 131.072 por padrão (até 1.048.576) | 128,000 | 128,000 |
| Entrada multimodal | Texto, imagem, vídeo (MoonViT-V2) | Somente texto | Texto, imagem |
| Raciocínio | Sempre ativo | Sempre ativo, reasoning_effort low/high/max | Sempre ativo, adaptativo, esforço por mensagem (beta) |
| Preço de entrada / 1M | US$ 3,00 | US$ 1,40 | US$ 10,00 |
| Entrada em cache / 1M | US$ 0,30 | US$ 0,26 | US$ 0,25 |
| Preço de saída / 1M | US$ 15,00 | US$ 4,40 | US$ 50,00 |
| Índice de Inteligência AA | 59.7 | 59.5 | Ainda não avaliado (Fable 5: 62,1) |
| Custo por tarefa de avaliação AA | US$ 0,84 | US$ 0,68 | — (Opus 5: US$ 2,34) |
| Pegada de auto-hospedagem | ~1,5 TB (MXFP4 nativo) | ~1,5 TB BF16 / ~750 GB FP8 | N/A |
| No Ollama | kimi-k3:cloud | glm-5.3:cloud | Via Claude Code / Claude Desktop como cliente |
Todos os preços são de tabela do próprio fabricante. Os números do Artificial Analysis vêm da captura do índice de setembro de 2026; o Fable 5.1 foi lançado em 1 de setembro e ainda não tinha sido avaliado de forma independente na época em que escrevi.
Por que esta comparação entre três é a que importa
Por dois anos, a conversa entre aberto e fechado teve um formato confortável: modelos fechados eram melhores, modelos abertos eram mais baratos, e você escolhia onde se posicionar nessa troca. Todo mundo sabia onde estava.
Esse formato se rompeu neste verão.
Nathan Lambert, que acompanha isso com mais cuidado do que quase qualquer pessoa, estima a atual diferença de capacidade entre modelos de fronteira de pesos abertos e modelos de fronteira fechados em três a cinco meses — abaixo dos seis a nove meses que as pessoas citavam um ano atrás. Na época em que ele escreveu, o Kimi K3 estava em #2 no índice da Vals AI e perto do topo do Artificial Analysiss, perdendo só para o Claude Fable e o GPT-5.6 Sol Max. A captura do índice de setembro que uso mais adiante neste artigo o coloca em quarto, atrás do Grok 4.6. De qualquer forma: isso não é “bom para um modelo aberto.” Isso é pódio.
Enquanto isso, os dados de uso foram para um lugar realmente surpreendente. Modelos de origem chinesa capturaram cerca de 61% de todos os tokens roteados pelo OpenRouter até maio de 2026. A fatia dos EUA nesse tráfego caiu de cerca de 70% para cerca de 30% em doze meses. O Meta’s Llama — o modelo que deu início à onda dos pesos abertos — caiu abaixo de 1% do volume roteado. A fatia do Google foi de cerca de 37% para 13%. O próprio estudo de 100 trilhões de tokens do OpenRouter com a a16z constatou que modelos de pesos abertos respondem por cerca de um terço de todo o volume de tokens na plataforma.
Dá para discutir o que o tráfego do OpenRouter representa. Ele sobre-representa desenvolvedores, hobistas e cargas sensíveis a custo, e sub-representa contratos corporativos que nunca passam por um roteador. Tudo bem. Mas é o maior conjunto de dados público que temos sobre o que as pessoas realmente escolhem quando podem escolher livremente, e a direção é inequívoca.
Então a pergunta em setembro de 2026 não é mais “modelos abertos já são bons o suficiente”. Ela é muito mais afiada:
Dados três modelos que todos passam no critério, para qual deles você aponta seu agente — e quanto custa de fato errar?
Essa é uma pergunta sobre benchmarks, preços, licenças e infraestrutura, mais ou menos na ordem em que as pessoas pensam neles e exatamente na ordem inversa da importância deles.
O que o Kimi K3 realmente é
A Moonshot AI anunciou o Kimi K3 em 16 de julho de 2026 e liberou todos os pesos em 27 de julho. Em contagem de parâmetros, é o maior modelo de pesos abertos já publicado — 2,8 trilhões de parâmetros totais, cerca de 75% maior que o DeepSeek V4 Pro.
Esse número é menos impressionante do que parece e mais impressionante do que parece, nessa ordem.
A arquitetura, em linguagem simples
O Kimi K3 é um modelo de mistura de especialistas que ativa 104 bilhões de parâmetros por token, selecionando 16 especialistas de um conjunto de 896. Então, embora o total seja 2,8T, qualquer passada adiante toca menos de 4% dos pesos. É daí que vem a economia: conhecimento armazenado enorme, custo de inferência moderado.
A engenharia interessante está na pilha de atenção. O K3 usa 93 camadas construídas a partir de 69 camadas KDA (Kimi Delta Attention) e 24 camadas Gated MLA — um design híbrido de atenção linear para completa, com proporção de intercalação de cerca de 3:1. O KDA é uma variante de atenção linear que roda em tempo linear em relação ao comprimento da sequência, e não quadrático, o que torna o contexto de 1M economicamente viável em vez de apenas anunciado. A Moonshot reporta até uma redução de 75% no cache KV e até 6× mais throughput de decodificação com contexto de 1M como resultado.
Sobre isso, está Attention Residuals (AttnRes), que a Moonshot descreve como um substituto direto das conexões residuais padrão, e uma Stable LatentMoE estrutura de roteamento. A combinação, segundo a empresa, entrega cerca de uma melhoria de 2,5× na eficiência geral de escala em relação ao Kimi K2.
A visão vem do MoonViT-V2, um codificador de 401M de parâmetros, e é nativo em vez de acoplado — o K3 lida com texto, imagens e vídeo em um único modelo.
Mais um detalhe que importa para quem pensa em auto-hospedagem: o K3 foi treinado com treinamento com reconhecimento de quantização MXFP4 nativo, com especialistas em MXFP4 e ativações em MXFP8. Isso não é quantização posterior. O checkpoint publicado é o modelo quantizado, e é por isso que 2,8 trilhões de parâmetros cabem em cerca de 1,5 TB em disco em vez dos ~5,6 TB que um checkpoint BF16 desse tamanho precisaria.
A história dos benchmarks
Os números publicados pela Moonshot são fortes em todos os quesitos e, o que é incomum, vários se sustentaram em avaliação independente:
- Terminal-Bench 2.1: 88,3 — a maior pontuação publicada nessa versão do benchmark
- FrontierSWE: 81,2
- DeepSWE: 67,5
- BrowseComp: 91,2 — estado da arte em pesquisa agêntica na web
- GPQA Diamond: 93,5
- MMMU-Pro: 81,6 / 83,4 (visão)
- SWE Marathon: 91,0
- OfficeQA Pro: 81,3
- AutomationBench: 30.8
- LMArena Frontend Code Arena: 1,679 Elo — primeiro lugar, à frente de Claude Fable 5 (1,631) e GPT-5.6 Sol (1,618), vencendo seis de sete domínios de frontend
Esse último merece uma pausa. Um modelo de pesos abertos que você baixa de graça ficou em primeiro lugar numa arena de código frontend avaliada por preferência humana, à frente dos modelos fechados de ponta dos dois laboratórios mais bem financiados do mundo. Seja o que for que você pense sobre benchmarks de arena como metodologia, essa é uma manchete que teria sido impensável em 2025.
Nos índices agregados, ele fica um pouco abaixo: 59.7 no Artificial Analysis Intelligence Index, terceiro no geral, atrás de Claude Opus 5 (63.0) e Claude Fable 5 (62.1). Os números de destaque da própria Moonshot — GDPval-AA v2 em 1,687 e AA-Briefcase em 1,527 — o colocam em terceiro e segundo, respectivamente, nessas avaliações de trabalho de conhecimento. No Vals Index v2, ele fica em 57.8%, contra 67.2% do Claude Opus 5, 66.0% do Claude Fable 5 e 63.7% do GPT-5.6 Sol — a maior diferença entre aberto e fechado em qualquer índice que encontrei, e que vale ter em mente quando você olhar os números de código.
As demos, e como lê-las
A Moonshot publicou duas demonstrações de autonomia de longo prazo que chamaram muita atenção: uma execução autônoma de 48 horas concluindo um pipeline completo de design de chip (um design de 4 mm fechando timing a 100 MHz, simulando a 8.700+ tokens por segundo), e uma reprodução da relação astrofísica I-Love-Q em cerca de duas horas, contra as uma a duas semanas que um pesquisador sênior normalmente precisaria.
São impressionantes de verdade, mas eu não basearia uma decisão de compra nelas. Demonstrações feitas, montadas e escolhidas pelo fornecedor mostram o que o modelo consegue fazer num dia bom, com supervisão especializada, não o que ele faz no seu repositório numa terça-feira. Trate isso como prova de existência da capacidade de longo prazo, não como especificação.
Mostrar imagem Duas arquiteturas publicadas e uma caixa-preta. Os modelos abertos mostram exatamente como funcionam; o fechado mostra quanto ele pontua.
O que o GLM-5.3 realmente é
O GLM-5.3 tem a história de lançamento mais estranha dos três, e é a que vale contar direito, porque é a primeira vez que um laboratório de ponta hesita visivelmente em publicar os pesos por motivos que não são comerciais.
A Z.ai anunciou o GLM-5.3 em 14 de agosto de 2026 com o slogan “Feito para código. Pronto para a defesa cibernética.” O modelo é um modelo de mistura de especialistas de 753 bilhões de parâmetros, com cerca de 40 bilhões ativos por token segundo estimativas da comunidade derivadas da configuração do GLM-5.2. Ele tem janela de contexto de 1M de tokens e saída máxima de 128K e — diferente do GLM-5.3-Flash, que é um modelo completamente outro — é apenas texto.
“Escalar o pós-treinamento foi tudo o que fizemos”
O fato técnico mais interessante do GLM-5.3 é que não existe modelo base novo. Ele reaproveita a mesma fundação pré-treinada do GLM-5.2. Todo o ganho veio de um pós-treinamento muito mais longo, que a Z.ai resumiu assim: “Escalar o pós-treinamento foi tudo o que fizemos no GLM-5.3.”
Os deltas não são pequenos:
| Benchmark | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Um ganho de seis vezes no Terminal-Bench e um salto de vinte pontos no DeepSWE, a partir dos mesmos pesos base, é um resultado realmente importante. Ele mostra que a fronteira ainda tem muito espaço no pós-treinamento, que é de longe a metade mais barata da conta de treinamento. É exatamente por isso que os laboratórios chineses, operando com, como Lambert coloca, “ordens de magnitude menos capital” que os americanos, seguem o mesmo ritmo.
As duas semanas que a Z.ai passou sem lançar
A Z.ai disse no lançamento que os pesos viriam “em etapas, após avaliações de segurança rigorosas”, com meta de cerca de duas semanas. O repositório dela no Hugging Face marcava 28 de agosto. A data chegou, passou por questão de horas, e então os pesos apareceram junto com um texto técnico explicando a demora.
O motivo foi capacidade cibernética. Durante a avaliação, a Z.ai relatou que o GLM-5.3 identificou 2.436 vulnerabilidades em 269 projetos de código aberto, das quais 1.097 foram classificadas como críticas ou de alta gravidade. Mais relevante ainda: o modelo demonstrou raciocínio de cadeia de exploração em vários estágios — encadeando etapas de exploração de forma autônoma — comportamento que a Z.ai caracterizou como “não totalmente intencional” e que “continuou crescendo conforme o treinamento escalava”.
Quero ter cuidado aqui, porque é fácil ler isso como marketing ou alarmismo, e provavelmente não é nenhum dos dois. Um modelo bom em encontrar vulnerabilidades é bom em encontrar vulnerabilidades; o uso defensivo e o ofensivo são a mesma capacidade apontada em direções diferentes. A distribuição de benchmarks da Z.ai reflete isso com honestidade: CyberGym 84.5% (descoberta de vulnerabilidades, onde ele lidera) contra ExploitBench 54.4% (exploração, onde o Claude Fable 5 marca 78.0%). O laboratório otimizou deliberadamente para a metade defensiva, e isso aparece.
O que é realmente notável é que um laboratório segurou um lançamento principal por duas semanas e publicou seu raciocínio. Quer você ache o raciocínio convincente ou não, o precedente é novo.
Onde o GLM-5.3 realmente se posiciona
O gráfico comparativo publicado pela Z.ai não reivindica uma vitória em tudo, o que é refrescante:
| Benchmark | GLM-5.3 | Melhor comparador |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3 lidera |
| CyberGym | 84.5% | GLM-5.3 lidera |
| GDPval-AA v2 | 1,769 | GLM-5.3 lidera |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34.6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72.7% |
| ExploitBench | 54.4% | Claude Fable 5: 78.0% |
| Code Bench (50K tokens) | 31.4% | — |
De forma independente, o Artificial Analysis o coloca em 59.5 no Intelligence Index — estatisticamente indistinguível dos 59.7 do Kimi K3, vindo de um modelo com cerca de um quarto dos parâmetros.
Uma ressalva da mesma avaliação que ninguém no marketing menciona: o GLM-5.3 gerou 170 milhões de tokens de saída na suíte do Artificial Analysis, contra uma mediana de 72 milhões para a categoria. Ele é prolixo. reasoning_effort usa por padrão max e o raciocínio não pode ser desativado, então você paga por muita deliberação, ganhe a tarefa ou não. Mesmo assim, o custo total para rodar a avaliação completa ficou em US$ 0,68 por tarefa, contra US$ 0,84 do Kimi K3 e US$ 2,34 do Claude Opus 5 — então a verbosidade não apaga a vantagem de preço. Só a reduz.
O que o Claude Fable 5.1 realmente é
A Anthropic lançou o Claude Fable 5.1 em 1 de setembro de 2026, junto com o Claude Mythos 5.1 — o mesmo modelo com configuração de salvaguardas diferente, disponível apenas por programas de acesso confiável para trabalhos de segurança cibernética e ciências da vida.
O posicionamento é específico e, na minha opinião, correto: este é “um modelo feito para trabalho que não termina em um prompt.” A Anthropic não está reivindicando um salto de inteligência geral. Está dizendo que sessões agênticas longas, de várias horas, saem melhores.
Os números
| Benchmark | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (parcial) | 72.9% | 77.9% | — |
| Humanity’s Last Exam (com ferramentas) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Para contexto externo na mesma régua: GPT-5.6 Sol marca 52.3% no Terminal-Bench 4.0, então os 55.8% do Fable 5.1 assumem a liderança e os 60.9% do Mythos 5.1 ampliam a vantagem.
O salto no Terminal-Bench-Science — de 24.7% para 52.6%, uma duplicação limpa — é o que eu ponderaria mais se seu trabalho envolve computação científica ou pipelines de dados. E no benchmark de uso de computador mais difícil do Browserbase, o Fable 5.1 completou 82% das tarefas, contra 74% do Claude Opus 5.
A Anthropic também relata uma redução de cerca de 60% nos falsos positivos de segurança cibernética — o modelo recusando trabalho legítimo de segurança porque viu padrão de algo perigoso. Se você já teve um assistente de código se recusando a ajudar a escrever um rate limiter, vai entender por que isso importa.
A mudança de preços é a notícia de verdade
As tarifas de tabela não mudaram: US$ 10 por milhão de tokens de entrada, US$ 50 por milhão de saída. O que mudou foi o multiplicador de leitura de cache, e mudou muito.
| Fable 5 | Fable 5.1 | |
|---|---|---|
| Entrada | US$ 10,00 | US$ 10,00 |
| Saída | US$ 50,00 | US$ 50,00 |
| Escrita em cache (5 min) | US$ 12,50 | US$ 12,50 |
| Escrita em cache (1 hora) | US$ 20,00 | US$ 20,00 |
| Leitura de cache | US$ 1,00 | US$ 0,25 |
É um corte de 75%, obtido movendo o multiplicador de leitura de cache do padrão de 0.1× da entrada base para 0.025×. A Anthropic cita cerca de 25% mais barato para cargas de trabalho típicas e até 45% mais barato para trabalho altamente agêntico — e esse segundo número é real, porque os loops agênticos são esmagadoramente leituras de cache. Uma sessão de agente de 60 turnos relê o mesmo contexto acumulado dezenas de vezes. A Batch API ainda corta pela metade entrada e saída, chegando a US$ 5/US$ 25.
É um corte de preço inteligente e direcionado. Deixa a coisa em que o Fable 5.1 é melhor — sessões longas — bem mais barata, sem desvalorizar o modelo em geral.
Três mudanças que quebram, uma regressão
Antes de atualizar uma integração em produção, leia isto com atenção.
1. O uso forçado de ferramentas acabou. Requisições usando tool_choice: "any" ou tool_choice: "tool" agora retornam um erro 400. O raciocínio está sempre ligado e não pode ser contornado, e forçar uma chamada de ferramenta o pularia. Você precisa usar tool_choice: "auto".
2. Os blocos de raciocínio são de mão única. O Fable 5.1 consegue ler blocos de raciocínio produzidos por modelos Claude anteriores, mas os anteriores não conseguem ler os do Fable 5.1. Só o Mythos 5.1 consegue. Se sua arquitetura troca de modelo no meio da conversa para economizar, esse fallback agora força um replanejamento.
3. Editar o histórico invalida os blocos de raciocínio. Para contas criadas depois de 31 de agosto de 2026, editar turnos anteriores, o prompt de sistema ou o array de ferramentas invalida todos os blocos de raciocínio seguintes — erros ou descartes silenciosos. É uma medida explícita contra destilação e quebra um padrão comum em que frameworks de agentes reescrevem o contexto entre turnos.
E uma regressão que vale conhecer: o paralelismo de chamadas de ferramenta está, segundo relatos, mais variável no 5.1, às vezes emitindo uma única chamada por turno onde o 5 agrupava várias. Num loop de agente longo, isso custa tempo de execução.
Há também um detalhe de tokenizador que pega muita gente nas comparações de custo: o Fable 5.1 usa o mesmo tokenizador do Claude Opus 4.7, que produz cerca de 30% mais tokens do que o tokenizador dos modelos Claude mais antigos para o mesmo texto. Se você está comparando custo com uma base de 2025, ajuste isso antes de concluir qualquer coisa.
O problema dos benchmarks: três modelos, três réguas diferentes
Esta é a parte que a maioria dos artigos de comparação erra, e vale ser direto.
Você não pode alinhar esses três modelos no Terminal-Bench. Olha:
- Kimi K3: 88.3 no Terminal-Bench 2.1
- GLM-5.3: 28.3 no Terminal-Bench 3.0
- Fable 5.1: 55.8 no Terminal-Bench 4.0
São três benchmarks diferentes que compartilham um nome. Cada versão ficou substancialmente mais difícil que a anterior — é exatamente o objetivo de lançar uma versão nova. Ler esses três números como um ranking diria que o Kimi K3 é três vezes melhor que o GLM-5.3 em trabalho de terminal, o que não faz sentido.
O mesmo problema vale para o AutomationBench, onde os números de versão são reportados de forma inconsistente, e para a família SWE-bench, onde as variantes Verified, Pro e Marathon medem coisas genuinamente diferentes. Os laboratórios não fazem isso para enganar ninguém — eles rodam a avaliação que estava vigente quando treinaram, e as avaliações mudam a cada poucos meses hoje. Mas o efeito sobre um leitor casual é o mesmo da enganação, então vale sinalizar em alto e bom som.
O que você pode comparar legitimamente, dentro de uma versão:
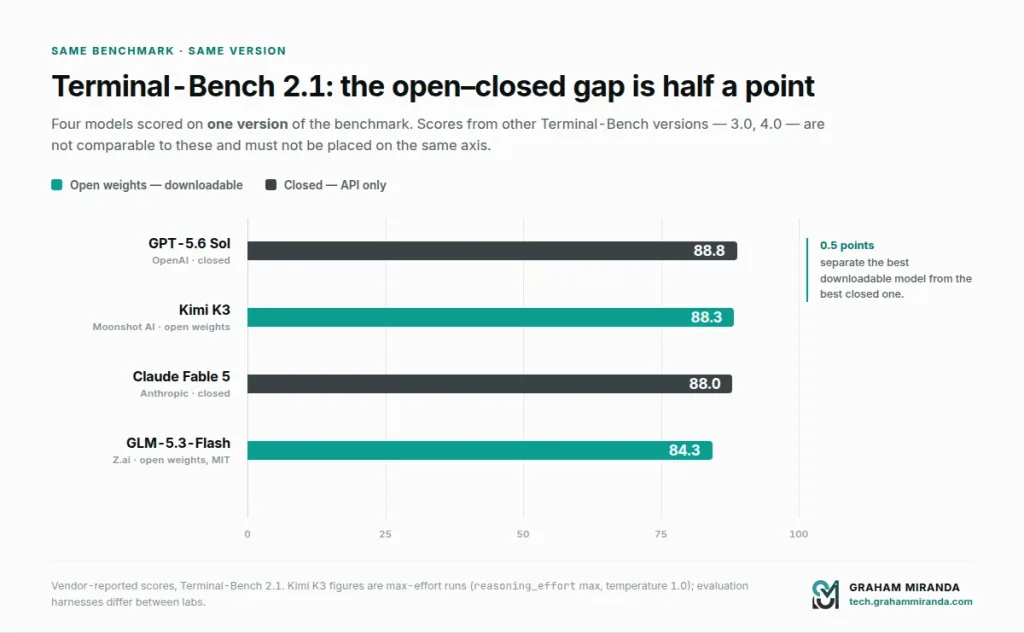
No Terminal-Bench 2.1: Kimi K3 (88.3), GPT-5.6 Sol (88.8), Claude Fable 5 (88.0) e GLM-5.3-Flash (84.3). Quatro modelos, uma régua. Essa é a comparação que realmente importa, e dei a ela uma tabela própria na próxima seção.
No Terminal-Bench 4.0: Fable 5.1 (55.8) contra GPT-5.6 Sol (52.3). O Fable vence.
Fora isso, desconfie de qualquer um que mostre um único gráfico de barras com os três modelos principais deste artigo no eixo do Terminal-Bench. Não dá para fazer isso com honestidade.
Onde eles realmente se encontram: os números comparáveis entre si
Tire as incompatibilidades de versão dos benchmarks e três comparações sobrevivem.
1. Artificial Analysis Intelligence Index (setembro de 2026)
Executado de forma independente, mesma metodologia para todos os modelos, sem envolvimento do fornecedor na seleção.
| Posição | Modelo | Pontuação | Pesos abertos |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | Não |
| 2 | Claude Fable 5 | 62.1 | Não |
| 3 | Grok 4.6 | 60.9 | Não |
| 4 | Kimi K3 | 59.7 | Sim |
| 5 | GLM-5.3 | 59.5 | Sim |
| 6 | GPT-5.6 Sol | 58.9 | Não |
| 7 | Qwen3.8 Max Preview | 58.1 | Pesos pendentes |
| 8 | GLM-5.3-Flash | 57.5 | Sim (MIT) |
| 31 | MiniMax M3 | 45.4 | Sim |
O Fable 5.1 ainda não tinha pontuação independente na hora em que escrevi — ele foi lançado no dia anterior. Dados os deltas de benchmark do 5.1 sobre o Fable 5, espere que ele fique em 62.1 ou acima quando for avaliado.
Uma nota sobre precisão: diferentes snapshots deste índice arredondam de forma diferente — uma coleta de setembro tem Kimi K3 e GLM-5.3 ambos em 60 e GPT-5.6 Sol em 61. A ordem no topo é estável; as diferenças de fração de ponto não são. Não construa um argumento em cima de meio ponto.
Leia essa tabela com atenção. O melhor modelo de pesos abertos está 3.3 pontos atrás do melhor modelo fechado no índice neutro mais amplo disponível. Há um ano, essa diferença era de dois dígitos.
2. Terminal-Bench 2.1 — a única versão em que três deles se encontram
Esta é a tabela mais útil do artigo, e eu quase a perdi. Kimi K3, Claude Fable 5 e GPT-5.6 Sol foram todos avaliados na mesma versão do Terminal-Bench:
| Modelo | Terminal-Bench 2.1 | Pesos abertos |
|---|---|---|
| GPT-5.6 Sol | 88.8 | Não |
| Kimi K3 | 88.3 | Sim |
| Claude Fable 5 | 88.0 | Não |
| GLM-5.3-Flash | 84.3 | Sim (MIT) |
Meio ponto separa um modelo que você pode baixar do melhor modelo fechado no mesmo benchmark, na mesma versão, em trabalho agêntico nativo de terminal.
É esse o número para lembrar. Não o agregado do índice, não o gráfico do fornecedor — este. No formato de tarefa que a codificação agêntica realmente tem, a diferença está dentro do ruído.
Uma ressalva, declarada pela fonte e que vale repetir: todos os números publicados do Kimi K3 são execuções de esforço máximo, com reasoning_effort maximum e temperatura 1.0. Laboratórios diferentes usam harnesses de avaliação e configurações de esforço diferentes, então até comparações da mesma versão carregam mais incerteza do que uma tabela limpa sugere.
3. Custo de rodar a mesma suíte de avaliação
Se a tabela acima é a melhor comparação de capacidade, esta é a melhor comparação de valor — porque é o único número que junta capacidade, verbosidade, custo de raciocínio e preço em um só valor:
| Modelo | Custo por tarefa do Intelligence Index |
|---|---|
| GLM-5.3 | US$ 0,68 |
| Kimi K3 | US$ 0,84 |
| Claude Opus 5 | US$ 2,34 |
Mesmas tarefas, mesma pontuação, faturas reais. O GLM-5.3 entrega 94% da pontuação de índice do Opus 5 por 29% do custo.
4. GDPval-AA v2 (trabalho de conhecimento)
| Modelo | Pontuação |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
Vale uma ressalva nesta: ela é montada a partir de gráficos publicados por fornecedores, não de uma execução independente única, e os sufixos “Max” indicam configurações de esforço diferentes. Mas a ordem é amplamente consistente entre as fontes, e diz algo real — em trabalho de conhecimento geral, ao contrário de código, os modelos fechados ainda mantêm uma liderança mais clara do que os benchmarks de código sugerem.
Esse é o padrão nas três comparações. Os modelos abertos basicamente alcançaram os fechados em código e tarefas agênticas. Ainda estão um passo atrás em trabalho de conhecimento amplo. Se sua carga de trabalho é a primeira, o argumento para pagar preços de modelo fechado é fraco. Se é a segunda, ainda é defensável.
Mostrar imagem Três pontos e pouco separam o melhor modelo fechado do melhor baixável. Essa diferença era de dois dígitos doze meses atrás.
A matemática de custo, com números reais
Benchmarks são abstratos. Faturas não.
O cenário
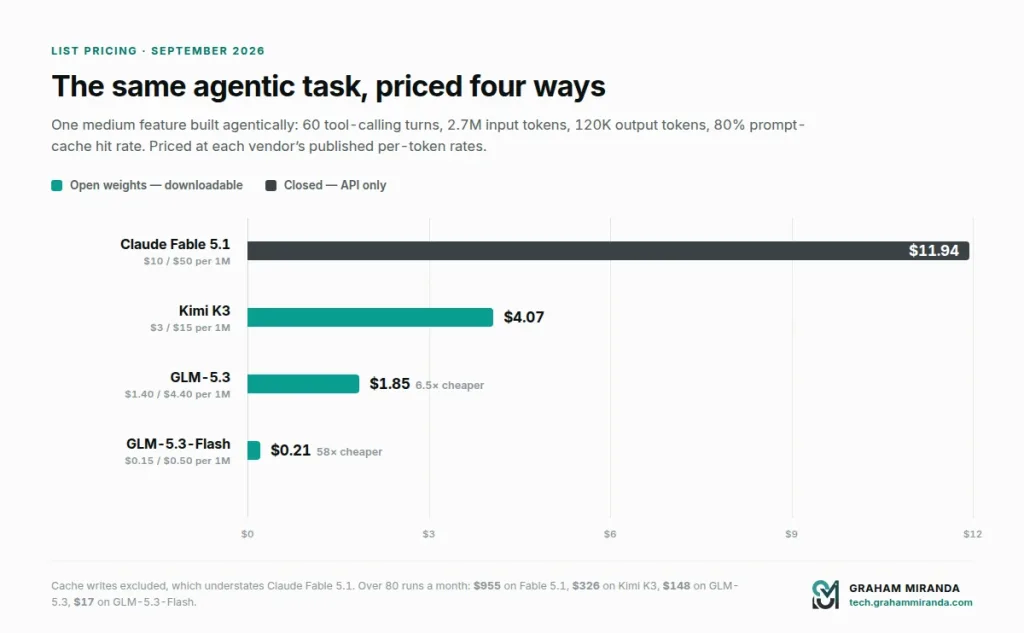
Uma feature média, feita de forma agêntica: cerca de 60 turnos de chamada de ferramentas, com média de 45.000 tokens de entrada por turno conforme o contexto se acumula, e 2.000 tokens de saída por turno.
- Entrada total: 2,7 milhões de tokens
- Saída total: 120 mil tokens
- Taxa de acerto de cache de prompt assumida: 80% (2,16 milhões em cache, 540 mil novos)
Claude Fable 5.1
| Componente | Tokens | Tarifa | Custo |
|---|---|---|---|
| Entrada nova | 540 mil | US$ 10,00/M | US$ 5,40 |
| Entrada em cache | 2,16 milhões | US$ 0,25/M | US$ 0,54 |
| Saída | 120 mil | US$ 50,00/M | US$ 6,00 |
| Total | ≈ US$ 11,94 |
Kimi K3
| Componente | Tokens | Tarifa | Custo |
|---|---|---|---|
| Entrada nova | 540 mil | US$ 3,00/M | US$ 1,62 |
| Entrada em cache | 2,16 milhões | US$ 0,30/M | US$ 0,65 |
| Saída | 120 mil | US$ 15,00/M | US$ 1,80 |
| Total | ≈ US$ 4,07 |
GLM-5.3
| Componente | Tokens | Tarifa | Custo |
|---|---|---|---|
| Entrada nova | 540 mil | US$ 1,40/M | US$ 0,76 |
| Entrada em cache | 2,16 milhões | US$ 0,26/M | US$ 0,56 |
| Saída | 120 mil | US$ 4,40/M | US$ 0,53 |
| Total | ≈ US$ 1,85 |
E para referência — GLM-5.3-Flash
| Componente | Tokens | Tarifa | Custo |
|---|---|---|---|
| Entrada nova | 540 mil | US$ 0,15/M | US$ 0,08 |
| Entrada em cache | 2,16 milhões | US$ 0,03/M | US$ 0,06 |
| Saída | 120 mil | US$ 0,50/M | US$ 0,06 |
| Total | ≈ US$ 0,21 |
As proporções
- GLM-5.3 é 6.5× mais barato que o Fable 5.1 para trabalho idêntico
- Kimi K3 é 2.9× mais barato que o Fable 5.1
- GLM-5.3 é 2.2× mais barato que o Kimi K3
- GLM-5.3-Flash é 58× mais barato que o Fable 5.1, com 57.5 no índice de inteligência contra 62.1 do Fable 5
Escalando para um mês de trabalho
Quatro tarefas assim por dia, vinte dias úteis — 80 execuções agênticas:
| Modelo | Custo mensal de tokens |
|---|---|
| Claude Fable 5.1 | ≈ US$ 955 |
| Kimi K3 | ≈ US$ 326 |
| GLM-5.3 | ≈ US$ 148 |
| GLM-5.3-Flash | ≈ US$ 17 |
Três ressalvas honestas sobre esses números
As gravações de cache não estão incluídas. O Fable 5.1 cobra US$ 12,50/M por gravações de cache de 5 minutos, e uma sessão longa grava cache repetidamente. Incluir as gravações move o número real do Fable para cima, não para baixo. A taxa de acerto de 80% também é otimista para sessões curtas.
Os tokens de raciocínio são cobrados como tokens de saída. Os três modelos têm raciocínio sempre ativo. O GLM-5.3 em particular é documentado como verboso — 170M tokens de saída contra uma mediana de 72M da própria categoria no conjunto do AA — então seu volume real de saída fica acima do que uma contagem ingênua de turnos sugere. O valor de US$ 0,68 por tarefa já leva isso em conta, e é por isso que confio mais nele do que no meu próprio modelo acima.
O tokenizador do Fable 5.1 produz ~30% mais tokens do que modelos Claude mais antigos para o mesmo texto. Se você estiver comparando com uma fatura histórica do Claude, ajuste.
Mesmo depois das três correções, a ordem não muda e a magnitude quase não muda. O trabalho com modelos de fronteira fechados custa cerca de seis vezes o que custa o melhor modelo de pesos abertos, por tarefa concluída.
Mostrar imagem A mesma tarefa agêntica de 60 turnos com o preço de tabela de cada fornecedor. O eixo vertical é todo o argumento a favor dos pesos abertos.
Licenças: o que “aberto” realmente compra para você em 2026
Esta é a seção que eu mais gostaria que as pessoas lessem, porque o vocabulário se desviou bastante e isso vai custar muito dinheiro a alguém.
Nem o Kimi K3 nem o GLM-5.3 são de código aberto. Ambos publicam pesos baixáveis sob licenças sob medida com condições acionadas por receita. Isso é algo significativamente diferente de MIT ou Apache 2.0, e a diferença recai justamente sobre o tipo de empresa que mais se beneficiaria da auto-hospedagem.
A licença do Kimi K3
Você vai ver “Modified MIT” repetido pela internet toda para o K3. Está errado — isso descrevia o K2. O K3 é distribuído sob um documento personalizado com dois critérios distintos:
O critério de Model-as-a-Service. Se você der a terceiros acesso à inferência ou ao ajuste fino do modelo — quando esses terceiros controlam entradas, parâmetros ou dados de treinamento — e “a receita agregada do Licenciado e de suas afiliadas excede 20 milhões de dólares americanos” em qualquer período consecutivo de 12 meses, você deve negociar um acordo comercial separado com a Moonshot. Observe agregada receita, em todas as afiliadas, não receita atribuível ao K3. Uma consultoria com € 25 mi de faturamento que revende inferência está fora da linha mesmo que o negócio de IA seja um erro de arredondamento.
O critério de atribuição. Produtos que ultrapassem 100 milhões de usuários ativos mensais ou US$ 20 milhões de receita mensal devem exibir “Kimi K3” em destaque na interface do produto.
A isenção que mais importa: o uso puramente interno é irrestrito. Rodar o K3 para apoiar seus próprios desenvolvedores, pesquisadores, equipe jurídica ou a produtividade geral dos funcionários não aciona nenhum dos dois critérios. Para a grande maioria das empresas — incluindo essencialmente todas as minhas — essa é a cláusula relevante, e a resposta é que você não tem problema.
A cláusula nova em relação ao K2 é o limite de US$ 20 mi para MaaS. O K2 só exigia atribuição acima de seus limites. O K3 acrescenta um limite de receita muito menor, voltado especificamente a revendedores comerciais de inferência. A Moonshot não está tentando impedir você de usar o modelo; está tentando impedir que provedores de nuvem construam um negócio sobre ele de graça.
A licença do glm-5.3
O carro-chefe da Z.ai seguiu outra direção, e é uma ruptura com o precedente maior do que a maioria das reportagens reconheceu.
O GLM-5.2 foi lançado sob MIT. O GLM-5.3-Flash foi lançado sob MIT. O GLM-5.3 não.
A licença personalizada permite que indivíduos e empresas comuns executem, implantem e façam ajuste fino do modelo sem restrições adicionais. O único critério é voltado aos provedores de hiperescala: uma entidade cuja “a receita agregada do Licenciado e de suas afiliadas excede 10 bilhões de dólares americanos (ou o equivalente em outras moedas) no total em qualquer período consecutivo de 12 meses” deve passar pela revisão de segurança da Z.AI antes de usar o modelo ou seus derivados para qualquer finalidade comercial.
Esse é um limite de US$ 10 bilhões. Exclui quase todo mundo. Mas dois detalhes nas letras miúdas merecem atenção:
Primeiro, a licença abre exceção explícita para desenvolvedores de aplicativos que incorporam o modelo a recursos, e para revendedores que apenas encaminham requisições a outros hosts. O alvo é estreito e claramente rotulado: empresas que querem hospedar o GLM-5.3 comercialmente em escala.
Segundo — e esta é a parte genuinamente incômoda — a licença não publica critérios, prazos nem processo de recurso para essa revisão de segurança. Ela declara apenas que seu “escopo e método… serão determinados de forma razoável pela Z.AI.” Se você é uma grande empresa, isso é uma dependência sem limites do arbítrio de um fornecedor estrangeiro, e sua equipe de compras vai dizer isso.
Também vale notar: apesar da pausa de duas semanas motivada por capacidades cibernéticas que antecedeu o lançamento, a licença não contém restrições de uso aceitável, nem exceções para fins cibernéticos, nem pretensões de propriedade sobre os resultados. A preocupação com segurança moldou o momento do lançamento, não os termos do lançamento..
Então o que ainda é realmente MIT?
GLM-5.3-Flash. 320B parâmetros, 18B ativos, nativamente multimodal, licença MIT, 57,5 no índice de inteligência e US$ 0,15/US$ 0,50 por milhão de tokens — atualmente metade disso com um desconto promocional válido até 9 de setembro de 2026. Se o seu requisito é licenciamento permissivo genuinamente irrestrito e não apenas pesos baixáveis, é aí que a fronteira está hoje, e ela está notavelmente alta.
O resumo prático
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Pesos baixáveis | Sim | Sim | Sim | Não |
| Código aberto no estilo OSI | Não | Não | Sim (MIT) | Não |
| Gatilho de restrição | US$ 20 mi de receita (MaaS) | US$ 10 bi de receita (MaaS) | Nenhum | N/A |
| Atribuição obrigatória | Acima de 100M MAU / US$ 20 mi-mês | Apenas aviso de direitos autorais | Apenas aviso de direitos autorais | N/A |
| Uso interno restrito | Não | Não | Não | N/A |
| Ajuste fino permitido | Sim | Sim | Sim | Não |
| Política de uso aceitável | Padrão | Nenhuma no texto da licença | Nenhum | Aplica-se o AUP da Anthropic |
Para uma típica empresa alemã do Mittelstand, uma agência ou uma consultoria que roda modelos internamente ou os incorpora a um produto: as três opções abertas podem ser usadas sem negociar nada. Os limites existem para pegar a AWS, não você. Mas “leia a licença” passou de conselho pedante a conselho de verdade, e se você tem mais ou menos € 20 mi de faturamento e revende inferência de qualquer forma, leve isso ao jurídico antes de implantar.
O argumento real a favor dos modelos abertos
Quero fazer esse argumento direito, e não como slogan, porque “modelos abertos são ótimos” não é um argumento, e os motivos reais são mais interessantes do que a torcida.
1. A queda de preços não é subsídio, é estrutural
A objeção instintiva aos modelos chineses baratos é que os preços são abaixo do custo e vão se normalizar para cima. Parte disso certamente é verdade. Mas o ponto estrutural se sustenta por si só: quando os pesos são públicos, a inferência se torna um mercado de commodities. Vinte provedores de hospedagem competem para servir o mesmo modelo, e nenhum deles consegue cobrar um prêmio por capacidade porque nenhum tem um fosso de capacidade. É por isso que o GLM-5.3 roda a US$ 1,40/US$ 4,40 e o Fable 5.1 roda a US$ 10/US$ 50 com pontuações separadas por três pontos.
O preço dos modelos fechados inclui a amortização de P&D, a margem e o fato de existir exatamente um vendedor. O preço dos modelos de pesos abertos inclui eletricidade, amortização de hardware e uma margem apertada. São negócios diferentes, e a diferença não vai fechar porque os modelos abertos ficarão mais caros.
A evidência de que isso é real e não temporário: a DeepSeek capturou cerca de 17% do uso de tokens na Vercel até maio de 2026, mantendo cerca de 1% da participação na receita. Isso não é uma anomalia de preços. É assim que a comoditização aparece em um gráfico.
2. Direitos de saída mudam sua posição de negociação mesmo que você nunca os exerça
A maioria das equipes que lê isto não vai auto-hospedar. A seção de hardware abaixo explica por quê — o Kimi K3 precisa de um rack. Mas a opção tem valor de qualquer forma.
Se a Anthropic aumentar os preços, descontinuar o modelo em que você se baseou, mudar sua política de uso aceitável de um jeito que quebre seu produto ou tiver um trimestre ruim, sua saída com um modelo fechado é um projeto de migração. Com um modelo de pesos abertos, sua saída é baixar um arquivo que você poderia ter baixado a qualquer momento. Você pode nunca fazer isso. O fato de você poder é o que torna a relação com o fornecedor comercial em vez de uma dependência.
Isso não é teórico. O Fable 5.1 chegou com três mudanças incompatíveis em 1º de setembro, uma das quais invalida blocos de pensamento quando você edita o histórico da conversa em contas criadas depois de 31 de agosto. Se esse padrão é estrutural na sua arquitetura, você está refatorando no calendário da Anthropic, não no seu.
3. Residência de dados deixa de ser um projeto
Para quem opera sob o GDPR, este é o argumento que realmente fecha negócios.
Com uma API fechada, todo prompt sai da sua infraestrutura. Você precisa de um contrato de processamento de dados, uma avaliação de impacto de transferência se o processador estiver fora do EEE, um mapa de fluxo de dados e uma resposta para o seu DPO sobre o que acontece com os dados em repouso. Tudo isso é viável. Também são semanas de trabalho por fornecedor, repetidas sempre que o fornecedor muda alguma coisa.
Com pesos abertos em infraestrutura que você controla — seu próprio hardware ou um provedor de GPU alemão ou da UE — a questão da transferência transfronteiriça não surge, porque não há transferência. O modelo roda onde seus dados já estão. A revisão jurídica passa de uma avaliação de transferência para a leitura de uma licença.
Para clientes alemães e da UE, isso frequentemente é o fator decisivo, e vale ser preciso sobre a ressalva: usar o GLM-5.3 pela API da Z.ai não oferece isso a você. Você obtém isso rodando os pesos por conta própria ou com um provedor que os hospeda na sua jurisdição. A licença torna isso legal; não o torna automático.
4. A capacidade de inspeção é real, ainda que subutilizada
Pesos abertos significam que você pode examinar a arquitetura, rodar suas próprias avaliações no modelo real em vez de em um endpoint que pode ser atualizado silenciosamente, quantizá-lo para caber no seu hardware, fazer ajuste fino com os dados do seu domínio e — o que é importante — fixar uma versão para sempre.
Esse último ponto é subestimado. APIs fechadas são atualizadas por trás de IDs de modelo estáveis. O comportamento muda aos poucos. Prompts que funcionavam param de funcionar, e você não consegue fazer diff da mudança porque não consegue vê-la. Um checkpoint local continua byte a byte idêntico daqui a um ano.
5. A pressão competitiva beneficia todos, inclusive usuários de modelos fechados
Veja o que aconteceu neste verão. O Kimi K3 chega em julho a US$ 3/US$ 15 com pontuações próximas da fronteira. O GLM-5.3 chega em agosto a US$ 1,40/US$ 4,40 a meio ponto dele. E em 1º de setembro, a Anthropic cortou as leituras de cache em 75%.
Não estou afirmando causalidade direta — a Anthropic não publica a lógica dos seus preços, e cortes na leitura de cache são uma otimização natural. Mas um mercado com substitutos baratos críveis tem preços diferentes de um sem eles, e os substitutos se tornaram críveis este ano. Se você usa modelos fechados exclusivamente, o ecossistema de pesos abertos continua reduzindo suas faturas em silêncio.
6. O pós-treinamento é onde estão os ganhos, e ele é barato
O principal resultado do GLM-5.3 — uma melhoria de seis vezes no Terminal-Bench a partir dos mesmos pesos base — é o número estrategicamente mais importante deste artigo inteiro, e não é sobre o GLM.
Ele diz que a parte cara de construir um modelo de fronteira (o pré-treinamento) é cada vez mais um insumo resolvido e comoditizado, e a parte que diferencia (pós-treinamento, ambientes de RL, design de tarefas de longo horizonte) é comparativamente acessível. É por isso que quatro laboratórios chineses com avaliação combinada de cerca de US$ 159 bilhões acompanham laboratórios americanos avaliados em múltiplos disso. A avaliação de Lambert é que os laboratórios chineses operam com “ordens de magnitude menos capital.”
Para quem está na ponta, a implicação é direta: o número de fornecedores de modelos críveis está crescendo, não diminuindo. Planeje sua arquitetura de acordo.
7. Os efeitos do ecossistema se acumulam
O Qwen passou de um bilhão de downloads acumulados no Hugging Face, superando o Llama, e agora ancora mais de 200.000 modelos etiquetados e 113.000+ derivados — cerca de 40% de todos os novos derivados de LLM na plataforma são baseados no Qwen. Isso é um ecossistema de ferramentas, quantização, ajuste fino e implantação que só existe porque os pesos são públicos.
Você se beneficia desse ecossistema, contribua ou não para ele. Conversões GGUF, kernels vLLM, adaptadores LoRA, receitas de quantização, estruturas de avaliação — tudo isso existe porque milhares de pessoas puderam pôr as mãos nos pesos reais.
8. É para onde os desenvolvedores já foram
Modelos de origem chinesa em ~61% dos tokens do OpenRouter. A participação dos modelos dos EUA caiu de ~70% para ~30% em um ano. Quatro dos cinco modelos mais usados no roteador são de origem chinesa. Só os modelos MiMo da Xiaomi respondem por cerca de 21% dos tokens roteados e cerca de 22% de todo o tráfego de programação.
O comportamento dos desenvolvedores é um indicador antecedente. Foi um indicador antecedente para Docker, Postgres e Linux. Apostar contra ele tem um histórico ruim.
…E o argumento honesto contra
Se eu escrevesse apenas a seção acima, isto seria um anúncio.
Pesos abertos não são código aberto, e a mudança gradual do vocabulário é um problema real. Dois dos três modelos aqui são distribuídos sob licenças sob medida condicionadas à receita, sem aprovação da OSI. A cláusula de revisão de segurança do GLM-5.3 não tem critérios publicados nem processo de recurso. Se a sua estrutura de conformidade exige licenciamento aprovado pela OSI, a resposta honesta é que suas opções são o GLM-5.3-Flash, os carros-chefe da DeepSeek licenciados sob MIT e uma lista cada vez menor de outros.
Benchmarks de fornecedores continuam sendo benchmarks de fornecedores. Todo número de destaque publicado pela Moonshot e pela Z.ai é autorrelatado e escolhido a dedo. Onde agregadores neutros mediram, os números em geral se sustentam — o que é genuinamente mérito dos dois laboratórios —, mas “em geral se sustentam” carrega muito peso nessa frase.
A auto-hospedagem é fantasia para a maioria das equipes. O Kimi K3 tem 1,5 TB, e a Moonshot recomenda 64+ aceleradores. O GLM-5.3 precisa de 8×H200 em FP8 como mínimo absoluto. O direito de saída é real; o custo de exercê-lo é um data center.
O suporte é o que você faz dele. Quando o Fable 5.1 quebra, há uma empresa com um SLA. Quando sua implantação auto-hospedada do GLM-5.3 produz lixo com 300K de contexto numa sexta à noite, restam uma issue no GitHub e a sua própria competência.
A geopolítica é um fator real nas decisões de compra. As três opções de pesos abertos discutidas aqui vêm de laboratórios chineses. Para alguns clientes — setor público, áreas ligadas à defesa, certos setores regulados — isso é um bloqueio absoluto, independentemente dos termos da licença ou de onde os pesos rodam. Não é meu trabalho dizer se essa preocupação tem fundamento. É meu trabalho dizer que ela vai surgir na reunião.
Os modelos fechados ainda lideram em trabalho de conhecimento geral. No GDPval-AA v2, o Fable 5.1 está em 1.853, contra 1.769 do GLM-5.3 e 1.687 do Kimi K3. Em programação, a diferença sumiu. Em trabalho profissional amplo baseado em conhecimento, não.
Mostrar imagem Pesos baixáveis, três conjuntos diferentes de regras. Só o GLM-5.3-Flash ainda é MIT.
Ollama em 2026: a mudança de preços que realmente importa
O Ollama se tornou discretamente a peça de infraestrutura mais importante desta conversa, e em 31 de agosto de 2026 ele mudou a forma como cobra de um jeito que vale a pena entender direito.
O que mudou
O Ollama passou seus planos Pro, Max e Team da cobrança por tempo de GPU para preços por token padrão do setor, com uma reserva de créditos de uso incluída em todos os planos. O motivo declarado pela empresa é concreto, o que é refrescante: modelos como o Kimi K3 tornaram as métricas de tempo de GPU impossíveis de prever. Quando um modelo ativa 104B de parâmetros e outro ativa 3B, “uma hora de GPU” deixa de significar qualquer coisa para quem paga.
Os novos planos
| Plano | Preço | Uso mensal incluído | Concorrência |
|---|---|---|---|
| Grátis | US$ 0 | Pequeno crédito mensal, modelos de entrada | 1 requisição |
| Pro | US$ 20/mês (ou US$ 200/ano) | US$ 60 de uso | 3 requisições |
| Max | US$ 100/mês | US$ 300 de uso | 10 requisições |
| Team | US$ 500/mês | US$ 1.000 compartilhado, usuários ilimitados | 10 requisições |
| Enterprise | Custom | Custom | Custom |
Leia a linha do Pro de novo. US$ 20 compram US$ 60 em tokens. Isso é um multiplicador de 3× sobre o uso incluído, e quando a reserva acaba você continua exatamente na mesma tarifa publicada por token — sem faixa de penalidade, sem taxa de serviço.
O que foi removido
Esta é a parte que os desenvolvedores de fato notaram: sem redefinições a cada 5 horas e sem limites semanais. Quem já esbarrou numa janela de uso deslizante no meio de uma refatoração vai entender por que isso importava mais do que o preço. A reserva mensal é renovada na data da sua assinatura e, o que é importante, não acumula para o mês seguinte — então dimensione seu plano para o seu mês normal, não para o mais movimentado.
Os termos que importam para trabalho na UE
Três compromissos do anúncio são diretamente relevantes se você lida com dados de clientes:
- Retenção zero de dados. Prompts e respostas nunca são registrados nem usados para treinamento.
- Hospedagem nos EUA e na Europa, além de Singapura para um conjunto limitado de modelos Qwen.
- Visibilidade de custo por requisição na sua conta — você vê exatamente quanto custou cada chamada.
Para uma consultoria alemã, esse é um argumento de conformidade bem melhor do que a maioria dos provedores de gateway oferece, embora “hospedado na Europa” seja uma declaração de roteamento e não uma garantia contratual de residência de dados. Se a residência for um requisito rígido e não uma preferência, peça isso ao Ollama por escrito antes de contar com isso.
As tarifas reais por token
É aqui que fica interessante. O Ollama publica tarifas por modelo, e elas acompanham de perto os preços do próprio fornecedor:
| Modelo no Ollama | Entrada / 1M | Em cache / 1M | Saída / 1M |
|---|---|---|---|
kimi-k3 | US$ 3,00 | US$ 0,30 | US$ 15,00 |
glm-5.3 | US$ 1,40 | US$ 0,26 | US$ 4,40 |
mistral-large-3 | US$ 0,50 | US$ 0,50 | US$ 1,50 |
gemma4 | US$ 0,14 | US$ 0,05 | US$ 0,40 |
nemotron-3-super | US$ 0.015 | US$ 0.015 | US$ 0,60 |
Passe a conta mensal de antes por isso. Oitenta execuções agênticas por mês no GLM-5.3 custam cerca de US$ 148 em tokens. Um plano Max a US$ 100/mês cobre US$ 300 de uso — então a mesma carga de trabalho que custaria cerca de US$ 955/mês no Fable 5.1 cabe confortavelmente numa assinatura Ollama de US$ 100, com folga.
Esse é todo o argumento econômico dos modelos abertos comprimido em uma linha de uma fatura.
Mostrar imagem Oitenta execuções agênticas por mês no GLM-5.3 cabem num plano Ollama Max de US$ 100 com troco. O mesmo trabalho no Fable 5.1 é uma fatura de US$ 955.
O que mais o Ollama lançou em 2026
A mudança de preços não aconteceu isolada. Os últimos meses foram movimentados:
- 25 de agosto — suporte ao Claude Desktop. O Ollama agora funciona como provedor de gateway de terceiros para o Claude Desktop, para que você possa usar modelos abertos pelo próprio cliente da Anthropic.
- 26 de agosto — v0.33.0. A integração do gateway com o Claude Desktop chegou, a recuperação de prefill foi restaurada no cache, e o Ollama desativou a mensagem de sistema de contagem regressiva de tokens do Claude Code, que invalidava o cache KV a cada turno. Esse último ponto é uma correção de desempenho discreta, mas significativa.
- 26 de agosto — v0.33.1. Suporte a MLX para o Qwen3.8 Flash Next, saída estruturada e uma correção para timeouts de GPU ao carregar modelos de armazenamento mais lento.
- 28 de agosto — v0.33.2. Modo escuro restaurado, Handoff do macOS corrigido e requisições de proxy do Claude Desktop mantidas ativas durante atualizações do catálogo de modelos.
- 20 de agosto — v0.32.15. Novo onboarding do aplicativo desktop e cache de metadados entre requisições que reduziu o tempo até o primeiro token em cerca de metade.
- 11 de agosto — NVIDIA Nemotron 3.5 Lightning, um modelo de 30B ajustado para fluxos de trabalho agênticos com chamada de ferramentas em hardware pessoal.
- 10 de agosto — Muse Glimmer da Meta, um modelo multimodal de 30B sob Apache 2.0, acelerado pelo motor MLX do Ollama. Vale notar, dada a queda do Llama no uso roteado — a Meta ainda está entregando pesos genuinamente permissivos.
- 9 de julho — rodada de US$ 88 mi, com o Ollama relatando 8,9 milhões de desenvolvedores.
- 29 de junho — Gemma 4 no MLX até 90% mais rápido via predição multi-token, o que beneficia desproporcionalmente agentes de codificação no Apple Silicon.
- 5 de junho — v0.30 adicionou compatibilidade com GGUF via llama.cpp, ampliando o suporte de hardware muito além do Apple Silicon.
O fio condutor é que o Ollama deixou de ser “o jeito fácil de rodar um modelo pequeno no seu laptop” e virou um gateway de uso geral que por acaso também roda modelos localmente. O catálogo na nuvem agora inclui kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 em sete tamanhos, gpt-oss em 20b e 120b, gemma4, a família Nemotron 3 e mistral-large-3.
Configurando tudo: configurações para copiar e colar
Ollama + Claude Code (o caminho mais rápido)
O Ollama traz um lançador de um comando só que cuida da ligação do ambiente para você:
bash
ollama launch claudeSe você preferir fazer manualmente — e você deve fazer isso se estiver automatizando — instale o Claude Code primeiro:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
Depois aponte para o Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
E execute com o modelo que você quiser:
bash
# A local model
claude --model qwen3.5

# A cloud model — note the :cloud suffix
claude --model kimi-k3:cloud
Ou inline, sem exportar nada globalmente:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Duas coisas que vão te pegar.
Primeiro, não exporte ANTHROPIC_BASE_URL permanentemente no seu perfil de shell. É uma variável global e vai redirecionar silenciosamente toda ferramenta que fala Anthropic na sua máquina para o Ollama, incluindo aquela que você queria conversando com a Anthropic. Restrinja por projeto ou por invocação.
Segundo, defina a sua janela de contexto em 64k ou mais para qualquer coisa que trabalhe num repositório de verdade. O padrão do Ollama é menor, e um agente de codificação que silenciosamente esgota a janela simplesmente começa a esquecer as coisas em vez de dar erro.
Para CI, Docker ou execuções por script, --yes pula os prompts interativos:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "how does this repository work?"GLM-5.3 direto do Z.ai
Se você quiser roteamento direto da fonte em vez de passar pelo Ollama, o Z.ai expõe três endpoints de protocolo:
| Protocolo | Base URL |
|---|---|
| Anthropic Messages | https://api.z.ai/api/anthropic |
| OpenAI Chat Completions | https://api.z.ai/api/coding/paas/v4 |
| OpenAI Responses | https://api.z.ai/api/v1 |
Um bloco de provedor do OpenCode para o GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Z.AI",
      "options": {
        "baseURL": "https://api.z.ai/api/coding/paas/v4",
        "apiKey": "{env:ZAI_API_KEY}"
      },
      "models": {
        "glm-5.3": {
          "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
          "options": { "reasoning_effort": "high", "temperature": 1 }
        }
      }
    }
  },
  "model": "zai/glm-5.3"
}
Nota importante sobre a atualização: O GLM-5.3 exige que o raciocínio esteja ativado. Se a sua configuração atual define thinking.type: "disabled", isso agora vai falhar. Mude para "enabled" e defina reasoning_effort: "low" se você quiser de volta o perfil de latência antigo.
reasoning_effort é o seu principal botão de qualidade versus custo: low para chamadas sensíveis à latência, high para trabalho substancial, max (o padrão) para problemas que realmente derrotaram high. Dada a verbosidade documentada, eu usaria high como configuração do dia a dia em vez de deixar max ligado e ficar se perguntando para onde foram os tokens de saída.
A configuração de roteamento que eu realmente recomendaria
Nada disso é uma decisão de “escolha um”. A resposta correta para a maioria das equipes é uma tabela de roteamento de três níveis, e todo harness de agentes sério suporta modelos por agente.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
      "description": "Architecture, root-cause analysis, anything expensive to get wrong",
      "model": "anthropic/claude-fable-5-1"
    },
    "build": {
      "description": "The bulk of implementation work",
      "model": "zai/glm-5.3",
      "options": { "reasoning_effort": "high" }
    },
    "research": {
      "description": "Long-context reading, web research, multi-source synthesis",
      "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
      "description": "Renames, docstrings, test scaffolding, lint fixes",
      "model": "ollama/glm-5.3-flash"
    }
  }
}
O raciocínio por trás de cada linha:
- O planejamento fica com o Fable 5.1. O planejamento é onde uma decisão ruim custa mais tokens a jusante, e a coerência de longo horizonte é exatamente para o que o 5.1 foi construído. É também onde você gasta menos tokens, então o prêmio de preço se aplica à menor fatia da sua conta.
- A construção fica com o GLM-5.3. Melhor capacidade por euro do mercado, e a maior parte do seu gasto com tokens cai aqui.
- A pesquisa fica com o Kimi K3. BrowseComp 91,2 e uma janela de contexto real de 1M fazem dele a melhor opção disponível para ler muitas coisas e sintetizá-las.
- O trabalho mecânico fica com o GLM-5.3-Flash. A US$ 0,15/US$ 0,50 é efetivamente de graça, e renomear um símbolo em 40 arquivos não precisa de raciocínio de fronteira.
small_modelfica com algo minúsculo para a própria manutenção do harness — geração de títulos, sumarização, chamadas utilitárias internas.
Você não está escolhendo um vencedor. Você está construindo uma caixa de câmbio. E escreva os IDs dos modelos de forma que trocar um seja uma mudança de uma linha, porque neste mercado você vai fazer essa mudança de novo dentro do trimestre.
O que você realmente consegue rodar localmente (a realidade do hardware)
Deixe eu matar uma suposição antes que ela custe dinheiro a alguém.
Você não consegue rodar o Kimi K3 ou o GLM-5.3 numa estação de trabalho. Nem com uma 5090. Nem com duas.
Kimi K3
- ~1,5 TB de pesos em MXFP4 nativo — e lembre-se, isso é é o checkpoint quantizado, não um ponto de partida para mais compressão
- A Moonshot recomenda no mínimo 64 aceleradores para um atendimento competitivo
- A auto-hospedagem realista começa em clusters multi-nó; implantações de referência usam racks GB300 NVL72
- Não existe entrada oficial na biblioteca do Ollama para o Kimi K3 local, e nenhuma conversão GGUF para consumidor que valha a pena indicar
- Existem relatos de ele rodando em clusters de RTX 5090 de consumidor, mas “um cluster de 5090s” não é um laptop e a vazão não é comparável
GLM-5.3
- ~1,5 TB em BF16, aproximadamente 750 GB em FP8
- Nó único mínimo viável: 8× H200 (1.128 GB de memória de GPU) em FP8, deixando cerca de 375 GB para cache KV
- BF16 precisa de dois nós 8×H200, ou de um único nó 8×B300 (2.304 GB)
- Um único nó 8×H200 em BF16 é pequeno demais para os pesos mais o cache
Mostrar imagem Os modelos abertos de fronteira precisam de um rack. A faixa de 24 GB é onde “roda na minha máquina” realmente vive — e ela ficou muito boa.
Então o que “IA local” realmente significa em setembro de 2026?
Significa uma faixa diferente de modelo, e essa faixa ficou realmente boa:
| Modelo | VRAM | Para que serve |
|---|---|---|
| Qwen3.8-27B | 24 GB em Q4 | Melhor opção geral em hardware de consumidor — 61,7% no SWE-bench |
| gpt-oss:20b | 16 GB | Melhor modelo pequeno, esforço de raciocínio ajustável |
| Gemma 4 E4B | ~6 GB | Visão mais chamada de ferramentas num laptop moderno |
| Mistral 7B | 8 GB | Opção de uso geral mais rápida, 40–60 tok/s |
| DeepSeek-R1 7B | 5 GB | Raciocínio em cadeia de pensamento numa GPU de laptop |
| Llama 4 Scout | ~55 GB em Q4 | Contexto de 10M, multimodal — território de estação de trabalho |
Um Qwen3.8-27B marcando 61,7% no SWE-bench, rodando inteiramente numa GPU de consumidor de 24 GB sem conexão de rede, é uma coisa notável que teria soado como ficção científica dezoito meses atrás. Ele não é o GLM-5.3 e não está fingindo ser.
O enquadramento honesto: pesos abertos na fronteira compram para você soberania e preço, não execução local. Pesos abertos na faixa de 7B–30B compram execução local de verdade, a um custo de capacidade real mas aceitável, e é nessa faixa que “roda na minha máquina, não vê rede” é um requisito alcançável.
A arquitetura que funciona para a maioria dos meus clientes é exatamente essa divisão: um modelo local pequeno para qualquer coisa que toque dados genuinamente sensíveis, e um modelo de fronteira de pesos abertos hospedado para todo o resto — com os pesos disponíveis como seguro, não como plano de implantação.
Onde cada modelo realmente quebra
Sem hype. Aqui estão as fraquezas honestas.
Fraquezas do Kimi K3
É caro para um modelo aberto. US$ 3/US$ 15 é 2,1× a tarifa de entrada do GLM-5.3 e 3,4× a de saída para essencialmente a mesma pontuação no índice de inteligência. Se você está escolhendo o K3 em vez do GLM-5.3, deixe claro o que está comprando com esse prêmio — geralmente é a pilha de visão ou o desempenho de navegação.
A licença tem o gatilho mais baixo. Um limite de MaaS de US$ 20 mi de receita agregada pega muito mais organizações do que os US$ 10 bi do GLM-5.3. Se a revenda de inferência está em qualquer lugar do seu modelo de negócio, o K3 é o mais restritivo dos dois.
A auto-hospedagem está fora de alcance para quase todo mundo. 1,5 TB e 64+ aceleradores é um compromisso de infraestrutura sério. O direito de saída é mais teórico aqui do que com qualquer outro modelo nesta comparação.
O trabalho de conhecimento amplo fica atrás. GDPval-AA v2 em 1.687 o coloca atrás do GLM-5.3, dos dois Claude Fable e do GPT-5.6 Sol Max. É um especialista em codificação e agentes que por acaso é enorme.
Fraquezas do GLM-5.3
Apenas texto. Sem entrada de imagem, sem vídeo. Se o seu fluxo de trabalho inclui depuração por captura de tela, design-to-code ou visão de documentos, o GLM-5.3 simplesmente não consegue e você precisa do GLM-5.3-Flash, do Kimi K3 ou do Fable 5.1. Este é o erro de configuração mais comum que espero ver as pessoas cometerem, porque os IDs dos modelos parecem relacionados e não são.
É verboso, e verbosidade é cobrada. 170M tokens de saída contra uma mediana de 72M da categoria no conjunto AA. reasoning_effort usa por padrão max, e o pensamento não pode ser desligado. Reserve mais tokens de saída do que a sua contagem de turnos sugere.
A licença não é mais MIT, e a cláusula de revisão de segurança é ilimitada. Para a maioria dos leitores, o limite de US$ 10 bi torna isso acadêmico. Para quem chega perto, “o escopo e o método serão razoavelmente determinados pela Z.AI” não é uma cláusula que seu jurídico vai adorar.
Terminal-Bench 3.0 em 28,3 fica atrás dos 34,6 do GPT-5.6 Sol. No benchmark específico mais próximo da codificação agêntica nativa de terminal, ele fica atrás da concorrência fechada na mesma régua.
É novo em pesos abertos. Lançado em 28 de agosto. A comunidade teve dias, não meses. Bugs de implantação de cauda longa ainda não apareceram.
Fraquezas do Claude Fable 5.1
O preço. Cerca de 6,5× o GLM-5.3 por tarefa agêntica concluída, mesmo depois do corte de 75% na leitura de cache. Para a maior parte do trabalho, essa diferença não se sustenta mais em termos de capacidade.
Três mudanças que quebram compatibilidade. Uso forçado de ferramentas retorna 400. Blocos de pensamento não viajam para trás para modelos mais antigos. Editar o histórico da conversa invalida blocos de pensamento em contas criadas depois de 31 de agosto de 2026. Qualquer uma delas pode quebrar uma integração que funcionava na atualização.
A chamada paralela de ferramentas regrediu. Relatos de uma chamada por turno onde o Fable 5 agrupava várias. Num loop de agente longo, isso é tempo de relógio que você paga duas vezes.
Zero opcionalidade de saída. Sem pesos, sem auto-hospedagem, sem fixação de versão além do que a Anthropic oferece, sem inspeção. Quando muda, você se adapta.
O tokenizador infla as comparações. ~30% mais tokens que modelos Claude mais antigos para o mesmo texto, o que torna comparações históricas de custo enganosas a favor da Anthropic se você não tomar cuidado.
O quadro de decisão: seis cenários
Mostrar imagem Seis cenários, seis respostas. Encontre a linha que parece com a sua semana.
1. “Quero um modelo. Configuro, esqueço, mantenho a conta razoável.”
GLM-5.3. A meio ponto do Kimi K3 e cerca de três pontos do melhor modelo fechado no índice neutro, a US$ 1,40/US$ 4,40. Rode-o pelo Ollama num plano Pro ou Max, defina reasoning_effort: high, e siga com o seu trabalho. A única coisa que deveria te tirar dessa resposta é precisar de entrada de imagem.
2. “Meu trabalho é visual — UI, design-to-code, depuração por captura de tela, documentos.”
Kimi K3 ou GLM-5.3-Flash, não GLM-5.3. O MoonViT-V2 do K3 lida com texto, imagens e vídeo nativamente e marca 81,6/83,4 no MMMU-Pro. O GLM-5.3-Flash é a opção econômica, com multimodalidade nativa e licença MIT. O GLM-5.3 é só texto e simplesmente vai recusar a entrada.
3. “Sessões autônomas longas onde estar errado é caro.”
Claude Fable 5.1. É para isso que ele foi construído, e os benchmarks confirmam: Terminal-Bench-Science dobrou, 82% nas tarefas de uso de computador mais difíceis do Browserbase contra os 74% do Opus 5, e os maiores ganhos publicados em trabalho agêntico de várias horas. O corte de 75% na leitura de cache torna exatamente essa carga de trabalho até 45% mais barata do que era. Pague o prêmio onde um erro custa mais que os tokens.
4. “Residência de dados na UE é um requisito rígido.”
GLM-5.3-Flash se você precisa de MIT, GLM-5.3 se você precisa de capacidade. Auto-hospede no seu próprio hardware ou num provedor de GPU na UE e a questão da transferência transfronteiriça deixa de existir. Reserve 8×H200 para o GLM-5.3 em FP8; o Flash é bem mais tratável em 320B/18B. Se a auto-hospedagem está fora do orçamento, a hospedagem europeia do Ollama com retenção zero de dados é o meio-termo pragmático — mas obtenha o compromisso de residência por escrito em vez de inferi-lo de uma página de marketing.
5. “Equipe pequena, orçamento apertado, codificando o dia todo.”
GLM-5.3-Flash como padrão, GLM-5.3 para problemas difíceis, Ollama Pro a US$ 20. O Flash custa US$ 0,15/US$ 0,50 — atualmente metade disso até 9 de setembro — e pontua 57,5 no índice de inteligência. Vinte dólares compram sessenta dólares em tokens sem limites semanais. Para uma equipe de duas a quatro pessoas, isso é quase imbatível. O GLM Coding Plan a US$ 18/mês (Lite) é a alternativa se você prefere uma cota fixa a um pool de créditos.
6. “Preciso justificar isso para uma equipe de compras ou jurídica.”
GLM-5.3-Flash. É o único modelo desta comparação sob uma licença padrão aprovada pela OSI (MIT), é nativamente multimodal, marca 57,5 no índice neutro, e os pesos estão no Hugging Face sem limites de receita, sem exigência de atribuição e sem cláusula de revisão de segurança. Quando a pergunta é “o que podemos defender numa revisão de contrato”, licenciamento permissivo vence três pontos de benchmark todas as vezes.
O que eu ficaria de olho no próximo trimestre
Se o Fable 5.1 fica acima de 62,1 no índice da Artificial Analysis. Ele foi lançado no dia anterior a este artigo e não foi pontuado de forma independente. Os deltas de benchmark sobre o Fable 5 sugerem que deveria, mas “deveria” não é “fez”, e a distância para os 59,7 do Kimi K3 é o número do qual depende todo o argumento aberto versus fechado.
Se a deriva de licenças continua. Em oito semanas passamos do GLM-5.2 sob MIT para o GLM-5.3 sob uma licença sob medida com revisão de segurança discricionária, e do MIT modificado do Kimi K2 para os termos com limite de receita do K3. Se o GLM-6 e o K4 apertarem mais, “pesos abertos” vira um termo de marketing em vez de uma categoria significativa. O GLM-5.3-Flash continuar em MIT é o contra-sinal que vale acompanhar.
Se outros laboratórios adotam o padrão Z.ai de lançamento em etapas. Uma retenção de duas semanas com uma justificativa de segurança publicada é uma nova norma. Se ela se mantém, é uma boa norma. Se ela se torna um motivo para os pesos saírem cada vez mais tarde, é um caminho suave para não enviá-los de jeito nenhum.
Replicação independente das alegações de capacidade cibernética. 2.436 vulnerabilidades em 269 projetos é um número extraordinário e é inteiramente auto-relatado. Alguém neutro precisa verificar, porque se for preciso isso reformula toda a conversa sobre segurança de pesos abertos, e se não for, foi marketing eficaz.
As tarifas por token do Ollama daqui a seis meses. US$ 20 por US$ 60 de uso é uma postura introdutória agressiva de uma empresa que levantou US$ 88 mi em julho. Se esses multiplicadores sobrevivem ao contato com a economia unitária real é a maior variável isolada da tese dos “modelos abertos baratos” para equipes pequenas.
Se os modelos locais fecham a distância na faixa de 30B. Qwen3.8-27B com 61,7% no SWE-bench em 24 GB é o resultado mais pouco discutido do ano. A fronteira ganha as manchetes; a faixa de 24 GB é o que muda o que um negócio comum consegue fazer sem uma chave de API.
Perguntas frequentes
O Kimi K3 é realmente código aberto? Não. Os pesos do Kimi K3 podem ser baixados gratuitamente do Hugging Face, mas sob uma “Kimi K3 License” personalizada, não uma licença de código aberto aprovada pela OSI. Operadores de Model-as-a-Service cuja receita agregada ultrapasse US$ 20 milhões em quaisquer 12 meses consecutivos precisam negociar um acordo comercial separado com a Moonshot, e produtos acima de 100 milhões de usuários ativos mensais ou US$ 20 milhões de receita mensal precisam exibir “Kimi K3” na interface. Uso puramente interno é irrestrito.
O GLM-5.3 é melhor que o Kimi K3? Eles estão efetivamente empatados no índice agregado neutro — 59,5 contra 59,7 na Artificial Analysis. O GLM-5.3 é 2,2× mais barato por tarefa agêntica e pontua mais alto em trabalho de conhecimento (GDPval-AA v2: 1.769 vs 1.687). O Kimi K3 é nativamente multimodal, lidera em navegação agêntica (BrowseComp 91,2) e ficou em primeiro lugar na arena de código frontend da Arena.AI. Escolha o GLM-5.3 por custo e codificação baseada em texto; o Kimi K3 para visão, navegação e pesquisa de longo horizonte.
Quanto mais baratos são os modelos abertos em comparação com o Claude Fable 5.1? Numa tarefa agêntica modelada de 60 turnos, o GLM-5.3 custa cerca de US$ 1,85 contra US$ 11,94 do Fable 5.1 — cerca de 6,5× mais barato. O Kimi K3 custa cerca de US$ 4,07, aproximadamente 2,9× mais barato. O GLM-5.3-Flash custa cerca de US$ 0,21, cerca de 58× mais barato. Em 80 execuções por mês, isso é US$ 148 contra US$ 955.
Consigo rodar o Kimi K3 ou o GLM-5.3 localmente? Não em hardware de consumidor. O Kimi K3 tem cerca de 1,5 TB mesmo no seu formato nativo MXFP4, e a Moonshot recomenda 64+ aceleradores. O GLM-5.3 precisa de no mínimo 8×H200 (1.128 GB) em FP8. Para execução local de verdade, veja o Qwen3.8-27B (24 GB em Q4), o gpt-oss:20b (16 GB) ou o Gemma 4 E4B (~6 GB).
O que mudou no Claude Fable 5.1? Lançado em 1º de setembro de 2026. As leituras de cache caíram 75%, de US$ 1,00 para US$ 0,25 por milhão de tokens, deixando cargas típicas cerca de 25% mais baratas e cargas agênticas até 45% mais baratas; entrada e saída ficaram em US$ 10/US$ 50. O Terminal-Bench 4.0 subiu de 42,0% para 55,8%, o Terminal-Bench-Science de 24,7% para 52,6%, o AutomationBench de 17,1% para 31,4%. Três mudanças incompatíveis afetam uso forçado de ferramentas, portabilidade de blocos de raciocínio e edição de histórico.
Quais são os novos preços do Ollama? A partir de 31 de agosto de 2026, os planos Pro, Max e Team usam preços por token com créditos inclusos: Pro $20/mês para $60 de uso, Max $100 para $300, Team $500 para $1.000 compartilhados entre usuários ilimitados. Os limites de 5 horas e semanais foram removidos por completo, não há taxas de serviço, os créditos não acumulam e todos os planos têm retenção zero de dados, com hospedagem nos Estados Unidos e na Europa.
Qual destes modelos realmente tem licença MIT? Só o GLM-5.3-Flash — um modelo separado de 320B/18B nativamente multimodal lançado em 26 de agosto de 2026, com 57,5 no índice do Artificial Analysis a US$ 0,15/US$ 0,50 por milhão de tokens. GLM-5.3 e Kimi K3 usam licenças sob medida com limites de receita; o Claude Fable 5.1 é totalmente proprietário.
Por que não consigo comparar esses modelos no Terminal-Bench? Porque cada um foi avaliado em uma versão diferente. O 88,3 do Kimi K3 é no Terminal-Bench 2.1, o 28,3 do GLM-5.3 é no 3.0, e o 55,8 do Fable 5.1 é no 4.0. Cada versão é consideravelmente mais difícil que a anterior, então os números não estão na mesma escala. Compare apenas dentro de uma mesma versão. No Terminal-Bench 2.1, por exemplo, o Kimi K3 marca 88,3 contra 88,0 do Claude Fable 5, 88,8 do GPT-5.6 Sol e 84,3 do GLM-5.3-Flash — essa comparação é válida, e é a que vale citar.
Devo usar o Ollama ou ir direto ao fornecedor? Ollama se você quer uma única relação de cobrança, uma única superfície de API, troca fácil de modelo e hospedagem na UE/EUA com retenção zero de dados — as tarifas por token acompanham de perto os preços de primeira parte. Direto se você precisa de recursos de primeira parte, como os reasoning_effort controles da Z.ai com fidelidade total, SLAs do fornecedor ou planos de assinatura como o GLM Coding Plan. Muitas equipes usam os dois e roteiam por carga de trabalho.
O GLM-5.3 aceita imagens? Não. O GLM-5.3 é só texto. O GLM-5.3-Flash — um modelo completamente diferente, apesar do nome parecido — é nativamente multimodal e aceita texto, imagem, vídeo e arquivos. Enviar imagens para o ID de modelo errado é o erro inicial mais comum com a família GLM.
A conclusão
Doze meses atrás, a pergunta sobre pesos abertos era se esses modelos eram usáveis. Seis meses atrás, era se eram competitivos. Em setembro de 2026, ela é genuinamente: por que você ainda paga um prêmio por modelo fechado?
Existe uma resposta real para essa pergunta, e ela é mais estreita do que costumava ser. O Claude Fable 5.1 lidera no trabalho agêntico sustentado mais difícil, no trabalho de conhecimento geral e naquele tipo de depuração em que um modelo precisa segurar um problema confuso na cabeça por horas sem se perder. O corte de 75% na leitura de cache da Anthropic mira exatamente essa carga de trabalho. Se o custo do seu erro passa do custo dos seus tokens, esse prêmio é racional.
Para todo o resto, a matemática mudou. O GLM-5.3 entrega 94% da pontuação de índice do Claude Opus 5 a 29% do custo. O Kimi K3 pontua 88,3 no Terminal-Bench 2.1 contra 88,0 do Claude Fable 5 na mesma versão, e ficou em primeiro lugar na Frontend Code Arena da LMArena, à frente dos dois modelos fechados de ponta. A Ollama vende US$ 60 em tokens por US$ 20 e, de quebra, remove os limites de uso. Essa combinação não existia na primavera.
Mas não deixe o entusiasmo passar por cima das letras miúdas, porque são duas e as duas importam.
A primeira é o licenciamento. “Pesos abertos” e “código aberto” silenciosamente deixaram de significar a mesma coisa. Kimi K3 e GLM-5.3 são distribuídos sob licenças personalizadas e condicionadas à receita. As barreiras são altas o suficiente para que a maioria dos leitores não seja afetada — mas “a maioria dos leitores não é afetada” não é o mesmo que “sem restrições”, e a cláusula indefinida de revisão de segurança do GLM-5.3 é um risco real de compras para grandes empresas. O GLM-5.3-Flash sob MIT é a última opção totalmente permissiva próxima da fronteira, e é exatamente por isso que merece mais atenção do que recebe.
A segunda é que a auto-hospedagem é, em grande parte, aspiracional. 1,5 TB de pesos e 64 aceleradores não é um plano de saída para uma empresa de médio porte. O que os pesos abertos compram nesse nível é um mercado competitivo de inferência, transparência de preços, fixação de versão, escolha de jurisdição e posição de negociação. Isso vale muito. Não é a mesma coisa que rodar o modelo no porão de casa.
A configuração que eu realmente montaria: GLM-5.3 como padrão, Fable 5.1 para planejamento e os problemas realmente difíceis, Kimi K3 para visão e pesquisa de longo horizonte, GLM-5.3-Flash para o trabalho braçal e um modelo local de 27B para tudo que nunca pode sair do prédio. Roteie por carga de trabalho, não por lealdade. Escreva sua configuração de modo que os IDs dos modelos sejam uma mudança de uma linha.
Porque a única previsão da qual eu tenho certeza é que este artigo vai precisar de atualização antes do Natal.
Você usa algum desses três em produção? Tenho interesse especial em saber se a verbosidade do GLM-5.3 vira um problema real de custo em escala, e se alguém já colocou a licença do Kimi K3 na frente do jurídico e conseguiu uma leitura clara da definição de MaaS. Entre em contato — correções e contraprovas são bem-vindas, e este artigo é atualizado quando o cenário muda.
Última atualização: 2 de setembro de 2026.


