
 Tiếng Việt
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 ไทย
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

Năm 2012, những hệ thống thị giác máy tính tốt nhất thế giới vẫn còn lúng túng khi phân biệt con chó với con mèo. Năm 2026, bạn chỉ cần gõ một câu và xem một thước phim dài ba mươi giây chân thực như ảnh chụp tự lắp ghép — chuyển động camera, ánh sáng điện ảnh, hội thoại khớp tiếng và tất cả — trong ít thời gian hơn cả việc rót một ly cà phê.
Đó không phải là một thập kỷ tiến bộ đều đặn. Đó là một hành tinh khác.
Câu chuyện về cách trí tuệ nhân tạo đi đến ngày hôm nay là một trong những đường cong tăng tốc kỳ lạ nhất trong lịch sử công nghệ. Trong năm mươi năm, nó bò thật chậm. Rồi trong khoảng mười năm, nó lao qua những cột mốc mà các nhà nghiên cứu từng cho là còn cách nhiều thế hệ. Nếu bạn thấy choáng khi cố bắt kịp — tên model mới vài tuần một lần, những năng lực tưởng như bất khả vào mùa xuân năm ngoái lại thành tính năng miễn phí vào mùa hè này — thì bạn không tưởng tượng đâu. Tốc độ thật sự nhanh đến vậy, và nó vẫn đang tăng tốc.
Đây là toàn bộ lịch sử, ở góc độ con người, của quá trình tăng tốc đó: AI đến từ đâu, vài bước đột phá đã thay đổi mọi thứ, cuộc chạy đua giữa model đóng và model mở, sự trỗi dậy của tạo ảnh và tạo video bằng AI, và hướng đi tiếp theo của tất cả.
Cầm ly cà phê đó đi. Bài này dài đấy.
Mục lục
- Con đường dài và chậm: AI trước thời bùng nổ (1950–2011)
- Tia lửa: học sâu bùng lên năm 2012
- Kiến trúc thay đổi mọi thứ: Transformer (2017)
- Kỷ nguyên GPT và sự ra đời của LLM hiện đại (2018–2022)
- ChatGPT: tuần AI trở thành xu hướng đại chúng
- Cuộc chạy đua vũ trang model đóng (2023–2026)
- Cách mạng model mở: trọng số cho mọi người
- Khi AI học nhìn và vẽ: câu chuyện tạo ảnh
- Khi AI học chuyển động: sự trỗi dậy của video AI
- Vượt ra ngoài chữ và điểm ảnh: giọng nói, đa phương thức và kỷ nguyên tác nhân
- Vì sao AI đột nhiên tiến nhanh đến vậy?
- AI sẽ đi đâu tiếp theo
- Câu hỏi thường gặp
Con đường dài và chậm: AI trước thời bùng nổ (1950–2011)
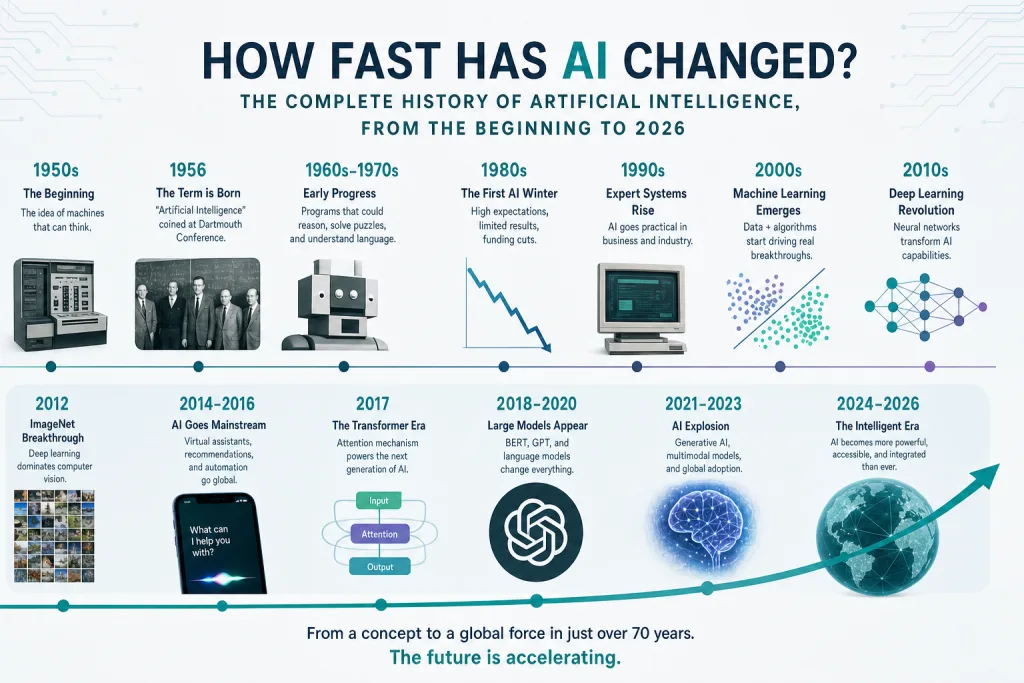
Thật dễ nghĩ rằng trí tuệ nhân tạo được phát minh vào khoảng năm 2022. Không phải vậy. Giấc mơ này gần như cũ ngang với chính chiếc máy tính hiện đại.
Năm 1950, Alan Turing đặt một câu hỏi tưởng chừng đơn giản — máy móc có biết suy nghĩ không? — và đề xuất trò chơi bắt chước mà nay ta gọi là Turing Test. Sáu năm sau, một hội thảo mùa hè tại Dartmouth College đặt tên cho lĩnh vực này và mang lại niềm lạc quan thuở ban đầu. Những người tiên phong tin rằng cỗ máy biết suy nghĩ có thể còn khoảng hai mươi năm nữa. Họ đã sai khoảng nửa thế kỷ, và chính sự tính toán sai đó đã định hình nên diện mạo lĩnh vực’ trong nhiều thập kỷ đầu tiên.
Cách tiếp cận ban đầu là AI biểu tượng: ý tưởng rằng trí thông minh có thể được gói gọn trong các quy tắc rõ ràng, logic và tri thức do người viết tay. Nếu bạn chỉ cần viết ra đủ nhiều nếu-cái-này-thì-cái-kia câu lệnh, thì lập luận sẽ tự đến. Cách này tạo ra vài “hệ chuyên gia” thực sự hữu ích trong thập niên 1970–80 — những chương trình có thể chẩn đoán một số bệnh hoặc cấu hình đơn đặt hàng máy tính — nhưng rồi nó vấp tường. Thế giới thực quá lộn xộn, quá nhiều ngoại lệ, không thể gói gọn bằng những quy tắc con người gõ tay.
Khi lời hứa vượt xa kết quả, tiền tài trợ cạn dần. Lĩnh vực này trải qua hai giai đoạn dài và lạnh giá mà nay gọi là mùa đông AI, khi “AI” gần như trở thành từ cấm kỵ với những nhà nghiên cứu nghiêm túc, những người không muốn đơn xin tài trợ của mình bị ném vào sọt rác.
Nhưng lặng lẽ, một ý tưởng khác vẫn sống sót ở bên lề: học máy. Thay vì lập trình trí thông minh bằng tay, sẽ thế nào nếu bạn để hệ thống tự học các mẫu từ dữ liệu? Mạng nơ-ron — lấy cảm hứng lỏng lẻo từ não bộ — đã tồn tại từ thập niên 1950, nhưng thiếu sức tính toán và hầu như bị gạt bỏ. Suốt thập niên 90 và 2000, học máy thống kê vận hành bộ lọc thư rác, công cụ gợi ý và xếp hạng tìm kiếm. Nó hiệu quả, nó sinh lời, và gần như chẳng ai ngoài lĩnh vực này gọi nó là “AI.” Nó chỉ là… phần mềm ngày càng tốt hơn khi có thêm dữ liệu.
Các quân cờ đã có trên bàn. Chúng chỉ cần đúng thời điểm.
Tia lửa: học sâu bùng lên năm 2012
Nếu bạn muốn một mốc duy nhất cho khởi đầu kỷ nguyên hiện đại, ứng viên sáng giá là 2012.
Năm đó, một mạng nơ-ron tên là AlexNet bước vào cuộc thi ImageNet — cuộc thi thường niên về gán nhãn đúng cho hàng triệu hình ảnh — và không chỉ thắng. Nó thắng áp đảo, cắt tỷ lệ lỗi mạnh đến mức kết quả trông như lỗi đánh máy. Nó dùng mạng nơ-ron “sâu” (nhiều lớp xếp chồng lên nhau) huấn luyện trên card đồ họa, hay GPU, thứ tình cờ lại cực giỏi đúng kiểu tính toán song song mà mạng nơ-ron cần.
Sự kết hợp đó — dữ liệu lớn, mạng sâu và tính toán song song rẻ — chính là tia lửa. Đột nhiên cách tiếp cận mạng nơ-ron từng bị gạt bỏ suốt nhiều thập kỷ không chỉ khả thi; nó trở nên thống trị. Trong vài năm, học sâu vượt xa các kỹ thuật cũ trong nhận dạng hình ảnh, nhận dạng giọng nói và dịch thuật. Các gã khổng lồ công nghệ để ý. Họ bắt đầu tuyển mọi nhà nghiên cứu học sâu tìm được và dồn những khoản ngân sách tính toán khổng lồ vào bài toán này.
Lần đầu tiên, “ném thêm dữ liệu và thêm sức tính toán vào một mạng lớn hơn” là chiến lược hoạt động đáng tin cậy. Hiểu biết đó sẽ sớm định hình lại cả ngành — nhưng lĩnh vực này vẫn thiếu một thành tố then chốt để xử lý ngôn ngữ cho đúng.
Kiến trúc thay đổi mọi thứ: Transformer (2017)
Đây là bước đột phá mà gần như không ai ngoài giới AI từng nghe, dù nó là nền móng cho gần như mọi thứ bạn dùng hôm nay.
Năm 2017, một nhóm nhà nghiên cứu của Google công bố bài báo với tiêu đề tinh nghịch: Attention Is All You Need. Bài báo giới thiệu Transformer, một kiến trúc mạng nơ-ron mới xây quanh cơ chế gọi là attention — cách để model cân nhắc mức độ liên quan giữa mỗi từ trong câu với mọi từ khác, cùng lúc, song song.
Nghe có vẻ trừu tượng, nên đây là lý do nó quan trọng. Các model ngôn ngữ trước đó xử lý văn bản từng từ một, theo trình tự, khiến chúng huấn luyện chậm và hay quên qua những đoạn dài. Transformer xử lý mọi thứ song song và có thể giữ các quan hệ xa trong “đầu.” Chúng huấn luyện nhanh hơn, mở rộng rất đẹp khi có thêm dữ liệu và sức tính toán, và — quan trọng nhất — chúng trở nên tốt hơn tốt lên một cách mượt mà, dễ đoán khi bạn làm chúng lớn hơn.
Đặc tính cuối cùng đó là động cơ thầm lặng của cả cuộc bùng nổ. Các nhà nghiên cứu khám phá ra thứ về sau gọi là định luật mở rộng: đổ thêm tham số, thêm dữ liệu và thêm sức tính toán, và hiệu năng cải thiện theo một đường cong đáng tin cậy. Với một lĩnh vực đã dành nhiều thập kỷ săn lùng các mẹo khéo léo, điều này gần như quá tốt. Bạn không cần ý tưởng mới mỗi năm. Bạn cần một phiên bản lớn hơn của cùng ý tưởng đó. Transformer biến trí thông minh thành thứ mà, ở một mức độ có ý nghĩa, bạn có thể mua.
Mọi mô hình ngôn ngữ lớn bạn từng nghe — GPT, Claude, Gemini, Llama, DeepSeek, Qwen và những cái khác — đều là Transformer, hoặc hậu duệ gần của nó. Bài báo năm 2017 đó là bản lề mà thế giới hiện đại xoay quanh.
Kỷ nguyên GPT và sự ra đời của LLM hiện đại (2018–2022)
Một phòng thí nghiệm non trẻ tên OpenAI đặt cược vào định luật mở rộng nghiêm túc hơn gần như tất cả. Luận điểm của họ đơn giản và, vào thời điểm đó, gây tranh cãi: lấy một Transformer, huấn luyện nó trên lượng văn bản internet khổng lồ để đoán từ tiếp theo, làm nó thật lớn, rồi xem chuyện gì xảy ra.
Kết quả đến theo những đợt leo thang:
- GPT-1 (2018) chứng minh khái niệm ở quy mô khiêm tốn.
- GPT-2 (2019) đủ giỏi tạo ra những đoạn văn mạch lạc đến mức ban đầu OpenAI ngần ngại phát hành toàn bộ model, với lý do lo bị lạm dụng — quyết định tạo ra tiêu đề báo và không ít cái nhìn trợn mắt, nhưng cũng báo hiệu rằng có điều gì đó đã thay đổi.
- GPT-3 (2020) mới là thứ khiến người ta há hốc miệng. Với 175 tỷ tham số, nó có thể viết bài luận, trả lời câu hỏi, tạo mã chạy được và bắt chước văn phong — tất cả mà không được huấn luyện riêng cho bất kỳ nhiệm vụ nào trong số đó. Nó học chúng như tác dụng phụ của việc học đoán văn bản. Những lập trình viên được dùng thử sớm nói về nó như người ta nói về một màn ảo thuật họ không thể giải thích.
Một điều sâu sắc đang diễn ra ở đây. Không ai lập trình GPT-3 để viết thơ hay gỡ lỗi Python. Những năng lực đó xuất hiện từ quy mô. Model chỉ đơn giản cố đoán từ tiếp theo, và khi trở nên rất giỏi việc đó, nó hấp thụ một xấp xỉ đủ dùng của ngữ pháp, sự kiện, lập luận và văn phong. Đặc tính này — các năng lực tự xuất hiện khi model lớn lên — được gọi là đột sinh, và đó là lý do ngay cả những nhà nghiên cứu xây dựng các hệ thống này cũng thường xuyên bất ngờ trước những gì chúng làm được.
Đến năm 2022, các model ngôn ngữ mạnh mẽ đã tồn tại. Nhưng chúng sống sau các API dành cho lập trình viên, nói năng thô ráp và đôi khi lệch lạc, và chỉ là sân chơi của vài nghìn người đam mê. Công chúng nói chung không hề biết. Điều đó sắp thay đổi chỉ sau một đêm.
ChatGPT: tuần AI trở thành xu hướng đại chúng
Ngày 30 tháng 11 năm 2022, OpenAI phát hành bản xem trước nghiên cứu miễn phí của một chatbot xây trên model GPT-3.5. Họ gọi nó là ChatGPT. Trong nội bộ, kỳ vọng khá khiêm tốn.
Nó trở thành ứng dụng tiêu dùng tăng trưởng nhanh nhất lịch sử, đạt một trăm triệu người dùng chỉ trong khoảng hai tháng.
Công nghệ bên dưới không mới về căn bản. Cái mới là cách đóng gói: một ô chat đơn giản, một model được tinh chỉnh để làm theo chỉ dẫn và trò chuyện, và — then chốt — không rào cản gia nhập. Ai cũng có thể vào một trang web và nói chuyện với nó. Bố mẹ bạn dùng được. Con bạn dùng được. Và với hàng triệu người, cuộc trò chuyện đầu tiên đó là khoảnh khắc “AI” trừu tượng trở thành một thứ cụ thể có thể viết email, giải thích bài tập, lên kế hoạch du lịch và phác thảo mã cho họ.
Vụ nổ văn hóa diễn ra tức thì. Các trường học hoảng loạn vì bài luận. Các công ty vội vã lập “chiến lược AI.” Nhà đầu tư mở sổ chi phiếu. Mọi giám đốc công nghệ trên hành tinh đột nhiên có một mục ở đầu danh sách ưu tiên. ChatGPT không chỉ ra mắt một sản phẩm; nó bắn phát súng lệnh cho cuộc cạnh tranh doanh nghiệp khốc liệt nhất mà ngành công nghệ từng thấy kể từ thời điện thoại thông minh — có thể nói là kể từ chính internet.
Từ đây, dòng thời gian không còn bò nữa mà bắt đầu nhoè đi.
Cuộc chạy đua vũ trang model đóng (2023–2026)
Khi ChatGPT chứng minh được thị trường, những phòng thí nghiệm lớn nhất, được tài trợ tốt nhất thế giới bước vào cuộc chiến. Đây là những model đóng — hệ thống độc quyền giữ trọng số riêng và được truy cập qua ứng dụng và API trả phí. Chúng nằm ở biên giới của năng lực thuần, và cuộc cạnh tranh giữa chúng chưa từng ngừng.
2023 đặt ra khuôn mẫu. OpenAI phát hành GPT-4, một bước nhảy ngoạn mục có thể lập luận, đỗ các kỳ thi chuyên môn và xử lý hình ảnh cũng như văn bản. Anthropic — do các nhà nghiên cứu cũ của OpenAI thành lập — ra mắt Claude, nhấn mạnh an toàn, tài liệu dài và phong cách trò chuyện chu đáo hơn. Google, bị ChatGPT làm cho trở tay dù chính họ phát minh ra Transformer, tập hợp lại và tung ra Gemini. Cuộc đua ba chiều bắt đầu.
Rồi nó cứ… leo thang. Mỗi phòng thí nghiệm vượt lên phòng khác vài tháng một lần. Cửa sổ ngữ cảnh — lượng văn bản model xử lý cùng lúc — nổ tung từ vài nghìn từ lên cả cuốn sách và cả codebase. Model có thêm khả năng nhìn ảnh, nghe âm thanh, duyệt web và dùng công cụ. xAI’ của Elon Musk vào cuộc với Grok, nối trực tiếp vào nền tảng xã hội X.
Hai bước chuyển định hình biên giới công nghệ ở thời điểm 2026, và chúng quan trọng hơn bất kỳ tên model đơn lẻ nào:
Thứ nhất, sự trỗi dậy của năng lực lập luận. Một lớp model “biết nghĩ” mới học cách giải quyết vấn đề từng bước trước khi trả lời — dừng lại để suy luận bên trong thay vì buột miệng đưa ra phản hồi đầu tiên. Điều này thu hẹp phần lớn khoảng cách cũ về toán, logic và lập trình phức tạp, đồng thời biến những benchmark từng làm bó tay model của năm 2023’ thành chiến thắng thường ngày.
Thứ hai, sự chuyển dịch từ chatbot sang người làm việc. Chủ đề định hình năm 2026 là AI tác nhân. Các model dẫn đầu không còn chỉ trả lời câu hỏi — chúng hành động. Chúng vận hành máy tính, viết và triển khai mã trên nhiều tệp, chạy các tác vụ nhiều bước kéo dài hàng phút hoặc hàng giờ, và kết nối vào hệ thống doanh nghiệp để thực sự hoàn thành công việc. Ẩn dụ giao diện lặng lẽ chuyển từ “trợ lý để bạn trò chuyện” sang “đồng nghiệp để bạn giao việc.”
Tính đến giữa năm 2026, biên giới model đóng là một cụm chặt ở tốp đầu: Anthropic’ Claude Opus 4.8, OpenAI’ GPT-5.5, Google’ Gemini 3.1 Pro và xAI’ Grok 4.3, với bốn phòng lab đổi ngôi dẫn đầu vài tuần một lần. <span>Điều gây ấn tượng nhất ở nhóm dẫn đầu hiện nay là khoảng cách đã hẹp đến mức nào — chênh lệch giữa “tốt nhất” và “thứ hai” giờ thường chỉ là sai số làm tròn, và nó đổi chủ liên tục.</span>
Cuộc đua cũng mang màu sắc địa chính trị. Giữa năm 2026, một model biên giới của Anthropic trở thành — theo những gì có thể biết — model đầu tiên bị cơ quan quản lý tắt rồi bật lại, tạm đình chỉ theo lệnh kiểm soát xuất khẩu của Hoa Kỳ trước khi được khôi phục truy cập. AI biên giới không còn chỉ là một loại sản phẩm. Nó là công cụ của chính sách quốc gia.
Cách mạng model mở: trọng số cho mọi người
Trong khi các gã khổng lồ giao chiến sau các API của mình, một câu chuyện song song và quan trọng không kém đang mở ra: sự trỗi dậy của model mở.
Bước ngoặt đến vào đầu năm 2023, khi Meta phát hành LLaMA, một model ngôn ngữ có năng lực mà trọng số bị rò rỉ rồi sau đó được chia sẻ chính thức với giới nghiên cứu. Lần đầu tiên, một model thực sự mạnh là thứ bạn có thể tải về, chạy trên phần cứng của mình, kiểm tra và sửa đổi. Một cộng đồng toàn cầu gồm lập trình viên và người đam mê bùng nổ quanh nó, tạo ra một làn sóng biến thể tinh chỉnh, tối ưu và công cụ đáng kinh ngạc — thường nhanh hơn cả việc các phòng thí nghiệm lớn tung tính năng.
Năng lượng cộng đồng đó không hề giảm, và đến năm 2026 hệ sinh thái mở đã trưởng thành thành đối thủ đáng gờm với biên giới đóng. Vài điều đáng hiểu:
Trọng số mở không giống mã nguồn mở. Sự phân biệt này làm nhiều người vấp. Mã nguồn mở nghĩa là mã huấn luyện, dữ liệu và trọng số đều được phát hành theo giấy phép thoáng. Trọng số mở nghĩa là bạn có tệp model để tải về và chạy, nhưng giấy phép có thể hạn chế cách bạn dùng, còn dữ liệu huấn luyện và công thức đầy đủ thường vẫn riêng tư. Hầu hết model mà người ta vẫn gọi là “mã nguồn mở” thực ra là trọng số mở. Sự khác biệt này cực kỳ quan trọng với doanh nghiệp lo về tuân thủ — đó là lý do cấp phép đã trở thành một tính năng cạnh tranh thực sự. Giấy phép Apache 2.0 và MIT thoáng (được các dòng như Qwen, DeepSeek và những dòng khác dùng) được quý chính vì chúng cho phép công ty xây dựng tự do.
Trọng tâm dịch về phía Đông. Một số model trọng số mở mạnh nhất năm 2026 đến từ các phòng thí nghiệm Trung Quốc: DeepSeek (được ca ngợi vì năng lực lập luận ngang tầm biên giới với chi phí thấp đến kinh ngạc), Alibaba’ Qwen (một dòng trải rộng, giấy phép thoáng, chạy từ model bé xíu trên laptop đến hệ thống khổng lồ), Moonshot’ Kimi, và Zhipu/Z.ai’ GLM series. Meta’ Llama 4 làm trụ cột cho tầng mở phương Tây, Google’ Gemma nhẹ được thiết kế để chạy trên một GPU hoặc thậm chí một laptop, và châu Âu’ Mistral đã chuyển các model hàng đầu của mình sang giấy phép thoáng. Bảng xếp hạng mở giờ xáo trộn gần như hàng tháng — các ảnh chụp gần đây đặt những model như GLM-5.2 và bản mới nhất của Kimi’ ở hoặc gần tốp đầu của các bảng xếp hạng mở độc lập, với vài model mở len vào lãnh địa từng chỉ thuộc về biên giới đóng.
Giá sụp đổ. Có lẽ câu chuyện model mở hệ trọng nhất là chuyện kinh tế. Cạnh tranh — phần lớn do các nhà cung cấp mở và giá rẻ này thúc đẩy — đã đẩy giá của trí tuệ xuống vực. Những năng lực mà hai năm trước tốn cả gia tài phí API nay có được với vài xu mỗi triệu từ, hoặc miễn phí nếu bạn tự lưu trữ. Các nhà phân tích nay ước tính trọng số mở tốt nhất chỉ kém model đóng tốt nhất tháng trên nhiều benchmark, chứ không phải vài năm. Với một mảng lớn tác vụ thực tế, lựa chọn mở nay đủ tốt, đủ rẻ và đủ riêng tư để thắng.
Đây là cuộc cách mạng thầm lặng bên dưới các tiêu đề. Biên giới công nghệ thu hút sự chú ý, nhưng việc “đủ tốt” AI trở thành hàng hóa phổ thông — chạy trên máy chủ của bạn, dưới sự kiểm soát của bạn, với chi phí biên gần như bằng không — có thể sẽ định hình lại nhiều ngành hơn bất kỳ model hàng đầu đơn lẻ nào.
Khi AI học nhìn và vẽ: câu chuyện tạo ảnh
Ngôn ngữ chỉ là một nửa cuộc cách mạng. Nửa còn lại là thị giác — và nó đến cũng nhanh như vậy.
Cỗ máy ban đầu cho ảnh AI là GAN (Mạng đối kháng tạo sinh), ra mắt năm 2014. Ý tưởng khéo léo: cho hai mạng đối đầu nhau, một tạo ảnh giả và một cố phát hiện ảnh giả, cho đến khi bộ tạo giỏi đến mức ảnh giả trở nên thuyết phục. GAN tạo ra những khuôn mặt chân thực đến rợn người — kỷ nguyên “những người này không tồn tại” — nhưng chúng khó tính khi huấn luyện và khó điều khiển bằng lời.
Bước đột phá thực sự cho người dùng đến từ một kỹ thuật khác: model khuếch tán, thứ học cách tạo ảnh bằng cách bắt đầu từ nhiễu thuần rồi dần tinh chỉnh thành một hình ảnh mạch lạc, dưới hướng dẫn của prompt văn bản. Kết quả, và cả tiến độ thời gian, thật choáng váng:
- DALL·E và DALL·E 2 (2021–2022) của OpenAI cho thế giới thấy bạn có thể gõ một câu ngộ nghĩnh — “một phi hành gia cưỡi ngựa theo phong cách chân thực như ảnh chụp” — và nhận lại một hình ảnh tốt đến giật mình.
- Midjourney (2022) xuất hiện với thẩm mỹ đặc trưng, lộng lẫy và xây dựng một cộng đồng khổng lồ, trở thành cách gọi tắt cho nghệ thuật AI đẹp.
- Stable Diffusion (2022) đã làm cho hình ảnh điều mà LLaMA sau này làm cho văn bản: nó được phát hành công khai. Ai cũng có thể chạy, tinh chỉnh và xây dựng trên nó. Cả một hệ sinh thái mở gồm công cụ, plugin và model tùy biến bùng nổ qua một đêm.
Từ đó, lĩnh vực này chạy nước rút. Những lỗi cũ — bàn tay méo mó, chữ vô nghĩa, khuôn mặt kỳ dị — lần lượt được giải quyết. Đến năm 2026, thị trường tạo ảnh đã chia thành các phe rõ ràng, và chất lượng đủ cao để kết quả thường xuyên qua mắt người xem thông thường:
- Midjourney (nay ở dòng V8) vẫn là lựa chọn thẩm mỹ được ưa thích cho nghệ thuật cách điệu, khiến người ta dừng lại khi lướt.
- OpenAI’ GPT Image model (hậu duệ của DALL·E, nay được tích hợp thẳng vào ChatGPT) dẫn đầu về việc làm theo chỉ dẫn phức tạp và hiển thị chữ trong ảnh cho đúng — vấn đề từng ám mọi model suốt nhiều năm.
- Black Forest Labs’ FLUX trở thành nhà vô địch trọng số mở, sánh ngang các model đóng cao cấp về độ chân thực với chi phí chỉ bằng một phần nhỏ, và kéo phần lớn người dùng mã nguồn mở nghiêm túc rời khỏi các bản Stable Diffusion cũ.
- Google’ Imagen và “Nano Banana” model và Adobe’ Firefly (huấn luyện trên dữ liệu được cấp phép, điều doanh nghiệp rất thích vì an toàn pháp lý) hoàn thiện sân chơi chuyên nghiệp.
- Và, lặp lại câu chuyện LLM, các model Trung Quốc như Seedream’ của ByteDance vọt lên trên bảng xếp hạng.
Biên giới công nghệ không còn chỉ là tạo ra một bức ảnh đẹp. Nó là về chỉnh sửa — chọn một vùng theo cách hội thoại và yêu cầu thay đổi — và về tính nhất quán, giữ nguyên một nhân vật hay sản phẩm qua hàng chục hình ảnh. Tạo ảnh bằng AI đi từ thứ mới lạ thành công cụ sản xuất chuyên nghiệp chỉ trong khoảng bốn năm.
Khi AI học chuyển động: sự trỗi dậy của video AI
Nếu hình ảnh là phép màu của bốn năm trước’, thì video là phép màu của thời này’. Và không gì khắc họa tốc độ tiến bộ của AI rõ bằng việc xem text-to-video đi từ trò cười thành mối đe dọa với ngành điện ảnh trong chưa đầy ba năm.
Mới năm 2023, “video AI” chỉ có nghĩa là vài giây chuyển động mờ nhoè, nhấp nháy với khuôn mặt tan chảy và vật thể biến dạng thành vô nghĩa giữa các khung hình. Đó là thứ gây tò mò, không phải công cụ.
Rồi đầu năm 2024, OpenAI giới thiệu trước Sora, và cuộc trò chuyện đổi ngay lập tức. Các clip của nó chân thực như ảnh chụp, nhất quán theo thời gian và mang tính điện ảnh đến mức như thể đã bỏ qua nhiều năm tiến bộ được dự đoán. Mọi đối thủ ngay lập tức bắt đầu đuổi theo mức đó.
Cuộc đua tạo ra một sân chơi đáng chú ý. Đến năm 2026, những ứng viên nghiêm túc gồm Google’ Veo, Runway’ Gen-4 dòng (được tích hợp vào một môi trường chỉnh sửa sáng tạo đầy đủ thay vì bán như model thô), và một làn sóng model Trung Quốc mạnh mẽ — Kling (Kuaishou), Seedance (ByteDance) và những cái khác — nay thống trị tốp đầu các bảng xếp hạng chất lượng video độc lập. Mức kỹ thuật tiến nhanh: có sẵn âm thanh đồng bộ — bao gồm hội thoại được tạo với khớp khẩu hình chính xác ở nhiều ngôn ngữ — đi từ khoa học viễn tưởng thành tính năng tiêu chuẩn chỉ trong khoảng một năm.
Cú twist không ai dự đoán: Sora, model khởi động cuộc đua, đã bị đóng cửa. OpenAI ngừng các trải nghiệm web và ứng dụng Sora vào tháng 4 năm 2026, API theo sau vào cuối năm đó. Công cụ đặt nhịp độ đã bị vượt qua và bị cho nghỉ hưu trong khi lĩnh vực nó truyền cảm hứng vẫn ầm ầm tiến — một biểu tượng gần như hoàn hảo cho tốc độ tàn nhẫn của không gian này. Đặt ra chuẩn mực, rồi mười tám tháng sau bạn có thể chỉ còn là một benchmark cũ.
Ngày nay, một người làm một mình với một prompt văn bản và ngân sách khiêm tốn có thể tạo ra những thước phim mà trước đây cần bối cảnh, một đoàn làm phim và ngân sách năm chữ số. Công nghệ vẫn có giới hạn thật — lỗi vật lý, tính nhất quán qua các cảnh dài, và những câu hỏi pháp lý, đạo đức nghiêm túc quanh hình ảnh cá nhân và việc công bố — nhưng quỹ đạo là không thể nhầm lẫn.
Vượt ra ngoài chữ và điểm ảnh: giọng nói, đa phương thức và kỷ nguyên tác nhân
Những phạm trù gọn gàng bài viết này dùng — văn bản, hình ảnh, video — thật lòng mà nói, đã đang tan rã. Hướng đi định hình của kỷ nguyên hiện tại là các năng lực này đang hòa vào những hệ thống duy nhất, thống nhất.
Đa phương thức là tên kỹ thuật của nó. Các model biên giới năm 2026 không phải model văn bản gắn thêm tính năng ảnh; chúng vốn dĩ nhìn, đọc, nghe và tạo ra xuyên định dạng trong một dòng chảy liên tục. Bạn có thể cho nó xem ảnh tủ lạnh và hỏi công thức, gửi ảnh chụp một lỗi và nhận bản sửa, hoặc nói chuyện với nó và được đáp lại bằng giọng nói tự nhiên, ngắt lời được, gần như không trễ. Vòng lặp cũ vụng về “gõ, chờ, đọc” đang nhường chỗ cho thứ giống hơn nhiều với việc nói chuyện với một người có năng lực.
Và rồi có tác nhân — chủ đề xâu chuỗi toàn bộ câu chuyện 2026. Tác nhân là hệ thống AI không chỉ phản hồi mà còn hành động: nó lập kế hoạch cho một tác vụ nhiều bước, dùng công cụ và phần mềm, tự kiểm tra việc của mình và đưa công việc đến hoàn tất với ít chỉ dẫn nhất. Đặt vé du lịch, đối chiếu bảng tính với ba nguồn dữ liệu, tái cấu trúc codebase, chạy một dự án nghiên cứu qua hàng chục trang web — những việc này đang chuyển từ “bản demo” sang “quy trình làm việc hàng ngày.” Giao diện đang dịch từ cửa sổ chat sang hàng đợi giao việc.
Đây là sợi chỉ xuyên suốt toàn bộ lịch sử AI, đi đến kết luận logic của nó. Chúng ta đã đi từ lập trình những cỗ máy tính với các quy tắc rõ ràng, đến huấn luyện chúng trên dữ liệu, đến trò chuyện với chúng bằng ngôn ngữ thông thường, đến — giờ đây — giao phó công việc thật cho chúng. Mỗi bước đã gỡ bỏ một lớp ma sát giữa ý định của con người và một kết quả hoàn chỉnh. Tác nhân là biên giới hiện tại của quá trình gỡ bỏ đó.
Vì sao AI đột nhiên tiến nhanh đến vậy?
Lùi lại khỏi những cái tên mô hình và số phiên bản, một câu hỏi tự nhiên hiện ra: sau năm mươi năm bò chậm, tại sao AI đột nhiên chạy nước rút? Một vài lực lượng hội tụ lại, và chính sự hội tụ — không phải bất kỳ lực lượng đơn lẻ nào — đã châm ngòi.
Sức mạnh tính toán trở nên mạnh mẽ và dồi dào một cách phi lý. Những GPU dùng để kết xuất trò chơi điện tử hóa ra lại hoàn hảo cho việc huấn luyện mạng nơ-ron. Khi chip cải thiện và trung tâm dữ liệu mở rộng, sức mạnh thô sẵn có cho huấn luyện AI tăng theo cấp số nhân. Những ý tưởng hợp lý về mặt lý thuyết vào thập niên 1990 đơn giản là không thể chạy cho đến khi phần cứng bắt kịp.
Dữ liệu trở thành một dòng thác. Internet đã dành ba mươi năm tích lũy một kho ngữ liệu gần như vô hạn về văn bản, hình ảnh và video của con người. Bản ghi khổng lồ, lộn xộn đó về tri thức và sự biểu đạt của con người đã trở thành tài liệu huấn luyện. Không có internet, không có AI hiện đại.
Transformer đã mở khóa quy mô. Như chúng ta đã thấy, kiến trúc năm 2017 giúp việc chuyển nhiều sức mạnh tính toán và nhiều dữ liệu hơn thành năng lực lớn hơn trở nên đáng tin cậy. Tính dự đoán được đó biến nghiên cứu thành thứ gì đó gần với kỹ thuật hơn — và các bài toán kỹ thuật được giải quyết nhanh khi có tiền.
Tiền đã xuất hiện. ChatGPT chứng minh có một thị trường khổng lồ, và dòng vốn tràn vào. Hàng chục tỷ đô la đổ vào phòng nghiên cứu, chip và nhân tài. Nguồn vốn đó nén những mốc thời gian lẽ ra kéo dài hàng thập kỷ.
Cạnh tranh khốc liệt đã định nhịp. Với OpenAI, Google, Anthropic, Meta, xAI và cả chục phòng nghiên cứu Trung Quốc cùng chạy đua, không ai có thể chậm lại. Một lợi thế mất sáu tháng để xây dựng có thể bốc hơi trong sáu tuần. Áp lực đó chính là lý do bạn thấy một mẫu chủ lực mới gần như mỗi lần xem tin tức.
Hệ sinh thái mở đã nhân bội nỗ lực. Mỗi mô hình phát hành công khai biến hàng nghìn nhà phát triển độc lập thành lực lượng R&D không lương. Trí tuệ tập thể của cộng đồng mã nguồn mở toàn cầu đã tăng tốc tiến bộ theo những cách không công ty nào có thể sánh được, và đẩy giá AI xuống mức sàn.
Ghép những điều đó lại, bạn có đường cong năng lực dốc nhất mà công nghệ từng tạo ra. Nó không giống một phát minh đơn lẻ mà giống một phản ứng dây chuyền hơn.
AI sẽ đi đâu tiếp theo
Dự đoán tương lai của AI là cách tuyệt vời để trông ngốc nghếch trong sáu tháng — bài viết này đã ghi lại việc các chuyên gia bị bất ngờ thường xuyên đến mức nào. Nhưng quỹ đạo hiện tại chỉ ra một vài điều với độ tin cậy vừa phải.
Tác nhân trở nên thực tế. Giai đoạn tiếp theo ít nói về những mô hình biết nhiều hơn và ngày càng nói nhiều hơn về những hệ thống thực sự nhiều hơn — hoàn thành công việc dài, phức tạp, nhiều bước với quyền tự chủ thực sự. Hãy chuẩn bị cho cách gọi “công nhân AI” ngày càng mạnh mẽ hơn, cùng những câu hỏi khó về giám sát, độ tin cậy và điều gì xảy ra với những công việc dựa trên các nhiệm vụ mà tác nhân giờ có thể đảm nhận.
Trí tuệ ngày càng rẻ hơn. Sự sụp đổ giá chưa kết thúc. Khi các mô hình mở thu hẹp khoảng cách và hiệu suất cải thiện, AI có năng lực đang tiến tới gần như miễn phí và chạy cục bộ — trên điện thoại, laptop hay máy chủ của chính bạn. Việc hàng hóa hóa đó có thể định hình lại toàn bộ các ngành một cách lặng lẽ và triệt để hơn bất kỳ mô hình nổi bật nào.
Các ranh giới tiếp tục tan biến. Văn bản, hình ảnh, âm thanh và video đang hội tụ thành những hệ thống thống nhất, và “sử dụng một AI” sẽ giống như một năng lực được đan cài vô hình vào mọi thứ bạn vẫn làm hơn là ghé thăm một công cụ.
Quản trị tiến ra sân khấu trung tâm. Việc một mô hình tiên phong bị cơ quan quản lý tạm dừng ngắn ngủi vào năm 2026 là một màn xem trước. Khi AI trở thành hạ tầng thiết yếu và một đòn bẩy quyền lực địa chính trị, các câu hỏi về an toàn, bản quyền, kiểm soát và chiến lược quốc gia sẽ định hình lĩnh vực này không kém gì bất kỳ đột phá nghiên cứu nào. Cuộc đua kỹ thuật và cuộc đua chính sách giờ là cùng một cuộc đua.
Dự đoán an toàn duy nhất là nhịp độ sẽ không chậm lại. Mỗi chương của lịch sử này đều được viết bởi những người tự tin đánh giá thấp tốc độ xuất hiện của chương tiếp theo.
Câu hỏi thường gặp
AI hiện đại thực sự bắt đầu khi nào? Khái niệm này có từ thập niên 1950, nhưng kỷ nguyên học sâu hiện đại thường được tính từ năm 2012, khi mạng nơ-ron AlexNet thống trị một cuộc thi nhận dạng hình ảnh và chứng minh rằng mạng sâu cộng dữ liệu lớn cộng sức mạnh tính toán GPU là sự kết hợp chiến thắng. Sự bùng nổ với công chúng đến muộn hơn, với sự ra mắt của ChatGPT vào tháng 11 năm 2022.
Sự khác biệt giữa mô hình AI mở và đóng là gì? Các mô hình đóng (như GPT-5.5, Claude và Gemini) giữ trọng số riêng tư và được dùng qua ứng dụng hoặc API trả phí. Các mô hình mở (như Llama, DeepSeek, Qwen và GLM) chia sẻ trọng số để bất kỳ ai cũng có thể tải, chạy và sửa đổi. Một điểm tinh tế quan trọng: “trọng số mở” nghĩa là bạn nhận được các tệp mô hình, còn “mã nguồn mở” thực sự còn bao gồm mã huấn luyện và dữ liệu — hầu hết các mô hình được gọi là mã nguồn mở thực ra là trọng số mở.
Đột phá quan trọng nhất trong lịch sử AI là gì? Nhiều nhà nghiên cứu chỉ ra kiến trúc Transformer năm 2017, được giới thiệu trong bài báo Attention Is All You Need. Nó giúp các mô hình có thể mở rộng quy mô và huấn luyện hiệu quả, và nó là nền tảng cho gần như mọi hệ thống AI lớn đang dùng hôm nay, từ chatbot đến trình tạo hình ảnh.
Làm sao việc tạo hình ảnh và video bằng AI lại tốt lên nhanh đến vậy? Tạo hình ảnh bùng nổ với các mô hình khuếch tán vào khoảng 2021–2022 (DALL·E, Midjourney, Stable Diffusion), rồi nhanh chóng giải quyết các vấn đề cũ như bàn tay méo mó và chữ không đọc được. Video theo một đường cong tương tự, từ vài giây chuyển động mờ vào năm 2023 đến những clip chân thực như ảnh chụp, đồng bộ âm thanh vào năm 2026, nhờ cạnh tranh gay gắt giữa các mô hình như Veo, Runway, Kling và Seedance.
Tiến bộ AI có chậm lại không? Chưa có dấu hiệu nào. Sự kết hợp của sức mạnh tính toán dồi dào, đầu tư khổng lồ, cạnh tranh khốc liệt giữa các phòng nghiên cứu và một cộng đồng mã nguồn mở đang phát triển mạnh tiếp tục đẩy nhịp độ đi lên. Nếu lịch sử ở trên dạy được điều gì, thì đó là làn sóng tiếp theo luôn đến nhanh hơn mọi người tưởng.


