
 हिन्दी
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 العربية

2012 में, दुनिया के सबसे अच्छे कंप्यूटर-विज़न सिस्टम भी कुत्ते और बिल्ली में फ़र्क़ बताने में लड़खड़ाते थे। 2026 में, आप एक वाक्य टाइप करके एक फ़ोटोरियलिस्टिक तीस सेकंड की फ़िल्म को खुद बनते हुए देख सकते हैं — कैमरा मूवमेंट, सिनेमैटिक लाइटिंग, सिंक किया गया डायलॉग और सब कुछ — कॉफ़ी डालने में जितना समय लगता है, उससे भी कम में।
यह एक दशक की स्थिर प्रगति नहीं है। यह एक अलग ही ग्रह है।
आर्टिफ़िशियल इंटेलिजेंस यहाँ तक कैसे पहुँचा, इसकी कहानी तकनीक के इतिहास के सबसे अजीब त्वरण-वक्रों में से एक है। पचास साल तक यह रेंगता रहा। फिर, क़रीब दस साल की अवधि में, इसने उन पड़ावों को दौड़कर पीछे छोड़ दिया जिन्हें शोधकर्ता एक समय पीढ़ियों दूर मानते थे। अगर आपने साथ बने रहने की कोशिश में गर्दन झटकने जैसा महसूस किया है — हर कुछ हफ़्तों में नए मॉडल के नाम, पिछली बसंत में जो असंभव लगता था वह इस गर्मी में मुफ़्त फ़ीचर बनकर आना — तो आप भ्रम में नहीं हैं। रफ़्तार वाक़ई इतनी तेज़ है, और यह अब भी बढ़ रही है।
यह उस त्वरण का पूरा, मानवीय इतिहास है: AI कहाँ से आया, वे गिनी-चुनी बड़ी सफलताएँ जिन्होंने सब कुछ बदल दिया, बंद और ओपन मॉडल के बीच की होड़, AI इमेज और वीडियो जनरेशन का उभार, और यह सब आगे कहाँ जा रहा है।
वह कॉफ़ी उठा लें। यह काफ़ी लंबा है।
विषय-सूची
- लंबा, धीमा रास्ता: बूम से पहले का AI (1950–2011)
- चिंगारी: 2012 में डीप लर्निंग की चिंगारी कैसे भड़की
- वह आर्किटेक्चर जिसने सब कुछ बदल दिया: Transformers (2017)
- GPT युग और आधुनिक LLM का जन्म (2018–2022)
- ChatGPT: जिस हफ़्ते AI मेनस्ट्रीम में पहुँचा
- बंद मॉडलों की होड़ (2023–2026)
- ओपन-मॉडल क्रांति: जनता के लिए वेट्स
- जब AI ने देखना और चित्र बनाना सीखा: इमेज-जनरेशन की कहानी
- जब AI ने चलना सीखा: AI वीडियो का उभार
- टेक्स्ट और पिक्सल से आगे: आवाज़, मल्टीमॉडैलिटी और एजेंट का युग
- AI अचानक इतना तेज़ क्यों हो गया?
- AI आगे कहाँ जाएगा
- अक्सर पूछे जाने वाले प्रश्न
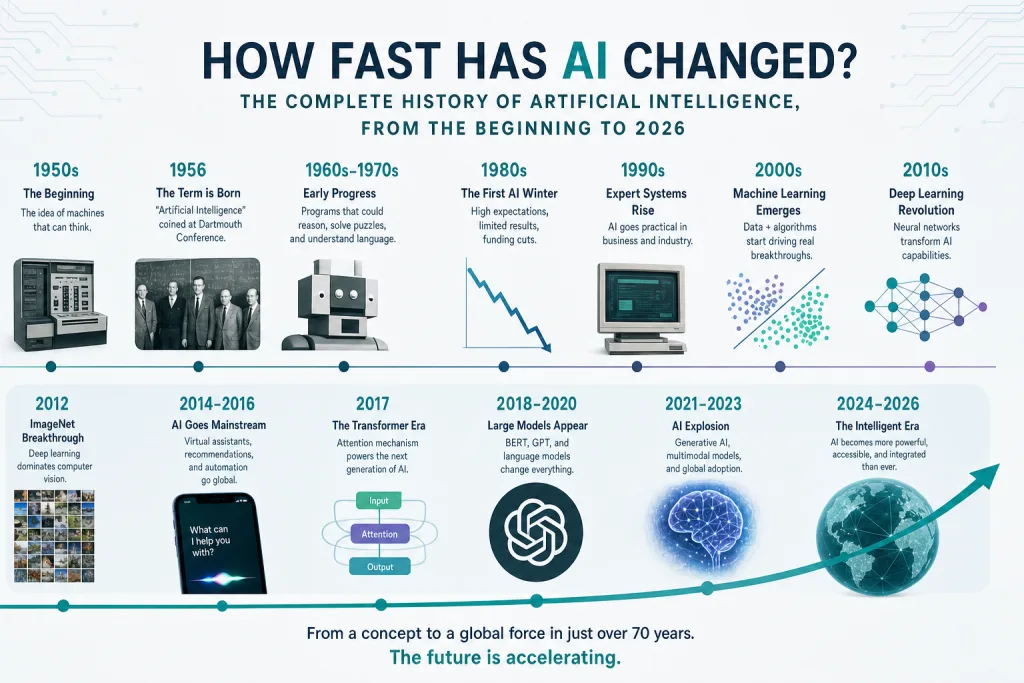
लंबा, धीमा रास्ता: बूम से पहले का AI (1950–2011)
यह सोचना लुभावना है कि आर्टिफ़िशियल इंटेलिजेंस 2022 के आसपास ईजाद हुआ। ऐसा नहीं है। यह सपना लगभग आधुनिक कंप्यूटर जितना ही पुराना है।
1950 में, Alan Turing ने एक धोखे से सरल लगने वाला सवाल पूछा — क्या मशीनें सोच सकती हैं? — और वह नक़ल का खेल सुझाया जिसे अब हम Turing Test कहते हैं। छह साल बाद, Dartmouth College में एक ग्रीष्मकालीन कार्यशाला ने इस क्षेत्र को उसका नाम और उसका शुरुआती आशावाद दिया। शुरुआती अग्रदूतों का मानना था कि सोचने वाली मशीन शायद बीस साल दूर है। वे क़रीब आधी सदी से ग़लत थे, और उस ग़लत अनुमान ने इस क्षेत्र’ के पहले कई दशकों को गढ़ा।
शुरुआती तरीक़ा था सिम्बॉलिक AI: यह विचार कि बुद्धिमत्ता को स्पष्ट नियमों, तर्क और हाथ से लिखे ज्ञान में क़ैद किया जा सकता है। अगर आप बस इतने अगर-यह-तो-वह कथन लिख दें, तो तर्क ख़ुद आ जाएगा। इससे 1970 और 80 के दशक में कुछ सचमुच उपयोगी “एक्सपर्ट सिस्टम” बने — ऐसे प्रोग्राम जो कुछ बीमारियों का पता लगा सकते थे या कंप्यूटर के ऑर्डर कॉन्फ़िगर कर सकते थे — लेकिन यह एक दीवार से टकरा गया। असली दुनिया बहुत बिखरी हुई है, अपवादों से भरी है, इतनी कि उसे कोई इंसान हाथ से टाइप किए नियमों में नहीं समेट सकता।
जब वादे नतीजों से आगे निकल गए, तो फंडिंग सूख गई। इस क्षेत्र ने दो लंबे, ठंडे दौर सहे, जिन्हें अब AI विंटर, जब “AI” गंभीर शोधकर्ताओं के बीच लगभग एक गाली बन गया, जो अपने ग्रांट आवेदन कूड़ेदान में नहीं फेंकवाना चाहते थे।
पर चुपचाप, एक अलग विचार हाशिये पर ज़िंदा बचा हुआ था: मशीन लर्निंग। बुद्धिमत्ता को हाथ से प्रोग्राम करने के बजाय, क्या हो अगर आप किसी सिस्टम को डेटा से पैटर्न सीखने दें? न्यूरल नेटवर्क — मोटे तौर पर दिमाग़ से प्रेरित — 1950 के दशक से मौजूद थे, लेकिन उन्हें कंप्यूट की ताक़त नसीब नहीं थी और ज़्यादातर नज़रअंदाज़ कर दिए गए। 90 और 2000 के दशक में, सांख्यिकीय मशीन लर्निंग ने स्पैम फ़िल्टर, रिकमंडेशन इंजन और सर्च रैंकिंग को चलाया। इसने काम किया, पैसा कमाया, और इस क्षेत्र के बाहर लगभग किसी ने इसे “AI” नहीं कहा। यह बस… ऐसा सॉफ़्टवेयर था जो ज़्यादा डेटा के साथ बेहतर होता गया।
सारे मोहरे बिसात पर थे। उन्हें बस सही पल चाहिए था।
चिंगारी: 2012 में डीप लर्निंग की चिंगारी कैसे भड़की
अगर आप आधुनिक युग की शुरुआत की एक ही तारीख़ चाहते हैं, तो एक मज़बूत दावेदार है 2012.
उस साल, एक न्यूरल नेटवर्क जिसका नाम था AlexNet ने ImageNet प्रतियोगिता में हिस्सा लिया — लाखों इमेज को सही तरीक़े से लेबल करने की सालाना प्रतियोगिता — और सिर्फ़ जीता ही नहीं। उसने बड़े अंतर से जीत हासिल की, त्रुटि दर को इतनी नाटकीय रूप से घटाया कि नतीजा टाइपो जैसा लगा। उसने ग्राफ़िक्स कार्ड, यानी GPU पर प्रशिक्षित एक “डीप” न्यूरल नेटवर्क का इस्तेमाल किया (कई परतें एक के ऊपर एक), और GPU संयोग से ठीक उसी तरह के समानांतर गणित में शानदार थे जिसकी न्यूरल नेटवर्क को ज़रूरत होती है।
यही संयोजन था — बड़ा डेटा, डीप नेटवर्क और सस्ता समानांतर कंप्यूट — वह चिंगारी थी। अचानक वह न्यूरल-नेटवर्क दृष्टिकोण, जिसे दशकों तक खारिज किया गया था, केवल व्यवहार्य ही नहीं था; वह प्रभावी था। कुछ ही वर्षों में डीप लर्निंग ने इमेज रिकग्निशन, स्पीच रिकग्निशन और अनुवाद में पुरानी तकनीकों को बहुत पीछे छोड़ दिया। टेक दिग्गजों ने ध्यान दिया। उन्होंने हर उस डीप-लर्निंग शोधकर्ता को नौकरी पर रखना शुरू किया जिसे वे ढूँढ सकते थे, और समस्या पर विशाल कंप्यूट बजट लगा दिया।
पहली बार, “बड़े नेटवर्क पर ज़्यादा डेटा और ज़्यादा कंप्यूट फेंकना” एक ऐसी रणनीति थी जो भरोसेमंद तरीके से काम करती थी। यह अंतर्दृष्टि जल्द ही पूरे उद्योग को नया आकार देने वाली थी — लेकिन भाषा को ठीक से संभालने के लिए इस क्षेत्र में अभी भी एक अहम चीज़ की कमी थी।
वह आर्किटेक्चर जिसने सब कुछ बदल दिया: Transformers (2017)
यह रही वह सफलता जिसके बारे में AI के बाहर लगभग किसी ने नहीं सुना, भले ही आप अब जो कुछ भी इस्तेमाल करते हैं, उसका लगभग सब कुछ इसी पर टिका है।
2017 में, Google के शोधकर्ताओं की एक टीम ने एक चुटीले शीर्षक वाला पेपर प्रकाशित किया: Attention Is All You Need. इसमें पेश हुआ Transformer, एक नया न्यूरल-नेटवर्क आर्किटेक्चर जो एक ऐसी क्रियाविधि पर आधारित है जिसे attention कहते हैं — एक ऐसा तरीका जिससे मॉडल आँकता है कि वाक्य का हर शब्द बाकी हर शब्द से कितना जुड़ा है, एक साथ, समानांतर रूप में।
यह अमूर्त लगता है, इसलिए यह समझें कि यह क्यों मायने रखता था। पहले के भाषा मॉडल टेक्स्ट को एक बार में एक शब्द, क्रमिक रूप से प्रोसेस करते थे, जिससे उन्हें प्रशिक्षित करना धीमा हो जाता था और लंबे अंशों में वे भूलते भी जाते थे। Transformer ने सब कुछ समानांतर रूप से प्रोसेस किया और लंबी दूरी के संबंधों को “दिमाग” में रख सकते थे। उन्हें प्रशिक्षित करना तेज़ था, ज़्यादा डेटा और कंप्यूट के साथ वे खूबसूरती से स्केल हुए, और — सबसे अहम बात — वे बेहतर तरीक़े से जैसे-जैसे आप उन्हें बड़ा बनाते गए, एक सहज, पूर्वानुमेय तरीके से बेहतर होते गए।
वह आखिरी गुण पूरे उछाल का खामोश इंजन है। शोधकर्ताओं ने उस चीज़ को खोजा जिसे आगे चलकर कहा जाने लगा scaling laws: ज़्यादा पैरामीटर, ज़्यादा डेटा और ज़्यादा कंप्यूट डालें, और प्रदर्शन एक भरोसेमंद वक्र में बेहतर होता है। जिस क्षेत्र ने दशकों चतुर तरकीबें ढूँढने में बिताए थे, उसके लिए यह लगभग हद से ज़्यादा अच्छा था। आपको हर साल नया विचार नहीं चाहिए था। आपको उसी विचार का बड़ा संस्करण चाहिए था। Transformer ने बुद्धिमत्ता को ऐसी चीज़ बना दिया जिसे आप, काफ़ी हद तक, ख़रीदें.
आपने जिस भी बड़े भाषा मॉडल के बारे में सुना है — GPT, Claude, Gemini, Llama, DeepSeek, Qwen और बाकी — वह एक Transformer है, या उसी का निकट वंशज। वह 2017 का पेपर वह कब्जा है जिस पर आधुनिक दुनिया घूमती है।
GPT युग और आधुनिक LLM का जन्म (2018–2022)
OpenAI नाम की एक युवा लैब ने scaling-laws के दाँव को लगभग सबसे ज़्यादा गंभीरता से लिया। उनका थीसिस सरल था और उस समय विवादास्पद भी: एक Transformer लें, उसे अगले शब्द का अनुमान लगाने के लिए इंटरनेट के चौंकाने वाले ढेर के टेक्स्ट पर प्रशिक्षित करें, उसे विशाल बनाएँ, और देखें क्या होता है।
नतीजे बढ़ती लहरों में आए:
- GPT-1 (2018) ने सीमित पैमाने पर अवधारणा साबित की।
- GPT-2 (2019) सुसंगत पैराग्राफ़ बनाने में इतना अच्छा था कि OpenAI ने शुरू में पूरा मॉडल जारी करने में झिझक की, दुरुपयोग की आशंका का हवाला देते हुए — एक ऐसा फ़ैसला जिसने सुर्खियाँ बनाईं और काफ़ी आँखें घुमाने वाली प्रतिक्रिया भी, लेकिन यह भी संकेत दिया कि कुछ बदल गया था।
- GPT-3 (2020) सबसे चौंकाने वाला था। 175 अरब पैरामीटर के साथ, यह निबंध लिख सकता था, सवालों के जवाब दे सकता था, काम करने वाला कोड बना सकता था, और शैलियों की नकल कर सकता था — और यह सब बिना किसी खास प्रशिक्षण के। इसने ये चीज़ें टेक्स्ट का अनुमान लगाना सीखने के दुष्प्रभाव के रूप में सीखीं। जिन डेवलपर्स को जल्दी पहुँच मिली, उन्होंने इसके बारे में वैसे बात की जैसे लोग उस जादू के करतब के बारे में बात करते हैं जिसे वे समझा नहीं सकते।
यहाँ कुछ बहुत गहरा हो रहा था। किसी ने प्रोग्राम नहीं किया था GPT-3 को कविता लिखने या Python डीबग करने के लिए। वे क्षमताएँ पैमाने से उभरीं। मॉडल बस अगले शब्द का अनुमान लगाने की कोशिश कर रहा था, और उसमें बहुत अच्छा होते-होते उसने व्याकरण, तथ्यों, तर्क और शैली का एक कामचलाऊ अनुमान सोख लिया। इस गुण का — मॉडल बड़े होने पर बिना बुलाए आती क्षमताएँ — नाम है emergence, और यही कारण है कि इन सिस्टम्स को बनाने वाले शोधकर्ता भी नियमित रूप से चौंकते हैं कि ये क्या कर सकते हैं।
2022 तक शक्तिशाली भाषा मॉडल मौजूद थे। लेकिन वे डेवलपर API के पीछे रहते थे, कच्चे और कभी-कभी बेलगाम अंदाज़ में बोलते थे, और कुछ हज़ार उत्साहियों तक सीमित थे। आम जनता को इसका पता ही नहीं था। वह रातों-रात बदलने वाला था।
ChatGPT: जिस हफ़्ते AI मेनस्ट्रीम में पहुँचा
30 नवंबर 2022 को OpenAI ने अपने GPT-3.5 मॉडल पर बने एक चैटबॉट का मुफ़्त रिसर्च प्रीव्यू जारी किया। उन्होंने इसका नाम रखा ChatGPT. अंदरूनी तौर पर उम्मीदें मामूली थीं।
यह इतिहास का सबसे तेज़ी से बढ़ने वाला कंज़्यूमर ऐप बन गया, जिसने लगभग दो महीनों में 100 मिलियन उपयोगकर्ता छू लिए।
नीचे की तकनीक बुनियादी तौर पर नई नहीं थी। नया था इसे पेश करने का तरीका: एक सरल चैट बॉक्स, निर्देशों का पालन करने और बातचीत जारी रखने के लिए ट्यून किया गया मॉडल, और — सबसे अहम — शुरुआत के लिए कोई बाधा नहीं। कोई भी किसी वेबसाइट पर जाकर उससे बात कर सकता था। आपके माता-पिता इसे इस्तेमाल कर सकते थे। आपके बच्चे इसे इस्तेमाल कर सकते थे। और लाखों लोगों के लिए, वह पहली बातचीत वह पल थी जब अमूर्त “AI” एक ठोस चीज़ बन गया जो उनके ईमेल लिख सकता था, उनका होमवर्क समझा सकता था, उनकी यात्राएँ प्लान कर सकता था, और उनका कोड ड्राफ़्ट कर सकता था।
सांस्कृतिक विस्फोट तुरंत हुआ। स्कूलों में निबंधों को लेकर हड़कंप मच गया। कंपनियाँ “AI रणनीतियाँ” बनाने में जुट गईं। निवेशकों ने अपनी जेबें खोल दीं। दुनिया के हर टेक्नोलॉजी एग्ज़ीक्यूटिव के एजेंडे में अचानक एक ही चीज़ सबसे ऊपर आ गई। ChatGPT ने सिर्फ़ एक प्रोडक्ट लॉन्च नहीं किया; उसने उस सबसे तीव्र कॉर्पोरेट मुक़ाबले की शुरुआती गोली चलाई जो टेक इंडस्ट्री ने स्मार्टफ़ोन के बाद देखा है — बल्कि कहें तो इंटरनेट के बाद।
यहाँ से टाइमलाइन रेंगना बंद कर देती है और धुँधली पड़ने लगती है।
बंद मॉडलों की होड़ (2023–2026)
जैसे ही ChatGPT ने बाज़ार का सबूत दिया, दुनिया की सबसे बड़ी और सबसे ज़्यादा फ़ंडिंग वाली लैब्स जंग पर उतर आईं। ये रहे क्लोज़्ड मॉडल — प्रोप्राइटरी सिस्टम, जिनके वेट्स निजी रखे जाते हैं और जिन तक ऐप और पेड API के ज़रिए पहुँचा जाता है। ये कच्ची क्षमता की सीमा पर खड़े हैं, और इनके बीच मुक़ाबला बेरहम रहा है।
2023 ने मिसाल क़ायम की। OpenAI ने जारी किया GPT-4, एक नाटकीय छलांग, जो तर्क कर सकता था, प्रोफ़ेशनल परीक्षाएँ पास कर सकता था, और टेक्स्ट के साथ-साथ इमेज भी संभाल सकता था। OpenAI के पूर्व शोधकर्ताओं द्वारा स्थापित Anthropic ने लॉन्च किया Claude, जिसमें सुरक्षा, लंबे दस्तावेज़ और अधिक सोच-विचार वाली बातचीत की शैली पर ज़ोर था। Transformer का आविष्कार करने के बावजूद ChatGPT से अचंभित रह गया Google फिर संभला और लॉन्च किया Gemini। तीन-तरफ़ा दौड़ शुरू हो गई थी।
फिर बात बस… बढ़ती ही गई। हर लैब हर कुछ महीनों में दूसरों से आगे निकल जाती थी। कॉन्टेक्स्ट विंडो — यानी एक मॉडल एक बार में कितना टेक्स्ट देख सकता है — कुछ हज़ार शब्दों से बढ़कर पूरी किताबों और कोडबेस तक पहुँच गई। मॉडलों में इमेज देखने, ऑडियो सुनने, वेब ब्राउज़ करने और टूल्स इस्तेमाल करने की क्षमता आ गई। Elon Musk’s xAI ने एंट्री की Grok, जिसे सीधे सोशल प्लेटफ़ॉर्म X से जोड़ा गया था।
सीमा आज जहाँ खड़ी है, उसे दो बदलाव परिभाषित करते हैं 2026, और ये किसी भी एक मॉडल के नाम से ज़्यादा मायने रखते हैं:
पहला, रीज़निंग का उभार। “सोचने वाले” मॉडलों की एक नई श्रेणी ने जवाब देने से पहले समस्याओं को स्टेप बाय स्टेप सुलझाना सीखा — पहला जवाब बेधड़क बोलने के बजाय अंदर ही अंदर सोचने के लिए रुकना। इसने गणित, तर्क और जटिल कोडिंग में पुराना अंतर काफ़ी हद तक पाट दिया, और 2023’s मॉडलों को अटकाने वाले बेंचमार्क सामान्य जीत बन गए।
दूसरा, चैटबॉट से कर्मचारी तक का बदलाव। 2026 की सबसे बड़ी थीम है एजेंटिक AI। अग्रणी मॉडल अब सिर्फ़ सवालों के जवाब नहीं देते — वे काम करते हैं। वे कंप्यूटर चलाते हैं, कई फ़ाइलों में कोड लिखते और डिप्लॉय करते हैं, ऐसे मल्टी-स्टेप टास्क पूरे करते हैं जो मिनटों या घंटों में फैले होते हैं, और असल में काम निपटाने के लिए बिज़नेस सिस्टम से जुड़ जाते हैं। इंटरफ़ेस का रूपक चुपचाप “वह असिस्टेंट जिससे आप चैट करते हैं” से “वह सहकर्मी जिसे आप काम सौंपते हैं” की ओर खिसक गया।
2026 के मध्य तक, क्लोज़्ड फ़्रंटियर शीर्ष पर एक सघन समूह है: Anthropic’s Claude Opus 4.8, OpenAI’s GPT-5.5, Google’s Gemini 3.1 Pro, और xAI’s Grok 4.3, जिसमें चारों लैब हर कुछ हफ़्तों में बढ़त की कमान बदलते रहते हैं। <span>मौजूदा टॉप टियर की सबसे चौंकाने वाली बात यह है कि वह कितना करीब आ गया है — “सबसे अच्छे” और “दूसरे सबसे अच्छे” के बीच का अंतर अब अक्सर राउंडिंग एरर जितना होता है, और वह लगातार हाथ बदलता रहता है।</span>
यह दौड़ भू-राजनीतिक भी हो गई। 2026 के मध्य में एक Anthropic फ़्रंटियर मॉडल — जहाँ तक किसी को पता है — इतिहास में पहला ऐसा मॉडल बना जिसे नियामकों ने बंद करके फिर चालू किया; अमेरिकी एक्सपोर्ट-कंट्रोल आदेश के तहत उसे थोड़े समय के लिए निलंबित किया गया, इससे पहले कि पहुँच बहाल हो जाए। फ़्रंटियर AI अब सिर्फ़ एक प्रोडक्ट श्रेणी नहीं है। यह राष्ट्रीय नीति का औज़ार है।
ओपन-मॉडल क्रांति: जनता के लिए वेट्स
जब दिग्गज अपने API के पीछे जंग लड़ रहे थे, तभी एक समानांतर और उतनी ही अहम कहानी सामने आ रही थी: उभार ओपन मॉडल.
निर्णायक मोड़ 2023 की शुरुआत में आया, जब Meta ने जारी किया LLaMA, एक सक्षम लैंग्वेज मॉडल, जिसके वेट्स लीक हुए और फिर औपचारिक रूप से शोधकर्ताओं के साथ साझा किए गए। पहली बार, वाकई मज़बूत मॉडल ऐसा था जिसे आप डाउनलोड कर सकते थे, अपने हार्डवेयर पर चला सकते थे, जाँच सकते थे और बदल सकते थे। इसके इर्द-गिर्द डेवलपर्स और शौक़ीन लोगों का एक वैश्विक समुदाय फूट पड़ा, जिसने फाइन-ट्यून किए गए वेरिएंट, ऑप्टिमाइज़ेशन और टूल्स की हैरान करने वाली लहर पैदा की — अक्सर बड़ी लैब्स के फ़ीचर लाने से भी तेज़।
उस समुदाय की ऊर्जा कभी कम नहीं हुई, और 2026 तक ओपन इकोसिस्टम क्लोज़्ड फ़्रंटियर का एक गंभीर प्रतिद्वंद्वी बन चुका है। कुछ बातें समझने लायक हैं:
ओपन वेट्स का मतलब ओपन सोर्स नहीं है। यह अंतर बहुत लोगों को उलझा देता है। ओपन सोर्स का मतलब है कि ट्रेनिंग कोड, डेटा और वेट्स सब एक पर्मिसिव लाइसेंस के तहत जारी होते हैं। ओपन-वेट का मतलब है कि आपको डाउनलोड करके चलाने के लिए मॉडल फ़ाइलें मिल जाती हैं, लेकिन लाइसेंस तय कर सकता है कि आप उन्हें कैसे इस्तेमाल करेंगे, और ट्रेनिंग डेटा तथा पूरा तरीक़ा अक्सर निजी रहता है। जिन मॉडलों को लोग बिना सोचे “ओपन सोर्स” कह देते हैं, वे असल में ओपन-वेट होते हैं। कॉम्प्लायंस की चिंता करने वाले बिज़नेस के लिए यह अंतर बहुत बड़ा है — इसीलिए लाइसेंसिंग एक असली प्रतिस्पर्धी विशेषता बन गई है। पर्मिसिव Apache 2.0 और MIT लाइसेंस (जो Qwen, DeepSeek और अन्य जैसे परिवार इस्तेमाल करते हैं) ठीक इसलिए कीमती हैं क्योंकि वे कंपनियों को खुलकर बनाने देते हैं।
गुरुत्वाकर्षण का केंद्र पूर्व की ओर खिसक गया। 2026 के सबसे सक्षम ओपन-वेट मॉडलों में से कुछ चीनी लैब्स से आते हैं: DeepSeek (जिसे हैरान करने वाली कम क़ीमत पर फ़्रंटियर-स्तर की रीज़निंग के लिए सराहा गया), Alibaba’s Qwen (एक विशाल, पर्मिसिव लाइसेंस वाला परिवार, जो छोटे लैपटॉप मॉडलों से लेकर बड़े सिस्टम तक फैला है), Moonshot’s Kimi, और Zhipu/Z.ai का GLM सीरीज़। Meta का Llama 4 पश्चिमी ओपन टियर की नींव है, Google के हल्के Gemma मॉडल एक ही GPU या लैपटॉप पर भी चलने के लिए बने हैं, और यूरोप का Mistral अपने फ़्लैगशिप मॉडल उदार लाइसेंसिंग पर ले आया। ओपन लीडरबोर्ड अब लगभग हर महीने बदलता है — हाल के स्नैपशॉट में GLM-5.2 और Kimi के नवीनतम मॉडल स्वतंत्र ओपन रैंकिंग में सबसे ऊपर या उसके बहुत करीब रहे हैं, और कई ओपन मॉडल उस इलाक़े में घुस रहे हैं जो पहले सिर्फ़ क्लोज़्ड फ्रंटियर का था।
कीमतों का धड़ाम। शायद ओपन मॉडल की सबसे बड़ी कहानी आर्थिक है। मुक़ाबले ने — जिसका बड़ा हिस्सा इन ओपन और कम लागत वाले प्रदाताओं से आया — बुद्धिमत्ता की कीमत को खड़ी चट्टान से नीचे गिरा दिया है। दो साल पहले API फ़ीस में जिन क्षमताओं पर छोटी-सी दौलत लगती थी, वे अब प्रति दस लाख शब्दों के कुछ सेंट में मिलती हैं, या सेल्फ़-होस्ट करें तो मुफ़्त। विश्लेषकों का अंदाज़ा है कि सबसे अच्छे ओपन वेट्स अब सबसे अच्छे क्लोज़्ड मॉडल से बस महीनों कई बेंचमार्क पर पीछे हैं, सालों नहीं। असली दुनिया के बहुत सारे कामों के लिए ओपन विकल्प अब इतना अच्छा, इतना सस्ता और इतना निजी है कि जीत जाए।
यह सुर्खियों के नीचे चल रही ख़ामोश क्रांति है। फ्रंटियर ध्यान खींचता है, लेकिन “काफ़ी अच्छे” AI का कमोडिटी बन जाना — अपने ही सर्वर पर, अपने ही कंट्रोल में, लगभग शून्य सीमांत लागत पर चलना — किसी भी एक फ़्लैगशिप मॉडल से ज़्यादा उद्योगों को बदल सकता है।
जब AI ने देखना और चित्र बनाना सीखा: इमेज-जनरेशन की कहानी
भाषा क्रांति का सिर्फ़ आधा हिस्सा थी। दूसरा आधा दृश्य था — और वह भी उतनी ही तेज़ी से आया।
AI इमेज के लिए शुरुआती मशीनरी थी GAN (Generative Adversarial Network), जिसे 2014 में पेश किया गया। चतुर आइडिया: दो नेटवर्क एक-दूसरे के ख़िलाफ़ खड़े कर दो, एक नक़ली इमेज बनाए और दूसरा नक़ली को पकड़ने की कोशिश करे, जब तक जनरेटर इतना अच्छा न हो जाए कि नक़ली असली लगने लगें। GAN ने डरावनी हद तक असली लगने वाले चेहरे बनाए — “ये लोग अस्तित्व में नहीं हैं” वाला दौर — लेकिन उन्हें ट्रेन करना मुश्किल और शब्दों से कंट्रोल करना कठिन था।
असली उपभोक्ता सफलता एक अलग तकनीक से आई: डिफ़्यूज़न मॉडल, जो शुद्ध शोर से शुरू करके उसे धीरे-धीरे एक सुसंगत तस्वीर में बदलना सीखते हैं, और इसमें टेक्स्ट प्रॉम्प्ट मार्गदर्शन करता है। नतीजे, और इसमें लगा समय, चौंकाने वाले थे:
- DALL·E और DALL·E 2 (2021–2022) OpenAI से आए और दुनिया को दिखाया कि आप एक मज़ेदार वाक्य टाइप कर सकते हैं — “फ़ोटोरियलिस्टिक अंदाज़ में घोड़े पर सवार एक अंतरिक्ष यात्री” — और चौंकाने वाली अच्छी इमेज वापस पा सकते हैं।
- Midjourney (2022) अपनी अलग और ख़ूबसूरत सौंदर्य-भाषा के साथ आया और एक बड़ा समुदाय बनाया, और सुंदर AI आर्ट का पर्याय बन गया।
- Stable Diffusion (2022) इमेज के लिए वही किया जो बाद में LLaMA ने टेक्स्ट के लिए किया: इसे खुलकर जारी किया गया। कोई भी इसे चला सकता था, फाइन-ट्यून कर सकता था और उस पर कुछ बना सकता था। टूल, प्लगइन और कस्टम मॉडल का पूरा ओपन इकोसिस्टम रातों-रात फूट पड़ा।
वहाँ से यह क्षेत्र दौड़ पड़ा। पुरानी ख़राबियाँ — बिगड़े हाथ, बेतुका टेक्स्ट, अजीब लगते चेहरे — एक-एक करके ठीक होती गईं। 2026 तक इमेज-जनरेशन बाज़ार साफ़ खेमों में बँट चुका है, और गुणवत्ता इतनी ऊँची है कि नतीजे आम आदमी की नज़र में आसानी से पास हो जाते हैं:
- Midjourney (अब अपनी V8 लाइन पर) स्टाइलिश, स्क्रॉल रोक देने वाले आर्ट के लिए सौंदर्य की पसंदीदा बनी हुई है।
- OpenAI का GPT Image मॉडल (DALL·E के उत्तराधिकारी, अब सीधे ChatGPT में बने हुए) जटिल निर्देश मानने और इमेज के अंदर टेक्स्ट सही तरीक़े से लिखने में आगे हैं — यह एक ऐसी समस्या थी जिसने सालों तक हर मॉडल को परेशान किया।
- Black Forest Labs का FLUX ओपन-वेट चैंपियन बन गया, फ़ोटोरियलिज़्म में प्रीमियम क्लोज़्ड मॉडल्स के बराबर पहुँच गया, वह भी बहुत कम लागत पर, और ज़्यादातर गंभीर ओपन सोर्स उपयोगकर्ताओं को पुराने Stable Diffusion बिल्ड्स से खींच लाया।
- Google का Imagen और “Nano Banana” मॉडल और Adobe का Firefly (लाइसेंस वाले डेटा पर ट्रेन किए गए, जो कानूनी सुरक्षा के लिए एंटरप्राइज़ को बहुत पसंद हैं) प्रोफ़ेशनल क्षेत्र को पूरा करते हैं।
- और, LLM की कहानी दोहराते हुए, चीनी मॉडल जैसे ByteDance का Seedream रैंकिंग में तेज़ी से चढ़ा।
फ्रंटियर अब सिर्फ़ एक सुंदर तस्वीर बनाने तक सीमित नहीं है। अब बात है एडिटिंग — बातचीत के लहज़े में किसी हिस्से को चुनकर बदलाव माँगना — और कंसिस्टेंसी, यानी दर्जनों इमेज में एक ही किरदार या प्रोडक्ट को एक जैसा बनाए रखना। AI इमेज जनरेशन लगभग चार वर्षों में एक नई चीज़ से एक पेशेवर प्रोडक्शन टूल बन गया।
जब AI ने चलना सीखा: AI वीडियो का उभार
अगर इमेज चार वर्ष पहले का चमत्कार थीं, तो वीडियो इस दौर का चमत्कार है। और AI की रफ़्तार को किसी चीज़ ने इतना नहीं दिखाया जितना यह देखकर पता चला कि text-to-video तीन वर्ष से भी कम समय में एक मज़ाक से फ़िल्म इंडस्ट्री के लिए ख़तरा बन गया।
2023 तक भी “AI वीडियो” का मतलब कुछ सेकंड की धुँधली, टिमटिमाती हलचल था, जिसमें चेहरे पिघलते थे और चीज़ें फ़्रेम के बीच बेतुकी शक्ल में बदल जाती थीं। वह एक करतब था, टूल नहीं।
फिर 2024 की शुरुआत में, OpenAI ने प्रीव्यू किया Sora, और बातचीत का रुख़ तुरंत बदल गया। इसकी क्लिप्स फ़ोटोरियलिस्टिक, समय के हिसाब से सुसंगत और इतनी सिनेमैटिक थीं कि लगा जैसे इसने कई वर्षों की अपेक्षित प्रगति एक झटके में लाँघ ली हो। हर प्रतिस्पर्धी ने तुरंत उसी स्तर का पीछा शुरू कर दिया।
इस पीछा करने से एक शानदार क्षेत्र बना। 2026 तक गंभीर दावेदारों में शामिल हैं Google का Veo, Runway का Gen-4 लाइन (जो कच्चे मॉडल के रूप में बेचने के बजाय एक पूरे क्रिएटिव एडिटिंग एनवायरनमेंट में बना दी गई है), और ताकतवर चीनी मॉडलों की एक लहर — Kling (Kuaishou), Seedance (ByteDance), और अन्य — जो अब स्वतंत्र वीडियो-क्वालिटी लीडरबोर्ड के शीर्ष पर राज करते हैं। तकनीकी स्तर तेज़ी से ऊपर गया: नेटिव सिंक्रोनाइज़्ड ऑडियो — जिसमें कई भाषाओं में सही लिप-सिंक के साथ जनरेट किया गया डायलॉग भी शामिल है — लगभग एक वर्ष में साइंस फ़िक्शन से एक स्टैंडर्ड फ़ीचर बन गया।
वह ट्विस्ट जिसकी किसी ने उम्मीद नहीं की थी: Sora, जिस मॉडल ने इस दौड़ की शुरुआत की, बंद कर दिया गया। OpenAI ने अप्रैल 2026 में Sora के वेब और ऐप अनुभव बंद कर दिए, और साल के आगे चलकर API भी बंद हो गया। जिस टूल ने रफ़्तार तय की थी, उसे पीछे छोड़कर रिटायर कर दिया गया, जबकि उससे प्रेरित क्षेत्र तेज़ी से आगे बढ़ता रहा — यह इस बात का लगभग सटीक प्रतीक है कि यह क्षेत्र कितनी बेरहमी से तेज़ी से आगे बढ़ता है। मानक तय करें, और अठारह महीने बाद आप खुद एक पुराना बेंचमार्क बन सकते हैं।
आज एक अकेला उद्यमी, एक टेक्स्ट प्रॉम्प्ट और सीमित बजट के साथ, ऐसी फ़ुटेज बना सकता है जिसके लिए कभी लोकेशन, क्रू और पाँच अंकों का बजट चाहिए था। तकनीक की असली सीमाएँ अब भी हैं — फ़िज़िक्स की गड़बड़ियाँ, लंबे सीन में कंसिस्टेंसी, और किसी की शक्ल-सूरत व जानकारी सार्वजनिक करने को लेकर गंभीर कानूनी और नैतिक सवाल — लेकिन दिशा साफ़ है।
टेक्स्ट और पिक्सल से आगे: आवाज़, मल्टीमॉडैलिटी और एजेंट का युग
इस लेख में इस्तेमाल की गई साफ़-सुथरी श्रेणियाँ — टेक्स्ट, इमेज, वीडियो — सच कहें तो पहले ही घुल रही हैं। इस दौर की तय करने वाली दिशा यह है कि ये क्षमताएँ एक ही एकीकृत सिस्टम में विलीन हो रही हैं।
मल्टीमॉडलिटी इसका तकनीकी नाम है। 2026 के फ़्रंटियर मॉडल ऐसे टेक्स्ट मॉडल नहीं हैं जिनमें इमेज फ़ीचर जोड़ दिया गया हो; वे एक ही निरंतर प्रवाह में अलग-अलग फ़ॉर्मैट में मूल रूप से देखते, पढ़ते, सुनते और जनरेट करते हैं। आप अपने फ़्रिज की फ़ोटो दिखाकर रेसिपी माँग सकते हैं, किसी बग का स्क्रीनशॉट भेजकर उसका फ़िक्स ले सकते हैं, या उससे बात कर सकते हैं और वह लगभग बिना किसी देरी के, बीच में टोकी जा सकने वाली प्राकृतिक आवाज़ में जवाब देगा। “टाइप करें, इंतज़ार करें, पढ़ें” का यह अनाड़ी पुराना चक्र अब किसी ऐसी चीज़ को जगह दे रहा है जो एक काबिल इंसान से बात करने जैसी लगती है।
और फिर आते हैं एजेंट — यही धागा पूरी 2026 की कहानी को जोड़ता है। एजेंट एक AI सिस्टम है जो सिर्फ़ जवाब नहीं देता, बल्कि काम करता है: वह कई चरणों वाले काम की योजना बनाता है, टूल और सॉफ़्टवेयर इस्तेमाल करता है, अपने काम की खुद जाँच करता है, और बिना ज़्यादा निर्देशन के काम को पूरा करता है। यात्रा की बुकिंग, एक स्प्रेडशीट को तीन डेटा स्रोतों से मिलाना, किसी कोडबेस को रीफ़ैक्टर करना, दर्जनों वेब पेजों पर एक रिसर्च प्रोजेक्ट चलाना — ये “डेमो” से “रोज़ के वर्कफ़्लो” की ओर बढ़ रहे हैं। इंटरफ़ेस चैट विंडो से एक डेलीगेशन क्यू की ओर बदल रहा है।
यह AI’ के पूरे इतिहास की मूल कड़ी है, जो अपने तार्किक निष्कर्ष पर पहुँचती है। हम यहाँ से आगे बढ़े — प्रोग्रामिंग स्पष्ट नियमों वाले कंप्यूटर बनाने से, फिर ट्रेनिंग उन्हें डेटा पर देने से, फिर बातचीत उनसे सामान्य भाषा में करने से, और अब — सौंपने उन्हें असली काम। हर कदम ने मानव की मंशा और तैयार नतीजे के बीच अड़चन की एक परत हटा दी। एजेंट उस अड़चन-हटाव का मौजूदा मोर्चा हैं।
AI अचानक इतना तेज़ क्यों हो गया?
मॉडल के नाम और वर्ज़न नंबर एक तरफ़ रखें, तो एक स्वाभाविक सवाल उठता है: पचास साल तक धीरे-धीरे रेंगने के बाद AI अचानक क्यों दौड़ पड़ा? कई ताकतें एक साथ आईं, और यही मिलन — कोई एक अकेली नहीं — आग लगाने वाला साबित हुआ।
कंप्यूट पावर बेतहाशा ताकतवर और भरपूर हो गई। जो GPU वीडियो गेम रेंडर करते हैं, वही न्यूरल नेटवर्क की ट्रेनिंग के लिए एकदम सही निकले। चिप्स के बेहतर होने और डेटा सेंटर के बढ़ने के साथ, AI ट्रेनिंग के लिए उपलब्ध कच्ची ताकत भी तेज़ी से बढ़ती गई। 1990 के दशक में जो विचार सिद्धांत रूप में सही थे, हार्डवेयर साथ न आने तक बस चल ही नहीं सकते थे।
डेटा की बाढ़ आ गई। इंटरनेट ने तीस साल में मानवीय टेक्स्ट, तस्वीरों और वीडियो का लगभग असीम भंडार जमा किया। मानव ज्ञान और अभिव्यक्ति का वह विशाल, बिखरा रिकॉर्ड ही ट्रेनिंग की सामग्री बन गया। इंटरनेट नहीं, तो आधुनिक AI नहीं।
Transformer ने स्केल का ताला खोल दिया। जैसा हमने देखा, 2017 की आर्किटेक्चर ने यह संभव बनाया कि ज़्यादा कंप्यूट और ज़्यादा डेटा को भरोसे के साथ ज़्यादा क्षमता में बदला जा सके। उस पूर्वानुमान-योग्यता ने शोध को इंजीनियरिंग के क़रीब ला दिया — और इंजीनियरिंग की समस्याएँ तेज़ी से हल होती हैं जब पैसा आता है।
पैसा आया। ChatGPT ने साबित कर दिया कि बाज़ार बहुत बड़ा है, और पूँजी उमड़ पड़ी। दसियों अरब डॉलर लैब, चिप्स और प्रतिभाओं में बह गए। उस फंडिंग ने वे समय-सीमाएँ सिकोड़ दीं जो वरना दशकों में फैलतीं।
कड़ी प्रतिस्पर्धा ने रफ़्तार तय की। OpenAI, Google, Anthropic, Meta, xAI और एक दर्जन चीनी लैब सब दौड़ में थे, तो कोई भी धीमा पड़ने का जोखिम नहीं ले सकता था। छह महीने में बनाई गई बढ़त छह हफ़्तों में गायब हो सकती थी। यही दबाव है कि आप ख़बरें देखते हैं तो लगभग हर बार एक नया फ़्लैगशिप मॉडल दिख जाता है।
ओपन इकोसिस्टम ने कोशिशों को कई गुना बढ़ा दिया। हर खुलकर जारी किए गए मॉडल ने हज़ारों स्वतंत्र डेवलपर्स को बिना वेतन का R&D बना दिया। वैश्विक ओपन सोर्स समुदाय की सामूहिक बुद्धि ने प्रगति को ऐसी रफ़्तार दी जो कोई अकेली कंपनी नहीं दे सकती थी, और AI की क़ीमत को ज़मीन के स्तर की ओर धकेल दिया।
इन सबको जोड़िए और आपको तकनीक के इतिहास की सबसे तीखी क्षमता-वक्र मिलती है। यह किसी एक आविष्कार से कम और एक शृंखला-प्रतिक्रिया से ज़्यादा लगती है।
AI आगे कहाँ जाएगा
AI’ के भविष्य की भविष्यवाणी करना छह महीने में ख़ुद को बेवकूफ़ साबित करने का शानदार तरीक़ा है — इस लेख ने दर्ज किया है कि विशेषज्ञ कितनी बार चौंके। फिर भी मौजूदा दिशा कुछ बातों की ओर ठोस भरोसे के साथ इशारा करती है।
एजेंट अब असली बन रहे हैं। अगला दौर ऐसे मॉडलों के बारे में कम है जो जानते हैं और ज़्यादा ऐसे सिस्टमों के बारे में जो भरोसे के साथ इन्हें और ज़्यादा करते हैं — लंबा, जटिल, कई चरणों वाला काम सच्ची स्वायत्तता के साथ पूरा करते हैं। मानें कि “AI वर्कर” वाला ढाँचा और तेज़ होगा, साथ ही निगरानी, भरोसे और उन नौकरियों के भविष्य पर कठिन सवाल भी, जो ऐसे कामों पर टिकी हैं जिन्हें अब एजेंट संभाल सकते हैं।
बुद्धिमत्ता और सस्ती होती जा रही है। क़ीमत का गिरना अभी ख़त्म नहीं हुआ। जैसे-जैसे ओपन मॉडल अंतर पाटते हैं और कार्यकुशलता बढ़ती है, सक्षम AI लगभग मुफ़्त होने और लोकल चलने की ओर बढ़ रही है — आपके फ़ोन पर, आपके लैपटॉप पर, आपके अपने सर्वर पर। यह कमोडिटीकरण किसी भी एक सुर्ख़ियों वाले मॉडल से ज़्यादा चुपचाप और ज़्यादा गहराई से पूरे उद्योगों को नया रूप दे सकता है।
सीमाएँ लगातार मिटती जा रही हैं। टेक्स्ट, तस्वीरें, ऑडियो और वीडियो एकीकृत सिस्टमों में पिघल रहे हैं, और “AI का इस्तेमाल करना” किसी टूल पर जाने जैसा कम और आप जो पहले से करते हैं उसमें अदृश्य रूप से गुँथी एक क्षमता जैसा ज़्यादा लगेगा।
गवर्नेंस मुख्य मंच पर आ जाता है। 2026 में एक फ़्रंटियर मॉडल के संक्षिप्त नियामकीय बंद होने की एक झलक मिल चुकी है। जैसे-जैसे AI महत्वपूर्ण अधोसंरचना और भू-राजनीतिक शक्ति का लीवर बनती है, सुरक्षा, कॉपीराइट, नियंत्रण और राष्ट्रीय रणनीति के सवाल किसी भी शोध-सफलता जितना ही इस क्षेत्र को आकार देंगे। तकनीकी दौड़ और नीति की दौड़ अब एक ही दौड़ है।
एक ही भरोसेमंद भविष्यवाणी है कि रफ़्तार धीमी नहीं होगी। इस इतिहास का हर अध्याय ऐसे लोगों ने लिखा जो पूरे भरोसे के साथ यह कम आँकते रहे कि अगला अध्याय कितनी जल्दी आएगा।
अक्सर पूछे जाने वाले प्रश्न
आधुनिक AI की शुरुआत असल में कब हुई? इसकी धारणा 1950 के दशक से है, लेकिन आधुनिक डीप-लर्निंग युग का श्रेय आम तौर पर 2012 को जाता है, जब AlexNet न्यूरल नेटवर्क ने एक इमेज-रिकग्निशन प्रतियोगिता में बाज़ी मारी और साबित किया कि डीप नेटवर्क, बड़ा डेटा और GPU कंप्यूट मिलकर एक जीतने वाला संयोजन हैं। जनता के सामने उछाल बाद में शुरू हुआ, नवंबर 2022 में ChatGPT’ के लॉन्च के साथ।
ओपन और क्लोज़्ड AI मॉडल में क्या अंतर है? क्लोज़्ड मॉडल (जैसे GPT-5.5, Claude और Gemini) अपने वेट निजी रखते हैं और ऐप या सशुल्क API के ज़रिए इस्तेमाल होते हैं। ओपन मॉडल (जैसे Llama, DeepSeek, Qwen और GLM) अपने वेट साझा करते हैं ताकि कोई भी उन्हें डाउनलोड, चला और बदल सके। एक अहम बारीकी: “ओपन-वेट” का मतलब है आपको मॉडल की फ़ाइलें मिलती हैं, जबकि सच्चे “ओपन सोर्स” में ट्रेनिंग कोड और डेटा भी शामिल होते हैं — तमाम तथाकथित ओपन-सोर्स मॉडल असल में ओपन-वेट ही हैं।
AI के इतिहास में सबसे अहम सफलता कौन-सी थी? कई शोधकर्ता 2017 की Transformer आर्किटेक्चर की ओर इशारा करते हैं, जो इस पेपर में पेश हुई Attention Is All You Need। इसने मॉडलों को स्केलेबल और ट्रेनिंग में कुशल बनाया, और आज इस्तेमाल होने वाला लगभग हर बड़ा AI सिस्टम — चैटबॉट से लेकर इमेज जनरेटर तक — इसी पर टिका है।
AI इमेज और वीडियो जनरेशन इतना अच्छा और इतना तेज़ कैसे हो गया? इमेज जनरेशन ने 2021–2022 के आसपास डिफ़्यूज़न मॉडल के साथ बड़ी छलांग लगाई (DALL·E, Midjourney, Stable Diffusion), फिर टेढ़े हाथों और न पढ़े जाने वाले टेक्स्ट जैसी पुरानी समस्याएँ तेज़ी से सुलझा दीं। वीडियो ने भी ऐसा ही वक्र अपनाया — 2023 में कुछ सेकंड की धुँधली हरकत से लेकर 2026 तक फ़ोटोरियलिस्टिक, ऑडियो-सिंक क्लिप तक — Veo, Runway, Kling और Seedance जैसे मॉडलों की तीव्र प्रतिस्पर्धा की वजह से।
क्या AI की प्रगति धीमी पड़ने वाली है? अभी तक इसका कोई संकेत नहीं है। भरपूर कंप्यूट, भारी निवेश, लैबों के बीच कड़ी प्रतिस्पर्धा और फलता-फूलता ओपन-सोर्स समुदाय — इन सबका मेल रफ़्तार को आगे धकेलता रहता है। अगर ऊपर का इतिहास कुछ सिखाता है, तो यह कि अगली लहर हमेशा उम्मीद से ज़्यादा तेज़ी से आई है।


