
 ไทย
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 Bahasa Indonesia
 Русский
 العربية
 हिन्दी

ในปี 2012 ระบบคอมพิวเตอร์วิทัศน์ที่ดีที่สุดในโลกยังแยกสุนัขกับแมวไม่ค่อยออก ในปี 2026 คุณพิมพ์ประโยคเดียวแล้วดูภาพยนตร์ความยาวสามสิบวินาทีที่สมจริงเหมือนภาพถ่ายประกอบตัวเองขึ้นมา — ทั้งการเคลื่อนกล้อง แสงแบบภาพยนตร์ บทสนทนาที่ตรงปาก และทุกอย่าง — ในเวลาน้อยกว่าการรินกาแฟสักแก้ว
นั่นไม่ใช่ความก้าวหน้าที่มั่นคงในรอบทศวรรษ นั่นคืออีกดาวหนึ่งเลย
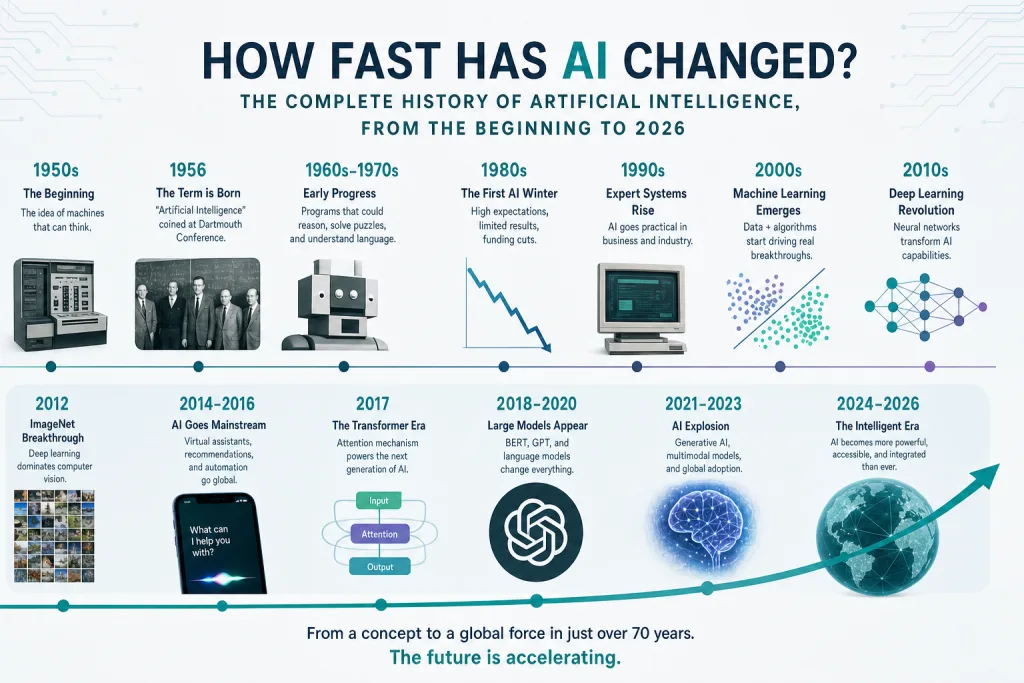
เรื่องราวที่ปัญญาประดิษฐ์เดินทางมาถึงจุดนี้เป็นหนึ่งในเส้นโค้งความเร่งที่แปลกที่สุดในประวัติศาสตร์เทคโนโลยี ห้าสิบปีมันคลานช้า จากนั้นในช่วงราวสิบปีมันวิ่งแซงหมุดหมายที่นักวิจัยเคยคิดว่าอีกหลายชั่วอายุคนจะไปถึง หากคุณรู้สึกเหมือนถูกสะบัดคอเพราะตามไม่ทัน — ชื่อโมเดลใหม่ทุกไม่กี่สัปดาห์ ความสามารถที่ดูเป็นไปไม่ได้เมื่อฤดูใบไม้ผลิที่แล้วกลายเป็นฟีเจอร์ฟรีในฤดูร้อนนี้ — คุณไม่ได้คิดไปเอง จังหวะมันเร็วขนาดนั้นจริง ๆ และยังเร็วขึ้นเรื่อย ๆ
นี่คือประวัติศาสตร์ฉบับสมบูรณ์ในมุมมนุษย์ของความเร่งนั้น: ว่า AI มาจากไหน การค้นพบไม่กี่ครั้งที่เปลี่ยนทุกอย่าง การแข่งขันทางอาวุธระหว่างโมเดลปิดและโมเดลเปิด การผงาดของการสร้างภาพและวิดีโอด้วย AI และทิศทางต่อไปของทั้งหมดนี้
กาแฟแก้วนั้นหยิบไว้เลย บทความนี้ยาว
สารบัญ
- ถนนยาวที่เชื่องช้า: AI ก่อนยุคเฟื่องฟู (1950–2011)
- ประกายไฟ: การเรียนรู้เชิงลึกจุดติดในปี 2012 ได้อย่างไร
- สถาปัตยกรรมที่เปลี่ยนทุกอย่าง: Transformer (2017)
- ยุค GPT และการกำเนิด LLM สมัยใหม่ (2018–2022)
- ChatGPT: สัปดาห์ที่ AI กลายเป็นกระแสหลัก
- การแข่งขันทางอาวุธของโมเดลปิด (2023–2026)
- การปฏิวัติโมเดลเปิด: เวตเพื่อทุกคน
- เมื่อ AI เรียนรู้ที่จะมองและวาด: เรื่องราวของการสร้างภาพ
- เมื่อ AI เรียนรู้ที่จะเคลื่อนไหว: การผงาดของวิดีโอ AI
- เหนือกว่าข้อความและพิกเซล: เสียง มัลติโมดัล และยุคของเอเจนต์
- ทำไม AI ถึงเดินหน้าเร็วขนาดนี้?
- AI จะไปทางไหนต่อ
- คำถามที่พบบ่อย
ถนนยาวที่เชื่องช้า: AI ก่อนยุคเฟื่องฟู (1950–2011)
ชวนให้คิดว่าปัญญาประดิษฐ์ถูกคิดค้นขึ้นราวปี 2022 แต่ไม่ใช่เลย ความฝันนี้เก่าเกือบเท่าคอมพิวเตอร์ยุคใหม่เอง
ในปี 1950 Alan Turing ถามคำถามที่ดูเรียบง่ายแต่หลอกตา — เครื่องจักรคิดได้ไหม? — และเสนอเกมเลียนแบบที่ตอนนี้เราเรียกว่า Turing Test หกปีต่อมา การประชุมเชิงปฏิบัติการภาคฤดูร้อนที่ Dartmouth College ก็มอบชื่อและความหวังตั้งต้นให้สาขานี้ ผู้บุกเบิกยุคแรกเชื่อว่าเครื่องจักรที่คิดได้จะมาถึงในอีกราวยี่สิบปี พวกเขาคิดผิดไปราวครึ่งศตวรรษ และการประเมินผิดนั้นเองที่นิยามหลายทศวรรษแรกของสาขานี้
แนวทางแรกเริ่มคือ AI เชิงสัญลักษณ์: แนวคิดที่ว่าความฉลาดสามารถจับใส่ไว้ในกฎที่ชัดเจน ตรรกะ และความรู้ที่เขียนขึ้นด้วยมือ หากคุณเพียงเขียน ถ้าอย่างนี้-ก็อย่างนั้น ข้อความมากพอ การให้เหตุผลก็จะตามมา แนวทางนี้ให้ผลเป็น “ระบบผู้เชี่ยวชาญ” ที่มีประโยชน์จริงในทศวรรษ 1970 และ 80 — โปรแกรมที่วินิจฉัยโรคบางชนิดได้หรือจัดสเปกคำสั่งซื้อคอมพิวเตอร์ — แต่มันชนกำแพง โลกจริงยุ่งเหยิงเกินไป เต็มไปด้วยข้อยกเว้นเกินกว่าจะจับด้วยกฎที่มนุษย์พิมพ์ใส่ด้วยมือ
เมื่อคำสัญญาแล่นเร็วกว่าผลลัพธ์ เงินทุนก็แห้งหาย สาขานี้ต้องทนกับช่วงยาวและหนาวเหน็บสองครั้งซึ่งตอนนี้รู้จักกันในชื่อ ฤดูหนาวของ AI, เมื่อ “AI” เกือบกลายเป็นคำหยาบในหมู่นักวิจัยจริงจังที่ไม่ต้องการให้ใบขอทุนของตัวเองถูกโยนลงถังขยะ
แต่เงียบ ๆ นั้น แนวคิดอีกแบบหนึ่งยังมีชีวิตรอดอยู่ที่ขอบ ๆ: การเรียนรู้ของเครื่อง. แทนที่จะเขียนความฉลาดลงไปด้วยมือ จะเป็นอย่างไรหากปล่อยให้ระบบเรียนรู้รูปแบบจากข้อมูล? โครงข่ายประสาทเทียม — ได้แรงบันดาลใจหลวม ๆ จากสมอง — มีมาตั้งแต่ทศวรรษ 1950 แต่ขาดพลังการคำนวณและส่วนใหญ่ถูกมองข้าม ตลอดทศวรรษ 90 และ 2000 การเรียนรู้ของเครื่องเชิงสถิติขับเคลื่อนตัวกรองสแปม ระบบแนะนำ และอันดับผลค้นหา มันได้ผล ทำเงินได้ และแทบไม่มีใครนอกสาขานี้เรียกมันว่า “AI” มันเป็นแค่… ซอฟต์แวร์ที่ยิ่งมีข้อมูลก็ยิ่งดีขึ้น
หมากทุกตัวอยู่บนกระดานแล้ว แค่ต้องรอจังหวะที่ใช่
ประกายไฟ: การเรียนรู้เชิงลึกจุดติดในปี 2012 ได้อย่างไร
หากคุณต้องการวันเดียวที่ยุคใหม่เริ่มต้น ตัวเลือกที่หนักแน่นคือ 2012.
ในปีนั้น โครงข่ายประสาทเทียมชื่อ AlexNet ลงแข่ง ImageNet — การแข่งขันประจำปีเพื่อติดป้ายภาพนับล้านให้ถูกต้อง — และไม่ใช่แค่ชนะ มันชนะแบบถล่มทลาย ลดอัตราความผิดพลาดลงมากจนผลลัพธ์ดูเหมือนพิมพ์ผิด มันใช้โครงข่ายประสาทเทียม “ลึก” (หลายชั้นซ้อนกัน) ที่ฝึกบนการ์ดจอหรือ GPU ซึ่งบังเอิญเก่งมากกับคณิตศาสตร์แบบขนานที่โครงข่ายประสาทเทียมต้องใช้พอดี
ส่วนผสมนั้น — บิ๊กดาต้า โครงข่ายลึก และพลังประมวลผลขนานราคาถูก — คือประกายไฟ ทันใดนั้นแนวทางโครงข่ายประสาทเทียมที่ถูกมองข้ามมาหลายทศวรรษก็ไม่ใช่แค่ทำได้ แต่กลายเป็นตัวหลัก ภายในไม่กี่ปี การเรียนรู้เชิงลึกก็วิ่งแซงเทคนิคเก่า ๆ ในการรู้จำภาพ การรู้จำเสียง และการแปล ยักษ์ใหญ่เทคโนโลยีเริ่มเห็น พวกเขาเริ่มจ้างนักวิจัยการเรียนรู้เชิงลึกทุกคนที่หาได้ และทุ่มงบประมาณการประมวลผลมหาศาลให้กับปัญหานี้
เป็นครั้งแรกที่ “ทุ่มข้อมูลและพลังประมวลผลเพิ่มให้โครงข่ายที่ใหญ่ขึ้น” เป็นกลยุทธ์ที่ได้ผลอย่างน่าเชื่อถือ ข้อค้นพบนั้นจะพลิกโฉมทั้งอุตสาหกรรมในไม่ช้า — แต่สาขานี้ยังขาดส่วนผสมสำคัญหนึ่งอย่างในการจัดการภาษาอย่างถูกต้อง
สถาปัตยกรรมที่เปลี่ยนทุกอย่าง: Transformer (2017)
นี่คือความก้าวหน้าที่แทบไม่มีใครนอกวงการ AI เคยได้ยิน ทั้งที่มันรองรับเกือบทุกอย่างที่คุณใช้อยู่ตอนนี้
ในปี 2017 ทีมนักวิจัยของ Google ตีพิมพ์บทความชิ้นหนึ่งด้วยชื่อที่กวน ๆ ว่า: Attention Is All You Need. มันแนะนำ Transformer, สถาปัตยกรรมโครงข่ายประสาทเทียมแบบใหม่ที่สร้างขึ้นรอบกลไกชื่อ แอตเทนชัน — วิธีที่โมเดลจะชั่งน้ำหนักว่าทุกคำในประโยคสัมพันธ์กับคำอื่นมากแค่ไหน พร้อมกันทั้งหมด แบบขนาน
ฟังดูเป็นนามธรรม ดังนั้นนี่คือเหตุผลที่มันสำคัญ โมเดลภาษาเดิมประมวลผลข้อความทีละคำตามลำดับ ทำให้ฝึกช้าและขี้หลงขี้ลืมเมื่อเจอข้อความยาว Transformer ประมวลผลทุกอย่างแบบขนานและเก็บความสัมพันธ์ระยะไกลไว้ใน “หัว” ได้ ฝึกได้เร็วกว่า ขยายขนาดได้สวยงามเมื่อมีข้อมูลและพลังประมวลผลเพิ่ม และ — ที่สำคัญ — มัน ดีกว่า ดีขึ้นอย่างราบรื่นและคาดเดาได้เมื่อคุณทำให้มันใหญ่ขึ้น
คุณสมบัติสุดท้ายนั้นคือเครื่องยนต์เงียบ ๆ ของความเฟื่องฟูทั้งหมด นักวิจัยค้นพบสิ่งที่ต่อมารู้จักในชื่อ กฎการขยายขนาด: ใส่พารามิเตอร์เพิ่ม ข้อมูลเพิ่ม และพลังประมวลผลเพิ่ม แล้วประสิทธิภาพจะดีขึ้นเป็นเส้นโค้งที่เชื่อถือได้ สำหรับสาขาที่ใช้เวลาหลายทศวรรษไล่ล่าเทคนิคฉลาด ๆ นี่ดีเกินจริงไปหน่อย คุณไม่ต้องมีไอเดียใหม่ทุกปี คุณแค่ต้องมีไอเดียเดิมในเวอร์ชันที่ใหญ่ขึ้น Transformer เปลี่ยนความฉลาดให้กลายเป็นสิ่งที่คุณสามารถ ในระดับที่มีความหมาย ซื้อ.
โมเดลภาษาขนาดใหญ่ทุกตัวที่คุณเคยได้ยินชื่อ — GPT, Claude, Gemini, Llama, DeepSeek, Qwen และอื่น ๆ — ล้วนเป็น Transformer หรือลูกหลานที่ใกล้ชิดของมัน บทความปี 2017 นั้นคือบานพับที่โลกยุคใหม่หมุนไปรอบ ๆ
ยุค GPT และการกำเนิด LLM สมัยใหม่ (2018–2022)
แล็บหนุ่มที่ชื่อ OpenAI กล้าเดิมพันกับกฎการขยายขนาดจริงจังกว่าใครเกือบทั้งหมด ข้อเสนอของพวกเขาง่าย และในตอนนั้นเป็นที่ถกเถียง: เอา Transformer มาฝึกด้วยข้อความจากอินเทอร์เน็ตปริมาณมหาศาลเพื่อทำนายคำถัดไป ทำให้มันใหญ่มหึมา แล้วดูว่าจะเกิดอะไรขึ้น
ผลลัพธ์มาเป็นระลอกที่ทวีความรุนแรงขึ้น:
- GPT-1 (2018) พิสูจน์แนวคิดในระดับพอประมาณ
- GPT-2 (2019) เก่งพอจะสร้างย่อหน้าที่สอดคล้องกันได้ จนตอนแรก OpenAI ลังเลที่จะปล่อยโมเดลเต็มตัว โดยอ้างความกังวลเรื่องการนำไปใช้ในทางที่ผิด — การตัดสินใจที่สร้างพาดหัวข่าวและเสียงกลอกตาไม่น้อย แต่ก็ส่งสัญญาณว่ามีบางอย่างเปลี่ยนไปแล้ว
- GPT-3 (2020) คือตัวที่ทำให้อ้าปากค้าง ด้วยพารามิเตอร์ 175 พันล้านตัว มันเขียนเรียงความ ตอบคำถาม สร้างโค้ดที่ใช้งานได้ และเลียนแบบสไตล์ — ทั้งหมดโดยไม่ได้รับการฝึกมาเพื่องานเหล่านั้นโดยเฉพาะ มันเรียนรู้สิ่งเหล่านี้เป็นผลข้างเคียงของการเรียนรู้ที่จะทำนายข้อความ นักพัฒนาที่ได้เข้าถึงก่อนใครพูดถึงมันเหมือนคนพูดถึงกลมายากลที่อธิบายไม่ได้
มีสิ่งลึกซึ้งกำลังเกิดขึ้นที่นี่ ไม่มีใคร เขียนโปรแกรม ให้ GPT-3 เขียนกลอนหรือดีบัก Python ความสามารถเหล่านั้น เกิดขึ้น จากขนาด โมเดลแค่พยายามเดาคำถัดไป และเมื่อเก่งมาก ๆ กับสิ่งนั้น มันก็ซึมซับไวยากรณ์ ข้อเท็จจริง การให้เหตุผล และสไตล์มาในระดับที่ใช้งานได้ คุณสมบัตินี้ — ความสามารถที่โผล่ขึ้นมาเองเมื่อโมเดลใหญ่ขึ้น — เรียกว่า emergence, และนี่คือเหตุผลที่แม้แต่นักวิจัยที่สร้างระบบเหล่านี้ก็ยังประหลาดใจเป็นประจำกับสิ่งที่มันทำได้
ถึงปี 2022 โมเดลภาษาทรงพลังมีอยู่แล้ว แต่พวกมันอยู่หลัง API ของนักพัฒนา พูดจาดิบ ๆ และบางทีก็หลุด ๆ และเป็นอาณาเขตของคนคลั่งไคล้เพียงไม่กี่พันคน สาธารณชนทั่วไปไม่รู้เรื่องเลย นั่นกำลังจะเปลี่ยนในชั่วข้ามคืน
ChatGPT: สัปดาห์ที่ AI กลายเป็นกระแสหลัก
เมื่อวันที่ 30 พฤศจิกายน 2022 OpenAI เปิดตัวพรีวิววิจัยฟรีของแชตบอตที่สร้างบนโมเดล GPT-3.5 พวกเขาเรียกมันว่า ChatGPT. ภายในองค์กร ความคาดหวังอยู่ในระดับพอประมาณ
มันกลายเป็นแอปพลิเคชันสำหรับผู้บริโภคที่เติบโตเร็วที่สุดในประวัติศาสตร์ ถึงหนึ่งร้อยล้านผู้ใช้ในราวสองเดือน
เทคโนโลยีเบื้องหลังไม่ได้ใหม่แบบพลิกขั้ว สิ่งที่ใหม่คือ การแพ็กเกจ: กล่องแชตเรียบง่าย โมเดลที่ปรับแต่งให้ทำตามคำสั่งและสนทนาได้ และ — ที่สำคัญ — ไม่มีกำแพงในการเข้าใช้งาน ใครก็เข้าเว็บไซต์แล้วคุยกับมันได้ พ่อแม่คุณใช้ได้ ลูกคุณใช้ได้ และสำหรับคนหลายล้านคน บทสนทนาครั้งแรกนั้นคือช่วงเวลาที่ “AI” นามธรรมกลายเป็นสิ่งที่เป็นรูปธรรม ซึ่งเขียนอีเมล อธิบายการบ้าน วางแผนทริป และร่างโค้ดให้ได้
การระเบิดทางวัฒนธรรมเกิดขึ้นทันที โรงเรียนตื่นตระหนกเรื่องเรียงความ บริษัทต่าง ๆ รีบเร่งสร้าง “กลยุทธ์ AI” นักลงทุนเปิดสมุดเช็ค ผู้บริหารเทคโนโลยีทุกคนบนโลกจู่ ๆ ก็มีเรื่องหนึ่งอยู่บนสุดของวาระ ChatGPT ไม่ได้แค่เปิดตัวผลิตภัณฑ์ มันยิงปืนสตาร์ทให้การแข่งขันระดับองค์กรที่ดุเดือดที่สุดที่อุตสาหกรรมเทคเคยเห็นนับตั้งแต่สมาร์ตโฟน — อาจจะนับตั้งแต่อินเทอร์เน็ตเองด้วยซ้ำ
จากตรงนี้ ไทม์ไลน์หยุดคลานและเริ่มเบลอ
การแข่งขันทางอาวุธของโมเดลปิด (2023–2026)
เมื่อ ChatGPT พิสูจน์ตลาดได้แล้ว แล็บที่ใหญ่ที่สุดและมีทุนหนาที่สุดในโลกก็ออกศึก นี่คือ โมเดลปิด — ระบบกรรมสิทธิ์ที่เก็บเวตไว้เป็นความลับและเข้าถึงผ่านแอปกับ API แบบจ่ายเงิน พวกมันอยู่ที่ชายแดนของความสามารถดิบ และการแข่งขันระหว่างกันไม่เคยหยุด
2023 วางแบบแผนไว้ OpenAI เปิดตัว GPT-4, ก้าวกระโดดครั้งใหญ่ที่ให้เหตุผลได้ สอบวิชาชีพผ่าน และจัดการภาพได้พอ ๆ กับข้อความ Anthropic — ก่อตั้งโดยอดีตนักวิจัย OpenAI — เปิดตัว Claude, เน้นความปลอดภัย เอกสารยาว และสไตล์การสนทนาที่คิดรอบคอบกว่า Google ซึ่งถูก ChatGPT จับได้ว่ายังไม่พร้อมทั้งที่ตัวเองเป็นผู้คิดค้น Transformer ก็ตั้งหลักใหม่และส่ง Gemini. การแข่งขันสามเส้าเริ่มขึ้น
จากนั้นมันก็… ทวีความรุนแรงขึ้นเรื่อย ๆ แต่ละแล็บแซงกันไปมาทุกไม่กี่เดือน หน้าต่างบริบท — ปริมาณข้อความที่โมเดลพิจารณาได้ในครั้งเดียว — ระเบิดจากไม่กี่พันคำเป็นหนังสือทั้งเล่มและโค้ดเบสทั้งชุด โมเดลได้ความสามารถในการมองเห็นภาพ ฟังเสียง ท่องเว็บ และใช้เครื่องมือ xAI ของ Elon Musk เข้ามาพร้อมกับ Grok, เชื่อมต่อตรงเข้ากับแพลตฟอร์มโซเชียล X
การเปลี่ยนแปลงสองอย่างนิยามชายแดนในสถานะปัจจุบันเมื่อปี 2026, และมันสำคัญกว่าชื่อโมเดลใดโมเดลหนึ่ง:
หนึ่งคือการผงาดของการให้เหตุผล โมเดล “คิด” กลุ่มใหม่เรียนรู้ที่จะไล่แก้ปัญหาทีละขั้นก่อนตอบ — หยุดคิดในใจแทนที่จะโพล่งคำตอบแรกออกมา สิ่งนี้ปิดช่องว่างเก่า ๆ ส่วนใหญ่ในคณิตศาสตร์ ตรรกะ และการเขียนโค้ดที่ซับซ้อน และเปลี่ยนเบนช์มาร์กที่เคยทำให้โมเดลปี 2023 ตันให้กลายเป็นชัยชนะปกติ
สองคือการเปลี่ยนจากแชตบอตเป็นผู้ทำงาน ธีมที่นิยามปี 2026 คือ AI แบบเอเจนต์. โมเดลชั้นนำไม่ได้แค่ตอบคำถามอีกต่อไป — พวกมันลงมือทำ พวกมันใช้คอมพิวเตอร์ เขียนและดีพลอยโค้ดข้ามหลายไฟล์ รันงานหลายขั้นตอนที่กินเวลาหลายนาทีหรือหลายชั่วโมง และต่อเข้ากับระบบธุรกิจเพื่อทำงานให้เสร็จจริง ๆ อุปมาของอินเทอร์เฟซค่อย ๆ เลื่อนจาก “ผู้ช่วยที่คุณคุยด้วย” ไปเป็น “เพื่อนร่วมงานที่คุณมอบหมายงานให้”
ณ กลางปี 2026 ชายแดนฝั่งโมเดลปิดคือกลุ่มแน่น ๆ ที่จุดสูงสุด: Claude Opus 4.8 ของ Anthropic, GPT-5.5 ของ OpenAI, Gemini 3.1 Pro ของ Google และ Grok 4.3 ของ xAIโดยสี่ห้องแล็บผลัดกันขึ้นนำทุกไม่กี่สัปดาห์ <span>สิ่งที่น่าสะดุดตาที่สุดเกี่ยวกับกลุ่มผู้นำในปัจจุบันคือมันชิดกันมากแค่ไหน — ช่องว่างระหว่าง “ดีที่สุด” กับ “รองลงมา” ตอนนี้มักเป็นแค่ความคลาดเคลื่อนจากการปัดเศษ และมันเปลี่ยนมืออยู่ตลอด</span>
การแข่งขันยังกลายเป็นเรื่องภูมิรัฐศาสตร์ กลางปี 2026 โมเดลชายแดนตัวหนึ่งของ Anthropic กลายเป็น — เท่าที่ใครจะบอกได้ — ตัวแรกที่ถูกหน่วยงานกำกับสั่งปิดแล้วเปิดกลับมา ถูกระงับชั่วคราวตามคำสั่งควบคุมการส่งออกของสหรัฐฯ ก่อนการเข้าถึงจะกลับคืนมา AI ชายแดนไม่ใช่แค่หมวดผลิตภัณฑ์อีกต่อไป มันเป็นเครื่องมือของนโยบายระดับชาติ
การปฏิวัติโมเดลเปิด: เวตเพื่อทุกคน
ในขณะที่ยักษ์ใหญ่ต่อสู้กันหลัง API ของตัวเอง เรื่องราวคู่ขนานที่สำคัญพอ ๆ กันก็กำลังคลี่คลาย: การผงาดของ โมเดลเปิด.
จุดเปลี่ยนมาถึงต้นปี 2023 เมื่อ Meta เปิดตัว LLaMA, โมเดลภาษาที่มีความสามารถ ซึ่งเวตหลุดออกไปแล้วต่อมาถูกแชร์อย่างเป็นทางการกับนักวิจัย เป็นครั้งแรกที่โมเดลที่แข็งแกร่งจริง ๆ เป็นสิ่งที่คุณดาวน์โหลดได้ รันบนฮาร์ดแวร์ของตัวเอง ตรวจดูข้างใน และดัดแปลงได้ ชุมชนนักพัฒนาและนักเล่นทั่วโลกผุดขึ้นรอบ ๆ มัน สร้างคลื่นของไฟน์ทูนิงหลากหลาย การปรับแต่ง และเครื่องมืออย่างน่าทึ่ง — บ่อยครั้งเร็วกว่าที่แล็บใหญ่จะปล่อยฟีเจอร์ได้ด้วยซ้ำ
พลังของชุมชนนั้นไม่เคยแผ่ว และถึงปี 2026 ระบบนิเวศเปิดก็เติบโตเป็นคู่แข่งจริงจังของชายแดนฝั่งโมเดลปิด มีบางเรื่องที่ควรเข้าใจ:
โอเพนเวตไม่เหมือนกับโอเพนซอร์ส ความแตกต่างนี้ทำให้คนจำนวนมากสะดุด โอเพนซอร์ส หมายความว่าโค้ดสำหรับฝึก ข้อมูล และเวต ทั้งหมดออกมาภายใต้สัญญาอนุญาตแบบเปิดกว้าง โอเพนเวต หมายความว่าคุณได้ไฟล์โมเดลไปดาวน์โหลดและรัน แต่สัญญาอนุญาตอาจจำกัดวิธีที่คุณใช้ และข้อมูลสำหรับฝึกกับสูตรเต็มมักยังเป็นความลับ โมเดลส่วนใหญ่ที่คนเรียกกันเล่น ๆ ว่า “โอเพนซอร์ส” จริง ๆ แล้วเป็นโอเพนเวต ความแตกต่างนี้สำคัญมหาศาลสำหรับธุรกิจที่กังวลเรื่องการปฏิบัติตามกฎ — ซึ่งเป็นเหตุผลที่สัญญาอนุญาตกลายเป็นคุณสมบัติแข่งขันจริง ๆ สัญญาอนุญาตแบบเปิดกว้างอย่าง Apache 2.0 และ MIT (ที่ตระกูลอย่าง Qwen, DeepSeek และอื่น ๆ ใช้) เป็นที่ต้องการก็เพราะมันให้บริษัทสร้างต่อได้อย่างอิสระ
จุดศูนย์ถ่วงเคลื่อนไปทางตะวันออก โมเดลโอเพนเวตที่เก่งที่สุดบางตัวของปี 2026 มาจากแล็บจีน: DeepSeek (เป็นที่ยกย่องเรื่องการให้เหตุผลระดับชายแดนในต้นทุนต่ำอย่างน่าตกใจ), Qwen ของ Alibaba (ตระกูลที่แผ่กว้างและใช้สัญญาอนุญาตแบบเปิด ตั้งแต่โมเดลจิ๋วสำหรับแล็ปท็อปไปจนถึงระบบขนาดมหึมา), Kimi ของ Moonshot, และ GLM ของ Zhipu/Z.ai ซีรีส์ ส่วน Llama 4 ของ Meta ยึดชั้นเปิดฝั่งตะวันตก และ Gemma ของ Google ถูกออกแบบให้รันบน GPU ตัวเดียวหรือแม้แต่แล็ปท็อป และฝั่งยุโรป Mistral ก็เปลี่ยนโมเดลเรือธงของตัวเองมาใช้สัญญาอนุญาตแบบเปิดกว้าง ตอนนี้ตารางอันดับฝั่งเปิดสลับที่กันเกือบทุกเดือน — สแนปช็ตล่าสุดจัดให้โมเดลอย่าง GLM-5.2 และ Kimi รุ่นล่าสุดอยู่ที่หรือใกล้จุดสูงสุดของการจัดอันดับโมเดลเปิดอิสระ โดยมีโมเดลเปิดหลายตัวคืบเข้าไปในอาณาเขตที่เคยเป็นของชายแดนฝั่งปิดเพียงผู้เดียว
การดิ่งของราคา บางทีเรื่องราวโมเดลเปิดที่ส่งผลมากที่สุดอาจเป็นเรื่องเศรษฐกิจ การแข่งขัน — ซึ่งส่วนใหญ่ขับเคลื่อนโดยผู้ให้บริการแบบเปิดและต้นทุนต่ำเหล่านี้ — ผลักราคาของความฉลาดตกหน้าผา ความสามารถที่เมื่อสองปีก่อนมีค่าใช้จ่ายมหาศาลในรูปค่าธรรมเนียม API ตอนนี้หาได้ในราคาไม่กี่เซนต์ต่อล้านคำ หรือฟรีหากคุณโฮสต์เอง ตอนนี้นักวิเคราะห์ประเมินว่าโอเพนเวตที่ดีที่สุดตามหลังโมเดลปิดที่ดีที่สุดเพียง เดือน ในหลายเบนช์มาร์ก ไม่ใช่หลายปี สำหรับงานจริงจำนวนมหาศาล ตัวเลือกแบบเปิดตอนนี้ดีพอ ถูกพอ และเป็นส่วนตัวพอที่จะชนะ
นี่คือการปฏิวัติเงียบใต้พาดหัวข่าว ชายแดนดึงความสนใจ แต่การกลายเป็นสินค้าพื้นฐานของ AI ที่ “ดีพอ” — รันบนเซิร์ฟเวอร์ของคุณเอง ภายใต้การควบคุมของคุณเอง ด้วยต้นทุนส่วนเพิ่มเกือบศูนย์ — อาจพลิกโฉมอุตสาหกรรมได้มากกว่าโมเดลเรือธงตัวใดตัวหนึ่ง
เมื่อ AI เรียนรู้ที่จะมองและวาด: เรื่องราวของการสร้างภาพ
ภาษาเป็นเพียงครึ่งหนึ่งของการปฏิวัติ อีกครึ่งคือภาพ — และมันมาก็เร็วพอ ๆ กัน
เครื่องจักรยุคแรกของภาพ AI คือ GAN (Generative Adversarial Network) ที่เปิดตัวในปี 2014 แนวคิดอันชาญฉลาด: ให้โครงข่ายสองตัวแข่งกัน ตัวหนึ่งสร้างภาพปลอม อีกตัวพยายามจับภาพปลอม จนกว่าตัวสร้างจะเก่งจนภาพปลอมดูสมจริง GAN สร้างใบหน้าที่สมจริงจนน่าขนลุก — ยุคของ “คนพวกนี้ไม่มีอยู่จริง” — แต่ฝึกยากจุกจิกและควบคุมด้วยคำสั่งยาก
ความก้าวหน้าจริงในระดับผู้บริโภคมาจากเทคนิคอีกแบบ: โมเดลดิฟฟิวชัน, ซึ่งเรียนรู้การสร้างภาพโดยเริ่มจากสัญญาณรบกวนล้วน ๆ แล้วค่อย ๆ ขัดเกลาให้เป็นภาพที่สอดคล้องกัน โดยมีพรอมต์ข้อความเป็นตัวนำ ผลลัพธ์และกรอบเวลานั้นน่าตะลึง:
- DALL·E and DALL·E 2 (2021–2022) จาก OpenAI แสดงให้โลกเห็นว่าคุณพิมพ์ประโยคเพี้ยน ๆ — “นักบินอวกาศขี่ม้าในสไตล์สมจริงเหมือนภาพถ่าย” — แล้วได้ภาพกลับมาดีจนตกใจ
- Midjourney (2022) มาพร้อมสุนทรียะที่โดดเด่นและสวยงาม และสร้างชุมชนขนาดใหญ่ กลายเป็นคำเรียกสั้น ๆ สำหรับงานศิลปะ AI ที่สวยงาม
- Stable Diffusion (2022) ทำกับภาพในสิ่งที่ LLaMA ทำกับข้อความในภายหลัง: มันถูกปล่อยออกมาอย่างเปิดเผย ใครก็รันได้ ไฟน์ทูนได้ และสร้างต่อยอดได้ ระบบนิเวศเปิดทั้งหมดของเครื่องมือ ปลั๊กอิน และโมเดลปรับแต่งเองก็ระเบิดขึ้นในชั่วข้ามคืน
จากตรงนั้น สาขานี้ก็วิ่งเต็มสปีด โหมดล้มเหลวแบบเก่า ๆ — มือพิการ ข้อความอ่านไม่ออก ใบหน้าที่ชวนขนลุก — ถูกแก้ทีละอย่าง ถึงปี 2026 ตลาดการสร้างภาพแตกเป็นค่ายชัดเจน และคุณภาพสูงพอที่ผลลัพธ์จะผ่านสายตามนุษย์ทั่วไปได้เป็นปกติ:
- Midjourney (ตอนนี้อยู่สาย V8) ยังเป็นที่ชื่นชอบด้านสุนทรียะสำหรับงานศิลปะจัดสไตล์ที่หยุดนิ้วคนเลื่อนฟีดได้
- GPT Image ของ OpenAI โมเดล (ทายาทของ DALL·E ตอนนี้ฝังอยู่ใน ChatGPT เลย) นำด้านการทำตามคำสั่งที่ซับซ้อนและการเรนเดอร์ข้อความในภาพได้ถูกต้อง — ปัญหาที่กัดกินทุกโมเดลมาหลายปี
- FLUX ของ Black Forest Labs กลายเป็นแชมป์ฝั่งโอเพนเวต เทียบได้กับโมเดลปิดระดับพรีเมียมในด้านความสมจริงเหมือนภาพถ่ายด้วยต้นทุนเพียงเศษเสี้ยว และดึงผู้ใช้โอเพนซอร์สจริงจังส่วนใหญ่ออกจากบิลด์ Stable Diffusion รุ่นเก่า
- Imagen ของ Google และ “Nano Banana” โมเดล และ Firefly ของ Adobe (ฝึกด้วยข้อมูลที่ได้รับอนุญาต ซึ่งองค์กรธุรกิจชอบเพราะปลอดภัยทางกฎหมาย) เติมเต็มสนามระดับมืออาชีพ
- และเช่นเดียวกับเรื่องราวของ LLM, โมเดลจีน อย่าง Seedream ของ ByteDance พุ่งขึ้นในตารางอันดับ
ชายแดนไม่ใช่แค่เรื่องการสร้างภาพสวย ๆ อีกต่อไป มันเป็นเรื่องของ การแก้ไขภาพ — เลือกพื้นที่แล้วสั่งให้เปลี่ยนผ่านบทสนทนา — และเรื่องของ ความสม่ำเสมอ, การรักษาตัวละครหรือสินค้าเดียวกันให้เหมือนกันในภาพหลายสิบภาพ การสร้างภาพด้วย AI เปลี่ยนจากของแปลกใหม่เป็นเครื่องมือผลิตระดับมืออาชีพในราวสี่ปี
เมื่อ AI เรียนรู้ที่จะเคลื่อนไหว: การผงาดของวิดีโอ AI
หากภาพคือปาฏิหาริย์เมื่อสี่ปีก่อน วิดีโอคือปาฏิหาริย์ของยุคนี้ และไม่มีอะไรจับความเร็วจริง ๆ ของความก้าวหน้า AI ได้ดีเท่าการดู text-to-video เปลี่ยนจากตัวตลกเป็นภัยคุกคามต่ออุตสาหกรรมภาพยนตร์ในเวลาไม่ถึงสามปี
เมื่อไม่นานถึงปี 2023 “วิดีโอ AI” หมายถึงการเคลื่อนไหวเบลอ ๆ กะพริบ ๆ ไม่กี่วินาที กับใบหน้าที่ละลายและวัตถุที่แปลงเป็นเรื่องไร้สาระระหว่างเฟรม มันเป็นของแปลกให้ดูเล่น ไม่ใช่เครื่องมือ
จากนั้นต้นปี 2024 OpenAI ก็เปิดพรีวิว Sora, และบทสนทนาก็เปลี่ยนทันที คลิปของมันสมจริงเหมือนภาพถ่าย ต่อเนื่องสอดคล้องตามเวลา และเป็นภาพยนตร์ในแบบที่รู้สึกเหมือนกระโดดข้ามความก้าวหน้าที่คาดไว้ไปหลายปี คู่แข่งทุกรายเริ่มไล่ตามมาตรฐานนั้นทันที
การไล่ตามนั้นสร้างสนามที่น่าทึ่ง ถึงปี 2026 ผู้ท้าชิงจริงจังได้แก่ Veo ของ Google, Gen-4 ของ Runway สาย (ที่ถูกประกอบเข้าในสภาพแวดล้อมการตัดต่อสร้างสรรค์เต็มรูปแบบ แทนที่จะขายเป็นโมเดลเปล่า ๆ) และคลื่นของโมเดลจีนทรงพลัง — Kling (Kuaishou), Seedance (ByteDance) และอื่น ๆ — ที่ตอนนี้ครองอันดับต้น ๆ ของตารางจัดอันดับคุณภาพวิดีโออิสระ มาตรฐานเทคนิคขยับเร็ว: เสียงที่ซิงก์กัน — รวมถึงบทสนทนาที่สร้างขึ้นพร้อมการขยับปากที่ตรงกันในหลายภาษา — เปลี่ยนจากนิยายวิทยาศาสตร์เป็นฟีเจอร์มาตรฐานในราวหนึ่งปี
จุดพลิกที่ไม่มีใครคาด: Sora โมเดลที่เริ่มการแข่งขัน ถูกปิดตัวลง OpenAI ยกเลิกประสบการณ์ Sora บนเว็บและแอปในเดือนเมษายน 2026 โดย API ตามมาทีหลังในปีเดียวกัน เครื่องมือที่กำหนดจังหวะถูกแซงและปลดระวาง ในขณะที่สนามที่มันจุดประกายยังคงคำรนไปข้างหน้า — สัญลักษณ์ที่เกือบสมบูรณ์แบบของความเร็วอันโหดร้ายของวงการนี้ ตั้งมาตรฐานไว้ แล้วสิบแปดเดือนต่อมาคุณอาจกลายเป็นเบนช์มาร์กตกยุค
ทุกวันนี้ คนทำธุรกิจคนเดียวที่มีพรอมต์ข้อความและงบประมาณพอประมาณสามารถสร้างฟุตเทจที่ครั้งหนึ่งต้องใช้สถานที่ ทีมงาน และงบประมาณห้าหลักได้ เทคโนโลยียังมีขีดจำกัดจริง — ฟิสิกส์ที่เพี้ยน ความสม่ำเสมอตลอดฉากยาว และคำถามทางกฎหมายกับจริยธรรมที่จริงจังเรื่องภาพลักษณ์บุคคลและการเปิดเผย — แต่วิถีนั้นชัดเจนไม่ผิด
เหนือกว่าข้อความและพิกเซล: เสียง มัลติโมดัล และยุคของเอเจนต์
หมวดหมู่เรียบร้อยที่บทความนี้ใช้ — ข้อความ ภาพ วิดีโอ — จริง ๆ แล้วกำลังละลายไปแล้ว ทิศทางที่นิยามยุคปัจจุบันคือความสามารถเหล่านี้กำลังหลอมรวมเป็นระบบเดียวที่เป็นหนึ่งเดียว
มัลติโมดัล คือชื่อทางเทคนิค โมเดลชายแดนของปี 2026 ไม่ใช่โมเดลข้อความที่เอาฟีเจอร์ภาพมาต่อเพิ่ม พวกมันมองเห็น อ่าน ฟัง และสร้างสรรค์ข้ามรูปแบบได้โดยกำเนิดในกระแสเดียวต่อเนื่อง คุณโชว์รูปตู้เย็นให้มันดูแล้วขอสูตรอาหาร แชร์สกรีนช็อตของบั๊กแล้วได้วิธีแก้ หรือพูดกับมันแล้วให้มันตอบกลับด้วยเสียงที่เป็นธรรมชาติ ถูกขัดจังหวะได้ และแทบไม่มีดีเลย์ ลูปเก่า ๆ ที่งุ่มง่ามอย่าง “พิมพ์ รอ อ่าน” กำลังเปิดทางให้สิ่งที่รู้สึกเหมือนคุยกับคนที่เก่งจริง ๆ มากกว่า
และยังมี เอเจนต์ — ธีมที่ร้อยเรื่องราวทั้งหมดของปี 2026 เข้าด้วยกัน เอเจนต์คือระบบ AI ที่ไม่ได้แค่ตอบสนอง แต่ ลงมือทำ: มันวางแผนงานหลายขั้นตอน ใช้เครื่องมือและซอฟต์แวร์ ตรวจงานของตัวเอง และพางานไปจนเสร็จโดยแทบไม่ต้องจูงมือ จองการเดินทาง กระทบยอดสเปรดชีตกับแหล่งข้อมูลสามแหล่ง รีแฟกเตอร์โค้ดเบส ทำโปรเจกต์วิจัยข้ามหน้าเว็บหลายสิบหน้า — สิ่งเหล่านี้กำลังย้ายจาก “เดโม” ไปเป็น “เวิร์กโฟลว์ประจำวัน” อินเทอร์เฟซกำลังเปลี่ยนจากหน้าต่างแชตเป็นคิวการมอบหมายงาน
นี่คือเส้นด้ายที่ร้อยเรียงประวัติศาสตร์ทั้งหมดของ AI’s มาจนถึงข้อสรุปตามตรรกะของมัน เราก้าวจาก การเขียนโปรแกรม คอมพิวเตอร์ด้วยกฎที่ระบุไว้ชัดเจน ไปสู่การ ฝึก มันด้วยข้อมูล ไปสู่การ สนทนา กับมันด้วยภาษาธรรมดา ไปสู่ — ตอนนี้ — การมอบหมาย งานจริงให้กับมัน แต่ละก้าวลดความฝืดระหว่างความตั้งใจของมนุษย์กับผลลัพธ์ที่เสร็จสมบูรณ์ลงหนึ่งชั้น เอเจนต์คือพรมแดนล่าสุดของการลดความฝืดนั้น
ทำไม AI ถึงเดินหน้าเร็วขนาดนี้?
ถอยออกมาจากชื่อโมเดลและหมายเลขเวอร์ชัน แล้วคำถามหนึ่งก็ผุดขึ้นมาตามธรรมชาติ: หลังจากคลานมาห้าสิบปี ทำไม AI จึง วิ่งพรวดขึ้นมา? แรงไม่กี่อย่างได้มาบรรจบกัน และการบรรจบกันนั้นเอง — ไม่ใช่แรงใดแรงหนึ่ง — ที่จุดชนวน
พลังประมวลผลกลายเป็นเรื่องเหลือเชื่อทั้งด้านความแรงและความอุดมสมบูรณ์ GPU ตัวเดียวกับที่เรนเดอร์วิดีโอเกมกลายเป็นสิ่งที่สมบูรณ์แบบสำหรับการฝึกโครงข่ายประสาทเทียม เมื่อชิปดีขึ้นและศูนย์ข้อมูลขยายขนาด พลังดิบที่ใช้ฝึก AI ก็เติบโตแบบทวีคูณ แนวคิดที่ฟังดูสมเหตุสมผลในทางทฤษฎีเมื่อทศวรรษ 1990 กลับรันไม่ได้เลยจนกว่าฮาร์ดแวร์จะตามทัน
ข้อมูลกลายเป็นสายน้ำที่พุ่งเข้ามาไม่หยุด อินเทอร์เน็ตใช้เวลาสามสิบปีสะสมคลังข้อความ ภาพ และวิดีโอของมนุษย์จนแทบไร้ขีดจำกัด บันทึกความรู้และการแสดงออกของมนุษย์ที่ทั้งกว้างใหญ่และไม่เป็นระเบียบนั้นกลายเป็นวัตถุดิบในการฝึก ไม่มีอินเทอร์เน็ต ก็ไม่มี AI สมัยใหม่
Transformer ปลดล็อกการขยายขนาด อย่างที่เราเห็น สถาปัตยกรรมปี 2017 ทำให้สามารถแปลงพลังประมวลผลและข้อมูลที่มากขึ้นให้เป็นความสามารถที่มากขึ้นได้อย่างไว้ใจได้ ความสามารถคาดเดาได้นี้เปลี่ยนการวิจัยให้กลายเป็นสิ่งที่ใกล้เคียงวิศวกรรมมากขึ้น — และปัญหาทางวิศวกรรมจะถูกแก้ได้เร็วเมื่อมีเงินเข้ามา
เงินก็ไหลเข้ามา ChatGPT พิสูจน์ว่ามีตลาดขนาดมหึมา และทุนก็หลั่งไหลเข้ามา เงินหลายหมื่นล้านดอลลาร์ทุ่มลงไปที่ห้องแล็บ ชิป และบุคลากร เงินทุนนั้นบีบกรอบเวลาซึ่งปกติต้องยืดออกไปหลายทศวรรษให้สั้นลง
การแข่งขันที่ดุเดือดกำหนดจังหวะ เมื่อ OpenAI, Google, Anthropic, Meta, xAI และห้องแล็บจีนอีกนับสิบต่างแข่งกัน ไม่มีใครชะลอได้ ความนำที่ใช้เวลาหกเดือนสร้างอาจหายไปภายในหกสัปดาห์ แรงกดดันนั้นคือเหตุผลที่คุณเห็นโมเดลเรือธงตัวใหม่แทบทุกครั้งที่เปิดดูข่าว
ระบบนิเวศแบบเปิดทวีความพยายามขึ้นหลายเท่า ทุกโมเดลที่เปิดเผยออกมาทำให้นักพัฒนาอิสระหลายพันคนกลายเป็นทีม R&D ที่ไม่ได้รับค่าจ้าง สติปัญญารวมหมู่ของชุมชนโอเพนซอร์สทั่วโลกเร่งความก้าวหน้าในแบบที่บริษัทเดียวไม่อาจเทียบได้ และดันราคาของ AI ให้ลงไปแตะพื้น
เมื่อรวมกันทั้งหมด คุณจะได้เส้นโค้งความสามารถที่ชันที่สุดเท่าที่เทคโนโลยีเคยสร้างมา มันไม่ค่อยเหมือนสิ่งประดิษฐ์ชิ้นเดียว แต่เหมือนปฏิกิริยาลูกโซ่มากกว่า
AI จะไปทางไหนต่อ
การทำนายอนาคตของ AI’s เป็นวิธีที่ดีเยี่ยมที่จะทำให้ตัวเองดูโง่ในอีกหกเดือน — บทความนี้ได้บันทึกไว้ว่าผู้เชี่ยวชาญถูกทำให้ประหลาดใจบ่อยแค่ไหน แต่เส้นทางปัจจุบันชี้ไปที่บางสิ่งด้วยความมั่นใจในระดับที่สมเหตุสมผล
เอเจนต์กลายเป็นของจริง ระยะต่อไปไม่ได้เน้นที่โมเดลที่ รู้ มากขึ้นเรื่อย ๆ แต่อยู่ที่ระบบที่ ต้อง ทำได้มากขึ้นอย่างไว้ใจได้ — ทำงานยาว ซับซ้อน และหลายขั้นตอนได้ด้วยความเป็นอิสระจริง คาดได้เลยว่ากรอบแนวคิด “พนักงาน AI” จะยิ่งเข้มข้นขึ้น พร้อมกับคำถามยาก ๆ เรื่องการกำกับดูแล ความน่าเชื่อถือ และอนาคตของงานที่สร้างขึ้นจากภารกิจซึ่งเอเจนต์จัดการได้แล้ว
ความฉลาดยังถูกลงเรื่อย ๆ ราคาที่ดิ่งลงยังไม่จบ เมื่อโมเดลเปิดไล่ช่องว่างแคบลงและประสิทธิภาพดีขึ้น AI ที่มีความสามารถก็มีแนวโน้มจะเกือบฟรีและรันในเครื่อง — บนสมาร์ตโฟน แล็ปท็อป หรือเซิร์ฟเวอร์ของคุณเอง การกลายเป็นสินค้าโภคภัณฑ์นี้อาจเปลี่ยนโฉมทั้งอุตสาหกรรมอย่างเงียบกว่าและทั่วถึงกว่าที่โมเดลพาดหัวตัวใดตัวหนึ่งจะทำได้
เส้นแบ่งยังคงละลายหายไป ข้อความ ภาพ เสียง และวิดีโอกำลังหลอมรวมเป็นระบบเดียว และ “การใช้ AI” จะรู้สึกเหมือนไปใช้เครื่องมือน้อยลง และเหมือนความสามารถที่ถูกทอไว้อย่างมองไม่เห็นในทุกสิ่งที่คุณทำอยู่แล้วมากขึ้น
การกำกับดูแลก้าวขึ้นมาเป็นจุดสนใจหลัก การสั่งปิดโมเดลแนวหน้าตามกฎระเบียบชั่วคราวในปี 2026 เป็นเพียงตัวอย่างล่วงหน้า เมื่อ AI กลายเป็นโครงสร้างพื้นฐานสำคัญและเป็นเครื่องมือของอำนาจภูมิรัฐศาสตร์ คำถามเรื่องความปลอดภัย ลิขสิทธิ์ การควบคุม และยุทธศาสตร์ชาติจะกำหนดทิศทางของวงการไม่แพ้ความก้าวหน้าในการวิจัยใด ๆ การแข่งขันทางเทคนิคกับการแข่งขันทางนโยบายตอนนี้เป็นการแข่งขันเดียวกัน
คำทำนายเดียวที่ปลอดภัยคือความเร็วนั้นไม่ช้าลง ทุกบทของประวัติศาสตร์นี้ถูกเขียนโดยคนที่มั่นใจและประเมินว่าบทต่อไปจะมาถึงเร็วแค่ไหนต่ำเกินไป
คำถามที่พบบ่อย
AI สมัยใหม่เริ่มต้นขึ้นจริงเมื่อไร แนวคิดนี้มีมาตั้งแต่ทศวรรษ 1950 แต่ยุคการเรียนรู้เชิงลึกสมัยใหม่มักถูกสาวไปถึงปี 2012 เมื่อโครงข่ายประสาทเทียม AlexNet ครองการแข่งขันจดจำภาพและพิสูจน์ว่าโครงข่ายเชิงลึกบวกข้อมูลมหาศาลบวกพลังประมวลผลจาก GPU คือสูตรที่ชนะ ความเฟื่องฟูที่สาธารณชนมองเห็นเริ่มขึ้นภายหลัง ด้วยการเปิดตัว ChatGPT’s ในเดือนพฤศจิกายน 2022
โมเดล AI แบบเปิดกับแบบปิดต่างกันอย่างไร โมเดลแบบปิด (อย่าง GPT-5.5, Claude และ Gemini) เก็บน้ำหนักโมเดลไว้เป็นความลับและใช้งานผ่านแอปหรือ API แบบจ่ายเงิน ส่วนโมเดลแบบเปิด (อย่าง Llama, DeepSeek, Qwen และ GLM) เปิดเผยน้ำหนักโมเดลให้ใครก็ดาวน์โหลด รัน และดัดแปลงได้ รายละเอียดสำคัญ: “โอเพนเวต” หมายถึงคุณได้ไฟล์โมเดล ขณะที่ “โอเพนซอร์ส” แท้จริงยังรวมถึงโค้ดและข้อมูลที่ใช้ฝึกด้วย — โมเดลที่ถูกเรียกว่าโอเพนซอร์สส่วนใหญ่จริง ๆ แล้วเป็นเพียงโอเพนเวต
ความก้าวหน้าครั้งสำคัญที่สุดในประวัติศาสตร์ AI คืออะไร นักวิจัยจำนวนมากชี้ไปที่สถาปัตยกรรม Transformer ปี 2017 ที่นำเสนอในบทความ Attention Is All You Needมันทำให้โมเดลขยายขนาดได้และฝึกได้อย่างมีประสิทธิภาพ และเป็นรากฐานของระบบ AI สำคัญแทบทุกตัวที่ใช้งานอยู่ในปัจจุบัน ตั้งแต่แชตบอตไปจนถึงเครื่องสร้างภาพ
การสร้างภาพและวิดีโอด้วย AI เก่งขึ้นเร็วขนาดนี้ได้อย่างไร การสร้างภาพกระโดดไปข้างหน้าด้วยโมเดล diffusion ราวปี 2021–2022 (DALL·E, Midjourney, Stable Diffusion) แล้วแก้ปัญหาเก่า ๆ อย่างมือเบี้ยวและข้อความที่อ่านไม่ออกได้อย่างรวดเร็ว วิดีโอตามมาในเส้นโค้งคล้ายกัน จากภาพเคลื่อนไหวเบลอ ๆ ไม่กี่วินาทีในปี 2023 สู่คลิปสมจริงระดับภาพถ่ายที่เสียงตรงกันภายในปี 2026 โดยมีการแข่งขันที่ดุเดือดระหว่างโมเดลอย่าง Veo, Runway, Kling และ Seedance เป็นแรงขับ
ความก้าวหน้าของ AI กำลังจะช้าลงหรือไม่ ยังไม่มีสัญญาณใด ๆ เลย การรวมกันของพลังประมวลผลที่อุดมสมบูรณ์ การลงทุนมหาศาล การแข่งขันที่ดุเดือดระหว่างห้องแล็บ และชุมชนโอเพนซอร์สที่เฟื่องฟู ยังคงดันจังหวะให้เร็วขึ้น ถ้าประวัติศาสตร์ข้างต้นสอนอะไรได้อย่างหนึ่ง นั่นคือคลื่นลูกต่อไปมาถึงเร็วกว่าที่ใครจะคาดคิดเสมอ


