
 Русский
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 العربية
 हिन्दी

В 2012 году лучшие в мире системы компьютерного зрения всё ещё путались, где собака, а где кошка. В 2026 году вы можете набрать одно предложение и увидеть, как фотореалистичный тридцатисекундный фильм собирается сам — движение камеры, кинематографический свет, синхронизированная речь и всё прочее — быстрее, чем успеете налить кофе.
Это не десять лет размеренного прогресса. Это другая планета.
История того, как искусственный интеллект дошёл до нынешнего состояния, — одна из самых странных кривых ускорения в истории технологий. Пятьдесят лет он полз. А потом примерно за десять лет промчался мимо рубежей, которые исследователи когда-то считали делом будущих поколений. Если у вас было ощущение хлыста, когда вы пытались успевать — новые названия моделей каждые несколько недель, возможности, казавшиеся невозможными прошлой весной, к лету становятся бесплатными функциями — вам это не кажется. Темп действительно такой, и он всё ещё растёт.
Это полная, человеческая история этого ускорения: откуда взялся ИИ, несколько прорывов, которые изменили всё, гонка вооружений между закрытыми и открытыми моделями, подъём генерации изображений и видео с помощью ИИ и куда всё это движется дальше.
Берите кофе. Материал длинный.
Содержание
- Долгая и медленная дорога: ИИ до бума (1950–2011)
- Искра: как зажглось глубокое обучение в 2012 году
- Архитектура, которая изменила всё: трансформеры (2017)
- Эпоха GPT и рождение современной LLM (2018–2022)
- ChatGPT: неделя, когда ИИ стал массовым
- Гонка вооружений закрытых моделей (2023–2026)
- Революция открытых моделей: веса для всех
- Когда ИИ научился видеть и рисовать: история генерации изображений
- Когда ИИ научился двигаться: подъём ИИ-видео
- За пределами текста и пикселей: голос, мультимодальность и эпоха агентов
- Почему ИИ вдруг пошёл так быстро?
- Куда дальше движется ИИ
- Часто задаваемые вопросы
Долгая и медленная дорога: ИИ до бума (1950–2011)
Легко подумать, что искусственный интеллект изобрели где-то в 2022 году. Это не так. Мечте почти столько же лет, сколько самому современному компьютеру.
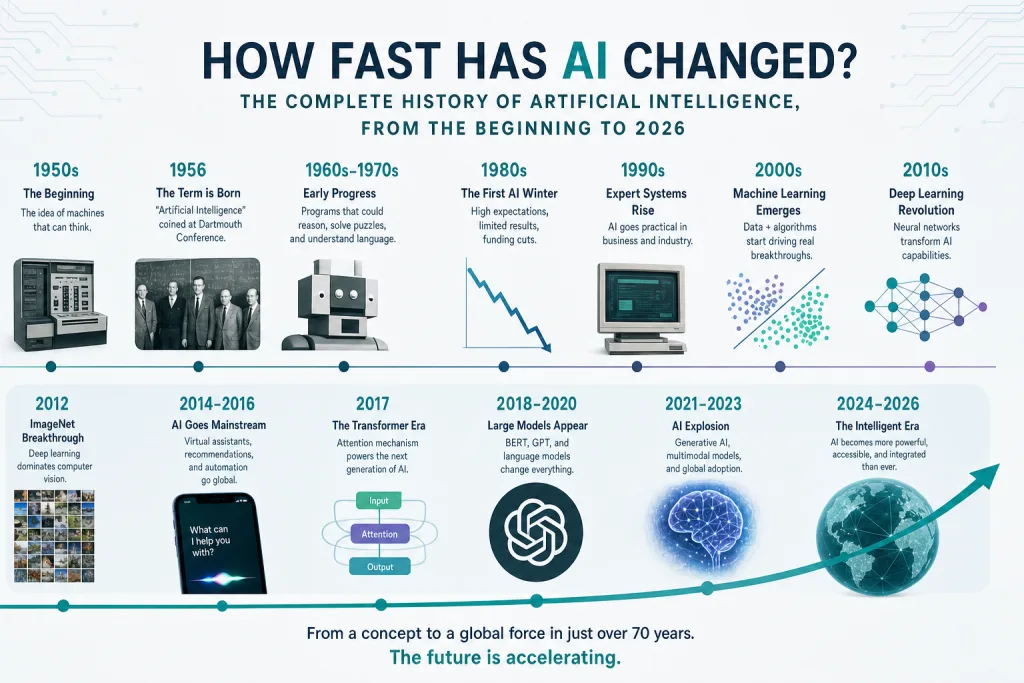
В 1950 году Алан Тьюринг задал обманчиво простой вопрос — могут ли машины мыслить? — и предложил ‘игру в имитацию’, которую мы теперь называем тестом Тьюринга. Шесть лет спустя летний семинар в Дартмутском колледже дал области её название и основополагающий оптимизм. Первые пионеры считали, что мыслящая машина появится лет через двадцать. Они ошиблись примерно на полвека, и этот просчёт определил первые несколько десятилетий существования области.
Ранним подходом был символьный ИИ: идея, что интеллект можно заключить в явных правилах, логике и вручную закодированных знаниях. Если просто записать достаточно «если — то»-операторов , рассуждение последовало бы само. Это дало несколько действительно полезных “экспертных систем” в 1970-х и 80-х — программ, способных диагностировать некоторые болезни или настраивать заказы компьютеров — но подход упёрся в стену. Реальный мир слишком хаотичен, слишком полон исключений, чтобы его можно было охватить правилами, которые человек набирает вручную.
Когда обещания обогнали результаты, финансирование иссякло. Область пережила два долгих холодных периода, которые теперь называют зимами ИИ, когда “ИИ” стало почти ругательством среди серьёзных исследователей, не желавших, чтобы их заявки на гранты выбрасывали в мусор.
Но тихо, на обочине, выживала другая идея: машинное обучение. Что если вместо того, чтобы вручную программировать интеллект, позволить системе выучить закономерности из данных? Нейронные сети — лишь отдалённо вдохновлённые мозгом — существовали с 1950-х, но им не хватало вычислений, и их в основном отвергали. В 90-х и 2000-х статистическое машинное обучение работало в спам-фильтрах, рекомендательных системах и поисковых рейтингах. Оно работало, приносило деньги, и почти никто вне области не называл его “ИИ.” Это было просто… программное обеспечение, которое становилось лучше с большим объёмом данных.
Фигуры уже стояли на доске. Им нужен был только подходящий момент.
Искра: как зажглось глубокое обучение в 2012 году
Если вам нужна одна дата, с которой начинается современная эпоха, сильный кандидат — 2012.
В том году нейронная сеть под названием AlexNet вошла в соревнование ImageNet — ежегодный конкурс на правильную разметку миллионов изображений — и не просто победила. Она победила с огромным отрывом, снизив долю ошибок настолько резко, что результат выглядел как опечатка. Она использовала “глубокую” нейронную сеть (много слоёв, наложенных друг на друга), обученную на видеокартах, или GPU, которые как раз отлично справлялись с тем видом параллельных вычислений, какой нужен нейронным сетям.
Это сочетание — большие данные, глубокие сети и дешёвые параллельные вычисления — и стало искрой. Внезапно подход на нейросетях, который десятилетиями отвергали, оказался не просто жизнеспособным, а доминирующим. За несколько лет глубокое обучение обошло старые методы в распознавании изображений, распознавании речи и переводе. Технологические гиганты это заметили. Они начали нанимать всех исследователей глубокого обучения, каких могли найти, и направлять на эту задачу огромные бюджеты вычислений.
Впервые стратегия “дать более крупной сети больше данных и больше вычислений” работала надёжно. Это понимание вскоре изменило всю отрасль — но области всё ещё не хватало одного важнейшего компонента, чтобы как следует работать с языком.
Архитектура, которая изменила всё: трансформеры (2017)
Вот прорыв, о котором почти никто за пределами ИИ не слышал, хотя он лежит в основе почти всего, чем вы сейчас пользуетесь.
В 2017 году команда исследователей Google опубликовала статью с дерзким названием: Внимание — это всё, что нужно. В ней представили Transformer, новую архитектуру нейросети, построенную вокруг механизма под названием внимание — способ для модели оценить, насколько каждое слово в предложении связано с каждым другим, сразу и параллельно.
Звучит абстрактно, поэтому объясню, почему это было важно. Прежние языковые модели обрабатывали текст по одному слову, последовательно, из-за чего медленно обучались и теряли нить на длинных фрагментах. Transformer обрабатывал всё параллельно и мог удерживать в “уме” связи на больших расстояниях. Он быстрее обучался, прекрасно масштабировался с ростом данных и вычислений и — что критично — становился лучше лучше плавно и предсказуемо по мере того, как вы делали его больше.
Именно это последнее свойство — тихий двигатель всего бума. Исследователи обнаружили то, что стало известно как законы масштабирования: добавьте больше параметров, больше данных и больше вычислений — и качество растёт по надёжной кривой. Для области, которая десятилетиями искала хитрые приёмы, это было почти слишком хорошо. Вам не нужна была новая идея каждый год. Нужна была увеличенная версия той же идеи. Transformer превратил интеллект в то, что можно в значительной степени купить.
Каждая крупная языковая модель, о которой вы слышали — GPT, Claude, Gemini, Llama, DeepSeek, Qwen и остальные — это Transformer или его близкий потомок. Та статья 2017 года — тот шарнир, вокруг которого вращается современный мир.
Эпоха GPT и рождение современной LLM (2018–2022)
Молодая лаборатория OpenAI отнеслась к ставке на законы масштабирования серьёзнее почти всех. Их тезис был простым и по тем временам спорным: возьмите Transformer, обучите его на ошеломляющем объёме интернет-текста предсказывать следующее слово, сделайте его огромным и посмотрите, что получится.
Результаты приходили нарастающими волнами:
- GPT-1 (2018) доказала концепцию в скромных масштабах.
- GPT-2 (2019) достаточно хорошо генерировала связные абзацы, что OpenAI поначалу не решалась выпустить полную модель, ссылаясь на опасения злоупотреблений — решение, которое наделало заголовков и вызвало немало усмешек, но также показало, что что-то изменилось.
- GPT-3 (2020) стала потрясением. При 175 миллиардах параметров она могла писать эссе, отвечать на вопросы, выдавать работающий код и имитировать стили — и всё это без специального обучения ни одной из этих задач. Она освоила их как побочный эффект обучения предсказанию текста. Разработчики, получившие ранний доступ, говорили о ней так, как люди говорят о фокусе, который не могут объяснить.
Здесь происходило нечто глубокое. Никто не программировал GPT-3 писать стихи или отлаживать Python. Эти способности появились из масштаба. Модель просто пыталась угадать следующее слово и, достигнув в этом большого мастерства, впитала рабочее приближение грамматики, фактов, рассуждений и стиля. Это свойство — способности, появляющиеся сами собой по мере роста моделей — называется эмерджентностью, и именно поэтому даже исследователи, создающие эти системы, регулярно удивляются тому, что они умеют.
К 2022 году мощные языковые модели уже существовали. Но они жили за API для разработчиков, говорили грубо и порой безумно и были уделом нескольких тысяч энтузиастов. Широкая публика понятия не имела. И это должно было измениться за одну ночь.
ChatGPT: неделя, когда ИИ стал массовым
30 ноября 2022 года OpenAI выпустила бесплатную исследовательскую версию чат-бота на основе модели GPT-3.5. Его назвали ChatGPT. Внутри компании ожидания были скромными.
Он стал самым быстрорастущим потребительским приложением в истории, набрав сто миллионов пользователей примерно за два месяца.
Технология под ним не была принципиально новой. Новым была упаковка: простое окно чата, модель, настроенная следовать инструкциям и поддерживать беседу, и — что критично — никаких барьеров для входа. Любой мог зайти на сайт и поговорить с ней. Ею могли пользоваться ваши родители. Ею могли пользоваться ваши дети. И для миллионов людей тот первый разговор стал моментом, когда абстрактный “ИИ” превратился в конкретную вещь, которая может писать их письма, объяснять их домашние задания, планировать их поездки и набрасывать их код.
Культурный взрыв был мгновенным. Школы запаниковали из-за сочинений. Компании бросились составлять “ИИ-стратегии.” Инвесторы раскрыли чековые книжки. У каждого технологического руководителя на планете внезапно появился один пункт во главе повестки. ChatGPT не просто выпустил продукт — он дал стартовый выстрел самой напряжённой корпоративной гонке, какую технологическая отрасль видела со времён смартфона, а возможно, и самого интернета.
С этого места хронология перестаёт ползти и начинает размываться.
Гонка вооружений закрытых моделей (2023–2026)
Как только ChatGPT доказал существование рынка, крупнейшие и лучше всех финансируемые лаборатории мира пошли на войну. Это закрытые модели — проприетарные системы, чьи веса держатся в тайне, а доступ к ним идёт через приложения и платные API. Они находятся на переднем крае чистой производительности, и конкуренция между ними не прекращается.
2023 задали образец. OpenAI выпустила GPT-4, резкий скачок: она умела рассуждать, сдавать профессиональные экзамены и работать с изображениями наравне с текстом. Anthropic, основанная бывшими исследователями OpenAI, выпустила Claude, делая упор на безопасность, длинные документы и более вдумчивый стиль общения. Google, застигнутую врасплох ChatGPT, несмотря на то что именно она изобрела Transformer, перегруппировалась и выпустила Gemini. Гонка трёх началась.
А потом это просто… продолжало нарастать. Каждая лаборатория перепрыгивала остальных каждые несколько месяцев. Контекстные окна — сколько текста модель может учитывать за раз — выросли с нескольких тысяч слов до целых книг и кодовых баз. Модели научились видеть изображения, слышать звук, просматривать веб и использовать инструменты. xAI Илона Маска вошла в игру с Grok, встроенным напрямую в социальную платформу X.
Два сдвига определяют передний край, каким он сложился в 2026, и они важнее любого отдельного названия модели:
Во-первых, подъём рассуждений. Новый класс “думающих” моделей научился прорабатывать задачи шаг за шагом, прежде чем ответить, — делая паузу на внутреннее рассуждение вместо того, чтобы выпалить первый ответ. Это во многом закрыло прежний разрыв в математике, логике и сложном программировании и превратило бенчмарки, ставившие в тупик модели 2023 года, в рутинные победы.
Во-вторых, сдвиг от чат-ботов к работникам. Определяющая тема 2026 года — это agentic AI. Ведущие модели больше не просто отвечают на вопросы — они действуют. Они управляют компьютерами, пишут и развёртывают код в десятках файлов, выполняют многошаговые задачи, растягивающиеся на минуты или часы, и подключаются к бизнес-системам, чтобы реально доводить дела до конца. Метафора интерфейса тихо сместилась с “ассистента, с которым вы беседуете” на “коллегу, которому вы делегируете”.
По состоянию на середину 2026 года закрытый передний край — это плотная группа на вершине: Claude Opus 4.8 от Anthropic, GPT-5.5 от OpenAI, Gemini 3.1 Pro от Google и Grok 4.3 от xAI, причём четыре лаборатории меняются лидерством каждые несколько недель. <span>Самое поразительное в текущем верхнем уровне — насколько близко всё сблизилось: разрыв между «лучшим» и «вторым лучшим» теперь часто в пределах погрешности и постоянно переходит из рук в руки.</span>
Гонка стала ещё и геополитической. В середине 2026 года одна фронтирная модель Anthropic стала — насколько можно судить — первой в истории, которую регуляторы отключили, а затем снова включили: её ненадолго приостановили по распоряжению об экспортном контроле США, а потом доступ восстановили. Передовой ИИ больше не просто категория продуктов. Это инструмент национальной политики.
Революция открытых моделей: веса для всех
Пока гиганты сражались за своими API, разворачивалась параллельная и не менее важная история: подъём открытых моделей.
Переломный момент наступил в начале 2023 года, когда Meta выпустила LLaMA, способную языковую модель, чьи веса утекли, а затем были официально переданы исследователям. Впервые по-настоящему сильную модель можно было скачать, запустить на своём железе, изучить и изменить. Вокруг неё возникло глобальное сообщество разработчиков и энтузиастов, породившее поразительную волну дообученных вариантов, оптимизаций и инструментов — часто быстрее, чем крупные лаборатории успевали выпускать новые функции.
Эта энергия сообщества не иссякла, и к 2026 году открытая экосистема превратилась в серьёзного соперника закрытого переднего края. Несколько вещей, которые стоит понимать:
Открытые веса — это не то же самое, что открытый исходный код. Это различие сбивает с толку многих. Открытый исходный код означает, что код обучения, данные и веса поставляются под разрешительной лицензией. Открытые веса означает, что вы получаете файлы модели для скачивания и запуска, но лицензия может ограничивать их использование, а данные обучения и полный рецепт часто остаются закрытыми. Большинство моделей, которые обычно называют “открытым исходным кодом”, на деле имеют открытые веса. Эта разница огромна для компаний, озабоченных соответствием требованиям, — поэтому лицензирование стало настоящей конкурентной характеристикой. Разрешительные лицензии Apache 2.0 и MIT (их используют семейства вроде Qwen, DeepSeek и другие) ценятся именно потому, что позволяют компаниям строить свободно.
Центр тяжести сместился на Восток. Некоторые из самых мощных моделей с открытыми весами 2026 года выходят из китайских лабораторий: DeepSeek (прославилась рассуждениями уровня переднего края при шокирующе низкой цене), Qwen от Alibaba (разросшееся семейство под разрешительной лицензией — от крошечных моделей для ноутбука до массивных систем), Kimi от Moonshot, и GLM от Zhipu/Z.ai серии. Что касается Meta, её Llama 4 закрепляет западный открытый эшелон; лёгкие Gemma модели от Google рассчитаны на работу на одном GPU или даже на ноутбуке, а в Европе Mistral флагманские модели перевели на разрешительную лицензию. Открытый рейтинг теперь перетасовывается почти ежемесячно — в недавних срезах модели вроде GLM-5.2 и новейшая Kimi оказывались на самом верху или рядом с ним в независимых открытых рейтингах, а несколько открытых моделей вплотную подошли к территории, которая раньше принадлежала исключительно закрытому переднему краю.
Обвал цен. Пожалуй, самая значимая история открытых моделей — экономическая. Конкуренция, во многом вызванная этими открытыми и дешёвыми провайдерами, обрушила цену интеллекта. Возможности, которые два года назад стоили целое состояние в виде платы за API, теперь доступны за центы за миллион слов — или бесплатно при самостоятельном хостинге. Аналитики теперь оценивают, что лучшие открытые веса отстают от лучших закрытых моделей всего на несколько месяцев во многих бенчмарках, а не на годы. Для огромной массы реальных задач открытый вариант теперь достаточно хорош, достаточно дёшев и обеспечивает достаточную конфиденциальность, чтобы победить.
Это тихая революция под заголовками. Передний край привлекает внимание, но превращение в товар ИИ, “достаточно хорошего”, — работающего на ваших собственных серверах, под вашим контролем, при почти нулевых предельных издержках, — может в итоге изменить больше отраслей, чем любая отдельная флагманская модель.
Когда ИИ научился видеть и рисовать: история генерации изображений
Язык был лишь половиной революции. Другая половина была визуальной — и пришла так же быстро.
Ранним механизмом для ИИ-изображений был GAN (Generative Adversarial Network, генеративно-состязательная сеть), представленный в 2014 году. Остроумная идея: столкнуть две сети друг с другом — одна генерирует поддельные изображения, другая пытается распознать подделку, — пока генератор не станет настолько хорош, что фальшивки начнут выглядеть убедительно. GAN порождали жутковато реалистичные лица — эпоха “этих людей не существует” — но их было капризно обучать и трудно управлять ими словами.
Настоящий потребительский прорыв пришёл от другой техники: диффузионные модели, которые учатся создавать изображения, начиная с чистого шума и постепенно превращая его в связную картинку под управлением текстового промпта. Результаты — и сроки — были ошеломляющими:
- DALL·E и DALL·E 2 (2021–2022) от OpenAI показали миру, что можно набрать причудливое предложение — “космонавт верхом на лошади в фотореалистичном стиле” — и получить в ответ на удивление хорошее изображение.
- Midjourney (2022) пришёл с узнаваемой, великолепной эстетикой и собрал огромное сообщество, став синонимом красивого ИИ-арта.
- Stable Diffusion (2022) сделала для изображений то, что LLaMA позже сделала для текста: её выпустили открыто. Любой мог запустить её, дообучить и строить на её основе. Целая открытая экосистема инструментов, плагинов и кастомных моделей выросла буквально за ночь.
С этого момента отрасль рванула вперёд. Старые проблемы — искалеченные руки, бессмысленный текст, жуткие лица — решались одна за другой. К 2026 году рынок генерации изображений разделился на чёткие лагеря, а качество выросло настолько, что результаты регулярно выдерживают беглый человеческий взгляд:
- Midjourney (сейчас на линейке V8) остаётся фаворитом по эстетике для стилизованного арта, от которого невозможно оторвать взгляд.
- Модели GPT Image от OpenAI (преемники DALL·E, теперь встроенные прямо в ChatGPT) лидируют в выполнении сложных инструкций и в правильном отображении текста внутри изображений — проблеме, которая годами мучила каждую модель.
- FLUX от Black Forest Labs стал чемпионом среди моделей с открытыми весами, сравнявшись с премиальными закрытыми моделями по фотореализму за малую долю их стоимости, и увёл большинство серьёзных пользователей открытого исходного кода от старых сборок Stable Diffusion.
- Модели Imagen и “Nano Banana” от Google и Firefly от Adobe (обученная на лицензированных данных, что корпоративные клиенты ценят за юридическую безопасность) замыкают профессиональный ряд.
- И, повторяя историю с LLM, китайские модели вроде Seedream от ByteDance взлетели в рейтингах.
Передний край — это уже не просто создание красивой картинки. Речь о том, чтобы редактировать — когда вы в диалоге выделяете область и просите внести изменения — и о последовательности, когда один и тот же персонаж или продукт остаётся неизменным на десятках изображений. Генерация изображений прошла путь от диковины до профессионального инструмента производства примерно за четыре года.
Когда ИИ научился двигаться: подъём ИИ-видео
Если изображения были чудом четырёхлетней давности, то видео — чудо нынешней эпохи. И ничто не передаёт скорость прогресса ИИ лучше, чем наблюдение за тем, как генерация видео по тексту меньше чем за три года прошла путь от шутки до угрозы киноиндустрии.
Ещё в 2023 году “видео с ИИ” означало несколько секунд размытого, мерцающего движения с плывущими лицами и предметами, которые между кадрами превращались в бессмыслицу. Это была диковина, а не инструмент.
Затем, в начале 2024 года, OpenAI представила Sora, и разговор мгновенно изменился. Её ролики были фотореалистичными, связными во времени и кинематографичными настолько, что казалось, будто пропущено несколько лет ожидаемого прогресса. Каждый конкурент тут же бросился догонять эту планку.
Погоня породила впечатляющий состав игроков. К 2026 году в число серьёзных претендентов входят Veo от Google, Gen-4 от Runway (линейка, встроенная в полноценную среду творческого редактирования, а не продаваемая как отдельная модель), а также волна мощных китайских моделей — Kling (Kuaishou), Seedance (ByteDance) и другие — которые теперь доминируют в верхней части независимых рейтингов качества видео. Техническая планка росла быстро: нативный синхронизированный звук — включая сгенерированные диалоги с правильной синхронизацией губ на нескольких языках — примерно за год прошёл путь от научной фантастики до стандартной функции.
Сюжетный поворот, которого никто не предсказывал: Sora — модель, которая начала гонку, — отключили. OpenAI прекратила работу веб-версии и приложения Sora в апреле 2026 года, а API — позже в том же году. Инструмент, задававший темп, обогнали и отправили на покой, пока вдохновлённая им отрасль неслась вперёд — почти идеальный символ того, насколько безжалостно быстро движется эта сфера. Задайте планку — и через восемнадцать месяцев вы, возможно, станете устаревшим бенчмарком.
Сегодня предприниматель-одиночка с текстовым промптом и скромным бюджетом может создать материал, для которого когда-то требовались локация, съёмочная команда и пятизначный бюджет. У технологии всё ещё есть реальные ограничения — сбои физики, согласованность в длинных сценах и серьёзные юридические и этические вопросы вокруг внешности и раскрытия информации — но траектория очевидна.
За пределами текста и пикселей: голос, мультимодальность и эпоха агентов
Аккуратные категории, которыми пользуется эта статья, — текст, изображение, видео — честно говоря, уже размываются. Определяющее направление нынешней эпохи в том, что эти возможности сливаются в единые, унифицированные системы.
Мультимодальность — это техническое название. Передовые модели 2026 года — не текстовые модели с прикрученной функцией работы с изображениями; они изначально видят, читают, слышат и генерируют данные в разных форматах в едином непрерывном потоке. Можно показать одной из них фотографию своего холодильника и попросить рецепт, отправить скриншот ошибки и получить исправление или заговорить с ней и услышать в ответ естественный голос, который можно перебить, почти без задержки. Неуклюжий старый цикл “наберите, подождите, прочитайте” уступает место чему-то, что гораздо больше похоже на разговор с толковым человеком.
А ещё есть агенты — тема, которая связывает воедино всю историю 2026 года. Агент — это система ИИ, которая не просто отвечает, а действует: она планирует многошаговую задачу, использует инструменты и программы, проверяет свою работу и доводит дело до конца при минимальном вмешательстве человека. Бронирование поездок, сверка таблицы с тремя источниками данных, рефакторинг кодовой базы, ведение исследовательского проекта по десяткам веб-страниц — всё это переходит из “демо” в “ежедневный рабочий процесс”. Интерфейс переходит от окна чата к очереди поручений.
Это сквозная линия всей истории ИИ, доходящая до своего логического завершения. Мы прошли путь от программирования компьютеров с явными правилами к тому, чтобы обучению их на данных, к общению с ними на простом языке, а теперь — к делегированию им настоящей работы. Каждый шаг убирал слой трения между намерением человека и готовым результатом. Агенты — текущий рубеж этого движения.
Почему ИИ вдруг пошёл так быстро?
Отвлекитесь от названий моделей и номеров версий — и возникает естественный вопрос: почему после пятидесяти лет ползания ИИ вдруг рванул? Несколько сил сошлись вместе, и именно их совпадение — а не какая-то одна — подожгло фитиль.
Вычислительные мощности стали абсурдно большими и доступными. Те же GPU, что отрисовывают видеоигры, оказались идеальны для обучения нейронных сетей. По мере совершенствования чипов и роста дата-центров сырая вычислительная мощность, доступная для обучения ИИ, росла экспоненциально. Идеи, теоретически обоснованные в 1990-х, просто нельзя было запустить, пока железо не подтянулось.
Данные хлынули потоком. Интернет за тридцать лет накопил почти безграничный корпус человеческих текстов, изображений и видео. Эта огромная, беспорядочная запись человеческих знаний и самовыражения стала материалом для обучения. Без интернета не было бы современного ИИ.
Transformer открыл масштабирование. Как мы видели, архитектура 2017 года позволила надёжно превращать больше вычислений и больше данных в больше возможностей. Эта предсказуемость превратила исследования в нечто более близкое к инженерии — а инженерные задачи решаются быстро, когда появляются деньги.
Появились деньги. ChatGPT доказал, что рынок колоссален, и капитал хлынул внутрь. Десятки миллиардов долларов влились в лаборатории, чипы и таланты. Это финансирование сжало сроки, которые иначе растянулись бы на десятилетия.
Жёсткая конкуренция задала темп. Когда OpenAI, Google, Anthropic, Meta, xAI и десяток китайских лабораторий несутся наперегонки, никто не может позволить себе замедлиться. Преимущество, на которое ушло полгода, могло испариться за шесть недель. Именно из-за этого давления вы почти каждый раз, заглянув в новости, видите новую флагманскую модель.
Открытые экосистемы умножили усилия. Каждая открыто выпущенная модель превращала тысячи независимых разработчиков в бесплатные исследования и разработки. Коллективный разум мирового сообщества открытого исходного кода ускорял прогресс так, как не могла бы ни одна компания, и гнал цену ИИ к самому низу.
Сложите всё это вместе — и получите самую крутую кривую роста возможностей, которую когда-либо давала технология. Это меньше похоже на отдельное изобретение и больше — на цепную реакцию.
Куда дальше движется ИИ
Предсказывать будущее ИИ — отличный способ через полгода выглядеть глупо: эта статья показала, как регулярно эксперты ошибались. Но текущая траектория с разумной уверенностью указывает на несколько вещей.
Агенты становятся реальностью. Следующий этап меньше связан с моделями, которые знают больше, и всё больше — с системами, которые надёжно делать делают больше — выполняя долгую, сложную, многошаговую работу с настоящей автономностью. Ожидайте, что формулировка “ИИ-работник” будет звучать всё настойчивее, вместе с трудными вопросами о надзоре, надёжности и о том, что произойдёт с рабочими местами, которые держатся на задачах, теперь доступных агентам.
Интеллект продолжает дешеветь. Обвал цен ещё не закончен. По мере того как открытые модели сокращают разрыв, а эффективность растёт, способный ИИ движется к тому, чтобы стать почти бесплатным и работать локально — на вашем телефоне, ноутбуке, собственных серверах. Эта коммодитизация может перекроить целые отрасли тише и основательнее, чем любая отдельная громкая модель.
Границы продолжают размываться. Текст, изображение, звук и видео сходятся в единые системы, и “использование ИИ” будет ощущаться меньше как визит к инструменту и больше как возможность, незримо вплетённая во всё, что вы уже делаете.
Управление выходит на первый план. Короткая остановка фронтирной модели регулятором в 2026 году была предвестием. По мере того как ИИ становится критической инфраструктурой и рычагом геополитической силы, вопросы безопасности, авторского права, контроля и национальной стратегии будут формировать отрасль не меньше, чем любой исследовательский прорыв. Техническая гонка и гонка политик теперь одна и та же гонка.
Единственный надёжный прогноз — темп не замедлится. Каждую главу этой истории писали люди, уверенно недооценивавшие, как быстро наступит следующая.
Часто задаваемые вопросы
Когда на самом деле начался современный ИИ? Концепция восходит к 1950-м, но современную эпоху глубокого обучения обычно отсчитывают от 2012 года, когда нейронная сеть AlexNet доминировала в соревновании по распознаванию изображений и доказала, что глубокие сети плюс большие данные плюс вычисления на GPU — выигрышная комбинация. Публичный бум начался позже, с запуска ChatGPT в ноябре 2022 года.
В чём разница между открытыми и закрытыми моделями ИИ? Закрытые модели (такие как GPT-5.5, Claude и Gemini) держат свои веса в тайне, и их используют через приложения или платные API. Открытые модели (такие как Llama, DeepSeek, Qwen и GLM) делятся своими весами, так что любой может скачать, запустить и изменить их. Важный нюанс: “открытые веса” означают, что вы получаете файлы модели, тогда как настоящий “открытый исходный код” включает также код и данные для обучения — большинство так называемых моделей с открытым исходным кодом на самом деле имеют открытые веса.
Каким был самый важный прорыв в истории ИИ? Многие исследователи указывают на архитектуру Transformer 2017 года, представленную в статье Внимание — это всё, что нужно. Она сделала модели масштабируемыми и эффективными в обучении и лежит в основе практически каждой крупной системы ИИ, используемой сегодня, от чат-ботов до генераторов изображений.
Как генерация изображений и видео с помощью ИИ стала такой хорошей так быстро? Генерация изображений рванула вперёд с диффузионными моделями примерно в 2021–2022 годах (DALL·E, Midjourney, Stable Diffusion), а затем быстро решила старые проблемы вроде искажённых рук и нечитаемого текста. Видео прошло похожую кривую: от нескольких секунд размытого движения в 2023 году до фотореалистичных клипов с синхронизированным звуком к 2026 году, подгоняемое ожесточённой конкуренцией между моделями вроде Veo, Runway, Kling и Seedance.
Замедлится ли прогресс ИИ? Пока нет никаких признаков этого. Сочетание изобилия вычислений, огромных инвестиций, жёсткой конкуренции между лабораториями и процветающего сообщества открытого исходного кода продолжает подгонять темп. Если история выше чему-то и учит, так это тому, что следующая волна неизменно приходила быстрее, чем кто-либо ожидал.


