
 Português do Brasil
 English
 Deutsch
 Español
 Italiano
 Français

Em 2012, os melhores sistemas de visão computacional do planeta ainda se atrapalhavam para distinguir um cachorro de um gato. Em 2026, você digita uma frase e assiste a um filme fotorrealista de trinta segundos se montar sozinho — movimentos de câmera, iluminação cinematográfica, diálogos sincronizados e tudo o mais — em menos tempo do que leva para passar um café.
Isso não é uma década de progresso constante. Isso é outro planeta.
A história de como a inteligência artificial chegou até aqui é uma das curvas de aceleração mais estranhas da história da tecnologia. Por cinquenta anos ela rastejou. Então, em cerca de dez anos, passou correndo por marcos que os pesquisadores um dia imaginaram estar a gerações de distância. Se você tem a sensação de um chicote no pescoço tentando acompanhar — nomes novos de modelos a cada poucas semanas, recursos que pareciam impossíveis na primavera passada surgindo como funções gratuitas neste verão —, não é imaginação sua. O ritmo é mesmo esse, e continua acelerando.
Esta é a história completa e humana dessa aceleração: de onde a IA veio, o punhado de avanços que mudou tudo, a corrida armamentista entre modelos fechados e abertos, a ascensão da geração de imagens e vídeos por IA e para onde tudo isso está indo agora.
Pegue aquele café. Este texto é longo.
Índice
- A estrada longa e lenta: a IA antes do boom (1950–2011)
- A faísca: como o aprendizado profundo pegou fogo em 2012
- A arquitetura que mudou tudo: os transformers (2017)
- A era GPT e o nascimento do LLM moderno (2018–2022)
- ChatGPT: a semana em que a IA virou mainstream
- A corrida armamentista dos modelos fechados (2023–2026)
- A revolução dos modelos abertos: pesos para o povo
- Quando a IA aprendeu a ver e a pintar: a história da geração de imagens
- Quando a IA aprendeu a se mover: a ascensão do vídeo com IA
- Além do texto e dos pixels: voz, multimodalidade e a era dos agentes
- Por que a IA de repente avançou tão rápido?
- Para onde a IA vai agora
- Perguntas frequentes
A estrada longa e lenta: a IA antes do boom (1950–2011)
É tentador pensar que a inteligência artificial foi inventada por volta de 2022. Não foi. O sonho é quase tão antigo quanto o computador moderno em si.
Em 1950, Alan Turing fez uma pergunta enganosamente simples — as máquinas podem pensar? — e propôs o jogo da imitação que hoje chamamos de Teste de Turing. Seis anos depois, um workshop de verão no Dartmouth College deu à área o seu nome e o seu otimismo fundador. Os primeiros pioneiros acreditavam que uma máquina pensante estava talvez a vinte anos de distância. Eles erraram por cerca de meio século, e esse erro de cálculo definiu as primeiras décadas do campo’ de pesquisa.
A abordagem inicial era a IA simbólica: a ideia de que a inteligência podia ser capturada em regras explícitas, lógica e conhecimento codificado à mão. Se você conseguisse simplesmente anotar se-isto-então-aquilo declarações suficientes, o raciocínio viria em seguida. Isso gerou alguns “sistemas especialistas” genuinamente úteis nos anos 1970 e 80 — programas capazes de diagnosticar certas doenças ou configurar pedidos de computadores — mas esbarrou num limite. O mundo real é bagunçado demais, tem exceções demais para ser capturado por regras que um humano digita à mão.
Quando as promessas ultrapassaram os resultados, o financiamento secou. A área atravessou dois longos e frios períodos hoje conhecidos como os invernos da IA, quando “IA” virou quase uma palavra suja entre pesquisadores sérios que não queriam seus pedidos de bolsa jogados na lixeira.
Em silêncio, porém, uma ideia diferente sobrevivia à margem: aprendizado de máquina. Em vez de programar a inteligência à mão, e se você deixasse um sistema aprender padrões a partir de dados? As redes neurais — inspiradas vagamente no cérebro — existiam desde os anos 1950, mas passavam fome de poder computacional e eram em geral descartadas. Nos anos 90 e 2000, o aprendizado de máquina estatístico movia filtros de spam, mecanismos de recomendação e rankings de busca. Funcionava, dava dinheiro, e quase ninguém fora da área chamava aquilo de “IA.” Era só… software que ficava melhor com mais dados.
As peças estavam no tabuleiro. Só faltava o momento certo.
A faísca: como o aprendizado profundo pegou fogo em 2012
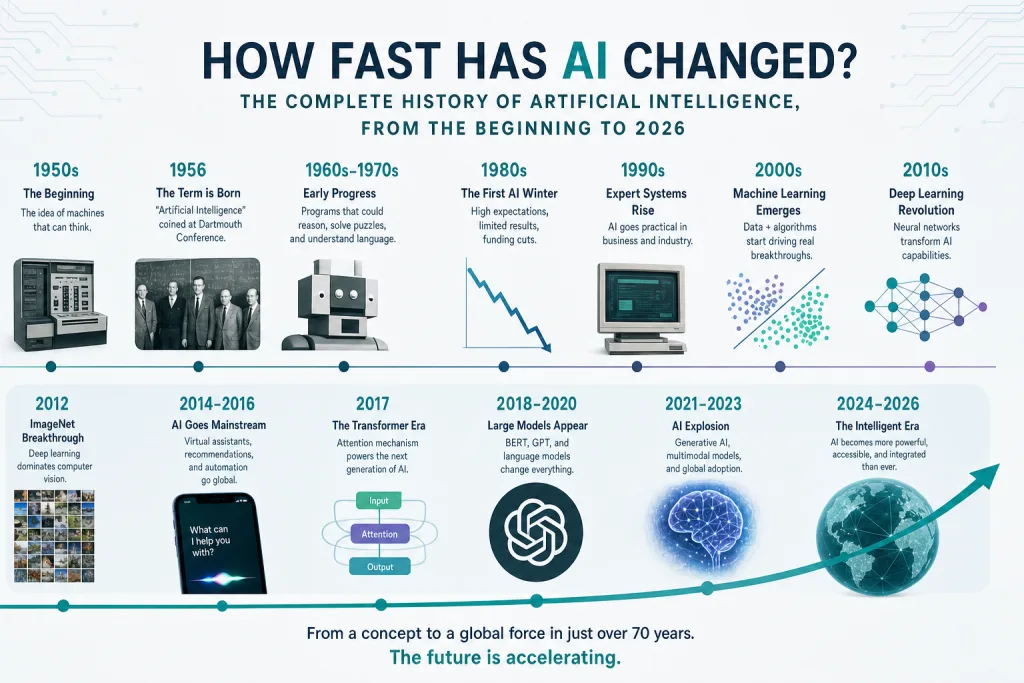
Se você quer uma única data em que a era moderna começa, um forte candidato é 2012.
Naquele ano, uma rede neural chamada AlexNet entrou na competição ImageNet — um concurso anual para rotular corretamente milhões de imagens — e não apenas venceu. Venceu de lavada, cortando a taxa de erro de forma tão dramática que o resultado parecia um erro de digitação. Ele usava uma rede neural “profunda” (muitas camadas empilhadas umas sobre as outras) treinada em placas de vídeo, ou GPUs, que por acaso eram excelentes exatamente no tipo de matemática paralela que as redes neurais exigem.
Essa combinação — big data, redes profundas e poder computacional paralelo barato — foi a faísca. De repente, a abordagem de redes neurais que tinha sido descartada por décadas não era apenas viável; era dominante. Em poucos anos, o aprendizado profundo passou por cima das técnicas mais antigas em reconhecimento de imagens, reconhecimento de fala e tradução. As gigantes da tecnologia notaram. Começaram a contratar todo pesquisador de aprendizado profundo que encontravam e a direcionar orçamentos enormes de computação para o problema.
Pela primeira vez, “jogar mais dados e mais poder computacional em uma rede maior” era uma estratégia que funcionava de forma confiável. Essa percepção logo reformularia toda a indústria — mas a área ainda carecia de um ingrediente crucial para lidar com linguagem de verdade.
A arquitetura que mudou tudo: os transformers (2017)
Aqui está o avanço que quase ninguém fora da IA já ouviu falar, embora ele sustente quase tudo o que você usa hoje.
Em 2017, uma equipe de pesquisadores do Google publicou um artigo com um título atrevido: Attention Is All You Need. Ele apresentava o Transformer, uma nova arquitetura de rede neural construída em torno de um mecanismo chamado atenção — uma forma de o modelo pesar o quanto cada palavra de uma frase se relaciona com todas as outras, tudo de uma vez, em paralelo.
Isso soa abstrato, então aqui está por que importava. Os modelos de linguagem anteriores processavam o texto uma palavra por vez, em sequência, o que os tornava lentos de treinar e esquecidos em trechos longos. Os Transformers processavam tudo em paralelo e conseguiam manter relações de longa distância na “mente”. Eram mais rápidos de treinar, escalavam lindamente com mais dados e poder computacional e — crucialmente — melhoravam melhor de forma suave e previsível à medida que você os tornava maiores.
Essa última propriedade é o motor silencioso de todo o boom. Os pesquisadores descobriram o que ficou conhecido como leis de escala: coloque mais parâmetros, mais dados e mais poder computacional, e o desempenho melhora numa curva confiável. Para uma área que passou décadas caçando truques espertos, isso era quase bom demais. Você não precisava de uma ideia nova todo ano. Precisava de uma versão maior da mesma ideia. O Transformer transformou a inteligência em algo que você podia, em boa medida, comprar.
Todo grande modelo de linguagem de que você já ouviu falar — GPT, Claude, Gemini, Llama, DeepSeek, Qwen e os demais — é um Transformer, ou um descendente próximo de um. Aquele artigo de 2017 é a dobradiça sobre a qual o mundo moderno gira.
A era GPT e o nascimento do LLM moderno (2018–2022)
Um laboratório jovem chamado OpenAI levou a aposta nas leis de escala mais a sério do que quase todo mundo. A tese deles era simples e, na época, polêmica: pegue um Transformer, treine-o com uma quantidade impressionante de texto da internet para prever a próxima palavra, deixe-o enorme e veja o que acontece.
Os resultados chegaram em ondas crescentes:
- GPT-1 (2018) provou o conceito em escala modesta.
- GPT-2 (2019) era bom o suficiente para gerar parágrafos coerentes, e a OpenAI hesitou em lançar o modelo completo, citando medo de uso indevido — uma decisão que gerou manchetes e bastante revirar de olhos, mas também sinalizou que algo tinha mudado.
- GPT-3 (2020) foi o de cair o queixo. Com 175 bilhões de parâmetros, conseguia escrever redações, responder perguntas, produzir código funcional e imitar estilos — tudo sem ter sido treinado especificamente para nenhuma dessas tarefas. Aprendeu isso como efeito colateral de aprender a prever texto. Os desenvolvedores que tiveram acesso antecipado falavam dele como as pessoas falam de um truque de mágica que não conseguem explicar.
Algo profundo estava acontecendo ali. Ninguém programou o GPT-3 para escrever poesia ou depurar Python. Essas habilidades surgiram da escala. O modelo estava simplesmente tentando adivinhar a próxima palavra e, ao ficar muito bom nisso, absorveu uma aproximação funcional de gramática, fatos, raciocínio e estilo. Essa propriedade — capacidades que aparecem sem serem pedidas conforme os modelos crescem — se chama emergência, e é por isso que até os pesquisadores que constroem esses sistemas se surpreendem rotineiramente com o que eles conseguem fazer.
Em 2022, já existiam modelos de linguagem poderosos. Mas eles viviam atrás de APIs para desenvolvedores, falavam de forma crua e às vezes desvairada, e eram domínio de alguns milhares de entusiastas. O público geral não fazia ideia. Isso estava prestes a mudar da noite para o dia.
ChatGPT: a semana em que a IA virou mainstream
Em 30 de novembro de 2022, a OpenAI lançou uma prévia de pesquisa gratuita de um chatbot construído sobre seu modelo GPT-3.5. Deram a ele o nome de ChatGPT. Internamente, as expectativas eram modestas.
Ele se tornou o aplicativo de consumo que mais cresceu rápido na história, alcançando cem milhões de usuários em cerca de dois meses.
A tecnologia por baixo não era radicalmente nova. O que era novo era o empacotamento: uma caixa de chat simples, um modelo ajustado para seguir instruções e manter uma conversa e — crucialmente — nenhuma barreira de entrada. Qualquer pessoa podia entrar num site e conversar com ele. Seus pais podiam usar. Seus filhos podiam usar. E, para milhões de pessoas, aquela primeira conversa foi o momento em que a “IA” abstrata virou uma coisa concreta, capaz de escrever seus e-mails, explicar o dever de casa, planejar suas viagens e rascunhar seu código.
A detonação cultural foi instantânea. Escolas entraram em pânico com redações. Empresas correram para montar “estratégias de IA”. Investidores abriram os talões de cheque. Todo executivo de tecnologia do planeta de repente tinha um item no topo da agenda. O ChatGPT não lançou só um produto; deu o tiro de largada da competição corporativa mais intensa que a indústria de tecnologia viu desde o smartphone — talvez desde a própria internet.
Daqui em diante, a linha do tempo para de rastejar e começa a embaçar.
A corrida armamentista dos modelos fechados (2023–2026)
Assim que o ChatGPT provou o mercado, os maiores e mais bem financiados laboratórios do mundo entraram em guerra. Estes são os modelos fechados — sistemas proprietários cujos pesos ficam privados e são acessados por aplicativos e APIs pagas. Eles ficam na fronteira da capacidade bruta, e a competição entre eles tem sido implacável.
2023 definiram o padrão. A OpenAI lançou GPT-4, um salto dramático que sabia raciocinar, passar em exames profissionais e lidar com imagens e também com texto. A Anthropic — fundada por ex-pesquisadores da OpenAI — lançou Claude, com ênfase em segurança, documentos longos e um estilo de conversa mais ponderado. O Google, pego de surpresa pelo ChatGPT apesar de ter inventado o Transformer, se reorganizou e lançou Gemini. A corrida entre os três estava lançada.
E então simplesmente… continuou escalando. Cada laboratório ultrapassava os outros a cada poucos meses. As janelas de contexto — quanto texto um modelo consegue considerar de uma vez — explodiram de alguns milhares de palavras para livros inteiros e bases de código. Os modelos ganharam a capacidade de ver imagens, ouvir áudio, navegar na web e usar ferramentas. A xAI de Elon Musk entrou com Grok, conectado diretamente à plataforma social X.
Duas mudanças definem a fronteira como ela está em 2026, e elas importam mais do que qualquer nome de modelo isolado:
Primeiro, a ascensão do raciocínio. Uma nova classe de modelos “pensantes” aprendeu a resolver problemas passo a passo antes de responder — parando para raciocinar internamente em vez de disparar a primeira resposta. Isso fechou boa parte da antiga lacuna em matemática, lógica e programação complexa, e transformou em vitórias rotineiras benchmarks que deixavam os modelos de 2023 perplexos.
Segundo, a mudança dos chatbots para os trabalhadores. O tema que define 2026 é IA agêntica. Os modelos líderes já não apenas respondem perguntas — eles tomam ações. Operam computadores, escrevem e implantam código em muitos arquivos, executam tarefas de várias etapas que se estendem por minutos ou horas e se conectam a sistemas de negócios para realmente fazer as coisas acontecerem. A metáfora da interface mudou discretamente de “assistente com quem você conversa” para “colega a quem você delega.”
Em meados de 2026, a fronteira fechada é um grupo compacto no topo: o Claude Opus 4.8 da Anthropic, o GPT-5.5 da OpenAI, o Gemini 3.1 Pro do Google e o Grok 4.3 da xAI, com os quatro laboratórios trocando a liderança a cada poucas semanas. <span>O mais impressionante no topo atual é o quão perto ele ficou — a diferença entre o “melhor” e o “segundo melhor” hoje costuma ser um erro de arredondamento, e ela muda de mãos o tempo todo.</span>
A corrida também ficou geopolítica. Em meados de 2026, um modelo de fronteira da Anthropic se tornou — pelo que se pode saber — o primeiro a ser desligado e depois religado por reguladores, suspenso brevemente por uma ordem de controle de exportação dos EUA antes que o acesso fosse restaurado. A IA de fronteira já não é apenas uma categoria de produto. É um instrumento de política nacional.
A revolução dos modelos abertos: pesos para o povo
Enquanto os gigantes brigavam por trás de suas APIs, uma história paralela e igualmente importante se desenrolava: a ascensão dos modelos abertos.
O ponto de virada veio no início de 2023, quando a Meta lançou o LLaMA, um modelo de linguagem competente cujos pesos vazaram e depois foram compartilhados formalmente com pesquisadores. Pela primeira vez, um modelo genuinamente forte era algo que você podia baixar, rodar no seu próprio hardware, inspecionar e modificar. Uma comunidade global de desenvolvedores e entusiastas surgiu ao redor dele, produzindo uma onda impressionante de variantes com ajuste fino, otimizações e ferramentas — muitas vezes mais rápido do que os grandes laboratórios conseguiam lançar recursos.
Essa energia da comunidade nunca diminuiu, e em 2026 o ecossistema aberto amadureceu até se tornar um rival sério da fronteira fechada. Algumas coisas que vale entender:
Pesos abertos não é a mesma coisa que código aberto. Essa distinção confunde muita gente. Código aberto significa que o código de treinamento, os dados e os pesos são todos distribuídos sob uma licença permissiva. Pesos abertos significa que você recebe os arquivos do modelo para baixar e rodar, mas a licença pode restringir como você os usa, e os dados de treinamento e a receita completa muitas vezes continuam privados. A maioria dos modelos que as pessoas chamam casualmente de “código aberto” na verdade têm pesos abertos. A diferença importa enormemente para empresas preocupadas com conformidade — e é por isso que o licenciamento se tornou um diferencial competitivo de verdade. As licenças permissivas Apache 2.0 e MIT (usadas por famílias como Qwen, DeepSeek e outras) são valorizadas justamente porque deixam as empresas construir livremente.
O centro de gravidade se deslocou para o Leste. Alguns dos modelos de pesos abertos mais capazes de 2026 vêm de laboratórios chineses: DeepSeek (celebrado por raciocínio de nível de fronteira a um custo surpreendentemente baixo), o Qwen da Alibaba (uma família extensa, com licença permissiva, que vai de modelos minúsculos para laptop a sistemas enormes), o Kimi da Moonshot, e e o GLM da Zhipu/Z.ai série. O Llama 4 ancora a camada aberta ocidental, e os Gemma do Google são feitos para rodar em uma única GPU ou até em um laptop, e a Mistral migrou seus modelos principais para licenças permissivas. O ranking aberto agora se reorganiza quase todo mês — instantâneos recentes colocaram modelos como GLM-5.2 e o mais recente do Kimi no topo, ou perto dele, dos rankings abertos independentes, com vários modelos abertos avançando para um território que antes pertencia exclusivamente à fronteira fechada.
O colapso dos preços. Talvez a história mais consequente dos modelos abertos seja econômica. A concorrência — boa parte dela impulsionada por esses provedores abertos e de baixo custo — empurrou o preço da inteligência ladeira abaixo. Capacidades que custavam uma pequena fortuna em taxas de API dois anos atrás agora saem por centavos por milhão de palavras, ou de graça se você fizer auto-hospedagem. Analistas hoje estimam que os melhores pesos abertos ficam atrás dos melhores modelos fechados por apenas meses em muitos benchmarks, não anos. Para uma enorme fatia das tarefas do mundo real, a opção aberta agora é boa o suficiente, barata o suficiente e privada o suficiente para vencer.
Essa é a revolução silenciosa por baixo das manchetes. A fronteira chama a atenção, mas a comoditização da IA “boa o suficiente” — rodando nos seus próprios servidores, sob seu próprio controle, a um custo marginal quase zero — pode acabar remodelando mais indústrias do que qualquer modelo de ponta isolado.
Quando a IA aprendeu a ver e a pintar: a história da geração de imagens
A linguagem era só metade da revolução. A outra metade era visual — e chegou igualmente rápido.
A maquinaria inicial das imagens de IA foi a GAN (Generative Adversarial Network), introduzida em 2014. A ideia engenhosa: colocar duas redes uma contra a outra, uma gerando imagens falsas e a outra tentando identificar as falsas, até que o gerador fique tão bom que as falsas se tornem convincentes. As GANs produziam rostos assustadoramente realistas — a era do “essas pessoas não existem” — mas eram chatas de treinar e difíceis de controlar com palavras.
O verdadeiro avanço para o consumidor veio de outra técnica: modelos de difusão, que aprendem a criar imagens partindo de puro ruído e refinando-o aos poucos até uma imagem coerente, guiados por um prompt de texto. Os resultados, e a cronologia, foram impressionantes:
- DALL·E e DALL·E 2 (2021–2022) da OpenAI mostraram ao mundo que você podia digitar uma frase caprichosa — “um astronauta montado num cavalo em estilo fotorrealista” — e receber de volta uma imagem surpreendentemente boa.
- Midjourney (2022) chegou com uma estética marcante e deslumbrante e construiu uma comunidade enorme, virando sinônimo de arte de IA bonita.
- Stable Diffusion (2022) fez pelas imagens o que o LLaMA depois fez pelo texto: foi lançado abertamente. Qualquer pessoa podia executá-lo, fazer ajuste fino e construir sobre ele. Um ecossistema aberto inteiro de ferramentas, plugins e modelos personalizados explodiu da noite para o dia.
A partir daí, o campo disparou. Os antigos modos de falha — mãos deformadas, textos sem sentido, rostos esquisitos — foram resolvidos um a um. Em 2026, o mercado de geração de imagens se dividiu em campos claros, e a qualidade é alta o bastante para que os resultados passem rotineiramente por uma inspeção humana casual:
- Midjourney (agora na linha V8) continua sendo o favorito estético para arte estilizada que faz o dedo parar de rolar.
- GPT Image da OpenAI modelos (os sucessores do DALL·E, agora integrados direto ao ChatGPT) lideram no seguimento de instruções complexas e na renderização correta de texto dentro das imagens — um problema que atormentou todos os modelos por anos.
- FLUX da Black Forest Labs se tornou o campeão dos pesos abertos, igualando modelos fechados premium em fotorrealismo por uma fração do custo, e afastando a maioria dos usuários sérios de código aberto das versões mais antigas do Stable Diffusion.
- Imagen do Google e “Nano Banana” modelos e Firefly da Adobe (treinado com dados licenciados, o que as empresas adoram pela segurança jurídica) completam o campo profissional.
- E, ecoando a história dos LLMs, modelos chineses como o Seedream da ByteDance subiram no ranking.
A fronteira não é mais só fazer uma imagem bonita. É sobre edição — selecionar uma região conversando e pedir mudanças — e sobre consistência, manter o mesmo personagem ou produto idêntico em dezenas de imagens. A geração de imagens por IA passou de novidade a ferramenta profissional de produção em cerca de quatro anos.
Quando a IA aprendeu a se mover: a ascensão do vídeo com IA
Se as imagens foram o milagre de quatro anos atrás, o vídeo é o milagre desta era. E nada capturou tão bem a velocidade bruta do progresso da IA quanto ver o texto-para-vídeo passar de piada a ameaça à indústria do cinema em menos de três anos.
Ainda em 2023, “vídeo de IA” significava alguns segundos de movimento embaçado e tremido, com rostos derretendo e objetos se transformando em bobagem entre os quadros. Era uma curiosidade, não uma ferramenta.
Então, no início de 2024, a OpenAI apresentou o Sora, e a conversa mudou na hora. Seus clipes eram fotorrealistas, coerentes no tempo e cinematográficos de um jeito que parecia ter pulado vários anos de progresso esperado. Todo concorrente começou imediatamente a perseguir esse patamar.
A corrida produziu um campo notável. Em 2026, os concorrentes sérios incluem o Veo do Google, Gen-4 da Runway (integrado a um ambiente completo de edição criativa em vez de vendido como modelo bruto), e uma onda de modelos chineses poderosos — Kling (Kuaishou), Seedance (ByteDance), e outros — que agora dominam o topo dos rankings independentes de qualidade de vídeo. O patamar técnico avançou rápido: áudio sincronizado nativo — incluindo diálogo gerado com sincronia labial correta em vários idiomas — passou de ficção científica a recurso padrão em cerca de um ano.
A reviravolta que ninguém previu: O Sora, o modelo que começou a corrida, foi desativado. A OpenAI descontinuou as experiências web e de aplicativo do Sora em abril de 2026, com a API seguindo mais tarde no ano. A ferramenta que ditou o ritmo foi superada e aposentada enquanto o campo que ela inspirou avançava a todo vapor — um símbolo quase perfeito de como esse espaço se move de forma brutalmente rápida. Defina o padrão e, dezoito meses depois, você pode ser um benchmark legado.
Hoje, um empreendedor solo com um prompt de texto e um orçamento modesto consegue gerar cenas que antes exigiriam uma locação, uma equipe e um orçamento de cinco dígitos. A tecnologia ainda tem limites reais — falhas de física, consistência ao longo de cenas longas e questões legais e éticas sérias em torno de semelhança e divulgação — mas a trajetória é inconfundível.
Além do texto e dos pixels: voz, multimodalidade e a era dos agentes
As categorias arrumadinhas que este artigo usa — texto, imagem, vídeo — já estão, francamente, se dissolvendo. A direção que define a era atual é que essas capacidades estão se fundindo em sistemas únicos e unificados.
Multimodalidade é o nome técnico. Os modelos de fronteira de 2026 não são modelos de texto com um recurso de imagem parafusado por cima; eles veem, leem, ouvem e geram nativamente em vários formatos, num fluxo contínuo. Você pode mostrar a foto da sua geladeira e pedir uma receita, compartilhar a captura de tela de um bug e receber a correção, ou falar com ele e ouvi-lo responder com uma voz natural, interrompível e quase sem atraso. O velho e desajeitado ciclo de “digitar, esperar, ler” está dando lugar a algo que se parece muito mais com conversar com uma pessoa competente.
E então existem os agentes — o tema que amarra toda a história de 2026. Um agente é um sistema de IA que não apenas responde, mas age: ele planeja uma tarefa de várias etapas, usa ferramentas e software, confere o próprio trabalho e leva o serviço até o fim com o mínimo de supervisão. Reservar viagem, conciliar uma planilha com três fontes de dados, refatorar uma base de código, tocar um projeto de pesquisa em dezenas de páginas web — tudo isso está saindo da fase de “demo” para virar “fluxo de trabalho diário.” A interface está mudando de uma janela de chat para uma fila de delegação.
Essa é a linha condutora de toda a história da IA, chegando à sua conclusão lógica. Passamos de programar computadores com regras explícitas, para treinar eles com dados, para conversar com eles em linguagem comum e, agora, delegar trabalho de verdade a eles. Cada etapa removeu uma camada de atrito entre a intenção humana e o resultado final. Agentes são a fronteira atual dessa remoção.
Por que a IA de repente avançou tão rápido?
Deixe de lado os nomes de modelos e números de versão e surge uma pergunta natural: depois de cinquenta anos engatinhando, por que a IA de repente disparou? Algumas forças convergiram, e foi a convergência — não uma só delas — que acendeu o pavio.
A computação ficou absurdamente potente e abundante. As mesmas GPUs que renderizam videogames se mostraram perfeitas para treinar redes neurais. Conforme os chips melhoraram e os data centers cresceram, a força bruta disponível para treinar IA cresceu exponencialmente. Ideias teoricamente sólidas nos anos 1990 eram simplesmente impossíveis de rodar até o hardware acompanhar.
Os dados viraram uma enxurrada. A internet passou trinta anos acumulando um corpus quase ilimitado de texto, imagens e vídeo produzidos por humanos. Esse registro vasto e bagunçado do conhecimento e da expressão humana virou material de treino. Sem internet, sem IA moderna.
O Transformer destravou a escala. Como vimos, a arquitetura de 2017 tornou possível converter, de forma confiável, mais computação e mais dados em mais capacidade. Essa previsibilidade transformou a pesquisa em algo mais próximo de engenharia — e problemas de engenharia se resolvem rápido quando aparece dinheiro.
O dinheiro apareceu. O ChatGPT provou que existia um mercado colossal, e o capital jorrou. Dezenas de bilhões de dólares foram para laboratórios, chips e talentos. Esse financiamento comprimiu prazos que, de outro modo, se arrastariam por décadas.
A concorrência feroz ditou o ritmo. Com OpenAI, Google, Anthropic, Meta, xAI e uma dúzia de laboratórios chineses todos correndo, ninguém podia se dar ao luxo de desacelerar. Uma vantagem que levava seis meses para ser construída podia evaporar em seis semanas. Essa pressão é exatamente o motivo de você ver um novo modelo carro-chefe quase toda vez que olha as notícias.
Ecossistemas abertos multiplicaram o esforço. Cada modelo liberado abertamente transformou milhares de desenvolvedores independentes em P&D não remunerado. A inteligência coletiva da comunidade global de código aberto acelerou o progresso de formas que nenhuma empresa sozinha conseguiria igualar, e empurrou o preço da IA para o chão.
Junte tudo isso e você tem a curva de capacidade mais íngreme que a tecnologia já produziu. É menos uma invenção isolada e mais uma reação em cadeia.
Para onde a IA vai agora
Prever o futuro da IA é uma ótima forma de parecer tolo em seis meses — este artigo documentou o quanto os especialistas foram surpreendidos, rotineiramente. Mas a trajetória atual aponta para algumas coisas com razoável confiança.
Agentes viram realidade. A próxima fase tem menos a ver com modelos que sabem e mais e mais com sistemas que entregam de forma confiável fazem mais — concluindo trabalho longo, complexo e de várias etapas com autonomia de verdade. Espere que o discurso do “trabalhador de IA” se intensifique, junto com perguntas difíceis sobre supervisão, confiabilidade e o que acontece com empregos baseados em tarefas que os agentes agora dão conta.
A inteligência continua ficando mais barata. O colapso de preços não acabou. Conforme os modelos abertos fecham a diferença e a eficiência melhora, a IA capaz tende a ficar quase de graça e a rodar localmente — no seu celular, no seu notebook, nos seus próprios servidores. Essa comoditização pode remodelar setores inteiros de forma mais silenciosa e mais profunda do que qualquer modelo manchete.
As fronteiras continuam se dissolvendo. Texto, imagem, áudio e vídeo estão convergindo em sistemas unificados, e “usar uma IA” vai parecer menos visitar uma ferramenta e mais uma capacidade tecida de forma invisível em tudo o que você já faz.
A governança vai para o centro do palco. O breve desligamento regulatório de um modelo de fronteira em 2026 foi uma prévia. Conforme a IA se torna infraestrutura crítica e alavanca de poder geopolítico, questões de segurança, direitos autorais, controle e estratégia nacional vão moldar a área tanto quanto qualquer avanço de pesquisa. A corrida técnica e a corrida política agora são a mesma corrida.
A única previsão segura é que o ritmo não diminui. Cada capítulo desta história foi escrito por pessoas que subestimaram com confiança a velocidade com que o próximo capítulo chegaria.
Perguntas frequentes
Quando a IA moderna realmente começou? O conceito remonta aos anos 1950, mas a era moderna do aprendizado profundo costuma ser situada em 2012, quando a rede neural AlexNet dominou uma competição de reconhecimento de imagens e provou que redes profundas mais big data mais poder de GPU era uma combinação vencedora. O boom voltado ao público começou depois, com o lançamento do ChatGPT em novembro de 2022.
Qual é a diferença entre modelos de IA abertos e fechados? Modelos fechados (como GPT-5.5, Claude e Gemini) mantêm seus pesos privados e são usados por apps ou APIs pagas. Modelos abertos (como Llama, DeepSeek, Qwen e GLM) compartilham seus pesos para que qualquer pessoa possa baixar, rodar e modificar. Uma nuance importante: “pesos abertos” significa que você recebe os arquivos do modelo, enquanto o verdadeiro “código aberto” também inclui o código e os dados de treino — a maioria dos modelos chamados de código aberto é, na verdade, de pesos abertos.
Qual foi o avanço mais importante da história da IA? Muitos pesquisadores apontam a arquitetura Transformer de 2017, apresentada no artigo Attention Is All You Need. Ela tornou os modelos escaláveis e eficientes de treinar, e sustenta praticamente todo sistema de IA relevante em uso hoje, de chatbots a geradores de imagens.
Como a geração de imagens e vídeos por IA ficou tão boa tão rápido? A geração de imagens deu um salto com os modelos de difusão por volta de 2021–2022 (DALL·E, Midjourney, Stable Diffusion) e depois resolveu rapidamente problemas antigos, como mãos distorcidas e texto ilegível. O vídeo seguiu uma curva parecida, passando de alguns segundos de movimento borrado em 2023 para clipes fotorrealistas com áudio sincronizado em 2026, impulsionado pela competição intensa entre modelos como Veo, Runway, Kling e Seedance.
O avanço da IA vai desacelerar? Não há sinal disso por enquanto. A combinação de computação abundante, investimento massivo, competição feroz entre laboratórios e uma comunidade de código aberto próspera segue empurrando o ritmo. Se a história acima ensina alguma coisa, é que a próxima onda sempre chegou mais rápido do que qualquer um esperava.


