 Italiano
 English
 Deutsch
 Español
 Français

Sei settimane fa avrei scritto questo articolo in modo diverso.
A luglio, Moonshot AI ha pubblicato su Hugging Face un modello all’avanguardia con 2,8 trilioni di parametri, rendendolo disponibile per il download a chiunque. Il 28 agosto, Z.ai ha finalmente rilasciato i pesi del GLM-5.3 che teneva in serbo da due settimane, dopo aver scoperto che il proprio modello era in grado di concatenare exploit in modi che nessuno gli aveva chiesto di fare. E il 1° settembre, Anthropic ha lanciato Claude Fable 5.1, rendendo il lavoro degli agenti fino a 45% più economico senza modificare il prezzo di listino.
Tre modelli. Tre risposte completamente diverse alla domanda su cosa un laboratorio di intelligenza artificiale debba al pubblico. E, per la prima volta da quando è iniziata tutta questa vicenda, le opzioni "open-weight" non rappresentano una scelta di compromesso.
Questa è la storia vera della fine del 2026, e vale circa ottomila parole, perché è proprio nei dettagli che si nascondono tutti i soldi e tutti gli errori.
Ho esaminato i documenti relativi all’architettura, le schede dei modelli, i testi delle licenze — con attenzione, riga per riga, perché due dei tre non sono proprio ciò che la gente chiama comunemente con quei nomi — i benchmark dei fornitori, i punteggi degli aggregatori neutrali, i tassi reali per token e il nuovissimo listino prezzi di Ollama. Poi ho calcolato i costi basandomi su un normale mese lavorativo anziché su uno scenario relativo al giorno del lancio.
Ecco cosa ne è venuto fuori.
TL;DR — Il verdetto in 60 secondi
GLM-5.3 rappresenta attualmente il miglior rapporto qualità-prezzo nel campo dell'intelligenza artificiale, e non c'è proprio paragone. Secondo Artificial Analysis, il modello si colloca a meno di mezzo punto da Kimi K3 e a circa tre punti e mezzo da Claude Opus 5, con $1,40 in entrata e $4,40 in uscita per milione di token. Per lo stesso compito di tipo agentico, costa all’incirca un sesto di quanto costa Fable 5.1. I pesi sono scaricabili. Se cercate un modello su cui basare il vostro agente e non gestite un’azienda con un fatturato di $10 miliardi, eccolo qui.
Kimi K3 è il programma più potente che si possa scaricare legalmente. 2,8 trilioni di parametri, 104 miliardi attivi, un contesto autentico da 1 milione, visione nativa, il miglior punteggio di navigazione agentica mai pubblicato (BrowseComp 91,2) e — il dato che dovrebbe porre fine alla tesi secondo cui “i modelli aperti sono in ritardo” — 88,3 su Terminal-Bench 2.1, contro l’88,0 di Claude Fable 5 e l’88,8 di GPT-5.6 Sol sulla stessa versione. Inoltre costa $3/$15 — più del doppio rispetto al GLM-5.3 — e i suoi 1,5 TB di pesi richiedono un rack, non una workstation. È il modello che si utilizza quando il compito è complesso e di lunga durata, ed è il modello che si cita quando qualcuno sostiene che i pesi aperti siano di una generazione arretrata.
Claude Fable 5.1 rimane il modello a cui ricorrere quando un errore può costare caro. È all’avanguardia nel lavoro agentico prolungato, della durata di diverse ore, e nel debug complesso che non compare mai in modo chiaro nelle classifiche. Il 1° settembre Anthropic ha ridotto le letture dalla cache di 75%, rendendo le sessioni lunghe degli agenti notevolmente più economiche rispetto al passato. Il suo costo per task è inoltre sei volte superiore a quello di GLM-5.3, è in versione chiusa e ora prevede restrizioni anti-distillazione che compromettono alcune integrazioni esistenti.
La battuta schietta: I modelli open-weight hanno ridotto il divario in termini di capacità a circa tre-cinque mesi e hanno azzerato il divario di prezzo. Ciò che in realtà si acquista da Anthropic nel settembre 2026 è l’affidabilità nelle attività più complesse del 10% — e il diritto di non dover pensare a nulla di tutto ciò.
E il colpo di scena che nessuno vuole ammettere ad alta voce: Né Kimi K3 né GLM-5.3 sono più distribuiti con licenza open source. Entrambi sono passati quest’estate a condizioni personalizzate, subordinate al raggiungimento di determinati ricavi. Pesi aperti, sì. Open source, no. Leggete la sezione sulle licenze prima che lo faccia il vostro team legale.
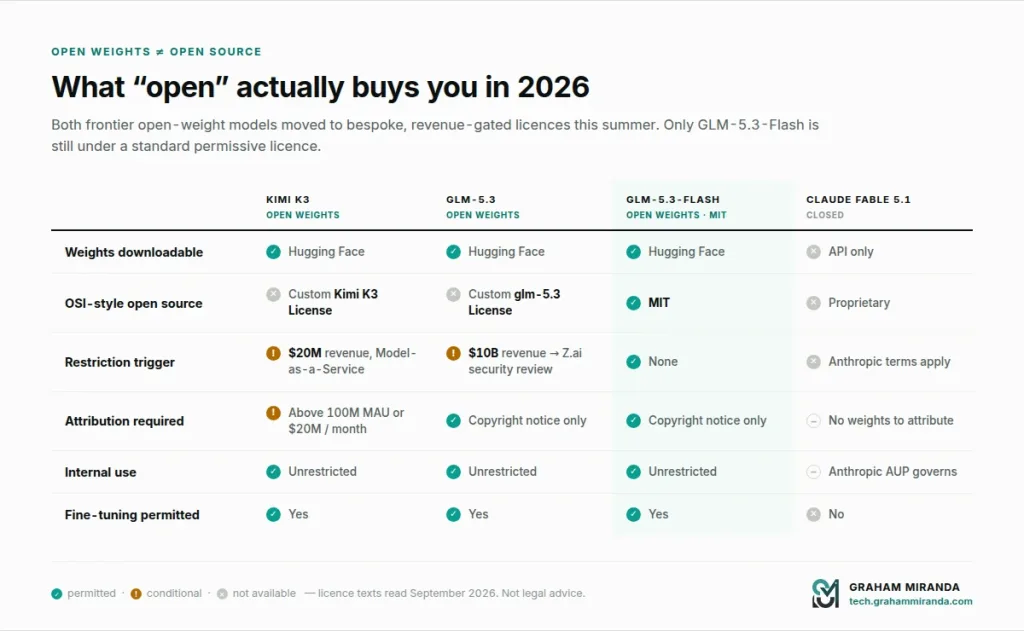
Tabella di confronto rapido
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Produttore | Moonshot AI | Z.ai (Zhipu AI) | Antropico |
| Pubblicato | 16 luglio 2026 (API) · 27 luglio (pesi) | 14 agosto 2026 (API) · 28 agosto (pesi) | 1° settembre 2026 |
| Pesi disponibili | Sì | Sì | No |
| Licenza | Licenza Kimi K3 (personalizzata, a pagamento) | Licenza glm-5.3 (personalizzata, basata sui ricavi) | Esclusivo |
| Parametri totali | 2,8 T | 753B | Non divulgato |
| Attivo per token | 104B (16 su 896 esperti) | ~40 miliardi (stima) | Non divulgato |
| Architettura | KDA + residui di attenzione, LatentMoE stabile, 69 livelli KDA + 24 livelli MLA con gate | MoE, con la stessa base del GLM-5.2, trae vantaggio esclusivamente dal post-addestramento | Non divulgato |
| Finestra di contesto | 1,048,576 | 1,000,000 | 1,000,000 |
| Potenza massima | 131.072 in default (fino a 1.048.576) | 128,000 | 128,000 |
| Input multimodale | Testo, immagine, video (MoonViT-V2) | Solo testo | Testo, immagine |
| Riflessioni | Sempre attivo | Sempre attivo, sforzo_di_ragionamento basso/alto/massimo | Sempre attivo, adattivo, sforzo per singolo messaggio (beta) |
| Prezzo di acquisto / 1 milione | $3.00 | $1.40 | $10.00 |
| Dati in cache / 1M | $0.30 | $0.26 | $0.25 |
| Prezzo di vendita / 1 milione | $15.00 | $4.40 | $50.00 |
| Indice di intelligenza AA | 59.7 | 59.5 | Non è ancora stato valutato (Fable 5: 62,1) |
| Costo per attività di valutazione AA | $0.84 | $0.68 | — (Opus 5: $2.34) |
| Impronta di hosting autonomo | ~1,5 TB (MXFP4 nativo) | ~1,5 TB BF16 / ~750 GB FP8 | N/D |
| Su Ollama | kimi-k3:cloud | glm-5.3:cloud | Tramite Claude Code / Claude Desktop come client |
Tutti i prezzi indicati sono quelli di listino del produttore. I dati di Artificial Analysis si riferiscono all’istantanea dell’indice di settembre 2026; Fable 5.1 è stato lanciato il 1° settembre e, al momento della stesura del presente documento, non era ancora stato valutato da fonti indipendenti.
Perché questo confronto a tre è quello che conta davvero
Per due anni il dibattito tra modelli aperti e chiusi ha seguito uno schema ben definito: i modelli chiusi erano migliori, quelli aperti più economici, e ognuno sceglieva la propria posizione in base a quel compromesso. Tutti sapevano da che parte stare.
Quella forma si è rotta quest’estate.
Nathan Lambert, che segue la questione con maggiore attenzione rispetto a quasi chiunque altro, stima che l'attuale divario di capacità tra i modelli "frontier open-weight" e quelli "frontier closed" sia pari a da tre a cinque mesi — in calo rispetto ai sei-nove mesi che si ipotizzavano un anno fa. Al momento in cui scriveva, Kimi K3 si collocava al #2 nell’indice Vals AI e vicino alla vetta di quello di Artificial Analysis, superato solo da Claude Fable e GPT-5.6 Sol Max. L’istantanea dell’indice di settembre che utilizzerò più avanti in questo articolo lo colloca al quarto posto, dietro a Grok 4.6. In ogni caso: non si tratta di un risultato “buono per un modello aperto”. È un piazzamento sul podio.
Nel frattempo, i dati sull’utilizzo hanno registrato un andamento davvero sorprendente. I modelli di origine cinese hanno registrato circa 61% di tutti i token instradati tramite OpenRouter entro maggio 2026. La quota statunitense di tale traffico è crollata da circa 70% a circa 30% nell’arco di dodici mesi. Llama di Meta — il modello che ha dato il via all’ondata dei modelli open-weight — è scesa al di sotto degli 1% di volume instradato. La quota di Google è passata da circa 37% a 13%. Lo studio condotto da OpenRouter in collaborazione con a16z su 100 trilioni di token ha rilevato che i modelli open-weight rappresentano circa un terzo del volume totale di token sulla piattaforma.
Si può discutere su cosa rappresenti il traffico di OpenRouter. Esso sovrastima la presenza di sviluppatori, appassionati e carichi di lavoro sensibili ai costi, mentre sottostima i contratti aziendali che non prevedono mai l’utilizzo di un router. Va bene. Ma si tratta del più ampio set di dati pubblico di cui disponiamo su ciò che le persone scelgono effettivamente quando possono scegliere liberamente, e la tendenza è inequivocabile.
Quindi, nel settembre 2026, la domanda non sarà più “i modelli aperti sono già abbastanza validi?”. Sarà molto più precisa:
Se ci sono tre modelli che soddisfano tutti i requisiti, quale indicheresti al tuo agente? E quanto ti costerebbe effettivamente sbagliare?
Si tratta di una questione che riguarda i benchmark, i prezzi, le licenze e le infrastrutture, più o meno nell’ordine in cui la gente li considera e esattamente nell’ordine inverso rispetto alla loro importanza.
Che cos’è in realtà la Kimi K3
Moonshot AI ha annunciato Kimi K3 il 16 luglio 2026 e ne ha reso noti i pesi completi il 27 luglio. Si tratta, in termini di numero di parametri, del modello a peso aperto più grande mai pubblicato: 2,8 trilioni di parametri in totale, circa 75% in più rispetto a DeepSeek V4 Pro.
Quel numero è meno impressionante di quanto sembri e più impressionante di quanto sembri, proprio in quest’ordine.
L'architettura, in parole semplici
Kimi K3 è un modello “mixture-of-experts” che attiva 104 miliardi di parametri per token, selezionando 16 esperti da un gruppo di 896. Quindi, sebbene il totale sia pari a 2,8T, ogni singolo passaggio in avanti coinvolge meno di 4% dei pesi. È da qui che deriva il vantaggio economico: un’enorme quantità di conoscenza immagazzinata, a fronte di un costo di inferenza moderato.
L'aspetto ingegneristico più interessante risiede nello stack di attenzione. K3 utilizza 93 livelli costituiti da 69 livelli KDA (Kimi Delta Attention) e 24 livelli Gated MLA — un modello ibrido che combina attenzione lineare e attenzione completa con un rapporto di interleaving di circa 3:1. Il KDA è una variante dell’attenzione lineare che opera in tempo lineare rispetto alla lunghezza della sequenza anziché in tempo quadratico, ed è proprio questo che rende il contesto da 1 milione di simboli economicamente fattibile, anziché solo teorico. Moonshot riporta valori fino a un 75% Riduzione della cache KV e fino a Velocità di decodifica 6 volte superiore con 1 milione di contesti di conseguenza.
Sopra c’è Attenzione ai residui (AttnRes), che Moonshot descrive come un sostituto diretto delle connessioni residue standard, e un LatentMoE stabile struttura per l’instradamento. Si sostiene che tale combinazione garantisca all’incirca un Miglioramento di 2,5 volte dell'efficienza complessiva di scalabilità contro Kimi K2.
La visione nasce da MoonViT-V2, un encoder con 401M parametri, integrato nativamente anziché aggiunto a posteriori: K3 gestisce testo, immagini e video in un unico modello.
Un altro dettaglio importante per chiunque stia valutando l’opzione dell’hosting autonomo: K3 è stato addestrato con addestramento nativo MXFP4 che tiene conto della quantizzazione, con esperti in MXFP4 e attivazioni in MXFP8. Non si tratta di una quantizzazione post hoc. Il checkpoint pubblicato è il modello quantizzato, motivo per cui 2,8 trilioni di parametri si attestano a circa 1,5 TB su disco anziché i circa 5,6 TB che un checkpoint BF16 di quelle dimensioni richiederebbe.
La storia del benchmark
I dati pubblicati da Moonshot sono ottimi su tutta la linea e, cosa insolita, molti di essi hanno superato una valutazione indipendente:
- Terminal-Bench 2.1: 88,3 — il punteggio più alto pubblicato per quella versione del benchmark
- FrontierSWE: 81,2
- DeepSWE: 67,5
- BrowseComp: 91,2 — lo stato dell’arte della ricerca sul web agenziale
- GPQA Diamond: 93,5
- MMMU-Pro: 81,6 / 83,4 (visione)
- Maratona SWE: 91,0
- OfficeQA Pro: 81,3
- AutomationBench: 30,8
- LMArena Frontend Code Arena: 1.679 Elo — primo posto, davanti a Claude Fable 5 (1.631) e GPT-5.6 Sol (1.618), aggiudicandosi sei dei sette domini frontend
Quest’ultimo dato merita una riflessione. Un modello a peso aperto scaricabile gratuitamente si è classificato al primo posto in una competizione di programmazione di front-end basata sulle preferenze umane, superando i modelli chiusi di punta dei due laboratori più finanziati al mondo. A prescindere da ciò che si pensi dei benchmark di questo tipo come metodologia, si tratta di una notizia che sarebbe stata impensabile nel 2025.
Per quanto riguarda gli indici aggregati, si attesta a un livello leggermente inferiore: 59,7 nell'Indice di Intelligenza Analitica Artificiale, terzo in classifica generale, dietro a Claude Opus 5 (63,0) e Claude Fable 5 (62,1). I dati di riferimento di Moonshot — GDPval-AA v2 a 1.687 e AA-Briefcase a 1.527 — lo collocano rispettivamente al terzo e al secondo posto in quelle valutazioni sul lavoro intellettuale. Nell’Indice di Vals v2 si colloca al 57.8%, rispetto al 67,21 TP3T di Claude Opus 5, il 66,01 TP3T di Claude Fable 5 e il 63,71 TP3T di GPT-5.6 Sol — il divario più ampio tra ’aperto’ e "chiuso" in qualsiasi indice che ho trovato, e che vale la pena tenere a mente quando si analizzano i dati di codifica.
Le demo e come interpretarle
Moonshot ha pubblicato due dimostrazioni di autonomia a lungo termine che hanno suscitato grande interesse: una Esecuzione autonoma di 48 ore che completa l'intero processo di progettazione di un chip (un progetto da 4 mm con frequenza di chiusura a 100 MHz, simulato a oltre 8.700 token al secondo) e una riproduzione dell'astrofisica Relazione I-Love-Q tra circa due ore, contro le una o due settimane di cui avrebbe normalmente bisogno un ricercatore senior.
Sono davvero impressionanti, ma non baserei su di esse una decisione di acquisto. Le dimostrazioni organizzate, preparate e selezionate dal fornitore mostrano ciò che un modello è in grado di fare in una giornata ideale sotto la supervisione di un esperto, non ciò che fa nel vostro repository un martedì qualsiasi. Consideratele una prova di fattibilità per capacità a lungo termine, non come specifiche tecniche.
Mostra immagine Due architetture rese pubbliche e una “scatola nera”. I modelli aperti spiegano esattamente come funzionano; quello chiuso indica il punteggio ottenuto.
Che cos’è in realtà GLM-5.3
La versione GLM-5.3 ha la storia di rilascio più singolare delle tre, ed è quella che vale la pena raccontare per bene, perché è la prima volta che un importante laboratorio ha visibilmente esitato a pubblicare i pesi per ragioni diverse da quelle commerciali.
Z.ai ha annunciato GLM-5.3 il 14 agosto 2026 con lo slogan “Built to Code. Ready for Cyber Defense.” Il modello è un Miscela di esperti con 753 miliardi di parametri, con circa 40 miliardi di token attivi secondo le stime della comunità ricavate dalla configurazione GLM-5.2. Presenta una finestra di contesto di 1 milione di token e un output massimo di 128K e — a differenza di GLM-5.3-Flash, che è un modello completamente diverso — è solo testo.
“Ci siamo limitati a scalare dopo l'allenamento”
L'aspetto tecnico più interessante del GLM-5.3 è che non esiste un nuovo modello di base. Esso riutilizza la stessa base preaddestrata del GLM-5.2. Tutti i miglioramenti sono stati ottenuti grazie a un post-addestramento notevolmente esteso, che Z.ai ha sintetizzato come segue: “Per la versione GLM-5.3 ci siamo limitati a ottimizzare le prestazioni dopo la fase di addestramento.”
I delta non sono trascurabili:
| Punto di riferimento | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Un miglioramento di sei volte rispetto a Terminal-Bench e un balzo di venti punti su DeepSWE, partendo dagli stessi pesi di base, è un risultato davvero significativo. Ciò dimostra che la frontiera ha ancora un ampio margine di miglioramento nella fase post-addestramento, che rappresenta di gran lunga la parte più economica del costo complessivo dell’addestramento. È proprio per questo che i laboratori cinesi, che operano con, come afferma Lambert, “ordin di grandezza inferiori di capitale” rispetto a quelli americani, riescono a tenere il passo.
Le due settimane in cui Z.ai non ha effettuato spedizioni
Z.ai aveva dichiarato al momento del lancio che i pesi sarebbero stati resi disponibili “in più fasi, al termine di rigorose valutazioni di sicurezza”, con un obiettivo di circa due settimane. Il suo repository su Hugging Face indicava la data del 28 agosto. Quella data è arrivata, è trascorsa nel giro di poche ore e poi i pesi sono stati pubblicati insieme a una nota tecnica che spiegava il ritardo.
Il motivo era legato alle capacità informatiche. Durante la valutazione, Z.ai ha riferito che GLM-5.3 ha identificato 2.436 vulnerabilità in 269 progetti open source, di cui 1.097 sono state classificate come critiche o di gravità elevata. Più precisamente, il modello ha dimostrato che ragionamento sulla catena di exploit a più fasi — concatenando in modo autonomo le fasi di sfruttamento — cosa che Z.ai ha definito come un comportamento “non del tutto intenzionale” e che “continuava ad aggravarsi man mano che l’addestramento si ampliava”.”
Voglio essere cauto su questo punto, perché è facile interpretare quanto detto come una mossa di marketing o come allarmismo, mentre probabilmente non è né l’uno né l’altro. Un modello che è efficace nell’individuare le vulnerabilità è efficace nell’individuare le vulnerabilità; gli usi difensivi e quelli offensivi sono la stessa capacità orientata in direzioni diverse. Il divario nei benchmark di Z.ai riflette onestamente questo aspetto: CyberGym 84.5% (individuazione delle vulnerabilità, con tutte le sue conseguenze) contro ExploitBench 54.4% (sfruttamento, dove Claude Fable 5 totalizza 78,01 TP3T). Il laboratorio ha ottimizzato deliberatamente la metà campo difensiva e i risultati lo dimostrano.
Ciò che è davvero degno di nota è che un laboratorio abbia ritardato di due settimane il lancio di un prodotto di punta e abbia reso pubbliche le proprie motivazioni. A prescindere dal fatto che si ritenga o meno convincenti tali motivazioni, si tratta comunque di un precedente senza precedenti.
Dove atterra effettivamente il GLM-5.3
La tabella comparativa pubblicata da Z.ai non pretende di essere esaustiva, il che è una boccata d’aria fresca:
| Punto di riferimento | GLM-5.3 | Il miglior comparatore |
|---|---|---|
| AutomationBench | 48.2% | Cavi GLM-5.3 |
| CyberGym | 84.5% | Cavi GLM-5.3 |
| GDPval-AA v2 | 1,769 | Cavi GLM-5.3 |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Risoluzione: 34,61 TP3T |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Risultato: 72,71 TP3T |
| ExploitBench | 54.4% | Claude Fable 5: 78.0% |
| Code Bench (50.000 token) | 31.4% | — |
Da parte sua, Artificial Analysis lo stima a 59,5 nell'Indice di intelligenza — statisticamente indistinguibile dal valore di 59,7 ottenuto da Kimi K3, ricavato da un modello con circa un quarto dei parametri.
Un aspetto da tenere presente, emerso dalla stessa valutazione, ma che nessuno nel reparto marketing menziona: GLM-5.3 ha generato 170 milioni di token generati dalla suite Artificial Analysis, a fronte di una mediana di 72 milioni per la sua categoria. È troppo prolisso. sforzo_di_ragionamento il valore predefinito è max e il pensiero non può essere disattivato, quindi si finisce per pagare per un lungo processo di riflessione, indipendentemente dal fatto che l’attività lo giustifichi o meno. Ciononostante, il costo totale per eseguire la valutazione completa è ammontato a $0,68 per attività, contro $0,84 per Kimi K3 e $2,34 per Claude Opus 5 — quindi la maggiore complessità non annulla il vantaggio in termini di prezzo, ma lo riduce soltanto.
Che cos’è in realtà Claude Fable 5.1
Anthropic ha rilasciato Claude Fable 5.1 il 1° settembre 2026, insieme a Claude Mythos 5.1 — lo stesso modello con una configurazione di sicurezza diversa, disponibile esclusivamente tramite programmi di accesso fidato destinati alla sicurezza informatica e alle scienze della vita.
La definizione è precisa e, a mio avviso, corretta: si tratta di “un modello creato per svolgere un lavoro che non si esaurisce in un unico comando”.” Anthropic non sostiene che si tratti di un salto di qualità in termini di intelligenza generale. Afferma piuttosto che le sessioni di interazione con gli agenti, prolungate e della durata di diverse ore, danno risultati migliori.
I numeri
| Punto di riferimento | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (parziale) | 72.9% | 77.9% | — |
| L'ultimo esame dell'umanità (con strumenti) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Per ulteriori informazioni sul contesto esterno relative allo stesso sovrano: GPT-5.6 Sol ottiene un punteggio di 52,31 TP3T su Terminal-Bench 4.0, quindi il 55,81 TP3T di Fable 5.1 si porta in testa e il 60,91 TP3T di Mythos 5.1 ne amplia il vantaggio.
Il salto registrato nel benchmark “Terminal-Bench-Science” — da 24,71 TP3T a 52,61 TP3T, un vero e proprio raddoppio — è quello a cui attribuirei maggiore importanza se il vostro lavoro riguardasse il calcolo scientifico o le pipeline di dati. E nel benchmark di Browserbase relativo all’utilizzo più intensivo del computer, Fable 5.1 ha completato 82% di attività contro le 74% di Claude Opus 5.
Anthropic riferisce inoltre che circa un 60%: riduzione dei falsi positivi nella sicurezza informatica — il modello che rifiuta un’operazione di sicurezza legittima perché la sua corrispondenza con un pattern indica qualcosa di pericoloso. Se vi è mai capitato che un assistente di programmazione si rifiutasse di aiutarvi a scrivere un limitatore di velocità, capirete perché questo è importante.
La novità vera e propria è la modifica dei prezzi
I tassi di riferimento sono rimasti invariati: $10 per milione di token in ingresso, $50 per milione di token in uscita. Ciò che è cambiato è il moltiplicatore di lettura della cache, e il cambiamento è stato notevole.
| Fable 5 | Fable 5.1 | |
|---|---|---|
| Input | $10.00 | $10.00 |
| Risultato | $50.00 | $50.00 |
| Scrittura nella cache (5 min) | $12.50 | $12.50 |
| Scrittura nella cache (1 ora) | $20.00 | $20.00 |
| Lettura dalla cache | $1.00 | $0.25 |
Si tratta di una riduzione denominata 75%, ottenuta portando il moltiplicatore di lettura della cache dal valore standard di 0,1× dell’input di base a 0,025×. Anthropic riporta approssimativamente 25% in meno per carichi di lavoro tipici e fino a 45% in meno per attività altamente agenti — e quella seconda cifra è reale, perché i cicli degli agenti consistono prevalentemente in letture dalla cache. Una sessione di un agente di 60 turni rilegge lo stesso contesto accumulato decine di volte. L’API Batch dimezza inoltre gli input e gli output, arrivando a $5/$25.
Si tratta di una riduzione di prezzo intelligente e mirata. Rende l'aspetto in cui Fable 5.1 eccelle — le sessioni di gioco prolungate — significativamente più conveniente senza sminuire il valore complessivo del modello.
Tre modifiche che comportano incompatibilità, una regressione
Prima di aggiornare un'integrazione in produzione, leggi attentamente queste istruzioni.
1. L'uso obbligatorio degli strumenti è stato eliminato. Richieste che utilizzano tool_choice: "qualsiasi" o scelta_strumento: "strumento" ora restituisci un Errore 400. Il processo di elaborazione è sempre attivo e non può essere bypassato; forzando l'esecuzione di uno strumento, lo si salterebbe. È necessario utilizzare tool_choice: "auto".
2. I blocchi di pensiero sono unidirezionali. Fable 5.1 è in grado di leggere i ’thinking block" generati dai modelli precedenti di Claude, ma i modelli precedenti non sono in grado di leggere quelli di Fable 5.1. Solo Mythos 5.1 è in grado di farlo. Se la vostra architettura cambia modello nel bel mezzo di una conversazione per risparmiare, tale soluzione di ripiego ora impone una ripianificazione.
3. La cronologia delle modifiche rende obsoleti i blocchi mentali. Per gli account creati dopo il 31 agosto 2026, la modifica dei turni precedenti, delle richieste del sistema o della matrice degli strumenti invalida tutti i blocchi di ragionamento successivi — sia che si tratti di errori che di omissioni silenziose. Si tratta di una misura esplicita contro la distillazione che interrompe un modello comune in cui i framework degli agenti riscrivono il contesto tra un turno e l’altro.
E un dato interessante da conoscere: A quanto pare, nella versione 5.1 le chiamate parallele alle funzioni sono più variabili: a volte viene emessa una sola chiamata per turno, mentre nella versione 5 ne venivano raggruppate diverse. In un ciclo lungo dell’agente, ciò comporta un dispendio di tempo reale.
C'è anche un dettaglio relativo al tokenizer che spesso sfugge quando si confrontano i costi: Fable 5.1 utilizza lo stesso tokenizer di Claude Opus 4.7, che produce all'incirca 30% altri gettoni rispetto al tokenizer dei modelli Claude precedenti per lo stesso testo. Se state confrontando i costi con un valore di riferimento del 2025, tenetene conto prima di trarre qualsiasi conclusione.
Il problema del benchmark: tre modelli, tre diversi criteri di valutazione
Ecco il punto su cui la maggior parte degli articoli comparativi sbaglia, e vale la pena dirlo senza mezzi termini.
Non è possibile allineare questi tre modelli su Terminal-Bench. Guarda:
- Kimi K3: 88.3 su Terminal-Bench 2.1
- GLM-5.3: 28.3 su Terminal-Bench 3.0
- Fable 5.1: 55.8 su Terminal-Bench 4.0
Si tratta di tre benchmark diversi che condividono lo stesso nome. Ogni versione è risultata notevolmente più difficile della precedente: è proprio questo lo scopo del rilascio di una nuova versione. Interpretare quei tre numeri come una classifica porterebbe a concludere che Kimi K3 sia tre volte migliore di GLM-5.3 nelle operazioni terminali, il che è una sciocchezza.
Lo stesso problema si riscontra in AutomationBench, dove i numeri di versione vengono riportati in modo incoerente, e nella famiglia SWE-bench, dove le varianti Verified, Pro e Marathon misurano aspetti effettivamente diversi. I laboratori non lo fanno con l’intento di ingannare nessuno: eseguono la valutazione che era in vigore al momento della loro formazione, e le valutazioni cambiano ormai ogni pochi mesi. Tuttavia, l’effetto su un lettore non esperto è lo stesso di un inganno, quindi vale la pena segnalarlo con forza.
Ciò che è possibile confrontare in modo legittimo, all'interno di una stessa versione:
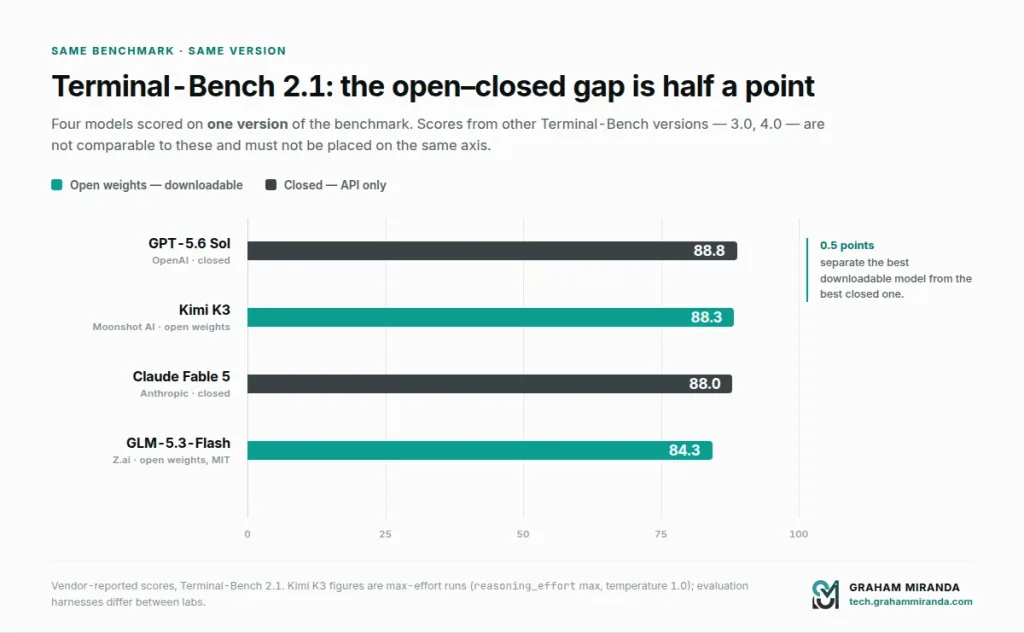
Su Terminal-Bench 2.1: Kimi K3 (88,3), GPT-5.6 Sol (88,8), Claude Fable 5 (88,0) e GLM-5.3-Flash (84,3). Quattro modelli, un unico metro di valutazione. Questo è il confronto che conta davvero e gli ho dedicato una tabella a parte nella sezione successiva.
Su Terminal-Bench 4.0: Fable 5.1 (55,8) contro GPT-5.6 Sol (52,3). Vince Fable.
Oltre a ciò, diffidate di chiunque vi mostri un unico grafico a barre che riporti tutti e tre i modelli citati nel titolo di questo articolo su un asse “Terminal-Bench”. Non è possibile farlo in modo onesto.
Dove si incontrano realmente: i dati comparabili tra loro
Se si escludono le discrepanze tra le versioni dei benchmark, rimangono tre confronti.
1. Indice di intelligenza artificiale applicata all'analisi (settembre 2026)
Gestione indipendente, stessa metodologia applicata a tutti i modelli, nessun coinvolgimento dei fornitori nella selezione.
| Classifica | Modello | Punteggio | Pesi liberi |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | No |
| 2 | Claude Fable 5 | 62.1 | No |
| 3 | Grok 4.6 | 60.9 | No |
| 4 | Kimi K3 | 59.7 | Sì |
| 5 | GLM-5.3 | 59.5 | Sì |
| 6 | GPT-5.6 Sol | 58.9 | No |
| 7 | Anteprima di Qwen 3.8 Max | 58.1 | Pesi da definire |
| 8 | GLM-5.3-Flash | 57.5 | Sì (MIT) |
| 31 | MiniMax M3 | 45.4 | Sì |
Al momento della stesura di questo articolo, Fable 5.1 non era ancora stato valutato da fonti indipendenti, essendo stato lanciato il giorno prima. Considerati i miglioramenti registrati da Fable 5.1 rispetto a Fable 5 nei benchmark, è prevedibile che, una volta valutato, il punteggio si attesti a 62,1 o oltre.
Una nota sulla precisione: i diversi istantanei di questo indice presentano variazioni diverse — in un’analisi di settembre, Kimi K3 e GLM-5.3 risultano entrambi a 60, mentre GPT-5.6 Sol è a 61. L’ordine nella parte alta della classifica è stabile; i distacchi tra i singoli punti non lo sono. Non basare le tue argomentazioni su mezzo punto.
Leggi attentamente quella tabella. Il miglior modello a ponderazione aperta registra un ritardo di 3,3 punti rispetto al miglior modello a ponderazione chiusa sull'indice neutro più ampio disponibile. Un anno fa quel divario era a due cifre.
2. Terminal-Bench 2.1 — l'unica versione in cui i tre si incontrano
Questa è la tabella più utile di tutto l’articolo, e per poco non me la lasciavo sfuggire. Kimi K3, Claude Fable 5 e GPT-5.6 Sol sono stati tutti valutati in base a la stessa versione di Terminal-Bench:
| Modello | Terminal-Bench 2.1 | Pesi liberi |
|---|---|---|
| GPT-5.6 Sol | 88.8 | No |
| Kimi K3 | 88.3 | Sì |
| Claude Fable 5 | 88.0 | No |
| GLM-5.3-Flash | 84.3 | Sì (MIT) |
Mezzo punto separa un modello scaricabile dal miglior modello chiuso nello stesso benchmark, nella stessa versione, nell’ambito del lavoro agentico nativo del terminale.
Questo è il numero da tenere a mente. Non l’aggregato dell’indice, né il grafico del fornitore: proprio questo. Per quanto riguarda la forma specifica del compito che la codifica agentica rappresenta di fatto, il divario è nascosto nel rumore.
Un avvertimento, sottolineato dalla fonte e che vale la pena ribadire: tutti i tempi pubblicati dalla Kimi K3 si riferiscono a giri percorsi al massimo, a sforzo_di_ragionamento massimo e temperatura 1,0. Laboratori diversi utilizzano sistemi di valutazione diversi e impostazioni di sforzo diverse, quindi anche i confronti tra versioni identiche comportano un margine di incertezza maggiore rispetto a quanto suggerirebbe una tabella semplice.
3. Costo di gestione della stessa suite di strumenti di valutazione
Se la tabella sopra riportata rappresenta il miglior confronto in termini di prestazioni, questo è il miglior confronto in termini di rapporto qualità-prezzo — poiché è l’unico dato che riunisce in un unico valore le prestazioni, la verbosità, il sovraccarico di ragionamento e il prezzo:
| Modello | Costo per attività dell’Intelligence Index |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
Stesse attività, stesso punteggio, fatture reali. GLM-5.3 raggiunge un punteggio indice di 94% secondo Opus 5 a un costo di 29%.
4. GDPval-AA v2 (lavoro intellettuale)
| Modello | Punteggio |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
È opportuno fare una precisazione: questo dato è stato ricavato da grafici pubblicati dai fornitori piuttosto che da un'unica analisi indipendente, e i suffissi “Max” indicano diverse impostazioni di sforzo. Tuttavia, l’ordine dei risultati è sostanzialmente coerente tra le diverse fonti e rivela un dato di fatto: per quanto riguarda il lavoro intellettuale in generale, a differenza della programmazione, i modelli chiusi mantengono ancora un vantaggio più netto rispetto a quanto suggeriscano i benchmark relativi alla programmazione.
Questo è lo schema che si ripete in tutti e tre i confronti. I modelli aperti hanno sostanzialmente recuperato il ritardo per quanto riguarda la programmazione e le attività di tipo agentico. Sono ancora un po’ indietro per quanto riguarda il lavoro intellettuale in senso lato. Se il vostro carico di lavoro rientra nella prima categoria, le ragioni a favore del pagamento dei prezzi previsti dal modello chiuso sono deboli. Se invece rientra nella seconda, la scelta è comunque giustificabile.
Mostra immagine Tre punti e mezzo separano il miglior modello chiuso da quello scaricabile. Dodici mesi fa quel divario era a due cifre.
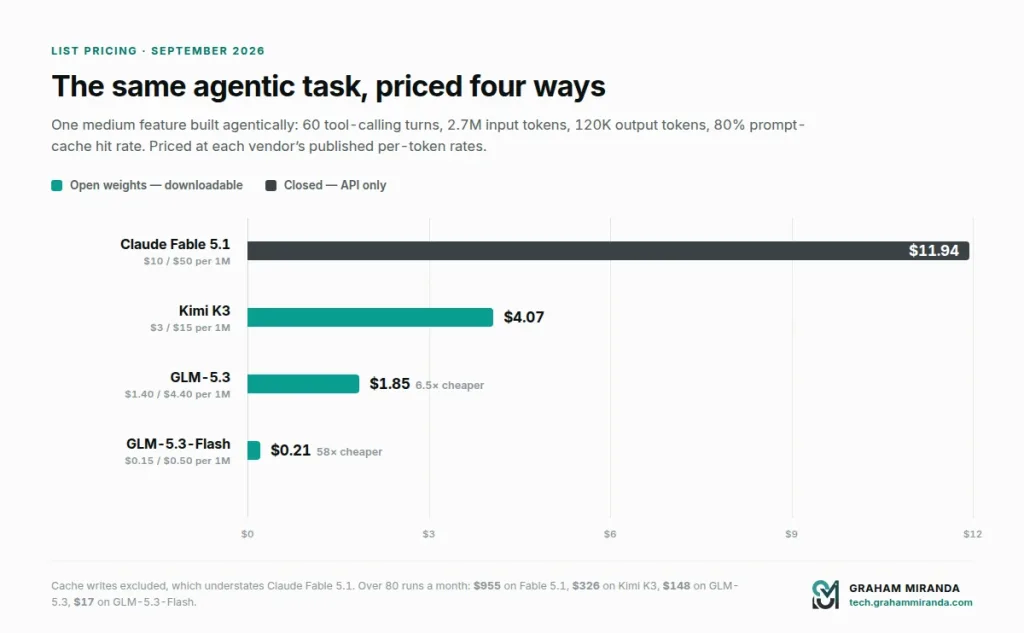
Il calcolo dei costi, con numeri reali
I parametri di riferimento sono astratti. Le fatture no.
Lo scenario
Un elemento di media entità, realizzato in modo autonomo: approssimativamente 60 turni di chiamata degli strumenti, con una media di 45.000 token di input per turno man mano che il contesto si arricchisce, e 2.000 token di output per turno.
- Totale immesso: 2,7 milioni di token
- Produzione totale: 120.000 token
- Tasso di successo nella cache dei prompt ipotizzato: 80% (2,16 milioni in cache, 540.000 aggiornati)
Claude Fable 5.1
| Componente | Gettoni | Tasso | Costo |
|---|---|---|---|
| Nuovi spunti | 540.000 | $10,00/M | $5.40 |
| Dati in cache | 2,16 milioni | $0,25/M | $0.54 |
| Risultato | 120.000 | $50,00/M | $6.00 |
| Totale | ≈ $11,94 |
Kimi K3
| Componente | Gettoni | Tasso | Costo |
|---|---|---|---|
| Nuovi spunti | 540.000 | $3,00/M | $1.62 |
| Dati in cache | 2,16 milioni | $0,30/M | $0.65 |
| Risultato | 120.000 | $15,00/M | $1.80 |
| Totale | ≈ $4,07 |
GLM-5.3
| Componente | Gettoni | Tasso | Costo |
|---|---|---|---|
| Nuovi spunti | 540.000 | $1,40/M | $0.76 |
| Dati in cache | 2,16 milioni | $0,26/M | $0.56 |
| Risultato | 120.000 | $4,40/M | $0.53 |
| Totale | ≈ $1,85 |
E, a titolo di riferimento: GLM-5.3-Flash
| Componente | Gettoni | Tasso | Costo |
|---|---|---|---|
| Nuovi spunti | 540.000 | $0,15/M | $0.08 |
| Dati in cache | 2,16 milioni | $0.03/M | $0.06 |
| Risultato | 120.000 | $0,50/M | $0.06 |
| Totale | ≈ $0,21 |
I rapporti
- GLM-5.3 costa 6,5 volte meno di Fable 5.1 per lo stesso lavoro
- Kimi K3 costa 2,9 volte meno di Fable 5.1
- Il GLM-5.3 costa 2,2 volte meno del Kimi K3
- GLM-5.3-Flash costa 58 volte meno di Fable 5.1, con un punteggio di 57,5 nell'indice di intelligenza rispetto al 62,1 di Fable 5
Conversione in un mese lavorativo
Quattro compiti di questo tipo al giorno, venti giorni lavorativi — 80 cicli di azione:
| Modello | Costo mensile dei token |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
Tre avvertenze sincere su questi dati
Le operazioni di scrittura nella cache sono escluse. Fable 5.1 imputa $12,50/M per le scritture in cache della durata di 5 minuti, mentre una sessione prolungata comporta ripetute scritture in cache. L’inclusione delle scritture fa aumentare, anziché diminuire, il valore effettivo di Fable. Anche il tasso di successo di 80% è ottimistico per le sessioni brevi.
I token di ragionamento vengono conteggiati come token di output. Tutti e tre i modelli utilizzano un approccio di elaborazione continua. Il GLM-5.3, in particolare, è documentato come molto prolisso — 170 milioni di token in output a fronte di una mediana di 72 milioni per classe nell’ambito della suite AA — quindi il suo volume di output effettivo è superiore a quanto suggerirebbe un semplice conteggio dei turni. Il dato di $0,68 per attività tiene già conto di questo aspetto, ed è per questo che mi fido di più di esso rispetto al mio modello sopra riportato.
Il tokenizzatore di Fable 5.1 produce circa 30% di token in più rispetto ai modelli precedenti di Claude per lo stesso testo. Se stai effettuando un confronto con una fattura storica di Claude, apporta le opportune modifiche.
Anche dopo tutte e tre le correzioni, l’ordine non cambia e l’entità varia solo di poco. Il lavoro con frontiera chiusa costa circa sei volte di più rispetto al miglior modello a peso libero, per ogni attività completata.
Mostra immagine Lo stesso compito agentico da 60 turni al prezzo di listino di ciascun fornitore. L’asse verticale rappresenta l’argomento completo per i pesi aperti.
Licenze: cosa offre realmente il termine “open” nel 2026
Questa è la parte che vorrei soprattutto che la gente leggesse, perché il vocabolario si è deteriorato parecchio e questo finirà per costare un sacco di soldi a qualcuno.
Né Kimi K3 né GLM-5.3 sono open source. Entrambe pubblicano modelli scaricabili con licenze personalizzate che prevedono condizioni legate ai ricavi. Si tratta di una differenza sostanziale rispetto alle licenze MIT o Apache 2.0, e tale differenza riguarda proprio il tipo di attività che trarrebbe il massimo vantaggio dall’autohosting.
La licenza Kimi K3
Su Internet vedrete spesso la dicitura “Modified MIT” associata a K3. È sbagliato: quella dicitura si riferiva a K2. K3 viene distribuito con un documento personalizzato che prevede due fasi distinte:
Il gateway "Model-as-a-Service". Se si concede a terzi l'accesso all'inferenza o alla messa a punto del modello — laddove tali terzi controllino gli input, i parametri o i dati di addestramento — e “il fatturato complessivo del licenziatario e delle sue affiliate supera i 20 milioni di dollari statunitensi” per qualsiasi periodo di 12 mesi consecutivi, è necessario stipulare un accordo commerciale separato con Moonshot. Nota aggregato fatturato complessivo di tutte le affiliate, non il fatturato attribuibile a K3. Una società di consulenza con un fatturato di 25 milioni di euro che rivende servizi di inferenza supera la soglia anche se l’attività legata all’IA è trascurabile.
Il caso dell’attribuzione. Prodotti che superano 100 milioni di utenti attivi al mese oppure $20 milioni di ricavi mensili deve riportare in modo ben visibile la dicitura “Kimi K3” nell’interfaccia del prodotto.
L'esenzione più importante: L'uso puramente interno non è soggetto ad alcuna restrizione. L'utilizzo di K3 a supporto dei propri sviluppatori, ricercatori, del team legale o per la produttività generale dei dipendenti non fa scattare nessuna delle due condizioni. Per la stragrande maggioranza delle aziende — compresa praticamente tutta la mia — questa è la clausola rilevante, e la risposta è che non c'è alcun problema.
La novità rispetto alla versione K2 è la soglia $20M per il MaaS. La versione K2 richiedeva l’attribuzione solo al di sopra delle proprie soglie. La versione K3 introduce una soglia di fatturato molto più bassa, mirata specificatamente ai rivenditori di servizi di inferenza commerciale. Moonshot non sta cercando di impedirvi di utilizzare il modello; sta cercando di impedire ai fornitori di servizi cloud di costruire un business basato su di esso gratuitamente.
Licenza glm-5.3
Il prodotto di punta di Z.ai ha preso una direzione diversa, e si tratta di una rottura con il passato più netta di quanto la maggior parte dei resoconti abbia riconosciuto.
GLM-5.2 è distribuito sotto licenza MIT. GLM-5.3-Flash è distribuito sotto licenza MIT. GLM-5.3 invece no.
La licenza personalizzata consente a privati e aziende di qualsiasi dimensione di eseguire, implementare e ottimizzare il modello senza ulteriori restrizioni. La licenza “Single Gate” è destinata agli hyperscaler: entità le cui “il fatturato complessivo del Licenziatario e delle sue affiliate superi i 10 miliardi di dollari statunitensi (o l’equivalente in altre valute) in totale nell’arco di qualsiasi periodo di 12 mesi consecutivi” mosto superare la verifica di sicurezza di Z.AI prima di utilizzare il modello o i suoi derivati per qualsiasi scopo commerciale.
Si tratta di una soglia di $10 miliardi. Esclude praticamente tutti. Ma due dettagli riportati in piccolo meritano attenzione:
In primo luogo, la licenza esclude esplicitamente gli sviluppatori di app che integrano il modello nelle proprie funzionalità e i rivenditori che si limitano a inoltrare le richieste ad altri host. Il target è ristretto e chiaramente definito: le aziende che desiderano host GLM-5.3 su larga scala a livello commerciale.
Secondo — e questa è la parte davvero imbarazzante — La licenza non prevede criteri, tempistiche né procedure di ricorso per tale verifica di sicurezza. Si afferma semplicemente che il suo “L’ambito e il metodo… saranno stabiliti in modo ragionevole da Z.AI.” Se siete una grande impresa, ciò comporta una dipendenza illimitata dalla discrezionalità di un fornitore estero, e il vostro team addetto agli acquisti ve lo dirà chiaramente.
Da notare inoltre che, nonostante la sospensione di due settimane delle operazioni informatiche che ha preceduto il rilascio, La licenza non prevede restrizioni relative all’uso accettabile, né esclusioni relative alla sicurezza informatica, né rivendicazioni di proprietà sui risultati. Le preoccupazioni in materia di sicurezza hanno influenzato il lancio tempistica, non la versione termini.
Ma allora, cos’è rimasto in realtà del MIT?
GLM-5.3-Flash. 320 miliardi di parametri, 18 miliardi attivi, multimodale nativo, con licenza MIT, indice di intelligenza pari a 57,5 e $0,15/$0,50 per milione di token — attualmente a metà prezzo grazie a uno sconto promozionale valido fino al 9 settembre 2026. Se ciò che cercate è una licenza realmente permissiva e senza restrizioni, piuttosto che semplici pesi scaricabili, è proprio lì che si trova attualmente la frontiera, ed è notevolmente alta.
Il riassunto pratico
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Pesi scaricabili | Sì | Sì | Sì | No |
| open source in stile OSI | No | No | Sì (MIT) | No |
| Condizione di attivazione della restrizione | Ricavi $20M (MaaS) | Ricavi $10B (MaaS) | Nessuno | N/D |
| È richiesta l'attribuzione | Oltre 100 milioni di utenti attivi mensili (MAU) / $20M-mese | Solo avviso sul copyright | Solo avviso sul copyright | N/D |
| Uso riservato | No | No | No | N/D |
| È consentita la regolazione di precisione | Sì | Sì | Sì | No |
| Politica di utilizzo accettabile | Standard | Nessuna nel testo della licenza | Nessuno | Si applica la Politica di utilizzo accettabile (AUP) di Anthropic |
Per una tipica impresa tedesca di medie dimensioni (Mittelstand), un’agenzia o una società di consulenza che utilizza modelli internamente o li integra in un prodotto: Tutte e tre le opzioni disponibili sono utilizzabili senza dover negoziare nulla. Questi limiti sono stati pensati per AWS, non per te. Ma il consiglio “leggi la licenza” è passato dall’essere un’osservazione pedante a un consiglio concreto, e se il tuo fatturato supera i 20 milioni di euro e rivendi servizi di inferenza in qualsiasi forma, sottoponilo a un consulente legale prima di procedere all’implementazione.
Le vere ragioni a favore dei modelli aperti
Vorrei sviluppare questa argomentazione in modo adeguato, anziché limitarla a uno slogan, perché dire che “i modelli aperti sono fantastici” non è un’argomentazione e le ragioni concrete sono più interessanti delle semplici esaltazioni.
1. Il crollo dei prezzi non è una sovvenzione, è un fenomeno strutturale
L'obiezione istintiva nei confronti dei modelli cinesi a basso costo è che i prezzi siano utilizzati come esca per attirare i clienti e che sono destinati a normalizzarsi al rialzo. In parte è certamente vero. Ma il punto strutturale rimane valido a prescindere: Quando i pesi sono di dominio pubblico, l’inferenza diventa un mercato di materie prime. Venti provider di hosting competono per offrire lo stesso modello, e nessuno di loro può applicare un sovrapprezzo per le proprie capacità, poiché nessuno dispone di un vantaggio competitivo in termini di capacità. Ecco perché GLM-5.3 funziona a $1,40/$4,40 e Fable 5.1 a $10/$50, con punteggi che differiscono di tre punti.
Il prezzo basato sul modello chiuso comprende l'ammortamento delle spese di ricerca e sviluppo, il margine e il fatto che vi sia un solo venditore. Il prezzo basato sul modello aperto comprende l'elettricità, l'ammortamento dell'hardware e un margine ridotto. Si tratta di attività commerciali diverse, e il divario non si colmerà con l'aumento dei prezzi dei modelli aperti.
La prova che si tratta di un fenomeno reale e non temporaneo: DeepSeek ha rilevato circa 17% di utilizzo di token su Vercel entro maggio 2026, mantenendo una quota di ricavi pari a circa 1%. Non si tratta di un’anomalia nei prezzi. È proprio così che si presenta la mercificazione su un grafico.
2. I diritti di recesso modificano la tua posizione negoziale anche se non li eserciti mai
La maggior parte dei team che leggeranno questo articolo non opterà per l'hosting autonomo. La sezione dedicata all'hardware qui di seguito spiega il motivo: Kimi K3 richiede un rack. Tuttavia, questa opzione presenta comunque dei vantaggi.
Se Anthropic aumenta i prezzi, rende obsoleto il modello su cui hai basato il tuo prodotto, modifica la propria politica di utilizzo accettabile in modo tale da compromettere il funzionamento del tuo prodotto, oppure registra un trimestre negativo, l’unica soluzione a tua disposizione con un modello chiuso è un progetto di migrazione. Con un modello a ponderazione aperta, invece, l’unica soluzione è scaricare un file che avresti potuto scaricare in qualsiasi momento. Potresti non farlo mai. Il fatto che tu potrebbe è ciò che rende il rapporto con il fornitore di natura commerciale anziché di dipendenza.
Non si tratta di una questione teorica. Il 1° settembre Fable 5.1 è stato rilasciato con tre modifiche che comportano incompatibilità, una delle quali invalida i “thinking block” quando si modifica la cronologia delle conversazioni per gli account creati dopo il 31 agosto. Se tale modello è fondamentale nella vostra architettura, sarete costretti a riorganizzarla secondo i tempi di Anthropic, non secondo i vostri.
3. La residenza dei dati non è più un progetto
Per chiunque operi nel rispetto del GDPR, questo è l’argomento che permette davvero di concludere gli affari.
Con un’API chiusa, ogni richiesta esce dalla vostra infrastruttura. È necessario stipulare un accordo con il responsabile del trattamento, effettuare una valutazione d’impatto sul trasferimento se il responsabile del trattamento si trova al di fuori del SEE, redigere una mappa dei flussi di dati e fornire una risposta al vostro responsabile della protezione dei dati (DPO) su cosa succede ai dati inattivi. Tutto ciò è fattibile. Si tratta però di settimane di lavoro per ogni fornitore, da ripetere ogni volta che il fornitore apporta una modifica.
Con i pesi aperti sulle infrastrutture che controlli — il tuo hardware o un host GPU tedesco o dell’UE — la questione del trasferimento transfrontaliero non si pone, poiché non vi è alcun trasferimento. Il modello viene eseguito proprio dove si trovano già i tuoi dati. La verifica legale passa da una valutazione del trasferimento alla lettura della licenza.
Per i clienti tedeschi e dell'UE questo è spesso il fattore decisivo, e vale la pena precisare bene questa avvertenza: L'utilizzo di GLM-5.3 tramite l'API di Z.ai non offre questa funzionalità. La si ottiene gestendo direttamente le attrezzature o tramite un fornitore che le ospita nella propria giurisdizione. La licenza rende tale attività legale, ma non la rende automatica.
4. L'ispezionabilità è una realtà, anche se sottoutilizzata
I pesi aperti consentono di esaminare l'architettura, eseguire valutazioni personalizzate sul modello effettivo anziché su un endpoint che potrebbe essere aggiornato in modo trasparente, quantizzarlo per adattarlo al proprio hardware, ottimizzarlo in base al proprio dominio e — cosa importante — fissare una versione in modo permanente.
Quest'ultimo aspetto è sottovalutato. Le API chiuse vengono aggiornate dietro ID di modelli stabili. Il comportamento subisce delle variazioni. I prompt che funzionavano smettono di funzionare e non è possibile individuare la differenza perché non è visibile. Un checkpoint locale rimane identico a livello di byte anche dopo un anno.
5. La pressione concorrenziale va a vantaggio di tutti, compresi gli utenti di modelli chiusi
Guardate cosa è successo quest’estate. Kimi K3 ha raggiunto a luglio un punteggio di $3/$15, con risultati vicini ai massimi livelli. GLM-5.3 ha raggiunto ad agosto un punteggio di $1,40/$4,40, a meno di mezzo punto di distanza. E il 1° settembre, Anthropic ha ridotto le letture della cache di 75%.
Non sto affermando che esista un nesso causale diretto: Anthropic non rende pubblica la logica alla base dei propri prezzi e la riduzione delle letture dalla cache è una naturale ottimizzazione. Tuttavia, un mercato in cui esistono sostituti credibili ed economici ha prezzi diversi rispetto a uno in cui tali sostituti non esistono, e quest’anno i sostituti sono diventati credibili. Se utilizzate esclusivamente modelli chiusi, l’ecosistema open-weight continua comunque, in modo discreto, a ridurre le vostre bollette.
6. È nel periodo post-allenamento che si ottengono i risultati, ed è poco costoso
Il risultato principale del GLM-5.3 — un miglioramento di sei volte del Terminal-Bench a parità di pesi di base — è il dato strategicamente più importante di tutto questo articolo, e non riguarda il GLM.
Si afferma che la parte più costosa della creazione di un modello di frontiera (pre-addestramento) sia sempre più un elemento risolto e standardizzato, mentre la parte che fa la differenza (post-addestramento, ambienti di apprendimento per rinforzo, progettazione di compiti a lungo termine) sia relativamente accessibile. Ecco perché quattro laboratori cinesi, con una valutazione complessiva di circa $159 miliardi, stanno tenendo il passo con i laboratori americani il cui valore è molte volte superiore. Secondo la valutazione di Lambert, i laboratori cinesi operano con “capitali di ordine di grandezza inferiore”.”
Per chiunque si trovi a valle, la conseguenza è chiara: Il numero di fornitori di modelli affidabili sta aumentando, non diminuendo. Progettate la vostra architettura di conseguenza.
7. Gli effetti sull'ecosistema si sommano
Qwen è venuta a trovarci un miliardo di download cumulativi su Hugging Face, superando Llama, e ora ospita oltre 200.000 modelli etichettati e più di 113.000 modelli derivati — all’incirca 40% di tutti i nuovi derivati LLM sulla piattaforma sono basati su Qwen. Si tratta di un ecosistema di strumenti, quantizzazione, messa a punto e implementazione che esiste solo perché i pesi sono pubblici.
Si trae vantaggio da quell’ecosistema indipendentemente dal fatto che si contribuisca o meno ad esso. Conversioni GGUF, kernel vLLM, adattatori LoRA, ricette di quantizzazione, framework di valutazione: tutto questo esiste perché migliaia di persone hanno potuto accedere ai pesi effettivi.
8. È lì che gli sviluppatori si sono già recati
Modelli di origine cinese presso ~61% di token OpenRouter. La quota dei modelli statunitensi è scesa da circa 70% a circa 30% in un anno. Quattro dei cinque modelli più utilizzati sul router sono di origine cinese. I soli modelli MiMo di Xiaomi rappresentano circa il 21% dei token instradati e circa il 22% di tutto il traffico di codifica.
Il comportamento degli sviluppatori è un indicatore anticipatore. Lo è stato per Docker, per Postgres e per Linux. Scommettere contro di esso ha dato risultati deludenti in passato.
…E le argomentazioni sincere contro
Se avessi scritto solo la sezione precedente, questo sarebbe un annuncio pubblicitario.
I pesi aperti non sono open source, e la deriva del vocabolario rappresenta un vero problema. Due dei tre modelli qui presentati vengono forniti con licenze personalizzate basate sui ricavi, prive di approvazione da parte dell’OSI. La clausola relativa alla revisione della sicurezza di GLM-5.3 non prevede criteri pubblicati né una procedura di ricorso. Se il vostro quadro di conformità richiede licenze approvate dall’OSI, la risposta onesta è che le vostre opzioni sono GLM-5.3-Flash, i prodotti di punta di DeepSeek con licenza MIT e un numero sempre più esiguo di altre soluzioni.
I benchmark dei fornitori restano pur sempre benchmark dei fornitori. Tutti i dati salienti pubblicati da Moonshot e Z.ai sono stati comunicati e selezionati autonomamente dai laboratori stessi. Laddove sono stati misurati da aggregatori neutrali, i dati risultano sostanzialmente confermati — il che va davvero a merito di entrambi i laboratori — ma l’espressione ’risultano sostanzialmente confermati“ assume un significato particolare in quella frase.
L'autogestione è un sogno irrealizzabile per la maggior parte dei team. Kimi K3 ha una capacità di 1,5 TB e Moonshot consiglia di utilizzare almeno 64 acceleratori. GLM-5.3 richiede come requisito minimo 8×H200 in modalità FP8. L’uscita a destra è reale; il costo dell’operazione è un data center.
Il supporto è ciò che tu ne fai. Quando Fable 5.1 smette di funzionare, c'è un'azienda che offre uno SLA. Quando la tua installazione self-hosted di GLM-5.3 produce dati spazzatura a 300K di contesto un venerdì sera, c'è un issue su GitHub e la tua competenza.
La geopolitica è un fattore determinante negli appalti. Tutte e tre le opzioni a peso libero qui discusse provengono da laboratori cinesi. Per alcuni clienti — settore pubblico, settori correlati alla difesa, determinati settori regolamentati — questo rappresenta un ostacolo insormontabile, indipendentemente dai termini della licenza o dall’entità dei pesi. Non spetta a me dirvi se tale preoccupazione sia fondata. Il mio compito è dirvi che la questione verrà sollevata durante la riunione.
I modelli chiusi continuano a dominare nel campo del lavoro intellettuale in generale. GDPval-AA v2 registra un punteggio di 1.853 per Fable 5.1, contro i 1.769 di GLM-5.3 e i 1.687 di Kimi K3. A livello di programmazione, il divario è scomparso; per quanto riguarda il lavoro intellettuale in senso lato, invece, permane.
Mostra immagine Pesi scaricabili, tre diversi set di corde. Solo GLM-5.3-Flash è ancora sotto licenza MIT.
Ollama nel 2026: il cambiamento di prezzo che conta davvero
Ollama è diventata, quasi inosservata, l’elemento infrastrutturale più importante in questo contesto, e su 31 agosto 2026 ha modificato il modo in cui si ricarica, ed è importante comprenderlo a fondo.
Cosa è cambiato
Ollama ha modificato i propri piani Pro, Max e Team, passando dalla fatturazione basata sul tempo di utilizzo della GPU a prezzi per token in linea con gli standard del settore, con un pacchetto di crediti di utilizzo incluso in ogni piano. La motivazione addotta dall’azienda è piacevolmente concreta: modelli come Kimi K3 hanno reso impossibile prevedere i tempi di elaborazione della GPU. Quando un modello attiva 104 miliardi di parametri e un altro ne attiva 3 miliardi, “un’ora di GPU” smette di avere alcun significato per chi paga.
I nuovi piani
| Piano | Prezzo | Consumo mensile incluso | Concorrenza |
|---|---|---|---|
| Gratuito | $0 | Piccolo credito mensile, modelli base | 1 richiesta |
| Pro | $20 al mese (oppure $200 all'anno) | $60 di utilizzo | 3 richieste |
| Max | $100/mese | $300 di utilizzo | 10 richieste |
| Squadra | $500/mese | $1.000 condivisi, utenti illimitati | 10 richieste |
| Impresa | Personalizzato | Personalizzato | Personalizzato |
Rileggi la riga “Pro”. $20 acquista $60 di token. Si tratta di un moltiplicatore 3× sull'utilizzo incluso e, una volta esaurito il pool, si continua esattamente alla stessa tariffa per token pubblicata — senza livelli di penalizzazione né commissioni di servizio.
Cosa è stato rimosso
Questa è la parte che gli sviluppatori hanno effettivamente notato: Nessun azzeramento ogni 5 ore e nessun limite settimanale. Chiunque si sia trovato a dover gestire una finestra di utilizzo a rotazione nel bel mezzo di una rifattorizzazione capirà perché questo aspetto fosse più importante del prezzo. Il pool mensile viene aggiornato alla data di rinnovo dell’abbonamento e, cosa importante, non si ribalta — quindi adatta il tuo piano al tuo mese tipo, non a quello più intenso.
I termini fondamentali per il lavoro nell'UE
Tre impegni contenuti nell'annuncio sono di diretta rilevanza per chi gestisce i dati dei clienti:
- Nessuna conservazione dei dati. I prompt e le risposte non vengono mai registrati né utilizzati per l'addestramento.
- Hosting negli Stati Uniti e in Europa, oltre a Singapore per una gamma limitata di modelli Qwen.
- Visibilità dei costi per singola richiesta nel tuo account: puoi vedere esattamente quanto è costata ogni chiamata.
Per una società di consulenza tedesca, si tratta di una situazione di conformità nettamente migliore rispetto a quella offerta dalla maggior parte dei provider di gateway, anche se l’indicazione “ospitato in Europa” è un’affermazione relativa al routing piuttosto che una garanzia contrattuale sulla residenza dei dati. Se la residenza dei dati è un requisito imprescindibile piuttosto che una semplice preferenza, richiedila per iscritto a Ollama prima di darla per scontata.
I tassi effettivi per token
È qui che la cosa si fa interessante. Ollama pubblica le tariffe per modello e ne monitora attentamente l’andamento rispetto ai prezzi di prima mano:
| Modello su Ollama | Ingresso / 1M | In cache / 1M | Uscita / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
Applica a questo caso i calcoli mensili fatti in precedenza. Ottanta esecuzioni "agentic" al mese su GLM-5.3 costano circa $148 in token. A Il piano Max da $100 al mese copre un utilizzo pari a $300 — quindi lo stesso carico di lavoro che su Fable 5.1 costerebbe circa $955 al mese rientra tranquillamente in un abbonamento Ollama da $100, lasciando ancora un ampio margine di riserva.
Ecco l’intera argomentazione economica a favore del modello aperto, sintetizzata in una sola riga di una fattura.
Mostra immagine Ottanta esecuzioni agentiche al mese su GLM-5.3 rientrano nel piano Ollama Max $100, con un po’ di margine. Lo stesso lavoro su Fable 5.1 comporta una fattura da $955.
Altre novità lanciate da Ollama nel 2026
Il cambiamento dei prezzi non è avvenuto in modo isolato. Gli ultimi mesi sono stati piuttosto intensi:
- 25 agosto — Assistenza tecnica per Claude Desktop. Ollama opera ora come fornitore di gateway di terze parti per Claude Desktop, consentendo così di utilizzare modelli aperti tramite il client di Anthropic.
- 26 agosto — v0.33.0. È stata implementata l'integrazione del gateway Claude Desktop, è stata ripristinata la compilazione automatica dei campi di recupero nella cache e Ollama ha disabilitato il messaggio di sistema relativo al conto alla rovescia dei token di Claude Code, che invalidava la cache KV ad ogni turno. Quest'ultima è una correzione delle prestazioni discreta ma significativa.
- 26 agosto — v0.33.1. Supporto MLX per Qwen 3.8 Flash Next, output strutturato e una correzione dei timeout della GPU durante il caricamento dei modelli da dispositivi di archiviazione più lenti.
- 28 agosto — v0.33.2. Modalità scura ripristinata, Handoff su macOS corretto e richieste proxy di Claude Desktop mantenute attive durante gli aggiornamenti del catalogo dei modelli.
- 20 agosto — v0.32.15. Nuova procedura di configurazione iniziale del desktop e memorizzazione dei metadati nella cache tra una richiesta e l'altra che ridurre di circa la metà il tempo necessario per ottenere il primo token.
- 11 agosto — NVIDIA Nemotron 3.5 Lightning, un modello 30B ottimizzato per flussi di lavoro agentici con richiamo di strumenti su hardware personale.
- 10 agosto — Muse Glimmer di Meta, un modello multimodale 30B nell'ambito di Apache 2.0, accelerato dal motore MLX di Ollama. È interessante notare che, nonostante il crollo dell’utilizzo dei modelli Llama, Meta continui a distribuire modelli con parametri davvero permissivi.
- 9 luglio — Round di finanziamento $88M, secondo quanto riportato da Ollama 8,9 milioni di sviluppatori.
- 29 giugno — Gemma 4 su MLX sale fino a 90% più velocemente tramite la previsione multi-token, che avvantaggia in modo sproporzionato gli agenti di codifica su Apple Silicon.
- 5 giugno — versione 0.30: aggiunta la compatibilità con GGUF tramite llama.cpp, ampliando il supporto hardware ben oltre l'Apple Silicon.
Il filo conduttore è che Ollama ha smesso di essere “il modo più semplice per eseguire un modello di piccole dimensioni sul proprio laptop” ed è diventato un gateway multiuso che, tra le altre cose, consente anche di eseguire modelli in locale. Il catalogo cloud ora include kimi-k3:cloud, glm-5.3:cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 in sette misure, gpt-oss ai punti 20b e 120b, gemma4, la famiglia Nemotron 3 e mistral-large-3.
Configurazione completa: configurazioni copia-incolla
Ollama + Claude Code (il percorso più veloce)
Ollama fornisce un launcher con un unico comando che gestisce automaticamente la configurazione dell'ambiente:
bash
ollama avvia claudeSe preferisci farlo manualmente — cosa che dovresti fare se stai scrivendo uno script — installa prima Claude Code:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
Quindi puntalo verso Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
E eseguilo con qualsiasi modello tu voglia:
bash
# Un modello locale
claude --model qwen3.5

# Un modello cloud — notare il suffisso :cloud
claude --model kimi-k3:cloud
Oppure direttamente nel codice, senza esportare nulla a livello globale:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Due cose che ti daranno fastidio.
Innanzitutto, non esportare ANTHROPIC_BASE_URL in modo permanente nel tuo profilo della shell. Si tratta di una variabile globale che reindirizzerà silenziosamente tutti gli strumenti che utilizzano Anthropic presenti sul tuo computer verso Ollama, compreso quello che volevi fosse in comunicazione con Anthropic. È possibile definirne l’ambito a livello di progetto o di singola chiamata.
In secondo luogo, imposta la lunghezza del contesto a 64k o superiore per qualsiasi operazione su un repository reale. L’impostazione predefinita di Ollama è più limitata, e un agente di codifica che gira silenziosamente in background finirà semplicemente per dimenticare alcune cose piuttosto che generare errori.
Per le esecuzioni CI, Docker o tramite script, --sì salta le richieste interattive:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "Come funziona questo repository?"GLM-5.3 direttamente da Z.ai
Se si desidera utilizzare il routing diretto anziché passare attraverso Ollama, Z.ai mette a disposizione tre endpoint di protocollo:
| Protocollo | URL di base |
|---|---|
| Messaggi antropici | https://api.z.ai/api/anthropic |
| Completamenti della chat di OpenAI | https://api.z.ai/api/coding/paas/v4 |
| Risposte di OpenAI | https://api.z.ai/api/v1 |
Un blocco provider OpenCode per GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
 "npm": "@ai-sdk/openai-compatible",
 "name": "Z.AI",
      "options": {
 "baseURL": "https://api.z.ai/api/coding/paas/v4",
 "apiKey": "{env:ZAI_API_KEY}"
      },
 "models": {
 "glm-5.3": {
 "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
 "options": { "reasoning_effort": "high", "temperature": 1 }
        }
 }
    }
  },
  "model": "zai/glm-5.3"
}
Nota importante sull'aggiornamento: GLM-5.3 richiede che il ragionamento sia abilitato. Se la configurazione attuale imposta thinking.type: "disabled", che ora non funzionerà. Modificalo in "abilitato" e impostare sforzo_di_ragionamento: "basso" se vuoi ripristinare il vecchio profilo di latenza.
sforzo_di_ragionamento è il tuo principale fattore di bilanciamento tra qualità e costo: basso per le chiamate sensibili alla latenza, alto per lavori di una certa entità, max (l'impostazione predefinita) per i problemi che hanno davvero messo in difficoltà alto. Data la verbosità documentata, io eseguirei alto come ambientazione quotidiana, piuttosto che andarsene max e mi chiedevo dove fossero finiti i token generati.
La configurazione del routing che consiglierei davvero
Non si tratta affatto di una scelta “o l’uno o l’altro”. La soluzione più indicata per la maggior parte dei team è una tabella di instradamento a tre livelli, e ogni harness per agenti che si rispetti supporta modelli specifici per ciascun agente.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
 "description": "Architettura, analisi delle cause alla radice, tutto ciò che è costoso da sbagliare",
 "model": "anthropic/claude-fable-5-1"
    },
    "build": {
 "description": "La maggior parte del lavoro di implementazione",
 "model": "zai/glm-5.3",
 "options": { "reasoning_effort": "high" }
    },
    "research": {
 "description": "Lettura di testi con contesti estesi, ricerca sul web, sintesi da più fonti",
 "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
 "description": "Rinominazioni, stringhe di documentazione, creazione di test, correzioni lint",
 "model": "ollama/glm-5.3-flash"
    }
  }
}
Il ragionamento alla base di ogni riga:
- Planning riceve Fable 5.1. È proprio nella fase di pianificazione che una decisione sbagliata ti costa il maggior numero di token a valle, e la coerenza a lungo termine è proprio ciò per cui è stata concepita la versione 5.1. È anche la fase in cui spendi il minor numero di token, quindi il sovrapprezzo si applica alla fetta più piccola del tuo conto.
- L'edificio riceve la certificazione GLM-5.3. Il miglior rapporto prestazioni-prezzo sul mercato, ed è qui che va a finire la maggior parte della tua spesa in token.
- La ricerca porta Kimi alla K3. BrowseComp 91.2 e un contesto 1M autentico lo rendono la migliore opzione disponibile per leggere una grande quantità di materiale e sintetizzarlo.
- Il lavoro meccanico passa a GLM-5.3-Flash. Con $0.15/$0.50 è praticamente gratuito, e rinominare un simbolo in 40 file non richiede ragionamenti complessi.
modello_piccolotrova qualcosa di piccolissimo per la gestione interna dell’harness — generazione dei titoli, sintesi, chiamate alle utilità interne.
Non state scegliendo un vincitore. State costruendo un cambio. E inserite gli ID dei modelli in modo che sostituirne uno richieda solo una riga di codice, perché in questo mercato dovrete ripetere quella modifica entro la fine del trimestre.
Cosa è effettivamente possibile eseguire in locale (la realtà hardware)
Vorrei sfatare un malinteso prima che costi denaro a qualcuno.
Non è possibile eseguire Kimi K3 o GLM-5.3 su una workstation. Né con una 5090, né con due.
Kimi K3
- circa 1,5 TB dei pesi nell'MXFP4 nativo — e ricordate che è il checkpoint quantizzato, non un punto di partenza per un'ulteriore compressione
- Moonshot consiglia almeno 64 acceleratori per il servizio agonistico
- Un vero self-hosting parte dai cluster multi-nodo; le implementazioni di riferimento utilizzano rack GB300 NVL72
- C'è non esiste una voce ufficiale nella biblioteca di Ollama per quanto riguarda la Kimi K3 locale, non c'è nessuna conversione GGUF per il mercato consumer che valga la pena segnalarti
- Esistono segnalazioni secondo cui funzionerebbe su cluster di schede RTX 5090 destinate al mercato consumer, ma “un cluster di 5090” non è un portatile e la velocità di elaborazione non è paragonabile
GLM-5.3
- circa 1,5 TB in BF16, all'incirca 750 GB a FP8
- Nodo singolo minimo funzionante: 8× H200 (1.128 GB di memoria GPU) a FP8, lasciando circa 375 GB per la cache KV
- BF16 richiede due nodi 8×H200 oppure un singolo nodo 8×B300 (2.304 GB)
- Un singolo nodo 8×H200 in BF16 è troppo piccolo per ospitare sia i pesi che la cache
Mostra immagine I modelli Frontier Open richiedono un rack. Il livello da 24 GB è proprio quello in cui “funziona sul mio computer” trova effettivamente la sua collocazione — ed è diventato davvero ottimo.
Ma cosa significa in realtà “IA locale” nel settembre 2026?
Significa una categoria diversa di modelli, e quella categoria è diventata davvero ottima:
| Modello | VRAM | A cosa serve |
|---|---|---|
| Qwen3.8-27B | 24 GB nel quarto trimestre | Il miglior prodotto versatile su hardware di consumo — 61,71 TP3T SWE-bench |
| gpt-oss:20b | 16 GB | Miglior modello di piccole dimensioni, sforzo di ragionamento regolabile |
| Gemma 4 E4B | circa 6 GB | L'applicazione Vision Plus in esecuzione su un laptop di ultima generazione |
| Mistral 7B | 8 GB | L'opzione più veloce per uso generico, 40–60 tok/sec |
| DeepSeek-R1 7B | 5 GB | Ragionamento a catena di pensieri su una GPU di un laptop |
| Llama 4 Scout | circa 55 GB nel quarto trimestre | Contesto 10M, multimodale — ambito delle workstation |
Un Qwen3.8-27B che totalizza 61,71 TP3T su SWE-bench, funzionante interamente su una GPU consumer da 24 GB senza connessione di rete, è un risultato straordinario che solo diciotto mesi fa sarebbe sembrato fantascienza. Non si tratta di GLM-5.3 e non pretende di esserlo.
La versione onesta: I pesi aperti alla frontiera ti garantiscono sovranità e prezzo, non esecuzione locale. I pesi aperti compresi nell'intervallo 7B–30B garantiscono un'esecuzione locale autentica, a un costo in termini di capacità reale ma accettabile, ed è proprio in questa fascia che il requisito “funziona sulla mia macchina, non vede la rete” diventa realizzabile.
L'architettura che funziona per la maggior parte dei miei clienti è proprio questa suddivisione: un piccolo modello locale per tutto ciò che riguarda dati realmente sensibili e un modello "frontier" ospitato e a peso variabile per tutto il resto — con i pesi disponibili come misura di sicurezza piuttosto che come piano di implementazione.
Dove si rompe effettivamente ogni modello
Niente esagerazioni. Ecco i punti deboli, senza giri di parole.
Punti deboli della Kimi K3
È costoso per essere un modello aperto. $3/$15 offre una velocità di input pari a 2,1 volte quella di GLM-5.3 e una velocità di output pari a 3,4 volte quella di GLM-5.3, a parità di punteggio dell’indice di intelligenza. Se si sceglie K3 al posto di GLM-5.3, è importante avere ben chiaro cosa si sta acquistando con quel sovrapprezzo: solitamente si tratta dello stack di elaborazione visiva o delle prestazioni di navigazione.
La licenza prevede il canone più basso. Una soglia MaaS basata sul fatturato complessivo di $20M comprende un numero di organizzazioni di gran lunga superiore rispetto a quella di 5,3 GLM, pari a $10B. Se la rivendita di inferenze rientra in qualsiasi modo nel vostro modello di business, K3 è la più restrittiva delle due.
L'hosting autonomo è fuori dalla portata di quasi tutti. 1,5 TB e oltre 64 acceleratori rappresentano un impegno infrastrutturale notevole. In questo caso, il diritto di recesso ha un carattere più teorico rispetto a qualsiasi altro modello presente in questo confronto.
Ampi percorsi di formazione nel campo del lavoro intellettuale. Con un punteggio di 1.687 in GDPval-AA v2, si colloca dietro a GLM-5.3, a Claude Fables e a GPT-5.6 Sol Max. Si tratta di uno specialista in programmazione e agenti che, per di più, è di dimensioni enormi.
Punti deboli del GLM-5.3
Solo testo. Senza immagini in ingresso, niente video. Se il vostro flusso di lavoro prevede il debug tramite screenshot, la conversione da progetto a codice o il riconoscimento ottico di documenti, GLM-5.3 semplicemente non è in grado di farlo e dovrete invece utilizzare GLM-5.3-Flash, Kimi K3 o Fable 5.1. Questo è l’errore di configurazione più comune che mi aspetto che le persone commettano, perché gli ID dei modelli sembrano correlati ma in realtà non lo sono.
È prolisso, e la prolissità viene fatturata. 170 milioni di token emessi a fronte di una mediana di 72 milioni nella suite AA. sforzo_di_ragionamento il valore predefinito è max, e il pensiero non può essere disattivato. Prevedi un numero di gettoni di output superiore a quello che il numero dei tuoi turni lascerebbe supporre.
La licenza non è più MIT e la clausola relativa alla revisione della sicurezza non prevede limiti. Per la maggior parte dei lettori, la soglia $10B rende la questione puramente teorica. Per chiunque si trovi vicino a tale soglia, la clausola secondo cui “l’ambito di applicazione e il metodo saranno determinati in modo ragionevole da Z.AI” non sarà certo gradita al proprio team legale.
Terminal-Bench 3.0, con un punteggio di 28,3, resta indietro rispetto al GPT-5.6 Sol, che ha totalizzato 34,6. Nel benchmark specifico più vicino alla codifica agenziale nativa del terminale, si colloca dietro al concorrente più vicino sulla stessa scala di valutazione.
È una novità nel campo dei pesi liberi. Rilasciato il 28 agosto. La comunità ha avuto a disposizione pochi giorni, non mesi. I bug di implementazione a lungo termine non sono ancora emersi.
Punti deboli di Claude Fable 5.1
Il prezzo. Circa 6,5× GLM-5.3 per ogni compito agenziale completato, anche dopo il taglio delle letture dalla cache 75%. Per la maggior parte dei lavori, tale divario non è più giustificabile in termini di capacità.
Tre modifiche che comportano incompatibilità. L'uso forzato dello strumento restituisce il codice di errore 400. I "thinking block" non sono retrocompatibili con i modelli precedenti. La modifica della cronologia delle conversazioni invalida i "thinking block" sugli account creati dopo il 31 agosto 2026. Qualsiasi di queste operazioni può compromettere il corretto funzionamento dell'integrazione in seguito all'aggiornamento.
Si è verificato un regresso nella chiamata degli strumenti paralleli. È stato segnalato che, mentre Fable 5 ne raggruppava diverse, veniva registrata una sola chiamata per turno. In un ciclo lungo dell’agente, si finisce per pagare due volte il tempo effettivo.
Opzionalità di uscita pari a zero. Nessun peso, nessun self-hosting, nessun blocco delle versioni oltre a quanto offerto da Anthropic, nessuna ispezione. Quando cambia, ci si adatta.
Il tokenizzatore esagera i confronti. ~30% token in più rispetto ai modelli Claude precedenti per lo stesso testo, il che rende fuorvianti i confronti storici sui costi a favore di Anthropic, se non si presta attenzione.
Il quadro decisionale: sei scenari
Mostra immagine Sei scenari, sei risposte. Trova la riga che rispecchia la tua settimana.
1. “Voglio un unico modello. Lo imposto una volta per tutte e non ci penso più, l’importo della bolletta rimane ragionevole.”
GLM-5.3. A meno di mezzo punto da Kimi K3 e a circa tre punti dal miglior modello chiuso sull’indice neutro, a $1,40/$4,40. Eseguilo su Ollama con un piano Pro o Max, imposta sforzo_di_ragionamento: elevato, e torna al tuo lavoro. L'unica cosa che potrebbe farti scartare questa risposta è la necessità di inserire un'immagine.
2. “Il mio lavoro è di natura visiva: interfaccia utente, trasposizione dal design al codice, debug tramite screenshot, documentazione.”
Kimi K3 o GLM-5.3-Flash, non GLM-5.3. MoonViT-V2 di K3 gestisce in modo nativo testo, immagini e video e ottiene un punteggio di 81,6/83,4 su MMMU-Pro. GLM-5.3-Flash è l'opzione più economica, con multimodalità nativa e licenza MIT. GLM-5.3 è solo per il testo e semplicemente rifiuterà l'input.
3. “Sessioni autonome di lunga durata in cui commettere errori comporta un costo elevato.”
Claude Fable 5.1. È proprio per questo che è stato progettato, e i benchmark lo confermano: Terminal-Bench-Science ha raddoppiato il punteggio, raggiungendo 82% nelle attività informatiche più impegnative di Browserbase rispetto ai 74% di Opus 5, registrando inoltre i maggiori miglioramenti mai pubblicati nelle attività agentiche della durata di diverse ore. La riduzione di 75% nella lettura della cache rende proprio questo carico di lavoro fino a 45% più economico rispetto a prima. Pagate il sovrapprezzo laddove un errore costa più dei token.
4. “La residenza dei dati nell’UE è un requisito imprescindibile.”
GLM-5.3-Flash se ti serve il MIT, GLM-5.3 se ti serve la funzionalità. Se si opta per l’hosting autonomo sul proprio hardware o presso un fornitore di GPU nell’UE, la questione del trasferimento transfrontaliero dei dati cessa di esistere. Per GLM-5.3 a FP8, il budget è di 8×H200; Flash è molto più gestibile con 320B/18B. Se l’hosting autonomo è fuori budget, l’hosting europeo di Ollama senza alcuna conservazione dei dati rappresenta una via di mezzo pragmatica — ma assicuratevi di ottenere l’impegno relativo alla residenza per iscritto, piuttosto che dedurlo da una pagina di marketing.
5. “Un piccolo team, un budget limitato, a programmare tutto il giorno.”
GLM-5.3-Flash come impostazione predefinita, GLM-5.3 per i problemi più complessi, Ollama Pro con configurazione $20. Flash costa $0,15/$0,50 — attualmente la metà fino al 9 settembre — e totalizza 57,5 nell’indice di intelligenza. Con venti dollari si acquistano sessanta dollari di token senza limiti settimanali. Per una squadra da due a quattro persone, questa offerta è praticamente imbattibile. Il piano GLM Coding a $18 al mese (Lite) è l’alternativa se si preferisce una quota fissa a un pool di crediti.
6. “Devo giustificare questa decisione davanti al team degli acquisti o a quello legale.”
GLM-5.3-Flash. È l’unico modello in questo confronto ad essere coperto da una licenza standard approvata dall’OSI (MIT); è multimodale di natura, ha un punteggio di 57,5 sull’indice di neutralità e i pesi sono disponibili su Hugging Face senza restrizioni di reddito, senza obblighi di attribuzione e senza clausole di revisione della sicurezza. Quando la domanda è “cosa possiamo difendere in una revisione contrattuale”, le licenze permissive superano di tre punti il benchmark ogni volta.
Cosa terrò d’occhio nel prossimo trimestre
Se Fable 5.1 supererà il valore di 62,1 nell'indice di Artificial Analysis. È stato lanciato il giorno prima della pubblicazione di questo articolo e non è stato ancora valutato in modo indipendente. I suoi scostamenti rispetto a Fable 5 nei benchmark suggeriscono che dovrebbe, ma “dovrebbe” non significa “ha fatto”, e il divario rispetto al 59,7 di Kimi K3 è il dato su cui ruota l’intera discussione tra open source e closed source.
Se la deriva delle licenze continuerà. In otto settimane siamo passati dal GLM-5.2 con licenza MIT al GLM-5.3 con una licenza su misura e una revisione di sicurezza discrezionale, e dal MIT modificato di Kimi K2 ai termini basati sui ricavi di K3. Se GLM-6 e K4 dovessero diventare ancora più restrittivi, il termine ’open weights’ diventerebbe un semplice slogan di marketing piuttosto che una categoria significativa. Il fatto che GLM-5.3-Flash rimanga sotto licenza MIT è il segnale contrario che vale la pena tenere d’occhio.
Resta da vedere se altri laboratori adotteranno il modello di rilascio graduale di Z.ai. Un periodo di sospensione di due settimane, accompagnato da una motivazione relativa alla sicurezza resa pubblica, è ormai la nuova norma. Se questa misura si mantiene, è una buona cosa. Se invece diventa un pretesto per ritardare sempre più la spedizione, è un modo indiretto per evitare del tutto la spedizione.
Verifica indipendente delle affermazioni relative alle capacità informatiche. 2.436 vulnerabilità distribuite su 269 progetti rappresentano una cifra straordinaria, e si tratta di dati interamente forniti dagli stessi soggetti interessati. È necessario che un soggetto imparziale li verifichi, perché se fossero accurati ridefinirebbero l’intero dibattito sulla sicurezza degli open-weight, mentre se non lo fossero, si tratterebbe comunque di una strategia di marketing efficace.
I tassi per token di Ollama tra sei mesi. Il rapporto $20 a $60 in termini di utilizzo rappresenta una strategia iniziale aggressiva da parte di un’azienda che a luglio ha raccolto $88M. La capacità di questi moltiplicatori di reggere il confronto con l’economia reale delle unità costituisce la variabile più importante nella tesi dei “modelli open a basso costo” per i piccoli team.
Se i modelli locali si avvicinano al livello 30B. Qwen3.8-24B a 61,71 TP3T su SWE-bench con 24 GB è il risultato meno discusso dell’anno. La frontiera fa notizia; è la fascia da 24 GB che cambia ciò che un’azienda normale può fare senza una chiave API.
Domande frequenti
Kimi K3 è davvero open source? No. I modelli di Kimi K3 sono scaricabili gratuitamente da Hugging Face, ma sono soggetti a una ’Licenza Kimi K3“ personalizzata, non a una licenza open source approvata dall’OSI. Gli operatori di Model-as-a-Service il cui fatturato complessivo superi $20 milioni in un periodo di 12 mesi consecutivi devono negoziare un accordo commerciale separato con Moonshot, e i prodotti con oltre 100 milioni di utenti attivi mensili o un fatturato mensile superiore a $20 milioni devono riportare la dicitura ”Kimi K3“ nella propria interfaccia. L’uso puramente interno non è soggetto ad alcuna restrizione.
Il GLM-5.3 è migliore del Kimi K3? Sono di fatto alla pari sull’indice aggregato neutro: 59,5 contro 59,7 su Artificial Analysis. GLM-5.3 è 2,2 volte più economico per ogni attività agentica e ottiene un punteggio più alto nel lavoro intellettuale (GDPval-AA v2: 1.769 contro 1.687). Kimi K3 è nativamente multimodale, è in testa nella navigazione agentica (BrowseComp 91,2) e si è classificato al primo posto nell’arena dedicata al codice frontend di Arena.AI. Scegliete GLM-5.3 per i costi e la programmazione basata su testo; Kimi K3 per la visione, la navigazione e la ricerca a lungo termine.
Quanto costano meno i modelli aperti rispetto a Claude Fable 5.1? In un compito agentico simulato di 60 turni, GLM-5.3 costa circa $1,85 contro l’$11,94 di Fable 5.1 — circa 6,5 volte meno. Kimi K3 costa circa $4,07, ovvero circa 2,9 volte meno. GLM-5.3-Flash costa circa $0,21, ovvero circa 58 volte meno. Oltre 80 esecuzioni al mese, ovvero $148 contro $955.
Posso eseguire Kimi K3 o GLM-5.3 in locale? Non su hardware di consumo. Kimi K3 occupa circa 1,5 TB anche nel suo formato nativo MXFP4 e Moonshot raccomanda l’uso di almeno 64 acceleratori. GLM-5.3 richiede un minimo di 8×H200 (1.128 GB) a FP8. Per un’esecuzione locale vera e propria, prendete in considerazione Qwen3.8-27B (24 GB a Q4), gpt-oss:20b (16 GB) o Gemma 4 E4B (~6 GB).
Cosa è cambiato nella versione 5.1 di Claude Fable? Pubblicato il 1° settembre 2026. Le letture dalla cache sono diminuite di 75%, passando da $1,00 a $0,25 per milione di token, rendendo i carichi di lavoro tipici circa 25% più economici e quelli di tipo “agentico” fino a 45% più economici; gli input e gli output sono rimasti a $10/$50. Il Terminal-Bench 4.0 è salito da 42,0% a 55,8%, Terminal-Bench-Science da 24,71 TP3T a 52,61 TP3T, AutomationBench da 17,11 TP3T a 31,41 TP3T. Tre modifiche sostanziali riguardano l’uso forzato degli strumenti, la portabilità dei blocchi di pensiero e la modifica della cronologia.
Qual è il nuovo listino prezzi di Ollama? A partire dal 31 agosto 2026, i piani Pro, Max e Team adotteranno una tariffazione per token con crediti inclusi: Pro $20 al mese per $60 di utilizzo, Max $100 per $300, Team $500 per $1.000 condivisi tra un numero illimitato di utenti. I limiti di 5 ore e settimanali sono stati completamente eliminati, non sono previste commissioni di servizio, i crediti non sono riportabili al mese successivo e tutti i piani prevedono zero conservazione dei dati con hosting negli Stati Uniti e in Europa.
Quale di questi modelli è effettivamente concesso in licenza MIT? Solo GLM-5.3-Flash — un modello multimodale nativo 320B/18B separato, rilasciato il 26 agosto 2026, che ha ottenuto un punteggio di 57,5 nell’indice Artificial Analysis a $0,15/$0,50 per milione di token. Sia GLM-5.3 che Kimi K3 utilizzano licenze personalizzate basate sui ricavi; Claude Fable 5.1 è interamente proprietario.
Perché non riesco a confrontare questi modelli su Terminal-Bench? Questo perché sono state valutate su versioni diverse. L’88,3 di Kimi K3 si riferisce alla versione 2.1 di Terminal-Bench, il 28,3 di GLM-5.3 alla versione 3.0 e il 55,8 di Fable 5.1 alla versione 4.0. Ogni versione è sostanzialmente più difficile della precedente, quindi i punteggi non sono sulla stessa scala. Confrontate solo all’interno della stessa versione. Su Terminal-Bench 2.1, ad esempio, Kimi K3 ottiene un punteggio di 88,3 contro l’88,0 di Claude Fable 5, l’88,8 di GPT-5.6 Sol e l’84,3 di GLM-5.3-Flash: questo confronto è valido ed è quello che vale la pena citare.
È meglio rivolgersi a Ollama o contattare direttamente il fornitore? Scegli Ollama se desideri un unico rapporto di fatturazione, un’unica interfaccia API, un facile cambio di modello e hosting in UE/USA senza alcuna conservazione dei dati: le sue tariffe per token seguono da vicino i prezzi del servizio originale. Scegli Direct se hai bisogno di funzionalità del servizio originale come quelle di Z.ai. sforzo_di_ragionamento controlli con massima precisione, SLA dei fornitori o piani di abbonamento come il GLM Coding Plan. Molti team utilizzano entrambi e scelgono l’opzione più adatta in base al carico di lavoro.
GLM-5.3 supporta le immagini? No. GLM-5.3 è un modello esclusivamente testuale. GLM-5.3-Flash — un modello completamente diverso nonostante il nome simile — è nativamente multimodale e gestisce input di testo, immagini, video e file. L'invio di immagini all'ID del modello sbagliato è l'errore iniziale più comune con la famiglia GLM.
In sintesi
Dodici mesi fa, la domanda che si poneva nella categoria open-weight era se questi modelli fossero utilizzabili. Sei mesi fa, invece, ci si chiedeva se fossero competitivi. A settembre 2026, la domanda è davvero: perché continui a pagare un sovrapprezzo per un modello chiuso?
Esiste una risposta concreta a questa domanda, ed è più circoscritta rispetto al passato. Claude Fable 5.1 eccelle nei compiti agenti più impegnativi e prolungati, nel lavoro di conoscenza generale e in quella categoria di debug in cui un modello deve tenere a mente un problema complesso per ore senza perdere la rotta. Il modello 75% di Anthropic con cache-read cut è progettato proprio per quel carico di lavoro. Se il costo di un errore supera il costo dei token, quel sovrapprezzo è razionale.
Per tutto il resto, i calcoli sono cambiati. GLM-5.3 raggiunge un punteggio di 94% nell’indice di Claude Opus 5 a un costo di 29%. Kimi K3 ottiene un punteggio di 88,3 su Terminal-Bench 2.1 contro l’88,0 di Claude Fable 5 sulla stessa versione, e si è aggiudicato il primo posto nella Frontend Code Arena di LMArena, davanti a entrambi i modelli chiusi di punta. Ollama vi venderà $60 di token a $20, eliminando al contempo i limiti di utilizzo. Questa combinazione non esisteva in primavera.
Ma non lasciate che l'entusiasmo vi faccia tralasciare le clausole scritte in piccolo, perché ce ne sono due ed entrambe sono importanti.
Il primo è quello delle licenze. “I termini ”open weights“ e ”open source“ hanno smesso, in modo quasi impercettibile, di significare la stessa cosa. Sia Kimi K3 che GLM-5.3 vengono distribuiti con licenze personalizzate e subordinate a condizioni di fatturato. Le barriere sono abbastanza alte da non influire sulla maggior parte dei lettori — ma ”non influire sulla maggior parte dei lettori“ non equivale a ”senza restrizioni’, e la clausola indefinita relativa alla revisione di sicurezza di GLM-5.3 rappresenta un vero e proprio rischio di approvvigionamento per le grandi imprese. GLM-5.3-Flash sotto licenza MIT è l’ultima opzione completamente permissiva che si avvicina ai limiti della libertà, ed è proprio per questo che merita più attenzione di quanta ne riceva.
Il secondo è che l'autogestione è per lo più un obiettivo a cui aspirare. 1,5 TB di risorse di calcolo e 64 acceleratori non rappresentano un piano di uscita per un’azienda di medie dimensioni. Ciò che le risorse di calcolo aperte offrono a questo livello è un mercato competitivo dell’inferenza, trasparenza dei prezzi, blocco delle versioni, scelta della giurisdizione e una posizione negoziale. Questi aspetti hanno un valore enorme. Non è la stessa cosa che gestire il tutto nel proprio seminterrato.
La configurazione che realizzerei effettivamente: GLM-5.3 come impostazione predefinita, Fable 5.1 per la pianificazione e i problemi davvero complessi, Kimi K3 per la visione d'insieme e la ricerca a lungo termine, GLM-5.3-Flash per il lavoro di routine e un modello locale da 27 miliardi per tutto ciò che non deve mai uscire dall'edificio. Indirizza in base al carico di lavoro, non alla fedeltà. Scrivi la configurazione in modo che gli ID dei modelli possano essere modificati in una sola riga.
Perché l'unica previsione di cui sono certo è che questo articolo dovrà essere aggiornato prima di Natale.
State utilizzando una di queste tre soluzioni in produzione? Mi interessa in particolare sapere se la verbosità di GLM-5.3 si traduca in un vero e proprio problema di costi su larga scala e se qualcuno abbia effettivamente sottoposto la licenza Kimi K3 all’esame di un consulente legale ottenendo una chiara interpretazione della definizione di MaaS. Contattatemi: correzioni e prove contrarie sono ben accette, e questo articolo verrà aggiornato non appena la situazione dovesse cambiare.
Ultimo aggiornamento: 2 settembre 2026.